이 자료는 Topic 9, 통계(Summary)를 다룹니다. (Extended) 로 표시된 부분은 Extended 시험에서만 출제되며, 나머지는 두 수준 모두에 해당합니다.
통계학
IGCSE 수학 · 주제 9
 8:09
통계학
세상은 매일 당신에 대해 수 많은 수치를 수집합니다: 이동 거리, 수면 시간, 시험 점수 등. 긴 수의 나열은 당신에게 거의…
영어 내레이션 · 영어 + 중국어 자막 burned-in
9.1 9.2
데이터 수집 및 표시

Syllabus
| 과목 내용 | 참고 사항 및 예시 |
|---|---|
| 통계 데이터를 분류하고 표로 정리합니다. | 예: 세기 표(tally tables), 이원 표(two-way tables). |
| 과목 내용 | 참고 사항 및 예시 |
|---|---|
| 1 표와 통계 도식에서 읽기, 해석 및 추론을 한다. | |
| 2 표, 그래프 및 통계 수치로 데이터 세트를 비교합니다. | 예: 두 데이터 세트 사이의 평균과 범위를 비교합니다. |
| 3 주어진 데이터로부터 결론을 내리는 데 있어 제한사항을 인지한다. |
| 과목 내용 | 참고 사항 및 예시 |
|---|---|
| 1 표와 통계 도식에서 읽기, 해석 및 추론을 한다. | |
| 2 표, 그래프 및 통계적 지표를 사용하여 데이터 집단을 비교하기. | 예: 두 데이터 집단 간의 평균 및 산폭(measures of spread) 비교. |
| 3 주어진 데이터로부터 결론을 내리는 데 있어 제한사항을 인지한다. |
출처: Cambridge International syllabus
통계적 데이터를 정리하기 위해 사용하십시오:
- ** tally table**: 각 값마다 표시(mark)를 한 후 세십시오.
- 양방향 표(two-way table): 두 가지 특성으로 동시에 데이터를 분류합니다 (예: 남자/여자와 걷기/버스 이용).
그래프를 읽을 때는 데이터가 실제로 지지하는 결론만을 도출하십시오.
탐색하기
데이터 처리 사이클
수집부터 표시까지 통계적 질문을 따르십시오.
어휘
연습하기
| English | 한국어 |
|---|---|
| statistical/stəˈtɪstɪkl/ | 통계적 |
| data/ˈdeɪtə/ | 데이터 |
| tally table/ˈtælɪ ˈteɪbl/ | 계수 표 |
| two-way table/tuː weɪ ˈteɪbl/ | 이중 표 |
9.3
평균 및 범위를

Syllabus
| 과목 내용 | 참고 사항 및 예시 |
|---|---|
| 개별 데이터에 대해 평균, 중앙값, 최빈값, 범위를 계산하고 이들이 사용되는 목적을 구분합니다. | 데이터는 목록이나 빈도 표로 제공될 수 있으나 그룹화(grouped)되지 않습니다. |
| 과목 내용 | 참고 사항 및 예시 |
|---|---|
| 1 개별 데이터에 대해 평균, 중앙값, 최빈값, 사분위점, 최대-최소값, 사분위범위를 계산하고 이들이 사용되는 목적을 구분하기. | |
| 2 그룹화된 이산 데이터 또는 그룹화된 연속 데이터에 대한 평균의 추정치를 계산하기. | |
| 3 그룹화 빈도 분포로부터 최빈 구간(modal class)을 식별하기. |
출처: Cambridge International syllabus
세 가지 평균이 데이터의 전형적인 값을 설명하고, 범위는 데이터가 얼마나 퍼져 있는지를 보여줍니다. 각각 다른 목적으로 사용됩니다:
- 평균(mean) $= \dfrac{\text{sum of all values}}{\text{how many values}}$.
- 중앙값(median) $=$: 데이터를 순서대로 나열했을 때 중간에 있는 값; 값의 개수가 짝수일 때는 중간 두 값의 평균을 취합니다.
- 최빈값(mode) $=$ 가장 자주 나타나는 값입니다.
- 범위(range) $=$ 최대값 $-$ - 최소값 (데이터가 얼마나 퍼져 있는지를 보여줍니다).
풀이 예제. $4, 7, 7, 2, 5$의 평균, 중앙값, 최빈값, 범위를 구하세요.
데이터를 순서대로 나열: $2, 4, 5, 7, 7$.
$$\text{mean} = \frac{4 + 7 + 7 + 2 + 5}{5} = \frac{25}{5} = 5, \quad \text{median} = 5, \quad \text{mode} = 7, \quad \text{range} = 7 - 2 = 5.$$
작은 예제: 값의 개수가 짝수인 경우. $12, 15, 9, 20, 14, 11$의 중앙값을 구하십시오.
순서대로 정리하면: $9, 11, 12, 14, 15, 20$입니다. 중간에 두 개의 값이 있으므로, 중앙값은 이 두 값의 정중간에 해당합니다: $\dfrac{12 + 14}{2} = 13$입니다.
작은 예제: 누락된 값 찾기. 다섯 숫자의 평균이 $8$입니다. 네 숫자는 $4$, $7$, $9$, $10$입니다. 다섯 번째 숫자를 구하십시오.
다섯 숫자의 합은 $5 \times 8 = 40$이며, 알려진 네 숫자의 합은 $30$이므로, 다섯 번째 숫자는 $40 - 30 = 10$입니다.
어떤 평균을 사용할 것인가? 최빈수는 범주(가장 인기 있는 색상)에 적합하며, 중위수는 극단적인 값 한 개에 의해 왜곡되지 않습니다(약간의 매우 높은 연봉). 평균은 모든 값을 사용합니다.
흔한 실수. 데이터를 순서대로 정렬하지 않고 중앙값을 구하거나, 위치 $\tfrac{n+1}{2}$을 답으로 제시하여 해당 위치에 있는 값을 제시하지 않는 것입니다.
탐색하기
평균 선택 실험실
데이터 상황에 맞는 평균을 선택하십시오.
어휘
연습하기
| English | 한국어 |
|---|---|
| mean/miːn/ | 평균 |
| median/ˈmiːdiːən/ | 중位数 |
| mode/məʊd/ | 최빈수 |
| range/reɪndʒ/ | 극차 |
9.3
빈도표에서의 평균
Syllabus
| 과목 내용 | 참고 사항 및 예시 |
|---|---|
| 개별 데이터에 대해 평균, 중앙값, 최빈값, 범위를 계산하고 이들이 사용되는 목적을 구분합니다. | 데이터는 목록이나 빈도 표로 제공될 수 있으나 그룹화(grouped)되지 않습니다. |
| 과목 내용 | 참고 사항 및 예시 |
|---|---|
| 1 개별 데이터에 대해 평균, 중앙값, 최빈값, 사분위점, 최대-최소값, 사분위범위를 계산하고 이들이 사용되는 목적을 구분하기. | |
| 2 그룹화된 이산 데이터 또는 그룹화된 연속 데이터에 대한 평균의 추정치를 계산하기. | |
| 3 그룹화 빈도 분포로부터 최빈 구간(modal class)을 식별하기. |
출처: Cambridge International syllabus
데이터가 빈도(각 값이 나타나는 횟수)와 함께 나열되어 있을 때, 평균은
$$\text{mean} = \frac{\sum (\text{value} \times \text{frequency})}{\sum \text{frequency}}.$$
풀이 예제. 값 $1, 2, 3$이 빈도 $4, 5, 1$로 나타납니다. 평균을 구하세요.
$$\text{mean} = \frac{1(4) + 2(5) + 3(1)}{4 + 5 + 1} = \frac{17}{10} = 1.7.$$
그룹화된 데이터 (Extended)
집계된 데이터의 경우 정확한 평균을 구할 수 없으므로, 각 그룹의 중간값을 값으로 사용하여 추정합니다. 최빈 구간은 단순히 빈도가 가장 높은 그룹입니다.
작은 예제: 평균 추정하기. $30$명의 학생들이 학교까지(Path to school) 이동하는 데 걸린 시간, $t$분은 아래에 그룹화되어 있습니다.
| Time $t$ (min) | $0 < t \leqslant 10$ | $10 < t \leqslant 20$ | $20 < t \leqslant 30$ | $30 < t \leqslant 50$ |
|---|---|---|---|---|
| 빈도 | $5$ | $12$ | $8$ | $5$ |
| 중점 | $5$ | $15$ | $25$ | $40$ |
$$\text{estimated mean} = \frac{5(5) + 15(12) + 25(8) + 40(5)}{30} = \frac{605}{30} = 20.2\text{ minutes}\ \text{(3 s.f.)}.$$
최빈 구간은 $10 < t \leqslant 20$입니다. 각 구간의 정확한 시간 범위를 알 수 없으므로 이 답은 추측에 불과합니다.
자주 하는 실수. 중점(또는 계급 폭) 대신 각 계급의 끝값을 곱하거나, 전체 빈도 $30$ 대신 계급의 개수 $4$로 나누는 것.
어휘
연습하기
| English | 한국어 |
|---|---|
| frequency/ˈfriːkwənsi/ | 빈도 |
| grouped data/ɡruːpt ˈdeɪtə/ | 구분 데이터 |
| modal class/ˈməʊdl klæs/ | 최빈 구간 |
9.3
분산도 지표 (확장)
Syllabus
| 과목 내용 | 참고 사항 및 예시 |
|---|---|
| 1 개별 데이터에 대해 평균, 중앙값, 최빈값, 사분위점, 최대-최소값, 사분위범위를 계산하고 이들이 사용되는 목적을 구분하기. | |
| 2 그룹화된 이산 데이터 또는 그룹화된 연속 데이터에 대한 평균의 추정치를 계산하기. | |
| 3 그룹화 빈도 분포로부터 최빈 구간(modal class)을 식별하기. |
출처: Cambridge International syllabus
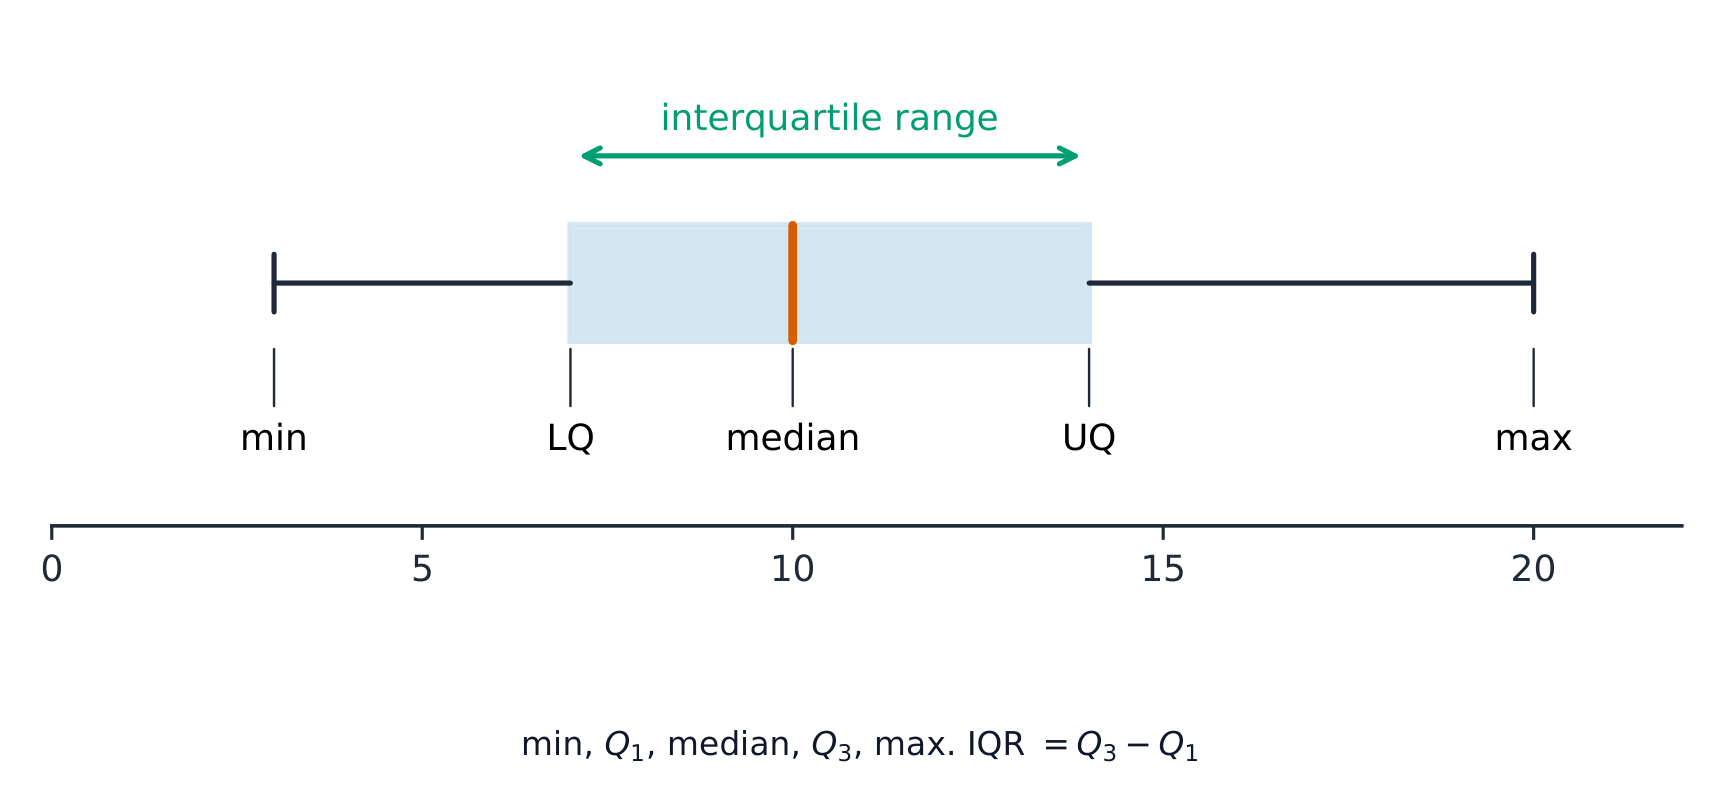
When data is in order, the quartiles cut it into four equal parts. The lower quartile (LQ) is one quarter of the way up; the upper quartile (UQ) is three quarters of the way up. The interquartile range measures the spread of the middle half:
$$\text{interquartile range} = \text{UQ} - \text{LQ}.$$
사분위범위는 극단값을 무시하므로 범위(Range)와 달리 유용합니다.
해설 예: 목록에서의 사분위수. 다음 데이터의 중앙값, 사분위수 및 사분위범위를 구하시오.
$$3,\ 5,\ 6,\ 8,\ 9,\ 10,\ 12,\ 13,\ 15,\ 18,\ 20.$$
데이터는 $n = 11$개이며 이미 순서대로 정렬되어 있습니다. 중앙값은 $\tfrac{n+1}{2} = 6$번째 값인 $10$입니다. 하사분위기는 $\tfrac{n+1}{4} = 3$번째 값인 $6$, 상사분위기는 $\tfrac{3(n+1)}{4} = 9$번째 값인 $15$입니다. 따라서 사분위 범위(interquartile range)는 $15 - 6 = 9$입니다.
해설 예: 두 분포 비교하기. 두 영화관이 한 달간 매일 관객 수를 기록했습니다.
| 평균 | 범위 | |
|---|---|---|
| 영화관 A | $78$ | $40$ |
| 영화관 B | $96$ | $18$ |
평균과 산란에 대해 각각 하나씩 비교하고, 그 의미를 맥락에 맞게 설명하십시오: "영화관 B가 평균적으로 더 많은 관객을 끌고 오는데, 이는 평균이 더 높기 때문입니다. 영화관 A의 관객 수는 변동성이 더 크며, 이는 범위가 더 넓기 때문입니다."
자주 하는 실수. "B의 평균이 더 크다"라고만 말하고 그것이 관객 수에 어떤 의미인지 설명하지 않거나, 두 평균만 비교하고 산란은 언급하지 않는 것.
탐색하기
상자 수염 그림(Box-and-whisker plot)
5개 요약통계량에서 상자 수염 그림을 만드십시오: 상자는 중간 50%(사분위범위)이며, 중앙값의 위치는 치우침을 보여줍니다.
어휘
연습하기
| English | 한국어 |
|---|---|
| quartile/ˈkwɔːtaɪl/ | 사분위수 |
| interquartile range/ˌɪntəˈkwɔːtaɪl reɪndʒ/ | 사분위수 범위 |
9.4
차트와 도표

Syllabus
| 과목 내용 | 참고 사항 및 예시 |
|---|---|
| 그리고 해석합니다: (a) 막대그래프 (b) 원그래프 (c) 픽토그램 (d) 줄기와 잎 그림(stem-and-leaf diagrams) (e) 단순 빈도 분포. | 합성(스택된) 및 이중(옆에 배치된) 막대그래프를 포함합니다. 줄기와 잎 그림은 정렬된 데이터와 키(key)를 가져야 합니다. |
출처: Cambridge International syllabus

| 차트 | 내용 |
|---|---|
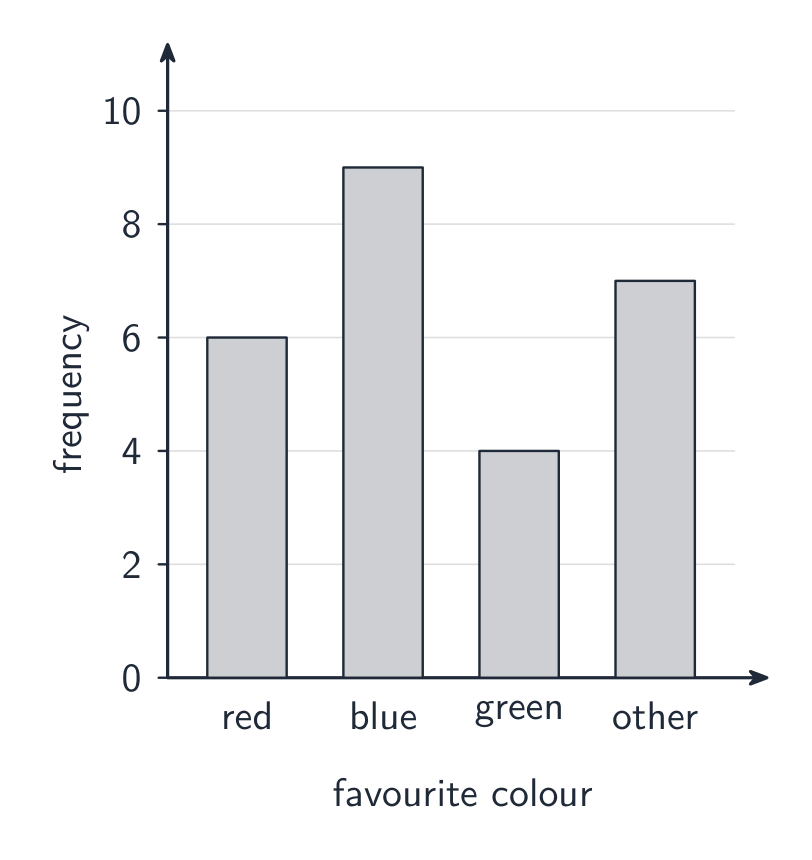
| 막대 그래프 | 범주마다 막대가 있으며 높이가 빈도입니다 |
| 원그래프 | 원이 조각으로 나뉘어 있으며 각 조각은 $360^{\circ}$의 일부분입니다 |
| 픽토그램 | 여러 항목을 나타내기 위해 기호를 사용합니다 |
| 줄기-잎 도표 | 정렬된 데이터의 자릿수를 유지하며 범례를 포함합니다 |
| 빈도 분포 | 값과 그에 해당하는 빈도의 표입니다 |
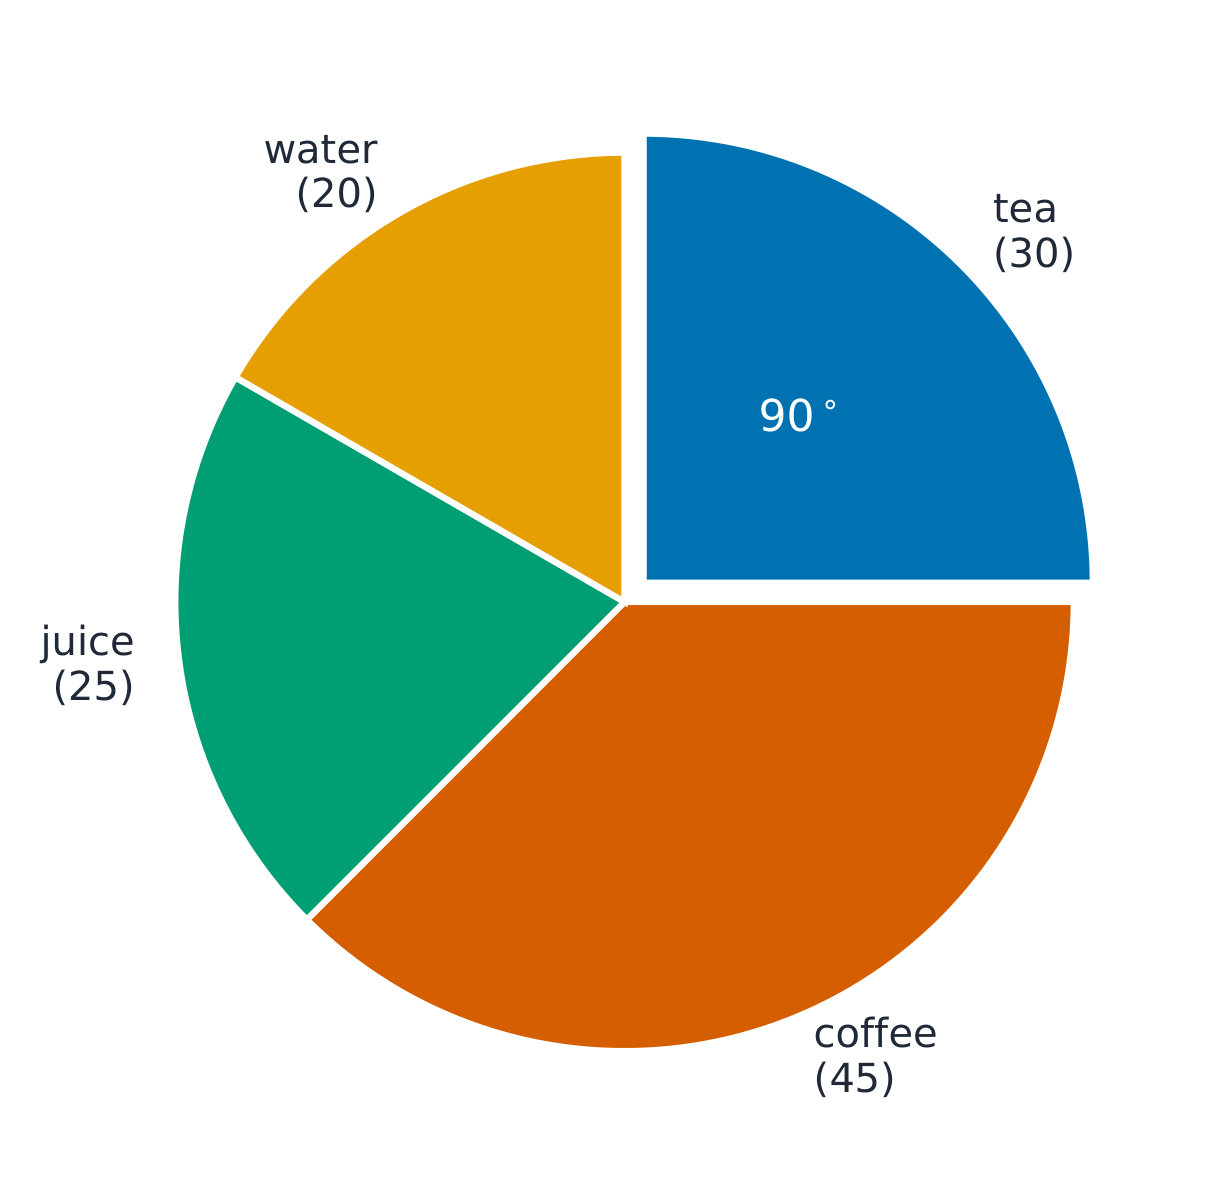
해설 예제 (원그래프). $120$ 명 중 $30$명이 차를 선택했습니다. 차 조각의 각도를 구하세요.
$$\frac{30}{120} \times 360^{\circ} = 90^{\circ}.$$
해설 예(피차트 역산). 피차트가 $450$ 명의 출근 교통수단 분포를 보여줍니다. 버스slice의 각도가 $72^{\circ}$일 때, 버스로 출근하는 사람은 몇 명입니까?
$$\frac{72}{360} \times 450 = 90\text{ people}.$$
탐색하기
파이 차트의 각도
각 슬라이스의 각도는 전체에 대한 비율을 도数为 환산한 것입니다 — 빈도 ÷ 총계 × 360 — 하며, 슬라이스들의 합은 항상 360°입니다.
탐색하기
차트 선택 실험실
데이터 유형에 맞는 차트를 선택하십시오.
어휘
연습하기
| English | 한국어 |
|---|---|
| bar chart/bɑː tʃɑːt/ | 막대그래프 |
| pie chart/paɪ tʃɑːt/ | 원그래프 |
| pictogram/ˈpɪktəɡræm/ | 상표도 |
| stem-and-leaf diagram/stem ænd liːf ˈdaɪəɡræm/ | 줄기와 잎 도표 |
| frequency distribution/ˈfriːkwənsi ˌdɪstrɪˈbjuːʃn/ | 빈도 분포 |
| scatter diagram/ˈskætə ˈdaɪəɡræm/ | 산점도 |
9.5
산점도와 상관관계

Syllabus
| 과목 내용 | 참고 사항 및 예시 |
|---|---|
| 1 산점도(scatter diagrams)를 그리며 해석합니다. | 표시된 점은 명확하게 표시되어야 하며, 예를 들어 작은 십자(x)로 표시할 수 있습니다. |
| 2 양의 상관관계, 음의 상관관계, 제로 상관관계의 의미를 이해한다. | |
| 3 시각으로 선형 회귀선을 그리고, 해석하며 사용함. | 선형 회귀선: • 관찰하여 그어진 단일 직선이어야 함 • 전체 데이터 세트에 걸쳐 확장되어야 함 • 모든 점이 정확히 일치할 필요는 없으나, 선 전체에 걸쳐 점들이 양측에 대략 고르게 분포되어 있어야 함. |
| 과목 내용 | 참고 사항 및 예시 |
|---|---|
| 1 산점도를 그리고 해석하기. | plotting된 점은 명확하게 표시되어야 하며, 예를 들어 작은 십자(x)로 표시. |
| 2 양의 상관관계, 음의 상관관계, 제로 상관관계의 의미를 이해한다. | |
| 3 시각으로 선형 회귀선을 그리고, 해석하며 사용함. | 선형 회귀선: • 관찰하여 그어진 단일 직선이어야 함 • 전체 데이터 세트에 걸쳐 확장되어야 함 • 모든 점이 정확히 일치할 필요는 없으나, 선 전체에 걸쳐 점들이 양측에 대략 고르게 분포되어 있어야 함. |
출처: Cambridge International syllabus
산점도는 두 가지 변수 간의 관계를 보여주는 점들로 쌍을 나타냅니다. 이 관계를 상관관계라고 합니다:
- 양(positive) 상관관계 — 하나가 증가하면 다른 하나도 증가합니다.
- 음(negative) 상관관계 — 하나가 증가하면 다른 하나는 감소합니다.
- 상관계수 0 — 명확한 직선적 경향이 없으며, 곡선 패턴이 존재할 수 있음.
상관관계가 있다면 최적拟合선(line of best fit) 을 그립니다: 점들 사이를 지나며 양쪽에 거의 같은 수의 점이 있는 하나의 직선입니다. 이를 사용하여 값을 예측합니다.
예측은 오직 데이터의 범위 내에서만 수행해야 합니다(보간법). plotting된 점 너머의 선을 읽는 것(외추법)은 신뢰할 수 없으며, 상관관계가 한 요인이 다른 요인의 원인이 된다는 것을 증명하지는 않습니다.

탐색하기
산점도와 상관관계
상관 관계의 강도를 변경하고 최적拟合 선을 추가하여 추세를 파악하세요.
어휘
연습하기
| English | 한국어 |
|---|---|
| correlation/ˌkɒrɪˈleɪʃn/ | 상관관계 |
| positive correlation/ˈpɒzɪtɪv ˌkɒrɪˈleɪʃn/ | 양(正)의 상관관계 |
| negative correlation/ˈneɡətɪv ˌkɒrɪˈleɪʃn/ | 음의 상관관계 |
| zero correlation/ˈzɪərəʊ ˌkɒrɪˈleɪʃn/ | 상관 없음 |
| line of best fit/laɪn ɒv best fɪt/ | 최적拟合선(최적拟合线) |
9.6
누적 빈도 도표 (확장)
Syllabus
| 과목 내용 | 참고 사항 및 예시 |
|---|---|
| 1 누적 빈도 표와 도표를 그린다. | 누적 빈도 도표에 plotted된 점은 명확히 표시해야 하며(예: 작은 십자 x), 매끄러운 곡선으로 연결된다. |
| 2 누적 빈도 도표로부터 중앙값, 백분위수, 사분위점 및 사분위범위를 추정하고 해석하기. |
출처: Cambridge International syllabus
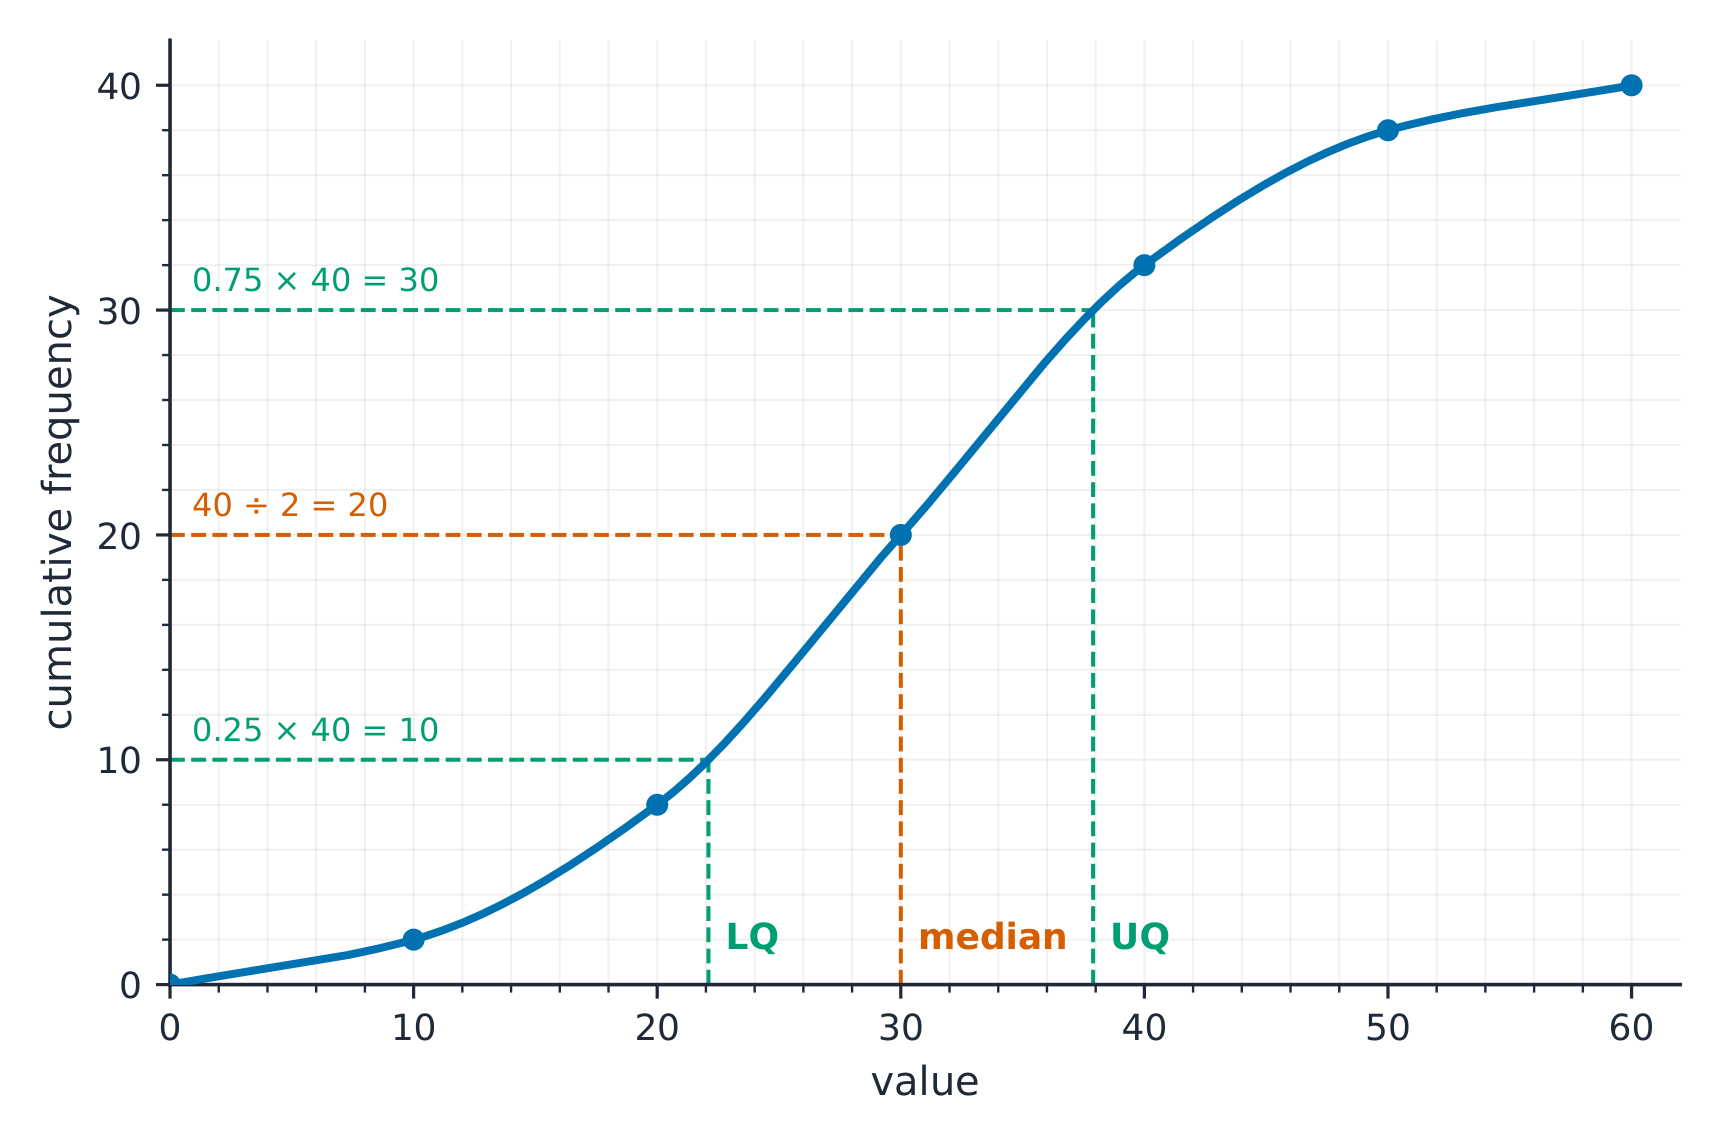
누적 빈도는 빈도의 누적 합입니다. 각 구간의 최상단 값에 대해 plotting하고 점을 부드러운 곡선으로 연결합니다.
위의 통근 시간에 대한 누적 빈도는 다음과 같습니다:
| Time $t$ (min) | $t \leqslant 10$ | $t \leqslant 20$ | $t \leqslant 30$ | $t \leqslant 50$ |
|---|---|---|---|---|
| 누적 빈도 | $5$ | $17$ | $25$ | $30$ |
$(10, 5)$, $(20, 17)$, $(30, 25)$, $(50, 30)$을 $(0, 0)$에서 시작하여 도표합니다. 수직축 $\tfrac{30}{2} = 15$에서 읽은 중앙값은 계급 $10 < t \leqslant 20$에 포함됩니다.
자주 하는 실수. 각 계급의 중점에 도표함. 누적 빈도는 계급의 상한에 도표해야 함.
곡선에서 총량의 절반에 해당하는 중앙값, 분의 1과 분의 3 지점에 해당하는 사분위수, 그리고 임의의 백분위 (예: $90$ 백분위는 총량의 $90\%$ 지점에 해당)를 읽을 수 있습니다.
탐색하기
누적 빈도 방법
원본 데이터를 따라 누적 빈도 곡선을 그리고 백분위수를 읽으세요.
어휘
연습하기
| English | 한국어 |
|---|---|
| cumulative frequency/ˈkjuːmjʊlətɪv ˈfriːkwənsi/ | 누적 빈도 |
| percentile/pəˈsentaɪl/ | 백분위수 |
9.7
히스토그램 (확장)
Syllabus
| 과목 내용 | 참고 사항 및 예시 |
|---|---|
| 1 히스토그램을 그리고 해석하기. | 히스토그램에서 세로축은 '빈도 밀도(Frequency density)'라고 표시됨. |
| 2 빈도 밀도를 사용하여 계산하기. | 빈도 밀도는 $\text{frequency density} = \text{frequency} \div \text{class width}$로 정의된다. |
출처: Cambridge International syllabus
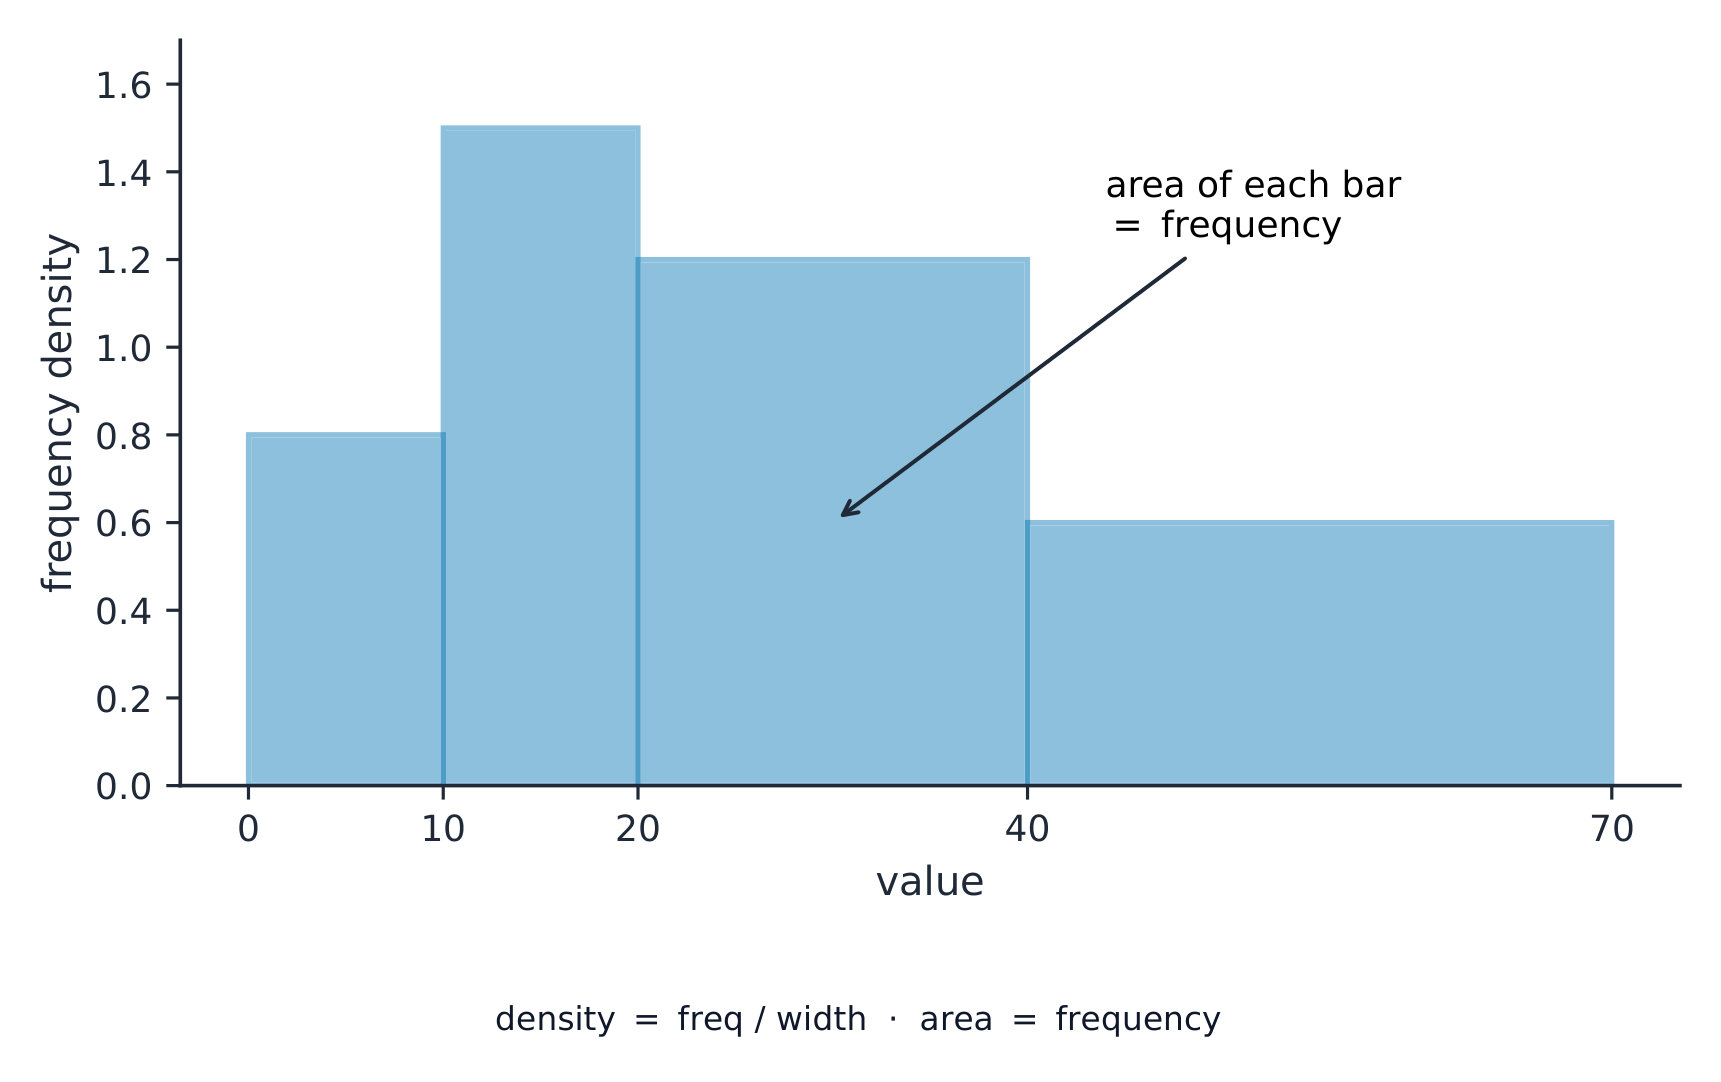
히스토그램은 막대 그래프처럼 보이지만 막대의 너비가 다를 수 있으며, 각 막대의 높이(높이)가 아닌 면적이 빈도를 나타냅니다. 세로축은 빈도 밀도(frequency density) 입니다:
$$\text{frequency density} = \frac{\text{frequency}}{\text{class width}}.$$
*구간 너비가 불균일할 때 막대의 면적(높이가 아님)이 빈도이므로, 축은 빈도 밀도입니다.
해설 예제. 한 반의 구간 너비(class width) 가 $10$이고 빈도가 $25$입니다. 빈도 밀도를 구하세요.
$$\text{frequency density} = \frac{25}{10} = 2.5.$$
해설 예: 막대그래프에서의 빈도. 히스토그램 막대가 $20 < h \leqslant 35$ 구간을 덮고 밀도가 $1.6$일 때, 이 계급에 포함된 값은 몇 개인가요?
$$\text{frequency} = \text{frequency density} \times \text{class width} = 1.6 \times 15 = 24.$$
해설 예: 막대 높이. 계급 $0 < x \leqslant 10$, $10 < x \leqslant 15$, $15 < x \leqslant 30$의 빈도가 각각 $15$, $20$, $18$일 때, 막대 높이는 $15 \div 10 = 1.5$, $20 \div 5 = 4$, $18 \div 15 = 1.2$입니다. 좁은 중간 계급이 가장 높은 막대를 가지는 이유는 해당 값들이 가장 밀집되어 있기 때문입니다.
자주 하는 실수. 구간의 폭이 다를 때 주파수를 막대 높이에 그리는 경우입니다.
탐색하기
빈도 밀도 히스토그램
계급 폭이 불균일할 경우 막대 높이는 빈도 밀도이며, 높이(높이)가 아닌 면적이 빈도를 나타냅니다.
어휘
연습하기
| English | 한국어 |
|---|---|
| histogram/ˈhɪstəɡræm/ | 히스토그램 |
| frequency density/ˈfriːkwənsi ˈdensɪti/ | 주파수 밀도 |
| class width/klæs wɪtθ/ | 계급 폭 |
9.7
시험 팁
- 세 가지 평균을 알고 있습니다: 평균 (모두 더하기 ÷ 개수), 중위수 (정렬된 값의 중간값, 또는 두 중간값의 평균), 최빈값 (가장 자주 나타나는 값). 범위는 최상단 − 최하단입니다.
- 빈도표에서 평균은 $\frac{\sum fx}{\sum f}$ — 행의 개수가 아닌 총빈도로 나누세요.
- 산점도에서 상관관계를 양, 음 또는 없음으로 설명하고, 평균점을 지나 최적拟合선을 그립니다.
- 구간 너비가 불균일한 히스토그램에서는 높이가 빈도 밀도(빈도 ÷ 구간 너비)이지 빈도가 아닙니다.
이 주제에 대한 인터랙티브 수업
즉시 체크 기능 exercises를 통해 단계별로 진행하세요.