| Candidates should be able to: | Notes and guidance |
|---|---|
| Show understanding of binary magnitudes and the difference between binary prefixes and decimal prefixes | Understand the difference between and use: • kibi and kilo • mebi and mega • gibi and giga • tebi and tera |
| Show understanding of different number systems | Use the binary, denary, hexadecimal number bases and Binary Coded Decimal (BCD) and one’s complement and two’s complement representation for binary numbers |
| Convert an integer value from one number base/ representation to another | |
| Perform binary addition and subtraction | Using positive and negative binary integers |
| Show understanding of how overflow can occur | |
| Describe practical applications where Binary Coded Decimal (BCD) and Hexadecimal are used | |
| Show understanding of and be able to represent character data in its internal binary form, depending on the character set used | Students are expected to be familiar with ASCII (American Standard Code for Information Interchange), extended ASCII and Unicode. Students will not be expected to memorise any particular character codes |
A-Level 计算机科学
学习建议
A-Level 计算机科学(9618)是两个感觉像不同学科的部分。理论部分从信息表示与通信,讲到硬件、处理器、系统软件、安全、数据库与伦理。实践部分是算法、数据结构、编程与软件开发,A2 还加入递归与面向对象编程。
理论卷的评分比学生预期的“字面”得多。存在一套标准术语——寄存器名称、寻址方式、范式,以及 validation 与 verification 的确切区别——用自己的话改述通常一分不得。请按考纲原文记定义。
编程卷奖励的是手写代码,写到你在脑子里就能“编译”通过。
-
1
信息表示
1.1
数据表示

大纲
来源:剑桥国际大纲
二进制计数:0 到 15 你必须使用的三种数制(number systems):
- 十进制(denary,decimal,基数 10)——用数字 0–9。位值是十的幂。
- 二进制(binary,基数 2)——用 0 和 1。位值是二的幂。每个字节(byte)是 8 个位(bits)。
- 十六进制(hexadecimal,基数 16)——用 0–9 然后 A–F 表示 10–15。每个十六进制数位(digit)恰好代表 4 个位。
算盘用位值表示数字——这与十进制、二进制和十六进制背后的想法相同 转换
十进制 → 二进制:不断除以 2 并记录余数,从下往上读。或者减去装得下的最大位值(place value,2 的幂)。
例子:$558_{10}$:$558 = 512 + 32 + 8 + 4 + 2 = 2^{9} + 2^{5} + 2^{3} + 2^{2} + 2^{1}$。用 12 位:
0010 0010 1110。二进制 → 十六进制:从右边起把位分成半字节(nibbles,4 位)并转换每一个。
0010 0010 1110→2 2 E→22E。十六进制 → 二进制:把每个十六进制数位换成它的 4 位模式。十六进制 → 十进制:把每个数位乘以它的位值。
22E$= 2 \times 256 + 2 \times 16 + 14 = 558$。例题。 把十进制 200 转换成 8 位二进制,然后转换成十六进制。
$200 = 128 + 64 + 8$,所以二进制是
11001000。分成半字节,11001000$= 12$ 和 $8$,即 $\text{C}$ 和 $8$,所以十六进制是C8。
从 200 的位值读它,然后把位分成半字节得到十六进制 C8 需要多少位?
考试题会规定寄存器宽度(register width)(8、12 或 16 位)。要用前导零补齐到这个宽度:$558$ 的 12 位形式是
0010 0010 1110,绝不能写成10 0010 1110。要找出能存储某个值的最少位数,问自己需要哪些位值:
- 从 $0$ 到 $2^{n} - 1$ 的无符号整数需要 $n$ 位:$200$ 需要 8 位(上限是 $255$),$1000$ 需要 10 位(上限是 $1023$),$16$ 需要 5 位(4 位到 $15$ 为止)。
- 从 $-2^{n-1}$ 到 $2^{n-1} - 1$ 的有符号补码整数需要 $n$ 位:$-200$ 需要 9 位,因为 8 位到 $-128$ 为止。
- 一个十六进制数位需要 4 位,一个 BCD 数位需要 4 位,一个 ASCII 字符需要 7 位(扩展 ASCII 为 8 位)。
二进制与十进制词头
两个词头族看起来相似但不同——十进制(10 的幂)和二进制(2 的幂):
十进制(SI) 二进制(内存) kilo $= 10^{3}$ kibi (Ki) $= 2^{10} = 1024$ mega $= 10^{6}$ mebi (Mi) $= 2^{20}$ giga $= 10^{9}$ gibi (Gi) $= 2^{30}$ tera $= 10^{12}$ tebi (Ti) $= 2^{40}$ 所以一个 tebibyte(TiB)略多于一个 terabyte(TB)。一个"1 TB"的驱动器容纳 $10^{12}$ 字节,但一个以 TiB 报告的操作系统显示一个较小的数字。
探索Binary, denary and hex
Type a number and see it in binary, denary and hexadecimal at once — and how the place values add up.
词汇表 训练英文 中文 拼音 number system/ˈnʌmbə ˈsɪstəm/ 数制 shù zhì binary/ˈbaɪnəri/ 二进制 èr jìn zhì denary/ˈdiːnəri/ 十进制 shí jìn zhì digit/ˈdɪdʒɪt/ 数位 shù wèi place value/pleɪs ˈvæljuː/ 位值 wèi zhí byte/baɪt/ 字节 zì jié bit/bɪt/ 位 wèi hexadecimal/ˌheksəˈdesɪml/ 十六进制 shí liù jìn zhì nibbles/ˈnɪblz/ 半字节 bàn zì jié nibble/ˈnɪbl/ 半字节 bàn zì jié register width/ˈredʒɪstə wɪtθ/ 寄存器宽度 jì cún qì kuān dù register/ˈredʒɪstə/ 寄存器 jì cún qì BCD/ˌbiː siː ˈdiː/ 二进码十进数 èr jìn mǎ shí jìn shù 1.1
二进制运算

二进制加法
从右边起逐列相加,像十进制那样进位:
位 A 位 B 进位输入 和位 进位输出 0 0 0 0 0 0 0 1 1 0 0 1 0 1 0 0 1 1 0 1 1 1 0 0 1 1 1 1 1 1 当结果需要的位比寄存器(register)能容纳的更多时,发生溢出(overflow)——最左列的进位输出就是溢出位。
例题。 把 8 位无符号整数 $10110101$ 和 $01101100$ 相加,并对结果作出评论。
$10110101 + 01101100 = 1\,00100001$。答案需要 9 位,所以放不进一个 8 位寄存器:发生了溢出。一个完整的答案要说出错误的名称并说明原因,用题目给出的字长:"溢出:真实结果($289$)大于 8 位寄存器能容纳的最大值($255$),所以最高有效位的进位输出丢失,存储的结果($00100001 = 33$)是错的。"
二进制减法
通常的方法是补码(two's complement)加法:要做 $A - B$,构成 $B$ 的补码(每一位取反并加 1),然后相加,并丢弃任何最终的进位输出。
从 $01100100$ 中减去 $00011110$(无符号 8 位):
- $00011110$ 的补码:取反 → $11100001$,加 1 → $11100010$。
- 加到 $01100100$:结果 $1\,01000110$(9 位)——丢弃前导的 1 → $01000110 = 70_{10}$。检验:$100 - 30 = 70$。✓
补码有符号整数
在一个 $n$ 位补码数中:
- 最高有效位(most significant bit,MSB)是符号位(sign bit):0 = 正,1 = 负。
- 要读一个负数:每一位取反,加 1,然后取负。
所以 $11100010$ 是负的;取反 → $00011101$,加 1 → $00011110 = 30$,所以它是 $-30$。这是一个有符号整数(signed integer,不同于无符号(unsigned)的)。$n$ 位的范围是 $-2^{n-1}$ 到 $+2^{n-1} - 1$;对 8 位,$-128$($10000000$)到 $+127$($01111111$)。
8 位补码:符号位把范围分成负($-128$ 到 $-1$)和正($0$ 到 $127$) 例题。 8 位补码数 $10110100$ 表示什么十进制值?
MSB 是 1,所以它是负的。取反 → $01001011$,加 1 → $01001100 = 76$,所以值是 $-76$。用位值检验:$-128 + 32 + 16 + 4 = -76$。
例题。 把 $-108$ 写成 12 位补码整数。
从 12 位的 $+108$ 开始:$108 = 64 + 32 + 8 + 4$,所以是
0000 0110 1100。每一位取反:1111 1001 0011。加 1:1111 1001 0100。用位值检验,其中最高位的值是 $-2^{11} = -2048$:$-2048 + 1024 + 512 + 256 + 128 + 16 + 4 = -108$。✓对于 12 位,范围是 $-2048$(
1000 0000 0000)到 $+2047$(0111 1111 1111)。要求写出最小值和最大值的题目要的就是这两个模式,所以记住规律:最小的负数是一个 1 后面全是 0;最大的正数是一个 0 后面全是 1。算术移位(arithmetic shift)把每一位向左或向右移动,但保持符号:向右移一位使数值减半,并把符号位复制到左边空出的位置,所以负数仍是负数(
1111 1001 0100向右移三位得到1111 1111 0010,即 $-14$:$-108 / 8 = -13.5$,右移时向下取整)。向左移一位使数值加倍。移位属于主题 4 的汇编指令集,但这道题是和这里的数制内容一起考的。有符号运算中的溢出发生在真实结果落在这个范围之外时——当符号位错误地翻转时可以发现(两个正数给出一个负数,或两个负数给出一个正数)。
反码
在补码之前,一个较老的方案叫反码(one's complement),它表示一个负数只是把正数的每一位取反——没有"加 1"步骤。
- $+30 = 00011110$,所以在反码中 $-30 = 11100001$(就是取反)。
- 缺点:它有两个零——$00000000$($+0$)和 $11111111$($-0$)——这浪费了一个位模式,并使运算别扭。
补码(取反并加 1)去除了负零:它有单一的零,并让加法和减法使用同一个电路。这就是为什么现代计算机以补码而非反码存储有符号整数。
探索Binary & signed integers
byte = Σ place values
See how an 8-bit pattern maps to a number (and how it would overflow past 255).
探索Two's complement signed bits
The leftmost bit carries a negative place value. Flip any bit — or hit Negate (invert every bit, then add 1) — and watch the signed value change.
词汇表 训练英文 中文 拼音 unsigned/ʌnˈsaɪnd/ 无符号 wú fú hào overflow/ˌəʊvəˈfləʊ/ 溢出 yì chū most significant bit/məʊst sɪɡˈnɪfɪkənt bɪt/ 最高有效位 zuì gāo yǒu xiào wèi two's complement/tuːz ˈkɒmplɪmənt/ 补码 bǔ mǎ signed integer/saɪnd ˈɪntɪdʒə/ 有符号整数 yǒu fú hào zhěng shù sign bit/saɪn bɪt/ 符号位 fú hào wèi arithmetic shift/ˌærɪθˈmetɪk ʃɪft/ 算术移位 suàn shù yí wèi one's complement/wʌnz ˈkɒmplɪmənt/ 反码 fǎn mǎ 1.1
二进制编码的十进制(BCD)

在 BCD(二进码十进数)中,每个十进制数位被写成它自己的 4 位模式。数字 $93$ 在 BCD 中是
1001 0011——不是二进制 93($01011101$)。每个半字节只用 0–9;模式 $1010$–$1111$ 是无效的。BCD 读法:
0010 0111 0101→ 2, 7, 5 → 275。用途:计算器、数字钟,以及显示十进制数位的设备——每个数位驱动一个七段显示器(7-segment display)。货币代码常用 BCD 以避免把像 0.1 这样的分数转换成二进制时的舍入误差。
"说明理由"类的答案必须把用途和 BCD 的某个性质联系起来:每个十进制数位都有自己的 4 位,所以一个数位可以直接送到它的显示器,或逐位相加,而不必转换整个数;而且像 $0.10$ 这样的十进制小数能被精确存储,二进制小数做不到这一点。
一个七段显示器显示一个十进制数位,常由 BCD 驱动 词汇表 训练英文 中文 拼音 7-segment display/ˈsevən ˈseɡmənt dɪˈspleɪ/ 七段显示器 qī duàn xiǎn shì qì 1.1
十六进制 —— 实际用途

十六进制是写二进制的一种紧凑方式(1 个十六进制数位 = 4 位):
一个字节是两个半字节;每个半字节是一个十六进制数位 - 底层编程中的内存地址(memory addresses)——
0x7FFE。 - HTML/CSS 中的颜色值——
#FF8800。 - MAC 地址——
AC:DE:48:00:11:22。
十六进制不改变存储的数据——它只是使二进制对人类更容易。
词汇表 训练英文 中文 拼音 memory address/ˈmeməri əˈdres/ 内存地址 nèi cún dì zhǐ 1.1
字符编码
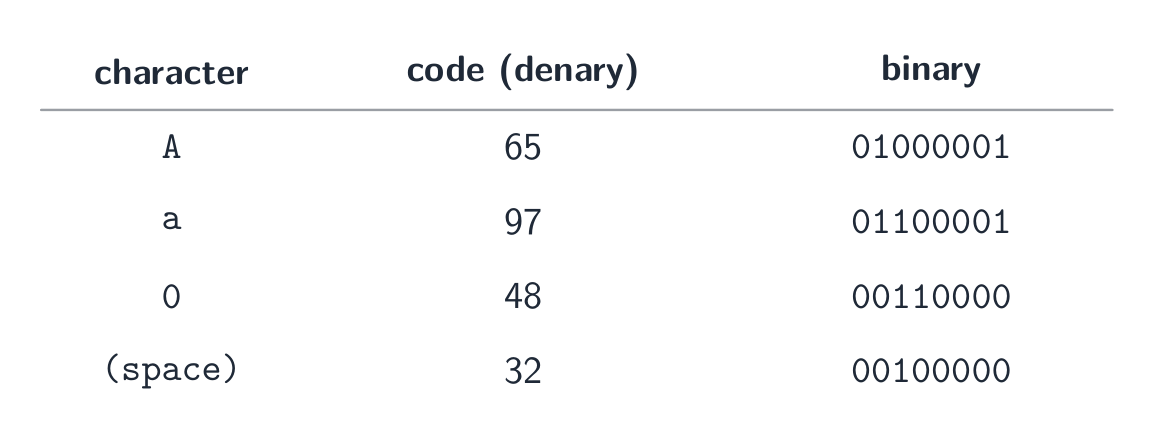
计算机把文本存储为数字;每个字符有一个由字符集(character set)设定的数字码点(code point)。
ASCII
- ASCII 用 7 位——128 个码点。基本拉丁字母、数字、标点和控制码。
- 扩展 ASCII 用 8 位——256 个码点;低 128 个与 ASCII 相符,高 128 个因地区而异。
每个字符被存储为一个数字——几个 ASCII 码点的十进制和二进制 Unicode
- Unicode 是一个通用字符集,涵盖几乎每一种文字,加上符号和表情符号。
- 常见的编码(encodings):UTF-8(1–4 字节,兼容 ASCII)、UTF-16(2 或 4 字节)、UTF-32(固定 4 字节)。
为什么 Unicode 胜过 ASCII
- 它表示多得多的字符(每一种文字、表情符号);ASCII 只涵盖基本英语。
- 文件可移植、没有代码页混乱,并允许一个文档中的多语言文本。
- 权衡:对于纯英语文本,Unicode 文件通常更大。
当题目要求区别时,要成对地、带着数字来给出:ASCII 用 7 位(扩展 ASCII 8 位),所以有 128(256)个字符;Unicode 最多用 32 位(UTF-8 用 1 到 4 个字节),所以有超过一百万个码点。ASCII 只涵盖基本英语;Unicode 涵盖每一种文字,而且它的前 128 个码点就是 ASCII 的那些。在 UTF-8 中一个英文字母仍只占 1 个字节,所以一个 40 个字母的英文文件名在 ASCII 和 UTF-8 中都是 40 字节,而一个汉字占 3 个字节。
探索A character is stored as a number
Each character has a code number — 'A' is 65. Flip the bits to see that code in binary and hex, exactly how the computer holds it.
词汇表 训练英文 中文 拼音 code point/kəʊd pɔɪnt/ 码点 mǎ diǎn character set/ˈkærɪktə set/ 字符集 zì fú jí encoding/enˈkəʊdɪŋ/ 编码 biān mǎ 1.2
多媒体
大纲
Candidates should be able to: Notes and guidance Show understanding of how data for a bitmapped image are encoded Use and understand the terms: pixel, file header, image resolution, screen resolution, colour depth / bit depth Perform calculations to estimate the file size for a bitmap image Show understanding of the effects of changing elements of a bitmap image on the image quality and file size Use the terms: image resolution, colour depth / bit depth Show understanding of how data for a vector graphic are encoded Use the terms: drawing object, property, drawing list Justify the use of a bitmap image or a vector graphic for a given task Show understanding of how sound is represented and encoded Use the terms: sampling, sampling rate, sampling resolution, analogue and digital data Show understanding of the impact of changing the sampling rate and resolution Including the impact on file size and accuracy 来源:剑桥国际大纲
一个位图(bitmap)图像(也叫位映射图像)在一个网格中存储每个像素(pixel)的颜色。在文件的开头,一个文件头(file header)记录图像的元数据——它的宽度、高度和颜色深度——这样软件就知道如何读取随后的像素数据。
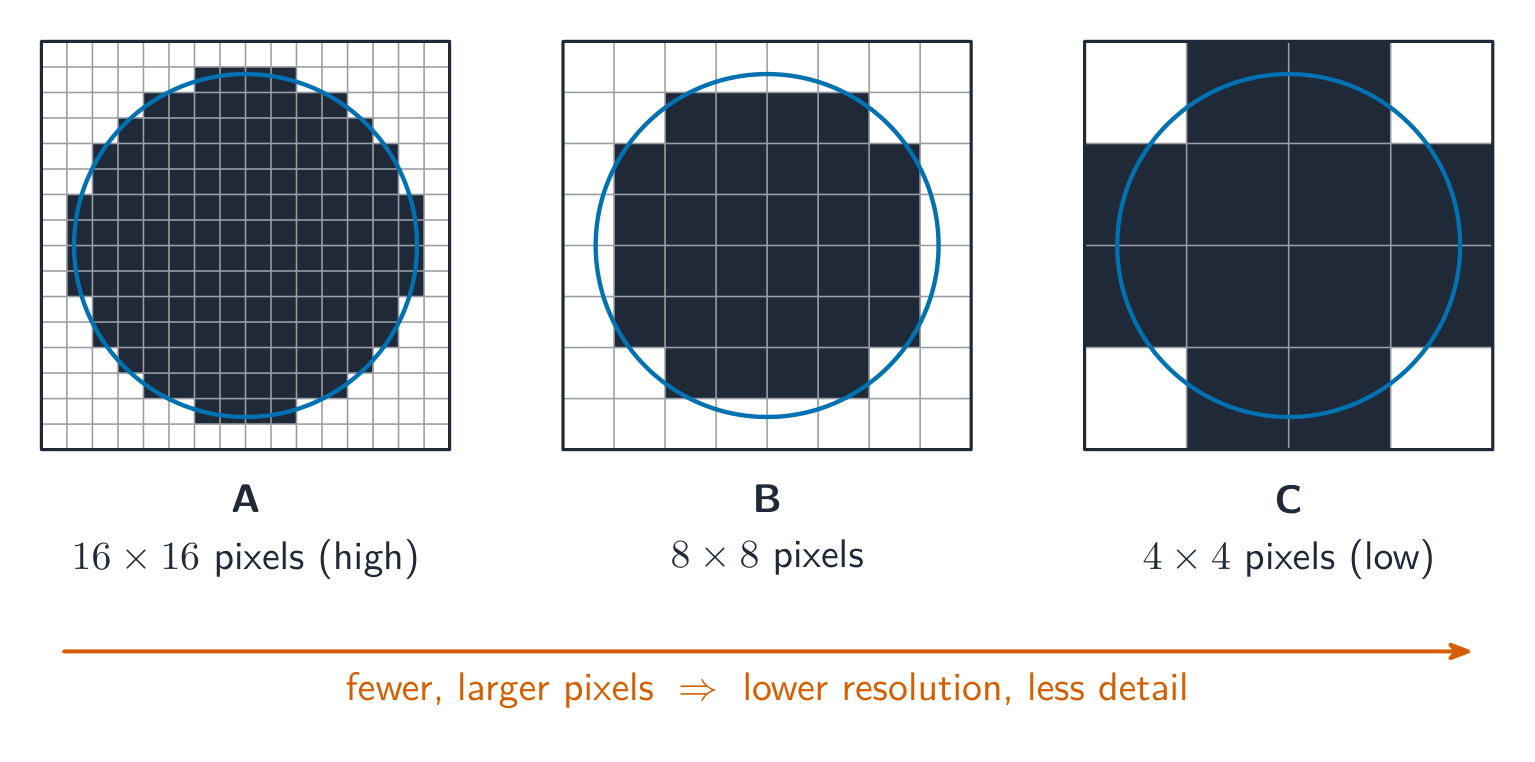
- 图像分辨率(image resolution):位图自身的大小,以像素计的宽 × 高(例如 1920 × 1080)。
- 屏幕分辨率(screen resolution):显示器能显示的宽 × 高。如果一个图像的分辨率比屏幕大,它被缩小以适应;一个低分辨率图像被拉伸到一个较高分辨率的屏幕上时看起来有块状感。
- 颜色深度(colour depth,位深度(bit depth)):每像素的位数。1 位 → 黑/白;8 位 → 256 种颜色;24 位 → 1670 万("真彩色")。
同一图像以三种分辨率存储,从高(A)到低(C):更少、更大的像素意味着更少的细节 文件大小
$$\text{size in bits} = \text{width} \times \text{height} \times \text{bit depth}.$$除以 8 得字节,除以 1024 得 KiB,等等。例子:一个 $3000 \times 2000$、24 bpp 的图像是 $3000 \times 2000 \times 24 = 1.44 \times 10^{8}$ 位 $\approx 17.2\ \text{MiB}$。
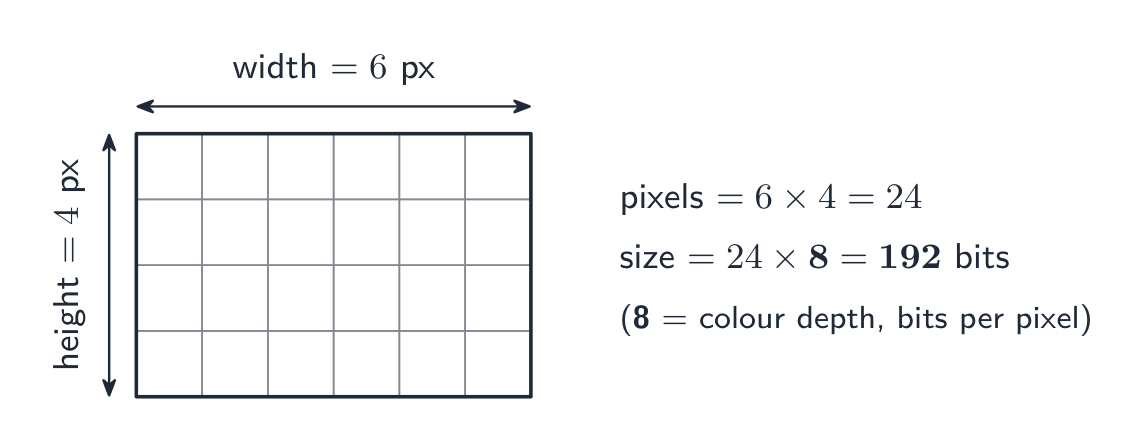
同一个公式用小数字演示:先数像素,再乘以颜色深度 写明你用的单位。评分标准接受 $1\ \text{MB} = 10^{6}$ 字节(SI 词头)或 $1\ \text{MiB} = 1024 \times 1024$ 字节(二进制词头),只要你的过程表明用的是哪一个;同一幅图像是 $18.0\ \text{MB}$ 或 $17.2\ \text{MiB}$。如果题目给出了文件头的大小,要把它加上。
视频是一系列位图图像,每一幅是一帧(frame)。压缩前它的大小是一帧的大小 $\times$ 帧率(frame rate,每秒帧数)$\times$ 以秒计的时长:每秒 30 帧、每帧 $1920 \times 1080$ 像素、24 位,就是每秒 $30 \times 1920 \times 1080 \times 24 \approx 1.5 \times 10^{9}$ 位,约 $187\ \text{MB}$。这就是为什么视频总是要压缩。
改变设置
- 较低分辨率 → 较小的文件,较少的细节(放大时看起来有块状感)。
- 较低颜色深度 → 较小的文件,但平滑的色调显示出条带。
- 两者中较高的 → 较大的文件,更好的质量。
词汇表 训练英文 中文 拼音 bitmap/ˈbɪtmæp/ 位图 wèi tú pixel/ˈpɪksl/ 像素 xiàng sù file header/faɪl ˈhedə/ 文件头 wén jiàn tóu colour depth/ˈkʌlə depθ/ 颜色深度 yán sè shēn dù image resolution/ˈɪmɪdʒ ˌrezəˈluːʃn/ 图像分辨率 tú xiàng fēn biàn lǜ screen resolution/skriːn ˌrezəˈluːʃn/ 屏幕分辨率 píng mù fēn biàn lǜ bit depth/bɪt depθ/ 位深度 wèi shēn dù frame/freɪm/ 帧 zhēn frame rate/freɪm reɪt/ 帧率 zhēn lǜ 1.2
矢量图形
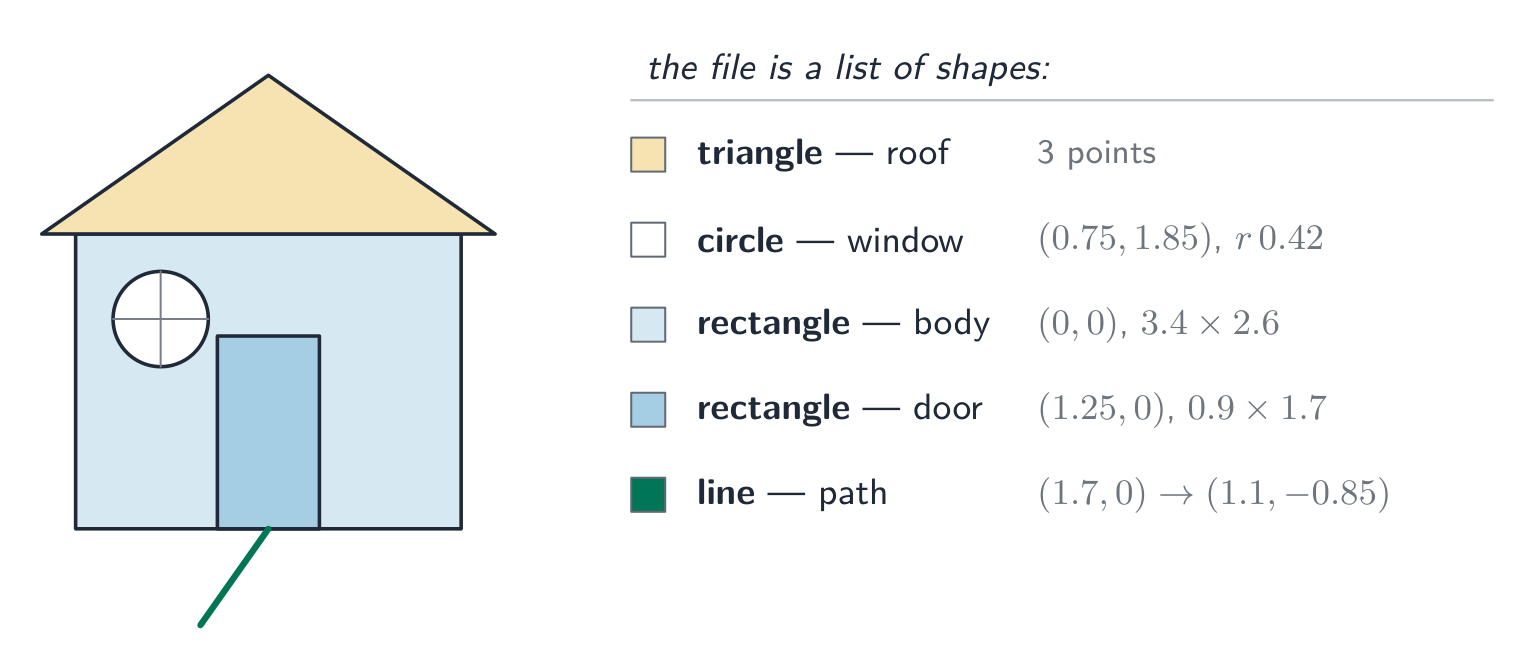
一个矢量图形(vector graphic)把画图像的指令存储为一个绘图列表(drawing list)——一个有序的绘图对象(drawing objects,几何图元(primitives):线、曲线、多边形、圆)列表。每个绘图对象有属性(properties),如颜色、填充、线宽和位置(坐标)。要显示它,程序以所需的任何分辨率渲染(renders)这个绘图列表。
一个矢量图像由标注的几何形状构成,每个带属性 位图与矢量
任务 较好的选择 为什么 照片 位图 复杂的像素级细节不能被描述为形状。 徽标、图标、标志 矢量 边缘清晰;缩放到任何大小都不模糊。 工程图 矢量 精确的几何和缩放。 绘画、纹理 位图 每个区域平滑的色调细节。 矢量的优点:它缩放而不损失质量——一个矢量徽标在任何大小都保持清晰,而一个位图放大时会模糊。矢量的缺点:它不能描述任意的像素细节(照片)。
"说明理由"类的答案要把选择和任务联系起来。"这个标志既要印在名片上又要印在广告牌上,所以应该用矢量图形:它以绘图对象的形式存储,能在任何尺寸下清晰地重新渲染;而位图放大时会显出像素。"对于照片,论证方向相反:没有可以描述的形状,所以必须存储每个像素的颜色。
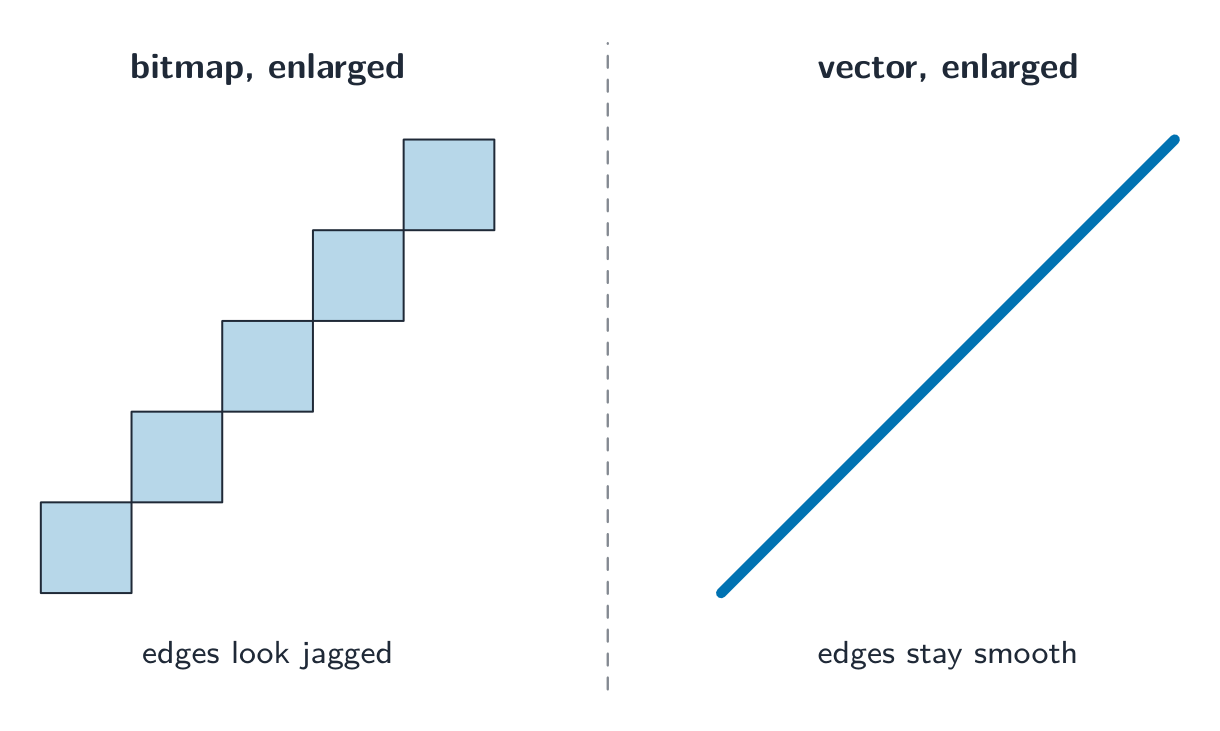
放大后,一个位图的像素变得锯齿状;一个矢量在任何大小都保持平滑 探索Computing concept lab
Classify concrete examples by the computing idea they demonstrate.
词汇表 训练英文 中文 拼音 vector graphic/ˈvektə ˈɡræfɪk/ 矢量图形 shǐ liàng tú xíng drawing list/ˈdrɔːɪŋ lɪst/ 绘图列表 huì tú liè biǎo drawing objects/ˈdrɔːɪŋ ˈɒbdʒekts/ 绘图对象 huì tú duì xiàng primitives/ˈprɪmɪtɪvz/ 图元 tú yuán primitive/ˈprɪmɪtɪv/ 图元 tú yuán properties/ˈprɒpətiz/ 属性 shǔ xìng render/ˈrendə/ 渲染 xuàn rǎn 1.2
声音
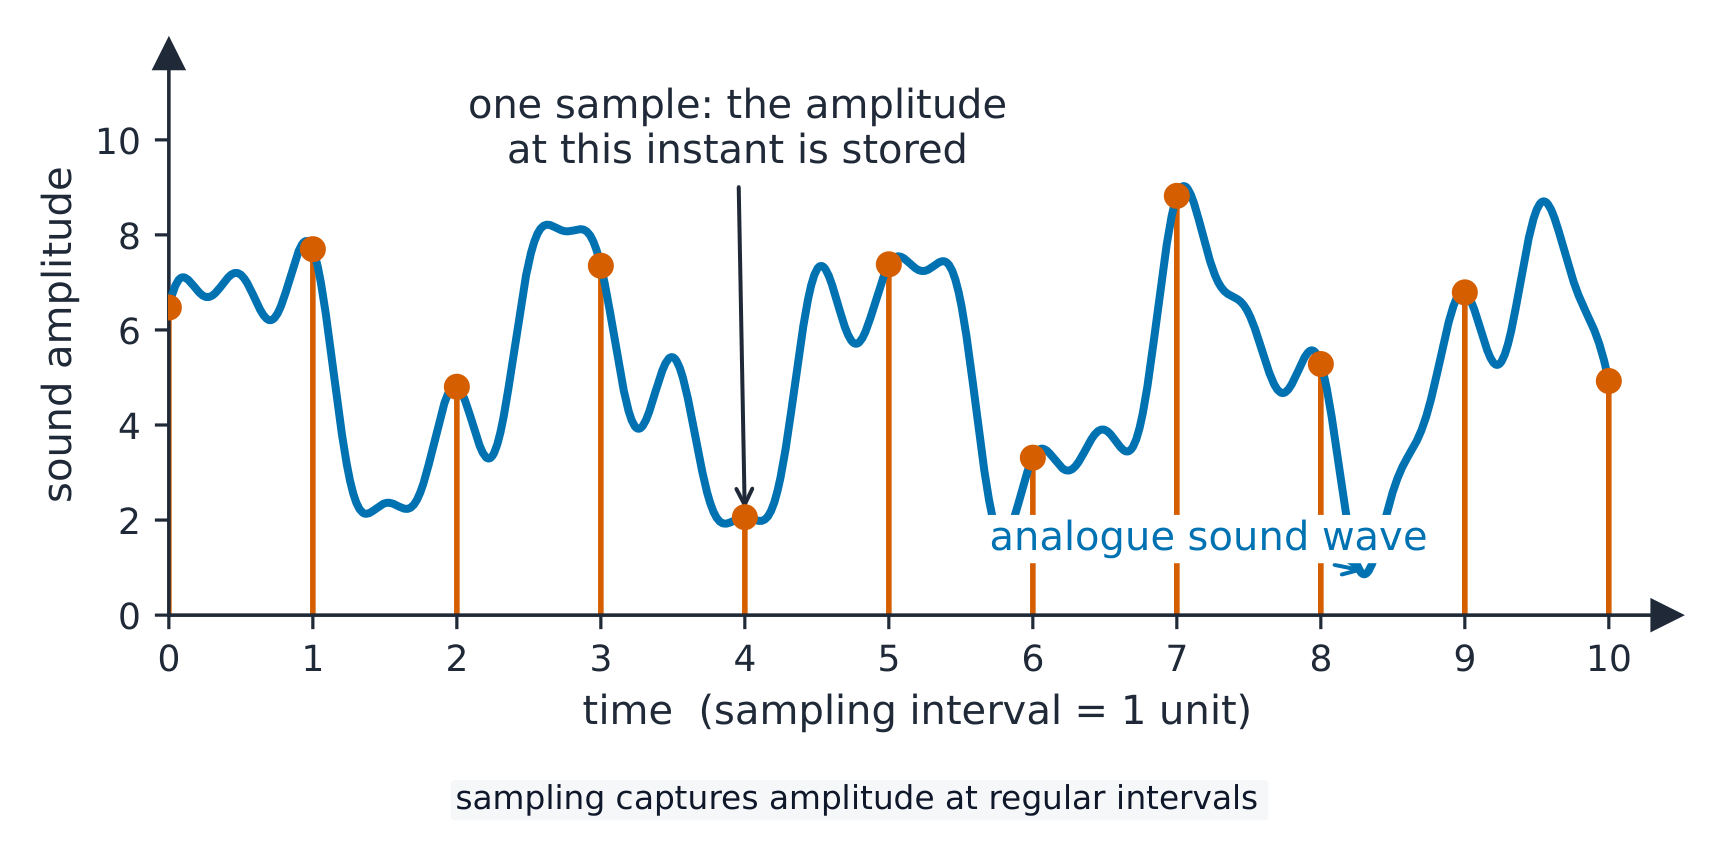
一个连续的模拟数据(analogue data,声音)波通过采样(sampling)被转换成数字数据(digital data):
- 采样率(sampling rate)——每秒的采样数(Hz)。CD 质量是 $44.1\ \text{kHz}$。
- 采样分辨率(sampling resolution,位深度)——每个采样的振幅(amplitude)的位数。CD 质量是 16 位。
采样一个声波:在每个时间间隔读它的振幅 文件大小
$$\text{size in bits} = \text{sampling rate} \times \text{resolution} \times \text{duration} \times \text{channels}.$$一段 10 秒的立体声 CD 片段:$44100 \times 16 \times 10 \times 2 = 14\,112\,000$ 位 $\approx 1.68\ \text{MiB}$。
改变设置
- 较高采样率 → 捕捉较高的音调,较大的文件。
- 较高采样分辨率 → 更精细的振幅步长,较少的量化(quantisation)噪声,较大的文件。
- 两者中较低的 → 较小的文件,明显的质量损失。
(采样率必须至少是你想保留的最高频率的两倍。)
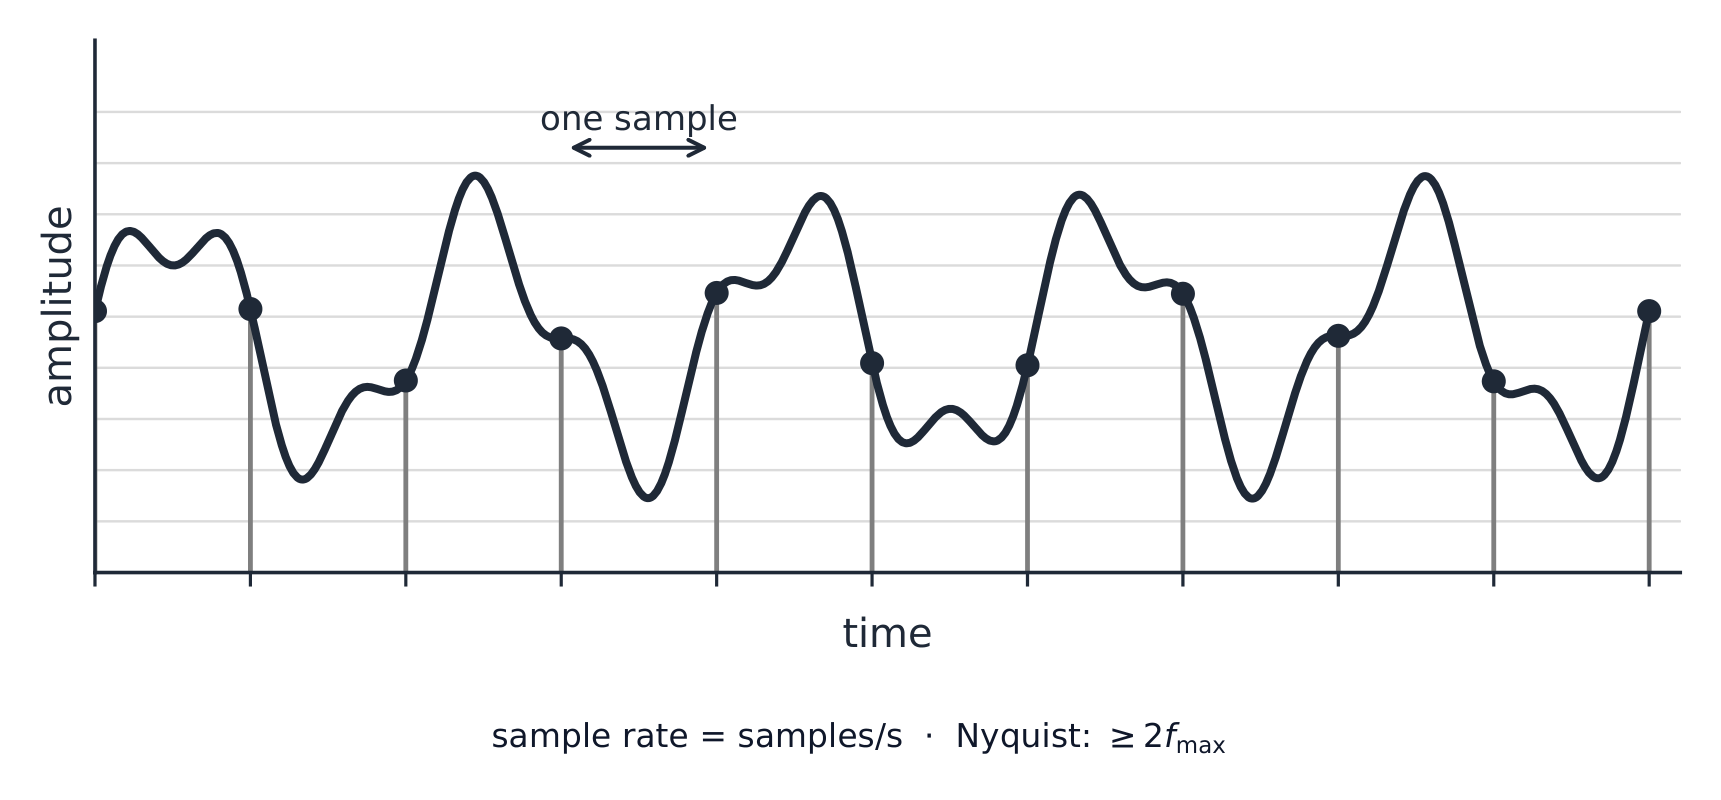
采样率是每秒的样本数;奈奎斯特规则解释了为什么它必须至少是所保留最高频率的两倍 探索Sound sampling
y = a sin(bt + c)
Sampling measures a sound wave at regular intervals — a higher rate copies it more truly.
词汇表 训练英文 中文 拼音 analogue data/ˈænəlɒɡ ˈdeɪtə/ 模拟数据 mó nǐ shù jù digital data/ˈdɪdʒɪtl ˈdeɪtə/ 数字数据 shù zì shù jù sampling/ˈsæmplɪŋ/ 采样 cǎi yàng sampling rate/ˈsæmplɪŋ reɪt/ 采样率 cǎi yàng lǜ sampling resolution/ˈsæmplɪŋ ˌrezəˈluːʃn/ 采样分辨率 cǎi yàng fēn biàn lǜ amplitude/ˈæmplɪtjuːd/ 振幅 zhèn fú sample resolution/ˈsæmpl ˌrezəˈluːʃn/ 采样分辨率 cǎi yàng fēn biàn lǜ quantisation/ˌkwɒntaɪˈzeɪʃn/ 量化 liàng huà 1.3
压缩
大纲
Candidates should be able to: Notes and guidance Show understanding of the need for and examples of the use of compression Show understanding of lossy and lossless compression and justify the use of a method in a given situation Show understanding of how a text file, bitmap image, vector graphic and sound file can be compressed Including the use of run-length encoding (RLE) 来源:剑桥国际大纲
压缩(compression)减小文件大小,节省存储和传输的带宽(bandwidth)。两种:
- 无损(lossless)——原始数据被精确恢复(文本、程序、ZIP/PNG)。
- 有损(lossy)——为了小得多的文件丢弃一些细节(JPEG、MP3、视频)。
何时用哪种
- 无损用于文档、源代码、医学图像——任何需要精确数据的东西。
- 有损用于流媒体。实时视频流用有损压缩,因为它必须在有限的带宽上实时发送大量数据;无损不能把它缩得足够小。原始高清视频是每分钟几个吉字节,所以没有压缩画面会不断卡住。
"说明理由"类的答案先说方法,再给出来自情境的原因:"无损,因为电子表格必须被精确地恢复;一个数值变了,账目就错了。"或者:"有损,因为这些照片是在手机屏幕上看的,丢掉的细节看不出来,而更小的文件上传更快、占的存储更少。"
无损方法
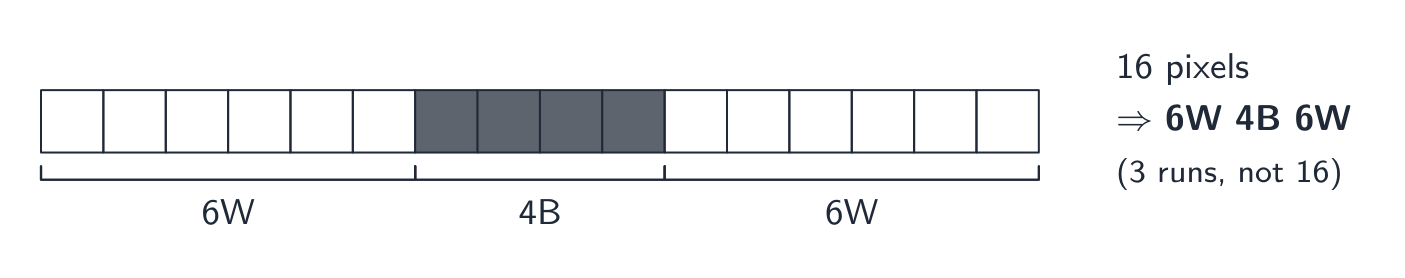
- 行程编码(run-length encoding,RLE):存储"接下来的 $n$ 个值是 $x$",而不是重复 $x$。对平坦区域很好;对噪声数据没用。
- 字典编码(dictionary methods,ZIP、PNG):用一个短引用替换重复的字节序列。对文本和代码很好。
- 霍夫曼编码(Huffman coding):给常见符号短码、给罕见符号长码,使平均码长接近数据的熵(entropy)。
各类文件如何压缩:
- 文本文件:字典编码和霍夫曼编码把重复的单词和常见字符变成短码。文本必须保持无损,因为改变一个字符就改变了意思。
- 位图图像:对相同像素的连续段用 RLE(图标、图表、黑白扫描件);对照片用有损的 JPEG,或降低颜色深度或分辨率。
- 矢量图形:绘图列表本来就小;删去不需要的绘图对象,坐标存更少的小数位,或对文件应用 ZIP 之类的无损方法。
- 声音文件:有损的 MP3 或 AAC 去掉耳朵听不到的部分;降低采样率或采样分辨率也是有损的;无损格式保留每一个样本,文件缩小得少得多。
单行上的行程编码:16 个像素变成 3 段行程 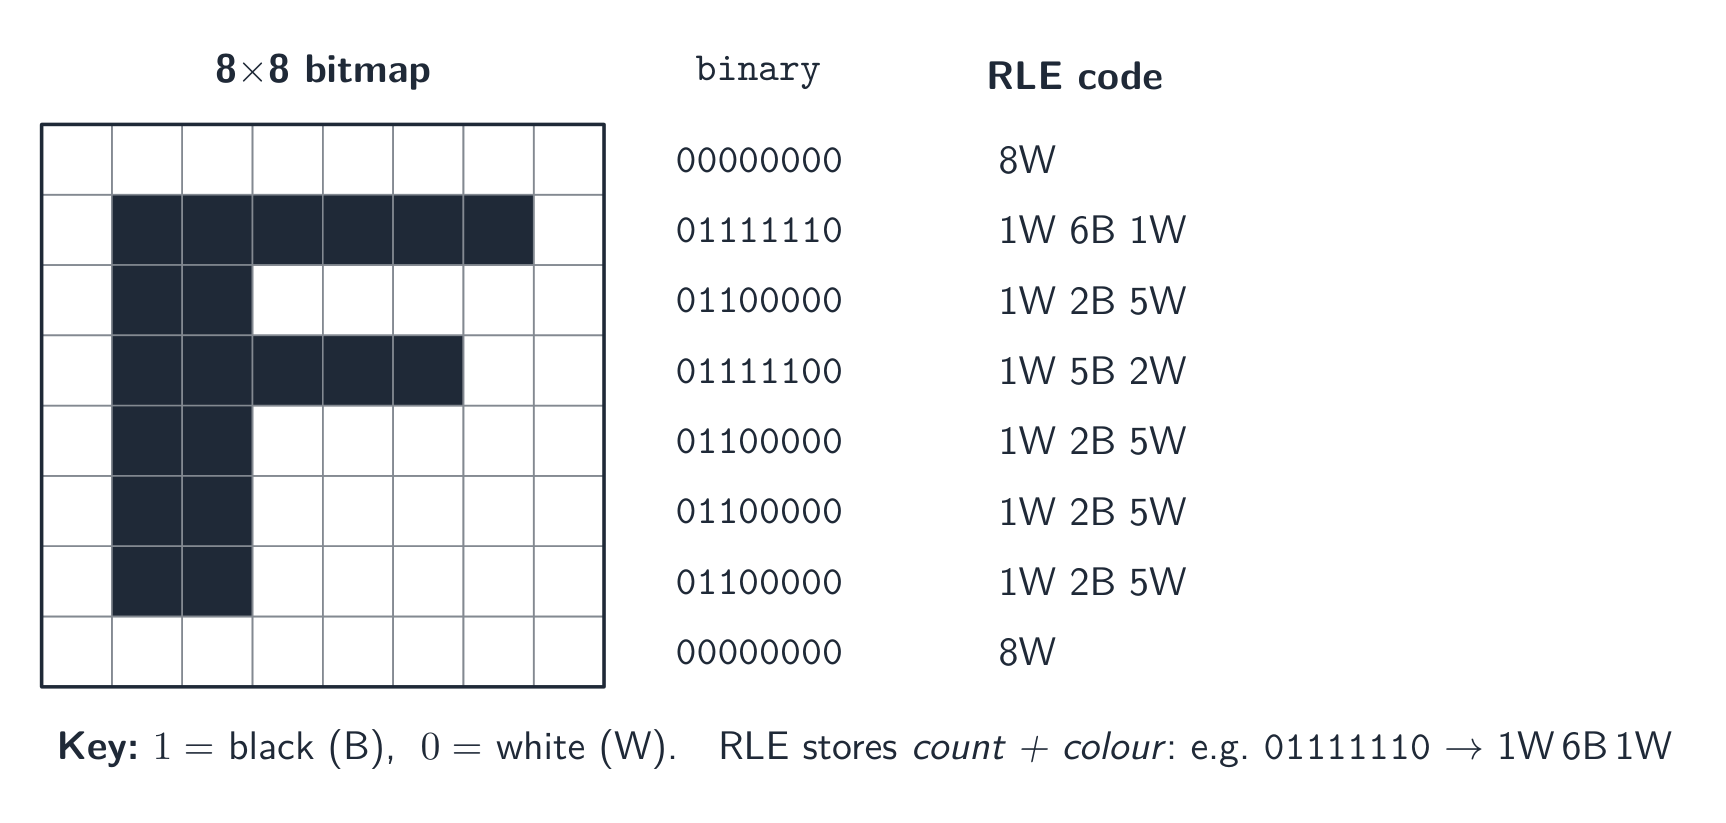
一个 $8\times8$ 黑白网格中字母 F 的行程编码 有损方法
- 图像(JPEG):丢弃眼睛几乎看不见的精细细节和颜色差异。
- 声音(MP3、AAC):丢弃我们听得不太清楚的音调,以及被较响声音掩盖的安静声音。
- 视频结合空间(spatial)压缩(在每一帧内,像 JPEG)与时间(temporal)压缩(大多数帧只存储与前一帧的差异)。
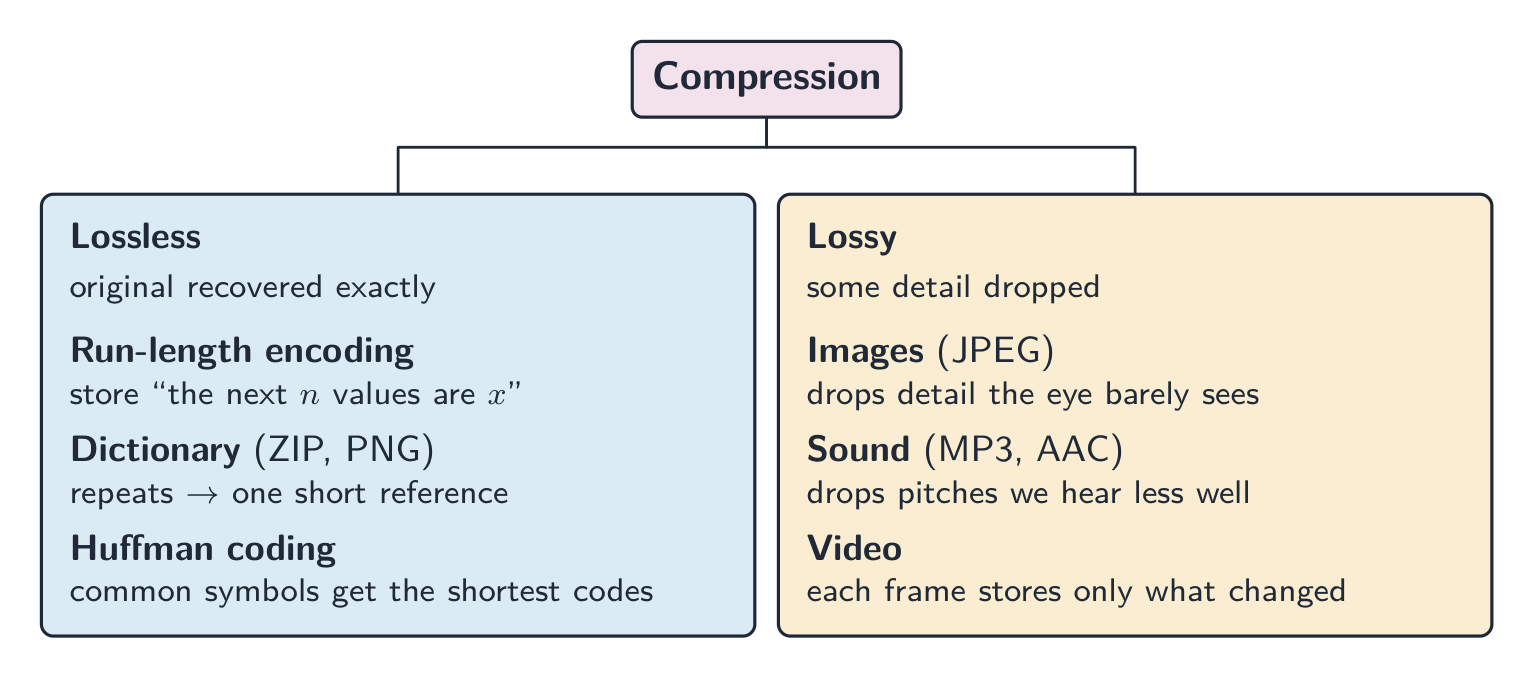
压缩方法:无损对有损,以及常见的例子 探索Run-length encoding
Watch a run of repeated symbols get squashed into a count — simple lossless compression.
词汇表 训练英文 中文 拼音 compression/kəmˈpreʃn/ 压缩 yā suō bandwidth/ˈbændwɪdθ/ 带宽 dài kuān lossless/ˈlɒsləs/ 无损 wú sǔn lossy/ˈlɒsi/ 有损 yǒu sǔn run-length encoding/rʌn leŋθ enˈkəʊdɪŋ/ 行程编码 xíng chéng biān mǎ dictionary methods/ˈdɪkʃənəri ˈmeθədz/ 字典编码 zì diǎn biān mǎ Huffman coding/ˈhʌfmən ˈkəʊdɪŋ/ 霍夫曼编码 huò fū màn biān mǎ entropy/ˈentrəpi/ 熵 shāng spatial/ˈspeɪʃl/ 空间 kōng jiān temporal/ˈtempərəl/ 时间 shí jiān 1.3
考官认可的定义
定义题按固定的表述给分。把这些记准确,并且只写一个答案。
术语 定义 位(bit) 一个二进制数字,0 或 1 字节(byte) 一组 8 位 二进制词头(binary prefix) 一个是 2 的幂(kibi = 1024)而不是 10 的幂(kilo = 1000)的倍数 补码(two's complement) 一种表示有符号整数的方法,其中最高有效位具有负的位值 溢出(overflow) 计算结果太大,无法用可用的位数表示 BCD(Binary Coded Decimal) 每个十进制数位存储为它自己的 4 位二进制模式 字符集(character set) 计算机能表示的字符的集合,每个字符有自己的二进制码 像素(pixel) 位图图像的最小元素,存储一个颜色值 图像分辨率(image resolution) 图像中的像素数,以宽 × 高给出 屏幕分辨率(screen resolution) 显示器能显示的像素数,以宽 × 高给出 颜色深度(colour depth) 用来存储一个像素颜色的位数 采样率(sampling rate) 每秒对声音采样的次数 采样分辨率(sampling resolution) 用来存储一个样本振幅的位数 无损压缩(lossless compression) 能把原始数据精确恢复的压缩 有损压缩(lossy compression) 永久去掉一些数据、原始数据无法恢复的压缩 行程编码(run-length encoding) 用一个值和一个计数来替换一段重复的值 1.3
考试技巧
- 显示进制转换的过程:十进制 → 二进制用位值,二进制 → 十六进制分半字节(4 位一组)。
- 对于补码,MSB 是负的;要取负,取反并加 1;当符号位错误地翻转时留意溢出。
- 区分位图(像素;文件大小 $=$ 宽 $\times$ 高 $\times$ 颜色深度)和矢量(绘图命令;缩放而不损失)。
- 声音文件大小取决于采样率 $\times$ 位深度 $\times$ 时间——每样越多意味着越好的质量但越大的文件。
- 比较无损与有损压缩并给出各自的一个用途。
常见错误
- 用"答案大于 255"或"它有 9 位"来解释溢出。先说出题目给的字长,再说结果无法用它表示。
- 把最高位设为 1、其余不动来构造负数(原码)。补码的意思是把正数的每一位取反,再加 1。
- 忘记把转换后的数补齐到题目要求的寄存器宽度。
- 在文件大小计算中混淆位和字节。先按位计算,只除以 8 一次,并说明用的是 1000 还是 1024。
- 用日常语言回答"描述"题("图片变差了")。要用大纲术语:颜色更少、出现条带、图像分辨率更低、像素更大。
-
2
通信
2.1
网络(含互联网)
大纲
Candidates should be able to: Notes and guidance Show understanding of the purpose and benefits of networking devices Show understanding of the characteristics of a LAN (local area network) and a WAN (wide area network) Explain the client-server and peer-to-peer models of networked computers Roles of the different computers within the network and subnetwork models Benefits and drawbacks of each model Justify the use of a model for a given situation Show understanding of thin-client and thick-client and the differences between them Show understanding of the bus, star, mesh and hybrid topologies Understand how packets are transmitted between two hosts for a given topology Justify the use of a topology for a given situation Show understanding of cloud computing Including the use of public and private clouds Benefits and drawbacks of cloud computing Show understanding of the differences between and implications of the use of wireless and wired networks Describe the characteristics of copper cable, fibre-optic cable, radio waves (including WiFi), microwaves, satellites Describe the hardware that is used to support a LAN Including switch, server, Network Interface Card (NIC), Wireless Network Interface Card (WNIC), Wireless Access Points (WAP), cables, bridge, repeater Describe the role and function of a router in a network Show understanding of Ethernet and how collisions are detected and avoided Including Carrier Sense Multiple Access/Collision Detection (CSMA/CD) Show understanding of bit streaming Methods of bit streaming, i.e. real-time and on-demand Importance of bit rates broadband speed on bit streaming Show understanding of the differences between the World Wide Web (WWW) and the internet Describe the hardware that is used to support the internet Including modems, PSTN (Public Switched Telephone Network), dedicated lines, cell phone network Explain the use of IP addresses in the transmission of data over the internet Including: • format of an IP address including IPv4 and IPv6 • use of subnetting in a network • how an IP address is associated with a device on a network • difference between a public IP address and a private IP address and the implications for security • difference between a static IP address and a dynamic IP address Explain how a Uniform Resource Locator (URL) is used to locate a resource on the World Wide Web (WWW) and the role of the Domain Name Service (DNS) 来源:剑桥国际大纲
一个网络(network)是一组连接起来以便能通信和共享资源的计算设备。好处:
- 共享资源(打印机、文件服务器、互联网)——比给每台计算机都配备更便宜。
- 共享数据——许多用户访问相同的文件。
- 集中管理——在一台服务器上一次性安装软件、管理用户和备份。
- 通信——电子邮件、视频通话、消息。
- 远程访问——从任何地方工作。
探索Network route lab
Follow data from a device through network hardware and protocols.
词汇表 训练英文 中文 拼音 network/ˈnetwɜːk/ 网络 wǎng luò 2.1
局域网与广域网

一个局域网(local area network,LAN)覆盖一个小区域——一个家庭、办公室或学校,通常由组织拥有,数据速率高、延迟(latency)低。
一个广域网(wide area network,WAN)覆盖一个大区域——一个城市、国家或全世界(互联网是最大的 WAN)。它使用电信公司的基础设施——常常是公共交换电话网(Public Switched Telephone Network,PSTN)、租用线路或光纤——数据速率较低、延迟较高。一个 WAN 把各个 LAN 连接在一起。
对于"给出 LAN 的两个特征":它覆盖一个小的地理区域(一个场所或一栋楼);硬件由组织自己拥有,而不是向电信公司租用;它通过自己的交换机、电缆和接入点连接。对于"WAN 的两点不同":它覆盖一个大的地理区域;它使用第三方(租用的或公共的)基础设施;数据速率更低、延迟更高;它通常把几个 LAN 连接起来。一所只有一个校区的学校是一个 LAN;在两个城市设有办公室的公司需要一个 WAN,两地之间用一条租用线路或互联网。用覆盖的区域和链路的归属来论证选择。
一个广域网把大区域上的许多系统连接起来 词汇表 训练英文 中文 拼音 local area network/ˈləʊkl ˈeərɪə ˈnetwɜːk/ 局域网 jú yù wǎng latency/ˈleɪtənsi/ 延迟 yán chí wide area network/waɪd ˈeərɪə ˈnetwɜːk/ 广域网 guǎng yù wǎng Public Switched Telephone Network/ˈpʌblɪk swɪtʃt ˈtelɪfəʊn ˈnetwɜːk/ 公共交换电话网 gōng gòng jiāo huàn diàn huà wǎng switch/swɪtʃ/ 交换机 jiāo huàn jī 2.1
客户端-服务器与对等网络

客户端-服务器
- 强大的机器充当服务器(servers),提供服务(文件、网页、电子邮件)。
- 其他机器是请求服务的客户端(clients)。
- 集中且易于管理,但除非备份,服务器是单点故障。
在一个客户端-服务器网络中,客户端向一个中央服务器请求服务 对等网络(P2P)
- 所有机器都是平等的对等方(peers);每个既可以是客户端又可以是服务器(对等网络(peer-to-peer))。
- 资源分散在各对等方上——没有中央服务器。对单个故障稳健,但更难保持安全和一致。
选择模型。 客户端-服务器适合学校或企业:文件集中存储和备份,用户用一个账户从任何机器登录,软件和安全只需管理一次,而且服务器可以是一台强大的机器。缺点是服务器和技术员的成本,以及服务器是单点故障。对等网络适合几个朋友共享文件或玩游戏:不用买服务器,容易搭建,每个用户保留对自己机器的控制。评分标准列出的缺点:文件分散在许多机器上,所以难以备份,而且拥有者的机器关机时文件就不可用;每台机器都必须单独做好安全;为别人提供服务的对等方会变慢。通过网页浏览器与其他用户一起玩的在线游戏是客户端-服务器模型:浏览器是客户端,游戏和它的共享虚拟世界运行在公司的服务器上,由它保持每个玩家看到的内容一致。

在一个对等网络中,每个节点既是客户端又是服务器 词汇表 训练英文 中文 拼音 server/ˈsɜːvə/ 服务器 fú wù qì client/ˈklaɪənt/ 客户端 kè hù duān peer-to-peer/pɪə tə pɪə/ 对等网络 duì děng wǎng luò 2.1
瘦客户端与胖客户端
一个瘦客户端(thin client)在本地做很少的处理,依赖一台强大的服务器(网页终端、远程桌面)。一个胖客户端(thick client)有强的本地处理和存储,自己运行完整的应用程序(一台普通的台式 PC)。
特性 瘦客户端 胖客户端 本地处理 极少 大量 本地存储 极少 大量 对网络的依赖 高 较低 服务器负载 高 较低 各自的角色:在瘦客户端模型中,服务器做处理并存储数据,客户端只发送输入和显示输出。一台便宜的终端就够了,而且一切都在服务器上备份和更新,但网络或服务器一旦故障就什么都不能用。在胖客户端模型中,客户端自己运行软件并存储文件,所以没有网络连接也能工作,并且给服务器的负载更小,代价是客户端更强大(也更贵),而且每台都必须分别更新和做好安全。学校的计算机房可以用瘦客户端(便宜、集中管理);视频剪辑师需要胖客户端。
词汇表 训练英文 中文 拼音 thick client/θɪk ˈklaɪənt/ 胖客户端 pàng kè hù duān thin client/θɪn ˈklaɪənt/ 瘦客户端 shòu kè hù duān 2.1
网络拓扑

拓扑(topology)是节点和链路如何排列。
- 总线(bus)——所有设备在一条共享电缆上。便宜;如果总线故障,整个 LAN 就故障;随着更多设备共享带宽(bandwidth),性能下降。
- 星形(star)——每个设备连到一个中央交换机。一个设备故障不影响其他;交换机故障使全部瘫痪。今天最常见。
- 网状(mesh)——每个设备直接连到其他设备,有许多路径。非常容错(fault-tolerant,流量重新路由),但需要大量布线。
- 混合(hybrid)——一种混合(每个办公室内一个星形,办公室之间网状链路)。
总线拓扑:所有设备共享一条电缆,每端有一个终结器 
星形拓扑:每个设备连到一个中央集线器或交换机 
网状拓扑:每个设备直接连到其他设备 
混合拓扑:由一条中央总线连接的星形簇 数据包在各种拓扑中如何传输
总线:发送设备把数据包放到共享电缆上;每个设备都能看到它,只有地址匹配的那个设备接收它。一次只能有一个设备发送,所以会发生冲突(见下面的 CSMA/CD)。星形:发送方把数据包交给中央交换机,交换机读取目标地址,只把它沿通往那个设备的电缆转发出去;另外两个设备可以同时通信。网状:数据包沿几条可能路线之一从一个节点传到下一个节点,直到到达目的地;一条链路故障时,改用另一条路线。
论证拓扑的选择:教室或办公室用星形(一根电缆故障只影响一个设备;容易增加设备;有交换机就没有冲突);最看重可靠性的地方用网状(医院、互联网的骨干);只有在成本最重要、共享的设备很少时才用总线。"画出星形拓扑"的意思是:交换机在中间,从交换机到每台计算机各一条线,服务器(以及路由器,如果有的话)也各用自己的一条线连到交换机。
探索Compare the network topologies
Tap through the four topologies. Each trades off cost, speed and how well it survives a failure — notice what breaks the whole network in each one.
词汇表 训练英文 中文 拼音 topology/təˈpɒlədʒi/ 拓扑 tuò pū bus/bʌs/ 总线 zǒng xiàn bandwidth/ˈbændwɪdθ/ 带宽 dài kuān star/stɑː/ 星形 xīng xíng mesh/meʃ/ 网状 wǎng zhuàng fault-tolerant/fɒlt ˈtɒlərənt/ 容错 róng cuò 2.1
云计算
云计算(cloud computing)通过互联网交付计算服务(服务器、存储、软件),由第三方托管。好处:可扩展性(scalability,按需付费)、较低的成本、从任何地方访问,以及可靠的冗余数据中心。缺点:需要互联网、你的数据由第三方持有,以及可能的供应商锁定。
对于一分的定义:云计算是由第三方通过互联网按需提供的计算服务(存储、处理、软件)。公有云(public cloud)由提供商拥有,许多客户通过互联网共享;私有云(private cloud)专属于一个组织,或在它自己的硬件上,或单独为它托管。评分标准接受的好处:任何有互联网连接的设备都能访问文件;存储按需伸缩;提供商负责硬件、备份和安全更新;不用购买或维护本地服务器。缺点:没有互联网连接就无法访问;数据在第三方的硬件上,所以安全和隐私取决于提供商;持续的订阅费用;提供商可能倒闭或遭到攻击;大文件传输可能很慢。"公司为什么用公有云"这类题要答:他们不需要自己的硬件,只为用到的部分付费,而且用户从任何地方都能访问。
词汇表 训练英文 中文 拼音 cloud computing/klaʊd kəmˈpjuːtɪŋ/ 云计算 yún jì suàn scalability/ˌskeɪləˈbɪlɪti/ 可扩展性 kě kuò zhǎn xìng public cloud/ˈpʌblɪk klaʊd/ 公有云 gōng yǒu yún private cloud/ˈpraɪvət klaʊd/ 私有云 sī yǒu yún 2.1
有线与无线
- 有线(以太网(Ethernet)通过双绞线(twisted-pair)或光纤(fibre-optic)):速度更高、延迟更低、错误更少、更安全。
- 无线(Wi-Fi、蓝牙、蜂窝):没有电缆、设备可以移动,但更慢、易受干扰和窃听。
对于同一代,有线在速度和可靠性上胜出;无线在便利性上胜出。
传输介质
介质 特点 铜缆(双绞线、同轴电缆) 便宜、容易安装;传送电信号;受电磁干扰影响;信号随距离减弱,所以需要中继器;带宽低于光纤 光纤 玻璃芯中的光脉冲;带宽极高;长距离无需中继器;不受干扰;难以窃听,所以安全;昂贵且需要熟练安装 无线电波(包括 WiFi) 没有电缆,所以设备可以移动;范围几十米,被墙壁削弱;共享频率,所以有干扰、速度较低;可能被截获,所以需要加密 微波 用于点对点链路的更高频率无线电;需要视线畅通;受雨和建筑物影响;带宽高 卫星 到达偏远地区和整个地球;延迟长,因为信号要往返轨道;受天气影响;昂贵 考试要求两个方向的比较。有线在速度、可靠性(没有干扰)、安全(必须物理接触电缆才能窃听)和稳定性上胜过无线;无线在移动性、安装成本以及不用布线就能增加设备上胜过有线。同时允许两者,让学生可以带着笔记本和手机走动,而固定的台式机保留更快、更安全的连接,没有网络端口的设备也仍能连接。用卫星代替铜缆能到达任何电缆都到不了的地方,但延迟更长、受天气干扰、成本更高。
词汇表 训练英文 中文 拼音 ethernet/ˈiːθənet/ 以太网 yǐ tài wǎng twisted-pair/ˈtwɪstɪd peə/ 双绞线 shuāng jiǎo xiàn fibre-optic/ˈfaɪbə ˈɒptɪk/ 光纤 guāng xiān 2.1
局域网硬件

- 网络接口卡(network interface card,NIC)——让一个设备能在网络上发送和接收;有一个唯一的 MAC 地址(MAC address,一个 48 位的硬件地址)。一个无线设备用一个无线网络接口卡(wireless network interface card,WNIC)。
- 交换机(switch)——只把以太网帧转发到目标 MAC 地址所对应的端口。
- 集线器(hub)——一个更简单的设备,把流量复制到所有端口(现已过时)。
- 无线接入点(wireless access point,WAP)——让无线客户端加入一个有线 LAN。
- 布线——短距离用双绞线;较长、较快的用光纤。
- 服务器——为其他设备提供服务的计算机:文件、打印、网页、电子邮件存储。
- 网桥(bridge)——把两个 LAN 网段连成一个网络,在它们之间传递流量。
- 中继器(repeater)——接收减弱的信号并以全强度重新发送,以延长电缆的覆盖距离。
WNIC 的功能,用于四分的描述题:它把数据转换成无线电信号并转换回来;它带有设备唯一的 MAC 地址;它把设备连到无线接入点并遵循无线协议(用哪个信道和频率);它为设备解码收到的信号。能把三十台带 NIC 的计算机物理连接起来的两种设备:交换机,或集线器。
一个网络交换机:每个设备的电缆插入它的一个端口 
一根双绞线以太网电缆上的一个 RJ-45 插头 
一个交换机只把每个帧发送到它目标所对应的端口 词汇表 训练英文 中文 拼音 hub/hʌb/ 集线器 jí xiàn qì repeater/rɪˈpiːtə/ 中继器 zhōng jì qì network interface card/ˈnetwɜːk ˈɪntəfeɪs kɑːd/ 网络接口卡 wǎng luò jiē kǒu kǎ MAC address/mæk əˈdres/ MAC地址 MAC dì zhǐ wireless network interface card/ˈwaɪələs ˈnetwɜːk ˈɪntəfeɪs kɑːd/ 无线网络接口卡 wú xiàn wǎng luò jiē kǒu kǎ wireless access point/ˈwaɪələs ˈækses pɔɪnt/ 无线接入点 wú xiàn jiē rù diǎn bridge/brɪdʒ/ 网桥 wǎng qiáo 2.1
路由器

一个路由器(router)连接不同的网络并在它们之间转发数据——通常在一个 LAN 与互联网的边界处。它做:
- 转发——读取每个数据包(packet)的目标 IP 地址(IP address),并用一个路由表(routing table)从正确的端口把它发出去。
- 网络地址转换(network address translation,NAT)——让许多私有 LAN 地址共享一个公共 IP。
- DHCP(动态主机配置协议)——向 LAN 设备分发私有 IP 地址。
- 防火墙(firewall)——阻止不需要的入站流量。
在分组交换(packet switching)中,一条消息被拆成独立发送的数据包。每个路由器读取数据包的目标 IP 地址,在它的路由表中查出下一跳并转发,所以同一条消息的数据包可能走不同的路线,在目的地按顺序重新组装。路由器确实会接收数据包、在网络之间转发它们并分发 IP 地址;它不查找 URL 的 IP 地址(那是 DNS 做的),也不存储网页。家里的路由器还包含调制解调器和无线接入点,所以一台设备就把 LAN 连到互联网。
一个路由器把一个 LAN 连到互联网或另一个网络 词汇表 训练英文 中文 拼音 internet/ˈɪntənet/ 互联网 hù lián wǎng packet/ˈpækɪt/ 数据包 shù jù bāo router/ˈruːtə/ 路由器 lù yóu qì IP address/ˌaɪ ˈpiː əˈdres/ IP地址 IP dì zhǐ routing table/ˈraʊtɪŋ ˈteɪbl/ 路由表 lù yóu biǎo network address translation/ˈnetwɜːk əˈdres trænˈsleɪʃn/ 网络地址转换 wǎng luò dì zhǐ zhuǎn huàn firewall/ˈfaɪəwɔːl/ 防火墙 fáng huǒ qiáng packet switching/ˈpækɪt ˈswɪtʃɪŋ/ 分组交换 fēn zǔ jiāo huàn URL/ˌjuː ɑː ˈel/ 统一资源定位符 tǒng yī zī yuán dìng wèi fú 2.1
以太网与 CSMA/CD

以太网是有线 LAN 的标准(协议):设备用双绞线或光纤电缆连接,数据以携带源和目标 MAC 地址的帧发送,共享介质用 CSMA/CD 处理冲突。在共享介质上,当两个设备同时发送时可能发生一次冲突(collision)。协议是 CSMA/CD(载波侦听多路访问,Carrier Sense Multiple Access with Collision Detection):
- 载波侦听——发送前先听;如果电缆繁忙就等待。
- 多路访问——许多设备共享介质。
- 冲突检测——发送时持续听;一次碰撞就是一次冲突。
- 发生冲突时,两者都停止,发送一个短暂的"干扰"信号,然后等待一个随机退避时间再重试。
按评分标准措辞的三项任务:设备在发送前先侦听(载波侦听);发送期间持续检查是否有冲突;发生冲突时停止、发送干扰信号、等待随机时间后重发。
现代交换式以太网使用全双工(full-duplex)点对点链路,所以冲突不再发生。
用于处理共享介质上冲突的 CSMA/CD 过程 词汇表 训练英文 中文 拼音 collision/kəˈlɪʒn/ 冲突 chōng tū CSMA/CD/ˌsiː es em ˈeɪ ˌsiː ˈdiː/ 载波侦听多路访问/冲突检测 zài bō zhēn tīng duō lù fǎng wèn / chōng tū jiǎn cè full-duplex/fʊl ˈdjuːpleks/ 全双工 quán shuāng gōng 2.1
比特流传输

流式传输(bit streaming)把多媒体作为一个连续的流发送,接收方在它到达时播放,而不是先下载整个文件。
- 实时(直播):在事件发生时被捕捉并流出(现场体育、视频通话)。你不能倒退;低延迟至关重要。
- 点播:在一台服务器上预先录制(YouTube、Netflix)。你可以暂停和倒退;服务器可以提前缓冲(buffer)。
实时流作为一个短流水线工作:
- 捕捉并采样源(一个摄像机或麦克风)。
- 编码它,用压缩(compression)缩小数据。
- 作为数据包在网络上发送它。
- 接收方缓冲一点,然后实时播放它——丢弃任何迟到的数据包,因为一个直播流不能等它。
这里用有损(lossy)压缩:活动画面掩盖小的损失,而流必须小到足以适应带宽。
为什么视频在实时流式传输前要压缩:未压缩的流需要的带宽超过连接所能提供的,帧会迟到,播放会卡顿。压缩减少比特数,使比特率(bit rate)保持在宽带速度以下,让延迟很小,并减少两端所需的存储和成本。比特率必须低于连接的速度:更高的比特率画质更好,但需要更快的连接;如果数据到达得比播放慢,缓冲区就会清空,视频就会卡住。点播流可以提前缓冲更多文件内容,所以能应付较慢的连接;实时流不能。
数据从服务器流入一个缓冲区,然后媒体播放器读取它 词汇表 训练英文 中文 拼音 bit streaming/bɪt ˈstriːmɪŋ/ 流式传输 liú shì chuán shū buffer/ˈbʌfə/ 缓冲 huǎn chōng compression/kəmˈpreʃn/ 压缩 yā suō lossy/ˈlɒsi/ 有损 yǒu sǔn bit rate/bɪt reɪt/ 比特率 bǐ tè lǜ 2.1
互联网与万维网

互联网(internet)是一个使用共同协议(protocol)族(TCP/IP)的全球网络的网络。万维网(World Wide Web,WWW)是在它上面运行的一项服务:由 URL 标识的超链接文档,通过 HTTP/HTTPS 在浏览器中查看。电子邮件和文件传输是其他不属于 WWW 的互联网服务。
网页邮箱两者都用:用万维网,因为邮箱是通过浏览器中的 URL、经 HTTP 访问的网页;用互联网,因为电子邮件本身在网络的网络上传送(电子邮件是与网页分开的一项互联网服务)。
万维网是运行在互联网之上的一项服务 支持互联网的硬件
- 调制解调器(modem)——把计算机的数字信号转换成电话线用的模拟信号,在另一端再转换回来(调制和解调)。
- PSTN——由交换局和线路组成的公共电话网;拨号或 DSL 连接通过它传送互联网数据。
- 专线(dedicated line)——组织与它的 ISP 之间的租用线路:始终在线,带宽固定且不共享,所以更快、更可靠,但昂贵。
- 蜂窝网络(cell phone network)——手机通过无线电把数据发送到最近的基站;基站连到电话公司的网络,由它把数据路由到互联网;手机移动时,从一个小区切换到下一个小区。
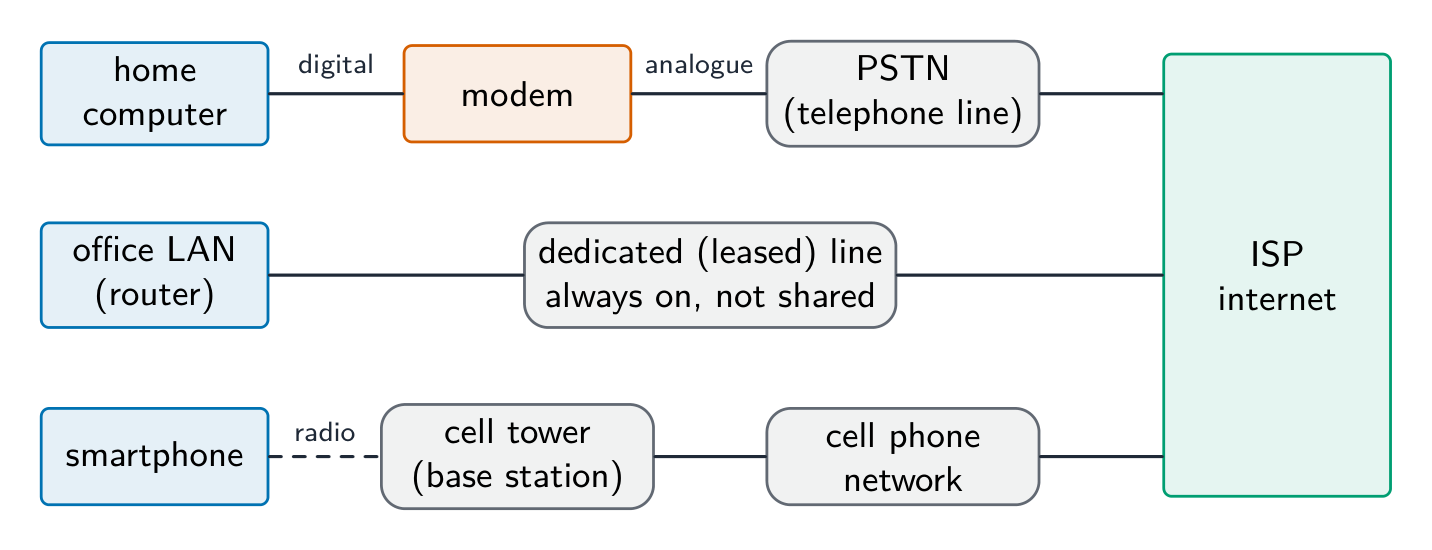
到达互联网的三条路:调制解调器加 PSTN、专线,以及蜂窝网络 词汇表 训练英文 中文 拼音 protocol/ˈprəʊtəkɒl/ 协议 xié yì modem/ˈməʊdem/ 调制解调器 tiáo zhì jiě tiáo qì World Wide Web/wɜːld waɪd web/ 万维网 wàn wéi wǎng dedicated line/ˈdedɪkeɪtɪd laɪn/ 专线 zhuān xiàn ISP/ˌaɪ es ˈpiː/ 互联网服务提供商 hù lián wǎng fú wù tí gōng shāng cell phone network/sel fəʊn ˈnetwɜːk/ 蜂窝网络 fēng wō wǎng luò 2.1
IP 地址

一个 IP 地址唯一地标识一个设备。
- IPv4——32 位,四个 0–255 的十进制数字(
192.168.1.10);约 $4.3 \times 10^{9}$ 个地址(现已耗尽)。 - IPv6——128 位,八组四个十六进制数位;约 $3.4 \times 10^{38}$ 个地址。
IPv4 写成用点分隔的四组十进制数;每组是一个 8 位数,所以范围是 0 到 255。IPv6 写成用冒号分隔的八组四个十六进制数位,如
2001:0db8:0000:0000:0000:ff00:0042:8329,连续的零组可以缩写成::。所以192.168.3.2不是 IPv6:它有四组而不是八组,用点而不是冒号分隔,而且各组是十进制而不是十六进制。256.0.0.A两种都不是有效的地址:IPv4 的一组不能超过 255,也不能是字母,而 IPv6 需要冒号和八组。子网划分
一个网络可以被分成子网(subnets)。IP 地址分成一个网络部分和一个主机部分,由一个子网掩码(subnet mask,例如
255.255.255.0= 前 24 位是网络)给出。子网划分改善管理、减少广播流量,并改善安全。子网中一个地址的两个部分:网络 ID(前面的若干位,同一子网中的每个设备都相同,由掩码中的 1 给出)和主机 ID(其余的位,每个设备唯一)。"描述子网划分的两个好处"要答:每个部分的流量更少,因为广播留在自己的子网内;安全性更好,因为一个部门的流量与其他部门隔开;更容易管理和排查故障;更高效地使用地址。掩码为
255.255.255.0的两个设备,前三组不同就在不同的子网中。把一个网络分成子网,每个部门一个网络 ID 公共地址与私有地址
- 私有地址在一个 LAN 内使用,在互联网上不可路由(例如
192.168.0.0/16)。 - 一个公共 IP 地址(public IP address)全球唯一且可路由,由一个 ISP(互联网服务提供商)分配。
在 NAT 后面带私有地址的设备不能从互联网直接到达,提供了一些保护。
表格要的描述:公共地址在互联网上可见且在整个互联网上唯一,由 ISP 分配;私有地址只在 LAN 内可见,被许多 LAN 重复使用,需要 NAT 才能到达互联网。静态地址永不改变(手动设置或保留,如服务器所需);动态地址由 DHCP 在设备每次连接时分配,可能改变。
静态与动态
- 一个静态 IP 地址(static IP address)是固定的;用于必须在一个已知地址被找到的服务器。
- 一个动态 IP 地址(dynamic IP address)由 DHCP 分配,可能改变;对客户端设备更容易,并高效地使用一个有限的地址池。
例题。 某主机的 IP 地址是
192.168.10.130,子网掩码是255.255.255.192。它在哪个网络上?192.168.10.200和它在同一个网络上吗?掩码的最后一段192的二进制是11000000,所以前 26 位是网络部分,后 6 位用于主机寻址。这使得各子网以 $256 - 192 = 64$ 为步长划分:.0、.64、.128、.192。地址130落在从.128开始的那一块,所以该主机在网络192.168.10.128/26上,其可用主机地址从.129到.190(.191是广播地址)。200落在下一块(.192)里,所以它在不同的子网上,两者之间的通信必须经过路由器。要先从掩码算出块大小($256$ 减去掩码那一段的值) - 只看前三段来猜,正是这类题出错的原因。词汇表 训练英文 中文 拼音 DHCP/ˌdiː eɪtʃ siː ˈpiː/ 动态主机配置协议 dòng tài zhǔ jī pèi zhì xié yì subnets/ˈsʌbnets/ 子网 zi wǎng subnet mask/ˈsʌbnet mæsk/ 子网掩码 zi wǎng yǎn mǎ 2.1
URL 与 DNS

一个 URL(统一资源定位符,Uniform Resource Locator)定位 WWW 上的一个资源:
https://www.example.com/about/contact.html protocol domain name path- protocol:
http、https等。 - domain name 域名:一个可读的服务器地址。
- path:那台服务器上的资源。
域名系统(Domain Name System,DNS,也叫域名服务)是一组分布式服务器,它把域名变成 IP 地址。当你输入一个 URL 时,浏览器向一个 DNS 解析器询问 IP,解析器查询 DNS 服务器(根 → 顶级 → 权威)直到找到它;然后浏览器连到那个 IP 并请求路径。DNS 使人类免于记忆 IP 地址,并让一个站点在不改变它名称的情况下更换服务器。
对于"解释浏览器如何使用 URL":浏览器把 URL 拆成协议、域名和路径;它把域名发给 DNS 服务器,后者返回对应的 IP 地址(计算机或 ISP 上的缓存可能先给出答案);它用该协议(HTTPS,端口 443)打开到那个 IP 地址的连接;它发送对该路径的请求;网页服务器返回页面,浏览器把它渲染出来。如果 DNS 查询失败,浏览器就报告找不到服务器。
DNS 如何在浏览器连接前找到一个网站的 IP 地址 探索How DNS finds a website
Step through a DNS lookup. The network routes by IP, not by name — so before anything loads, DNS must turn the domain name into an IP address.
词汇表 训练英文 中文 拼音 domain name/dəˈmeɪn neɪm/ 域名 yù míng Domain Name System/dəˈmeɪn neɪm ˈsɪstəm/ 域名系统 yù míng xì tǒng 2.1
考官认可的定义
定义题按固定的表述给分。把这些记准确。
术语 定义 LAN 覆盖一个小的地理区域(通常是一个场所)、硬件由组织自己拥有的网络 WAN 覆盖一个大的地理区域、通过第三方(租用或公共)链路把 LAN 连接起来的网络 客户端-服务器(client-server) 客户端计算机向一台提供服务的、更强大的中央服务器请求服务的模型 对等网络(peer-to-peer) 每台计算机地位平等、既可作客户端又可作服务器、没有中央服务器的模型 瘦客户端(thin client) 自己几乎不做处理或存储、两者都依赖服务器的客户端 胖客户端(thick client) 自己做处理和存储、没有服务器也能工作的客户端 网状拓扑(mesh topology) 每个设备直接与许多其他设备相连、两个设备之间有不止一条路线的拓扑 云计算(cloud computing) 由第三方通过互联网按需提供的计算服务(存储、处理、软件) 以太网(Ethernet) 有线 LAN 的标准协议,以帧发送数据,在共享介质上使用 CSMA/CD 交换机(switch) 在 LAN 内只把每个帧转发到其目标 MAC 地址所在端口的设备 路由器(router) 连接各个网络、按目标 IP 地址在网络之间转发数据包的设备 流式传输(bit streaming) 发送连续的比特流,使接收方在媒体到达时就播放,而不必先下载整个文件 互联网(internet) 使用 TCP/IP 协议的全球性网络的网络 万维网(World Wide Web) 由 URL 标识、通过浏览器经互联网访问的超链接网页的集合 URL 定位网上一个资源的地址:协议、域名和路径 DNS 把域名翻译成存放该资源的服务器的 IP 地址的服务 2.1
考试技巧
- 通过谁存储和控制资源来区分 LAN 与 WAN 以及客户端-服务器与对等网络。
- 把每种拓扑(总线、星形、网状)与它的优点和缺点(成本、可靠性、冲突)匹配。
- 知道每个设备的工作:一个交换机按 MAC 地址在一个 LAN 内定向,一个路由器按 IP 在网络之间路由。
- 解释流式传输以及为什么需要缓冲(数据到达的速率与播放不同)。
- 区分 IPv4 与 IPv6 以及公共与私有地址;DNS 把一个 URL 变成一个 IP 地址。
常见错误
- 说交换机按 IP 地址工作。交换机在 LAN 内按 MAC 地址转发;路由器在网络之间按 IP 地址转发。
- 把互联网和万维网当作同一个东西。万维网是运行在互联网上的一项服务;电子邮件和文件传输是另外的服务。
- 把"更快"当作有线与无线的全部比较。要说更快并且更可靠、更安全,而且在题目要求比较时也要给出无线的一面(移动性、不用布线)。
- 写路由器查找 URL 的 IP 地址。那是 DNS 做的;路由器把数据包转发给它。
- 用点和十进制的组来描述 IPv6。应是用冒号分隔的八组四个十六进制数位。
- 把星形拓扑画成环或链。每个设备都有自己的一条线连到中间的交换机。
-
3
硬件
3.1
计算机及其部件

大纲
Candidates should be able to: Notes and guidance Show understanding of the need for input, output, primary memory and secondary (including removable) storage Show understanding of embedded systems Including: benefits and drawbacks of embedded systems Describe the principal operations of hardware devices Including: Laser printer, 3D printer, microphone, speakers, magnetic hard disk, solid state (flash) memory, optical disc reader/writer, touchscreen, virtual reality headset Show understanding of the use of buffers Explain the differences between Random Access Memory (RAM) and Read Only Memory (ROM) Including their use in a range of devices and systems Explain the differences between Static RAM (SRAM) and Dynamic RAM (DRAM) Including the use of SRAM and DRAM in a range of devices and systems and the reasons for using one instead of the other depending on the device and its use Explain the difference between Programmable ROM (PROM), Erasable Programmable ROM (EPROM) and Electrically Erasable Programmable ROM (EEPROM) Show an understanding of monitoring and control systems Including: • difference between monitoring and control • use of sensors (including temperature, pressure, infra-red, sound) and actuators • importance of feedback 来源:剑桥国际大纲
一台通用计算机有四个构件:
- 输入设备(input devices)——把数据输入(键盘、鼠标、麦克风、扫描仪、传感器)。
- 输出设备(output devices)——把结果输出(显示器、扬声器、打印机、执行器)。
- 主存储器(primary memory)——处理器(processor,CPU)直接访问的快速存储器(RAM 和 ROM)。容纳运行中的程序及其数据。
- 辅助存储器(secondary storage)——较慢、较大,在不用时保存程序和数据(硬盘、SSD、光盘、U 盘)。
大纲要求说明为什么需要每一种。需要输入设备,是因为计算机只能处理已经输入的数据和指令。需要输出设备,是为了把结果以人能使用的形式呈现出来。需要主存储器,是因为处理器只能执行和使用它能直接寻址的存储器中的指令和数据,而且必须能快速取到。需要辅助存储器,是因为主存储器是易失的且容量小:程序和数据必须在断电后仍然保存,存放在一个更大、更便宜的存储器里;而可移动存储器让数据能在计算机之间转移或作为备份保存。
一个键盘:用于输入文本和命令的常见输入设备 
一个鼠标:一个指点输入设备 
一个平板扫描仪:把一张纸页变成一个数字图像的输入设备 
一个显示器:显示屏幕图像的常见输出设备 探索Tap the blocks of a computer system
Explore the four blocks plus the CPU. Data flows input → processing → output, while primary memory holds the running program and secondary storage keeps it for later.
探索Network route lab
Follow data from a device through network hardware and protocols.
词汇表 训练英文 中文 拼音 input devices/ˈɪnpʊt dɪˈvaɪsɪz/ 输入设备 shū rù shè bèi output devices/ˈaʊtpʊt dɪˈvaɪsɪz/ 输出设备 shū chū shè bèi primary memory/ˈpraɪməri ˈmeməri/ 主存储器 zhǔ cún chǔ qì processor/ˈprəʊsesə/ 处理器 chǔ lǐ qì RAM/ræm/ 随机存取存储器 suí jī cún qǔ cún chǔ qì secondary storage/ˈsekəndəri ˈstɔːrɪdʒ/ 辅助存储器 fǔ zhù cún chǔ qì 3.1
嵌入式系统
一个嵌入式系统(embedded system)是一台内置于另一个设备中、做一个固定工作的计算机(洗衣机、微波炉、汽车发动机单元、恒温器)。
- 好处:为一个任务优化,所以体积小、功耗低、批量制造便宜;可靠,因为它运行一个固定的程序,出错的机会少;启动快,不需要用户设置;通过简单的界面易于使用。
- 缺点:限于它的一个任务,所以不能升级去做更多事;难以更新(它的固件(firmware)可能需要特殊工具,或者根本无法更改);难以排查故障,失效时通常要整台设备更换;如果它接入网络,可能成为安全弱点,因为它的软件很少打补丁。
"描述缺点"类的题目要求把每个缺点写成完整的一点:限制是什么,以及它对用户意味着什么,例如"固件无法更新,所以后来发现的安全漏洞无法修补"。
词汇表 训练英文 中文 拼音 embedded system/emˈbedɪd ˈsɪstəm/ 嵌入式系统 qiàn rù shì xì tǒng firmware/ˈfɜːmweə/ 固件 gù jiàn 3.1
主要硬件设备

激光打印机
一台激光打印机(laser printer)把页面图像扫描到一个带电的感光感光鼓(drum)上。墨粉(toner)黏附到带电区域,转移到纸上,并被一个定影器熔上去。快速、清晰、大批量。
一台激光打印机:用一个带电的感光鼓和墨粉进行快速、清晰的打印 它的工作原理,按评分标准列出的步骤:
- 页面的数据被送到打印机的缓冲区。
- 感光鼓被均匀地充上静电。
- 激光经旋转的反射镜把页面图像扫描到鼓上,照到的地方电荷被消除,于是鼓上留下的电荷与图像一致。
- 墨粉(带电的粉末)只被吸附到鼓上带电的部分。
- 纸被充上相反的电荷并压过鼓面,墨粉就转移到纸上。
- 定影器(fuser,一对加热的辊)把墨粉熔进纸里。然后鼓被放电并清洁,准备打印下一页。
3D 打印机
一台 3D 打印机(3D printer)逐层构建一个物体:FDM 通过一个喷嘴熔化塑料丝;立体光刻用一个 UV 激光固化液态树脂。用于原型和定制医疗部件。

一台 FDM 3D 打印机通过熔化塑料丝逐层构建一个物体 它的工作原理:
- 在 CAD 软件中设计(或扫描)物体的模型。
- 切片软件把模型分成很薄的水平层,并为每一层生成指令。
- 打印机一次构建一层:FDM 打印机熔化塑料丝(filament),通过移动的喷嘴把它铺下;树脂打印机用激光或紫外光固化液态树脂;粉末打印机用激光熔合粉末。
- 每一层与下面的一层结合,平台(或喷嘴)移动一层的厚度。
- 最后一层完成后,去掉支撑材料。用途包括原型、假肢等定制医疗部件,以及按需打印的备件。
麦克风和扬声器
一个麦克风(microphone)把声音变成一个电信号(一个膜片振动,改变电容器(capacitor)的电荷或线圈位置);信号被一个模数转换器(analogue-to-digital converter,ADC)数字化。一个扬声器做相反的——一个变化的信号驱动一个磁场中的线圈,移动一个纸盆来发声。

一个麦克风把声音变成一个电信号 
一个麦克风的内部:声音使膜片和线圈振动以产生一个电流 
一个扬声器的内部:线圈中一个变化的电流移动纸盆来发声 麦克风的工作原理:声波使膜片(diaphragm)振动;在动圈式麦克风中,连在膜片上的线圈在磁场中运动,于是线圈中感应出变化的电流;在电容式麦克风中,膜片是电容器的一个极板,它运动时电容随之改变;变化的模拟信号随后由 ADC 采样并存为数字数据。扬声器把这条链反过来:数模转换器(digital-to-analogue converter,DAC)产生变化的电流,线圈中的电流产生变化的磁场并与永磁体相互作用,线圈和纸盆前后运动,纸盆的运动在空气中产生压力波。
磁性硬盘(HDD)
一个硬盘(hard disk)把数据存储在涂有磁性材料的旋转盘片上。每个盘片有分成扇区(sectors)的磁道(tracks)。一个读写头(read/write head)浮在其上方,磁化微小区域(写)或感应它们(读)。每吉字节便宜,但比 SSD 慢,并有运动部件。

一个打开的硬盘:执行臂载着读写头越过一个盘片 
一个硬盘盘片上的磁道和扇区 它的工作原理:盘片高速旋转(每分钟几千转);每个盘面分成同心的磁道,每条磁道分成扇区;磁头臂(actuator arms)上的读写头横越盘片移动到正确的磁道;写入时,磁头把一个微小区域磁化成两种极性之一,代表 0 或 1;读取时,它在该区域从下方经过时检测其极性。等待磁头臂到达磁道、等待扇区转过来的延迟,正是硬盘比 SSD 慢的原因。
固态(闪存)存储器
一个固态硬盘(solid-state drive)把数据作为电荷存储在晶体管(transistors)中,没有运动部件。随机访问比 HDD 快、更耐用、功耗更低,但每吉字节更贵;每个单元在许多次写入后会磨损。

一个 SSD 的内部:数据存储在闪存芯片中,没有运动部件(比较上面的硬盘) 它的工作原理:每个单元是一个浮栅晶体管(floating-gate transistor);困在浮栅上的电荷代表一位,断电后仍保留;一个控制器芯片把每个地址映射到一个单元,并把写入分散到各个单元上,因为一个单元只能承受有限次数的写入。
磁性硬盘 固态硬盘 运动部件 盘片和磁头 无 速度 较慢:寻道和旋转延迟 随机访问快得多 每吉字节成本 较低 较高 坚固程度 受撞击会损坏;有噪音;耗电更多 抗震;无声;耗电更少 寿命 可反复重写多次;机械磨损 每个单元的写入次数有限 "为什么服务器用硬盘而不用 SSD"类的题目要的是左边一列:超大容量下每吉字节更便宜、在不断重写下寿命长,以及数据更容易恢复。
光盘
一个激光检测来自一个光盘(optical disc,CD、DVD、蓝光)上微小凹坑的反射。驱动器是一个光盘读写器:写入用一个更强的激光来改变表面的反射率。

一个光盘驱动器:一个激光读取一张 CD、DVD 或蓝光盘上的微小凹坑 它的工作原理:光盘上有一条长长的螺旋磁道,由凹坑(pits)和平台(lands,凹坑之间的平坦区域)组成;光盘旋转,激光聚焦在磁道上;从平台反射的光与在凹坑边缘反射的光不同,光传感器把每一次变化读作 1、没有变化读作 0。写入时用更强的激光改变染料层或合金层的反射率。蓝光用波长更短的蓝色激光,所以它的凹坑更小、更密,这就是它比 DVD 容量更大的原因。
触摸屏
一个触摸屏(touchscreen)感应接触。电阻式(resistive):两个导电层被压在一起;能与任何东西一起工作但不太准确。电容式(capacitive):一根手指扰乱一个电荷场;准确、多点触控,用于手机。

一个触摸屏感应一根手指触碰玻璃的位置 它的工作原理:电阻屏有两个由隔离点分开的薄导电层;按压把上层压到下层上,在该点接通电路,控制器读取电压来求出坐标。电容屏有一层镀有透明导体的玻璃,它带有电荷;手指触碰时会引走一个微小的电流,四个角上分别测量这个电流,控制器根据差异算出触碰位置。电容屏对轻触和多指同时触碰都有反应,但对戴手套的手指或普通触笔没有反应。
虚拟现实头显
一个虚拟现实(virtual reality,VR)头显有两个小显示屏(每只眼一个)和跟踪头部运动的运动传感器(加速度计(accelerometer)、陀螺仪(gyroscope)),这样当你环顾四周时场景就移动。

一个虚拟现实头显:两个小显示屏和运动传感器跟踪头部 它的工作原理:每只眼睛透过一个透镜看自己的显示屏,两幅图像略有差别,所以大脑看到了深度;传感器(加速度计、陀螺仪,有时还有摄像头)报告头部的位置和朝向;计算机每秒多次从这个视点重新渲染场景,所以转头就转动了视野;耳机给出与方向相符的声音。用于游戏、飞行或手术模拟等训练,以及在建造之前查看设计。
词汇表 训练英文 中文 拼音 microphone/ˈmaɪkrəfəʊn/ 麦克风 mài kè fēng actuator/ˈæktʃuːeɪtə/ 执行器 zhí xíng qì hard disk/hɑːd dɪsk/ 硬盘 yìng pán optical disc/ˈɒptɪkl dɪsk/ 光盘 guāng pán laser printer/ˈleɪzə ˈprɪntə/ 激光打印机 jī guāng dǎ yìn jī drum/drʌm/ 感光鼓 gǎn guāng gǔ toner/ˈtəʊnə/ 墨粉 mò fěn fuser/ˈfjuːsə/ 定影器 dìng yǐng qì 3D printer/ˌθriː ˈdiː ˈprɪntə/ 3D打印机 3D dǎ yìn jī filament/ˈfɪləmənt/ 塑料丝 sù liào sī diaphragm/ˈdaɪəfræm/ 膜片 mó piàn capacitor/kəˈpæsɪtə/ 电容器 diàn róng qì analogue-to-digital converter/ˈænəlɒɡ tə ˈdɪdʒɪtl kənˈvɜːtə/ 模数转换器 mó shù zhuǎn huàn qì digital-to-analogue converter/ˈdɪdʒɪtl tʊ ˈænəlɒɡ kənˈvɜːtə/ 数模转换器 shù mó zhuǎn huàn qì tracks/træks/ 磁道 cí dào sectors/ˈsektəz/ 扇区 shàn qū read/write head/riːd raɪt hed/ 读写头 dú xiě tóu actuator arms/ˈæktʃuːeɪtə ɑːmz/ 磁头臂 cí tóu bì solid-state drive/ˈsɒlɪd steɪt draɪv/ 固态硬盘 gù tài yìng pán transistors/trænˈzɪstəz/ 晶体管 jīng tǐ guǎn floating-gate transistor/ˈfləʊtɪŋ ɡeɪt trænˈzɪstə/ 浮栅晶体管 fú zhà jīng tǐ guǎn pits/pɪts/ 凹坑 āo kēng lands/lændz/ 平台 píng tái touchscreen/ˈtʌtʃskriːn/ 触摸屏 chù mō píng resistive/rɪˈzɪstɪv/ 电阻式 diàn zǔ shì capacitive/kəˈpæsɪtɪv/ 电容式 diàn róng shì virtual reality/ˈvɜːtʃuːəl rɪˈælɪti/ 虚拟现实 xū nǐ xiàn shí accelerometer/əkˌseləˈrɒmɪtə/ 加速度计 jiā sù dù jì gyroscope/ˈdʒaɪrəskəʊp/ 陀螺仪 tuó luó yí 3.1
缓冲区
一个缓冲(buffer)是在数据于不同速度的设备之间移动时暂时容纳数据的存储器。例子:CPU 快速地把一个文档写入一个打印机缓冲区,然后就能自由地做其他工作,而打印机以它自己的速度从缓冲区打印。缓冲区阻止快设备等待慢设备(也用于流式传输、键盘和磁盘访问)。
"说明为什么 3D 打印机需要缓冲区":计算机发送打印数据的速度远快于打印机构建各层的速度,所以数据保存在缓冲区中,直到打印机准备好接收,处理器则被释放去做其他工作。当缓冲区快空时,打印机发出一个中断(interrupt)来请求更多数据(主题 4)。视频流的原理相同:缓冲区先于播放填满,这样网络速度短暂下降时画面不会停住。
词汇表 训练英文 中文 拼音 buffer/ˈbʌfə/ 缓冲 huǎn chōng interrupt/ˈɪntərʌpt/ 中断 zhōng duàn 3.1
RAM 与 ROM

- RAM(随机存取存储器,Random Access Memory)——易失性(volatile,断电丢失数据)。容纳操作系统、运行中的程序及其数据;不断地读和写。
- ROM(只读存储器,Read-Only Memory)——非易失性(non-volatile,断电保持数据)。通常写一次;容纳启动时所需的固件(BIOS / 引导加载程序)。
RAM 是易失性且读/写的;ROM 是非易失性且只读的 ROM 启动系统;然后 RAM 容纳活动的工作。
RAM ROM 易失? 是:断电后内容丢失 否:断电后内容保留 可读写? 不断地读和写 正常使用时只读 存放 操作系统、运行中的程序及其数据 启动计算机的固件和引导程序 容量 大,通常可以扩充 小且固定 典型用途 计算机或手机的主存储器 PC 的启动代码;洗衣机等嵌入式系统的整个程序 更多的 RAM 让计算机能同时容纳更多的程序和数据,所以在内存和磁盘之间交换得更少、运行更快;这就是"解释为什么 RAM 更多的计算机性能更好"的答案。

一个 RAM 模块(DIMM)插入主板,作为计算机的快速主存储器 探索Device and storage lab
Classify computing examples by what job they do in a system.
词汇表 训练英文 中文 拼音 ROM/rɒm/ 只读存储器 zhī dú cún chǔ qì volatile/ˈvɒlətaɪl/ 易失性 yì shī xìng non-volatile/nɒn ˈvɒlətaɪl/ 非易失性 fēi yì shī xìng 3.1
SRAM 与 DRAM
- SRAM(静态 RAM,Static RAM)把每一位存储在一个由几个晶体管构成的触发器(flip-flop)中。快,但昂贵且不密集。用于 CPU 高速缓存(cache)。
- DRAM(动态 RAM,Dynamic RAM)把每一位作为电荷存储在一个微小的电容器上。更便宜、更密集但更慢,并且必须每秒刷新(refreshed,重写)数千次。用于主存储器。
小的快速存储器(高速缓存)用 SRAM;大的主存储器用 DRAM。
SRAM DRAM 每一位存储在 由几个晶体管构成的触发器中 一个电容器和一个晶体管中 需要刷新? 否 是,每秒数千次 速度 更快 更慢 密度和成本 每片位数更少,更贵 每片位数更多,更便宜 功耗 空闲时功耗更低 更高,因为要刷新 用于 处理器高速缓存 主存储器,包括嵌入式系统中的 "解释为什么嵌入式系统使用 DRAM":它需要在小空间里以低成本获得大量存储器,而对速度的要求不高,所以更便宜、更密集的 DRAM 是正确的选择;SRAM 留给最讲究速度的小容量高速缓存。
词汇表 训练英文 中文 拼音 SRAM/ˈesræm/ 静态 jìng tài DRAM/ˈdiːræm/ 动态 dòng tài flip-flop/flɪp flɒp/ 触发器 chù fā qì cache/kæʃ/ 高速缓存 gāo sù huǎn cún refreshed/rɪˈfreʃt/ 刷新 shuā xīn 3.1
PROM、EPROM 与 EEPROM
制造后你能编程的 ROM 变体:
- PROM(可编程 ROM)——写一次(由一个编程器烧断熔丝);不能改变。
- EPROM(可擦可编程 ROM)——通过一个窗口用强 UV 光擦除,然后重写(一次整个芯片)。
- EEPROM(电可擦可编程 ROM)——电气地擦除和重写,一次一个字节,在电路中。闪存是一个为块擦除优化的衍生物。
PROM EPROM EEPROM 写入 一次,由用户用编程器写入 多次 多次 擦除方式 不能擦除 通过石英窗口用紫外光 用电信号 擦除范围 无 一次整个芯片 一次一个字节或一块 重新编程时要从电路中取下? 不适用 是 否 "给出 EPROM 和 EEPROM 的两个区别"要的是这个表中的两行,每一行都要对两种类型分别说明。
3.1
监测与控制系统

两者都读传感器;区别在于它们接下来做什么。
- 监控(monitoring)——收集并报告数据但不采取行动(一个记录读数的气象站)。
- 控制系统(control system)——用传感器数据通过执行器来决定并行动,通常在一个反馈回路中(一个开关锅炉的恒温器)。
三分的"描述区别"答案:监控系统只测量、记录或显示读数,最多发出警告;控制系统把每个读数与一个预设值(preset value)比较,如果超出范围,就向改变物理过程的执行器发送信号;这个变化随后被再次测量,所以控制系统包含反馈,而监控系统没有。一个给定的系统属于哪一种,就用这个判据来定:测量车辆高度并点亮警告牌的桥梁系统是监控,因为它做的事没有改变车辆;放下栏杆的系统则是控制。
例题。 描述一个自动系统如何在有人处于 2 米以内时开门、无人时关门。
一个红外或超声波传感器测量门前物体的距离;模拟读数由 ADC 转换为数字并送到处理器;处理器把距离与预设的 2 米比较;若小于 2 米,处理器向执行器(电机)发送信号开门;传感器持续测量,当收不到低于 2 米的读数时,处理器向电机发信号关门。每次动作之后的反复测量就是反馈,它阻止门在错误的时候开关。
监控报告数据;一个控制系统通过一个反馈回路行动 传感器和执行器
一个传感器(sensor)把一个物理量变成一个信号:温度(一个热敏电阻(thermistor)或热电偶)、压力(应变片)、红外、声音。模拟信号需要先经过一个 ADC。一个执行器(actuator)做相反的——把一个信号变成一个动作(一个电机、阀门、加热器、蜂鸣器)。

一个热敏电阻:一个电阻随热变化的温度传感器 
一个小电机:一个把信号变成运动的执行器 反馈
在一个控制系统中,执行器改变环境,传感器随即重新测量它——一个反馈(feedback)回路。没有反馈,系统不能自我纠正或知道何时停止(一个没有温度反馈的恒温器会永远加热)。
探索The control feedback loop
Tap round the loop a thermostat or autopilot repeats. A control system doesn't just read the world — it acts, then re-measures, correcting itself again and again.
词汇表 训练英文 中文 拼音 sensor/ˈsensə/ 传感器 chuán gǎn qì monitoring/ˈmɒnɪtərɪŋ/ 监控 jiān kòng control system/kənˈtrəʊl ˈsɪstəm/ 控制系统 kòng zhì xì tǒng feedback/ˈfiːdbæk/ 反馈 fǎn kuì preset value/ˈpriːset ˈvæljuː/ 预设值 yù shè zhí thermistor/ˈθɜːmɪstə/ 热敏电阻 rè mǐn diàn zǔ 3.2
逻辑门与逻辑电路

大纲
Candidates should be able to: Notes and guidance Use the following logic gate symbols: [NOT, AND, OR, NAND, NOR, XOR] Understand and define the functions of: NOT, AND, OR, NAND, NOR and XOR (EOR) gates All gates except the NOT gate will have two inputs only. Construct the truth table for each of the logic gates above Construct a logic circuit From: • a problem statement • a logic expression • a truth table Construct a truth table From: • a problem statement • a logic circuit • a logic expression Construct a logic expression From: • a problem statement • a logic circuit • a truth table 来源:剑桥国际大纲
半加器:XOR + AND 相加两个位 一个逻辑门(logic gate)是一个做一个布尔(Boolean)运算的小电路。输入和输出是 0(假、低)或 1(真、高)。要知道每个门的符号、功能和真值表(truth table)。
六个逻辑门的符号 NOT(反相器)
A NOT A 0 1 1 0 AND —— 仅当所有输入都为 1 时输出 1
A B A AND B 0 0 0 0 1 0 1 0 0 1 1 1 OR —— 若至少一个输入为 1 则输出 1
A B A OR B 0 0 0 0 1 1 1 0 1 1 1 1 NAND(NOT AND)—— 仅当所有输入都为 1 时输出 0
A B A NAND B 0 0 1 0 1 1 1 0 1 1 1 0 NOR(NOT OR)—— 仅当所有输入都为 0 时输出 1
A B A NOR B 0 0 1 0 1 0 1 0 0 1 1 0 XOR(异或,也叫 EOR)—— 若输入不同则输出 1
A B A XOR B 0 0 0 0 1 1 1 0 1 1 1 0 探索Logic gates
Switch the inputs and pick a gate. Each gate has its own rule — the building blocks of every digital circuit.
词汇表 训练英文 中文 拼音 logic gate/ˈlɒdʒɪk ɡeɪt/ 逻辑门 luó jí mén Boolean/ˈbuːlɪən/ 布尔 bù ěr truth table/truːθ ˈteɪbl/ 真值表 zhēn zhí biǎo 3.2
逻辑电路

一个逻辑电路(logic circuit)是一个执行一个布尔表达式的门网络。你应当能够在一个问题陈述、一个逻辑表达式、一个真值表和一个电路图之间转换。
试卷用文字写表达式,
X = (A AND NOT B) OR (B AND C),也接受代数形式 $X = A\overline{B} + BC$,其中点(或省略)表示 AND,加号表示 OR,上划线表示 NOT。题目用哪种,你就用哪种。从表达式到电路
每个运算符画一个门并把它们连起来。对于 $X = (A \text{ AND } B) \text{ OR } (\text{NOT } C)$:$C$ 上一个 NOT 门、$A$ 和 $B$ 上一个 AND 门,然后两个结果上一个 OR 门。
连接在一起的门执行一个布尔表达式 从电路到表达式
从输入向前推进,标注每个门的输出,直到你到达最终输出。
例题。 写出下面电路的表达式,然后补全它的真值表。
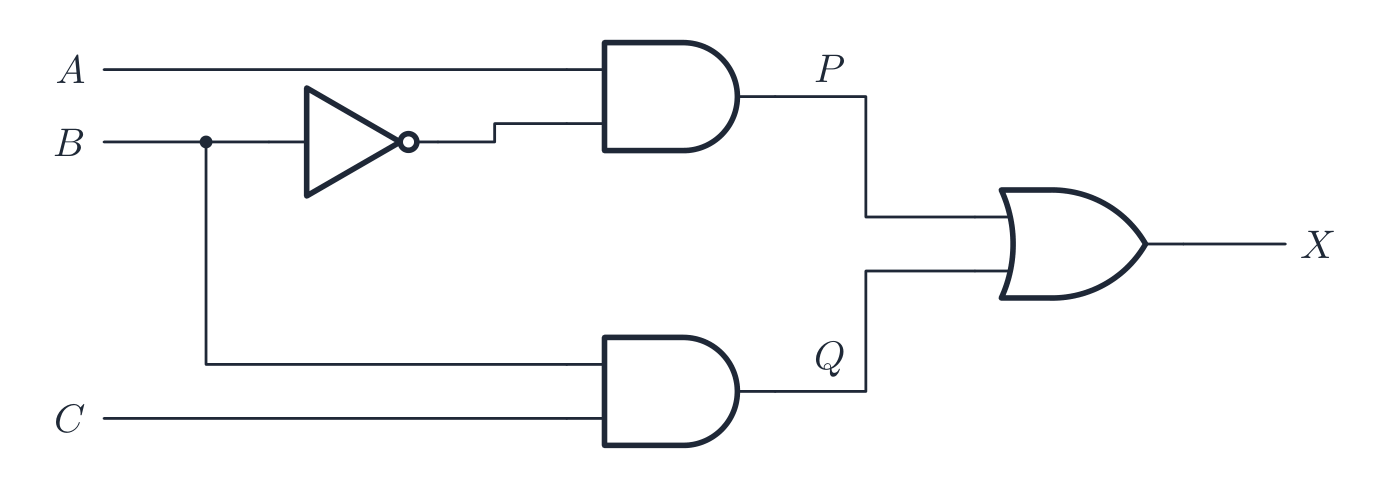
给每个中间输出加标注:这里 P 是 A AND NOT B,Q 是 B AND C,所以 X 是 P OR Q 标注各门的输出:$P = A \text{ AND NOT } B$,$Q = B \text{ AND } C$,所以 $X = P \text{ OR } Q = (A \text{ AND NOT } B) \text{ OR } (B \text{ AND } C)$。然后给真值表每个中间输出加一列,这样每一行都能一个门一个门地检查:
A B C NOT B P Q X 0 0 0 1 0 0 0 0 0 1 1 0 0 0 0 1 0 0 0 0 0 0 1 1 0 0 1 1 1 0 0 1 1 0 1 1 0 1 1 1 0 1 1 1 0 0 0 0 0 1 1 1 0 0 1 1 由表达式画电路是同一条路反着走:从最内层的括号开始,每个运算符画一个门,任何带 NOT 的输入在它的导线上画一个 NOT 门,输入放在左边、唯一的输出放在右边,并给输出标上字母。每条线都必须终止于某个门的输入或最终输出;一条哪里都不去的线会丢分。
从电路到真值表
对于 $n$ 个输入有 $2^{n}$ 行。列出每个输入组合;对每一个,算出内部的门再算出输出。
从真值表到表达式(积之和)
对每个输出为 1 的行,写一个输入的 AND(对那一行中为 0 的任何输入取 NOT);把这些 OR 在一起。例子:一个只在 $(A=0,B=1)$ 和 $(A=1,B=0)$ 输出 1 的表给出 $\overline{A}B + A\overline{B}$,即 $A \text{ XOR } B$。
从一个问题陈述
先把英语变成一个布尔表达式:"A and B" → A AND B;"A or B or both" → A OR B;"exactly one of A and B" → A XOR B;"neither A nor B" → A NOR B;"not both" → A NAND B。
例题。 某机器的警报 $X$ 在防护罩打开($A=1$)并且电机运转($B=1$)或温度过高($C=1$)时鸣响。写出布尔表达式,并给出 $X=1$ 的各行。把英文一句一句地转成逻辑:"B 或 C"是 $B + C$,"A 并且这个"是 $X = A\cdot(B + C)$。至于各行,$X=1$ 需要 $A=1$ 并且 $B$、$C$ 中至少有一个为 1 - 所以是 $(A,B,C) = (1,0,1)$、$(1,1,0)$ 和 $(1,1,1)$,八行中的三行。注意 $A=0$ 时无论 $B$ 和 $C$ 怎样都不会报警。在与 A 相与之前要给 OR 加括号:$X = A\cdot B + C$ 完全是另一个电路,它会在防护罩关着时也因高温而报警。
探索Half adder
Wire XOR and AND to the same two inputs: XOR gives the sum bit, AND gives the carry. Click A and B.
探索Logic circuits
gates combine into circuits
Each gate has a fixed rule; chaining them builds every circuit — start with one gate.
词汇表 训练英文 中文 拼音 logic circuit/ˈlɒdʒɪk ˈsɜːkɪt/ 逻辑电路 luó jí diàn lù 3.2
考官认可的定义
定义题按固定的表述给分。把这些记准确,并且只写一个答案。
术语 定义 嵌入式系统(embedded system) 内置于更大设备中、具有专门功能的计算机系统 缓冲区(buffer) 在不同速度的设备之间传输数据时暂时存放数据的一块存储区 RAM 可读可写的易失性存储器,存放正在使用的程序和数据 ROM 正常使用中内容不能更改的非易失性存储器,存放启动指令 SRAM 用触发器存储每一位、不需要刷新的静态 RAM DRAM 用电容器上的电荷存储每一位、必须不断刷新的动态 RAM 监控系统(monitoring system) 用传感器测量并报告一个物理过程而不改变它的系统 控制系统(control system) 根据传感器读数决定并通过执行器执行改变物理过程的动作的系统 传感器(sensor) 测量一个物理量并把它转换成计算机信号的装置 执行器(actuator) 把来自计算机的信号转换成物理动作的装置 反馈(feedback) 控制系统的输出被测量并作为输入送回,使系统能自我纠正 逻辑门(logic gate) 对一个或多个二进制输入执行布尔运算、给出一个二进制输出的电子电路 真值表(truth table) 列出逻辑电路的每一种输入组合及其对应输出的表 3.2
考试技巧
- 区分 **RAM(易失性、读/写)**和 ROM(非易失性、容纳引导程序);SRAM(高速缓存、更快)和 DRAM(主存储器、需要刷新)。
- 对于一个逻辑电路,逐门构建布尔表达式,然后一个覆盖每个输入组合的真值表。
- 学每个门(AND、OR、NOT、NAND、NOR、XOR)的符号、表达式和真值表。
- 解释一个缓冲(一个桥接两个不同速度的临时存储)以及一个中断的作用。
常见错误
- 说出设备的名称而不是描述它的工作过程。"它使用激光"得不到分;各个步骤(给鼓充电、激光消除电荷、吸附墨粉、转移、定影)才得分。
- 说监控系统"控制"了什么。如果没有任何东西改变物理过程,那就是监控;加上执行器和反馈,它才成为控制。
- 写 RAM"永久存储文件"或 ROM"存储用户的数据"。RAM 是易失的工作存储器;ROM 存放固定的启动指令。
- 真值表少于 $2^{n}$ 行,或者各行顺序随意。从 000 数到 111 按二进制计数,就不会漏掉组合。
- 为了保险从一个门的输出画两条线,或者留下一条哪里都不去的导线。只画表达式需要的那些连接。
-
4
处理器基础
4.1
中央处理器(CPU)体系结构
大纲
Candidates should be able to: Notes and guidance Show understanding of the basic Von Neumann model for a computer system and the stored program concept Show understanding of the purpose and role of registers, including the difference between general purpose and special purpose registers Special purpose registers including: • Program Counter (PC) • Memory Data Register (MDR) • Memory Address Register (MAR) • The Accumulator (ACC) • Index Register (IX) • Current Instruction Register (CIR) • Status Register Show understanding of the purpose and roles of the Arithmetic and Logic Unit (ALU), Control Unit (CU) and system clock, Immediate Access Store (IAS) Show understanding of how data are transferred between various components of the computer system using the address bus, data bus and control bus Show understanding of how factors contribute to the performance of the computer system Including: • processor type and number of cores • the bus width • clock speed • cache memory Understand how different ports provide connection to peripheral devices Including connection to: • Universal Serial Bus (USB) • High Definition Multimedia Interface (HDMI) • Video Graphics Array (VGA) Describe the stages of the Fetch-Execute (F-E) cycle Describe and use 'register transfer' notation to describe the F-E cycle Show understanding of the purpose of interrupts Including: • possible causes of interrupts • applications of interrupts • use of an Interrupt Service Routine (ISR) • when interrupts are detected during the fetch-execute cycle • how interrupts are handled 来源:剑桥国际大纲
取指-译码-执行周期 冯·诺依曼体系结构(Von Neumann architecture)是几乎每一台通用计算机的基础:
- 一个单一存储器——立即存取存储器(Immediate Access Store,IAS)——同时容纳程序指令和数据(存储程序(stored program)概念)。
- 一个处理器(processor,CPU)从存储器取指令并一次运行一条。
- 除非一个分支改变流程,指令按顺序运行。
存储程序的想法就是使一台计算机灵活的东西:改变程序,你就改变它所做的事,不用重新布线。
探索Tap the parts of a Von Neumann computer
Explore each block. The CPU (control unit, ALU, registers) talks to a single main memory over the buses — and that one shared memory for instructions AND data is the Von Neumann idea.
词汇表 训练英文 中文 拼音 Von Neumann architecture/vɒn ˈnɔɪmən ˈɑːkɪtektʃə/ 冯·诺依曼体系结构 féng · nuò yī màn tǐ xì jié gòu Immediate Access Store/ɪˈmiːdɪət ˈækses stɔː/ 立即存取存储器 lì jí cún qǔ cún chǔ qì stored program/stɔːd ˈprəʊɡræm/ 存储程序 cún chǔ chéng xù processor/ˈprəʊsesə/ 处理器 chǔ lǐ qì arithmetic and logic unit/ˌærɪθˈmetɪk ənd ˈlɒdʒɪk ˈjuːnɪt/ 算术逻辑单元 suàn shù luó jí dān yuán 4.1
CPU 的主要部件

所有这些部件都位于一个小芯片内。本节后面的图显示它们如何连接;下面的照片显示实物。
一个现代 CPU:整个处理器是一个小芯片(这里从下方看,显示触点) 
主板上匹配的 CPU 插座:芯片的触点压到这些针脚上 算术逻辑单元(ALU)
ALU(算术逻辑单元)做算术(加、减……)和逻辑(AND、OR、比较)。它从寄存器(registers)取操作数,并把结果放回一个寄存器。
控制单元(CU)
控制单元(control unit)译码每条指令,并发送控制信号来执行它——打开数据通路、告诉 ALU 做什么,以及控制存储器读和写。
系统时钟
时钟发送一串稳定的脉冲,使 CPU 保持同步。每条指令占固定数目的周期,时钟频率(clock speed,例如 3.8 GHz)是性能的一个因素。
"解释 CU 和系统时钟如何协同工作":时钟以固定频率发出脉冲;控制单元用每个脉冲把取指-执行周期推进一步,并与脉冲同步地发出它的控制信号,于是处理器的每个部分一起改变状态。更快的时钟意味着每秒更多的步骤,直到电路来不及在脉冲之间稳定下来为止。
寄存器
寄存器是 CPU 内微小、非常快的存储。专用寄存器(special purpose registers)各在周期中有一个固定的工作:
- 程序计数器(Program Counter,PC)——下一条指令的地址。
- 内存地址寄存器(Memory Address Register,MAR)——正在读或写的地址。
- 内存数据寄存器(Memory Data Register,MDR)——正在往存储器去或从存储器来的数据。
- 当前指令寄存器(Current Instruction Register,CIR)——正在译码的指令。
- 累加器(Accumulator,ACC)——ALU 正在处理的值。
- 状态寄存器(Status Register)——容纳分支所用的标志(flags,进位、零、负、溢出)。每个标志是一位,由 ALU 在一次运算后置位或清零:比较相等后置零标志,加法溢出寄存器时置进位标志,结果为负时置负标志。条件跳转读取这些标志来决定是否分支,而溢出标志可以引发一个中断。
- 变址寄存器(Index Register)——变址寻址中加到地址上的一个偏移量;把它递增就能一次一个元素地遍历数组。
"补全表格,描述每个寄存器的作用"这道题要求用这些说法为每个寄存器写一句准确的话:PC 存放下一条要取的指令的地址;MAR 存放正在读或写的存储单元的地址;MDR 存放刚从该单元读出、或即将写入该单元的数据或指令;CIR 存放当前正在译码和执行的指令;ACC 存放最近一次算术或逻辑运算的结果。
通用寄存器(general-purpose registers)由程序员用于计算过程中的临时值。寄存器与存储器之间的数据移动用寄存器传送(register transfer)记法写——例如
MAR ← [PC]("把 PC 的内容复制到 MAR")。
冯·诺依曼 CPU:由总线连接的寄存器、控制单元和 ALU 词汇表 训练英文 中文 拼音 ALU/ˌeɪ el ˈjuː/ 算术逻辑单元 suàn shù luó jí dān yuán register/ˈredʒɪstə/ 寄存器 jì cún qì control unit/kənˈtrəʊl ˈjuːnɪt/ 控制单元 kòng zhì dān yuán clock speed/klɒk spiːd/ 时钟频率 shí zhōng pín lǜ special purpose registers/ˈspeʃl ˈpɜːpəs ˈredʒɪstəz/ 专用寄存器 zhuān yòng jì cún qì Program Counter/ˈprəʊɡræm ˈkaʊntə/ 程序计数器 chéng xù jì shù qì Memory Address Register/ˈmeməri əˈdres ˈredʒɪstə/ 内存地址寄存器 nèi cún dì zhǐ jì cún qì Memory Data Register/ˈmeməri ˈdeɪtə ˈredʒɪstə/ 内存数据寄存器 nèi cún shù jù jì cún qì Current Instruction Register/ˈkʌrənt ɪnˈstrʌkʃn ˈredʒɪstə/ 当前指令寄存器 dāng qián zhǐ lìng jì cún qì accumulator/əˈkjuːmjʊleɪtə/ 累加器 lěi jiā qì Status Register/ˈsteɪtəs ˈredʒɪstə/ 状态寄存器 zhuàng tài jì cún qì flags/flæɡz/ 标志 biāo zhì Index Register/ˈɪndeks ˈredʒɪstə/ 变址寄存器 biàn zhǐ jì cún qì general-purpose registers/ˈdʒenərəl ˈpɜːpəs ˈredʒɪstəz/ 通用寄存器 tōng yòng jì cún qì register transfer/ˈredʒɪstə ˈtrænsfɜː/ 寄存器传送 jì cún qì chuán sòng 4.1
总线

三条内部总线(buses,一组组并行导线)连接各部件:
- 地址总线(address bus)——传送存储器地址。单向(CPU → 存储器)。
- 数据总线(data bus)——传送数据。双向。
- 控制总线(control bus)——传送控制信号(读、写、中断)。双向。
一条 $n$ 位地址总线能到达 $2^{n}$ 个存储单元。数据总线宽度决定每次访问移动多少位(常常是字长)。
连接 CPU、存储器和输入/输出的三条系统总线 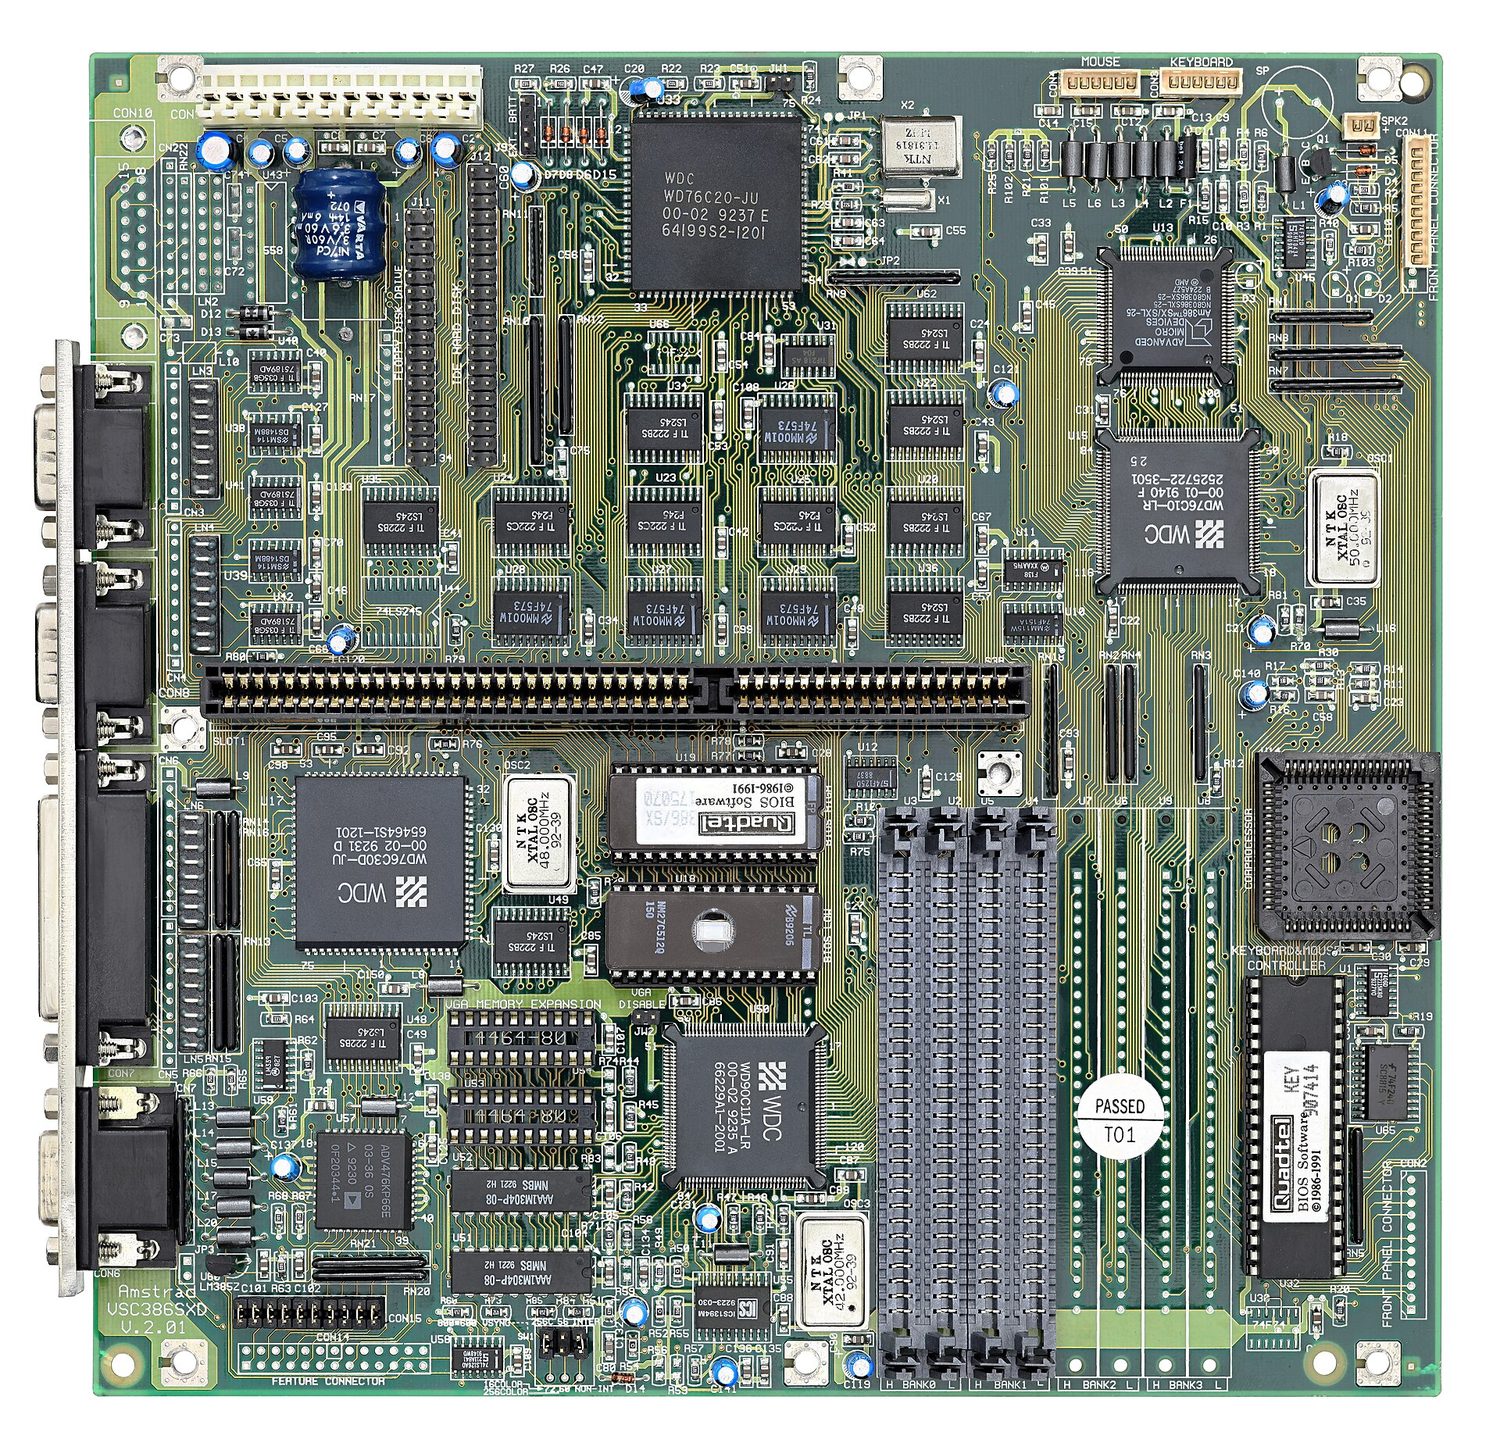
一块主板:CPU、内存和输入/输出都挂在同一组总线上——就是它们之间的那些印制线路 词汇表 训练英文 中文 拼音 control bus/kənˈtrəʊl bʌs/ 控制总线 kòng zhì zǒng xiàn buses/ˈbʌsɪz/ 总线 zǒng xiàn address bus/əˈdres bʌs/ 地址总线 dì zhǐ zǒng xiàn data bus/ˈdeɪtə bʌs/ 数据总线 shù jù zǒng xiàn 4.1
影响性能的因素
- 时钟频率——每秒更多的周期。
- 核心数(cores)——一个多核 CPU 一次运行几个线程。
- 字长(word size)——一个 64 位 CPU 每周期处理 64 位块,并能寻址比一个 32 位的多得多的存储器。
- RAM 数量(随机存取存储器)——更多的 RAM 容纳更多的工作集;太少迫使操作系统页(page)到磁盘。
- 高速缓存(cache memory)大小——更多的高速缓存减少平均存储器访问时间。
- 辅助存储器(secondary storage)类型——一个 SSD 加载程序比一个 HDD 快得多。
- 总线宽度和速度——更宽/更快的总线更快地移动数据。
使规格与工作负载匹配:一个四核在并行工作上胜过一个双核,但更高的每核速度在单线程工作上胜出。
每个因素都是一道带理由的两分题:
- 更多核心:每个核心能同时取出并执行自己的指令,所以多个程序,或一个程序的多个线程,可以并行运行。但程序必须被编写成能使用多个核心,所以核心数加倍不会使速度加倍。
- 更高的时钟频率:每秒更多的取指-执行周期,所以每秒执行更多指令;限制在于产生的热量。
- 更宽的总线:更宽的数据总线在每次传送中移动更多的位,所以同样的数据需要更少的传送次数;更宽的地址总线能寻址更多的存储单元。
- 高速缓存:处理器内部或紧邻处理器的一小块快速存储器,保存最近或最常使用的指令和数据。从高速缓存读取比从 RAM 读取快得多,所以处理器等待的时间更少。
"解释为什么新计算机性能更好"要逐行比较两台机器的规格:更高的时钟频率每秒执行更多指令,更多核心同时运行更多任务,更多高速缓存意味着更少的慢速 RAM 访问,更多 RAM 意味着更少的磁盘传送。
词汇表 训练英文 中文 拼音 word size/wɜːd saɪz/ 字长 zì cháng number of cores/ˈnʌmbə ɒv kɔːz/ 核心 hé xīn cores/kɔːz/ 核心 hé xīn amount of RAM/əˈmaʊnt ɒv ræm/ 随机存取存储器 suí jī cún qǔ cún chǔ qì RAM/ræm/ 随机存取存储器 suí jī cún qǔ cún chǔ qì page/peɪdʒ/ 页 yè cache memory/kæʃ ˈmeməri/ 高速缓存 gāo sù huǎn cún cache/kæʃ/ 高速缓存 gāo sù huǎn cún secondary storage/ˈsekəndəri ˈstɔːrɪdʒ/ 辅助存储器 fǔ zhù cún chǔ qì 4.1
端口
一个端口(port)是一个用于连接外围设备(peripheral)的物理插座:
- USB(通用串行总线)——通用(键盘、驱动器、手机)。
- HDMI(高清多媒体接口)——向一个屏幕的数字视频和音频。
- VGA(视频图形阵列)——向一个显示器的较老的模拟视频输出。
- Ethernet(RJ-45)——有线 LAN。音频插孔——耳机/麦克风。
不同的端口用不同的信号,所以一根 HDMI 电缆不会装进一个 USB 插座。USB-C 不寻常,它携带视频、数据和电力。
"解释计算机如何通过 HDMI 连接显示器":HDMI 端口把视频和音频作为一个数字信号沿一根电缆发送,所以不需要转换成模拟信号,画面不会劣化;电缆传输高清分辨率,显示器自己的端口对信号解码。USB 设备是即插即用的:接入时计算机检测到它、识别它、加载或安装它需要的驱动程序,并能为它供电,全程不需要重启。
词汇表 训练英文 中文 拼音 port/pɔːt/ 端口 duān kǒu peripheral/pəˈrɪfərəl/ 外围设备 wài wéi shè bèi 4.1
取指-执行周期

CPU 重复取指-执行周期(fetch-execute cycle),每条机器指令运行一次。
取指
- PC 的地址被复制到 MAR。
- PC 被递增以指向下一条指令。
- 一个读信号经控制总线传送。
- 存储器把指令放到数据总线上。
- 它被复制到 MDR,然后到 CIR。
考试要求用寄存器传送记法(register transfer notation)写出这些步骤,其中
[X]表示寄存器 X 的内容,[[MAR]]表示地址存放在 MAR 中的那个存储单元的内容:MAR ← [PC] 下一条指令的地址送到 MAR PC ← [PC] + 1 PC 现在指向再下一条指令 MDR ← [[MAR]] 该地址处的指令被读入 MDR CIR ← [MDR] 指令被复制到 CIR 以便译码顺序很重要:PC 的地址一被复制出去就立即递增,这样后面执行的跳转仍能覆盖它。执行阶段用同样的记法描述每条指令;例如对
LDD 200,就是MAR ← 200,MDR ← [[MAR]],ACC ← [MDR]。一次取指中的寄存器传送:PC → MAR → 存储器 → MDR → CIR,PC 被递增 译码
CU 译码 CIR 中的指令——什么运算,以及哪些操作数或地址。
执行
CU 执行它:算术/逻辑去 ALU(结果到 ACC);一个加载/存储在存储器和一个寄存器之间移动数据;一个分支改变 PC。然后周期重复。

取指-执行周期,每次都有一个中断检查 探索The fetch-execute cycle
Tap round the loop the CPU repeats billions of times a second. Watch how fetch uses the PC/MAR/MDR/CIR registers, then decode and execute act on what was fetched.
探索The fetch–execute cycle
Step through how the CPU runs one instruction — fetch it from memory, decode it, then execute it, over and over.
词汇表 训练英文 中文 拼音 fetch-execute cycle/fetʃ ˈeksɪkjuːt ˈsaɪkl/ 取指-执行周期 qǔ zhǐ - zhí xíng zhōu qī register transfer notation/ˈredʒɪstə ˈtrænsfɜː nəʊˈteɪʃn/ 寄存器传送记法 jì cún qì chuán sòng jì fǎ 4.1
中断

一个中断(interrupt)是一个暂停正常周期的信号,以便 CPU 能处理一个紧急事件(一次按键、一个数据包到达、一个硬件故障、除以零、操作系统计时器)。
处理一个:
- 完成当前指令。
- 保存状态(PC 和寄存器)。
- 把中断服务程序(interrupt service routine,ISR)的地址加载到 PC 并运行它。
- ISR 处理事件。
- 恢复保存的状态并继续。
中断让系统及时响应,而 CPU 不用不断检查设备,并且这是操作系统多任务的方式。
"解释来自输入设备的中断如何在取指-执行周期中被检测和处理"是一道四分题,要点如下:设备发送一个中断信号,把中断寄存器(interrupt register)中的中断标志置位;处理器在每个取指-执行周期结束时、当前指令执行完毕之后检查该寄存器;如果有标志被置位且该中断的优先级高于当前任务,PC 和其他寄存器的内容被保存到栈(stack)上;中断服务程序的地址被加载到 PC,该程序运行;它结束后,保存的值从栈中恢复,被中断的程序从停下的地方继续。
值得说出名称的原因:来自设备的硬件中断(按键、打印机缓冲区空了、网络数据包到达),来自故障的软件中断(除以零、非法指令、算术溢出),操作系统标记时间片结束的定时器中断,以及电源故障警告。
一个中断如何嵌入取指-执行周期 词汇表 训练英文 中文 拼音 interrupt/ˈɪntərʌpt/ 中断 zhōng duàn interrupt service routine/ˈɪntərʌpt ˈsɜːvɪs ruːˈtiːn/ 中断服务程序 zhōng duàn fú wù chéng xù interrupt register/ˈɪntərʌpt ˈredʒɪstə/ 中断寄存器 zhōng duàn jì cún qì stack/stæk/ 栈 zhàn 4.2
汇编语言

大纲
Candidates should be able to: Notes and guidance Show understanding of the relationship between assembly language and machine code Describe the different stages of the assembly process for a two-pass assembler Apply the two-pass assembler process to a given simple assembly language program Trace a given simple assembly language program Show understanding that a set of instructions are grouped Including the following groups: • Data movement • Input and output of data • Arithmetic operations • Unconditional and conditional instructions • Compare instructions Show understanding of and be able to use different modes of addressing Including immediate, direct, indirect, indexed, relative 来源:剑桥国际大纲
CPU 实际运行机器码(machine code)——位模式,专属于一个体系结构。汇编语言(assembly language)是一种可读的形式,每条机器指令一条指令,用像
LDD、ADD、JMP这样的助记符(mnemonics)书写。一个汇编器(assembler)把它翻译成机器码。一个汇编器把助记符变成机器码位模式 两遍汇编器
一个两遍汇编器读源两次:
- 第一遍构建一个符号表(symbol table):每当一个标签(label,如
LOOP:)出现时,记录它的地址;还不生成代码。 - 第二遍生成代码:翻译每条指令,当一条引用一个标签(如
JMP LOOP)时,在符号表中查找它的地址。
两遍处理前向引用(forward references,一个跳到后面定义的标签的跳转)。
例题。 对下面这个程序应用两遍处理过程,它的第一条指令存放在地址 100。
        LDD  COUNT
LOOP:   DEC  ACC
        CMP  #0
        JPN  LOOP
        END
COUNT:  5
第一遍逐行读取,数出每行将占用的地址,并把每个标签记入符号表:
LOOP= 101(DEC那一行)、COUNT= 105(数据行)。不产生任何代码。第二遍再次读取程序,把每一行翻译成机器码,把每个助记符换成它的操作码(opcode),把每个符号地址换成符号表中的数字:LDD COUNT变成LDD的操作码加操作数(operand)105,JPN LOOP变成JPN的操作码加操作数 101。往回跳到LOOP用一遍就能解决,但向前跳到一个尚未见到的标签就不行,这正是汇编器要做两遍的原因。示例指令集
剑桥用一个小的通用集,印在试卷的参考表中,只有一个通用寄存器即累加器(ACC),以及一个变址寄存器(IX)。写成
#n的操作数是十进制数,Bn是二进制数,&n是十六进制数;<address>是一个单元编号或一个标签。组 指令 作用 数据移动 LDM #n把数 n 加载到 ACC(立即) LDD <address>把该地址的内容加载到 ACC(直接) LDI <address>该地址存放另一个地址;把那个地址的内容加载到 ACC(间接) LDX <address>把 IX 加到地址上,把结果处的内容加载到 ACC(变址) LDR #n把数 n 加载到 IX MOV <register>把 ACC 复制到指定的寄存器(IX) STO <address>把 ACC 的内容存到该地址 输入和输出 IN读取一次按键,把它的 ASCII 码放入 ACC OUT输出 ASCII 码在 ACC 中的那个字符 算术 ADD <address>/ADD #n把该地址的内容或该数加到 ACC SUB <address>/SUB #n从 ACC 中减去 INC <register>/DEC <register>把 ACC 或 IX 加 1 或减 1 比较 CMP <address>/CMP #n把 ACC 与该地址的内容或与 n 比较,并设置标志 CMI <address>把 ACC 与该地址所存地址处的内容比较(间接) 跳转 JMP <address>无条件跳到该地址 JPE <address>/JPN <address>若上次比较相等 / 不相等则跳转 位操作 AND、OR、XOR带#n、Bn、&n或<address>对 ACC 做按位运算 LSL #n/LSR #n把 ACC 逻辑左移或右移 n 位 END结束程序 "汇编语言指令是分组的"这道题要求写出各组的名称,并各举一条指令:数据移动、输入和输出、算术、无条件和条件跳转、比较,以及位操作。
探索How a two-pass assembler works
Step through it. The assembler reads your code twice: pass 1 just finds where every label lives, so pass 2 can fill in the addresses — that is how a jump to a label defined later still works.
词汇表 训练英文 中文 拼音 operand/ˈɒpərænd/ 操作数 cāo zuò shù assembly language/əˈsemblɪ ˈlæŋɡwɪdʒ/ 汇编语言 huì biān yǔ yán machine code/məˈʃiːn kəʊd/ 机器码 jī qì mǎ mnemonics/nɪˈmɒnɪks/ 助记符 zhù jì fú assembler/əˈsemblə/ 汇编器 huì biān qì symbol table/ˈsɪmbl ˈteɪbl/ 符号表 fú hào biǎo label/ˈleɪbl/ 标签 biāo qiān forward references/ˈfɔːwəd ˈrefrənsɪz/ 前向引用 qián xiàng yǐn yòng opcode/ˈɒpkəʊd/ 操作码 cāo zuò mǎ 4.2
寻址方式

寻址方式(addressing mode)说明 CPU 如何找到操作数:
- 立即寻址(immediate addressing)——操作数是指令中的值。
LDM #10加载 10。 - 直接寻址(direct addressing)——指令容纳一个地址;操作数是那里的值。
LDD 200。 - 间接寻址(indirect addressing)——指令容纳一个地址,它容纳另一个地址,那才是数据。
LDI 200。 - 变址寻址(indexed addressing)——有效地址是
address + index register;用于数组。LDX 100且 IR = 5 读地址 105。
(相对寻址(relative addressing)把地址作为从 PC 起的一个偏移量给出——用于跳转。)
每种寻址方式如何到达它的操作数——立即、直接、间接和变址 例题。 内存中:地址
200存放250,地址250存放99,地址105存放7。变址寄存器中是5。分别执行LDM #200、LDD 200、LDI 200和LDX 100之后,累加器中各是什么?跟着每种寻址方式要找多远来看。LDM #200是立即寻址 - 操作数就是指令中写的那个数,所以累加器中是 200。LDD 200是直接寻址 - 去地址 200 取出其中的内容:250。LDI 200是间接寻址 - 地址 200 中存的是 250,那是另一个地址,所以继续去地址 250:99。LDX 100是变址寻址 - 把变址寄存器加到地址上,$100 + 5 = 105$,再读地址 105:7。用"跳几次"来区分它们:立即 0 次,直接 1 次,间接 2 次,变址 1 次(在加上变址值之后)。词汇表 训练英文 中文 拼音 indexed addressing/ˈɪndekst əˈdresɪŋ/ 变址寻址 biàn zhǐ xún zhǐ addressing mode/əˈdresɪŋ məʊd/ 寻址方式 xún zhǐ fāng shì immediate addressing/ɪˈmiːdɪət əˈdresɪŋ/ 立即寻址 lì jí xún zhǐ direct addressing/daɪˈrekt əˈdresɪŋ/ 直接寻址 zhí jiē xún zhǐ indirect addressing/ɪndaɪˈrekt əˈdresɪŋ/ 间接寻址 jiàn jiē xún zhǐ relative addressing/ˈrelətɪv əˈdresɪŋ/ 相对寻址 xiāng duì xún zhǐ 4.2
跟踪汇编程序
要跟踪它:做一个表,列有 PC、ACC、变址寄存器、每个变量和任何标志。逐条走过指令,每条之后更新表;当分支改变 PC 时跟随它们;在
END停止。一个常见模式是用变址寻址在一个数组上循环。例题。 跟踪这个程序。地址 200 存放 5,地址 201 存放 0。
100   LDD  200
101   CMP  #0
102   JPE  108
103   OUT
104   DEC  ACC
105   STO  200
106   LDD  201
107   JMP  100
108   END
每执行一条指令写一行,只填发生变化的列:
指令 ACC 200 201 输出 开始 5 0 LDD 2005 CMP #0JPE 108未跳转 OUT码为 5 的字符 DEC ACC4 STO 2004 LDD 2010 JMP 100LDD 2004 如此继续,直到
LDD 200加载到 0,比较置相等标志,JPE 108跳转,程序结束。考官检查三件事:CMP不改变任何寄存器,只改变标志;未跳转的跳转指令仍算执行过;OUT输出的是字符,所以它写在输出列而不是 ACC 列。"说明把LDD 10改为LDM #10的效果":ACC 将存放数 10,而不是地址 10 的内容。4.3
位操作

大纲
Candidates should be able to: Notes and guidance Show understanding of and perform binary shifts Logical, arithmetic and cyclic Left shift, right shift Show understanding of how bit manipulation can be used to monitor/control a device Carry out bit manipulation operations Test and set a bit (using bit masking) Instruction Label | Opcode | Operand Explanation AND #n / Bn / &n Bitwise AND operation of the contents of ACC with the operand AND Bitwise AND operation of the contents of ACC with the contents of XOR #n / Bn / &n Bitwise XOR operation of the contents of ACC with the operand XOR Bitwise XOR operation of the contents of ACC with the contents of OR #n / Bn / &n Bitwise OR operation of the contents of ACC with the operand OR Bitwise OR operation of the contents of ACC with the contents of LSL #n Bits in ACC are shifted logically n places to the left. Zeros are introduced on the right hand end LSR #n Bits in ACC are shifted logically n places to the right. Zeros are introduced on the left hand end Labels an instruction Gives a symbolic address All questions will assume there is only one general purpose register available (Accumulator) ACC denotes Accumulator IX denotes Index Register can be an absolute or symbolic address # denotes a denary number, e.g. #123 B denotes a binary number, e.g. B01001010 & denotes a hexadecimal number, e.g. &4A 来源:剑桥国际大纲
一个逻辑移位(logical shift)把所有位向左或向右移若干位,用 0 填充新位置。
- 左移 1(
LSL #1)——位向左移,一个 0 从右边进入;对一个无符号数这是 × 2。 - 右移 1(
LSR #1)——位向右移,一个 0 从左边进入;对一个无符号数这是整数 ÷ 2。
移 $n$ 位乘以或除以 $2^{n}$。例子:
00001011(11)LSL #1→00010110(22)。移出末端的位就丢失了,所以只有当它们是零时,乘法才是正确的。对补码整数
11001010做LSL #2得到00101000:从左边掉出的两个 1 没有了,符号位变了,结果也不再是原来的四倍。一个算术右移保留符号位,使一个负的有符号数保持为负。一个循环移位(cyclic shift,旋转)把从一端掉出的位从另一端送回,所以没有位丢失。
"写出对
10011110算术右移 3 位的结果":把符号位复制到每个空出的位置,得11110011。同样的移位作用于01011100得00001011。对10000110循环左移 1 位得00001101:最高的那个 1 从右边重新出现。逻辑左($\times 2$)、逻辑右($\div 2$)和算术右(保留符号位) 用于监控/控制的位操作
嵌入式设备常常每个信号用一个寄存器位(bit)(例如位 $n$ = LED $n$)。用一个掩码(mask)——位掩码——你可以:
- 置位 $n$:
R = R OR一个位 $n$ 置位的掩码。 - 清位 $n$:
R = R AND一个位 $n$ 清零而其余置位的掩码。 - 翻转位 $n$:
R = R XOR一个位 $n$ 置位的掩码。 - 测试位 $n$:
R AND掩码,然后检查结果是否非零。

用 OR 置一个位、用 AND 清它、用 XOR 翻转它——每个都用一个掩码 位操作快、用很少的存储器,并让一个字节容纳至多 8 个开/关状态。
在考试的指令集中,这些就是
AND、OR和XOR,掩码写成十进制、二进制或十六进制的操作数。设 ACC 存放10101100:指令 掩码 ACC 中的结果 效果 AND B000011110000111100001100只保留低四位(清除其余各位) OR #10000000110101101置最低有效位,其余不变 XOR &FF1111111101010011把每一位取反 AND B00001000然后CMP #00000100000001000测试位 3:比较结果不相等,所以位 3 是置位的 LSL #210110000左移两位,丢掉最高两位 LSR #300010101右移三位,左边补零 "写出把最低有效位置为 1 而其余各位不变的指令":
OR #1,或OR B00000001。要清除某一位,用一个该位为 0、其余为 1 的掩码做AND;要测试某一位,用一个只有该位为 1 的掩码做AND,再把结果与零比较。在监控设备中,寄存器的每一位对应一个传感器,一条AND就能检查某个传感器是否开启,一条OR就能在不影响其他位的情况下打开某个执行器的控制位。探索Shift and mask the bits of a byte
Pick an operator and watch each result bit. A left shift (<<) moves every bit up one place (×2); a right shift (>>) moves them down (÷2); AND with a mask clears the bits you don't want.
词汇表 训练英文 中文 拼音 bit/bɪt/ 位 wèi logical shift/ˈlɒdʒɪkl ʃɪft/ 逻辑移位 luó jí yí wèi cyclic shift/ˈsaɪklɪk ʃɪft/ 循环移位 xún huán yí wèi mask/mæsk/ 掩码 yǎn mǎ 4.3
考官认可的定义
定义题按固定的表述给分。把这些记准确,并且只写一个答案。
术语 定义 存储程序概念(stored program concept) 程序指令和数据都存放在主存储器中,指令被逐条取出并执行 寄存器(register) 处理器内部一个小而极快、有特定用途的存储位置 程序计数器(Program Counter) 存放下一条要取的指令的地址的寄存器 内存地址寄存器(Memory Address Register) 存放正在读或写的存储单元的地址的寄存器 内存数据寄存器(Memory Data Register) 存放刚从存储器读出、或即将写入存储器的数据或指令的寄存器 当前指令寄存器(Current Instruction Register) 存放当前正在译码和执行的指令的寄存器 累加器(Accumulator) 存放最近一次算术或逻辑运算结果的通用寄存器 高速缓存(cache memory) 靠近处理器的小而快的存储器,存放常用的指令和数据 中断(interrupt) 来自设备或程序的信号,使处理器暂停当前任务并运行中断服务程序 汇编语言(assembly language) 每条助记符指令对应一条机器码指令的低级语言 立即寻址(immediate addressing) 操作数就是指令中写的值 直接寻址(direct addressing) 操作数是指令中所写地址的内容 间接寻址(indirect addressing) 指令中的地址存放操作数的地址 变址寻址(indexed addressing) 操作数的地址是指令中的地址加上变址寄存器的内容 相对寻址(relative addressing) 操作数的地址以相对当前指令地址的偏移量给出 逻辑移位(logical shift) 每一位移动给定的位数,空出的位置用零填充 4.3
考试技巧
- 用寄存器传送术语(PC、MAR、MDR、CIR、ACC)学取指-执行周期,以及什么递增 PC。
- 说出每个寄存器的工作;地址总线是单向的,数据总线是双向的。
- 区分寻址方式(立即、直接、间接、变址)——一个常见的题目。
- 解释时钟频率、核心数、高速缓存大小和字长如何影响性能。
- 对于一个二进制移位,说明它是逻辑的还是算术的;左移乘以 2,右移除以 2。
常见错误
- 说 PC 存放当前指令,或说 MDR 存放地址。PC 存放下一条指令的地址;MDR 存放数据或指令,从不存放地址。
- 在取指中漏掉 PC 的递增,或把它放到执行之后。地址一被复制到 MAR,递增就发生。
- 把
LDD 10读成"加载 10"。LDD 10加载地址 10 的内容;LDM #10加载数 10。 - 给
CMP或OUT在 ACC 列里填值。比较只设置标志;输出写在输出列。 - 说中断被"立即"处理。处理器先完成当前指令,在周期结束时才检查中断。
- 对负的补码数用逻辑右移。只有算术移位才保留符号位。
-
5
系统软件
讲义 双页 词汇表 双页 词汇测验 7 双页 词汇测验 8 双页 词汇测验 9 双页 词汇测验 10 双页 词汇测验 14 双页 词汇测验 16 双页 词汇测验 17 双页 词汇测验 18 双页 观看视频课5.1
操作系统

大纲
Candidates should be able to: Notes and guidance Explain why a computer system requires an Operating System (OS) Explain the key management tasks carried out by the Operating System Including memory management, file management, security management, hardware management (input/output/peripherals), process management Show understanding of the need for typical utility software provided with an Operating System Including disk formatter, virus checker, defragmentation software, disk contents analysis / disk repair software, file compression, back-up software Show understanding of program libraries Including: • software under development is often constructed using existing code from program libraries • the benefits to the developer of software constructed using library files, including Dynamic Link Library (DLL) files 来源:剑桥国际大纲
为什么一台计算机需要一个操作系统
硬件本身只能取指令并运行它们——它对文件、程序、网络或用户一无所知。操作系统(operating system,OS)是这样一个软件层,它:
- 为运行中的程序管理硬件(处理器(processor)、内存、I/O、存储)。
- 通过一个清晰的接口提供服务(文件系统、网络、用户账户),所以程序不必直接与硬件对话。
- 提供一个用户界面(命令行、GUI、触控)。
- 让几个程序安全地共享硬件——每个获得公平的 CPU 时间并被挡在其他程序的内存之外。
没有操作系统,每个程序都需要它自己的驱动,而且一次只能安全地运行一个程序。
"描述操作系统的用途"——五分清单。 操作系统(1)在用户与硬件之间提供一个接口;(2)向用户和应用程序隐藏硬件的复杂性;(3)管理硬件资源——处理器时间、内存、存储和输入/输出设备——并在程序之间分配它们;(4)把应用软件加载到内存并运行它,给每个程序同样的运行平台;(5)让几个程序同时运行(多任务处理(multitasking)),同时保证它们和用户数据的安全。给出五个不同的要点;只说"它运行计算机"或"它管理资源"不得分。
一个桌面操作系统为用户管理屏幕、文件和程序 
手机同样需要操作系统:这是一个移动操作系统 Android 关键的管理任务
大纲列出五项。下面每个要点都是操作系统实际做的一件事,这正是"描述"题想要的。
- 内存管理(memory management)——在程序加载时给它分配内存,使每个程序的内存彼此分开(内存保护(memory protection)),让一个程序不能覆盖另一个;程序结束时释放内存;并在 RAM(随机存取存储器)与辅助存储器(secondary storage,即磁盘)之间交换页面(虚拟内存(virtual memory)/分页(paging)),使打开的程序可以多于物理内存所能容纳的。
- 进程管理(process management)——运行中的程序是一个进程(process)。操作系统创建和结束进程,决定下一个由哪个进程使用 CPU(调度(scheduling))以及用多久(一个时间片(time slice)),在它们之间切换,在两个进程争用同一资源时解决冲突,并能终止一个停止响应的进程。
- 硬件管理(输入/输出与外围设备)——通过每个设备的设备驱动(device driver)与之通信,把发往打印机等慢速设备的数据排队和缓冲,响应来自设备的中断(interrupts),并让几个程序共用一台设备。
- 文件管理——创建、命名、复制、移动和删除文件与文件夹,维护目录(directory)结构并记录每个文件存放在磁盘的哪里,给文件分配磁盘空间,并对每个用户执行访问权限(access rights)(读 / 写 / 执行)。
- 安全管理——用户账户和密码(身份验证(authentication))、访问权限、存储数据的加密、防火墙、自动安全更新,以及谁做了什么的日志。

操作系统所管理的主要工作 
内存保护使每个应用程序保持在它自己的内存块中 内存管理与进程管理如何支持多任务处理(常见的四分题)。内存管理把几个程序同时加载到内存中,各在自己受保护的区域,并记录哪些地址属于哪个程序;进程管理在它们之间分配处理器——每个进程运行一个时间片,操作系统保存它的状态并切换到下一个,切换快到所有程序看起来在同时运行。中断让操作系统在设备需要处理时随时从进程手中收回处理器。
中断。 硬件中断(hardware interrupt)来自设备:按下一个键、点击鼠标、打印机缺纸、磁盘完成一次传输、电源故障。软件中断(software interrupt)来自程序:除以零、无效指令、试图使用不属于它的内存,或请求一项操作系统服务。操作系统的中断处理程序(interrupt handler)保存正在运行的进程的状态,处理中断,然后恢复该进程(专题 4 讲取指-执行的细节)。
实用软件
实用程序(utility programs)是维护、修复或优化计算机而不是完成用户任务的系统软件;考官接受"执行一项特定的维护任务,改善性能或安全"。大多数操作系统捆绑这些:

实用程序:杀毒软件、备份、压缩和碎片整理 - 磁盘格式化程序——为一个新磁盘(或抹掉一个旧磁盘)做好使用准备:建立它的文件系统和分区,删除任何已有数据。
- 病毒检查器(杀毒软件(antivirus))——扫描文件和内存,把代码与已知病毒签名(signatures)的数据库比对并监视可疑行为,然后隔离或删除发现的东西;按计划运行、每次下载时运行,并且需要随新病毒出现而更新。
- 碎片整理软件(磁盘碎片整理(disk defragmenter))——硬盘把文件存放在它找到的任何空闲块中,所以经过多次保存和删除后,一个文件分散(碎片化(fragmented))在盘片各处,读写头必须在各碎片之间跳来跳去。碎片整理程序把每个文件的各部分挪到一起,并把空闲空间集中到一个区域,于是文件加载更快,新文件也不会碎片化。SSD 没有移动的磁头,不需要它。
- 磁盘内容分析 / 磁盘修复软件——显示什么占用了磁盘空间(大文件、重复文件或临时文件),以便删除;找到并修复坏扇区、丢失簇和文件系统错误。
- 文件压缩(压缩(compression))——缩小文件,使它们占用更少存储并更快传输;归档把许多文件打包成一个。
- 备份软件(备份(backup))——按计划把文件复制到另一个介质(外部磁盘、网络、云端),使数据在丢失、损坏或勒索软件攻击后可以恢复;一次完整备份之后是只备份变化部分的增量备份(incremental backups)。
- 防火墙(firewall)(按规则过滤网络流量)和加密工具,用于安全;一个系统监视器和自动更新。
把这些与操作系统捆绑,省去用户安装每一个。
哪个实用程序做什么。 *性能:*碎片整理(更快的文件访问)、磁盘修复(有错误的磁盘会变慢或失效)、磁盘内容分析(删除垃圾释放空间)、压缩(磁盘能装更多)。*安全:*病毒检查器、防火墙、加密,以及备份(勒索软件之后唯一的恢复手段)。"连线"题把每个实用程序与恰好一个用途配对——记住上面的配对,并使用大纲的名称。
例题。 解释碎片整理如何改善计算机的性能(3 分)。
随着时间推移,一个文件被存放在分散于硬盘各处的块中,所以读取它需要读写头多次移动。碎片整理程序重新排列这些块,使每个文件连续存放,空闲空间集中在一起。此后读取文件的磁头移动更少,加载更快,新文件也能写入一段连续的空间。
探索Where the operating system sits
Tap each layer. The OS is the middle layer — it sits between your applications and the hardware, sharing the machine safely so programs never touch the hardware directly.
词汇表 训练英文 中文 拼音 operating system/ˈɒpəreɪtɪŋ ˈsɪstəm/ 操作系统 cāo zuò xì tǒng processor/ˈprəʊsesə/ 处理器 chǔ lǐ qì multitasking/ˈmʌltitæskɪŋ/ 多任务处理 duō rèn wù chǔ lǐ memory management/ˈmeməri ˈmænɪdʒmənt/ 内存管理 nèi cún guǎn lǐ memory protection/ˈmeməri prəˈtekʃn/ 内存保护 nèi cún bǎo hù RAM/ræm/ 随机存取存储器 suí jī cún qǔ cún chǔ qì secondary storage/ˈsekəndəri ˈstɔːrɪdʒ/ 辅助存储器 fǔ zhù cún chǔ qì virtual memory/ˈvɜːtʃuːəl ˈmeməri/ 虚拟内存 xū nǐ nèi cún paging/ˈpeɪdʒɪŋ/ 分页 fēn yè process management/ˈprəʊses ˈmænɪdʒmənt/ 进程管理 jìn chéng guǎn lǐ process/ˈprəʊses/ 进程 jìn chéng scheduling/ˈʃedjuːlɪŋ/ 调度 diào dù time slice/taɪm slaɪs/ 时间片 shí jiān piàn device driver/dɪˈvaɪs ˈdraɪvə/ 设备驱动 shè bèi qū dòng interrupts/ˈɪntərʌpts/ 中断 zhōng duàn directory/daɪˈrektəri/ 目录 mù lù access rights/ˈækses raɪts/ 访问权限 fǎng wèn quán xiàn authentication/ɔːˌθentɪˈkeɪʃn/ 身份验证 shēn fèn yàn zhèng firewall/ˈfaɪəwɔːl/ 防火墙 fáng huǒ qiáng hardware interrupt/ˈhɑːdweə ˈɪntərʌpt/ 硬件中断 yìng jiàn zhōng duàn software interrupt/ˈsɒftweə ˈɪntərʌpt/ 软件中断 ruǎn jiàn zhōng duàn interrupt handler/ˈɪntərʌpt ˈhændlə/ 中断处理程序 zhōng duàn chǔ lǐ chéng xù utility program/juːˈtɪlɪti ˈprəʊɡræm/ 实用程序 shí yòng chéng xù antivirus/ˌæntɪˈvaɪrəs/ 杀毒软件 shā dú ruǎn jiàn backup/ˈbækʌp/ 备份 bèi fèn compression/kəmˈpreʃn/ 压缩 yā suō disk defragmenter/dɪsk ˌdiːˈfræɡmentə/ 碎片整理 suì piàn zhěng lǐ signatures/ˈsɪɡnɪtʃəz/ 签名 qiān míng fragmented/fræɡˈmentɪd/ 碎片化 suì piàn huà incremental backups/ˌɪŋkrɪˈmentl ˈbækʌps/ 增量备份 zēng liàng bèi fèn 5.1
程序库

一个程序库(program library)是预先写好的代码(子程序(subroutines)、类、模块),程序重用它而不是自己写——例如一个数学库、一个网络库、一个图形库。
一个新程序重用来自库的现成例程 好处:节省时间(现成的代码)、可靠(经过充分测试、广泛使用),以及标准化(一致的行为)。
考官的好处清单,针对开发者。 库例程(library routines)已经写好并测试过,所以开发更快、更便宜;它们可靠,而且被许多程序使用,基本没有错误;开发者不需要该领域的专长(图形、压缩、加密、路径搜索);程序更容易维护,因为公共代码只在一处;整个团队可以用同样的例程,得到一致的结果。**缺点:**例程可能不完全符合你的需要而你又无法修改它;你的程序依赖于库的可用、正确和安全——库中的一个错误或安全漏洞就是你程序中的错误;而且你必须学会如何调用它。
- 一个静态库(static library)在编译时被复制到可执行文件中(独立,但更大且需要重建来更新)。
- 一个动态库(dynamic library,DLL,动态链接库;
.so)在运行时被加载(可执行文件更小、被许多程序共享、一次更新惠及所有)。

静态:库被复制到可执行文件中。动态:一个共享库文件在运行时被加载 动态链接库(DLL)文件。 DLL 是一种只在程序调用它时才于运行时加载到内存的库,它保持为一个独立文件,而不是被复制进可执行文件。*好处:*可执行文件更小;几个运行中的程序共享内存中的一份 DLL;DLL 可以更新(修复错误、支持新设备)而不必重新编译使用它的程序;内存只在需要该例程时才被占用。*缺点:*如果 DLL 缺失、被移动或版本不对,程序就无法运行;更新后的 DLL 可能破坏依赖旧行为的程序;被替换成假的 DLL 会以程序的权限运行。
例题。 一个团队为餐厅机器人编写软件,使用了一个包含"寻找餐桌之间最短路径"例程的程序库。解释对团队的两个好处和一个缺点。
*好处:*例程已经写好并测试过,团队节省时间并可以信任结果;团队不必自己理解路径搜索算法,可以把时间花在机器人自身的功能上。*缺点:*例程可能无法处理餐厅的具体需求(移动的椅子、单行通道),而团队无法修改它,因此可能不得不绕开它的限制。
探索Computing concept lab
Classify concrete examples by the computing idea they demonstrate.
词汇表 训练英文 中文 拼音 program library/ˈprəʊɡræm ˈlaɪbrəri/ 程序库 chéng xù kù subroutines/ˈsʌbruːtiːnz/ 子程序 zi chéng xù library routines/ˈlaɪbrəri ruːˈtiːnz/ 库例程 kù lì chéng static library/ˈstætɪk ˈlaɪbrəri/ 静态库 jìng tài kù dynamic library/daɪˈnæmɪk ˈlaɪbrəri/ 动态库 dòng tài kù 5.2
语言翻译程序

大纲
Candidates should be able to: Notes and guidance Show understanding of the need for: • assembler software for the translation of an assembly language program • a compiler for the translation of a high-level language program • an interpreter for translation and execution of a high-level language program Explain the benefits and drawbacks of using either a compiler or interpreter and justify the use of each Show awareness that high-level language programs may be partially compiled and partially interpreted, such as Java (console mode) Describe features found in a typical Integrated Development Environment (IDE) Including: • for coding, including context-sensitive prompts • for initial error detection, including dynamic syntax checks • for presentation, including prettyprint, expand and collapse code blocks • for debugging, including single stepping, breakpoints, i.e. variables, expressions, report window 来源:剑桥国际大纲
你写源代码;计算机运行机器码(machine code)。一个翻译器(translator)在它们之间转换。
汇编器
一个汇编器(assembler)把汇编语言(assembly language)翻译成机器码:每条助记符指令(
LDD、ADD、JMP)恰好变成一条机器码指令,符号地址和标号被替换成真实地址。需要它是因为处理器只执行机器码;在程序员需要直接控制硬件的地方(嵌入式系统、设备驱动)使用汇编。编译器
一个编译器(compiler)在运行之前一次性把一个高级程序翻译成机器码。
- 它在编译时报告所有错误;一旦干净,它产生一个独立的可执行文件(executable),它在没有安装编译器的情况下运行,并能运行许多次。
- 通常运行时更快(运行时没有翻译),但绑定到一个 CPU/OS——为每个平台重新编译。
两分的描述:*编译器在运行之前把整个高级语言程序翻译成机器码(目标代码(object code)),生成一个可执行文件,并在翻译结束时把所有语法错误一起列出。*它不运行程序。
解释器
一个解释器(interpreter)一次一行地翻译并运行一个高级程序,不产生可执行文件。
- 它在到达那一行时报告一个错误,然后停止;你可以修正它并继续——对开发很好。
- 必须安装解释器才能运行程序;通常更慢(每次运行都重新翻译),但容易跨平台移植(port)。
两分的描述:*解释器一次翻译高级语言程序的一条语句并立即执行它,再处理下一条;不生成可执行文件;遇到第一个错误就停下并报告。*每次运行程序时,源代码和解释器都必须在场。
一个编译器一次性翻译成一个独立程序;一个解释器每次运行都逐行翻译 在它们之间选择
用编译器当: 用解释器当: 运行时速度重要 你想要快速的编辑-运行循环 分发给没有开发工具的用户 编写跨平台脚本 程序运行许多次 程序小或只运行一次 教初学者 好处与缺点,按标准答案的列法。
编译器 解释器 执行速度 快——已经是机器码 较慢——每次运行都要翻译 用户需要什么 只要可执行文件;不需要翻译器,源代码保持私密 源代码和解释器 发现错误 整个程序翻译完后一次列出所有错误 每个错误在出现的那一行报告,边开发边发现 修改代码 每次修改后重新编译整个程序 编辑后立即再运行 可移植性 机器码只能在一个平台运行;每个平台重新编译 同样的源代码在任何有解释器的地方运行 例题。 一个开发者在编写程序时使用解释器,在完成后使用编译器。解释每一个是如何使用的(4 分)。
开发期间,解释器立刻运行写了一部分的程序,不必等待完整翻译;遇到错误时它报告所在行,开发者修正后立即再运行——一个快速的编辑-运行循环,更便于调试。程序完成后,编译器把整个程序翻译成一个可执行文件,它运行更快、用户电脑上不需要翻译器、也不暴露源代码,因此可以卖给公众。
混合:Java
Java 被编译成字节码(bytecode,一种平台无关的中间形式),一个虚拟机(virtual machine,JVM)随即解释它——或使用即时编译(just-in-time compilation)把热点部分变成本地代码。所以错误被及早捕获、字节码在任何有 JVM 的地方运行("一次编写,到处运行"),并且长时间运行的程序达到接近本地的速度。C# 和 Python 用类似的设计。
大纲的说法是"部分编译、部分解释":编译阶段捕捉语法错误并生成紧凑、可移植(portable)的字节码;解释阶段让这一个字节码文件在任何装有虚拟机的机器上运行,代价是损失一些速度。控制台模式(从命令行运行的文本程序)下的 Java 是大纲的例子。

Java 编译成可移植的字节码,任何 JVM 都能运行它——一次编写,到处运行 例题。 Java 源代码被编译成字节码,再由 JVM 解释执行。为什么两者都用,而不直接编译成机器码?编译器生成的是针对某一种处理器和操作系统的机器码,所以在一台机器上编译的程序无法在另一台上运行。而 Java 的编译器面向的是一台虚拟机器,所以它产生的字节码在哪里都完全相同;各个平台再各自提供自己的 JVM,把这些字节码解释成本平台的原生指令。因此一个编译好的文件可以在任何有 JVM 的地方运行 - "一次编写,到处运行"。代价是速度:解释字节码比运行原生代码慢,这正是真实的 JVM 还会用 JIT 编译在运行时把频繁执行的字节码转成原生代码的原因。要把两面都说出来 - 得分点是用速度换来的可移植性。
探索The compiler route: source to running program
Step through how a compiler works — translating the whole program once, before it runs. Contrast it with an interpreter, which translates and runs one line at a time.
词汇表 训练英文 中文 拼音 executable/ɪɡˈzekjʊtəbl/ 可执行文件 kě zhí xíng wén jiàn translator/trænˈsleɪtə/ 翻译器 fān yì qì machine code/məˈʃiːn kəʊd/ 机器码 jī qì mǎ assembler/əˈsemblə/ 汇编器 huì biān qì assembly language/əˈsemblɪ ˈlæŋɡwɪdʒ/ 汇编语言 huì biān yǔ yán compiler/kəmˈpaɪlə/ 编译器 biān yì qì object code/ˈɒbdʒekt kəʊd/ 目标代码 mù biāo dài mǎ interpreter/ɪnˈtɜːprɪtə/ 解释器 jiě shì qì bytecode/ˈbaɪtkəʊd/ 字节码 zì jié mǎ virtual machine/ˈvɜːtʃuːəl məˈʃiːn/ 虚拟机 xū nǐ jī just-in-time compilation/dʒʌst ɪn taɪm ˌkɒmpɪˈleɪʃn/ 即时编译 jí shí biān yì portable/ˈpɔːtəbl/ 可移植的 kě yí zhí de 5.2
集成开发环境(IDE)

一个集成开发环境(integrated development environment,IDE)把写、测试和调试代码的工具带进一个应用程序:
一个 IDE 捆绑编辑器、一个运行按钮和一个调试器 大纲把这些功能分成四类。记住每个功能属于哪一类,因为题目会要求你归类,并从每一类中描述一个。
- 用于编码: 上下文相关提示(context-sensitive prompts)——在你输入时,IDE 弹出适合代码当前位置的标识符、关键字或参数;自动补全(auto-complete)替你补完名称;自动缩进和括号匹配在你输入时保持版面正确。
- 用于初步错误检测: 动态语法检查(dynamic syntax checks)——编辑器在你输入时检查语法,并在程序翻译之前立即给错误加下划线或高亮;翻译之后,带行号的错误信息。
- 用于呈现: 代码美化(prettyprint)——关键字、标识符、字符串和注释用不同的颜色或字体显示(语法高亮(syntax highlighting)),并保持一致的缩进,使结构一目了然;展开和折叠代码块——隐藏一个循环、一个 IF 或一个子程序的主体,只看轮廓。
- 用于调试: 断点(breakpoints)——程序到达标记的行时暂停;单步执行(single stepping)——从暂停处一次运行一行;一个显示变量和表达式当前值及其变化的窗口;以及一个列出错误、警告和输出的报告窗口(report window)。
其他功能:翻译器集成(一键编译或运行,错误内联显示)、驱动上述调试功能的调试器(debugger)、版本控制(version control)集成(git)、项目管理、帮助系统、重构(refactoring)工具(安全重命名)和单元测试(unit test)集成。
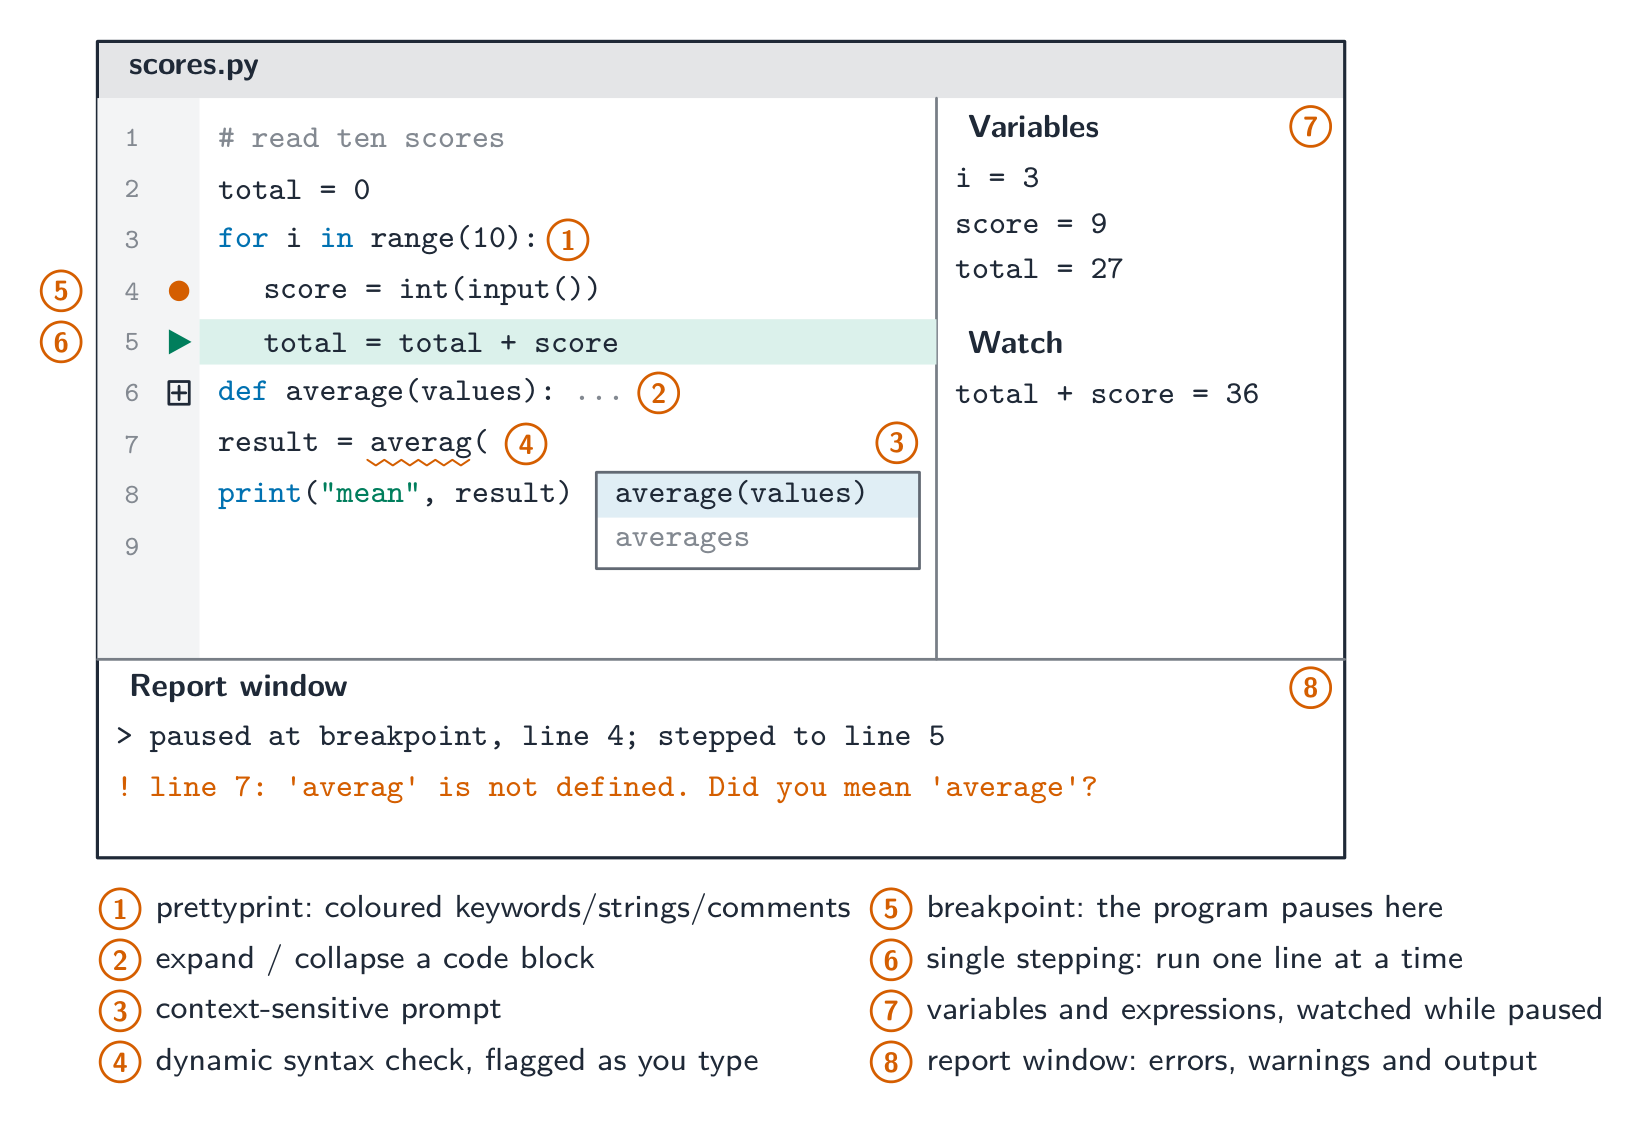
大纲点名的 IDE 功能,以及你在屏幕上看到它们的位置 一个 IDE 通过把写 → 运行 → 调试 → 修正放在一个接口后面来加速开发。常见的 IDE:Visual Studio、PyCharm、Eclipse、VS Code。

一个调试器:设置一个断点、运行,然后暂停来检查变量并单步执行代码 例题。 程序运行时,函数
Calculate()返回一个意外的值。描述典型 IDE 的调试功能如何帮助找出原因(4 分)。在
Calculate()的第一行设置一个断点,程序会在那里暂停而不是一直跑完。然后在函数中单步执行,一次一行。每一步之后读取变量的值以及你让 IDE 监视的任何表达式的值,与你预期的值比较;第一个使某个值出错的行之后就是逻辑错误所在。报告窗口显示任何运行时错误信息和到目前为止产生的输出。例题。 把每个功能归入它的大纲类别:代码美化、上下文相关提示、动态语法检查、断点、展开/折叠代码块、报告窗口。
编码:上下文相关提示。初步错误检测:动态语法检查。呈现:代码美化、展开/折叠代码块。调试:断点、报告窗口。
词汇表 训练英文 中文 拼音 integrated development environment/ˈɪntɪɡreɪtɪd dɪˈveləpmənt enˈvaɪrənmənt/ 集成开发环境 jí chéng kāi fā huán jìng debugger/ˈdiːbʌɡə/ 调试器 tiáo shì qì context-sensitive prompts/ˈkɒntekst ˈsensɪtɪv prɒmpts/ 上下文相关提示 shàng xià wén xiāng guān tí shì auto-complete/ˈɔːtəʊ kəmˈpliːt/ 自动补全 zì dòng bǔ quán dynamic syntax checks/daɪˈnæmɪk ˈsɪntæks tʃeks/ 动态语法检查 dòng tài yǔ fǎ jiǎn chá prettyprint/ˈpretɪprɪnt/ 代码美化 dài mǎ měi huà syntax highlighting/ˈsɪntæks ˈhaɪlaɪtɪŋ/ 语法高亮 yǔ fǎ gāo liàng breakpoints/ˈbreɪkpɔɪnts/ 断点 duàn diǎn single stepping/ˈsɪŋɡl ˈstepɪŋ/ 单步执行 dān bù zhí xíng report window/rɪˈpɔːt ˈwɪndəʊ/ 报告窗口 bào gào chuāng kǒu version control/ˈvɜːʃn kənˈtrəʊl/ 版本控制 bǎn běn kòng zhì refactoring/rɪˈfæktərɪŋ/ 重构 chóng gòu unit test/ˈjuːnɪt test/ 单元测试 dān yuán cè shì 5.2
考官认可的定义
定义题按固定措辞给分。把这些记准,并且只给一个答案。
术语 定义 操作系统 管理计算机硬件和资源,并在用户、应用程序与硬件之间提供接口的软件 实用软件 执行一项特定任务以维护、优化或保护计算机的系统软件,例如病毒检查器或碎片整理程序 程序库 一组预先写好并测试过的例程(子程序、类、模块),程序可以使用它们而不必自己编写 动态链接库(DLL) 其例程只在程序调用时于运行时加载到内存、并在程序之间共享的程序库 汇编器 把汇编语言程序转换成机器码的翻译器,每条指令对应一条 编译器 在运行之前把整个高级语言程序转换成机器码、生成可执行文件的翻译器 解释器 一次翻译并执行高级语言程序一条语句的翻译器 集成开发环境 提供编写、翻译、运行和调试程序所需工具的单一应用程序 上下文相关提示 建议适合代码当前位置的标识符、关键字或参数的弹出框 动态语法检查 在输入时检查代码的语法,并在程序翻译之前标出错误 代码美化 用不同的颜色或字体显示关键字、标识符和注释,并保持一致的缩进 断点 一个标记的行,运行中的程序在此暂停以便检查变量 单步执行 在程序员控制下,让暂停的程序一次运行一条语句 5.2
考试技巧
- 用大纲名称列出操作系统的工作(内存、进程、硬件、文件和安全管理),并说出每项做什么——单说"管理资源"太含糊。
- 比较编译器对解释器对汇编器:每个翻译什么、何时翻译,以及如何报告错误。
- 用大纲的分类解释一个 IDE 提供什么:编码、初步错误检测、呈现、调试。
- "对开发者的好处"要点出开发者省下的东西:时间、成本、专长、可靠性或维护。"缺点"要点出一种依赖:可用性、版本、契合度、安全。
- "描述某翻译器的工作方式"要给出三件事:翻译什么(整个程序还是一条语句)、何时翻译(运行前还是运行中)、如何报告错误(一次全部还是在第一个错误处)。
常见错误
- 写"操作系统控制计算机"或"管理资源"而没有任何具体任务。每一分都是一项有名称的任务加上它做什么。
- 说解释器"逐行编译"。解释器翻译并执行每条语句;它从不生成可执行文件。
- 说编译器运行程序。它只翻译;可执行文件稍后在没有编译器的情况下运行。
- 把 DLL 放"在"可执行文件里。那是静态库;DLL 保持为运行时加载的独立文件。
- 说碎片整理"删除"或"压缩"文件,或者 SSD 需要它。它只是移动块,使每个文件连续存放。
- 把代码美化或折叠代码块归入"调试"。它们是呈现功能;调试是断点、单步执行、监视变量和报告窗口。
-
6
安全、隐私与数据完整性
6.1
数据安全
大纲
Candidates should be able to: Notes and guidance Explain the difference between the terms security, privacy and integrity of data Show appreciation of the need for both the security of data and the security of the computer system Describe security measures designed to protect computer systems, ranging from the stand-alone PC to a network of computers Including user accounts, passwords, authentication techniques such as digital signatures and biometrics, firewall, anti-virus software, anti-spyware, encryption Show understanding of the threats to computer and data security posed by networks and the internet Including malware (virus, spyware), hackers, phishing, pharming Describe methods that can be used to restrict the risks posed by threats Describe security methods designed to protect the security of data Including encryption, access rights 来源:剑桥国际大纲
这些听起来相似,但意思不同:
- 安全(security)——保护数据免于未授权(unauthorised)的访问、更改或破坏。
- 隐私(privacy)——个人控制谁看到他们个人数据的权利,带有同意和一个明确的目的。
- 完整性(integrity)——数据是准确且完整的——没有被损坏或意外更改。
一个文件可以是安全的(只有正确的人能打开它)但缺乏完整性(一个拼写错误把它损坏了);或者准确但不私密(任何人都能读它)。三者都需要。
评分标准要的区别,各一句话:安全是保护数据不丢失、不被未授权访问;隐私是保持数据机密,只有有权看的人才能看;完整性是数据正确、一致、完整。所以"安全与隐私的区别":安全是防止不该访问的人访问、更改或丢失数据;隐私是个人决定谁可以看自己个人数据的权利。"安全与完整性的区别":安全保护数据免于未授权访问;完整性是数据准确且最新,由验证和核对来保护。
探索Risk and responsibility lab
Sort examples by the rule, risk or protection involved.
词汇表 训练英文 中文 拼音 security/sɪˈkjʊərɪti/ 安全 ān quán privacy/ˈprɪvəsi/ 隐私 yǐn sī integrity/ɪnˈteɡrɪti/ 完整性 wán zhěng xìng unauthorised/ʌnˈɔːθəraɪzd/ 未授权 wèi shòu quán 6.1
安全为何重要
要保护两样东西:数据本身(保持它机密、完整和可用)和计算机系统(一个被攻破的系统可以攻击其他人、窃取凭据,或被勒索赎金)。
"学校为什么两者都要保护?"数据:它是个人的、机密的,所以不能被未授权的人读取、更改或删除,而且丢失会让学校停摆。系统:侵入计算机系统的人可以安装恶意软件、用它攻击其他系统、损坏硬件或软件,或者用勒索软件锁住它;安全的系统是其上数据的第一道防线。
6.1
来自网络和互联网的威胁

威胁分成三组。
一个中间人攻击者坐在双方之间 1. 恶意软件(malware,malicious software)——有害的程序:
- 病毒(virus)——附着到其他程序、在它们运行时传播的自我复制代码。
- 蠕虫(worm)——在网络(networks)上无需用户操作就传播的自我复制代码。
- 木马(Trojan horse)——看起来有用但隐藏恶意代码。
- 间谍软件(spyware)——秘密收集信息(击键、密码)。
- 勒索软件(ransomware)——加密你的文件并要求付款。
- 广告软件(adware)——推送不需要的广告。
2. 欺骗人(社会攻击):
- 网络钓鱼(phishing)——欺骗用户交出凭据的假邮件/网站。
- 域名欺骗(pharming)——即使用户输入正确的地址,也把他们重定向到一个假网站。
- 社会工程(social engineering)——欺骗人交出信息。
评分标准对四种点名威胁的描述:病毒是会自我复制、附着到其他文件并删除或破坏数据的恶意软件;间谍软件是记录用户的按键和操作并发送给第三方、以获取密码和个人数据的恶意软件;网络钓鱼邮件假装来自合法机构,含有指向假网站的链接,在那里要求用户提供个人或银行信息;域名欺骗是安装在用户计算机或网络服务器上的恶意代码,即使用户输入了正确的地址也把他们重定向到假网站。间谍软件与病毒的相似之处:两者都是恶意软件,都在用户不知情时安装,都能把数据发给第三方或损坏系统;区别是病毒自我复制,而间谍软件记录并传送信息。网络钓鱼和域名欺骗都把用户引到收集其数据的假网站;网络钓鱼需要用户点击邮件里的链接,域名欺骗通过计算机或 DNS 服务器上的代码起作用,不需要邮件。
3. 对网络的攻击:
- 黑客(hackers)的黑客入侵(hacking)——未授权访问,常通过弱密码或软件缺陷。
- 拒绝服务(denial of service,DoS/DDoS)——淹没一台服务器,使真实用户不能到达它。
- 窃听(eavesdropping)——捕获传输中的数据(在开放 Wi-Fi 上的一个风险)。
- 中间人攻击(man-in-the-middle)——一个攻击者秘密地在双方之间转发或更改消息。
例题。 指出并描述学校网络上数据面临的两种威胁,并各给出一种不同的预防方法。
威胁一,恶意软件:从邮件附件或下载复制到计算机上的病毒自我复制并破坏或删除文件;预防:扫描文件并保持更新的杀毒软件。威胁二,黑客入侵:未授权的人例如通过猜出弱密码进入网络,读取或更改数据;预防:阻止未授权连接的防火墙,或强密码加双因素认证。第三对,网络钓鱼:邮件把用户引到收集其登录信息的假网站;预防:培训用户检查发件人和 URL,并过滤邮件。措施必须与威胁匹配:加密挡不住病毒,杀毒软件挡不住网络钓鱼。

恶意软件按行为:自我传播(病毒、蠕虫)对隐藏/伪装(木马、间谍软件、勒索软件、广告软件) 词汇表 训练英文 中文 拼音 malware/ˈmælweə/ 恶意软件 è yì ruǎn jiàn ransomware/ˈrænsəmweə/ 勒索软件 lè suǒ ruǎn jiàn networks/ˈnetwɜːks/ 网络 wǎng luò man-in-the-middle/mæn ɪnðə ˈmɪdl/ 中间人攻击 zhōng jiān rén gōng jī virus/ˈvaɪrəs/ 病毒 bìng dú worm/wɜːm/ 蠕虫 rú chóng Trojan horse/ˈtrəʊdʒn hɔːs/ 木马 mù mǎ spyware/ˈspaɪweə/ 间谍软件 jiàn dié ruǎn jiàn adware/ˈædweə/ 广告软件 guǎng gào ruǎn jiàn phishing/ˈfɪʃɪŋ/ 网络钓鱼 wǎng luò diào yú pharming/ˈfɑːmɪŋ/ 域名欺骗 yù míng qī piàn social engineering/ˈsəʊʃl ˌendʒɪˈnɪərɪŋ/ 社会工程 shè huì gōng chéng hacking/ˈhækɪŋ/ 黑客入侵 hēi kè rù qīn hackers/ˈhækəz/ 黑客 hēi kè denial of service/dɪˈnaɪəl ɒv ˈsɜːvɪs/ 拒绝服务 jù jué fú wù eavesdropping/ˈiːvzdrɒpɪŋ/ 窃听 qiè tīng 6.1
安全措施

措施既保护数据的安全(免于丢失、被盗或损坏)又保护计算机系统的安全(它的硬件、软件和网络)。
一台独立 PC
- 一个强密码;保持最新的杀毒软件;及时的软件更新;向单独介质的备份(backup);全盘加密(encryption);一个锁定的屏幕。
一台联网 PC
以上全部,加上一个防火墙(firewall)、每用户的权限(admin 权限只给 admin)、用户账户(user accounts)的集中管理,以及审计日志(audit logs,谁登录、他们碰了什么)。
各项措施如何起作用,按评分标准给分的措辞:
- 防火墙:检查每一次进出的传输,并与设定的准则(地址、端口和协议的白名单或黑名单)比较;拦截不符合准则的传输;可以阻止访问某些网站,并对未授权访问的企图发出警告。
- 加密:数据用密钥打乱(编码)成密文,所以被截获的副本没有密钥就无法理解;接收方用密钥解密。它保护传输中和存储中的数据,但不能阻止数据被截获或删除。
- 密码和用户账户:只有知道密码的用户才能登录;强密码(长、字符混合、定期更换)猜不出来;多次失败后账户锁定;每个账户带有自己的访问权限。
- 杀毒和反间谍软件:对照已知恶意软件特征的数据库扫描文件和程序,检查行为,隔离或删除找到的东西,而且必须更新才能识别新的恶意软件。
- 访问权限:给每个用户(或用户组)分配对每个文件或表的权限,例如只读或读写,这样用户看不到、也改不了不属于自己的数据;数据库还可以只向每个用户呈现含有其所需字段的视图。
- 生物识别:设备采集面部、指纹或虹膜的图像,转换成数字数据,与该用户存储的数据比较,只在匹配时允许访问;它不会像密码那样被忘记、外借或猜出。
- 备份:数据在单独介质上的副本,异地保存,以便丢失或损坏的数据可以恢复。
用三分限制恶意软件的风险:安装反恶意软件并保持更新;使用防火墙;不打开来源不明的附件或下载文件;保持操作系统和应用程序打好补丁;培训用户。
一个防火墙位于用户的计算机和互联网之间 跨越互联网
- VPN(虚拟专用网)——加密用户和企业网关之间的流量。
- HTTPS / TLS——加密网络流量。
- 数字签名(digital signatures)——证明谁发送了一个消息,以及它在传输中没有被更改。
- 入侵检测——观察流量以寻找已知的攻击模式。
数字签名如何验证文档的真实性(五分):发送方把消息通过哈希函数得到摘要;发送方用自己的私钥加密摘要,这个加密后的摘要就是数字签名;消息和签名一起发送;接收方用发送方的公钥解密签名,得到摘要;接收方对收到的消息做哈希,并比较两个摘要;如果相同,消息就来自该发送方(只有他持有私钥)并且在传输中未被更改。签名证明谁发了消息以及消息完好;它不隐藏内容,隐藏内容是对消息加密的事。
数字签名:消息的哈希用发送方的私钥加密,由接收方对照新算出的哈希来检查 词汇表 训练英文 中文 拼音 firewall/ˈfaɪəwɔːl/ 防火墙 fáng huǒ qiáng encryption/enˈkrɪpʃn/ 加密 jiā mì backup/ˈbækʌp/ 备份 bèi fèn user accounts/ˈjuːzə əˈkaʊnts/ 用户账户 yòng hù zhàng hù audit logs/ˈɔːdɪt lɒɡz/ 审计日志 shěn jì rì zhì VPN/ˌviː piː ˈen/ 虚拟专用网 xū nǐ zhuān yòng wǎng digital signatures/ˈdɪdʒɪtl ˈsɪɡnɪtʃəz/ 数字签名 shù zì qiān míng 6.1
使措施与威胁相匹配
- 传输中被拦截 → 加密数据(HTTPS、VPN)。被拦截的密文没有密钥就没用。
- 未授权访问 → 强身份验证(authentication,长密码;带手机码或密钥的双因素认证(two-factor authentication));用户授权(authorisation);登录失败后锁定。
- 恶意软件 → 带实时扫描的杀毒软件和反间谍软件(anti-spyware);打补丁;避免不受信任的下载。
- 网络钓鱼 → 用户培训;邮件过滤;在输入凭据前检查 URL。
- 内部威胁 → 最小权限(least-privilege)原则(只给每个用户他们需要的);审计。
- DDoS → 速率限制和流量过滤。
对于跨越互联网的机密数据,评分标准的方法是加密:数据用密钥编码成密文,这样截获它的未授权者无法读取,只有持有密钥的目标接收方才能解码。对于用邮件发送去测试的程序文件,同样的答案也适用(加密文件,或通过加密的连接发送),再加上文件本身的密码。
词汇表 训练英文 中文 拼音 two-factor authentication/tuː ˈfæktə ɔːˌθentɪˈkeɪʃn/ 双因素认证 shuāng yīn sù rèn zhèng authentication/ɔːˌθentɪˈkeɪʃn/ 身份验证 shēn fèn yàn zhèng anti-spyware/ˈænti ˈspaɪweə/ 反间谍软件 fǎn jiàn dié ruǎn jiàn authorisation/ˌɔːθəraɪˈzeɪʃn/ 授权 shòu quán least-privilege/liːst ˈprɪvɪlɪdʒ/ 最小权限 zuì xiǎo quán xiàn 6.1
保护数据本身

- 加密——用一个密钥把明文(plaintext)变成密文(ciphertext)。对称加密(symmetric encryption,AES)用一个共享密钥;非对称加密(asymmetric encryption,RSA)用一个公钥(public key)和一个私钥(private key)。保护静止和传输中的数据。
- 访问控制(access control)——文件权限(读/写/执行)和访问权限(access rights),由操作系统强制执行。
- 身份验证——身份验证技术核实用户:你知道的东西(密码)、你有的东西(令牌、手机),或你是的东西(生物识别(biometrics)——指纹、面部、虹膜);组合起来最强。
- 备份——保留副本(一些异地),使丢失或损坏可恢复。
- 物理安全——上锁的服务器机房、电缆锁。
数据库中的访问权限,用三分描述:每个用户得到一个带用户名和密码的账户;数据库管理员为每个账户分配对每个表的权限,例如只读、读写或无权访问;用户只能看到允许他们看的表和字段,所以顾客打不开员工表,而办事员能读但不能改价格。DBMS 用它的访问权限和视图来强制执行,还可以把存储的数据加密。
对称用一个共享密钥;非对称用一个公钥加密、一个私钥解密 
一个安全令牌显示一个变化的码用于双因素认证("你有的东西") 
一个指纹读取器检查"你是的东西"——一个人的特征,而不是一个密码 探索Encrypt with a Caesar cipher
Change the shift — that is the key. Each letter slides that many places along the alphabet to make the ciphertext, and the same key slides it back. That shared key is symmetric encryption in miniature.
词汇表 训练英文 中文 拼音 ciphertext/ˈsaɪfətekst/ 密文 mì wén access rights/ˈækses raɪts/ 访问权限 fǎng wèn quán xiàn biometrics/ˌbaɪəʊˈmetrɪks/ 生物识别 shēng wù shí bié private key/ˈpraɪvət kiː/ 私钥 sī yào public key/ˈpʌblɪk kiː/ 公钥 gōng yào plaintext/ˈpleɪntekst/ 明文 míng wén Symmetric encryption/sɪˈmetrɪk enˈkrɪpʃn/ 对称加密 duì chèn jiā mì asymmetric encryption/ˌeɪsɪˈmetrɪk enˈkrɪpʃn/ 非对称加密 fēi duì chèn jiā mì access control/ˈækses kənˈtrəʊl/ 访问控制 fǎng wèn kòng zhì 6.2
数据完整性
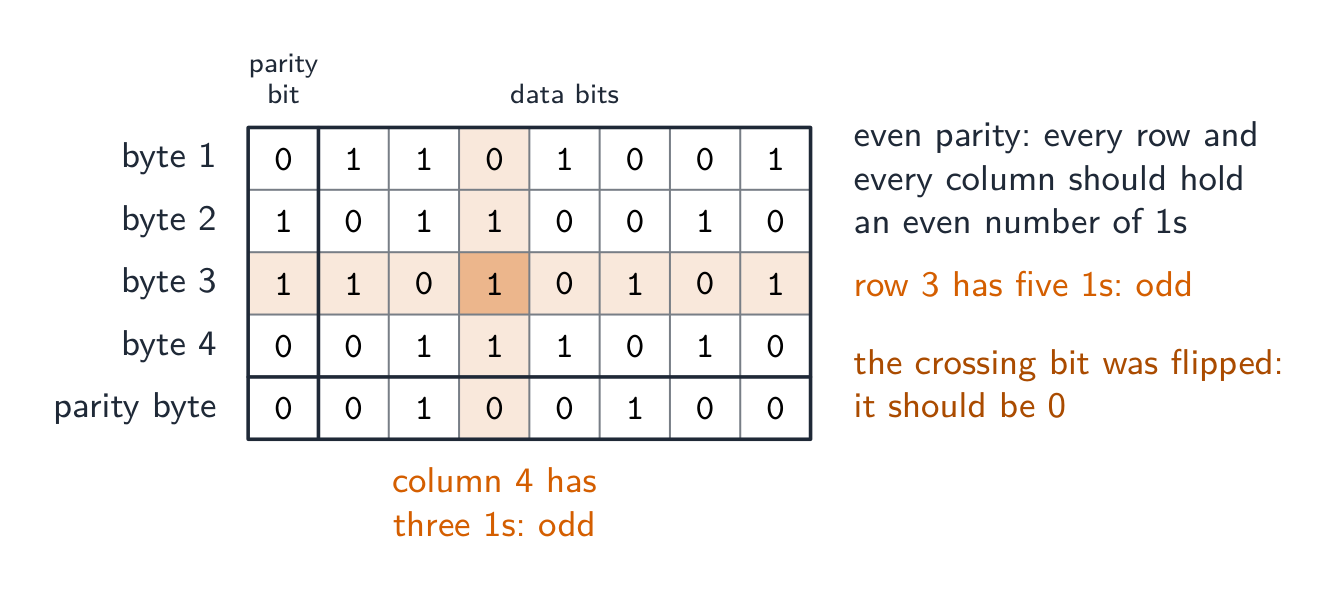
大纲
Candidates should be able to: Notes and guidance Describe how data validation and data verification help protect the integrity of data Describe and use methods of data validation Including range check, format check, length check, presence check, existence check, limit check, check digit Describe and use methods of data verification during data entry and data transfer During data entry including visual check, double entry During data transfer including parity check (byte and block), checksum 来源:剑桥国际大纲
数据在它准确且完整时有完整性。两种技术:数据验证(在存储前抓住坏数据)和数据核对(确认数据被正确地输入或传输)。
验证——数据说得通吗?
验证(validation)自动地对照合理的规则检查数据:
- 范围检查——在限度内(一个月是 1–12)。
- 界限检查——在一个单一界限的正确一侧(例如年龄 ≥ 18)。
- 存在检查——被引用的项存在(例如一个产品代码在表中)。
- 长度检查——正确数目的字符。
- 类型 / 字符检查——正确种类的数据(一个电话字段只允许数字)。
- 格式检查——匹配一个模式(一个电子邮件必须含有
@)。 - 存在性检查——必填字段不为空。
- 校验位(check digit)——从其他位算出的一个额外数位(ISBN、卡号),它发现誊写错误。
例题。 在一种简单的校验位方案中,校验位是各位数字之和除以 $10$ 的余数,附加在数的末尾。数 $4162$ 的数字和是 $13$,所以存为 $41623$。用户输入 $14623$:前两位被调换了,但和仍是 $13$,校验位仍然匹配,错误没有被抓住。输入 $41523$ 的用户会被抓住,因为 $4 + 1 + 5 + 2 = 12$ 给出校验位 $2$。能抓住调换数字的方案给每个位置不同的权重,如 ISBN-13 的校验(权重 $1, 3, 1, 3, \ldots$,然后取使总和为 $10$ 的倍数的那个数字)。校验位属于验证:它在输入的那一刻对照规则检验这个数。
- 查找检查和一致性检查(例如交货日期 ≥ 订购日期)。
验证抓住格式错误的数据,但抓不住格式正确却事实上错误的数据("Bob" 写成 "Bib")。
例题。 指出每段伪代码执行的是哪种验证检查。
伪代码 检查 IF x < 0 OR x > 10 THEN OUTPUT "Invalid"范围检查:值必须在两个界限之间 IF x = "" THEN OUTPUT "Invalid"存在性检查:字段不能为空 IF NOT(x = "Red" OR x = "Yellow" OR x = "Blue") THEN OUTPUT "Invalid"查找(存在)检查:值必须是列表之一 IF LENGTH(x) <> 6 THEN OUTPUT "Invalid"长度检查:字符数目正确 IF MID(x, 1, 1) < "A" OR MID(x, 1, 1) > "Z" THEN OUTPUT "Invalid"格式检查:某个位置的字符必须是字母 要验证一个必须是一个字母、三个数字、两个字母的车牌号:格式检查逐个位置对照模式检验,长度检查确认六个字符。要验证出生日期:格式检查(
DD/MM/YYYY)、范围检查(月份在 $1$ 到 $12$,年份不在未来)和存在性检查(没有留空)。介于 $0$ 和该测验满分之间的分数需要类型检查(整数)和范围检查,上限从该测验自己的记录中读取:验证就是这样保护完整性的,它拒绝不可能正确的数据。核对——数据被正确地输入或传输了吗?
核对(verification)检查数据在从一个地方移到另一个地方时没有被改变。
在输入时:双重输入(输入两次并比较,如同一个新密码)或目视检查。
按评分标准的措辞,双重输入是由同一个人或两个人把数据输入两次,由计算机比较两个版本并报告任何差异;目视检查是由人把屏幕上的内容与原始源文件比较,在保存前改正任何差异。两者都通过确保存储的数据与来源一致来保护完整性。即使经过验证和核对,数据仍可能是错的:它可能既合理又与来源一致,但来源本身就错了,或者用户输入了一个与本意不同但有效的值。
在传输时(位可能翻转):
- 奇偶校验(parity check)——一个额外的位使 1 的数目为偶(偶校验)或奇。接收方重新计数。抓住单位错误。
- 校验和(checksum)——发送方发送数据的一个摘要值;接收方重新计算它并比较。
- 循环冗余校验(cyclic redundancy check,CRC)——一个用多项式除法的更强的校验和,抓住多得多的错误类型。
一个奇偶块校验(parity block check)更进一步,还能定位错误。把字节排成一个网格:给每个字节一个行奇偶位,然后计算一个额外的奇偶字节,它的各位是上方字节的列奇偶。一个翻转的单一位现在会使一行和一列都不通过——它们的交叉点精确指出哪一位改变了,所以它甚至能被纠正。
例题。 四个字节以偶校验发送,后面跟着一个校验字节。找出被破坏的位。
奇偶块校验:出错的行与出错的列交叉在被翻转的位上 数每一行和每一列的 1。每行每列都应是偶数个;字节 3 有五个,第 4 列有三个。该行与该列交叉处的位就是变化的那一位,所以把它从 1 改回 0。单独的奇偶校验能发现一个字节有错但说不出是哪一位;同一字节中的两个错误互相抵消而不被发现。校验和,用三分解释:发送方把数据块通过一个算法得到校验和的值;数据和校验和一起发送;接收方对收到的数据运行同一个算法;两个校验和相同就接受数据,不同就拒绝并重发。

校验位被设置以使 1 的数目为偶或奇 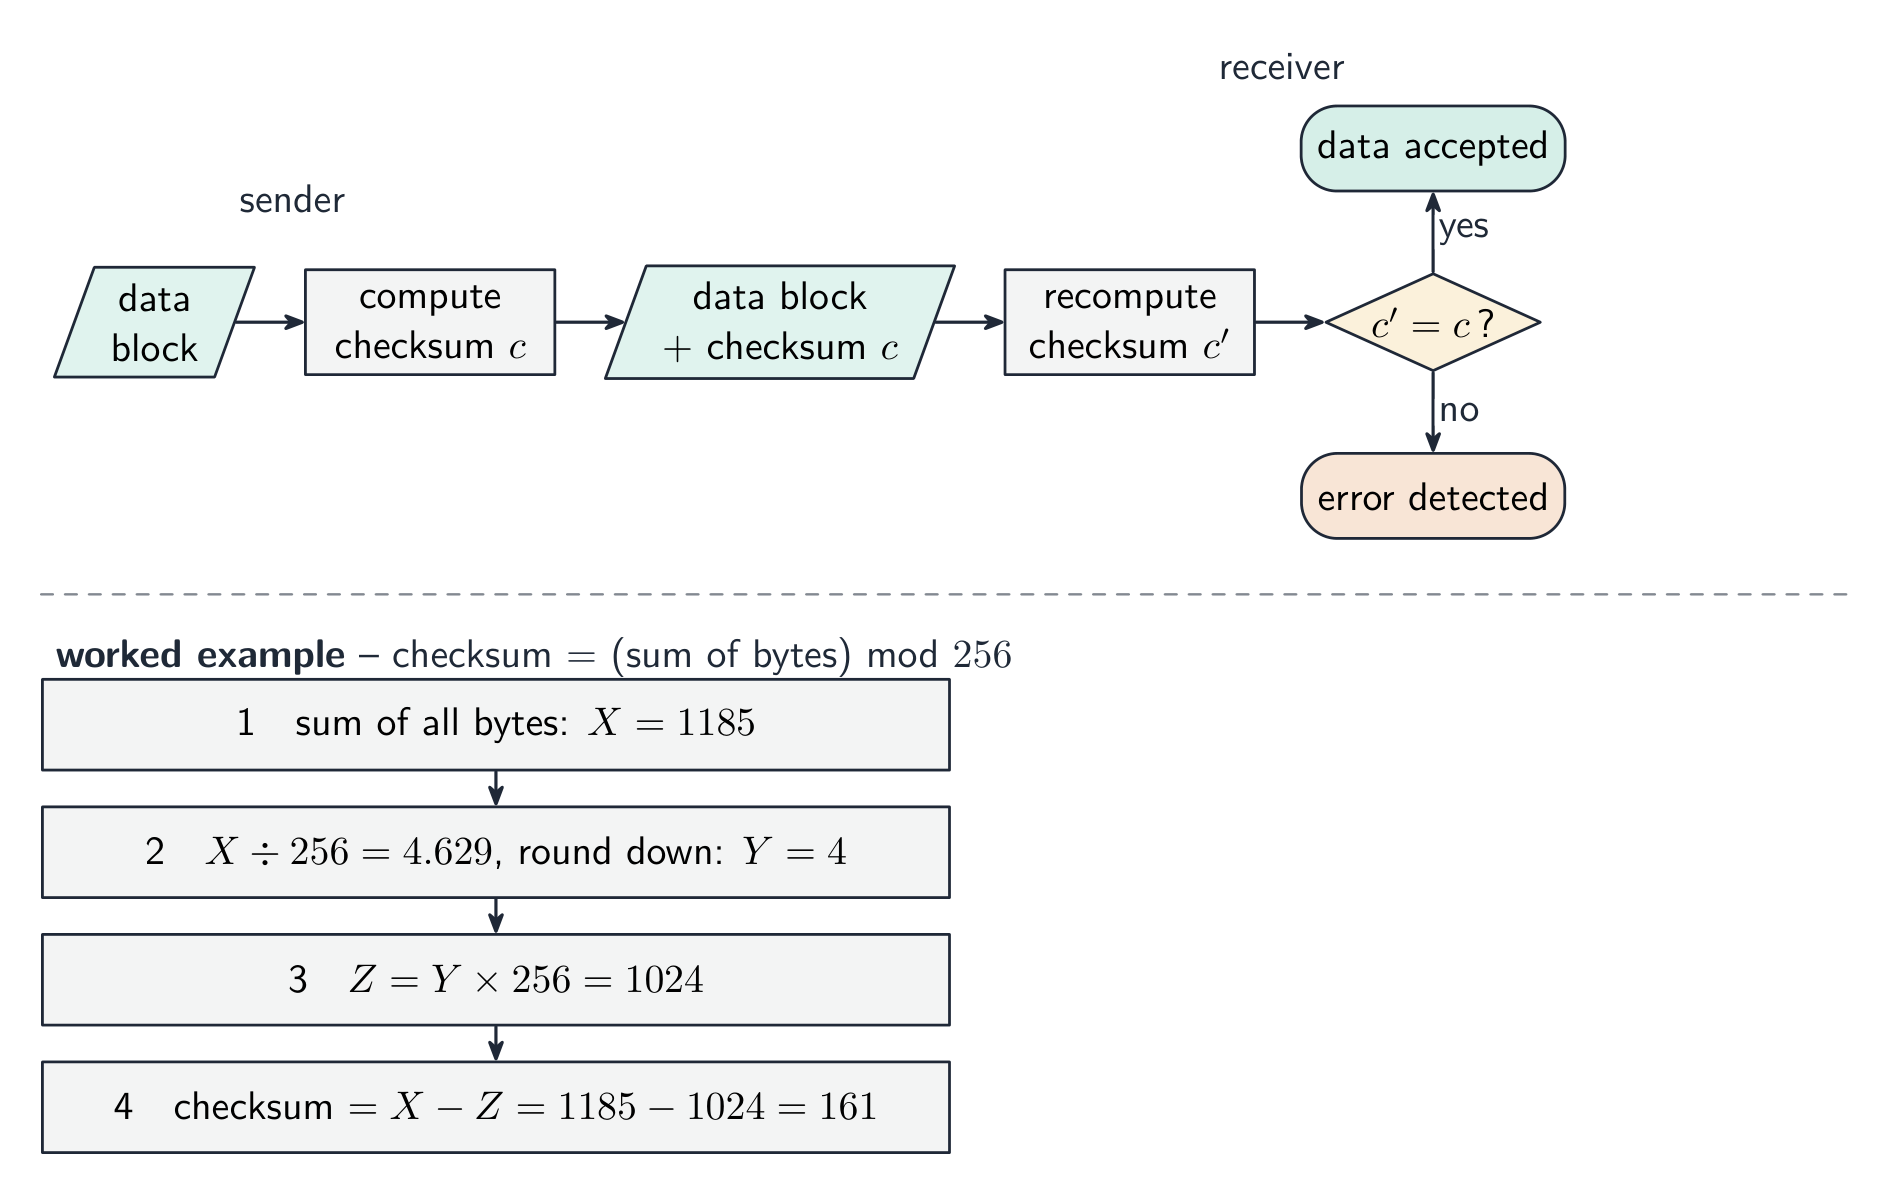
为一个数据块算出一个校验和 核对只证明到达的与发送的相符——不证明数据是正确的,也不能抵御蓄意篡改。验证问"这说得通吗?";核对问"这被正确地复制了吗?"——两者都用。
表格题按使用时机给方法分类:数据输入时,双重输入和目视检查;数据传输时,奇偶校验(字节或块)和校验和。把视频文件从摄像机传到服务器用校验和:摄像机算出它,服务器重新计算,不一致就重传。

验证检查数据说得通;核对检查它被无变化地复制 例题。 一位用户把出生日期输成
31/02/2009,并把电子邮箱地址输入了两遍。哪种检查能抓到哪个错误?两者的区别是什么?验证(合法性检查)问的是"这个数据合理吗?" - 计算机按某条规则去检验它,格式检查或范围检查会拒绝31/02/2009,因为二月从来没有 31 号。核验问的是"这个数据输入正确吗?" - 把邮箱输两遍就是双重输入,比较两份副本就能抓到打字失误。正是它们的局限使这成为常考题:验证永远无法告诉你数据是正确的,只能说明它是可能的 - 即使用户其实生于另一天,01/02/2009也能通过所有验证规则。要说清每种检查能抓什么、不能抓什么。探索Computing concept lab
Classify concrete examples by the computing idea they demonstrate.
词汇表 训练英文 中文 拼音 validation/ˌvælɪˈdeɪʃn/ 验证 yàn zhèng verification/ˌverɪfɪˈkeɪʃn/ 核对 hé duì check digit/tʃek ˈdɪdʒɪt/ 校验位 jiào yàn wèi parity check/ˈpærɪti tʃek/ 奇偶校验 jī ǒu jiào yàn checksum/ˈtʃeksəm/ 校验和 jiào yàn hé cyclic redundancy check/ˈsaɪklɪk rɪˈdʌndənsi tʃek/ 循环冗余校验 xún huán rǒng yú jiào yàn parity block check/ˈpærɪti blɒk tʃek/ 奇偶块校验 jī ǒu kuài jiào yàn 6.2
考官认可的定义
定义题按固定的表述给分。把这些记准确。
术语 定义 数据安全(data security) 保护数据不丢失、不被未授权访问、更改或删除 数据隐私(data privacy) 保持数据机密,只有有权看的人才能看到 数据完整性(data integrity) 数据准确、一致、完整 恶意软件(malware) 在用户不知情时安装、用来损坏系统或窃取数据的恶意软件 病毒(virus) 自我复制、附着到其他文件并破坏或删除数据的恶意软件 间谍软件(spyware) 记录用户的按键或操作并发送给第三方的恶意软件 网络钓鱼(phishing) 假装来自合法机构、把用户引到假网站以收集个人数据的邮件 域名欺骗(pharming) 即使输入了正确的地址也把用户重定向到假网站的恶意代码 防火墙(firewall) 对照设定准则检查进出系统的所有流量、拦截不符合者的硬件或软件 加密(encryption) 用密钥把数据打乱成密文,没有解密密钥就无法理解 数字签名(digital signature) 用发送方私钥加密的消息哈希,用来证明发送者身份和消息未被更改 数据验证(data validation) 自动检查输入的数据是否合理并符合设定的规则 数据核对(data verification) 通过与来源或重新计算的值比较,检查数据是否被正确输入或传输 校验位(check digit) 由一个数的其他数字算出并附加在其后的额外数位,用来发现该数中的错误 奇偶校验(parity check) 加在一个字节上使 1 的个数为偶(或奇)的额外一位,由接收方重新计数 校验和(checksum) 由算法从数据块算出并随数据发送的值,由接收方重新计算并比较 6.2
考试技巧
- 把这三个概念分开:安全(保持数据安全)、隐私(谁可以看它)、完整性(保持它正确)。
- 把每种威胁(恶意软件、黑客入侵、网络钓鱼、拦截)与一种措施(防火墙、加密、身份验证、访问权限)匹配。
- 加密保护机密性,而不是完整性——用一个校验和、奇偶校验或校验位来保护完整性。
- 区分一个病毒、蠕虫和木马以及每个如何传播。
常见错误
- 给两种威胁同一种措施,或者给出与威胁不匹配的措施。表格中每种威胁都需要一种真正能挡住它的、不同的预防方法。
- 只写措施的名字而不说它如何起作用。"防火墙"要跟上"把流量与设定准则比较并拦截不符合者"才得分。
- 把验证说成检查数据是否正确。验证检查数据是否合理;核对检查它是否与来源一致。两者都不能证明它是真的。
- 说数字签名给消息加密。它用私钥加密的是消息的哈希;接收方用公钥解密并比较哈希。
- 把校验位说成核对,或把奇偶校验说成验证。校验位是输入时的验证规则;奇偶校验和校验和是对传输的核对。
- 写病毒"把数据发给第三方"、间谍软件"自我复制"。自我复制的是病毒;记录的是间谍软件。
-
7
伦理与所有权
7.1
伦理与所有权

大纲
Candidates should be able to: Notes and guidance Show understanding of the need for and purpose of ethics as a computing professional Understand the importance of joining a professional ethical body including BCS (British Computer Society), IEEE (Institute of Electrical and Electronic Engineers) Show understanding of the need to act ethically and the impact of acting ethically or unethically for a given situation Show understanding of the need for copyright legislation Show understanding of the different types of software licencing and justify the use of a licence for a given situation Licences to include free Software Foundation, the Open Source Initiative, shareware and commercial software Show understanding of Artificial Intelligence (AI) Understand the impact of AI including social, economic and environmental issues Understand the applications of AI 来源:剑桥国际大纲
一个计算专业人员是这样的人:他的工作——软件、系统、网络、数据——影响其他人。因为工作是技术性的,其他人往往无法判断它是否做得好或做得诚实。所以这个职业遵循共享的伦理(ethics,良好行为的原则)。
为什么伦理重要
- 信任——用户和雇主信任专业人员会为他们的利益行事。没有那种信任,软件就失去可信度。
- 影响——软件运行医疗设备、银行、车辆。粗心或不诚实的工作会伤害人。
专业团体(BCS、ACM、IEEE)为其成员发布伦理准则。
闭路电视引发隐私顾虑——一个计算专业人员必须权衡的伦理问题之一 
被丢弃的电子设备(电子垃圾)是计算日益增长的环境代价 
软件开发以几种方式影响公众的福祉 典型的原则
- 公众利益优先——保护受影响者的安全和福利。
- 诚实和胜任——对你的技能诚实;不要声称你缺乏的专长。
- 保密性(confidentiality)——保护客户和雇主的私密信息。
- 避免利益冲突(conflicts of interest)——不要接受你的利益与客户的相冲突的工作。
- 保持你的技能与时俱进;尊重知识产权(intellectual property)和隐私(privacy);公平地对待同事。
加入专业团体
教学大纲点名了两个:BCS(英国计算机学会)和 IEEE(电气与电子工程师学会)。两者都发布成员同意遵守的行为准则(code of conduct)。按评分标准措辞的加入好处:有一套可遵循的伦理指南,决定不再只凭个人判断;培训、会议和出版物使成员与时俱进;出现问题时的建议和支持,包括法律帮助;以及公认的专业身份,使雇主和客户信任该成员的工作。不加入的后果:没有伦理决定上的指导,所以程序员可能不知不觉地做出不合伦理的行为;在雇主和客户那里可信度较低,所以更难获得工作;发生争议时没有支持;以及跟不上发展和法律的更新。行为准则的目的(两分):创造一个安全、互相尊重、专业的工作环境,并确保每个员工都明白对他们的期望以及他们行为的后果。
例题。 解释程序员为什么需要对同事和公众合乎伦理地行事。
对同事:公平对待他们,不歧视;尊重他们的工作、想法和保密信息;对错误诚实,该归功于谁就归功于谁;支持而不是打压他们的发展。对公众:保护他们的个人数据和隐私;做出安全、可靠、经过充分测试的软件,因为缺陷会造成伤害;对软件能做什么实话实说;只承接自己能力范围内的工作;遵守法律并考虑对社会和环境的更广泛影响。每一边靠"理由加后果"得分,而不是单靠"公平"一个词。
合乎伦理地行事对不合伦理地行事
合乎伦理地行事保护用户、加强声誉、减少法律风险,并建立信任。不合伦理地行事(跳过测试、隐藏漏洞、滥用数据)会伤害真实用户、导致解雇或法律诉讼、损害声誉,并总体上侵蚀对技术的信任。
当你面对一个模棱两可的决定时:辨认谁的利益受影响、查阅伦理准则和法律、权衡后果、请教一位受信任的前辈,并选择把用户置于短期便利之上的选项。
例题。 你团队的新 AI 招聘工具把简历分类快十倍,但你注意到它拒绝了更多较年长的申请人。发布它会取悦你的经理,但它不公平地对待一个群体。合乎伦理的选择是把它扣住直到偏见被修正——公众利益和公平先于短期便利。
伦理也适用于用户。一个把个人电脑接入学校网络的学生应当尊重他人的隐私和数据,不当地使用社交媒体或欺凌他人是不行的,不下载或分享受版权保护的材料,不引入恶意软件或试图访问无权访问的系统,并且只为提供网络的目的使用它。"给出三个伦理考虑"的答案列出其中三条。
探索Risk and responsibility lab
Sort examples by the rule, risk or protection involved.
词汇表 训练英文 中文 拼音 ethics/ˈeθɪks/ 伦理 lún lǐ privacy/ˈprɪvəsi/ 隐私 yǐn sī confidentiality/ˌkɒnfɪˌdenʃiˈæləti/ 保密性 bǎo mì xìng conflicts of interest/ˈkɒnflɪkts ɒv ˈɪntrest/ 利益冲突 lì yì chōng tū intellectual property/ˌɪntəˈlektʃuːəl ˈprɒpəti/ 知识产权 zhī shí chǎn quán code of conduct/kəʊd ɒv ˈkɒndʌkt/ 行为准则 xíng wéi zhǔn zé 7.1
版权

版权(copyright)是一个原创作品的创作者控制它如何被复制、分发、修改和表演的法律权利。它自动适用(无需注册)于源代码、软件、文档、图像、音频和视频。
没有版权,任何人都可以自由复制软件,开发者就得不到报酬,而剽窃就是合法的。有了版权,开发者能从他们的工作中挣钱(鼓励更多的软件),用户知道谁制作了它,而再利用通过许可以开发者的条件发生。版权持续很长时间(常常是创作者死后 70 年)。一般的想法和算法不受版权覆盖,但可能受一个专利(patent)覆盖。
按评分标准的措辞,程序员为什么应该给程序申明版权:为了被认定为所有者和作者(所有权得到正式承认);这样如果有人复制或窃取它就会有法律后果;限制竞争者出售同样的作品;以及能够通过授权许可赚钱。版权适用于写成的程序本身;做同样工作的另一个程序并不侵犯它。
版权是自动的且长久的;一个专利必须申请,持续约 20 年 探索Risk and responsibility lab
Sort examples by the rule, risk or protection involved.
词汇表 训练英文 中文 拼音 copyright/ˈkɒpɪraɪt/ 版权 bǎn quán patent/ˈpeɪtənt/ 专利 zhuān lì 7.1
软件许可

一个软件许可证(software licence)是一个以所有者的条件授予使用软件许可的合同;选择并应用一个叫作软件许可。
商业(专有)
- 商业软件被出售:你购买一个许可证;软件只在它的条件内使用。
- 不给出源代码(一个专有(proprietary)产品);你不能修改或再分发它。
- 例子:Microsoft Office、Adobe Photoshop、大多数游戏。
在开发者想要每个用户的收入并保持对代码的控制时使用。
开源
- 源代码是公开的;用户可以读、修改和再分发它(开源(open-source))。
- 宽松(permissive)许可证(MIT、BSD)允许几乎任何使用;著佐权(copyleft)许可证(GPL)要求修改后的版本以相同的许可证发布("相同方式共享")。
- 自由软件基金会(FSF)和开源促进会(OSI)推动并批准开源许可证。
教学大纲两个都点了名,而且它们被当作不同的答案来评分。自由软件(FSF 的用语)的"自由"指的是自由而不是价格:用户可以为任何目的运行程序、研究并修改它(所以源代码必须可得)、再分发副本,以及分发修改后的版本;一份副本仍然可以收费。开源(OSI 的定义)要求源代码可得、程序可以被修改和再分发,并且许可证不歧视任何人或任何用途。"指出两种允许其他人编辑和再分发程序的许可证类型"就用这两个来回答。
- 例子:Linux、Python、Apache。
在开发者想要软件被广泛使用并由社区改进时使用。
免费软件和共享软件
- 免费软件(freeware)——免费,没有源代码,可以再分发但不能修改(Acrobat Reader、WhatsApp)。
- 共享软件(shareware)——试用期免费,然后你付费才能继续使用;没有源代码。
评分标准的描述:共享软件免费分发供试用(限时或限功能),用户付费后继续使用完整版;商业软件收费出售,不提供源代码,许可证保护开发者的知识产权,而且费用通常包含支持和更新。共享软件对程序员的好处:用户可以先试后买,所以更可能购买;它几乎不花广告费就能广泛传播;留下来用的人会付费。商业许可证的好处:开发者每份副本都能收费;代码及其权利受到保护;收入用于支持、更新和进一步开发。
类型 成本 源代码 再分发 修改 商业 付费 否 否 否 开源 免费 是 是 常常可以,带条件 免费软件 免费 否 是 否 共享软件 免费试用,然后付费 否 有时 否 从开发者的目标选择一个许可证 要论证一个许可证选择,把它与开发者的目标(收入、覆盖面、社区)、用户的需求(成本、定制)和用例联系起来。
例题。 一位程序员写了一个要向公众出售的游戏。指出最合适的许可证并加以论证。
商业许可证:游戏收费出售,所以程序员从每份副本赚钱;不发布源代码,所以没人能复制这个游戏,或者改动后当作自己的出售;许可证保护知识产权;买家得到更新和支持。开源不合适,因为源代码会公开,游戏可能被复制、修改和再分发而不付费。
例题。 一个程序通过朗读商品标签来帮助购物者。解释为什么开源许可证可能不合适。
源代码会公开,所以它可能被改动;改动后的版本可能输出错误的商品信息,购物者就可能买错东西;而且程序员会失去对以该程序名义分发的版本的质量和安全的控制。反过来,程序以开源方式发布,是为了让其他开发者改进和扩展它、让它免费地被广泛采用,以及让用户按自己的需要调整它。
词汇表 训练英文 中文 拼音 software licence/ˈsɒftweə ˈlaɪsəns/ 软件许可证 ruǎn jiàn xǔ kě zhèng proprietary/prəˈpraɪətəri/ 专有 zhuān yǒu open-source/ˈəʊpən sɔːs/ 开源 kāi yuán copyleft/ˈkɒpɪleft/ 著佐权 zhù zuǒ quán freeware/ˈfriːweə/ 免费软件 miǎn fèi ruǎn jiàn shareware/ˈʃeəweə/ 共享软件 gòng xiǎng ruǎn jiàn 7.1
人工智能(AI)

人工智能(artificial intelligence)构建做过去认为需要人类智能的任务的系统——识别语音和图像、翻译、玩游戏、驾驶。
大多数现代 AI 用机器学习(machine learning)——通过从大量数据中学习模式而在一个任务上进步的算法,而不是被一步一步地编程。用有许多层的神经网络(neural networks)的深度学习(deep learning)是今天领先的方法。
日常例子
AI 任务分成两种——理解输入,和产生输出或决策。
理解输入:
- 语音识别(speech recognition)——口语词到文本(语音助手)。
- 图像识别(image recognition)——在图像中找出物体、面部或文本。
产生输出或决策:
- 机器翻译(machine translation)——语言之间的自动翻译。
- 推荐系统(recommendation systems)——建议产品、视频或音乐。
- 自动驾驶汽车(autonomous vehicles)和机器人。
一个常见的考试场景:一个程序用一个摄像头读一个标签、翻译它,并大声读它——用光学字符识别(optical character recognition)找出词、用机器翻译转换它们,用文本转语音(text-to-speech)转成音频。
一个常见的场景:OCR → 机器翻译 → 文本转语音大声读一个外语标签 四分的"解释 AI 如何被使用"要按流水线一步步答:图像识别(OCR)分析照片的像素以定位字符;像素的图案被转换成一个个字符和单词;机器翻译把单词转换成用户的语言;文本转语音产生语音输出。每一步一分。
好处
- 无障碍——语音/图像 AI 帮助有障碍的用户;翻译帮助非母语者。
- 生产力——自动化重复任务使人腾出手来做创造性工作。
- 决策支持——AI 在巨大的数据集中发现模式(医学诊断、欺诈检测)。
- 始终可用,并为每个用户个性化。
影响:社会、经济、环境
教学大纲要求从三个方面说 AI 的影响,题目会点明其中一个。要给出影响和它的后果。
- 社会:好处——读标签的程序帮助视力受损的人、看不懂这门语言的人和有阅读困难的人;机场的人脸识别加快身份核查,并能拦下通缉的人。坏处——人脸识别可能认错人,而且未经同意就追踪每一个人,隐私因此丧失;用 AI 做作业的学生可能发展不出推理和解决问题的能力,可能依赖它而不是学习,并且可能失去一起做事带来的协作和面对面交流。
- 经济:修理厂里的 AI 故障诊断模块诊断更快更准,所以每天修好的车更多、成本下降;但可能需要的熟练技工更少,岗位因此流失,而且模块要花钱购买和维护。更一般地说,AI 提高生产率,在一些领域创造新岗位,同时在另一些领域取代常规岗位。
- 环境:训练和运行大模型在数据中心消耗大量电力和冷却用水,硬件变成电子垃圾;另一方面,AI 被用来减少建筑能耗、优化交通和监测环境。
- 伦理(课堂那道题):批改作业或监看学生的 AI 必须对每个学生公平,不能泄露他们的数据,在对他们做出决定时必须可解释,并且不能在要紧的地方取代教师的判断。
顾虑
- 偏见(bias)——训练数据中不公平的模式变成不公平的 AI 决策(招聘、放贷)。
- 岗位替代——AI 可能取代一些角色。
- 隐私——训练常常使用大量个人数据。
- 透明度——大模型是"黑盒",难以解释。
- 问责——当 AI 出错时,谁负责:开发者、用户,还是运营者?
- 滥用——深度伪造、错误信息、监视。

偏见如何进入 AI:有偏见的数据 → 一个有偏见的模型 → 不公平的决策 专业人员必须理解他们所构建的 AI 的局限、告知用户,并减少伤害。
探索Computing concept lab
Classify concrete examples by the computing idea they demonstrate.
词汇表 训练英文 中文 拼音 bias/ˈbaɪəs/ 偏见 piān jiàn artificial intelligence/ˌɑːtɪˈfɪʃl ɪnˈtelɪdʒəns/ 人工智能 rén gōng zhì néng machine learning/məˈʃiːn ˈlɜːnɪŋ/ 机器学习 jī qì xué xí Deep learning/diːp ˈlɜːnɪŋ/ 深度学习 shēn dù xué xí neural networks/ˈnjuːrəl ˈnetwɜːks/ 神经网络 shén jīng wǎng luò speech recognition/spiːtʃ ˌrekəɡˈnɪʃn/ 语音识别 yǔ yīn shí bié image recognition/ˈɪmɪdʒ ˌrekəɡˈnɪʃn/ 图像识别 tú xiàng shí bié machine translation/məˈʃiːn trænˈsleɪʃn/ 机器翻译 jī qì fān yì recommendation systems/ˌrekəmenˈdeɪʃn ˈsɪstəmz/ 推荐系统 tuī jiàn xì tǒng autonomous vehicles/ɔːˈtɒnəməs ˈvɪəklz/ 自动驾驶汽车 zì dòng jià shǐ qì chē optical character recognition/ˈɒptɪkl ˈkærɪktə ˌrekəɡˈnɪʃn/ 光学字符识别 guāng xué zì fú shí bié text-to-speech/tekst tə spiːtʃ/ 文本转语音 wén běn zhuǎn yǔ yīn 7.1
考官认可的定义
定义题按固定的表述给分。把这些记准确。
术语 定义 伦理(ethics) 支配一个人行为的道德原则;在一个职业中,就是其行为准则规定的标准 行为准则(code of conduct) 一个组织或专业团体为其成员的行为方式制定的规则 版权(copyright) 原创作品的创作者控制作品如何被复制、分发和修改的法律权利 软件许可证(software licence) 规定一个软件可以如何被使用、复制和分发的法律协议 商业软件(commercial software) 收费出售、不带源代码、在保护开发者知识产权的许可证下发布的软件 自由软件(free software,FSF) 用户可以自由运行、研究、修改和再分发的软件,因此其源代码可得 开源(open source,OSI) 源代码可得、并可在其许可证下修改和再分发的软件 共享软件(shareware) 免费分发供限时试用或功能受限试用、之后用户付费继续使用的软件 免费软件(freeware) 免费使用和复制、但不发布源代码且不得修改的软件 人工智能(artificial intelligence) 执行通常需要人类智能的任务(如识别图像和语音)的计算机系统 机器学习(machine learning) 系统通过从数据中学习模式、而不是通过明确编程来提高任务表现的一种 AI 7.1
考试技巧
- 对照一个职业行为准则(公众利益、胜任、诚实)而非个人观点来回答伦理问题。
- 区分版权(保护表达)和一个专利(保护一个发明)。
- 比较软件许可证:专有、开源、免费软件、共享软件和 FOSS。
常见错误
- 给出个人观点("这是错的"),而不是带后果的理由("有缺陷的软件会伤害用户,所以必须测试")。
- 把自由软件和免费软件当作同一回事。自由软件讲的是研究和修改代码的自由;免费软件只是不收费。
- 说开源就是免费。开源指源代码可得并可修改和再分发;仍然可以收费。
- 写版权必须注册。它自动适用于写成的作品。
- 只说影响不说后果。"岗位流失"要与原因挂钩才得分:AI 做了诊断,所以需要的技工更少。
- 描述 AI 是什么而不是它如何被使用。分数在步骤上:识别、转换、翻译、朗读。
-
8
数据库
8.1
数据库概念

大纲
Candidates should be able to: Notes and guidance Show understanding of the limitations of using a file-based approach for the storage and retrieval of data Describe the features of a relational database that address the limitations of a file-based approach Show understanding of and use the terminology associated with a relational database model Including entity, table, record, field, tuple, attribute, primary key, candidate key, secondary key, foreign key, relationship (one-to-many, one-to-one, many-to-many), referential integrity, indexing Use an entity-relationship (E-R) diagram to document a database design Show understanding of the normalisation process First Normal Form (1NF), Second Normal Form (2NF) and Third Normal Form (3NF) Explain why a given set of database tables are, or are not, in 3NF Produce a normalised database design for a description of a database, a given set of data, or a given set of tables 来源:剑桥国际大纲
在数据库之前,程序把数据存储在平面文件(flat files)中——通常每个程序一个文件。这对小数据没问题,但在规模上会崩溃。
基于文件的存储把数据保存在分开的文件中,像文件柜里的纸——难以搜索且容易重复 局限
- 数据冗余(data redundancy)——相同的数据(一个客户的地址)保存在几个文件中,每个程序一个,既浪费存储,每个副本又都要更新。
- 数据不一致(data inconsistency)——一个副本更新了而另一个没有,文件之间互相矛盾,没人知道哪个是对的。
- 数据依赖(data dependence)——每个程序都是针对其文件的确切布局写的;改一个字段的长度或加一个字段,每个读该文件的程序都要重写。
- 无法共享访问——一个程序使用文件时文件被锁定,用户不能同时处理数据。
- 完整性(integrity)薄弱——没有集中规则阻止无效值或指向不存在客户的链接;安全薄弱——访问按文件而不是按字段控制;跨文件的查询每次都要一个新程序。

基于文件的方法:每个程序保存它自己的文件 一个关系数据库(relational database)通过把数据存储在由一个所有程序都使用的软件(DBMS)管理的表中来修复这些。

数据库方法:一个 DBMS 为所有程序服务 为什么关系数据库更好——三分答案。 每项数据只在一个表中存储一次,表之间用键连接,所以没有冗余、没有不一致;数据与程序独立,程序向 DBMS 索取需要的数据,结构改变时不受影响;DBMS 集中执行完整性规则,按用户和按字段控制访问,允许多用户同时使用,并且无需编写新程序就能回答任何查询。
例题。 一家维修店用基于文件的方法存储顾客、设备和维修工作,每个程序一个文件。给出这造成的三个问题,并描述关系数据库如何消除它们。
顾客的姓名和电话既存在维修文件里又存在发票文件里(冗余);顾客换号码时,一个文件更新了而另一个没有(不一致);店里想要一份新报表——每位技师的维修数——就得写一个新程序去读文件(无法即席查询)。在关系数据库中,顾客只在 CUSTOMER 表中存储一次,REPAIR 表用 CustomerID 引用它,所以改动只做一次、处处可见;报表只是一条 SQL 查询。
词汇表 训练英文 中文 拼音 flat files/flæt faɪlz/ 平面文件 píng miàn wén jiàn data redundancy/ˈdeɪtə rɪˈdʌndənsi/ 数据冗余 shù jù rǒng yú data inconsistency/ˈdeɪtə ˌɪnkənˈsɪstənsi/ 数据不一致 shù jù bù yī zhì integrity/ɪnˈteɡrɪti/ 完整性 wán zhěng xìng relational database/rɪˈleɪʃənl ˈdeɪtəbeɪs/ 关系数据库 guān xì shù jù kù DBMS/ˌdiː biː em ˈes/ 数据库管理系统 shù jù kù guǎn lǐ xì tǒng SQL/ˌes kjuː ˈel/ 结构化查询语言 jié gòu huà chá xún yǔ yán 8.1
关系模型 —— 术语
- 表(table,关系)——行和列的一个网格;每种实体(entity)一个表(例如
CUSTOMER)。 - 记录(record,行,也叫元组(tuple))——一行;实体的一个实例。
- 字段(field,列,也叫属性(attribute))——一列;关于每条记录的一条信息。
- 主键(primary key)——唯一标识每条记录的一个字段(或多个字段);从不为空或重复。
- 外键(foreign key)——一个值匹配另一个表主键的字段,把两者链接起来。
- 复合键(composite key)——由两个或更多字段一起构成的一个主键。
- 候选键(candidate key)——任何可以是主键的字段。
- 次键(secondary key)——一个为快速搜索而建立索引的非主字段。
- 索引(indexing)——在一个字段上建立一个索引,使查找和连接运行得更快。
- 参照完整性(referential integrity)——每个外键值必须匹配一个现有的主键(没有孤立记录)。
一个表用简写书写,主键加下划线、外键标注:
CUSTOMER(CustomerID, Name, Phone)
ORDER(OrderID, CustomerID, OrderDate)   -- CustomerID is FK → CUSTOMER
一个外键链接两个表:ORDER.CustomerID 匹配主键 CUSTOMER.CustomerID 例题。 说明关系数据库模型中实体、主键和参照完整性的含义,并补全元组和属性的术语 ↔ 描述表。
实体是被存储数据的对象——一个人、物体或事件——它成为一个表。主键是唯一标识表中每条记录的属性(或属性组合)。参照完整性指每个外键值必须匹配它所引用的表中某个主键的值,这样一条记录就不能引用一条不存在的记录。元组是表的一行(一条记录);属性是一列(一个字段)。记住这些配对:表/关系,记录/元组,字段/属性。
探索Read a relational table with SELECT
A relational table is just rows (records) and columns (fields). WHERE keeps the rows that match a condition; SELECT then keeps only the columns you asked for.
词汇表 训练英文 中文 拼音 field/fiːld/ 字段 zì duàn table/ˈteɪbl/ 表 biǎo entity/ˈentɪti/ 实体 shí tǐ record/ˈrekɔːd/ 记录 jì lù tuple/ˈtuːpl/ 元组 yuán zǔ attribute/ˈætrɪbjuːt/ 属性 shǔ xìng primary key/ˈpraɪməri kiː/ 主键 zhǔ jiàn foreign key/ˈfɒrən kiː/ 外键 wài jiàn composite key/ˈkɒmpəzɪt kiː/ 复合键 fù hé jiàn candidate key/ˈkændɪdeɪt kiː/ 候选键 hòu xuǎn jiàn secondary key/ˈsekəndəri kiː/ 次键 cì jiàn indexing/ˈɪndeksɪŋ/ 索引 suǒ yǐn referential integrity/ˌrefəˈrenʃl ɪnˈteɡrɪti/ 参照完整性 cān zhào wán zhěng xìng 8.1
实体-关系(E-R)图

一个实体关系图(entity-relationship diagram)显示结构:每个实体是一个矩形,每个关系是一条线,在每端标注基数(cardinality):
- 一对一(1:1)。
- 一对多(one-to-many,1:M)——每个客户有许多订单;每个订单有一个客户。
- 多对多(many-to-many,M:N)——学生选许多课程,而课程有许多学生。
一个 E-R 图:一个班有许多学生 
一个关系基数的鸦爪符号 一个多对多关系不能直接存储。把它拆成两个一对多关系,通过一个容纳两个外键的连接表(link table):
ENROLMENT(StudentID, CourseID, EnrolmentDate)
一个连接表把一个多对多关系解决为两个一对多关系 为给定的一组表画 E-R 图。 每个表成为一个实体。凡是一个表持有指向另一个表的外键,就存在一个关系;它从持有外键的表(多的一端)连到以该键为主键的表(一的一端)。一个有两个外键、没有其他身份的表通常是解决多对多关系的连接表。给每条线标上关系类型。
从表画图:每个外键就是一个一对多关系,"多"在持有它的表那一端 例题。 一家维修店有表
CUSTOMER(CustomerID, Name, Phone)、DEVICE(DeviceID, CustomerID, Type, Model)、TECHNICIAN(TechnicianID, Name)和REPAIR(RepairID, DeviceID, TechnicianID, RepairDate, Cost)。指出各关系及其类型。DEVICE持有CustomerID,所以 CUSTOMER–DEVICE 是一对多(一个顾客,许多设备)。REPAIR持有DeviceID,所以 DEVICE–REPAIR 是一对多;它还持有TechnicianID,所以 TECHNICIAN–REPAIR 是一对多。没有直接的 CUSTOMER–REPAIR 线:联系经由 DEVICE。三条线,三个鸦爪,都在 REPAIR 或 DEVICE 那一端。词汇表 训练英文 中文 拼音 entity-relationship diagram/ˈentɪti rɪˈleɪʃənʃɪp ˈdaɪəɡræm/ 实体关系图 shí tǐ guān xì tú cardinality/ˌkɑːdɪˈnælɪti/ 基数 jī shù one-to-many/wʌn tə ˈmeni/ 一对多 yī duì duō link table/lɪŋk ˈteɪbl/ 连接表 lián jiē biǎo 8.1
规范化

规范化(normalisation)组织表以减少冗余和不一致,按顺序经过各范式(normal forms)。
- 第一范式(1NF)——每个字段容纳一个单一(原子(atomic))值,没有重复组,并有一个主键。
- 第二范式(2NF)——处于 1NF,并且每个非键字段依赖于整个主键(只对一个复合键有意义)。
- 第三范式(3NF)——处于 2NF,并且每个非键字段只依赖于主键,而不依赖于另一个非键字段(没有传递依赖(transitive dependency))。
一个 3NF 设计把每个事实存储一次,所以插入/更新/删除异常消失。权衡是更多的表和更多的连接。以 3NF 为目标。
要产生一个 3NF 设计:找出实体及其属性;为每个选择一个主键;拆分重复/非原子字段(1NF);拆分依赖于一个复合键一部分的字段(2NF);拆分传递地依赖于键的字段(3NF);为关系添加外键。
规范化通过把重复的数据拆到它自己的表中来去除冗余 例题。 表
ORDER(OrderID, CustomerID, CustomerName, ProductID, Quantity)的复合主键是(OrderID, ProductID)。把它规范化到 3NF。逐个用主键去检验每个非键字段。Quantity同时依赖OrderID和ProductID,这没问题。但CustomerID只依赖OrderID- 也就是复合主键的一部分。这是部分依赖,所以该表不满足 2NF。把它拆成ORDER_LINE(OrderID, ProductID, Quantity)和ORDER(OrderID, CustomerID, CustomerName)。再检验 3NF:在新的ORDER表中,CustomerName依赖于CustomerID,而后者不是主键 - 这是传递依赖。再拆一次:ORDER(OrderID, CustomerID)和CUSTOMER(CustomerID, CustomerName)。要点出破坏每种范式的那种依赖(部分依赖破坏 2NF,传递依赖破坏 3NF);写"它有重复数据"只是在描述症状,得不到分。对任何表都要问的三个问题。 每个单元格是否都是单一值、没有重复组? 不是,就不在 1NF。如果键是复合的,每个非键字段是否都依赖于整个键? 若某字段只依赖于它的一部分,就存在部分依赖(partial dependency),表不在 2NF。每个非键字段是否只依赖于键? 若某字段依赖于另一个非键字段,就存在传递依赖,表不在 3NF。"解释为什么该表不在 3NF"的答案要说出依赖的名称和涉及的字段。
1NF 去除重复组,2NF 去除部分依赖,3NF 去除传递依赖 例题。 一家租车店把每次租车记录为
RENTAL(RentalID, RentalDate, CustomerID, CustomerName, CustomerPhone, CarReg, CarModel, DailyRate, Days),一次租车可以包含几辆车。解释为什么该表未规范化,并给出 3NF 设计。不在 1NF: 汽车字段
CarReg, CarModel, DailyRate, Days构成一个重复组——一次租车有几辆车。把它们移到RENTAL_CAR(RentalID, CarReg, CarModel, DailyRate, Days),复合键为(RentalID, CarReg)。不在 2NF: 在RENTAL_CAR中,CarModel和DailyRate只依赖于CarReg——部分依赖。把它们移到CAR(CarReg, CarModel, DailyRate),留下RENTAL_CAR(RentalID, CarReg, Days)。不在 3NF: 在RENTAL中,CustomerName和CustomerPhone依赖于非键字段CustomerID——传递依赖。把它们移到CUSTOMER(CustomerID, CustomerName, CustomerPhone),留下RENTAL(RentalID, RentalDate, CustomerID)。3NF 设计是四个表——CUSTOMER、RENTAL、RENTAL_CAR、CAR——以CustomerID、RentalID和CarReg为外键;给每个主键加下划线。词汇表 训练英文 中文 拼音 normalisation/ˌnɔːməlaɪˈzeɪʃn/ 规范化 guī fàn huà normal forms/ˈnɔːml fɔːmz/ 范式 fàn shì atomic/əˈtɒmɪk/ 原子 yuán zi transitive dependency/ˈtrænsɪtɪv dɪˈpendənsi/ 传递依赖 chuán dì yī lài partial dependency/ˈpɑːʃl dɪˈpendənsi/ 部分依赖 bù fèn yī lài 8.2
数据库管理系统(DBMS)

大纲
Candidates should be able to: Notes and guidance Show understanding of the features provided by a Database Management System (DBMS) that address the issues of a file based approach Including: • data management, including maintaining a data dictionary • data modelling • logical schema • data integrity • data security, including backup procedures and the use of access rights to individuals / groups of users Show understanding of how software tools found within a DBMS are used in practice Including the use and purpose of: • developer interface • query processor 来源:剑桥国际大纲
一个 DBMS(数据库管理系统)集中管理数据库。修复基于文件的局限的特性:
- 数据字典(data dictionary)——对每个表、字段、类型和键的描述;程序查询它而不是硬编码结构。
- 冗余/一致性控制——每个事实存储一次。
- 并发访问(concurrent access)控制——锁和事务让许多用户一次工作。
- 备份(backup)和恢复;安全和每用户权限。
- 完整性规则——键、唯一和范围约束,集中强制执行。
- 事务(transactions)——一组全部成功或全部失败的操作。
- 视图(views)——向每个用户显示"他们的"那一片数据的虚拟表。
- 数据管理(data management)和数据建模(data modelling)——控制数据如何存储,并把它的结构定义为一个逻辑模式(logical schema,逻辑设计,独立于物理存储)。
- 数据完整性(data integrity)和数据安全(data security)——集中强制正确性并控制访问。
- 一个查询处理器(query processor)运行查询;一个开发者接口(developer interface)给出构建应用程序的工具和 API。
它的工具包括一个数据字典编辑器、一个查询构建器、一个表单构建器、一个报表生成器、用户管理,以及一个 SQL 编辑器。
数据字典里有什么("给出三项"的题目):表的名称;每个表中字段的名称;每个字段的数据类型和长度;主键、外键以及表之间的关系;验证规则;索引;以及谁可以访问每个表。它是元数据——关于数据的数据——DBMS 用它检查每条查询和每次改动。
DBMS 如何保证数据安全("描述两种方法"的题目):身份验证(authentication)——任何访问之前先输入用户名和密码,或用生物特征;访问权限——每个用户或用户组只被允许读、写或删除某些表或字段,常通过视图实现;对存储的数据和传给它的数据加密,使复制出去的文件无法读取;定期备份,使数据在丢失后可以恢复;还有一份记录谁改了什么的事务日志。
两个软件工具。 开发者接口是程序员用来构建数据库及其上应用程序的工具:创建表、设置键和验证、编写查询和 SQL、设计表单和报表,而不必知道数据在物理上如何存储。查询处理器接受一条查询(来自程序的 SQL,或在接口中构建的查询),对照数据字典检查它,找出最高效的执行方式,取出数据并返回结果。
逻辑模式。 DBMS 把逻辑设计(存在哪些表和字段、它们如何关联)与物理存储(文件、索引、磁盘块)分开。程序面对的是逻辑模式,所以物理存储可以重新组织而一个程序都不用改——这正是基于文件的方法所缺少的数据独立性。
逻辑模式所隐藏的物理存储:硬盘旋转的盘片和读写磁头 探索Database service lab
Watch how a DBMS turns a query into safe shared data access.
探索Database service lab
Watch how a DBMS turns a query into safe shared data access.
词汇表 训练英文 中文 拼音 query/ˈkwɪərɪ/ 查询 chá xún data dictionary/ˈdeɪtə ˈdɪkʃənəri/ 数据字典 shù jù zì diǎn concurrent access/kənˈkʌrənt ˈækses/ 并发访问 bìng fā fǎng wèn transactions/trænˈsækʃnz/ 事务 shì wù backup/ˈbækʌp/ 备份 bèi fèn views/vjuːz/ 视图 shì tú data management/ˈdeɪtə ˈmænɪdʒmənt/ 数据管理 shù jù guǎn lǐ data modelling/ˈdeɪtə ˈmɒdəlɪŋ/ 数据建模 shù jù jiàn mó logical schema/ˈlɒdʒɪkl ˈskiːmə/ 逻辑模式 luó jí mó shì data integrity/ˈdeɪtə ɪnˈteɡrɪti/ 数据完整性 shù jù wán zhěng xìng data security/ˈdeɪtə sɪˈkjʊərɪti/ 数据安全 shù jù ān quán query processor/ˈkwɪərɪ ˈprəʊsesə/ 查询处理器 chá xún chǔ lǐ qì developer interface/dɪˈveləpə ˈɪntəfeɪs/ 开发者接口 kāi fā zhě jiē kǒu authentication/ɔːˌθentɪˈkeɪʃn/ 身份验证 shēn fèn yàn zhèng 8.3
数据定义语言(DDL)与数据操纵语言(DML)
大纲
Candidates should be able to: Notes and guidance Show understanding that the DBMS carries out all creation/modification of the database structure using its Data Definition Language (DDL) Show understanding that the DBMS carries out all queries and maintenance of data using its DML Show understanding that the industry standard for both DDL and DML is Structured Query Language (SQL) Understand a given SQL statement Understand given SQL (DDL) statements and be able to write simple SQL (DDL) statements using a sub-set of statements Create a database (CREATE DATABASE) Create a table definition (CREATE TABLE), including the creation of attributes with appropriate data types: • CHARACTER • VARCHAR(n) • BOOLEAN • INTEGER • REAL • DATE • TIME change a table definition (ALTER TABLE) add a primary key to a table (PRIMARY KEY (field)) add a foreign key to a table (FOREIGN KEY (field) REFERENCES Table (Field)) Write an SQL script to query or modify data (DML) which are stored in (at most two) database tables Queries including SELECT... FROM, WHERE, ORDER BY, GROUP BY, INNER JOIN, SUM, COUNT, AVG Data maintenance including INSERT INTO, DELETE FROM, UPDATE 来源:剑桥国际大纲
SQL(结构化查询语言,Structured Query Language)有两半:
DDL 构建数据库结构;DML 处理数据 - 数据定义语言(Data Definition Language,DDL)——创建或改变结构(表、键、约束)。
- 数据操纵语言(Data Manipulation Language,DML)——处理数据(插入、更新、删除、查询(query))。
DDL 基础
CREATE TABLE CUSTOMER (
  CustomerID INTEGER PRIMARY KEY,
  Name VARCHAR(50) NOT NULL,
  Phone VARCHAR(20)
);
添加一个外键:
CREATE TABLE ORDER (
  OrderID INTEGER PRIMARY KEY,
  CustomerID INTEGER,
  OrderDate DATE,
  FOREIGN KEY (CustomerID) REFERENCES CUSTOMER(CustomerID)
);
修改和删除:
ALTER TABLE CUSTOMER ADD Email VARCHAR(100);
DROP TABLE CUSTOMER;
常见类型:
INTEGER、REAL、VARCHAR(n)、CHAR(n)(也叫CHARACTER(n))、DATE、TIME、BOOLEAN、DECIMAL(p, s)。DML 基础
用
SELECT查询:
一个 SELECT 查询只返回匹配它条件的行 SELECT Name, Phone FROM CUSTOMER WHERE City = 'London' ORDER BY Name ASC;SELECT列出字段,FROM命名表,WHERE过滤行,ORDER BY排序。一个连接(join)用一个外键关系组合两个表:
SELECT C.Name, O.OrderDate
FROM CUSTOMER C INNER JOIN ORDER O
  ON C.CustomerID = O.CustomerID
WHERE O.OrderDate >= '2024-01-01';
查询的各部分,按必须书写的顺序 聚合函数(aggregate functions,
COUNT、SUM、AVG、MIN、MAX)常与GROUP BY一起用:SELECT CustomerID, COUNT(*) AS NumOrders FROM ORDER GROUP BY CustomerID;插入、更新、删除:
INSERT INTO CUSTOMER (CustomerID, Name, Phone)
VALUES (101, 'Ada Lovelace', '020-1234-5678');

UPDATE CUSTOMER SET Phone = '020-9999-0000' WHERE CustomerID = 101;

DELETE FROM CUSTOMER WHERE CustomerID = 101;
总是在
UPDATE和DELETE上加一个WHERE子句,否则改变会命中每一行。考试 SQL 的提示
- 使用题目中确切的表名和字段名。
- 用单引号引起字符串(
'Smith');不要引起数字。 - 比较:
=、<、>、<=、>=、<>。 LIKE 'A%'匹配任何以 A 开头的(%= 任何字符串,_= 一个字符);IN (1,2,3);BETWEEN 10 AND 20。- 用
AND/OR/NOT组合条件,并以一个分号结束每条语句。
考试要的 DDL 模式。 每条
CREATE TABLE给每个字段命名并写出类型,标出主键,并声明每个外键及其引用的表;复合键单独占一行声明:CREATE TABLE RENTAL_CAR ( RentalID INTEGER, CarReg VARCHAR(8), Days INTEGER, PRIMARY KEY (RentalID, CarReg), FOREIGN KEY (RentalID) REFERENCES RENTAL(RentalID), FOREIGN KEY (CarReg) REFERENCES CAR(CarReg) );例题。 用
CUSTOMER(CustomerID, Name, Phone)和DEVICE(DeviceID, CustomerID, Type, Model),写 SQL 脚本:(a) 按姓名字母顺序列出每个拥有类型为'tablet'的设备的顾客的姓名和电话;(b) 统计每种类型的设备数;(c) 记录顾客 17 现在的电话号码是'0771 234 5678';(d) 添加一台新设备,ID 305,类型'laptop'、型号'X1',属于顾客 17。(a)
SELECT CUSTOMER.Name, CUSTOMER.Phone
FROM CUSTOMER INNER JOIN DEVICE
  ON CUSTOMER.CustomerID = DEVICE.CustomerID
WHERE DEVICE.Type = 'tablet'
ORDER BY CUSTOMER.Name ASC;
(b)
SELECT Type, COUNT(DeviceID) AS NumberOfDevices
FROM DEVICE
GROUP BY Type;
(c)
UPDATE CUSTOMER SET Phone = '0771 234 5678' WHERE CustomerID = 17;(d)INSERT INTO DEVICE (DeviceID, CustomerID, Type, Model) VALUES (305, 17, 'laptop', 'X1');分数按子句给——字段、表、连接条件、
WHERE、ORDER BY——所以一个子句错了的脚本仍能得到其余的分。涉及两个表时一律写表.字段。例题。 解释这段脚本做什么:
SELECT T.Name, SUM(R.Cost) AS Total FROM TECHNICIAN T INNER JOIN REPAIR R ON T.TechnicianID = R.TechnicianID GROUP BY T.Name;它输出每位技师的姓名以及该技师所做维修的总费用,每位技师一行:两个表通过 TechnicianID 连接,行按姓名分组,每组的费用相加。被问脚本做什么时,描述结果,而不是语法。
探索Stitch two tables with INNER JOIN
A join matches rows where the foreign key equals the primary key — here Orders.CustomerID = Customer.CustomerID — and combines each matching pair into one wider row.
探索SELECT … WHERE
Step through a query: WHERE keeps the rows that match, then SELECT picks the columns you asked for.
词汇表 训练英文 中文 拼音 join/dʒɔɪn/ 连接 lián jiē Data Definition Language/ˈdeɪtə ˌdefɪˈnɪʃn ˈlæŋɡwɪdʒ/ 数据定义语言 shù jù dìng yì yǔ yán Data Manipulation Language/ˈdeɪtə məˌnɪpjʊˈleɪʃn ˈlæŋɡwɪdʒ/ 数据操纵语言 shù jù cāo zòng yǔ yán aggregate functions/ˈæɡrɪɡeɪt ˈfʌŋkʃnz/ 聚合函数 jù hé hán shù 8.3
考官认可的定义
定义题按固定措辞给分。把这些记准,并且只给一个答案。
术语 定义 实体 被存储数据的对象——人、物体或事件——在关系数据库中成为一个表 属性 实体的一项数据(表中的一列) 元组 表中的一行:一个实体的一个实例 主键 唯一标识表中每条记录的一个属性或属性组合 外键 一个表中的属性,其值与另一个表中的主键匹配,用来把两个表连接起来 候选键 任何可以选作主键的属性(或组合) 次键 为快速搜索或排序而建立索引的非主键属性 复合键 由两个或更多属性一起构成的主键 参照完整性 每个外键值必须与被引用表中已有的主键值匹配 第一范式 每个属性都是原子值、没有重复组、有主键的表 第二范式 处于 1NF,且每个非键属性都依赖于整个主键(没有部分依赖) 第三范式 处于 2NF,且非键属性之间没有依赖(没有传递依赖) 数据字典 DBMS 保存的关于数据库结构的元数据:表、字段、类型、键、关系、验证 DDL / DML 用来定义或修改数据库结构的语言 / 用来查询和维护数据库中数据的语言 8.3
考试技巧
- 精确地定义术语:实体、属性、主键、外键,以及关系类型(1:1、1:多、多:多)。
- 在每个范式给出一个理由:1NF(没有重复组)、2NF(没有部分依赖)、3NF(没有非键依赖)——并说出涉及的字段。
- 解释一个 DBMS 提供什么(数据独立性、安全、完整性、并发访问、数据字典、开发者接口、查询处理器)。
- 区分 DDL(定义结构)和 DML(查询和改变数据),并按子句写 SQL:
SELECT、FROM、INNER JOIN … ON、WHERE、GROUP BY、ORDER BY。 - 从表画 E-R 图时,先找出每个外键:每个外键就是一个一对多关系,"多"在持有它的表那一端。
常见错误
- 直接画多对多关系。它必须通过一个持有两个外键的连接表拆成两个一对多关系。
- 用"数据重复了"解释一个表不在 3NF。要说出依赖(部分或传递)以及涉及的字段。
- 在 SQL 中用双引号引字符串,或给数字加引号。字符串用
'单引号',数字不加引号。 INNER JOIN后漏掉ON条件。没有它两个表就没有连接起来。- 在
SELECT里把一个普通字段与COUNT或SUM放在一起却没有GROUP BY。 UPDATE或DELETE没有WHERE。这会改变或删除表中的每一行。
-
9
算法设计与问题求解
9.1
计算思维技能

大纲
Candidates should be able to: Notes and guidance Show an understanding of abstraction Need for and benefits of using abstraction Describe the purpose of abstraction Produce an abstract model of a system by only including essential details Describe and use decomposition Break down problems into sub-problems leading to the concept of a program module (procedure / function) 来源:剑桥国际大纲
计算思维(computational thinking)是分析一个问题并设计一个计算机能运行的解决方案的一套心智工具。两个关键的是抽象和分解。
计算思维把一个大问题分成更小、更容易的部分——像解一个拼图 抽象
抽象(abstraction)意味着保留一个问题的本质特征并忽略无关的细节,给出一个更简单的模型。
例子:
- 一张铁路网络图保留车站和线路,但去掉地理。
- 面向对象编程中的一个类只保留系统需要的属性和方法。
- 一个函数把一段工作隐藏在一个名称后面。
任何真实问题的完整模型都太大而无法推理,所以抽象是必不可少的。
考官会问抽象的目的和它的好处。目的:得到一个只包含解决问题所需细节的更简单的模型。好处:问题更容易理解和编程;程序更小,写起来和测试起来更快;同一个模型可以在类似的问题上重用。当题目要求你建立一个抽象模型时,只列出任务需要的数据和操作。对于学校课表来说,那就是班级、教室、教师和课时;而不是教室的颜色或教师的年龄。

抽象保留本质(车站和线路)并去掉无关的细节(地理) 分解
分解(decomposition)意味着把一个大问题分成更小的子问题,每个更容易解决并一次处理一个。
- 找出任务的主要部分。
- 把每个分成更小的子任务。
- 继续直到每个都小到能直接设计。
- 解决小任务并把它们组合起来。
对于库存控制:"管理库存" → "记录销售"、"记录到货"、"生成报表" → ("记录销售")"查找产品"、"减少库存计数"、"保存交易"。分解使大问题可管理、让一个团队分担工作,并给出模块化的代码——每个模块成为一个过程(procedure)或函数。
"解释为什么使用分解"是一道有固定形状的三分题。给出三个各自独立的好处:每个子问题(sub-problem)都小到可以单独设计、编码和测试;不同的程序员可以同时做不同的模块(module);已经存在的模块(或库例程)可以重用,而且错误更容易找到,因为它只在一个模块里。结构图(主题 12)就是分解的图示:程序在顶部,它的模块在下面,以及它们之间传递的数据。

把一个程序分解成模块和子模块 探索Solving a problem the computational way
Step through the four cornerstones in the order you'd use them — break the problem down, spot what repeats, strip it to essentials, then write the steps.
词汇表 训练英文 中文 拼音 computational thinking/ˌkɒmpjuːˈteɪʃənl ˈθɪŋkɪŋ/ 计算思维 jì suàn sī wéi abstraction/əbˈstrækʃn/ 抽象 chōu xiàng decomposition/ˌdiːkɒmpəˈzɪʃn/ 分解 fēn jiě sub-problem/sʌb ˈprɒbləm/ 子问题 zi wèn tí procedure/prəˈsiːdʒə/ 过程 guò chéng modules/ˈmɒdjuːlz/ 模块 mó kuài 9.2
算法
大纲
Candidates should be able to: Notes and guidance Show understanding that an algorithm is a solution to a problem expressed as a sequence of defined steps Use suitable identifier names for the representation of data used by a problem and represent these using an identifier table Write pseudocode that contains input, process and output Write pseudocode using the three basic constructs of sequence, selection and iteration (repetition) Document a simple algorithm using a structured English description, a flowchart or pseudocode Write pseudocode from: • a structured English description • a flowchart Draw a flowchart from: • a structured English description • pseudocode Describe and use the process of stepwise refinement to express an algorithm to a level of detail from which the task may be programmed Use logic statements to define parts of an algorithm solution 来源:剑桥国际大纲
冒泡排序,一趟接一趟 一个算法(algorithm)是表述为一系列已定义步骤的解决方案。每一步是无歧义的(unambiguous,一个意思)、确定性的(deterministic,相同输入 → 相同输出)、有限的(finite,步骤会结束),以及有效的(effective,每一步都能做)。一个算法说明做什么,与用来实现它的编程语言无关。
探索Selection: follow the IF / ELSE branches
Drag the score and watch which branch runs. Selection tests each condition in turn and takes the FIRST one that is true — that is how IF … ELSE IF … ELSE works.
词汇表 训练英文 中文 拼音 algorithm/ˈælɡərɪθəm/ 算法 suàn fǎ unambiguous/ʌnæmˈbɪɡjuːəs/ 无歧义 wú qí yì deterministic/dɪˌtɜːmɪˈnɪstɪk/ 确定性 què dìng xìng 9.2
标识符表

当你开始一个算法时,在一个标识符表(identifier table)中列出每一份数据——它的标识符(identifier,即变量(variable)名)、数据类型(data type)和描述。考试中的表恰好就是这三列:
标识符 数据类型 描述 CategorySTRING产品类别 SaleDateDATE商品售出的时间 ItemCostREAL商品的成本 InStockBOOLEAN若有库存则为 TRUESalesARRAY[1:30] OF REAL最近 30 天的每日销售总额 使用描述性的名称(
ItemCost,而不是x):标识符以字母开头,不含空格,并且每次出现都写得一模一样。常见类型是INTEGER、REAL、STRING、CHAR、BOOLEAN、DATE,加上数组。这个表迫使你在写代码之前命名每一份数据;"补全标识符表"的题目每个正确的数据类型或描述各给一分,所以类型要严格按伪代码指南的写法写。一个标识符表在你写代码之前命名每一份数据 词汇表 训练英文 中文 拼音 identifier table/aɪˈdentɪfaɪə ˈteɪbl/ 标识符表 biāo shí fú biǎo identifier/aɪˈdentɪfaɪə/ 标识符 biāo shí fú variable/ˈveərɪəbl/ 变量 biàn liàng data type/ˈdeɪtə taɪp/ 数据类型 shù jù lèi xíng Boolean/ˈbuːlɪən/ 布尔 bù ěr 9.2
伪代码 —— 三种基本结构

伪代码(pseudocode)是一种描述算法的结构化、语言中立的方式。
任何算法的三个构件:顺序、选择和迭代 1. 顺序
步骤一个接一个地运行(顺序(sequence)):
INPUT Name
INPUT Age
OUTPUT "Hello", Name
2. 选择
基于一个条件选择运行哪些步骤(选择(selection)):
IF Age >= 18 THEN
    OUTPUT "Adult"
ELSE
    OUTPUT "Minor"
ENDIF
对于更多的选项,用
CASE OF ... ENDCASE。3. 迭代
重复一个块(迭代(iteration),一个循环(loop)):
FOR i ← 1 TO 10
    OUTPUT i
NEXT i
一个 WHILE 循环在每一趟之前测试条件(可能运行零次);一个 REPEAT...UNTIL 循环在每一趟之后测试(总是至少运行一次)。
WHILE Total < 100 DO
    INPUT Value
    Total ← Total + Value
ENDWHILE

REPEAT
    INPUT Mark
UNTIL Mark >= 0 AND Mark <= 100
WHILE 循环在循环体运行之前测试;REPEAT ... UNTIL 循环在之后测试,所以它的循环体总是至少运行一次 选对循环本身就是一分:知道重复多少次时用
FOR(计数循环(count-controlled loop));循环可能一次都不运行时用WHILE(前测循环(pre-condition loop));必须至少运行一次时用REPEAT ... UNTIL,例如验证一次输入(后测循环(post-condition loop))。"描述迭代结构"的答案要说出结构的名称、条件在哪里测试,以及后果(零次或至少一次)。常见操作
- 赋值(assignment):
x ← 5(一个箭头;=用于比较)。 - 输入/输出:
INPUT variable、OUTPUT expression。 - 比较
=、<>、<、>、<=、>=;逻辑AND、OR、NOT。 - 算术
+ - * /,加上DIV(整数除法)和MOD(余数)。 - 字符串:
LENGTH、LEFT、RIGHT、MID,以及&用于拼接(concatenation,连接)。
考试要求的伪代码
每一个伪代码答案都按剑桥公布的伪代码指南评分。要严格按这些形式写:
结构 伪代码 声明变量 DECLARE Total : INTEGER声明数组 DECLARE Marks : ARRAY[1:30] OF REAL常量 CONSTANT MaxTries = 3赋值 Total ← Total + Value输入和输出 INPUT Name和OUTPUT "Hello ", Name多个选项 CASE OF Choice...1 : OUTPUT "Add"...OTHERWISE OUTPUT "Error"...ENDCASE计数循环 FOR i ← 1 TO 10 STEP 2...NEXT i前测循环 WHILE Total < 100 DO...ENDWHILE后测循环 REPEAT...UNTIL Mark >= 0整除和余数 DIV和MOD:17 DIV 5 = 3,17 MOD 5 = 2字符串函数 LENGTH(S)、LEFT(S, 3)、RIGHT(S, 2)、MID(S, 2, 4)、UCASE(S)、LCASE(S)转换 INT(3.7) = 3、NUM_TO_STR(12)、STR_TO_NUM("4.5")、ASC('A') = 65、CHR(66) = 'B'随机数 RAND(100)给出一个从 0 到(但不包括)100 的实数;INT(RAND(100)) + 1给出 1 到 100 的整数有两个习惯在每道题上都能得分:声明你用到的每个变量,类型取自你的标识符表;在改变它们的循环之前,初始化(initialise)每个计数器(counter)和总和(
Count ← 0、Total ← 0)。输入 → 处理 → 输出
每个程序都遵循这个形状:
INPUT Length
INPUT Width
Area ← Length * Width
OUTPUT "Area = ", Area
先列出输入和输出使算法更清晰。
例题。 写伪代码:输入 100 个整数,输出其中落在 10 到 20(含)之间的数有多少个,以及这些数的总和。
标识符表:
Count : INTEGER(循环计数器)、Value : INTEGER(刚输入的整数)、InRange : INTEGER(在范围内的个数)、Total : INTEGER(它们的和)。DECLARE Count, Value, InRange, Total : INTEGER InRange ← 0 Total ← 0 FOR Count ← 1 TO 100 INPUT Value IF Value >= 10 AND Value <= 20 THEN InRange ← InRange + 1 Total ← Total + Value ENDIF NEXT Count OUTPUT InRange, Total如果题目接着要求你"指出两种结构并说明各自如何使用",就用同样的形状回答:迭代,即
FOR循环,把输入重复 100 次;选择,即IF语句,只在数值处于范围内时才把它加上。例题。 程序从 1 到 100 中选一个秘密整数。用户一直猜到猜对为止;每次猜错后程序说"Too low"或"Too high",最后输出一共猜了多少次。
标识符表:
Secret : INTEGER(要猜的数)、Guess : INTEGER(用户的输入)、Tries : INTEGER(到目前为止猜了多少次)。DECLARE Secret, Guess, Tries : INTEGER Secret ← INT(RAND(100)) + 1 Tries ← 0 REPEAT INPUT Guess Tries ← Tries + 1 IF Guess < Secret THEN OUTPUT "Too low" ELSE IF Guess > Secret THEN OUTPUT "Too high" ENDIF ENDIF UNTIL Guess = Secret OUTPUT "You took ", Tries, " guesses"REPEAT ... UNTIL循环是正确的选择,因为用户必须至少猜一次。给分点是:范围正确的随机数、猜对时结束的循环、从零开始并在循环内递增的计数器、在正确条件下输出的两条信息,以及最后的输出。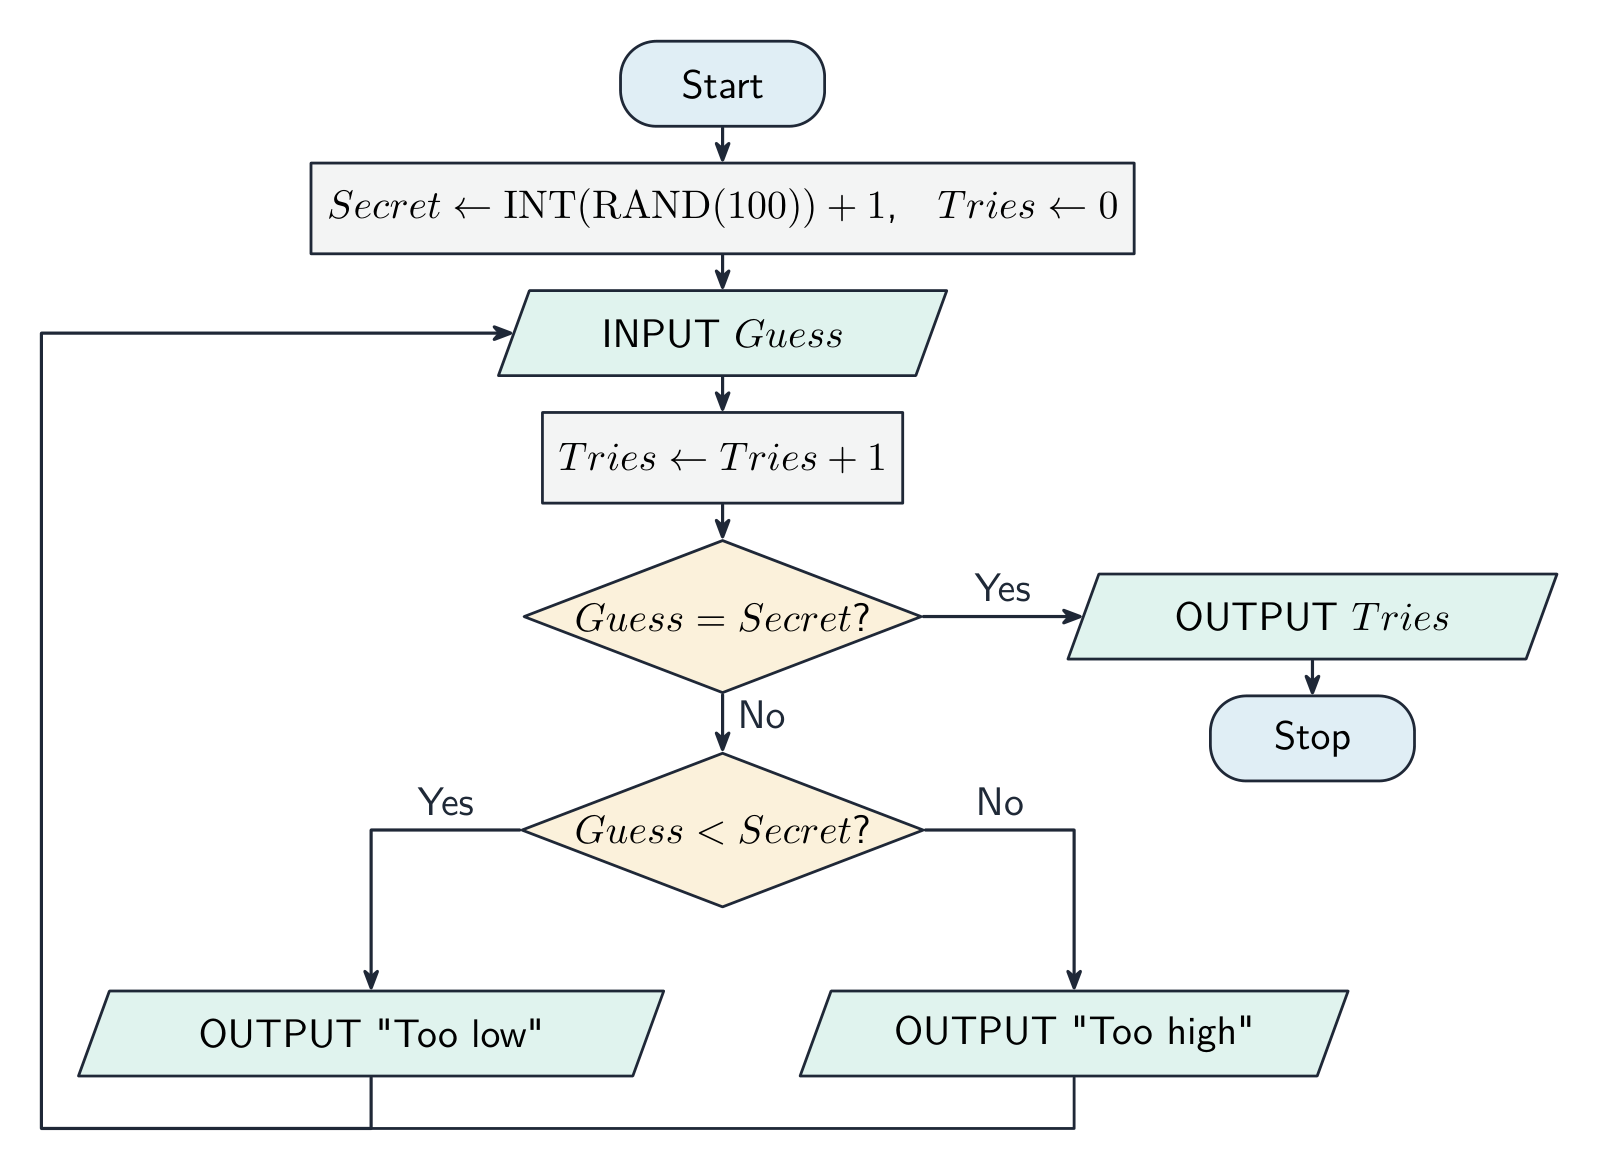
同一个猜数游戏的流程图:两个判断菱形就是两个 IF 语句,回去的箭头就是 REPEAT ... UNTIL 循环 例题。 输出两个不同的随机整数,每个都在 $-10$ 到 $10$(含)之间。
可能的值有 21 个,所以
INT(RAND(21))给出 0 到 20,减去 10 就把它移到 $-10$ 到 $10$ 的范围。第二个数必须重新生成,直到它与第一个不同:DECLARE First, Second : INTEGER First ← INT(RAND(21)) - 10 REPEAT Second ← INT(RAND(21)) - 10 UNTIL Second <> First OUTPUT First, Second
每个程序都遵循输入、处理、输出的形状 探索IF … ELSE selection
Change the value and watch which branch runs — how a program makes a decision.
词汇表 训练英文 中文 拼音 sequence/ˈsiːkwəns/ 顺序 shùn xù pseudocode/ˈsuːdəʊkəʊd/ 伪代码 wěi dài mǎ flowchart/ˈfləʊtʃɑːt/ 流程图 liú chéng tú selection/sɪˈlekʃn/ 选择 xuǎn zé iteration/ˌɪtəˈreɪʃn/ 迭代 dié dài loop/luːp/ 循环 xún huán count-controlled loop/kaʊnt kənˈtrəʊld luːp/ 计数循环 jì shù xún huán pre-condition loop/priː kənˈdɪʃn luːp/ 前测循环 qián cè xún huán post-condition loop/pəʊst kənˈdɪʃn luːp/ 后测循环 hòu cè xún huán assignment/əˈsaɪnmənt/ 赋值 fù zhí concatenation/kənˌkætəˈneɪʃn/ 拼接 pīn jiē initialise/ɪˈnɪʃəlaɪz/ 初始化 chū shǐ huà counter/ˈkaʊntə/ 计数器 jì shù qì 9.2
三种表示法

同一个算法可以用三种方式书写。
- 结构化英语(structured English)——带缩进和固定关键字的自然语言;适合一个高层描述。
- 流程图(flowchart)——一个带标准形状的图:
形状 意义 圆角矩形 开始 / 停止 平行四边形 输入 / 输出 矩形 处理 菱形 判断 箭头 控制流 - 伪代码——上面的关键字记法;最接近代码。
你应当能够在任何一对之间转换:每个
IF是一个判断菱形,每个循环是一个回箭头,一个顺序是堆叠的矩形。把流程图转换成伪代码:从终止符开始,按顺序沿箭头走;平行四边形变成
INPUT或OUTPUT;矩形变成赋值;两个出口在下方重新汇合的菱形变成IF ... THEN ... ELSE ... ENDIF;只有一个出口且箭头向上回去的菱形是循环——如果菱形在被重复的方框之前就是WHILE循环,如果在之后就是REPEAT ... UNTIL循环。反过来转换时,每条语句恰好画一个方框、每个条件恰好画一个菱形,并给菱形的每个出口标上"是"或"否"。一个用标准形状求一列数字平均值的流程图 词汇表 训练英文 中文 拼音 structured English/ˈstrʌktʃəd ˈɪŋɡlɪʃ/ 结构化英语 jié gòu huà yīng yǔ 9.2
逐步求精

逐步求精(stepwise refinement)从一个高层大纲开始,展开每一步直到它小到能编码。对于 $n$ 个数字的平均值:
第 1 层:
Read in the numbers
Compute the average
Output the average
第 2 层:
INPUT n
total ← 0
FOR i ← 1 TO n
    INPUT value
    total ← total + value
NEXT i
average ← total / n
OUTPUT average
每次求精都保留之前的结构并添加细节。
六分的"应用逐步求精"题会给你一个高层大纲,要你把每一步展开成程序员能直接编码的具体语句。保持步骤的顺序不变,写出每一步读入或产生的数据的名称,直到每一行都是单独的一个输入、赋值、输出、循环或条件为止。例如,"验证密码"展开为:输入密码;检查它的长度至少为 8;检查它至少含一个数字;两项检查都通过则输出"accepted",否则输出"rejected"。
逐步求精:把每个高层步骤展开成详细的伪代码 探索Stepwise refinement: outline to code
Step down the levels. You start with the whole task in one line and keep expanding each step into smaller ones — until every step is simple enough to code directly.
词汇表 训练英文 中文 拼音 stepwise refinement/ˈstepwaɪz rɪˈfaɪnmənt/ 逐步求精 zhú bù qiú jīng 9.2
逻辑语句

一个逻辑语句(logic statement)是一个控制分支的布尔(Boolean)条件,由比较(
x > 10)、连接词(AND、OR、NOT)和括号构成。把它用作IF、WHILE或REPEAT...UNTIL的条件:WHILE attempts < 3 AND NOT loggedIn DO INPUT password IF password = correctPassword THEN loggedIn ← TRUE ELSE attempts ← attempts + 1 ENDIF ENDWHILE优先级(precedence,从高到低):
NOT,然后AND,然后OR。不确定时用括号。常见错误:a = 1 OR 2是错的——写a = 1 OR a = 2。NOT a > 5意味着NOT (a > 5),即a <= 5。NOT (A AND B)与(NOT A) OR (NOT B)相同(德摩根定律(De Morgan's law))——对简化条件很方便。
把一句话变成逻辑语句是试卷直接考查的技能。"5 岁以下或 65 岁以上免票"变成
Age < 5 OR Age > 65。"分数有效当且仅当它是 0 到 100 的整数"变成Mark >= 0 AND Mark <= 100。"文件结束或已读 10 条记录时循环停止"变成UNTIL EOF(File) OR Count = 10。每个比较都要写完整:Age > 65和Age < 5,绝不能写Age > 65 OR < 5。优先级:NOT 先绑定到 loggedIn,然后 AND 组合两边 例题。 写出标识符表和伪代码:读入 10 个数并输出最大的那个。标识符表为每个变量写明数据类型和用途:
Count : INTEGER(循环计数器)、Num : REAL(刚读入的数)、Max : REAL(到目前为止的最大值)。Max ← -999999 FOR Count ← 1 TO 10 INPUT Num IF Num > Max THEN Max ← Num ENDIF NEXT Count OUTPUT Max承载分数的设计决定是
Max的初始化:它必须从一个比任何可能的输入都低的值开始 - 或者更稳妥地,把它设成第一个读入的数。若把它初始化为0,那么对一串负数,该算法会错误地返回 0;这个 bug 只有当你的测试数据里包含负数时,追踪才会把它暴露出来。词汇表 训练英文 中文 拼音 logic statement/ˈlɒdʒɪk ˈsteɪtmənt/ 逻辑语句 luó jí yǔ jù precedence/ˈpresɪdəns/ 优先级 yōu xiān jí De Morgan's law/də ˈmɔːɡənz lɔː/ 德摩根定律 dé mó gēn dìng lǜ 9.2
考官认可的定义
定义题按固定的表述给分。把这些记准确,并且只写一个答案。
术语 定义 抽象(abstraction) 保留问题的本质细节,去掉不需要的细节 分解(decomposition) 把一个问题分成更小的子问题,每个都可以单独解决 算法(algorithm) 表述为一系列已定义步骤的问题解决方案 标识符表(identifier table) 列出算法中用到的每个标识符及其数据类型和用途描述的表 伪代码(pseudocode) 一种与语言无关的、结构化地书写算法步骤的方式 流程图(flowchart) 用箭头连接的标准符号表示算法的步骤和判断的图 顺序(sequence) 语句按书写顺序一条接一条地执行 选择(selection) 根据一个条件选择执行哪些语句 迭代(iteration) 当(或直到)某个条件成立时重复一组语句 逐步求精(stepwise refinement) 反复把大纲中的每一步分成更小的步骤,直到每一步都能直接编码 逻辑语句(logic statement) 由比较和 AND、OR、NOT 运算符构成、取值为 TRUE 或 FALSE 的条件 9.2
考试技巧
- 把一个算法定义为一个无歧义、有限、确定性的步骤序列,与语言无关。
- 正确地使用三种结构——顺序、选择、迭代——并保留一个带数据类型的标识符表。
- 通过分解和抽象把一个问题分解,然后逐步求精。
- 写实际能运行的伪代码:声明变量并遵循考试的伪代码风格。
常见错误
- 用
=来赋值。赋值是←;=是比较。 - 漏掉
ENDIF、ENDWHILE、ENDCASE或NEXT。每种结构都要闭合,而结构的分数正是在闭合词处检查的。 - 循环之前不初始化总和或计数器,导致算法往一个从未存在的值上累加。
- 在重复次数未知时使用
FOR循环。读到哨兵值或猜对为止需要WHILE或REPEAT ... UNTIL。 - 写成
Age > 65 OR < 5。OR和AND的每一边都必须是一个完整的比较。 - 用同一个好处的三种说法来回答"解释为什么使用分解"。三分需要三个不同的好处。
-
10
数据类型与数据结构
10.1
数据类型与记录
大纲
Candidates should be able to: Notes and guidance Select and use appropriate data types for a problem solution including integer, real, char, string, Boolean, date (pseudocode will use the following data types: INTEGER, REAL, CHAR, STRING, BOOLEAN, DATE, ARRAY, FILE) Show understanding of the purpose of a record structure to hold a set of data of different data types under one identifier Write pseudocode to define a record structure Write pseudocode to read data from a record structure and save data to a record structure 来源:剑桥国际大纲
每个变量都需要一个数据类型(data type)——它容纳的值的种类和允许的操作:
INTEGER— 一个整数(42、-7)。用于计数、索引、ID。REAL— 一个带小数部分的数(3.14)。用于金额、测量。STRING— 引号中的字符("Hello")。用于文本。CHAR— 一个单一字符('A')。BOOLEAN—TRUE或FALSE。用于标志。DATE— 一个日历日期。
选择适合的最小而精确的类型:
INTEGER用于整数计数,BOOLEAN用于标志(而不是字符串"yes"/"no")。"给出合适的数据类型"表格由值的用法决定:全班的平均分是
REAL(有小数部分);电子邮箱地址是STRING;学生人数是INTEGER;学生是否已缴费是BOOLEAN;出生日期是DATE;数组下标永远是INTEGER;单个等级字母是CHAR;电话号码是STRING,因为它以0开头且从不参与算术。BOOLEAN用于只有两种状态的标志:查找是否找到目标、会员是否已缴费、座位是否已订。在标识符表中,变量名也必须有意义:NumberOfPeople,而不是n。词汇表 训练英文 中文 拼音 data type/ˈdeɪtə taɪp/ 数据类型 shù jù lèi xíng 10.1
记录

一个记录(record,一个记录结构(record structure))在一个名称下容纳几个不同类型的字段——当几个值描述同一件事物时很有用。
TYPE TStockItem DECLARE ItemID : INTEGER DECLARE Category : STRING DECLARE ItemCost : REAL DECLARE InStock : BOOLEAN ENDTYPE这定义了类型
TStockItem;声明它的变量:DECLARE Item1 : TStockItem DECLARE Items : ARRAY[1:100] OF TStockItem用点记法访问每个字段(field):
Item1.Category ← "Fruit" OUTPUT Item1.Category, " costs ", Item1.ItemCost当值总是属于一起时(一个客户、一个库存商品)用一个记录;对无关的值用分开的变量。
例题。 一个俱乐部为每个学生存储学生 ID(字符串)、姓名、出生日期和最多三个俱乐部编号(整数)。写出伪代码来声明记录类型、一个容纳 $3000$ 个学生的数组,以及把一个姓名存入第一个元素的语句。
TYPE Student
    DECLARE StudentID : STRING
    DECLARE Name : STRING
    DECLARE DateOfBirth : DATE
    DECLARE Club : ARRAY[1:3] OF INTEGER
ENDTYPE

DECLARE Membership : ARRAY[1:3000] OF Student
Membership[1].Name ← "Li Wei"
给分点:带标识符的
TYPE和ENDTYPE;每个字段以合适的类型声明;数组带边界和OF Student声明;用下标和点访问字段。"指出记录声明中的错误"通常指向缺少ENDTYPE、没有类型的字段,或者一个必须参与算术却声明为STRING的字段。两个约定本身就得分:未使用的元素用一个不可能是真实数据的值标记(空字符串、-1、ID 为0),而且处处用同一个标记是好习惯,这样每个模块都能识别未使用的槽;未使用的俱乐部字段是0。记录数组的好处,用于"说出三个好处":一个实体的全部数据保存在一个标识符下;各字段可以有不同的数据类型;一个数组代替了几个必须保持同步的平行数组;整个集合可以用一个循环处理或作为一个参数传递;增加字段只需改类型定义。对一个客户,合适的结构是记录(一个名称下不同类型的字段);对所有客户,是记录数组。一个记录在一个名称下容纳几个不同类型的字段 探索A record groups fields under one name
A record bundles related fields together. Each field is a named label you reach with dot notation — Item1.Category — not by a numeric index.
词汇表 训练英文 中文 拼音 record/ˈrekɔːd/ 记录 jì lù record structure/ˈrekɔːd ˈstrʌktʃə/ 记录结构 jì lù jié gòu field/fiːld/ 字段 zì duàn 10.2
数组

大纲
Candidates should be able to: Notes and guidance Use the technical terms associated with arrays Including index, upper bound and lower bound Select a suitable data structure (1D or 2D array) to use for a given task Write pseudocode for 1D and 2D arrays Write pseudocode to process array data Sort using a bubble sort Search using a linear search 来源:剑桥国际大纲
一个数组(array)是同一类型的项的一个有序集合,在一个名称下,用一个索引(index)访问。
- 元素(element)——数组中的一项。
- 边界(bounds)——最低和最高的有效索引。
- 维度(dimension)——1-D(一个列表)、2-D(一个表格),等等。
- 下界(lower bound)和上界(upper bound)——第一个和最后一个有效下标;元素个数是上界减下界加一,二维数组则是两个个数之积。
所以在
ThisArray[n] ← 42中,数组有一个维度,下标是变量n(一个INTEGER),该下标处的元素得到42。声明数组之前,除了边界还需要它的数据类型。声明 $120$ 个可能带小数的值:DECLARE Data : ARRAY[1:120] OF REAL;一个 $150$ 行、两列的字符串表:DECLARE Data : ARRAY[1:150, 1:2] OF STRING,它有 $300$ 个元素。数组相对分开的变量的好处,用于两分的解释:一个标识符代替三十个;元素可以用以下标为计数器的循环处理;大小容易改变;整个集合可以作为一个参数传给模块。数组还可以代替一串选择语句:DaysInMonth[Month]直接查出答案,代替十二个IF子句,更短、更快写、更易维护。1-D arrays
DECLARE Names : ARRAY[1:5] OF STRING
Names[3] ← "Cara"
OUTPUT Names[3]
用一个
FOR循环处理每个元素:FOR i ← 1 TO 5 OUTPUT Names[i] NEXT i一个 1-D 数组(一个列表),带索引和边界 2-D arrays (2D array)
DECLARE Grid : ARRAY[1:3, 1:4] OF INTEGER
Grid[2, 3] ← 99
第一个索引是行,第二个是列。用嵌套循环访问每个单元。对一个单一序列用 1-D,对两个自然维度(一个网格,行 × 列)用 2-D。

一个 2-D 数组(一个表格),带行索引和列索引 Common operations
一个线性查找(linear search)检查每个元素直到找到:
FOR i ← 1 TO n
    IF A[i] = Target THEN
        OUTPUT "Found at ", i
    ENDIF
NEXT i
要求一个和、计数、最大值或最小值,设一个运行中的变量,然后扫过:
Max ← A[1] FOR i ← 2 TO n IF A[i] > Max THEN Max ← A[i] NEXT i一个冒泡排序(bubble sort)把一个数组排序:扫过它,比较每个相邻对,并交换任何顺序错误的;重复各趟直到某一趟不再有交换。
Paper 2 既要求把这些算法写成伪代码,也要求写成文字步骤,有时还要"高效"的形式:
- 最大值:把
Largest设为第一个元素;对其余每个元素,如果它比Largest大,就存入Largest;循环后输出Largest。要求最大值的位置,就再用一个变量,在Largest每次改变时存下标。 - 返回位置的线性查找:循环前设
FoundAt ← -1(一个绝不可能是有效下标的值,所以表示"未找到");遍历数组;元素匹配时存下标并离开循环;循环后检验FoundAt。 - 计数或输出非空元素:把每个元素与未使用元素的标记(
""或-1)比较,只计数或输出不同的那些。 - 删除一项:用线性查找找到它的下标;把后面的每个元素向前移一位,填上空缺;把最后一个元素标为未使用(或把计数减一)。
- 插入到有序数组:找到第一个元素更大的下标;把该元素及其后的每个元素向后移一位;把新值存入空缺。
- 高效冒泡排序:一个
Swapped标志,使某一趟没有交换时就停止;一个每趟减一的上限,因为最大值已经到达末尾。
REPEAT
    Swapped ← FALSE
    FOR Index ← 1 TO Limit - 1
        IF Data[Index] > Data[Index + 1] THEN
            Temp ← Data[Index]
            Data[Index] ← Data[Index + 1]
            Data[Index + 1] ← Temp
            Swapped ← TRUE
        ENDIF
    NEXT Index
    Limit ← Limit - 1
UNTIL Swapped = FALSE
给分点是:重复直到没有交换的外层循环、在
IF内设置的标志、用临时变量的三行交换,以及逐渐缩小的上限。"分步"(逐步求精)的排序是:重复直到有序;每趟比较相邻对;交换顺序错误的一对;每趟之后最大的未排序值位于末尾。两个记录数组或平行数据的数组用一个循环和一个下标处理;二维数组需要嵌套循环,外层遍历行、内层遍历列,在某一行中查找就固定行下标、循环列。
冒泡排序的一趟:相邻对被比较并交换,把最大值冒泡到末端 探索A 2-D array
Pick a row and column to read one element — how a grid of data is stored and indexed.
词汇表 训练英文 中文 拼音 index/ˈɪndeks/ 索引 suǒ yǐn element/ˈelɪmənt/ 元素 yuán sù bounds/baʊndz/ 边界 biān jiè dimension/daɪˈmenʃn/ 维度 wéi dù lower bound/ˈləʊə baʊnd/ 下界 xià jiè upper bound/ˈʌpə baʊnd/ 上界 shàng jiè linear search/ˈlɪnɪə sɜːtʃ/ 线性查找 xiàn xìng chá zhǎo bubble sort/ˈbʌbl sɔːt/ 冒泡排序 mào pào pái xù 10.3
文件

大纲
Candidates should be able to: Notes and guidance Show understanding of why files are needed Write pseudocode to handle text files that consist of one or more lines 来源:剑桥国际大纲
一个文件(file)是存储在辅助存储器(secondary storage)上的数据,在程序运行之间保留。RAM 中的变量在程序结束时消失,所以要永久保存数据(高分、记录、设置),程序写入一个文件。文件也让程序共享数据并从一个保存的状态重启。
RAM 中的变量在程序结束时消失;磁盘上的一个文件在运行之间持久保留 一个文本文件(text file)容纳一行或多行可读字符;程序逐行读写文本文件。使用前打开一个文件,用后关闭它:
OPENFILE "data.txt" FOR READ // or FOR WRITE, FOR APPEND WHILE NOT EOF("data.txt") DO READFILE "data.txt", LineString OUTPUT LineString ENDWHILE CLOSEFILE "data.txt"EOF在读取之前测试文件结束(end of file)。要写入:OPENFILE "log.txt" FOR WRITE FOR i ← 1 TO 100 WRITEFILE "log.txt", "Event " & i NEXT i CLOSEFILE "log.txt"总是关闭每个文件——否则缓冲的写入可能丢失,而且其他程序可能被锁在外面。
为什么用文件(两分):数据在程序结束后仍然保留,下次运行时可用;可以与其他程序共享;可以容纳超过内存容量的数据。让程序能逐行处理文本文件的特性是:它是一系列行,从头开始一行接一行地读。三种模式:
READ从头读取;WRITE创建新文件,会删除已有的内容,所以不能用来向文件添加;APPEND在已有文件末尾添加行。每次读取前检验EOF,而且即使几个模块都用同一个文件也只打开一次。例题。 写出过程
LastLines(FileName : STRING)的伪代码,按顺序输出一个文本文件的最后三行。PROCEDURE LastLines(BYVAL FileName : STRING) DECLARE LineX, LineY, LineZ : STRING LineX ← "" LineY ← "" LineZ ← "" OPENFILE FileName FOR READ WHILE NOT EOF(FileName) DO LineX ← LineY LineY ← LineZ READFILE FileName, LineZ ENDWHILE CLOSEFILE FileName OUTPUT LineX OUTPUT LineY OUTPUT LineZ ENDPROCEDURE每读一行新内容就把前三行往前推一格,所以文件结束时三个变量正好保存它的最后三行;行数不足的文件输出空字符串。要输出前五行,就数已读的行数,在读满五行或到
EOF时停止,以先到者为准;空文件通过打开后EOF立即为TRUE来判断。一行中的字段。 文本文件保存的是字符串,所以一个记录写成一行,各字段用一个分隔符(separator)字符连接,每个数或布尔值用
NUM_TO_STR转换(读回时用STR_TO_NUM,或与"TRUE"比较)。选一个绝不会出现在数据中的分隔符:姓名和数字用逗号或|,姓名可能含空格时绝不用空格。如果某个字段可以含任何字符,分隔符就会与数据混淆;解决办法是把每个字段单独放一行,或在字段前写出它的长度。每项一行读回简单,但用的行更多,而且一条记录更难被看成一个整体。读取行按已知顺序(按 ID 升序)排列的文件时,一读到更大的 ID 就可以停止查找,而不必读到末尾。每次存档都新建的存档文件需要有意义的文件名,例如玩家姓名加日期和时间,这样任何较早的存档都能恢复。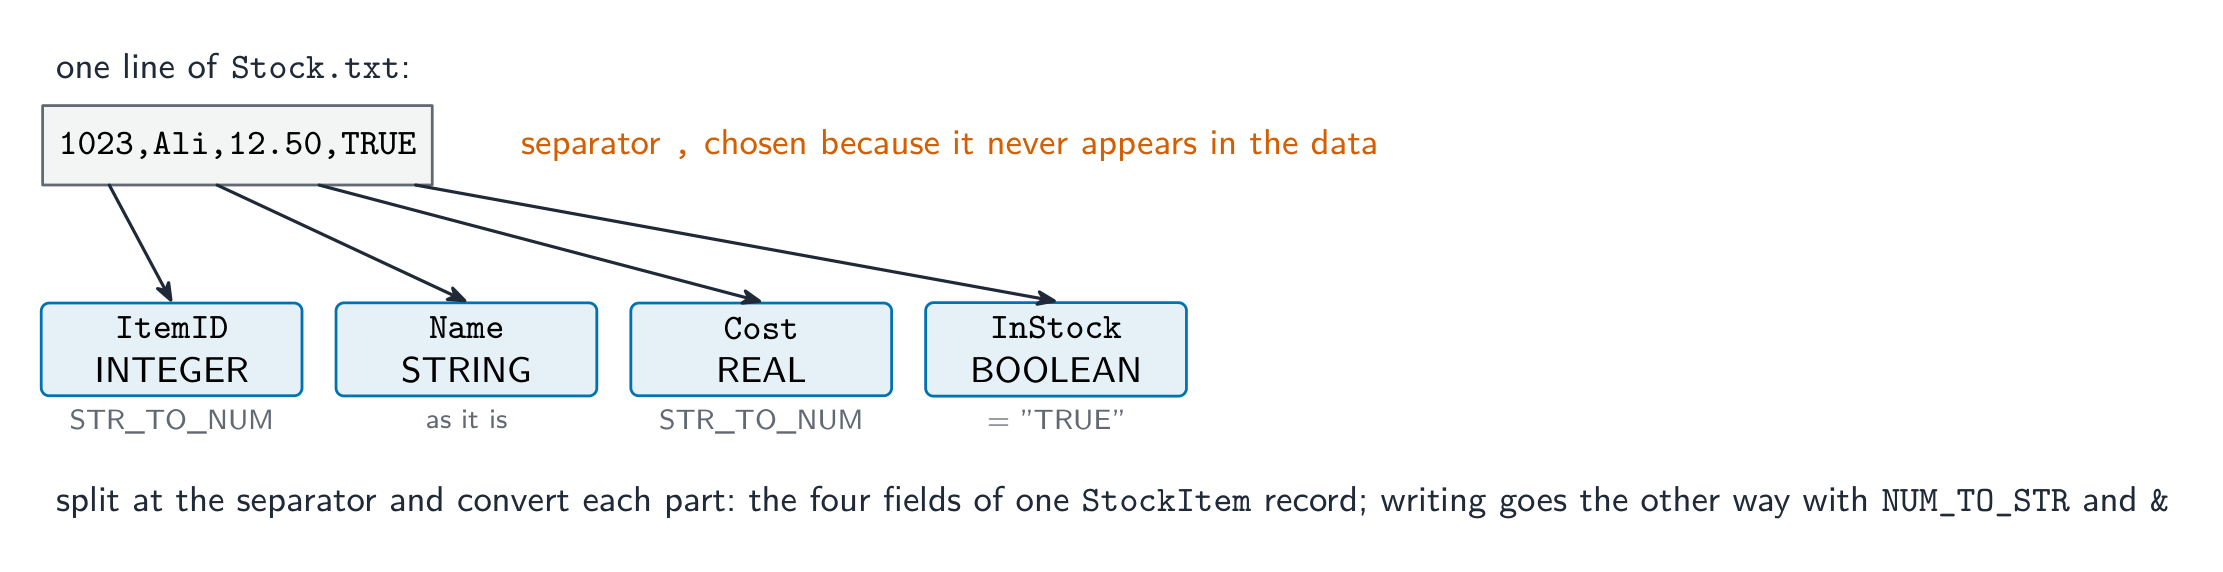
文本文件的一行就是一条记录:字段用分隔符连接,读回时转换成各自的类型 探索Handling a file: open → use → close
Step through the lifecycle every file follows. The two easy-to-forget parts are testing EOF while reading in a loop, and always closing at the end.
词汇表 训练英文 中文 拼音 file/faɪl/ 文件 wén jiàn secondary storage/ˈsekəndəri ˈstɔːrɪdʒ/ 辅助存储器 fǔ zhù cún chǔ qì text file/tekst faɪl/ 文本文件 wén běn wén jiàn end of file/end ɒv faɪl/ 文件结束 wén jiàn jié shù separator/ˈsepəreɪtə/ 分隔符 fēn gé fú 10.4
抽象数据类型(ADT)导论

大纲
Candidates should be able to: Notes and guidance Show understanding that an ADT is a collection of data and a set of operations on those data Show understanding that a stack, queue and linked list are examples of ADTs Describe the key features of a stack, queue and linked list and justify their use for a given situation Use a stack, queue and linked list to store data Candidates will not be required to write pseudocode for these structures, but they should be able to add, edit and delete data from these structures Describe how a queue, stack and linked list can be implemented using arrays 来源:剑桥国际大纲
链表:通过重新连接指针来插入 栈对队列:LIFO 和 FIFO 一个抽象数据类型(Abstract Data Type,ADT)是一组数据加上对它的操作,由它做什么定义,而不是它如何存储。用户只通过操作工作;实现被隐藏,所以它可以改变而不影响使用该 ADT 的代码。要知道三个:栈、队列、链表。
一分的定义:ADT 是一组数据连同对该数据的一组操作。栈、队列、链表、二叉树和数组都是 ADT。要论证选择:当各项必须按到达顺序处理时用队列(打印任务、按键、商店里的顾客),因为它先进先出;当最近的项必须最先处理时用栈(撤销、网页后退、颠倒顺序、嵌套调用的返回地址),因为它后进先出;当经常在有序序列的中间插入和删除时用链表,因为只改指针,不必移动任何东西。要比较栈和队列:两者都是有顺序的线性结构,都用数组和指针实现,都需要在添加前检查是否满、在移除前检查是否空;栈有一个指针,在同一端添加和移除,队列有两个指针,在一端添加、在另一端移除。
Stack
一个栈(stack)以 LIFO(后进先出,Last In, First Out)顺序工作。操作:入栈(push,加到顶部)、出栈(pop,从顶部移除)、peek(查看顶部),以及对空/满的测试。用途:撤销历史、函数调用返回地址、表达式解析、回溯。
push 和 pop 改变顶指针;底指针保持不动 例题。 一个字符栈从底部起存有
'P'、'N'、'Z'、'X'、'Y'、'W',栈顶指针指向'W'(200–207 中的内存位置 202)。执行操作POP、POP、PUSH 'A'、PUSH 'B'、POP。栈中有什么,指针指向哪里?两次 pop 先后移除
'W'和'Y';两次 push 在它们的位置加入'A'和'B';最后一次 pop 移除'B'。栈现在存有'P'、'N'、'Z'、'X'、'A',指针指向'A',位置 203。在栈中停留最久的值是底部的项'P';栈空之前最多还能 pop 五次,而对空栈 pop 是错误,所以Pop()先检验是否为空。成功时返回TRUE的Push()函数先检验指针是否在数组顶端(满),若是则返回FALSE。数组元素使用前不需要初始化,因为仅凭指针就知道哪些元素在使用中。
一摞书就是一个看得见的栈。你只能从顶部加书或取书,所以最后放上去的是第一个取下来的——这正是 LIFO(后进先出) Queue
一个队列(queue)以 FIFO(先进先出,First In, First Out)顺序工作。操作:入队(enqueue,加到后端)、出队(dequeue,从前端移除),以及对空/满的测试。用途:打印假脱机、调度、广度优先搜索、缓冲。

enqueue 在后端添加;dequeue 从前端移除 要描述添加一项:检查队列未满;把该项存入队尾指针给出的位置;队尾指针加一(计数也加一)。要描述移除:检查队列非空;读取队首指针处的项;队首指针加一(计数减一)。说明你用的约定:如果队尾指针标记的是下一个空位,队首和队尾指针相等就表示队列为空;如果它标记的是最后一项,指针相等表示有一项。在线性队列中队首指针只会向前移动,所以它后面的单元被浪费;下面的循环队列正是解决这一点的。要说出的队列的两个特征:项在后端添加、从前端移除,所以最先添加的最先移除。

一队人就是一个看得见的队列。你从后面加入,从前面被服务,所以等得最久的人最先被服务——这正是 FIFO(先进先出) Linked list
一个链表(linked list)把数据存储为一系列节点(nodes)。每个节点容纳一个值和一个指向下一个节点的指针(pointer);一个头指针标记起点,而最后一个节点的指针是一个哨兵(例如
NULL)。操作:插入、删除、搜索,以及遍历(traverse,按顺序访问每个节点)。它相对数组的优点是廉价的插入/删除(只需调整指针);它的缺点是慢的随机访问(你必须从头跟随指针)。
一个链表:每个节点指向下一个 按顺序添加节点(四分):从头指针出发沿指针遍历链表,直到找到目标位置之前的节点(最后一个值更小的节点);取一个空闲节点并把新值存入其中;把新节点的指针设为前一个节点原来指向的地址;把前一个节点的指针设为新节点。如果新值应在最前面,则改头指针。删除节点:找到它前面的节点,把该节点的指针设为被删节点原来指向的地址,链表就绕过了它;释放的节点回到空闲列表。与一维数组相比,链表中插入或删除不需要移动其他项,而且链表可以增长到内存用完为止;代价是每一项都要额外存一个指针,以及到达第 $n$ 项要顺着 $n$ 个指针走,因为没有直接的下标。
探索A linked list: nodes joined by pointers
Each node stores a value and a pointer to the next node. Inserting or deleting just re-links pointers — no items shift along, unlike an array.
探索Stacks and queues
Push and pop. A stack is last-in-first-out; a queue is first-in-first-out — two key ADTs.
词汇表 训练英文 中文 拼音 stack/stæk/ 栈 zhàn push/pʊʃ/ 入栈 rù zhàn Abstract Data Type/ˈæbstrækt ˈdeɪtə taɪp/ 抽象数据类型 chōu xiàng shù jù lèi xíng linked list/lɪŋkt lɪst/ 链表 liàn biǎo pointer/ˈpɔɪntə/ 指针 zhǐ zhēn queue/kjuː/ 队列 duì liè LIFO/ˈlaɪfəʊ/ 后进先出 hòu jìn xiān chū FIFO/ˈfaɪfəʊ/ 先进先出 xiān jìn xiān chū pop/pɒp/ 出栈 chū zhàn enqueue/enˈkjuː/ 入队 rù duì dequeue/diːˈkjuː/ 出队 chū duì nodes/nəʊdz/ 节点 jié diǎn node/nəʊd/ 节点 jié diǎn traverse/trəˈvɜːs/ 遍历 biàn lì 10.4
用数组实现抽象数据类型

Stack using an array
把项保存在
Stack[1:MaxSize]中,带一个整数Top(空时为 0)。Push(x):若Top = MaxSize则栈满(溢出(overflow));否则Top ← Top + 1;Stack[Top] ← x。Pop():若Top = 0则栈空(下溢(underflow));否则返回Stack[Top]并Top ← Top - 1。
Queue using a circular array
一个简单队列让
Front和Rear走出末端,浪费起始部分。修正是一个循环数组(circular array)——当一个指针到达MaxSize时它绕回到 1:Enqueue(x):检查满;否则Rear ← (Rear MOD MaxSize) + 1;Queue[Rear] ← x。Dequeue():检查空;否则返回Queue[Front]并Front ← (Front MOD MaxSize) + 1。
跟踪一个单独的计数以区分空和满。
队尾指针的算法,用文字表述:如果计数等于大小,报告队列已满并停止;否则队尾指针加一;如果它超过了最后一个下标,就设为第一个下标;把项存在那里并把计数加一。五分的"描述声明和初始化"答案要列出的声明:带大小和元素类型的数组;队首指针和队尾指针,都初始化为第一个下标(或者队首为第一个下标、队尾为下一个空位);以及初始化为 $0$ 的项数计数。
例如,当
MaxSize = 6时:若Rear = 5,则(5 MOD 6) + 1 = 6,所以下一项放入单元 6;若Rear = 6,则(6 MOD 6) + 1 = 1,所以指针绕回到单元 1。一个循环队列把指针绕回到数组的起点 Linked list using an array
用一个记录的数组,每个带一个
Next索引:TYPE TNode DECLARE Value : INTEGER DECLARE Next : INTEGER // index of the next node, or -1 for end ENDTYPE DECLARE Nodes : ARRAY[1:MaxSize] OF TNode DECLARE Head : INTEGER // index of first node, -1 if empty DECLARE FreeListHead : INTEGER // first available free node一个空闲列表(free list)把未使用的槽链在一起,正如数据列表把它用过的槽链在一起。要插入:从
FreeListHead取一个槽,设新节点的值和Next,并更新前一个节点的Next(或Head)。要删除:解开该节点的链接并把它的槽还给空闲列表。这给出一个链式结构的灵活性和一个数组的静态分配。
一个存储在数组中的链表:一个数据数组和一个指针数组 例题。 一个链表存放在
Data数组和Pointer数组中,Start指向下标 1。链表是 1 → 3 → 4(下标 1 存D40,下标 3 存D32,下标 4 存D11,其指针为 $\emptyset$);空闲列表从下标 2 开始,接着 2 → 5。在D32和D11之间插入D6。取第一个空闲节点下标 2,并把
FreeStart设为它的指针 5;把D6存入Data[2];把Pointer[2]设为Pointer[3]原来的值 4;把Pointer[3]设为 2。链表变为 1 → 3 → 2 → 4,空闲列表是 5 → $\emptyset$。"链表如何实现"的答案正是这些部分:存数据的数组(或记录数组)、存下标的平行指针数组、一个起始指针、一个空闲列表指针,以及像 $-1$ 这样表示末尾的空值。例题。 一个循环队列存放在大小为 5 的数组中(下标 0 到 4),此时
Front = 3、Rear = 3,存有一个元素。先加入两个元素,再移除两个。指针各在哪里?为什么要用循环队列?每次移动都用(指针 + 1) MOD 大小,所以指针会回绕。加入两次会移动Rear:$3 \rightarrow 4$,然后 $4 \rightarrow 0$(因为 $(4+1) \bmod 5 = 0$),所以Rear = 0,存有三个元素。移除两次同样地移动Front:$3 \rightarrow 4$,然后 $4 \rightarrow 0$,剩下Front = 0和一个元素。回绕正是它的意义所在:在线性数组队列中,指针一路走到末端,前面腾出的空间即使队列已空也被浪费掉。记住队列在 Front 端移除、在 Rear 端加入 - 而栈的两端共用一个指针。探索Implementing ADTs with arrays
FIFO
A queue is first-in-first-out — enqueue at the back, dequeue from the front.
词汇表 训练英文 中文 拼音 array/əˈreɪ/ 数组 shù zǔ free list/friː lɪst/ 空闲列表 kòng xián liè biǎo overflow/ˌəʊvəˈfləʊ/ 溢出 yì chū underflow/ˌʌndəˈfləʊ/ 下溢 xià yì circular array/ˈsɜːkjʊlə əˈreɪ/ 循环数组 xún huán shù zǔ 10.4
考官认可的定义
定义题按固定的表述给分。把这些记准确。
术语 定义 记录(record) 在一个标识符下容纳一组不同数据类型的数据项(字段)的数据结构 数组(array) 在一个标识符下容纳固定个数、同一数据类型的元素、各由下标访问的数据结构 下标(index) 标识数组中一个元素的数 上界、下界(upper bound, lower bound) 数组最大和最小的有效下标 文本文件(text file) 以字符行存储数据、程序一次读写一行的文件 抽象数据类型(abstract data type) 一组数据连同对该数据的一组操作 栈(stack) 在同一端(顶部)添加和移除项的列表,所以最后添加的最先移除(LIFO) 队列(queue) 在后端添加、从前端移除项的列表,所以最先添加的最先移除(FIFO) 链表(linked list) 每个节点存一个数据项和指向下一个节点的指针、并有指向第一个节点的起始指针的列表 指针(pointer) 存放一个节点或结构中某位置的地址(或下标)的变量 线性查找(linear search) 从第一个元素起逐个检查,直到找到目标或到达末尾 冒泡排序(bubble sort) 反复遍历数组,比较相邻对并交换顺序错误的,直到某一趟没有交换 10.4
考试技巧
- 选择正确的数据结构并为它辩护(一个记录用于混合字段,一个 2-D 数组用于网格)。
- 知道如何用一个数组和指针实现一个栈、队列和链表(top;front/rear;next)。
- 区分一个 ADT(它的行为)和它的实现(数组加指针)。
常见错误
- 记录声明没有
ENDTYPE,或字段没有类型。每个字段都是一行带类型的DECLARE。 - 读过文件末尾,或者在文件必须保留内容时用
WRITE写。每次读前检验EOF;要添加就用APPEND。 - 把数直接写进文本文件而不转换。文件存的是字符串:出去用
NUM_TO_STR,回来用STR_TO_NUM。 - 忘了检查。
Push和入队先检验是否满;Pop和出队先检验是否空,而且答案里要写出来。 - 插入节点时丢掉链表的其余部分。先把新节点的指针设为原来的下一个节点,再改前一个节点的指针。
- 线性查找从不报告"未找到"。把位置初始化为 $-1$,循环后检验它。
-
11
程序设计
11.1
编程基础

大纲
Candidates should be able to: Notes and guidance Implement and write pseudocode from a given design presented as either a program flowchart or structured English Write pseudocode statements for: • the declaration and initialisation of constants • the declaration of variables • the assignment of values to variables • expressions involving any of the arithmetic or logical operators input from the keyboard and output to the console Use built-in functions and library routines Any functions not given in the pseudocode guide will be provided String manipulation functions will always be given 来源:剑桥国际大纲
编程把一个设计变成写成代码的指令 
一个程序员写代码并随手测试它 From design to code
你应当能够把一个设计——一张流程图(flowchart,程序流程图)或结构化英语(structured English)——变成伪代码(pseudocode),然后变成一门真实的语言:
- 找出变量(variables)及其数据类型(data types)。
- 把输入/输出框变成
INPUT/OUTPUT。 - 把判断菱形变成
IF...ELSE...ENDIF(或CASE)。 - 把循环箭头变成
WHILE、REPEAT...UNTIL或FOR。 - 把处理框变成赋值或计算。
- 通过追踪一个小输入来检查。

每个流程图符号变成一个伪代码关键字 Constants and variables
一个常量(constant)容纳一个从不改变的值;一个变量容纳一个可能改变的值。用一个类型声明它们:

一个变量的值可以改变;一个常量保持固定 CONSTANT Pi ← 3.14159 DECLARE Radius : REAL DECLARE Area : REAL Radius ← 5 Area ← Pi * Radius * Radius对反复出现的固定值用常量(
Pi、MaxScore);它们使代码更清晰,并且易于在一处改变。在考试中,常量是"指出一种更合适的表示方式"这类题的答案:一个固定值,例如税率或最高分,在伪代码的好几处出现。评分标准列出的好处:该值只设定一次,不会被程序意外改变;修改只需在一处进行,并作用于每一条使用它的语句;标识符赋予该值一个含义(
MaxScore而不是100),所以代码更易读、更易检查;而且像3.14159这样的长数值打错的风险更小。"说出一个可以用常量代替的值"这类题要的是伪代码里的字面值(0.2、40),而不是一个新名字。每个变量在使用之前只声明一次,带一个标识符(identifier,即它的名字)和一个数据类型。9618 伪代码指南中的六种类型:
类型 存放 在代码中写成 典型用途 INTEGER整数 42、-3计数、数组下标、循环计数器 REAL带小数部分的数 3.75价格、平均值 CHAR一个字符 'A'(单引号)等级字母、菜单按键 STRING一串字符 "Hello"(双引号)姓名、邮政编码 BOOLEANTRUE或FALSETRUEFound这样的标志DATE一个日历日期 12/05/2026出生日期 "给出合适的数据类型"这类题目要从变量在伪代码中怎样被使用来回答:带小数点的值是
REAL;被赋为TRUE或FALSE的是BOOLEAN;单引号里的值是CHAR;用作数组下标、或与DIV和MOD一起用的值是INTEGER。类型用大写字母写,拼写与指南一致。例题。 说出每个变量合适的数据类型。
Found ← FALSE Initial ← 'K' Price ← 12.99 Count ← Count + 1 Name ← "Li Wei"Found是BOOLEAN(它存放FALSE);Initial是CHAR(单引号里的一个字符);Price是REAL(一个小数值);Count是INTEGER(一个每次加一的计数器);Name是STRING(双引号里的文本)。Assignment and expressions
用
←表示赋值(assignment):Total ← Total + 1 Average ← Sum / Count表达式用运算符(operators):
- 算术
+ - * /,加上DIV(整数除法)和MOD(余数):7 DIV 2 = 3;7 MOD 2 = 1。 - 比较
=、<>、<、>、<=、>=。 - 逻辑
AND、OR、NOT。
优先级(precedence,从高到低):
NOT→* / DIV MOD→+ -→ 比较 →AND→OR。不确定时用括号。Input and output
OUTPUT "Enter your name:"
INPUT Name
OUTPUT "Hello, ", Name
Built-in functions and library routines
许多任务有现成的库例程(library routines),所以你不必自己写它们。Paper 2 的附页(insert)列出了你可以使用的例程,以及它们确切的名称、参数和返回类型;题目需要的任何其他函数会在题目中给出。下面是 9618 的名称——IGCSE 的名称(
UCASE、VAL、STR)不被接受。一个程序库(program library)存放已经写好、编译好并测试过的例程;程序调用它们,而不是自己再写。评分标准接受的好处,用于"说出三个好处"的题:这些例程已经测试过,所以更不容易含有错误;它们节省开发时间;它们可能做到程序员自己写不出的事(复杂的统计、图形);它们由专家编写并在许多程序中重复使用;而且接口固定的例程可以在程序的任何地方调用。
例程 返回 例子 LENGTH(s)s中的字符个数LENGTH("Hello") = 5LEFT(s, n)/RIGHT(s, n)开头 / 末尾的 n个字符RIGHT("Hello", 2) = "lo"MID(s, start, n)从位置 start起的n个字符(位置从 1 数起)MID("Hello", 2, 3) = "ell"TO_UPPER(s)/TO_LOWER(s)大写 / 小写的 sTO_UPPER("ab1") = "AB1"NUM_TO_STR(x)/STR_TO_NUM(s)数变成字符串 / 字符串变成数 STR_TO_NUM("3.5") = 3.5IS_NUM(s)若 s是一个有效的数则为TRUEIS_NUM("12a") = FALSEASC(c)/CHR(n)c的字符编码 / 编码为n的字符ASC('A') = 65、CHR(66) = 'B'INT(x)x的整数部分INT(7.9) = 7RAND(n)从 0 到(不含) n的一个随机实数INT(RAND(6)) + 1是掷一次骰子DAY(d)、MONTH(d)、YEAR(d)一个 DATE的各部分YEAR(TODAY())DAYINDEX(d)、SETDATE(d, m, y)、TODAY()星期几(1 = 星期日);由三个整数构成的日期;今天的日期 EOF(f)当文件 f没有更多行可读时为TRUEWHILE NOT EOF("data.txt")字符串用
&连接(连接(concatenation)):"A" & "BC"是"ABC"。使用附页里确切的名称,参数按它的顺序。日期和随机数常以单行语句出现。
SETDATE(17, 11, 2007)构造 2007 年 11 月 17 日;12 - MONTH(MyDOB)是从出生月份到年底的月数;IF DAYINDEX(MyDOB) = 5 THEN检验是否星期四,因为星期日是第 1 天。RAND(n)返回一个从0到(不含)n的实数,所以从Low到High(含)的随机整数是INT(RAND(High - Low + 1)) + Low:INT(RAND(21)) - 10给出-10到10之间的值。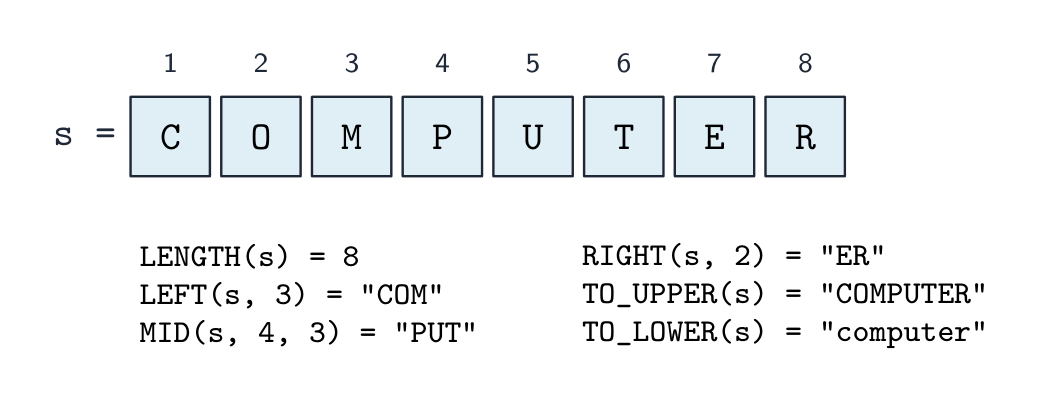
常见的字符串例程作用于 s = "COMPUTER"(位置 1–8)例题。 已知
Word ← "Program"、Code ← 'Q'和N ← 7,求每个表达式的值。表达式 值 原因 LENGTH(Word)7七个字符 MID(Word, 4, 2)"gr"从位置 4 起的两个字符 LEFT(Word, 3) & "!""Pro!"用 &连接TO_UPPER(RIGHT(Word, 2))"AM"内层函数先运行 ASC(Code) - ASC('A')16'Q'是 81,'A'是 65N DIV 2 + N MOD 243 + 1NUM_TO_STR(N) & "th""7th"数先变成字符串 INT(N / 2)33.5截去小数部分由内向外计算,并保留引号:
"7"是字符串,而7是数。例题。 每条语句在函数或运算符的使用上都可能有错误。描述错误,或写 NO ERROR。(假设每个变量的类型都正确。)
语句 错误 Result ← 2 & 4&连接字符串;2和4是整数,所以需要+SubString ← MID("pseudocode", 4, 1)NO ERROR:从位置 4 起的一个字符, "u"IF x = 3 OR 4 THENOR两边各需要一个布尔值:IF x = 3 OR x = 4 THENResult ← Status AND INT(x / 2)AND需要两个布尔值;INT(x / 2)是整数Message ← "Done" + LENGTH(MyString)+不能把字符串和整数相加:"Done" & NUM_TO_STR(LENGTH(MyString))每个运算符只作用于特定的类型:
&作用于字符串,+ - * / DIV MOD作用于数,AND OR NOT作用于布尔值,而= <>作用于两个同一类型的值。"求每个表达式的值,或写 ERROR"的表格按同样的方式评分:LENGTH(42)和"A" + 1是 ERROR,因为类型与函数或运算符不匹配。例题。 已知
Points ← 100、Active ← TRUE和Exempt ← FALSE,求每个表达式的值。表达式 值 原因 (Points > 99) OR ActiveTRUE两边都为真;一边为真就够了 (Points MOD 2 = 0) OR ExemptTRUE100 MOD 2是0(Points <= 75) AND (Active OR Exempt)FALSE第一边为假,而 AND需要两边都为真(Active OR NOT Active) AND NOT ExemptTRUEActive OR NOT Active永远为真最后一个表达式可以化简:无论
X是什么,X OR NOT X都是TRUE,所以整个表达式就是NOT Exempt。先算括号,再算NOT,然后AND,最后OR。探索A variable is a labelled box
Each assignment stores one value in a named box; reassigning the same name overwrites it. Step through the program and watch each box take its current value.
词汇表 训练英文 中文 拼音 flowchart/ˈfləʊtʃɑːt/ 流程图 liú chéng tú structured English/ˈstrʌktʃəd ˈɪŋɡlɪʃ/ 结构化英语 jié gòu huà yīng yǔ pseudocode/ˈsuːdəʊkəʊd/ 伪代码 wěi dài mǎ variables/ˈveərɪəblz/ 变量 biàn liàng data types/ˈdeɪtə taɪps/ 数据类型 shù jù lèi xíng assignment/əˈsaɪnmənt/ 赋值 fù zhí constant/ˈkɒnstənt/ 常量 cháng liàng identifier/aɪˈdentɪfaɪə/ 标识符 biāo shí fú operators/ˈɒpəreɪtəz/ 运算符 yùn suàn fú precedence/ˈpresɪdəns/ 优先级 yōu xiān jí library routines/ˈlaɪbrəri ruːˈtiːnz/ 库例程 kù lì chéng insert/ˈɪnsɜːt/ 附页 fù yè program library/ˈprəʊɡræm ˈlaɪbrəri/ 程序库 chéng xù kù concatenation/kənˌkætəˈneɪʃn/ 连接 lián jiē IDE/ˌaɪ diː ˈiː/ 集成开发环境 jí chéng kāi fā huán jìng 11.2
程序结构

大纲
Candidates should be able to: Notes and guidance Use pseudocode to write: • an ‘IF’ statement including the ‘ELSE’ clause and nested IF statements • a ‘CASE’ structure • a ‘count-controlled’ loop: • a ‘post-condition’ loop • a ‘pre-condition’ loop Justify why one loop structure may be better suited to solve a problem than the others 来源:剑桥国际大纲
选择(selection)选择哪些步骤运行。
IF age >= 18 THEN
    OUTPUT "Adult"
ELSE
    OUTPUT "Minor"
ENDIF
一个 IF...ELSE 测试条件一次,然后恰好运行一个分支 对于多于两种情况,你可以用一个嵌套(nested)IF,但深度嵌套难以阅读——当把一个值对照几个选项测试时,一个
CASE更清爽:CASE OF Grade "A": OUTPUT "Excellent" "B": OUTPUT "Good" OTHERWISE: OUTPUT "Try again" ENDCASECambridge 的
CASE允许单个值、值列表(1, 2, 3:)和范围(1 TO 5:)。嵌套 IF 是放在另一个 IF 的某个分支里的 IF。每个
IF都需要自己的ENDIF,而且阅卷人会检查每个结构是否都被关闭:IF Mark >= 50 THEN IF Mark >= 80 THEN OUTPUT "Distinction" ELSE OUTPUT "Pass" ENDIF ELSE OUTPUT "Fail" ENDIF边界是丢分的地方。"50 分或以上及格"是
Mark >= 50,不是Mark > 50;CASE中"其他情况"的最后一个分支写成OTHERWISE,而不是> 200这样的条件。这里一个错误的比较就是一个逻辑错误(logic error):程序能运行,但对某些输入给出错误的输出——而用50这样的边界值做一张跟踪表就是找到它的方法。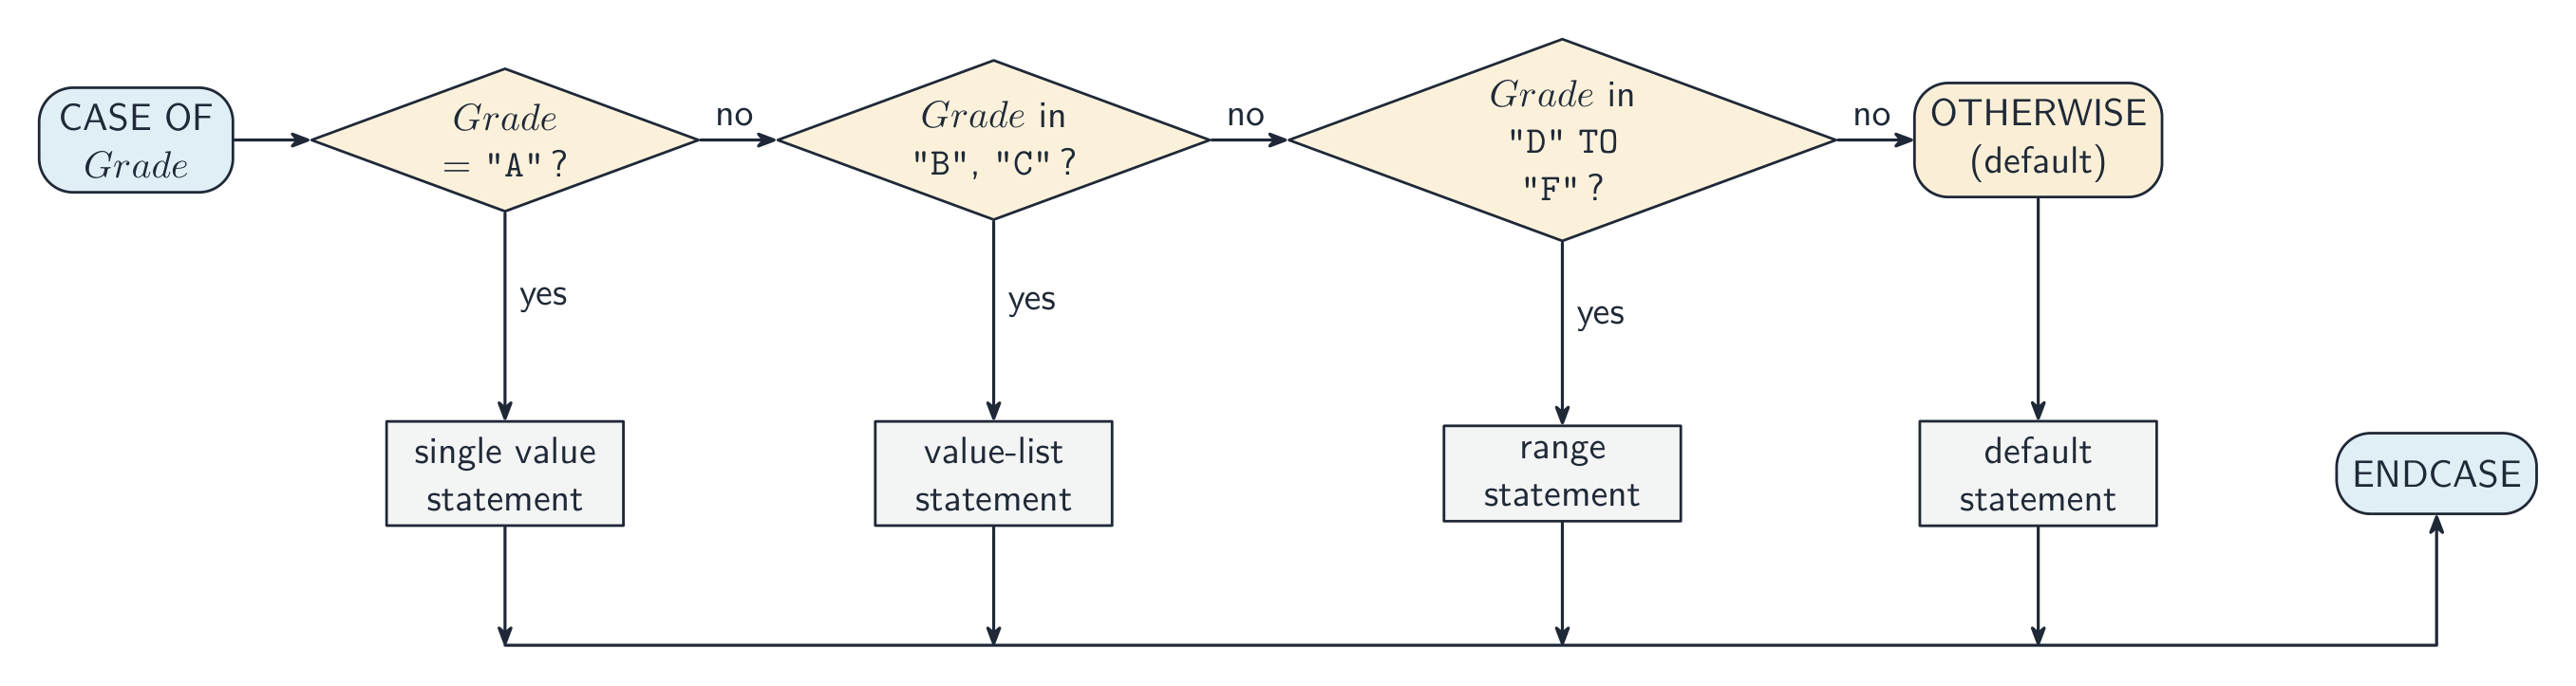
一个 CASE 语句运行匹配该值的分支 例题。 不使用 CASE 结构,改写出功能相同的伪代码。
CASE OF MySwitch
    1: ThisChar ← 'a'
    2: ThisChar ← 'y'
    3: ThisChar ← '7'
    OTHERWISE: ThisChar ← '*'
ENDCASE
每个值变成 IF 链中的一个分支,
OTHERWISE变成最后的ELSE:IF MySwitch = 1 THEN ThisChar ← 'a' ELSE IF MySwitch = 2 THEN ThisChar ← 'y' ELSE IF MySwitch = 3 THEN ThisChar ← '7' ELSE ThisChar ← '*' ENDIF ENDIF ENDIF赋同一个值的两个子句合并成一个带值列表的子句:
1, 2: ThisChar ← 'a'。卫式按顺序检验:对于1 TO 50:后面跟着40 TO 60:这样的范围,值45走第一个匹配的分支,所以后面分支里的赋值可能永远不会执行——而当前面的分支已经覆盖了所有可能的值时,OTHERWISE分支也永远不会到达。反过来,检验几个布尔值的嵌套 IF 写成每种结果一个条件会更清楚:
IF A AND B AND C THEN CALL Sub1(),然后IF A AND B AND NOT C THEN CALL Sub2(),依此类推。用AND和OR把检验连起来就去掉了嵌套,而且IF A THEN可以代替IF A = TRUE THEN。探索Selection (IF / ELSE)
Change the input and see which branch runs — the essence of selection.
词汇表 训练英文 中文 拼音 selection/sɪˈlekʃn/ 选择 xuǎn zé nested/ˈnestɪd/ 嵌套 qiàn tào logic error/ˈlɒdʒɪk ˈerə/ 逻辑错误 luó jí cuò wù 11.2
迭代

迭代(iteration)重复一个块。三个循环在主体运行多少次上不同。
Count-controlled (FOR) loop
一个计数循环(count-controlled loop)——当你知道要重复多少次时用它:
FOR i ← 1 TO 10
    OUTPUT i
NEXT i
一个
STEP可以改变计数(例如FOR i ← 10 TO 1 STEP -1)。最适合固定次数的重复或处理一个数组(array)的每个元素。Pre-condition (WHILE) loop
一个前测循环(pre-condition loop)在每一趟之前测试条件,所以它可能运行零次:
WHILE total < 100 DO
    INPUT n
    total ← total + n
ENDWHILE
Post-condition (REPEAT...UNTIL) loop
一个后测循环(post-condition loop)在每一趟之后测试条件,所以它总是至少运行一次:
REPEAT
    INPUT password
UNTIL password = correctPassword
Choosing the right loop
三个循环在条件被测试的位置上不同——在主体之前(WHILE)、之后(REPEAT),或做设定的次数(FOR) - 事先知道计数 → FOR。
- 可能需要零趟 → WHILE。
- 总是至少一趟 → REPEAT...UNTIL。
用计数是否已知、以及主体是否必须至少运行一次来为你的选择辩护。一个典型的题目给出一个场景("要求密码直到正确,但总是至少要求一次")并问哪个循环合适。
这两分分别给循环的名称和按评分标准措辞的理由:计数控制,因为迭代次数在循环开始前已知;后测,因为循环体必须至少执行一次;前测,因为循环可能根本不需要执行。一个遍历数组四个元素、却写成带计数器的
WHILE的循环"不是最合适的":次数(四)已知,所以FOR循环合适。例题。 每个任务适合哪种循环?(a) 打印 12 的乘法表;(b) 不断读入数字,直到用户输入 0;(c) 反复要求输入密码,直到正确为止。判断的依据是循环体运行多少次,以及在何时检验条件。(a) 次数事先已知(12 次),所以用 FOR 循环。(b) 次数未知,而且第一个输入就可能已经是 0 - 所以条件必须在循环体之前检验:用 WHILE 循环,它可以运行零次或多次。(c) 次数未知,但你必须至少问一次之后才有东西可检验 - 所以条件在循环体之后检验:用 REPEAT...UNTIL,它运行一次或多次。决定性的问题是:循环体是否必须至少运行一次 - WHILE 可能运行零次,REPEAT 总是运行一次。
Dry running with a trace table
跟踪表(trace table)记录你手工跟踪(dry run,即用手一步步走一遍)一个算法时每个变量的值。它是在纸上测试一个循环的方法,也是大多数 Paper 2 上一道六分的题。
DECLARE Count, Total : INTEGER
Count ← 1
Total ← 0
WHILE Total < 10
    Total ← Total + Count * 2
    Count ← Count + 1
ENDWHILE
OUTPUT Count, Total
Count Total Total < 10 OUTPUT 1 0 TRUE 2 2 TRUE 3 6 TRUE 4 12 FALSE 4, 12 得分的规则:每个变量一列,按题目给出的顺序;只在值改变时才写它;循环每重复一次就另起一行;用当前的值计算条件,并在它变为
FALSE的那一刻停止;把输出放在它自己的一列里,与实际显示的完全一样。按算法写的那样去跟踪,而不是按你认为它想要的那样——如果它永不停止,就说明这一点。例题。 每一行用了哪些结构——选择、迭代还是子程序调用?
伪代码 选择 迭代 子程序 IF Ready = TRUE THEN CALL Start() ENDIF是 是 FOR I ← 1 TO 20 ... NEXT I是 WHILE NOT IsFull() ... ENDWHILE是 是 CASE OF Key ... OTHERWISE ... ENDCASE是 IF和CASE是选择;FOR、WHILE和REPEAT是迭代;名字后面跟着括号——Start()、IsFull()——就是对过程或函数的调用,无论它出现在哪里,包括在条件里面。探索Trace a loop, pass by pass
A trace table records each variable after every pass of the loop. Watch the counter i climb while the running total builds up — exactly what an exam trace question asks you to fill in.
探索Tracing a loop
Step through the loop and watch the variables change each pass — exactly what a trace table records.
词汇表 训练英文 中文 拼音 array/əˈreɪ/ 数组 shù zǔ trace table/treɪs ˈteɪbl/ 跟踪表 gēn zōng biǎo iteration/ˌɪtəˈreɪʃn/ 迭代 dié dài count-controlled loop/kaʊnt kənˈtrəʊld luːp/ 计数循环 jì shù xún huán pre-condition loop/priː kənˈdɪʃn luːp/ 前测循环 qián cè xún huán post-condition loop/pəʊst kənˈdɪʃn luːp/ 后测循环 hòu cè xún huán dry run/draɪ rʌn/ 手工跟踪 shǒu gōng gēn zōng 11.3
结构化编程

大纲
Candidates should be able to: Notes and guidance Define and use a procedure Explain where in the construction of an algorithm it would be appropriate to use a procedure Use parameters A procedure may have none, one or more parameters A parameter can be passed by reference or by value Define and use a function Explain where in the construction of an algorithm it is appropriate to use a function A function is used in an expression, e.g. the return value replaces the call Use the terminology associated with procedures and functions including procedure/function header, procedure/function interface, parameter, argument, return value Write efficient pseudocode 来源:剑桥国际大纲
结构化编程(structured programming)从小的、有名字的子程序(subroutines)构建一个程序,每个有一件工作。
Procedure
一个过程(procedure)是一个有名字的块,它做一个动作;它可以取参数(parameters),但不返回一个值。
PROCEDURE Greet(name : STRING)
    OUTPUT "Hello, ", name
ENDPROCEDURE

CALL Greet("Ada")
Function
一个函数(function)像一个过程,但它返回一个值,该值成为一个表达式的一部分。
FUNCTION Square(x : INTEGER) RETURNS INTEGER RETURN x * x ENDFUNCTION result ← Square(5) + 1 // result = 26当子程序执行一个动作时用一个过程;当它为调用者计算一个值时用一个函数。
教学大纲问的是在构造算法的哪里用哪一个合适。在同一组步骤在几处都需要的地方(验证一个输入、打印一个菜单、交换两个值),用过程合适:步骤只写一次,然后按名字
CALL。在必须算出一个值然后在表达式中使用的地方——一个总数、一个TRUE/FALSE的结果、两个数中较大的一个——用函数合适,因为返回值(return value)替换了调用:IF IsValid(Code) THEN。一个过程做一个动作并不返回任何东西;一个函数返回一个你在表达式中使用的值 Parameters
一个参数(parameter)是一个子程序声明用来接收输入的变量;调用者提供的值是实参(arguments)。传递它们的两种方式:
- 传值(pass by value)——例程得到一个副本;它内部的改变不影响调用者。用于它只读取的输入。
- 传引用(pass by reference)——例程得到一个到调用者变量的引用;改变确实影响调用者。当它必须更新一个参数时用。

传值把值复制到一个新框;传引用让例程改变调用者自己的变量 PROCEDURE Swap(BYREF a : INTEGER, BYREF b : INTEGER) DECLARE temp : INTEGER temp ← a a ← b b ← temp ENDPROCEDURECambridge 伪代码在头部里、每个参数前写出传递方式
BYVAL或BYREF。两者都不写时默认是BYVAL,所以必须改变调用者变量的例程——Swap,或者更新一个累计总数的过程——头部里需要BYREF。例题。 输出是什么?
PROCEDURE Adjust(BYREF X : INTEGER, BYVAL Y : INTEGER) X ← X + Y Y ← Y * 2 ENDPROCEDURE A ← 5 B ← 3 CALL Adjust(A, B) OUTPUT A, BX是到A的引用,所以A变成8。Y是B的一个副本,所以把Y加倍后B仍是3。输出是8, 3。如果头部写的是BYVAL X,A仍会是5。Local vs global variables
一个局部变量(local variable)在一个子程序内部声明,只在它运行时存在。一个全局变量(global variable)在外部声明,处处可见。优先用局部变量和参数——大量使用全局变量使代码难以理解和测试。(一个名称可见的区域是它的作用域(scope)。)
一句话的区别:全局变量可以在程序的任何地方访问,局部变量只能在声明它的子程序内部访问。评分标准接受的局部变量的好处:同一个标识符可以在另一个子程序里使用而不冲突;它的值不会被程序的其他部分意外改变;子程序结束时内存被释放;而且子程序是自包含的,所以可以单独测试并在另一个程序中重用。
局部变量在子程序每次被调用时创建、返回时销毁,所以它不能把一个值从一次调用带到下一次。因此,一个在多次调用中逐步拼接字符串的过程需要那个字符串是全局的(或以
BYREF传入)。如果把MyString从全局变量改成在MyOutput()内部声明的局部变量,每次调用都从一个新的、空的MyString开始,之前调用加上的文本就丢失了,过程"不能按预期工作"。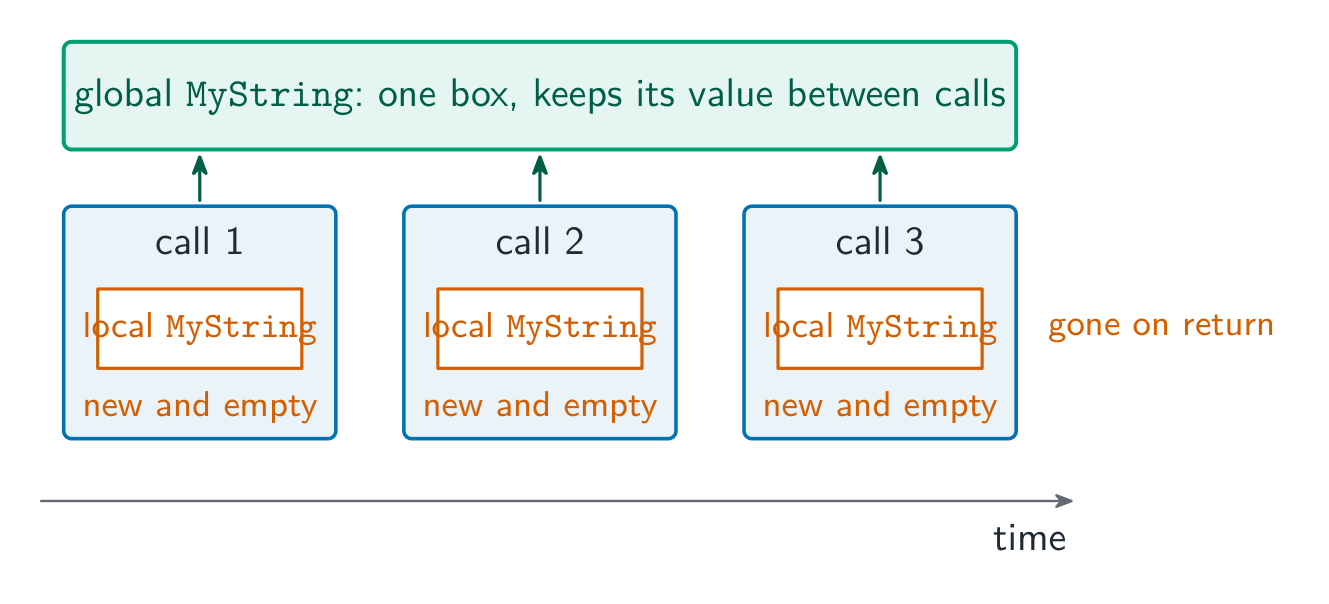
局部变量在每次调用时都是一个新的、空的框;只有全局变量(或 BYREF 参数)能在各次调用之间保留值 
一个全局变量处处可见;一个局部变量只在它自己的过程内部存在 When to use a subroutine
在以下情况用一个子程序:
- 同样的逻辑出现在不止一处——写它一次,调用它多次。
- 一个块有一个清晰、有名字的目的——名称记录它做什么。
- 程序复杂——把它分成部分(分解(decomposition))。
- 你想孤立地测试一个片段。
不要把它们做得那么小,以至于调用的代价超过里面的工作。
Terminology
- definition——
PROCEDURE ... ENDPROCEDURE(或函数)块。 - call——它被调用的地方。argument——一个被传入的值。parameter——接收它的变量。
- return value——一个函数传回什么。
- procedure/function header——给出名称和参数的第一行(
PROCEDURE Name(params)或FUNCTION Name(params) RETURNS type)。 - procedure/function interface / signature(签名)——名称 + 参数 + 返回类型:一个调用者要用它必须知道什么。
例题。 描述头部
FUNCTION Pass2(Count : INTEGER) RETURNS BOOLEAN中用到的每个术语。术语 含义 FUNCTION一个返回值的子程序 Pass2用来调用它的标识符 Count参数:接收传入的实参的标识符 INTEGER参数的数据类型 RETURNS BOOLEAN函数返回的值的数据类型 PROCEDURE MyProc(Count : INTEGER, Message : STRING)里的两个标识符是参数:它们在过程被调用时接收传入的值,并在过程内部像局部变量一样使用。把过程改成函数:把
PROCEDURE改为FUNCTION并加上RETURNS <type>;把OUTPUT(或者把结果带出去的BYREF参数)换成一条RETURN语句;并修改每一处调用,使返回值被使用,即Result ← Unpack(Text)而不是CALL Unpack(Text, Result)。对于"写出头部"的题,写出整行:FUNCTION Calculate(Expression : STRING) RETURNS INTEGER。数组参数是按引用传递的,所以向数组里写入的过程会改变调用者的数组。当一个程序增加一个新模块时,首先要商定的就是接口:名称、参数(几个、什么顺序、什么类型)和返回类型,再加上该模块读取或写入的任何全局数据。一个在到期日之前发送提醒的模块需要把记录(或它的下标)作为参数,并且不返回任何东西,所以它是一个过程;主程序对每条记录调用它一次。
Writing a module for Paper 2
Paper 2 的一半是"为模块 X 写伪代码"。评分标准按特征逐项给分,所以一个没写完的模块仍能为每个正确的部分得分。阅卷人要找的部分:
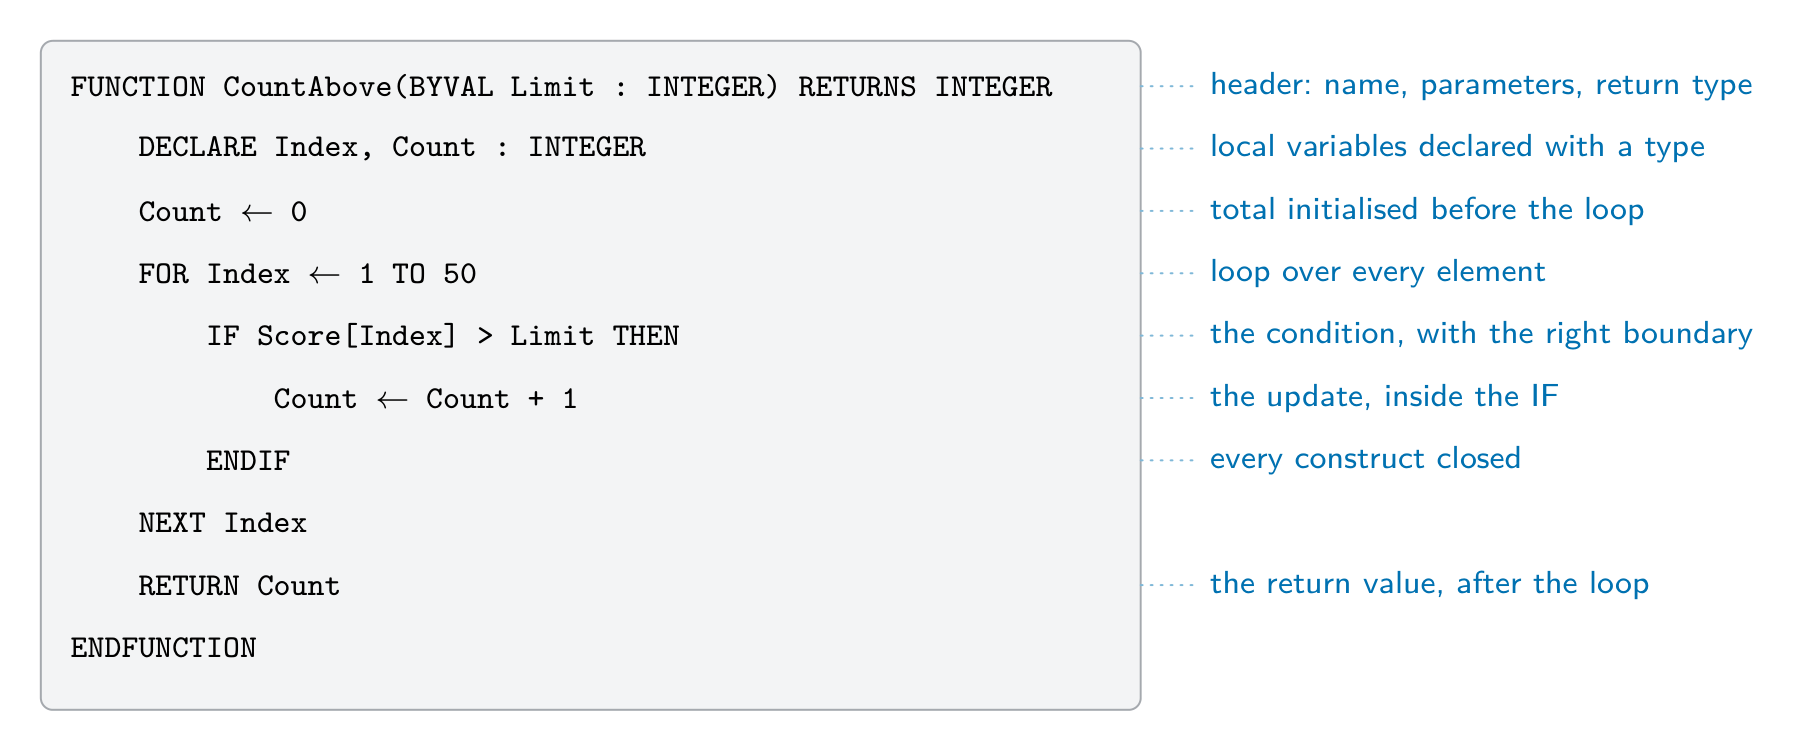
模块答案的每个部分都有自己的分,所以即使某一部分没有把握,也要把所有部分写出来 - 头部,按题目描述的写:
PROCEDURE Name(Param : TYPE)或FUNCTION Name(Param : TYPE) RETURNS TYPE,在例程必须改变实参的地方加BYREF。 - 局部声明:用
DECLARE声明每个局部变量及其类型,并初始化计数器和总数(Count ← 0)。 - 访问每个元素的循环:对于给出了大小的数组用
FOR Index ← 1 TO 50;对于文件用WHILE NOT EOF(...)。 - 条件,用正确的比较和边界,针对正确的项:
IF Score[Index] > Limit THEN。 - 分支内部的更新:计数增加、值被存储,或消息被输出。
- 结尾:函数中在循环之后
RETURN一次;ENDFUNCTION或ENDPROCEDURE;并且每个IF、FOR和WHILE都关闭。
例题。 一个全局数组
Score : ARRAY[1:50] OF INTEGER存放测验分数。写一个函数CountAbove(Limit : INTEGER),返回有多少个分数大于Limit。FUNCTION CountAbove(BYVAL Limit : INTEGER) RETURNS INTEGER DECLARE Index, Count : INTEGER Count ← 0 FOR Index ← 1 TO 50 IF Score[Index] > Limit THEN Count ← Count + 1 ENDIF NEXT Index RETURN Count ENDFUNCTION给分点:带参数和
RETURNS INTEGER的头部;Count被声明并设为0;遍历全部 50 个元素的循环;比较> Limit(不是>=);在IF内部更新计数;循环之后RETURN Count。主程序在表达式或输出中使用返回值:OUTPUT "Above 70: ", CountAbove(70)。例题。 写一个函数
IsValid(Code : STRING),当Code是两个大写字母后跟四个数字——即格式(format)AB1234——时返回TRUE,否则返回FALSE。FUNCTION IsValid(BYVAL Code : STRING) RETURNS BOOLEAN DECLARE Index : INTEGER DECLARE Ch : STRING IF LENGTH(Code) <> 6 THEN RETURN FALSE ENDIF FOR Index ← 1 TO 6 Ch ← MID(Code, Index, 1) IF Index <= 2 THEN IF Ch < "A" OR Ch > "Z" THEN RETURN FALSE ENDIF ELSE IF Ch < "0" OR Ch > "9" THEN RETURN FALSE ENDIF ENDIF NEXT Index RETURN TRUE ENDFUNCTION长度检查放在最前面,这样
MID就永远不会被要求取一个不存在的位置。这样的验证(validation)返回一个BOOLEAN,以便调用者可以写IF IsValid(Entry) THEN ... ELSE OUTPUT "Invalid code" ENDIF:给用户的消息由调用者输出,而不是由函数输出——函数计算,过程行动。例题。 写一个函数
IsPalindrome(Word : STRING),当Word倒过来读也一样(例如"RACECAR")时返回TRUE。从两端向中间比较字符:位置
Index与位置Len - Index + 1配对,只需检验前一半。
回文检验把位置 i与位置Len - i + 1配对,到中间为止FUNCTION IsPalindrome(BYVAL Word : STRING) RETURNS BOOLEAN DECLARE Len, Index : INTEGER Len ← LENGTH(Word) FOR Index ← 1 TO Len DIV 2 IF MID(Word, Index, 1) <> MID(Word, Len - Index + 1, 1) THEN RETURN FALSE ENDIF NEXT Index RETURN TRUE ENDFUNCTION同样的三件工具——遍历各位置的
FOR、读取一个字符的MID(s, i, 1)、拼出新字符串的&——能解答 Paper 2 上大多数字符串模块:数一个字符出现多少次(IF MID(s, i, 1) = Ch THEN Count ← Count + 1),替换某个字符的每一次出现(在每个位置把NewChar或原字符加到NewString上),隐藏银行卡号除最后四位以外的数字(直到Len - 4的每个位置都加一个'*'),或者自己写一个MID()(把从Start到Start + Length - 1的字符连接起来)。向MID要一个超出字符串末尾的位置是运行时错误,所以先检查LENGTH。文件。 变量里的值在程序结束时就消失了,所以一个必须为下一次运行保留数据的模块要把数据写到文件里:
OPENFILE "scores.txt" FOR WRITE,在循环里每行一个WRITEFILE "scores.txt", NUM_TO_STR(Score[Index]),循环之后CLOSEFILE "scores.txt"一次;读回来用FOR READ、READFILE和WHILE NOT EOF("scores.txt")。主题 10 有完整的文件部分;这里的分给以正确的模式打开、在循环内读或写、以及在循环之后关闭一次。探索The call stack: push on call, pop on return
Calling a subroutine pushes a new frame on top; returning pops it and hands a value back to the caller. The call that is running is always the frame on top.
词汇表 训练英文 中文 拼音 function/ˈfʌŋkʃn/ 函数 hán shù parameters/pəˈræmɪtəz/ 参数 cān shù procedure/prəˈsiːdʒə/ 过程 guò chéng structured programming/ˈstrʌktʃəd ˈprəʊɡræmɪŋ/ 结构化编程 jié gòu huà biān chéng subroutines/ˈsʌbruːtiːnz/ 子程序 zi chéng xù return value/rɪˈtɜːn ˈvæljuː/ 返回值 fǎn huí zhí arguments/ˈɑːɡjuːmənts/ 实参 shí cān pass by value/pæs baɪ ˈvæljuː/ 传值 chuán zhí pass by reference/pæs baɪ ˈrefrəns/ 传引用 chuán yǐn yòng global variable/ˈɡləʊbl ˈveərɪəbl/ 全局变量 quán jú biàn liàng local variable/ˈləʊkl ˈveərɪəbl/ 局部变量 jú bù biàn liàng scope/skəʊp/ 作用域 zuò yòng yù decomposition/ˌdiːkɒmpəˈzɪʃn/ 分解 fēn jiě signature/ˈsɪɡnɪtʃə/ 签名 qiān míng format/ˈfɔːmæt/ 格式 gé shì Validation/ˌvælɪˈdeɪʃn/ 验证 yàn zhèng 11.3
编写高效的伪代码

让伪代码更易理解的三个特征——"说出三个特征"这类题的答案——是有意义的标识符(
Total,而不是t)、每个结构内部语句的缩进,以及说明目的的注释(// ...);关键字大写、一行一条语句、各部分之间留空行也被接受。高效的伪代码更进一步:- 把不变量移出循环——若一个值(一个不变量(invariant))不随循环计数器改变,在循环之前计算它一次。
- 当答案被找到时尽早退出一个循环(一旦目标出现就停止一个线性查找(linear search))。
- 避免冗余的工作——存储一个结果并重用它,而不是重新计算。
- 选择正确的数据结构——当各项属于一起时,一个数组胜过许多分开的变量。
- 当把一个值对照许多选项测试时,用 CASE 替换深度嵌套的 IF。
- 注释意图,而不是机制(
// validate the postcode,而不是// loop 6 times)。 - 使用有意义的名称(
numberOfPupils,而不是n)并在使用前初始化变量。
把不变的工作移出循环,所以它运行一次 词汇表 训练英文 中文 拼音 invariant/ɪnˈveərɪənt/ 不变量 bù biàn liàng linear search/ˈlɪnɪə sɜːtʃ/ 线性查找 xiàn xìng chá zhǎo 11.3
测试与错误
三种错误,每种用不同的方式发现:
错误 是什么 例子 由什么发现 语法错误(syntax error) 违反语言规则的语句 缺少 ENDIF;OUTPT "Hi"翻译程序,在程序运行之前 运行时错误(run-time error) 程序能运行,但某条语句无法执行 除以零;数组下标为 0 或 51;用无效的参数调用函数;永不结束的循环,使程序"卡死" 运行时:程序停止或挂起 逻辑错误 程序运行到结束,但输出是错的 该用 >=的地方用了>;总数从未设为0用跟踪表和选定的测试数据进行测试 集成开发环境(IDE)帮助发现后两种:断点(breakpoint)让程序在选定的一行停下;然后单步执行(single stepping)一次运行一条语句;而报告(或监视)窗口显示那一刻每个变量的值,于是值出错的那一行可以直接看到。测试方法和测试数据在主题 12。
词汇表 训练英文 中文 拼音 run-time error/rʌn taɪm ˈerə/ 运行时错误 yùn xíng shí cuò wù syntax error/ˈsɪntæks ˈerə/ 语法错误 yǔ fǎ cuò wù breakpoint/ˈbreɪkpɔɪnt/ 断点 duàn diǎn single stepping/ˈsɪŋɡl ˈstepɪŋ/ 单步执行 dān bù zhí xíng 11.3
考官认可的定义
定义题按固定的表述给分。把这些记准确。
术语 定义 过程(procedure) 执行一项任务(一系列步骤)且不返回值的子程序;用 CALL调用函数(function) 把一个值返回到调用它的地方的子程序,因此可以在表达式中使用 参数(parameter) 子程序头部中的标识符,在子程序被调用时接收一个值或一个引用 实参(argument) 调用中提供的值(或变量),与一个参数对应 传值(passing by value) 把实参值的一个副本交给子程序,所以子程序内部的改变不影响原来的变量 传引用(passing by reference) 把变量的地址交给子程序,所以子程序内部的改变会改变原来的变量 头部(header) 子程序定义的第一行:它的名称、它的参数,以及函数的返回类型 接口(interface) 调用程序使用一个子程序必须知道的东西:它的名称、参数(个数、顺序、类型)和返回类型 返回值(return value) 函数传回给调用它的表达式的值 局部变量(local variable) 在子程序内部声明;只在子程序运行时存在,并且只能在其内部使用 全局变量(global variable) 在所有子程序之外声明;可以在程序的任何地方使用 计数循环(count-controlled loop) 由一个计数器控制,重复固定的次数( FOR ... NEXT)前测循环(pre-condition loop) 在每次迭代之前检验条件,所以循环体可能一次也不运行( WHILE ... ENDWHILE)后测循环(post-condition loop) 在每次迭代之后检验条件,所以循环体至少运行一次( REPEAT ... UNTIL)常量(constant) 一个在程序运行期间不能改变的、有名字的值 子程序(subroutine) 一段自包含的、执行一项任务并按名字调用的代码:过程或函数 库例程(library routine) 已经写好并测试过、可供程序调用的子程序 11.3
考试技巧
- 区分一个过程(无返回值)和一个函数(返回一个值);知道传值对传引用。
- 选择正确的循环:当重复次数已知时用计数循环(FOR),否则用条件控制循环(WHILE/REPEAT)。
- 区分局部对全局变量和作用域;在可重用模块中优先用局部变量。
- 使用附页里确切的例程名称和参数顺序;
UCASE和VAL是 IGCSE 的名称,在这里不得分。 - 在"写伪代码"的答案里,头部、声明、循环、条件、更新和
RETURN各有一分:即使某一部分没有把握,也要把六个部分都写出来。
常见错误
- 调用了函数却不使用它返回的值。把结果赋给变量,或在表达式或输出中使用它:
Sorted ← BubbleSort(MyArray, 7)。 - 传入的长度差一:七个元素的数组传了
6,或者在要长度的地方传了最后一个下标。想清楚参数是长度还是下标,并检查最后一个元素是否被访问到。 - 在读文件的循环里面关闭文件。打开一次,在循环之后关闭一次。
- 直接把输入当作文件名。加上题目给的扩展名:
FileName ← Choice & ".txt"。 - 结构没有关闭。每个
IF都需要它的ENDIF,每个FOR需要它的NEXT,每个WHILE需要它的ENDWHILE,每个函数需要它的RETURN;评分标准里有这一分。 - 错误的边界:"至少"用了
>(应该是>=),或者对声明为[1:50]的数组从0开始FOR循环。 - 计数器或总数在循环之前从未设为
0。 - 在跟踪表里每一行都重写所有变量,或者在改变某个值的语句运行之前就改了它。
- 半个条件:
IF x = 3 OR 4——OR和AND的两边都必须是完整的比较。而且+不连接字符串,&才是。 - 把必须在各次调用之间保留的值声明为局部变量。累计总数或在多次调用中拼起来的字符串应该是全局的或
BYREF。
-
12
软件开发
12.1
程序开发生命周期

大纲
Candidates should be able to: Notes and guidance Show understanding of the purpose of a development life cycle Show understanding of the need for different development life cycles depending on the program being developed Including: waterfall, iterative, rapid application development (RAD) Describe the principles, benefits and drawbacks of each type of life cycle Show understanding of the analysis, design, coding, testing and maintenance stages in the program development life cycle 来源:剑桥国际大纲
一个开发生命周期(development life cycle)是从想法到完成、被维护的软件的一套阶段。它的存在是为了规划、管理和控制一个项目——按时、以好的质量构建正确的产品。
软件由遵循一个开发生命周期以保持协调的团队构建 
一张流程图在生命周期的设计阶段规划一个程序的逻辑 Why a life cycle is needed
考官关于"开发生命周期的用途"的清单:它把一个大项目分成可以规划和管理的阶段;它确保在设计和编码开始之前找到并确认需求;它把测试和文档内建进来,而不是留到最后;它让团队按里程碑跟踪进度并管理风险;它给客户定义好的评审节点。没有它,团队会先写代码,然后很晚才发现做错了东西。
Why there are different ones
没有单一的生命周期适合每个项目,所以存在几种开发生命周期(development life cycles)。选择取决于规模和复杂度、开始时需求(requirements)有多清晰、预期有多少变化、风险级别、团队,以及截止日期。
Common models
- 瀑布模型(Waterfall)——一个线性序列(分析 → 设计 → 编码 → 测试 → 维护),每个阶段在下一个之前完成。清晰且文档完善;适合稳定的需求,但不擅长应对项目中途的变化,而且客户直到最后才看到任何能工作的东西。
- 迭代模型(iterative model)——重复的趟数,每趟产出一个被评审和精炼的部分版本。更早发现问题;适合需求随时间被发现的情况,但更难估算。
- 快速应用开发(Rapid Application Development,RAD)——大量使用一个原型(prototype)和用户反馈。非常快的首次交付;适合变化的需求,但依赖用户的可用性并适合较小的系统。
- 敏捷(Agile)——短迭代("冲刺")、持续的协作和测试。灵活且适应性强,但需要一个投入的客户和一个熟练的团队。

瀑布模型:每个阶段在下一个开始之前完成 
迭代模型:重复的趟数精炼程序 
快速应用开发:团队并行地在各部分上工作 原则、好处与缺点——按标准答案的列法。
模型 原则 好处 缺点 瀑布 各阶段按固定顺序进行,每个阶段完成并签字确认后下一个才开始;回头意味着重走顺序 易于管理;每个阶段都有完整文档;需求早早固定,所以能估算成本和日期 阶段完成后就不灵活了;很晚才有能用的软件;分析阶段的错误后期修复代价高;客户看不到进度 迭代 先做一个小的可运行版本,然后通过后续版本反复改进直到完成 早且频繁地有可用软件;问题在早期版本中就被发现;客户的反馈塑造每个版本;需求可以改变 难以估计总时间和成本;反复测试耗费工作量;需要客户随时参与;版本不规划就会跑偏 RAD 快速构建系统各部分的原型并与用户一起完善直到被接受,常由几个团队并行进行 第一版交付非常快;用户全程参与,产品贴合需求;变化容易吸收 需要熟练的开发者和投入的用户;文档薄弱;不太适合大型或安全关键系统 例题。 一家公司必须率先推出一款新游戏机的网站,而设计会随着游戏机功能的公布而改变。说出最合适的生命周期并说明理由。
RAD。 网站的原型几天内就能做出并给用户看,并随需求变化而完善;网站规模小到适合原型驱动的方法,而交付速度是首要要求。瀑布模型会在任何页面做出之前就固定需求,并且直到最后才有交付。
The standard stages
每个阶段都有目的、产出和典型活动——"描述……阶段"的题目要的是其中两三条。
- analysis(分析)——找出程序必须做什么。活动:对现有系统的访谈、问卷和观察;可行性研究;确认需求规格说明,后面每个阶段都对照它检查。
- design(设计)——决定怎么做。产出:结构图(模块和参数)、每个模块的流程图或伪代码、标识符表和数据结构、屏幕和文件布局,以及现在就根据规格说明写好的测试计划——在任何代码存在之前。
- coding(编码,实现(implementation))——用高级语言按照设计逐个模块编写程序;每个模块写好就测试。
- testing(测试)——对照测试计划(正常、异常、极端和边界数据)运行程序并纠正发现的错误;随后是集成、α、β 和验收测试。
- maintenance(维护)——发布后,纠正故障,使程序适应新的硬件、软件或法律,并改进它(见下文)。
例题。 补全瀑布图 分析 → ? → ? → ? → 维护,并描述设计阶段发生什么。
缺少的阶段是设计、编码、测试。在设计阶段,需求被变成程序的规划:把问题分解成模块(结构图),每个模块的算法写成伪代码或流程图,选定数据结构和标识符,布置屏幕和文件,并根据规格说明写出测试计划。
探索The program development life cycle
Step through the stages every project passes through. Getting the requirements right in analysis matters most — a mistake caught in testing is far costlier to fix than one caught early.
探索Software process lab
Classify development examples by the stage or tool they belong to.
词汇表 训练英文 中文 拼音 development life cycle/dɪˈveləpmənt laɪf ˈsaɪkl/ 开发生命周期 kāi fā shēng mìng zhōu qī requirements/rɪˈkwaɪəmənts/ 需求 xū qiú waterfall/ˈwɔːtəfɔːl/ 瀑布模型 pù bù mó xíng maintenance/ˈmeɪntənəns/ 维护 wéi hù iterative model/ˈɪtərətɪv ˈmɒdl/ 迭代模型 dié dài mó xíng Rapid Application Development/ˈræpɪd ˌæplɪˈkeɪʃn dɪˈveləpmənt/ 快速应用开发 kuài sù yìng yòng kāi fā prototype/ˈprəʊtəʊtaɪp/ 原型 yuán xíng Agile/ˈædʒaɪl/ 敏捷 mǐn jié implementation/ˌɪmplɪmənˈteɪʃn/ 实现 shí xiàn 12.2
程序设计

大纲
Candidates should be able to: Notes and guidance Use a structure chart to decompose a problem into sub-tasks and express the parameters passed between the various modules/procedures/functions which are part of the algorithm design Describe the purpose of a structure chart Construct a structure chart for a given problem Derive equivalent pseudocode from a structure chart Show understanding of the purpose of state-transition diagrams to document an algorithm 来源:剑桥国际大纲
Structure chart
一个结构图(structure chart)显示一个程序到模块(子程序(subroutines))的层次分解(hierarchical decomposition)以及它们之间传递的参数(parameters)。每个模块是一个矩形;线把调用者(上方)连到被调用者(下方);小箭头显示数据往下走、结果往上回。这个设计随后可被变成等价的伪代码(pseudocode)。
                CalculatePay
            /        |         \
       GetEmployee  CalculateBonus  CalculateTax
       Returns:     Takes: sales    Takes: gross
       employeeID   Returns: bonus  Returns: tax
它是一个设计阶段的工具,你可以从它读出过程签名。
一张结构图:模块及它们之间传递的参数 考官会问的符号。 一个框是一个模块;一条线把调用者(上方)与它调用的模块(下方)连起来,按调用顺序从左到右读。尾部带空心圆的小箭头是数据耦合——向下传入模块的参数或向上返回的值;带实心圆的箭头是控制耦合,一个告诉调用者发生了什么的标志(通常是 BOOLEAN)。分支处的菱形表示选择:根据条件,只调用它下方模块中的一个。横扫各连线的弯曲箭头表示迭代:它下面的模块在循环中被反复调用。
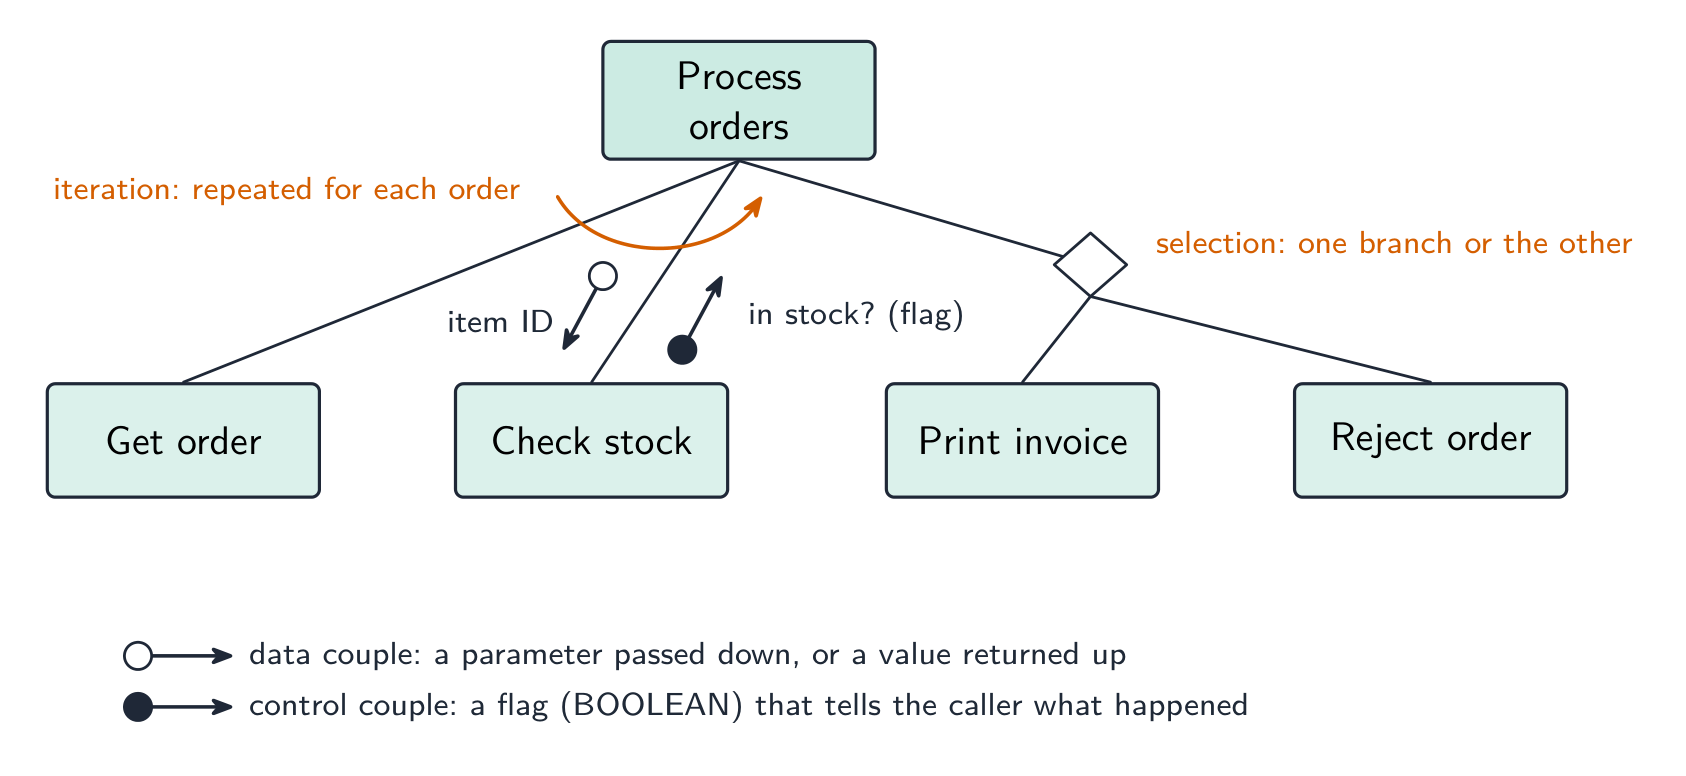
结构图符号:数据耦合与控制耦合、选择菱形和迭代箭头 例题。 四个模块定义为
PROCEDURE Main()、PROCEDURE ReadData(BYREF Count : INTEGER)、FUNCTION IsValid(Value : INTEGER) RETURNS BOOLEAN和PROCEDURE Report(Total : INTEGER, Count : INTEGER)。Main 调用 ReadData,然后对读入的每个值调用一次 IsValid,最后调用 Report。描述这张结构图。Main 在顶部;ReadData、IsValid 和 Report 在它下方一行,按调用顺序从左到右。ReadData 的连线上有一个向上的数据耦合
Count(BYREF 参数会传回来)。IsValid 的连线上有一个向下的数据耦合Value和一个向上的控制耦合(BOOLEAN 结果),这条连线上还有一个弯曲的迭代箭头,因为它对每个值都被调用。Report 的连线上有两个向下的数据耦合Total和Count。反过来读,凡返回值的模块都是函数——它的头部需要RETURNS和返回类型。State-transition diagram
一个状态转换图(state-transition diagram)显示一个系统可以处于的状态(states)以及在它们之间移动它的事件——适合自动售货机、交通灯、用户界面。状态转换图被用来记录一个算法或系统的行为。每个状态是一个圆;每个转换是一个用事件标注的箭头。
   coin inserted               item selected
[Idle] ──────────────→ [Awaiting selection] ──────────→ [Dispensing]
它使遗漏的转换容易被发现("如果在等待选择时投入第二枚硬币会怎样?")。

一个代码为 259 的门锁的状态转换图 读图与画图。 每个转换标注为输入 | 输出(或条件 | 动作):发生了什么,然后系统在改变状态时做什么。题目会给一张当前状态、输入、输出、下一状态的表并要求画图,或者反过来——表中的每一行恰好是一个箭头。检查每个状态对每种可能出现的输入都有一个离开它的箭头,包括让状态保持不变的那些(绕回同一状态的箭头)。
例题。 一个水泵控制器有水泵关和水泵开两个状态。在水泵关时,输入检测到低水位产生输出启动水泵并转到水泵开;在水泵开时,检测到正常水位产生停止水泵并转到水泵关。其他任何输入都不改变状态。画出表格。
当前状态 输入 输出 下一状态 水泵关 检测到低水位 启动水泵 水泵开 水泵关 检测到正常水位 — 水泵关 水泵开 检测到正常水位 停止水泵 水泵关 水泵开 检测到低水位 — 水泵开 两行"无变化"在图上是自环箭头;漏掉它们会丢完整性的分。
探索Software process lab
Classify development examples by the stage or tool they belong to.
词汇表 训练英文 中文 拼音 structure chart/ˈstrʌktʃə tʃɑːt/ 结构图 jié gòu tú parameters/pəˈræmɪtəz/ 参数 cān shù pseudocode/ˈsuːdəʊkəʊd/ 伪代码 wěi dài mǎ hierarchical decomposition/haɪəˈrɑːkɪkl ˌdiːkɒmpəˈzɪʃn/ 分解 fēn jiě decomposition/ˌdiːkɒmpəˈzɪʃn/ 分解 fēn jiě subroutines/ˈsʌbruːtiːnz/ 子程序 zi chéng xù state-transition diagram/steɪt trænˈsɪʃn ˈdaɪəɡræm/ 状态转换图 zhuàng tài zhuǎn huàn tú states/steɪts/ 状态 zhuàng tài 12.3
程序测试与维护

大纲
Candidates should be able to: Notes and guidance Show understanding of ways of exposing and avoiding faults in programs Locate and identify the different types of errors • syntax errors • logic errors • run-time errors Correct identified errors Show understanding of the methods of testing available and select appropriate data for a given method Including dry run, walkthrough, white-box, black-box, integration, alpha, beta, acceptance, stub Show understanding of the need for a test strategy and test plan and their likely contents Choose appropriate test data for a test plan Including normal, abnormal and extreme/boundary Show understanding of the need for continuing maintenance of a system and the differences between each type of maintenance Including perfective, adaptive, corrective Analyse an existing program and make amendments to enhance functionality 来源:剑桥国际大纲
- syntax error(语法错误)——破坏语言的语法(遗漏括号、拼错关键字)。在翻译时被捕获;在修正之前程序不会运行。
- run-time error(运行时错误)——在运行时发生(除以零、文件未找到、数组索引越界)。程序崩溃或抛出一个异常;通过添加检查来修正。
- logic error(逻辑错误)——程序运行但给出错误的结果(用
+代替-、一个差一的循环、条件顺序错误)。最难找到;唯一的迹象是错误的输出,所以用仔细的测试和追踪。
每种错误何时出现:语法在翻译时,运行时在运行期间,逻辑在输出中 暴露和避免故障。 故障通过对照测试计划的测试、手工跟踪或跟踪表、与同事的走查,以及 IDE 的调试器(断点、单步执行、监视变量)被暴露。它们通过先设计后编码(结构图、伪代码)、带有意义的标识符和注释的模块化代码、对每个输入的验证、处理异常而不是让运行时错误使程序崩溃,以及 IDE 在输入时的动态语法检查被避免。
例题。 说出每种情况的错误类型及其表现。(a)
Result <- STR_TO_NUM(x) / STR_TO_NUM(y)在y = "0"时运行。(b) 同一行在x = "12a"时运行。(c) 写成FOR i <- 1 TO 9的循环处理一个十元素数组。(d)OUTPUT "Total: " Total少了一个逗号。(a) 运行时错误——除以零;这一行用这个数据执行时程序崩溃。(b) 运行时错误——字符串无法转换成数字。(c) 逻辑错误——程序能运行,但第十个元素从未被处理,所以输出错误。(d) 语法错误——该语句违反语言规则,在程序运行前就被翻译器报告。
例题。 纠正这段伪代码中的错误,它应当输出十个分数的平均值。
Total <- 0
FOR i <- 1 TO 10
    INPUT Mark
    Total <- Total + Mark
NEXT i
Average <- Total / 9
OUTPUT "Average" Average
除数应当是 10 而不是 9(逻辑错误);输出行在字符串和值之间需要一个逗号或
&(语法错误);Average从未被声明为 REAL(语法或运行时错误,取决于语言)。要说明是哪一行以及改正后的行是什么:Average <- Total / 10。词汇表 训练英文 中文 拼音 syntax error/ˈsɪntæks ˈerə/ 语法错误 yǔ fǎ cuò wù run-time error/rʌn taɪm ˈerə/ 运行时错误 yùn xíng shí cuò wù logic error/ˈlɒdʒɪk ˈerə/ 逻辑错误 luó jí cuò wù 12.3
测试方法

- dry run(手工跟踪)——在纸上追踪代码,在一个表格里写下每个变量的值。
- walkthrough(走查)——对代码的一次团队评审。
- white-box testing(白盒测试)——从代码的内部结构设计,覆盖每条语句、分支和循环。
- black-box testing(黑盒测试)——只从规格说明设计:喂入输入,检查输出。
- integration testing(集成测试)——组合模块并测试它们之间的接口。
- alpha testing(α测试)——由开发者/内部在发布前;beta testing(β测试)——由有限的一组真实用户在他们自己的环境中。
- acceptance testing(验收测试)——由客户,以决定产品是否适合用途。
- stub(桩)——一个还不存在的模块的占位符,以便结构可以自顶向下地被测试。
黑盒测试规格说明;白盒测试代码路径 何时用哪种方法。 手工跟踪和走查不需要计算机——手工跟踪是你用跟踪表(trace table)追踪算法;走查是作者逐行解释代码、同事寻找故障的会议,所以它还在团队中传播代码知识,并对照设计检查代码。白盒测试由能看到代码的人编写,目标是走遍每条路径;黑盒测试根据规格说明编写,只对照预期输出检查输入,所以用户或独立测试者也能做。集成测试在模块测试之后:单独通过的模块在它们之间传递的数据类型或顺序不对时仍会失败。α 测试在内部进行;β 测试把候选发布版交给一部分真实用户,他们从真实使用中报告故障;验收测试是客户在付款前对照需求检查成品。桩让自顶向下的测试在所有模块存在之前就能开始。
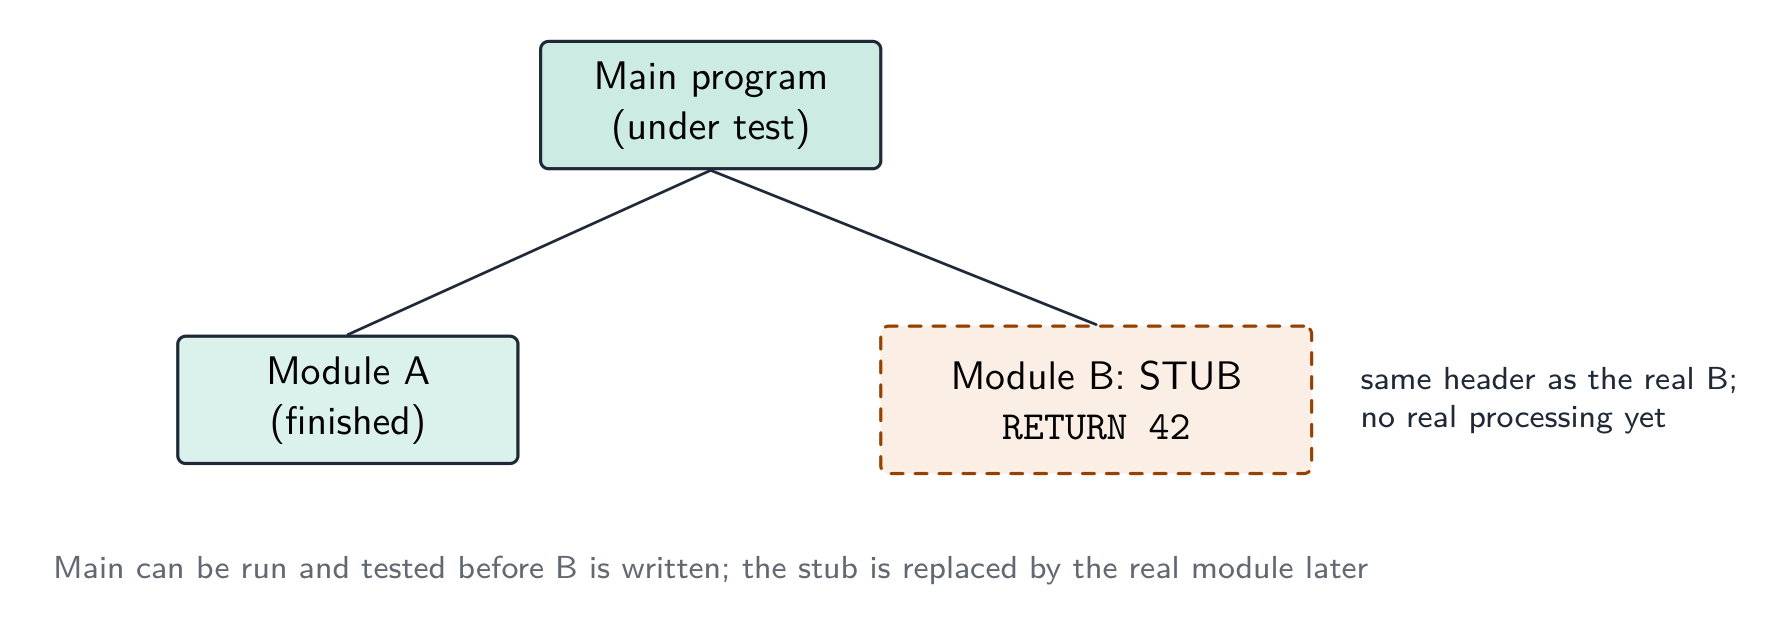
桩代替尚未编写的模块,使它上面的模块现在就能测试 例题。 程序通过内部测试后,被交给一组用户在发布前试用。说出这种测试的名称,并说明接下来发生什么。
β 测试——真实用户在自己的环境中使用,报告开发者没发现的故障。故障被纠正后,客户对照需求进行验收测试,然后程序发布;正式使用中发现的故障之后由纠正性维护处理。
例题。 给出用走查测试程序的三个好处。
错误由没有写这段代码的人发现,他们读代码时没有先入之见;逻辑对照设计和规格说明检查,而不只对照测试数据;几个人学会了代码的工作方式,有助于日后维护;不需要测试数据或能用的计算机,所以可以早做。
词汇表 训练英文 中文 拼音 acceptance testing/əkˈseptəns ˈtestɪŋ/ 验收测试 yàn shōu cè shì dry run/draɪ rʌn/ 手工跟踪 shǒu gōng gēn zōng trace table/treɪs ˈteɪbl/ 跟踪表 gēn zōng biǎo walkthrough/ˈwɔːkθruː/ 走查 zǒu chá white-box testing/waɪt bɒks ˈtestɪŋ/ 白盒测试 bái hé cè shì black-box testing/blæk bɒks ˈtestɪŋ/ 黑盒测试 hēi hé cè shì integration testing/ˌɪntɪˈɡreɪʃn ˈtestɪŋ/ 集成测试 jí chéng cè shì alpha testing/ˈælfə ˈtestɪŋ/ α测试 α cè shì beta testing/ˈbiːtə ˈtestɪŋ/ β测试 β cè shì stub/stʌb/ 桩 zhuāng 12.3
测试策略与测试计划

一个测试策略(test strategy)是高层的方法——哪几种测试、谁做、何时,以及往前推进的标准。一个测试计划(test plan)是详细的测试清单——每个带输入数据、预期输出,以及一个记录实际输出的列。
各自包含什么。 测试策略说明在哪个阶段用哪些测试方法(程序员做模块测试,然后是集成、α、β、验收),每项由谁负责,需要什么测试数据,以及进入下一阶段的标准。测试计划列出各个测试:对每个测试,写明被测模块或功能、输入数据、选择该数据的理由(正常、异常、极端、边界)、预期结果、留给实际结果的空位,以及两者不同时怎么办。计划在设计阶段根据规格说明写成,这样它测的是程序应当做什么,而不是它碰巧做什么。
Choosing test data
对每个字段或条件,包含三种:
- normal data(正常数据)——有效范围内的典型值(对于分数 0–100:
50、75)。 - abnormal data(异常数据)——应当被拒绝的值(
-10、200、"abc")。 - extreme data(极端数据)——仍被接受的最大和最小值(
0和100)。 - boundary data(边界数据)——在边缘的值,差一错误藏在那里(每个被接受的极端值和刚好在它外面被拒绝的值:
0/-1、100/101)。
一个 0–100 字段的测试数据:正常在里面,极端在边界,异常在外面 例题。 某字段接受 0 到 100 的考试分数。给出各类测试数据及其预期结果。正常数据:
50- 被接受,是范围内的典型值。异常数据:-10、200、"abc"- 全部被拒绝,因为超出范围或数据类型错误。极端数据:0和100- 仍然被接受的最大值和最小值。边界数据:跨在每个边缘两侧的成对值 - 被拒绝的-1配上被接受的0,以及被接受的100配上被拒绝的101。每个值都必须写上它的预期结果,否则这份测试计划什么也证明不了。极端数据和边界数据是最常被混淆的一对:极端值处在范围之内且被接受,而边界测试永远是边缘两侧的一对值 - 那里正是差一错误藏身的地方。例题。 一个部件的重量(精确到克)在目标 50 g 的 3 g 之内即合格,也就是 47 g 到 53 g(含)。写出这项检查的测试计划各行。
测试数据 类型 理由 预期结果 50 正常 范围内的典型值 接受 47、53 极端(边界) 仍必须被接受的最小和最大值 接受 46、54 边界 刚好在范围之外的值,差一错误会把它们接受 拒绝 20、90 异常 远在范围之外的值 拒绝 "abc"、−5 异常 类型错误、负的重量 拒绝 每一行都必须说明为什么选这个值和应当发生什么;光列一串数字不得分。
词汇表 训练英文 中文 拼音 test plan/test plæn/ 测试计划 cè shì jì huà boundary data/ˈbaʊndəri ˈdeɪtə/ 边界数据 biān jiè shù jù test strategy/test ˈstrætədʒi/ 测试策略 cè shì cè lüè normal data/ˈnɔːml ˈdeɪtə/ 正常数据 zhèng cháng shù jù abnormal data/əbˈnɔːml ˈdeɪtə/ 异常数据 yì cháng shù jù extreme data/ekˈstriːm ˈdeɪtə/ 极端数据 jí duān shù jù 12.3
维护

一个程序生命期成本的大部分在维护中。三种:
三种维护:完善性、适应性和纠正性 - perfective maintenance(完善性维护)——即使它能工作,也改进性能或功能(一个更快的查询、一个新选项)。
- adaptive maintenance(适应性维护)——在一个变化的环境中保持它工作(一个新 OS、一个新 API、一个法律变更)。
- corrective maintenance(纠正性维护)——修复使用中发现的漏洞。
一个程序在它一生中可能需要全部三种。
为什么需要每一种——标准答案列出的原因。 纠正性:发布后用户报告了故障,或在测试未覆盖的特定情况下发现输出不正确。适应性:操作系统、硬件或浏览器升级;法律或公司规定改变(税率、数据保护要求);程序必须与新的外部系统或文件格式配合。完善性:用户要求额外功能或更好的界面;程序被做得更快或占用更少内存;整理代码以便日后修改。
例题。 (a) 一个已发布的程序在某些情况下输出错误的值。(b) 运行程序的硬件被更换。(c) 顾客要求咖啡店的积分程序在顾客生日时发送消息。说出每种情况的维护类型。
(a) 纠正性——修复交付程序中的故障。(b) 适应性——修改程序以在新环境中运行。(c) 完善性——给一个已经能工作的程序增加功能。
词汇表 训练英文 中文 拼音 corrective maintenance/kəˈrektɪv ˈmeɪntənəns/ 纠正性维护 jiū zhèng xìng wéi hù perfective maintenance/pəˈfektɪv ˈmeɪntənəns/ 完善性维护 wán shàn xìng wéi hù adaptive maintenance/əˈdæptɪv ˈmeɪntənəns/ 适应性维护 shì yìng xìng wéi hù 12.3
修改现有程序
当被要求添加一个功能或修复一个漏洞时:
- 阅读现有代码,直到你理解算法和数据流。
- 找出改动在哪里——哪个子程序、哪些行。
- 让改动尽可能小——不要重写能工作的代码。
- 更新相关部分——一个改动过的参数列表的每个调用者、使用一个改动过的数据结构的每个例程。
- 测试新行为和旧行为(回归测试(regression testing)——检查你没弄坏任何东西)。
- 记录改动。
清晰的注释、有意义的名称、分解的子程序和一张结构图使一个程序更容易被修改——这就是为什么设计工具即使在首次发布之后也重要。
分析一个不是你写的程序。 从标识符表和模块头开始:在读它的任何一行主体之前,它们已经告诉你每个模块接收什么、返回什么。然后用跟踪表对一个小输入追踪算法,记下每个输出值来自哪里。这之后再决定增强功能放在哪里——通常是从现有模块调用的一个新模块,这样能工作的代码被扰动得最少——并写出改动的伪代码和证明它的测试数据。
词汇表 训练英文 中文 拼音 regression testing/rɪˈɡreʃn ˈtestɪŋ/ 回归测试 huí guī cè shì 12.3
考官认可的定义
定义题按固定措辞给分。把这些记准,并且只给一个答案。
术语 定义 开发生命周期 为产出并支持一个程序而遵循的、从分析到维护的一系列阶段 瀑布模型 各阶段按固定顺序进行、每个阶段完成后下一个才开始的生命周期 迭代模型 先产出一个可运行版本、然后反复完善直到完成的生命周期 快速应用开发 快速构建原型并用用户反馈完善直到被接受的生命周期 结构图 显示程序如何分解成模块、模块的调用顺序以及它们之间传递的参数的图 状态转换图 显示系统可能处于的状态以及使其在状态间转移的输入的图 语法错误 语句书写方式的错误,违反语言规则而无法翻译 逻辑错误 算法中的错误,程序能运行但产生错误的结果 运行时错误 程序运行期间发生并使其停止的错误,如除以零 手工跟踪 手工执行算法,在跟踪表中记录变量的值 走查 作者与寻找错误的同事一起逐步过一遍代码的评审 桩 头部正确、返回固定值的占位模块,用来测试调用它的模块 测试计划 将要进行的测试的清单,每项带有测试数据、选择数据的理由和预期结果 边界数据 有效范围每一边缘处的值,既包括最后一个被接受的值,也包括第一个被拒绝的值 纠正性 / 适应性 / 完善性维护 修复使用中发现的故障 / 改变程序以适应变化的环境 / 改进已经能工作的程序 12.3
考试技巧
- 按原则、好处、缺点比较开发模型(瀑布、迭代、RAD),并知道程序开发生命周期的五个阶段及各自的产出。
- 按每种错误何时显现来区分语法、逻辑和运行时错误:翻译时、输出中、运行期间。
- 选择每一类测试数据——正常、异常、极端和边界——并给出每个值的理由和预期结果。
- 按为什么改动来区分各类维护(纠正性、适应性、完善性)。
- 在结构图上说出每个符号的名称:框、调用线、数据耦合、控制耦合、选择菱形、迭代箭头。从图中读出模块头时,记住函数有
RETURNS。
常见错误
- 只用名称描述生命周期的阶段("在设计阶段设计程序")。要说产出什么:结构图、伪代码、测试计划。
- 把错误的输出叫作"运行时错误"。如果程序运行到结束,那是逻辑错误。
- 把边界数据只给成极端值。得分需要边缘两侧的值。
- 把 α 测试和 β 测试当成一回事。α 由开发者在内部做;β 由外部真实用户做。
- 混淆适应性和完善性维护。适应性是对程序之外变化的响应;完善性是改进一个没人非改不可的程序。
- 结构图上模块随意排列。它们按调用顺序从左到右读,每个参数都需要它的箭头。
-
13
数据表示
13.1
用户自定义数据类型

大纲
Candidates should be able to: Notes and guidance Show understanding of why user-defined types are necessary Define and use non-composite types Including enumerated, pointer Define and use composite data types Including set, record and class/object Choose and design an appropriate user-defined data type for a given problem 来源:剑桥国际大纲
内建类型(
INTEGER、REAL、STRING、CHAR、BOOLEAN)覆盖最简单的情况。对于更丰富的问题,你可以定义用户定义类型(user-defined types),使代码更清晰、编译器更严格。Why they are needed
一个内建的
STRING让你在一个应当只容纳几个合法值之一的字段里存储乱七八糟的东西;一个用户定义类型可以限制它。真实的实体通常是不同类型的值的一个集合。而DECLARE Taxi : Vehicle比DECLARE Taxi : STRING更清晰(自我说明)。"描述用户定义数据类型的目的"(两分)。 由程序员定义、基于已有(内建)类型构建的数据类型,使得在没有内建类型合适时能表示该问题特有的数据。 两半都得分:由程序员定义和基于已有类型。考官也接受"使程序更易读、更易维护"作为辅助点,但决不单独给分。
"解释非复合数据类型和复合数据类型是什么意思"(四分)。 非复合类型的定义不引用其他类型:它容纳单个值,例如整数、实数或枚举值。复合类型是其他类型(它们本身也可以是复合的)的集合:它在一个标识符下容纳多个值,例如记录、集合、数组或类。每个定义都要举一个例子;考试会要求。
Non-composite types
Enumerated type
一个枚举类型(enumerated type)的值是一个命名常量的固定列表:
TYPE Vehicle = (M100, M230, T101, T102, T120, T150)
DECLARE MyTaxi : Vehicle
MyTaxi ← T102
这些名称是新类型的值(内部存储为小整数);你不能赋任何列表之外的东西。用途:星期几、颜色、状态码。
"说明枚举数据类型是什么意思。" 通过(按顺序)列出全部可能的值来定义的非复合用户定义类型。 因为这些值是有序的,它们可以比较和逐个遍历:有了
TYPE Month = (January, February, ..., December),测试IF ThisMonth > June是合法的,而且这些值在内部存储为整数。伪代码有三部分,考试各给分:关键字TYPE、带=的标识符、以及括号内用逗号分隔的列表。例题。 写出伪代码,定义一个枚举类型表示学校开放的日子(周一到周五),并声明一个该类型的变量,设为周三。
TYPE SchoolDay = (Monday, Tuesday, Wednesday, Thursday, Friday)
DECLARE Today : SchoolDay
Today ← Wednesday
枚举类型的变量不能被赋予列表之外的值,这正是要点:
Today ← Saturday是编译时错误,而STRING会接受"Saturdy"。一个枚举类型是一个命名值的固定列表 Pointer type
一个指针(pointer)容纳另一个变量的内存地址(或
NULL表示"没有目标")。指针构建动态结构(链表、树)并传递引用而不复制。TYPE PNode = ^TNode // pointer to a TNode DECLARE p : PNode p ← NEW TNode p^.Value ← 42 // dereference to reach the fields解引用(dereference,
p^)意味着访问它指向的变量。"说明指针数据类型是什么意思。" 其值是某给定类型变量的内存地址(引用)的非复合类型。 伪代码用一个位于所指类型之前的脱字符声明该类型,考试要的正是这一行:
TYPE SelectParts = ^Parts // 指向 Parts 类型值的指针 DECLARE Chosen : SelectParts Chosen ← ^Keyboard // Chosen 现在保存 Keyboard 的地址 OUTPUT Chosen^ // 解引用:存储在该地址的值指针是动态链表或二叉树(第 19 讲)的构件:每个节点保存指向下一个节点的指针。这里常丢两分:把指针类型写得好像它保存值本身,以及通过指针读取时忘记脱字符。

一个指针容纳一个地址; p^解引用它以访问该节点的字段Composite types
一个复合类型(composite type,复合数据类型之一)把几个值组合在一个名称下。

一个集合是一个唯一值的无序集合 
一个记录把不同类型的字段组合在一个名称下 - record(记录,主题 10)——一个
TYPE ... ENDTYPE块中不同类型的字段。 - set(集合)——一个唯一值的无序集合,带操作:添加、移除、成员测试、并集、交集:
DECLARE Available : SET OF Colour Available ← {Red, Blue} IF Green IN Available THEN ...- class(类)/ object(对象)——OOP 复合类型,把数据字段(属性(attributes))与对它们的操作(方法(methods))结合。一个对象是一个类的一个实例:
CLASS Taxi
    PRIVATE Capacity : INTEGER
    PUBLIC FUNCTION GetCapacity() RETURNS INTEGER
        RETURN Capacity
    ENDFUNCTION
ENDCLASS
Choosing a type
对来自一个固定列表的值用枚举,为间接性用指针,为一组字段用记录,为一个无序的唯一集合用集合,而当你需要状态和行为在一起时用类。
"描述用户定义数据类型集合"(三分)。 一种复合类型,容纳同一类型的值的集合,没有特定顺序、没有重复;可以添加和移除值,并可测试某值是否为成员。 用
SET OF声明类型,然后用括号内的值定义一个集合常量:TYPE EvenNumbers = SET OF INTEGER DEFINE Evens (2, 4, 6, 8, 10, 12) : EvenNumbers TYPE SymbolSet = SET OF CHAR DEFINE Operators ('+', '-', '*', '/') : SymbolSet"描述用户定义数据类型记录"(三分)。 由固定数目的字段(项)组成的复合类型,每个字段有自己的标识符和类型,整体用一个标识符引用;字段用点记法访问。
例题。 写出伪代码,声明记录类型
ClubMember,存储俱乐部成员的名、姓、会员编号(整数)、入会日期以及是否已缴费;然后声明一个变量并设置它的两个字段。TYPE ClubMember DECLARE FirstName : STRING DECLARE LastName : STRING DECLARE Code : INTEGER DECLARE DateJoined : DATE DECLARE FeesPaid : BOOLEAN ENDTYPE DECLARE NewMember : ClubMember NewMember.LastName ← "Chen" NewMember.FeesPaid ← TRUE每个字段需要自己的
DECLARE行和合适的类型,块以ENDTYPE结束,字段(field)以变量.字段访问。被要求为每个字段选择类型时,按数据匹配:只用于比较的编号若可含字母则为STRING,需要算术或排序则为INTEGER;是/否为BOOLEAN;日期为DATE。能取少数几个命名值的字段(宠物的种类、颜色)正是该做成枚举类型的那个。
记录数组:每个元素是一整条记录,下标选元素,点选字段 数组和文件中的记录。 许多成员的表是
DECLARE Members : ARRAY[1:100] OF ClubMember;于是Members[3].LastName是一个元素的一个字段,对下标的循环处理每条记录。记录也是写入和读出文件(见下)的自然单位,每次PUTRECORD或WRITEFILE一条记录。例题。 复合类型
Pet存储每只宠物的名字(字符串)、种类(狗、猫、兔、仓鼠之一)和以千克计的体重(实数)。定义这些类型并声明一个变量。TYPE Species = (Dog, Cat, Rabbit, Hamster) TYPE Pet DECLARE Name : STRING DECLARE Kind : Species DECLARE Weight : REAL ENDTYPE DECLARE MyPet : Pet MyPet.Kind ← Rabbit枚举类型要先定义,因为记录要用到它:伪代码里顺序和编译器里一样重要。
伪代码中的类。 类是同时带有行为的复合类型。考试要求写出声明:属性标为
PRIVATE,一个名为NEW的构造函数(constructor)设置它们,以及用于获取或修改它们的PUBLIC方法:CLASS Appointment PRIVATE PatientName : STRING PRIVATE Treatment : STRING PRIVATE Medication : STRING PUBLIC PROCEDURE NEW(Name : STRING, Treat : STRING, Med : STRING) PatientName ← Name Treatment ← Treat Medication ← Med ENDPROCEDURE PUBLIC FUNCTION GetTreatment() RETURNS STRING RETURN Treatment ENDFUNCTION ENDCLASS DECLARE Visit : Appointment Visit ← NEW Appointment("A. Chen", "filling", "none") OUTPUT Visit.GetTreatment()属性设为私有,使它们只能通过方法改变(封装,第 20 讲);构造函数是一个名为
NEW、每个属性一个参数的过程;获取器是返回属性的函数。每一项都是单独的一分。探索Programming concept lab
Connect examples to the programming idea they show.
词汇表 训练英文 中文 拼音 user-defined types/ˈjuːzə dɪˈfaɪnd taɪps/ 用户定义类型 yòng hù dìng yì lèi xíng user-defined type/ˈjuːzə dɪˈfaɪnd taɪp/ 用户定义类型 yòng hù dìng yì lèi xíng field/fiːld/ 字段 zì duàn record/ˈrekɔːd/ 记录 jì lù set/set/ 集合 jí hé class/klæs/ 类 lèi composite type/ˈkɒmpəzɪt taɪp/ 复合类型 fù hé lèi xíng enumerated type/ɪˈnjuːməreɪtɪd taɪp/ 枚举类型 méi jǔ lèi xíng pointer/ˈpɔɪntə/ 指针 zhǐ zhēn dereference/ˌdiːˈrefrəns/ 解引用 jiě yǐn yòng object/ˈɒbdʒekt/ 对象 duì xiàng attributes/ˈætrɪbjuːts/ 属性 shǔ xìng methods/ˈmeθədz/ 方法 fāng fǎ constructor/kənˈstrʌktə/ 构造函数 gòu zào hán shù 13.2
文件组织与访问

大纲
Candidates should be able to: Notes and guidance Show understanding of the methods of file organisation and select an appropriate method of file organisation and file access for a given problem Including serial, sequential (using a key field), random (using a record key) Show understanding of methods of file access Including Sequential access for serial and sequential files Direct access for sequential and random files Show understanding of hashing algorithms Describe and use different hashing algorithms to read from and write data to a random/sequential file 来源:剑桥国际大纲
文件组织(file organisation)是数据如何布置;文件存取(file access)是程序如何访问一条记录。
- serial file(串行文件)——记录按添加的顺序,没有排序。存取只能是顺序的;追加很快;搜索很慢。用于日志和审计追踪。
- sequential file(顺序文件)——记录按一个键排序。搜索更快(你可以尽早停止或二分查找);插入很慢(记录必须移位)。用于批量更新的主文件。
- random (direct-access) file(随机文件)——记录在从键算出的位置(常用一个散列)。按键的直接存取非常快;按键顺序读取更难。用于大的查找表和客户账户。
串行文件:记录保持在它们被添加的顺序 
顺序文件:记录按一个键字段排序 
随机文件:记录坐在从键算出的位置 两种存取方法是顺序存取(sequential access,从头读到尾)和直接存取(direct access,直接跳到一个已知位置)。把结构匹配到主导操作:单键查找偏向随机;按序报表偏向顺序。
描述每种组织方式(得分的措辞)。 *串行:*记录按加入的顺序一条接一条存储,不按键排序。*顺序:*记录按某个键字段的顺序(已排序)存储。*随机:*每条记录存储在由散列算法从其键计算出的地址处,所以记录没有任何顺序。**比较串行与顺序:**两者都把记录一条接一条存储,都顺序读取,但顺序文件按键有序,所以一旦读到大于目标的键搜索就可以停止,而新记录必须插入到正确位置(通常要重写文件);串行文件则只是追加。
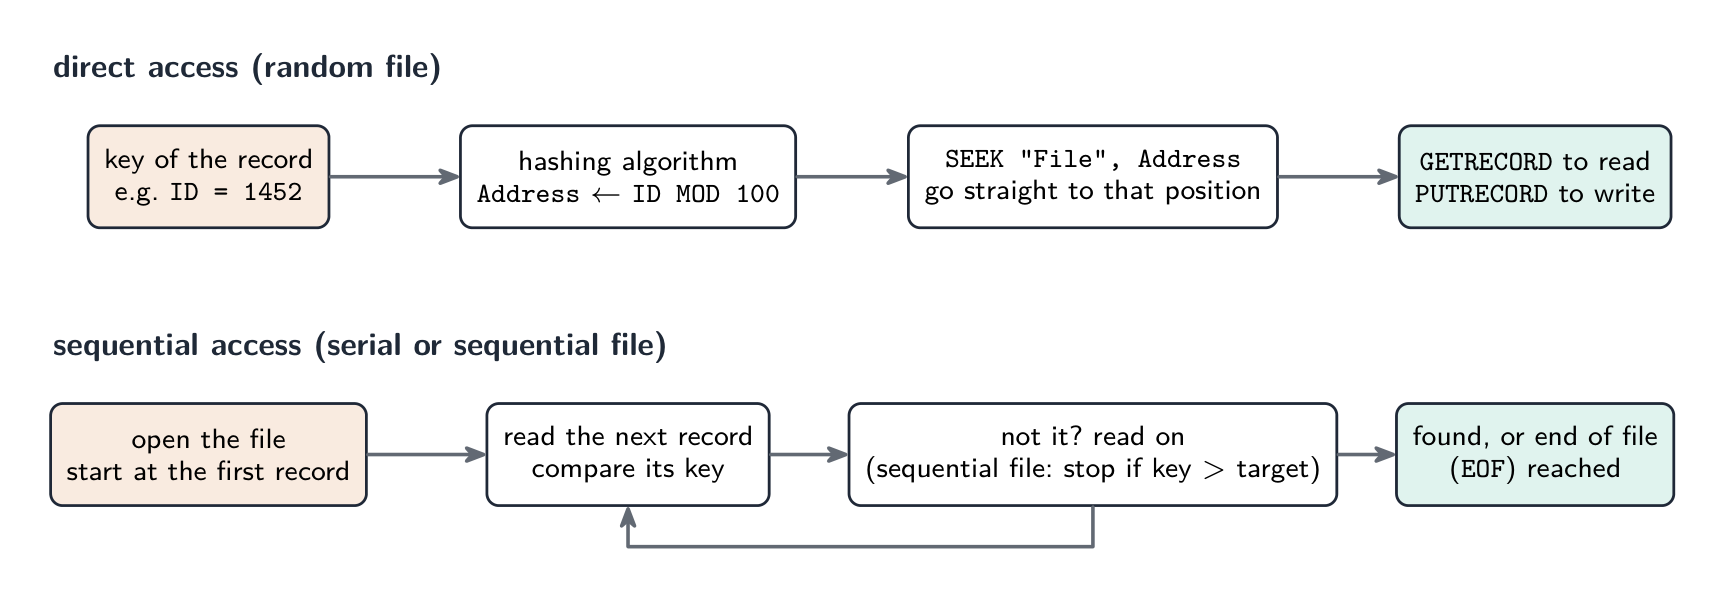
作为过程的两种存取方法:直接存取算出该看哪里;顺序存取依次看遍每一处 描述每种存取方法。 *顺序存取:*从文件开头开始,一条接一条(按存储顺序)读记录,直到找到所需记录或到达文件末尾。用于串行文件意味着读到匹配为止的每条记录,并要读完整个文件才能确定记录不存在;用于顺序文件时搜索可以提前停止,一旦读到大于目标的键即可。*直接存取:*记录的地址由其键计算得出(用散列算法,或由索引),程序直接到那个位置,不读它前面的记录;这是随机文件以及磁盘上由唯一地址引用的记录所用的存取方法。
选择。 批处理、逐条处理每条记录的工资或公用事业账单主文件适合顺序文件;按发生顺序记录交易的日志适合串行文件;程序运行时按键查找并更新单条记录的库存或客户文件适合用直接存取的随机文件。
伪代码中的文件处理。 考试要求标准语句,试卷 3 出的算法会用到它们:
任务 语句 打开文本文件 OPENFILE "Scores.txt" FOR READ(或FOR WRITE,创建或覆盖;或FOR APPEND)读或写一行 READFILE "Scores.txt", Line和WRITEFILE "Scores.txt", Line检测末尾 WHILE NOT EOF("Scores.txt")关闭 CLOSEFILE "Scores.txt"打开随机文件 OPENFILE "Stock.dat" FOR RANDOM移到记录位置 SEEK "Stock.dat", Address读或写整条记录 GETRECORD "Stock.dat", Item和PUTRECORD "Stock.dat", Item例题。 随机文件
Stock.dat保存StockItem类型的记录,存储在ItemID MOD 100给出的地址处。写出伪代码:若散列地址处为空则存入新条目,否则报告该位置已被占用。DECLARE Item, Existing : StockItem DECLARE Address : INTEGER INPUT Item.ItemID, Item.Description, Item.Quantity Address ← Item.ItemID MOD 100 OPENFILE "Stock.dat" FOR RANDOM SEEK "Stock.dat", Address GETRECORD "Stock.dat", Existing IF Existing.ItemID = 0 THEN // 0 表示空位置 SEEK "Stock.dat", Address PUTRECORD "Stock.dat", Item OUTPUT "Stored at ", Address ELSE OUTPUT "Position ", Address, " is in use" ENDIF CLOSEFILE "Stock.dat"评分方案检查两个细节:每次
GETRECORD或PUTRECORD之前都要SEEK(读取会使位置前移,所以写之前要再次定位),以及文件以FOR RANDOM打开并在最后关闭。要把随机文件的每条记录复制到另一个文件,就对地址循环,用SEEK、从一个文件GETRECORD、向另一个文件PUTRECORD,跳过空位置。探索File access route
Follow a file from storage to program and back safely.
词汇表 训练英文 中文 拼音 File organisation/faɪl ˌɔːɡənaɪˈzeɪʃn/ 文件组织 wén jiàn zǔ zhī serial file/ˈsɪərɪəl faɪl/ 串行文件 chuàn xíng wén jiàn sequential file/siːˈkwenʃl faɪl/ 顺序文件 shùn xù wén jiàn random file/ˈrændəm faɪl/ 随机文件 suí jī wén jiàn direct access/daɪˈrekt ˈækses/ 直接存取 zhí jiē cún qǔ sequential access/siːˈkwenʃl ˈækses/ 顺序存取 shùn xù cún qǔ 13.2
散列

一个散列函数(hash function,一个散列算法)取一个记录键并产生一个存储记录的地址(address)。一个好的散列函数快、确定性(deterministic),并把键均匀地铺开。
$N$ 个槽的常见散列算法:取模散列
address ← key MOD N;折叠(把键拆开、把各部分相加、MOD N);一个字符串散列(把字符码相加、MOD N)。一个冲突(collision)是当两个键散列到同一个地址时。解决它的三种方式:
策略 它如何工作 权衡 线性探测(linear probing) 用下一个空闲槽(绕回) 简单,但键聚集 链接法(chaining) 每个槽指向一个记录的链表(linked list) 无聚集,但用更多内存 再散列 应用第二个散列函数 铺开键,但更多工作 解决一个散列冲突:线性探测用下一个空闲槽;链接法为每个槽保持一个链表 要搜索:散列键,读那个槽;若键匹配你就完成了,否则跟随解决策略直到一个匹配或一个空槽。要插入:散列键,写入那个槽或下一个空闲的。保持装填因子(load factor,记录 ÷ 槽)低于约 70% 以获得接近 O(1) 的查找。
"解释文件存取语境下散列算法是什么意思"(三分)。 对记录的键字段进行的一种计算(函数),产生一个值,该值用作记录在文件中存储的地址(位置),并据此取回记录。 对同一个键做同样的计算总是给出同样的地址,这就是不用搜索也能再次找到记录的原因。
"概述克服冲突的两种方法。" (1) 线性探测(开放寻址):把记录存到计算地址之后的下一个空闲位置,必要时绕回开头;取回时从散列地址开始向前读,直到键匹配。(2) 溢出区(overflow area)或链接法:把冲突的记录存到单独的溢出区(或挂在该地址上的链表),主地址不匹配后再顺序搜索它。两者都得分;存储和取回都要描述。
例题。 一个随机文件有 11 个记录位置,编号 0 到 10,散列算法为
Address ← Key MOD 11。键为 1250、1381、1452、1613 和 1470 的记录按此顺序用线性探测存入。指出每条记录的位置,并描述如何取回键 1470。$1250 \bmod 11 = 7$;$1381 \bmod 11 = 6$;$1452 \bmod 11 = 0$;$1613 \bmod 11 = 7$,与 1250 冲突,所以 1613 取下一个空闲位置 8;$1470 \bmod 11 = 7$ 再次,位置 7 和 8 已满,所以 1470 到 9。取回 1470:算出 $7$,读位置 7(键 1250,不匹配),读 8(1613,不是),读 9(1470,找到)。若在匹配之前遇到空位置,则记录不在文件中。冲突是小文件的代价:好的散列算法把键均匀分散,而且文件保持远未填满,使探测保持短。
探索A hash table
Watch each key get hashed to a bucket. A good hash spreads keys out so lookups stay fast.
词汇表 训练英文 中文 拼音 linked list/lɪŋkt lɪst/ 链表 liàn biǎo hash function/hæʃ ˈfʌŋkʃn/ 散列函数 sàn liè hán shù deterministic/dɪˌtɜːmɪˈnɪstɪk/ 确定性 què dìng xìng collision/kəˈlɪʒn/ 冲突 chōng tū linear probing/ˈlɪnɪə ˈprəʊbɪŋ/ 线性探测 xiàn xìng tàn cè chaining/ˈtʃeɪnɪŋ/ 链接法 liàn jiē fǎ load factor/ləʊd ˈfæktə/ 装填因子 zhuāng tián yīn zi overflow area/ˌəʊvəˈfləʊ ˈeərɪə/ 溢出区 yì chū qū overflow/ˌəʊvəˈfləʊ/ 溢出 yì chū 13.3
浮点数的表示与运算

大纲
Candidates should be able to: Notes and guidance Describe the format of binary floating-point real numbers Use two's complement form Understand of the effects of changing the allocation of bits to mantissa and exponent in a floating-point representation Convert binary floating-point real numbers into denary and vice versa Normalise floating-point numbers Understand the reasons for normalisation Show understanding of the consequences of a binary representation only being an approximation to the real number it represents (in certain cases) Understand how underflow and overflow can occur Show understanding that binary representations can give rise to rounding errors 来源:剑桥国际大纲
为了存储大小非常不同的实数,计算机用一个浮点(floating-point)格式——科学记数法的一个二进制形式,带两个字段:
- 一个尾数(mantissa)——有效数字。
- 一个指数(exponent)——要乘的 2 的幂。
两者都存储为补码(two's complement)整数。值是
$$\text{number} = \text{mantissa} \times 2^{\text{exponent}}.$$把尾数读作一个二进制分数——小数点后第一位值 $1/2$,下一位 $1/4$,然后 $1/8$,如此等等。所以
0.1010000是 $1/2 + 1/8 = 0.625$;带指数00000010(= 2)值是 $0.625 \times 2^{2} = 2.5$。一个 8 位尾数和一个 8 位指数的位值 Converting
- 二进制 → 十进制:把尾数(若为负用补码规则)读作一个分数,把指数读作一个有符号整数,然后把尾数乘以 $2^{\text{exponent}}$。
- 十进制 → 二进制:把数写成一个二进制分数 × 一个 2 的幂,然后把尾数和指数存储为约定的格式。
例题。 一个数有尾数
10110000和指数00000011。求它的十进制值。指数
00000011是 $+3$。尾数以一个 1 开始,所以它是负的。在补码中读作1.0110000,符号位值 $-1$,分数位加上 $\tfrac{1}{4} + \tfrac{1}{8} = 0.375$,所以尾数是 $-1 + 0.375 = -0.625$。于是$$\text{number} = -0.625 \times 2^{3} = -5.0.$$例题。 在这个格式中存储 $+2.5$。
在二进制中 $2.5 = 10.1$。写成一个规格化的分数,$2.5 = 0.101 \times 2^{2}$。所以尾数是
01010000(符号位 0,然后.101)而指数是00000010($= 2$)。考试的格式:补码、尾数和指数
考试给出诸如 10 位尾数和 6 位指数、两者都用补码的格式。尾数的二进制小数点位于其第一位(符号位)之后,所以正尾数是
0.xxxxxxxxx,负尾数是1.xxxxxxxxx;指数是普通的有符号整数。每次转换都用同样的三步:把尾数读作分数(若以 1 开头则用补码规则),把指数读作整数,乘以 $2^{\text{指数}}$。例题(二进制到十进制)。 尾数
0101100000,指数000011。尾数:$0.101100000_2 = \tfrac{1}{2} + \tfrac{1}{8} + \tfrac{1}{16} = 0.6875$。指数:$000011_2 = 3$。值:$0.6875 \times 2^{3} = 5.5$。
例题(负尾数)。 尾数
1011000000,指数000010。尾数以 1 开头,所以为负。它的值是 $-1 + 0.011000000_2 = -1 + (\tfrac{1}{4} + \tfrac{1}{8}) = -0.625$;指数 $= 2$;值 $-0.625 \times 4 = -2.5$。(或者,取尾数的补码
0101000000$= 0.625$,再加上负号。)负指数如111110$= -2$ 则是除:尾数 $0.5$ 配该指数是 $0.5 \times 2^{-2} = 0.125$。例题(十进制到二进制)。 在 10 位和 6 位的格式中以规格化形式存储 $+6.5$ 和 $-6.5$。
$6.5 = 110.1_2 = 0.1101_2 \times 2^{3}$,所以尾数是
0110100000,指数是000011。对 $-6.5$,取尾数的补码:1001100000(检验:$-1 + 0.0011_2 = -1 + 0.1875 = -0.8125$,且 $-0.8125 \times 8 = -6.5$),指数000011不变。符号决不进入指数;负数有负的尾数。Normalisation
一个数在它的第一个有效位紧跟在二进制小数点之后时是规格化的(normalised,没有浪费的前导零)。这最大化精度,因为每个尾数位都携带信息。要规格化,把尾数左移并减小指数(或右移并增大它),直到第一个有效位就位;值不变。对负(补码)尾数,符号位(1)之后紧跟一个 0。
识别和产生规格化形式。 正的规格化尾数以
01开头;负的以10开头。所以0011000000不是规格化的(左移一位并把指数减一:0110000000,指数少一)而1100000000也不是(左移直到模式为10...)。尾数每左移一位都必须对应把指数减一,否则值就变了。"解释为什么数以规格化形式存储"(两分)。 (1) 它对可用的位数给出最大精度(准确度),因为没有位浪费在前导零(或负数的前导一)上;(2) 每个数于是有唯一的表示,所以数可以比较;(3) 它最好地利用了可用的范围。任意两点得分。

规格化:把尾数左移以去除前导零,把指数降低同样的量 Approximation and rounding errors
许多十进制实数不能在二进制中被精确存储——例如 $0.1_{10}$ 是循环二进制分数 $0.000110011\ldots_{2}$,它必须被截断。后果:
- 舍入误差(rounding errors)在许多操作上累积(
0.1 + 0.2不精确地是0.3)。 - 比较失败——测试
ABS(x - 0.3) < 1e-9而不是x = 0.3。 - 两个几乎相等的值相减会损失精度。
- 当指数用尽范围时,溢出(overflow,一个对指数范围太大的结果)和下溢(underflow,一个太小的结果,舍入为零)发生。
对于精确的需要(货币),用定点(fixed-point)或 BCD(二进码十进数)而不是浮点。
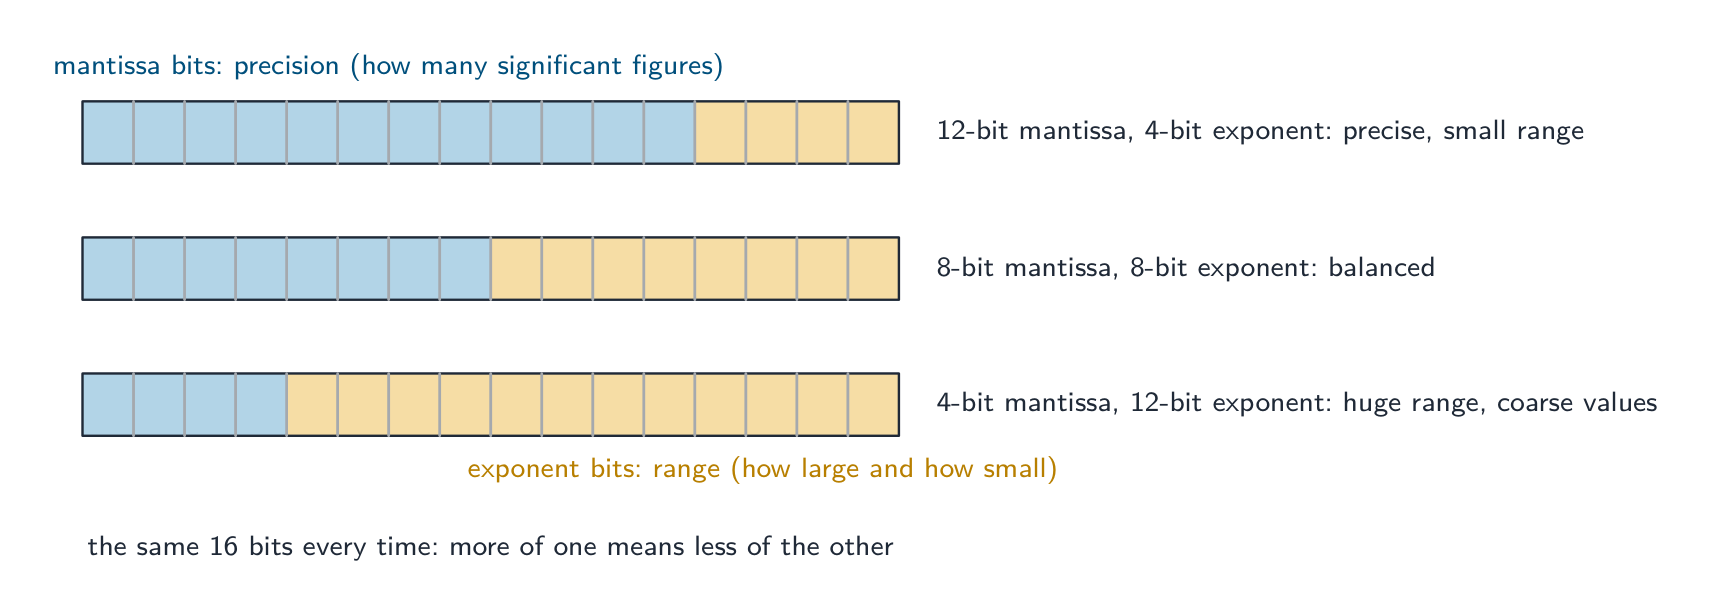
同样的总位数以两种方式分配:尾数位换精度,指数位换范围,一方增长只能以另一方为代价 "描述改变位分配的影响"(三分)。 总位数固定时,增加尾数、减少指数给出更高的精度(precision)(更多有效数字、更小的舍入误差)但更小的范围(range)(能存储的最大和最小量值缩小);增加指数则相反:以精度为代价换更大的范围。两种影响、两个方向都要说。
最大和最小。 在 10 位尾数、6 位指数的格式中,最大正数的尾数为
0111111111($= 1 - 2^{-9}$),指数为011111($= 31$):约 $2^{31}$。最小的正规格化数尾数为0100000000($= 0.5$),指数为100000($= -32$):$0.5 \times 2^{-32} = 2^{-33}$。最负的数尾数为1000000000($= -1$),指数为 $31$:$-2^{31}$。"解释溢出和下溢是什么意思。" 当计算结果大于能表示的最大数、指数需要的位数超过它拥有的位数时,发生溢出;当结果小于能表示的最小(非零)数、太接近零以至于指数无法表达时,发生下溢,它被存为零。两者都源于指数的范围,而不是尾数的。
为什么二进制表示只是近似。 二进制分数只能精确表示 $\tfrac{1}{2}, \tfrac{1}{4}, \tfrac{1}{8}, \ldots$ 之和;像 $0.1$ 或 $\tfrac{1}{3}$ 这样的值有无限的二进制展开,而尾数位数固定,所以存储的是能放下的最接近的值。差值就是舍入误差;对一个数它很小,但在重复计算中会累积(把 $0.1$ 加十次可能不恰好得到 $1$),这就是决不应对实数做精确相等测试的原因。
探索Build a floating-point number
Flip the mantissa and exponent bits to make a value, and check whether it is normalised.
探索Normalising a floating-point number
Step through normalisation. Shifting the mantissa to remove wasted leading zeros — and adjusting the exponent to match — keeps the value the same but spends every bit on precision.
词汇表 训练英文 中文 拼音 floating-point/ˈfləʊtɪŋ pɔɪnt/ 浮点 fú diǎn mantissa/mænˈtɪsə/ 尾数 wěi shù exponent/ekˈspəʊnənt/ 指数 zhǐ shù two's complement/tuːz ˈkɒmplɪmənt/ 补码 bǔ mǎ normalised/ˈnɔːməlaɪzd/ 规格化 guī gé huà rounding errors/ˈraʊndɪŋ ˈerəz/ 舍入误差 shě rù wù chā underflow/ˌʌndəˈfləʊ/ 下溢 xià yì fixed-point/fɪkst pɔɪnt/ 定点 dìng diǎn BCD/ˌbiː siː ˈdiː/ 二进码十进数 èr jìn mǎ shí jìn shù precision/prɪˈsɪʒn/ 精度 jīng dù range/reɪndʒ/ 范围 fàn wéi 13.3
考官认可的定义
定义题按固定措辞评分。准确学会这些,只给一个答案。
术语 定义 用户定义数据类型 由程序员基于已有类型定义的、表示该问题特有数据的数据类型 非复合类型 定义时不引用其他类型的类型;容纳单个值(整数、实数、枚举、指针) 复合类型 由其他类型组成的类型;在一个标识符下容纳多个值(记录、集合、数组、类) 枚举类型 通过按顺序列出全部可能值来定义的非复合类型 指针类型 其值为某给定类型变量的内存地址的非复合类型 集合 容纳同一类型值的集合、无序且无重复的复合类型 记录 由固定数目的字段组成、每个字段有自己的标识符和类型、用点记法访问的复合类型 类 把属性(数据)与作用于它们的方法(过程和函数)结合起来的复合类型;对象是类的实例 串行文件 记录按加入的顺序一条接一条存储 顺序文件 记录按某键字段的顺序一条接一条存储 随机文件 记录存储在由散列算法从其键算出的地址处 顺序存取 从文件开头依次读记录直到找到所需记录 直接存取 由键算出记录的地址并直接到该位置 散列算法 对记录的键进行的计算,给出记录存储和查找的地址 冲突 两个不同的键产生同一个地址 尾数 浮点数中以补码分数形式保存其有效位的部分 指数 给出尾数所乘的 2 的幂的补码整数 规格化 尾数以 01(正)或 10(负)开头的浮点数,没有位浪费在前导零或一上 溢出 结果太大,无法用可用位数表示 下溢 非零结果太小无法表示,因而存为零 舍入误差 实数与二进制表示能保存的最接近值之间的差 13.3
考试技巧
- 伪代码声明逐行评分:枚举用
TYPE ... = (...),指针用TYPE ... = ^...,集合用TYPE ... = SET OF ...再DEFINE ... (...) : ...,记录用TYPE ... DECLARE ... ENDTYPE,类用CLASS ... PRIVATE ... PUBLIC PROCEDURE NEW ... ENDCLASS。 - 按数据匹配类型:固定的命名值用枚举;一组不同字段用记录;唯一值的集合用集合;数据加行为用类;地址用指针。
- 文件组织是记录如何存储;文件存取是如何找到它们。串行和顺序文件顺序读取;随机文件通过键的散列直接存取。对顺序文件的顺序搜索可以提前停止;对串行文件不能。
- 随机文件伪代码:
OPENFILE ... FOR RANDOM,每次GETRECORD或PUTRECORD之前SEEK,最后CLOSEFILE。描述散列时要说明冲突如何解决。 - 浮点:尾数作为补码分数(小数点在符号位之后),指数作为整数,乘以 $2^{\text{指数}}$;规格化时左移并把指数减一;尾数买精度,指数买范围。
- 三个"解释"标准答案:为什么规格化(精度、唯一形式、范围)、重新分配位的影响(精度对范围)、为什么 $0.1$ 不能精确存储(有限尾数中的无限二进制分数)。
常见错误
- 新类型写
DECLARE而不是TYPE,或漏掉ENDTYPE;声明集合时没有SET OF,或枚举值加引号。 - 把浮点数的符号放进指数;符号是尾数的第一位。
- 把负尾数当作原码读;它是补码,所以
1011000000是 $-0.625$,不是 $-0.375$。 - 规格化时移动尾数而不改指数,或改错方向(左移,指数减)。
- 把随机文件描述成"随机顺序";记录在由键算出的地址处。
- 说顺序存取对顺序文件读"整个文件";遇到更大的键就停止。
- 解释散列时不说算出的值用来做什么(存储和取回记录的地址),或没有处理冲突的方法。
- 把溢出定义为"位数太多"而不是超出最大可表示值的结果,或把它归咎于尾数。
- record(记录,主题 10)——一个
-
14
通信与互联网技术
14.1
协议

大纲
Candidates should be able to: Notes and guidance Show understanding of why a protocol is essential for communication between computers Show understanding of how protocol implementation can be viewed as a stack, where each layer has its own functionality Show understanding of the TCP/IP protocol suite Four Layers (Application, Transport, Internet, Link) Purpose and function of each layer Application when a message is sent from one host to another on the internet Show understanding of protocols (HTTP, FTP, POP3, IMAP, SMTP, BitTorrent) and their purposes BitTorrent protocol provides peer-to-peer file sharing 来源:剑桥国际大纲
一个协议(protocol)是设备如何通信的一套规则。两端都必须遵循同样的规则,否则一方的信号对另一方毫无意义。协议定义数据的格式(地址和有效载荷在哪里)、消息的顺序(谁先说话、何时确认)、每个消息的含义、定时(超时、重传),以及出错时做什么。没有一个约定的协议,通信就失败——像两个人说不同的语言而没有翻译。
"解释为什么协议对计算机之间的通信是必不可少的"(三分)。 (1) 协议是发送方和接收方都同意的一套规则;(2) 没有它,两台计算机会以不同方式解释数据(格式、顺序、各部分的含义),消息就无法被理解;(3) 它使不同类型和不同厂商的计算机能够通信,因为大家实现同一个标准。要提到规则涵盖什么:数据的格式、消息的顺序、错误检测和恢复、以及速度或时序。
一个协议是共享的规则:格式、顺序、定时和错误 词汇表 训练英文 中文 拼音 protocol/ˈprəʊtəkɒl/ 协议 xié yì 14.1
分层协议
联网是复杂的,所以它被拆成层(layers),每层有一件专注的工作,只与上面和下面的层对话。好处:模块化(modularity,替换一层——比如用 Wi-Fi 替换 Ethernet——而不碰其他层)、标准化(供应商互操作),以及抽象(abstraction,你忽略别处处理的细节)。互联网用 TCP/IP 协议栈(protocol suite,4 层)。
词汇表 训练英文 中文 拼音 layers/ˈleɪəz/ 层 céng modularity/ˌmɒdjʊˈlærɪti/ 模块化 mó kuài huà abstraction/əbˈstrækʃn/ 抽象 chōu xiàng protocol suite/ˈprəʊtəkɒl swiːt/ 协议栈 xié yì zhàn 14.1
TCP/IP 协议族

层 目的 例子 Application 用户程序做什么 HTTP, FTP, SMTP, IMAP Transport 进程之间端到端的传递 TCP, UDP Internet 在网络之间路由数据包 IP Link 在物理介质上发送比特 Ethernet, Wi-Fi TCP/IP 协议栈的四层 各层的目的,按评分方案的措辞。 *应用层:*提供用户应用程序使用的协议(网页用 HTTP,电子邮件用 SMTP)以及应用程序与网络之间的接口;它产生要发送的数据并把它交给传输层。*传输层:*建立端到端的连接,把数据拆分成数据包(段),加上端口号和序号;接收时按顺序重组数据包并请求缺失的包(TCP),或者不带这些保证地发送(UDP)。*网络层:*加上源和目的 IP 地址形成 IP 数据包(数据报),并通过路由器在网络之间路由它们;它不保证送达。*链路层:*加上 MAC 地址和校验位形成帧,并通过网络接口卡在物理局域网(Ethernet 或 Wi-Fi)上传输比特。"补全协议栈"就是这四层,从上到下依次为:Application、Transport、Internet、Link。
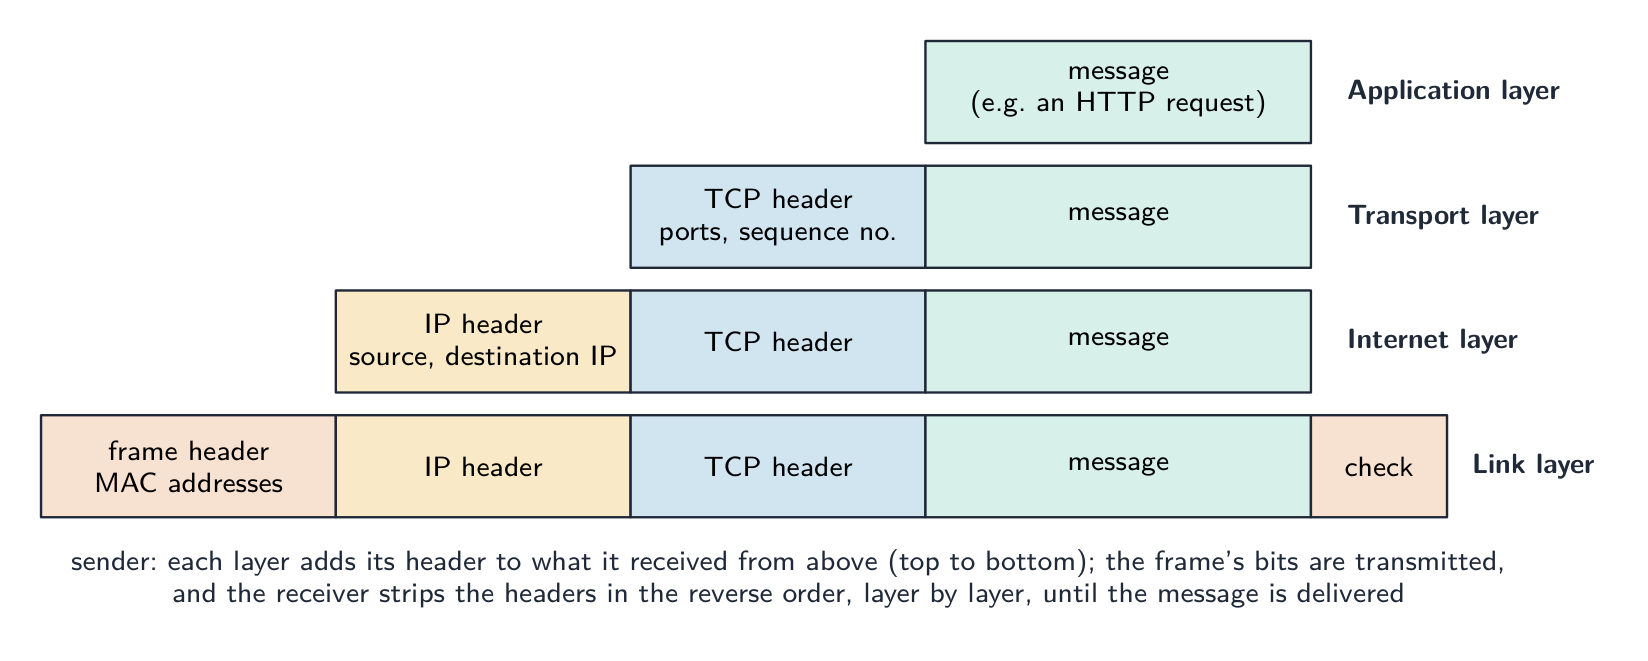
封装:每一层给它从上一层收到的内容加上自己的首部(header),所以线路上的比特携带四组信息;接收方逐层去掉它们 "描述当消息从一台主机发送到另一台主机时 TCP/IP 协议簇如何被应用"(五分)。 在发送方,消息沿栈向下传递:(1) 应用层用 HTTP 或 SMTP 等协议产生数据;(2) 传输层把它拆成数据包,并加上带端口号和序号的首部;(3) 网络层加上带源和目的 IP 地址的首部并选择路由;(4) 链路层加上下一台设备的 MAC 地址,并通过物理链路发送帧。沿途的路由器读取网络层首部并转发每个数据包。在接收方,帧沿栈向上传递:每一层去掉并处理自己的首部,传输层按序号顺序重组数据包并请求缺失的包,应用层呈现消息。两端每一层用同一个协议,正是交换得以成功的原因。
Application layer
应用层(application layer)给用户程序提供服务并定义它们说的协议(网络用 HTTP,电子邮件用 SMTP)。这是一个程序员最常工作的地方。
Transport layer
传输层(transport layer)在进程之间端到端地传递数据,进程由端口号(port numbers)标识。两个协议:

TCP 连接并按序传递;UDP 发了就忘 - TCP(传输控制协议)——面向连接(connection-oriented):建立一个连接、确保所有数据按序到达、重传丢失的数据包(packets)、控制流量。可靠但有开销。被 HTTP、HTTPS、SMTP、FTP 使用。
- UDP(用户数据报协议)——无连接(connectionless):发了就忘,没有确认或排序。开销低,无保证。用于流媒体、DNS 和游戏,那里速度胜过可靠性。
Internet layer
网络层(internet layer)用 IP 在主机之间携带数据包。每个数据包有一个源和目的 IP 地址(IP address),路由器(routers)把它往前转发。它不保证传递——那是 TCP 的工作。
一个家用路由器为你的家做这件工作:它读每个数据包的目的地址并把它送往互联网,再送回正确的设备。

一个家用 Wi-Fi 路由器:它在你的设备和互联网之间转发数据包 在路由器到达更广的互联网之前,一个调制解调器(modem)通过提供商的电缆或电话线把家连到互联网提供商。它的灯显示链路已连通并在线。

一个电缆调制解调器把一个家庭网络连到互联网提供商 Link layer
链路层(link layer)在一条物理链路(Ethernet、Wi-Fi)上发送比特。它加一个带 MAC 地址(MAC addresses)的帧头并处理介质访问(例如 Ethernet 上的 CSMA/CD(载波侦听多路访问))。

一个典型 Ethernet 帧的各部分 在一个有线局域网上,一个交换机(switch)把许多设备连在一起。每个设备用一根 Ethernet 电缆(一个 RJ45 插头)插入一个端口,而交换机用每个帧里的 MAC 地址把它只发到正确的端口。

一个网络交换机在一个局域网上连接许多有线设备 物理链路可以是一根铜线、一个无线电信号(Wi-Fi),或一根光纤(fibre-optic cable)。在一根光纤中,比特作为光的闪烁穿过非常细的玻璃丝行进,这很快并把数据带很远。

一根光纤:数据作为光穿过细玻璃丝行进 一个无线电链路可以到达远得多。一个卫星天线(satellite dish)向一颗卫星发送和接收无线电信号,把数据带到有线链路不易到达的地方。

一个卫星天线通过无线电在远距离上发送和接收数据 探索Tap the four layers of the TCP/IP model
Explore each layer. Data travels DOWN the stack as it's sent (each layer adds its header) and back UP as it's received — and any layer can be swapped without touching the others.
词汇表 训练英文 中文 拼音 application layer/ˌæplɪˈkeɪʃn ˈleɪə/ 应用层 yìng yòng céng transport layer/ˈtrænspɔːt ˈleɪə/ 传输层 chuán shū céng port numbers/pɔːt ˈnʌmbəz/ 端口号 duān kǒu hào TCP/ˌtiː siː ˈpiː/ 传输控制协议 chuán shū kòng zhì xié yì connection-oriented/kəˈnekʃn ˈɔːrɪəntɪd/ 面向连接 miàn xiàng lián jiē packets/ˈpækɪts/ 数据包 shù jù bāo UDP/ˌjuː diː ˈpiː/ 用户数据报协议 yòng hù shù jù bào xié yì connectionless/kəˈnekʃənləs/ 无连接 wú lián jiē internet layer/ˈɪntənet ˈleɪə/ 网络层 wǎng luò céng routers/ˈruːtəz/ 路由器 lù yóu qì modem/ˈməʊdem/ 调制解调器 tiáo zhì jiě tiáo qì link layer/lɪŋk ˈleɪə/ 链路层 liàn lù céng CSMA/CD/ˌsiː es em ˈeɪ ˌsiː ˈdiː/ 载波侦听多路访问/冲突检测 zài bō zhēn tīng duō lù fǎng wèn / chōng tū jiǎn cè switch/swɪtʃ/ 交换机 jiāo huàn jī fibre-optic cable/ˈfaɪbə ˈɒptɪk ˈkeɪbl/ 光纤 guāng xiān satellite dish/ˈsætəlaɪt dɪʃ/ 卫星天线 wèi xīng tiān xiàn HTTP/ˌeɪtʃ tiː tiː ˈpiː/ 超文本传输协议 chāo wén běn chuán shū xié yì FTP/ˌef tiː ˈpiː/ 文件传输协议 wén jiàn chuán shū xié yì SMTP/ˌes em tiː ˈpiː/ 简单邮件传输协议 jiǎn dān yóu jiàn chuán shū xié yì IP address/ˌaɪ ˈpiː əˈdres/ IP地址 IP dì zhǐ MAC addresses/mæk əˈdresɪz/ MAC地址 MAC dì zhǐ header/ˈhedə/ 首部 shǒu bù 14.1
常见的应用层协议

- HTTP(超文本传输协议)——浏览器从服务器取网页(经 TCP,端口 80)。HTTPS 是 HTTP 经 TLS——加密,端口 443。
- FTP(文件传输协议)——在客户端和服务器之间传输文件。
- SMTP(简单邮件传输协议)——在客户端和服务器之间、以及服务器之间发送电子邮件。接收用 POP3 或 IMAP。
- POP3——下载电子邮件并通常从服务器删除它。IMAP——把电子邮件留在服务器上并跨设备同步,所以同一个收件箱处处出现。
- BitTorrent——一个对等网络(peer-to-peer)协议;一个文件被拆成从许多对等方并行下载的片,所以没有单一的服务器承担全部负载。
BitTorrent:一个 tracker 帮助对等方找到彼此,然后它们直接共享文件片 各协议的目的,用得分的措辞。
协议 目的(这样表述) HTTP 在网页服务器和浏览器之间传输网页(超文本);HTTPS 是加密版本 FTP 在客户端和服务器之间传输文件(向文件服务器上传和从它下载) SMTP 把电子邮件从客户端发送到邮件服务器,以及在邮件服务器之间发送("推"协议) POP3 把电子邮件从服务器下载到客户端,通常从服务器删除,所以在一台设备上阅读 IMAP 让客户端读取和管理留在服务器上的电子邮件,所以每台设备看到同一个邮箱 BitTorrent 对等分享文件:文件的片段同时从许多其他用户下载,并上传给他们 被问到两个电子邮件协议时,发送给 SMTP,接收给 POP3 或 IMAP;被要求描述 IMAP 时,要说消息留在服务器上并在各设备之间同步,这是它与 POP3 的区别。
"描述如何用 BitTorrent 协议分享文件"(四分)。 (1) 文件被拆成片段(通常每片 256 KB),一个小的 torrent 文件描述它们(它们的散列值)并指定一个追踪器(tracker)。(2) 想要该文件的对等方联系追踪器,追踪器保存当前分享该文件的群(swarm)中的对等方列表。(3) 该对等方同时从许多对等方下载不同的片段,一旦持有某片段就把它上传给其他人;拥有完整文件的对等方是种子(seed),仍在下载的是吸血者。(4) 所有片段到齐后重组并对照散列值检验。"解释对等文件分享是什么意思":没有保存文件的中央服务器;每台计算机既是客户端也是服务器,从其他方下载并上传给其他方,所以负载和带宽分散在整个群中,对等方越多速度越快。
探索Network route lab
Follow data from a device through network hardware and protocols.
词汇表 训练英文 中文 拼音 peer-to-peer/pɪə tə pɪə/ 对等网络 duì děng wǎng luò tracker/ˈtrækə/ 追踪器 zhuī zōng qì swarm/swɔːm/ 群 qún seed/siːd/ 种子 zhǒng zi 14.2
电路交换与分组交换

大纲
Candidates should be able to: Notes and guidance Show understanding of circuit switching Benefits, drawbacks and where it is applicable Show understanding of packet switching Benefits, drawbacks and where it is applicable Show understanding of the function of a router in packet switching Explain how packet switching is used to pass messages across a network, including the internet 来源:剑桥国际大纲
Circuit switching
在发送任何数据之前,在两端之间建立一条专用路径(电路交换(circuit switching)),为整个会话保留,然后释放。它给出保留的带宽(bandwidth)和按序传递,但在静默期间低效且建立慢。经典例子:传统电话网络。
电路交换:一条专用路径被端到端地保留 "描述作为数据传输方法的电路交换"(三分)。 (1) 在发送任何数据之前,在发送方和接收方之间建立一条专用路径(电路);(2) 整个消息沿该路径按顺序作为一个连续的流发送;(3) 电路在通信的持续期间被保留,之后释放。
优点和缺点。 *优点:*电路的全部带宽可用且有保证;数据按序到达,不需要重组,电路建立后没有延迟;路由不变,所以时序可预测(适合实时语音和视频)。*缺点:*发送任何东西之前要花时间建立电路;即使没有数据流动电路也被保留,所以带宽被浪费,其他用户不能共享;两端必须同时空闲;路径上任何地方的故障都会中断整个通话,并且没有自动的备用路由。*适用场合:*电话通话或实时视频链路,稳定不间断的流比效率更重要。
Packet switching
数据被拆成数据包,每个独立地发送(分组交换(packet switching))。每个数据包携带目的地址;路由器为每个数据包做决定,所以数据包可能走不同的路由并乱序到达,而目的地把它们重组。它高效(一条链路在许多会话间被多路复用(multiplexed))、健壮(绕过一个故障重新路由),但有可变的延迟(latency)和可能的丢失(TCP 处理可靠性)。被互联网使用。

分组交换:数据包独立地行进,可能走不同的路由 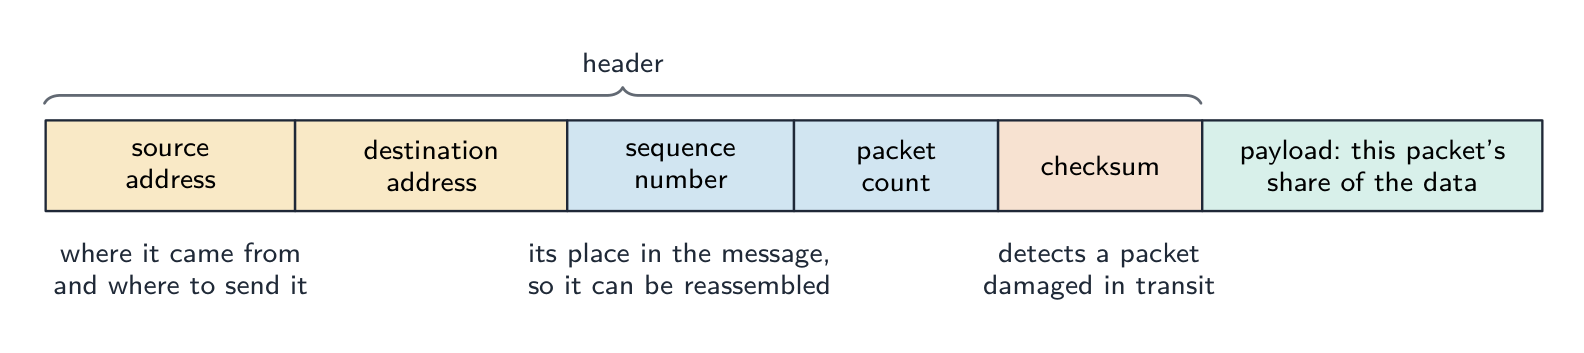
让数据包能独立传输的东西:地址说去哪里,序号说它是消息的哪一部分,校验和表明它是否完好到达 "描述如何用分组交换在网络上传递消息"(四分)。 (1) 消息被拆成固定最大尺寸的数据包;(2) 每个数据包被加上一个首部,包含源和目的地址、一个序号(sequence number)和一个校验;(3) 每个数据包独立发送,可能走由它遇到的路由器选择的不同路由;(4) 在目的地用序号把数据包按序重组,缺失的数据包被再次请求。若题目排除检查和重发,就去掉最后一句。
"描述路由器在分组交换中的功能"(三分)。 路由器接收一个数据包,读取其首部中的目的 IP 地址,查阅它的路由表(routing table)决定朝该目的地的最佳下一跳,并考虑流量(拥塞)和故障链路;然后把数据包转发到该链路上。同一消息的数据包可能从不同路由离开;链路繁忙时路由器把数据包放在队列中。
"描述分组交换确保完整消息被接收的两种方式。" (1) 每个数据包携带序号,所以接收方能把数据包排序并能判断某个包缺失;(2) 接收方对到达的数据包发送确认(acknowledgement);在时限内未被确认的数据包由发送方重传。每个数据包中的校验和(checksum)让接收方检测出损坏的数据包并丢弃它,进而触发重发。
优点和缺点。 *优点:*不需要建立电路;网络的链路被许多消息共享,所以带宽利用高效;数据包可以绕开故障或拥塞的链路重新路由,所以传输健壮;丢失或损坏的数据包只需重发那个包,而不是整个消息。*缺点:*数据包可能乱序到达,必须重组,有些可能丢失或延迟;首部增加开销;可变的延迟使它不加额外措施就不太适合实时语音和视频;负载很重的网络会丢包。*适用场合:*电子邮件、网页、文件下载和任何"突发"流量,以及整个互联网。
方面 电路交换 分组交换 路径 专用、保留 共享、每包 建立时间 慢 无 带宽使用 低效 高效 顺序 按序 可能乱序 健壮性 一个故障切断电路 绕过故障重新路由 适合 恒速流(语音) 突发流(网络、电子邮件) 现代网络因分组交换的高效和韧性而使用它。
四个区别,成对表述。 (1) 电路交换在发送前建立专用路径;分组交换不建立路径就发送。(2) 电路交换中整个消息走一条路由;分组交换中数据包可能走不同路由。(3) 电路交换按序送达数据、不需要重组;分组交换需要序号来重组。(4) 电路交换为一次通话保留带宽,即使空闲也如此;分组交换在许多消息之间共享链路。(也可接受:链路故障会中断电路,而数据包会被重新路由;电路交换适合实时流,分组交换适合突发数据。)每个区别都要写出两半;只写一边不得分。
Describing packet switching in a few sentences
一个好的考试答案:"消息被分成小数据包。每个数据包携带目的和源地址以及一个序列号。每个数据包独立地穿过网络行进,路由器为每个数据包选择下一跳。数据包可能走不同的路径并乱序到达。目的地用序列号重组消息,而丢失的数据包可以再次被请求。"
例题。 一通电话和一个大文件下载共用一个网络。各自适合哪种交换方式?为什么?电话需要平稳、低延迟的数据流,如果有片段迟到或乱序到达就会严重受影响 - 所以电路交换适合它:在整通电话期间建立一条专用路径,并为其保留带宽。文件下载并不在意时序或到达顺序,因为接收端会重新组装它,而且它能从任何恰好空闲的带宽中获益 - 所以分组交换适合它:文件被拆成独立传输的数据包,每个包带有源地址、目的地址和序号,路由器为每个包各自选择下一跳。要点出决定性的那条流量特性:电话要的是保留带宽和低延迟,下载要的是效率和容错。
探索A packet's journey across the internet
Step through packet switching. The message is split up, each packet finds its own way, and the destination puts them back together — which is why the internet is so efficient and hard to break.
词汇表 训练英文 中文 拼音 circuit switching/ˈsɜːkɪt ˈswɪtʃɪŋ/ 电路交换 diàn lù jiāo huàn reserved bandwidth/rɪˈzɜːvd ˈbændwɪdθ/ 带宽 dài kuān packet switching/ˈpækɪt ˈswɪtʃɪŋ/ 分组交换 fēn zǔ jiāo huàn multiplexed/ˌmʌltɪˈplekst/ 多路复用 duō lù fù yòng variable latency/ˈveərɪəbl ˈleɪtənsi/ 延迟 yán chí sequence number/ˈsiːkwəns ˈnʌmbə/ 序号 xù hào routing table/ˈraʊtɪŋ ˈteɪbl/ 路由表 lù yóu biǎo acknowledgement/əkˈnɒlɪdʒmənt/ 确认 què rèn checksum/ˈtʃeksəm/ 校验和 jiào yàn hé bandwidth/ˈbændwɪdθ/ 带宽 dài kuān latency/ˈleɪtənsi/ 延迟 yán chí 14.2
考官认可的定义
定义题按固定措辞评分。准确学会这些,只给一个答案。
术语 定义 协议 管理数据如何传输的一套规则,由发送方和接收方共同遵守,使双方以同样方式解释数据 协议栈 各有自己功能、共同完成通信的协议各层;每一层只与其上下相邻的层通信 应用层 提供应用程序交换数据所用的协议(HTTP、SMTP、FTP、IMAP、POP3) 传输层 建立端到端通信,把数据拆成带端口号和序号的数据包,重组它们并请求缺失的包(TCP),或不带保证地发送(UDP) 网络层 加上 IP 地址形成数据包,并通过路由器在网络之间路由它们 链路层 加上 MAC 地址形成帧,并在物理局域网上传输比特 路由器 读取数据包的目的地址并沿朝该目的地的最佳可用路由转发它的设备 电路交换 在发送数据之前在两端之间建立一条专用通信路径,并在整个传输期间保持 分组交换 消息被拆成各带首部的数据包,独立地经可能不同的路由发送,并在目的地重组 数据包 携带首部(地址、序号、校验)和有效载荷的数据单元 对等 没有中央服务器的文件分享,每台计算机既是客户端也是服务器 14.2
考试技巧
- 为什么要协议:共同的规则、相同的解释、任何品牌的计算机。为什么分层:每层只做一件事,可以独立更换。
- 四层从上到下的顺序:Application、Transport、Internet、Link。用一句话说出每层的任务,把"消息从主机到主机"的答案写成沿栈向下再向上的过程。
- 协议的目的是一句话:HTTP 网页,FTP 文件,SMTP 发送邮件,POP3 下载邮件,IMAP 邮件留在服务器,BitTorrent 从群中对等获取片段。
- 电路交换:先建专用路径、整个消息、持续期间保持。分组交换:拆分、带地址和序号的首部、独立路由、重组。优缺点成对出现、互为相反。
- 路由器读取目的地址、查路由表、沿最佳路由转发;这是考试最常问的分组交换题。
- "适用场合":电路交换用于电话或实时视频通话;分组交换用于电子邮件、网页和下载。
常见错误
- 把协议定义为"一种语言"或"软件";它是一套规则。
- 把各层顺序弄错,或给出 OSI 的七层而不是 TCP/IP 的四层。
- 把传输层描述成"路由",或把网络层描述成"拆分成数据包";端口和拆分属于传输层,IP 地址和路由属于网络层。
- 混淆 POP3 与 IMAP,或说 SMTP 接收邮件。
- 描述分组交换时没有首部(地址和序号)或没有重组。
- 说路由器"把数据包发到所有地方";它从路由表中选择一个下一跳。
- 把分组交换的优点当作电路交换的缺点却不说电路交换那一边;每个区别都需要两半。
- 声称分组交换本身保证送达;做到这一点的是传输层的序号和确认。
-
15
硬件与虚拟机
15.1
处理器、并行处理与虚拟机

大纲
Candidates should be able to: Notes and guidance Show understanding of Reduced Instruction Set Computers (RISC) and Complex Instruction Set Computers (CISC) processors Differences between RISC and CISC Understand interrupt handling on CISC and RISC processors Show understanding of the importance/use of pipelining and registers in RISC processors Show understanding of the four basic computer architectures SISD, SIMD, MISD, MIMD Show understanding of the characteristics of massively parallel computers Show understanding of the concept of a virtual machine Give examples of the role of virtual machines Understand the benefits and limitations of virtual machines 来源:剑桥国际大纲
两种 CPU 设计风格。CPU 本身插入主板(motherboard),就是把处理器、内存和计算机的每个其他部件连在一起的主要板子。
CISC 有许多复杂的指令;RISC 有少数简单的指令 
一块主板把 CPU、内存和其他部件连在一起 CISC
一个 CISC(复杂指令集,Complex Instruction Set Computers)有许多、往往复杂的指令(一条可能做几次内存访问和操作)、变长,所以译码很繁复。它在硬件里每条指令做得更多。例子:Intel x86。
RISC
一个 RISC(精简指令集,Reduced Instruction Set Computers)有一小组简单的指令,每条做一个基本操作、全部定长(译码快)。只有 load 和 store 碰内存;其他一切都是寄存器(register)到寄存器。程序更长,但每条指令快而可预测,这适合流水线。例子:ARM、RISC-V。
特性 CISC RISC 指令集 许多 少数 指令长度 变长 定长 内存访问 许多指令 只有 load/store 流水线友好 更难 天然 每指令周期 变化 通常 1 权衡是每条指令做更多(CISC)对每条指令更快、更可预测(RISC)。现代 Intel 芯片在内部把 CISC 指令翻译成更简单的类 RISC 微操作。
"指出 RISC 处理器的四个特征。" 任选四条:一个小的、由简单指令组成的指令集;定长(一个字)的指令;大多数指令在一个时钟周期内完成;许多通用寄存器;只有装载和存储指令访问内存(所有算术都在寄存器之间进行);硬连线控制(没有微码);为流水线设计;编译器做更多的工作,所以程序含更多指令、需要更多内存。"指出 CISC 处理器的四个特征。" 任选四条:一个大的指令集,其中许多指令复杂(一条指令可以做几个操作);变长指令;需要几个时钟周期的指令;较少的寄存器;能直接访问内存的指令;微程序控制;不太适合流水线;程序更短,所以编译器更简单、内存更少。**"描述 RISC 和 CISC 是什么意思"(各两分):**说出全称并给出定义性的思想(少数简单的单周期指令;许多复杂的多周期指令)。
两种设计上的中断处理。 在 CISC 处理器上,当前指令不论多复杂都先完成,然后再处理中断;处理器接着把寄存器(包括程序计数器)的内容保存到栈上,跳到中断服务程序,之后恢复寄存器。在带流水线的 RISC 处理器上,中断(interrupt)到来的那一刻有几条指令正在进行中,所以处理器要么让流水线中的每条指令都完成,要么丢弃(冲刷)部分执行的指令并在中断后重新开始;无论哪种方式流水线都被清空,寄存器被保存,服务程序运行。考试的表述:"流水线使中断处理更复杂,因为在中断能被处理之前必须先处理流水线中的内容"。
词汇表 训练英文 中文 拼音 motherboard/ˈmʌðəbɔːd/ 主板 zhǔ bǎn CISC/sɪsk/ 复杂指令集 fù zá zhǐ lìng jí RISC/rɪsk/ 精简指令集 jīng jiǎn zhǐ lìng jí register/ˈredʒɪstə/ 寄存器 jì cún qì interrupt/ˈɪntərʌpt/ 中断 zhōng duàn 15.1
流水线
一个流水线(pipeline)以重叠的阶段处理指令,像一条装配线:取指 → 译码 → 执行(在 ALU(算术逻辑单元)中)→ 内存访问 → 写回。每个阶段同时处理一条不同的指令,所以一旦流水线满了,每周期完成一条指令。RISC 的定长、简单指令使每个阶段花同样的时间。一个流水线可能因一个冒险(hazard)而停顿——一个数据冒险(一条指令需要一个还没准备好的结果)或一个控制冒险(一个分支使下一个地址未知)。
流水线重叠六条指令的各阶段,所以每周期完成一条 RISC 芯片把数据保存在许多寄存器中,因为内存慢而寄存器快;编译器明智地把值分配到寄存器。
"描述 RISC 处理器中流水线的使用"(三分)。 (1) 取指–执行周期被分成若干阶段(取指、译码、执行、访存、写回);(2) 几条指令同时在流水线中,各处于不同阶段,所以一条在执行时下一条在译码、再下一条在取指;(3) 流水线充满后每个时钟周期都有一条新指令开始、一条指令完成,这提高了吞吐量(throughput)(每秒完成的指令数),尽管每条指令单独看仍需同样的时间。定长、单周期的 RISC 指令使各阶段相等,流水线才成为可能。
例题。 一个处理器使用五个流水线阶段(IF、ID、OF、EX、WB)。四条指令一条接一条进入流水线。最后一条指令在哪个周期完成?不用流水线时这四条要多少个周期?
指令 1 在周期 1 占用 IF,周期 2 占 ID,周期 3 占 OF,周期 4 占 EX,周期 5 占 WB;指令 2 晚一个周期开始,在周期 6 完成;指令 3 在周期 7;指令 4 在周期 8。一般地,$n$ 条指令通过 $k$ 个阶段需要 $n + k - 1$ 个周期,这里 $4 + 5 - 1 = 8$。不用流水线时每条指令要占满五个周期下一条才能开始:$4 \times 5 = 20$ 个周期。考试的表格是把每条指令的各阶段沿对角线写出,比前一条指令右移一列。
一个跑这么快的处理器放出很多热,所以一个散热器(heat-sink)和风扇坐在它顶上。金属鳍片散开热量,风扇把它吹走,使 CPU 保持足够凉以工作。

一个 CPU 散热器和风扇把热量从处理器带走 探索How pipelining fills up
Step through the clock cycles. Once the pipeline is full, a new instruction finishes every cycle — even though each one still takes several stages — because the stages of different instructions overlap.
词汇表 训练英文 中文 拼音 pipeline/ˈpaɪplaɪn/ 流水线 liú shuǐ xiàn ALU/ˌeɪ el ˈjuː/ 算术逻辑单元 suàn shù luó jí dān yuán hazard/ˈhæzəd/ 冒险 mào xiǎn throughput/ˈθruːpʊt/ 吞吐量 tūn tǔ liàng heat-sink/hiːt sɪŋk/ 散热器 sàn rè qì 15.1
弗林分类法
弗林分类(Flynn's taxonomy)按指令流和数据流的数目给计算机分类:
- SISD——一条指令、一个数据流(一个传统的单核)。
- SIMD(单指令多数据)——一条指令一次作用于许多数据项(GPU、CPU 向量扩展)。对图像、视频、科学数组很好。
- MISD——对同样的数据做几个操作;罕见,大多是理论上的。
- MIMD(多指令多数据)——许多处理器对不同数据运行不同指令(多核 CPU、集群)。最通用。
描述四种体系结构(各两分)。 SISD:单个处理器一次对一项数据执行一条指令;没有并行,是传统的冯·诺依曼机器。SIMD:一条指令同时作用于许多数据项,由许多处理单元步调一致地执行;用于数组和图形处理。MISD:几个处理器对同一数据执行不同指令;很少使用,例如几个处理器检查同一数据流的容错系统。MIMD:许多处理器,每个独立地对自己的数据执行自己的指令;多核计算机和集群。
SIMD:许多处理器对不同数据运行同一条指令 一个显卡(graphics card,带它的 GPU)是 SIMD 硬件的一个真实例子:它有数千个小核心,一次对许多像素或数字运行同一条指令,这就是为什么 GPU 对图像、视频和机器学习如此快。

一块显卡:它的 GPU 一次对许多数据项运行同一条指令(SIMD) 
MIMD:每个处理器对它自己的数据运行它自己的指令 词汇表 训练英文 中文 拼音 Flynn's taxonomy/flɪnz tækˈsɒnəmi/ 弗林分类 fú lín fēn lèi SIMD/ˈsɪmdiː/ 单指令多数据 dān zhǐ lìng duō shù jù graphics card/ˈɡræfɪks kɑːd/ 显卡 xiǎn kǎ 15.1
大规模并行计算机

一个大规模并行(massively parallel)系统在一个快速网络上使用数千个处理器,每个有它自己的内存(分布式内存(distributed memory)),通过消息交换数据。它是 MIMD,需要专门编写的软件(MPI、CUDA),并适合气候模拟、大型机器学习(machine learning)训练和天体物理学。最大的超级计算机(supercomputers)是大规模并行的。
"概述大规模并行计算机的特征"(三分)。 非常多的处理器(数千个),每个有自己的内存,由网络(高速互连或总线)连接,使它们能互相传递消息;它们同时处理同一个问题的各部分,所以问题必须写成能拆分成并行运行、再合并结果的各部分的程序。它是 MIMD 布置。
这些处理器住在高高的服务器(server)机架里,往往填满整个房间(一个数据中心(data centre)),连在一起以便它们能同时处理一个大问题。
一个数据中心里一排排服务器,像用于大规模并行计算的那些 词汇表 训练英文 中文 拼音 MIMD/ˈmɪmdiː/ 多指令多数据 duō zhǐ lìng duō shù jù massively parallel/ˈmæsɪvli ˈpærəlel/ 大规模并行 dà guī mó bìng xíng distributed memory/ˈdɪstrɪbjuːtɪd ˈmeməri/ 分布式内存 fēn bù shì nèi cún machine learning/məˈʃiːn ˈlɜːnɪŋ/ 机器学习 jī qì xué xí supercomputers/ˌsuːpəkəmˈpjuːtəz/ 超级计算机 chāo jí jì suàn jī server/ˈsɜːvə/ 服务器 fú wù qì data centre/ˈdeɪtə ˈsentə/ 数据中心 shù jù zhōng xīn 15.1
虚拟机
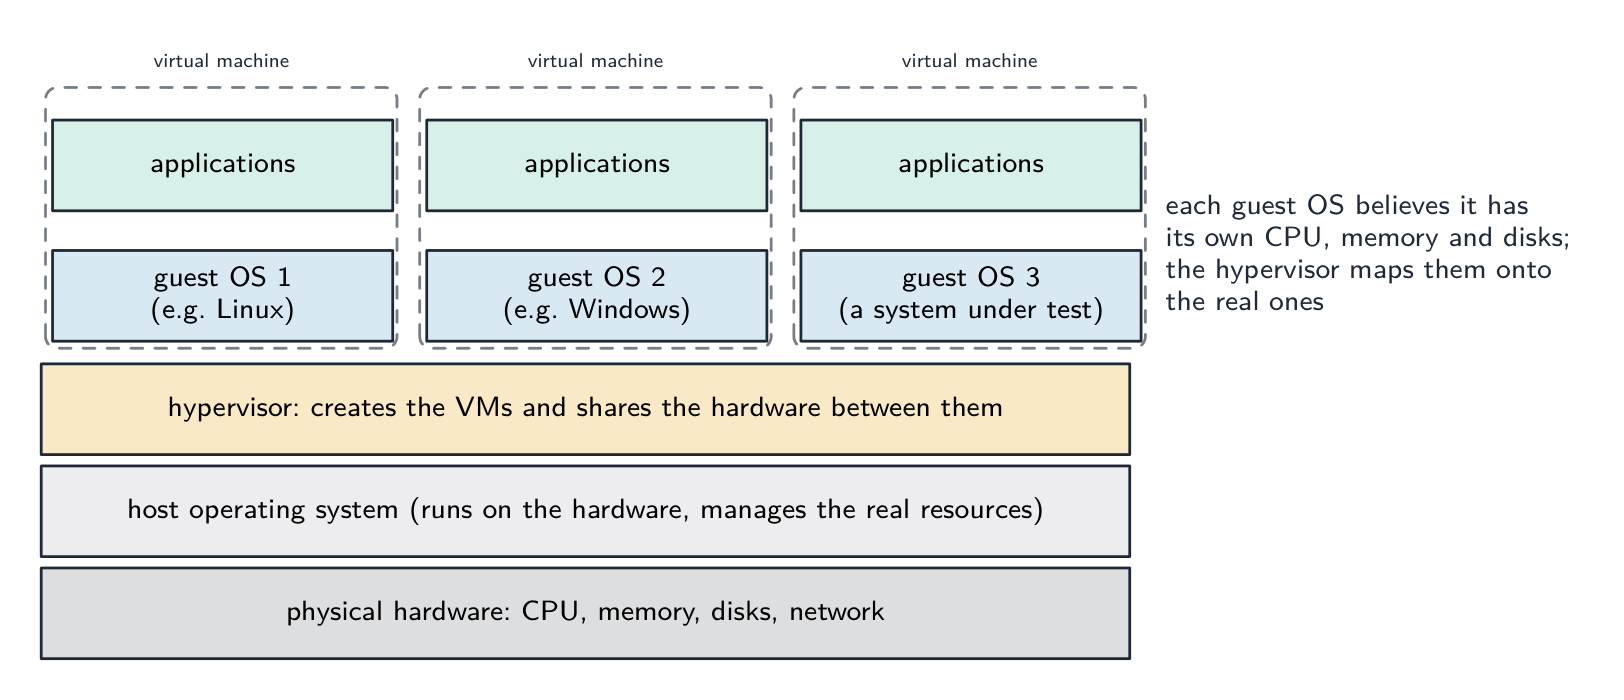
一个虚拟机(virtual machine,VM)是整台计算机的一个软件仿真——里面的软件看到一个 CPU、内存和磁盘,它们看起来真实,但由宿主软件管理。
- 一个系统 VM运行一个完整的 OS。一个虚拟机监控器(hypervisor)创建并管理 VM,每个引导它自己的客户 OS。用途:在一台机器上运行不同的 OS;服务器整合;沙箱(sandboxing,有风险的软件隔离运行);快照。
- 一个进程(语言)VM在可移植的字节码(bytecode)中运行一个程序——JVM(Java)、CLR(.NET)、CPython。好处:可移植性("一次编写,到处运行")、运行时安全检查,以及即时编译(just-in-time compilation)以获得接近本地的速度。代价是一个额外的层和需要安装该 VM。
一台真实计算机,几台表面上的计算机:宿主操作系统和虚拟机监控器共享硬件,每个客户操作系统都像拥有自己的机器一样运行 "描述虚拟机是什么意思"(两分)。 在宿主计算机上运行的计算机系统的软件仿真(实现),对运行在其中的程序而言,它表现得像一台有自己处理器、内存和存储的独立物理计算机。 宿主操作系统(host operating system)运行在真实硬件上,管理真实资源,并(通过虚拟机监控器)创建和控制虚拟机;每个客户操作系统(guest operating system)运行在一个虚拟机内,管理其中的应用程序,并不知道它的硬件是虚拟的。
优点(给出两条)。 几个不同的操作系统可以同时在一台机器上运行;软件可以在许多系统上测试而不必购买硬件;新的计算机系统可以在建造之前仿真试用;每个 VM 是隔离的,一个中的崩溃或恶意软件不影响宿主或其他 VM;VM 可以作为文件复制、移动和备份,一台服务器可在许多用户之间共享,降低硬件成本。局限(给出两条)。 VM 比真实硬件运行得更慢,因为每条指令都经过仿真层;它消耗宿主的内存和处理能力,所以宿主必须强大;有些硬件特性或设备不被精确仿真,所以测试过的软件在真机上可能表现不同;每个客户 OS 都需要许可证,搭建系统需要专业知识。
探索Computing concept lab
Classify concrete examples by the computing idea they demonstrate.
词汇表 训练英文 中文 拼音 virtual machine/ˈvɜːtʃuːəl məˈʃiːn/ 虚拟机 xū nǐ jī hypervisor/ˌhaɪpəˈvaɪzə/ 虚拟机监控器 xū nǐ jī jiān kòng qì sandboxing/ˈsændbɒksɪŋ/ 沙箱 shā xiāng bytecode/ˈbaɪtkəʊd/ 字节码 zì jié mǎ just-in-time compilation/dʒʌst ɪn taɪm ˌkɒmpɪˈleɪʃn/ 即时编译 jí shí biān yì host operating system/həʊst ˈɒpəreɪtɪŋ ˈsɪstəm/ 宿主操作系统 sù zhǔ cāo zuò xì tǒng guest operating system/ɡest ˈɒpəreɪtɪŋ ˈsɪstəm/ 客户操作系统 kè hù cāo zuò xì tǒng 15.2
布尔代数与逻辑电路
大纲
Candidates should be able to: Notes and guidance Produce truth tables for logic circuits including half adders and full adders May include logic gates with more than two inputs Show understanding of a flip-flop (SR, JK) Draw a logic circuit and derive a truth table for a flip-flop Understand of the role of flip-flops as data storage elements Show understanding of Boolean algebra Understand De Morgan’s laws Perform Boolean algebra using De Morgan’s laws Simplify a logic circuit/expression using Boolean algebra Show understanding of Karnaugh maps (K-map) Understand of the benefits of using Karnaugh maps Solve logic problems using Karnaugh maps 来源:剑桥国际大纲
半加器:XOR + AND 把两个比特相加 布尔代数(Boolean algebra)简化布尔(Boolean)表达式,它们同样可以用真值表(truth tables)描述。符号:
+表示 OR,·表示 AND(常被省略),一个上划线表示 NOT。关键定律包括交换律、结合律和分配律(如同普通代数),加上:
- 同一律 $A + 0 = A$,$A \cdot 1 = A$;零律 $A + 1 = 1$,$A \cdot 0 = 0$。
- 幂等律 $A + A = A$;逆 $A + \overline{A} = 1$,$A \cdot \overline{A} = 0$。
- 德摩根定律(De Morgan's laws):$(A + B)' = A' \cdot B'$;$(A \cdot B)' = A' + B'$——对整体取反、交换 AND/OR、对每个操作数取反。
- 吸收律(absorption):$A + AB = A$。
简化减少项的数目,所以得到的逻辑电路有更少的门。例子:$Z = AB + A\overline{B} = A(B + \overline{B}) = A$。
带名称的定律(被要求"写出全部步骤"时每一步引用名称)。
定律 OR 形式 AND 形式 同一律 $A + 0 = A$ $A \cdot 1 = A$ 零律(吸零律) $A + 1 = 1$ $A \cdot 0 = 0$ 幂等律 $A + A = A$ $A \cdot A = A$ 互补律(逆) $A + \overline{A} = 1$ $A \cdot \overline{A} = 0$ 交换律 $A + B = B + A$ $A \cdot B = B \cdot A$ 结合律 $A + (B + C) = (A + B) + C$ $A(BC) = (AB)C$ 分配律 $A + BC = (A + B)(A + C)$ $A(B + C) = AB + AC$ 吸收律 $A + AB = A$ $A(A + B) = A$ 德摩根 $\overline{A + B} = \overline{A} \cdot \overline{B}$ $\overline{A \cdot B} = \overline{A} + \overline{B}$ 双重否定 $\overline{\overline{A}} = A$ 例题。 化简 $X = \overline{\overline{(A \cdot B)} \cdot \overline{(A + B)}}$,写出全部步骤。
$X = \overline{\overline{(A \cdot B)}} + \overline{\overline{(A + B)}}$(对外层横线用德摩根)$= A \cdot B + A + B$(双重否定)$= A + B$(吸收律 $A + AB = A$,$A + B$ 吸收了 $AB$)。
例题。 化简 $(\overline{A + B}) \cdot (\overline{A} + B)$。
$= \overline{A} \cdot \overline{B} \cdot (\overline{A} + B)$(德摩根)$= \overline{A}\,\overline{B}\,\overline{A} + \overline{A}\,\overline{B}\,B$(分配律)$= \overline{A}\,\overline{B} + 0$(幂等律、互补律)$= \overline{A}\,\overline{B}$。
例题。 化简 $Y = \overline{A}\,\overline{B}\,\overline{C} + \overline{A}\,\overline{B}\,C + A\,\overline{B}\,C$。
$= \overline{A}\,\overline{B}(\overline{C} + C) + A\,\overline{B}\,C$(分配律)$= \overline{A}\,\overline{B} + A\,\overline{B}\,C$(互补律、同一律)$= \overline{B}(\overline{A} + AC)$(分配律)$= \overline{B}(\overline{A} + C)$,用到 $\overline{A} + AC = (\overline{A} + A)(\overline{A} + C) = \overline{A} + C$。对三输入项应用德摩根方式相同:$\overline{A + B + C} = \overline{A} \cdot \overline{B} \cdot \overline{C}$。
由真值表写积之和。 取每一行输出为 1 的行,写出它的输入的 AND(变量为 0 处加横线),再把各项 OR 起来:$A = 1, B = 0, C = 1$ 的行给出 $A\,\overline{B}\,C$。这就是考试要求的积之和(sum-of-products)形式,也是代数化简和卡诺图两者的出发点。
探索Boolean algebra
A·B, A+B, Ā …
Boolean algebra is just these gates written as expressions — compare the truth tables.
探索Boolean truth tables
Pick an operator and the inputs to build its truth table — the algebra behind logic circuits.
词汇表 训练英文 中文 拼音 Boolean algebra/ˈbuːlɪən ˈældʒɪbrə/ 布尔代数 bù ěr dài shù Boolean/ˈbuːlɪən/ 布尔 bù ěr truth tables/truːθ ˈteɪblz/ 真值表 zhēn zhí biǎo De Morgan's laws/də ˈmɔːɡənz lɔːz/ 德摩根定律 dé mó gēn dìng lǜ absorption/əbˈsɔːpʃn/ 吸收律 xī shōu lǜ sum-of-products/sʌm ɒv ˈprɒdʌkts/ 积之和 jī zhī hé half adder/hɑːf ˈædə/ 半加器 bàn jiā qì 15.2
卡诺图
一个卡诺图(Karnaugh map,K-map)通过把相邻的 1 分组来简化一个布尔表达式,这些 1 来自一个真值表。列和行用格雷码(Gray code)顺序(
00、01、11、10),所以相邻的单元在一个变量上不同。在每个输出为 1 的单元里放一个 1。找出 1 的矩形组,它们的边是 2 的幂(1、2、4、8),若能构成一个更大的组就绕过边缘。组越大,项越简单:一个 2 的组去掉一个变量,一个 4 的组去掉两个,如此等等——在组内改变的变量消失。把组的项 OR 在一起得到简化的表达式。用尽可能少、尽可能大的组覆盖每个 1。
例题。 $A$ 和 $B$ 的卡诺图在 $\overline{A}B$ 和 $AB$ 两格中为 1。化简它。这两个 1 是相邻的 - 它们同处 $B=1$ 那一列 - 所以把它们圈成一个大小为 2 的矩形。在这个圈内,$B$ 始终保持为 1,而 $A$ 从 0 变到 1,凡是在圈内发生变化的变量都会消失。所以这个圈只剩下 $X = B$。把它与直接从真值表读出的与或式 $\overline{A}B + AB$ 相比:同样的电路,少了两个门。两条规则完成了大部分工作 - 每个圈要尽可能大(圈 2 个去掉一个变量,圈 4 个去掉两个,圈 8 个去掉三个),并且要记住卡诺图的边缘是回绕的,所以最左列和最右列是相邻的。那个回绕正是大多数考生漏掉的圈法。
1、2、4 或 8 个 1 的圈;一个圈的项只保留圈内不变的变量。边是相接的,所以圈可以绕回,四个角算作相邻 构建和读卡诺图。 把列标为 $AB$、行标为 $C$(或 $CD$),按格雷码顺序
00 01 11 10,使相邻单元只有一个变量不同。在表达式中出现的每个最小项(或真值表输出为 1 的行)对应的单元填 1。然后画出覆盖每个 1 的最少、最大的圈:每个圈必须是 $1, 2, 4$ 或 $8$ 个单元的矩形,圈可以重叠,可以跨左右和上下边缘绕回,四个角合起来算一个圈。对每个圈写出圈内不变的变量(为 0 则加横线),再把各圈的项 OR 起来:这就是最优积之和。为什么用它?它不用代数、几步就给出最简表达式,出错的机会更少,而且同一张图适用于三或四个变量。例题。 $Z = \overline{A}\,\overline{B}\,\overline{C} + \overline{A}\,\overline{B}\,C + \overline{A}\,B\,\overline{C} + \overline{A}\,B\,C + A\,\overline{B}\,\overline{C} + A\,\overline{B}\,C$。
在三变量图上,1 填满 00、01 和 10 列的两行。覆盖 00 和 01 列的四格圈内始终 $A = 0$,而 $B$、$C$ 都在变:项为 $\overline{A}$。覆盖 00 和 10 列(绕回)的四格圈内始终 $B = 0$:项为 $\overline{B}$。所以 $Z = \overline{A} + \overline{B}$,布尔代数可以印证:$\overline{A}(\overline{B} + B) + \ldots = \overline{A} + \overline{B}$。两个两格圈也正确但不是最优;圈要在 1 允许的范围内尽可能大。
例题(四变量)。 一张图只在四个角有 1:$\overline{A}\,\overline{B}\,\overline{C}\,\overline{D}$、$A\,\overline{B}\,\overline{C}\,\overline{D}$、$\overline{A}\,\overline{B}\,C\,\overline{D}$ 和 $A\,\overline{B}\,C\,\overline{D}$。因为上下两行相邻、外侧两列也相邻,四个角是一个四格圈;其中 $B = 0$ 且 $D = 0$ 始终成立而 $A$ 和 $C$ 在变,所以 $Z = \overline{B}\,\overline{D}$。
词汇表 训练英文 中文 拼音 Karnaugh map/ˈkɑːnɔː mæp/ 卡诺图 kǎ nuò tú Gray code/ɡreɪ kəʊd/ 格雷码 gé léi mǎ 15.2
半加器与全加器

一个半加器(half adder)把两个单比特 $A$ 和 $B$ 相加,给出一个和 $S$ 和一个进位(carry)$C$:
A B S C 0 0 0 0 0 1 1 0 1 0 1 0 1 1 0 1 所以 $S = A \text{ XOR } B$ 且 $C = A \text{ AND } B$。它忽略任何进位输入——因此叫"半"。
一个半加器,作为一个块和作为一个 XOR 门与一个 AND 门的电路 一个全加器(full adder)把三个比特($A$、$B$、进位输入)相加,给出一个和和一个进位输出:$S = A \text{ XOR } B \text{ XOR } C_{\text{in}}$。它可以从两个半加器加一个 OR 门构建。把全加器串起来(每个进位输出馈入下一个进位输入)构成一个多位的"行波进位"加法器。

一个全加器从两个半加器和一个 OR 门构建 全加器真值表。 输入为 $A$、$B$ 和进位输入 $C_{\text{in}}$:当输入中有奇数个 1 时和 $S$ 为 1,当两个或更多输入为 1 时进位输出为 1。
$A$ $B$ $C_{\text{in}}$ $S$ $C_{\text{out}}$ 0 0 0 0 0 0 0 1 1 0 0 1 0 1 0 0 1 1 0 1 1 0 0 1 0 1 0 1 0 1 1 1 0 0 1 1 1 1 1 1 考试出的电路题。 给出一个由共享两个输入的 XOR 门和 AND 门组成的电路,或两个半加器加一个 OR 门,"补全真值表(写出过程)"意味着为每个中间门的输出加一列并按行顺序填写;"说出电路的名称"是半加器或全加器;"说出每个输出的用途"是各位之和以及向下一位的进位。半加器的积之和:$S = \overline{A}B + A\overline{B}$,$C = AB$。一串全加器,每个把进位输出传给下一个的进位输入,就能相加两个多位数。
探索The gates inside an adder
A half-adder's sum bit is an XOR gate and its carry is an AND gate — toggle A and B and watch the truth-table row light up.
词汇表 训练英文 中文 拼音 carry/ˈkæri/ 进位 jìn wèi full adder/fʊl ˈædə/ 全加器 quán jiā qì 15.2
触发器
一个触发器(flip-flop)是一个双稳态(bistable)电路——两个稳定状态(0 和 1)——它记住它的状态。它存储一个比特,是寄存器和 SRAM 的基本元件。
SR flip-flop
一个 SR 触发器(SR flip-flop)有输入 S(置位)和 R(复位)以及输出 Q 和 $\overline{Q}$。
S=1,R=0把 Q 置为 1;S=0,R=1把它复位为 0;S=0,R=0保持;S=1,R=1是无效的。从两个交叉耦合的 NOR 门构建。SR 触发器:两个互相馈送的 NOR 门。两个输入都为 0 时输出保持原状,这就是记忆;S 把 Q 置 1,R 复位它,而 S = R = 1 不允许 "画出 SR 触发器的逻辑电路并标出输入。" 两个 NOR 门(或两个 NAND 门),每个门的输出接回另一个门的一个输入;一个门的空闲输入是 S,另一个的是 R;输出为 $Q$ 和 $\overline{Q}$。反馈是得分点:没有它就没有记忆。"说明触发器的用途。" 存储一位数据;它是构成寄存器和静态 RAM 的基本记忆元件,在被有意改变之前一直保持它的值。无效输入 $S = R = 1$ 使两个输出都为 0,于是 $\overline{Q}$ 不再是 $Q$ 的补,而两个输入都回到 0 后的状态不可预测,这是 SR 触发器的弱点。
JK flip-flop
一个 JK 触发器(JK flip-flop)通过把之前无效的
1,1输入用作一个翻转(toggle,输出翻转)来改进它。这使它成为构建计数器(counters,一串翻转的触发器)的理想选择。它通常是时钟控制的——输入只在一个时钟边沿起作用,使触发器保持同步。
一个 JK 触发器:它的符号和一个从 NAND 门的构建 触发器是寄存器(n 位 = n 个触发器)、计数器和 SRAM(静态RAM)单元的构件。
JK 触发器真值表。 时钟(clock)输入决定何时读取 J 和 K 输入,所以输出只在时钟脉冲上改变:$J = K = 0$ 时输出保持;$J = 1, K = 0$ 把 $Q$ 置为 1;$J = 0, K = 1$ 把它复位为 0;$J = K = 1$ 使它翻转(Q 变为 $\overline{Q}$)。最后一行正是把 SR 触发器的禁止输入变成了有用的输入,这就是 JK 更受青睐的原因:每种输入组合都有效,而时钟控制的操作使它成为计数器和移位寄存器的构件。
词汇表 训练英文 中文 拼音 flip-flop/flɪp flɒp/ 触发器 chù fā qì bistable/baɪˈsteɪbl/ 双稳态 shuāng wěn tài toggle/ˈtɒɡl/ 翻转 fān zhuǎn counters/ˈkaʊntəz/ 计数器 jì shù qì SRAM/ˈesræm/ 静态RAM jìng tài RAM clock/klɒk/ 时钟 shí zhōng SR flip-flop/ˌes ˈɑː flɪp flɒp/ SR触发器 SR chù fā qì JK flip-flop/ˌdʒeɪ ˈkeɪ flɪp flɒp/ JK触发器 JK chù fā qì 15.2
考官认可的定义
定义题按固定措辞评分。准确学会这些,只给一个答案。
术语 定义 RISC 具有少量简单定长指令、大多数在一个时钟周期内执行、使用许多寄存器和流水线的处理器 CISC 具有大量复杂变长指令、许多需要几个时钟周期并直接访问内存的处理器 流水线 把取指–执行周期分成若干阶段,使几条指令同时被处理,各处于不同阶段 SISD / SIMD / MISD / MIMD 一条指令对一项数据;一条指令对许多数据;许多指令对一项数据;许多指令对许多数据 大规模并行计算机 数千个各有自己内存的处理器,由网络连接,同时处理一个问题 虚拟机 在宿主计算机上运行、表现得像一台独立物理计算机的计算机系统软件仿真 虚拟机监控器 创建虚拟机并在它们之间共享宿主硬件的软件 真值表 列出逻辑电路每种输入组合及其输出的表 积之和 写成 AND 项的 OR 的布尔表达式,每个给出 1 的输入组合对应一项 卡诺图 按格雷码顺序排列真值表输出的网格,其中相邻 1 的圈给出化简后的表达式 半加器 把两位相加、产生和与进位的电路 全加器 把两位与一个进位输入相加、产生和与进位输出的电路 触发器 存储一位、在输入改变它之前保持输出的双稳态电路 15.2
考试技巧
- RISC 和 CISC 以特征列表作答:简单、定长、单周期、许多寄存器、装载/存储、流水线,对复杂、变长、多周期、较少寄存器、直接访存、微码。各四条。
- 流水线:阶段、几条指令同时、每周期完成一条、更高吞吐量;$n$ 条指令通过 $k$ 个阶段需 $n + k - 1$ 个周期;中断必须清空流水线。
- 弗林的四类是"多少条指令流"乘"多少条数据流";说清什么跑在什么上。大规模并行:许多处理器、自己的内存、网络、同一问题。
- 虚拟机:在宿主上仿真一台计算机;宿主 OS 在硬件上,虚拟机监控器共享硬件,客户 OS 在其中。两个优点和两个局限,各写成完整句子。
- 布尔代数:每用一条定律就说出它的名称;德摩根交换运算符并对每项取反;拿不准时用真值表检验。
- 卡诺图:格雷码顺序,1/2/4/8 的最大圈,允许绕回,每圈一项、保留不变的变量。说明理由:不用代数得到最简表达式。
- 半加器给出和与进位;全加器还接受进位输入;SR 触发器是两个交叉耦合的 NOR/NAND 门,存储一位;JK 的 1,1 输入翻转。
常见错误
- 把 RISC 和 CISC 的特征列表弄反,或把"更快"当作特征;要给出设计特征,而不是结论。
- 把流水线描述成"在几个核上并行运行指令";它是一个处理器的各阶段重叠。
- 混淆 SIMD(一条指令、许多数据)与 MIMD(两者都多),或把 MISD 描述成常见情况。
- 把虚拟机定义为"一台计算机的副本"而没有仿真一词或宿主与客户。
- 只对长横线下表达式的一部分应用德摩根,或去掉横线却不把 AND 换成 OR。
- 在卡诺图中圈三个一组,或圈非矩形的组;把列排成 00、01、10、11 而不是格雷码。
- 把半加器的进位写成 XOR、和写成 AND。
- 把 SR 触发器画成两个没有反馈的门,或在它的真值表中漏掉无效状态。
-
16
系统软件
16.1
操作系统(OS)的功能

大纲
Candidates should be able to: Notes and guidance Show understanding of how an OS can maximise the use of resources Describe the ways in which the user interface hides the complexities of the hardware from the user Show understanding of process management The concept of multi-tasking and a process The process states: running, ready and blocked The need for scheduling and the function and benefits of different scheduling routines (including round robin, shortest job first, first come first served, shortest remaining time) How the kernel of the OS acts as an interrupt handler and how interrupt handling is used to manage low-level scheduling Show understanding of virtual memory, paging and segmentation for memory management The concepts of paging, virtual memory and segmentation The difference between paging and segmentation How pages can be replaced How disk thrashing can occur 来源:剑桥国际大纲
一台计算机有许多资源(CPU 时间、内存、磁盘、I/O)和许多程序争夺它们。OS 公平且高效地共享它们,使每个都被好好利用,系统保持响应:
OS 在程序之间共享 CPU、内存、磁盘和 I/O - 多任务(multi-tasking)——在进程之间快速切换 CPU,使几个看起来一次运行。
- 内存管理(memory management)——给每个进程它需要的内存;当 RAM 用尽时用磁盘分页(paging)。
- 假脱机(spooling)和缓冲——打印作业在磁盘上排队,所以 CPU 从不等打印机。
- 缓存(caching)——把最近用过的磁盘数据保存在高速缓存(cache)/ RAM 中。

处理器是 OS 在争夺的任务之间共享的一个关键资源 
OS 也管理内存(RAM),决定在它里面保留什么、把什么分页到磁盘 词汇表 训练英文 中文 拼音 multi-tasking/ˈmʌlti ˈtæskɪŋ/ 多任务 duō rèn wù paging/ˈpeɪdʒɪŋ/ 分页 fēn yè spooling/ˈspuːlɪŋ/ 假脱机 jiǎ tuō jī cache/kæʃ/ 高速缓存 gāo sù huǎn cún 16.1
用户界面
用户界面把硬件隐藏在友好的抽象之后:用户看到窗口、菜单和文件夹,而不是地址或扇区。在一个图标上点一下,使 OS 在磁盘上找到程序、分配内存、加载它并启动它。一个 CLI(命令行)对专家强大且可脚本化;一个 GUI(图形)更容易学。大多数系统两者都提供。
"描述硬件的复杂性对用户隐藏的两种方式。" (1) 用户用名字操作文件和文件夹,由 OS 把它们翻译成磁盘的磁道、扇区和块;(2) 用户用一次点击或一条命令运行程序,由 OS 装载它、分配内存并调度它,用户不需要知道任何地址;(3) 设备驱动程序让用户打印或保存而不必知道打印机或磁盘如何控制;(4) 图形界面用图标、窗口和菜单取代机器级命令。对学生的好处及例子:OS 使硬件无需技术知识即可使用,例如把文档的图标拖过去就能保存到 U 盘。
"说明 OS 如何最大化资源的利用。" 它调度处理器,使有进程就绪时处理器决不空闲;它管理内存,把内存分配给进程、回收并用虚拟内存扩展它;它管理输入和输出,用缓冲和假脱机使快慢设备的工作重叠;它管理存储,记录空闲空间和文件。每一点都要点名一种资源以及 OS 对它做什么。
16.1
进程管理
一个进程(process)是执行中的一个程序——它的代码、当前状态、内存和打开的文件。
Scheduling
调度器(scheduler)选择哪个就绪进程接下来运行,以及运行多久:
- 轮转(round robin)——每个进程得到一个固定的时间片(time slice),然后去到队列的后面。
- 先来先服务;最短作业优先;最短剩余时间(shortest remaining time,运行剩余工作最少的作业);优先级;多级反馈队列。
权衡是响应性对吞吐量对公平性。
"描述多任务是什么意思以及它如何有益于进程管理。" 几个进程同时保存在内存中,处理器在它们之间切换得如此之快,以至于它们看起来在同时运行,每个轮流得到一份处理器时间。好处:当一个进程等待输入或输出时处理器决不闲置,所以吞吐量更高,用户可以同时在几个程序上工作。"解释调度的必要性。" 进程多于处理器,所以必须决定哪个进程接下来运行以及运行多久;调度确保每个进程都取得进展、处理器被充分利用、响应时间可接受,并且优先级得到尊重。
同样的工作换个顺序:最短作业优先先把短作业解决掉,所以大多数作业等得更少,代价是长作业可能永远等下去 调度例程,按考试要求的描述方式。
例程 功能 优点 缺点 先来先服务(FCFS) 进程按到达就绪队列的顺序运行,各运行到结束 简单;每个进程都轮到,没有饥饿 一个长进程拖住它后面所有的短进程;响应差 最短作业优先(SJF) 估计运行时间最短的就绪进程下一个运行,直到结束 平均等待时间最小;许多短作业很快完成 运行时间必须预先知道;长作业可能永远不运行(饥饿) 最短剩余时间(SRT) SJF 的抢占式(pre-emptive)版本:若新到的进程剩余时间少于正在运行的,它就接管 短进程得到更快的服务;吞吐量好 更多上下文切换;长作业可能被反复打断而饥饿 轮转(RR) 每个就绪进程轮流得到固定的时间片;到期后进程回到队尾 公平;每个进程在有限时间内响应,适合交互使用 上下文切换开销;时间片太短浪费时间,太长则延误其他进程 优先级 优先级最高的就绪进程先运行 重要或时间紧迫的工作先做 除非优先级随时间提升,低优先级进程可能饥饿 例题。 三个进程同时到达,CPU 时间分别为 8、4 和 2 ms。比较 FCFS(按到达顺序 A、B、C)和最短作业优先下的平均等待时间。
FCFS:A 等 0,B 等 8,C 等 12;平均 $(0 + 8 + 12)/3 = 6.7\ \text{ms}$。SJF 运行 C、B、A:C 等 0,B 等 2,A 等 6;平均 $2.7\ \text{ms}$。两种方式总工作量都是 14 ms;顺序决定谁等待。时间片 2 ms 的轮转让 A、B、C 在前 6 ms 内各得一轮,所以 C 在 6 ms 完成,B 在 12 ms,A 在 14 ms:响应最好,但平均不是最快。

四个进程的先来先服务调度 
轮转:每个进程依次得到一个固定的时间片,然后下一个运行(不像先来先服务) Process states
一个进程是新建(new)、就绪(ready,等待 CPU)、运行(running)、阻塞(blocked,等待 I/O 或一个锁),或终止(terminated)。当它的时间片结束时它从运行 → 就绪;当它请求 I/O 时它从运行 → 阻塞;当 I/O 完成时它从阻塞 → 就绪。

一个进程在新建、就绪、运行、阻塞和终止状态之间移动 三个状态以及进程为什么转移。 *运行:*进程占有处理器。*就绪:*它可以运行但在等待处理器。*阻塞:*在其他事件发生之前它不能运行。每种转移的原因,考试会逐个问:运行到就绪,当它的时间片用完,或当一个更高优先级的进程变为就绪并抢占它(一次中断);运行到阻塞,当它请求输入或输出,或等待某个资源或另一个进程;阻塞到就绪,当它等待的 I/O 完成(由中断通知);就绪到运行,当调度器派遣它。阻塞的进程决不能直接进入运行:它必须先变为就绪。
Process control block and context switch
对每个进程,OS 保存一个进程控制块(process control block,PCB)——保存的程序计数器、寄存器、状态和内存信息。

一次上下文切换保存一个进程的状态并加载另一个的 - 一次上下文切换(context switch)挂起一个进程并启动另一个:它把状态保存进一个 PCB 并从另一个恢复它。这个小代价在每次切换时付出。
- 内核(kernel,OS 的核心)充当一个中断处理程序(interrupt handler)。当一个设备或定时器发起一个中断时,中断处理(interrupt handling)保存运行中的进程并运行正确的例程——这就是驱动底层调度的东西。
"概述内核如何充当中断处理程序"(两分)。 中断发生时,内核保存正在运行进程的状态(它的寄存器和程序计数器,存入进程控制块),识别中断的来源和优先级,运行相应的中断服务例程,然后恢复被中断的进程(或一个更高优先级的进程),使执行继续。定时器就是这样结束时间片的,完成的 I/O 操作也是这样解除进程阻塞的。
Inter-process communication
进程是隔离的,所以 OS 提供进程间通信(inter-process communication):管道(pipes,一个程序的输出馈入另一个的输入)、共享内存(shared memory,几个进程可以用的一个区域),以及消息传递。
探索The life of a process
Tap round the loop a process travels. It only runs when the scheduler picks it; needing I/O sends it to blocked, and finishing its time slice sends it back to ready — round and round until it's done.
词汇表 训练英文 中文 拼音 process/ˈprəʊses/ 进程 jìn chéng scheduler/ˈʃedjʊlə/ 调度器 diào dù qì round robin/raʊnd ˈrɒbɪn/ 轮转 lún zhuàn time slice/taɪm slaɪs/ 时间片 shí jiān piàn pre-emptive/priː ˈemptɪv/ 抢占式 qiǎng zhàn shì blocked/blɒkt/ 阻塞 zǔ sè process control block/ˈprəʊses kənˈtrəʊl blɒk/ 进程控制块 jìn chéng kòng zhì kuài context switch/ˈkɒntekst swɪtʃ/ 上下文切换 shàng xià wén qiè huàn kernel/ˈkɜːnl/ 内核 nèi hé interrupt handler/ˈɪntərʌpt ˈhændlə/ 中断处理程序 zhōng duàn chǔ lǐ chéng xù interrupt handling/ˈɪntərʌpt ˈhændlɪŋ/ 中断处理 zhōng duàn chǔ lǐ inter-process communication/ˈɪntə ˈprəʊses kəˌmjuːnɪˈkeɪʃn/ 进程间通信 jìn chéng jiān tōng xìn pipes/paɪps/ 管道 guǎn dào shared memory/ʃeəd ˈmeməri/ 共享内存 gòng xiǎng nèi cún 16.1
虚拟内存、分页与分段

每个进程得到它自己的虚拟地址空间(virtual address space)——OS 映射到物理内存的一个干净、连续的地址范围。这给每个进程一个简单的空间,保护进程彼此隔离,并让总内存超过物理 RAM。
在分页中,虚拟空间被拆成固定大小的页(pages),物理内存被拆成同样大小的页框(frames)。一个页表把每个页映射到一个页框。若一个被访问的页不在 RAM 中——一个缺页(page fault)——OS 从交换文件(swap file)把它读进一个页框,若 RAM 满了就逐出另一个页。频繁的缺页导致抖动(thrashing,磁盘抖动),那里 OS 把它的大部分时间花在交换页而不是做有用的工作。
分页把逻辑内存的每个页映射到物理内存的一个页框 在分段(segmentation)中,内存被拆成可变大小的逻辑段(代码、栈、堆),每个有它自己的权限。许多系统在段内使用分页。

分段用一个段映射表映射可变大小的段 "解释虚拟内存是什么意思"(三分)。 用辅助存储器(磁盘)扩展 RAM,使可用内存显得比物理内存大;进程的地址空间被分成页,只有当前需要的页保存在 RAM 中,其余在磁盘上等待;页按需要在 RAM 和磁盘之间交换,OS 把每个虚拟地址翻译成物理地址。OS 为什么需要它:正在运行的程序可能需要比安装的 RAM 更多的内存;它让更多(或更大)的程序同时运行;程序可以比物理内存大;内存得到高效利用,因为只有程序的活动部分占据 RAM。
分页对分段:考试要的区别。 分页把内存分成由硬件决定的固定大小的块(页和页框),不考虑程序的结构,映射对程序员不可见;分段把程序分成大小可变的逻辑单元(一个过程、一个数组、栈),其大小和边界跟随程序,所以一个段可以作为整体被保护或共享。"描述分段的过程":程序被拆成大小不同的段,每段给一个段号;段表记录每段在内存中从哪里开始、有多长;逻辑地址是段号加偏移量,OS 把偏移量加到该段的基地址上得到物理位置。
"解释磁盘抖动是什么意思"以及它何时发生。 磁盘抖动(disk thrashing)是页在 RAM 中换入换出如此频繁,以至于处理器花在搬页上的时间多于执行指令、系统几乎停顿的状态。它发生在 RAM 对正在运行的进程所需的页(它们的工作集)来说太小时:刚换出的页几乎立刻又被需要,于是被取回,又挤出另一个很快就要用的页,如此往复。进程太多,或程序以不可预测的方式访问内存,都会引起它;更多 RAM 或更少进程能治愈它。
探索What happens on a page fault
Step through a page fault. When the program touches a page that isn't in RAM, the OS quietly fetches it from disk and updates the page table — so the program sees more memory than physically exists.
词汇表 训练英文 中文 拼音 virtual address space/ˈvɜːtʃuːəl əˈdres speɪs/ 虚拟地址空间 xū nǐ dì zhǐ kōng jiān pages/ˈpeɪdʒɪz/ 页 yè frames/freɪmz/ 页框 yè kuāng page fault/peɪdʒ fɒlt/ 缺页 quē yè swap file/swɒp faɪl/ 交换文件 jiāo huàn wén jiàn thrashing/ˈθræʃɪŋ/ 抖动 dǒu dòng segmentation/ˌseɡmənˈteɪʃn/ 分段 fēn duàn disk thrashing/dɪsk ˈθræʃɪŋ/ 磁盘抖动 cí pán dǒu dòng 16.2
翻译软件
大纲
Candidates should be able to: Notes and guidance Show understanding of how an interpreter can execute programs without producing a translated version Show understanding of the various stages in the compilation of a program Including lexical analysis, syntax analysis, code generation and optimisation Show understanding of how the grammar of a language can be expressed using syntax diagrams or Backus-Naur Form (BNF) notation Show understanding of how Reverse Polish Notation (RPN) can be used to carry out the evaluation of expressions 来源:剑桥国际大纲
一个解释器(interpreter)同时翻译并运行源代码。对每条语句它读这行、做词法和语法分析、检查类型,然后执行该动作,并继续。错误被立即报告,它通常停止;不产生可执行文件。翻译每次运行都重做(更慢),但它给出快速的开发反馈并且是可移植的。
"解释解释器如何在不产生翻译版本的情况下执行程序"(三分)。 解释器一次取一条语句(一行),翻译(分析)它,并立即执行,然后再处理下一条;不创建或存储整个程序的翻译版本,所以每条语句每次执行都要翻译,包括循环的每一趟;若某条语句有错误,执行在那里停止并报告错误。这就是解释器适合开发和测试(错误在到达时被发现,修改可以立即试验)但运行成品程序较慢的原因。
词汇表 训练英文 中文 拼音 interpreter/ɪnˈtɜːprɪtə/ 解释器 jiě shì qì 16.2
编译的各阶段

一个编译器(compiler)分阶段把源代码变成机器码(machine code):
- 词法分析(lexical analysis)——词法分析器把字符分组成词法单元(tokens,关键字、标识符、运算符、字面量),丢弃空白和注释。
- 语法分析(解析)(syntax analysis / parsing)——检查词法单元符合文法并构建一棵抽象语法树(abstract syntax tree)。一个遗漏的括号给出一个语法错误(syntax error)。
- 语义分析(semantic analysis)——检查程序说得通(变量已声明、类型匹配)。
- 代码生成(code generation)——遍历树并发出目标代码,选择寄存器和布局。
- 代码优化(code optimisation)——去除冗余的工作、折叠常量、为流水线重排。
输出是一个可执行文件。
编译的各阶段,从源代码到一个优化的可执行文件 各阶段的目的,用得分的措辞。 *词法分析:*去掉空白和注释;把源代码的字符转换成词法单元(关键字、标识符、运算符、常量),检查每一个在该语言中是否有效;把标识符登记到符号表(symbol table)中。*语法分析:*检查词法单元序列是否符合语言的文法(语法规则);构建解析树(抽象语法树);报告语法错误;类型检查和变量声明的检查有时归入语义分析。*代码生成:*把检查过的树转换成目标代码或机器码(可能经由中间代码),分配内存和寄存器。*优化:*使代码运行更快或占用更少内存,通过去除冗余指令、合并或简化计算、重组循环,而不改变程序的功能。配对题把每个阶段与这些描述之一配对。
探索The phases of compilation
Step through what a compiler does to your source. Each phase hands its output to the next — characters become tokens, tokens become a tree, the tree becomes optimised machine code.
词汇表 训练英文 中文 拼音 compiler/kəmˈpaɪlə/ 编译器 biān yì qì machine code/məˈʃiːn kəʊd/ 机器码 jī qì mǎ lexical analysis/ˈleksɪkl əˈnæləsɪs/ 词法分析 cí fǎ fēn xī tokens/ˈtəʊkənz/ 词法单元 cí fǎ dān yuán syntax analysis (parsing)/ˈsɪntæks əˈnæləsɪs/ 语法分析 yǔ fǎ fēn xī abstract syntax tree/ˈæbstrækt ˈsɪntæks triː/ 抽象语法树 chōu xiàng yǔ fǎ shù syntax error/ˈsɪntæks ˈerə/ 语法错误 yǔ fǎ cuò wù semantic analysis/səˈmæntɪk əˈnæləsɪs/ 语义分析 yǔ yì fēn xī code generation/kəʊd ˌdʒenəˈreɪʃn/ 代码生成 dài mǎ shēng chéng code optimisation/kəʊd ˌɒptɪmaɪˈzeɪʃn/ 代码优化 dài mǎ yōu huà symbol table/ˈsɪmbl ˈteɪbl/ 符号表 fú hào biǎo 16.2
文法:BNF 与语法图

一个文法(grammar)说明哪些词法单元序列是有效的程序。
巴科斯-诺尔范式(Backus-Naur Form,BNF)是文本的。一个产生式(production rule)有这样的形式:
<symbol> ::= alternative1 | alternative2 | ...每个候选是一个终结符(terminal)符号(字面文本)和非终结符(non-terminal)符号(其他规则名)的序列:
<digit>      ::= 0 | 1 | 2 | 3 | 4 | 5 | 6 | 7 | 8 | 9
<identifier> ::= <letter> | <identifier> <letter> | <identifier> <digit>
递归的第三条规则表达"一个字母后跟任意数目的字母或数字"。一个
IF语句:<if-statement> ::= IF <condition> THEN <statement> ENDIF | IF <condition> THEN <statement> ELSE <statement> ENDIF一个语法图(syntax diagram,铁路图)以图形显示同样的东西:非终结符用方框、终结符用圆角框、有效路径用箭头、重复用循环。两种记法是等价的。解析器用文法来判定一个程序是否有效。
一个赋值语句的语法(铁路)图 
语法图和 BNF 规则说的是同一件事:一个选择变成用竖线分隔的候选,一个循环变成引用自身的规则 读考试的图。 每张图定义一个非终结符;沿箭头从入口走到出口,能走通的每条路径都是一个有效字符串。并排的选择框是一组候选;回头的循环是"想重复多少次都行";另一个非终结符的框表示"插入那条规则允许的任何东西"。"说明该字符串为什么无效"要的是它违反的规则,用文字表述:
9K作为变量无效,因为第一个字符必须是字母而不是数字;若规则只允许数字前有一个字母,或J不在列出的字母集合中,JJ90就是无效的口令。总是对照图实际允许的字符集合检查字符串,而不是对照真实语言会接受什么。由图写 BNF。 每张图变成一条规则
<名称> ::= ...;候选用|分隔;序列一个符号接一个符号地写;而重复用递归来写,因为 BNF 没有循环符号:"一个或多个字母"是<word> ::= <letter> | <letter><word>,"一个字母后接零个或多个数字"是<variable> ::= <letter> | <letter><digits>,其中<digits> ::= <digit> | <digit><digits>。例题。 补全车辆登记号的 BNF:必须以两个字母(取自
A B C)开头,后接一位、两位或三位数字(取自0 1 2)。<letter> ::= A | B | C <digit> ::= 0 | 1 | 2 <digits> ::= <digit> | <digit><digit> | <digit><digit><digit> <registration> ::= <letter><letter><digits>AB12有效;A12无效(只有一个字母);AB1234无效(四位数字);AD1无效(D不是列出的字母)。被要求加约束如"第三个字符也可以是符号"时,只给那个位置的规则加额外候选,并用单独的规则定义<symbol>。例题。 写出表达式的 BNF:表达式是一个变量,后接一个运算符,再接一个变量或一个数,其中变量是取自
a b c的单个小写字母,运算符是+或-。<variable> ::= a | b | c <operator> ::= + | - <number> ::= <digit> | <digit><number> <expression> ::= <variable><operator><variable> | <variable><operator><number>递归的
<number>规则允许任意多位数字;<expression>的两个候选覆盖定义中提到的两种情况。每个非终结符都放在尖括号里,每个终结符都不加。词汇表 训练英文 中文 拼音 grammar/ˈɡræmə/ 文法 wén fǎ Backus-Naur Form/ˈbækəs nɔː fɔːm/ 巴科斯-诺尔范式 bā kē sī - nuò ěr fàn shì production rule/prəˈdʌkʃn ruːl/ 产生式 chǎn shēng shì terminal/ˈtɜːmɪnl/ 终结符 zhōng jié fú non-terminal/nɒn ˈtɜːmɪnl/ 非终结符 fēi zhōng jié fú syntax diagram/ˈsɪntæks ˈdaɪəɡræm/ 语法图 yǔ fǎ tú 16.2
逆波兰表示法(RPN)
在中缀(infix)记法中,运算符坐在它的操作数之间(
3 + 4 * 2),需要括号和优先级规则。在逆波兰表示法(Reverse Polish Notation,RPN,后缀(postfix))中,运算符跟在它的操作数之后(3 4 2 * +),不需要括号。Converting infix to RPN
用一个运算符栈(stack)。从左到右扫描:输出一个操作数;对一个运算符,先把任何更高或相等****优先级(precedence)的已入栈运算符弹到输出,然后把它压栈;把
(压栈;遇到)弹出到输出直到匹配的(。在最后,弹出所有运算符。例子:(3 + 4) * 2→3 4 + 2 *。Evaluating RPN
用一个操作数栈。从左到右扫描:把每个操作数压栈;遇到一个运算符,弹出顶上两个、应用它,并把结果压栈。求值
3 4 2 * +:词法单元 栈 33 43, 4 23, 4, 2 *3, 8 +11 结果:11。RPN 在求值时不需要括号并适合一个栈机器——这就是 JVM 和许多字节码(bytecode)解释器工作的方式。
"解释为什么用 RPN 求表达式的值"(两分)。 在 RPN 中运算符按它们被应用的顺序出现,所以表达式可以从左到右一趟求值,不需要括号,也不需要优先级规则;因此编译器或解释器处理起来更简单、更快。"指出一种合适的数据结构并说明理由":**栈,因为求值需要先用最近**压入的操作数(后进先出):每个操作数被压入,每个运算符弹出顶部两个,应用自身,再压入结果。被要求时要写出每个词法单元之后的栈内容。
手工把中缀转成 RPN。 (1) 按优先级规则给表达式完全加括号;(2) 把每个运算符移到它自己那对括号的右括号之后;(3) 去掉括号。于是 $(a - b) * (a + c) / 7$ 变成 $((a - b) * (a + c)) / 7$,再变成
a b - a c + * 7 /。注意*和/从左到右应用,所以除法是最后一个运算符,而不是乘法。更多转换:$((7 + 3) - (2 * 8)) / 6$ 是7 3 + 2 8 * - 6 /;$(7 - 2 + 8) / (9 - 5)$ 是7 2 - 8 + 9 5 - /;$a * b + b - d + 15$ 是a b * b + d - 15 +;$(2 - 6) * (13 + 7) / 5$ 是2 6 - 13 7 + * 5 /。把 RPN 转回中缀。 用一个表达式栈处理 RPN:压入每个操作数;对每个运算符弹出两个,加括号写在它两侧,再压入结果。于是
a b / 4 * a b + -是 $((a / b) * 4) - (a + b)$;5 2 + 9 3 - / 3 *是 $((5 + 2) / (9 - 3)) * 3$;b a c - + d b + * c /是 $((b + (a - c)) * (d + b)) / c$;a b - c + c a - * d /是 $(((a - b) + c) * (c - a)) / d$。保留括号:去掉它们可能改变含义。例题。 当 $a = 17$、$b = 5$、$c = 7$、$d = 3$、$e = 10$ 时求
a b - c d + * e /的值,写出栈。词法单元 动作 栈(栈顶在右) a压入 17 17 b压入 5 17, 5 -弹出 5 和 17,压入 $17 - 5$ 12 c压入 7 12, 7 d压入 3 12, 7, 3 +弹出 3 和 7,压入 $7 + 3$ 12, 10 *弹出 10 和 12,压入 $12 \times 10$ 120 e压入 10 120, 10 /弹出 10 和 120,压入 $120 / 10$ 12 结果 12。对
-和/弹出的顺序很重要:第二个弹出的值是左操作数,所以a b -是 $a - b$,不是 $b - a$。再来两个,方法相同:d a b + * c a - /在 $a = 6, b = 12, c = 15, d = 5$ 时给出 $5 \times (6 + 12) / (15 - 6) = 90 / 9 = 10$;c a - b d + * b c + /在 $a = 4, b = 12, c = 24, d = 6$ 时给出 $(24 - 4) \times (12 + 6) / (12 + 24) = 360 / 36 = 10$。例题。 把 $(A + B) \times (C - D)$ 转换成逆波兰式,然后计算 $(3 + 4) \times (5 - 2)$。用一个运算符栈从左向右扫描。压入
(;输出A;压入+;输出B;遇到)时弹出直到匹配的(,此时已输出A B +。压入×,第二个括号同样处理,得到C D -。最后弹出×。结果是:A B + C D - ×。要计算数值,则用一个操作数栈:压入 3,压入 4;+弹出两者并压入 7;压入 5,压入 2;-弹出两者并压入 3;×弹出 7 和 3 并压入 21。有两点能让这类题做得稳:转换过程中操作数保持原来的顺序(只有运算符在移动),而且每个运算符作用于栈中紧挨着它下面的两个值。探索Operator precedence — what RPN removes
In ordinary infix maths × and ÷ bind tighter than + and −, so you must apply rules in the right order. Reverse Polish Notation writes the operands first (3 4 2 × + 1 −), fixing the order so no precedence rules are needed.
词汇表 训练英文 中文 拼音 infix/ˈɪnfɪks/ 中缀 zhōng zhuì Reverse Polish Notation/rɪˈvɜːs ˈpəʊlɪʃ nəʊˈteɪʃn/ 逆波兰表示法 nì bō lán biǎo shì fǎ postfix/ˈpəʊstfɪks/ 后缀 hòu zhuì stack/stæk/ 栈 zhàn precedence/ˈpresɪdəns/ 优先级 yōu xiān jí bytecode/ˈbaɪtkəʊd/ 字节码 zì jié mǎ 16.2
考官认可的定义
定义题按固定措辞评分。准确学会这些,只给一个答案。
术语 定义 多任务 几个进程同时保存在内存中,处理器在它们之间切换,使它们看起来在同时运行 进程 已装入内存并正在执行(或准备执行)的程序 运行 / 就绪 / 阻塞 占有处理器 / 等待处理器 / 在 I/O 完成等事件发生之前不能继续 调度 决定哪个就绪进程接下来得到处理器,以及得到多久 抢占式调度 正在运行的进程可以被中断并移到就绪,让另一个进程运行 虚拟内存 用辅助存储器扩展 RAM,只把当前需要的页保存在物理内存中 分页 把内存和程序分成固定大小的页,按需要在磁盘和 RAM 之间移动 分段 把程序分成大小可变的逻辑段,每段由段表映射到内存 磁盘抖动 页在 RAM 和磁盘之间交换得如此频繁,以至于几乎没有有用的处理 解释器 一次一条语句地翻译并执行程序,不产生翻译版本 编译器 在运行之前把整个高级语言程序翻译成机器(目标)代码 词法分析 把源代码转换成词法单元,去掉空白和注释,并建立符号表 语法分析 检查词法单元是否符合语言的文法并构建解析树 巴科斯-诺尔范式 语言文法的一种记法:由终结符和非终结符构成的 <名称> ::= 候选形式的规则逆波兰表示法 把每个运算符写在其操作数之后的表达式写法,使表达式能用栈、不用括号求值 16.2
考试技巧
- OS 题按点名的机制评分:调度、内存管理、I/O 缓冲和假脱机、文件管理;对界面,文件名而非地址、点击而非命令、驱动程序、GUI。
- 进程状态及其转移和每种转移的原因;调度例程按功能加优点加缺点;内核保存状态、识别中断、处理、恢复。
- 虚拟内存:磁盘扩展 RAM、页交换、地址翻译;分页是固定大小且不可见,分段是可变大小且逻辑的;抖动是交换而不是工作。
- 解释器:一次一条语句,先翻译再执行,不存储任何东西。编译阶段:词法单元和符号表、文法和解析树、代码、优化。
- BNF:每张图一条规则,
|表示选择,递归表示重复,终结符不加括号而非终结符加尖括号。要说出字符串违反了哪条规则。 - RPN:运算符在操作数之后,用栈求值,写出每一步;转换时完全加括号;转回时保留括号。
常见错误
- 把多任务描述成"同时运行几个程序"而不说处理器在它们之间切换。
- 让阻塞的进程直接进入运行,或把"时间片用完"当作运行到阻塞的原因。
- 混淆最短作业优先(非抢占)与最短剩余时间(抢占),或混淆轮转与优先级。
- 把虚拟内存定义为"把硬盘当 RAM 用"而不提页的交换。
- 说解释器"把程序转换成机器码然后运行";那是编译器。
- 把语法检查放进词法分析,或在配对题中把优化放在代码生成之前。
- 把 BNF 的重复写成
<letter>*或用省略号;要用递归。非终结符漏掉尖括号。 - 求 RPN 值时把
-或/的操作数弄反,或把 $a * b + c$ 的 RPN 写成a b c + *。
-
17
安全
17.1
加密、加密协议与数字证书

大纲
Candidates should be able to: Notes and guidance Show understanding of how encryption works Including the use of public key, private key, plain text, cipher text, encryption, symmetric key cryptography and asymmetric key cryptography How the keys can be used to send a private message from the public to an individual/organisation How the keys can be used to send a verified message to the public How data is encrypted and decrypted, using symmetric and asymmetric cryptography Purpose, benefits and drawbacks of quantum cryptography Show awareness of the Secure Socket Layer (SSL) / Transport Layer Security (TLS) Purpose of SSL/TLS Use of SSL/TLS in client-server communication Situations where the use of SSL/TLS would be appropriate Show understanding of digital certification How a digital certificate is acquired How a digital certificate is used to produce digital signatures 来源:剑桥国际大纲
加密(encryption)用一个依赖于密钥(key)的数学运算,把可读的明文(plaintext)变成不可读的密文(ciphertext)。只有有正确密钥的人才能逆转它——解密(decryption)——以取回明文。一个没有密钥就截获密文的攻击者只看到无意义的数据,因为尝试每一个可能的密钥会花太长的时间。一个较新的方法,量子密码学(quantum cryptography),用量子物理以一种揭示任何窃听者的方式共享一个密钥。
Enigma 机在第二次世界大战中加密消息——一个早期的机械密码设备 
加密用一个密钥打乱明文;解密逆转它 Symmetric encryption
对称加密(symmetric encryption,对称密钥密码学)对加密和解密都用同一个密钥,所以发送方和接收方必须都持有这个秘密密钥。它快,适合大批数据(整个磁盘、一个视频流)。它的问题是密钥分发(key distribution):你一开始怎么安全地共享密钥?非对称加密解决这个。
"描述对称密钥加密是什么意思"(两分)。 用同一个密钥加密明文和解密密文,所以密钥必须在发送方和接收方之间共享,并对其他所有人保密。两个缺点。 发送消息之前密钥必须先交换,若它在传输中被截获,截获者就能读所有消息;每一对通信者都需要单独的密钥;而且它不能证明消息是谁发的,因为两端持有同一个密钥。"给出使用密钥密码学的两个理由":使数据对截获它的任何人不可读(机密性);使接收方能确信数据来自声称的发送方且未被篡改(真实性和完整性(integrity))。两种方法是对称和非对称密钥密码学。

对称加密在两端用同一个秘密密钥 Asymmetric encryption (public-key)
非对称加密(asymmetric encryption,非对称密钥密码学)给每个用户一对相关的密钥:一个他们公布的公钥(public key),和一个他们保密的私钥(private key)。用公钥加密的数据只能用匹配的私钥解密,反之亦然。

每个用户有一个要共享的公钥和一个要保密的私钥 要给 Alice 发一个秘密消息:取她公布的公钥、用它加密,并发送。只有 Alice——持有匹配的私钥——能解密。不需要事先的密钥交换。权衡是它比对称慢得多,所以它不用于大数据。
"说明私钥是什么意思。" 只有其拥有者知道(决不传输)的密钥,用于解密用配对公钥加密的数据,以及创建数字签名。 "描述非对称加密的过程"(四分):(1) 接收方生成一对密钥,一个公钥和一个私钥,在数学上相关;(2) 公钥提供给任何想发送给他们的人;(3) 发送方用接收方的公钥加密明文;(4) 密文只能用接收方的私钥解密,而私钥从不离开接收方,所以截获消息的人都读不了。
例题。 Fred 想给 Sheila 发一份机密文件。解释如何使用非对称加密。
Sheila 有一对密钥;她把她的公钥发给 Fred(或者他从她的证书获取)。Fred 用 Sheila 的公钥加密文件并发送密文。只有 Sheila 的私钥能解密它,而只有 Sheila 持有私钥,所以其他任何人,包括加密之后的 Fred,都读不了这份文件。密钥按接收方的方式使用:她的公钥上锁,她的私钥开锁。持有一对密钥"用于接收安全传输"的组织正是这样做的:公布公钥,保留私钥,解密收到的东西。
对称与非对称加密的两个区别。 对称加密两个方向用一个密钥;非对称加密用两个相关的密钥,一个加密另一个解密。对称加密中密钥必须由双方保密并安全交换;非对称加密中公钥可以公开,只有私钥保密。对称加密快得多,适合大量数据;非对称较慢,所以用于密钥和签名而不是批量数据。
一个私钥必须保密,所以它有时被保存在一个小的硬件安全密钥(hardware security key)上。你插入它或轻触它来证明你是谁,而这个秘密密钥从不离开设备。

一个硬件安全密钥存储一个秘密密钥来证明你是谁 Hybrid approach (used by almost every real system)
用非对称加密来交换一个新鲜的会话密钥(session key),然后对数据用那个对称密钥:
- 客户端制作一个随机会话密钥。
- 它用服务器的公钥加密会话密钥。
- 服务器用它的私钥解密它。
- 两端现在共享会话密钥,并对其余部分用快速的对称加密。
这就是 HTTPS 和 SSH 工作的方式。
考试版的密钥交换问题。 "在发送消息之前要交换一个对称密钥。解释如何安全地交换该密钥。"发送方用接收方的公钥加密对称密钥并发送;接收方用自己的私钥解密;双方现在都持有这个从未在传输中暴露的对称密钥,并用它处理消息。非对称加密解决分发问题;对称加密再做快速的工作。

混合方法:非对称密码学一次性共享一个会话密钥,然后快速的对称加密保护数据 Hashing (related, not encryption)
一个密码散列(cryptographic hash)函数取任何输入并给出一个固定大小的摘要(digest),使得同样的输入总是给出同样的摘要、找到两个有同样摘要的输入是不可行的,而输入中一个微小的改变会完全改变摘要。散列是单向的——你不能取回输入。它被用于存储密码检查、完整性(integrity)检查和数字签名。

一个密码散列给出一个固定的摘要;一个微小的输入改变会完全改变它,而它不能被逆转 量子密码学
量子密码学(quantum cryptography)用光的物理来分发密钥:密钥的各位作为光子发送,其量子态编码取值。"描述它的目的":以能检测到任何截获企图的方式安全地传输加密密钥,因为测量光子会改变它的状态;窃听者(eavesdropper)因此会留下证据,被破坏的密钥被丢弃并发送新的。优点:截获总能被检测;密钥不能在不被改变的情况下复制;它对未来计算能力的进步是安全的(数学密钥终究能被破解,量子密钥不被扰动就无法读取)。缺点:需要专门的、昂贵的设备;只在专用光纤(或视距)上有限的距离内工作,不能跨越现有互联网;它只分发密钥,消息仍由普通加密保护;而且它是一项新技术,供应商少、经验少。
探索Hashing and the avalanche effect
A hash is one-way: easy to compute, practically impossible to reverse. A tiny change in the input flips a large, unpredictable part of the output — the avalanche effect that makes hashes good for passwords.
探索The Caesar cipher
Shift each letter to encrypt the message. A simple cipher shows the idea of a key — and why a small key is easy to break.
词汇表 训练英文 中文 拼音 encryption/enˈkrɪpʃn/ 加密 jiā mì plaintext/ˈpleɪntekst/ 明文 míng wén ciphertext/ˈsaɪfətekst/ 密文 mì wén decryption/dɪˈkrɪpʃn/ 解密 jiě mì quantum cryptography/ˈkwɒntəm krɪpˈtɒɡrəfi/ 量子密码学 liàng zǐ mì mǎ xué eavesdropper/ˈiːvzdrɒpə/ 窃听者 qiè tīng zhě symmetric encryption/sɪˈmetrɪk enˈkrɪpʃn/ 对称加密 duì chèn jiā mì key distribution/kiː ˌdɪstrɪˈbjuːʃn/ 密钥分发 mì yào fēn fā asymmetric encryption/ˌeɪsɪˈmetrɪk enˈkrɪpʃn/ 非对称加密 fēi duì chèn jiā mì integrity/ɪnˈteɡrɪti/ 完整性 wán zhěng xìng public key/ˈpʌblɪk kiː/ 公钥 gōng yào private key/ˈpraɪvət kiː/ 私钥 sī yào hardware security key/ˈhɑːdweə sɪˈkjʊərɪti kiː/ 硬件安全密钥 yìng jiàn ān quán mì yào session key/ˈseʃn kiː/ 会话密钥 huì huà mì yào cryptographic hash/ˌkrɪptəˈɡræfɪk hæʃ/ 密码散列 mì mǎ sàn liè digest/ˈdaɪdʒest/ 摘要 zhāi yào 17.1
SSL / TLS
TLS(传输层安全,Transport Layer Security,安全套接层(Secure Socket Layer,SSL)的后继者)是一个为通过一个网络发送的数据提供加密和身份验证的协议。它加密传输中的数据、用一个证书认证服务器,并提供完整性(检测篡改)。
一次 TLS 握手的概要:
- 客户端连接并提议密码选项。
- 服务器挑一个并发送它的数字证书(带它的公钥)——颁发和验证这些证书是数字认证。
- 客户端检查该证书。
- 两端用非对称密码学交换一个新鲜的会话密钥(session key)。
- 所有后续流量用会话密钥用快速的对称加密。
结果是一个为更高层协议(HTTP、SMTP)加密、认证、完整性检查的隧道。它在任何发送敏感信息的地方都适用:HTTPS 网络浏览、网上银行和支付、安全电子邮件,以及 VPN。
"描述 SSL/TLS 的目的"和"说出两个功能"。 目的是在客户端和服务器之间通过网络提供安全通信。它的功能:加密发送的数据,使其被截获也无法读取;通过数字证书认证(authenticate)服务器(也可以认证客户端),使客户端知道它在与真正的站点通话;检查数据的完整性,使传输中的改动被发现。两个适合使用的例子:网上银行和网上购物(银行卡支付);还有登录、私人电子邮件、文件传输、VoIP 和即时通讯:任何私密数据跨越互联网的交易。
组成 TLS 的两个协议。 握手(handshake)协议建立会话:商定加密算法(密码套件),用证书认证服务器,交换会话密钥。记录协议再传送数据:用会话密钥加密每条消息,加上完整性校验,交给传输层。
安全会话如何开始:证书证明服务器是谁,服务器的公钥保护会话密钥的传送,会话密钥保护此后的一切 "解释客户端–服务器通信发起时如何使用 SSL/TLS"(六分)。 (1) 客户端(浏览器)向服务器发送安全连接请求,说明它支持哪些加密方法。(2) 服务器回送它的数字证书,其中包含它的公钥。(3) 客户端检查证书有效(由受信任的证书颁发机构颁发、未过期、对应正确的域名)。(4) 客户端生成一个会话密钥,用服务器的公钥加密后发送。(5) 服务器用它的私钥解密会话密钥。(6) 双方现在都持有会话密钥,此后所有数据都用它以对称加密发送。按这个顺序给出步骤;分数在于证书、公钥、会话密钥和转到对称加密。
探索The TLS handshake
Step through what happens before a padlock appears. The slow public-key crypto is used only to agree a shared key; the actual page then travels under fast symmetric encryption.
词汇表 训练英文 中文 拼音 TLS/ˌtiː el ˈes/ 传输层安全 chuán shū céng ān quán handshake/ˈhændʃeɪk/ 握手 wò shǒu 17.1
数字证书

一个数字证书(digital certificate)把一个身份(一个域、一个组织)绑定到一个公钥,并由一个受信任的证书颁发机构(Certificate Authority,CA)签名。它包含主体(它标识谁)、主体的公钥、颁发者(CA)、一个有效期,以及 CA 对所有这些的签名。
一个证书颁发机构颁发一个把一个身份绑定到一个公钥的数字证书 要验证一个证书,客户端(它持有一个受信任的根 CA 列表):
- 检查过期日期。
- 检查主体名匹配 URL。
- 检查它由一个受信任的 CA 签名,用 CA 的公钥来验证签名。
- 沿证书链往上一直到一个受信任的根。
若任何一项失败,浏览器显示"你的连接不是私密的"警告。当它干净地验证时,客户端知道身份被一个受信任的 CA 审核过、公钥真的属于那个身份,而证书是当前的。
"描述数字证书是什么意思"(两分)。 由证书颁发机构颁发的电子文档,验证其拥有者(个人、组织或网站)的身份,并包含拥有者的公钥。 其中的项目:**序列号;拥有者的名称(主体),对网站则是其域名;拥有者的公钥**;颁发 CA 的名称;有效期(日期);所用的签名算法;以及 CA 对整个证书的数字签名。
"解释组织如何获取数字证书"(四分)。 (1) 组织生成自己的密钥对,一个公钥和一个私钥。(2) 它向证书颁发机构发送一个包含其公钥和身份信息的请求。(3) CA 核实身份(检查申请者确实是该组织或拥有该域名)。(4) CA 创建包含公钥和身份的证书,用 CA 自己的私钥签名,并返回。(5) 组织把证书安装在服务器上,以便发送给客户端。私钥从不离开组织。
"解释为什么验证数字签名需要数字证书。" 检查签名时接收方需要发送方的公钥,并且需要确信该密钥确实属于声称的发送方;证书把公钥和身份一起提供,而且因为证书由受信任的 CA 签名,接收方可以信任这种绑定。没有它,冒名者可以用别人的名字公布一个公钥并以其名义签名。同样的道理回答"从互联网下载的程序应附带什么以证明它是真的":一个数字签名,对照发布者的证书检查。
词汇表 训练英文 中文 拼音 digital certificate/ˈdɪdʒɪtl səˈtɪfɪkət/ 数字证书 shù zì zhèng shū Certificate Authority/səˈtɪfɪkət əˈθɒrɪti/ 证书颁发机构 zhèng shū bān fā jī gòu 17.1
数字签名

一个数字签名(digital signature)证明谁签了一个消息以及它没有被改变。要签名:
- 计算消息的一个密码散列。
- 用发送方的私钥加密该散列——那就是签名。
- 发送消息和签名。
要验证:计算收到的消息的散列;用发送方的公钥解密签名以得到发送方的散列;比较。若它们匹配,消息被私钥的持有者签名(身份验证(authentication))且没有被改变(完整性)。一个签名不隐藏消息——要同时保密,就既加密又签名。
签名把消息散列并用私钥加密摘要;接收方用公钥检查它 "解释数字证书在创建数字签名中的作用"(三分)。 发送方的证书由 CA 颁发,包含发送方的公钥和发送方的身份;发送方通过对消息散列并用自己的私钥加密该散列值(证书中密钥的配对密钥)来产生签名;接收方用证书中的公钥解密散列值,又因为证书把该密钥绑定到发送方,签名就证明了是谁签的。
"解释如何用数字签名验证消息"(四分)。 (1) 接收方用发送方的公钥(取自发送方的证书)解密签名,得到发送方计算的散列值。(2) 接收方用同样的散列算法对收到的消息散列。(3) 比较两个散列值。(4) 若匹配,消息来自私钥的持有者(真实)并且自签名以来未被篡改(完整性);若不同,消息被拒绝。银行家收到带签名的机密数据时正是这样做才信任它;数据本身可以另外用银行家的公钥加密以保机密。
Putting it together
一个到
https://www.bank.com的安全请求:服务器发送它的证书;客户端对照受信任的 CA 验证它;客户端用服务器的公钥来交换一个会话密钥;然后数据用那个密钥加密流动。加密阻止窃听者,证书证明服务器的身份,而完整性检查阻止一个中间人攻击(man-in-the-middle)篡改数据。例题。 Alice 给 Bob 发送一份合同。她希望 Bob 能确信这份合同来自她本人且未被篡改,并且希望别人都读不到它。她要用哪些密钥?方向如何?这是两件不同的事,需要两对不同的密钥。用于签名(身份验证与完整性):Alice 对合同做哈希,并用她自己的私钥加密这个哈希值;Bob 用 Alice 的公钥解密它,再与自己对该消息算出的哈希值比对。只有 Alice 持有她的私钥,所以只有她能生成它。用于机密性:Alice 用 Bob 的公钥加密合同本身,这样只有 Bob 的私钥才能打开它。有一条规则能把这四者理清:用自己的私钥签名,用接收方的公钥加密。只有签名本身并不能隐藏消息内容。
词汇表 训练英文 中文 拼音 digital signature/ˈdɪdʒɪtl ˈsɪɡnɪtʃə/ 数字签名 shù zì qiān míng authentication/ɔːˌθentɪˈkeɪʃn/ 身份验证 shēn fèn yàn zhèng authenticates/ɔːˈθentɪkeɪts/ 认证 rèn zhèng man-in-the-middle/mæn ɪnðə ˈmɪdl/ 中间人攻击 zhōng jiān rén gōng jī 17.1
考官认可的定义
定义题按固定措辞评分。准确学会这些,只给一个答案。
术语 定义 加密 用算法和密钥把明文转换成密文,使其被截获时无法理解 明文 / 密文 原始可读的数据 / 它的加密后不可读的形式 对称密钥密码学 用同一个秘密密钥加密和解密,所以双方必须安全地共享它 非对称密钥密码学 用一对相关的密钥:公钥加密,只有配对的私钥能解密 公钥 提供给任何人的密钥,用于加密发给其拥有者的消息和验证拥有者的签名 私钥 只有拥有者知道的密钥,用于解密用公钥加密的消息和签名 SSL/TLS 在客户端和服务器之间提供安全(加密、认证、完整性校验)通信的协议 数字证书 由证书颁发机构颁发的电子文档,验证拥有者身份并包含其公钥 数字签名 用发送方私钥加密的消息散列值,证明发送者是谁以及消息未被篡改 证书颁发机构 核实身份并颁发和签署数字证书的受信任组织 量子密码学 利用光子的量子态分发密钥,使任何截获都能被检测 17.1
考试技巧
- 对称:一个共享的秘密密钥,快,密钥交换是弱点。非对称:公钥加密、私钥解密,慢,没有交换问题。两个区别、两个缺点、两个理由:考试成对地问。
- 机密性用接收方的密钥(公钥上锁,私钥开锁);签名用发送方的密钥(私钥签,公钥验)。每次都说清是谁的密钥。
- TLS 的启动是六步:请求、带公钥的证书、检查、用公钥加密的会话密钥、用私钥解密、此后对称加密。
- 证书是身份加公钥,由 CA 签名;获取过程是密钥对、请求、核实、签名、安装。验证签名需要它,因为它证明公钥是谁的。
- 签名是用私钥加密的散列值;验证是解密、重新散列、比较。它证明的两件事是完整性和真实性。
- 量子密码学分发密钥并检测窃听;它的限制是成本、距离和新颖。
常见错误
- 说消息用发送方的公钥加密;是接收方的公钥加密、接收方的私钥解密。
- 把签名描述成"用私钥加密消息"而不是加密它的散列值。
- 声称证书包含私钥;它保存公钥和身份,由 CA 签名。
- 在 TLS 握手中写"服务器发送它的私钥";只有公钥在证书内传输。
- 把"SSL/TLS 使连接更快"当作功能;它的功能是加密、认证和完整性。
- 混淆散列与加密:散列不可逆且没有密钥;加密用密钥可逆。
- 用"为了加密它"回答"为什么签名需要证书";需要它是为了信任公钥。
-
18
人工智能(AI)
18.1
人工智能(AI)

大纲
Candidates should be able to: Notes and guidance Show understanding of how graphs can be used to aid Artificial Intelligence (AI) Purpose and structure of a graph Use A algorithm* and Dijkstra’s algorithm to perform searches on a graph Candidates will not be required to write algorithms to set up, access, or perform searches on graphs Show understanding of how artificial neural networks have helped with machine learning Show understanding of Deep Learning, Machine Learning and Reinforcement Learning and the reasons for using these methods. Understand machine learning categories, including supervised learning, unsupervised learning Show understanding of back propagation of errors and regression methods in machine learning 来源:剑桥国际大纲
人工智能(artificial intelligence,AI)构建做通常需要人类智能的任务的系统——识别语音和图像、翻译、玩游戏、驾驶、生成文本。大多数现代 AI 用机器学习(machine learning)——从数据中学习模式而不是被一步步编程的算法。在它之内,用有许多层的神经网络(neural networks)的深度学习(deep learning)自 2010 年代以来一直占主导。
一个人形机器人(humanoid robot)把这些能力中的许多放进一个身体:它用 AI 看脸、理解语音,并以逼真的方式移动它的脸和手臂。
一个人形机器人用 AI 像人一样看、听和回应 
深度学习是机器学习的一部分,机器学习是 AI 的一部分 探索AI learning type lab
Classify AI examples by the type of learning or concern involved.
词汇表 训练英文 中文 拼音 artificial intelligence/ˌɑːtɪˈfɪʃl ɪnˈtelɪdʒəns/ 人工智能 rén gōng zhì néng deep learning/diːp ˈlɜːnɪŋ/ 深度学习 shēn dù xué xí neural networks/ˈnjuːrəl ˈnetwɜːks/ 神经网络 shén jīng wǎng luò humanoid robot/ˈhjuːmənɔɪd ˈrəʊbɒt/ 人形机器人 rén xíng jī qì rén 18.1
人工智能中的图

许多 AI 问题坐在一个图(graph)上——节点(nodes,状态、地点)由边(edges,移动、关系)连接。
- 寻路:道路构成一个图;最短路线是一个图搜索(Dijkstra 算法、A* 算法)。
- 玩游戏:每个棋盘位置是一个节点,每步是一条边;带 alpha-beta 剪枝的极小化极大(minimax)搜索博弈树。
- 状态空间搜索:一个规划问题是通过应用算子在状态之间移动以到达一个目标。
- 知识表示:一个语义网络(semantic network)以概念为节点、关系为边("狗 IS-A 动物");一个知识图谱(knowledge graph)为搜索引擎和助手存储关于世界的事实。
AI 问题常坐在一个图上;这里最短路径被高亮 导航图的标准工具包括广度优先搜索(breadth-first search)和深度优先搜索(depth-first search)。
"描述 AI 系统中图的目的和结构。" *目的:*把一个问题表示为一组状态(或地点)以及它们之间可能的移动,使算法能搜索它以求得解,例如最短或最便宜的路线,或最佳的下一步。*结构:*一组节点(顶点),各表示一个状态、地点或项目,由表示它们之间连接的边相连;每条边可以带一个权重(代价、距离或时间),边可以是有向的(单向)或无向的。**"解释图如何辅助 AI":*图是 AI 搜索算法运行所依赖的模型:A 和 Dijkstra 算法在其中找最优路径(导航、路由),棋局位置构成一棵被搜索最佳走法的树,而以图存储的知识让系统能推理事实之间的关系。
 下面用到的图:边上的数是真实距离;红色的数是每个节点对目标还有多远的启发式(heuristic)估计,只有 A 使用它*
Dijkstra 算法。 它求从起点到每个节点的最短距离。保存一张到每个节点目前找到的最佳距离表(起点 0,其余无穷大)。反复取出距离最小的未访问节点,标记为已访问,并对它的每个邻居检查经过该节点是否给出更短的距离;若是则更新并记录来自何处。所有节点(或目标)都访问过后停止。
例题。 求上图中从 H 到其他每个节点的最短距离。
步骤 访问 H A B C D G 开始 0 ∞ ∞ ∞ ∞ ∞ 1 H (0) 0 4 (H) 3 (H) ∞ ∞ ∞ 2 B (3) 0 4 (H) 3 ∞ 9 (B) ∞ 3 A (4) 0 4 3 9 (A) 8 (A) ∞ 4 D (8) 0 4 3 9 (A) 8 10 (D) 5 C (9) 0 4 3 9 8 10 (D) 6 G (10) 最短距离:A 4,B 3,D 8,C 9,G 10,到 G 的路径是 H–A–D–G(倒着读"来自"标记)。第 3 步 A 给 D 提供了 $4 + 4 = 8$ 的距离,比经 B 找到的 9 好,所以 D 被更新;第 5 步 C 可以以 $9 + 3 = 12$ 到达 G,比 10 差,所以没有变化。写出这些比较就是题目要求的"过程"。
A* 算法。 Dijkstra 向各个方向探索。A* 加入一个启发式值 $h$,即还要走多远的估计,总是扩展 $f = g + h$ 最小的节点,其中 $g$ 是目前已走的距离。用合理的启发式(从不高估),它找到同样的最短路径却只看少得多的节点,这就是导航仪和游戏用它的原因。考试给出每个节点的 $h$ 和一张要填的表。
例题。 用 A* 求从 H 到 G 的路径,写出过程。
扩展的节点 目前的 $g$ $h$ $f = g + h$ 加入的邻居(节点:$g$、$h$、$f$) H 0 7 7 A:4、5、9;B:3、6、9 B(与 A 并列;任选) 3 6 9 经 B 到 D:9、2、11 A 4 5 9 C:9、3、12;经 A 到 D:8、2、10(优于 11,保留) D 8 2 10 G:10、0、10;经 D 到 C:9(不更优) G 10 0 10 到达目标 路径 H–A–D–G,长度 10,与 Dijkstra 相同,但 C 从未被扩展。每当一个节点被第二条路线到达时,保留较小的 $g$;当目标成为 $f$ 最小的节点时搜索结束。每一行都写出 $g$、$h$ 和 $f$ 的值:那就是分数所在。
词汇表 训练英文 中文 拼音 graph/ɡræf/ 图 tú nodes/nəʊdz/ 节点 jié diǎn edges/ˈedʒɪz/ 边 biān minimax/ˈmɪnɪmæks/ 极小化极大 jí xiǎo huà jí dà semantic network/səˈmæntɪk ˈnetwɜːk/ 语义网络 yǔ yì wǎng luò knowledge graph/ˈnɒlɪdʒ ɡræf/ 知识图谱 zhī shí tú pǔ breadth-first search/bredθ fɜːst sɜːtʃ/ 广度优先搜索 guǎng dù yōu xiān sōu suǒ depth-first search/depθ fɜːst sɜːtʃ/ 深度优先搜索 shēn dù yōu xiān sōu suǒ heuristic/hjuːˈrɪstɪk/ 启发式 qǐ fā shì 18.1
人工神经网络(ANN)

一个 ANN 受大脑神经元的启发。一个人工神经元(artificial neuron):
- 取几个输入值,把每个乘以一个权重(weight),并把它们加起来,再加上一个偏置项(bias term)。
- 对这个和应用一个激活函数(activation function,一个非线性函数,如 ReLU)。
- 输出结果,它馈入更靠后的神经元。
一个单一的神经元:每个输入乘以它的权重、加上一个偏置求和,然后一个激活函数 神经元坐在层里:一个输入层、一个或多个隐藏层(hidden layers,在那里学到有用的内部模式),和一个输出层。有许多隐藏层时,它是一个深度神经网络(deep neural network),而训练它就是深度学习。

一个带一个输入层、两个隐藏层和一个输出层的神经网络 ANN 让模型直接从原始数据(像素、音频、文本)学习复杂模式,而不需要手工设计的特征——推动了图像识别(image recognition)、语音识别(speech recognition)、机器翻译(machine translation)和玩游戏的突破。它们在大量数据、含噪或非常复杂的输入,以及太难用显式规则捕获的模式上做得好。
"解释人工神经网络是什么意思。" 一个模仿大脑神经元网络的模型,由分层的相连节点组成:一个输入层、一个或多个隐藏层和一个输出层。 每个连接有一个权重;每个节点把它的加权输入求和,通过激活函数传给下一层。"解释 ANN 如何使机器学习成为可能"(三分):网络在许多样例上训练;对每个样例,输出与期望结果比较,误差被用来调整权重(反向传播)使误差下降;经过足够多的样例后,权重编码了数据中的模式,网络就能对它从未见过的新数据分类或预测。"说明多个隐藏层的理由":每增加一层都把前一层找到的特征组合成更复杂、更抽象的特征,所以网络能学到更复杂的关系(边缘,然后形状,然后物体);这就是网络"深"的含义。
探索Tap the parts of a neural network
Explore the layers. Data flows left to right: the input layer takes the features, the hidden layers learn patterns, and the output layer gives the answer — with every connection carrying a weight that training adjusts.
词汇表 训练英文 中文 拼音 weight/weɪt/ 权重 quán zhòng artificial neuron/ˌɑːtɪˈfɪʃl ˈnjuːrɒn/ 人工神经元 rén gōng shén jīng yuán bias term/ˈbaɪəs tɜːm/ 偏置项 piān zhì xiàng activation function/ˌæktɪˈveɪʃn ˈfʌŋkʃn/ 激活函数 jī huó hán shù hidden layers/ˈhɪdn ˈleɪəz/ 隐藏层 yǐn cáng céng deep neural network/diːp ˈnjuːrəl ˈnetwɜːk/ 深度神经网络 shēn dù shén jīng wǎng luò image recognition/ˈɪmɪdʒ ˌrekəɡˈnɪʃn/ 图像识别 tú xiàng shí bié speech recognition/spiːtʃ ˌrekəɡˈnɪʃn/ 语音识别 yǔ yīn shí bié machine translation/məˈʃiːn trænˈsleɪʃn/ 机器翻译 jī qì fān yì 18.1
机器学习、深度学习与强化学习
Machine learning
总括术语——任何从数据中学习的算法。三种范式:
- 监督学习(supervised learning)——数据有标签(labels,图像被标为"猫"/"狗");算法学习输入 → 标签。用于分类(classification,一个类别)和回归。
- 无监督学习(unsupervised learning)——没有标签;算法找出结构,例如相似客户的一个聚类(cluster)。
- 强化学习(下面)。
当显式规则不切实际时用 ML(垃圾邮件过滤器、推荐、欺诈检测)。
同一批数据的两种看法:有标签时,任务是学出区分各类的东西;没有标签时,任务是发现究竟有哪些组 "描述监督学习和无监督学习"(评分措辞)。 监督学习:算法在**带标签的**训练数据**(training data)上训练,每个样例配有正确输出(目标);它学习输入与输出之间的关系,并用它对新输入分类或预测;训练时答案已知,所以误差可以度量。*无监督学习:*数据没有标签,不给正确答案;算法自己在数据中寻找模式、结构或分组(把相似项聚类、发现关联);输出是一组事先未定义的类别或关系。它们的区别:带标签对无标签的数据;已知输出对发现的结构;监督学习用于预测(分类、回归),无监督学习用于探索(聚类、异常检测)。两者都是机器学习的类别;第三类是强化学习。

监督学习:一个模型在带标签的数据上训练,然后识别新数据 Deep learning
ML 的一个子集,用深度神经网络。较低的层学习简单模式(边缘、音素),较高的层把它们组合成抽象概念。它需要大量数据和大量计算(GPU);对于小数据集,更简单的 ML 方法往往做得更好。
"解释深度学习是什么意思"(三分)。 使用带许多隐藏层(深度网络)的人工神经网络的机器学习;网络在非常大量的数据上训练,每一层从下一层的输出中提取特征,所以网络自己学到它需要的特征,而不是由程序员指定。 使用它的理由:它能解决对手写规则或浅层模型来说太复杂的问题(识别人脸、理解语音、翻译文本);数据越多它越好;它免去了人工特征工程的需要;它能处理图像、声音和文本等非结构化数据。**如何使它更有效:**更多(且标签更好的)训练数据;在不过拟合的限度内更多的层或节点;更多的处理能力(GPU)和训练时间;调整学习率等参数。**例子:**语音助手中的语音识别、医学扫描和自动驾驶汽车中的图像识别、机器翻译、推荐系统。
Reinforcement learning
在强化学习(reinforcement learning)中,一个智能体(agent)在一个环境中行动;每个动作改变状态并返回一个奖励(reward)。智能体通过试错(trial and error,一开始没有标签)学习一个随时间最大化总奖励的策略(policy,一个策略)。用于序贯决策问题——游戏、机器人控制、自动驾驶。
"解释强化学习是什么意思"(三分)。 一个智能体通过与环境交互学习:它采取一个动作,环境转到新状态并返回一个奖励(或惩罚),智能体调整它的行为以最大化长期总奖励。 没有带标签的数据:智能体通过试错学习,从收集到的奖励中发现哪些动作是好的,并逐渐形成一个规定在每个状态该做什么的策略。用于事先不知道正确答案、但动作的结果可以打分的场合:玩游戏(国际象棋、围棋)、机器人控制、交通灯配时、资源分配。计算机与用户下棋时就这样学习,或者用极小化极大搜索博弈树,选择最坏结果最好的那一步。

强化学习:智能体行动,环境返回一个新状态和一个奖励,而智能体从中学习 一辆自动驾驶汽车(self-driving car)是一个真实的例子。激光雷达(lidar)和摄像头传感器(车顶上旋转的单元)建立道路的一个实时图像,而一个学到的策略决定如何安全地转向、加速和刹车。

一辆自动驾驶汽车用摄像头和激光雷达传感器看它周围的道路 
一条生产线上的工业机器人臂:强化学习能教一个机器人控制它的移动 词汇表 训练英文 中文 拼音 machine learning/məˈʃiːn ˈlɜːnɪŋ/ 机器学习 jī qì xué xí labels/ˈleɪblz/ 标签 biāo qiān reinforcement learning/ˌriːɪnˈfɔːsmənt ˈlɜːnɪŋ/ 强化学习 qiáng huà xué xí supervised learning/ˈsuːpəvaɪzd ˈlɜːnɪŋ/ 监督学习 jiān dū xué xí classification/ˌklæsɪfɪˈkeɪʃn/ 分类 fēn lèi unsupervised learning/ʌnˈsuːpəvaɪzd ˈlɜːnɪŋ/ 无监督学习 wú jiān dū xué xí cluster/ˈklʌstə/ 聚类 jù lèi training data/ˈtreɪnɪŋ ˈdeɪtə/ 训练数据 xùn liàn shù jù self-driving car/self ˈdraɪvɪŋ kɑː/ 自动驾驶汽车 zì dòng jià shǐ qì chē agent/ˈeɪdʒənt/ 智能体 zhì néng tǐ reward/rɪˈwɔːd/ 奖励 jiǎng lì policy/ˈpɒlɪsi/ 策略 cè lüè lidar/ˈlaɪdɑː/ 激光雷达 jī guāng léi dá 18.1
训练神经网络:反向传播
训练调整权重,使输出匹配目标。标准方法是带梯度下降(gradient descent)的反向传播(backpropagation,误差的反向传播)。对每个训练样例:
- 前向传播(forward pass)——把输入馈送到输出。
- 计算误差,用一个损失函数(loss function,一个表示输出有多错的单一数字)。
- 反向传播(backward pass)——把误差向后传播,用链式法则找出每个权重的梯度(它对误差贡献了多少)。
- 更新权重,走一小步(由学习率(learning rate)设定)以减少误差。
在许多样例和许多趟(训练轮次(epochs))上重复,直到误差停止缩小。名字"反向"来自第 3 步:误差从输出向后流向输入,所以每个权重的梯度在一趟中被找到。训练之后,一个新输入只需要一次前向传播就能得到一个预测。
"描述误差反向传播方法"(四分)。 (1) 一个输入被前向送过网络,其输出与期望(目标)输出比较;(2) 差值就是误差;(3) 误差从输出到输入逐层向后传过网络,算出每个权重对误差的份额;(4) 权重按其贡献比例调整,方向为减小误差;(5) 用许多样例重复这一过程,直到误差小到所需程度。这个方法的要点在于,带隐藏层的网络没有直接的办法知道哪个内部权重导致了输出误差;反向传播分摊责任。
训练调整权重以到达最小误差 词汇表 训练英文 中文 拼音 learning rate/ˈlɜːnɪŋ reɪt/ 学习率 xué xí lǜ backpropagation/ˌbækprəpəˈɡeɪʃn/ 反向传播 fǎn xiàng chuán bō gradient descent/ˈɡreɪdɪənt dɪˈsent/ 梯度下降 tī dù xià jiàng loss function/lɒs ˈfʌŋkʃn/ 损失函数 sǔn shī hán shù epochs/ˈiːpɒks/ 训练轮次 xùn liàn lún cì 18.1
回归

一些任务预测一个数(一个房价、明天的温度)——回归(regression),与分类(一个类别)相对。
线性回归(linear regression)拟合一条直线(或超平面):
$$y = m_{1} x_{1} + m_{2} x_{2} + \ldots + m_{n} x_{n} + c.$$选择系数以最小化误差平方和,对照训练数据。当关系看起来大致线性且你想要一个可解释的模型时用它。对于弯曲的数据,用多项式、决策树或神经网络的回归方法——同样的思想:定义一个模型、定义一个损失,并调整参数以最小化它。回归和分类都是监督的;选择取决于答案是一个数还是一个类别。
"描述机器学习中的回归方法"(两分)。 通过用总误差最小的函数(直线或曲线)拟合训练数据,找出输入变量与连续输出之间关系的统计方法;拟合出的函数随后用于对新输入预测输出。 线性回归拟合直线;其他方法拟合曲线。回归预测一个值(价格、温度、时间);分类预测一个类别,这正是考试要问的区别。
线性回归拟合使总误差平方(虚线间隙)尽可能小的那条线 探索Fitting a regression line
Drag the controls. Linear regression draws the straight line that makes the squared distances to the data points as small as possible — then it predicts a number for any new input.
词汇表 训练英文 中文 拼音 regression/rɪˈɡreʃn/ 回归 huí guī linear regression/ˈlɪnɪə rɪˈɡreʃn/ 线性回归 xiàn xìng huí guī 18.1
人工智能在真实场景中的应用
许多考试场景用同样的模式——一个在带标签的数据上训练的深度学习模型,常常几个组合成一个流水线:
- 在一个自动商店的客户识别:系统在带标签的人脸图像上训练;一个摄像头捕获一张脸;图像识别提取一个表示;它对照注册的客户被匹配;最接近的匹配识别该人。
- 从图像读文本:图像识别找到文本区域;光学字符识别(optical character recognition)提取字符;机器翻译转换它们;文本转语音(text-to-speech)大声读它们。
- 收银台商品检测:在带标签的产品图像上训练的物体检测 AI,看到哪些商品进入一个购物篮并向账户收费。
当一个用户与系统交互时,模型是快的——它只做前向传播推理;智能在训练期间学到的模式中。
场景题的范例答案。 *停车场摄像头读取车牌:*摄像头拍摄图像;在许多带标签的车牌图像上训练的 AI 在图像中定位车牌;字符识别(同样在带标签的字符上训练的深度学习分类器)把车牌转换成文本;文本与时间一起存储,车辆离开时匹配。*CCTV 系统检测并跟踪一个人:*在带标签的人像上训练的图像识别软件在每一帧中识别出人;系统比较连续帧以跟随其移动;异常移动可以触发警报。*把语音变成命令:*在许多录音上训练的语音识别把声音转成文本;系统把文本匹配到一组已知命令;它在被纠正中改进。*对人脸对焦的相机:*在带标签的人脸上训练的人脸检测模型找到人脸区域,镜头调整使该区域清晰。*银行的人脸识别登录:*应用捕捉人脸,深度网络提取其特征,并与该客户存储的特征比较。所有情形的模式都是:在带标签的样例上训练、提取特征、对新输入匹配或分类。
例题。 对每个任务,说明它需要回归还是分类,以及人工神经网络的输出层会是什么样:(a) 预测明天的气温;(b) 判断一封邮件是否为垃圾邮件。要问的是被预测的是哪一类东西。(a) 气温是连续标度上的一个数值,所以这是回归,输出层是持有该数值的单个神经元。(b) 垃圾邮件与非垃圾邮件是一个类别,所以这是分类,输出给出每个类别的概率。两者都是有监督学习:各自都需要带标签的样本来训练,训练通过反向传播调整权重以减小误差。决定性的问题很简单,就是数值还是类别 - 而不是这个任务感觉有多难。
词汇表 训练英文 中文 拼音 optical character recognition/ˈɒptɪkl ˈkærɪktə ˌrekəɡˈnɪʃn/ 光学字符识别 guāng xué zì fú shí bié text-to-speech/tekst tə spiːtʃ/ 文本转语音 wén běn zhuǎn yǔ yīn 18.1
考官认可的定义
定义题按固定措辞评分。准确学会这些,只给一个答案。
术语 定义 图(AI 中) 表示状态或地点的一组节点,由表示连接(常带权重)的边相连,搜索算法可以探索它 Dijkstra 算法 通过总是访问目前距离最小的未访问节点,求从起点到其他每个节点的最短距离 A* 算法 一种最短路径搜索,扩展"已走距离加到目标的启发式估计"之和最小的节点 人工神经网络 模仿大脑神经元的模型:由加权连接相连的多层节点,通过调整权重来训练 机器学习 从数据中学习并随经验改进、而不是遵循固定规则的算法 监督学习 从每个输入的正确输出已知的带标签训练数据中学习 无监督学习 通过发现无标签数据中的模式、分组或结构来学习 强化学习 智能体通过试错学习,在环境中选择动作以最大化获得的奖励 深度学习 使用多隐藏层神经网络、在大量数据上训练、每层从下一层提取特征的机器学习 误差反向传播 把网络的输出与目标比较,把误差反向传过各层,并调整每个权重以减小它 回归 用函数拟合训练数据,以便由输入预测连续的输出值 18.1
考试技巧
- 图的答案要点名节点、边和权重以及它们代表什么;然后是算法。Dijkstra:距离表,访问最小的,更新邻居。A*:每一行写 $g$、$h$ 和 $f = g + h$,扩展 $f$ 最小的。
- ANN 的答案要点名各层、加权连接和训练;深度学习加上许多隐藏层、大数据和自动特征提取,再给一个理由和一个例子。
- 三个类别各一句话:带标签数据和已知输出;无标签数据和发现的结构;智能体、环境、动作和奖励。
- 反向传播:与目标比较、误差向后穿过各层、调整权重以减小它、重复。回归预测值;分类预测类别。
- 场景题要流水线:在带标签的样例上训练、提取特征、识别或分类新输入;点名 AI 的类型(图像识别、语音识别、深度学习)。
常见错误
- 把图描述成"图表";在 AI 中它是节点和边。
- 运行 Dijkstra 时挑当前节点的最近邻居,而不是尚未访问的总距离最小者;或出现更短路线时忘记更新节点。
- 在 A* 中把 $h$ 加进下一步的 $g$;$g$ 只是真实距离,$h$ 由表重新读取。
- 说深度学习是"学得很多";它是许多隐藏层。
- 混淆无监督学习与强化学习;前者在数据中找结构,后者从奖励中学习。
- 描述反向传播时不提与期望输出的比较,或不说权重被调整。
- 把对价格的预测叫作"分类";连续值是回归。
-
19
计算思维与问题求解
19.1
算法

大纲
Candidates should be able to: Notes and guidance Show understanding of linear search and binary search methods Write an algorithm to implement a linear search Write an algorithm to implement a binary search The conditions necessary for the use of a binary search How the performance of a binary search varies according to the number of data items Show understanding of insertion sort and bubble sort methods Write an algorithm to implement an insertion sort Write an algorithm to implement a bubble sort Performance of a sorting routine may depend on the initial order of the data and the number of data items Show understanding of and use Abstract Data Types (ADT) Write algorithms to find an item in each of the following: linked list, binary tree Write algorithms to insert an item into each of the following: stack, queue, linked list, binary tree Write algorithms to delete an item from each of the following: stack, queue, linked list Show understanding that a graph is an example of an ADT. Describe the key features of a graph and justify its use for a given situation. Candidates will not be required to write code for a graph structure Show how it is possible for ADTs to be implemented from another ADT Describe the following ADTs and demonstrate how they can be implemented from appropriate built-in types or other ADTs: stack, queue, linked list, dictionary, binary tree Show understanding that different algorithms which perform the same task can be compared by using criteria (e.g. time taken to complete the task and memory used) Including use of Big O notation to specify time and space complexity 来源:剑桥国际大纲
大 O:算法如何伸缩 插入排序:把每张牌滑入位置 冒泡排序,一趟接一趟 二分查找:折半并征服 一个搜索(search)在一个集合(常常是一个数组(array))中找一个目标值并返回它的位置,或"未找到"。
搜索一个已排序的列表,像一本电话簿,比逐条检查每个条目快得多 Linear search
一个线性查找(linear search)从头走到尾,把每个元素与目标比较:
FOR i ← 1 TO n
    IF A[i] = target THEN RETURN i
NEXT i
RETURN -1   // not found
不需要准备,所以它在任何列表上都能用。最坏情况 O($n$)(目标在末端或不存在);最好情况 1 次比较。在未排序的数据或小列表上用它。(返回的
-1是一个哨兵值——一个表示"未找到"的不可能位置;调用者测试IF result = -1。)考试的版本。 试卷 3 要你补全用标志和
WHILE循环写的线性查找,试卷 4 要你写一个返回下标或计数的函数。两者都像这样:FUNCTION LinearSearch(Data : ARRAY OF INTEGER, Target : INTEGER) RETURNS INTEGER DECLARE Index, Count : INTEGER Count ← 0 FOR Index ← 1 TO 100 IF Data[Index] = Target THEN Count ← Count + 1 ENDIF NEXT Index RETURN Count // Target 出现的次数;0 表示未找到 ENDFUNCTION要在第一个匹配处停止,改用
WHILE Index <= 100 AND NOT Found循环,设置Found ← TRUE并记住下标。分数在于遍历每个元素的循环、比较,以及值不存在时返回什么。
线性查找依次检查每个字母——找到 W 需要 23 次比较 Binary search
一个二分查找(binary search)需要数据已排序。看中间元素;若它是目标,完成;若目标更小,搜索左半,否则右半——每次把范围折半:
low ← 1
high ← n
WHILE low <= high DO
    mid ← (low + high) DIV 2
    IF A[mid] = target THEN RETURN mid
    IF A[mid] < target THEN
        low ← mid + 1
    ELSE
        high ← mid - 1
    ENDIF
ENDWHILE
RETURN -1
最坏情况 O($\log_{2} n$)——对一百万项,约 20 次比较。在大的已排序数组上比线性查找快得多,但你必须先排序(一个一次性的 O($n \log n$) 代价),若你搜索许多次就值得。
"说明二分查找的必要条件。" 数据必须有序(按所查找的键升序或降序排列)。"描述如何进行二分查找"(三分):(1) 找到列表(或当前范围)的中间项并与目标比较;(2) 若匹配则查找结束;若目标更小,对下半部分重复,若更大则对上半部分重复;(3) 不断折半范围,直到找到该项或范围为空,即它不存在。
带边界和标志的考试版本,是被要求补全算法时要复现的:
DECLARE Lower, Upper, Mid : INTEGER
DECLARE Found : BOOLEAN
Lower ← 0
Upper ← 99
Found ← FALSE
WHILE Lower <= Upper AND NOT Found
    Mid ← (Lower + Upper) DIV 2
    IF Names[Mid] = Target THEN
        Found ← TRUE
    ELSE
        IF Names[Mid] < Target THEN
            Lower ← Mid + 1
        ELSE
            Upper ← Mid - 1
        ENDIF
    ENDIF
ENDWHILE
IF Found THEN OUTPUT Mid ELSE OUTPUT "Not found" ENDIF
"解释性能如何随项数变化。" 每次比较把剩余项数折半,所以最大比较次数约为 $\log_{2} n$:列表规模加倍只多一次比较。这是 O($\log n$)。"比较线性查找和二分查找":线性查找最多需要 $n$ 次比较(O($n$)),平均为其一半,但对未排序数据也能用;二分查找最多需要 $\log_{2} n$ 次(O($\log n$)),对大列表快得多,但数据必须先排序,并且必须能直接访问中间项(数组,而不是链表)。对 $1000$ 项:$1000$ 次对 $10$ 次比较。

二分查找每步把范围折半(low / mid / high)——找到 W 只需 3 次比较 
卡片目录:正是有序的记录才让二分查找成为可能——对半、查看、再对半 探索Linear vs binary search
Search for a value. Binary search halves the list each step (only on sorted data); linear search checks one by one.
词汇表 训练英文 中文 拼音 binary search/ˈbaɪnəri sɜːtʃ/ 二分查找 èr fēn chá zhǎo array/əˈreɪ/ 数组 shù zǔ linear search/ˈlɪnɪə sɜːtʃ/ 线性查找 xiàn xìng chá zhǎo 19.1
排序算法

Bubble sort
一个冒泡排序(bubble sort)反复走过数组,交换顺序错误的相邻对,所以最大的每趟"冒泡"到末端:
FOR pass ← 1 TO n - 1
    swapped ← FALSE
    FOR i ← 1 TO n - pass
        IF A[i] > A[i + 1] THEN
            temp ← A[i]
            A[i] ← A[i + 1]
            A[i + 1] ← temp
            swapped ← TRUE
        ENDIF
    NEXT i
    IF swapped = FALSE THEN EXIT FOR   // already sorted
NEXT pass
最好情况 O($n$)(已排序,带早退);平均/最坏 O($n^{2}$)。简单但对大的 $n$ 慢。
Insertion sort
一个插入排序(insertion sort)从左边构建一个已排序的前缀,通过把较大的向右移把每个新元素插入位置:
FOR i ← 2 TO n
    key ← A[i]
    j ← i - 1
    WHILE j >= 1 AND A[j] > key DO
        A[j + 1] ← A[j]
        j ← j - 1
    ENDWHILE
    A[j + 1] ← key
NEXT i
最好情况 O($n$)(已排序);最坏 O($n^{2}$)。适合小或近乎已排序的数组。它原地(in place)排序并且是稳定的(stable,保持相等元素的顺序)。
Tracing a sort
一个常见的任务是显示每一次外趟之后的数组。对
[D, T, H, R]用插入排序:趟 1(key T)无变化;趟 2(key H)→[D, H, T, R];趟 3(key R)→[D, H, R, T]。从头写一个排序。 "写出把
DataArray[1:1000]升序排序的伪代码"用带提前退出标志的完整冒泡排序或插入排序作答,带声明和缩进;只要对每种输入都正确,两者都得满分:DECLARE Pass, Index, Temp : INTEGER DECLARE Swapped : BOOLEAN Pass ← 1 REPEAT Swapped ← FALSE FOR Index ← 1 TO 1000 - Pass IF DataArray[Index] > DataArray[Index + 1] THEN Temp ← DataArray[Index] DataArray[Index] ← DataArray[Index + 1] DataArray[Index + 1] ← Temp Swapped ← TRUE ENDIF NEXT Index Pass ← Pass + 1 UNTIL Swapped = FALSE OR Pass = 1000要降序就把
>改成<;要按某个字段排序记录或二维数组,比较该字段但交换整条记录(或每一列)。被要求写一个"完成与给定冒泡排序相同任务"的插入排序时,保持同样的数组名和方向,复现上面的插入排序,若为降序则把比较反过来。"描述排序性能受数据影响的两种方式"(两分)。 (1) 项目的数量:$O(n^{2})$ 的排序对两倍的项目要花四倍的时间。(2) 数据已经有序到什么程度:带标志的冒泡排序或插入排序对已排序的数据一趟就结束($O(n)$),对逆序数据做的工作最多;交换次数取决于有多少对是乱序的。(也可接受:取值范围或重复值的数量,以及项目是否是移动代价高的大记录。)冒泡排序和插入排序在最坏和平均情况下都是 O($n^{2}$),最好情况 O($n$);快速排序和归并排序是 O($n \log n$),这就是它们用于大数据的原因。
[D, T, H, R]的一个插入排序,一趟接一趟把每个 key 移入它的位置探索Watch a sort run
Step through a sort and watch the bars settle into order — how a sorting algorithm works pass by pass.
词汇表 训练英文 中文 拼音 insertion sort/ɪnˈsɜːʃn sɔːt/ 插入排序 chā rù pái xù bubble sort/ˈbʌbl sɔːt/ 冒泡排序 mào pào pái xù in place/ɪn pleɪs/ 原地 yuán dì stable/ˈsteɪbl/ 稳定 wěn dìng 19.1
算法中的抽象数据类型
主题 10 的抽象数据类型(ADT)出现在许多算法内部:一个栈(stack)驱动深度优先遍历和撤销;一个队列(queue)驱动广度优先遍历和打印排序;一个链表(linked list)让数据增长和收缩。
ADT 可以从其他 ADT 构建,而不只是从数组:一个队列从两个栈;一个栈从一个链表(push = 在头部前置一个节点(node));一个队列从一个带头和尾指针(pointers)的链表;一棵二叉树(binary tree)从带两个孩子指针的节点;一个字典(dictionary)存储键→值对(常在一个哈希表上)。这样分层分离关注点——使用该 ADT 的算法不必知道它如何构建。
考试要你描述和实现的 ADT
栈(后进先出):项目在同一端即栈顶加入(压入)和移除(弹出);指针
TopOfStack保存栈顶项的下标。用一个数组和这一个指针实现:压入检查栈未满、递增指针并存入项目;弹出检查栈非空、返回栈顶项并递减指针。FUNCTION Push(Item : INTEGER) RETURNS BOOLEAN IF TopOfStack = 9 THEN RETURN FALSE ENDIF // 已满(数组 0 到 9) TopOfStack ← TopOfStack + 1 StackData[TopOfStack] ← Item RETURN TRUE ENDFUNCTION FUNCTION Pop() RETURNS INTEGER IF TopOfStack = -1 THEN RETURN -1 ENDIF // 已空 TopOfStack ← TopOfStack - 1 RETURN StackData[TopOfStack + 1] ENDFUNCTION队列(先进先出):项目在队尾加入(入队)、从队首离开(出队);两个指针和一个计数。在线性队列中队首指针沿数组前移,开头的空间被浪费;循环队列(circular queue)用
MOD让两个指针绕回,使每个单元都被重用。循环队列:队尾和队首指针用 MOD 前进,所以数组开头的单元在其项目离开后被重用 FUNCTION Enqueue(Item : STRING) RETURNS BOOLEAN IF Count = 6 THEN RETURN FALSE ENDIF // 已满 Rear ← (Rear + 1) MOD 6 QueueArray[Rear] ← Item Count ← Count + 1 RETURN TRUE ENDFUNCTION FUNCTION Dequeue() RETURNS STRING IF Count = 0 THEN RETURN "" ENDIF // 已空 DECLARE Item : STRING Item ← QueueArray[Front] Front ← (Front + 1) MOD 6 Count ← Count - 1 RETURN Item ENDFUNCTION链表:一串节点,每个保存一个数据项和指向下一个节点的指针;起始指针给出第一个节点,空指针(0 或 $-1$)结束链表。用数组实现时,两个平行数组保存数据和指针,未用的单元串成空闲列表(free list),使插入时知道把新节点放在哪里。
两个数组中的链表:链表的顺序在指针里,不在位置里;插入一个名字意味着从空闲列表取一个单元并重新链接两个指针 FUNCTION FindInList(Target : STRING) RETURNS INTEGER // 下标,不存在则为 0 DECLARE Current : INTEGER Current ← Start WHILE Current <> 0 IF Data[Current] = Target THEN RETURN Current ENDIF Current ← Pointer[Current] ENDWHILE RETURN 0 ENDFUNCTION要插入有序链表:取第一个空闲单元(
NewNode ← FreeList,FreeList ← Pointer[FreeList]),存入项目,然后用Previous和Current指针遍历链表直到Data[Current] > Item或到末尾;设Pointer[NewNode] ← Current和Pointer[Previous] ← NewNode(若排在最前则Start ← NewNode)。要删除,把前一个节点重新链接到被删节点之后,并把该单元归还空闲列表。二叉树:一个根节点,每个节点保存数据、一个指向较小值子树的左指针和一个指向较大值子树的右指针。实现为二维数组(或三个一维数组)
Tree[Index, 0..2],存左指针、数据、右指针,加一个根指针和一个下一空闲指针。FUNCTION FindInTree(Target : INTEGER) RETURNS INTEGER // 下标,不存在则为 -1 DECLARE Current : INTEGER Current ← Root WHILE Current <> -1 IF Tree[Current, 1] = Target THEN RETURN Current ENDIF IF Target < Tree[Current, 1] THEN Current ← Tree[Current, 0] // 向左 ELSE Current ← Tree[Current, 2] // 向右 ENDIF ENDWHILE RETURN -1 ENDFUNCTION要插入:把项目存入下一个空闲节点,两个指针都设为 $-1$;若树为空则令它为根;否则从根向下,按比较向左或向右,直到要跟随的指针为 $-1$,把该指针设为新节点。用一个 ADT 构建另一个 ADT:栈是压入和弹出都在起始端进行的链表;队列是带起始和末尾指针的链表;队列可以用两个栈构成(压入一个,从另一个弹出,第二个为空时把全部搬过去);二叉树的节点是由指针链接的记录或对象,所以它由节点的链式结构构成。要说明新 ADT 的哪些操作对应旧 ADT 的哪些操作。

一棵二叉树:每个节点最多有两个孩子节点 
一棵二叉树的三种深度优先遍历:前序、中序(已排序顺序)和后序 词汇表 训练英文 中文 拼音 linked list/lɪŋkt lɪst/ 链表 liàn biǎo stack/stæk/ 栈 zhàn queue/kjuː/ 队列 duì liè node/nəʊd/ 节点 jié diǎn pointers/ˈpɔɪntəz/ 指针 zhǐ zhēn binary tree/ˈbaɪnəri triː/ 二叉树 èr chā shù dictionary/ˈdɪkʃənəri/ 字典 zì diǎn circular queue/ˈsɜːkjʊlə kjuː/ 循环队列 xún huán duì liè free list/friː lɪst/ 空闲列表 kòng xián liè biǎo 19.1
比较算法
Time complexity
时间复杂度(time complexity)是运行时间如何随输入大小 $n$ 增长,写成大O表示法(Big-O notation,主导项):O(1) 常数、O($\log n$) 二分查找、O($n$) 线性查找、O($n \log n$) 好的排序、O($n^{2}$) 冒泡/插入排序。较小的阶在规模上更好,即使另一个算法对小 $n$ 更快。
具体地说:要排序一百万项,一个 $O(n \log n)$ 排序在不到一秒内完成,而一个 $O(n^{2})$ 排序可能花几分钟。
例题。 一个已排序的列表容纳 $1000$ 项。每个搜索在最坏情况下需要多少次比较?
一个线性查找一次检查一项,所以它可能需要多达 $1000$ 次比较——这是 $O(n)$。一个二分查找每步把列表折半,所以它最多需要 $\lceil \log_2 1000 \rceil = 10$ 次比较——这是 $O(\log n)$。把列表翻倍到 $2000$ 项只给二分查找加一次比较,但给线性查找加多达另外 $1000$ 次——这就是为什么增长的阶,而不是原始速度,决定规模上的赢家。
描述一个阶。 *O(1):*时间恒定,与项数无关(压栈、读数组元素)。*O($\log n$):*时间随项数的对数增长,所以数据加倍只多一个固定的步骤(二分查找)。*O($n$):*时间与项数成比例增长(线性查找,遍历一遍列表)。*O($n \log n$):*比线性稍差(高效排序)。*O($n^{2}$):*时间随项数的平方增长,所以数据加倍时间变为四倍(冒泡和插入排序)。"说出对
Names[0:99]二分查找的大 O"答 $O(\log n)$,"描述其含义"如上;大 O 度量时间或内存如何伸缩,而不是实际时间。常见的增长阶如何比较:较小的阶在规模上取胜 
排序时间如何随元素数目 $n$ 增长:$O(n^2)$ 排序爬升离开一个 $O(n\log n)$ 排序 Space complexity
空间复杂度(space complexity)是需要的额外内存。冒泡和插入排序用 O(1) 额外(原地);归并排序用 O($n$);递归用与它的深度成正比的栈内存。常常有一个时间–内存权衡。
Other criteria
简单性(更容易编码和维护)、稳定性,以及自适应性(在近乎已排序的数据上更快)。正确的算法取决于数据和约束。
探索How running time grows with n
Slide n upward and compare the curves: O(1) and O(log n) stay almost flat, O(n) rises steadily, O(n²) explodes. This is why Big-O — not a stopwatch — is how we compare algorithms on large inputs.
探索Big-O growth
Change the input size n and compare how fast each algorithm's work grows — the idea behind time complexity.
词汇表 训练英文 中文 拼音 time complexity/taɪm kəmˈpleksɪti/ 时间复杂度 shí jiān fù zá dù Big-O notation/bɪɡ əʊ nəʊˈteɪʃn/ 大O表示法 dà O biǎo shì fǎ space complexity/speɪs kəmˈpleksɪti/ 空间复杂度 kōng jiān fù zá dù 19.2
递归

大纲
Candidates should be able to: Notes and guidance Show understanding of recursion Essential features of recursion How recursion is expressed in a programming language Write and trace recursive algorithms When the use of recursion is beneficial Show awareness of what a compiler has to do to translate recursive programming code Use of stacks and unwinding 来源:剑桥国际大纲
递归:调用栈盘绕起来又展开 递归算法用递归(recursion):例程用同一问题的一个更小的版本调用它自己,直到一个基本情形(base case)结束这条链。它有两部分:基本情形(小到能直接解决——没有它递归永不停止)和递归情形(recursive case,减小输入并调用它自己)。
阶乘(factorial):
FUNCTION Factorial(n : INTEGER) RETURNS INTEGER IF n = 0 OR n = 1 THEN RETURN 1 ELSE RETURN n * Factorial(n - 1) ENDIF ENDFUNCTION递归对自相似的问题是自然的:树、分治(divide-and-conquer,二分查找、归并排序)和嵌套数据。当它不合适时,一个循环通常更清爽。
"描述递归是什么意思"(两分)。 用自身定义的函数或过程:它在自己的函数体内调用自己,每次处理一个更小的问题版本,直到到达基本情形。 "说出递归的三个基本特征":(1) 一个基本情形(停止条件),不再调用而直接返回一个值;(2) 一个一般情形(general case),其中例程调用自身;(3) 每次调用使问题更接近基本情形(参数减小),从而递归终止。有些评分方案还加上:值在调用解退时返回。
"描述递归何时有益,并举例。" 当问题天然地由其更小版本定义,使得递归解比循环更短、更清晰、更接近数学定义时:阶乘或斐波那契数、二分查找、遍历二叉树、归并排序或快速排序,以及处理文件夹套文件夹这样的嵌套结构。当深度很大(栈可能溢出)或同一子问题被计算多次(朴素的斐波那契)时,它是糟糕的选择。
Tracing a recursive call
对
Factorial(4):调用往下走到Factorial(1)=1,然后展开往上乘回来:2*1=2、3*2=6、4*6=24。最终结果24。在一个栈上跟踪每个待处理的调用。例题。 下面的函数没有说明。追踪
Unknown(3, 5),说出它的输出和返回值。FUNCTION Unknown(BYVAL X, BYVAL Y : INTEGER) RETURNS INTEGER IF X < Y THEN OUTPUT X + Y RETURN Unknown(X + 1, Y - 1) + 1 ELSE RETURN 0 ENDIF ENDFUNCTION调用 1:$X = 3, Y = 5$:$3 < 5$,输出 8,调用
Unknown(4, 4)。调用 2:$4 < 4$ 为假,返回 0。解退:调用 1 返回 $0 + 1 = 1$。输出 8,返回值 1。把追踪写成每次调用一行的表(参数、条件、输出、返回什么),并从最深的调用向上做返回:那就是评分方案要找的解退。例题(斐波那契)。
Fib(n)在n < 2时返回n,否则返回Fib(n - 1) + Fib(n - 2)。求Fib(5)。Fib(5) = Fib(4) + Fib(3);Fib(4) = Fib(3) + Fib(2);Fib(3) = Fib(2) + Fib(1);Fib(2) = Fib(1) + Fib(0) = 1 + 0 = 1。所以Fib(3) = 1 + 1 = 2,Fib(4) = 2 + 1 = 3,Fib(5) = 3 + 2 = 5。基本情形被到达许多次(Fib(2)被计算三次),这就是这个版本慢的原因:对 $n = 5$ 它做 15 次调用,$n$ 每增加 1 调用数大约翻倍。把递归改成迭代。 每个递归例程都可以用循环改写,占用更少内存且更快:保存一个累积结果,从基本情形向上循环。循环版的阶乘:
FUNCTION Factorial(N : INTEGER) RETURNS INTEGER
    DECLARE Result, Count : INTEGER
    Result ← 1
    FOR Count ← 2 TO N
        Result ← Result * Count
    NEXT Count
    RETURN Result
ENDFUNCTION
被要求把递归的插入排序或查找改成迭代版本时,用一个对递归所步进的下标的循环取代自调用,并把基本情形变成循环的退出条件。
递归用调用栈:调用把帧往下压到基本情形,然后返回向上展开 Risks
- 若错过基本情形则无限递归——用一个栈溢出(stack overflow)崩溃。
- 深度递归的高内存使用。
- 若它重复工作则慢(朴素的斐波那契是指数的——用一个循环或记忆化(memoisation))。
探索Recursion unwinds from the leaves up
Step through fib(4) in the order the calls actually finish: the leaves (base cases) resolve first, then each parent combines its children. Notice fib(2) is computed twice — that repeated work is why naive recursion is slow.
词汇表 训练英文 中文 拼音 recursion/rɪˈkɜːʃn/ 递归 dì guī base case/beɪs keɪs/ 基本情形 jī běn qíng xíng recursive case/rɪˈkɜːsɪv keɪs/ 递归情形 dì guī qíng xíng factorial/fækˈtɔːrɪəl/ 阶乘 jiē chéng divide-and-conquer/dɪˈvaɪd ænd ˈkɒŋkə/ 分治 fēn zhì general case/ˈdʒenərəl keɪs/ 一般情形 yì bān qíng xíng stack overflow/stæk ˌəʊvəˈfləʊ/ 栈溢出 zhàn yì chū memoisation/ˌmeməʊaɪˈzeɪʃn/ 记忆化 jì yì huà 19.2
编译器如何处理递归代码
递归需要每个调用有它自己的副本,包括它的参数(parameters)和局部变量(local variables)。编译器把这些保存在调用栈(call stack)上。对每个调用它压入一个栈帧(stack frame),容纳参数、局部变量和返回地址(return address,在调用者中在哪里恢复)。当函数返回时,返回值被交回、帧被弹出,而控制在返回地址恢复。
因为每个调用有它自己的帧,递归调用不会践踏彼此的变量。栈对深度递归可能变得很大,这就是为什么非常深的递归可能使它溢出。这是用于普通(非递归)调用的同一个调用-返回机制——没有特殊的"递归机制"。
"解释为什么栈适合实现递归"(三分)。 每次递归调用必须保存它的返回地址(return address)、参数和局部变量,而各调用以与发起相反的顺序完成(最后发起的调用最先结束),这正是栈的后进先出行为:每个新调用压入一个帧,每次返回弹出最近的帧,恢复调用者的状态并告诉它从哪里继续。这就是编译器翻译递归代码时的工作:它在每次调用时生成压入栈帧、每次返回时生成弹出,帧随着结果的返回而解退。
词汇表 训练英文 中文 拼音 call stack/kɔːl stæk/ 调用栈 diào yòng zhàn parameters/pəˈræmɪtəz/ 参数 cān shù local variables/ˈləʊkl ˈveərɪəblz/ 局部变量 jú bù biàn liàng stack frame/stæk freɪm/ 栈帧 zhàn zhēn return address/rɪˈtɜːn əˈdres/ 返回地址 fǎn huí dì zhǐ 19.2
考官认可的定义
定义题按固定措辞评分。准确学会这些,只给一个答案。
术语 定义 线性查找 从开头依次检查每一项,直到找到目标或到达末尾 二分查找 反复把目标与已排序列表的中间项比较,丢弃不可能包含它的那一半 冒泡排序 反复遍历列表,交换顺序错误的相邻项,直到某一趟没有交换 插入排序 依次取每一项,把它插入到已排序项中的正确位置 抽象数据类型 一组数据及可对其执行的操作,其定义独立于存储方式 栈 在栈顶压入和弹出的后进先出结构 队列 项目在队尾加入、从队首移除的先进先出结构 链表 一串节点,每个保存数据和指向下一节点的指针,带一个起始指针 二叉树 每个节点保存数据以及指向较小值左子树和较大值右子树的指针 大 O 表示法 按算法所需时间(或内存)随输入规模的增长方式对其分类的方法 递归 用问题的更小版本调用自身、直到基本情形停止调用的例程 基本情形 递归例程不再调用自身而直接返回的条件 解退 一串递归调用从最深的调用回到第一个的返回过程,栈帧被逐个弹出 19.2
考试技巧
- 查找:线性查找不需要顺序,O($n$);二分查找需要已排序数组,每次折半,O($\log n$)。两个算法都要熟记,包括边界和标志。
- 排序:带交换标志的冒泡排序,用一个键把较大项右移的插入排序;两者最坏都是 O($n^{2}$),对已排序数据是 O($n$)。性能取决于项数和有序程度。
- ADT 实现就是指针簿记:一个栈顶指针;带 MOD 的队首、队尾和计数;起始指针、指针和空闲列表;带左右指针的根。总要检查满和空。
- 大 O 关乎伸缩:常数、对数、线性、平方。对二分查找要说"数据加倍多一次比较"。
- 递归:基本情形、一般情形、向基本情形推进;当问题用自身定义时有益;栈保存返回地址和变量,因为调用以相反顺序返回。用表格追踪,从最深的调用解退。
常见错误
- 对未排序数据或链表用二分查找;以及把
Lower ← Mid而不是Mid + 1,导致死循环。 - 冒泡排序的内循环每趟都跑到数组末尾,或不用临时变量就交换。
- 压入或入队不检测满,弹出或出队不检测空。
- 在循环队列中移动队首指针不用 MOD,或把队首 = 队尾一律当作空。
- 通过移动数组内容来插入链表;只有指针改变。
- 递归函数没有基本情形,或其递归调用没有让问题变小。
- 追踪递归调用但忘记在返回途中加上待做的工作。
- 用"因为它快"回答"为什么用栈";理由是返回的后进先出顺序。
-
20
进阶程序设计
20.1
编程范式

大纲
Candidates should be able to: Notes and guidance Understanding what is meant by a programming paradigm Show understanding of the characteristics of a number of programming paradigms: • Low-level Low-level Programming: • understanding of and ability to write low-level code that uses various addressing modes: immediate, direct, indirect, indexed and relative • Imperative (Procedural) Imperative (Procedural) programming: • Assumed knowledge and understanding of Structural Programming (see details in AS content section 11.3) • understanding of and ability to write imperative (procedural) programming code that uses variables, constructs, procedures and functions. See details in AS content • Object Oriented Object-Oriented Programming (OOP): • understanding of the terminology associated with OOP (including objects, properties/attributes, methods, classes, inheritance, polymorphism, containment (aggregation), encapsulation, getters, setters, instances) • understanding of how to solve a problem by designing appropriate classes • understanding of and ability to write code that demonstrates the use of OOP • Declarative Declarative programming: • understanding of and ability to solve a problem by writing appropriate facts and rules based on supplied information • understanding of and ability to write code that can satisfy a goal using facts and rules 来源:剑桥国际大纲
一个编程范式(programming paradigm)是一种编程风格——一种构造程序的方式,有它自己的思想和语言特性。本考纲里有四个编程范式。
"描述命令式(过程式)语言是什么意思"(两分)。 一种语言,其程序是按顺序执行并改变程序状态的一系列指令;程序员用过程、顺序、选择和迭代说明任务如何完成。 "描述声明式语言是什么意思":程序陈述事实和规则(已知什么、想要什么),由语言的推理引擎找出如何得到答案;程序员不*给出步骤的顺序。*
从代码样本识别范式(试卷 3 的常规题):
LDD 200、ADD #5、STO 201是低级(助记符、寄存器、内存地址);带过程和赋值的FOR Count ← 1 TO 10 … NEXT Count是命令式;CLASS Dog … PRIVATE Name : STRING … PUBLIC PROCEDURE NEW(…)是面向对象;type(lion, wild).和dangerous(X) IF type(X, wild)是声明式(逻辑)。在连线题中:低级配"与机器指令直接对应的助记符",命令式配"改变状态的一系列语句",OOP 配"把属性和方法结合起来的对象",声明式配"事实和规则,不给出执行顺序"。四个范式:低级、命令式、面向对象和声明式 Low-level programming
贴近硬件地用机器码(machine code)或汇编语言(assembly language)编程,那里每条指令映射到 CPU 运行的东西。它给出对寄存器(registers)和内存地址(memory addresses)的直接访问,用不同的寻址方式(addressing modes,立即、直接、间接、变址和相对)。它非常快而紧凑,但特定于架构、繁琐,且难以维护。这是低级(low-level)编程,用于设备驱动、固件和引导加载程序。
五种寻址方式。 大纲要求会写用每种寻址方式(addressing mode)的低级代码(指令集在主题 4)。装载指令的操作数可以有五种读法,考试给出内存内容并问累加器保存什么:
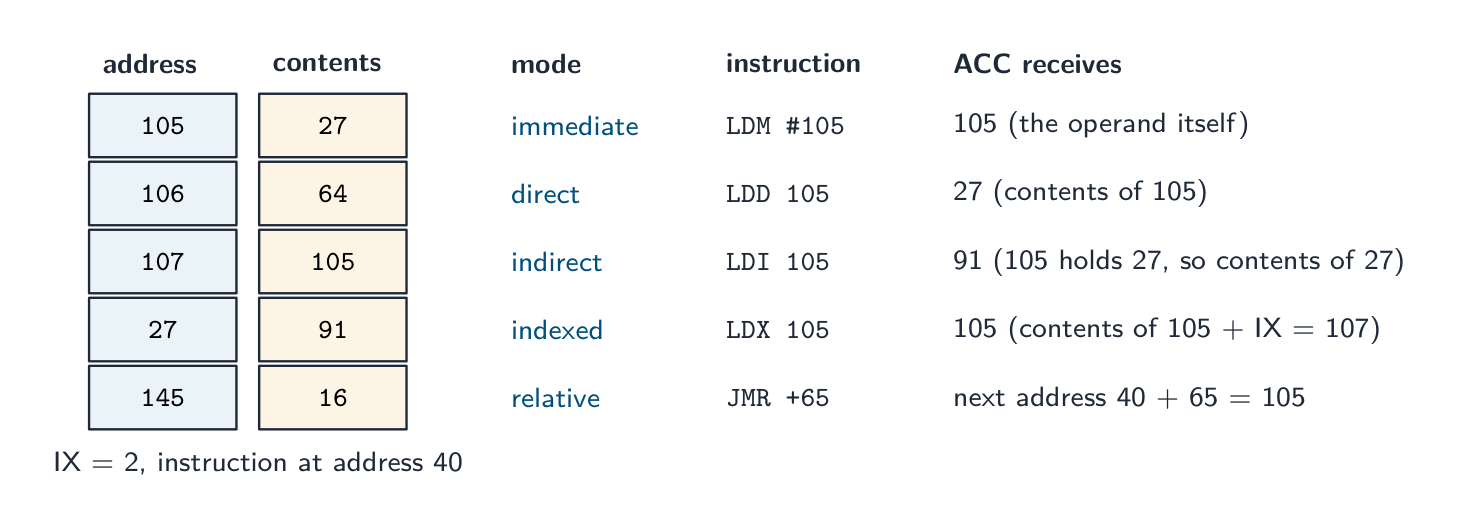
同一个操作数 105 的五种读法:作为值、作为地址、作为地址的地址、作为地址加变址寄存器、作为相对当前指令的偏移 - 立即寻址(
LDM #105):操作数就是值;ACC 变为 105。 - 直接寻址(
LDD 105):操作数是值的地址;ACC 变为 105 的内容,这里是 27。 - 间接寻址(
LDI 105):操作数是一个地址的地址;ACC 变为 27 的内容,这里是 91。用于指针和位置在运行时才确定的数据。 - 变址寻址(
LDX 105):地址是操作数加变址寄存器 IX;IX = 2 时,ACC 变为 107 的内容。用于通过递增 IX 遍历数组。 - 相对寻址(
JMR +65):目标是相对当前指令地址的偏移,这使代码可重定位。
例题。 内存:105 存 27,106 存 64,200 存 0。写代码把 105 和 106 的内容相加,结果存入 200 并输出。
LDD 105(ACC = 27),ADD 106(ACC = 91),STO 200,OUT。若改为把 105 中的值加倍:LDD 105,ADD 105,STO 105。被要求追踪时,写出每行之后的寄存器内容。Imperative (procedural) programming
在命令式编程(imperative programming)中,程序员写一个改变程序状态的命令序列——赋值、条件、循环、函数调用。变量(variables)容纳状态;语句改变它;代码被组织成过程和函数(也叫结构化编程)。这是主题 9 和 11 的风格(Python、C)。当算法有清晰的顺序步骤时很强。
Object-oriented programming (OOP)
在面向对象编程(object-oriented programming)中,程序从对象(objects)构建——把数据(属性(attributes))和操作(方法(methods))结合的单元。对象是类(classes)的实例(instances)。四大支柱:
- 封装(encapsulation)——一个对象的数据被隐藏在它的方法之后;外部代码只用公共方法,而不直接用数据。这保护对象并让它的内部改变而不弄坏调用者。例如,一个
BankAccount隐藏它的balance;你只通过deposit()和withdraw()改变它,它们能强制执行一条规则如"永不低于零"。 - 继承(inheritance)——一个子类(subclass)特化一个父类(superclass),继承它的属性和方法并添加或重写(overriding)它们。为"是一个"("一个 Manager 是一个 Employee")建模。
- 多态(polymorphism)——不同的对象对同一个方法调用做出不同的响应;调用者不必知道确切的类型。每个
Shape有Area(),而一个Circle和一个Rectangle各以它们自己的方式实现它。 - 抽象(abstraction)——显示一个简单的接口并隐藏实现。
其他术语:
- 一个构造函数(constructor)是一个在对象被创建时运行的特殊方法,用来设置它的属性。
- getter 和 setter 通过方法读写一个对象的属性(它的性质)。
- 聚合(aggregation)和包含(containment)从其他对象构建一个对象(一个"有一个"关系)。
OOP 用于大型系统、GUI、模拟和游戏。

多态:同一个方法调用运行每个对象自己的代码 
一个 Shape 的类图:私有属性和公共方法 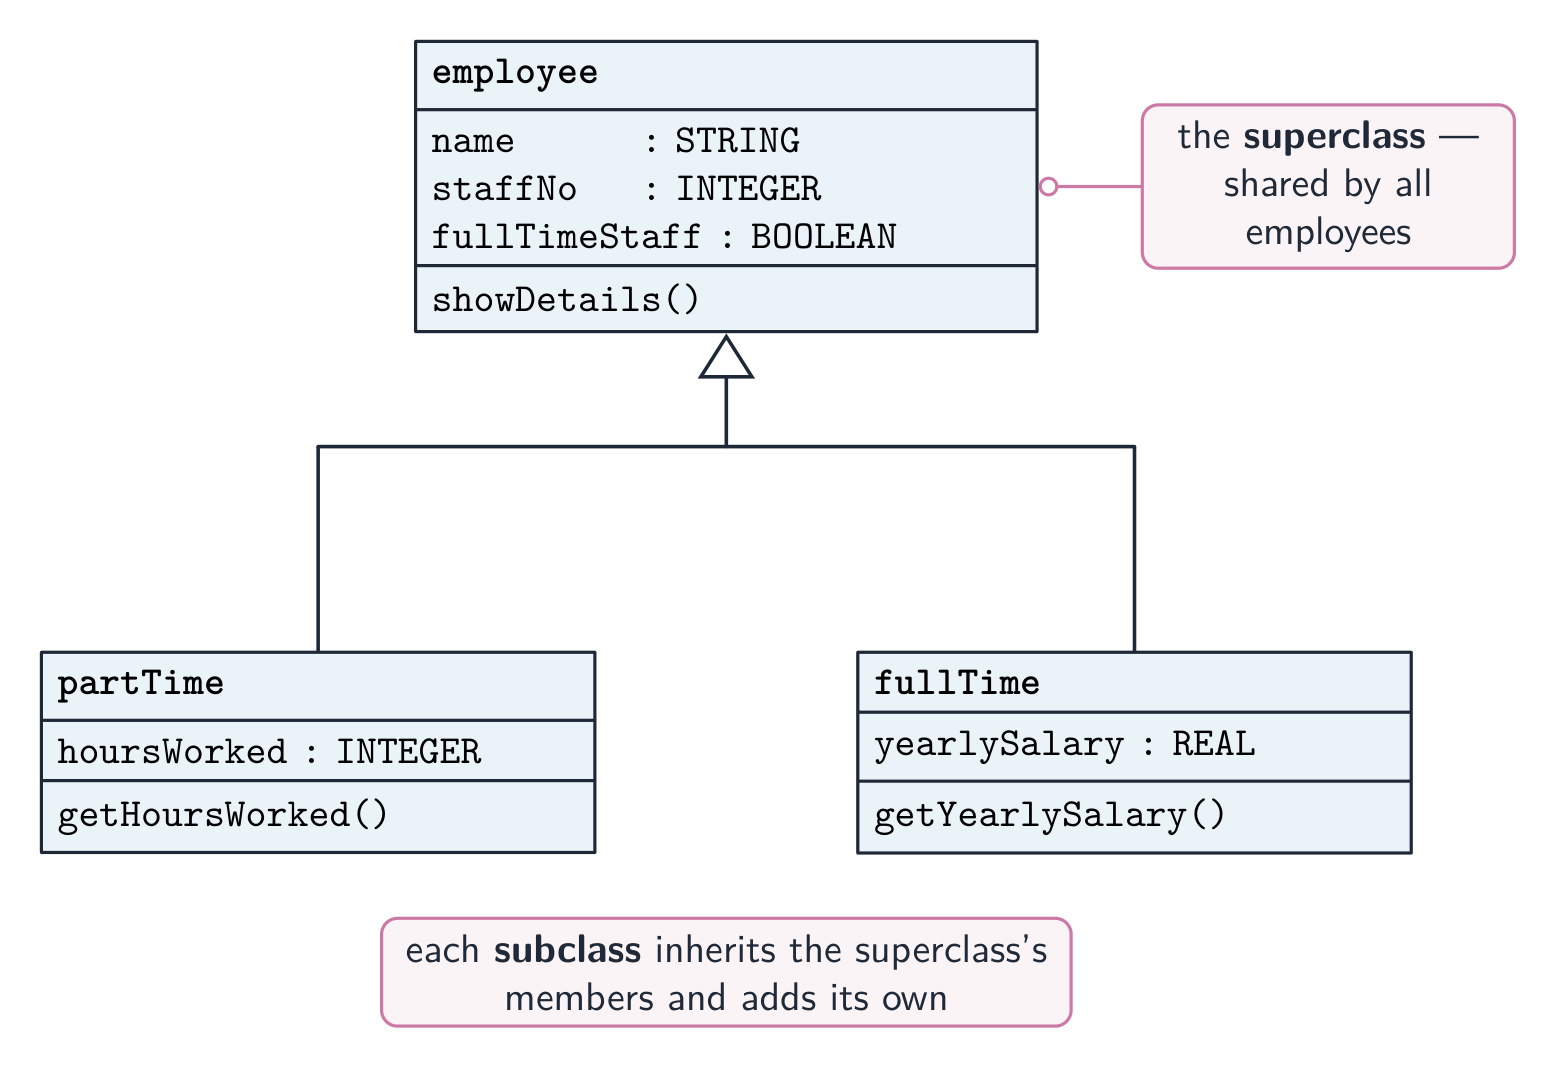
继承:partTime 和 fullTime 是 employee 的子类 
封装:一个对象的数据是私有的,只通过它的公共方法访问 按评分方式理解的 OOP
定义。 *类:*定义该类型对象的属性和方法的模板(蓝图)。*对象:*类的一个实例(instance),由类创建,有自己的属性值("一个对象的出现"是考试对实例的说法)。*属性:*属于类的一个数据项。*方法:*属于类、作用于其属性的过程或函数。*封装:*把属性和方法组合在一个类中并限制外部访问数据:属性是私有的,只能通过公有方法读取或改变。*继承:*子类获得父(超)类的属性和方法,并可以增加自己的或重写它们。多态:同名方法在不同类中行为不同;通常子类重新定义父类的一个方法,每个对象运行正确的版本。*包含:*一个类把另一个类的对象作为属性(汽车有发动机)。"指出限制外部访问数据的特性"是封装;"一个对象的出现的术语"是实例。
"概述类的结构"(三分):保存对象数据的属性,通常声明为私有;作用于这些属性的方法(过程和函数),通常是公有的;以及一个构造函数,在创建对象时运行以初始化属性。"给出 OOP 的三个好处":代码通过继承重用;数据由封装保护,只能被类自己的方法改变;大型程序拆分成独立编写和测试的类,更易维护和扩展;类为现实世界实体建模,设计更易理解;多态让同一个调用适用于不同对象。
伪代码中的类,如试卷 3 所设:
CLASS Car
    PRIVATE Registration : STRING
    PRIVATE Year : INTEGER
    PRIVATE Mileage : INTEGER
    PUBLIC PROCEDURE NEW(NewReg : STRING, NewYear : INTEGER)
        Registration ← NewReg
        Year ← NewYear
        Mileage ← 0
    ENDPROCEDURE
    PUBLIC FUNCTION GetMileage() RETURNS INTEGER
        RETURN Mileage
    ENDFUNCTION
    PUBLIC PROCEDURE AddMileage(Extra : INTEGER)
        Mileage ← Mileage + Extra
    ENDPROCEDURE
ENDCLASS
对象用
MyCar ← NEW Car("AB12 CDE", 2020)创建,用MyCar.AddMileage(150)和OUTPUT MyCar.GetMileage()使用。子类通过SUPER重用父类的构造函数:CLASS ElectricCar INHERITS Car PRIVATE BatteryCapacity : REAL PUBLIC PROCEDURE NEW(NewReg : STRING, NewYear : INTEGER, NewCapacity : REAL) SUPER.NEW(NewReg, NewYear) BatteryCapacity ← NewCapacity ENDPROCEDURE ENDCLASS同一个类的 Python 版,如试卷 4 所期望:属性用双下划线设为私有,构造函数是
__init__,子类在括号中写父类名并调用super().__init__(…):class Car: def __init__(self, reg, year): self.__registration = reg self.__year = year self.__mileage = 0 def get_mileage(self): return self.__mileage def add_mileage(self, extra): self.__mileage = self.__mileage + extra class ElectricCar(Car): def __init__(self, reg, year, capacity): super().__init__(reg, year) self.__capacity = capacity cars = [] cars.append(Car("AB12 CDE", 2020)) cars.append(ElectricCar("EV21 XYZ", 2023, 75.0)) cars[1].add_mileage(150) print(cars[1].get_mileage())在 Java 中同样的想法是
private/public字段、与类同名的构造函数、extends和super(…);在 VB.NET 中是Private/Public、Sub New、Inherits和MyBase.New。多态方法在父类中写出、在子类中用同名重写;通过父类类型变量的调用运行子类的版本。作为对象的数据结构。 试卷 4 用一个
Node类构建栈、链表或二叉树,其属性是数据和指向其他节点的一或两个引用;一个Tree(或LinkedList)类保存根(或起点)和各方法。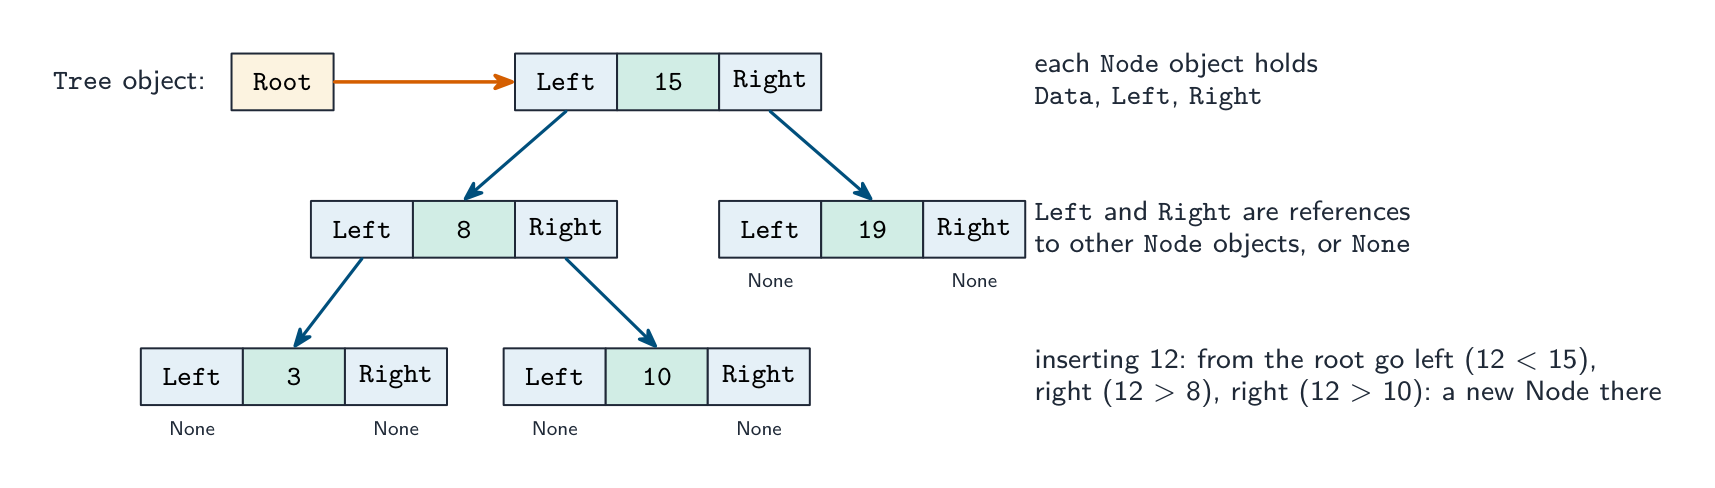
由对象构建的二叉树:每个 Node 保存 Data 加 Left 和 Right 引用,Tree 保存 Root;插入沿引用向下走 CLASS Node PUBLIC Data : INTEGER PUBLIC Left : Node // 没有子节点时为 NULL PUBLIC Right : Node PUBLIC PROCEDURE NEW(NewData : INTEGER) Data ← NewData Left ← NULL Right ← NULL ENDPROCEDURE ENDCLASS CLASS Tree PRIVATE Root : Node PUBLIC PROCEDURE Insert(NewData : INTEGER) DECLARE NewNode, Current : Node DECLARE Placed : BOOLEAN NewNode ← NEW Node(NewData) IF Root = NULL THEN Root ← NewNode ELSE Current ← Root Placed ← FALSE WHILE NOT Placed IF NewData < Current.Data THEN IF Current.Left = NULL THEN Current.Left ← NewNode Placed ← TRUE ELSE Current ← Current.Left ENDIF ELSE IF Current.Right = NULL THEN Current.Right ← NewNode Placed ← TRUE ELSE Current ← Current.Right ENDIF ENDIF ENDWHILE ENDIF ENDPROCEDURE ENDCLASS查找方法沿同一路径走,
Current.Data = Target时返回TRUE,到达NULL时返回FALSE;中序输出方法是递归的:输出左子树、该节点、然后右子树。对链表,节点有一个引用Next,链表类保存Start;对由链表构建的栈,压入和弹出都在Start进行。例题。 一个游戏有角色。每个角色有名字、生命值(初始 100)和由 X、Y 给出的位置。写一个类
Character,带构造函数和一个改变位置的方法Move(DX, DY);再写一个子类Wizard,增加Mana(初始 50)和一个方法CastSpell(),消耗 10 点法力,若法力足够则返回TRUE。CLASS Character PRIVATE Name : STRING PRIVATE Health : INTEGER PRIVATE X : INTEGER PRIVATE Y : INTEGER PUBLIC PROCEDURE NEW(NewName : STRING, StartX : INTEGER, StartY : INTEGER) Name ← NewName Health ← 100 X ← StartX Y ← StartY ENDPROCEDURE PUBLIC PROCEDURE Move(DX : INTEGER, DY : INTEGER) X ← X + DX Y ← Y + DY ENDPROCEDURE ENDCLASS CLASS Wizard INHERITS Character PRIVATE Mana : INTEGER PUBLIC PROCEDURE NEW(NewName : STRING, StartX : INTEGER, StartY : INTEGER) SUPER.NEW(NewName, StartX, StartY) Mana ← 50 ENDPROCEDURE PUBLIC FUNCTION CastSpell() RETURNS BOOLEAN IF Mana >= 10 THEN Mana ← Mana - 10 RETURN TRUE ELSE RETURN FALSE ENDIF ENDFUNCTION ENDCLASS分数在于私有属性、设置每个属性的构造函数、继承行、对父类构造函数的调用,以及使用并改变对象自身数据的方法。当题目要求类图时,画一个三部分的方框(名字;属性,私有用
-;方法,公有用+),并用指向父类的箭头把子类连到父类。Declarative programming
在声明式编程(declarative programming)中,你说要计算什么,而不是怎么——运行时算出步骤。两种:
- 函数式编程(functional programming)——从纯函数(pure functions,无副作用(side effects);同样的输入总是给出同样的输出)组合而成。例子:Haskell、Lisp。
- 逻辑编程(logic programming)——陈述事实和规则;引擎通过推理回答一个目标(goal,查询)。例子:Prolog。
一个熟悉的声明式例子是 SQL(结构化查询语言):
SELECT * FROM Customer WHERE Country = 'UK'说你想要什么,而不是怎么走过记录。事实、规则和目标是考试在声明式范式中考查的内容。给定这些事实(facts)(为真的陈述)和一条规则(rule)(条件成立时成立的结论):
01 type(leopard, wild).
02 type(lion, wild).
03 type(tabby, domestic).
04 size(leopard, large).
05 size(lion, large).
06 size(tabby, small).
07 dangerous(X) IF type(X, wild) AND size(X, large).
"写出目标
type(X, wild)的结果":X = leopard, X = lion。引擎把目标依次与每条事实匹配;每次匹配都是一个解,大写字母是由匹配填入的变量。"写一条事实表示猎豹是野生的":type(cheetah, wild)."解释第 07 行的作用":它定义了一条结论为dangerous(X)的规则,对任何既野生又大型的X为真,所以dangerous(A)返回A = leopard, A = lion。"写一条规则:若F是特性、B是车身样式且F对B不是不可用的,则特性F可能对车身样式B可用":may_be_available(F, B) IF feature(F) AND body_style(B) AND NOT unavailable(F, B)。照抄题目事实中的谓词名和参数顺序;新事实以句号结尾,规则的条件用AND连接。Comparing paradigms
范式 强项 典型语言 低级 最大控制、速度 assembly 命令式 直接、直观 C, Python 面向对象 模块化、为实体建模 Java, C#, Python 函数式 清晰、无副作用 Haskell, F# 逻辑 推理、规则 Prolog 数据库 数据查询 SQL 现代语言常常混合范式——Python 支持过程式、OOP 和函数式全部。正确的那个取决于问题。
探索Programming concept lab
Connect examples to the programming idea they show.
词汇表 训练英文 中文 拼音 programming paradigm/ˈprəʊɡræmɪŋ ˈpærədaɪm/ 编程范式 biān chéng fàn shì facts/fækts/ 事实 shì shí rule/ruːl/ 规则 guī zé low-level/ləʊ ˈlevl/ 低级 dī jí registers/ˈredʒɪstəz/ 寄存器 jì cún qì memory addresses/ˈmeməri əˈdresɪz/ 内存地址 nèi cún dì zhǐ objects/ˈɒbdʒekts/ 对象 duì xiàng attributes/ˈætrɪbjuːts/ 属性 shǔ xìng methods/ˈmeθədz/ 方法 fāng fǎ machine code/məˈʃiːn kəʊd/ 机器码 jī qì mǎ assembly language/əˈsemblɪ ˈlæŋɡwɪdʒ/ 汇编语言 huì biān yǔ yán addressing modes/əˈdresɪŋ məʊdz/ 寻址方式 xún zhǐ fāng shì imperative programming/ɪmˈperətɪv ˈprəʊɡræmɪŋ/ 命令式编程 mìng lìng shì biān chéng Variables/ˈveərɪəblz/ 变量 biàn liàng object-oriented programming/ˈɒbdʒekt ˈɔːrɪəntɪd ˈprəʊɡræmɪŋ/ 面向对象编程 miàn xiàng duì xiàng biān chéng instances/ˈɪnstənsɪz/ 实例 shí lì classes/ˈklæsɪz/ 类 lèi encapsulation/ɪnˌkæpsjʊˈleɪʃn/ 封装 fēng zhuāng inheritance/ɪnˈherɪtəns/ 继承 jì chéng subclass/ˈsʌbklæs/ 子类 zi lèi superclass/ˈsuːpəklæs/ 父类 fù lèi overriding/ˌəʊvəˈraɪdɪŋ/ 重写 chóng xiě polymorphism/ˈpɒlɪmɔːfɪzəm/ 多态 duō tài abstraction/əbˈstrækʃn/ 抽象 chōu xiàng constructor/kənˈstrʌktə/ 构造函数 gòu zào hán shù aggregation/ˌæɡrɪˈɡeɪʃn/ 聚合 jù hé containment/kənˈteɪnmənt/ 包含 bāo hán declarative programming/dɪˈklærətɪv ˈprəʊɡræmɪŋ/ 声明式编程 shēng míng shì biān chéng functional programming/ˈfʌŋkʃənl ˈprəʊɡræmɪŋ/ 函数式编程 hán shù shì biān chéng pure functions/pjʊə ˈfʌŋkʃnz/ 纯函数 chún hán shù side effects/saɪd ɪˈfekts/ 副作用 fù zuò yòng logic programming/ˈlɒdʒɪk ˈprəʊɡræmɪŋ/ 逻辑编程 luó jí biān chéng SQL/ˌes kjuː ˈel/ 结构化查询语言 jié gòu huà chá xún yǔ yán 20.2
文件处理与异常处理

大纲
Candidates should be able to: Notes and guidance Write code to perform file-processing operations Open (in read, write, append mode) and close a file Read a record from a file and write a record to a file Perform file-processing operations on serial, sequential, random files Show understanding of an exception and the importance of exception handling Know when it is appropriate to use exception handling Write program code to use exception handling 来源:剑桥国际大纲
这扩展主题 10 的文件(file)处理,处理串行、顺序和随机(直接存取)文件。伪代码操作:
OPENFILE name FOR READ | WRITE | APPEND(READ 打开一个现有文件,WRITE 创建/覆盖,APPEND 加到末端);READFILE name, line;WRITEFILE name, value;CLOSEFILE name;以及EOF(name),它在末端为 TRUE。读整个文件:
OPENFILE "names.txt" FOR READ
WHILE NOT EOF("names.txt") DO
    READFILE "names.txt", thisName
    OUTPUT thisName
ENDWHILE
CLOSEFILE "names.txt"
搜索一个文件(找到时停止):
found ← FALSE
OPENFILE "people.txt" FOR READ
WHILE NOT EOF("people.txt") AND NOT found DO
    READFILE "people.txt", line
    IF line = target THEN found ← TRUE
ENDWHILE
CLOSEFILE "people.txt"
Updating a file in place
大多数语言不能原地编辑一个文本文件。而是:打开原始文件为 READ、一个临时文件为 WRITE;对每行,若它应当改变就写新版本,否则写原始;关闭两者;然后用临时文件替换原始文件。同样的模式处理删除行(跳过它们)和插入行。
原地更新一个文件:读原始、把改动写到一个临时文件,然后替换原始 记录和随机访问文件
打开模式。
READ:文件必须存在,从开头读取。WRITE:创建一个新文件,同名的已有文件被覆盖。APPEND:写入添加到已有文件的末尾。每个打开的文件都用CLOSEFILE关闭,读完最后一项后EOF(name)为TRUE。三种文件组织。 串行文件中记录按加入顺序排列;顺序文件中按键的顺序排列;两者都从头读取。随机文件(random file)(直接访问文件)把每条记录存放在由哈希(hashing)函数根据其键计算出的地址上,所以不用读其他记录就能找到一条记录。记录声明为用户定义类型:
TYPE AccountRecord
    DECLARE AccNo : INTEGER
    DECLARE Name : STRING
    DECLARE Balance : REAL
    DECLARE Active : BOOLEAN
ENDTYPE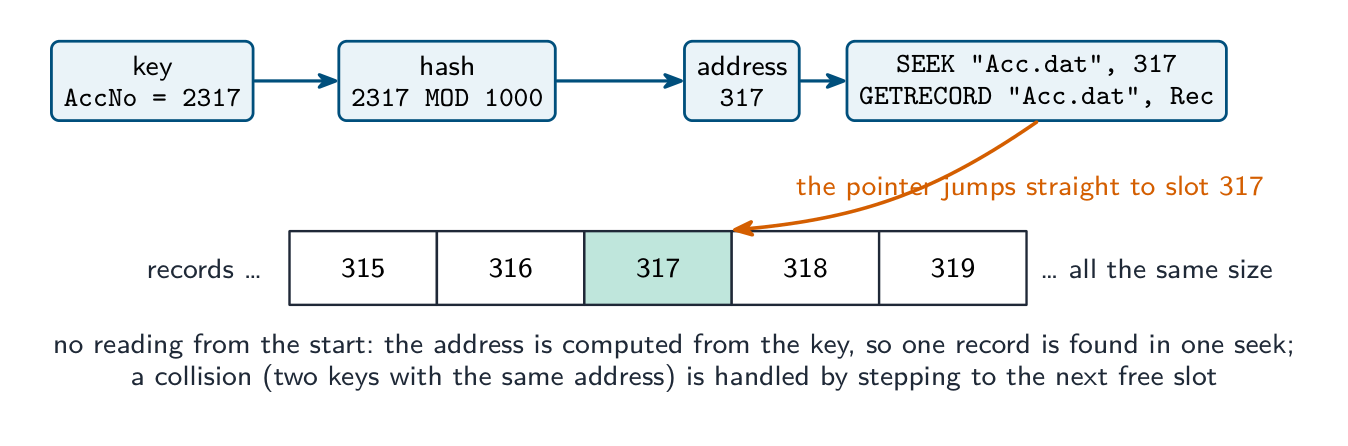
在随机文件中找一条记录:键被哈希为地址,文件指针直接定位到该槽并读出记录;不触及其他记录 伪代码中的随机文件操作是
OPENFILE "Acc.dat" FOR RANDOM、SEEK "Acc.dat", Address(把文件指针移到该记录)、GETRECORD "Acc.dat", Rec(读那里的记录)和PUTRECORD "Acc.dat", Rec(把记录写到那里)。按账号查找客户,如试卷 3 所设:DECLARE Rec : AccountRecord DECLARE Target, Address : INTEGER INPUT Target Address ← Target MOD 1000 // 哈希函数 OPENFILE "Acc.dat" FOR RANDOM SEEK "Acc.dat", Address GETRECORD "Acc.dat", Rec WHILE Rec.AccNo <> Target AND Rec.AccNo <> 0 // 0 表示空槽 Address ← Address + 1 // 冲突:试下一个槽 SEEK "Acc.dat", Address GETRECORD "Acc.dat", Rec ENDWHILE IF Rec.AccNo = Target THEN OUTPUT Rec.Name, Rec.Balance ELSE OUTPUT "No such account" ENDIF CLOSEFILE "Acc.dat"要存储一条记录,对其键哈希、
SEEK到该地址并PUTRECORD,越过已被占用的槽。分数给哈希、GET 或 PUT 之前的 SEEK、与目标的比较、冲突的处理,以及关闭文件。例题。
ActiveFile.dat保存AccountRecord记录。写伪代码把每条Active字段为FALSE的记录复制到ArchiveFile.dat的末尾。DECLARE Rec : AccountRecord OPENFILE "ActiveFile.dat" FOR READ OPENFILE "ArchiveFile.dat" FOR APPEND WHILE NOT EOF("ActiveFile.dat") READFILE "ActiveFile.dat", Rec IF Rec.Active = FALSE THEN WRITEFILE "ArchiveFile.dat", Rec ENDIF ENDWHILE CLOSEFILE "ActiveFile.dat" CLOSEFILE "ArchiveFile.dat"Python 中的文本文件(试卷 4):
file = open("HighScore.txt", "r"),然后for line in file:,用line.strip()和line.split(",")分开各字段,用int(…)转换分数,再file.close();写入用open(name, "w")(或"a"追加)和file.write(str(score) + "\n")。高分表被读入一个记录列表,新分数插入其位置,再把整个列表写回。评分看用正确模式打开、读取每一行的循环、文本到数字的转换,以及关闭。Pitfalls
忘记关闭一个文件(数据可能丢失);本想 APPEND 却打开为 WRITE(覆盖一切);读过
EOF;硬编码的路径——一个像/Users/Admin/data.txt的路径在另一台机器上失效,所以用一个相对常量如DataFile = "./data/scores.txt"。探索File access route
Follow a file from storage to program and back safely.
词汇表 训练英文 中文 拼音 file/faɪl/ 文件 wén jiàn random file/ˈrændəm faɪl/ 随机文件 suí jī wén jiàn hashing/ˈhæʃɪŋ/ 哈希 hā xī 20.2
异常处理

一个异常(exception)是执行期间的一个错误或意外情况——除以零、文件未找到、网络失败、一个数组(array)索引越界。异常处理(exception handling)让一个程序检测它并优雅地响应,而不是崩溃。
它重要是因为真实的程序面对无法事先预防的错误(文件被移动、网络中断、坏输入);没有它,每个操作都需要它自己的
IF检查;而且它把正常流程与错误处理分开,所以主路径读起来干净。例如,一个文件可能在你的程序检查它存在和实际打开它之间被另一个用户删除——你无法预防那个,只能在它发生时处理失败。"举例描述异常是什么意思"(两分)。 在程序执行期间(运行时)发生并中断其正常流程的意外事件或错误;例如除以零、打开不存在的文件、把非数字输入转换为整数、数组下标越界,或内存耗尽。 **"指出异常的两个可能原因"**从该列表作答,再加上"设备或网络不可用"和"输入了无效的数据类型"。
"说明包含异常处理的理由"(三分)。 为了阻止程序崩溃(意外终止);为了向用户输出有意义的消息而不是系统错误;为了让程序能恢复并继续,例如再次要求输入,或在结束前安全地关闭文件;以及因为有些错误在编写程序时无法预测。**"描述如何避免因异常导致程序终止":把可能引发异常的语句放在 TRY 块内;为该异常写一个 EXCEPT(catch)块来处理它,例如输出一条消息,使执行在该块之后继续而不是停止。"解释异常处理是什么意思":**在异常发生时检测到它并运行处理它的代码(处理程序),使程序得以继续。
Pattern
TRY OPENFILE "data.txt" FOR READ READFILE "data.txt", line OUTPUT line CLOSEFILE "data.txt" EXCEPT FileNotFound OUTPUT "Sorry, the file does not exist." EXCEPT ReadError OUTPUT "Sorry, error reading the file." ENDTRYTRY块容纳可能失败的代码;第一个匹配的EXCEPT块运行。真实的语言也有一个包罗一切的EXCEPT和一个FINALLY块,它无论异常是否发生都运行——对清理(关闭文件)有用。异常流程:一个异常跳到匹配的 EXCEPT;FINALLY 总是在程序继续之前运行 Raising an exception
一个检测到错误的子程序能抛出(raise)一个异常,以便调用者处理它:
PROCEDURE Divide(a : INTEGER, b : INTEGER) RETURNS INTEGER
    IF b = 0 THEN
        RAISE DivideByZero
    ENDIF
    RETURN a DIV b
ENDPROCEDURE
Where to handle exceptions
若响应简单(一个消息、一次重试)就在贴近错误处处理它们,或若只有外层代码知道怎么做就在调用栈(call stack)更高处(一个顶层 GUI 循环记录错误并显示一个友好的对话框)。不要静默地吞掉异常——至少记录它们,否则调试变得不可能。
常见异常:
FileNotFound、IOError、DivisionByZero、IndexOutOfRange、InvalidArgument、NullReference、OutOfMemory。把每个可能失败的操作包在一个带正确EXCEPT处理程序的TRY中,给出一个优雅降级而不是崩溃的程序。例题(试卷 4)。 写一个函数,从名字作为参数传入的文件中逐行读取整数并以列表返回。文件不存在或某行不是整数时它不能崩溃。
def read_scores(filename): scores = [] try: file = open(filename, "r") for line in file: scores.append(int(line)) file.close() except FileNotFoundError: print("The file", filename, "does not exist") except ValueError: print("A line in the file was not a whole number") return scorestry块容纳可能失败的代码(打开和转换);每个except指明一种异常并做有用的事;函数仍然返回一个列表,所以调用者可以继续。在 Java 中同样的形式是try { … } catch (FileNotFoundException e) { … } catch (NumberFormatException e) { … };在 VB.NET 中是Try … Catch ex As FileNotFoundException … End Try。分数:有风险的语句在 try 内部、正确的异常名、每种异常一条消息、程序之后继续;笼统的except:得到"不崩溃"的分,得不到"恰当的异常"的分。例题。 一个会员文本文件需要修改某位会员的电话号码。为什么程序不能直接覆盖那一行?正确的模式是什么?文本文件中各行的长度不同,而文件中并没有空隙来吸收长度差:更长的新内容会侵入下一条记录,更短的则会把旧行的尾巴留在那里。所以正确的模式是:以读方式打开原文件,以写方式打开一个临时文件,逐行读取,对需要修改的那一行写入新版本,其余各行则写入原来的内容,关闭两个文件,然后用临时文件替换原文件。删除(跳过该行)和插入(多写一行)也是同样的套路。注意每一行都要被写出,而不是只写改动的那一行 - 只写新记录、把文件其余部分弄丢,是经典的失误。
探索How exception handling flows
Step through what happens when code fails. The exception jumps out of the normal flow to a handler, FINALLY cleans up either way, and the program carries on instead of crashing.
词汇表 训练英文 中文 拼音 array/əˈreɪ/ 数组 shù zǔ exception/ekˈsepʃn/ 异常 yì cháng exception handling/ekˈsepʃn ˈhændlɪŋ/ 异常处理 yì cháng chǔ lǐ raise/reɪz/ 抛出 pāo chū call stack/kɔːl stæk/ 调用栈 diào yòng zhàn 20.2
考官认可的定义
定义题按固定措辞评分。准确学会这些,只给一个答案。
术语 定义 编程范式 一种编程风格或方式,有自己组织程序的方法 命令式语言 程序是改变程序状态的一系列语句;程序员说明任务如何完成 声明式语言 程序陈述事实和规则,由推理引擎找出如何得到答案 类 定义该类型对象的属性和方法的模板 对象(实例) 类的一次出现,有自己的属性值 属性 属于类的一个数据项 方法 属于类并作用于其属性的过程或函数 封装 把属性和方法一起放在类中并限制外部访问数据,使数据只能通过公有方法改变 继承 子类获得父类的属性和方法,并可以增加或重写它们 多态 同名方法在不同类中行为不同 构造函数 创建对象时运行并初始化其属性的方法 包含 一个类把另一个类的对象作为它的一个属性 事实 声明式程序中为真的陈述 规则 条件为真时成立的结论 串行、顺序、随机文件 记录按加入顺序;记录按键顺序;每条记录在由其键计算的地址上 异常 执行期间中断正常流程的意外错误或事件 异常处理 在异常发生时检测到它并运行处理它的代码,使程序继续 20.2
考试技巧
- 范式:记住每种的一句话描述,并准备好从代码样本说出范式;低级题要五种寻址方式和累加器得到什么。
- OOP 定义每次考试都出现:类、对象、属性、方法、封装、继承、多态、构造函数。用伪代码写一个带 PRIVATE 属性、PUBLIC NEW 和 getter 的类;用 INHERITS 和 SUPER.NEW 写子类。
- 声明式:带变量的目标返回每条匹配的事实;规则是结论 IF 用 AND 连接的条件;照抄题目的谓词名。
- 文件:三种模式及各自对已有文件的作用;WHILE NOT EOF 循环中的 READFILE;随机文件用哈希、SEEK、GETRECORD 和 PUTRECORD,冲突时向后步进。
- 异常:带例子的定义、处理它们的三个理由,以及让程序继续的带具名 EXCEPT 的 TRY。
常见错误
- 把声明式程序描述为"给出答案的一系列步骤";它陈述什么为真、想要什么,而不是如何做。
- 混淆对象和类,或实例和属性;"一个对象的出现"要答实例。
- 把属性声明为 PUBLIC,或从类外直接访问它们而不是通过 getter,这会丢掉封装分。
- 子类构造函数直接设置父类的属性而不调用 SUPER.NEW。
- 把多态解释为"许多对象";它是同名方法对不同类行为不同。
- 用 FOR WRITE 打开文件来添加记录,这会毁掉已有内容;要用 APPEND。
- 从头读随机文件;先 SEEK 到哈希地址。
- 把异常处理程序套在不会失败的代码外,或不带消息地捕获一切,或把异常处理描述为"用 IF 检查输入"。
- 立即寻址(