| 考生应能: | 注释与指导 |
|---|---|
| 展示对精简指令集计算机(RISC)和复杂指令集计算机(CISC)处理器的理解 | RISC 与 CISC 之间的区别 了解 CISC 和 RISC 处理器上的中断处理机制 |
| 展示对 RISC 处理器中流水线技术及寄存器重要性的理解 | |
| 展示对四种基本计算机体系结构的理解 | SISD、SIMD、MISD、MIMD |
| 展示对大规模并行计算机特性的理解 | |
| 展示对虚拟机概念的理解 | 举例说明虚拟机的作用 理解虚拟机的优势与局限性 |
硬件与虚拟机
A-Level 计算机科学 · 知识点 15
 14:55
RISC、流水线与逻辑
两位芯片设计师面临同一问题:让程序运行更快。一位主张——构建强大的指令,使每条指令完成大量工作。另一位主张——保持……
英语旁白 · 英中内嵌字幕
15.1
处理器、并行处理与虚拟机

教学大纲
来源:Cambridge International 教学大纲
两种 CPU 设计风格。CPU 本身插入主板(motherboard),就是把处理器、内存和计算机的每个其他部件连在一起的主要板子。

CISC 复杂指令集
一个 CISC(复杂指令集,Complex Instruction Set Computers)有许多、往往复杂的指令(一条可能做几次内存访问和操作)、变长,所以译码很繁复。它在硬件里每条指令做得更多。例子:Intel x86。
RISC 精简指令集
一个 RISC(精简指令集,Reduced Instruction Set Computers)有一小组简单的指令,每条做一个基本操作、全部定长(译码快)。只有 load 和 store 碰内存;其他一切都是寄存器(register)到寄存器。程序更长,但每条指令快而可预测,这适合流水线。例子:ARM、RISC-V。
| 特征 | CISC | RISC |
|---|---|---|
| 指令集 | 许多 | 少数 |
| 指令长度 | 变长 | 定长 |
| 内存访问 | 许多指令 | 只有 load/store |
| 流水线友好 | 更难 | 天然 |
| 每指令周期 | 变化 | 通常 1 |
权衡是每条指令做更多(CISC)对每条指令更快、更可预测(RISC)。现代 Intel 芯片在内部把 CISC 指令翻译成更简单的类 RISC 微操作。
"指出 RISC 处理器的四个特征。" 任选四条:一个小的、由简单指令组成的指令集;定长(一个字)的指令;大多数指令在一个时钟周期内完成;许多通用寄存器;只有装载和存储指令访问内存(所有算术都在寄存器之间进行);硬连线控制(没有微码);为流水线设计;编译器做更多的工作,所以程序含更多指令、需要更多内存。"指出 CISC 处理器的四个特征。" 任选四条:一个大的指令集,其中许多指令复杂(一条指令可以做几个操作);变长指令;需要几个时钟周期的指令;较少的寄存器;能直接访问内存的指令;微程序控制;不太适合流水线;程序更短,所以编译器更简单、内存更少。**"描述 RISC 和 CISC 是什么意思"(各两分):**说出全称并给出定义性的思想(少数简单的单周期指令;许多复杂的多周期指令)。
两种设计上的中断处理。 在 CISC 处理器上,当前指令不论多复杂都先完成,然后再处理中断;处理器接着把寄存器(包括程序计数器)的内容保存到栈上,跳到中断服务程序,之后恢复寄存器。在带流水线的 RISC 处理器上,中断(interrupt)到来的那一刻有几条指令正在进行中,所以处理器要么让流水线中的每条指令都完成,要么丢弃(冲刷)部分执行的指令并在中断后重新开始;无论哪种方式流水线都被清空,寄存器被保存,服务程序运行。考试的表述:"流水线使中断处理更复杂,因为在中断能被处理之前必须先处理流水线中的内容"。
词汇
训练
| English | 中文 | 拼音 |
|---|---|---|
| motherboard/ˈmʌðəbɔːd/ | 主板 | zhǔ bǎn |
| CISC/sɪsk/ | 复杂指令集 | fù zá zhǐ lìng jí |
| RISC/rɪsk/ | 精简指令集 | jīng jiǎn zhǐ lìng jí |
| register/ˈredʒɪstə/ | 寄存器 | jì cún qì |
| interrupt/ˈɪntərʌpt/ | 中断 | zhōng duàn |
15.1
流水线
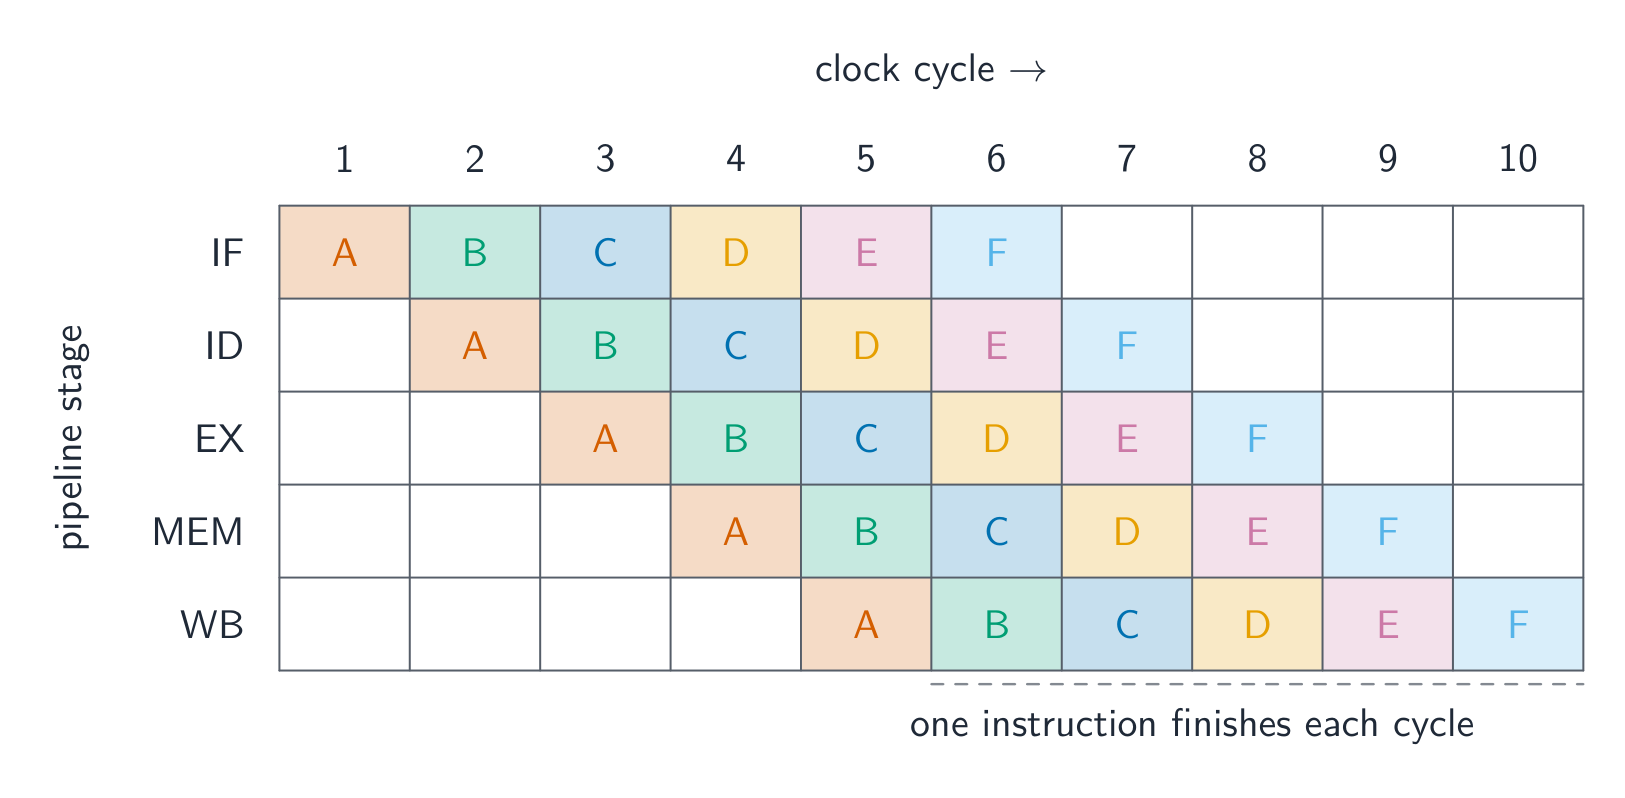
一个流水线(pipeline)以重叠的阶段处理指令,像一条装配线:取指 → 译码 → 执行(在 ALU(算术逻辑单元)中)→ 内存访问 → 写回。每个阶段同时处理一条不同的指令,所以一旦流水线满了,每周期完成一条指令。RISC 的定长、简单指令使每个阶段花同样的时间。一个流水线可能因一个冒险(hazard)而停顿——一个数据冒险(一条指令需要一个还没准备好的结果)或一个控制冒险(一个分支使下一个地址未知)。
RISC 芯片把数据保存在许多寄存器中,因为内存慢而寄存器快;编译器明智地把值分配到寄存器。
"描述 RISC 处理器中流水线的使用"(三分)。 (1) 取指–执行周期被分成若干阶段(取指、译码、执行、访存、写回);(2) 几条指令同时在流水线中,各处于不同阶段,所以一条在执行时下一条在译码、再下一条在取指;(3) 流水线充满后每个时钟周期都有一条新指令开始、一条指令完成,这提高了吞吐量(throughput)(每秒完成的指令数),尽管每条指令单独看仍需同样的时间。定长、单周期的 RISC 指令使各阶段相等,流水线才成为可能。
例题。 一个处理器使用五个流水线阶段(IF、ID、OF、EX、WB)。四条指令一条接一条进入流水线。最后一条指令在哪个周期完成?不用流水线时这四条要多少个周期?
指令 1 在周期 1 占用 IF,周期 2 占 ID,周期 3 占 OF,周期 4 占 EX,周期 5 占 WB;指令 2 晚一个周期开始,在周期 6 完成;指令 3 在周期 7;指令 4 在周期 8。一般地,$n$ 条指令通过 $k$ 个阶段需要 $n + k - 1$ 个周期,这里 $4 + 5 - 1 = 8$。不用流水线时每条指令要占满五个周期下一条才能开始:$4 \times 5 = 20$ 个周期。考试的表格是把每条指令的各阶段沿对角线写出,比前一条指令右移一列。
一个跑这么快的处理器放出很多热,所以一个散热器(heat-sink)和风扇坐在它顶上。金属鳍片散开热量,风扇把它吹走,使 CPU 保持足够凉以工作。

探索
流水线如何填满
逐步走过时钟周期。一旦流水线满了,每个周期完成一条新指令——即使每条仍然要经过几个阶段——因为不同指令的阶段重叠。
词汇
训练
| English | 中文 | 拼音 |
|---|---|---|
| pipeline/ˈpaɪplaɪn/ | 流水线 | liú shuǐ xiàn |
| ALU/ˌeɪ el ˈjuː/ | 算术逻辑单元 | suàn shù luó jí dān yuán |
| hazard/ˈhæzəd/ | 冒险 | mào xiǎn |
| throughput/ˈθruːpʊt/ | 吞吐量 | tūn tǔ liàng |
| heat-sink/hiːt sɪŋk/ | 散热器 | sàn rè qì |
15.1
弗林分类法
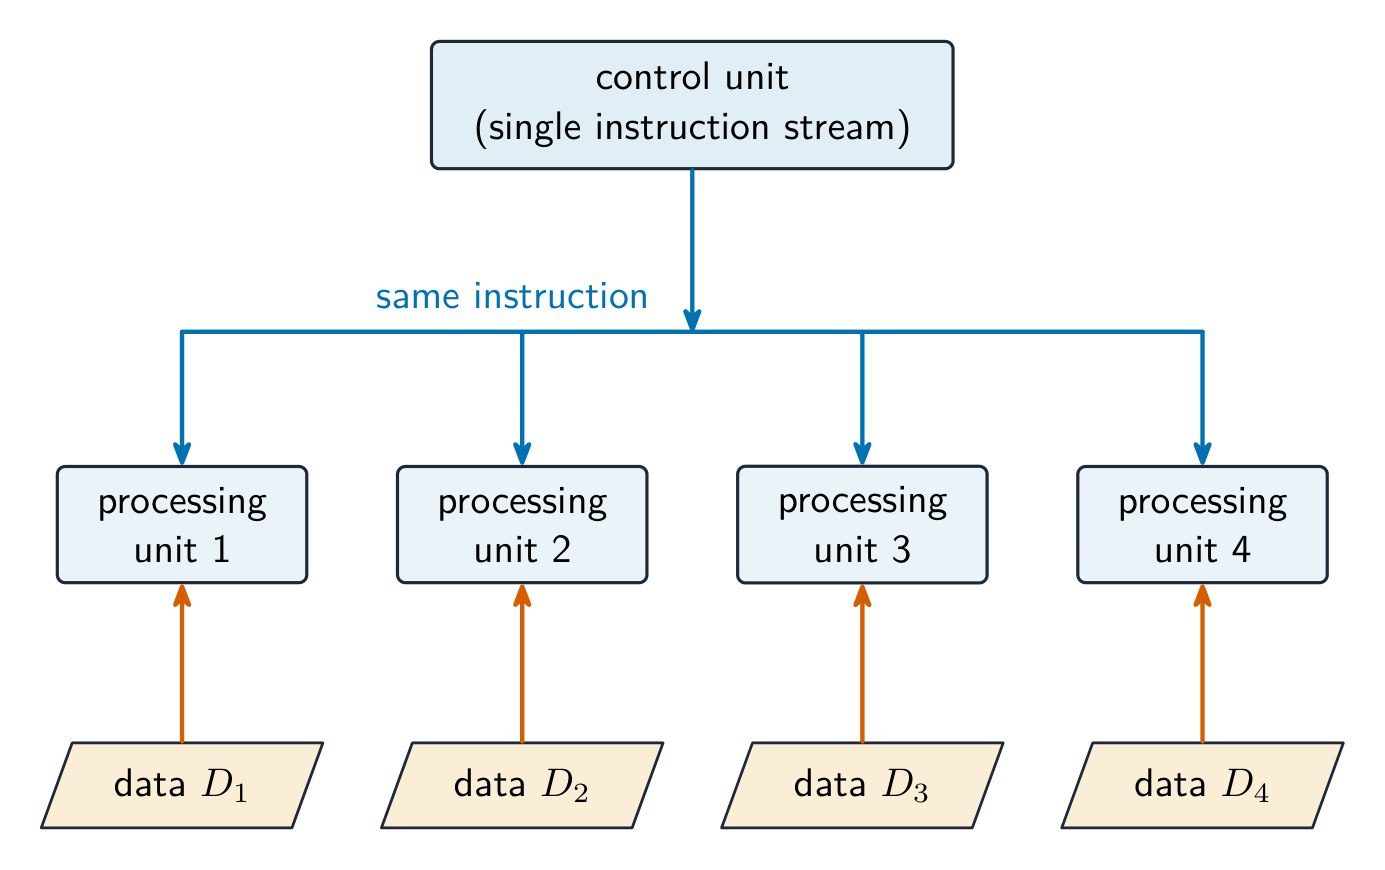
弗林分类(Flynn's taxonomy)按指令流和数据流的数目给计算机分类:
- SISD——一条指令、一个数据流(一个传统的单核)。
- SIMD(单指令多数据)——一条指令一次作用于许多数据项(GPU、CPU 向量扩展)。对图像、视频、科学数组很好。
- MISD——对同样的数据做几个操作;罕见,大多是理论上的。
- MIMD(多指令多数据)——许多处理器对不同数据运行不同指令(多核 CPU、集群)。最通用。
描述四种体系结构(各两分)。 SISD:单个处理器一次对一项数据执行一条指令;没有并行,是传统的冯·诺依曼机器。SIMD:一条指令同时作用于许多数据项,由许多处理单元步调一致地执行;用于数组和图形处理。MISD:几个处理器对同一数据执行不同指令;很少使用,例如几个处理器检查同一数据流的容错系统。MIMD:许多处理器,每个独立地对自己的数据执行自己的指令;多核计算机和集群。
一个显卡(graphics card,带它的 GPU)是 SIMD 硬件的一个真实例子:它有数千个小核心,一次对许多像素或数字运行同一条指令,这就是为什么 GPU 对图像、视频和机器学习如此快。


词汇
训练
| English | 中文 | 拼音 |
|---|---|---|
| Flynn's taxonomy/flɪnz tækˈsɒnəmi/ | 弗林分类 | fú lín fēn lèi |
| SIMD/ˈsɪmdiː/ | 单指令多数据 | dān zhǐ lìng duō shù jù |
| graphics card/ˈɡræfɪks kɑːd/ | 显卡 | xiǎn kǎ |
15.1
大规模并行计算机

一个大规模并行(massively parallel)系统在一个快速网络上使用数千个处理器,每个有它自己的内存(分布式内存(distributed memory)),通过消息交换数据。它是 MIMD,需要专门编写的软件(MPI、CUDA),并适合气候模拟、大型机器学习(machine learning)训练和天体物理学。最大的超级计算机(supercomputers)是大规模并行的。
"概述大规模并行计算机的特征"(三分)。 非常多的处理器(数千个),每个有自己的内存,由网络(高速互连或总线)连接,使它们能互相传递消息;它们同时处理同一个问题的各部分,所以问题必须写成能拆分成并行运行、再合并结果的各部分的程序。它是 MIMD 布置。
这些处理器住在高高的服务器(server)机架里,往往填满整个房间(一个数据中心(data centre)),连在一起以便它们能同时处理一个大问题。
词汇
训练
| English | 中文 | 拼音 |
|---|---|---|
| MIMD/ˈmɪmdiː/ | 多指令多数据 | duō zhǐ lìng duō shù jù |
| massively parallel/ˈmæsɪvli ˈpærəlel/ | 大规模并行 | dà guī mó bìng xíng |
| distributed memory/ˈdɪstrɪbjuːtɪd ˈmeməri/ | 分布式内存 | fēn bù shì nèi cún |
| machine learning/məˈʃiːn ˈlɜːnɪŋ/ | 机器学习 | jī qì xué xí |
| supercomputers/ˌsuːpəkəmˈpjuːtəz/ | 超级计算机 | chāo jí jì suàn jī |
| server/ˈsɜːvə/ | 服务器 | fú wù qì |
| data centre/ˈdeɪtə ˈsentə/ | 数据中心 | shù jù zhōng xīn |
15.1
虚拟机
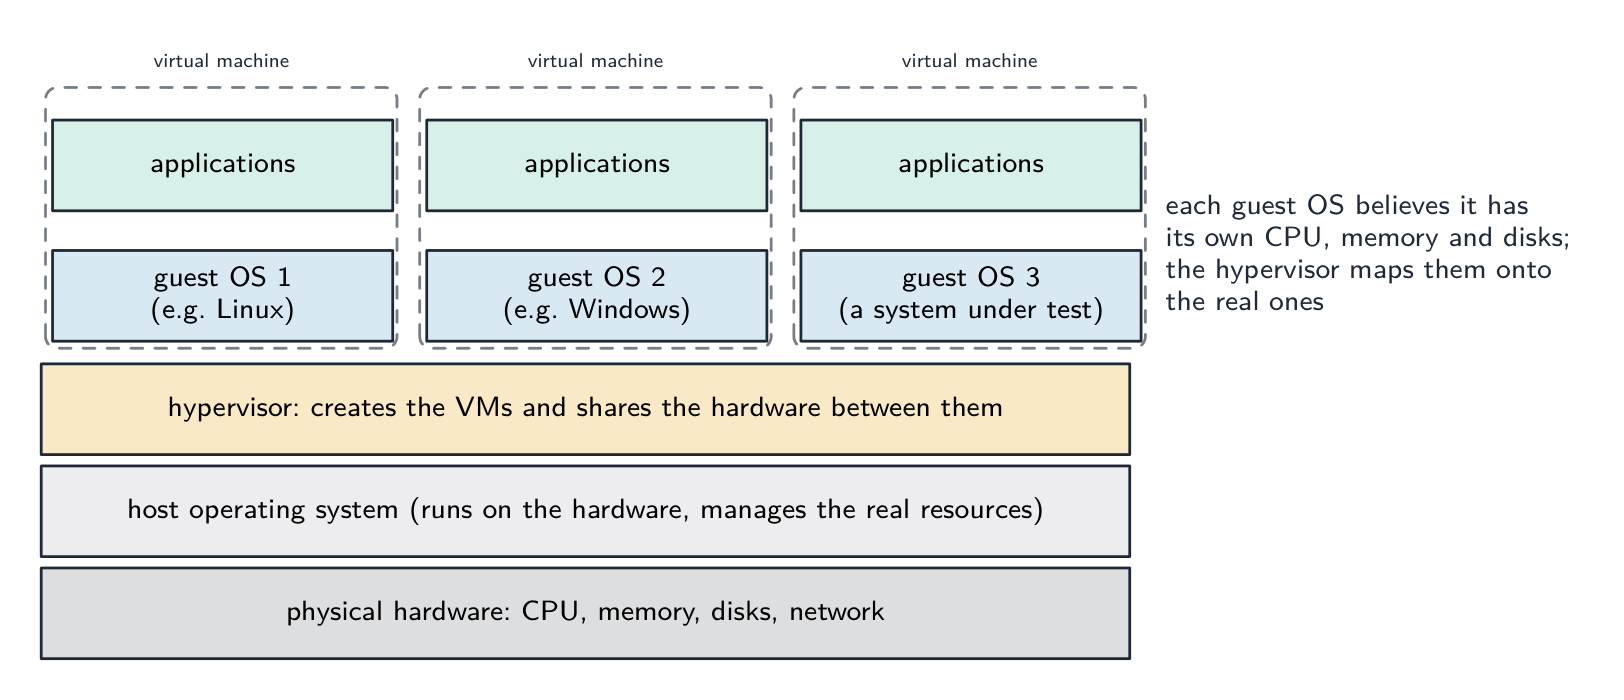
一个虚拟机(virtual machine,VM)是整台计算机的一个软件仿真——里面的软件看到一个 CPU、内存和磁盘,它们看起来真实,但由宿主软件管理。
- 一个系统 VM运行一个完整的 OS。一个虚拟机监控器(hypervisor)创建并管理 VM,每个引导它自己的客户 OS。用途:在一台机器上运行不同的 OS;服务器整合;沙箱(sandboxing,有风险的软件隔离运行);快照。
- 一个进程(语言)VM在可移植的字节码(bytecode)中运行一个程序——JVM(Java)、CLR(.NET)、CPython。好处:可移植性("一次编写,到处运行")、运行时安全检查,以及即时编译(just-in-time compilation)以获得接近本地的速度。代价是一个额外的层和需要安装该 VM。
"描述虚拟机是什么意思"(两分)。 在宿主计算机上运行的计算机系统的软件仿真(实现),对运行在其中的程序而言,它表现得像一台有自己处理器、内存和存储的独立物理计算机。 宿主操作系统(host operating system)运行在真实硬件上,管理真实资源,并(通过虚拟机监控器)创建和控制虚拟机;每个客户操作系统(guest operating system)运行在一个虚拟机内,管理其中的应用程序,并不知道它的硬件是虚拟的。
优点(给出两条)。 几个不同的操作系统可以同时在一台机器上运行;软件可以在许多系统上测试而不必购买硬件;新的计算机系统可以在建造之前仿真试用;每个 VM 是隔离的,一个中的崩溃或恶意软件不影响宿主或其他 VM;VM 可以作为文件复制、移动和备份,一台服务器可在许多用户之间共享,降低硬件成本。局限(给出两条)。 VM 比真实硬件运行得更慢,因为每条指令都经过仿真层;它消耗宿主的内存和处理能力,所以宿主必须强大;有些硬件特性或设备不被精确仿真,所以测试过的软件在真机上可能表现不同;每个客户 OS 都需要许可证,搭建系统需要专业知识。
探索
计算概念实验
根据它们所演示的计算概念对具体示例进行分类。
词汇
训练
| English | 中文 | 拼音 |
|---|---|---|
| virtual machine/ˈvɜːtʃuːəl məˈʃiːn/ | 虚拟机 | xū nǐ jī |
| hypervisor/ˌhaɪpəˈvaɪzə/ | 虚拟机监控器 | xū nǐ jī jiān kòng qì |
| sandboxing/ˈsændbɒksɪŋ/ | 沙箱 | shā xiāng |
| bytecode/ˈbaɪtkəʊd/ | 字节码 | zì jié mǎ |
| just-in-time compilation/dʒʌst ɪn taɪm ˌkɒmpɪˈleɪʃn/ | 即时编译 | jí shí biān yì |
| host operating system/həʊst ˈɒpəreɪtɪŋ ˈsɪstəm/ | 宿主操作系统 | sù zhǔ cāo zuò xì tǒng |
| guest operating system/ɡest ˈɒpəreɪtɪŋ ˈsɪstəm/ | 客户操作系统 | kè hù cāo zuò xì tǒng |
15.2
布尔代数与逻辑电路
教学大纲
| 考生应能够: | 注释与指导 |
|---|---|
| 绘制包括半加器和全加器在内的逻辑电路的真值表 | 可能包含具有多于两个输入的逻辑门 |
| 展示对触发器(SR、JK)的理解 | 绘制触发器的逻辑电路图并推导其真值表;理解触发器作为数据存储元件的作用 |
| 展示对布尔代数的理解 | 理解德·摩根定律;运用德·摩根定律进行布尔代数运算;使用布尔代数简化逻辑电路/表达式 |
| 展示对卡诺图(K-map)的理解 | 理解使用卡诺图的优势;利用卡诺图解决逻辑问题 |
来源:Cambridge International 教学大纲
布尔代数(Boolean algebra)简化布尔(Boolean)表达式,它们同样可以用真值表(truth tables)描述。符号:+ 表示 OR,· 表示 AND(常被省略),一个上划线表示 NOT。
关键定律包括交换律、结合律和分配律(如同普通代数),加上:
- 同一律 $A + 0 = A$,$A \cdot 1 = A$;零律 $A + 1 = 1$,$A \cdot 0 = 0$。
- 幂等律 $A + A = A$;逆 $A + \overline{A} = 1$,$A \cdot \overline{A} = 0$。
- 德摩根定律(De Morgan's laws):$(A + B)' = A' \cdot B'$;$(A \cdot B)' = A' + B'$——对整体取反、交换 AND/OR、对每个操作数取反。
- 吸收律(absorption):$A + AB = A$。
简化减少项的数目,所以得到的逻辑电路有更少的门。例子:$Z = AB + A\overline{B} = A(B + \overline{B}) = A$。
带名称的定律(被要求"写出全部步骤"时每一步引用名称)。
| 定律 | OR 形式 | AND 形式 |
|---|---|---|
| 同一律 | $A + 0 = A$ | $A \cdot 1 = A$ |
| 零律(吸零律) | $A + 1 = 1$ | $A \cdot 0 = 0$ |
| 幂等律 | $A + A = A$ | $A \cdot A = A$ |
| 互补律(逆) | $A + \overline{A} = 1$ | $A \cdot \overline{A} = 0$ |
| 交换律 | $A + B = B + A$ | $A \cdot B = B \cdot A$ |
| 结合律 | $A + (B + C) = (A + B) + C$ | $A(BC) = (AB)C$ |
| 分配律 | $A + BC$ $= (A + B)(A + C)$ |
$A(B + C)$ $= AB + AC$ |
| 吸收律 | $A + AB = A$ | $A(A + B) = A$ |
| 德摩根 | $\overline{A + B} = \overline{A} \cdot \overline{B}$ | $\overline{A \cdot B} = \overline{A} + \overline{B}$ |
| 双重否定 | $\overline{\overline{A}} = A$ |
例题。 化简 $X = \overline{\overline{(A \cdot B)} \cdot \overline{(A + B)}}$,写出全部步骤。
$X = \overline{\overline{(A \cdot B)}} + \overline{\overline{(A + B)}}$(对外层横线用德摩根)$= A \cdot B + A + B$(双重否定)$= A + B$(吸收律 $A + AB = A$,$A + B$ 吸收了 $AB$)。
例题。 化简 $(\overline{A + B}) \cdot (\overline{A} + B)$。
$= \overline{A} \cdot \overline{B} \cdot (\overline{A} + B)$(德摩根)$= \overline{A}\,\overline{B}\,\overline{A} + \overline{A}\,\overline{B}\,B$(分配律)$= \overline{A}\,\overline{B} + 0$(幂等律、互补律)$= \overline{A}\,\overline{B}$。
例题。 化简 $Y = \overline{A}\,\overline{B}\,\overline{C} + \overline{A}\,\overline{B}\,C + A\,\overline{B}\,C$。
$= \overline{A}\,\overline{B}(\overline{C} + C) + A\,\overline{B}\,C$(分配律)$= \overline{A}\,\overline{B} + A\,\overline{B}\,C$(互补律、同一律)$= \overline{B}(\overline{A} + AC)$(分配律)$= \overline{B}(\overline{A} + C)$,用到 $\overline{A} + AC = (\overline{A} + A)(\overline{A} + C) = \overline{A} + C$。对三输入项应用德摩根方式相同:$\overline{A + B + C} = \overline{A} \cdot \overline{B} \cdot \overline{C}$。
由真值表写积之和。 取每一行输出为 1 的行,写出它的输入的 AND(变量为 0 处加横线),再把各项 OR 起来:$A = 1, B = 0, C = 1$ 的行给出 $A\,\overline{B}\,C$。这就是考试要求的积之和(sum-of-products)形式,也是代数化简和卡诺图两者的出发点。
探索
布尔代数
A·B, A+B, Ā …
布尔代数就是这些门写成表达式——比较真值表。
探索
布尔真值表
选择一个运算符和输入以构建其真值表——逻辑电路背后的代数。
词汇
训练
| English | 中文 | 拼音 |
|---|---|---|
| Boolean algebra/ˈbuːlɪən ˈældʒɪbrə/ | 布尔代数 | bù ěr dài shù |
| Boolean/ˈbuːlɪən/ | 布尔 | bù ěr |
| truth tables/truːθ ˈteɪblz/ | 真值表 | zhēn zhí biǎo |
| De Morgan's laws/də ˈmɔːɡənz lɔːz/ | 德摩根定律 | dé mó gēn dìng lǜ |
| absorption/əbˈsɔːpʃn/ | 吸收律 | xī shōu lǜ |
| sum-of-products/sʌm ɒv ˈprɒdʌkts/ | 积之和 | jī zhī hé |
| half adder/hɑːf ˈædə/ | 半加器 | bàn jiā qì |
15.2
卡诺图
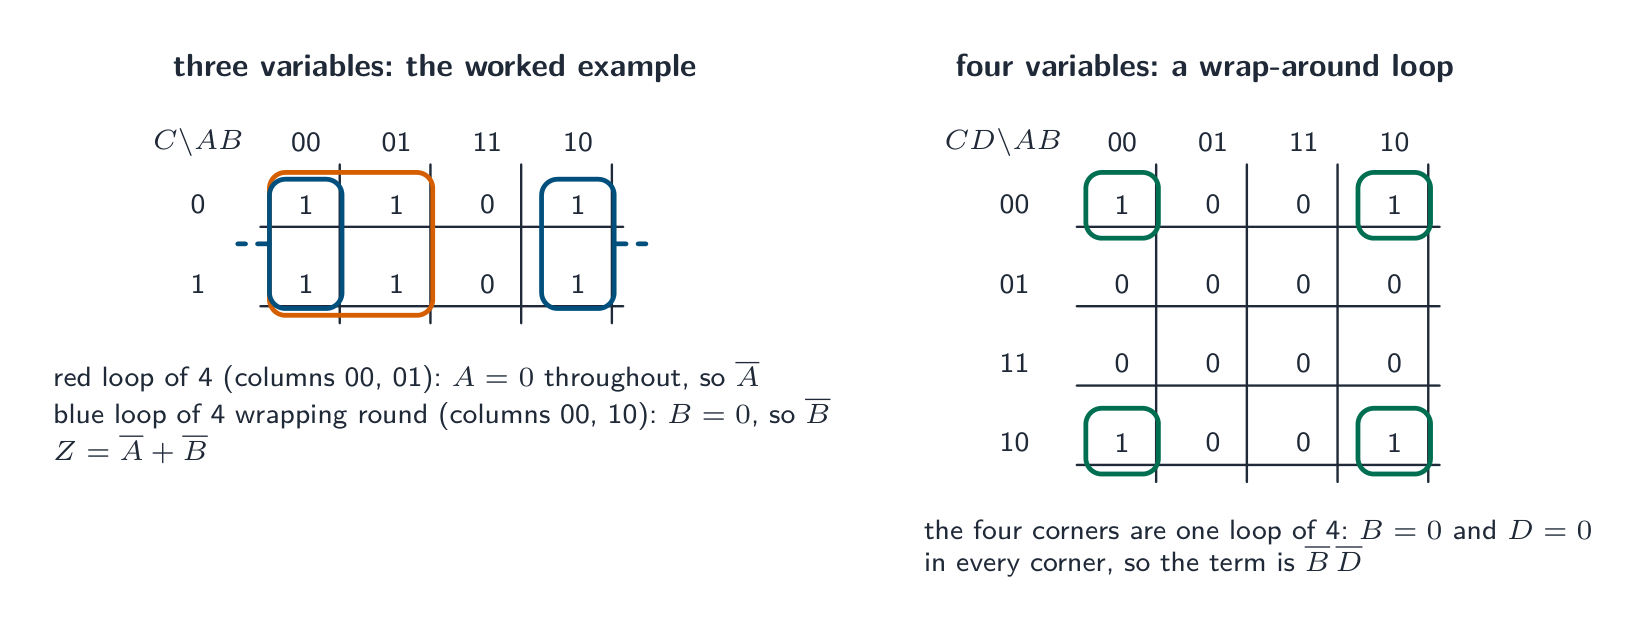
卡诺图(Karnaugh map, K-map)通过对真值表中的相邻 1 进行分组来简化布尔表达式。列和行采用格雷码(Gray code)顺序(00, 01, 11, 10),使得相邻单元格仅在一个变量上不同。
在每个输出为 1 的单元里放一个 1。找出 1 的矩形组,它们的边是 2 的幂(1、2、4、8),若能构成一个更大的组就绕过边缘。组越大,项越简单:一个 2 的组去掉一个变量,一个 4 的组去掉两个,如此等等——在组内改变的变量消失。把组的项 OR 在一起得到简化的表达式。用尽可能少、尽可能大的组覆盖每个 1。
例题。 $A$ 和 $B$ 的卡诺图在 $\overline{A}B$ 和 $AB$ 两格中为 1。化简它。这两个 1 是相邻的 - 它们同处 $B=1$ 那一列 - 所以把它们圈成一个大小为 2 的矩形。在这个圈内,$B$ 始终保持为 1,而 $A$ 从 0 变到 1,凡是在圈内发生变化的变量都会消失。所以这个圈只剩下 $X = B$。把它与直接从真值表读出的与或式 $\overline{A}B + AB$ 相比:同样的电路,少了两个门。两条规则完成了大部分工作 - 每个圈要尽可能大(圈 2 个去掉一个变量,圈 4 个去掉两个,圈 8 个去掉三个),并且要记住卡诺图的边缘是回绕的,所以最左列和最右列是相邻的。那个回绕正是大多数考生漏掉的圈法。
构建和读卡诺图。 把列标为 $AB$、行标为 $C$(或 $CD$),按格雷码顺序 00 01 11 10,使相邻单元只有一个变量不同。在表达式中出现的每个最小项(或真值表输出为 1 的行)对应的单元填 1。然后画出覆盖每个 1 的最少、最大的圈:每个圈必须是 $1, 2, 4$ 或 $8$ 个单元的矩形,圈可以重叠,可以跨左右和上下边缘绕回,四个角合起来算一个圈。对每个圈写出圈内不变的变量(为 0 则加横线),再把各圈的项 OR 起来:这就是最优积之和。为什么用它?它不用代数、几步就给出最简表达式,出错的机会更少,而且同一张图适用于三或四个变量。
算例。 $Z = \overline{A}\,\overline{B}\,\overline{C} + \overline{A}\,\overline{B}\,C + \overline{A}\,B\,\overline{C} + \overline{A}\,B\,C + A\,\overline{B}\,\overline{C} + A\,\overline{B}\,C$。
在三变量图上,1 填满 00、01 和 10 列的两行。覆盖 00 和 01 列的四格圈内始终 $A = 0$,而 $B$、$C$ 都在变:项为 $\overline{A}$。覆盖 00 和 10 列(绕回)的四格圈内始终 $B = 0$:项为 $\overline{B}$。所以 $Z = \overline{A} + \overline{B}$,布尔代数可以印证:$\overline{A}(\overline{B} + B) + \ldots = \overline{A} + \overline{B}$。两个两格圈也正确但不是最优;圈要在 1 允许的范围内尽可能大。
例题(四变量)。 一张图只在四个角有 1:$\overline{A}\,\overline{B}\,\overline{C}\,\overline{D}$、$A\,\overline{B}\,\overline{C}\,\overline{D}$、$\overline{A}\,\overline{B}\,C\,\overline{D}$ 和 $A\,\overline{B}\,C\,\overline{D}$。因为上下两行相邻、外侧两列也相邻,四个角是一个四格圈;其中 $B = 0$ 且 $D = 0$ 始终成立而 $A$ 和 $C$ 在变,所以 $Z = \overline{B}\,\overline{D}$。
词汇
训练
| English | 中文 | 拼音 |
|---|---|---|
| Karnaugh map/ˈkɑːnɔː mæp/ | 卡诺图 | kǎ nuò tú |
| Gray code/ɡreɪ kəʊd/ | 格雷码 | gé léi mǎ |
15.2
半加器与全加器

一个半加器(half adder)把两个单比特 $A$ 和 $B$ 相加,给出一个和 $S$ 和一个进位(carry)$C$:
| A | B | S | C |
|---|---|---|---|
| 0 | 0 | 0 | 0 |
| 0 | 1 | 1 | 0 |
| 1 | 0 | 1 | 0 |
| 1 | 1 | 0 | 1 |
所以 $S = A \text{ XOR } B$ 且 $C = A \text{ AND } B$。它忽略任何进位输入——因此叫"半"。
一个全加器(full adder)把三个比特($A$、$B$、进位输入)相加,给出一个和和一个进位输出:$S = A \text{ XOR } B \text{ XOR } C_{\text{in}}$。它可以从两个半加器加一个 OR 门构建。把全加器串起来(每个进位输出馈入下一个进位输入)构成一个多位的"行波进位"加法器。

全加器真值表。 输入为 $A$、$B$ 和进位输入 $C_{\text{in}}$:当输入中有奇数个 1 时和 $S$ 为 1,当两个或更多输入为 1 时进位输出为 1。
| $A$ | $B$ | $C_{\text{in}}$ | $S$ | $C_{\text{out}}$ |
|---|---|---|---|---|
| 0 | 0 | 0 | 0 | 0 |
| 0 | 0 | 1 | 1 | 0 |
| 0 | 1 | 0 | 1 | 0 |
| 0 | 1 | 1 | 0 | 1 |
| 1 | 0 | 0 | 1 | 0 |
| 1 | 0 | 1 | 0 | 1 |
| 1 | 1 | 0 | 0 | 1 |
| 1 | 1 | 1 | 1 | 1 |
考试出的电路题。 给出一个由共享两个输入的 XOR 门和 AND 门组成的电路,或两个半加器加一个 OR 门,"补全真值表(写出过程)"意味着为每个中间门的输出加一列并按行顺序填写;"说出电路的名称"是半加器或全加器;"说出每个输出的用途"是各位之和以及向下一位的进位。半加器的积之和:$S = \overline{A}B + A\overline{B}$,$C = AB$。一串全加器,每个把进位输出传给下一个的进位输入,就能相加两个多位数。
探索
加法器内部的门
半加器的和位是一个 XOR 门,进位是一个 AND 门——切换 A 和 B,看真值表的行点亮。
词汇
训练
| English | 中文 | 拼音 |
|---|---|---|
| carry/ˈkæri/ | 进位 | jìn wèi |
| full adder/fʊl ˈædə/ | 全加器 | quán jiā qì |
15.2
触发器
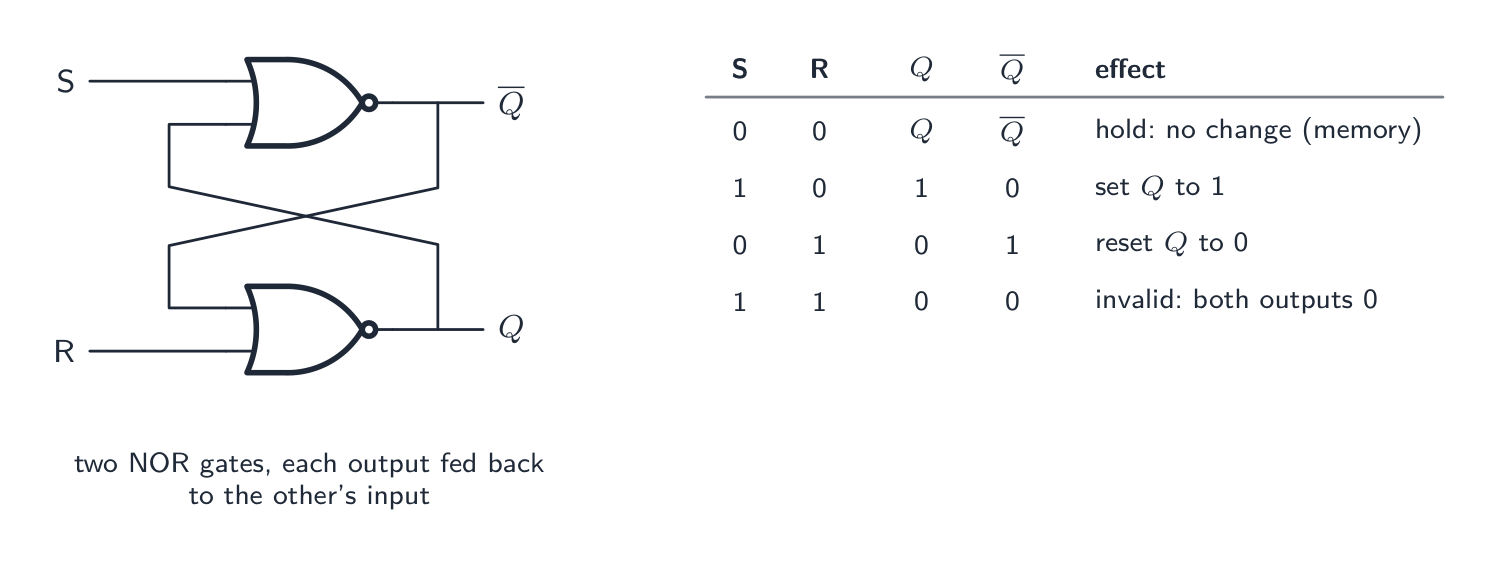
一个触发器(flip-flop)是一个双稳态(bistable)电路——两个稳定状态(0 和 1)——它记住它的状态。它存储一个比特,是寄存器和 SRAM 的基本元件。
SR 触发器
一个 SR 触发器(SR flip-flop)有输入 S(置位)和 R(复位)以及输出 Q 和 $\overline{Q}$。S=1,R=0 把 Q 置为 1;S=0,R=1 把它复位为 0;S=0,R=0 保持;S=1,R=1 是无效的。从两个交叉耦合的 NOR 门构建。
"画出 SR 触发器的逻辑电路并标出输入。" 两个 NOR 门(或两个 NAND 门),每个门的输出接回另一个门的一个输入;一个门的空闲输入是 S,另一个的是 R;输出为 $Q$ 和 $\overline{Q}$。反馈是得分点:没有它就没有记忆。"说明触发器的用途。" 存储一位数据;它是构成寄存器和静态 RAM 的基本记忆元件,在被有意改变之前一直保持它的值。无效输入 $S = R = 1$ 使两个输出都为 0,于是 $\overline{Q}$ 不再是 $Q$ 的补,而两个输入都回到 0 后的状态不可预测,这是 SR 触发器的弱点。
JK 触发器
一个 JK 触发器(JK flip-flop)通过把之前无效的 1,1 输入用作一个翻转(toggle,输出翻转)来改进它。这使它成为构建计数器(counters,一串翻转的触发器)的理想选择。它通常是时钟控制的——输入只在一个时钟边沿起作用,使触发器保持同步。

触发器是寄存器(n 位 = n 个触发器)、计数器和 SRAM(静态RAM)单元的构件。
JK 触发器真值表。 时钟(clock)输入决定何时读取 J 和 K 输入,所以输出只在时钟脉冲上改变:$J = K = 0$ 时输出保持;$J = 1, K = 0$ 把 $Q$ 置为 1;$J = 0, K = 1$ 把它复位为 0;$J = K = 1$ 使它翻转(Q 变为 $\overline{Q}$)。最后一行正是把 SR 触发器的禁止输入变成了有用的输入,这就是 JK 更受青睐的原因:每种输入组合都有效,而时钟控制的操作使它成为计数器和移位寄存器的构件。
词汇
训练
| English | 中文 | 拼音 |
|---|---|---|
| flip-flop/flɪp flɒp/ | 触发器 | chù fā qì |
| bistable/baɪˈsteɪbl/ | 双稳态 | shuāng wěn tài |
| toggle/ˈtɒɡl/ | 翻转 | fān zhuǎn |
| counters/ˈkaʊntəz/ | 计数器 | jì shù qì |
| SRAM/ˈesræm/ | 静态RAM | jìng tài RAM |
| clock/klɒk/ | 时钟 | shí zhōng |
| SR flip-flop/ˌes ˈɑː flɪp flɒp/ | SR触发器 | SR chù fā qì |
| JK flip-flop/ˌdʒeɪ ˈkeɪ flɪp flɒp/ | JK触发器 | JK chù fā qì |
15.2
考官认可的定义
定义题按固定的表述给分。把这些记准确,并且只写一个答案。
| 术语 | 定义 |
|---|---|
| RISC | 具有少量简单定长指令、大多数在一个时钟周期内执行、使用许多寄存器和流水线的处理器 |
| CISC | 具有大量复杂变长指令、许多需要几个时钟周期并直接访问内存的处理器 |
| 流水线 | 把取指–执行周期分成若干阶段,使几条指令同时被处理,各处于不同阶段 |
| SISD / SIMD / MISD / MIMD | 一条指令对一项数据;一条指令对许多数据;许多指令对一项数据;许多指令对许多数据 |
| 大规模并行计算机 | 数千个各有自己内存的处理器,由网络连接,同时处理一个问题 |
| 虚拟机 | 在宿主计算机上运行、表现得像一台独立物理计算机的计算机系统软件仿真 |
| 虚拟机监控器 | 创建虚拟机并在它们之间共享宿主硬件的软件 |
| 真值表 | 列出逻辑电路每种输入组合及其输出的表 |
| 积之和 | 写成 AND 项的 OR 的布尔表达式,每个给出 1 的输入组合对应一项 |
| 卡诺图 | 按格雷码顺序排列真值表输出的网格,其中相邻 1 的圈给出化简后的表达式 |
| 半加器 | 把两位相加、产生和与进位的电路 |
| 全加器 | 把两位与一个进位输入相加、产生和与进位输出的电路 |
| 触发器 | 存储一位、在输入改变它之前保持输出的双稳态电路 |
15.2
考试技巧
- RISC 和 CISC 以特征列表作答:简单、定长、单周期、许多寄存器、装载/存储、流水线,对复杂、变长、多周期、较少寄存器、直接访存、微码。各四条。
- 流水线技术:阶段划分、同时处理多条指令、每周期完成一条、吞吐量更高;$n + k - 1$个周期处理$n$条指令经过$k$个阶段;中断必须清空流水线。
- 弗林的四类是"多少条指令流"乘"多少条数据流";说清什么跑在什么上。大规模并行:许多处理器、自己的内存、网络、同一问题。
- 虚拟机:在宿主上仿真一台计算机;宿主 OS 在硬件上,虚拟机监控器共享硬件,客户 OS 在其中。两个优点和两个局限,各写成完整句子。
- 布尔代数:每用一条定律就说出它的名称;德摩根交换运算符并对每项取反;拿不准时用真值表检验。
- 卡诺图:格雷码顺序,1/2/4/8 的最大圈,允许绕回,每圈一项、保留不变的变量。说明理由:不用代数得到最简表达式。
- 半加器给出和与进位;全加器还接受进位输入;SR 触发器是两个交叉耦合的 NOR/NAND 门,存储一位;JK 的 1,1 输入翻转。
常见错误
- 把 RISC 和 CISC 的特征列表弄反,或把"更快"当作特征;要给出设计特征,而不是结论。
- 把流水线描述成"在几个核上并行运行指令";它是一个处理器的各阶段重叠。
- 混淆 SIMD(一条指令、许多数据)与 MIMD(两者都多),或把 MISD 描述成常见情况。
- 把虚拟机定义为"一台计算机的副本"而没有仿真一词或宿主与客户。
- 只对长横线下表达式的一部分应用德摩根,或去掉横线却不把 AND 换成 OR。
- 在卡诺图中圈三个一组,或圈非矩形的组;把列排成 00、01、10、11 而不是格雷码。
- 把半加器的进位写成 XOR、和写成 AND。
- 把 SR 触发器画成两个没有反馈的门,或在它的真值表中漏掉无效状态。
该知识点的互动课程
逐步完成,配合即时检查练习。