| 考生应能够: | 注释与指导 |
|---|---|
| 展示对图如何辅助**人工智能(AI)**的理解 | 图的用途与结构;使用A*算法和迪杰斯特拉算法在图上进行搜索。考生无需编写用于建立、访问或对图进行搜索的算法 |
| 展示对人工神经网络如何促进机器学习的理解 | |
| 展示对深度学习、机器学习和强化学习及其使用原因的理解 | 理解机器学习的分类,包括监督学习、无监督学习等 |
| 展示对机器学习中误差反向传播及回归方法的理解 |
人工智能(AI)
A-Level 计算机科学 · 知识点 18
 13:12
什么是人工智能
从来没有人写过区分猫和狗的规则。没有程序员坐下来输入“如果它有尖耳朵和胡须”。然而你的手机却能做到……
英语旁白 · 英中内嵌字幕
18.1
人工智能(AI)

教学大纲
来源:Cambridge International 教学大纲
人工智能(artificial intelligence,AI)构建做通常需要人类智能的任务的系统——识别语音和图像、翻译、玩游戏、驾驶、生成文本。大多数现代 AI 用机器学习(machine learning)——从数据中学习模式而不是被一步步编程的算法。在它之内,用有许多层的神经网络(neural networks)的深度学习(deep learning)自 2010 年代以来一直占主导。
一个人形机器人(humanoid robot)把这些能力中的许多放进一个身体:它用 AI 看脸、理解语音,并以逼真的方式移动它的脸和手臂。

探索
AI学习类型实验
根据涉及的学习类型或关注点对AI示例进行分类。
词汇
训练
| English | 中文 | 拼音 |
|---|---|---|
| artificial intelligence/ˌɑːtɪˈfɪʃl ɪnˈtelɪdʒəns/ | 人工智能 | rén gōng zhì néng |
| machine learning/məˈʃiːn ˈlɜːnɪŋ/ | 机器学习 | jī qì xué xí |
| deep learning/diːp ˈlɜːnɪŋ/ | 深度学习 | shēn dù xué xí |
| neural networks/ˈnjuːrəl ˈnetwɜːks/ | 神经网络 | shén jīng wǎng luò |
| humanoid robot/ˈhjuːmənɔɪd ˈrəʊbɒt/ | 人形机器人 | rén xíng jī qì rén |
18.1
人工智能中的图

许多 AI 问题坐在一个图(graph)上——节点(nodes,状态、地点)由边(edges,移动、关系)连接。
- 寻路:道路构成一个图;最短路线是一个图搜索(Dijkstra 算法、A* 算法)。
- 玩游戏:每个棋盘位置是一个节点,每步是一条边;带 alpha-beta 剪枝的极小化极大(minimax)搜索博弈树。
- 状态空间搜索:一个规划问题是通过应用算子在状态之间移动以到达一个目标。
- 知识表示:一个语义网络(semantic network)以概念为节点、关系为边("狗 IS-A 动物");一个知识图谱(knowledge graph)为搜索引擎和助手存储关于世界的事实。
导航图的标准工具包括广度优先搜索(breadth-first search)和深度优先搜索(depth-first search)。
"描述 AI 系统中图的目的和结构。" *目的:*把一个问题表示为一组状态(或地点)以及它们之间可能的移动,使算法能搜索它以求得解,例如最短或最便宜的路线,或最佳的下一步。*结构:*一组节点(顶点),各表示一个状态、地点或项目,由表示它们之间连接的边相连;每条边可以带一个权重(代价、距离或时间),边可以是有向的(单向)或无向的。**"解释图如何辅助 AI":*图是 AI 搜索算法运行所依赖的模型:A 和 Dijkstra 算法在其中找最优路径(导航、路由),棋局位置构成一棵被搜索最佳走法的树,而以图存储的知识让系统能推理事实之间的关系。
 下面用到的图:边上的数是真实距离;红色的数是每个节点对目标还有多远的启发式(heuristic)估计,只有 A 使用它*
Dijkstra 算法。 它求从起点到每个节点的最短距离。保存一张到每个节点目前找到的最佳距离表(起点 0,其余无穷大)。反复取出距离最小的未访问节点,标记为已访问,并对它的每个邻居检查经过该节点是否给出更短的距离;若是则更新并记录来自何处。所有节点(或目标)都访问过后停止。
例题。 求上图中从 H 到其他每个节点的最短距离。
| 步骤 | 访问 | H | A | B | C | D | G |
|---|---|---|---|---|---|---|---|
| 开始 | 0 | ∞ | ∞ | ∞ | ∞ | ∞ | |
| 1 | H (0) | 0 | 4 (H) | 3 (H) | ∞ | ∞ | ∞ |
| 2 | B (3) | 0 | 4 (H) | 3 | ∞ | 9 (B) | ∞ |
| 3 | A (4) | 0 | 4 | 3 | 9 (A) | 8 (A) | ∞ |
| 4 | D (8) | 0 | 4 | 3 | 9 (A) | 8 | 10 (D) |
| 5 | C (9) | 0 | 4 | 3 | 9 | 8 | 10 (D) |
| 6 | G (10) |
最短距离:A 4,B 3,D 8,C 9,G 10,到 G 的路径是 H–A–D–G(倒着读"来自"标记)。第 3 步 A 给 D 提供了 $4 + 4 = 8$ 的距离,比经 B 找到的 9 好,所以 D 被更新;第 5 步 C 可以以 $9 + 3 = 12$ 到达 G,比 10 差,所以没有变化。写出这些比较就是题目要求的"过程"。
A* 算法。 Dijkstra 向各个方向探索。A* 加入一个启发式值 $h$,即还要走多远的估计,总是扩展 $f = g + h$ 最小的节点,其中 $g$ 是目前已走的距离。用合理的启发式(从不高估),它找到同样的最短路径却只看少得多的节点,这就是导航仪和游戏用它的原因。考试给出每个节点的 $h$ 和一张要填的表。
例题。 用 A* 求从 H 到 G 的路径,写出过程。
| 扩展的节点 | 目前的 $g$ | $h$ | $f = g + h$ | 加入的邻居(节点:$g$、$h$、$f$) |
|---|---|---|---|---|
| H | 0 | 7 | 7 | A: 4, 5, 9; B: 3, 6, 9 |
| B(与 A 并列;任选) | 3 | 6 | 9 | 经 B 到 D:9、2、11 |
| A | 4 | 5 | 9 | C:9、3、12;经 A 到 D:8、2、10(优于 11,保留) |
| D | 8 | 2 | 10 | G:10、0、10;经 D 到 C:9(不更优) |
| G | 10 | 0 | 10 | 到达目标 |
路径 H–A–D–G,长度 10,与 Dijkstra 相同,但 C 从未被扩展。每当一个节点被第二条路线到达时,保留较小的 $g$;当目标成为 $f$ 最小的节点时搜索结束。每一行都写出 $g$、$h$ 和 $f$ 的值:那就是分数所在。
词汇
训练
| English | 中文 | 拼音 |
|---|---|---|
| graph/ɡræf/ | 图 | tú |
| nodes/nəʊdz/ | 节点 | jié diǎn |
| edges/ˈedʒɪz/ | 边 | biān |
| minimax/ˈmɪnɪmæks/ | 极小化极大 | jí xiǎo huà jí dà |
| semantic network/səˈmæntɪk ˈnetwɜːk/ | 语义网络 | yǔ yì wǎng luò |
| knowledge graph/ˈnɒlɪdʒ ɡræf/ | 知识图谱 | zhī shí tú pǔ |
| breadth-first search/bredθ fɜːst sɜːtʃ/ | 广度优先搜索 | guǎng dù yōu xiān sōu suǒ |
| depth-first search/depθ fɜːst sɜːtʃ/ | 深度优先搜索 | shēn dù yōu xiān sōu suǒ |
| heuristic/hjuːˈrɪstɪk/ | 启发式 | qǐ fā shì |
18.1
人工神经网络(ANN)

一个 ANN 受大脑神经元的启发。一个人工神经元(artificial neuron):
- 取几个输入值,把每个乘以一个权重(weight),并把它们加起来,再加上一个偏置项(bias term)。
- 对这个和应用一个激活函数(activation function,一个非线性函数,如 ReLU)。
- 输出结果,它馈入更靠后的神经元。
神经元坐在层里:一个输入层、一个或多个隐藏层(hidden layers,在那里学到有用的内部模式),和一个输出层。有许多隐藏层时,它是一个深度神经网络(deep neural network),而训练它就是深度学习。

ANN 让模型直接从原始数据(像素、音频、文本)学习复杂模式,而不需要手工设计的特征——推动了图像识别(image recognition)、语音识别(speech recognition)、机器翻译(machine translation)和玩游戏的突破。它们在大量数据、含噪或非常复杂的输入,以及太难用显式规则捕获的模式上做得好。
"解释人工神经网络是什么意思。" 一个模仿大脑神经元网络的模型,由分层的相连节点组成:一个输入层、一个或多个隐藏层和一个输出层。 每个连接有一个权重;每个节点把它的加权输入求和,通过激活函数传给下一层。"解释 ANN 如何使机器学习成为可能"(三分):网络在许多样例上训练;对每个样例,输出与期望结果比较,误差被用来调整权重(反向传播)使误差下降;经过足够多的样例后,权重编码了数据中的模式,网络就能对它从未见过的新数据分类或预测。"说明多个隐藏层的理由":每增加一层都把前一层找到的特征组合成更复杂、更抽象的特征,所以网络能学到更复杂的关系(边缘,然后形状,然后物体);这就是网络"深"的含义。
探索
点击一个神经网络的各部分
探索各层。数据从左到右流动:输入层接收特征,隐藏层学习模式,输出层给出答案——每个连接携带一个训练调整的权重。
词汇
训练
| English | 中文 | 拼音 |
|---|---|---|
| weight/weɪt/ | 权重 | quán zhòng |
| artificial neuron/ˌɑːtɪˈfɪʃl ˈnjuːrɒn/ | 人工神经元 | rén gōng shén jīng yuán |
| bias term/ˈbaɪəs tɜːm/ | 偏置项 | piān zhì xiàng |
| activation function/ˌæktɪˈveɪʃn ˈfʌŋkʃn/ | 激活函数 | jī huó hán shù |
| hidden layers/ˈhɪdn ˈleɪəz/ | 隐藏层 | yǐn cáng céng |
| deep neural network/diːp ˈnjuːrəl ˈnetwɜːk/ | 深度神经网络 | shēn dù shén jīng wǎng luò |
| image recognition/ˈɪmɪdʒ ˌrekəɡˈnɪʃn/ | 图像识别 | tú xiàng shí bié |
| speech recognition/spiːtʃ ˌrekəɡˈnɪʃn/ | 语音识别 | yǔ yīn shí bié |
| machine translation/məˈʃiːn trænˈsleɪʃn/ | 机器翻译 | jī qì fān yì |
18.1
机器学习、深度学习与强化学习
机器学习
总括术语——任何从数据中学习的算法。三种范式:
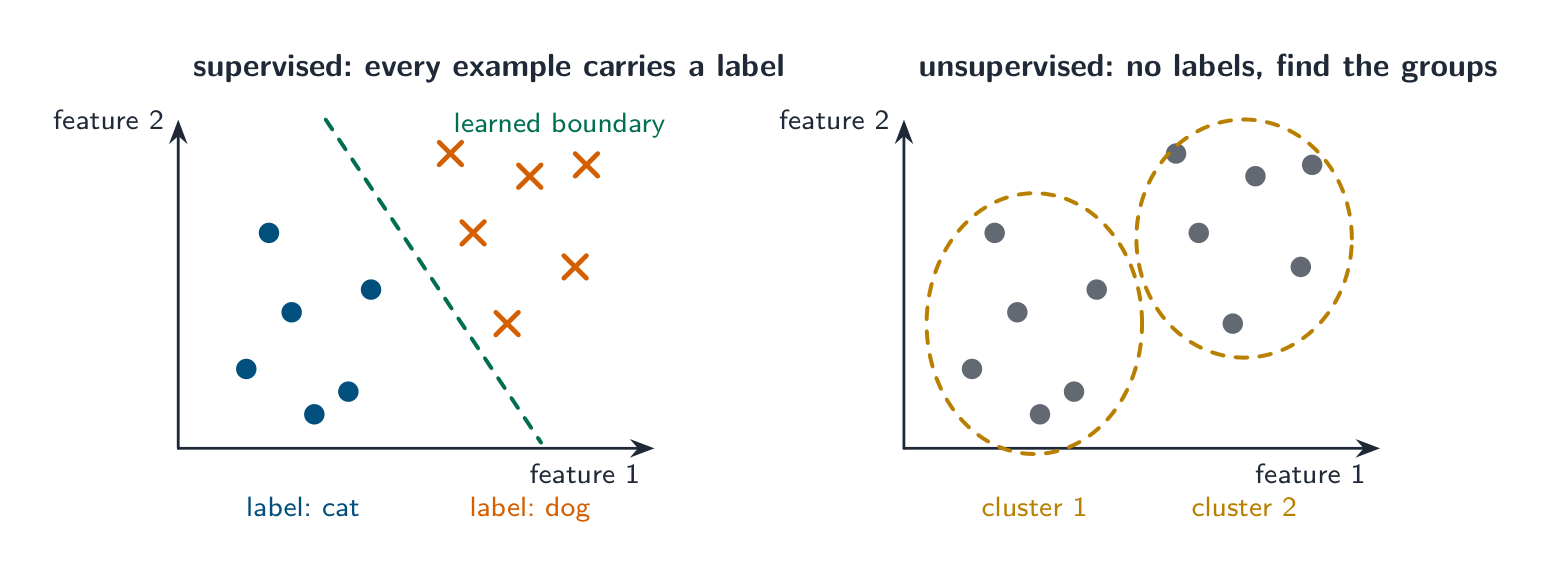
- 监督学习(supervised learning)——数据有标签(labels,图像被标为"猫"/"狗");算法学习输入 → 标签。用于分类(classification,一个类别)和回归。
- 无监督学习(unsupervised learning)——没有标签;算法找出结构,例如相似客户的一个聚类(cluster)。
- 强化学习(下面)。
当显式规则不切实际时用 ML(垃圾邮件过滤器、推荐、欺诈检测)。
"描述监督学习和无监督学习"(评分措辞)。 监督学习:算法在**带标签的**训练数据**(training data)上训练,每个样例配有正确输出(目标);它学习输入与输出之间的关系,并用它对新输入分类或预测;训练时答案已知,所以误差可以度量。*无监督学习:*数据没有标签,不给正确答案;算法自己在数据中寻找模式、结构或分组(把相似项聚类、发现关联);输出是一组事先未定义的类别或关系。它们的区别:带标签对无标签的数据;已知输出对发现的结构;监督学习用于预测(分类、回归),无监督学习用于探索(聚类、异常检测)。两者都是机器学习的类别;第三类是强化学习。

深度学习
ML 的一个子集,用深度神经网络。较低的层学习简单模式(边缘、音素),较高的层把它们组合成抽象概念。它需要大量数据和大量计算(GPU);对于小数据集,更简单的 ML 方法往往做得更好。
"解释深度学习是什么意思"(三分)。 使用带许多隐藏层(深度网络)的人工神经网络的机器学习;网络在非常大量的数据上训练,每一层从下一层的输出中提取特征,所以网络自己学到它需要的特征,而不是由程序员指定。 使用它的理由:它能解决对手写规则或浅层模型来说太复杂的问题(识别人脸、理解语音、翻译文本);数据越多它越好;它免去了人工特征工程的需要;它能处理图像、声音和文本等非结构化数据。**如何使它更有效:**更多(且标签更好的)训练数据;在不过拟合的限度内更多的层或节点;更多的处理能力(GPU)和训练时间;调整学习率等参数。**例子:**语音助手中的语音识别、医学扫描和自动驾驶汽车中的图像识别、机器翻译、推荐系统。
强化学习
在强化学习(reinforcement learning)中,一个智能体(agent)在一个环境中行动;每个动作改变状态并返回一个奖励(reward)。智能体通过试错(trial and error,一开始没有标签)学习一个随时间最大化总奖励的策略(policy,一个策略)。用于序贯决策问题——游戏、机器人控制、自动驾驶。
"解释强化学习是什么意思"(三分)。 一个智能体通过与环境交互学习:它采取一个动作,环境转到新状态并返回一个奖励(或惩罚),智能体调整它的行为以最大化长期总奖励。 没有带标签的数据:智能体通过试错学习,从收集到的奖励中发现哪些动作是好的,并逐渐形成一个规定在每个状态该做什么的策略。用于事先不知道正确答案、但动作的结果可以打分的场合:玩游戏(国际象棋、围棋)、机器人控制、交通灯配时、资源分配。计算机与用户下棋时就这样学习,或者用极小化极大搜索博弈树,选择最坏结果最好的那一步。

一辆自动驾驶汽车(self-driving car)是一个真实的例子。激光雷达(lidar)和摄像头传感器(车顶上旋转的单元)建立道路的一个实时图像,而一个学到的策略决定如何安全地转向、加速和刹车。


词汇
训练
| English | 中文 | 拼音 |
|---|---|---|
| labels/ˈleɪblz/ | 标签 | biāo qiān |
| reinforcement learning/ˌriːɪnˈfɔːsmənt ˈlɜːnɪŋ/ | 强化学习 | qiáng huà xué xí |
| supervised learning/ˈsuːpəvaɪzd ˈlɜːnɪŋ/ | 监督学习 | jiān dū xué xí |
| classification/ˌklæsɪfɪˈkeɪʃn/ | 分类 | fēn lèi |
| unsupervised learning/ʌnˈsuːpəvaɪzd ˈlɜːnɪŋ/ | 无监督学习 | wú jiān dū xué xí |
| cluster/ˈklʌstə/ | 聚类 | jù lèi |
| training data/ˈtreɪnɪŋ ˈdeɪtə/ | 训练数据 | xùn liàn shù jù |
| self-driving car/self ˈdraɪvɪŋ kɑː/ | 自动驾驶汽车 | zì dòng jià shǐ qì chē |
| agent/ˈeɪdʒənt/ | 智能体 | zhì néng tǐ |
| reward/rɪˈwɔːd/ | 奖励 | jiǎng lì |
| policy/ˈpɒlɪsi/ | 策略 | cè lüè |
| lidar/ˈlaɪdɑː/ | 激光雷达 | jī guāng léi dá |
18.1
训练神经网络:反向传播
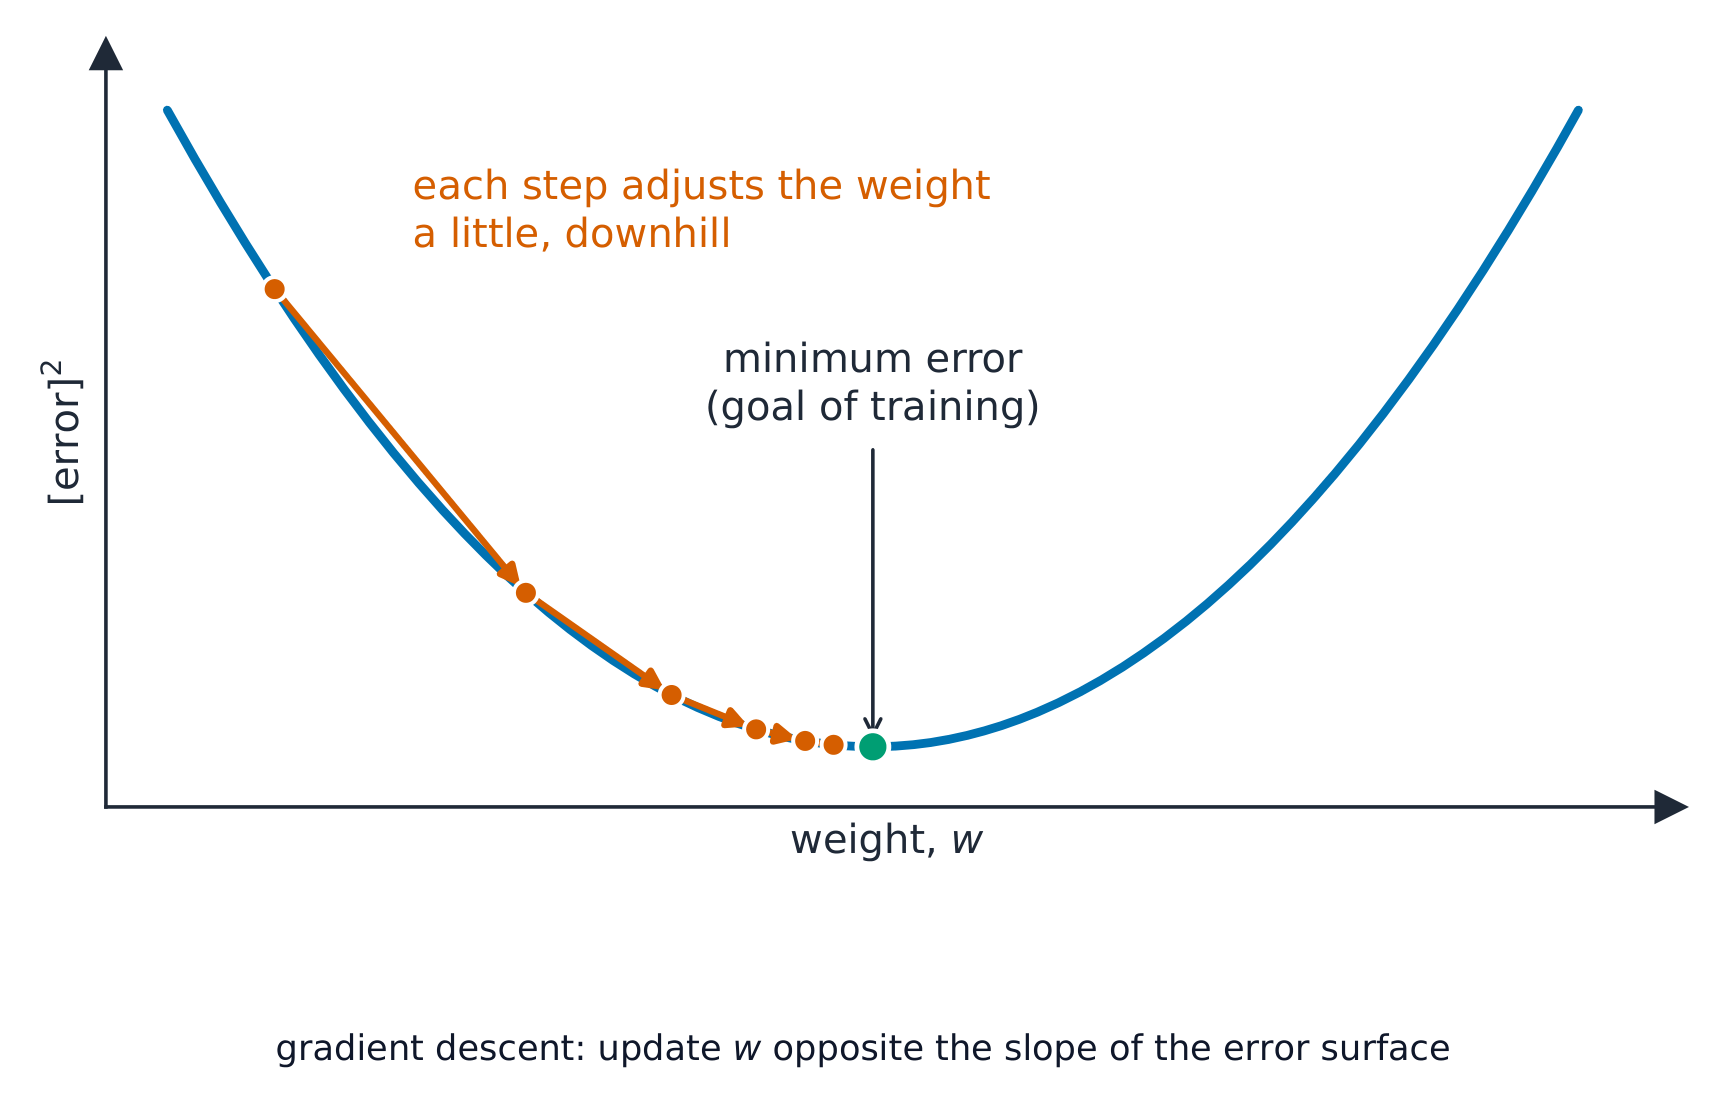
训练调整权重,使输出匹配目标。标准方法是带梯度下降(gradient descent)的反向传播(backpropagation,误差的反向传播)。对每个训练样例:
- 前向传播(forward pass)——把输入馈送到输出。
- 计算误差,用一个损失函数(loss function,一个表示输出有多错的单一数字)。
- 反向传播(backward pass)——把误差向后传播,用链式法则找出每个权重的梯度(它对误差贡献了多少)。
- 更新权重,走一小步(由学习率(learning rate)设定)以减少误差。
在许多样例和许多趟(训练轮次(epochs))上重复,直到误差停止缩小。名字"反向"来自第 3 步:误差从输出向后流向输入,所以每个权重的梯度在一趟中被找到。训练之后,一个新输入只需要一次前向传播就能得到一个预测。
"描述误差反向传播方法"(四分)。 (1) 一个输入被前向送过网络,其输出与期望(目标)输出比较;(2) 差值就是误差;(3) 误差从输出到输入逐层向后传过网络,算出每个权重对误差的份额;(4) 权重按其贡献比例调整,方向为减小误差;(5) 用许多样例重复这一过程,直到误差小到所需程度。这个方法的要点在于,带隐藏层的网络没有直接的办法知道哪个内部权重导致了输出误差;反向传播分摊责任。
词汇
训练
| English | 中文 | 拼音 |
|---|---|---|
| learning rate/ˈlɜːnɪŋ reɪt/ | 学习率 | xué xí lǜ |
| backpropagation/ˌbækprəpəˈɡeɪʃn/ | 反向传播 | fǎn xiàng chuán bō |
| gradient descent/ˈɡreɪdɪənt dɪˈsent/ | 梯度下降 | tī dù xià jiàng |
| loss function/lɒs ˈfʌŋkʃn/ | 损失函数 | sǔn shī hán shù |
| epochs/ˈiːpɒks/ | 训练轮次 | xùn liàn lún cì |
18.1
回归
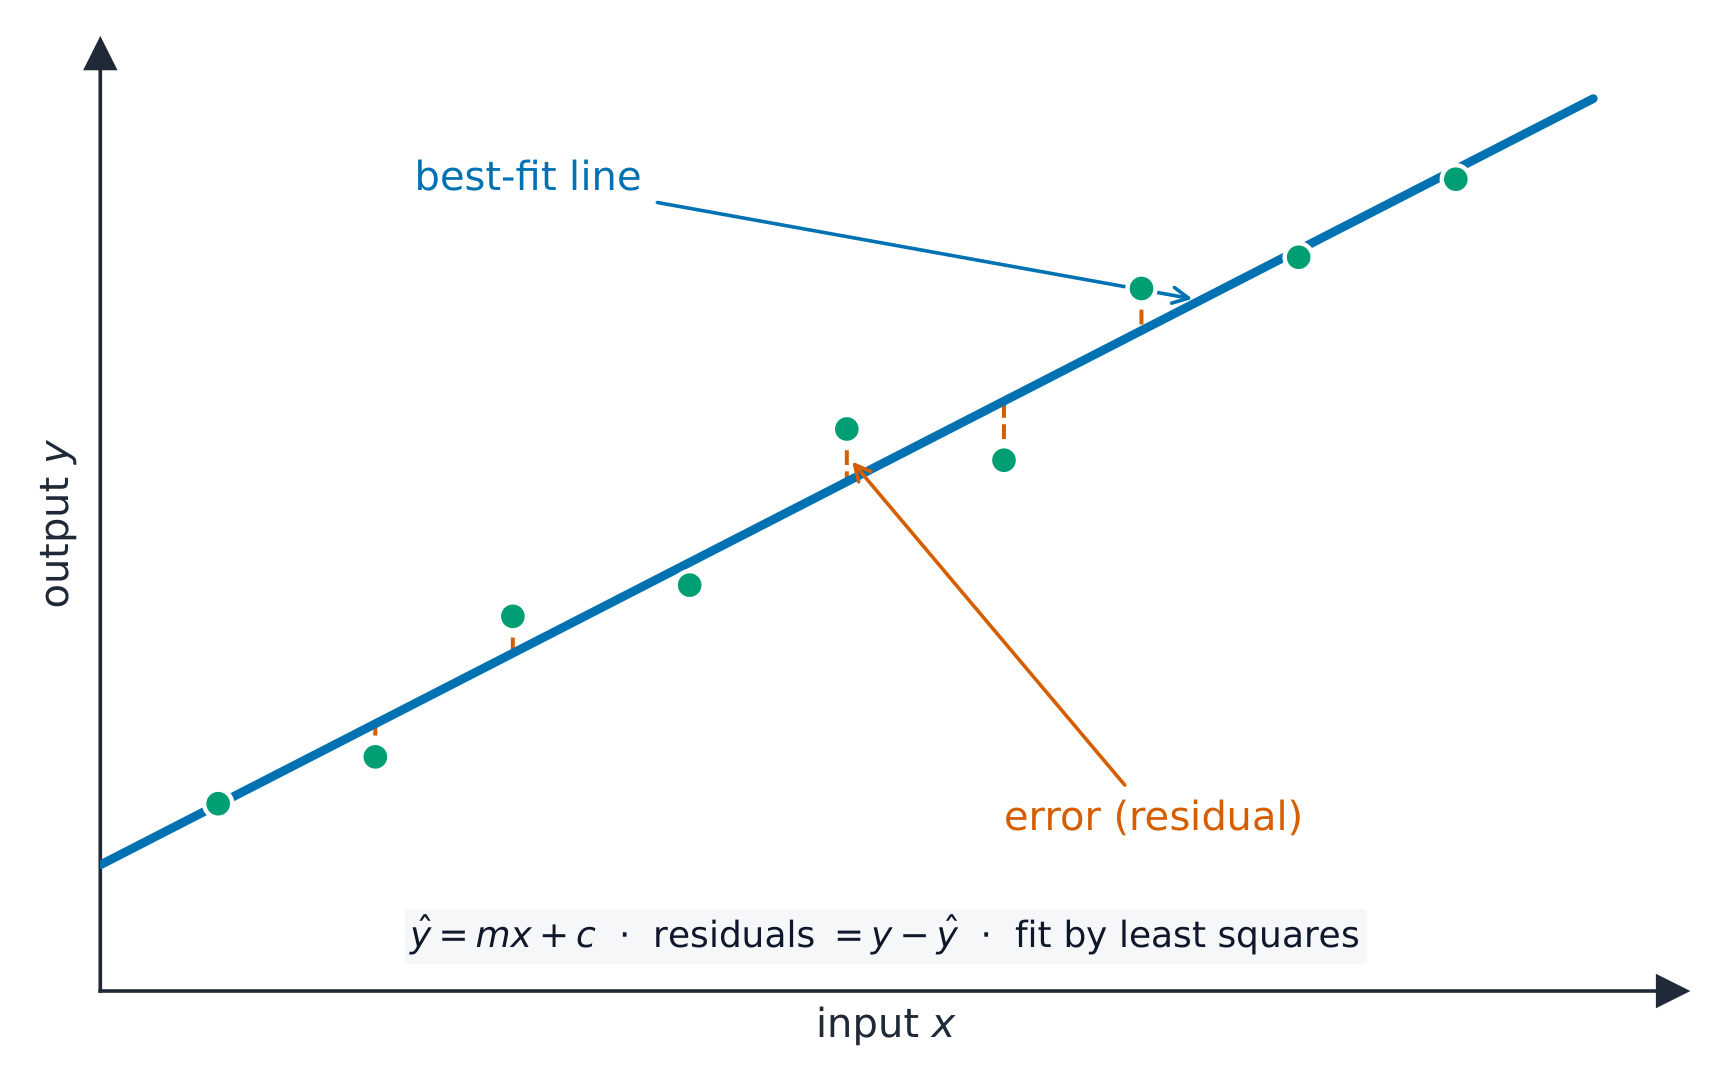
一些任务预测一个数(一个房价、明天的温度)——回归(regression),与分类(一个类别)相对。
线性回归(linear regression)拟合一条直线(或超平面):
$$y = m_{1} x_{1} + m_{2} x_{2} + \ldots + m_{n} x_{n} + c。$$
选择系数以最小化误差平方和,对照训练数据。当关系看起来大致线性且你想要一个可解释的模型时用它。对于弯曲的数据,用多项式、决策树或神经网络的回归方法——同样的思想:定义一个模型、定义一个损失,并调整参数以最小化它。回归和分类都是监督的;选择取决于答案是一个数还是一个类别。
"描述机器学习中的回归方法"(两分)。 通过用总误差最小的函数(直线或曲线)拟合训练数据,找出输入变量与连续输出之间关系的统计方法;拟合出的函数随后用于对新输入预测输出。 线性回归拟合直线;其他方法拟合曲线。回归预测一个值(价格、温度、时间);分类预测一个类别,这正是考试要问的区别。
探索
拟合一条回归线
拖动控件。线性回归画出使到数据点的平方距离尽可能小的那条直线——然后它为任何新输入预测一个数。
词汇
训练
| English | 中文 | 拼音 |
|---|---|---|
| regression/rɪˈɡreʃn/ | 回归 | huí guī |
| linear regression/ˈlɪnɪə rɪˈɡreʃn/ | 线性回归 | xiàn xìng huí guī |
18.1
人工智能在真实场景中的应用
许多考试场景用同样的模式——一个在带标签的数据上训练的深度学习模型,常常几个组合成一个流水线:
- 在一个自动商店的客户识别:系统在带标签的人脸图像上训练;一个摄像头捕获一张脸;图像识别提取一个表示;它对照注册的客户被匹配;最接近的匹配识别该人。
- 从图像读文本:图像识别找到文本区域;光学字符识别(optical character recognition)提取字符;机器翻译转换它们;文本转语音(text-to-speech)大声读它们。
- 收银台商品检测:在带标签的产品图像上训练的物体检测 AI,看到哪些商品进入一个购物篮并向账户收费。
当一个用户与系统交互时,模型是快的——它只做前向传播推理;智能在训练期间学到的模式中。
场景题的范例答案。 *停车场摄像头读取车牌:*摄像头拍摄图像;在许多带标签的车牌图像上训练的 AI 在图像中定位车牌;字符识别(同样在带标签的字符上训练的深度学习分类器)把车牌转换成文本;文本与时间一起存储,车辆离开时匹配。*CCTV 系统检测并跟踪一个人:*在带标签的人像上训练的图像识别软件在每一帧中识别出人;系统比较连续帧以跟随其移动;异常移动可以触发警报。*把语音变成命令:*在许多录音上训练的语音识别把声音转成文本;系统把文本匹配到一组已知命令;它在被纠正中改进。*对人脸对焦的相机:*在带标签的人脸上训练的人脸检测模型找到人脸区域,镜头调整使该区域清晰。*银行的人脸识别登录:*应用捕捉人脸,深度网络提取其特征,并与该客户存储的特征比较。所有情形的模式都是:在带标签的样例上训练、提取特征、对新输入匹配或分类。
例题。 对每个任务,说明它需要回归还是分类,以及人工神经网络的输出层会是什么样:(a) 预测明天的气温;(b) 判断一封邮件是否为垃圾邮件。要问的是被预测的是哪一类东西。(a) 气温是连续标度上的一个数值,所以这是回归,输出层是持有该数值的单个神经元。(b) 垃圾邮件与非垃圾邮件是一个类别,所以这是分类,输出给出每个类别的概率。两者都是有监督学习:各自都需要带标签的样本来训练,训练通过反向传播调整权重以减小误差。决定性的问题很简单,就是数值还是类别 - 而不是这个任务感觉有多难。
词汇
训练
| English | 中文 | 拼音 |
|---|---|---|
| optical character recognition/ˈɒptɪkl ˈkærɪktə ˌrekəɡˈnɪʃn/ | 光学字符识别 | guāng xué zì fú shí bié |
| text-to-speech/tekst tə spiːtʃ/ | 文本转语音 | wén běn zhuǎn yǔ yīn |
18.1
考官认可的定义
定义题按固定的表述给分。把这些记准确,并且只写一个答案。
| 术语 | 定义 |
|---|---|
| 图(AI 中) | 表示状态或地点的一组节点,由表示连接(常带权重)的边相连,搜索算法可以探索它 |
| Dijkstra 算法 | 通过总是访问目前距离最小的未访问节点,求从起点到其他每个节点的最短距离 |
| A* 算法 | 一种最短路径搜索,扩展"已走距离加到目标的启发式估计"之和最小的节点 |
| 人工神经网络 | 模仿大脑神经元的模型:由加权连接相连的多层节点,通过调整权重来训练 |
| 机器学习 | 从数据中学习并随经验改进、而不是遵循固定规则的算法 |
| 监督学习 | 从每个输入的正确输出已知的带标签训练数据中学习 |
| 无监督学习 | 通过发现无标签数据中的模式、分组或结构来学习 |
| 强化学习 | 智能体通过试错学习,在环境中选择动作以最大化获得的奖励 |
| 深度学习 | 使用多隐藏层神经网络、在大量数据上训练、每层从下一层提取特征的机器学习 |
| 误差反向传播 | 把网络的输出与目标比较,把误差反向传过各层,并调整每个权重以减小它 |
| 回归 | 用函数拟合训练数据,以便由输入预测连续的输出值 |
18.1
考试技巧
- 图的答案要点名节点、边和权重以及它们代表什么;然后是算法。Dijkstra:距离表,访问最小的,更新邻居。A*:每一行写 $g$、$h$ 和 $f = g + h$,扩展 $f$ 最小的。
- ANN 的答案要点名各层、加权连接和训练;深度学习加上许多隐藏层、大数据和自动特征提取,再给一个理由和一个例子。
- 三个类别各一句话:带标签数据和已知输出;无标签数据和发现的结构;智能体、环境、动作和奖励。
- 反向传播:与目标比较、误差向后穿过各层、调整权重以减小它、重复。回归预测值;分类预测类别。
- 场景题要流水线:在带标签的样例上训练、提取特征、识别或分类新输入;点名 AI 的类型(图像识别、语音识别、深度学习)。
常见错误
- 把图描述成"图表";在 AI 中它是节点和边。
- 运行 Dijkstra 时挑当前节点的最近邻居,而不是尚未访问的总距离最小者;或出现更短路线时忘记更新节点。
- 在 A* 中把 $h$ 加进下一步的 $g$;$g$ 只是真实距离,$h$ 由表重新读取。
- 说深度学习是"学得很多";它是许多隐藏层。
- 混淆无监督学习与强化学习;前者在数据中找结构,后者从奖励中学习。
- 描述反向传播时不提与期望输出的比较,或不说权重被调整。
- 把对价格的预测叫作"分类";连续值是回归。
该知识点的互动课程
逐步完成,配合即时检查练习。