
ขอบเขตและเงื่อนไขก่อนเข้าเรียน
อ้างอิงตามกรอบ Digital SAT งานทดสอบบนกระดาษเหล่านี้ไม่ใช่แบบ adaptive และไม่ทำนายคะแนนที่ปรับระดับแล้ว
- Interpret ค่าประมาณจากตัวอย่างและ margin of error (误差范围) ที่ระบุไว้
- แยกแยะ random sampling (การสุ่มตัวอย่าง) ออกจาก random assignment (การสุ่มกลุ่ม)
- ระบุประชากรและขอบเขตเชิงเหตุและผลที่การศึกษาสนับสนุน
ความรู้พื้นฐาน: เปอร์เซ็นต์; ประชากร; การสุ่มตัวอย่างและการจัดกลุ่มแบบสุ่ม
อธิบายและเลือกวิธีการ
สถิติจากตัวอย่างประมาณค่าปริมาณของประชากร ค่าประมาณที่รายงานมา 58% พร้อมช่วงความคลาดเคลื่อน 4 จุดเปอร์เซ็นต์ ให้ช่วงตั้งแต่ 54% ถึง 62% ภายใต้กระบวนการที่กำหนดไว้ มันไม่ได้หมายความว่า 58% ของผู้ตอบคำถามตอบด้วยข้อผิดพลาดสี่เปอร์เซ็นต์ และมันไม่รับประกันว่าตัวอย่างแต่ละชุดจะมีค่าจริง
ตัวอย่างสุ่มที่เป็นตัวแทนช่วยในการสรุปไปยังประชากรที่มาจากการสุ่มนั้น ตัวอย่างที่เลือกตามความสะดวกหรือการตอบด้วยใจสมัครอาจมีอคติแม้จะมีขนาดใหญ่ การเพิ่มขนาดตัวอย่างที่ดีออกแบบไว้ทั่วไปจะช่วยลดความแปรปรวนจากการสุ่มและช่วงความคลาดเคลื่อนในระดับความเชื่อมั่นเดียวกัน แต่ไม่สามารถแก้ไขกลุ่มที่ถูกกีดกันอย่างมีระบบได้อัตโนมัติ
Random assignment (การสุ่มกลุ่ม) กระจายผู้เข้าร่วมไปยัง treatment groups และสนับสนุนการหาความสัมพันธ์เชิงสาเหตุ (causal inference) โดยปรับสมดุลปัจจัยที่ขัดแย้งกันในภาพรวม Random sampling (การสุ่มตัวอย่าง) เลือกว่าใครเข้า participates การทดลองแบบสุ่มที่ทำกับ volunteers เฉพาะกลุ่มอาจ support ผลกระทบของการรักษาสำหรับ participants ของ them โดยไม่ได้ยืนยันว่าทุกคนมีผล相同的 effect
การศึกษาด้านการสังเกตวัดความแตกต่างที่มีอยู่โดยไม่กำหนดการรักษา ความสัมพันธ์อาจสะท้อนถึงปัจจัยรบกวน การเปรียบเทียบนักเรียนที่เลือกเรียนเสริมกับผู้ที่ไม่เลือกอาจผสมผสานการเรียนเสริมกับความตั้งใจหรือผลสัมฤทธิ์เดิม เพื่อตัดสินข้ออ้าง ระบุการเลือก การจัดกลุ่ม การเปรียบเทียบ ผลลัพธ์ที่วัด และประชากรที่แท้จริงก่อนยอมรับความเป็นเหตุเป็นผลหรือการสรุปโดยทั่วไป
ข้อผิดพลาดของช่วงความเชื่อมั่นจะเพิ่มและลดเป็นเปอร์เซ็นต์พอยท์ การประมาณ 63% ด้วยข้อผิดพลาด 4 พอยท์ จะได้ 59%–67% นี่คือช่วงความเชื่อมั่นจากกระบวนการทางสถิติ ไม่ใช่การรับประกันว่าคำตอบของแต่ละบุคคลจะอยู่ใกล้ 63% การสุ่มตัวอย่างช่วยในการสรุปผลเกี่ยวกับประชากร; การสุ่มจัดกลุ่มช่วยในการเปรียบเทียบผลการรักษา
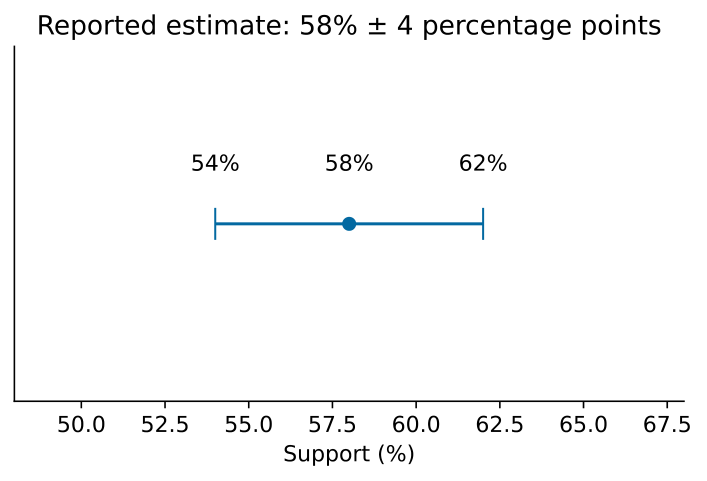
ตัวอย่างแบบมีคำอธิบาย. ตัวอย่างสุ่มจาก 400 นักเรียนโรงเรียน ได้ 58% สนับสนุน ±4 จุดเปอร์เซ็นต์: ช่วงที่ระบุ 54%–62%. นี้ประมาณประชากรโรงเรียนที่ถูกสุ่ม, ไม่ใช่所有นักเรียนทั่วโลก. หากผู้สมัครถูกสุ่มจัด分配到สองวิธีการทบทวน, ความแตกต่างของผลลัพธ์ที่ควบคุมได้สามารถรองรับการเปรียบเทียบเชิงเหตุและผลในกลุ่มผู้เข้าร่วม; การเลือกผู้สมัครยังคงจำกัดการ generalize ไปยังภายนอก
วัสดุฝึกฝน
แต่ละคำถามฝึกฝนด้านล่างระบุข้อมูลทั้งหมดที่จำเป็น
ฝึกฝนด้วยเหตุผล
ฝึก 1
ตัวอย่างสุ่มของสมาชิกห้องสมุดจดทะเบียน 500 คน รายงาน支持力度 62% สำหรับการเปลี่ยนแปลง พร้อมขอบเขตความคลาดเคลื่อน 4 จุดเปอร์เซ็นต์. ระบุช่วงและประชากร. มันยืนยัน支持力度ในประชาชนทุกคนในเมืองหรือไม่?
เหตุผล ช่วงคือ $62\%-4\%=58\%$ ถึง $62\%+4\%=66\%$, ที่การลบหมายถึงพอยท์ ประชากรคือสมาชิกที่ลงทะเบียนในกรอบการสุ่ม ตัวอย่างที่ไม่ใช่สมาชิกไม่ได้ถูกสุ่ม ดังนั้นการประมาณจึงไม่สามารถพิสูจน์การสนับสนุนของผู้ κατο居住ทุกคนได้
ฝึก 2
อาสาสมัครสี่สิบคนถูกสุ่มจัดกลุ่มไปยังคำแนะนำเก่าหรือใหม่ โดยมีงานและเงื่อนไขเดียวกัน กลุ่มใหม่ทำเสร็จเร็วขึ้น. ข้ออ้างเชิงสาเหตุและข้ออ้างเกี่ยวกับประชากรใดสมเหตุสมผล?
เหตุผล การจัดแบบสุ่มรองรับการเปรียบเทียบเชิงสาเหตุของรูปแบบการสอนสำหรับผู้เข้าร่วมภายใต้เงื่อนไขที่ทดสอบ ภายใต้ความแปรปรวน การเลือกโดยสมัครใจจำกัดการสรุปไปยังประชากร มันไม่ได้พิสูจน์ว่าผู้ใช้ทุกคนในอนาคตจะเสร็จเร็วขึ้น
ฝึก 3
การสำรวจอาสาสมัครเว็บไซต์ 10000 มีข้อผิดพลาดรายงานแคบ อธิบายทำไมขนาดเพียงอย่างเดียวไม่สามารถแก้ไขความเบี่ยงเบนของการเลือก และเสนอวิธีการสรรหาที่ดีกว่า
เหตุผล ผู้ที่เลือกตอบอาจแตกต่างอย่างเป็นระบบจากผู้ที่ไม่ตอบ ข้อผิดพลาดสำหรับการแปรผันของการสุ่มไม่ขจัดความเบี่ยงเบนนี้ เลือกแบบสุ่มจากประชากรเป้าหมายที่กำหนดและติดตามผู้ที่ไม่ตอบ; ยังคงรายงานข้อจำกัด
ข้อจำกัดและการใช้งานต่อไป
ขนาดตัวอย่าง การเลือกแบบสุ่ม และการจัดกลุ่มแบบสุ่มไม่ใช่สิ่งแทนกันได้ ขอบเขตความคลาดเคลื่อนที่แคบไม่ขจัดอคติในการเลือก
นี่คือโจทย์ฝึกฝนต้นฉบับที่เขียนขึ้นสำหรับรายวิชานี้ ไม่ใช่ข้อสอบอย่างเป็นทางการ