Cette fiche couvre le Sujet 6 : Probabilités & Statistiques 概率统计 2. Elle ajoute le modèle de Poisson, la combinaison de variables aléatoires, les distributions continues, et les notions d'estimation et de test.
Probabilités et Statistiques 2
Mathématiques A-Level · Sujet 6
 10:06
Probabilités et Statistiques 2
Cambridge, les années 1920. Lors d'une réception dans un jardin, une dame dit quelque chose de surprenant. Elle prétend pouvoir goûter et déterminer si le lait a été versé dans la tasse…
Narration en anglais · Sous-titres anglais + 中文 incrustés
6.1
La distribution de Poisson

Programme
| Les candidats doivent être capables de : | Notes et exemples |
|---|---|
| utiliser les formules pour calculer des probabilités pour la distribution $\text{Po}(\lambda)$ | |
| utiliser le fait que si $X \sim \text{Po}(\lambda)$ alors la moyenne et la variance de $X$ sont chacune égales à $\lambda$ | La démonstration n'est pas requise. |
| comprendre la pertinence de la distribution de Poisson pour la distribution d'événements aléatoires, et utiliser la distribution de Poisson comme modèle | |
| utiliser la distribution de Poisson comme approximation de la distribution binomiale là où cela est approprié | Les conditions que $n$ est grand et $p$ est petit doivent être connues ; $n > 50$ et $np < 5$, approximativement. |
| utiliser la distribution normale, avec correction de continuité, comme approximation de la distribution de Poisson là où cela est approprié. | La condition que $\lambda$ est grand doit être connue ; $\lambda > 15$, approximativement. |
Source : Programme Cambridge International
La distribution de Poisson 泊松分布 $X \sim \mathrm{Po}(\lambda)$ modélise le nombre d'événements aléatoires dans un intervalle fixe, quand ils se produisent à un taux moyen stable $\lambda$ :
$$P(X = r) = e^{-\lambda}\frac{\lambda^r}{r!}.$$
Pour une variable de Poisson, la moyenne et la variance sont toutes deux égales à $\lambda$. La distribution de Poisson est une bonne approximation 近似 de la distribution binomiale lorsque $n$ est grand et $p$ est petit. La distribution normale (avec correction de continuité) approxime la Poisson lorsque $\lambda$ est grand.
Exemple résolu. $X \sim \mathrm{Po}(3)$. Trouvez $P(X = 2)$.
$$P(X = 2) = e^{-3}\frac{3^2}{2!} = e^{-3}\times 4.5 = 0.224.$$

Explorer
La loi de Poisson
Changez la moyenne λ. Poisson modélise le nombre d'événements aléatoires dans un intervalle fixe — les événements rares donnent une forme asymétrique.
Vocabulaire
Entrainer
| Anglais | Chinois | Pinyin |
|---|---|---|
| Poisson distribution/ˈpɔɪsn ˌdɪstrɪˈbjuːʃn/ | 泊松分布 | pō sōng fēn bù |
| approximation/əˌprɒksɪˈmeɪʃn/ | 近似 | jìn sì |
| expectation/ekspɪkˈteɪʃn/ | 期望 | qī wàng |
6.2
Combinaisons linéaires de variables aléatoires
Programme
| Les candidats doivent être capables de : | Notes et exemples |
|---|---|
| • utiliser, lors de la résolution de problèmes, les résultats suivants : – $\text{E}(aX + b) = a\text{E}(X) + b$ et $\text{Var}(aX + b) = a^2\text{Var}(X)$ – $\text{E}(aX + bY) = a\text{E}(X) + b\text{E}(Y)$ – $\text{Var}(aX + bY) = a^2\text{Var}(X) + b^2\text{Var}(Y)$ pour des $X$ indépendantes et $Y$ – si $X$ suit une loi normale alors $aX + b$ aussi – si $X$ et $Y$ suivent des lois normales indépendantes alors $aX + bY$ suit une loi normale – si $X$ et $Y$ suivent des lois de Poisson indépendantes alors $X + Y$ suit une loi de Poisson. | Les démonstrations de ces résultats ne sont pas requises. |
Source : Programme Cambridge International
Quand vous transformez une variable selon une règle linéaire, l'espérance 期望 (moyenne) et la variance 方差 suivent ces règles :
$$E(aX + b) = aE(X) + b, \qquad \mathrm{Var}(aX + b) = a^2\,\mathrm{Var}(X).$$
Pour deux variables indépendantes $X$ et $Y$ :
$$E(aX + bY) = aE(X) + bE(Y), \qquad \mathrm{Var}(aX + bY) = a^2\,\mathrm{Var}(X) + b^2\,\mathrm{Var}(Y).$$
Deux faits utiles : si $X$ suit une distribution normale 正态分布, alors $aX + b$ aussi ; et la somme de variables de Poisson indépendantes est encore de Poisson.
Exemple résolu. $X$ a pour moyenne $5$ et variance $4$. Trouvez $E(3X - 1)$ et $\mathrm{Var}(3X - 1)$.
$$E(3X - 1) = 3(5) - 1 = 14, \qquad \mathrm{Var}(3X - 1) = 3^2 \times 4 = 36.$$
Explorer
Laboratoire sur les combinaisons linéaires
E(aX + b) = aE(X) + b
Changez un facteur d'échelle et voyez comment la valeur attendue s'échelle.
Vocabulaire
Entrainer
| Anglais | Chinois | Pinyin |
|---|---|---|
| variance/ˈveərɪəns/ | 方差 | fāng chà |
| normal distribution/ˈnɔːml ˌdɪstrɪˈbjuːʃn/ | 正态分布 | zhèng tài fēn bù |
| continuous random variable/kənˈtɪnjuːəs ˈrændəm ˈveərɪəbl/ | 连续型随机变量 | lián xù xíng suí jī biàn liàng |
| probability density function/ˌprɒbəˈbɪlɪti ˈdensɪti ˈfʌŋkʃn/ | 概率密度函数 | gài lǜ mì dù hán shù |
| cumulative distribution function/ˈkjuːmjʊlətɪv ˌdɪstrɪˈbjuːʃn ˈfʌŋkʃn/ | 累积分布函数 | lěi jī fēn bù hán shù |
| median/ˈmiːdiːən/ | 中位数 | zhōng wèi shù |
6.3
Variables aléatoires continues
Programme
| Les candidats doivent être capables de : | Notes et exemples |
|---|---|
| comprendre le concept d'une variable aléatoire continue, et rappeler et utiliser les propriétés d'une fonction de densité de probabilité | Pour les fonctions de densité définies sur un seul intervalle uniquement ; le domaine peut être infini, p.ex. $\frac{3}{x^4}$ pour $x \geqslant 1$. |
| utiliser une fonction de densité de probabilité pour résoudre des problèmes impliquant des probabilités, et pour calculer la moyenne et la variance d'une distribution. | Y compris la localisation de la médiane ou d'autres percentiles d'une distribution par considération directe d'une aire utilisant la fonction de densité. La connaissance explicite de la fonction de répartition n'est pas incluse. |
Source : Programme Cambridge International
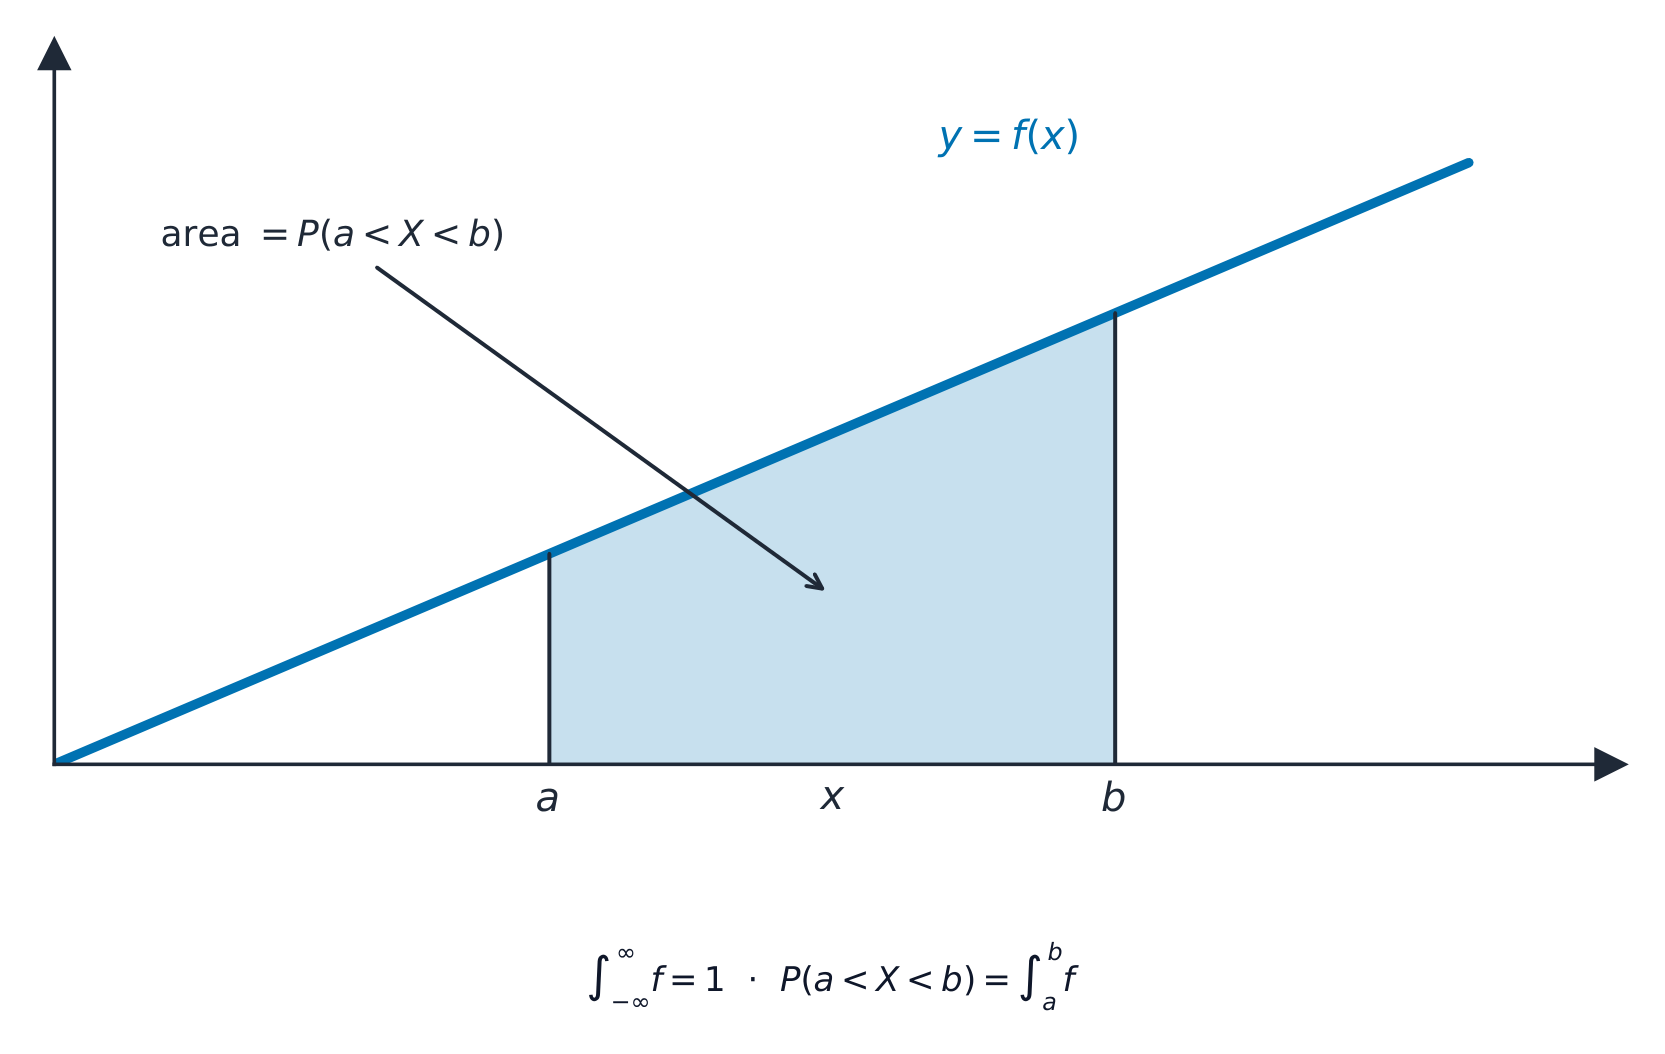
Une variable aléatoire continue 连续型随机变量 peut prendre n'importe quelle valeur dans un intervalle. Ses probabilités proviennent d'une fonction de densité de probabilité 概率密度函数 $f(x)$, avec deux propriétés clés :
$$f(x) \geqslant 0, \qquad \int_{-\infty}^{\infty} f(x)\,dx = 1.$$
Une probabilité est l'aire sous $f$, et la moyenne se trouve par intégration :
$$P(a < X < b) = \int_a^b f(x)\,dx, \qquad E(X) = \int_{-\infty}^{\infty} x\,f(x)\,dx.$$
La fonction de répartition 累积分布函数 est $F(x) = P(X \leqslant x) = \int_{-\infty}^{x} f(t)\,dt$ ; la médiane 中位数 résout $F(m) = 0.5$, et d'autres percentiles 百分位数 résolvent $F(x) = p$.
Exemple résolu. Une variable continue a $f(x) = \tfrac12 x$ pour $0 \leqslant x \leqslant 2$ (et $0$ ailleurs). Trouvez $E(X)$.
$$E(X) = \int_0^2 x\cdot\tfrac12 x\,dx = \int_0^2 \tfrac12 x^2\,dx = \left[\tfrac{x^3}{6}\right]_0^2 = \frac{8}{6} = \frac{4}{3}.$$
La variance utilise la même idée, $\mathrm{Var}(X)=\displaystyle\int_{-\infty}^{\infty}x^2 f(x)\,dx-\big(E(X)\big)^2$. Pour les mêmes $f(x)=\tfrac12 x$ sur $[0,2]$ : $\displaystyle\int_0^2 x^2\cdot\tfrac12 x\,dx=\left[\tfrac{x^4}{8}\right]_0^2=2$, donc $\mathrm{Var}(X)=2-\left(\tfrac43\right)^2=2-\tfrac{16}{9}=\tfrac{2}{9}$.
Explorer
Aire = probabilité
P(a < X < b) = ∫ f(x) dx
Pour une variable continue, la probabilité est l'aire sous la courbe de densité entre deux valeurs.
Vocabulaire
Entrainer
| Anglais | Chinois | Pinyin |
|---|---|---|
| percentiles/pəˈsentaɪlz/ | 百分位数 | bǎi fēn wèi shù |
| sample/ˈsæmpl/ | 样本 | yàng běn |
6.4
Échantillonnage et estimation

Programme
| Les candidats doivent être capables de : | Notes et exemples |
|---|---|
| comprendre la distinction entre un échantillon et une population, et apprécier la nécessité de la randomisation dans le choix des échantillons | |
| expliquer en termes simples pourquoi une méthode d'échantillonnage donnée peut être insatisfaisante | Y compris une compréhension élémentaire de l'utilisation de nombres aléatoires pour produire des échantillons aléatoires. La connaissance de méthodes d'échantillonnage particulières, telles que l'échantillonnage par quotas ou stratifié, n'est pas requise. |
| reconnaître qu'une moyenne d'échantillon peut être considérée comme une variable aléatoire, et utiliser les faits que $\text{E}(\overline{X}) = \mu$ et que $\text{Var}(\overline{X}) = \frac{\sigma^2}{n}$ | |
| utiliser le fait que $\overline{X}$ suit une distribution normale si $X$ suit une distribution normale | |
| utiliser le Théorème Central Limite là où c'est approprié | Seule une compréhension informelle du Théorème Central Limite (TCL) est requise ; pour de grands tailles d'échantillon, la distribution d'une moyenne d'échantillon est approximativement normale. |
| calculer des estimations sans biais de la moyenne et de la variance de la population à partir d'un échantillon, en utilisant soit des données brutes, soit des données résumées | Seule une compréhension simple du terme 'sans biais' est requise, p.ex. que bien que les estimations individuelles varient, le processus donne un résultat précis 'en moyenne'. |
| déterminer et interpréter un intervalle de confiance pour la moyenne de la population dans les cas où la population est normalement distribuée avec une variance connue ou où un grand échantillon est utilisé | |
| déterminer, à partir d'un grand échantillon, un intervalle de confiance approximatif pour une proportion de population. |
Source : Programme Cambridge International
Un échantillon 样本 est un petit groupe choisi parmi toute la population 总体. Un échantillon aléatoire nécessite de la randomisation 随机性, afin que chaque membre ait une chance équitable d'être sélectionné.
Certaines méthodes sont insatisfaisantes car elles sont biaisées 有偏 : prélever uniquement des volontaires ou les 20 premières personnes arrivées sureprésente certains types de personnes. Un véritable échantillon aléatoire utilise des nombres aléatoires – numérotez chaque membre de la population, puis tirez des nombres (à partir d'un tableau ou d'un générateur) pour décider qui est dans l'échantillon.
La moyenne de l'échantillon $\bar{X}$ est elle-même une variable aléatoire, avec
$$E(\bar{X}) = \mu, \qquad \mathrm{Var}(\bar{X}) = \frac{\sigma^2}{n}.$$
Par le Théorème Central Limite 中心极限定理, pour un grand échantillon $\bar{X}$ est approximativement normale, quelle que soit la forme de la population.

À partir d'un échantillon, vous pouvez trouver des estimations sans biais 无偏估计 de la moyenne et de la variance de la population. Un intervalle de confiance 置信区间 fournit une plage qui contient probablement la vraie moyenne. Quand la population est normale avec une variance connue $\sigma$ (ou l'échantillon est grand), un intervalle $95\%$ est
$$\bar{x} \pm 1.96\,\frac{\sigma}{\sqrt{n}}.$$

Vous pouvez également trouver un intervalle de confiance pour une proportion de population 总体比例 à partir d'un grand échantillon.
Exemple résolu. Un échantillon de $n = 64$ a pour moyenne $\bar{x} = 50$, provenant d'une population avec $\sigma = 8$. Trouvez un intervalle de confiance $95\%$ pour la moyenne de la population.
$$50 \pm 1.96\times\frac{8}{\sqrt{64}} = 50 \pm 1.96 \;\Rightarrow\; (48.0,\ 52.0).$$
Explorer
La distribution d'échantillonnage
X̄ ~ N(μ, σ²/n)
Par le Théorème Central Limite, les moyennes d'échantillon suivent une courbe normale — plus étroite pour des échantillons plus grands.
Vocabulaire
Entrainer
| Anglais | Chinois | Pinyin |
|---|---|---|
| population/ˌpɒpjʊˈleɪʃn/ | 总体 | zǒng tǐ |
| randomness/ˈrændəmnəs/ | 随机性 | suí jī xìng |
| biased/ˈbaɪəst/ | 有偏 | yǒu piān |
| Central Limit Theorem/ˈsentrəl ˈlɪmɪt ˈθɪərəm/ | 中心极限定理 | zhōng xīn jí xiàn dìng lǐ |
| unbiased estimates/ʌnˈbaɪəst ˈestɪməts/ | 无偏估计 | wú piān gū jì |
| confidence interval/ˈkɒnfɪdəns ˈɪntəvl/ | 置信区间 | zhì xìn qū jiān |
| population proportion/ˌpɒpjʊˈleɪʃn prəˈpɔːʃn/ | 总体比例 | zǒng tǐ bǐ lì |
6.5
Tests d'hypothèses

Programme
| Les candidats doivent être capables de : | Notes et exemples |
|---|---|
| comprendre la nature d'un test d'hypothèse, la différence entre les tests à une queue et à deux queues, et les termes hypothèse nulle, hypothèse alternative, niveau de significativité, zone de rejet (ou zone critique), zone d'acceptation et statistique de test | Les résultats des tests d'hypothèses doivent être interprétés en termes de contextes dans lesquels les questions sont posées. |
| formuler des hypothèses et effectuer un test d'hypothèse dans le contexte d'une observation unique provenant d'une population ayant une distribution binomiale ou de Poisson, en utilisant – l'évaluation directe des probabilités – une approximation normale de la distribution binomiale ou de Poisson, là où c'est approprié | |
| formuler des hypothèses et effectuer un test d'hypothèse concernant la moyenne de la population dans les cas où la population est normalement distribuée avec une variance connue ou où un grand échantillon est utilisé | |
| comprendre les termes erreur de Type I et erreur de Type II par rapport aux tests d'hypothèses | |
| calculer les probabilités de commettre des erreurs de Type I et de Type II dans des situations spécifiques impliquant des tests basés sur une distribution normale ou l'évaluation directe de probabilités binomiales ou de Poisson. |
Source : Programme Cambridge International
Un test d'hypothèse 假设检验 utilise des données d'échantillon pour juger d'une affirmation. Vous établissez deux énoncés : l'hypothèse nulle 原假设 $H_0$ (l'affirmation testée, généralement "aucun changement") et l'hypothèse alternative 备择假设 $H_1$ (ce que vous soupçonnez à la place). Le test est unilatéral 单尾 si $H_1$ pointe dans un sens (ex. $\mu > 50$) et bilatéral 双尾 s'il permet les deux sens ($\mu \neq 50$).
Vous fixez un niveau de signification 显著性水平 (souvent $5\%$), calculez une statistique de test 检验统计量 à partir des données, et voyez si elle tombe dans la zone de rejet 拒绝域 (aussi appelée zone critique) ; si c'est le cas, vous rejetez $H_0$, sinon la statistique est dans la zone d'acceptation.
Deux erreurs sont possibles : une erreur de Type I 第一类 erreur consiste à rejeter $H_0$ quand elle est en fait vraie ; une erreur de Type II 第二类 erreur consiste à accepter $H_0$ quand elle est en fait fausse. Vous pouvez trouver leurs probabilités depuis la zone de rejet : $P(\text{Type I})=P(\text{statistic in the rejection region}\mid H_0)$ – cela équivaut au niveau de signification – et $P(\text{Type II})=P(\text{statistic in the acceptance region}\mid H_1$ vrai pour une valeur donnée$)$, calculé à partir de la binomiale, de Poisson ou de la normale.
Exemple résolu. On prétend qu'une population a une moyenne $50$, avec $\sigma = 8$. Un échantillon de $n = 64$ donne $\bar{x} = 52$. Testez au niveau $5\%$ si la moyenne a changé.
$H_0\!: \mu = 50$ et $H_1\!: \mu \neq 50$ (bilatéral). La statistique de test est
$$z = \frac{\bar{x} - \mu}{\sigma/\sqrt{n}} = \frac{52 - 50}{8/8} = 2.$$
La valeur critique à $5\%$ (bilatéral) est $1.96$. Puisque $2 > 1.96$, vous rejetez $H_0$ : il y a des preuves que la moyenne a changé.
Exemple résolu (test binomial). Une pièce est censée être juste mais suspectée de tomber trop rarement pile : $H_0\!:p=0.5$, $H_1\!:p<0.5$. En $n=30$ lancers, vous observez $X=9$ têtes. Sous $H_0$, $X\sim B(30,0.5)$, donc la probabilité de queue unilatérale est
$$P(X\leqslant 9)=\sum_{k=0}^{9}\binom{30}{k}(0.5)^{30}\approx 0.021.$$
Puisque $0.021<0.05$, rejetez $H_0$ : la pièce semble bien biaisée contre les têtes. (Pour un grand $n$, la binomiale est approximée par une normale ; un test Poisson fonctionne de la même manière pour les événements rares. Et ici, si la règle est "rejeter lorsque $X\leqslant 9$", alors $P(\text{Type I})=P(X\leqslant 9\mid p=0.5)\approx0.021$.)
Explorer
La région de rejet
rejeter H₀ si z < −z*
La zone hachurée file d'attente est la région de rejet — si la statistique de test y tombe, rejeter H₀.
Vocabulaire
Entrainer
| Anglais | Chinois | Pinyin |
|---|---|---|
| hypothesis test/haɪˈpɒθəsɪs test/ | 假设检验 | jiǎ shè jiǎn yàn |
| null hypothesis/nʌl haɪˈpɒθəsɪs/ | 原假设 | yuán jiǎ shè |
| alternative hypothesis/ɔːlˈtɜːnətɪv haɪˈpɒθəsɪs/ | 备择假设 | bèi zé jiǎ shè |
| one-tailed/wʌn teɪld/ | 单尾 | dān wěi |
| two-tailed/tuː teɪld/ | 双尾 | shuāng wěi |
| significance level/sɪɡˈnɪfɪkəns ˈlevl/ | 显著性水平 | xiǎn zhù xìng shuǐ píng |
| test statistic/test stəˈtɪstɪk/ | 检验统计量 | jiǎn yàn tǒng jì liàng |
| rejection region/rɪˈdʒekʃn ˈriːdʒn/ | 拒绝域 | jù jué yù |
| Type I error/taɪp aɪ ˈerə/ | 第一类错误 | dì yī lèi cuò wù |
| Type II error/taɪp ˈtuː ˈerə/ | 第二类错误 | dì èr lèi cuò wù |
| Probability & Statistics/ˌprɒbəˈbɪlɪti ænd stəˈtɪstɪks/ | 概率统计 | gài lǜ tǒng jì |
6.5
Conseils d'examen
- Utilisez la distribution de Poisson pour des événements rares, aléatoires et indépendants ; sa moyenne est égale à sa variance ($= \lambda$).
- Lors de la combinaison de variables aléatoires indépendantes, les variances s'additionnent (elles ne se soustraient jamais).
- Pour un test d'hypothèse, énoncez $H_0$ et $H_1$, le niveau de signification, la statistique de test, et une conclusion dans le contexte.
- Pour un intervalle de confiance, utilisez la bonne valeur $z$ (ou $t$) et interprétez-la en mots.
Leçons interactives sur ce sujet
Traversez-le étape par étape, avec des exercices à vérification instantanée.