Hai nhà thiết kế chip đối mặt với cùng một vấn đề: làm cho chương trình chạy nhanh. Người này nói — hãy xây dựng các lệnh mạnh mẽ, để mỗi lệnh làm rất nhiều việc. Người kia nói — hãy giữ…
English narration · English + 中文 subtitles burned in · Giọng đọc tiếng Anh · phụ đề tiếng Anh + 中文 được ghi trực tiếp
15.1
RISC vs CISC processors · Bộ xử lý RISC so với CISC
Syllabus · Chương trình
English
Candidates should be able to:
Notes and guidance
Show understanding of Reduced Instruction Set Computers (RISC) and Complex Instruction Set Computers (CISC) processors
Differences between RISC and CISC Understand interrupt handling on CISC and RISC processors
Show understanding of the importance/use of pipelining and registers in RISC processors
Show understanding of the four basic computer architectures
SISD, SIMD, MISD, MIMD
Show understanding of the characteristics of massively parallel computers
Show understanding of the concept of a virtual machine
Give examples of the role of virtual machines Understand the benefits and limitations of virtual machines
Tiếng Việt
Thí sinh cần có thể:
Ghi chú và hướng dẫn
Thể hiện sự hiểu biết về Máy tính tập lệnh đơn giản (RISC) và Máy tính tập lệnh phức tạp (CISC)
Sự khác biệt giữa RISC và CISC Hiểu cách xử lý ngắt trên bộ xử lý CISC và RISC
Thể hiện sự hiểu biết về tầm quan trọng/sử dụng pipelining và ký hiệu registers trong bộ xử lý RISC
Thể hiện sự hiểu biết về bốn kiến trúc máy tính cơ bản
SISD, SIMD, MISD, MIMD
Thể hiện sự hiểu biết về đặc điểm của máy tính song song quy mô lớn
Thể hiện sự hiểu biết về khái niệm máy ảo
Đưa ra ví dụ về vai trò của máy ảo Hiểu lợi ích và hạn chế của máy ảo
Source: Cambridge International syllabus · Nguồn: Chương trình Cambridge International
English
Two styles of CPU design. The CPU itself plugs into the motherboard 主板, the main board that links the processor, the memory and every other part of the computer together.
CISC
A CISC 复杂指令集 (Complex Instruction Set Computers) has many, often complex instructions (one may do several memory accesses and operations), of variable length, so decoding is intricate. It does more per instruction in hardware. Examples: Intel x86.
RISC
A RISC 精简指令集 (Reduced Instruction Set Computers) has a small set of simple instructions, each doing one basic operation, all of fixed length (fast to decode). Only load and store touch memory; everything else is register 寄存器 to register. Programs are longer but each instruction is quick and predictable, which suits pipelining. Examples: ARM, RISC-V.
Feature
CISC
RISC
Instruction set
many
few
Instruction length
variable
fixed
Memory access
many instructions
only load/store
Pipeline-friendly
harder
naturally
Per-instruction cycles
varies
usually 1
The trade-off is doing more per instruction (CISC) vs doing each instruction faster and more predictably (RISC). Modern Intel chips translate CISC instructions into simpler RISC-like micro-ops internally.
"Identify four features of a RISC processor." Any four of: a small set of simple instructions; instructions of fixed length (one word); most instructions complete in one clock cycle; many general-purpose registers; only load and store instructions access memory (all arithmetic is register to register); hard-wired control (no microcode); designed for pipelining; the compiler does more of the work, so programs contain more instructions and need more memory. "Identify four features of a CISC processor." Any four of: a large set of instructions, many of them complex (one instruction may do several operations); instructions of variable length; instructions that take several clock cycles; fewer registers; instructions that can access memory directly; microprogrammed control; less suited to pipelining; shorter programs, so a simpler compiler and less memory. "Describe what is meant by RISC and CISC" (two marks each): name the expansion and give the defining idea (few simple single-cycle instructions; many complex multi-cycle instructions).
Interrupt handling on the two designs. On a CISC processor the current instruction, however complex, is completed before the interrupt is serviced; the processor then saves the contents of its registers (including the program counter) on the stack, jumps to the interrupt service routine, and restores the registers afterwards. On a RISC processor with a pipeline, several instructions are part-way through at the moment the interrupt 中断 arrives, so the processor must either let every instruction in the pipeline finish, or discard (flush) the partly executed instructions and restart them after the interrupt; either way the pipeline is emptied, the registers are saved, and the service routine runs. The exam phrasing: "pipelining makes interrupt handling more complex, because the contents of the pipeline must be dealt with before the interrupt can be serviced".
Tiếng Việt
Hai kiểu thiết kế CPU. Bản thân CPU cắm vào bo mạch chủ (motherboard), là bo mạch chính kết nối bộ xử lý, bộ nhớ và mọi linh kiện khác của máy tính với nhau.
CISC có nhiều lệnh phức tạp; RISC có ít lệnh đơn giảnBo mạch chủ kết nối CPU, bộ nhớ và các bộ phận khác với nhau
CISC
CISC (Complex Instruction Set Computers - Máy tính tập lệnh phức tạp) có nhiều, thường phức tạp các lệnh (một lệnh có thể thực hiện nhiều truy cập bộ nhớ và thao tác), có độ dài biến đổi, do đó giải mã rất phức tạp. Nó thực hiện nhiều hơn trong mỗi lệnh bằng phần cứng. Ví dụ: Intel x86.
RISC
RISC (Reduced Instruction Set Computers - Máy tính tập lệnh rút gọn) có một tập hợp nhỏ các lệnh đơn giản, mỗi lệnh thực hiện một thao tác cơ bản, tất cả đều có độ dài cố định (giải mã nhanh). Chỉ có load và store tiếp xúc với bộ nhớ; mọi thứ còn lại là từ register sang register. Chương trình dài hơn nhưng mỗi lệnh chạy nhanh và dự đoán được, phù hợp với kỹ thuật pipeline. Ví dụ: ARM, RISC-V.
Tính năng
CISC
RISC
Tập lệnh
nhiều
ít
Độ dài lệnh
biến đổi
cố định
Truy cập bộ nhớ
nhiều lệnh
chỉ load/store
Thân thiện với pipeline
khó hơn
tự nhiên
Chu kỳ trên mỗi lệnh
thay đổi
thường là 1
Sự đánh đổi là làm nhiều hơn trong mỗi lệnh (CISC) so với việc thực hiện mỗi lệnh nhanh hơn và dự đoán được hơn (RISC). Các chip Intel hiện đại dịch các lệnh CISC thành các micro-ops RISC đơn giản hơn bên trong.
"Xác định bốn đặc điểm của bộ xử lý RISC." Bất kỳ bốn đặc điểm nào: một tập hợp nhỏ các lệnh đơn giản; các lệnh có độ dài cố định (một từ); hầu hết các lệnh hoàn thành trong một chu kỳ xung nhịp; nhiều thanh ghi đa năng; chỉ các lệnh load và store truy cập bộ nhớ (tất cả phép toán là register sang register); điều khiển cứng (không có microcode); được thiết kế cho pipeline; trình biên dịch làm nhiều công việc hơn, nên chương trình chứa nhiều lệnh hơn và cần nhiều bộ nhớ hơn. "Xác định bốn đặc điểm của bộ xử lý CISC." Bất kỳ bốn đặc điểm nào: một tập hợp lớn các lệnh, nhiều trong số đó phức tạp (một lệnh có thể thực hiện nhiều thao tác); các lệnh có độ dài biến đổi; các lệnh mất vài chu kỳ xung nhịp; ít thanh ghi hơn; các lệnh có thể truy cập bộ nhớ trực tiếp; điều khiển viên lập trình (microprogrammed); ít phù hợp với pipeline; ngắn hơn, nên trình biên dịch đơn giản hơn và cần ít bộ nhớ hơn. "Mô tả ý nghĩa của RISC và CISC" (hai điểm mỗi câu): nêu tên viết tắt và đưa ra ý tưởng định nghĩa (các lệnh đơn giản một chu kỳ ít; các lệnh phức tạp nhiều chu kỳ nhiều).
Xử lý ngắt trên hai kiến trúc. Trên bộ xử lý CISC, lệnh hiện tại, dù phức tạp thế nào đi nữa, cũng phải được hoàn thành trước khi ngắt được phục vụ; sau đó, bộ xử lý lưu nội dung các thanh ghi (bao gồm bộ đếm chương trình) lên ngăn xếp, nhảy đến thủ tục xử lý ngắt, và khôi phục các thanh ghi sau này. Trên bộ xử lý RISC có pipeline, vài lệnh đang ở giữa quá trình thực thi ngay khi ngắt xuất hiện, vì vậy bộ xử lý phải hoặc để mọi lệnh trong pipeline finish, hoặc xóa bỏ (flush) các lệnh đã thực thi một phần và khởi động lại chúng sau khi ngắt; theo bất kỳ cách nào, pipeline bị trống, các thanh ghi được lưu, và thủ tục phục vụ chạy. Cách diễn đạt đề thi: "kỹ thuật pipeline làm việc xử lý ngắt phức tạp hơn, vì nội dung của pipeline phải được xử lý trước khi ngắt có thể được phục vụ".
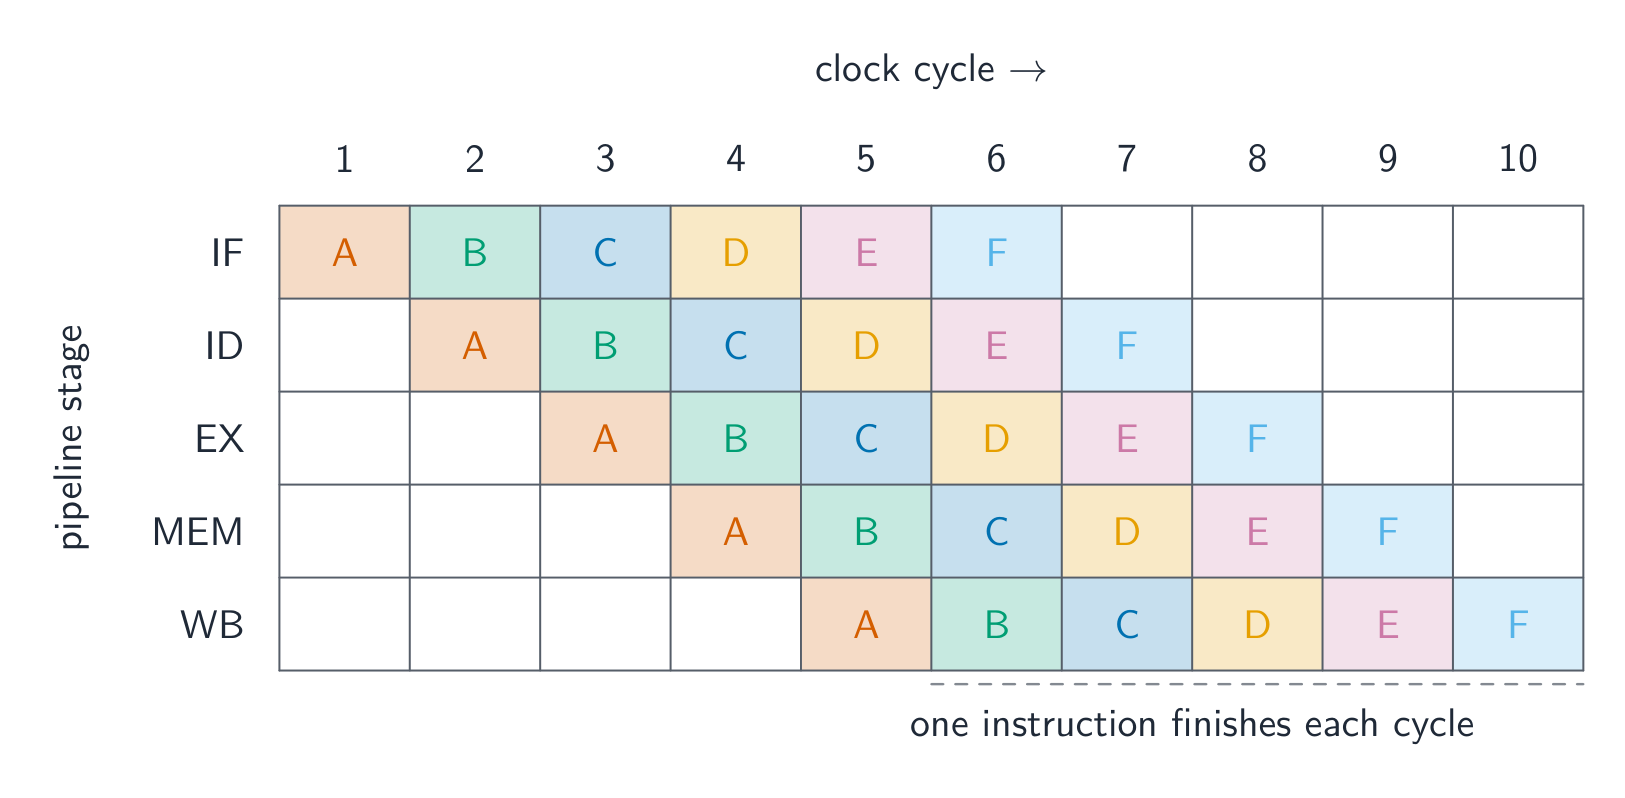
A pipeline 流水线 processes instructions in overlapping stages, like an assembly line: Fetch → Decode → Execute (in the ALU 算术逻辑单元) → Memory access → Write back. Each stage works on a different instruction at once, so once the pipeline is full, one instruction completes per cycle. RISC's fixed-length, simple instructions make every stage take the same time. A pipeline can stall on a hazard 冒险 — a data hazard (an instruction needs a result not ready yet) or a control hazard (a branch makes the next address unknown).
RISC chips keep data in many registers because memory is slow and registers are fast; the compiler allocates values to registers wisely.
"Describe the use of pipelining in RISC processors" (three marks). (1) The fetch–execute cycle is divided into stages (fetch, decode, execute, memory access, write back); (2) several instructions are in the pipeline at once, each at a different stage, so while one is being executed the next is being decoded and the one after fetched; (3) a new instruction is started, and one completed, in every clock cycle once the pipeline is full, which increases throughput 吞吐量 (the number of instructions completed per second), although each instruction still takes the same time on its own. Fixed-length single-cycle RISC instructions are what make the stages equal and the pipeline possible.
Worked example. A processor uses five pipeline stages (IF, ID, OF, EX, WB). Four instructions enter the pipeline one after another. In which cycle does the last instruction complete, and how many cycles would the four take without pipelining?
Instruction 1 occupies IF in cycle 1, ID in 2, OF in 3, EX in 4 and WB in 5; instruction 2 starts one cycle later and finishes in cycle 6; instruction 3 in cycle 7; instruction 4 in cycle 8. In general $n$ instructions through $k$ stages take $n + k - 1$ cycles, here $4 + 5 - 1 = 8$. Without pipelining each instruction takes all five cycles before the next starts: $4 \times 5 = 20$ cycles. The exam's table is filled by writing each instruction's stages diagonally, one column to the right of the previous instruction.
A processor running this fast gives off a lot of heat, so a heat-sink 散热器 and fan sit on top of it. The metal fins spread the heat and the fan blows it away, keeping the CPU cool enough to work.
Tiếng Việt
Một pipeline xử lý các lệnh theo các giai đoạn xen kẽ, giống như dây chuyền lắp ráp: Nhặt lệnh → Giải mã → Thực thi (trong ALU) → Truy cập bộ nhớ → Ghi lại. Mỗi giai đoạn làm việc với một lệnh khác nhau cùng lúc, vì vậy một khi pipeline đầy, một lệnh hoàn thành mỗi chu kỳ. Các lệnh RISC độ dài cố định, đơn giản khiến mỗi giai đoạn mất cùng một khoảng thời gian. Một pipeline có thể bị tắc nghẽn do một nguy hiểm — nguy hiểm dữ liệu (một lệnh cần kết quả chưa sẵn có) hoặc nguy hiểm điều khiển (nhánh làm địa chỉ tiếp theo không xác định).
Pipeline xen kẽ các giai đoạn của sáu lệnh, nên một lệnh hoàn thành mỗi chu kỳ
Các chip RISC giữ dữ liệu trong nhiều thanh ghi vì bộ nhớ chậm và thanh ghi nhanh; trình biên dịch phân bổ giá trị cho các thanh ghi một cách thông minh.
"Mô tả việc sử dụng pipeline trong bộ xử lý RISC" (ba điểm). (1) Chu kỳ nhặt-thực thi được chia thành các giai đoạn (nhặt, giải mã, thực thi, truy cập bộ nhớ, ghi lại); (2) nhiều lệnh nằm trong pipeline cùng lúc, mỗi lệnh ở một giai đoạn khác nhau, nên trong khi một lệnh đang được thực thi thì lệnh tiếp theo đang được giải mã và lệnh sau đó đang được nhặt; (3) một lệnh mới được bắt đầu, và một lệnh hoàn thành, trong mỗi chu kỳ xung nhịp một khi pipeline đầy, điều này tăng thông lượng (số lệnh hoàn thành mỗi giây), mặc dù mỗi lệnh vẫn mất cùng một thời gian nếu xét riêng lẻ. Các lệnh RISC độ dài cố định một chu kỳ là yếu tố khiến các giai đoạn bằng nhau và cho phép pipeline hoạt động.
Ví dụ có lời giải. Một bộ xử lý sử dụng năm giai đoạn pipeline (IF, ID, OF, EX, WB). Bốn lệnh đi vào pipeline lần lượt. Lệnh cuối cùng hoàn thành ở chu kỳ nào, và sẽ mất bao nhiêu chu kỳ để bốn lệnh đó hoàn thành nếu không có pipeline?
Lệnh 1 chiếm IF ở chu kỳ 1, ID ở 2, OF ở 3, EX ở 4 và WB ở 5; lệnh 2 bắt đầu sau một chu kỳ và hoàn thành ở chu kỳ 6; lệnh 3 ở chu kỳ 7; lệnh 4 ở chu kỳ 8. Nhìn chung $n$ lệnh qua $k$ giai đoạn mất $n + k - 1$ chu kỳ, ở đây là $4 + 5 - 1 = 8$. Không có pipelining, mỗi lệnh cần cả năm chu kỳ trước khi lệnh tiếp theo bắt đầu: $4 \times 5 = 20$ chu kỳ. Bảng đề thi được điền bằng cách viết các giai đoạn của từng lệnh theo đường chéo, mỗi lệnh nằm một cột về phía bên phải so với lệnh trước đó.
Một bộ xử lý chạy nhanh này sinh ra rất nhiều nhiệt, vì vậy một tản nhiệt và quạt đặt ngay trên nó. Các cánh tản nhiệt kim loại spread nhiệt và quạt thổi đi, giữ cho CPU đủ mát để hoạt động.
Tản nhiệt và quạt CPU mang nhiệt ra xa khỏi bộ xử lý
Explore · Khám phá
How pipelining fills up · Cách pipeline được lấp đầy
Step through the clock cycles. Once the pipeline is full, a new instruction finishes every cycle — even though each one still takes several stages — because the stages of different instructions overlap. · Xét qua các chu kỳ đồng hồ. Một khi pipeline đã đầy, một lệnh mới hoàn thành sau mỗi chu kỳ — mặc dù mỗi lệnh vẫn mất nhiều giai đoạn — vì các giai đoạn của các lệnh khác nhau trùng lặp với nhau.
Flynn's taxonomy 弗林分类 sorts computers by the number of instruction and data streams:
SISD — one instruction, one data stream (a traditional single core).
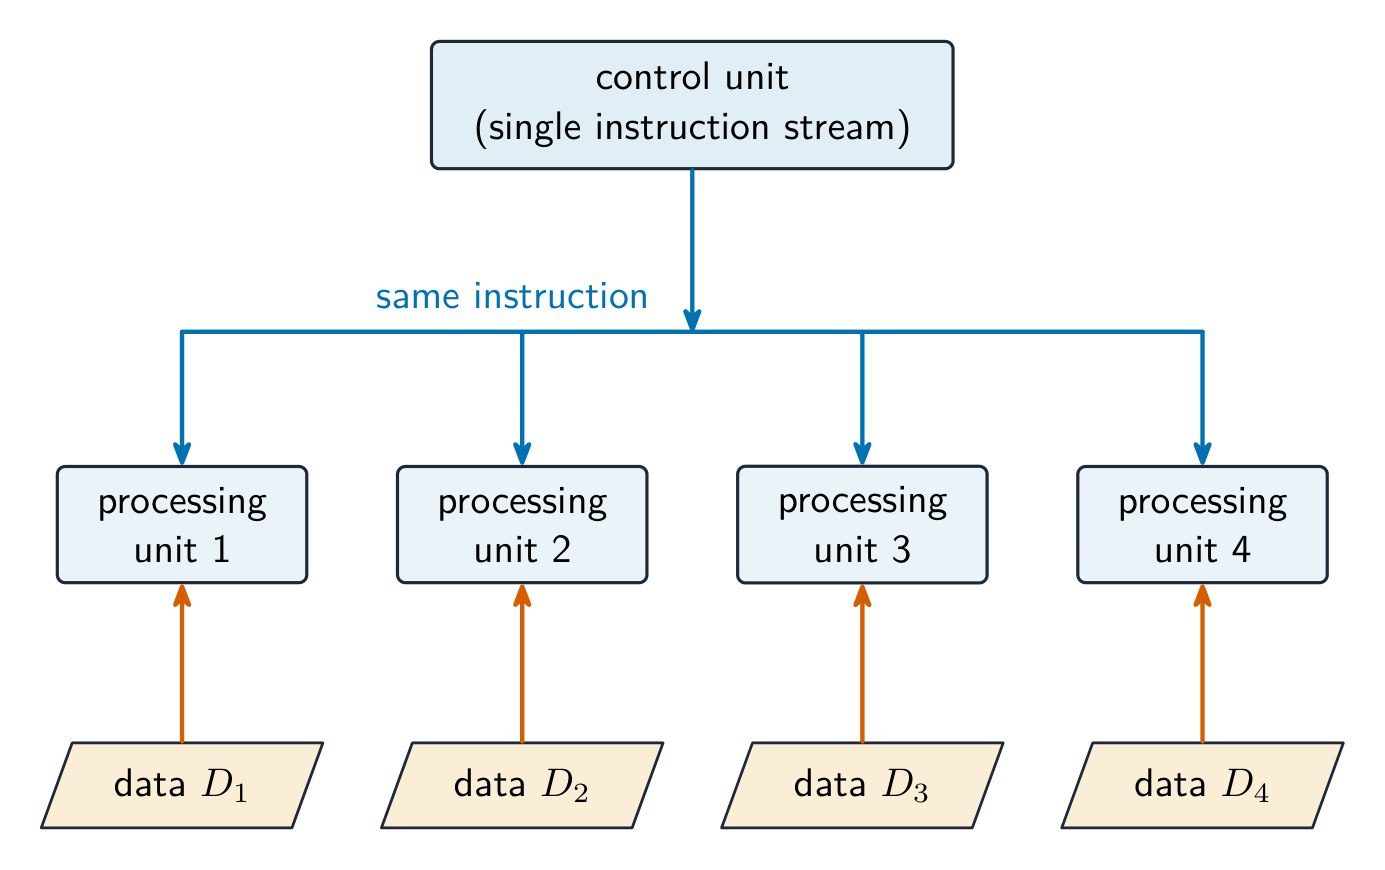
SIMD 单指令多数据 — one instruction works on many data items at once (GPUs, CPU vector extensions). Great for images, video, scientific arrays.
MISD — several operations on the same data; rare, mostly theoretical.
MIMD 多指令多数据 — many processors run different instructions on different data (multi-core CPUs, clusters). The most general.
Describing the four architectures (two marks each).SISD: a single processor executes one instruction at a time on one item of data; no parallelism, the traditional von Neumann machine. SIMD:one instruction is applied simultaneously to many data items, by many processing elements acting in step; used for array and graphics processing. MISD:several processors apply different instructions to the same data; rarely used, for example a fault-tolerant system where several processors check one stream. MIMD:many processors, each executing its own instructions on its own data, independently; the multi-core computer and the cluster.
A graphics card 显卡 (with its GPU) is a real example of SIMD hardware: it has thousands of small cores that run the same instruction on many pixels or numbers at once, which is why GPUs are so fast for images, video and machine learning.
Tiếng Việt
Phân loại Flynn sắp xếp máy tính dựa trên số lượng luồng lệnh và luồng dữ liệu:
SISD — một lệnh, một luồng dữ liệu (lõi đơn truyền thống).
SIMD — một lệnh thực hiện trên nhiều mục dữ liệu cùng lúc (GPU, mở rộng vector CPU). Phù hợp cho hình ảnh, video, mảng khoa học.
MISD — nhiều thao tác trên cùng một dữ liệu; hiếm gặp, chủ yếu là lý thuyết.
MIMD — nhiều bộ xử lý chạy các lệnh khác nhau trên các dữ liệu khác nhau (CPU đa lõi, cụm máy). Phổ biến nhất.
Mô tả bốn kiến trúc (mỗi câu hai điểm).SISD: một bộ xử lý duy nhất thực thi một lệnh tại một thời điểm trên một mục dữ liệu; không có song song, máy von Neumann truyền thống. SIMD:một lệnh được áp dụng đồng thời lên nhiều mục dữ liệu, bởi nhiều phần tử xử lý hoạt động cùng nhịp; dùng cho xử lý mảng và đồ họa. MISD:nhiều bộ xử lý áp dụng các lệnh khác nhau lên cùng một dữ liệu; ít dùng, ví dụ hệ thống chịu lỗi nơi nhiều bộ xử lý kiểm tra một luồng. MIMD:nhiều bộ xử lý, mỗi cái thực thi lệnh riêng của nó trên dữ liệu riêng của nó, độc lập; máy đa lõi và cụm máy.
SIMD: nhiều bộ xử lý chạy cùng một lệnh trên các dữ liệu khác nhau
Một card đồ họa (với GPU của nó) là ví dụ thực tế của phần cứng SIMD: nó có hàng nghìn nhân nhỏ chạy cùng một lệnh trên nhiều pixel hoặc số cùng lúc, đó là lý do tại sao GPU rất nhanh đối với hình ảnh, video và học máy.
Card đồ họa: GPU của nó chạy cùng một lệnh trên nhiều mục dữ liệu cùng lúc (SIMD)MIMD: mỗi bộ xử lý chạy các lệnh riêng của nó trên dữ liệu riêng của nó
Massively parallel computers · Máy tính song song cực lớn
English
A massively parallel 大规模并行 system uses thousands of processors on a fast network, each with its own memory (distributed memory 分布式内存), exchanging data by messages. It is MIMD, needs specially-written software (MPI, CUDA), and suits climate simulation, large machine learning 机器学习 training, and astrophysics. The largest supercomputers 超级计算机 are massively parallel.
"Outline the characteristics of massively parallel computers" (three marks). A very large number of processors (thousands), each with its own memory, connected by a network (a high-speed interconnect or bus) so that they can pass messages to one another; they work simultaneously on parts of the same problem, so the problem must be written as a program that can be split into parts that run in parallel and combine their results. It is an MIMD arrangement.
The processors live in tall server 服务器 racks, often filling a whole room (a data centre 数据中心), wired together so they can work on one big problem at the same time.
Tiếng Việt
Hệ thống song song cực lớn sử dụng hàng nghìn bộ xử lý trên mạng tốc độ cao, mỗi bộ có bộ nhớ riêng (bộ nhớ phân tán), trao đổi dữ liệu qua tin nhắn. Nó là MIMD, cần phần mềm được viết đặc biệt (MPI, CUDA), và phù hợp cho mô phỏng khí hậu, huấn luyện học máy quy mô lớn, và thiên văn vật lý. Các siêu máy tính lớn nhất đều là song song cực lớn.
"Nêu đặc điểm của máy tính song song cực lớn" (ba điểm). Một số lượng rất lớn bộ xử lý (hàng nghìn), mỗi cái có bộ nhớ riêng, được kết nối bởi mạng (cổng kết nối tốc độ cao hoặc bus) để chúng có thể gửi tin nhắn cho nhau; chúng làm việc đồng thời trên các phần của cùng một vấn đề, vì vậy vấn đề phải được viết dưới dạng chương trình có thể chia thành các phần chạy song song và tổng hợp kết quả. Đây là cấu hình MIMD.
Các bộ xử lý sống trong các giá máy chủ cao, thường lấp đầy cả một phòng (một trung tâm dữ liệu), được đấu dây với nhau để chúng có thể giải quyết cùng một vấn đề lớn cùng lúc.
Hàng giá máy chủ trong trung tâm dữ liệu, giống như những gì được dùng cho tính toán song song cực lớn
A virtual machine 虚拟机 (VM) is a software emulation of a whole computer — the software inside sees a CPU, memory and disks that look real but are managed by host software.
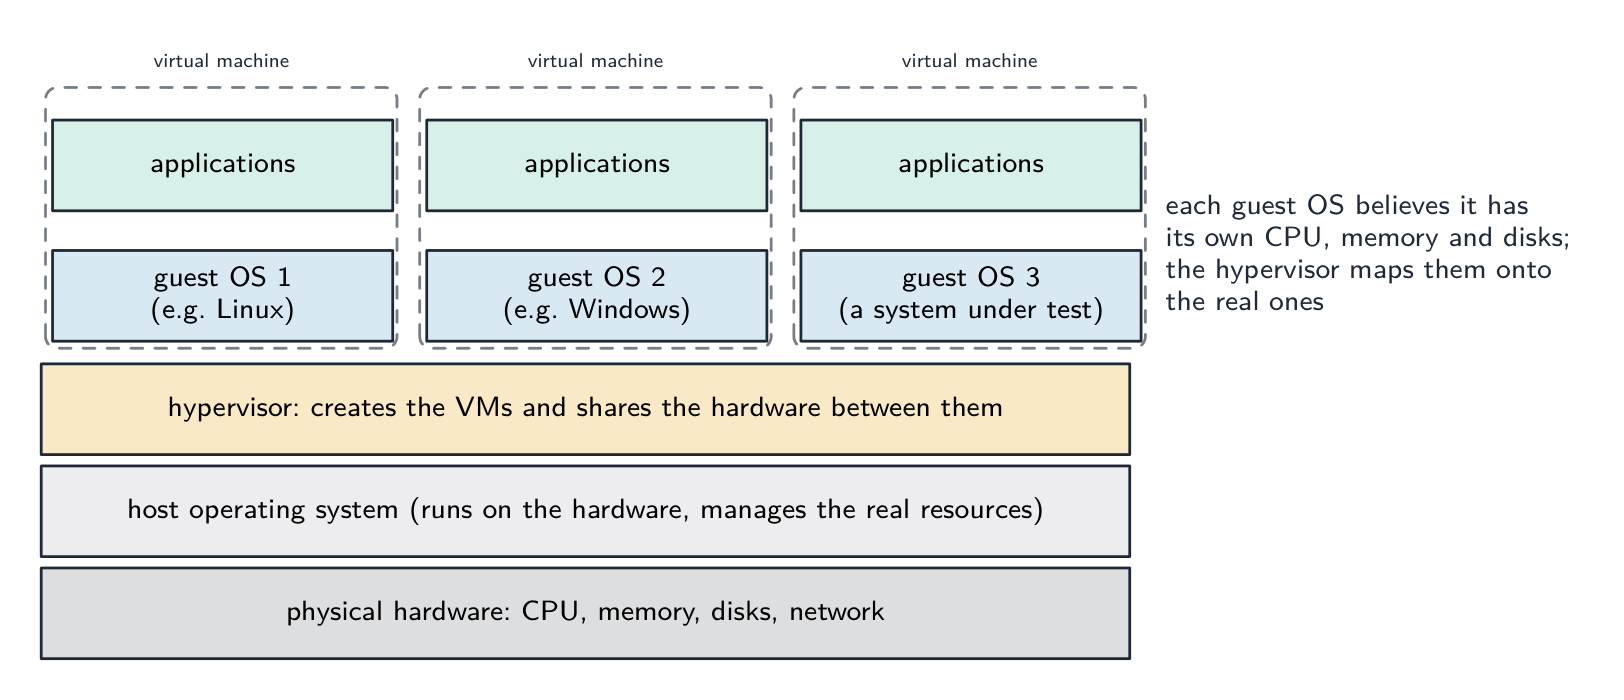
a system VM runs a complete OS. A hypervisor 虚拟机监控器 creates and manages VMs, each booting its own guest OS. Uses: run different OSes on one machine; server consolidation; sandboxing 沙箱 (risky software runs isolated); snapshots.
a process (language) VM runs one program in portable bytecode 字节码 — the JVM (Java), the CLR (.NET), CPython. Benefits: portability ("write once, run anywhere"), runtime safety checks, and just-in-time compilation 即时编译 for near-native speed. The cost is an extra layer and needing the VM installed.
"Describe what is meant by a virtual machine" (two marks).A software emulation (implementation) of a computer system that runs on a host computer and behaves, to the programs running inside it, like a separate physical computer with its own processor, memory and storage. The host operating system 宿主操作系统 runs on the actual hardware, manages the real resources and (through the hypervisor) creates and controls the virtual machines; each guest operating system 客户操作系统 runs inside a virtual machine, manages the applications in it, and is unaware that its hardware is virtual.
Benefits (give two). Several different operating systems can run on one machine at the same time; software can be tested on many systems without buying the hardware; a new computer system can be emulated and tried before it is built; each VM is isolated, so a crash or malware in one does not affect the host or the others; VMs can be copied, moved and backed up as files, and a server can be shared between many users, reducing hardware cost. Limitations (give two). A VM runs more slowly than the real hardware because every instruction passes through the emulation layer; it consumes the host's memory and processing power, so the host must be powerful; some hardware features or devices are not emulated exactly, so the tested software may behave differently on the real machine; licences are needed for each guest OS, and setting the system up needs expertise.
Tiếng Việt
Một máy ảo (VM) là sự mô phỏng phần mềm của toàn bộ máy tính — phần mềm bên trong thấy một CPU, bộ nhớ và ổ đĩa trông thật nhưng được quản lý bởi phần mềm máy chủ.
một system VM chạy một OS hoàn chỉnh. Một hypervisor tạo và quản lý VMs, mỗi cái khởi động guest OS riêng của nó. Ứng dụng: chạy các OS khác nhau trên một máy; gộp máy chủ; sandboxing (phần mềm rủi ro chạy cô lập); ảnh chụp nhanh.
một process (language) VM chạy một chương trình trong bytecode di động — JVM (Java), CLR (.NET), CPython. Lợi ích: portability ("viết một lần, chạy mọi nơi"), kiểm tra an toàn runtime, và just-in-time compilation cho tốc độ gần như bản địa. Chi phí là thêm một lớp và cần cài đặt VM.
Một máy thật, nhiều máy giả: hệ điều hành máy chủ và hypervisor chia sẻ phần cứng, và mỗi hệ điều hành khách chạy như thể nó có một máy riêng
"Mô tả ý nghĩa của một máy ảo" (hai điểm).Một sự mô phỏng (triển khai) phần mềm của một hệ thống máy tính chạy trên máy chủ và hoạt động, đối với các chương trình chạy bên trong nó, giống như một máy tính vật lý riêng biệt có bộ xử lý, bộ nhớ và bộ lưu trữ riêng.Hệ điều hành chủ chạy trên phần cứng thực tế, quản lý tài nguyên thực và (thông qua hypervisor) tạo ra và kiểm soát các máy ảo; mỗi hệ điều hành khách chạy bên trong một máy ảo, quản lý các ứng dụng trong đó, và không nhận biết được phần cứng của mình là ảo.
Lợi ích (đưa ra hai). Nhiều hệ điều hành khác nhau có thể chạy trên một máy cùng lúc; phần mềm có thể được kiểm thử trên nhiều hệ thống mà không cần mua phần cứng; một hệ thống máy tính mới có thể được mô phỏng và thử nghiệm trước khi chế tạo; mỗi VM được cô lập, nên lỗi sập hoặc malware trong một VM sẽ không ảnh hưởng đến máy chủ hay các VM khác; các VM có thể được sao chép, di chuyển và sao lưu dưới dạng tệp, và một máy chủ có thể được chia sẻ giữa nhiều người dùng, giảm chi phí phần cứng. Hạn chế (đưa ra hai). Một VM chạy chậm hơn phần cứng thực vì mọi lệnh đều phải đi qua lớp mô phỏng; nó tiêu thụ bộ nhớ và công suất xử lý của máy chủ, do đó máy chủ phải mạnh mẽ; một số tính năng hoặc thiết bị phần cứng không được mô phỏng chính xác, nên phần mềm được kiểm thử có thể hoạt động khác trên máy thực; cần bản quyền cho mỗi hệ điều hành khách, và việc thiết lập hệ thống đòi hỏi chuyên môn.
Produce truth tables for logic circuits including half adders and full adders
May include logic gates with more than two inputs
Show understanding of a flip-flop (SR, JK)
Draw a logic circuit and derive a truth table for a flip-flop Understand of the role of flip-flops as data storage elements
Show understanding of Boolean algebra
Understand De Morgan’s laws Perform Boolean algebra using De Morgan’s laws Simplify a logic circuit/expression using Boolean algebra
Show understanding of Karnaugh maps (K-map)
Understand of the benefits of using Karnaugh maps Solve logic problems using Karnaugh maps
Tiếng Việt
Thí sinh cần có thể:
Ghi chú và hướng dẫn
Lập bảng chân lý cho các mạch logic bao gồm bộ cộng nửa (half adders) và bộ cộng đầy đủ (full adders)
Có thể bao gồm cửa logic với nhiều hơn hai đầu vào
Thể hiện sự hiểu biết về flip-flop (SR, JK)
Vẽ mạch logic và rút ra bảng chân lý cho flip-flop Hiểu vai trò của flip-flops như các phần tử lưu trữ dữ liệu
Thể hiện sự hiểu biết về đại số Boolean
Hiểu định luật De Morgan Thực hiện đại số Boolean bằng định luật De Morgan Rút gọn mạch logic/biểu thức bằng đại số Boolean
Thể hiện sự hiểu biết về bản đồ Karnaugh (K-map)
Hiểu lợi ích của việc sử dụng bản đồ Karnaugh Giải quyết bài toán logic bằng bản đồ Karnaugh
Source: Cambridge International syllabus · Nguồn: Chương trình Cambridge International
English
The half adder: XOR + AND add two bits
Boolean algebra 布尔代数 simplifies Boolean 布尔 expressions, which can equally be described by truth tables 真值表. Symbols: + for OR, · for AND (often omitted), an overbar for NOT.
Key laws include commutative, associative and distributive (as in ordinary algebra), plus:
Worked example. Simplify $X = \overline{\overline{(A \cdot B)} \cdot \overline{(A + B)}}$, showing all working.
$X = \overline{\overline{(A \cdot B)}} + \overline{\overline{(A + B)}}$ (De Morgan on the outer bar) $= A \cdot B + A + B$ (double negation) $= A + B$ (absorption, $A + AB = A$, applied with $A + B$ absorbing $AB$).
Worked example. Simplify $(\overline{A + B}) \cdot (\overline{A} + B)$.
Worked example. Simplify $Y = \overline{A}\,\overline{B}\,\overline{C} + \overline{A}\,\overline{B}\,C + A\,\overline{B}\,C$.
$= \overline{A}\,\overline{B}(\overline{C} + C) + A\,\overline{B}\,C$ (distributive) $= \overline{A}\,\overline{B} + A\,\overline{B}\,C$ (complement, identity) $= \overline{B}(\overline{A} + AC)$ (distributive) $= \overline{B}(\overline{A} + C)$, using $\overline{A} + AC = (\overline{A} + A)(\overline{A} + C) = \overline{A} + C$. Applying De Morgan to a three-input term works the same way: $\overline{A + B + C} = \overline{A} \cdot \overline{B} \cdot \overline{C}$.
Sum-of-products from a truth table. Take every row whose output is 1, write the AND of its inputs (a variable barred where it is 0), and OR the terms: a row with $A = 1, B = 0, C = 1$ gives $A\,\overline{B}\,C$. This is the sum-of-products 积之和 form the exam asks for, and it is the starting point for both algebraic simplification and the Karnaugh map.
Tiếng Việt
Bộ cộng nửa: XOR + AND cộng hai bit
Đại số Boole rút gọn biểu thức Boole, những biểu thức này cũng có thể được mô tả bằng bảng chân lý. Ký hiệu: + cho OR, · cho AND (thường bị bỏ qua), gạch ngang phía trên cho NOT.
Các định luật quan trọng bao gồm giao hoán, kết hợp và phân phối (như trong đại số thông thường), cùng:
Ví dụ có hướng dẫn. Rút gọn $X = \overline{\overline{(A \cdot B)} \cdot \overline{(A + B)}}$, hiện thị tất cả các bước giải.
$X = \overline{\overline{(A \cdot B)}} + \overline{\overline{(A + B)}}$ (De Morgan trên vạch ngoài) $= A \cdot B + A + B$ (phủ định kép) $= A + B$ (hấp thụ, $A + AB = A$, áp dụng với $A + B$ đang hấp thụ $AB$).
$= \overline{A}\,\overline{B}(\overline{C} + C) + A\,\overline{B}\,C$ (phân phối) $= \overline{A}\,\overline{B} + A\,\overline{B}\,C$ (bổ sung, định danh) $= \overline{B}(\overline{A} + AC)$ (phân phối) $= \overline{B}(\overline{A} + C)$, sử dụng $\overline{A} + AC = (\overline{A} + A)(\overline{A} + C) = \overline{A} + C$. Áp dụng De Morgan cho một biểu thức ba đầu vào hoạt động tương tự: $\overline{A + B + C} = \overline{A} \cdot \overline{B} \cdot \overline{C}$.
Tổng-tích từ bảng chân lý. Lấy mỗi hàng mà đầu ra là 1, viết tích AND của các đầu vào của hàng đó (biến bị gạch ngang nếu giá trị là 0), sau đó cộng OR các toán hạng: một hàng với $A = 1, B = 0, C = 1$ sẽ tạo ra $A\,\overline{B}\,C$. Đây là dạng tổng-tích mà đề thi yêu cầu, và đây là điểm xuất phát cho cả việc rút gọn đại số lẫn bản đồ Karnaugh.
Explore · Khám phá
Boolean algebra · Đại số Boole
A·B, A+B, Ā …
Boolean algebra is just these gates written as expressions — compare the truth tables. · Đại số Boole chỉ là các cổng logic viết dưới dạng biểu thức — hãy so sánh bảng chân lý.
Explore · Khám phá
Boolean truth tables · Bảng chân lý Boolean
Pick an operator and the inputs to build its truth table — the algebra behind logic circuits. · Chọn toán tử và đầu vào để xây dựng bảng chân lý của nó — đại số đằng sau các mạch logic.
A Karnaugh map 卡诺图 (K-map) simplifies a Boolean expression by grouping adjacent 1s from a truth table. Columns and rows use Gray code 格雷码 order (00, 01, 11, 10) so adjacent cells differ in one variable.
Place a 1 in each cell where the output is 1. Find rectangular groups of 1s whose sides are powers of 2 (1, 2, 4, 8), wrapping around edges if it makes a bigger group. The larger the group, the simpler the term: a group of 2 drops one variable, a group of 4 drops two, and so on — variables that change within the group disappear. OR the group terms together for the simplified expression. Cover every 1 using as few, as large, groups as possible.
Worked example. A Karnaugh map for $A$ and $B$ has 1s in the cells $\overline{A}B$ and $AB$. Simplify. The two 1s are adjacent - they share the $B=1$ column - so group them as a rectangle of 2. Inside that group $B$ stays 1 throughout while $A$changes from 0 to 1, and any variable that changes within a group disappears. So the group leaves simply $X = B$. Compare that with the sum of products read straight off the table, $\overline{A}B + AB$: the same circuit, two gates fewer. Two rules do most of the work - make each group as large as possible (a group of 2 drops one variable, 4 drops two, 8 drops three), and remember the map wraps around its edges, so the leftmost and rightmost columns are adjacent. That wrap is the grouping most candidates miss.
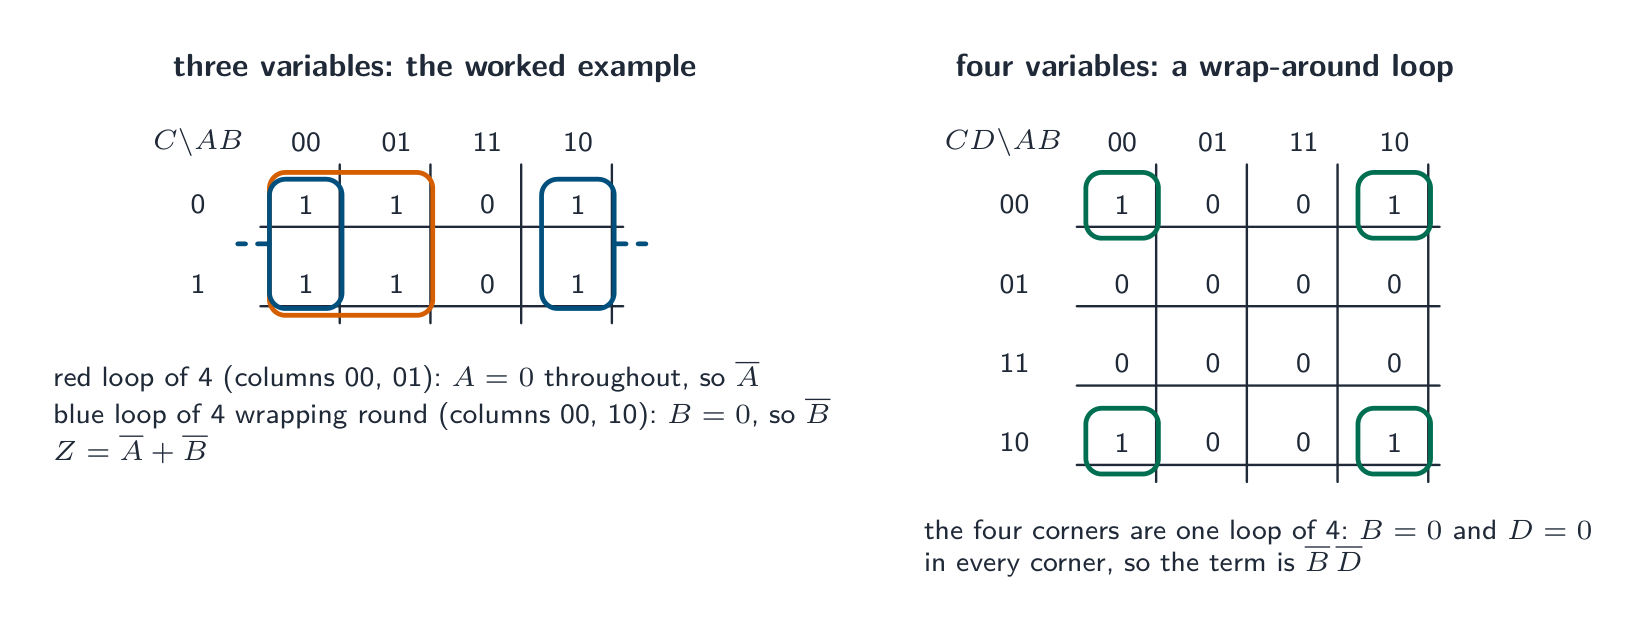
Building and reading a K-map. Label the columns $AB$ and the rows $C$ (or $CD$) in Gray-code order 00 01 11 10, so that neighbouring cells differ in one variable only. Put a 1 in every cell whose minterm appears in the expression (or whose truth-table row outputs 1). Then draw the fewest, largest loops that cover every 1: each loop must be a rectangle of $1, 2, 4$ or $8$ cells, loops may overlap, may wrap across the left–right and top–bottom edges, and the four corners together make a loop. For each loop write the variables that are constant inside it (barred if 0), and OR the loop terms: that is the optimal sum-of-products. Why use one? It gives the simplest expression without algebra, in a few steps, with less chance of error, and the same map suits three or four variables.
On the three-variable map the 1s fill columns 00, 01 and 10 in both rows. The loop of four over columns 00 and 01 has $A = 0$ throughout and $B$, $C$ both varying: term $\overline{A}$. The loop of four over columns 00 and 10 (wrapping round) has $B = 0$ throughout: term $\overline{B}$. So $Z = \overline{A} + \overline{B}$, which Boolean algebra confirms: $\overline{A}(\overline{B} + B) + \ldots = \overline{A} + \overline{B}$. Two loops of two would also be correct but not optimal; a loop is as large as the 1s allow.
Worked example (four variables). A map has 1s only in its four corners: $\overline{A}\,\overline{B}\,\overline{C}\,\overline{D}$, $A\,\overline{B}\,\overline{C}\,\overline{D}$, $\overline{A}\,\overline{B}\,C\,\overline{D}$ and $A\,\overline{B}\,C\,\overline{D}$. Because the top and bottom rows are adjacent and so are the outer columns, the corners are one loop of four; $B = 0$ and $D = 0$ in all of them while $A$ and $C$ vary, so $Z = \overline{B}\,\overline{D}$.
Tiếng Việt
Một bản đồ Karnaugh (K-map) rút gọn biểu thức Boole bằng cách nhóm các số 1 kề nhau từ bảng chân lý. Các cột và hàng sử dụng thứ tự mã Gray (00, 01, 11, 10) để các ô kề nhau chỉ khác nhau ở một biến.
Đặt số 1 vào mỗi ô mà đầu ra là 1. Tìm các nhóm hình chữ nhật gồm các số 1 có cạnh là lũy thừa của 2 (1, 2, 4, 8), có thể cuộn quanh các cạnh nếu giúp tạo thành nhóm lớn hơn. Nhóm càng lớn thì toán hạng càng đơn giản: một nhóm 2 loại bỏ một biến, nhóm 4 loại bỏ hai biến, v.v. — các biến thay đổi bên trong nhóm sẽ biến mất. Cộng OR các toán hạng nhóm lại để có biểu thức rút gọn. Bao phủ tất cả các số 1 bằng số lượng nhóm ít nhất, nhưng mỗi nhóm phải lớn nhất có thể.
Ví dụ có hướng dẫn. Một bản đồ Karnaugh cho $A$ và $B$ có các số 1 tại các ô $\overline{A}B$ và $AB$. Rút gọn. Hai số 1 này là kề nhau - chúng chia sẻ cột $B=1$ - nên nhóm chúng thành một hình chữ nhật gồm 2. Bên trong nhóm đó $B$ luôn giữ nguyên giá trị 1 trong khi $A$thay đổi từ 0 sang 1, và bất kỳ biến nào thay đổi bên trong một nhóm sẽ biến mất. Vậy nhóm này chỉ còn lại đơn giản là $X = B$. So sánh điều đó với tổng-tích đọc trực tiếp từ bảng, $\overline{A}B + AB$: cùng một mạch điện, nhưng ít hơn hai cổng. Hai quy tắc thực hiện hầu hết công việc - hãy tạo mỗi nhóm lớn nhất có thể (nhóm 2 loại bỏ một biến, 4 loại bỏ hai, 8 loại bỏ ba), và nhớ rằng bản đồ cuộn quanh các cạnh, nên cột trái cùng và cột phải cùng là kề nhau. Sự cuộn quanh này là phần nhóm mà hầu hết các thí sinh bỏ sót.
Vòng lặp của 1, 2, 4 hoặc 8 số một; thuật ngữ vòng lặp chỉ giữ lại các biến không thay đổi bên trong nó. Các cạnh nối lại, do đó một vòng lặp có thể quấn quanh, và bốn góc được coi là kề nhau
Xây dựng và đọc bản đồ Karnaugh. Gán nhãn cho các cột $AB$ và các hàng $C$ (hoặc $CD$) theo thứ tự mã Gray 00 01 11 10, sao cho các ô lân cận chỉ khác nhau ở một biến duy nhất. Đặt số 1 vào mọi ô mà minterm của nó xuất hiện trong biểu thức (hoặc ô có hàng bảng chân lý tương ứng cho kết quả là 1). Sau đó vẽ số lượng ít nhất, lớn nhất các vòng bao phủ tất cả các số 1: mỗi vòng phải là hình chữ nhật gồm $1, 2, 4$ hoặc $8$ ô, các vòng có thể chồng lên nhau, có thể vòng qua các cạnh trái–phải và trên–dưới, và bốn góc cùng tạo thành một vòng. Với mỗi vòng, viết ra các biến không đổi bên trong nó (có bar nếu bằng 0), sau đó OR các thừa số của các vòng lại với nhau: đó chính là tổng của các tích tối ưu. Tại sao sử dụng? Nó mang lại biểu thức đơn giản nhất mà không cần đại số, chỉ qua vài bước, giảm thiểu sai sót, và cùng một bản đồ cũng áp dụng được cho ba hoặc bốn biến.
Trên bản đồ ba biến, các số 1 điền đầy các cột 00, 01 và 10 ở cả hai hàng. Vòng gồm bốn ô trên các cột 00 và 01 có $A = 0$ không đổi throughout và $B$, $C$ đều thay đổi: thừa số $\overline{A}$. Vòng gồm bốn ô trên các cột 00 và 10 (quay vòng) có $B = 0$ không đổi throughout: thừa số $\overline{B}$. Vậy $Z = \overline{A} + \overline{B}$, điều này cũng được đại số Boolean xác nhận: $\overline{A}(\overline{B} + B) + \ldots = \overline{A} + \overline{B}$. Hai vòng gồm hai ô cũng đúng nhưng không tối ưu; một vòng sẽ lớn đến mức các số 1 cho phép.
Ví dụ minh họa (bốn biến). Một bản đồ chỉ có các số 1 ở bốn góc: $\overline{A}\,\overline{B}\,\overline{C}\,\overline{D}$, $A\,\overline{B}\,\overline{C}\,\overline{D}$, $\overline{A}\,\overline{B}\,C\,\overline{D}$ và $A\,\overline{B}\,C\,\overline{D}$. Vì hàng trên và hàng dưới liền kề, và các cột ngoài cũng liền kề, nên bốn góc tạo thành một vòng gồm bốn ô; $B = 0$ và $D = 0$ không đổi trong tất cả chúng trong khi $A$ và $C$ thay đổi, do đó $Z = \overline{B}\,\overline{D}$.
Half adder and full adder · Bộ cộng nửa và bộ cộng đầy đủ
English
A half adder 半加器 adds two single bits $A$ and $B$, giving a sum $S$ and a carry 进位$C$:
A
B
S
C
0
0
0
0
0
1
1
0
1
0
1
0
1
1
0
1
So $S = A \text{ XOR } B$ and $C = A \text{ AND } B$. It ignores any carry-in — hence "half".
A full adder 全加器 adds three bits ($A$, $B$, carry-in), giving a sum and a carry-out: $S = A \text{ XOR } B \text{ XOR } C_{\text{in}}$. It can be built from two half adders plus an OR gate. Chaining full adders (each carry-out feeding the next carry-in) makes a multi-bit "ripple-carry" adder.
The full-adder truth table. With inputs $A$, $B$ and the carry-in $C_{\text{in}}$: the sum $S$ is 1 when an odd number of inputs is 1, and the carry-out is 1 when two or more inputs are 1.
$A$
$B$
$C_{\text{in}}$
$S$
$C_{\text{out}}$
0
0
0
0
0
0
0
1
1
0
0
1
0
1
0
0
1
1
0
1
1
0
0
1
0
1
0
1
0
1
1
1
0
0
1
1
1
1
1
1
The circuit questions the exam sets. Given a circuit of an XOR and an AND gate sharing two inputs, or two half adders and an OR gate, "complete the truth table (show your working)" means adding a column for every intermediate gate output and filling the rows in order; "state the name of the circuit" is half adder or full adder; "state the purpose of each output" is the sum of the bits and the carry to the next column. Sum-of-products for the half adder: $S = \overline{A}B + A\overline{B}$, $C = AB$. A chain of full adders, each passing its carry-out to the next carry-in, adds two multi-bit numbers.
Tiếng Việt
Một bộ cộng nửa cộng hai bit đơn lẻ $A$ và $B$, cho ra tổng $S$ và cước$C$:
A
B
S
C
0
0
0
0
0
1
1
0
1
0
1
0
1
1
0
1
Vậy $S = A \text{ XOR } B$ và $C = A \text{ AND } B$. Nó bỏ qua任何 carry-in — vì vậy gọi là "nửa".
A half adder, as a block and as a circuit of an XOR and an AND gate
Một bộ cộng đầy đủ cộng ba bit ($A$, $B$, carry-in), cho ra tổng và carry-out: $S = A \text{ XOR } B \text{ XOR } C_{\text{in}}$. Nó có thể được xây dựng từ hai bộ cộng nửa cộng với một cổng OR. Nối tiếp các bộ cộng đầy đủ (mỗi carry-out cung cấp carry-in cho bộ tiếp theo) tạo thành bộ cộng "ripple-carry" nhiều bit.
A full adder is built from two half adders and an OR gate
Bảng chân lý của bộ cộng đầy đủ. Với các đầu vào $A$, $B$ và carry-in $C_{\text{in}}$: tổng $S$ bằng 1 khi có số lượng đầu vào là lẻ bằng 1, và carry-out bằng 1 khi hai hoặc nhiều hơn đầu vào bằng 1.
$A$
$B$
$C_{\text{in}}$
$S$
$C_{\text{out}}$
0
0
0
0
0
0
0
1
1
0
0
1
0
1
0
0
1
1
0
1
1
0
0
1
0
1
0
1
0
1
1
1
0
0
1
1
1
1
1
1
Các câu hỏi mạch điện mà đề thi đưa ra. Cho một mạch gồm một cổng XOR và một cổng AND chia sẻ hai đầu vào, hoặc hai bộ cộng nửa và một cổng OR, yêu cầu "hoàn thành bảng chân lý (trình bày lời giải)" nghĩa là thêm một cột cho từng đầu ra trung gian của cổng và điền các hàng theo thứ tự; "nêu tên của mạch" là bộ cộng nửa hoặc bộ cộng đầy đủ; "nêu mục đích của từng đầu ra" là tổng của các bit và cước sang cột tiếp theo. Tổng của các tích cho bộ cộng nửa: $S = \overline{A}B + A\overline{B}$, $C = AB$. Một chuỗi các bộ cộng đầy đủ, mỗi bộ truyền carry-out của nó sang carry-in của bộ kế tiếp, để cộng hai số nhiều bit.
Explore · Khám phá
The gates inside an adder · Các cổng bên trong máy cộng
A half-adder's sum bit is an XOR gate and its carry is an AND gate — toggle A and B and watch the truth-table row light up. · Bit tổng của máy cộng bán phần là cổng XOR và bit carry là cổng AND — hãy đảo A và B và xem hàng bảng chân lý nào sáng lên.
A flip-flop 触发器 is a bistable 双稳态 circuit — two stable states (0 and 1) — that remembers its state. It stores one bit and is the basic element of registers and SRAM.
SR flip-flop
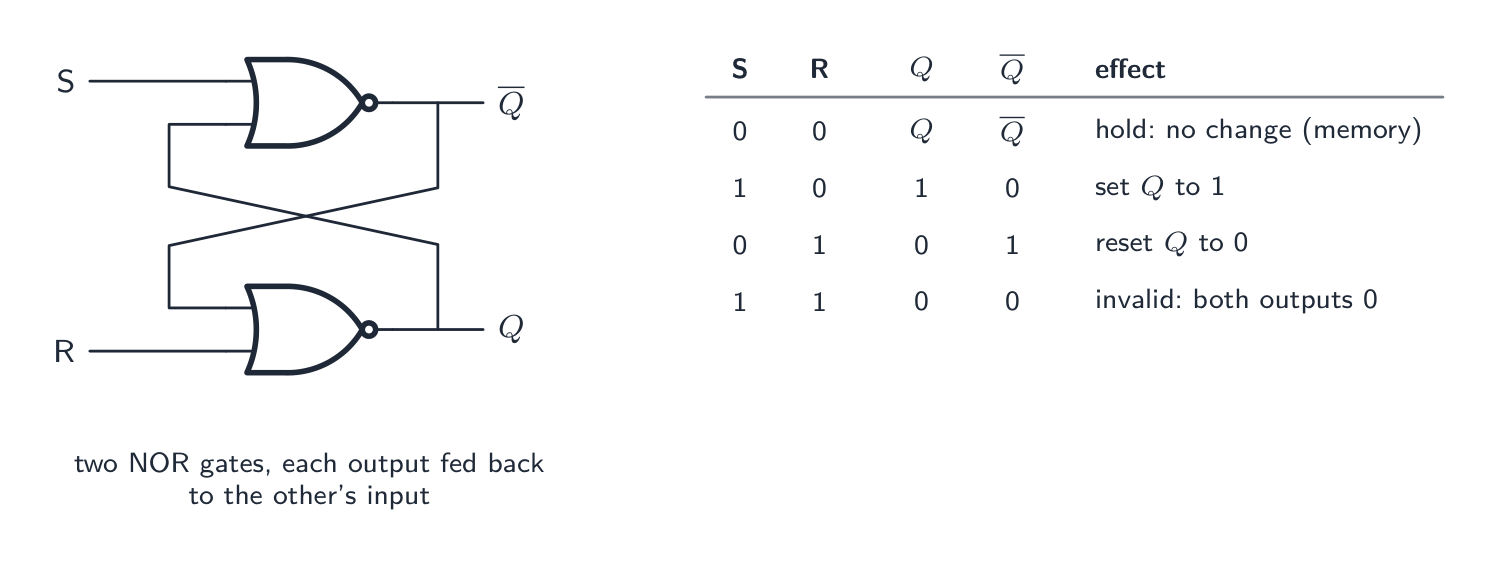
An SR flip-flop SR触发器 has inputs S (set) and R (reset) and outputs Q and $\overline{Q}$. S=1,R=0 sets Q to 1; S=0,R=1 resets it to 0; S=0,R=0 holds; S=1,R=1 is invalid. Built from two cross-coupled NOR gates.
"Draw a logic circuit for an SR flip-flop and label the inputs." Two NOR gates (or two NAND gates), the output of each connected back to one input of the other; the free input of one gate is S, of the other R; the outputs are $Q$ and $\overline{Q}$. The feedback is what the marks are for: without it there is no memory. "State the purpose of a flip-flop."To store one bit of data; it is the basic memory element from which registers and static RAM are built, and it holds its value until it is deliberately changed. The invalid input $S = R = 1$ makes both outputs 0, so that $\overline{Q}$ is no longer the complement of $Q$, and the state after both inputs return to 0 is unpredictable, which is the SR flip-flop's weakness.
JK flip-flop
A JK flip-flop JK触发器 improves on it by using the previously-invalid 1,1 input as a toggle 翻转 (the output flips). This makes it ideal for building counters 计数器 (a chain of toggling flip-flops). It is usually clocked — inputs act only on a clock edge, keeping flip-flops synchronised.
Flip-flops are the building blocks of registers (n bits = n flip-flops), counters, and SRAM 静态RAM cells.
JK flip-flop truth table. The clock 时钟 input decides when the J and K inputs are read, so the output changes only on a clock pulse: with $J = K = 0$ the output is held; $J = 1, K = 0$sets$Q$ to 1; $J = 0, K = 1$resets it to 0; $J = K = 1$toggles it (Q becomes $\overline{Q}$). The last row is exactly the SR flip-flop's forbidden input turned into a useful one, which is why the JK is preferred: every input combination is valid, and the clocked operation makes it the building block of counters and shift registers.
Tiếng Việt
Một flip-flop là một mạch b ổn định — có hai trạng thái ổn định (0 và 1) — nhớ trạng thái của nó. Nó lưu trữ một bit và là phần tử cơ bản của registers và SRAM.
Flip-flop SR
Một flip-flop SR có đầu vào S (set) và R (reset) và các đầu ra Q và $\overline{Q}$. S=1,R=0 đặt Q về 1; S=0,R=1 đặt nó về 0; S=0,R=0 giữ nguyên; S=1,R=1 là không hợp lệ. Được xây dựng từ hai cổng NOR ghép chéo.
The SR flip-flop: two NOR gates feeding each other. With both inputs 0 the outputs hold whatever they were, which is the memory; S sets Q to 1, R resets it, and S = R = 1 is not allowed
"Vẽ một mạch logic cho flip-flop SR và gán nhãn các đầu vào." Hai cổng NOR (hoặc hai cổng NAND), đầu ra của mỗi cổng được nối ngược lại một đầu vào của cổng kia; đầu vào còn lại của cổng này là S, của cổng kia là R; các đầu ra là $Q$ và $\overline{Q}$. Phản hồi chính là điểm đánh giá: nếu không có phản hồi thì không có bộ nhớ. "Nêu mục đích của một flip-flop."Để lưu trữ một bit dữ liệu; nó là phần tử bộ nhớ cơ bản được xây dựng từ đó các register và static RAM, và nó giữ giá trị cho đến khi bị thay đổi cố ý. Đầu vào không hợp lệ $S = R = 1$ khiến cả hai đầu ra bằng 0, do đó $\overline{Q}$ không còn là phần bổ của $Q$, và trạng thái sau khi cả hai đầu vào trở về 0 là khó dự đoán, đây là điểm yếu của flip-flop SR.
Flip-flop JK
Một flip-flop JK cải tiến loại này bằng cách sử dụng đầu vào trước đây không hợp lệ 1,1 làm toggle (đầu ra đảo chiều). Điều này khiến nó lý tưởng để xây dựng bộ đếm (một chuỗi các flip-flop toggle). Nó thường được đồng bộ hóa — các đầu vào chỉ tác động tại cạnh xung clock, giúp đồng bộ hóa các flip-flop.
A JK flip-flop: its symbol and a build from NAND gates
Flip-flops là các khối xây dựng của registers (n bit = n flip-flop), bộ đếm, và các ô nhớ SRAM.
Bảng chân lý flip-flop JK. Đầu vào clock quyết định thời điểm đọc các đầu vào J và K, do đó đầu ra chỉ thay đổi khi có xung clock: với $J = K = 0$ đầu ra được giữ nguyên; $J = 1, K = 0$đặt$Q$ thành 1; $J = 0, K = 1$xóa nó thành 0; $J = K = 1$lật ngược (Q trở thành $\overline{Q}$). Dòng cuối cùng chính là đầu vào cấm của flip-flop SR được biến thành một đầu vào hữu ích, đó là lý do JK được ưu tiên: mọi tổ hợp đầu vào đều hợp lệ, và hoạt động có xung clock khiến nó trở thành khối xây dựng cơ bản của bộ đếm và thanh ghi dịch chuyển.
RISC and CISC are answered as lists of features: simple, fixed, one cycle, many registers, load/store, pipelined against complex, variable, multi-cycle, fewer registers, direct memory access, microcode. Four of each.
Pipelining: stages, several instructions at once, one completed per cycle, higher throughput; $n + k - 1$ cycles for $n$ instructions through $k$ stages; interrupts must empty the pipeline.
Flynn's four categories are "how many instruction streams" by "how many data streams"; say what runs on what. Massively parallel: many processors, own memory, network, same problem.
Virtual machine: emulation of a computer on a host; host OS on the hardware, hypervisor sharing it, guest OS inside. Two benefits and two limitations, each a full sentence.
Boolean algebra: name each law as you use it; De Morgan swaps the operator and negates each term; check with a truth table if in doubt.
K-map: Gray-code order, largest loops of 1/2/4/8, wrapping allowed, one term per loop with the unchanging variables. State why: simplest expression with no algebra.
Half adder gives sum and carry; full adder also takes a carry-in; SR flip-flop is two cross-coupled NOR/NAND gates and stores one bit; JK's 1,1 input toggles.
Common mistakes
Swapping the RISC and CISC feature lists, or offering "faster" as a feature; give the design features, not a verdict.
Describing pipelining as "running instructions in parallel on several cores"; it is stages of one processor overlapping.
Confusing SIMD (one instruction, many data) with MIMD (many of both), or describing MISD as the common case.
Defining a virtual machine as "a copy of a computer" without the word emulation or the host and guest.
Applying De Morgan to only part of an expression under a long bar, or dropping the bar without swapping AND for OR.
Looping a group of three, or a non-rectangular group, in a K-map; ordering the columns 00, 01, 10, 11 instead of Gray code.
Writing the carry of a half adder as XOR and the sum as AND.
Drawing an SR flip-flop as two gates with no feedback, or leaving out the invalid state from its truth table.
Tiếng Việt
RISC và CISC được trả lời dưới dạng danh sách đặc điểm: đơn giản, cố định, một chu kỳ, nhiều thanh ghi, load/store, pipeline so với phức tạp, biến thiên, đa chu kỳ, ít thanh ghi hơn, truy cập bộ nhớ trực tiếp, microcode. Bốn đặc điểm cho mỗi loại.
Pipelining: các giai đoạn, nhiều lệnh cùng lúc, hoàn thành một lệnh mỗi chu kỳ, thông lượng cao hơn; $n + k - 1$ chu kỳ để xử lý $n$ lệnh qua $k$ giai đoạn; ngắt phải làm rỗng pipeline.
Bốn phân loại Flynn là "số luồng lệnh" theo "số luồng dữ liệu"; nói rõ cái gì chạy trên cái gì. Song song quy mô lớn: nhiều bộ xử lý, bộ nhớ riêng, mạng, cùng một bài toán.
Máy ảo: giả lập máy tính trên máy chủ; OS máy chủ trên phần cứng, hypervisor chia sẻ, OS khách bên trong. Hai lợi ích và hai hạn chế, mỗi câu đầy đủ.
Đại số Boolean: gọi tên từng luật khi áp dụng; De Morgan đảo toán tử và phủ định từng term; kiểm tra lại bằng bảng chân lý nếu không chắc chắn.
Bản đồ K: thứ tự Gray-code, vòng lớn nhất 1/2/4/8, phép cuộn allowed, một term cho mỗi vòng với các biến không đổi. Giải thích tại sao: biểu thức đơn giản nhất mà không cần đại số.
Half adder cho tổng và carry; full adder còn nhận carry-in; SR flip-flop gồm hai cổng NOR/NAND ghép chéo và lưu một bit; JK với đầu vào 1,1 sẽ chuyển trạng thái.
Lỗi thường gặp
Đảo ngược danh sách đặc điểm RISC và CISC, hoặc đưa "nhanh hơn" làm đặc điểm; hãy đưa đặc điểm thiết kế, không phải phán xét.
Miêu tả pipeline là "chạy lệnh song song trên nhiều nhân"; thực tế là các giai đoạn của một bộ xử lý xen kẽ.
Nhầm lẫn SIMD (một lệnh, nhiều dữ liệu) với MIMD (nhiều cả hai), hoặc mô tả MISD là trường hợp phổ biến.
Định nghĩa máy ảo là "bản sao của máy tính" mà không dùng từ giả lập hay máy chủ và máy khách.
Áp dụng De Morgan chỉ vào một phần biểu thức nằm dưới thanh dài, hoặc bỏ thanh mà không đổi AND sang OR.
Vẽ vòng bao gồm ba ô, hoặc nhóm không hình chữ nhật trong bản đồ K; sắp xếp cột 00, 01, 10, 11 thay vì thứ tự Gray code.
Viết carry của half adder là XOR và tổng là AND.
Vẽ SR flip-flop làm hai cổng không có feedback, hoặc bỏ trạng thái bất hợp lệ khỏi bảng chân lý.
Interactive lessons on this topic · Bài học tương tác về chủ đề này
Work through it step by step, with instant-check exercises. · Làm theo từng bước, kèm theo bài tập kiểm tra ngay lập tức.
More topics in A-Level Computer Science · Khoa học máy tính A-Level · Nhiều chủ đề hơn trong A-Level Computer Science · Khoa học máy tính A-Level
Pick one and the site follows you — notes, papers, videos and practice all open on it. · Chọn một môn và trang sẽ điều hướng theo — ghi chú, tài liệu, video và bài tập đều mở ở đó.
Type to search notes, lessons, code, vocabulary and past-paper questions across every subject. · Nhập để tìm ghi chú, bài học, mã, từ vựng và câu hỏi đề thi cũ trên mọi môn học.