| 응시자가 다음을 수행할 수 있어야 함: | 참고 사항 및 가이드라인 |
|---|---|
| RISC와 CISC 프로세서에 대한 이해 | RISC와 CISC의 차이점 CISC 및 RISC 프로세서의 인터럽트 처리 이해 |
| RISC 프로세서에서 파이프라인과 레지스터의 중요성/용도에 대한 이해를 보임 | |
| 네 가지 기본 컴퓨터 아키텍처에 대한 이해 | SISD, SIMD, MISD, MIMD |
| 대규모 병렬 컴퓨터의 특징에 대한 이해를 보임 | |
| 가상 머신 개념에 대한 이해 | 가상 머신의 역할 예시 제시 가상 머신의 장점과 한계 이해 |
하드웨어 및 가상 머신
A-Level 컴퓨터 과학 · 주제 15
 15:02
RISC, 파이프라인 및 논리 회로
두 칩 설계자가 같은 문제에 직면합니다: 프로그램을 빠르게 만듭니다. 하나는这样说 — 강력한 명령어를 만들라고 says,这样每个命令都做很多工作。另一个说 — 保持简单 — make instructions simple so they can execute quickly.
영어 내레이션 · 영어 + 중국어 자막 burned-in
15.1
RISC vs CISC 프로세서

Syllabus
출처: Cambridge International syllabus
CPU 설계의 두 가지 스타일. CPU 자체는 프로세서, 메모리 및 컴퓨터의 모든 다른 부품을 연결하는 메인 보드인 메인보드에 장착됩니다.

CISC
CISC(Complex Instruction Set Computers)는 다수이며 종종 복잡한 명령어(한 번에 여러 메모리 접근 및 연산을 수행할 수 있음)를 가변 길이로 가져, 디코딩이 복잡합니다. 하드웨어에서 명령어당 더 많은 작업을 수행합니다. 예: Intel x86.
RISC
RISC(Reduced Instruction Set Computers)는 소수의 단순한 명령어를 가지는 작은 세트를 가지며, 각 명령어는 하나의 기본 연산을 수행하고 모두 고정 길이(디코딩이 빠름)입니다. load와 store 명령어만 메모리에 접근하며, 나머지는 모두 register 간 연산입니다. 프로그램은 길어지지만 각 명령어의 처리 속도가 빠르고 예측 가능하여 파이프라이닝에 적합합니다. 예: ARM, RISC-V.
| 기능 | CISC | RISC |
|---|---|---|
| 명령어 세트 | 많음 | 적음 |
| 명령어 길이 | 가변 | 고정 |
| 메모리 접근 | 많은 명령어 | load/store만 |
| 파이프라이닝 적합성 | 어려움 | 자연스러움 |
| 명령어당 사이클 | 변동적 | 보통 1 |
교차점은 명령어당 더 많은 작업(CISC) vs 각 명령어를 더 빠르고 예측 가능하게 수행(RISC) 하는 것입니다. 최신 인텔 칩은 내부적으로 CISC 명령어를 더 간단한 RISC 유사 마이크로 퍼레이션으로 변환합니다.
"RISC 프로세서의 네 가지 특징을 식별하시오." 다음 중 네 가지 선택: 소수의 간단한 명령어 세트; 고정 길이(한 단어) 명령어; 대부분의 명령어가 하나의 클럭 사이클 내에 완료됨; 다수의 범용 레지스터; load와 store 명령어만 메모리에 접근(모든 산술 연산은 register-to-register); 하드 와어드 제어(마이크로코드 없음); 파이프라이닝을 위해 설계됨; 컴파일러가 더 많은 작업을 담당하므로 프로그램에 더 많은 명령어가 포함되어 더 많은 메모리가 필요함. "CISC 프로세서의 네 가지 특징을 식별하시오." 다음 중 네 가지 선택: 대량의 명령어 세트, 그중 많은 것이 복잡(한 명령어로 여러 연산 수행 가능); 가변 길이 명령어; 여러 클럭 사이클이 소요되는 명령어; 적은 레지스터; 메모리에 직접 접근 가능한 명령어; 마이크로 프로그래밍된 제어; 파이프라이닝에 덜 적합; 짧은 프로그램으로 인해 컴파일러가 단순하고 메모리 사용량이 적음. "RISC와 CISC의 의미를 서술하시오" (각 2점): 약자를 풀어서 설명하고 정의적 개념 제시(짧은 단일 사이클 단순 명령어; 긴 다중 사이클 복잡한 명령어).
두 설계에서의 인터럽트 처리. CISC 프로세서에서는 현재 명령어가 아무리 복잡하더라도 완료된 후에야 인터럽트가 처리되며, 프로세서는 이후 레지스터 내용(프로세스 카운터 포함)을 스택에 저장한 뒤 인터럽트 서비스 루틴으로 점프한 후 레지스터를 복원합니다. 파이프라이닝이 적용된 RISC 프로세서에서는 인터럽트가 발생했을 때 파이프라인에 있는 몇몇 명령어들이 중간 단계에 위치하므로, 프로세서는 파이프라인에 있는 모든 명령어가 완료되도록 하거나 파기(flush)하고 인터럽트处理后 재시작해야 합니다. 어떤 경우든 파이프라인이 비워지고 레지스터가 저장되며 서비스 루틴이 실행됩니다. 시험 문제의 표현: "파이프라이닝은 파이프라인의 내용을 처리하기 전에 인터럽트를 처리할 수 없으므로 인터럽트 처리를 더 복잡하게 만듭니다."
어휘
연습하기
| English | 한국어 |
|---|---|
| motherboard/ˈmʌðəbɔːd/ | 메인보드 |
| CISC/sɪsk/ | CISC |
| RISC/rɪsk/ | RISC |
| register/ˈredʒɪstə/ | 레지스터(register) |
| interrupt/ˈɪntərʌpt/ | 인터럽트 |
15.1
파이프라이닝
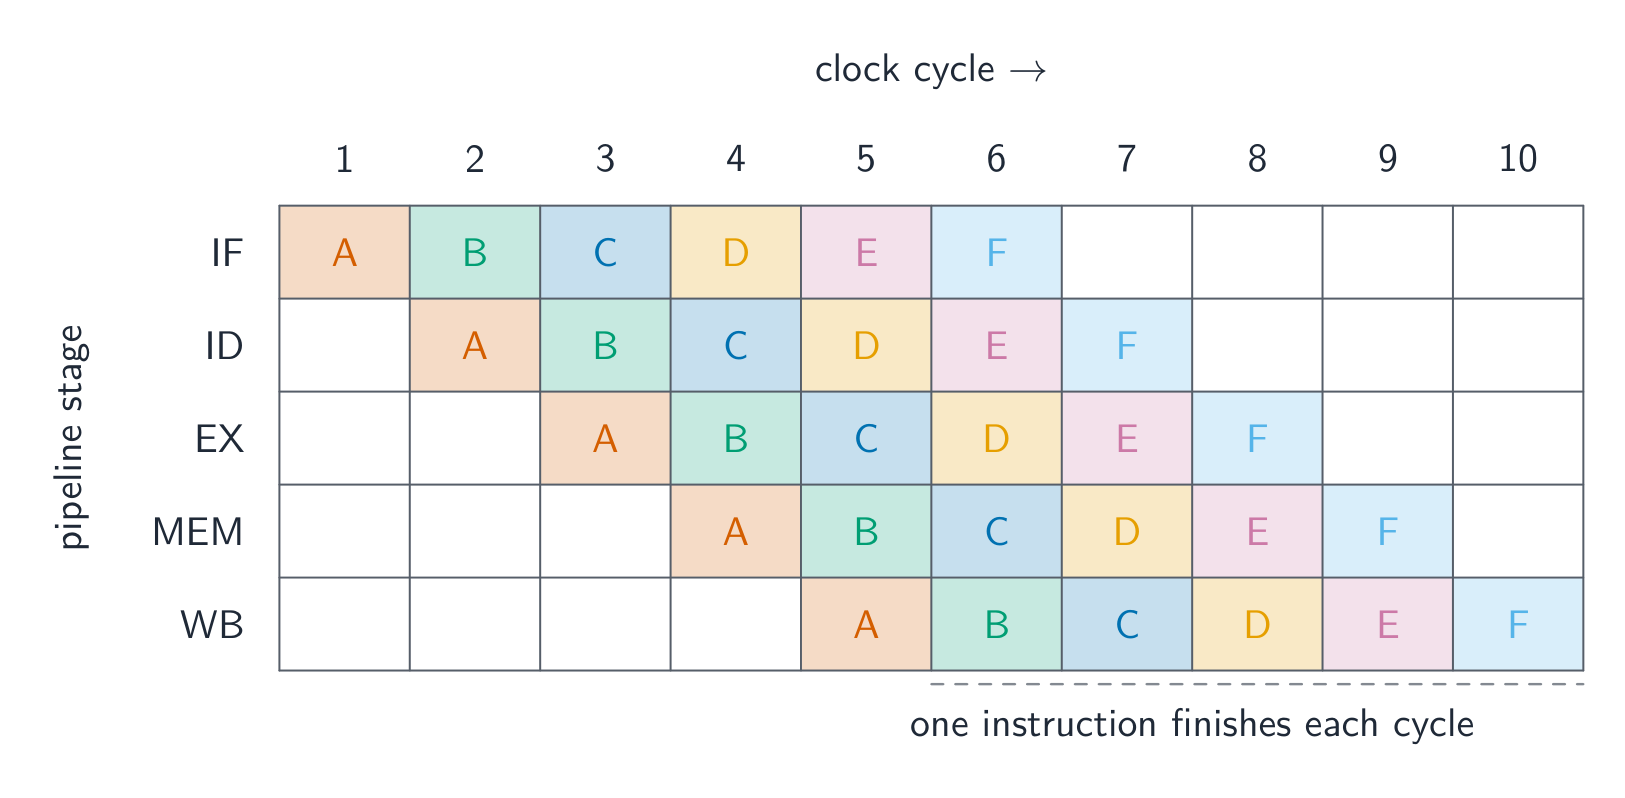
파이프라인은 조립 라인처럼 중첩된 단계로 명령어를 처리합니다: Fetch → Decode → Execute (ALU 내) → Memory access → Write back. 각 단계는 동시에 다른 명령어를 처리하므로, 파이프라인이 채워지면 매 사이클마다 한 명령어가 완료됩니다. RISC의 고정 길이 단순 명령어는 모든 단계를 동일한 시간으로 만듭니다. 파이프라인은 **해저드(hazard)**에서停滞될 수 있습니다 — 데이터 해저드(명령어가 아직 준비되지 않은 결과를 필요로 함) 또는 컨트롤 해저드(브랜치가 다음 주소를 불확실하게 함).
RISC 칩은 메모리가 느리고 레지스터가 빠르므로 데이터를 다수의 레지스터에 보관하며, 컴파일러는 값을 레지스터에 합리적으로 할당합니다.
"RISC 프로세서에서의 파이프라이닝 활용을 서술하시오" (3점). (1) .fetch–execute 사이클이 단계로 나뉩니다(fetch, decode, execute, memory access, write back); (2) 여러 명령어가 동시에 파이프라인에 있어 각기 다른 단계에 있으므로, 하나가 실행되는 동안 다음 것은 디코딩되고 그 다음 것은SPELL됩니다; (3) 파이프라인이 채워지면 매 클럭 사이클마다 새로운 명령어가 시작되고 하나가 완료되어 indhput(초당 완료되는 명령어 수)이 증가하지만, 개별 명령어 자체의 소요 시간은 동일합니다. 고정 길이 단일 사이클 RISC 명령어가 단계를 동일하게 만들고 파이프라이닝을 가능하게 합니다.
**해설 예시.**某 프로세서는 5개 파이프라인 단계(IF, ID, OF, EX, WB)를 사용합니다. 네 개의 명령어가 순차적으로 파이프라인에 진입합니다. 마지막 명령어가 완료되는 사이클은 언제이며, 파이프라이닝 없이 이 네 개가 소요되는 사이클 수는 몇 개인가요?
指令 1 在第 1 周期处于 IF 阶段,第 2 周期处于 ID 阶段,第 3 周期处于 OF 阶段,第 4 周期处于 EX 阶段,第 5 周期处于 WB 阶段;指令 2 晚一个周期开始,并在第 6 周期完成;指令 3 出现在第 7 周期;指令 4 出现在 第 8 周期。一般而言,$n$ 条指令经过 $k$ 个阶段需要 $n + k - 1$ 个周期,此处为 $4 + 5 - 1 = 8$。若无流水线技术,每条指令均需占用全部五个周期才能启动下一条,总计 $4 \times 5 = 20$ 个周期。考试中的表格通过沿对角线填写各指令的阶段生成,每列比前一指令右移一格。
이렇게 빠른 속도로 작동하는 프로세서는 많은 열을 발생시키므로 그 위에 **히트 싱크(열 방출판)**와 팬이 장착되어 있습니다. 금속 핀이 열을 퍼뜨리고 팬이 이를 날려보내 CPU가 작동할 수 있는 충분한 냉각 상태를 유지합니다.

탐색하기
파이프라인이 채워지는 과정
클럭 사이클을 단계별로 살펴보십시오. 파이프라인이 가득 차면 — 각 명령어가 여전히 여러 단계를 거치더라도 — 서로 다른 명령어의 단계가 겹치므로 매 클럭 사이클마다 새로운 명령어가 완료됩니다.
어휘
연습하기
| English | 한국어 |
|---|---|
| pipeline/ˈpaɪplaɪn/ | 파이프라인 |
| ALU/ˌeɪ el ˈjuː/ | ALU |
| hazard/ˈhæzəd/ | 위협 |
| throughput/ˈθruːpʊt/ | 처리량(스루풋) |
| heat-sink/hiːt sɪŋk/ | 히트싱크(방열판) |
| Flynn's taxonomy/flɪnz tækˈsɒnəmi/ | 플린의 분류법 |
15.1
플린 분류법
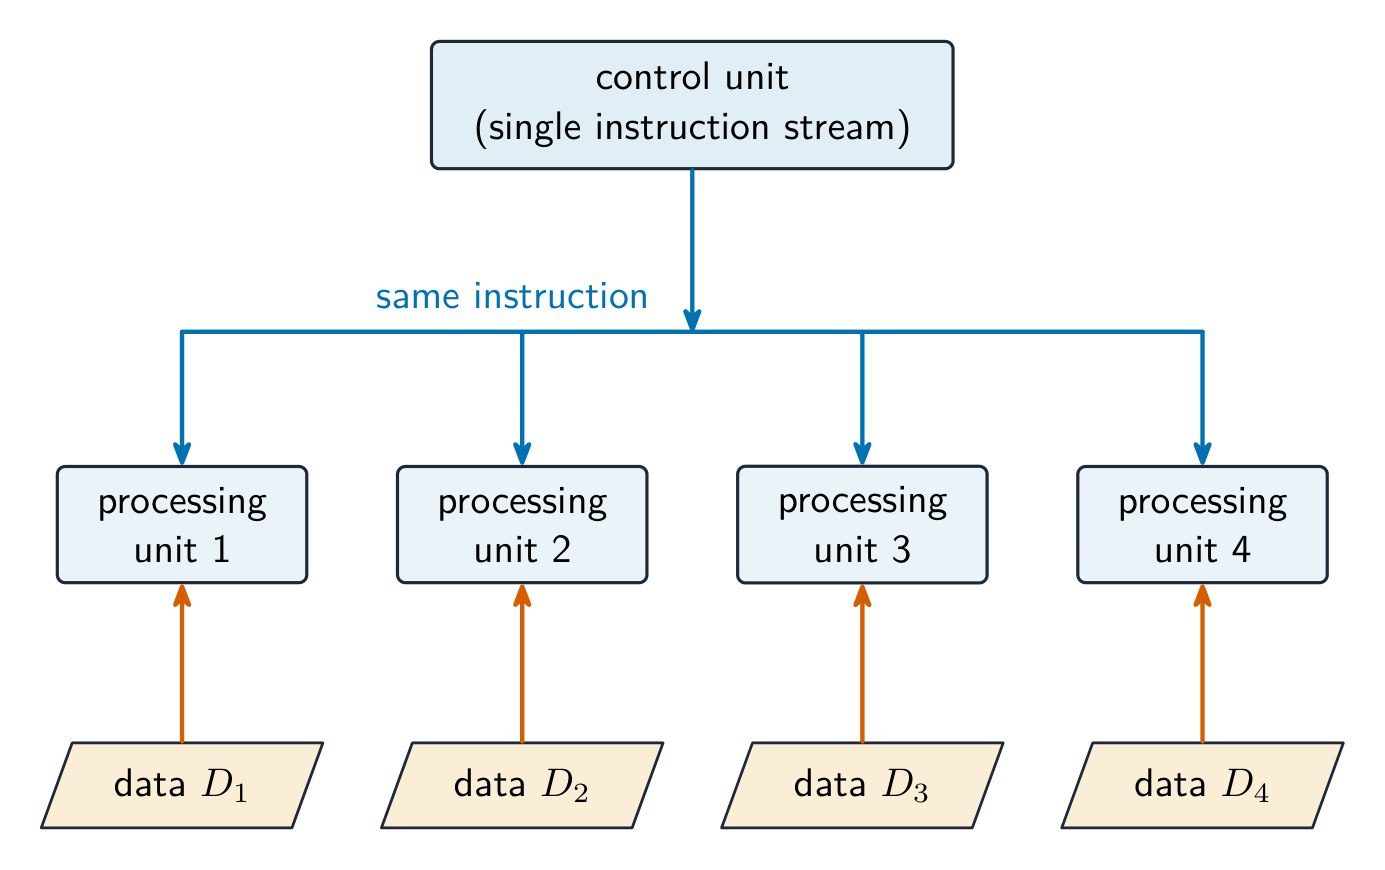
플린 분류법은 컴퓨터를 명령 및 데이터 스트림의 개수에 따라 분류합니다:
- SISD — 하나의 명령, 하나의 데이터 스트림 (전통적인 단일 코어).
- SIMD — 하나의 명령이 여러 데이터 항목을 동시에 처리합니다 (GPU, CPU 벡터 확장 기능). 이미지, 영상, 과학적 배열 처리에 적합합니다.
- MISD — 동일한 데이터를 대상으로 여러 연산 수행; 드물고 주로 이론적으로 논의됩니다.
- MIMD — 여러 프로세서가 서로 다른 데이터를 대상으로 서로 다른 명령을 실행합니다 (멀티코어 CPU, 클러스터). 가장 일반적인 유형입니다.
네 가지 아키텍처 설명 (각 2점). SISD: 단일 프로세서가 하나의 데이터 항목을 대상으로 한 번에 하나의 명령을 실행하며, 병렬성이 없고 전통적인 폰 노이만 머신입니다. SIMD: 하나의 명령이 동기화된 여러 처리 요소를 통해 여러 데이터 항목에 동시에 적용되며, 배열 및 그래픽 처리에 사용됩니다. MISD: 여러 프로세서가 동일한 데이터에 대해 서로 다른 명령을 적용합니다. 매우 드물게 사용되며, 예를 들어 여러 프로세서가 하나의 스트림을 확인하는 내결함성 시스템 등에 활용됩니다. MIMD: 여러 프로세서가 각자 자신의 데이터를 대상으로 그들만의 명령을 독립적으로 실행하며, 멀티코어 컴퓨터와 클러스터가 이에 해당합니다.
그래픽 카드(GPU 포함)는 SIMD 하드웨어의 실제 예시입니다: 수천 개의 작은 코어가 하나의 명령을 수백만 개의 픽셀이나 숫자에 동시에 실행하므로, GPUs가 이미지, 영상 및 기계 학습 처리에 매우 빠릅니다.


어휘
연습하기
| English | 한국어 |
|---|---|
| SIMD/ˈsɪmdiː/ | SIMD |
| MIMD/ˈmɪmdiː/ | MIMD |
| graphics card/ˈɡræfɪks kɑːd/ | 그래픽 카드(GPU) |
15.1
대규모 병렬 컴퓨터

대규모 병렬 시스템은 빠른 네트워크 위에 수천 개의 프로세서를 사용하며, 각 프로세서는 자체 메모리를 가집니다 (분산 메모리), 메시지를 통해 데이터를 교환합니다. MIMD이며, 특별히 작성된 소프트웨어(MPI, CUDA)가 필요하며, 기후 시뮬레이션, 대형 기계 학습 훈련, 천체 물리학에 적합합니다. 가장 큰 슈퍼컴퓨터들은 대부분 대규모 병렬 구조입니다.
"대규모 병렬 컴퓨터의 특징을 간략히 서술하시오 (3점).
프로세서는高大的 서버 랙(server racks)에 배치되며, 종종 전체 방을 채우는 데이터 센터(data centre) 내에 위치합니다. 여러 프로세서가 하나의 큰 문제를 동시에 처리할 수 있도록 유선으로 연결되어 있습니다.
어휘
연습하기
| English | 한국어 |
|---|---|
| massively parallel/ˈmæsɪvli ˈpærəlel/ | 대규모 병렬 |
| distributed memory/ˈdɪstrɪbjuːtɪd ˈmeməri/ | 분산 메모리 |
| machine learning/məˈʃiːn ˈlɜːnɪŋ/ | 머신러닝 |
| supercomputers/ˌsuːpəkəmˈpjuːtəz/ | 슈퍼컴퓨터 |
| server/ˈsɜːvə/ | 서버 |
| data centre/ˈdeɪtə ˈsentə/ | 데이터 센터 |
| virtual machine/ˈvɜːtʃuːəl məˈʃiːn/ | 가상 머신 |
| hypervisor/ˌhaɪpəˈvaɪzə/ | 하이퍼바이저 |
| sandboxing/ˈsændbɒksɪŋ/ | 샌드박싱 |
| bytecode/ˈbaɪtkəʊd/ | 바이트코드 |
| just-in-time compilation/dʒʌst ɪn taɪm ˌkɒmpɪˈleɪʃn/ | just-in-time 컴파일 |
| host operating system/həʊst ˈɒpəreɪtɪŋ ˈsɪstəm/ | 호스트 운영체제 |
| guest operating system/ɡest ˈɒpəreɪtɪŋ ˈsɪstəm/ | 게스트 운영체제 |
| Boolean algebra/ˈbuːlɪən ˈældʒɪbrə/ | 부울 대수 |
| Boolean/ˈbuːlɪən/ | Boolean |
| truth tables/truːθ ˈteɪblz/ | 진리표 |
| De Morgan's laws/də ˈmɔːɡənz lɔːz/ | 데摩根의 법칙들 |
| absorption/əbˈsɔːpʃn/ | 흡수 |
15.1
가상 머신
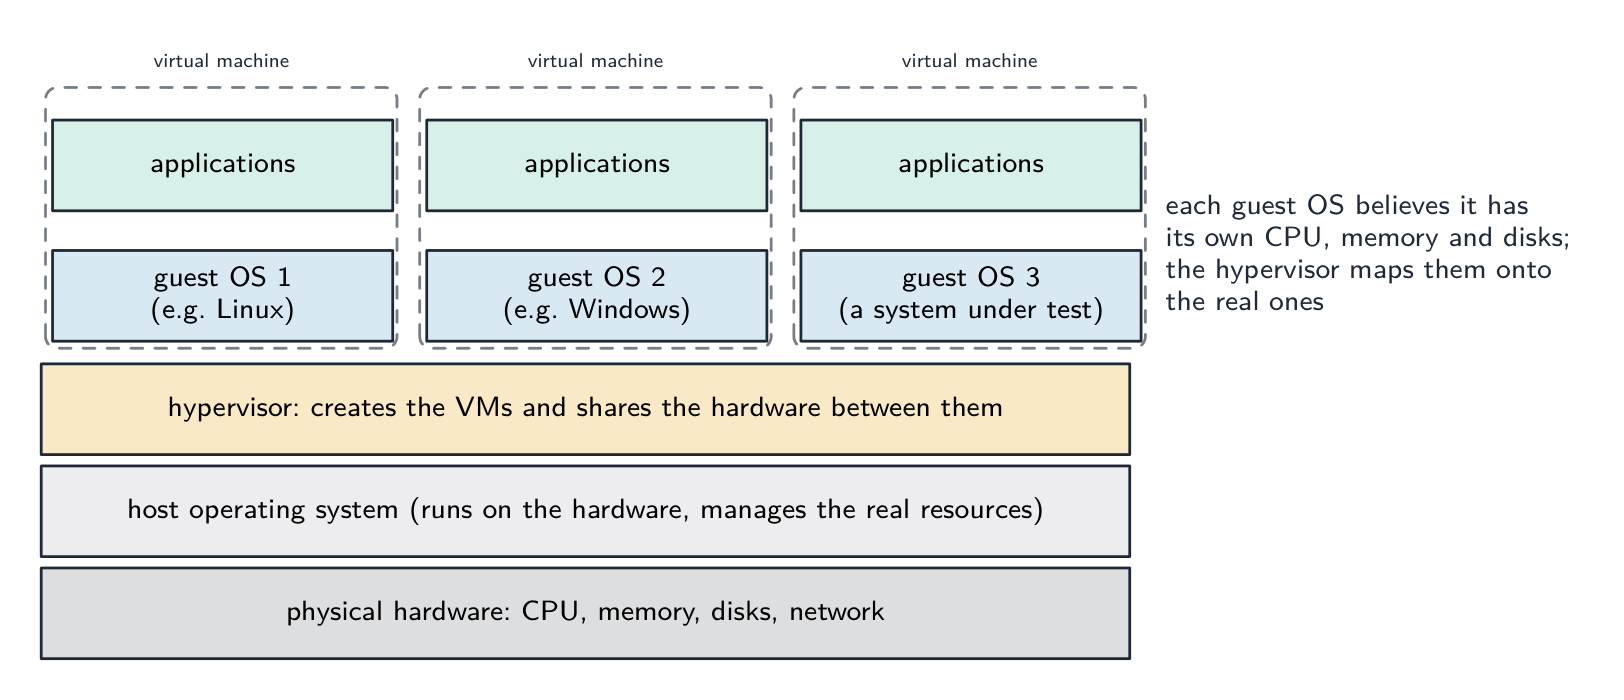
가상 머신(VM)은 전체 컴퓨터의 소프트웨어 시뮬레이션입니다. 내부 소프트웨어는 실제처럼 보이는 CPU, 메모리, 디스크를 보지만, 이들은 호스트 소프트웨어에 의해 관리됩니다.
- 시스템 VM은 완전한 OS를 실행합니다. 하이퍼바이저는 각 VM이 자체 게스트 OS를 부팅하도록 VM을 생성하고 관리합니다. 용도: 한 기계에서 여러 OS 실행; 서버 통합; 샌드박싱(위험한 소프트웨어를 격리하여 실행); 스냅샷.
- 프로세스(언어) VM은 포터블 바이트코드로 하나의 프로그램을 실행합니다—JVM(Java), CLR(.NET), CPython 등. 장점: 포터빌리티("한 번 작성, 어디든 실행"), 런타임 안전성 검사, ** Just-in-time 컴파일**을 통한 원생 스피드에 근접함. 단점: 추가 레이어가 필요하며, VM 설치 prerequisite가 있습니다.
"가상 머신의 의미를 설명하시오 (2점). 호스트 컴퓨터 위에서 실행되며, 내부에서 실행되는 프로그램에게는 자체 프로세서, 메모리, 저장 장치를 가진 별도의 물리적 컴퓨터처럼 동작하는 컴퓨터 시스템의 소프트웨어 시뮬레이션(구현). 호스트 운영체제는 실제 하드웨어 위에서 실행되어 실제 자원을 관리하며(하이퍼바이저를 통해) 가상 머신을 생성 및 제어합니다. 각 게스트 운영체제는 가상 머신 내에서 실행되어 내부의 애플리케이션을 관리하며, 자신의 하드웨어가 가상임을 알지 못합니다.
장점 (두 가지 제시). 여러 다른 운영체제를 한 기계에서 동시에 실행할 수 있음; 하드웨어 구매 없이 다양한 시스템에서 소프트웨어를 테스트 가능; 구축 전 새로운 컴퓨터 시스템을 시뮬레이션하여 테스트 가능; 각 VM이 격리되어 있어 하나에서의 충돌이나 말웨어가 호스트나 다른 VM에 영향을 주지 않음; VM을 파일로 복사, 이동, 백업 가능하며, 여러 사용자가 서버를 공유하여 하드웨어 비용 감소. 단점 (두 가지 제시). 모든 명령어가 시뮬레이션 계층을 거치므로 실제 하드웨어보다 느리게 실행됨; 호스트의 메모리 및 처리 능력을 소모하므로 호스트가 강력해야 함; 일부 하드웨어 기능 또는 기기는 정확히 시뮬레이션되지 않아 테스트된 소프트웨어가 실제 기계에서 다르게 동작할 수 있음; 각 게스트 OS마다 라이선스가 필요하며, 시스템 설정에는 전문 지식이 필요함.
탐색하기
컴퓨팅 개념 실험실
구체적인 예시를 그들이 시연하는 컴퓨팅 개념에 따라 분류하십시오.
15.2
부울 대수
Syllabus
| 응시자가 다음을 수행할 수 있어야 함: | 참고 사항 및 가이드라인 |
|---|---|
| 반 더미 및 풀 더미를 포함하는 논리 회로의 진리표 생성 | 두 개 이상의 입력을 가진 논리 게이트 포함 가능 |
| 플립플롭 (SR, JK)에 대한 이해 | 플립플롭의 논리 회로 도면 그리기 및 진리표 도출 플립플롭이 데이터 저장 요소로서 하는 역할 이해 |
| 부등식 대수에 대한 이해 | 데 모르간 법칙 이해 데 모르간 법칙을 사용하여 부등식 대수 수행 논리 회로/식을 부등식 대수를 사용하여 단순화 |
| 카나프 지도 (K-map)에 대한 이해 | 카나프 지도 사용의 장점 이해 카나프 지도를 사용하여 논리 문제 해결 |
출처: Cambridge International syllabus
부울 대수는 부울 식을 단순화하며, 이는 진리표로도 동일한 방식으로 기술될 수 있습니다. 기호: +는 OR, ·는 AND(주로 생략), 오버바는 NOT를 의미합니다.
주요 법칙으로는 일반 대수와 동일한 환원법, 결합법, 분배법이 있으며, 다음도 포함됩니다:
- 항등 $A + 0 = A$, $A \cdot 1 = A$; 영 ⟨$A + 1 = 1$, $A \cdot 0 = 0$.
- 항등법 $A + A = A$; 역원 $A + \overline{A} = 1$, $A \cdot \overline{A} = 0$.
- 데 모르간의 법칙: $(A + B)' = A' \cdot B'$; $(A \cdot B)' = A' + B'$ — 전체를 negation하고 AND/OR를 교체하며, 각 피연산자를 negation합니다.
- 흡수법: $A + AB = A$.
단순화는 항의 수를 줄여 최종 논리 회로의 게이트 수를 감소시킵니다. 예: $Z = AB + A\overline{B} = A(B + \overline{B}) = A$.
법칙과 그에 해당하는 이름 ("모든 과정 표시" 요청 시 각 단계마다 이름을 인용).
| 법칙 | OR 형식 | AND 형식 |
|---|---|---|
| 항등 | $A + 0 = A$ | $A \cdot 1 = A$ |
| 영 (소거) | $A + 1 = 1$ | $A \cdot 0 = 0$ |
| 이다항 | $A + A = A$ | $A \cdot A = A$ |
| 보수 (역원) | $A + \overline{A} = 1$ | $A \cdot \overline{A} = 0$ |
| 교환법칙 | $A + B = B + A$ | $A \cdot B = B \cdot A$ |
| 결합법칙 | $A + (B + C) = (A + B) + C$ | $A(BC) = (AB)C$ |
| 분배법칙 | $A + BC = (A + B)(A + C)$ | $A(B + C) = AB + AC$ |
| 흡수법칙 | $A + AB = A$ | $A(A + B) = A$ |
| 더모르강 | $\overline{A + B} = \overline{A} \cdot \overline{B}$ | $\overline{A \cdot B} = \overline{A} + \overline{B}$ |
| 이중 부정 | $\overline{\overline{A}} = A$ |
해설 예시. $X = \overline{\overline{(A \cdot B)} \cdot \overline{(A + B)}}$를 모두 계산 과정을 보여서 단순화하시오.
$X = \overline{\overline{(A \cdot B)}} + \overline{\overline{(A + B)}}$ (외부 바에 대한 더모르강) $= A \cdot B + A + B$ (이중 부정) $= A + B$ (흡수법칙, $A + AB = A$, $A + B$가 $AB$을 흡수하도록 적용됨).
해설 예시. $(\overline{A + B}) \cdot (\overline{A} + B)$를 단순화하시오.
$= \overline{A} \cdot \overline{B} \cdot (\overline{A} + B)$ (더모르강) $= \overline{A}\,\overline{B}\,\overline{A} + \overline{A}\,\overline{B}\,B$ (분배법칙) $= \overline{A}\,\overline{B} + 0$ (이다항, 보수) $= \overline{A}\,\overline{B}$.
해설 예시. $Y = \overline{A}\,\overline{B}\,\overline{C} + \overline{A}\,\overline{B}\,C + A\,\overline{B}\,C$를 단순화하시오.
$= \overline{A}\,\overline{B}(\overline{C} + C) + A\,\overline{B}\,C$ (분배법칙) $= \overline{A}\,\overline{B} + A\,\overline{B}\,C$ (보수, 항등원) $= \overline{B}(\overline{A} + AC)$ (분배법칙) $= \overline{B}(\overline{A} + C)$, $\overline{A} + AC = (\overline{A} + A)(\overline{A} + C) = \overline{A} + C$을 사용함. 세 개의 입력을 가지는 항에 대해 더모르강을 적용하는 방법도 동일하다: $\overline{A + B + C} = \overline{A} \cdot \overline{B} \cdot \overline{C}$.
진리표에서 곱의 합(SOP) 구하기. 출력이 1인 모든 행을 취하고, 해당 행의 입력에 대한 AND식을 작성한다(변수가 0인 위치에는 바를 붙인다), 그리고 항들을 OR로 연결한다: $A = 1, B = 0, C = 1$인 행은 $A\,\overline{B}\,C$을 준다. 이것이 시험에서 요구하는 곱의 합(Sum-of-products) 형태이며, 대수적 단순화와 카나프 지도(Karnaugh map) 모두의 시작점이다.
탐색하기
부울 대수
A·B, A+B, Ā …
부울 대수는 단순히 진리표를 비교하여 식으로 표현된 게이트들입니다.
탐색하기
부울리안 진리표
연산자와 입력을 선택하여 진리표를 구성하세요—논리 회로의 대수적 배경입니다.
어휘
연습하기
| English | 한국어 |
|---|---|
| sum-of-products/sʌm ɒv ˈprɒdʌkts/ | 곱의 합(sum-of-products) |
| Karnaugh map/ˈkɑːnɔː mæp/ | 카르네그 마프 |
| half adder/hɑːf ˈædə/ | 하프 어더 |
15.2
카나프 지도
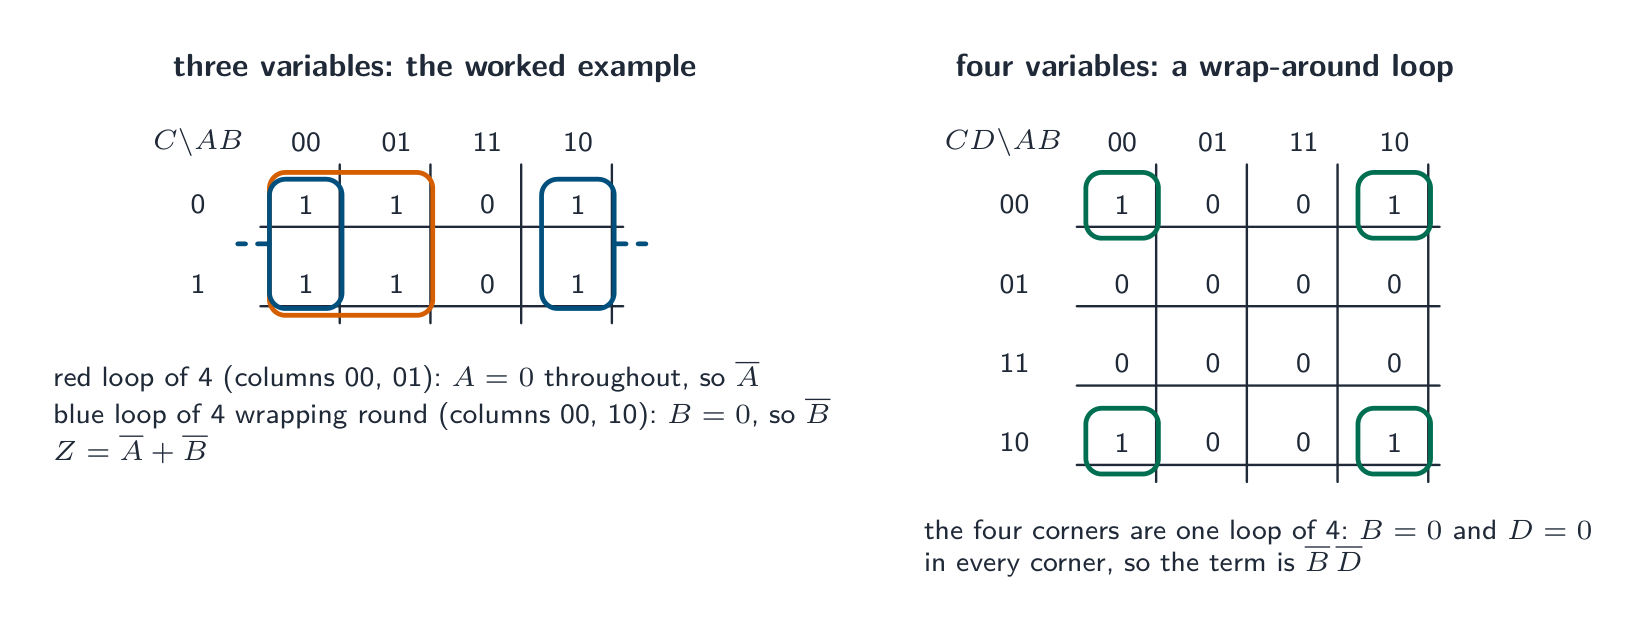
카나프 지도(K-map)는 진리표에서 인접한 1들을 그룹하여 부호 함수 표현식을 단순화한다. 열과 줄은 그레이 코드(Gray code) 순서(00, 01, 11, 10)로 배치되어 인접한 셀은 한 개의 변수만 다르다.
在输出为 1 的单元格中填入 1。寻找由 1 组成的矩形组,其边长必须是 2 的幂次(如 1、2、4、8),若绕回边缘能组成更大的组则允许环绕。组越大,对应的乘积项越简单:2 个元素的组可减少一个变量,4 个元素的组可减少两个变量,依此类推——组内发生变化的变量会被消去。最后将所有组对应的乘积项用 OR 连接,得到简化表达式。覆盖所有 1 时应尽可能使用数量少且面积大的组。
해설 예시. $A$과 $B$의 카나프 지도에서 1들이 셀 $\overline{A}B$과 $AB$에 있다. 단순화하시오. 두 1는 인접해 있으며 $B=1$ 열을 공유하므로, 2 크기의 직사각형으로 그룹화할 수 있다. 그 그룹 내부에서 $B$은 내내 1로 유지되지만 $A$은 0에서 1로 변화하므로, 그룹 내에서 변하는 변수는 사라진다. 따라서 이 그룹은 단순히 $X = B$만을 남긴다. 표에서 직접 읽은 곱의 합, $\overline{A}B + AB$과 비교해보면 같은 회로를 게이트 두 개 줄여 구현했다. 두 가지 규칙이 대부분의 작업을 처리한다 — 각 그룹을 가능한 한 크게 만들 것(2 그룹은 변수 하나를, 4은 두 개를, 8은 세 개를 제거), 그리고 지도가 가장자리를 감싸돌아 connects 하므로 왼쪽 끝과 오른쪽 끝 열은 인접함을 기억할 것. 이 감싸돌아 연결은 많은 지원자들이 놓치는 가장 중요한 그룹화 요소이다.
K-맵의 구성 및 판독. 열을 $AB$, 행을 $C$(또는 $CD$)로格雷码顺序00 01 11 10로 표시하여 인접한 셀은 한 변수만 다릅니다. 표현식에 미터미노가 포함되거나(또는 진리표의 해당 줄이 1를 출력하는) 모든 셀에 1를 넣으십시오. 이후 모든 1를 덮는 최소且 최대 크기의 루프를 그리십시오: 각 루프는 $1, 2, 4$ 또는 $8$개의 셀로 이루어진 직사각형이어야 하며, 루프는 서로 중叠할 수 있으며, 좌우 및 상하 가장자리를 감싸 갈 수 있으며, 네 모서리가 합쳐져 하나의 루프를 이룹니다. 각 루프에 대해 내부에서 일정인 변수를 기입하십시오(바(bar)가 0인 경우). 그리고 루프 항들을 OR하여 최적의 SOP(합의 곱)를 얻으십시오. 왜 하나? 대수 연산 없이 몇 단계 만에 가장 간단한 식을 얻을 수 있어 실수 확률이 낮으며, 3개 또는 4개 변수에도 동일한 맵을 사용할 수 있습니다.
풀이 예제. $Z = \overline{A}\,\overline{B}\,\overline{C} + \overline{A}\,\overline{B}\,C + \overline{A}\,B\,\overline{C} + \overline{A}\,B\,C + A\,\overline{B}\,\overline{C} + A\,\overline{B}\,C$.
在三变量卡诺图上,1 填满了两行中的列 00、01 和 10。跨越列 00 和 01 的四元素圈在所有位置均为 $A = 0$,而 $B$ 和 $C$ 均发生变化,故对应项为 $\overline{A}$。跨越列 00 和 10(含绕回)的四元素圈在所有位置均为 $B = 0$,故对应项为 $\overline{B}$。因此 $Z = \overline{A} + \overline{B}$ 成立,布尔代数验证如下:$\overline{A}(\overline{B} + B) + \ldots = \overline{A} + \overline{B}$。两个双元素圈也是正确的,但并非最优解;圈的大小应达到 1 所允许的最大值。
해설 예제 (4변수). 맵의 네 모서리에만 1이 있습니다: $\overline{A}\,\overline{B}\,\overline{C}\,\overline{D}$, $A\,\overline{B}\,\overline{C}\,\overline{D}$, $\overline{A}\,\overline{B}\,C\,\overline{D}$, $A\,\overline{B}\,C\,\overline{D}$. 위아래 행이 인접하고 양쪽 끝 열이 인접하므로 네 모서리는 하나의 4개 셀 루프가 됩니다; $B = 0$과 $D = 0$가 모두 일정하며 $A$과 $C$이 변하므로 $Z = \overline{B}\,\overline{D}$입니다.
어휘
연습하기
| English | 한국어 |
|---|---|
| Gray code/ɡreɪ kəʊd/ | 그레이 코드 |
15.2
하프 어더와 풀 어더

하프 어더(Half adder) 는 두 단일 비트 $A$과 $B$을 더하여 합계 $S$와 카리(Carry) $C$를 생성합니다:
| A | B | S | C |
|---|---|---|---|
| 0 | 0 | 0 | 0 |
| 0 | 1 | 1 | 0 |
| 1 | 0 | 1 | 0 |
| 1 | 1 | 0 | 1 |
따라서 $S = A \text{ XOR } B$과 $C = A \text{ AND } B$입니다. 입력 카리는 무시하므로 "하프"라고 합니다.
풀 어더(Full adder) 는 세 비트($A$, $B$, 입력 카리)를 더하여 합계와 출력 카리를 생성합니다: $S = A \text{ XOR } B \text{ XOR } C_{\text{in}}$. 두 개의 하프 어더와 OR 게이트로 구성할 수 있습니다. 풀 어더를 체인(각 출력 카리가 다음 입력 카리에 연결됨)하면(various bit) " ripple-carry" 어더를 만들 수 있습니다.

풀 어더의 진리표. 입력이 $A$, $B$ 및 입력 카리 $C_{\text{in}}$일 때: 기수 개수의 입력이 1일 때 합계 $S$는 1이며, 두 개 이상의 입력이 1일 때 출력 카리는 1입니다.
| $A$ | $B$ | $C_{\text{in}}$ | $S$ | $C_{\text{out}}$ |
|---|---|---|---|---|
| 0 | 0 | 0 | 0 | 0 |
| 0 | 0 | 1 | 1 | 0 |
| 0 | 1 | 0 | 1 | 0 |
| 0 | 1 | 1 | 0 | 1 |
| 1 | 0 | 0 | 1 | 0 |
| 1 | 0 | 1 | 0 | 1 |
| 1 | 1 | 0 | 0 | 1 |
| 1 | 1 | 1 | 1 | 1 |
시험에서 출제되는 회로 문제. XOR 게이트와 AND 게이트가 두 개의 입력을 공유하거나, 두 개의 하프 어더와 OR 게이트가 있는 회로에서 "진리표를 완성하시오(작업 과정 제시)"는 모든 중간 게이트 출력에 대한 열을 추가하고 행을 순서대로 채우는 것을 의미합니다; "회로의 이름을 명시하시오"는 하프 어더 또는 풀 어더입니다; "각 출력의 용도를 명시하시오"는 비트들의 합계(Sum) 와 다음 칸으로 가는 카리(Carry) 입니다. 하프 어더의 SOP: $S = \overline{A}B + A\overline{B}$, $C = AB$. 풀 어더 체인에서 각 어더가自己的输出卡里传递给下一个输入卡里,从而对两个多位数进行加法运算。
탐색하기
가산기 내부의 논리문자
하프 가산기의 합 산출(Sum bit)은 XOR 문자이며,進位(Carry)는 AND 문자입니다. A와 B를 전환하면 진리표 행이 점등되는 것을 확인할 수 있습니다.
어휘
연습하기
| English | 한국어 |
|---|---|
| carry/ˈkæri/ | 카리(Carry) |
| full adder/fʊl ˈædə/ | 풀 어더 |
15.2
플립플롭(Flip-flop)
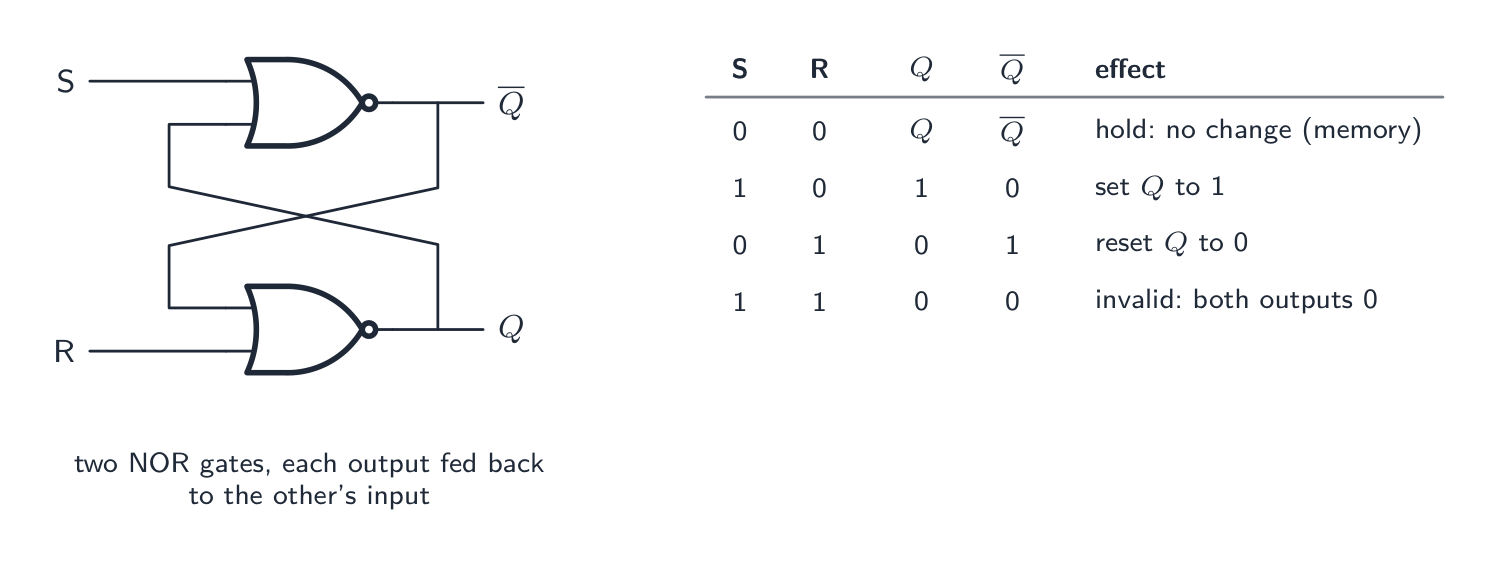
플립플롭 은 이안정(bistable) 회로—두 가지 안정 상태(0과 1)—로서 상태를 기억합니다. 1비트를 저장하며 레지스터와 SRAM의 기본 요소입니다.
SR 플립플롭
SR 플립플롭 은 S(set), R(reset) 입력과 Q, $\overline{Q}$ 출력을 가집니다. S=1,R=0은 Q를 1로 설정하고; S=0,R=1은 0로 초기화하며; S=0,R=0는 유지하고; S=1,R=1는 불허용입니다. 두 개의 교차 결합 NOR 게이트로 제작됩니다.
"SR 플립플롭의 논리 회로를 그리고 입력에 레이블을 붙이시오. 두 개의 NOR 게이트(또는 NAND 게이트), 각 게이트의 출력이 다른 게이트의其中一个输入로 피드백되며; 하나의 게이트의 남은 입력은 S, 다른 것은 R입니다; 출력은 $Q$과 $\overline{Q}$입니다. 피드백이 배점 포인트입니다: 없으면 메모리가 없습니다. "플립플롭의 용도를 명시하시오." 1비트의 데이터 저장; 레지스터와 정적 RAM을 만드는 기본 메모리 요소이며, 의도적으로 변경될 때까지 값을 유지합니다. 불허용 입력 $S = R = 1$은 두 출력을 모두 0으로 만들어, $\overline{Q}$가 더 이상 $Q$의 반대가 되지 않으며, 두 입력이 모두 0로 돌아온 후의 상태는 예측 불가능하므로, 이것이 SR 플립플롭의 약점입니다
JK 플립플롭
JK 플립플롭은 기존에 유효하지 않던 1,1 입력을 토글링(toggle)(출력 반전)으로 활용하여 개선되었습니다. 이를 통해 카운터(토글링 플립플롭들의 연쇄)를 구축하는 데 적합합니다. 일반적으로 **클럭 클락(clk)**이 적용되어 — 입력은 클럭 에지에서만 작동하여 플립플롭들이 동기화됩니다.

플립플롭은 레지스터(n 비트 = n 플립플롭), 카운터 및 SRAMRAM 셀의 기본 구성 요소입니다.
JK 플립플롭 진리표. 클록 입력은 J 및 K 입력이 읽히는 시기를 결정하므로, 출력은 클록 펄스에만 변경됩니다: $J = K = 0$일 때 출력이 유지되며; $J = 1, K = 0$일 때 $Q$를 설정하여 1로 만듭니다; $J = 0, K = 1$일 때 이를 리셋하여 0으로 만듭니다; $J = K = 1$일 때 이를 전환합니다(Q가 $\overline{Q}$로 바뀜). 마지막 행은 SR 플립플롭의 허용되지 않는 입력을 유용한 것으로 변환한 것이므로, JK 플립플롭이 선호되는 이유입니다. 모든 입력 조합이 유효하며, 클록 제어 작동 방식은 카운터와 쉬프트 레지스터의 기본 구성 요소가 됩니다.
어휘
연습하기
| English | 한국어 |
|---|---|
| flip-flop/flɪp flɒp/ | 플립플롭 |
| bistable/baɪˈsteɪbl/ | 바이스테이블 |
| toggle/ˈtɒɡl/ | 토글 |
| counters/ˈkaʊntəz/ | 카운터 |
| SRAM/ˈesræm/ | SRAM |
| clock/klɒk/ | 클럭(시계 신호) |
| SR flip-flop/ˌes ˈɑː flɪp flɒp/ | SR 플립플롭 |
| JK flip-flop/ˌdʒeɪ ˈkeɪ flɪp flɒp/ | JK 플립플롭 |
15.2
출제자가 인정하는 정의
정의 문제는 고정된 문구로 채점합니다. 이 내용들을 정확히 외우고, 답은 하나만 제시하십시오.
| 용어 | 정의 |
|---|---|
| RISC | 단순하고 고정된 길이의指令 집합이 작은 프로세서로, 대부분의 명령어는 클록 사이클 하나에 실행되며, 많은 레지스터와 파이프라인을 사용함 |
| CISC | 복잡하고 가변 길이의指令 집합이 큰 프로세서로, 여러 명령어는 여러 클록 사이클이 소요되며 메모리에 직접 접근함 |
| 파이프라인 | .fetch–execute 사이클을 단계로 나누어 여러 명령어를 동시에 처리하되 각기 다른 단계에 배치함 |
| SISD / SIMD / MISD / MIMD | 하나의 명령어가 하나의 데이터 항목에 적용됨; 하나의 명령어가 여러 데이터 항목에 적용됨; 여러 명령어가 하나의 데이터 항목에 적용됨; 여러 명령어가 여러 데이터 항목에 적용됨 |
| 대량 병렬 컴퓨터 | 수천 개의 프로세서를 가지며, 각기 자체 메모리를 가지고 네트워크로 연결되어 동일한 문제를 동시에 처리함 |
| 가상 머신 | 호스트 컴퓨터 위에서 실행되는 컴퓨터 시스템의 소프트웨어 에뮬레이션으로, 독립적인 물리적 컴퓨터처럼 동작함 |
| 하이퍼바이저 | 가상 머신을 생성하고 호스트의 하드웨어를它们之间共享하는 소프트웨어 |
| 진리표 | 논리 회로의 모든 입력 조합과 그에 따른 출력(들)을 나열한 표 |
| SOP(积之和) | AND 항들의 OR로 표현된 부울表达式,每个输入组合对应一个输出为1的项 |
| 카나프 지도 | 진리표 출력을 그레이 코드 순서로 배열한 격자로, 인접한 1들의 루프가 간소화된 expression을 제공함 |
| 반 더더기 | 두 비트를 더하여 합계와_Handle产生电路 |
| 전 더더기 | 두 비트와_Handle入来,产生合和_Handle出电路 |
| 플립플롭 | 한 비트를 저장하는双稳态电路,其输出在输入改变前保持恒定 |
15.2
시험 팁
- RISC와 CISC의 답변은 기능 목록 형태로 제시됨: 단순함, 고정, 단일 사이클, 많은 레지스터, 로드/스토어, 파이프라인 vs 복잡함, 가변, 다중 사이클, 적은 레지스터, 직접 메모리 접근, 마이크로코드. 각각 네 가지씩.
- 파이프라인: 단계, 동시에 여러 명령어, 사이클당 하나 완료, 높은 처리량; $n + k - 1$ 사이클에 $n$ 명령어가 $k$ 단계를 거침; 인터럽트는 파이프라인 비우기가 필요함.
- 플린의 네 가지 범주는 "얼마나 많은指令流"를 "얼마나 많은 데이터流"에 의해 분류함; 무엇에서 무엇이 실행되는지 명시. 대량 병렬: 많은 프로세서, 자체 메모리, 네트워크, 동일 문제 처리.
- 가상 머신: 호스트 위에서의 컴퓨터 에뮬레이션; 하드웨어 위의 호스트 OS, 이를 공유하는 하이퍼바이저, 내부의 게스트 OS. 두 가지 장점과 두 가지 제한 사항, 각각 완전한 문장으로 서술.
- 부울 대수: 사용할 때마다 법칙 이름을 명시; 데摩根은 연산자를 교체하고 각 항을 부정함; 의문이 있을 경우 진리표로 확인.
- K-지도: 그레이 코드 순서, 가장 큰 1/2/4/8 루프,.Interface允许,每个루프마다 변하지 않는 변수가 포함된 하나의 항. 이유 명시: 대수 없이 가장 간단한 expression.
- 반 더더기는 합계와_Handle生成;全加器也接受进位输入;SR 플립플롭은 교차 결합된 NOR/NAND 게이트 두 개이며 한 비트를 저장함;JK의 1,1 입력은 전환함.
흔한 실수
- RISC와 CISC 기능 목록을交换或提供“更快速度”作为功能;设计特征而非判断。
- 파이프라인을 "여러 코어에서 병렬로 명령어를 실행"으로 설명하는 것;실제로는 하나의 프로세서의 단계들이 겹치는 것이다。
- SIMD(하나의 명령어, 여러 데이터)와 MIMD(두 가지 모두 여러 개)를混同或描述MISD为常见情况。
- 가상 머신을 "컴퓨터의 복사본"으로 정의하면서 에뮬레이션 또는 호스트와 게스트라는 단어를 사용하지 않음。
- 긴 막대 아래 부분 expression에만 데모르간을 적용하거나 AND와 OR를交換而不删除长bar。
- K-지도에서 세 개의 그룹이나 비직사각형 그룹을 루핑하거나 열을 그레이 코드 대신 00, 01, 10, 11 순서로 정렬함。
- 반 더더기의 Handle用XOR로,合用AND作为处理。
- SR 플립플롭을 피드백 없는 두 게이트로 그리거나 진리표에서 무효 상태를 누락함。
이 주제에 대한 인터랙티브 수업
즉시 체크 기능 exercises를 통해 단계별로 진행하세요.