| 受験者は以下的能力を備えているべきである: | メモおよびガイドライン |
|---|---|
| **簡易命令セットコンピュータ(RISC)および複雑命令セットコンピュータ(CISC)**プロセッサの理解 | RISCとCISCの違い CISCおよびRISCプロセッサにおける割り込み処理の理解 |
| RISCプロセッサにおけるパイプラインおよびレジスタの重要性/用途を理解する | |
| 4つの基本的なコンピュータアーキテクチャの理解 | SISD, SIMD, MISD, MIMD |
| 大規模並列コンピュータの特徴を理解する | |
| 仮想マシンの概念の理解 | 仮想マシンの役割に関する例の提示 仮想マシンの利点と限界の理解 |
ハードウェアと仮想マシン
A-Levelコンピュータ科学 · トピック 15
 15:02
RISC、パイプライン & ロジック
2人のチップデザイナーが同じ問題に直面しています:プログラムを高速に実行することです。一人はこう言います——強力な命令を作成して、1つの命令で多くの作業を行わせることです。もう一人はこう言います——keep…
英語ナレーション・英語+中文字幕 burning-in
15.1
RISC と CISC プロセッサ

シラバス
出典: Cambridge International シラバス
CPUの2つの設計スタイル。CPU自体はマザーボードに接続されます。これはプロセッサ、メモリ、およびコンピュータの他のすべての部品を結びつける主要な基板です。

CISC
CISC(Complex Instruction Set Computers:複雑命令セットコンピュータ)は、多く、かつ複雑な命令(一つで複数のメモリアクセスや演算を行うことのあるものなど)を備えており、可変長であるためデコードが複雑になります。ハードウェア内で命令あたりより多くの処理を行います。例:Intel x86。
RISC
RISC(Reduced Instruction Set Computers:簡易命令セットコンピュータ)は、単純な命令の少量のセットを持ち、それぞれが単一の基本操作を行ない、全てが固定長(高速でデコード可能)です。ロードとストアのみがメモリにアクセスし、他は全てレジスタ間で行われます。プログラムは長くなりますが、各命令は素早く予測可能であり、パイプライン化に適しています。例:ARM, RISC-V。
| 特徴 | CISC | RISC |
|---|---|---|
| 命令セット | 多い | 少ない |
| 命令長 | 可変 | 固定 |
| メモリアクセス | 多くの命令 | ロード/ストアのみ |
| パイプライン対応性 | 難しい | 本質的 |
| 命令あたりのクロックサイクル数 | 変動する | 通常1 |
トレードオフは、命令あたり多くの処理を行うこと(CISC) versus 各命令を速くかつ予測可能に行うこと(RISC)です。現代のIntelチップは、内部でCISC命令を単純なRISC類似のマイクロオペレーションに翻訳します。
「RISCプロセッサの4つの特徴を挙げよ。」 次のうち4つ: 単純な命令の少量のセット;固定長の命令(1ワード);多くの命令が1つのクロックサイクルで完了;多数の汎用レジスタ;ロードとストア命令のみがメモリにアクセス(全ての演算はレジスタ間);ハードワイヤード制御(マイクロコードなし);パイプライン化を意図した設計;コンパイラがより多くの作業を行うため、プログラムには命令が多く含まれ、より多くのメモリが必要です。 「CISCプロセッサの4つの特徴を挙げよ。」 次のうち4つ:命令の大量のセット、その多くが複雑(一つの命令で複数の操作を行うことがある);可変長の命令;複数のクロックサイクルを要する命令;** fewer(少ない)** レジスタ;メモリに直接アクセスできる命令;マイクロプログラミングされた制御;パイプライン化には不向き;短いプログラム因此、より単純なコンパイラと少ないメモリで済む。 「RISCとCISCの意味を説明せよ」(各2点) : 略語を名指し定義の核心(few simple single-cycle instructions; many complex multi-cycle instructions: 少量の単純な単サイクル命令;多数の複雑なマルチサイクル命令)を述べる。
両設計における割り込み処理。 CISCプロセッサでは、現在の命令が how ever complex(いずれほど複雑であっても)、完了するまで割り込みサービスは行われません。その後、プロセッサはレジスタの内容(プログラムカウンタを含む)をスタックに保存し、割り込みサービスルーチンへジャンプし、後にレジスタを復元します。パイプラインを持つRISCプロセッサでは、割り込みが発生した時点でパイプライン内の複数の命令が途中段階にあります。そのため、プロセッサはパイプライン内の全命令を完了させるか、**破棄(フラッシュ)**して実行途中の命令を捨てて割り込み後に再実行するか、どちらかの選択を迫られます。いずれの場合でもパイプラインは空になり、レジスタは保存され、サービスルーチンが実行されます。 試験での表現:「パイプライン化は割り込み処理を複雑にする。なぜなら、割り込みサービスを行う前にパイプラインの内容に対処しなければならないからである」。
語彙
練習する
| English | 日本語 |
|---|---|
| motherboard/ˈmʌðəbɔːd/ | マザーボード |
| CISC/sɪsk/ | 複合命令セット |
| RISC/rɪsk/ | 単純命令セット |
| register/ˈredʒɪstə/ | レジスタ |
| interrupt/ˈɪntərʌpt/ | 割り込み |
15.1
パイプライン化
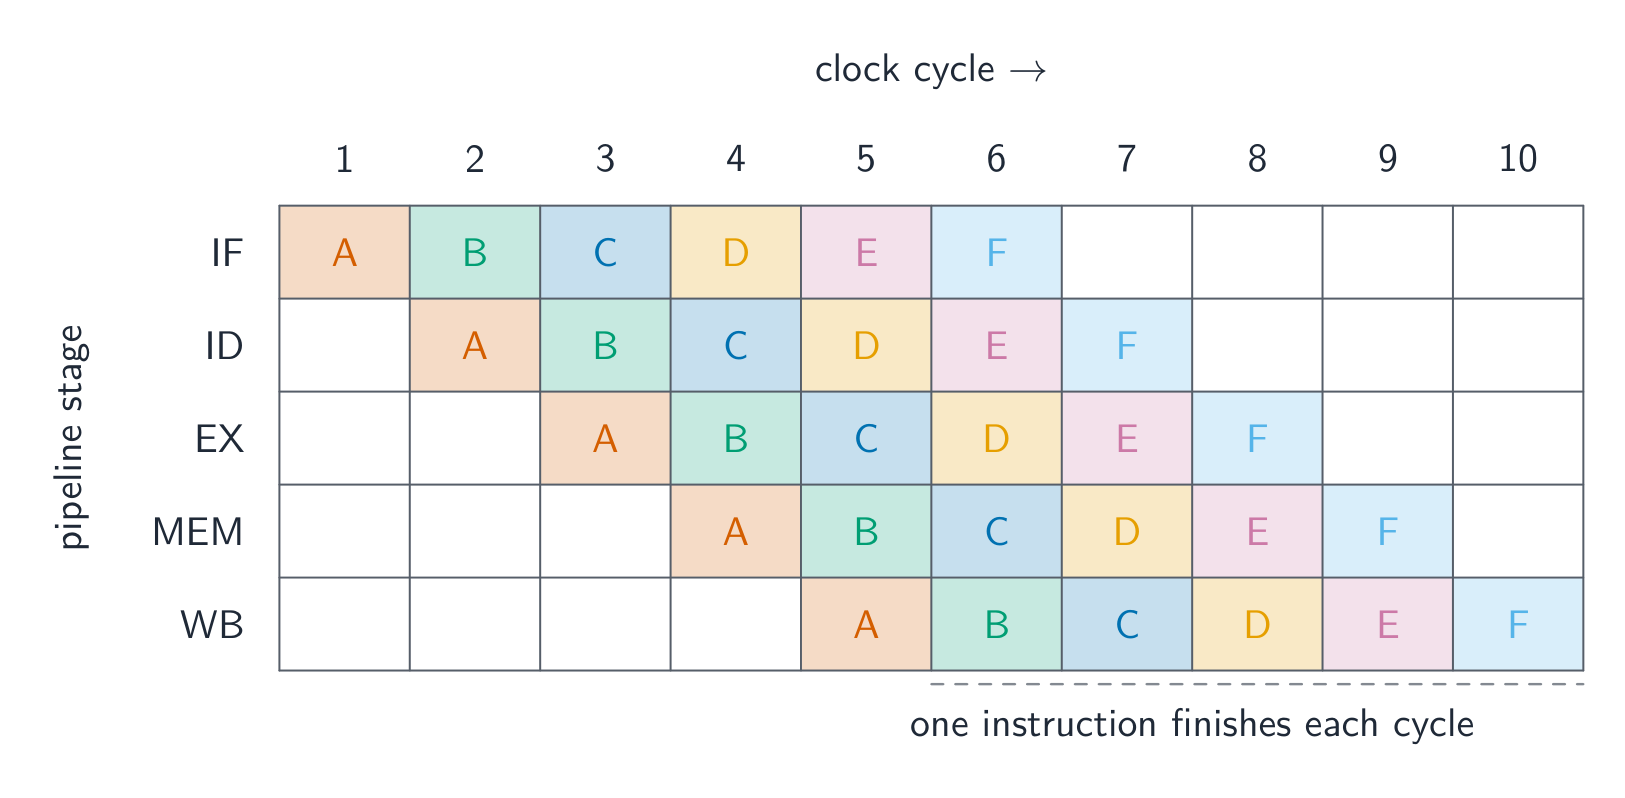
A pipeline processes instructions in overlapping stages, like an assembly line: Fetch → Decode → Execute (in the ALU) → Memory access → Write back. Each stage works on a different instruction at once, so once the pipeline is full, one instruction completes per cycle. RISC's fixed-length, simple instructions make every stage take the same time. A pipeline can stall on a hazard — a data hazard (an instruction needs a result not ready yet) or a control hazard (a branch makes the next address unknown).
RISCチップはメモリが遅くレジスタが速いため、データを多数のレジスタに保持し、コンパイラは値をレジスタに賢く割り当てます。
「RISCプロセッサにおけるパイプライン化の使用法を説明せよ」(3点)。 (1) fetch–execute cycle(fetch-Executeサイクル)は工程に分割される(fetch, decode, execute, memory access, write back);(2) 複数の命令が一度にパイプライン内にあり、それぞれが異なる工程にあるため、一つが実行されている間に次の一个是がデコードされ、さらにその次のはfetchされます;(3) パイプラインが満杯になったら、各クロックサイクルで新しい命令が開始され、一つが完了するため、スループット(1秒あたりに完了する命令数)が増加しますが、個別の命令が単独で処理される時間は同じままです。固定長・単サイクルのRISC命令が、工程の均等化とパイプラインの実現を可能にしています。
** worked example( worked example).** プロセッサは5つのパイプライン工程(IF, ID, OF, EX, WB)を使用します。4つの命令が順次パイプラインに入ります。最後の命令はどのサイクルで完了し、パイプライン化なしでは4つの命令に何サイクルかかるでしょうか?
命令1はサイクル1でIF、2でID、3でOF、4でEX、5でWBを行います。命令2は1サイクル遅れて始まり、6サイクルで完了します。命令3は7サイクル、命令4は8サイクルです。一般的に$n$命令が$k$ステージを要し、这里是$n + k - 1$サイクル、ここでは$4 + 5 - 1 = 8$です。パイプライン化がない場合、各命令は次の命令が始まる前に全5サイクルを要します:$4 \times 5 = 20$サイクル。試験の表は、各命令のステージを対角線上に書き、前の命令より右に1列ずらして埋めていきます。
この高速なプロセッサは多くの熱を発生するため、その上にはヒートシンクとファンが設置されています。金属のフィンが熱を広げ、ファンがそれを排風することで、CPUが動作できる温度に保たれています。

探索
パイプラインが飽和する様子
クロックサイクルを順に確認しましょう。パイプラインが饱和したら、各命令がまだ複数の工程を要しても、異なる命令の工程が重なるため、1サイクルごとに新しい命令が完了します。
語彙
練習する
| English | 日本語 |
|---|---|
| pipeline/ˈpaɪplaɪn/ | パイプライン |
| ALU/ˌeɪ el ˈjuː/ | ALU(演算論理回路) |
| hazard/ˈhæzəd/ | ハザード |
| throughput/ˈθruːpʊt/ | スループット |
| heat-sink/hiːt sɪŋk/ | ヒートシンク |
| Flynn's taxonomy/flɪnz tækˈsɒnəmi/ | フリン分類 |
15.1
フリンの分類法
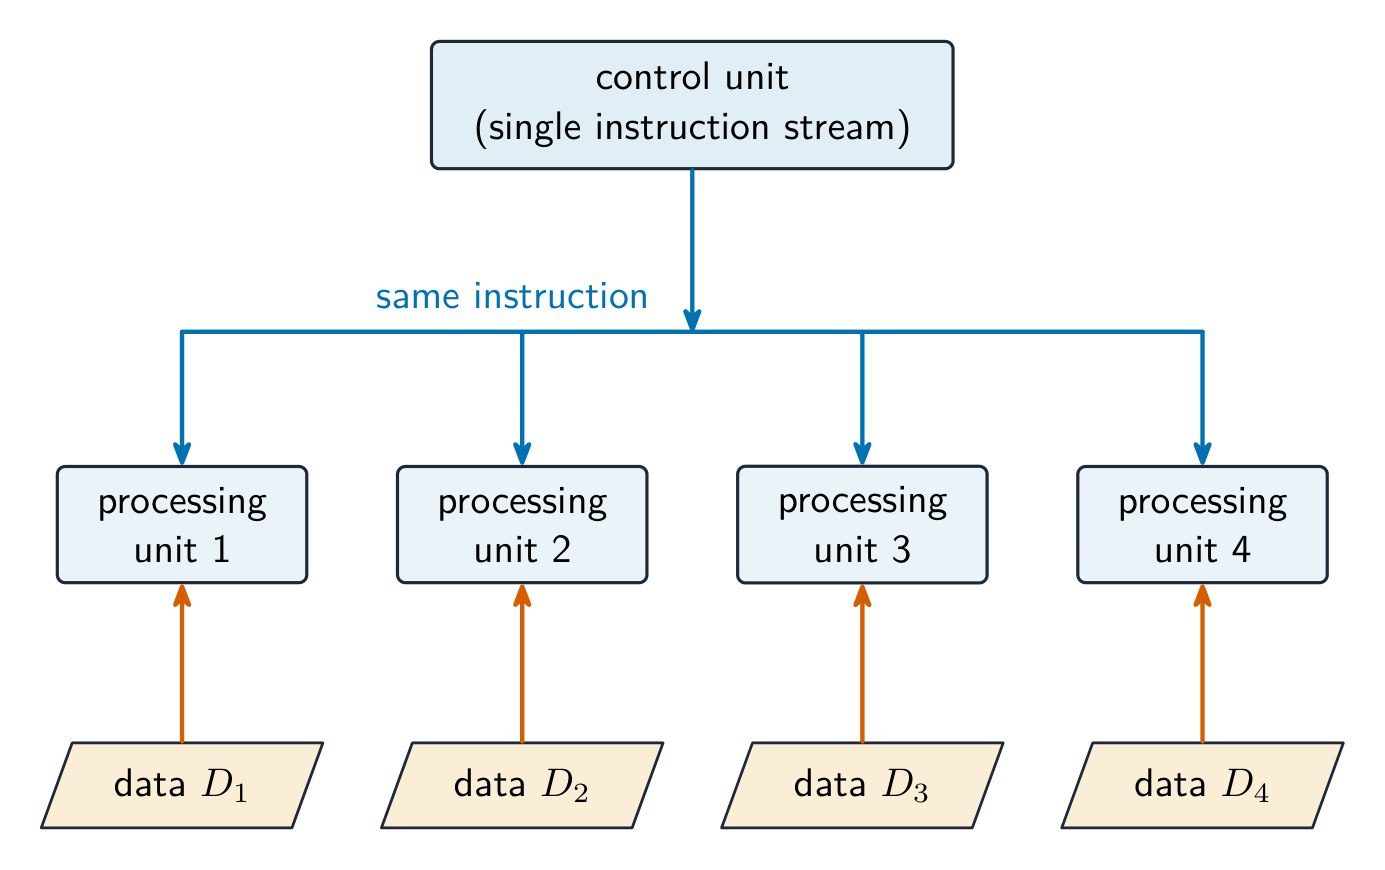
フリンの分類法は、命令およびデータストリームの数によってコンピュータを分類します:
- SISD — 1つの命令、1つのデータストリーム(従来の単一コア)。
- SIMD — 1つの命令が多数のデータ項目を同時に処理します(GPU、CPUベクトル拡張機能)。画像、動画、科学的配列に最適です。
- MISD — 同一データに対して複数の操作を行う;稀であり、主に理論的なものです。
- MIMD — 多数のプロセッサが異なるデータを対象に異なる命令を実行します(マルチコアCPU、クラスター)。最も一般的な形式です。
4つのアーキテクチャの説明(各2点)。 SISD: 単一のプロセッサが一度に1つの命令を1つのデータ項目に対して実行します。並列性はなく、従来のフォン・ノイマンマシンです。SIMD: 1つの命令が、同期して動作する多数の処理要素によって多数のデータ項目に同時に適用されます。配列およびグラフィックス処理に使用されます。MISD: 複数のプロセッサが同一のデータに対して異なる命令を適用します。稀に使用され、例えば複数のプロセッサが1つのストリームを確認する耐故障システムなどがあります。MIMD: 多数のプロセッサがそれぞれ独自の命令を独自のデータに対して独立して実行します。マルチコアコンピュータおよびクラスターです。
グラフィックスカード(GPU付き)はSIMDハードウェアの実際の例です。数千の小さなコアを持ち、多数のピクセルや数値に対して同じ命令を同時に実行するため、GPUは画像、動画、機械学習において非常に高速です。


語彙
練習する
| English | 日本語 |
|---|---|
| SIMD/ˈsɪmdiː/ | SIMD(単一命令多データ) |
15.1
大規模並列コンピュータ

大規模並列システムは、高速ネットワーク上で数千のプロセッサを使用し、それぞれが独自のメモリ(分散メモリ)を持ち、メッセージによるデータ交換を行います。これはMIMDであり、特別に書かれたソフトウェア(MPI、CUDA)を必要とし、気候シミュレーション、大規模機械学習トレーニング、天体物理学に適しています。最大のスーパーコンピュータは大規模並列です。
「大規模並列コンピュータの特徴を概説せよ」(3点)。 非常に多数のプロセッサ(数千)、それぞれが独自のメモリを持ち、メッセージを互いに送受信できるように、ネットワーク(高速インターコネクトまたはバス)で接続されています。同じ問題の一部を同時に処理するため、問題は並列に実行可能で結果を統合できる部分に分割されたプログラムとして記述する必要があります。これはMIMD構成です。
プロセッサは高いサーバーラックに配置され、しばしば部屋全体(データセンター)を満たしており、 wiringされて1つの大きな問題を同時に処理できるようになっています。
語彙
練習する
| English | 日本語 |
|---|---|
| MIMD/ˈmɪmdiː/ | MIMD(複数命令多データ) |
| graphics card/ˈɡræfɪks kɑːd/ | グラフィックスカード |
| massively parallel/ˈmæsɪvli ˈpærəlel/ | 大規模並列処理 |
| distributed memory/ˈdɪstrɪbjuːtɪd ˈmeməri/ | 分散メモリ |
| machine learning/məˈʃiːn ˈlɜːnɪŋ/ | 機械学習 |
| supercomputers/ˌsuːpəkəmˈpjuːtəz/ | スーパーコンピュータ |
| server/ˈsɜːvə/ | サーバー |
| data centre/ˈdeɪtə ˈsentə/ | データセンター |
| virtual machine/ˈvɜːtʃuːəl məˈʃiːn/ | 仮想マシン |
| hypervisor/ˌhaɪpəˈvaɪzə/ | ハイパーバイザー |
| sandboxing/ˈsændbɒksɪŋ/ | サンドボックス化 |
| bytecode/ˈbaɪtkəʊd/ | バイトコード |
| just-in-time compilation/dʒʌst ɪn taɪm ˌkɒmpɪˈleɪʃn/ | 即時コンパイル |
| host operating system/həʊst ˈɒpəreɪtɪŋ ˈsɪstəm/ | ホストOS |
| guest operating system/ɡest ˈɒpəreɪtɪŋ ˈsɪstəm/ | ゲストOS |
| Boolean algebra/ˈbuːlɪən ˈældʒɪbrə/ | ブール代数 |
| Boolean/ˈbuːlɪən/ | ブール |
| truth tables/truːθ ˈteɪblz/ | 真値表 |
| De Morgan's laws/də ˈmɔːɡənz lɔːz/ | ド・モルガンの法則 |
| absorption/əbˈsɔːpʃn/ | 吸収律 |
15.1
仮想マシン
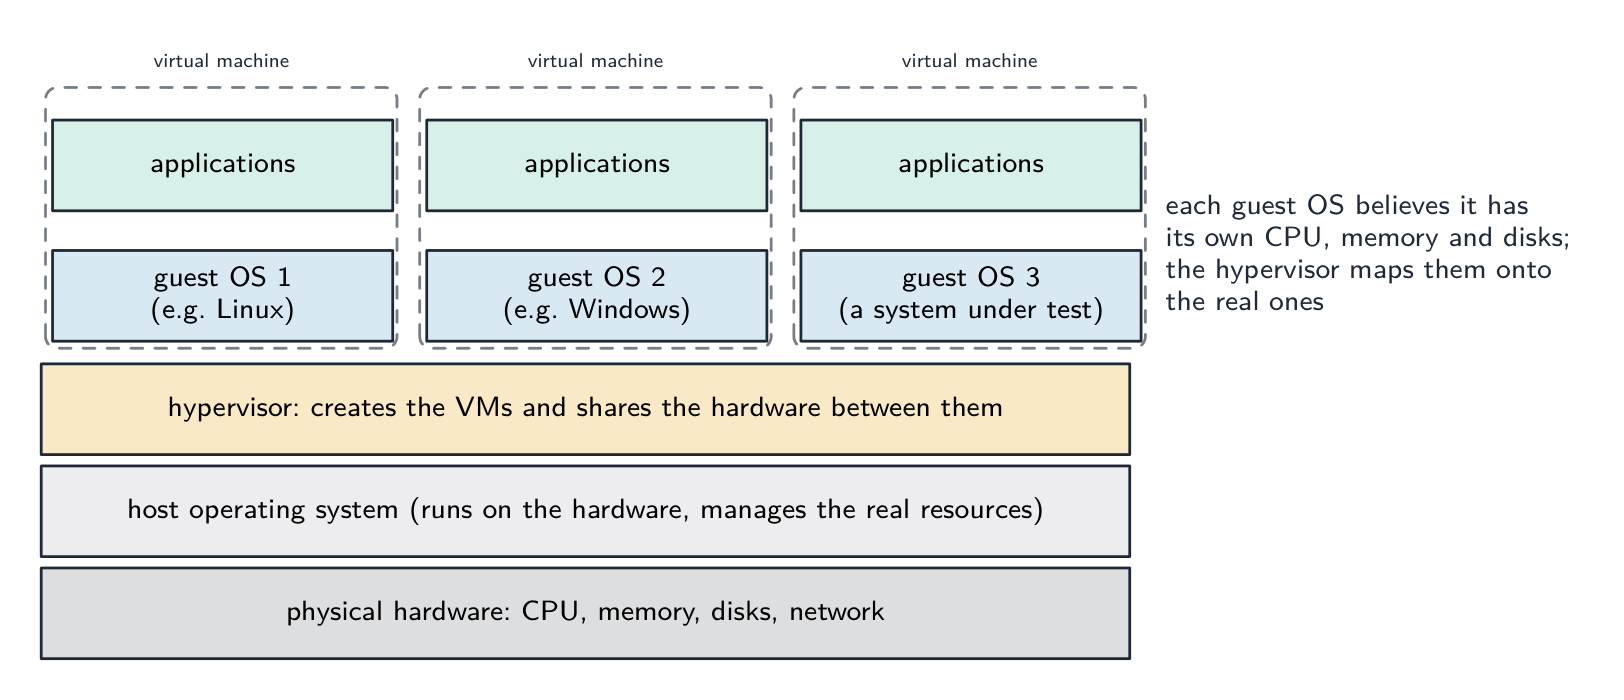
仮想マシン(VM)はコンピュータ全体のソフトウェアエミュレーションです。内部のソフトウェアは、実際のように見えるがホストソフトウェアによって管理されているCPU、メモリ、ディスクを見ます。
- システムVM は完全なOSを実行します。ハイパーバイザはVMを作成・管理し、各VMはゲストOSをブートします。用途:1台のマシンで異なるOSの実行;サーバー集約;サンドボックス(危険なソフトウェアを隔離して実行);スナップショット。
- プロセス(言語)VM はポータブルバイトコードで1つのプログラムを実行します — JVM (Java)、CLR (.NET)、CPython。利点:ポータビリティ("一度書けばどこでも実行")、ランタイム安全チェック、およびネイティブに近い速度のためのジューインタイムコンパイル。コストは追加のレイヤーとVMのインストールが必要であること。
「仮想マシンの意味を説明せよ」(2点)。 ホストコンピュータ上で動作し、内部で実行されているプログラムにとっては、独自のプロセッサ、メモリ、ストレージを持つ別の物理コンピュータのように振る舞う、コンピュータシステムのソフトウェアエミュレーション(実装)である。 ホストOSは実際のハードウェア上で動作し、リアルなリソースを管理し、(ハイパバイザを通じて)仮想マシンを作成・制御する;各ゲストOSは仮想マシン内で動作し、その中のアプリケーションを管理しており、自身のハードウェアが仮想化されていることに気づいていない。
利点(2つ挙げよ)。 複数の異なるOSを1台の機械で同時に動作させることができ、ハードウェアを購入せずに多くのシステム上でソフトウェアをテストできる;構築される前に新しいコンピュータシステムのエミュレーションを行って試すことができ、各VMは隔離されているため、あるVMでのクラッシュやマルウェアがホストや他のVMに影響を与えない;VMをファイルとしてコピー、移動、バックアップでき、1台のサーバーを多数のユーザーで共有することで、ハードウェアコストを削減できる。欠点(2つ挙げよ)。 VMはエミュレーション層を介してすべての命令が通過するため、実際のハードウェアより遅い。ホストのメモリと処理能力を消費するため、ホストは強力な仕様である必要があります;一部のハードウェア機能やデバイスは正確にエミュレートされないため、テストされたソフトウェアが実際の機械では異なる挙動を示すことがあります;各ゲストOSにはライセンスが必要であり、システム設定には専門知識が必要です。
探索
コンピューティング概念ラボ
具体的な例を、それが示すコンピューティングのアイデアに基づいて分類せよ。
15.2
ブール代数
シラバス
| 受験者は以下的能力を備えているべきである: | メモおよびガイドライン |
|---|---|
| ハーフ加算器およびフル加算器を含む論理回路の真値表を作成する能力 | 2つ以上の入力を持つ論理ゲートを含む場合あり |
| フラップフロップ(SR, JK)の理解 | フラップフロップの論理回路を描き、真値表を導く データ格納素子としてのフラップフロップの役割の理解 |
| ブール代数の理解 | ド・モルガンの法則の理解 ド・モルガンの法則を用いたブール代数の実行 論理回路/式をブール代数で簡略化する |
| カルノー図(K-map)の理解 | カルノー図を使用する利点の理解 カルノー図を用いて論理問題を解く |
出典: Cambridge International シラバス
ブール代数はブール式を簡略化し、これらは同様に真偽表でも記述できます。記号:+はOR、·はAND(省略されることが多い)、バー(上線)はNOTを表します。
主要な法則には、通常の代数と同様の可換律、結合律、分配律に加え、以下が含まれます:
- 同一性$A + 0 = A$, $A \cdot 1 = A$; 零$A + 1 = 1$, $A \cdot 0 = 0$。
- 同一律 $A + A = A$; 逆元律 $A + \overline{A} = 1$, $A \cdot \overline{A} = 0$。
- ド・モルガンの法則: $(A + B)' = A' \cdot B'$; $(A \cdot B)' = A' + B'$ — 全体を否定し、AND/ORを入れ替え、各演算子を否定する。
- 吸収律: $A + AB = A$。
簡略化により項数が減り、結果となる論理回路のゲート数も少なくなります。例:$Z = AB + A\overline{B} = A(B + \overline{B}) = A$。
名付けた法則(「全過程を示せ」と求められた場合は、各ステップで名前を引用すること)。
| 法則 | OR形 | AND形 |
|---|---|---|
| 同一律 | $A + 0 = A$ | $A \cdot 1 = A$ |
| 零律(無効律) | $A + 1 = 1$ | $A \cdot 0 = 0$ |
| 同一律 | $A + A = A$ | $A \cdot A = A$ |
| 補完律(逆元律) | $A + \overline{A} = 1$ | $A \cdot \overline{A} = 0$ |
| 可換律 | $A + B = B + A$ | $A \cdot B = B \cdot A$ |
| 結合律 | $A + (B + C) = (A + B) + C$ | $A(BC) = (AB)C$ |
| 分配律 | $A + BC$ $= (A + B)(A + C)$ |
$A(B + C)$ $= AB + AC$ |
| 吸収律 | $A + AB = A$ | $A(A + B) = A$ |
| ド・モルガンの法則 | $\overline{A + B} = \overline{A} \cdot \overline{B}$ | $\overline{A \cdot B} = \overline{A} + \overline{B}$ |
| 二重否定 | $\overline{\overline{A}} = A$ |
** worked example.** $X = \overline{\overline{(A \cdot B)} \cdot \overline{(A + B)}}$ を簡略化し、全過程を示せ。
$X = \overline{\overline{(A \cdot B)}} + \overline{\overline{(A + B)}}$ (外側のバーに対するド・モルガンの法則) $= A \cdot B + A + B$ (二重否定) $= A + B$ (吸収律、$A + AB = A$、$A + B$が$AB$を吸収するように適用)。
** worked example.** $(\overline{A + B}) \cdot (\overline{A} + B)$ を簡略化せ。
$= \overline{A} \cdot \overline{B} \cdot (\overline{A} + B)$ (ド・モルガン) $= \overline{A}\,\overline{B}\,\overline{A} + \overline{A}\,\overline{B}\,B$ (分配則) $= \overline{A}\,\overline{B} + 0$ (冪等律、補数) $= \overline{A}\,\overline{B}$。
** worked example.** $Y = \overline{A}\,\overline{B}\,\overline{C} + \overline{A}\,\overline{B}\,C + A\,\overline{B}\,C$ を簡略化せ。
$= \overline{A}\,\overline{B}(\overline{C} + C) + A\,\overline{B}\,C$ (分配律) $= \overline{A}\,\overline{B} + A\,\overline{B}\,C$ (補完律、同一律) $= \overline{B}(\overline{A} + AC)$ (分配律) $= \overline{B}(\overline{A} + C)$、$\overline{A} + AC = (\overline{A} + A)(\overline{A} + C) = \overline{A} + C$を用いる。3入力項に対するド・モルガンの法則の適用も同じように機能する:$\overline{A + B + C} = \overline{A} \cdot \overline{B} \cdot \overline{C}$。
真偽表からの積和標準形。 出力が1となる各行を取り上げ、入力のANDを記述する(変数が0の場合はバー付きにし)、これらの項をORで結ぶ:$A = 1, B = 0, C = 1$を含む行は$A\,\overline{B}\,C$を与える。これが試験で求められる積和標準形であり、代数的簡略化およびカルノー図の両方の出発点となる。
探索
ブール代数
A·B, A+B, Ā …
ブール代数とは、これらのゲートを式として書いたものにすぎません。真値表を比較してみてください。
探索
ブール論理の真理表
演算子と入力を指定して真理表を作成します。これは論理回路の代数的基础です。
語彙
練習する
| English | 日本語 |
|---|---|
| half adder/hɑːf ˈædə/ | ハーフアダクター |
15.2
カルノー図
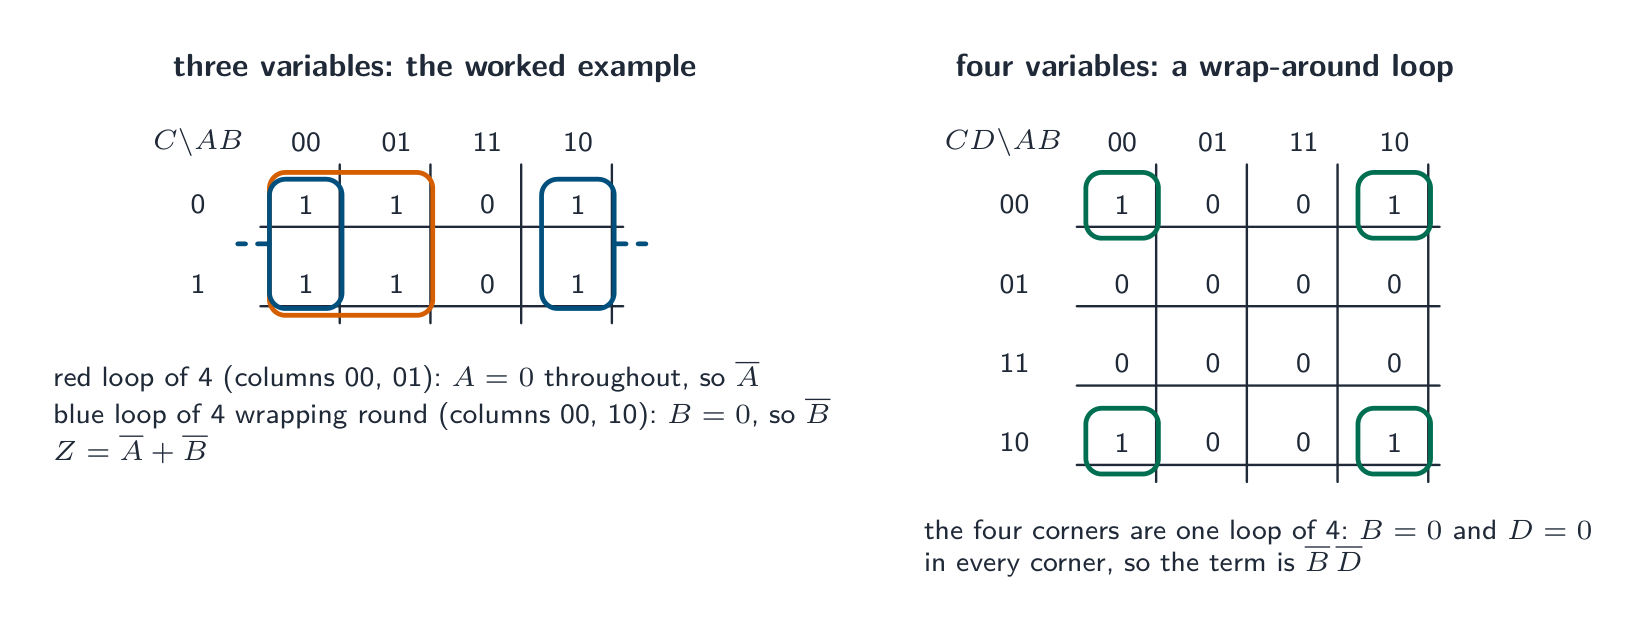
カルノー図(K-map)は、真偽表から隣接する1をグループ化することでブール式を簡略化する。列と行はグレイコード順(00, 01, 11, 10)で配置されており、隣接するセルは1つの変数のみで異なる。
出力が1となる各セルに1を配置する。1の長方形のグループを見つけ、辺の長さは2の累乗(1, 2, 4, 8)とする必要があり、より大きなグループになる場合は端を巻き返してもよい。グループが大きければ大きいほど、項は単純になる:2個のグループは1つの変数を除外し、4個のグループは2つの変数を除外する、というように — グループ内で変化する変数は消滅する。グループごとの項をORで結んで簡略化された式を得る。すべての1を、できるだけ少なく、できるだけ大きなグループで覆う。
** worked example.** $A$ と $B$ のカノー図には、セル $\overline{A}B$ と $AB$ に 1 が配置されています。簡略化してください。2つの 1 は 隣接 しており、$B=1$ カラムを共有しています。したがって、これらを 2 の長方形としてグループ化します。このグループ内では、$B$ は常に 1 のままですが、$A$ は 0 から 1 に 変化 します。グループ内で変化する変数はすべて 消滅 します。よって、このグループから残るのは単に $X = B$ です。真値表からそのまま読み取った積の和 $\overline{A}B + AB$ と比較すると、同じ回路でありながらゲートが2つ少なくなっています。2つのルールで大半の処理が行われます。各グループは 可能な限り大きくする ことです(グループに 2 が含まれると1つ変数が減り、4 で2つ、8 で3つ減ります)。また、カノー図の端は 巻き返る ことを忘れないでください。つまり、左端と右端のカラムは隣接しています。この巻き返しは、受験生が最も見落としやすい grouping です。
Kマップの作成と読み取り。 列を$AB$、行を$C$(または$CD$)にグレイコード順で00 01 11 10配置し、隣接するセルが1つだけ変数 differed するようにします。式に含まれる最小項(または真値表で出力が1となる行)に対応するセルには1を書き込みます。次に、すべての1を覆う最少かつ最大のループを描きます:各ループは$1, 2, 4$個または$8$個のセルからなる長方形であり、ループ同士は重複しても構わず、左右および上下のエッジをまたいで折り返すことができ、四隅のセル全体で一つのループを形成することもあります。各ループについて、内部で一定である変数(0の場合はバー付き)を記載し、ループごとの項をORしてまとめます。これが最適化された積和形です。なぜそれを使うのか? 代数計算なしで、数ステップで最も単純な表現を得られ、誤りの可能性も低く、3変数や4変数の場合でも同じマップが使えます。
worked example. $Z = \overline{A}\,\overline{B}\,\overline{C} + \overline{A}\,\overline{B}\,C + \overline{A}\,B\,\overline{C} + \overline{A}\,B\,C + A\,\overline{B}\,\overline{C} + A\,\overline{B}\,C$.
3変数のマップでは、1が両方の行の列00, 01, 10を埋めています。列00と01にまたがる4つのセルのループでは、$A = 0$が常に一定で、$B$と$C$はどちらも変化するため、項は$\overline{A}$となります。列00と10にまたがる4つのセルのループ(折り返し)では、$B = 0$が常に一定なので、項は$\overline{B}$となります。よって$Z = \overline{A} + \overline{B}$となり、これはブール代数によっても確認できます:$\overline{A}(\overline{B} + B) + \ldots = \overline{A} + \overline{B}$。2つのセルからなる2つのループでも正解ですが、最適ではありません。ループは1が存在する範囲内でできるだけ大きくする必要があります。
** worked example (4変数)。** マップの四隅にのみ1があります:$\overline{A}\,\overline{B}\,\overline{C}\,\overline{D}$, $A\,\overline{B}\,\overline{C}\,\overline{D}$, $\overline{A}\,\overline{B}\,C\,\overline{D}$, $A\,\overline{B}\,C\,\overline{D}$。上段と下段の行は隣接しており、外側の列も隣接しているため、四隅は1つの4セルループとなります。$B = 0$と$D = 0$はすべて一定で、$A$と$C$は変化するため、結果は$Z = \overline{B}\,\overline{D}$となります。
15.2
ハーフエーダーとフルエーダー

ハーフエーダーは、2つの単一ビット$A$と$B$を加算し、和$S$とキャリー$C$を出力します:
| A | B | S | C |
|---|---|---|---|
| 0 | 0 | 0 | 0 |
| 0 | 1 | 1 | 0 |
| 1 | 0 | 1 | 0 |
| 1 | 1 | 0 | 1 |
したがって$S = A \text{ XOR } B$と$C = A \text{ AND } B$です。入力されるキャリーを無視するため、「ハーフ」と呼ばれます。
全加算器は3ビット($A$, $B$, carry-in)を加算し、sumとcarry-outを生成する:$S = A \text{ XOR } B \text{ XOR } C_{\text{in}}$。これは2つの半加算器とORゲートから構築できる。全加算器をチェーンする(各carry-outが次のcarry-inに入力される)ことで、多ビットの「リップルキャリー」加算器が作られる。

フルエーダーの真値表。 入力が$A$, $B$、キャリーインが$C_{\text{in}}$の場合、和$S$は、入力の1の数が奇数のとき1になります。また、キャリーアウトは、入力の1の数が2以上のとき1になります。
| $A$ | $B$ | $C_{\text{in}}$ | $S$ | $C_{\text{out}}$ |
|---|---|---|---|---|
| 0 | 0 | 0 | 0 | 0 |
| 0 | 0 | 1 | 1 | 0 |
| 0 | 1 | 0 | 1 | 0 |
| 0 | 1 | 1 | 0 | 1 |
| 1 | 0 | 0 | 1 | 0 |
| 1 | 0 | 1 | 0 | 1 |
| 1 | 1 | 0 | 0 | 1 |
| 1 | 1 | 1 | 1 | 1 |
試験が出題する回路に関する質問。 XORゲートとANDゲートが2つの入力共用の回路、あるいは2つのハーフエーダーとORゲートの回路に対して、「真値表を完成させよ(計算過程を示せ)」とは、中間ゲート出力ごとに列を追加し、行を順に埋めることを意味します。「回路の名前を述べよ」はハーフエーダーまたはフルエーダーです。「各出力の役割を述べよ」は、ビットの和と、次の桁へのキャリーです。ハーフエーダーの積和形:$S = \overline{A}B + A\overline{B}$, $C = AB$。各エーダーがキャリーアウトを次のエーダーのキャリーインに渡すフルエーダーのチェーンにより、2つの多ビット数が加算されます。
探索
加算器内部のゲート
ハーフ加算器の和 bit は XOR ゲート、 carry bit は AND ゲートです — A と B を切り替えて、真値表の行が点灯するか確認してください。
語彙
練習する
| English | 日本語 |
|---|---|
| carry/ˈkæri/ | Carry(進位) |
| full adder/fʊl ˈædə/ | フル加法器 |
15.2
フリップフロップ
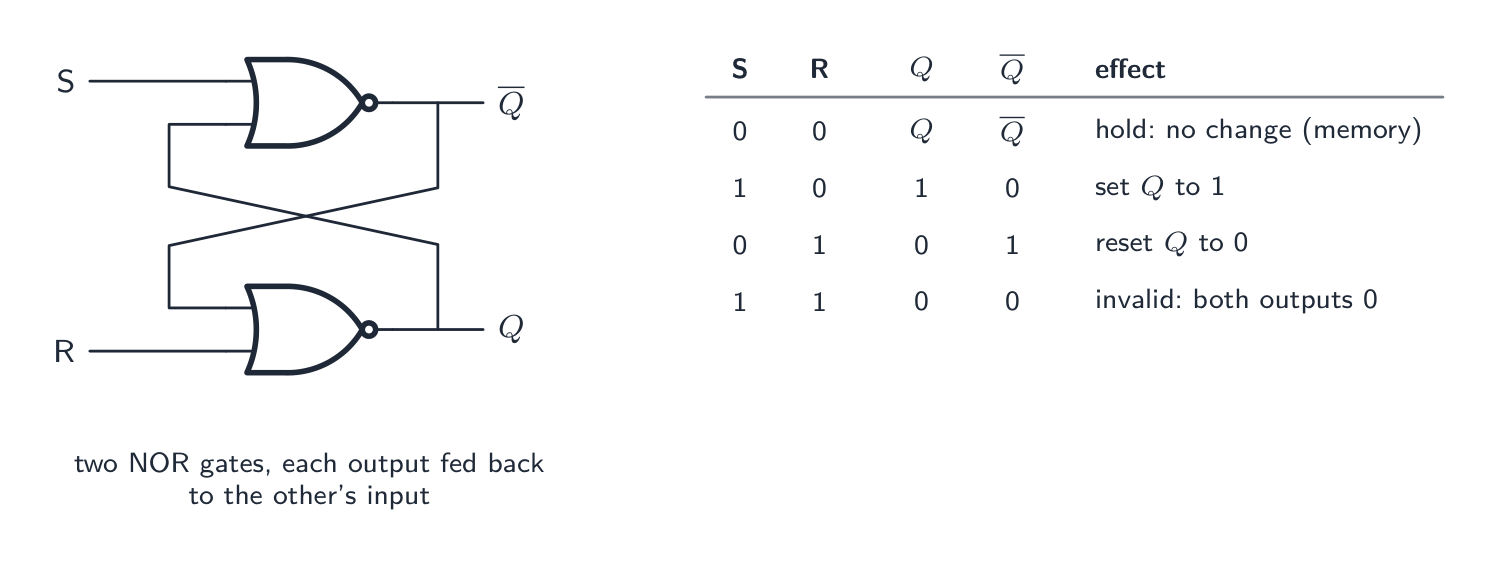
フリップフロップはバイスタブル回路——安定した2つの状態(0と1)——を持ち、その状態を記憶します。1ビットを格納し、レジスタやSRAMの基本要素となります。
SRフリップフロップ
SRフリップフロップ SRは、入力としてS(セット)とR(リセット)、出力としてQと$\overline{Q}$を持ちます。S=1,R=0でQを1にセットし;S=0,R=1で0にリセットし;S=0,R=0で保持します;S=1,R=1は無効です。2つのクロスカップリングNORゲートから構成されます。
*SRフリップフロップ:互いに接続された2つのNORゲート。両方の入力が0のとき、出力はそれまで保持されており、これがメモリ機能です。SでQを1にセットし、Rでリセットしますが、S = R = 1は許可されません。
"** SR フリップフロップの論理回路を描き、入力にラベルを付記せ。" 2つの NORゲート(または2つの NANDゲート)を使用し、各ゲートの出力を他方のゲートの入力の一つに接続します。片方のゲートの空き入力を S、もう片方を R とし、出力は $Q$ と $\overline{Q}$ とします。フィードバック が採点ポイントです。これがなければ記憶機能は存在しません。「フリップフロップの用途を述べよ。」** データ1ビットを保持すること;これはレジスタや静的RAMの基礎となるメモリ要素であり、意図的に変更されるまでその値を維持します。無効な入力 $S = R = 1$ は両方の出力を 0 にするため、$\overline{Q}$ は $Q$ の逆数不再是不再成为,且当两个输入均返回到 0 后的状态变得不可预测,这是SR触发器的弱点。
JKフリップフロップ
JKフリップフロップ JKは、以前無効だった1,1入力をトグル(出力を反転)として利用することで改善されています。これにより、カウンタ(トグルするフリップフロップのチェーン)の構築に最適です。通常はクロック同期型であり、入力はクロックエッジでのみ動作し、複数のフリップフロップを同期させることができます。

フリップフロップは、レジスタ(nビット=n個のフリップフロップ)、カウンタ、およびSRAMメモリアレオの構成要素です。
JKフリップフロップの真値表。 クロック入力がJとKの入力を読み取るタイミングを決定するため、出力はクロックパルスの時にのみ変化します: $J = K = 0$では出力が 保持 されます; $J = 1, K = 0$で $Q$ を セット (1) します; $J = 0, K = 1$で リセット (0) します; $J = K = 1$で トグル (Qが $\overline{Q}$ に切り替わります)。最後の行はSRフリップフロップの禁止入力を用いられるものに変換されたものであり、これがJKフリップフロップが好まれる理由です。すべての入力組み合わせが有効であり、クロック制御動作により、カウンタやシフトレジスタの基礎構成要素となっています。
語彙
練習する
| English | 日本語 |
|---|---|
| flip-flop/flɪp flɒp/ | フリップフロップ |
| bistable/baɪˈsteɪbl/ | 双安定回路 |
| toggle/ˈtɒɡl/ | トグル |
| counters/ˈkaʊntəz/ | カウンタ |
| SRAM/ˈesræm/ | 静的RAM |
| clock/klɒk/ | クロック |
| SR flip-flop/ˌes ˈɑː flɪp flɒp/ | SRフリップフロップ |
| JK flip-flop/ˌdʒeɪ ˈkeɪ flɪp flɒp/ | JKフリップフロップ |
15.2
出題者が認める定義
定義問題は固定された用語に基づいて採点されます。これらを正確に暗記し、一つの答えのみを答えてください。
| 用語 | 定義 |
|---|---|
| RISC | 単純な固定長命令の少数セットを持つプロセッサ。多くの命令は1つのクロックサイクルで実行され、多数のレジスタとパイプラインingを使用する |
| CISC | 複雑な可変長命令の数多くセットを持つプロセッサ。多くの命令は数クロックサイクルかかり、メモリに直接アクセスする |
| パイプライン | フォッチ-エグゼキューテcycleをステージに分割し、複数の命令を同時に処理する(各命令は異なるステージにある) |
| SISD / SIMD / MISD / MIMD | 1つの命令に1つのデータ項目;1つの命令に多数のデータ項目;多数の命令に1つのデータ項目;多数の命令に多数のデータ項目 |
| マッサーリーパラレルコンピュータ | 数千のプロセッサがあり、それぞれが独自のメモリを持ち、ネットワークで接続され、同じ問題に対して同時に動作する |
| 仮想マシン | ホストコンピュータ上で動作し、単一の物理コンピュータのように振る舞うコンピュータシステムのソフトウェアエミュレーション |
| ハイパーバイザ | 仮想マシンを作成し、ホストのハードウェアをそれら間で共有するソフトウェア |
| 真値表 | 論理回路へのすべての入力組み合わせと、その結果となる出力をリストした表 |
| 和の積 (Sum-of-products) | AND項のORとして書かれたブール表达式。1となる入力組み合わせごとに1つの項を持つ |
| カナープ図 | 真値表の出力をグレーコード順に並べたグリッド。隣接する1のループが簡略化された表达式を与える |
| ハーフアダー | 2ビットを加算し、和とキャリーを生成する回路 |
| フルアダー | 2ビットとインキャリーを加算し、和とアウトキャリーを生成する回路 |
| フリップフロップ | 1ビットを格納する双安定回路。入力が変わるまで出力を保持する |
語彙
練習する
| English | 日本語 |
|---|---|
| sum-of-products/sʌm ɒv ˈprɒdʌkts/ | 積和形 |
| Karnaugh map/ˈkɑːnɔː mæp/ | カーノ図 |
| Gray code/ɡreɪ kəʊd/ | グレーコード |
15.2
試験対策
- RISCとCISCは特徴のリストとして答える:単純、固定、1サイクル、多数のレジスタ、ロード/ストア、パイプライン対、複雑、可変、マルチサイクル、 fewer レジスタ、直接メモリアクセス、マイクロコード。各4つ。
- パイプライン化:段階、一度に複数の命令、1サイクルあたりの完了数、スループット向上;$n + k - 1$サイクルで$n$命令が$k$段階を通過;割り込みはパイプラインを空にする必要がある。
- フラインの4分類は「命令ストリーム数が」+「データストリーム数が」;何が何の上で動いているか述べる。マッサーリーパラレル:多数のプロセッサ、独自メモリ、ネットワーク、同一問題。
- 仮想マシン:ホスト上でのコンピュータのエミュレーション;ハードウェア上のホストOS、ハイパーバイザーによる共有、ゲストOSの内部実行。2つの利点と2つの制限があり、それぞれ完全な文で記述すること。
- ブール代数:使うたびに法則の名前を言う。ド・モルガンの法則は演算子を入れ替え、各項を否定する。疑問があれば真値表で確認。
- カナープ図:グレーコード順、最大のループ(1/2/4/8)、ラッピング可、ループごとに1項(不変変数)。なぜそうするか:アルゲブラなしで最も簡単な表达式。
- ハーフアダーは和とキャリーを出す;フルアダーもインキャリーを取る;SRフリップフロップは2つのクロス結合NOR/NANDゲートで1ビットを格納;JKの1,1入力でトグル。
一般的なミス
- RISCとCISCの特徴リストを交換したり、「速い」を特徴として提示したりすると誤り。判断ではなく設計特徴を記述。
- パイプラインを「多数のコアで命令を並列に実行する」と説明すると誤り。1つのプロセッサのステージが重なり合うことである。
- SIMD (1命令、多数データ) とMIMD (多数両方) を混同するか、MISDを一般的なケースだと説明するか誤り。
- 仮想マシンを「コンピュータのコピー」と定義し、エミュレーション、ホスト、ゲストという語を使わないと誤り。
- 長いバーの下での部分式にのみド・モルガンを適用するか、バーを外してAND/ORを入れ替えずに済ませると誤り。
- カナープ図で3つのグループや非長方形のグループをループさせるか、列を00, 01, 10, 11順(グレーコード以外)に並べると誤り。
- ハーフアダーのキャリーにXOR、和にANDを書くと誤り。
- SRフリップフロップをフィードバックのない2つのゲートで描くか、真値表から無効状態を省略すると誤り。
このトピックのインタラクティブ授業
一歩ずつ進め、即時チェック付きの問題で学習します。