О курсе и способе его использования
Это пятый курс программы «Бизнес в университете»: бизнес-статистика. Он посвящён тому, как превращать данные в решения, не обманывая себя. Через весь курс проходит один набор данных, который каждый может воспроизвести: 40 значений времени доставки еды навынос в минутах, полученных при работе службы Nimbus в выходные. Каждый статистический показатель в этом материале можно заново рассчитать по данным, приведённым в конце.
Главный принцип курса: сформулируйте утверждение, укажите неопределённость и скажите, что заставило бы вас изменить мнение. Средние значения сопровождаются стандартными ошибками, статистические тесты — своими допущениями, а корреляции — предупреждениями. Каждый разобранный пример был проверен по набору данных.
- Разделы 5.1–5.2 посвящены сбору и описанию данных: выборке, систематическим ошибкам и достоверным графикам.
- Разделы 5.3–5.5 посвящены случайности: вероятности, оцениванию и проверке гипотез.
- Модули 5.6–5.7 устанавливают связи и принимают решения: регрессия, корреляция и принятие ограничения, которые отличают анализ от попытки убеждения.
Каждый раздел начинается с вопроса, затем излагается метод, а после приводятся два разобранных примеры (второй сложнее), типичные ошибки и краткие итоги.
Данные и выборка
Почему это важно. Каждое число в деловом отчёте получено в результате определённого способа отбора данных. Прежде чем интерпретировать число, нужно знать, что и как было отобрано и кто остался за пределами выборки. Иначе последующий анализ лишь придаёт видимость обоснованности догадке.
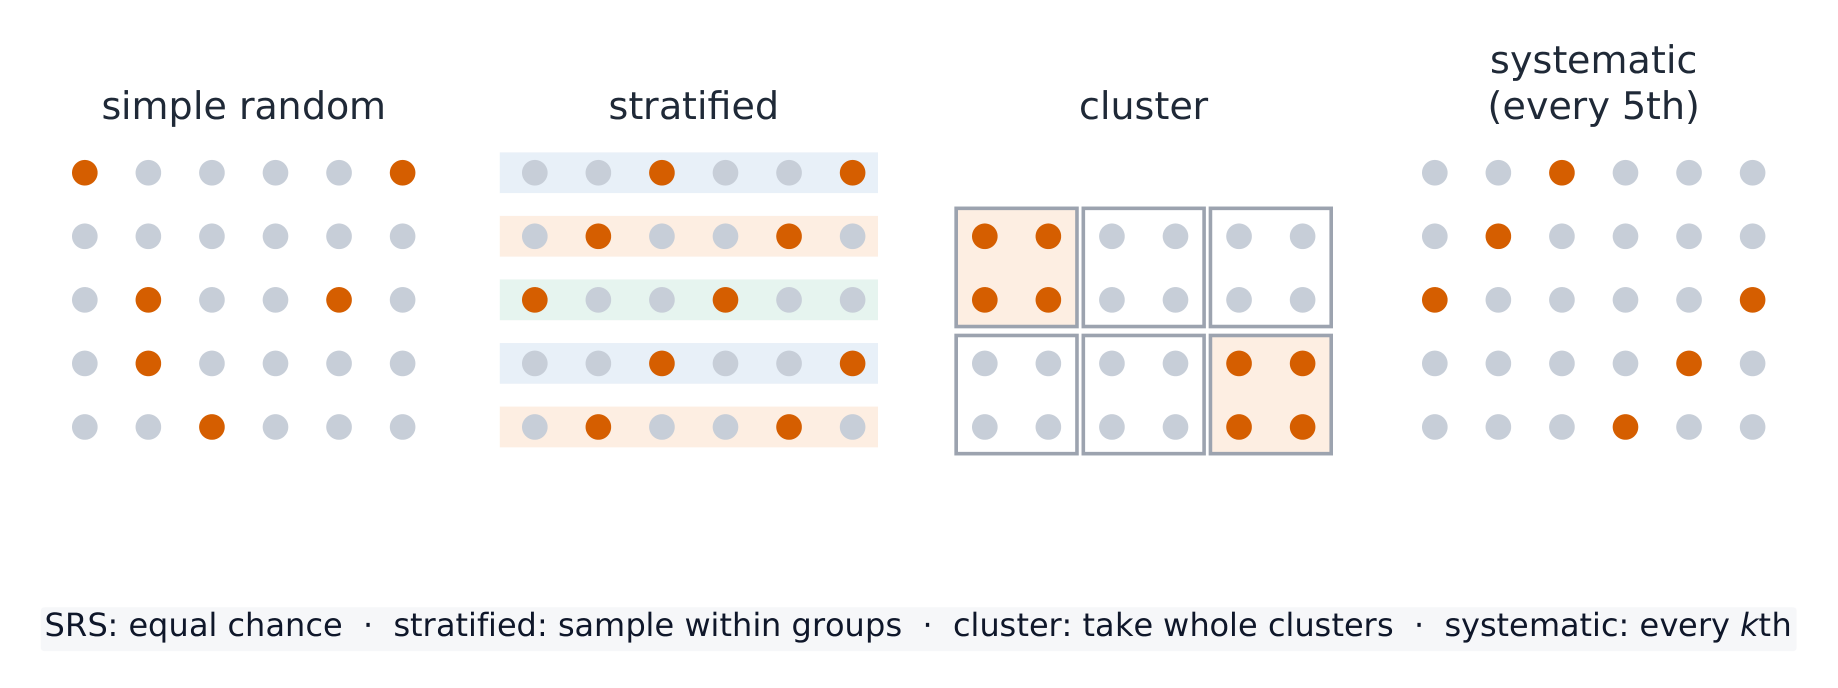
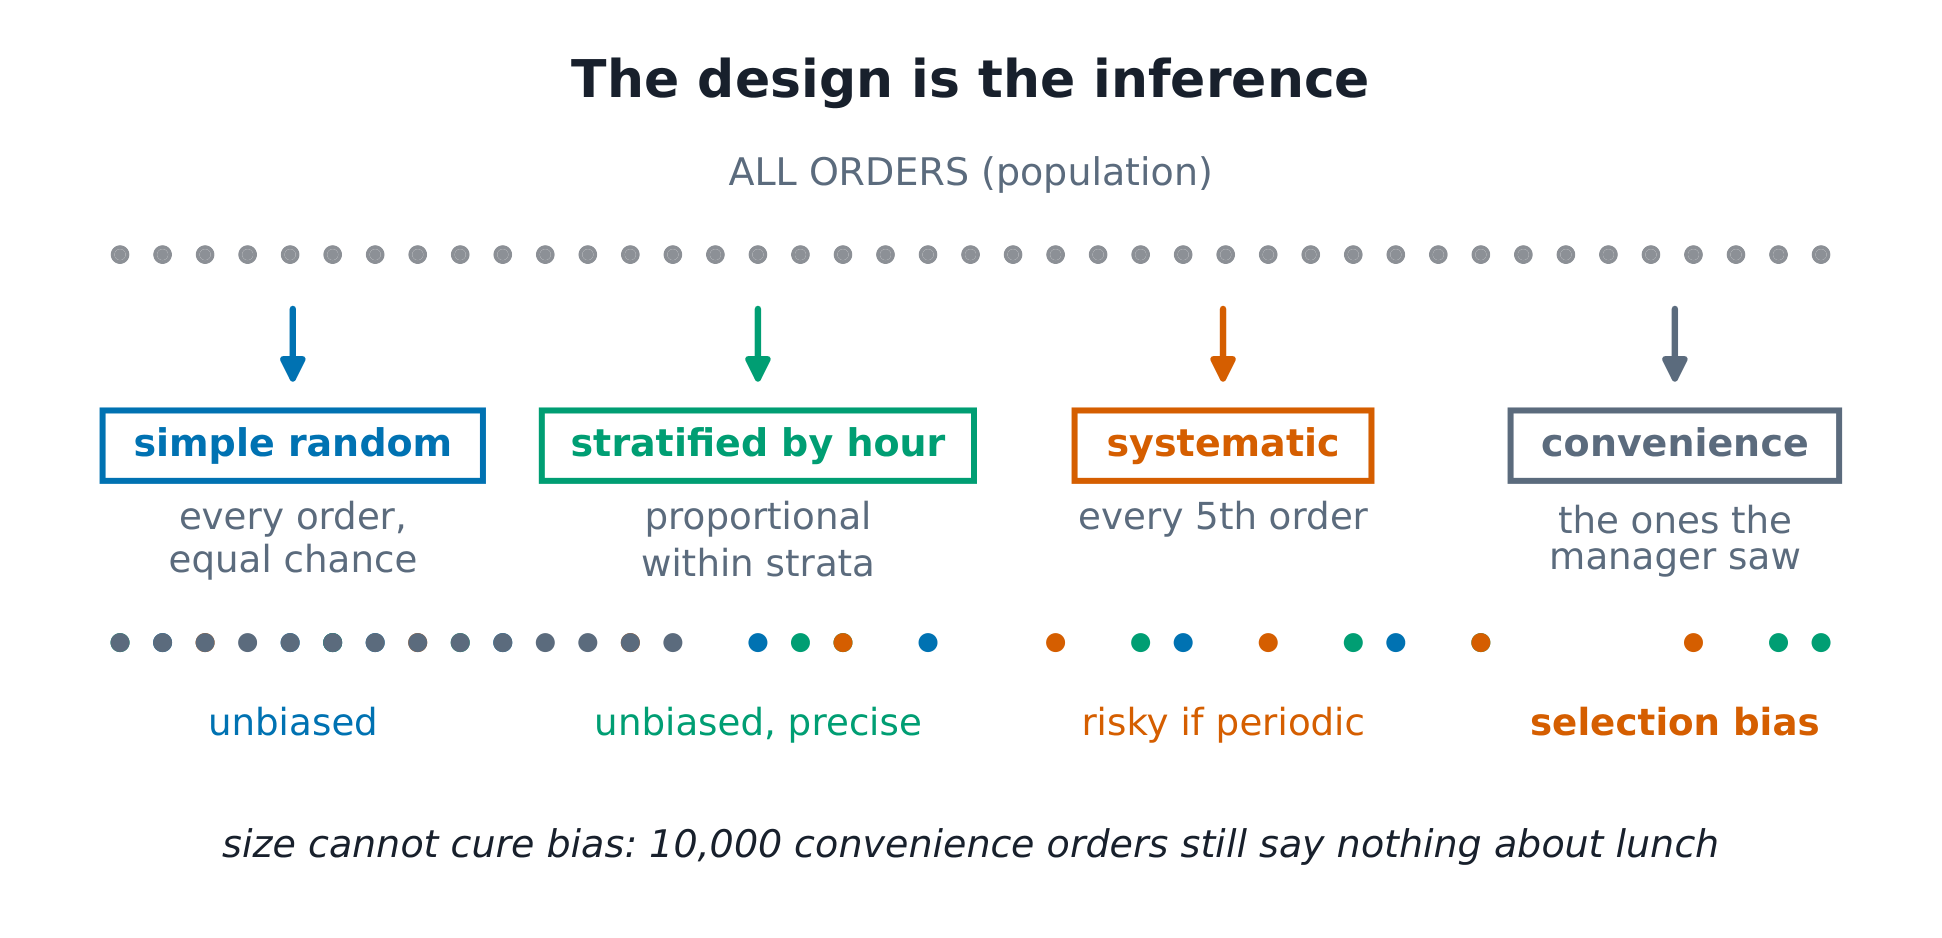
Суть. 40 значений времени доставки составляют выборку из заказов выходного дня; все заказы за определённый период составили бы генеральную совокупность. Способ отбора определяет, какие обоснованные выводы можно сделать по выборке. При простой случайной выборке каждый заказ имеет одинаковую вероятность попасть в неё. Выборка по доступности, например заказы, которые случайно увидел менеджер, этого не обеспечивает.
 Определения. Данные бывают количественными (время доставки в минутах) или
Определения.
- Данные бывают количественными (время доставки в минутах) или категориальными (какой курьер выполнил заказ).
- Шкалы измерения бывают номинальными, порядковыми, интервальными и шкалами отношений. Минуты измеряются по шкале отношений: ноль означает отсутствие времени.
- Систематическая ошибка — это ошибка, вызванная схемой исследования:
- ошибка отбора: кого можно охватить;
- ошибка неответов: кто отвечает;
- ошибка выжившего: кто всё ещё присутствует.
- Словарь данных фиксирует значение, единицу измерения и кодировку каждого поля. Это паспорт набора данных, и его критическое изучение — нулевой шаг любого анализа.
Почему размер не устраняет систематическую ошибку. Если выборка случайна, выборочное среднее является несмещённой оценкой среднего генеральной совокупности: в среднем по множеству выборок оно совпадает с истинным значением. Если схема отбора даёт смещение, никакой объём выборки не исправит ситуацию. Выборка по доступности из 10,000 вечерних заказов по-прежнему ничего не говорит об обеденных заказах. Смещение определяется схемой отбора, а не размером выборки.
Разобранный пример 1: изучаем словарь данных. Словарь набора данных:
| поле | тип | примечания |
|---|---|---|
delivery_min |
шкала отношений, минуты, один знак после запятой | значение отсутствует, когда курьер забыл остановить таймер (3 случаев) |
hour |
порядковая шкала, 11–21 | |
rider_id |
номинальная шкала |
Прежде чем вычислять любое среднее: 3 пропущенных значений не равны нулю минут, и их отсутствие неслучайно: курьеры чаще забывают остановить таймер, когда заняты. Решение: сообщить среднее по 37 полным наблюдениям, а также указать пропущенные значения и никогда не умалчивать о них при сообщении среднего.
Разобранный пример 2: согласование схемы исследования с вопросом. Nimbus хочет узнать, работает ли служба медленнее в выходные.
- Схема A: проанализировать 40 значений времени доставки, все за субботу.
- Схема B: отобрать 20 заказов за субботу и 20 заказов за среду — это стратифицированная выборка, поскольку вопрос предполагает сравнение дней.
Схема A отвечает на вопрос «как обстоят дела в субботу?»; только схема B отвечает на поставленный вопрос. Рассмотрим и обратную ловушку: если отобрать 20 + 20 заказов, а затем рассчитать одно среднее, обоим дням будет придан одинаковый вес независимо от того, действительно ли заказы распределяются так между днями. Схема исследования должна соответствовать утверждению в обоих отношениях.
Типичные ошибки.
- Считать выборку по доступности случайной из-за её большого размера.
- Игнорировать неответы. Клиенты, которые не ответили на опрос, тоже могут кое о чём рассказать.
- Изучать набор данных без словаря. Ошибки в анализе часто возникают из-за единиц измерения и кодов.
Итоги. Схема исследования определяет, какие выводы можно сделать. Смещение носит систематический характер, и увеличение выборки его не устранит. Словарь — часть данных.
Описательные меры и визуализация
Почему это важно. «Среднее время доставки: 27.4 минут» — одна фраза, которая скрывает целое распределение. Описание — не формальность перед «настоящая» статистика: именно здесь обнаруживается большинство важных закономерностей для бизнеса и именно здесь большинство деловых графиков вводит в заблуждение.
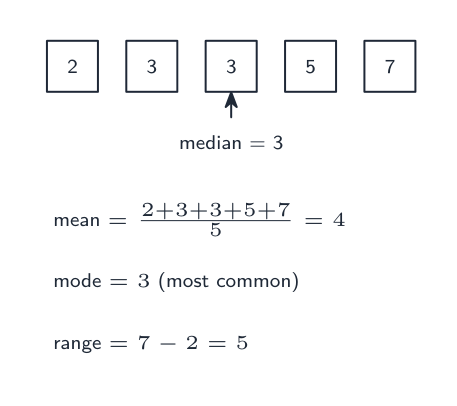
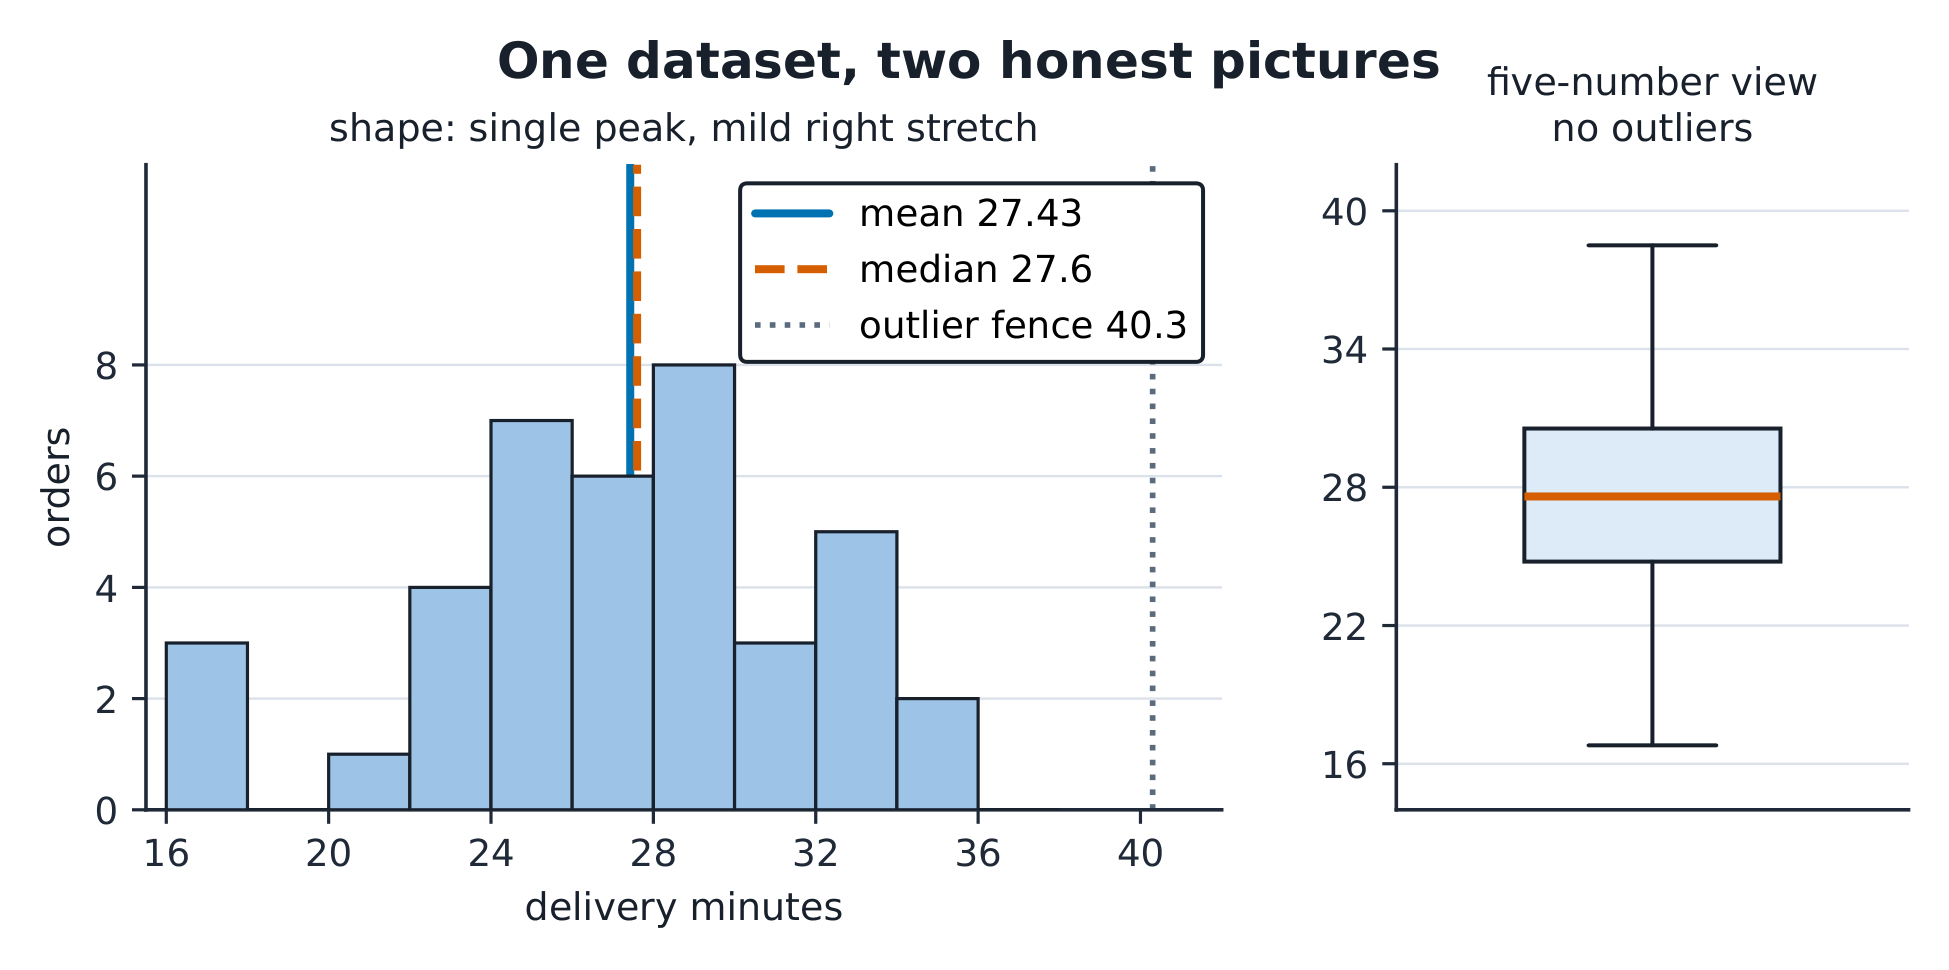
Идея. Каждый набор данных отвечает на четыре вопроса: где находится центр, каков разброс, какова форма распределения и есть ли выбросы. Для 40 значений времени:
| показатель | значение |
|---|---|
| среднее | 27.43 |
| медиана | 27.6 |
| стандартное отклонение | 4.91 |
| квартили (по правилу $(n+1)p$) | 24.5 / 27.6 / 30.9 |
| межквартильный размах (IQR) | 6.3 |
Гистограмма имеет один пик и примерно симметрична, немного вытягиваясь вправо. Наибольшее время, 38.5, велико, но находится внутри границы выбросов: Q3 + 1.5 × IQR = 40.3.
Определения.
- Среднее = сумма ÷ $n$; медиана = срединное значение в упорядоченном ряду.
- Стандартное отклонение: $s = \sqrt{\sum(x_i-\bar x)^2/(n-1)}$.
- IQR = Q3 − Q1. Выбросы — это значения ниже Q1 − 1.5 × IQR или выше Q3 + 1.5 × IQR.
- Форма: симметричная, асимметричная или с несколькими пиками.
Среднее смещается в сторону длинного хвоста; медиана устойчива к его влиянию. Для асимметричных данных таких как доходы или задержки, указывайте медиану и объясняйте почему.
Вычисления. Для этих данных $\bar x = 1{,}097.2/40 = 27.43$. Числитель формулы стандартного отклонения равен $\sum(x_i-\bar x)^2 = 940.3$, поэтому $s = \sqrt{940.3/39} = 4.91$. Почему делим на $n - 1$? Отклонения в выборке связаны между собой ($\sum(x_i - \bar x) = 0$), поэтому деление на $n$ занижает разброс. Одна «степень свободы» расходуется на предварительную оценку среднего.
Разобранный пример 1: достоверная картина. На маркетинговом слайде показан график времени доставки, на котором ось y начинается с 24 минут. Заказы со временем 17–23 минут исчезают, а различия кажутся втрое больше. Перерисуйте график, начав ось с нуля (или чётко обозначив её разрыв), и среднее 27.4 окажется на достоверном графике. Усечение оси — старейший приём: числа не изменились, а картинка изменилась.
Разобранный пример 2: один выброс. Добавим одну ошибку ввода данных: доставку за 168 минут (таймер не остановили). При 41 значениях:
| показатель | до | после | изменение |
|---|---|---|---|
| среднее | 27.43 | 30.86 | +3.43 |
| медиана | 27.6 | 27.7 | +0.1 |
| стандартное отклонение | 4.91 | 22.5 | больше примерно в 4.5 раза |
Одно ошибочное нажатие клавиши сдвинуло среднее более чем на 3 минут и увеличило стандартное отклонение в четыре с половиной раза, но почти не повлияло на медиану. Сверим с границей выбросов: квартили почти не изменились, Q3 + 1.5 × IQR по-прежнему составляет около 40, а 168 находится далеко за этой границей. Граница помогает обнаружить ошибку, а словарь данных объясняет её. Работа с выбросами: изучите их, запишите, что вы обнаружили, а затем примите решение. Никогда не удаляйте их без объяснения.
Типичные ошибки.
- Указывать среднее для асимметричных данных, не отмечая асимметрию.
- Удалять выбросы до их изучения.
- Выбирать типы диаграмм по внешней привлекательности. Столбчатая диаграмма для одной непрерывной переменной скрывает всё то, что показывает гистограмма.
Итог. Указывайте все четыре характеристики: центр (среднее и медиану), разброс (стандартное отклонение, IQR), форму и выбросы. График может вводить в заблуждение, даже если числа верны.
Вероятность и распределения
Почему это важно. «Какова вероятность опоздания заказа?» — это вопрос о вероятности, и две основные модели — биномиальное и нормальное вопрос о вероятности. Две стандартные модели, биномиальная и нормальная, помогают ответить на большинство таких вопросов в бизнесе. Важно уметь подобрать модель к вопросу и объяснить свой выбор.
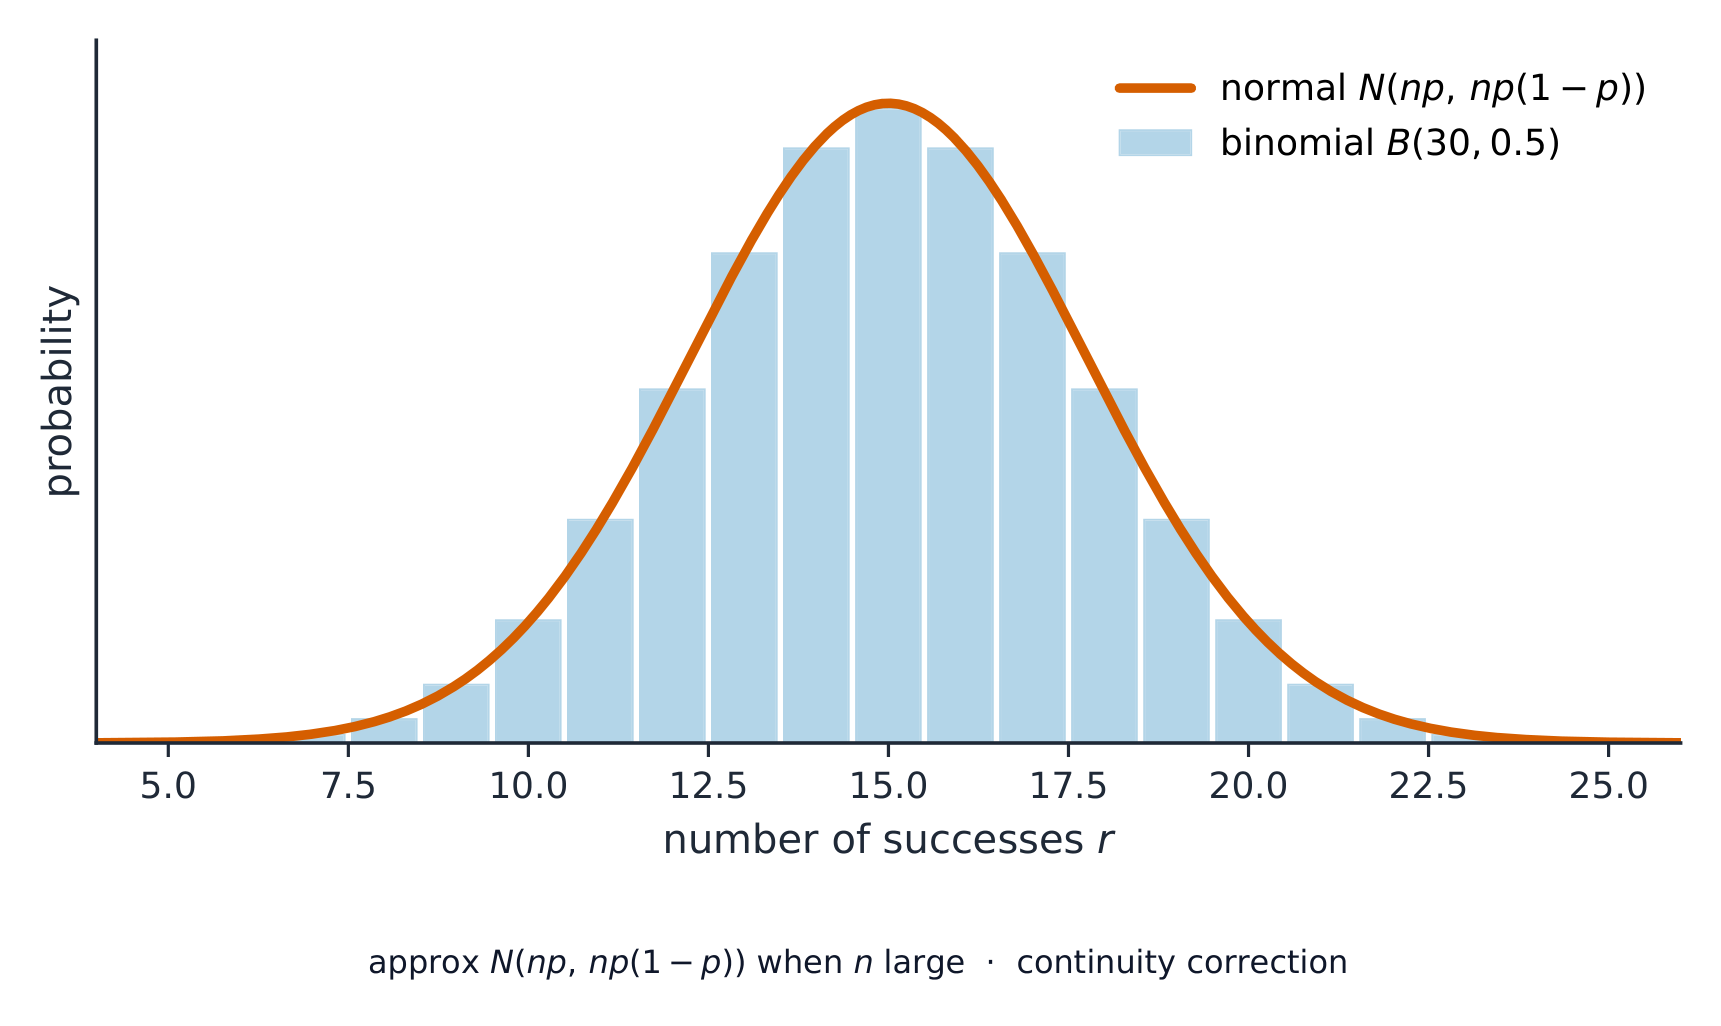
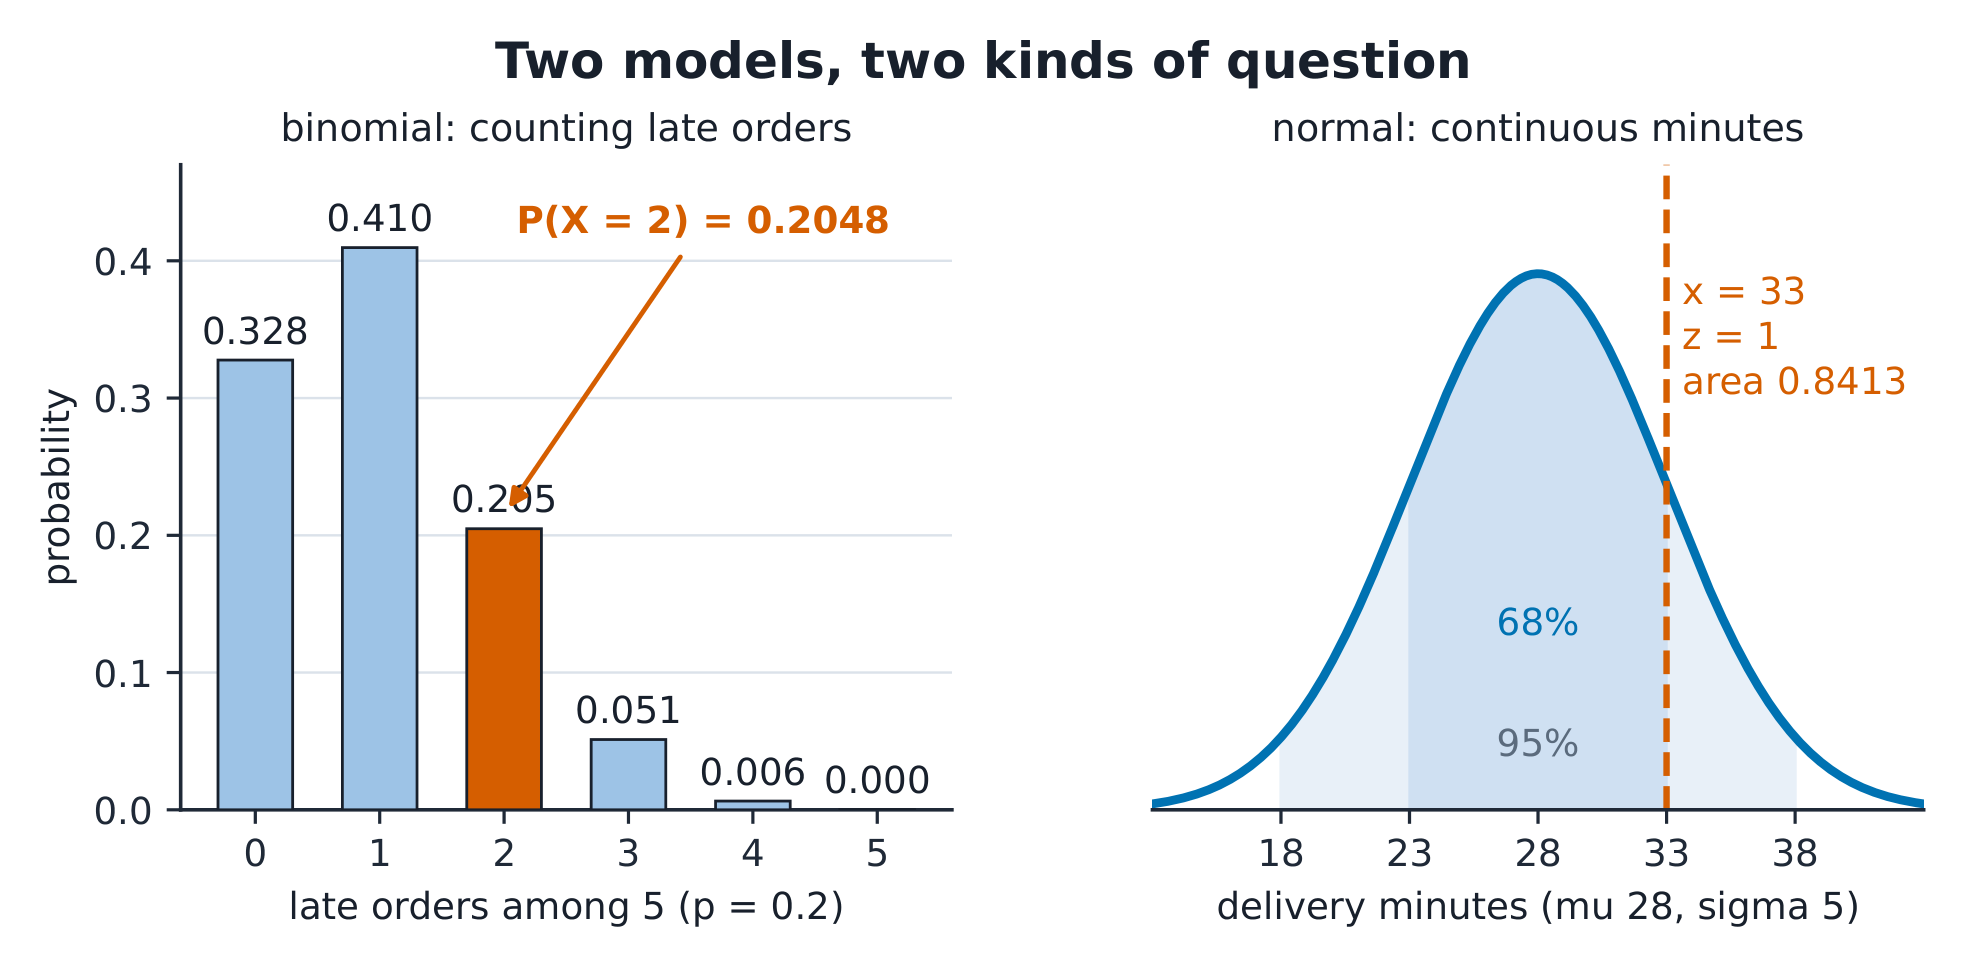
Идея. Если 20% заказов доставляются с опозданием, то число опоздавших заказов среди следующих 5 подчиняется биномиальному распределению:
Значения времени доставки группируются вокруг центра, образуя симметричные хвосты. Они моделируются нормальной кривой, при этом 68%, 95% и 99.7% значений находятся в пределах 1, 2 и 3 стандартных отклонений от среднего.
Определения.
- Правило сложения: $P(A \cup B) = P(A) + P(B) - P(A \cap B)$.
- Независимость: $P(A|B) = P(A)$.
- Биномиальное распределение: $n$ независимых испытаний, каждое с вероятностью успеха $p$.
- Нормальное распределение: симметричное, колоколообразное, полностью определяется средним $\mu$ и стандартным отклонением $\sigma$.
- Стандартизация: $z = (x - \mu)/\sigma$ преобразует любое нормальное распределение в стандартное нормальное распределение.
Расчёты.
- Биномиальное распределение: существует $\binom{5}{2} = 10$ вариантов заказов, в которых 2 из 5 могут опоздать, каждый с вероятностью $0.2^2 \times 0.8^3 = 0.02048$, поэтому $P(X = 2) = 0.2048$. Также $P(X \le 1) = 0.8^5 + 5(0.2)(0.8^4) = 0.7373$.
- Нормальное распределение: при $\mu = 28$ и $\sigma = 5$ заказ, на который уходит 33 минут, находится на $z = 1$ выше среднего, а $\Phi(1) = 0.8413$ заказов выполняются быстрее. Это наиболее часто используемое число в таблице.
Разобранный пример 1: обещание клиентам. Nimbus обещает «30 минут или ваш десерт бесплатно». В рамках модели $\mu = 28$ при параметрах $\sigma = 5$:
Таким образом, треть заказов получила бы бесплатный десерт. При более быстрой работе кухни, $\mu = 26$: $P(X > 30) = P(z > 0.8) = 0.2119$, всё ещё один из пяти. Стоимость обещания определяется вероятностью. Только более быстрая работа кухни (меньшее $\mu$) меняет хвост распределения; увеличение обещанного срока лишь сдвигает границу.
Разобранный пример 2: выбор модели для вопроса.
| вопрос | модель | ответ |
|---|---|---|
| (a) вероятность того, что не менее 4 из следующих 20 заказов опоздают ($p = 0.2$) | биномиальная | $1 - P(X \le 3) = 1 - 0.4114 = 0.5886$ |
| (b) вероятность того, что выполнение одного заказа займёт более 35 минут ($\mu = 28$, $\sigma = 5$) | нормальная | $z = 1.4$, хвост $0.0808$ |
| (c) повар случайным образом проверил 2 из 3 сегодняшних десертов: вероятность того, что оба оказались среди 2 долго готовившихся | подсчёт с использованием сочетаний | $1/\binom{3}{2} = 1/3$ |
Неверная модель остаётся неверной, даже если вычисления выполнены уверенно. Обоснование выбора модели — часть ответа.
Типичные ошибки.
- Складывать вероятности событий, которые могут произойти одновременно, не вычитая вероятность их пересечения.
- Использовать нормальную модель для подсчётов (используйте биномиальную) или для асимметричных данных о задержках, не отмечая асимметрию.
- Принимать хвост распределения в таблице за его основную часть. Всегда набросайте кривую и заштрихуйте область, прежде чем искать число в таблице.
Итог. Подсчёты → биномиальное распределение; симметричные непрерывные данные → нормальное; $z = (x-\mu)/\sigma$ позволяет переходить между ними. Укажите модель до того, как начнёте вычисления.
Распределения выборочных статистик и оценка
Почему это важно. 40 значений времени — это одна выборка. Nimbus могла бы дисциплина, позволяющая сказать, что одно число, которое у вас есть, говорит об истине, придерживаться строгого подхода: объяснять, что имеющееся число говорит об истинном значении, которое нельзя наблюдать, указывая обоснованный интервал вокруг него.
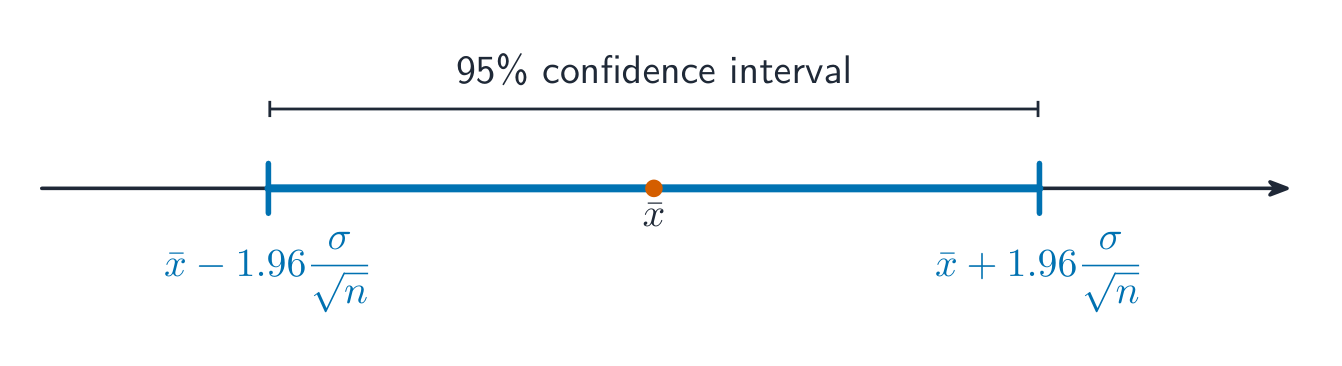
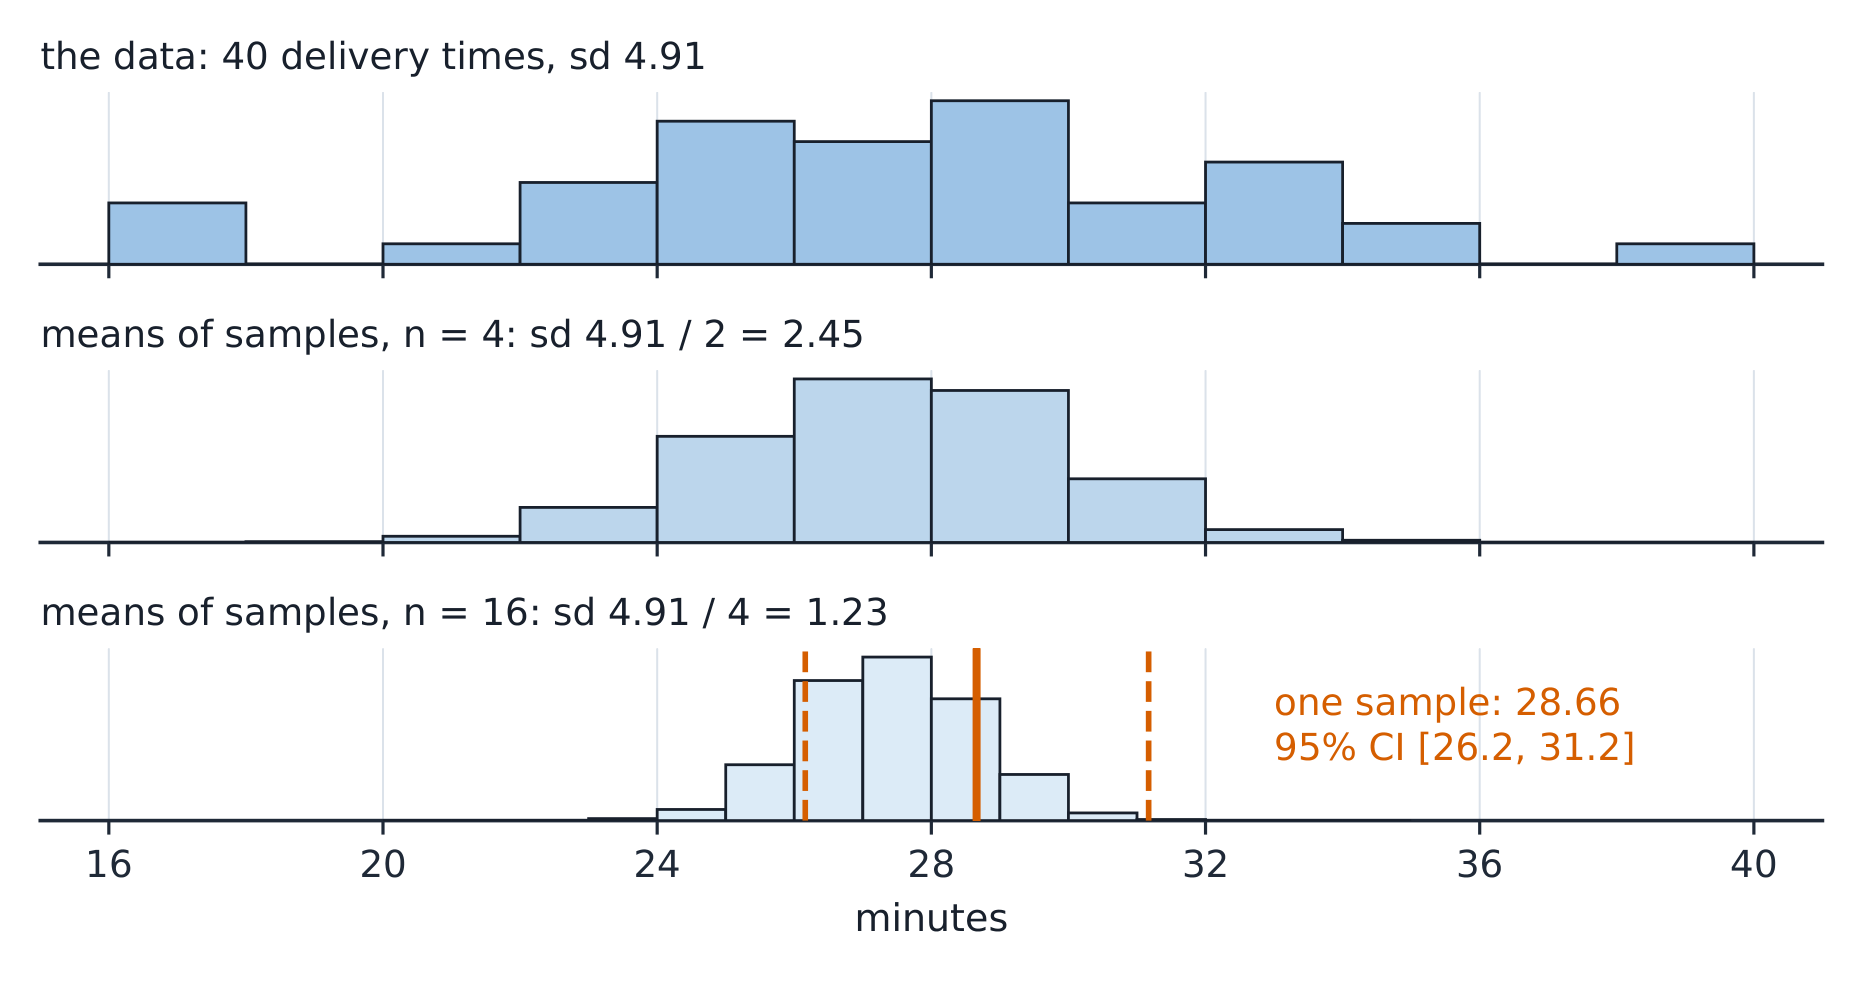
Идея. Возьмите случайную выборку из 16 заказов и вычислите её среднее; затем повторите это снова и снова. Сами средние образуют распределение: оно уже распределения данных и сосредоточено вокруг истинного среднего. Это центральная предельная теорема, а ширина этого распределения уменьшается с ростом $\sqrt{n}$.
Определения.
- Стандартная ошибка среднего, $SE = s/\sqrt{n}$, — это стандартное отклонение выборочного среднего, а не данных.
- 95%-й доверительный интервал равен $\bar x \pm t \times SE$.
- Доверительный уровень характеризует метод: 95% интервалов, построенных таким образом содержат истинное среднее. Это не означает «вероятность 95% того, что истинное значение находится в этом конкретном интервале».
Вычисление. Случайная выборка курса из 16 заказов (полученная с начальным значением генератора случайных чисел 11) имеет среднее 28.66 и стандартное отклонение 4.70, поэтому $SE = 4.70/\sqrt{16} = 1.175$. При $t_{15} = 2.131$ доверительный интервал уровня 95% равен $28.66 \pm 2.50$, то есть [26.2, 31.2]. Увеличьте выборку в четыре раза (до 64 заказов), и стандартная ошибка уменьшится вдвое. Точность стоит $\sqrt{n}$: это самый дорогой обменный курс в статистике.
Разобранный пример 1: правильное понимание интервала. «Среднее время доставки составляет от 26.2 до 31.2 минут с доверительным уровнем 95%». Три трактовки:
- (a) «Вероятность того, что истинное среднее находится в [26.2, 31.2], равна 95%». Неверно.
- (b) «95% заказов выполняются за 26–31 минут». Неверно: для этого нужен прогнозный интервал, который был бы намного шире.
- (c) «Метод, с помощью которого получен этот интервал, охватывает истинное среднее в 95% случаев применения». Верно.
Интервал относится к среднему, а доверительный уровень — к методу.
Разобранный пример 2: цена точности. Менеджер хочет узнать среднее с точностью до ±0.5 минут. Условие: $t \cdot s/\sqrt{n} \le 0.5$. При необходимом объёме выборки $t \approx 1.97$ (а не 2.131 от $n = 16$), поэтому
Повышение точности в пять раз (с ±2.5 до ±0.5) требует более чем в двадцать раз больше данных (от 16 до 343). А если эти заказы составляли выборку по доступности, то 343 смещённых наблюдений означают ошибку, повторённую 343 раз. Точность и отсутствие смещения — две разные вещи, за каждую из которых приходится платить.
Типичные ошибки.
- Путать стандартное отклонение (разброс данных) и стандартную ошибку (неопределённость среднего).
- Считать доверительный уровень вероятностью, относящейся к этому конкретному интервалу.
- Забывать, что интервал предполагает случайную выборку. Вычисления не могут исправить недостатки плана исследования.
Итог. $SE = s/\sqrt{n}$. Благодаря центральной предельной теореме распределение средних приблизительно нормально. Используйте $\bar x \pm t \cdot SE$ и понимайте доверительный уровень как свойство метода.
Проверка гипотез
Почему это важно. «Действительно ли обслуживание в будние дни медленнее, чем в выходные?» Статистический критерий позволяет формально оценить, насколько данные были бы неожиданными при отсутствии различий. При добросовестном применении он делает выводы обоснованными; при формальном превращается в способ их фабрикации.
Идея. Сформулируйте нулевую гипотезу ($H_0$: среднее равно 30) и альтернативную. Определите, насколько экстремальной была бы выборка, если бы $H_0$ была верна, и отвергайте $H_0$, только если результат выходит за выбранный порог. p-значение p — это вероятность получить данные не менее экстремальные, чем наблюдаемые, если бы $H_0$ была верна.
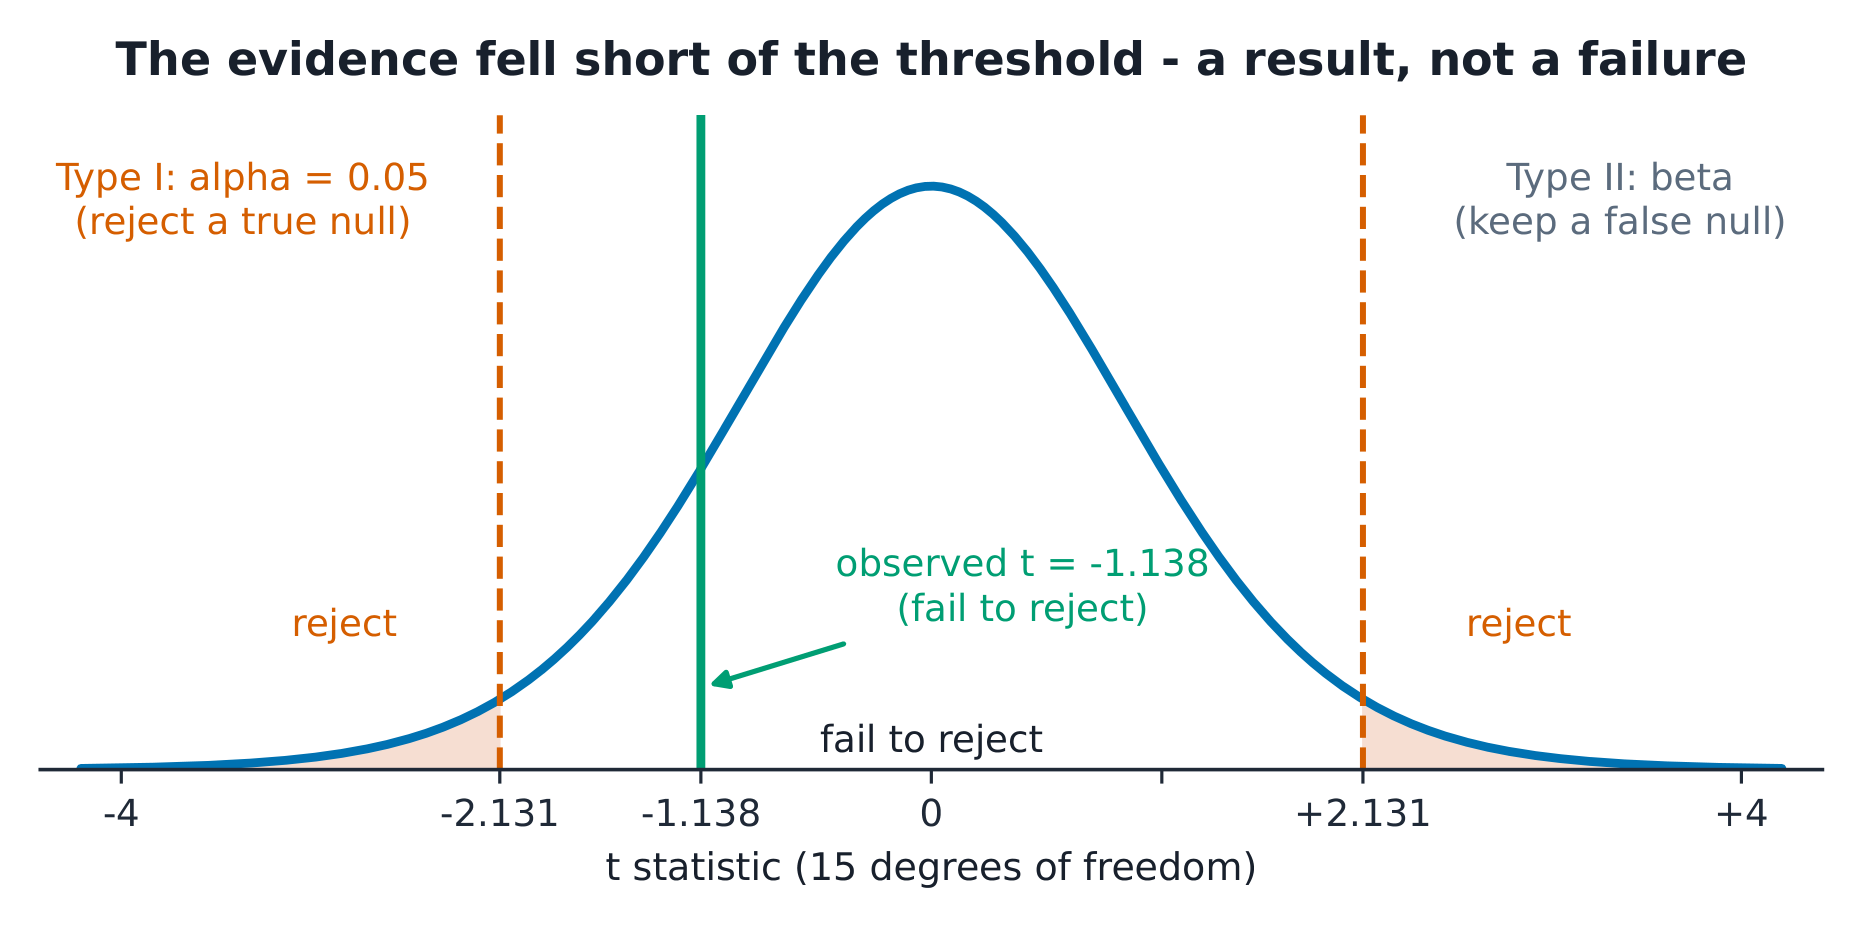
Определения. При проверке гипотезы сравнивают, насколько экстремальны данные, с выбранным порогом.
- Статистика критерия: $t = (\bar x - \mu_0)/(s/\sqrt n)$.
- Уровень значимости $\alpha$: выбранная частота ошибок первого рода (отклонения верной $H_0$), обычно 0.05.
- Ошибка второго рода $\beta$: неспособность обнаружить реальный эффект. Мощность $= 1 - \beta$.
- «Статистически значимо» означает лишь, что $p < \alpha$.
Вычисление. Равно ли среднее 30 минутам? Для выборки с начальным значением генератора 11:
Критическое значение при $\alpha = 0.05$ для двустороннего критерия с 15 степенями свободы равно $|t| > 2.131$. Поскольку $1.14 < 2.131$, мы не отвергаем $H_0$. Данные согласуются со средним значением 30 минут, а также со многими другими значения тоже. Обратите внимание, чего здесь не утверждается: ни «среднее равно 30», ни «различия нет», а только «эта выборка не была бы неожиданной, если бы среднее равнялось 30».
Разобранный пример 1: честная интерпретация p-значения. Курьер утверждает, что его субботний маршрут быстрее. Его 16 поездок занимают в среднем 26.9 минут по сравнению с 28.7 у заведения, при $s = 4.0$, поэтому $t = (26.9 - 28.7)/(4.0/4) = -1.8$ и $p \approx 0.09$. «Почти значимо» — не статистическая категория: укажите $p = 0.09$ и при принятии решения учитывайте цену ошибки. Если от ответа зависят только бесплатные десерты, $\alpha = 0.10$ может быть подходящим выбором; если же от него зависит переобучение персонала, используйте 0.05 или 0.01. $\alpha$ — это деловое решение с греческим названием.
Разобранный пример 2: значимость не равнозначна важности.
- При 4,000 заказах в каждой из двух групп разность в 0.4 минут даёт $SE = 5\sqrt{2/4000} \approx 0.11$, поэтому $z \approx 3.6$ и $p < 0.01$. Она статистически значима, но ни один клиент не заметит 24 секунд.
- При 8 заказах в каждой группе разность в 3 минут даёт $SE = 5\sqrt{2/8} = 2.5$, поэтому $t = 1.2$ и $p \approx 0.25$. Критерий не выявляет её, но каждый клиент заметил бы её.
Решение — указывать величину эффекта вместе с её интервалом: «0.4 минут, 95% ДИ [0.2, 0.6]: значимо, но практически ничтожно». Значимость отвечает на вопрос «есть ли эффект?»; величина эффекта — на вопрос «имеет ли он значение?». Для бизнеса нужен второй ответ.
Типичные ошибки.
- «Принятие» нулевой гипотезы. Вы не отвергаете её: отсутствие свидетельств эффекта не доказывает его отсутствия.
- Представление о том, что $p$ — это вероятность истинности гипотезы.
- Подгонка под p-значение: многократное проведение проверок, пока одна из них не преодолеет порог 0.05. Раздел 5.7 посвящён этому вопросу.
Итог. $t = (\bar x - \mu_0)/SE$. Отвергайте гипотезу при превышении порога, выбранного с учётом допустимого риска ошибки. $p$ относится к данным, а не к гипотезе. Значимое не обязательно важно: всегда указывайте величину эффекта.
Регрессия и корреляция
Почему это важно. «Связано ли увеличение времени доставки с тем, что адреса находятся дальше?» Регрессия превращает пары чисел в прямую, измеряет, насколько тесно они изменяются вместе, и при неосторожной интерпретации может указать на причину. В этом разделе мы строим прямую, рассматриваем то, чего она не объясняет, и ограничиваем выводы о причинах.
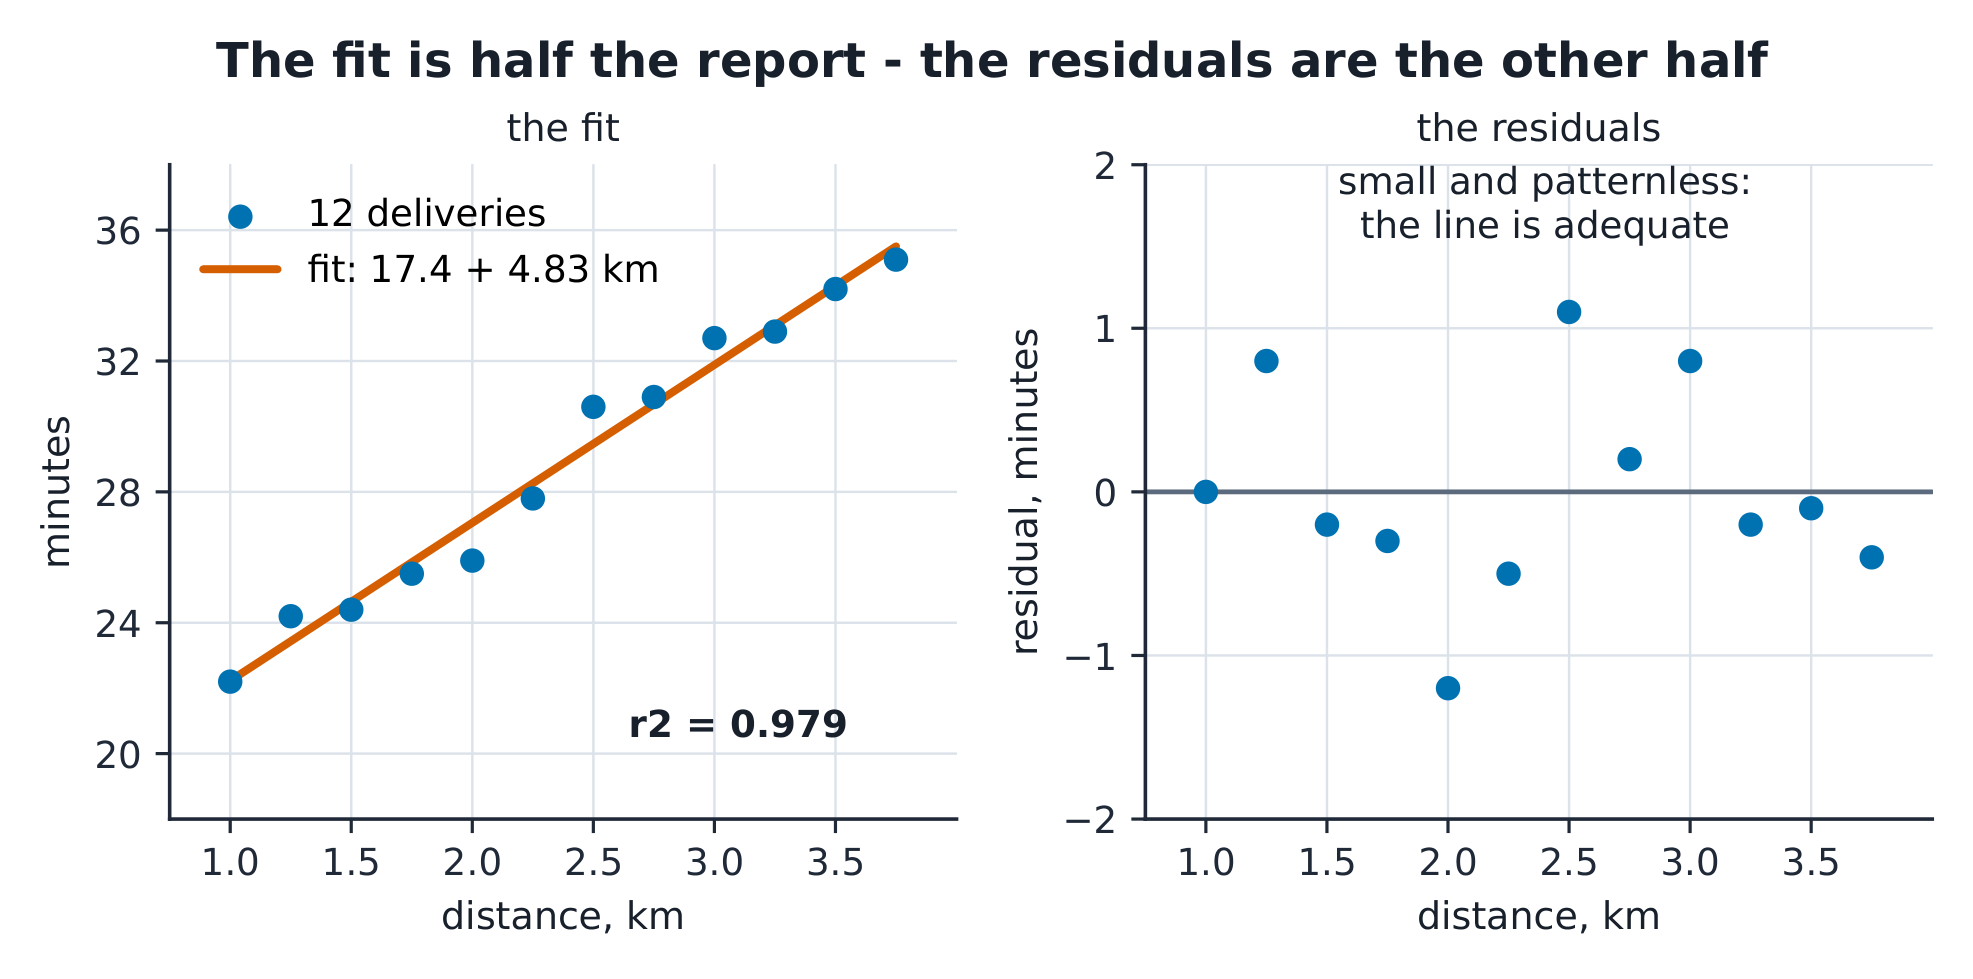
Идея. Для двенадцати отслеженных доставок известны расстояние (1.0–3.75 км) и время. Точки расположены близко друг к другу и поднимаются вправо. Прямая, построенная методом наименьших квадратов, имеет вид линия — это
поэтому каждый дополнительный километр добавляет 4.83 минут. Корреляция равна $r = 0.989$, а $r^2 = 0.979$: 97.9% вариации времени связано с расстоянием.
Определения.
- Угловой коэффициент: изменение $\hat y$ при увеличении $x$ на единицу.
- Свободный член: $\hat y$ при $x = 0$ (часто не имеет смысла: 0 км — это не доставка).
- Остаток: $y - \hat y$, часть, которую прямая не объясняет.
- $r^2$: доля вариации $y$, которую объясняет прямая.
- Экстраполяция за пределы диапазона данных — вымысел.
Как находят прямую. Метод наименьших квадратов минимизирует $\sum(y_i - a - bx_i)^2$, что даёт $b = r \, s_y/s_x$ и $a = \bar y - b\bar x$. Для 12 доставок $b = 4.83$ и $a = 17.4$. Остатки составляют от −1.2 до +1.1 минут и не образуют закономерности, поэтому прямая хорошо подходит в этом случае, а график остатков служит тому подтверждением.
Разобранный пример 1: интерпретация модели.
- Прогнозируемое время доставки на 2 км составляет $17.4 + 9.7 = 27.1$ минут; на 3 км — 31.9 минут.
- Свободный член, 17.4 минут при 0 км, можно интерпретировать как время приготовления на кухне и передачи заказа. Такая интерпретация здесь имеет смысл только потому, что есть реальные основания ожидать фиксированное время приготовления. Явно указывайте такие интерпретации; не принимайте их просто на веру.
- Прогноз для 7 км (51 минут) — это экстраполяция: за пределами 3.75 км нет данных, подтверждающих применимость прямой.
Разобранный пример 2: корреляция не означает причинно-следственную связь. Корреляция 0.989 столь же сильна, как и самые сильные корреляции в деловых данных, но всё равно ничего не доказывает о причинной связи. Могут действовать и другие факторы: расстояние и время увеличиваются при интенсивном движении, а способ распределения заказов (курьеры берут дальние заказы в спокойное время) может приводить к совместному изменению расстояния и времени, хотя расстояние и не влияет на время с интенсивностью, заданной построенной моделью. Корректная формулировка: «В этой выборке расстояние позволяет прогнозировать время ($r^2 = 0.98$); для оценки причинного влияния потребовалось бы сохранить способ распределения маршрутов неизменным». Корреляция описывает, как две переменные изменялись вместе в этом наборе данных; причинно-следственная связь — это утверждение о том, что изменилось бы при вмешательстве. Разные утверждения требуют разных доказательств.
Типичные ошибки.
- Интерпретация $r^2 = 0.98$ как «прогнозов с точностью 98%».
- Интерпретация свободного члена, когда $x = 0$ не имеет смысла.
- Экстраполяция за пределы данных.
- Классическая ошибка: вывод о причинно-следственной связи на основании корреляции без объяснения механизма, без эксперимента и без должной осторожности.
Итог. $\hat y = a + bx$ методом наименьших квадратов. Проверяйте остатки; не принимайте предположения о них на веру. $r^2$ измеряет связь; только план исследования может выявить причинно-следственную связь.
Ограничения решений
Почему это важно. Всё, что было изучено до этого модуля, может быть выполнено правильно и всё же прийти к ложному выводу: задавая множество вопросов, останавливаясь в удобный момент или заявляя об уверенности, которой никогда не было. Этот заключительный раздел содержит контрольный список, который помогает статистике оставаться научной дисциплиной, а не превращаться в средство убеждения.
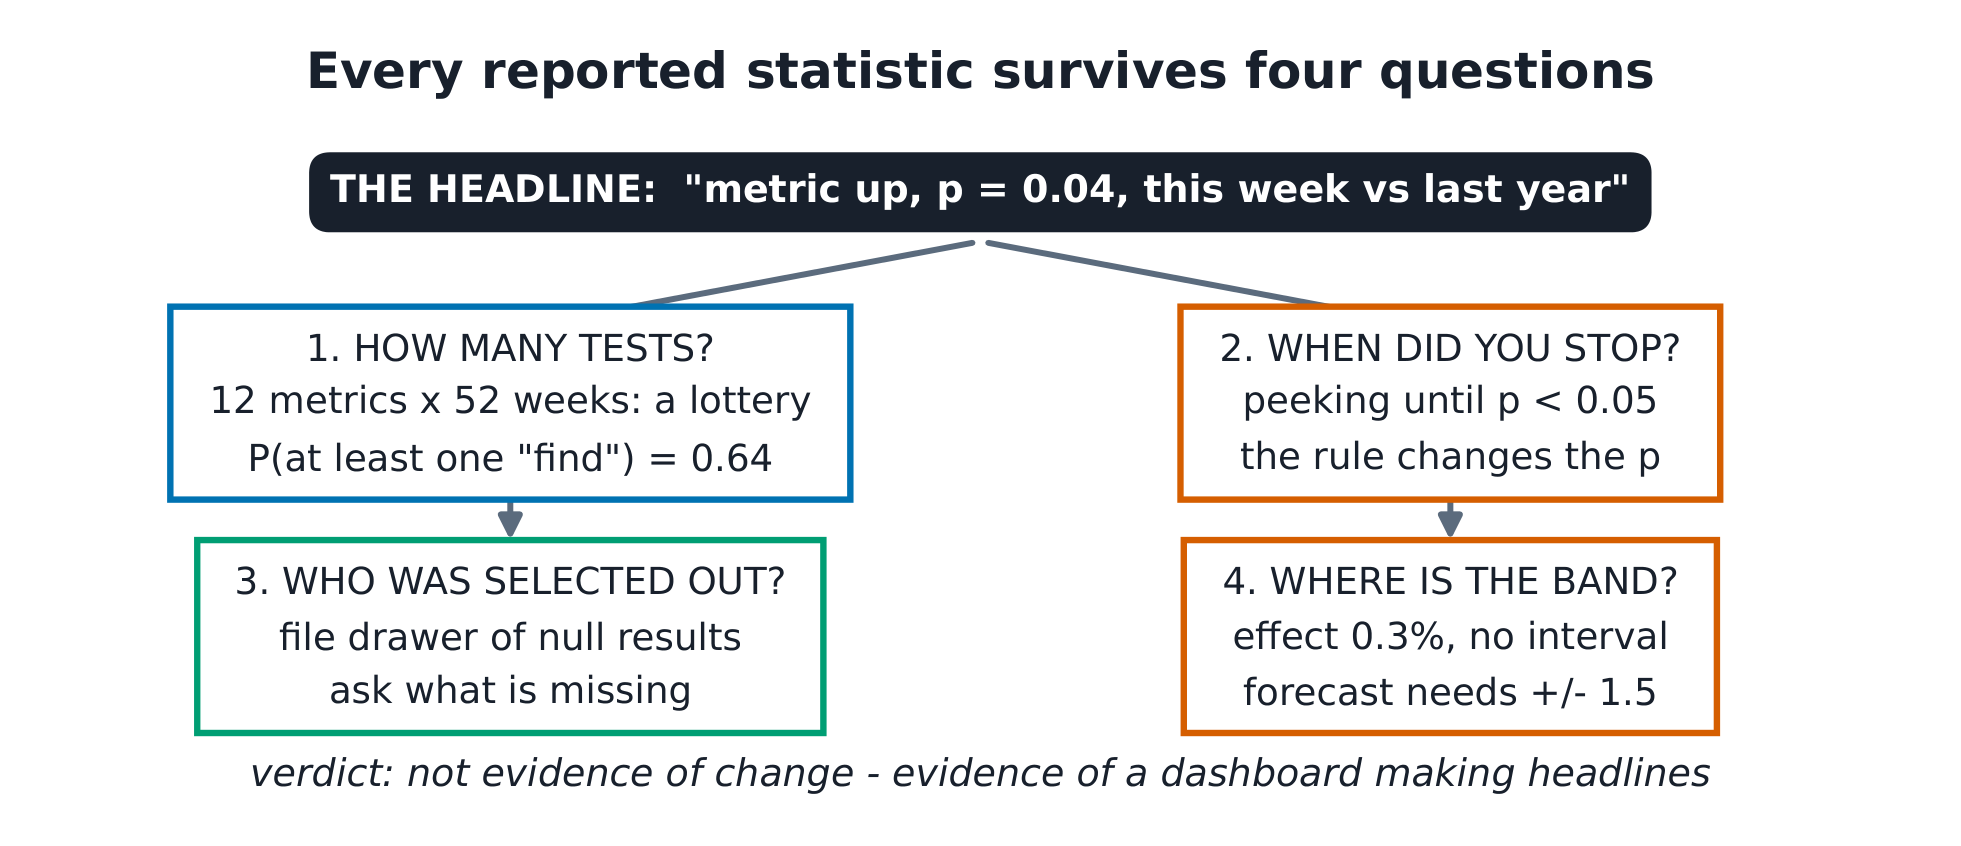
Идея. Ловушки:
- множественные проверки: 20 вопросов при $\alpha = 0.05$ неизбежно приведут к случайным «значимым» результатам;
- правила остановки: многократный просмотр данных и остановка сразу после того, как $p < 0.05$;
- выбор результатов: сообщение только того показателя, который изменился;
- ложная уверенность: прогнозы в виде отдельных чисел без интервалов.
Определения.
- Подгонка под p-значение: проверка множества вариантов анализа, пока один из них не преодолеет порог.
- Формулирование гипотезы после получения результатов: выдвижение гипотезы после ознакомления с результатами.
- Смещение из-за публикации или отбора: ящик, полный результатов без эффекта, которые вам никто не показывает.
- Прогноз без интервала — лишь выражение настроения.
Арифметика множественных проверок. При 20 независимых проверках на уровне $\alpha = 0.05$:
Таким образом, вероятнее случайная находка, а не открытие. Правило Бонферрони: для 20 проверок с общим $\alpha$, равным 0.05, для каждой проверки требуется $p < 0.05/20 = 0.0025$. Пример из раздела 5.5 теперь можно рассмотреть с двух сторон: $p = 0.09$ не является значимым и при этом относится к немногим проверкам, о которых сообщили. Число проверок, о которых не сообщили, влияет на смысл p-значения.
Разобранный пример 1: проверка панели показателей. Панель отслеживает 12 показателей каждую неделю. На этой неделе один из них показывает $p = 0.04$ по сравнению с прошлым годом.
- Сколько сравнений? 12 показателей × 52 недель: эта «находка» получена в лотерее с сотнями билетов.
- Было ли это объявлено заранее? Нет.
- Имеет ли значение величина эффекта? Она составляет 0.3%.
Вывод: это не свидетельство изменения; это свидетельство того, что панели показателей могут порождать громкие заголовки. Правильный ответ — подтверждающая проверка, заранее запланированная и проведённая на новых данных.
Разобранный пример 2: честный прогноз. Менеджер прогнозирует: «Среднее время доставки в следующую субботу: 27.4 минут». Ответ на основе набора данных: среднее для новой субботы с 40 заказами имеет $SE \approx 4.91/\sqrt{40} = 0.78$, а 27.4, на основе которого делается прогноз, имеет такую же погрешность. Поэтому погрешность прогноза равна
и прогноз следует записать так: «27.4 ± 2.2, с доверительной вероятностью 95%». Даже тогда среднее за отдельную субботу будет выходить за пределы этого диапазона примерно один раз из двадцати. Следствие для принятия решений: планируйте численность персонала по верхней границе диапазона (29.6), а не по одному числу. Число без указания неопределённости не позволяет управлять ситуацией, остаётся лишь надеяться.
Типичные ошибки.
- Принятие одного значимого результата среди множества за открытие.
- Представление о том, что «мы не отвергли» означает «мы доказали нулевую гипотезу», — зеркальное отражение ловушки из раздела 5.5.
- Ожидание определённости от прогноза вместо запроса интервала.
Итог. Подсчитывайте проверки, заранее объявляйте правила, показывайте, что было исключено, и указывайте диапазон для каждого прогноза. Статистика заслуживает права направлять решения, признавая то, чего она не знает.
Набор данных (воспроизводимый)
Время доставки 40 заказов еды, в минутах, с точностью до одного десятичного знака, по возрастанию:
16.8, 17.2, 17.3, 21.1, 22.8, 22.9, 23.0, 23.0, 24.3, 24.4, 24.9, 25.2, 25.2, 25.2, 25.5, 26.0, 26.1, 26.9, 27.4, 27.5, 27.7, 28.2, 28.4, 28.7, 28.7, 28.9, 28.9, 29.2, 29.3, 30.4, 31.0, 31.4, 32.2, 32.5, 33.2, 33.3, 33.7, 34.8, 35.5, 38.5
Проверенные статистические показатели: $n$ = 40; сумма 1,097.2; среднее 27.43; медиана 27.6; стандартное отклонение 4.91; квартили (по правилу $(n+1)p$) 24.5 / 27.6 / 30.9; межквартильный размах 6.3; точек за границами 1.5 × межквартильный размах (15.0 и 40.3) нет. Выборка для оценивания (начальное значение генератора 11, $n$ = 16): среднее 28.66, стандартное отклонение 4.70, стандартная ошибка 1.175, 95% ДИ [26.2, 31.2], $t$ относительно 30 = −1.14. Пары для регрессии (12 доставок, километры и минуты): угловой коэффициент 4.83, свободный член 17.4, $r$ = 0.989, $r^2$ = 0.979. Все числовые результаты в этом учебном материале можно заново вычислить по этим значениям.