Дублин, девятнадцатьсот восемь. Внутри пивоварни Guinness молодой химик по имени Уильям Госсет сталкивается с очень практичной проблемой. Он может протестировать лишь несколько партий…
English narration · English + 中文 subtitles burned in · Английское озвучивание · Английский + китайские субтитры (встроенные)
English
This handout covers Topic 4: Further Probability & Statistics 进阶概率统计. It adds continuous distributions, small-sample inference, the chi-squared and non-parametric tests, and probability generating functions.
Русский
Эта методичка охватывает тему 4: Дополнительная теория вероятностей и статистика. Она включает непрерывные распределения, вывод для малых выборок, критерий хи-квадрат и непараметрические тесты, а также производящие функции вероятности.
4.1
Continuous random variables · Непрерывные случайные величины
Syllabus · Программа
English
Candidates should be able to:
Notes and examples
use a probability density function which may be defined piecewise
use the general result $\text{E}(g(X)) = \int f(x)g(x) \, \mathrm{d}x$ where $f(x)$ is the probability density function of the continuous random variable $X$ and $g(X)$ is a function of $X$
understand and use the relationship between the probability density function (PDF) and the cumulative distribution function (CDF), and use either to evaluate probabilities or percentiles
use cumulative distribution functions (CDFs) of related variables in simple cases.
e.g. given the CDF of a variable $X$, find the CDF of a related variable $Y$, and hence its PDF, e.g. where $Y = X^3$.
Русский
Кандидаты должны уметь:
Примечания и примеры
использовать функцию плотности вероятности, которая может быть задана кусочно
использовать общее следствие $\text{E}(g(X)) = \int f(x)g(x) \, \mathrm{d}x$, где $f(x)$ является функцией плотности вероятности непрерывной случайной величины $X$, а $g(X)$ — функция от $X$
понимать и использовать связь между функцией плотности вероятности (PDF) и функцией распределения (CDF), а также использовать любую из них для вычисления вероятностей или перцентилей
использовать функции распределения (CDF) связанных величин в простых случаях.
Например, зная CDF величины $X$, найти CDF связанной величины $Y$, а затем её PDF, например, когда $Y = X^3$.
Source: Cambridge International syllabus · Источник: Программа Cambridge International
English
A continuous variable $X$ is described by a probability density function 概率密度函数$f(x)$, which may be defined piecewise. The probability over a range is the area under $f$, and the mean of any function of $X$ is
$$E(g(X)) = \int g(x)\,f(x)\,dx.$$
The cumulative distribution function 累积分布函数$F(x) = P(X \leqslant x)$ is the running total: $F(x) = \displaystyle\int_{-\infty}^{x} f(t)\,dt$, and $f(x) = F'(x)$. Use $F$ to find probabilities and percentiles 百分位数 (for example, the median 中位数 solves $F(x) = 0.5$).
Worked example. A variable has $f(x) = \tfrac12 x$ for $0 \leqslant x \leqslant 2$. Find the median.
The cumulative distribution function is $F(x) = \displaystyle\int_0^x \tfrac12 t\,dt = \tfrac14 x^2$. Set $F(m) = 0.5$:
The distribution of a related variable. If $Y=g(X)$, find $Y$'s distribution through its cumulative function. For $Y=X^2$: $F_Y(y)=P(X^2\leqslant y)=P(-\sqrt y\leqslant X\leqslant\sqrt y)=F_X(\sqrt y)-F_X(-\sqrt y)$, then differentiate for $f_Y=F_Y'$. When $g$ is monotonic increasing there is a shortcut, $F_Y(y)=F_X\big(g^{-1}(y)\big)$.
Worked example. With $f_X(x)=\tfrac12 x$ on $[0,2]$ (so $F_X(x)=\tfrac14 x^2$), let $Y=X^2$. For $0\leqslant y\leqslant 4$, $F_Y(y)=F_X(\sqrt y)=\tfrac14 y$, so $f_Y(y)=F_Y'(y)=\tfrac14$ – that is, $Y$ is uniform on $[0,4]$.
Русский
Непреремнная переменная $X$ описывается функцией плотности вероятности$f(x)$, которая может быть задана кусочно. Вероятность попадания в диапазон равна площади под $f$, а среднее значение любой функции от $X$ равно
$$E(g(X)) = \int g(x)\,f(x)\,dx.$$
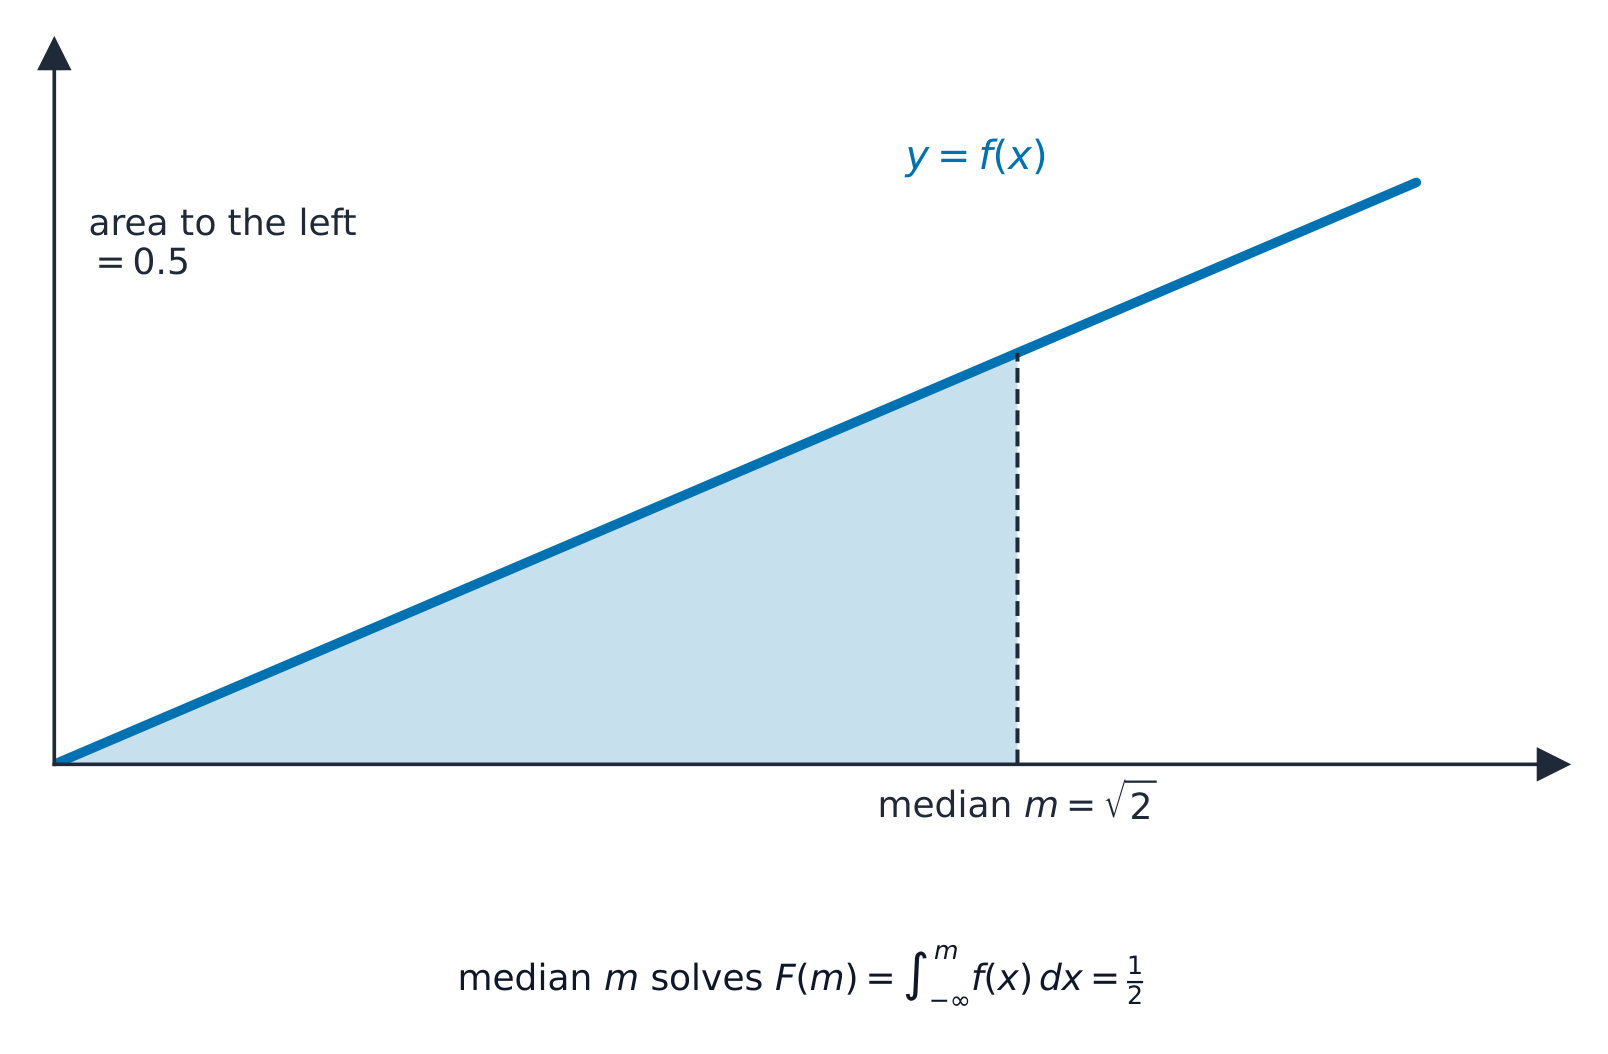
Медиана находится там, где площадь под $f(x)$ слева от нее составляет ровно $0.5$.
Функция накопленного распределения$F(x) = P(X \leqslant x)$ — это накопленная сумма: $F(x) = \displaystyle\int_{-\infty}^{x} f(t)\,dt$, и $f(x) = F'(x)$. Используйте $F$ для нахождения вероятностей и перцентилей (например, медиана определяет $F(x) = 0.5$).
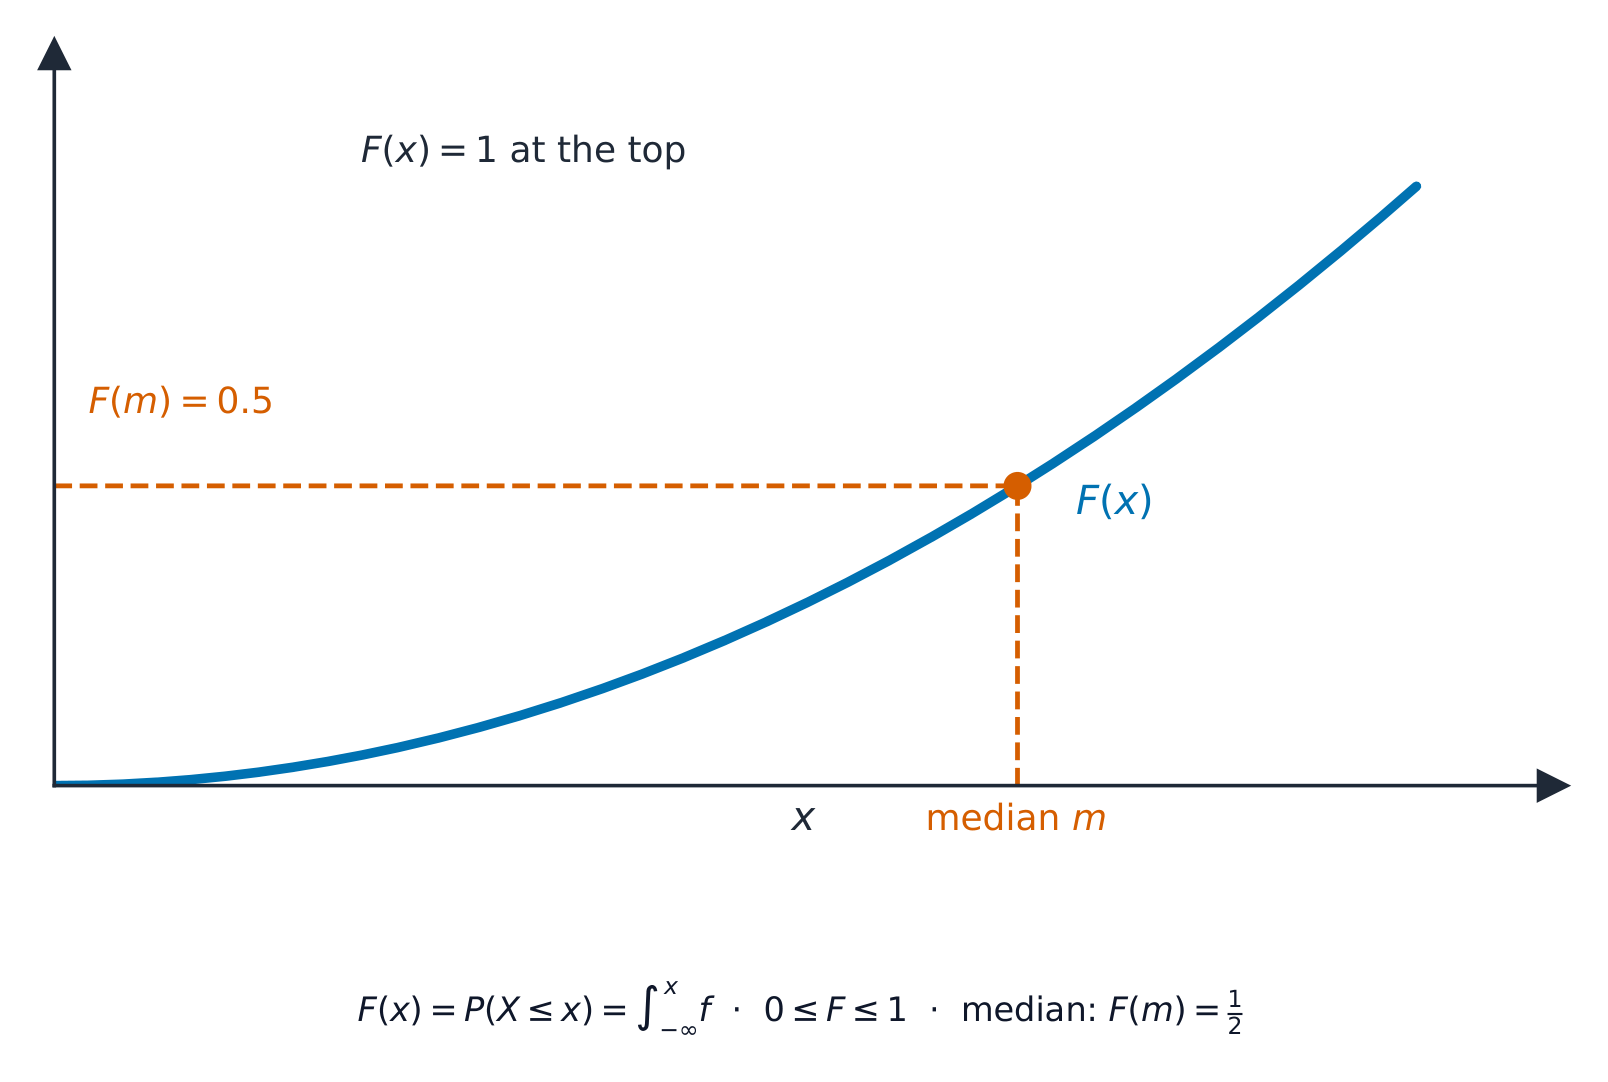
График накопленного распределения $F(x)$ возрастает от $0$ до $1$; высота $0.5$ достигается в точке медианы.
Разбор примера. Случайная величина имеет $f(x) = \tfrac12 x$ при $0 \leqslant x \leqslant 2$. Найдите медиану.
Функция накопленного распределения равна $F(x) = \displaystyle\int_0^x \tfrac12 t\,dt = \tfrac14 x^2$. Приравняйте $F(m) = 0.5$:
Распределение связанной переменной. Если $Y=g(X)$, найдите распределение $Y$ через его функцию накопления. Для $Y=X^2$: $F_Y(y)=P(X^2\leqslant y)=P(-\sqrt y\leqslant X\leqslant\sqrt y)=F_X(\sqrt y)-F_X(-\sqrt y)$, затем дифференцируйте для получения $f_Y=F_Y'$. Когда $g$ монотонно возрастает, существует упрощение, $F_Y(y)=F_X\big(g^{-1}(y)\big)$.
Разбор примера. Имеется $f_X(x)=\tfrac12 x$ на интервале $[0,2]$ (поэтому $F_X(x)=\tfrac14 x^2$), пусть $Y=X^2$. Для $0\leqslant y\leqslant 4$, $F_Y(y)=F_X(\sqrt y)=\tfrac14 y$, следовательно $f_Y(y)=F_Y'(y)=\tfrac14$ — то есть $Y$ распределена равномерно на $[0,4]$.
Explore · Исследовать
Continuous random variables · Непрерывные случайные величины
P(a < X < b) = ∫ f(x) dx
For a continuous variable, probability is the area under the density curve. · Для непрерывной переменной вероятность равна площади под кривой плотности.
Inference using normal and t-distributions · Вывод на основе нормального и t-распределений
Syllabus · Программа
English
Candidates should be able to:
Notes and examples
formulate hypotheses and apply a hypothesis test concerning the population mean using a small sample drawn from a normal population of unknown variance, using a t-test
calculate a pooled estimate of a population variance from two samples
Calculations based on either raw or summarised data may be required.
formulate hypotheses concerning the difference of population means, and apply, as appropriate: - a 2-sample t-test - a paired sample t-test - a test using a normal distribution
The ability to select the test appropriate to the circumstances of a problem is expected.
determine a confidence interval for a population mean, based on a small sample from a normal population with unknown variance, using a t-distribution
determine a confidence interval for a difference of population means, using a t-distribution or a normal distribution, as appropriate.
Русский
Кандидаты должны уметь:
Примечания и примеры
формулировать гипотезы и применять проверку гипотезы относительно среднего значения генеральной совокупности на основе малой выборки, выбранной из нормального распределения с неизвестной дисперсией, используя t-критерий
вычислять объединенную оценку дисперсии генеральной совокупности по двум выборкам
Могут потребоваться расчеты как на основе исходных данных, так и на основе сводных данных.
Формулировать гипотезы относительно разности средних генеральных совокупностей и применять, где уместно: - t-критерий для выборки ⟨2⟩ - ** paired t-критерий (для парных выборок)** - тест с использованием нормального распределения
Ожидается способность выбирать тест, соответствующий обстоятельствам задачи.
определить доверительный интервал для среднего значения генеральной совокупности на основе малой выборки из нормального распределения с неизвестной дисперсией, используя t-распределение
определить доверительный интервал для разности средних значений генеральных совокупностей, используя t-распределение или нормальное распределение, в зависимости от обстоятельств.
Source: Cambridge International syllabus · Источник: Программа Cambridge International
English
When a sample is small and the population variance is unknown, base your hypothesis test 假设检验 on the $t$-distribution instead of the normal. The same idea gives a confidence interval 置信区间 for the mean:
$$\bar{x} \pm t\,\frac{s}{\sqrt{n}},$$
where $t$ comes from the $t$-tables with $n - 1$ degrees of freedom. To compare two populations, use a two-sample (2-sample) or paired-sample$t$-test, after finding a pooled estimate 合并估计 of the shared variance when appropriate.
Worked example. A sample of $n = 10$ has mean $\bar{x} = 50$ and standard deviation $s = 4$. Find a $95\%$ confidence interval for the mean (use $t = 2.262$ for $9$ degrees of freedom).
Доска Гальтона: падающие шары через штырьки складываются в колоколообразное нормальное распределение.
Когда выборка мала, а дисперсия генеральной совокупности неизвестна, основывайте гипотезу на распределении $t$ вместо нормального. Та же идея дает доверительный интервал для среднего:
$$\bar{x} \pm t\,\frac{s}{\sqrt{n}},$$
где $t$ берется из таблиц распределения $t$ с $n - 1$ степенями свободы. Для сравнения двух совокупностей используйте двухвыборочный (2-выборочный) или парный тест $t$, предварительно найдя объединенную оценку общей дисперсии при необходимости.
Для малой выборки распределение $t$ более полого с тяжелыми хвостами, поэтому его критические значения больше.
Разобранное решение. Образец $n = 10$ имеет среднее значение $\bar{x} = 50$ и стандартное отклонение $s = 4$. Найдите доверительный интервал для среднего со степенью достоверности $95\%$ (используйте $t = 2.262$ для $9$ степеней свободы).
Why small samples need t instead of z · Почему малым выборкам нужен t вместо z
With $\sigma$ unknown you use $t$, and $t$ has heavier tails than the normal (drawn dashed behind it) — so its critical values are larger and the interval is wider. At the worked example's $9$ degrees of freedom the widget reads $t^* = 2.262$, exactly the table value used above. Sweep df up and $t$ collapses onto the normal. · При неизвестном $\sigma$ используется $t$, и $t$ имеет более тяжелые хвосты, чем нормальное (нарисовано пунктиром позади него) — поэтому его критические значения больше, а интервал шире. При $9$ степенях свободы, указанных в разобранном решении, виджет показывает $t^* = 2.262$, точно такое же табличное значение, что использовалось выше. Прокрутите df вверх, и $t$ совпадет с нормальным распределением.
Explore · Исследовать
The normal distribution · Нормальное распределение
Shade a tail to find a probability — the basis of confidence intervals and hypothesis tests. · Заштрихуйте хвост, чтобы найти вероятность — это основа доверительных интервалов и тестов гипотез.
4.3
Chi-squared tests · Критерии хи-квадрат
Syllabus · Программа
English
Candidates should be able to:
Notes and examples
fit a theoretical distribution, as prescribed by a given hypothesis, to given data
Questions will not involve lengthy calculations.
use a $\chi^2$-test, with the appropriate number of degrees of freedom, to carry out the corresponding goodness of fit analysis
Classes should be combined so that each expected frequency is at least 5.
use a $\chi^2$-test, with the appropriate number of degrees of freedom, for independence in a contingency table.
Yates’ correction is not required. Where appropriate, either rows or columns should be combined so that the expected frequency in each cell is at least 5.
Русский
Кандидаты должны уметь:
Примечания и примеры
подбирать теоретическое распределение, предписанное данной гипотезой, к имеющимся данным
Задания не будут включать длительные вычисления.
использовать $\chi^2$-критерий с соответствующим числом степеней свободы для проведения анализа соответствия (goodness of fit)
Классы следует объединять так, чтобы каждая ожидаемая частота была не менее 5.
использовать $\chi^2$-критерий с соответствующим числом степеней свободы для проверки независимости в таблице сопряженности.
Поправка Йейтса не требуется. При необходимости следует объединять строки или столбцы так, чтобы ожидаемая частота в каждой ячейке составляла не менее 5.
Source: Cambridge International syllabus · Источник: Программа Cambridge International
English
A $\chi^2$-test (chi-squared test 卡方检验) compares observed counts $O$ with expected counts $E$ from a theoretical distribution 理论分布:
$$\chi^2 = \sum \frac{(O - E)^2}{E}.$$
Compare this with a table value for the right number of degrees of freedom 自由度. Two uses: a goodness of fit 拟合优度 test (does the data follow the proposed model?), and a test for independence 独立性 of two variables in a contingency table 列联表.
Worked example. Four equally likely categories give observed counts $20, 30, 25, 25$ (so each expected count is $25$). Test the fit at the $5\%$ level.
With $4 - 1 = 3$ degrees of freedom the table value is $7.815$. Since $2 < 7.815$, do not reject the model.
Русский
Критерий $\chi^2$ (χ²-критерий) сравнивает наблюдаемые частоты $O$ с ожидаемыми частотами $E$ из теоретического распределения:
$$\chi^2 = \sum \frac{(O - E)^2}{E}.$$
Сравните это значение с табличным для соответствующего числа степеней свободы. Два применения: тест пригодности (соответствуют ли данные предложенной модели?) и тест на независимость двух переменных в таблице сопряженности.
Критерий отвергает модель, когда $\chi^2$ превышает критическое значение, попадая в заштрихованный правый хвост $5\%$.
Разбор примера. Четыре равновероятные категории дают наблюдаемые частоты $20, 30, 25, 25$ (поэтому каждая ожидаемая частота равна $25$). Проверьте соответствие на уровне значимости $5\%$.
При $4 - 1 = 3$ степенях свободы табличное значение равно $7.815$. Поскольку $2 < 7.815$, не отвергаем модель.
Explore · Исследовать
The chi-squared distribution and its 5% tail · Распределение хи-квадрат и его хвост на 5%
The worked example on this page gives $\chi^2 = 2$ with $3$ degrees of freedom against a table value of $7.815$ — the widget reproduces both. Drag df to see why the critical value changes with the number of categories. · Разобранное решение на этой странице дает $\chi^2 = 2$ при $3$ степенях свободы против табличного значения $7.815$ — виджет воспроизводит оба. Перетащите df, чтобы увидеть, почему критическое значение меняется в зависимости от числа категорий.
Explore · Исследовать
Chi-squared test route · Маршрут хи-квадрат теста
Follow observed and expected counts to a test decision. · Следуйте наблюдаемым и ожидаемым частотам для принятия решения по тесту.
4.4
Non-parametric tests · Непараметрические тесты
Syllabus · Программа
English
Candidates should be able to:
Notes and examples
understand the idea of a non-parametric test and appreciate situations in which such a test might be useful
e.g. when sampling from a population which cannot be assumed to be normally distributed.
understand the basis of the sign test, the Wilcoxon signed-rank test and the Wilcoxon rank-sum test
Including knowledge that Wilcoxon tests are valid only for symmetrical distributions.
use a single-sample sign test and a single-sample Wilcoxon signed-rank test to test a hypothesis concerning a population median
Including the use of normal approximations where appropriate. Questions will not involve tied ranks or observations equal to the population median value being tested.
use a paired-sample sign test, a Wilcoxon matched-pairs signed-rank test and a Wilcoxon rank-sum test, as appropriate, to test for identity of populations.
Including the use of normal approximations where appropriate. Questions will not involve tied ranks or zero‑difference pairs.
Русский
Кандидаты должны уметь:
Примечания и примеры
понимать концепцию непараметрического критерия и оценивать ситуации, в которых такой критерий может быть полезен
например, при выборочном исследовании из генеральной совокупности, которую нельзя считать нормально распределенной.
понимать основу знакового теста, теста Вилкоксона о рангах со знаками и теста Вилкоксона о сумме рангов
Включая знание того, что тесты Вилкоксона применимы только для симметричных распределений.
использовать одновыборочный знаковый тест и одновыборочный тест Вилкоксона о рангах со знаками для проверки гипотезы относительно медианы генеральной совокупности
Включая использование нормальных приближений там, где это уместно. Задания не будут включать одинаковые ранги или наблюдения, равные проверяемому значению медианы генеральной совокупности.
использовать парный знаковый тест, тест Вилкоксона для спаренных выборок о рангах со знаками и тест Вилкоксона о сумме рангов (при необходимости) для проверки равенства генеральных совокупностей.
Включая использование нормальных приближений там, где это уместно. Задания не будут включать одинаковые ранги или пары нулевой разницы.
Source: Cambridge International syllabus · Источник: Программа Cambridge International
English
A non-parametric test 非参数检验 makes no assumption that the data is normal, so it is useful when that assumption fails. The basic ones are:
the sign test 符号检验: count how many values fall above and below a proposed median, and test those counts with a binomial model;
the Wilcoxon signed-rank test 威尔科克森符号秩检验 (the matched-pairs test for paired data), which also uses the sizes of the differences, not just their signs;
the Wilcoxon rank-sum test 威尔科克森秩和检验, for comparing two separate samples.
Worked example. Test whether a median is $5$. In a sample of $10$ values (none equal to $5$), $9$ lie above$5$ and $1$ lies below. Test at the $5\%$ level (two-tailed).
Under $H_0$ (median $= 5$) the number above follows $B(10, 0.5)$. The observed result ($9$ above) is extreme, so find $P(X \geq 9) = \binom{10}{9}(0.5)^{10} + (0.5)^{10} = \dfrac{11}{1024} = 0.0107$. For a two-tailed test compare with $\tfrac{1}{2}(5\%) = 0.025$. Since $0.0107 < 0.025$, reject $H_0$: there is evidence the median is not $5$.
Русский
Непараметрический тест не предполагает нормальное распределение данных, поэтому он полезен, когда это предположение нарушается. Основные из них:
знаковый тест: подсчитайте, сколько значений находятся выше и ниже предполагаемой медианы, и протестируйте эти подсчеты с помощью биномиальной модели;
критерий Вилкоксона для связанных выборок (тест для парных данных), который также использует величины различий, а не только их знаки;
критерий Вилкоксона для независимых выборок, для сравнения двух отдельных выборок.
Знаковый тест подсчитывает, сколько значений находится выше и ниже предлагаемой медианы, затем проверяет эти подсчеты с помощью биномиальной модели
Разобранный пример. Проверьте, является ли медиана равной $5$. В выборке из $10$ значений (ни одно не равно $5$), $9$ находятся выше$5$, а $1$ — ниже. Проведите тест на уровне значимости $5\%$ (двусторонний).
При условии $H_0$ (медиана $= 5$) количество наблюдений выше нее следует распределению $B(10, 0.5)$. Наблюдаемый результат ($9$ над медианой) является экстремальным, поэтому найдите P-значение $P(X \geq 9) = \binom{10}{9}(0.5)^{10} + (0.5)^{10} = \dfrac{11}{1024} = 0.0107$. Для двустороннего теста сравните со значением $\tfrac{1}{2}(5\%) = 0.025$. Поскольку $0.0107 < 0.025$, отвергаем гипотезу $H_0$: есть доказательства того, что медиана не равна $5$.
Explore · Исследовать
Non-parametric test chooser · Выбор непараметрического теста
Choose the rank-based test that matches the data situation. · Выберите ранговый тест, соответствующий ситуации с данными.
probability generating function/ˌprɒbəˈbɪlɪti ˈdʒenəreɪtɪŋ ˈfʌŋkʃn/
функция порождения вероятностей
Further Probability & Statistics/ˈfɜːðə ˌprɒbəˈbɪlɪti ænd stəˈtɪstɪks/
Дополнительная теория вероятностей и статистика
4.5
Probability generating functions · Генерирующие функции вероятностей
Syllabus · Программа
English
Candidates should be able to:
Notes and examples
understand the concept of a probability generating function (PGF) and construct and use the PGF for given distributions
Including the discrete uniform, binomial, geometric and Poisson distributions.
use formulae for the mean and variance of a discrete random variable in terms of its PGF, and use these formulae to calculate the mean and variance of a given probability distribution
use the result that the PGF of the sum of independent random variables is the product of the PGFs of those random variables.
Русский
Кандидаты должны уметь:
Примечания и примеры
понимать концепцию функции порождения вероятностей (PGF) и составлять и использовать PGF для заданных распределений
Включая дискретное равномерное, биномиальное, геометрическое и пуассоновское распределения.
использовать формулы для математического ожидания и дисперсии дискретной случайной переменной через её PGF, а также применять эти формулы для вычисления математического ожидания и дисперсии заданного распределения вероятностей
использовать результат о том, что PGF суммы независимых случайных величин является произведением их PGF.
Source: Cambridge International syllabus · Источник: Программа Cambridge International
English
The probability generating function 概率母函数 of a discrete variable $X$ is
$$G(t) = E(t^X) = \sum_x P(X = x)\,t^x.$$
It packs the whole distribution into one function. The mean and variance come from its derivatives at $t = 1$: $E(X) = G'(1)$ and $\mathrm{Var}(X) = G''(1) + G'(1) - \big(G'(1)\big)^2$. Also, the PGF of a sum of independent variables is the product of their PGFs.
Worked example.$X$ has $P(X=0) = 0.5$, $P(X=1) = 0.3$, $P(X=2) = 0.2$. Find $E(X)$ using the PGF.
Here $G(t) = 0.5 + 0.3t + 0.2t^2$, so $G'(t) = 0.3 + 0.4t$ and
$$E(X) = G'(1) = 0.3 + 0.4 = 0.7.$$
Русский
Игральные кости: отправная точка для теории вероятностей и дискретных случайных величин.
Генерирующая функция вероятностей дискретной случайной величины $X$ имеет вид
$$G(t) = E(t^X) = \sum_x P(X = x)\,t^x.$$
Она упаковывает всё распределение в одну функцию. Математическое ожидание и дисперсия получаются из её производных при $t = 1$: $E(X) = G'(1)$ и $\mathrm{Var}(X) = G''(1) + G'(1) - \big(G'(1)\big)^2$. Кроме того, ГФ суммы независимых величин равна произведению их ГФ.
Разбор примера. Случайная величина $X$ принимает значения $P(X=0) = 0.5$, $P(X=1) = 0.3$, $P(X=2) = 0.2$. Найдите P-функцию (PGF) $E(X)$.
Здесь $G(t) = 0.5 + 0.3t + 0.2t^2$, следовательно $G'(t) = 0.3 + 0.4t$ и
$$E(X) = G'(1) = 0.3 + 0.4 = 0.7.$$
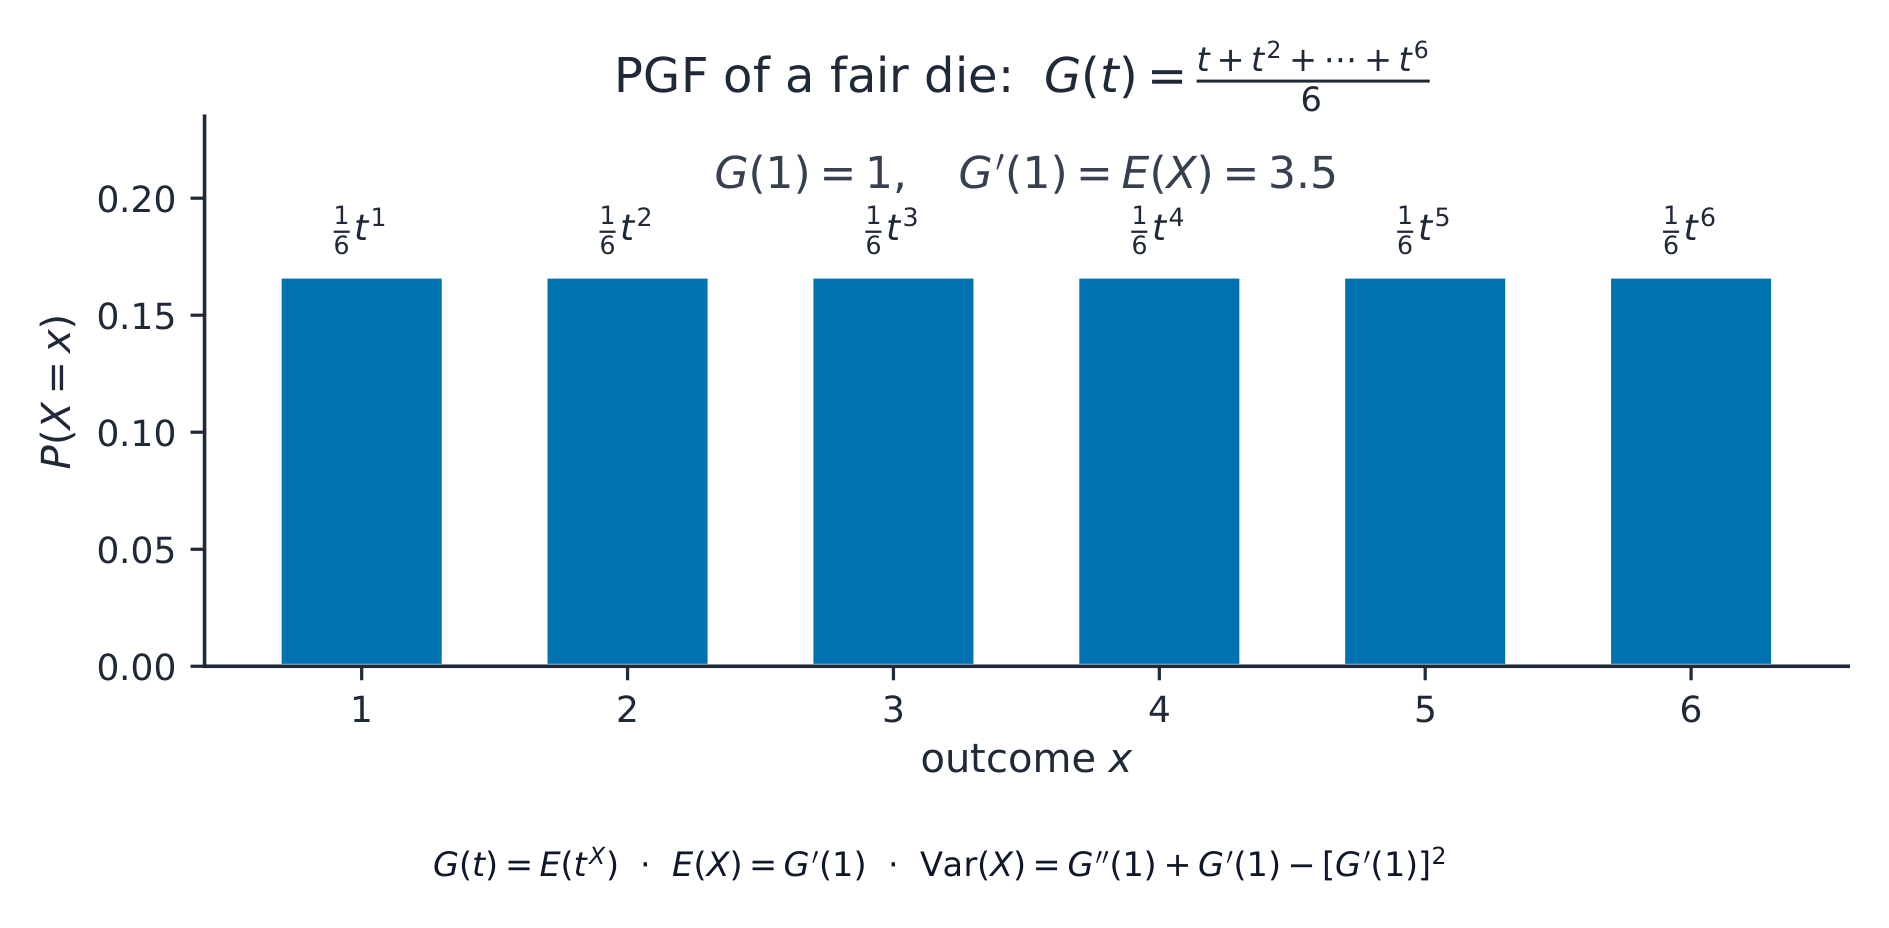
ГФ честной игральной кости упаковывает одинаковые массы от 1 до 6 в G(t)
Explore · Исследовать
Probability generating function lab · Лабораторная работа: функция порождения вероятностей
G(x) = p0 + p1 x + p2 x^2 + ...
Change x and see how a PGF stores probabilities in powers of x. · Измените x и посмотрите, как ФПВ хранит вероятности в степенях x.
4.5
Exam tips · Советы для экзамена
English
For a continuous random variable, the pdf integrates to $1$ over its range, and $E(X) = \int x f(x)\,dx$.
Use the $t$-distribution when the sample is small and the population variance is unknown; state the degrees of freedom.
For a chi-squared test compute $\sum (O-E)^2/E$, compare with the critical value at the right degrees of freedom, and combine classes with $E < 5$.
State $H_0$ and $H_1$ and give the conclusion in context for every test.
Русский
Для непрерывной случайной величины плотность вероятности интегрируется до $1$ по всему диапазону, а интеграл равен $E(X) = \int x f(x)\,dx$.
Используйте распределение t-Стьюдента ($t$-распределение), когда выборка мала, а генеральная дисперсия неизвестна; укажите число степеней свободы.
Для χ²-критерия вычислите статистику $\sum (O-E)^2/E$, сравните её с критическим значением для соответствующих степеней свободы и объедините классы с малыми частотами $E < 5$.
Укажите нулевую и альтернативную гипотезы $H_0$ и $H_1$ и дайте вывод в контексте задачи для каждого теста.
Interactive lessons on this topic · Интерактивные уроки по этой теме
Work through it step by step, with instant-check exercises. · Пройдите его шаг за шагом с упражнениями мгновенной проверки.
More topics in A-Level Further Mathematics · A-Level Дополнительная математика · Больше тем в A-Level Further Mathematics · A-Level Дополнительная математика
Pick one and the site follows you — notes, papers, videos and practice all open on it. · Выберите один, и сайт будет вести вас — конспекты, работы, видео и практика откроются там.
Type to search notes, lessons, code, vocabulary and past-paper questions across every subject. · Введите запрос для поиска заметок, уроков, кода, словаря и вопросов с реальных экзаменов по всем предметам.