Skip to content · ⁨Перейти к содержанию⁩

Information representation · ⁨Представление информации⁩

A-Level Computer Science · ⁨A-Level Информатика⁩ · Topic 1 · ⁨Тема 1⁩

Video lesson for this topic · ⁨Видеоурок по этой теме⁩ Open the video page · ⁨Открыть страницу видео⁩
22:30

Числовые системы и данные

Это фото. Эта песня. Это самое видео. Ваше имя, ваши сообщения, каждый файл на каждом устройстве — внутри компьютера все это есть лишь единицы и нули.…

English narration · English + 中文 subtitles burned in · ⁨Английское озвучивание · Английский + китайские субтитры (встроенные)⁩

1.1

Number systems · ⁨Системы счисления⁩

Syllabus · ⁨Программа⁩
English
Candidates should be able to: Notes and guidance
Show understanding of binary magnitudes and the difference between binary prefixes and decimal prefixes Understand the difference between and use: • kibi and kilo • mebi and mega • gibi and giga • tebi and tera
Show understanding of different number systems Use the binary, denary, hexadecimal number bases and Binary Coded Decimal (BCD) and one’s complement and two’s complement representation for binary numbers
Convert an integer value from one number base/ representation to another
Perform binary addition and subtraction Using positive and negative binary integers
Show understanding of how overflow can occur
Describe practical applications where Binary Coded Decimal (BCD) and Hexadecimal are used
Show understanding of and be able to represent character data in its internal binary form, depending on the character set used Students are expected to be familiar with ASCII (American Standard Code for Information Interchange), extended ASCII and Unicode. Students will not be expected to memorise any particular character codes
Русский
Кандидаты должны уметь: Примечания и рекомендации
Демонстрировать понимание бинарных величин и различия между бинарными и десятичными приставками Понимать различия и уметь использовать: • kibi и kilo • mebi и mega • gibi и giga • tebi и tera
Демонстрировать понимание различных систем счисления Использовать системы счисления: бинарная, десятичная, шестнадцатеричная, а также представление двоично-кодовый десятичный код (BCD), однозначный дополненный и двузначный дополненный для бинарных чисел
Переводить целочисленное значение из одной системы счисления/представления в другую
Выполнять сложение и вычитание в двоичной системе С использованием положительных и отрицательных бинарных целых чисел
Демонстрировать понимание того, как может возникнуть переполнение
Описывать практические области применения двоично-кодового десятичного кода (BCD) и шестнадцатеричной системы
Демонстрировать понимание и уметь представлять символьные данные во внутреннем бинарном виде в зависимости от используемого набора символов Ожидается, что студенты будут знакомы с ASCII (Американский стандартный код обмена информацией), расширенным ASCII и Unicode. Студентам не нужно запоминать конкретные коды символов

Source: Cambridge International syllabus · ⁨Источник: Программа Cambridge International⁩

English
Counting in binary: 0 to 15

The three number systems 数制 you must use:

  • denary 十进制 (decimal, base 10) — uses digits 0–9. Place values are powers of ten.
  • binary 二进制 (base 2) — uses 0 and 1. Place values are powers of two. Every byte 字节 is 8 bits 位.
  • hexadecimal 十六进制 (base 16) — uses 0–9 then A–F for 10–15. Each hex digit 数位 stands for exactly 4 bits.

Conversions

Denary → binary: keep dividing by 2 and record the remainders, read bottom-up. Or subtract the largest place value 位值 (power of 2) that fits.

Example: $558_{10}$: $558 = 512 + 32 + 8 + 4 + 2 = 2^{9} + 2^{5} + 2^{3} + 2^{2} + 2^{1}$. In 12 bits: 0010 0010 1110.

Binary → hex: group the bits into nibbles 半字节 (4 bits) from the right and convert each. 0010 0010 1110 → 2 2 E → 22E.

Hex → binary: replace each hex digit with its 4-bit pattern. Hex → denary: multiply each digit by its place value. 22E $= 2 \times 256 + 2 \times 16 + 14 = 558$.

Worked example. Convert denary 200 to 8-bit binary, then to hexadecimal.

$200 = 128 + 64 + 8$, so the binary is 11001000. In nibbles, 1100 1000 $= 12$ and $8$, i.e. $\text{C}$ and $8$, so the hexadecimal is C8.

How many bits?

Exam questions fix the register width 寄存器宽度 (8, 12 or 16 bits). Pad with leading zeros to that width: $558$ in 12 bits is 0010 0010 1110, never 10 0010 1110.

To find the minimum number of bits that can store a value, ask which place values you need:

  • an unsigned integer from $0$ to $2^{n} - 1$ needs $n$ bits: $200$ needs 8 bits (the top is $255$), $1000$ needs 10 bits (the top is $1023$), $16$ needs 5 bits (4 bits stop at $15$).
  • a signed two's-complement integer from $-2^{n-1}$ to $2^{n-1} - 1$ needs $n$ bits: $-200$ needs 9 bits, because 8 bits stop at $-128$.
  • one hexadecimal digit needs 4 bits, one BCD digit needs 4 bits, and one ASCII character needs 7 bits (8 for extended ASCII).

Binary vs decimal prefixes

Two prefix families look similar but differ — decimal (powers of 10) and binary (powers of 2):

Decimal (SI) Binary (memory)
kilo $= 10^{3}$ kibi (Ki) $= 2^{10} = 1024$
mega $= 10^{6}$ mebi (Mi) $= 2^{20}$
giga $= 10^{9}$ gibi (Gi) $= 2^{30}$
tera $= 10^{12}$ tebi (Ti) $= 2^{40}$

So a tebibyte (TiB) is slightly more than a terabyte (TB). A "1 TB" drive holds $10^{12}$ bytes, but an operating system that reports in TiB shows a smaller number.

Русский
Подсчет в двоичной системе: от 0 до 15

Три системы счисления, которые вы должны знать:

  • десятичная (основание 10) — использует цифры 0–9. Разрядные значения являются степенями десяти.
  • двоичная (основание 2) — использует 0 и 1. Разрядные значения являются степенями двух. Каждый байт состоит из 8 битов.
  • шестнадцатеричная (основание 16) — использует цифры 0–9, затем A–F для значений 10–15. Каждая шестнадцатеричная цифра соответствует ровно 4 битам.
Счёты на традиционном абаксе
Абак представляет числа по разрядным значениям — та же идея лежит в основе десятичной, двоичной и шестнадцатеричной систем

Переводы

Десятичная → двоичная: делите на 2 и записывайте остатки, читая снизу вверх. Или вычитайте наибольшее значение разряда (степень 2), которое помещается.

Пример: $558_{10}$: $558 = 512 + 32 + 8 + 4 + 2 = 2^{9} + 2^{5} + 2^{3} + 2^{2} + 2^{1}$. В 12 битах: 0010 0010 1110.

Двоичная → шестнадцатеричная: сгруппируйте биты в нибблы (по 4 бита) справа налево и переведите каждый. 0010 0010 1110 → 2 2 E → 22E.

Шестнадцатеричная → двоичная: замените каждую шестнадцатеричную цифру на её 4-битный паттерн. Шестнадцатеричная → десятичная: умножьте каждую цифру на её разрядное значение. 22E $= 2 \times 256 + 2 \times 16 + 14 = 558$.

Разобранный пример. Переведите десятичное число 200 в 8-битную двоичную систему, а затем в шестнадцатеричную.

$200 = 128 + 64 + 8$, поэтому двоичная запись выглядит как 11001000. При разделении на нибблы получаем 1100 1000 $= 12$ и $8$, то есть $\text{C}$ и $8$, следовательно, шестнадцатеричное число равно C8.

Двоичная таблица значений разрядов для 200: столбцы 128, 64, 32, 16, 8, 4, 2, 1 содержат биты 1,1,0,0,1,0,0,0; два полубайта 4-битных 1100 и 1000 становятся шестнадцатеричными цифрами C и 8, так что 200 = 11001000 = C8 *Чтение числа 200 из разрядных значений, затем группировка битов в нибблы для получения шестнадцатеричного C8

Сколько битов?

В экзаменационных вопросах фиксируется ширина регистра (8, 12 или 16 бит). Добавляйте ведущие нули до этой ширины: $558$ в 12 битах записывается как 0010 0010 1110, никогда как 10 0010 1110.

Чтобы найти минимальное количество битов для хранения значения, определите, какие разрядные значения вам нужны:

  • беззнаковое целое число от $0$ до $2^{n} - 1$ требует $n$ бит: $200$ требует 8 бит (максимум $255$), $1000$ требует 10 бит (максимум $1023$), $16$ требует 5 бит (4 бита ограничены значением $15$).
  • знаковое целое число в дополнительном коде от $-2^{n-1}$ до $2^{n-1} - 1$ требует $n$ бит: $-200$ требует 9 бит, потому что 8 бит ограничены значением $-128$.
  • одна шестнадцатеричная цифра требует 4 бита, одна BCD-цифра требует 4 бита, а один символ ASCII требует 7 бит (8 для расширенного ASCII).

Двоичные и десятичные префиксы

Два семейства префиксов выглядят похоже, но различаются: десятичные (степени 10) и двоичные (степени 2):

Десятичный (SI) Двоичный (память)
кило $= 10^{3}$ киби (Ki) $= 2^{10} = 1024$
мега $= 10^{6}$ меби (Mi) $= 2^{20}$
гига $= 10^{9}$ гиби (Gi) $= 2^{30}$
тера $= 10^{12}$ теби (Ti) $= 2^{40}$

Таким образом, тетабайт (TiB) немного больше, чем терабайт (TB). Жесткий диск «1 TB» содержит $10^{12}$ байтов, но операционная система, отображающая размер в TiB, покажет меньшее число.

Explore · ⁨Исследовать⁩

Binary, denary and hex · ⁨Двоичная, десятичная и шестнадцатеричная системы⁩

Type a number and see it in binary, denary and hexadecimal at once — and how the place values add up. · ⁨Введите число и посмотрите на него одновременно в двоичной, десятичной и шестнадцатеричной системах — и как складываются разряды.⁩

Vocabulary · ⁨Словарь⁩ Train · ⁨Тренировать⁩
English Русский
number system/ˈnʌmbə ˈsɪstəm/ система счисления
binary/ˈbaɪnəri/ бинарная
denary/ˈdiːnəri/ десятичный
digit/ˈdɪdʒɪt/ цифра
place value/pleɪs ˈvæljuː/ разрядное значение
byte/baɪt/ байт
BCD/ˌbiː siː ˈdiː/ BCD (двоично-десятичный код)
overflow/ˌəʊvəˈfləʊ/ переполнение
most significant bit/məʊst sɪɡˈnɪfɪkənt bɪt/ старший значащий бит
two's complement/tuːz ˈkɒmplɪmənt/ дополнительный код
signed integer/saɪnd ˈɪntɪdʒə/ знаковое целое число
sign bit/saɪn bɪt/ знаковый бит
arithmetic shift/ˌærɪθˈmetɪk ʃɪft/ арифметический сдвиг
one's complement/wʌnz ˈkɒmplɪmənt/ инверсный код
7-segment display/ˈsevən ˈseɡmənt dɪˈspleɪ/ 7-сегментный дисплей
memory address/ˈmeməri əˈdres/ адрес памяти
1.1

Binary arithmetic · ⁨Двоичная арифметика⁩

English

Binary addition

Add column by column from the right, carrying as in denary:

Bit A Bit B Carry in Sum bit Carry out
0 0 0 0 0
0 0 1 1 0
0 1 0 1 0
0 1 1 0 1
1 1 0 0 1
1 1 1 1 1

Overflow 溢出 happens when the result needs more bits than the register 寄存器 can hold — the carry-out of the leftmost column is the overflow bit.

Worked example. Add the 8-bit unsigned integers $10110101$ and $01101100$, and comment on the result.

$10110101 + 01101100 = 1\,00100001$. The answer needs 9 bits, so it does not fit in an 8-bit register: overflow has occurred. A full answer names the error and says why, using the word size the question gave: "Overflow: the true result ($289$) is larger than the largest value an 8-bit register can hold ($255$), so the carry out of the most significant bit is lost and the stored result ($00100001 = 33$) is wrong."

Binary subtraction

The usual way is two's complement 补码 addition: to do $A - B$, form the two's complement of $B$ (invert every bit and add 1), then add, and discard any final carry-out.

To subtract $00011110$ from $01100100$ (unsigned 8-bit):

  • two's complement of $00011110$: invert → $11100001$, add 1 → $11100010$.
  • add to $01100100$: result $1\,01000110$ (9 bits) — discard the leading 1 → $01000110 = 70_{10}$. Check: $100 - 30 = 70$. ✓

Two's complement signed integers

In an $n$-bit two's-complement number:

  • the most significant bit 最高有效位 (MSB) is the sign bit 符号位: 0 = positive, 1 = negative.
  • to read a negative number: invert every bit, add 1, then negate.

So $11100010$ is negative; invert → $00011101$, add 1 → $00011110 = 30$, so it is $-30$. This is a signed integer 有符号整数 (unlike an unsigned 无符号 one). The range for $n$ bits is $-2^{n-1}$ to $+2^{n-1} - 1$; for 8 bits, $-128$ ($10000000$) to $+127$ ($01111111$).

The same bits mean different numbers depending on the agreed reading. As an unsigned integer every bit is a place value, so 8 bits run from $0$ to $255$; as a signed two's-complement integer the top bit is the sign, so the same 8 bits run from $-128$ to $+127$. The pattern $11111111$ is $255$ read one way and $-1$ read the other — nothing in the bits themselves says which.

The same byte read as unsigned and as signed: only the agreed interpretation tells them apart 8-bit two's complement: the sign bit splits the range into negative ($-128$ to $-1$) and positive ($0$ to $127$)

Worked example. What denary value does the 8-bit two's-complement number $10110100$ represent?

The MSB is 1, so it is negative. Invert → $01001011$, add 1 → $01001100 = 76$, so the value is $-76$. Check with place values: $-128 + 32 + 16 + 4 = -76$.

Worked example. Write $-108$ as a 12-bit two's-complement integer.

Start from $+108$ in 12 bits: $108 = 64 + 32 + 8 + 4$, so 0000 0110 1100. Invert every bit: 1111 1001 0011. Add 1: 1111 1001 0100. Check with place values, where the top bit is worth $-2^{11} = -2048$: $-2048 + 1024 + 512 + 256 + 128 + 16 + 4 = -108$. ✓

For 12 bits the range is $-2048$ (1000 0000 0000) to $+2047$ (0111 1111 1111). Questions that ask for the smallest and largest values want these two patterns, so learn the rule: the most negative number is a 1 followed by zeros; the most positive is a 0 followed by ones.

An arithmetic shift 算术移位 moves every bit left or right but keeps the sign: a shift right by one place halves the value and copies the sign bit into the empty space on the left, so a negative number stays negative (1111 1001 0100 shifted right three places is 1111 1111 0010, which is $-14$: $-108 / 8 = -13.5$, and a shift right rounds down). A shift left doubles the value. Shifts belong to the assembly instruction set in topic 4, but this question is asked with the number work here.

Overflow in signed arithmetic happens when the true result falls outside this range — spotted when the sign bit flips wrongly (two positives giving a negative, or two negatives giving a positive).

One's complement

Before two's complement, an older scheme called one's complement 反码 represented a negative number by simply inverting every bit of the positive — there is no "add 1" step.

  • $+30 = 00011110$, so in one's complement $-30 = 11100001$ (just the inverse).
  • Drawback: it has two zeros — $00000000$ ($+0$) and $11111111$ ($-0$) — which wastes a bit pattern and makes arithmetic awkward.

Two's complement (invert and add 1) removes the negative zero: it has a single zero and lets addition and subtraction use the same circuit. That is why modern computers store signed integers in two's complement, not one's complement.

Русский

Двоичное сложение

Складывайте по столбцам справа налево, перенося разряды так же, как в десятичной системе:

Бит A Бит B Перенос Сумма Перенос наружу
0 0 0 0 0
0 0 1 1 0
0 1 0 1 0
0 1 1 0 1
1 1 0 0 1
1 1 1 1 1

Переполнение происходит, когда результат требует больше битов, чем может вместить регистр — перенос наружу самого левого столбца является битом переполнения.

Разобранный пример. Сложите 8-битные беззнаковые целые числа $10110101$ и $01101100$ и прокомментируйте результат.

$10110101 + 01101100 = 1\,00100001$. Ответ требует 9 бит, поэтому он не помещается в 8-битный регистр: произошло переполнение. Полный ответ должен назвать ошибку и объяснить причину, используя указанную в вопросе разрядность: «Переполнение: истинный результат ($289$) больше максимального значения, которое может хранить 8-битный регистр ($255$), поэтому перенос из старшего бита теряется, а сохранённый результат ($00100001 = 33$) неверен».

Вычитание в двоичной системе

Обычный способ — сложение с дополнительным кодом: чтобы выполнить $A - B$, нужно образовать дополнительный код для $B$ (инвертировать каждый бит и прибавить 1), затем сложить и отбросить любой финальный перенос.

Чтобы вычесть $00011110$ из $01100100$ (беззнаковые 8-битные числа):

  • дополнительный код для $00011110$: инверсия → $11100001$, прибавление 1 → $11100010$.
  • добавить к $01100100$: результат $1\,01000110$ (9 бит) — отбросить старший 1 → $01000110 = 70_{10}$. Проверка: $100 - 30 = 70$. ✓

Знаковые целые числа в дополнительном коде

В $n$-битном числе в дополнительном коде:

  • старший бит (MSB) является знакомым битом: 0 = положительное, 1 = отрицательное.
  • чтобы прочитать отрицательное число: инвертируйте каждый бит, прибавьте 1, затем измените знак.

Таким образом, $11100010$ — отрицательное; инверсия → $00011101$, прибавление 1 → $00011110 = 30$, значит оно равно $-30$. Это знаковое целое число (в отличие от беззнакового). Диапазон для $n$ бит составляет от $-2^{n-1}$ до $+2^{n-1} - 1$; для 8 бит — от $-128$ ($10000000$) до $+127$ ($01111111$).

Одни и те же биты означают разные числа в зависимости от согласованного способа чтения. Как беззнаковое целое число каждый бит представляет разрядное значение, поэтому 8 бит охватывают диапазон от $0$ до $255$; как знаковое число в дополнительном коде верхний бит является знаковым, поэтому те же 8 бит охватывают диапазон от $-128$ до $+127$. Паттерн $11111111$ читается как $255$ одним способом и как $-1$ другим — сами по себе биты не указывают, какой именно.
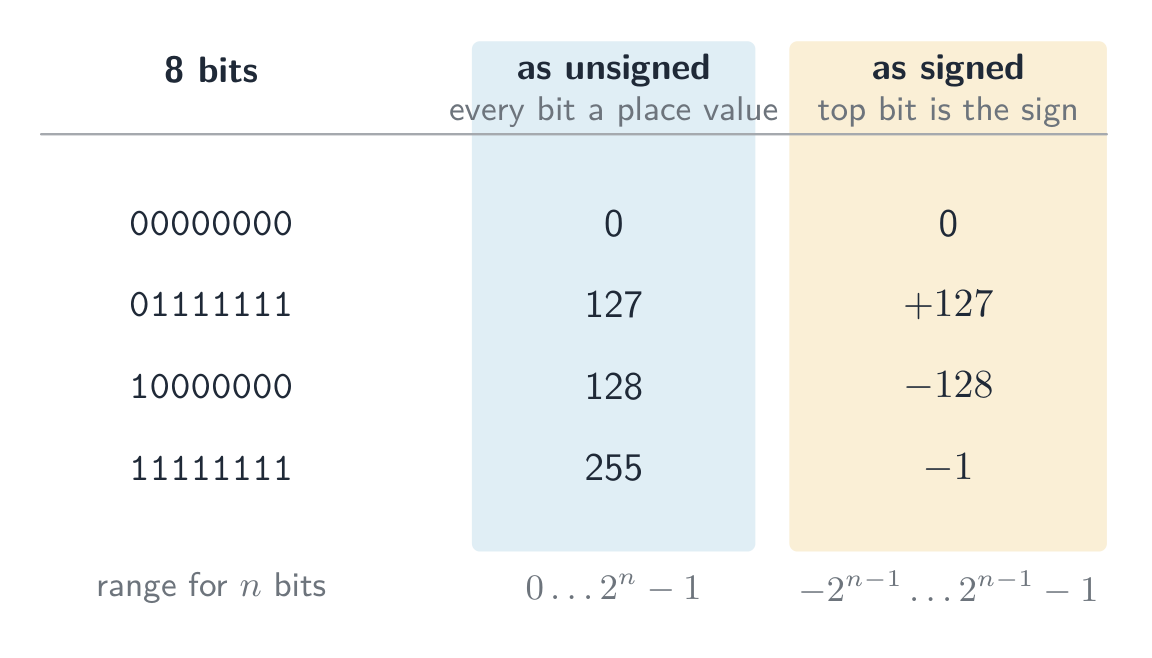
Таблица четырёх 8-битных паттернов, прочитанных дважды: 00000000 — это 0 в любом случае, 01111111 — это 127 беззнаково и +127 знаково, 10000000 — это 128 беззнаково, но -128 знаково, и 11111111 — это 255 беззнаково, но -1 знаково Один и тот же байт, прочитанный как беззнаковый и как знаковый: различить их можно только по согласованной интерпретации Числовая ось для 8-битного числа в дополнительном коде от -128 (10000000) до +127 (01111111); числа со знаковым битом 1 являются отрицательными, а со знаковым битом 0 — положительными, при этом -1 = 11111111 находится непосредственно под 0 = 00000000 8-битное число в дополнительном коде: знаковый бит делит диапазон на отрицательные ($-128$ до $-1$) и положительные ($0$ до $127$)

Разобранный пример. Какое десятичное значение представляет 8-битное число в дополнительном коде $10110100$?

Старший бит равен 1, значит число отрицательное. Инверсия → $01001011$, прибавление 1 → $01001100 = 76$, значит значение равно $-76$. Проверка с использованием разрядных значений: $-128 + 32 + 16 + 4 = -76$.

Разобранный пример. Запишите $-108$ как 12-битное число в дополнительном коде.

Начните со $+108$ в 12 битах: $108 = 64 + 32 + 8 + 4$, значит 0000 0110 1100. Инвертируйте каждый бит: 1111 1001 0011. Прибавьте 1: 1111 1001 0100. Проверка с помощью значений разрядов, где старший бит равен $-2^{11} = -2048$: $-2048 + 1024 + 512 + 256 + 128 + 16 + 4 = -108$. ✓

Для 12 бит диапазон составляет от $-2048$ (1000 0000 0000) до $+2047$ (0111 1111 1111). Вопросы, требующие найти наименьшее и наибольшее значения, имеют в виду эти два паттерна, поэтому запомните правило: самое отрицательное число — это 1, за которым следуют нули; самое положительное — это 0, за которым следуют единицы.

Арифметический сдвиг перемещает все биты влево или вправо, сохраняя знак: сдвиг вправо на один разряд делит значение пополам и копирует знаковый бит в освободившееся место слева, поэтому отрицательное число остаётся отрицательным (1111 1001 0100, сдвинутый вправо на три разряда, становится 1111 1111 0010, что равно $-14$: $-108 / 8 = -13.5$, а сдвиг вправо округляет вниз). Сдвиг влево удваивает значение. Сдвиги относятся к набору инструкций ассемблера в теме 4, но этот вопрос задан с использованием работы с числами здесь.

Переполнение в знаковой арифметике происходит, когда истинный результат выходит за пределы этого диапазона — обнаруживается, когда знаковый бит неправильно меняется (два положительных дают отрицательное, или два отрицательных дают положительное).

Обратный код

До появления дополнительного кода более старая схема под названием обратный код представляла отрицательное число простым инвертированием каждого бита положительного — нет шага «прибавить 1».

  • $+30 = 00011110$, значит в обратном коде это $-30 = 11100001$ (просто инверсия).
  • Недостаток: в нём два нуля — $00000000$ ($+0$) и $11111111$ ($-0$), что тратит битовый шаблон и затрудняет арифметику.

Дополнительный код (инверсия и прибавление 1) устраняет отрицательный ноль: в нём只有一个 ноль, и он позволяет использовать одну и ту же схему для сложения и вычитания. Именно поэтому современные компьютеры хранят знаковые целые числа в дополнительном коде, а не в обратном.

Explore · ⁨Исследовать⁩

Binary & signed integers · ⁨Двоичные & знаковые целые числа⁩

byte = Σ place values · ⁨байт = сумма позиций значений⁩

See how an 8-bit pattern maps to a number (and how it would overflow past 255). · ⁨Посмотрите, как 8-битный паттерн отображается на число (и как происходит переполнение за пределы 255).⁩

Explore · ⁨Исследовать⁩

Two's complement signed bits · ⁨Знаковые биты дополнения до двух⁩

The leftmost bit carries a negative place value. Flip any bit — or hit Negate (invert every bit, then add 1) — and watch the signed value change. · ⁨Левый бит имеет отрицательное значение разряда. Инвертируйте любой бит — или нажмите Negate (инвертировать все биты, затем добавить 1) — и наблюдайте, как меняется знаковое значение.⁩

Vocabulary · ⁨Словарь⁩ Train · ⁨Тренировать⁩
English Русский
unsigned/ʌnˈsaɪnd/ без знака
1.1

Binary Coded Decimal (BCD) · ⁨Двоично-десятичный код (BCD)⁩

English

In BCD 二进码十进数, each denary digit is written as its own 4-bit pattern. The number $93$ is 1001 0011 in BCD — not binary 93 ($01011101$). Each nibble uses only 0–9; patterns $1010$–$1111$ are invalid.

BCD reading: 0010 0111 0101 → 2, 7, 5 → 275.

Use: calculators, digital clocks, and devices that show denary digits — each digit drives a 7-segment display 七段显示器. Currency code often uses BCD to avoid the rounding errors of converting fractions like 0.1 to binary.

A "justify" answer must link the use to a property of BCD: each denary digit has its own 4 bits, so a digit can be sent straight to its display, or added digit by digit, with no conversion of the whole number; and a decimal fraction such as $0.10$ is stored exactly, which a binary fraction cannot do.

Русский

В BCD каждая десятичная цифра записывается своим собственным 4-битовым шаблоном. Число $93$ в BCD записывается как 1001 0011, а не как двоичное 93 ($01011101$). Каждый ниббл использует только коды 0–9; шаблоны $1010$–$1111$ недопустимы.

Чтение BCD: 0010 0111 0101 → 2, 7, 5 → 275.

Применение: калькуляторы, цифровые часы и устройства, отображающие десятичные цифры — каждая цифра управляет 7-сегментным дисплеем. Код валюты часто использует BCD, чтобы избежать ошибок округления при преобразовании дробей, таких как 0.1, в двоичную систему.

Ответ, обосновывающий применение, должен связать его со свойством BCD: каждая десятичная цифра имеет свои собственные 4 бита, поэтому цифру можно отправить напрямую на дисплей или складывать поцифрово без преобразования всего числа; а десятичная дробь, такая как $0.10$, хранится точно, чего не может сделать двоичная дробь.

Компонент одностороннего семисегментного светодиодного дисплея, показывающий семь отдельных полос
Семисегментный дисплей отображает одну десятичную цифру, часто управляемую через BCD
1.1

Hexadecimal — practical uses · ⁨Шестнадцатеричная система — практическое применение⁩

English

Hex is a compact way to write binary (1 hex digit = 4 bits):

  • memory addresses 内存地址 in low-level programming — 0x7FFE.
  • colour values in HTML/CSS — #FF8800.
  • MAC addresses — AC:DE:48:00:11:22.

Hex does not change the stored data — it just makes binary easier for humans.

Русский

Шестнадцатеричная система — компактный способ записи двоичного кода (1 шестнадцатеричная цифра = 4 бита):

Байт разделяется на два полубайта; каждый полубайт соответствует одной шестнадцатеричной цифре
Байт состоит из двух полубайтов; каждый полубайт — это одна шестнадцатеричная цифра
  • адреса памяти в программировании низкого уровня — 0x7FFE.
  • цветовые значения в HTML/CSS — #FF8800.
  • MAC-адреса — AC:DE:48:00:11:22.

Шестнадцатеричная система не изменяет хранящиеся данные — она лишь делает двоичный код более понятным для человека.

1.1

Character codes · ⁨Коды символов⁩

English

Computers store text as numbers; each character has a numeric code point 码点 set by a character set 字符集.

ASCII

  • ASCII uses 7 bits — 128 code points. Basic Latin letters, digits, punctuation, and control codes.
  • Extended ASCII uses 8 bits — 256 code points; the lower 128 match ASCII, the upper 128 vary by region.

Unicode

  • Unicode is a universal character set covering almost every script, plus symbols and emoji.
  • common encodings 编码: UTF-8 (1–4 bytes, ASCII-compatible), UTF-16 (2 or 4 bytes), UTF-32 (fixed 4 bytes).

Why Unicode beats ASCII

  • it represents far more characters (every script, emoji); ASCII covers only basic English.
  • files are portable with no code-page confusion, and allow multilingual text in one document.
  • trade-off: Unicode files are usually larger for English-only text.

When a question asks for differences, give them in pairs with numbers: ASCII uses 7 bits (extended ASCII 8), so 128 (256) characters; Unicode uses up to 32 bits (UTF-8 uses 1 to 4 bytes), so more than a million code points. ASCII covers basic English only; Unicode covers every script, and its first 128 code points are the ASCII ones. In UTF-8 an English letter still takes 1 byte, so a 40-letter English file name is 40 bytes in ASCII and in UTF-8 alike, while a Chinese character takes 3 bytes.

Русский

Компьютеры хранят текст как числа; каждому символу присвоен числовой код точки (code point), определяемый набором символов.

ASCII

  • ASCII использует 7 бит — 128 кодовых точек. Базовые латинские буквы, цифры, знаки препинания и управляющие коды.
  • Расширенный ASCII использует 8 бит — 256 кодовых точек; нижние 128 совпадают с ASCII, верхние 128 различаются в зависимости от региона.
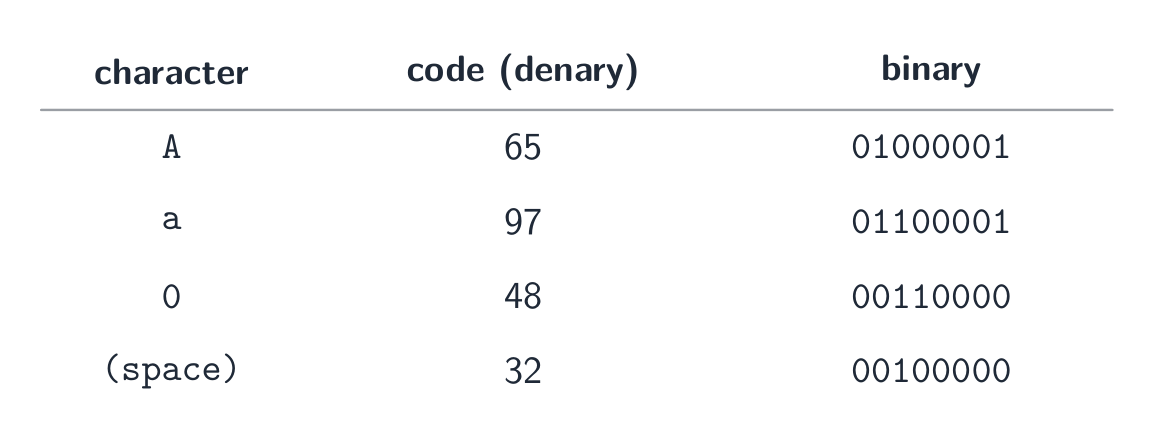
Маленькая таблица ASCII: символ A имеет код 65 = 01000001, a — 97 = 01100001, цифра 0 — 48 = 00110000, а пробел — 32 = 00100000
Каждый символ хранится как число — несколько кодовых точек ASCII в десятичной и двоичной системах

Unicode

  • Unicode — универсальный набор символов, охватывающий почти все письменности, а также символы и эмодзи.
  • распространенные кодировки: UTF-8 (1–4 байта, совместима с ASCII), UTF-16 (2 или 4 байта), UTF-32 (фиксированно 4 байта).

Почему Unicode превосходит ASCII

  • он представляет гораздо больше символов (все письменности, эмодзи); ASCII покрывает только базовый английский язык.
  • файлы переносимы без путаницы в кодировках и позволяют использовать многоязычный текст в одном документе.
  • компромисс: файлы Unicode обычно больше при использовании только английского языка.

Когда в вопросе требуется указать различия, приводите их парами с цифрами: ASCII использует 7 бит (расширенный ASCII — 8), поэтому 128 (256) символов; Unicode использует до 32 бит (UTF-8 — от 1 до 4 байт), поэтому более миллиона кодовых точек. ASCII покрывает только базовый английский; Unicode охватывает все письменности, а его первые 128 кодовых точек соответствуют ASCII. В UTF-8 английская буква по-прежнему занимает 1 байт, поэтому имя файла на 40 английских букв весит 40 байт как в ASCII, так и в UTF-8, в то время как китайский символ занимает 3 байта.

Explore · ⁨Исследовать⁩

A character is stored as a number · ⁨Символ хранится в виде числа⁩

Each character has a code number — 'A' is 65. Flip the bits to see that code in binary and hex, exactly how the computer holds it. · ⁨У каждого символа есть номер кода — 'A' это 65. Инвертируйте биты, чтобы увидеть этот код в двоичной и шестнадцатеричной системах, точно так, как компьютер его хранит.⁩

Vocabulary · ⁨Словарь⁩ Train · ⁨Тренировать⁩
English Русский
code point/kəʊd pɔɪnt/ код точки
character set/ˈkærɪktə set/ набор символов
encoding/enˈkəʊdɪŋ/ кодирование
1.2

Bitmap images · ⁨Растровые изображения⁩

Syllabus · ⁨Программа⁩
English
Candidates should be able to: Notes and guidance
Show understanding of how data for a bitmapped image are encoded Use and understand the terms: pixel, file header, image resolution, screen resolution, colour depth / bit depth
Perform calculations to estimate the file size for a bitmap image
Show understanding of the effects of changing elements of a bitmap image on the image quality and file size Use the terms: image resolution, colour depth / bit depth
Show understanding of how data for a vector graphic are encoded Use the terms: drawing object, property, drawing list
Justify the use of a bitmap image or a vector graphic for a given task
Show understanding of how sound is represented and encoded Use the terms: sampling, sampling rate, sampling resolution, analogue and digital data
Show understanding of the impact of changing the sampling rate and resolution Including the impact on file size and accuracy
Русский
Кандидаты должны уметь: Примечания и рекомендации
Демонстрировать понимание способа кодирования данных для растрового изображения Использовать и понимать термины: пиксель, заголовок файла, разрешение изображения, разрешение экрана, глубина цвета / битовая глубина
Выполнять расчеты для оценки размера файла растрового изображения
Демонстрировать понимание влияния изменения элементов растрового изображения на качество изображения и размер файла Использовать термины: разрешение изображения, глубина цвета / битовая глубина
Демонстрировать понимание способа кодирования данных для векторной графики Использовать термины: объект рисования, свойство, список рисования
Обосновывать использование растрового изображения или векторной графики для конкретной задачи
Демонстрировать понимание способа представления и кодирования звука Использовать термины: дискретизация, частота дискретизации, разрешение дискретизации, аналоговые и цифровые данные
Демонстрировать понимание влияния изменения частоты дискретизации и разрешения Включая влияние на размер файла и точность

Source: Cambridge International syllabus · ⁨Источник: Программа Cambridge International⁩

English

A bitmap 位图 image (also called a bitmapped image) stores the colour of every pixel 像素 in a grid. At the start of the file a file header 文件头 records the image's metadata — its width, height and colour depth — so software knows how to read the pixel data that follows.

  • image resolution 图像分辨率: the bitmap's own size, width × height in pixels (e.g. 1920 × 1080).
  • screen resolution 屏幕分辨率: the width × height the display can show. If an image's resolution is larger than the screen it is scaled down to fit; a low-resolution image looks blocky when stretched onto a higher-resolution screen.
  • colour depth 颜色深度 (bit depth 位深度): bits per pixel. 1 bit → black/white; 8 bits → 256 colours; 24 bits → 16.7 million ("true colour").

File size

$$\text{size in bits} = \text{width} \times \text{height} \times \text{bit depth}.$$

Divide by 8 for bytes, by 1024 for KiB, etc. Example: a $3000 \times 2000$ image at 24 bpp is $3000 \times 2000 \times 24 = 1.44 \times 10^{8}$ bits $\approx 17.2\ \text{MiB}$.

State the units you used. The mark scheme accepts $1\ \text{MB} = 10^{6}$ bytes (the SI prefix) or $1\ \text{MiB} = 1024 \times 1024$ bytes (the binary prefix), as long as your working shows which one; the same image is $18.0\ \text{MB}$ or $17.2\ \text{MiB}$. Add the size of the file header if the question gives one.

A video is a sequence of bitmap images, each one a frame 帧. Before compression its size is the size of one frame $\times$ the frame rate 帧率 (frames per second) $\times$ the duration in seconds: 30 frames per second of $1920 \times 1080$ pixels at 24 bits is $30 \times 1920 \times 1080 \times 24 \approx 1.5 \times 10^{9}$ bits, about $187\ \text{MB}$, for every second. That is why video is always compressed.

Changing settings

  • lower resolution → smaller file, less detail (looks blocky when enlarged).
  • lower colour depth → smaller file, but smooth shades show banding.
  • higher of either → larger file, better quality.
Русский

Растровое изображение (также называемое битмапом) хранит цвет каждого пикселя в сетке. В начале файла заголовок файла фиксирует метаданные изображения — его ширину, высоту и глубину цвета — чтобы программное обеспечение знало, как читать последующие пиксельные данные.

  • разрешение изображения: собственный размер битмапа, ширина × высота в пикселях (например, 1920 × 1080).
  • разрешение экрана: ширина × высота, которые может показать дисплей. Если разрешение изображения превышает разрешение экрана, оно уменьшается по масштабу, чтобы поместиться; низкоразрешающее изображение выглядит пиксельным при растягивании на экран с высоким разрешением.
  • глубина цвета (битовая глубина): бит на пиксель. 1 бит → черно-белое; 8 бит → 256 цветов; 24 бита → 16,7 млн ("истинный цвет").
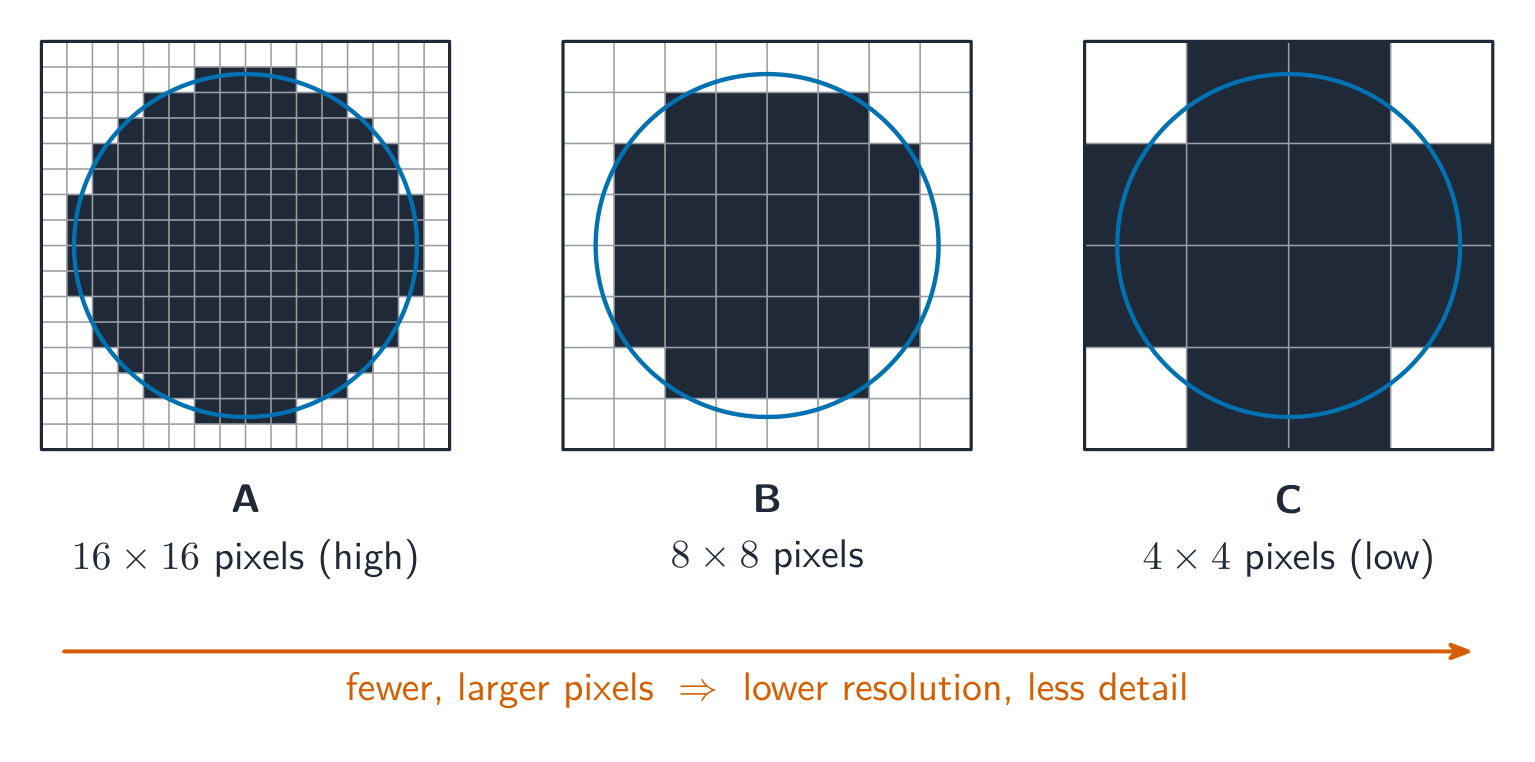
Один и тот же диск, сохраненный в трех пиксельных сетках от A до C, становящийся более пиксельным по мере увеличения размера пикселей и уменьшения их количества
Одно и то же изображение, сохраненное при трех разрешениях: от высокого (A) до низкого (C): меньше пикселей, они крупнее, что дает меньшую детализацию

Размер файла

$$\text{size in bits} = \text{width} × \text{height} × \text{bit depth}.$$

Разделите на 8 для байтов, на 1024 для KiB и т. д. Пример: изображение размером $3000 \times 2000$ при разрешении 24 bpp имеет размер $3000 \times 2000 \times 24 = 1.44 \times 10^{8}$ бит $\approx 17.2\ \text{MiB}$.

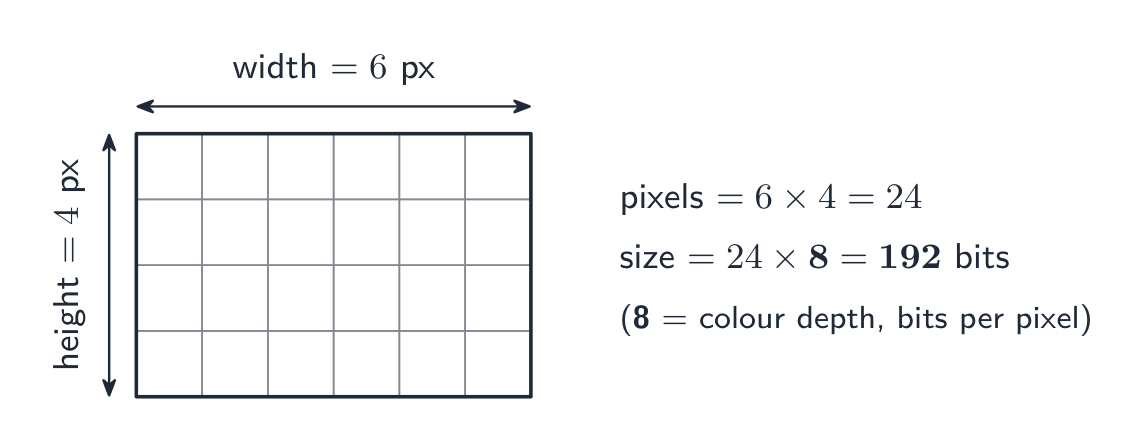
Сетка 6 на 4 пикселя с подписанными шириной и высотой; пиксели = 6 умножить на 4 = 24, а при 8 битах на пиксель размер = 24 умножить на 8 = 192 бита
Та же формула на малых числах: подсчитайте количество пикселей, затем умножьте на глубину цвета

Укажите использованные единицы. Схема оценивания принимает $1\ \text{MB} = 10^{6}$ байтов (SI-префикс) или $1\ \text{MiB} = 1024 \times 1024$ байтов (бинарный префикс), при условии что в решении указано, какой из них был использован; то же изображение имеет размер $18.0\ \text{MB}$ или $17.2\ \text{MiB}$. Прибавьте размер заголовка файла, если он указан в задании.

Видео — это последовательность растровых изображений, каждое из которых является кадром. До сжатия его размер равен размеру одного кадра $\times$ частоту кадров (кадров в секунду) $\times$ продолжительность в секундах: 30 кадров в секунду при разрешении $1920 \times 1080$ пикселей и глубине 24 бита составляют $30 \times 1920 \times 1080 \times 24 \approx 1.5 \times 10^{9}$ бит, примерно $187\ \text{MB}$, на каждую секунду. Именно поэтому видео всегда сжимается.

Изменение параметров

  • низкое разрешение → меньший размер файла, меньше деталей (выглядит пиксельным при увеличении).
  • низкая глубина цвета → меньший размер файла, но плавные переходы отображаются с полосами (бандингом).
  • более высокие значения любого из них → больший размер файла, лучшее качество.
Vocabulary · ⁨Словарь⁩ Train · ⁨Тренировать⁩
English Русский
bit/bɪt/ бит
hexadecimal/ˌheksəˈdesɪml/ шестнадцатеричный
nibble/ˈnɪbl/ ниббл
register width/ˈredʒɪstə wɪtθ/ ширина регистра
register/ˈredʒɪstə/ регистром
bitmap/ˈbɪtmæp/ растровый
pixel/ˈpɪksl/ пиксель
file header/faɪl ˈhedə/ заголовок файла
colour depth/ˈkʌlə depθ/ глубина цвета
image resolution/ˈɪmɪdʒ ˌrezəˈluːʃn/ разрешение изображения
screen resolution/skriːn ˌrezəˈluːʃn/ разрешение экрана
bit depth/bɪt depθ/ глубина цвета (битовая глубина)
frame/freɪm/ рам
1.2

Vector graphics · ⁨Векторная графика⁩

English

A vector graphic 矢量图形 stores the instructions to draw the image as a drawing list 绘图列表 — an ordered list of drawing objects 绘图对象 (geometric primitives 图元: lines, curves, polygons, circles). Each drawing object has properties 属性 such as colour, fill, line width and position (coordinates). To show it, the program renders 渲染 the drawing list at any resolution needed.

Bitmap vs vector

Task Better choice Why
Photograph Bitmap Complex pixel-level detail can't be described as shapes.
Logo, icon, sign Vector Sharp edges; scales to any size without blur.
Engineering drawing Vector Precise geometry and scaling.
Painting, texture Bitmap Smooth tonal detail per area.

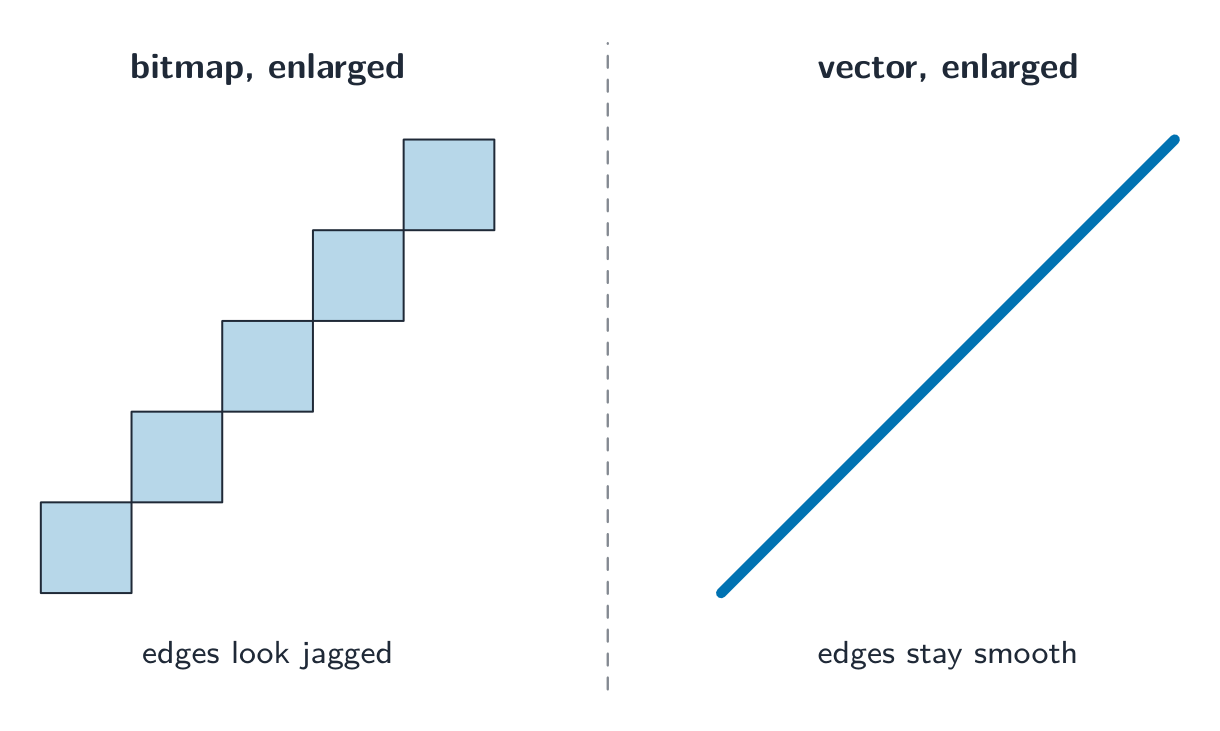
Vector advantage: it scales without losing quality — a vector logo stays sharp at any size, while a bitmap blurs when enlarged. Vector disadvantage: it cannot describe arbitrary pixel detail (photographs).

A "justify" answer links the choice to the task. "The logo must appear on a business card and on a billboard, so it should be a vector graphic: it is stored as drawing objects and is re-rendered sharply at any size, whereas a bitmap would show its pixels when enlarged." For a photograph the argument runs the other way: there are no shapes to describe, so every pixel's colour must be stored.

Русский

Векторная графика хранит инструкции для рисования изображения в виде списка объектов — упорядоченного списка рисующих объектов (геометрических примитивов: линий, кривых, многоугольников, кругов). Каждый рисующий объект имеет свойства, такие как цвет, заливка, толщина линии и положение (координаты). Для отображения программа рендерит список рисования в любом необходимом разрешении.

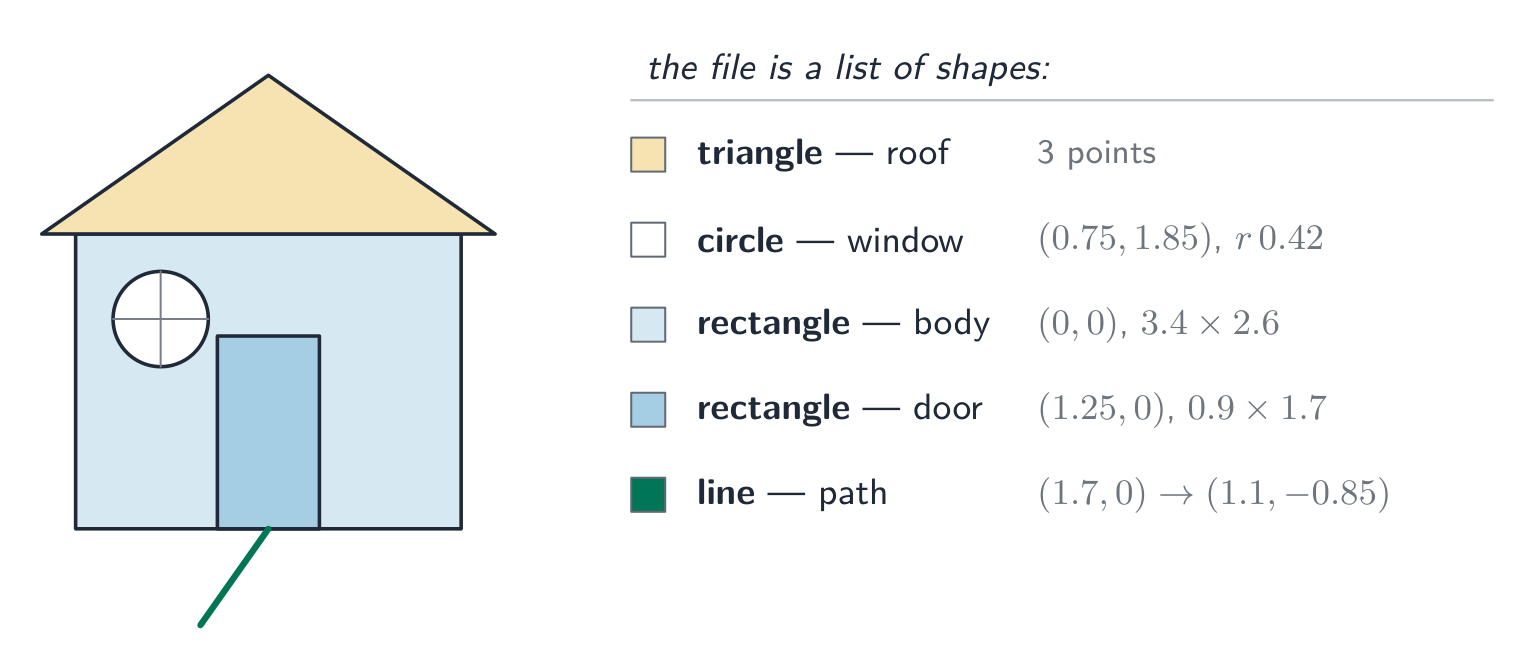
Простой рисунок дома, состоящий из прямоугольного корпуса, треугольной крыши, круглого окна, дверного проема-прямоугольника и линии, каждый элемент подписан типом фигуры и атрибутами
Векторное изображение строится из подписанных геометрических фигур, каждая со своими атрибутами

Растр против вектора

Задача Лучший выбор Причина
Фотография Растр Сложная детализация на уровне пикселей невозможно описать формами.
Логотип, иконка, знак Вектор Четкие края; масштабирование любого размера без размытия.
Технический чертеж Вектор Точная геометрия и масштабирование.
Картина, текстура Растр Плавная тональная детализация на каждом участке.

Преимущество вектора: он масштабируется без потери качества — векторный логотип остается четким при любом размере, тогда как растр размывается при увеличении. Недостаток вектора: он не может описать произвольную пиксельную детализацию (фотографии).

Ответ «обосновать» связывает выбор с заданием. «Логотип должен出现在 визитке и на билборде, поэтому он должен быть векторным: он хранится как объекты рисования и перерисовывается четко при любом размере, тогда как растровый изображение покажет пиксели при увеличении.» Для фотографии аргумент обратный: там нет форм для описания, поэтому цвет каждого пикселя должен быть сохранен.

Сбоку друг от друга, оба увеличены: диагональ растрового изображения — это зубчатая лестница из пикселей, в то время как векторная диагональ остается гладкой прямой линией
При увеличении пиксели растрового изображения становятся зубчатыми; векторное изображение остается гладким при любом размере
Explore · ⁨Исследовать⁩

Computing concept lab · ⁨Лаборатория вычислительных концепций⁩

Classify concrete examples by the computing idea they demonstrate. · ⁨Классифицируйте конкретные примеры по вычислительной идее, которую они демонстрируют.⁩

Vocabulary · ⁨Словарь⁩ Train · ⁨Тренировать⁩
English Русский
vector graphic/ˈvektə ˈɡræfɪk/ векторная графика
drawing list/ˈdrɔːɪŋ lɪst/ список рисования
drawing objects/ˈdrɔːɪŋ ˈɒbdʒekts/ рисующие объекты
primitive/ˈprɪmɪtɪv/ простой примитив
properties/ˈprɒpətiz/ свойства
render/ˈrendə/ рендерить
analogue data/ˈænəlɒɡ ˈdeɪtə/ аналоговые данные
digital data/ˈdɪdʒɪtl ˈdeɪtə/ цифровые данные
1.2

Sound · ⁨Звук⁩

English

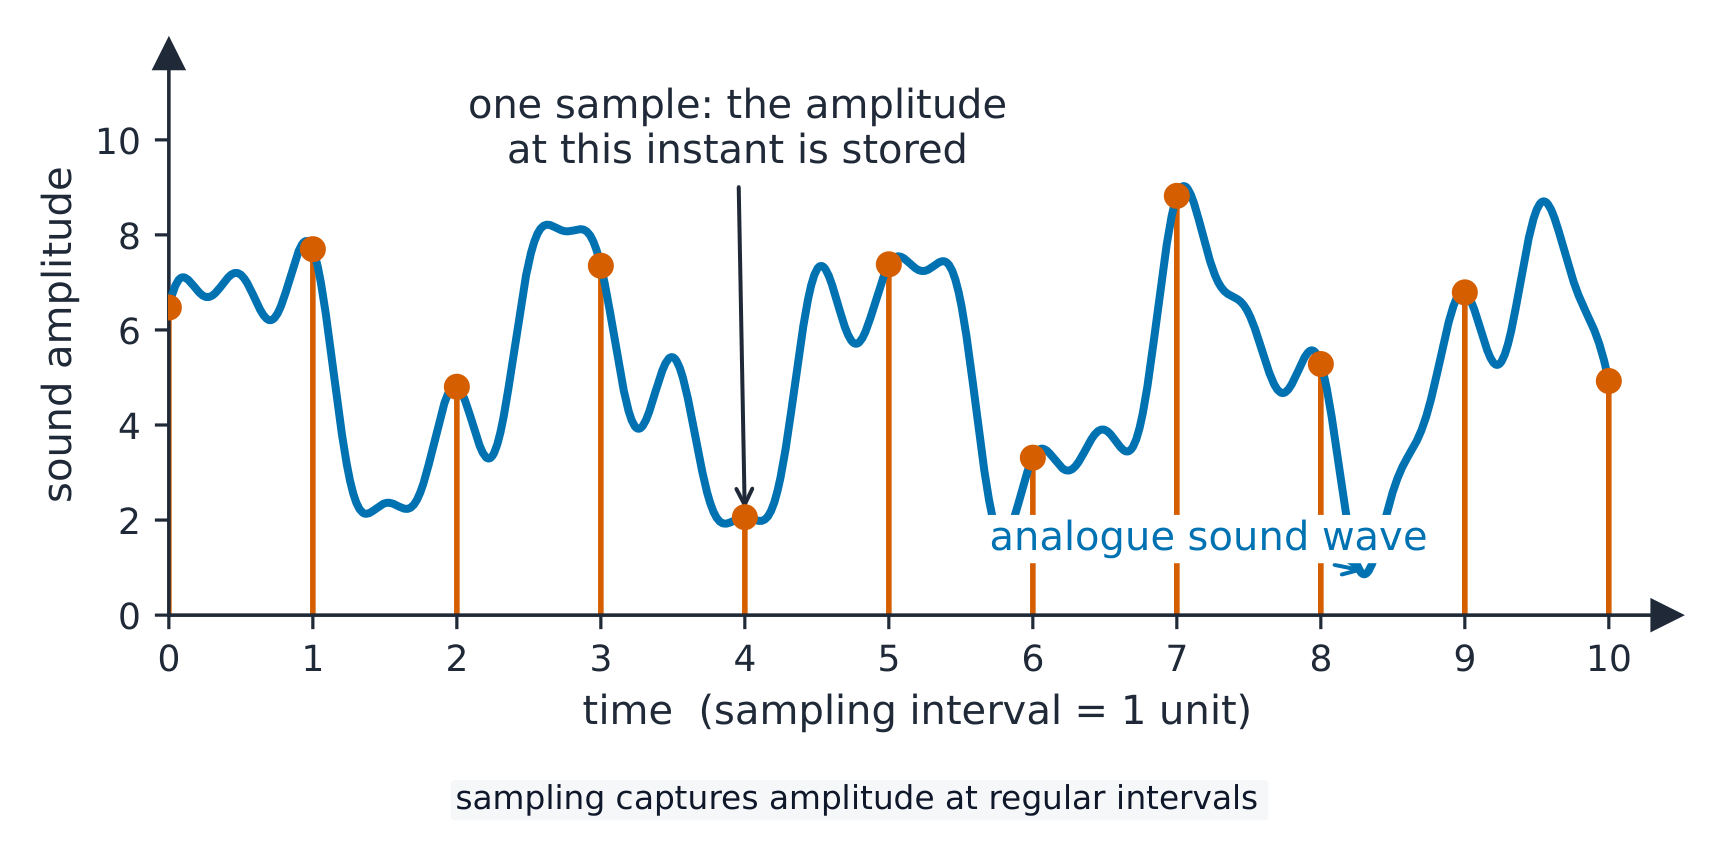
A continuous wave of analogue data 模拟数据 (the sound) is converted into digital data 数字数据 by sampling 采样:

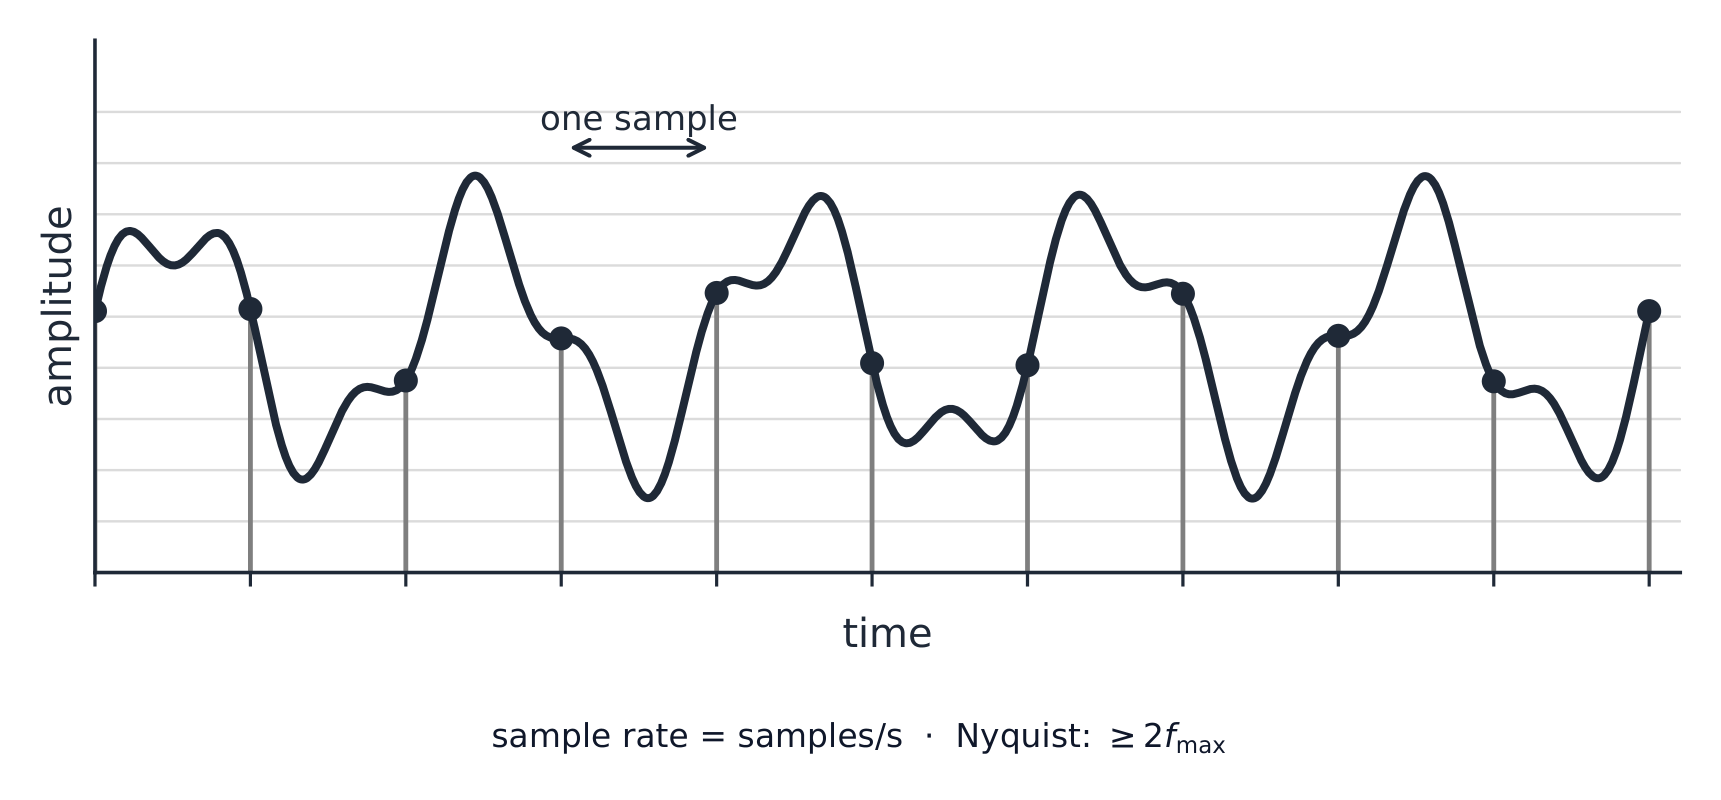
  • sampling rate 采样率 — samples per second (Hz). CD quality is $44.1\ \text{kHz}$.
  • sampling resolution 采样分辨率 (bit depth) — bits per sample's amplitude 振幅. CD quality is 16 bits.

File size

$$\text{size in bits} = \text{sampling rate} \times \text{resolution} \times \text{duration} \times \text{channels}.$$

A 10-second stereo CD clip: $44100 \times 16 \times 10 \times 2 = 14\,112\,000$ bits $\approx 1.68\ \text{MiB}$.

Changing settings

  • higher sampling rate → captures higher pitches, larger file.
  • higher sample resolution → finer amplitude steps, less quantisation 量化 noise, larger file.
  • lower of either → smaller file, clear quality loss.

(The sampling rate must be at least twice the highest frequency you want to keep.)

Русский

Непрерывная волна аналоговых данных (звук) преобразуется в цифровые данные посредством дискретизации:

  • частота дискретизации — количество сэмплов в секунду (Гц). Качество CD составляет $44.1\ \text{kHz}$.
  • разрешение дискретизации (глубина цвета) — биты на амплитуду каждого сэмпла. Качество CD составляет 16 бит.
Гладкая аналоговая звуковая волна с вертикальными линиями выборок через равные промежутки времени, каждая линия показывает амплитуду волны
Дискретизация звуковой волны: ее амплитуда снимается на каждом временном интервале

Размер файла

$$\text{size in bits} = \text{sampling rate} × \text{resolution} × \text{duration} × \text{channels}.$$

10-секундный стерео-клип CD: $44100 \times 16 \times 10 \times 2 = 14\,112\,000$ бит $\approx 1.68\ \text{MiB}$.

Изменение параметров

  • более высокая частота дискретизации → захват более высоких частот, больший размер файла.
  • более высокое разрешение выборки → более мелкие ступени амплитуды, меньше шума квантования, больший размер файла.
  • меньшее значение любого из параметров → меньший файл, четкая потеря качества.

(Частота дискретизации должна быть как минимум вдвое больше максимальной частоты, которую вы хотите сохранить.)

Звуковая волна, перечеркнутая равномерно распределенными линиями выборки, по одной точке на каждый сэмпл, отмечена как частота выборки = сэмплы в секунду и Нейквист как минимум вдвое больше самой высокой частоты
Частота выборки — это сэмплы в секунду; правило Нейквиста объясняет, почему она должна быть как минимум вдвое больше самой высокой сохраняемой частоты
Explore · ⁨Исследовать⁩

Sound sampling · ⁨Дискретизация звука⁩

y = a sin(bt + c)

Sampling measures a sound wave at regular intervals — a higher rate copies it more truly. · ⁨Дискретизация измеряет звуковую волну через равные промежутки времени — чем выше частота, тем точнее она копирует волну.⁩

Vocabulary · ⁨Словарь⁩ Train · ⁨Тренировать⁩
English Русский
sampling/ˈsæmplɪŋ/ дискретизация (sampling)
sampling rate/ˈsæmplɪŋ reɪt/ частота дискретизации
sampling resolution/ˈsæmplɪŋ ˌrezəˈluːʃn/ разрешающая способность
amplitude/ˈæmplɪtjuːd/ точке амплитуды
sample resolution/ˈsæmpl ˌrezəˈluːʃn/ разрешение выборки
quantisation/ˌkwɒntaɪˈzeɪʃn/ квантование
bandwidth/ˈbændwɪdθ/ пропускная способность
lossless/ˈlɒsləs/ без потерь
lossy/ˈlɒsi/ с потерями
run-length encoding/rʌn leŋθ enˈkəʊdɪŋ/ кодировка длин серий
dictionary methods/ˈdɪkʃənəri ˈmeθədz/ методы словаря
1.3

Compression · ⁨Сжатие⁩

Syllabus · ⁨Программа⁩
English
Candidates should be able to: Notes and guidance
Show understanding of the need for and examples of the use of compression
Show understanding of lossy and lossless compression and justify the use of a method in a given situation
Show understanding of how a text file, bitmap image, vector graphic and sound file can be compressed Including the use of run-length encoding (RLE)
Русский
Кандидаты должны уметь: Примечания и рекомендации
Демонстрировать понимание необходимости и примеров использования сжатия
Демонстрировать понимание потерьного и без потерь сжатия и обосновывать выбор метода в данной ситуации
Демонстрировать понимание способов сжатия текстового файла, растрового изображения, векторной графики и звукового файла Включая использование подрядовой кодировки (RLE)

Source: Cambridge International syllabus · ⁨Источник: Программа Cambridge International⁩

English

Compression 压缩 reduces file size, saving storage and transmission bandwidth 带宽. Two kinds:

  • lossless 无损 — the original data is recovered exactly (text, programs, ZIP/PNG).
  • lossy 有损 — some detail is dropped for much smaller files (JPEG, MP3, video).

When to use which

  • lossless for documents, source code, medical images — anything needing exact data.
  • lossy for streaming media. Real-time video streaming uses lossy compression because it must send huge amounts of data in real time over limited bandwidth; lossless would not shrink it enough. Raw HD video is gigabytes per minute, so without compression the picture would keep freezing.

A "justify" answer names the method, then the reason from the situation: "Lossless, because the spreadsheet must be restored exactly; a single changed value would make the accounts wrong." Or: "Lossy, because the photographs are viewed on a phone screen where the dropped detail is not visible, and the smaller files upload faster and use less storage."

Lossless methods

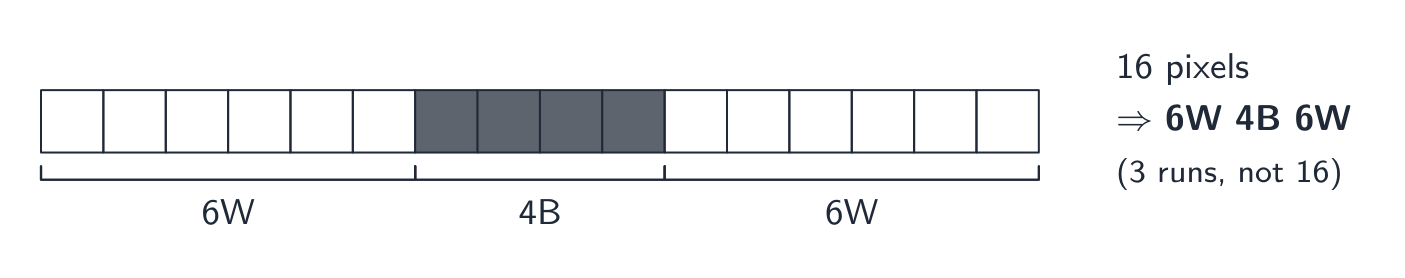
  • run-length encoding 行程编码 (RLE): store "the next $n$ values are $x$" instead of repeating $x$. Great for flat areas; useless for noisy data.
  • dictionary methods 字典编码 (ZIP, PNG): replace repeated byte sequences with a short reference. Good for text and code.
  • Huffman coding 霍夫曼编码: give short codes to common symbols and long codes to rare ones, bringing the average code length near the data's entropy 熵.

How each kind of file is compressed:

  • text file: dictionary methods and Huffman coding turn repeated words and common characters into short codes. Text must stay lossless, because one changed character changes the meaning.
  • bitmap image: RLE for runs of identical pixels (icons, diagrams, black-and-white scans); lossy JPEG for photographs, or a lower colour depth or resolution.
  • vector graphic: the drawing list is already small; remove drawing objects that are not needed, store coordinates to fewer decimal places, or apply a lossless method such as ZIP to the file.
  • sound file: lossy MP3 or AAC removes what the ear cannot hear; a lower sampling rate or resolution is also lossy; lossless formats keep every sample and shrink the file much less.

Lossy methods

  • images (JPEG): drop fine detail and colour differences the eye barely sees.
  • sound (MP3, AAC): drop pitches we hear less well, and quiet sounds hidden by louder ones.
  • video combines spatial 空间 compression (within each frame, like JPEG) with temporal 时间 compression (most frames store only the differences from the previous frame).
Русский

Сжатие уменьшает размер файла, экономя место хранения и пропускную способность канала передачи. Два вида:

  • без потерь — исходные данные восстанавливаются точно (текст, программы, ZIP/PNG).
  • с потерями — некоторые детали отбрасываются ради значительно меньшего размера файлов (JPEG, MP3, видео).

Когда использовать какой метод

  • без потерь для документов, исходного кода, медицинских изображений — всего, что требует точных данных.
  • с потерями для потокового мультимедиа. Видеостриминг в реальном времени использует сжатие с потерями, потому что он должен передавать огромные объемы данных в реальном времени через ограниченную полосу пропускания; сжатие без потерь не уменьшило бы его достаточно. Сырое HD-видео занимает гигабайты в минуту, поэтому без сжатия картинка постоянно зависала бы.

Ответ «обосновать» называет метод, затем причину из ситуации: «Без потерь, потому что таблицу необходимо восстановить точно; одно измененное значение сделает отчет неверным». Или: «С потерями, потому что фотографии просматриваются на экране телефона, где утраченные детали незаметны, а меньшие файлы загружаются быстрее и занимают меньше места.»

Методы без потерь

  • побегочное кодирование (RLE): хранить «следующие $n$ значений равны $x$» вместо повторения $x$. Отлично подходит для плоских участков; бесполезно для зашумленных данных.
  • словарные методы (ZIP, PNG): заменять повторяющиеся последовательности байтов короткими ссылками. Хорошо подходят для текста и кода.
  • кодирование Хаффмана: присваивать короткие коды частым символам и длинные редким, приближая среднюю длину кода к энтропии данных.

Как сжимается каждый вид файлов:

  • текстовый файл: словарные методы и кодирование Хаффмана превращают повторяющиеся слова и часто встречающиеся символы в короткие коды. Текст должен оставаться без потерь, так как изменение одного символа меняет смысл.
  • растровое изображение: RLE для серий одинаковых пикселей (иконки, схемы, черно-белые сканы); JPEG с потерями для фотографий, или меньшая глубина цвета или разрешение.
  • векторная графика: список объектов рисования уже мал; убрать ненужные объекты рисования, сохранить координаты с меньшим количеством знаков после запятой или применить метод без потерь, такой как ZIP, к файлу.
  • звуковой файл: MP3 или AAC с потерями удаляют то, что ухо не слышит; более низкая частота или разрешение выборки также являются потерями; форматы без потерь сохраняют каждый сэмпл и уменьшают файл гораздо меньше.
Ряд из 16 пикселей: 6 белых, 4 черных и 6 белых ячеек; три серии обведены скобками и подписаны 6B, 4Ч, 6B, таким образом 16 пикселей хранятся как 3 серии 6B 4Ч 6B
Побегочное кодирование на одном ряду: 16 пикселей становятся 3 сериями
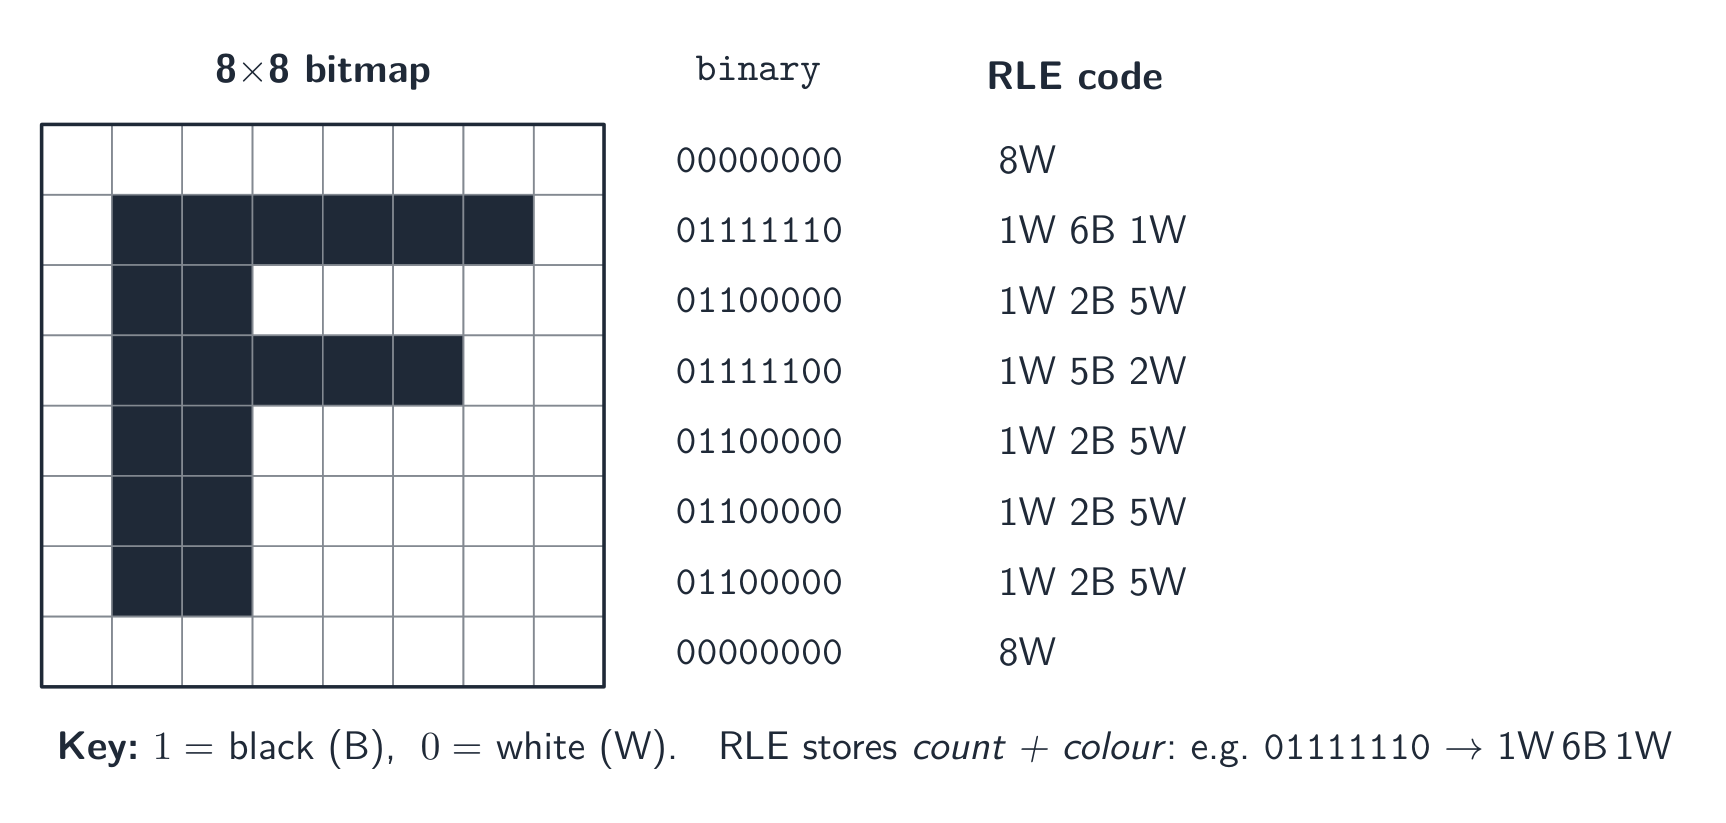
Чёрно-белая сетка размером 8 на 8, показывающая букву F, с перечислением двоичных паттернов каждой строки и её более короткого кода длин серий рядом
Побегочное кодирование буквы F в сетке $8\times8$ черно-белых клеток
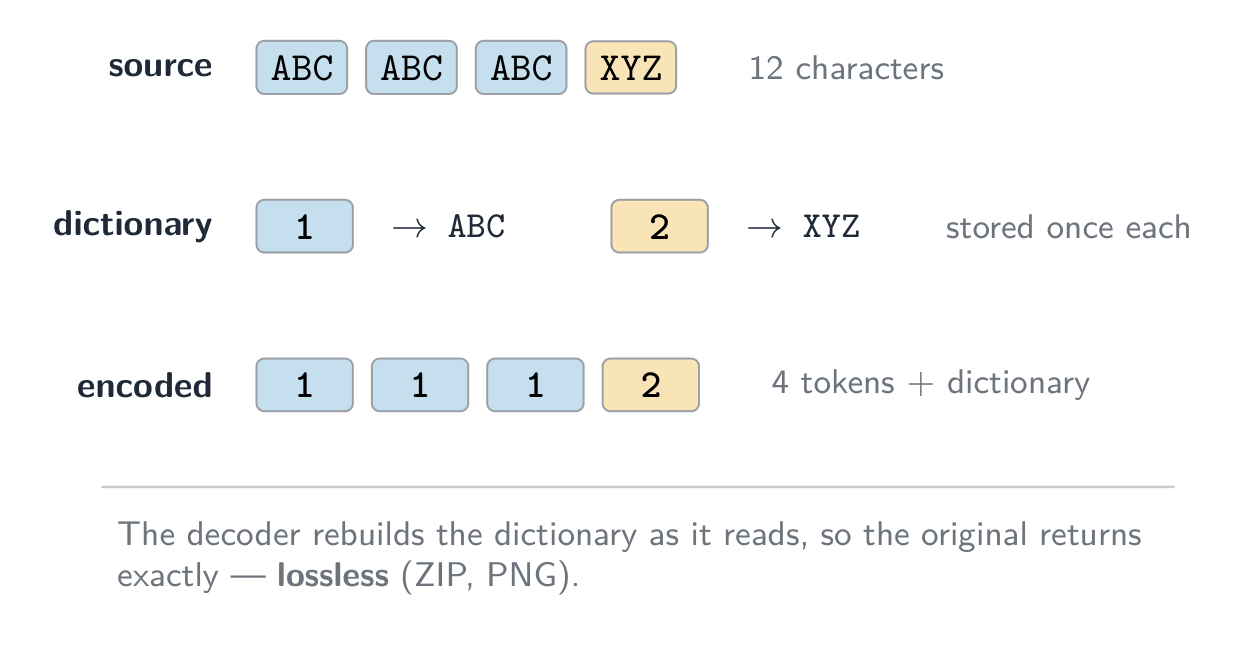
Пример словарного кодирования: исходник ABC ABC ABC XYZ, словарь, в котором 1 соответствует ABC, а 2 — XYZ, и закодированный поток 1 1 1 2
Словарное кодирование: каждая повторяющаяся последовательность сохраняется один раз, а каждое вхождение становится коротким индексом
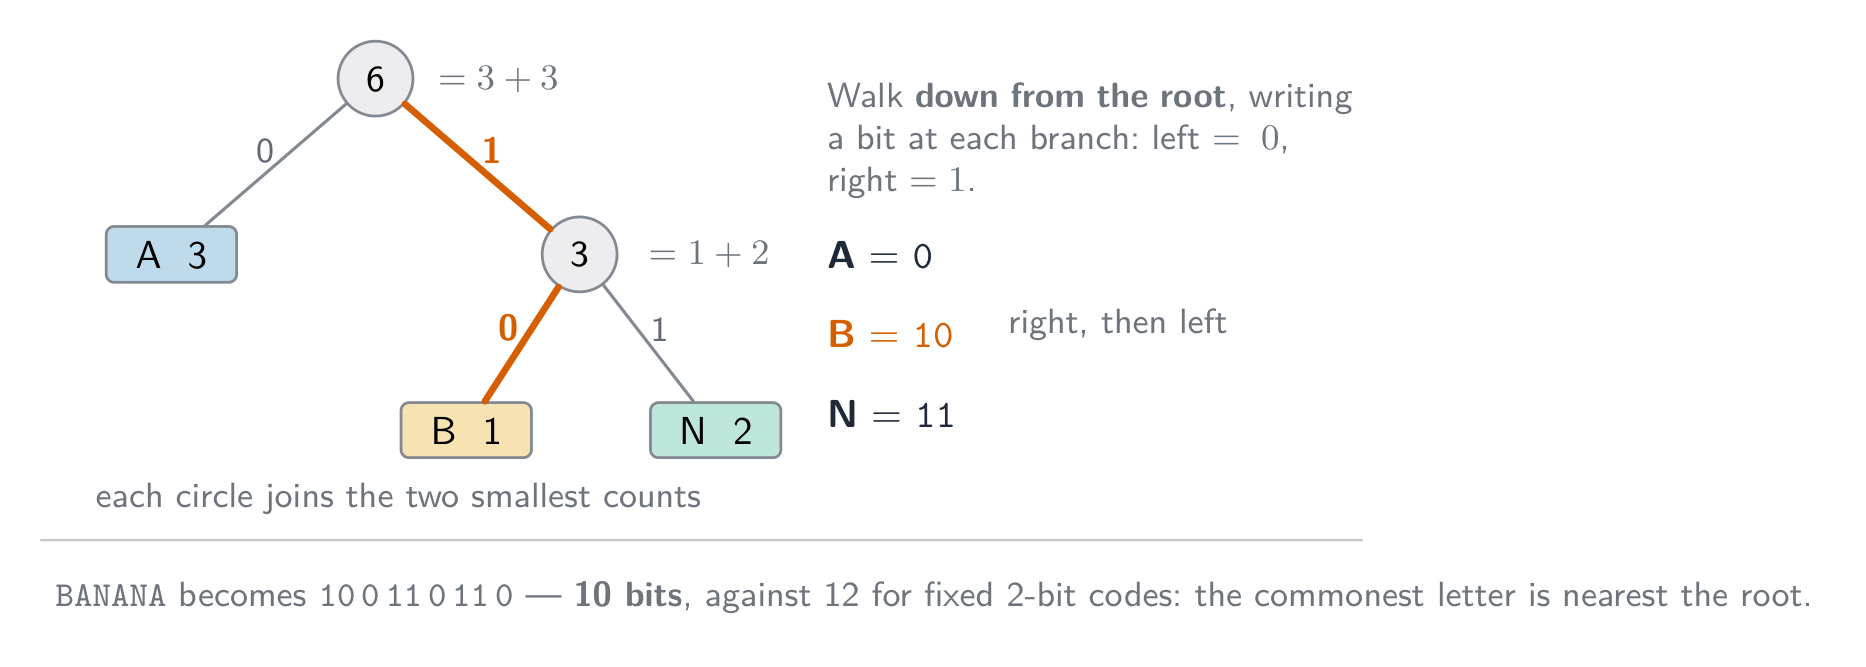
Пример кодирования Хаффмана на слове BANANA: подсчет букв A 3, N 2 и B 1, дерево кодов, построенное на их основе, и полученные коды A = 0, B = 10, N = 11
Кодирование Хаффмана: самый частый символ получает самый короткий код, поэтому BANANA требует 10 бит вместо 12

Методы с потерями

  • изображения (JPEG): отбрасывать мелкую деталь и цветовые различия, которые глаз едва заметит.
  • звук (MP3, AAC): отбрасывать частоты, которые мы слышим хуже, и тихие звуки, скрытые более громкими.
  • видео объединяет пространственное сжатие (внутри каждого кадра, как в JPEG) с временным сжатием (большинство кадров хранят только различия с предыдущим кадром).
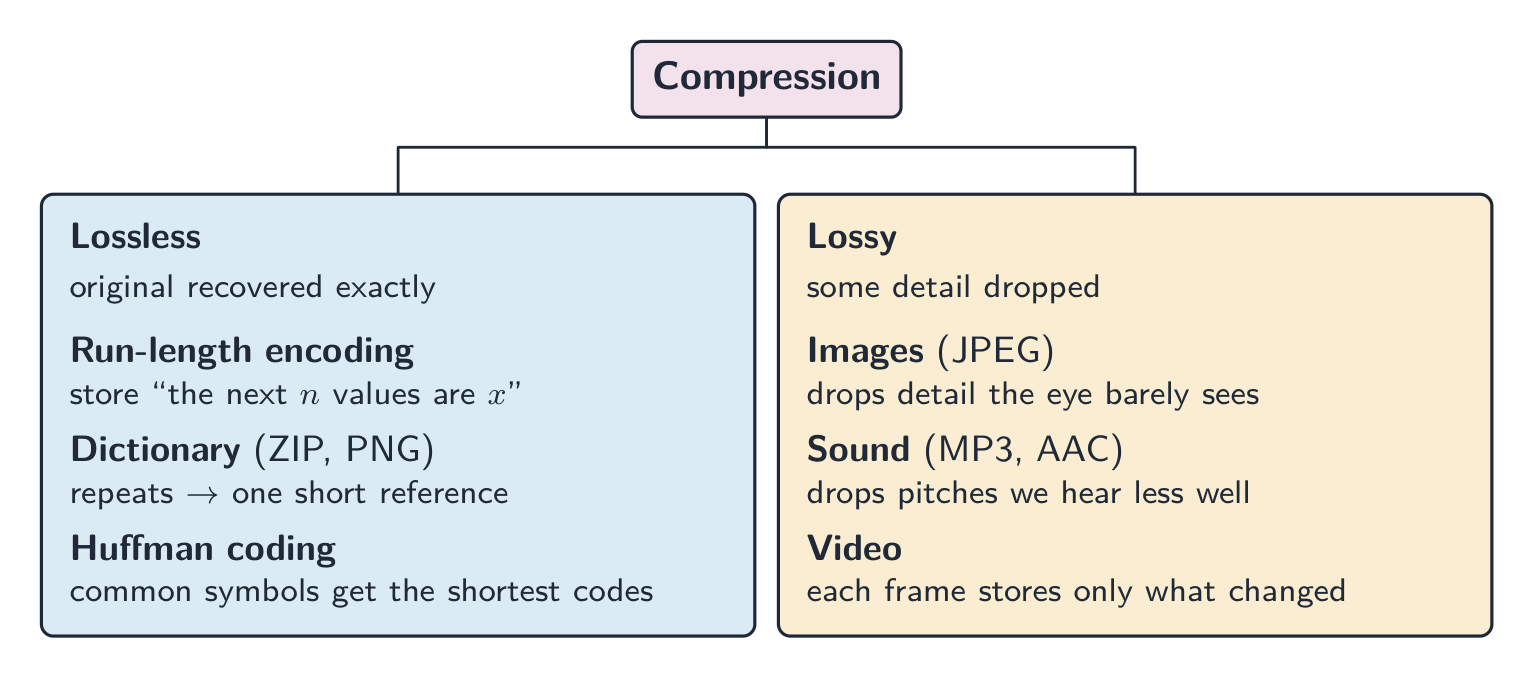
Дерево, классифицирующее сжатие на без потерь (RLE, словари/ZIP/PNG, Хаффмана) и с потерями (изображения JPEG, звук MP3/AAC, видео) с примерами под каждой ветвью
Методы сжатия: без потерь против с потерями, с распространенными примерами
Explore · ⁨Исследовать⁩

Run-length encoding · ⁨Кодирование длин серий⁩

Watch a run of repeated symbols get squashed into a count — simple lossless compression. · ⁨Наблюдайте, как серия повторяющихся символов сжимается в счётчик — простая потерянностная компрессия.⁩

Vocabulary · ⁨Словарь⁩ Train · ⁨Тренировать⁩
English Русский
compression/kəmˈpreʃn/ сжатие
frame rate/freɪm reɪt/ частота кадров
Huffman coding/ˈhʌfmən ˈkəʊdɪŋ/ кодирование Хаффмана
entropy/ˈentrəpi/ энтропии
spatial/ˈspeɪʃl/ пространственный
temporal/ˈtempərəl/ временной
Watch lesson · ⁨Смотреть урок⁩
1.3

Definitions the examiner accepts · ⁨Определения, принимаемые экзаменатором⁩

English

A definition question is marked against fixed wording. Learn these exactly, and give one answer only.

Term Definition
bit a single binary digit, 0 or 1
byte a group of 8 bits
binary prefix a multiplier that is a power of 2 (kibi = 1024) rather than a power of 10 (kilo = 1000)
two's complement a way of representing signed integers in which the most significant bit has a negative place value
overflow the result of a calculation is too large to be represented in the number of bits available
Binary Coded Decimal each denary digit is stored as its own 4-bit binary pattern
character set the set of characters a computer can represent, each with its own binary code
pixel the smallest element of a bitmap image, storing one colour value
image resolution the number of pixels in an image, given as width by height
screen resolution the number of pixels a display can show, given as width by height
colour depth the number of bits used to store the colour of one pixel
sampling rate the number of samples of the sound taken per second
sampling resolution the number of bits used to store the amplitude of one sample
lossless compression compression from which the original data can be recovered exactly
lossy compression compression that permanently removes some data, so the original cannot be recovered
run-length encoding replacing a run of repeated values with one value and a count
Русский

Вопросы на определение оцениваются по фиксированной формулировке. Выучите их точно и дайте только один ответ.

Термин Определение
бит одна двоичная цифра, 0 или 1
байт группа из 8 бит
бинарный префикс множитель, являющийся степенью 2 (kibi = 1024), а не степенью 10 (kilo = 1000)
дополненный до двух способ представления знаковых целых чисел, при котором старший значащий разряд имеет отрицательное место значение
переполнение результат вычисления слишком велик для представления в доступном количестве бит
двоично-десятичный код (BCD) каждая десятичная цифра хранится в виде собственного 4-битного двоичного паттерна
набор символов множество символов, которые может представлять компьютер, каждый со своим собственным двоичным кодом
пиксель наименьший элемент растрового изображения, хранящий одно цветовое значение
разрешение изображения количество пикселей в изображении, указываемое как ширина на высоту
разрешение экрана количество пикселей, которое может показать дисплей, указываемое как ширина на высоту
глубина цвета количество бит, используемых для хранения цвета одного пикселя
частота дискретизации количество выборок звука, взятых за одну секунду
разрядность дискретизации количество бит, используемых для хранения амплитуды одной выборки
сжатие без потерь сжатие, из которого исходные данные могут быть восстановлены точно
сжатие с потерями сжатие, которое навсегда удаляет часть данных, поэтому исходные данные восстановить невозможно
побитовое кодирование длин (RLE) замена последовательности повторяющихся значений одним значением и счетчиком
1.3

Exam tips · ⁨Советы для экзамена⁩

English
  • Show working for base conversions: denary → binary by place values, binary → hexadecimal in nibbles (groups of 4 bits).
  • For two's complement the MSB is negative; to negate, invert and add 1; watch for overflow when the sign bit flips wrongly.
  • Distinguish bitmap (pixels; file size $=$ width $\times$ height $\times$ colour depth) from vector (drawing commands; scales without loss).
  • Sound file size depends on sample rate $\times$ bit depth $\times$ time — more of each means better quality but a bigger file.
  • Compare lossless vs lossy compression and give a use for each.

Common mistakes

  • Explaining an overflow with "the answer was greater than 255" or "it has 9 bits". State the word size the question gave, then say the result cannot be represented in it.
  • Making a negative number by setting the top bit to 1 and leaving the rest (sign and magnitude). Two's complement means invert every bit of the positive value, then add 1.
  • Forgetting to pad a converted number to the register width the question asks for.
  • Mixing bits and bytes in a file-size calculation. Work in bits, divide by 8 once, and say whether you used 1000 or 1024.
  • Answering "describe" in everyday words ("the picture gets worse"). Use the syllabus terms: fewer colours, banding, lower image resolution, larger pixels.
Русский
  • Показывать ход вычислений при переводе систем счисления: десятичная → двоичная через разрядные значения, двоичная → шестнадцатеричная в тетрадах (группах из 4 бит).
  • Для дополненного до двух старший значащий разряд отрицательный; чтобы инвертировать число, инвертируйте все биты и добавьте 1; следите за переполнением, когда знаковый разряд меняется неверно.
  • Различайте растровый (пиксели; размер файла $=$ ширина $\times$ высота $\times$ глубина цвета) и векторный (команды рисования; масштабируется без потери качества).
  • Размер звукового файла зависит от частоты дискретизации $\times$ разрядности $\times$ времени — больше каждого означает лучшее качество, но больший размер файла.
  • Сравните сжатие без потерь и с потерями и приведите пример использования для каждого.

Распространенные ошибки

  • Объяснение переполнения фразами «ответ был больше 255» или «у него 9 бит». Укажите разрядность вопроса, затем скажите, что результат не может быть представлен в ней.
  • Создание отрицательного числа установкой старшего бита в 1 и оставлением остальных (знак и величина). Дополненный до двух означает инвертировать каждый бит положительного значения, затем добавить 1.
  • Забывание дополнить переведенное число нулями до ширины регистра, требуемой в вопросе.
  • Смешение битов и байтов в расчете размера файла. Работайте в битах, разделите на 8 один раз и укажите, использовали ли вы 1000 или 1024.
  • Ответ на «опишите» простыми словами («картинка становится хуже»). Используйте термины программы: меньше цветов, полосатость, меньшее разрешение изображения, большие пиксели.

Interactive lessons on this topic · ⁨Интерактивные уроки по этой теме⁩

Work through it step by step, with instant-check exercises. · ⁨Пройдите его шаг за шагом с упражнениями мгновенной проверки.⁩

Past Papers · ⁨Архив экзаменационных работ⁩

More topics in A-Level Computer Science · ⁨A-Level Информатика⁩ · ⁨Больше тем в A-Level Computer Science · ⁨A-Level Информатика⁩⁩

Log in or create account · ⁨Войти или создать аккаунт⁩

IGCSE, A-Level & AP