Skip to content · ⁨Lompat ke konten⁩

Exploring One-Variable Data · ⁨Mengeksplorasi Data Satu Variabel⁩

AP Statistics · ⁨AP Statistik⁩ · Topic 1 · ⁨Topik 1⁩

Video lesson for this topic · ⁨Pelajaran video untuk topik ini⁩ Open the video page · ⁨Buka halaman video⁩
9:03

Mengeksplorasi Data Satu Variabel

Ukur hal yang sama dua puluh kali dan kamu tidak akan mendapatkan jawaban yang sama dua puluh kali. Dua puluh siswa mengukur meja yang sama. Nilainya bervariasi. Itu bukan…

English narration · English + 中文 subtitles burned in · ⁨Narasi bahasa Inggris · Subtitle bahasa Inggris + 中文 disematkan langsung⁩

1.1

Introducing Statistics: What Can We Learn from Data? · ⁨Memperkenalkan Statistik: Apa yang Bisa Kita Pelajari dari Data?⁩

Syllabus · ⁨Silabus⁩
English

Enduring Understanding (VAR-1): Given that variation may be random or not, conclusions are uncertain.

Learning Objective VAR-1.A: Identify questions to be answered, based on variation in one-variable data. [Skill 1.A]

  • VAR-1.A.1 Numbers may convey meaningful information, when placed in context.
Bahasa Indonesia

Pemahaman Abadi (VAR-1): Mengingat variasi bisa bersifat acak atau tidak, kesimpulan bersifat tidak pasti.

Tujuan Pembelajaran VAR-1.A: Identifikasi pertanyaan yang akan dijawab, berdasarkan variasi dalam data satu variabel. [Keterampilan 1.A]

  • VAR-1.A.1 Angka dapat menyampaikan informasi yang bermakna, ketika ditempatkan dalam konteks.
Source: College Board AP Course and Exam Description · ⁨Sumber: Deskripsi Kursus dan Ujian College Board AP⁩

English

Statistics 统计学 is the science of learning from data 数据 – numbers or labels collected from the real world. Data vary, so we describe patterns and account for the variation 变异 rather than expecting every value to match. A statistical question anticipates an answer based on data that vary.

Two distinctions run through the whole course. A parameter 参数 is a numerical summary of a whole population; a statistic 统计量 is a numerical summary of a sample - we use the statistic to estimate the parameter we cannot measure directly. And descriptive statistics 描述统计 only summarise the data set in hand, while inferential statistics 推断统计 use a sample to make and test claims about the larger population.

Bahasa Indonesia

Statistik adalah ilmu mempelajari dari data – angka atau label yang dikumpulkan dari dunia nyata. Data bervariasi, jadi kita menggambarkan pola dan memperhitungkan variasi alih-alih mengharapkan setiap nilai sesuai. Pertanyaan statistik mengantisipasi jawaban berdasarkan data yang bervariasi.

Dua pembedaan melintasi seluruh kursus. Parameter adalah ringkasan numerik dari seluruh populasi; statistik adalah ringkasan numerik dari sampel - kita menggunakan statistik untuk memperkirakan parameter yang tidak dapat kita ukur secara langsung. Dan statistik deskriptif hanya merangkum himpunan data yang ada, sementara statistik inferensial menggunakan sampel untuk membuat dan menguji klaim tentang populasi yang lebih besar.

Vocabulary · ⁨Kosa kata⁩ Train · ⁨Latih⁩
English Bahasa Indonesia
data/ˈdeɪtə/ data
variation/ˌveərɪˈeɪʃn/ variasi
parameter/pəˈræmɪtə/ parameter
1.2

The Language of Variation: Variables · ⁨Bahasa Variasi: Variabel⁩

Syllabus · ⁨Silabus⁩
English

Enduring Understanding (VAR-1): Given that variation may be random or not, conclusions are uncertain.

Learning Objective VAR-1.B: Identify variables in a set of data. [Skill 2.A]

  • VAR-1.B.1 A variable is a characteristic that changes from one individual to another.

Learning Objective VAR-1.C: Classify types of variables. [Skill 2.A]

  • VAR-1.C.1 A categorical variable takes on values that are category names or group labels.
  • VAR-1.C.2 A quantitative variable is one that takes on numerical values for a measured or counted quantity.
    • Illustrative examples for VAR-1.C:
      • Categorical variables:
        • Dominant hand
        • Age group (young or old)
        • Highest degree earned
      • Quantitative variables:
        • Age of a structure
        • Height of a child
        • Concentration of a sample
Bahasa Indonesia

Pemahaman Abadi (VAR-1): Mengingat variasi bisa bersifat acak atau tidak, kesimpulan bersifat tidak pasti.

Tujuan Pembelajaran VAR-1.B: Identifikasi variabel dalam sekumpulan data. [Keterampilan 2.A]

  • VAR-1.B.1 Variabel adalah karakteristik yang berubah dari satu individu ke individu lain.

Tujuan Pembelajaran VAR-1.C: Klasifikasikan jenis variabel. [Keterampilan 2.A]

  • VAR-1.C.1 Variabel kategorikal mengambil nilai yang merupakan nama kategori atau label kelompok.
  • VAR-1.C.2 Variabel kuantitatif adalah variabel yang mengambil nilai numerik untuk kuantitas yang diukur atau dihitung.
    • Contoh ilustratif untuk VAR-1.C:
      • Variabel kategorikal:
        • Tangan dominan
        • Kelompok usia (muda atau tua)
        • Gelar tertinggi yang diraih
      • Variabel kuantitatif:
        • Umur suatu struktur
        • Tinggi seorang anak
        • Konsentrasi suatu sampel

Source: College Board AP Course and Exam Description · ⁨Sumber: Deskripsi Kursus dan Ujian College Board AP⁩

English

A variable 变量 is a characteristic that can differ between individuals. Two kinds:

  • Categorical 分类 (qualitative): values are labels/groups (eye colour, brand).
  • Quantitative 定量: values are numbers you can do arithmetic on (height, age). Quantitative variables are discrete (countable) or continuous (measured).

Choosing the right graph and summary depends on which kind you have.

Bahasa Indonesia

Variabel adalah karakteristik yang dapat berbeda antar individu. Dua jenis:

  • Kategorikal (kualitatif): nilainya adalah label/kelompok (warna mata, merek).
  • Kuantitatif: nilainya adalah angka yang bisa Anda lakukan aritmatika padanya (tinggi badan, usia). Variabel kuantitatif bersifat diskrit (dapat dihitung) atau kontinu (diukur).

Memilih grafik dan ringkasan yang tepat bergantung pada jenis yang Anda miliki.

Explore · ⁨Jelajahi⁩

Categorical or quantitative? · ⁨Kategorikal atau kuantitatif?⁩

Every variable is either categorical (it labels each unit with a group) or quantitative (a measured number you can average). Which kind it is decides the graphs and summaries you are allowed to use. · ⁨Setiap variabel bersifat kategori (memberi label unit dengan kelompok) atau kuantitatif (angka terukur yang bisa dirata-ratakan). Jenisnya menentukan grafik dan ringkasan yang boleh Anda gunakan.⁩

1.3

Representing a Categorical Variable with Tables · ⁨Mewakili Variabel Kategorikal dengan Tabel⁩

Syllabus · ⁨Silabus⁩
English

Enduring Understanding (UNC-1): Graphical representations and statistics allow us to identify and represent key features of data.

Learning Objective UNC-1.A: Represent categorical data using frequency or relative frequency tables. [Skill 2.B]

  • UNC-1.A.1 A frequency table gives the number of cases falling into each category. A relative frequency table gives the proportion of cases falling into each category.

Learning Objective UNC-1.B: Describe categorical data represented in frequency or relative tables. [Skill 2.A]

  • UNC-1.B.1 Percentages, relative frequencies, and rates all provide the same information as proportions.
  • UNC-1.B.2 Counts and relative frequencies of categorical data reveal information that can be used to justify claims about the data in context.
Bahasa Indonesia

Pemahaman Berkelanjutan (UNC-1): Representasi grafis dan statistik memungkinkan kita untuk mengidentifikasi dan merepresentasikan fitur utama dari data.

Tujuan Pembelajaran UNC-1.A: Mewakili data kategorikal menggunakan tabel frekuensi atau frekuensi relatif. [Keterampilan 2.B]

  • UNC-1.A.1 Tabel frekuensi memberikan jumlah kasus yang jatuh ke dalam setiap kategori. Tabel frekuensi relatif memberikan proporsi kasus yang jatuh ke dalam setiap kategori.

Tujuan Pembelajaran UNC-1.B: Mendeskripsikan data kategorikal yang direpresentasikan dalam tabel frekuensi atau tabel frekuensi relatif. [Keterampilan 2.A]

  • UNC-1.B.1 Persentase, frekuensi relatif, dan laju semuanya menyediakan informasi yang sama dengan proporsi.
  • UNC-1.B.2 Jumlah dan frekuensi relatif dari data kategorikal mengungkapkan informasi yang dapat digunakan untuk membenarkan klaim tentang data dalam konteksnya.

Source: College Board AP Course and Exam Description · ⁨Sumber: Deskripsi Kursus dan Ujian College Board AP⁩

English

A frequency table 频数表 lists each category's count (frequency); a relative frequency 相对频率 table lists each category's proportion 比例 (count ÷ total). Relative frequencies let you compare groups of different sizes fairly.

Bahasa Indonesia

Tabel frekuensi mencantumkan jumlah (frekuensi) setiap kategori; tabel frekuensi relatif mencantumkan proporsi setiap kategori (jumlah ÷ total). Frekuensi relatif memungkinkan Anda membandingkan kelompok dengan ukuran berbeda secara adil.

1.4

Representing a Categorical Variable with Graphs · ⁨Mewakili Variabel Kategorikal dengan Grafik⁩

Syllabus · ⁨Silabus⁩
English

Enduring Understanding (UNC-1): Graphical representations and statistics allow us to identify and represent key features of data.

Learning Objective UNC-1.C: Represent categorical data graphically. [Skill 2.B]

  • UNC-1.C.1 Bar charts (or bar graphs) are used to display frequencies (counts) or relative frequencies (proportions) for categorical data.
  • UNC-1.C.2 The height or length of each bar in a bar graph corresponds to either the number or proportion of observations falling within each category.
  • UNC-1.C.3 There are many additional ways to represent frequencies (counts) or relative frequencies (proportions) for categorical data.

Learning Objective UNC-1.D: Describe categorical data represented graphically. [Skill 2.A]

  • UNC-1.D.1 Graphical representations of a categorical variable reveal information that can be used to justify claims about the data in context.

Learning Objective UNC-1.E: Compare multiple sets of categorical data. [Skill 2.D]

  • UNC-1.E.1 Frequency tables, bar graphs, or other representations can be used to compare two or more data sets in terms of the same categorical variable.
Bahasa Indonesia

Pemahaman Berkelanjutan (UNC-1): Representasi grafis dan statistik memungkinkan kita untuk mengidentifikasi dan merepresentasikan fitur utama dari data.

Tujuan Pembelajaran UNC-1.C: Mewakili data kategorikal secara grafis. [Keterampilan 2.B]

  • UNC-1.C.1 Diagram batang (atau grafik batang) digunakan untuk menampilkan frekuensi (jumlah) atau frekuensi relatif (proporsi) untuk data kategorikal.
  • UNC-1.C.2 Tinggi atau panjang setiap batang pada diagram batang sesuai dengan jumlah atau proporsi observasi yang jatuh ke dalam setiap kategori.
  • UNC-1.C.3 Ada banyak cara tambahan untuk merepresentasikan frekuensi (jumlah) atau frekuensi relatif (proporsi) untuk data kategorikal.

Tujuan Pembelajaran UNC-1.D: Mendeskripsikan data kategorikal yang direpresentasikan secara grafis. [Keterampilan 2.A]

  • UNC-1.D.1 Representasi grafis dari variabel kategorikal mengungkapkan informasi yang dapat digunakan untuk membenarkan klaim tentang data dalam konteksnya.

Tujuan Pembelajaran UNC-1.E: Membandingkan beberapa set data kategorikal. [Keterampilan 2.D]

  • UNC-1.E.1 Tabel frekuensi, diagram batang, atau representasi lain dapat digunakan untuk membandingkan dua set data atau lebih berdasarkan variabel kategorikal yang sama.

Source: College Board AP Course and Exam Description · ⁨Sumber: Deskripsi Kursus dan Ujian College Board AP⁩

English

Bar charts 条形图 show the count or proportion of each category as separated bars; a pie chart shows each category's share of the whole. The bar heights (or slices) let you compare categories at a glance. Bars may be ordered by size or by a natural category order.

Bahasa Indonesia

Diagram batang menunjukkan jumlah atau proporsi setiap kategori sebagai batang terpisah; diagram lingkaran menunjukkan porsi setiap kategori dari keseluruhan. Tinggi batang (atau irisan) memungkinkan Anda membandingkan kategori sekilas. Batang dapat diurutkan berdasarkan ukuran atau urutan kategori alami.

Explore · ⁨Jelajahi⁩

Show a categorical variable as a pie chart · ⁨Tampilkan variabel kategori sebagai diagram pie⁩

A pie chart turns each category's share of the whole into a slice: a bigger share is a bigger slice, and every slice together makes 100%. It is a picture of a relative-frequency table. · ⁨A diagram pie mengubah porsi setiap kategori terhadap keseluruhan menjadi irisan: porsi lebih besar adalah irisan lebih besar, dan semua irisan bersama-sama membentuk 100%. Ini adalah gambar dari tabel frekuensi relatif.⁩

1.5

Representing a Quantitative Variable with Graphs · ⁨Mewakili Variabel Kuantitatif dengan Grafik⁩

Syllabus · ⁨Silabus⁩
English

Enduring Understanding (UNC-1): Graphical representations and statistics allow us to identify and represent key features of data.

Learning Objective UNC-1.F: Classify types of quantitative variables. [Skill 2.A]

  • UNC-1.F.1 A discrete variable can take on a countable number of values. The number of values may be finite or countably infinite, as with the counting numbers.
  • UNC-1.F.2 A continuous variable can take on infinitely many values, but those values cannot be counted. No matter how small the interval between two values of a continuous variable, it is always possible to determine another value between them.
    • Illustrative examples for UNC-1.F:
      • A discrete variable:
        • Number of students in a class
      • A continuous variable:
        • Height of a child

Learning Objective UNC-1.G: Represent quantitative data graphically. [Skill 2.B]

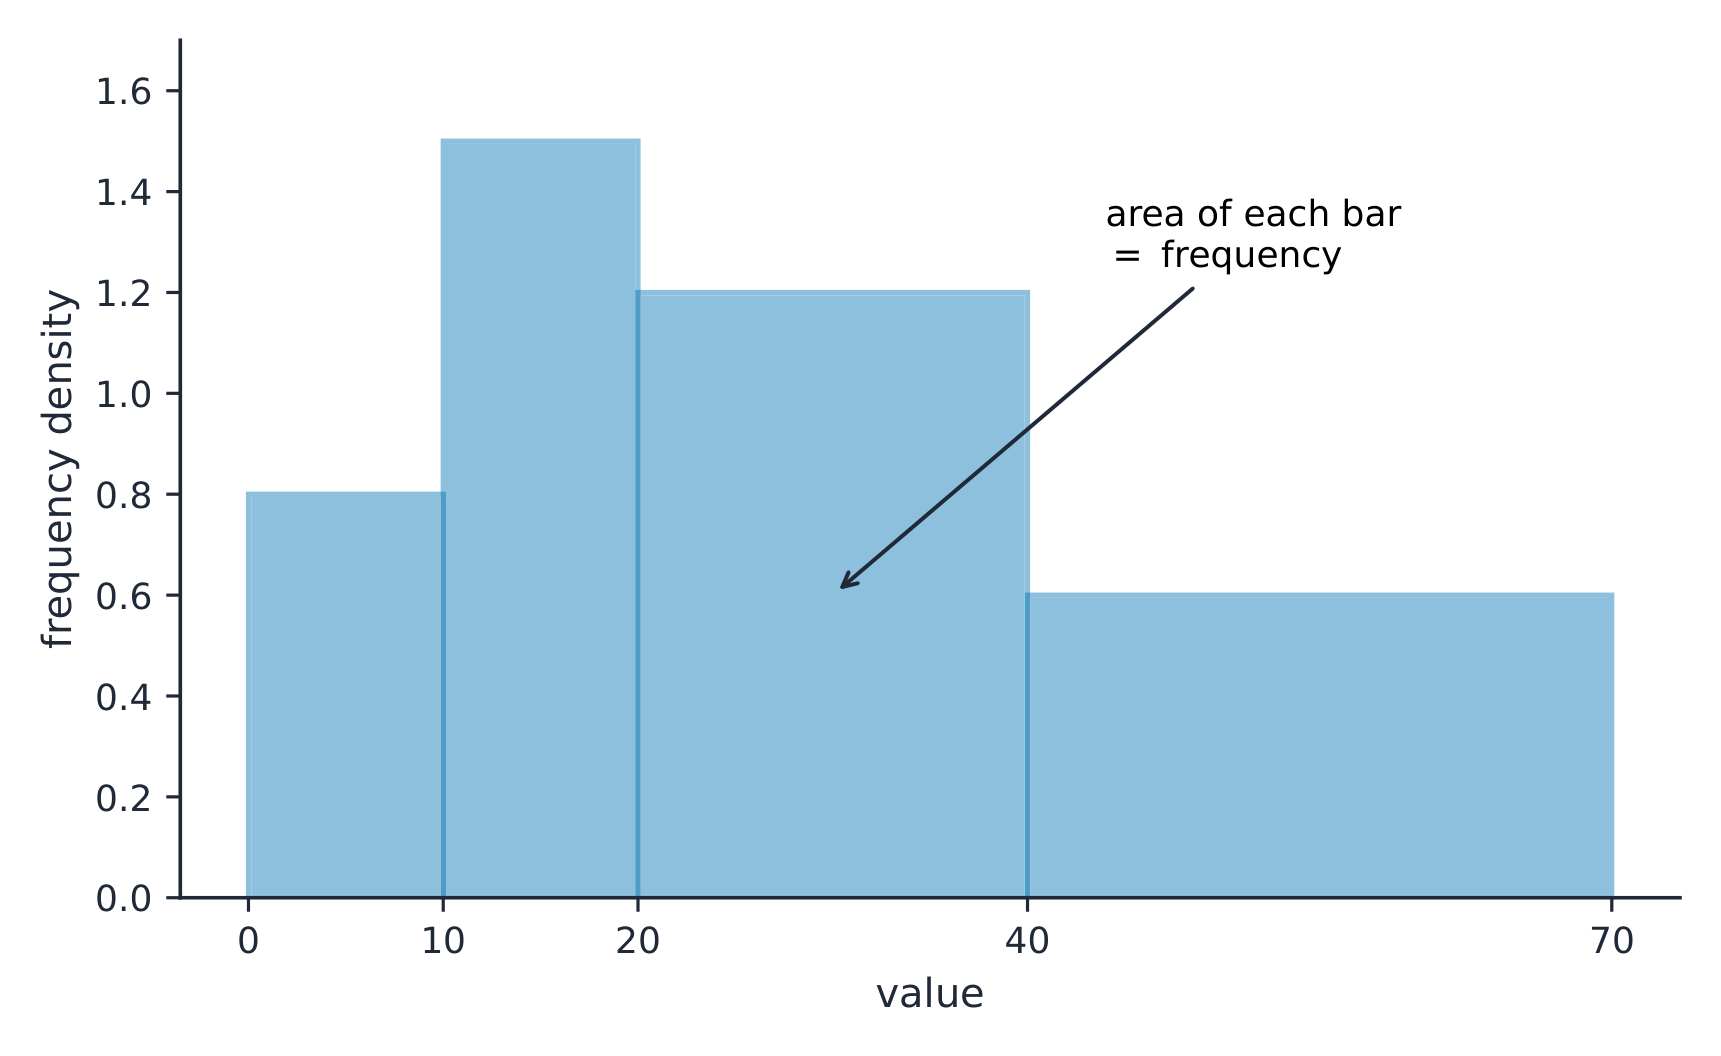
  • UNC-1.G.1 In a histogram, the height of each bar shows the number or proportion of observations that fall within the interval corresponding to that bar. Altering the interval widths can change the appearance of the histogram.
  • UNC-1.G.2 In a stem and leaf plot, each data value is split into a "stem" (the first digit or digits) and a "leaf" (usually the last digit).
  • UNC-1.G.3 A dotplot represents each observation by a dot, with the position on the horizontal axis corresponding to the data value of that observation, with nearly identical values stacked on top of each other.
  • UNC-1.G.4 A cumulative graph represents the number or proportion of a data set less than or equal to a given number.
  • UNC-1.G.5 There are many additional ways to graphically represent distributions of quantitative data.
Bahasa Indonesia

Pemahaman Berkelanjutan (UNC-1): Representasi grafis dan statistik memungkinkan kita untuk mengidentifikasi dan merepresentasikan fitur utama dari data.

Tujuan Pembelajaran UNC-1.F: Mengklasifikasikan jenis variabel kuantitatif. [Keterampilan 2.A]

  • UNC-1.F.1 Variabel diskrit dapat mengambil sejumlah nilai yang dapat dihitung. Jumlah nilainya mungkin terbatas atau tak hingga yang dapat dihitung, seperti bilangan cacah.
  • UNC-1.F.2 Variabel kontinu dapat mengambil tak hingga banyak nilai, tetapi nilai-nilai tersebut tidak dapat dihitung. Sekecil apa pun interval antara dua nilai variabel kontinu, selalu mungkin untuk menentukan nilai lain di antaranya.
    • Contoh ilustratif untuk UNC-1.F:
      • Variabel diskrit:
        • Jumlah siswa dalam sebuah kelas
      • Variabel kontinu:
        • Tinggi seorang anak

Tujuan Pembelajaran UNC-1.G: Mewakili data kuantitatif secara grafis. [Keterampilan 2.B]

  • UNC-1.G.1 Dalam histogram, tinggi setiap batang menunjukkan jumlah atau proporsi observasi yang jatuh ke dalam interval yang sesuai dengan batang tersebut. Mengubah lebar interval dapat mengubah tampilan histogram.
  • UNC-1.G.2 Dalam diagram batang daun, setiap nilai data dibagi menjadi "batang" (digit pertama atau digit-digit awal) dan "daun" (biasanya digit terakhir).
  • UNC-1.G.3 Dotplot merepresentasikan setiap observasi dengan titik, dengan posisi pada sumbu horizontal yang sesuai dengan nilai data dari observasi tersebut, dengan nilai yang hampir identik ditumpuk satu sama lain.
  • UNC-1.G.4 Grafik kumulatif merepresentasikan jumlah atau proporsi dari himpunan data yang kurang dari atau sama dengan angka tertentu.
  • UNC-1.G.5 Ada banyak cara tambahan untuk merepresentasikan distribusi data kuantitatif secara grafis.

Source: College Board AP Course and Exam Description · ⁨Sumber: Deskripsi Kursus dan Ujian College Board AP⁩

English

For numbers, use a dotplot 点图, stem-and-leaf plot 茎叶图, or histogram 直方图 (bars over value intervals called bins). These show the distribution 分布 – how the values spread out. A histogram's bin width changes the picture, so choose it to reveal the shape.

Bahasa Indonesia

Untuk angka, gunakan dotplot, stem-and-leaf plot, atau histogram (batang di atas interval nilai yang disebut bin). Ini menunjukkan distribusi – bagaimana nilai-nilai tersebar. Lebar bin histogram mengubah tampilan, jadi pilihlah untuk mengungkapkan bentuknya.

Pada histogram dengan lebar kelas tidak sama, luas batang adalah frekuensi
Explore · ⁨Jelajahi⁩

Explore how bin width shapes a histogram · ⁨Jelajahi bagaimana lebar bin membentuk histogram⁩

A histogram groups data into equal-width bins and draws a bar over each. Change the bins and notice how the same data can look jagged (too narrow) or smooth (too wide) — the shape is a choice. · ⁨A histogram mengelompokkan data ke dalam bin berlebar sama dan menggambar batang di atas masing-masing. Ubah bin-nya dan perhatikan bagaimana data yang sama bisa terlihat bergerigi (terlalu sempit) atau halus (terlalu lebar) — bentuknya adalah pilihan.⁩

Vocabulary · ⁨Kosa kata⁩ Train · ⁨Latih⁩
English Bahasa Indonesia
Statistics/stəˈtɪstɪks/ Statistik
statistic/stəˈtɪstɪk/ statistik
descriptive statistics/dɪˈskrɪptɪv stəˈtɪstɪks/ statistik deskriptif
inferential statistics/ɪnfəˈrenʃl stəˈtɪstɪks/ statistik inferensial
variable/ˈveərɪəbl/ pembolehubah
Categorical/ˌkætɪˈɡɒrɪkl/ Kategori
Quantitative/ˈkwɒntɪteɪtɪv/ Kuantitatif
frequency table/ˈfriːkwənsi ˈteɪbl/ tabel frekuensi
relative frequency/ˈrelətɪv ˈfriːkwənsi/ frekuensi relatif
proportion/prəˈpɔːʃn/ proporsi
Bar charts/bɑː tʃɑːts/ diagram batang
dotplot/ˈdɒtplɒt/ dotplot
stem-and-leaf plot/stem ænd liːf plɒt/ diagram batang-daun
histogram/ˈhɪstəɡræm/ histogram
1.6

Describing the Distribution of a Quantitative Variable · ⁨Mendeskripsikan Distribusi Variabel Kuantitatif⁩

Syllabus · ⁨Silabus⁩
English

Enduring Understanding (UNC-1): Graphical representations and statistics allow us to identify and represent key features of data.

Learning Objective UNC-1.H: Describe the characteristics of quantitative data distributions. [Skill 2.A]

  • UNC-1.H.1 Descriptions of the distribution of quantitative data include shape, center, and variability (spread), as well as any unusual features such as outliers, gaps, clusters, or multiple peaks.
  • UNC-1.H.2 Outliers for one-variable data are data points that are unusually small or large relative to the rest of the data.
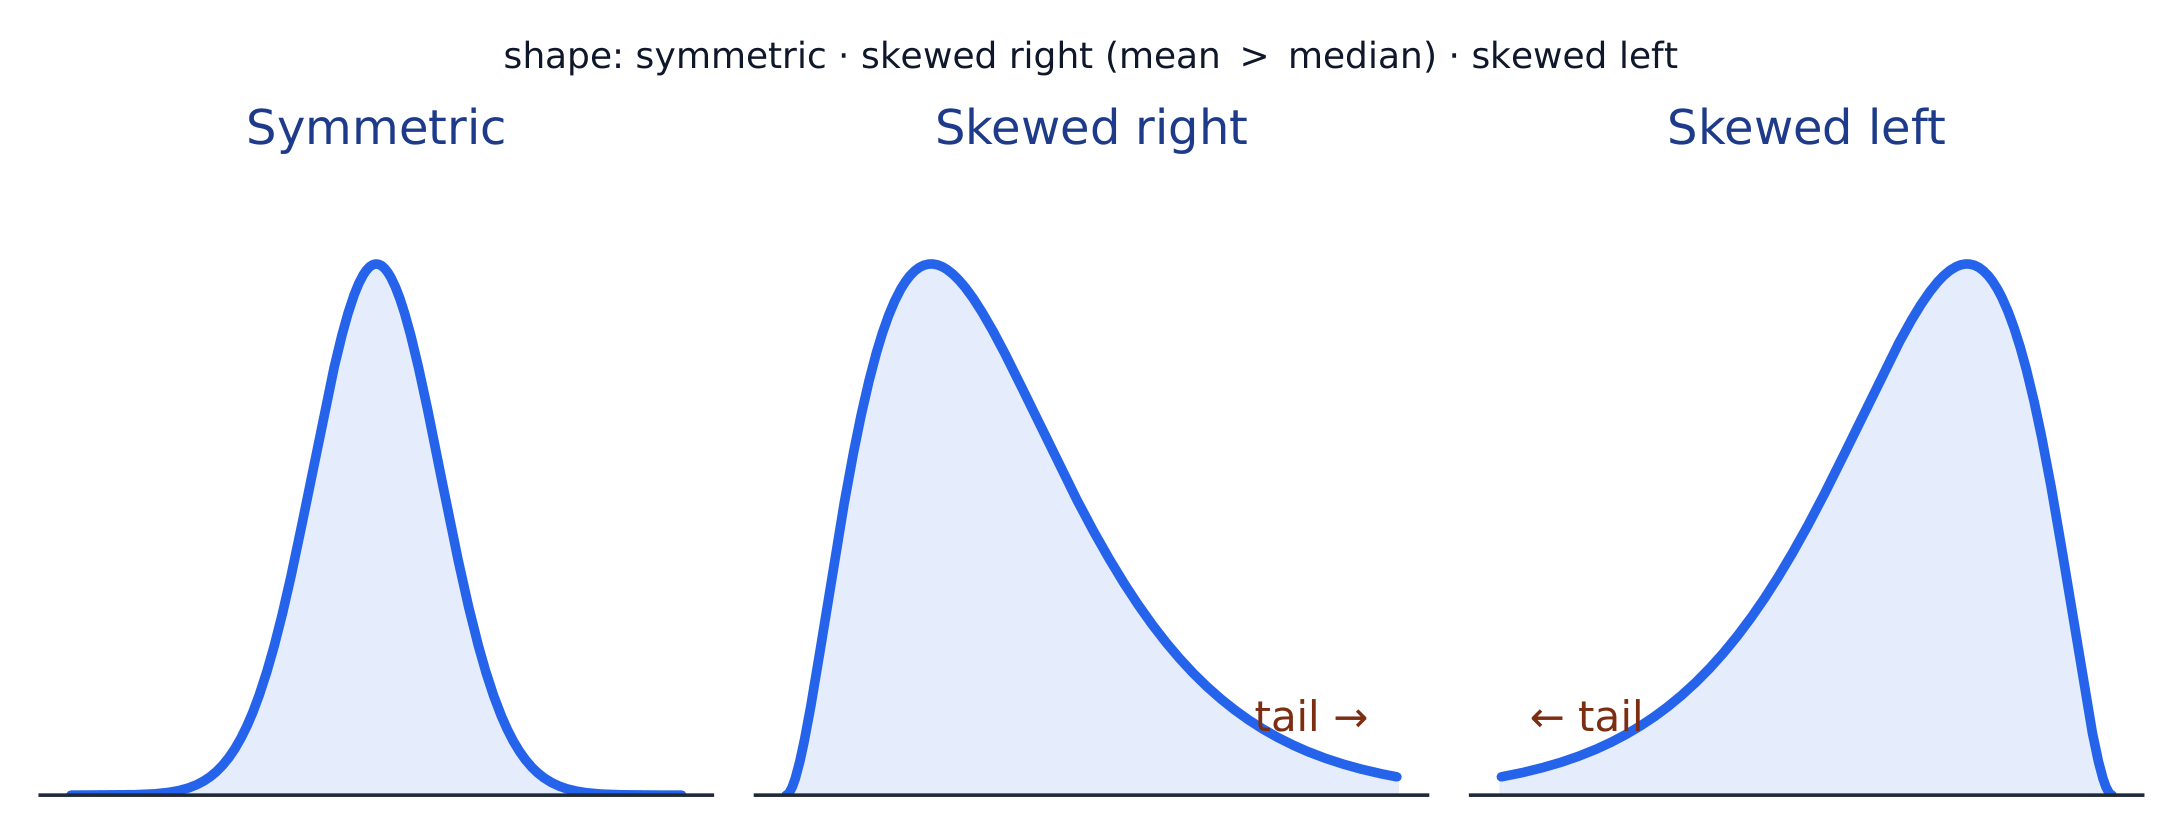
  • UNC-1.H.3 A distribution is skewed to the right (positive skew) if the right tail is longer than the left. A distribution is skewed to the left (negative skew) if the left tail is longer than the right. A distribution is symmetric if the left half is the mirror image of the right half.
  • UNC-1.H.4 Univariate graphs with one main peak are known as unimodal. Graphs with two prominent peaks are bimodal. A graph where each bar height is approximately the same (no prominent peaks) is approximately uniform.
  • UNC-1.H.5 A gap is a region of a distribution between two data values where there are no observed data.
  • UNC-1.H.6 Clusters are concentrations of data usually separated by gaps.
  • UNC-1.H.7 Descriptive statistics does not attribute properties of a data set to a larger population, but may provide the basis for conjectures for subsequent testing.
Bahasa Indonesia

Pemahaman Berkelanjutan (UNC-1): Representasi grafis dan statistik memungkinkan kita untuk mengidentifikasi dan merepresentasikan fitur utama dari data.

Tujuan Pembelajaran UNC-1.H: Mendeskripsikan karakteristik distribusi data kuantitatif. [Keterampilan 2.A]

  • UNC-1.H.1 Deskripsi distribusi data kuantitatif mencakup bentuk, pusat, dan variabilitas (sebaran), serta fitur-fitur tidak biasa seperti pencilan, celah, kluster, atau puncak ganda.
  • UNC-1.H.2 Pencilan untuk data satu variabel adalah titik data yang terlalu kecil atau terlalu besar dibandingkan dengan sisa data.
  • UNC-1.H.3 Distribusi miring ke kanan (skewness positif) jika ekor kanan lebih panjang daripada kiri. Distribusi miring ke kiri (skewness negatif) jika ekor kiri lebih panjang daripada kanan. Distribusi simetris jika setengah kiri adalah bayangan cermin dari setengah kanan.
  • UNC-1.H.4 Grafik univariat dengan satu puncak utama dikenal sebagai unimodal. Grafik dengan dua puncak menonjol adalah bimodal. Grafik di mana tinggi setiap batang kira-kira sama (tidak ada puncak menonjol) adalah mendekati seragam.
  • UNC-1.H.5 Celah adalah wilayah dari distribusi antara dua nilai data di mana tidak ada data yang teramati.
  • UNC-1.H.6 Kluster adalah konsentrasi data yang biasanya dipisahkan oleh celah.
  • UNC-1.H.7 Statistik deskriptif tidak atribut sifat-sifat dari himpunan data kepada populasi yang lebih besar, tetapi dapat menyediakan dasar untuk spekulasi pengujian lanjutan.

Source: College Board AP Course and Exam Description · ⁨Sumber: Deskripsi Kursus dan Ujian College Board AP⁩

English

Describe four things (remember SOCS):

  • Shape 形状: symmetric, or skewed 偏斜 left/right (a long tail on that side), and how many peaks - one main peak is unimodal 单峰, two prominent peaks bimodal 双峰, and roughly equal bars uniform 均匀.
  • Outliers 离群值: unusual values far from the rest.
  • Center: a typical value (mean or median).
  • Spread: how much the values vary (range, IQR, standard deviation).

Always describe shape/center/spread in context, with units.

Bahasa Indonesia

Deskripsikan empat hal (ingat SOCS):

  • Bentuk: simetris, atau menceng ke kiri/kanan (ekor panjang di sisi itu), dan berapa banyak puncak - satu puncak utama adalah unimodal, dua puncak menonjol bimodal, dan batang yang kira-kira sama uniform.
  • Pencilan: nilai yang tidak biasa jauh dari yang lain.
  • Tengah: nilai tipikal (mean atau median).
  • Spread: seberapa besar nilai-nilai bervariasi (rentang, IQR, simpangan baku).

Selalu deskripsikan bentuk/pusat/sebaran dalam konteks, dengan satuan.

Bentuk distribusi: simetris, miring kanan (ekor kanan panjang), atau miring kiri
Vocabulary · ⁨Kosa kata⁩ Train · ⁨Latih⁩
English Bahasa Indonesia
distribution/ˌdɪstrɪˈbjuːʃn/ distribusi
Shape/ʃeɪp/ Bentuk
skewed/skjuːd/ menceng
unimodal/ˌʌnɪˈmɒdl/ unimodal
bimodal/baɪˈmɒdl/ bimodal
uniform/ˈjuːnɪfɔːm/ seragam
Outliers/ˈaʊtlaɪəz/ Pencilan
mean/miːn/ rata-rata
median/ˈmiːdiːən/ median
interquartile range/ˌɪntəˈkwɔːtaɪl reɪndʒ/ jangkauan interkuartil
1.7

Summary Statistics for a Quantitative Variable · ⁨Ringkasan Statistik untuk Variabel Kuantitatif⁩

Syllabus · ⁨Silabus⁩
English

Enduring Understanding (UNC-1): Graphical representations and statistics allow us to identify and represent key features of data.

Learning Objective UNC-1.I: Calculate measures of center and position for quantitative data. [Skill 2.C]

  • UNC-1.I.1 A statistic is a numerical summary of sample data.
  • UNC-1.I.2 The mean is the sum of all the data values divided by the number of values. For a sample, the mean is denoted by $x$-bar: $\bar{x} = \dfrac{1}{n}\sum_{i=1}^{n} x_i$, where $x_i$ represents the $i^{\text{th}}$ data point in the sample and $n$ represents the number of data values in the sample.
  • UNC-1.I.3 The median of a data set is the middle value when data are ordered. When the number of data points is even, the median can take on any value between the two middle values. In AP Statistics, the most commonly used value for the median of a data set with an even number of values is the average of the two middle values.
  • UNC-1.I.4 The first quartile, Q1, is the median of the half of the ordered data set from the minimum to the position of the median. The third quartile, Q3, is the median of the half of the ordered data set from the position of the median to the maximum. Q1 and Q3 form the boundaries for the middle 50% of values in an ordered data set.
  • UNC-1.I.5 The $p^{\text{th}}$ percentile is interpreted as the value that has $p\%$ of the data less than or equal to it.

Learning Objective UNC-1.J: Calculate measures of variability for quantitative data. [Skill 2.C]

  • UNC-1.J.1 Three commonly used measures of variability (or spread) in a distribution are the range, interquartile range, and standard deviation.
  • UNC-1.J.2 The range is defined as the difference between the maximum data value and the minimum data value. The interquartile range (IQR) is defined as the difference between the third and first quartiles: $Q3 - Q1$. Both the range and the interquartile range are possible ways of measuring variability of the distribution of a quantitative variable.
  • UNC-1.J.3 Standard deviation is a way to measure variability of the distribution of a quantitative variable. For a sample, the standard deviation is denoted by $s$: $s_x = \sqrt{\dfrac{1}{n-1}\sum(x_i - \bar{x})^2}$. The square of the sample standard deviation, $s^2$, is called the sample variance.
  • UNC-1.J.4 Changing units of measurement affects the values of the calculated statistics.

Learning Objective UNC-1.K: Explain the selection of a particular measure of center and/or variability for describing a set of quantitative data. [Skill 4.B]

  • UNC-1.K.1 There are many methods for determining outliers. Two methods frequently used in this course are:
    • UNC-1.K.1.i An outlier is a value greater than $1.5 \times \text{IQR}$ above the third quartile or more than $1.5 \times \text{IQR}$ below the first quartile.
    • UNC-1.K.1.ii An outlier is a value located 2 or more standard deviations above, or below, the mean.
  • UNC-1.K.2 The mean, standard deviation, and range are considered nonresistant (or non-robust) because they are influenced by outliers. The median and IQR are considered resistant (or robust), because outliers do not greatly (if at all) affect their value.
Bahasa Indonesia

Pemahaman Berkelanjutan (UNC-1): Representasi grafis dan statistik memungkinkan kita untuk mengidentifikasi dan merepresentasikan fitur utama dari data.

Tujuan Pembelajaran UNC-1.I: Menghitung ukuran pusat dan posisi untuk data kuantitatif. [Keterampilan 2.C]

  • UNC-1.I.1 Statistik adalah ringkasan numerik dari data sampel.
  • UNC-1.I.2 Rata-rata adalah jumlah seluruh nilai data dibagi dengan banyak nilai. Untuk suatu sampel, rata-rata dilambangkan dengan $x$-bar: $\bar{x} = \dfrac{1}{n}\sum_{i=1}^{n} x_i$, di mana $x_i$ merepresentasikan titik data ke-$i^{\text{th}}$ dalam sampel dan $n$ merepresentasikan banyak nilai data dalam sampel.
  • UNC-1.I.3 Median dari suatu himpunan data adalah nilai tengah ketika data diurutkan. Ketika banyak titik data genap, median dapat mengambil nilai apa pun antara dua nilai tengah. Dalam Statistika AP, nilai yang paling umum digunakan untuk median dari himpunan data dengan banyak nilai genap adalah rata-rata dari dua nilai tengah tersebut.
  • UNC-1.I.4 Kuartil pertama, Q1, adalah median dari setengah himpunan data terurut mulai dari minimum hingga posisi median. Kuartil ketiga, Q3, adalah median dari setengah himpunan data terurut mulai dari posisi median hingga maksimum. Q1 dan Q3 membentuk batas untuk 50% nilai tengah dalam himpunan data terurut.
  • UNC-1.I.5 Persentil ke-$p^{\text{th}}$ ditafsirkan sebagai nilai yang memiliki $p\%$ bagian data kurang dari atau sama dengannya.

Tujuan Pembelajaran UNC-1.J: Hitung ukuran variabilitas untuk data kuantitatif. [Keterampilan 2.C]

  • UNC-1.J.1 Tiga ukuran variabilitas (atau sebaran) yang umum digunakan dalam distribusi adalah jangkauan, rentang interkuartil, dan simpangan baku.
  • UNC-1.J.2 Jangkauan didefinisikan sebagai selisih antara nilai data maksimum dan nilai data minimum. Rentang interkuartil (IQR) didefinisikan sebagai selisih antara kuartil ketiga dan kuartil pertama: $Q3 - Q1$. Baik jangkauan maupun rentang interkuartil merupakan cara yang mungkin untuk mengukur variabilitas distribusi variabel kuantitatif.
  • UNC-1.J.3 Simpangan baku adalah cara untuk mengukur variabilitas distribusi variabel kuantitatif. Untuk suatu sampel, simpangan baku dilambangkan dengan $s$: $s_x = \sqrt{\dfrac{1}{n-1}\sum(x_i - \bar{x})^2}$. Kuadrat dari simpangan baku sampel, $s^2$, disebut varians sampel.
  • UNC-1.J.4 Mengubah satuan pengukuran mempengaruhi nilai statistik yang dihitung.

Tujuan Pembelajaran UNC-1.K: Jelaskan pemilihan ukuran pusat dan/atau variabilitas tertentu untuk mendeskripsikan suatu set data kuantitatif. [Keterampilan 4.B]

  • UNC-1.K.1 Ada banyak metode untuk menentukan pencilan. Dua metode yang sering digunakan dalam kursus ini adalah:
    • UNC-1.K.1.i Pencilan adalah nilai lebih dari $1.5 \times \text{IQR}$ di atas kuartil ketiga atau lebih dari $1.5 \times \text{IQR}$ di bawah kuartil pertama.
    • UNC-1.K.1.ii Pencilan adalah nilai yang terletak 2 atau lebih simpangan baku di atas, atau di bawah, rata-rata.
  • UNC-1.K.2 Rata-rata, simpangan baku, dan jangkauan dianggap tidak resisten (atau tidak kuat) karena dipengaruhi oleh pencilan. Median dan IQR dianggap resisten (kuat), karena pencilan tidak secara signifikan (jika sama sekali) mempengaruhi nilainya.

Source: College Board AP Course and Exam Description · ⁨Sumber: Deskripsi Kursus dan Ujian College Board AP⁩

English
Standard deviation: spread about the mean
  • Center: the mean 均值 $\bar{x}=\dfrac{\sum x_i}{n}$ (average) and the median 中位数 (middle value). The median resists outliers; the mean is pulled toward a skew.
  • Spread: the range, the interquartile range 四分位距 $\text{IQR}=Q_3-Q_1$ (middle 50%), and the standard deviation 标准差 $s_x=\sqrt{\dfrac{\sum(x_i-\bar{x})^2}{n-1}}$ (typical distance from the mean; its square is the variance 方差).
  • The five-number summary 五数概括: min, $Q_1$, median, $Q_3$, max.

Use resistant measures (median, IQR) for skewed data; mean and standard deviation for roughly symmetric data.

The percentile 百分位数 of a value is the percent of the data at or below it – so the median is the 50th percentile and $Q_1$ the 25th. A cumulative relative frequency graph 累积相对频率图 makes percentiles easy to read: for each value it plots the proportion of the data at or below it, rising from 0 to 1. Go up from a value to the curve and across to its percentile, or reverse the steps to find the value at a given percentile (the same reading works from a cumulative-frequency table).

Worked example. For the data $4, 8, 6, 10, 7$: the mean is $\bar{x}=\dfrac{4+8+6+10+7}{5}=\dfrac{35}{5}=7$. Sorting to $4,6,7,8,10$, the median is the middle value, $7$. The mean and median agree here because the data are roughly symmetric.

Bahasa Indonesia
Simpangan baku: sebaran di sekitar rata-rata
  • Pusat: mean $\bar{x}=\dfrac{\sum x_i}{n}$ (rata-rata) dan median (nilai tengah). Median tahan terhadap pencilan; mean tertarik ke arah kemencengan.
  • Sebaran: rentang, rentang antar kuartil $\text{IQR}=Q_3-Q_1$ (50% tengah), dan simpangan baku $s_x=\sqrt{\dfrac{\sum(x_i-\bar{x})^2}{n-1}}$ (jarak tipikal dari rata-rata; kuadratnya adalah varians).
  • Ringkasan lima angka: min, $Q_1$, median, $Q_3$, max.

Gunakan ukuran tahan (median, IQR) untuk data yang menceng; mean dan simpangan baku untuk data yang hampir simetris.

Persentil dari suatu nilai adalah persentase data yang berada pada atau di bawahnya—sehingga median adalah persentil ke-50 dan $Q_1$ adalah persentil ke-25. Graf frekuensi relatif kumulatif memudahkan pembacaan persentil: untuk setiap nilai, graf memplot proporsi data pada atau di bawah nilai tersebut, naik dari 0 hingga 1. Naik dari sebuah nilai ke kurva lalu melintang ke persentilnya, atau sebaliknya untuk menemukan nilai pada persentil tertentu (pembacaan yang sama berlaku dari tabel frekuensi kumulatif).

Contoh terpecahkan. Untuk data $4, 8, 6, 10, 7$: mean adalah $\bar{x}=\dfrac{4+8+6+10+7}{5}=\dfrac{35}{5}=7$. Mengurutkan ke $4,6,7,8,10$, median adalah nilai tengah, $7$. Mean dan median sepakat di sini karena data hampir simetris.

Vocabulary · ⁨Kosa kata⁩ Train · ⁨Latih⁩
English Bahasa Indonesia
standard deviation/ˈstændəd ˌdiːvɪˈeɪʃn/ simpangan baku
variance/ˈveərɪəns/ variansi
five-number summary/faɪv ˈnʌmbə ˈsʌməri/ ringkasan lima angka
percentile/pəˈsentaɪl/ persentil
cumulative relative frequency graph/ˈkjuːmjʊlətɪv ˈrelətɪv ˈfriːkwənsi ɡræf/ grafik frekuensi relatif kumulatif
1.8

Graphical Representations of Summary Statistics · ⁨Representasi Grafis dari Ringkasan Statistik⁩

Syllabus · ⁨Silabus⁩
English

Enduring Understanding (UNC-1): Graphical representations and statistics allow us to identify and represent key features of data.

Learning Objective UNC-1.L: Represent summary statistics for quantitative data graphically. [Skill 2.B]

  • UNC-1.L.1 Taken together, the minimum data value, the first quartile (Q1), the median, the third quartile (Q3), and the maximum data value make up the five-number summary.
  • UNC-1.L.2 A boxplot is a graphical representation of the five-number summary (minimum, first quartile, median, third quartile, maximum). The box represents the middle 50% of data, with a line at the median and the ends of the box corresponding to the quartiles. Lines ("whiskers") extend from the quartiles to the most extreme point that is not an outlier, and outliers are indicated by their own symbol beyond this.

Learning Objective UNC-1.M: Describe summary statistics of quantitative data represented graphically. [Skill 2.A]

  • UNC-1.M.1 Summary statistics of quantitative data, or of sets of quantitative data, can be used to justify claims about the data in context.
  • UNC-1.M.2 If a distribution is relatively symmetric, then the mean and median are relatively close to one another. If a distribution is skewed right, then the mean is usually to the right of the median. If the distribution is skewed left, then the mean is usually to the left of the median.
Bahasa Indonesia

Pemahaman Berkelanjutan (UNC-1): Representasi grafis dan statistik memungkinkan kita untuk mengidentifikasi dan merepresentasikan fitur utama dari data.

Tujuan Pembelajaran UNC-1.L: Representasikan statistik ringkasan untuk data kuantitatif secara grafis. [Keterampilan 2.B]

  • UNC-1.L.1 Secara bersama-sama, nilai data minimum, kuartil pertama (Q1), median, kuartil ketiga (Q3), dan nilai data maksimum membentuk lima angka ringkasan.
  • UNC-1.L.2 Boxplot adalah representasi grafis dari lima angka ringkasan (minimum, kuartil pertama, median, kuartil ketiga, maksimum). Kotak mewakili 50% data tengah, dengan garis pada median dan ujung kotak sesuai dengan kuartil. Garis ("bulu") membentang dari kuartil ke titik paling ekstrem yang bukan pencilan, dan pencilan ditandai dengan simbolnya sendiri di luar itu.

Tujuan Pembelajaran UNC-1.M: Deskripsikan statistik ringkasan dari data kuantitatif yang direpresentasikan secara grafis. [Keterampilan 2.A]

  • UNC-1.M.1 Statistik ringkasan dari data kuantitatif, atau dari set data kuantitatif, dapat digunakan untuk memvalidasi klaim tentang data dalam konteksnya.
  • UNC-1.M.2 Jika distribusi relatif simetris, maka rata-rata dan median relatif berdekatan satu sama lain. Jika distribusi miring kanan, maka rata-rata biasanya berada di sebelah kanan median. Jika distribusi miring kiri, maka rata-rata biasanya berada di sebelah kiri median.

Source: College Board AP Course and Exam Description · ⁨Sumber: Deskripsi Kursus dan Ujian College Board AP⁩

English

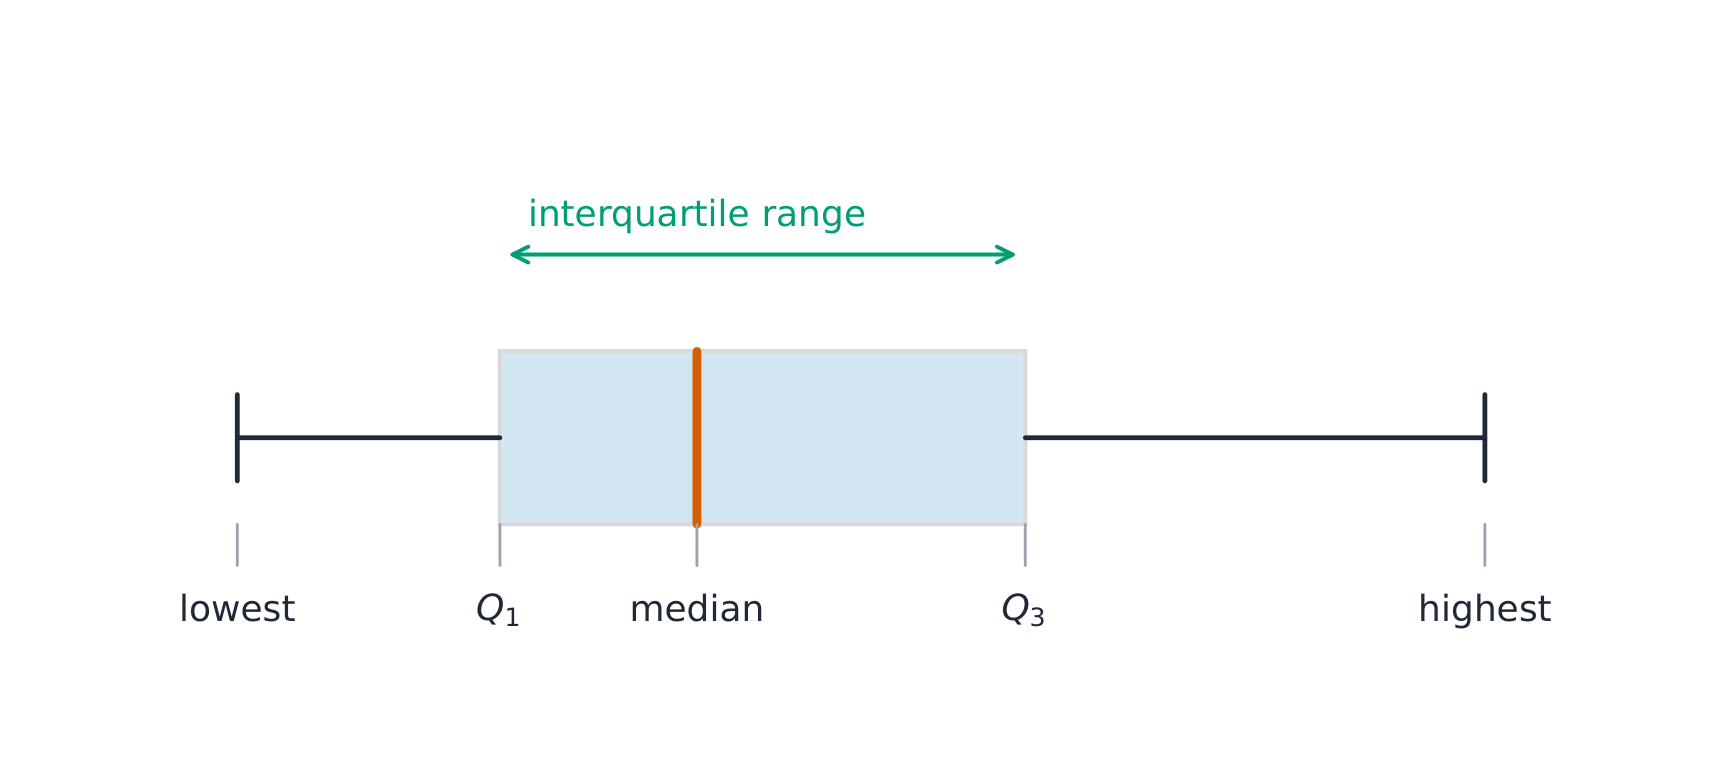
A boxplot 箱线图 draws the five-number summary: a box from $Q_1$ to $Q_3$ with the median inside, and whiskers to the most extreme non-outlier values. A point is an outlier if it lies more than $1.5\times\text{IQR}$ beyond a quartile – a rule you may be asked to apply. Boxplots are ideal for comparing several groups side by side.

Worked example. A dataset has $Q_1=20$ and $Q_3=32$, so $\text{IQR}=12$. The outlier fences are $Q_1-1.5(12)=2$ and $Q_3+1.5(12)=50$. Any value below $2$ or above $50$ is flagged as an outlier.

Bahasa Indonesia

Boxplot menggambar ringkasan lima angka: kotak dari $Q_1$ ke $Q_3$ dengan median di dalamnya, dan garis kumis menuju nilai ekstrem non-pencilan. Sebuah titik adalah pencilan jika terletak lebih dari $1.5\times\text{IQR}$ melampaui sebuah kuartil—aturan yang mungkin diminta untuk Anda terapkan. Boxplot sangat ideal untuk membandingkan beberapa kelompok berdampingan.

Contoh terpecahkan. Suatu dataset memiliki $Q_1=20$ dan $Q_3=32$, sehingga $\text{IQR}=12$. Pagar pencilan adalah $Q_1-1.5(12)=2$ dan $Q_3+1.5(12)=50$. Nilai apa pun di bawah $2$ atau di atas $50$ ditandai sebagai pencilan.

Diagram box-and-whisker menunjukkan kuartil dan rentang
Boxplot menggambar ringkasan lima angka; kotak membentang sepanjang IQR
Explore · ⁨Jelajahi⁩

Explore the five-number summary as a boxplot · ⁨Jelajahi ringkasan lima angka sebagai boxplot⁩

Drag $Q_1$, the median, and $Q_3$ to see the box (its length is the IQR) and how the median's position inside the box reveals skew — a median close to $Q_1$ signals a right-skewed distribution. · ⁨Seret $Q_1$, median, dan $Q_3$ untuk melihat kotak (panjangnya adalah IQR) dan bagaimana posisi median di dalam kotak mengungkap kemencengan — median dekat dengan $Q_1$ mengindikasikan distribusi miring kanan.⁩

Vocabulary · ⁨Kosa kata⁩ Train · ⁨Latih⁩
English Bahasa Indonesia
boxplot/ˈbɒksplɒt/ boxplot
normal distribution/ˈnɔːml ˌdɪstrɪˈbjuːʃn/ normal distribution
1.9

Comparing Distributions of a Quantitative Variable · ⁨Membandingkan Distribusi Variabel Kuantitatif⁩

Syllabus · ⁨Silabus⁩
English

Enduring Understanding (UNC-1): Graphical representations and statistics allow us to identify and represent key features of data.

Learning Objective UNC-1.N: Compare graphical representations for multiple sets of quantitative data. [Skill 2.D]

  • UNC-1.N.1 Any of the graphical representations, e.g., histograms, side-by-side boxplots, etc., can be used to compare two or more independent samples on center, variability, clusters, gaps, outliers, and other features.

Learning Objective UNC-1.O: Compare summary statistics for multiple sets of quantitative data. [Skill 2.D]

  • UNC-1.O.1 Any of the numerical summaries (e.g., mean, standard deviation, relative frequency, etc.) can be used to compare two or more independent samples.
Bahasa Indonesia

Pemahaman Berkelanjutan (UNC-1): Representasi grafis dan statistik memungkinkan kita untuk mengidentifikasi dan merepresentasikan fitur utama dari data.

Tujuan Pembelajaran UNC-1.N: Bandingkan representasi grafis untuk beberapa set data kuantitatif. [Keterampilan 2.D]

  • UNC-1.N.1 Salah satu representasi grafis, mis., histogram, boxplot berdampingan, dll., dapat digunakan untuk membandingkan dua atau lebih sampel independen pada pusat, variabilitas, kluster, celah, pencilan, dan fitur lainnya.

Tujuan Pembelajaran UNC-1.O: Bandingkan statistik ringkasan untuk beberapa set data kuantitatif. [Keterampilan 2.D]

  • UNC-1.O.1 Salah satu ringkasan numerik (mis., rata-rata, simpangan baku, frekuensi relatif, dll.) dapat digunakan untuk membandingkan dua atau lebih sampel independen.

Source: College Board AP Course and Exam Description · ⁨Sumber: Deskripsi Kursus dan Ujian College Board AP⁩

English

To compare two or more groups, compare shape, center, and spread, and mention outliers – always with comparative words ("Group A has a higher median than Group B") and in context. Do not just describe each group separately; make the comparison explicit.

Bahasa Indonesia

Untuk membandingkan dua atau lebih kelompok, bandingkan bentuk, pusat, dan sebaran, dan sebutkan pencilan—selalu dengan kata-kata perbandingan ("Kelompok A memiliki median yang lebih tinggi daripada Kelompok B") dan dalam konteks. Jangan hanya mendeskripsikan setiap kelompok secara terpisah; buat perbandingan secara eksplisit.

Explore · ⁨Jelajahi⁩

Compare distributions with box plots · ⁨Bandingkan distribusi dengan box plot⁩

A box plot draws the five-number summary. Placing two box plots on the same scale compares their centre (median), spread (IQR = box width) and skew at a glance — the fair way to compare groups. · ⁨A box plot menggambar ringkasan lima angka. Menempatkan dua box plot pada skala yang sama membandingkan pusat (median), sebaran (IQR = lebar kotak) dan kemencengan sekilas — cara adil untuk membandingkan kelompok.⁩

1.10

The Normal Distribution · ⁨Distribusi Normal⁩

Syllabus · ⁨Silabus⁩
English

Enduring Understanding (VAR-2): The normal distribution can be used to represent some population distributions.

Learning Objective VAR-2.A: Compare a data distribution to the normal distribution model. [Skill 2.D]

  • VAR-2.A.1 A parameter is a numerical summary of a population.
  • VAR-2.A.2 Some sets of data may be described as approximately normally distributed. A normal curve is mound-shaped and symmetric. The parameters of a normal distribution are the population mean, $\mu$, and the population standard deviation, $\sigma$.
  • VAR-2.A.3 For a normal distribution, approximately 68% of the observations are within 1 standard deviation of the mean, approximately 95% of observations are within 2 standard deviations of the mean, and approximately 99.7% of observations are within 3 standard deviations of the mean. This is called the empirical rule.
  • VAR-2.A.4 Many variables can be modeled by a normal distribution.
    • Illustrative examples for VAR-2.A:
      • Variables that can be modeled by a normal distribution:
        • Body temperature
        • Weight of a loaf of bread

Learning Objective VAR-2.B: Determine proportions and percentiles from a normal distribution. [Skill 3.A]

  • VAR-2.B.1 A standardized score for a particular data value is calculated as (data value − mean)/(standard deviation), and measures the number of standard deviations a data value falls above or below the mean.
  • VAR-2.B.2 One example of a standardized score is a $z$-score, which is calculated as $z\text{-score} = \left(\dfrac{x_i - \mu}{\sigma}\right)$. A $z$-score measures how many standard deviations a data value is from the mean.
  • VAR-2.B.3 Technology, such as a calculator, a standard normal table, or computer-generated output, can be used to find the proportion of data values located on a given interval of a normally distributed random variable.
  • VAR-2.B.4 Given the area of a region under the graph of the normal distribution curve, it is possible to use technology, such as a calculator, a standard normal table, or computer-generated output, to estimate parameters for some populations.

Learning Objective VAR-2.C: Compare measures of relative position in data sets. [Skill 2.D]

  • VAR-2.C.1 Percentiles and $z$-scores may be used to compare relative positions of points within a data set or between data sets.
Bahasa Indonesia

Pemahaman Abadi (VAR-2): Distribusi normal dapat digunakan untuk merepresentasikan beberapa distribusi populasi.

Tujuan Pembelajaran VAR-2.A: Bandingkan distribusi data dengan model distribusi normal. [Keterampilan 2.D]

  • VAR-2.A.1 Parameter adalah ringkasan numerik dari suatu populasi.
  • VAR-2.A.2 Beberapa kumpulan data dapat digambarkan sebagai terdistribusi secara normal. Kurva normal berbentuk seperti gundukan dan simetris. Parameter dari distribusi normal adalah rata-rata populasi, $\mu$, dan simpangan baku populasi, $\sigma$.
  • VAR-2.A.3 Untuk distribusi normal, sekitar 68% observasi berada dalam 1 simpangan baku dari rata-rata, sekitar 95% observasi berada dalam 2 simpangan baku dari rata-rata, dan sekitar 99.7% observasi berada dalam 3 simpangan baku dari rata-rata. Ini disebut aturan empiris.
  • VAR-2.A.4 Banyak variabel dapat dimodelkan oleh distribusi normal.
    • Contoh ilustratif untuk VAR-2.A:
      • Variabel yang dapat dimodelkan oleh distribusi normal:
        • Suhu tubuh
        • Berat sepotong roti

Tujuan Pembelajaran VAR-2.B: Tentukan proporsi dan persentil dari distribusi normal. [Keterampilan 3.A]

  • VAR-2.B.1 Skor standar untuk nilai data tertentu dihitung sebagai (nilai data − rata-rata)/(simpangan baku), dan mengukur berapa banyak simpangan baku nilai data jatuh di atas atau di bawah rata-rata.
  • VAR-2.B.2 Salah satu contoh skor standar adalah skor $z$, yang dihitung sebagai $z\text{-score} = \left(\dfrac{x_i - \mu}{\sigma}\right)$. Skor $z$ mengukur berapa banyak simpangan baku nilai data dari rata-rata.
  • VAR-2.B.3 Teknologi, seperti kalkulator, tabel normal standar, atau output yang dihasilkan komputer, dapat digunakan untuk menemukan proporsi nilai data yang terletak pada interval tertentu dari variabel acak yang terdistribusi normal.
  • VAR-2.B.4 Diberikan luas daerah di bawah kurva distribusi normal, memungkinkan penggunaan teknologi, seperti kalkulator, tabel normal standar, atau output yang dihasilkan komputer, untuk memperkirakan parameter untuk beberapa populasi.

Tujuan Pembelajaran VAR-2.C: Bandingkan ukuran posisi relatif dalam kumpulan data. [Keterampilan 2.D]

  • VAR-2.C.1 Persentil dan skor $z$ dapat digunakan untuk membandingkan posisi relatif titik-titik dalam kumpulan data atau antar kumpulan data.

Source: College Board AP Course and Exam Description · ⁨Sumber: Deskripsi Kursus dan Ujian College Board AP⁩

English

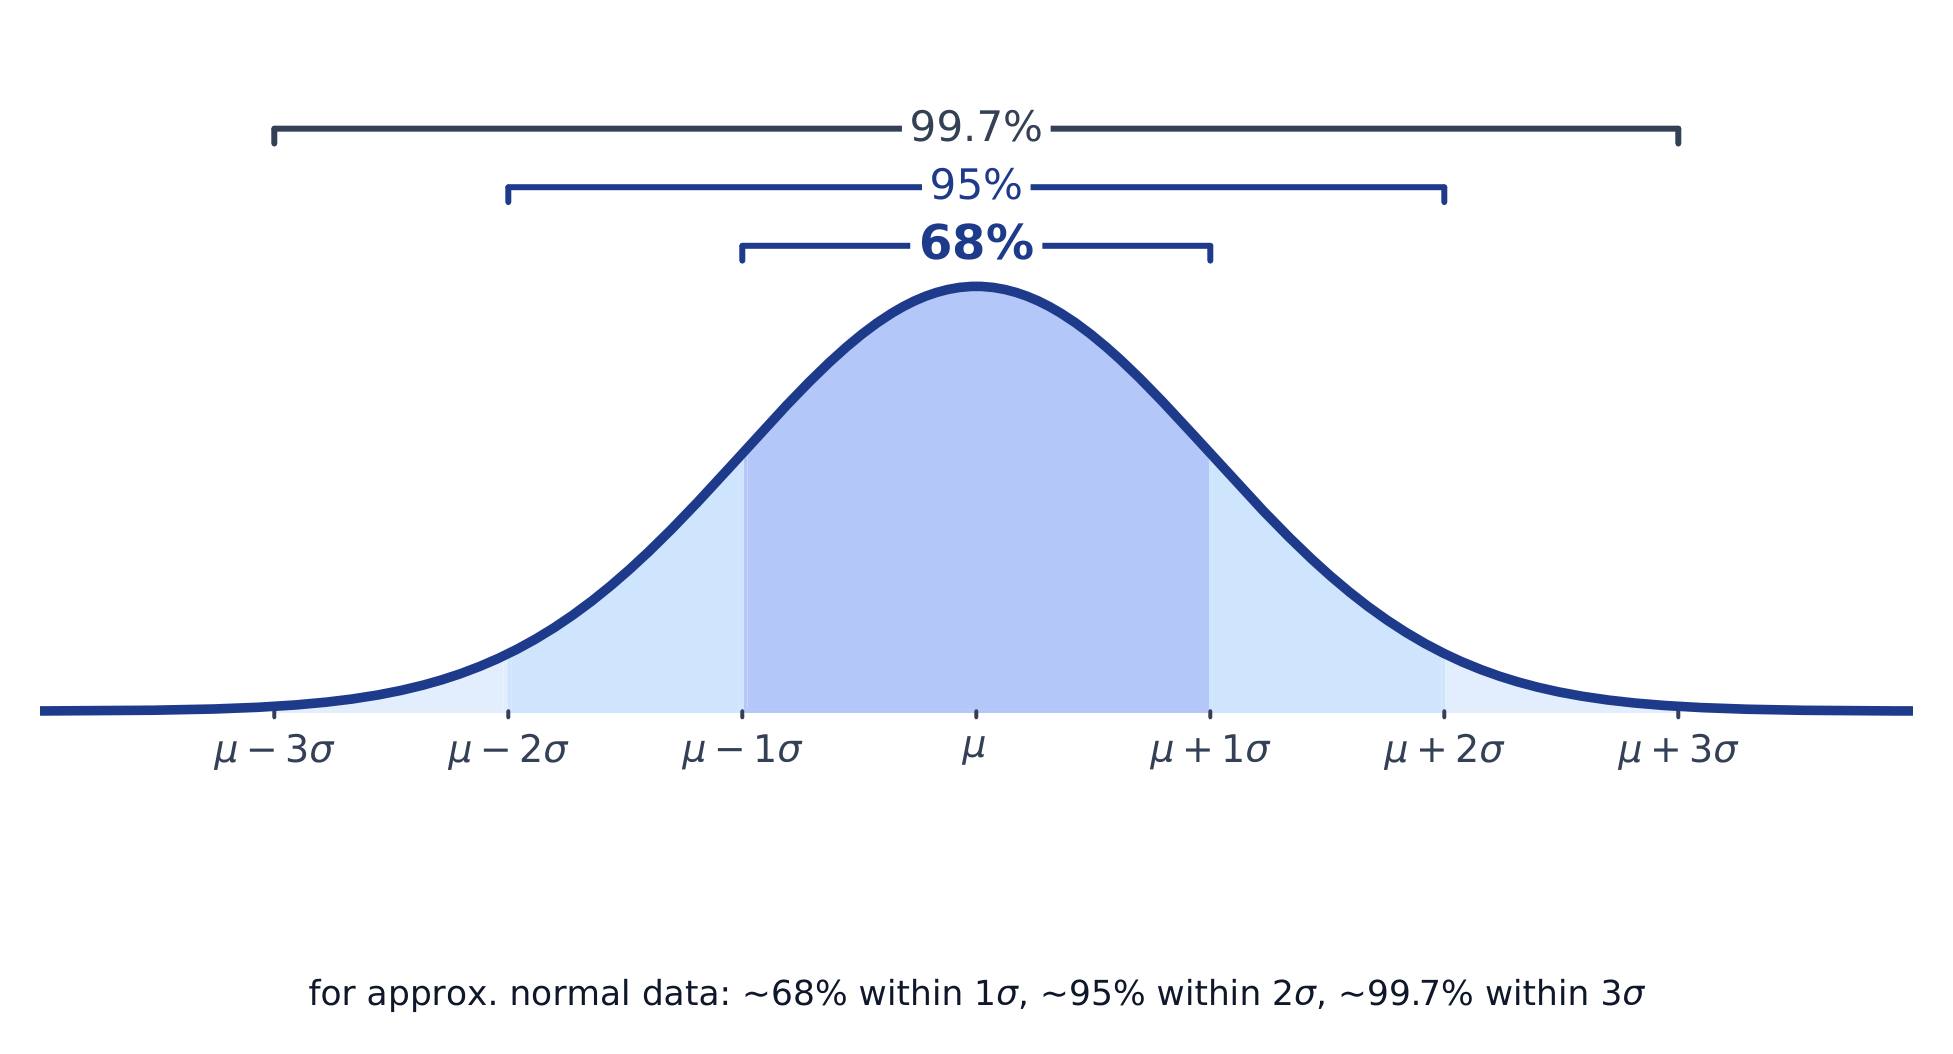
A normal distribution 正态分布 is a symmetric, bell-shaped model described by its mean $\mu$ and standard deviation $\sigma$. The empirical rule 经验法则 (68–95–99.7): about 68% of values lie within $1\sigma$ of the mean, 95% within $2\sigma$, and 99.7% within $3\sigma$.

A $z$-score 标准分数 measures how many standard deviations a value is from the mean:

$$z=\frac{x-\mu}{\sigma}.$$
Convert to a $z$-score, then use the normal table or technology to find the proportion (area) below, above, or between values – and reverse the process to find a value from a given percentile.

Worked example. Test scores are normal with $\mu=500$ and $\sigma=100$. A score of $700$ has $z=\dfrac{700-500}{100}=2$. By the empirical rule, $95\%$ of scores lie within $2\sigma$, so $2.5\%$ lie above $700$ – meaning a $700$ is at about the $97.5$th percentile.

Bahasa Indonesia

Distribusi normal adalah model simetris berbentuk lonceng yang dijelaskan oleh rata-rata $\mu$ dan simpangan baku $\sigma$. Aturan empiris (68–95–99.7): sekitar 68% nilai berada dalam $1\sigma$ dari rata-rata, 95% dalam $2\sigma$, dan 99.7% dalam $3\sigma$.

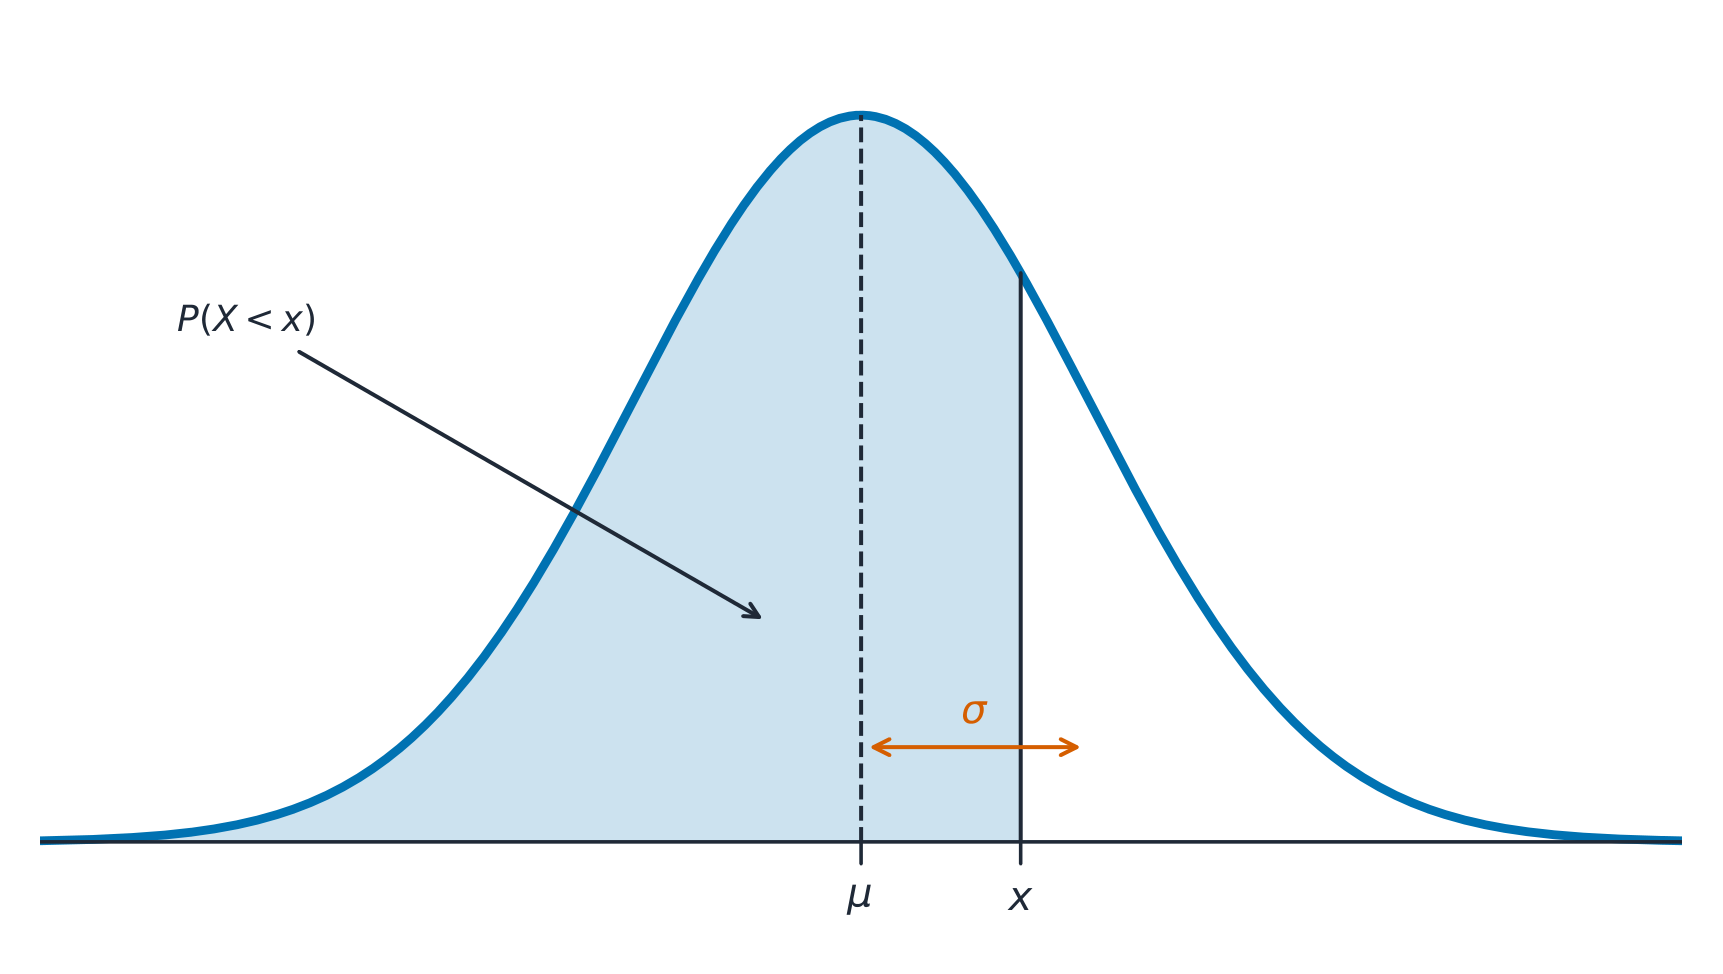
Kurva normal: probabilitas adalah luas di bawahnya, berpusat pada mean

Sebuah $z$-score mengukur berapa banyak simpangan baku suatu nilai berada dari mean:

$$z=\frac{x-\mu}{\sigma}.$$
Konversikan ke skor $z$, kemudian gunakan tabel normal atau teknologi untuk menemukan proporsi (luas area) di bawah, di atas, atau antara nilai—dan balik prosesnya untuk menemukan nilai dari persentil tertentu.

Contoh terpecahkan. Skor ujian berdistribusi normal dengan $\mu=500$ dan $\sigma=100$. Skor $700$ memiliki $z=\dfrac{700-500}{100}=2$. Berdasarkan aturan empiris, $95\%$ skor berada dalam $2\sigma$, sehingga $2.5\%$ berada di atas $700$—yang berarti skor $700$ berada di sekitar persentil ke-$97.5$.

Kurva normal dan aturan empiris 68-95-99.7
Explore · ⁨Jelajahi⁩

Explore area under the normal curve · ⁨Jelajahi area di bawah kurva normal⁩

The proportion of data below a value equals the area under the curve to its left. Shade a tail or a central band to see the 68–95–99.7 empirical rule and read a $z$-score as an area. · ⁨Proporsi data di bawah suatu nilai sama dengan area di bawah kurva ke kiri nilai tersebut. arsir ekor atau pita sentral untuk melihat aturan empiris 68–95–99.7 dan baca skor $z$ sebagai area.⁩

Vocabulary · ⁨Kosa kata⁩ Train · ⁨Latih⁩
English Bahasa Indonesia
empirical rule/emˈpɪrɪkl ruːl/ aturan empiris
$z$-score/ˈzed skɔː/ $z$-score
1.10

Exam tips · ⁨Tips ujian⁩

English
  • Describe a distribution by shape, center, spread, and outliers (SOCS) — always in context.
  • The mean is pulled by outliers; the median resists them, so prefer the median for skewed data.
  • For a normal distribution use the 68–95–99.7 rule and z-scores $z=\tfrac{x-\mu}{\sigma}$.
  • Compare distributions with side-by-side boxplots and comment on center, spread, and shape.
  • Standard deviation measures a typical distance from the mean; the IQR pairs with the median.
Bahasa Indonesia
  • Deskripsikan distribusi dengan bentuk, pusat, sebaran, dan pencilan (SOCS)—selalu dalam konteks.
  • Mean tertarik oleh pencilan; median menahannya, sehingga pilihlah median untuk data yang menceng.
  • Untuk distribusi normal gunakan aturan 68–95–99.7 dan skor-z $z=\tfrac{x-\mu}{\sigma}$.
  • Bandingkan distribusi dengan boxplot berdampingan dan berkomentar tentang pusat, sebaran, dan bentuk.
  • Simpangan baku mengukur jarak tipikal dari mean; IQR berpasangan dengan median.

Interactive lessons on this topic · ⁨Pelajaran interaktif untuk topik ini⁩

Work through it step by step, with instant-check exercises. · ⁨Kerjakan langkah demi langkah, dengan latihan pengecekan instan.⁩

Past Papers · ⁨Soal-Soil Masa Lalu⁩

More topics in AP Statistics · ⁨AP Statistik⁩ · ⁨Topik lain dalam AP Statistics · ⁨AP Statistik⁩⁩

Log in or create account · ⁨Masuk atau buat akun⁩

IGCSE, A-Level & AP