Mỗi giá trị mà chương trình của bạn lưu trữ đều cần một kiểu dữ liệu — và việc chọn đúng loại rất quan trọng. Giả sử bạn muốn lưu trạng thái hàng có còn trong kho hay không. Bạn có thể viết từ yes…
English narration · English + 中文 subtitles burned in · Giọng đọc tiếng Anh · phụ đề tiếng Anh + 中文 được ghi trực tiếp
10.1
Choosing data types · Chọn kiểu dữ liệu
Syllabus · Chương trình
English
Candidates should be able to:
Notes and guidance
Select and use appropriate data types for a problem solution
including integer, real, char, string, Boolean, date (pseudocode will use the following data types: INTEGER, REAL, CHAR, STRING, BOOLEAN, DATE, ARRAY, FILE)
Show understanding of the purpose of a record structure to hold a set of data of different data types under one identifier
Write pseudocode to define a record structure
Write pseudocode to read data from a record structure and save data to a record structure
Tiếng Việt
Thí sinh cần có thể:
Ghi chú và hướng dẫn
Chọn và sử dụng các loại dữ liệu phù hợp cho lời giải quyết vấn đề
bao gồm integer, real, char, string, Boolean, date (pseudocode sẽ sử dụng các loại dữ liệu sau: INTEGER, REAL, CHAR, STRING, BOOLEAN, DATE, ARRAY, FILE)
Thể hiện sự hiểu biết về mục đích của cấu trúc record để lưu trữ một tập dữ liệu có các loại dữ liệu khác nhau dưới một định danh duy nhất
Viết pseudocode để xác định cấu trúc record
Viết pseudocode để đọc dữ liệu từ cấu trúc record và lưu dữ liệu vào cấu trúc record
Source: Cambridge International syllabus · Nguồn: Chương trình Cambridge International
English
Every variable needs a data type 数据类型 — the kind of value it holds and the operations allowed:
INTEGER — a whole number (42, -7). For counts, indexes, IDs.
REAL — a number with a fractional part (3.14). For money, measurements.
STRING — characters in quotes ("Hello"). For text.
CHAR — a single character ('A').
BOOLEAN — TRUE or FALSE. For flags.
DATE — a calendar date.
Pick the smallest precise type that fits: INTEGER for whole counts, BOOLEAN for flags (not the strings "yes"/"no").
The "give the appropriate data type" tables are decided by how the value is used: the average mark of a class is REAL (it has a fractional part); an email address is STRING; the number of students is INTEGER; whether a student has paid is BOOLEAN; a date of birth is DATE; an array index is always INTEGER; a single grade letter is CHAR; a phone number is a STRING, because it starts with 0 and is never used in arithmetic. A BOOLEAN is used for a flag with only two states: whether a search has found its target, whether a member has paid, whether a seat is booked. For the identifier table, the variable name must be meaningful too: NumberOfPeople, not n.
Tiếng Việt
Mỗi biến cần một kiểu dữ liệu — loại giá trị nó chứa và các phép toán được phép:
INTEGER — số nguyên (42, -7). Dùng cho bộ đếm, chỉ mục, ID.
REAL — số có phần thập phân (3.14). Dùng cho tiền tệ, đo lường.
STRING — ký tự trong dấu ngoặc kép ("Hello"). Dùng cho văn bản.
CHAR — một ký tự đơn lẻ ('A').
BOOLEAN — TRUE hoặc FALSE. Dùng cho cờ.
DATE — ngày tháng lịch.
Chọn kiểu dữ liệu nhỏ nhất nhưng đủ chính xác: INTEGER cho các số đếm nguyên, BOOLEAN cho cờ (không phải chuỗi "yes"/"no").
Các bảng "cho kiểu dữ liệu phù hợp" phụ thuộc vào cách sử dụng giá trị: điểm trung bình lớp học là REAL (có phần thập phân); địa chỉ email là STRING; số lượng sinh viên là INTEGER; sinh viên đã thanh toán hay chưa là BOOLEAN; ngày sinh là DATE; chỉ mục mảng luôn là INTEGER; một chữ cái điểm số đơn lẻ là CHAR; số điện thoại là một STRING, vì nó bắt đầu bằng 0 và không bao giờ dùng trong toán học. Một BOOLEAN được dùng cho cờ có hai trạng thái duy nhất: liệu tìm kiếm đã tìm thấy mục tiêu hay chưa, liệu thành viên đã thanh toán hay chưa, liệu ghế đã được đặt hay chưa. Đối với bảng định danh, tên biến cũng phải có ý nghĩa: NumberOfPeople, không phải n.
10.1
Records · Bản ghi
English
A record 记录 (a record structure 记录结构) holds several fields of different types under one name — useful when several values describe one thing.
This defines the typeTStockItem; declare variables of it:
Use dot notation to reach each field 字段:
Use a record when values always belong together (a customer, a stock item); use separate variables for unrelated values.
Worked example. A club stores, for each student, a student ID (a string), a name, a date of birth and up to three club numbers (integers). Write pseudocode to declare the record type, an array to hold $3000$ students, and a statement that stores a name in the first element.
The marks: TYPE with the identifier and ENDTYPE; each field declared with a suitable type; the array declared with its bounds and OF Student; the field reached with the index and a dot. A "state the error in the record declaration" question usually points at a missing ENDTYPE, a field with no type, or a field declared as a STRING that must hold arithmetic. Two conventions score marks on their own: an unused element is marked with a value that cannot be real data (an empty string, -1, an ID of 0), and it is good practice to use the same marker everywhere so that every module can recognise an unused slot; an unused club field is 0. The benefits of an array of records, for a "state three benefits": all the data for one entity is held under one identifier; the fields can have different data types; one array replaces several parallel arrays that would have to be kept in step; the whole set can be processed by one loop or passed as one parameter; and adding a field changes the type definition only. For one customer the suitable structure is a record (fields of different types under one name); for all customers it is an array of records.
Tiếng Việt
Một bản ghi (cấu trúc bản ghi) chứa nhiều trường với các kiểu khác nhau dưới một tên duy nhất — hữu ích khi nhiều giá trị mô tả một đối tượng.
TYPE TStockItem
    DECLARE ItemID : INTEGER
    DECLARE Category : STRING
    DECLARE ItemCost : REAL
    DECLARE InStock : BOOLEAN
ENDTYPE
Đây là định nghĩa kiểuTStockItem; khai báo các biến của nó:
DECLARE Item1 : TStockItem
DECLARE Items : ARRAY[1:100] OF TStockItem
Sử dụng một bản ghi khi các giá trị luôn đi kèm với nhau (một khách hàng, một mặt hàng tồn kho); sử dụng các biến riêng biệt cho các giá trị không liên quan.
Ví dụ đã giải. Một câu lạc bộ lưu trữ, đối với mỗi học sinh, mã số học sinh (một chuỗi), tên, ngày sinh và tối đa ba mã câu lạc bộ (số nguyên). Viết giả mã để khai báo kiểu bản ghi, một mảng chứa $3000$ học sinh, và một lệnh lưu tên vào phần tử đầu tiên.
TYPE Student
    DECLARE StudentID : STRING
    DECLARE Name : STRING
    DECLARE DateOfBirth : DATE
    DECLARE Club : ARRAY[1:3] OF INTEGER
ENDTYPE

DECLARE Membership : ARRAY[1:3000] OF Student
Membership[1].Name ← "Li Wei"
Các điểm: TYPE với định danh và ENDTYPE; mỗi trường được khai báo với kiểu thích hợp; mảng được khai báo với cận của nó và OF Student; trường được truy cập bằng chỉ mục và dấu chấm. Một câu hỏi "nêu lỗi trong việc khai báo bản ghi" thường chỉ ra một ENDTYPE bị thiếu, một trường không có kiểu, hoặc một trường được khai báo là STRING mà phải chứa phép tính toán học. Hai quy ước đạt điểm riêng: một phần tử không dùng được đánh dấu bằng một giá trị không thể là dữ liệu thực tế (chuỗi rỗng, -1, mã số là 0), và tốt hơn hết nên sử dụng cùng một đánh dấu ở mọi nơi để mỗi mô-đun đều nhận biết được ô trống; một trường câu lạc bộ không dùng là 0. Lợi ích của mảng bản ghi, đối với câu hỏi "nêu ba lợi ích": toàn bộ dữ liệu của một thực thể được lưu dưới một định danh; các trường có thể có các kiểu dữ liệu khác nhau; một mảng thay thế nhiều mảng song song phải được giữ đồng bộ; toàn bộ tập hợp có thể được xử lý bởi một vòng lặp hoặc truyền như một tham số duy nhất; và thêm một trường chỉ thay đổi định nghĩa kiểu. Đối với một khách hàng, cấu trúc phù hợp là bản ghi (các trường khác nhau dưới một tên); đối với tất cả khách hàng, đó là mảng bản ghi.
Một bản ghi chứa nhiều trường với các kiểu khác nhau dưới một tên
Explore · Khám phá
A record groups fields under one name · Một bản ghi nhóm các trường dưới một tên duy nhất
A record bundles related fields together. Each field is a named label you reach with dot notation — Item1.Category — not by a numeric index. · Một bản ghi gom các trường liên quan lại với nhau. Mỗi trường là một nhãn có tên mà bạn truy cập bằng ký hiệu chấm — Item1.Category — chứ không phải bằng chỉ số số.
Select a suitable data structure (1D or 2D array) to use for a given task
Write pseudocode for 1D and 2D arrays
Write pseudocode to process array data
Sort using a bubble sort Search using a linear search
Tiếng Việt
Thí sinh cần có thể:
Ghi chú và hướng dẫn
Sử dụng các thuật ngữ kỹ thuật liên quan đến mảng
Bao gồm chỉ số, giới hạn trên và giới hạn dưới
Chọn cấu trúc dữ liệu phù hợp (mảng 1 chiều hoặc mảng 2 chiều) để sử dụng cho một nhiệm vụ cụ thể
Viết pseudocode cho mảng 1 chiều và 2 chiều
Viết pseudocode để xử lý dữ liệu mảng
Sắp xếp sử dụng bubble sort Tìm kiếm sử dụng linear search
Source: Cambridge International syllabus · Nguồn: Chương trình Cambridge International
English
An array 数组 is an ordered collection of items of the same type, under one name, reached by an index 索引.
element 元素 — one item in the array.
bounds 边界 — the lowest and highest valid indices.
dimension 维度 — 1-D (a list), 2-D (a table), etc.
lower bound 下界 and upper bound 上界 — the first and last valid index; the number of elements is upper bound minus lower bound plus one, and for a 2-D array the product of the two counts.
So in ThisArray[n] ← 42 the array has one dimension, the index is the variable n (an INTEGER), and the element at that index receives 42. Before an array can be declared you need its data type as well as its bounds. To declare $120$ values that may include a decimal place: DECLARE Data : ARRAY[1:120] OF REAL; a $150$-row, two-column table of strings: DECLARE Data : ARRAY[1:150, 1:2] OF STRING, which has $300$ elements. The benefits of an array over separate variables, for a two-mark explain: one identifier instead of thirty; the elements can be processed by a loop with the index as the counter; the size is easy to change; and the whole set can be passed to a module as one parameter. An array can also replace a chain of selection statements: DaysInMonth[Month] looks up the answer directly instead of twelve IF clauses, which is shorter, faster to write and easier to maintain.
1-D arrays
Process every element with a FOR loop:
2-D arrays (2D array)
The first index is the row, the second the column. Use nested loops to visit every cell. Use 1-D for a single sequence, 2-D for two natural dimensions (a grid, rows × columns).
Common operations
A linear search 线性查找 checks each element until found:
To find a sum, count, maximum or minimum, set a running variable then sweep through:
A bubble sort 冒泡排序 puts an array in order: pass through it comparing each adjacent pair and swapping any that are out of order; repeat the passes until one pass makes no swaps.
Paper 2 asks for these algorithms both as pseudocode and as steps in words, and sometimes in their "efficient" form:
Largest value: set Largest to the first element; for each remaining element, if it is bigger than Largest, store it in Largest; after the loop output Largest. For the position of the largest, keep a second variable that stores the index each time Largest changes.
Linear search returning a position: set FoundAt ← -1 before the loop (a value that can never be a valid index, so it means "not found"); loop through the array; when the element matches, store the index and leave the loop; after the loop test FoundAt.
Count or output the non-blank elements: compare each element with the marker for an unused element ("" or -1) and count or output only those that differ.
Remove an item: find its index by a linear search; move every later element one place towards the start, so the gap closes; mark the last element as unused (or decrease the count).
Insert into a sorted array: find the first index whose element is larger; move that element and every later one one place towards the end; store the new value in the gap.
Efficient bubble sort: a Swapped flag so that the passes stop as soon as a pass makes no swap, and an upper limit that falls by one each pass because the largest value has already reached the end.
The marks are for the outer loop that repeats until no swaps, the flag set inside the IF, the three-line swap with a temporary variable, and the shrinking limit. A sort in "steps" (stepwise refinement) is: repeat until sorted; on each pass compare adjacent pairs; swap a pair that is out of order; after each pass the largest unsorted value is at the end. Two 1-D arrays of records or of parallel data are processed with one loop and one index; a 2-D array needs a nested loop, the outer over rows and the inner over columns, and a search in one row fixes the row index and loops over the column.
Tiếng Việt
Một mảng là một tập hợp có thứ tự các đối tượng có cùng kiểu, dưới một tên, truy cập qua một chỉ mục.
phần tử — một đối tượng trong mảng.
cận — chỉ mục hợp lệ thấp nhất và cao nhất.
chiều — 1-D (danh sách), 2-D (bảng), v.v.
cận dưới và cận trên — chỉ mục hợp lệ đầu tiên và cuối cùng; số lượng phần tử là cận trên trừ cận dưới cộng một, và đối với mảng 2-D là tích của hai số lượng đó.
Vì vậy trong ThisArray[n] ← 42 mảng có một chiều, chỉ mục là biến n (một INTEGER), và phần tử tại chỉ mục đó nhận 42. Trước khi khai báo mảng, bạn cần biết kiểu dữ liệu cũng như các giới hạn của nó. Để khai báo $120$ giá trị có thể chứa phần thập phân: DECLARE Data : ARRAY[1:120] OF REAL; một bảng chuỗi gồm $150$ dòng, hai cột: DECLARE Data : ARRAY[1:150, 1:2] OF STRING, có $300$ phần tử. Lợi ích của mảng so với các biến riêng biệt, để giải thích cho hai điểm: thay vì ba mươi biến, chỉ dùng một định danh; các phần tử có thể được xử lý bởi vòng lặp với chỉ mục làm bộ đếm; kích thước dễ dàng thay đổi; và toàn bộ tập hợp có thể được truyền sang module như một tham số duy nhất. Mảng cũng có thể thay thế một chuỗi các câu lệnh lựa chọn: DaysInMonth[Month] tra cứu đáp án trực tiếp thay vì mười hai câu IF, điều này ngắn hơn, viết nhanh hơn và dễ bảo trì hơn.
Chỉ mục đầu tiên là hàng, chỉ mục thứ hai là cột. Sử dụng vòng lặp lồng nhau để duyệt qua từng ô. Sử dụng 1-D cho một dãy đơn, 2-D cho hai chiều tự nhiên (lưới, hàng × cột).
Mảng 2-D (bảng) với chỉ mục hàng và cột
Các phép toán thường gặp
Tìm kiếm tuyến tính kiểm tra từng phần tử cho đến khi tìm thấy:
FOR i ← 1 TO n
    IF A[i] = Target THEN
        OUTPUT "Found at ", i
    ENDIF
NEXT i
Để tìm tổng, đếm, giá trị lớn nhất hoặc nhỏ nhất, thiết lập biến chạy sau đó quét qua:
Max ← A[1]
FOR i ← 2 TO n
    IF A[i] > Max THEN
        Max ← A[i]
    ENDIF
NEXT i
Sắp xếp bọt đặt mảng theo thứ tự: lướt qua nó so sánh từng cặp kề nhau và hoán đổi bất kỳ cặp nào không đúng thứ tự; lặp lại các lượt lướt cho đến khi một lượt lướt không hoán đổi gì.
Giấy bài 2 yêu cầu các thuật toán này dưới dạng giả mã và dưới dạng các bước bằng lời, và đôi khi ở dạng "hiệu quả":
Giá trị lớn nhất: thiết lập Largest bằng phần tử đầu tiên; với mỗi phần tử còn lại, nếu nó lớn hơn Largest, lưu nó vào Largest; sau vòng lặp xuất Largest. Đối với vị trí của giá trị lớn nhất, giữ một biến thứ hai lưu chỉ mục mỗi khi Largest thay đổi.
Tìm kiếm tuyến tính trả về vị trí: thiết lập FoundAt ← -1 trước vòng lặp (một giá trị không thể bao giờ là chỉ mục hợp lệ, vì vậy nó có nghĩa là "không tìm thấy"); duyệt qua mảng; khi phần tử khớp, lưu chỉ mục và thoát khỏi vòng lặp; sau vòng lặp kiểm tra FoundAt.
Đếm hoặc xuất các phần tử khác rỗng: so sánh từng phần tử với dấu hiệu của phần tử chưa sử dụng ("" hoặc -1) và chỉ đếm hoặc xuất những phần tử khác biệt.
Xóa một mục: tìm chỉ mục của nó bằng tìm kiếm tuyến tính; di chuyển mọi phần tử sau đó một vị trí về phía đầu, sao cho khoảng trống đóng lại; đánh dấu phần tử cuối cùng là không dùng (hoặc giảm số lượng đếm).
Chèn vào mảng đã sắp xếp: tìm chỉ mục đầu tiên có phần tử lớn hơn; di chuyển phần tử đó và mọi phần tử sau đó một vị trí về phía cuối; lưu giá trị mới vào khoảng trống.
Sắp xếp bọt hiệu quả: một Swapped cờ để các lượt lướt dừng ngay khi một lượt lướt không hoán đổi, và cận trên giảm đi một mỗi lượt lướt vì giá trị lớn nhất đã đạt đến cuối.
REPEAT
    Swapped ← FALSE
    FOR Index ← 1 TO Limit - 1
        IF Data[Index] > Data[Index + 1] THEN
            Temp ← Data[Index]
            Data[Index] ← Data[Index + 1]
            Data[Index + 1] ← Temp
            Swapped ← TRUE
        ENDIF
    NEXT Index
    Limit ← Limit - 1
UNTIL Swapped = FALSE
Các điểm đánh giá bao gồm vòng lặp ngoài lặp lại cho đến khi không còn hoán đổi, cờ được đặt bên trong IF, đoạn hoán đổi ba dòng với biến tạm, và giới hạn thu nhỏ. Một sắp xếp theo "bước" (tinh chỉnh từng bước) là: lặp lại cho đến khi đã sắp xếp; ở mỗi lượt so sánh các cặp kề nhau; hoán đổi một cặp bị sai thứ tự; sau mỗi lượt, giá trị chưa sắp xếp lớn nhất sẽ nằm ở cuối. Hai mảng 1-D chứa bản ghi hoặc dữ liệu song song được xử lý bằng một vòng lặp và một chỉ số; mảng 2-D cần vòng lặp lồng nhau, vòng ngoài duyệt theo hàng và vòng trong duyệt theo cột, và việc tìm kiếm trong một hàng cố định chỉ số hàng và lặp theo cột.
Một lượt của thuật toán sắp xếp nổi bọt: các cặp kề nhau được so sánh và hoán đổi, đẩy giá trị lớn nhất lên cuối
Explore · Khám phá
A 2-D array · Mảng 2-D
Pick a row and column to read one element — how a grid of data is stored and indexed. · Chọn một hàng và cột để đọc một phần tử — cách dữ liệu dạng lưới được lưu trữ và chỉ mục.
Write pseudocode to handle text files that consist of one or more lines
Tiếng Việt
Thí sinh cần có thể:
Ghi chú và hướng dẫn
Thể hiện sự hiểu biết tại sao cần tệp
Viết pseudocode để xử lý tệp văn bản bao gồm một hoặc nhiều dòng
Source: Cambridge International syllabus · Nguồn: Chương trình Cambridge International
English
A file 文件 is data stored on secondary storage 辅助存储器, kept between program runs. Variables in RAM disappear when the program ends, so to save data permanently (high scores, records, settings) the program writes to a file. Files also let programs share data and restart from a saved state.
A text file 文本文件 holds one or more lines of readable characters; programs read and write text files line by line. Open a file before use and close it after:
EOF tests the end of file 文件结束 before reading. To write:
Always close every file — otherwise buffered writes may be lost and other programs may be locked out.
Why files (two marks): the data is kept after the program ends, so it is available the next time the program runs; it can be shared with other programs; and it can hold more than fits in memory. The characteristic of a text file that lets a program work through it is that it is a sequence of lines, read one after another from the start. The three modes: READ to read from the start; WRITE to create a new file, which deletes any existing contents, so it cannot be used to add to a file; APPEND to add lines at the end of an existing file. Test EOF before every read, and open the file only once, even when several modules use it.
Worked example. Write pseudocode for a procedure LastLines(FileName : STRING) that outputs the last three lines of a text file, in order.
Each new line pushes the previous three along, so when the file ends the three variables hold its last three lines; a file with fewer lines outputs empty strings. To output the first five lines, count the lines read and stop the loop at five or at EOF, whichever comes first; a file that is empty is detected by EOF being TRUE immediately after opening.
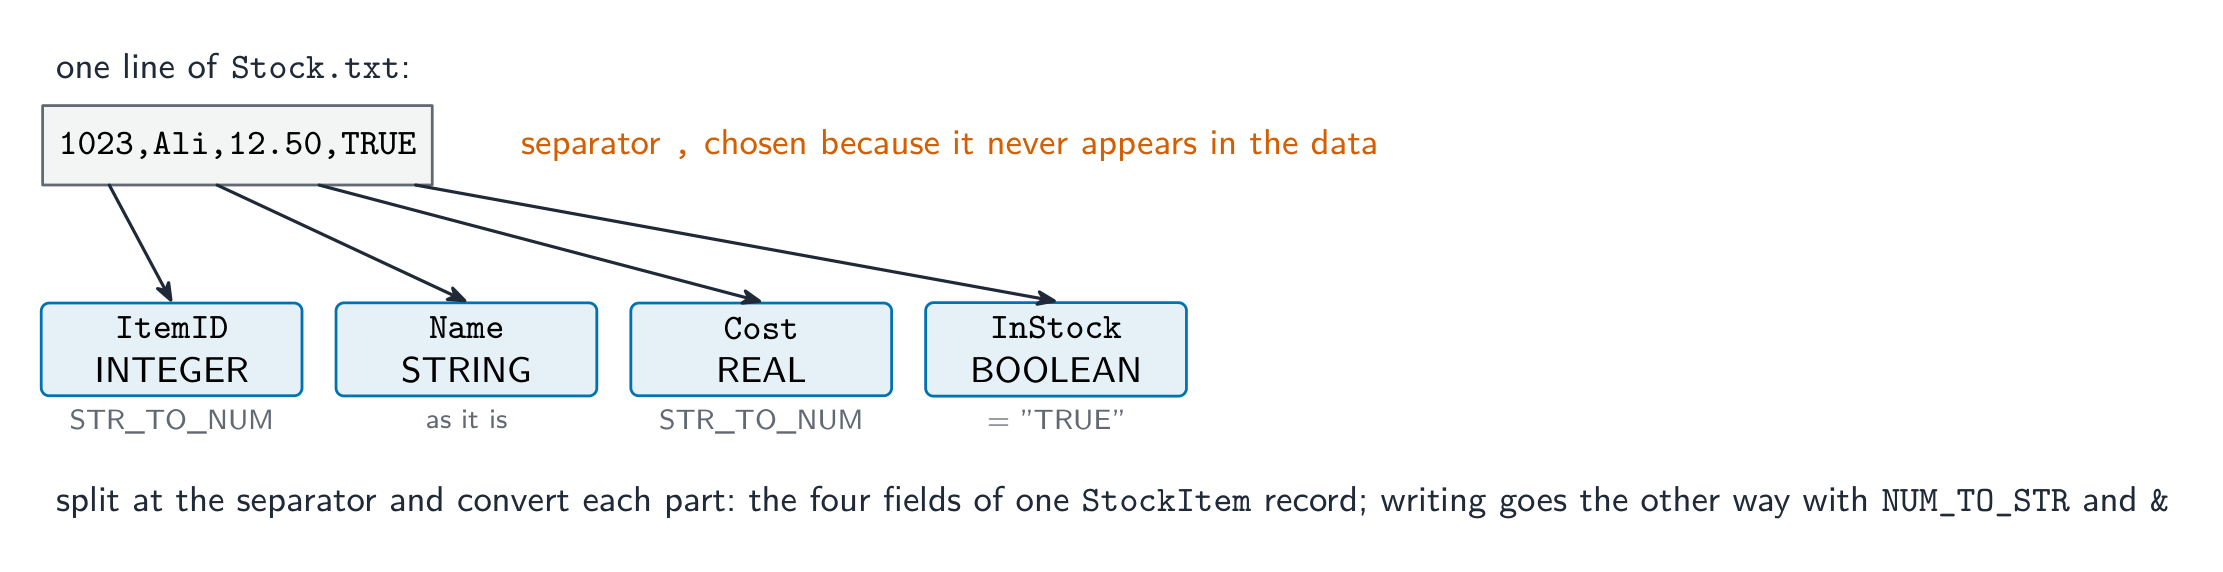
Fields in a line. A text file holds strings, so a record is written as one line with its fields joined by a separator 分隔符 character, and each number or Boolean converted with NUM_TO_STR (and read back with STR_TO_NUM, or by comparing with "TRUE"). Choose a separator that can never appear in the data: a comma or | for names and numbers, never a space when a name may contain one. If a field may contain any character, the separator can be confused with data; the fix is to put each field on its own line, or to write the field's length before it. One item per line is simple to read back but uses more lines and makes a record harder to see as a unit. Reading a file whose lines are in a known order (ascending by an ID) allows the search to stop as soon as a larger ID is read, instead of reading to the end. A save file that is created each time the game is saved needs a meaningful filename, for instance the player's name and the date and time, so that any earlier save can be restored.
Tiếng Việt
Một tập tin là dữ liệu được lưu trữ trên bộ nhớ phụ, được giữ lại giữa các lần chạy chương trình. Các biến trong RAM biến mất khi chương trình kết thúc, nên để lưu dữ liệu vĩnh viễn (điểm cao nhất, hồ sơ, cài đặt), chương trình phải ghi vào tập tin. Tập tin cũng cho phép các chương trình chia sẻ dữ liệu và khởi động lại từ trạng thái đã lưu.
*Biến trong RAM biến mất khi chương trình kết thúc; một tập tin trên đĩa tồn tại giữa các lần chạy
Một tập tin văn bản chứa một hoặc nhiều dòng ký tự có thể đọc được; chương trình đọc và ghi tập tin văn bản theo từng dòng. Mở tập tin trước khi sử dụng và đóng nó sau:
OPENFILE "data.txt" FOR READ      // or FOR WRITE, FOR APPEND
WHILE NOT EOF("data.txt") DO
    READFILE "data.txt", LineString
    OUTPUT LineString
ENDWHILE
CLOSEFILE "data.txt"
EOF kiểm tra cuối tập tin trước khi đọc. Để ghi:
OPENFILE "log.txt" FOR WRITE
FOR i ← 1 TO 100
    WRITEFILE "log.txt", "Event " & i
NEXT i
CLOSEFILE "log.txt"
Luôn đóng mọi tập tin — nếu không các ghi bộ đệm có thể bị mất và các chương trình khác có thể bị khóa truy cập.
Tại sao dùng tập tin (hai điểm): dữ liệu được giữ lại sau khi chương trình kết thúc, nên có sẵn vào lần chạy tiếp theo; có thể chia sẻ với các chương trình khác; và có thể chứa nhiều hơn dung lượng bộ nhớ. Đặc tính của tập tin văn bản giúp chương trình duyệt qua nó là cấu trúc chuỗi các dòng, được đọc lần lượt từ đầu. Ba chế độ: READ để đọc từ đầu; WRITE để tạo tập tin mới, điều này xóa toàn bộ nội dung hiện có, nên không thể dùng để thêm vào tập tin; APPEND để thêm dòng vào cuối tập tin hiện có. Kiểm tra EOF trước mỗi lần đọc, và mở tập tin chỉ một lần, ngay cả khi nhiều mô-đun sử dụng nó.
Ví dụ minh họa. Viết pseudocode cho thủ tục LastLines(FileName : STRING) xuất ra ba dòng cuối cùng của một tập tin văn bản, theo thứ tự.
Mỗi dòng mới đẩy ba dòng trước đó đi, nên khi tập tin kết thúc, ba biến sẽ chứa ba dòng cuối cùng; tập tin có ít dòng hơn sẽ xuất chuỗi rỗng. Để xuất năm dòng đầu tiên, đếm số dòng đã đọc và dừng vòng lặp tại năm hoặc tại EOF, tùy cái nào xảy ra trước; tập tin trống được phát hiện khi EOF bằng TRUE ngay sau khi mở.
Các trường trong một dòng. Một tập tin văn bản chứa chuỗi, nên một bản ghi được viết dưới dạng một dòng với các trường của nó được nối bởi một ký tự ngăn cách, và mỗi số hay giá trịBoolean được chuyển đổi bằng NUM_TO_STR (và đọc lại bằng STR_TO_NUM, hoặc bằng cách so sánh với "TRUE"). Chọn ký tự ngăn cách không bao giờ xuất hiện trong dữ liệu: dấu phẩy hoặc | cho tên và số, tuyệt đối không dùng khoảng trắng khi tên có thể chứa khoảng trắng. Nếu một trường có thể chứa bất kỳ ký tự nào, ký tự ngăn cách có thể bị nhầm lẫn với dữ liệu; giải pháp là đặt mỗi trường vào một dòng riêng biệt, hoặc ghi độ dài trường trước khi ghi nội dung. Một mục trên mỗi dòng dễ đọc lại nhưng tốn nhiều dòng hơn và khiến bản ghi khó nhận diện thành một khối. Đọc một tập tin mà các dòng có thứ tự đã biết (tăng dần theo ID) cho phép tìm kiếm dừng lại ngay khi đọc được ID lớn hơn, thay vì đọc đến tận cuối. Một tập tin lưu game được tạo mỗi lần chơi cần một tên tập tin có ý nghĩa, ví dụ tên người chơi và ngày giờ, để bất kỳ lần lưu nào trước đó đều có thể được khôi phục.
*Một dòng của tập tin văn bản là một bản ghi: các trường nối bởi ngăn cách, được chuyển đổi sang kiểu tương ứng khi đọc lại
Explore · Khám phá
Handling a file: open → use → close · Xử lý tệp tin: mở → sử dụng → đóng
Step through the lifecycle every file follows. The two easy-to-forget parts are testing EOF while reading in a loop, and always closing at the end. · Trải qua chu kỳ sống mà mọi tệp tin đều tuân theo. Hai phần dễ bị quên nhất là kiểm tra EOF khi đọc trong vòng lặp, và luôn đóng ở cuối.
Show understanding that an ADT is a collection of data and a set of operations on those data
Show understanding that a stack, queue and linked list are examples of ADTs
Describe the key features of a stack, queue and linked list and justify their use for a given situation
Use a stack, queue and linked list to store data
Candidates will not be required to write pseudocode for these structures, but they should be able to add, edit and delete data from these structures
Describe how a queue, stack and linked list can be implemented using arrays
Tiếng Việt
Thí sinh cần có thể:
Ghi chú và hướng dẫn
Thể hiện sự hiểu biết rằng một ADT là một tập hợp dữ liệu và một tập hợp các thao tác trên dữ liệu đó
Thể hiện sự hiểu biết rằng stack, queue và linked list là các ví dụ về ADTs
Mô tả các đặc điểm chính của stack, queue và linked list và giải thích việc sử dụng chúng cho một tình huống cụ thể
Sử dụng stack, queue và linked list để lưu trữ dữ liệu
Thí sinh không yêu cầu phải viết pseudocode cho các cấu trúc này, nhưng họ cần có khả năng thêm, chỉnh sửa và xóa dữ liệu khỏi các cấu trúc này
Mô tả cách queue, stack và linked list có thể được triển khai sử dụng arrays
Source: Cambridge International syllabus · Nguồn: Chương trình Cambridge International
English
Linked list: insert by rewiring pointersStack vs queue: LIFO and FIFO
An Abstract Data Type 抽象数据类型 (ADT) is a collection of data plus operations on it, defined by what it does, not how it is stored. The user works only through the operations; the implementation is hidden, so it can change without affecting code that uses the ADT. Know three: stack, queue, linked list.
The one-mark definition: an ADT is a collection of data together with a set of operations on that data. A stack, a queue, a linked list, a binary tree and an array are all ADTs. To justify a choice: a queue when items must be handled in the order they arrived (print jobs, key presses, customers in a shop), because it is first in, first out; a stack when the most recent item must be handled first (undo, going back through web pages, reversing an order, the return addresses of nested calls), because it is last in, first out; a linked list when items are inserted and deleted in the middle of an ordered sequence often, because only pointers change and nothing has to be shifted. To compare a stack and a queue: both are linear structures of items with an order, both are implemented with an array and pointers, and both need a check for full before adding and for empty before removing; a stack has one pointer and adds and removes at the same end, a queue has two pointers and adds at one end and removes at the other.
Stack
A stack 栈 works in LIFO 后进先出 order (Last In, First Out). Operations: push 入栈 (add to the top), pop 出栈 (remove from the top), peek (look at the top), and tests for empty/full. Uses: undo history, function-call return addresses, expression parsing, backtracking.
Worked example. A stack of characters holds, from the bottom, 'P', 'N', 'Z', 'X', 'Y', 'W', with the top-of-stack pointer at 'W' (memory location 202 of 200–207). The operations POP, POP, PUSH 'A', PUSH 'B', POP are performed. What is on the stack, and where does the pointer point?
The two pops remove 'W' then 'Y'; the pushes add 'A' then 'B' in their places; the last pop removes 'B'. The stack now holds 'P', 'N', 'Z', 'X', 'A' and the pointer is at 'A', location 203. The value that has been on the stack longest is the bottom item, 'P'; at most five further pops are possible before the stack is empty, and a pop on an empty stack is an error, which is why Pop() tests for empty first. A Push() function that returns TRUE on success first tests whether the pointer is at the top of the array (full) and returns FALSE if so. The array elements need no initialising before use, because the pointer alone says which elements are in use.
Queue
A queue 队列 works in FIFO 先进先出 order (First In, First Out). Operations: enqueue 入队 (add to the rear), dequeue 出队 (remove from the front), and tests for empty/full. Uses: print spooling, scheduling, breadth-first search, buffering.
To describe adding an item: check that the queue is not full; store the item at the position given by the end-of-queue pointer; increment the end pointer (and the count). To describe removing: check that the queue is not empty; read the item at the front pointer; increment the front pointer (and decrement the count). State the convention you use: if the end pointer marks the next free space, front and end pointers being equal means the queue is empty; if it marks the last item, equal pointers mean one item. In a linear queue the front pointer only ever moves forward, so cells behind it are wasted; that is what the circular queue below fixes. The two features of a queue to state: items are added at the rear and removed from the front, so the first item added is the first removed.
Linked list
A linked list 链表 stores data as a sequence of nodes 节点. Each node holds a value and a pointer 指针 to the next node; a head pointer marks the start, and the last node's pointer is a sentinel (e.g. NULL). Operations: insert, delete, search, and traverse 遍历 (visit each node in order). Its advantage over an array is cheap insertion/deletion (just adjust pointers); its disadvantage is slow random access (you must follow pointers from the head).
Adding a node in order (four marks): traverse the list from the head, following the pointers, until the node before the position is found (the last node whose value is smaller); take a free node and store the new value in it; set the new node's pointer to the address the previous node pointed to; set the previous node's pointer to the new node. If the new value belongs at the front, the head pointer is changed instead. Deleting a node: find the node before it, and set that node's pointer to the address the deleted node pointed to, so the list bypasses it; the freed node returns to the free list. Compared with a 1-D array, inserting or deleting in a linked list needs no shifting of the other items, and the list can grow until memory runs out; the cost is the extra pointer stored with every item, and that reaching the $n$th item means following $n$ pointers, since there is no direct index.
Tiếng Việt
*Danh sách liên kết: chèn bằng cách nối lại con trỏ
*Ngăn xếp vs Hàng đợi: LIFO và FIFO
Một Kiểu Dữ Liệu Trừ Tượng (ADT) là sự kết hợp của dữ liệu cùng các thao tác trên nó, được xác định bởi những gì nó làm chứ không phải cách thức lưu trữ. Người dùng chỉ làm việc thông qua các thao tác; phần thực thi bị ẩn đi, nên có thể thay đổi mà không ảnh hưởng đến mã nguồn sử dụng ADT. Cần biết ba loại: ngăn xếp, hàng đợi, danh sách liên kết.
Định nghĩa một điểm: ADT là một tập hợp dữ liệu cùng với một tập hợp các thao tác trên dữ liệu đó. Ngăn xếp, hàng đợi, danh sách liên kết, cây nhị phân và mảng đều là các ADT. Để giải thích một lựa chọn: hàng đợi khi các mục phải được xử lý theo thứ tự chúng đến (công việc in, phím bấm, khách hàng trong cửa hàng), vì nó tuân theo nguyên tắc vào trước ra trước; ngăn xếp khi mục mới nhất phải được xử lý trước (hoàn tác, quay lại qua các trang web, đảo ngược thứ tự, địa chỉ trả về của các cuộc gọi lồng nhau), vì nó tuân theo nguyên tắc vào sau ra trước; danh sách liên kết khi các mục được chèn và xóa ở giữa một dãy có thứ tự thường xuyên, vì chỉ con trỏ thay đổi và không cần dịch chuyển gì. Để so sánh ngăn xếp và hàng đợi: cả hai đều là cấu trúc tuyến tính của các mục có thứ tự, cả hai đều được triển khai bằng mảng và con trỏ, và cả hai đều cần kiểm tra trạng thái đầy trước khi thêm và trống trước khi xóa; ngăn xếp có một con trỏ và thêm/xóa ở cùng một đầu, hàng đợi có hai con trỏ và thêm ở một đầu, xóa ở đầu kia.
Ngăn xếp
Ngăn xếp hoạt động theo thứ tự LIFO (Vào Sau Ra Trước). Các thao tác: push (thêm vào đỉnh), pop (xóa từ đỉnh), peek (nhìn vào đỉnh), và các phép kiểm tra trạng thái trống/đầy. Ứng dụng: lịch sử hoàn tác, địa chỉ trả về của hàm, phân tích biểu thức, truy hồi.
Push và pop thay đổi con trỏ Đỉnh; con trỏ Đáy giữ nguyên
Ví dụ minh họa. Một ngăn xếp ký tự chứa, từ dưới lên trên, 'P', 'N', 'Z', 'X', 'Y', 'W', với con trỏ đỉnh ngăn xếp tại 'W' (vị trí bộ nhớ 202 của 200–207). Thực hiện các thao tác POP, POP, PUSH 'A', PUSH 'B', POP. Trên ngăn xếp còn những gì, và con trỏ đang chỉ vào đâu?
Hai lần pop loại bỏ 'W' rồi 'Y'; các lần push thêm 'A' rồi 'B' vào đúng vị trí cũ; lần pop cuối cùng loại bỏ 'B'. Ngăn xếp hiện chứa 'P', 'N', 'Z', 'X', 'A' và con trỏ nằm ở 'A', vị trí 203. Giá trị đã tồn tại trên ngăn xếp lâu nhất là mục đáy, 'P'; tối đa năm lần pop nữa là có thể thực hiện trước khi ngăn xếp trống, và việc pop trên ngăn xếp trống là lỗi, do đó Pop() kiểm tra trạng thái trống trước. Một hàm Push() trả về TRUE thành công sẽ kiểm tra xem con trỏ có nằm ở đỉnh mảng (đầy) hay không và trả về FALSE nếu đúng như vậy. Các phần tử mảng không cần khởi tạo trước khi sử dụng, vì bản thân con trỏ đã xác định phần tử nào đang được dùng.
Một đống sách là một ngăn xếp bạn có thể thấy. Bạn chỉ có thể thêm hoặc lấy một cuốn sách từ đỉnh, nên cuốn cuối cùng bạn đặt lên chính là cuốn đầu tiên bạn lấy xuống — đó chính xác là LIFO
Hàng đợi
Hàng đợi hoạt động theo thứ tự FIFO (Vào Trước Ra Trước). Các thao tác: enqueue (thêm vào đuôi), dequeue (xóa từ đầu), và các phép kiểm tra trạng thái trống/đầy. Ứng dụng: spooling in, lập lịch, tìm kiếm theo độ rộng, đệm dữ liệu.
Enqueue thêm vào đuôi; dequeue xóa từ đầu
Để mô tả việc thêm một mục: kiểm tra hàng đợi chưa đầy; lưu mục vào vị trí do con trỏ cuối hàng đợi chỉ định; tăng con trỏ cuối (và biến đếm). Để mô tả việc xóa: kiểm tra hàng đợi chưa trống; đọc mục tại con trỏ đầu; tăng con trỏ đầu (và giảm biến đếm). Nêu quy ước bạn sử dụng: nếu con trỏ cuối đánh dấu ô trống tiếp theo, thì con trỏ đầu và cuối bằng nhau có nghĩa hàng đợi trống; nếu nó đánh dấu mục cuối cùng, thì con trỏ bằng nhau có nghĩa còn một mục. Trong hàng đợi tuyến tính, con trỏ đầu chỉ bao giờ di chuyển về phía trước, nên các ô phía sau bị lãng phí; đó chính là điều mà hàng đợi vòng tròn bên dưới khắc phục. Hai đặc điểm của hàng đợi cần nêu: các mục được thêm vào đuôi và xóa từ đầu, nên mục đầu tiên được thêm sẽ là mục đầu tiên bị xóa.
Một hàng người là một hàng đợi bạn có thể thấy. Bạn xếp vào đuôi và được phục vụ từ đầu, nên ai waited lâu nhất sẽ được phục vụ đầu tiên — đó chính xác là FIFO
Danh sách liên kết
Danh sách liên kết lưu trữ dữ liệu dưới dạng chuỗi các nút. Mỗi nút chứa một giá trị và một con trỏ trỏ đến nút tiếp theo; con trỏ đầu đánh dấu điểm bắt đầu, và con trỏ của nút cuối là sentinel (ví dụ: NULL). Các thao tác: chèn, xóa, tìm kiếm, và duyệt (thăm từng nút theo thứ tự). Ưu điểm so với mảng là chi phí thấp cho việc chèn/xóa (chỉ điều chỉnh con trỏ); nhược điểm là truy cập ngẫu nhiên chậm (bạn phải đi theo con trỏ từ nút đầu).
Danh sách liên kết: mỗi nút trỏ đến nút tiếp theo
Thêm một nút vào đúng thứ tự (bốn điểm): duyệt danh sách từ đầu, theo các con trỏ, cho đến khi tìm thấy nút ngay trước vị trí cần chèn (nút cuối cùng có giá trị nhỏ hơn); lấy một nút rỗng và lưu giá trị mới vào đó; đặt con trỏ của nút mới chỉ đến địa chỉ mà nút trước đó đang trỏ tới; đặt con trỏ của nút trước đó trỏ tới nút mới. Nếu giá trị mới nằm ở đầu, con trỏ đầu sẽ được thay đổi. Xóa một nút: tìm nút ngay trước nó, và đặt con trỏ của nút này chỉ đến địa chỉ mà nút bị xóa đang trỏ tới, để danh sách bỏ qua nó; nút được giải phóng trở lại danh sách rỗng. So với mảng 1-D, việc chèn hoặc xóa trong danh sách liên kết không cần dịch chuyển các phần tử khác, và danh sách có thể mở rộng cho đến khi hết bộ nhớ; chi phí là con trõ bổ sung được lưu kèm với mỗi phần tử, và việc truy cập $n$th mục tiêu đòi hỏi phải đi theo $n$ con trỏ, vì không có chỉ mục trực tiếp nào.
Explore · Khám phá
A linked list: nodes joined by pointers · Danh sách liên kết: các nơ-đơ được nối với nhau bằng con trỏ.
Each node stores a value and a pointer to the next node. Inserting or deleting just re-links pointers — no items shift along, unlike an array. · Mỗi nơ-đơ lưu trữ một giá trị và một con trỏ đến nơ-đơ tiếp theo. Việc chèn hoặc xóa chỉ cần thay đổi các con trỏ — không có phần tử nào bị dịch chuyển, khác với mảng.
Explore · Khám phá
Stacks and queues · Ngăn xếp và hàng đợi
Push and pop. A stack is last-in-first-out; a queue is first-in-first-out — two key ADTs. · Push và pop. Một ngăn xếp là cuối vào đầu ra; một hàng đợi là đầu vào đầu ra — hai ADT then chốt.
Implementing ADTs using arrays · Thực hiện ADTs bằng mảng
English
Stack using an array
Hold items in Stack[1:MaxSize] with an integer Top (0 when empty).
Push(x): if Top = MaxSize the stack is full (overflow 溢出); else Top ← Top + 1; Stack[Top] ← x.
Pop(): if Top = 0 the stack is empty (underflow 下溢); else return Stack[Top] and Top ← Top - 1.
Queue using a circular array
A simple queue lets Front and Rear march off the end, wasting the start. The fix is a circular array 循环数组 — when a pointer reaches MaxSize it wraps back to 1:
Dequeue(): check empty; else return Queue[Front] and Front ← (Front MOD MaxSize) + 1.
Track a separate count to tell empty from full.
The algorithm for the end pointer, in words: if the count equals the size, report that the queue is full and stop; otherwise add one to the end pointer; if it is now past the last index, set it to the first index; store the item there and add one to the count. The declarations that a five-mark "describe the declaration and initialisation" answer lists: the array with its size and element type; a front pointer and an end pointer, both initialised to the first index (or the front to the first index and the end to the next free space); and a count of items, initialised to $0$.
For example, with MaxSize = 6: if Rear = 5, then (5 MOD 6) + 1 = 6, so the next item goes in cell 6; if Rear = 6, then (6 MOD 6) + 1 = 1, so the pointer wraps back to cell 1.
Linked list using an array
Use an array of records, each with a Next index:
A free list 空闲列表 chains the unused slots, just as the data list chains its used ones. To insert: take a slot from FreeListHead, set the new node's value and Next, and update the previous node's Next (or Head). To delete: unlink the node and return its slot to the free list. This gives the flexibility of a linked structure with the static allocation of an array.
Worked example. A linked list is held in a Data array and a Pointer array, with Start pointing to index 1. The list is 1 → 3 → 4 (index 1 holds D40, index 3 holds D32, index 4 holds D11, whose pointer is $\emptyset$); the free list starts at index 2 and continues 2 → 5. Insert D6 between D32 and D11.
Take the first free node, index 2, and set FreeStart to its pointer, 5; store D6 in Data[2]; set Pointer[2] to the value Pointer[3] held, which is 4; set Pointer[3] to 2. The list reads 1 → 3 → 2 → 4 and the free list is 5 → $\emptyset$. The answer to "how can the linked list be implemented" is exactly these parts: an array (or array of records) for the data, a parallel array for the pointers holding indices, a start pointer, a free-list pointer and a null value such as $-1$ for the end.
Worked example. A circular queue is held in an array of size 5 (indices 0 to 4) with Front = 3, Rear = 3 and one item stored. Two items are added, then two are removed. Where are the pointers, and why use a circular queue at all? Every move uses (pointer + 1) MOD size, so the pointers wrap. Adding twice moves Rear: $3 \rightarrow 4$, then $4 \rightarrow 0$ (because $(4+1) \bmod 5 = 0$), so Rear = 0 and three items are stored. Removing twice moves Front the same way: $3 \rightarrow 4$, then $4 \rightarrow 0$, leaving Front = 0 and one item. The wrap is the whole point: in a linear array queue the pointers march to the end and the freed space at the front is wasted even when the queue is empty. Remember a queue removes at the Front and adds at the Rear - a stack uses one pointer for both.
Tiếng Việt
Ngăn xếp dùng mảng
Giữ các phần tử trong Stack[1:MaxSize] bằng một số nguyên Top (0 khi trống).
Push(x): nếu Top = MaxSize thì ngăn xếp đầy (tràn); ngược lại Top ← Top + 1; Stack[Top] ← x.
Pop(): nếu Top = 0 thì ngăn xếp rỗng (rỗng dưới); ngược lại trả về Stack[Top] và Top ← Top - 1.
Hàng đợi dùng mảng vòng
Hàng đợi đơn giản khiến Front và Rear di chuyển ra khỏi cuối, lãng phí phần đầu. Giải pháp là mảng vòng — khi một con trỏ đạt đến MaxSize nó sẽ quay lại 1:
Enqueue(x): kiểm tra đầy; ngược lại Rear ← (Rear MOD MaxSize) + 1; Queue[Rear] ← x.
Dequeue(): kiểm tra rỗng; ngược lại trả về Queue[Front] và Front ← (Front MOD MaxSize) + 1.
Theo dõi một biến đếm riêng biệt để phân biệt trạng thái rỗng và đầy.
Thuật toán cho con trỏ cuối, diễn giải bằng lời: nếu biến đếm bằng kích thước, thông báo hàng đợi đầy và dừng; ngược lại tăng con trỏ cuối lên 1; nếu nó vượt quá chỉ mục cuối cùng, đặt nó thành chỉ mục đầu tiên; lưu phần tử vào đó và tăng biến đếm lên 1. Các khai báo cho câu trả lời "mô tả khai báo và khởi tạo" gồm 5 điểm: mảng với kích thước và kiểu phần tử; một con trỏ đầu và một con trỏ cuối, cả hai đều khởi tạo thành chỉ mục đầu tiên (hoặc con trỏ đầu là chỉ mục đầu và con trỏ cuối là không gian trống tiếp theo); và một biến đếm số lượng phần tử, khởi tạo thành $0$.
Ví dụ, với MaxSize = 6: nếu Rear = 5, thì (5 MOD 6) + 1 = 6, nên phần tử tiếp theo sẽ vào ô 6; nếu Rear = 6, thì (6 MOD 6) + 1 = 1, nên con trỏ quay lại ô 1.
Hàng đợi vòng quay các con trỏ trở lại đầu mảng
Danh sách liên kết dùng mảng
Sử dụng mảng bản ghi, mỗi bản ghi có một Next chỉ mục:
TYPE TNode
    DECLARE Value : INTEGER
    DECLARE Next : INTEGER     // index of the next node, or -1 for end
ENDTYPE

DECLARE Nodes : ARRAY[1:MaxSize] OF TNode
DECLARE Head : INTEGER         // index of first node, -1 if empty
DECLARE FreeListHead : INTEGER // first available free node
Một danh sách rỗng nối các ô chưa sử dụng, giống như cách danh sách dữ liệu nối các ô đã sử dụng. Để chèn: lấy một ô từ FreeListHead, đặt giá trị và Next của nút mới, và cập nhật Next của nút trước (hoặc Head). Để xóa: tách nút ra và trả ô của nó về danh sách rỗng. Điều này mang lại tính linh hoạt của cấu trúc liên kết với việc cấp phát tĩnh của mảng.
Danh sách liên kết được lưu trong mảng: mảng dữ liệu và mảng con trỏ
Ví dụ đã làm. Một danh sách liên kết được lưu trong một Data mảng và một Pointer mảng, với Start trỏ tới chỉ mục 1. Danh sách là 1 → 3 → 4 (chỉ mục 1 chứa D40, chỉ mục 3 chứa D32, chỉ mục 4 chứa D11, con trỏ của nó là $\emptyset$); danh sách rỗng bắt đầu từ chỉ mục 2 và tiếp tục 2 → 5. Chèn D6 giữa D32 và D11.
Lấy nút rỗng đầu tiên, chỉ mục 2, và đặt FreeStart thành con trỏ của nó, 5; lưu D6 vào Data[2]; đặt Pointer[2] thành giá trị Pointer[3] đang chứa, tức là 4; đặt Pointer[3] thành 2. Danh sách đọc là 1 → 3 → 2 → 4 và danh sách rỗng là 5 → $\emptyset$. Câu trả lời cho "danh sách liên kết có thể được thực hiện như thế nào" chính xác bao gồm những phần này: một mảng (hoặc mảng bản ghi) cho dữ liệu, một mảng song song cho các con trỏ chứa chỉ mục, một con trỏ bắt đầu, một con trỏ danh sách rỗng và một giá trị null như $-1$ cho phần cuối.
Ví dụ đã làm. Một hàng đợi vòng được lưu trong mảng có kích thước 5 (các chỉ mục 0 đến 4) với Front = 3, Rear = 3 và một phần tử được lưu. Hai phần tử được thêm vào, sau đó hai phần tử được loại bỏ. Các con trỏ nằm ở đâu, và tại sao lại dùng hàng đợi vòng? Mỗi lần di chuyển đều sử dụng (pointer + 1) MOD size, nên các con trỏ quay. Thêm hai lần sẽ di chuyển Rear: $3 \rightarrow 4$, rồi $4 \rightarrow 0$ (vì $(4+1) \bmod 5 = 0$), nên Rear = 0 và ba phần tử được lưu. Xóa hai lần di chuyển Front theo cách tương tự: $3 \rightarrow 4$, rồi $4 \rightarrow 0$, để lại Front = 0 và một phần tử. Sự quay lại là mục đích cốt lõi: trong hàng đợi mảng tuyến tính, các con trỏ di chuyển ra cuối và không gian được giải phóng ở phía trước bị lãng phí ngay cả khi hàng đợi rỗng. Hãy nhớ rằng hàng đợi loại bỏ ở Đầu và thêm ở Cuối - ngăn xếp chỉ dùng một con trỏ cho cả hai chức năng.
Explore · Khám phá
Implementing ADTs with arrays · Triển khai các ADT sử dụng mảng.
FIFO · FIFO.
A queue is first-in-first-out — enqueue at the back, dequeue from the front. · Một hàng đợi hoạt động theo nguyên tắc đầu vào - đầu ra — thêm vào phía sau, lấy ra từ phía trước.
Definitions the examiner accepts · Các định nghĩa mà giám khảo chấp nhận
English
A definition question is marked against fixed wording. Learn these exactly.
Term
Definition
record
a data structure that holds a set of data items (fields) of different data types under one identifier
array
a data structure that holds a fixed number of elements of the same data type under one identifier, each accessed by an index
index
the number that identifies one element of an array
upper bound, lower bound
the largest and smallest valid index of an array
text file
a file that stores data as lines of characters, which a program reads and writes one line at a time
abstract data type
a collection of data together with a set of operations on that data
stack
a list in which items are added to and removed from the same end, the top, so the last item added is the first removed (LIFO)
queue
a list in which items are added at the rear and removed from the front, so the first item added is the first removed (FIFO)
linked list
a list in which each node holds a data item and a pointer to the next node, with a start pointer to the first node
pointer
a variable that holds the address (or index) of a node or of a position in a structure
linear search
checking each element in turn from the first until the target is found or the end is reached
bubble sort
repeated passes through the array comparing adjacent pairs and swapping those out of order, until a pass makes no swaps
Tiếng Việt
Một câu hỏi định nghĩa được chấm dựa trên từ ngữ cố định. Hãy học những câu này đúng chính xác.
Thuật ngữ
Định nghĩa
bản ghi
một cấu trúc dữ liệu giữ một tập hợp các mục dữ liệu (các trường) với các kiểu dữ liệu khác nhau dưới một định danh duy nhất
mảng
một cấu trúc dữ liệu giữ một số lượng phần tử cố định của cùng một kiểu dữ liệu dưới một định danh duy nhất, mỗi phần tử được truy cập bằng chỉ mục
chỉ mục
số xác định một phần tử của mảng
cận trên, cận dưới
chỉ mục hợp lệ lớn nhất và nhỏ nhất của một mảng
tệp văn bản
một tệp lưu dữ liệu dưới dạng các dòng ký tự, mà chương trình đọc và viết từng dòng một
kiểu dữ liệu trừu tượng
một tập hợp dữ liệu kèm theo một tập hợp các thao tác trên dữ liệu đó
ngăn xếp
một danh sách nơi các phần tử được thêm vào và loại bỏ từ cùng một đầu, đỉnh, nên phần tử được thêm cuối cùng sẽ là phần tử được loại bỏ đầu tiên (LIFO)
hàng đợi
một danh sách nơi các phần tử được thêm vào ở phía sau và loại bỏ từ phía trước, nên phần tử được thêm đầu tiên sẽ là phần tử được loại bỏ đầu tiên (FIFO)
danh sách liên kết
một danh sách trong đó mỗi nút chứa một mục dữ liệu và con trỏ đến nút tiếp theo, với con trỏ bắt đầu trỏ đến nút đầu tiên
con trỏ
một biến chứa địa chỉ (hoặc chỉ số) của một nút hoặc vị trí trong cấu trúc
tìm kiếm tuyến tính
kiểm tra từng phần tử lần lượt từ đầu cho đến khi tìm thấy mục tiêu hoặc đạt đến cuối danh sách
sắp xếp nổi bọt
lặp lại các lượt duyệt qua mảng để so sánh các cặp kề nhau và hoán đổi những cặp không đúng thứ tự, cho đến khi một lượt duyệt nào đó không thực hiện hoán đổi nào nữa
10.4
Exam tips · Mẹo làm bài thi
English
Choose the right data structure and justify it (a record for mixed fields, a 2-D array for a grid).
Know how to implement a stack, queue and linked list with an array and pointers (top; front/rear; next).
Distinguish an ADT (its behaviour) from its implementation (array plus pointers).
Common mistakes
A record declaration without ENDTYPE, or fields without types. Every field is a DECLARE line with a type.
Reading past the end of a file, or writing with WRITE when the file must keep its contents. Test EOF before each read; use APPEND to add.
Writing a number to a text file without converting it. A file holds strings: NUM_TO_STR out, STR_TO_NUM back.
Forgetting the checks. Push and enqueue test for full first; Pop and dequeue test for empty first, and the answer says so.
Losing the rest of the list when inserting a node. Set the new node's pointer to the old next node before changing the previous node's pointer.
A linear search that never says "not found". Initialise the position to $-1$ and test it after the loop.
Tiếng Việt
Chọn cấu trúc dữ liệu phù hợp và giải thích lý do (một bản ghi cho các trường hỗn hợp, một mảng 2-D cho lưới).
Hiểu cách triển khai ngăn xếp, hàng đợi và danh sách liên kết bằng mảng và con trỏ (đỉnh; trước/sau; tiếp theo).
Phân biệt ADT (hành vi của nó) với việc triển khai của nó (mảng cộng con trỏ).
Lỗi thường gặp
Khai báo bản ghi thiếu ENDTYPE, hoặc các trường thiếu kiểu. Mỗi trường là một DECLARE dòng có kèm kiểu.
Đọc vượt quá cuối tập tin, hoặc ghi với WRITE khi tập tin cần giữ nguyên nội dung. Kiểm tra EOF trước mỗi phép đọc; dùng APPEND để thêm.
Ghi một số vào tập tin văn bản mà không chuyển đổi. Tập tin chứa chuỗi: NUM_TO_STR ra, STR_TO_NUM vào.
Bỏ qua các phép kiểm tra. Push và enqueue kiểm tra đầy trước; Pop và dequeue kiểm tra rỗng trước, và câu trả lời nêu rõ điều này.
Mất phần còn lại của danh sách khi chèn một nút. Đặt con trỏ của nút mới trỏ đến nút tiếp theo cũ trước khi thay đổi con trỏ của nút trước đó.
Một thuật toán tìm kiếm tuyến tính không bao giờ báo "không tìm thấy". Khởi tạo vị trí ở $-1$ và kiểm tra sau vòng lặp.
Interactive lessons on this topic · Bài học tương tác về chủ đề này
Work through it step by step, with instant-check exercises. · Làm theo từng bước, kèm theo bài tập kiểm tra ngay lập tức.
More topics in A-Level Computer Science · Khoa học máy tính A-Level · Nhiều chủ đề hơn trong A-Level Computer Science · Khoa học máy tính A-Level
Pick one and the site follows you — notes, papers, videos and practice all open on it. · Chọn một môn và trang sẽ điều hướng theo — ghi chú, tài liệu, video và bài tập đều mở ở đó.
Type to search notes, lessons, code, vocabulary and past-paper questions across every subject. · Nhập để tìm ghi chú, bài học, mã, từ vựng và câu hỏi đề thi cũ trên mọi môn học.


 *Một dòng của tập tin văn bản là một bản ghi: các trường nối bởi ngăn cách, được chuyển đổi sang kiểu tương ứng khi đọc lại


