デジタルコンピュータは、2つの論理状態1と0を用いてデータを表現する。2桁のみを使用するシステムを二進法(基数2)という。

コンピュータが処理できる前に、あらゆる種類のデータ(数値、テキスト、音声、画像)はバイナリに変換されなければなりません。コンピュータはこのバイナリを論理ゲートを用いて処理し、レジスタ(プロセッサ内の小型・高速記憶装置)に格納します。

IGCSE Computer Science · トピック 1
 21:16
コンピュータが二進数を使う理由
プロセッサの中には数十億の微小なスイッチがあります。それぞれはオンかオフかのいずれかしかできません。これがコンピュータの物理的な全てです—三も七もありません…
英語ナレーション・英語+中文字幕 burning-in
デジタルコンピュータは、2つの論理状態1と0を用いてデータを表現する。2桁のみを使用するシステムを二進法(基数2)という。
コンピュータが処理できる前に、あらゆる種類のデータ(数値、テキスト、音声、画像)はバイナリに変換されなければなりません。コンピュータはこのバイナリを論理ゲートを用いて処理し、レジスタ(プロセッサ内の小型・高速記憶装置)に格納します。
| English | 日本語 |
|---|---|
| binary/ˈbaɪnəri/ | 二进制 |
| data/ˈdeɪtə/ | データ |
| logic gate/ˈlɒdʒɪk ɡeɪt/ | 論理ゲート |
| processor/ˈprəʊsesə/ | プロセッサ |
| register/ˈredʒɪstə/ | レジスタ |
| number system/ˈnʌmbə ˈsɪstəm/ | 数値系 |

| 受験者は以下的能力を備えているべきである: | メモおよびガイドライン |
|---|---|
| 1 コンピュータがすべての形のデータをバイナリで表現する仕組みと理由を理解する | • 任意の形のデータは、コンピュータによって処理されるためにバイナリに変換される必要がある • データは論理ゲートを使用して処理され、レジスタに格納される |
| 2 (a) 十進法、二進法および十六進法の数値体系を理解する (b) (i) 正の十進数と正の二進数の間の変換 (ii) 正の十進数と正の十六進数の間の変換 (iii) 正の十六進数と正の二進数の間の変換を行う | • 十進法は基数10の体系である • 二進法は基数2の体系である • 十六進法は基数16の体系である • 使用される値は整数のみとする • 両方向の変換を行う(例:十進数から二進数へ、または二進数から十進数へ) • 最大二進数桁数は16ビット |
| 3 十六進法がデータの表現にとって有益な方法として用いられる仕組みと理由を理解する | • 情報科学のどの分野で十六進法が使われているかを特定できる • 十六進法はバイナリの短い表現であるため、人間にとって理解しやすい |
| 4 (a) Add two positive 8-bit binary integers (b) Understand the concept of overflow and why it occurs in binary addition | • An overflow error will occur if the value is greater than 255 in an 8-bit register • A computer or a device has a predefined limit that it can represent or store, for example 16-bit • An overflow error occurs when a value outside this limit should be returned |
| 5 正の8ビット二进制整数に対して論理二进制シフトを実行し、これが正の二进制整数に与える影響を理解する | • 論理左シフトを実行する • 論理右シフトを実行する • 複数回シフトを実行する • レジスタの端からシフトされるビットは失われ、反対側の端にはゼロがシフトされる • 正の二进制整数は、実行されたシフトに応じて乗算または除算される • 最上位ビットまたは最下位ビットが失われる |
| 6 2の補数数系を使用して、正および負の8ビット二进制整数を表す | • 正の二进制または十進整数を2の補数8ビット整数に変換し、その逆変換を行う • 負の二进制または十進整数を2の補数8ビット整数に変換し、その逆変換を行う |
出典: Cambridge International シラバス
進位法とは、固定された数字のセットを使って数値を表す方法のことです。ここでは3つの進位法が必要です。
| システム | 基数 | 使用する数字 |
|---|---|---|
| 十進法 | 10 | 0–9 |
| Binary | 2 | 0 and 1 |
| Hexadecimal | 16 | 0–9 then A–F |
基数は、そのシステムがいくつの異なる数字を使用するかを示します。
各桁には位取りがあります。二進法では右から左へ位取りが倍増します。8ビットの数に対しては以下のようになります:
128 64 32 16 8 4 2 1
1つのビットは単一の0または1です。8つのビットで1つのバイトになります。4つのビット(バイトの半分)はニブルと呼ばれます。
デナリ → バイナリ。位置値を書き出します。必要な数字の合計が指定した数になるように各位置値の下に1を置き、それ以外の下には0を置きます。
例:デナリ150をバイナリに変換します。$150 = 128 + 16 + 4 + 2$。
128 64 32 16 8 4 2 1
  1  0  0  1 0 1 1 0
したがって $150$ = 10010110 です。
バイナリ → デナリ。1が存在する位置値をすべて加算します。10010110 $= 128 + 16 + 4 + 2 = 150$。
ヘキサデシマル → バイナリ。各ヘキサ数字を独立した4ビットグループ(ニブル)に変換します。
例:ヘキサF08。$F = 1111$、$0 = 0000$、$8 = 1000$ なので、F08 = 1111 0000 1000 です。

バイナリ → ヘキサデシマル。右端から始まって4ビットずつグループ化(ニブル化)し、各ニブルを1つのヘキサ数字に変換します。
デナリ → ヘキサデシマル。最も簡単な方法は、まずバイナリに変換し、次にバイナリからヘキサに変換することです。
この表はヘキサのアルファベット変換に役立ちます:
| Denary | Binary | Hex |
|---|---|---|
| 10 | 1010 | A |
| 11 | 1011 | B |
| 12 | 1100 | C |
| 13 | 1101 | D |
| 14 | 1110 | E |
| 15 | 1111 | F |
Cambridgeの問題では、最大16ビットまでのバイナリ数が使用されます。
** worked example(演習例)**。デナリ100を8ビットバイナリに変換し、さらにヘキサデシマルに変換します。
$100 = 64 + 32 + 4$ なので、バイナリは 01100100 です。ニブルに分割すると 0110 0100 $= 6$ および $4$ となり、したがってヘキサデシマルは 64 です。
ヘキサはバイナリより短く、人間が読み書きしやすいです。1つのヘキサ数字は4つのバイナリ数字に相当するため、誤りを減らせます。数値自体は変化せず、同じバイナリ表現をより短い形式で示すための手法に過ぎません。
コンピュータ科学者は以下のような場面でヘキサを使用します:
#FF0000 は赤色)Type a number and see it in binary, denary and hex — and how the place values build it.
| English | 日本語 |
|---|---|
| denary/ˈdiːnəri/ | 十进制 |
| hexadecimal/ˌheksəˈdesɪml/ | 十六进制 |
| base/beɪs/ | 基数 |
| place value/pleɪs ˈvæljuː/ | 位値 |
| nibble/ˈnɪbl/ | 半バイト |
| memory address/ˈmeməri əˈdres/ | メモリアドレス |

デナリと同様に、2つの8ビットバイナリ数を右端から列ごとに足すことができます。1列あたりの規則は以下の通りです:
| A | B | 結果ビット | キャリー |
|---|---|---|---|
| 0 | 0 | 0 | 0 |
| 0 | 1 | 1 | 0 |
| 1 | 0 | 1 | 0 |
| 1 | 1 | 0 | 1 |
キャリーが入力される場合も、$1 + 1 + 1 = 1$ でキャリー1となります。
例:01110110 (118) と 00110000 (48) を足す。
  0 1 1 1 0 1 1 0    (118)
+ 0 0 1 1 0 0 0 0    (48)
-------------------
  1 0 1 0 0 1 1 0    (166)
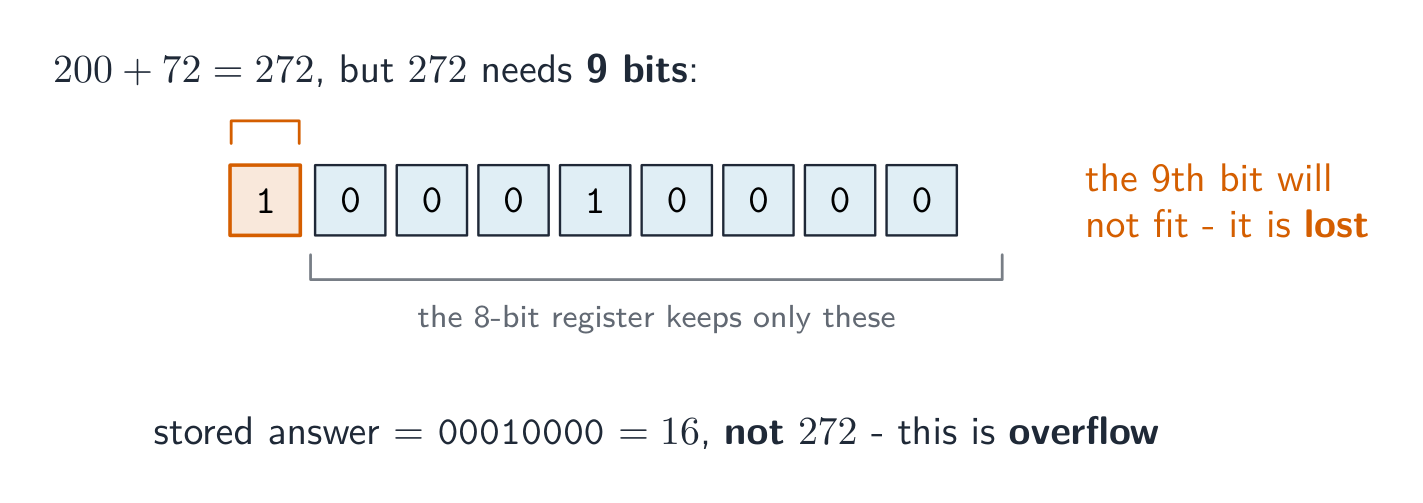
符号なし整数として解釈した場合、8ビットレジスタは0から255までの値を保持する。加算の結果が255を超えると、答えには9番目のビットが必要となる。レジスタはこの追加ビットを保持できないため、それは失われる。これをオーバーフロー(オーバーフローエラー)と呼ぶ。値がレジスタが保持できる限界を超えた場合に発生する。
例:11001000 (200) + $+$ 01001000 (72) = $= 272$。バイナリでは 1 00010000 となり、9ビットが必要です。先頭の1は8ビットに収まらず、格納された答えは誤りとなります。
| English | 日本語 |
|---|---|
| overflow/ˌəʊvəˈfləʊ/ | オーバーフロー |
| logical binary shift/ˈlɒdʒɪkl ˈbaɪnəri ʃɪft/ | 論理バイナリシフト |
| least significant bit/liːst sɪɡˈnɪfɪkənt bɪt/ | 最低位ビット |
| two's complement/tuːz ˈkɒmplɪmənt/ | 2の補数 |
| most significant bit/məʊst sɪɡˈnɪfɪkənt bɪt/ | 最上位ビット |
| character set/ˈkærɪktə set/ | 文字集合 |
| emoji/ɪˈməʊdʒi/ | 絵文字 |

ロジカル・バイナリシフトとは、すべてのビットを一定の位数だけ左または右へ移動させる操作です。
符号なし整数において、左シフトは、非ゼロビットが失われない場合、移動するごとに2倍となる。論理的右シフトは、移動するごとに2で割った整数結果を与える。最も右側のビット(最下位ビット)は失われる。
例:00110101 (53) を2つシフト(左シフト)します。
start:         0 0 1 1 0 1 0 1
left shift 2:  1 1 0 1 0 1 0 0
結果は11010100 (212) となり、これは$53 \times 4$です。左側の2つのビットが失われ、右側から2つのゼロが入りました。末尾から1が押し出されると、その情報は完全に失われます。

これまで正の数だけを考えましたが、2の補数を使うと8ビットレジスタで負の数も扱えます。
2の補数では、左端のビット(最上位ビット、またはMSB)が 負 の位取りを持ちます:
-128 64 32 16 8 4 2 1
正の数を負にする方法: 正のバイナリを書き出し、すべてのビットを反転させ(0↔1)、最後に1を加えます。
例:$-40$を负にする。
001010001101011111011000よって$-40$ = 11011000 です。位取りを加算して確認します:$-128 + 64 + 16 + 8 = -40$。
負の2の補数の数を読むには、単に位取りを加算します(MSBは$-128$としてカウントされます)。8ビット2の補数の範囲は$-128$から$+127$です。
| 受験者は以下的能力を備えているべきである: | メモおよびガイドライン |
|---|---|
| 1 コンピュータがテキストをどのようにそしてなぜ表現するかを理解し、文字セットの使用法(アメリカン標準情報交換コード(ASCII)およびユニコードを含む)を理解する | • テキストはコンピュータによって処理されるように二进制に変換される • ユニコードは、異なる言語や絵文字を含む、ASCIIよりも広範な文字と記号の範囲を許容する • ASCIIに比べて、ユニコードは文字あたりより多くのビットを必要とする |
| 2 Understand how and why a computer represents sound, including the effects of the sample rate and sample resolution | • A sound wave is sampled for sound to be converted to binary, which is processed by a computer • The sample rate is the number of samples taken in a second • The sample resolution is the number of bits per sample • The accuracy of the recording and the file size increases as the sample rate and resolution increase |
| 3 コンピュータが画像をどのように、なぜ表現するかを理解する。解像度と色深度の影響を含む | • 画像はピクセルの連続体であり、これらはバイナリに変換され、コンピュータによって処理される • 解像度は画像内のピクセル数である • 色深度は各色を表すのに使用されるビット数である • 解像度と色深度が増加すると、ファイルサイズと画像の品質も向上する |
出典: Cambridge International シラバス
コンピュータはテキストを保存するために、各文字に番号を与え、それをバイナリで保存します。コンピュータが使用できる文字のセットとその番号を合わせたものを 文字集合 と呼びます。
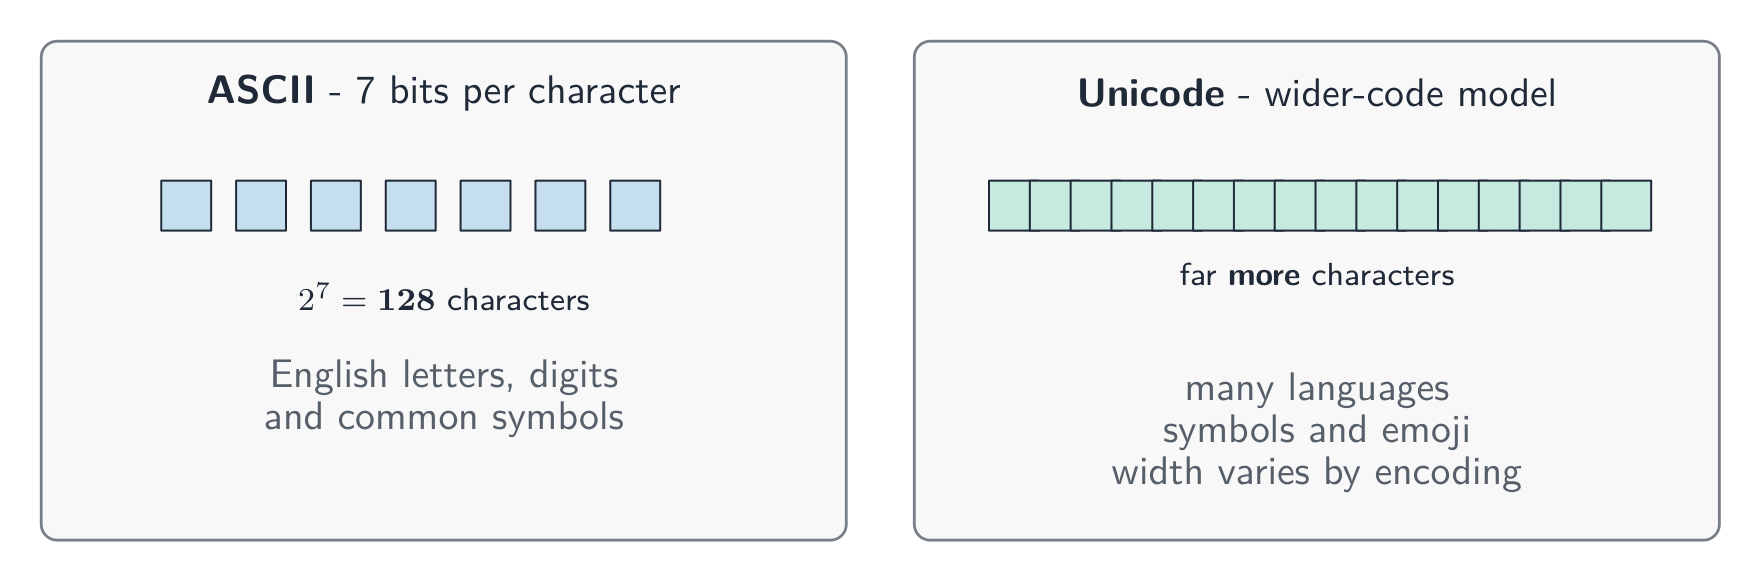
ASCII は 7ビットの文字コードを使用し、$N = 2^b = 2^7 = 128$種類のコードを提供します。英語の文字、数字、一般的な記号を含みますが、すべての 128 コードがアルファベットではありません。Unicode は、異なる言語や絵文字を含む、はるかに広い範囲の文字を表します。
試してみよう — 短いメッセージを符号化しよう。 ASCII のこの抜粋では、A = 65、B = 66、C = 67、スペース = 32 です。CAB の4つの 7 ビットグループ(末尾のスペースを含む)を書き出してください。次に、グループ 1000010 1000001 1000011 を復号してください。
Worked answer. Look up each character, then convert its code to binary:
| 文字 | コード | 7ビット |
|---|---|---|
| C | 67 | 1000011 |
| A | 65 | 1000001 |
| B | 66 | 1000010 |
| スペース | 32 | 0100000 |
したがって CAB は 1000011 1000001 1000010 0100000 です。2つ目のメッセージを復号すると BAC になります。スペースにもコードがあります。これはデータが存在しないことを意味するものではありません。送信者と受信者は、メッセージを正しく解釈するために同じ文字コードマッピングを使用する必要があります。
Why a larger range matters. ASCII cannot directly represent a Chinese name. Unicode includes Chinese characters as well as English characters and many other languages. For the syllabus comparison, explain that a greater range needs more distinct binary codes, requiring more bits per character than the 7-bit ASCII model.
試してみよう — 指定された格納モデルを比較する。 4つの文字CAB を (A) キャラクターあたり7ビット、(B) キャラクターあたり16ビットで格納します。パディングや追加ファイル情報がなく、ビットが詰まれていると仮定します。各モデルにおけるテキストデータのサイズを求めます。この16ビットの値はこの例のための仮定であり、すべてのUnicode文字が16ビットを取るというルールではありません。
計算例。 文字数が同じ場合、指定されたビット数(キャラクターあたり)を掛け合わせます:
モデル B は、この例で指定されたコード幅が大きいため、より多くのストレージを使用します。試験問題で与えられた幅を使用してください。実際のファイルでは、エンコーディングも重要です:UTF-8 は、ASCII ファイルと同じバイトで ASCII 文字を格納するため、Unicode テキストが必ずしもより多くのバイトを占有するわけではありません。カリキュラム比較のために UTF-8 の詳細なルールを知る必要はありません。
y = a sin(bt + c)
音は波であり、サンプリングでは每秒にその振幅を多数回記録します。
| English | 日本語 |
|---|---|
| bit/bɪt/ | ビット |
| byte/baɪt/ | バイト |
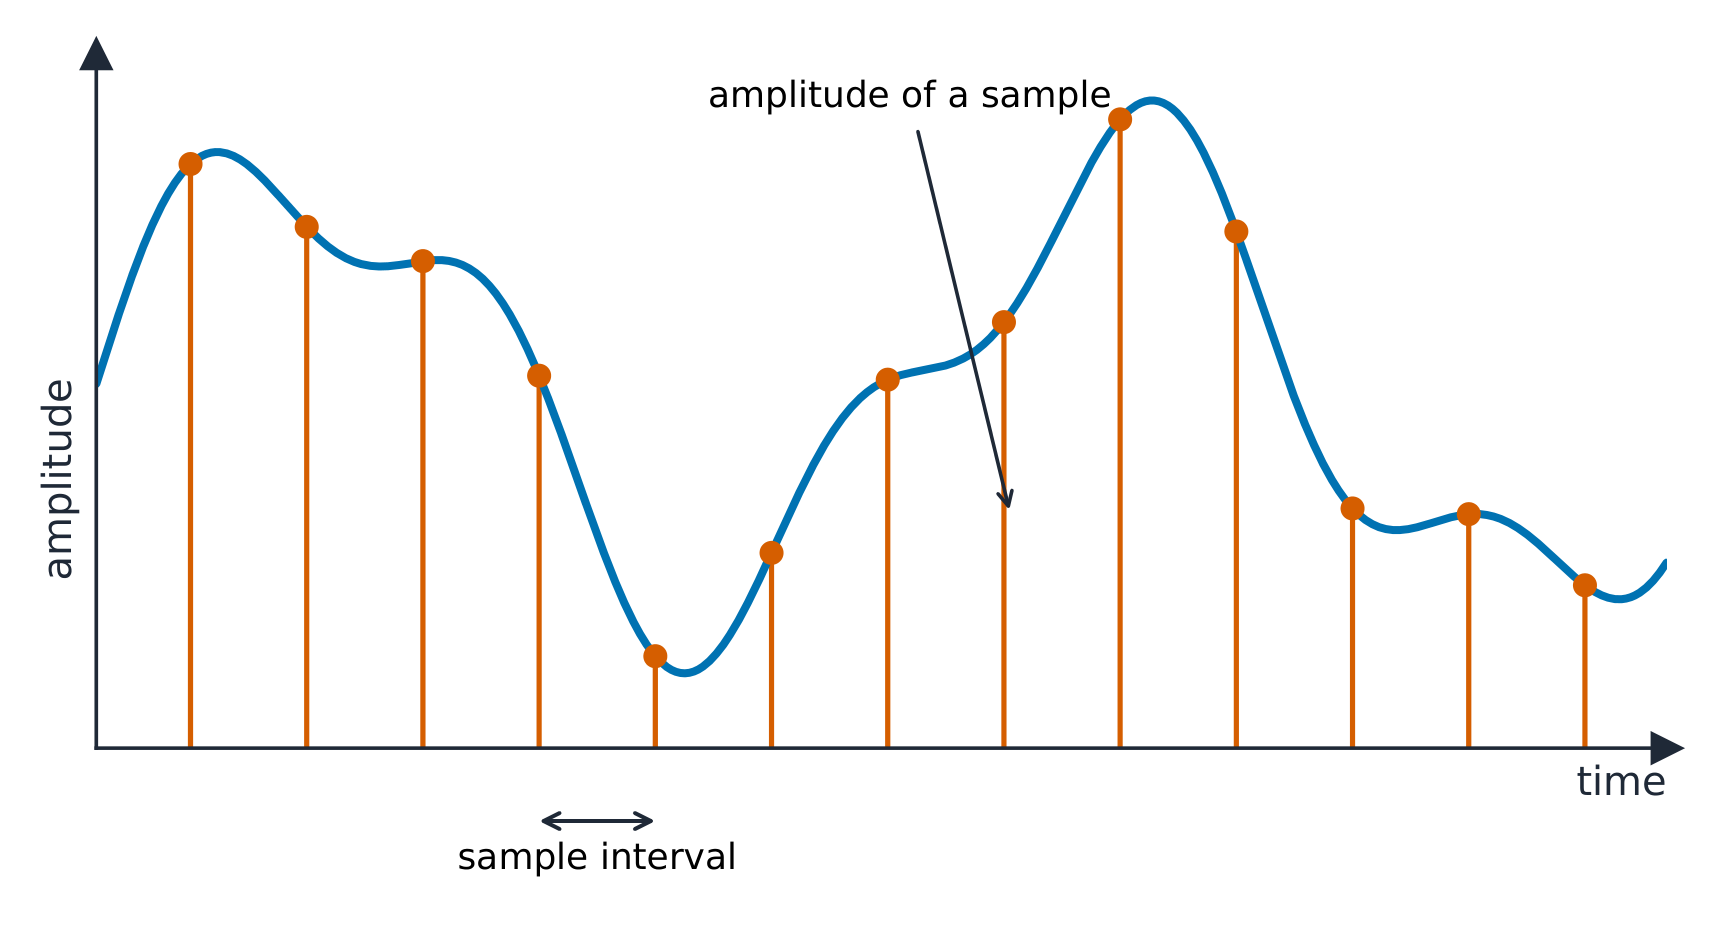
音波 は滑らかで常に変化しています。これを保存するには、コンピュータは一定の間隔で波の高さを測定します。これを サンプリング と呼び、各測定値をサンプルといいます。
高いサンプリングレートおよび高いサンプリング分解能はより正確な録音をもたらしますが、ファイルサイズも大きくなります。
y = a sin(bt + c)
音は波であり、サンプリングでは每秒にその振幅を多数回記録します。
| English | 日本語 |
|---|---|
| sampling/ˈsæmplɪŋ/ | サンプリング |
| sample rate/ˈsæmpl reɪt/ | サンプルレート |
| sample resolution/ˈsæmpl ˌrezəˈluːʃn/ | サンプリング分解能 |
| amplitude/ˈæmplɪtjuːd/ | 振幅 |

コンピュータ画像は、ピクセル と呼ばれる小さな点のグリッドで構成されています。
高い解像度と高いカラーディプスを使用すると、より高品質な画像が得られますが、ファイルサイズが大きくなります。
| English | 日本語 |
|---|---|
| pixel/ˈpɪksl/ | ピクセル |
| resolution/ˌrezəˈluːʃn/ | 解像度 |
| colour depth/ˈkʌlə depθ/ | カラー深度 |
| compression/kəmˈpreʃn/ | 圧縮 |
| bandwidth/ˈbændwɪdθ/ | 帯域幅 |
| transmission/trænˈsmɪʃn/ | 伝送 |
| lossless/ˈlɒsləs/ | 無損 |
| run-length encoding/rʌn leŋθ enˈkəʊdɪŋ/ | ラン長符号化 |
| lossy/ˈlɒsi/ | 可逆 |
| 受験者は以下的能力を備えているべきである: | メモおよびガイドライン |
|---|---|
| 1 データストレージの測定方法を理解する | • 以下を含む:– ビット – ニブル – バイト – キビバイト (KiB) – メビバイト (MiB) – ギビバイト (GiB) – テビバイト (TiB) – ペビバイト (PiB) – エクサバイト (EiB) • データストレージサイズに含まれる上記単位の量、例: – バイトあたり8ビット – ギビバイトあたり1024メビバイト |
| 2 与えられた情報を用いて、画像ファイルおよび音声ファイルのファイルサイズを計算する | • 回答は問題で指定された単位で行う。計算には 1024 の測定値を使用し、1000 を使用してはいけない • 与えられた情報には以下が含まれる: – 画像解像度と色深度 – 音声サンプリングレート、分解能、トラック長さ |
| 3 データ圧縮の目的と必要性を理解する | • 圧縮はファイルサイズを小さくするために存在する • これによる影響とは何か、例: – 必要な帯域幅が少ない – 必要なストレージスペースが少ない – 伝送時間が短い |
| 4 ロス圧縮およびロスレス圧縮方法を用いてファイルを圧縮する方法を理解する | • ロス圧縮はデータを永続的に削除することでファイルサイズを削減する。例:解像度や色深度の削減、サンプルレートや解像度の低下 • ロスレス圧縮はデータの永続的な損失なくファイルサイズを削減する。例:ルーン長エンコーディング (RLE) |
出典: Cambridge International シラバス
データストレージは以下の単位で計測されます。ニブルは4ビット、バイトは8ビットです。キビバイト以上では、各単位は前の単位の1024倍です($1024 = 2^{10}$ に適合するため)。
| 単位 | 等価 |
|---|---|
| ビット | 単一の0または1 |
| ニブル | 4ビット |
| バイト | 8ビット |
| キビバイト (KiB) | 1024バイト |
| メビバイト (MiB) | 1024 KiB |
| ギビバイト (GiB) | 1024 MiB |
| テビバイト (TiB) | 1024 GiB |
| ペビバイト (PiB) | 1024 TiB |
| エクシバイト (EiB) | 1024 PiB |
| English | 日本語 |
|---|---|
| storage/ˈstɔːrɪdʒ/ | ストレージ |
| sound wave/saʊnd weɪv/ | 音波 |
イメージファイルサイズ(ビット単位)$=$ 解像度 $\times$ カラーディプス $=$ 幅 $\times$ 高さ $\times$ カラーディプス。
例:ある画像は $1024 \times 1024$ ピクセルで、カラーディプスは2バイト($= 16$ ビット)です。
サウンドファイルサイズ(ビット単位)$=$ サンプルレート $\times$ サンプル解像度 $\times$ 長さ(秒単位)。
これらの数式はファイルヘッダーなしの圧縮されていないデータの数を計算します。音声用数式は1チャンネル分であり、問題で複数のチャンネルが指定されている場合はチャンネル数で掛け合わせます。
KiB、MiBなどに変換する際は常に1024で除算してください(1000ではなく)。質問で指定された単位で答えを提示してください。
** worked example.** サンプルレート8,000 Hz、サンプル解像度16ビットで30秒間録音された音のファイルサイズをキビバイト(KiB)で求めよ。

圧縮 はファイルを小さくします。小さいファイルは:
2つの種類があります。
ロスレス 圧縮はデータの 永久的な損失なし でファイルを小さくします。元のファイルを正確に再構築できます。
一つの手法に ラン長エンコーディング (RLE) があります。繰り返される値の連続列を、その値の1つのコピーと繰り返しの回数で置き換えます。例えば WWWWWWWW (8個の白) は "8 W" として保存されます。データに繰り返しが多い場合に効果的です。
可失性圧縮は、データを永久に削除することでファイルを大幅に小さくします。削除されたデータは復元できません。例えば:
テキストやプログラムファイルなど、すべての詳細を維持する必要がある場合は無失性圧縮を使用します。写真、音楽、動画などは、品質のわずかな低下でる大幅なファイルサイズ削減が可能であるため、可失性圧縮が適しています。
繰り返しの記号がカウントに圧縮されていく様子を見よ——単純なロスレス圧縮である。
| English | 日本語 |
|---|---|
| digit/ˈdɪdʒɪt/ | 桁 |
一歩ずつ進め、即時チェック付きの問題で学習します。