| 受験者は以下的能力を備えているべきである: | メモおよびガイドライン |
|---|---|
| **抽象化(abstraction)**に対する理解を示す | **抽象化(abstraction)**を使用する必要性と利益 **抽象化(abstraction)**の目的を説明する 必要な詳細のみを含めてシステムの抽象モデルを作成する |
| **分解(decomposition)**を説明し使用する | 問題をサブプロブレムに分解し、プログラムモジュール(手続き(procedure) / 関数(function))の概念につなげる |
アルゴリズム設計と問題解決
A-Level Computer Science · トピック 9
 14:52
計算思考
あるタスクがあります:全店舗の在庫管理システムを構築することです。すべての商品、すべての売上、すべての入荷、すべてのレポートを含みます。一つの巨大な問題として捉えると、それは…にまで大きすぎて...
英語ナレーション・英語+中文字幕 burning-in
9.1
コンピューティング的思考

シラバス
出典: Cambridge International シラバス
コンピューティング的思考とは、問題分析とコンピュータが実行可能な解決策の設計のための思考ツールセットです。その重要な要素として抽象化と分解があります。
抽象化
抽象化とは、問題の本質的な特徴を残しつつ、無関係な詳細を除外し、より単純なモデルを提供することを意味します。
例:
- 鉄道網マップは駅と路線を保ち、地理情報を切り捨てます。
- クラス(オブジェクト指向プログラミング)は、システムが必要とするアトリビュートとメソッドのみを保持します。
- 関数は、ある処理を名前の背後に隠します。
現実の問題の完全なモデルは推論するほど大きすぎるため、抽象化は不可欠です。
出題者は、抽象化の目的とその利点を求めています。目的:問題解決に必要最小限の詳細のみを含むより単純なモデルを作成することです。利点:問題を理解したりプログラムしたりすることが容易になります;プログラムは小さくなり、記述やテストが速くなります;類似した問題に対して同じモデルを再利用できます。システムに対する抽象モデルを作成するよう求められた場合、タスクに必要なデータと操作のみをリストアップしてください。学校の時間割であれば、授業、教室、教員、時限を含みますが、教室の色や教員の年齢などは含みません。

分解
分解とは、大きな問題をより小さな部分問題に分割することであり、各部分問題は解きやすく、一つずつ順に処理されます。
- タスクの主要な部分を特定する。
- それらをさらに小さな部分タスクに分割する。
- 各部分が直接設計できるほど小さくなるまで続ける。
- 小さなタスクを解決し、それらを組み合わせる。
在庫管理の場合:「在庫管理」→「販売記録」「入荷記録」「レポート作成」→(「販売記録」)「商品検索」「在庫数を減らす」「取引を保存」。分解により大きな問題は管理可能になり、チームで作業を分担でき、モジュール化されたコードが得られます。各モジュールは手続きまたは関数となります。
「なぜ分解が用いられるかを説明せよ」という3点問には固定的な構成があります。3つの独立した利点を挙げます:各部分問題は小さ enough で、単独で設計・コーディング・テストできる;異なるプログラマが同時に異なるモジュールを担当できる;既存のモジュール(またはライブラリdirname)を再利用でき、エラーが特定のモジュール内に限定されるため見つけやすい。構造図(トピック12)は分解の図示であり、上部にプログラム全体、その下にモジュール、そしてそれら間で渡されるデータを示す。

探索
計算的なアプローチで問題を解決する
利用する順序で4つの柱を順に確認 — 問題を分解し、繰り返しや共通点を見つけ、本質だけを抽出して、手順を書きます。
語彙
練習する
| English | 日本語 |
|---|---|
| computational thinking/ˌkɒmpjuːˈteɪʃənl ˈθɪŋkɪŋ/ | 計算思考 |
| abstraction/əbˈstrækʃn/ | 抽象化 |
| decomposition/ˌdiːkɒmpəˈzɪʃn/ | 分解 |
| sub-problem/sʌb ˈprɒbləm/ | サブ問題 |
| procedure/prəˈsiːdʒə/ | 手続 |
| modules/ˈmɒdjuːlz/ | モジュール |
| algorithm/ˈælɡərɪθəm/ | アルゴリズム |
| sequence/ˈsiːkwəns/ | 順序 |
| unambiguous/ʌnæmˈbɪɡjuːəs/ | 曖昧さのない |
| deterministic/dɪˌtɜːmɪˈnɪstɪk/ | 決定論的 |
9.2
アルゴリズム
シラバス
| 受験者は以下的能力を備えているべきである: | メモおよびガイドライン |
|---|---|
| アルゴリズムが定義された一連のステップとして表現された問題解決策であることを理解する | |
| 問題で使用されるデータの表現に適した識別子名を使用し、これらを**識別子表(identifier table)**で表す | |
| 入力、処理、出力を含む**擬似コード(pseudocode)**を記述する | |
| シーケンス(sequence)、選択(selection)、**反復(iteration)という3つの基本構成要素を用いた擬似コード(pseudocode)**を記述する | |
| 単純なアルゴリズムを、構造化英語による記述、フローチャート(flowchart)、または**擬似コード(pseudocode)**で文書化する | |
| 擬似コードを書く: • 構造化された英語の説明から • フローチャートから | |
| フローチャートを描く: • 構造化された英語の説明から • 擬似コードから | |
| **段階的精密化(stepwise refinement)**のプロセスを説明し使用し、アルゴリズムをプログラム可能なレベルの詳細まで表現する | |
| ロジック文を使用してアルゴリズムの解の一部を定義する |
出典: Cambridge International シラバス
アルゴリズムとは、定義された一連の手順として表現された解決策です。各手順は曖昧さがない(意味が一意)、決定論的である(同じ入力→同じ出力)、有限である(手順に終端がある)、有効である(各行動が実行可能)。アルゴリズムは何をすべきかを示し、実装に用いるプログラミング言語に依存しません。
探索
選択構造:IF / ELSE の分岐に従うこと
スコアをドラッグしてどの分岐が実行されるか確認します。選択構造は各条件を順にテストし、最初に見つかったTRUE(真)の条件を採用します。これが IF … ELSE IF … ELSE が動作する仕組みです。
9.2
識別子テーブル

アルゴリズムを開始する際、すべてのデータを識別子テーブルにリストアップします。識別子(変数名)、データ型、および説明を含めます。試験での表は以下の3列のみを持ちます:
| 識別子 | データ型 | 説明 |
|---|---|---|
Category |
STRING |
製品カテゴリー |
SaleDate |
DATE |
商品の販売日時 |
ItemCost |
REAL |
商品の原価 |
InStock |
BOOLEAN |
TRUE 在庫ありの場合 |
Sales |
ARRAY[1:30] OF REAL |
過去30日の日次売上合計 |
意味のある名前を使用する(ItemCost、xではなく):識別子は文字で始まり、スペースを含まず、出現するたびに表記が一定である必要があります。一般的なタイプは INTEGER, REAL, STRING, CHAR, BOOLEAN, DATE、および配列です。この表はコードを書く前にすべてのデータの名称を指定させるもので、「識別子テーブルを完成させよ」の問題では正しいデータ型または説明ごとに1点与えられます。そのため、データ型は擬似コードガイドに従って正確に記入してください。
語彙
練習する
| English | 日本語 |
|---|---|
| identifier table/aɪˈdentɪfaɪə ˈteɪbl/ | 識別子表 |
| identifier/aɪˈdentɪfaɪə/ | 識別子 |
| Boolean/ˈbuːlɪən/ | ブール |
9.2
擬似コード — 3つの基本構文

擬似コードは、アルゴリズムを記述するための構造化され、言語に依存しない方法です。
1. 順次
ステップが一つずつ続いて実行される(順次):
INPUT Name
INPUT Age
OUTPUT "Hello", Name
2. 選択
条件に基づいてどのステップを実行するかを選ぶ(選択):
IF Age >= 18 THEN
    OUTPUT "Adult"
ELSE
    OUTPUT "Minor"
ENDIF
より多くの選択肢がある場合は、CASE OF ... ENDCASEを使用する。
3. 反復
ブロックを繰り返す(反復、ループ):
FOR i ← 1 TO 10
    OUTPUT i
NEXT i
WHILEループは条件を各反復の前にテストします(ゼロ回実行される可能性があります)。一方、REPEAT...UNTILループは条件を各反復の後にテストするため、必ず一度は実行されます。
WHILE Total < 100 DO
    INPUT Value
    Total ← Total + Value
ENDWHILE

REPEAT
    INPUT Mark
UNTIL Mark >= 0 AND Mark <= 100
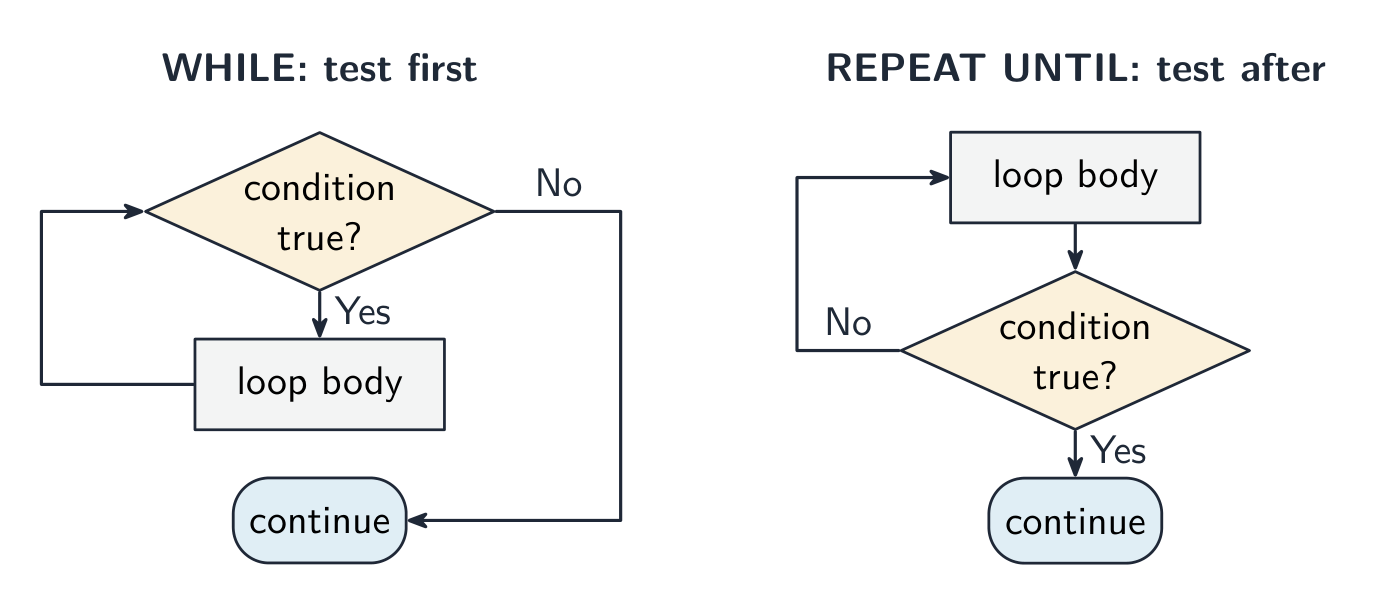
ループの選択自体が採点対象です: FOR は反復回数が既知の場合(カウント制御ループ);WHILE はループが一度も実行されない可能性がある場合(前条件ループ);REPEAT ... UNTIL は入力検証のように少なくとも一度実行される必要がある場合(後条件ループ)。「反復構造を説明せよ」という回答では、構造の名前を挙げ、条件がどこでテストされるか、そしてその結果(ゼロ回または少なくとも一度)を示す必要があります。
一般的な演算子
- 代入:
x ← 5(矢印;=は比較のため)。 - 入出力:
INPUT variable,OUTPUT expression。 - 比較演算子
=,<>,<,>,<=,>=; 論理演算子AND,OR,NOT。 - 算術
+ - * /、加算DIV(整数除法)およびMOD(剰余)。 - 文字列: 連結(結合)のための
LENGTH,LEFT,RIGHT,MID,&。
試験で求められる擬似コード
すべての擬似コードの解答はCambridgeが公開する擬似コードガイドに基づいて採点されます。以下の形式を正確に記述してください:
| 構文 | 擬似コード |
|---|---|
| 変数 | DECLARE Total : INTEGER |
| 配列 | DECLARE Marks : ARRAY[1:30] OF REAL |
| 定数 | CONSTANT MaxTries = 3 |
| 代入 | Total ← Total + Value |
| 入力 / 出力 | INPUT NameOUTPUT "Hello ", Name |
| 選択 | CASE OF Choice1 : OUTPUT "Add"OTHERWISE OUTPUT "Error"ENDCASE |
| FORループ | FOR i ← 1 TO 10 STEP 2 ... NEXT i |
| WHILEループ | WHILE Total < 100 DO ... ENDWHILE |
| REPEATループ | REPEAT ... UNTIL Mark >= 0 |
| 整数演算 | 17 DIV 5 = 317 MOD 5 = 2 |
| 文字列 | LENGTH(S), LEFT(S, 3), RIGHT(S, 2)MID(S, 2, 4), TO_UPPER(S), TO_LOWER(S) |
| 型変換 | INT(3.7) = 3, NUM_TO_STR(12)STR_TO_NUM("4.5"), ASC('A') = 65, CHR(66) = 'B' |
| ランダム | RAND(100)INT(RAND(100)) + 1 |
RAND(100) は 0 以上 100 未満の実数を返します。INT(RAND(100)) + 1 は 1 から 100 の整数を返します。
全問で得点される2つの習慣があります:使用中的所有変数を識別子表の型と共に宣言し、ループ内で変更されるカウンタと合計値(Count ← 0, Total ← 0)をループ前に初期化することです。
入力 → 処理 → 出力
すべてのプログラムはこの形に従います:
INPUT Length
INPUT Width
Area ← Length * Width
OUTPUT "Area = ", Area
入出力を先にリストアップするとアルゴリズムがすっきりします。
** worked example.** 100個の整数を入力し、そのうち10以上20以下(両端を含む)にあるものの個数と総和を出力する擬似コードを記述してください。
識別子表: Count : INTEGER (ループカウンタ), Value : INTEGER (直近の入力された整数), InRange : INTEGER (範囲内だった個数), Total : INTEGER (それらの合計)。
DECLARE Count, Value, InRange, Total : INTEGER
InRange ← 0
Total ← 0
FOR Count ← 1 TO 100
    INPUT Value
    IF Value >= 10 AND Value <= 20 THEN
        InRange ← InRange + 1
        Total ← Total + Value
    ENDIF
NEXT Count
OUTPUT InRange, Total
問題が「2つの構文を特定し、それぞれ如何使用を述べよ」と問う場合、同じ形で答えてください: 反復構造である FOR ループは入力を100回繰り返す; 選択構造である IF 文は範囲内にある場合にのみ値を加える。
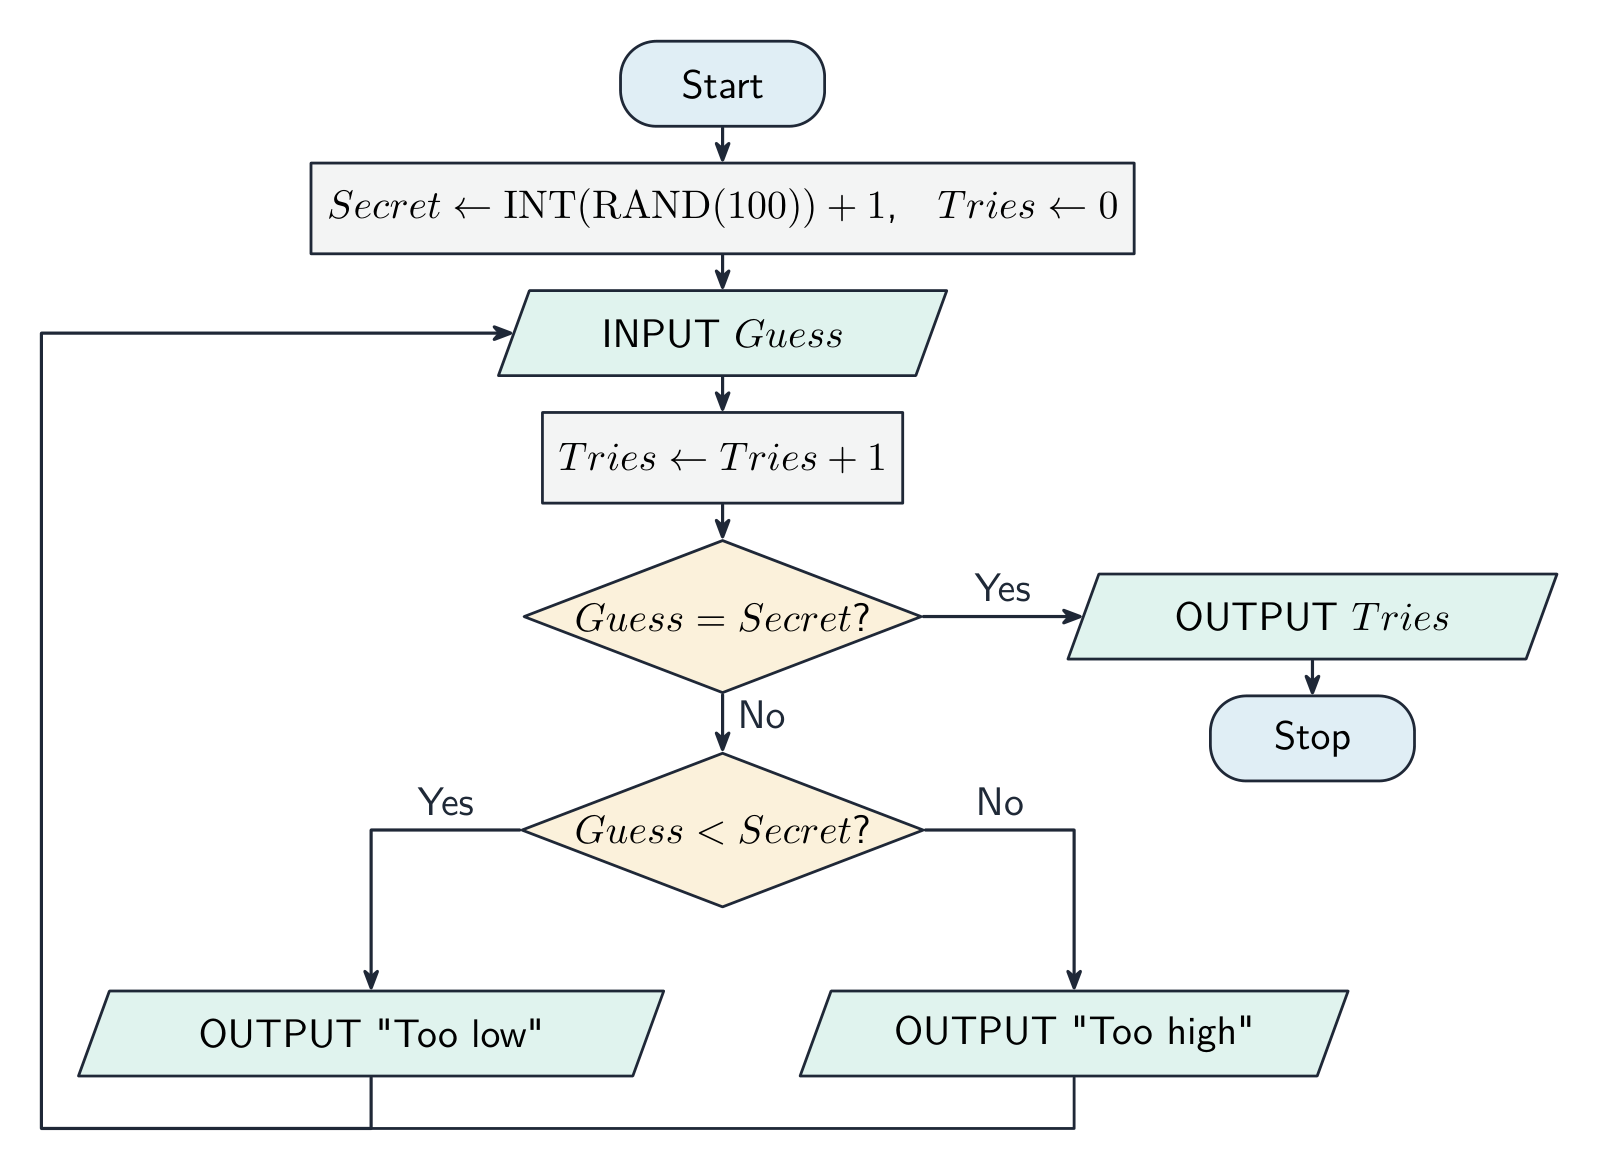
** worked example.** プログラムが1から100の秘密の整数を選びます。ユーザーが正解するまで推測を続け、不正解ごとに「低すぎ」または「高すぎ」と表示され、最後に何回の推測であったかを出力します。
識別子表: Secret : INTEGER (推測すべき数), Guess : INTEGER (ユーザーの入力), Tries : INTEGER (これまでに試した回数)。
DECLARE Secret, Guess, Tries : INTEGER
Secret ← INT(RAND(100)) + 1
Tries ← 0
REPEAT
    INPUT Guess
    Tries ← Tries + 1
    IF Guess < Secret THEN
        OUTPUT "Too low"
    ELSE
        IF Guess > Secret THEN
            OUTPUT "Too high"
        ENDIF
    ENDIF
UNTIL Guess = Secret
OUTPUT "You took ", Tries, " guesses"
REPEAT ... UNTIL ループが適切です。なぜならユーザーは少なくとも一度試す必要があるからです。採点は以下の要素に対するものです: 正しい範囲内のランダム数、正しい推測で終了するループ、ゼロから始まりループ内で増加するカウンタ、正しい条件の下にある2つのメッセージ、そして最終的な出力。
** worked example.** 2つの異なるランダム整数を出力し、それぞれが$-10$から$10$まで(両端を含む)であるようにしてください。
21個 possible な値があるため、INT(RAND(21)) は 0 から 20 を返し、10を引くことで$-10$から$10$の範囲に変換されます。2番目の数は1番目と異なるまで再生成する必要があります:
DECLARE First, Second : INTEGER
First ← INT(RAND(21)) - 10
REPEAT
    Second ← INT(RAND(21)) - 10
UNTIL Second <> First
OUTPUT First, Second

探索
IF … ELSE 選択構造
値を変化させてどの分岐が実行されるか観察してください。これがプログラムが判断を下す仕組みです。
語彙
練習する
| English | 日本語 |
|---|---|
| variable/ˈveərɪəbl/ | 変数 |
| data type/ˈdeɪtə taɪp/ | データ型 |
| pseudocode/ˈsuːdəʊkəʊd/ | 擬似コード |
| flowchart/ˈfləʊtʃɑːt/ | フローチャート |
| selection/sɪˈlekʃn/ | 選択 |
| iteration/ˌɪtəˈreɪʃn/ | 反復 |
| loop/luːp/ | ループ |
| count-controlled loop/kaʊnt kənˈtrəʊld luːp/ | カウント制御ループ |
| pre-condition loop/priː kənˈdɪʃn luːp/ | 前条件ループ |
| post-condition loop/pəʊst kənˈdɪʃn luːp/ | 後条件ループ |
| assignment/əˈsaɪnmənt/ | 代入 |
| concatenation/kənˌkætəˈneɪʃn/ | 連結 |
| initialise/ɪˈnɪʃəlaɪz/ | 初期化 |
| counter/ˈkaʊntə/ | カウンタ |
| structured English/ˈstrʌktʃəd ˈɪŋɡlɪʃ/ | 構造化英語 |
| stepwise refinement/ˈstepwaɪz rɪˈfaɪnmənt/ | 段階的精密化 |
| logic statement/ˈlɒdʒɪk ˈsteɪtmənt/ | 論理式 |
| precedence/ˈpresɪdəns/ | 優先順位 |
| De Morgan's law/də ˈmɔːɡənz lɔː/ | ド・モルガンの法則 |
9.2
3つの表記法

同一のアルゴリズムを3通りの方法で記述できます。
- 構文英語 — インデントと固定キーワードを用いた自然言語; 高レベルの説明に適しています。
- フローチャート — 標準形状の図:
| 形状 | 意味 |
|---|---|
| 丸角長方形 | Start / Stop |
| 平行四辺形 | Input / Output |
| 長方形 | Process |
| 菱形 | Decision |
| 矢印 | 制御の流れ |
- 擬似コード — 上記のキーワード表記; コードに最も近いです。
任意のペア間で変換できる必要があります: 各 IF は判断菱形、各ループは逆矢印、シーケンスは積み重ねられた長方形です。
IF ... THEN ... ELSE ... ENDIF
9.2
ステップバイステップ細分化

ステップバイステップ細分化 は高レベルのアウトラインから始め、各ステップを拡大してコード可能なサイズになるまで進めます。$n$ 個の数の平均の場合:
Level 1:
Read in the numbers
Compute the average
Output the average
Level 2:
INPUT n
total ← 0
FOR i ← 1 TO n
    INPUT value
    total ← total + value
NEXT i
average ← total / n
OUTPUT average
各細分化では前の構造を維持し、詳細を追加します。
6点満点の「段階的精密化を適用する」問題では、高レベルのアウトラインが提示され、各ステップをプログラマーがコードとして実装できる具体的な記述に拡張することを求める。ステップの順序を維持し、各ステップで読み込むまたは生成するデータ名を明記し、すべての行が単一の入力、代入、出力、ループ、または条件文になるまで進める。例えば、「パスワードを検証する」場合: パスワードを入力; その長さが少なくとも 8 であることを確認; 少なくとも1桁の数字を含んでいることを確認; 両方のチェックが通った場合は「承認」、それ以外は「拒否」を出力する。
探索
段階的精密化:アウトラインからコードへ
レベルを下げていきます。全体タスクを1行で始め、各ステップをより小さなものへと拡張し続け、すべてのステップが直接コーディングできるほど単純になるまで続けます。
9.2
論理式

論理式とは、比較演算子(x > 10)、論理演算子(AND, OR, NOT)および括弧から構成され、分岐を制御するブール条件です。IF、WHILEまたはREPEAT...UNTILの条件として使用します:
WHILE attempts < 3 AND NOT loggedIn DO
    INPUT password
    IF password = correctPassword THEN
        loggedIn ← TRUE
    ELSE
        attempts ← attempts + 1
    ENDIF
ENDWHILE
優先順位(高い順):NOT、次にAND、次にOR。不明な場合は括弧を使用してください。一般的なミス:
a = 1 OR 2は誤りです —a = 1 OR a = 2と書きなさい。NOT a > 5はNOT (a > 5)を意味し、つまりa <= 5です。NOT (A AND B)は(NOT A) OR (NOT B)と同じです(ド・モルガンの法則)— 条件を簡略化するのに便利です。
文を論理式に変換するスキルは、試験で直接問われます。「5歳未満または65歳以上の誰かにはチケットが無料である」はAge < 5 OR Age > 65になります。「0から100までの整数であれば得点は有効である」はMark >= 0 AND Mark <= 100になります。「ファイルが終了したか、または10レコード読み取った時点でループは停止する」はUNTIL EOF(File) OR Count = 10になります。各比較を完全に書きなさい:Age > 65およびAge < 5、決してAge > 65 OR < 5とは書かないでください。
** worked example(解例)。** 10個の数字を読み取り、最大値を出力するための識別子表と擬似コードを作成します。識別子表では、データ型と用途を含めて各変数名を指定します:Count : INTEGER(ループカウンタ)、Num : REAL(直近で読み取った数)、Max : REAL(これまでに最大の値)。
Max ← -999999
FOR Count ← 1 TO 10
    INPUT Num
    IF Num > Max THEN
        Max ← Num
    ENDIF
NEXT Count
OUTPUT Max
点数がつけられる設計上の決断は**Maxの初期化です:これはあり得る入力のいずれよりも低い値で開始する必要があります — または、より安全には、読み取った最初の数**に設定します。0で初期化すると、負の数のリストに対してアルゴリズムは誤って0を返してしまいます。これはテストデータに負の数が含まれた場合にのみトレースで暴露されるバグです。
アルゴリズム問題のためのプログラミング前提知識
アルゴリズムを書いたりトレースしたりする前に、シート11.1.1–11.1.2にある式および組み込み関数の方法を使用してください。TO_UPPERとTO_LOWERは文字列全体を受け取りますが、ガイド内のUCASEとLCASEは単一文字に対して動作します。問題文の指示に従ってください。
文字列を&で結合し、結合する前に数値をNUM_TO_STRで変換してください。プロシージャをCALL Name(arguments)で呼び出し、関数は式として使用します。SETDATE(day, month, year)はDATE値を構築します。評価前に型を確認してください:無効な式はERRORであり、推測された変換ではありません。
複数の合計があるフローチャートの場合、ループ开始前に各累加器を初期化してください。正しいブランチで更新し、カウンタを進め、終了条件をテストしてください。平均値はループの後に配置し、実際に含まれた値の数を使用してください。
9.2
出題者が認める定義
定義問題は固定された用語に基づいて採点されます。これらを正確に暗記し、一つの答えのみを答えてください。
| 用語 | 定義 |
|---|---|
| 抽象化 | 問題の必要な詳細を残し、不要な詳細を除外すること |
| 分解 | 問題をより小さなサブ問題に分割し、それぞれを個別に解決できるようにすること |
| アルゴリズム | 定義された一連のステップとして表現された問題への解決策 |
| 識別子表 | アルゴリズムで使用される各識別子のデータ型とその用途の説明を列挙した表 |
| 擬似コード | アルゴリズムのステップを記述する構造化された言語非依存の方式 |
| フローチャート | 標準的なシンボルを用いてアルゴリズムのステップと判断を示し、矢印で結んだ図 |
| 順序 | 記述された順に一つずつ実行されるステートメント |
| 選択 | 条件に基づいて実行すべきステートメントを選択すること |
| 反復 | 条件が成立している間、または成立しなくなるまで、一連のステートメントを繰り返すこと |
| 段階的精密化 | アウトラインの各ステップをより小さなステップに分割し、各ステップがそのままコード可能になるまで繰り返し行うこと |
| 論理式 | 比較演算子およびAND、OR、NOT演算子から構成され、TRUEまたはFALSEを評価する条件 |
9.2
試験対策
- アルゴリズムを、言語に依存せず、曖昧さのない有限かつ決定論的な一連のステップとして定義する。
- 三つの構成要素(順序、選択、反復)を正しく使用し、データ型を含む識別子表を保持する。
- 分解と抽象化によって問題を分解し、その後段階的精密化を行う。
- 実際に実行可能な擬似コードを書く:変数を宣言し、試験の擬似コードスタイルに従う。
一般的なミス
=を使用して値を割り当てる。代入は←であり、=は比較である。ENDIF、ENDWHILE、ENDCASE、またはNEXTを忘れる。すべての構成要素は閉じられ、閉じる言葉がその構成要素に対する採点ポイントで確認される。- ループ前に合計やカウンタを初期化しないため、存在しなかった値に足し算してしまう。
- 反復回数が未知の場合に
FORループを使用する。哨兵値や正しい推測まで読むにはWHILEまたはREPEAT ... UNTILが必要である。 Age > 65 OR < 5を書く。ORおよびANDの両辺は完全な比較でなければならない。- 「なぜ分解が使われるか説明せよ」という質問に対し、同じメリットを3通り異なる方法で書く。3点の問題には3つの異なるメリットが必要である。
このトピックのインタラクティブ授業
一歩ずつ進め、即時チェック付きの問題で学習します。