| 受験者は以下的能力を備えているべきである: | メモおよびガイドライン |
|---|---|
| コンピュータシステムの基本的なVon Neumannモデルおよび格納_program概念に関する理解を示す | |
| レジスタの目的と役割に関する理解を示す。汎用レジスタと特殊レジスタの違いを含む | 特殊レジスタには以下が含まれる:• プログラムカウンタ(PC)• メモリデータレジスタ(MDR)• メモリアドレスレジスタ(MAR)• アキュムレータ(ACC)• インデックスレジスタ(IX)• 現在指令レジスタ(CIR)• ステータスレジスタ |
| 演算論理ユニット(ALU)、制御ユニット(CU)、システムクロック、即時アクセスストレージ(IAS)の目的と役割に関する理解を示す | |
| アドレスバス、データバス、制御バスを用いてコンピュータシステムの異なるコンポーネント間でデータが転送される仕組みに関する理解を示す | |
| 要因がコンピュータシステムの性能に寄与する仕組みを理解する | • プロセッサの種類とコアの数 • バス幅 • クロック速度 • キャッシュメモリ を含む |
| 異なるポートが周辺機器への接続を提供する仕組みを理解する | 以下の接続を含む:• ユニバーサルシリアルバス(USB)• ハイディフェニションマルチメディアインターフェース(HDMI)• ビデオグラフィクスアレイ(VGA) |
| Fetch-Execute(F-E)サイクルの段階を説明する | F-Eサイクルを記述するためにレジスタ転送表記法を使用・記述する |
| 割り込みの目的に関する理解を示す | • 割り込みの可能性がある原因 • 割り込みの応用例 • 割り込みサービスルーチン(ISR)の使用 • Fetch-executeサイクル中の割り込み検出タイミング • 割り込みの処理方法 を含む |
プロセッサーの基礎
A-Level Computer Science · トピック 4
 21:25
Von Neumannアーキテクチャ
歴史の大部分において、機械は1つの作業しか行いませんでした。織機は布を織り、電卓は足し算をしました。新しいことをさせるには、再構築する必要がありました。そして、巧妙に単純な…が訪れました。
英語ナレーション・英語+中文字幕 burning-in
4.1
ヴォン・ネーマン構造
シラバス
出典: Cambridge International シラバス
ヴォン・ネーマン構造は、ほぼすべての汎用コンピュータの基盤となっています:
- 単一のメモリである即時アクセスストレージ(IAS)が、プログラム指令とデータの両方を保持する(格納プログラム概念)。
- **プロセッサ(CPU)**がメモリから指令をフェッチし、順に実行する。
- ブランチによってフローが変わらない限り、指令は順次実行される。
格納プログラムの考え方がコンピュータの柔軟性を生み出します。プログラムを変えれば配線の変更なく機能を変えることができます。
探索
Von Neumann コンピュータの各部分にタップしてください
各ブロックを調べましょう。CPU(制御ユニット、ALU、レジスタ)はバスを介して単一のメインメモリと通信し、命令とデータの両方を共有するこの単一メモリーが Von Neumann の発想です。
4.1
CPUの主要な構成要素

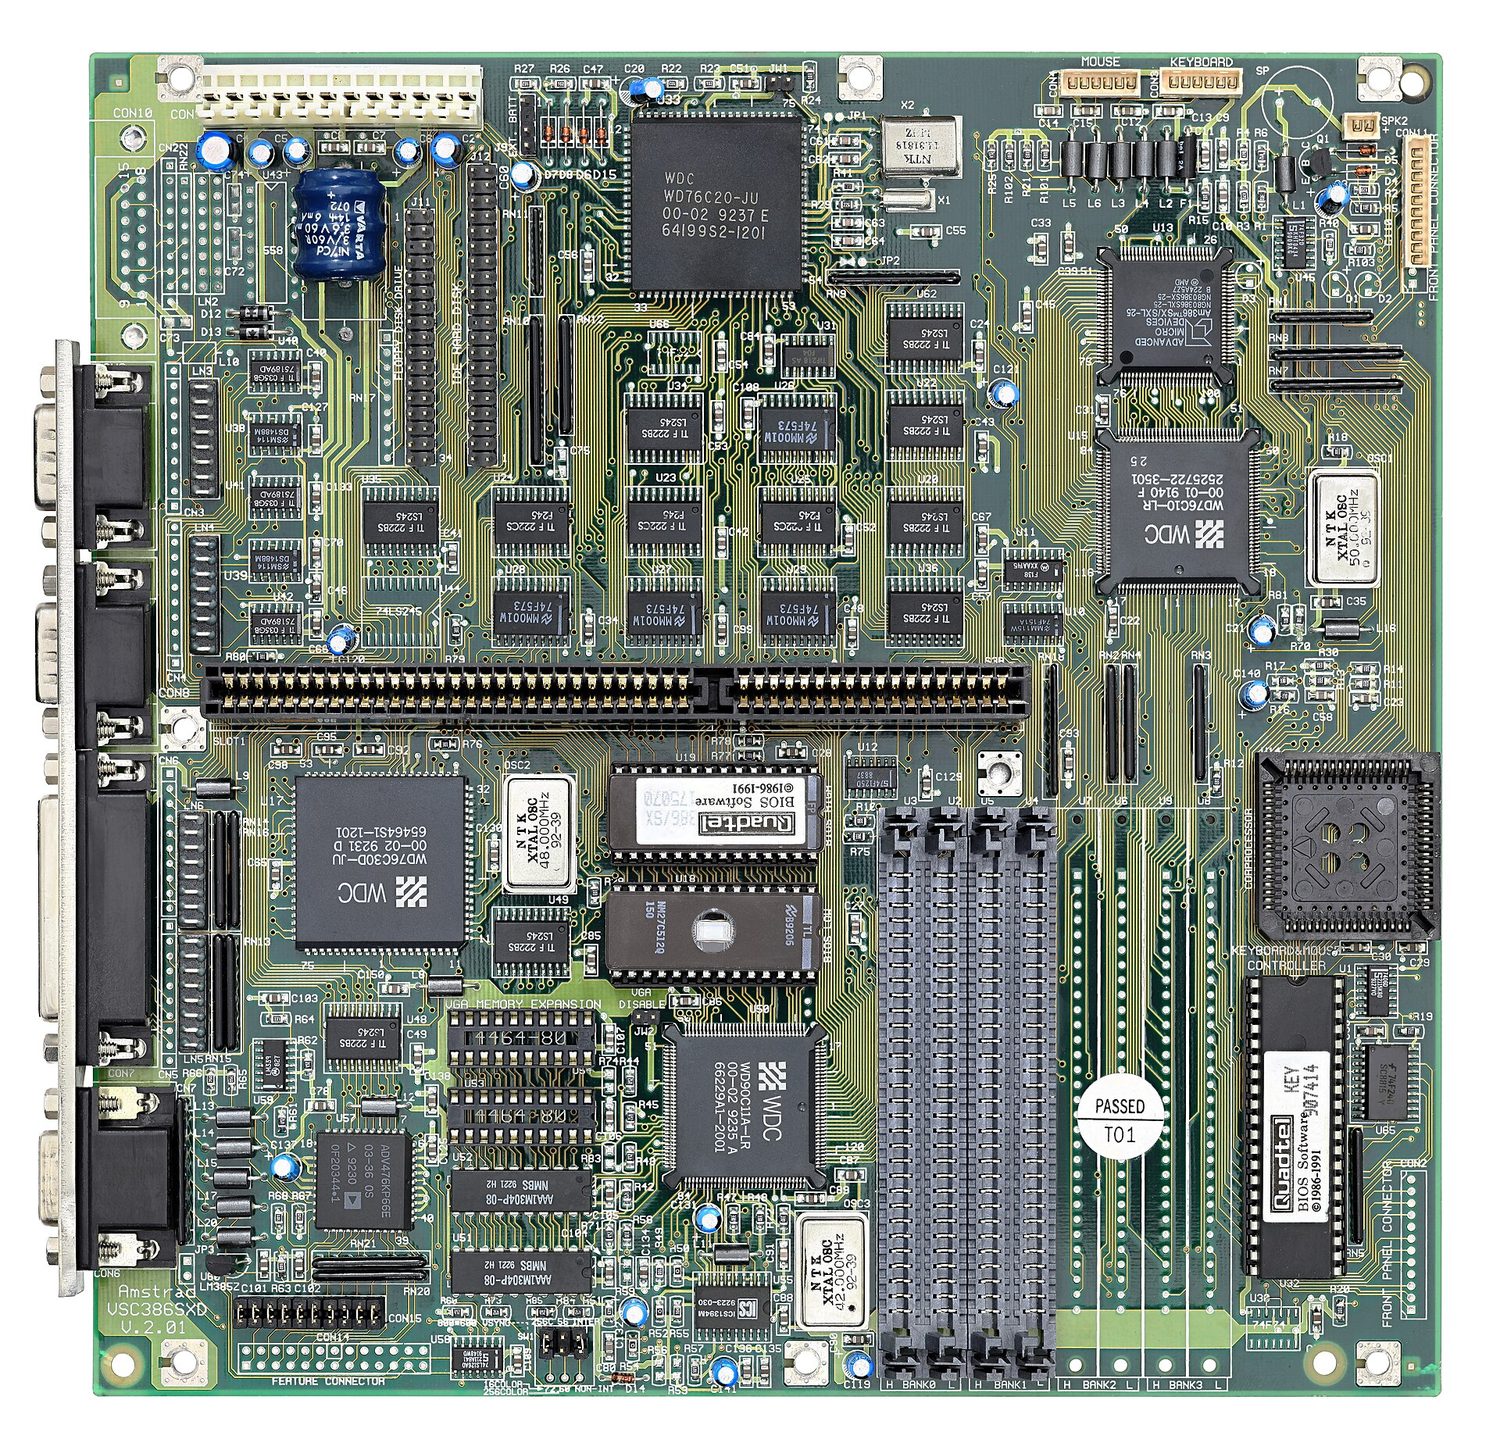
これらの構成要素はすべて小さなチップ内に収まっています。このセクション後の図は接続方法を示しており、下の写真が実際の部品です。

演算論理ユニット(ALU)
ALUは演算(加算、減算など)と論理演算(AND, OR, 比較)を行う。レジスタから操作数を受け取り、結果を再びレジスタに返す。
コントロールユニット(CU)
コントロールユニットは各指令をデコードし、それを実行するための制御信号を送信する——データパスを開く、ALUに指示を出し、メモリの読み出しと書き込みを制御する。
システムクロック
クロックは安定したパルスストリームを送信し、CPUを同期させる。各指令には一定数のサイクルがかかり、クロック速度(例:3.8 GHz)が性能の要因の一つとなる。
"CUとシステムクロックがどのように連携するか説明せよ": クロックは一定の周波数でパルスを発生させ、制御ユニットは各パルスを使ってフェチ・エグゼキューションサイクルを1ステップ進め、パルス同期で制御信号を送信する。その結果、プロセッサのすべての部分が一斉に状態を変化させる。より高速なクロックは、回路がパルスの間に安定する限界に達するまで、秒あたりのステップ数を増やす。
レジスタ
レジスタはCPU内部にある小型で非常に高速なストレージである。特殊目的レジスタはそれぞれサイクル内で固定された役割を持つ:
- プログラムカウンタ(PC) — 次の指令のアドレス。
- メモリアドレスレジスタ(MAR) — 読み出しまたは書き込みされているアドレス。
- メモリデータレジスタ(MDR) — メモリへ送られるか、メモリから来ているデータ。
- 現在指令レジスタ(CIR) — デコードされている指令。
- アキュムレータ(ACC) — ALUが処理中の値。
- ステータスレジスタ — ブランチに使用されるフラグ(キャリー、ゼロ、ネガティブ、オーバーフロー)を保持する。各フラグは1ビットで、演算後にALUによって設定またはクリアされる:比較で一致した後のゼロフラグ、加算でレジスタの範囲を超えた後のキャリーフラグ、結果が負の場合のネガティブフラグ。条件付きジャンプはフラグを読み取って分岐の有無を決定し、オーバーフローフラグは割り込みを引き起こすことがある。
- インデックスレジスタ — インデックス addressing でアドレスに加えられるオフセット;インクリメントすることで配列を1要素ずつ順に通過する。
「各レジスタの役割を記述する表を完成させる」問題では、以下の用語でレジスタごとに正確な1文を記述すること:PCはフェッチされる次の指令のアドレスを保持する;MARは読み出しまたは書き込みされている位置のアドレスを保持する;MDRはその位置から直近で読み出されたデータまたは、書き込まれようとしているデータを保持する;CIRは現在デコード・実行されている指令を保持する;ACCは最後の演算または論理演算の結果を保持する。
汎用レジスタは、計算中に一時的な値を保持するためにプログラマによって使用されます。レジスタとメモリ間のデータ移動はレジスタ転送記法で表され、例として MAR ← [PC]("PCの内容をMARにコピーする")があります。

語彙
練習する
| English | 日本語 |
|---|---|
| Von Neumann architecture/vɒn ˈnɔɪmən ˈɑːkɪtektʃə/ | フォン・ノイマン型アーキテクチャ |
| Immediate Access Store/ɪˈmiːdɪət ˈækses stɔː/ | 即時アクセスメモリ |
| stored program/stɔːd ˈprəʊɡræm/ | プログラム記憶方式 |
| processor/ˈprəʊsesə/ | プロセッサー |
| arithmetic and logic unit/ˌærɪθˈmetɪk ənd ˈlɒdʒɪk ˈjuːnɪt/ | 演算論理回路(ALU) |
| ALU/ˌeɪ el ˈjuː/ | ALU(演算論理回路) |
4.1
バス

3つの内部バス(平行配線のセット)が各部品を接続しています:
- アドレスバス — メモリアドレスを伝達します。単方向(CPU → メモリ)。
- データバス — データを伝達します。双方向。
- 制御バス — 制御信号(読み出し、書き込み、割り込み)を伝達します。双方向。
An $n$-bit address bus can reach $2^{n}$ memory locations. The data-bus width sets how many bits move per access (often the word size).
語彙
練習する
| English | 日本語 |
|---|---|
| bit/bɪt/ | ビット |
| buses/ˈbʌsɪz/ | バス |
| address bus/əˈdres bʌs/ | アドレスバス |
| data bus/ˈdeɪtə bʌs/ | データバス |
| word size/wɜːd saɪz/ | ワードサイズ |
| number of cores/ˈnʌmbə ɒv kɔːz/ | コア数 |
4.1
パフォーマンスに影響を与える要因
- クロック速度 — 秒あたりのサイクル数が増加する。
- コア数 — マルチコアCPUは複数のスレッドを同時に実行します。
- ワードサイズ — 64ビットCPUは1サイクルあたり64ビット単位を処理でき、32ビットCPUよりもはるかに多くのメモリにアドレス指定できます。
- RAM容量 — 多いほど動作セットを多く保持できます。不足するとOSがディスクへページングする必要があります。
- キャッシュメモリ容量 — 大きいほど平均的なメモリアクセス時間が短縮されます。
- 二次記憶装置の種類 — SSDはHDDよりもプログラムを大幅に高速で読み込みます。
- バスの幅と速度 — 幅が広く速いバスの方がデータをより早く転送できます。
仕様と負荷を対応させます:マルチタスクではクアッドコアがデュアルコアより優れていますが、シングルスレッド作業ではコアあたりの速度が高い方が勝ります。
各要因は理由付きで2点満点の回答となります:
- コア数の増加:各コアが独自の命令を同時に取得・実行できるため、複数のプログラムや1つのプログラムのスレッドが並列で実行されます。ただし、プログラムが複数コアを使用するように書かれていない限り、コア数を倍にしても速度が倍になるわけではありません。
- 高いクロック速度: 秒あたりのフェチ・エグゼキューションサイクル数が増加するため、秒あたりの命令処理数も増加する。ただし、発熱が限界となる。
- より広いバス: より広いデータバスは、各転送で多くのビットを転送するため、同じデータを扱うために必要な転送回数が少なくなる。また、より広いアドレスバスは、より多くのメモリ位置にアクセスできる。
- キャッシュメモリ:プロセッサ内部またはその隣にある小型かつ高速なメモリで、最も最近または最も頻繁に使われた指令やデータを保持します。これらにアクセスするのはRAMから行うよりも遥かに速いため、プロセッサの待ち時間が短縮されます。
"Explain why the new computer performs better" is answered by comparing the two specifications line by line: a higher clock speed executes more instructions per second, more cores run more tasks at once, more cache means fewer slow accesses to RAM, and more RAM means fewer transfers to disk.
語彙
練習する
| English | 日本語 |
|---|---|
| clock speed/klɒk spiːd/ | クロック速度 |
| cores/kɔːz/ | コア |
| amount of RAM/əˈmaʊnt ɒv ræm/ | RAM容量 |
| RAM/ræm/ | RAM(ランダムアクセスメモリ) |
| page/peɪdʒ/ | ページ |
| cache memory/kæʃ ˈmeməri/ | キャッシュメモリ |
| cache/kæʃ/ | キャッシュ |
| secondary storage/ˈsekəndəri ˈstɔːrɪdʒ/ | 補助記憶装置 |
| port/pɔːt/ | ポート |
| peripheral/pəˈrɪfərəl/ | 周辺機器 |
| register transfer notation/ˈredʒɪstə ˈtrænsfɜː nəʊˈteɪʃn/ | レジスタ転送記法 |
| interrupt service routine/ˈɪntərʌpt ˈsɜːvɪs ruːˈtiːn/ | 割り込みサービスルーチン |
| interrupt register/ˈɪntərʌpt ˈredʒɪstə/ | 割り込みレジスタ |
| stack/stæk/ | スタック |
| assembly language/əˈsemblɪ ˈlæŋɡwɪdʒ/ | アセンブリ言語 |
4.1
ポート
ポートとは、周辺機器を接続するための物理的なソケットです:
- USB (Universal Serial Bus) — 汎用(キーボード、ドライブ、携帯電話など)。
- HDMI (High Definition Multimedia Interface) — スクリーンへのデジタル映像・音声出力。
- VGA (Video Graphics Array) — モニターへの古いアナログ映像出力。
- Ethernet (RJ-45) — 有線LAN。オーディオジャック — ヘッドフォン/マイク。
異なるポートは異なる信号を使用するため、HDMIケーブルはUSBソケットには差し込めません。USB-Cは映像、データ、電力を同時に伝送する点で特徴的です。
"コンピュータがHDMIを通じてモニターに接続する方法"を説明すると:HDMIポートは映像とオーディオを1つのデジタル信号として単一のケーブルを介して送信するため、アナログへの変換が不要で画質が劣化しない。ケーブルは高解像度対応であり、モニター自体のポートが信号をデコードする。USBデバイスはプラグ&プレイである:接続するとコンピュータが検出し、識別し、必要なドライバーをロードまたはインストールし、電源を供給することができ、すべて再起動なしで行われる。
4.1
取得-実行サイクル

CPUは機械語指令ごとに1回ずつ取得-実行サイクルを繰り返します。
取得 (Fetch)
- PCのアドレスがMARにコピーされます。
- PCがインクリメントされて次の指令を指します。
- 読み出し信号が制御バスを介して送られます。
- メモリが指令をデータバスに乗せます。
- それはMDRにコピーされ、次にCIRに入力されます。
試験ではこれらの手順をレジスタ転送記法で求めることがあり、[X]はレジスタXの内容を、[[MAR]]はMARに格納されたアドレスを持つメモリ位置の内容を意味します。
MAR ← [PC]          the address of the next instruction goes to the MAR
PC  ← [PC] + 1      the PC now points to the following instruction
MDR ← [[MAR]]       the instruction at that address is read into the MDR
CIR ← [MDR]         the instruction is copied into the CIR for decoding
順序は重要です:ジャンプ指令が後から実行されたとしてもPCを上書きできるよう、PCのアドレスがコピーされた直後にPCはインクリメントされます。実行中も同様にこの記法を用いて各指令を記述します。例えば LDD 200 に対して、MAR ← 200, MDR ← [[MAR]], ACC ← [MDR] が用いられます。
デコード (Decode)
CUはCIR内の命令をデコードする——どの演算であり、どのオペランドまたはアドレスか。
実行
CUがこれを処理する:算术/論理演算はALUへ送られ(結果はACCへ)、ロード/ストアはメモリとレジスタ間のデータ転送を行う、分岐はPCを変更する。その後、サイクルが繰り返される。

探索
フェチ・エグゼキューションサイクル
CPu が秒間数十億回繰り返すループの周りをタップしてください。PC/MAR/MDR/CIR レジスタを使って how fetch が動作するか、そしてデコードとエグゼキューションがフェチされた内容进行如何处理看Watch how fetch uses the PC/MAR/MDR/CIR registers, then decode and execute act on what was fetched.
探索
フェッチ・エグゼクートサイクル
CPUが命令を実行する手順を追跡します:フェッチでメモリから読み出し、デコードして解釈し、エグゼクートして実行し、これを繰り返します。
語彙
練習する
| English | 日本語 |
|---|---|
| fetch-execute cycle/fetʃ ˈeksɪkjuːt ˈsaɪkl/ | 取指-実行サイクル |
| special purpose registers/ˈspeʃl ˈpɜːpəs ˈredʒɪstəz/ | 専用レジスタ |
| Program Counter/ˈprəʊɡræm ˈkaʊntə/ | プログラムカウンタ |
| Memory Address Register/ˈmeməri əˈdres ˈredʒɪstə/ | メモリアドレスレジスタ |
| Memory Data Register/ˈmeməri ˈdeɪtə ˈredʒɪstə/ | メモリデータレジスタ |
| Current Instruction Register/ˈkʌrənt ɪnˈstrʌkʃn ˈredʒɪstə/ | 現在指令レジスタ |
4.1
中断

中断とは、CPUが緊急イベント(キー入力、パケット到着、ハードウェア故障、ゼロ除算、OSタイマー)を処理できるよう通常のカイクルを一時的に停止させるシグナルである。
処理手順:
- 現在の命令を完了させる。
- 状態を保存する(PCとレジスタ)。
- 中断サービスルーチン(ISR)のアドレスをPCにロードして実行する。
- ISRがイベントを処理する。
- 保存された状態を復元し、続きから実行する。
中断により、システムはCPUがデバイスを常に監視する必要なく即座に対応でき、OSがマルチタスクを行う仕組みとなる。
「F-Eサイクルにおいて、入力機器からの中断が検出され処理される過程を説明せよ」という設問は4点満点で、以下の要点を含む:機器から中断シグナルが送られ、中断レジスタ内の中断フラグがセットされる。プロセッサは各フェチ-エグゼクート・サイクルの終了時、現在の命令の実行完了後にそのレジスタを確認する。フラグがセットされており、かつ中断の優先度が現在のタスクより高い場合、PCおよび他のレジスタの内容がスタックに保存される。中断サービスルーチンのアドレスがPCにロードされ、ルーチンが実行される。完了後、スタックから保存値が復元され、中断されたプログラムが停止した地点から再開される。
名乗るべき原因:機器からのハードウェア中断(キー押下、プリンタバッファ空、ネットワークパケット到着)、faultからのソフトウェア中断(ゼロ除算、不正指令、算术オーバーフロー)、OSによるタイムスライスの終了を示すタイマー中断、電源障害警告。
語彙
練習する
| English | 日本語 |
|---|---|
| interrupt/ˈɪntərʌpt/ | 割り込み |
4.2
アセンブラ言語とマシンコード

シラバス
| 受験者は以下的能力を備えているべきである: | メモおよびガイドライン |
|---|---|
| アセンブリ言語と機械語の関係に関する理解を示す | |
| 2パスアセンブラの組み立てプロセスにおける各段階を説明する | 与えられた単純なアセンブリ言語プログラムに対して2パスアセンブラのプロセスを適用する |
| 与えられた単純なアセンブリ言語プログラムのトレースを行う | |
| 命令セットがグループ化されていることを理解する | 以下のグループを含む: • データ転送 • データの入出力 • 演算処理 • 無条件および条件付き命令 • 比較命令 |
| 異なるアドレス指定モードを理解し、使用できる | 即値, 直接, 間接, インデックス, 相対 を含む |
出典: Cambridge International シラバス
CPUが実際に実行するのはマシンコード——特定のアーキテクチャ固有のビットパターンである。アセンブラ言語は readable な形式で、1つのマシン命令に対して1つの命令が割り当てられ、LDD、ADD、JMPのようなオペコード・ミモニックを用いて書かれる。アセンブラがこれをマシンコードに変換する。
2パス・アセンブラ
A two-pass assembler reads the source twice:
- pass 1:シンボルテーブルを構築する。每一次ラベル(例:
LOOP:)が出現するたびに、そのアドレスを記録する。この段階ではまだコード生成は行わない。 - pass 2:コードを生成する。各命令を変換し、ラベル(例:
JMP LOOP)を参照する場合、そのアドレスをシンボルテーブルから照合する。
2パス処理は前方参照(後で定義されるラベルへのジャンプ)を処理するために用いられる。
** worked example.** このプログラムに対して2パス処理を適用する。最初の命令はアドレス100に格納されている。
        LDD  COUNT
LOOP:   DEC  ACC
        CMP  #0
        JPN  LOOP
        END
COUNT:  5
Pass 1 reads each line, counts the address it will occupy, and records every label in the symbol table: LOOP = 101 (the DEC line) and COUNT = 105 (the data line). No code is produced. Pass 2 reads the program again and translates each line into machine code, replacing each mnemonic by its opcode and each symbolic address by the number from the symbol table: LDD COUNT becomes the opcode for LDD with operand 105, and JPN LOOP becomes the opcode for JPN with operand 101. The jump back to LOOP could have been resolved in one pass, but a jump forward to a label not yet seen could not, which is why the assembler makes two.
例示の命令セット
Cambridgeでは小さな汎用セットを使用し、試験紙の参照表に記載されている。1つの汎用レジスタとして累加器(ACC)とインデックスレジスタ(IX)がある。オペランドの表記法として、#nはデナリ数、Bnはバイナリ数、&nはヘキサデシマル数、<address>はロケーション番号またはラベルを表す。
| グループ | 命令 | 機能 |
|---|---|---|
| データ移動 | LDM #n |
数nをACCにロード(即時 addressing) |
LDD <address> |
指定アドレスの内容をACCにロード(直接 addressing) | |
LDI <address> |
そのアドレスが別のアドレスを指している;その先の内容をACCにロード(間接 addressing) | |
LDX <address> |
IXをアドレスに加えた結果の場所から内容を取り出しACCにロード(インデックス addressing) | |
LDR #n |
数nをIXにロード | |
MOV <register> |
ACCの内容を指定されたレジスタ(IX)にコピー | |
STO <address> |
ACCの内容を指定アドレスにストア | |
| 入出力 | IN |
キー押しのASCIIコードを読み取りACCに格納 |
OUT |
ACC の ASCII コードを持つ文字を出力する | |
| 算术 | ADD <address> / ADD #n |
アドレスの内容または数nをACCに加算 |
SUB <address> / SUB #n |
ACCから引き算 | |
INC <register> / DEC <register> |
ACCまたはIXに+1/-1 | |
| 比較 | CMP <address> / CMP #n |
ACCとアドレスの内容またはnを比較しフラグを設定 |
CMI <address> |
ACCと指定アドレスが指す先の内容を比較(間接 addressing) | |
| ジャンプ | JMP <address> |
無条件で指定アドレスへジャンプ |
JPE <address> / JPN <address> |
最後の比較が等しい/等しくない場合にジャンプ | |
| ビット操作 | AND, OR, XOR と #n, Bn, &n または <address> |
ACC に対するビット演算 |
LSL #n / LSR #n |
ACC を論理的に n 桁左または右へシフト | |
END |
プログラム終了 |
「アセンブリ言語の命令はグループ化されている」という問題では、各グループ名とその例として、データ移動、入出力、算術演算、无条件分岐( unconditional jump)、条件分岐( conditional jump)、比較、ビット操作の命令を一つずつ答える必要があります。
探索
2パス・アセンブラの動作原理
Step through it. The assembler reads your code twice: pass 1 just finds where every label lives, so pass 2 can fill in the addresses — that is how a jump to a label defined later still works.
語彙
練習する
| English | 日本語 |
|---|---|
| operand/ˈɒpərænd/ | オペランド |
| register/ˈredʒɪstə/ | レジスタ |
| control unit/kənˈtrəʊl ˈjuːnɪt/ | 制御ユニット |
| machine code/məˈʃiːn kəʊd/ | 機械語 |
| mnemonics/nɪˈmɒnɪks/ | 助記符 |
| assembler/əˈsemblə/ | アセンブラ |
| symbol table/ˈsɪmbl ˈteɪbl/ | シンボルテーブル |
| label/ˈleɪbl/ | ラベル |
| forward references/ˈfɔːwəd ˈrefrənsɪz/ | 前方参照 |
| opcode/ˈɒpkəʊd/ | オペコード |
4.2
アドレス指定モード
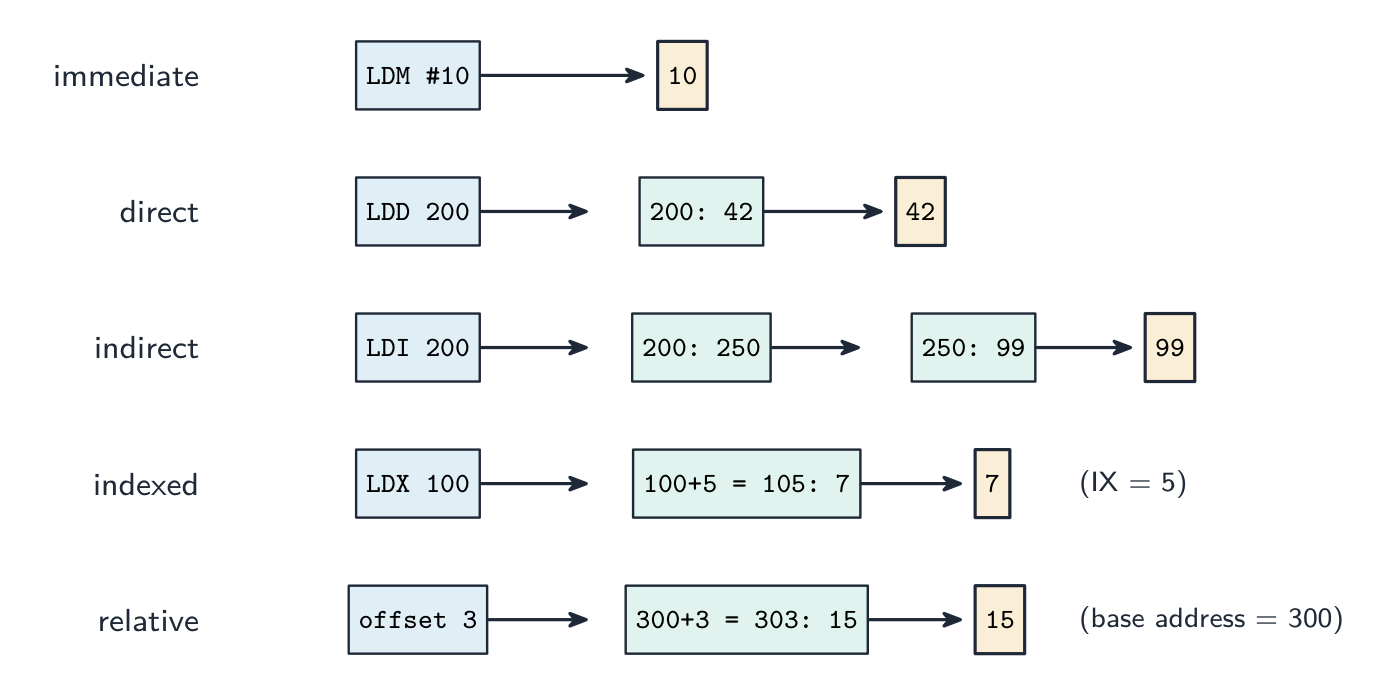
アドレス指定モード(アドレス指定のモード)とは、CPUがオペランドを見つける方法を指します:
- 即値指定 — オペランドは命令内の値そのものです。
LDM #10は 10 を読み込みます。 - 直接指定 — 命令内にアドレスが含まれており、オペランドはそのアドレスにある値です。
LDD 200。 - 間接指定 — 命令内にあるアドレスが別のアドレスを含んでおり、それがデータとなります。
LDI 200。 - インデックス付アドレス指定 — 有効アドレスは
address + index registerです。配列で用いられます。IX = 5を用いてLDX 100を読み出すと、アドレス105が参照されます。
(相対指定では、PCからのオフセットとしてアドレスが与えられます。ジャンプに使用されます。)
** worked example.** メモリには:位置 200 = 250、位置 250 = 99、位置 105 = 7 が格納されています。インデックスレジスタには 5 が格納されています。LDM #200、LDD 200、LDI 200、LDX 100 のそれぞれ後にAccumulator (ACC) には何が入っているか?各モードがどこまで探しているかを確認してください。LDM #200 は 即値指定 です — オペランド は 命令に書かれている数字そのものなので、ACC には 200 が格納されます。LDD 200 は 直接指定 です — 位置 200 に移動してそこにある値を取得します:250。LDI 200 は 間接指定 です — 位置 200 には 250 があり、これは 別のアドレス なので、さらに位置 250 に移動します:99。LDX 100 は インデックス指定 です — インデックスレジスタの値をアドレスに足し合わせ、$100 + 5 = 105$ 、そして位置 105 を読み込みます:7。区別するために「ホップ」数を数えます:即値指定 0、直接指定 1、間接指定 2、インデックス指定 1(インデックスを加えた後)。
語彙
練習する
| English | 日本語 |
|---|---|
| accumulator/əˈkjuːmjʊleɪtə/ | 累加器 |
| Status Register/ˈsteɪtəs ˈredʒɪstə/ | ステータスレジスタ |
| flags/flæɡz/ | フラグ |
| Index Register/ˈɪndeks ˈredʒɪstə/ | インデックスレジスタ |
| indexed addressing/ˈɪndekst əˈdresɪŋ/ | インデックスアドレス指定 |
| general-purpose registers/ˈdʒenərəl ˈpɜːpəs ˈredʒɪstəz/ | 汎用レジスタ |
| register transfer/ˈredʒɪstə ˈtrænsfɜː/ | レジスタ転送 |
| control bus/kənˈtrəʊl bʌs/ | 制御バス |
| addressing mode/əˈdresɪŋ məʊd/ | アドレス指定モード |
| immediate addressing/ɪˈmiːdɪət əˈdresɪŋ/ | 即値指定 |
| direct addressing/daɪˈrekt əˈdresɪŋ/ | 直接アドレス指定 |
| indirect addressing/ɪndaɪˈrekt əˈdresɪŋ/ | 間接アドレス指定 |
| relative addressing/ˈrelətɪv əˈdresɪŋ/ | 相対アドレス指定 |
| logical shift/ˈlɒdʒɪkl ʃɪft/ | 論理シフト |
| cyclic shift/ˈsaɪklɪk ʃɪft/ | 巡回シフト |
4.2
アセンブリプログラムのトレース
プログラムを トレース するには、PC、ACC、インデックスレジスタ、各変数、およびフラグの列を持つ表を作成します。命令を順にたどり、每一步ごとに表を更新します。PCが変わる分支(分岐)も追跡します。END に到達したら停止します。一般的なパターンは、インデックス指定を用いて配列をループ処理することです。
** worked example.** このプログラムをトレースしてください。アドレス 200 には 5、アドレス 201 には 0 が格納されています。
100   LDD  200
101   CMP  #0
102   JPE  108
103   OUT
104   DEC  ACC
105   STO  200
106   LDD  201
107   JMP  100
108   END
実行された命令ごとに1行書き、変化した列のみ埋めてください:
| 命令 | ACC | 200 | 201 | 出力 |
|---|---|---|---|---|
| スタート | 5 | 0 | ||
LDD 200 |
5 | |||
CMP #0 |
||||
JPE 108 |
分岐なし | |||
OUT |
コード 5 の文字 | |||
DEC ACC |
4 | |||
STO 200 |
4 | |||
LDD 201 |
0 | |||
JMP 100 |
||||
LDD 200 |
4 |
このようにLDD 200 が 0 を読み込んで、比較で等号フラグが設定され、JPE 108 が分岐してプログラムが終了するまで続きます。受験者が確認する3つのポイント:a CMP はレジスタではなくフラグのみを変更する;b 分岐しないジャンプでも実行済みと数える;c OUT は文字を出力するため、出力列に入り、ACC列には入らない。「LDD 10 を LDM #10 に変更した影響を示せ」:ACC にはアドレス 10 の内容ではなく、数値 10 が格納されることになります。
4.3
バイナシフト

シラバス
| 受験者は以下的能力を備えているべきである: | メモおよびガイドライン |
|---|---|
| ビットシフトを理解し、実行できる | 論理, 算術, 巡回 左シフト, 右シフト |
| ビット操作を用いてデバイスの監視・制御を行う方法を理解する | ビット操作を実行する バイトのテストとセット (ビットマスクを使用して) |
| 命令ラベル | オペコード | 演算子 | 説明 |
| AND #n / Bn / &n | ACCの内容と演算子のビット単位のAND演算 |
| AND | ACCの内容と の内容とのビット単位のAND演算 |
| XOR #n / Bn / &n | ACCの内容と演算子のビット単位のXOR演算 |
| XOR | ACCの内容と の内容とのビット単位のXOR演算 |
| OR #n / Bn / &n | ACCの内容と演算者のビット単位のOR演算 |
| OR | ACCの内容と の内容とのビット単位のOR演算 |
| LSL #n | ACC内のビットを論理的にn桁左へシフト。右端にゼロを挿入 |
| LSR #n | ACC内のビットを論理的にn桁右へシフト。左端にゼロを挿入 |
| 命令にラベルを割り当てる | |
| 内容が であるメモリ位置に記号アドレス | |
| 全問題は利用可能な汎用レジスタが1つ(累加器)のみであることを前提とする。ACCは累加器、IXはインデックレジスタを表す。 は絶対アドレスまたは記号アドレス可以是。# は十進数(例: #123)、B は二進数(例: B01001010)、& は十六進数(例: &4A)を表す |
出典: Cambridge International シラバス
論理シフト は、すべてのビットを一定の桁数だけ左または右へ移動させ、新しい位置には 0 を埋めます。
- 1桁左シフト (
LSL #1) — ビットが左へ移動し、右側に 0 が追加されます。符号なし数に対しては × 2 となります。 - 1桁右シフト (
LSR #1) — ビットが右へ移動し、左側に 0 が追加されます。符号なし数に対しては 整数 ÷ 2 となります。
$n$ 桁シフトすると、$2^{n}$ 倍または除算されます。例:00001011 (11) LSL #1 → 00010110 (22)。
右端にシフトされて消えたビットは失われるため、それらがゼロであった間のみ乗算は正しくなります。LSL #2 を 2 の補数整数 11001010 に適用すると 00101000 が得られます:左から落ちた 2 つの 1 は消失し、符号ビットが変化するため、結果はもはや元の値の4倍ではありません。
算術右シフト は符号ビットを維持するため、負の符号付き数は負のままです。巡回シフト(回転)では、片端から外れた bit をもう片端に戻すため、ビットが失われることはありません。
"10011110 に対して3桁の算術右シフトの結果を示せ": 空いた位置にすべて符号ビットをコピーし、11110011 になります。同じシフトを 01011100 に行うと 00001011 になります。10000110 に対して1桁の巡回左シフトを行うと 00001101 になります:先頭の1が右側にも現れます。
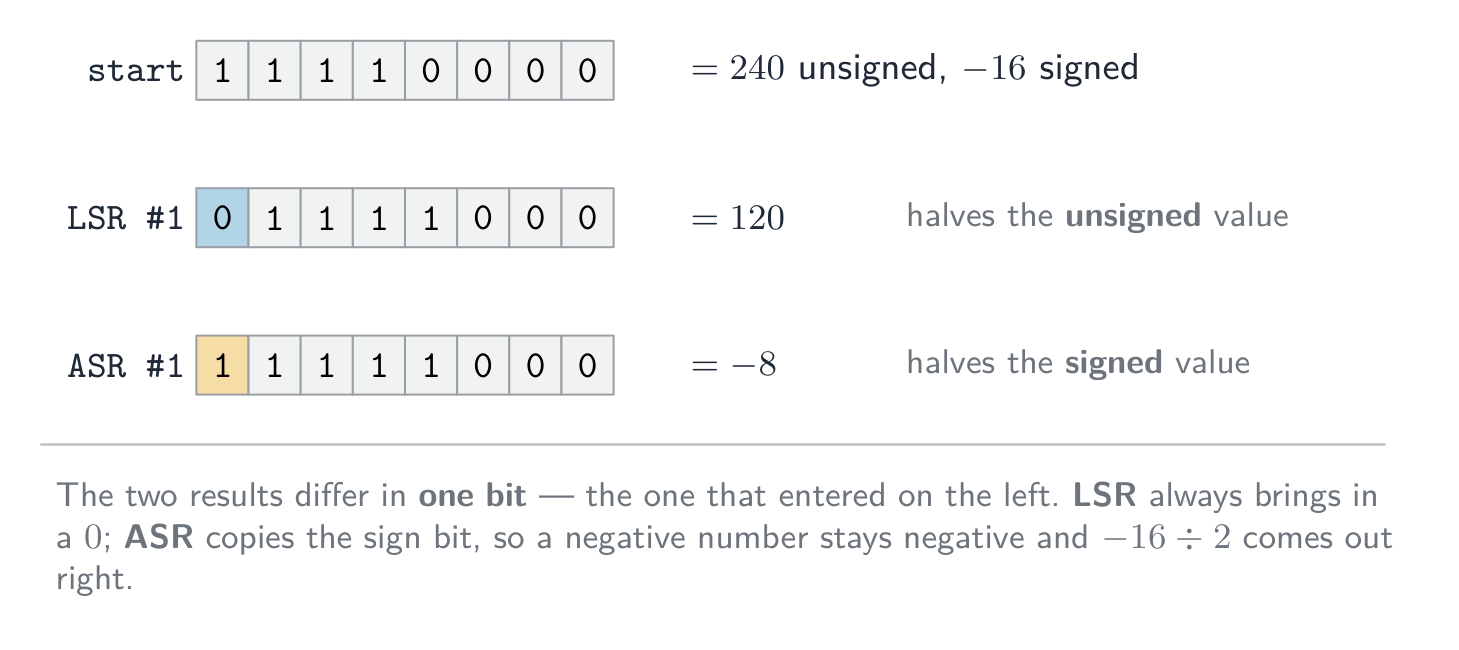
右シフト2つの違いは1ビットです。11110000 を無符号として解釈すると 240 、有符号として解釈すると $-16$ になります。LSR #1 は 0 を取り込んで 01111000 $= 120$ を生成し、これは 240 の正しい半分です。ASR #1 は符号ビットをコピーして 11111000 $= -8$ を生成し、これは $-16$ の正しい半分です。どちらが間違っているわけではありません。それぞれの解釈において値を半分にするのです。
モニタリング/制御のためのビット操作
組み込みデバイスは、信号ごとにレジスタのビットを1つ使用することが多いです(例:bit $n$ = LED $n$)。マスク — ビットマスク — を使用すると以下が行えます。
- セット bit $n$:
R = R ORbit $n$ がセットされたマスク。 - クリア bit $n$:
R = R ANDbit $n$ がクリアされ、残りがセットされたマスク。 - トグル bit $n$:
R = R XORbit $n$ がセットされたマスク。 - テスト bit $n$:
R ANDマスクし、結果がゼロ以外かどうかを確認する。

ビット操作は高速でメモリ消費が少なく、1バイトで最大8つのオン/オフ状態を保持できます。
試験の命令セットでは、これらは AND, OR および XOR であり、マスクは十進法、二進法または十六進法の演算子として書かれます。ACCが 10101100 を保持している場合:
| 命令 | マスク | ACC内の結果 | 効果 |
|---|---|---|---|
AND B00001111 |
00001111 |
00001100 |
下位4ビットのみを維持(他をクリア) |
OR #1 |
00000001 |
10101101 |
最下位ビットをセットし、其余を変更しない |
XOR &FF |
11111111 |
01010011 |
全ビットを反転する |
AND B00001000 then CMP #0 |
00001000 |
00001000 |
bit 3 をテスト: 比較結果が不等であるため、bit 3 はセットされていた |
LSL #2 |
10110000 |
左へ2桁シフトし、上位2ビットを喪失 | |
LSR #3 |
00010101 |
右へ3桁シフトし、左側からゼロが入る |
"最小有効ビットを 1 に設定し、他のビットは変更しない命令を書け": OR #1 または OR B00000001。ビットをクリアするには、該当する位置に 0 を持ち、他には 1 があるマスクで AND を使用します。ビットをテストするには、該当する位置にのみ 1 を持つマスクで AND を実行し、結果がゼロと比較されます。モニタリングデバイスでは、1ビットのレジスタが1つのセンサーに対応しており、単一の AND で特定のセンサーがオンかチェックでき、また単一の OR でアクチュエータの制御ビットをオンにしつつ他のビットを乱すことなく操作できます。
探索
バイトのビットをシフトしてマスク適用する
演算子を選び、各結果ビットを見る。左シフト (<<) moves every bit up one place (×2); a right shift (>>) は値を下へ移動させ(÷2)、マスクとのANDで不要なビットをクリアする。
語彙
練習する
| English | 日本語 |
|---|---|
| mask/mæsk/ | マスク |
4.3
出題者が認める定義
定義問題は固定された用語に基づいて採点されます。これらを正確に暗記し、一つの答えのみを答えてください。
| 用語 | 定義 |
|---|---|
| 格納プログラム概念 | プログラム命令とデータは両方とも主記憶に格納されており、命令は一度に1つずつ取得・実行される |
| レジスタ | プロセッサ内部にある特定の目的を持つ小型の高速ストレージ場所 |
| プログラムカウンタ | 次の指令を取得するためのアドレスを保持するレジスタ |
| メモリアドレスレジスタ | 読み出しまたは書き込み対象のメモリの場所のアドレスを保持するレジスタ |
| メモリデータレジスタ | 直近でメモリから読み出されたデータや指令、あるいは書き込まれようとしているデータや指令を保持するレジスタ |
| 現在指令レジスタ | 現在デコードおよび実行されている指令を保持するレジスタ |
| アキュムレーター | 最後の演算論理演算の結果を保持する汎用レジスタ |
| キャッシュメモリ | プロセッサ付近にある小容量高速メモリで、頻繁に使用される指令やデータを保持 |
| インターラプト | デバイスやプログラムからの信号で、プロセッサが現在のタスクを一時停止し、インターラプトサービスルーチンを実行させること |
| アセンブリ言語 | 各MNEMONIC指令が1つの機械語指令に対応する低レベル言語 |
| 即座のアドレス指定 | 演算子は指令内に書かれた値である |
| 直接アドレス指定 | 演算子は指令内に書かれたアドレスの内容である |
| 間接アドレス指定 | 指令内のアドレスが演算子のアドレスを指す |
| 索引付きアドレス指定 | 演算子のアドレスは指令内のアドレスにインデックスレジスタの内容を加えたものである |
| 相対アドレス指定 | 演算子のアドレスは現在の指令のアドレスからのオフセットとして与えられる |
| 論理的シフト | 各ビットが指定された桁数移動し、空いた位置にはゼロが入る |
4.3
試験対策
- フェッチ-エグゼクートサイクルをレジスター転送の用語(PC, MAR, MDR, CIR, ACC)で学び、PCをインクリメントするものが何かを理解する。
- 各レジスタの役割を名指し;アドレスバスは一方向、データバスは双方向である。
- アドレス指定モード(即座、直接、間接、索引付き)を区別すること — 頻出問題。
- クロック速度、コア数、キャッシュサイズ、ワード長がパフォーマンスに与える影響を説明する。
- バイナリシフトについて、それが論理シフトか算術シフトかを述べる;左シフトは2倍、右シフトは2分の一にする。
一般的なミス
- PCが現在の指令を保持している、あるいはMDRがアドレスを保持していると言う。PCは次の指令のアドレスを保持し、MDRはデータや指令を保持し、決してアドレスを保持しない。
- フェッチからPCのインクリメントを除外するか、エグゼクートの後に置く。アドレスがMARにコピーされた瞬間に行われる。
LDD 10を "load 10" と読む。LDD 10はアドレス10の内容をロード;LDM #10は数10をロードする。CMPまたはOUTのACC列に値を入れる。比較はフラッグのみを設定;出力は出力列へ向かう。- インターラプトが "即時" に処理されると言う。プロセッサは現在の指令を完了させ、サイクルの終わりにインターラプトをチェックする。
- 負の2の補数に対して論理的右シフトを行う。符号ビットを維持するのは算術シフトのみである。
このトピックのインタラクティブ授業
一歩ずつ進め、即時チェック付きの問題で学習します。