| 受験者は以下的能力を備えているべきである: | メモおよびガイドライン |
|---|---|
| 問題解決に適した データ型 を選択して使用する | 整数, 実数, char, 文字列, ブール, 日付 を含む(擬似コードでは以下のデータ型を使用する:INTEGER, REAL, CHAR, STRING, BOOLEAN, DATE, ARRAY, FILE) |
| 単一の識別子の下で異なるデータ型のデータセットを保持するための レコード構造 の目的を理解する | レコード構造を定義する擬似コードを書く |
| レコード構造からデータを読み書きし、レコード構造にデータを保存する擬似コードを書く |
データ型とデータ構造
A-Levelコンピュータ科学 · トピック 10
 17:40
データ型と構造体
プログラムが格納するすべての値にはデータ型が必要であり、適切なものを選ぶことが重要です。ある商品が在庫にあるかどうかを格納する場合来说、yesという単語を書き込むこともできます…
英語ナレーション・英語+中文字幕 burning-in
10.1
データタイプの選択
シラバス
出典: Cambridge International シラバス
すべての変数にはデータタイプが必要です — 保持する値の種類と許容される操作です:
INTEGER— 整数(42,-7)。カウント、インデックス、ID用。REAL— 小数部を持つ数(3.14)。金銭、測定値用。STRING— 引用符内の文字("Hello")。テキスト用。CHAR— 単一の文字('A')。BOOLEAN—TRUEまたはFALSE。フラグ用。DATE— カレンダー日付。
正確に収まる最も小さいタイプを選ぶ:整数のカウントにはINTEGER、フラグにはBOOLEAN(文字列"yes"/"no"ではなく)を使う。
"適切なデータタイプを与えよ」という表は、値の使用法によって決定されます:クラス平均得点はREAL(小数部があるため);メールアドレスはSTRING;生徒数はINTEGER;生徒が支払い済みかどうかはBOOLEAN;生年月日はDATE;配列のインデックスは常にINTEGER;単一のグレード文字はCHAR;電話番号はSTRINGである。なぜなら、0で始まり、計算には使われないからである。BOOLEANは、検索がターゲットを見つけたかどうか、メンバーが支払い済みのかどうか、座席が予約されているかどうかなど、2つの状態しかないフラグに使用される。識別子表については、変数名も意味のあるものにしなければならない:NumberOfPeople、nではない。
10.1
レコード

レコード(レコード構造)は、一つの名前の下に複数の異なる種類のフィールドを保持する — 複数の値が一つのものを記述する場合に有用である。
TYPE TStockItem
    DECLARE ItemID : INTEGER
    DECLARE Category : STRING
    DECLARE ItemCost : REAL
    DECLARE InStock : BOOLEAN
ENDTYPE
これは型TStockItemを定義しており、それ可以使用する変数を宣言する:
DECLARE Item1 : TStockItem
DECLARE Items : ARRAY[1:100] OF TStockItem
ドット表記を使用して各フィールドにアクセスする:
Item1.Category ← "Fruit"
OUTPUT Item1.Category, " costs ", Item1.ItemCost
値が常にセットで存在する場合(顧客、在庫商品など)にレコードを使用し、無関係な値には個別の変数を使用します。
計算例。 クラブは、各生徒について、生徒ID(文字列)、氏名、生年月日、最大3つのクラブ番号(整数)を格納します。レコード型、$3000$人の生徒を保持する配列、および先頭要素に氏名を格納する文を宣言する疑似コードを書きなさい。
TYPE Student
    DECLARE StudentID : STRING
    DECLARE Name : STRING
    DECLARE DateOfBirth : DATE
    DECLARE Club : ARRAY[1:3] OF INTEGER
ENDTYPE

DECLARE Membership : ARRAY[1:3000] OF Student
Membership[1].Name ← "Li Wei"
得点:TYPEと識別子、ENDTYPE;各フィールドは適切な型で宣言され、配列は境界値とOF Studentで宣言され、フィールドはインデックスとドットで参照されます。「レコード宣言の誤りを述べよ」という問題は通常、欠落したENDTYPE、型のないフィールド、または算術値を保持すべきSTRINGとして宣言されたフィールドを指します。独自に得点される2つの慣例があります。一つは未使用の要素を現実的なデータになり得ない値(空の文字列、-1、0のID)でマークすることです。また、すべてのモジュールが未使用スロットを認識できるように、どこでも同じマーカーを使用するのが良い習慣であり、未使用のクラブフィールドは0となります。「3つの利点を述べよ」という問題に対して、レコードの配列を用いる利点は、一つのエンティティに関する全てのデータを一つの識別子の下に保持できる点、フィールドが異なるデータ型を持つことができる点、複数の平行配列を同期して管理する必要がなく一つの配列で代替できる点、全てのデータを一つのループで処理したり一つのパラメータとして渡したりできる点、そしてフィールドを追加する場合に型定義を変更すればよい点です。一人の顧客に対しては適した構造はレコード(一つの名の下の異なる型のフィールド)であり、全ての顧客に対してはレコードの配列です。
探索
レコードは複数のフィールドを一つの名称の下にまとめます
レコードは関連するフィールドを束ねます。各フィールドは名前付きラベルであり、数値インデックスではなく、ドット表記(Item1.Category)でアクセスします。
語彙
練習する
| English | 日本語 |
|---|---|
| array/əˈreɪ/ | 配列 |
| record/ˈrekɔːd/ | レコード |
| record structure/ˈrekɔːd ˈstrʌktʃə/ | レコード構造 |
| field/fiːld/ | フィールド |
| element/ˈelɪmənt/ | 要素 |
| bounds/baʊndz/ | 境界 |
| stack/stæk/ | スタック |
| dimension/daɪˈmenʃn/ | 次元 |
10.2
配列

シラバス
| 受験者は以下的能力を備えているべきである: | メモおよびガイドライン |
|---|---|
| 配列 に関連する技術用語を使用する | インデックス, 上限, 下限 を含む |
| 特定のタスクに適したデータ構造(1D または 2D 配列)を選択する | |
| 1D および 2D 配列の擬似コードを書く | |
| 配列データの処理を行う擬似コードを書く | バブルソート によるソート、線形探索 による検索 |
出典: Cambridge International シラバス
配列とは、一つの名の下で同じ型の項目の順序立てられた集合であり、インデックスによって参照されます。
- 要素 — 配列内の一つの項目。
- 境界 — 有効なインデックスの最小値と最大値。
- 次元 — 1-D(リスト)、2-D(表)など。
- 下限と上限 — 最初の有効インデックスと最後の有効インデックス;要素数は上限から下限を引いた値に1を加えたものとなり、2-D配列では二つの個数の積となります。
したがってThisArray[n] ← 42において、この配列は一次元であり、インデックスは変数n(INTEGER)であり、そのインデックスの要素には42が入ります。配列を宣言するには、境界値だけでなくデータ型も必要です。小数点を含む可能性がある$120$の値を宣言するために:DECLARE Data : ARRAY[1:120] OF REAL;2列×$150$行の文字列表:DECLARE Data : ARRAY[1:150, 1:2] OF STRING、これは$300$の要素を持ちます。個別の変数よりも配列を用いる利点について、「2点説明せよ」という問題では、三十個の変数名ではなく一つの識別子である点、インデックスをカウンタとしてループで要素を処理できる点、サイズの変更が可能である点、全てのデータを一つのパラメータとしてモジュールに渡せる点が挙げられます。配列はまた、選択文の連鎖を置き換えることもできます。DaysInMonth[Month]は直接答えを検索するため、十二個のIF節を必要とせず、短く、書きやすく、保守しやすいです。
1-D配列
DECLARE Names : ARRAY[1:5] OF STRING
Names[3] ← "Cara"
OUTPUT Names[3]
FORループを使ってすべての要素を処理します:
FOR i ← 1 TO 5
    OUTPUT Names[i]
NEXT i
2-D配列(2D配列)
DECLARE Grid : ARRAY[1:3, 1:4] OF INTEGER
Grid[2, 3] ← 99
最初のインデックスは行、次のインデックスは列を表します。すべてのセルを訪問するために嵌套ループを使用します。単一のシーケンスには1-D、自然な2つの次元(グリッド、行×列)には2-Dを使用します。

一般的な演算子
線形探索は、見つかるまで各要素をチェックします:
FOR i ← 1 TO n
    IF A[i] = Target THEN
        OUTPUT "Found at ", i
    ENDIF
NEXT i
合計、カウント、最大値、最小値を見つけるには、累加変数を初期化してから走査します:
Max ← A[1]
FOR i ← 2 TO n
    IF A[i] > Max THEN
        Max ← A[i]
    ENDIF
NEXT i
バブルソートは配列を整列させます:隣り合うペアを比較して順序が逆になっている場合は交換し、通し回すことを繰り返します。一連の通し回しが交換を行わないまで続けます。
Paper 2では、これらのアルゴリズムを疑似コードおよび言葉での手順として求められ、時にはその「効率的」な形式でも求められます:
- 最大値:
Largestを最初の要素に設定します。残りの各要素について、もしLargestより大きい場合、Largestに保存します。ループ後、Largestを出力します。最大値の位置については、Largestが変わるたびにインデックスを保存する第二の変数を維持します。 - 位置を返す線形探索: ループ前に
FoundAt ← -1を設定します(有効なインデックスになり得ない値なので、「見つかっていない」ことを意味します)。配列をループして、要素が一致したらインデックスを保存してループを抜け、ループ後にFoundAtをテストします。 - 非空白要素のカウントまたは出力: 各要素を未使用要素のマーカー(
""または-1)と比較し、異なるもののみをカウントまたは出力します。 - 要素の削除: 線形探索でそのインデックスを見つけ、それ以降の要素をすべて始点到め方向へ一つずつ移動して隙間を埋めます。最後尾の要素を未使用としてマークするか(またはカウントを減らす)。
- 整列済み配列への挿入: 要素が大きい最初のインデックスを見つけ、その要素とそれ以降の要素をすべて終点指向方向へ一つずつ移動し、隙間に新しい値を格納します。
- 効率的なバブルソート: 一連の通し回しが交換を行わなければすぐに終了するための
Swappedフラグ、および最大値が既に終点に到達しているため通し回すごとに1つずつ減少する上限値。
REPEAT
    Swapped ← FALSE
    FOR Index ← 1 TO Limit - 1
        IF Data[Index] > Data[Index + 1] THEN
            Temp ← Data[Index]
            Data[Index] ← Data[Index + 1]
            Data[Index + 1] ← Temp
            Swapped ← TRUE
        ENDIF
    NEXT Index
    Limit ← Limit - 1
UNTIL Swapped = FALSE
得点は、スワップが行われなくなるまで繰り返す外側ループ、IF内で設定されるフラグ、一時変数を用いた3行の交换処理、および縮小する上限値に与えられます。「ステップ(段階的精密化)によるソート」とは:整列するまで繰り返す;各パスで隣接するペアを比較する;順序が逆なペアを交换する;各パス後、未整列部分の最大値が末尾に来る、というものです。レコードまたは平行データの2つの1次元配列は、1つのループと1つのインデックスで処理されます。2次元配列は、外側ループが行数、内側ループが列数を指す重複ループを必要とし、ある行内の探索では行インデックスが固定され、列方向にループします。

探索
2次元配列
行と列を選択して特定の要素を読み取ります。データグリッドの格納方法とインデックス付けの仕組みです。
語彙
練習する
| English | 日本語 |
|---|---|
| lower bound/ˈləʊə baʊnd/ | 下界 |
| upper bound/ˈʌpə baʊnd/ | 上界 |
| linear search/ˈlɪnɪə sɜːtʃ/ | 線形探索 |
| bubble sort/ˈbʌbl sɔːt/ | バブルソート |
10.3
ファイル

シラバス
| 受験者は以下的能力を備えているべきである: | メモおよびガイドライン |
|---|---|
| ファイル が必要となる理由を理解する | |
| 1つ以上の行で構成される テキストファイル を扱う擬似コードを書く |
出典: Cambridge International シラバス
ファイルとは、セカンダリストレージに格納されたデータであり、プログラム実行の間に保持されます。RAM内の変数はプログラム終了時に消失するため、データを永続的に保存したい場合(高得点記録、レコード、設定など)、プログラムはファイルに書き込みます。ファイルはまた、プログラム間でデータを共有したり、保存した状態から再起動したりするための手段でもあります。
A text file holds one or more lines of readable characters; programs read and write text files line by line. Open a file before use and close it after:
OPENFILE "data.txt" FOR READ      // or FOR WRITE, FOR APPEND
WHILE NOT EOF("data.txt") DO
    READFILE "data.txt", LineString
    OUTPUT LineString
ENDWHILE
CLOSEFILE "data.txt"
EOF は読み出し前にファイルの終端を検査します。書き出すには:
OPENFILE "log.txt" FOR WRITE
FOR i ← 1 TO 100
    WRITEFILE "log.txt", "Event " & i
NEXT i
CLOSEFILE "log.txt"
常にすべてのファイルを閉じる——否则、バッファ書き込みが失われたり、他のプログラムへのアクセスが阻害されたりする可能性があります。
ファイルを使う理由(2点):データがプログラム終了後も保持されるため、次の実行時に利用可能である;他のプログラムと共有できる;メモリに収まらない分のデータも保持できる、という点です。テキストファイルがプログラムによって順次処理できる特徴は、それが開始端から順に読み取られる行の系列であることです。3つのモード:READ で先頭からの読み取り;WRITE で新しいファイルを作成し、これは既存の内容をすべて削除するため、追加用には使えません;APPEND で既存ファイルの末尾に行を追加。読み出しの前に必ず EOF をテストし、複数のモジュールが使う場合でもファイルは1回だけ開く。
** worked example.** テキストファイルの最終3行を、順に出力する手続 LastLines(FileName : STRING) の擬似コードを書け。
PROCEDURE LastLines(BYVAL FileName : STRING)
    DECLARE LineX, LineY, LineZ : STRING
    LineX ← ""
    LineY ← ""
    LineZ ← ""
    OPENFILE FileName FOR READ
    WHILE NOT EOF(FileName) DO
        LineX ← LineY
        LineY ← LineZ
        READFILE FileName, LineZ
    ENDWHILE
    CLOSEFILE FileName
    OUTPUT LineX
    OUTPUT LineY
    OUTPUT LineZ
ENDPROCEDURE
新しい各行が入力されるたびに、前の3つの値が順にずれるため、ファイル終了時に3つの変数はその最後の3行を保持します。行数が少ないファイルでは空文字列が出力されます。最初 の5行を出力するには、読み取った行数をカウントし、ループを5または EOF のいずれか小さい方で停止します。空のファイルは、EOF が開いた直後に TRUE であることで検出されます。
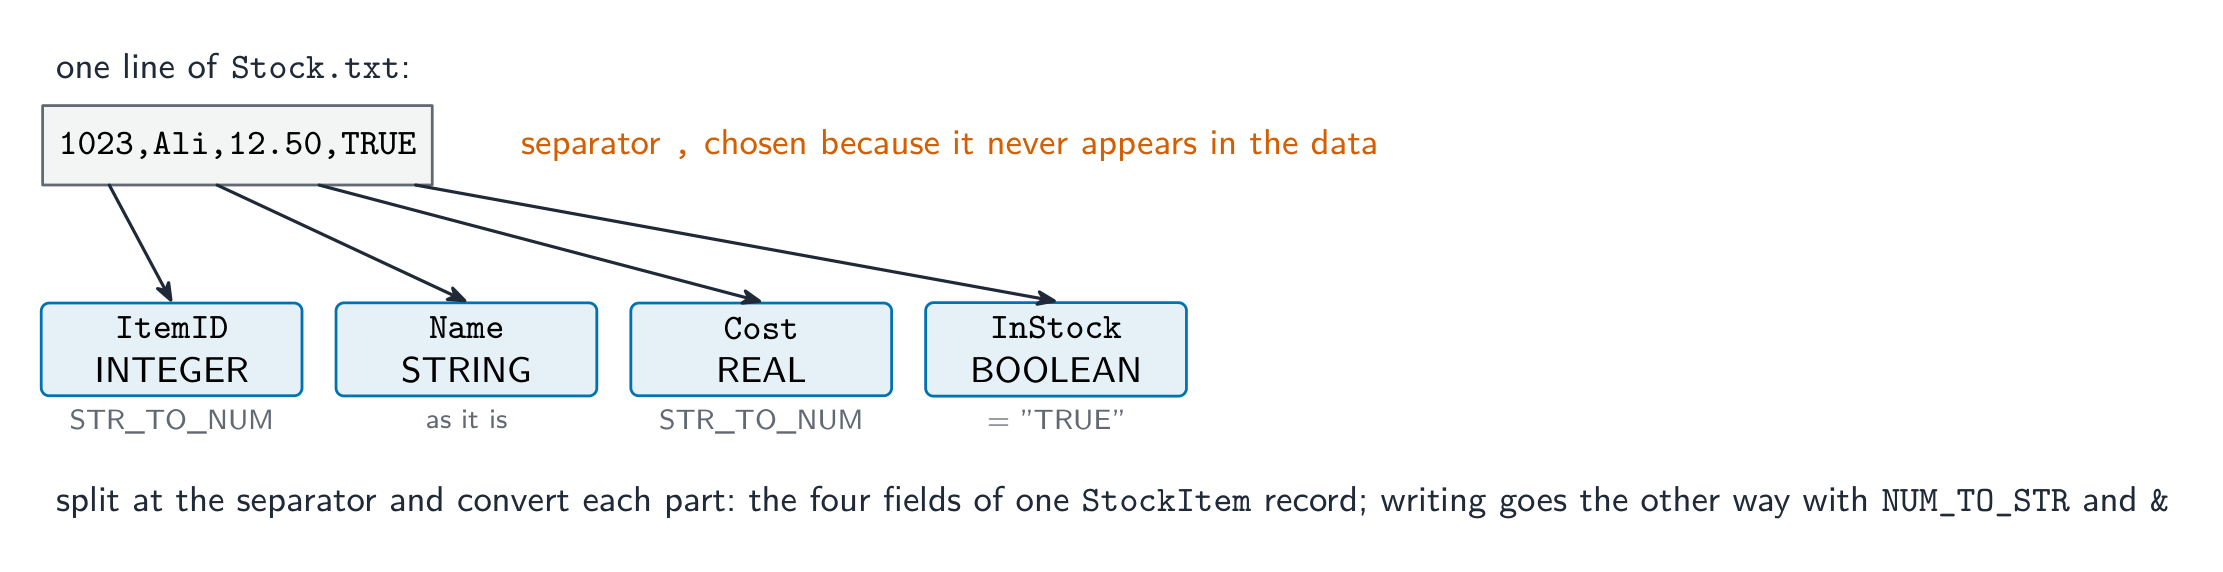
行内のフィールド。 テキストファイルは文字列を保持するため、レコードはセパレーター文字で結合された1行として書き込まれ、各数値やブール値は NUM_TO_STR (そして STR_TO_NUM または "TRUE" との比較で読み戻し)を使って変換される。データに絶対に現れないセパレーターを選ぶ:名前の場合はコンマや | 、数値の場合はコンマ。名前にスペースが含まれる可能性がある場合、スペースは使わない。フィールドに任意の字符が含まれる可能性があれば、セパレーターがデータと混同されるおそれがあり、修正法は各フィールドを独立した行にするか、フィールドの長さをその前に書き込むことである。1行に1項目とするのは読み戻しが単純だが、より多くの行を使用し、レコードを単位として見にくくする。行が既知の順序(IDによる昇順)で並んだファイルを読む場合、より大きなIDを読み取った時点で検索を停止でき、末尾まで読む必要がない。ゲームを保存するたびに作成されるセーブファイルには、 player's name と日付時刻などの意味のあるファイル名が必要であり、これにより過去のセーブを復元できる。
探索
ファイルの扱い:開く → 使用する → 閉じる
すべてのファイルが通すライフサイクルをステップごとに確認してください。忘れやすい2つのポイントは、ループ内で読み込む際にEOFテストを行うこと、そして最後に必ずファイルを閉じることです。
語彙
練習する
| English | 日本語 |
|---|---|
| file/faɪl/ | ファイル |
| secondary storage/ˈsekəndəri ˈstɔːrɪdʒ/ | 補助記憶装置 |
| text file/tekst faɪl/ | テキストファイル |
| end of file/end ɒv faɪl/ | ファイル終端 |
10.4
抽象データ型 (ADT)

シラバス
| 受験者は以下的能力を備えているべきである: | メモおよびガイドライン |
|---|---|
| ADT がデータとそれらに対する操作の集合であることを理解する | |
| スタック, キュー, リンクedList が ADT の例であることを理解する | スタック, キュー, リンクedList の主要な特徴を説明し、特定の状況での使用を正当化する |
| スタック, キュー, リンクedList を用いてデータを格納する | これらの構造に対して擬似コードを書く必要はないが、データ追加、編集、削除ができるべきである |
| キュー, スタック, リンクedList が 配列 を用いてどのように実装されるかを説明する |
出典: Cambridge International シラバス
抽象データ型 (ADT) とは、データコレクションとそれに対する操作の組み合わせであり、何をするかによって定義され、どのように格納されているかではありません。ユーザーは操作を通じてのみ動作し、実装は隠蔽されているため、ADTを使用するコードに影響を与えずに変更できます。スタック、キュー、リンクドリストの3つを知っておくべきです。
1点定義:ADT(抽象データ型)とは、データの集合と、そのデータに対する一連の操作の集合を指す。スタック、キュー、連結リスト、二進木、配列はすべてADTである。選択肢を正当化する: 項目が到着した順に処理される必要がある場合(印刷ジョブ、キー入力、店舗での顧客など)、FIFO(先着先出し)であるためキューを選ぶ;最も最近の項目を最初に処理する必要がある場合(元に戻す、ウェブページの履歴戻る、順序の逆転、ネスト呼び出しの戻りアドレスなど)、LIFO(後入先出し)であるためスタックを選ぶ;整列されたシーケンスの真ん中で挿入や削除が頻繁に行われる場合、ポインタのみが変わり、要素をシフトする必要がないため連結リストを選ぶ。スタックとキューを比較する: どちらも順序を持つ線形構造であり、配列とポインタで実装され、追加前に満杯チェック、削除前に空チェックが必要である。スタックは1つのポインタを持ち、両端が同一で追加・削除を行う。キューは2つのポインタを持ち、一方の端で追加し、もう一方の端で削除を行う。
スタック
スタックはLIFO(Last In, First Out)順に動作する。操作:push(上部への追加)、pop(上部からの削除)、peek(上部の参照)、および空/満杯のテスト。用途:Undo履歴、関数呼び出しの戻りアドレス、式解析、バックトラック。
計算例。 スタックには、下から 'P', 'N', 'Z', 'X', 'Y', 'W' が格納されており、スタックポインタは 'W'(200–207 のメモリ位置 202)にあります。操作 POP, POP, PUSH 'A', PUSH 'B', POP が実行されます。スタックには何があり、ポインタはどこを指していますか?
2回のpopで'W'、次に'Y'が削除され、pushでその代わりに'A'、次に'B'が追加されます。最後のpopで'B'が削除されます。現在、スタックには'P'、'N'、'Z'、'X'、'A'が含まれ、ポインタは'A'、位置203にあります。スタックに最も長く存在している値は最下部のアイテムである'P'です。スタックが空になるまで最大5回さらにpop可能ですが、空のスタックでのpopはエラーであり、そのためPop()ではまず空かどうかをチェックします。成功時にTRUEを返すPush()関数は、まずポインタが配列の先頭(満杯)にあるかチェックし、そうであればFALSEを返します。配列要素の使用前に初期化する必要はありません。ポインタのみがどの要素が使用中かを示すためです。

キュー
キューはFIFO(First In, First Out)順に動作する。操作:enqueue(後部への追加)、dequeue(前方からの削除)、および空/満杯のテスト。用途:プリントスプーリング、スケジューリング、幅優先探索、バッファリング。

アイテムを追加する際の説明: キューが満杯でないことを確認し、末尾ポインタで指定された位置にアイテムを格納し、末尾ポインタ(およびカウント)をインクリメントする。削除時の説明: キューが空でないことを確認し、フロントポインタの位置にあるアイテムを読み出し、フロントポインタをインクリメント(カウントをデクリメント)する。使用する規約を明記せよ。末尾ポインタが次の空きスペースを示す場合、フロントと末尾ポインタが等しいことはキューが空であることを意味する。末尾ポインタが最終アイテムを示す場合、等しいポインタはアイテムが1つあることを意味する。線形キューではフロントポインタは常に前方に進むため、背後のセルは使用不能となる。これこそが以下の円形キューで解決される問題である。キューの2つの特徴を述べる:アイテムは後部で追加され前方から削除されるため、最初に追加されたものが最初に削除される。

連結リスト
連結リストはノードの列としてデータを格納する。各ノードは値と次のノードへのポインタを保持する。ヘッドポインタは開始点を示し、最終ノードのポインタはSentinel(例:NULL)となる。操作:insert, delete, search, および traverse(順序通り各ノードを訪問する)。配列との違い:利点は安価な挿入・削除(ポインタ調整のみで済み)、欠点はランダムアクセスが遅い(ヘッドからポインタを辿る必要がある)。

順序にノードを追加する(4点): ヘッドからリストをトラバースし、ポインタに従って位置の前のノード(値が小さい最後のノード)を見つける;フリーノードを取得して新しい値を格納する;新しいノードのポインタを前ノードが指していたアドレスに設定する;前ノードのポインタを新しいノードに設定する。新しい値が先頭に来る場合は、ヘッドポインタを変更する。ノードの削除: ノードの前のものを見つけ、そのノードのポインタを削除されたノードが指していたアドレスに設定して、リストをバイパスさせる;解放されたノードはフリーリストに戻る。1次元配列と比較して、リンクドリストでの挿入や削除には他のアイテムのシフトが不要であり、メモリが尽きるまでリストは拡大できる;コストは各アイテムに追加で保存されるポインタと、$n$番目のアイテムに到達するには直接インデックスがないため、$n$個のポインタをたどる必要があることである。
探索
リンクドリスト:ポインタで結合されたノード群
各ノードは値と次のノードへのポインタを保持します。挿入や削除は単にポインタの再接続を行うだけであり、配列のように要素がずれることはありません。
探索
スタックとキュー
プッシュとポップ。スタックはLIFO(後入れ先出し)、キューはFIFO(先入れ先出し)——これらは主要な抽象データ型です。
語彙
練習する
| English | 日本語 |
|---|---|
| push/pʊʃ/ | スタックへの格納 |
| separator/ˈsepəreɪtə/ | 区切り文字 |
| linked list/lɪŋkt lɪst/ | 連結リスト |
| queue/kjuː/ | キュー |
| LIFO/ˈlaɪfəʊ/ | 後入先出 |
| FIFO/ˈfaɪfəʊ/ | FIFO |
| pop/pɒp/ | ポップ |
| enqueue/enˈkjuː/ | エントゥ |
| dequeue/diːˈkjuː/ | ディキュー |
| traverse/trəˈvɜːs/ | トラバーサル |
| free list/friː lɪst/ | フリーリスト |
| overflow/ˌəʊvəˈfləʊ/ | オーバーフロー |
| underflow/ˌʌndəˈfləʊ/ | アンダーフロー |
| circular array/ˈsɜːkjʊlə əˈreɪ/ | 巡回配列 |
10.4
配列を用いたADTの実装

配列によるスタック
Stack[1:MaxSize]にアイテムを保持し、整数Top(空の時は0)を使用する。
Push(x):Top = MaxSizeの場合スタックは満杯である(オーバーフロー);否则Top ← Top + 1;Stack[Top] ← x。Pop():Top = 0の場合スタックは空である(アンダーフロー);否则 returnStack[Top]andTop ← Top - 1。
円形配列によるキュー
単純なキューではFrontとRearが端を過ぎて消えてしまい、先頭のスペースが無駄になる。解決策は円形配列であり、ポインタがMaxSizeに達すると1に戻り:
Enqueue(x): 満杯か確認;否则Rear ← (Rear MOD MaxSize) + 1;Queue[Rear] ← x。Dequeue(): 空か確認;否则 returnQueue[Front]andFront ← (Front MOD MaxSize) + 1。
空と満杯を区別するために別のカウントを追跡する。
エンドポインタのアルゴリズムを言葉で表すと:カウントがサイズに等しい場合はキューが満杯であると報告して終了する;否则 エンドポインタに1を加える;これが最終インデックスを超えた場合は最初のインデックスに設定する;そこにアイテムを格納してカウントを1加算する。5点の「宣言と初期化を記述せよ」という問題の回答が示す宣言:サイズと要素型を持つ配列;最初インデックス(またはフロンツが最初インデックス、エンドが次の空きスペース)に初期化されたフロントポインタとエンドポインタ;そして、$0$に初期化されたアイテムのカウント。
例えば、MaxSize = 6の場合:Rear = 5であれば、(5 MOD 6) + 1 = 6となるので、次のアイテムはセル6に入れる;Rear = 6であれば、(6 MOD 6) + 1 = 1となり、ポインタはセル1へ戻る。
配列によるリンクドリスト
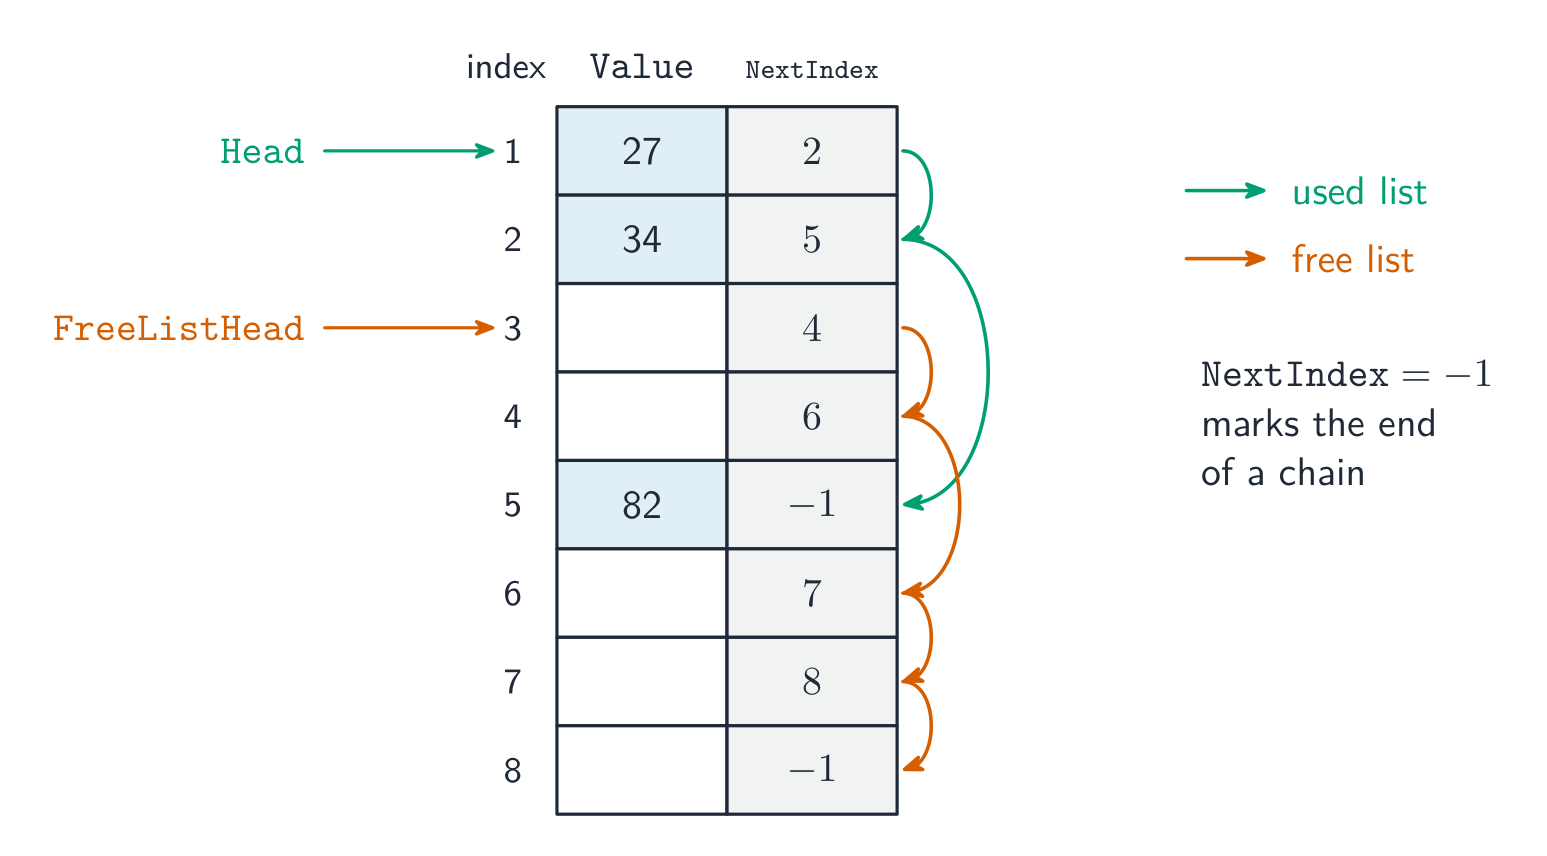
各がNextIndexインデックスを持つレコードの配列を使用する:
TYPE TNode
    DECLARE Value : INTEGER
    DECLARE NextIndex : INTEGER     // index of the next node, or -1 for end
ENDTYPE

DECLARE Nodes : ARRAY[1:MaxSize] OF TNode
DECLARE Head : INTEGER         // index of first node, -1 if empty
DECLARE FreeListHead : INTEGER // first available free node
フリーリストは未使用のスロットをチェーンしており、データリストが使用済みをチェーンしているのと同じようにする。挿入する場合:FreeListHeadからスロットを取り出し、新しいノードの値とNextIndexを設定し、前ノードのNextIndex(またはHead)を更新する。削除する場合:ノードを.unlinkし、そのスロットをフリーリストに戻す。これにより、配列の静的割り当てとリンク構造の柔軟性を併せ持てる。
計算例。 リンクedListはData配列とPointer配列に格納されており、Startがインデックス1を指しています。リストは1 → 3 → 4です(インデックス1にはD40、インデックス3にはD32、インデックス4にはD11が含まれており、そのポインタは$\emptyset$です)。フリーリストはインデックス2から始まり、2 → 5 continuesします。D6をD32とD11の間に挿入します。
最初のフリーノード(インデックス2)を取り出し、FreeStartをそのポインタである5に設定する;D6をData[2]に格納する;Pointer[2]を保持している値Pointer[3](4)に設定する;Pointer[3]を2に設定する。リストは 1 → 3 → 2 → 4 となり、フリーリストは 5 → $\emptyset$ となる。「リンクドリストをどのように実装できるか」への答えはまさにこれらの部分である:データを格納するための配列(またはレコードの配列)、インデックスを保持するポインタのための並列配列、スタートポインタ、フリーリストポインタ、および終端のためのnull値(例:$-1$)。
Worked example. A circular queue is held in an array of size 5 (indices 0 to 4) with Front = 3, Rear = 3 and one item stored. Two items are added, then two are removed. Where are the pointers, and why use a circular queue at all? Every move uses (pointer + 1) MOD size, so the pointers wrap. Adding twice moves Rear: $3 \rightarrow 4$, then $4 \rightarrow 0$ (because $(4+1) \bmod 5 = 0$), so Rear = 0 and three items are stored. Removing twice moves Front the same way: $3 \rightarrow 4$, then $4 \rightarrow 0$, leaving Front = 0 and one item. The wrap is the whole point: in a linear array queue the pointers march to the end and the freed space at the front is wasted even when the queue is empty. Remember a queue removes at the Front and adds at the Rear - a stack uses one pointer for both.
探索
配列によるADTの実装
FIFO
キューは先入れ先出しであり、最後尾でエンキューし、先頭でデキューする。
語彙
練習する
| English | 日本語 |
|---|---|
| index/ˈɪndeks/ | 添字 |
| pointer/ˈpɔɪntə/ | ポインタ |
| node/nəʊd/ | ノード |
10.4
出題者が認める定義
定義問題は固定された用語に基づいて採点されます。これらを正確に覚えてください。
| 用語 | 定義 |
|---|---|
| record | 一つの識別子の下で異なるデータ型の複数のデータ項目(フィールド)を保持するデータ構造 |
| array | 一つの識別子の下で固定数の同じデータ型要素を保持し、それぞれインデックスによってアクセスされるデータ構造 |
| index | 配列の1つの要素を識別する数 |
| upper bound, lower bound | 配列の有効なインデックスの最大値と最小値 |
| text file | データを文字の行として格納し、プログラムが一度に1行ずつ読み書きするファイル |
| abstract data type | データの集合とそのデータに対する一連の操作の組み合わせ |
| stack | アイテムが同じ端(トップ)に追加され、同じ端から取り出されるリスト。最後に追加されたものが最初に取り出される(LIFO) |
| queue | アイテムが後方(Rear)に追加され、前方(Front)から取り出されるリスト。最初に追加されたものが最初に取り出される(FIFO) |
| リンクリスト | 各ノードがデータ項目と次のノードへのポインタを持ち、最初のノードへのスタートポインタを持つリスト |
| ポインタ | ノードや構造体の位置のアドレス(またはインデックス)を保持する変数 |
| 線形検索 | 最初から順に各要素を確認し、ターゲットが見つかるか末尾に到達するまで行う |
| バブルソート | 配列を繰り返し通過して隣り合うペアを比較し、順序不同れなものを交換し、一度も交換がないパスになるまで行う |
語彙
練習する
| English | 日本語 |
|---|---|
| data type/ˈdeɪtə taɪp/ | データ型 |
| Abstract Data Type/ˈæbstrækt ˈdeɪtə taɪp/ | 抽象データ型 |
10.4
試験対策
- 適切なデータ構造を選び、その理由を述べる(混合フィールドにはレコード、グリッドには2次元配列)。
- スタック、キュー、リンクドリストを配列とポインタで実装する方法を知る(トップ; フロント/リアール; ネクスト)。
- ADT(その振る舞い)と実装(配列とポインタ)を区別する。
一般的なミス
ENDTYPEやフィールドに型を持たないレコード宣言。すべてのフィールドはDECLARE行で、型が指定されている。- ファイルの末尾を超えて読み込む、またはファイルの内容を維持すべき時に
WRITEで書き込む。各読み込み前にEOF进行测试;追加するにはAPPENDを使用する。 - 文字列として保持されるファイルに数字を文字列変換なしで書き込む。
NUM_TO_STR出力、STR_TO_NUM戻す。 - チェックを忘れる。
Pushとenqueueではまず満杯テストを行い;Popとdequeueではまず空テストを行う。答えはその通りである。 - ノードを挿入する際に残りのリストを失う。前のノードのポインタを変える前に、新しいノードのポインタを古いネクストノードに設定する。
- 「見つかりません」と言わない直列探索。位置を$-1$で初期化し、ループ後にテストする。
このトピックのインタラクティブ授業
一歩ずつ進め、即時チェック付きの問題で学習します。