בתוך מעבד יש מיליארדים של מתגים זעירים. כל אחד מהם יכול להיות רק בדלק או בכיבוי. זהו כל מה שיש למחשב פיזית — אין שלושים, אין שבעים, אין…
קריינות באנגלית · כתוביות באנגלית ובסינית 中文 שאפשר להחליף ביניהן
1.1
מדוע מחשבים משתמשים במערכת בין-ספרתית
מחשבים דיגיטליים מייצגים נתונים באמצעות שני מצבי לוגיקה, הכתובים כ1 ו0. מערכת המשתמשת רק בשני ספרות נקראת בינארי (בסיס 2).
מחשבים מייצגים כל נתון — מספרים, טקסט, קול ותמונות — כמחלקות בינאריות של 0s ו-1s
כל סוג של נתון — מספרים, טקסט, קול ותמונות — חייב להיות מומש לבינארי לפני שמחשב יכול להשתמש בו. המחשב מעבד את הבינארי הזה באמצעות שער לוגי, ואחסנו אותו ב-ריגיסטר (אחסון קטן ומהיר בתוך המעבד).
מעבד מיक्रוחזיק מיליוני טרנזיסטורים זעירים, כל אחד מתחלף הוא הפועל (1) או הכבוי (0) — הבסיס הפיזי של הבינארית
1 הבן כיצד ומדוע מחשבים משתמשים בבינארי כדי לייצג כל צורות נתונים
• כל צורת נתונים צריכה להיות מומרת לבינארי כדי לעובד על ידי מחשב • נתונים מעובדים באמצעות שערי לוגיקה ואחסונים ברישמות
2 (א) הבנת מערכות הספרות עשרוניות, דו-ספרתיות ו-שיש-עשרוניות (ב) המרה בין (i) עשרוני חיובי לדו-ספרתי חיובי (ii) עשרוני חיובי לשיש-עשרוני חיובי (iii) שיש-עשרוני חיובי לדו-ספרתי חיובי
• מערכת עשרונית היא מערכת בסיס 10 • מערכת דו-ספרתית היא מערכת בסיס 2 • מערכת שיש-עשרונית היא מערכת בסיס 16 • הערכים המשמשים יהיו מספרים שלמים בלבד • המרות בשני הכיוונים, למשל מערכת עשרונית לדו-ספרתית או דו-ספרתית לעשרונית • אורך מקסימלי של מספר דו-ספרתי הוא 16-ביט
3 הבן כיצד ומדוע הקסדצימאלי משמש כשיטה מועילה לייצוג נתונים
• יש לזהות תחומים בתחום מדעי המחשב בהם משתמשים בקסדצימאלי • הקסדצימאלי קל יותר לאנושים להבנה מאשר בינארי, מכיוון שהוא ייצור קצר יותר לבינארי
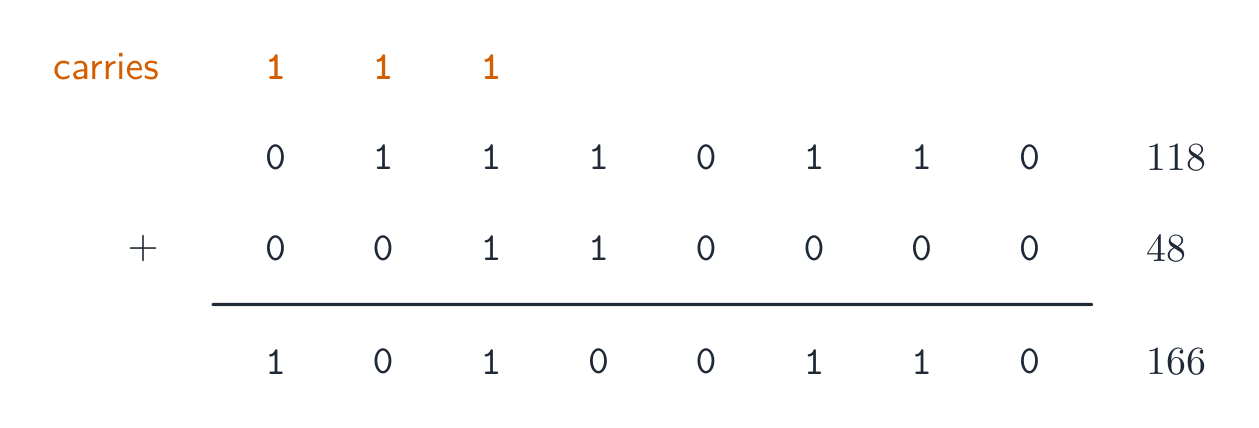
4 (א) חבר שני מספרים שלמים בינאריים חיוביים בגודל 8-ביט (ב) הבן את מושג העלאת סף (overflow) ומדוע היא מתרחשת בחיבור בינארי
• שגיאת העלאת סף תתרחש אם הערך גדול מ-255 ברישום 8-ביט • למחשב או למכשיר יש מגבלה מוגדרת מראש שיכול לייצג או לאחסן, לדוגמה 16-ביט • שגיאת העלאת סף מתרחשת כאשר ערך מחוץ לגבול זה צריך להיות מוחזר
5 בצע הזזה לוגית בינארית על מספר שלם בינארי חיובי בגודל 8-ביט והבן את ההשפעה שיש לכך על המספר הבינארי החיובי
• בצע הזזות שמאל לוגיות • בצע הזזות ימינה לוגיות • בצע הזזות מרובות • ביטים המוזזים מהקצה של הרישום אבודים ואפסים מוזזים לתוך הקצה הנגדי של הרישום • המספר הבינארי החיובי מכפיל או מחולק בהתאם להזזה שבוצעה • הביט(ים) המשמעותי(ים) ביותר או הביט(ים) המשמעותי(ים) פחות אובדים
6 השתמש במערכת המספרים משלים לשניים כדי לייצג מספרים שלמים בינאריים חיוביים ושליליים בגודל 8-ביט
• המר מספר שלם בינארי או עשרוני חיובי למספר שלם בגודל 8-ביט במשלים לשניים ולהפך • המר מספר שלם בינארי או עשרוני שלילי למספר שלם בגודל 8-ביט במשלים לשניים ולהפך
מקור: הסיילבוס הבינלאומי של קמבריד'ג'
ספירה במערכת דו-ספרתית: 0 עד 15
מערכת ספרות היא דרך לכתיבת מספרים באמצעות ערכה קבועה של דיגיטים. אתם צריכים שלושה מהם.
מערכת
בסיס
דיגיטים בשימוש
עשרונית
10
0–9
דו-ספרתית
2
0 ו-1
התרסעירית
16
0–9 ולאחר מכן A–F
עשרוני היא מערכת הספירה הרגילה (נקראת גם עשרונית).
בינארית משתמשת רק ב-0 וב-1.
הקסאדצימלית (הקס) משתמשת בששה עשר דיגיטים: 0–9, ולאחר מכן A, B, C, D, E, F מייצגים 10, 11, 12, 13, 14, 15.
הבסיס מספר כמה דיגיטים שונים מערכת משתמשת.
ערך מקום
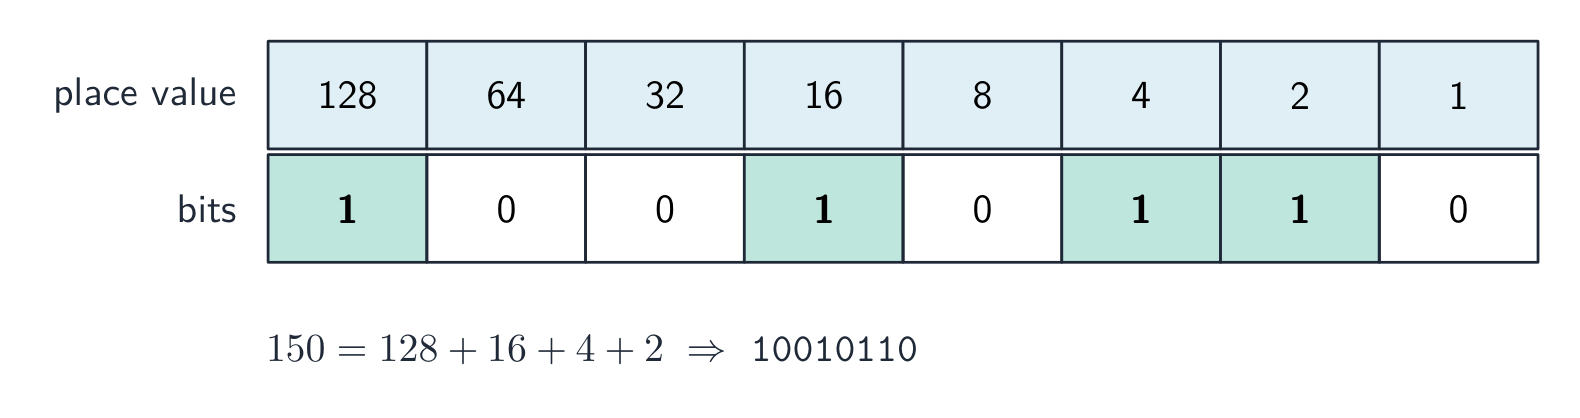
לכל עמודה במספר יש ערך מקום. במערכת הבינארית, ערכי המקום כפולים מימין לשמאל. עבור מספר ב-8 ביט, הם:
128 64 32 16 8 4 2 1
טבלת ערכי מקום ל-8 ביט: ה-1s נמצאים מתחת לערכים שמסכמים ל-150
ביט אחד הוא 0 או 1 יחיד. שמונה ביטים יוצרים בייט אחד. ארבעה ביטים (חצי בייט) קרוי ניבול.
המרה בין מערכות ספרות
מערכת עשרונית → בינארית. כתוב את ערכי המקום. הנח 1 מתחת לכל ערך שצריך כדי שיסכמו למספר שלך; הנח 0 מתחת לשאר.
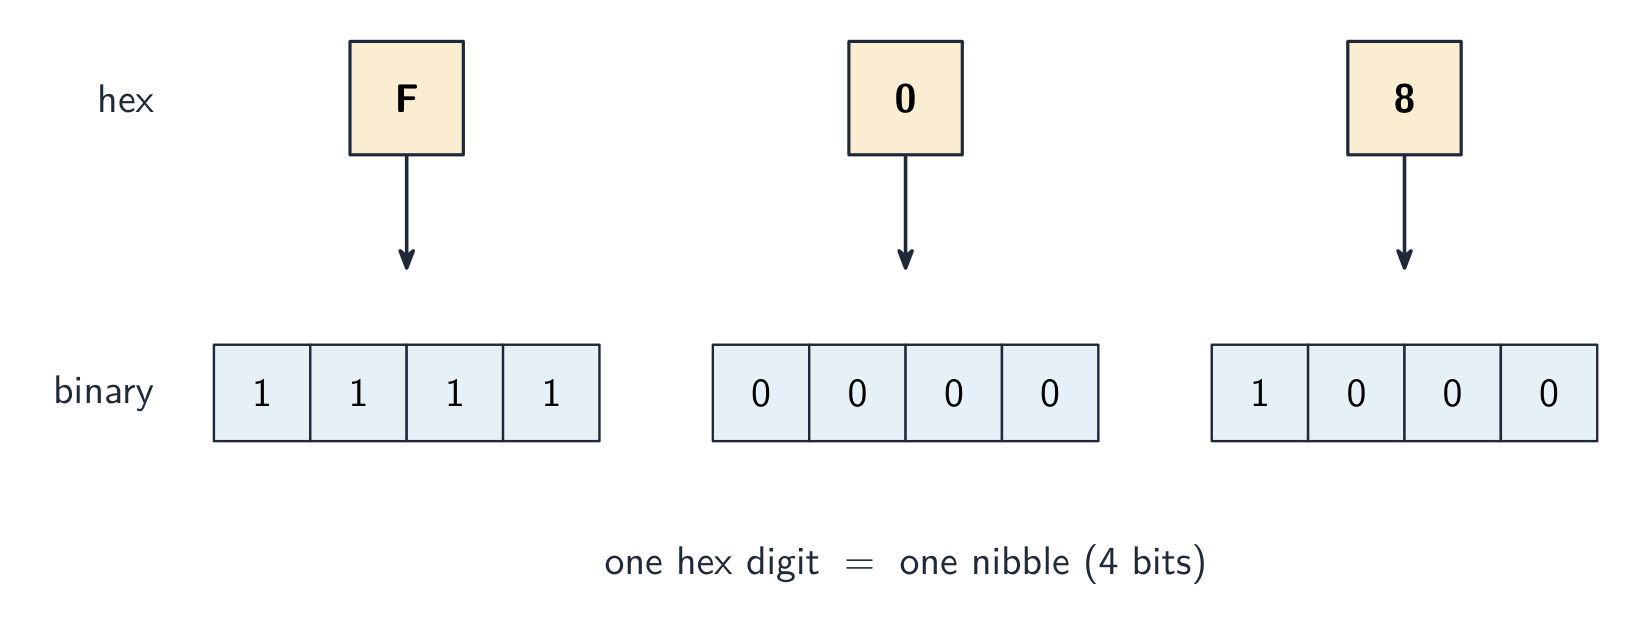
כל ספרה הקסדצימלית מתאימה לניבול של 4 ביטים משלה — F08 = 1111 0000 1000
בינארי → הקסדצימליות. חלק את הביטים לקבוצות של 4 ביטים (ניבולים), החל מימין. הפוך כל ניבול לספרה הקסדצימלית אחת.
עשרוני → הקסדצימליות. הדרך הקלה היא להפוך תחילה לבינארי, ואז מהבינארי להקסדצימליות.
טבלה זו מסייעת עם אותיות ההקסדצימליות:
עשרונית
בינארית
עשירית עשרונית
10
1010
A
11
1011
B
12
1100
C
13
1101
D
14
1110
E
15
1111
F
שאלות Cambridge משתמשות במספרים בינאריים באורך עד 16 ביט.
דוגמה פותרת. המר את 100 בעשרונית לבינארי ב-8 ביט, ולאחר מכן להקסדצימליות.
$100 = 64 + 32 + 4$, ולכן הבינארי הוא 01100100. בחלוקה לניבולים, 01100100$= 6$ ו-$4$, ולכן ההקסדצימליות היא 64.
דוגמה פתורה (בסיס שש-עשרה → בסיס עשר). המירו את המספר 2C מבסיס שש-עשרה לבסיס עשר. ערכי המקום בבסיס שש-עשרה הם $16$ ו-$1$. ערכו של 2 הוא $2 \times 16 = 32$ וערכו של C הוא $12$, ולכן 2C$= 32 + 12 = 44$. בדקו באמצעות בסיס שתיים: 0010 1100$= 32 + 8 + 4 = 44$.
למה משתמשים בהקסדצימליות
הקוד המעריכי קצר יותר מהבינארי וקל יותר לקריאה וכתיבה על ידי אנשים. ספרת מעריכית אחת מחליפה 4 ספרות בינאריות, ולכן עושים פחות טעויות. הערך אינו משתנה — הקוד המעריכי הוא רק דרך קצרה להציג את אותו בינארי.
מדעיני מחשב משתמשים בקוד מעריכי עבור:
כתובות MAC וכתובות IPv6
קודי צבע ב-HTML (לדוגמה #FF0000 הוא אדום)
כתובות זיכרון וקודי שגיאה
הצגת תוכן הזיכרון (״היטל זיכרון״)
חקור
בינארי, עשרוני ו-HEX
הקלד מספר וראה אותו ב-בינארי, עשרוני ו-HEX — ואיך ערכי המקום בונים אותו.
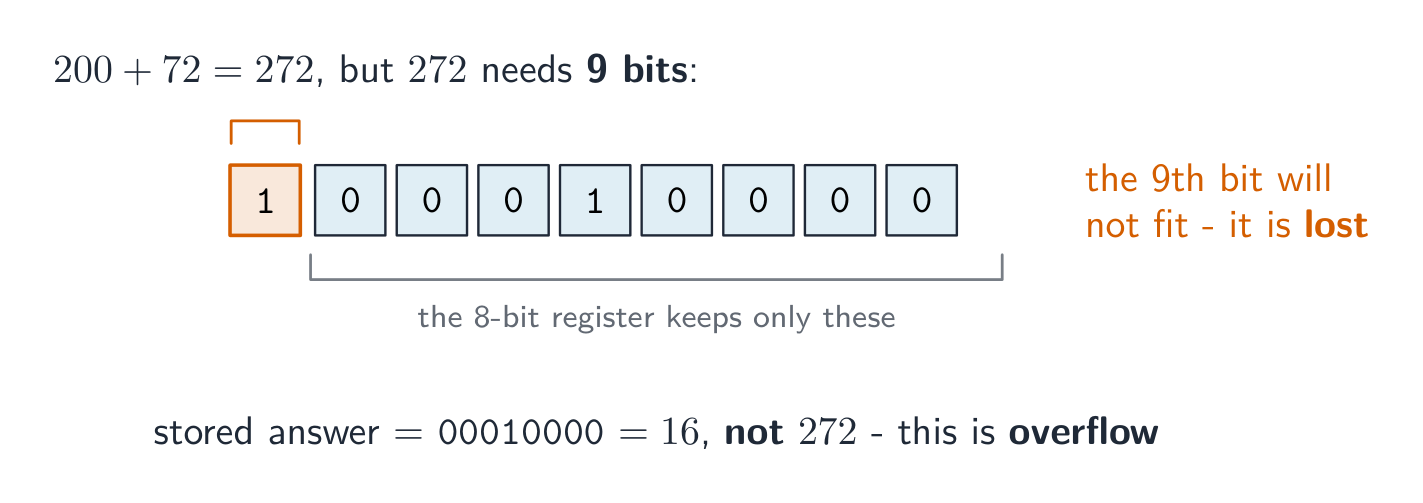
כאשר מפרשים אותו כמספר שלם ללא סימן, אוגר בן 8 סיביות מכיל ערכים מ-0 עד 255. אם חיבור נותן תוצאה מעל 255, התשובה זקוקה לסיבית מספר 9. האוגר אינו יכול להכיל סיבית נוספת זו, ולכן היא אובדת. מצב זה נקרא גלישה (שגיאת גלישה). הוא מתרחש כאשר ערך חורג מהגבול שהאוגר יכול לאחסן.
דוגמה: 11001000 (200) $+$01001000 (72) $= 272$. בבינארי זהו 1 00010000, הדורש 9 ביטים. הביט הראשון 1 לא יכנס ב-8 ביטים, ולכן התשובה המאוחסנת שגויה.
הוספת 200 ו-72 דורשת 9 ביטים, אך רשמה של 8 ביטים מוותרת על הביט התשיעי, ולכן התשובה שגויה
הזזה לוגית בינארית מזיזה את כל הביטים שמאלה או ימינה במספר מקומות.
ביטים שיוצאים מהקצה של הרגסטר נאבדים.
אפסים נוספים בקצה הריק.
עבור מספר נטורלי, הזזה שמאלית מכפלת ב2 לכל מקום שנעשה אם לא אבד ביט שאינו אפס. הזזה ימינית לוגית נותנת את תוצאת החלוקה המספרית של division ב2 לכל מקום; הביטים הימניים ביותר (הביטים הפחות משמעותיים) אובדים.
שלוש הסיביות הימניות ביותר (100) אובדות ושלושה אפסים נכנסים משמאל: 00010110$= 16 + 4 + 2 = 22$. הזזה ימינה ב-3 מקומות מחלקת ב-$2^3 = 8$: $180 \div 8 = 22.5$, וההזזה שומרת רק את החלק השלם, $22$. הערך $0.5$ יוצג על ידי הסיבית 1 שאבדה.
דוגמה פתורה (הזזה שמאלה שמשתבשת). הזיזו את 01100100 (100) שמאלה ב־2 מקומות. התוצאה היא 10010000$= 144$, ולא $400$: סיבית 1 נדחקה אל מחוץ לקצה השמאלי, וממילא $400$ גדול מדי לייצוג ב־8 סיביות. הזזה שמאלה מבצעת כפל נכון רק כל עוד לא אובדות סיביות 1.
1.1
תשלום שניים
עד כה המספרים היו חיוביים. תשלום שניים מאפשר לרגסטר 8 ביט להכיל גם מספרים שליליים.
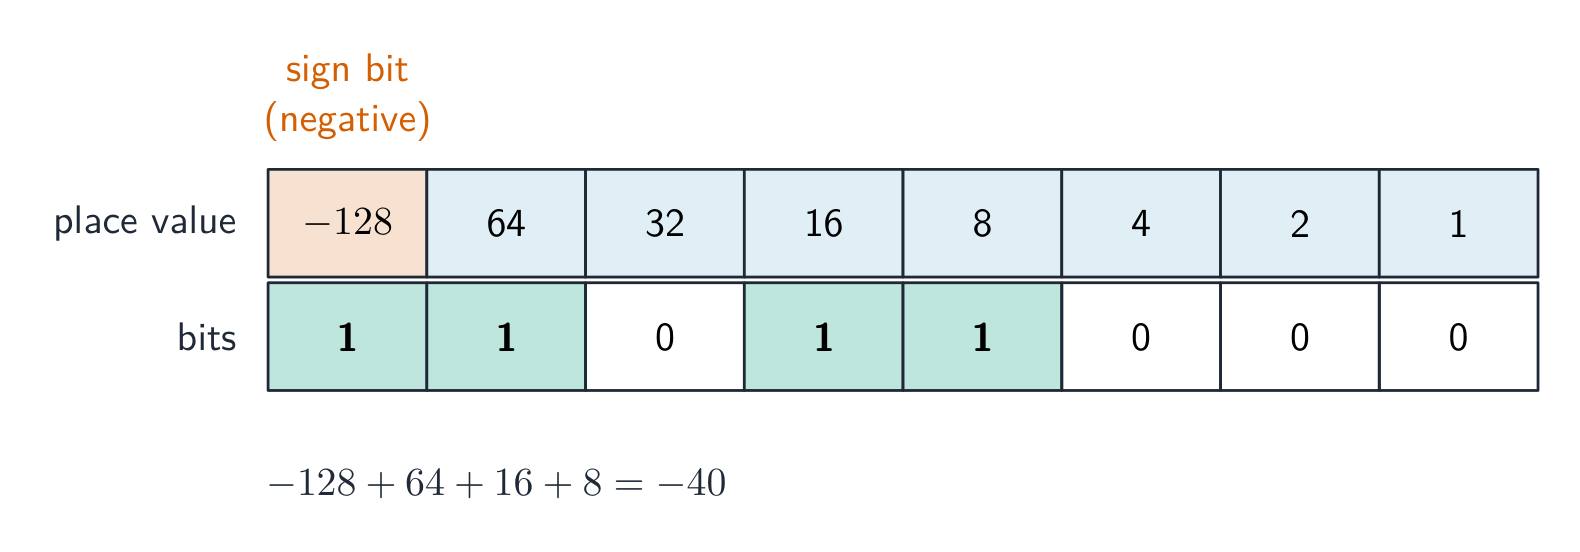
בתשלום שניים, הביט השמאלי ביותר (הביט המשמעותי ביותר, או MSB) הוא בעל ערך מקום שלילי:
-128 64 32 16 8 4 2 1
אם ה-BIT המקודם ביותר (MSB) הוא 0, המספר הוא אפס או חיובי.
אם ה-MSB הוא 1, המספר שלילי.
להפוך מספר חיובי לשלילי: כתוב את הבינארי החיובי, הפוך כל ביט (0↔1), ואז הוסף 1.
דוגמה: הפוך את $-40$.
$+40$ = 00101000
הפכת הביטים = 11010111
הוספת 1 = 11011000
אז $-40$ = 11011000. בדוק על ידי חיבור ערכי המקום: $-128 + 64 + 16 + 8 = -40$.
הביט המשמעותי ביותר שווה ל-128−, ולכן 11011000 = −128 + 64 + 16 + 8 = −40
לקרוא מספר בשלילי בתשלום שניים, פשוט חבר את ערכי המקום (ה-MSB נחשב כ$-128$). הטווח של מספר בשלילי בתשלום שניים 8 ביט הוא $-128$ עד $+127$.
דוגמה פתורה. המירו את המספר 10011010 המיוצג בשיטת המשלים ל־2 למספר עשרוני. הסיבית המשמעותית ביותר היא 1, ולכן המספר שלילי: $-128 + 16 + 8 + 2 = -102$. בדקו בשיטה האחרת: הפכו את הסיביות (01100101) והוסיפו 1 (01100110$= 102$), ולכן המספר הוא $-102$.
1 הבן כיצד ומדוע מחשב מייצג טקסט ואת השימוש בסטיות תווים, כולל קוד סטנדרטי אמריקאי להחלפת מידע (ASCII) ו-יוניקוד
• טקסט מומר לבינארי כדי לעובד על ידי מחשב • יוניקוד מאפשר טווח רחב יותר של תווים וסמלים מאשר ASCII, כולל שפות שונות ואימוג'ים • יוניקוד דורש יותר ביטים לכל תוו מאשר ASCII
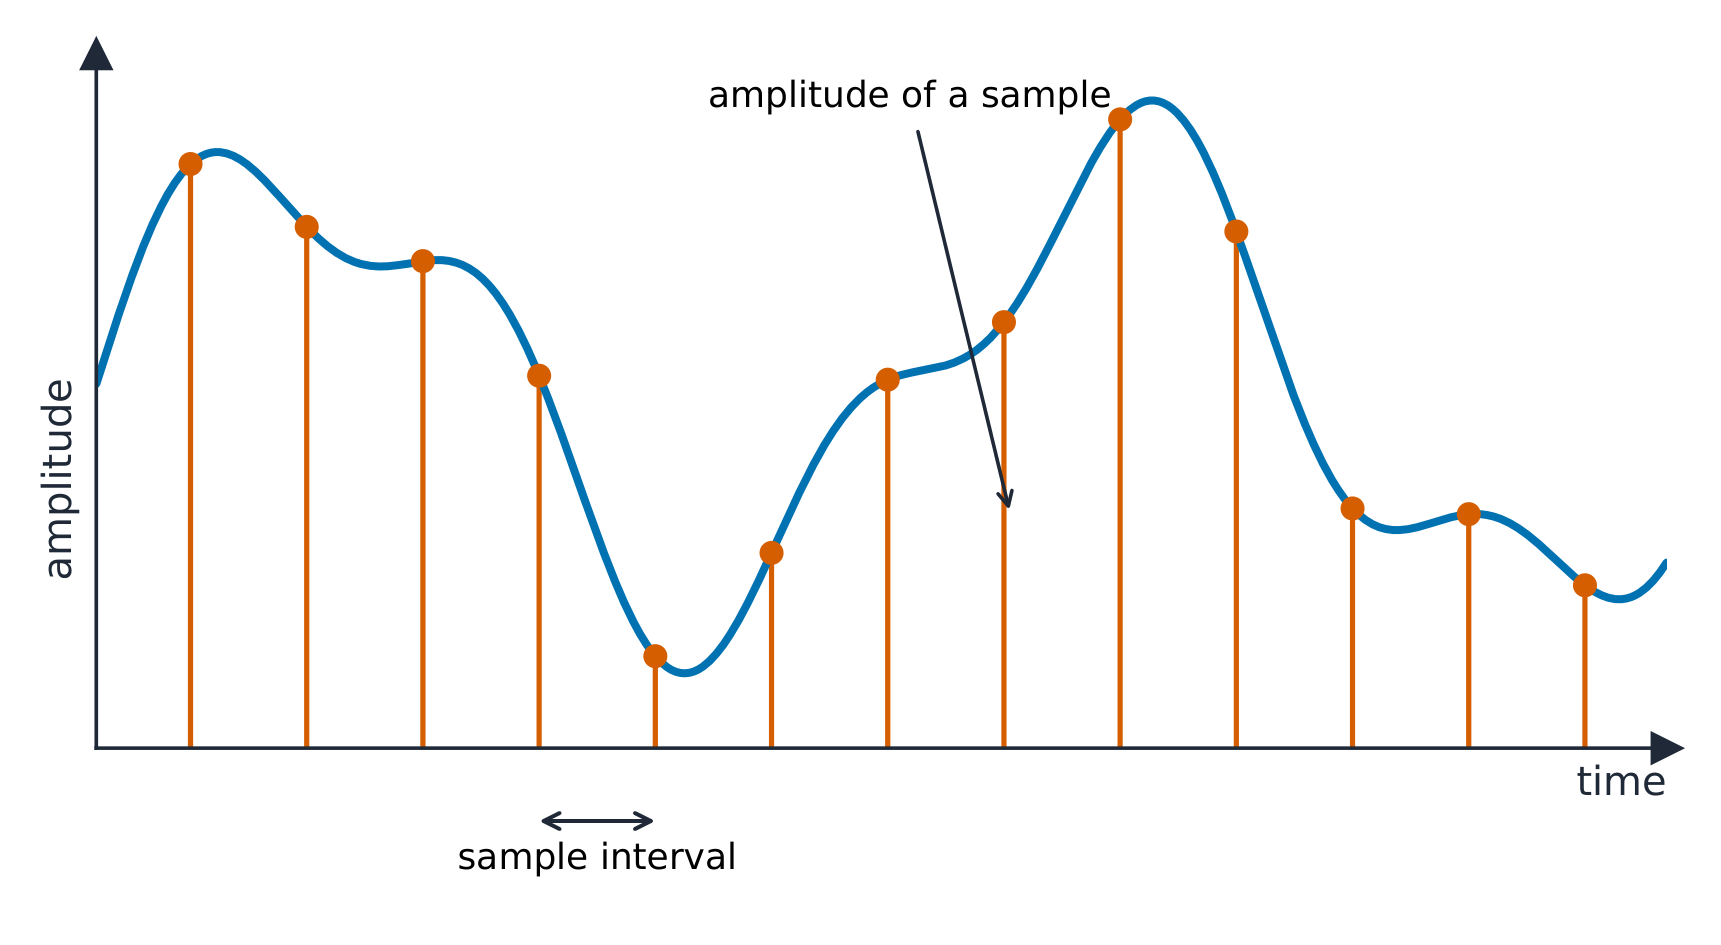
2 הבן כיצד ומדוע מחשב מייצג קול, כולל השפעות קצב הדגימה ורזולוציית הדגימה
• גל קול נדגם כדי לקול יומר לבינארי, שיעובד על ידי מחשב • קצב הדגימה הוא מספר הדגימות שנלקחות בשנייה • רזולוציית הדגימה היא מספר הביטים לכל דגימה • הדיוק של ההקלטה וגודל הקובץ עולים ככל שקצב הדגימה והרזולוציה עולים
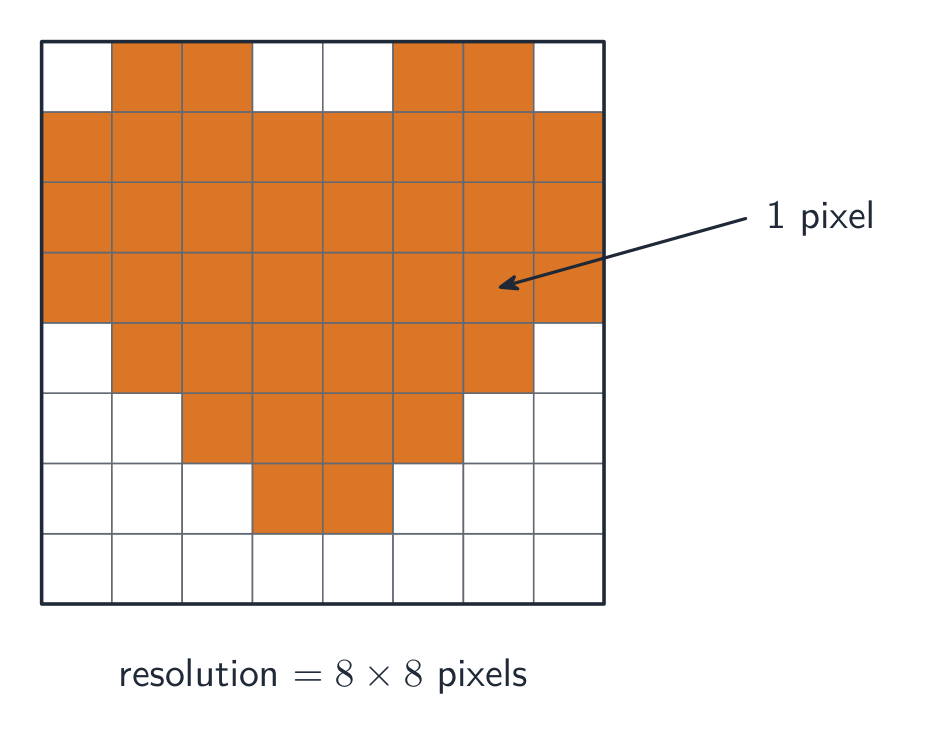
3 הבן כיצד ומדוע מחשב מייצג תמונה, כולל השפעות רזולוציה ועומק צבע
• תמונה היא סדרה של פיקסלים שהמרה לבינארי, שיעובד על ידי מחשב • הרזולוציה היא מספר הפיקסלים בתמונה • עומק הצבע הוא מספר הביטים המשמשים לייצוג כל צבע • גודל הקובץ ואיכות התמונה עולים ככל שרזולוציה ועומק הצבע עולים
מקור: הסיילבוס הבינלאומי של קמבריד'ג'
מחשבים מאחסנים טקסט על ידי הענקת כל אות מספר, ולאחר מכן אחסנת המספר בבינארי. ערכת האותות שהמחשב יכול להשתמש בהם, יחד עם המספרים שלהם, נקראת ערכת אותות.
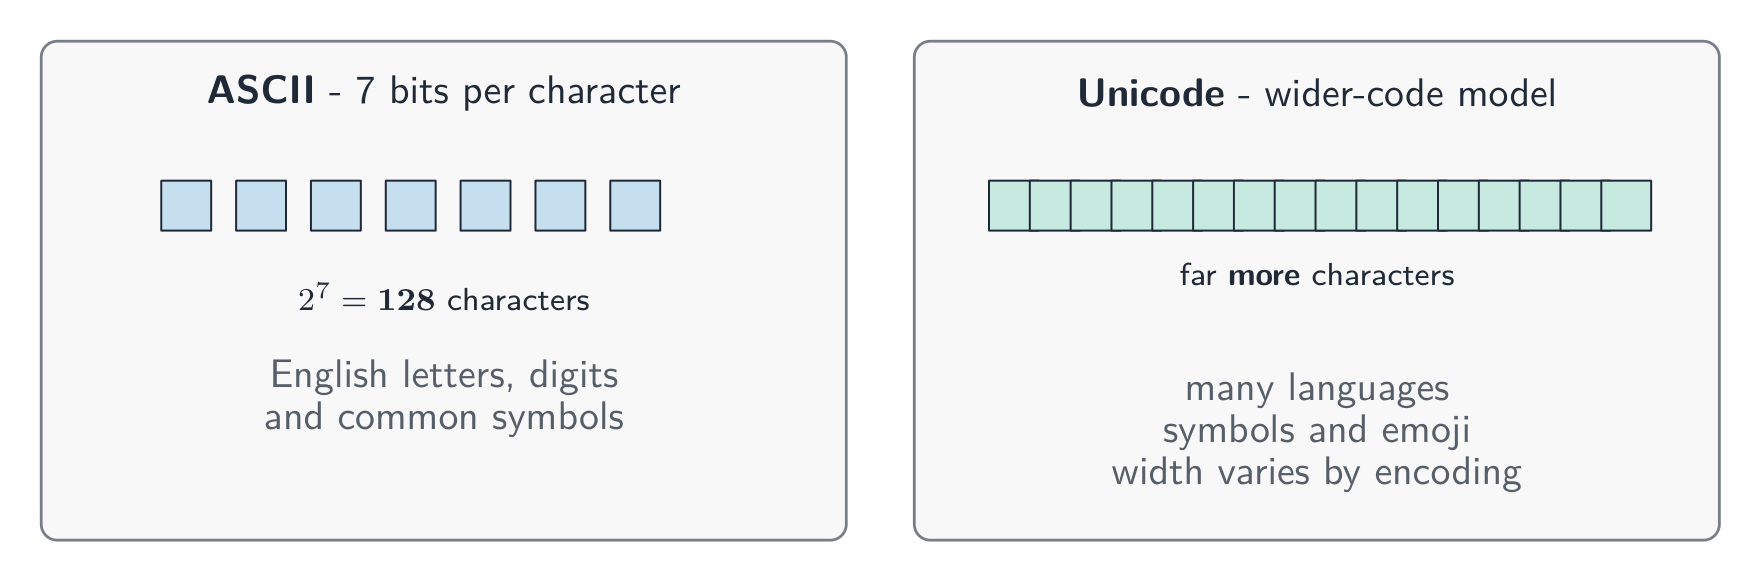
ASCII משתמש בקודי תווים בעלי 7 ביטים, מה שנותן $N = 2^b = 2^7 = 128$ קודים שונים. הוא כולל אותיות אנגליות, ספרות וסמלים נפוצים; לא כל הקודים ב-128 הם אותיות. Unicode מייצג טווח גדול הרבה יותר של תווים, כולל שפות שונות ו-emoji.
נסה זאת — קוד מסר קצר. קטע זה מ-ASCII נותן A = 65, B = 66, C = 67 ו-רווח = 32. כתוב את ארבעת להקות ה-7-ביט עבור CAB , כולל הרווח הסופי שלו. לאחר מכן פתור את להקות ה-1000010 1000001 1000011.
תשובה מופיעה. חפש כל תווה, ולאחר מכן המר את הקוד לבנארי:
Character
Code
Seven bits
C
67
1000011
A
65
1000001
B
66
1000010
space
32
0100000
לכן CAB הוא 1000011 1000001 1000010 0100000. המסר השני מתפענח ל-BAC. לרווח יש גם קוד; זוהי לא היעדר נתונים מאוחסנים. השולח והמקבל חייבים להשתמש באותו מיפוי קודי תווים כדי לפענח את המסר נכון.
ASCII כולל 128 קודים. Unicode תומך במגוון רחב הרבה יותר; השורה הרחבה ממחישה את דגם התוכנית.
מדוע מגוון רחב חשוב. ASCII אינו יכול לייצג ישירות שם בסין. Unicode כולל תווים סיניים לצד תווים אנגליים ועוד שפות רבות אחרות. בהשוואת התוכנית, הסבר כי מגוון רחב יותר דורש קודים בינאריים ייחודיים יותר, ולכן נדרשים מספר ביטים גדול יותר לכל תווה מאשר בדגם ASCII בעל 7 ביט.
נסה — השוואת דגמי אחסון מצוינים. אחסן ארבעה תווים CAB באמצעות (A) 7 ביטים לתווה ו-(B) 16 ביטים לתווה. הנחש שהביטים ארוזים בצפיפות ללא טפילים או מידע נוסף. חשב את גודל הנתונים בטקסט בכל דגם. הערך 16 הוא הנחה לדוגמה זו, ואינו כלל שכל תווה Unicode תופס 16 ביט.
תשובה מפורטת. עבור אותו מספר תווים, כפול במספר הביטים המצוין לכל תווה:
$$S = n b = 4 \times 7\ \text{bits} = 28\ \text{bits}$$
$$S = n b = 4 \times 16\ \text{bits} = 64\ \text{bits}$$
דגם B דורש יותר אחסון לדוגמה זו מכיוון שרוחב הקוד המצוין בו גדול יותר. השתמש ברוחב הנתון בשאלת מבחן. בקבצים אמיתיים, ההצפנה גם כן עשויה להיות רלוונטית: UTF-8 מאחסן תוויות ASCII באותו בייט כמו קובץ ASCII, ולכן טקסט Unicode אינו תופס תמיד יותר בייטים. אין צורך בכללי ה-UTF-8 המפורטים להשוואת התוכנית זו.
חקור
ייצוג קול
y = a sin(bt + c)
קול הוא גל; דגימה תועדת את גובהו מספר פעמים בשנייה.
תמונת מחשב מורכבת ממערך של נקודות קטנות הנקראות פיक्सלים.
ביטמאפ הוא מערך של פיקסלים; הרזולוציה היא כמה פיקסלים יש בה
רזולוציה היא מספר הפיקסלים בתמונה (לדוגמה $1920 \times 1080$).
עומק צבע הוא מספר הביטים המשמשים לאחסון הצבע של כל פיקסל.
רזולוציה גבוהה ועומק צבע גבוה נותנים תמונה באיכות טובה יותר, אך קובץ גדול יותר.
עומק הצבע קובע כמה צבעים שונים כל פיקסל יכול לייצג: עם $n$ סיביות יש $2^n$ צבעים. עומק צבע של 1 סיבית נותן 2 צבעים (שחור ולבן), 8 סיביות נותנות $2^8 = 256$ צבעים, ו־24 סיביות נותנות יותר מ־16 מיליון צבעים.
דוגמה פתורה. תמונה משתמשת ב־64 צבעים שונים. מהו עומק הצבע הקטן ביותר האפשרי שלה? מצאו את $n$ הקטן ביותר שעבורו $2^n \geqslant 64$: $2^6 = 64$, ולכן נדרשות 6 סיביות לפיקסל. אילו השתמשה ב־65 צבעים, היו נדרשות 7 סיביות, משום ש־6 סיביות יכולות ליצור רק 64 תבניות שונות.
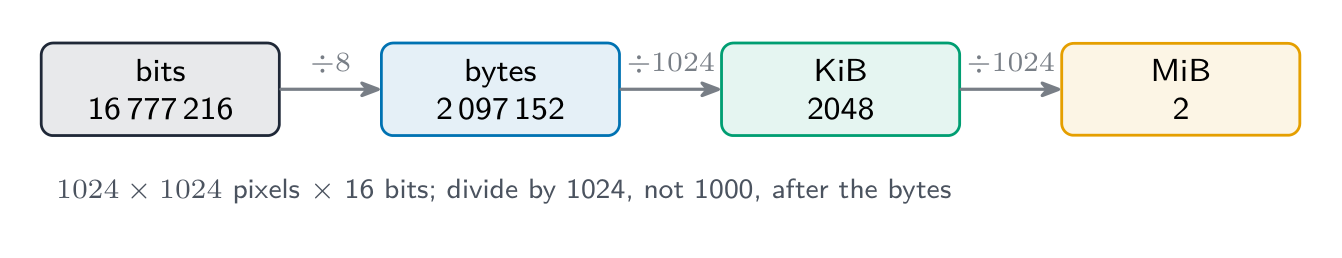
2 חשב את גודל הקובץ של קובץ תמונה וקובץ קול, באמצעות מידע שניתן
• התשובות חייבות להיות נתונות ביחידות שנקבעו בשאלה. החישובים חייבים להשתמש במדידה של 1024 ולא 1000 • המידע שניתן עשוי לכלול: – רזולוציה ותמונה ועומק צבע – קצב דגימת קול, רזולוציה ואורך רצועה
3 הבן את המטרה והצורך בדחיסת נתונים
• דחיסה קיימת כדי להקטין את גודל הקובץ • מה ההשפעה של כך, לדוגמה: – פס רחב פחות נדרש – מקום אחסון פחות נדרש – זמן העברה קצר יותר
4 הבן כיצד קבצים דחוסים באמצעות שיטות דחיסה מאבדת ודחיסה ללא אובדן
• דחיסה מאבדת מצמצמת את גודל הקובץ על ידי הסרת נתונים לצמיתות, לדוגמה: הפחתת רזולוציה או עומק צבע, הפחתת תדירות דגימה או רזולוציה • דחיסה ללא אובדן מצמצמת את גודל הקובץ ללא אובדן נתונים לצמיתות, לדוגמה: קידוד אורך-רצף (RLE)
מקור: הסיילבוס הבינלאומי של קמבריד'ג'
נפח אחסון נתונים נמדד ביחידות הבאות. ניבל הוא 4 ביטים ובית הוא 8 ביטים; החל מקיבייט ומעלה, כל יחידה היא פי 1024 מהיחידה הקודמת לה (מכיוון ש$1024 = 2^{10}$, שהתאים למערכת הספרות הדרווי).
יחידה
שווה ל-
bit
0 או 1 בודדים
nibble
4 ביטים
byte
8 ביטים
kibibyte (KiB)
1024 בייטים
mebibyte (MiB)
1024 KiB
gibibyte (GiB)
1024 MiB
tebibyte (TiB)
1024 GiB
pebibyte (PiB)
1024 TiB
exbibyte (EiB)
1024 PiB
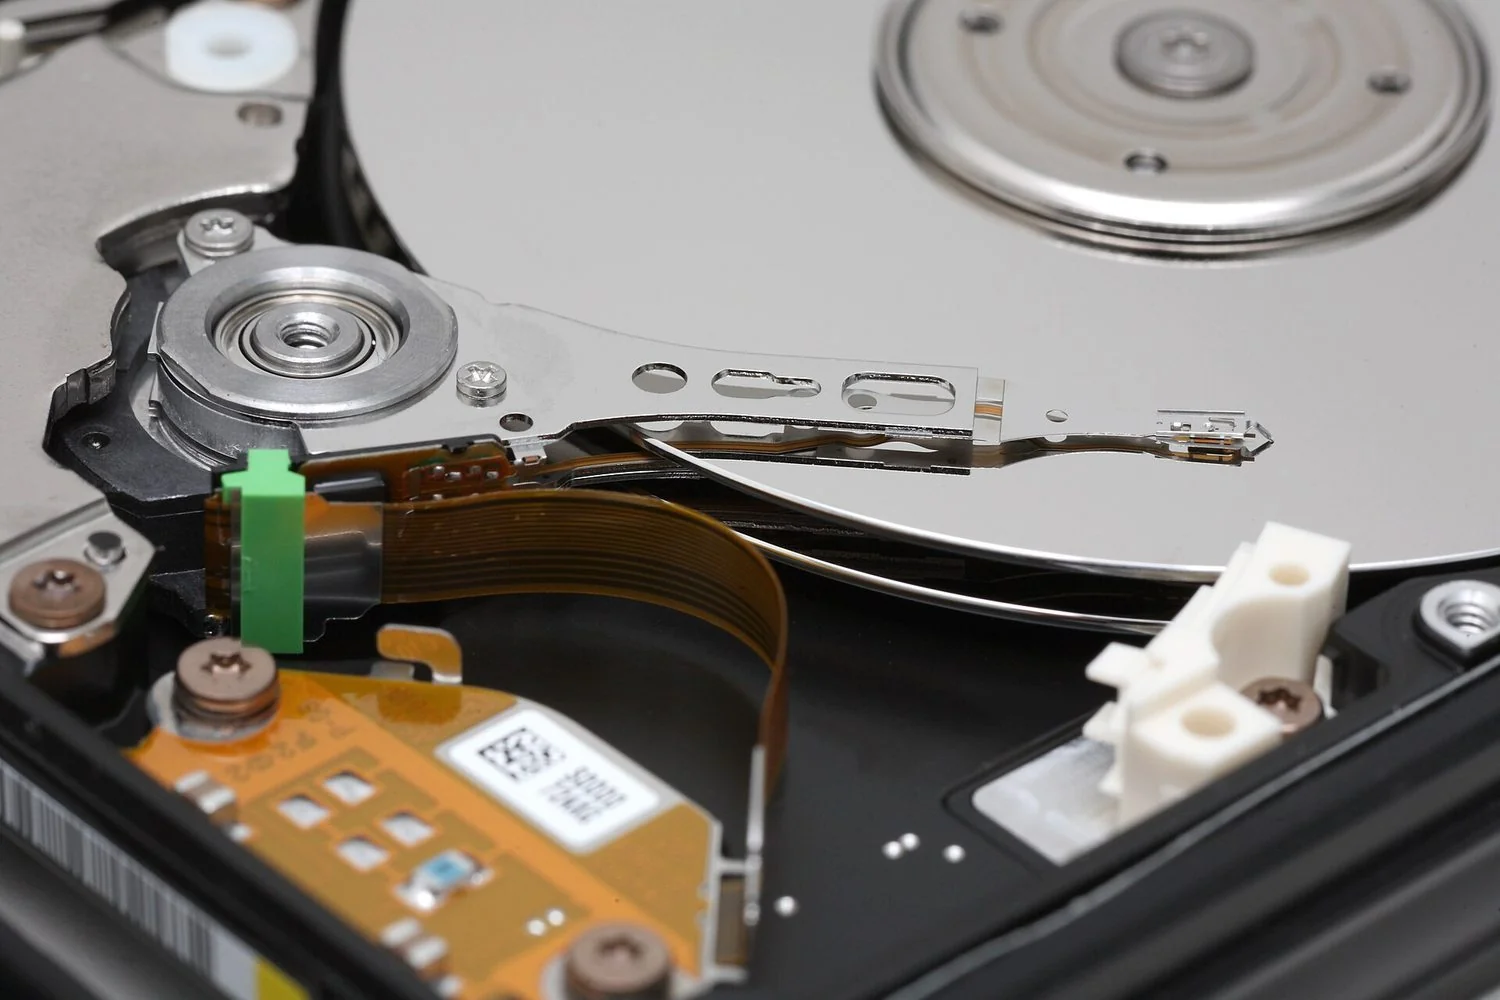
צלחות דיסק קשיח: נפח אחסון נמדד בבייטים — כדי לדעת גודל קובץ יש צורך במידע על רוחב × גובה × עומק צבע לתמונות
זקוק ל-רוחב פס קטן יותר (כמות המידע שאפשר לשאת בקישור),
לוקח זמן קצר יותר להעברה (זמן שידור קצר יותר).
ישנם שני סוגים.
דחיסה ללא איבוד נתונים
דחיסה ללא איבוד נתונים הופכת את הקובץ לקטן יותר ללא אובדן צמטי של מידע. ניתן לבנות מחדר את הקובץ המקורי בדיוק.
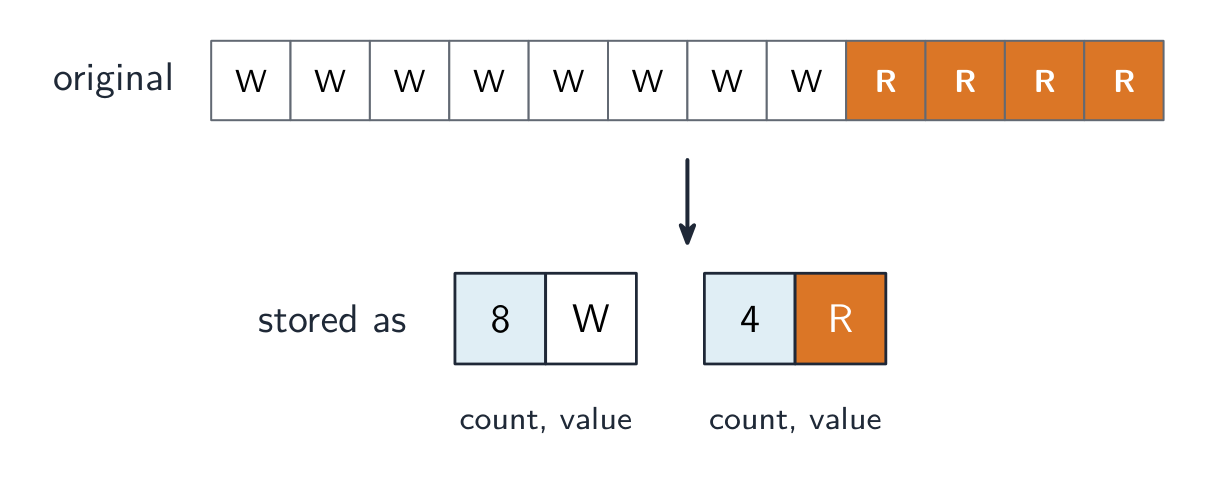
שיטה אחת היא קידוד אורך רצף (RLE). היא מחליפה רצף של ערכים חוזרים בעותק אחד של הערך ובמספר הפעמים שהוא חוזר. למשל, WWWWWWWW (8 פיקסלים לבנים) נשמר כך: “8 W”. השיטה יעילה כאשר בנתונים יש חזרות רבות.
הצפנת אורך רצף מאחסנת כל רצף פעם אחת כספירה וערך
דוגמה פתורה. שורה אחת בתמונה בשחור־לבן היא B B B B B W W B B B B B B B B B (16 פיקסלים). דחסו אותה באמצעות RLE וציינו אם נחסך מקום כאשר כל ספירה וכל צבע נשמרים בבית אחד.
הרצפים הם 5 שחורים, 2 לבנים, 9 שחורים, ולכן נתוני ה־RLE הם 5 B 2 W 9 B: נדרשים 6 בתים במקום 16 בתים במקור (בית אחד לפיקסל). נחסך מקום משום שבשורה יש רצפים ארוכים. שורה שצבעה משתנה בכל פיקסל, B W B W …, תהפוך ל־1 B 1 W 1 B 1 W … ותהיה גדולה פי שניים מהמקור: קידוד RLE מועיל רק כאשר נתונים חוזרים על עצמם.
דחיסה עם איבוד נתונים
דחיסה עם איבוד נתונים הופכת את הקובץ לקטן משמעותית על ידי הסרה צמטית של חלק מהנתונים. הנתונים שהוסרו לא יכולים לחזור. לדוגמה:
הפחתת הרזולוציה או עומק הצבע של תמונה,
הפחתת תדירות הדגימה או רזולוציית הדגימה של קלטת שמע.
השתמשו בדחיסה ללא איבוד נתונים כאשר חובה לשמור על כל פרט (קבצי טקסט ותוכנה). השתמשו בדחיסה עם איבוד נתונים לתמונות, מוזיקה ווידאו, שבו איבוד קטן באיכות שווה לקובץ קטן הרבה יותר.
חקור
אנכוד רצפים
התבונן בסמלים חוזרים הנדחסים לספירה — דחיסה פשוטה ללא איבוד נתונים.
1.3
טיפים לבחינות
ממירו מערכת עשרונית → בינארית על ידי חיסור ערכי המקום (128, 64, 32 …); בינארית → עשרונית על ידי חיבור ערכי המקום שמכילים 1.
להמרה לשישה עשר, יש לסדר את הבינארי בקבוצות של 4 ביטים (ניבלים) מימין לשמאל; כל ניבל מייצג בדיוק דיגיט אחד בשישה עשר.
התפוצצות מתרחשת כאשר התוצאה נמצאת מחוץ לטווח ההצגה הנבחר. מספרים שלמים אי-שליליים בגודל 8 ביטים מייצגים 0–255; שני משלים בגודל 8 ביטים מייצגים −128–127.
File size in bits: for an image, width × height × colour depth; for sound, sample rate × resolution × seconds. Divide by 8 for bytes, then by 1024 for each larger unit.
דחיסה ללא אובדן שומרת על כל הביט (טקסט; קידוד אורך רצף); דחיסה עם אובדן מסירה נתונים לצמיתות (תמונות, מוזיקה) כדי לקבל תיקון קטן הרבה יותר.