| המועמדים צריכים להיות מסוגלים: | הערות והנחיות |
|---|---|
| לבחור ולהשתמש ב-סוגי מידע מתאימים לפתרון בעיה | כולל מספר שלם, מספר אמיתי, תווית, מחרוזת, בוואליאני, תאריך (בסימול-קוד יושמשו סוגי המידע הבאים: INTEGER, REAL, CHAR, STRING, BOOLEAN, DATE, ARRAY, FILE) |
| להראות הבנה של המטרות של מבנה נתונים כדי לאחסן ערכת מידע בסוגי מידע שונים תחת מזהה אחד | כתוב סימול-קוד להגדרת מבנה נתונים |
| כתוב סימול-קוד לקריאת מידע ממבנה נתונים ולאחסון מידע במבנה נתונים |
סוגי נתונים ומבנים
מדעי המחשב A-Level · נושא 10
 17:40
סוגי נתונים ומבנים
כל ערך שאתה מאחסן בתוכנית צריך סוג נתונים — ובחירת הסוג הנכון חשובה. נניח שאתה אוסף האם מוצר קיים במלאי. היית יכול לכתוב את המילה yes…
קריאת קול באנגלית · תרגום אנגלי + סינית שרוף בתוך הסרטון
10.1
בחירת סוגי נתונים
סיילבוס
מקור: הסיילבוס הבינלאומי של קמבריד'ג'
לכל משתנה יש סוג נתונים — סוג הערך שהוא מכיל והפעולות המותרות:
INTEGER— מספר שלם (42,-7). לספירות, אינדקסים, זיהויים.REAL— מספר עם חלק שברוני (3.14). לכסף, למדידות.STRING— תווים בתוך quotation marks ("Hello"). הטקסט.CHAR— תווית בודדת ('A').BOOLEAN—TRUEאוFALSE. למשתנים סמליים.DATE— תאריך לוח שנה.
בחר את סוג הנתונים הקטן והמדויק ביותר המתאים: INTEGER לספירות שלמות, BOOLEAN למשתנים סמליים (לא המילים ⟨"yes"⟩/"no").
הטבלאות "תן את סוג הנתונים המתאים" נקבעות לפי השימוש בערך: הציון הממוצע של כיתה הוא REAL (יש לו חלק שברוני); כתובת דוא"ל היא STRING; מספר התלמידים הוא INTEGER; האם תלמיד שילם הוא BOOLEAN; תאריך לידה הוא DATE; אינדקס של מערך הוא תמיד INTEGER; אות ציון יחידה היא CHAR; מספר טלפון הוא STRING, כי הוא מתחיל ב 0 ואינו משמש לעריכה אריתמטית. BOOLEAN משמש למשתנה סמלי עם שני מצבים בלבד: האם חיפוש מצא את היעד, האם חבר שילם, האם מושב שמור. בטבלאת הזיהויים, שם המשתנה חייב להיות גם משמעותי: NumberOfPeople, לא n.
10.1
רשומות

רשומה (מבנה רשומה) מחזיקה מספר שדות מסוגים שונים תחת שם אחד — שימושי כאשר ערכים רבים מתארים דבר אחד.
TYPE TStockItem
    DECLARE ItemID : INTEGER
    DECLARE Category : STRING
    DECLARE ItemCost : REAL
    DECLARE InStock : BOOLEAN
ENDTYPE
זה מגדיר את ה-סוג TStockItem; הכרז משתנים ממנו:
DECLARE Item1 : TStockItem
DECLARE Items : ARRAY[1:100] OF TStockItem
השתמש בסימון נקודות כדי לגשת לכל שדה:
Item1.Category ← "Fruit"
OUTPUT Item1.Category, " costs ", Item1.ItemCost
השתמש ברקורד כאשר ערכים תמיד שייכים יחד (לקוח, פריט במלאי); השתמש במשתנים נפרדים לערכים שאינם קשורים.
דוגמה מפורטת. מועדון מאחסן, עבור כל סטודנט, תעודת זיהוי (סטרינג), שם, תאריך לידה ועד שלושה מספרי מועדון (שלמים). כתוב פסאודו-קוד להצהרת סוג הרקורד, מערך להחזקת $3000$ סטודנטים, והצהרה שמאחסנת שם באלמנט הראשון.
TYPE Student
    DECLARE StudentID : STRING
    DECLARE Name : STRING
    DECLARE DateOfBirth : DATE
    DECLARE Club : ARRAY[1:3] OF INTEGER
ENDTYPE

DECLARE Membership : ARRAY[1:3000] OF Student
Membership[1].Name ← "Li Wei"
הציונים: TYPE עם המזהה וENDTYPE; כל שדה מוגדר עם סוג מתאים; המערך מוגדר עם הגבולות שלו וOF Student; השדה מושג עם האינדקס ונקודה. שאלה "ציינו את השגיאה בהגדרת הרקורד" בדרך כלל מצביעה על ENDTYPE חסר, שדה ללא סוג, או שדה המוגדר כSTRING שמחזיק אריתמטיקה. שתי מסורתות מייצרות ציון עצמאי: אלמנט לא בשימוש מסומן בערך שלא יכול להיות נתון אמיתי (מחרוזת ריקה, -1, מזהה של 0), ואינו מעשי טוב להשתמש באותו סמן בכל מקום כך שכל מודול יוכל לזהות חריץ לא בשימוש; שדה קבוצה לא בשימוש הוא 0. יתרונות של מערך רקורדים, בשאלה "ציינו שלושה יתרונות": כל הנתונים עבור ישות אחת נשמרים תחת מזהה אחד; השדות יכולים להיות בעלי סוגי נתונים שונים; מערך אחד מחליף מספר מערכים מקבילים שצריכו להיות בקצב; כל הסט יכול להיות מעובד על ידי לולאה אחת או להעברת פרמטר אחד; והוספת שדה משנה את הגדרת הסוג רק פעם אחת. עבור לקוח אחד המבנה המתאים הוא רקורד (שדות בעלי סוגים שונים תחת שם אחד); עבור כל הלקוחות זהו מערך רקורדים.
חקור
רקורד מקבץ שדות תחת שם אחד
רקורד מאגד שדות הקשורים יחד. כל שדה הוא תווית ממונפת שמגיעים אליה באמצעות סימן נקודה — Item1.Category — ולא באמצעות אינדקס מספרי.
מילון מונחים
אימון
| English | עברית |
|---|---|
| array/əˈreɪ/ | מערך |
| record/ˈrekɔːd/ | רשום |
| record structure/ˈrekɔːd ˈstrʌktʃə/ | מבנה רקורד |
| field/fiːld/ | שדה |
| element/ˈelɪmənt/ | אלמנט |
| bounds/baʊndz/ | גבולות |
10.2
מערכים

סיילבוס
| המועמדים צריכים להיות מסוגלים: | הערות והנחיות |
|---|---|
| להשתמש במונחים הטכניים הקשורים למערכים | כולל מדד, גבול עליון וגבול תחתון |
| בחר מבנה נתונים מתאים (מערך 1D או 2D) לשימוש במשימה נתונה | |
| כתוב פסאודוקוד למערכים 1D ו-2D | |
| כתוב סימול-קוד לעיבוד מידע ממערכים | מיון באמצעות מיון בועות חיפוש באמצעות חיפוש ליניארי |
מקור: הסיילבוס הבינלאומי של קמבריד'ג'
מערך הוא איסוף מסודר של פריטים בעלי אותו סוג, תחת שם אחד, המגיעים באמצעות אינדקס.
- אלמנט — פריט אחד במערך.
- גבולות — האינדקסים התקפים הנמוכים והגבוהים ביותר.
- מימד — 1-D (רשימה), 2-D (טבלה), וכו'.
- גבול תחתון וגבול עליון — האינדקס הראשון והאחרון תקפים; מספר האלמנטים הוא גבול עליון מינוס גבול תחתון פלוס אחד, וא对于一个 מערכת בעלת 2-ממד, המכפלה בין שני הספירות.
לכן בThisArray[n] ← 42 למערכת יש מימד אחד, האינדקס הוא המשתנה n (INTEGER), והאלמנט באותו אינדקס מקבל את 42. לפני הצהרת מערכת יש צורך גם בסוג הנתונים וגם בגבולותיה. להצהרת $120$ ערכים שעשויים לכלול נקודה עשרונית: DECLARE Data : ARRAY[1:120] OF REAL; טבלת מחרוזות בעלת $150$-שורות ועמודה אחת: DECLARE Data : ARRAY[1:150, 1:2] OF STRING, שמכילה $300$ אלמנטים. היתרונות של מערכת על פני משתנים נפרדים, להסבר בשני ציונים: מזהה אחד במקום שלושים; את האלמנטים ניתן לעבד במעגל כאשר האינדקס הוא הסופר; הגודל קל לשינוי; ואת כל הקבוצה ניתן להעביר למודול כפרמטר בודד. מערכת יכולה גם להחליף שרשרת הוראות בחירה: DaysInMonth[Month] מחפש את התשובה ישירות במקום שנים עשר בלוקי IF, מה שקצר יותר, מהיר לכתיבה וקל לתחזוקה.
מערכיות בעלות 1-ממד
DECLARE Names : ARRAY[1:5] OF STRING
Names[3] ← "Cara"
OUTPUT Names[3]
עבד על כל אלמנט באמצעות לולאת FOR:
FOR i ← 1 TO 5
    OUTPUT Names[i]
NEXT i
מערכיות בעלות 2-ממד (מערכת בעלת 2-ממד)
DECLARE Grid : ARRAY[1:3, 1:4] OF INTEGER
Grid[2, 3] ← 99
האינדקס הראשון הוא השורה, השני הוא העמודה. השתמש בלולאות מוטבות כדי לבקר בכל תא. השתמש ב-1-D עבור רצף יחיד, ו-2-D עבור שני מימדים טבעיים (מסגרת, שורות × עמודות).

פעולות נפוצות
חיפוש ליניארי בודק כל אלמנט עד למציאתו:
FOR i ← 1 TO n
    IF A[i] = Target THEN
        OUTPUT "Found at ", i
    ENDIF
NEXT i
למצוא סכום, ספירה, מקסימום או מינימום, הגדר משתנה מצטבר ולאחר מכן עבור על המערך:
Max ← A[1]
FOR i ← 2 TO n
    IF A[i] > Max THEN
        Max ← A[i]
    ENDIF
NEXT i
מיון בועלי מסדר מערך: עובר עליו בהשוואה בין כל זוג שכנים ומבצע החלפה של כל זוג שאינו בסדר; חוזרים על העוברים עד שמעבר אחד אינו מבצע החלפות.
במסמך 2 נדרשים אלגוריתמים אלו גם כ-伪代码 וגם כ-שלבים במילים, ולעיתים בצורתם "יעילה":
- ערך מקסימלי: הגדר
Largestלאלמנט הראשון; עבור כל אלמנט שנותר, אם הוא גדול יותר מLargest, אחסן אותו בLargest; לאחר מחזור ההוצאLargest. עבור המיקום של המקסימום, שמור משתנה שנייה האוחזת את האינדקס בכל פעם שLargestמתעדכן. - חיפוש ליניארי החוזר מיקום: הגדר
FoundAt ← -1לפני המחזור (ערך לעולם לא יתאים כאינדקס תקף, ולכן פירושו "לא נמצא"); עבור על המערך; כאשר האלמנט תואם, אחסן את האינדקס וצא מהמחזור; לאחר המחזור בדוק אתFoundAt. - ספור או הדפס את האלמנטים שאינם ריקים: השווה כל אלמנט לסימן של אלמנט שאינו משמש (
""או-1) וספור או הדפס רק את אלו שנבדלים. - הסרת פריט: מצא את האינדקס שלו בחיפוש ליניארי; הזז כל אלמנט שלאחריו מקום אחד קדימה כך שהרווח ייסגר; סמן את האלמנט האחרון כאינו משומש (או צמצם את הספירה).
- הוספה למערך מסודר: מצא את האינדקס הראשון שבו האלמנט גדול יותר; הזז את האלמנט הזה וכל אחד שלאחריו מקום אחד אחורה; אחסן את הערך החדש ברווח.
- מיון בועלי יעיל: דגל
Swappedכדי שהעוברים יפסקו ברגע שמעבר אינו ביצע החלפה, וגבול עליון היורד ב-1 בכל מעבר מכיוון שהערך המקסימלי הגיע כבר לקצה.
REPEAT
    Swapped ← FALSE
    FOR Index ← 1 TO Limit - 1
        IF Data[Index] > Data[Index + 1] THEN
            Temp ← Data[Index]
            Data[Index] ← Data[Index + 1]
            Data[Index + 1] ← Temp
            Swapped ← TRUE
        ENDIF
    NEXT Index
    Limit ← Limit - 1
UNTIL Swapped = FALSE
הציונים הם על המעגל החיצוני שחוזר עד שאין העברות, על הפלאג שמוגדר בתוך הIF, על ההעברה בת三条 שורות עם משתנה זמני, ועל הגבול המתכווץ. מיון ב"שלבים" (פיצול הדרגתי) הוא: חזור עד למיון; בכל מעבר השווה זוגות סמוכים; העבר זוג שאינו בסדר; לאחר כל מעבר הערך הגדול ביותר שלא מומן נמצא בסוף. שתי מערכיות בעלות 1-ממד של רקורדים או של נתונים מקבילים מעובדות במעגל אחד ובאינדקס אחד; מערכת בעלת 2-ממד דורשת מעגל תוך-תוך, החיצוני על שורות והפנימי על עמודות, וחידוש בשורה אחת קובע את אינדקס השורה ומעגל על העמודה.

חקור
מערך דו-ממדי 2
בחר שורה ועמודה לקריאת אלמנט אחד – כיצד רשת נתונים מאוחסת ומדדדת.
מילון מונחים
אימון
| English | עברית |
|---|---|
| data type/ˈdeɪtə taɪp/ | סוג נתונים |
| index/ˈɪndeks/ | מדד |
| bubble sort/ˈbʌbl sɔːt/ | מיון בועה |
10.3
קבצים

סיילבוס
| המועמדים צריכים להיות מסוגלים: | הערות והנחיות |
|---|---|
| להראות הבנה מדוע נדרשים קבצים | |
| כתוב פסאודו-קוד לטיפול בקבצי טקסט המורכבים מקו אחד או יותר |
מקור: הסיילבוס הבינלאומי של קמבריד'ג'
קובץ הוא נתונים מאוחזים באחסון משני, נשמרים בין הרצות התוכנית. משתנים ב-RAM נעלמים כשהתוכנית מסתיימת, ולכן כדי לשמור נתונים לצמיתות (שיאים, ריקורדים, הגדרות) התוכנית כותבת לקובץ. קבצים מאפשרים גם לתוכניות לשתף נתונים ולהתחיל מחדש ממצב שמור.
*משתנים ב-RAM נעלמים כשהתוכנית מסתיימת; קובץ על דיסק נשאר קיים בין הרצות
קובץ טקסט מכיל קו אחד או יותר של תווים קריאים; תוכניות קוראות וכותבות קובצי טקסט קו אחר קו. פתח קובץ לפני השימוש וסגור אותו לאחר מכן:
OPENFILE "data.txt" FOR READ      // or FOR WRITE, FOR APPEND
WHILE NOT EOF("data.txt") DO
    READFILE "data.txt", LineString
    OUTPUT LineString
ENDWHILE
CLOSEFILE "data.txt"
EOF בודק את סוף הקובץ לפני הקריאה. לכתיבה:
OPENFILE "log.txt" FOR WRITE
FOR i ← 1 TO 100
    WRITEFILE "log.txt", "Event " & i
NEXT i
CLOSEFILE "log.txt"
תמיד סגור כל קובץ — אחרת כתיבות במאגר זמני עשויות לאבד והיציאה של תוכניות אחרות עשויה להיות חסומה.
מדוע קובצים (שתי נקודות): הנתונים נשמרים לאחר סיום התוכנית, כך שהם זמינים בפעם הבאה שהתוכנית פועלת; ניתן לשתף אותם עם תוכניות אחרות; וניתן להכיל יותר ממה שמתאים לזיכרון. המאפיין של קובץ טקסט שמאפשר לתוכנית לעבוד עליו הוא שהוא רצף של שורות, הקריאה אחת מהשנייה מהתחלה. שלושת המצבים: READ לקרוא מהתחלה; WRITE ליצור קובץ חדש, שזה מוחק כל תוכן קיים, ולכן אינו יכול לשמש להוספה לקובץ; APPEND להוסיף שורות בסוף קובץ קיים. בדיקת EOF לפני כל קריאה, ופתיחת הקובץ פעם אחת בלבד, גם כאשר מספר מודולים משתמשים בו.
דוגמה מופיעה. כתוב מדומה עבור הליך LastLines(FileName : STRING) שיפלט את השלוש שורות האחרונות של קובץ טקסט, בסדר.
PROCEDURE LastLines(BYVAL FileName : STRING)
    DECLARE LineX, LineY, LineZ : STRING
    LineX ← ""
    LineY ← ""
    LineZ ← ""
    OPENFILE FileName FOR READ
    WHILE NOT EOF(FileName) DO
        LineX ← LineY
        LineY ← LineZ
        READFILE FileName, LineZ
    ENDWHILE
    CLOSEFILE FileName
    OUTPUT LineX
    OUTPUT LineY
    OUTPUT LineZ
ENDPROCEDURE
כל שורה חדשה דוחפת את השלוש הקודמות קדימה, כך שבסוף הקובץ השלוש משתנים מחזיקים את השלוש שורות האחרונות שלו; קובץ עם פחות משלוש שורות מפלט מחרוזות ריקות. כדי להפלט את החמש שורות הראשונות, ספור את השורות שנקראו ועצור את הלולאה בחמישי או ב-EOF, תלוי מי מגיע קודם; קובץ ריק מתגלה כאשר EOF הוא TRUE מיד לאחר הפתיחה.
שדות בשורה. קובץ טקסט מכיל מחרוזות, ולכן רשום נכתב כשורה אחת עם השדות המחוברים על ידי תווית מפריד, וכל מספר או בוליאני מומר עם NUM_TO_STR (וקורא חזרה עם STR_TO_NUM, או על ידי השוואה ל-"TRUE"). בחר מפריד שלא יוכל לעולם להופיע בנתונים: פסיקה או | לשמות ומספרים, לעולם רווח כאשר ייתכן ששם יכיל אחד. אם שדה עשוי להכיל כל תווית, המפריד עשוי להתבלבל עם הנתונים; הפתרון הוא לשים כל שדה בשורה עצמאית, או לכתוב אורך השדה לפניו. פריט אחד בשורה קל לקריאה חזרה אך משתמש בשורות יותר וגורם לרשום להיות קשה לראות כיחידה. קריאת קובץ שבו השורות בסדר ידוע (עולה לפי מזהה) מאפשרת לחיפוש להפסיק ברגע שקוראים מזהה גדול יותר, במקום לקרוא עד הסוף. קובץ שמירה שנוצר בכל פעם שהמשחק נשמר צריך שם קובץ משמעותי, לדוגמת שם השחקן והתאריך והשעה, כך שכל שמירה קודמת תוכל להיות שוחזרת.
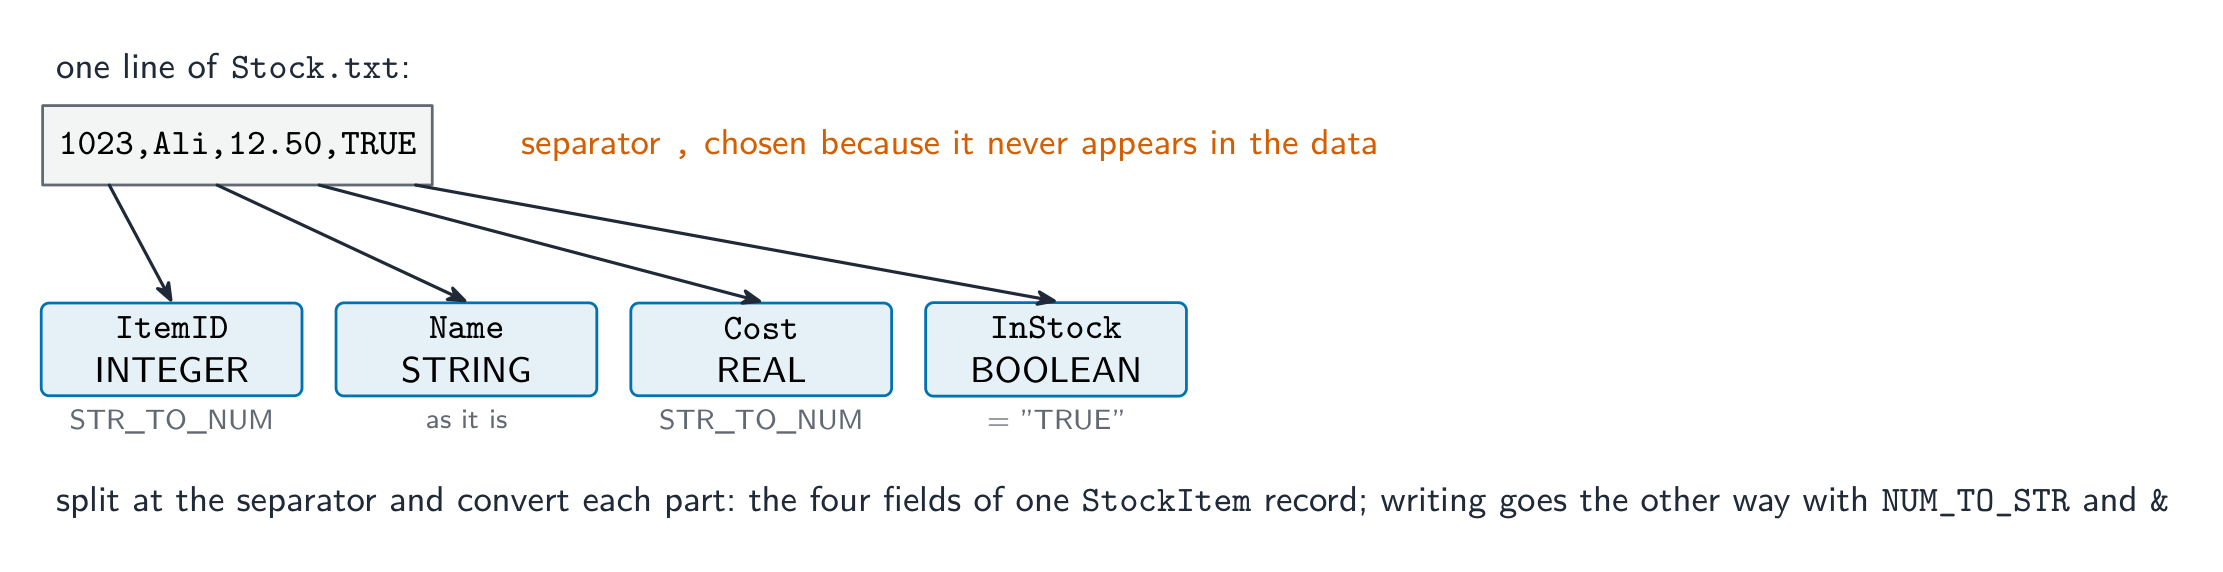
חקור
טיפול בקובץ: פתיחה → שימוש → סגירה
עבור על מחזור החיים של כל קובץ. שני חלקים שקל לשכוח הם בדיקת EOF בזמן קריאה בתוך לולאה, וסגירה תמידית בסוף.
מילון מונחים
אימון
| English | עברית |
|---|---|
| file/faɪl/ | קובץ |
| secondary storage/ˈsekəndəri ˈstɔːrɪdʒ/ | אחסון משני |
| text file/tekst faɪl/ | קובץ טקסט |
| end of file/end ɒv faɪl/ | סוף קובץ |
10.4
סוגי נתונים מ 추 abstraction (ADTs)

סיילבוס
| המועמדים צריכים להיות מסוגלים: | הערות והנחיות |
|---|---|
| הצג הבנה כי ADT הוא קבוצת נתונים ומערכת פעולות על הנתונים הללו | |
| הצג הבנה כי ערימה, תור ורשימה מקושרת הם דוגמאות ל-ADTs | תאר את התכונות המרכזיות של ערימה, תור ורשימה מקושרת והסבר את שימושם במצב נתון |
| השתמש ב-ערימה, תור ורשימה מקושרת לאחסון נתונים | לא ידרשו מהמועמדים לכתוב פסאודו-קוד למבנים אלו, אך עליהם להיות מסוגלים להוסיף, לערוך ולמחוק נתונים מתוך המבנים האלו |
| תאר כיצד ניתן ליישם תור, ערימה ורשימה מקושרת באמצעות מערכים |
מקור: הסיילבוס הבינלאומי של קמבריד'ג'
סוג נתון מ abstract (ADT) הוא איסוף נתונים פלוס פעולות עליו, המוגדר לפי מה הוא עושה, ולא איך הוא מאוחסן. המשתמש עובד רק דרך הפעולות; היישום מוסתר, כך שהוא יכול להשתנות ללא השפעה על קוד המשמש את ADT. יש להכיר שלושה: אגרוף, תור, רשימה מקושרת.
ההגדרה בנקודה אחת: ADT הוא איסוף נתונים יחד עם סט של פעולות על הנתונים הללו. אגרוף, תור, רשימה מקושרת, עץ בינארי ומערך הם כולם ADTs. כדי להצדיק בחירה: תור כאשר פריטים חייבים להתנהל בסדר הגעתם (משימות הדפסה, לחיצות מקשים, לקוחות בחנות), כי זה ראשון נכנס, ראשון יוצא; אגרוף כאשר הפריט העדכני חייב להתנהל ראשון (ביטול, גלילה אחורית דרך דפי רשת, הפוך הזמנה, כתובות החזרה של קריאות מצטוותות), כי זה אחרון נכנס, ראשון יוצא; רשימה מקושרת כאשר פריטים מוסיפים ומוחקים באמצע רצף מסודר לעיתים קרובות, כי רק اشارهנים משתנים ואין צורך להזיז דבר. כדי להשוות אגרוף ותור: שניהם מבנים ליניאריים של פריטים עם סדר, שניהם מיושמים עם מערך ושארשנים, ושניהם זקוקים לבדיקת מלא לפני הוספה וריקה לפני הסרה; לאגרוף יש שארשן אחד והוספה והסרה באותו קצה, לתור יש שני שארשנים והוספה בקצה אחד והסרה בקצה השני.
אגרוף
אגרוף עובד בסדר LIFO (אחרון נכנס, ראשון יוצא). פעולות: push (הוספה בראש), pop (הסרה מראש), peek (הסתכלות בראש), ובדיקות לריק/מלא. שימושים: היסטוריית ביטול, כתובות החזרה של פונקציות, ניתוח ביטויים, גילוי חזרה.
דוגמה מופיעה. אגרוף של תווים מחזיק, מהתחתית, 'P', 'N', 'Z', 'X', 'Y', 'W', עם שארשן ראש האגרוף ב-'W' (מיקום בזיכרון 202 של 200–207). הפעולות POP, POP, PUSH 'A', PUSH 'B', POP מבוצעות. מה נמצא באגרוף, ואיפה שארשן מצביק?
שתי ה-pops מסירות את 'W' ולאחר מכן את 'Y'; ה-pushes מוסיפות את 'A' ולאחר מכן את 'B' במקומותיהם; ה-last pop מסירה את 'B'. האגרוף כעת מחזיק את 'P', 'N', 'Z', 'X', 'A' וארשן נמצא ב-'A', מיקום 203. הערך שהיה באגרוף הכי הרבה זמן הוא הפריט התחתון, 'P'; עד חמש pops נוספות אפשריות לפני שהאגרוף יהיה ריק, ו-pop על אגרוף ריק הוא שגיאה, ולכן Pop() בודק ריקות קודם. פונקציית Push() שמחזירה TRUE בהצלחה בודקת תחילה האם שארשן נמצא בראש המערך (מלא) ומחזירה FALSE אם כן. אלמנטים במערך אינם זקוקים לאיפוס לפני השימוש, כי שארשן בלבד אומר אילו אלמנטים בשימוש.

תור
תור פועל לפי סדר FIFO (First In, First Out). פעולות: enqueue (הוספה בקצה), dequeue (הסרה מהתחלה), ובדיקות למצב ריק/מלא. שימושים: הוצאת קובץ בהדפסה, תזמון, חיפוש רוחב, בופרים.

כדי לתאר הוספת פריט: ודא שהתור אינו מלא; אחסן את הפריט במיקום שמסמן חציין סוף התור; הגדל את חציין הסוף (וגם את הספירה). כדי לתאר הסרה: ודא שהתור אינו ריק; קרא את הפריט בחציין ההתחלה; הגדל את חציין ההתחלה (וגם הנמך את הספירה). ציין את הקונבנציה שאתה משתמש בה: אם חציין הסוף מסמן את המקום החופשי הבא, שוויון חצייני ההתחלה והסוף מעיד על כך שהתור ריק; אם הוא מסמן את הפריט האחרון, שוויון חציינים מעיד על פריט אחד. בתור לינייארי חציין ההתחלה זז רק קדימה, ולכן תאים מאחוריו נשארים לבזבזים; זה מה שתיקון התור המחזורי למטה. שתי תכונות התור לציין: פריטים מוסיפים בקצה ומוצאים מהתחלה, ולכן הפריט הראשון שהוסף הוא הראשון שהוסר.

רשימה מקושרת
רשימה מקושרת מאחסנת נתונים כרצף של צמתים. כל צומח מכיל ערך ו-חציין לצומח הבא; חציין ראש מסמן את ההתחלה, וחציין הצומח האחרון הוא סימן סיום (למשל NULL). פעולות: הוספה, מחיקה, חיפוש, ו-traverse (ביקור בכל צומח בסדר). היתרון שלו לעומת מערך הוא הוספה/מחיקה זולה (רק מתכווננים חציינים); החסרון הוא גישה אקראית איטית (צריך לעבור על חציינים מהראש).

הוספת נקודה בסדר (ארבע ציונים): עבור ברשימה מהראש, בעקבות השליוניות, עד למציאת הנקודה לפני המיקום (הנקודה האחרונה שערכה קטן יותר); קח נקודה פנויה ואחסן את הערך החדש בה; הגדר את שליונית הנקודה החדשה לכתובת עליה указывала הנקודה הקודמת; הגדר את שליונית הנקודה הקודמת לנקודה החדשה. אם הערך החדש שייך בראש, שליונית הראש משתנה במקום זאת. מחק נקודה: מצא את הנקודה לפניה, והגדר את שליונית הנקודה זו לכתובת עליה указывa deleted node so the list bypasses it; the freed node returns to the free list. בהשוואה למערך 1-D, הוספה או מחיקה ברשימה מקושרת אינה דורשת הזזת הפריטים האחרים, והרשימה יכולה לגדול עד שתגמר הזיכרון; העלות היא שליונית נוספת הארוכה עם כל פריט, והשגירה ל$n$th פריט דורשת מעקב אחר $n$ שליוניות, מכיוון שאין אינדקס ישיר.
חקור
רשימה מקושרת: נקודות מחוברות על ידי מצביעים
כל נקודה מאחסנת ערך ומצביע לנקודה הבאה. ההוספה או המחיקה משנות רק את הקישור במצביעים — אין הזזה של פריטים, בניגוד למערך.
חקור
ערימות ותורות
הוספה והסרה. ערימה היא Last-In-First-Out; תור הוא First-In-First-Out – שתי מבני נתונים מופשטים מרכזיים.
מילון מונחים
אימון
| English | עברית |
|---|---|
| stack/stæk/ | סטק |
| dimension/daɪˈmenʃn/ | ממד |
| lower bound/ˈləʊə baʊnd/ | גבול תחתון |
| upper bound/ˈʌpə baʊnd/ | גבול עליון |
| linear search/ˈlɪnɪə sɜːtʃ/ | חיפוש ליניארי |
| push/pʊʃ/ | הכנסה לתור |
| separator/ˈsepəreɪtə/ | מפריד |
| Abstract Data Type/ˈæbstrækt ˈdeɪtə taɪp/ | סוג נתונים מ 추상 (Abstract Data Type) |
| linked list/lɪŋkt lɪst/ | רשימה מקושרת |
| queue/kjuː/ | תור |
| LIFO/ˈlaɪfəʊ/ | אחרון נכנס, אחרון יוצא (LIFO) |
| FIFO/ˈfaɪfəʊ/ | ראשון נכנס, ראשון יוצא (FIFO) |
| pop/pɒp/ | הוצאה מתור |
| enqueue/enˈkjuː/ | הוספה לתור |
| dequeue/diːˈkjuː/ | הסרה מתור |
| node/nəʊd/ | צומת |
| traverse/trəˈvɜːs/ | מעבר |
| free list/friː lɪst/ | רשימת פנויים |
10.4
מימוש ADTs באמצעות מערכים

ערימה באמצעות מערך
אחסן פריטים בStack[1:MaxSize] עם integer Top (0 כאשר ריק).
Push(x): אםTop = MaxSizeהערימה מלאה (overflow); אחרתTop ← Top + 1;Stack[Top] ← x.Pop(): אםTop = 0הערימה ריקה (underflow); אחרת החזרStack[Top]וTop ← Top - 1.
תור באמצעות מערך מחזורי
מאחנה פשוטה מאפשרת לFront ולRear לצאת מהסוף, ובכך מבזבזת את ההתחלה. הפתרון הוא מערך מעגלי – כאשר מחוון מגיע לMaxSize הוא חוזר לאחור ל-1:
Enqueue(x): בדוק אם מלא; אחרתRear ← (Rear MOD MaxSize) + 1;Queue[Rear] ← x.Dequeue(): בדוק אם ריק; אחרת החזרQueue[Front]וFront ← (Front MOD MaxSize) + 1.
עקוב אחרי ספן נפרד כדי להבדיל בין מצב ריק למצב מלא.
האלגוריתם עבור מחוון הסוף, במילים: אם הספן שווה לגודל, דווח שהמאחנה מלאה ועצור; אחרת הוסף 1 למחוון הסוף; אם הוא עכשיו עבר את האינדקס האחרון, הגדר אותו לאינדקס הראשון; שמור את הפריט שם והוסף 1 לספן. הצהרות שמתוך תשובה על "תיאור הצהרה והתחלה" המציינת 5 נקודות מציגות: את המערך עם גודלו וסוג האלמנטים; מחוון קדמי ומחוון סופי, שתחילה משני מחוונים מוגדרים לאינדקס הראשון (או הקדמי לאינדקס הראשון והסופי למקום החופשי הבא); וספן של פריטים, המוגדר ל-$0$.
למשל, עם MaxSize = 6: אם Rear = 5, אז(5 MOD 6) + 1 = 6, כך שהפריט הבא ייכנס לתא 6; אם Rear = 6, אז(6 MOD 6) + 1 = 1, כך שהמחוון חוזר לאחור לתא 1.
רשימה מקושרת באמצעות מערכת
השתמש במערכת של רקורדים, כל אחד עם אינדקס Next:
TYPE TNode
    DECLARE Value : INTEGER
    DECLARE Next : INTEGER     // index of the next node, or -1 for end
ENDTYPE

DECLARE Nodes : ARRAY[1:MaxSize] OF TNode
DECLARE Head : INTEGER         // index of first node, -1 if empty
DECLARE FreeListHead : INTEGER // first available free node
רשימת פנויים מקשרת את התאים שאינם בשימוש, בדיוק כפי הרשימה הנתונים מקשרת את אלו שבשימוש. להוספה: לקחת תא מFreeListHead, להגדיר את ערך הצומת החדש וNext, ולעדכן את הNext של הצומת הקודם (או Head). למחיקה: ניתוק הצומת והחזרת התא שלו לרשימת הפנויים. זה נותן גמישות של מבנה מקושר עם הקצה השתוקף של מערכת.

דוגמה מפורטת. רשימה מקושרת מאוחסנת במערכת בעלת Data ומערכת בעלת Pointer, כאשר Start מכוון לאינדקס 1. הרשימה היא 1 → 3 → 4 (אינדקס 1 מכיל D40, אינדקס 3 מכיל D32, אינדקס 4 מכיל D11, whose pointer is $\emptyset$); the free list starts at index 2 and continues 2 → 5. Insert D6 between D32 and D11.
קח את הנודד הפנוי הראשון, אינדקס 2, והגדר את FreeStart לקישור שלו, 5; אחסן D6 בData[2]; הגדר את Pointer[2] לערך Pointer[3] המאוחסן, שהוא 4; הגדר את Pointer[3] ל2. הרשימה קוראת 1 → 3 → 2 → 4 והרשימה הפנויה היא 5 → $\emptyset$. התשובה לשאלה "איך ניתן לממש רשימה מקושרת" היא בדיוק חלקים אלו: מערכת (או מערכת של רקורדים) לנתונים, מערכת מקבילה לקישורים המחזיקים אינדקסים, נקודת התחלה, נקודת רשימה פנויה וערך null כמו $-1$ לסיום.
דוגמה מפורטת. תור מעגלי מוחזק במערך בגודל 5 (אינדקסים 0 עד 4) עם Front = 3, Rear = 3 ואחד פריט מאוחסנים. שני פריטים נוספים, ואז שניים נמחקים. היכן הנקודות, ולמה משתמשים בתור מעגלי בכלל? כל תנועה משתמשת ב(pointer + 1) MOD size, לכן הנקודות מתחלפות. הוספת פעמיים מזיזה את Rear: $3 \rightarrow 4$, ואז $4 \rightarrow 0$ (כי $(4+1) \bmod 5 = 0$), לכן Rear = 0 ושלושה פריטים מאוחסנים. הסרה פעמיים מזיזה את Front באותו אופן: $3 \rightarrow 4$, ואז $4 \rightarrow 0$, משאירה Front = 0 ופריט אחד. ההחלפה היא整点 העניין: בתור במערך ליניארי הנקודות הולכות לקצה והמרחב הפנוי בחלק הקדמי נשאר לא בשימוש גם כשהתור ריק. זכרו שתור מסיר מה-חזית ומוסיף ב**-ה后方** - ערימה משתמשת בנקודה אחת לשתי הפעולות.
חקור
יישום ADTs עם מערכים
ראשון נכנס, ראשון יוצא (FIFO)
תור הוא ראשון נכנס ראשון יוצא — הזרקה מהגב, פריקה מהחזית.
מילון מונחים
אימון
| English | עברית |
|---|---|
| pointer/ˈpɔɪntə/ | איشارת זיכרון |
| overflow/ˌəʊvəˈfləʊ/ | גלישה |
| underflow/ˌʌndəˈfləʊ/ | היפחתות מתחת לגבול |
| circular array/ˈsɜːkjʊlə əˈreɪ/ | מערך מעגלי |
10.4
הגדרות מקובלות בקורס
שאלה המגדירה מוערכת לפי נוסח קבוע. לימוד אלו בדיוק.
| מונח | הגדרה |
|---|---|
| רקורד | מבנה נתונים המוחזר סט של פריטי נתונים (שדות) בעלי סוגי נתונים שונים תחת מזהה אחד |
| מערכת | מבנה נתונים המוחזר מספר קבוע של אלמנטים מאותו סוג נתונים תחת מזהה אחד, כל אחד נגיש באמצעות אינדקס |
| אינדקס | המספר המזהה אלמנט אחד במערכת |
| גבול עליון, גבול תחתון | האינדקס הגדול והקטן תקפים ביותר במערכת |
| קובץ טקסט | קובץ שמאחסן נתונים בשורות של תווים, שם תוכנה קוראת וכותבת שורה אחת בכל פעם |
| סוג נתונים抽象 (ADT) | אוסף נתונים יחד עם סט של פעולות על הנתונים האלו |
| ערימה (Stack) | רשימה בה פריטים נוספים ונמחקים מאותו קצה, העליון, כך שהפריט המנוסה אחר הוא הראשון שנמחק (LIFO) |
| תור (Queue) | רשימה בה פריטים נוספים בקצה האחורי ונמחקים מהחזית, כך שהפריט המנוסה ראשון הוא הראשון שנמחק (FIFO) |
| רשימה מקושרת | רשימה בה כל צומת מכיל פריט נתונים ומצביע לצומת הבא, עם מצביע התחלה לצומת הראשון |
| מצביע | משתנה המכיל את הכתובת (או האינדקס) של צומת או של מיקום במבנה |
| חיפוש ליני | בדיקה של כל אלמנט בסדר מהראשון עד למציאת היעד או הגעה לסוף |
| מיון בועות | מעברים חוזרים באר레이 השוואה זוגות סמוכים והחלפתם אם הם מחוץ לסדר, עד שמעבר אחד אינו מבצע החלפות |
10.4
טיפים לבחינות
- בחרו את המבנה הנתונים הנכון והסבירו זאת (רקע לשדות מעורבים, מערך 2-D לרשת).
- לדעת כיצד ליישם ערימה, תור ורשימה מקושרת בעזרת מערך ומצביעים (עליון; חזית/אחור; הבא).
- להבחין בין ADT (ההתנהגות שלו) לבין היישום שלו (מערך וצביעים).
טעויות נפוצות
- הצהרת רקליד ללא
ENDTYPE, או שדות ללא סוגים. כל שדה הוא שורתDECLAREעם סוג. - קריאה מעבר לסוף קובץ, או כתיבה עם
WRITEכאשר הקובץ חייב לשמור את תוכנו. בדוקEOFלפני כל קריאה; השתמש בAPPENDלהוספה. - כתיבת מספר לקובץ טקסט ללא המרה. קובץ מכיל מחרוזות:
NUM_TO_STRיוצא,STR_TO_NUMחוזר. - לשכוח את הבדיקות.
Pushו-enqueue בודקים תחילה אם מלא;Popו-dequeue בודקים תחילה אם ריק, והתשובה מציינת זאת. - לאבד את שאר הרשימה בהכנסת צומת. הגדר את מצביע הצומת החדש לצומת הבא הישן לפני שינוי מצביע הצומת הקודם.
- חיפוש ליני שלא אומר לעולם "לא נמצא". אתחל את המיקום ל$-1$ ובדוק אותו לאחר הלולאה.
שיעורים אינטראקטיביים בנושא זה
לעבור על הדברים צעד אחר צעד, עם תרגילים לבדיקה מיידית.