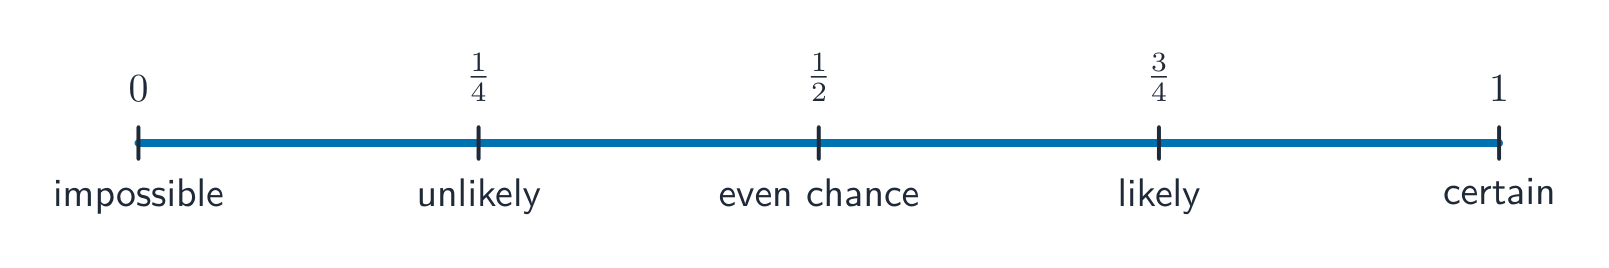AP Statistics cubre explorar datos, muestreo y diseño experimental, probabilidad y variables aleatorias, distribuciones muestrales e inferencia — intervalos de confianza y pruebas de significancia. Hay poco álgebra; la dificultad radica en expresar correctamente sobre la incertidumbre.
Toda respuesta de inferencia tiene cuatro partes: nombrar el procedimiento, verificar las condiciones, calcular y concluir en contexto con un vínculo a la hipótesis alternativa. La rúbrica califica las cuatro, por lo que una p-valor correcto solo obtiene una puntuación baja.
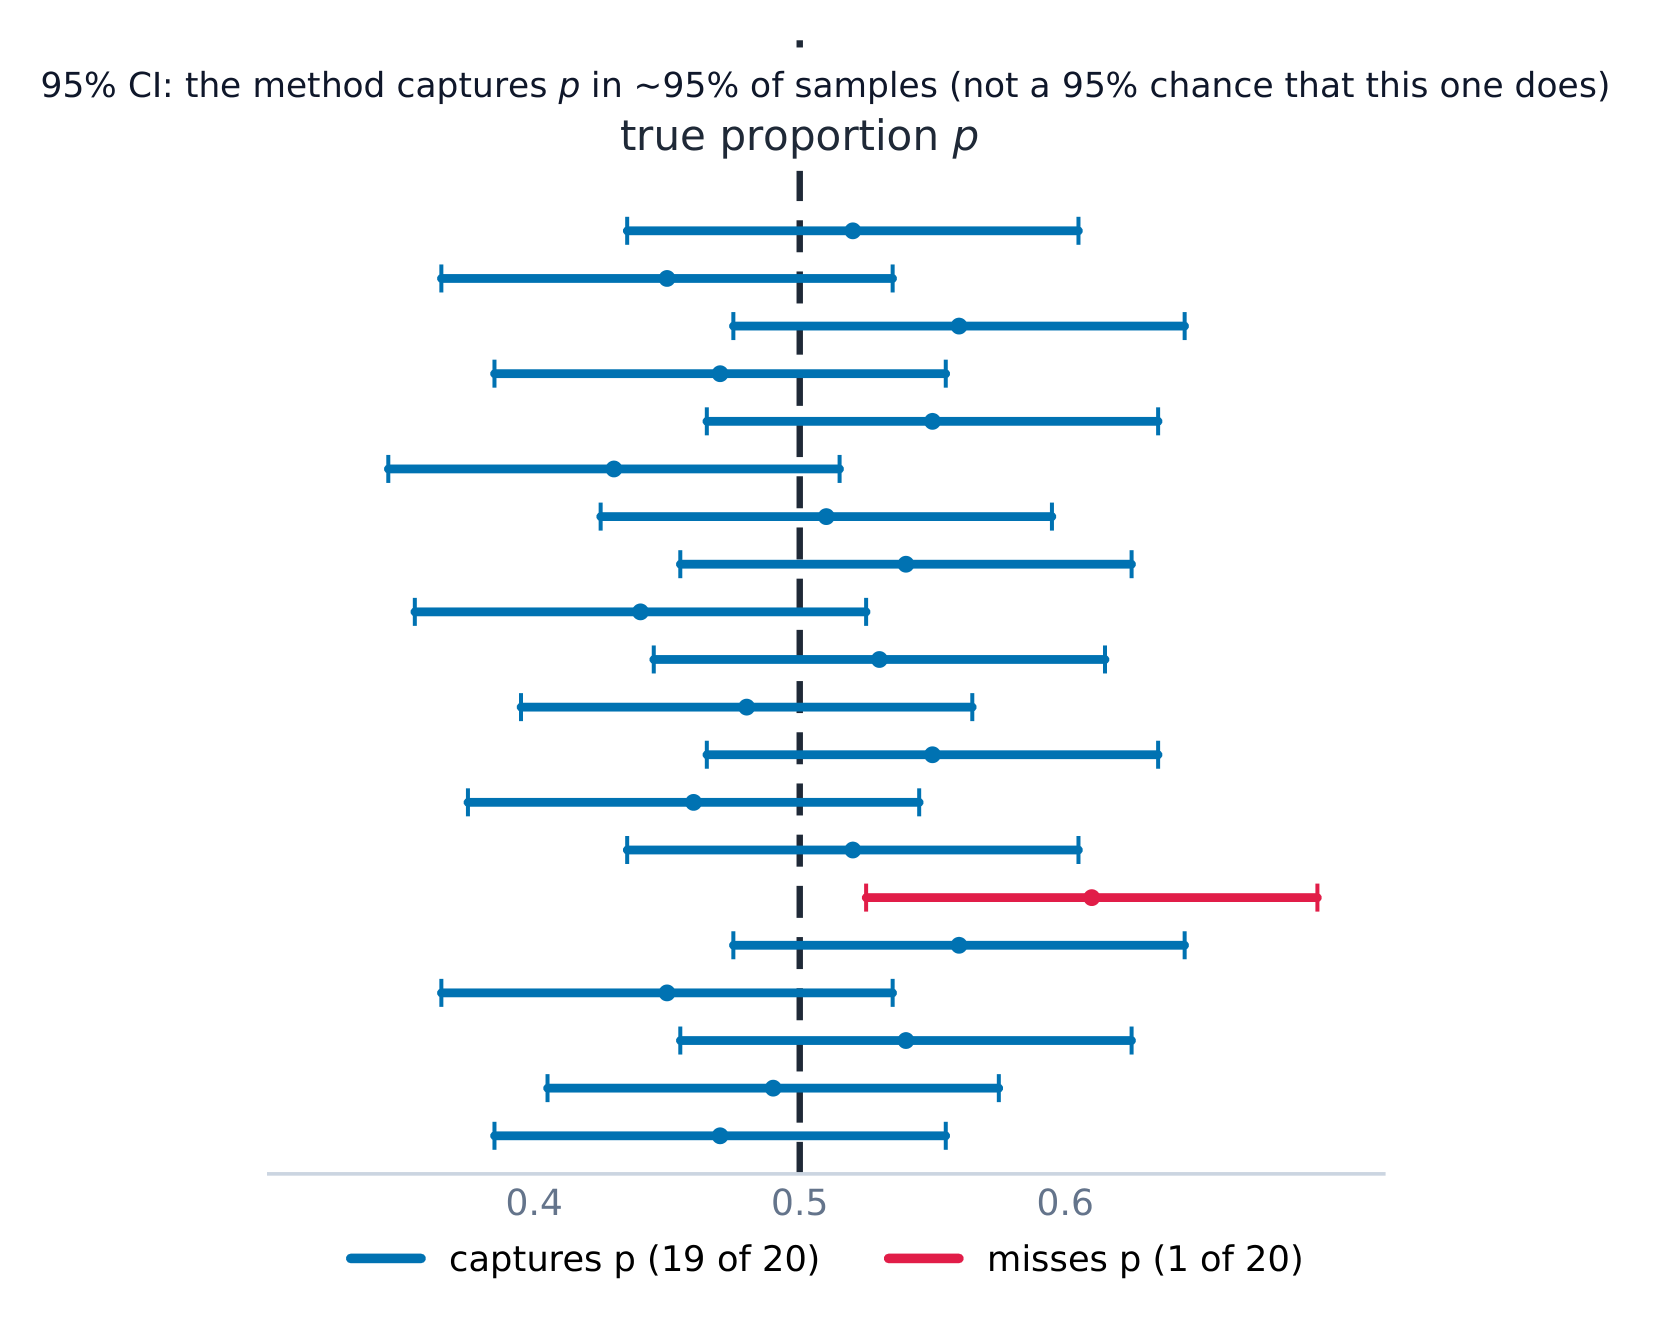
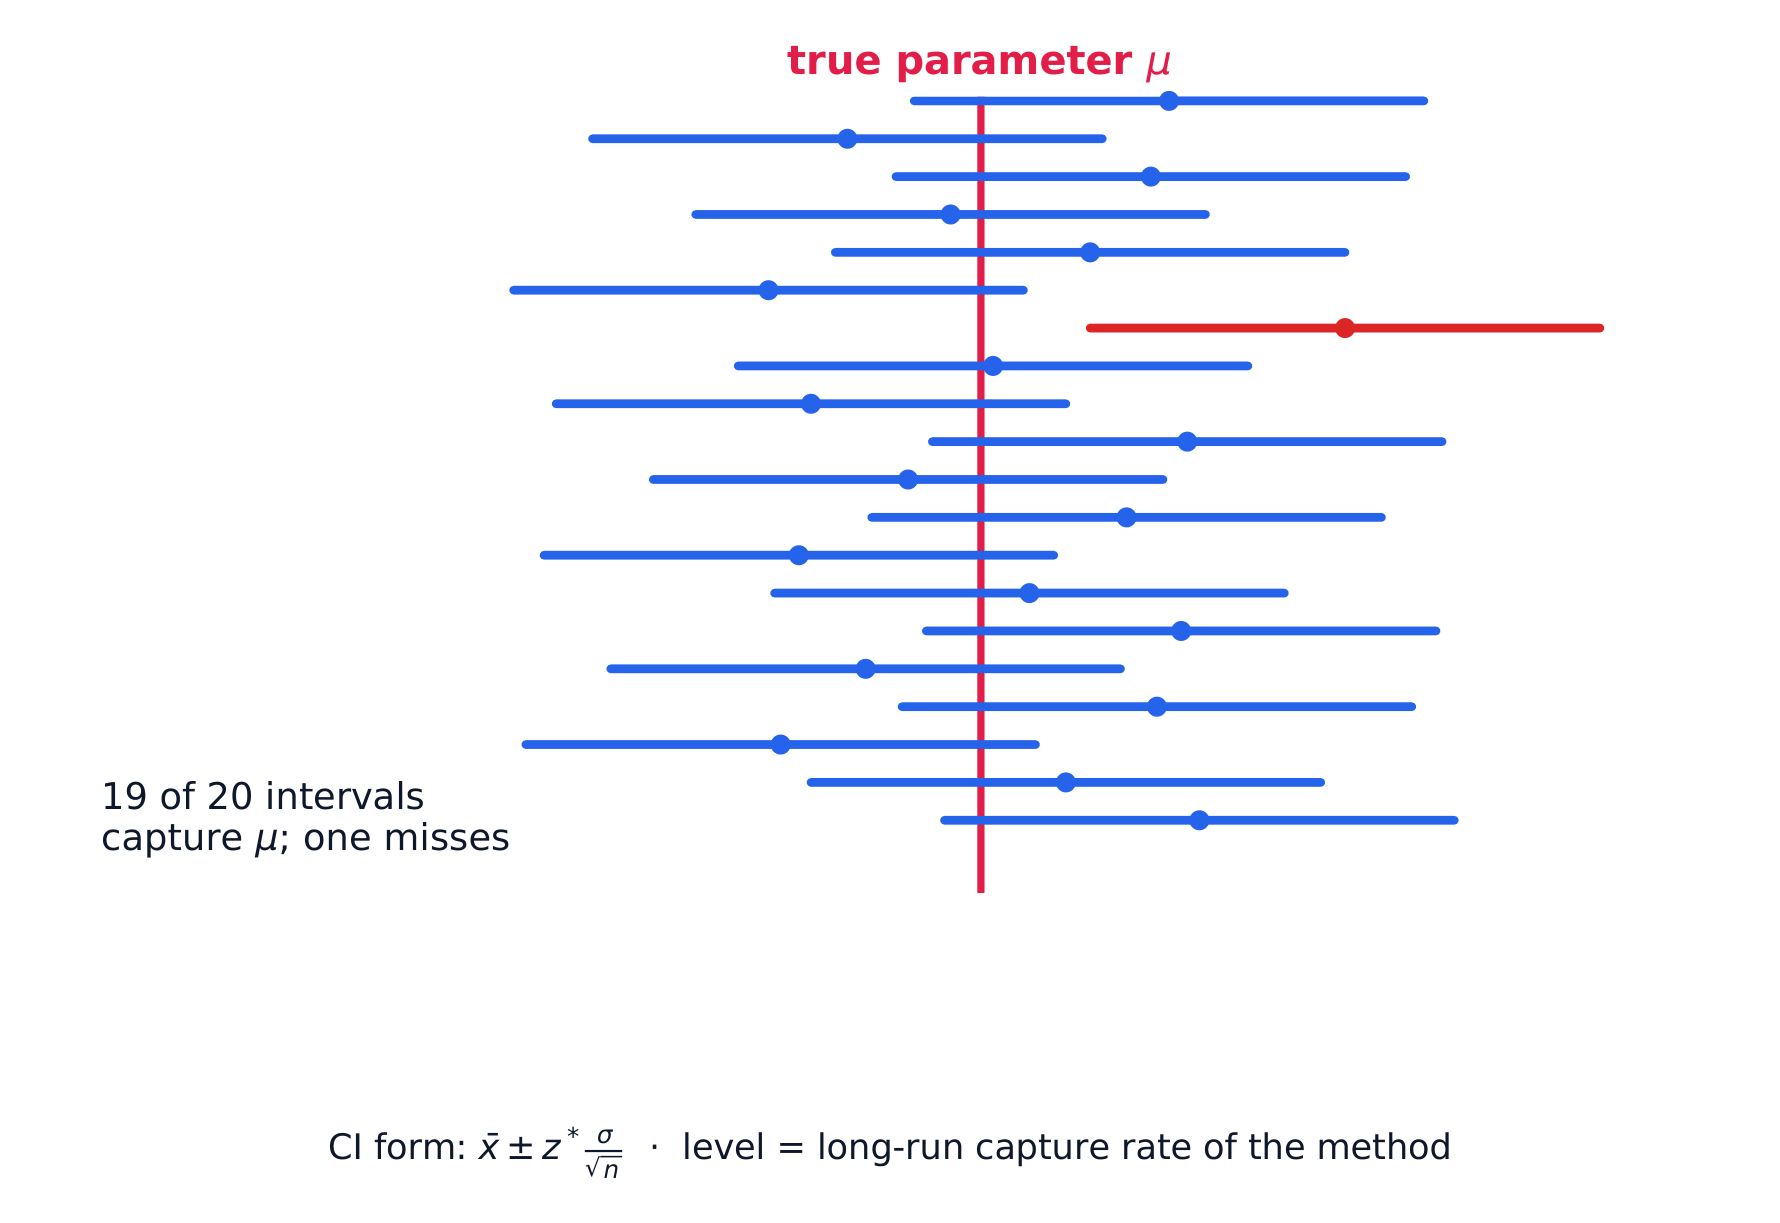
Se califica el lenguaje. "Rechazamos H₀" no es igual a "demostramos H₁"; un intervalo de confianza se refiere al comportamiento a largo plazo del método, no a la probabilidad de que un intervalo particular contenga el parámetro. Estas distinciones determinan los puntos.
Las notas abordan las nueve unidades con cada procedimiento de inferencia desarrollado paso a paso. Las FRQs publicadas están en la biblioteca. Estadística otorga puntos por enunciar las condiciones e interpretar en contexto, por lo que toda respuesta resuelta nombra las condiciones antes de realizar la prueba.
Introduciendo la estadística: ¿Qué podemos aprender de los datos?
Syllabus
Comprensión perdurable (VAR-1): Dado que la variación puede ser aleatoria o no, las conclusiones son inciertas.
Objetivo de aprendizaje VAR-1.A: Identificar preguntas para responder, basándose en la variación en datos de una variable. [Habilidad 1.A]
VAR-1.A.1 Los números pueden transmitir información significativa cuando se colocan en contexto.
Fuente: College Board AP Course and Exam Description
Estadística 统计学 es la ciencia de aprender a partir de datos 数据 – números o etiquetas recopilados del mundo real. Los datos varían, por lo que describimos patrones y tenemos en cuenta la variación 变异 en lugar de esperar que cada valor coincida. Una pregunta estadística anticipa una respuesta basada en datos que varían.
Dos distinciones atraviesan todo el curso. Un parámetro 参数 es un resumen numérico de toda una población; una estadística 统计量 es un resumen numérico de una muestra - usamos la estadística para estimar el parámetro que no podemos medir directamente. Y la estadística descriptiva 描述统计 solo resume el conjunto de datos a mano, mientras que la estadística inferencial 推断统计 usa una muestra para hacer y contrastar afirmaciones sobre la población más grande.
1.2
El lenguaje de la variación: Variables
Syllabus
Comprensión perdurable (VAR-1): Dado que la variación puede ser aleatoria o no, las conclusiones son inciertas.
Objetivo de aprendizaje VAR-1.B: Identificar variables en un conjunto de datos. [Habilidad 2.A]
VAR-1.B.1 Una variable es una característica que cambia de un individuo a otro.
Objetivo de aprendizaje VAR-1.C: Clasificar los tipos de variables. [Habilidad 2.A]
VAR-1.C.1 Una variable categórica toma valores que son nombres de categorías o etiquetas de grupos.
VAR-1.C.2 Una variable cuantitativa es aquella que toma valores numéricos para una cantidad medida o contada.
Ejemplos ilustrativos para VAR-1.C:
Variables categóricas:
Mano dominante
Grupo de edad (joven o mayor)
Título académico más alto obtenido
Variables cuantitativas:
Edad de una estructura
Altura de un niño
Concentración de una muestra
Fuente: College Board AP Course and Exam Description
Una variable 变量 es una característica que puede diferir entre individuos. Dos tipos:
Categorica 分类 (cualitativa): los valores son etiquetas/grupos (color de ojos, marca).
Cuantitativa 定量: los valores son números con los que se puede hacer aritmética (altura, edad). Las variables cuantitativas son discretas (contables) o continuas (medidas).
Elegir el gráfico y el resumen adecuados depende del tipo que tengas.
Explorar
¿Cualitativa o cuantitativa?
Cada variable es ya sea categórica (etiqueta cada unidad con un grupo) o cuantitativa (un número medido que puedes promediar). Qué tipo es decide los gráficos y resúmenes que tienes permitido usar.
Comprensión duradera (UNC-1): Las representaciones gráficas y las estadísticas nos permiten identificar y representar características clave de los datos.
Objetivo de aprendizaje UNC-1.A: Representar datos categóricos utilizando tablas de frecuencia o frecuencia relativa. [Habilidad 2.B]
UNC-1.A.1 Una tabla de frecuencia proporciona el número de casos que caen en cada categoría. Una tabla de frecuencia relativa proporciona la proporción de casos que caen en cada categoría.
Objetivo de aprendizaje UNC-1.B: Describir datos categóricos representados en tablas de frecuencia o frecuencia relativa. [Habilidad 2.A]
UNC-1.B.1 Los porcentajes, las frecuencias relativas y las tasas proporcionan la misma información que las proporciones.
UNC-1.B.2 Los conteos y las frecuencias relativas de los datos categóricos revelan información que puede utilizarse para justificar afirmaciones sobre los datos en su contexto.
Fuente: College Board AP Course and Exam Description
Una tabla de frecuencias 频数表 enumera el recuento (frecuencia) de cada categoría; una tabla de frecuencia relativa 相对频率 enumera la proporción 比例 de cada categoría (recuento ÷ total). Las frecuencias relativas te permiten comparar grupos de diferentes tamaños de manera justa.
1.4
Representando una variable categorica con gráficos
Syllabus
Comprensión duradera (UNC-1): Las representaciones gráficas y las estadísticas nos permiten identificar y representar características clave de los datos.
Objetivo de aprendizaje UNC-1.C: Representar datos categóricos gráficamente. [Habilidad 2.B]
UNC-1.C.1 Los diagramas de barras (o gráficos de barras) se utilizan para mostrar frecuencias (conteos) o frecuencias relativas (proporciones) en datos categóricos.
UNC-1.C.2 La altura o longitud de cada barra en un gráfico de barras corresponde al número o proporción de observaciones que caen dentro de cada categoría.
UNC-1.C.3 Existen muchas formas adicionales de representar frecuencias (conteos) o frecuencias relativas (proporciones) para datos categóricos.
Objetivo de aprendizaje UNC-1.D: Describir datos categóricos representados gráficamente. [Habilidad 2.A]
UNC-1.D.1 Las representaciones gráficas de una variable categórica revelan información que puede utilizarse para justificar afirmaciones sobre los datos en su contexto.
Objetivo de aprendizaje UNC-1.E: Comparar múltiples conjuntos de datos categóricos. [Habilidad 2.D]
UNC-1.E.1 Las tablas de frecuencias, los gráficos de barras u otras representaciones pueden utilizarse para comparar dos o más conjuntos de datos en términos de la misma variable categórica.
Fuente: College Board AP Course and Exam Description
Los gráficos de barras 条形图 muestran el recuento o proporción de cada categoría como barras separadas; un gráfico circular muestra la participación de cada categoría en el total. Las alturas de las barras (o rebanadas) te permiten comparar categorías de un vistazo. Las barras pueden ordenarse por tamaño o por un orden natural de categorías.
Explorar
Mostrar una variable categórica como un gráfico circular
Un gráfico circular convierte la participación de cada categoría del total en una porción: una participación mayor es una porción mayor, y todas las porciones juntas hacen el 100%. Es una imagen de una tabla de frecuencia relativa.
1.5
Representando una variable cuantitativa con gráficos
Syllabus
Comprensión perdurable (UNC-1): Las representaciones gráficas y las estadísticas nos permiten identificar y representar características clave de los datos.
Objetivo de aprendizaje UNC-1.F: Clasificar tipos de variables cuantitativas. [Habilidad 2.A]
UNC-1.F.1 Una variable discreta puede asumir un número contable de valores. El número de valores puede ser finito o infinitamente contable, como ocurre con los números naturales.
UNC-1.F.2 Una variable continua puede asumir infinitos valores, pero estos no pueden contarse. Independientemente de lo pequeño que sea el intervalo entre dos valores de una variable continua, siempre es posible determinar otro valor intermedio.
Ejemplos ilustrativos para UNC-1.F:
Una variable discreta:
Número de estudiantes en una clase
Una variable continua:
Altura de un niño
Objetivo de aprendizaje UNC-1.G: Representar datos cuantitativos gráficamente. [Habilidad 2.B]
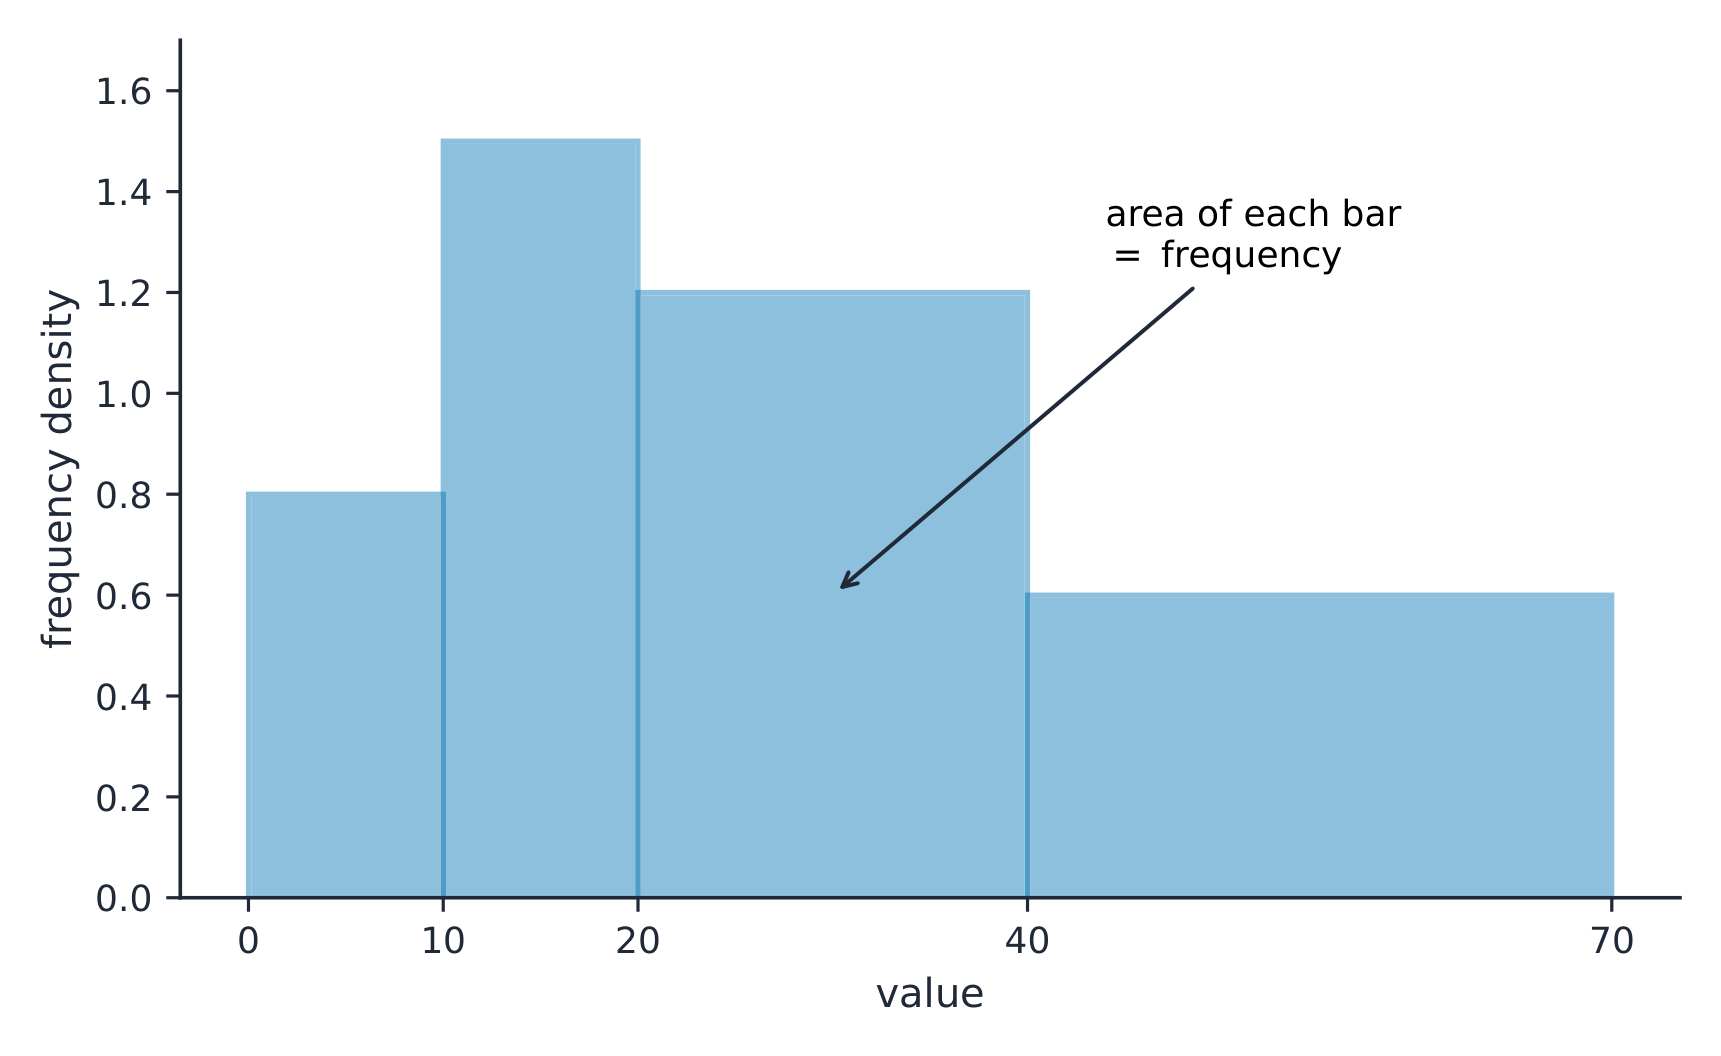
UNC-1.G.1 En un histograma, la altura de cada barra indica el número o proporción de observaciones que caen dentro del intervalo correspondiente a dicha barra. Modificar los anchos de los intervalos puede alterar la apariencia del histograma.
UNC-1.G.2 En un diagrama de tallo y hoja, cada valor de dato se divide en un "tallo" (el primer dígito o dígitos) y una "hoja" (usualmente el último dígito).
UNC-1.G.3 Un gráfico de puntos representa cada observación mediante un punto, donde la posición en el eje horizontal corresponde al valor de dato de esa observación, apilándose casi valores idénticos unos sobre otros.
UNC-1.G.4 Un gráfico acumulativo representa el número o proporción de un conjunto de datos menor o igual a un número dado.
UNC-1.G.5 Existen muchas formas adicionales de representar gráficamente distribuciones de datos cuantitativos.
Fuente: College Board AP Course and Exam Description
Para números, usa un gráfico de puntos 点图, un diagrama de tallo y hoja 茎叶图, o un histograma 直方图 (barras sobre intervalos de valores llamados clases). Estos muestran la distribución 分布 – cómo se dispersan los valores. El ancho de clase de un histograma cambia la imagen, así que elígelo para revelar la forma.
En un histograma con anchos de clase desiguales, el área de la barra es la frecuencia
Explorar
Explorar cómo el ancho de clase moldea un histograma
Un histograma agrupa datos en clases de ancho igual y dibuja una barra sobre cada una. Cambie las clases y note cómo los mismos datos pueden verse escalonados (demasiado estrechos) o suaves (demasiado anchos) — la forma es una elección.
Describiendo la distribución de una variable cuantitativa
Syllabus
Comprensión Duradera (UNC-1): Las representaciones gráficas y las estadísticas nos permiten identificar y representar características clave de los datos.
Objetivo de Aprendizaje UNC-1.H: Describir las características de las distribuciones de datos cuantitativos. [Habilidad 2.A]
UNC-1.H.1 Las descripciones de la distribución de datos cuantitativos incluyen la forma, el centro y la variabilidad (dispersión), así como cualquier característica inusual como valores atípicos, lagunas, agrupaciones o múltiples picos.
UNC-1.H.2 Los valores atípicos para datos de una sola variable son puntos de datos que son inusualmente pequeños o grandes en relación con el resto de los datos.
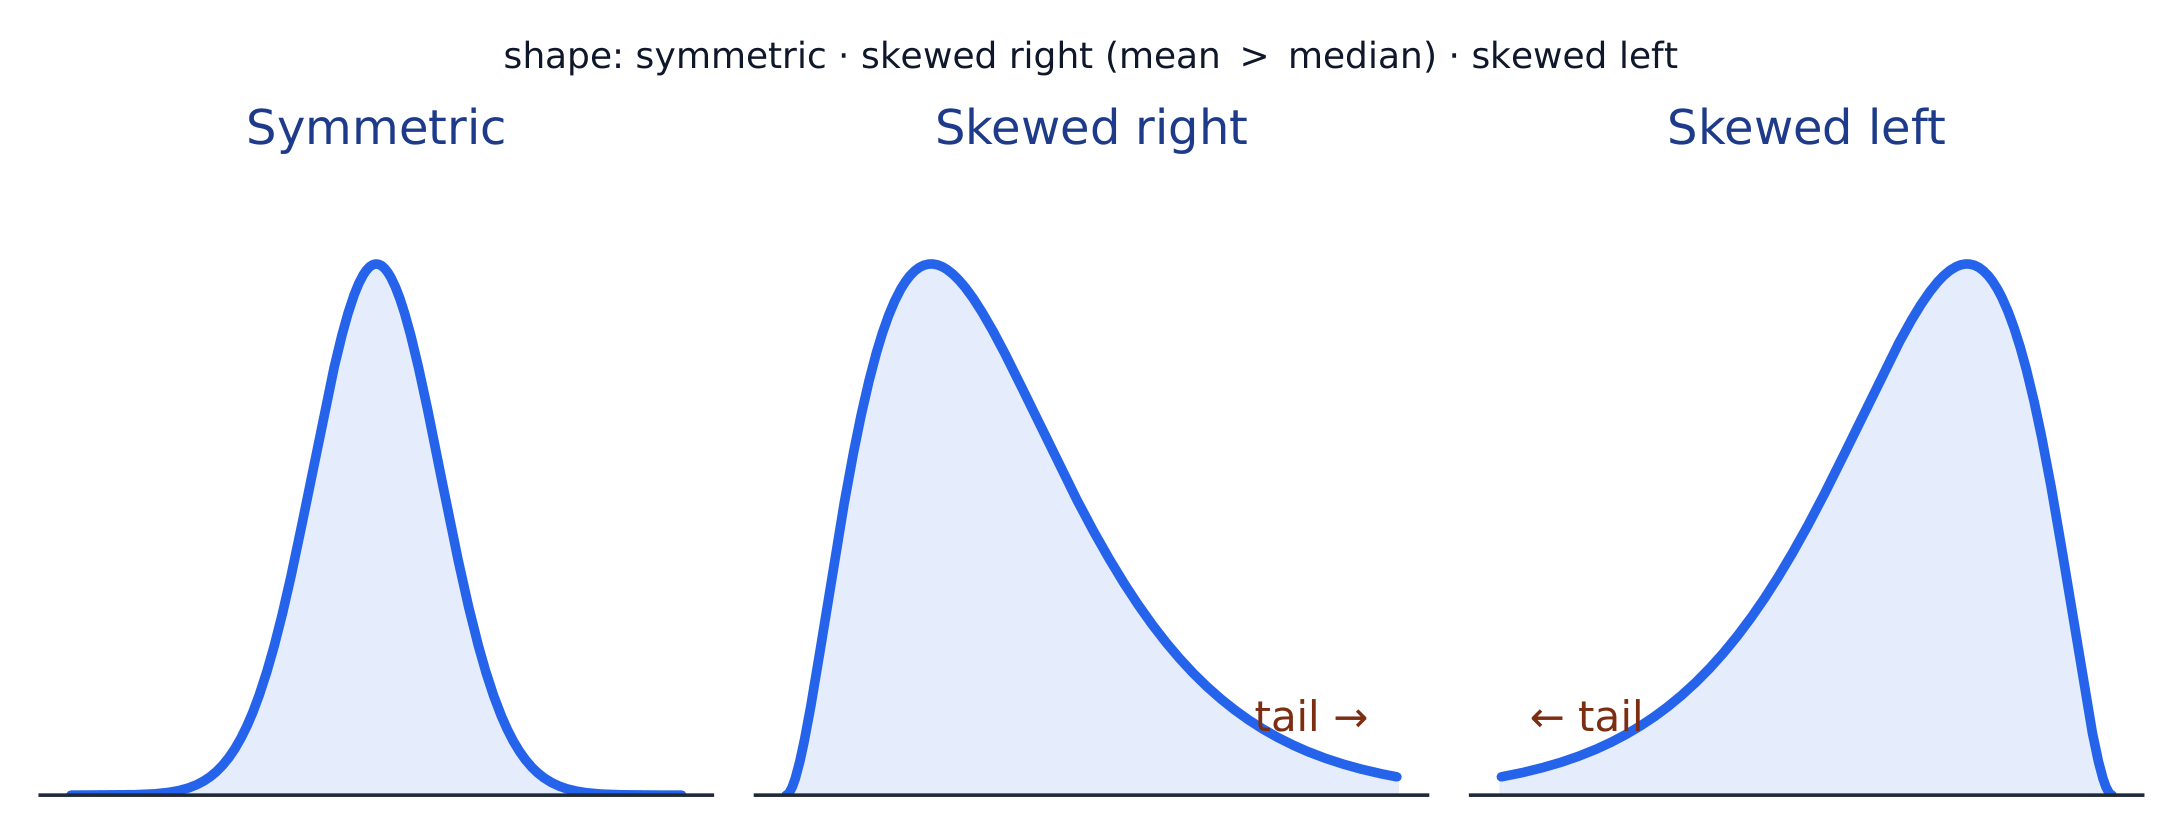
UNC-1.H.3 Una distribución está sesgada a la derecha (sesgo positivo) si la cola derecha es más larga que la izquierda. Una distribución está sesgada a la izquierda (sesgo negativo) si la cola izquierda es más larga que la derecha. Una distribución es simétrica si la mitad izquierda es la imagen especular de la mitad derecha.
UNC-1.H.4 Los gráficos univariados con un pico principal se denominan unimodales. Los gráficos con dos picos prominentes son bimodales. Un gráfico donde la altura de cada barra es aproximadamente la misma (sin picos prominentes) es aproximadamente uniforme.
UNC-1.H.5 Una laguna es una región de la distribución entre dos valores de datos donde no hay datos observados.
UNC-1.H.6 Las agrupaciones son concentraciones de datos generalmente separadas por lagunas.
UNC-1.H.7 La estadística descriptiva no atribuye propiedades de un conjunto de datos a una población más grande, pero puede proporcionar la base para conjeturas destinadas a pruebas posteriores.
Fuente: College Board AP Course and Exam Description
Describe cuatro cosas (recuerda SOCS):
Forma 形状: simétrica, o sesgada 偏斜 izquierda/derecha (una cola larga en ese lado), y cuántos picos tiene - un pico principal es unimodal 单峰, dos picos prominentes bimodal 双峰, y barras aproximadamente iguales uniforme 均匀.
Valores atípicos 离群值: valores inusuales muy alejados del resto.
Centro: un valor típico (media o mediana).
Dispersión: cuánto varían los valores (rango, IQR, desviación estándar).
Siempre describe la forma/centro/dispersión en contexto, con unidades.
La forma de una distribución: simétrica, sesgada a la derecha (cola larga a la derecha) o sesgada a la izquierda
Estadísticas resumidas para una variable cuantitativa
Syllabus
Comprensión duradera (UNC-1): Las representaciones gráficas y las estadísticas nos permiten identificar y representar las características clave de los datos.
Objetivo de aprendizaje UNC-1.I: Calcular medidas de tendencia central y de posición para datos cuantitativos. [Habilidad 2.C]
UNC-1.I.1 Una estadística es un resumen numérico de los datos de la muestra.
UNC-1.I.2 La media es la suma de todos los valores de datos dividida por el número de valores. Para una muestra, la media se denota con la barra de $x$: $\bar{x} = \dfrac{1}{n}\sum_{i=1}^{n} x_i$, donde $x_i$ representa el $i^{\text{th}}$ punto de datos en la muestra y $n$ representa el número de valores de datos en la muestra.
UNC-1.I.3 La mediana de un conjunto de datos es el valor central cuando los datos están ordenados. Cuando el número de puntos de datos es par, la mediana puede tomar cualquier valor entre los dos valores centrales. En Estadística AP, el valor más comúnmente utilizado para la mediana de un conjunto de datos con un número par de valores es el promedio de los dos valores centrales.
UNC-1.I.4 El primer cuartil, Q1, es la mediana de la mitad del conjunto de datos ordenado desde el mínimo hasta la posición de la mediana. El tercer cuartil, Q3, es la mediana de la mitad del conjunto de datos ordenado desde la posición de la mediana hasta el máximo. Q1 y Q3 forman los límites para el 50% central de valores en un conjunto de datos ordenado.
UNC-1.I.5 El $p^{\text{th}}$ percentil se interpreta como el valor que tiene $p\%$ de los datos menores o iguales a él.
Objetivo de aprendizaje UNC-1.J: Calcular medidas de variabilidad para datos cuantitativos. [Habilidad 2.C]
UNC-1.J.1 Tres medidas comúnmente utilizadas de variabilidad (o dispersión) en una distribución son el rango, el rango intercuartílico y la desviación estándar.
UNC-1.J.2 El rango se define como la diferencia entre el valor máximo de datos y el valor mínimo de datos. El rango intercuartílico (IQR) se define como la diferencia entre el tercer y el primer cuartil: $Q3 - Q1$. Tanto el rango como el rango intercuartílico son formas posibles de medir la variabilidad de la distribución de una variable cuantitativa.
UNC-1.J.3 La desviación estándar es una forma de medir la variabilidad de la distribución de una variable cuantitativa. Para una muestra, la desviación estándar se denota con $s$: $s_x = \sqrt{\dfrac{1}{n-1}\sum(x_i - \bar{x})^2}$. El cuadrado de la desviación estándar de la muestra, $s^2$, se denomina varianza de la muestra.
UNC-1.J.4 Cambiar las unidades de medida afecta los valores de las estadísticas calculadas.
Objetivo de aprendizaje UNC-1.K: Explicar la selección de una medida particular de tendencia central y/o variabilidad para describir un conjunto de datos cuantitativos. [Habilidad 4.B]
UNC-1.K.1 Existen muchos métodos para determinar valores atípicos. Dos métodos utilizados frecuentemente en este curso son:
UNC-1.K.1.i Un valor atípico es un valor mayor que $1.5 \times \text{IQR}$ por encima del tercer cuartil o más de $1.5 \times \text{IQR}$ por debajo del primer cuartil.
UNC-1.K.1.ii Un valor atípico es un valor ubicado 2 o más desviaciones estándar por encima o por debajo de la media.
UNC-1.K.2 La media, la desviación estándar y el rango se consideran no resistentes (o no robustas) porque se ven influenciadas por los valores atípicos. La mediana y el IQR se consideran resistentes (o robustas), porque los valores atípicos no afectan significativamente (si acaso) su valor.
Fuente: College Board AP Course and Exam Description
Desviación estándar: dispersión alrededor de la media
Centro: la media 均值$\bar{x}=\dfrac{\sum x_i}{n}$ (promedio) y la mediana 中位数 (valor medio). La mediana resiste a los valores atípicos; la media es arrastrada hacia un sesgo.
Dispersión: el rango, el rango intercuartílico 四分位距$\text{IQR}=Q_3-Q_1$ (el 50% central) y la desviación estándar 标准差$s_x=\sqrt{\dfrac{\sum(x_i-\bar{x})^2}{n-1}}$ (distancia típica desde la media; su cuadrado es la varianza 方差).
El resumen de cinco números 五数概括: mínimo, $Q_1$, mediana, $Q_3$, máximo.
Usa medidas resistentes (mediana, IQR) para datos sesgados; media y desviación estándar para datos aproximadamente simétricos.
El percentil 百分位数 de un valor es el porcentaje de datos en o por debajo de él – por lo tanto, la mediana es el percentil 50 y $Q_1$ el percentil 25. Un gráfico de frecuencia relativa acumulada 累积相对频率 hace fácil leer los percentiles: para cada valor traza la proporción de datos en o por debajo de él, subiendo de 0 a 1. Sube desde un valor hasta la curva y luego horizontalmente hacia su percentil, o invierte los pasos para encontrar el valor en un percentil dado (la misma lectura funciona desde una tabla de frecuencia acumulada).
Ejemplo resuelto. Para los datos $4, 8, 6, 10, 7$: la media es $\bar{x}=\dfrac{4+8+6+10+7}{5}=\dfrac{35}{5}=7$. Ordenando a $4,6,7,8,10$, la mediana es el valor central, $7$. La media y la mediana coinciden aquí porque los datos son aproximadamente simétricos.
cumulative relative frequency graph/ˈkjuːmjʊlətɪv ˈrelətɪv ˈfriːkwənsi ɡræf/
累积相对频率图
lěi jī xiāng duì pín lǜ tú
1.8
Representaciones gráficas de estadísticas resumidas
Syllabus
Comprensión Duradera (UNC-1): Las representaciones gráficas y las estadísticas nos permiten identificar y representar las características clave de los datos.
Objetivo de Aprendizaje UNC-1.L: Representar estadísticas resumidas para datos cuantitativos de forma gráfica. [Habilidad 2.B]
UNC-1.L.1 Juntos, el valor mínimo de los datos, el primer cuartil (Q1), la mediana, el tercer cuartil (Q3) y el valor máximo de los datos conforman el resumen de cinco números.
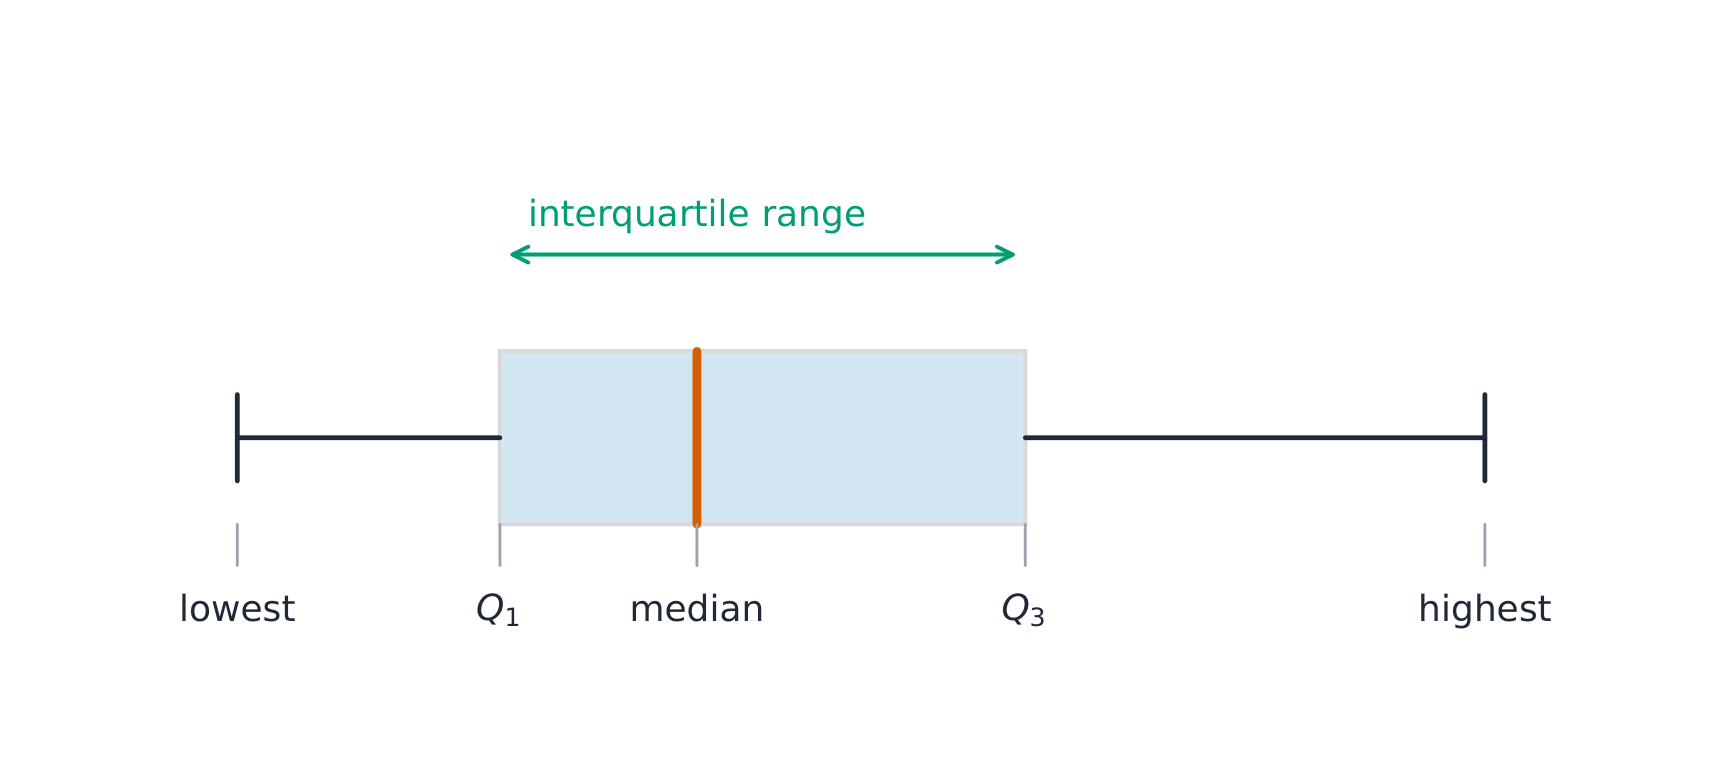
UNC-1.L.2 Un diagrama de caja es una representación gráfica del resumen de cinco números (mínimo, primer cuartil, mediana, tercer cuartil, máximo). La caja representa el 50% central de los datos, con una línea en la mediana y los extremos de la caja correspondientes a los cuartiles. Las líneas ("bigotes") se extienden desde los cuartiles hasta el punto más extremo que no sea un valor atípico, y los valores atípicos se indican con su propio símbolo más allá de este.
Objetivo de Aprendizaje UNC-1.M: Describir estadísticas resumidas de datos cuantitados representadas gráficamente. [Habilidad 2.A]
UNC-1.M.1 Las estadísticas resumidas de datos cuantitativos, o de conjuntos de datos cuantitativos, pueden utilizarse para justificar afirmaciones sobre los datos en contexto.
UNC-1.M.2 Si una distribución es relativamente simétrica, entonces la media y la mediana están relativamente cerca una de la otra. Si una distribución está sesgada hacia la derecha, entonces la media suele estar a la derecha de la mediana. Si la distribución está sesgada hacia la izquierda, entonces la media suele estar a la izquierda de la mediana.
Fuente: College Board AP Course and Exam Description
Un diagrama de caja 箱线图 dibuja el resumen de cinco números: una caja de $Q_1$ a $Q_3$ con la mediana dentro, y bigotes hacia los valores extremos no atípicos. Un punto es un valor atípico si se encuentra más allá de $1.5\times\text{IQR}$ de un cuartil – una regla que podrías ser solicitado a aplicar. Los diagramas de caja son ideales para comparar varios grupos uno al lado del otro.
Ejemplo resuelto. Un conjunto de datos tiene $Q_1=20$ y $Q_3=32$, por lo tanto $\text{IQR}=12$. Los límites de valores atípicos son $Q_1-1.5(12)=2$ y $Q_3+1.5(12)=50$. Cualquier valor por debajo de $2$ o por encima de $50$ se marca como un valor atípico.
Un diagrama de caja y bigotes muestra los cuartiles y el rangoUn diagrama de caja dibuja el resumen de cinco números; la caja abarca el IQR
Explorar
Explorar el resumen de cinco números como un diagrama de caja
Arrastre $Q_1$, la mediana, y $Q_3$ para ver la caja (su longitud es la RIC) y cómo la posición de la mediana dentro de la caja revela la asimetría — una mediana cercana a $Q_1$ señala una distribución sesgada a la derecha.
Comparando distribuciones de una variable cuantitativa
Syllabus
Comprensión perdurable (UNC-1): Las representaciones gráficas y las estadísticas nos permiten identificar y representar las características clave de los datos.
Objetivo de aprendizaje UNC-1.N: Comparar representaciones gráficas para múltiples conjuntos de datos cuantitativos. [Habilidad 2.D]
UNC-1.N.1 Cualquier tipo de representación gráfica, p. ej., histogramas, diagramas de caja lado a lado, etc., puede utilizarse para comparar dos o más muestras independientes en cuanto a la medida de tendencia central, variabilidad, agrupamientos, vacíos, valores atípicos y otras características.
Objetivo de aprendizaje UNC-1.O: Comparar estadísticas descriptivas para múltiples conjuntos de datos cuantitativos. [Habilidad 2.D]
UNC-1.O.1 Cualquier resumen numérico (p. ej., media, desviación estándar, frecuencia relativa, etc.) puede utilizarse para comparar dos o más muestras independientes.
Fuente: College Board AP Course and Exam Description
Para comparar dos o más grupos, compara forma, centro y dispersión, y menciona los valores atípicos – siempre con palabras comparativas ("El Grupo A tiene una mediana más alta que el Grupo B") y en contexto. No simplemente describa cada grupo por separado; haga la comparación explícita.
Explorar
Comparar distribuciones con diagramas de caja
Un diagrama de caja dibuja el resumen de cinco números. Colocar dos diagramas de caja en la misma escala compara su centro (mediana), dispersión (RIC = ancho de la caja) y asimetría de un vistazo — la forma justa de comparar grupos.
1.10
La distribución normal
Syllabus
Comprensión duradera (VAR-2): La distribución normal puede utilizarse para representar algunas distribuciones poblacionales.
Objetivo de aprendizaje VAR-2.A: Comparar una distribución de datos con el modelo de distribución normal. [Habilidad 2.D]
VAR-2.A.1 Un parámetro es un resumen numérico de una población.
VAR-2.A.2 Algunos conjuntos de datos pueden describirse como aproximadamente normalmente distribuidos. Una curva normal tiene forma de montículo y es simétrica. Los parámetros de una distribución normal son la media poblacional, $\mu$, y la desviación estándar poblacional, $\sigma$.
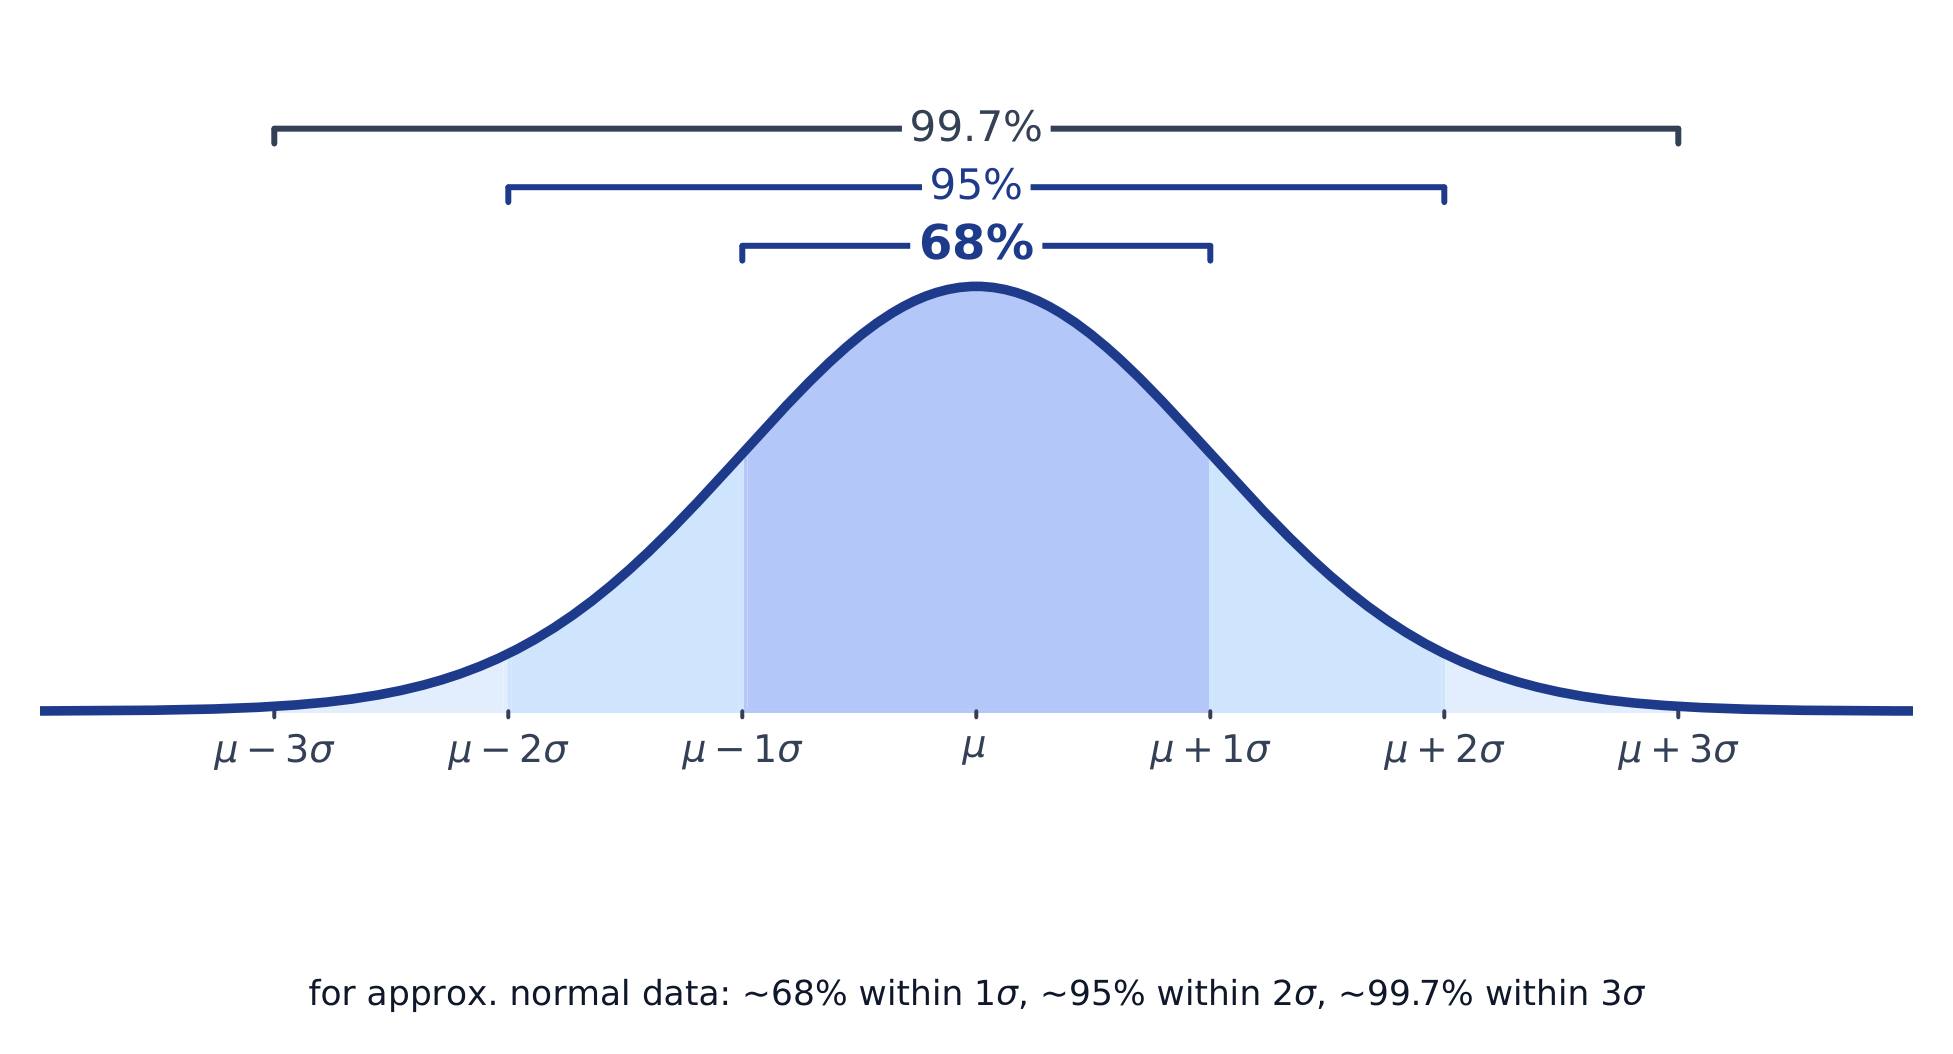
VAR-2.A.3 Para una distribución normal, aproximadamente el 68 % de las observaciones se encuentran dentro de 1 desviación estándar de la media, aproximadamente el 95 % de las observaciones se encuentran dentro de 2 desviaciones estándar de la media y aproximadamente el 99,7 % de las observaciones se encuentran dentro de 3 desviaciones estándar de la media. Esto se conoce como la regla empírica.
VAR-2.A.4 Muchas variables pueden modelarse mediante una distribución normal.
Ejemplos ilustrativos para VAR-2.A:
Variables que pueden modelarse mediante una distribución normal:
Temperatura corporal
Peso de una hogaza de pan
Objetivo de aprendizaje VAR-2.B: Determinar proporciones y percentiles a partir de una distribución normal. [Habilidad 3.A]
VAR-2.B.1 Una puntuación estandarizada para un valor de dato determinado se calcula como (valor de dato − media)/(desviación estándar) y mide el número de desviaciones estándar que un valor de dato está por encima o por debajo de la media.
VAR-2.B.2 Un ejemplo de puntuación estandarizada es una puntuación $z$, que se calcula como $z\text{-score} = \left(\dfrac{x_i - \mu}{\sigma}\right)$. Una puntuación $z$ mide cuántas desviaciones estándar está un valor de dato de la media.
VAR-2.B.3 Se puede utilizar tecnología, como una calculadora, una tabla normal estándar o salidas generadas por computadora, para encontrar la proporción de valores de datos ubicados en un intervalo dado de una variable aleatoria normalmente distribuida.
VAR-2.B.4 Dada el área de una región bajo la gráfica de la curva de la distribución normal, es posible utilizar tecnología, como una calculadora, una tabla normal estándar o salidas generadas por computadora, para estimar parámetros de algunas poblaciones.
Objetivo de aprendizaje VAR-2.C: Comparar medidas de posición relativa en conjuntos de datos. [Habilidad 2.D]
VAR-2.C.1 Los percentiles y las puntuaciones $z$ pueden utilizarse para comparar las posiciones relativas de puntos dentro de un conjunto de datos o entre conjuntos de datos.
Fuente: College Board AP Course and Exam Description
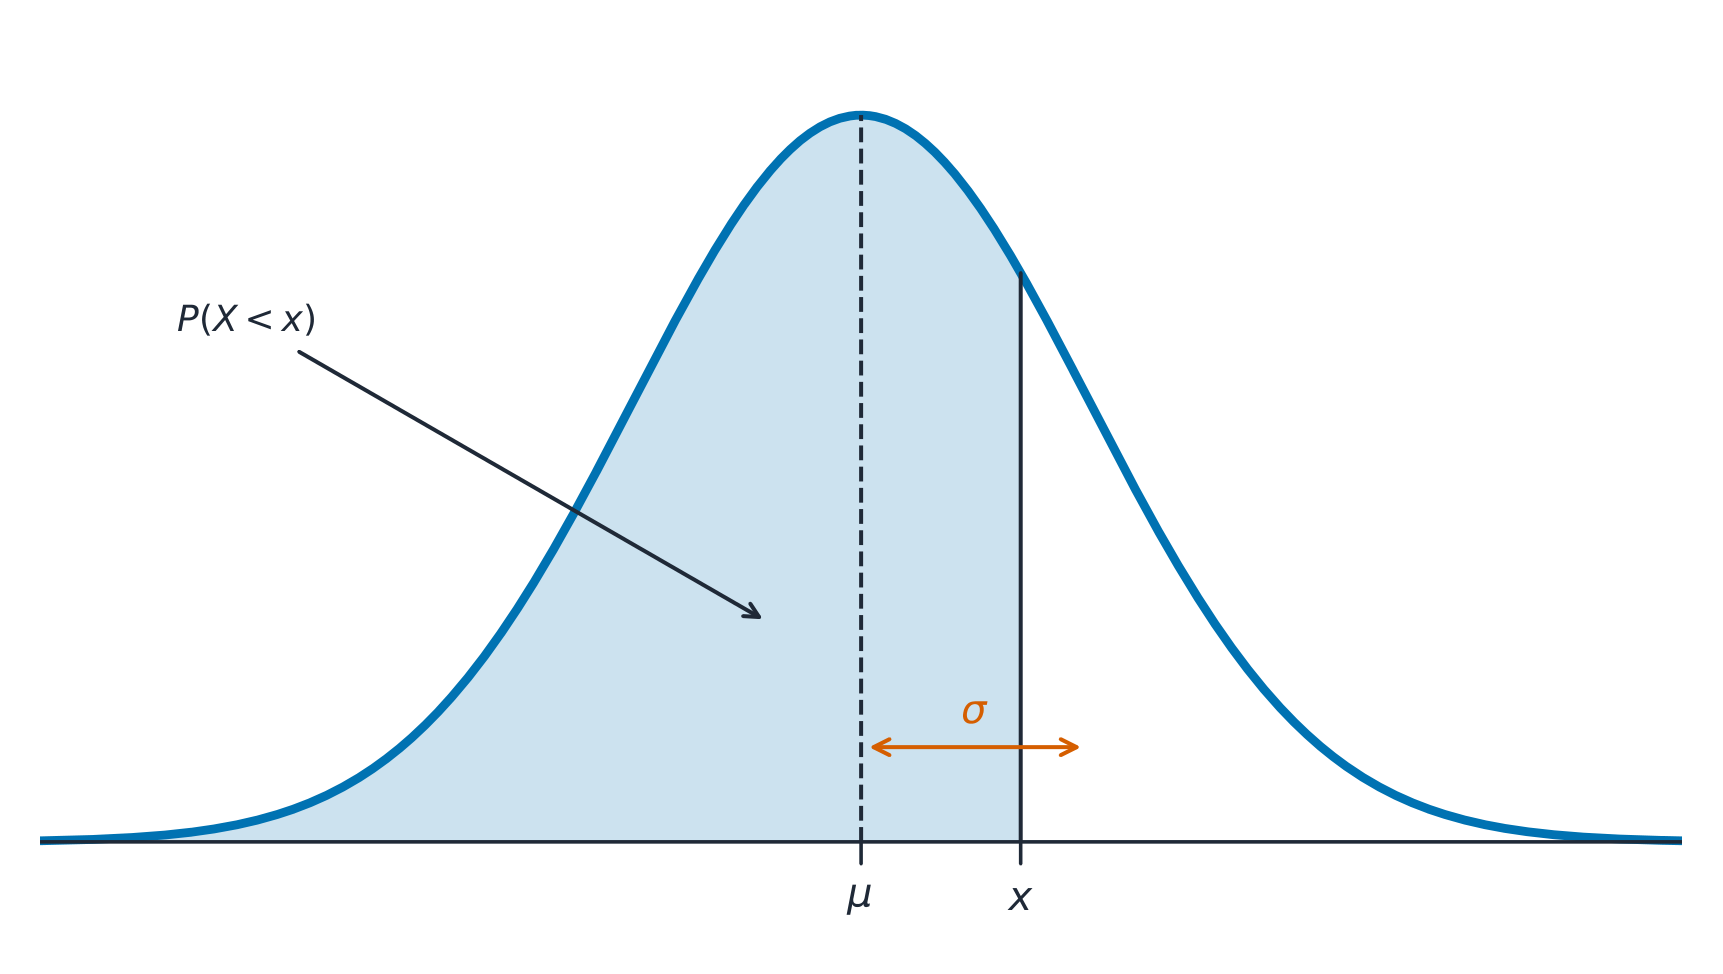
Una distribución normal 正态分布 es un modelo simétrico en forma de campana descrito por su media $\mu$ y desviación estándar $\sigma$. La regla empírica 经验法则 (68–95–99.7): aproximadamente el 68% de los valores están dentro de $1\sigma$ de la media, el 95% dentro de $2\sigma$, y el 99.7% dentro de $3\sigma$.
La curva normal: una probabilidad es el área bajo ella, centrada en la media
Un $z$-score 标准分数 mide cuántas desviaciones estándar está un valor de la media:
$$z=\frac{x-\mu}{\sigma}.$$
Convierte a un $z$-score, luego usa la tabla normal o tecnología para encontrar la proporción (área) por debajo, por encima o entre valores – e invierte el proceso para encontrar un valor a partir de un percentil dado.
Ejemplo resuelto. Las puntuaciones de examen son normales con $\mu=500$ y $\sigma=100$. Una puntuación de $700$ tiene $z=\dfrac{700-500}{100}=2$. Por la regla empírica, $95\%$ de las puntuaciones se encuentran dentro de $2\sigma$, por lo que $2.5\%$ están por encima de $700$ – lo que significa que una $700$ está aproximadamente en el percentil $97.5$.
La curva normal y la regla empírica 68-95-99.7
Explorar
Explorar el área bajo la curva normal
La proporción de datos por debajo de un valor igual al área bajo la curva a su izquierda. Sombree una cola o una banda central para ver la regla empírica 68–95–99.7 y lea una puntuación-z $z$ como un área.
Comprensión duradera (VAR-1): Dado que la variación puede ser aleatoria o no, las conclusiones son inciertas.
Objetivo de aprendizaje VAR-1.D: Identificar preguntas para responder sobre posibles relaciones en los datos. [Habilidad 1.A]
VAR-1.D.1 Los patrones y asociaciones aparentes en los datos pueden ser aleatorios o no.
Fuente: College Board AP Course and Exam Description
Los datos de dos variables nos permiten preguntarnos si dos características están asociadas – saber una nos dice algo sobre la otra. Una variable explicativa (la "entrada") puede ayudar a predecir una variable de respuesta (la "salida"). La asociación no es lo mismo que la causalidad.
2.2
Dos variables categóricas
Syllabus
Comprensión Duradera (UNC-1): Las representaciones gráficas y las estadísticas nos permiten identificar y representar características clave de los datos.
Objetivo de Aprendizaje UNC-1.P: Comparar representaciones numéricas y gráficas para dos variables categóricas. [Habilidad 2.D]
UNC-1.P.1 Los gráficos de barras lado a lado, los gráficos de barras segmentadas y los diagramas de mosaico son ejemplos de gráficos de barras para una variable categórica, desglosados por categorías de otra variable categórica.
UNC-1.P.2 Las representaciones gráficas de dos variables categóricas se pueden utilizar para comparar distribuciones y/o determinar si las variables están asociadas.
UNC-1.P.3 Una tabla de contingencia, también llamada tabla de doble entrada, se utiliza para resumir dos variables categóricas. Las entradas en las celdas pueden ser recuentos de frecuencia o frecuencias relativas.
UNC-1.P.4 Una frecuencia relativa conjunta es la frecuencia de una celda dividida por el total de toda la tabla.
Fuente: College Board AP Course and Exam Description
Una tabla bidireccional (tabla de contingencia) cuenta individuos según dos variables categóricas al mismo tiempo. Una distribución marginal es el total de una fila o columna expresado como fracción del total general (los totales en sí mismos son solo conteos). Comparar las celdas internas muestra si las variables están relacionadas.
2.3
Comparación de grupos con distribuciones condicionales
Syllabus
Comprensión perdurable (UNC-1): Las representaciones gráficas y las estadísticas nos permiten identificar y representar las características clave de los datos.
Objetivo de aprendizaje UNC-1.Q: Calcular estadísticas para dos variables categóricas. [Habilidad 2.C]
UNC-1.Q.1 Las frecuencias relativas marginales son los totales de filas y columnas en una tabla de doble entrada divididos por el total de toda la tabla.
UNC-1.Q.2 Una frecuencia relativa condicional es una frecuencia relativa correspondiente a una parte específica de la tabla de contingencia (por ejemplo, las frecuencias de las celdas en una fila divididas por el total de esa fila).
Objetivo de aprendizaje UNC-1.R: Comparar estadísticas para dos variables categóricas. [Habilidad 2.D]
UNC-1.R.1 Las estadísticas descriptivas para dos variables categóricas pueden utilizarse para comparar distribuciones y/o determinar si las variables están asociadas.
Fuente: College Board AP Course and Exam Description
Una distribución condicional es la distribución de una variable dentro de una categoría fija de la otra (se obtiene dividiendo cada celda por su total de fila o columna). Si las distribuciones condicionales difieren entre grupos, las dos variables están asociadas; si son iguales, no hay asociación. Los gráficos de barras segmentadas o los diagramas mosaico las muestran.
2.4
Diagramas de dispersión para dos variables cuantitativas
Syllabus
Comprensión duradera (UNC-1): Las representaciones gráficas y las estadísticas nos permiten identificar y representar características clave de los datos.
Objetivo de aprendizaje UNC-1.S: Representar datos cuantitivos bivariados mediante diagramas de dispersión. [Habilidad 2.B]
UNC-1.S.1 Un conjunto de datos cuantitativos bivariados consiste en observaciones de dos variables cuantitativas diferentes realizadas sobre individuos en una muestra o población.
UNC-1.S.2 Un diagrama de dispersión muestra dos valores numéricos para cada observación, uno correspondiente al valor en el eje $x$ y otro correspondiente al valor en el eje $y$.
UNC-1.S.3 Una variable explicativa es una variable cuyos valores se utilizan para explicar o predecir valores correspondientes en la variable de respuesta.
Comprensión duradera (DAT-1): Los modelos de regresión pueden permitirnos predecir respuestas ante cambios en una variable explicativa.
Objetivo de aprendizaje DAT-1.A: Describir las características de un diagrama de dispersión. [Habilidad 2.A]
DAT-1.A.1 Una descripción de un diagrama de dispersión incluye forma, dirección, fuerza y características inusuales.
DAT-1.A.2 La dirección de la asociación mostrada en un diagrama de dispersión, si existe, puede describirse como positiva o negativa.
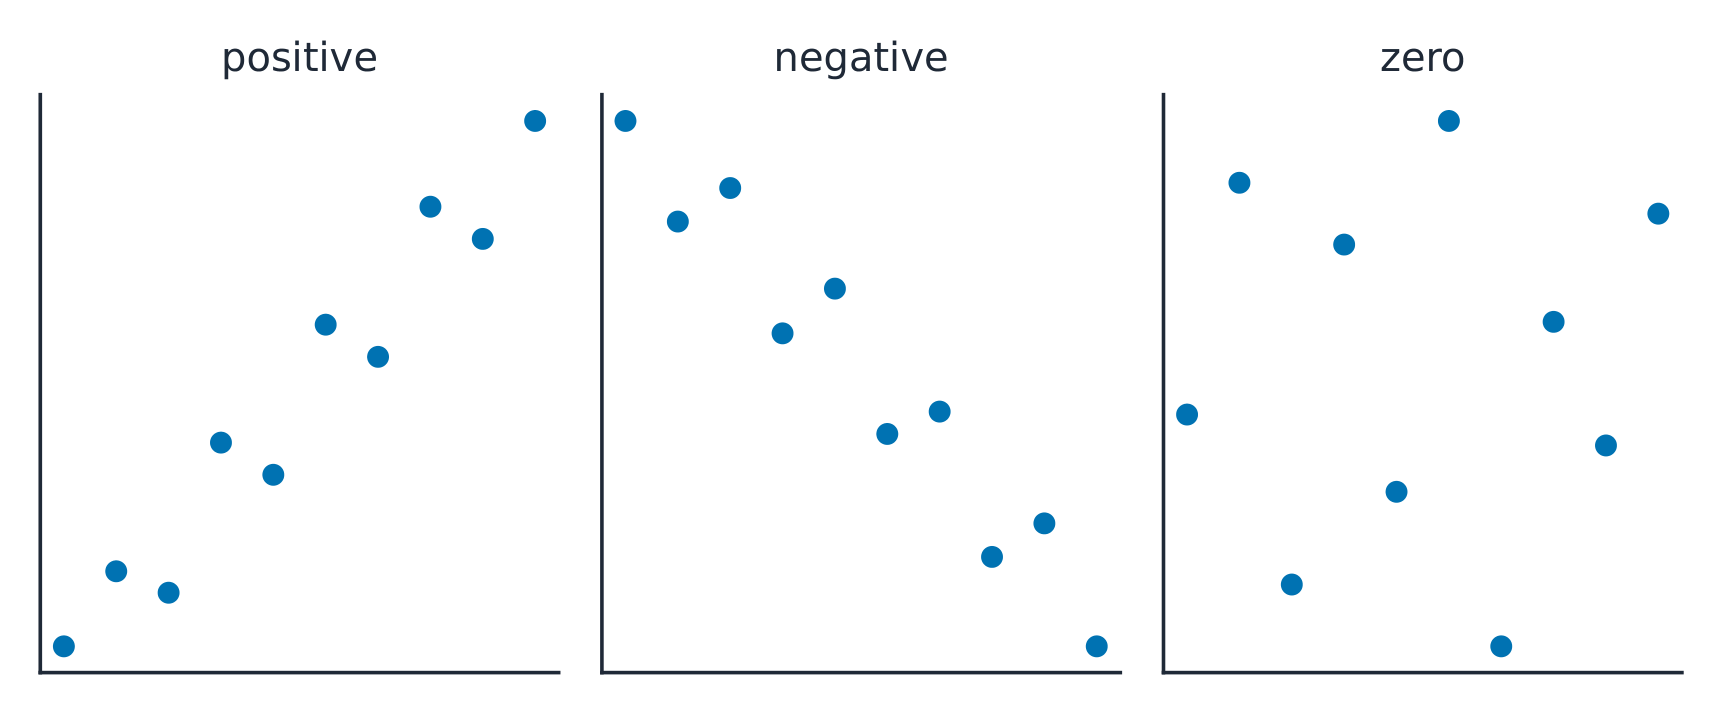
DAT-1.A.3 Una asociación positiva significa que a medida que aumentan los valores de una variable, los valores de la otra variable tienden a aumentar. Una asociación negativa significa que a medida que aumentan los valores de una variable, los valores de la otra variable tienden a disminuir.
DAT-1.A.4 La forma de la asociación mostrada en un diagrama de dispersión, si existe, puede describirse como lineal o no lineal en diversos grados.
DAT-1.A.5 La fuerza de la asociación indica qué tan cerca siguen los puntos individuales un patrón específico, p. ej., lineal, y puede mostrarse en un diagrama de dispersión. La fuerza puede describirse como fuerte, moderada o débil.
DAT-1.A.6 Las características inusuales de un diagrama de dispersión incluyen agrupaciones de puntos o puntos con discrepancias relativamente grandes entre el valor de la variable de respuesta y un valor predicho para dicha variable.
Fuente: College Board AP Course and Exam Description
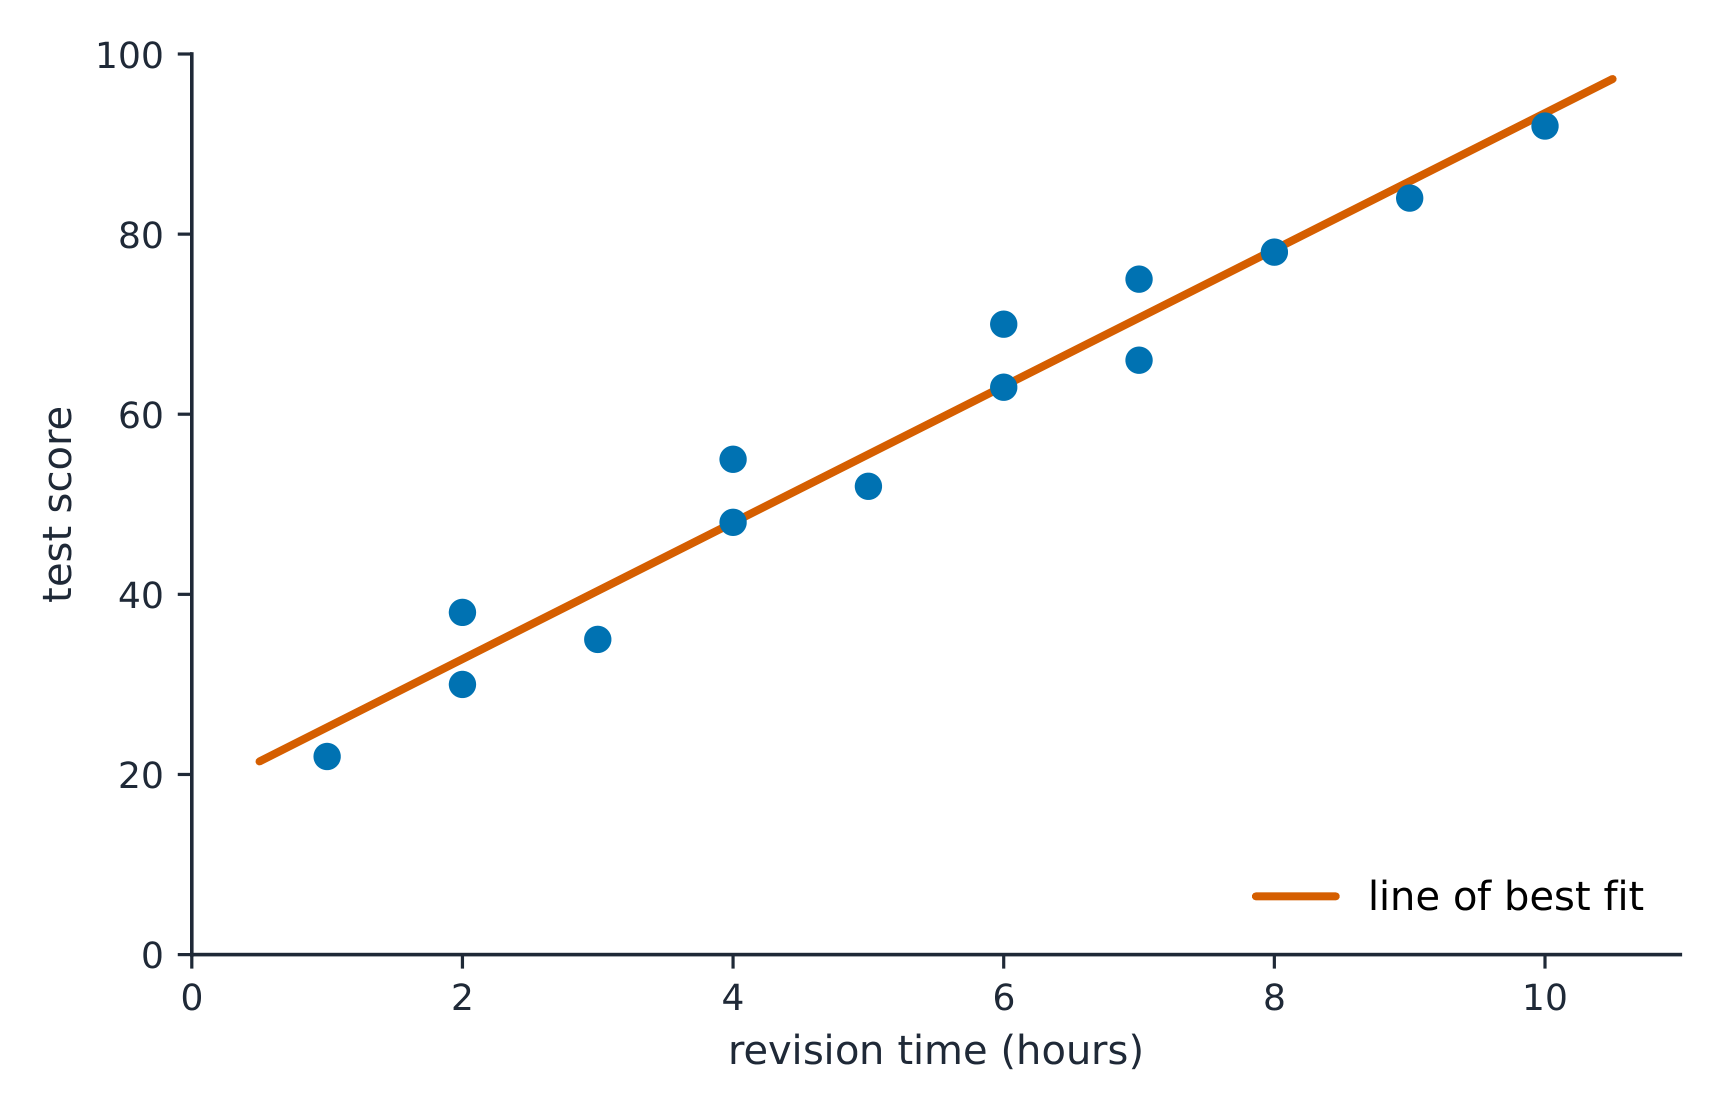
Un diagrama de dispersión representa a cada individuo como un punto, con la variable explicativa en el eje $x$ y la variable de respuesta en el eje $y$. Describirlo mediante DUFS: Dirección (positiva/negativa), Inusuales (valores atípicos, agrupamientos), Forma (lineal o curva) y Fuerza (qué tan estrechamente siguen los puntos el patrón) – siempre contextualizado.
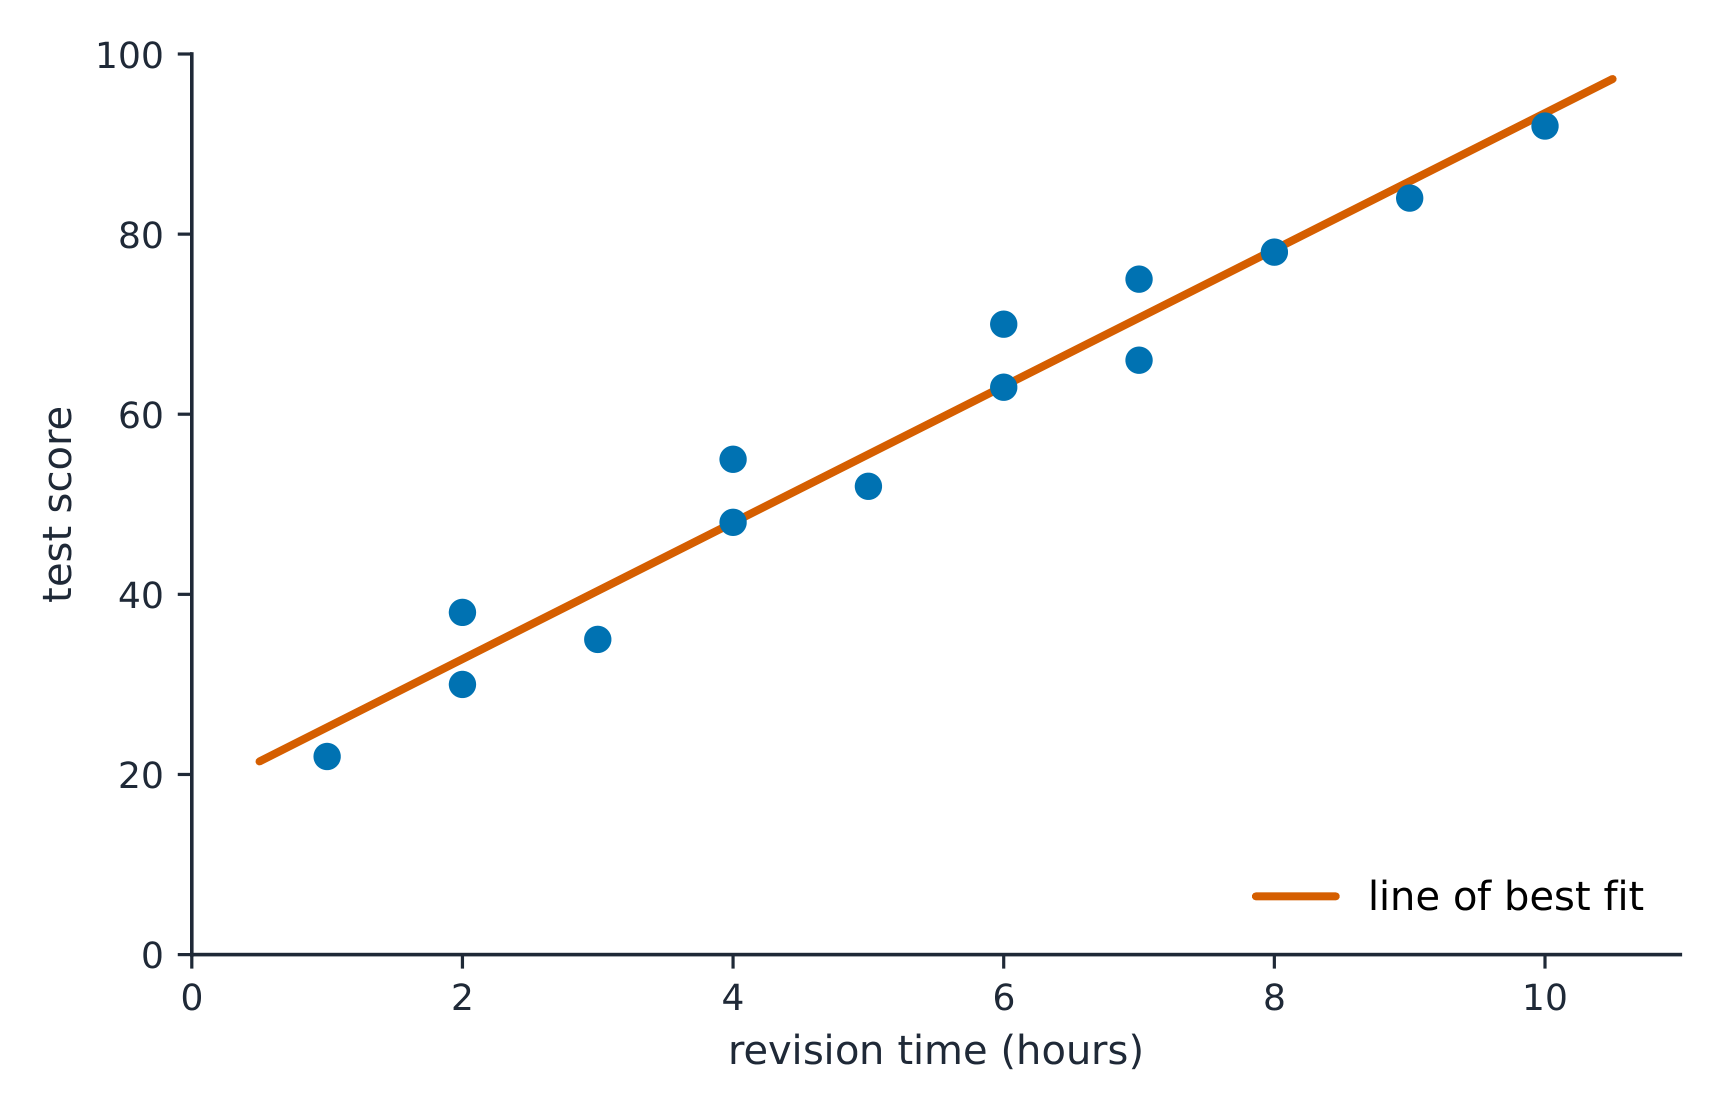
Una línea de ajuste óptimo pasa por el centro de los puntos dispersos
2.5
Correlación
Syllabus
Comprensión Duradera (DAT-1): Los modelos de regresión pueden permitirnos predecir respuestas ante cambios en una variable explicativa.
Objetivo de Aprendizaje DAT-1.B: Determinar la correlación para una relación lineal. [Habilidad 2.C]
DAT-1.B.1 La correlación, $r$, indica la dirección y cuantifica la fuerza de la asociación lineal entre dos variables cuantitativas.
DAT-1.B.2 El coeficiente de correlación se puede calcular mediante: $r = \dfrac{1}{n-1} \sum \left( \dfrac{x_i - \bar{x}}{s_x} \right) \left( \dfrac{y_i - \bar{y}}{s_y} \right)$. Sin embargo, la forma más común de determinar $r$ es utilizando tecnología.
DAT-1.B.3 Un coeficiente de correlación cercano a 1 o $-1$ no significa necesariamente que un modelo lineal sea apropiado.
Objetivo de Aprendizaje DAT-1.C: Interpretar la correlación para una relación lineal. [Habilidad 4.B]
DAT-1.C.1 La correlación, $r$, es adimensional y siempre está comprendida entre $-1$ y 1, inclusive. Un valor de $r = 0$ indica que no existe asociación lineal. Un valor de $r = 1$ o $r = -1$ indica que existe una asociación lineal perfecta.
DAT-1.C.2 Una relación percibida o real entre dos variables no implica que los cambios en una variable causen cambios en la otra. Es decir, la correlación no necesariamente implica causalidad.
Fuente: College Board AP Course and Exam Description
Lo que mide realmente r
El coeficiente de correlación$r$ mide la fuerza y dirección de una relación lineal. Varía desde $-1$ hasta $1$: cerca de $\pm 1$ indica una fuerte relación lineal, cerca de $0$ indica una débil relación lineal. $r$ no tiene unidades y no cambia si se intercambian las variables. Advertencias: $r$ solo mide la fuerza lineal, no es robusto ante valores atípicos y una fuerte $r$ no prueba causalidad.
La correlación positiva aumenta conjuntamente; la correlación negativa se mueve en direcciones opuestas
Explorar
Fuerza de una relación lineal
Correlación$r$ va de $-1$ a $1$: cerca de $\pm1$ los puntos abrazan una línea, cerca de 0 se dispersan. Cámbielo y vea cómo la nube se ajusta o expande.
2.6
Modelos de Regresión Lineal
Syllabus
Comprensión Duradera (DAT-1): Los modelos de regresión pueden permitirnos predecir respuestas ante cambios en una variable explicativa.
Objetivo de Aprendizaje DAT-1.D: Calcular un valor de respuesta predicho utilizando un modelo de regresión lineal. [Habilidad 2.C]
DAT-1.D.1 Un modelo de regresión lineal simple es una ecuación que utiliza una variable explicativa, $x$, para predecir la variable de respuesta, $y$.
DAT-1.D.2 El valor de respuesta predicho, denotado por $\hat{y}$, se calcula como $\hat{y} = a + bx$, donde $a$ es la intersección con el eje $y$, $b$ es la pendiente de la recta de regresión y $x$ es el valor de la variable explicativa.
DAT-1.D.3 La extrapolación es predecir un valor de respuesta utilizando un valor para la variable explicativa que está fuera del intervalo de valores de $x$ utilizados para determinar la recta de regresión. El valor predicho es menos confiable como estimación cuanto más nos alejamos en la extrapolación.
Fuente: College Board AP Course and Exam Description
La línea de regresión por mínimos cuadrados 最小二乘回归线 predice la respuesta: $\hat{y}=a+bx$, donde $\hat{y}$ es la respuesta predicha. La pendiente 斜率$b$ es el cambio previsto en $y$ por cada aumento de una unidad en $x$; la intersección en el eje $y$ 截距$a$ es la respuesta prevista en $y$ cuando $x=0$. Interpreta ambos en contexto y con unidades – una habilidad evaluada. Evita la extrapolación 外推 (predecir muy lejos fuera de los datos).
Ejemplo resuelto. Un estudio de las horas estudiadas ($x$) y la nota del examen ($y$) arroja $\hat{y}=20+3x$. La pendiente indica que cada hora adicional de estudio se asocia con un aumento previsto de $3$ puntos en la nota. Se predice que un estudiante que estudia $5$ horas obtendrá una nota de $\hat{y}=20+3(5)=35$.
Explorar
Ajustar una línea de mínimos cuadrados
Una línea de regresión es el mejor ajuste de línea recta, minimizando las distancias verticales al cuadrado. Su pendiente predice cómo $y$ cambia por unidad de $x$.
2.7
Residuos
Syllabus
Comprensión Duradera (DAT-1): Los modelos de regresión pueden permitirnos predecir las respuestas a los cambios en una variable explicativa.
Objetivo de Aprendizaje DAT-1.E: Representar las diferencias entre las respuestas medidas y las predichas mediante gráficos de residuos. [Habilidad 2.B]
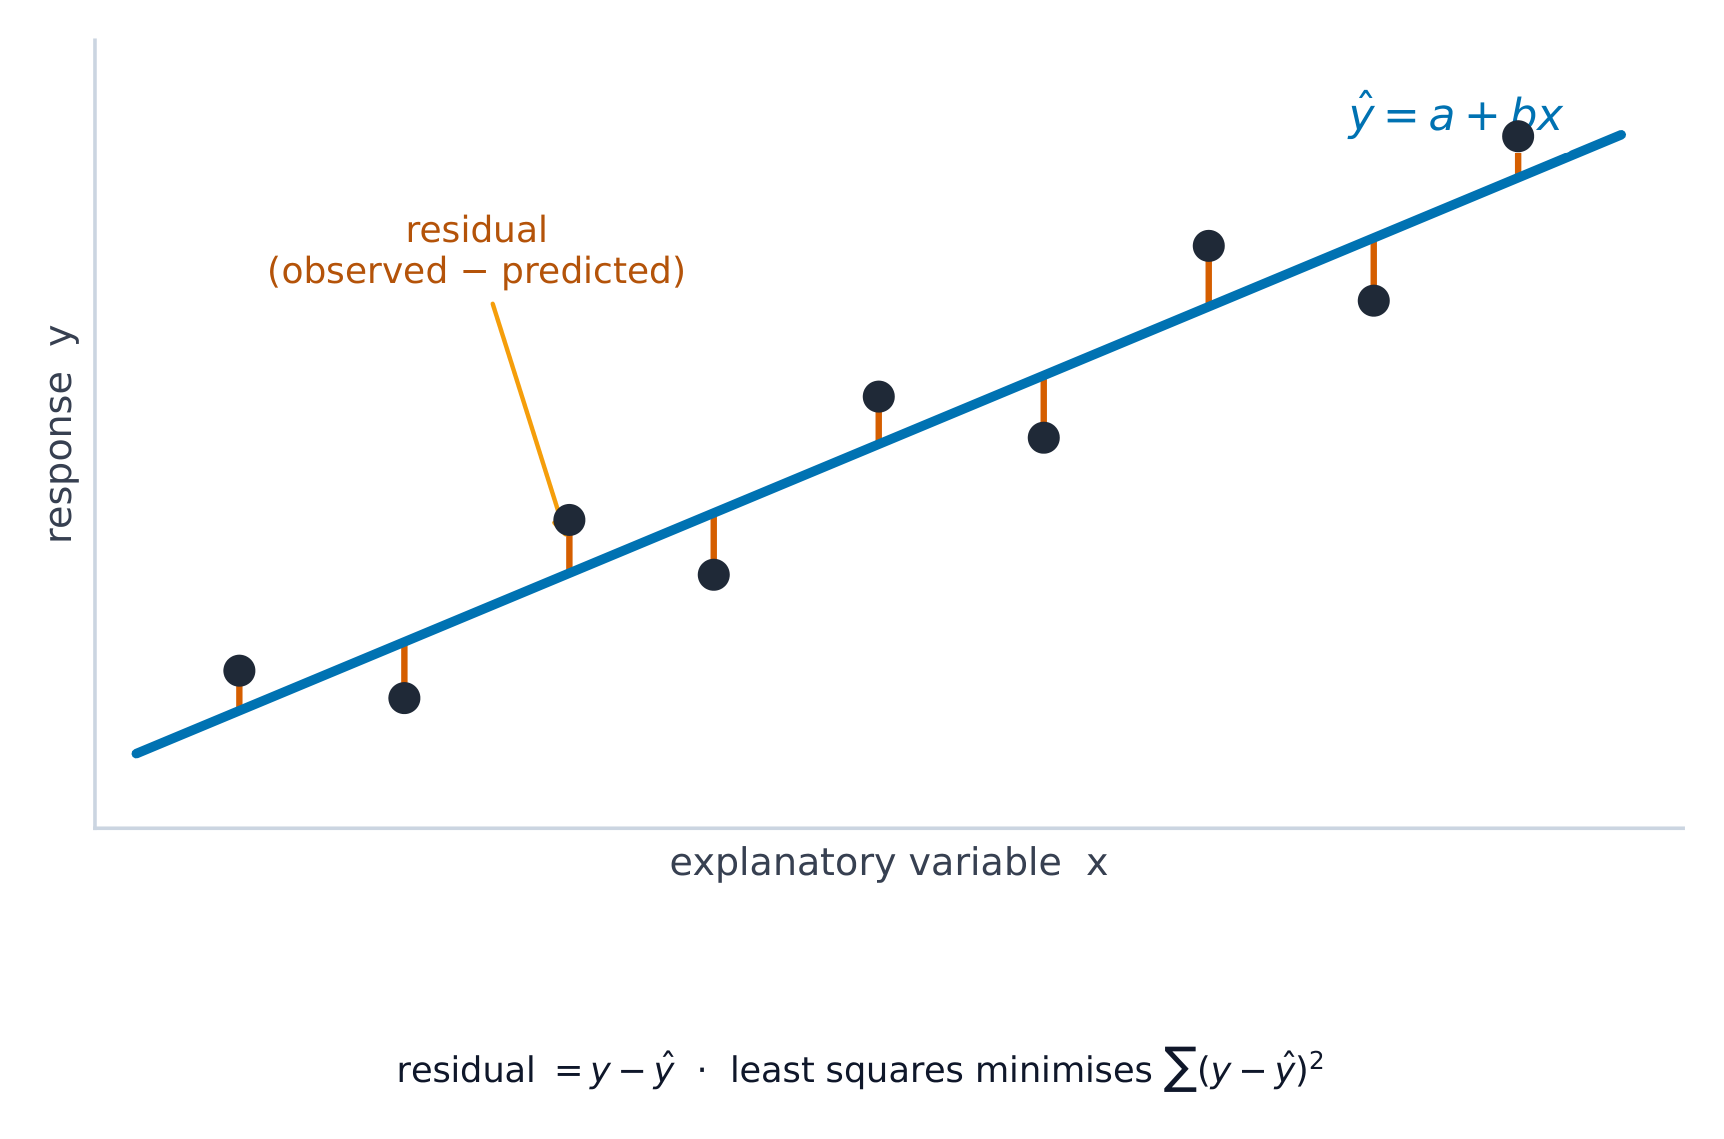
DAT-1.E.1 El residuo es la diferencia entre el valor real y el valor predicho: $\text{residual} = y - \hat{y}$.
DAT-1.E.2 Un gráfico de residuos es un gráfico de los residuos frente a los valores de la variable explicativa o de los valores de respuesta predicha.
Objetivo de Aprendizaje DAT-1.F: Describir la forma de asociación de los datos bivariados utilizando gráficos de residuos. [Habilidad 2.A]
DAT-1.F.1 La aleatoriedad aparente en un gráfico de residuos para un modelo lineal es evidencia de una forma lineal en la asociación entre las variables.
DAT-1.F.2 Los gráficos de residuos pueden utilizarse para investigar la idoneidad de un modelo seleccionado.
Fuente: College Board AP Course and Exam Description
Regresión de mínimos cuadrados
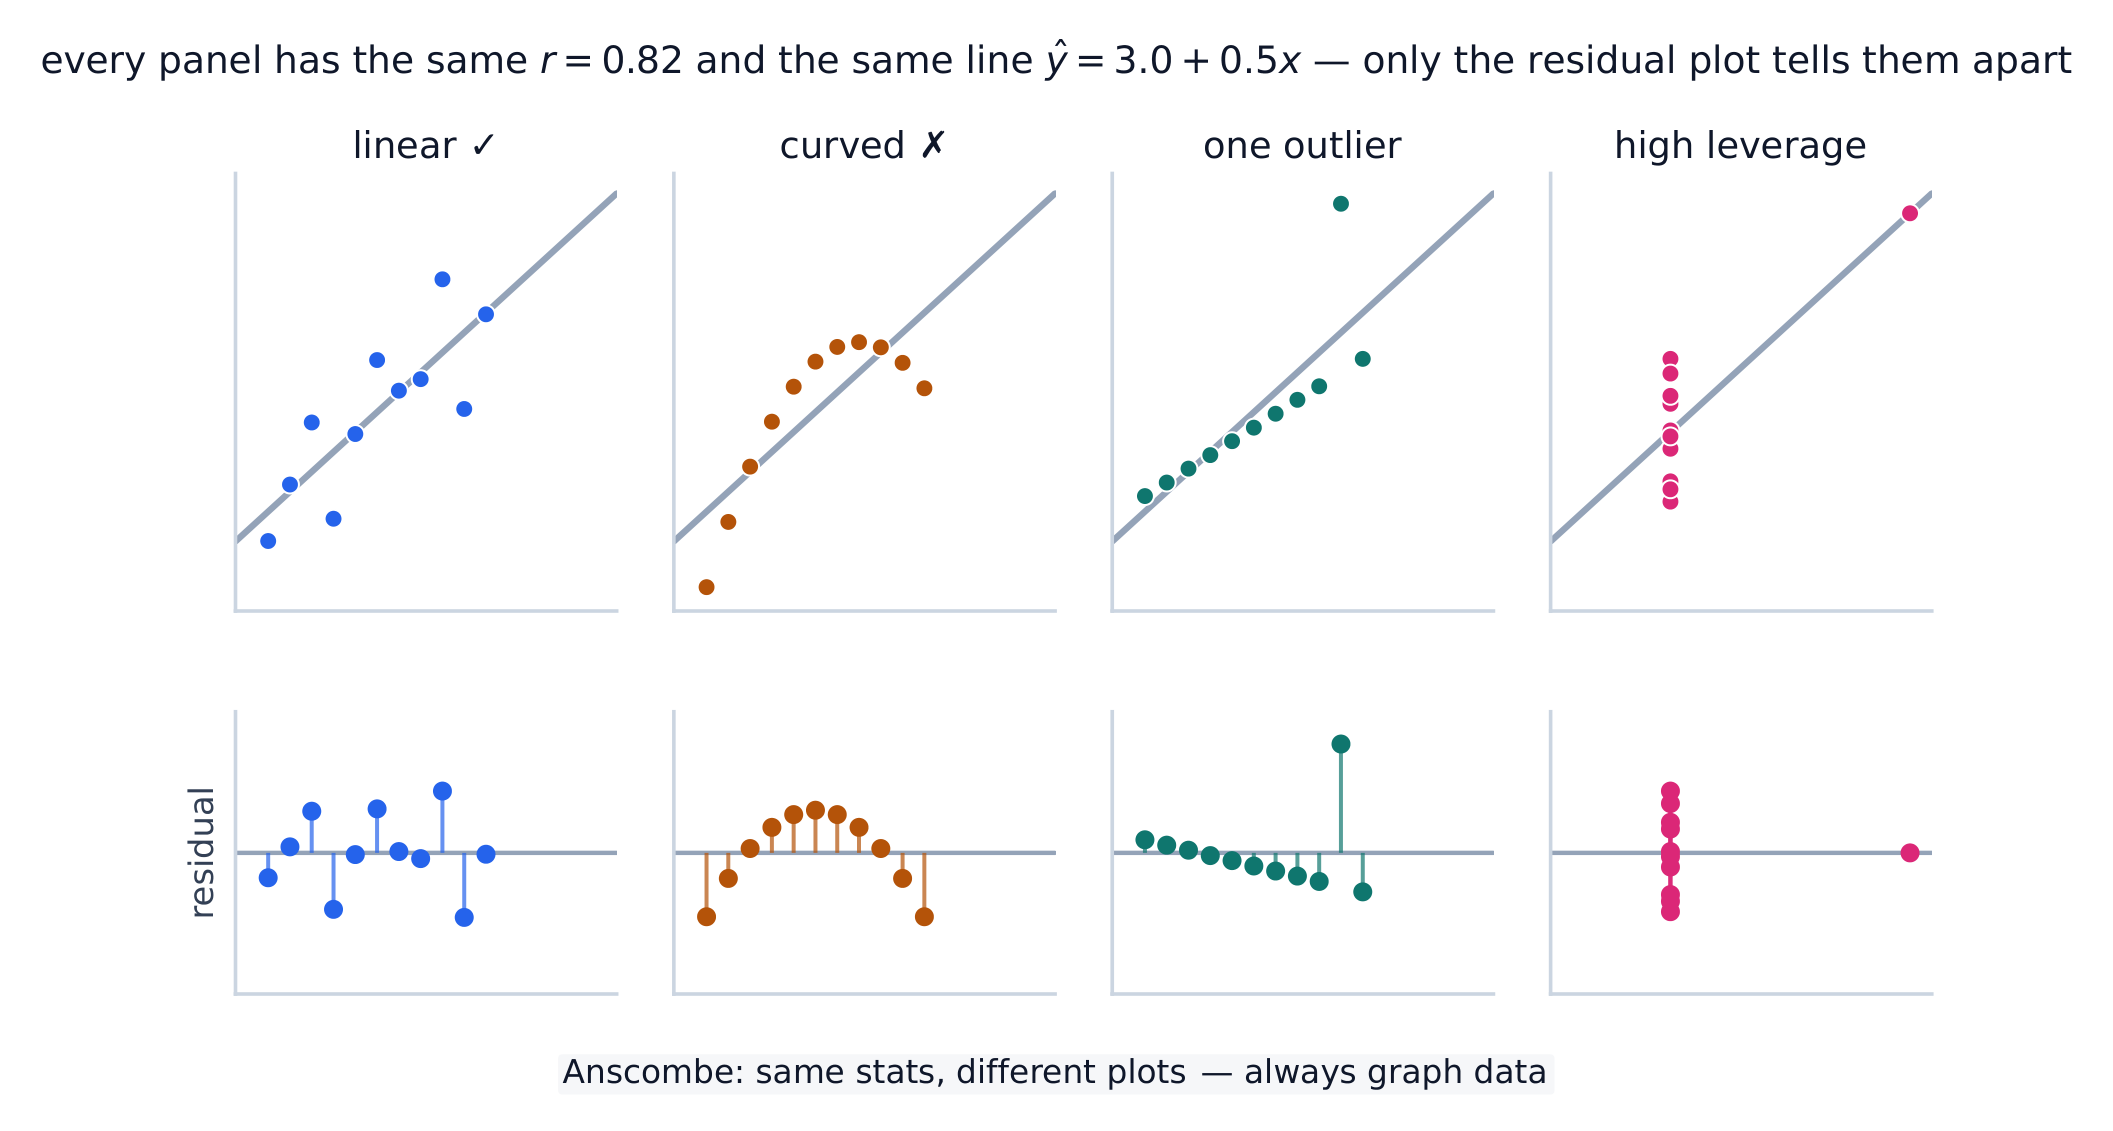
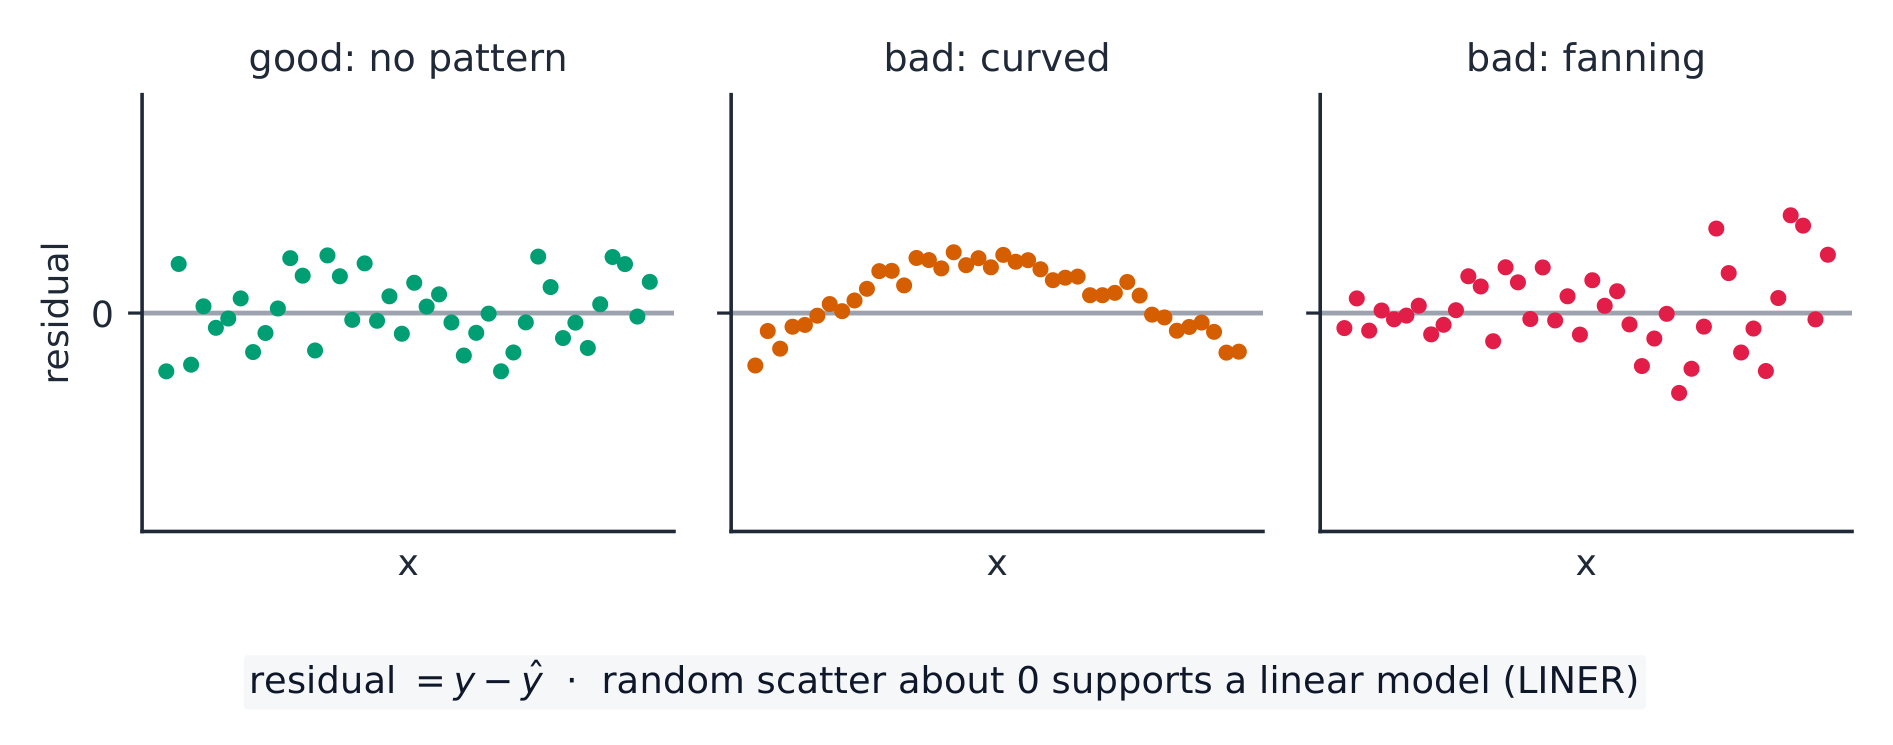
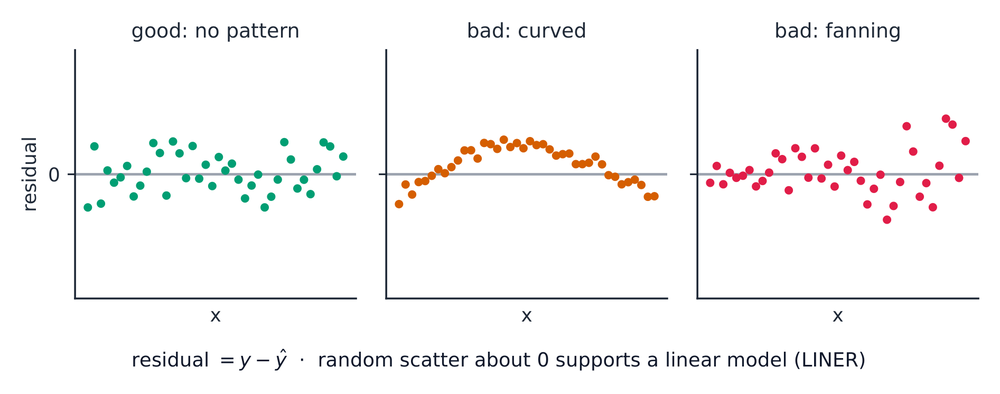
Una residual 残差 es la diferencia entre el valor real y el predicho, $y-\hat{y}$: qué tan lejos se sitúa un punto por encima (+) o por debajo (−) de la línea. Un gráfico de residuos 残差图 grafica los residuos en función de $x$. Si no muestra ningún patrón (dispersión aleatoria), un modelo lineal es apropiado; un patrón curvo o en abanico indica que el modelo lineal es un ajuste deficiente.
Ejemplo resuelto. Continuando con el estudio anterior, un estudiante que estudió $5$ horas obtuvo realmente una puntuación de $40$. El residuo es $y-\hat{y}=40-35=+5$: la línea subestimó en $5$ puntos, por lo que este punto se sitúa por encima de la línea.
Una advertencia sobre $r$ y la recta: los cuatro conjuntos de datos tienen el mismo $r=0.82$ y el mismo $\hat{y}=3.0+0.5x$, pero solo el primero es genuinamente lineal. Los diagramas de dispersión apenas difieren — lo que revela la curvatura, el valor atípico y el punto de alta influencia es el diagrama de residuos debajo de cada uno.
coefficient of determination/ˌkəʊɪˈfɪʃənt ɒv dɪˌtɜːmɪˈneɪʃn/
决定系数
jué dìng xì shù
high-leverage/haɪ ˈliːvərɪdʒ/
高杠杆
gāo gàng gǎn
influential/ˌɪnfluːˈenʃl/
有影响的
yǒu yǐng xiǎng de
2.8
Regresión por Mínimos Cuadrados y su Ajuste
Syllabus
Comprensión Duradera (DAT-1): Los modelos de regresión pueden permitirnos predecir respuestas ante cambios en una variable explicativa.
Objetivo de Aprendizaje DAT-1.G: Estimar parámetros para el modelo de la recta de regresión de mínimos cuadrados. [Habilidad 2.C]
DAT-1.G.1 El modelo de regresión de mínimos cuadrados minimiza la suma de los cuadrados de los residuos y contiene el punto $(\bar{x}, \bar{y})$.
DAT-1.G.2 La pendiente, $b$, de la recta de regresión se puede calcular como $b = r \left( \dfrac{s_y}{s_x} \right)$, donde $r$ es la correlación entre $x$ e $y$, $s_y$ es la desviación estándar muestral de la variable de respuesta, $y$, y $s_x$ es la desviación estándar muestral de la variable explicativa, $x$.
DAT-1.G.3 A veces, la intersección con el eje $y$ de la recta no tiene una interpretación lógica en el contexto.
DAT-1.G.4 En la regresión lineal simple, $r^2$ es el cuadrado de la correlación, $r$. También se le llama coeficiente de determinación. $r^2$ representa la proporción de variación en la variable de respuesta que es explicada por la variable explicativa en el modelo.
Objetivo de Aprendizaje DAT-1.H: Interpretar coeficientes para el modelo de la recta de regresión de mínimos cuadrados. [Habilidad 4.B]
DAT-1.H.1 Los coeficientes del modelo de regresión de mínimos cuadrados son la pendiente estimada y la intersección con el eje $y$.
DAT-1.H.2 La pendiente es la cantidad que cambia el valor predicho de $y$ por cada aumento unitario en $x$.
DAT-1.H.3 El valor de la intersección con el eje $y$ es el valor predicho de la variable de respuesta cuando la variable explicativa es igual a $0$. La fórmula para la intersección con el eje $y$, $a$, es $a = \bar{y} - b\bar{x}$.
Fuente: College Board AP Course and Exam Description
La recta de mínimos cuadrados minimiza la suma de los residuos al cuadrado
La recta minimiza la suma de los residuos al cuadrado. Su ajuste se mide mediante:
$s$, la desviación estándar de los residuos: el error típico de predicción, en las unidades de la variable respuesta.
$r^2$, el coeficiente de determinación 决定系数 – la proporción de la variación en $y$ que el modelo lineal explica (un valor entre $0$ y $1$; multiplique por $100$ para expresarlo como porcentaje). Indíquelo en contexto: "$r^2 = 0.81$ significa que el 81% de la variación en $y$ es explicada por la relación lineal con $x$."
2.9
Desviaciones de la Linealidad
Syllabus
Comprensión perdurable (DAT-1): Los modelos de regresión pueden permitirnos predecir respuestas ante cambios en una variable explicativa.
Objetivo de aprendizaje DAT-1.I: Identificar puntos influyentes en la regresión. [Habilidad 2.A]
DAT-1.I.1 Un valor atípico en la regresión es un punto que no sigue la tendencia general mostrada en el resto de los datos y tiene un residuo grande cuando se calcula la Recta de Regresión por Mínimos Cuadrados (LSRL, por sus siglas en inglés).
DAT-1.I.2 Un punto de alta apalancamiento (high-leverage point) en la regresión tiene un valor de $x$ considerablemente mayor o menor que el resto de las observaciones.
DAT-1.I.3 Un punto influyente en la regresión es cualquier punto que, si se elimina, cambia sustancialmente la relación. Ejemplos incluyen una pendiente diferente, un intercepto en $y$ diferente y/o una correlación diferente. Los valores atípicos y los puntos de alta apalancamiento suelen ser influyentes.
Objetivo de aprendizaje DAT-1.J: Calcular una respuesta predicha utilizando una recta de regresión por mínimos cuadrados para un conjunto de datos transformados. [Habilidad 2.C]
DAT-1.J.1 Las transformaciones de variables, como evaluar el logaritmo natural de cada valor de la variable de respuesta o elevar al cuadrado cada valor de la variable explicativa, pueden utilizarse para crear conjuntos de datos transformados, que pueden tener una forma más lineal que los datos sin transformar.
DAT-1.J.2 El aumento de aleatoriedad en los gráficos de residuos después de la transformación de los datos y/o el movimiento de $r^2$ hacia un valor más cercano a 1 ofrece evidencia de que la recta de regresión por mínimos cuadrados para los datos transformados es un modelo más apropiado para usar en la predicción de respuestas ante la variable explicativa que la recta de regresión para los datos sin transformar.
Fuente: College Board AP Course and Exam Description
Algunos puntos afectan fuertemente a la recta. Un punto de alta apalancamiento 高杠杆 tiene un valor extremo de $x$; un punto influyente 有影响的 cambia notablemente la pendiente o el $r$ al ser eliminado; aquí, un punto atípico es aquel con un residuo grande. Cuando el patrón es curvo, transforme una variable (p. ej., tome un logaritmo) para linearizarla, luego ajuste una recta a los datos transformados.
2.9
Consejos para el examen
En un diagrama de dispersión describa la dirección, forma, intensidad y valores atípicos; $r$ oscila entre $-1$ y $1$.
La correlación no implica causalidad: una variable oculta puede influir en ambas.
Interprete la pendiente de la recta de mínimos cuadrados en contexto ("por cada unidad de $x$, la predicción de $y$ cambia en $b$").
Revise un gráfico de residuos: ausencia de patrones indica que la recta se ajusta bien; un patrón curvo indica que no. Evite la extrapolación.
$r^2$ es la fracción de variación en $y$ explicada por el modelo.
Comprensión duradera (VAR-1): Dado que la variación puede ser aleatoria o no, las conclusiones son inciertas.
Objetivo de aprendizaje VAR-1.E: Identificar preguntas sobre los métodos de recolección de datos. [Habilidad 1.A]
VAR-1.E.1: Los métodos de recolección de datos que no se basan en el azar dan lugar a conclusiones poco fiables.
Fuente: College Board AP Course and Exam Description
Una conclusión es tan buena como los datos que la respaldan. Cómo se recopilan los datos determina lo que puedes concluir: si puedes generalizar a una población, y si puedes afirmar causa y efecto. Los datos mal recopilados pueden ser peores que no tener datos.
3.2
Estudios Observacionales y Experimentos
Syllabus
Comprensión perdurable (DAT-2): La forma en que se recopila la datos influye en lo que podemos y no podemos afirmar sobre una población.
Objetivo de aprendizaje DAT-2.A: Identificar el tipo de un estudio. [Habilidad 1.C]
DAT-2.A.1 Una población consiste en todos los elementos o sujetos de interés.
DAT-2.A.2 Una muestra seleccionada para un estudio es un subconjunto de la población.
DAT-2.A.3 En un estudio observacional, no se imponen tratamientos. Los investigadores examinan datos de una muestra de individuos (retrospectivo) o siguen a una muestra de individuos hacia el futuro recolectando datos (prospectivo) con el fin de investigar un tema de interés sobre la población. Una encuesta muestral es un tipo de estudio observacional que recolecta datos de una muestra con el propósito de aprender sobre la población de la cual se tomó la muestra.
DAT-2.A.4 En un experimento, diferentes condiciones (tratamientos) se asignan a unidades experimentales (participantes o sujetos).
Objetivo de aprendizaje DAT-2.B: Identificar generalizaciones y conclusiones apropiadas basadas en estudios observacionales. [Habilidad 4.A]
DAT-2.B.1 Solo es apropiado hacer generalizaciones sobre una población basándose en muestras que han sido seleccionadas al azar o que de otra manera sean representativas de dicha población.
DAT-2.B.2 Una muestra solo es extrapolable a la población de la cual fue seleccionada.
DAT-2.B.3 No es posible determinar relaciones causales entre variables utilizando datos recopilados en un estudio observacional.
Fuente: College Board AP Course and Exam Description
En un estudio observacional, mides individuos sin intentar influir en ellos. Puede mostrar una asociación, pero no causalidad, porque variables latentes podrían explicar el vínculo.
En un experimento, impones deliberadamente un tratamiento y comparas las respuestas. Un experimento bien diseñado puede establecer causa y efecto.
Explorar
¿Estudio observacional o experimento?
En un experimento el investigador impone un tratamiento (y puede mostrar causalidad); un estudio observacional solo registra lo que ya sucede (y puede mostrar asociación, no causalidad).
Comprensión Duradera (DAT-2): La forma en que se recopilan los datos influye en lo que podemos y no podemos afirmar sobre una población.
Objetivo de Aprendizaje DAT-2.C: Identificar un método de muestreo, dada la descripción de un estudio. [Habilidad 1.C]
DAT-2.C.1 Cuando un elemento de una población puede ser seleccionado solo una vez, esto se denomina muestreo sin reemplazo. Cuando un elemento de la población puede ser seleccionado más de una vez, esto se denomina muestreo con reemplazo.
DAT-2.C.2 Una muestra aleatoria simple (MAS) es una muestra en la que cada grupo de un tamaño dado tiene la misma probabilidad de ser elegido. Este método es la base para muchos tipos de mecanismos de muestreo. Algunos ejemplos de mecanismos utilizados para obtener MAS incluyen numerar a los individuos y usar un generador de números aleatorios para seleccionar cuáles incluir en la muestra, ignorando repeticiones; usar una tabla de números aleatorios; o extraer una carta de una baraja sin reemplazo.
DAT-2.C.3 Un muestreo aleatorio estratificado implica la división de una población en grupos separados, llamados estratos, basándose en atributos o características compartidas (agrupación homogénea). Dentro de cada estrato se selecciona una muestra aleatoria simple, y las unidades seleccionadas se combinan para formar la muestra.
DAT-2.C.4 Un muestreo por conglomerados implica la división de una población en grupos más pequeños, llamados conglomerados. Idealmente, debe haber heterogeneidad dentro de cada conglomerado, y los conglomerados deben ser similares entre sí en su composición. Se selecciona una muestra aleatoria simple de conglomerados de la población para formar la muestra de conglomerados. Los datos se recopilan de todas las observaciones en los conglomerados seleccionados.
DAT-2.C.5 Un muestreo aleatorio sistemático es un método mediante el cual los miembros de la muestra de una población se seleccionan según un punto de inicio aleatorio y un intervalo fijo y periódico.
DAT-2.C.6 Un censo selecciona todos los elementos/sujetos de una población.
Objetivo de Aprendizaje DAT-2.D: Explicar por qué un método de muestreo en particular es o no es apropiado para una situación dada. [Habilidad 1.C]
DAT-2.D.1 Cada método de muestreo tiene ventajas y desventajas dependiendo de la pregunta que se deba responder y de la población de la cual se extraerá la muestra.
Fuente: College Board AP Course and Exam Description
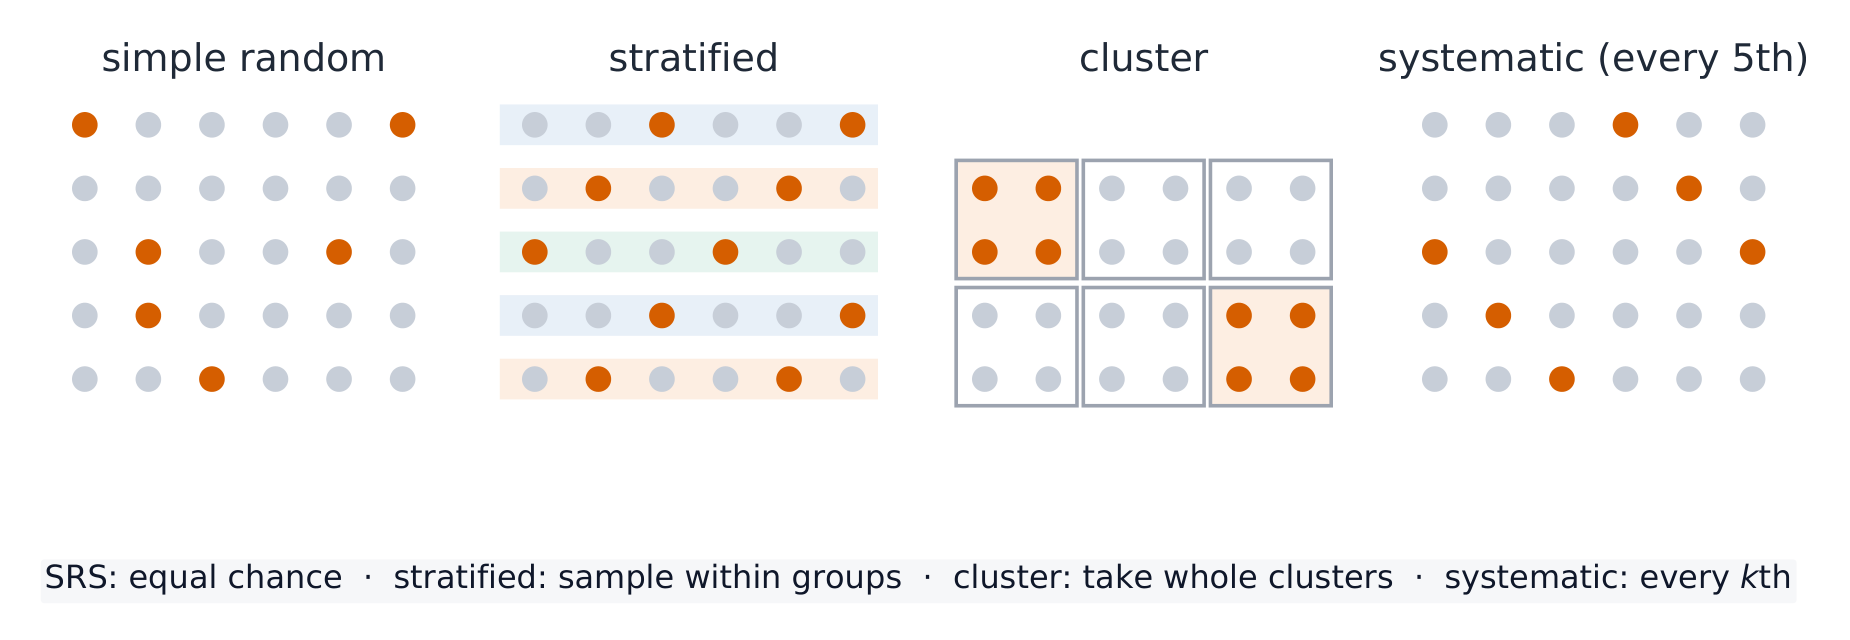
Para aprender sobre una población, tomas una muestra. El muestreo aleatorio protege contra el sesgo de selección y permite generalizar (no puede corregir la cobertura insuficiente, la falta de respuesta o el sesgo de respuesta; vea abajo). Diseños comunes:
Muestra aleatoria simple (MAS): cada grupo del tamaño seleccionado tiene igual probabilidad de ser elegido.
Estratificado: divide la población en estratos similares y luego muestra dentro de cada uno.
Por conglomerados: divide en conglomerados y selecciona aleatoriamente conglomerados completos.
Sistemático: selecciona cada $k$-ésimo individuo a partir de un inicio aleatorio.
Cuatro diseños de muestreo aleatorio: quién es seleccionado y cómo
Una muestra por conveniencia o de respuesta voluntariano es aleatoria y está sesgada.
Ejemplo resuelto. Para encuestar a una escuela, un administrador lista a todos los estudiantes por grado y selecciona aleatoriamente $20$ de cada grado. Esta es una muestra estratificada —los grados son los estratos—, lo que garantiza que todos los grados estén representados, a diferencia de una MAS que podría tener por azar fewer estudiantes de un grado.
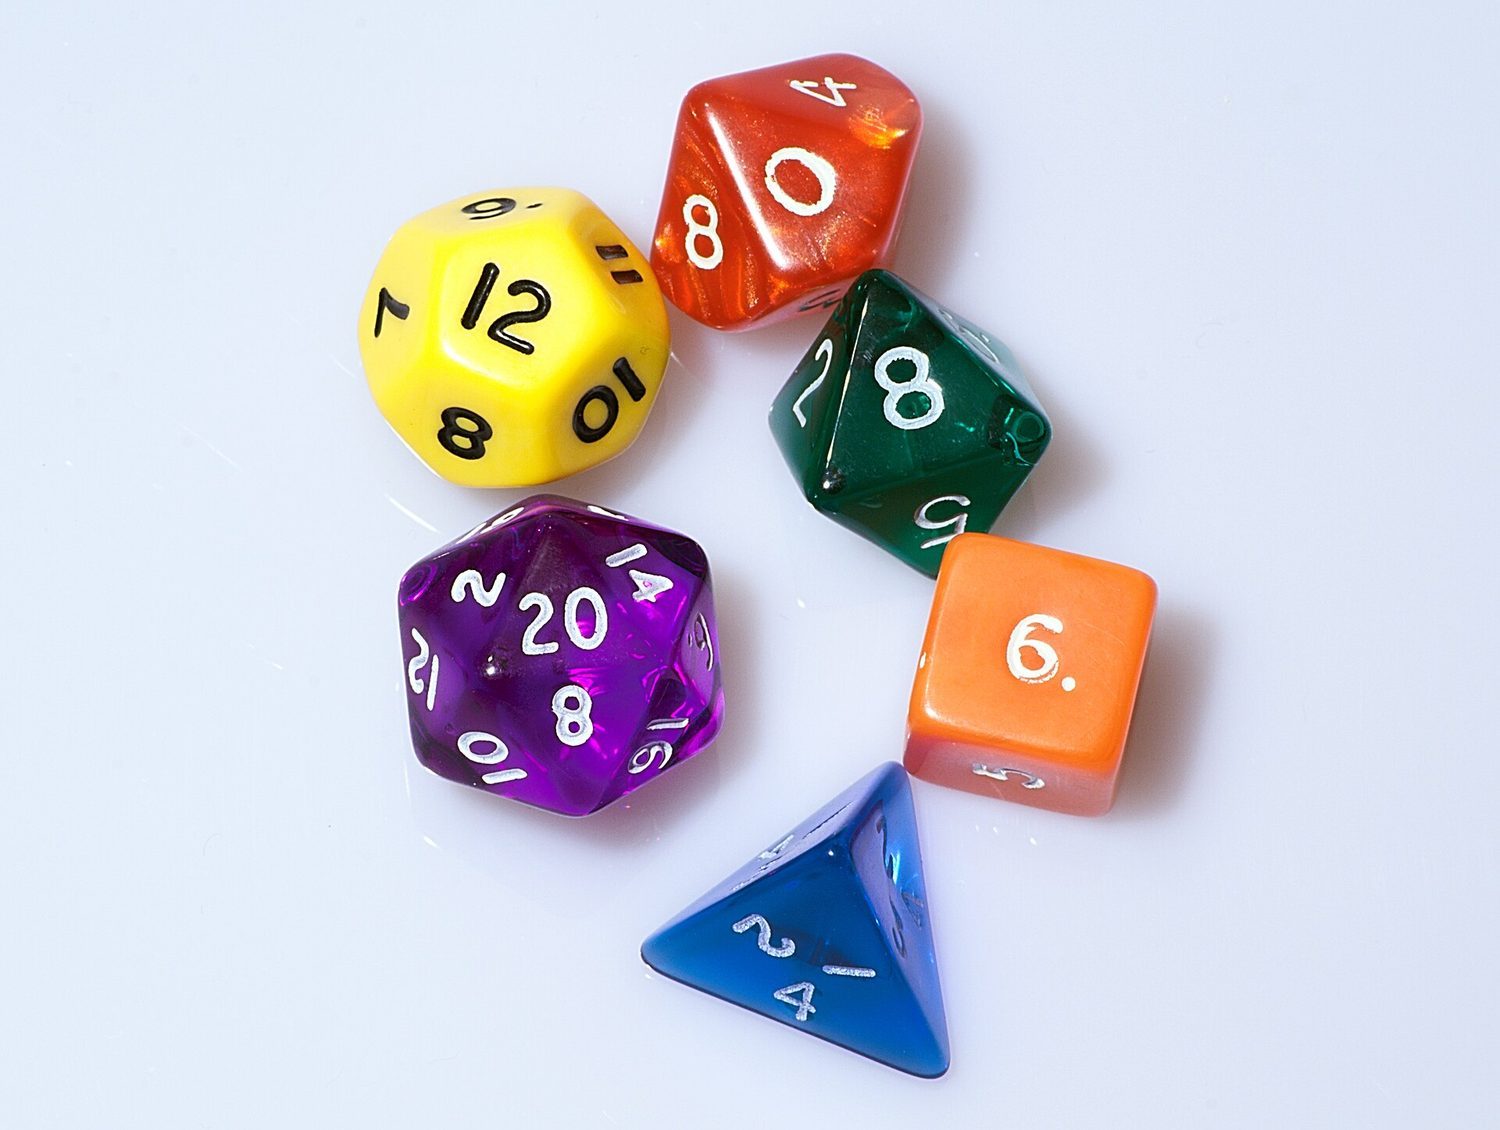
Resultados aleatorios: los dados hacen que cada cara sea equally probable bajo condiciones justas
3.4
Cuando el Muestreo Sale Mal
Syllabus
Comprensión duradera (DAT-2): La forma en que se recopila la datos influye en lo que podemos y no podemos afirmar sobre una población.
Objetivo de aprendizaje DAT-2.E: Identificar posibles fuentes de sesgo en los métodos de muestreo. [Habilidad 1.C]
DAT-2.E.1 El sesgo ocurre cuando ciertas respuestas son sistemáticamente favorecidas sobre otras.
DAT-2.E.2 Cuando una muestra está compuesta exclusivamente por voluntarios o personas que optan por participar, la muestra típicamente no será representativa de la población (sesgo de respuesta voluntaria).
DAT-2.E.3 Cuando una parte de la población tiene una probabilidad reducida de ser incluida en la muestra, la muestra típicamente no será representativa de la población (sesgo de cobertura insuficiente).
DAT-2.E.4 Los individuos seleccionados para la muestra para quienes no se puede obtener datos (o que se niegan a responder) pueden diferir de aquellos para quienes sí se pueden obtener datos (sesgo de no respuesta).
DAT-2.E.5 Problemas en el instrumento o proceso de recolección de datos dan lugar a un sesgo de respuesta. Ejemplos incluyen preguntas confusas o sugerentes (sesgo en la redacción de las preguntas) y respuestas autoinformadas.
DAT-2.E.6 Los métodos de muestreo no aleatorios (por ejemplo, muestras elegidas por conveniencia o respuesta voluntaria) introducen potencial de sesgo porque no utilizan el azar para seleccionar a los individuos.
Fuente: College Board AP Course and Exam Description
El sesgo hace que las estimaciones fallen sistemáticamente respecto a la verdad:
Cobertura insuficiente: algunos grupos quedan excluidos del marco muestral.
Falta de respuesta: las personas seleccionadas no contestan.
Sesgo de respuesta: las personas responden inexactamente (mala redacción, temas sensibles).
El sesgo se refiere a un error constante en una dirección; aumentar el tamaño de la muestra no lo corrige.
Muestras por conveniencia no representan a la población: el sesgo se filtra cuando la selección no es aleatoria
Comprensión duradera (VAR-3): Los experimentos bien diseñados pueden establecer evidencia de relaciones causales.
Objetivo de aprendizaje VAR-3.A: Identificar los componentes de un experimento. [Habilidad 1.C]
VAR-3.A.1 Las unidades experimentales son las unidades individuales (que pueden ser personas u otros objetos de estudio) a las que se les asignan tratamientos. Cuando las unidades experimentales consisten en personas, a veces se les denomina participantes o sujetos.
VAR-3.A.2 Una variable explicativa (o factor) en un experimento es una variable cuyos niveles se manipulan intencionalmente. Los niveles o la combinación de niveles de la(s) variable(s) explicativa(s) se denominan tratamientos.
VAR-3.A.3 Una variable de respuesta en un experimento es un resultado de las unidades experimentales que se mide después de haber administrado los tratamientos.
VAR-3.A.4 Una variable de confusión en un experimento es una variable que está relacionada con la variable explicativa e influye en la variable de respuesta y puede crear una falsa percepción de asociación entre las dos.
Objetivo de aprendizaje VAR-3.B: Describir elementos de un experimento bien diseñado. [Habilidad 1.B]
VAR-3.B.1 Un experimento bien diseñado debe incluir lo siguiente:
a. Comparaciones de al menos dos grupos de tratamiento, uno de los cuales podría ser un grupo control.
b. Asignación/alocación aleatoria de tratamientos a las unidades experimentales.
c. Replicación (más de una unidad experimental en cada grupo de tratamiento).
d. Control de variables de confusión potenciales donde sea apropiado.
Objetivo de aprendizaje VAR-3.C: Comparar diseños y métodos experimentales. [Habilidad 1.C]
VAR-3.C.1 En un diseño completamente aleatorizado, los tratamientos se asignan a las unidades experimentales completamente al azar. La asignación aleatoria tiende a equilibrar los efectos de las variables no controladas (de confusión) para que las diferencias en las respuestas puedan atribuirse a los tratamientos.
VAR-3.C.2 Los métodos para asignar treatments aleatoriamente a las unidades experimentales en un diseño completamente aleatorizado incluyen el uso de un generador de números aleatorios, una tabla de valores aleatorios, extraer fichas sin reemplazo, etc.
VAR-3.C.3 En un experimento de doble ciego, los sujetos no saben qué tratamiento están recibiendo, pero los miembros del equipo de investigación sí, o viceversa.
VAR-3.C.4 En un experimento doble ciego ni los sujetos ni los miembros del equipo de investigación que interactúan con ellos saben qué tratamiento está recibiendo un sujeto.
VAR-3.C.5 Un grupo control es un conjunto de unidades experimentales que no reciben un tratamiento de interés o que reciben un tratamiento con una sustancia inactiva (placebo) con el fin de determinar si el tratamiento de interés tiene algún efecto.
VAR-3.C.6 El efecto placebo ocurre cuando las unidades experimentales tienen una respuesta a un placebo.
VAR-3.C.7 Para los diseños de bloques completos aleatorizados, los tratamientos se asignan completamente al azar dentro de cada bloque.
VAR-3.C.8 El bloqueo asegura que al inicio del experimento las unidades dentro de cada bloque sean similares entre sí respecto a al menos una variable de bloqueo. Un diseño de bloques aleatorizados ayuda a separar la variabilidad natural de las diferencias debidas a la variable de bloqueo.
VAR-3.C.9 Un diseño de pares emparejados es un caso especial de un diseño de bloques aleatorizados. Utilizando una variable de bloqueo, los sujetos (ya sean personas o no) se organizan en parejas coincidentes en factores relevantes. Los pares emparejados pueden formarse de manera natural o por parte del experimentador. Cada par recibe ambos tratamientos asignando aleatoriamente un tratamiento a un miembro del par y posteriormente asignando el tratamiento restante al segundo miembro del par. Alternativamente, cada sujeto puede recibir ambos tratamientos.
Fuente: College Board AP Course and Exam Description
Los buenos experimentos siguen tres principios:
Comparación con un grupo control (a menudo un placebo).
Asignación aleatoria de sujetos a tratamientos, para equilibrar otras variables.
Replicación: suficientes sujetos por tratamiento para observar un efecto real.
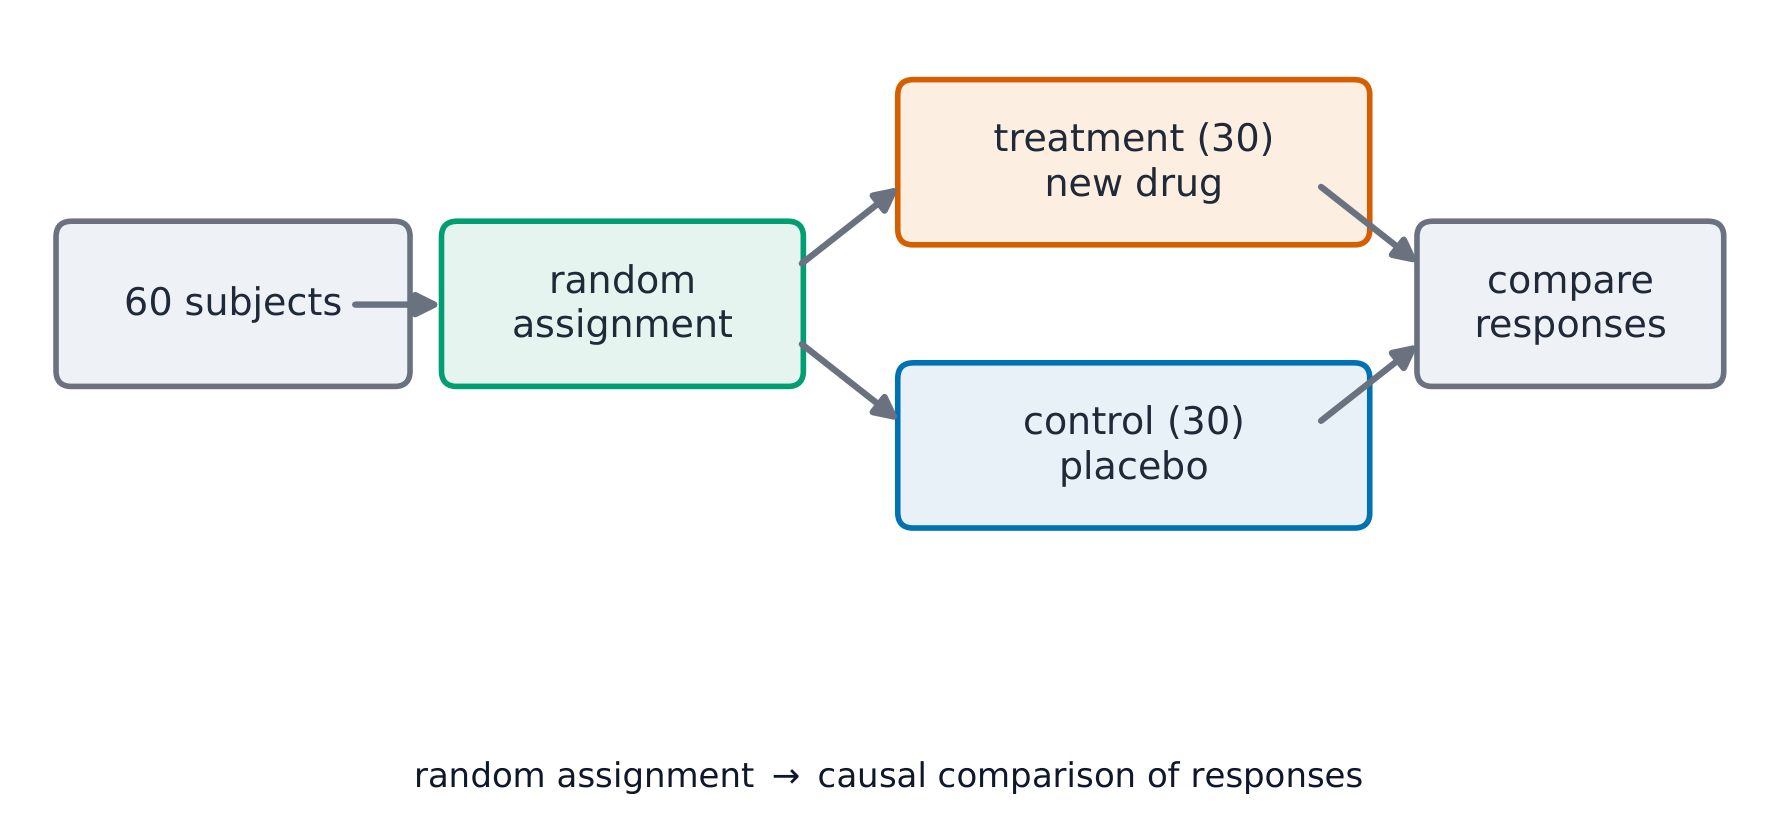
Un experimento completamente aleatorio compara un grupo de tratamiento con un grupo control
El confundimiento ocurre cuando otra variable está ligada al tratamiento de tal manera que sus efectos no pueden separarse; la asignación aleatoria lo previene. El ceguero oculta quién recibe qué tratamiento para evitar efectos de expectativa: en un estudio simple ciego, solo una parte permanece sin saberlo (usualmente los sujetos, o solo las personas que evalúan el resultado), mientras que en un estudio doble ciego, ni los sujetos ni los investigadores que interactúan con ellos saben, bloqueando tanto el efecto placebo como la evaluación sesgada. El bloqueo agrupa sujetos similares y realiza la aleatorización dentro de cada bloque para reducir la variabilidad.
Un ensayo clínico: la asignación aleatoria separa el tratamiento del control
Comprensión duradera (VAR-3): Los experimentos bien diseñados pueden establecer evidencia de relaciones causales.
Objetivo de aprendizaje VAR-3.D: Explicar por qué un diseño experimental particular es apropiado. [Habilidad 1.C]
VAR-3.D.1 Cada diseño experimental tiene ventajas y desventajas que dependen de la pregunta de interés, los recursos disponibles y la naturaleza de las unidades experimentales.
Fuente: College Board AP Course and Exam Description
Ajusta el diseño al objetivo: usa un diseño completamente aleatorio para sujetos uniformes; un diseño de bloques aleatorizados cuando una variable conocida (sexo, edad) afecta la respuesta; un diseño de pares pareados cuando cada sujeto puede servir como su propio control. Establece cómo llevarías a cabo la aleatorización.
3.7
Lo Que un Experimento Te Permite Concluir
Syllabus
Comprensión duradera (VAR-3): Los experimentos bien diseñados pueden establecer evidencia de relaciones causales.
Objetivo de aprendizaje VAR-3.E: Interpretar los resultados de un experimento bien diseñado. [Habilidad 4.B]
VAR-3.E.1 La inferencia estadística atribuye conclusiones basadas en datos a la distribución de la cual se recopilaron los datos.
VAR-3.E.2 La asignación aleatoria de tratamientos a las unidades experimentales permite a los investigadores concluir que algunos cambios observados son tan grandes que es poco probable que hayan ocurrido por azar. A tales cambios se les dice que son estadísticamente significativos.
VAR-3.E.3 Las diferencias estadísticamente significativas entre o entre grupos de tratamiento experimental constituyen evidencia de que los tratamientos causaron el efecto.
VAR-3.E.4 Si las unidades experimentales utilizadas en un experimento son representativas de un grupo más grande de unidades, los resultados del experimento pueden generalizarse a dicho grupo más amplio. La selección aleatoria de unidades experimentales ofrece mayores probabilidades de que sean representativas.
Fuente: College Board AP Course and Exam Description
Dos preguntas determinan el alcance de una conclusión:
¿Se usó asignación aleatoria? Entonces una diferencia significativa puede atribuirse al tratamiento (causalidad) —para estos sujetos—.
¿Se hizo muestreo aleatorio de una población? Entonces los resultados se generalizan a esa población.
Solo un experimento con asignación aleatoria respalda una afirmación de causa y efecto; solo el muestreo aleatorio respalda la generalización. Di exactamente cuál tienes.
Ejemplo resuelto. Los investigadores asignan aleatoriamente a $100$voluntarios a un nuevo medicamento o a un placebo, y el grupo del medicamento mejora significativamente más. Debido a la asignación aleatoria, la mejora puede atribuirse al medicamento (causalidad); pero como los sujetos no fueron muestreados aleatoriamente, la conclusión aplica solo a estos voluntarios y no se generaliza automáticamente a todos.
3.7
Consejos para exámenes
Diferencia un estudio observacional (encuentra asociación) de un experimento (puede mostrar causalidad).
Una buena muestra es aleatoria (MAS, estratificada, por conglomerados) —ten cuidado con el sesgo (respuesta voluntaria, cobertura insuficiente, falta de respuesta).
Los buenos experimentos usan control, aleatorización y replicación; el bloqueo maneja una variable molesta conocida.
Solo un experimento aleatorizado respalda una conclusión de causa y efecto.
Nombra claramente la población, la muestra y cualquier variable confundente.
4
Probabilidad, variables aleatorias y distribuciones de probabilidad
Comprensión duradera (VAR-1): Dado que la variación puede ser aleatoria o no, las conclusiones son inciertas.
Objetivo de aprendizaje VAR-1.F: Identificar preguntas sugeridas por los patrones en los datos. [Habilidad 1.A]
VAR-1.F.1 Los patrones en los datos no necesariamente significan que la variación no sea aleatoria.
Fuente: College Board AP Course and Exam Description
Algo es aleatorio (random) si los resultados individuales son inciertos, pero emerge un patrón regular tras muchas repeticiones. Los resultados a corto plazo parecen erráticos; las frecuencias relativas a largo plazo se estabilizan. Esta estabilidad a largo plazo es lo que hace útil la probabilidad.
Comprensión duradera (UNC-2): La simulación nos permite anticipar patrones en los datos.
Objetivo de aprendizaje UNC-2.A: Estimar probabilidades usando simulación. [Habilidad 3.A]
UNC-2.A.1 Un proceso aleatorio genera resultados que son determinados por el azar.
UNC-2.A.2 Un resultado es el producto de una prueba de un proceso aleatorio.
UNC-2.A.3 Un evento es una colección de resultados.
UNC-2.A.4 La simulación es una forma de modelar eventos aleatorios, de modo que los resultados simulados coincidan estrechamente con los resultados del mundo real. Todos los resultados posibles se asocian con un valor a determinar por azar. Registre las frecuencias de los resultados simulados y la frecuencia total.
UNC-2.A.5 La frecuencia relativa de un resultado o evento en datos simulados o empíricos puede usarse para estimar la probabilidad de ese resultado o evento.
UNC-2.A.6 La ley de los grandes números establece que las probabilidades simuladas (empíricas) tienden a acercarse a la probabilidad verdadera a medida que aumenta el número de pruebas.
Ejemplos ilustrativos para UNC-2.A:
Un resultado: Obtener un valor específico al lanzar un dado de seis caras es uno de los seis resultados posibles.
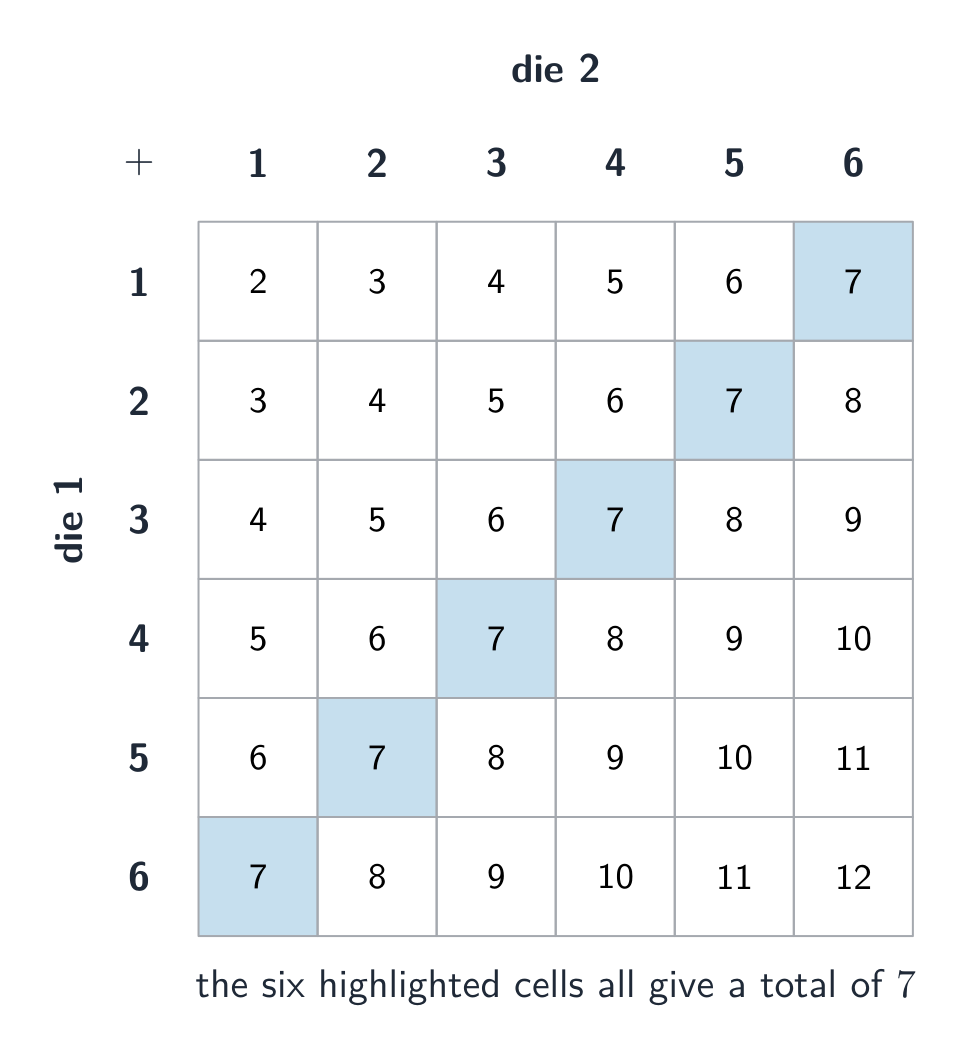
Un evento: Al lanzar dos dados de seis caras, un evento sería obtener una suma de siete. La colección correspondiente de resultados sería $(1, 6)$, $(2, 5)$, $(3, 4)$, $(4, 3)$, $(5, 2)$ y $(6, 1)$, donde los pares ordenados indican (el valor de la cara en un dado, el valor de la cara en el otro dado).
Fuente: College Board AP Course and Exam Description
Una simulación imita un proceso al azar utilizando dígitos aleatorios o tecnología. Pasos: plantear el modelo, asignar dígitos a los resultados, realizar muchas repeticiones y registrar la proporción de repeticiones que cumplen la condición. La proporción resultante estima la probabilidad; más repeticiones dan una mejor estimación.
4.3
Introducción a la Probabilidad
Syllabus
Comprensión duradera (VAR-4): La probabilidad de un evento aleatorio puede cuantificarse.
Objetivo de aprendizaje VAR-4.A: Calcular probabilidades de eventos y sus complementos. [Habilidad 3.A]
VAR-4.A.1 El espacio muestral de un proceso aleatorio es el conjunto de todos los resultados posibles no superpuestos.
VAR-4.A.2 Si todos los resultados en el espacio muestral son igualmente probables, entonces la probabilidad de que ocurra un evento E se define como la fracción: $\dfrac{\text{number of outcomes in event E}}{\text{total number of outcomes in sample space}}$
VAR-4.A.3 La probabilidad de un evento es un número entre 0 y 1, inclusive.
VAR-4.A.4 La probabilidad del complemento de un evento E, $E'$ o $E^{C}$ (es decir, no E), es igual a $1 - P(E)$.
Objetivo de aprendizaje VAR-4.B: Interpretar probabilidades de eventos. [Habilidad 4.B]
VAR-4.B.1 Las probabilidades de eventos en situaciones repetibles pueden interpretarse como la frecuencia relativa con la que el evento ocurrirá a largo plazo.
Fuente: College Board AP Course and Exam Description
La probabilidad de un evento es un número entre $0$ y $1$ que indica su frecuencia relativa a largo plazo. El espacio muestral es el conjunto de todos los resultados posibles. Para un evento $A$, la regla del complemento: $P(A^c)=1-P(A)$. Las probabilidades de todos los resultados suman $1$.
La probabilidad va desde 0 (imposible) hasta 1 (cierto)Una baraja de cartas es una fuente clásica de probabilidad: 52 resultados igualmente probables facilitan el conteo de las posibilidades
Explorar
Explorar la probabilidad con dados
Probabilidad es la fracción a largo plazo de veces que ocurre un resultado. Lanza el dado muchas veces y observa cómo las proporciones experimentales se estabilizan hacia los valores teóricos.
Comprensión perdurable (VAR-4): La probabilidad de un evento aleatorio puede cuantificarse.
Objetivo de aprendizaje VAR-4.C: Explicar por qué dos eventos son (o no son) mutuamente excluyentes. [Habilidad 4.B]
VAR-4.C.1: La probabilidad de que los eventos $A$ y $B$ ocurran ambos, a veces llamada probabilidad conjunta, es la probabilidad de la intersección de $A$ y $B$, denotada como $P(A \cap B)$.
VAR-4.C.2: Dos eventos son mutuamente excluyentes o disjuntos si no pueden ocurrir al mismo tiempo. Por lo tanto, $P(A \cap B) = 0$.
Fuente: College Board AP Course and Exam Description
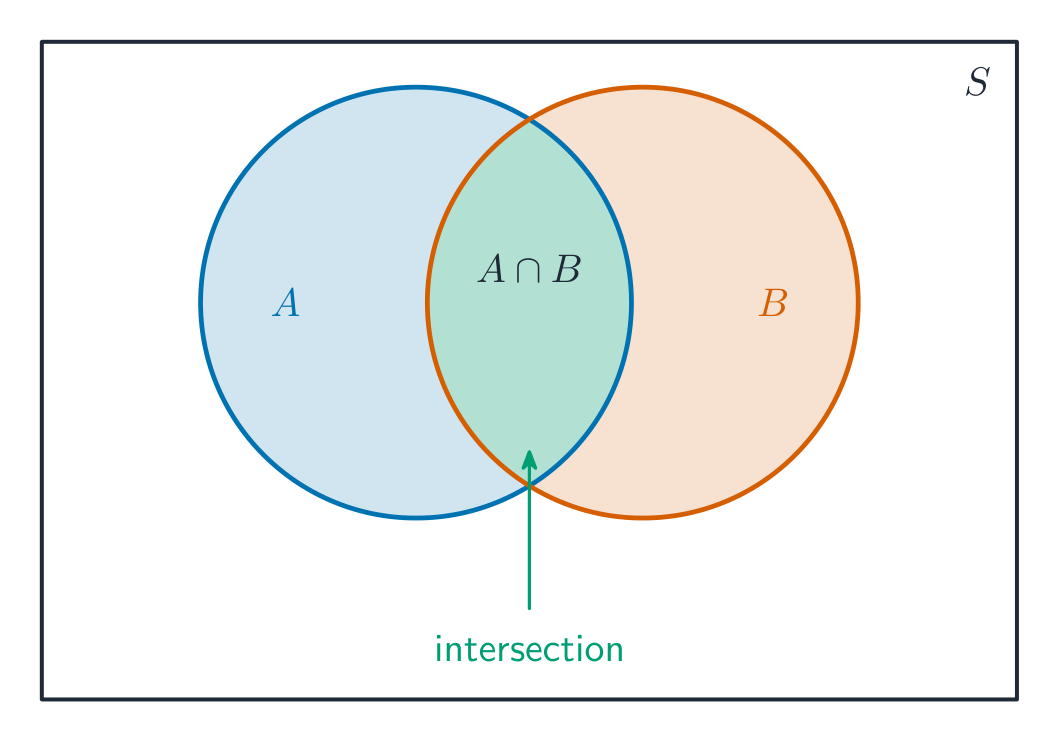
Dos eventos son mutuamente excluyentes (disjuntos) si no pueden ocurrir ambos. Entonces la regla de adición se simplifica:
$$P(A\text{ or }B)=P(A)+P(B)\quad(\text{if mutually exclusive}).$$
En general, $P(A\text{ or }B)=P(A)+P(B)-P(A\text{ and }B)$ — se resta la intersección para no contarla dos veces.
Un diagrama de Venn: la superposición es la intersección de dos eventos
Comprensión Duradera (VAR-4): La probabilidad de un evento aleatorio puede cuantificarse.
Objetivo de Aprendizaje VAR-4.D: Calcular probabilidades condicionales. [Habilidad 3.A]
VAR-4.D.1 La probabilidad de que el evento $A$ ocurra dado que el evento $B$ ha ocurrido se denomina probabilidad condicional y se denota como $P(A \mid B) = \dfrac{P(A \cap B)}{P(B)}$.
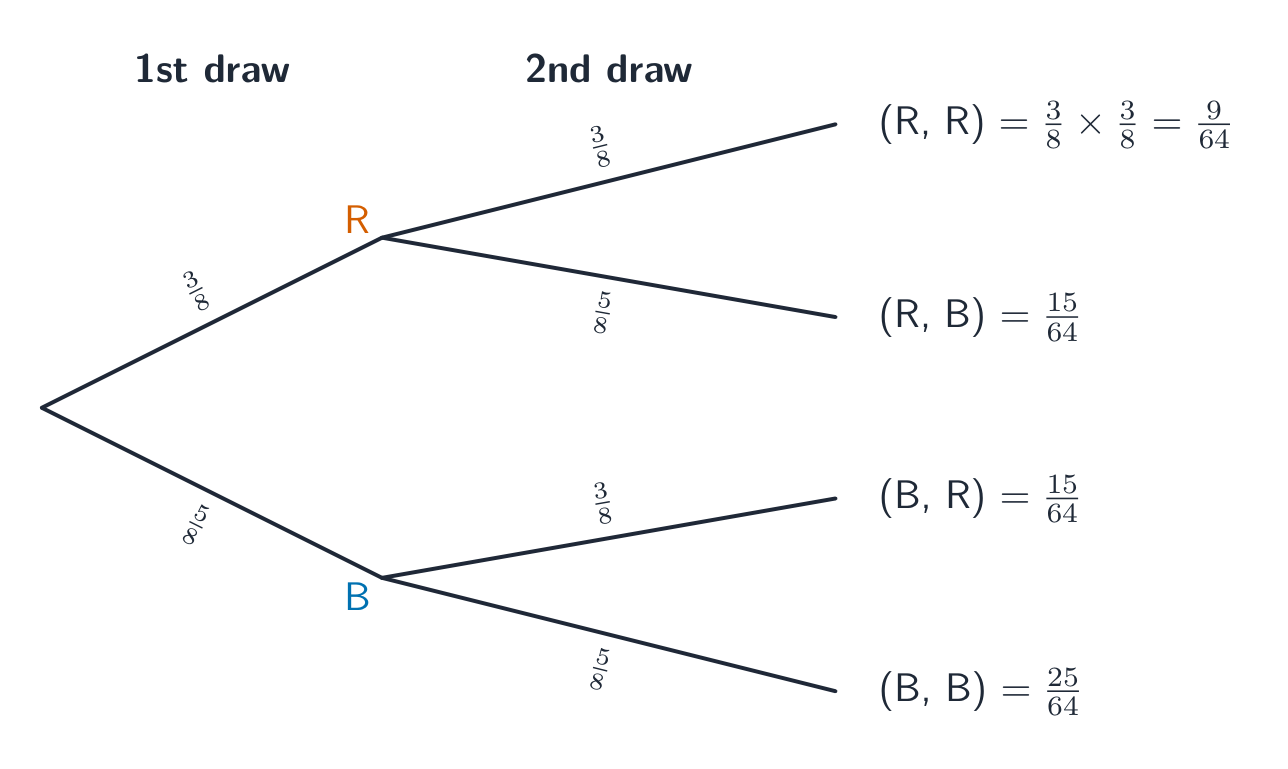
VAR-4.D.2 La regla de la multiplicación establece que la probabilidad de que los eventos $A$ y $B$ ocurran simultáneamente es igual a la probabilidad de que ocurra el evento $A$ multiplicada por la probabilidad de que ocurra el evento $B$, dado que $A$ ha ocurrido. Esto se denota como $P(A \cap B) = P(A) \cdot P(B \mid A)$.
Fuente: College Board AP Course and Exam Description
Probabilidad condicional
La probabilidad condicional de $A$ dado $B$ es
$$P(A\mid B)=\frac{P(A\text{ and }B)}{P(B)}.$$
Es la probabilidad de $A$ una vez que se sabe que ocurrió $B$. Las tablas de doble entrada facilitan esto: restríngase a la fila/columna correspondiente a $B$, luego encuentre la participación de $A$.
En un diagrama de árbol, multiplique las probabilidades a lo largo de las ramas
Explorar
Actualizar una probabilidad con nueva información
La probabilidad condicional$P(B\mid A)$ es la probabilidad de $B$ una vez que sabes que ocurrió $A$. Cambia las probabilidades de rama y observa cómo la condicionamiento remodela el resultado.
Comprensión Duradera (VAR-4): La probabilidad de un evento aleatorio puede cuantificarse.
Objetivo de Aprendizaje VAR-4.E: Calcular probabilidades para eventos independientes y para la unión de dos eventos. [Habilidad 3.A]
VAR-4.E.1 Los eventos $A$ y $B$ son independientes si, y solo si, saber si el evento $A$ ha ocurrido (o ocurrirá) no cambia la probabilidad de que el evento $B$ ocurra.
VAR-4.E.2 Si, y solo si, los eventos $A$ y $B$ son independientes, entonces $P(A \mid B) = P(A)$, $P(B \mid A) = P(B)$, y $P(A \cap B) = P(A) \cdot P(B)$.
VAR-4.E.3 La probabilidad de que ocurra el evento $A$ o el evento $B$ (o ambos) es la probabilidad de la unión de $A$ y $B$, denotada como $P(A \cup B)$.
VAR-4.E.4 La regla de la suma establece que la probabilidad de que ocurra el evento $A$ o el evento $B$ o ambos es igual a la probabilidad de que ocurra el evento $A$ más la probabilidad de que ocurra el evento $B$ menos la probabilidad de que ocurran ambos eventos $A$ y $B$. Esto se denota como $P(A \cup B) = P(A) + P(B) - P(A \cap B)$.
Fuente: College Board AP Course and Exam Description
Los eventos son independientes si conocer uno no cambia la probabilidad del otro: $P(A\mid B)=P(A)$. Entonces la regla de multiplicación se simplifica:
$$P(A\text{ and }B)=P(A)\,P(B)\quad(\text{if independent}).$$
Independiente no es lo mismo que mutuamente excluyente; los eventos mutuamente excluyentes con probabilidad distinta de cero son en realidad dependientes (si ocurre uno, el otro no puede ocurrir).
Un diagrama del espacio muestral lista cada resultado igualmente probable
Explorar
Combinar eventos con un diagrama de Venn
Para una unión$P(A\cup B)=P(A)+P(B)-P(A\cap B)$ — restas la superposición para que no se cuente dos veces. Cambia la operación para ver iluminarse cada región.
probability distribution/ˌprɒbəˈbɪlɪti ˌdɪstrɪˈbjuːʃn/
概率分布
gài lǜ fēn bù
mean (expected value)/miːn/
期望值
qī wàng zhí
4.7
Variables Aleatorias y Distribuciones de Probabilidad
Syllabus
Comprensión duradera (VAR-5): Las distribuciones de probabilidad pueden utilizarse para modelar la variación en poblaciones.
Objetivo de aprendizaje VAR-5.A: Representar la distribución de probabilidad de una variable aleatoria discreta. [Habilidad 2.B]
VAR-5.A.1 Los valores de una variable aleatoria son los resultados numéricos del comportamiento aleatorio.
VAR-5.A.2 Una variable aleatoria discreta es aquella que solo puede tomar un número contable de valores. A cada valor se le asocia una probabilidad. La suma de las probabilidades sobre todos los valores posibles debe ser igual a 1.
VAR-5.A.3 Una distribución de probabilidad puede representarse como un gráfico, tabla o función que muestra las probabilidades asociadas con los valores de una variable aleatoria.
VAR-5.A.4 Una distribución de probabilidad acumulada puede representarse como una tabla o función que muestra la probabilidad de ser menor o igual a cada valor de la variable aleatoria.
Ejemplos ilustrativos para VAR-5.A: Resultados de ensayos de un proceso aleatorio:
La suma de los resultados al lanzar dos dados
El número de cachorros en una camada seleccionada al azar de una raza canina determinada
Objetivo de aprendizaje VAR-5.B: Interpretar una distribución de probabilidad. [Habilidad 4.B]
VAR-5.B.1 La interpretación de una distribución de probabilidad proporciona información sobre la forma, el centro y la dispersión de una población y permite extraer conclusiones sobre la población de interés.
Fuente: College Board AP Course and Exam Description
Una variable aleatoria asigna un número a cada resultado de un proceso al azar. Una distribución de probabilidad lista cada valor posible con su probabilidad (suman $1$). Una distribución puede ser discreta (una tabla de valores) o continua (un modelo de área bajo una curva como la normal).
4.8
Media y Desviación Estándar de Variables Aleatorias
Syllabus
Comprensión Duradera (VAR-5): Las distribuciones de probabilidad pueden utilizarse para modelar la variación en poblaciones.
Objetivo de Aprendizaje VAR-5.C: Calcular parámetros de una variable aleatoria discreta. [Habilidad 3.B]
VAR-5.C.1 Un valor numérico que mide una característica de una población o de la distribución de una variable aleatoria se conoce como parámetro, el cual es un único valor fijo.
VAR-5.C.2 La media, o valor esperado, de una variable aleatoria discreta $X$ es $\mu_X = \sum x_i \cdot P(x_i)$.
VAR-5.C.3 La desviación estándar de una variable aleatoria discreta $X$ es $\sigma_X = \sqrt{\sum (x_i - \mu_x)^2 \cdot P(x_i)}$.
Objetivo de Aprendizaje VAR-5.D: Interpretar parámetros de una variable aleatoria discreta. [Habilidad 4.B]
VAR-5.D.1 Los parámetros de una variable aleatoria discreta deben interpretarse utilizando unidades apropiadas y dentro del contexto de una población específica.
Fuente: College Board AP Course and Exam Description
La media (valor esperado) de una variable aleatoria discreta es el promedio ponderado por la probabilidad:
$$\mu_X=E(X)=\sum x_i\,P(x_i).$$
La desviación estándar$\sigma_X=\sqrt{\sum (x_i-\mu_X)^2\,P(x_i)}$ mide la dispersión típica respecto a la media. El valor esperado es el promedio a largo plazo, no un valor que se espera en cualquier ensayo individual.
Ejemplo resuelto. Un juego paga $\$5$ with probability $0.2$ and costs you $\$1$ (un resultado de $-1$) con probabilidad $0.8$. El valor esperado es
$$E(X)=5(0.2)+(-1)(0.8)=1-0.8=\$0.20,$$
por lo que, a lo largo de muchos juegos, gana aproximadamente $20$ centavos por juego en promedio, aunque ningún juego individual dé exactamente esa cantidad.
4.9
Combinación de Variables Aleatorias
Syllabus
Comprensión perdurable (VAR-5): Las distribuciones de probabilidad pueden utilizarse para modelar la variación en las poblaciones.
Objetivo de aprendizaje VAR-5.E: Calcular parámetros para combinaciones lineales de variables aleatorias. [Habilidad 3.B]
VAR-5.E.1 Para las variables aleatorias $X$ e $Y$ y los números reales $a$ y $b$, la media de $aX + bY$ es $a\mu_x + b\mu_y$.
VAR-5.E.2 Dos variables aleatorias son independientes si conocer información sobre una de ellas no cambia la distribución de probabilidad de la otra.
VAR-5.E.3 Para variables aleatorias independientes $X$ e $Y$ y números reales $a$ y $b$, la media de $aX + bY$ es $a\mu_x + b\mu_y$, y la varianza de $aX + bY$ es $a^2\sigma^2_x + b^2\sigma^2_y$.
Objetivo de aprendizaje VAR-5.F: Describir los efectos de las transformaciones lineales de los parámetros de las variables aleatorias. [Habilidad 3.C]
VAR-5.F.1 Para $Y = a + bX$, la distribución de probabilidad de la variable aleatoria transformada, $Y$, tiene la misma forma que la distribución de probabilidad de $X$, siempre que $a > 0$ y $b > 0$. La media de $Y$ es $\mu_y = a + b\mu_x$. La desviación estándar de $Y$ es $\sigma_y = |b|\sigma_x$.
Fuente: College Board AP Course and Exam Description
Cuando suma o resta variables aleatorias, las medias se suman: $\mu_{X\pm Y}=\mu_X\pm\mu_Y$. Si $X$ e $Y$ son independientes, las varianzas se suman (incluso cuando se restan):
$$\sigma^2_{X\pm Y}=\sigma^2_X+\sigma^2_Y.$$
Tome la raíz cuadrada para obtener la desviación estándar. Además, para escalados: $\mu_{aX+b}=a\mu_X+b$ y $\sigma_{aX+b}=|a|\sigma_X$.
4.10
Introducción a la Distribución Binomial
Syllabus
Comprensión Duradera (UNC-3): El razonamiento probabilístico nos permite anticipar patrones en los datos.
Objetivo de Aprendizaje UNC-3.A: Estimar probabilidades de variables aleatorias binomiales utilizando datos de una simulación. [Habilidad 3.A]
UNC-3.A.1 Una distribución de probabilidad puede construirse mediante las reglas de la probabilidad o estimarse mediante una simulación usando generadores de números aleatorios.
UNC-3.A.2 Una variable aleatoria binomial, $X$, cuenta el número de éxitos en $n$ ensayos independientes repetidos; cada ensayo tiene dos resultados posibles (éxito o fracaso), con probabilidad de éxito $p$ y probabilidad de fracaso $1 - p$.
Objetivo de Aprendizaje UNC-3.B: Calcular probabilidades para una distribución binomial. [Habilidad 3.A]
UNC-3.B.1 La probabilidad de que una variable aleatoria binomial, $X$, tenga exactamente $x$ éxitos en $n$ ensayos independientes, cuando la probabilidad de éxito es $p$, se calcula como $P(X = x) = \binom{n}{x} p^x (1 - p)^{n-x}, x = 0, 1, 2, \ldots, n$. Esta es la función de probabilidad binomial.
Fuente: College Board AP Course and Exam Description
La distribución binomial
Un escenario binomial (BINS): un número fijo $n$ de ensayos independientes, cada uno con dos resultados (éxito/fallo) y la misma probabilidad de éxito $p$. La variable aleatoria $X=$ número de éxitos. Su probabilidad:
$$P(X=k)=\binom{n}{k}p^k(1-p)^{n-k}.$$
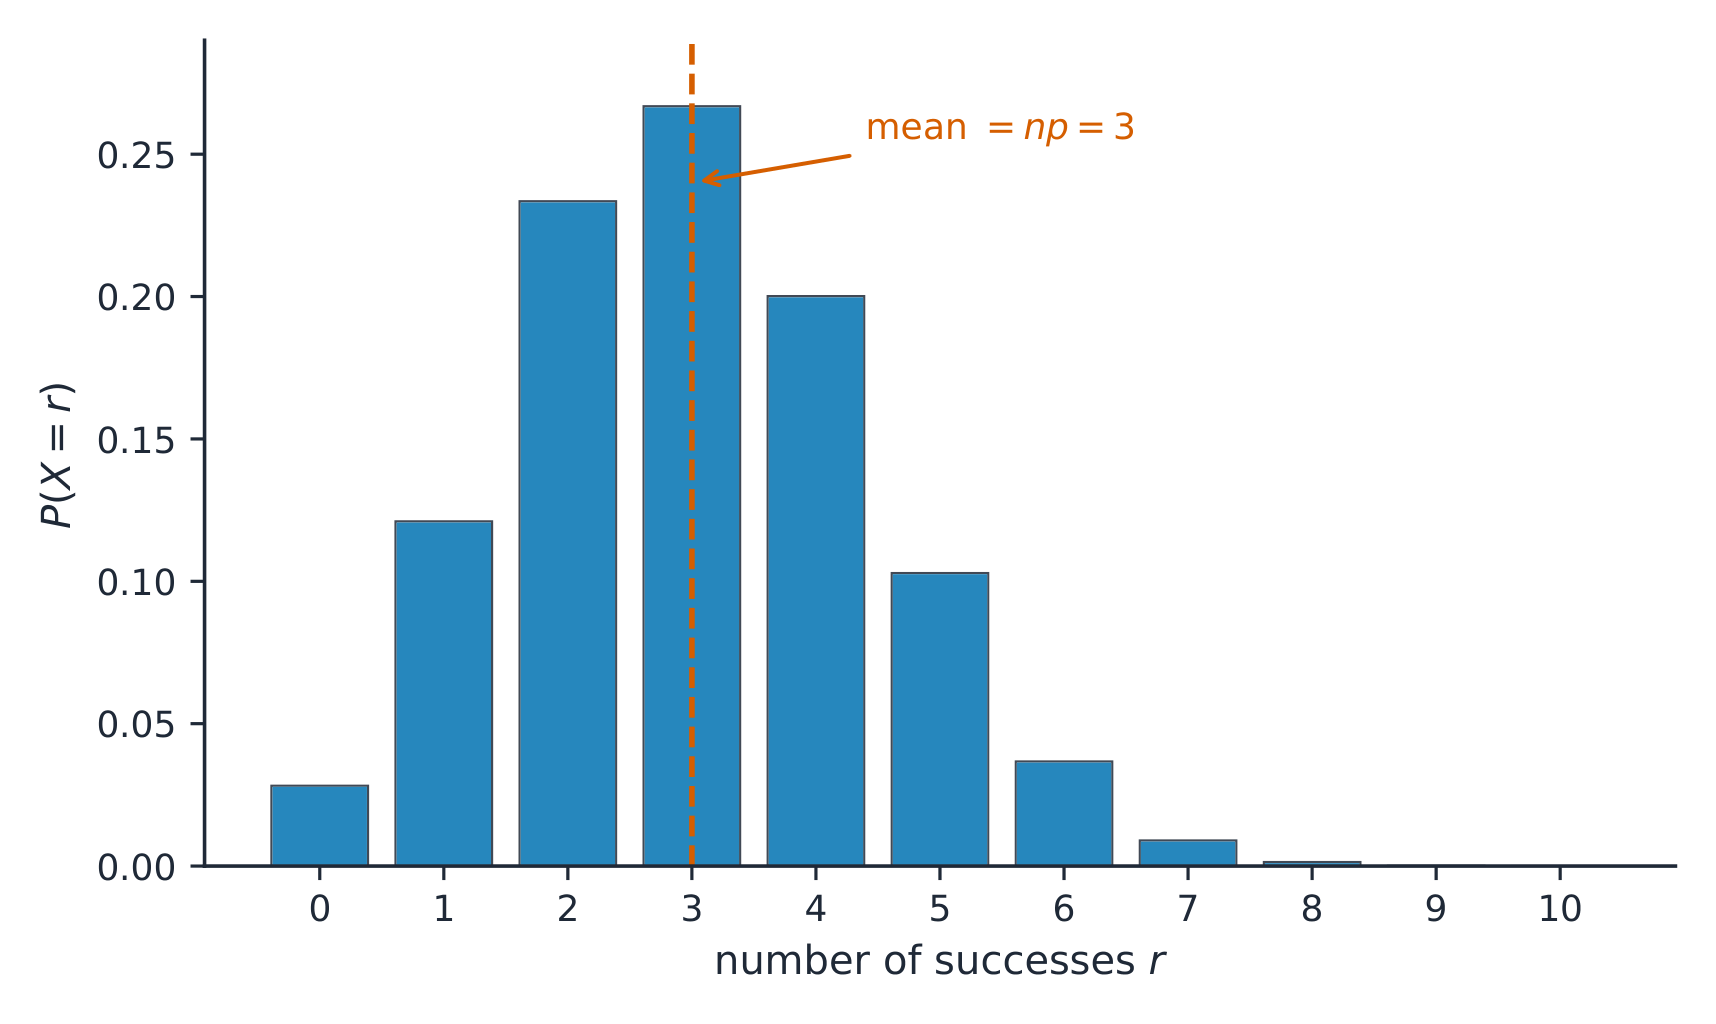
La distribución binomial, con media n por p
Explorar
Formar una distribución binomial
Una distribución binomial cuenta los éxitos en $n$ ensayos independientes, cada uno con probabilidad $p$. Cambia $n$ y $p$ y observa cómo cambian y se expanden las barras.
Comprensión perdurable (UNC-3): El razonamiento probabilístico nos permite anticipar patrones en los datos.
Objetivo de aprendizaje UNC-3.C: Calcular parámetros de una distribución binomial. [Habilidad 3.B]
UNC-3.C.1 Si una variable aleatoria es binomial, su media, $\mu_x$, es $np$ y su desviación estándar, $\sigma_x$, es $\sqrt{np(1 - p)}$.
Objetivo de aprendizaje UNC-3.D: Interpretar probabilidades y parámetros de una distribución binomial. [Habilidad 4.B]
UNC-3.D.1 Las probabilidades y parámetros de una distribución binomial deben interpretarse utilizando unidades apropiadas y dentro del contexto de una población o situación específica.
Fuente: College Board AP Course and Exam Description
Para una binomial $X$ con $n$ ensayos y probabilidad de éxito $p$:
$$\mu_X=np,\qquad \sigma_X=\sqrt{np(1-p)}.$$
Use estos para preguntas sobre "cuántos éxitos esperamos y cuánto varían".
Ejemplo resuelto. Un jugador acierta el $70\%$ de los tiros libres. En $n=10$ tiros, la probabilidad de acertar exactamente $8$ es
y el número esperado de aciertos es $\mu=np=10(0.7)=7$, con $\sigma=\sqrt{10(0.7)(0.3)}\approx1.45$.
4.12
La Distribución Geométrica
Syllabus
Comprensión Duradera (UNC-3): El razonamiento probabilístico nos permite anticipar patrones en los datos.
Objetivo de Aprendizaje UNC-3.E: Calcular probabilidades para variables aleatorias geométricas. [Habilidad 3.A]
UNC-3.E.1 Para una secuencia de ensayos independientes, una variable aleatoria geométrica, $X$, indica el número del ensayo en que ocurre el primer éxito. Cada ensayo tiene dos resultados posibles (éxito o fracaso) con la probabilidad de éxito $p$ y la probabilidad de fracaso $1 - p$.
UNC-3.E.2 La probabilidad de que el primer éxito en ensayos independientes repetidos con probabilidad de éxito $p$ ocurra en el ensayo $x$ se calcula como $P(X = x) = (1 - p)^{x-1} p, x = 1, 2, 3, \ldots$. Esta es la función de probabilidad geométrica.
Objetivo de Aprendizaje UNC-3.F: Calcular parámetros de una distribución geométrica. [Habilidad 3.B]
UNC-3.F.1 Si una variable aleatoria es geométrica, su media, $\mu_x$, es $\dfrac{1}{p}$ y su desviación estándar, $\sigma_x$, es $\dfrac{\sqrt{(1 - p)}}{p}$.
Objetivo de Aprendizaje UNC-3.G: Interpretar probabilidades y parámetros para una distribución geométrica. [Habilidad 4.B]
UNC-3.G.1 Las probabilidades y parámetros de una distribución geométrica deben interpretarse utilizando unidades apropiadas y dentro del contexto de una población o situación específica.
Fuente: College Board AP Course and Exam Description
Un escenario geométrico es igual al binomial pero sin un $n$ fijo: sigue intentando hasta obtener el primer éxito. La variable aleatoria $Y=$ el ensayo del primer éxito:
Por qué dos muestras nunca coinciden: Variabilidad muestral
Syllabus
Comprensión duradera (VAR-1): Dado que la variación puede ser aleatoria o no, las conclusiones son inciertas.
Objetivo de aprendizaje VAR-1.G: Identificar preguntas sugeridas por la variación en estadísticas para muestras recolectadas de la misma población. [Habilidad 1.A]
VAR-1.G.1 La variación en estadísticas para muestras tomadas de la misma población puede ser aleatoria o no.
Fuente: College Board AP Course and Exam Description
Un estadístico (como la media muestral $\bar{x}$ o la proporción muestral $\hat{p}$) se calcula a partir de una muestra y varía de una muestra a otra; esto es la variabilidad muestral. Un parámetro ($\mu$ o $p$) es la verdad fija sobre la población. La distribución muestral es la distribución de un estadístico sobre todas las muestras posibles de un tamaño dado; es el puente entre una muestra y la inferencia.
5.2
La curva normal como modelo para un estadístico
Syllabus
Comprensión Duradera (VAR-6): La distribución normal puede utilizarse para modelar la variación.
Objetivo de Aprendizaje VAR-6.A: Calcular la probabilidad de que un valor particular se encuentre en un intervalo dado de una distribución normal. [Habilidad 3.A]
VAR-6.A.1 Una variable aleatoria continua es una variable que puede tomar cualquier valor dentro de un dominio especificado. A cada intervalo dentro del dominio le está asociada una probabilidad.
VAR-6.A.2 Una variable aleatoria continua con una distribución normal se utiliza comúnmente para describir poblaciones. La distribución de una variable aleatoria normal puede describirse mediante una curva normal o de forma de "campana".
VAR-6.A.3 El área bajo una curva normal sobre un intervalo dado representa la probabilidad de que un valor particular se encuentre en ese intervalo.
Ejemplos ilustrativos para VAR-6.A: Variable aleatoria continua: Si se observa un reloj en un momento al azar, la probabilidad de que el minutero esté entre las 3 y las 6 es un cuarto.
Objetivo de Aprendizaje VAR-6.B: Determinar el intervalo asociado a un área dada en una distribución normal. [Habilidad 3.A]
VAR-6.B.1 Los límites de un intervalo asociado a un área dada en una distribución normal pueden determinarse utilizando puntuaciones $z$ o tecnología, como una calculadora, una tabla de la normal estándar o una salida generada por computadora.
VAR-6.B.2 Los intervalos asociados a un área dada en una distribución normal pueden determinarse asignando desigualdades apropiadas a los límites de los intervalos:
a. $P(X < x_a) = \dfrac{p}{100}$ significa que el $p\%$ más bajo de valores se encuentra a la izquierda de $x_a$.
b. $P(x_a < X < x_b) = \dfrac{p}{100}$ significa que el $p\%$ de valores se encuentra entre $x_a$ y $x_b$.
c. $P(X > x_b) = \dfrac{p}{100}$ significa que el $p\%$ más alto de valores se encuentra a la derecha de $x_b$.
d. Para determinar el $p\%$ más extremo de valores requiere dividir el área asociada con el $p\%$ en dos áreas iguales en cada extremo de la distribución: $P(X < x_a) = \dfrac{1}{2}\dfrac{p}{100}$ y $P(X > x_b) = \dfrac{1}{2}\dfrac{p}{100}$ significan que la mitad de los valores más extremos del $p\%$ se encuentran a la izquierda de $x_a$ y la mitad de los valores más extremos del $p\%$ se encuentran a la derecha de $x_b$.
Objetivo de Aprendizaje VAR-6.C: Determinar la conveniencia de utilizar la distribución normal para aproximar probabilidades de distribuciones desconocidas. [Habilidad 3.C]
VAR-6.C.1 Las distribuciones normales son simétricas y tienen forma de "campana". Como resultado, las distribuciones normales pueden utilizarse para aproximar distribuciones con características similares.
Fuente: College Board AP Course and Exam Description
La distribución normal
Para muestras lo suficientemente grandes, muchas distribuciones muestrales son aproximadamente normales. Esto nos permite describir un estadístico mediante su centro (su media), su dispersión (su error estándar) y su forma normal, y luego calcular la probabilidad de obtener un resultado muestral dado.
Explorar
Usar la curva normal para encontrar una proporción
Un modelo normal convierte un rango de valores en un área, que equivale a una proporción. Sombree una banda para leer la fracción de muestras que caen dentro de ella (la regla 68-95-99.7).
5.3
El Teorema del Límite Central
Syllabus
Comprensión Duradera (UNC-3): El razonamiento probabilístico nos permite anticipar patrones en los datos.
Objetivo de Aprendizaje UNC-3.H: Estimar distribuciones muestrales mediante simulación. [Habilidad 3.C]
UNC-3.H.1 Una distribución muestral de una estadística es la distribución de valores para esa estadística para todas las muestras posibles de un tamaño dado extraídas de una población dada.
UNC-3.H.2 El teorema del límite central (TLC) establece que cuando el tamaño de la muestra es suficientemente grande, una distribución muestral de la media de una variable aleatoria estará aproximadamente distribuida de forma normal.
UNC-3.H.3 El teorema del límite central requiere que los valores de la muestra sean independientes entre sí y que $n$ sea suficientemente grande.
UNC-3.H.4 Una distribución de randomización es un conjunto de estadísticas generadas por simulación asumiendo valores conocidos para los parámetros. Para un experimento aleatorizado, esto significa reasignar/reasignar aleatoriamente los valores de respuesta a los grupos de tratamiento repetidamente.
UNC-3.H.5 La distribución muestral de una estadística puede ser simulada generando muestras aleatorias repetidas de una población.
Fuente: College Board AP Course and Exam Description
El Teorema del Límite Central
El Teorema del Límite Central (TLC): para una media muestral, si el tamaño de la muestra $n$ es lo suficientemente grande (una regla común es $n\ge 30$), la distribución muestral de $\bar{x}$ es aproximadamente normal, sin importar la forma de la población. Cuanto mayor sea $n$, más normal será la distribución y más ajustada estará.
La media muestral es casi normal independientemente de la forma de la población
Explorar
Observar cómo una distribución muestral se vuelve normal
El Teorema del Límite Central: para una muestra lo suficientemente grande, la distribución de la media muestral es aproximadamente normal, independientemente de la forma de la población.
Comprensión Duradera (UNC-3): El razonamiento probabilístico nos permite anticipar patrones en los datos.
Objetivo de Aprendizaje UNC-3.I: Explicar por qué un estimador es o no sesgado. [Habilidad 4.B]
UNC-3.I.1 Al estimar un parámetro de la población, un estimador es insesgado si, en promedio, el valor del estimador es igual al parámetro de la población.
Objetivo de Aprendizaje UNC-3.J: Calcular estimaciones para un parámetro de la población. [Habilidad 3.B]
UNC-3.J.1 Al estimar un parámetro de la población, un estimador presenta variabilidad que puede modelarse mediante probabilidad.
UNC-3.J.2 Una estadística muestral es un estimador puntual del correspondiente parámetro de la población.
Fuente: College Board AP Course and Exam Description
Un estadístico es insesgado si la media de su distribución muestral es igual al parámetro; es decir, es correcto en promedio. El sesgo se refiere a que el centro está desplazado; la variabilidad se refiere a la dispersión. Un buen estimador debe ser insesgado (centrado correctamente) y tener baja variabilidad (preciso); las muestras más grandes reducen la variabilidad, pero no corrigen el sesgo derivado de un mal muestreo.
El sesgo y la variabilidad son fallos separados. Solo el estimador superior izquierdo está centrado en $\theta$ y es ajustado; el inferior izquierdo es preciso pero sistematicamente incorrecto, algo que ninguna cantidad adicional de datos podrá corregir.
5.5
La distribución muestral de una proporción muestral
Syllabus
Comprensión perdurable (UNC-3): El razonamiento probabilístico nos permite anticipar patrones en los datos.
Objetivo de aprendizaje UNC-3.K: Determinar los parámetros de una distribución de muestreo para proporciones muestrales. [Habilidad 3.B]
UNC-3.K.1 Para muestras independientes (muestreo con reemplazo) de una variable categórica de una población con proporción poblacional $p$, la distribución de muestreo de la proporción muestral, $\hat{p}$, tiene una media, $\mu_{\hat{p}} = p$ y una desviación estándar, $\sigma_{\hat{p}} = \sqrt{\dfrac{p(1-p)}{n}}$.
UNC-3.K.2 Si el muestreo se realiza sin reemplazo, la desviación estándar de la proporción muestral es menor que la dada por la fórmula anterior. Si el tamaño de la muestra es inferior al 10% del tamaño de la población, la diferencia es insignificante.
Objetivo de aprendizaje UNC-3.L: Determinar si una distribución de muestreo para una proporción muestral puede describirse como aproximadamente normal. [Habilidad 3.C]
UNC-3.L.1 Para una variable categórica, la distribución de muestreo de la proporción muestral, $\hat{p}$, tendrá una distribución aproximadamente normal, siempre que el tamaño de la muestra sea lo suficientemente grande: $np \geq 10$ y $n(1-p) \geq 10$.
Objetivo de aprendizaje UNC-3.M: Interpretar probabilidades y parámetros para una distribución de muestreo de una proporción muestral. [Habilidad 4.B]
UNC-3.M.1 Las probabilidades y los parámetros de una distribución de muestreo para una proporción muestral deben interpretarse utilizando unidades apropiadas y dentro del contexto de una población específica.
Fuente: College Board AP Course and Exam Description
Para una proporción muestral $\hat{p}$ obtenida mediante una Muestraje Aleatorio Simple (MAS): la media es $p$ (insesgada) y la desviación estándar es
$$\sigma_{\hat p}=\sqrt{\frac{p(1-p)}{n}}.$$
Esta dispersión tiene dos nombres: es la desviación estándar de la distribución muestral, y se denomina error estándar cuando hay que estimarla a partir de la muestra (reemplazando $p$ por $\hat p$), lo cual es exactamente lo que hacen las unidades posteriores de inferencia.
Es aproximadamente normal cuando se cumple la condición de Conteos Grandes ($np\ge 10$ y $n(1-p)\ge 10$), y la condición del $10\%$ ($n\le 0.10N$) mantiene las observaciones casi independientes.
Ejemplo resuelto. Supongamos que el $40\%$ de los votantes favorece una medida ($p=0.4$) y usted toma una muestra de $n=100$. El error estándar es $\sigma_{\hat p}=\sqrt{\dfrac{0.4(0.6)}{100}}=0.049$. La probabilidad de que la muestra dé un $\hat{p}>0.5$ es $z=\dfrac{0.5-0.4}{0.049}=2.04$, por lo tanto $P(\hat p>0.5)\approx0.02$; una mayoría en la muestra sería sorprendente.
5.6
Comparando dos grupos: Diferencia de proporciones muestrales
Syllabus
Comprensión duradera (UNC-3): El razonamiento probabilístico nos permite anticipar patrones en los datos.
Objetivo de aprendizaje UNC-3.N: Determinar los parámetros de una distribución de muestreo para una diferencia en proporciones muestrales. [Habilidad 3.B]
UNC-3.N.1 Para una variable categórica, al realizar muestreos aleatorios con reemplazo a partir de dos poblaciones independientes con proporciones poblacionales $p_1$ y $p_2$, la distribución de muestreo de la diferencia en proporciones muestrales $\hat{p}_1 - \hat{p}_2$ tiene media $\mu_{\hat{p}_1 - \hat{p}_2} = p_1 - p_2$ y desviación estándar $\sigma_{\hat{p}_1 - \hat{p}_2} = \sqrt{\dfrac{p_1(1-p_1)}{n_1} + \dfrac{p_2(1-p_2)}{n_2}}$.
UNC-3.N.2 Si el muestreo se realiza sin reemplazo, la desviación estándar de la diferencia en proporciones muestrales es menor que la indicada por la fórmula anterior. Si los tamaños de muestra son menores que el 10% de los tamaños de población, la diferencia es despreciable.
Objetivo de aprendizaje UNC-3.O: Determinar si una distribución de muestreo para una diferencia en proporciones muestrales puede describirse como aproximadamente normal. [Habilidad 3.C]
UNC-3.O.1 La distribución de muestreo de la diferencia en proporciones muestrales $\hat{p}_1 - \hat{p}_2$ tendrá una distribución normal aproximada siempre que los tamaños de muestra sean lo suficientemente grandes: $n_1 p_1 \geq 10, n_1(1-p_1) \geq 10, n_2 p_2 \geq 10, n_2(1-p_2) \geq 10$.
Objetivo de aprendizaje UNC-3.P: Interpretar probabilidades y parámetros para una distribución de muestreo para una diferencia en proporciones. [Habilidad 4.B]
UNC-3.P.1 Los parámetros de una distribución de muestreo para una diferencia en proporciones deben interpretarse utilizando unidades apropiadas y dentro del contexto de poblaciones específicas.
Fuente: College Board AP Course and Exam Description
Para $\hat{p}_1-\hat{p}_2$ de dos muestras independientes: la media es $p_1-p_2$, y como las muestras son independientes, las varianzas se suman:
Es aproximadamente normal cuando la condición de Conteos Grandes se cumple en ambas muestras.
5.7
La distribución muestral de una media muestral
Syllabus
Comprensión perdurable (UNC-3): El razonamiento probabilístico nos permite anticipar patrones en los datos.
Objetivo de aprendizaje UNC-3.Q: Determinar los parámetros de una distribución de muestreo para las medias muestrales. [Habilidad 3.B]
UNC-3.Q.1 Para una variable numérica, cuando se realiza un muestreo aleatorio con reemplazo de una población con media $\mu$ y desviación estándar $\sigma$, la distribución de muestreo de la media muestral tiene media $\mu_{\bar{x}} = \mu$ y desviación estándar $\sigma_{\bar{x}} = \dfrac{\sigma}{\sqrt{n}}$.
UNC-3.Q.2 Si el muestreo es sin reemplazo, la desviación estándar de la media muestral es menor que la dada por la fórmula anterior. Si el tamaño de la muestra es menor al 10% del tamaño de la población, la diferencia es insignificante.
Objetivo de aprendizaje UNC-3.R: Determinar si una distribución de muestreo para una media muestral puede describirse como aproximadamente normal. [Habilidad 3.C]
UNC-3.R.1 Para una variable numérica, si la distribución poblacional puede modelarse con una distribución normal, la distribución de muestreo de la media muestral, $\bar{x}$, también puede modelarse con una distribución normal.
UNC-3.R.2 Para una variable numérica, si la distribución poblacional no puede modelarse con una distribución normal, la distribución de muestreo de la media muestral, $\bar{x}$, puede modelarse aproximadamente mediante una distribución normal, siempre que el tamaño de la muestra sea lo suficientemente grande, p. ej., mayor o igual a 30.
Objetivo de aprendizaje UNC-3.S: Interpretar probabilidades y parámetros para una distribución de muestreo de una media muestral. [Habilidad 4.B]
UNC-3.S.1 Las probabilidades y los parámetros para una distribución de muestreo de una media muestral deben interpretarse utilizando unidades apropiadas y dentro del contexto de una población específica.
Fuente: College Board AP Course and Exam Description
Para una media muestral $\bar{x}$ obtenida mediante una MAS: la media es $\mu$ (insesgada) y la desviación estándar es
$$\sigma_{\bar x}=\frac{\sigma}{\sqrt{n}}.$$
Su forma es normal si la población es normal, o aproximadamente normal para $n$ grande debido al TLC. Observe que la dispersión disminuye proporcionalmente a $\sqrt{n}$: cuadruplicar la muestra reduce a la mitad el error estándar.
Ejemplo resuelto. Una población tiene $\mu=70$ y $\sigma=12$. Para muestras de $n=36$, la distribución muestral de $\bar{x}$ está centrada en $70$ con un error estándar de $\dfrac{12}{\sqrt{36}}=2$. La probabilidad de que la media muestral exceda $73$ es $z=\dfrac{73-70}{2}=1.5$, por lo tanto $P(\bar x>73)\approx0.067$.
La población de la izquierda está fuertemente sesgada, sin embargo cada distribución muestral de $\bar{x}$ está centrada en $\mu$. Un $n$ mayor reduce el error estándar $\sigma/\sqrt{n}$, por lo que la curva se hace más alta y estrecha; además se endereza: sigue siendo claramente sesgada en $n=2$, pero casi perfectamente normal (línea punteada) para $n=30$.
Comparando dos grupos: Diferencia de medias muestrales
Syllabus
Comprensión perdurable (UNC-3): El razonamiento probabilístico nos permite anticipar patrones en los datos.
Objetivo de aprendizaje UNC-3.T: Determinar los parámetros de una distribución de muestreo para una diferencia en las medias muestrales. [Habilidad 3.B]
UNC-3.T.1 Para una variable numérica, al realizar un muestreo aleatorio con reemplazo de dos poblaciones independientes con medias poblacionales $\mu_1$ y $\mu_2$ y desviaciones estándar poblacionales $\sigma_1$ y $\sigma_2$, la distribución de muestreo de la diferencia en las medias muestrales $\bar{x}_1 - \bar{x}_2$ tiene media $\mu_{(\bar{x}_1 - \bar{x}_2)} = \mu_1 - \mu_2$ y desviación estándar $\sigma_{(\bar{x}_1 - \bar{x}_2)} = \sqrt{\dfrac{\sigma_1^2}{n_1} + \dfrac{\sigma_2^2}{n_2}}$.
UNC-3.T.2 Si el muestreo se realiza sin reemplazo, la desviación estándar de la diferencia en las medias muestrales es menor que la dada por la fórmula anterior. Si los tamaños muestrales son menores al 10% de los tamaños poblacionales, la diferencia es despreciable.
Objetivo de aprendizaje UNC-3.U: Determinar si una distribución de muestreo para una diferencia en las medias muestrales puede describirse como aproximadamente normal. [Habilidad 3.C]
UNC-3.U.1 La distribución de muestreo de la diferencia en las medias muestrales $\bar{x}_1 - \bar{x}_2$ puede modelarse con una distribución normal si las dos distribuciones poblacionales pueden modelarse con una distribución normal.
UNC-3.U.2 La distribución de muestreo de la diferencia en las medias muestrales $\bar{x}_1 - \bar{x}_2$ puede modelarse aproximadamente mediante una distribución normal si las dos distribuciones poblacionales no pueden modelarse con una distribución normal pero ambos tamaños muestrales son mayores o iguales a 30.
Objetivo de aprendizaje UNC-3.V: Interpretar probabilidades y parámetros para una distribución de muestreo para una diferencia en las medias muestrales. [Habilidad 4.B]
UNC-3.V.1 Las probabilidades y parámetros de una distribución de muestreo para una diferencia de medias muestrales deben interpretarse utilizando unidades apropiadas y dentro del contexto de poblaciones específicas.
Fuente: College Board AP Course and Exam Description
Para $\bar{x}_1-\bar{x}_2$ de dos muestras independientes: la media es $\mu_1-\mu_2$, y (siendo independientes, las varianzas se suman)
Esto constituye la base para la inferencia de dos muestras en las próximas unidades.
5.8
Consejos para el examen
Una distribución muestral es la distribución de un estadístico sobre muchas muestras, centrada en el parámetro verdadero.
El Teorema del Límite Central: para una muestra lo suficientemente grande, la media muestral es aproximadamente normal, incluso si la población no lo es.
Las muestras más grandes producen menos variabilidad (un error estándar menor).
Verifique las condiciones (aleatoriedad, independencia/10%, tamaño suficiente) antes de usar un modelo normal.
Mantenga distinguido lo que varía —el estadístico— frente al parámetro fijo.
Comprensión perdurable (VAR-1): Dado que la variación puede ser aleatoria o no, las conclusiones son inciertas.
Objetivo de aprendizaje VAR-1.H: Identificar preguntas sugeridas por la variación en las formas de las distribuciones de muestras extraídas de la misma población. [Habilidad 1.A]
VAR-1.H.1 La variación en las formas de las distribuciones de datos puede ser aleatoria o no.
Fuente: College Board AP Course and Exam Description
Debido a que una proporción muestral $\hat{p}$ se distribuye aproximadamente de forma normal (cuando se cumplen las condiciones), podemos medir qué tan lejos está un resultado muestral de un valor afirmado en errores estándar y convertirlo en una probabilidad. Esto es lo que hace posible la inferencia 推断 – sacar conclusiones sobre una población a partir de una muestra.
6.2
Intervalo de confianza para una proporción
Syllabus
Comprensión Duradera (UNC-4): Se debe utilizar un intervalo de valores para estimar parámetros, con el fin de tener en cuenta la incertidumbre.
Objetivo de Aprendizaje UNC-4.A: Identificar un procedimiento de intervalo de confianza apropiado para una proporción poblacional. [Habilidad 1.D]
UNC-4.A.1 El procedimiento de intervalo de confianza apropiado para una proporción de una sola muestra para una variable categórica es un intervalo $z$ de una sola muestra para una proporción.
Objetivo de Aprendizaje UNC-4.B: Verificar las condiciones para calcular intervalos de confianza para una proporción poblacional. [Habilidad 4.C]
UNC-4.B.1 Para hacer supuestos necesarios para inferencias sobre proporciones poblacionales, medias y pendientes, debemos verificar la independencia en los métodos de recolección de datos y la selección de la distribución muestral adecuada.
UNC-4.B.2 Para calcular un intervalo de confianza que estime una proporción poblacional, $p$, debemos verificar la independencia y que la distribución muestral sea aproximadamente normal.
a. Para verificar la independencia:
i. Los datos deben recolectarse mediante una muestra aleatoria o un experimento aleatorizado.
ii. Cuando se muestree sin reemplazo, verifique que $n \leq 10\%N$, donde $N$ es el tamaño de la población.
b. Para verificar que la distribución muestral de $\hat{p}$ es aproximadamente normal (forma):
i. Para variables categóricas, verifique que tanto el número de éxitos, $n\hat{p}$, como el número de fracasos, $n(1-\hat{p})$, sean al menos 10, de modo que el tamaño de la muestra sea lo suficientemente grande para respaldar un supuesto de normalidad.
Objetivo de Aprendizaje UNC-4.C: Determinar el margen de error para un tamaño de muestra dado y una estimación para el tamaño de muestra que resultará en un margen de error específico para una proporción poblacional. [Habilidad 3.D]
UNC-4.C.1 Basado en los datos de la muestra, el error estándar de una estadística es una estimación para la desviación estándar de dicha estadística. El error estándar de $\hat{p}$ es $SE_{\hat{p}} = \sqrt{\dfrac{\hat{p}(1-\hat{p})}{n}}$.
UNC-4.C.2 Un margen de error indica cuánto es probable que varíe un valor de una estadística muestral respecto al valor del correspondiente parámetro poblacional.
UNC-4.C.3 Para variables categóricas, el margen de error es igual al valor crítico ($z^*$) multiplicado por el error estándar (SE) de la estadística relevante, lo cual equivale a $z^* \sqrt{\dfrac{\hat{p}(1-\hat{p})}{n}}$ para una proporción de una sola muestra.
UNC-4.C.4 La fórmula del margen de error puede reordenarse para despejar $n$, el tamaño mínimo de muestra necesario para lograr un margen de error dado. Para este propósito, utilice un valor estimado para $\hat{p}$ o use $\hat{p} = 0.5$ a fin de encontrar un límite superior para el tamaño de muestra que resultará en un margen de error dado.
Objetivo de Aprendizaje UNC-4.D: Calcular un intervalo de confianza apropiado para una proporción poblacional. [Habilidad 3.D]
UNC-4.D.1 En general, un intervalo estimado puede construirse como estimación puntual ± (margen de error). Para una proporción de una sola muestra, el intervalo estimado es $\hat{p} \pm z^* \sqrt{\dfrac{\hat{p}(1-\hat{p})}{n}}$.
Aclaración: Las fórmulas para intervalos estimados no aparecen explícitamente en la Hoja de Fórmulas de Estadística AP proporcionada con el Examen de Estadística AP. Sin embargo, estas fórmulas no necesitan memorizarse, ya que pueden construirse basándose en la fórmula general de la estadística de prueba y las fórmulas relevantes de error estándar que se encuentran en la hoja de fórmulas.
UNC-4.D.2 Los valores críticos representan los límites que abarcan el C% central de la distribución normal estándar, donde C% es un nivel de confianza aproximado para una proporción.
Objetivo de Aprendizaje UNC-4.E: Calcular un intervalo estimado basado en un intervalo de confianza para una proporción poblacional. [Habilidad 3.D]
UNC-4.E.1 Los intervalos de confianza para proporciones poblacionales pueden utilizarse para calcular intervalos estimados con unidades especificadas.
Fuente: College Board AP Course and Exam Description
Qué significa un intervalo de confianza
Un intervalo de confianza 置信区间 estima el parámetro como un rango: estadístico $\pm$margen de error 误差幅度.
$z^{*}$ es el valor crítico para el nivel de confianza 置信水平 (por ejemplo, $1.96$ para un 95%). Condiciones: muestra aleatoria, Grandes Recuentos ($n\hat p\ge 10$ y $n(1-\hat p)\ge 10$) y la condición del 10%. Interpreta esto: "Estamos 95% seguros de que la proporción verdadera de... está entre... y...". Interpreta el nivel: "En el 95% de las muestras, este método produce un intervalo que captura la proporción verdadera."
En muchas muestras, aproximadamente el 95% de los intervalos de confianza del 95% capturan la proporción verdadera
Ejemplo resuelto. En una muestra aleatoria de $200$ personas, $120$ apoyan una política, por lo que $\hat{p}=0.60$. Un intervalo $95\%$ utiliza $z^*=1.96$:
Estamos $95\%$ seguros de que la proporción verdadera de partidarios se encuentra entre $53.2\%$ y $66.8\%$.
Un intervalo de confianza 95% se extiende 1.96 errores estándar a cada lado de la estimación
Elegir el tamaño de la muestra. Para mantener el margen de error no mayor que un objetivo $m$, establezca $z^{*}\sqrt{\dfrac{\hat p(1-\hat p)}{n}}\le m$ y resuelva para $n$. Cuando no tiene una estimación de $\hat p$, use $\hat p=0.5$: esto hace que $\hat p(1-\hat p)$ sea lo más grande posible, proporcionando el tamaño de muestra requerido más seguro (más grande). Siempre redondee el resultado hacia arriba al siguiente número entero de personas.
Ejemplo resuelto. ¿Cuántas personas debe encuestar para un intervalo $95\%$ con un margen de error de a lo sumo $0.03$? Usando $\hat p=0.5$ y $z^*=1.96$:
Justificar una afirmación a partir de un intervalo
Syllabus
Comprensión perdurable (UNC-4): Se debe utilizar un intervalo de valores para estimar parámetros, a fin de tener en cuenta la incertidumbre.
Objetivo de aprendizaje UNC-4.F: Interpretar un intervalo de confianza para una proporción poblacional. [Habilidad 4.B]
UNC-4.F.1 Un intervalo de confianza para una proporción poblacional contiene o no la proporción poblacional, ya que cada intervalo se basa en datos de una muestra aleatoria, los cuales varían de una muestra a otra.
UNC-4.F.2 Tenemos un C% de confianza de que el intervalo de confianza para una proporción poblacional captura la proporción poblacional.
UNC-4.F.3 En muestreo aleatorio repetido con el mismo tamaño de muestra, aproximadamente el C% de los intervalos de confianza creados capturarán la proporción poblacional.
UNC-4.F.4 La interpretación de un intervalo de confianza para una proporción de una sola muestra debe incluir una referencia a la muestra tomada y detalles sobre la población que representa.
Ejemplos ilustrativos para UNC-4.F.4: Para interpretar un intervalo de confianza del 99% de (0,268, 0,292), basado en la proporción de una muestra representativa a nivel nacional de estudiantes de último año de secundaria que respondieron correctamente una pregunta de opción múltiple específica: "Tenemos un 99% de confianza de que el intervalo de 0,268 a 0,292 contiene la proporción poblacional de todos los estudiantes de último año de secundaria de Estados Unidos que responderían correctamente a esta pregunta" (Pregunta libre de examen 2011, 6(a)).
Objetivo de aprendizaje UNC-4.G: Justificar una afirmación basada en un intervalo de confianza para una proporción poblacional. [Habilidad 4.D]
UNC-4.G.1 Un intervalo de confianza para una proporción poblacional proporciona un intervalo de valores que puede ofrecer evidencia suficiente para respaldar una afirmación particular en contexto.
Objetivo de aprendizaje UNC-4.H: Identificar las relaciones entre el tamaño de la muestra, el ancho de un intervalo de confianza, el nivel de confianza y el margen de error para una proporción poblacional. [Habilidad 4.A]
UNC-4.H.1 Cuando todo lo demás permanece igual, el ancho del intervalo de confianza para una proporción poblacional tiende a disminuir a medida que aumenta el tamaño de la muestra. Para una proporción poblacional, el ancho del intervalo es proporcional a $\dfrac{1}{\sqrt{n}}$.
UNC-4.H.2 Para una muestra dada, el ancho del intervalo de confianza para una proporción poblacional aumenta a medida que aumenta el nivel de confianza.
UNC-4.H.3 El ancho de un intervalo de confianza para una proporción poblacional es exactamente el doble del margen de error.
Fuente: College Board AP Course and Exam Description
Para juzgar un valor afirmado: si se encuentra dentro del intervalo, los datos son consistentes con él; si se encuentra fuera, los datos proporcionan evidencia en contra. Fundamente la conclusión en si los valores plausibles incluyen la afirmación, en contexto.
6.4
Preparar una prueba para una proporción
Syllabus
Comprensión duradera (VAR-6): La distribución normal puede utilizarse para modelar la variación.
Objetivo de aprendizaje VAR-6.D: Identificar las hipótesis nula y alternativa para una proporción poblacional. [Habilidad 1.F]
VAR-6.D.1 La hipótesis nula es la situación que se asume correcta a menos que la evidencia sugiera lo contrario, y la hipótesis alternativa es la situación para la cual se está recolectando evidencia.
VAR-6.D.2 Para hipótesis sobre parámetros, la hipótesis nula contiene una referencia de igualdad (=, ≥ o ≤), mientras que la hipótesis alternativa contiene una desigualdad estricta (<, > o ≠). El tipo de desigualdad en la hipótesis alternativa se basa en la pregunta de interés. Las hipótesis alternativas con < o > se llaman unilaterales, y las hipótesis alternativas con ≠ se llaman bilaterales. Aunque la hipótesis nula para una prueba unilateral puede incluir un símbolo de desigualdad, todavía se prueba en el límite de igualdad.
VAR-6.D.3 La hipótesis nula para una proporción poblacional es: $H_0 : p = p_0$, donde $p_0$ es el valor hipotetizado nulo para la proporción poblacional.
VAR-6.D.4 Una hipótesis alternativa unilateral para una proporción es ya sea $H_a : p < p_0$ o $H_a : p > p_0$. Una hipótesis alternativa bilateral es $H_a : p_1 \neq p_2$.
VAR-6.D.5 Para una prueba $z$ de una muestra para una proporción poblacional, la hipótesis nula especifica un valor para la proporción poblacional, usualmente uno que indica ausencia de diferencia o efecto.
Objetivo de aprendizaje VAR-6.E: Identificar un método de prueba apropiado para una proporción poblacional. [Habilidad 1.E]
VAR-6.E.1 Para una sola variable categórica, el método de prueba apropiado para una proporción poblacional es una prueba $z$ de una muestra para una proporción poblacional.
Objetivo de aprendizaje VAR-6.F: Verificar las condiciones para realizar inferencias estadísticas al probar una proporción poblacional. [Habilidad 4.C]
VAR-6.F.1 Con el fin de realizar inferencias estadísticas al probar una proporción poblacional, debemos verificar la independencia y que la distribución muestral sea aproximadamente normal:
a. Para verificar la independencia:
i. Los datos deben recolectarse mediante una muestra aleatoria o un experimento aleatorizado.
ii. Al muestrear sin reemplazo, verifique que $n \leq 10\%N$.
b. Para verificar que la distribución muestral de $\hat{p}$ sea aproximadamente normal (forma):
i. Asumiendo que $H_0$ es verdadera $(p = p_0)$, verifique que tanto el número de éxitos, $np_0$, como el número de fracasos, $n(1-p_0)$, sean al menos 10, de modo que el tamaño de la muestra sea lo suficientemente grande para apoyar la suposición de normalidad.
Fuente: College Board AP Course and Exam Description
Una prueba de significancia 显著性检验 pondera la evidencia contra una afirmación. Enuncie una hipótesis nula 原假设$H_0$ y una hipótesis alternativa 备择假设$H_a$ sobre el parámetro $p$:
Verifique las mismas condiciones (aleatoriedad, Grandes Conteos usando $p_0$, 10%). La estadística de prueba 检验统计量 cuenta los errores estándar desde $p_0$:
$$z=\frac{\hat p-p_0}{\sqrt{p_0(1-p_0)/n}}.$$
Ejemplo resuelto. Una empresa afirma $90\%$ satisfacción ($p_0=0.90$); una muestra de $100$ encuentra $84$ satisfechos ($\hat{p}=0.84$). Pruebe $H_0:p=0.90$ contra $H_a:p\neq0.90$ al nivel $\alpha=0.05$:
lo que da un valor $p$ de dos colas de aproximadamente $2(0.023)=0.046$. Dado que $0.046<0.05$, rechazar $H_0$ – hay evidencia de que la tasa de satisfacción verdadera difiere de (es menor que) $90\%$.
Una prueba de dos colas al 5% rechaza la hipótesis nula en las colas sombreadas
6.5
Interpretación de los valores p
Syllabus
Comprensión duradera (VAR-6): La distribución normal puede utilizarse para modelar la variación.
Objetivo de aprendizaje VAR-6.G: Calcular una estadística de prueba adecuada y un valor $p$ para una proporción poblacional. [Habilidad 3.E]
VAR-6.G.1 La distribución de la estadística de prueba asumiendo que la hipótesis nula es verdadera (distribución nula) puede ser ya sea una distribución de aleatorización o, cuando se asume que un modelo de probabilidad es verdadero, una distribución teórica ($z$).
VAR-6.G.2 Al utilizar una prueba $z$, la estadística de prueba estandarizada puede escribirse: $\text{test statistic} = \dfrac{\text{sample statistic} - \text{null value of the parameter}}{\text{standard deviation of the statistic}}$. Esto se denomina estadística $z$ para proporciones.
VAR-6.G.3 La estadística de prueba para una proporción poblacional es: $z = \dfrac{\hat{p} - p_0}{\sqrt{\dfrac{p_0(1-p_0)}{n}}}$.
Declaración aclaratoria: Las fórmulas para las estadísticas de prueba no aparecen explícitamente en la Hoja de Fórmulas de Estadística AP proporcionada con el Examen de Estadística AP. Sin embargo, estas fórmulas no necesitan memorizarse, ya que pueden construirse basándose en la fórmula general de la estadística de prueba y las fórmulas relevantes del error estándar que se proporcionan en la hoja de fórmulas.
VAR-6.G.4 Un valor $p$ es la probabilidad de obtener una estadística de prueba tan extrema o más extrema que la estadística de prueba observada cuando se asume que la hipótesis nula y el modelo de probabilidad son verdaderos. El nivel de significancia puede estar dado o determinado por el investigador.
Comprensión duradera (DAT-3): Las pruebas de significancia nos permiten tomar decisiones sobre hipótesis dentro de un contexto particular.
Objetivo de aprendizaje DAT-3.A: Interpretar el valor $p$ de una prueba de significancia para una proporción poblacional. [Habilidad 4.B]
DAT-3.A.1 El valor $p$ es la proporción de valores para la distribución nula que son tan extremos o más extremos que el valor observado de la estadística de prueba. Esto es:
a. La proporción igual o superior al valor observado de la estadística de prueba, si la alternativa es >.
b. La proporción igual o inferior al valor observado de la estadística de prueba, si la alternativa es <.
c. La proporción menor o igual al negativo del valor absoluto de la estadística de prueba más la proporción mayor o igual al valor absoluto de la estadística de prueba, si la alternativa es ≠.
DAT-3.A.2 Una interpretación del valor $p$ de una prueba de significancia para una proporción de una muestra debe reconocer que el valor $p$ se calcula asumiendo que el modelo de probabilidad y la hipótesis nula son verdaderos, es decir, asumiendo que la proporción poblacional verdadera es igual al valor particular indicado en la hipótesis nula.
Fuente: College Board AP Course and Exam Description
Qué significa un valor p
El $p$-valor P es la probabilidad de obtener un resultado muestral tan extremo o más extremo que el observado, asumiendo que $H_0$ es verdadera. Un valor $p$ pequeño indica que los datos serían sorprendentes si $H_0$ se mantuviera – evidencia en contra de $H_0$. No es la probabilidad de que $H_0$ sea verdadera.
Explorar
Un valor p como área de cola
Un valor p es la probabilidad, si la hipótesis nula fuera verdadera, de obtener un resultado al menos tan extremo: el área sombreada de la cola. Los valores p pequeños cuestionan la hipótesis nula.
Comprensión perdurable (DAT-3): Las pruebas de significancia nos permiten tomar decisiones sobre hipótesis dentro de un contexto particular.
Objetivo de aprendizaje DAT-3.B: Justificar una afirmación sobre la población basada en los resultados de una prueba de significancia para la proporción de una población. [Habilidad 4.E]
DAT-3.B.1 El nivel de significancia, $\alpha$, es la probabilidad predeterminada de rechazar la hipótesis nula dado que esta es verdadera.
DAT-3.B.2 Una decisión formal compara explícitamente el valor $p$ con el nivel de significancia, $\alpha$. Si el valor $p$$\leq \alpha$, rechazar la hipótesis nula. Si el valor $p$$> \alpha$, no rechazar la hipótesis nula.
DAT-3.B.3 Rechazar la hipótesis nula significa que existe suficiente evidencia estadística para apoyar la hipótesis alternativa. No rechazar la hipótesis nula significa que hay insuficiente evidencia estadística para apoyar la hipótesis alternativa.
DAT-3.B.4 La conclusión sobre la hipótesis alternativa debe expresarse en el contexto del problema.
DAT-3.B.5 Una prueba de significancia puede llevar a rechazar o no rechazar la hipótesis nula, pero nunca puede llevar a concluir o probar que la hipótesis nula es verdadera. La falta de evidencia estadística para la hipótesis alternativa no es lo mismo que evidencia a favor de la hipótesis nula.
DAT-3.B.6 Los valores $p$ pequeños indican que el valor observado del estadístico de prueba sería inusual si la hipótesis nula y el modelo de probabilidad fueran verdaderos, por lo que proporcionan evidencia a favor de la hipótesis alternativa. Cuanto menor sea el valor $p$, más convincente será la evidencia estadística para la hipótesis alternativa.
DAT-3.B.7 Los valores $p$ que no son pequeños indican que el valor observado del estadístico de prueba no sería inusual si la hipótesis nula y el modelo de probabilidad fueran verdaderos; por lo tanto, no proporcionan evidencia estadística convincente para la hipótesis alternativa ni tampoco ofrecen evidencia de que la hipótesis nula sea verdadera.
DAT-3.B.8 Una decisión formal compara explícitamente el valor $p$ con la significancia $\alpha$. Si el valor $p$$\leq \alpha$, entonces rechazar la hipótesis nula, $H_0 : p = p_0$. Si el valor $p$$> \alpha$, entonces no rechazar la hipótesis nula.
DAT-3.B.9 Los resultados de una prueba de significancia para la proporción de una población pueden servir como razonamiento estadístico para respaldar la respuesta a una pregunta de investigación sobre la población que fue muestreada.
Fuente: College Board AP Course and Exam Description
Compare el valor $p$ con el nivel de significancia 显著性水平$\alpha$ (a menudo $0.05$):
$p\le\alpha$: rechazar $H_0$ – hay evidencia convincente a favor de $H_a$.
$p>\alpha$: no rechazar $H_0$ – no hay suficiente evidencia para $H_a$ (nunca "aceptar $H_0$").
Siempre escribe la conclusión en contexto, vinculándola de nuevo a la afirmación.
6.7
Errores Tipo I y Tipo II
Syllabus
Comprensión Duradera (UNC-5): Las probabilidades de los errores de Tipo I y Tipo II influyen en la inferencia.
Objetivo de Aprendizaje UNC-5.A: Identificar errores de Tipo I y Tipo II. [Habilidad 1.B]
UNC-5.A.1 Un error de Tipo I ocurre cuando la hipótesis nula es verdadera y se rechaza (falso positivo).
UNC-5.A.2 Un error de Tipo II ocurre cuando la hipótesis nula es falsa y no se rechaza (falso negativo).
Tabla de Errores: Con el Valor Verdadero de la Población en la parte superior ($H_0$ verdadera; $H_a$ verdadera) y la Decisión a lo largo del lado (Rechazar $H_0$; No Rechazar $H_0$): Rechazar $H_0$ cuando $H_0$ verdadera = Error de Tipo I; Rechazar $H_0$ cuando $H_a$ verdadera = Decisión Correcta; No Rechazar $H_0$ cuando $H_0$ verdadera = Decisión Correcta; No Rechazar $H_0$ cuando $H_a$ verdadera = Error de Tipo II.
Objetivo de Aprendizaje UNC-5.B: Calcular la probabilidad de errores de Tipo I y Tipo II. [Habilidad 3.A]
UNC-5.B.1 El nivel de significancia, $\alpha$, es la probabilidad de cometer un error de Tipo I, si la hipótesis nula es verdadera.
UNC-5.B.2 La potencia de una prueba es la probabilidad de que una prueba rechace correctamente una hipótesis nula falsa.
UNC-5.B.3 La probabilidad de cometer un error de Tipo II es $= 1 - power$.
Objetivo de Aprendizaje UNC-5.C: Identificar factores que afectan la probabilidad de errores en las pruebas de significancia. [Habilidad 4.A]
UNC-5.C.1 La probabilidad de un error de Tipo II disminuye cuando ocurre cualquiera de lo siguiente, siempre que los demás no cambien:
i. Aumenta el tamaño de la muestra(s).
ii. Aumenta el nivel de significancia ($\alpha$) de una prueba.
iii. Disminuye el error estándar.
iv. El valor verdadero del parámetro está más lejos de la hipótesis nula.
Objetivo de Aprendizaje UNC-5.D: Interpretar errores de Tipo I y Tipo II. [Habilidad 4.B]
UNC-5.D.1 Si un error de Tipo I o uno de Tipo II es más trascendental depende de la situación.
UNC-5.D.2 Dado que el nivel de significancia, $\alpha$, es la probabilidad de un error de Tipo I, las consecuencias de un error de Tipo I influyen en las decisiones sobre un nivel de significancia.
Fuente: College Board AP Course and Exam Description
Errores Tipo I y Tipo II
Un error Tipo I 第一类错误: rechazar un $H_0$verdadero (una falsa alarma). Su probabilidad es $\alpha$.
Un error de Tipo II 第二类错误: no rechazar una hipótesis nula $H_0$falsa (una detección fallida). Su probabilidad es $\beta$.
La potencia 检验效能$=1-\beta$ es la probabilidad de detectar correctamente un efecto real. La potencia aumenta con una muestra más grande, un efecto más grande o un $\alpha$ más grande.
Describa cada error y su consecuencia en el contexto del problema.
Explorar
Dos formas en que una prueba puede ser incorrecta
Un error Tipo I rechaza una hipótesis nula verdadera (falsa alarma); un error Tipo II mantiene una hipótesis nula falsa (una omisión). Reducir uno generalmente aumenta el otro.
Intervalo de confianza para la diferencia de proporciones
Syllabus
Comprensión perdurable (UNC-4): Se debe utilizar un intervalo de valores para estimar parámetros, con el fin de tener en cuenta la incertidumbre.
Objetivo de aprendizaje UNC-4.I: Identificar un procedimiento de intervalo de confianza apropiado para una comparación de proporciones poblacionales. [Habilidad 1.D]
UNC-4.I.1 El procedimiento de intervalo de confianza apropiado para una comparación de dos muestras de proporciones de una variable categórica es un intervalo $z$ de dos muestras para una diferencia entre proporciones poblacionales.
Objetivo de aprendizaje UNC-4.J: Verificar las condiciones para calcular intervalos de confianza para una diferencia entre proporciones poblacionales. [Habilidad 4.C]
UNC-4.J.1 Para calcular intervalos de confianza que estimen una diferencia entre proporciones, debemos verificar la independencia y que la distribución muestral sea aproximadamente normal:
a. Para verificar la independencia:
i. Los datos deben recolectarse utilizando dos muestras aleatorias independientes o un experimento aleatorizado.
ii. Cuando se muestree sin reemplazo, verifique que $n_1 \leq 10\%N_1$ y $n_2 \leq 10\%N_2$.
b. Para verificar que la distribución muestral de $\hat{p}_1 - \hat{p}_2$ sea aproximadamente normal (forma).
i. Para variables categóricas, verifique que $n_1\hat{p}_1$, $n_1(1-\hat{p}_1)$, $n_2\hat{p}_2$ y $n_2\left(1-\hat{p}_2\right)$ sean todos mayores o iguales a algún valor predeterminado, típicamente 5 o 10.
Objetivo de aprendizaje UNC-4.K: Calcular un intervalo de confianza apropiado para una comparación de proporciones poblacionales. [Habilidad 3.D]
UNC-4.K.1 Para una comparación de proporciones, la estimación del intervalo es $(\hat{p}_1 - \hat{p}_2) \pm z^* \sqrt{\dfrac{\hat{p}_1(1-\hat{p}_1)}{n_1} + \dfrac{\hat{p}_2(1-\hat{p}_2)}{n_2}}$.
Aclaración: Las fórmulas para las estimaciones del intervalo no aparecen explícitamente en la Hoja de fórmulas de Estadística AP proporcionada con el Examen de Estadística AP. Sin embargo, estas fórmulas no necesitan memorizarse, ya que pueden construirse basándose en la fórmula general del estadístico de prueba y las fórmulas de error estándar relevantes que se proporcionan en la hoja de fórmulas.
Objetivo de aprendizaje UNC-4.L: Calcular una estimación de intervalo basada en un intervalo de confianza para una diferencia de proporciones. [Habilidad 3.D]
UNC-4.L.1 Los intervalos de confianza para una diferencia en proporciones pueden utilizarse para calcular estimaciones de intervalo con unidades especificadas.
Fuente: College Board AP Course and Exam Description
Para comparar dos proporciones, estimar $p_1-p_2$:
Las condiciones deben cumplirse en ambas muestras, y las muestras deben ser independientes.
6.9
Justificar una afirmación sobre dos proporciones
Syllabus
Comprensión duradera (UNC-4): Se debe utilizar un intervalo de valores para estimar parámetros, con el fin de tener en cuenta la incertidumbre.
Objetivo de aprendizaje UNC-4.M: Interpretar un intervalo de confianza para la diferencia de proporciones. [Habilidad 4.B]
UNC-4.M.1 En muestreo aleatorio repetido con el mismo tamaño muestral, aproximadamente C% de los intervalos de confianza creados capturarán la diferencia en las proporciones poblacionales.
UNC-4.M.2 La interpretación de un intervalo de confianza para la diferencia entre proporciones poblacionales debe incluir una referencia a la muestra tomada y detalles sobre la población que representa.
Objetivo de aprendizaje UNC-4.N: Justificar una afirmación basada en un intervalo de confianza para la diferencia de proporciones. [Habilidad 4.D]
UNC-4.N.1 Un intervalo de confianza para la diferencia en proporciones poblacionales proporciona un intervalo de valores que puede ofrecer evidencia suficiente para respaldar una afirmación particular en su contexto.
Fuente: College Board AP Course and Exam Description
Si el intervalo para $p_1-p_2$ contiene $0$, los datos son consistentes con no haber diferencia; si está completamente por encima o por debajo de $0$, hay evidencia de una diferencia (en esa dirección). Indicar la dirección y el contexto.
6.10
Preparar una prueba para una diferencia
Syllabus
Comprensión duradera (VAR-6): La distribución normal puede utilizarse para modelar la variación.
Objetivo de aprendizaje VAR-6.H: Identificar las hipótesis nula y alternativa para una diferencia de dos proporciones poblacionales. [Habilidad 1.F]
VAR-6.H.1 Para una prueba de dos muestras para una diferencia de dos proporciones, la hipótesis nula especifica un valor de $0$ para la diferencia en las proporciones poblacionales, lo que indica que no hay diferencia ni efecto.
VAR-6.H.2 La hipótesis nula para una diferencia en las proporciones es: $H_0 : p_1 = p_2$, o $H_0 : p_1 - p_2 = 0$.
VAR-6.H.3 Una hipótesis alternativa unilateral para una diferencia en las proporciones es $H_a : p_1 < p_2$, o, $H_a : p_1 > p_2$. Una hipótesis alternativa bilateral para una diferencia de proporciones es $H_a : p_1 \neq p_2$.
Objetivo de aprendizaje VAR-6.I: Identificar un método de prueba adecuado para la diferencia de dos proporciones poblacionales. [Habilidad 1.E]
VAR-6.I.1 Para una única variable categórica, el método de prueba adecuado para la diferencia de dos proporciones poblacionales es una prueba de chi-cuadrado de dos muestras $z$ para una diferencia entre dos proporciones poblacionales.
Objetivo de aprendizaje VAR-6.J: Verificar las condiciones para realizar inferencias estadísticas al probar una diferencia de dos proporciones poblacionales. [Habilidad 4.C]
VAR-6.J.1 Con el fin de realizar inferencias estadísticas al probar una diferencia entre proporciones poblacionales, debemos verificar la independencia y que la distribución muestral sea aproximadamente normal:
a. Para verificar la independencia:
i. Los datos deben recopilarse utilizando dos muestras aleatorias independientes o un experimento aleatorizado.
ii. Al muestrear sin reemplazo, verifique que $n_1 \leq 10\%N_1$ y $n_2 \leq 10\%N_2$.
b. Para verificar que la distribución muestral de $\hat{p}_1 - \hat{p}_2$ sea aproximadamente normal (forma):
i. Para la muestra combinada, defina la proporción combinada (o agrupada), $\hat{p}_c = \dfrac{n_1\hat{p}_1 + n_2\hat{p}_2}{n_1 + n_2}$. Asumiendo que $H_0$ es verdadera $(p_1 - p_2 = 0$ o $p_1 = p_2)$, verifique que $n_1\hat{p}_c$, $n_1\left(1-\hat{p}_c\right)$, $n_2\hat{p}_c$ y $n_2\left(1-\hat{p}_c\right)$ sean todos mayores o iguales a algún valor predeterminado, típicamente 5 o 10.
Fuente: College Board AP Course and Exam Description
Las hipótesis comparan las dos proporciones: $H_0: p_1=p_2$ frente a $H_a: p_1\neq p_2$ (o $<,>$). Dado que $H_0$ establece que las proporciones son iguales, se utiliza una proporción muestral combinada (agrupada) $\hat p_c=\dfrac{\text{total successes}}{\text{total sample size}}$ para estimar la proporción común $p$.
6.11
Realización de una prueba para una diferencia
Syllabus
Comprensión duradera (VAR-6): La distribución normal puede utilizarse para modelar la variación.
Objetivo de aprendizaje VAR-6.K: Calcular una estadística de prueba adecuada para la diferencia de dos proporciones poblacionales. [Habilidad 3.E]
VAR-6.K.1 La estadística de prueba para una diferencia en las proporciones es: $z = \dfrac{(\hat{p}_1 - \hat{p}_2) - 0}{\sqrt{\hat{p}_c(1-\hat{p}_c)}\sqrt{\dfrac{1}{n_1} + \dfrac{1}{n_2}}}$, donde $\hat{p}_c = \dfrac{n_1\hat{p}_1 + n_2\hat{p}_2}{n_1 + n_2}$.
Declaración aclaratoria: Las fórmulas para las estadísticas de prueba no aparecen explícitamente en la Hoja de Fórmulas de Estadística AP proporcionada con el Examen de Estadística AP. Sin embargo, estas fórmulas no necesitan memorizarse, ya que pueden construirse basándose en la fórmula general de la estadística de prueba y las fórmulas del error estándar para cada una de las estadísticas de prueba relevantes que se proporcionan en la hoja de fórmulas.
Comprensión duradera (DAT-3): El análisis de significancia nos permite tomar decisiones sobre hipótesis dentro de un contexto particular.
Objetivo de aprendizaje DAT-3.C: Interpretar el valor $p$ de una prueba de significancia para una diferencia de proporciones poblacionales. [Habilidad 4.B]
DAT-3.C.1 Una interpretación del valor $p$ de una prueba de significancia para una diferencia de dos proporciones poblacionales debe reconocer que el valor $p$ se calcula asumiendo que la hipótesis nula es verdadera, es decir, asumiendo que las verdaderas proporciones poblacionales son iguales entre sí.
Objetivo de aprendizaje DAT-3.D: Justificar una afirmación sobre la población basada en los resultados de una prueba de significancia para una diferencia de proporciones poblacionales. [Habilidad 4.E]
DAT-3.D.1 Una decisión formal compara explícitamente el valor $p$ con la significancia $\alpha$. Si el $p\text{-value} \leq \alpha$, entonces rechazar la hipótesis nula, $H_0 : p_1 = p_2$, o $H_0 : p_1 - p_2 = 0$. Si el valor $p$$> \alpha$, entonces no rechazar la hipótesis nula.
DAT-3.D.2 Los resultados de una prueba de significancia para una diferencia de dos proporciones poblacionales pueden servir como razonamiento estadístico para respaldar la respuesta a una pregunta de investigación sobre las dos poblaciones que fueron muestreadas.
Fuente: College Board AP Course and Exam Description
Encuentre el valor $p$ del modelo normal, compárelo con $\alpha$ y concluya en contexto: la misma lógica de cuatro pasos que la de la prueba de una proporción.
6.11
Consejos para el examen
Enuncie las condiciones (aleatoriedad, 10 %, conteos grandes $np,\,nq\ge10$) antes de cualquier inferencia sobre proporciones.
Un intervalo de confianza = estimación $\pm$ margen de error; "95 % de confianza" se refiere a la tasa de captura a largo plazo del método.
Para una prueba, escribe $H_0$ y $H_a$, calcula la estadística de prueba, encuentra el valor p y compáralo con $\alpha$.
Un valor p pequeño es evidencia en contra de $H_0$; no rechazar no prueba$H_0$.
Muestras más grandes reducen el margen de error; un nivel de confianza más alto lo amplía.
Comprensión duradera (VAR-1): Dado que la variación puede ser aleatoria o no, las conclusiones son inciertas.
Objetivo de aprendizaje VAR-1.I: Identificar preguntas sugeridas por las probabilidades de error en la inferencia estadística. [Habilidad 1.A]
VAR-1.I.1 La variación aleatoria puede dar lugar a errores en la inferencia estadística.
Fuente: College Board AP Course and Exam Description
Errores Tipo I y Tipo II
La inferencia para una media funciona como la inferencia para una proporción, con un cambio: raramente conocemos la desviación estándar de la población $\sigma$, así que la estimamos con la muestral $s$. Esa incertidumbre adicional significa que usamos la distribución $t$ en lugar de la normal – una distribución 分布 que es acampanada pero con colas más pesadas, y depende de los grados de libertad 自由度$df=n-1$; a medida que $n$ crece, se aproxima a la normal.
Comprensión duradera (VAR-7): La distribución $t$ puede utilizarse para modelar variaciones.
Objetivo de aprendizaje VAR-7.A: Describir las distribuciones $t$. [Habilidad 3.C]
VAR-7.A.1 Cuando se utiliza $s$ en lugar de $\sigma$ para calcular una estadística de prueba, la distribución correspondiente, conocida como la distribución $t$, difiere de la distribución normal en su forma, ya que una mayor proporción del área se asigna a las colas de la curva de densidad que en una distribución normal.
VAR-7.A.2 A medida que aumentan los grados de libertad, el área en las colas de una distribución $t$ disminuye.
Comprensión duradera (UNC-4): Se debe utilizar un intervalo de valores para estimar parámetros, con el fin de tener en cuenta la incertidumbre.
Objetivo de aprendizaje UNC-4.O: Identificar un procedimiento de intervalo de confianza apropiado para la media poblacional, incluida la diferencia media entre valores en pares emparejados. [Habilidad 1.D]
UNC-4.O.1 Dado que $\sigma$ generalmente no es conocido para las distribuciones de variables cuantitativas, el procedimiento de intervalo de confianza apropiado para estimar la media poblacional de una variable cuantitativa para una muestra es un intervalo $t$ de una muestra para la media.
UNC-4.O.2 Para una variable cuantitativa $X$ que sigue una distribución normal, la distribución de $t = \dfrac{(\overline{x} - \mu)}{\frac{s}{\sqrt{n}}}$ es una distribución $t$ con $n-1$ grados de libertad.
UNC-4.O.3 Los pares emparejados pueden considerarse como una sola muestra de pares. Una vez que se encuentran las diferencias entre los pares de valores, la inferencia para los intervalos de confianza prosigue como para la media poblacional.
Objetivo de aprendizaje UNC-4.P: Verificar las condiciones para calcular intervalos de confianza para la media poblacional, incluida la diferencia media entre valores en pares emparejados. [Habilidad 4.C]
UNC-4.P.1 Para calcular intervalos de confianza que estimen la media poblacional, debemos verificar la independencia y que la distribución muestral sea aproximadamente normal:
a. Para verificar la independencia:
i. Los datos deben recopilarse mediante una muestra aleatoria o un experimento aleatorizado.
ii. Al muestrear sin reemplazo, verifique que $n \leq 10\%N$, donde $N$ es el tamaño de la población.
b. Para verificar que la distribución muestral de $\overline{x}$ sea aproximadamente normal (forma):
i. Si la distribución observada está sesgada, $n$ debería ser mayor que 30.
ii. Si el tamaño de la muestra es menor que 30, la distribución de los datos muestrales debe estar libre de sesgos fuertes y valores atípicos.
Objetivo de aprendizaje UNC-4.Q: Determinar el margen de error para un tamaño de muestra dado para un intervalo $t$ de una muestra. [Habilidad 3.D]
UNC-4.Q.1 El valor crítico $t^*$ con $n-1$ grados de libertad se puede encontrar utilizando una tabla o salida generada por computadora.
UNC-4.Q.2 El error estándar para una media muestral viene dado por $SE = \dfrac{s}{\sqrt{n}}$, donde $s$ es la desviación estándar muestral.
UNC-4.Q.3 Para un intervalo $t$ de una muestra para la media, el margen de error es el valor crítico ($t^*$) multiplicado por el error estándar ($SE$), lo cual equivale a $t^*\left(\dfrac{s}{\sqrt{n}}\right)$.
Objetivo de aprendizaje UNC-4.R: Calcular un intervalo de confianza apropiado para la media poblacional, incluida la diferencia media entre valores en pares emparejados. [Habilidad 3.D]
UNC-4.R.1 La estimación puntual para la media poblacional es la media muestral, $\overline{x}$.
UNC-4.R.2 Para la media poblacional de una muestra con desviación estándar poblacional desconocida, el intervalo de confianza es $\overline{x} \pm t^* \dfrac{s}{\sqrt{n}}$.
Enunciado sobre límites: Las fórmulas para las estimaciones por intervalo no aparecen explícitamente en la Hoja de Fórmulas del AP Statistics proporcionada con el Examen AP Statistics. Sin embargo, estas fórmulas no necesitan memorizarse, ya que pueden construirse basándose en la fórmula general de la estadística de prueba y las fórmulas de error estándar relevantes que se proporcionan en la hoja de fórmulas.
Fuente: College Board AP Course and Exam Description
Qué significa un intervalo de confianza
Un intervalo de una muestra $t$ para $\mu$:
$$\bar{x}\pm t^{*}\frac{s}{\sqrt{n}}.$$
$t^{*}$ es el valor crítico con $df=n-1$. Condiciones: muestra aleatoria, Normal/Muestra Grande (población normal, o $n\ge 30$ por el TCL, o una muestra aproximadamente simétrica sin valores atípicos), y la condición del 10%. Interprete el intervalo y el nivel de confianza en contexto.
Ejemplo resuelto. Una muestra aleatoria de $n=25$ tiene $\bar{x}=50$ y $s=8$. Para un intervalo de $95\%$, $df=24$ da $t^*=2.064$:
La distribución t tiene un pico más bajo y colas más pesadas que la normal"Confiar al 95%" describe el método, no un solo intervalo: en muchas muestras, aproximadamente el 95% de los intervalos contienen $\mu$ y aproximadamente el 5% lo omiten.
Explorar
Por qué un intervalo t es más ancho que un intervalo z
Un intervalo para la media utiliza $t^*$, no $1.96$, porque $\sigma$ se estima mediante $s$. Arrastra df hacia abajo y observa cómo crece $t^*$ — en $df=10$ es $2.228$, y el intervalo es más ancho para ello. Arrastra df hacia arriba y $t^*$ vuelve a caer hacia $1.96$, por eso las muestras grandes pueden usar $z$.
7.3
Justificar una afirmación sobre una media
Syllabus
Comprensión duradera (UNC-4): Se debe utilizar un intervalo de valores para estimar parámetros, con el fin de tener en cuenta la incertidumbre.
Objetivo de aprendizaje UNC-4.S: Interpretar un intervalo de confianza para la media poblacional, incluida la diferencia entre las medias de valores emparejados. [Habilidad 4.B]
UNC-4.S.1 Un intervalo de confianza para la media poblacional contiene o no contiene a la media poblacional, ya que cada intervalo se basa en datos de una muestra aleatoria, la cual varía de una muestra a otra.
UNC-4.S.2 Tenemos una confianza del C% de que el intervalo de confianza para la media poblacional capta a la media poblacional.
UNC-4.S.3 Una interpretación de un intervalo de confianza para la media poblacional incluye una referencia a la muestra tomada y detalles sobre la población que representa.
Ejemplos ilustrativos para UNC-4.S.3: Para interpretar un intervalo de confianza del 96% para la longitud media del pie de todos los huellas encontradas en una cueva basado en una muestra seleccionada al azar particular de huellas en la cueva: "Tenemos un 96% de confianza de que la longitud media del pie de todas las huellas encontradas en la cueva se encuentra dentro del intervalo de confianza" (basado en la pregunta de respuesta libre 2000 FRQ 2).
Objetivo de aprendizaje UNC-4.T: Justificar una afirmación basada en un intervalo de confianza para la media poblacional, incluida la diferencia entre las medias de valores emparejados. [Habilidad 4.D]
UNC-4.T.1 Un intervalo de confianza para la media poblacional proporciona un intervalo de valores que puede ofrecer evidencia suficiente para respaldar una afirmación particular en contexto.
Objetivo de aprendizaje UNC-4.U: Identificar las relaciones entre el tamaño de la muestra, el ancho de un intervalo de confianza, el nivel de confianza y el margen de error para una media poblacional. [Habilidad 4.A]
UNC-4.U.1 Cuando todo lo demás permanece igual, el ancho de un intervalo de confianza para la media poblacional tiende a disminuir a medida que aumenta el tamaño de la muestra.
UNC-4.U.2 Para una sola media, el ancho del intervalo es proporcional a $\dfrac{1}{\sqrt{n}}$.
UNC-4.U.3 Para una muestra dada, el ancho del intervalo de confianza para la media poblacional aumenta a medida que aumenta el nivel de confianza.
Fuente: College Board AP Course and Exam Description
Al igual que con las proporciones: una media afirmada dentro del intervalo es plausible; fuera del intervalo, los datos ofrecen evidencia en contra. Responda en contexto usando el rango plausible.
7.4
Preparar una prueba para una media
Syllabus
Comprensión duradera (VAR-7): La distribución $t$ puede utilizarse para modelar la variación.
Objetivo de aprendizaje VAR-7.B: Identificar un método de prueba apropiado para la media poblacional con $\sigma$ desconocido, incluida la diferencia media entre valores en pares emparejados. [Habilidad 1.E]
VAR-7.B.1 La prueba apropiada para la media poblacional con $\sigma$ desconocido es una prueba $t$ de una muestra para la media poblacional.
VAR-7.B.2 Los pares emparejados pueden considerarse como una sola muestra de pares. Una vez que se encuentran las diferencias entre los pares de valores, la inferencia para la prueba de significancia prosigue como para la media poblacional.
Objetivo de aprendizaje VAR-7.C: Identificar las hipótesis nula y alternativa para la media poblacional con $\sigma$ desconocido, incluida la diferencia media entre valores en pares emparejados. [Habilidad 1.F]
VAR-7.C.1 La hipótesis nula para una prueba $t$ de una muestra para la media poblacional es $H_0 : \mu = \mu_0$, donde $\mu_0$ es el valor hipotetizado. Dependiendo de la situación, la hipótesis alternativa es $H_a : \mu < \mu_0$, o $H_a : \mu > \mu_0$, o $H_a : \mu \neq \mu_0$.
VAR-7.C.2 Al encontrar la diferencia media, $\mu_d$, entre valores en un par emparejado, es importante definir el orden de la resta.
Objetivo de aprendizaje VAR-7.D: Verificar las condiciones para la prueba de la media poblacional, incluida la diferencia media entre valores en pares emparejados. [Habilidad 4.C]
VAR-7.D.1 Con el fin de realizar inferencias estadísticas al probar la media poblacional, debemos verificar la independencia y que la distribución muestral sea aproximadamente normal:
a. Para verificar la independencia:
i. Los datos deben recopilarse mediante una muestra aleatoria o un experimento aleatorizado.
ii. Cuando se muestree sin reemplazo, verifique que $n \leq 10\%N$.
b. Para verificar que la distribución muestral de $\overline{x}$ sea aproximadamente normal (forma):
i. Si la distribución observada está sesgada, $n$ debería ser mayor que 30.
ii. Si el tamaño de la muestra es menor que 30, la distribución de los datos de la muestra debe estar libre de fuerte sesgo y valores atípicos.
Fuente: College Board AP Course and Exam Description
Qué significa un valor p
Plantee hipótesis sobre $\mu$: $H_0:\mu=\mu_0$ versus $H_a:\mu\neq\mu_0$ (o $<,>$). Verifique las mismas condiciones. La estadística de $t$ de una sola muestra:
Esto $t$ se encuentra muy en la cola (prueba bilateral $p<0.01$), por lo que rechazar $H_0$ – hay evidencia sólida de que la media no es $45$. Obsérvese que $45$ también queda fuera del intervalo $95\%$$(46.7,53.3)$, llegando a la misma conclusión por dos vías distintas.
7.5
Realizar una prueba para una media
Syllabus
Comprensión duradera (VAR-7): La distribución $t$ puede utilizarse para modelar la variación.
Objetivo de aprendizaje VAR-7.E: Calcular una estadística de prueba adecuada para la media poblacional, incluida la diferencia media entre valores en pares emparejados. [Habilidad 3.E]
VAR-7.E.1 Para una única variable cuantitativa cuando se realiza un muestreo aleatorio con reemplazo de una población que puede modelarse con una distribución normal con media $\mu$ y desviación estándar $\sigma$, la distribución muestral de $t = \dfrac{\overline{x} - \mu}{\frac{s}{\sqrt{n}}}$ tiene una distribución $t$ con $n - 1$ grados de libertad.
Declaración de límite: Las fórmulas para las estadísticas de prueba no aparecen explícitamente en la Hoja de Fórmulas de Estadística AP proporcionada con el Examen de Estadística AP. Sin embargo, estas fórmulas no necesitan memorizarse, ya que pueden construirse a partir de la fórmula general de la estadística de prueba y las fórmulas relevantes del error estándar que se proporcionan en la hoja de fórmulas.
Comprensión duradera (DAT-3): La prueba de significancia nos permite tomar decisiones sobre hipótesis dentro de un contexto particular.
Objetivo de aprendizaje DAT-3.E: Interpretar el valor $p$ de una prueba de significancia para la media poblacional, incluida la diferencia media entre valores en pares emparejados. [Habilidad 4.B]
DAT-3.E.1 Una interpretación del valor $p$ de una prueba de significancia para la media poblacional debe reconocer que el valor $p$ se calcula asumiendo que la hipótesis nula es verdadera, es decir, asumiendo que la media poblacional verdadera es igual al valor particular indicado en la hipótesis nula.
Objetivo de aprendizaje DAT-3.F: Justificar una afirmación sobre la población basada en los resultados de una prueba de significancia para la media poblacional. [Habilidad 4.E]
DAT-3.F.1 Una decisión formal compara explícitamente el valor $p$ con la significancia $\alpha$. Si el valor $p$$\leq \alpha$, entonces rechazar la hipótesis nula, $H_0 : \mu = \mu_0$. Si el valor $p$$> \alpha$, entonces no rechazar la hipótesis nula.
DAT-3.F.2 Los resultados de una prueba de significancia para la media poblacional pueden servir como razonamiento estadístico para respaldar la respuesta a una pregunta de investigación sobre la población que fue muestreada.
Fuente: College Board AP Course and Exam Description
Encuentre el valor $p$ de la distribución $t$ con $df=n-1$, compárelo con $\alpha$ y saque una conclusión en contexto – rechace o no rechace $H_0$, luego indique lo que eso significa para la afirmación. Muestre el nombre de la prueba, la estadística, $df$ y el valor $p$.
Explorar
Leer un valor p desde la curva t
El valor p es el área sombreada de la cola más allá de tu estadístico $t$ — ambas colas para un $H_a$ de dos colas. La curva normal punteada detrás de $t$ muestra lo que habrías obtenido usando erróneamente $z$: con pocos grados de libertad, la cola $t$ es visiblemente más gruesa, por lo que el verdadero valor p es mayor de lo que sugeriría la normal.
7.6
Intervalo de confianza para la diferencia de dos medias
Syllabus
Comprensión duradera (UNC-4): Se debe utilizar un intervalo de valores para estimar parámetros, a fin de tener en cuenta la incertidumbre.
Objetivo de aprendizaje UNC-4.V: Identificar un procedimiento de intervalo de confianza apropiado para la diferencia de dos medias poblacionales. [Habilidad 1.D]
UNC-4.V.1 Considere una muestra aleatoria simple de la población 1 de tamaño $n_1$, media $\mu_1$ y desviación estándar $\sigma_1$, y una segunda muestra aleatoria simple de la población 2 de tamaño $n_2$, media $\mu_2$ y desviación estándar $\sigma_2$. Si las distribuciones de las poblaciones 1 y 2 son normales o si tanto $n_1$ como $n_2$ son mayores que 30, entonces la distribución muestral de la diferencia de medias, $\overline{x}_1 - \overline{x}_2$, también es normal. La media de la distribución muestral de $\overline{x}_1 - \overline{x}_2$ es $\mu_1 - \mu_2$. La desviación estándar de $\overline{x}_1 - \overline{x}_2$ es $\sqrt{\dfrac{(\sigma_1)^2}{n_1} + \dfrac{(\sigma_2)^2}{n_2}}$.
UNC-4.V.2 El procedimiento de intervalo de confianza apropiado para una variable cuantitativa con dos muestras independientes es un intervalo $t$ de dos muestras para la diferencia entre las medias poblacionales.
Objetivo de aprendizaje UNC-4.W: Verificar las condiciones para calcular intervalos de confianza para la diferencia de dos medias poblacionales. [Habilidad 4.C]
UNC-4.W.1 Para calcular intervalos de confianza que estimen una diferencia de medias poblacionales, debemos verificar la independencia y que la distribución muestral sea aproximadamente normal:
a. Para verificar la independencia:
i. Los datos deben recolectarse utilizando dos muestras aleatorias e independientes o un experimento aleatorizado.
ii. Cuando se muestree sin reemplazo, verifique que $n_1 \leq 10\%N_1$ y $n_2 \leq 10\%N_2$.
b. Para verificar que la distribución muestral de $(\overline{x}_1 - \overline{x}_2)$ sea aproximadamente normal (forma):
i. Si las distribuciones observadas están sesgadas, tanto $n_1$ como $n_2$ deben ser mayores que 30.
Objetivo de aprendizaje UNC-4.X: Determinar el margen de error para la diferencia de dos medias poblacionales. [Habilidad 3.D]
UNC-4.X.1 Para la diferencia de dos medias muestrales, el margen de error es igual al valor crítico ($t^*$) multiplicado por el error estándar ($SE$) de la diferencia de las dos medias.
UNC-4.X.2 El error estándar para la diferencia en dos medias muestrales con desviaciones estándar muestrales, $s_1$ y $s_2$, es $\sqrt{\dfrac{(s_1)^2}{n_1} + \dfrac{(s_2)^2}{n_2}}$.
Objetivo de aprendizaje UNC-4.Y: Calcular un intervalo de confianza apropiado para la diferencia de dos medias poblacionales. [Habilidad 3.D]
UNC-4.Y.1 La estimación puntual para la diferencia de dos medias poblacionales es la diferencia en las medias muestrales, $\overline{x}_1 - \overline{x}_2$.
UNC-4.Y.2 Para la diferencia de dos medias poblacionales donde las desviaciones estándar poblacionales no son conocidas, el intervalo de confianza es $(\overline{x}_1 - \overline{x}_2) \pm t^* \sqrt{\dfrac{s_1^2}{n_1} + \dfrac{s_2^2}{n_2}}$, donde $\pm t^*$ son los valores críticos para el C% central de una distribución $t$ con los grados de libertad apropiados, los cuales pueden encontrarse utilizando tecnología.
Afirmación sobre límites: Las fórmulas para estimaciones de intervalo no aparecen explícitamente en la Hoja de Fórmulas del Examen AP Estadísticas proporcionada con el examen. Sin embargo, estas fórmulas no necesitan memorizarse, ya que pueden construirse basándose en la fórmula general de la estadística de prueba y las fórmulas relevantes de error estándar que se proporcionan en la hoja de fórmulas.
Fuente: College Board AP Course and Exam Description
Para muestras independientes, estime $\mu_1-\mu_2$:
Las condiciones deben cumplirse en ambas muestras. (Utilice tecnología para calcular el $df$; no combine las varianzas en el examen AP.)
La aleatorización sustenta una comparación justa de dos grupos en una prueba de diferencia de medias
7.7
Justificar una afirmación sobre dos medias
Syllabus
Comprensión duradera (UNC-4): Se debe utilizar un intervalo de valores para estimar parámetros, con el fin de tener en cuenta la incertidumbre.
Objetivo de aprendizaje UNC-4.Z: Interpretar un intervalo de confianza para la diferencia de las medias poblacionales. [Habilidad 4.B]
UNC-4.Z.1 En muestreo aleatorio repetido con el mismo tamaño de muestra, aproximadamente C% de los intervalos de confianza creados capturarán la diferencia de las medias poblacionales.
UNC-4.Z.2 Una interpretación para un intervalo de confianza para la diferencia de dos medias poblacionales debe incluir una referencia a las muestras tomadas y detalles sobre las poblaciones que representan.
Ejemplos ilustrativos para UNC-4.Z.2: Para interpretar un intervalo de confianza para una diferencia entre los tiempos medios de respuesta de dos estaciones de bomberos (norte - sur): "Basado en estas muestras, se puede estar 95 por ciento seguro de que la diferencia en los tiempos medios de respuesta de la población (norte - sur) está entre -2.37 minutos y 0.37 minutos" (Pregunta de Respuesta Libre 2009, Pregunta 4).
Objetivo de aprendizaje UNC-4.AA: Justificar una afirmación basada en un intervalo de confianza para la diferencia de las medias poblacionales. [Habilidad 4.D]
UNC-4.AA.1 Un intervalo de confianza para la diferencia de las medias poblacionales proporciona un intervalo de valores que puede ofrecer evidencia suficiente para respaldar una afirmación particular en contexto.
Objetivo de aprendizaje UNC-4.AB: Identificar los efectos del tamaño de la muestra en el ancho de un intervalo de confianza para la diferencia de dos medias. [Habilidad 4.A]
UNC-4.AB.1 Cuando todas las demás cosas permanecen iguales, el ancho del intervalo de confianza para la diferencia de dos tiende a disminuir a medida que aumentan los tamaños de muestra.
Fuente: College Board AP Course and Exam Description
Si el intervalo para $\mu_1-\mu_2$ contiene $0$, los datos son consistentes con medias iguales; si excluye $0$, hay evidencia de una diferencia en esa dirección. Interprete en contexto.
7.8
Configuración de una Prueba para la Diferencia de Medias
Syllabus
Comprensión Duradera (VAR-7): La distribución $t$ puede utilizarse para modelar la variación.
Objetivo de Aprendizaje VAR-7.F: Identificar una selección adecuada del método de prueba para la diferencia de dos medias poblacionales. [Habilidad 1.E]
VAR-7.F.1 Para una variable cuantitativa, la prueba adecuada para la diferencia de dos medias poblacionales es una prueba $t$ de dos muestras para la diferencia de dos medias poblacionales.
Objetivo de Aprendizaje VAR-7.G: Identificar las hipótesis nula y alternativa para la diferencia de dos medias poblacionales. [Habilidad 1.F]
VAR-7.G.1 La hipótesis nula para una prueba $t$ de dos muestras para la diferencia de dos medias poblacionales, $\mu_1$ y $\mu_2$, es: $H_0 : \mu_1 - \mu_2 = 0$, o $H_0 : \mu_1 = \mu_2$. La hipótesis alternativa es $H_a : \mu_1 - \mu_2 < 0$, o $H_a : \mu_1 - \mu_2 > 0$, o $H_a : \mu_1 - \mu_2 \neq 0$, o $H_a : \mu_1 > \mu_2$, o $H_a : \mu_1 < \mu_2$, o $H_a : \mu_1 \neq \mu_2$.
Objetivo de Aprendizaje VAR-7.H: Verificar las condiciones para la prueba de significancia de la diferencia de dos medias poblacionales. [Habilidad 4.C]
VAR-7.H.1 Para realizar inferencias estadísticas al probar una diferencia entre las medias poblacionales, debemos verificar la independencia y que la distribución muestral sea aproximadamente normal:
a. Las observaciones individuales deben ser independientes:
i. Los datos deben recolectarse utilizando muestreo aleatorio simple o un experimento aleatorizado.
ii. Al muestrear sin reemplazo, verifique que $n_1 \leq 10\%N_1$ y $n_2 \leq 10\%N_2$.
b. La distribución muestral de $\overline{x}_1 - \overline{x}_2$ debe ser aproximadamente normal (forma).
i. Si la distribución observada está sesgada, tanto $n_1$ como $n_2$ deben ser mayores a 30.
ii. Si el tamaño de la muestra es menor a 30, la distribución de los datos muestrales debe estar exenta de fuerte sesgo y valores atípicos. Esto debe verificarse para AMBAS muestras.
Fuente: College Board AP Course and Exam Description
Hipótesis: $H_0:\mu_1=\mu_2$ frente a $H_a:\mu_1\neq\mu_2$ (o $<,>$). Distinga entre dos muestras independientes y datos emparejados – para datos emparejados (antes/después, sujetos apareados), primero calcule las diferencias y aplique un procedimiento de una muestra $t$ sobre ellas.
7.9
Realización de una Prueba para la Diferencia de Medias
Syllabus
Comprensión duradera (VAR-7): La distribución $t$ puede utilizarse para modelar variaciones.
Objetivo de aprendizaje VAR-7.I: Calcular un estadístico de prueba apropiado para una diferencia de dos medias. [Habilidad 3.E]
VAR-7.I.1 Para una variable cuantitativa única, los datos recolectados mediante muestras aleatorias independientes o un experimento aleatorizado de dos poblaciones, cada una de las cuales puede modelarse con una distribución normal, la distribución muestral de $t = \dfrac{(\overline{x}_1 - \overline{x}_2) - (\mu_1 - \mu_2)}{\sqrt{\dfrac{s_1^2}{n_1} + \dfrac{s_2^2}{n_2}}}$ es una aproximación a la distribución $t$ con grados de libertad que pueden determinarse utilizando tecnología. Los grados de libertad se encuentran entre el menor de $n_1 - 1$ y $n_2 - 1$, y $n_1 + n_2 - 2$.
Ejemplos ilustrativos para VAR-7.I.1: En un estudio que compara los tiempos medios de recuperación de dos procedimientos quirúrgicos para reparar un ligamento cruzado anterior (LCA) desgarrado, el grupo que recibió un procedimiento tenía un tamaño muestral de 110, mientras que el otro tenía un tamaño muestral de 100. Los grados de libertad están entre 100 (el menor de 110 y 100) y 208 (110 + 100 - 2), y pueden determinarse con tecnología. Si el estadístico de prueba es $t \approx 7.13$, el valor $p$ es el área por encima de 7.13 en una distribución $t$ con $df = 207.18$ (pregunta de respuesta libre 4 de 2018).
Declaración de límite: Las fórmulas para los estadísticos de prueba no aparecen explícitamente en la Hoja de Fórmulas del AP Statistics proporcionada con el Examen de Estadística AP. Sin embargo, estas fórmulas no necesitan memorizarse, ya que pueden construirse basándose en la fórmula general del estadístico de prueba y las fórmulas del error estándar para cada uno de los estadísticos de prueba relevantes que se proporcionan en la hoja de fórmulas.
Comprensión duradera (DAT-3): Las pruebas de significancia permiten tomar decisiones sobre hipótesis dentro de un contexto particular.
Objetivo de aprendizaje DAT-3.G: Interpretar el valor-$p$ de una prueba de significancia para una diferencia de medias poblacionales. [Habilidad 4.B]
DAT-3.G.1 Una interpretación del valor-$p$ de una prueba de significancia para una diferencia de dos medias poblacionales debe reconocer que el valor-$p$ se calcula asumiendo que la hipótesis nula es verdadera, es decir, asumiendo que las verdaderas medias poblacionales son iguales entre sí.
Objetivo de aprendizaje DAT-3.H: Justificar una afirmación sobre la población basada en los resultados de una prueba de significancia para una diferencia de dos medias poblacionales en contexto. [Habilidad 4.E]
DAT-3.H.1 Una decisión formal compara explícitamente el valor $p$ con la significación $\alpha$. Si el valor $p$$\leq \alpha$, entonces se rechaza la hipótesis nula, $H_0 : \mu_1 - \mu_2 = 0$, o $H_0 : \mu_1 = \mu_2$. Si el valor $p$$> \alpha$, entonces no se rechaza la hipótesis nula.
DAT-3.H.2 Los resultados de una prueba de significancia para una prueba de dos muestras para una diferencia entre dos medias poblacionales pueden servir como razonamiento estadístico para respaldar la respuesta a una pregunta de investigación sobre las poblaciones que fueron muestreadas.
Fuente: College Board AP Course and Exam Description
Obtenga el valor $p$ (tecnología para $df$), compárelo con $\alpha$ y concluya en contexto.
7.10
Selección y comunicación de un procedimiento
Syllabus
Este tema tiene como objetivo centrarse en la habilidad de seleccionar un procedimiento de inferencia adecuado, una vez que los estudiantes disponen de una variedad de opciones. Se deben proporcionar oportunidades a los estudiantes para practicar cuándo y cómo aplicar todos los objetivos de aprendizaje relacionados con la inferencia que involucra proporciones o medias.
Fuente: College Board AP Course and Exam Description
La habilidad de examen más difícil es elegir el procedimiento correcto: ¿una o dos muestras? ¿proporción o media? ¿apareado o independiente? ¿intervalo de confianza o prueba? Lea la pregunta para identificar qué se está estimando o afirmando, luego nombre el procedimiento, verifique sus condiciones, ejecútelo y comunique la conclusión claramente con números y contexto.
7.10
Consejos para el examen
Use procedimientos t para medias (la desviación estándar poblacional $\sigma$ desconocida) — la distribución t tiene colas más pesadas que la normal.
Verifique las condiciones: aleatoriedad, independencia y aproximadamente normal (o muestra grande $n$).
Interprete un intervalo y una prueba en contexto, siempre vinculados al parámetro (la verdadera media).
Seleccione el procedimiento adecuado: una muestra, dos muestras o apareado (busque un emparejamiento natural).
Indique los grados de libertad; para una prueba $t$ de dos muestras use el valor proporcionado por la tecnología (o, a mano, el conservador menor $n-1$).
Comprensión perdurable (VAR-1): Dado que la variación puede ser aleatoria o no, las conclusiones son inciertas.
Objetivo de aprendizaje VAR-1.J: Identificar preguntas sugeridas por la variación entre los conteos observados y esperados en datos categóricos. [Habilidad 1.A]
VAR-1.J.1 La variación entre lo que encontramos y lo que esperamos encontrar puede ser aleatoria o no.
Fuente: College Board AP Course and Exam Description
Cuando los datos son conteos distribuidos entre varias categorías, se prueba si los conteos observados difieren de lo que predice una afirmación. La herramienta es la estadística chi-cuadrado ($\chi^2$), que suma las brechas estandarizadas entre los conteos observados y esperados:
Un valor grande de $\chi^2$ indica que los conteos observados están lejos de los esperados, lo cual constituye evidencia en contra de la afirmación. La distribución chi-cuadrado está sesgada hacia la derecha y depende de sus grados de libertad.
8.2
Preparación de una prueba de ajuste (goodness-of-fit)
Syllabus
Comprensión Duradera (VAR-8): La distribución de chi-cuadrada puede utilizarse para modelar la variación.
Objetivo de Aprendizaje VAR-8.A: Describir las distribuciones de chi-cuadrada. [Habilidad 3.C]
VAR-8.A.1 Los conteos esperados de datos categóricos son conteos consistentes con la hipótesis nula. En general, un conteo esperado es el tamaño de la muestra multiplicado por una probabilidad.
La estadística de chi-cuadrada mide la distancia entre los conteos observados y los esperados en relación con los conteos esperados.
Las distribuciones de chi-cuadrada tienen valores positivos y están sesgadas a la derecha. Dentro de una familia de curvas de densidad, el sesgo se vuelve menos pronunciado a medida que aumentan los grados de libertad.
Objetivo de Aprendizaje VAR-8.B: Identificar las hipótesis nula y alternativa en una prueba para una distribución de proporciones en un conjunto de datos categóricos. [Habilidad 1.F]
VAR-8.B.1 Para una prueba de ajuste al cuadrado, la hipótesis nula especifica proporciones nulas para cada categoría, y la hipótesis alternativa es que al menos una de estas proporciones no sea como se especifica en la hipótesis nula.
Objetivo de Aprendizaje VAR-8.C: Identificar un método de prueba apropiado para una distribución de proporciones en un conjunto de datos categóricos. [Habilidad 1.E]
VAR-8.C.1 Al considerar una distribución de proporciones para una variable categórica, la prueba apropiada es la prueba de chi-cuadrada para ajuste al cuadrado.
Objetivo de Aprendizaje VAR-8.D: Calcular conteos esperados para la prueba de ajuste al cuadrado. [Habilidad 3.A]
VAR-8.D.1 Los conteos esperados para una prueba de ajuste al cuadrado son (tamaño de la muestra)(proporción nula).
Objetivo de Aprendizaje VAR-8.E: Verificar las condiciones para realizar inferencias estadísticas al probar el ajuste al cuadrado de una distribución de chi-cuadrada. [Habilidad 4.C]
VAR-8.E.1 Con el fin de realizar inferencias estadísticas para una prueba de ajuste al cuadrado, debemos verificar lo siguiente:
a. Para verificar la independencia:
i. Los datos deben recolectarse utilizando una muestra aleatoria o un experimento aleatorizado.
ii. Cuando se muestree sin reemplazo, verifique que $n \leq 10\%N$.
b. La prueba de ajuste al cuadrado se vuelve más precisa con más observaciones, por lo que deben usarse conteos grandes (forma).
i. Una verificación conservadora para conteos grandes es que todos los conteos esperados sean mayores que 5.
Fuente: College Board AP Course and Exam Description
La prueba chi-cuadrado (χ²)
Una prueba de ajuste (GOF) verifica si una variable categórica sigue una distribución afirmada (por ejemplo, «el dado es justo»). Hipótesis:
$$H_0:\text{the distribution is as claimed}\qquad H_a:\text{at least one proportion differs}.$$
Conteo esperado para cada categoría $=n\times(\text{claimed proportion})$. Condiciones: muestra aleatoria, todos los conteos esperados $\ge 5$, y la condición del 10%.
La distribución chi-cuadrado es asimétrica a la derecha. Un estadístico grande se ubica en la cola sombreada a la derecha, más allá del valor crítico – ese es el lugar donde rechazas el modelo.
VAR-8.F.2 La distribución de la estadística de prueba asumiendo que la hipótesis nula es verdadera (distribución nula) puede ser tanto una distribución de aleatorización como, cuando se asume que un modelo de probabilidad es verdadero, una distribución teórica (chi-cuadrada).
Objetivo de Aprendizaje VAR-8.G: Determinar el valor $p$ para una prueba de significancia de ajuste a la bondad chi-cuadrada. [Habilidad 3.E]
VAR-8.G.1 El valor $p$ para una prueba chi-cuadrada de ajuste a la bondad para un número dado de grados de libertad se encuentra utilizando la tabla correspondiente o la salida generada por computadora.
Comprensión Duradera (DAT-3): Las pruebas de significancia nos permiten tomar decisiones sobre hipótesis dentro de un contexto particular.
Objetivo de Aprendizaje DAT-3.I: Interpretar el valor $p$ para la prueba chi-cuadrada de ajuste a la bondad. [Habilidad 4.B]
DAT-3.I.1 Una interpretación del valor $p$ para la prueba chi-cuadrada de ajuste a la bondad es la probabilidad, dado que la hipótesis nula y el modelo de probabilidad son verdaderos, de obtener una estadística de prueba tan extrema o más que el valor observado.
Objetivo de Aprendizaje DAT-3.J: Justificar una afirmación sobre la población basada en los resultados de una prueba chi-cuadrada de ajuste a la bondad. [Habilidad 4.E]
DAT-3.J.1 La decisión de rechazar o no rechazar la hipótesis nula se basa en la comparación del valor $p$ con el nivel de significancia, $\alpha$.
DAT-3.J.2 Los resultados de una prueba chi-cuadrada de ajuste a la bondad pueden servir como razonamiento estadístico para respaldar la respuesta a una pregunta de investigación sobre la población que fue muestreada.
Fuente: College Board AP Course and Exam Description
Calcula $\chi^2=\sum\dfrac{(O-E)^2}{E}$ con $df=(\text{number of categories})-1$. Encuentra el valor-p $p$ de la distribución chi-cuadrado (cola superior), compáralo con $\alpha$, y concluye en contexto. Un componente grande de la suma señala la categoría que más se desvía.
La prueba de chi-cuadrado compara los conteos observados con aquellos esperados bajo la hipótesis nula
Ejemplo resuelto. Un dado lanzado $60$ veces produce conteos $8,10,12,9,11,10$. Si es justo, cada conteo esperado es $60/6=10$, por lo que
con $df=6-1=5$. Enumere cada categoría, incluidas las dos que coinciden exactamente con su conteo esperado y por lo tanto agregan $0$ – la suma se realiza sobre las seis categorías, y $df$ cuenta categorías, no solo aquellas que difieren. Este $\chi^2$ es pequeño (un valor de $p$ grande), por lo que no rechazamos$H_0$ – no hay evidencia de que el dado sea injusto.
Explorar
Explorar la distribución chi-cuadrado y su valor p
El valor p es el área en la cola derecha más allá de tu estadístico de prueba, por lo que un $\chi^2$mayor significa un valor p menor. Arrastra $\chi^2$ para observar cómo esa área se reduce, y arrastra df para ver cómo cambia toda la familia de curvas — fuertemente sesgada a la derecha con pocos grados de libertad, más simétrica a medida que aumentan los grados de libertad.
8.4
Conteos Esperados en Tablas de Dos Vías
Syllabus
Comprensión Duradera (VAR-8): La distribución chi-cuadrado puede utilizarse para modelar la variación.
Objetivo de Aprendizaje VAR-8.H: Calcular los recuentos esperados para tablas de contingencia de datos categóricos. [Habilidad 3.A]
VAR-8.H.1 El recuento esperado en una celda particular de una tabla de contingencia de datos categóricos se puede calcular utilizando la fórmula:
Este es el conteo que se observaría si las variables de fila y columna fueran independientes.
Ejemplo resuelto. En una tabla de doble entrada, la suma total de la fila de una celda es $40$, su suma total de columna es $50$ y el total general es $200$. Su recuento esperado es $E=\dfrac{40\times50}{200}=10$. Repitiendo este cálculo para cada celda se obtiene la tabla esperada que se compara con la observada.
Una hoja de cálculo organiza los conteos categóricos antes de realizar una prueba chi-cuadrado
8.5
¿Homogeneidad o Independencia?
Syllabus
Comprensión Duradera (VAR-8): La distribución chi-cuadrada puede utilizarse para modelar la variación.
Objetivo de Aprendizaje VAR-8.I: Identificar las hipótesis nula y alternativa para una prueba chi-cuadrada de homogeneidad o independencia. [Habilidad 1.F]
VAR-8.I.1 Las hipótesis adecuadas para una prueba chi-cuadrada de homogeneidad son:
$H_0$: No hay diferencia en las distribuciones de una variable categórica entre poblaciones o tratamientos.
$H_a$: Hay una diferencia en las distribuciones de una variable categórica entre poblaciones o tratamientos.
VAR-8.I.2 Las hipótesis adecuadas para una prueba chi-cuadrada de independencia son:
$H_0$: No existe asociación entre dos variables categóricas en una población dada, o las dos variables categóricas son independientes.
$H_a$: Dos variables categóricas en una población están asociadas o son dependientes.
Objetivo de Aprendizaje VAR-8.J: Identificar un método de prueba adecuado para comparar distribuciones en tablas de contingencia de datos categóricos. [Habilidad 1.E]
VAR-8.J.1 Al comparar distribuciones para determinar si las proporciones en cada categoría de los datos categóricos recolectados de diferentes poblaciones son iguales, la prueba adecuada es la prueba chi-cuadrada de homogeneidad.
VAR-8.J.2 Para determinar si las variables de fila y columna en una tabla de contingencia de datos categóricos podrían estar asociadas en la población de la que se tomaron las muestras, la prueba adecuada es la prueba chi-cuadrada de independencia.
Objetivo de Aprendizaje VAR-8.K: Verificar las condiciones para realizar inferencias estadísticas al probar una distribución chi-cuadrada de independencia u homogeneidad. [Habilidad 4.C]
VAR-8.K.1 Con el fin de realizar inferencias estadísticas para una prueba chi-cuadrada de tablas de contingencia (homogeneidad o independencia), debemos verificar lo siguiente:
a. Para verificar la independencia:
i. Para una prueba de independencia: Los datos deben recolectarse mediante una muestra aleatoria simple.
ii. Para una prueba de homogeneidad: Los datos deben recolectarse mediante una muestra aleatoria estratificada o un experimento aleatorizado.
iii. Cuando se muestree sin reemplazo, verifique que $n \leq 10\%N$.
b. Las pruebas chi-cuadrada de independencia y homogeneidad se vuelven más precisas con más observaciones, por lo que se deben utilizar conteos grandes (forma).
i. Una verificación conservadora de conteos grandes es que todos los conteos esperados sean mayores que 5.
Fuente: College Board AP Course and Exam Description
Dos pruebas utilizan la misma matemática $\chi^2$ pero responden a preguntas diferentes:
Prueba de homogeneidad 同质性: ¿son las distribuciones de una variable categórica iguales en varias poblaciones o grupos (muestras/tratamientos separados)?
Prueba de independencia 独立性: ¿están asociadas dos variables categóricas dentro de una única población (una sola muestra, dos variables medidas)?
El diseño (varias muestras frente a una sola muestra) determina qué nombre e hipótesis utilizar.
8.6
Realización de una Prueba de Homogeneidad o Independencia
Syllabus
Comprensión duradera (VAR-8): La distribución chi-cuadrada puede utilizarse para modelar la variación.
Objetivo de aprendizaje VAR-8.L: Calcular el estadístico apropiado para una prueba chi-cuadrada de homogeneidad o independencia. [Habilidad 3.E]
VAR-8.L.1 El estadístico de prueba apropiado para una prueba chi-cuadrada de homogeneidad o independencia es el estadístico chi-cuadrada:
Objetivo de aprendizaje VAR-8.M: Determinar el valor $p$ para una prueba de significancia chi-cuadrada de independencia o homogeneidad. [Habilidad 3.E]
VAR-8.M.1 El valor $p$ para una prueba chi-cuadrada de independencia o homogeneidad para un número dado de grados de libertad se encuentra utilizando la tabla o tecnología adecuada.
VAR-8.M.2 Para una prueba de independencia o homogeneidad en una tabla de contingencia, el valor $p$ es la proporción de valores en una distribución chi-cuadrada con los grados de libertad adecuados que son iguales o mayores que el estadístico de prueba.
Comprensión duradera (DAT-3): Las pruebas de significancia permiten tomar decisiones sobre hipótesis dentro de un contexto particular.
Objetivo de aprendizaje DAT-3.K: Interpretar el valor $p$ para la prueba chi-cuadrada de homogeneidad o independencia. [Habilidad 4.B]
DAT-3.K.1 Una interpretación del valor $p$ para la prueba chi-cuadrada de homogeneidad o independencia es la probabilidad, asumiendo que la hipótesis nula y el modelo de probabilidad son verdaderos, de obtener un estadístico de prueba tan extremo o más extremo que el valor observado.
Objetivo de aprendizaje DAT-3.L: Justificar una afirmación sobre la población basándose en los resultados de una prueba chi-cuadrada de homogeneidad o independencia. [Habilidad 4.E]
DAT-3.L.1 La decisión de rechazar o no rechazar la hipótesis nula para una prueba chi-cuadrada de homogeneidad o independencia se basa en la comparación del valor $p$ con el nivel de significancia, $\alpha$.
DAT-3.L.2 Los resultados de una prueba chi-cuadrada de homogeneidad o independencia pueden servir como razonamiento estadístico para respaldar la respuesta a una pregunta de investigación sobre la población que fue muestreada (independencia) o las poblaciones que fueron muestreadas (homogeneidad).
Fuente: College Board AP Course and Exam Description
Calcule los recuentos esperados y, a continuación, $\chi^2=\sum\dfrac{(O-E)^2}{E}$ sobre todas las celdas, con
$$df=(\text{rows}-1)(\text{columns}-1).$$
Condiciones: datos aleatorios, todos los conteos esperados $\ge 5$, condición del 10%. Encuentre el valor-p $p$, compárelo con $\alpha$ y concluya en contexto – evidencia de una diferencia entre grupos (homogeneidad) o de una asociación (independencia).
8.7
Elegir el Procedimiento Categórico Correcto
Syllabus
Este tema tiene como objetivo centrarse en la habilidad de seleccionar un procedimiento de inferencia adecuado, una vez que los estudiantes han adquirido un abanico de opciones. Se debe brindar a los estudiantes oportunidades para practicar cuándo y cómo aplicar todos los objetivos de aprendizaje relacionados con la inferencia para datos categóricos.
Fuente: College Board AP Course and Exam Description
Decida según el diseño: una variable categórica frente a una distribución postulada $\Rightarrow$ajuste-bond; una muestra cruzada por dos variables $\Rightarrow$independencia; varias muestras/grupos en comparación $\Rightarrow$homogeneidad. Comparar solo dos proporciones puede usar una prueba de dos proporciones $z$ o una prueba chi-cuadrado, pero solo para una alternativa de dos colas, donde coinciden exactamente ($\chi^2=z^2$). Una prueba chi-cuadrado es siempre de dos colas, por lo que no puede dar una conclusión direccional: si $H_a$ es de una cola (por ejemplo, $p_1>p_2$), use la prueba de dos proporciones $z$.
Explorar
¿Cuál es esta prueba chi-cuadrado?
Las tres pruebas utilizan la misma aritmética $\chi^2$, por lo que los puntos se ganan nombrando la correcta. El diseño decide: cuántas muestras se tomaron y cuántas variables se midieron en cada unidad.
8.7
Consejos para el examen
Use $\chi^2=\sum\tfrac{(O-E)^2}{E}$ para datos categóricos; divida siempre por el recuento esperado.
Elija la prueba correcta: ajuste-bond (una variable), independencia o homogeneidad (tabla bidireccional).
Calcule los recuentos esperados como $\tfrac{\text{row total}\times\text{column total}}{\text{grand total}}$ y verifique que cada uno sea $\ge5$.
Un $\chi^2$ grande (p-valor pequeño) significa que los recuentos observados difieren de los esperados más allá del azar.
Especifique correctamente los grados de libertad (categorías $-1$, o $(r-1)(c-1)$).
Comprensión perdurable (VAR-1): Dado que la variación puede ser aleatoria o no, las conclusiones son inciertas.
Objetivo de aprendizaje VAR-1.K: Identificar preguntas sugeridas por la variación en los diagramas de dispersión. [Habilidad 1.A]
VAR-1.K.1 La variación en la posición de los puntos respecto a una línea teórica puede ser aleatoria o no aleatoria.
Fuente: College Board AP Course and Exam Description
Un gráfico de dispersión 散点图 muestra una pendiente muestral 样本斜率$b$ para la recta de regresión 回归 por mínimos cuadrados – pero una muestra diferente daría una pendiente ligeramente distinta. Por lo tanto, $b$ es una estadística con variabilidad muestral 抽样变异性 que estima la pendiente verdadera (poblacional) 总体斜率$\beta$. Esta unidad realiza inferencia 推断 sobre $\beta$: ¿existe una relación lineal 线性 real y qué tan fuerte es?
9.2
Intervalo de Confianza para una Pendiente
Syllabus
Comprensión duradera (UNC-4): Se debe utilizar un intervalo de valores para estimar parámetros, con el fin de tener en cuenta la incertidumbre.
Objetivo de aprendizaje UNC-4.AC: Identificar un procedimiento de intervalo de confianza apropiado para la pendiente de un modelo de regresión. [Habilidad 1.D]
UNC-4.AC.1 Considere una variable de respuesta, $y$, que está linealmente relacionada con una variable explicativa, $x$. Para una muestra aleatoria simple de $n$ observaciones, la línea de regresión muestral, $\hat{y} = a + bx$, es una estimación de la línea de regresión poblacional $\mu_y = \alpha + \beta x$. Para una observación particular, $(x_i, y_i)$, el residuo de la línea de regresión muestral, $y_i - \hat{y}_i = y_i - (a + bx_i)$, es una estimación de $y_i - (\alpha + \beta x_i)$, la desviación de la variable de respuesta con respecto a la línea de regresión poblacional. Para todos los puntos $(x, y)$ en la población, la desviación estándar de todas las desviaciones de la variable de respuesta con respecto a la línea de regresión poblacional, $\sigma$, puede estimarse mediante la desviación estándar de los residuos de la línea de regresión muestral, $s = \sqrt{\dfrac{\sum\left(y_i - \hat{y}_i\right)^2}{n-2}}$. (Nota: Esta fórmula utiliza $n-2$ en el denominador en lugar de $n-1$ porque se deben estimar dos parámetros, $\alpha$ y $\beta$, para obtener los valores predichos a partir de la línea de regresión por mínimos cuadrados).
UNC-4.AC.2 Para una muestra aleatoria simple de $n$ observaciones, sea $b$ la pendiente de una línea de regresión muestral. Entonces, la media de la distribución muestral para $b$ es igual a la pendiente poblacional: $\mu_b = \beta$. La desviación estándar de la distribución muestral para $b$ es $\sigma_b = \dfrac{\sigma}{\sigma_x \sqrt{n}}$, donde $\sigma_x = \sqrt{\dfrac{\sum\left(x_i - \bar{x}\right)^2}{n}}$.
UNC-4.AC.3 El intervalo de confianza apropiado para la pendiente de un modelo de regresión es un intervalo-$t$ para la pendiente.
Objetivo de aprendizaje UNC-4.AD: Verificar las condiciones para calcular intervalos de confianza para la pendiente de un modelo de regresión. [Habilidad 4.C]
UNC-4.AD.1 Con el fin de calcular un intervalo de confianza para estimar la pendiente de una línea de regresión, debemos verificar lo siguiente:
a. La relación verdadera entre $x$ y $y$ es lineal. El análisis de residuos puede utilizarse para verificar la linealidad.
b. La desviación estándar para $y$, $\sigma_y$, no varía con $x$. El análisis de residuos puede utilizarse para comprobar desviaciones estándar aproximadamente iguales para todos los $x$.
c. Para verificar la independencia:
i. Los datos deben recopilarse utilizando una muestra aleatoria o un experimento aleatorizado.
ii. Al muestrear sin reemplazo, verifique que $n \le 10\% N$.
d. Para un valor particular de $x$, las respuestas (valores $y$) siguen aproximadamente una distribución normal. El análisis de representaciones gráficas de residuos puede utilizarse para verificar la normalidad.
i. Si la distribución observada es sesgada, $n$ debe ser mayor que 30.
Objetivo de aprendizaje UNC-4.AE: Determinar el margen de error dado para la pendiente de un modelo de regresión. [Habilidad 3.D]
UNC-4.AE.1 Para la pendiente de una línea de regresión, el margen de error es el valor crítico $\left(t^*\right)$ multiplicado por el error estándar ($SE$) de la pendiente.
UNC-4.AE.2 El error estándar para la pendiente de una línea de regresión con desviación estándar muestral, $s$, es $SE = \dfrac{s}{s_x \sqrt{n-1}}$, donde $s$ es la estimación de $\sigma$ y $s_x$ es la desviación estándar muestral de los valores $x$.
Objetivo de aprendizaje UNC-4.AF: Calcular un intervalo de confianza apropiado para la pendiente de un modelo de regresión. [Habilidad 3.D]
UNC-4.AF.1 La estimación puntual para la pendiente de un modelo de regresión es la pendiente de la línea de mejor ajuste, $b$.
UNC-4.AF.2 Para la pendiente de un modelo de regresión, la estimación por intervalo es $b \pm t^* \left(SE_b\right)$.
Fuente: College Board AP Course and Exam Description
Un intervalo de $t$ para la pendiente verdadera $\beta$:
$$b\pm t^{*}\,SE_b,\qquad df=n-2,$$
donde $b$ es la pendiente muestral y $SE_b$ su error estándar (leído en la salida del computador). Condiciones (LINER): la relación verdadera es Lineal, las observaciones son Independientes, los residuos son Normales y los residuos tienen Igual amplitud (verifique el gráfico de residuos y un histograma de residuos), a partir de datos Aleatorios. Interprete el intervalo para $\beta$ en contexto, con unidades de $y$ por unidad de $x$.
Un gráfico de residuos aleatorio y sin patrones apoya las condiciones; una curva o un abanico no lo hacen
El gráfico de residuos 残差图 es donde verifica Linealidad e Igual-amplitud: desea una nube sin forma alrededor de cero. Una curva significa que la relación no es lineal; un abanico (amplitud creciente con $x$) significa que los residuos no tienen igual amplitud – ambos violan una condición.
Ejemplo resuelto. La salida de regresión da una pendiente $b=2.5$ con $SE_b=0.8$ a partir de $n=20$ puntos. Para un intervalo de $95\%$, $df=18$ proporciona $t^*=2.101$:
$$2.5\pm2.101(0.8)=2.5\pm1.68=(0.82,\ 4.18).$$
Dado que $0$no está en el intervalo, hay evidencia de una relación lineal positiva.
La inferencia de la pendiente se basa en la recta de regresión por mínimos cuadrados que pasa por los puntosRegresión por mínimos cuadrados: la recta que minimiza la suma de los residuos al cuadrado
Explorar
Inferencia para la pendiente de una regresión
La pendiente muestral varía de muestra a muestra; un intervalo de confianza y una prueba t preguntan si la pendiente verdadera podría ser cero (sin relación lineal).
Comprensión perdurable (UNC-4): Se debe utilizar un intervalo de valores para estimar parámetros, con el fin de tener en cuenta la incertidumbre.
Objetivo de aprendizaje UNC-4.AG: Interpretar un intervalo de confianza para la pendiente de un modelo de regresión. [Habilidad 4.B]
UNC-4.AG.1 En muestreo aleatorio repetido con el mismo tamaño de muestra, aproximadamente C% de los intervalos de confianza creados capturarán la pendiente del modelo de regresión, es decir, la verdadera pendiente del modelo de regresión poblacional.
UNC-4.AG.2 Una interpretación para un intervalo de confianza para la pendiente de una recta de regresión debe incluir una referencia a la muestra tomada y detalles sobre la población que representa.
Objetivo de aprendizaje UNC-4.AH: Justificar una afirmación basada en un intervalo de confianza para la pendiente de un modelo de regresión. [Habilidad 4.D]
UNC-4.AH.1 Un intervalo de confianza para la pendiente de un modelo de regresión proporciona un intervalo de valores que puede ofrecer evidencia suficiente para respaldar una afirmación particular en su contexto.
Objetivo de aprendizaje UNC-4.AI: Identificar los efectos del tamaño de la muestra en el ancho de un intervalo de confianza para la pendiente de un modelo de regresión. [Habilidad 4.A]
UNC-4.AI.1 Cuando todo lo demás se mantiene constante, el ancho del intervalo de confianza para la pendiente de un modelo de regresión tiende a disminuir a medida que aumenta el tamaño de la muestra.
Fuente: College Board AP Course and Exam Description
Si el intervalo de confianza para $\beta$ contiene $0$, una pendiente de cero es plausible – no hay evidencia de una relación lineal. Si el intervalo es enteramente positivo o negativo, hay evidencia de una relación lineal real (positiva o negativa). Establezca la dirección en contexto.
9.4
Configurar una prueba para una pendiente
Syllabus
Comprensión duradera (VAR-7): La distribución $t$ puede utilizarse para modelar la variación.
Objetivo de aprendizaje VAR-7.J: Identificar la selección adecuada de un método de prueba para la pendiente de un modelo de regresión. [Habilidad 1.E]
VAR-7.J.1 La prueba adecuada para la pendiente de un modelo de regresión es una prueba $t$ para una pendiente.
Objetivo de aprendizaje VAR-7.K: Identificar las hipótesis nula y alternativa adecuadas para la pendiente de un modelo de regresión. [Habilidad 1.F]
VAR-7.K.1 La hipótesis nula para una prueba $t$ para una pendiente es: $H_0 : \beta = \beta_0$, donde $\beta_0$ es el valor hipotético procedente de la hipótesis nula. La hipótesis alternativa es $H_0 : \beta < \beta_0$ o $H_0 : \beta > \beta_0$, o $H_0 : \beta \neq \beta_0$.
Objetivo de aprendizaje VAR-7.L: Verificar las condiciones para la prueba de significancia de la pendiente de un modelo de regresión. [Habilidad 4.C]
VAR-7.L.1 Con el fin de realizar inferencias estadísticas al probar la pendiente de un modelo de regresión, debemos verificar lo siguiente:
a. La relación verdadera entre $x$ y $y$ es lineal. El análisis de los residuos puede utilizarse para verificar la linealidad.
b. La desviación estándar de $y$, $\sigma_y$, no varía con $x$. El análisis de los residuos puede utilizarse para comprobar desviaciones estándar aproximadamente iguales para todos los $x$.
c. Para verificar la independencia:
i. Los datos deben recopilarse mediante una muestra aleatoria o un experimento aleatorizado.
ii. Cuando se muestrea sin reemplazo, verifique que $n \le 10\% N$.
d. Para un valor particular de $x$, las respuestas (valores $y$) están distribuidas aproximadamente de forma normal. El análisis de representaciones gráficas de los residuos puede utilizarse para comprobar la normalidad.
i. Si la distribución observada está sesgada, $n$ debe ser mayor que 30.
ii. Si el tamaño de la muestra es menor que 30, la distribución de los datos de la muestra debe estar libre de sesgo fuerte y valores atípicos.
Fuente: College Board AP Course and Exam Description
La prueba habitual pregunta si existe alguna relación lineal:
$$H_0:\beta=0 \quad(\text{no linear relationship})\qquad H_a:\beta\neq 0 \ (\text{or } <,\,>).$$
Verifique las condiciones LINER. Esta es una prueba $t$ sobre la pendiente.
Revise los gráficos de residuos antes de confiar en un IC o prueba de pendiente
9.5
Realizar una prueba para una pendiente
Syllabus
Comprensión duradera (VAR-7): La distribución $t$ puede utilizarse para modelar la variación.
Objetivo de aprendizaje VAR-7.M: Calcular una estadística de prueba adecuada para la pendiente de un modelo de regresión. [Habilidad 3.E]
VAR-7.M.1 La distribución de la pendiente de un modelo de regresión, asumiendo que se cumplen todas las condiciones y que la hipótesis nula es verdadera (distribución nula), es una distribución $t$.
VAR-7.M.2 Para la regresión lineal simple, cuando se realiza un muestreo aleatorio de una población para la variable de respuesta que puede modelarse con una distribución normal para cada valor de la variable explicativa, la distribución muestral de $t = \dfrac{b - \beta}{SE_b}$ tiene una distribución $t$ con grados de libertad iguales a $n - 2$. Al realizar la prueba de la pendiente en un modelo de regresión lineal simple con un parámetro, la pendiente, la prueba de la pendiente tiene $df = n - 1$.
Comprensión duradera (DAT-3): El contraste de significación nos permite tomar decisiones sobre las hipótesis dentro de un contexto determinado.
Objetivo de aprendizaje DAT-3.M: Interpretar el valor $p$ de un contraste de significación para la pendiente de un modelo de regresión. [Habilidad 4.B]
DAT-3.M.1 Una interpretación del valor $p$ de un contraste de significación para la pendiente de un modelo de regresión debe reconocer que el valor $p$ se calcula asumiendo que la hipótesis nula es verdadera, es decir, asumiendo que la pendiente poblacional verdadera es igual al valor concreto indicado en la hipótesis nula.
Objetivo de aprendizaje DAT-3.N: Justificar una afirmación sobre la población basada en los resultados de un contraste de significación para la pendiente de un modelo de regresión. [Habilidad 4.E]
DAT-3.N.1 Una decisión formal compara explícitamente el valor $p$ con el nivel de significación $\alpha$. Si el valor $p$$\le \alpha$, entonces se rechaza la hipótesis nula, $H_0 : \beta = \beta_0$. Si el valor $p$$> \alpha$, entonces no se rechaza la hipótesis nula.
DAT-3.N.2 Los resultados de un contraste de significación para la pendiente de un modelo de regresión pueden servir como razonamiento estadístico para respaldar la respuesta a una pregunta de investigación sobre esa muestra.
Fuente: College Board AP Course and Exam Description
La estadística de la pendiente $t$:
$$t=\frac{b-0}{SE_b},\qquad df=n-2.$$
Tanto $b$ como $SE_b$ provienen directamente de la salida de regresión. Encuentre el valor $p$ a partir de la distribución $t$, compárelo con $\alpha$ y concluya en contexto – evidencia (o falta de ella) de una relación lineal entre las dos variables.
Cuidado con las colas. La salida de regresión siempre imprime el valor $p$ de dos colas (para $H_a:\beta\neq 0$). Si su $H_a$ es de una sola cola, divídalo por dos – y primero verifique que la pendiente muestral realmente apunte en la dirección que $H_a$ afirma; si apunta hacia el otro lado, el valor $p$ de una sola cola estará por encima de $0.5$ y no puede rechazar $H_0$.
Ejemplo resuelto. Para la misma salida ($b=2.5$, $SE_b=0.8$, $n=20$), prueba $H_0:\beta=0$:
$$t=\frac{2.5-0}{0.8}=3.13,\qquad df=18,$$
un valor $p$ pequeño ($<0.01$), por lo tanto rechazar $H_0$ – evidencia convincente de una relación lineal. Esto coincide con el intervalo, que excluyó $0$.
9.6
Selección del procedimiento adecuado
Syllabus
Este tema tiene como objetivo centrarse en la habilidad de seleccionar un procedimiento de inferencia adecuado, una vez que los estudiantes han adquirido un abanico de opciones. Se debe brindar a los estudiantes oportunidades para practicar cuándo y cómo aplicar todos los objetivos de aprendizaje relacionados con la inferencia.
Fuente: College Board AP Course and Exam Description
En toda la inferencia estadística, identifica: qué se estima o afirma (una proporción, una media, una diferencia, una distribución de conteos o una pendiente), cuántas muestras hay y qué diseño se utiliza (independiente o emparejado; muestra o experimento). Luego nombra el procedimiento, verifica sus condiciones, ejecútalo y comunica la conclusión con la estadística, el valor $p$ o el intervalo, y una respuesta en lenguaje claro en el contexto. Esta habilidad de selección y comunicación es lo que más recompensa la pregunta de tarea investigativa.
9.6
Consejos para el examen
La inferencia para una pendiente prueba si la verdadera pendiente es $0$ (sin relación lineal).
Si el intervalo de confianza de una pendiente incluye 0, no puedes concluir una relación lineal real; las variables aún podrían estar relacionadas de manera curva.
Lee la pendiente, el error estándar, la estadística t y el valor p directamente de la salida informática; pero el valor p impreso es bilateral, así que divídelo por dos para un ⟨$H_a$⟩ unilateral.
Verifica las condiciones de regresión (linealidad, independencia, residuos aproximadamente normales, dispersión uniforme) mediante el gráfico de residuos.
Interpreta el intervalo y la prueba en el contexto, vinculados a la verdadera pendiente.