| Los candidatos deben ser capaces de: | Notas y orientación |
|---|---|
| Demostrar comprensión de las magnitudes binarias y la diferencia entre prefijos binarios y prefijos decimales | Comprender la diferencia y utilizar: • kibi y kilo • mebi y mega • gibi y giga • tebi y tera |
| Demostrar comprensión de los diferentes sistemas numéricos | Utilizar las bases numéricas binaria, decimal y hexadecimal, así como la representación en Código Decimal Codificado por Bites (BCD), complemento a uno y complemento a dos para números binarios |
| Convertir un valor entero de una base numérica o representación a otra | |
| Realizar sumas y restas binarias | Utilizando enteros binarios positivos y negativos |
| Demostrar comprensión de cómo puede producirse el desbordamiento (overflow) | |
| Describir aplicaciones prácticas donde se utilizan el Código Decimal Codificado por Bites (BCD) y el Hexadecimal | |
| Demostrar comprensión y poder representar datos de caracteres en su forma binaria interna, según el conjunto de caracteres utilizado | Se espera que los estudiantes estén familiarizados con ASCII (American Standard Code for Information Interchange), ASCII extendido y Unicode. No se espera que los estudiantes memoricen ningún código de carácter específico |
Consejos
A-Level Computer Science (9618) es dos mitades que parecen asignaturas diferentes. La mitad de teoría abarca desde la representación y comunicación de información, hardware, procesadores, software del sistema, seguridad, bases de datos y ética. La mitad práctica incluye algoritmos, estructuras de datos, programación y desarrollo de software, y el A2 añade recursividad y programación orientada a objetos.
Los exámenes de teoría se califican de forma mucho más literal de lo que los estudiantes esperan. Existe un vocabulario correcto — nombres de registros, modos de direccionamiento, formas normales, la diferencia exacta entre validación y verificación — y una paraphrase usualmente no obtiene puntos. Aprende las definiciones con la redacción del temario.
Los exámenes de programación recompensan escribir código a mano hasta que compila mentalmente.
-
1
Representación de información
Ver lección1.1
Sistemas numéricos

Syllabus
Fuente: Plan de estudios Cambridge International
Contando en binario: 0 a 15 Los tres sistemas numéricos 数制 que debes usar:
- decimal 十进制 (denary, base 10) — usa los dígitos 0–9. Los valores de posición son potencias de diez.
- binario 二进制 (base 2) — usa 0 y 1. Los valores de posición son potencias de dos. Cada byte 字节 está formado por 8 bits 位.
- hexadecimal 十六进制 (base 16) — usa 0–9 seguido de A–F para representar 10–15. Cada dígito hexadecimal representa exactamente 4 bits.
Un ábaco representa números mediante valores de posición — la misma idea detrás del decimal, binario y hexadecimal Conversiones
Decimal → binario: sigue dividiendo entre 2 y anota los residuos; léelos de abajo hacia arriba. O bien, resta el mayor valor de posición 位值 (potencia de 2) que quepa.
Ejemplo: $558_{10}$: $558 = 512 + 32 + 8 + 4 + 2 = 2^{9} + 2^{5} + 2^{3} + 2^{2} + 2^{1}$. En 12 bits:
0010 0010 1110.Binario → hexadecimal: agrupa los bits en nibbles 半字节 (4 bits) desde la derecha y convierte cada grupo.
0010 0010 1110→2 2 E→22E.Hexadecimal → binario: sustituye cada dígito hexadecimal por su patrón de 4 bits. Hexadecimal → decimal: multiplica cada dígito por su valor de posición.
22E$= 2 \times 256 + 2 \times 16 + 14 = 558$.Ejercicio resuelto. Convierte el decimal 200 a binario de 8 bits y luego a hexadecimal.
$200 = 128 + 64 + 8$, por lo tanto el binario es
11001000. Agrupado en nibbles,11001000y $= 12$ $8$, es decir, $\text{C}$ y $8$, así que el hexadecimal esC8.
Lectura de 200 a partir de sus valores de posición, y agrupación de los bits en nibbles para obtener C8 en hexadecimal ¿Cuántos bits?
Las preguntas de examen fijan el ancho del registro 寄存器宽度 (8, 12 o 16 bits). Rellena con ceros a la izquierda hasta alcanzar ese ancho: $558$ en 12 bits es
0010 0010 1110, nunca10 0010 1110.Para encontrar el número mínimo de bits necesarios para almacenar un valor, pregunta qué valores de posición necesitas:
- Un entero sin signo desde $0$ hasta $2^{n} - 1$ necesita $n$ bits: $200$ necesita 8 bits (el máximo es $255$), $1000$ necesita 10 bits (el máximo es $1023$), $16$ necesita 5 bits (4 bits se detienen en $15$).
- Un entero en complemento a dos desde $-2^{n-1}$ hasta $2^{n-1} - 1$ necesita $n$ bits: $-200$ necesita 9 bits, porque 8 bits se detienen en $-128$.
- Un dígito hexadecimal necesita 4 bits, un dígito BCD necesita 4 bits y un carácter ASCII necesita 7 bits (8 para ASCII extendido).
Prefijos binarios vs decimales
Dos familias de prefijos parecen similares pero difieren — decimal (potencias de 10) y binario (potencias de 2):
Decimal (SI) Binario (memoria) kilo $= 10^{3}$ kibi (Ki) $= 2^{10} = 1024$ mega $= 10^{6}$ mebi (Mi) $= 2^{20}$ giga $= 10^{9}$ gibi (Gi) $= 2^{30}$ tera $= 10^{12}$ tebi (Ti) $= 2^{40}$ Por lo tanto, un tebibyte (TiB) es ligeramente mayor que un terabyte (TB). Una unidad de almacenamiento marcada como "1 TB" contiene $10^{12}$ bytes, pero un sistema operativo que informa en TiB mostrará un número menor.
ExplorarBinario, decimal y hexadecimal
Escribe un número y vélo en binario, decimal y hexadecimal a la vez — y cómo se suman los valores posicionales.
Vocabulario EntrenarInglés Chino Pinyin number system/ˈnʌmbə ˈsɪstəm/ 数制 shù zhì binary/ˈbaɪnəri/ 二进制 èr jìn zhì denary/ˈdiːnəri/ 十进制 shí jìn zhì place value/pleɪs ˈvæljuː/ 位值 wèi zhí byte/baɪt/ 字节 zì jié bit/bɪt/ 位 wèi hexadecimal/ˌheksəˈdesɪml/ 十六进制 shí liù jìn zhì nibble/ˈnɪbl/ 半字节 bàn zì jié register width/ˈredʒɪstə wɪtθ/ 寄存器宽度 jì cún qì kuān dù register/ˈredʒɪstə/ 寄存器 jì cún qì BCD/ˌbiː siː ˈdiː/ 二进码十进数 èr jìn mǎ shí jìn shù 1.1
Aritmética binaria
Suma binaria
Se suma columna por columna de derecha a izquierda, llevándolos tal como se hace en decimal:
Bit A Bit B Acarreo entrante Bit de suma Acarreo saliente 0 0 0 0 0 0 0 1 1 0 0 1 0 1 0 0 1 1 0 1 1 1 0 0 1 1 1 1 1 1 Desbordamiento (Overflow) ocurre cuando el resultado necesita más bits de los que puede contener el registro; el acarreo saliente de la columna más a la izquierda es el bit de desbordamiento.
Ejemplo resuelto. Sume los enteros sin signo de 8 bits $10110101$ y $01101100$, y comente sobre el resultado.
$10110101 + 01101100 = 1\,00100001$. La respuesta necesita 9 bits, por lo que no cabe en un registro de 8 bits: ha ocurrido un desbordamiento. Una respuesta completa debe nombrar el error y explicar por qué, utilizando el tamaño de palabra dado en la pregunta: "Desbordamiento: el resultado real ($289$) es mayor que el valor máximo que puede contener un registro de 8 bits ($255$), por lo que el acarreo saliente del bit más significativo se pierde y el resultado almacenado ($00100001 = 33$) es incorrecto."
Resta binaria
La forma habitual es mediante la suma del complemento a dos: para realizar $A - B$, forme el complemento a dos de $B$ (invierta cada bit y sume 1), luego sume y descarte cualquier acarreo saliente final.
Para restar $00011110$ de $01100100$ (sin signo, 8 bits):
- Complemento a dos de $00011110$: invertir → $11100001$, sumar 1 → $11100010$.
- Sumar a $01100100$: resultado $1\,01000110$ (9 bits) — descarte el 1 inicial → $01000110 = 70_{10}$. Verificación: $100 - 30 = 70$. ✓
Enteros con signo en complemento a dos
En un número en complemento a dos de $n$ bits:
- El bit más significativo (MSB) es el bit de signo: 0 = positivo, 1 = negativo.
- Para leer un número negativo: invierta cada bit, sume 1 y luego cambie el signo.
Así, $11100010$ es negativo; invierte → $00011101$, suma 1 → $00011110 = 30$, por lo que es $-30$. Esto es un entero con signo (a diferencia de uno sin signo). El rango para $n$ bits es de $-2^{n-1}$ a $+2^{n-1} - 1$; para 8 bits, de $-128$ ($10000000$) a $+127$ ($01111111$).
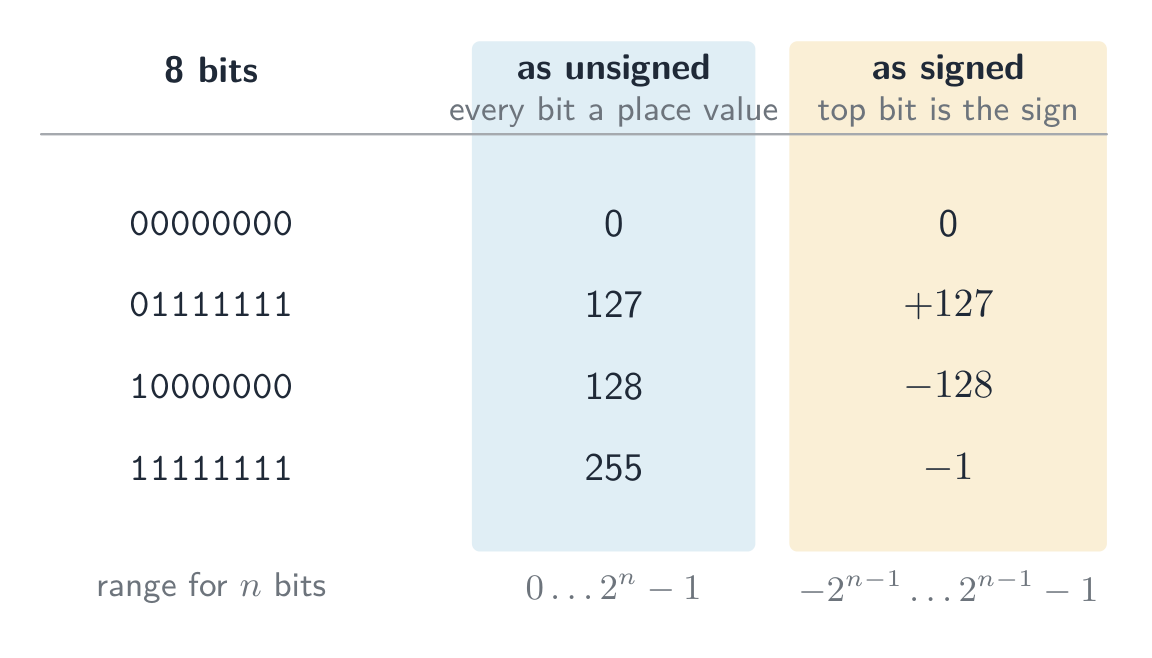
Los mismos bits significan diferentes números dependiendo de la lectura acordada. Como un entero sin signo, cada bit es un valor posicional, por lo que 8 bits van desde $0$ hasta $255$; como un entero signado en complemento a dos, el bit superior es el signo, por lo que los mismos 8 bits van desde $-128$ hasta $+127$. El patrón $11111111$ representa $255$ leído de una manera y $-1$ leído de la otra —nada en los propios bits indica cuál es la correcta.
El mismo byte leído como sin signo y como signado: solo la interpretación acordada los distingue
 Complemento a dos de 8 bits: el bit de signo divide el rango en negativo ($-128$ a $-1$) y positivo ($0$ a $127$)
Ejemplo resuelto. ¿Qué valor decimal representa el número en complemento a dos de 8 bits $10110100$?
El MSB es 1, por lo tanto es negativo. Invertir → $01001011$, sumar 1 → $01001100 = 76$, por lo tanto el valor es $-76$. Verificar con valores posicionales: $-128 + 32 + 16 + 4 = -76$.
Ejemplo resuelto. Escribir $-108$ como un entero en complemento a dos de 12 bits.
Empezar con $+108$ en 12 bits: $108 = 64 + 32 + 8 + 4$, por lo tanto
0000 0110 1100. Invertir cada bit:1111 1001 0011. Sumar 1:1111 1001 0100. Verificar con valores posicionales, donde el bit superior vale $-2^{11} = -2048$: $-2048 + 1024 + 512 + 256 + 128 + 16 + 4 = -108$. ✓Para 12 bits, el rango va de $-2048$ (
1000 0000 0000) hasta $+2047$ (0111 1111 1111). Las preguntas que solicitan los valores más pequeños y más grandes buscan estos dos patrones específicos, por lo que se debe aprender la regla: el número más negativo es un 1 seguido de ceros; el más positivo es un 0 seguido de unos.Un corrimiento aritmético 算术移位 mueve cada bit hacia la izquierda o hacia la derecha pero mantiene el signo: un corrimiento a la derecha por una posición reduce a la mitad el valor y copia el bit de signo en el espacio vacío a la izquierda, por lo que un número negativo permanece negativo (
1111 1001 0100desplazado tres posiciones a la derecha es1111 1111 0010, que equivale a $-14$: $-108 / 8 = -13.5$, y un corrimiento a la derecha redondea hacia abajo). Un corrimiento a la izquierda duplica el valor. Los corrimientos pertenecen al conjunto de instrucciones de ensamblaje en el tema 4, pero esta pregunta se formula en el contexto del trabajo numérico aquí tratado.El desbordamiento en aritmética signada ocurre cuando el resultado real cae fuera de este rango —se detecta cuando el bit de signo cambia incorrectamente (dos positivos dando como resultado un negativo, o dos negativos dando como resultado un positivo).
Complemento a uno
Antes del complemento a dos, un esquema más antiguo llamado complemento a uno 反码 representaba un número negativo simplemente invertiendo todos los bits del positivo —no existe el paso de "sumar 1".
- $+30 = 00011110$, por lo tanto en complemento a uno $-30 = 11100001$ (solo el inverso).
- Desventaja: tiene dos ceros —$00000000$ ($+0$) y $11111111$ ($-0$)— lo cual desperdicia un patrón de bits y complica la aritmética.
El complemento a dos (invertir y sumar 1) elimina el cero negativo: tiene un único cero y permite que la suma y la resta utilicen el mismo circuito. Por eso las computadoras modernas almacenan enteros signados en complemento a dos, no en complemento a uno.
ExplorarBinario y enteros con signo
byte = Σ valores de posición
Ver cómo un patrón de 8 bits se mapea a un número (y cómo desbordaría más allá de 255).
ExplorarBits con signo en complemento a dos
El bit más a la izquierda tiene un valor de posición negativo. Invierta cualquier bit o haga clic en Negar (invertir todos los bits, luego sumar 1) y observe cómo cambia el valor con signo.
Vocabulario EntrenarInglés Chino Pinyin unsigned/ʌnˈsaɪnd/ 无符号 wú fú hào overflow/ˌəʊvəˈfləʊ/ 溢出 yì chū most significant bit/məʊst sɪɡˈnɪfɪkənt bɪt/ 最高有效位 zuì gāo yǒu xiào wèi two's complement/tuːz ˈkɒmplɪmənt/ 补码 bǔ mǎ signed integer/saɪnd ˈɪntɪdʒə/ 有符号整数 yǒu fú hào zhěng shù sign bit/saɪn bɪt/ 符号位 fú hào wèi arithmetic shift/ˌærɪθˈmetɪk ʃɪft/ 算术移位 suàn shù yí wèi one's complement/wʌnz ˈkɒmplɪmənt/ 反码 fǎn mǎ 7-segment display/ˈsevən ˈseɡmənt dɪˈspleɪ/ 七段显示器 qī duàn xiǎn shì qì memory address/ˈmeməri əˈdres/ 内存地址 nèi cún dì zhǐ code point/kəʊd pɔɪnt/ 码点 mǎ diǎn character set/ˈkærɪktə set/ 字符集 zì fú jí encoding/enˈkəʊdɪŋ/ 编码 biān mǎ render/ˈrendə/ 渲染 xuàn rǎn analogue data/ˈænəlɒɡ ˈdeɪtə/ 模拟数据 mó nǐ shù jù digital data/ˈdɪdʒɪtl ˈdeɪtə/ 数字数据 shù zì shù jù 1.1
Decimal codificado binariamente (BCD)

En BCD (código decimal binario), cada dígito decimal se escribe como su propio patrón de 4 bits. El número $93$ es
1001 0011en BCD — no el binario 93 ($01011101$). Cada nibble usa solo 0–9; los patrones $1010$–$1111$ son inválidos.Lectura BCD:
0010 0111 0101→ 2, 7, 5 → 275.Uso: calculadoras, relojes digitales y dispositivos que muestran dígitos decimales — cada dígito acciona un pantalla de 7 segmentos (七段显示器). Los códigos de divisa suelen usar BCD para evitar errores de redondeo al convertir fracciones como 0.1 a binario.
Una respuesta de "justificación" debe vincular el uso con una propiedad del BCD: cada dígito decimal tiene sus propios 4 bits, por lo que un dígito puede enviarse directamente a su pantalla o sumarse dígito por dígito, sin conversión de todo el número; y una fracción decimal como $0.10$ se almacena exactamente, algo que una fracción binaria no puede hacer.
Una pantalla de 7 segmentos muestra un dígito decimal, frecuentemente accionada por BCD Vocabulario EntrenarInglés Chino Pinyin digit/ˈdɪdʒɪt/ 数位 shù wèi 1.1
Hexadecimal — usos prácticos

El hexadecimal es una forma compacta de escribir binario (1 dígito hex = 4 bits):
Un byte son dos nibbles; cada nibble es un dígito hexadecimal - direcciones de memoria (内存地址) en programación de bajo nivel —
0x7FFE. - valores de color en HTML/CSS —
#FF8800. - direcciones MAC —
AC:DE:48:00:11:22.
El hexadecimal no cambia los datos almacenados — solo hace el binario más fácil para los humanos.
1.1
Códigos de caracteres
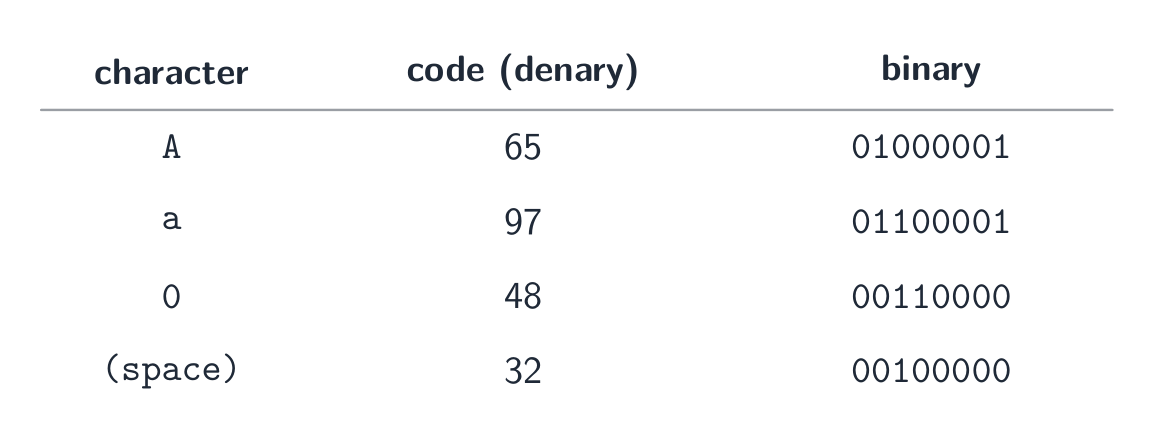
Las computadoras almacenan texto como números; cada carácter tiene un punto de código (码点) numérico definido por un juego de caracteres (字符集).
ASCII
- ASCII usa 7 bits — 128 puntos de código. Letras latinas básicas, dígitos, puntuación y códigos de control.
- ASCII extendido usa 8 bits — 256 puntos de código; los primeros 128 coinciden con ASCII, los últimos 128 varían según la región.
Cada carácter se almacena como un número — algunos puntos de código ASCII en decimal y binario Unicode
- Unicode es un juego de caracteres universal que cubre casi todos los alfabetos, además de símbolos y emojis.
- codificaciones (编码) comunes: UTF-8 (1–4 bytes, compatible con ASCII), UTF-16 (2 o 4 bytes), UTF-32 (fijo de 4 bytes).
Por qué Unicode supera a ASCII
- representa mucho más caracteres (todos los alfabetos, emojis); ASCII cubre solo inglés básico.
- los archivos son portátiles sin confusión de páginas de código, y permiten texto multilingüe en un solo documento.
- compromiso: los archivos Unicode suelen ser más grandes para texto en inglés únicamente.
Cuando una pregunta pide diferencias, da las respuestas en pares con números: ASCII usa 7 bits (ASCII extendido 8), así que 128 (256) caracteres; Unicode usa hasta 32 bits (UTF-8 usa de 1 a 4 bytes), así que más de un millón de puntos de código. ASCII cubre solo inglés básico; Unicode cubre todos los alfabetos, y sus primeros 128 puntos de código son los de ASCII. En UTF-8, una letra en inglés aún ocupa 1 byte, así que un nombre de archivo en inglés de 40 letras mide 40 bytes tanto en ASCII como en UTF-8, mientras que un carácter chino ocupa 3 bytes.
ExplorarUn carácter se almacena como un número
Cada carácter tiene un código numérico: 'A' es 65. Invierte los bits para ver ese código en binario y hexadecimal, exactamente como lo guarda el ordenador.
1.2
Imágenes bitmap
Syllabus
Los candidatos deben ser capaces de: Notas y orientación Demostrar comprensión de cómo se codifican los datos de una imagen bitmap Utilizar y comprender los términos: píxel, cabecera del archivo, resolución de imagen, resolución de pantalla, profundidad de color / profundidad de bits Realizar cálculos para estimar el tamaño de un archivo de una imagen bitmap Demostrar comprensión de los efectos que produce el cambio de elementos en una imagen bitmap sobre la calidad de la imagen y el tamaño del archivo Utilizar los términos: resolución de imagen, profundidad de color / profundidad de bits Demostrar comprensión de cómo se codifican los datos de una gráfica vectorial Utilizar los términos: objeto de dibujo, propiedad, lista de dibujos Justificar el uso de una imagen bitmap o una gráfica vectorial para una tarea dada Demostrar comprensión de cómo se representa y codifica el sonido Utilizar los términos: muestreo, frecuencia de muestreo, resolución de muestreo, datos analógicos y datos digitales Demostrar comprensión del impacto del cambio en la frecuencia de muestreo y la resolución Incluye el impacto en el tamaño del archivo y la precisión Fuente: Plan de estudios Cambridge International
Una imagen bitmap (también llamada imagen bitmap) almacena el color de cada píxel (像素) en una cuadrícula. Al inicio del archivo, un encabezado de archivo (文件头) registra los metadatos de la imagen — su ancho, alto y profundidad de color — para que el software sepa cómo leer los datos de píxeles que siguen.
- resolución de imagen (图像分辨率): el tamaño propio del bitmap, ancho × alto en píxeles (ej. 1920 × 1080).
- resolución de pantalla (屏幕 resolución): el ancho × alto que el pantalla puede mostrar. Si la resolución de una imagen es mayor que la pantalla, se escala hacia abajo para caber; una imagen de baja resolución se ve pixelada al estirarla sobre una pantalla de mayor resolución.
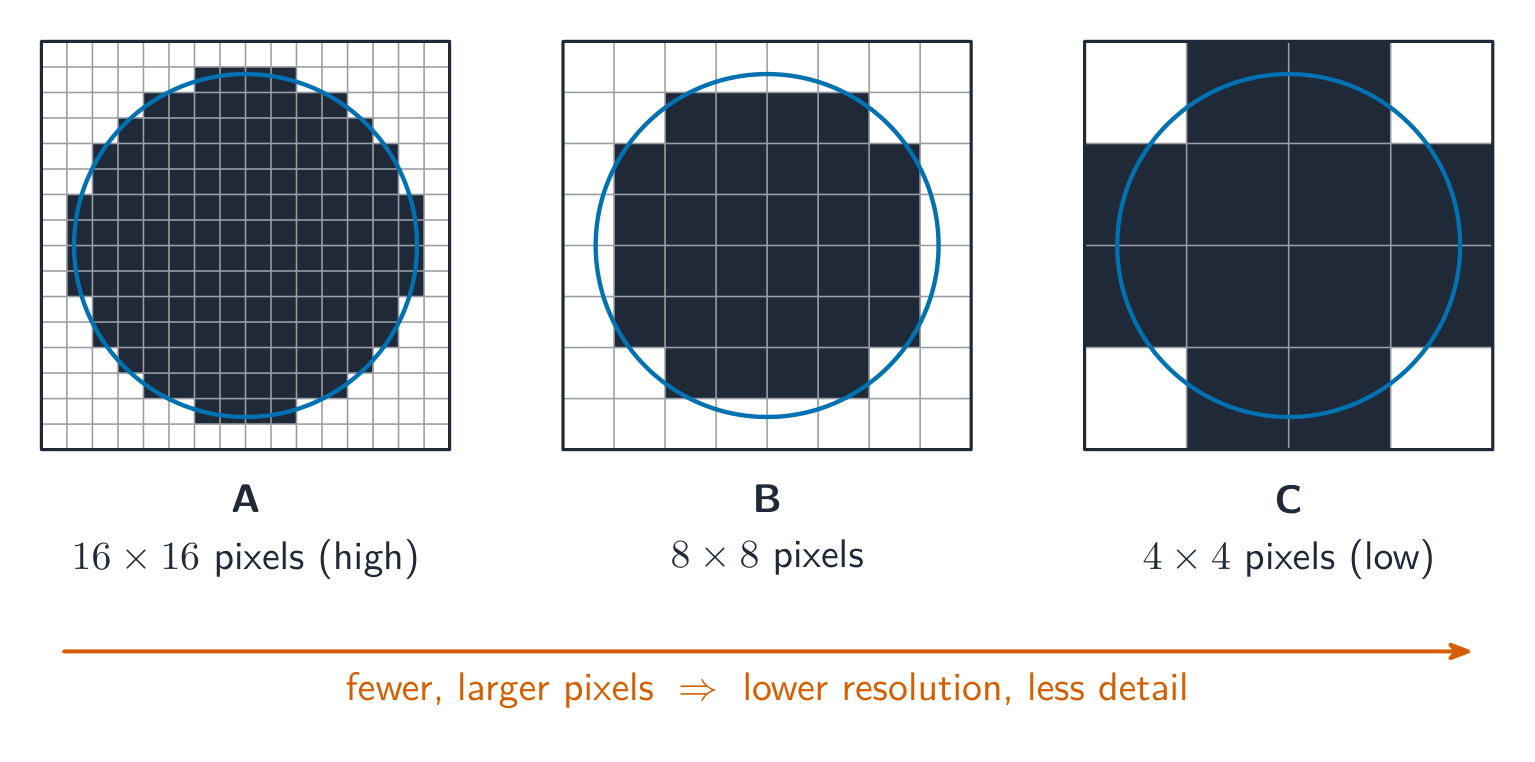
- profundidad de color 颜色深度 (profundidad de bits 位深度): bits por píxel. 1 bit → blanco y negro; 8 bits → 256 colores; 24 bits → 16.7 millones ("color verdadero").
La misma imagen almacenada a tres resoluciones, de alta (A) a baja (C): menos píxeles, más grandes significan menos detalle Tamaño de archivo
$$\text{size in bits} = \text{width} \times \text{height} \times \text{bit depth}.$$Divide entre 8 para bytes, entre 1024 para KiB, etc. Ejemplo: una imagen $3000 \times 2000$ a 24 bpp es $3000 \times 2000 \times 24 = 1.44 \times 10^{8}$ bits $\approx 17.2\ \text{MiB}$.
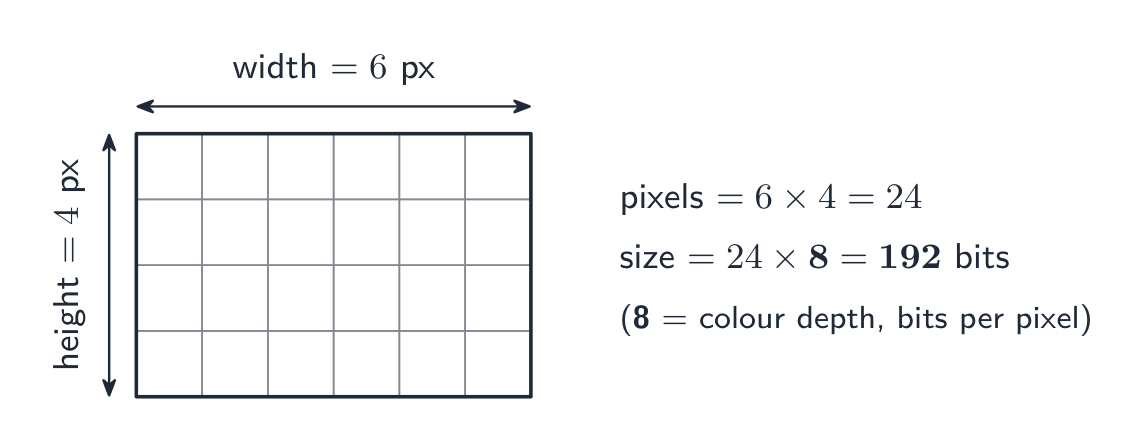
La misma fórmula con números pequeños: cuenta los píxeles, luego multiplica por la profundidad de color Indica las unidades que usaste. La rúbrica acepta $1\ \text{MB} = 10^{6}$ bytes (el prefijo SI) o $1\ \text{MiB} = 1024 \times 1024$ bytes (el prefijo binario), siempre que tu procedimiento muestre cuál usaste; la misma imagen mide $18.0\ \text{MB}$ o $17.2\ \text{MiB}$. Añade el tamaño del encabezado de archivo si la pregunta te lo proporciona.
Un video es una secuencia de imágenes bitmap, cada una es un frame (帧). Antes de la compresión, su tamaño es el de un frame $\times$ la velocidad de fotogramas (帧率) (fotogramas por segundo) $\times$ la duración en segundos: 30 fotogramas por segundo de $1920 \times 1080$ píxeles a 24 bits es $30 \times 1920 \times 1080 \times 24 \approx 1.5 \times 10^{9}$ bits, aproximadamente $187\ \text{MB}$, por cada segundo. Por eso el video siempre se comprime.
Cambiar configuraciones
- menor resolución → archivo más pequeño, menos detalle (se ve pixelado al ampliarse).
- menor profundidad de color → archivo más pequeño, pero los degradados suaves muestran bandas.
- mayor de cualquiera de los dos → archivo más grande, mejor calidad.
Vocabulario EntrenarInglés Chino Pinyin bitmap/ˈbɪtmæp/ 位图 wèi tú pixel/ˈpɪksl/ 像素 xiàng sù file header/faɪl ˈhedə/ 文件头 wén jiàn tóu colour depth/ˈkʌlə depθ/ 颜色深度 yán sè shēn dù image resolution/ˈɪmɪdʒ ˌrezəˈluːʃn/ 图像分辨率 tú xiàng fēn biàn lǜ screen resolution/skriːn ˌrezəˈluːʃn/ 屏幕分辨率 píng mù fēn biàn lǜ bit depth/bɪt depθ/ 位深度 wèi shēn dù frame/freɪm/ 帧 zhēn 1.2
Gráficos vectoriales
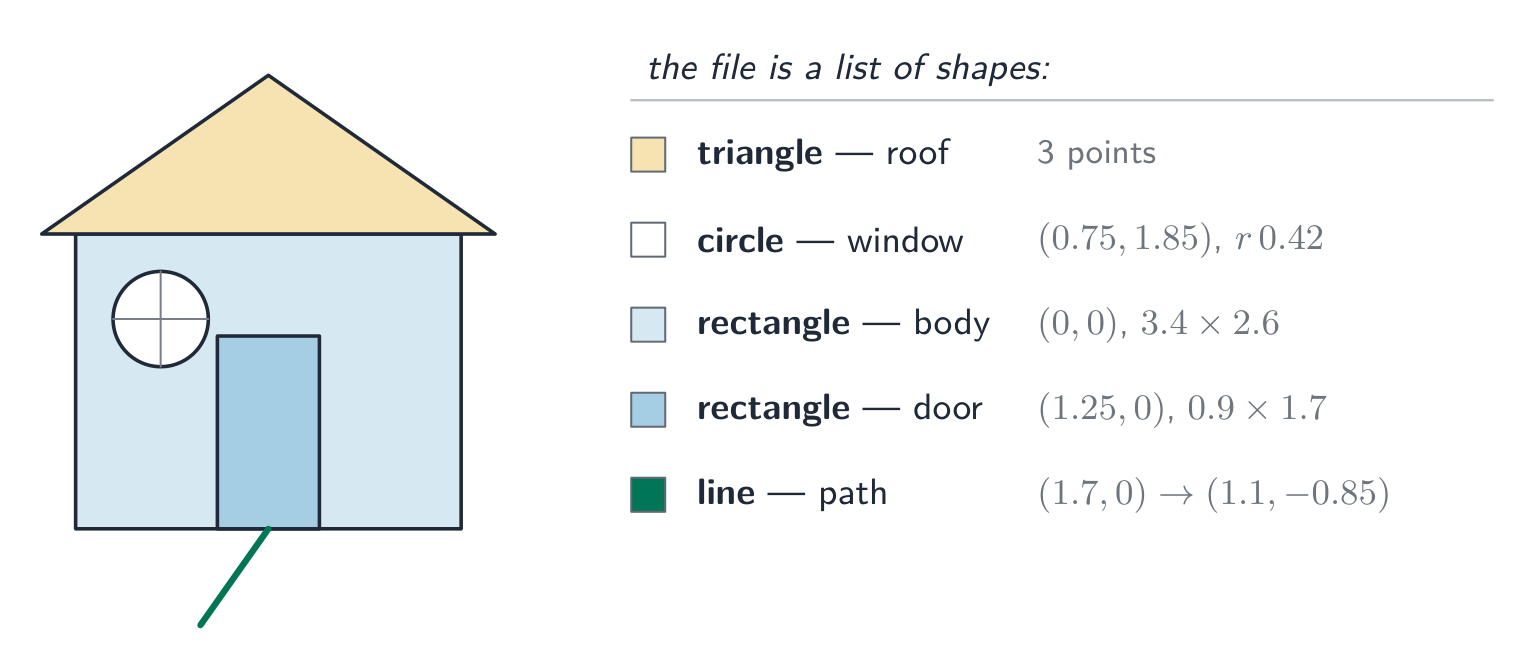
Un gráfico vectorial (矢量图形) almacena las instrucciones para dibujar la imagen como una lista de dibujo (绘图列表) — una lista ordenada de objetos de dibujo (绘图对象) (primitivas geométricas 图元: líneas, curvas, polígonos, círculos). Cada objeto de dibujo tiene propiedades (属性) como color, relleno, grosor de línea y posición (coordenadas). Para mostrarlo, el programa renderiza (渲染) la lista de dibujo a cualquier resolución necesaria.
Una imagen vectorial está construida a partir de formas geométricas etiquetadas, cada una con atributos Bitmap vs vector
Tarea Mejor opción Por qué Fotografía Bitmap El detalle complejo a nivel de píxel no se puede describir como formas. Logo, icono, señal Vector Bordes nítidos; escala a cualquier tamaño sin desenfoque. Dibujo técnico Vector Geometría precisa y escalado. Pintura, textura Bitmap Detalle tonal suave por área. Ventaja vectorial: escala sin perder calidad — un logo vectorial permanece nítido a cualquier tamaño, mientras que un bitmap se desenfoca al ampliarse. Desventaja vectorial: no puede describir arbitrary detalle de píxeles (fotografías).
Una respuesta de "justificación" vincula la elección con la tarea. "El logo debe aparecer en una tarjeta de visita y en un cartel publicitario, por lo que debería ser un gráfico vectorial: se almacena como objetos de dibujo y se renderiza con nitidez a cualquier tamaño, mientras que un bitmap mostraría sus píxeles al ampliarse." Para una fotografía el argumento funciona a la inversa: no hay formas que describir, por lo que el color de cada píxel debe almacenarse.
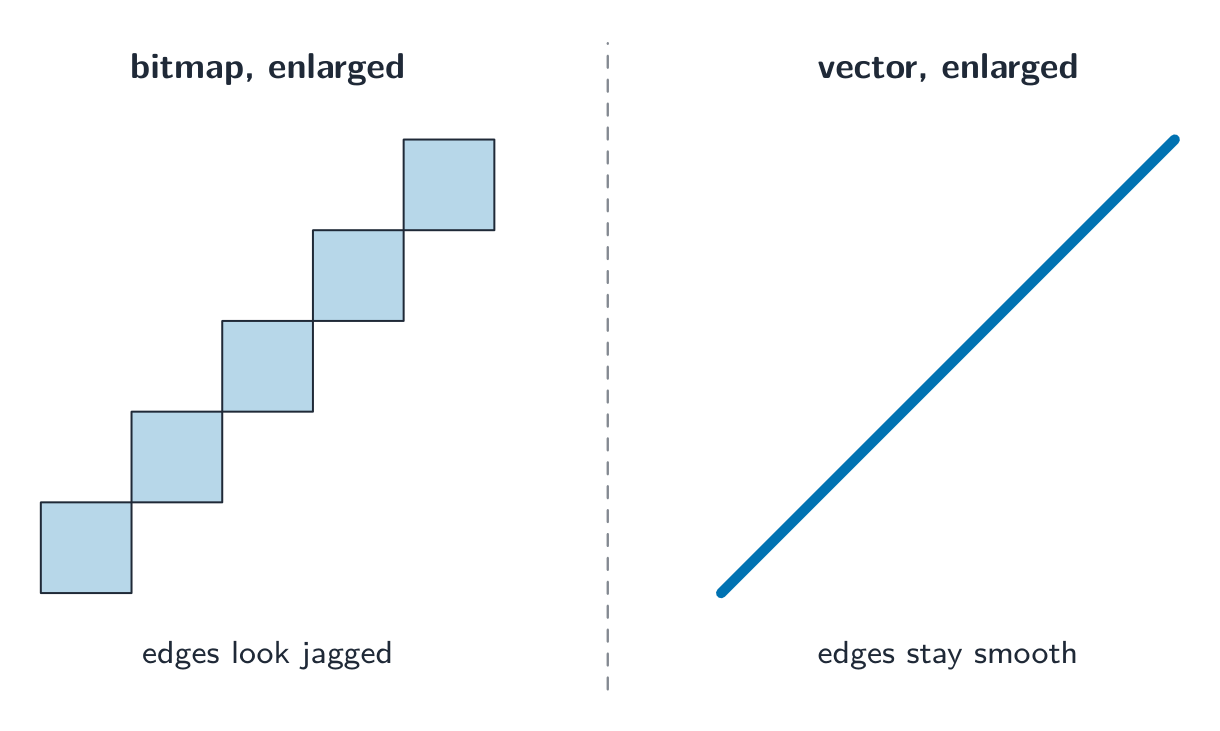
Al agrandar, los píxeles de un mapa de bits se vuelven dentados; un vector permanece suave a cualquier tamaño ExplorarLaboratorio de conceptos informáticos
Clasificar ejemplos concretos según la idea informática que demuestran.
Vocabulario EntrenarInglés Chino Pinyin vector graphic/ˈvektə ˈɡræfɪk/ 矢量图形 shǐ liàng tú xíng drawing list/ˈdrɔːɪŋ lɪst/ 绘图列表 huì tú liè biǎo drawing objects/ˈdrɔːɪŋ ˈɒbdʒekts/ 绘图对象 huì tú duì xiàng primitive/ˈprɪmɪtɪv/ 图元 tú yuán properties/ˈprɒpətiz/ 属性 shǔ xìng 1.2
Sonido
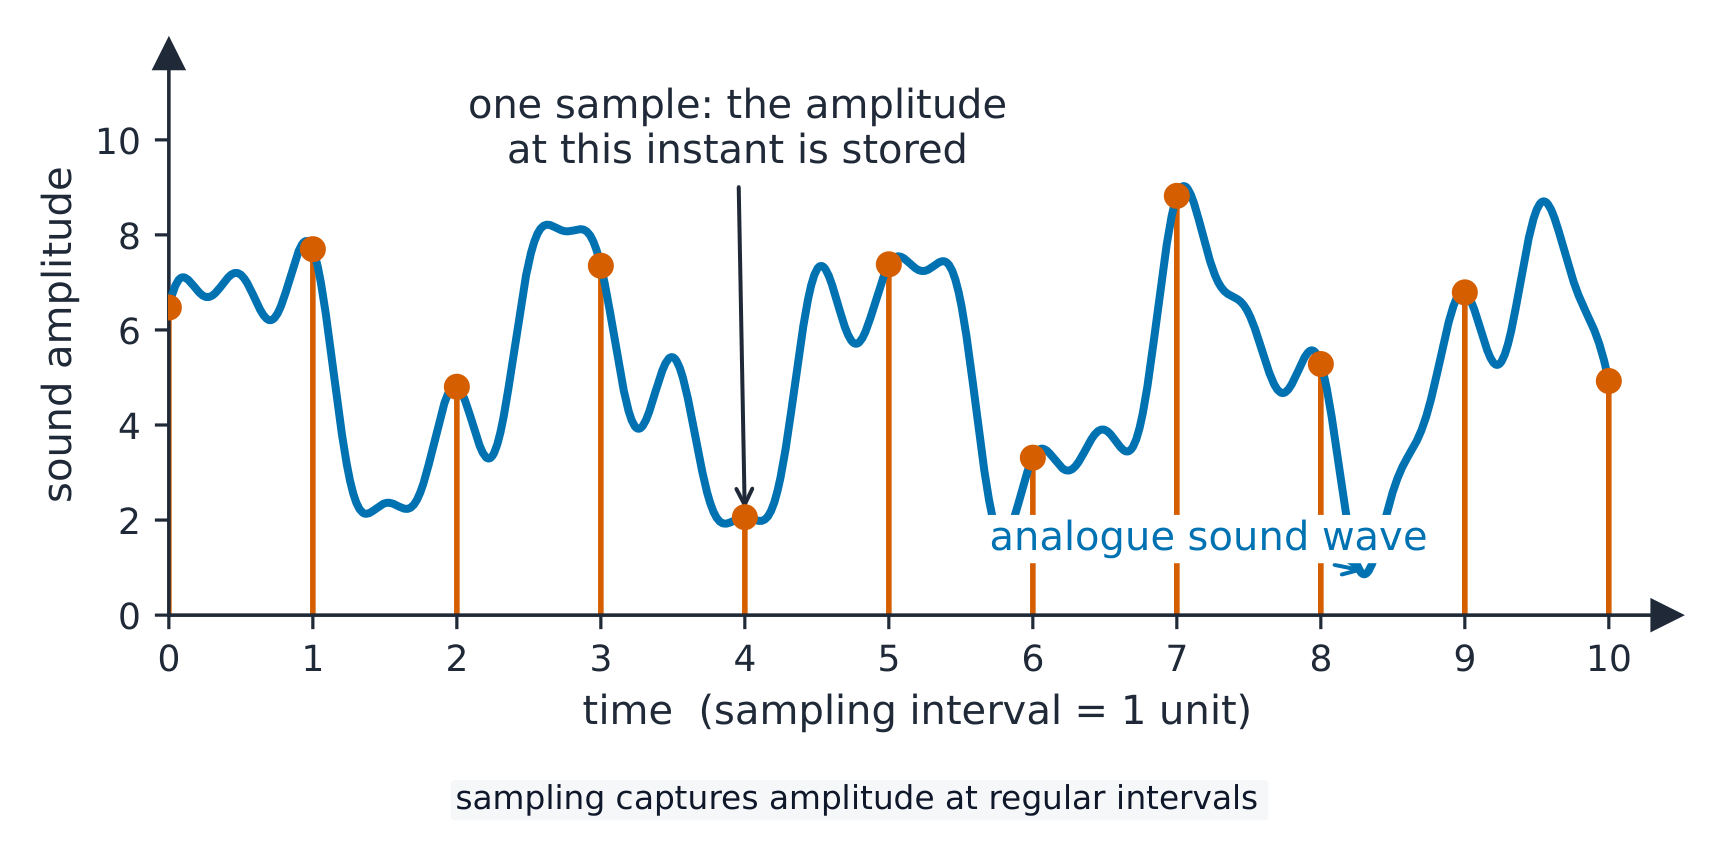
Una onda continua de datos analógicos 模拟数据 (el sonido) se convierte en datos digitales 数字数据 mediante el muestreo 采样:
- frecuencia de muestreo 采样率 — muestras por segundo (Hz). La calidad CD es $44.1\ \text{kHz}$.
- resolución de muestreo 采样分辨率 (profundidad de bits) — bits por muestra de amplitud 振幅. La calidad CD es 16 bits.
Muestreo de una onda sonora: su amplitud se lee en cada intervalo de tiempo Tamaño de archivo
$$\text{size in bits} = \text{sampling rate} \times \text{resolution} \times \text{duration} \times \text{channels}.$$Un clip estéreo CD de 10 segundos: $44100 \times 16 \times 10 \times 2 = 14\,112\,000$ bits $\approx 1.68\ \text{MiB}$.
Cambiar configuraciones
- mayor frecuencia de muestreo → capta tonos más agudos, archivo más grande.
- mayor resolución de muestreo → pasos de amplitud más finos, menos ruido de cuantificación 量化, archivo más grande.
- menor cualquiera de ellos → archivo más pequeño, pérdida clara de calidad.
(La frecuencia de muestreo debe ser al menos el doble de la frecuencia más alta que desees mantener.)
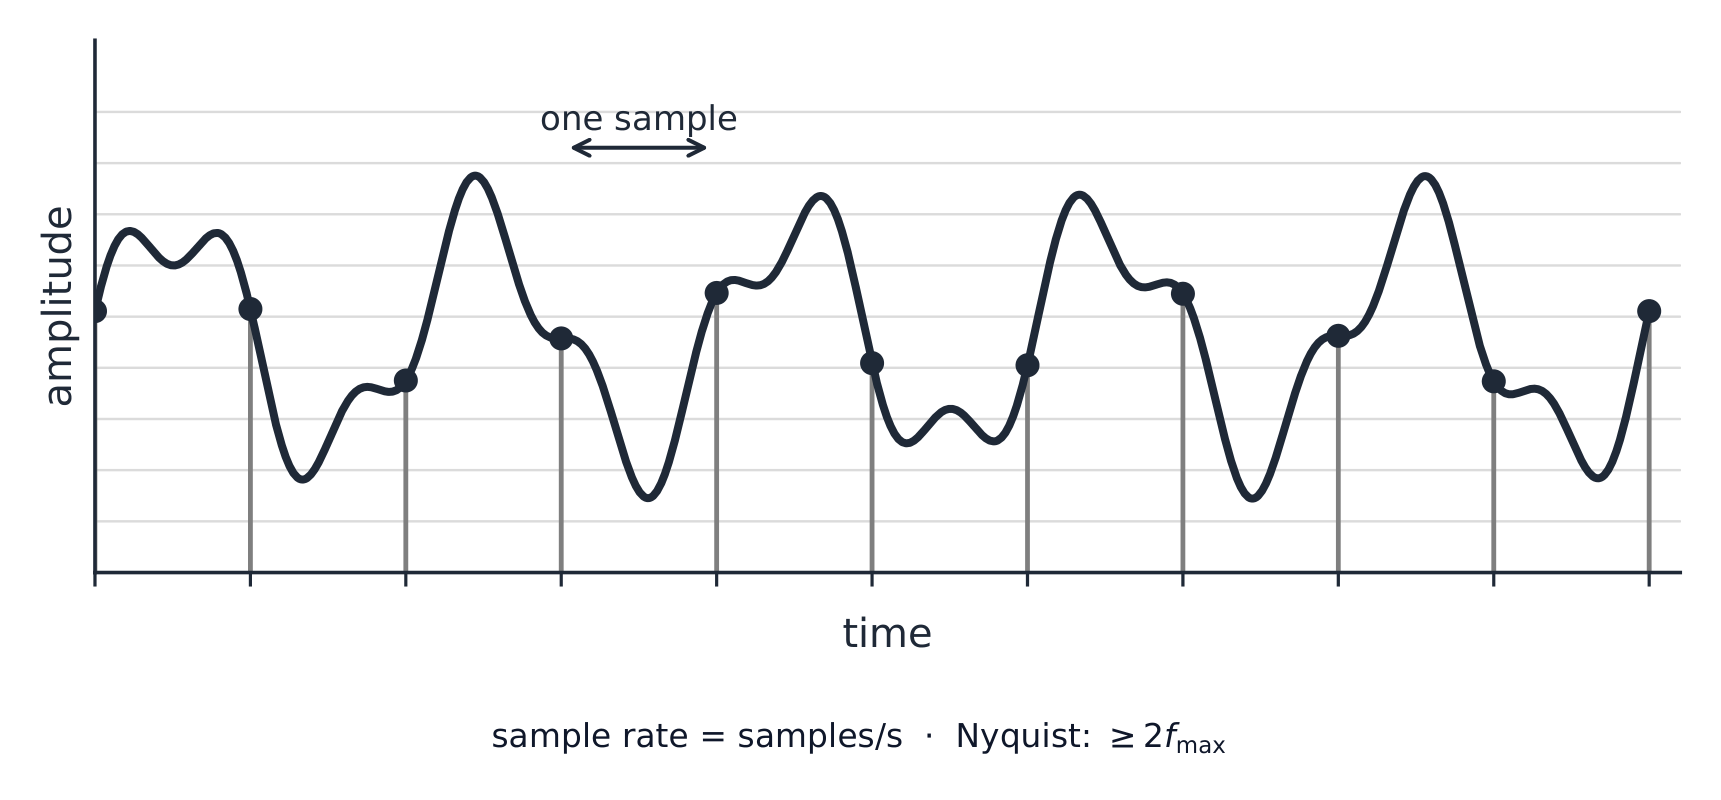
La tasa de muestreo son muestras por segundo; la regla de Nyquist explica por qué debe ser al menos el doble de la frecuencia más alta mantenida ExplorarMuestreo de sonido
y = a sin(bt + c)
El muestreo mide una onda sonora a intervalos regulares; una tasa mayor la copia con mayor fidelidad.
Vocabulario EntrenarInglés Chino Pinyin sampling/ˈsæmplɪŋ/ 采样 cǎi yàng sampling rate/ˈsæmplɪŋ reɪt/ 采样率 cǎi yàng lǜ sampling resolution/ˈsæmplɪŋ ˌrezəˈluːʃn/ 采样分辨率 cǎi yàng fēn biàn lǜ amplitude/ˈæmplɪtjuːd/ 振幅 zhèn fú sample resolution/ˈsæmpl ˌrezəˈluːʃn/ 采样分辨率 cǎi yàng fēn biàn lǜ quantisation/ˌkwɒntaɪˈzeɪʃn/ 量化 liàng huà bandwidth/ˈbændwɪdθ/ 带宽 dài kuān lossless/ˈlɒsləs/ 无损 wú sǔn lossy/ˈlɒsi/ 有损 yǒu sǔn run-length encoding/rʌn leŋθ enˈkəʊdɪŋ/ 行程编码 xíng chéng biān mǎ dictionary methods/ˈdɪkʃənəri ˈmeθədz/ 字典编码 zì diǎn biān mǎ 1.3
Compresión
Syllabus
Los candidatos deben ser capaces de: Notas y orientación Demostrar comprensión de la necesidad y los ejemplos de uso de la compresión Demostrar comprensión de la compresión con pérdida y sin pérdida, y justificar el uso de un método en una situación determinada Demostrar comprensión de cómo se puede comprimir un archivo de texto, una imagen mapa de bits, un gráfico vectorial y un archivo de sonido Incluyendo el uso del codificación por longitud de corrida (RLE) Fuente: Plan de estudios Cambridge International
La compresión 压缩 reduce el tamaño del archivo, ahorrando almacenamiento y ancho de banda 带宽 para la transmisión. Dos tipos:
- sin pérdida 无损 — los datos originales se recuperan exactamente (texto, programas, ZIP/PNG).
- con pérdida 有损 — se descarta algún detalle para obtener archivos mucho más pequeños (JPEG, MP3, vídeo).
Cuándo usar cada uno
- sin pérdida para documentos, código fuente, imágenes médicas: cualquier cosa que necesite datos exactos.
- con pérdida para medios en streaming. El vídeo en streaming en tiempo real usa compresión con pérdida porque debe enviar grandes cantidades de datos en tiempo real sobre ancho de banda limitado; la sin pérdida no lo reduciría lo suficiente. El vídeo HD sin comprimir pesa gigabytes por minuto, así que sin compresión la imagen seguiría congelándose.
Una respuesta "justificar" menciona el método y luego la razón derivada de la situación: "Sin pérdida, porque la hoja de cálculo debe restaurarse exactamente; un único valor cambiado haría que las cuentas estuvieran mal". O: "Con pérdida, porque las fotografías se ven en una pantalla de teléfono donde el detalle descartado no es visible, y los archivos más pequeños se cargan más rápido y ocupan menos almacenamiento".
Métodos sin pérdida
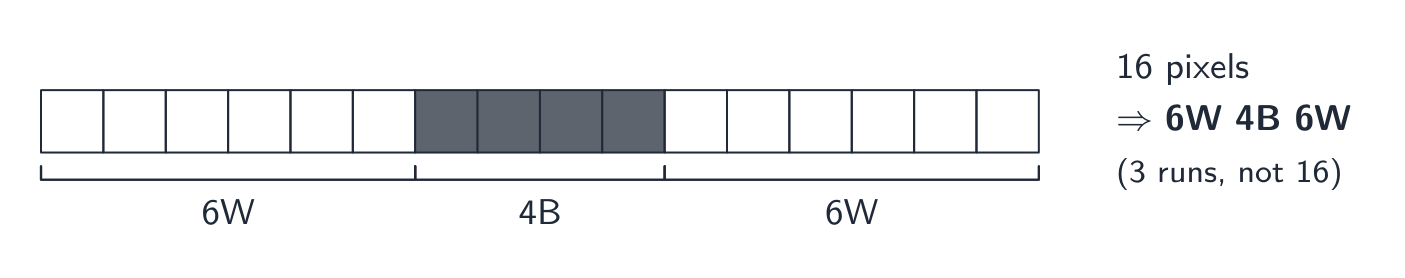
- código de longitud de corrida 行程编码 (RLE): almacena "los siguientes $n$ valores son $x$" en lugar de repetir $x$. Ideal para zonas planas; inútil para datos ruidosos.
- métodos de diccionario 字典编码 (ZIP, PNG): reemplazan secuencias repetidas de bytes con una referencia corta. Bueno para texto y código.
- codificación Huffman 霍夫曼编码: asigna códigos cortos a símbolos comunes y largos a raros, acercando la longitud promedio del código a la entropía 熵 de los datos.
Cómo se comprime cada tipo de archivo:
- archivo de texto: los métodos de diccionario y la codificación Huffman convierten palabras repetidas y caracteres comunes en códigos cortos. El texto debe permanecer sin pérdida, porque un solo carácter cambiado altera el significado.
- imagen bitmap: RLE para series de píxeles idénticos (iconos, diagramas, escaneados en blanco y negro); JPEG con pérdida para fotografías, o menor profundidad de color o resolución.
- gráfico vectorial: la lista de dibujo ya es pequeña; eliminar objetos de dibujo innecesarios, almacenar coordenadas con menos decimales, o aplicar un método sin pérdida como ZIP al archivo.
- archivo de sonido: MP3 o AAC con pérdida elimina lo que el oído no puede escuchar; una frecuencia o resolución de muestreo menor también es con pérdida; los formatos sin pérdida mantienen cada muestra y reducen el archivo significativamente menos.
Código de longitud de corrida en una sola fila: 16 píxeles se convierten en 3 corridas 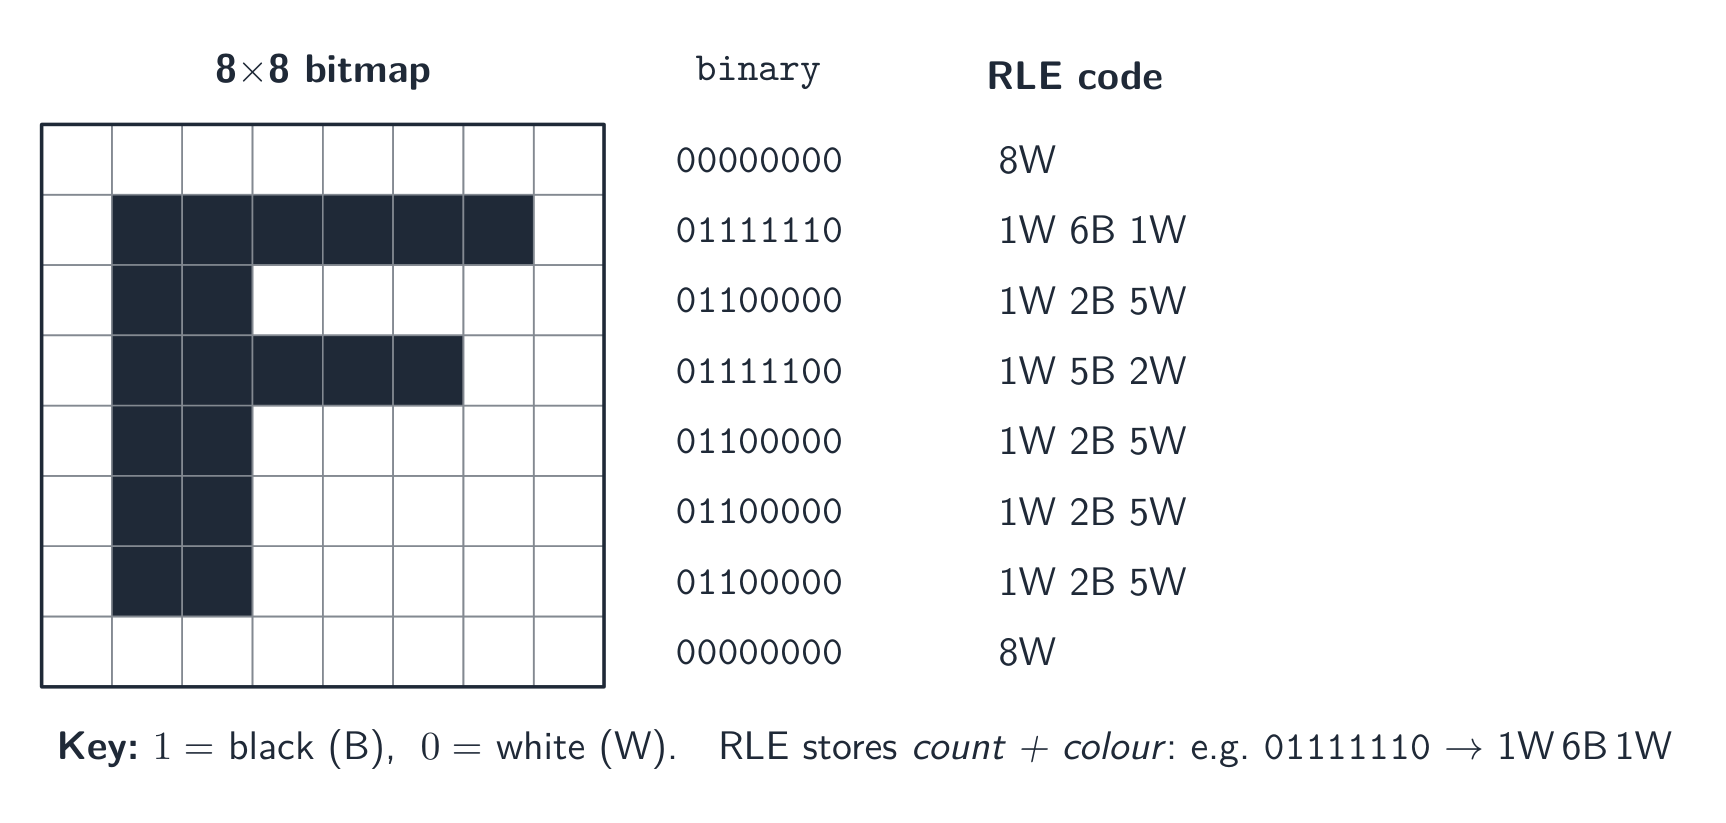
Código de longitud de corrida de la letra F en una cuadrícula blanco y negro de $8\times8$ 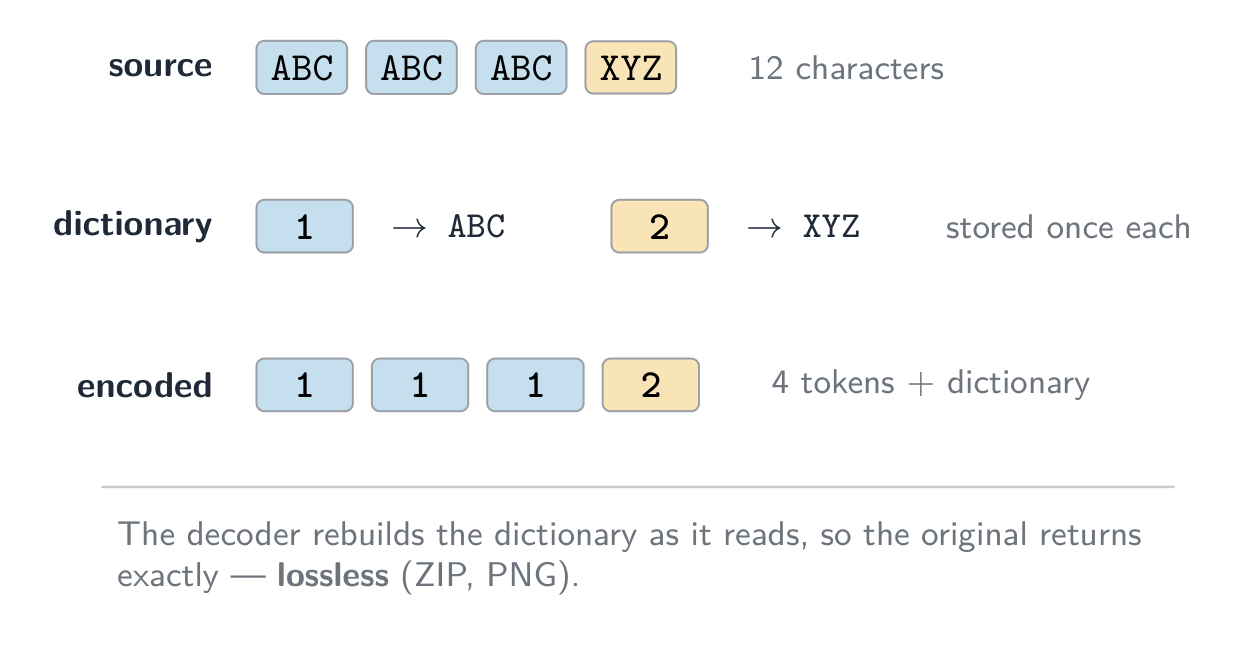
Codificación de diccionario: cada secuencia repetida se almacena una vez, y cada ocurrencia se convierte en un índice corto 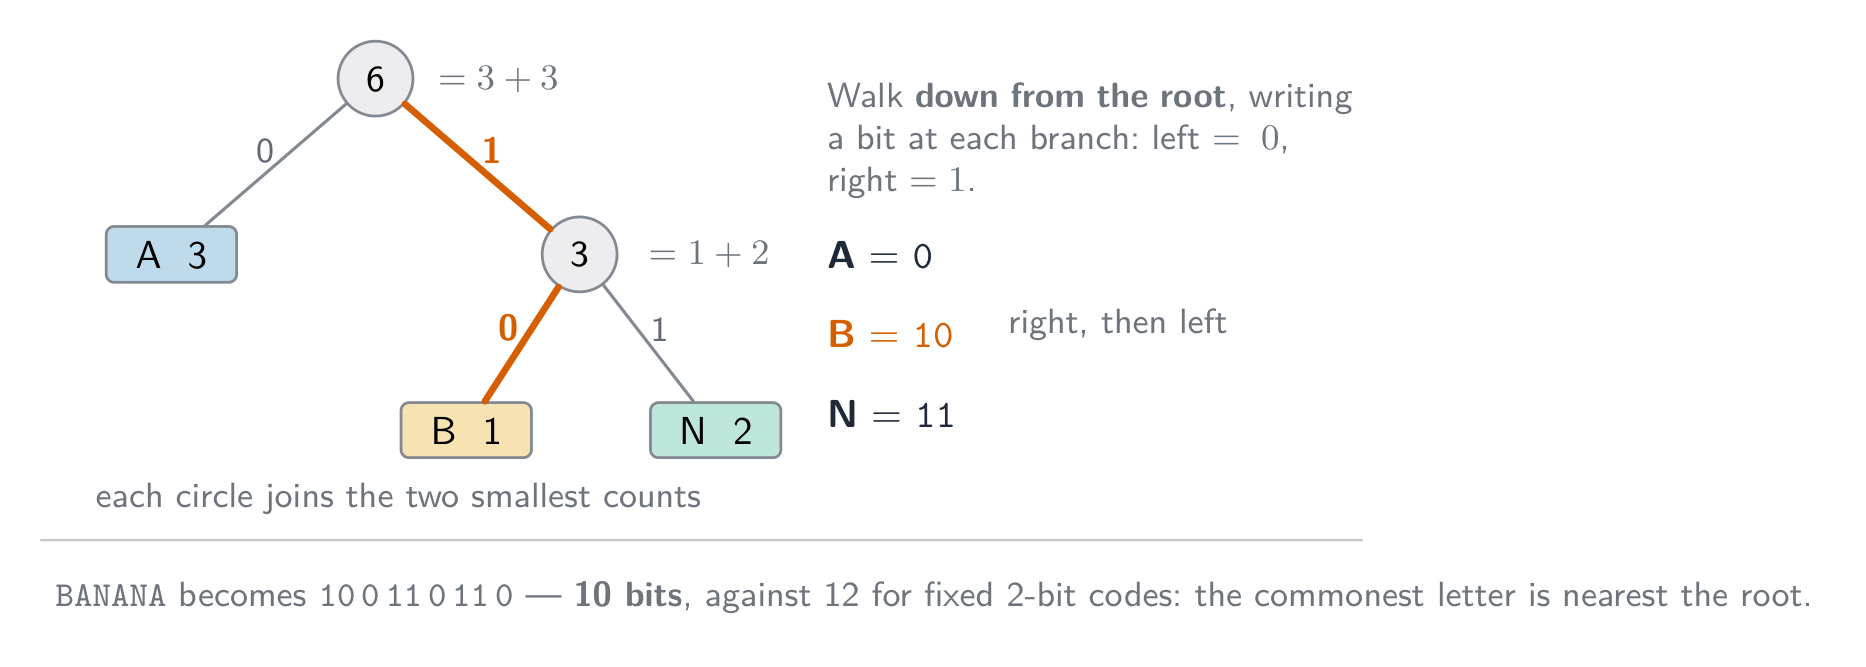
Codificación Huffman: el símbolo más común obtiene el código más corto, por lo que BANANA necesita 10 bits en lugar de 12 Métodos con pérdida
- imágenes (JPEG): descarta detalles finos y diferencias de color que el ojo apenas percibe.
- sonido (MP3, AAC): descarta tonos que escuchamos peor y sonidos silenciosos ocultados por otros más fuertes.
- vídeo combina compresión espacial 空间 (dentro de cada fotograma, como JPEG) con compresión temporal 时间 (la mayoría de los fotogramas solo almacenan las diferencias respecto al fotograma anterior).
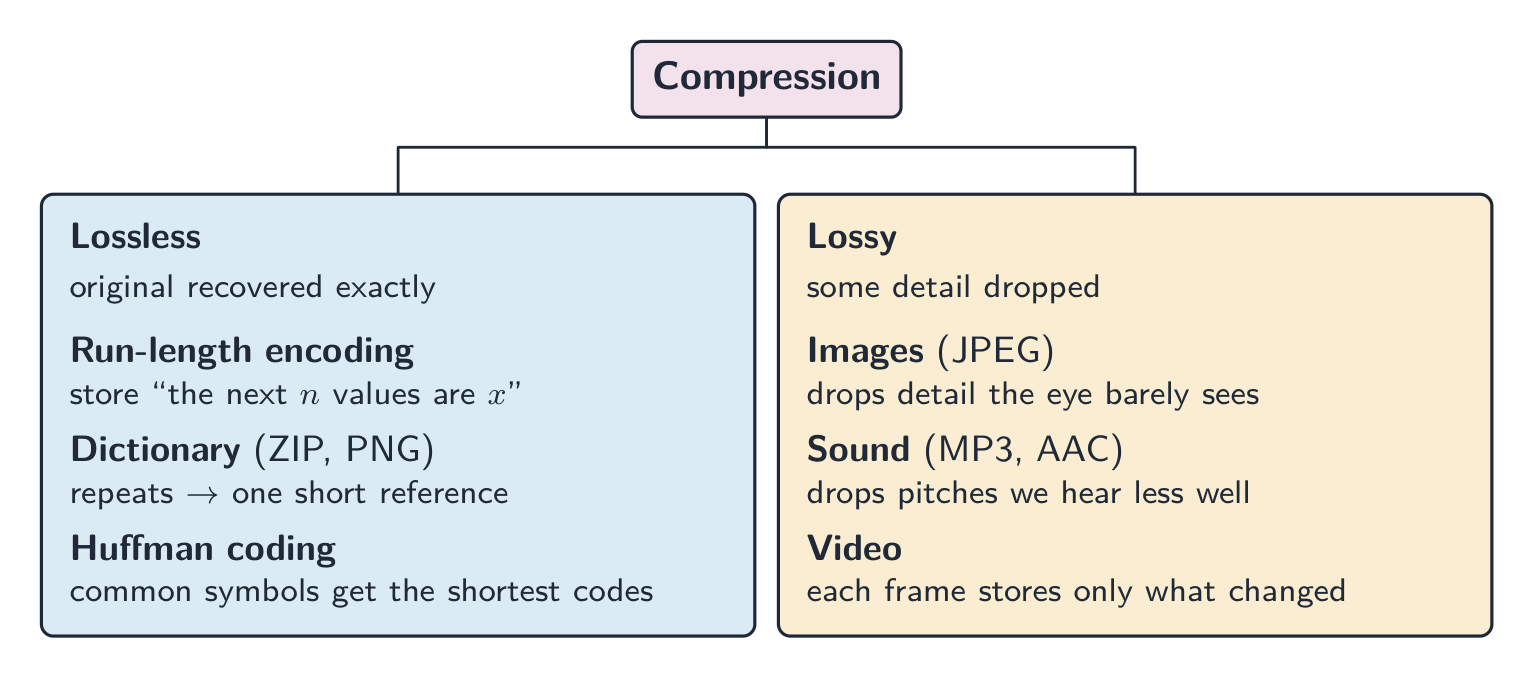
Métodos de compresión: sin pérdida versus con pérdida, con ejemplos comunes ExplorarCodificación de longitud de corrida
Observa cómo una serie de símbolos repetidos se comprime en un conteo — compresión sin pérdida simple.
Vocabulario EntrenarInglés Chino Pinyin compression/kəmˈpreʃn/ 压缩 yā suō frame rate/freɪm reɪt/ 帧率 zhēn lǜ Huffman coding/ˈhʌfmən ˈkəʊdɪŋ/ 霍夫曼编码 huò fū màn biān mǎ entropy/ˈentrəpi/ 熵 shāng spatial/ˈspeɪʃl/ 空间 kōng jiān temporal/ˈtempərəl/ 时间 shí jiān 1.3
Definiciones aceptadas por el examinador
Una pregunta de definición se califica según un texto fijo. Aprende estas definiciones exactamente, y da solo una respuesta.
Término Definición bit un solo dígito binario, 0 o 1 byte un grupo de 8 bits prefijo binario un multiplicador que es una potencia de 2 (kibi = 1024) en lugar de una potencia de 10 (kilo = 1000) complemento a dos una forma de representar enteros con signo en la que el bit más significativo tiene un valor posicional negativo desbordamiento el resultado de un cálculo es demasiado grande para ser representado en el número de bits disponibles Decimal Codigo Binario cada dígito decimal se almacena como su propio patrón binario de 4 bits conjunto de caracteres el conjunto de caracteres que una computadora puede representar, cada uno con su propio código binario píxel el elemento más pequeño de una imagen bitmap, que almacena un valor de color resolución de imagen el número de píxeles en una imagen, dado como ancho por alto resolución de pantalla el número de píxeles que una pantalla puede mostrar, dado como ancho por alto profundidad de color el número de bits usados para almacenar el color de un píxel frecuencia de muestreo el número de muestras de sonido tomadas por segundo resolución de muestreo el número de bits usados para almacenar la amplitud de una muestra compresión sin pérdida compresión de la cual los datos originales pueden recuperarse exactamente compresión con pérdida compresión que elimina permanentemente algunos datos, por lo que los originales no pueden recuperarse código de longitud de corrida reemplazar una serie de valores repetidos con un valor y un conteo 1.3
Consejos para el examen
- Mostrar el procedimiento para conversiones de bases: decimal → binario por posiciones, binario → hexadecimal en nibbles (grupos de 4 bits).
- Para el complemento a dos, el bit más significativo es negativo; para negar, invertir y sumar 1; tener cuidado con el desbordamiento cuando el bit de signo cambia incorrectamente.
- Diferenciar entre mapa de bits (píxeles; tamaño del archivo $=$ ancho $\times$ alto $\times$ profundidad de color) y vectorial (comandos de dibujo; escala sin pérdida).
- El tamaño de un archivo de sonido depende de la tasa de muestreo $\times$ profundidad de bits $\times$ tiempo: mayor cantidad de cada uno implica mejor calidad pero un archivo más grande.
- Comparar la compresión sin pérdidas vs con pérdidas y dar un uso para cada una.
Errores comunes
- Explicar un desbordamiento diciendo "la respuesta fue mayor que 255" o "tiene 9 bits". Indicar el tamaño de palabra dado en la pregunta, luego afirmar que el resultado no puede representarse en él.
- Crear un número negativo estableciendo el bit superior en 1 y dejando el resto igual (signo y magnitud). El complemento a dos significa invertir todos los bits del valor positivo, luego sumar 1.
- Olvidar rellenar con ceros un número convertido hasta alcanzar el ancho de registro que pide la pregunta.
- Mezclar bits y bytes en un cálculo del tamaño de un archivo. Trabajar en bits, dividir entre 8 una sola vez, e indicar si se usaron 1000 o 1024.
- Responder "describe" con lenguaje cotidiano ("la imagen empeora"). Usar los términos del programa: menos colores, banda de color, menor resolución de imagen, píxeles más grandes.
-
2
Comunicación
Ver lección2.1
Networks: purpose and benefits
Syllabus
Los candidatos deben ser capaces de: Notas y orientación Demostrar comprensión del propósito y los beneficios de las redes de dispositivos Demostrar comprensión de las características de una LAN (red de área local) y una WAN (red de área amplia) Explicar los modelos cliente-servidor y par-a-par de computadoras en red Roles de las diferentes computadoras dentro del modelo de red y subred Beneficios y desventajas de cada modelo Justificar el uso de un modelo para una situación dada Demostrar comprensión de los conceptos de Thin-client (cliente ligero) y Thick-client (cliente grueso) y sus diferencias Demostrar comprensión de las topologías bus, estrella, malla e híbrida Comprender cómo se transmiten los paquetes entre dos hosts para una topología dada Justificar el uso de una topología para una situación dada Demostrar comprensión de la computación en la nube Incluye el uso de nubes públicas y privadas Beneficios y desventajas de la computación en la nube Demostrar comprensión de las diferencias e implicaciones del uso de redes inalámbricas y con cable Describir las características del cable de cobre, el cable de fibra óptica, las ondas de radio (incluido WiFi), las microondas y los satélites Describir el hardware utilizado para soportar una LAN Incluye switch, servidor, Tarjeta de Interfaz de Red (NIC), Tarjeta de Interfaz de Red Inalámbrica (WNIC), Puntos de Acceso Inalámbricos (WAP), cables, puente, repetidor Describir el rol y la función de un router en una red Demostrar comprensión de Ethernet y cómo se detectan y evitan las colisiones Incluye Acceso Múltiple por Detección de Portadora/Colisión (CSMA/CD) Demostrar comprensión del transmisión de bits (bit streaming) Métodos de transmisión de bits, es decir, en tiempo real y bajo demanda Importancia de las tasas de bits y la velocidad de banda ancha en la transmisión de bits Demostrar comprensión de las diferencias entre la World Wide Web (WWW) e internet Describir el hardware utilizado para soportar internet Incluye módems, PSTN (Red Telefónica Conmutada Pública), líneas dedicadas, red de telefonía celular Explicar el uso de direcciones IP en la transmisión de datos a través de internet Incluye: • formato de una dirección IP, incluyendo IPv4 e IPv6 • uso de subredes en una red • cómo se asocia una dirección IP con un dispositivo en una red • diferencia entre una dirección IP pública y una dirección IP privada y las implicaciones para la seguridad • diferencia entre una dirección IP estática y una dirección IP dinámica Explicar cómo se utiliza un Uniform Resource Locator (URL) para localizar un recurso en la World Wide Web (WWW) y el rol del Domain Name Service (DNS) Fuente: Plan de estudios Cambridge International
Una roja 网络 es un conjunto de dispositivos informáticos conectados para poder comunicarse y compartir recursos. Ventajas:
- compartir recursos (impresoras, servidores de archivos, internet) — más barato que equipar cada ordenador.
- compartir datos — muchos usuarios acceden a los mismos archivos.
- gestión centralizada — instalar software, gestionar usuarios y hacer copias de seguridad una sola vez en un servidor.
- communication — email, video calls, messaging.
- remote access — work from anywhere.
ExplorarLaboratorio de rutas de red
Seguir los datos de un dispositivo a través del hardware de red y los protocolos.
Vocabulario EntrenarInglés Chino Pinyin ISP/ˌaɪ es ˈpiː/ 互联网服务提供商 hù lián wǎng fú wù tí gōng shāng cell phone network/sel fəʊn ˈnetwɜːk/ 蜂窝网络 fēng wō wǎng luò subnets/ˈsʌbnets/ 子网 zi wǎng subnet mask/ˈsʌbnet mæsk/ 子网掩码 zi wǎng yǎn mǎ 2.1
LAN vs WAN

Una red de área local 局域网 (LAN) cubre un área pequeña — una casa, oficina o escuela, generalmente propiedad de la organización, con altas tasas de datos y baja latencia 延迟.
Una red de área amplia 广域网 (WAN) cubre un gran área — una ciudad, país o el mundo (internet es la WAN más grande). Utiliza infraestructura de compañías de telecomunicaciones — a menudo la Red Telefónica Pública Conmutada 公共交换电话网 (PSTN), líneas arrendadas o fibra — con tasas de datos más bajas y mayor latencia. Una WAN conecta LANs entre sí.
Para "dar dos características de una LAN": cubre un área geográfica pequeña (un sitio o edificio); el hardware es propiedad de la organización, no alquilado a una empresa de telecomunicaciones; se conecta mediante sus propios switches, cables y puntos de acceso. Para "dos formas en que una WAN es diferente": cubre un área geográfica grande; utiliza infraestructura de terceros (alquilada o pública); las velocidades de datos son menores y la latencia mayor; generalmente une varias LANs. Una escuela en un solo sitio es una LAN; una empresa con oficinas en dos ciudades necesita una WAN, con una línea alquilada o internet entre los sitios. Justifique la elección con el área cubierta y quién posee los enlaces.
Una red de área amplia conecta muchos sistemas a través de una gran área 2.1
Client-server and peer-to-peer

Client-server
- máquinas potentes actúan como servidores 服务器, proporcionando servicios (archivos, páginas web, correo electrónico).
- other machines are clients 客户端 that request services.
- centralizadas y fáciles de gestionar, pero el servidor es un único punto de fallo si no está respaldado.
En una red cliente-servidor, los clientes solicitan servicios a un servidor central Peer-to-peer (P2P)
- todas las máquinas son pares iguales; cada una puede ser tanto cliente como servidor (peer-to-peer 对等网络).
- los recursos se distribuyen entre los pares — sin servidor central. Robusto ante un fallo individual, pero más difícil de mantener seguro y consistente.
Elegir un modelo. El modelo cliente-servidor se adapta a una escuela o negocio: los archivos se almacenan y respaldan centralmente, un usuario inicia sesión con una cuenta desde cualquier máquina, el software y la seguridad se gestionan una sola vez, y el servidor puede ser una máquina potente. Las desventajas son el costo del servidor y de un técnico, y que el servidor es un único punto de fallo. El modelo peer-to-peer (punto a punto) se adapta a unos pocos amigos compartiendo archivos o jugando: no hay servidor que comprar, fácil de configurar, y cada usuario mantiene el control de su propia máquina. Las desventajas que enumera el esquema: los archivos están distribuidos en muchas máquinas, por lo que son difíciles de respaldar y un archivo no está disponible cuando la máquina de su propietario está apagada; cada máquina debe protegerse por separado; y un par que sirve a los demás ralentiza. Un juego en línea jugado a través de un navegador web con otros usuarios es el modelo cliente-servidor: el navegador es el cliente, y el juego y su mundo virtual compartido se ejecutan en el servidor de la empresa, que mantiene consistente la vista de cada jugador.

En una red peer-to-peer, cada nodo es tanto cliente como servidor Vocabulario EntrenarInglés Chino Pinyin server/ˈsɜːvə/ 服务器 fú wù qì client/ˈklaɪənt/ 客户端 kè hù duān peer-to-peer/pɪə tə pɪə/ 对等网络 duì děng wǎng luò bus/bʌs/ 总线 zǒng xiàn bandwidth/ˈbændwɪdθ/ 带宽 dài kuān 2.1
Thin and thick clients
Un cliente ligero 瘦 cliente realiza poco procesamiento local y depende de un servidor potente (terminales web, escritorios remotos). Un cliente grueso 胖 cliente tiene fuerte capacidad de procesamiento y almacenamiento local y ejecuta aplicaciones completas por sí mismo (un PC de escritorio normal).
Feature Thin client Thick client Local processing minimal substantial Local storage minimal substantial Reliance on network alto menor Server load alto menor Los roles: en un modelo de cliente ligero (thin-client) el servidor realiza el procesamiento y almacena los datos, y el cliente solo envía entradas y muestra la salida. Basta con un terminal barato, y todo se respalda y actualiza en el servidor, pero nada funciona si falla la red o el servidor. En un modelo de cliente grueso (thick-client) el cliente ejecuta el software y almacena archivos él mismo, por lo que puede funcionar sin conexión a la red y pone menos carga en el servidor, a costa de clientes más potentes (y más caros) que deben actualizarse y protegerse individualmente. Una sala de ordenadores escolar puede usar clientes ligeros (baratos, gestionados centralmente); un editor de vídeo necesita un cliente grueso.
Vocabulario EntrenarInglés Chino Pinyin network/ˈnetwɜːk/ 网络 wǎng luò thick client/θɪk ˈklaɪənt/ 胖客户端 pàng kè hù duān thin client/θɪn ˈklaɪənt/ 瘦客户端 shòu kè hù duān 2.1
Network topologies

La topología 拓扑 es la disposición de los nodos y enlaces.
- bus — todos los dispositivos conectados a un cable compartido. Es económico; si falla el bus, falla toda la LAN; el rendimiento disminuye a medida que más dispositivos comparten el ancho de banda.
- estrella 星形 — cada dispositivo se conecta a un switch central. El fallo de un dispositivo no afecta a los demás; el fallo del switch detiene todo. Es la más común hoy en día.
- malla 网状 — cada dispositivo se enlaza directamente con los demás, con múltiples caminos. Muy tolerante a fallos 容错 (el tráfico se reenvía) pero requiere mucho cableado.
- híbrida — una mezcla (una estrella en cada oficina, enlaces de malla entre oficinas).
Topología en bus: todos los dispositivos comparten un cable con un terminador en cada extremo 
Topología en estrella: cada dispositivo se conecta a un hub o switch central 
Topología en malla: cada dispositivo se enlaza directamente con los demás 
Topología híbrida: clústeres en estrella unidos por un bus central How packets travel in each topology
Bus: el dispositivo emisor coloca el paquete en el cable compartido; todos los dispositivos lo ven, y solo aquel cuya dirección coincide lo acepta. Solo un dispositivo puede transmitir a la vez, por lo que ocurren colisiones (CSMA/CD, abajo). Estrella: el remitente pasa el paquete al switch central, que lee la dirección de destino y lo reenvía únicamente por el cable hacia ese dispositivo; otros dos dispositivos pueden hablar al mismo tiempo. Malla: el paquete se pasa de nodo en nodo a lo largo de una de varias rutas posibles hasta llegar al destino; si falla un enlace, se utiliza otra ruta.
Para justificar una topología: una estrella para un aula u oficina (un cable fallido afecta a un dispositivo; es fácil añadir un dispositivo; con un switch no hay colisiones); una malla donde la fiabilidad sea lo más importante (un hospital, la columna vertebral de internet); un bus solo donde importe el coste y pocos dispositivos lo compartan. "Dibujar la topología en estrella" significa: el switch en el centro, una línea desde el switch a cada ordenador, y el servidor (y el router, si lo hay) en sus propias líneas hacia el switch.
ExplorarComparar las topologías de red
Pase por las cuatro topologías. Cada una representa un compromiso entre costo, velocidad y resistencia a fallos: observe qué interrumpe toda la red en cada una.
Vocabulario EntrenarInglés Chino Pinyin topology/təˈpɒlədʒi/ 拓扑 tuò pū star/stɑː/ 星形 xīng xíng mesh/meʃ/ 网状 wǎng zhuàng fault-tolerant/fɒlt ˈtɒlərənt/ 容错 róng cuò packet/ˈpækɪt/ 数据包 shù jù bāo 2.1
Cloud computing
Computación en la nube 云计算 proporciona servicios informáticos (servidores, almacenamiento, software) a través de internet, alojados por un tercero. Ventajas: escalabilidad 可扩展性 (pagar por lo necesario), menor coste, acceso desde cualquier lugar y centros de datos redundantes fiables. Inconvenientes: requiere internet, tus datos son custodiados por un tercero y posible bloqueo del proveedor.
Para la definición de un punto: la computación en la nube es servicios informáticos bajo demanda (almacenamiento, procesamiento, software) proporcionados a través de internet por un tercero. Una cloud pública 公有云 es propiedad de un proveedor y compartida por muchos clientes a través de internet; una cloud privada 私有云 está dedicada a una organización, en su propio hardware o alojada exclusivamente para ella. Beneficios que acepta el esquema: los archivos son accesibles desde cualquier dispositivo con conexión a internet; el almacenamiento escala según sea necesario; el proveedor gestiona el hardware, los respaldos y las actualizaciones de seguridad; no hay servidor local que comprar o mantener. Inconvenientes: sin conexión a internet no hay acceso; los datos están en el hardware de un tercero, por lo que la seguridad y la privacidad dependen del proveedor; un coste de suscripción continuo; el proveedor podría fallar o ser atacado; los archivos grandes pueden transferirse lentamente. Una respuesta a "por qué la empresa usa una cloud pública" dice que no necesitan hardware propio, pagan solo por lo que usan, y sus usuarios pueden acceder desde cualquier lugar.
2.1
Wired vs wireless
- cableado (Ethernet 以太网 sobre par trenzado 双绞线 o fibra óptica 光纤): mayor velocidad, menor latencia, menos errores, más seguro.
- inalámbrico (Wi-Fi, Bluetooth, celular): sin cables, los dispositivos pueden moverse, pero más lento, propenso a interferencias y espionaje.
Para la misma generación, lo cableado gana en velocidad y fiabilidad; lo inalámbrico gana en comodidad.
Transmission media
Medium Characteristics cable de cobre (par trenzado, coaxial) barato y fácil de instalar; transporta una señal eléctrica; afectado por interferencias electromagnéticas; la señal se debilita con la distancia, por lo que se necesitan repetidores; menor ancho de banda que la fibra cable de fibra óptica pulsos de luz en un núcleo de vidrio; muy alto ancho de banda; largas distancias sin repetidores; inmune a interferencias; difícil de interceptar, por lo que es seguro; caro y requiere instalación especializada ondas de radio (incluido WiFi) sin cable, por lo que los dispositivos pueden moverse; alcance de decenas de metros, debilitado por paredes; frecuencia compartida, por lo que hay interferencias y menor velocidad; puede ser interceptado, por lo que necesita cifrado microondas radio de mayor frecuencia para enlaces punto a punto; requiere línea de visión; afectado por lluvia y edificios; alto ancho de banda satélites alcanzan áreas remotas y todo el globo; una gran demora (latencia), porque la señal viaja a la órbita y vuelve; afectados por el clima; costosos El examen pide la comparación en ambas direcciones. Los cables superan a la inalámbrica en velocidad, fiabilidad (sin interferencias), seguridad (un cable debe ser manipulado físicamente) y consistencia; la inalámbrica supera a los cables en movilidad, el coste de instalación y añadir un dispositivo sin cableado. Permitir ambos permite a los estudiantes moverse con portátiles y teléfonos mientras los escritorios fijos mantienen la conexión más rápida y segura, y un dispositivo sin puerto de red aún puede conectarse. La satélite frente al cobre alcanza lugares a los que no llega ningún cable, pero con más demora, interferencias climáticas y mayor coste.
Vocabulario EntrenarInglés Chino Pinyin ethernet/ˈiːθənet/ 以太网 yǐ tài wǎng 2.1
LAN hardware

- tarjeta de interfaz de red 网络接口卡 (NIC) — permite a un dispositivo enviar y recibir en la red; tiene una dirección MAC MAC地址 única (una dirección de hardware de 48 bits). Un dispositivo inalámbrico utiliza una tarjeta de interfaz de red inalámbrica 无线网络接口卡 (WNIC).
- switch 交换机 — reenvía tramas Ethernet solo al puerto correspondiente a la dirección MAC de destino.
- hub 集线器 — un dispositivo más simple que copia el tráfico a todos los puertos (ahora obsoleto).
- punto de acceso inalámbrico 无线接入点 (WAP) — permite a los clientes inalámbricos unirse a una LAN cableada.
- cableado — par trenzado para cortas distancias; fibra óptica para distancias más largas y rápidas.
- servidor — un ordenador que proporciona un servicio a los otros dispositivos: archivos, impresión, páginas web, almacenamiento de correo electrónico.
- puente 网桥 — une dos segmentos de LAN en una sola red, pasando el tráfico entre ellos.
- repetidor 中继器 — recibe una señal debilitada y la retransmite a plena fuerza, para extender el alcance de un cable.
Las funciones de una WNIC, para una descripción de cuatro puntos: convierte los datos en señales de radio y viceversa; lleva la dirección MAC única del dispositivo; conecta el dispositivo a un punto de acceso inalámbrico y sigue el protocolo inalámbrico (qué canal y frecuencia usar); y decodifica las señales entrantes para el dispositivo. Dos dispositivos que pueden conectar físicamente treinta ordenadores con NICs: un switch, o un hub.
Un switch de red: el cable de cada dispositivo se enchufa en uno de sus puertos 
An RJ-45 plug on a twisted-pair Ethernet cable 
Un switch envía cada trama solo al puerto de su destino Vocabulario EntrenarInglés Chino Pinyin switch/swɪtʃ/ 交换机 jiāo huàn jī hub/hʌb/ 集线器 jí xiàn qì twisted-pair/ˈtwɪstɪd peə/ 双绞线 shuāng jiǎo xiàn fibre-optic/ˈfaɪbə ˈɒptɪk/ 光纤 guāng xiān repeater/rɪˈpiːtə/ 中继器 zhōng jì qì network interface card/ˈnetwɜːk ˈɪntəfeɪs kɑːd/ 网络接口卡 wǎng luò jiē kǒu kǎ MAC address/mæk əˈdres/ MAC地址 MAC dì zhǐ wireless network interface card/ˈwaɪələs ˈnetwɜːk ˈɪntəfeɪs kɑːd/ 无线网络接口卡 wú xiàn wǎng luò jiē kǒu kǎ wireless access point/ˈwaɪələs ˈækses pɔɪnt/ 无线接入点 wú xiàn jiē rù diǎn bridge/brɪdʒ/ 网桥 wǎng qiáo 2.1
Routers

Un router 路由器 conecta diferentes redes y reenvía datos entre ellas — usualmente en el límite de una LAN e internet. Hace:
- reenvío — lee la dirección IP IP地址 de destino de cada paquete 数据包 y lo envía por el puerto correcto, utilizando una tabla de enrutamiento 路由表.
- traducción de direcciones de red 网络地址转换 (NAT) — permite que muchas direcciones LAN privadas compartan una única IP pública.
- DHCP 动态主机配置协议 — hands out private IP addresses to LAN devices.
- firewall 防火墙 — blocks unwanted incoming traffic.
En el packet switching 分组交换 un mensaje se divide en paquetes que se envían independientemente. Cada router lee la dirección IP de destino de un paquete, busca el siguiente salto en su tabla de enrutamiento y lo reenvía, por lo que los paquetes de un mensaje pueden tomar diferentes rutas y se reensamblan en orden en el destino. Un router recibe paquetes, los reenvía entre redes y asigna direcciones IP; no encuentra la dirección IP para una URL (DNS hace eso) y no almacena páginas web. Un router doméstico también contiene el módem y el punto de acceso inalámbrico, por lo que una sola caja conecta la LAN a internet.
Un router conecta una LAN a internet u otra red Vocabulario EntrenarInglés Chino Pinyin router/ˈruːtə/ 路由器 lù yóu qì cloud computing/klaʊd kəmˈpjuːtɪŋ/ 云计算 yún jì suàn scalability/ˌskeɪləˈbɪlɪti/ 可扩展性 kě kuò zhǎn xìng public cloud/ˈpʌblɪk klaʊd/ 公有云 gōng yǒu yún private cloud/ˈpraɪvət klaʊd/ 私有云 sī yǒu yún IP address/ˌaɪ ˈpiː əˈdres/ IP地址 IP dì zhǐ routing table/ˈraʊtɪŋ ˈteɪbl/ 路由表 lù yóu biǎo network address translation/ˈnetwɜːk əˈdres trænˈsleɪʃn/ 网络地址转换 wǎng luò dì zhǐ zhuǎn huàn DHCP/ˌdiː eɪtʃ siː ˈpiː/ 动态主机配置协议 dòng tài zhǔ jī pèi zhì xié yì firewall/ˈfaɪəwɔːl/ 防火墙 fáng huǒ qiáng packet switching/ˈpækɪt ˈswɪtʃɪŋ/ 分组交换 fēn zǔ jiāo huàn URL/ˌjuː ɑː ˈel/ 统一资源定位符 tǒng yī zī yuán dìng wèi fú modem/ˈməʊdem/ 调制解调器 tiáo zhì jiě tiáo qì 2.1
Ethernet and CSMA/CD

Ethernet es el estándar (protocolo) para LANs cableadas: los dispositivos se unen por cable de par trenzado o fibra, los datos se envían en frames que llevan las direcciones MAC de origen y destino, y un medio compartido utiliza CSMA/CD para gestionar las colisiones. En medios compartidos puede ocurrir una colisión 冲突 cuando dos dispositivos envían a la vez. El protocolo es CSMA/CD 载波侦听多路访问/冲突检测 (Acceso Múltiple con Sondeo de Portadora y Detección de Colisiones):
- detección de portadora — escuchar antes de enviar; esperar si el cable está ocupado.
- multiple access — many devices share the medium.
- detección de colisiones — seguir escuchando mientras se envía; una colisión es una colisión.
- en caso de colisión, ambos dejan de transmitir, envían una breve señal de "jam" y luego esperan un tiempo de backoff aleatorio antes de reintentar.
Las tres tareas, en las palabras del esquema: el dispositivo escucha (sondea la portadora) antes de transmitir; sigue verificando la presencia de una colisión mientras transmite; ante una colisión detiene, envía una señal de jam, espera un tiempo aleatorio y retransmite.
El Ethernet conmutado moderno utiliza enlaces punto a punto full-duplex 全双plo, por lo que ya no ocurren colisiones.
The CSMA/CD process for handling collisions on shared media Vocabulario EntrenarInglés Chino Pinyin collision/kəˈlɪʒn/ 冲突 chōng tū CSMA/CD/ˌsiː es em ˈeɪ ˌsiː ˈdiː/ 载波侦听多路访问/冲突检测 zài bō zhēn tīng duō lù fǎng wèn / chōng tū jiǎn cè full-duplex/fʊl ˈdjuːpleks/ 全双工 quán shuāng gōng 2.1
Bit streaming

Streaming de bits 流式传输 envía contenido multimedia como un flujo continuo que el receptor reproduce a medida que llega, en lugar de descargar primero todo el archivo.
- en tiempo real (en vivo): capturado y transmitido tal como sucede (deportes en vivo, videollamadas). No se puede rebobinar; la baja latencia es vital.
- bajo demanda: previamente grabado en un servidor (YouTube, Netflix). Se puede pausar y rebobinar; el servidor puede bufferizar 缓冲 por adelantado.
Real-time streaming works as a short pipeline:
- capturar y muestrear la fuente (una cámara o micrófono).
- codificarla, utilizando compresión 压缩 para reducir los datos.
- send it across the network as packets.
- el receptor bufferiza un poco y luego lo reproduce en vivo — descartando cualquier paquete que llegue tarde, porque un flujo en vivo no puede esperar a él.
Compresión con pérdida 有损 se utiliza aquí: las imágenes en movimiento ocultan pequeñas pérdidas, y el flujo debe ser lo suficientemente pequeño para caber en el ancho de banda.
Por qué un vídeo se comprime antes del streaming en tiempo real: el flujo sin comprimir necesitaría más ancho de banda del que tiene la conexión, por lo que los fotogramas llegarían tarde y la reproducción se congelaría. La compresión reduce el número de bits, por lo que la tasa de bits 比特率 se mantiene por debajo de la velocidad de banda ancha, la demora permanece pequeña y se necesita menos almacenamiento y coste en ambos extremos. La tasa de bits debe ser inferior a la velocidad de la conexión: una tasa de bits más alta ofrece mejor calidad pero requiere una conexión más rápida, y si los datos llegan más lentamente de lo que se reproducen, el búfer se vacía y el vídeo se congela. El streaming bajo demanda puede almacenar más del archivo por adelantado, por lo que tolera una conexión más lenta; el streaming en tiempo real no puede.
Los datos fluyen desde el servidor hacia un buffer antes de que el reproductor multimedia los lea Vocabulario EntrenarInglés Chino Pinyin bit streaming/bɪt ˈstriːmɪŋ/ 流式传输 liú shì chuán shū buffer/ˈbʌfə/ 缓冲 huǎn chōng compression/kəmˈpreʃn/ 压缩 yā suō lossy/ˈlɒsi/ 有损 yǒu sǔn bit rate/bɪt reɪt/ 比特率 bǐ tè lǜ 2.1
The internet and the World Wide Web

La internet 互联网 es una red de redes global que utiliza un conjunto de protocolos 协议 común (TCP/IP). La World Wide Web 万维网 (WWW) es un servicio que se ejecuta sobre ella: documentos hipervinculados identificados por URLs, visualizados en navegadores vía HTTP/HTTPS. El correo electrónico y la transferencia de archivos son otros servicios de internet que no forman parte de la WWW.
El correo web utiliza ambos: la WWW, porque la bandeja de entrada es una página web alcanzable a través de una URL en un navegador sobre HTTP; y la internet, porque el correo electrónico en sí viaja a través de la red de redes (el correo electrónico es un servicio de internet separado de la web).
La Web es un servicio que se ejecuta sobre Internet Hardware that supports the internet
- módem 调制解调or — convierte la señal digital del ordenador en una señal analógica para una línea telefónica, y viceversa al otro extremo (modulación y demodulación).
- PSTN — la red telefónica pública de centrales y líneas; una conexión dial-up o DSL transporta datos de internet a través de ella.
- línea dedicada 专线 — una línea arrendada entre una organización y su ISP: siempre activa, con un ancho de banda fijo que no se comparte, por lo que es más rápida y fiable, pero cara.
- red de telefonía celular — el teléfono envía datos por radio a la torre de celda más cercana (estación base); las torres están vinculadas a la red de la compañía telefónica, que enruta los datos hacia internet; a medida que el teléfono se mueve, se transfiere de una celda a otra.
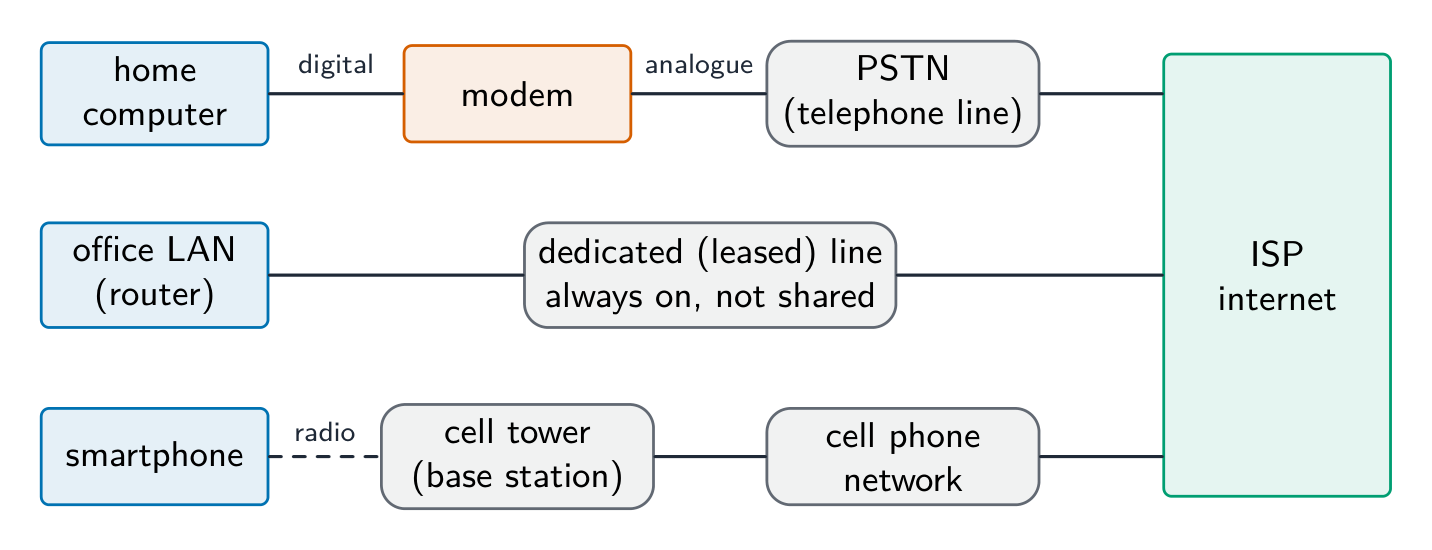
Tres formas de alcanzar internet: un módem y la PSTN, una línea dedicada y la red telefónica celular Vocabulario EntrenarInglés Chino Pinyin internet/ˈɪntənet/ 互联网 hù lián wǎng local area network/ˈləʊkl ˈeərɪə ˈnetwɜːk/ 局域网 jú yù wǎng latency/ˈleɪtənsi/ 延迟 yán chí wide area network/waɪd ˈeərɪə ˈnetwɜːk/ 广域网 guǎng yù wǎng Public Switched Telephone Network/ˈpʌblɪk swɪtʃt ˈtelɪfəʊn ˈnetwɜːk/ 公共交换电话网 gōng gòng jiāo huàn diàn huà wǎng protocol/ˈprəʊtəkɒl/ 协议 xié yì World Wide Web/wɜːld waɪd web/ 万维网 wàn wéi wǎng dedicated line/ˈdedɪkeɪtɪd laɪn/ 专线 zhuān xiàn 2.1
IP addresses

An IP address uniquely identifies a device.
- IPv4 — 32 bits, cuatro números decimales 0–255 (
192.168.1.10); aproximadamente $4.3 \times 10^{9}$ direcciones (agotadas ahora). - IPv6 — 128 bits, ocho grupos de cuatro dígitos hexadecimales; aproximadamente $3.4 \times 10^{38}$ direcciones.
IPv4 se escribe como cuatro grupos de números decimales separados por puntos; cada grupo es un número de 8 bits, por lo que va de 0 a 255. IPv6 se escribe como ocho grupos de cuatro dígitos hexadecimales separados por dos puntos,
2001:0db8:0000:0000:0000:ff00:0042:8329, y una serie de grupos cero puede acortarse a::. Por tanto,192.168.3.2no es IPv6: tiene cuatro grupos, no ocho, separados por puntos en lugar de dos puntos, y sus grupos son decimales, no hexadecimales.256.0.0.Ano es una dirección válida de ningún tipo: un grupo IPv4 no puede superar 255 ni contener letras, y IPv6 necesitaría dos puntos y ocho grupos.Subnetting
Una red puede dividirse en subredes. La dirección IP se divide en una parte de red y una parte de host, determinada por una máscara de subred (por ejemplo,
255.255.255.0= los primeros 24 bits son de red). La subnetting mejora la gestión, reduce el tráfico de difusión y mejora la seguridad.Las dos partes de una dirección en una subred: la network ID (los primeros bits, iguales para cada dispositivo en esa subred, dados por los unos en la máscara) y la host ID (los bits restantes, únicos para cada dispositivo). Beneficios de la subnetting, para "describe dos beneficios": menos tráfico en cada parte, porque las transmisiones difusas permanecen dentro de su subred; mejor seguridad, porque el tráfico de un departamento se mantiene alejado de los demás; gestión más fácil y detección de fallos; uso más eficiente de las direcciones. Dos dispositivos con la máscara
255.255.255.0están en subredes diferentes cuando sus primeros tres grupos difieren.División de una red en subredes, una netID por departamento Public vs private addresses
- las direcciones privadas se utilizan dentro de una LAN y no son enruteables en internet (por ejemplo,
192.168.0.0/16). - una dirección IP pública es única globalmente y enruteable, asignada por un ISP.
Los dispositivos detrás de NAT con direcciones privadas no son directamente accesibles desde internet, lo que proporciona cierta protección.
Las descripciones que quieren las tablas: una dirección public es visible en internet y única en toda ella, asignada por el ISP; una dirección private es visible solo dentro de la LAN, es reutilizada por muchas LANs y necesita NAT para alcanzar internet. Una dirección static nunca cambia (establecida manualmente o reservada, como necesita un servidor); una dirección dynamic es asignada por DHCP cada vez que el dispositivo se conecta y puede cambiar.
Static vs dynamic
- una dirección IP estática es fija; se utiliza para servidores que deben encontrarse en una dirección conocida.
- una dirección IP dinámica se asigna mediante DHCP y puede cambiar; es más fácil para los dispositivos cliente y utiliza eficientemente un conjunto limitado de direcciones.
Ejemplo resuelto. Un anfitrión tiene la dirección IP
192.168.10.130con máscara de subred255.255.255.192. ¿A qué red pertenece y está192.168.10.200en la misma? El último octeto de la máscara,192, es11000000en binario, por lo que los primeros 26 bits corresponden a la parte de red y los últimos 6 bits dirigen al anfitrión. Esto hace que las subredes avancen en bloques de $256 - 192 = 64$:.0,.64,.128,.192. La dirección130cae en el bloque que comienza en.128, por lo que el anfitrión se encuentra en la red192.168.10.128/26, cuyos hosts utilizables van desde.129hasta.190(.191es la dirección de broadcast). El número200cae en el siguiente bloque (.192), por lo que se encuentra en una subred diferente y el tráfico entre ambas debe pasar por un router. Obtenga primero el tamaño del bloque a partir de la máscara ($256$ menos el octeto de la máscara) —adivinar basándose en los tres primeros octetos es lo que provoca errores en estos ejercicios.2.1
URL y DNS

Un URL (Uniform Resource Locator, Localizador de Recursos Uniforme) localiza un recurso en la WWW:
https://www.example.com/about/contact.html protocol domain name path- protocolo:
http,https, etc. - nombre de dominio: una dirección de servidor legible.
- ruta: el recurso en ese servidor.
El Sistema de Nombres de Dominio (DNS, también llamado Servicio de Nombres de Dominio) es un conjunto distribuido de servidores que convierte nombres de dominio en direcciones IP. Cuando escribe una URL, el navegador solicita a un resolutor DNS la IP, la cual consulta servidores DNS (raíz → nivel superior → autoritativo) hasta encontrarla; luego, el navegador se conecta a esa IP y solicita la ruta. El DNS evita que los humanos deban memorizar direcciones IP y permite que un sitio cambie de servidor sin cambiar su nombre.
Para "explicar cómo usa el navegador la URL": el navegador divide la URL en el protocolo, el nombre de dominio y la ruta; envía el nombre de dominio a un servidor DNS, que devuelve la dirección IP coincidente (una caché en la computadora o en el ISP puede responder primero); establece una conexión a esa dirección IP usando el protocolo (HTTPS en el puerto 443); envía una solicitud para la ruta; y el servidor web devuelve la página, que el navegador renderiza. Si la búsqueda DNS falla, el navegador informa que no se puede encontrar el servidor.
Cómo DNS encuentra la dirección IP de un sitio web antes de que el navegador se conecte ExplorarCómo DNS encuentra un sitio web
Paso a paso en una consulta DNS. La red enrutó por dirección IP, no por nombre — así que antes de que cargue cualquier cosa, DNS debe convertir el nombre de dominio en una dirección IP.
Vocabulario EntrenarInglés Chino Pinyin domain name/dəˈmeɪn neɪm/ 域名 yù míng Domain Name System/dəˈmeɪn neɪm ˈsɪstəm/ 域名系统 yù míng xì tǒng 2.1
Definiciones aceptadas por el examinador
Una pregunta de definición se califica según palabras fijas. Aprenda estas exactamente.
Término Definición LAN una red que cubre un área geográfica pequeña, generalmente un solo sitio, cuyo hardware es propiedad de la organización WAN una red que cubre un área geográfica grande, que une LANs a través de enlaces de terceros (arrendados o públicos) cliente-servidor un modelo en el que las computadoras cliente solicitan servicios a un servidor central más potente que se los proporciona par-a-par un modelo en el que cada computadora es igual y puede actuar tanto como cliente como servidor, sin servidor central cliente ligero un cliente que realiza poco procesamiento ni almacenamiento por sí mismo y depende del servidor para ambos cliente pesado un cliente que realiza su propio procesamiento y almacenamiento y puede trabajar sin el servidor topología malla una topología en la que cada dispositivo está conectado directamente a muchos otros, proporcionando más de una ruta entre dos dispositivos computación en la nube servicios de cómputo bajo demanda (almacenamiento, procesamiento, software) proporcionados a través de internet por un tercero Ethernet el protocolo estándar para LANs cableadas, que transmite datos en tramas y utiliza CSMA/CD en un medio compartido switch un dispositivo que reenvía cada trama solo al puerto de su dirección MAC de destino, dentro de una LAN router un dispositivo que conecta redes y reenvía paquetes entre ellas mediante su dirección IP de destino bit streaming enviar un flujo continuo de bits para que el receptor reproduzca los medios a medida que llegan, sin descargar todo el archivo primero internet la red global de redes que utiliza los protocolos TCP/IP World Wide Web la colección de páginas web hiperenlazadas, identificadas por URLs y accesibles a través de internet mediante un navegador URL la dirección que localiza un recurso en la web: protocolo, nombre de dominio y ruta DNS el servicio que traduce un nombre de dominio en la dirección IP del servidor que aloja el recurso 2.1
Consejos para el examen
- Distinga LAN vs WAN y cliente-servidor vs par-a-par según quién almacena y controla los recursos.
- Asocie cada topología (tira, estrella, malla) con sus ventajas y desventajas (costo, fiabilidad, colisiones).
- Conozca la función de cada dispositivo: un switch dirige dentro de una LAN mediante la dirección MAC, un router encamina entre redes mediante la dirección IP.
- Explique el bit streaming y por qué se necesita el buffering (los datos llegan a una tasa diferente a la de reproducción).
- Distinga IPv4 vs IPv6 y direcciones públicas vs privadas; DNS convierte una URL en una dirección IP.
Errores comunes
- Decir que un switch funciona mediante direcciones IP. Un switch reenvía mediante direcciones MAC dentro de la LAN; el router reenvía mediante direcciones IP entre redes.
- Tratar el internet y la World Wide Web como lo mismo. La web es un servicio que corre sobre el internet; el correo electrónico y la transferencia de archivos son otros.
- Dar "más rápido" como la única comparación entre cableado e inalámbrico. Diga más rápido y más fiable y más seguro, y mencione el lado inalámbrico (movilidad, sin cableado) cuando la pregunta pida una comparación.
- Escribir que un router busca la dirección IP para una URL. Eso lo hace DNS; el router reenvía paquetes hacia él.
- Describir IPv6 con puntos y grupos decimales. Ocho grupos de cuatro dígitos hexadecimales, separados por dos puntos.
- Dibujar una topología estrella como un anillo o una cadena. Cada dispositivo tiene su propia línea hacia el switch en el centro.
-
3
Hardware
Ver lección3.1
Ordenadores y sus componentes

Syllabus
Los candidatos deben ser capaces de: Notas y orientación Demostrar comprensión de la necesidad de entrada, salida, memoria principal y almacenamiento secundario (incluyendo el removible) Demostrar comprensión de los sistemas embebidos Incluyendo: ventajas e inconvenientes de los sistemas embebidos Describir las operaciones principales de los dispositivos de hardware Incluyendo: impresora láser, impresora 3D, micrófono, altavoces, disco duro magnético, memoria de estado sólido (flash), lector/grabador óptico, pantalla táctil, gafas de realidad virtual Demostrar comprensión del uso de los buffers Explicar las diferencias entre la Memoria de Acceso Aleatorio (RAM) y la Memoria de Solo Lectura (ROM) Incluyendo su uso en una variedad de dispositivos y sistemas Explicar las diferencias entre la Memoria RAM Estática (SRAM) y la Memoria RAM Dinámica (DRAM) Incluyendo el uso de SRAM y DRAM en una variedad de dispositivos y sistemas, así como las razones para utilizar uno u otro según el dispositivo y su aplicación Explicar la diferencia entre la Memoria ROM Programable (PROM), la Memoria ROM Programable Reemplazable (EPROM) y la Memoria ROM Eléctricamente Reemplazable (EEPROM) Demostrar comprensión de los sistemas de monitoreo y control Incluyendo: • diferencia entre monitoreo y control • uso de sensores (incluyendo temperatura, presión, infrarrojos, sonido) y actuadores • importancia de la retroalimentación Fuente: Plan de estudios Cambridge International
Un ordenador de propósito general tiene cuatro bloques constructivos:
- dispositivos de entrada 输入设备 — obtienen datos (teclado, ratón, micrófono, escáner, sensores).
- dispositivos de salida 输出设备 — entregan resultados (monitor, altavoces, impresora, actuadores).
- memoria principal 主存储器 — memoria rápida a la que el procesador 处理器 (CPU) accede directamente (RAM y ROM). Almacena el programa en ejecución y sus datos.
- almacenamiento secundario 辅助存储器 — más lento, mayor capacidad, mantiene programas y datos cuando no están en uso (disco duro, SSD, disco óptico, memoria USB).
El temario pide explicar por qué cada uno es necesario. Los dispositivos de entrada son necesarios porque el ordenador solo puede trabajar con los datos e instrucciones que han sido introducidos. Los dispositivos de salida son necesarios para presentar los resultados en un formato que las personas puedan utilizar. La memoria principal es necesaria porque el procesador solo puede ejecutar instrucciones y utilizar datos que se almacenan en una memoria a la que puede acceder directamente, y debe llegar a ellos rápidamente. El almacenamiento secundario es necesario porque la memoria principal es volátil y de pequeña capacidad: los programas y datos deben sobrevivir al apagado del equipo, en un almacenamiento más grande y económico, y el almacenamiento amovible permite mover datos entre ordenadores o mantenerlos como copia de seguridad.
Un teclado: un dispositivo de entrada común para escribir texto y comandos 
Un ratón: un dispositivo de entrada puntero 
Un escáner de cama plana: un dispositivo de entrada que convierte una página de papel en una imagen digital 
Un monitor: un dispositivo de salida común que muestra la imagen de la pantalla ExplorarToca los bloques de un sistema informático
Explora los cuatro bloques más la CPU. Los datos fluyen entrada → procesamiento → salida, mientras que la memoria primaria almacena el programa en ejecución y el almacenamiento secundario lo guarda para después.
ExplorarLaboratorio de rutas de red
Seguir los datos de un dispositivo a través del hardware de red y los protocolos.
Vocabulario EntrenarInglés Chino Pinyin sensor/ˈsensə/ 传感器 chuán gǎn qì output devices/ˈaʊtpʊt dɪˈvaɪsɪz/ 输出设备 shū chū shè bèi 3.1
Sistemas embebidos
Un sistema embebido 嵌入式系统 es un ordenador construido dentro de otro dispositivo para realizar una tarea fija (lavadora, microondas, unidad de motor de automóvil, termostato).
- ventajas: optimizado para una única tarea, por lo que es pequeño, consume poca energía y es barato de fabricar en volumen; fiable, porque ejecuta un programa fijo con pocas posibilidades de fallo; arranca rápidamente y no requiere configuración por parte del usuario; fácil de usar gracias a una interfaz simple.
- inconvenientes: limitado a su única tarea, por lo que no puede actualizarse para hacer más cosas; difícil de actualizar (su firmware 固件 puede necesitar herramientas especiales o no poder modificarse en absoluto); difícil de diagnosticar averías, y generalmente todo el dispositivo debe reemplazarse si falla; si está conectado a una red, puede ser una vulnerabilidad de seguridad, ya que su software rara vez recibe parches.
Una pregunta de "describir los inconvenientes" exige que cada inconveniente sea un punto completo: cuál es la limitación y qué significa para el usuario, por ejemplo "el firmware no se puede actualizar, por lo que un fallo de seguridad detectado después no puede solucionarse".
Vocabulario EntrenarInglés Chino Pinyin firmware/ˈfɜːmweə/ 固件 gù jiàn 3.1
Dispositivos de hardware principales

Impresora láser
Una impresora láser 激光打印机 escanea la imagen de la página sobre un tambor 感光鼓 fotosensible cargado. El toner 墨粉 se adhiere a las áreas cargadas, se transfiere al papel y se funde mediante un fijador. Rápida, nítida, alta producción.
Una impresora láser: impresión rápida y nítida utilizando un tambor cargado y toner Cómo funciona, según los pasos que enumera la guía de calificación:
- Los datos de la página se envían al búfer de la impresora.
- Se aplica una carga electrostática uniforme al tambor.
- Un láser, reflejado por un espejo giratorio, escanea la imagen de la página sobre el tambor, eliminando la carga donde incide, de modo que la carga restante en el tambor coincide con la imagen.
- El toner, un polvo cargado, es atraído únicamente a las partes cargadas del tambor.
- El papel recibe la carga opuesta y pasa rodando contra el tambor, transfiriendo así el toner sobre él.
- El fijador 定影器, un par de rodillos calentados, funde el toner dentro del papel. A continuación, el tambor se descarga y limpia para la siguiente página.
Impresora 3D
Una impresora 3D 3D打印机 construye un objeto capa por capa: FDM funde filamento de plástico a través de una boquilla; litografía estereoscópica cura resina líquida con un láser UV. Utilizada para prototipos y piezas médicas personalizadas.

Una impresora 3D FDM construye un objeto capa por capa fundiendo filamento de plástico Cómo funciona:
- Se diseña un modelo del objeto en software CAD (o se escanea).
- El software de segmentación divide el modelo en finas capas horizontales y genera las instrucciones para cada una.
- La impresora construye el objeto capa por capa: una impresora FDM funde filamento 塑料丝 de plástico y lo deposita a través de una boquilla móvil; una impresora de resina cura resina líquida con un láser o luz UV; una impresora de polvo fusiona polvo con un láser.
- Cada capa se une a la capa inferior, y la plataforma (o la boquilla) se mueve un grosor de capa.
- Cuando se completa la última capa, se elimina cualquier material de soporte. Sus usos incluyen prototipos, piezas médicas personalizadas como prótesis, y repuestos impresos bajo demanda.
Micrófono y altavoces
Un micrófono 麦克风 convierte sonido en señal eléctrica (un diafragma vibra, cambiando la carga del condensador 电容器 o la posición de una bobina); la señal se digitaliza mediante un conversor analógico-digital 模数转换器 (ADC). Un altavoz hace lo contrario: una señal variable impulsa una bobina en un campo magnético, moviendo un cono para producir sonido.

Un micrófono convierte sonido en señal eléctrica 
Interior de un micrófono: el sonido vibra el diafragma y la bobina para producir corriente 
En el interior de un altavoz: una corriente variable en la bobina mueve el cono para producir sonido Cómo funciona un micrófono: las ondas sonoras hacen vibrar un diafragma 膜片; en un micrófono dinámico, una bobina unida al diafragma se mueve en un campo magnético, induciendo una corriente variable en ella, y en un micrófono condensador, el diafragma es una placa de un condensador cuya capacitancia cambia a medida que se mueve; la señal analógica variable luego es muestreada por un ADC y almacenada como datos digitales. Un altavoz invierte esta cadena: un conversor digital-analógico 数模转换器 (DAC) produce una corriente variable, la corriente en la bobina crea un campo magnético cambiante que empuja contra el imán permanente, la bobina y el cono se mueven hacia adentro y afuera, y el movimiento del cono genera ondas de presión en el aire.
Disco duro magnético (HDD)
Un disco duro 硬盘 almacena datos en platos giratorios recubiertos de material magnético. Cada plato tiene pistas 磁道 divididas en sectores 扇区. Una cabeza de lectura/escritura 读写头 flota justo encima y magnetiza regiones minúsculas (escritura) o las detecta (lectura). Bajo costo por gigabyte, pero más lento que los SSD y tiene partes móviles.

Un disco duro abierto: el brazo actuador transporta la cabeza de lectura/escritura sobre un plato 
Pistas y sectores en un plato de disco duro Cómo funciona: los platos giran a alta velocidad (miles de revoluciones por minuto); cada superficie está dividida en pistas concéntricas y cada pista en sectores; las cabezas de lectura/escritura en brazos actuadores 磁头臂 se mueven sobre los platos hacia la pista correcta; para escribir, la cabeza magnetiza una pequeña región con una de dos polaridades, representando 0 o 1; para leer, detecta la polaridad mientras la región pasa debajo de ella. Los retrasos, esperando a que el brazo llegue a la pista y a que el sector gire, son la razón por la que un disco duro es más lento que un SSD.
Memoria de estado sólido (flash)
Un disco de estado sólido 固态硬盘 almacena datos como carga en transistores 晶体管, sin partes móviles. Acceso aleatorio más rápido que los HDD, más resistente, menor consumo de energía, pero más caro por gigabyte; cada celda se desgasta tras muchas escrituras.

Interior de un SSD: los datos se almacenan en chips de memoria flash, sin partes móviles (compare con el disco duro anterior) Cómo funciona: cada celda es un transistor de puerta flotante 浮栅晶体管; una carga atrapada en la puerta flotante representa un bit y permanece allí cuando se apaga la alimentación; un chip controlador mapea cada dirección a una celda y distribuye las escrituras entre las celdas, porque una celda solo soporta un número limitado de escrituras.
Disco duro magnético Disco de estado sólido Partes móviles platos y cabezas ninguna Velocidad más lento: retrasos de búsqueda y rotación acceso aleatorio mucho más rápido Costo por gigabyte menor mayor Robustez dañado por golpes; ruidoso; consume más energía resistente a choques; silencioso; menos energía Vida útil muchas reescrituras; desgaste mecánico ciclos de escritura limitados por celda Una pregunta "por qué un servidor usa discos duros en lugar de SSDs" busca la columna izquierda: más barato por gigabyte para grandes capacidades, larga vida bajo reescritura constante y recuperación de datos más fácil.
Disco óptico
Un láser detecta reflexiones desde pequeños surcos en un disco óptico 光盘 (CD, DVD, Blu-ray). La unidad es un lector/grabador de discos ópticos: la grabación usa un láser más fuerte para cambiar la reflectividad de la superficie.

Una unidad de disco óptico: un láner lee pequeños surcos en un CD, DVD o disco Blu-ray Cómo funciona: el disco lleva una larga pista espiral de surcos 凹坑 y terrenos 平台 (las áreas planas entre ellos); el disco gira y un láser se enfoca en la pista; la luz reflejada de un terreno difiere de la luz reflejada en el borde de un surco, y un sensor de luz lee cada cambio como un 1 y la ausencia de cambio como un 0. La grabación usa un láser más fuerte para cambiar la reflectividad de una capa de tinte o aleación. Un Blu-ray usa un láser azul con longitud de onda más corta, por lo que sus surcos son más pequeños y están más juntos, lo cual es la razón por la que almacena más datos que un DVD.
Pantalla táctil
Una pantalla táctil 触摸屏 detecta contacto. Resistiva 电阻式: dos capas conductoras presionadas juntas; funciona con cualquier objeto pero es menos precisa. Capacitiva 电容式: un dedo perturba un campo de carga; precisa, multitoque, usada en teléfonos.

Una pantalla táctil detecta dónde toca el dedo al vidrio Cómo funciona: una pantalla resistiva tiene dos finas capas conductoras separadas por espaciadores; al presionar, la capa superior empuja contra la inferior, cerrando un circuito en ese punto, y el controlador lee el voltaje para encontrar las coordenadas. Una pantalla capacitiva tiene una capa de vidrio recubierta con un conductor transparente que mantiene una carga; un dedo que la toca extrae una pequeña corriente, la corriente se mide en cada esquina, y el controlador calcula la posición del toque a partir de las diferencias. Las pantallas capacitivas responden a toques ligeros y varios dedos a la vez, pero no a un dedo con guante ni a un lápiz óptico común.
Auricular de realidad virtual
Un auricular de realidad virtual 虚拟现实 (VR) tiene dos pantallas pequeñas (una por ojo) y sensores de movimiento (acelerómetro 加速度计, giroscopio 陀螺仪) que rastrean el movimiento de la cabeza para que la escena cambie según mira alrededor.

Un auricular de realidad virtual: dos pantallas pequeñas y sensores de movimiento rastrean la cabeza Cómo funciona: cada ojo ve su propia pantalla a través de una lente, y las dos imágenes difieren ligeramente, por lo que el cerebro percibe profundidad; los sensores (acelerómetro, giroscopio, a veces cámaras) informan dónde está la cabeza y hacia dónde apunta; la computadora vuelve a renderizar la escena desde ese punto de vista varias veces por segundo, por lo que girar la cabeza gira la vista; los auriculares proporcionan sonido que coincide con la dirección. Usado para juegos, para entrenamiento como simuladores de vuelo o cirugía, y para ver diseños antes de ser construidos.
Vocabulario EntrenarInglés Chino Pinyin input devices/ˈɪnpʊt dɪˈvaɪsɪz/ 输入设备 shū rù shè bèi microphone/ˈmaɪkrəfəʊn/ 麦克风 mài kè fēng optical disc/ˈɒptɪkl dɪsk/ 光盘 guāng pán laser printer/ˈleɪzə ˈprɪntə/ 激光打印机 jī guāng dǎ yìn jī drum/drʌm/ 感光鼓 gǎn guāng gǔ toner/ˈtəʊnə/ 墨粉 mò fěn fuser/ˈfjuːsə/ 定影器 dìng yǐng qì 3D printer/ˌθriː ˈdiː ˈprɪntə/ 3D打印机 3D dǎ yìn jī filament/ˈfɪləmənt/ 塑料丝 sù liào sī diaphragm/ˈdaɪəfræm/ 膜片 mó piàn tracks/træks/ 磁道 cí dào sectors/ˈsektəz/ 扇区 shàn qū read/write head/riːd raɪt hed/ 读写头 dú xiě tóu actuator arms/ˈæktʃuːeɪtə ɑːmz/ 磁头臂 cí tóu bì solid-state drive/ˈsɒlɪd steɪt draɪv/ 固态硬盘 gù tài yìng pán transistors/trænˈzɪstəz/ 晶体管 jīng tǐ guǎn floating-gate transistor/ˈfləʊtɪŋ ɡeɪt trænˈzɪstə/ 浮栅晶体管 fú zhà jīng tǐ guǎn pits/pɪts/ 凹坑 āo kēng lands/lændz/ 平台 píng tái touchscreen/ˈtʌtʃskriːn/ 触摸屏 chù mō píng resistive/rɪˈzɪstɪv/ 电阻式 diàn zǔ shì capacitive/kəˈpæsɪtɪv/ 电容式 diàn róng shì virtual reality/ˈvɜːtʃuːəl rɪˈælɪti/ 虚拟现实 xū nǐ xiàn shí accelerometer/əkˌseləˈrɒmɪtə/ 加速度计 jiā sù dù jì gyroscope/ˈdʒaɪrəskəʊp/ 陀螺仪 tuó luó yí interrupt/ˈɪntərʌpt/ 中断 zhōng duàn non-volatile/nɒn ˈvɒlətaɪl/ 非易失性 fēi yì shī xìng 3.1
Buffers
Un buffer 缓冲 es memoria que almacena datos temporalmente mientras se mueven entre dispositivos de diferentes velocidades. Ejemplo: la CPU escribe un documento en un buffer de impresora rápidamente, luego queda libre para hacer otro trabajo mientras la impresora imprime desde el buffer a su propio ritmo. Los buffers evitan que el dispositivo rápido espere al lento (también usados en streaming, el teclado y el acceso a disco).
"Explique por qué una impresora 3D necesita un buffer": la computadora envía los datos de impresión mucho más rápido de lo que la impresora puede construir las capas, por lo que los datos se mantienen en el buffer hasta que la impresora está lista para recibirlos, y el procesador queda liberado para hacer otro trabajo. Cuando el buffer se agota, la impresora envía una interrupción 中断 para pedir más (tema 4). Un flujo de video funciona de manera similar: el buffer se llena por adelantado para que una breve caída en la velocidad de la red no detenga la imagen.
Vocabulario EntrenarInglés Chino Pinyin buffer/ˈbʌfə/ 缓冲 huǎn chōng 3.1
RAM y ROM

- RAM 随机存取存储器 (Random Access Memory) — volátil 易失性 (pierde datos sin energía). Almacena el SO, programas en ejecución y sus datos; se lee y escribe constantemente.
- ROM 只读存储器 (Read-Only Memory) — no volátil 非易失性 (mantiene datos sin energía). Generalmente escrita una sola vez; almacena firmware necesario en el arranque (BIOS / boot loader).
RAM es volátil y de lectura/escritura; ROM es no volátil y de solo lectura La ROM inicia el sistema; la RAM luego mantiene el trabajo activo.
RAM ROM ¿Volatile? sí: contenido perdido al apagar no: contenido mantenido sin energía Lectura/escritura? leído y escrito constantemente solo lectura en uso normal Almacena el sistema operativo, programas en ejecución y sus datos el firmware y programa de arranque que inician la computadora Tamaño grande y usualmente ampliable pequeño y fijo Uso típico memoria principal de una computadora o teléfono código de arranque de PC; programa completo de un sistema embebido como lavadora Más RAM permite a una computadora mantener más programas y datos a la vez, por lo que intercambia menos entre memoria y disco y corre más rápido; esa es la respuesta a "explique por qué la computadora con más RAM tiene mejor rendimiento".

Módulo de RAM (DIMM) conectado a la placa base como memoria principal rápida de la computadora La misma división de memoria es importante en un dispositivo portátil: su programa fijo debe permanecer disponible tras apagarlo, mientras que sus lecturas en vivo cambian durante el uso.

Un monitor de frecuencia cardíaca para la muñeca ExplorarLaboratorio de dispositivos y almacenamiento
Clasificar ejemplos computacionales según la función que cumplen en un sistema.
Vocabulario EntrenarInglés Chino Pinyin RAM/ræm/ 随机存取存储器 suí jī cún qǔ cún chǔ qì ROM/rɒm/ 只读存储器 zhī dú cún chǔ qì secondary storage/ˈsekəndəri ˈstɔːrɪdʒ/ 辅助存储器 fǔ zhù cún chǔ qì hard disk/hɑːd dɪsk/ 硬盘 yìng pán volatile/ˈvɒlətaɪl/ 易失性 yì shī xìng embedded system/emˈbedɪd ˈsɪstəm/ 嵌入式系统 qiàn rù shì xì tǒng 3.1
SRAM vs DRAM
- SRAM Static RAM (Memoria RAM Estática) almacena cada bit en un flip-flop flip-flop de varios transistores. Rápida, pero costosa y no densa. Se usa para cache cache de CPU.
- DRAM Dynamic RAM (Memoria RAM Dinámica) almacena cada bit como carga en un condensador pequeño. Más barata y densa, pero más lenta, y debe ser refreshed refresh (reescrita) miles de veces por segundo. Se usa para memoria principal.
Use SRAM para memoria pequeña y rápida (cache); DRAM para memoria principal grande.
SRAM DRAM Cada bit almacenado en un flip-flop de varios transistores un condensador y un transistor ¿Necesita refresco? no sí, miles de veces por segundo Velocidad más rápido más lento Densidad y costo menos bits por chip, más caro más bits por chip, más barato Energía usa menos energía en reposo usa más, debido al refresco Uso caché del procesador memoria principal, incluida en sistemas embebidos "Explique por qué el sistema embebido usa DRAM": necesita una gran cantidad de memoria a bajo costo en un espacio pequeño, y su requisito de velocidad es modesto, por lo que la DRAM más barata y densa es la opción correcta; la SRAM se mantiene para la caché pequeña donde la velocidad es más importante.
Vocabulario EntrenarInglés Chino Pinyin SRAM/ˈesræm/ 静态 jìng tài DRAM/ˈdiːræm/ 动态 dòng tài flip-flop/flɪp flɒp/ 触发器 chù fā qì cache/kæʃ/ 高速缓存 gāo sù huǎn cún refreshed/rɪˈfreʃt/ 刷新 shuā xīn 3.1
PROM, EPROM y EEPROM

Variantes de ROM que puede programar después de la fabricación:
- PROM (Programmable ROM — ROM Programable) — escrita una sola vez (fusibles quemados por un programador); no se puede cambiar.
- EPROM (Erasable Programmable ROM — ROM Programable Borrable) — borrada con luz UV intensa a través de una ventana, luego reescrita (todo el chip a la vez).
- EEPROM (Electrically Erasable Programmable ROM — ROM Programable Borrable Eléctricamente) — borrada y reescrita eléctricamente, byte por byte, en circuito. La memoria Flash es una derivación optimizada para borrado por bloques.
Un chip EPROM con una ventana para borrado ultravioleta PROM EPROM EEPROM Escrita una vez, por el usuario con un programador muchas veces muchas veces Borrada por no se puede borrar luz ultravioleta a través de una ventana de cuarzo una señal eléctrica Qué borra nada todo el chip a la vez un byte o bloque a la vez ¿Debe quitarse del circuito para reprogramar? no aplica sí no "Da dos diferencias entre EPROM y EEPROM" pide dos filas de esta tabla, cada una expresada para ambos tipos.
3.1
Sistemas de monitoreo y control

Ambos leen sensores; la diferencia es lo que hacen después.
- monitoring monitoring — recopila e informa datos pero no toma acciones (una estación meteorológica registrando lecturas).
- control system control system — usa los datos del sensor para decidir y actuar a través de actuadores, generalmente en un bucle de retroalimentación (un termostato encendiendo/apagando una caldera).
La respuesta de tres puntos "describe las diferencias": un sistema de monitoreo solo mide, registra o muestra las lecturas, y a lo sumo activa una advertencia; un sistema de control compara cada lectura con un preset value preset value y, si está fuera del rango, envía señales a los actuadores que cambian el proceso físico; el cambio se vuelve a medir, por lo que un sistema de control contiene retroalimentación y un sistema de monitoreo no. Si un sistema dado es uno u otro se decide mediante esa prueba: un sistema de puente que mide la altura de un vehículo y enciende un letrero de advertencia es monitoreo, porque nada de lo que hace cambia al vehículo; un sistema que baja una barrera es control.
Ejemplo resuelto. Describe cómo un sistema automatizado abre una puerta cuando una persona está a menos de 2 metros y la cierra cuando no hay nadie.
Un sensor infrarrojo o ultrasónico mide la distancia a cualquier objeto frente a la puerta; la lectura analógica se convierte a digital mediante un ADC y se envía al procesador; el procesador compara la distancia con los 2 metros preestablecidos; si es menor, el procesador envía una señal al actuador (un motor) para abrir la puerta; el sensor sigue midiendo, y cuando no se recibe ninguna lectura inferior a 2 metros, el procesador indica al motor que cierre la puerta. La medición repetida después de cada acción es la retroalimentación que evita que la puerta se abra y cierre en momentos incorrectos.
El monitoreo reporta datos; un sistema de control actúa a través de un bucle de retroalimentación Sensores y actuadores
Un sensor sensor convierte una magnitud física en una señal: temperatura (un thermistor termistor o termopar), presión (galga extensiométrica), infrarrojo, sonido. Las señales analógicas necesitan primero un ADC. Un actuator actuador hace lo contrario: convierte una señal en una acción (un motor, válvula, calefactor, zumbador).

Un termistor: un sensor de temperatura cuya resistencia cambia con el calor 
Un motor eléctrico pequeño: un actuador que convierte una señal en movimiento Retroalimentación
En un sistema de control, el actuador cambia el entorno, que los sensores vuelven a medir: un bucle de feedback feedback. Sin retroalimentación, el sistema no puede corregirse ni saber cuándo detenerse (un termostato sin retroalimentación de temperatura calentaría indefinidamente).
ExplorarEl lazo de retroalimentación del control
Toca alrededor del bucle una termostato o un piloto automático se repite. Un sistema de control no solo lee el mundo — actúa, luego vuelve a medir, corrigiéndose una y otra vez.
Vocabulario EntrenarInglés Chino Pinyin actuator/ˈæktʃuːeɪtə/ 执行器 zhí xíng qì primary memory/ˈpraɪməri ˈmeməri/ 主存储器 zhǔ cún chǔ qì processor/ˈprəʊsesə/ 处理器 chǔ lǐ qì monitoring/ˈmɒnɪtərɪŋ/ 监控 jiān kòng control system/kənˈtrəʊl ˈsɪstəm/ 控制系统 kòng zhì xì tǒng feedback/ˈfiːdbæk/ 反馈 fǎn kuì preset value/ˈpriːset ˈvæljuː/ 预设值 yù shè zhí thermistor/ˈθɜːmɪstə/ 热敏电阻 rè mǐn diàn zǔ 3.2
Compuertas lógicas

Syllabus
Los candidatos deben ser capaces de: Notas y orientación Utilizar los siguientes símbolos de compuertas lógicas: [NOT, AND, OR, NAND, NOR, XOR] Comprender y definir las funciones de: NOT, AND, OR, NAND, NOR y XOR (EOR) Todas las compuertas excepto la NOT tendrán únicamente dos entradas. Construir la tabla de verdad para cada una de las compuertas lógicas anteriores Construir un circuito lógico A partir de: • un enunciado del problema • una expresión lógica • una tabla de verdad Construir una tabla de verdad A partir de: • un enunciado del problema • un circuito lógico • una expresión lógica Construir una expresión lógica A partir de: • un enunciado del problema • un circuito lógico • una tabla de verdad Fuente: Plan de estudios Cambridge International
El semisumador: XOR + AND suma dos bits Una logic gate compuerta lógica es un pequeño circuito que realiza una operación Boolean booleana. Las entradas y salidas son 0 (falso, bajo) o 1 (verdadero, alto). Conozca el símbolo, la función y la truth table tabla de verdad para cada compuerta.
Los símbolos para las seis compuertas lógicas NOT (invertidor)
A NOT A 0 1 1 0 AND — salida 1 solo si todos los inputs son 1
A B A AND B 0 0 0 0 1 0 1 0 0 1 1 1 OR — salida 1 si al menos un input es 1
A B A OR B 0 0 0 0 1 1 1 0 1 1 1 1 NAND (NOT AND) — salida 0 solo cuando todos los inputs son 1
A B A NAND B 0 0 1 0 1 1 1 0 1 1 1 0 NOR (NOT OR) — salida 1 solo cuando todos los inputs son 0
A B A NOR B 0 0 1 0 1 0 1 0 0 1 1 0 XOR (Exclusive OR, también llamado EOR) — salida 1 si los inputs son diferentes
A B A XOR B 0 0 0 0 1 1 1 0 1 1 1 0 ExplorarCompuertas lógicas
Cambia las entradas y elige una puerta. Cada puerta tiene su propia regla — los bloques de construcción de cada circuito digital.
Vocabulario EntrenarInglés Chino Pinyin logic gate/ˈlɒdʒɪk ɡeɪt/ 逻辑门 luó jí mén Boolean/ˈbuːlɪən/ 布尔 bù ěr truth table/truːθ ˈteɪbl/ 真值表 zhēn zhí biǎo 3.2
Circuitos lógicos

Un logic circuit circuito lógico es una red de compuertas que ejecuta una expresión booleana. Deberías poder pasar de un enunciado de problema, a una expresión lógica, a una tabla de verdad y a un diagrama de circuito.
El examen escribe expresiones en palabras,
X = (A AND NOT B) OR (B AND C), y acepta la forma algebraica $X = A\overline{B} + BC$ donde un punto (o nada) es AND, un signo más es OR, y una barra es NOT. Usa la que utilice la pregunta.De expresión a circuito
Dibuja una compuerta por operador y conéctalos. Para $X = (A \text{ AND } B) \text{ OR } (\text{NOT } C)$: una compuerta NOT sobre $C$, una compuerta AND sobre $A$ y $B$, luego una compuerta OR sobre los dos resultados.
Compuertas conectadas para ejecutar una expresión booleana De circuito a expresión
Trabaja hacia adelante desde las entradas, etiquetando la salida de cada compuerta, hasta llegar a la salida final.
Ejemplo resuelto. Escribe la expresión del circuito siguiente, luego completa su tabla de verdad.
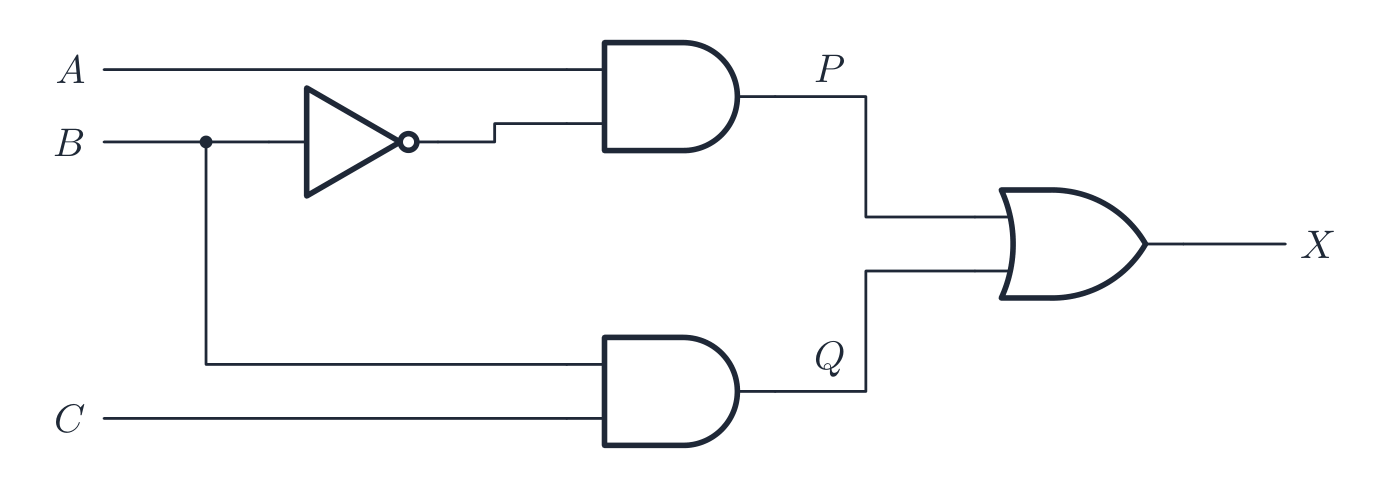
Etiqueta cada salida intermedia: aquí P es A Y NO B y Q es B Y C, por lo que X es P O Q Etiqueta las salidas de las compuertas: $P = A \text{ AND NOT } B$, $Q = B \text{ AND } C$, así $X = P \text{ OR } Q = (A \text{ AND NOT } B) \text{ OR } (B \text{ AND } C)$. Luego dale a la tabla de verdad una columna por cada salida intermedia, para que cada fila pueda verificarse una compuerta a la vez:
A B C NOT B P Q X 0 0 0 1 0 0 0 0 0 1 1 0 0 0 0 1 0 0 0 0 0 0 1 1 0 0 1 1 1 0 0 1 1 0 1 1 0 1 1 1 0 1 1 1 0 0 0 0 0 1 1 1 0 0 1 1 Dibujar un circuito a partir de una expresión es el mismo recorrido en reversa: comienza desde los paréntesis más internos, dibuja una compuerta por operador, dibuja una compuerta NOT en el cable de cualquier entrada que aparezca con NOT, mantén las entradas a la izquierda y la única salida a la derecha, y etiqueta la salida con su letra. Cada línea debe terminar en una entrada de compuerta o en la salida; una línea que no va a ningún lado pierde puntos.
De circuito a tabla de verdad
Para $n$ entradas hay $2^{n}$ filas. Enumera cada combinación de entradas; para cada una, calcula las compuertas internas y luego la salida.
De tabla de verdad a expresión (suma de productos)
Para cada fila que tiene salida 1, escribe un AND de las entradas (con NOT en cualquier entrada que sea 0 en esa fila); OR estas juntas. Ejemplo: una tabla que es 1 solo en $(A=0,B=1)$ y $(A=1,B=0)$ da $\overline{A}B + A\overline{B}$, que es $A \text{ XOR } B$.
De un enunciado de problema
Convierte el inglés a una expresión booleana primero: "A y B" → A AND B; "A o B o ambos" → A OR B; "exactamente uno de A y B" → A XOR B; "ni A ni B" → A NOR B; "no ambos" → A NAND B.
Ejemplo resuelto. La alarma de una máquina $X$ suena cuando la puerta está abierta ($A=1$) y ya sea el motor está en marcha ($B=1$) o la temperatura es alta ($C=1$). Escribe la expresión booleana y da las filas donde $X=1$. Convierte el inglés a lógica una cláusula a la vez: "ya sea B o C" es $B + C$, y "A y eso" es $X = A\cdot(B + C)$. Para las filas, $X=1$ necesita $A=1$ y al menos uno de $B$, $C$ igual a 1 - así $(A,B,C) = (1,0,1)$, $(1,1,0)$ y $(1,1,1)$, tres filas de ocho. Nota que $A=0$ nunca puede sonar la alarma, sin importar qué hagan $B$ y $C$. Encierra entre paréntesis el OR antes de hacerle AND: $X = A\cdot B + C$ es un circuito completamente diferente, uno que sonaría la alarma por alta temperatura incluso con la puerta cerrada.
ExplorarSumador parcial
Conecta XOR y AND a las mismas dos entradas: XOR da el bit de suma, AND da la acarreo. Haz clic en A y B.
ExplorarCircuitos lógicos
las compuertas se combinan en circuitos
Cada compuerta tiene una regla fija; encadenarlas construye cualquier circuito — comienza con una compuerta.
Vocabulario EntrenarInglés Chino Pinyin logic circuit/ˈlɒdʒɪk ˈsɜːkɪt/ 逻辑电路 luó jí diàn lù 3.2
Definiciones aceptadas por el examinador
Una pregunta de definición se califica según un texto fijo. Aprende estas definiciones exactamente, y da solo una respuesta.
Término Definición sistema embebido un sistema computacional con una función dedicada integrada en un dispositivo más grande búfer un área de memoria que almacena temporalmente datos mientras se transfieren entre dispositivos que operan a diferentes velocidades RAM memoria volátil que se puede leer y escribir, que contiene los programas y datos en uso ROM memoria no volátil cuyo contenido no puede cambiarse en uso normal, que contiene las instrucciones de arranque SRAM RAM estática que almacena cada bit en un flip-flop y no necesita refresco DRAM RAM dinámica que almacena cada bit como una carga en un capacitor y debe ser refrescada continuamente sistema de monitoreo un sistema que usa sensores para medir e informar sobre un proceso físico sin modificarlo sistema de control un sistema que usa lecturas de sensores para decidir y ejecutar acciones, mediante actuadores, que modifican un proceso físico sensor un dispositivo que mide una magnitud física y la convierte en una señal para la computadora actuador un dispositivo que convierte una señal de la computadora en una acción física retroalimentación la salida de un sistema de control siendo medida y devuelta como entrada para que el sistema pueda corregirse compuerta lógica un circuito electrónico que realiza una operación booleana sobre una o más entradas binarias para dar una salida binaria tabla de verdad una tabla que enumera todas las combinaciones de entradas de un circuito lógico con la salida correspondiente para cada una Vocabulario EntrenarInglés Chino Pinyin capacitor/kəˈpæsɪtə/ 电容器 diàn róng qì analogue-to-digital converter/ˈænəlɒɡ tə ˈdɪdʒɪtl kənˈvɜːtə/ 模数转换器 mó shù zhuǎn huàn qì digital-to-analogue converter/ˈdɪdʒɪtl tʊ ˈænəlɒɡ kənˈvɜːtə/ 数模转换器 shù mó zhuǎn huàn qì 3.2
Consejos para el examen
- Distingue RAM (volátil, lectura/escritura) de ROM (no volátil, contiene el bootstrap); SRAM (caché, más rápida) de DRAM (memoria principal, necesita refresco).
- Para un circuito lógico, construye la expresión booleana compuerta por compuerta, luego una tabla de verdad que cubra todas las combinaciones de entradas.
- Aprende el símbolo, la expresión y la tabla de verdad de cada compuerta (AND, OR, NOT, NAND, NOR, XOR).
- Explica un búfer (un almacenamiento temporal que puentea dos velocidades distintas) y el papel de una interrupción.
Errores comunes
- Nombrar el dispositivo en lugar de describir su funcionamiento. "Usa un láser" no otorga puntos; los pasos (cargar el tambor, el láser elimina la carga, el tóner es atraído, transferido, fundido) sí otorgan puntos.
- Decir que un sistema de monitoreo "controla" algo. Si nada modifica el proceso físico, es monitoreo; agrega el actuador y la retroalimentación y se convierte en control.
- Escribir que RAM "almacena archivos permanentemente" o que ROM "almacena los datos del usuario". RAM es memoria de trabajo volátil; ROM contiene las instrucciones de arranque fijas.
- Una tabla de verdad con menos de $2^{n}$ filas, o filas en orden aleatorio. Cuenta en binario de 000 a 111 para no omitir ninguna combinación.
- Dibujar dos líneas desde una salida de una compuerta por seguridad, o dejar un cable que termina en ningún lado. Dibuja exactamente las conexiones que necesita la expresión.
-
4
Fundamentos del procesador
Ver lección4.1
Arquitectura de Von Neumann
Syllabus
Los candidatos deben ser capaces de: Notas y orientación Demostrar comprensión del modelo básico Von Neumann para un sistema informático y el concepto de programa almacenado Demostrar comprensión del propósito y papel de los registros, incluyendo la diferencia entre registros de propósito general y propósito especial Registros de propósito especial que incluyen: • Contador de Programa (PC) • Registro de Datos de Memoria (MDR) • Registro de Direcciones de Memoria (MAR) • El Acumulador (ACC) • Registro de Índice (IX) • Registro de Instrucción Actual (CIR) • Registro de Estado Demostrar comprensión del propósito y roles de la Unidad Aritmética Lógica (ALU), la Unidad de Control (CU) y el reloj del sistema, Almacenamiento de Acceso Inmediato (IAS) Demostrar comprensión de cómo se transfieren los datos entre los diversos componentes del sistema informático utilizando el bus de direcciones, el bus de datos y el bus de control Demostrar comprensión de cómo los factores contribuyen al rendimiento del sistema informático Incluyendo: • tipo de procesador y número de núcleos • el ancho del bus • la velocidad de reloj • memoria caché Comprender cómo los diferentes puertos proporcionan conexión a dispositivos periféricos Incluyendo conexiones a: • Bus Serial Universal (USB) • Interfaz Multimedia de Alta Definición (HDMI) • Matriz de Gráficos de Vídeo (VGA) Describir las etapas del ciclo Búsqueda-Ejecución (F-E) Describir y utilizar la notación de 'transferencia de registro' para describir el ciclo F-E Demostrar comprensión del propósito de las interrupciones Incluyendo: • posibles causas de interrupciones • aplicaciones de las interrupciones • uso de una Rutina de Servicio de Interrupción (ISR) • cuándo se detectan las interrupciones durante el ciclo búsqueda-ejecución • cómo se manejan las interrupciones Fuente: Plan de estudios Cambridge International
El ciclo de búsqueda-decodificación-ejecución La arquitectura de Von Neumann 冯·诺依曼体系结构 subyace en casi todas las computadoras de propósito general:
- una memoria única — la Memoria de Acceso Inmediato 立即存取存储器 (IAS) — almacena tanto instrucciones del programa como datos (el concepto de programa almacenado 存储程序).
- un procesador 处理器 (CPU) busca instrucciones de la memoria y las ejecuta una a la vez.
- las instrucciones se ejecutan en orden a menos que una ramificación cambie el flujo.
La idea del programa almacenado es lo que hace flexible a una computadora: cambia el programa y cambias lo que hace, sin necesidad de reconfigurar cables.
ExplorarToca las partes de una computadora de Von Neumann
Explora cada bloque. La CPU (unidad de control, ALU, registros) se comunica con una única memoria principal a través de los buses —y esa memoria compartida para instrucciones Y datos es la idea de Von Neumann.
4.1
Partes principales de la CPU

Todas estas partes están dentro de un solo chip pequeño. El diagrama más adelante en esta sección muestra cómo se conectan; la foto de abajo muestra el dispositivo real.
Una CPU moderna: todo el procesador es un solo chip pequeño (aquí visto desde abajo, mostrando los contactos) 
El zócalo correspondiente de la CPU en la placa base: los contactos del chip presionan sobre estos pines Unidad Aritmética Lógica (ALU)
La ALU 算术逻辑单元 realiza operaciones aritméticas (suma, resta, ...) y lógicas (AND, OR, comparaciones). Toma operandos de los registros 寄存器 y coloca los resultados de vuelta en un registro.
Unidad de Control (CU)
La unidad de control 控制单元 decodifica cada instrucción y envía las señales de control para llevarla a cabo: abre rutas de datos, indica a la ALU qué hacer y controla las lecturas y escrituras de memoria.
Reloj del sistema
El reloj envía un flujo constante de pulsos que mantienen al CPU sincronizado. Cada instrucción toma un número fijo de ciclos, y la velocidad del reloj 时钟频率 (p. ej., 3.8 GHz) es un factor en el rendimiento.
"Explica cómo trabajan juntos la CU y el reloj del sistema": el reloj emite pulsos a una frecuencia fija; la unidad de control usa cada pulso para avanzar el ciclo de búsqueda-ejecución en un paso, enviando sus señales de control a tiempo con los pulsos, de modo que cada parte del procesador cambia de estado al mismo tiempo. Un reloj más rápido significa más pasos por segundo, hasta el punto en que los circuitos no pueden estabilizarse entre pulsos.
Registros
Los registros son memorias pequeñas y muy rápidas dentro del CPU. Los registros de uso especial 专用寄存器 tienen cada uno una función fija en el ciclo:
- Contador de Programa 程序计数器 (PC) — la dirección de la siguiente instrucción.
- Registro de Dirección de Memoria 内存地址寄存器 (MAR) — la dirección que se está leyendo o escribiendo.
- Registro de Datos de Memoria 内存数据寄存器 (MDR) — los datos que van hacia o vienen de la memoria.
- Registro de Instrucción Actual 当前指令寄存器 (CIR) — la instrucción que se está decodificando.
- Acumulador 累加器 (ACC) — el valor sobre el que trabaja la ALU.
- Registro de Estado 状态寄存器 — mantiene banderas 标志 (acarreo, cero, negativo, desbordamiento) usadas por las ramificaciones. Cada bandera es un bit, establecido o eliminado por la ALU después de una operación: la bandera cero tras una comparación que coincidió, la bandera de acarreo cuando una suma desbordó el registro, la bandera negativa cuando un resultado es negativo. Un salto condicional lee las banderas para decidir si debe ramificar, y una bandera de desbordamiento puede generar una interrupción.
- Registro de Índice 变址寄存器 — un desplazamiento añadido a una dirección en el direccionamiento indexado; incrementarlo permite recorrer un array un elemento a la vez.
La pregunta "completa la tabla que describe el papel de cada registro" pide una oración precisa por registro en estos términos: el PC contiene la dirección de la siguiente instrucción que será buscada; el MAR contiene la dirección de la ubicación que se está leyendo o escribiendo; el MDR contiene los datos o instrucción leídos recientemente de, o a punto de ser escritos en, esa ubicación; el CIR contiene la instrucción que se está decodificando y ejecutando actualmente; el ACC contiene el resultado de la última operación aritmética o lógica.
Los registros de uso general 通用寄存器 son usados por el programador para valores temporales durante un cálculo. Los movimientos de datos entre registros y memoria se escriben en notación de transferencia de registros 寄存器传送 — p. ej.
MAR ← [PC]("copia el contenido del PC en el MAR").
La CPU de Von Neumann: registros, unidad de control y ALU conectados por buses Vocabulario EntrenarInglés Chino Pinyin Von Neumann architecture/vɒn ˈnɔɪmən ˈɑːkɪtektʃə/ 冯·诺依曼体系结构 féng · nuò yī màn tǐ xì jié gòu Immediate Access Store/ɪˈmiːdɪət ˈækses stɔː/ 立即存取存储器 lì jí cún qǔ cún chǔ qì stored program/stɔːd ˈprəʊɡræm/ 存储程序 cún chǔ chéng xù processor/ˈprəʊsesə/ 处理器 chǔ lǐ qì arithmetic and logic unit/ˌærɪθˈmetɪk ənd ˈlɒdʒɪk ˈjuːnɪt/ 算术逻辑单元 suàn shù luó jí dān yuán ALU/ˌeɪ el ˈjuː/ 算术逻辑单元 suàn shù luó jí dān yuán buses/ˈbʌsɪz/ 总线 zǒng xiàn address bus/əˈdres bʌs/ 地址总线 dì zhǐ zǒng xiàn data bus/ˈdeɪtə bʌs/ 数据总线 shù jù zǒng xiàn word size/wɜːd saɪz/ 字长 zì cháng number of cores/ˈnʌmbə ɒv kɔːz/ 核心 hé xīn cores/kɔːz/ 核心 hé xīn amount of RAM/əˈmaʊnt ɒv ræm/ 随机存取存储器 suí jī cún qǔ cún chǔ qì RAM/ræm/ 随机存取存储器 suí jī cún qǔ cún chǔ qì page/peɪdʒ/ 页 yè cache memory/kæʃ ˈmeməri/ 高速缓存 gāo sù huǎn cún cache/kæʃ/ 高速缓存 gāo sù huǎn cún secondary storage/ˈsekəndəri ˈstɔːrɪdʒ/ 辅助存储器 fǔ zhù cún chǔ qì 4.1
Buses

Tres buses internos 总线 (conjuntos de cables paralelos) conectan las partes:
- bus de direcciones 地址总线 — transporta la dirección de memoria. Unidireccional (CPU → memoria).
- bus de datos 数据总线 — transporta los datos. Bidireccional.
- bus de control 控制总线 — transporta señales de control (lectura, escritura, interrupción). Bidireccional.
Un bus de direcciones de $n$ bits puede alcanzar $2^{n}$ ubicaciones de memoria. El ancho del bus de datos determina cuántos bits se mueven por acceso (a menudo el tamaño de palabra).
Los tres buses del sistema que conectan la CPU, la memoria y entrada/salida 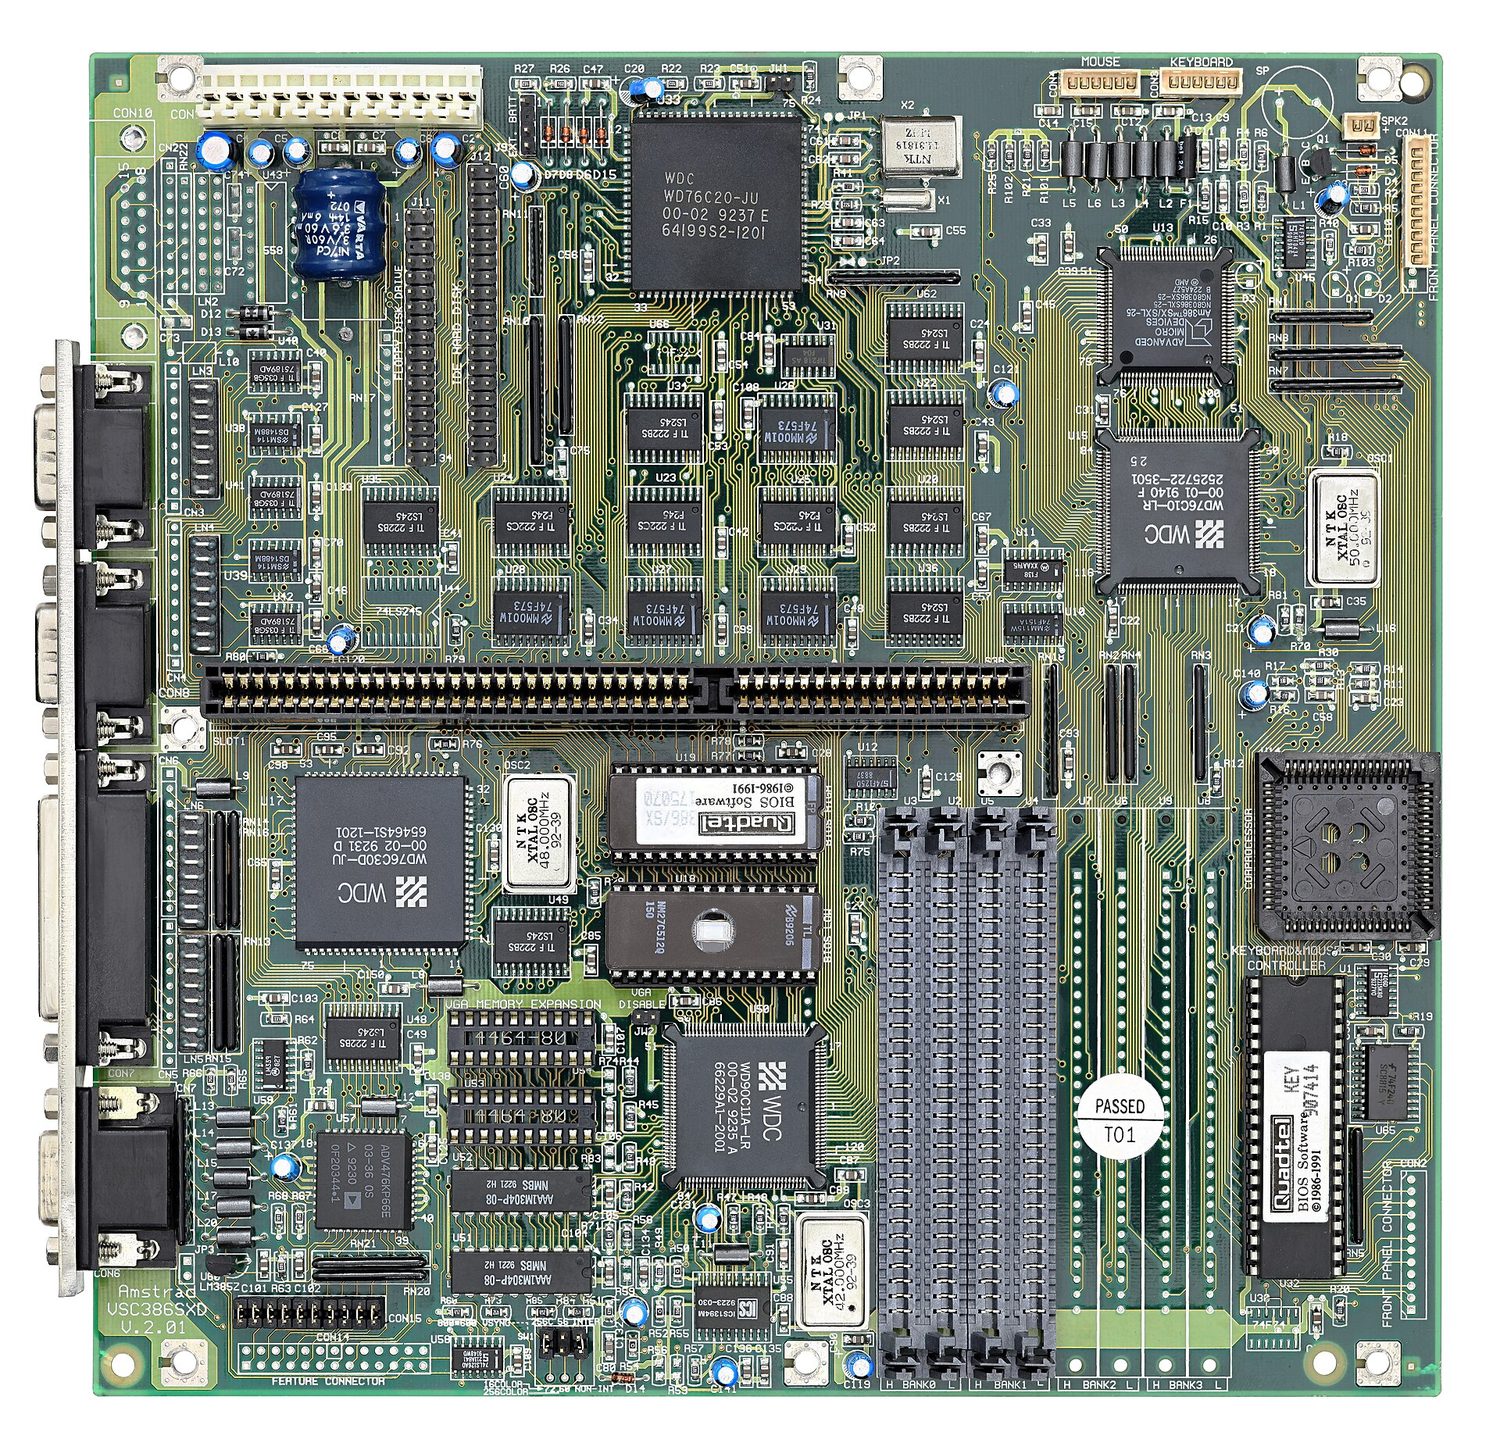
Una placa base: la CPU, la memoria y E/S están todas en un solo conjunto de buses — las pistas impresas que corren entre ellas Vocabulario EntrenarInglés Chino Pinyin port/pɔːt/ 端口 duān kǒu peripheral/pəˈrɪfərəl/ 外围设备 wài wéi shè bèi register transfer notation/ˈredʒɪstə ˈtrænsfɜː nəʊˈteɪʃn/ 寄存器传送记法 jì cún qì chuán sòng jì fǎ interrupt service routine/ˈɪntərʌpt ˈsɜːvɪs ruːˈtiːn/ 中断服务程序 zhōng duàn fú wù chéng xù interrupt register/ˈɪntərʌpt ˈredʒɪstə/ 中断寄存器 zhōng duàn jì cún qì stack/stæk/ 栈 zhàn assembly language/əˈsemblɪ ˈlæŋɡwɪdʒ/ 汇编语言 huì biān yǔ yán machine code/məˈʃiːn kəʊd/ 机器码 jī qì mǎ mnemonics/nɪˈmɒnɪks/ 助记符 zhù jì fú assembler/əˈsemblə/ 汇编器 huì biān qì symbol table/ˈsɪmbl ˈteɪbl/ 符号表 fú hào biǎo label/ˈleɪbl/ 标签 biāo qiān forward references/ˈfɔːwəd ˈrefrənsɪz/ 前向引用 qián xiàng yǐn yòng 4.1
Factores que afectan el rendimiento
- velocidad del reloj — más ciclos por segundo.
- número de núcleos 核心 — una CPU multi-núcleo ejecuta varios hilos a la vez.
- tamaño de palabra 字长 — una CPU de 64 bits maneja bloques de 64 bits por ciclo y puede acceder a mucha más memoria que una de 32 bits.
- cantidad de RAM 随机存取存储器 — más RAM almacena más del conjunto de trabajo; poca RAM obliga al SO a paginar 页 en disco.
- tamaño de la memoria caché 高速缓存 — más caché reduce el tiempo promedio de acceso a memoria.
- tipo de almacenamiento secundario 辅助存储器 — un SSD carga programas mucho más rápido que un HDD.
- ancho y velocidad del bus — buses más anchos/rápidos mueven datos más rápidamente.
Asigna las especificaciones a la carga de trabajo: un quad-core supera a un dual-core en tareas paralelas, pero mayor velocidad por núcleo gana en tareas de un solo hilo.
Cada factor es una respuesta de dos puntos con una razón adjunta:
- Más núcleos: cada núcleo puede buscar y ejecutar su propia instrucción al mismo tiempo, así que varios programas, o los hilos de un programa, se ejecutan en paralelo. Pero un programa debe estar escrito para usar más de un núcleo, por lo que duplicar los núcleos no duplica la velocidad.
- Mayor velocidad del reloj: más ciclos de búsqueda-ejecución por segundo, así que más instrucciones por segundo; el límite es el calor producido.
- Bus más ancho: un bus de datos más ancho mueve más bits en cada transferencia, así que se necesitan menos transferencias para los mismos datos; un bus de direcciones más ancho puede acceder a más ubicaciones de memoria.
- Memoria caché: una memoria pequeña y rápida dentro o junto al procesador que guarda las instrucciones y datos usados más recientemente o con mayor frecuencia. Leerlos desde la caché es mucho más rápido que desde la RAM, así que el procesador pasa menos tiempo esperando.
"Explica por qué la nueva computadora tiene mejor rendimiento" se responde comparando las dos especificaciones línea por línea: una mayor velocidad del reloj ejecuta más instrucciones por segundo, más núcleos ejecutan más tareas a la vez, más caché significa menos accesos lentos a RAM, y más RAM significa menos transferencias a disco.
4.1
Puertos
Un puerto 端口 es un conector físico para conectar un periférico 外围设备:
- USB (Universal Serial Bus) — de propósito general (teclados, unidades de almacenamiento, teléfonos).
- HDMI (High Definition Multimedia Interface) — video y audio digitales a una pantalla.
- VGA (Video Graphics Array) — salida de video analógica más antigua a un monitor.
- Ethernet (RJ-45) — red local cableada. Jacks de audio — auriculares/micrófono.
Diferentes puertos utilizan diferentes señales, por lo que un cable HDMI no encajará en un puerto USB. USB-C es inusual al transmitir video, datos y energía simultáneamente.
"Explica cómo la computadora se conecta al monitor a través de HDMI": el puerto HDMI envía el video y el audio como una sola señal digital por un solo cable, por lo que no se necesita conversión a analógico y la imagen no se degrada; el cable transporta resoluciones de alta definición y el propio puerto del monitor decodifica la señal. Un dispositivo USB es plug-and-play: cuando se conecta, la computadora lo detecta, lo identifica, carga o instala el controlador necesario y puede proporcionarle energía, todo sin necesidad de reiniciar.
4.1
Ciclo de búsqueda-ejecución

La CPU repite el ciclo de búsqueda-ejecución 取指-执行周期, una ejecución por instrucción de máquina.
Búsqueda
- la dirección del PC se copia al MAR.
- el PC se incrementa para apuntar a la siguiente instrucción.
- una señal de lectura viaja por el bus de control.
- la memoria coloca la instrucción en el bus de datos.
- se copia en el MDR, luego en el CIR.
El examen pide estos pasos en notación de transferencia de registros 寄存器传送记法, donde
[X]significa el contenido del registro X y[[MAR]]significa el contenido de la ubicación de memoria cuya dirección está en el MAR:MAR ← [PC] the address of the next instruction goes to the MAR PC ← [PC] + 1 the PC now points to the following instruction MDR ← [[MAR]] the instruction at that address is read into the MDR CIR ← [MDR] the instruction is copied into the CIR for decodingEl orden importa: el PC se incrementa inmediatamente después de que su dirección se ha copiado, para que un salto ejecutado más tarde pueda sobrescribirlo. Durante la ejecución, la misma notación describe cada instrucción; por ejemplo, para
LDD 200,MAR ← 200,MDR ← [[MAR]],ACC ← [MDR].Las transferencias de registros en una búsqueda: PC → MAR → memoria → MDR → CIR, con el PC incrementado Decodificación
La UC decodifica la instrucción en el CIR: qué operación y cuáles son los operandos o direcciones.
Ejecución
La UC la lleva a cabo: las operaciones aritméticas/lógicas van a la ALU (el resultado va al AC); una carga/almacenamiento mueve datos entre la memoria y un registro; un salto cambia el PC. Luego el ciclo se repite.

El ciclo de búsqueda-ejecución, con una comprobación de interrupciones cada vez ExplorarEl ciclo de búsqueda-ejecución
Toca alrededor del bucle que la CPU repite miles de millones de veces por segundo. Observa cómo la búsqueda utiliza los registros PC/MAR/MDR/CIR, luego decodifica y ejecuta actúa sobre lo que se buscó.
ExplorarEl ciclo de búsqueda-ejecución
Recorre cómo la CPU ejecuta una instrucción: buscala en la memoria, la decodifica y luego la ejecuta, repetidamente.
Vocabulario EntrenarInglés Chino Pinyin fetch-execute cycle/fetʃ ˈeksɪkjuːt ˈsaɪkl/ 取指-执行周期 qǔ zhǐ - zhí xíng zhōu qī special purpose registers/ˈspeʃl ˈpɜːpəs ˈredʒɪstəz/ 专用寄存器 zhuān yòng jì cún qì Program Counter/ˈprəʊɡræm ˈkaʊntə/ 程序计数器 chéng xù jì shù qì Memory Address Register/ˈmeməri əˈdres ˈredʒɪstə/ 内存地址寄存器 nèi cún dì zhǐ jì cún qì Memory Data Register/ˈmeməri ˈdeɪtə ˈredʒɪstə/ 内存数据寄存器 nèi cún shù jù jì cún qì Current Instruction Register/ˈkʌrənt ɪnˈstrʌkʃn ˈredʒɪstə/ 当前指令寄存器 dāng qián zhǐ lìng jì cún qì accumulator/əˈkjuːmjʊleɪtə/ 累加器 lěi jiā qì Status Register/ˈsteɪtəs ˈredʒɪstə/ 状态寄存器 zhuàng tài jì cún qì flags/flæɡz/ 标志 biāo zhì 4.1
Interrupciones

Una interrupción 中断 es una señal que pausa el ciclo normal para que la CPU pueda manejar un evento urgente (un pulsador de tecla, la llegada de un paquete, un fallo de hardware, división por cero, el temporizador del SO).
Para manejar una:
- terminar la instrucción actual.
- guardar el estado (PC y registros).
- cargar la dirección de la rutina de servicio de interrupción 中断服务程序 (ISR) en el PC y ejecutarla.
- la ISR maneja el evento.
- restaurar el estado guardado y continuar.
Las interrupciones permiten que el sistema responda rápidamente sin que la CPU revise constantemente los dispositivos, y son la forma en que el SO gestiona la multitarea.
"Explica cómo se detecta y maneja una interrupción de un dispositivo de entrada en el ciclo B-E" es una respuesta de cuatro puntos con estos elementos: el dispositivo envía una señal de interrupción que activa la bandera de interrupción en el registro de interrupciones 中断寄存器; el procesador revisa ese registro al final de cada ciclo de búsqueda-ejecución, después de que la instrucción actual haya terminado de ejecutarse; si una bandera está activada y la interrupción tiene mayor prioridad que la tarea actual, el contenido del PC y los otros registros se guardan en la pila 栈; la dirección de la rutina de servicio de interrupción se carga en el PC y la rutina se ejecuta; cuando termina, los valores guardados se restauran desde la pila y el programa interrumpido continúa desde donde se detuvo.
Causas dignas de nombrar: una interrupción de hardware de un dispositivo (una tecla presionada, un búfer de impresora vacío, la llegada de un paquete de red), una interrupción de software causada por un fallo (división por cero, una instrucción ilegal, desbordamiento aritmético), una interrupción de temporizador del sistema operativo que marca el final de un intervalo de tiempo, y una advertencia de falla de alimentación.
Cómo se integra una interrupción en el ciclo de búsqueda-ejecución Vocabulario EntrenarInglés Chino Pinyin interrupt/ˈɪntərʌpt/ 中断 zhōng duàn 4.2
Lenguaje ensamblador y código máquina

Syllabus
Los candidatos deben ser capaces de: Notas y orientación Demostrar comprensión de la relación entre el lenguaje ensamblador y el código máquina Describir las diferentes etapas del proceso de ensamblado para un ensamblador de dos pasadas Aplicar el proceso del ensamblador de dos pasadas a un programa dado en lenguaje ensamblador simple Rastrear un programa dado en lenguaje ensamblador simple Demostrar comprensión de que un conjunto de instrucciones se agrupan Incluyendo los siguientes grupos: • Movimiento de datos • Entrada y salida de datos • Operaciones aritméticas • Instrucciones incondicionales y condicionales • Instrucciones de comparación Demostrar comprensión y poder utilizar diferentes modos de direccionamiento Incluyendo inmediato, directo, indirecto, indexado, relativo Fuente: Plan de estudios Cambridge International
La CPU realmente ejecuta código máquina 机器码 — patrones de bits, específicos de una arquitectura. El lenguaje ensamblador 汇编语言 es una forma legible, con una instrucción por instrucción de máquina, escrita usando mnemotécnicos 助记符 como
LDD,ADD,JMP. Un ensamblador 汇编器 lo traduce a código máquina.Un ensamblador convierte mnemotécnicos en patrones de bits de código máquina Ensamblador de dos pasadas
Un ensamblador de dos pasadas lee el código fuente dos veces:
- paso 1 construye una tabla de símbolos 符号表: cada vez que aparece una etiqueta 标签 (como
LOOP:), se registra su dirección; aún no hay código. - paso 2 genera el código: traduce cada instrucción y, cuando una hace referencia a una etiqueta (como
JMP LOOP), busca su dirección en la tabla de símbolos.
Dos pasadas manejan referencias hacia adelante 前向引用 (un salto a una etiqueta definida más adelante).
Ejemplo resuelto. Aplique el proceso de dos pasadas a este programa, cuya primera instrucción se almacena en la dirección 100.
        LDD  COUNT
LOOP:   DEC  ACC
        CMP  #0
        JPN  LOOP
        END
COUNT:  5
El paso 1 lee cada línea, cuenta la dirección que ocupará y registra cada etiqueta en la tabla de símbolos:
LOOP= 101 (la líneaDEC) yCOUNT= 105 (la línea de datos). No se produce código. El paso 2 lee el programa nuevamente y traduce cada línea a código máquina, reemplazando cada mnemotécnico por su opcode 操作码 y cada dirección simbólica por el número de la tabla de símbolos:LDD COUNTse convierte en el opcode paraLDDcon operandos 操作数 105, yJPN LOOPse convierte en el opcode paraJPNcon operandos 101. El salto de regreso aLOOPpodría haberse resuelto en una sola pasada, pero un salto hacia adelante a una etiqueta aún no vista no podría, por eso el ensamblador realiza dos.Conjunto de instrucciones de ejemplo
Cambridge utiliza un conjunto genérico pequeño, impreso en la tabla de referencias del examen, con un registro de propósito general, el acumulador (AC), y un registro índice (IX). Un operandos escrito
#nes un número decimal,Bnun número binario y&nun número hexadecimal;<address>es un número de ubicación o una etiqueta.Grupo Instrucción Lo que hace Movimiento de datos LDM #ncarga el número n en ACC (inmediato) LDD <address>carga los contenidos de la dirección en ACC (directo) LDI <address>la dirección contiene otra dirección; carga los contenidos de esta última en ACC (indirecto) LDX <address>suma IX a la dirección y carga los contenidos del resultado en ACC (indexado) LDR #ncarga el número n en IX MOV <register>copia ACC al registro nombrado (IX) STO <address>almacena los contenidos de ACC en la dirección Entrada y salida INlee una pulsación de tecla y coloca su código ASCII en ACC OUTmuestra el carácter cuyo código ASCII está en ACC Aritmética ADD <address>/ADD #nsuma los contenidos de la dirección, o el número, a ACC SUB <address>/SUB #nresta a ACC INC <register>/DEC <register>suma 1 a, o resta 1 de, ACC o IX Comparación CMP <address>/CMP #ncompara ACC con los contenidos de la dirección, o con n, y establece la bandera CMI <address>compara ACC con los contenidos de la dirección almacenada en la dirección (indirecto) Salto JMP <address>salta a la dirección incondicionalmente JPE <address>/JPN <address>salta si la última comparación fue igual / no igual Manipulación de bits AND,OR,XORcon#n,Bn,&no<address>operación bit a bit sobre ACC LSL #n/LSR #ndesplaza ACC lógicamente n posiciones a la izquierda o a la derecha ENDfinaliza el programa La pregunta "las instrucciones del lenguaje ensamblador están agrupadas" pide los nombres de los grupos y una instrucción de cada uno: movimiento de datos, entrada y salida, aritmética, saltos incondicionales y condicionales, comparación y manipulación de bits.
ExplorarCómo funciona un ensamblador de dos pasadas
Paso a paso. El ensamblador lee tu código dos veces: la pasada 1 solo encuentra dónde vive cada etiqueta, para que la pasada 2 pueda rellenar las direcciones; así es como un salto a una etiqueta definida más tarde todavía funciona.
Vocabulario EntrenarInglés Chino Pinyin operand/ˈɒpərænd/ 操作数 cāo zuò shù register/ˈredʒɪstə/ 寄存器 jì cún qì control unit/kənˈtrəʊl ˈjuːnɪt/ 控制单元 kòng zhì dān yuán clock speed/klɒk spiːd/ 时钟频率 shí zhōng pín lǜ opcode/ˈɒpkəʊd/ 操作码 cāo zuò mǎ 4.2
Modos de direccionamiento

El modo de direccionamiento 寻址方式 (los modos de acceso) indica cómo encuentra el operando la CPU:
- direccionamiento inmediato 立即寻址 — el operando es el valor en la instrucción.
LDM #10carga 10. - direccionamiento directo 直接寻址 — la instrucción contiene una dirección; el operando es el valor allí.
LDD 200. - direccionamiento indirecto 间接寻址 — la instrucción contiene una dirección que contiene otra dirección, que es el dato.
LDI 200. - direccionamiento indexado 变址寻址 — la dirección efectiva es
address + index register; usado para arreglos.LDX 100con IR = 5 lee la dirección 105.
(Direccionamiento relativo 相对寻址 da la dirección como un desplazamiento desde el PC — usado para saltos.)
Cómo cada modo de direccionamiento accede a su operando — inmediato, directo, indirecto e indexado Ejemplo resuelto. La memoria contiene: dirección
200=250, dirección250=99, dirección105=7. El registro índice contiene5. ¿Qué hay en el acumulador después de cada una de⟩LDM #200,LDD 200,LDI 200yLDX 100? Siga la distancia que debe recorrer cada modo.LDM #200es inmediato: el operando es el número escrito en la instrucción, por lo que el acumulador contiene 200.LDD 200es directo: vaya a la dirección 200 y tome lo que haya allí: 250.LDI 200es indirecto: la dirección 200 contiene 250, que es otra dirección, así que continúe hasta la dirección 250: 99.LDX 100es indexado: sume el registro índice a la dirección, $100 + 5 = 105$, y lea la dirección 105: 7. Cuente los saltos para diferenciarlos: inmediato 0, directo 1, indirecto 2, indexado 1 (una vez que se ha añadido el índice).Vocabulario EntrenarInglés Chino Pinyin Index Register/ˈɪndeks ˈredʒɪstə/ 变址寄存器 biàn zhǐ jì cún qì indexed addressing/ˈɪndekst əˈdresɪŋ/ 变址寻址 biàn zhǐ xún zhǐ general-purpose registers/ˈdʒenərəl ˈpɜːpəs ˈredʒɪstəz/ 通用寄存器 tōng yòng jì cún qì register transfer/ˈredʒɪstə ˈtrænsfɜː/ 寄存器传送 jì cún qì chuán sòng control bus/kənˈtrəʊl bʌs/ 控制总线 kòng zhì zǒng xiàn addressing mode/əˈdresɪŋ məʊd/ 寻址方式 xún zhǐ fāng shì immediate addressing/ɪˈmiːdɪət əˈdresɪŋ/ 立即寻址 lì jí xún zhǐ direct addressing/daɪˈrekt əˈdresɪŋ/ 直接寻址 zhí jiē xún zhǐ indirect addressing/ɪndaɪˈrekt əˈdresɪŋ/ 间接寻址 jiàn jiē xún zhǐ relative addressing/ˈrelətɪv əˈdresɪŋ/ 相对寻址 xiāng duì xún zhǐ logical shift/ˈlɒdʒɪkl ʃɪft/ 逻辑移位 luó jí yí wèi cyclic shift/ˈsaɪklɪk ʃɪft/ 循环移位 xún huán yí wèi 4.2
Rastrear un programa ensamblador
Para rastrearlo: haga una tabla con columnas para el PC, ACC, registro índice, cada variable y cualquier bandera. Pase por las instrucciones actualizando la tabla después de cada una; siga las ramas cuando cambien el PC; deténgase en
END. Un patrón común es un bucle sobre un array utilizando direccionamiento indexado.Ejemplo resuelto. Rastree este programa. La dirección 200 contiene 5 y la dirección 201 contiene 0.
100   LDD  200
101   CMP  #0
102   JPE  108
103   OUT
104   DEC  ACC
105   STO  200
106   LDD  201
107   JMP  100
108   END
Escriba una fila por cada instrucción ejecutada, rellenando solo las columnas que cambian:
Instrucción ACC 200 201 Salida inicio 5 0 LDD 2005 CMP #0JPE 108no tomada OUTcarácter con código 5 DEC ACC4 STO 2004 LDD 2010 JMP 100LDD 2004 y así sucesivamente, hasta que
LDD 200carga 0, la comparación establece la bandera de igualdad,JPE 108es tomada y el programa termina. Tres cosas que revisa el examinador: unCMPno cambia ningún registro, solo una bandera; un salto no tomado sigue contando como ejecutado; yOUTemite un carácter, por lo que va en la columna de salida, no en la del ACC. "Indique el efecto de cambiarLDD 10aLDM #10": el ACC contendría el número 10 en lugar del contenido de la dirección 10.4.3
Desplazamientos binarios

Syllabus
Los candidatos deben ser capaces de: Notas y orientación Demostrar comprensión y realizar desplazamientos binarios Lógica, aritmética y desplazamiento cíclico, a la izquierda y a la derecha Demostrar comprensión de cómo se puede utilizar la manipulación de bits para monitorear/controlar un dispositivo Realizar operaciones de manipulación de bits. Verificar y establecer un bit (mediante enmascaramiento de bits) Etiqueta de instrucción | Opcode | Operando Explicación AND #n / Bn / &n Operación AND bit a bit del contenido del ACC con el operando AND <dirección> Operación AND bit a bit del contenido del ACC con el contenido de <dirección> XOR #n / Bn / &n Operación XOR bit a bit del contenido del ACC con el operando XOR <dirección> Operación XOR bit a bit del contenido del ACC con el contenido de <dirección> OR #n / Bn / &n Operación OR bit a bit del contenido del ACC con el operando OR <dirección> Operación OR bit a bit del contenido del ACC con el contenido de <dirección> LSL #n Los bits en el ACC se desplazan lógicamente n posiciones hacia la izquierda. Se introducen ceros en el extremo derecho LSR #n Los bits en el ACC se desplazan lógicamente n posiciones hacia la derecha. Se introducen ceros en el extremo izquierdo : Etiqueta una instrucción : Asigna una dirección simbólica a la ubicación de memoria con contenido Todas las preguntas asumirán que solo hay un registro de propósito general disponible (Acumulador). ACC denota Acumulador. IX denota Registro Índice. <dirección> puede ser una dirección absoluta o simbólica. # denota un número decimal, ej. #123. B denota un número binario, ej. B01001010. & denota un número hexadecimal, ej. &4A Fuente: Plan de estudios Cambridge International
Un desplazamiento lógico 逻辑移位 mueve todos los bits a la izquierda o a la derecha por algún lugar, rellenando las nuevas posiciones con 0.
- desplazamiento a la izquierda en 1 (
LSL #1) — los bits se mueven a la izquierda, entra un 0 por la derecha; para un número sin signo esto es × 2. - desplazamiento a la derecha en 1 (
LSR #1) — los bits se mueven a la derecha, entra un 0 por la izquierda; para un número sin signo esto es división entera ÷ 2.
Desplazar $n$ lugares multiplica o divide por $2^{n}$. Ejemplo:
00001011(11)LSL #1→00010110(22).Los bits desplazados fuera del extremo se pierden, por lo que la multiplicación solo es correcta mientras esos bits fueran ceros.
LSL #2en el entero de complemento a dos11001010da como resultado00101000: los dos 1s que cayeron por la izquierda han desaparecido, el bit de signo ha cambiado y el resultado ya no es cuatro veces el valor original.Un desplazamiento aritmético a la derecha mantiene el bit de signo para que un número con signo negativo permanezca negativo. Un desplazamiento cíclico (rotar) introduce el bit que cae de un extremo de nuevo en el otro extremo, por lo que no se pierden bits.
"Muestra el resultado de un desplazamiento aritmético a la derecha de 3 posiciones sobre
10011110": copia el bit de signo en cada posición vacante,11110011. El mismo desplazamiento aplicado a01011100produce00001011. Un desplazamiento cíclico a la izquierda de 1 sobre10000110da como resultado00001101: el 1 inicial reaparece a la derecha.Desplazamiento lógico a la izquierda ($\times 2$), desplazamiento lógico a la derecha ($\div 2$) y desplazamiento aritmético a la derecha (mantiene el bit de signo) La diferencia entre los dos desplazamientos a la derecha es un solo bit. Toma
11110000, que vale 240 si se lee sin signo y $-16$ si se lee con signo.LSR #1introduce un 0 y produce01111000$= 120$, que es la mitad correcta de 240. En cambio,ASR #1copia el bit de signo y produce11111000$= -8$, que es la mitad correcta de $-16$. Ninguno es incorrecto; cada uno reduce a la mitad el valor bajo una interpretación concreta.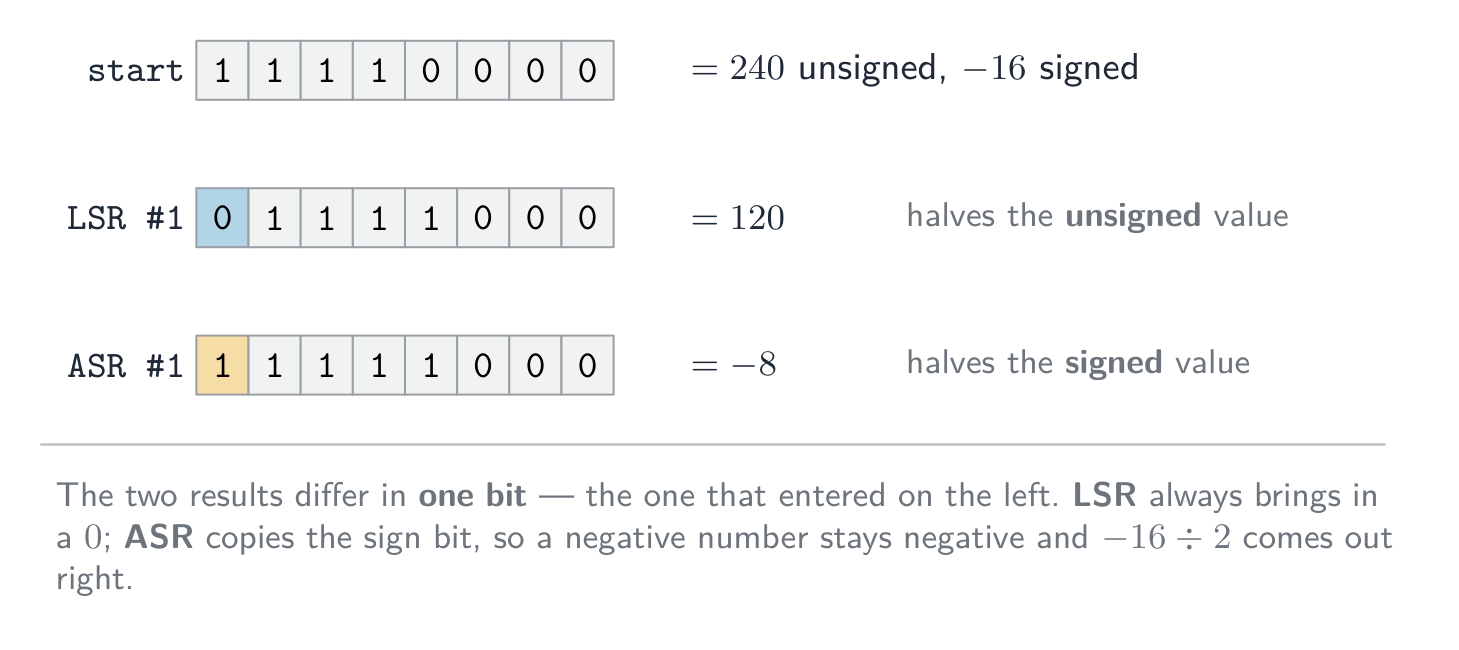
Desplazamiento lógico y aritmético a la derecha en el mismo byte: solo difiere el bit que entra por la izquierda Manipulación de bits para monitoreo/control
Los dispositivos embebidos suelen utilizar un único bit 位 de un registro por señal (p. ej., bit $n$ = LED $n$). Mediante una máscara 掩码 — enmascaramiento de bits—, puedes:
- establecer el bit $n$:
R = R ORuna máscara con el bit $n$ establecido. - borrar el bit $n$:
R = R ANDuna máscara con el bit $n$ borrado y el resto establecido. - invertir el bit $n$:
R = R XORuna máscara con el bit $n$ establecido. - comprobar el bit $n$:
R ANDla máscara, luego verificar si el resultado es distinto de cero.

Establecer un bit con OR, borrarlo con AND, invertirlo con XOR — cada operación utilizando una máscara La manipulación de bits es rápida, consume poca memoria y permite que un solo byte almacene hasta 8 estados encendido/apagado.
En el conjunto de instrucciones del examen, estas operaciones son
AND,ORyXORcon una máscara escrita como operando decimal, binario o hexadecimal. Con el ACC conteniendo10101100:Instrucción Máscara Resultado en ACC Efecto AND B000011110000111100001100mantiene solo los cuatro bits menos significativos (desactiva los demás) OR #10000000110101101establece el bit menos significativo, dejando el resto sin cambios XOR &FF1111111101010011invierte cada bit AND B00001000seguido deCMP #00000100000001000prueba el bit 3: la comparación no es igual, por lo que el bit 3 estaba establecido LSL #210110000desplaza a la izquierda dos posiciones, perdiendo los dos bits más significativos LSR #300010101desplaza a la derecha tres posiciones, introduciendo ceros por la izquierda "Escriba la instrucción que establece el bit menos significativo en 1 y deja los demás sin cambios":
OR #1, oOR B00000001. Para desactivar un bit utiliceANDcon una máscara que tenga un 0 en esa posición y 1s en las demás; para probar un bit,ANDcon una máscara que tenga un 1 solo en esa posición, luego compare el resultado con cero. En un dispositivo de monitorización, un bit de registro por sensor permite que una solaANDcompruebe si un sensor particular está activo, y unaORactiva el bit de control de un actuador sin perturbar los demás.ExplorarDesplaza y enmascara los bits de un byte
Elige un operador y observa cada bit resultante. Un desplazamiento a la izquierda (<<) moves every bit up one place (×2); a right shift (>>) los mueve hacia abajo (÷2); AND con una máscara borra los bits que no quieres.
Vocabulario EntrenarInglés Chino Pinyin bit/bɪt/ 位 wèi mask/mæsk/ 掩码 yǎn mǎ 4.3
Definiciones aceptadas por el examinador
Una pregunta de definición se califica según un texto fijo. Aprende estas definiciones exactamente, y da solo una respuesta.
Término Definición concepto de programa almacenado las instrucciones del programa y los datos están ambos almacenados en la memoria principal, y las instrucciones se buscan y ejecutan una a la vez registro una ubicación de almacenamiento pequeña y muy rápida dentro del procesador con un propósito específico Contador de Programa el registro que contiene la dirección de la siguiente instrucción que será buscada Registro de Dirección de Memoria el registro que contiene la dirección de la ubicación de memoria que se está leyendo o escribiendo Registro de Datos de Memoria el registro que contiene los datos o la instrucción leídos recientemente, o a punto de ser escritos en la memoria Registro de Instrucción Actual el registro que contiene la instrucción que se está decodificando y ejecutando actualmente Acumulador el registro de propósito general que contiene el resultado de la última operación aritmética o lógica memoria caché memoria pequeña y rápida cercana al procesador que contiene instrucciones y datos de uso frecuente interrupción una señal de un dispositivo o programa que hace que el procesador pause la tarea actual y ejecute una rutina de servicio de interrupción lenguaje ensamblador un lenguaje de bajo nivel en el cual cada instrucción mnemotécnica corresponde a una instrucción de código máquina direccionamiento inmediato el operando es el valor escrito en la instrucción direccionamiento directo el operando es el contenido de la dirección escrita en la instrucción direccionamiento indirecto la dirección en la instrucción contiene la dirección del operando direccionamiento indexado la dirección del operando es la dirección en la instrucción más el contenido del registro índice direccionamiento relativo la dirección del operando se da como un desplazamiento desde la dirección de la instrucción actual desplazamiento lógico cada bit se mueve el número dado de posiciones y los ceros rellenan las posiciones vacantes 4.3
Consejos para el examen
- Aprenda el ciclo de búsqueda-ejecución en términos de transferencia de registros (PC, MAR, MDR, CIR, ACC) y qué incrementa el PC.
- Nombre la función de cada registro; el bus de direcciones es de un solo sentido, el bus de datos es de doble sentido.
- Distinga los modos de direccionamiento (inmediato, directo, indirecto, indexado) — una pregunta frecuente.
- Explique cómo la velocidad del reloj, el número de núcleos, el tamaño de la caché y la longitud de palabra afectan el rendimiento.
- Para un desplazamiento binario, indique si es lógico o aritmético; un desplazamiento a la izquierda multiplica por 2, un desplazamiento a la derecha divide por 2.
Errores comunes
- Decir que el PC contiene la instrucción actual, o que el MDR contiene una dirección. El PC contiene la dirección de la siguiente instrucción; el MDR contiene datos o una instrucción, nunca una dirección.
- Dejar fuera el incremento del PC en la búsqueda, o ponerlo después de la ejecución. Ocurre tan pronto como la dirección ha sido copiada al MAR.
- Leer
LDD 10como "cargar 10".LDD 10carga el contenido de la dirección 10;LDM #10carga el número 10. - Poner un valor en la columna ACC para
CMPoOUT. Una comparación establece una bandera únicamente; una salida va a la columna de salida. - Decir que una interrupción se maneja "inmediatamente". El procesador termina la instrucción actual y verifica las interrupciones al final del ciclo.
- Usar un desplazamiento lógico a la derecha en un número complementario a dos negativo. Solo un desplazamiento aritmético mantiene el bit de signo.
-
5
Software de sistema
Ver lección5.1
Sistemas operativos

Syllabus
Los candidatos deben ser capaces de: Notas y orientaciones Explicar por qué un sistema informático requiere un Sistema Operativo (SO) Explicar las tareas clave de gestión realizadas por el Sistema Operativo Incluye la gestión de memoria, gestión de archivos, gestión de seguridad, gestión del hardware (entrada/salida/periféricos), gestión de procesos Demostrar comprensión de la necesidad de los programas utilitarios típicos proporcionados con un Sistema Operativo Incluye formateador de disco, antivirus, software de desfragmentación, análisis/repair de contenido de disco, compresión de archivos, software de copia de seguridad Demostrar comprensión de las bibliotecas de programas Incluye: • el software en desarrollo a menudo se construye utilizando código existente de bibliotecas de programas • los beneficios para el desarrollador al utilizar archivos de biblioteca, incluyendo archivos de Biblioteca de Enlace Dinámico (DLL) Fuente: Plan de estudios Cambridge International
Por qué una computadora necesita un SO
El hardware por sí solo solo puede buscar y ejecutar instrucciones; no sabe nada sobre archivos, programas, redes ni usuarios. El sistema operativo (SO) es la capa de software que:
- gestiona el hardware (procesador, memoria, E/S, almacenamiento) para los programas en ejecución.
- proporciona servicios (sistema de archivos, red, cuentas de usuario) a través de una interfaz clara, para que los programas no tengan que comunicarse directamente con el hardware.
- proporciona una interfaz de usuario (línea de comandos, GUI, táctil).
- permite que varios programas compartan el hardware de forma segura — cada uno obtiene tiempo de CPU justo y se mantiene fuera de la memoria de los demás.
Sin un SO, cada programa necesitaría sus propios controladores, y solo un programa podría ejecutarse de forma segura a la vez.
"Describe el propósito de un SO" — la lista de cinco puntos. El SO (1) proporciona una interfaz entre el usuario y el hardware; (2) oculta la complejidad del hardware al usuario y a los programas de aplicación; (3) gestiona los recursos de hardware — tiempo de procesador, memoria, almacenamiento y dispositivos de entrada/salida — y los comparte entre programas; (4) carga el software de aplicación en la memoria y lo ejecuta, dando a cada programa la misma plataforma para ejecutarse; (5) permite que varios programas se ejecuten a la vez (multitarea) manteniendo seguros tanto a los programas como los datos de los usuarios. Da cinco puntos diferentes; "ejecuta la computadora" o "gestiona recursos" por separado no otorgan puntos.
Un sistema operativo de escritorio gestiona la pantalla, los archivos y los programas para el usuario 
Un teléfono lo necesita tanto como una computadora: este es un sistema operativo móvil, Android Tareas de gestión clave
El programa de estudios nombra cinco. Cada punto a continuación es una cosa que el SO realmente hace, lo cual es lo que pide una pregunta de "describe".
- gestión de la memoria — asigna memoria a cada programa cuando se carga, mantiene separada la memoria de cada programa (protección de memoria) para que uno no sobrescriba a otro, libera la memoria cuando un programa termina, e intercambia páginas entre RAM y almacenamiento secundario (el disco) (memoria virtual / paginación) para que más programas puedan estar abiertos de los que permite la memoria física.
- gestión de procesos — un programa en ejecución es un proceso. El SO crea y finaliza procesos, decide qué proceso obtendrá la CPU siguiente (planificación) y por cuánto tiempo (una rebanada de tiempo), cambia entre ellos, resuelve conflictos cuando dos quieren el mismo recurso, y puede matar uno que deja de responder.
- gestión del hardware (entrada/salida y periféricos) — se comunica con cada dispositivo a través de su controlador de dispositivo, encola y amortigua datos enviados a dispositivos lentos como una impresora, responde a interrupciones de dispositivos, y comparte un dispositivo entre varios programas.
- gestión de archivos — crea, nombra, copia, mueve y elimina archivos y carpetas, mantiene la estructura de directorio y un registro de dónde se almacena cada archivo en el disco, asigna espacio en disco a los archivos, y aplica derechos de acceso (lectura / escritura / ejecución) para cada usuario.
- gestión de seguridad — cuentas de usuario y contraseñas (autenticación), derechos de acceso, cifrado de datos almacenados, un cortafuegos, actualizaciones de seguridad automáticas y un registro de quién hizo qué.

Los trabajos principales que gestiona el sistema operativo 
La protección de memoria mantiene cada aplicación en su propio bloque de memoria Cómo la gestión de memoria y de procesos apoya la multitarea (un favorito de cuatro puntos). La gestión de memoria carga varios programas en la memoria al mismo tiempo, cada uno en su propia área protegida, y lleva la cuenta de qué direcciones pertenecen a cuáles; la gestión de procesos comparte el procesador entre ellos — cada proceso se ejecuta durante una rebanada de tiempo, el SO guarda su estado y cambia al siguiente, y el cambio es tan rápido que todos los programas parecen ejecutarse juntos. Las interrupciones permiten que el SO recupere el procesador de un proceso siempre que un dispositivo necesite atención.
Interrupciones. Una interrupción de hardware proviene de un dispositivo: una tecla presionada, un clic del ratón, una impresora sin papel, un disco terminando una transferencia, un fallo de energía. Una interrupción de software proviene de un programa: división por cero, una instrucción inválida, un intento de usar memoria que no le pertenece, o una solicitud de servicio del SO. El manejador de interrupciones del SO guarda el estado del proceso en ejecución, maneja la interrupción y luego restaura el proceso (el tema 4 cubre el detalle de búsqueda-ejecución).
Software de utilidad
Los programas de utilidad son software del sistema que mantienen, reparan u optimizan la computadora en lugar de realizar una tarea del usuario; el examinador acepta "realiza una tarea de mantenimiento específica que mejora el rendimiento o la seguridad". La mayoría de los SO los incluyen:

Programas de utilidad: antivirus, respaldo, compresión y desfragmentador - formateador de disco — prepara un disco nuevo (o borra uno viejo) para su uso: establece su sistema de archivos y particiones, eliminando cualquier dato existente.
- verificador de virus (antivirus) — escanea archivos y memoria, compara código contra una base de datos de firmas de virus conocidas y vigila comportamientos sospechosos, luego cuarentena o elimina lo que encuentra; se ejecuta según un horario y en cada descarga, y necesita actualizaciones a medida que aparecen nuevos virus.
- software de desfragmentación — un disco duro almacena un archivo en los bloques libres que encuentra, por lo que después de muchas guardas y eliminaciones, un archivo queda disperso (fragmentado) a través del plato y el cabezal de lectura/escritura debe saltar entre las piezas. El desfragmentador mueve las piezas de cada archivo una junto a la otra y agrupa el espacio libre en una sola región, para que los archivos carguen más rápido y los nuevos archivos no se fragmenten. No es necesario en una SSD, que no tiene cabezal móvil.
- análisis de contenido de disco / software de reparación de discos — muestra qué está usando el espacio en disco (archivos grandes, duplicados o temporales) para que puedan ser eliminados; encuentra y repara sectores defectuosos, clústeres perdidos y errores del sistema de archivos.
- compresión de archivos — encoge los archivos para que ocupen menos almacenamiento y se transfieran más rápido; el archivado agrupa muchos archivos en uno.
- software de respaldo — copia archivos a otro medio (disco externo, red, nube) según un horario para que los datos puedan restaurarse tras una pérdida, corrupción o ataque de ransomware; un copiado completo es seguido por respaldos incrementales de solo lo que cambió.
- un cortafuegos (filtra el tráfico de red por reglas) y herramientas de cifrado, para seguridad; un monitor del sistema y actualizaciones automáticas.
Incluirlos con el SO ahorra al usuario instalar cada uno.
Qué hace cada programa de utilidad. Rendimiento: desfragmentación (acceso a archivos más rápido), reparación de discos (un disco con errores es lento o falla), análisis de contenido de disco (espacio libre al eliminar basura), compresión (más caben en el disco). Seguridad: verificador de virus, cortafuegos, cifrado y respaldo (la única recuperación ante ransomware). Una pregunta de "dibuja una línea" empareja cada programa de utilidad con exactamente un propósito — aprende los pares anteriores y usa los nombres del programa de estudios.
Ejemplo resuelto. Explica cómo la desfragmentación puede mejorar el rendimiento de una computadora (3 puntos).
Con el tiempo, un archivo se almacena en bloques dispersos a través del disco duro, por lo que leerlo requiere muchos movimientos del cabezal de lectura/escritura. El desfragmentador reordena los bloques para que cada archivo se almacene contiguamente y el espacio libre esté junto. Los archivos se leen entonces con menos movimientos del cabezal, por lo que cargan más rápido, y los nuevos archivos pueden escribirse en un espacio continuo.
ExplorarDónde se sitúa el sistema operativo
Toca cada capa. El SO es la capa intermedia: se sitúa entre tus aplicaciones y el hardware, compartiendo la máquina de forma segura para que los programas nunca accedan al hardware directamente.
Vocabulario EntrenarInglés Chino Pinyin operating system/ˈɒpəreɪtɪŋ ˈsɪstəm/ 操作系统 cāo zuò xì tǒng processor/ˈprəʊsesə/ 处理器 chǔ lǐ qì multitasking/ˈmʌltitæskɪŋ/ 多任务处理 duō rèn wù chǔ lǐ memory management/ˈmeməri ˈmænɪdʒmənt/ 内存管理 nèi cún guǎn lǐ memory protection/ˈmeməri prəˈtekʃn/ 内存保护 nèi cún bǎo hù RAM/ræm/ 随机存取存储器 suí jī cún qǔ cún chǔ qì secondary storage/ˈsekəndəri ˈstɔːrɪdʒ/ 辅助存储器 fǔ zhù cún chǔ qì virtual memory/ˈvɜːtʃuːəl ˈmeməri/ 虚拟内存 xū nǐ nèi cún paging/ˈpeɪdʒɪŋ/ 分页 fēn yè process management/ˈprəʊses ˈmænɪdʒmənt/ 进程管理 jìn chéng guǎn lǐ process/ˈprəʊses/ 进程 jìn chéng scheduling/ˈʃedjuːlɪŋ/ 调度 diào dù time slice/taɪm slaɪs/ 时间片 shí jiān piàn device driver/dɪˈvaɪs ˈdraɪvə/ 设备驱动 shè bèi qū dòng interrupts/ˈɪntərʌpts/ 中断 zhōng duàn directory/daɪˈrektəri/ 目录 mù lù access rights/ˈækses raɪts/ 访问权限 fǎng wèn quán xiàn authentication/ɔːˌθentɪˈkeɪʃn/ 身份验证 shēn fèn yàn zhèng firewall/ˈfaɪəwɔːl/ 防火墙 fáng huǒ qiáng hardware interrupt/ˈhɑːdweə ˈɪntərʌpt/ 硬件中断 yìng jiàn zhōng duàn software interrupt/ˈsɒftweə ˈɪntərʌpt/ 软件中断 ruǎn jiàn zhōng duàn interrupt handler/ˈɪntərʌpt ˈhændlə/ 中断处理程序 zhōng duàn chǔ lǐ chéng xù utility program/juːˈtɪlɪti ˈprəʊɡræm/ 实用程序 shí yòng chéng xù antivirus/ˌæntɪˈvaɪrəs/ 杀毒软件 shā dú ruǎn jiàn backup/ˈbækʌp/ 备份 bèi fèn compression/kəmˈpreʃn/ 压缩 yā suō disk defragmenter/dɪsk ˌdiːˈfræɡmentə/ 碎片整理 suì piàn zhěng lǐ signatures/ˈsɪɡnɪtʃəz/ 签名 qiān míng fragmented/fræɡˈmentɪd/ 碎片化 suì piàn huà incremental backups/ˌɪŋkrɪˈmentl ˈbækʌps/ 增量备份 zēng liàng bèi fèn program library/ˈprəʊɡræm ˈlaɪbrəri/ 程序库 chéng xù kù subroutines/ˈsʌbruːtiːnz/ 子程序 zi chéng xù library routines/ˈlaɪbrəri ruːˈtiːnz/ 库例程 kù lì chéng static library/ˈstætɪk ˈlaɪbrəri/ 静态库 jìng tài kù executable/ɪɡˈzekjʊtəbl/ 可执行文件 kě zhí xíng wén jiàn dynamic library/daɪˈnæmɪk ˈlaɪbrəri/ 动态库 dòng tài kù translator/trænˈsleɪtə/ 翻译器 fān yì qì machine code/məˈʃiːn kəʊd/ 机器码 jī qì mǎ assembler/əˈsemblə/ 汇编器 huì biān qì assembly language/əˈsemblɪ ˈlæŋɡwɪdʒ/ 汇编语言 huì biān yǔ yán 5.1
Bibliotecas de programas

Una biblioteca de programas es código preescrito (subrutinas, clases, módulos) que los programas reutilizan en lugar de escribirlo ellos mismos — por ejemplo, una biblioteca matemática, una biblioteca de red, una biblioteca gráfica.
Un nuevo programa reutilizando rutinas listas de bibliotecas Beneficios: ahorra tiempo (código listo para usar), confiable (bien probado, ampliamente usado) y estandarizado (comportamiento consistente).
La lista de beneficios del examinador, para el desarrollador. Las rutinas de la biblioteca ya están escritas y probadas, por lo que el desarrollo es más rápido y barato; son confiables y, al ser usadas por muchos programas, largely error-free (con errores mínimos); el desarrollador no necesita experticia en esa área (gráficos, compresión, cifrado, búsqueda de rutas); el programa es más fácil de mantener porque el código común vive en un solo lugar; y todo un equipo puede usar las mismas rutinas, dando resultados consistentes. Inconvenientes: una rutina puede no hacer exactamente lo que necesitas y no puedes cambiarla; tu programa depende de que la biblioteca esté disponible, sea correcta y segura — un error o una brecha de seguridad en la biblioteca es un error en tu programa; y debes aprender cómo llamarla.
- una biblioteca estática se copia en el ejecutable en tiempo de compilación (funciona por sí sola, pero es más grande y necesita recompilarse para actualizarse).
- una biblioteca dinámica (DLL, Dynamic Link Library;
.so) se carga en tiempo de ejecución (ejecutables más pequeños, compartida por muchos programas, se actualiza una vez para todos).

Estático: la biblioteca se copia en el ejecutable. Dinámico: un archivo de biblioteca compartida se carga en tiempo de ejecución Archivos de Dynamic Link Library (DLL). Una DLL es una biblioteca que se carga en la memoria solo cuando un programa la llama, en tiempo de ejecución, y permanece como un archivo separado en lugar de copiarse en el ejecutable. Beneficios: el ejecutable es más pequeño; varios programas en ejecución comparten una copia de la DLL en la memoria; una DLL se puede actualizar (corrección de errores, nuevo dispositivo) sin recompilar los programas que la usan; y la memoria se usa solo mientras se necesita la rutina. Inconvenientes: el programa no funcionará si falta la DLL, se mueve o es la versión incorrecta; una DLL actualizada puede romper un programa que dependía del comportamiento anterior; y una DLL falsa colocada en su lugar se ejecuta con los privilegios del programa.
Ejemplo resuelto. Un equipo que escribe software para un robot de restaurante usa una biblioteca de programas que incluye una rutina para encontrar el camino más corto entre mesas. Explica dos beneficios y un inconveniente para el equipo.
Beneficios: la rutina ya está escrita y probada, así que el equipo ahorra tiempo y puede confiar en el resultado; el equipo no necesita entender algoritmos de búsqueda de rutas por sí mismo y puede dedicar el tiempo a las características propias del robot. Inconveniente: la rutina puede no manejar las necesidades exactas del restaurante (mover sillas, pasillos de un solo sentido) y el equipo no puede alterarla, por lo que podrían tener que work around (adaptarse a) sus limitaciones.
ExplorarLaboratorio de conceptos informáticos
Clasificar ejemplos concretos según la idea informática que demuestran.
5.2
Traductores de lenguajes

Syllabus
Los candidatos deben ser capaces de: Notas y orientación Demostrar comprensión de la necesidad de: • software ensamblador para la traducción de un programa en lenguaje ensamblador • un compilador para la traducción de un programa en lenguaje de alto nivel • un intérprete para la traducción y ejecución de un programa en lenguaje de alto nivel Explicar las ventajas e inconvenientes del uso de un compilador o un intérprete, y justificar el uso de cada uno Demostrar conocimiento de que los programas en lenguajes de alto nivel pueden ser parcialmente compilados y parcialmente interpretados, como Java (modo consola) Describir las características de un entorno de desarrollo integrado (IDE) típico Incluyendo: • para la codificación, incluyendo indicaciones sensibles al contexto • para la detección inicial de errores, incluyendo verificaciones sintácticas dinámicas • para la presentación, incluyendo formato estético (prettyprint), expansión y colapso de bloques de código • para la depuración, incluyendo paso a paso, puntos de interrupción, variables, expresiones y ventana de informes Fuente: Plan de estudios Cambridge International
Escribes código fuente; la computadora ejecuta código máquina. Un traductor convierte entre ambos.
Ensamblador
Un ensamblador traduce lenguaje ensamblador a código máquina: cada instrucción mnemotécnica (
LDD,ADD,JMP) se convierte exactamente en una instrucción de código máquina, y las direcciones simbólicas y etiquetas se reemplazan por direcciones reales. Es necesario porque el procesador solo ejecuta código máquina, y el ensamblador se usa donde el programador necesita control directo del hardware (sistemas embebidos, controladores de dispositivos).Compilador
Un compilador traduce un programa de alto nivel a código máquina una vez, antes de ejecutarse.
- informa todos los errores en tiempo de compilación; una vez limpio, produce un ejecutable independiente que se ejecuta sin el compilador instalado y puede ejecutarse muchas veces.
- generalmente más rápido en tiempo de ejecución (sin traducción mientras se ejecuta), pero ligado a una CPU/SO específico — recompilar para cada plataforma.
La descripción de dos puntos: un compilador traduce el programa completo de alto nivel a código máquina (código objeto) antes de ejecutarse, produce un archivo ejecutable e informa todos los errores de sintaxis juntos como una lista al final de la traducción. No ejecuta el programa.
Intérprete
Un intérprete traduce y ejecuta un programa de alto nivel una línea a la vez, sin producir un ejecutable.
- informa un error cuando llega a esa línea, luego se detiene; puedes corregirlo y continuar — bueno para el desarrollo.
- el intérprete debe estar instalado para ejecutar el programa; generalmente más lento (cada ejecución vuelve a traducir), pero fácil de portar entre plataformas.
La descripción de dos puntos: un intérprete traduce una declaración del programa de alto nivel a la vez y la ejecuta inmediatamente antes de pasar a la siguiente; no se produce un archivo ejecutable; se detiene en el primer error que encuentra y lo informa. Tanto el código fuente como el intérprete deben estar presentes cada vez que se ejecuta el programa.
Un compilador traduce una vez en un programa independiente; un intérprete traduce línea por línea, cada ejecución Elegir entre ellos
Usa un compilador cuando: Usa un intérprete cuando: importa la velocidad en tiempo de ejecución quieres ciclos rápidos de edición-ejecución distribuyes a usuarios sin herramientas de desarrollo escribes scripts multiplataforma el programa se ejecuta muchas veces el programa es pequeño o se ejecuta una vez enseñando a principiantes Beneficios e inconvenientes, según los criterios de calificación.
compilador intérprete velocidad de ejecución rápida — ya es código máquina más lenta — traducida en cada ejecución lo que necesita el usuario solo el ejecutable; sin traductor, y el código fuente se mantiene privado el código fuente y el intérprete encontrar errores todos los errores listados a la vez, después de traducir el programa completo cada error informado en la línea donde ocurre, mientras desarrollas cambiar el código recompilar el programa completo después de cada cambio editar y ejecutar de nuevo inmediatamente portabilidad el código máquina solo corre en una plataforma; recompilar para cada uno la misma fuente corre dondequiera que exista un intérprete Ejemplo resuelto. Un desarrollador usa un intérprete mientras escribe un programa y un compilador cuando ha terminado. Explica cómo se usa cada uno (4 puntos).
Durante el desarrollo, el intérprete ejecuta el programa parcialmente escrito de inmediato, sin esperar una traducción completa; cuando encuentra un error informa la línea, así que el desarrollador lo corrige y ejecuta de nuevo inmediatamente — un ciclo rápido de edición-ejecución que es más fácil para depurar. Cuando el programa termina, el compilador traduce todo el programa en un ejecutable que se ejecuta más rápido, no necesita traductor en la computadora del usuario y no revela el código fuente, por lo que se puede vender al público.
Híbrido: Java
Java se compila a bytecode (una forma intermedia independiente de la plataforma), que luego interpreta una máquina virtual (la JVM) — o usa compilación just-in-time para convertir partes calientes en código nativo. Así, los errores se detectan temprano, el bytecode corre en cualquier lugar con una JVM ("escribe una vez, ejecuta en cualquier lugar"), y los programas de larga duración alcanzan velocidades cercanas al código nativo. C# y Python usan diseños similares.
La frase del programa de estudios es "parcialmente compilado y parcialmente interpretado": la etapa de compilación detecta errores de sintaxis y produce bytecode compacto y portable; la etapa de interpretación permite que ese único archivo de bytecode se ejecute en cualquier máquina que tenga una máquina virtual, a costa de algo de velocidad. Java en modo consola (un programa de texto ejecutado desde la línea de comandos) es el ejemplo del programa de estudios.

Java compila a bytecode portable que cualquier JVM ejecuta — escribe una vez, ejecuta en cualquier lugar Ejemplo resuelto. El código fuente de Java se compila a bytecode, que una JVM luego interpreta. ¿Por qué usar ambos, en lugar de compilar directamente a código máquina? Un compilador produce código máquina para un procesador y sistema operativo, por lo que un programa compilado en una máquina no correrá en otra. El compilador de Java, en cambio, apunta a una máquina virtual, por lo que el bytecode que produce es idéntico en todas partes; cada plataforma luego proporciona su propia JVM para interpretar ese bytecode en sus propias instrucciones nativas. Por lo tanto, un solo archivo compilado corre en cualquier lugar que exista una JVM - "escribe una vez, ejecuta en cualquier lugar". El precio es la velocidad: interpretar bytecode es más lento que ejecutar código nativo, por eso una JVM real también usa compilación JIT para convertir bytecode ejecutado frecuentemente en código nativo mientras el programa se ejecuta. Nombra ambos lados - los puntos son por la portabilidad obtenida a costa de la velocidad.
ExplorarLa ruta del compilador: desde el código fuente hasta el programa en ejecución
Paso a paso cómo funciona un compilador: traduce todo el programa una vez, antes de ejecutarlo. Contrástalo con un intérprete, que traduce y ejecuta línea por línea.
Vocabulario EntrenarInglés Chino Pinyin compiler/kəmˈpaɪlə/ 编译器 biān yì qì object code/ˈɒbdʒekt kəʊd/ 目标代码 mù biāo dài mǎ interpreter/ɪnˈtɜːprɪtə/ 解释器 jiě shì qì bytecode/ˈbaɪtkəʊd/ 字节码 zì jié mǎ virtual machine/ˈvɜːtʃuːəl məˈʃiːn/ 虚拟机 xū nǐ jī just-in-time compilation/dʒʌst ɪn taɪm ˌkɒmpɪˈleɪʃn/ 即时编译 jí shí biān yì portable/ˈpɔːtəbl/ 可移植的 kě yí zhí de integrated development environment/ˈɪntɪɡreɪtɪd dɪˈveləpmənt enˈvaɪrənmənt/ 集成开发环境 jí chéng kāi fā huán jìng 5.2
Entorno de Desarrollo Integrado (IDE)

Un entorno de desarrollo integrado (IDE) reúne las herramientas para escribir, probar y depurar código en una sola aplicación:
Un IDE agrupa el editor, un botón Ejecutar y un depurador El programa de estudios agrupa las características en cuatro tipos. Aprende cuál característica pertenece a cuál, porque las preguntas te piden clasificarlas y describir una de cada grupo.
- Para codificar: avisos sensibles al contexto — mientras escribes, el IDE muestra identificadores, palabras clave o parámetros que corresponden en ese punto del código; autocompletado termina el nombre por ti; la indentación automática y la coincidencia de paréntesis mantienen el formato correcto mientras escribes.
- Para detección inicial de errores: verificaciones de sintaxis dinámicas — el editor verifica la sintaxis mientras escribes y subraya o resalta un error inmediatamente, antes de que el programa se traduzca; después de la traducción, mensajes de error con números de línea.
- Para presentación: prettyprint — palabras clave, identificadores, cadenas y comentarios mostrados en diferentes colores o fuentes (resaltado de sintaxis) con indentación consistente, para que la estructura sea visible de un vistazo; expandir y contraer bloques de código — oculta el cuerpo de un bucle, un IF o una subrutina para que veas el esquema.
- Para depuración: puntos de ruptura — el programa se pausa cuando llega a una línea marcada; paso a paso — desde la pausa, ejecuta una línea a la vez; una ventana que muestra los valores actuales de variables y expresiones a medida que cambian; y una ventana de informe que enumera errores, advertencias y salida.
Otras características: integración de traductores (compilar o ejecutar con una tecla, errores mostrados en línea), un depurador que acciona las funciones de depuración anteriores, integración de control de versiones (git), gestión de proyectos, un sistema de ayuda, herramientas de refactorización (renombrado seguro) e integración de pruebas unitarias.
Las características del IDE con los nombres del programa de estudios, en los lugares donde las verías en pantalla Un IDE acelera el desarrollo poniendo escribir → ejecutar → depurar → corregir detrás de una sola interfaz. IDEs comunes: Visual Studio, PyCharm, Eclipse, VS Code.

Un depurador: establece un punto de ruptura, ejecuta, luego pausa para inspeccionar variables y paso a paso a través del código Ejemplo resuelto. Una función
Calculate()devuelve un valor inesperado cuando el programa se ejecuta. Describe cómo las funciones de depuración de un IDE típico ayudan a encontrar la causa (4 puntos).Establece un punto de ruptura en la primera línea de
Calculate(), para que el programa se pause allí en lugar de ejecutarse a través. Luego pasa paso a paso a través de la función línea por línea. Después de cada paso lee los valores de las variables y de cualquier expresión que hayas pedido al IDE que vigile, y compáralos con los valores que esperabas; la primera línea después de la cual un valor es incorrecto es donde está el error lógico. La ventana de informe muestra cualquier mensaje de error en tiempo de ejecución y la salida producida hasta ahora.Ejemplo resuelto. Coloca cada característica en su grupo del programa de estudios: prettyprint, aviso sensible al contexto, verificación de sintaxis dinámica, punto de ruptura, expandir/contraer bloques de código, ventana de informe.
Codificación: aviso sensible al contexto. Detección inicial de errores: verificación de sintaxis dinámica. Presentación: prettyprint, expandir/contraer bloques de código. Depuración: punto de ruptura, ventana de informe.
Vocabulario EntrenarInglés Chino Pinyin debugger/ˈdiːbʌɡə/ 调试器 tiáo shì qì context-sensitive prompts/ˈkɒntekst ˈsensɪtɪv prɒmpts/ 上下文相关提示 shàng xià wén xiāng guān tí shì auto-complete/ˈɔːtəʊ kəmˈpliːt/ 自动补全 zì dòng bǔ quán dynamic syntax checks/daɪˈnæmɪk ˈsɪntæks tʃeks/ 动态语法检查 dòng tài yǔ fǎ jiǎn chá prettyprint/ˈpretɪprɪnt/ 代码美化 dài mǎ měi huà syntax highlighting/ˈsɪntæks ˈhaɪlaɪtɪŋ/ 语法高亮 yǔ fǎ gāo liàng breakpoints/ˈbreɪkpɔɪnts/ 断点 duàn diǎn single stepping/ˈsɪŋɡl ˈstepɪŋ/ 单步执行 dān bù zhí xíng report window/rɪˈpɔːt ˈwɪndəʊ/ 报告窗口 bào gào chuāng kǒu version control/ˈvɜːʃn kənˈtrəʊl/ 版本控制 bǎn běn kòng zhì refactoring/rɪˈfæktərɪŋ/ 重构 chóng gòu unit test/ˈjuːnɪt test/ 单元测试 dān yuán cè shì 5.2
Definiciones aceptadas por el examinador
Una pregunta de definición se califica contra una redacción fija. Aprende estas exactamente, y da solo una respuesta.
Término Definición sistema operativo software que gestiona el hardware y los recursos del ordenador y proporciona una interfaz entre el usuario, los programas de aplicación y el hardware software de utilidad software de sistema que realiza una tarea específica para mantener, optimizar o proteger el ordenador, como un antivirus o un desfragmentador biblioteca de programas colección de rutinas preescritas y probadas (subrutinas, clases, módulos) que un programa puede utilizar en lugar de escribir las suyas propias Biblioteca de Enlaces Dinámicos (DLL) biblioteca de programas cuyas rutinas se cargan en la memoria solo cuando el programa las llama, en tiempo de ejecución, y que son compartidas entre programas ensamblador traductor que convierte un programa en lenguaje de ensamblaje en código máquina, una instrucción por cada instrucción compilador traductor que convierte todo un programa en lenguaje de alto nivel en código máquina antes de ser ejecutado, produciendo un archivo ejecutable intérprete traductor que traduce y ejecuta un programa en lenguaje de alto nivel una sentencia a la vez entorno de desarrollo integrado (IDE) aplicación única que proporciona las herramientas para escribir, traducir, ejecutar y depurar un programa indicación contextual ventana emergente que sugiere identificadores, palabras clave o parámetros que corresponden al punto actual del código comprobación de sintaxis dinámica comprobación de la sintaxis del código mientras se escribe y señalización de errores antes de que el programa sea traducido formateo estético visualización del código con palabras clave, identificadores y comentarios en diferentes colores o fuentes, y con sangrías consistentes punto de interrupción línea marcada en la que el programa en ejecución se pausa para poder inspeccionar variables paso a paso ejecución de un programa pausado una sentencia a la vez bajo el control del programador 5.2
Consejos para el examen
- Enumere las funciones del SO según sus nombres del temario (gestión de memoria, procesos, hardware, archivos y seguridad) y explique qué hace cada una: decir simplemente "gestiona recursos" es demasiado vago.
- Comparar compilador vs. intérprete vs. ensamblador: qué traducen, cuándo lo hacen y cómo se informan los errores.
- Explique qué proporciona un IDE utilizando los grupos del temario: codificación, detección inicial de errores, presentación y depuración.
- Una respuesta sobre una "ventaja para el desarrollador" menciona el ahorro del desarrollador: tiempo, coste, experiencia, fiabilidad o mantenimiento. Una "desventaja" menciona una dependencia: disponibilidad, versión, compatibilidad o seguridad.
- Para "describir el funcionamiento de" un traductor, proporcione tres cosas: qué se traduce (programa completo o una sentencia), cuándo (antes de ejecutar o durante la ejecución) y cómo se informan los errores (todos a la vez o en el primer error).
Errores comunes
- Escribir "el OS controla el ordenador" o "gestiona recursos" sin dar una tarea de ejemplo. Cada punto vale por una tarea nombrada con lo que hace.
- Decir que un intérprete "compila línea por línea". Un intérprete traduce y ejecuta cada sentencia; nunca produce un ejecutable.
- Decir que un compilador ejecuta el programa. Solo traduce; el ejecutable se ejecuta después, sin el compilador.
- Colocar una DLL "dentro" del ejecutable. Eso es una biblioteca estática; una DLL permanece como un archivo separado que se carga en tiempo de ejecución.
- Decir que la desfragmentación "elimina" o "comprime" archivos, o que es necesaria en una SSD. Solo mueve bloques para que cada archivo se almacene de forma contigua.
- Clasificar el formateo estético o el colapso de bloques bajo "depuración". Son características de presentación; la depuración incluye puntos de interrupción, paso a paso, observación de variables y ventana de informes.
-
6
Seguridad, privacidad e integridad de datos
Ver lección6.1
Seguridad, privacidad e integridad — tres ideas diferentes
Syllabus
Los candidatos deben ser capaces de: Notas y orientación Explicar la diferencia entre los términos seguridad, privacidad e integridad de los datos Demostrar comprensión de la necesidad tanto de la seguridad de los datos como de la seguridad del sistema informático Describir las medidas de seguridad diseñadas para proteger sistemas informáticos, desde un PC independiente hasta una red de computadoras Incluyendo cuentas de usuario, contraseñas, técnicas de autenticación como firmas digitales y biometría, firewall, software antivirus, antiespías, cifrado Demostrar comprensión de las amenazas a la seguridad de los computadores y los datos planteadas por las redes e Internet Incluyendo malware (virus, spyware), hackers, phishing, pharming Describir métodos que pueden utilizarse para reducir los riesgos planteados por las amenazas Describir métodos de seguridad diseñados para proteger la integridad de los datos Incluyendo cifrado, derechos de acceso Fuente: Plan de estudios Cambridge International
Estos suenan similares pero significan cosas diferentes:
- seguridad seguridad — proteger los datos contra el acceso, la modificación o la destrucción no autorizada.
- privacidad privacidad — el derecho de una persona a controlar quién ve sus datos personales, con consentimiento y un propósito claro.
- integridad integridad — que los datos sean exactos y completos, sin corrupción ni cambios accidentales.
Un archivo puede ser seguro (solo las personas adecuadas pueden abrirlo) pero carecer de integridad (una errata lo corrompió); o ser exacto pero no privado (cualquiera puede leerlo). Se necesitan los tres.
Las diferencias que exige el plan de estudios, una oración cada una: la seguridad es mantener los datos a salvo de pérdidas y accesos no autorizados; la privacidad es mantener los datos confidenciales, de modo que solo quienes tienen derecho puedan verlos; la integridad es que los datos sean correctos, coherentes y completos. Por tanto, "la diferencia entre seguridad y privacidad": la seguridad se refiere a proteger los datos para que no sean accedidos, modificados o perdidos por personas indebidas; la privacidad se refiere al derecho del individuo a decidir quién puede ver sus datos personales. "La diferencia entre seguridad e integridad": la seguridad protege los datos contra accesos no autorizados; la integridad se refiere a que los datos sean exactos y estén actualizados, lo cual protegen la validación y la verificación.
ExplorarLaboratorio de riesgos y responsabilidad
Clasifique los ejemplos según la regla, riesgo o protección involucrados.
6.1
Por qué importa la seguridad
Dos cosas que proteger: los propios datos (mantener su confidencialidad, integridad y disponibilidad) y el sistema informático (un sistema comprometido puede atacar a otros, robar credenciales o ser secuestrado mediante ransomware).
"¿Por qué necesita la escuela mantener ambos seguros?" Datos: son personales y confidenciales, por lo que no deben ser leídos, modificados ni eliminados por personas no autorizadas, y su pérdida impediría el funcionamiento de la escuela. Sistema: un intruso que acceda al sistema informático puede instalar malware, utilizarlo para atacar otros sistemas, dañar el hardware o software, o bloquearlo con ransomware; un sistema seguro es la primera línea de defensa para los datos que contiene.
Vocabulario EntrenarInglés Chino Pinyin malware/ˈmælweə/ 恶意软件 è yì ruǎn jiàn ransomware/ˈrænsəmweə/ 勒索软件 lè suǒ ruǎn jiàn networks/ˈnetwɜːks/ 网络 wǎng luò 6.1
Amenazas desde redes e internet

Las amenazas se dividen en tres grupos.
Un atacante de intermediario se sitúa entre las dos partes - Malware (software malicioso) — programas dañinos:
- virus — código auto-replicante que se adjunta a otros programas y se propaga cuando estos se ejecutan.
- gusano — código auto-replicante que se propaga a través de redes sin necesidad de intervención del usuario.
- caballo de Troya — parece útil pero oculta código malicioso.
- spyware — recopila información secretamente (pulsaciones de teclado, contraseñas).
- ransomware — cifra tus archivos y exige un pago.
- adware — muestra publicidad no deseada.
2. Engañar a las personas (ataques sociales):
- phishing — correos electrónicos o sitios web falsos que engañan a los usuarios para que faciliten sus credenciales.
- pharming — redirige a un usuario a un sitio falso incluso cuando escribe la dirección correcta.
- ingeniería social — engañar a las personas para que revelen información.
Las descripciones del plan de estudios de las cuatro amenazas nombradas: un virus es software malicioso que se replica (se copia a sí mismo), se adjunta a otros archivos y elimina o corrompe datos; el spyware es software malicioso que registra las pulsaciones de tecla y acciones del usuario y las envía a un tercero para obtener contraseñas y datos personales; un correo de phishing finge provenir de una organización legítima y contiene un enlace a un sitio web falso donde se pide al usuario datos personales o bancarios; el pharming es código malicioso instalado en el ordenador del usuario o en un servidor web que redirige al usuario a un sitio web falso aunque haya escrito la dirección correcta. Similitudes entre spyware y virus: ambos son malware, ambos se instalan sin el conocimiento del usuario, ambos pueden enviar datos a un tercero o dañar el sistema; la diferencia es que el virus se replica mientras que el spyware registra y transmite información. Phishing y pharming llevan ambos al usuario a un sitio web falso que recopila sus datos; el phishing requiere que el usuario haga clic en un enlace en un correo electrónico, mientras que el pharming funciona mediante código en el ordenador o en el servidor DNS y no necesita correo electrónico.
3. Ataques a la red:
- hacking — acceso no autorizado, a menudo mediante contraseñas débiles o vulnerabilidades de software.
- denegación de servicio (DoS/DDoS) — satura un servidor para que los usuarios reales no puedan acceder a él.
- escucha clandestina (eavesdropping) — captura de datos en tránsito (riesgo en Wi-Fi abierto).
- intermediario (man-in-the-middle) — un atacante retransmite o altera secretamente los mensajes entre dos partes.
Ejemplo resuelto. Identifica y describe dos amenazas a los datos en una red escolar, y proporciona un método de prevención diferente para cada una.
Amenaza 1, malware: un virus copiado en un ordenador desde un adjunto de correo electrónico o una descarga se replica y corrompe o elimina archivos; prevención: software antivirus que escanea archivos y se mantiene actualizado. Amenaza 2, hacking: una persona no autorizada obtiene acceso a la red, por ejemplo adivinando una contraseña débil, y lee o modifica los datos; prevención: un cortafuegos que bloquee conexiones no autorizadas, o contraseñas fuertes con autenticación de dos factores. Un tercer par, phishing: un correo electrónico lleva a un usuario a un sitio falso que recopila sus credenciales de inicio de sesión; prevención: formación de usuarios para verificar el remitente y la URL, y filtrado de correo electrónico. La medida debe coincidir con la amenaza: el cifrado no detiene un virus, y el software antivirus no detiene el phishing.

Malware por comportamiento: propagación autónoma (virus, gusano) frente a oculto/disfrazado (Troya, spyware, ransomware, adware) Vocabulario EntrenarInglés Chino Pinyin man-in-the-middle/mæn ɪnðə ˈmɪdl/ 中间人攻击 zhōng jiān rén gōng jī virus/ˈvaɪrəs/ 病毒 bìng dú worm/wɜːm/ 蠕虫 rú chóng Trojan horse/ˈtrəʊdʒn hɔːs/ 木马 mù mǎ spyware/ˈspaɪweə/ 间谍软件 jiàn dié ruǎn jiàn adware/ˈædweə/ 广告软件 guǎng gào ruǎn jiàn phishing/ˈfɪʃɪŋ/ 网络钓鱼 wǎng luò diào yú pharming/ˈfɑːmɪŋ/ 域名欺骗 yù míng qī piàn social engineering/ˈsəʊʃl ˌendʒɪˈnɪərɪŋ/ 社会工程 shè huì gōng chéng hacking/ˈhækɪŋ/ 黑客入侵 hēi kè rù qīn hackers/ˈhækəz/ 黑客 hēi kè denial of service/dɪˈnaɪəl ɒv ˈsɜːvɪs/ 拒绝服务 jù jué fú wù eavesdropping/ˈiːvzdrɒpɪŋ/ 窃听 qiè tīng 6.1
Medidas de seguridad

Las medidas protegen tanto la seguridad de los datos (contra pérdidas, robo o corrupción) como la seguridad del sistema informático (su hardware, software y red).
Un PC independiente
- una contraseña fuerte; antivirus mantenido actualizado; actualizaciones de software oportunas; copia de seguridad en medios separados; cifrado completo del disco; pantalla bloqueada.
Un PC conectado a red
Todo lo anterior, más un cortafuegos, permisos por usuario (derechos de administrador solo para administradores), gestión centralizada de cuentas de usuario, y registros de auditoría (quién inició sesión, qué tocó).
Cómo funcionan las medidas, con la redacción que otorga puntos el plan de estudios:
- cortafuegos: examina cada transmisión entrante y saliente y la compara con criterios establecidos (una lista blanca o negra de direcciones, puertos y protocolos); bloquea cualquier cosa que no cumpla los criterios; puede prevenir el acceso a ciertos sitios y advertir de intentos de acceso no autorizado.
- cifrado: los datos se codifican (encriptan) con una clave en texto cifrado, de modo que una copia interceptada no pueda entenderse sin la clave; el receptor utiliza una clave para descifrarlos. Protege los datos en tránsito y en almacenamiento, pero no evita que los datos sean interceptados o eliminados.
- contraseñas y cuentas de usuario: solo un usuario que conozca la contraseña puede iniciar sesión; una contraseña fuerte (larga, con caracteres variados, cambiada regularmente) no puede ser adivinada; las cuentas se bloquean tras varios intentos fallidos; cada cuenta tiene sus propios derechos de acceso.
- software antivirus y antispyware: escanea archivos y programas comparándolos con una base de datos de firmas de malware conocidas, verifica el comportamiento, cuarentena o elimina lo que encuentra, y debe actualizarse para reconocer nuevo malware.
- derechos de acceso: se otorgan permisos a cada usuario (o grupo) para cada archivo o tabla, como solo lectura o lectura y escritura, de modo que un usuario no pueda ver ni modificar datos que no le pertenecen; una base de datos también puede presentar a cada usuario una vista que contenga solo los campos que necesita.
- biometría: el dispositivo captura una imagen de la cara, huella dactilar o iris, la convierte en datos digitales, la compara con los datos almacenados para ese usuario y permite el acceso solo si hay coincidencia; no puede olvidarse, prestarse ni adivinarse como una contraseña.
- copias de seguridad: una copia de los datos en medios separados, guardada fuera del sitio, de modo que los datos perdidos o corruptos puedan restaurarse.
Para restringir los riesgos del malware, en tres puntos: instalar software anti-malware y mantenerlo actualizado; usar un cortafuegos; no abrir adjuntos ni descargar archivos de fuentes desconocidas; mantener el sistema operativo y las aplicaciones parcheadas; y formar a los usuarios.
Un cortafuegos se sitúa entre el ordenador del usuario e internet A través de internet
- VPN — cifra el tráfico entre el usuario y la puerta de enlace corporativa.
- HTTPS / TLS — cifra el tráfico web.
- firmas digitales — prueban quién envió un mensaje y que no fue alterado en tránsito.
- detección de intrusiones — vigila el tráfico en busca de patrones de ataque conocidos.
Cómo una firma digital autentica un documento (cinco puntos): el emisor pasa el mensaje por una función hash para producir un resumen; el emisor cifra el resumen con su clave privada, y ese resumen cifrado es la firma digital; el mensaje y la firma se envían juntos; el receptor descifra la firma con la clave pública del emisor para recuperar el resumen; el receptor calcula el hash del mensaje recibido y compara los dos resúmenes; si coinciden, el mensaje provino del emisor (solo ellos poseen la clave privada) y no fue alterado en la transmisión. Una firma prueba quién envió el mensaje y que está intacto; no oculta el contenido, para eso sirve el cifrado del mensaje.
Una firma digital: un hash del mensaje, cifrado con la clave privada del emisor, verificado por el receptor contra un hash fresco Vocabulario EntrenarInglés Chino Pinyin firewall/ˈfaɪəwɔːl/ 防火墙 fáng huǒ qiáng two-factor authentication/tuː ˈfæktə ɔːˌθentɪˈkeɪʃn/ 双因素认证 shuāng yīn sù rèn zhèng authentication/ɔːˌθentɪˈkeɪʃn/ 身份验证 shēn fèn yàn zhèng VPN/ˌviː piː ˈen/ 虚拟专用网 xū nǐ zhuān yòng wǎng digital signatures/ˈdɪdʒɪtl ˈsɪɡnɪtʃəz/ 数字签名 shù zì qiān míng private key/ˈpraɪvət kiː/ 私钥 sī yào public key/ˈpʌblɪk kiː/ 公钥 gōng yào authorisation/ˌɔːθəraɪˈzeɪʃn/ 授权 shòu quán least-privilege/liːst ˈprɪvɪlɪdʒ/ 最小权限 zuì xiǎo quán xiàn plaintext/ˈpleɪntekst/ 明文 míng wén Symmetric encryption/sɪˈmetrɪk enˈkrɪpʃn/ 对称加密 duì chèn jiā mì asymmetric encryption/ˌeɪsɪˈmetrɪk enˈkrɪpʃn/ 非对称加密 fēi duì chèn jiā mì access control/ˈækses kənˈtrəʊl/ 访问控制 fǎng wèn kòng zhì check digit/tʃek ˈdɪdʒɪt/ 校验位 jiào yàn wèi 6.1
Coincidir medidas con amenazas
- intercepción en tránsito → cifrar los datos (HTTPS, VPN). El texto cifrado interceptado es inútil sin la clave.
- acceso no autorizado → autenticación fuerte (contraseñas largas; autenticación de dos factores con código de teléfono o llave); autorización de usuario; bloqueo tras inicios de sesión fallidos.
- malware → software antivirus y antispyware con escaneo en tiempo real; parcheo; evitar descargas no confiables.
- phishing → formación de usuarios; filtrado de correo electrónico; verificar la URL antes de introducir credenciales.
- amenazas internas → principio de mínimo privilegio (dar a cada usuario solo lo necesario); auditoría.
- DDoS → limitación de velocidad y filtrado de tráfico.
Para datos confidenciales que cruzan internet, el método del plan de estudios es el cifrado: los datos se codifican con una clave en texto cifrado, de modo que una persona no autorizada que los intercepte no pueda leerlos, y solo el receptor previsto, que posee la clave, pueda decodificarlos. Para un archivo de programa enviado por correo electrónico para pruebas, la misma respuesta aplica (cifrar el archivo, o enviarlo sobre una conexión cifrada), junto con una contraseña en el propio archivo.
6.1
Proteger los propios datos

- cifrado — convertir texto en claro 明文 en texto cifrado 密wen con una clave. El cifrado simétrico 对称加密 (AES) utiliza una clave compartida; el cifrado asimétrico 非对称加密 (RSA) utiliza una clave pública 公钥 y una clave privada 私钥. Protege los datos en reposo y en tránsito.
- control de acceso 访问控制 — permisos de archivo (lectura/escritura/ejecución) y derechos de acceso 访问权限, aplicados por el sistema operativo.
- autenticación — las técnicas de autenticación verifican al usuario: algo que sabe (contraseña), algo que tiene (token, teléfono) o algo que es (biometría 生物识别 — huella dactilar, rostro, iris); la combinación es más fuerte.
- copias de seguridad — mantener copias (algunas fuera del sitio) para que la pérdida o corrupción sea recuperable.
- seguridad física — salas de servidores con cerradura, candados para cables.
Los derechos de acceso en una base de datos, descritos para tres puntos: a cada usuario se le asigna una cuenta con un nombre de usuario y contraseña; el administrador de la base de datos asigna a cada cuenta permisos para cada tabla, como solo lectura, lectura y escritura, o sin acceso; los usuarios ven solo las tablas y campos que tienen permitido, por lo que un cliente no puede abrir la tabla del personal y un cajero puede leer pero no cambiar los precios. El SGDBD aplica esto mediante sus derechos de acceso y mediante vistas, y también puede cifrar los datos almacenados.
Simétrico usa una clave compartida; asimétrico usa una clave pública para cifrar y una clave privada para descifrar 
Un token de seguridad muestra un código cambiante para la autenticación de dos factores ("algo que tienes") 
Un lector de huellas dactilares verifica "algo que eres" — una característica de la persona, no una contraseña ExplorarCifrar con un cifrado César
Cambiar el desplazamiento: esa es la clave. Cada letra se desplaza ese número de lugares a lo largo del alfabeto para crear el texto cifrado, y la misma clave lo devuelve al lugar original. Esa clave compartida es la encriptación simétrica en miniatura.
Vocabulario EntrenarInglés Chino Pinyin security/sɪˈkjʊərɪti/ 安全 ān quán privacy/ˈprɪvəsi/ 隐私 yǐn sī integrity/ɪnˈteɡrɪti/ 完整性 wán zhěng xìng unauthorised/ʌnˈɔːθəraɪzd/ 未授权 wèi shòu quán encryption/enˈkrɪpʃn/ 加密 jiā mì backup/ˈbækʌp/ 备份 bèi fèn user accounts/ˈjuːzə əˈkaʊnts/ 用户账户 yòng hù zhàng hù audit logs/ˈɔːdɪt lɒɡz/ 审计日志 shěn jì rì zhì ciphertext/ˈsaɪfətekst/ 密文 mì wén access rights/ˈækses raɪts/ 访问权限 fǎng wèn quán xiàn anti-spyware/ˈænti ˈspaɪweə/ 反间谍软件 fǎn jiàn dié ruǎn jiàn biometrics/ˌbaɪəʊˈmetrɪks/ 生物识别 shēng wù shí bié 6.2
Integridad de los datos
Syllabus
Los candidatos deben ser capaces de: Notas y orientaciones Describir cómo la validación de datos y la verificación de datos ayudan a proteger la integridad de los datos Describir y utilizar métodos de validación de datos Incluye comprobación de rango, comprobación de formato, comprobación de longitud, comprobación de presencia, comprobación de existencia, límite de comprobación y dígito de control Describir y utilizar métodos de verificación de datos durante la introducción y transferencia de datos Durante la introducción, incluye comprobación visual y entrada doble. Durante la transferencia, incluye comprobación de paridad (byte y bloque) y suma de verificación Fuente: Plan de estudios Cambridge International
Los datos tienen integridad cuando son precisos y completos. Dos técnicas: validación de datos (detectar datos incorrectos antes de almacenarlos) y verificación de datos (confirmar que los datos fueron ingresados o transferidos correctamente).
Validación — ¿tienen sentido los datos?
Validación 验证 comprueba los datos frente a reglas sensatas, automáticamente:
- comprobación de rango — dentro de límites (un mes es 1–12).
- comprobación de límite — en el lado correcto de un único límite (por ejemplo, edad ≥ 18).
- comprobación de existencia — el elemento referenciado existe (por ejemplo, un código de producto está en la tabla).
- comprobación de longitud — el número correcto de caracteres.
- comprobación de tipo/carácter — el tipo correcto de datos (un campo de teléfono permite solo dígitos).
- comprobación de formato — coincide con un patrón (un correo electrónico debe contener
@). - comprobación de presencia — los campos obligatorios no están vacíos.
- dígito de control 校验位 — un dígito extra calculado a partir de los demás (ISBN, números de tarjeta) que detecta errores de transcripción.
Ejemplo resuelto. En un esquema sencillo de dígito de control, el dígito de control es el resto cuando la suma de los dígitos se divide por $10$, añadido al número. El número $4162$ tiene una suma de dígitos de $13$, por lo que se almacena como $41623$. Un usuario escribe $14623$: los dos primeros dígitos están intercambiados, pero la suma sigue siendo $13$, por lo que el dígito de control sigue coincidiendo y el error no se detecta. Un usuario que escribe $41523$ es detectado, porque $4 + 1 + 5 + 2 = 12$ da un dígito de control de $2$. Un esquema que detecta dígitos intercambiados pondera cada posición de manera diferente, como hace la comprobación ISBN-13 (ponderaciones $1, 3, 1, 3, \ldots$, luego el dígito que hace que el total sea un múltiplo de $10$). Un dígito de control es validación: prueba el número contra una regla en el momento en que se introduce.
- comprobación de búsqueda y comprobación de consistencia (por ejemplo, fecha de entrega ≥ fecha de pedido).
La validación detecta datos mal formateados, pero no datos que tengan el formato correcto pero sean factualmente erróneos ("Bob" por "Bib").
Ejemplo resuelto. Identificar la comprobación de validación que realiza cada fragmento de pseudocódigo.
Pseudocódigo Comprobación IF x < 0 OR x > 10 THEN OUTPUT "Invalid"comprobación de rango: el valor debe estar entre dos límites IF x = "" THEN OUTPUT "Invalid"comprobación de presencia: el campo no debe estar vacío IF NOT(x = "Red" OR x = "Yellow" OR x = "Blue") THEN OUTPUT "Invalid"comprobación de búsqueda (existencia): el valor debe ser uno de una lista IF LENGTH(x) <> 6 THEN OUTPUT "Invalid"comprobación de longitud: el número correcto de caracteres IF MID(x, 1, 1) < "A" OR MID(x, 1, 1) > "Z" THEN OUTPUT "Invalid"comprobación de formato: un carácter particular debe ser una letra Para validar un número de matrícula de coche que debe constar de una letra, tres dígitos y dos letras: una comprobación de formato prueba cada posición frente a su patrón, y una comprobación de longitud confirma seis caracteres. Para validar una fecha de nacimiento: una comprobación de formato (
DD/MM/YYYY), una comprobación de rango (el mes es de $1$ a $12$, el año no está en el futuro) y una comprobación de presencia (no se deja en blanco). Una puntuación entre $0$ y el máximo para la prueba necesita una comprobación de tipo (un entero) y una comprobación de rango, con el límite superior leído desde el propio registro de la prueba: así es como la validación protege la integridad, rechazando datos que no podrían ser correctos.Verificación — ¿se introdujeron o transfirieron los datos correctamente?
Verificación 核对 comprueba que los datos no cambiaron al moverse de un lugar a otro.
Durante la entrada: entrada doble (escribirlo dos veces y comparar, como para una nueva contraseña) o comprobación visual.
En palabras del esquema, la entrada doble consiste en ingresar los datos dos veces, por la misma persona o por dos personas, y tener que el ordenador compare las dos versiones e informe cualquier diferencia; una comprobación visual es la persona comparando lo que hay en la pantalla con el documento fuente original y corrigiendo cualquier diferencia antes de guardar. Ambas protegen la integridad asegurando que los datos almacenados coincidan con la fuente. Incluso después de la validación y verificación, los datos aún pueden ser incorrectos: pueden ser sensatos y coincidir con la fuente, pero la fuente misma era incorrecta, o el usuario escribió un valor diferente pero válido distinto del pretendido.
Durante la transferencia (los bits pueden volverse invertidos):
- comprobación de paridad 奇偶校验 — un bit extra hace que el número de 1s sea par (paridad par) o impar. El receptor vuelve a contar. Detecta errores de un solo bit.
- suma de comprobación 校验和 — el remitente envía un valor resumen de los datos; el receptor lo recalcular y compara.
- comprobación de redundancia cíclica 循环冗余校验 (CRC) — una suma de comprobación más fuerte que utiliza división polinómica, detectando muchos más tipos de errores.
Una comprobación de bloque de paridad 奇偶块校验 va más allá y localiza el error. Organizar los bytes en una cuadrícula: dar a cada byte un bit de paridad de fila, luego calcular un byte de paridad extra cuyos bits sean la paridad de columna de los bytes anteriores. Un único bit invertido ahora falla en una fila y una columna — su intersección apunta exactamente a qué bit cambió, por lo que incluso puede corregirse.
Ejemplo resuelto. Se envían cuatro bytes con paridad par, seguidos de un byte de paridad. Encontrar el bit que fue corrupto.
Una comprobación de bloque de paridad: la fila que falla y la columna que falla se cruzan en el bit invertido Contar los 1s en cada fila y cada columna. Cada fila y columna debería tener un número par; el byte 3 tiene cinco y la columna 4 tiene tres. El bit donde esa fila y esa columna se cruzan es el que cambió, por lo que se restablece de 1 a 0. Una comprobación de paridad por sí sola detecta un error en un byte pero no puede decir qué bit; dos errores en el mismo byte se cancelan y pasan desapercibidos. Una suma de comprobación, explicada para tres puntos: el remitente pasa el bloque de datos a través de un algoritmo que produce un valor de suma de comprobación; los datos y la suma de comprobación se envían juntos; el receptor ejecuta el mismo algoritmo sobre los datos que recibió; si las dos sumas de comprobación coinciden, los datos se aceptan, y si no, se rechazan y reenvían.

El bit de paridad se establece para que el número de 1s sea par o impar 
Calculando una suma de comprobación para un bloque de datos La verificación solo demuestra que lo recibido coincide con lo enviado — no que los datos sean correctos, ni contra manipulaciones deliberadas. La validación pregunta "¿son estos datos sensatos?"; la verificación pregunta "¿se copiaron correctamente?" — usar ambas.
Las preguntas de la tabla clasifican los métodos según cuándo se usan: durante la entrada de datos, entrada doble y una comprobación visual; durante la transferencia de datos, una comprobación de paridad (byte o bloque) y una suma de comprobación. Transferir archivos de vídeo de una cámara a un servidor utiliza una suma de comprobación: la cámara la calcula, el servidor la recalcula, una discrepancia significa retransmisión.

La validación comprueba que los datos tienen sentido; la verificación comprueba que se copiaron sin cambios Ejemplo resuelto. Un usuario escribe su fecha de nacimiento como
31/02/2009, y escribe su dirección de correo electrónico dos veces. ¿Qué comprobación detecta qué error, y cuál es la diferencia? La validación pregunta "¿son estos datos sensatos?" - el ordenador los prueba contra una regla, y una comprobación de formato o rango rechaza31/02/2009porque febrero nunca tiene 31 días. La verificación pregunta "¿se introdujeron correctamente estos datos?" - escribir el correo electrónico dos veces es entrada doble, y comparar las dos copias detecta un error de tipeo. El límite es lo que hace que esta sea una pregunta favorita: la validación nunca puede decirte que los datos están correctos, solo que son posibles -01/02/2009pasa todas las reglas de validación incluso si el usuario nació realmente en un día diferente. Di qué puede y qué no puede detectar cada comprobación.ExplorarLaboratorio de conceptos informáticos
Clasificar ejemplos concretos según la idea informática que demuestran.
Vocabulario EntrenarInglés Chino Pinyin validation/ˌvælɪˈdeɪʃn/ 验证 yàn zhèng verification/ˌverɪfɪˈkeɪʃn/ 核对 hé duì parity check/ˈpærɪti tʃek/ 奇偶校验 jī ǒu jiào yàn checksum/ˈtʃeksəm/ 校验和 jiào yàn hé cyclic redundancy check/ˈsaɪklɪk rɪˈdʌndənsi tʃek/ 循环冗余校验 xún huán rǒng yú jiào yàn parity block check/ˈpærɪti blɒk tʃek/ 奇偶块校验 jī ǒu kuài jiào yàn 6.2
Definiciones aceptadas por el examinador
Una pregunta de definición se califica según palabras fijas. Aprenda estas exactamente.
Término Definición seguridad de los datos mantener los datos a salvo de pérdidas y de acceso, cambio o eliminación no autorizados privacidad de los datos mantener los datos confidenciales, de modo que solo sean vistos por aquellos que tienen derecho a verlos integridad de los datos que los datos sean precisos, consistentes y completos malware software malicioso que se instala sin el conocimiento del usuario para dañar un sistema o robar datos virus malware que se replica, se adjunta a otros archivos y corrompe o elimina datos spyware malware que registra las pulsaciones de tecla o acciones del usuario y las envía a un tercero phishing un correo electrónico que finge ser de una organización legítima que lleva al usuario a un sitio web falso para recopilar datos personales pharming código malicioso que redirige al usuario a un sitio web falso incluso cuando se ingresa la dirección correcta firewall hardware o software que examina todo el tráfico que entra o sale de un sistema contra criterios establecidos y bloquea lo que no los cumple cifrado codificación de datos con una clave en texto cifrado, de modo que no pueda entenderse sin la clave para descifrarlo firma digital un hash de un mensaje cifrado con la clave privada del remitente, utilizado para probar quién lo envió y que no fue alterado validación de datos una comprobación automática de que los datos ingresados son razonables y siguen reglas establecidas verificación de datos una comprobación de que los datos han sido introducidos o transferidos correctamente, comparándolos con la fuente o con un valor recalculation dígito de control un dígito adicional calculado a partir de los demás dígitos de un número y añadido a este, para que se pueda detectar un error en el número comprobación de paridad un bit adicional añadido a un byte para que el número de 1s sea par (o impar), lo cual el receptor vuelve a contar suma de verificación un valor calculado a partir de un bloque de datos mediante un algoritmo y enviado junto con él, recalculado por el receptor y comparado 6.2
Consejos para el examen
- Mantenga separadas las tres ideas: seguridad (mantener los datos a salvo), privacidad (quién puede verlos) e integridad (mantenerlos correctos).
- Relacione cada amenaza (malware, hacking, phishing, interceptación) con una medida (cortafuegos, cifrado, autenticación, derechos de acceso).
- El cifrado protege la confidencialidad, no la integridad: utilice una suma de verificación, una comprobación de paridad o un dígito de control para la integridad.
- Distinga entre virus, gusano y troyano y cómo se propaga cada uno.
Errores comunes
- Dar la misma medida para dos amenazas, o una medida que no se ajuste a la amenaza. Cada amenaza en la tabla necesita una prevención diferente que realmente la detenga.
- Nombrar una medida sin decir cómo funciona. "Cortafuegos" obtiene puntos cuando va seguido de "compara el tráfico con criterios establecidos y bloquea lo que no cumple".
- Llamando validación a una comprobación de que los datos son correctos. La validación comprueba que los datos sean razonables; la verificación comprueba que coincidan con la fuente. Ninguna prueba que sean verdaderos.
- Decir que una firma digital cifra el mensaje. Cifra un hash del mensaje con la clave privada; el receptor lo descifra con la clave pública y compara los hashes.
- Describir un dígito de control como verificación, o una comprobación de paridad como validación. El dígito de control es una regla de validación en la entrada; las paridades y sumas de verificación verifican una transferencia.
- Escribir que un virus "envía datos a un tercero" y que el spyware "se replica". El que se replica es el virus; el que graba es el spyware.
-
7
Ética y propiedad
Ver lección7.1
Ética para profesionales de la computación

Syllabus
Los candidatos deben ser capaces de: Notas y orientación Demostrar comprensión de la necesidad y el propósito de la ética como profesional de la informática Comprender la importancia de afiliarse a un cuerpo ético profesional, incluyendo la BCS (British Computer Society), la IEEE (Institute of Electrical and Electronic Engineers) Demostrar comprensión de la necesidad de actuar con ética y del impacto que tiene actuar de manera ética o no ética en una situación dada Demostrar comprensión de la necesidad de la legislación sobre derechos de autor Demostrar comprensión de los diferentes tipos de licencias de software y justificar el uso de una licencia para una situación dada Las licencias incluyen la Free Software Foundation, la Open Source Initiative, el shareware y el software comercial Demostrar comprensión de la Inteligencia Artificial (IA) Comprender el impacto de la IA, incluidas las cuestiones sociales, económicas y medioambientales Comprender las aplicaciones de la IA Fuente: Plan de estudios Cambridge International
Un profesional de la computación es alguien cuyo trabajo —software, sistemas, redes, datos— afecta a otras personas. Dado que el trabajo es técnico, otros a menudo no pueden juzgar si fue realizado bien o con honestidad. Por lo tanto, la profesión sigue una ética compartida (principios para un buen comportamiento).
Por qué importa la ética
- confianza — los usuarios y empleadores confían en que los profesionales actuarán en su interés. Sin esa confianza, el software pierde credibilidad.
- impacto — el software gestiona dispositivos médicos, banca, vehículos. Un trabajo descuidado o deshonesto puede dañar a las personas.
Los organismos profesionales (BCS, ACM, IEEE) publican códigos de ética para sus miembros.
Las cámaras de seguridad plantean preocupaciones sobre la privacidad: uno de los problemas éticos que un profesional de la computación debe sopesar 
La basura electrónica (e-waste) representa un costo ambiental creciente de la computación 
El desarrollo de software afecta el bienestar público de varias maneras Principios típicos
- interés público primero — proteger la seguridad y el bienestar de aquellos afectados.
- honestidad y competencia — ser honesto sobre sus habilidades; no reclamar experticia que no posee.
- confidencialidad — proteger la información privada de clientes y empleadores.
- evitar conflictos de interés — no aceptar trabajos donde su interés choque con el del cliente.
- mantener sus habilidades actualizadas; respetar la propiedad intelectual y la privacidad; tratar a los colegas con equidad.
Afiliarse a un organismo profesional
El programa de estudios menciona dos: la BCS (British Computer Society) y el IEEE (Institute of Electrical and Electronics Engineers). Ambos publican un código de conducta al que los miembros se comprometen a seguir. Los beneficios de afiliarse, según el programa: un conjunto de directrices éticas a seguir, para que las decisiones no queden a juicio personal; capacitación, conferencias y publicaciones que mantienen al miembro actualizado; asesoramiento y apoyo, incluido ayuda legal cuando surge un problema; y estatus profesional reconocido, para que empleadores y clientes confíen en el trabajo del miembro. Las consecuencias de no afiliarse: sin orientación sobre decisiones éticas, por lo que el programador podría actuar de manera poco ética sin darse cuenta; menor credibilidad ante empleadores y clientes, dificultando la obtención de trabajo; sin apoyo en disputas; y quedarse desactualizado respecto a desarrollos y leyes. El propósito de un código de conducta (dos puntos): crear un entorno laboral seguro, respetuoso y profesional, y asegurar que cada empleado entienda lo que se espera y las consecuencias de sus acciones.
Ejemplo resuelto. Explique por qué un programador necesita actuar éticamente hacia sus colegas y hacia el público.
Colegas: tratarlos con equidad y sin discriminación; respetar su trabajo, sus ideas e información confidencial; ser honesto sobre errores y dar crédito donde corresponde; apoyar su desarrollo en lugar de socavarlo. Público: proteger sus datos personales y privacidad; producir software seguro, fiable y debidamente probado, ya que los fallos pueden causar daño; ser honesto sobre lo que el software puede hacer; asumir solo trabajo dentro de su competencia; cumplir la ley y considerar los efectos más amplios en la sociedad y el medio ambiente. Cada parte obtiene puntos por una razón y su consecuencia, no solo por la palabra "equidad".
Actuar ética vs. éticamente
Actuar éticamente protege a los usuarios, fortalece la reputación, reduce riesgos legales y construye confianza. Actuar poco éticamente (omitir pruebas, ocultar errores, mal uso de datos) puede dañar a usuarios reales, llevar al despido o a acciones legales, dañar la reputación y erosionar la confianza en la tecnología en general.
Cuando se enfrenta a una decisión límite: identifique a quién le afectan los intereses, revise el código de ética y la ley, sopesé las consecuencias, pregunte a un superior de confianza y elija la opción que proteja a los usuarios por encima de la conveniencia a corto plazo.
Ejemplo resuelto. La nueva herramienta de IA para contratación de su equipo clasifica currículums diez veces más rápido, pero nota que rechaza a más solicitantes mayores. Entregarla complacería a su gerente, pero trata injustamente a un grupo. La elección ética es retenerla hasta que se corrija el sesgo: el interés público y la equidad prevalecen sobre la conveniencia a corto plazo.
La ética también aplica a los usuarios. Un estudiante que conecta una computadora personal a la red escolar debe respetar la privacidad y datos de otros, no usar redes sociales de manera inapropiada o acoso, no descargar ni compartir material con derechos de autor, no introducir malware ni intentar acceder a sistemas a los que no tiene permiso, y usar la red para el propósito para el cual fue proporcionada. Una respuesta de "dar tres consideraciones éticas" enumera tres de estas.
ExplorarLaboratorio de riesgos y responsabilidad
Clasifique los ejemplos según la regla, riesgo o protección involucrados.
7.1
Derechos de autor

Los derechos de autor son el derecho legal del creador de una obra original para controlar cómo esta es copiada, distribuida, modificada y ejecutada. Se aplican automáticamente (sin registro) al código fuente, software, documentos, imágenes, audio y video.
Sin derechos de autor, cualquiera podría copiar software libremente, el desarrollador no sería pagado y el plagio sería legal. Con derechos de autor, los desarrolladores pueden ganar dinero con su trabajo (fomentando más software), los usuarios saben quién lo creó, y la reutilización ocurre bajo los términos del desarrollador mediante licencias. Los derechos de autor duran mucho tiempo (a menudo 70 años después de la muerte del creador). Ideas generales y algoritmos no están cubiertos por derechos de autor, pero pueden estarlo bajo una patente.
Por qué un programador debería aplicar derechos de autor a un programa, según el programa: para ser identificado como dueño y autor (reconocimiento formal de propiedad); para que existan consecuencias legales si alguien lo copia o roba; para restringir a competidores de vender el mismo trabajo; y para poder generar ingresos licenciándolo. Los derechos de autor se aplican al programa tal como está escrito; un programa diferente que hace lo mismo no lo infringe.
Los derechos de autor son automáticos y de larga duración; una patente debe solicitarse y dura unos 20 años ExplorarLaboratorio de riesgos y responsabilidad
Clasifique los ejemplos según la regla, riesgo o protección involucrados.
Vocabulario EntrenarInglés Chino Pinyin copyright/ˈkɒpɪraɪt/ 版权 bǎn quán patent/ˈpeɪtənt/ 专利 zhuān lì software licence/ˈsɒftweə ˈlaɪsəns/ 软件许可证 ruǎn jiàn xǔ kě zhèng proprietary/prəˈpraɪətəri/ 专有 zhuān yǒu 7.1
Licencias de software

Una licencia de software es un contrato que otorga permiso para usar software bajo los términos del propietario; elegir y aplicar una se llama licenciamiento de software.
Comercial (propietario)
- el software comercial se vende: usted compra una licencia; el software se usa solo dentro de sus términos.
- el código fuente no se entrega (un producto propietario); no puede modificarlo ni redistribuirlo.
- ejemplos: Microsoft Office, Adobe Photoshop, la mayoría de los juegos.
Se utiliza cuando el desarrollador desea ingresos por usuario y mantener el control del código.
Código abierto (Open-source)
- el código fuente es público; los usuarios pueden leer, modificar y redistribuirlo (code open-source).
- licencias permisivas (MIT, BSD) permiten casi cualquier uso; licencias copyleft (GPL) requieren que las versiones modificadas se publiquen bajo la misma licencia ("compartir igual").
- la Free Software Foundation (FSF) y la Open Source Initiative (OSI) promueven y aprueban licencias de código abierto.
El programa de estudios menciona ambos, y se marcan como respuestas distintas. Software Libre (el término de la FSF) significa libertad en sentido de libertad, no precio: el usuario puede ejecutar el programa para cualquier propósito, estudiarlo y cambiarlo (por lo que el código fuente debe estar disponible), redistribuir copias, y distribuir versiones modificadas; aún se puede cobrar una tarifa por una copia. Código Abierto (la definición de la OSI) requiere que el código fuente esté disponible, que el programa pueda ser modificado y redistribuido, y que la licencia no discrimine a ninguna persona o campo de uso. "Identificar dos tipos de licencia que permitan a otras personas editar y redistribuir el programa" se responde con estos dos.
- ejemplos: Linux, Python, Apache.
Se utiliza cuando el desarrollador desea que el software sea ampliamente utilizado y mejorado por la comunidad.
Freeware y shareware
- freeware — gratuito, sin código fuente, puede ser redistribuido pero no modificado (Acrobat Reader, WhatsApp).
- shareware — gratuito por un período de prueba, luego paga para continuar usándolo; sin código fuente.
Las descripciones del programa: shareware se distribuye gratis para una prueba (tiempo limitado o funciones limitadas) y el usuario paga para continuar usando la versión completa; software comercial se vende por una tarifa, no se suministra el código fuente, la licencia protege la propiedad intelectual del desarrollador, y la tarifa generalmente compra soporte y actualizaciones. Beneficios del shareware para el programador: los usuarios pueden probar el programa antes de comprar, por lo que es más probable que compren; se difunde ampliamente con costos de publicidad casi nulos; y quienes lo conservan pagan. Beneficios de una licencia comercial: el desarrollador gana una tarifa por cada copia; el código y sus derechos permanecen protegidos; y los ingresos financian soporte, actualizaciones y mayor desarrollo.
Tipo Costo Fuente Redistribuir Modificar Comercial Pagado No No No Código abierto Gratis Sí Sí A menudo, con condiciones Freeware Gratis No Sí No Shareware Prueba gratis, luego pagado No A veces No Elección de una licencia desde el objetivo del desarrollador Para justificar una elección de licencia, Vincúlela al objetivo del desarrollador (ingresos, alcance, comunidad), las necesidades del usuario (costo, personalización) y el caso de uso.
Ejemplo resuelto. Un programador ha escrito un juego para vender al público. Identifique la licencia más adecuada y justifíquela.
Una licencia comercial: el juego se vende por una tarifa, por lo que el programador gana dinero por cada copia; el código fuente no se libera, por lo que nadie puede copiar el juego o cambiarlo y venderlo como propio; la licencia protege la propiedad intelectual; y los compradores reciben actualizaciones y soporte. El código abierto no sería adecuado, porque el código fuente estaría disponible, por lo que el juego podría copiarse, cambiarse y redistribuirse sin pago.
Ejemplo resuelto. Un programa ayuda a los compradores leyendo etiquetas de productos en voz alta. Explique por qué una licencia de código abierto podría no ser adecuada.
El código fuente sería accesible, por lo que podría cambiarse; una versión modificada podría mostrar información incorrecta del producto, por lo que los compradores podrían adquirir el artículo equivocado; y el programador perdería el control sobre la calidad y seguridad de lo distribuido bajo el nombre del programa. En el otro sentido, los programas se lanzan como código abierto para que otros desarrolladores puedan mejorarlos y extenderlos, para que sean adoptados ampliamente sin costo, y para que los usuarios puedan adaptarlos a sus propias necesidades.
Vocabulario EntrenarInglés Chino Pinyin open-source/ˈəʊpən sɔːs/ 开源 kāi yuán copyleft/ˈkɒpɪleft/ 著佐权 zhù zuǒ quán freeware/ˈfriːweə/ 免费软件 miǎn fèi ruǎn jiàn shareware/ˈʃeəweə/ 共享软件 gòng xiǎng ruǎn jiàn artificial intelligence/ˌɑːtɪˈfɪʃl ɪnˈtelɪdʒəns/ 人工智能 rén gōng zhì néng machine learning/məˈʃiːn ˈlɜːnɪŋ/ 机器学习 jī qì xué xí Deep learning/diːp ˈlɜːnɪŋ/ 深度学习 shēn dù xué xí neural networks/ˈnjuːrəl ˈnetwɜːks/ 神经网络 shén jīng wǎng luò speech recognition/spiːtʃ ˌrekəɡˈnɪʃn/ 语音识别 yǔ yīn shí bié image recognition/ˈɪmɪdʒ ˌrekəɡˈnɪʃn/ 图像识别 tú xiàng shí bié machine translation/məˈʃiːn trænˈsleɪʃn/ 机器翻译 jī qì fān yì recommendation systems/ˌrekəmenˈdeɪʃn ˈsɪstəmz/ 推荐系统 tuī jiàn xì tǒng autonomous vehicles/ɔːˈtɒnəməs ˈvɪəklz/ 自动驾驶汽车 zì dòng jià shǐ qì chē optical character recognition/ˈɒptɪkl ˈkærɪktə ˌrekəɡˈnɪʃn/ 光学字符识别 guāng xué zì fú shí bié text-to-speech/tekst tə spiːtʃ/ 文本转语音 wén běn zhuǎn yǔ yīn 7.1
Inteligencia Artificial (IA)

La inteligencia artificial construye sistemas que realizan tareas que antes se pensaba que requerían inteligencia humana: reconocimiento de voz e imágenes, traducción, juegos, conducción.
La mayoría de la IA moderna utiliza aprendizaje automático — algoritmos que mejoran en una tarea aprendiendo patrones de grandes cantidades de datos, en lugar de ser programados paso a paso. El aprendizaje profundo, utilizando redes neuronales con muchas capas, es el enfoque líder hoy en día.
Ejemplos cotidianos
Las tareas de IA se dividen en dos clases: comprensión de entrada y producción de salida o decisiones.
Comprensión de entrada:
- reconocimiento de voz — palabras habladas a texto (asistentes de voz).
- reconocimiento de imágenes — encontrar objetos, rostros o texto en imágenes.
Producción de salida o decisiones:
- traducción automática — traducción automática entre idiomas.
- sistemas de recomendación — sugerir productos, videos o música.
- vehículos autónomos y robots.
Un escenario de examen común: un programa lee una etiqueta con una cámara, la traduce y la lee en voz alta — usando reconocimiento óptico de caracteres para encontrar las palabras, traducción automática para convertirlas, y síntesis de voz para el audio.
Un escenario común: OCR → traducción automática → síntesis de voz lee una etiqueta extranjera en voz alta Una respuesta de cuatro puntos "explique cómo se usa la IA" sigue la tubería paso a paso: reconocimiento de imágenes (OCR) analiza los píxeles de la fotografía para localizar los caracteres; los patrones de píxeles se convierten en caracteres y palabras individuales; la traducción automática convierte las palabras al idioma del usuario; y la síntesis de voz produce la salida hablada. Cada paso vale un punto.
Beneficios
- accesibilidad — la IA de voz/imágenes ayuda a usuarios con discapacidades; la traducción ayuda a no nativos.
- productividad — automatizar tareas repetitivas libera a las personas para el trabajo creativo.
- soporte de decisiones — la IA detecta patrones en conjuntos de datos masivos (diagnóstico médico, detección de fraude).
- siempre disponible y personalizada para cada usuario.
Impactos: social, económico, ambiental
El programa de estudios pide el impacto de la IA bajo tres encabezados, y una pregunta nombra uno de ellos. Dé el impacto y su consecuencia.
- Sociales: beneficios — un programa de lectura de etiquetas ayuda a personas con discapacidad visual, personas que no pueden leer el idioma y personas con dificultades de lectura; el reconocimiento facial en aeropuertos acelera los controles de identidad y puede impedir la entrada de personas buscadas. Daños — el reconocimiento facial puede identificar erróneamente a personas y rastrea a todos sin consentimiento, por lo que se pierde la privacidad; estudiantes que usan IA para hacer su tarea pueden no desarrollar habilidades de razonamiento y resolución de problemas, pueden depender de ella en lugar de aprender, y pueden perder la colaboración y comunicación cara a cara que trae trabajar juntos.
- Económico: un módulo de diagnóstico de fallas de IA en un taller de reparaciones diagnostica fallas más rápido y con mayor precisión, por lo que más vehículos se reparan por día y los costos disminuyen; pero se necesitan menos mecánicos calificados, por lo que se pierden empleos, y el módulo debe comprarse y mantenerse. En general, la IA aumenta la productividad y crea nuevos empleos en algunos campos mientras elimina empleos rutinarios en otros.
- Ambiental: entrenar y ejecutar modelos grandes consume mucha electricidad y agua para refrigeración en centros de datos, y el hardware se convierte en basura electrónica; por otro lado, la IA se usa para reducir el consumo energético en edificios, optimizar el transporte y monitorear el medio ambiente.
- Ético (pregunta de aula): una IA que califica trabajos o vigila a estudiantes debe ser justa con cada estudiante, no debe filtrar sus datos, debe ser explicable cuando toma una decisión sobre ellos, y no debe reemplazar el juicio de un maestro donde eso importa.
Preocupaciones
- sesgo — patrones injustos en los datos de entrenamiento se convierten en decisiones injustas de IA (contratación, préstamos).
- desplazamiento laboral — la IA puede reemplazar algunos roles.
- privacidad — el entrenamiento a menudo usa grandes cantidades de datos personales.
- transparencia — los modelos grandes son "cajas negras", difíciles de explicar.
- responsabilidad — cuando la IA se equivoca, ¿quién es responsable: desarrollador, usuario u operador?
- mal uso — deepfakes, desinformación, vigilancia.

Cómo entra el sesgo en la IA: datos con sesgo → un modelo con sesgo → decisiones injustas Los profesionales deben comprender los límites de la IA que construyen, informar a los usuarios y reducir el daño.
ExplorarLaboratorio de conceptos informáticos
Clasificar ejemplos concretos según la idea informática que demuestran.
Vocabulario EntrenarInglés Chino Pinyin ethics/ˈeθɪks/ 伦理 lún lǐ privacy/ˈprɪvəsi/ 隐私 yǐn sī confidentiality/ˌkɒnfɪˌdenʃiˈæləti/ 保密性 bǎo mì xìng conflicts of interest/ˈkɒnflɪkts ɒv ˈɪntrest/ 利益冲突 lì yì chōng tū intellectual property/ˌɪntəˈlektʃuːəl ˈprɒpəti/ 知识产权 zhī shí chǎn quán code of conduct/kəʊd ɒv ˈkɒndʌkt/ 行为准则 xíng wéi zhǔn zé bias/ˈbaɪəs/ 偏见 piān jiàn 7.1
Definiciones aceptadas por el examinador
Una pregunta de definición se califica contra un vocabulario fijo. Aprenda estas exactamente.
Término Definición ética los principios morales que rigen cómo se comporta una persona; en una profesión, los estándares establecidos en su código de conducta código de conducta las reglas que una organización u organismo profesional establece para el comportamiento de sus miembros derechos de autor el derecho legal del creador de una obra original para controlar cómo es copiada, distribuida y modificada licencia de software el acuerdo legal que establece cómo puede usarse, copiarse y distribuirse un software software comercial software vendido por una tarifa, sin código fuente, bajo una licencia que protege la propiedad intelectual del desarrollador software libre (FSF) software cuyos usuarios tienen libertad de ejecutar, estudiar, cambiar y redistribuir, por lo que su código fuente está disponible código abierto (OSI) software cuyo código fuente está disponible y que puede ser modificado y redistribuido bajo su licencia shareware software distribuido gratis por un período de prueba o con funciones limitadas, después de lo cual el usuario paga para continuar freeware software que es gratuito para usar y copiar, pero cuyo código fuente no se libera y no puede ser modificado inteligencia artificial sistemas informáticos que realizan tareas que normalmente requieren inteligencia humana, como reconocer imágenes y voz aprendizaje automático una forma de IA en la que un sistema mejora en una tarea aprendiendo patrones de datos en lugar de mediante programación explícita 7.1
Consejos para el examen
- Responda preguntas de ética basándose en un código de conducta profesional (interés público, competencia, honestidad), no en opinión personal.
- Distinga derechos de autor (protege la expresión) de una patente (protege una invención).
- Compare licencias de software: propietarias, de código abierto, freeware, shareware y FOSS.
Errores comunes
- Dar una opinión personal ("es incorrecto") en lugar de una razón con consecuencia ("el software defectuoso podría dañar a los usuarios, por lo que debe probarse").
- Tratar el software libre y el freeware como lo mismo. El software libre trata sobre la libertad de estudiar y cambiar el código; el freeware es simplemente gratuito.
- Decir que código abierto significa gratuito. Significa que el código fuente está disponible y puede ser modificado y redistribuido; aún se puede cobrar una tarifa.
- Escribir que los derechos de autor deben registrarse. Se aplican automáticamente a la obra tal como está escrita.
- Nombrar un impacto sin su consecuencia. "Pérdida de empleos" puntúa cuando se vincula a la razón: la IA realiza el diagnóstico, por lo que se necesitan menos mecánicos.
- Describir qué es la IA en lugar de cómo se usa. Los puntos son por los pasos: reconocer, convertir, traducir, hablar.
-
8
Bases de datos
Ver lección8.1
Almacenamiento basado en archivos y sus límites

Syllabus
Los candidatos deben ser capaces de: Notas y orientación Demostrar comprensión de las limitaciones del uso de un enfoque basado en archivos para el almacenamiento y recuperación de datos Describir las características de una base de datos relacional que abordan las limitaciones de un enfoque basado en archivos Demostrar comprensión y utilizar la terminología asociada con un modelo de base de datos relacional Incluye entidad, tabla, registro, campo, tupla, atributo, clave primaria, clave candidata, clave secundaria, clave foránea, relación (uno a muchos, uno a uno, muchos a muchos), integridad referencial, indexación Utilizar un diagrama de entidad-relación (E-R) para documentar un diseño de base de datos Demostrar comprensión del proceso de normalización Primera Forma Normal (1FN), Segunda Forma Normal (2FN) y Tercera Forma Normal (3FN) Explicar por qué un conjunto dado de tablas de base de datos está o no está en 3FN Producir un diseño de base de datos normalizado a partir de una descripción de una base de datos, un conjunto dado de datos o un conjunto dado de tablas Fuente: Plan de estudios Cambridge International
Antes de las bases de datos, los programas almacenaban datos en archivos planos — usualmente un archivo por programa. Esto es adecuado para datos pequeños, pero falla a gran escala.
El almacenamiento basado en archivos mantiene los datos en archivos separados, como papeles en un archivador — difícil de buscar y fácil de duplicar Limitaciones
- redundancia de datos — los mismos datos (la dirección de un cliente) se mantienen en varios archivos, uno por programa; se desperdicia almacenamiento y cada copia debe actualizarse.
- inconsistencia de datos — cuando una copia se actualiza y otra no, los archivos discrepan y nadie sabe cuál es la correcta.
- dependencia de datos — cada programa está escrito para el layout exacto de sus archivos; si se cambia la longitud de un campo o se añade uno nuevo, todos los programas que leen el archivo deben reescribirse.
- sin acceso compartido — un archivo se bloquea mientras un programa lo usa, por lo que los usuarios no pueden trabajar en los datos simultáneamente.
- integridad débil — no hay reglas centrales que impidan valores inválidos o enlaces a clientes que no existen; seguridad débil — el acceso es por archivo, no por campo; y las consultas entre archivos requieren un programa nuevo cada vez.

El enfoque basado en archivos: cada programa mantiene sus propios archivos Una base de datos relacional corrige esto almacenando datos en tablas gestionadas por un único software (el SGBD) que utilizan todos los programas.

El enfoque de base de datos: un SGBD sirve a todos los programas Por qué una base de datos relacional es mejor — la respuesta de tres puntos. Cada elemento de dato se almacena una sola vez, en una tabla, y las tablas están vinculadas por claves, por lo que no hay redundancia ni inconsistencia; los datos son independientes de los programas, que solicitan al SGBD lo que necesitan y no se ven afectados cuando cambia la estructura; y el SGBD aplica reglas de integridad, controla el acceso por usuario y por campo, permite muchos usuarios a la vez y responde cualquier consulta sin necesidad de escribir un programa nuevo.
Ejercicio resuelto. Una tienda de reparaciones almacena sus clientes, dispositivos y trabajos de reparación usando un enfoque basado en archivos, un archivo por programa. Indique tres problemas que esto causa y describa cómo una base de datos relacional los eliminaría.
El nombre y el teléfono del cliente se almacenan en el archivo de reparaciones y en el archivo de facturas (redundancia); cuando un cliente cambia su número, se actualiza un archivo y el otro no (inconsistencia); y cuando la tienda desea un informe nuevo — reparaciones por técnico — se debe escribir un programa nuevo para leer los archivos (sin consultas ad-hoc). En una base de datos relacional, el cliente se almacena una sola vez en una tabla CUSTOMER y se hace referencia mediante CustomerID desde la tabla REPAIR, por lo que el cambio se realiza una sola vez y se ve en todas partes; el informe es una única consulta SQL.
8.1
Modelo relacional — términos
- tabla — una cuadrícula de filas y columnas; una tabla por tipo de entidad (ej.
CUSTOMER). - registro (fila, también llamado tupla) — una fila; una instancia de la entidad.
- campo (columna, también llamado atributo) — una columna; una pieza de información sobre cada registro.
- clave primaria — un campo (o campos) que identifica de forma única cada registro; nunca nulo ni duplicado.
- clave foránea — un campo cuyo valor coincide con la clave primaria de otra tabla, vinculándolas.
- clave compuesta — una clave primaria formada por dos o más campos juntos.
- clave candidata — cualquier campo(s) que podría ser la clave primaria.
- clave secundaria — un campo no primario que está indexado para búsquedas rápidas.
- indexación — crear un índice en un campo para que las búsquedas y uniones sean más rápidas.
- integridad referencial — cada valor de clave foránea debe coincidir con una clave primaria existente (no hay registros huérfanos).
Una tabla se escribe en abreviatura subrayando la clave primaria y señalando las claves foráneas:
CUSTOMER(CustomerID, Name, Phone)
ORDER(OrderID, CustomerID, OrderDate)   -- CustomerID is FK → CUSTOMER
Una clave foránea vincula dos tablas: ORDER.CustomerID coincide con la clave primaria CUSTOMER.CustomerID Ejercicio resuelto. Explique qué significan entidad, clave primaria e integridad referencial en una base de datos relacional, y complete la tabla de término ↔ descripción para tupla y atributo.
Una entidad es algo sobre lo cual se almacenan datos — una persona, objeto o evento — que se convierte en una tabla. Una clave primaria es el atributo (o combinación de atributos) que identifica de forma única cada registro en una tabla. La integridad referencial significa que cada valor de clave foránea debe coincidir con el valor de una clave primaria en la tabla a la que hace referencia, por lo que un registro no puede referirse a uno que no existe. Una tupla es una fila de una tabla (un registro); un atributo es una columna (un campo). Aprenda los pares: tabla/relación, registro/tupla, campo/atributo.
ExplorarLeer una tabla relacional con SELECT
Una tabla relacional son simplemente filas (registros) y columnas (campos). WHERE mantiene las filas que coinciden con una condición; SELECT luego mantiene solo las columnas que solicitaste.
Vocabulario EntrenarInglés Chino Pinyin table/ˈteɪbl/ 表 biǎo 8.1
Diagramas de entidad-relación (E-R)

Un diagrama de entidad-relación muestra la estructura: cada entidad es un rectángulo, cada relación una línea, con la cardinalidad marcada en cada extremo:
- uno a uno (1:1).
- uno a muchos (1:M) — cada Cliente tiene muchos Pedidos; cada Pedido tiene un Cliente.
- muchos a muchos (M:N) — los Estudiantes toman muchos Cursos, y los Cursos tienen muchos Estudiantes.
Un diagrama E-R: una clase tiene muchos estudiantes 
Símbolos de pie de gallo para la cardinalidad de una relación Una relación de muchos a muchos no se puede almacenar directamente. Divídala en dos relaciones de uno a muchos a través de una tabla de enlace que contiene las dos claves foráneas:
ENROLMENT(StudentID, CourseID, EnrolmentDate)
Una tabla de enlace resuelve una relación de muchos a muchos en dos relaciones de uno a muchos Dibujar el diagrama E-R para un conjunto dado de tablas. Cada tabla se convierte en una entidad. Existe una relación donde una tabla contiene una clave foránea hacia otra; esta va desde la tabla que contiene la clave foránea (el extremo muchos) hasta la tabla cuya clave primaria es (el extremo uno). Una tabla con dos claves foráneas y sin otra identidad suele ser una tabla de enlace que resuelve una relación de muchos a muchos. Etiquete cada línea con el tipo de relación.
El diagrama se dibuja a partir de las tablas: cada clave foránea representa una relación uno a muchos, con el "muchos" en la tabla que la contiene Ejemplo resuelto. Una taller de reparaciones tiene las tablas
CUSTOMER(CustomerID, Name, Phone),DEVICE(DeviceID, CustomerID, Type, Model),TECHNICIAN(TechnicianID, Name)yREPAIR(RepairID, DeviceID, TechnicianID, RepairDate, Cost). Identifique las relaciones y sus tipos.DEVICEcontieneCustomerID, por lo tanto CUSTOMER–DEVICE es uno a muchos (un cliente, muchos dispositivos).REPAIRcontieneDeviceID, por lo tanto DEVICE–REPAIR es uno a muchos; también contieneTechnicianID, por lo tanto TECHNICIAN–REPAIR es uno a muchos. No hay línea directa CUSTOMER–REPAIR: el enlace pasa a través de DEVICE. Tres líneas, tres patas de gallo, todas en los extremos REPAIR o DEVICE.Vocabulario EntrenarInglés Chino Pinyin cardinality/ˌkɑːdɪˈnælɪti/ 基数 jī shù one-to-many/wʌn tə ˈmeni/ 一对多 yī duì duō link table/lɪŋk ˈteɪbl/ 连接表 lián jiē biǎo 8.1
Normalización

Normalización 规范化 organiza las tablas para reducir la redundancia e inconsistencia, pasando por formas normales 范式 en orden.
- Primera forma normal (1NF) — cada campo contiene un único valor (atómico 原子), sin grupos repetidos, y con una clave primaria.
- Segunda forma normal (2NF) — en 1NF, y cada campo no clave depende de la clave primaria entera (solo importa si es una clave compuesta).
- Tercera forma normal (3NF) — en 2NF, y cada campo no clave depende únicamente de la clave primaria, no de otro campo no clave (sin dependencia transitiva 传递依赖).
Un diseño 3NF almacena cada dato una sola vez, por lo que desaparecen las anomalías de inserción, actualización y eliminación. La contrapartida es tener más tablas y más uniones (joins). Se debe apuntar a 3NF.
Para obtener un diseño 3NF: encuentre las entidades y sus atributos; elija una clave primaria para cada una; divida campos repetidos o no atómicos (1NF); divida campos que dependen de parte de una clave compuesta (2NF); divida campos que dependen transitivamente de la clave (3NF); añada claves foráneas para las relaciones.
La normalización elimina la redundancia al separar los datos repetidos en su propia tabla Ejemplo resuelto. La tabla
ORDER(OrderID, CustomerID, CustomerName, ProductID, Quantity)tiene la clave primaria compuesta(OrderID, ProductID). Normalícela a 3NF. Pruebe cada campo no clave contra la clave.Quantitydepende de ambosOrderIDyProductID, lo cual está bien. PeroCustomerIDdepende deOrderIDsolo - solo parte de la clave compuesta. Eso es una dependencia parcial, por lo que la tabla no está en 2NF. Divídala enORDER_LINE(OrderID, ProductID, Quantity)yORDER(OrderID, CustomerID, CustomerName). Ahora pruebe 3NF: en esa nueva tablaORDER,CustomerNamedepende deCustomerID, que no es la clave - una dependencia transitiva. Vuelva a dividir:ORDER(OrderID, CustomerID)yCUSTOMER(CustomerID, CustomerName). Nombren la dependencia que rompe cada forma (la parcial rompe 2NF, la transitiva rompe 3NF); decir "tiene datos repetidos" describe el síntoma pero no otorga puntos.Las tres preguntas para hacer a cualquier tabla. ¿Celda contiene un único valor, sin grupo repetido? Si no, no está en 1NF. Si la clave es compuesta, ¿cada campo no clave depende de toda la clave? Si algún campo depende de parte de ella, hay una dependencia parcial 部分依赖 y la tabla no está en 2NF. ¿Cada campo no clave depende solo de la clave? Si un campo depende de otro campo no clave, hay una dependencia transitiva y la tabla no está en 3NF. Una respuesta a "explique por qué la tabla no está en 3NF" debe nombrar la dependencia y los campos implicados.
1NF elimina el grupo repetido, 2NF la dependencia parcial, 3NF la dependencia transitiva Ejemplo resuelto. Un alquiler de coches registra cada alquiler como
RENTAL(RentalID, RentalDate, CustomerID, CustomerName, CustomerPhone, CarReg, CarModel, DailyRate, Days), donde un alquiler puede incluir varios coches. Explique por qué la tabla no está normalizada y produzca un diseño 3NF.No está en 1NF: los campos de
CarReg, CarModel, DailyRate, Daysforman un grupo repetitivo — una renta tiene varios coches. Moverlos aRENTAL_CAR(RentalID, CarReg, CarModel, DailyRate, Days)con la clave compuesta(RentalID, CarReg). No está en 2NF: enRENTAL_CAR,CarModelyDailyRatedependen solo deCarReg— una dependencia parcial. Moverlos aCAR(CarReg, CarModel, DailyRate), dejandoRENTAL_CAR(RentalID, CarReg, Days). No está en 3NF: enRENTAL,CustomerNameyCustomerPhonedependen deCustomerID, un campo no clave — una dependencia transitiva. Moverlos aCUSTOMER(CustomerID, CustomerName, CustomerPhone), dejandoRENTAL(RentalID, RentalDate, CustomerID). El diseño en 3NF son cuatro tablas —CUSTOMER,RENTAL,RENTAL_CAR,CAR— conCustomerID,RentalIDyCarRegcomo claves foráneas; subrayar todas las claves primarias.Vocabulario EntrenarInglés Chino Pinyin join/dʒɔɪn/ 连接 lián jiē referential integrity/ˌrefəˈrenʃl ɪnˈteɡrɪti/ 参照完整性 cān zhào wán zhěng xìng entity-relationship diagram/ˈentɪti rɪˈleɪʃənʃɪp ˈdaɪəɡræm/ 实体关系图 shí tǐ guān xì tú normalisation/ˌnɔːməlaɪˈzeɪʃn/ 规范化 guī fàn huà normal forms/ˈnɔːml fɔːmz/ 范式 fàn shì atomic/əˈtɒmɪk/ 原子 yuán zi transitive dependency/ˈtrænsɪtɪv dɪˈpendənsi/ 传递依赖 chuán dì yī lài partial dependency/ˈpɑːʃl dɪˈpendənsi/ 部分依赖 bù fèn yī lài 8.2
Sistema de Gestión de Bases de Datos (DBMS)

Syllabus
Los candidatos deben ser capaces de: Notas y orientación Demostrar comprensión de las características que proporciona un Sistema de Gestión de Bases de Datos (DBMS) para abordar los problemas del enfoque basado en archivos Incluyendo: • gestión de datos, incluyendo el mantenimiento de un diccionario de datos • modelado de datos • esquema lógico • integridad de datos • seguridad de datos, incluyendo procedimientos de copia de seguridad y el uso de permisos de acceso a individuos/grupos de usuarios Demostrar comprensión de cómo se utilizan en la práctica las herramientas de software incluidas en un DBMS Incluyendo el uso y propósito de: • interfaz de desarrollador • procesador de consultas Fuente: Plan de estudios Cambridge International
Un DBMS 数据库管理系统 gestiona la base de datos centralmente. Funcionalidades que corrigen las limitaciones basadas en archivos:
- data dictionary 数据字典 — una descripción de cada tabla, campo, tipo y clave; los programas la consultan en lugar de codificar la estructura de forma fija.
- control de redundancia/consistencia — cada dato se almacena una sola vez.
- control de acceso concurrente 并发访问 — los bloqueos y transacciones permiten que muchos usuarios trabajen simultáneamente.
- backup 备份 y recuperación; seguridad y permisos por usuario.
- reglas de integridad — claves, restricciones de unicidad y rango, aplicadas centralmente.
- transacciones 事务 — un grupo de operaciones que todas tienen éxito o todas fallan.
- vistas 视图 — tablas virtuales que muestran a cada usuario "su" fragmento de los datos.
- gestión de datos 数据管理 y modelado de datos 数据建模 — controlan cómo se almacenan los datos y definen su estructura como un esquema lógico 逻辑模式 (el diseño lógico, independiente del almacenamiento físico).
- integridad de datos 数据完整性 y seguridad de datos 数据安全 — garantizan la corrección y controlan el acceso centralmente.
- un procesador de consultas 查询处理器 ejecuta consultas; una interfaz de desarrollador 开发者接口 proporciona herramientas y APIs para crear aplicaciones.
Sus herramientas incluyen un editor de diccionario de datos, un constructor de consultas, un constructor de formularios, un generador de informes, gestión de usuarios y un editor SQL.
Lo que contiene el diccionario de datos (una pregunta de "dar tres elementos"): los nombres de las tablas; los nombres de los campos en cada tabla; el tipo de dato y longitud de cada campo; las claves primarias y foráneas y las relaciones entre tablas; reglas de validación; índices; y quién puede acceder a cada tabla. Es metadatos — datos sobre los datos — y el DBMS lo usa para verificar cada consulta y cada cambio.
Cómo mantiene seguro el DBMS los datos (una pregunta de "describir dos métodos"): autenticación 身份验证 — un nombre de usuario y contraseña, o biométrica, antes de cualquier acceso; derechos de acceso — a cada usuario o grupo se le permite leer, escribir o eliminar solo ciertas tablas o campos, a menudo a través de una vista; cifrado de los datos almacenados y de los datos enviados a ellos, para que un archivo copiado sea ilegible; copias de seguridad tomadas regularmente, para restaurar los datos tras una pérdida; y un registro de transacciones que registra quién cambió qué.
Las dos herramientas de software. La interfaz de desarrollador es lo que utiliza un programador para construir la base de datos y las aplicaciones sobre ella: crear tablas y establecer claves y validaciones, escribir consultas y SQL, y diseñar formularios e informes, sin saber cómo se almacenan físicamente los datos. El procesador de consultas toma una consulta (SQL desde un programa, o una consulta construida en la interfaz), la verifica contra el diccionario de datos, determina la forma más eficiente de ejecutarla, recupera los datos y devuelve los resultados.
Esquema lógico. El DBMS mantiene el diseño lógico (qué tablas y campos existen y cómo se relacionan) separado del almacenamiento físico (archivos, índices, bloques de disco). Los programas trabajan con el esquema lógico, por lo que el almacenamiento físico puede reorganizarse sin cambiar un solo programa — esta es la independencia de datos que carecía el enfoque basado en archivos.
El almacenamiento físico que oculta el esquema lógico: platos giratorios y cabezal de lectura/escritura de un disco duro ExplorarLaboratorio de servicio de base de datos
Observa cómo un SGBD transforma una consulta en acceso seguro a datos compartidos.
ExplorarLaboratorio de servicio de base de datos
Observa cómo un SGBD transforma una consulta en acceso seguro a datos compartidos.
Vocabulario EntrenarInglés Chino Pinyin DBMS/ˌdiː biː em ˈes/ 数据库管理系统 shù jù kù guǎn lǐ xì tǒng data dictionary/ˈdeɪtə ˈdɪkʃənəri/ 数据字典 shù jù zì diǎn concurrent access/kənˈkʌrənt ˈækses/ 并发访问 bìng fā fǎng wèn transactions/trænˈsækʃnz/ 事务 shì wù backup/ˈbækʌp/ 备份 bèi fèn views/vjuːz/ 视图 shì tú data management/ˈdeɪtə ˈmænɪdʒmənt/ 数据管理 shù jù guǎn lǐ data modelling/ˈdeɪtə ˈmɒdəlɪŋ/ 数据建模 shù jù jiàn mó logical schema/ˈlɒdʒɪkl ˈskiːmə/ 逻辑模式 luó jí mó shì data integrity/ˈdeɪtə ɪnˈteɡrɪti/ 数据完整性 shù jù wán zhěng xìng data security/ˈdeɪtə sɪˈkjʊərɪti/ 数据安全 shù jù ān quán query processor/ˈkwɪərɪ ˈprəʊsesə/ 查询处理器 chá xún chǔ lǐ qì developer interface/dɪˈveləpə ˈɪntəfeɪs/ 开发者接口 kāi fā zhě jiē kǒu authentication/ɔːˌθentɪˈkeɪʃn/ 身份验证 shēn fèn yàn zhèng 8.3
DDL y DML
Syllabus
Los candidatos deben ser capaces de: Notas y orientación Demostrar comprensión de que el SGDB realiza toda la creación/modificación de la estructura de la base de datos mediante su Lenguaje de Definición de Datos (DDL) Demostrar comprensión de que el SGDB realiza todas las consultas y mantenimiento de los datos mediante su DML Demostrar comprensión de que el estándar de la industria tanto para el DDL como para el DML es el Lenguaje de Consulta Estructurado (SQL) Comprender una instrucción SQL dada Comprender instrucciones SQL (DDL) dadas y ser capaces de escribir instrucciones simples SQL (DDL) utilizando un subconjunto de instrucciones Crear una base de datos (CREATE DATABASE) Crear una definición de tabla (CREATE TABLE), incluyendo la creación de atributos con tipos de datos apropiados: • CHARACTER • VARCHAR(n) • BOOLEAN • INTEGER • REAL • DATE • TIME Cambiar una definición de tabla (ALTER TABLE) Añadir una clave primaria a una tabla (PRIMARY KEY (campo)) Añadir una clave foránea a una tabla (FOREIGN KEY (campo) REFERENCES Tabla (Campo)) Escribir un script SQL para consultar o modificar los datos (DML) almacenados en (como máximo dos) tablas de base de datos Consultas que incluyen SELECCIONAR... DE, DONDE, ORDER BY, GROUP BY, INNER JOIN, SUM, COUNT, AVG Mantenimiento de datos que incluye INSERT INTO, DELETE FROM, UPDATE Fuente: Plan de estudios Cambridge International
SQL 结构化查询语言 (Structured Query Language) tiene dos mitades:
DDL construye la estructura de la base de datos; DLM trabaja con los datos - Data Definition Language 数据定义语言 (DDL) — crea o modifica la estructura (tablas, claves, restricciones).
- Data Manipulation Language 数据操纵语言 (DML) — trabaja con los datos (insertar, actualizar, eliminar, consultar 查询).
Fundamentos de DDL
CREATE TABLE CUSTOMER (
  CustomerID INTEGER PRIMARY KEY,
  Name VARCHAR(50) NOT NULL,
  Phone VARCHAR(20)
);
Añadir una clave foránea:
CREATE TABLE ORDER (
  OrderID INTEGER PRIMARY KEY,
  CustomerID INTEGER,
  OrderDate DATE,
  FOREIGN KEY (CustomerID) REFERENCES CUSTOMER(CustomerID)
);
Modificar y eliminar:
ALTER TABLE CUSTOMER ADD Email VARCHAR(100);
DROP TABLE CUSTOMER;
Tipos comunes:
INTEGER,REAL,VARCHAR(n),CHAR(n)(tambiénCHARACTER(n)),DATE,TIME,BOOLEAN,DECIMAL(p, s).Fundamentos de DML
Consultar con
SELECT:
Una consulta SELECT devuelve solo las filas que coinciden con su condición SELECT Name, Phone FROM CUSTOMER WHERE City = 'London' ORDER BY Name ASC;SELECTlista los campos,FROMnombra la tabla,WHEREfiltra las filas yORDER BYordena.Un join (unión) combina dos tablas mediante una relación de clave foránea:
SELECT C.Name, O.OrderDate
FROM CUSTOMER C INNER JOIN ORDER O
  ON C.CustomerID = O.CustomerID
WHERE O.OrderDate >= '2024-01-01';
Las partes de una consulta, en el orden en que deben escribirse Las funciones agregadas (
COUNT,SUM,AVG,MIN,MAX) se utilizan a menudo conGROUP BY:SELECT CustomerID, COUNT(*) AS NumOrders FROM ORDER GROUP BY CustomerID;Insertar, actualizar, eliminar:
INSERT INTO CUSTOMER (CustomerID, Name, Phone)
VALUES (101, 'Ada Lovelace', '020-1234-5678');

UPDATE CUSTOMER SET Phone = '020-9999-0000' WHERE CustomerID = 101;

DELETE FROM CUSTOMER WHERE CustomerID = 101;
Siempre incluya una cláusula
WHEREenUPDATEyDELETE; de lo contrario, el cambio afectará todas las filas.Consejos para el examen de SQL
- Use los nombres exactos de tablas y campos del enunciado.
- Encierre las cadenas entre comillas simples (
'Smith'); no encierre los números. - Operadores de comparación:
=,<,>,<=,>=,<>. LIKE 'A%'coincide con cualquier cadena que empiece por A (%= cualquier cadena,_= un carácter);IN (1,2,3);BETWEEN 10 AND 20.- Combine condiciones con
AND/OR/NOTy termine cada sentencia con punto y coma.
El patrón DDL que busca el examen. Cada
CREATE TABLEnombra cada campo con su tipo, marca la clave primaria y declara cada clave foránea indicando la tabla referenciada; una clave compuesta se declara en su propia línea:CREATE TABLE RENTAL_CAR ( RentalID INTEGER, CarReg VARCHAR(8), Days INTEGER, PRIMARY KEY (RentalID, CarReg), FOREIGN KEY (RentalID) REFERENCES RENTAL(RentalID), FOREIGN KEY (CarReg) REFERENCES CAR(CarReg) );Ejemplo resuelto. Usando
CUSTOMER(CustomerID, Name, Phone)yDEVICE(DeviceID, CustomerID, Type, Model), escriba scripts SQL para: (a) listar el nombre y número de teléfono de todos los clientes que poseen un dispositivo de tipo'tablet', en orden alfabético por nombre; (b) contar los dispositivos de cada tipo; (c) registrar que el cliente 17 tiene ahora el número de teléfono'0771 234 5678'; (d) añadir un nuevo dispositivo, ID 305, un'laptop'del modelo'X1'perteneciente al cliente 17.(a)
SELECT CUSTOMER.Name, CUSTOMER.Phone
FROM CUSTOMER INNER JOIN DEVICE
  ON CUSTOMER.CustomerID = DEVICE.CustomerID
WHERE DEVICE.Type = 'tablet'
ORDER BY CUSTOMER.Name ASC;
(b)
SELECT Type, COUNT(DeviceID) AS NumberOfDevices
FROM DEVICE
GROUP BY Type;
(c)
UPDATE CUSTOMER SET Phone = '0771 234 5678' WHERE CustomerID = 17;(d)INSERT INTO DEVICE (DeviceID, CustomerID, Type, Model) VALUES (305, 17, 'laptop', 'X1');Se otorgan marcas por cláusula — los campos, las tablas, la condición de unión, el
WHERE, elORDER BY— por lo que un script con una sola cláusula incorrecta aún obtiene crédito en el resto. EscribeTable.Fieldsiempre que se involucren dos tablas.Ejemplo resuelto. Explica qué hace este script:
SELECT T.Name, SUM(R.Cost) AS Total FROM TECHNICIAN T INNER JOIN REPAIR R ON T.TechnicianID = R.TechnicianID GROUP BY T.Name;Expresa el nombre de cada técnico junto con el coste total de las reparaciones realizadas por ese técnico, una fila por técnico: las dos tablas se unen mediante TechnicianID, las filas se agrupan por nombre y los costes de cada grupo se suman. Cuando te pidan explicar qué hace un script, describe el resultado, no la sintaxis.
ExplorarCombinar dos tablas con INNER JOIN
Un join coincide filas donde la clave foránea es igual a la clave primaria — aquí Orders.CustomerID = Customer.CustomerID — y combina cada par coincidente en una sola fila más ancha.
ExplorarSELECT … WHERE
Recorre una consulta: DONDE conserva las filas que coinciden, luego SELECCIONAR selecciona las columnas solicitadas.
Vocabulario EntrenarInglés Chino Pinyin flat files/flæt faɪlz/ 平面文件 píng miàn wén jiàn data redundancy/ˈdeɪtə rɪˈdʌndənsi/ 数据冗余 shù jù rǒng yú data inconsistency/ˈdeɪtə ˌɪnkənˈsɪstənsi/ 数据不一致 shù jù bù yī zhì field/fiːld/ 字段 zì duàn integrity/ɪnˈteɡrɪti/ 完整性 wán zhěng xìng relational database/rɪˈleɪʃənl ˈdeɪtəbeɪs/ 关系数据库 guān xì shù jù kù query/ˈkwɪərɪ/ 查询 chá xún SQL/ˌes kjuː ˈel/ 结构化查询语言 jié gòu huà chá xún yǔ yán entity/ˈentɪti/ 实体 shí tǐ record/ˈrekɔːd/ 记录 jì lù tuple/ˈtuːpl/ 元组 yuán zǔ attribute/ˈætrɪbjuːt/ 属性 shǔ xìng primary key/ˈpraɪməri kiː/ 主键 zhǔ jiàn foreign key/ˈfɒrən kiː/ 外键 wài jiàn composite key/ˈkɒmpəzɪt kiː/ 复合键 fù hé jiàn candidate key/ˈkændɪdeɪt kiː/ 候选键 hòu xuǎn jiàn secondary key/ˈsekəndəri kiː/ 次键 cì jiàn indexing/ˈɪndeksɪŋ/ 索引 suǒ yǐn Data Definition Language/ˈdeɪtə ˌdefɪˈnɪʃn ˈlæŋɡwɪdʒ/ 数据定义语言 shù jù dìng yì yǔ yán Data Manipulation Language/ˈdeɪtə məˌnɪpjʊˈleɪʃn ˈlæŋɡwɪdʒ/ 数据操纵语言 shù jù cāo zòng yǔ yán aggregate functions/ˈæɡrɪɡeɪt ˈfʌŋkʃnz/ 聚合函数 jù hé hán shù 8.3
Definiciones aceptadas por el examinador
Una pregunta de definición se califica según un texto fijo. Aprende estas definiciones exactamente, y da solo una respuesta.
Término Definición entidad algo sobre el cual se almacena datos — una persona, objeto o evento — que se convierte en una tabla en una base de datos relacional atributo un único dato sobre una entidad (una columna de la tabla) tupla una única fila de una tabla: una instancia de la entidad clave primaria un atributo, o combinación de atributos, que identifica de forma única cada registro en una tabla clave foránea un atributo en una tabla cuyo valor coincide con una clave primaria en otra tabla, utilizado para vincular ambas clave candidata cualquier atributo (o combinación) que podría elegirse como clave primaria clave secundaria un atributo no primario que está indexado para permitir búsquedas o clasificaciones rápidas en la tabla clave compuesta una clave primaria formada por dos o más atributos juntos integridad referencial cada valor de clave foránea debe coincidir con un valor de clave primaria existente en la tabla a la que hace referencia primera forma normal una tabla en la que cada atributo es atómico, no hay grupos repetidos y existe una clave primaria segunda forma normal en 1NF, y cada atributo no clave depende de toda la clave primaria (sin dependencias parciales) tercera forma normal en 2NF, y ningún atributo no clave depende de otro atributo no clave (sin dependencias transitivas) diccionario de datos los metadatos que un SGBD conserva sobre la estructura de la base de datos: tablas, campos, tipos, claves, relaciones, validación DDL / DML el lenguaje utilizado para definir o cambiar la estructura de una base de datos / el lenguaje utilizado para consultar y mantener los datos en ella 8.3
Consejos para el examen
- Define los términos exactamente: entidad, atributo, clave primaria, clave foránea, y los tipos de relación (1:1, 1:muchos, muchos:muchos).
- Da una razón en cada forma normal: 1FN (sin grupos repetidos), 2FN (sin dependencia parcial), 3FN (sin dependencia no clave) — y nombra los campos implicados.
- Explica qué ofrece un SGBD (independencia de datos, seguridad, integridad, acceso concurrente, un diccionario de datos, una interfaz para desarrolladores, un procesador de consultas).
- Distingue DDL (define la estructura) de DML (consulta y modifica los datos), y escribe la cláusula SQL por cláusula:
SELECT,FROM,INNER JOIN … ON,WHERE,GROUP BY,ORDER BY. - Para dibujar un diagrama E-R a partir de tablas, busca primero cada clave foránea: cada clave foránea representa una relación uno-a-muchos, siendo el "muchos" la tabla que la contiene.
Errores comunes
- Dibujar una relación muchos-a-muchos directamente. Debe dividirse en dos relaciones uno-a-muchos a través de una tabla de enlace que contenga ambas claves foráneas.
- Explicar "no está en 3FN" simplemente diciendo "los datos están repetidos". Nombra la dependencia (parcial o transitiva) y los campos implicados.
- Usar comillas dobles alrededor de cadenas en SQL, o comillas alrededor de números. Las cadenas requieren
'single quotes'; los números no requieren ninguno. - Omisión de la condición
ONdespués deINNER JOIN. Sin ella, las dos tablas no quedan vinculadas. - Colocar un campo ordinario junto a
COUNToSUMdentro de unSELECTsin especificar unGROUP BY. UPDATEoDELETEsin incluir unWHERE. Este cambia o elimina todas las filas de la tabla.
-
9
Diseño de algoritmos y resolución de problemas
Ver lección9.1
Pensamiento computacional

Syllabus
Los candidatos deben ser capaces de: Notas y orientaciones Demostrar comprensión de la abstracción Necesidad y beneficios del uso de la abstracción. Describir el propósito de la abstracción. Producir un modelo abstracto de un sistema incluyendo únicamente los detalles esenciales. Describir y utilizar la descomposición Desglosar problemas en subproblemas, lo que conduce al concepto de módulo de programa (procedimiento / función). Fuente: Plan de estudios Cambridge International
El pensamiento computacional 计算思维 es el conjunto de herramientas mentales para analizar un problema y diseñar una solución que un ordenador pueda ejecutar. Dos conceptos clave son la abstracción y la descomposición.
El pensamiento computacional divide un problema grande en partes más pequeñas y fáciles — como resolver un rompecabezas Abstracción
La abstracción 抽象 significa mantener las características esenciales de un problema e ignorar los detalles irrelevantes, creando así un modelo más simple.
Ejemplos:
- un mapa de una red ferroviaria mantiene las estaciones y líneas, pero omite la geografía real.
- una clase en programación orientada a objetos conserva solo los atributos y métodos que el sistema necesita.
- una función oculta una parte del trabajo tras un nombre.
Un modelo completo de cualquier problema real sería demasiado complejo para analizar, por lo que la abstracción es esencial.
Al examinador le piden el propósito de la abstracción y sus beneficios. Propósito: producir un modelo más simple de un problema que contenga únicamente los detalles necesarios para resolverlo. Beneficios: el problema es más fácil de entender y programar; el programa es más pequeño, se escribe y prueba más rápido; el mismo modelo puede reutilizarse para problemas similares. Cuando se te pide crear un modelo abstracto de un sistema, enumera solo los datos y acciones que la tarea requiere. Para un horario escolar, esto significa clases, aulas, profesores y periodos; no significa el color de las aulas ni la edad de los profesores.

La abstracción mantiene lo esencial (estaciones y líneas) y elimina los detalles irrelevantes (la geografía) Descomposición
La descomposición 分解 significa dividir un problema grande en subproblemas más pequeños, cada uno más fácil de resolver y abordado uno a la vez.
- encontrar las partes principales de la tarea.
- dividir cada parte en subtareas más pequeñas.
- continuar hasta que cada una sea lo suficientemente pequeña para diseñarla directamente.
- resolver las tareas pequeñas y combinarlas.
Para el control de stock: "gestionar stock" → "registrar ventas", "registrar entregas", "producir informes" → ("registrar ventas") "consultar producto", "disminuir contador de stock", "guardar transacción". La descomposición hace manejables los problemas grandes, permite que un equipo divida el trabajo y proporciona código modular — cada módulo se convierte en una procedimiento 过程 o función.
"Plicar por qué se usa la descomposición" es una pregunta de tres puntos con una estructura fija. Da tres beneficios separados: cada subproblema 子问题是 lo suficientemente pequeño para diseñar, codificar y probar por sí mismo; diferentes programadores pueden trabajar en diferentes módulos 模块 al mismo tiempo; un módulo que ya existe (o una rutina de biblioteca) puede reutilizarse, y un fallo es más fácil de localizar porque está contenido dentro de un solo módulo. Un diagrama estructural (tema 12) es el diagrama de una descomposición: el programa en la parte superior, sus módulos debajo, y los datos que se pasan entre ellos.

Descomponer un programa en módulos y submódulos ExplorarResolver un problema a la manera computacional
Recorra los cuatro pilares en el orden en que los usaría: descomponga el problema, identifique lo que se repite, simplifíquelo a lo esencial y luego escriba los pasos.
Vocabulario EntrenarInglés Chino Pinyin computational thinking/ˌkɒmpjuːˈteɪʃənl ˈθɪŋkɪŋ/ 计算思维 jì suàn sī wéi abstraction/əbˈstrækʃn/ 抽象 chōu xiàng decomposition/ˌdiːkɒmpəˈzɪʃn/ 分解 fēn jiě sub-problem/sʌb ˈprɒbləm/ 子问题 zi wèn tí procedure/prəˈsiːdʒə/ 过程 guò chéng modules/ˈmɒdjuːlz/ 模块 mó kuài algorithm/ˈælɡərɪθəm/ 算法 suàn fǎ sequence/ˈsiːkwəns/ 顺序 shùn xù unambiguous/ʌnæmˈbɪɡjuːəs/ 无歧义 wú qí yì deterministic/dɪˌtɜːmɪˈnɪstɪk/ 确定性 què dìng xìng 9.2
Algoritmos
Syllabus
Los candidatos deben ser capaces de: Notas y orientación Demostrar comprensión de que un algoritmo es una solución a un problema expresada como una secuencia de pasos definidos Utilizar nombres de identificadores adecuados para la representación de datos utilizados por un problema y representarlos mediante una tabla de identificadores Escribir pseudocódigo que contenga entrada, proceso y salida Escribir pseudocódigo utilizando las tres construcciones básicas de secuencia, selección e iteración (repetición) Documentar un algoritmo simple mediante una descripción en inglés estructurado, un diagrama de flujo o pseudocódigo Escribir pseudocódigo a partir de: • una descripción en inglés estructurado • un diagrama de flujo Dibujar un diagrama de flujo a partir de: • una descripción en inglés estructurado • pseudocódigo Describir y utilizar el proceso de refinamiento progresivo para expresar un algoritmo hasta un nivel de detalle desde el cual la tarea pueda ser programada Utilizar sentencias lógicas para definir partes de una solución algorítmica Fuente: Plan de estudios Cambridge International
Ordenamiento burbuja, paso a paso Un algoritmo 算法 es una solución expresada como una secuencia de pasos definidos. Cada paso es sin ambigüedad 无歧义 (un significado), determinista 确定性 (misma entrada → misma salida), finito (los pasos terminan) y efectivo (cada uno puede ejecutarse). Un algoritmo dice qué hacer, independientemente del lenguaje de programación utilizado para implementarlo.
ExplorarSelección: seguir las ramas IF / ELSE
Arrastra la puntuación y observa qué rama se ejecuta. La selección prueba cada condición a su vez y toma la PRIMERA que sea verdadera; así es como funciona IF … ELSE IF … ELSE.
9.2
Tabla de identificadores

Cuando inicias un algoritmo, lista cada pieza de datos en una tabla de identificadores 标识符表 — su identificador 标识符 (el nombre de la variable 变量), tipo de dato 数据类型 y descripción. La tabla del examen tiene exactamente estas tres columnas:
Identificador Tipo de dato Descripción CategorySTRINGcategoría del producto SaleDateDATEcuándo se vendió el artículo ItemCostREALcosto del artículo InStockBOOLEANTRUEsi está en stockSalesARRAY[1:30] OF REALlos totales diarios de ventas de los últimos 30 días Usa nombres descriptivos (
ItemCost, nox): un identificador comienza con una letra, no contiene espacios y se escribe de la misma manera cada vez que aparece. Los tipos comunes sonINTEGER,REAL,STRING,CHAR,BOOLEAN,DATE, además de arreglos. La tabla te obliga a nombrar cada pieza de datos antes de escribir código, y una pregunta de "completar la tabla de identificadores" otorga un punto por cada tipo de dato o descripción correcta, así que escribe el tipo exactamente como lo hace la guía de pseudocódigo.Una tabla de identificadores nombra cada pieza de datos antes de escribir código Vocabulario EntrenarInglés Chino Pinyin identifier table/aɪˈdentɪfaɪə ˈteɪbl/ 标识符表 biāo shí fú biǎo identifier/aɪˈdentɪfaɪə/ 标识符 biāo shí fú variable/ˈveərɪəbl/ 变量 biàn liàng data type/ˈdeɪtə taɪp/ 数据类型 shù jù lèi xíng 9.2
Pseudocódigo — las tres construcciones básicas

El pseudocódigo 伪代码 es una forma estructurada y neutral al lenguaje para describir algoritmos.
Los tres bloques constructores de cualquier algoritmo: secuencia, selección e iteración 1. Secuencia
Los pasos se ejecutan uno después de otro (secuencia 顺序):
INPUT Name
INPUT Age
OUTPUT "Hello", Name
2. Selección
Una elección de qué pasos ejecutar, basada en una condición (selección 选择):
IF Age >= 18 THEN
    OUTPUT "Adult"
ELSE
    OUTPUT "Minor"
ENDIF
Para más opciones, usa
CASE OF ... ENDCASE.3. Iteración
Repetir un bloque (iteración 迭代, un bucle 循环):
FOR i ← 1 TO 10
    OUTPUT i
NEXT i
Un bucle MIENTRAS verifica la condición antes de cada pasada (puede ejecutarse cero veces); un bucle REPETIR...HASTA verifica después de cada pasada (siempre se ejecuta al menos una vez).
WHILE Total < 100 DO
    INPUT Value
    Total ← Total + Value
ENDWHILE

REPEAT
    INPUT Mark
UNTIL Mark >= 0 AND Mark <= 100
Un bucle MIENTRAS verifica antes de que se ejecute el cuerpo; un bucle REPETIR ... HASTA verifica después, por lo que su cuerpo siempre se ejecuta al menos una vez Elegir el bucle es en sí mismo un punto:
FORcuando sabes cuántas veces (un bucle controlado por contador 计数循环);WHILEcuando el bucle podría no ejecutarse en absoluto (un bucle de precondición 前测循环);REPEAT ... UNTILcuando debe ejecutarse al menos una vez, como en la validación de una entrada (un bucle de poscondición 后测循环). Una respuesta que "describe la construcción de iteración" nombra la construcción, dice dónde se verifica la condición y da la consecuencia (cero veces o al menos una vez).Operaciones comunes
- asignación 赋值:
x ← 5(una flecha;=es para comparación). - entrada/salida:
INPUT variable,OUTPUT expression. - comparaciones
=,<>,<,>,<=,>=; lógicaAND,OR,NOT. - aritmética
+ - * /, además deDIV(división entera) yMOD(resto). - cadenas:
LENGTH,LEFT,RIGHT,MID, y¶ concatenación 拼接 (unir).
El pseudocódigo que espera el examen
Cada respuesta de pseudocódigo se califica según la guía publicada de Cambridge. Escribe estas formas exactamente:
Construcción Pseudocódigo Variable DECLARE Total : INTEGERArreglo DECLARE Marks : ARRAY[1:30] OF REALConstante CONSTANT MaxTries = 3Asignación Total ← Total + ValueEntrada / salida INPUT NameOUTPUT "Hello ", NameSelección CASE OF Choice1 : OUTPUT "Add"OTHERWISE OUTPUT "Error"ENDCASEBucle PARA FOR i ← 1 TO 10 STEP 2...NEXT iBucle MIENTRAS WHILE Total < 100 DO...ENDWHILEBucle REPETIR REPEAT...UNTIL Mark >= 0Aritmética entera 17 DIV 5 = 317 MOD 5 = 2Cadenas LENGTH(S),LEFT(S, 3),RIGHT(S, 2)MID(S, 2, 4),UCASE(S),LCASE(S)Conversiones INT(3.7) = 3,NUM_TO_STR(12)STR_TO_NUM("4.5"),ASC('A') = 65,CHR(66) = 'B'Aleatorio RAND(100)INT(RAND(100)) + 1RAND(100)da un número real desde 0 hasta (pero sin incluir) 100.INT(RAND(100)) + 1da un entero de 1 a 100.Dos hábitos ganan puntos en cada pregunta: declarar todas las variables que uses, con el tipo de tu tabla de identificadores, e inicializar 初始化 todo contador 计数器 y total (
Count ← 0,Total ← 0) antes del bucle que lo cambia.Entrada → Proceso → Salida
Todo programa sigue esta forma:
INPUT Length
INPUT Width
Area ← Length * Width
OUTPUT "Area = ", Area
Listar las entradas y salidas primero hace que el algoritmo sea más limpio.
Ejemplo resuelto. Escribe pseudocódigo que introduzca 100 enteros y devuelva cuántos de ellos y la suma de aquellos que están entre 10 y 20 inclusive.
Tabla de identificadores:
Count : INTEGER(contador de bucle),Value : INTEGER(el entero acaba de ser introducido),InRange : INTEGER(cuántos estaban en rango),Total : INTEGER(su suma).DECLARE Count, Value, InRange, Total : INTEGER InRange ← 0 Total ← 0 FOR Count ← 1 TO 100 INPUT Value IF Value >= 10 AND Value <= 20 THEN InRange ← InRange + 1 Total ← Total + Value ENDIF NEXT Count OUTPUT InRange, TotalSi la pregunta luego te pide "identificar dos construcciones y stating cómo se usa cada una", responde con la misma estructura: iteración, el bucle
FOR, repite la entrada 100 veces; selección, la instrucciónIF, añade un valor solo cuando está en rango.Ejemplo resuelto. Un programa elige un entero secreto de 1 a 100. El usuario adivina hasta acertar; después de cada intento incorrecto el programa dice "Demasiado bajo" o "Demasiado alto", y al final devuelve cuántos intentos se hicieron.
Tabla de identificadores:
Secret : INTEGER(el número a adivinar),Guess : INTEGER(la entrada del usuario),Tries : INTEGER(cuántos intentos ha habido hasta ahora).DECLARE Secret, Guess, Tries : INTEGER Secret ← INT(RAND(100)) + 1 Tries ← 0 REPEAT INPUT Guess Tries ← Tries + 1 IF Guess < Secret THEN OUTPUT "Too low" ELSE IF Guess > Secret THEN OUTPUT "Too high" ENDIF ENDIF UNTIL Guess = Secret OUTPUT "You took ", Tries, " guesses"Un bucle
REPEAT ... UNTILes la opción correcta porque el usuario debe adivinar al menos una vez. Los puntos son para: el número aleatorio en el rango correcto, un bucle que termina con un acierto, el contador que empieza en cero y aumenta dentro del bucle, los dos mensajes bajo las condiciones correctas, y la salida final.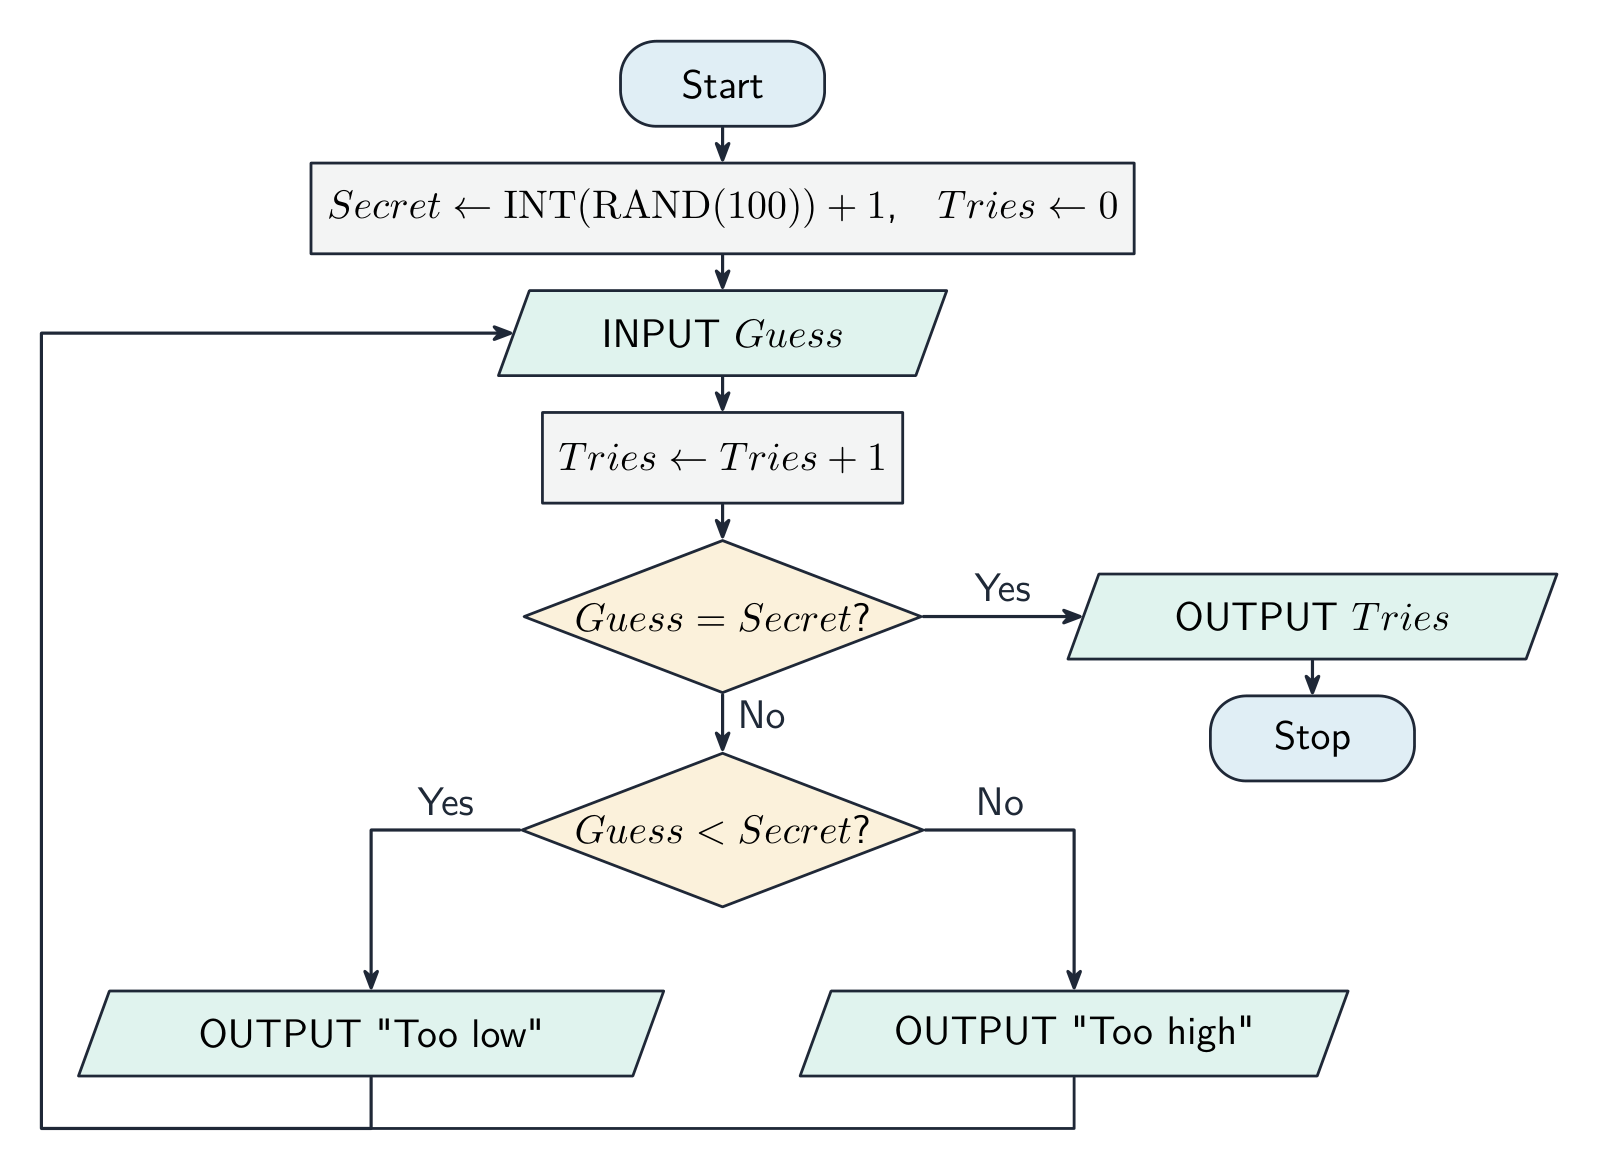
El mismo juego de adivinanza como diagrama de flujo: los dos rombos de decisión son las dos instrucciones SI, y la flecha de retorno es el bucle REPETIR ... HASTA Ejemplo resuelto. Devuelve dos enteros aleatorios diferentes, cada uno entre $-10$ y $10$ inclusive.
Hay 21 valores posibles, por lo que
INT(RAND(21))da de 0 a 20 y restar 10 lo desplaza al rango $-10$ a $10$. El segundo número debe generarse nuevamente hasta que difiera del primero:DECLARE First, Second : INTEGER First ← INT(RAND(21)) - 10 REPEAT Second ← INT(RAND(21)) - 10 UNTIL Second <> First OUTPUT First, Second
Todo programa sigue la forma Entrada, Proceso, Salida ExplorarIF … ELSE selección
Cambia el valor y observa qué rama se ejecuta: cómo un programa toma una decisión.
Vocabulario EntrenarInglés Chino Pinyin pseudocode/ˈsuːdəʊkəʊd/ 伪代码 wěi dài mǎ flowchart/ˈfləʊtʃɑːt/ 流程图 liú chéng tú selection/sɪˈlekʃn/ 选择 xuǎn zé iteration/ˌɪtəˈreɪʃn/ 迭代 dié dài loop/luːp/ 循环 xún huán count-controlled loop/kaʊnt kənˈtrəʊld luːp/ 计数循环 jì shù xún huán pre-condition loop/priː kənˈdɪʃn luːp/ 前测循环 qián cè xún huán post-condition loop/pəʊst kənˈdɪʃn luːp/ 后测循环 hòu cè xún huán assignment/əˈsaɪnmənt/ 赋值 fù zhí concatenation/kənˌkætəˈneɪʃn/ 拼接 pīn jiē initialise/ɪˈnɪʃəlaɪz/ 初始化 chū shǐ huà counter/ˈkaʊntə/ 计数器 jì shù qì structured English/ˈstrʌktʃəd ˈɪŋɡlɪʃ/ 结构化英语 jié gòu huà yīng yǔ stepwise refinement/ˈstepwaɪz rɪˈfaɪnmənt/ 逐步求精 zhú bù qiú jīng logic statement/ˈlɒdʒɪk ˈsteɪtmənt/ 逻辑语句 luó jí yǔ jù precedence/ˈpresɪdəns/ 优先级 yōu xiān jí De Morgan's law/də ˈmɔːɡənz lɔː/ 德摩根定律 dé mó gēn dìng lǜ 9.2
Tres notaciones

El mismo algoritmo puede escribirse de tres formas.
- inglés estructurado 结构化英语 — lenguaje natural con sangría y palabras clave fijas; bueno para una descripción de alto nivel.
- diagrama de flujo 流程图 — un diagrama con formas estándar:
Forma Significado Rectángulo redondeado Inicio / Parada Paralelogramo Entrada / Salida Rectángulo Proceso Rombo Decisión Flecha Flujo de control - pseudocódigo — la notación de palabras clave anterior; más cercano al código.
Deberías poder convertir entre cualquier par: cada
IFes un rombo de decisión, cada bucle es una flecha de retorno, y una secuencia son rectángulos apilados.SI ... ENTONCES ... DE LO CONTRARIO ... FIN SI
Un diagrama de flujo para promediar una lista de números, usando las formas estándar 9.2
Refinamiento progresivo

El refinamiento progresivo 逐步求精 comienza con un esquema de alto nivel y expande cada paso hasta que sea lo suficientemente pequeño para codificarlo. Para un promedio de $n$ números:
Nivel 1:
Read in the numbers
Compute the average
Output the average
Nivel 2:
INPUT n
total ← 0
FOR i ← 1 TO n
    INPUT value
    total ← total + value
NEXT i
average ← total / n
OUTPUT average
Cada refinamiento mantiene la estructura anterior y añade detalles.
Una pregunta de seis puntos de "aplicar refinamiento progresivo" te da un esquema de alto nivel y quiere que cada paso se expanda en las instrucciones concretas que un programador podría codificar. Mantén los pasos en el mismo orden, nombra los datos que cada paso lee o produce, y detente cuando cada línea sea una sola entrada, asignación, salida, bucle o condición. Por ejemplo, "validar la contraseña" se convierte en: introducir la contraseña; verificar que su longitud sea de al menos 8; verificar que contenga al menos un dígito; output "aceptado" si ambas verificaciones pasan, de lo contrario output "rechazado".
Refinamiento progresivo: expande cada paso de alto nivel en pseudocódigo detallado ExplorarRefinamiento paso a paso: de esquema a código
Descender los niveles. Comienza con toda la tarea en una sola línea y sigue expandiendo cada paso en pasos más pequeños — hasta que cada paso sea lo suficientemente simple para codificarse directamente.
9.2
Sentencias lógicas

Una sentencia lógica 逻辑语句 es una condición Booleana 布尔 que controla el salto, construida a partir de comparaciones (
x > 10), conectores (AND,OR,NOT) y paréntesis. Úsala como condición deIF,WHILEoREPEAT...UNTIL:WHILE attempts < 3 AND NOT loggedIn DO INPUT password IF password = correctPassword THEN loggedIn ← TRUE ELSE attempts ← attempts + 1 ENDIF ENDWHILEPrioridad 优先级 (de mayor a menor):
NOT, luegoAND, luegoOR. Usa paréntesis si estás inseguro. Errores comunes:a = 1 OR 2es incorrecto — escribea = 1 OR a = 2.NOT a > 5significaNOT (a > 5), es decir,a <= 5.NOT (A AND B)es lo mismo que(NOT A) OR (NOT B)(Ley de De Morgan 德摩根定律) — útil para simplificar condiciones.
Convertir una oración en una sentencia lógica es una habilidad que los exámenes prueban directamente. "Un boleto es gratis para cualquiera menor de 5 o mayor de 65" se convierte en
Age < 5 OR Age > 65. "Una nota es válida si es un número entero de 0 a 100" se convierte enMark >= 0 AND Mark <= 100. "El bucle se detiene cuando el archivo termina o se han leído diez registros" se convierte enUNTIL EOF(File) OR Count = 10. Escribe cada comparación completa:Age > 65yAge < 5, nuncaAge > 65 OR < 5.Prioridad: NO se une a logueado primero, luego Y combina ambos lados Ejemplo resuelto. Escribe una tabla de identificadores y pseudocódigo para leer 10 números y devolver el mayor. La tabla de identificadores nombra cada variable con su tipo de dato y propósito:
Count : INTEGER(contador de bucle),Num : REAL(el número acabado de leer),Max : REAL(mayor hasta ahora).Max ← -999999 FOR Count ← 1 TO 10 INPUT Num IF Num > Max THEN Max ← Num ENDIF NEXT Count OUTPUT MaxLa decisión de diseño que lleva los puntos es inicializar
Max: debe empezar más bajo que cualquier posible entrada - o, aún más seguro, ser configurado al primer número leído. Inicializarlo a0haría que el algoritmo devolviera erróneamente 0 para una lista de números negativos, un error que solo expones si los datos de prueba incluyen un negativo.Vocabulario EntrenarInglés Chino Pinyin Boolean/ˈbuːlɪən/ 布尔 bù ěr 9.2
Definiciones que acepta el examinador
Una pregunta de definición se califica contra un texto fijo. Aprende estas exactamente, y da solo una respuesta.
Término Definición abstracción mantener los detalles esenciales de un problema y omitir los detalles que no se necesitan descomposición dividir un problema en subproblemas más pequeños, cada uno de los cuales puede resolverse por separado algoritmo una solución a un problema expresada como una secuencia de pasos definidos tabla de identificadores una tabla que lista cada identificador usado en un algoritmo con su tipo de dato y una descripción de su propósito pseudocódigo una forma estructurada e independiente del lenguaje para escribir los pasos de un algoritmo diagrama de flujo un diagrama que muestra los pasos y decisiones de un algoritmo usando símbolos estándar unidos por flechas secuencia instrucciones ejecutadas una después de otra en el orden escrito selección elegir qué instrucciones ejecutar según una condición iteración repetir un grupo de instrucciones mientras, o hasta, se cumpla una condición refinamiento progresivo dividir cada paso de un esquema en pasos más pequeños, repetidamente, hasta que cada paso pueda codificarse directamente sentencia lógica una condición construida a partir de comparaciones y los operadores Y, O y NO que evalúa a VERDADERO o FALSO 9.2
Consejos de examen
- Define un algoritmo como una secuencia de pasos sin ambigüedad, finita y determinista, independiente del lenguaje.
- Usa correctamente las tres construcciones — secuencia, selección, iteración — y mantén una tabla de identificadores con tipos de dato.
- Divide un problema mediante descomposición y abstracción, luego refinamiento progresivo.
- Escribe pseudocódigo que realmente funcionaría: declara variables y sigue el estilo de pseudocódigo del examen.
Errores comunes
- Usar
=para asignar un valor. La asignación es←;=es una comparación. - Olvidar
ENDIF,ENDWHILE,ENDCASEoNEXT. Cada construcción se cierra, y la palabra de cierre es donde se verifica el punto de la construcción. - No inicializar un total o contador antes del bucle, por lo que el algoritmo suma a un valor que nunca existió.
- Usar un bucle
FORcuando el número de repeticiones es desconocido. Leer hasta un valor centinela o un acierto necesitaWHILEoREPEAT ... UNTIL. - Escribir
Age > 65 OR < 5. Cada lado deORyANDdebe ser una comparación completa. - Responder "explicar por qué se usa la descomposición" con un beneficio escrito de tres formas. Tres puntos necesitan tres beneficios diferentes.
-
10
Tipos y estructuras de datos
Ver lección10.1
Elección de tipos de datos
Syllabus
Los candidatos deben ser capaces de: Notas y orientación Seleccionar y utilizar tipos de datos adecuados para la solución de un problema incluyendo entero, real, char, cadena, Booleano, fecha (el pseudocódigo utilizará los siguientes tipos de datos: ENTERO, REAL, CHAR, CADENA, BOOLEANO, FECHA, ARREGLO, ARCHIVO) Demostrar comprensión del propósito de una estructura de registro para almacenar un conjunto de datos de diferentes tipos bajo un único identificador Escribir pseudocódigo para definir una estructura de registro Escribir pseudocódigo para leer datos de una estructura de registro y guardar datos en una estructura de registro Fuente: Plan de estudios Cambridge International
Cada variable necesita un tipo de dato 数据类型 — el tipo de valor que contiene y las operaciones permitidas:
INTEGER— un número entero (42,-7). Para conteos, índices, IDs.REAL— un número con parte fraccionaria (3.14). Para dinero, mediciones.STRING— caracteres entre comillas ("Hello"). Para texto.CHAR— un solo carácter ('A').BOOLEAN—TRUEoFALSE. Para banderas.DATE— una fecha del calendario.
Elige el tipo más pequeño pero preciso que se adapte:
INTEGERpara conteos enteros,BOOLEANpara banderas (no las cadenas"yes"/"no").Las tablas de "dar el tipo de dato adecuado" se determinan por cómo se usa el valor: la nota media de una clase es
REAL(tiene parte fraccionaria); una dirección de correo electrónico esSTRING; el número de estudiantes esINTEGER; si un estudiante ha pagado esBOOLEAN; una fecha de nacimiento esDATE; un índice de array es siempreINTEGER; una sola letra de calificación esCHAR; un número de teléfono es unaSTRING, porque comienza con0y nunca se usa en aritmética. UnaBOOLEANse usa para una bandera con solo dos estados: si una búsqueda ha encontrado su objetivo, si un miembro ha pagado, si un asiento está reservado. Para la tabla de identificadores, el nombre de la variable también debe ser significativo:NumberOfPeople, non.10.1
Registros

Un registro 记录 (una estructura de registro 记录结构) almacena varios campos de diferentes tipos bajo un solo nombre — útil cuando varios valores describen una misma cosa.
TYPE TStockItem
    DECLARE ItemID : INTEGER
    DECLARE Category : STRING
    DECLARE ItemCost : REAL
    DECLARE InStock : BOOLEAN
ENDTYPE
Esto define el tipo
TStockItem; declara variables de este tipo:DECLARE Item1 : TStockItem DECLARE Items : ARRAY[1:100] OF TStockItemUsa notación de puntos para acceder a cada campo 字段:
Item1.Category ← "Fruit"
OUTPUT Item1.Category, " costs ", Item1.ItemCost
Usa un registro cuando los valores siempre pertenecen juntos (un cliente, un artículo de inventario); usa variables separadas para valores no relacionados.
Ejemplo resuelto. Un club almacena, para cada estudiante, un ID de estudiante (una cadena), un nombre, una fecha de nacimiento y hasta tres números de club (enteros). Escribe pseudocódigo para declarar el tipo de registro, un array para almacenar $3000$ estudiantes, y una instrucción que almacene un nombre en el primer elemento.
TYPE Student
    DECLARE StudentID : STRING
    DECLARE Name : STRING
    DECLARE DateOfBirth : DATE
    DECLARE Club : ARRAY[1:3] OF INTEGER
ENDTYPE

DECLARE Membership : ARRAY[1:3000] OF Student
Membership[1].Name ← "Li Wei"
Las puntuaciones:
TYPEcon el identificador yENDTYPE; cada campo declarado con un tipo adecuado; la array declarada con sus límites yOF Student; el campo alcanzado mediante el índice y un punto. Una pregunta de "enunciar el error en la declaración del registro" suele señalar una falta deENDTYPE, un campo sin tipo, o un campo declarado comoSTRINGque debe contener aritmética. Dos convenciones obtienen puntos por sí solas: un elemento no utilizado se marca con un valor que no puede ser datos reales (una cadena vacía,-1, un ID de0), y es buena práctica usar el mismo marcador en todas partes para que cada módulo pueda reconocer una ranura no utilizada; un campo de club no utilizado es0. Las ventajas de una array de registros, para "enunciar tres ventajas": todos los datos de una entidad se almacenan bajo un solo identificador; los campos pueden tener diferentes tipos de datos; una array reemplaza a varias arrays paralelas que tendrían que mantenerse sincronizadas; todo el conjunto se puede procesar con un solo bucle o pasarse como un solo parámetro; y añadir un campo cambia solo la definición del tipo. Para un cliente, la estructura adecuada es un registro (campos de diferentes tipos bajo un nombre); para todos los clientes es una array de registros.Un registro contiene varios campos de diferentes tipos bajo un solo nombre ExplorarUn registro agrupa campos bajo un solo nombre
Un registro agrupa campos relacionados. Cada campo es una etiqueta con nombre a la que accedes mediante notación por puntos — Item1.Category — no mediante un índice numérico.
Vocabulario EntrenarInglés Chino Pinyin record/ˈrekɔːd/ 记录 jì lù record structure/ˈrekɔːd ˈstrʌktʃə/ 记录结构 jì lù jié gòu field/fiːld/ 字段 zì duàn 10.2
Arreglos

Syllabus
Los candidatos deben ser capaces de: Notas y orientación Utilizar los términos técnicos asociados a arreglos Incluyendo índice, límite superior y límite inferior Seleccionar una estructura de datos adecuada (arreglo unidimensional o bidimensional) para una tarea dada Escribir pseudocódigo para arreglos unidimensionales y bidimensionales Escribir pseudocódigo para procesar datos de arreglos Ordenamiento mediante ordenamiento burbuja Búsqueda mediante búsqueda lineal Fuente: Plan de estudios Cambridge International
Un array 数组 es una colección ordenada de elementos del mismo tipo, bajo un solo nombre, alcanzados por un índice 索引.
- elemento 元素 — un elemento en la array.
- bounds 边界 — los índices válidos más bajos y más altos.
- dimension 维度 — 1-D (una lista), 2-D (una tabla), etc.
- lower bound 下界 y upper bound 上界 — el primer y último índice válido; el número de elementos es límite superior menos límite inferior más uno, y para una array 2-D es el producto de ambas cantidades.
Así que en
ThisArray[n] ← 42la array tiene una dimensión, el índice es la variablen(unINTEGER), y el elemento en ese índice recibe42. Antes de declarar una array necesitas su tipo de datos así como sus límites. Para declarar $120$ valores que puedan incluir un punto decimal:DECLARE Data : ARRAY[1:120] OF REAL; una tabla de strings de $150$ filas y dos columnas:DECLARE Data : ARRAY[1:150, 1:2] OF STRING, que tiene $300$ elementos. Las ventajas de una array sobre variables separadas, para una explicación de dos puntos: un identificador en lugar de treinta; los elementos se pueden procesar con un bucle usando el índice como contador; el tamaño es fácil de cambiar; y todo el conjunto se puede pasar a un módulo como un solo parámetro. Una array también puede reemplazar una cadena de sentencias de selección:DaysInMonth[Month]busca la respuesta directamente en lugar de doce cláusulasIF, lo cual es más corto, más rápido de escribir y más fácil de mantener.Arrays 1-D
DECLARE Names : ARRAY[1:5] OF STRING
Names[3] ← "Cara"
OUTPUT Names[3]
Procesa cada elemento con un bucle
FOR:FOR i ← 1 TO 5 OUTPUT Names[i] NEXT iUna array 1-D (una lista) con índices y límites Arrays 2-D (array 2D)
DECLARE Grid : ARRAY[1:3, 1:4] OF INTEGER
Grid[2, 3] ← 99
El primer índice es la fila, el segundo la columna. Usa bucles anidados para visitar cada celda. Usa 1-D para una secuencia única, 2-D para dos dimensiones naturales (una cuadrícula, filas × columnas).

Una array 2-D (una tabla) con índices de fila y columna Operaciones comunes
Una búsqueda lineal 线性查找 revisa cada elemento hasta encontrarlo:
FOR i ← 1 TO n
    IF A[i] = Target THEN
        OUTPUT "Found at ", i
    ENDIF
NEXT i
Para encontrar una suma, conteo, máximo o mínimo, establece una variable acumuladora luego escanea a través:
Max ← A[1]
FOR i ← 2 TO n
    IF A[i] > Max THEN
        Max ← A[i]
    ENDIF
NEXT i
Un ordenamiento burbuja 冒泡排序 coloca una array en orden; pasa a través ella comparando cada par adyacente e intercambiando cualquier par fuera de orden; repite los pasos hasta que un paso no realice intercambios.
El Examen 2 pide estos algoritmos tanto en pseudocódigo como en pasos en palabras, y a veces en su forma "eficiente":
- Valor más grande: establece
Largestal primer elemento; para cada elemento restante, si es mayor queLargest, guárdalo enLargest; después del bucle emiteLargest. Para la posición del más grande, mantén una segunda variable que almacene el índice cada vez queLargestcambie. - Búsqueda lineal devolviendo una posición: establece
FoundAt ← -1antes del bucle (un valor que nunca puede ser un índice válido, por lo que significa "no encontrado"); recorre la array; cuando el elemento coincida, guarda el índice y sal del bucle; después del bucle verificaFoundAt. - Contar o emitir los elementos no vacíos: compara cada elemento con el marcador de elemento no utilizado (
""o-1) y cuenta o emite solo aquellos que difieran. - Eliminar un elemento: encuentra su índice mediante una búsqueda lineal; mueve cada elemento posterior un lugar hacia el inicio, cerrando el espacio; marca el último elemento como no utilizado (o disminuye el conteo).
- Insertar en una array ordenada: encuentra el primer índice cuyo elemento sea mayor; mueve ese elemento y cada siguiente un lugar hacia el final; almacena el nuevo valor en el espacio abierto.
- Ordenamiento burbuja eficiente: una bandera
Swappedpara que los pasos se detengan tan pronto como un paso no haga ningún intercambio, y un límite superior que disminuye en uno cada paso porque el valor más grande ya ha llegado al final.
REPEAT
    Swapped ← FALSE
    FOR Index ← 1 TO Limit - 1
        IF Data[Index] > Data[Index + 1] THEN
            Temp ← Data[Index]
            Data[Index] ← Data[Index + 1]
            Data[Index + 1] ← Temp
            Swapped ← TRUE
        ENDIF
    NEXT Index
    Limit ← Limit - 1
UNTIL Swapped = FALSE
Las puntuaciones son por el bucle exterior que se repite hasta que no hay intercambios, la bandera establecida dentro del
IF, el intercambio de tres líneas con una variable temporal, y el límite decreciente. Un ordenamiento en "pasos" (refinamiento paso a paso) es: repetir hasta ordenar; en cada paso comparar pares adyacentes; intercambiar un par fuera de orden; después de cada paso el valor no ordenado más grande está al final. Dos arrays 1-D de registros o de datos paralelos se procesan con un bucle y un índice; una array 2-D necesita un bucle anidado, el exterior sobre filas y el interior sobre columnas, y una búsqueda en una fila fija el índice de fila y itera sobre la columna.
Una pasada de un ordenamiento burbuja: se comparan e intercambian pares adyacentes, moviendo el valor más grande hacia el final ExplorarUna matriz 2-D
Selecciona una fila y una columna para leer un elemento: cómo se almacena e indexa una cuadrícula de datos.
Vocabulario EntrenarInglés Chino Pinyin data type/ˈdeɪtə taɪp/ 数据类型 shù jù lèi xíng index/ˈɪndeks/ 索引 suǒ yǐn array/əˈreɪ/ 数组 shù zǔ element/ˈelɪmənt/ 元素 yuán sù bounds/baʊndz/ 边界 biān jiè dimension/daɪˈmenʃn/ 维度 wéi dù lower bound/ˈləʊə baʊnd/ 下界 xià jiè upper bound/ˈʌpə baʊnd/ 上界 shàng jiè linear search/ˈlɪnɪə sɜːtʃ/ 线性查找 xiàn xìng chá zhǎo bubble sort/ˈbʌbl sɔːt/ 冒泡排序 mào pào pái xù 10.3
Archivos

Syllabus
Los candidatos deben ser capaces de: Notas y orientación Demostrar comprensión de por qué se necesitan los archivos Escribir pseudocódigo para manejar archivos de texto que constan de una o más líneas Fuente: Plan de estudios Cambridge International
Un archivo 文件 es datos almacenados en almacenamiento secundario 辅助存储器, mantenidos entre ejecuciones del programa. Las variables en RAM desaparecen cuando termina el programa, por lo que para guardar datos permanentemente (puntuaciones altas, registros, configuraciones) el programa escribe en un archivo. Los archivos también permiten que los programas compartan datos y reinicien desde un estado guardado.
Las variables en RAM desaparecen al finalizar el programa; un archivo en disco persiste entre ejecuciones Un archivo de texto 文本文件 contiene una o más líneas de caracteres legibles; los programas leen y escriben archivos de texto línea por línea. Abra un archivo antes de usarlo y cierre después:
OPENFILE "data.txt" FOR READ // or FOR WRITE, FOR APPEND WHILE NOT EOF("data.txt") DO READFILE "data.txt", LineString OUTPUT LineString ENDWHILE CLOSEFILE "data.txt"EOFverifica el final del archivo 文件结束 antes de leer. Para escribir:OPENFILE "log.txt" FOR WRITE FOR i ← 1 TO 100 WRITEFILE "log.txt", "Event " & i NEXT i CLOSEFILE "log.txt"Siempre cierre cada archivo — de lo contrario las escrituras en búfer pueden perderse y otros programas podrían quedar bloqueados.
Por qué archivos (dos puntos): los datos se mantienen después de que el programa termina, por lo que están disponibles la próxima vez que se ejecuta; puede compartirse con otros programas; y puede contener más de lo que cabe en memoria. La característica de un archivo de texto que permite a un programa procesarlo es que es una secuencia de líneas, leídas una tras otra desde el inicio. Los tres modos:
READpara leer desde el inicio;WRITEpara crear un nuevo archivo, lo cual elimina cualquier contenido existente, por lo que no puede usarse para añadir a un archivo;APPENDpara añadir líneas al final de un archivo existente. VerifiqueEOFantes de cada lectura, y abra el archivo solo una vez, incluso cuando varios módulos lo utilicen.Ejemplo resuelto. Escriba pseudocódigo para un procedimiento
LastLines(FileName : STRING)que muestre las últimas tres líneas de un archivo de texto, en orden.PROCEDURE LastLines(BYVAL FileName : STRING) DECLARE LineX, LineY, LineZ : STRING LineX ← "" LineY ← "" LineZ ← "" OPENFILE FileName FOR READ WHILE NOT EOF(FileName) DO LineX ← LineY LineY ← LineZ READFILE FileName, LineZ ENDWHILE CLOSEFILE FileName OUTPUT LineX OUTPUT LineY OUTPUT LineZ ENDPROCEDURECada nueva línea empuja las tres anteriores, por lo que al finalizar el archivo las tres variables contienen sus últimas tres líneas; un archivo con menos líneas genera cadenas vacías. Para mostrar las cinco primeras líneas, cuente las líneas leídas y detenga el bucle en cinco o en
EOF, lo que ocurra primero; un archivo vacío se detecta porqueEOFmarTRUEinmediatamente después de abrirlo.Campos en una línea. Un archivo de texto contiene cadenas, por lo que un registro se escribe como una línea con sus campos unidos por un carácter separador 分隔符, y cada número o booleano se convierte con
NUM_TO_STR(y se lee de nuevo conSTR_TO_NUM, o comparando con"TRUE"). Elija un separador que nunca aparezca en los datos: una coma o|para nombres y números, nunca un espacio si un nombre podría contener uno. Si un campo puede contener cualquier carácter, el separador puede confundirse con los datos; la solución es poner cada campo en su propia línea, o escribir la longitud del campo antes de este. Un elemento por línea es simple de leer de nuevo pero usa más líneas y hace que un registro sea menos evidente como unidad. Leer un archivo cuyas líneas están en un orden conocido (ascendente según un ID) permite que la búsqueda se detenga tan pronto como se lee un ID mayor, en lugar de leer hasta el final. Un archivo de guardado que se crea cada vez que se guarda el juego necesita un nombre de archivo significativo, por ejemplo el nombre del jugador y la fecha y hora, para que cualquier guardado anterior pueda restaurarse.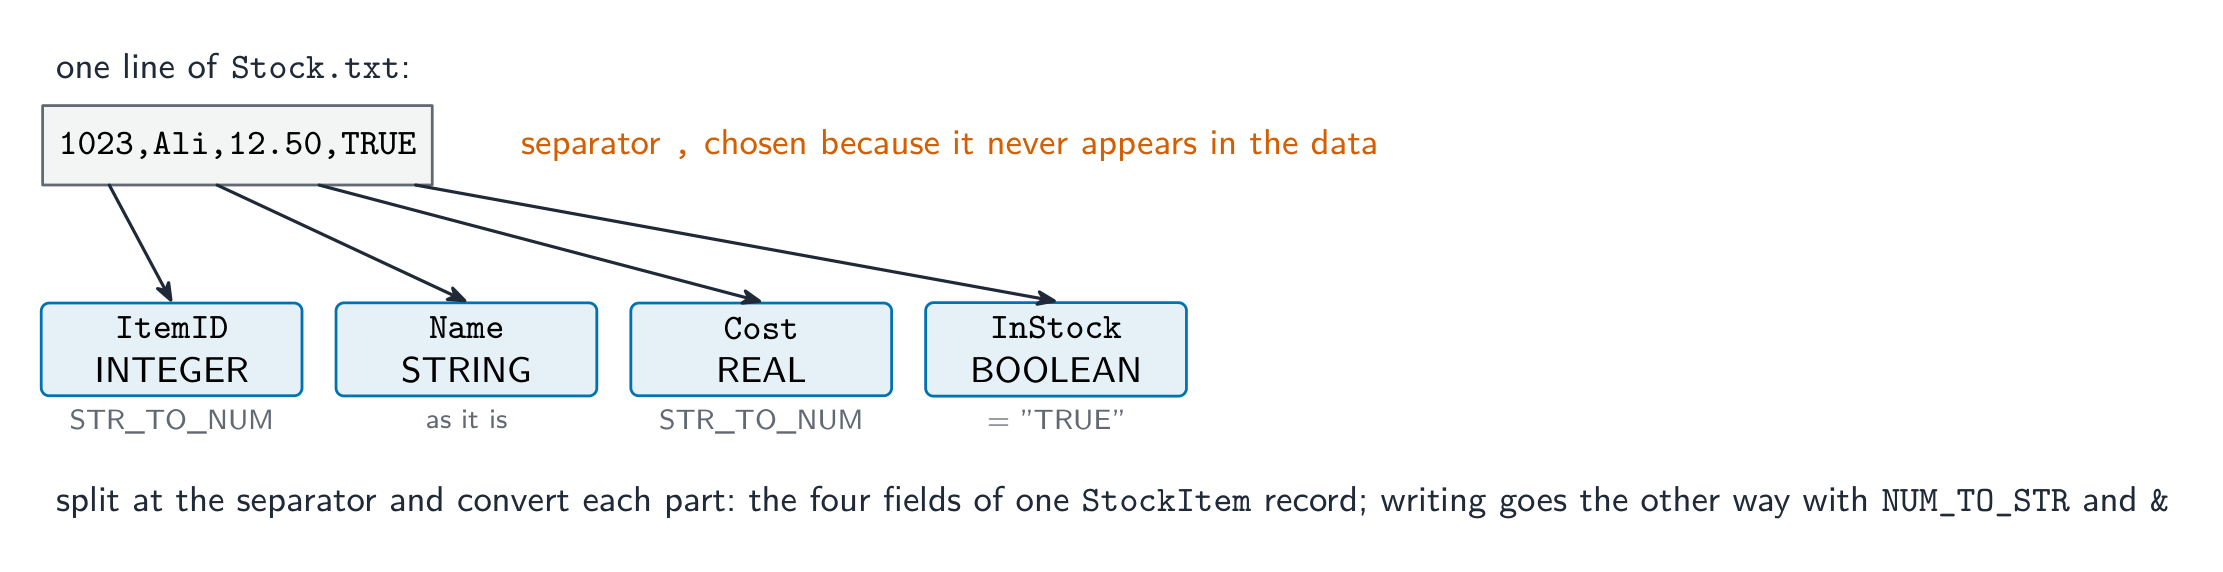
Una línea de un archivo de texto es un registro: campos unidos por un separador, convertidos a sus tipos al leerse de nuevo ExplorarManejo de un archivo: abrir → usar → cerrar
Paso a paso el ciclo de vida que sigue cada archivo. Las dos partes fáciles de olvidar son verificar el final del archivo (EOF) al leer en un bucle, y siempre cerrar al final.
Vocabulario EntrenarInglés Chino Pinyin file/faɪl/ 文件 wén jiàn secondary storage/ˈsekəndəri ˈstɔːrɪdʒ/ 辅助存储器 fǔ zhù cún chǔ qì text file/tekst faɪl/ 文本文件 wén běn wén jiàn end of file/end ɒv faɪl/ 文件结束 wén jiàn jié shù 10.4
Tipos de Datos Abstractos (TDA)

Syllabus
Los candidatos deben ser capaces de: Notas y orientación Demostrar comprensión de que un TDA es una colección de datos y un conjunto de operaciones sobre esos datos Demostrar comprensión de que una pila, una cola y una lista enlazada son ejemplos de TDAs Describir las características clave de una pila, una cola y una lista enlazada y justificar su uso para una situación dada Utilizar una pila, una cola y una lista enlazada para almacenar datos A los candidatos no se les requerirá escribir pseudocódigo para estas estructuras, pero sí deberán poder añadir, editar y eliminar datos de ellas Describir cómo se pueden implementar una cola, una pila y una lista enlazada utilizando arrays Fuente: Plan de estudios Cambridge International
Lista enlazada: insertar reconfigurando punteros Pila vs cola: LIFO y FIFO Un Tipo de Dato Abstracto 抽象数据类型 (TDA) es una colección de datos más operaciones sobre ellos, definido por qué hace, no cómo se almacena. El usuario trabaja solo a través de las operaciones; la implementación está oculta, por lo que puede cambiar sin afectar el código que usa el TDA. Conozca tres: pila, cola, lista enlazada.
La definición de un punto: un TDA es una colección de datos junto con un conjunto de operaciones sobre esos datos. Una pila, una cola, una lista enlazada, un árbol binario y un array son todos TDAs. Para justificar una elección: una cola cuando los elementos deben manejarse en el orden en que llegaron (trabajos de impresión, pulsaciones de tecla, clientes en una tienda), porque es primero en entrar, primero en salir; una pila cuando el elemento más reciente debe manejarse primero (deshacer, retroceder en páginas web, invertir un orden, las direcciones de retorno de llamadas anidadas), porque es último en entrar, primero en salir; una lista enlazada cuando los elementos se insertan y eliminan frecuentemente en medio de una secuencia ordenada, porque solo cambian los punteros y nada tiene que desplazarse. Para comparar una pila y una cola: ambas son estructuras lineales de elementos con un orden, ambas se implementan con un array y punteros, y ambas necesitan una verificación de lleno antes de agregar y de vacío antes de eliminar; una pila tiene un puntero y agrega y elimina en el mismo extremo, una cola tiene dos punteros y agrega en un extremo y elimina en el otro.
Pila
Una pila 栈 funciona en orden LIFO 后进先出 (Last In, First Out). Operaciones: empujar 入栈 (agregar en la parte superior), sacar 出栈 (quitar de la parte superior), inspeccionar (ver la parte superior), y pruebas de vacío/lleno. Usos: historial de deshacer, direcciones de retorno de llamadas de función, análisis de expresiones, retroceso.
Empujar y sacar cambian el puntero superior; el puntero base permanece fijo Ejemplo resuelto. Una pila de caracteres contiene, desde la parte inferior,
'P','N','Z','X','Y','W', con el puntero de parte superior de la pila en'W'(ubicación de memoria 202 de 200–207). Se realizan las operacionesPOP,POP,PUSH 'A',PUSH 'B',POP. ¿Qué hay en la pila y dónde apunta el puntero?Los dos pops eliminan
'W'luego'Y'; los pushes añaden'A'luego'B'en su lugar; el último pop elimina'B'. La pila ahora contiene'P','N','Z','X','A'y el puntero está en'A', ubicación 203. El valor que ha estado en la pila más tiempo es el elemento inferior,'P'; como máximo cinco pops adicionales son posibles antes de que la pila esté vacía, y un pop sobre una pila vacía es un error, por esoPop()verifica primero si está vacía. Una funciónPush()que retornaTRUEen caso de éxito verifica primero si el puntero está en la parte superior del array (llena) y retornaFALSEsi es así. Los elementos del array no necesitan inicialización previa al uso, porque solo el punter indica cuáles están en uso.
Una pila de libros es una pila que puedes ver. Solo puedes añadir o tomar un libro desde la parte superior, así que el último que pones es el primero que quitas — eso es exactamente LIFO Cola
Una cola 队列 funciona en orden FIFO 先进先出 (First In, First Out). Operaciones: enqueue 入队 (añadir al final), dequeue 出队 (eliminar desde el principio), y pruebas para vacío/lleno. Usos: colas de impresión, programación, búsqueda en anchura, buffering.

Enqueue añade al final; dequeue elimina desde el principio Para describir añadir un elemento: verificar que la cola no esté llena; almacenar el elemento en la posición indicada por el punter de fin de cola; incrementa el punter de fin (y el contador). Para describir eliminar: verificar que la cola no esté vacía; leer el elemento en el punter de inicio; incrementa el punter de inicio (y decrementa el contador). Establece la convención que usas: si el punter de fin marca el siguiente espacio libre, que los punters de inicio y fin sean iguales significa que la cola está vacía; si marca el último elemento, punters iguales significan un solo elemento. En una cola lineal el punter de inicio solo se mueve hacia adelante, por lo que las celdas detrás de él se desperdician; eso es lo que corrige la cola circular de abajo. Las dos características de una cola a mencionar: los elementos se añaden al final y se eliminan desde el principio, así que el primer elemento añadido es el primero en eliminarse.

Una fila de personas es una cola que puedes ver. Te unes por la parte trasera y te atienden desde la parte delantera, así que quien esperó más tiempo es atendido primero — eso es exactamente FIFO Lista enlazada
Una lista enlazada 链表 almacena datos como una secuencia de nodos 节点. Cada nodo contiene un valor y un puntero 指针 al siguiente nodo; un punter de cabeza marca el inicio, y el punter del último nodo es un sentinela (ej.
NULL). Operaciones: insertar, eliminar, buscar y recorrer 遍历 (visitar cada nodo en orden). Su ventaja frente a un array es la inserción/eliminación barata (solo ajustar punters); su desventaja es el acceso aleatorio lento (debes seguir los punters desde la cabeza).
Una lista enlazada: cada nodo apunta al siguiente Añadir un nodo en orden (cuatro puntos): recorre la lista desde la cabeza, siguiendo los punters, hasta encontrar el nodo anterior a la posición deseada (el último cuyo valor sea menor); toma un nodo libre y almacena el nuevo valor en él; establece el punter del nuevo nodo para que apunte a la dirección a la que apuntaba el nodo anterior; establece el punter del nodo anterior para que apunte al nuevo nodo. Si el nuevo valor debe ir al principio, se modifica el punter de cabeza en su lugar. Eliminar un nodo: encuentra el nodo anterior y establece el punter de ese nodo para que apunte a la dirección a la que apuntaba el nodo eliminado, saltándolo; el nodo liberado vuelve a la lista de nodos libres. Comparado con un array 1-D, insertar o eliminar en una lista enlazada no requiere desplazar otros elementos, y la lista puede crecer hasta agotar la memoria; el coste es el punter adicional almacenado con cada elemento, y llegar al ⟨$n$⟩-ésimo elemento implica seguir ⟨$n$⟩ punters, ya que no hay índice directo.
ExplorarUna lista enlazada: nodos unidos por punteros
Cada nodo almacena un valor y un puntero al siguiente nodo. Insertar o eliminar solo re-conecta los punteros — ningún elemento se desplaza, a diferencia de un array.
ExplorarPilas y colas
Push y pop. Una pila es de último en entrar, primero en salir; una cola es de primero en entrar, primero en salir: dos ADTs clave.
Vocabulario EntrenarInglés Chino Pinyin stack/stæk/ 栈 zhàn push/pʊʃ/ 入栈 rù zhàn separator/ˈsepəreɪtə/ 分隔符 fēn gé fú Abstract Data Type/ˈæbstrækt ˈdeɪtə taɪp/ 抽象数据类型 chōu xiàng shù jù lèi xíng linked list/lɪŋkt lɪst/ 链表 liàn biǎo pointer/ˈpɔɪntə/ 指针 zhǐ zhēn queue/kjuː/ 队列 duì liè LIFO/ˈlaɪfəʊ/ 后进先出 hòu jìn xiān chū FIFO/ˈfaɪfəʊ/ 先进先出 xiān jìn xiān chū pop/pɒp/ 出栈 chū zhàn enqueue/enˈkjuː/ 入队 rù duì dequeue/diːˈkjuː/ 出队 chū duì 10.4
Implementación de ADTs usando arrays

Pila usando un array
Almacena elementos en
Stack[1:MaxSize]con un enteroTop(0 cuando está vacía).Push(x): siTop = MaxSizela pila está llena (overflow 溢出); sinoTop ← Top + 1;Stack[Top] ← x.Pop(): siTop = 0la pila está vacía (underflow 下溢); sino retornaStack[Top]yTop ← Top - 1.
Cola usando un array circular
Una cola simple permite que
FrontyRearse marchen al final, desperdiciando el inicio. La solución es un array circular 循环数组 — cuando un punter llega aMaxSize, se reinicia a 1:Enqueue(x): verificar lleno; de lo contrarioRear ← (Rear MOD MaxSize) + 1;Queue[Rear] ← x.Dequeue(): verificar vacío; de lo contrario devolverQueue[Front]yFront ← (Front MOD MaxSize) + 1.
Rastrear un contador separado para distinguir entre vacío y lleno.
El algoritmo para el puntero final, en palabras: si el contador es igual al tamaño, informar que la cola está llena y detenerse; de lo contrario, sumar uno al puntero final; si ahora supera el último índice, establecerlo en el primer índice; almacenar el elemento allí y sumar uno al contador. Las declaraciones que una respuesta de "describir la declaración e inicialización" de cinco puntos enumera: el array con su tamaño y tipo de elemento; un puntero frontal y un puntero final, ambos inicializados al primer índice (o el frontal al primer índice y el final al siguiente espacio libre); y un contador de elementos, inicializado a $0$.
Por ejemplo, con
MaxSize = 6: siRear = 5, entonces(5 MOD 6) + 1 = 6, por lo que el próximo elemento va en la celda 6; siRear = 6, entonces(6 MOD 6) + 1 = 1, por lo que el puntero vuelve a enrollarse a la celda 1.Una cola circular devuelve los punteros al inicio del array Lista enlazada usando un array
Utilice un array de registros, cada uno con un índice de
Next:TYPE TNode DECLARE Value : INTEGER DECLARE Next : INTEGER // index of the next node, or -1 for end ENDTYPE DECLARE Nodes : ARRAY[1:MaxSize] OF TNode DECLARE Head : INTEGER // index of first node, -1 if empty DECLARE FreeListHead : INTEGER // first available free nodeUna lista de espacios libres encadena las casillas no utilizadas, así como la lista de datos encadena las utilizadas. Para insertar: tome una casilla de
FreeListHead, establezca el valor del nuevo nodo y suNext, y actualice elNextdel nodo anterior (o suHead). Para eliminar: desvincule el nodo y devuelva su casilla a la lista de espacios libres. Esto ofrece la flexibilidad de una estructura enlazada con la asignación estática de un array.
Una lista enlazada almacenada en un array: un array de datos y un array de punteros Ejercicio resuelto. Una lista enlazada se mantiene en un array de
Datay un array dePointer, conStartapuntando al índice 1. La lista es 1 → 3 → 4 (el índice 1 contieneD40, el índice 3 contieneD32, el índice 4 contieneD11, cuyo puntero es $\emptyset$); la lista de espacios libres comienza en el índice 2 y continúa 2 → 5. InserteD6entreD32yD11.Tome el primer nodo libre, índice 2, y establezca
FreeStarta su puntero, 5; almaceneD6enData[2]; establezcaPointer[2]al valorPointer[3]contenido, que es 4; establezcaPointer[3]a 2. La lista se lee 1 → 3 → 2 → 4 y la lista de espacios libres es 5 → $\emptyset$. La respuesta a "cómo puede implementarse la lista enlazada" son exactamente estas partes: un array (o array de registros) para los datos, un array paralelo para los punteros que contienen índices, un puntero de inicio, un puntero de lista de espacios libres y un valor nulo como $-1$ para el final.Ejemplo resuelto. Una cola circular se almacena en un array de tamaño 5 (índices del 0 al 4) con
Front = 3,Rear = 3y un elemento almacenado. Se añaden dos elementos y luego se eliminan dos. ¿Dónde están los punteros y por qué usar una cola circular? Cada movimiento usa(pointer + 1) MOD size, así que los punteros envuelven. Añadir dos veces mueveRear: $3 \rightarrow 4$, luego $4 \rightarrow 0$ (porque $(4+1) \bmod 5 = 0$), por lo queRear = 0y hay tres elementos almacenados. Eliminar dos veces mueveFrontde la misma manera: $3 \rightarrow 4$, luego $4 \rightarrow 0$, dejandoFront = 0y un elemento. El envoltorio es el punto principal: en una cola de array lineal, los punteros avanzan hacia el final y el espacio liberado en la parte delantera se desperdicia incluso cuando la cola está vacía. Recuerda que una cola elimina desde el Frontal (delantero) y añade en el Rear (trasero); una pila usa un solo puntero para ambas operaciones.ExplorarImplementación de ADT con arrays
FIFO
Una cola es primero en entrar, primero en salir: se inserta al final y se extrae desde el frente.
Vocabulario EntrenarInglés Chino Pinyin node/nəʊd/ 节点 jié diǎn traverse/trəˈvɜːs/ 遍历 biàn lì free list/friː lɪst/ 空闲列表 kòng xián liè biǎo overflow/ˌəʊvəˈfləʊ/ 溢出 yì chū underflow/ˌʌndəˈfləʊ/ 下溢 xià yì circular array/ˈsɜːkjʊlə əˈreɪ/ 循环数组 xún huán shù zǔ 10.4
Definiciones aceptadas por el examinador
Una pregunta de definición se califica según palabras fijas. Aprenda estas exactamente.
Término Definición registro una estructura de datos que contiene un conjunto de elementos de datos (campos) de diferentes tipos de datos bajo un único identificador array una estructura de datos que contiene un número fijo de elementos del mismo tipo de datos bajo un único identificador, cada uno accedido mediante un índice índice el número que identifica un elemento de un array límite superior, límite inferior el índice válido más grande y el más pequeño de un array archivo de texto un archivo que almacena datos como líneas de caracteres, que un programa lee y escribe una línea a la vez tipo de dato abstracto una colección de datos junto con un conjunto de operaciones sobre esos datos pila una lista en la que los elementos se añaden y se eliminan del mismo extremo, la parte superior, de modo que el último elemento añadido es el primero en eliminarse (LIFO) cola una lista en la que los elementos se añaden en la parte trasera y se eliminan desde la parte delantera, de modo que el primer elemento añadido es el primero en eliminarse (FIFO) lista enlazada una lista en la que cada nodo contiene un elemento de datos y un puntero al siguiente nodo, con un puntero de inicio al primer nodo puntero una variable que contiene la dirección (o índice) de un nodo o de una posición en una estructura búsqueda lineal revisar cada elemento sucesivamente desde el primero hasta que se encuentra el objetivo o se alcanza el final ordenamiento burbuja pasadas repetidas por el array comparando pares adyacentes e intercambiando aquellos que están desordenados, hasta que una pasada no realiza intercambios 10.4
Consejos para el examen
- Elige la estructura de datos adecuada y justifícala (un registro para campos mixtos, un array 2-D para una cuadrícula).
- Conoce cómo implementar una pila, cola y lista enlazada con un array y punteros (top; front/rear; next).
- Distingue un TDA (su comportamiento) de su implementación (array más punteros).
Errores comunes
- Una declaración de registro sin
ENDTYPE, o campos sin tipos. Cada campo es una línea deDECLAREcon un tipo. - Leer más allá del final de un archivo, o escribir con
WRITEcuando el archivo debe mantener su contenido. PruebaEOFantes de cada lectura; usaAPPENDpara añadir. - Escribir un número en un archivo de texto sin convertirlo. Un archivo contiene cadenas:
NUM_TO_STRfuera,STR_TO_NUMdentro. - Olvidar las comprobaciones.
Pushy enqueue prueban si está llena primero;Popy dequeue prueban si está vacía primero, y la respuesta lo indica. - Perder el resto de la lista al insertar un nodo. Establece el puntero del nuevo nodo al nodo siguiente anterior antes de cambiar el puntero del nodo anterior.
- Una búsqueda lineal que nunca dice "no encontrado". Inicializa la posición a $-1$ y compruébala después del bucle.
-
11
Programación
Ver lección11.1
Conceptos básicos de programación

Syllabus
Los candidatos deben ser capaces de: Notas y orientación Implementar y escribir pseudocódigo a partir de un diseño dado presentado como diagrama de flujo del programa o inglés estructurado Escribir sentencias en pseudocódigo para: • la declaración e inicialización de constantes • la declaración de variables • la asignación de valores a variables • expresiones que involucren cualquiera de los operadores aritméticos o lógicos entrada desde el teclado y salida en la consola Utilizar funciones integradas y rutinas de biblioteca Cualquier función no especificada en la guía de pseudocódigo se proporcionará Las funciones de manipulación de cadenas siempre se proporcionarán Fuente: Plan de estudios Cambridge International
La programación convierte un diseño en instrucciones escritas como código 
Un programador escribe el código y lo prueba a medida que avanza From design to code
Deberías poder convertir un diseño — un diagrama de flujo (diagrama de flujo del programa) o inglés estructurado — en pseudocódigo, y luego en un lenguaje real:
- find the variables 变量 and their data types 数据类型.
- turn input/output boxes into
INPUT/OUTPUT. - turn decision diamonds into
IF...ELSE...ENDIF(orCASE). - turn loop arrows into
WHILE,REPEAT...UNTIL, orFOR. - turn process boxes into assignments or calculations.
- check by tracing a small input.

Cada símbolo del diagrama de flujo se convierte en una palabra clave del pseudocódigo Constants and variables
Una constante mantiene un valor que nunca cambia; una variable mantiene uno que puede cambiar. Decláralas con un tipo:

El valor de una variable puede cambiar; el de una constante permanece fijo CONSTANT Pi = 3.14159 DECLARE Radius : REAL DECLARE Area : REAL Radius ← 5 Area ← Pi * Radius * RadiusUsa constantes para valores fijos que se repiten (
Pi,MaxScore); hacen el código más claro y fácil de cambiar en un solo lugar.En el examen, una constante es la respuesta a "identificar una forma más adecuada de representar" un valor fijo, como una tasa impositiva o una puntuación máxima, que aparece en varios lugares en el pseudocódigo. Los beneficios que menciona el esquema: el valor se establece una vez y no puede cambiarse accidentalmente por el programa; un cambio se realiza en un solo lugar y alcanza todas las sentencias que lo utilizan; el identificador da al valor un significado (
MaxScoreen lugar de100), por lo que el código es más fácil de leer y verificar; y hay menos riesgo de un error de escritura en un valor largo como3.14159. Una pregunta de "indique un valor que podría reemplazarse por una constante" busca el literal del pseudocódigo (0.2,40), no un nuevo nombre.Cada variable se declara una sola vez, con un identificador (su nombre) y un tipo de dato, antes de ser usada. Los seis tipos en la guía de pseudocódigo 9618:
Tipo Holds Written in the code as Typical use INTEGERnúmeros enteros 42,-3un contador, un índice de matriz, un contador de bucle REALnúmeros con parte fraccionaria 3.75un precio, un promedio CHARun carácter 'A'(comillas simples)una letra de calificación, una tecla de menú STRINGuna secuencia de caracteres "Hello"(comillas dobles)un nombre, un código postal BOOLEANTRUEorFALSETRUEa flag such as FoundDATEa calendar date 12/05/2026a date of birth Una pregunta de "dar el tipo de datos adecuado" se responde según cómo se utiliza la variable en el pseudocódigo: un valor con un punto decimal es
REAL; algo establecido aTRUEoFALSEesBOOLEAN; un valor entre comillas simples esCHAR; un valor utilizado como índice de array, o conDIVyMOD, esINTEGER. Escriba el tipo en mayúsculas, escrito tal como lo escribe la guía.Ejemplo resuelto. Establece el tipo de dato apropiado para cada variable.
Found ← FALSE Initial ← 'K' Price ← 12.99 Count ← Count + 1 Name ← "Li Wei"FoundesBOOLEAN(contieneFALSE);InitialesCHAR(un carácter entre comillas simples);PriceesREAL(un valor decimal);CountesINTEGER(un contador que aumenta de uno en uno);NameesSTRING(texto entre comillas dobles).Assignment and expressions
Use
←for assignment 赋值:Total ← Total + 1 Average ← Sum / CountExpressions use operators 运算符:
- arithmetic
+ - * /, plusDIV(integer division) andMOD(remainder):7 DIV 2 = 3;7 MOD 2 = 1. - comparisons
=,<>,<,>,<=,>=. - logic
AND,OR,NOT.
Precedence 优先级 (highest to lowest):
NOT→* / DIV MOD→+ -→ comparisons →AND→OR. Use brackets when unsure.Input and output
OUTPUT "Enter your name:"
INPUT Name
OUTPUT "Hello, ", Name
Built-in functions and library routines
Muchas tareas tienen rutinas de biblioteca 库例程 listas, por lo que no es necesario escribirlas. El Paper 2 insert 附页 enumera las que puede utilizar, con sus nombres exactos, parámetros y tipos de retorno; cualquier otra función que necesite una pregunta se proporciona en la propia pregunta. Los nombres siguientes son los del insert.
VALySTRson nombres de IGCSE y no aparecen en ningún documento 9618, por lo que no otorgan puntos.UCASEyLCASEson un caso diferente: son 9618, definidas en la Guía de Pseudocódigo, pero toman un únicoCHAR, y el insert no las enumera en absoluto: para una cadena completa en el Paper 2, la rutina esTO_UPPER.Una biblioteca de programas 程序库 contiene rutinas que ya han sido escritas, compiladas y probadas; un programa las llama en lugar de escribir las suyas propias. Los beneficios que acepta el esquema, para una pregunta de "indique tres beneficios": las rutinas están ya probadas, por lo que es menos probable que contengan errores; ahorran tiempo de desarrollo; pueden hacer cosas que el programador no podría escribir (estadísticas complejas, gráficos); están escritas por expertos y se reutilizan en muchos programas; y una rutina con una interfaz fija puede ser llamada desde cualquier parte del programa.
Routine Retorna Ejemplo LENGTH(s)the number of characters in sLENGTH("Hello") = 5LEFT(s, n)/RIGHT(s, n)the first / last ncharactersRIGHT("Hello", 2) = "lo"MID(s, start, n)ncharacters from positionstart(positions count from 1)MID("Hello", 2, 3) = "ell"TO_UPPER(s)/TO_LOWER(s)sin capitals / in small lettersTO_UPPER("ab1") = "AB1"NUM_TO_STR(x)/STR_TO_NUM(s)un número como cadena / una cadena como número STR_TO_NUM("3.5") = 3.5IS_NUM(s)TRUEifsis a valid numberIS_NUM("12a") = FALSEASC(c)/CHR(n)el código de carácter de c/ el carácter con códigonASC('A') = 65,CHR(66) = 'B'INT(x)the whole-number part of xINT(7.9) = 7RAND(n)un número real aleatorio desde 0 hasta, pero sin incluir, nINT(RAND(6)) + 1es el lanzamiento de un dadoDAY(d),MONTH(d),YEAR(d)the parts of a DATEYEAR(TODAY())DAYINDEX(d),SETDATE(d, m, y),TODAY()el día de la semana (1 = Domingo); una fecha construida de tres enteros; la fecha de hoy EOF(f)TRUEcuando el archivofno tiene más líneas para leerWHILE NOT EOF("data.txt")Las cadenas se unen con
&(concatenación 连接):"A" & "BC"es"ABC". Utilice los nombres exactos del insert, con los parámetros en su orden.Las fechas y los números aleatorios aparecen como sentencias de una línea.
SETDATE(17, 11, 2007)construye el 17 de noviembre de 2007;12 - MONTH(MyDOB)es el número de meses desde el mes de nacimiento hasta el final del año;IF DAYINDEX(MyDOB) = 5 THENprueba si es jueves, porque el domingo es el día 1.RAND(n)devuelve un número real desde0hasta, pero sin incluir,n, por lo que un entero aleatorio desdeLowhastaHighinclusive esINT(RAND(High - Low + 1)) + Low:INT(RAND(21)) - 10da un valor desde-10hasta10.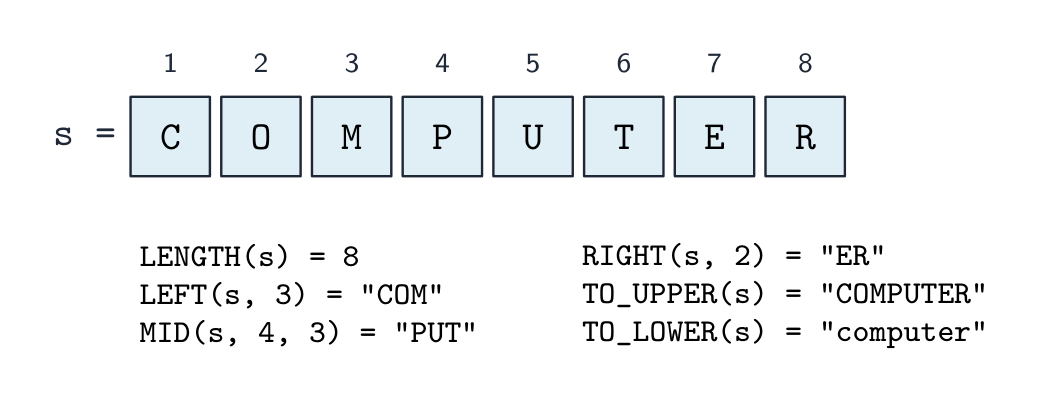
Las rutinas comunes de cadenas actuando sobre s = "COMPUTER"(posiciones 1–8)Worked example. Evaluate each expression, given
Word ← "Program",Code ← 'Q'yN ← 7.Expression Valor Por qué LENGTH(Word)7seven characters MID(Word, 4, 2)"gr"two characters, starting at position 4 LEFT(Word, 3) & "!""Pro!"joined with &TO_UPPER(RIGHT(Word, 2))"AM"the inner function runs first ASC(Code) - ASC('A')16'Q'is 81 and'A'is 65N DIV 2 + N MOD 243 + 1NUM_TO_STR(N) & "th""7th"the number becomes a string first INT(N / 2)33.5cut to its whole partTrabaja desde el interior hacia afuera, y mantén las comillas:
"7"es una cadena y7es un número.Ejemplo resuelto. Cada declaración puede contener un error en su uso de una función o operador. Describe el error, o escribe NO ERROR. (Asume que cada variable tiene el tipo correcto.)
Instrucción Error Result ← 2 & 4&une cadenas;2y4son enteros, por lo que se necesita+SubString ← MID("pseudocode", 4, 1)NO ERROR: one character from position 4, "u"IF x = 3 OR 4 THENORneeds a Boolean on each side:IF x = 3 OR x = 4 THENResult ← Status AND INT(x / 2)ANDneeds two Booleans;INT(x / 2)is an integerMessage ← "Done" + LENGTH(MyString)+cannot add a string to an integer:"Done" & NUM_TO_STR(LENGTH(MyString))Cada operador funciona sobre tipos específicos:
&sobre cadenas,+ - * / DIV MODsobre números,AND OR NOTsobre booleanos, y= <>sobre dos valores del mismo tipo. Una tabla de "evalúe cada expresión, o escriba ERROR" se marca de la misma manera:LENGTH(42)y"A" + 1son ERROR, porque el tipo no coincide con la función o el operador.Worked example. With
Points ← 100,Active ← TRUEyExempt ← FALSE, evaluate each expression.Expression Valor Por qué (Points > 99) OR ActiveTRUEboth sides are true; one would do (Points MOD 2 = 0) OR ExemptTRUE100 MOD 2is0(Points <= 75) AND (Active OR Exempt)FALSEel primer lado es falso, y ANDnecesita ambos(Active OR NOT Active) AND NOT ExemptTRUEActive OR NOT Activeis always trueLa última expresión se simplifica:
X OR NOT XesTRUEindependientemente de lo que seaX, por lo que toda la expresión es simplementeNOT Exempt. Evalúe primero los paréntesis, luegoNOT, luegoAND, luegoOR.ExplorarUna variable es una caja etiquetada
Cada asignación almacena un valor en una caja con nombre; reasignar el mismo nombre lo sobrescribe. Recorra el programa y observe cómo cada caja toma su valor actual.
Vocabulario EntrenarInglés Chino Pinyin pseudocode/ˈsuːdəʊkəʊd/ 伪代码 wěi dài mǎ variables/ˈveərɪəblz/ 变量 biàn liàng data types/ˈdeɪtə taɪps/ 数据类型 shù jù lèi xíng assignment/əˈsaɪnmənt/ 赋值 fù zhí constant/ˈkɒnstənt/ 常量 cháng liàng operators/ˈɒpəreɪtəz/ 运算符 yùn suàn fú precedence/ˈpresɪdəns/ 优先级 yōu xiān jí function/ˈfʌŋkʃn/ 函数 hán shù library routines/ˈlaɪbrəri ruːˈtiːnz/ 库例程 kù lì chéng insert/ˈɪnsɜːt/ 附页 fù yè 11.2
Selección

Syllabus
Los candidatos deben ser capaces de: Notas y orientaciones Utilizar pseudocódigo para escribir: • una instrucción ‘IF’ que incluya la cláusula ‘ELSE’ e instrucciones ‘IF’ anidadas • una estructura ‘CASE’ • un bucle ‘controlado por contador’: • un bucle ‘post-condición’ • un bucle ‘pre-condición’ Justificar por qué una estructura de bucle puede ser más adecuada para resolver un problema que las otras Fuente: Plan de estudios Cambridge International
Selección 选择 chooses which steps run.
IF age >= 18 THEN
    OUTPUT "Adult"
ELSE
    OUTPUT "Minor"
ENDIF
Un IF...ELSE evalúa la condición una vez, luego ejecuta exactamente una rama Para más de dos casos puedes usar un IF anidado, pero la anidación profunda es difícil de leer — un
CASEes más limpio al probar un valor contra varias opciones:CASE OF Grade "A": OUTPUT "Excellent" "B": OUTPUT "Good" OTHERWISE: OUTPUT "Try again" ENDCASECambridge
CASEallows single values, value lists (1, 2, 3:), and ranges (1 TO 5:).Un IF anidado es un IF dentro de una rama de otro IF. Cada
IFnecesita su propioENDIF, y el examinador verifica que cada constructo esté cerrado:IF Mark >= 50 THEN IF Mark >= 80 THEN OUTPUT "Distinction" ELSE OUTPUT "Pass" ENDIF ELSE OUTPUT "Fail" ENDIFLos límites son donde se pierden puntos. "Una nota de 50 o más aprueba" es
Mark >= 50, noMark > 50; la última ramaCASE, para "cualquier otra cosa", se escribeOTHERWISE, no una condición como> 200. Una comparación incorrecta aquí es un error lógico 逻辑错误: el programa se ejecuta, pero produce la salida incorrecta para algunas entradas: y una tabla de seguimiento con un valor límite como50es cómo se encuentra.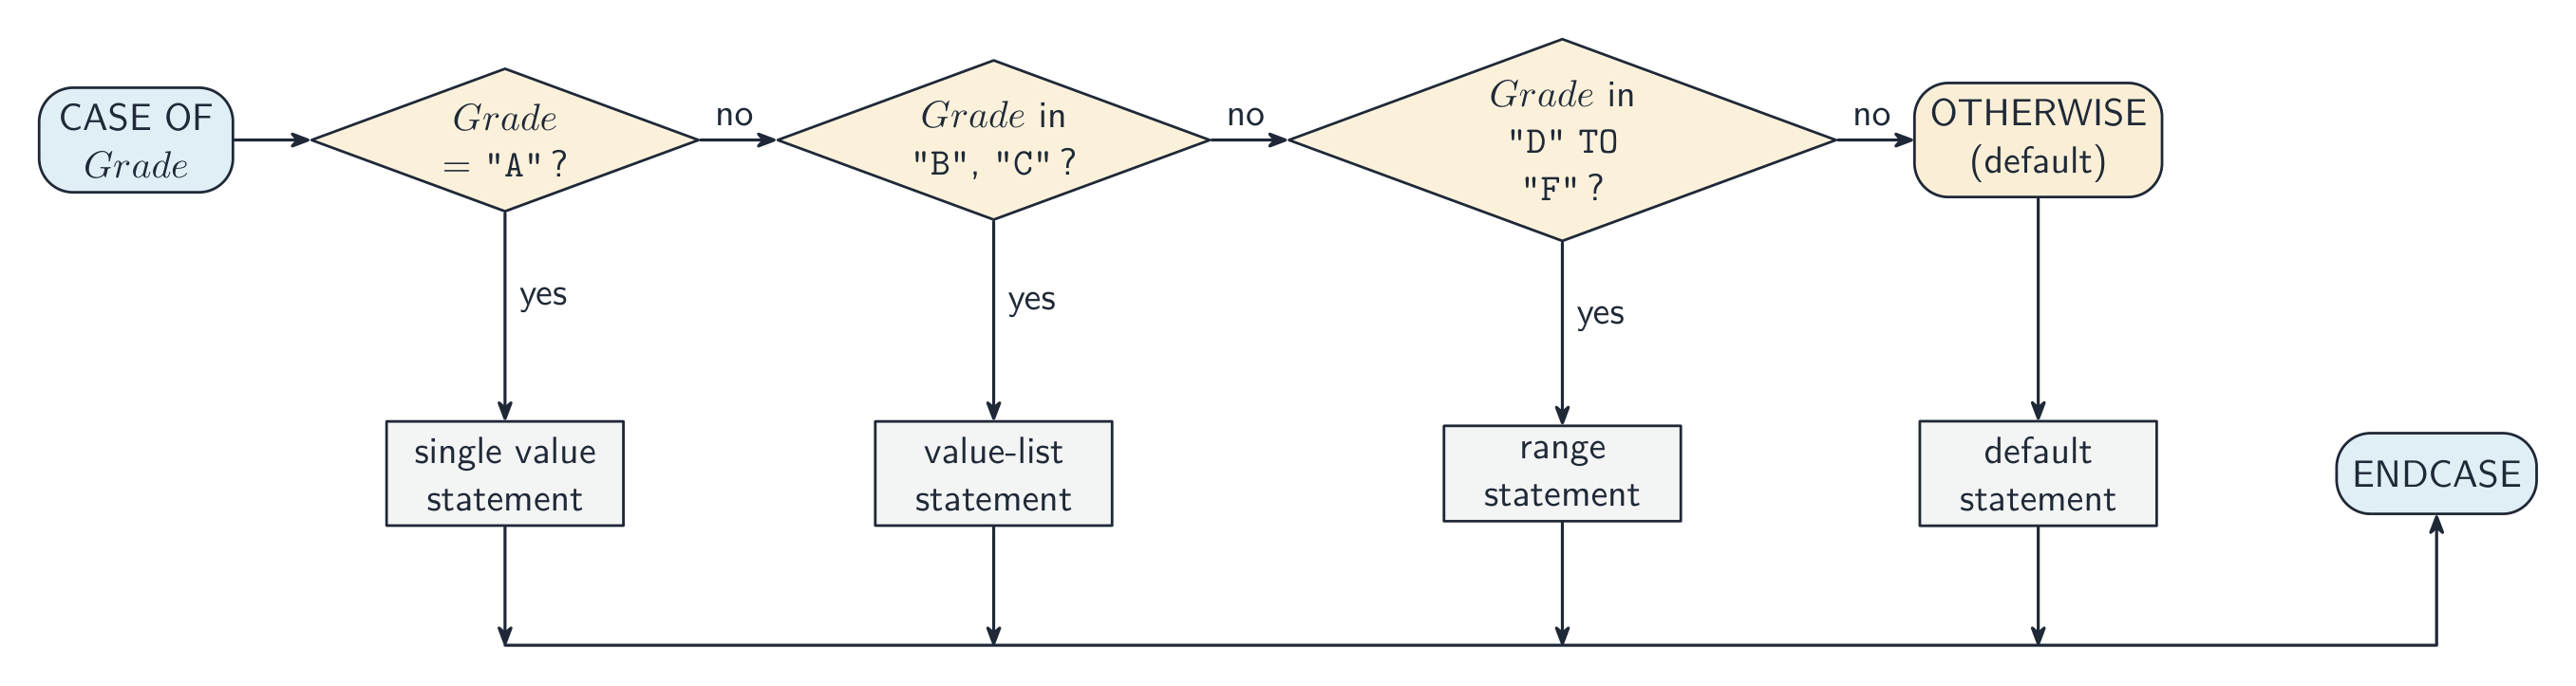
Una instrucción CASE ejecuta la rama que coincide con el valor Ejemplo resuelto. Reescriba esto con la misma funcionalidad, sin usar una estructura CASE.
CASE OF MySwitch
    1: ThisChar ← 'a'
    2: ThisChar ← 'y'
    3: ThisChar ← '7'
    OTHERWISE: ThisChar ← '*'
ENDCASE
Cada valor se convierte en una rama de una cadena de IFs, y
OTHERWISEse convierte en el últimoELSE:IF MySwitch = 1 THEN ThisChar ← 'a' ELSE IF MySwitch = 2 THEN ThisChar ← 'y' ELSE IF MySwitch = 3 THEN ThisChar ← '7' ELSE ThisChar ← '*' ENDIF ENDIF ENDIFDos cláusulas que asignan el mismo valor se fusionan en una sola cláusula con una lista de valores:
1, 2: ThisChar ← 'a'. Las guardias se prueban en orden: con rangos como1 TO 50:seguidos de40 TO 60:, un valor de45toma la primera rama que coincide, por lo que una asignación en una rama posterior puede nunca realizarse: y cuando las ramas anteriores ya cubren todos los valores posibles, la ramaOTHERWISEtampoco se alcanza nunca.Yendo en sentido contrario, las IF anidadas que prueban varios booleanos son más claras como una condición por resultado:
IF A AND B AND C THEN CALL Sub1(), luegoIF A AND B AND NOT C THEN CALL Sub2(), y así sucesivamente. Unir pruebas conANDyORelimina el anidamiento, yIF A THENse acepta en lugar deIF A = TRUE THEN.ExplorarSelección (IF / ELSE)
Cambia la entrada y observa qué rama se ejecuta: la esencia de la selección.
Vocabulario EntrenarInglés Chino Pinyin flowchart/ˈfləʊtʃɑːt/ 流程图 liú chéng tú structured English/ˈstrʌktʃəd ˈɪŋɡlɪʃ/ 结构化英语 jié gòu huà yīng yǔ selection/sɪˈlekʃn/ 选择 xuǎn zé nested/ˈnestɪd/ 嵌套 qiàn tào logic error/ˈlɒdʒɪk ˈerə/ 逻辑错误 luó jí cuò wù 11.2
Iteración

Iteración 迭代 repite un bloque. Tres bucles difieren en cuántas veces se ejecuta el cuerpo.
Count-controlled (FOR) loop
Un bucle controlado por contador 计数循环 — úsalo cuando sabes cuántas veces repetir:
FOR i ← 1 TO 10
    OUTPUT i
NEXT i
Un
STEPpuede cambiar el contador (p. ej.FOR i ← 10 TO 1 STEP -1). Mejor para un número fijo de repeticiones o procesar cada elemento de un array 数组.Pre-condition (WHILE) loop
Un bucle de precondición 前测循环 prueba la condición antes de cada pasada, por lo que puede ejecutarse cero veces:
WHILE total < 100 DO
    INPUT n
    total ← total + n
ENDWHILE
Post-condition (REPEAT...UNTIL) loop
Un bucle de postcondición 后测循环 prueba la condición después de cada pasada, por lo que siempre se ejecuta al menos una vez:
REPEAT
    INPUT password
UNTIL password = correctPassword
Choosing the right loop
Los tres bucles difieren en dónde se evalúa la condición — antes del cuerpo (WHILE), después (REPEAT), o un número fijo de veces (FOR) - count known up front → FOR.
- may need zero passes → WHILE.
- always at least one pass → REPEAT...UNTIL.
Justifique su elección según si el conteo es conocido y si el cuerpo debe ejecutarse al menos una vez. Una pregunta típica presenta un escenario ("pregunte por una contraseña hasta que sea correcta, pero pregunte siempre al menos una vez") y pide cuál de los bucles se ajusta mejor.
Las dos marcas son para el nombre del bucle y la razón, en las palabras del esquema: controlado por conteo, porque el número de iteraciones es conocido antes de que comience el bucle; post-condición, porque el cuerpo del bucle debe ejecutarse al menos una vez; pre-condición, porque el bucle puede no necesitar ejecutarse en absoluto. Un bucle sobre los cuatro elementos de un array que ha sido escrito como un
WHILEcon un contador "no es el más apropiado": el conteo, cuatro, es conocido, por lo que un bucleFORse ajusta mejor.Ejemplo resuelto. ¿Qué bucle se adapta a cada tarea? (a) imprimir la tabla del 12; (b) seguir leyendo números hasta que el usuario introduzca 0; (c) pedir una contraseña hasta que sea correcta. Elija preguntándose cuántas veces se ejecuta el cuerpo y cuándo ocurre la prueba. (a) El conteo se conoce de antemano (12), por lo que use un bucle FOR. (b) El conteo es desconocido, y la primera entrada podría ya ser 0: por lo tanto, la prueba debe venir antes del cuerpo: un bucle WHILE, que se ejecuta cero o más veces. (c) El conteo es desconocido, pero debe preguntar al menos una vez antes de que haya algo que probar: por lo tanto, la prueba viene después del cuerpo: un REPEAT...UNTIL, que se ejecuta uno o más veces. La pregunta decisiva es si el cuerpo debe ejecutarse al menos una vez: WHILE puede ejecutarse cero veces, REPEAT siempre se ejecuta una vez.
Dry running with a trace table
Una tabla de trazas 跟踪表 registra el valor de cada variable mientras haces un ejecución manual 手工跟踪 (recorrido a mano) de un algoritmo. Es cómo pruebas un bucle en papel, y una pregunta de seis marcas en la mayoría de los Exámenes 2.
DECLARE Count, Total : INTEGER
Count ← 1
Total ← 0
WHILE Total < 10
    Total ← Total + Count * 2
    Count ← Count + 1
ENDWHILE
OUTPUT Count, Total
Count Total Total < 10 OUTPUT 1 0 VERDADERO 2 2 VERDADERO 3 6 VERDADERO 4 12 FALSO 4, 12 Reglas que otorgan puntos: una columna por variable, en el orden que da la pregunta; escriba un valor solo cuando cambie; inicie una nueva fila cada vez que el bucle se repita; evalúe la condición con los valores actuales, y deténgase en el momento en que es
FALSE; ponga la salida en su propia columna, exactamente como aparecería. Rastree el algoritmo tal como está escrito, no el que cree que estaba previsto: si nunca termina, dígalo.Ejemplo resuelto. ¿Qué constructos usa cada línea: selección, iteración o llamada a subrutina?
Pseudocode Selección Iteración Subroutine IF Ready = TRUE THEN CALL Start()ENDIF |
FOR I ← 1 TO 20 ... NEXT I| | yes | | |WHILE NOT IsFull() ... ENDWHILE| | yes | yes | |CASE OF Key ... OTHERWISE ... ENDCASE| yes | | |IFyCASEson selección;FOR,WHILEyREPEATson iteración; un nombre seguido de paréntesis —Start(),IsFull()— es una llamada a un procedimiento o función, dondequiera que aparezca, incluso dentro de una condición.ExplorarRastrear un bucle, paso a paso
Una tabla de rastreo registra cada variable después de cada pasada del bucle. Observa cómo aumenta el contador i mientras se acumula el total — exactamente lo que una pregunta de examen sobre trazas te pide completar.
ExplorarSeguimiento de un bucle
Recorre el bucle y observa cómo cambian las variables en cada pasada: exactamente lo que registra una tabla de trazado.
Vocabulario EntrenarInglés Chino Pinyin array/əˈreɪ/ 数组 shù zǔ trace table/treɪs ˈteɪbl/ 跟踪表 gēn zōng biǎo iteration/ˌɪtəˈreɪʃn/ 迭代 dié dài dry run/draɪ rʌn/ 手工跟踪 shǒu gōng gēn zōng 11.3
Procedimientos y funciones

Syllabus
Los candidatos deben ser capaces de: Notas y orientaciones Definir y utilizar un procedimiento Explicar en qué parte de la construcción de un algoritmo sería apropiado usar un procedimiento Utilizar parámetros Un procedimiento puede tener cero, uno o más parámetros. Un parámetro se puede pasar por referencia o por valor. Definir y utilizar una función Explicar en qué parte de la construcción de un algoritmo es apropiado usar una función Una función se utiliza en una expresión, p. ej., el valor de retorno reemplaza a la llamada. Utilizar la terminología asociada con los procedimientos y las funciones incluyendo encabezado del procedimiento/función, interfaz del procedimiento/función, parámetro, argumento, valor de retorno Escribir pseudocódigo eficiente Fuente: Plan de estudios Cambridge International
Programación estructurada 结构化编程 construye un programa a partir de pequeñas subrutinas 子程序 nombradas, cada una con una sola tarea.
Procedure
Un procedimiento 过程 es un bloque nombrado que realiza una acción; puede tomar parámetros 参数 pero no devuelve un valor.
PROCEDURE Greet(name : STRING)
    OUTPUT "Hello, ", name
ENDPROCEDURE

CALL Greet("Ada")
Function
Una función 函数 es como un procedimiento pero devuelve un valor que forma parte de una expresión.
FUNCTION Square(x : INTEGER) RETURNS INTEGER
    RETURN x * x
ENDFUNCTION

result ← Square(5) + 1     // result = 26
Usa un procedimiento cuando la subrutina realiza una acción; usa una función cuando calcula un valor para quien llama.
El programa de estudios pide dónde en la construcción de un algoritmo es apropiado cada uno. Un procedimiento es apropiado donde se necesita el mismo grupo de pasos en varios puntos (validar una entrada, imprimir un menú, intercambiar dos valores): los pasos se escriben una vez y se
CALLan por nombre. Una función es apropiada donde se debe calcular un único valor y luego usarse en una expresión: un total, un resultadoTRUE/FALSE, el mayor de dos números: porque el valor de retorno 返回值 reemplaza la llamada:IF IsValid(Code) THEN.Un procedimiento realiza una acción y no devuelve nada; una función devuelve un valor que usas en una expresión Parámetros
Un parámetro es una variable que declara una subrutina para recibir entrada; los valores que proporciona el llamador son argumentos 实参. Dos formas de pasarlos:
- paso por valor 传值 — la rutina obtiene una copia; los cambios dentro no afectan al llamador. Úsalo para entradas que solo lee.
- paso por referencia 传引用 — la rutina obtiene una referencia a la variable del llamante; los cambios sí afectan al llamante. Úselo cuando deba actualizar un parámetro.

Pasar por valor copia el valor en una nueva caja; pasar por referencia permite a la rutina cambiar la variable propia del solicitante PROCEDURE Swap(BYREF a : INTEGER, BYREF b : INTEGER) DECLARE temp : INTEGER temp ← a a ← b b ← temp ENDPROCEDUREEl pseudocódigo de Cambridge escribe el modo en la cabecera,
BYVALoBYREF, antes de cada parámetro. Si no se escribe ninguno, se asumeBYVAL, por lo que una rutina que debe cambiar la variable del llamante —Swap, o un procedimiento que actualiza un total acumulado — necesitaBYREFen su cabecera.Worked example. What is output?
PROCEDURE Adjust(BYREF X : INTEGER, BYVAL Y : INTEGER) X ← X + Y Y ← Y * 2 ENDPROCEDURE A ← 5 B ← 3 CALL Adjust(A, B) OUTPUT A, BXes una referencia aA, por lo queAse convierte en8.Yes una copia deB, por lo que duplicarYdejaBen3. La salida es8, 3. Si la cabecera dijeraBYVAL X,Aseguiría siendo5.Local vs global variables
Una variable local se declara dentro de una subrutina y existe solo mientras esta se ejecuta. Una variable global se declara fuera y es visible en todas partes. Prefiera las variables locales y los parámetros; el uso excesivo de globales hace que el código sea difícil de seguir y probar. (La región donde un nombre es visible es su alcance).
La diferencia de una línea: una variable global puede accederse desde cualquier lugar del programa; una variable local solo dentro de la subrutina que la declara. Beneficios de las variables locales que acepta el esquema: se puede usar el mismo identificador en otra subrutina sin conflicto; el valor no puede cambiarse accidentalmente por otras partes del programa; la memoria se libera cuando termina la subrutina; y la subrutina es autocontenida, por lo que puede probarse por sí sola y reutilizarse en otro programa.
Una variable local se crea cada vez que se llama a la subrutina y se destruye cuando esta retorna, por lo que no puede conservar un valor de una llamada a la siguiente. Por tanto, un procedimiento que acumula una cadena en llamadas repetidas necesita que dicha cadena sea global (o pasada
BYREF). SiMyStringcambia de ser global a ser una variable local declarada dentro deMyOutput(), cada llamada comienza con una nueva cadena vacíaMyString, el texto añadido en llamadas anteriores se pierde y el procedimiento "no funciona como se espera".
Una variable local es una nueva caja vacía en cada llamada; solo una variable global (o un parámetro BYREF) mantiene un valor entre llamadas 
Una variable global es visible en todas partes; una variable local existe solo dentro de su propio procedimiento When to use a subroutine
Use a subroutine when:
- la misma lógica aparece en más de un lugar — escríbela una vez, llámala muchas veces.
- un bloque tiene un propósito nombrado claro — el nombre documenta qué hace.
- el programa es complejo — divídelo en partes (descomposición 分解).
- quieres probar una pieza de forma aislada.
No las hagas tan pequeñas que el costo de la llamada supere al trabajo dentro de ella.
Terminology
- definition — the
PROCEDURE ... ENDPROCEDURE(or function) block. - llamar — dónde se invoca. argumento — un valor pasado. parámetro — la variable que lo recibe.
- return value — what a function passes back.
- cabecera de procedimiento/función — la primera línea que da el nombre y los parámetros (
PROCEDURE Name(params)oFUNCTION Name(params) RETURNS type). - interfaz de procedimiento/función / firma 签名 — nombre + parámetros + tipo de retorno: lo que un llamador debe saber para usarla.
Worked example. Describe each term used in the header
FUNCTION Pass2(Count : INTEGER) RETURNS BOOLEAN.Term Significado FUNCTIONa subroutine that returns a value Pass2the identifier used to call it Countel parámetro: el identificador que recibe el argumento pasado INTEGERthe data type of the parameter RETURNS BOOLEANel tipo de datos del valor que devuelve la función Los dos identificadores en
PROCEDURE MyProc(Count : INTEGER, Message : STRING)son parámetros: reciben los valores pasados cuando se llama al procedimiento y se usan dentro de él como variables locales.Para convertir un procedimiento en una función: cambiar
PROCEDUREaFUNCTIONy añadirRETURNS <type>; reemplazar elOUTPUT(o el parámetroBYREFque llevaba el resultado hacia afuera) con una declaraciónRETURN; y cambiar cada llamada para que el valor devuelto se utilice,Result ← Unpack(Text)en lugar deCALL Unpack(Text, Result). Para una pregunta de "escribir la cabecera", escribir toda la línea:FUNCTION Calculate(Expression : STRING) RETURNS INTEGER. Un parámetro de matriz se pasa por referencia, por lo que un procedimiento que escribe en una matriz cambia la matriz del llamante.Cuando un programa gana un nuevo módulo, la interfaz es lo que se acuerda primero: el nombre, los parámetros (cuántos, en qué orden, de qué tipo) y el tipo de retorno, además de cualquier dato global que el módulo lea o escriba. Un módulo que envía un recordatorio antes de la fecha límite necesita el registro (o su índice) como parámetro y no devuelve nada, por lo que es un procedimiento; el programa principal lo llama una vez por registro.
Writing a module for Paper 2
La mitad del Paper 2 es "escribir pseudocódigo para el módulo X". El esquema otorga una marca por característica, por lo que un módulo que no está terminado aún obtiene puntos por cada parte correcta. Las partes que busca el examinador:
Cada parte de la respuesta del módulo lleva su propia marca, así escribe todas ellas incluso cuando una sea incierta - La cabecera, según la describe la pregunta:
PROCEDURE Name(Param : TYPE)oFUNCTION Name(Param : TYPE) RETURNS TYPE, conBYREFdonde la rutina debe cambiar el argumento. - Declaraciones locales:
DECLAREcada variable local con su tipo, e inicializar contadores y totales (Count ← 0). - El bucle que visita cada elemento:
FOR Index ← 1 TO 50para un array cuyo tamaño está dado;WHILE NOT EOF(...)para un archivo. - La condición, con la comparación y el límite correctos, en el elemento adecuado:
IF Score[Index] > Limit THEN. - La actualización dentro de la rama: el contador aumentado, el valor almacenado o el mensaje emitido.
- El final:
RETURNuna vez, después del bucle, en una función;ENDFUNCTIONoENDPROCEDURE; y cadaIF,FORyWHILEcerrado.
Ejemplo resuelto. Un array global
Score : ARRAY[1:50] OF INTEGERguarda puntuaciones de examen. Escribe una funciónCountAbove(Limit : INTEGER)que devuelva cuántas puntuaciones son mayores queLimit.FUNCTION CountAbove(BYVAL Limit : INTEGER) RETURNS INTEGER DECLARE Index, Count : INTEGER Count ← 0 FOR Index ← 1 TO 50 IF Score[Index] > Limit THEN Count ← Count + 1 ENDIF NEXT Index RETURN Count ENDFUNCTIONMarcas: la cabecera con su parámetro y
RETURNS INTEGER;Countdeclarado y establecido en0; un bucle sobre todos los 50 elementos; la comparación> Limit(no>=); el contador actualizado dentro delIF;RETURN Countdespués del bucle. El programa principal utiliza el valor devuelto en una expresión o una salida:OUTPUT "Above 70: ", CountAbove(70).Ejemplo resuelto. Escribe una función
IsValid(Code : STRING)que devuelvaTRUEcuandoCodesean dos letras mayúsculas seguidas de cuatro dígitos — el formato 格式AB1234— yFALSEde lo contrario.FUNCTION IsValid(BYVAL Code : STRING) RETURNS BOOLEAN DECLARE Index : INTEGER DECLARE Ch : STRING IF LENGTH(Code) <> 6 THEN RETURN FALSE ENDIF FOR Index ← 1 TO 6 Ch ← MID(Code, Index, 1) IF Index <= 2 THEN IF Ch < "A" OR Ch > "Z" THEN RETURN FALSE ENDIF ELSE IF Ch < "0" OR Ch > "9" THEN RETURN FALSE ENDIF ENDIF NEXT Index RETURN TRUE ENDFUNCTIONLa comprobación de longitud viene primero, por lo que nunca se pide a
MIDuna posición que no existe. La validación 验证 de este tipo devuelve unBOOLEANpara que el llamante pueda escribirIF IsValid(Entry) THEN ... ELSE OUTPUT "Invalid code" ENDIF: un mensaje al usuario es emitido por el llamante, no por la función; una función calcula, un procedimiento actúa.Ejemplo resuelto. Escribe una función
IsPalindrome(Word : STRING)que devuelvaTRUEcuandoWordse lea igual al revés, como"RACECAR".Comparar los caracteres desde ambos extremos, moviéndose hacia adentro: la posición
Indexse empareja con la posiciónLen - Index + 1, y solo se necesita probar la primera mitad.
Una comprobación de palíndromo empareja la posición icon la posiciónLen - i + 1y se detiene en el medioFUNCTION IsPalindrome(BYVAL Word : STRING) RETURNS BOOLEAN DECLARE Len, Index : INTEGER Len ← LENGTH(Word) FOR Index ← 1 TO Len DIV 2 IF MID(Word, Index, 1) <> MID(Word, Len - Index + 1, 1) THEN RETURN FALSE ENDIF NEXT Index RETURN TRUE ENDFUNCTIONLas mismas tres herramientas — un
FORsobre las posiciones,MID(s, i, 1)para leer un carácter, y¶ construir una nueva cadena — responden a la mayoría de los módulos de cadenas en el Paper 2: contar cuántas veces ocurre un carácter (IF MID(s, i, 1) = Ch THEN Count ← Count + 1), reemplazar cada instancia de un carácter (añadir ya seaNewCharo el carácter original aNewStringen cada posición), ocultar todos menos los últimos cuatro dígitos de un número de tarjeta (añadir'*'para cada posición hastaLen - 4), o escribir tu propioMID()uniendo los caracteres desdeStarthastaStart + Length - 1. Pedirle aMIDuna posición pasada el final de la cadena es un error de tiempo de ejecución, por lo que comprobarLENGTHprimero.Archivos. Los valores en las variables desaparecen cuando el programa finaliza, por lo que un módulo que debe conservar datos para la siguiente ejecución los escribe en un archivo:
OPENFILE "scores.txt" FOR WRITE, una líneaWRITEFILE "scores.txt", NUM_TO_STR(Score[Index])por iteración dentro del bucle, yCLOSEFILE "scores.txt"una vez, después del bucle; la lectura posterior utilizaFOR READ,READFILEyWHILE NOT EOF("scores.txt"). El tema 10 contiene la sección completa sobre archivos; aquí las marcas se otorgan por abrir con el modo correcto, realizar la lectura o escritura dentro del bucle y cerrar una vez al finalizarlo.ExplorarLa pila de llamadas: apilado en la llamada, desapilado al retorno
Llamar a una subrutina apila un nuevo marco en la parte superior; retornar lo desapila y devuelve un valor al llamador. La llamada que se está ejecutando es siempre el marco en la parte superior.
Vocabulario EntrenarInglés Chino Pinyin identifier/aɪˈdentɪfaɪə/ 标识符 biāo shí fú parameters/pəˈræmɪtəz/ 参数 cān shù program library/ˈprəʊɡræm ˈlaɪbrəri/ 程序库 chéng xù kù concatenation/kənˌkætəˈneɪʃn/ 连接 lián jiē procedure/prəˈsiːdʒə/ 过程 guò chéng structured programming/ˈstrʌktʃəd ˈprəʊɡræmɪŋ/ 结构化编程 jié gòu huà biān chéng subroutines/ˈsʌbruːtiːnz/ 子程序 zi chéng xù return value/rɪˈtɜːn ˈvæljuː/ 返回值 fǎn huí zhí arguments/ˈɑːɡjuːmənts/ 实参 shí cān pass by value/pæs baɪ ˈvæljuː/ 传值 chuán zhí pass by reference/pæs baɪ ˈrefrəns/ 传引用 chuán yǐn yòng global variable/ˈɡləʊbl ˈveərɪəbl/ 全局变量 quán jú biàn liàng scope/skəʊp/ 作用域 zuò yòng yù decomposition/ˌdiːkɒmpəˈzɪʃn/ 分解 fēn jiě signature/ˈsɪɡnɪtʃə/ 签名 qiān míng format/ˈfɔːmæt/ 格式 gé shì Validation/ˌvælɪˈdeɪʃn/ 验证 yàn zhèng run-time error/rʌn taɪm ˈerə/ 运行时错误 yùn xíng shí cuò wù 11.3
Writing efficient pseudocode

Tres características que hacen que el pseudocódigo sea más fácil de entender — la respuesta a una pregunta de "indica tres características" — son identificadores significativos (
Total, not), la indentación de las instrucciones dentro de cada construcción, y los comentarios (// ...) que explican el propósito; también se aceptan palabras clave en mayúsculas, una instrucción por línea y líneas en blanco entre secciones. El pseudocódigo eficiente va más allá:- mover invariantes fuera de los bucles — si un valor (un invariante 不变量) no cambia con el contador del bucle, calcularlo una vez antes del bucle.
- salir de un bucle temprano cuando se encuentra la respuesta (detener una búsqueda lineal 线性查找 en cuanto aparezca el objetivo).
- evitar trabajo redundante — almacenar un resultado y reutilizarlo en lugar de recalcularlo.
- elegir la estructura de datos adecuada — un array supera a muchas variables separadas cuando los elementos pertenecen juntos.
- reemplazar IF anidados profundos con CASE al probar un valor contra muchos.
- comment the intent, not the mechanics (
// validate the postcode, not// loop 6 times). - usar nombres significativos (
numberOfPupils, non) e inicializar variables antes de usarlas.
Mover el trabajo invariable fuera del bucle para que se ejecute una vez Vocabulario EntrenarInglés Chino Pinyin invariant/ɪnˈveərɪənt/ 不变量 bù biàn liàng linear search/ˈlɪnɪə sɜːtʃ/ 线性查找 xiàn xìng chá zhǎo syntax error/ˈsɪntæks ˈerə/ 语法错误 yǔ fǎ cuò wù 11.3
Testing and errors
Tres tipos de error, cada uno encontrado de manera diferente:
Error What it is Ejemplo Found by error de sintaxis 语法错误 una instrucción que rompe las reglas del lenguaje un ENDIFfaltante;OUTPT "Hi"el traductor, antes de que el programa se ejecute error de tiempo de ejecución 运行时错误 el programa se ejecuta, pero una instrucción no puede llevarse a cabo división por cero; un índice de matriz de 0 o 51; una función llamada con un parámetro inválido; un bucle que nunca termina, por lo que el programa se "congela" durante la ejecución: el programa se detiene o se cuelga error lógico el programa se ejecuta hasta el final, pero la salida es incorrecta >donde se necesitaba>=; un total nunca establecido en0prueba con una tabla de trazas y datos de prueba elegidos Un IDE 集成开发环境 ayuda a encontrar los dos últimos: un punto de ruptura 断point detiene el programa en una línea elegida; el ejecución paso a paso 单步执行 luego ejecuta una instrucción a la vez; y la ventana de informe (o vigilancia) muestra el valor de cada variable en ese momento, por lo que la línea donde un valor se vuelve incorrecto se ve directamente. Los métodos de prueba y los datos de prueba están en el tema 12.
Vocabulario EntrenarInglés Chino Pinyin IDE/ˌaɪ diː ˈiː/ 集成开发环境 jí chéng kāi fā huán jìng breakpoint/ˈbreɪkpɔɪnt/ 断点 duàn diǎn single stepping/ˈsɪŋɡl ˈstepɪŋ/ 单步执行 dān bù zhí xíng 11.3
Definiciones aceptadas por el examinador
Una pregunta de definición se califica según palabras fijas. Aprenda estas exactamente.
Término Definición procedure un subprograma que realiza una tarea (una secuencia de pasos) y no devuelve un valor; se llama con CALLfunción un subprograma que devuelve un único valor al punto donde fue llamado, por lo que puede usarse en una expresión parameter el identificador en la cabecera de un subprograma que recibe un valor o una referencia cuando se llama al subprograma argument el valor (o variable) suministrado en la llamada, coincidente con un parámetro paso por valor se da una copia del valor del argumento a la subrutina, por lo que los cambios dentro de ella no afectan a la variable original paso por referencia se da la dirección de la variable a la subrutina, por lo que los cambios dentro de ella cambian la variable original header la primera línea de una definición de subprograma: su nombre, sus parámetros y, para una función, su tipo de retorno interface lo que un programa llamador debe saber para usar un subprograma: su nombre, sus parámetros (número, orden, tipo) y su tipo de retorno return value el valor que una función pasa de vuelta a la expresión que la llamó local variable declarada dentro de un subprograma; existe solo mientras el subprograma se ejecuta y solo puede usarse dentro de él global variable declarada fuera de todos los subprogramas; puede usarse en cualquier lugar del programa count-controlled loop se repite un número fijo de veces, controlado por un contador ( FOR ... NEXT)pre-condition loop prueba su condición antes de cada iteración, por lo que el cuerpo puede nunca ejecutarse ( WHILE ... ENDWHILE)post-condition loop prueba su condición después de cada iteración, por lo que el cuerpo se ejecuta al menos una vez ( REPEAT ... UNTIL)constante un valor nombrado que no puede cambiar mientras el programa se ejecuta subroutine un bloque autocontenido de código que realiza una tarea y se llama por nombre: un procedimiento o una función library routine un subprograma que ya ha sido escrito y probado, y está disponible para ser llamado desde un programa Vocabulario EntrenarInglés Chino Pinyin count-controlled loop/kaʊnt kənˈtrəʊld luːp/ 计数循环 jì shù xún huán pre-condition loop/priː kənˈdɪʃn luːp/ 前测循环 qián cè xún huán post-condition loop/pəʊst kənˈdɪʃn luːp/ 后测循环 hòu cè xún huán local variable/ˈləʊkl ˈveərɪəbl/ 局部变量 jú bù biàn liàng 11.3
Consejos para el examen
- Distinguir un procedimiento (sin valor de retorno) de una función (devuelve un valor); conocer paso por valor frente a paso por referencia.
- Elegir el bucle correcto: controlado por contador (FOR) cuando se conoce el número de repeticiones, controlado por condición (WHILE/REPEAT) de lo contrario.
- Distinguir variables locales frente a globales y alcance; preferir variables locales en módulos reutilizables.
- Usar los nombres exactos de rutina y orden de parámetros del inserto.
VALySTRson nombres IGCSE y no puntúan;UCASEyLCASEson rutinas reales 9618 de la Guía de Pseudocódigo pero actúan sobre un carácter, por lo que en el Examen 2 una cadena completa tomaTO_UPPERoTO_LOWER. - En una respuesta de "escribir pseudocódigo" la cabecera, las declaraciones, el bucle, la condición, la actualización y el
RETURNllevan cada uno una marca: escribir las seis partes, incluso si una es incierta.
Errores comunes
- Llamar a una función y no usar lo que devuelve. Asignar el resultado, o usarlo en la expresión o salida:
Sorted ← BubbleSort(MyArray, 7). - Pasar una longitud de uno hacia afuera:
6para una matriz de siete elementos, o el último índice donde se quería la longitud. Decidir si el parámetro es una longitud o un índice, y comprobar que el último elemento se visita. - Cerrar un archivo dentro del bucle que lo lee. Abrir una vez, cerrar una vez, después del bucle.
- Usar la entrada como un nombre de archivo directamente. Añadir la extensión que dio la pregunta:
FileName ← Choice & ".txt". - Dejar constructos abiertos. Cada
IFnecesita suENDIF, cadaFORsuNEXT, cadaWHILEsuENDWHILE, y cada función suRETURN; el esquema tiene una marca para ello. - Límites incorrectos:
>para "al menos" (que es>=), o unFORque comienza en0para un array declarado[1:50]. - Un contador o total que nunca se establece en
0antes del bucle. - En una tabla de trazas, reescribir cada variable en cada fila, o cambiar un valor antes de que se ejecute la instrucción que lo cambia.
- Una condición a medias:
IF x = 3 OR 4— cada lado deORyANDdebe ser una comparación completa. Y+no une cadenas;&sí. - Declarar como local un valor que debe sobrevivir entre llamadas. Un total acumulado o una cadena construida a lo largo de varias llamadas es global o
BYREF.
-
12
Desarrollo de software
Ver lección12.1
Ciclo de vida del desarrollo

Syllabus
Los candidatos deben ser capaces de: Notas y orientación Demostrar comprensión del propósito de un ciclo de vida del desarrollo Demostrar comprensión de la necesidad de diferentes ciclos de vida del desarrollo según el programa que se esté desarrollando Incluyendo: en cascada, iterativo, desarrollo rápido de aplicaciones (RAD) Describir los principios, beneficios y desventajas de cada tipo de ciclo de vida Demostrar comprensión de las etapas de análisis, diseño, programación, pruebas y mantenimiento en el ciclo de vida del desarrollo de programas Fuente: Plan de estudios Cambridge International
Un ciclo de vida del desarrollo 开发生命周期 es el conjunto de etapas desde la idea hasta un software terminado y mantenido. Existe para planificar, gestionar y controlar un proyecto: construir el producto correcto, a tiempo y con buena calidad.
El software lo construyen equipos que siguen un ciclo de vida del desarrollo para mantenerse coordinados 
Un diagrama de flujo planifica la lógica de un programa durante la etapa de diseño del ciclo Por qué se necesita un ciclo de vida
La lista del examinador sobre "el propósito de un ciclo de vida del desarrollo": divide un proyecto grande en etapas que pueden planificarse y gestionarse; asegura que los requisitos 需求 se identifiquen y aprueben antes de comenzar el diseño y la codificación; incluye pruebas y documentación en lugar de dejarlas para el final; permite al equipo seguir el progreso frente a hitos y gestionar riesgos; y ofrece al cliente puntos definidos para revisar el trabajo. Sin uno, un equipo programa primero y descubre tarde que ha construido lo incorrecto.
Por qué existen diferentes tipos
Ningún único ciclo de vida sirve para todos los proyectos, por lo que hay varios ciclos de vida del desarrollo. La elección depende del tamaño y la complejidad, qué tan claros estén los requisitos 需求 al inicio, cuánto cambio se espera, el nivel de riesgo, el equipo y el plazo.
Modelos comunes
- Waterfall 瀑布模型 — una secuencia lineal (Análisis → Diseño → Codificación → Pruebas → Mantenimiento), donde cada etapa se termina antes de comenzar la siguiente. Claro y bien documentado; bueno para requisitos estables, pero poco apto para manejar cambios a mitad del proyecto, y el cliente no ve nada funcionando hasta el final.
- Modelo iterativo 迭代模型 — pasadas repetidas, cada una produciendo una versión parcial que se revisa y refina. Detecta problemas temprano; bueno cuando los requisitos se descubren con el tiempo, pero más difícil de estimar.
- Desarrollo Rápido de Aplicaciones 快速应用开发 (RAD) — uso intensivo de un prototipo 原型 y retroalimentación del usuario. Entrega muy rápida de la primera versión; bueno para requisitos cambiantes, pero depende de la disponibilidad del usuario y se adapta mejor a sistemas pequeños.
- Agile 敏捷 — iteraciones cortas ("sprints"), colaboración constante y pruebas. Flexible y adaptable, pero requiere un cliente comprometido y un equipo capacitado.

El modelo Waterfall: cada etapa se termina antes de que comience la siguiente 
El modelo iterativo: pasadas repetidas refinan el programa 
Desarrollo Rápido de Aplicaciones: los equipos trabajan en partes en paralelo Principios, beneficios y desventajas — según enumera la guía de calificación.
Modelo Principio Beneficios Desventajas waterfall las etapas se ejecutan en un orden fijo, cada una completada y aprobada antes de que comience la siguiente; volver atrás significa reiniciar la secuencia fácil de gestionar; cada etapa está totalmente documentada; los requisitos se fijan pronto, por lo que los costos y fechas se pueden estimar inflexible una vez terminada una etapa; no hay software funcional hasta tarde; un error en el análisis es costoso de corregir después; el cliente no puede ver el progreso iterative se construye primero una pequeña versión funcional, luego se mejora repetidamente mediante versiones adicionales hasta estar completo software funcional pronto y a menudo; problemas encontrados en versiones tempranas; la retroalimentación del cliente moldea cada versión; los requisitos pueden cambiar difícil estimar el tiempo total y costo; las pruebas repetidas requieren esfuerzo; necesita que el cliente esté disponible; puede desviarse si las versiones no están planificadas RAD prototipos de partes del sistema se construyen rápidamente y se refinan con el usuario hasta ser aceptados, a menudo en paralelo por varios equipos entrega muy rápida de una primera versión; el usuario está involucrado todo el tiempo, por lo que el producto se ajusta a sus necesidades; los cambios son fáciles de absorber necesita desarrolladores capacitados y usuarios comprometidos; la documentación es débil; menos adecuado para sistemas grandes o críticos para la seguridad Ejemplo resuelto. Una empresa debe ser la primera en lanzar un sitio web para una nueva consola de videojuegos, y el diseño cambiará a medida que se anuncien las características de la consola. Nombre el ciclo de vida más adecuado y justifíquelo.
RAD. Se puede construir y mostrar un prototipo del sitio a los usuarios en cuestión de días, y refinarlo a medida que cambian los requisitos; el sitio es pequeño suficiente para un enfoque impulsado por prototipos, y la velocidad de entrega es el requisito principal. Waterfall fijaría los requisitos antes de construir cualquier página y no entregaría nada hasta el final.
Las etapas estándar
Cada etapa tiene un propósito, una salida y actividades típicas —una pregunta de "describir la … etapa" busca dos o tres de estos elementos.
- análisis — averiguar qué debe hacer el programa. Actividades: entrevistas, cuestionarios y observación del sistema actual; un estudio de viabilidad; acordar la especificación de requisitos, contra la cual se verifica cada etapa posterior.
- diseño — decidir cómo lo hará. Salidas: el diagrama de estructura (módulos y parámetros), diagramas de flujo o pseudocódigo para cada módulo, tablas de identificadores y estructuras de datos, diseños de pantallas y archivos, y el plan de pruebas escrito ahora, desde la especificación, antes de que exista código.
- codificación (implementación 实现) — escribir el programa en un lenguaje de alto nivel, módulo por módulo, siguiendo el diseño; cada módulo se prueba a medida que se escribe.
- pruebas — ejecutar el programa según el plan de pruebas (datos normales, anormales, extremos y de límite) y corregir los errores encontrados; le siguen pruebas de integración, alpha, beta y aceptación.
- mantenimiento 维护 — después del lanzamiento, corregir fallos, adaptar el programa a nuevo hardware, software o leyes, y mejorarlo (ver abajo).
Ejemplo resuelto. Complete el diagrama Waterfall Análisis → ? → ? → ? → Mantenimiento y describa qué sucede en la etapa de diseño.
Las etapas faltantes son Diseño, Codificación, Pruebas. En la etapa de diseño, los requisitos se convierten en un plan para el programa: el problema se descompone en módulos (un diagrama de estructura), el algoritmo de cada módulo se escribe como pseudocódigo o diagrama de flujo, se eligen las estructuras de datos e identificadores, se diseñan las pantallas y archivos, y se redacta el plan de pruebas desde la especificación.
ExplorarEl ciclo de vida del desarrollo de programas
Recorra las etapas por las que pasa cada proyecto. Obtener correctamente los requisitos en el análisis es lo más importante: un error detectado en las pruebas es mucho más costoso de corregir que uno detectado temprano.
ExplorarLaboratorio de procesos de software
Clasificar ejemplos de desarrollo según la etapa o herramienta a la que pertenecen.
Vocabulario EntrenarInglés Chino Pinyin development life cycle/dɪˈveləpmənt laɪf ˈsaɪkl/ 开发生命周期 kāi fā shēng mìng zhōu qī requirements/rɪˈkwaɪəmənts/ 需求 xū qiú waterfall/ˈwɔːtəfɔːl/ 瀑布模型 pù bù mó xíng iterative model/ˈɪtərətɪv ˈmɒdl/ 迭代模型 dié dài mó xíng Rapid Application Development/ˈræpɪd ˌæplɪˈkeɪʃn dɪˈveləpmənt/ 快速应用开发 kuài sù yìng yòng kāi fā prototype/ˈprəʊtəʊtaɪp/ 原型 yuán xíng Agile/ˈædʒaɪl/ 敏捷 mǐn jié 12.2
Herramientas de diseño de programas

Syllabus
Los candidatos deben ser capaces de: Notas y orientación Utilizar un diagrama de estructura para descomponer un problema en subtareas y expresar los parámetros que se transmiten entre los diversos módulos/procedimientos/funciones que forman parte del diseño del algoritmo Describir el propósito de un diagrama de estructura. Construir un diagrama de estructura para un problema dado. Derivar pseudocódigo equivalente a partir de un diagrama de estructura. Demostrar comprensión del propósito de los diagramas de transición de estado para documentar un algoritmo Fuente: Plan de estudios Cambridge International
Diagrama de estructura
Un diagrama de estructura 结构图 muestra la descomposición jerárquica 分解 de un programa en módulos (subrutinas 子程序) y los parámetros 参数 que se transmiten entre ellos. Cada módulo es un rectángulo; líneas conectan al llamador (arriba) con el llamado (abajo); pequeñas flechas muestran los datos bajando y los resultados subiendo. El diseño luego puede convertirse en pseudocódigo 伪代码 equivalente.
                CalculatePay
            /        |         \
       GetEmployee  CalculateBonus  CalculateTax
       Returns:     Takes: sales    Takes: gross
       employeeID   Returns: bonus  Returns: tax
Es una herramienta de la etapa de diseño, y puedes leer las firmas de procedimiento directamente de él.
Un diagrama de estructura: módulos con los parámetros transmitidos entre ellos Los símbolos que el examinador pide. Una caja es un módulo; una línea enlaza a un solicitante (arriba) con los módulos que llama (abajo), leyéndose de izquierda a derecha en el orden en que se invocan. Una pequeña flecha con un círculo abierto en su cola es un par de datos: un parámetro pasado hacia abajo dentro de un módulo o un valor devuelto hacia arriba; una flecha con un círculo relleno es un par de control, una bandera (generalmente BOOLEAN) que informa al solicitante de lo ocurrido. Un rombo en una bifurcación indica selección: solo uno de los módulos debajo es llamado, dependiendo de una condición. Una flecha curva que barre sobre las líneas significa iteración: los módulos bajo ella se llaman repetidamente en un bucle.
Los símbolos del diagrama de estructura: pares de datos y control, un rombo de selección y una flecha de iteración Ejemplo resuelto. Se definen cuatro módulos como
PROCEDURE Main(),PROCEDURE ReadData(BYREF Count : INTEGER),FUNCTION IsValid(Value : INTEGER) RETURNS BOOLEANyPROCEDURE Report(Total : INTEGER, Count : INTEGER). Main llama a ReadData, luego llama a IsValid una vez por cada valor leído, y finalmente llama a Report. Describa el diagrama de estructura.Main en la parte superior; ReadData, IsValid y Report en una fila debajo, de izquierda a derecha según el orden de llamada. En la línea de ReadData hay un par de datos ascendente
Count(un parámetro BYREF regresa). En la línea de IsValid hay un par de datos descendenteValuey un par de control ascendente (el resultado BOOLEAN), con una flecha curva de iteración sobre esa línea porque se llama para cada valor. En la línea de Report hay dos pares de datos descendentes,TotalyCount. Leyendo en sentido inverso, una función es cualquier módulo que devuelve un valor: su cabecera necesitaRETURNSy el tipo devuelto.Diagrama de transición de estados
Un diagrama de transición de estados 状态转换图 muestra los estados 状态 en los que puede encontrarse un sistema y los eventos que lo mueven entre ellos — útil para máquinas expendedoras, semáforos e interfaces de usuario. Los diagramas de transición de estados se utilizan para documentar el comportamiento de un algoritmo o sistema. Cada estado es un círculo; cada transición es una flecha etiquetada con el evento.
   coin inserted               item selected
[Idle] --------------→ [Awaiting selection] ----------→ [Dispensing]
Facilita detectar transiciones faltantes ("¿qué pasa si se introduce una segunda moneda mientras se espera la selección?").

Un diagrama de transición de estados para una cerradura con código 259 Lectura y dibujo. Cada transición está etiquetada como entrada | salida (o condición | acción): qué ocurrió, seguido de lo que hace el sistema al cambiar de estado. Una pregunta presenta una tabla de estado actual, entrada, salida, próximo estado y pide el diagrama, o viceversa: cada fila de la tabla corresponde exactamente a una flecha. Verifique que cada estado tenga una flecha saliente para cada entrada posible, incluidas las que dejan el estado sin cambios (una flecha que vuelve sobre sí mismo).
Ejemplo resuelto. Un controlador de bomba tiene estados bomba apagada y bomba encendida. En bomba apagada, la entrada nivel bajo detectado produce la salida activar bomba y pasa a bomba encendida; en bomba encendida, nivel normal detectado produce desactivar bomba y pasa a bomba apagada. Cualquier otra entrada deja el estado sin cambios. Dibuje la tabla.
Estado actual Entrada Salida Próximo estado bomba apagada nivel bajo detectado activar bomba bomba encendida bomba apagada nivel normal detectado — bomba apagada bomba encendida nivel normal detectado desactivar bomba bomba apagada bomba encendida nivel bajo detectado — bomba encendida Las dos filas de "sin cambio" se convierten en flechas de bucle en el diagrama; omitirlas resulta en pérdida de puntos por incompletitud.
ExplorarLaboratorio de procesos de software
Clasificar ejemplos de desarrollo según la etapa o herramienta a la que pertenecen.
Vocabulario EntrenarInglés Chino Pinyin structure chart/ˈstrʌktʃə tʃɑːt/ 结构图 jié gòu tú parameters/pəˈræmɪtəz/ 参数 cān shù pseudocode/ˈsuːdəʊkəʊd/ 伪代码 wěi dài mǎ test plan/test plæn/ 测试计划 cè shì jì huà implementation/ˌɪmplɪmənˈteɪʃn/ 实现 shí xiàn boundary data/ˈbaʊndəri ˈdeɪtə/ 边界数据 biān jiè shù jù acceptance testing/əkˈseptəns ˈtestɪŋ/ 验收测试 yàn shōu cè shì hierarchical decomposition/haɪəˈrɑːkɪkl ˌdiːkɒmpəˈzɪʃn/ 分解 fēn jiě decomposition/ˌdiːkɒmpəˈzɪʃn/ 分解 fēn jiě subroutines/ˈsʌbruːtiːnz/ 子程序 zi chéng xù state-transition diagram/steɪt trænˈsɪʃn ˈdaɪəɡræm/ 状态转换图 zhuàng tài zhuǎn huàn tú states/steɪts/ 状态 zhuàng tài syntax error/ˈsɪntæks ˈerə/ 语法错误 yǔ fǎ cuò wù run-time error/rʌn taɪm ˈerə/ 运行时错误 yùn xíng shí cuò wù logic error/ˈlɒdʒɪk ˈerə/ 逻辑错误 luó jí cuò wù dry run/draɪ rʌn/ 手工跟踪 shǒu gōng gēn zōng trace table/treɪs ˈteɪbl/ 跟踪表 gēn zōng biǎo 12.3
Errores

Syllabus
Los candidatos deben ser capaces de: Notas y orientación Demostrar comprensión de las formas de detectar y evitar fallos en los programas Localizar e identificar los diferentes tipos de errores • errores de sintaxis • errores de lógica • errores en tiempo de ejecución Corregir los errores identificados Demostrar comprensión de los métodos de prueba disponibles y seleccionar datos apropiados para un método dado Incluyendo prueba seca, recorrido, caja blanca, caja negra, integración, alfa, beta, aceptación, stub Demostrar comprensión de la necesidad de una estrategia y un plan de prueba, así como de su probable contenido Elegir datos de prueba adecuados para un plan de prueba Incluyendo normales, anormales y extremos/borde Demostrar comprensión de la necesidad del mantenimiento continuo de un sistema y de las diferencias entre cada tipo de mantenimiento Incluyendo perfectivo, adaptativo, correctivo Analizar un programa existente y realizar modificaciones para mejorar su funcionalidad Fuente: Plan de estudios Cambridge International
- error de sintaxis 语法错误 — rompe la gramática del lenguaje (corchete faltante, palabra clave mal escrita). Se captura durante la traducción; el programa no ejecutará hasta que se corrija.
- error de tiempo de ejecución 运行时错误 — ocurre durante la ejecución (división por cero, archivo no encontrado, índice de matriz fuera de rango). El programa se bloquea o genera una excepción; se corrige añadiendo comprobaciones.
- error lógico 逻辑错误 — el programa se ejecuta pero da resultados incorrectos (usar
+en lugar de-, un bucle de error de uno, condiciones en orden incorrecto). Es el más difícil de encontrar; la única señal es la salida errónea, así que use pruebas cuidadosas y trazado.
Cuándo aparece cada error: sintaxis en la traducción, tiempo de ejecución durante la ejecución, lógica en la salida Exposición y prevención de fallos. Los fallos son expuestos mediante pruebas contra un plan de prueba, mediante una ejecución en seco o tabla de trazado, mediante una revisión con colegas y mediante el depurador del IDE (puntos de interrupción, paso a paso, observación de variables). Se previenen diseñando antes de programar (diagrama de estructura, pseudocódigo), mediante código modular con identificadores y comentarios significativos, mediante la validación de todas las entradas, manejando excepciones en lugar de dejar que un error de tiempo de ejecución bloquee el programa, y mediante las comprobaciones de sintaxis dinámica del IDE mientras escribe.
Ejemplo resuelto. Indique el tipo de error en cada caso y cómo se manifiesta. (a)
Result <- STR_TO_NUM(x) / STR_TO_NUM(y)se ejecuta cony = "0". (b) La misma línea se ejecuta conx = "12a". (c) Un bucle escrito comoFOR i <- 1 TO 9procesa una matriz de diez elementos. (d) AOUTPUT "Total: " Totalle falta una coma.(a) Error de tiempo de ejecución — división por cero; el programa se bloquea cuando se ejecuta esta línea con esos datos. (b) Error de tiempo de ejecución — la cadena no puede convertirse en número. (c) Error lógico — el programa se ejecuta pero el décimo elemento nunca se procesa, por lo que la salida es incorrecta. (d) Error de sintaxis — la instrucción viola las reglas del lenguaje y es reportada por el traductor antes de ejecutar el programa.
Ejemplo resuelto. Corrija los errores en este pseudocódigo, que debería mostrar el promedio de diez calificaciones.
Total <- 0
FOR i <- 1 TO 10
    INPUT Mark
    Total <- Total + Mark
NEXT i
Average <- Total / 9
OUTPUT "Average" Average
La división debe ser por 10, no por 9 (error lógico); la línea de salida necesita una coma o un
&entre la cadena y el valor (error de sintaxis); yAveragenunca se declara como REAL (error de sintaxis o tiempo de ejecución, según el lenguaje). Indique qué línea y cuál es la línea corregida:Average <- Total / 10.12.3
Métodos de prueba

- ejecución en seco 手工跟踪 — tracee el código en papel, escribiendo el valor de cada variable en una tabla.
- revisión 走查 — una revisión en equipo del código.
- prueba de caja blanca 白盒测试 — diseñada a partir de la estructura interna del código, cubriendo cada instrucción, rama y bucle.
- prueba de caja negra 黑盒测试 — diseñada únicamente a partir de la especificación: introduzca entradas y compruebe salidas.
- prueba de integración 集成测试 — combine módulos y pruebe las interfaces entre ellos.
- prueba alfa α测试 — realizada por los desarrolladores/interna antes del lanzamiento; prueba beta β测试 — realizada por un grupo limitado de usuarios reales en su propio entorno.
- prueba de aceptación 验收测试 — realizada por el cliente para decidir si el producto cumple su propósito.
- stub 桩 — un marcador de posición para un módulo que aún no existe, para poder probar la estructura de forma descendente.
Las pruebas de caja negra verifican la especificación; las de caja blanca verifican los caminos del código ¿Qué método, cuándo. Una prueba en seco y un recorrido no requieren computadora — la prueba en seco es cuando tú trazas el algoritmo con una tabla de trazado; el recorrido es una reunión en la que el autor explica el código línea por línea y los colegas buscan errores, por lo que también difunde el conocimiento del código entre el equipo y lo verifica contra el diseño. Las pruebas de caja blanca son escritas por alguien que puede ver el código y tiene como objetivo ejecutar todos los caminos; las pruebas de caja negra se escriben a partir de la especificación y verifican solo las entradas contra las salidas esperadas, por lo que un usuario o un probador separado pueden realizarlas. La prueba de integración sigue a la prueba de módulos: los módulos que pasan individualmente aún pueden fallar cuando los datos pasados entre ellos tienen el tipo incorrecto o están en el orden equivocado. La prueba alfa es interna; la prueba beta entrega un candidato a versión a una muestra de usuarios reales, quienes reportan errores desde su uso real; la prueba de aceptación es cuando el cliente verifica el producto terminado contra los requisitos antes de pagar por él. Un stub permite iniciar las pruebas de arriba hacia abajo antes de que exista cada módulo.
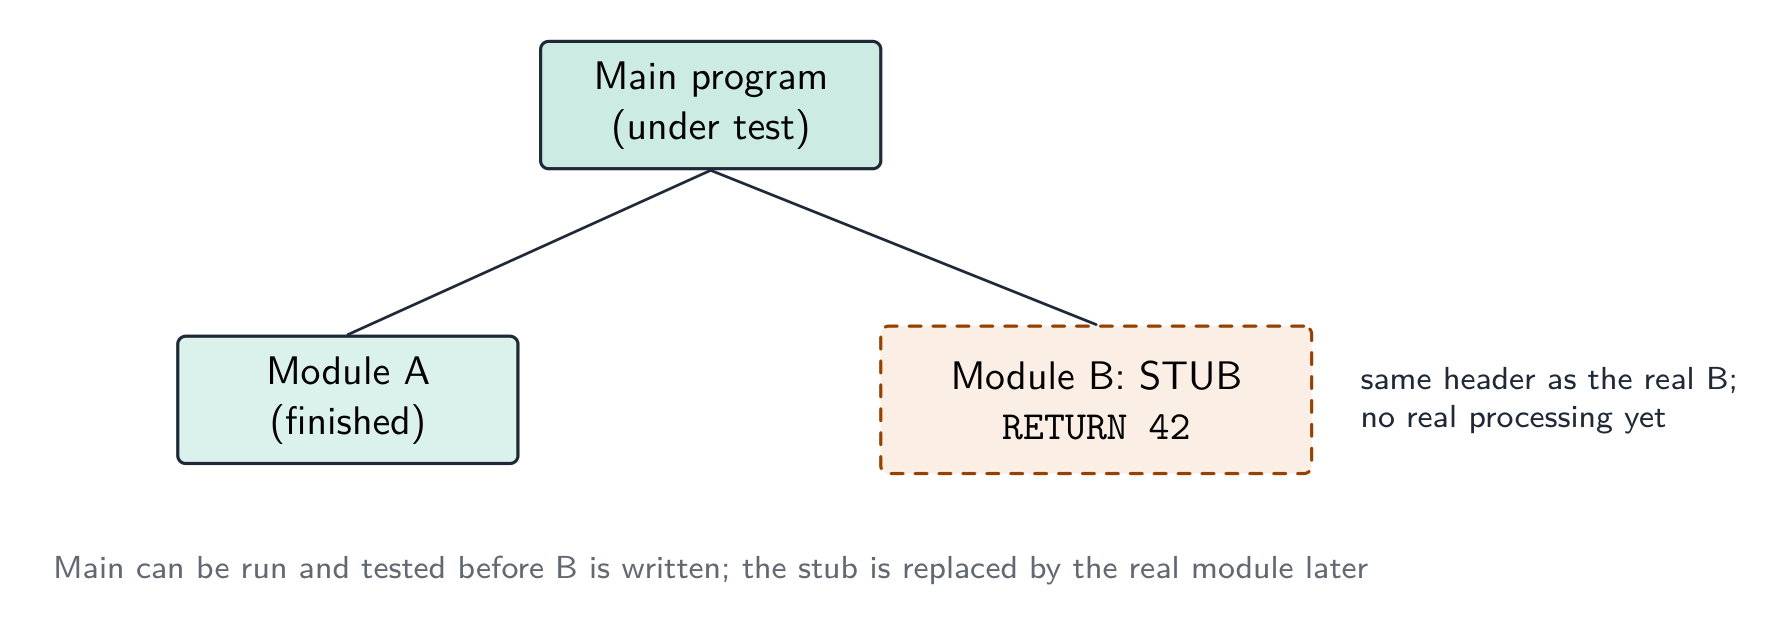
Un stub sustituye a un módulo que aún no está escrito, para que los módulos superiores puedan probarse ahora Ejemplo resuelto. Después de que el programa pasó sus pruebas internas, se le entregó a un grupo de usuarios para que lo probaran antes del lanzamiento. Nombra este tipo de prueba y establece qué sucede después.
Prueba beta — usuarios reales en su propio entorno, reportando errores que los desarrolladores no encontraron. Los errores se corrigen, luego el cliente lleva a cabo la prueba de aceptación contra los requisitos y se lanza el programa; los errores encontrados en uso en vivo son gestionados entonces mediante mantenimiento correctivo.
Ejemplo resuelto. Da tres beneficios de probar un programa mediante un recorrido.
Los errores son encontrados por personas que no escribieron el código y por lo tanto lo leen sin suposiciones; la lógica se verifica contra el diseño y la especificación, no solo contra los datos de prueba; varias personas aprenden cómo funciona el código, lo que ayuda en el mantenimiento posterior; y no se necesitan datos de prueba ni una computadora funcional, por lo que puede realizarse temprano.
Vocabulario EntrenarInglés Chino Pinyin stub/stʌb/ 桩 zhuāng corrective maintenance/kəˈrektɪv ˈmeɪntənəns/ 纠正性维护 jiū zhèng xìng wéi hù test strategy/test ˈstrætədʒi/ 测试策略 cè shì cè lüè normal data/ˈnɔːml ˈdeɪtə/ 正常数据 zhèng cháng shù jù abnormal data/əbˈnɔːml ˈdeɪtə/ 异常数据 yì cháng shù jù extreme data/ekˈstriːm ˈdeɪtə/ 极端数据 jí duān shù jù perfective maintenance/pəˈfektɪv ˈmeɪntənəns/ 完善性维护 wán shàn xìng wéi hù adaptive maintenance/əˈdæptɪv ˈmeɪntənəns/ 适应性维护 shì yìng xìng wéi hù regression testing/rɪˈɡreʃn ˈtestɪŋ/ 回归测试 huí guī cè shì 12.3
Estrategia y plan de prueba

Una estrategia de prueba es el enfoque de alto nivel — qué tipos de pruebas, quién las realiza, cuándo, y los criterios para avanzar. Un plan de prueba es la lista detallada de pruebas — cada una con datos de entrada, salida esperada y una columna para la salida real.
Qué contiene cada uno. Una estrategia de prueba indica qué métodos de prueba se usarán en qué etapa (pruebas de módulo por el programador, luego integración, alpha, beta, aceptación), quién es responsable de cada una, qué datos de prueba se requieren y los criterios para pasar a la siguiente etapa. Un plan de prueba enumera las pruebas individuales: para cada una, el módulo o función bajo prueba, los datos de entrada, la razón por la que se eligió el dato (normal, anormal, extremo, límite), el resultado esperado, un espacio para el resultado real y qué hacer si difieren. El plan se escribe en la etapa de diseño, basado en la especificación, para que pruebe lo que el programa debería hacer en lugar de lo que simplemente hace.
Elegir datos de prueba
Para cada campo o condición, incluye tres clases:
- datos normales — valores típicos dentro del rango válido (para calificaciones 0–100:
50,75). - datos anormales — valores que deberían ser rechazados (
-10,200,"abc"). - datos extremos — los valores más grandes y más pequeños que aún son aceptados (
0y100). - datos límite — valores en los bordes, donde se esconden los errores de "fuera de uno" (cada valor extremo aceptado y el valor rechazado justo fuera de él:
0/-1,100/101).
Datos de prueba para un campo de 0–100: normal adentro, extremos en los límites, anormal afuera Ejemplo resuelto. Un campo acepta una calificación de examen de 0 a 100. Da datos de prueba de cada clase con su resultado esperado. Normal:
50- aceptado, un valor típico dentro del rango. Anormal:-10,200,"abc"- todos rechazados, al estar fuera del rango o tener el tipo de datos equivocado. Extremo:0y100- el valor más grande y el más pequeño que aún son aceptados. Límite: los pares que cruzan cada borde --1rechazado junto con0aceptado, y100aceptado junto con101rechazado. Cada valor debe llevar su resultado esperado, de lo contrario el plan de prueba no demuestra nada. Extremo y límite son el par más confundido frecuentemente: un valor extremo se sitúa dentro y es aceptado, mientras que una prueba límite siempre es un par a ambos lados del borde - que es exactamente donde se esconden los errores de "fuera de uno".Ejemplo resuelto. Un componente pasa si su peso, medido al gramo más cercano, está dentro de 3 g del objetivo de 50 g, es decir, de 47 g a 53 g inclusive. Prepara las filas del plan de prueba para la verificación.
Datos de prueba Tipo Razón Resultado esperado 50 normal un valor típico bien dentro del rango aceptado 47, 53 extremo (límite) los valores más pequeños y más grandes que deben seguir siendo aceptados aceptado 46, 54 límite los valores justo fuera del rango, donde un error de "fuera de uno" los aceptaría rechazado 20, 90 anormal valores muy fuera del rango rechazado "abc", −5 anormal el tipo equivocado, un peso negativo rechazado Cada fila debe decir por qué se eligió el valor y qué debería ocurrir; una lista simple de números no obtiene puntos.
12.3
Mantenimiento

La mayor parte del costo de vida útil de un programa está en el mantenimiento. Tres clases:
Tres clases de mantenimiento: perfectivo, adaptativo y correctivo - mantenimiento perfectivo — mejorar el rendimiento o características aunque funcione correctamente (una consulta más rápida, una nueva opción).
- mantenimiento adaptativo — mantenerlo funcionando en un entorno cambiante (un nuevo sistema operativo, una nueva API, un cambio legal).
- mantenimiento correctivo — corregir errores encontrados en uso.
Un programa puede necesitar los tres durante toda su vida.
Por qué se necesita cada uno — las razones que lista la rúbrica de calificación. Correctivo: se reporta un fallo por un usuario después del lanzamiento, o se nota una salida incorrecta en circunstancias particulares que las pruebas no cubrieron. Adaptativo: se actualiza el sistema operativo, el hardware o el navegador; cambia una ley o regla corporativa (tasas impositivas, requisitos de protección de datos); el programa debe funcionar con un nuevo sistema externo o formato de archivo. Perfectivo: los usuarios piden funciones adicionales o una mejor interfaz; se hace el programa más rápido o reduce el uso de memoria; se limpia el código para facilitar cambios futuros.
Ejemplo resuelto. (a) Un programa lanzado produce un valor incorrecto bajo ciertas circunstancias. (b) Se reemplaza el hardware que ejecuta un programa. (c) Los clientes solicitan que el programa de fidelidad de la cafetería envíe un mensaje en el cumpleaños del cliente. Nombra el tipo de mantenimiento en cada caso.
(a) Correctivo — se está corrigiendo un fallo en el programa entregado. (b) Adaptativo — el programa se modifica para ejecutarse en su nuevo entorno. (c) Perfectivo — se añade una función a un programa que ya funciona.
Vocabulario EntrenarInglés Chino Pinyin maintenance/ˈmeɪntənəns/ 维护 wéi hù 12.3
Modificar un programa existente
Cuando se pide agregar una función o corregir un error:
- Lee el código existente hasta que comprendas el algoritmo y el flujo de datos.
- Encuentra dónde va el cambio — en qué subrutina, en qué líneas.
- Haz el cambio lo más pequeño posible — no reescribas código que funcione.
- Actualiza las partes relacionadas — cada invocador de una lista de parámetros cambiada, cada rutina que use una estructura de datos modificada.
- Prueba el nuevo comportamiento y el antiguo (pruebas de regresión 回归测试 — verifica que no has roto nada).
- Documenta el cambio.
Comentarios claros, nombres significativos, subrutinas descompuestas y un diagrama de estructura hacen que un programa sea mucho más fácil de modificar — por eso importan las herramientas de diseño incluso después del primer lanzamiento.
Analizar un programa que no escribiste. Comienza con la tabla de identificadores y los encabezados de módulo: te dicen qué recibe y devuelve cada módulo antes de leer una sola línea de su cuerpo. Luego traza el algoritmo con una tabla de trazado para una entrada pequeña, tomando nota de dónde proviene cada valor de salida. Solo entonces decide dónde va la mejora — usualmente un nuevo módulo llamado desde el existente, para alterar el código funcional lo menos posible — y escribe el pseudocódigo para el cambio y los datos de prueba que lo demuestren.
12.3
Definiciones aceptadas por el examinador
Una pregunta de definición se califica según un texto fijo. Aprende estas definiciones exactamente, y da solo una respuesta.
Término Definición ciclo de vida del desarrollo la secuencia de etapas, desde el análisis hasta el mantenimiento, seguidas para producir y dar soporte a un programa modelo en cascada (waterfall) un ciclo de vida en el que las etapas se realizan en un orden fijo, cada una completada antes de que comience la siguiente modelo iterativo un ciclo de vida en el que se produce una versión funcional y luego se refina repetidamente hasta que está completa desarrollo rápido de aplicaciones (RAD) un ciclo de vida que construye prototipos rápidamente, refinándolos con la retroalimentación de los usuarios hasta que son aceptados diagrama de estructura un diagrama que muestra cómo se descompone un programa en módulos, el orden en que se invocan y los parámetros que se pasan entre ellos diagrama de transición de estado un diagrama que muestra los estados en los que puede estar un sistema y las entradas que lo hacen cambiar entre ellos error de sintaxis un error en la forma en que está escrita una instrucción, por lo que viola las reglas del lenguaje y no puede ser traducido error lógico un error en el algoritmo, por lo que el programa se ejecuta pero produce el resultado incorrecto error en tiempo de ejecución un error que ocurre mientras el programa se ejecuta, como la división por cero, y lo detiene ensayo en seco recorrer el algoritmo manualmente, registrando los valores de las variables en una tabla de trazado revisión (walkthrough) una revisión en la que el autor pasa paso a paso por el código con colegas que buscan errores stub (módulo simulador) un módulo marcador de posición con el encabezado correcto que devuelve un valor fijo, utilizado para que los módulos que lo invocan puedan probarse plan de pruebas una lista de las pruebas a realizar, cada una con sus datos de prueba, el motivo de los datos y el resultado esperado datos límite valores en cada borde del rango válido, tanto el último valor aceptado como el primer valor rechazado mantenimiento correctivo / adaptativo / perfectivo corregir fallos encontrados en uso / cambiar el programa para adaptarse a un entorno modificado / mejorar un programa que ya funciona Vocabulario EntrenarInglés Chino Pinyin walkthrough/ˈwɔːkθruː/ 走查 zǒu chá white-box testing/waɪt bɒks ˈtestɪŋ/ 白盒测试 bái hé cè shì black-box testing/blæk bɒks ˈtestɪŋ/ 黑盒测试 hēi hé cè shì integration testing/ˌɪntɪˈɡreɪʃn ˈtestɪŋ/ 集成测试 jí chéng cè shì alpha testing/ˈælfə ˈtestɪŋ/ α测试 α cè shì beta testing/ˈbiːtə ˈtestɪŋ/ β测试 β cè shì 12.3
Consejos para el examen
- Compara los modelos de desarrollo (cascada, iterativo, RAD) por principio, beneficio, desventaja, y conoce las cinco etapas del ciclo de vida del desarrollo de programas y qué produce cada una.
- Distingue los errores sintácticos, lógicos y en tiempo de ejecución por cuándo se manifiestan: durante la traducción, en la salida, durante la ejecución.
- Elige datos de prueba de todo tipo — normales, anormales, extremos y límites — y proporciona el motivo y el resultado esperado para cada valor.
- Distingue los tipos de mantenimiento (correctivo, adaptativo, perfectivo) por por qué se realiza el cambio.
- En un diagrama de estructura, nombra cada símbolo: caja, línea de llamada, acople de datos, acople de control, diamante de selección, flecha de iteración. Al leer los encabezados de módulo de un diagrama, recuerda que una función tiene
RETURNS.
Errores comunes
- Describir una etapa del ciclo de vida solo por su nombre ("en la etapa de diseño se diseña el programa"). Di qué se produce: diagrama de estructura, pseudocódigo, plan de pruebas.
- Lamar "error en tiempo de ejecución" a una salida incorrecta. Si el programa llega al final, es un error lógico.
- Dar datos límite solo como los extremos. La calificación requiere los valores en ambos lados del borde.
- Tratar las pruebas alpha y beta como si fueran lo mismo. Alpha es interna por parte de los desarrolladores; beta es por parte de usuarios reales externos.
- Confundir el mantenimiento adaptativo y perfectivo. El adaptativo responde a un cambio externo al programa; el perfectivo mejora un programa que nadie tuvo que cambiar.
- Dibujar un diagrama de estructura con los módulos en cualquier orden. Se leen de izquierda a derecha en el orden en que se invocan, y cada parámetro necesita su flecha.
-
13
Representación de datos
Ver lección13.1
Tipos de datos definidos por el usuario

Syllabus
Los candidatos deben ser capaces de: Notas y orientación Demostrar comprensión de la necesidad de los tipos definidos por el usuario Definir y utilizar tipos no compuestos Incluyendo enumerados, punteros Definir y utilizar tipos de datos compuestos Incluyendo conjuntos, registros y clases/objetos Elegir y diseñar un tipo de dato definido por el usuario adecuado para un problema dado Fuente: Plan de estudios Cambridge International
Los tipos integrados (
INTEGER,REAL,STRING,CHAR,BOOLEAN) cubren los casos más simples. Para problemas más complejos, puedes definir tipos definidos por el usuario 用户定义类型, lo que hace el código más claro y al compilador más estricto.Por qué son necesarios
Un tipo integrado
STRINGpermite almacenar sin sentido en un campo que debería contener uno de unos pocos valores legales; un tipo definido por el usuario puede restringirlo. Las entidades reales suelen ser una colección de valores de diferentes tipos. YDECLARE Taxi : Vehiclees más claro (autodocumentado) queDECLARE Taxi : STRING."Describe la función de un tipo de dato definido por el usuario" (dos puntos). Un tipo de dato definido por el programador, construido a partir de tipos existentes (integrados), para que los datos específicos del problema puedan representarse cuando ningún tipo integrado se ajusta. Ambas mitades puntúan: definido por el programador y basado en tipos existentes. El examinador también acepta "para facilitar la lectura y el mantenimiento del programa" como punto de apoyo, nunca por sí solo.
"Explica qué significan los tipos de datos no compuestos y compuestos" (cuatro puntos). Un tipo no compuesto está definido sin referencia a otro tipo: almacena un único valor, por ejemplo un entero, un real o un valor enumerado. Un tipo compuesto es una colección de otros tipos (que pueden ser ellos mismos compuestos): almacena varios valores bajo un único identificador, por ejemplo un registro, un conjunto, una matriz o una clase. Da un ejemplo con cada definición; el examen pide uno.
Tipos no compuestos
Tipo enumerado
Un tipo enumerado 枚举类型 tiene valores que son una lista fija de constantes nombradas:
TYPE Vehicle = (M100, M230, T101, T102, T120, T150)
DECLARE MyTaxi : Vehicle
MyTaxi ← T102
Los nombres son valores del nuevo tipo (almacenados internamente como enteros pequeños); no se puede asignar nada fuera de la lista. Usos: días de la semana, colores, códigos de estado.
"Indica qué significa un tipo de dato enumerado." Un tipo definido por el usuario no compuesto definido listando todos sus posibles valores (en orden). Como los valores están ordenados, se pueden comparar y recorrer secuencialmente: con
TYPE Month = (January, February, ..., December), la pruebaIF ThisMonth > Junees legal, y los valores se almacenan internamente como enteros. El pseudocódigo tiene tres partes y el examen puntúa cada una: la palabra claveTYPE, el identificador con=, y la lista entre corchetes separada por comas.Ejemplo resuelto. Escribe pseudocódigo para definir un tipo enumerado para los días en que una escuela está abierta (lunes a viernes), y declara una variable de ese tipo establecida en miércoles.
TYPE SchoolDay = (Monday, Tuesday, Wednesday, Thursday, Friday)
DECLARE Today : SchoolDay
Today ← Wednesday
Una variable de un tipo enumerado no puede recibir un valor fuera de la lista, que es todo el punto:
Today ← Saturdayes un error de tiempo de compilación, mientras que unSTRINGhabría aceptado"Saturdy".Un tipo enumerado es una lista fija de valores nombrados Tipo puntero
Un puntero 指针 almacena la dirección de memoria de otra variable (o
NULLpara "sin destino"). Los punteros construyen estructuras dinámicas (listas enlazadas, árboles) y pasan referencias sin copiar.TYPE PNode = ^TNode // pointer to a TNode DECLARE p : PNode p ← NEW TNode p^.Value ← 42 // dereference to reach the fieldsDesreferenciar 解引用 (
p^) significa acceder a la variable a la que apunta."Indica qué significa un tipo de dato puntero." Un tipo no compuesto cuyo valor es la dirección de memoria de (una referencia a) una variable de un tipo dado. El pseudocódigo declara el tipo con un acento circunflejo antes del tipo al que apunta, y el examen pide exactamente esa línea:
TYPE SelectParts = ^Parts        // a pointer to a value of type Parts
DECLARE Chosen : SelectParts
Chosen ← ^Keyboard               // Chosen now holds the address of Keyboard
OUTPUT Chosen^                   // dereference: the value stored at that address
Los punteros son lo que constituye una lista enlazada dinámica o un árbol binario (Tema 19): cada nodo contiene un puntero al siguiente. Se pierden comúnmente dos puntos aquí: escribir el tipo puntero como si almacenara el valor en sí, y olvidar el acento circunflejo al leer a través del puntero.

Un puntero almacena una dirección; p^lo desreferencia para acceder a los campos del nodoTipos compuestos
Un tipo compuesto 复合类型 (uno de los tipos de datos compuestos) agrupa varios valores bajo un mismo nombre.

Un conjunto es una colección desordenada de valores únicos 
Un registro agrupa campos de diferentes tipos bajo un mismo nombre - registro 记录 (Tema 10) — campos de diferentes tipos en un bloque
TYPE ... ENDTYPE. - conjunto 集合 — una colección desordenada de valores únicos, con operaciones añadir, eliminar, prueba de pertenencia, unión, intersección:
DECLARE Available : SET OF Colour Available ← {Red, Blue} IF Green IN Available THEN ... ENDIF- clase 类 / objeto 对象 — el tipo compuesto POO, combinando campos de datos (atributos 属性) con operaciones sobre ellos (métodos 方法). Un objeto es una instancia de una clase:
CLASS Taxi
    PRIVATE Capacity : INTEGER
    PUBLIC FUNCTION GetCapacity() RETURNS INTEGER
        RETURN Capacity
    ENDFUNCTION
ENDCLASS
Elegir un tipo
Usa enumerado para un valor de una lista fija, puntero para indirección, registro para un grupo de campos, conjunto para una colección única desordenada, y clase cuando necesitas estado y comportamiento juntos.
"Describe el tipo de dato definido por el usuario conjunto" (tres puntos). Un tipo compuesto que almacena una colección de valores del mismo tipo, sin un orden específico y sin duplicados; se pueden añadir y eliminar valores, y se puede probar la pertenencia de un valor. Declara el tipo con
SET OF, luego define una constante de conjunto con sus valores entre corchetes:TYPE EvenNumbers = SET OF INTEGER DEFINE Evens (2, 4, 6, 8, 10, 12) : EvenNumbers TYPE SymbolSet = SET OF CHAR DEFINE Operators ('+', '-', '*', '/') : SymbolSet"Describe el tipo de dato definido por el usuario registro" (tres puntos). Un tipo compuesto formado por un número fijo de campos (elementos), cada uno con su propio identificador y su propio tipo, referidos bajo un único identificador; los campos se acceden con notación de punto.
Ejemplo resuelto. Escribe pseudocódigo para declarar un tipo de registro
ClubMemberpara el nombre, apellido, código de membresía (un entero), fecha de adhesión y si se han pagado las cuotas de un miembro de un club; luego declara una variable y establece dos de sus campos.TYPE ClubMember DECLARE FirstName : STRING DECLARE LastName : STRING DECLARE Code : INTEGER DECLARE DateJoined : DATE DECLARE FeesPaid : BOOLEAN ENDTYPE DECLARE NewMember : ClubMember NewMember.LastName ← "Chen" NewMember.FeesPaid ← TRUECada campo necesita su propia línea
DECLAREcon un tipo apropiado, el bloque termina conENDTYPE, y un campo 字段 se alcanza comovariable.field. Al pedir elegir un tipo para cada campo, empareja con los datos: un código que solo se compara es unSTRINGsi puede contener letras, unINTEGERsi se necesita aritmética o ordenamiento; un sí/no esBOOLEAN; una fecha esDATE. Un campo que puede tomar uno de unos pocos valores nombrados (la especie de una mascota, un color) es el que debe convertirse en un tipo enumerado.
Una matriz de registros: cada elemento es un registro completo, un índice elige el elemento y un punto elige el campo. Registros en matrices y archivos. Una tabla de muchos miembros es
DECLARE Members : ARRAY[1:100] OF ClubMember; entoncesMembers[3].LastNamees un campo de un elemento, y un bucle sobre el índice procesa cada registro. Un registro también es la unidad natural escrita y leída de un archivo (más abajo), un registro porPUTRECORDoWRITEFILE.Ejemplo resuelto. Un tipo compuesto
Petalmacena el nombre de cada mascota (cadena), la especie (uno de perro, gato, conejo o hámster) y el peso en kilogramos (real). Defina los tipos y declare una variable.TYPE Species = (Dog, Cat, Rabbit, Hamster) TYPE Pet DECLARE Name : STRING DECLARE Kind : Species DECLARE Weight : REAL ENDTYPE DECLARE MyPet : Pet MyPet.Kind ← RabbitEl tipo enumerado se define primero, porque el registro lo utiliza: el orden importa en el pseudocódigo al igual que en un compilador.
Clases en pseudocódigo. Una clase es el tipo compuesto que también transporta comportamiento. El examen pide la declaración con sus atributos marcados
PRIVATE, un constructor 构造函数 llamadoNEWque los establece, yPUBLICmétodos para obtenerlos o cambiarlos:CLASS Appointment PRIVATE PatientName : STRING PRIVATE Treatment : STRING PRIVATE Medication : STRING PUBLIC PROCEDURE NEW(Name : STRING, Treat : STRING, Med : STRING) PatientName ← Name Treatment ← Treat Medication ← Med ENDPROCEDURE PUBLIC FUNCTION GetTreatment() RETURNS STRING RETURN Treatment ENDFUNCTION ENDCLASS DECLARE Visit : Appointment Visit ← NEW Appointment("A. Chen", "filling", "none") OUTPUT Visit.GetTreatment()Los atributos son privados para que solo puedan cambiarse a través de métodos (encapsulamiento, Tema 20); el constructor es un procedimiento llamado
NEWcon un parámetro por atributo; un getter es una función que devuelve el atributo. Cada uno de estos es una calificación separada.ExplorarLaboratorio de conceptos de programación
Conectar ejemplos con la idea de programación que muestran.
Vocabulario EntrenarInglés Chino Pinyin user-defined type/ˈjuːzə dɪˈfaɪnd taɪp/ 用户定义类型 yòng hù dìng yì lèi xíng field/fiːld/ 字段 zì duàn record/ˈrekɔːd/ 记录 jì lù set/set/ 集合 jí hé class/klæs/ 类 lèi composite type/ˈkɒmpəzɪt taɪp/ 复合类型 fù hé lèi xíng enumerated type/ɪˈnjuːməreɪtɪd taɪp/ 枚举类型 méi jǔ lèi xíng pointer/ˈpɔɪntə/ 指针 zhǐ zhēn linked list/lɪŋkt lɪst/ 链表 liàn biǎo dereference/ˌdiːˈrefrəns/ 解引用 jiě yǐn yòng object/ˈɒbdʒekt/ 对象 duì xiàng attributes/ˈætrɪbjuːts/ 属性 shǔ xìng methods/ˈmeθədz/ 方法 fāng fǎ constructor/kənˈstrʌktə/ 构造函数 gòu zào hán shù File organisation/faɪl ˌɔːɡənaɪˈzeɪʃn/ 文件组织 wén jiàn zǔ zhī 13.2
Organización y acceso a archivos

Syllabus
Los candidatos deben ser capaces de: Notas y orientación Demostrar comprensión de los métodos de organización de archivos y seleccionar un método apropiado de organización y acceso a archivos para un problema dado Incluyendo secuencial, lineal (usando un campo clave), aleatorio (usando una clave de registro) Demostrar comprensión de los métodos de acceso a archivos Incluye Acceso lineal para archivos secuenciales y lineales
Acceso directo para archivos lineales y aleatoriosDemostrar comprensión de algoritmos de hash
Describir y utilizar diferentes algoritmos de hash para leer datos y escribir en un archivo aleatorio/linealFuente: Plan de estudios Cambridge International
Organización de archivos 文件组织 es cómo se dispone los datos; acceso a archivos es cómo el programa accede a un registro.
- archivo serial 串行文件 — registros en el orden de adición, sin ordenar. El acceso es solo secuencial; la anexión es rápida; la búsqueda es lenta. Usado para registros y rastros de auditoría.
- archivo secuencial 顺序文件 — registros ordenados por una clave. La búsqueda es más rápida (se puede detener antes o buscar binariamente); la inserción es lenta (los registros deben desplazarse). Usado para archivos maestros actualizados por lotes.
- archivo aleatorio 随机文件 (archivo de acceso directo) — registros en posiciones calculadas a partir de la clave (a menudo mediante un hash). El acceso directo por clave es muy rápido; leer en orden de clave es más difícil. Usado para grandes tablas de consulta y cuentas de clientes.
Archivo serial: los registros se mantienen en el orden en que fueron añadidos 
Archivo secuencial: los registros están ordenados por un campo clave 
Archivo aleatorio: los registros se sitúan en posiciones calculadas a partir de la clave Los dos métodos de acceso son acceso secuencial 顺序存取 (leer desde el inicio hasta el final) y acceso directo 直接存取 (saltar directamente a una posición conocida). Alinee la estructura con la operación dominante: las búsquedas de una sola clave favorecen el aleatorio; los informes en orden favorecen el secuencial.
Describiendo cada organización (el redacción que obtiene puntos). Serial: los registros se almacenan uno tras otro en el orden en que fueron añadidos, sin ordenamiento por clave. Secuencial: los registros se almacenan en orden de un campo clave (ordenados). Aleatorio: cada registro se almacena en una dirección calculada a partir de su clave mediante un algoritmo de hash, por lo que los registros no están en ningún orden. Comparando serial y secuencial: ambos almacenan registros uno tras otro y ambos se leen secuencialmente, pero un archivo secuencial está ordenado por clave, por lo que una búsqueda puede detenerse tan pronto como se lee una clave mayor que la objetivo, y un nuevo registro debe insertarse en su posición correcta (generalmente reescribiendo el archivo), mientras que un archivo serial simplemente se anexiona.
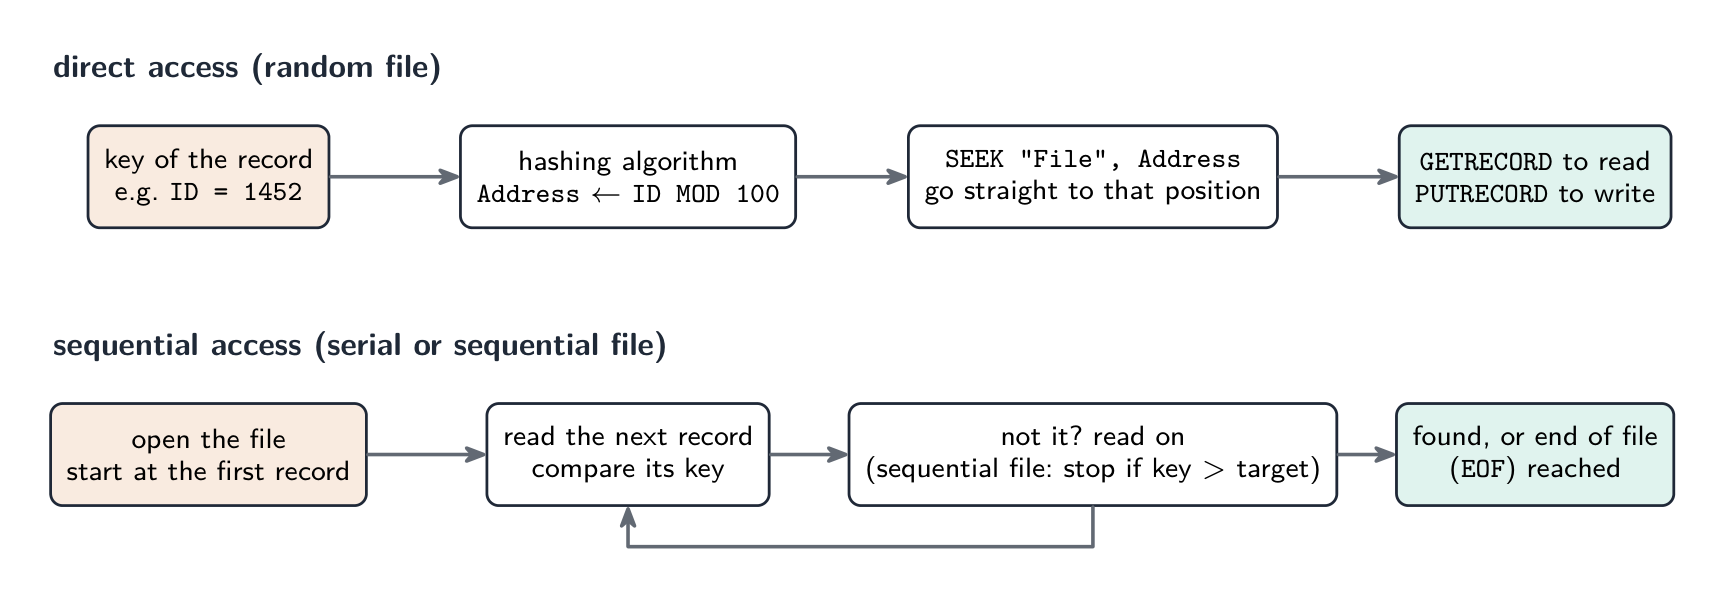
Los dos métodos de acceso como procedimientos: el acceso directo calcula dónde buscar; el acceso secuencial busca todo a su vez Describiendo cada método de acceso. Acceso secuencial: comienza en el inicio del archivo y lee los registros uno tras otro (en el orden almacenado) hasta que se encuentra el registro requerido o se alcanza el final del archivo. Aplicado a un archivo serial esto significa leer todos los registros hasta la coincidencia, y leer todo el archivo para establecer que un registro está ausente; aplicado a un archivo secuencial la búsqueda puede detenerse antes, tan pronto como se lee una clave mayor que la objetivo. Acceso directo: la dirección del registro se calcula a partir de su clave (mediante un algoritmo de hash, o a partir de un índice), y el programa va directamente a esa posición sin leer los registros anteriores; este es el método de acceso para archivos aleatorios, y para un registro referenciado por una dirección única en un disco.
Elección. Un archivo maestro de nómina o facturación de servicios procesado por lotes, cada registro a su vez, se adapta a un archivo secuencial; un registro de transacciones en el orden en que ocurrieron se adapta a un archivo serial; un archivo de existencias o clientes donde se buscan y actualizan registros individuales por clave mientras el programa se ejecuta se adapta a un archivo aleatorio con acceso directo.
Manejo de archivos en pseudocódigo. El examen espera las sentencias estándar, y el Examen 3 establece algoritmos que las utilizan:
Tarea Sentencias abrir un archivo de texto OPENFILE "Scores.txt" FOR READ(oFOR WRITE, que crea o sobrescribe, oFOR APPEND)leer o escribir una línea READFILE "Scores.txt", LineyWRITEFILE "Scores.txt", Lineprobar el final WHILE NOT EOF("Scores.txt")cerrar CLOSEFILE "Scores.txt"abrir un archivo aleatorio OPENFILE "Stock.dat" FOR RANDOMmover a una posición de registro SEEK "Stock.dat", Addressleer o escribir un registro completo GETRECORD "Stock.dat", ItemyPUTRECORD "Stock.dat", ItemEjemplo resuelto. Un archivo aleatorio
Stock.datcontiene registros de tipoStockItem, almacenados en la dirección dada porItemID MOD 100. Escriba pseudocódigo que almacene un nuevo artículo en su dirección hasheada si esa posición está vacía, informando la posición si ya está en uso.DECLARE Item, Existing : StockItem DECLARE Address : INTEGER INPUT Item.ItemID, Item.Description, Item.Quantity Address ← Item.ItemID MOD 100 OPENFILE "Stock.dat" FOR RANDOM SEEK "Stock.dat", Address GETRECORD "Stock.dat", Existing IF Existing.ItemID = 0 THEN // 0 marks an empty position ENDIF SEEK "Stock.dat", Address PUTRECORD "Stock.dat", Item OUTPUT "Stored at ", Address ELSE OUTPUT "Position ", Address, " is in use" ENDIF CLOSEFILE "Stock.dat"Dos detalles que verifica el esquema de corrección:
SEEKantes de cadaGETRECORDoPUTRECORD(la lectura avanza la posición, por lo que hay que volver a buscar antes de escribir), y el archivo abiertoFOR RANDOMy cerrado al final. Para copiar cada registro de un archivo aleatorio a otro, se recorre con bucle las direcciones usandoSEEK,GETRECORDdesde un archivo yPUTRECORDhacia el otro, omitiendo las posiciones vacías.ExplorarRuta de acceso al archivo
Seguir un archivo desde el almacenamiento hasta el programa y de vuelta de forma segura.
Vocabulario EntrenarInglés Chino Pinyin serial file/ˈsɪərɪəl faɪl/ 串行文件 chuàn xíng wén jiàn sequential file/siːˈkwenʃl faɪl/ 顺序文件 shùn xù wén jiàn random file/ˈrændəm faɪl/ 随机文件 suí jī wén jiàn direct access/daɪˈrekt ˈækses/ 直接存取 zhí jiē cún qǔ hash function/hæʃ ˈfʌŋkʃn/ 散列函数 sàn liè hán shù sequential access/siːˈkwenʃl ˈækses/ 顺序存取 shùn xù cún qǔ deterministic/dɪˌtɜːmɪˈnɪstɪk/ 确定性 què dìng xìng collision/kəˈlɪʒn/ 冲突 chōng tū linear probing/ˈlɪnɪə ˈprəʊbɪŋ/ 线性探测 xiàn xìng tàn cè chaining/ˈtʃeɪnɪŋ/ 链接法 liàn jiē fǎ load factor/ləʊd ˈfæktə/ 装填因子 zhuāng tián yīn zi overflow area/ˌəʊvəˈfləʊ ˈeərɪə/ 溢出区 yì chū qū overflow/ˌəʊvəˈfləʊ/ 溢出 yì chū 13.2
Hashing

Una función hash 散列函数 (un algoritmo de hashing) toma una clave de registro y produce una dirección donde se almacena el registro. Una buena función es rápida, determinista 确定性, y distribuye las claves de manera uniforme.
Algoritmos de hashing comunes para $N$ ranuras: hash por módulo
address ← key MOD N; plegado (dividir la clave, sumar las piezas, MOD N); un hash de cadena (sumar los códigos de carácter, MOD N).Una colisión 冲突 ocurre cuando dos claves tienen el mismo hash en la misma dirección. Tres formas de resolverla:
Estrategia Cómo funciona Compromiso prueba lineal 线性探测 usar la siguiente ranura libre (envolviendo) simple, pero las claves se agrupan encadenamiento 链接法 cada ranura apunta a una lista enlazada 链表 de registros sin agrupación, pero usa más memoria rehashing aplicar una segunda función hash dispersa las claves, pero requiere más trabajo Resolución de una colisión de hash: la prueba lineal usa la siguiente ranura libre; el encadenamiento mantiene una lista enlazada por ranura Para buscar: hashear la clave, leer esa ranura; si las claves coinciden, has terminado, de lo contrario seguir la estrategia de resolución hasta encontrar una coincidencia o una ranura vacía. Para insertar: hashear la clave, escribir en esa ranura o en la siguiente libre. Mantener el factor de carga 装填因子 (registros ÷ ranuras) por debajo del 70% aproximadamente para búsquedas casi O(1).
"Explica qué se entiende por algoritmo de hashing en el contexto de acceso a archivos" (tres marcas). Un cálculo (función) realizado sobre el campo clave de un registro que produce un valor, que se utiliza como la dirección (ubicación) en la que se almacena el registro en el archivo y desde la cual se recupera. El mismo cálculo sobre la misma clave siempre da la misma dirección, por eso el registro se puede encontrar nuevamente sin búsqueda.
"Describe dos métodos para superar una colisión." (1) Sondeo lineal (direccionamiento abierto): almacene el registro en la siguiente posición libre después de la dirección calculada, volviendo al inicio si es necesario; para recuperar, comience en la dirección hash y lea hacia adelante hasta que la clave coincida. (2) Un área de desbordamiento o encadenamiento: almacene el registro que colisiona en un área de desbordamiento separada (o en una lista enlazada adjunta a la dirección), la cual se busca secuencialmente después de que la dirección principal no coincida. Se otorgan puntos por cualquiera de las dos respuestas; describa tanto el almacenamiento como la recuperación.
Ejemplo resuelto. Un archivo aleatorio tiene 11 posiciones de registro, numeradas del 0 al 10, y el algoritmo de hash es
Address ← Key MOD 11. Los registros con claves 1250, 1381, 1452, 1613 y 1470 se almacenan en ese orden, utilizando sondeo lineal. Muestre dónde va cada registro y describa cómo se recupera la clave 1470.$1250 \bmod 11 = 7$; $1381 \bmod 11 = 6$; $1452 \bmod 11 = 0$; $1613 \bmod 11 = 7$, una colisión con 1250, por lo que 1613 toma la siguiente posición libre, 8; $1470 \bmod 11 = 7$ nuevamente, y las posiciones 7 y 8 están llenas, por lo que 1470 va a la 9. Para recuperar 1470: calcule $7$, lea la posición 7 (clave 1250, sin coincidencia), lea la 8 (1613, sin coincidencia), lea la 9 (1470, encontrada). Si se alcanza una posición vacía antes de una coincidencia, el registro no está en el archivo. Las colisiones son el precio de un archivo pequeño: un buen algoritmo de hash distribuye las claves uniformemente, y el archivo se mantiene muy por debajo de su capacidad completa para que las sondas permanezcan cortas.
ExplorarUna tabla hash
Observa cómo cada clave se transforma mediante hash en un bucket. Un buen hash distribuye las claves para que las búsquedas sigan siendo rápidas.
13.3
Números de punto flotante

Syllabus
Los candidatos deben ser capaces de: Notas y orientación Describir el formato de los números reales binarios de punto flotante Utilizar la forma de complemento a dos. Comprender los efectos de cambiar la asignación de bits a la manta y al exponente en una representación de punto flotante. Convertir números reales binarios de punto flotante a decimal y viceversa Normalizar números de punto flotante Comprender las razones para la normalización. Demostrar comprensión de las consecuencias de que una representación binaria sea solo una aproximación al número real que representa (en ciertos casos) Comprender cómo pueden ocurrir el desbordamiento hacia abajo (underflow) y el desbordamiento hacia arriba (overflow). Demostrar comprensión de que las representaciones binarias pueden dar lugar a errores de redondeo Fuente: Plan de estudios Cambridge International
Para almacenar números reales de tamaños muy diferentes, las computadoras utilizan un formato de punto flotante — una forma binaria de notación científica, con dos campos:
- una mantisa — los dígitos significativos.
- un exponente — la potencia de 2 por la que se multiplica.
Ambos se almacenan como enteros en complemento a dos. El valor es
$$\text{number} = \text{mantissa} \times 2^{\text{exponent}}.$$Lee la mantisa como una fracción binaria: el primer bit después del punto vale $1/2$, el siguiente $1/4$, luego $1/8$, y así sucesivamente. Por lo tanto,
0.1010000es $1/2 + 1/8 = 0.625$; con exponente00000010(= 2), el valor es $0.625 \times 2^{2} = 2.5$.Los valores posicionales de una mantisa de 8 bits y un exponente de 8 bits Conversión
- binario → decimal: lee la mantisa (utiliza las reglas del complemento a dos si es negativa) como una fracción, lee el exponente como un entero con signo y luego multiplica la mantisa por $2^{\text{exponent}}$.
- decimal → binario: escribe el número como una fracción binaria multiplicada por una potencia de 2 y, a continuación, almacena la mantisa y el exponente en los formatos acordados.
Ejemplo resuelto. Un número tiene una mantisa
10110000y un exponente00000011. Encuentra su valor decimal.El exponente
00000011es $+3$. La mantisa comienza con un 1, por lo que es negativa. Leída como1.0110000en complemento a dos, el bit de signo vale $-1$ y los bits fraccionarios suman $\tfrac{1}{4} + \tfrac{1}{8} = 0.375$, por lo que la mantisa es $-1 + 0.375 = -0.625$. Entonces$$\text{number} = -0.625 \times 2^{3} = -5.0.$$Ejemplo resuelto. Almacena $+2.5$ en este formato.
En binario $2.5 = 10.1$. Escrito como fracción normalizada, $2.5 = 0.101 \times 2^{2}$. Por lo tanto, la mantisa es
01010000(bit de signo 0, seguido de.101) y el exponente es00000010($= 2$).El formato del examen: complemento a dos, una mantisa y un exponente
El examen establece un formato tal como 10 bits para la mantisa y 6 bits para el exponente, ambos en complemento a dos. El punto binario de la mantisa se sitúa después de su primer bit (signo), por lo que una mantisa positiva es
0.xxxxxxxxxy una negativa1.xxxxxxxxx; el exponente es un entero con signo ordinario. Cada conversión utiliza los mismos tres pasos: leer la mantisa como una fracción (reglas de complemento a dos si comienza con 1), leer el exponente como un entero y multiplicar por $2^{\text{exponent}}$.Ejercicio resuelto (binario a decimal). Mantisa
0101100000, exponente000011.Mantisa: $0.101100000_2 = \tfrac{1}{2} + \tfrac{1}{8} + \tfrac{1}{16} = 0.6875$. Exponente: $000011_2 = 3$. Valor: $0.6875 \times 2^{3} = 5.5$.
Ejercicio resuelto (mantisa negativa). Mantisa
1011000000, exponente000010.La mantisa comienza con 1, por lo que es negativa. Su valor es $-1 + 0.011000000_2 = -1 + (\tfrac{1}{4} + \tfrac{1}{8}) = -0.625$; exponente $= 2$; valor $-0.625 \times 4 = -2.5$. (Alternativamente, tome el complemento a dos de la mantisa,
0101000000$= 0.625$, y anexe el signo menos). Un exponente negativo como111110$= -2$ divide en lugar de multiplicar: una mantisa de $0.5$ con ese exponente es $0.5 \times 2^{-2} = 0.125$.Ejercicio resuelto (decimal a binario). Almacene $+6.5$ y $-6.5$ en el formato de 10 bits y 6 bits, respectivamente, normalizado.
$6.5 = 110.1_2 = 0.1101_2 \times 2^{3}$, por lo que la mantisa es
0110100000y el exponente000011. Para $-6.5$, tome el complemento a dos de la mantisa:1001100000(compruebe: $-1 + 0.0011_2 = -1 + 0.1875 = -0.8125$, y $-0.8125 \times 8 = -6.5$), exponente000011sin cambios. El signo nunca pasa al exponente; un número negativo tiene una mantisa negativa.Normalización
Un número está normalizado cuando el primer bit significativo está inmediatamente después del punto binario (sin ceros iniciales desperdiciados). Esto maximiza la precisión, ya que cada bit de la mantisa transporta información. Para normalizar, desplace la mantisa a la izquierda y disminuya el exponente (o desplace a la derecha y aumentéelo) hasta que el primer bit significativo esté en su posición; el valor permanece inalterado. Para mantisas negativas (en complemento a dos), el bit de signo (1) va seguido inmediatamente de un 0.
Reconocer y producir forma normalizada. Una mantisa positiva normalizada comienza
01; una negativa comienza10. Por lo tanto,0011000000no está normalizado (desplazar a la izquierda un lugar y restar uno al exponente:0110000000, exponente uno menos) y1100000000tampoco lo está (desplazar a la izquierda hasta que el patrón sea10...). Cada desplazamiento a la izquierda de la mantisa debe ir seguido de restar uno al exponente, o el valor cambiará."Explique por qué los números se almacenan en forma normalizada" (dos marcas). (1) Proporciona la máxima precisión (exactitud) para el número de bits disponibles, ya que no se desperdician bits en ceros iniciales (o unos iniciales para un número negativo); (2) cada número tiene así una representación única, por lo que los números pueden compararse; y (3) hace el mejor uso del rango disponible. Cualquier dos de estas respuestas son válidas.

Normalización: desplazar la mantisa a la izquierda para eliminar los ceros iniciales, reduciendo el exponente en la misma cantidad Errores de aproximación y redondeo
Muchos reales decimales no pueden almacenarse exactamente en binario — p. ej., $0.1_{10}$ es la fracción binaria periódica $0.000110011\ldots_{2}$, que debe truncarse. Consecuencias:
- errores de redondeo 舍入误差 se acumulan tras muchas operaciones (
0.1 + 0.2no es exactamente0.3). - fallan las comparaciones — nunca compruebe si un real es igual. Compruebe que la diferencia sea menor que una tolerancia pequeña,
IF Difference < 0.000001, donde la diferencia se calcule en el orden correcto o mediante una función módulo que definiría el enunciado.ABSno figura ni en el inserto 9618 ni en la Guía de Pseudocódigo, por lo que no asuma su existencia: la guía indica que cualquier función necesaria será proporcionada. - restar dos valores casi iguales pierde precisión.
- desbordamiento 溢出 (un resultado demasiado grande para el rango del exponente) e inundación inferior 下溢 (un resultado demasiado pequeño, redondeándose a cero) ocurren cuando el exponente sale de su rango válido.
Para necesidades de exactitud (moneda), utilice punto fijo 定点 o BCD 二进码十进数 en lugar de punto flotante.
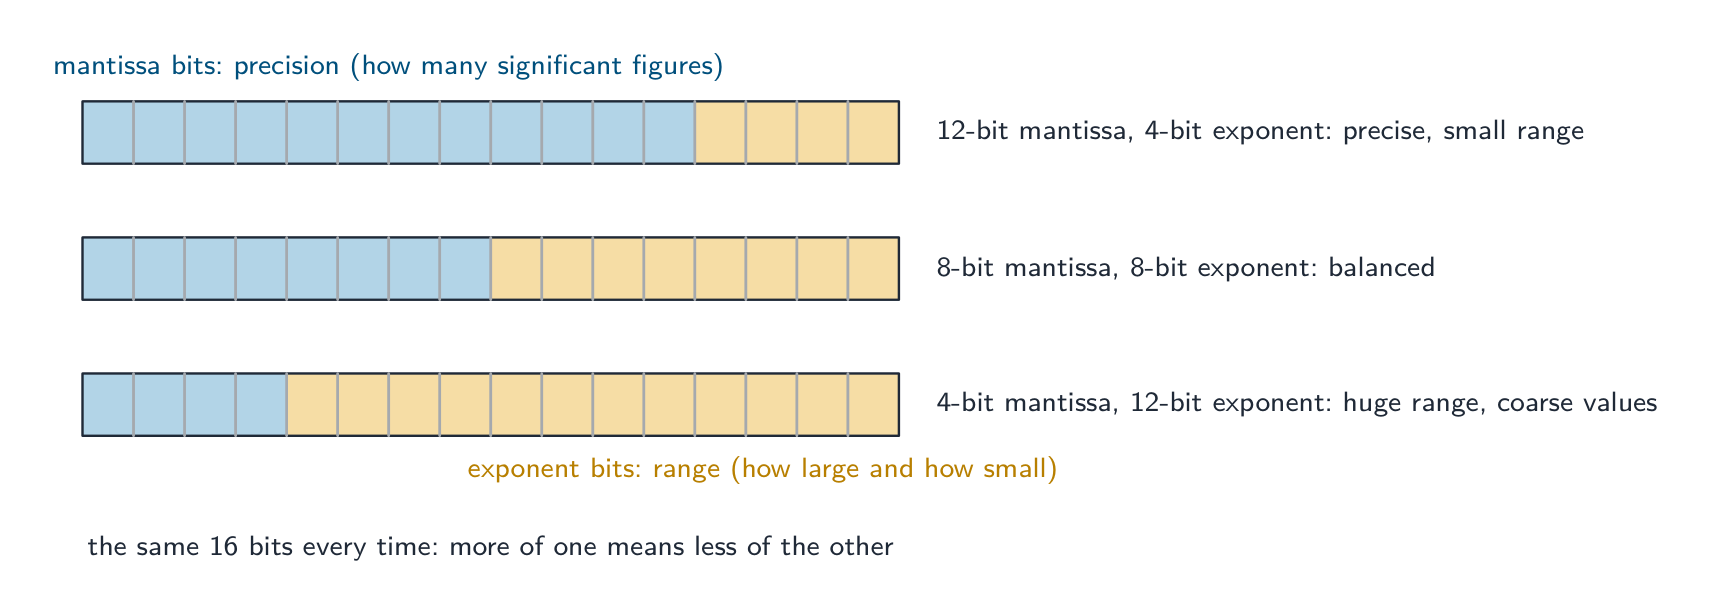
Mismo total de bits compartidos de dos formas: los bits de la mantisa compran precisión, los bits del exponente compran rango, y uno solo puede crecer a expensas del otro "Describa el efecto de cambiar la asignación de bits" (tres marcas). Con un número total de bits fijo, aumentar la mantisa y reducir el exponente otorga mayor precisión 精度 (más cifras significativas, menores errores de redondeo) pero un rango más pequeño 范围 (las magnitudes máxima y mínima que pueden almacenarse disminuyen); aumentar el exponente hace lo contrario: un rango mayor a costa de la precisión. Nombren ambos efectos y ambas direcciones.
Mayor y menor. En el formato de mantisa de 10 bits y exponente de 6 bits, el número positivo más grande tiene mantisa
0111111111($= 1 - 2^{-9}$) y exponente011111($= 31$): aproximadamente $2^{31}$. El número positivo normalizado más pequeño tiene mantisa0100000000($= 0.5$) y exponente100000($= -32$): $0.5 \times 2^{-32} = 2^{-33}$. El número más negativo tiene mantisa1000000000($= -1$) y exponente $31$: $-2^{31}$."Explique qué se entiende por desbordamiento e inundación inferior." El desbordamiento ocurre cuando el resultado de un cálculo es mayor que el número más grande que puede representarse, por lo que el exponente necesitaría más bits de los que tiene; la inundación inferior ocurre cuando un resultado es menor que el más pequeño (no nulo) que puede representarse, demasiado cercano a cero para que el exponente lo exprese, por lo que se almacena como cero. Ambos provienen del rango del exponente, no del de la mantisa.
Por qué una representación binaria es solo una aproximación. Una fracción binaria solo puede representar sumas de $\tfrac{1}{2}, \tfrac{1}{4}, \tfrac{1}{8}, \ldots$ con exactitud; un valor como $0.1$ o $\tfrac{1}{3}$ tiene una expansión binaria infinita, y la mantisa tiene un número fijo de bits, por lo que el valor almacenado es el más cercano que cabe. La diferencia es un error de redondeo; es pequeño para un número pero se acumula en cálculos repetidos (sumar $0.1$ diez veces puede no dar exactamente $1$), razón por la cual los reales nunca deben probarse para igualdad exacta.
ExplorarConstruir un número de punto flotante
Invertir los bits de la mantisa y del exponente para obtener un valor, y verificar si está normalizado.
ExplorarNormalización de un número de punto flotante
Paso a paso por la normalización. Desplazar la mantisa para eliminar ceros iniciales innecesarios —y ajustar el exponente en consecuencia— mantiene el valor sin cambios pero utiliza cada bit para la precisión.
Vocabulario EntrenarInglés Chino Pinyin floating-point/ˈfləʊtɪŋ pɔɪnt/ 浮点 fú diǎn mantissa/mænˈtɪsə/ 尾数 wěi shù exponent/ekˈspəʊnənt/ 指数 zhǐ shù two's complement/tuːz ˈkɒmplɪmənt/ 补码 bǔ mǎ normalised/ˈnɔːməlaɪzd/ 规格化 guī gé huà rounding errors/ˈraʊndɪŋ ˈerəz/ 舍入误差 shě rù wù chā underflow/ˌʌndəˈfləʊ/ 下溢 xià yì fixed-point/fɪkst pɔɪnt/ 定点 dìng diǎn BCD/ˌbiː siː ˈdiː/ 二进码十进数 èr jìn mǎ shí jìn shù precision/prɪˈsɪʒn/ 精度 jīng dù range/reɪndʒ/ 范围 fàn wéi 13.3
Definiciones aceptadas por el examinador
Una pregunta de definición se califica según un texto fijo. Aprende estas definiciones exactamente, y da solo una respuesta.
Término Definición tipo de dato definido por el usuario un tipo de dato definido por el programador, basado en tipos existentes, para representar datos específicos del problema tipo no compuesto un tipo definido sin referencia a otro tipo; contiene un único valor (entero, real, enumerado, puntero) tipo compuesto un tipo formado por otros tipos; contiene varios valores bajo un mismo identificador (registro, conjunto, matriz, clase) tipo enumerado un tipo no compuesto definido listando todos sus posibles valores, en orden tipo puntero un tipo no compuesto cuyo valor es la dirección de memoria de una variable de un tipo dado conjunto un tipo compuesto que contiene una colección de valores de un solo tipo, sin orden y sin duplicados registro un tipo compuesto con un número fijo de campos, cada uno con su propio identificador y tipo, accedido mediante notación de puntos clase un tipo compuesto que combina atributos (datos) con métodos (procedimientos y funciones) que actúan sobre ellos; un objeto es una instancia de una clase archivo serial registros almacenados uno tras otro en el orden en que fueron añadidos archivo secuencial registros almacenados uno tras otro en orden de un campo clave archivo aleatorio registros almacenados en direcciones calculadas a partir de sus claves mediante un algoritmo de hash acceso secuencial leer los registros sucesivamente desde el inicio del archivo hasta encontrar el requerido acceso directo calcular la dirección de un registro a partir de su clave y acceder directamente a esa posición algoritmo de hash un cálculo realizado sobre la clave de un registro que proporciona la dirección en la que se almacena y encuentra el registro colisión dos claves diferentes que producen la misma dirección mantisa la parte de un número de punto flotante que contiene sus bits significativos, como fracción en complemento a dos exponente el entero en complemento a dos que da la potencia de dos por la cual se multiplica la mantisa normalizado un número de punto flotante cuya mantisa comienza 01 (positivo) o 10 (negativo), de modo que no se desperdician bits en ceros o unos iniciales desbordamiento un resultado demasiado grande para ser representado con el número de bits disponibles inundación inferior un resultado no nulo demasiado pequeño para ser representado, por lo que se almacena como cero error de redondeo la diferencia entre un número real y el valor más cercano que la representación binaria puede contener 13.3
Consejos para el examen
- Las declaraciones de pseudocódigo se marcan línea por línea:
TYPE ... = (...)para enumerado,TYPE ... = ^...para puntero,TYPE ... = SET OF ...y luegoDEFINE ... (...) : ...para un conjunto,TYPE ... DECLARE ... ENDTYPEpara un registro,CLASS ... PRIVATE ... PUBLIC PROCEDURE NEW ... ENDCLASSpara una clase. - Asocia el tipo con los datos: valores fijos nominales, enumerado; un grupo de campos diferentes, registro; una colección de valores únicos, conjunto; datos más comportamiento, clase; una dirección, puntero.
- La organización de archivos es cómo se almacenan los registros; el acceso a archivos es cómo se localizan. Serial y secuencial se leen secuencialmente; los archivos aleatorios usan acceso directo mediante un hash de la clave. La búsqueda secuencial de un archivo secuencial puede detenerse anticipadamente; en un archivo serial no puede.
- Pseudocódigo de archivo aleatorio:
OPENFILE ... FOR RANDOM,SEEKantes de cadaGETRECORDoPUTRECORD,CLOSEFILEal final. Explica cómo se resuelve una colisión al describir el hashing. - Punto flotante: mantisa como fracción en complemento a dos (punto después del bit de signo), exponente como entero, multiplicar por $2^{\text{exponent}}$; desplazar a la izquierda y restar uno al exponente para normalizar; la mantisa compra precisión, el exponente compra rango.
- Las tres respuestas estándar de "explicar": por qué normalizar (precisión, forma única, rango), el efecto de reasignar bits (precisión contra rango) y por qué $0.1$ no se puede almacenar exactamente (una fracción binaria infinita en una mantisa finita).
Errores comunes
- Escribir
DECLAREen lugar deTYPEpara un nuevo tipo, u omitirENDTYPE; declarar un conjunto sinSET OF, o un tipo enumerado con comillas alrededor de sus valores. - Colocar el signo de un número de punto flotante en el exponente; el signo es el primer bit de la mantisa.
- Leer una mantisa negativa como si fuera signo-magnitud; es complemento a dos, por lo que
1011000000es $-0.625$, no $-0.375$. - Desplazar la mantisa para normalizar sin cambiar el exponente, o cambiarlo de manera incorrecta (desplazamiento a la izquierda, exponente hacia abajo).
- Describir un archivo aleatorio como "en orden aleatorio"; los registros están en direcciones calculadas a partir de sus claves.
- Decir que el acceso secuencial lee "todo el archivo" para un archivo secuencial; se detiene cuando se encuentra una clave mayor.
- Explicar el hashing sin decir para qué se usa el valor calculado (la dirección para almacenar y recuperar el registro), o sin un método para manejar colisiones.
- Definir desbordamiento como "demasiados dígitos" en lugar de un resultado más allá del valor representable más grande, o culpar a la mantisa por ello.
- registro 记录 (Tema 10) — campos de diferentes tipos en un bloque
-
14
Tecnologías de comunicación e Internet
Ver lección14.1
Por qué se necesitan los protocolos

Syllabus
Los candidatos deben ser capaces de: Notas y orientación Demostrar comprensión de por qué un protocolo es esencial para la comunicación entre ordenadores Demostrar comprensión de cómo la implementación de un protocolo puede verse como una pila, donde cada capa tiene su propia funcionalidad Demostrar comprensión del conjunto de protocolos TCP/IP Cuatro capas (Aplicación, Transporte, Internet, Enlace) Propósito y función de cada capa Aplicación cuando se envía un mensaje desde un host a otro en Internet Demostrar comprensión de los protocolos (HTTP, FTP, POP3, IMAP, SMTP, BitTorrent) y sus propósitos Protocolo BitTorrent proporciona intercambio de archivos entre pares (peer-to-peer) Fuente: Plan de estudios Cambridge International
Un protocolo es un conjunto de reglas para cómo los dispositivos comunican. Ambos extremos deben seguir las mismas reglas, o las señales de una parte no tendrán sentido para la otra. Los protocolos definen el formato de los datos (dónde se sitúan las direcciones y la carga útil), el orden de los mensajes (quién habla primero, cuándo se debe confirmar), el significado de cada mensaje, el temporizado (timeouts, retransmisiones) y qué hacer en caso de error. Sin un protocolo acordado, la comunicación falla —como dos personas hablando idiomas diferentes sin traductor.
"Explique por qué los protocolos son esenciales para la comunicación entre ordenadores" (tres marcas). (1) Un protocolo es un conjunto de reglas acordado tanto por el emisor como por el receptor; (2) sin él, los dos ordenadores interpretarían los datos de forma diferente (formato, orden, significado de cada parte), por lo que el mensaje no podría entenderse; (3) permite a ordenadores de diferentes tipos y fabricantes comunicarse, porque todos implementan el mismo estándar. Mencione qué cubren las reglas: el formato de los datos, el orden de los mensajes, la detección y recuperación de errores, y la velocidad o temporizado.
Un protocolo son las reglas compartidas: formato, orden, temporizado y errores Vocabulario EntrenarInglés Chino Pinyin protocol/ˈprəʊtəkɒl/ 协议 xié yì 14.1
Protocolos en capas
La red es compleja, por lo que se divide en capas 层, cada una con una función específica, hablando solo con la capa superior e inferior. Beneficios: modularidad 模块化 (reemplazar una capa —por ejemplo, Ethernet por Wi-Fi— sin tocar las otras), estandarización (los proveedores interoperan) y abstracción 抽象 (ignora los detalles manejados en otro lugar). Internet utiliza la suite de protocolos TCP/IP 协议栈 (4 capas).
14.1
Suite de protocolos TCP/IP

Capa Propósito Ejemplos Aplicación lo que hace el programa del usuario HTTP, FTP, SMTP, IMAP Transporte entrega extremo a extremo entre procesos TCP, UDP Internet enrutamiento de paquetes entre redes IP Enlace envío de bits sobre el medio físico Ethernet, Wi-Fi Las cuatro capas de la suite de protocolos TCP/IP El propósito de cada capa, tal como lo expresan las palabras del esquema de corrección. Capa de aplicación: proporciona los protocolos que usan las aplicaciones de usuario (HTTP para la web, SMTP para correo electrónico) y la interfaz entre la aplicación y la red; produce los datos para ser enviados y los pasa a la capa de transporte. Capa de transporte: establece la conexión extremo a extremo, fragmenta los datos en paquetes (segmentos) y añade números de puerto y números de secuencia; al recibirlos, reensambla los paquetes en orden y solicita aquellos que falten (TCP), o envía sin esas garantías (UDP). Capa de internet: añade las direcciones IP de origen y destino para formar paquetes IP (datagramas) y los enruta a través de las redes mediante routers; no garantiza la entrega. Capa de enlace: añade las direcciones MAC y los bits de comprobación de errores para formar un trama y transmite los bits sobre la red local física (Ethernet o Wi-Fi) a través de la tarjeta de interfaz de red. "Completar la pila" significa estas cuatro, en este orden, desde arriba: Aplicación, Transporte, Internet, Enlace.
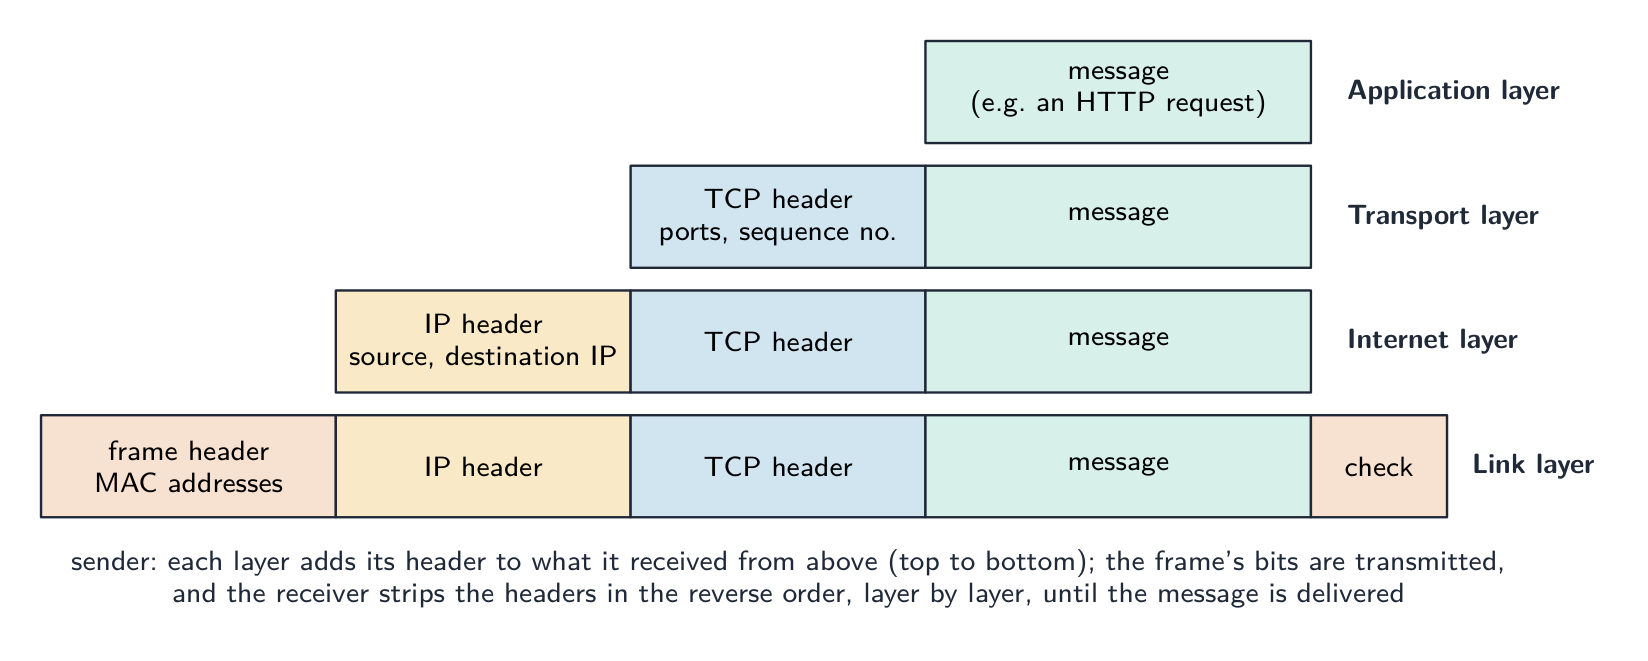
Encapsulamiento: cada capa añade su propia cabecera 首部 a lo que recibe de la capa superior, por lo que los bits en el cable portan cuatro conjuntos de información; el receptor los elimina una capa a la vez "Describa cómo se aplica la suite TCP/IP cuando se envía un mensaje de un host a otro" (cinco marcas). En el emisor, el mensaje pasa hacia abajo por la pila: (1) la capa de aplicación produce los datos usando un protocolo como HTTP o SMTP; (2) la capa de transporte lo divide en paquetes y añade una cabecera con los números de puerto y un número de secuencia; (3) la capa de internet añade una cabecera con las direcciones IP de origen y destino y elige la ruta; (4) la capa de enlace añade las direcciones MAC del siguiente dispositivo y envía la trama sobre el enlace físico. Los routers a lo largo del camino leen la cabecera de la capa de internet y reenvían cada paquete. En el receptor, la trama pasa hacia arriba por la pila: cada capa elimina y actúa sobre su propia cabecera, la capa de transporte reensambla los paquetes en orden de número de secuencia y pide aquellos que faltan, y la capa de aplicación presenta el mensaje. El mismo protocolo en cada capa en ambos extremos es lo que hace que el intercambio funcione.
Capa de aplicación
La capa de aplicación 应用层 da servicios a los programas de usuario y define los protocolos que hablan (HTTP para web, SMTP para correo electrónico). Es donde un programador trabaja más a menudo.
Capa de transporte
La capa de transporte 传输层 entrega datos extremo a extremo entre procesos, identificados por números de puerto 端口号. Dos protocolos:

TCP se conecta y entrega en orden; UDP envía y olvida - TCP 传输控制协议 — orientado a conexión 面向连接: establece una conexión, asegura que todos los datos lleguen en orden, retransmite paquetes 数据包 perdidos, controla el flujo. Confiable pero con sobrecarga. Usado por HTTP, HTTPS, SMTP, FTP.
- UDP 用户数据报协议 — sin conexión 无连接: envía y olvida, sin confirmaciones ni orden. Baja sobrecarga, sin garantías. Usado para streaming, DNS y juegos, donde la velocidad supera a la fiabilidad.
Capa de internet
La capa de internet 网络层 transporta paquetes entre hosts usando IP. Cada paquete tiene una dirección IP de origen IP地址 y una de destino, y los routers 路由器 lo reenvían hacia adelante. No garantiza la entrega —ese es el trabajo de TCP.
Un router doméstico hace este trabajo para tu casa: lee la dirección de destino de cada paquete y lo envía hacia internet, y de vuelta al dispositivo correcto.

Un router Wi-Fi doméstico: reenvía paquetes entre tus dispositivos e internet Antes de que el router llegue a internet más amplio, un módem 调制解modem conecta el hogar al proveedor de internet a través de su cable o línea telefónica. Sus luces indican que el enlace está activo y en línea.

Un módem de cable conecta una red doméstica al proveedor de internet Capa de enlace
La capa de enlace 链路层 envía bits sobre un enlace físico (Ethernet, Wi-Fi). Añade una cabecera de trama con direcciones MAC MAC地址 y maneja el acceso al medio (p. ej., CSMA/CD 载波侦听多路访问/冲突检测 en Ethernet).

Las partes de una trama Ethernet típica En una red local cableada, un switch 交换机 une muchos dispositivos juntos. Cada dispositivo se conecta a un puerto con un cable Ethernet (un enchufe RJ45), y el switch usa las direcciones MAC en cada trama para enviarla solo al puerto correcto.

Un switch de red conecta muchos dispositivos cableados en una red local El enlace físico puede ser un cable de cobre, una señal de radio (Wi-Fi) o un cable de fibra óptica 光纤. En un cable de fibra óptica, los bits viajan como destellos de luz a través de finas hebras de vidrio, lo cual es rápido y transporta datos a gran distancia.

Un cable de fibra óptica: los datos viajan como luz a través de finas hebras de vidrio Un enlace de radio puede llegar mucho más lejos. Una antena parabólica 卫星天线 envía y recibe señales de radio a y desde un satélite, llevando datos a lugares que los enlaces cableados no pueden alcanzar fácilmente.

Una antena parabólica envía y recibe datos por radio a larga distancia ExplorarToca las cuatro capas del modelo TCP/IP
Explora cada capa. Los datos viajan HACIA ABAJO por la pila al enviarse (cada capa añade su encabezado) y hacia ARRIBA al recibirse, y cualquier capa puede intercambiarse sin tocar las demás.
Vocabulario EntrenarInglés Chino Pinyin layers/ˈleɪəz/ 层 céng modularity/ˌmɒdjʊˈlærɪti/ 模块化 mó kuài huà abstraction/əbˈstrækʃn/ 抽象 chōu xiàng protocol suite/ˈprəʊtəkɒl swiːt/ 协议栈 xié yì zhàn application layer/ˌæplɪˈkeɪʃn ˈleɪə/ 应用层 yìng yòng céng transport layer/ˈtrænspɔːt ˈleɪə/ 传输层 chuán shū céng port numbers/pɔːt ˈnʌmbəz/ 端口号 duān kǒu hào TCP/ˌtiː siː ˈpiː/ 传输控制协议 chuán shū kòng zhì xié yì connection-oriented/kəˈnekʃn ˈɔːrɪəntɪd/ 面向连接 miàn xiàng lián jiē packets/ˈpækɪts/ 数据包 shù jù bāo UDP/ˌjuː diː ˈpiː/ 用户数据报协议 yòng hù shù jù bào xié yì connectionless/kəˈnekʃənləs/ 无连接 wú lián jiē internet layer/ˈɪntənet ˈleɪə/ 网络层 wǎng luò céng routers/ˈruːtəz/ 路由器 lù yóu qì modem/ˈməʊdem/ 调制解调器 tiáo zhì jiě tiáo qì link layer/lɪŋk ˈleɪə/ 链路层 liàn lù céng CSMA/CD/ˌsiː es em ˈeɪ ˌsiː ˈdiː/ 载波侦听多路访问/冲突检测 zài bō zhēn tīng duō lù fǎng wèn / chōng tū jiǎn cè switch/swɪtʃ/ 交换机 jiāo huàn jī fibre-optic cable/ˈfaɪbə ˈɒptɪk ˈkeɪbl/ 光纤 guāng xiān satellite dish/ˈsætəlaɪt dɪʃ/ 卫星天线 wèi xīng tiān xiàn 14.1
Protocolos comunes de capa de aplicación

- HTTP 超文本传输协议 — los navegadores obtienen páginas web de servidores (sobre TCP, puerto 80). HTTPS es HTTP sobre TLS — cifrado, puerto 443.
- FTP 文件传输协议 — transfiere archivos entre cliente y servidor.
- SMTP 简单邮件传输协议 — envía correo electrónico entre cliente y servidor, y entre servidores. La recepción usa POP3 o IMAP.
- POP3 — descarga correo electrónico y generalmente lo elimina del servidor. IMAP — deja el correo electrónico en el servidor y lo sincroniza entre dispositivos, por lo que la misma bandeja de entrada aparece en todas partes.
- BitTorrent — un protocolo punto a punto 对等网络; un archivo se divide en fragmentos descargados de muchos pares en paralelo, por lo que ningún servidor individual soporta toda la carga.
BitTorrent: un rastreador ayuda a los pares a encontrarse, luego comparten fragmentos de archivos directamente El propósito de cada protocolo, en las palabras que otorgan puntos.
Protocolo Propósito (indíquese esto) HTTP transfiere páginas web (hipertexto) entre un servidor web y un navegador; HTTPS es la versión cifrada FTP transfiere archivos entre un cliente y un servidor (subiendo a y descargando de un servidor de archivos) SMTP envía correo electrónico desde un cliente a un servidor de correo, y entre servidores de correo (un protocolo "push") POP3 descarga correo electrónico del servidor al cliente, generalmente eliminándolo del servidor, para que se lea en un dispositivo IMAP permite al cliente leer y gestionar el correo electrónico que permanece en el servidor, de modo que la misma carpeta de entrada se ve en cada dispositivo BitTorrent comparte archivos punto a punto: fragmentos de un archivo se descargan de y se cargan a muchos otros usuarios simultáneamente Si se piden los dos protocolos de correo electrónico, dé SMTP para enviar y POP3 o IMAP para recibir; si se pide describir IMAP, diga que los mensajes permanecen en el servidor y están sincronizados entre dispositivos, que es la diferencia con POP3.
"Describa cómo se comparten archivos usando el protocolo BitTorrent" (cuatro marcas). (1) El archivo se divide en fragmentos (típicamente de 256 KB cada uno), y un pequeño archivo torrent los describe (sus hashes) y nombra un rastreador 追踪器. (2) Un par que desea el archivo se pone en contacto con el rastreador, que mantiene una lista de los pares en la bandada 群 que actualmente comparten ese archivo. (3) El par descarga diferentes fragmentos de muchos pares al mismo tiempo, y tan pronto como posee un fragmento lo carga a otros; un par con todo el archivo es una semilla 种子, uno que aún descarga es un leech. (4) Cuando todos los fragmentos están, se reensamblan y verifican contra los hashes. "Explique qué significa compartir archivos punto a punto": no hay un servidor central que almacene el archivo; cada computadora es tanto un cliente como un servidor, descargando de y cargando a los demás, por lo que la carga y el ancho de banda se distribuyen entre la bandada y cuanto más pares haya, más rápido ocurre.
ExplorarLaboratorio de rutas de red
Seguir los datos de un dispositivo a través del hardware de red y los protocolos.
Vocabulario EntrenarInglés Chino Pinyin HTTP/ˌeɪtʃ tiː tiː ˈpiː/ 超文本传输协议 chāo wén běn chuán shū xié yì FTP/ˌef tiː ˈpiː/ 文件传输协议 wén jiàn chuán shū xié yì SMTP/ˌes em tiː ˈpiː/ 简单邮件传输协议 jiǎn dān yóu jiàn chuán shū xié yì peer-to-peer/pɪə tə pɪə/ 对等网络 duì děng wǎng luò tracker/ˈtrækə/ 追踪器 zhuī zōng qì swarm/swɔːm/ 群 qún seed/siːd/ 种子 zhǒng zi 14.2
Conmutación de circuitos vs conmutación de paquetes

Syllabus
Los candidatos deben ser capaces de: Notas y orientación Demostrar comprensión de la conmutación de circuitos Beneficios, desventajas y áreas de aplicación Demostrar comprensión de la conmutación de paquetes Beneficios, desventajas y áreas de aplicación. Demostrar comprensión de la función de un router en la conmutación de paquetes. Explicar cómo se utiliza la conmutación de paquetes para transmitir mensajes a través de una red, incluida Internet Fuente: Plan de estudios Cambridge International
Conmutación de circuitos
Se establece un camino dedicado entre los dos extremos antes de enviar cualquier dato (conmutación de circuitos 电路交换), reservado para toda la conversación, luego liberado. Ofrece ancho de banda reservado 带宽 y entrega en orden, pero es ineficiente durante silencios y lento para establecerse. Ejemplo clásico: la red telefónica tradicional.
Conmutación de circuitos: un camino dedicado está reservado extremo a extremo "Describa la conmutación de circuitos como un método de transmisión de datos" (tres marcas). (1) Un camino dedicado (circuito) se establece entre el emisor y el receptor antes de enviar cualquier dato; (2) el todo el mensaje se envía a lo largo de ese camino, en orden, como un flujo continuo; (3) el circuito está reservado para la duración de la comunicación y se libera después.
Beneficios y desventajas. Beneficios: el ancho de banda completo del circuito está disponible y garantizado; los datos llegan en orden sin reensamblaje ni demora una vez establecido el circuito; la ruta no cambia, por lo que el temporizado es predecible (bueno para voz y video en tiempo real). Desventajas: se pierde tiempo estableciendo el circuito antes de enviar algo; el circuito está reservado incluso mientras no fluye ningún dato, por lo que el ancho de banda se desperdicia y otros usuarios no pueden compartirlo; ambos extremos deben estar libres al mismo tiempo; un fallo en cualquier punto del camino interrumpe toda la llamada, y no hay ruta alternativa automática. Cuándo es apropiado: una llamada telefónica o un enlace de video en vivo, donde un flujo constante e ininterrumpido importa más que la eficiencia.
Conmutación de paquetes
Los datos se dividen en paquetes, cada uno enviado independientemente (conmutación de paquetes 分组交换). Cada paquete lleva la dirección de destino; los routers toman decisiones por paquete, por lo que los paquetes pueden tomar rutas diferentes y llegar fuera de orden, y el destino los reensambla. Es eficiente (un enlace se multiplexa 多路复用 a través de muchas conversaciones), robusto (redirecciona alrededor de un fallo), pero tiene latencia variable 延迟 y posible pérdida (TCP maneja la confiabilidad). Usado por internet.

Conmutación de paquetes: los paquetes viajan independientemente y pueden tomar diferentes rutas 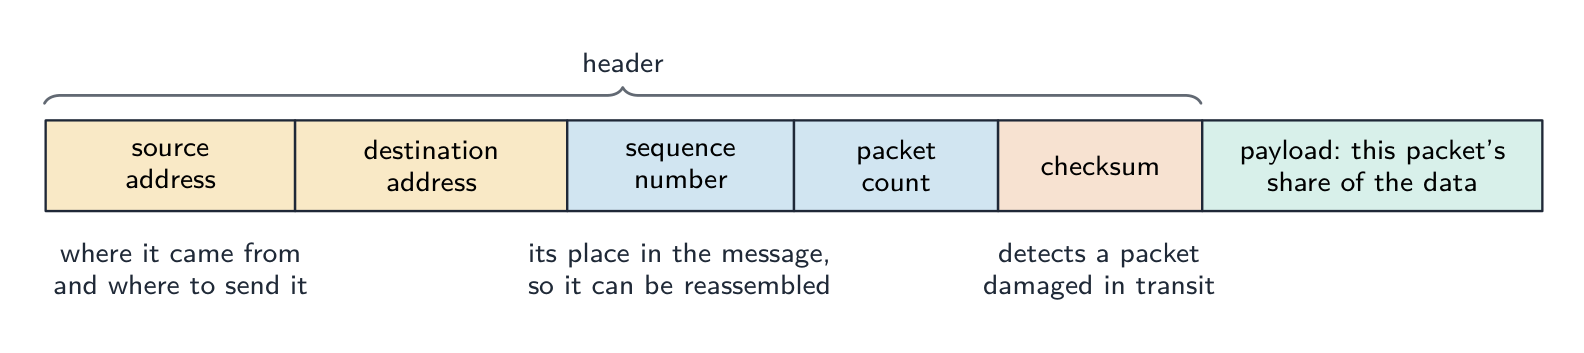
Lo que permite que un paquete viaje por su cuenta: las direcciones dicen dónde, el número de secuencia dice qué parte del mensaje es, y el sumatorio de verificación muestra si llegó intacto "Describa cómo se usa la conmutación de paquetes para pasar mensajes a través de una red" (cuatro marcas). (1) El mensaje se divide en paquetes de un tamaño máximo fijo; (2) a cada paquete se le asigna una cabecera que contiene las direcciones de origen y destino, un número de secuencia 序号 y una comprobación de errores; (3) cada paquete se envía independientemente y puede tomar una ruta diferente, elegida por los routers que encuentra; (4) en el destino, los paquetes se reensamblan en orden usando los números de secuencia, y se solicita nuevamente cualquier paquete faltante. Si la pregunta excluye la comprobación y reenvío, omita la última cláusula.
"Describa la función de un router en la conmutación de paquetes" (tres marcas). Un router recibe un paquete, lee la dirección IP de destino en su cabecera, y consulta su tabla de enrutamiento 路由表 para decidir el siguiente salto 最佳 next hop hacia ese destino, teniendo en cuenta el tráfico (congestión) y enlaces fallidos; luego reenvía el paquete a ese enlace. Los paquetes del mismo mensaje pueden salir por diferentes rutas; el router mantiene paquetes en una cola cuando un enlace está ocupado.
"Describa dos formas en que la conmutación de paquetes asegura que se reciba el mensaje completo." (1) Cada paquete lleva un número de secuencia, por lo que el receptor puede poner los paquetes en orden y saber que uno está faltando, y (2) el receptor envía una confirmación 确认 para los paquetes que llegan; un paquete no confirmado dentro de un límite de tiempo es retransmitido por el emisor. Un sumatorio de verificación 校验和 en cada paquete permite al receptor detectar un paquete corrupto y descartarlo, lo que desencadena el reenvío.
Beneficios y desventajas. Beneficios: no hay circuito que establecer; los enlaces de la red se comparten con muchos mensajes, por lo que el ancho de banda se usa eficientemente; los paquetes pueden ser redireccionados alrededor de un enlace fallido o congestionado, por lo que la transmisión es robusta; un paquete perdido o dañado significa reenviar solo ese paquete, no todo el mensaje. Desventajas: los paquetes pueden llegar fuera de orden y deben reensamblarse, y algunos pueden perderse o retrasarse; las cabeceras añaden sobrecarga; la demora variable lo hace menos adecuado para voz y video en tiempo real sin medidas adicionales; una red muy cargada pierde paquetes. Cuándo es apropiado: correo electrónico, páginas web, descargas de archivos y cualquier tráfico "intermitente", e internet en general.
Aspecto Conmutación de circuitos Conmutación de paquetes Ruta dedicada, reservada compartida, por paquete Tiempo de configuración lento ninguno Uso del ancho de banda ineficiente eficiente Orden en orden puede estar fuera de orden Robustez un fallo corta el circuito redirección alrededor de fallos Apropiado para flujos de tasa constante (voz) flujos intermitentes (web, correo) Las redes modernas usan conmutación de paquetes por su eficiencia y resiliencia.
Cuatro diferencias, expresadas como pares. (1) La conmutación de circuitos establece un camino dedicado antes de enviar; la conmutación de paquetes envía sin establecer un camino. (2) En la conmutación de circuitos todo el mensaje sigue una sola ruta; en la conmutación de paquetes los paquetes pueden tomar rutas diferentes. (3) La conmutación de circuitos entrega los datos en orden sin reensamblaje; la conmutación de paquetes necesita números de secuencia para reensamblarlos. (4) La conmutación de circuitos reserva ancho de banda para una conversación incluso en reposo; la conmutación de paquetes comparte los enlaces entre muchos mensajes. (También aceptable: un enlace fallido rompe un circuito pero los paquetes se redirigen; la conmutación de circuitos es adecuada para flujos en tiempo real, la conmutación de paquetes para datos intermitentes). Escriba cada diferencia como ambas mitades; un lado solo no obtiene puntos.
Describir la conmutación de paquetes en pocas oraciones
Una buena respuesta de examen: "El mensaje se divide en pequeños paquetes. Cada paquete lleva las direcciones de destino y origen y un número de secuencia. Cada paquete viaja a través de la red de forma independiente, con los routers eligiendo el siguiente salto por paquete. Los paquetes pueden tomar diferentes caminos y llegar fuera de orden. El destino usa los números de secuencia para reensamblar el mensaje, y los paquetes faltantes se pueden solicitar nuevamente."
Ejemplo resuelto. Una llamada telefónica y una descarga de archivo grande comparten una red. ¿Qué método de conmutación es adecuado para cada uno y por qué? Una llamada telefónica necesita un flujo constante con baja latencia, y sufriría gravemente si los fragmentos llegaran tarde o fuera de orden — así que conmutación de circuitos es adecuada para ella: se establece un camino dedicado para toda la llamada y su capacidad está reservada durante la duración. Una descarga de archivo no se preocupa por el temporizado o el orden de llegada, porque el receptor lo reensambla, y se beneficia de usar la capacidad que esté disponible — así que conmutación de paquetes es adecuada para ella: el archivo se divide en paquetes que viajan de forma independiente, cada uno llevando direcciones de origen y destino y un número de secuencia, con routers eligiendo un siguiente salto por paquete. Nombre la propiedad del tráfico que lo decide: capacidad reservada y baja latencia para la llamada, eficiencia y resiliencia para la descarga.
ExplorarEl viaje de un paquete a través de internet
Recorra la conmutación de paquetes. El mensaje se divide, cada paquete encuentra su propio camino, y el destino los vuelve a juntar, lo cual es por lo que internet es tan eficiente y difícil de romper.
Vocabulario EntrenarInglés Chino Pinyin circuit switching/ˈsɜːkɪt ˈswɪtʃɪŋ/ 电路交换 diàn lù jiāo huàn reserved bandwidth/rɪˈzɜːvd ˈbændwɪdθ/ 带宽 dài kuān packet switching/ˈpækɪt ˈswɪtʃɪŋ/ 分组交换 fēn zǔ jiāo huàn multiplexed/ˌmʌltɪˈplekst/ 多路复用 duō lù fù yòng variable latency/ˈveərɪəbl ˈleɪtənsi/ 延迟 yán chí sequence number/ˈsiːkwəns ˈnʌmbə/ 序号 xù hào routing table/ˈraʊtɪŋ ˈteɪbl/ 路由表 lù yóu biǎo acknowledgement/əkˈnɒlɪdʒmənt/ 确认 què rèn checksum/ˈtʃeksəm/ 校验和 jiào yàn hé IP address/ˌaɪ ˈpiː əˈdres/ IP地址 IP dì zhǐ MAC addresses/mæk əˈdresɪz/ MAC地址 MAC dì zhǐ bandwidth/ˈbændwɪdθ/ 带宽 dài kuān latency/ˈleɪtənsi/ 延迟 yán chí header/ˈhedə/ 首部 shǒu bù 14.2
Definiciones que acepta el examinador
Una pregunta de definición se califica según un texto fijo. Aprenda estas exactamente, y dé solo una respuesta.
Término Definición protocolo un conjunto de reglas que rige cómo se transmiten los datos, acordado por el emisor y el receptor para que ambos lo interpreten de la misma manera pila de protocolos las capas de protocolos, cada una con su propia función, que juntas realizan la comunicación; cada capa se comunica solo con las capas superior e inferior capa de aplicación proporciona los protocolos usados por las aplicaciones para intercambiar datos (HTTP, SMTP, FTP, IMAP, POP3) capa de transporte establece la comunicación extremo a extremo, divide los datos en paquetes con números de puerto y secuencia, los reensambla y solicita los faltantes (TCP), o envía sin garantías (UDP) capa de internet añade direcciones IP para formar paquetes y los enruta entre redes a través de routers capa de enlace añade direcciones MAC para formar tramas y transmite los bits sobre la red local física router un dispositivo que lee la dirección de destino de un paquete y lo reenvía a lo largo de la mejor ruta disponible hacia ese destino conmutación de circuitos se establece un camino de comunicación dedicado entre los dos extremos antes de enviar los datos y se mantiene para toda la transmisión conmutación de paquetes el mensaje se divide en paquetes, cada uno con una cabecera, enviado independientemente por posibles rutas diferentes y reensamblado en el destino paquete una unidad de datos que lleva una cabecera (direcciones, número de secuencia, comprobación de errores) y una carga útil punto a punto intercambio de archivos sin un servidor central, cada computadora actuando como cliente y servidor a la vez 14.2
Consejos de examen
- Por qué protocolos: reglas compartidas, misma interpretación, cualquier marca de ordenador. Por qué capas: cada capa tiene un trabajo y puede cambiarse independientemente.
- Las cuatro capas en orden, de arriba hacia abajo: Aplicación, Transporte, Internet, Enlace. Dé el trabajo de cada capa en una oración, y la respuesta "mensaje de host a host" como un recorrido hacia abajo y hacia arriba por la pila.
- Los propósitos de los protocolos son frases cortas: HTTP páginas web, FTP archivos, SMTP envío de correo, POP3 descarga de correo, IMAP correo guardado en el servidor, BitTorrent fragmentos punto a punto de una bandada.
- Conmutación de circuitos: camino dedicado primero, todo el mensaje, mantenido durante la duración. Conmutación de paquetes: dividido, cabecera con direcciones y número de secuencia, rutas independientes, reensamblaje. Beneficios y desventajas vienen en pares opuestos.
- Un router lee la dirección de destino, consulta su tabla de enrutamiento, reenvía por la mejor ruta; es la pregunta de conmutación de paquetes que el examen hace con más frecuencia.
- "Cuándo es apropiado": conmutación de circuitos para una llamada telefónica o de video en vivo; conmutación de paquetes para correo electrónico, la web y descargas.
Errores comunes
- Definir un protocolo como "un lenguaje" o "software"; es un conjunto de reglas.
- Colocar las capas en el orden incorrecto, o mencionar las siete capas del modelo OSI en lugar de las cuatro de TCP/IP.
- Describir la capa de transporte como "enrutamiento" o la capa de Internet como "división en paquetes"; los puertos y la división son funciones de transporte, mientras que las direcciones IP y el enrutamiento corresponden a la capa de Internet.
- Confundir POP3 con IMAP, o afirmar que SMTP recibe correos electrónicos.
- Describir el conmutación de paquetes sin incluir el encabezado (direcciones y número de secuencia) o sin la reensamblaje.
- Decir que un router "envía el paquete a todas partes"; en realidad, selecciona una única siguiente etapa según su tabla de enrutamiento.
- Mencionar como ventaja de la conmutación de paquetes la desventaja de la conmutación de circuitos sin especificar el lado opuesto; cada diferencia debe presentarse con ambas caras.
- Afirmar que la conmutación de paquetes garantiza la entrega por sí sola; esa garantía la proporcionan los números de secuencia y los acuses de recibo de la capa de transporte.
-
15
Hardware y máquinas virtuales
Ver lección15.1
Procesadores RISC frente a CISC

Syllabus
Los candidatos deben ser capaces de: Notas y orientación Demostrar comprensión de los procesadores RISC (Reduced Instruction Set Computers, Computadoras con Juego de Instrucciones Reducidas) y CISC (Complex Instruction Set Computers, Computadoras con Juego de Instrucciones Complejo) Diferencias entre RISC y CISC. Comprensión del manejo de interrupciones en procesadores CISC y RISC. Demostrar comprensión de la importancia/uso del pipelining (procesoamiento en cascada) y los registros en procesadores RISC Demostrar comprensión de las cuatro arquitecturas informáticas básicas SISD, SIMD, MISD, MIMD Demostrar comprensión de las características de las computadoras paralelas masivas Demostrar comprensión del concepto de una máquina virtual Dar ejemplos del papel de las máquinas virtuales. Comprender las ventajas y limitaciones de las máquinas virtuales. Fuente: Plan de estudios Cambridge International
Dos estilos de diseño de CPU. La CPU se conecta directamente a la placa base 主板, la placa principal que une el procesador, la memoria y todas las demás partes del ordenador.
El CISC tiene muchas instrucciones complejas; el RISC tiene pocas instrucciones simples 
Una placa base une la CPU, la memoria y otras partes entre sí CISC
Un CISC 复杂指令集 (Computers con Conjunto de Instrucciones Complejas) dispone de muchas instrucciones, a menudo complejas (una puede realizar varios accesos a memoria y operaciones), de longitud variable, por lo que su decodificación es intrincada. Realiza más tareas por instrucción en el hardware. Ejemplos: Intel x86.
RISC
Un RISC 精简指令集 (Computers con Conjunto de Instrucciones Reducidas) cuenta con un conjunto pequeño de instrucciones simples, donde cada una realiza una única operación básica, todas de longitud fija (rápido de decodificar). Solo las instrucciones de carga y almacenamiento acceden a la memoria; todo lo demás es registro a registro 寄存器. Los programas son más largos, pero cada instrucción es rápida y predecible, lo cual favorece la canalización. Ejemplos: ARM, RISC-V.
Característica CISC RISC Conjunto de instrucciones muchas pocas Longitud de instrucción variable fija Acceso a memoria muchas instrucciones solo carga/almacenamiento Compatible con canalización más difícil naturalmente Ciclos por instrucción varía generalmente 1 La compensación consiste en hacer más por instrucción (CISC) frente a ejecutar cada instrucción más rápido y de forma más predecible (RISC). Los chips Intel modernos traducen las instrucciones CISC a micro-ops más simples similares a RISC internamente.
"Identifica cuatro características de un procesador RISC." Cualquier cuatro de: un conjunto pequeño de instrucciones simples; instrucciones de longitud fija (una palabra); la mayoría de las instrucciones se completan en un ciclo de reloj; muchos registros de propósito general; solo las instrucciones de carga y almacenamiento acceden a la memoria (toda la aritmética es de registro a registro); control por cableado fijo (sin microcódigo); diseñado para pipelining; el compilador hace más trabajo, por lo que los programas contienen más instrucciones y necesitan más memoria. "Identifica cuatro características de un procesador CISC." Cualquier cuatro de: un conjunto grande de instrucciones, muchas de ellas complejas (una instrucción puede hacer varias operaciones); instrucciones de longitud variable; instrucciones que toman varios ciclos de reloj; menos registros; instrucciones que pueden acceder a la memoria directamente; control microprogramado; menos adecuado para pipelining; programas más cortos, por lo que un compilador más simple y menos memoria. "Describe qué significa RISC y CISC" (dos marcas cada una): nombra la expansión y da la idea definitoria (pocas instrucciones simples de un solo ciclo; muchas instrucciones complejas de múltiples ciclos).
Manejo de interrupciones en los dos diseños. En un procesador CISC, la instrucción actual, por compleja que sea, se completa antes de que se atienda la interrupción; el procesador entonces guarda el contenido de sus registros (incluido el contador de programa) en la pila, salta a la rutina de servicio de interrupción y restaura los registros después. En un procesador RISC con una pipeline, varias instrucciones están a mitad de ejecución en el momento en que llega la interrupción, por lo que el procesador debe permitir que cada instrucción en la pipeline termine, o descartar (vaciar) las instrucciones parcialmente ejecutadas y reiniciarlas después de la interrupción; en cualquier caso, la pipeline se vacía, los registros se guardan y se ejecuta la rutina de servicio. La redacción del examen: "la pipelining hace más complejo el manejo de interrupciones, porque los contenidos de la pipeline deben gestionarse antes de que se pueda atender la interrupción".
Vocabulario EntrenarInglés Chino Pinyin motherboard/ˈmʌðəbɔːd/ 主板 zhǔ bǎn CISC/sɪsk/ 复杂指令集 fù zá zhǐ lìng jí RISC/rɪsk/ 精简指令集 jīng jiǎn zhǐ lìng jí register/ˈredʒɪstə/ 寄存器 jì cún qì interrupt/ˈɪntərʌpt/ 中断 zhōng duàn pipeline/ˈpaɪplaɪn/ 流水线 liú shuǐ xiàn 15.1
Pipelining
Una pipeline procesa instrucciones en etapas superpuestas, como una línea de ensamblaje: Búsqueda → Decodificación → Ejecución (en la ALU) → Acceso a memoria → Escritura de resultado. Cada etapa trabaja en una instrucción diferente al mismo tiempo, por lo que una vez que la pipeline está llena, una instrucción se completa por ciclo. Las instrucciones simples y de longitud fija de RISC hacen que cada etapa tome el mismo tiempo. Una pipeline puede detenerse debido a un peligro — un peligro de datos (una instrucción necesita un resultado que aún no está listo) o un peligro de control (una ramificación hace desconocida la siguiente dirección).
La pipelining superpone las etapas de seis instrucciones, por lo que una termina cada ciclo Los chips RISC mantienen los datos en muchos registros porque la memoria es lenta y los registros son rápidos; el compilador asigna los valores a los registros de manera inteligente.
"Describe el uso de la canalización (pipelining) en procesadores RISC" (tres puntos). (1) El ciclo fetch–execute se divide en etapas (fetch, decode, execute, memory access, write back); (2) varias instrucciones están en la canalización al mismo tiempo, cada una en una etapa diferente, por lo que mientras una se está ejecutando, la siguiente se está decodificando y la siguiente se está buscando; (3) se inicia una nueva instrucción y se completa una en cada ciclo de reloj una vez que la canalización está llena, lo que aumenta throughput 吞吐量 (el número de instrucciones completadas por segundo), aunque cada instrucción sigue tomando el mismo tiempo por sí sola. Las instrucciones RISC de longitud fija y un solo ciclo son las que hacen que las etapas sean iguales y permitan la canalización.
Ejemplo resuelto. Un procesador utiliza cinco etapas de canalización (IF, ID, OF, EX, WB). Cuatro instrucciones entran en la canalización una tras otra. En qué ciclo completa la última instrucción, y cuántos ciclos tardarían las cuatro sin canalización?
La instrucción 1 ocupa IF en el ciclo 1, ID en 2, OF en 3, EX en 4 y WB en 5; la instrucción 2 comienza un ciclo después y termina en el ciclo 6; la instrucción 3 en el ciclo 7; la instrucción 4 en el ciclo 8. En general $n$ instrucciones a través de $k$ etapas toman $n + k - 1$ ciclos, aquí $4 + 5 - 1 = 8$. Sin pipelining cada instrucción toma todos los cinco ciclos antes de que comience la siguiente: $4 \times 5 = 20$ ciclos. La tabla del examen se llena escribiendo las etapas de cada instrucción en diagonal, una columna a la derecha de la instrucción anterior.
Un procesador que funciona rápido genera mucho calor, por lo que un disipador de calor 散热器 y un ventilador están colocados encima. Las aletas metálicas dispersan el calor y el ventilador lo expulsa, manteniendo la CPU lo suficientemente fría para funcionar.

Un disipador de calor y ventilador de CPU llevan el calor lejos del procesador ExplorarCómo se llena el pipeline
Pase por los ciclos de reloj. Una vez que el pipeline está lleno, una nueva instrucción termina cada ciclo —aunque cada una todavía requiere varios stages— porque los stages de diferentes instrucciones se superponen.
Vocabulario EntrenarInglés Chino Pinyin ALU/ˌeɪ el ˈjuː/ 算术逻辑单元 suàn shù luó jí dān yuán hazard/ˈhæzəd/ 冒险 mào xiǎn throughput/ˈθruːpʊt/ 吞吐量 tūn tǔ liàng heat-sink/hiːt sɪŋk/ 散热器 sàn rè qì Flynn's taxonomy/flɪnz tækˈsɒnəmi/ 弗林分类 fú lín fēn lèi 15.1
Taxonomía de Flynn
La taxonomía de Flynn 弗林分类 clasifica las computadoras según el número de flujos de instrucciones y datos:
- SISD — un flujo de instrucción, un flujo de datos (un núcleo único tradicional).
- SIMD 单指令多数据 — una instrucción opera sobre muchos elementos de datos a la vez (GPUs, extensiones vectoriales de CPU). Ideal para imágenes, video y arreglos científicos.
- MISD — varias operaciones sobre los mismos datos; raro, principalmente teórico.
- MIMD 多指令多数据 — muchos procesadores ejecutan diferentes instrucciones sobre diferentes datos (CPUs multi-núcleo, clústers). El más general.
Describiendo las cuatro arquitecturas (dos puntos cada una). SISD: un procesador único ejecuta una instrucción a la vez sobre un solo elemento de datos; no hay paralelismo, es la máquina tradicional de von Neumann. SIMD: una sola instrucción se aplica simultáneamente a muchos elementos de datos, por medio de muchos elementos de procesamiento que actúan sincronizados; se utiliza para el procesamiento de matrices y gráficos. MISD: varios procesadores aplican instrucciones diferentes al mismo dato; raramente se usa, por ejemplo en sistemas tolerantes a fallos donde varios procesadores verifican un mismo flujo de datos. MIMD: muchos procesadores, cada uno ejecutando sus propias instrucciones sobre sus propios datos, de forma independiente; es la computadora multicore y el clúster.
SIMD: muchos procesadores ejecutan la misma instrucción sobre distintos datos Una tarjeta gráfica 显卡 (con su GPU) es un ejemplo real de hardware SIMD: tiene miles de núcleos pequeños que ejecutan la misma instrucción sobre muchos píxeles o números al mismo tiempo, razón por la cual las GPUs son tan rápidas para imágenes, video y aprendizaje automático.

Una tarjeta gráfica: su GPU ejecuta la misma instrucción sobre muchos elementos de datos al mismo tiempo (SIMD) 
MIMD: cada procesador ejecuta sus propias instrucciones sobre sus propios datos Vocabulario EntrenarInglés Chino Pinyin SIMD/ˈsɪmdiː/ 单指令多数据 dān zhǐ lìng duō shù jù MIMD/ˈmɪmdiː/ 多指令多数据 duō zhǐ lìng duō shù jù graphics card/ˈɡræfɪks kɑːd/ 显卡 xiǎn kǎ massively parallel/ˈmæsɪvli ˈpærəlel/ 大规模并行 dà guī mó bìng xíng distributed memory/ˈdɪstrɪbjuːtɪd ˈmeməri/ 分布式内存 fēn bù shì nèi cún machine learning/məˈʃiːn ˈlɜːnɪŋ/ 机器学习 jī qì xué xí supercomputers/ˌsuːpəkəmˈpjuːtəz/ 超级计算机 chāo jí jì suàn jī 15.1
Computadoras masivamente paralelas

Un sistema masivamente paralelo 大规模并行 utiliza miles de procesadores en una red rápida, cada uno con su propia memoria (memoria distribuida 分布式内存), intercambiando datos mediante mensajes. Es MIMD, requiere software escrito especialmente (MPI, CUDA) y se adapta a simulaciones climáticas, entrenamiento de gran escala de aprendizaje automático 机器学习 y astrofísica. Los mayores supercomputadores 超级计算机 son masivamente paralelos.
"Enumere las características de las computadoras masivamente paralelas" (tres puntos). Un número muy grande de procesadores (miles), cada uno con su propia memoria, conectados por una roja (un interconector de alta velocidad o bus) para poder pasarse mensajes entre sí; trabajan simultáneamente en partes del mismo problema, por lo que este debe programarse como un programa que pueda dividirse en partes que se ejecuten en paralelo y combinen sus resultados. Es una disposición MIMD.
Los procesadores se encuentran en gabinetes altos de servidores 服务器, que a menudo llenan toda una habitación (un centro de datos 数据中心), cableados juntos para que puedan trabajar en un gran problema al mismo tiempo.
Filas de servidores en un centro de datos, como los utilizados para computación masivamente paralela Vocabulario EntrenarInglés Chino Pinyin server/ˈsɜːvə/ 服务器 fú wù qì data centre/ˈdeɪtə ˈsentə/ 数据中心 shù jù zhōng xīn virtual machine/ˈvɜːtʃuːəl məˈʃiːn/ 虚拟机 xū nǐ jī hypervisor/ˌhaɪpəˈvaɪzə/ 虚拟机监控器 xū nǐ jī jiān kòng qì sandboxing/ˈsændbɒksɪŋ/ 沙箱 shā xiāng 15.1
Máquinas virtuales
Una máquina virtual 虚拟机 es una emulación por software de una computadora completa: el software interno ve una CPU, memoria y discos que parecen reales pero que son gestionados por el software anfitrión.
- Una máquina virtual de sistema ejecuta un SO completo. Un hipervisor 虚拟机监控器 crea y gestiona máquinas virtuales, cada una iniciando su propio SO invitado. Usos: ejecutar distintos SOs en una misma máquina; consolidación de servidores; aislamiento 沙箱 (el software riesgoso se ejecuta aislado); instantáneas.
- Una máquina virtual de proceso (lenguaje) ejecuta un programa en bytecode 字节码 portable: la JVM (Java), el CLR (.NET), CPython. Beneficios: portabilidad ("escribir una vez, ejecutar en cualquier lugar"), comprobaciones de seguridad en tiempo de ejecución y compilación just-in-time 即时编译 para velocidad cercana a la nativa. El coste es una capa adicional y la necesidad de tener instalada la VM.
Una computadora real, varias aparentes: el sistema operativo anfitrión y el hipervisor comparten el hardware, y cada sistema operativo invitado se ejecuta como si tuviera su propia máquina "Describa qué se entiende por máquina virtual" (dos puntos). Una emulación (implementación) por software de un sistema informático que se ejecuta en una computadora anfitriona y se comporta, para los programas que corren en su interior, como una computadora física separada con su propio procesador, memoria y almacenamiento. El sistema operativo anfitrión 宿主操作系统 se ejecuta sobre el hardware real, gestiona los recursos físicos y (a través del hipervisor) crea y controla las máquinas virtuales; cada sistema operativo invitado 客户操作系统 corre dentro de una máquina virtual, gestiona las aplicaciones en ella y no sabe que su hardware es virtual.
Beneficios (de dos). Pueden correr distintos sistemas operativos en una misma máquina al mismo tiempo; el software puede ser probado en múltiples sistemas sin comprar el hardware; un nuevo sistema informático puede ser emulado y probado antes de construirse; cada VM está aislada, por lo que un fallo o malware en una no afecta al anfitrión ni a las demás; las VMs pueden ser copiadas, movidas y respaldadas como archivos, y un servidor puede compartirse entre muchos usuarios, reduciendo el costo de hardware. Limitaciones (de dos). Una VM ejecuta más lentamente que el hardware real porque cada instrucción pasa por la capa de emulación; consume la memoria y potencia de procesamiento del anfitrión, por lo que este debe ser potente; algunas funciones o dispositivos de hardware no se emulan exactamente, por lo que el software probado puede comportarse de forma distinta en la máquina real; se necesitan licencias para cada SO invitado, y configurar el sistema requiere experiencia.
ExplorarLaboratorio de conceptos informáticos
Clasificar ejemplos concretos según la idea informática que demuestran.
Vocabulario EntrenarInglés Chino Pinyin bytecode/ˈbaɪtkəʊd/ 字节码 zì jié mǎ just-in-time compilation/dʒʌst ɪn taɪm ˌkɒmpɪˈleɪʃn/ 即时编译 jí shí biān yì host operating system/həʊst ˈɒpəreɪtɪŋ ˈsɪstəm/ 宿主操作系统 sù zhǔ cāo zuò xì tǒng guest operating system/ɡest ˈɒpəreɪtɪŋ ˈsɪstəm/ 客户操作系统 kè hù cāo zuò xì tǒng Boolean algebra/ˈbuːlɪən ˈældʒɪbrə/ 布尔代数 bù ěr dài shù 15.2
Álgebra de Boole
Syllabus
Los candidatos deben ser capaces de: Notas y orientación Elaborar tablas de verdad para circuitos lógicos que incluyan semisumadores y sumadores completos Pueden incluir puertas lógicas con más de dos entradas Demostrar comprensión de un flip-flop (SR, JK) Dibujar un circuito lógico y derivar una tabla de verdad para un flip-flop. Comprender el papel de los flip-flops como elementos de almacenamiento de datos Demostrar comprensión del álgebra de Boole Comprender las leyes de De Morgan. Realizar operaciones con álgebra de Boole aplicando las leyes de De Morgan. Simplificar un circuito o expresión lógica mediante el álgebra de Boole Demostrar comprensión de los mapas de Karnaugh (K-map) Comprender los beneficios del uso de los mapas de Karnaugh. Resolver problemas lógicos utilizando mapas de Karnaugh Fuente: Plan de estudios Cambridge International
El semisumador: XOR + AND suma dos bits El álgebra de Boole 布尔代数 simplifica expresiones Booleanas 布尔, que también pueden describirse mediante tablas de verdad 真值表. Símbolos:
+para OR,·para AND (a menudo omitido), una barra superior para NOT.Las leyes clave incluyen las conmutativa, asociativa y distributiva (como en el álgebra ordinaria), además de:
- identidad $A + 0 = A$, $A \cdot 1 = A$; nulo $A + 1 = 1$, $A \cdot 0 = 0$.
- idempotente $A + A = A$; inverso $A + \overline{A} = 1$, $A \cdot \overline{A} = 0$.
- Leyes de De Morgan 德摩根定律: $(A + B)' = A' \cdot B'$; $(A \cdot B)' = A' + B'$ — negar todo, cambiar AND/OR, negar cada operandos.
- absorción 吸收律: $A + AB = A$.
La simplificación reduce el número de términos, de modo que el circuito lógico resultante tiene menos puertas lógicas. Ejemplo: $Z = AB + A\overline{B} = A(B + \overline{B}) = A$.
Las leyes con sus nombres (cite el nombre en cada paso cuando se pida "mostrar todo el procedimiento").
Ley Forma OR Forma AND identidad $A + 0 = A$ $A \cdot 1 = A$ nulo (anulación) $A + 1 = 1$ $A \cdot 0 = 0$ idempotente $A + A = A$ $A \cdot A = A$ complemento (inverso) $A + \overline{A} = 1$ $A \cdot \overline{A} = 0$ conmutativa $A + B = B + A$ $A \cdot B = B \cdot A$ asociativa $A + (B + C) = (A + B) + C$ $A(BC) = (AB)C$ distributiva $A + BC = (A + B)(A + C)$ $A(B + C) = AB + AC$ absorción $A + AB = A$ $A(A + B) = A$ De Morgan $\overline{A + B} = \overline{A} \cdot \overline{B}$ $\overline{A \cdot B} = \overline{A} + \overline{B}$ doble negación $\overline{\overline{A}} = A$ Ejercicio resuelto. Simplifique $X = \overline{\overline{(A \cdot B)} \cdot \overline{(A + B)}}$, mostrando todo el procedimiento.
$X = \overline{\overline{(A \cdot B)}} + \overline{\overline{(A + B)}}$ (De Morgan en la barra exterior) $= A \cdot B + A + B$ (doble negación) $= A + B$ (absorción, $A + AB = A$, aplicada con $A + B$ absorbiendo $AB$).
Ejemplo resuelto. Simplifique $(\overline{A + B}) \cdot (\overline{A} + B)$.
$= \overline{A} \cdot \overline{B} \cdot (\overline{A} + B)$ (De Morgan) $= \overline{A}\,\overline{B}\,\overline{A} + \overline{A}\,\overline{B}\,B$ (distributiva) $= \overline{A}\,\overline{B} + 0$ (idempotente, complemento) $= \overline{A}\,\overline{B}$.
Ejemplo resuelto. Simplifique $Y = \overline{A}\,\overline{B}\,\overline{C} + \overline{A}\,\overline{B}\,C + A\,\overline{B}\,C$.
$= \overline{A}\,\overline{B}(\overline{C} + C) + A\,\overline{B}\,C$ (distributiva) $= \overline{A}\,\overline{B} + A\,\overline{B}\,C$ (complemento, identidad) $= \overline{B}(\overline{A} + AC)$ (distributiva) $= \overline{B}(\overline{A} + C)$, usando $\overline{A} + AC = (\overline{A} + A)(\overline{A} + C) = \overline{A} + C$. Aplicar De Morgan a un término de tres entradas funciona de la misma manera: $\overline{A + B + C} = \overline{A} \cdot \overline{B} \cdot \overline{C}$.
Suma de productos a partir de una tabla de verdad. Tome cada fila cuya salida sea 1, escriba el AND de sus entradas (una variable con barra donde es 0), y OR los términos: una fila con $A = 1, B = 0, C = 1$ da como resultado $A\,\overline{B}\,C$. Esta es la forma suma de productos 积之和 que pide el examen, y es el punto de partida tanto para la simplificación algebraica como para el mapa de Karnaugh.
ExplorarÁlgebra de Boole
A·B, A+B, Ā …
El álgebra de Boole son simplemente estas compuertas escritas como expresiones — compara las tablas de verdad.
ExplorarTablas de verdad booleanas
Elige un operador y las entradas para construir su tabla de verdad: el álgebra detrás de los circuitos lógicos.
Vocabulario EntrenarInglés Chino Pinyin Boolean/ˈbuːlɪən/ 布尔 bù ěr truth tables/truːθ ˈteɪblz/ 真值表 zhēn zhí biǎo De Morgan's laws/də ˈmɔːɡənz lɔːz/ 德摩根定律 dé mó gēn dìng lǜ absorption/əbˈsɔːpʃn/ 吸收律 xī shōu lǜ sum-of-products/sʌm ɒv ˈprɒdʌkts/ 积之和 jī zhī hé Karnaugh map/ˈkɑːnɔː mæp/ 卡诺图 kǎ nuò tú Gray code/ɡreɪ kəʊd/ 格雷码 gé léi mǎ half adder/hɑːf ˈædə/ 半加器 bàn jiā qì 15.2
Mapas de Karnaugh
Un mapa de Karnaugh 卡诺图 (K-map) simplifica una expresión Booleana agrupando 1s adyacentes de una tabla de verdad. Las columnas y filas utilizan el orden de código Gray 格雷码 (
00,01,11,10) para que las celdas adyacentes difieran en una variable.Coloca un 1 en cada celda donde la salida sea 1. Encuentra grupos rectangulares de 1s cuyos lados sean potencias de 2 (1, 2, 4, 8), envolviendo alrededor de los bordes si esto hace un grupo más grande. Cuanto mayor sea el grupo, más simple será el término: un grupo de 2 elimina una variable, un grupo de 4 elimina dos, y así sucesivamente — las variables que cambian dentro del grupo desaparecen. OR los términos del grupo juntos para la expresión simplificada. Cubre cada 1 usando tan pocos grupos grandes como sea posible.
Ejemplo resuelto. Un mapa de Karnaugh para $A$ y $B$ tiene 1s en las celdas $\overline{A}B$ y $AB$. Simplificar. Los dos 1s son adyacentes - comparten la columna $B=1$ - por lo que se agrupan como un rectángulo de 2. Dentro de ese grupo $B$ permanece 1 constantemente mientras $A$ cambia de 0 a 1, y cualquier variable que cambie dentro de un grupo desaparece. Por lo tanto, el grupo deja simplemente $X = B$. Comparar eso con la suma de productos leída directamente desde la tabla, $\overline{A}B + AB$: el mismo circuito, dos puertas menos. Dos reglas realizan la mayor parte del trabajo: hacer cada grupo lo más grande posible (un grupo de 2 elimina una variable, 4 elimina dos, 8 elimina tres), y recordar que el mapa se envuelve en sus bordes, por lo que las columnas izquierda y derecha son adyacentes. Ese envoltorio es el agrupamiento que la mayoría de los candidatos pasan por alto.
Bucles de 1, 2, 4 u 8 unos; el término de un bucle conserva solo las variables que no cambian dentro de él. Los bordes se conectan, por lo que un bucle puede rodear el mapa, y las cuatro esquinas cuentan como adyacentes Construcción y lectura de un mapa K. Etiquete las columnas $AB$ y las filas $C$ (o $CD$) en orden de código Gray
00 01 11 10, de modo que las celdas vecinas difieran en solo una variable. Coloque un 1 en cada celda cuyo mintermo aparezca en la expresión (o cuya fila de la tabla de verdad tenga salida 1). Luego dibuje los menos, más grandes bucles posibles que cubran cada 1: cada bucle debe ser un rectángulo de $1, 2, 4$ o $8$ celdas, los bucles pueden superponerse, pueden envolverse a través de los bordes izquierdo-derecho y superior-inferior, y las cuatro esquinas juntas forman un bucle. Para cada bucle, escriba las variables que son constantes dentro de él (con barra si son 0), y OR los términos de los bucles: esa es la suma de productos óptima. ¿Por qué usar uno? Proporciona la expresión más simple sin álgebra, en pocos pasos, con menos probabilidad de error, y el mismo mapa sirve para tres o cuatro variables.Ejemplo resuelto. $Z = \overline{A}\,\overline{B}\,\overline{C} + \overline{A}\,\overline{B}\,C + \overline{A}\,B\,\overline{C} + \overline{A}\,B\,C + A\,\overline{B}\,\overline{C} + A\,\overline{B}\,C$.
En el mapa de tres variables, los 1s llenan las columnas 00, 01 y 10 en ambas filas. El bucle de cuatro sobre las columnas 00 y 01 tiene $A = 0$ en toda su extensión y $B$, $C$ varían: término $\overline{A}$. El bucle de cuatro sobre las columnas 00 y 10 (envolviendo) tiene $B = 0$ en toda su extensión: término $\overline{B}$. Por lo tanto $Z = \overline{A} + \overline{B}$, lo cual la álgebra booleana confirma: $\overline{A}(\overline{B} + B) + \ldots = \overline{A} + \overline{B}$. Dos bucles de dos también serían correctos pero no óptimos; un bucle debe ser tan grande como lo permitan los 1s.
Ejemplo resuelto (cuatro variables). Un mapa tiene 1s únicamente en sus cuatro esquinas: $\overline{A}\,\overline{B}\,\overline{C}\,\overline{D}$, $A\,\overline{B}\,\overline{C}\,\overline{D}$, $\overline{A}\,\overline{B}\,C\,\overline{D}$ y $A\,\overline{B}\,C\,\overline{D}$. Dado que las filas superior e inferior son adyacentes y lo son también las columnas exteriores, las esquinas forman un solo bucle de cuatro; $B = 0$ y $D = 0$ están presentes en todos ellos mientras que $A$ y $C$ varían, por lo tanto $Z = \overline{B}\,\overline{D}$.
15.2
Sumador medio y sumador completo

Un sumador medio 半加器 suma dos bits simples $A$ y $B$, produciendo una suma $S$ y una llevada 进位 $C$:
A B S C 0 0 0 0 0 1 1 0 1 0 1 0 1 1 0 1 Por lo tanto $S = A \text{ XOR } B$ y $C = A \text{ AND } B$. Ignora cualquier entrada de llevar —de ahí "medio".
Un sumador medio, como bloque y como circuito con una compuerta XOR y una AND Un sumador completo 全加器 suma tres bits ($A$, $B$, entrada de llevar), produciendo una suma y una salida de llevar: $S = A \text{ XOR } B \text{ XOR } C_{\text{in}}$. Puede construirse a partir de dos sumadores medios más una compuerta OR. Encadenar sumadores completos (donde cada salida de llevar alimenta la siguiente entrada de llevar) forma un sumador "ripple-carry" de múltiples bits.

Un sumador completo se construye a partir de dos sumadores medios y una compuerta OR La tabla de verdad del sumador completo. Con entradas $A$, $B$ y la entrada de llevar $C_{\text{in}}$: la suma $S$ es 1 cuando un número impar de entradas es 1, y la salida de llevar es 1 cuando dos o más entradas son 1.
$A$ $B$ $C_{\text{in}}$ $S$ $C_{\text{out}}$ 0 0 0 0 0 0 0 1 1 0 0 1 0 1 0 0 1 1 0 1 1 0 0 1 0 1 0 1 0 1 1 1 0 0 1 1 1 1 1 1 Las preguntas de circuitos que plantea el examen. Dado un circuito con una XOR y una AND compartiendo dos entradas, o dos sumadores medios y una OR, "completar la tabla de verdad (mostrar el procedimiento)" significa añadir una columna para cada salida intermedia de compuerta y rellenar las filas en orden; "indicar el nombre del circuito" es sumador medio o sumador completo; "indicar el propósito de cada salida" es la suma de los bits y la llevada hacia la siguiente columna. Suma de productos para el sumador medio: $S = \overline{A}B + A\overline{B}$, $C = AB$. Una cadena de sumadores completos, donde cada uno pasa su salida de llevar a la siguiente entrada de llevar, suma dos números de múltiples bits.
ExplorarLas puertas dentro de un sumador
El bit de suma de un medio sumador es una puerta XOR y su acarreo es una puerta AND; alterna A y B y observa cómo se ilumina la fila de la tabla de verdad.
Vocabulario EntrenarInglés Chino Pinyin carry/ˈkæri/ 进位 jìn wèi full adder/fʊl ˈædə/ 全加器 quán jiā qì 15.2
Flip-flops
Un flip-flop 触发器 es un circuito bistable 双稳态 —dos estados estables (0 y 1)— que recuerda su estado. Almacena un bit y es el elemento básico de registros y SRAM.
Flip-flop SR
Un flip-flop SR SR触发器 tiene entradas S (set) y R (reset) y salidas Q y $\overline{Q}$.
S=1,R=0establece Q en 1;S=0,R=1lo restablece a 0;S=0,R=0mantiene el valor;S=1,R=1es inválido. Construido con dos puertas NOR acopladas cruzadamente.El flip-flop SR: dos puertas NOR que se alimentan mutuamente. Con ambas entradas en 0, las salidas mantienen lo que eran, lo cual es la memoria; S establece Q en 1, R lo restablece, y S = R = 1 no está permitido. "Dibuje un circuito lógico para un flip-flop SR y etiquete las entradas." Dos puertas NOR (o dos puertas NAND), la salida de cada una conectada de vuelta a una entrada de la otra; la entrada libre de una puerta es S, la de la otra R; las salidas son $Q$ y $\overline{Q}$. La retroalimentación es por lo que se otorgan puntos: sin ella no hay memoria. "Indique el propósito de un flip-flop." Almacenar un bit de datos; es el elemento básico de memoria del que se construyen registros y RAM estática, y mantiene su valor hasta que se cambia deliberadamente. La entrada inválida $S = R = 1$ hace que ambas salidas sean 0, por lo que $\overline{Q}$ deja de ser el complemento de $Q$, y el estado después de que ambas entradas vuelven a 0 es impredecible, lo cual es la debilidad del flip-flop SR.
Flip-flop JK
Un flip-flop JK JK触发器 mejora al anterior utilizando la entrada anteriormente inválida
1,1como un toggle 翻转 (la salida cambia). Esto lo hace ideal para construir contadores 计数器 (una cadena de flip-flops con toggle). Generalmente es con reloj: las entradas actúan solo en un flanco de reloj, manteniendo los flip-flops sincronizados.
Un flip-flop JK: su símbolo y una construcción con puertas NAND Los flip-flops son los bloques de construcción de registros (n bits = n flip-flops), contadores y celdas de SRAM 静态RAM.
Tabla de verdad del flip-flop JK. La entrada clock 时钟 decide cuándo se leen las entradas J y K, por lo que la salida cambia solo en un pulso de reloj: con $J = K = 0$ la salida se mantiene; $J = 1, K = 0$ establece $Q$ en 1; $J = 0, K = 1$ lo restablece a 0; $J = K = 1$ lo cambia (Q se convierte en $\overline{Q}$). La última fila es exactamente la entrada prohibida del flip-flop SR convertida en una útil, por eso se prefiere el JK: todas las combinaciones de entrada son válidas, y la operación con reloj lo convierte en el bloque de construcción de contadores y registros de desplazamiento.
Vocabulario EntrenarInglés Chino Pinyin flip-flop/flɪp flɒp/ 触发器 chù fā qì bistable/baɪˈsteɪbl/ 双稳态 shuāng wěn tài toggle/ˈtɒɡl/ 翻转 fān zhuǎn counters/ˈkaʊntəz/ 计数器 jì shù qì SRAM/ˈesræm/ 静态RAM jìng tài RAM clock/klɒk/ 时钟 shí zhōng SR flip-flop/ˌes ˈɑː flɪp flɒp/ SR触发器 SR chù fā qì JK flip-flop/ˌdʒeɪ ˈkeɪ flɪp flɒp/ JK触发器 JK chù fā qì 15.2
Definiciones aceptadas por el examinador
Una pregunta de definición se califica según un texto fijo. Aprende estas definiciones exactamente, y da solo una respuesta.
Término Definición RISC un procesador con un conjunto pequeño de instrucciones simples, de longitud fija, ejecutadas mayoritariamente en un ciclo de reloj, usando muchos registros y pipelining CISC un procesador con un gran conjunto de instrucciones complejas, de longitud variable, muchas que requieren varios ciclos de reloj y acceden directamente a la memoria pipelining dividir el ciclo de búsqueda-ejecución en etapas para que varias instrucciones se procesen a la vez, cada una en una etapa diferente SISD / SIMD / MISD / MIMD una instrucción sobre un ítem de datos; una instrucción sobre muchos ítems de datos; muchas instrucciones sobre un ítem de datos; muchas instrucciones sobre muchos ítems de datos computadora masivamente paralela miles de procesadores, cada uno con su propia memoria, conectados por una red y trabajando simultáneamente en un mismo problema máquina virtual una emulación de software de un sistema informático que se ejecuta en una computadora anfitriona y se comporta como una computadora física independiente hipervisor el software que crea máquinas virtuales y comparte el hardware del anfitrión entre ellas tabla de verdad una tabla que enumera cada combinación de entradas de un circuito lógico con la(s) salida(s) resultante(s) suma de productos una expresión booleana escrita como la OR de términos AND, un término para cada combinación de entrada que da 1 mapa de Karnaugh una cuadrícula de las salidas de la tabla de verdad, organizadas en orden de código Gray, en la que bucles de 1s adyacentes dan la expresión simplificada sumador medio un circuito que suma dos bits, produciendo una suma y un acarreo sumador completo un circuito que suma dos bits y un acarreo de entrada, produciendo una suma y un acarreo de salida flip-flop un circuito bistable que almacena un bit, manteniendo su salida hasta que sus entradas lo cambian 15.2
Consejos para el examen
- RISC y CISC se responden como listas de características: simple, fija, un ciclo, muchos registros, carga/almacenamiento, pipeline frente a complejo, variable, multi-ciclo, menos registros, acceso directo a memoria, microcódigo. Cuatro de cada una.
- Pipelining: etapas, varias instrucciones a la vez, una completada por ciclo, mayor rendimiento; $n + k - 1$ ciclos para $n$ instrucciones a través de $k$ etapas; las interrupciones deben vaciar el pipeline.
- Las cuatro categorías de Flynn son "cuántos flujos de instrucciones" por "cuántos flujos de datos"; diga qué se ejecuta en qué. Masivamente paralela: muchos procesadores, memoria propia, red, mismo problema.
- Máquina virtual: emulación de una computadora en un anfitrión; SO anfitrión en el hardware, hipervisor compartiendo, SO huésped dentro. Dos beneficios y dos limitaciones, cada uno una oración completa.
- Álgebra de Boole: nombre cada ley a medida que la use; De Morgan intercambia el operador y niega cada término; verifique con una tabla de verdad si tiene dudas.
- Mapa K: orden de código Gray, bucles más grandes de 1/2/4/8, permite envoltura, un término por bucle con las variables invariables. Indique por qué: expresión más simple sin álgebra.
- Sumador medio da suma y acarreo; sumador completo también toma acarreo de entrada; flip-flop SR son dos puertas NOR/NAND acopladas cruzadamente y almacena un bit; el input 1,1 del JK realiza toggle.
Errores comunes
- Intercambiar las listas de características de RISC y CISC, u ofrecer "más rápido" como característica; dé las características de diseño, no un juicio.
- Describir el pipelining como "ejecutar instrucciones en paralelo en varios núcleos"; son etapas de un solo procesador superpuestas.
- Confundir SIMD (una instrucción, muchos datos) con MIMD (muchos de ambos), o describir MISD como el caso común.
- Definir una máquina virtual como "una copia de una computadora" sin la palabra emulación o el anfitrión y el huésped.
- Aplicar De Morgan solo a parte de una expresión bajo una barra larga, o eliminar la barra sin intercambiar AND por OR.
- Hacer un bucle con un grupo de tres, o un grupo no rectangular, en un mapa K; ordenar las columnas 00, 01, 10, 11 en lugar de código Gray.
- Escribir el acarreo de un sumador medio como XOR y la suma como AND.
- Dibujar un flip-flop SR como dos puertas sin retroalimentación, u omitir el estado inválido de su tabla de verdad.
-
16
Software de sistema
Ver lección16.1
Cómo el SO maximiza el uso de recursos

Syllabus
Los candidatos deben ser capaces de: Notas y orientación Demostrar comprensión de cómo un SO puede maximizar el uso de los recursos Describir las formas en que la interfaz de usuario oculta las complejidades del hardware al usuario Demostrar comprensión de la gestión de procesos El concepto de multitarea y un proceso
Los estados del proceso: ejecución, listo y bloqueado
La necesidad de planificación y la función y beneficios de diferentes rutinas de planificación (incluyendo round robin, shortest job first, first come first served, shortest remaining time)
Cómo el kernel del SO actúa como manejador de interrupciones y cómo el manejo de interrupciones se utiliza para gestionar la planificación a bajo nivelDemostrar comprensión de la memoria virtual, el paginación y la segmentación para la gestión de memoria Los conceptos de paginación, memoria virtual y segmentación
La diferencia entre paginación y segmentación
Cómo pueden reemplazarse las páginas
Cómo puede ocurrir el thrashing (agotamiento) del discoFuente: Plan de estudios Cambridge International
Un ordenador dispone de muchos recursos (tiempo de CPU, memoria, disco, E/S) y varios programas compiten por ellos. El SO los comparte de forma justa y eficiente para que cada uno se utilice adecuadamente y el sistema permanezca reactivo:
El SO comparte la CPU, la memoria, el disco y las E/S entre los programas - multitarea — cambiar rápidamente la CPU entre procesos para que varios parezcan ejecutarse a la vez.
- gestión de memoria — asignar a cada proceso la memoria que necesita; utilizar el paging 分页 del disco cuando se agota la RAM.
- spooling 假脱机 y buffering: las tareas de impresión se encolan en el disco para que la CPU nunca espere a la impresora.
- caching: mantener datos recientes del disco en una cache 高速缓存 / RAM.

El procesador es un recurso clave que el SO comparte entre tareas competidoras 
El SO también gestiona la memoria (RAM), decidiendo qué mantener en ella y qué enviar al disco mediante paging Vocabulario EntrenarInglés Chino Pinyin multi-tasking/ˈmʌlti ˈtæskɪŋ/ 多任务 duō rèn wù paging/ˈpeɪdʒɪŋ/ 分页 fēn yè spooling/ˈspuːlɪŋ/ 假脱机 jiǎ tuō jī cache/kæʃ/ 高速缓存 gāo sù huǎn cún process/ˈprəʊses/ 进程 jìn chéng scheduler/ˈʃedjʊlə/ 调度器 diào dù qì 16.1
La interfaz de usuario
La interfaz de usuario oculta el hardware detrás de abstracciones amigables: el usuario ve ventanas, menús y carpetas, no direcciones ni sectores. Un solo clic en un icono hace que el SO localice el programa en el disco, le asigne memoria, lo cargue y lo inicie. Una CLI (línea de comandos) es potente y scriptable para expertos; una GUI (gráfica) es más fácil de aprender. La mayoría de sistemas ofrecen ambos.
"Describa dos formas en que se ocultan al usuario las complejidades del hardware." (1) El usuario trabaja con archivos y carpetas por nombre, y el SO los traduce en pistas, sectores y bloques del disco; (2) el usuario ejecuta un programa con un clic o un comando, y el SO lo carga, le asigna memoria y lo programa sin que el usuario conozca ninguna dirección; (3) los controladores de dispositivo permiten al usuario imprimir o guardar sin saber cómo se controla la impresora o el disco; (4) una interfaz gráfica sustituye los comandos a nivel de máquina por iconos, ventanas y menús. El beneficio para un estudiante, con un ejemplo: el SO hace que el hardware sea utilizable sin conocimientos técnicos, por ejemplo, guardando un documento en una unidad USB arrastrando su icono.
"Muestre cómo un SO maximiza el uso de recursos." Programa el procesador para que nunca esté inactivo mientras haya un proceso listo; gestiona la memoria, asignándola a los procesos, recuperándola y ampliándola con memoria virtual; gestiona la entrada y salida, utilizando buffers y spooling para que dispositivos rápidos y lentos superpongan sus trabajos; y gestiona el almacenamiento, llevando un registro del espacio libre y los archivos. Cada punto nombra un recurso y lo que hace el SO con él.
16.1
Gestión de procesos
Un proceso 进程 es un programa en ejecución: su código, estado actual, memoria y archivos abiertos.
Programación
El programador 调度器 elige qué proceso listo se ejecutará a continuación y durante cuánto tiempo:
- round robin 轮转 — cada proceso recibe un time slice 时间片 fijo y luego pasa al final de la cola.
- primero en llegar, primero en ser atendido; trabajo más corto primero; tiempo restante más corto (ejecutar el trabajo con menos trabajo pendiente); prioridad; colas de retroalimentación multinivel.
El compromiso es la reactividad frente al rendimiento frente a la equidad.
"Describa lo que significa multitarea y cómo beneficia a la gestión de procesos." Varios procesos se mantienen en memoria al mismo tiempo y el procesador cambia entre ellos tan rápido que parecen ejecutarse simultáneamente, recibiendo cada uno turnos de tiempo de procesador a su vez. El beneficio: el procesador nunca queda inactivo mientras un proceso espera entrada o salida, por lo que el rendimiento es mayor y el usuario puede trabajar con varios programas a la vez. "Explique la necesidad de programar." Hay más procesos que procesadores, por lo que se debe decidir cuál proceso se ejecutará a continuación y por cuánto tiempo; la programación asegura que todos los procesos avanzen, que el procesador esté plenamente utilizado, que los tiempos de respuesta sean aceptables y que se puedan respetar las prioridades.
Mismo trabajo en orden diferente: shortest-job-first elimina primero los trabajos cortos, por lo que la mayoría espera menos, con el riesgo de que un trabajo largo espere indefinidamente Las rutinas de programación, tal como las pide el examen.
Rutina Función Beneficio Inconveniente primero en llegar, primero en ser atendido (FCFS) los procesos se ejecutan en el orden en que llegan a la cola de listos, hasta completarse simple; cada proceso se atiende a su turno, ninguno es privado de servicio un proceso largo retrasa a todos los cortos que están detrás; mala respuesta trabajo más corto primero (SJF) el proceso listo con el tiempo de ejecución estimado más corto se ejecuta a continuación, hasta completarse minimiza el tiempo de espera promedio; muchos trabajos cortos terminan rápidamente los tiempos de ejecución deben conocerse de antemano; un trabajo largo podría no ejecutarse nunca (privación de servicio) tiempo restante más corto (SRT) versión preemptive 抢占式 de SJF: si llega un nuevo proceso con menos tiempo restante que el que se está ejecutando, toma el control los procesos cortos se atienden aún más rápido; buen rendimiento más cambios de contexto; un trabajo largo puede ser interrumpido repetidamente y sufrir privación de servicio round robin (RR) cada proceso listo recibe un time slice fijo a su vez; cuando expira, el proceso pasa al final de la cola justo; cada proceso responde dentro de un tiempo acotado, bueno para uso interactivo sobrecarga por cambio de contexto; un time slice muy corto desperdicia tiempo, uno largo retrasa a otros prioridad el proceso listo con mayor prioridad se ejecuta primero el trabajo importante o crítico en el tiempo se realiza primero los procesos de baja prioridad pueden sufrir privación de servicio a menos que las prioridades envejecan Ejemplo resuelto. Tres procesos llegan juntos con tiempos de CPU de 8, 4 y 2 ms. Compare el tiempo de espera promedio bajo FCFS (en orden de llegada A, B, C) y bajo shortest job first.
FCFS: A espera 0, B espera 8, C espera 12; promedio $(0 + 8 + 12)/3 = 6.7\ \text{ms}$. SJF ejecuta C, B, A: C espera 0, B espera 2, A espera 6; promedio $2.7\ \text{ms}$. El trabajo total es el mismo, 14 ms en ambos casos; el orden decide quién espera. Round robin con un time slice de 2 ms daría a A, B y C un turno en los primeros 6 ms, por lo que C termina en 6 ms, B en 12 ms y A en 14 ms: el más reactivo, no necesariamente el más rápido en promedio.

Programación primero en llegar, primero en ser atendido de cuatro procesos 
Round-robin: cada proceso recibe un time slice fijo a su vez, luego se ejecuta el siguiente (a diferencia de primero en llegar, primero en ser atendido) Estados de proceso
Un proceso es nuevo, listo (esperando la CPU), en ejecución, bloqueado 阻塞 (esperando E/S o un bloqueo) o terminado. Cuando termina su time slice pasa de executing → ready; cuando solicita E/S pasa de executing → blocked; cuando finaliza la E/S pasa de blocked → ready.

Un proceso se mueve entre los estados new, ready, running, blocked y terminated Los tres estados y las razones por las que un proceso cambia de estado. En ejecución: el proceso tiene el procesador. Listo para ejecutar: podría ejecutarse pero está esperando por el procesador. Bloqueado: no puede ejecutarse hasta que ocurra algo más. Razones para cada transición, lo cual el examen pide una a la vez: de ejecución a listo cuando termina su intervalo de tiempo, o cuando un proceso de mayor prioridad se vuelve listo y lo preempe (una interrupción); de ejecución a bloqueado cuando solicita entrada/salida o espera por un recurso u otro proceso; de bloqueado a listo cuando finaliza la E/S en la que estaba esperando (señalada por una interrupción); de listo a ejecución cuando el planificador lo despacha. Un proceso bloqueado nunca pasa directamente a ejecución: primero debe convertirse en listo.
Bloque de control de proceso y cambio de contexto
Para cada proceso, el SO mantiene un bloque de control de proceso 进程控制块 (PCB) — el contador de programa guardado, registros, estado e información de memoria.

Un cambio de contexto guarda el estado de un proceso y carga el de otro - un cambio de contexto 上下文切换 suspende un proceso e inicia otro: guarda el estado en un PCB y lo restaura desde otro. Este pequeño costo se paga en cada cambio.
- el núcleo 内核 (el núcleo del SO) actúa como manejador de interrupciones 中断处理程序. Cuando un dispositivo o el temporizador generan una interrupción, el manejo de interrupciones 中断处理 salva el proceso en ejecución y ejecuta la rutina adecuada — esto es lo que impulsa la planificación de bajo nivel.
"Describa cómo actúa el núcleo como manejador de interrupciones" (dos puntos). Cuando se genera una interrupción, el núcleo guarda el estado del proceso en ejecución (sus registros y contador de programa, en su bloque de control de proceso), identifica la fuente y la prioridad de la interrupción, ejecuta la rutina de servicio de interrupción correspondiente y luego restaura el proceso interrumpido (o uno de mayor prioridad) para que la ejecución continúe. Así es como el temporizador termina un intervalo de tiempo y cómo una operación de E/S completada desbloquea un proceso.
Comunicación entre procesos
Los procesos están aislados, por lo que el SO proporciona comunicación entre procesos 进程间通信: tuberías 管道 (la salida de un programa alimenta la entrada de otro), memoria compartida 共享内存 (una región que varios procesos pueden usar) y paso de mensajes.
ExplorarLa vida de un proceso
Toca alrededor del bucle que recorre un proceso. Solo se ejecuta cuando el planificador lo selecciona; necesitar E/S lo envía a bloqueado, y terminar su tiempo de CPU lo devuelve a listo — rode y rode hasta que termine.
Vocabulario EntrenarInglés Chino Pinyin round robin/raʊnd ˈrɒbɪn/ 轮转 lún zhuàn time slice/taɪm slaɪs/ 时间片 shí jiān piàn pre-emptive/priː ˈemptɪv/ 抢占式 qiǎng zhàn shì blocked/blɒkt/ 阻塞 zǔ sè process control block/ˈprəʊses kənˈtrəʊl blɒk/ 进程控制块 jìn chéng kòng zhì kuài context switch/ˈkɒntekst swɪtʃ/ 上下文切换 shàng xià wén qiè huàn 16.1
Memoria virtual, segmentación y paginación

Cada proceso recibe su propio espacio de direcciones virtuales 虚拟地址 espacio — un rango limpio y contiguo de direcciones que el SO mapea a la memoria física. Esto otorga a cada proceso un espacio sencillo, protege los procesos entre sí y permite que la memoria total exceda la RAM física.
En la paginación, el espacio virtual se divide en páginas 页 de tamaño fijo y la memoria física en marcos 页框 del mismo tamaño. Una tabla de páginas mapea cada página a un marco. Si una página accedida no está en RAM —un fallo de página 缺页—, el SO la lee desde el archivo de intercambio 交换文件 hacia un marco, eliminando otra página si la RAM está llena. Los fallos frecuentes causan thrashing 抖动 (thrashing de disco), donde el SO dedica la mayor parte del tiempo a intercambiar páginas en lugar de realizar trabajo útil.
La paginación mapea cada página de la memoria lógica a un marco de la memoria física En la segmentación 分段, la memoria se divide en segmentos lógicos de tamaño variable (código, pila, heap), cada uno con sus propios permisos. Muchos sistemas utilizan paginación dentro de segmentos.

La segmentación mapea segmentos de tamaño variable usando una tabla de mapas de segmento "Explique qué se entiende por memoria virtual" (tres puntos). El almacenamiento secundario (disco) se utiliza para extender la RAM, de modo que la memoria disponible parece mayor que la memoria física; el espacio de direcciones de un proceso se divide en páginas, y solo las páginas actualmente necesarias se mantienen en RAM mientras el resto esperan en disco; las páginas se intercambian entre RAM y disco según sea necesario, y el SO traduce cada dirección virtual en una física. ¿Por qué lo necesita el SO: los programas en ejecución pueden necesitar más memoria de la instalada; permite que más (o más grandes) programas se ejecuten a la vez; un programa puede ser más grande que la memoria física; la memoria se usa eficientemente porque solo las partes activas de los programas ocupan RAM.
Paginación frente a segmentación: la diferencia que busca el examen. La paginación divide la memoria en bloques de tamaño fijo (páginas y marcos) elegidos por el hardware, sin importar la estructura del programa, y el mapeo es invisible para el programador; la segmentación divide un programa en unidades lógicas de tamaño variable (un procedimiento, una matriz, la pila) cuyos tamaños y límites siguen al programa, de modo que un segmento puede protegerse o compartirse como unidad. "Describa el proceso de segmentación": el programa se divide en segmentos de diferentes tamaños, a cada uno se le asigna un número de segmento; una tabla de segmentos registra dónde comienza cada segmento en la memoria y cuánto mide; una dirección lógica es un número de segmento más un desplazamiento, y el SO suma el desplazamiento a la dirección base del segmento para encontrar la ubicación física.
"Explique qué se entiende por thrashing de disco" y cuándo ocurre. Thrashing de disco 磁盘抖动 es el estado en el que las páginas se intercambian dentro y fuera de RAM con tanta frecuencia que el procesador pasa más tiempo moviendo páginas que ejecutando instrucciones, y el sistema se ralentiza casi hasta detenerse. Ocurre cuando la RAM es demasiado pequeña para las páginas que necesitan los procesos en ejecución (sus conjuntos de trabajo): una página acabada de eliminar se vuelve a necesitar casi de inmediato, por lo que se recupera, lo que elimina otra página que pronto también será necesaria, y así sucesivamente. Demasiados procesos, o un programa que accede a la memoria de forma impredecible, lo provocan; más RAM o menos procesos lo solucionan.
ExplorarQué ocurre en una falta de página
Recorra paso a paso una falta de página. Cuando el programa accede a una página que no está en la RAM, el SO la obtiene silenciosamente del disco y actualiza la tabla de páginas, haciendo que el programa vea más memoria de la que físicamente existe.
Vocabulario EntrenarInglés Chino Pinyin thrashing/ˈθræʃɪŋ/ 抖动 dǒu dòng segmentation/ˌseɡmənˈteɪʃn/ 分段 fēn duàn disk thrashing/dɪsk ˈθræʃɪŋ/ 磁盘抖动 cí pán dǒu dòng interpreter/ɪnˈtɜːprɪtə/ 解释器 jiě shì qì compiler/kəmˈpaɪlə/ 编译器 biān yì qì machine code/məˈʃiːn kəʊd/ 机器码 jī qì mǎ lexical analysis/ˈleksɪkl əˈnæləsɪs/ 词法分析 cí fǎ fēn xī 16.2
Cómo ejecuta un programa un intérprete
Syllabus
Los candidatos deben ser capaces de: Notas y orientación Demostrar comprensión de cómo un intérprete puede ejecutar programas sin producir una versión traducida Demostrar comprensión de las diversas etapas en la compilación de un programa Incluyendo el análisis léxico, análisis sintáctico, generación de código y optimización Demostrar comprensión de cómo la gramática de un lenguaje puede expresarse mediante diagramas de sintaxis o notación Forma Normal de Backus-Naur (BNF) Demostrar comprensión de cómo se puede utilizar la Notación Polaca Inversa (NPI) para llevar a cabo la evaluación de expresiones Fuente: Plan de estudios Cambridge International
Un intérprete 解释器 traduce y ejecuta el código fuente al mismo tiempo. Para cada instrucción lee la línea, realiza análisis léxico y sintáctico, verifica tipos y luego ejecuta la acción, y continúa. Los errores se reportan inmediatamente y generalmente se detiene; no se produce un ejecutable. La traducción se rehace en cada ejecución (más lento), pero ofrece retroalimentación rápida de desarrollo y es portable.
"Explique cómo un intérprete ejecuta un programa sin producir una versión traducida" (tres puntos). El intérprete toma una instrucción (línea) a la vez, la traduce (analiza) y la ejecuta inmediatamente, antes de pasar a la siguiente; no se crea ni almacena una versión traducida de todo el programa, por lo que cada instrucción se traduce cada vez que se ejecuta, incluyendo cada paso por un bucle; si una instrucción contiene un error, la ejecución se detiene allí y se reporta el error. Esto es lo que hace que un intérprete sea bueno para el desarrollo y las pruebas (los errores se encuentran a medida que se alcanzan y un cambio puede probarse de inmediato) pero más lento para ejecutar programas terminados.
16.2
Fases de compilación

Un compilador 编译器 convierte el código fuente en código máquina 机器码 en fases:
- análisis léxico — El lexer agrupa caracteres en tokens (palabras clave, identificadores, operadores, literales), descartando espacios en blanco y comentarios.
- análisis sintáctico (parsing) — Verifica que los tokens se ajusten a la gramática y construye un árbol de sintaxis abstracta. Un paréntesis faltante genera un error de sintaxis.
- análisis semántico — Verifica que el programa tenga sentido (variables declaradas, tipos coincidentes).
- generación de código — Recorre el árbol y emite código objetivo, eligiendo registros y distribuciones.
- optimización de código — Elimina trabajo redundante, pliega constantes y reordena para la tubería.
La salida es un ejecutable.
Las fases de compilación, desde el código fuente hasta un ejecutable optimizado El propósito de cada etapa, con las palabras clave. Análisis léxico: elimina espacios en blanco y comentarios; convierte los caracteres del código fuente en tokens (palabras clave, identificadores, operadores, constantes), verificando que cada uno sea válido en el lenguaje; registra los identificadores en la tabla de símbolos. Análisis sintáctico: verifica que la secuencia de tokens obedezca la gramática (reglas de sintaxis) del lenguaje; construye un árbol de análisis (árbol de sintaxis abstracta); informa errores de sintaxis; la verificación de tipos y la comprobación de declaraciones de variables a veces se cuentan aquí como análisis semántico. Generación de código: convierte el árbol validado en código objeto o código máquina (posiblemente mediante código intermedio), asignando memoria y registros. Optimización: hace que el código ejecute más rápido o utilice menos memoria, eliminando instrucciones redundantes, combinando o simplificando cálculos y reorganizando bucles, sin alterar lo que hace el programa. La pregunta de emparejamiento asocia cada etapa con una de estas descripciones.
ExplorarLas fases de la compilación
Recorra paso a paso lo que hace un compilador con su código fuente. Cada fase entrega su salida a la siguiente: los caracteres se convierten en tokens, los tokens en un árbol, y el árbol en código máquina optimizado.
Vocabulario EntrenarInglés Chino Pinyin tokens/ˈtəʊkənz/ 词法单元 cí fǎ dān yuán syntax analysis (parsing)/ˈsɪntæks əˈnæləsɪs/ 语法分析 yǔ fǎ fēn xī abstract syntax tree/ˈæbstrækt ˈsɪntæks triː/ 抽象语法树 chōu xiàng yǔ fǎ shù syntax error/ˈsɪntæks ˈerə/ 语法错误 yǔ fǎ cuò wù semantic analysis/səˈmæntɪk əˈnæləsɪs/ 语义分析 yǔ yì fēn xī code generation/kəʊd ˌdʒenəˈreɪʃn/ 代码生成 dài mǎ shēng chéng code optimisation/kəʊd ˌɒptɪmaɪˈzeɪʃn/ 代码优化 dài mǎ yōu huà symbol table/ˈsɪmbl ˈteɪbl/ 符号表 fú hào biǎo grammar/ˈɡræmə/ 文法 wén fǎ 16.2
Gramáticas: BNF y diagramas de sintaxis

Una gramática dice qué secuencias de tokens son programas válidos.
Backus-Naur Form (BNF) es textual. Una regla de producción tiene la forma:
<symbol> ::= alternative1 | alternative2 | ...Cada alternativa es una secuencia de símbolos terminales (texto literal) y símbolos no terminales (otros nombres de reglas):
<digit>      ::= 0 | 1 | 2 | 3 | 4 | 5 | 6 | 7 | 8 | 9
<identifier> ::= <letter> | <identifier> <letter> | <identifier> <digit>
La tercera regla recursiva expresa "una letra seguida de cualquier número de letras o dígitos". Una instrucción
IF:<if-statement> ::= IF <condition> THEN <statement> ENDIF | IF <condition> THEN <statement> ELSE <statement> ENDIFUn diagrama de sintaxis (diagrama de vías) muestra lo mismo gráficamente: cajas para no terminales, cajas redondeadas para terminales, flechas para caminos válidos, bucles para repetición. Las dos notaciones son equivalentes. El analizador usa la gramática para decidir si un programa es válido.
Un diagrama de sintaxis (vías) para una instrucción de asignación 
Un diagrama de sintaxis y una regla BNF dicen lo mismo: una elección se convierte en alternativas separadas por barras, y un bucle se convierte en una regla que se refiere a sí misma Lectura de los diagramas del examen. Cada diagrama define un no terminal; sigue las flechas desde la entrada hasta la salida, y cada camino que puedas trazar es una cadena válida. Una elección de cajas lado a lado es un conjunto de alternativas; un bucle hacia atrás significa "repetir tantas veces como quieras"; una caja para otro no terminal significa "insertar cualquier cosa que permita esa regla". "Explica por qué la cadena es inválida" pide la regla que rompe, en palabras:
9Kes inválido como variable porque el primer carácter debe ser una letra, no un dígito;JJ90es una contraseña inválida si la regla permite solo una letra antes de los dígitos, o siJno está en el conjunto de letras listadas. Siempre verifica la cadena contra el conjunto de caracteres que el diagrama realmente permite, no contra lo que aceptaría un lenguaje real.Escritura de BNF a partir de un diagrama. Cada diagrama se convierte en una regla
<name> ::= ...; las alternativas se separan por|; una secuencia se escribe un símbolo después del otro; y la repetición se escribe con recursión, porque BNF no tiene símbolo de bucle: "una o más letras" es<word> ::= <letter> | <letter><word>, y "cero o más dígitos después de una letra" es<variable> ::= <letter> | <letter><digits>con<digits> ::= <digit> | <digit><digits>.Ejemplo resuelto. Completa el BNF para un número de matrícula de vehículo que debe comenzar con dos letras (de
A B C) seguidas de uno, dos o tres dígitos (de0 1 2).<letter> ::= A | B | C <digit> ::= 0 | 1 | 2 <digits> ::= <digit> | <digit><digit> | <digit><digit><digit> <registration> ::= <letter><letter><digits>AB12es válido;A12no lo es (solo una letra);AB1234no lo es (cuatro dígitos);AD1no lo es (Dno es una letra listada). Se pide añadir una restricción como "el tercer carácter también puede ser un símbolo", añade la alternativa extra a la regla de esa posición únicamente, y define<symbol>con su propia regla.Ejemplo resuelto. Escribe BNF para una expresión que es una variable, seguida de un operador, seguido de ya sea una variable o un número, donde una variable es una sola letra minúscula de
a b cy un operador es+o-.<variable> ::= a | b | c <operator> ::= + | - <number> ::= <digit> | <digit><number> <expression> ::= <variable><operator><variable> | <variable><operator><number>La regla recursiva
<number>permite cualquier número de dígitos; las dos alternativas de<expression>cubren ambos casos nombrados en la definición. Mantén cada no terminal entre ángulos y cada terminal sin ellos.Vocabulario EntrenarInglés Chino Pinyin Backus-Naur Form/ˈbækəs nɔː fɔːm/ 巴科斯-诺尔范式 bā kē sī - nuò ěr fàn shì production rule/prəˈdʌkʃn ruːl/ 产生式 chǎn shēng shì terminal/ˈtɜːmɪnl/ 终结符 zhōng jié fú non-terminal/nɒn ˈtɜːmɪnl/ 非终结符 fēi zhōng jié fú syntax diagram/ˈsɪntæks ˈdaɪəɡræm/ 语法图 yǔ fǎ tú infix/ˈɪnfɪks/ 中缀 zhōng zhuì Reverse Polish Notation/rɪˈvɜːs ˈpəʊlɪʃ nəʊˈteɪʃn/ 逆波兰表示法 nì bō lán biǎo shì fǎ postfix/ˈpəʊstfɪks/ 后缀 hòu zhuì stack/stæk/ 栈 zhàn precedence/ˈpresɪdəns/ 优先级 yōu xiān jí 16.2
Notación Polaca Inversa (RPN)
En la notación infija el operador se sitúa entre sus operandos (
3 + 4 * 2), requiriendo paréntesis y reglas de precedencia. En la Notación Polaca Inversa (RPN, postfija) el operador sigue a sus operandos (3 4 2 * +), no requiriendo paréntesis.Conversión de infija a RPN
Usa una pila de operadores. Escanea de izquierda a derecha: emite un operando; para un operador, primero popa cualesquiera operadores apilados de precedencia igual o superior a la salida, luego empújalo; empuja
(; sobre)popa a la salida hasta el correspondiente(. Al final, popa todos los operadores. Ejemplo:(3 + 4) * 2→3 4 + 2 *.Evaluación de RPN
Usa una pila de operandos. Escanea de izquierda a derecha: empuja cada operando; sobre un operador, popa los dos superiores, aplícalo y empuja el resultado. Evaluando
3 4 2 * +:Token Pila 33 43, 4 23, 4, 2 *3, 8 +11 Resultado: 11. La RPN no requiere paréntesis en el momento de la evaluación y se adapta a una máquina de pila — que es como funcionan la JVM y muchos interpretadores de bytecode.
"Explique por qué se utiliza la RPN para evaluar expresiones" (dos puntos). En la RPN, los operadores aparecen en el orden en que se aplican, por lo que una expresión puede evaluarse mediante un único recorrido de izquierda a derecha sin necesidad de paréntesis ni de reglas de precedencia; por tanto, es más simple y rápida para que el compilador o el intérprete la procesen. "Identifique, con justificación, una estructura de datos adecuada": una pila, porque la evaluación necesita primero los operandos empujados más recientemente (último en entrar, primero en salir): cada operando se empuja, y cada operador extrae los dos superiores, aplica su operación y empuja el resultado. Muestre el contenido de la pila tras cada token cuando se solicite.
Conversión manual de infija a RPN. (1) Encierre completamente la expresión usando las reglas de precedencia; (2) mueva cada operador justo después del paréntesis de cierre correspondiente; (3) elimine los paréntesis. Así, $(a - b) * (a + c) / 7$ se convierte en $((a - b) * (a + c)) / 7$, y luego en
a b - a c + * 7 /. Tenga en cuenta que*y/se aplican de izquierda a derecha, por lo que la división es el último operador, no la multiplicación. Más conversiones: $((7 + 3) - (2 * 8)) / 6$ es7 3 + 2 8 * - 6 /; $(7 - 2 + 8) / (9 - 5)$ es7 2 - 8 + 9 5 - /; $a * b + b - d + 15$ esa b * b + d - 15 +; $(2 - 6) * (13 + 7) / 5$ es2 6 - 13 7 + * 5 /.Conversión de RPN de vuelta a infija. Procese la RPN utilizando una pila de expresiones: empuje cada operando; para cada operador, extraiga dos elementos, escríbalos a ambos lados del mismo entre paréntesis, y empuje el resultado. Así,
a b / 4 * a b + -es $((a / b) * 4) - (a + b)$;5 2 + 9 3 - / 3 *es $((5 + 2) / (9 - 3)) * 3$;b a c - + d b + * c /es $((b + (a - c)) * (d + b)) / c$;a b - c + c a - * d /es $(((a - b) + c) * (c - a)) / d$. Mantenga los paréntesis: eliminarlos puede alterar el significado.Ejemplo resuelto. Evalúe
a b - c d + * e /sabiendo que $a = 17$, $b = 5$, $c = 7$, $d = 3$ y $e = 10$, mostrando la pila.token acción pila (arriba a la derecha) aapilar 17 17 bapilar 5 17, 5 -desapilar 5 y 17, apilar $17 - 5$ 12 capilar 7 12, 7 dapilar 3 12, 7, 3 +desapilar 3 y 7, apilar $7 + 3$ 12, 10 *desapilar 10 y 12, apilar $12 \times 10$ 120 eapilar 10 120, 10 /desapilar 10 y 120, apilar $120 / 10$ 12 Resultado 12. El orden de las desapilaciones es importante para
-y/: el valor desapilado segundo es el operando izquierdo, por lo quea b -es $a - b$, no $b - a$. Dos más, de la misma manera:d a b + * c a - /con $a = 6, b = 12, c = 15, d = 5$ da como resultado $5 \times (6 + 12) / (15 - 6) = 90 / 9 = 10$;c a - b d + * b c + /con $a = 4, b = 12, c = 24, d = 6$ da como resultado $(24 - 4) \times (12 + 6) / (12 + 24) = 360 / 36 = 10$.Ejemplo resuelto. Convertir $(A + B) \times (C - D)$ a RPN, luego evaluar $(3 + 4) \times (5 - 2)$. Escanear de izquierda a derecha usando una pila de operadores. Apilar
(; emitirA; apilar+; emitirB; al encontrar), desapilar hasta el par correspondiente(, obteniendoA B +hasta ahora. Apilar×, y el segundo corchete se comporta de la misma manera, dando como resultadoC D -. Al final, desapilar el ⟨×⟩. Resultado:A B + C D - ×. Para evaluar los números, usar una pila de operandos: apilar 3, apilar 4;+desapila ambos y apila 7; apilar 5, apilar 2;-desapila ambos y apila 3;×desapila 7 y 3 y apila 21. Dos factores hacen esto confiable: los operandos mantienen su orden original durante la conversión (solo se mueven los operadores), y cada operador actúa sobre los dos valores inmediatamente inferiores en la pila.ExplorarPrecedencia de operadores — lo que elimina la RPN
En matemáticas infixas ordinarias, × y ÷ tienen mayor precedencia que + y −, por lo que se deben aplicar reglas en el orden correcto. La Notación Polaca Inversa escribe los operandos primero (3 4 2 × + 1 −), fijando el orden para que no sean necesarias reglas de precedencia.
Vocabulario EntrenarInglés Chino Pinyin bytecode/ˈbaɪtkəʊd/ 字节码 zì jié mǎ 16.2
Definiciones aceptadas por el examinador
Una pregunta de definición se califica según un texto fijo. Aprende estas definiciones exactamente, y da solo una respuesta.
Término Definición multitarea varios procesos mantenidos en memoria a la vez, con el procesador alternando entre ellos para que parezcan ejecutarse simultáneamente proceso un programa que ha sido cargado en memoria y se está ejecutando (o está listo para serlo) ejecutando / listo / bloqueado tiene el procesador / esperando por el procesador / no puede continuar hasta que un evento como una E/S se complete programación decidir qué proceso listo obtendrá el procesador a continuación y durante cuánto tiempo programación preemptiva el proceso en ejecución puede ser interrumpido y movido al estado listo para que otro proceso se ejecute memoria virtual usar almacenamiento secundario para extender la RAM, manteniendo solo las páginas actualmente necesarias en memoria física segmentación dividir la memoria y los programas en páginas de tamaño fijo que se mueven entre disco y RAM según sea necesario segmentación dividir un programa en segmentos lógicos de tamaño variable, cada uno mapeado a la memoria mediante una tabla de segmentos thrashing del disco páginas siendo intercambiadas entre RAM y disco tan frecuentemente que se realiza muy poco procesamiento útil intérprete traduce y ejecuta un programa una instrucción a la vez, sin producir una versión traducida compilador traduce un programa completo de alto nivel a código máquina (objeto) antes de su ejecución análisis léxico convierte el código fuente en tokens, eliminando espacios en blanco y comentarios, y construye la tabla de símbolos análisis sintáctico verifica que los tokens obedezcan la gramática del lenguaje y construye un árbol de análisis Forma Backus-Naur una notación para la gramática de un lenguaje: reglas de la forma <name> ::= alternativesconstruidas desde terminales y no terminalesNotación Polaca Inversa una manera de escribir expresiones con cada operador después de sus operandos, de modo que puedan evaluarse con una pila y sin paréntesis 16.2
Consejos para el examen
- Las preguntas del SO se evalúan sobre mecanismos nombrados: programación, gestión de memoria, bufferización y spooling de E/S, gestión de archivos; para la interfaz, nombres de archivo no direcciones, clics no comandos, controladores, GUI.
- Estados del proceso con sus transiciones y la razón de cada una; rutinas de programación como función más beneficio más desventaja; el kernel guarda el estado, identifica la interrupción, la atiende, la restaura.
- Memoria virtual: el disco extiende la RAM, páginas intercambiadas, traducción de direcciones; la segmentación es de tamaño fijo e invisible, la segmentación es de tamaño variable y lógica; el thrashing es intercambiar en lugar de trabajar.
- Intérprete: una instrucción a la vez, traducido luego ejecutado, nada almacenado. Etapas del compilador: tokens y tabla de símbolos, gramática y árbol de análisis, código, optimización.
- BNF: una regla por diagrama,
|para elección, recursión para repetición, terminales desnudos y no terminales entre ángulos. Decir qué regla rompe una cadena. - RPN: operadores después de operandos, evaluar con una pila, mostrar cada paso; convertir completamente entre paréntesis; al convertir de vuelta, mantener los paréntesis.
Errores comunes
- Describir la multitarea como "ejecutar varios programas al mismo tiempo" sin mencionar que el procesador alterna entre ellos.
- Enviar un proceso bloqueado directamente al estado ejecutando, o dar "se acabó el intervalo de tiempo" como razón para pasar de ejecutando a bloqueado.
- Confundir shortest job first (no preemptivo) con shortest remaining time (preemptivo), o round robin con prioridad.
- Definir la memoria virtual como "usar el disco duro como RAM" sin mencionar que las páginas son intercambiadas.
- Decir que un intérprete "convierte el programa a código máquina y luego lo ejecuta"; eso es un compilador.
- Colocar la verificación sintáctica en el análisis léxico, o la optimización antes de la generación de código en la pregunta de emparejamiento.
- Escribir la repetición en BNF como
<letter>*o con puntos suspensivos; usar recursión. Dejar fuera los paréntesis angulares de los no terminales. - Invertir los operandos de
-o/al evaluar RPN, o escribir la RPN de $a * b + c$ comoa b c + *.
Vocabulario EntrenarInglés Chino Pinyin kernel/ˈkɜːnl/ 内核 nèi hé interrupt handler/ˈɪntərʌpt ˈhændlə/ 中断处理程序 zhōng duàn chǔ lǐ chéng xù interrupt handling/ˈɪntərʌpt ˈhændlɪŋ/ 中断处理 zhōng duàn chǔ lǐ inter-process communication/ˈɪntə ˈprəʊses kəˌmjuːnɪˈkeɪʃn/ 进程间通信 jìn chéng jiān tōng xìn pipes/paɪps/ 管道 guǎn dào shared memory/ʃeəd ˈmeməri/ 共享内存 gòng xiǎng nèi cún virtual address space/ˈvɜːtʃuːəl əˈdres speɪs/ 虚拟地址空间 xū nǐ dì zhǐ kōng jiān pages/ˈpeɪdʒɪz/ 页 yè frames/freɪmz/ 页框 yè kuāng page fault/peɪdʒ fɒlt/ 缺页 quē yè swap file/swɒp faɪl/ 交换文件 jiāo huàn wén jiàn -
17
Seguridad
Ver lección17.1
Cómo funciona el cifrado

Syllabus
Los candidatos deben ser capaces de: Notas y orientación Demostrar comprensión del funcionamiento del cifrado Incluye el uso de clave pública, clave privada, texto plano, texto cifrado, cifrado, criptografía de clave simétrica y criptografía de clave asimétrica. Cómo se pueden usar las claves para enviar un mensaje privado desde el público hacia un individuo u organización. Cómo se pueden usar las claves para enviar un mensaje verificado al público. Cómo se cifran y descifran los datos, utilizando criptografía simétrica y asimétrica. Propósito, beneficios y desventajas de la criptografía cuántica. Demostrar conocimiento de la Capa de Sockets Seguros (SSL) / Seguridad en la Capa de Transporte (TLS) Propósito de SSL/TLS. Uso de SSL/TLS en la comunicación cliente-servidor. Situaciones en las que sería apropiado utilizar SSL/TLS. Demostrar comprensión de la certificación digital Cómo se obtiene un certificado digital. Cómo se utiliza un certificado digital para generar firmas digitales. Fuente: Plan de estudios Cambridge International
El cifrado (encryption) convierte el texto legible texto plano (plaintext) en un texto ilegible texto cifrado (ciphertext) mediante una operación matemática que depende de una clave. Solo alguien con la clave adecuada puede revertirlo — descifrado (decryption) — para recuperar el texto plano. Un atacante que intercepte el texto cifrado sin la clave solo verá datos sin sentido, ya que intentar todas las claves posibles tomaría demasiado tiempo. Un enfoque más reciente, la criptografía cuántica (quantum cryptography), utiliza la física cuántica para compartir una clave de manera que revelaría a cualquier espía.
La máquina Enigma cifró mensajes durante la Segunda Guerra Mundial: un dispositivo de cifrado mecánico temprano 
El cifrado desordena el texto plano con una clave; el descifrado lo invierte Cifrado simétrico
El cifrado simétrico (symmetric encryption) o criptografía de clave simétrica utiliza la misma clave tanto para cifrar como para descifrar, por lo que el emisor y el receptor deben poseer ambos la clave secreta. Es rápido y adecuado para datos masivos (un disco completo, un flujo de video). Su problema es la distribución de claves: ¿cómo se comparte la clave de forma segura en primer lugar? El cifrado asimétrico resuelve esto.
"Describa lo que se entiende por cifrado de clave simétrica" (dos puntos). Se utiliza la misma clave para cifrar el texto plano y para descifrar el texto cifrado, por lo que la clave debe ser compartida entre el emisor y el receptor y mantenido secreta ante todos los demás. Dos desventajas. La clave debe ser intercambiada antes de que pueda enviarse el mensaje, y si es interceptada en tránsito, el interceptador puede leer cada mensaje; se necesita una clave separada para cada par de correspondientes; y no ofrece prueba de quién envió el mensaje, porque ambos extremos poseen la misma clave. "Dé dos razones para usar la criptografía de claves": para que los datos sean ilegibles para quienquiera que los intercepte (confidencialidad); para que el receptor esté seguro de que los datos provenían del emisor declarado y no fueron alterados (autenticidad e integridad). Los dos métodos son la criptografía de clave simétrica y asimétrica.

El cifrado simétrico utiliza la misma clave secreta en ambos extremos Cifrado asimétrico (de clave pública)
El cifrado asimétrico (asymmetric encryption) o criptografía de clave asimétrica proporciona a cada usuario un par de claves relacionadas: una clave pública (public key) que publican, y una clave privada (private key) que mantienen en secreto. Los datos cifrados con la clave pública pueden descifrarse solo con la clave privada correspondiente, y viceversa.

Cada usuario tiene una clave pública para compartir y una clave privada para mantener en secreto Para enviar un mensaje secreto a Alice: obtener su clave pública publicada, cifrarla con ella y enviarla. Solo Alice —que posee la clave privada correspondiente— puede descifrarla. No se necesita un intercambio previo de claves. La compensación es que es mucho más lento que el simétrico, por lo que no se utiliza para datos grandes.
"Indique lo que se entiende por una clave privada". Una clave conocida solo por su propietario (nunca transmitida), utilizada para descifrar datos que fueron cifrados con la clave pública correspondiente, y para crear firmas digitales. "Describa el proceso de cifrado asimétrico" (cuatro puntos): (1) el receptor genera un par de claves, una clave pública y una clave privada, matemáticamente relacionadas; (2) la clave pública se pone a disposición de cualquiera que quiera enviarle algo; (3) el emisor cifra el texto plano con la clave pública del receptor; (4) el texto cifrado solo puede descifrarse con la clave privada del receptor, que nunca sale del receptor, por lo que nadie que intercepte el mensaje puede leerlo.
Ejemplo resuelto. Fred quiere enviarle a Sheila un documento confidencial. Explique cómo se utiliza el cifrado asimétrico.
Sheila tiene un par de claves; le envía a Fred su clave pública (o él la obtiene de su certificado). Fred cifra el documento con la clave pública de Sheila y envía el texto cifrado. Solo la clave privada de Sheila puede descifrarlo, y solo Sheila la posee, por lo que nadie más, incluido Fred una vez que está cifrado, puede leer el documento. Las claves se usan a la inversa del emisor: su clave pública para bloquear, su clave privada para desbloquear. Una organización que mantiene un par de claves "para recibir transmisiones seguras" hace exactamente esto: publica la clave pública, guarda la clave privada y descifra lo que llega.
Dos diferencias entre el cifrado simétrico y asimétrico. El simétrico usa una clave para ambas direcciones; el asimétrico usa dos claves relacionadas, una para cifrar y la otra para descifrar. En el cifrado simétrico, la clave debe mantenerse en secreto por ambas partes e intercambiarse de forma segura; en el asimétrico, la clave pública puede ser publicada y solo la clave privada es secreta. El cifrado simétrico es mucho más rápido y se adapta a grandes cantidades de datos; el asimétrico es más lento, por lo que se utiliza para claves y firmas en lugar de datos masivos.
Una clave privada debe permanecer en secreto, por lo que a veces se guarda en una pequeña llave de seguridad de hardware (hardware security key). La conectas o la tocas para demostrar quién eres, y la clave secreta nunca sale del dispositivo.

Una llave de seguridad de hardware almacena una clave secreta para verificar tu identidad Enfoque híbrido (utilizado por casi todos los sistemas reales)
Utilice el cifrado asimétrico para intercambiar una clave de sesión (session key) fresca, y luego utilice esa clave simétrica para los datos:
- el cliente genera una clave de sesión aleatoria.
- cifra la clave de sesión con la clave pública del servidor.
- el servidor la descifra con su clave privada.
- ambos extremos ahora comparten la clave de sesión y utilizan el cifrado simétrico rápido para el resto.
Así es como funcionan HTTPS y SSH.
La versión del examen del problema de intercambio de claves. "Se debe intercambiar una clave simétrica antes de enviar el mensaje. Explique cómo puede intercambiarse la clave de forma segura." El emisor cifra la clave simétrica con la clave pública del receptor y la envía; el receptor la descifra con su clave privada; ambos ahora poseen la clave simétrica, que nunca fue expuesta en tránsito, y la utilizan para los mensajes. El cifrado asimétrico resuelve el problema de distribución; el cifrado simétrico realiza luego el trabajo rápido.

El enfoque híbrido: la criptografía asimétrica comparte una clave de sesión una vez, y luego el cifrado simétrico rápido protege los datos Hashing (relacionado, no cifrado)
Una función de hash criptográfico (cryptographic hash) toma cualquier entrada y produce un resumen (digest) de tamaño fijo tal que la misma entrada siempre produce el mismo resumen, es inviable encontrar dos entradas con el mismo resumen, y un cambio mínimo en la entrada cambia completamente el resumen. El hashing es de una sola vía (one-way): no puedes recuperar la entrada original. Se utiliza para verificar contraseñas almacenadas, verificaciones de integridad y firmas digitales.

Un hash criptográfico produce un resumen fijo; un cambio mínimo en la entrada lo cambia completamente, y no puede revertirse Criptografía cuántica
La criptografía cuántica utiliza la física de la luz para distribuir claves: los bits de una clave se envían como fotones cuyos estados cuánticos codifican los valores. "Describa su propósito": transmitir una clave de cifrado de forma segura, de tal manera que cualquier intento de interceptarla pueda ser detectado, ya que medir un fotón cambia su estado; un espía (eavesdropper) deja evidencia, y la clave corrupta se descarta y se envía una nueva. Beneficios: la interceptación siempre es detectable; la clave no puede copiarse sin alterarse; es segura contra futuros avances en potencia computacional (una clave matemática eventualmente puede ser rota, una cuántica no se puede leer sin perturbarla). Desventajas: requiere equipos especializados y caros; solo funciona a distancias limitadas en fibra óptica dedicada (o línea de vista), no a través de internet existente; distribuye la clave solo, por lo que el cifrado ordinario aún protege el mensaje; y es una tecnología nueva con pocos proveedores y poca experiencia.
ExplorarHashing y el efecto avalancha
Un hash es unidireccional: fácil de calcular, prácticamente imposible de revertir. Un cambio mínimo en la entrada invierte una parte grande e impredecible de la salida — el efecto avalancha que hace que los hashes sean buenos para contraseñas.
ExplorarEl cifrado César
Desplaza cada letra para cifrar el mensaje. Un cifrado simple muestra la idea de una clave: y por qué una clave pequeña es fácil de romper.
Vocabulario EntrenarInglés Chino Pinyin encryption/enˈkrɪpʃn/ 加密 jiā mì plaintext/ˈpleɪntekst/ 明文 míng wén ciphertext/ˈsaɪfətekst/ 密文 mì wén decryption/dɪˈkrɪpʃn/ 解密 jiě mì quantum cryptography/ˈkwɒntəm krɪpˈtɒɡrəfi/ 量子密码学 liàng zǐ mì mǎ xué eavesdropper/ˈiːvzdrɒpə/ 窃听者 qiè tīng zhě symmetric encryption/sɪˈmetrɪk enˈkrɪpʃn/ 对称加密 duì chèn jiā mì key distribution/kiː ˌdɪstrɪˈbjuːʃn/ 密钥分发 mì yào fēn fā asymmetric encryption/ˌeɪsɪˈmetrɪk enˈkrɪpʃn/ 非对称加密 fēi duì chèn jiā mì integrity/ɪnˈteɡrɪti/ 完整性 wán zhěng xìng public key/ˈpʌblɪk kiː/ 公钥 gōng yào private key/ˈpraɪvət kiː/ 私钥 sī yào hardware security key/ˈhɑːdweə sɪˈkjʊərɪti kiː/ 硬件安全密钥 yìng jiàn ān quán mì yào session key/ˈseʃn kiː/ 会话密钥 huì huà mì yào cryptographic hash/ˌkrɪptəˈɡræfɪk hæʃ/ 密码散列 mì mǎ sàn liè digest/ˈdaɪdʒest/ 摘要 zhāi yào 17.1
SSL / TLS
TLS (Transport Layer Security, Seguridad de Capa de Transporte, sucesor de la Secure Socket Layer, SSL) es un protocolo que proporciona cifrado y autenticación para los datos enviados a través de una red. Cifra los datos en tránsito, autentifica el servidor con un certificado y proporciona integridad (detección de manipulaciones).
Resumen de un apretón de manos (handshake) de TLS:
- el cliente se conecta y propone opciones de cifrado.
- el servidor selecciona una y envía su certificado digital (con su clave pública): emitir y validar estos certificados es la certificación digital.
- el cliente verifica el certificado.
- los dos extremos intercambian una clave de sesión fresca utilizando criptografía asimétrica.
- todo el tráfico posterior utiliza cifrado simétrico rápido con la clave de sesión.
El resultado es un túnel cifrado, autenticado y verificado en integridad para protocolos de nivel superior (HTTP, SMTP). Es apropiado dondequiera que se envíe información sensible: navegación web HTTPS, banca en línea y pagos, correo electrónico seguro y VPNs.
"Describa el propósito de SSL/TLS" e "indique dos funciones". El propósito es proporcionar comunicación segura entre un cliente y un servidor a través de una red. Sus funciones: cifra los datos enviados, para que no puedan leerse si son interceptados; autentifica el servidor (y opcionalmente el cliente) mediante un certificado digital, para que el cliente sepa que se está comunicando con el sitio legítimo; y verifica la integridad de los datos, para detectar cambios en tránsito. Dos ejemplos de dónde es apropiado: banca en línea y compras en línea (pagos con tarjeta); también inicios de sesión, correo privado, transferencia de archivos, VoIP y mensajería instantánea: cualquier transacción en la que datos privados crucen internet.
Los dos protocolos que componen TLS. El protocolo de apretón de manos (handshake) establece la sesión: acuerda los algoritmos de cifrado (cipher suite), autentifica el servidor con su certificado e intercambia la clave de sesión. El protocolo de registro (record) transporta luego los datos: cifra cada mensaje con la clave de sesión, agrega una verificación de integridad y lo pasa a la capa de transporte.
Cómo comienza una sesión segura: el certificado demuestra quién es el servidor, la clave pública del servidor protege la clave de sesión en su camino, y la clave de sesión protege todo lo que viene después "Explique cómo se utiliza SSL/TLS cuando se inicia la comunicación cliente-servidor" (seis puntos). (1) El cliente (navegador) envía una solicitud al servidor para una conexión segura, indicando qué métodos de cifrado soporta. (2) El servidor devuelve su certificado digital, que contiene su clave pública. (3) El cliente verifica que el certificado sea válido (emitido por una Autoridad Certificadora de confianza, no expirado, para el dominio correcto). (4) El cliente genera una clave de sesión, la cifra con la clave pública del servidor y la envía. (5) El servidor descifra la clave de sesión con su clave privada. (6) Ambos lados ahora poseen la clave de sesión y todos los datos posteriores se envían utilizando cifrado simétrico con ella. Dé los pasos en este orden; los puntos son por el certificado, la clave pública, la clave de sesión y el cambio al cifrado simétrico.
ExplorarEl apretón de manos TLS
Paso a paso lo que ocurre antes de que aparezca el candado. La criptografía pública lenta solo se usa para acordar una clave compartida; la página real viaja luego bajo cifrado simétrico rápido.
Vocabulario EntrenarInglés Chino Pinyin TLS/ˌtiː el ˈes/ 传输层安全 chuán shū céng ān quán authentication/ɔːˌθentɪˈkeɪʃn/ 身份验证 shēn fèn yàn zhèng authenticates/ɔːˈθentɪkeɪts/ 认证 rèn zhèng handshake/ˈhændʃeɪk/ 握手 wò shǒu 17.1
Certificados digitales

Un certificado digital (digital certificate) vincula una identidad (un dominio, una organización) a una clave pública, y está firmado por una Autoridad Certificadora (Certificate Authority, CA) de confianza. Contiene el sujeto (quién identifica), la clave pública del sujeto, el emisor (la CA), un período de validez y la firma de la CA sobre todo ello.
Una Autoridad Certificadora emite un certificado digital que vincula una identidad a una clave pública Para verificar uno, el cliente (que posee una lista de CAs raíz de confianza):
- verifica las fechas de vencimiento.
- verifica que el nombre del sujeto coincida con la URL.
- verifica que esté firmado por una CA de confianza, utilizando la clave pública de la CA para verificar la firma.
- sigue la cadena de certificados hasta una raíz de confianza.
Si algo falla, el navegador muestra la advertencia "Su conexión no es privada". Cuando verifica correctamente, el cliente sabe que la identidad fue verificada por una CA de confianza, que la clave pública realmente pertenece a esa identidad y que el certificado está vigente.
"Describa lo que se entiende por un certificado digital" (dos puntos). Un documento electrónico emitido por una Autoridad Certificadora que verifica la identidad de su propietario (una persona, organización o sitio web) y contiene la clave pública del propietario. Elementos encontrados en uno: el número de serie; el nombre del propietario (sujeto) y, para un sitio web, su dominio; la clave pública del propietario; el nombre de la CA emisora; el período de validez (fechas); el algoritmo de firma utilizado; y la firma digital de la CA en todo el certificado.
"Explique cómo una organización adquiere un certificado digital" (cuatro puntos). (1) La organización genera su propio par de claves, una clave pública y una clave privada. (2) Envía una solicitud que contiene su clave pública y sus detalles de identidad a una Autoridad Certificadora. (3) La CA verifica la identidad (verifica que el solicitante sea realmente la organización o posea el dominio). (4) La CA crea el certificado que contiene la clave pública y la identidad, lo firma con su propia clave privada y lo devuelve. (5) La organización instala el certificado en su servidor para que pueda enviarse a los clientes. La clave privada nunca sale de la organización.
"Explique por qué se requiere un certificado digital para validar una firma digital". Para verificar una firma, el receptor necesita la clave pública del emisor y debe estar seguro de que la clave realmente pertenece al emisor declarado; el certificado proporciona la clave pública junto con la identidad, y como el certificado está firmado por una CA de confianza, el receptor puede confiar en ese vínculo. Sin él, un impostor podría publicar una clave pública a nombre de otra persona y firmar mensajes en su nombre. El mismo razonamiento responde "qué debería incluirse con un programa descargado de internet para probar que es genuino": una firma digital, verificada contra el certificado del editor.
Vocabulario EntrenarInglés Chino Pinyin digital certificate/ˈdɪdʒɪtl səˈtɪfɪkət/ 数字证书 shù zì zhèng shū Certificate Authority/səˈtɪfɪkət əˈθɒrɪti/ 证书颁发机构 zhèng shū bān fā jī gòu 17.1
Firmas digitales

Una firma digital (digital signature) demuestra quién firmó un mensaje y que no fue cambiado. Para firmar:
- calcular un hash criptográfico del mensaje.
- cifrar el hash con la clave privada del emisor: esa es la firma.
- enviar el mensaje y la firma.
Para verificar: calcular el hash del mensaje recibido; descifrar la firma con la clave pública del emisor para obtener el hash del emisor; comparar. Si coinciden, el mensaje fue firmado por el titular de la clave privada (autenticación) y no fue alterado (integridad). Una firma no oculta el mensaje; para confidencialidad además, cifrar y firmar.
Firmar calcula el hash del mensaje y cifra el resumen con la clave privada; el receptor lo verifica con la clave pública "Explique el papel de un certificado digital en la creación de una firma digital" (tres puntos). El certificado del emisor fue emitido por una CA y contiene la clave pública del emisor junto con su identidad; el emisor produce la firma calculando el hash del mensaje y cifrando el hash con su clave privada, la pareja de la clave en el certificado; el receptor utiliza la clave pública del certificado para descifrar el hash y, dado que el certificado vincula esa clave al emisor, la firma demuestra quién firmó.
"Explique cómo se utiliza una firma digital para verificar un mensaje" (cuatro puntos). (1) El receptor descifra la firma con la clave pública del emisor (tomada del certificado del emisor), lo que arroja el hash que el emisor calculó. (2) El receptor calcula el hash del mensaje recibido con el mismo algoritmo de hash. (3) Se comparan los dos hashes. (4) Si coinciden, el mensaje provino del titular de la clave privada (auténtico) y no ha sido alterado desde que fue firmado (integridad); si difieren, el mensaje se rechaza. Un banco que recibe datos confidenciales con una firma hace exactamente esto antes de confiar en ellos; los propios datos pueden estar cifrados aparte con la clave pública del banco para confidencialidad.
Poniéndolo todo junto
Una solicitud segura a
https://www.bank.com: el servidor envía su certificado; el cliente lo verifica contra las CAs de confianza; el cliente usa la clave pública del servidor para intercambiar una clave de sesión; luego los datos fluyen cifrados con esa clave. El cifrado detiene a los espías, el certificado demuestra la identidad del servidor y las verificaciones de integridad detienen un ataque hombre-en-el-medio (man-in-the-middle) que altera los datos.Ejemplo resuelto. Alice le envía a Bob un contrato. Quiere que Bob esté seguro de que vino de ella y no fue alterado, y quiere que nadie más pueda leerlo. ¿Qué claves usa y en qué dirección? Son dos trabajos diferentes que requieren dos pares de claves distintos. Para la firma (autenticación e integridad): Alice calcula el hash del contrato y cifra ese hash con su propia clave privada; Bob lo descifra con la clave pública de Alice y lo compara con su propio hash del mensaje. Solo Alice posee su clave privada, así que solo ella pudo haberla producido. Para la confidencialidad: Alice cifra el contrato en sí con la clave pública de Bob, para que solo la clave privada de Bob pueda abrirlo. Una regla mantiene claras las cuatro cosas: firme con su propia clave privada y cifre con la clave pública del destinatario. Una firma por sí sola no oculta el mensaje.
Vocabulario EntrenarInglés Chino Pinyin digital signature/ˈdɪdʒɪtl ˈsɪɡnɪtʃə/ 数字签名 shù zì qiān míng man-in-the-middle/mæn ɪnðə ˈmɪdl/ 中间人攻击 zhōng jiān rén gōng jī 17.1
Definiciones aceptadas por el examinador
Una pregunta de definición se califica según palabras exactas. Aprenda estas definiciones tal cual y dé solo una respuesta.
Término Definición encryption (cifrado) convertir texto plano en texto cifrado usando un algoritmo y una clave para que no pueda entenderse si es interceptado plaintext / ciphertext (texto plano / texto cifrado) los datos originales legibles / la forma cifrada e ilegible de los mismos symmetric key cryptography (criptografía de clave simétrica) se usa la misma clave secreta para cifrar y descifrar, por lo que debe compartirse de forma segura por ambas partes asymmetric key cryptography (criptografía de clave asimétrica) se usa un par de claves relacionadas: la clave pública cifra y solo la clave privada correspondiente descifra public key (clave pública) una clave puesta a disposición de cualquiera, usada para cifrar mensajes dirigidos a su propietario y para verificar las firmas del propietario private key (clave privada) una clave conocida solo por su propietario, usada para descifrar mensajes cifrados con la clave pública y para firmar SSL/TLS protocolos que proporcionan comunicación segura (cifrada, autenticada, verificada en integridad) entre un cliente y un servidor digital certificate (certificado digital) un documento electrónico emitido por una Autoridad Certificadora que verifica la identidad del propietario y contiene su clave pública digital signature (firma digital) un hash de un mensaje cifrado con la clave privada del emisor, que demuestra quién lo envió y que no ha sido alterado Certificate Authority (Autoridad Certificadora) una organización de confianza que verifica identidades y emite y firma certificados digitales quantum cryptography (criptografía cuántica) el uso de estados cuánticos de fotones para distribuir claves de modo que cualquier interceptación sea detectada 17.1
Consejos para el examen
- Simétrico: una clave secreta compartida, rápida, el intercambio de claves es la debilidad. Asimétrico: clave pública para cifrar, clave privada para descifrar, lento, no hay problema de intercambio. Dos diferencias, dos desventajas, dos razones: el examen pide que las presente en pares.
- La confidencialidad usa las claves del receptor (pública para bloquear, privada para desbloquear); una firma usa las claves del emisor (privada para firmar, pública para verificar). Diga de quién es la clave cada vez.
- El inicio de TLS tiene seis pasos: solicitud, certificado con clave pública, verificación, clave de sesión cifrada con la pública, descifrada con la privada, cifrado simétrico a partir de entonces.
- Un certificado es identidad más clave pública, firmado por una CA; la adquisición es par de claves, solicitud, verificación, firma, instalación. Se necesita para validar una firma porque demuestra de quién es la clave pública.
- Una firma es un hash cifrado con la clave privada; la verificación es descifrar, recalcular el hash, comparar. Integridad y autenticidad son las dos cosas que demuestran.
- La criptografía cuántica distribuye claves y detecta espías; sus límites son costo, distancia y novedad.
Errores comunes
- Decir que un mensaje se cifra con la clave pública del emisor; la clave pública del receptor cifra, la clave privada del receptor descifra.
- Describir una firma como "cifrar el mensaje con la clave privada" en lugar de cifrar su hash.
- Afirmar que un certificado contiene la clave privada; contiene la clave pública y la identidad, firmada por la CA.
- Listar "el servidor envía su clave privada" en el apretón de manos de TLS; solo viaja la clave pública, dentro del certificado.
- Dar "SSL/TLS hace la conexión más rápida" como función; sus funciones son cifrado, autenticación e integridad.
- Confundir hashing con cifrado: un hash no puede revertirse y no tiene clave; el cifrado es reversible con la clave.
- Responder "por qué se necesita un certificado para una firma" con "para cifrarlo"; se necesita para confiar en la clave pública.
-
18
Inteligencia artificial (AI)
Ver lección18.1
Qué es la IA

Syllabus
Los candidatos deben ser capaces de: Notas y orientación Demostrar comprensión de cómo los grafos pueden utilizarse para apoyar la Inteligencia Artificial (IA) Propósito y estructura de un grafo. Utilizar el algoritmo A* y el algoritmo de Dijkstra para realizar búsquedas en un grafo. No se requerirá a los candidatos que escriban algoritmos para configurar, acceder o realizar búsquedas en grafos. Demostrar comprensión de cómo las redes neuronales artificiales han contribuido al aprendizaje automático Demostrar comprensión del Aprendizaje Profundo, el Aprendizaje Automático y el Aprendizaje por Refuerzo, así como de las razones para utilizar estos métodos. Comprender las categorías del aprendizaje automático, incluido el aprendizaje supervisado y el aprendizaje no supervisado. Demostrar comprensión de la propagación inversa del error y los métodos de regresión en el aprendizaje automático Fuente: Plan de estudios Cambridge International
Inteligencia artificial (IA) construye sistemas que realizan tareas que normalmente requieren inteligencia humana: reconocimiento de voz e imágenes, traducción, juego, conducción y generación de texto. La mayoría de la IA moderna utiliza aprendizaje automático — algoritmos que aprenden patrones a partir de datos en lugar de ser programados paso a paso. Dentro de este campo, el aprendizaje profundo, que utiliza redes neuronales con muchas capas, ha sido dominante desde la década de 2010.
Un robot humanoide integra muchas de estas capacidades en un solo cuerpo: utiliza la IA para ver rostros, comprender el habla y mover su rostro y brazos de una manera realista.
Un robot humanoide usa IA para ver, escuchar y responder como una persona 
El aprendizaje profundo es parte del aprendizaje automático, que es parte de la IA ExplorarLaboratorio de tipos de aprendizaje de IA
Clasificar ejemplos de IA según el tipo de aprendizaje o la preocupación involucrada.
Vocabulario EntrenarInglés Chino Pinyin artificial intelligence/ˌɑːtɪˈfɪʃl ɪnˈtelɪdʒəns/ 人工智能 rén gōng zhì néng machine learning/məˈʃiːn ˈlɜːnɪŋ/ 机器学习 jī qì xué xí deep learning/diːp ˈlɜːnɪŋ/ 深度学习 shēn dù xué xí neural networks/ˈnjuːrəl ˈnetwɜːks/ 神经网络 shén jīng wǎng luò humanoid robot/ˈhjuːmənɔɪd ˈrəʊbɒt/ 人形机器人 rén xíng jī qì rén 18.1
Grafos en la IA

Muchos problemas de IA se sitúan sobre un grafo: nodos (estados, lugares) unidos por aristas (movimientos, relaciones).
- búsqueda de rutas: las carreteras forman un grafo; la ruta más corta es una búsqueda en grafos (algoritmo de Dijkstra, algoritmo A*).
- juego: cada posición del tablero es un nodo, cada movimiento es una arista; minimax con poda alfa-beta busca en el árbol del juego.
- búsqueda en espacio de estados: un problema de planificación implica moverse entre estados aplicando operadores para alcanzar una meta.
- representación del conocimiento: una red semántica tiene conceptos como nodos y relaciones como aristas ("perro ES-UN animal"); un grafo de conocimiento almacena hechos sobre el mundo para buscadores y asistentes.
Los problemas de IA suelen situarse sobre un grafo; aquí se resalta el camino más corto Las herramientas estándar para navegar en grafos incluyen la búsqueda en anchura y la búsqueda en profundidad.
"Describe el propósito y la estructura de un grafo en un sistema de IA." Propósito: representar un problema como un conjunto de estados (o lugares) y los posibles movimientos entre ellos, para que un algoritmo pueda buscarlo en busca de una solución, como la ruta más corta o barata, o el mejor siguiente movimiento. Estructura: un conjunto de nodos (vértices), cada uno representando un estado, ubicación o elemento, unidos por aristas que representan las conexiones entre ellos; cada arista puede llevar un peso (un costo, distancia o tiempo), y las aristas pueden ser dirigidas (de un solo sentido) o no dirigidas. "Explica el uso de grafos para ayudar a la IA": el grafo es el modelo sobre el cual funcionan los algoritmos de búsqueda de la IA: A* y el algoritmo de Dijkstra encuentran caminos óptimos a través de él (navegación, enrutamiento), las posiciones del juego forman un árbol buscado para encontrar el mejor movimiento, y el conocimiento almacenado como un grafo permite a un sistema razonar sobre cómo se relacionan los hechos.

El grafo usado abajo: los números de las aristas son distancias reales; los números rojos son la estimación heurística de cada nodo de cuánto falta para la meta, lo cual solo usa A* Algoritmo de Dijkstra. Encuentra la distancia más corta desde el inicio hasta cada nodo. Mantén una tabla con la mejor distancia encontrada hasta ahora a cada nodo (inicio 0, todos los demás infinito). Repite tomar el nodo no visitado con la distancia más pequeña, márcalo como visitado, y para cada vecino verifica si pasar por este nodo da una distancia más corta; si es así, actualízala y registra de dónde vino. Detente cuando todos los nodos estén visitados (o se alcance el objetivo).
Ejemplo trabajado. Encuentra las distancias más cortas desde H hasta cada otro nodo en el grafo anterior.
paso visitar H A B C D G inicio 0 ∞ ∞ ∞ ∞ ∞ 1 H (0) 0 4 (H) 3 (H) ∞ ∞ ∞ 2 B (3) 0 4 (H) 3 ∞ 9 (B) ∞ 3 A (4) 0 4 3 9 (A) 8 (A) ∞ 4 D (8) 0 4 3 9 (A) 8 10 (D) 5 C (9) 0 4 3 9 8 10 (D) 6 G (10) Distancias más cortas: A 4, B 3, D 8, C 9, G 10, y el camino a G es H–A–D–G (lee las etiquetas "vino de" hacia atrás). En el paso 3, A ofrece a D una distancia de $4 + 4 = 8$, mejor que el 9 encontrado a través de B, así que D se actualiza; en el paso 5, C podría llegar a G en $9 + 3 = 12$, peor que 10, así que nada cambia. Mostrar estas comparaciones es el "procedimiento" que pide la pregunta.
El algoritmo A*. Dijkstra explora en todas direcciones. A* añade una heurística $h$, una estimación de la distancia restante, y siempre expande el nodo con el menor $f = g + h$, donde $g$ es la distancia recorrida hasta ahora. Con una heurística sensata (que nunca sobreestime), encuentra la misma ruta más corta mientras mira muchos menos nodos, por eso los satnavs y los juegos lo usan. El examen da $h$ para cada nodo y una tabla para rellenar.
Ejemplo trabajado. Encuentra un camino de H a G con A*, mostrando el procedimiento.
nodo expandido $g$ hasta ahora $h$ $f = g + h$ vecinos añadidos (nodo: $g$, $h$, $f$) H 0 7 7 A: 4, 5, 9; B: 3, 6, 9 B (empate con A; cualquiera) 3 6 9 D vía B: 9, 2, 11 A 4 5 9 C: 9, 3, 12; D vía A: 8, 2, 10 (mejor que 11, mantener) D 8 2 10 G: 10, 0, 10; C vía D: 9 (no mejor) G 10 0 10 meta alcanzada Camino H–A–D–G, longitud 10, el mismo que Dijkstra, pero C nunca fue expandido. Cada vez que un nodo se alcanza por una segunda ruta, mantén el $g$ más pequeño; la búsqueda termina cuando la meta es el nodo con el $f$ más pequeño. Indica los valores de $g$, $h$ y $f$ en cada fila: esos son los puntos.
Vocabulario EntrenarInglés Chino Pinyin graph/ɡræf/ 图 tú nodes/nəʊdz/ 节点 jié diǎn edges/ˈedʒɪz/ 边 biān minimax/ˈmɪnɪmæks/ 极小化极大 jí xiǎo huà jí dà semantic network/səˈmæntɪk ˈnetwɜːk/ 语义网络 yǔ yì wǎng luò knowledge graph/ˈnɒlɪdʒ ɡræf/ 知识图谱 zhī shí tú pǔ breadth-first search/bredθ fɜːst sɜːtʃ/ 广度优先搜索 guǎng dù yōu xiān sōu suǒ depth-first search/depθ fɜːst sɜːtʃ/ 深度优先搜索 shēn dù yōu xiān sōu suǒ weight/weɪt/ 权重 quán zhòng heuristic/hjuːˈrɪstɪk/ 启发式 qǐ fā shì labels/ˈleɪblz/ 标签 biāo qiān 18.1
Redes neuronales artificiales (ANNs)

Una ANN está inspirada en las neuronas del cerebro. Un neurona artificial:
- toma varios valores de entrada, multiplica cada uno por un peso, y los suma junto con un término de sesgo.
- aplica una función de activación (una función no lineal como ReLU) a la suma.
- entrega el resultado, que alimenta a neuronas más adelante.
Una neurona individual: cada entrada por su peso, sumada con un sesgo, luego una función de activación Las neuronas están en capas: una capa de entrada, una o más capas ocultas (donde se aprenden patrones internos útiles), y una capa de salida. Con muchas capas ocultas es una red neuronal profunda, y entrenarla es aprendizaje profundo.

Una red neuronal con una capa de entrada, dos capas ocultas y una capa de salida Las ANNs permiten a los modelos aprender patrones complejos directamente desde datos crudos (píxeles, audio, texto) sin características diseñadas manualmente — impulsando avances en reconocimiento de imágenes, reconocimiento de voz, traducción automática y juego. Funcionan bien con grandes cantidades de datos, entrada ruidosa o muy compleja, y patrones demasiado difíciles de capturar con reglas explícitas.
"Explica qué se entiende por una red neuronal artificial." Un modelo de la red de neuronas del cerebro, hecho de capas de nodos conectados: una capa de entrada, una o más capas ocultas y una capa de salida. Cada conexión tiene un peso; cada nodo suma sus entradas ponderadas y pasa el resultado a través de una función de activación a la siguiente capa. "Explica cómo las ANNs habilitan el aprendizaje automático" (tres puntos): la red se entrena con muchos ejemplos; para cada ejemplo la salida se compara con el resultado esperado y el error se usa para ajustar los pesos (propagación hacia atrás) para que el error disminuya; después de suficientes ejemplos los pesos codifican los patrones en los datos, y la red puede entonces clasificar o predecir para nuevos datos que nunca ha visto. "Indica la razón para múltiples capas ocultas": cada capa adicional combina las características encontradas por la capa anterior en características más complejas y más abstractas, para que la red pueda aprender relaciones más complejas (bordes, luego formas, luego objetos); eso es lo que hace que una red sea profunda.
ExplorarToca las partes de una red neuronal
Explora las capas. Los datos fluyen de izquierda a derecha: la capa de entrada toma las características, las capas intermedias aprenden patrones y la capa de salida da la respuesta — con cada conexión que lleva un peso que el entrenamiento ajusta.
Vocabulario EntrenarInglés Chino Pinyin artificial neuron/ˌɑːtɪˈfɪʃl ˈnjuːrɒn/ 人工神经元 rén gōng shén jīng yuán bias term/ˈbaɪəs tɜːm/ 偏置项 piān zhì xiàng activation function/ˌæktɪˈveɪʃn ˈfʌŋkʃn/ 激活函数 jī huó hán shù hidden layers/ˈhɪdn ˈleɪəz/ 隐藏层 yǐn cáng céng deep neural network/diːp ˈnjuːrəl ˈnetwɜːk/ 深度神经网络 shēn dù shén jīng wǎng luò image recognition/ˈɪmɪdʒ ˌrekəɡˈnɪʃn/ 图像识别 tú xiàng shí bié speech recognition/spiːtʃ ˌrekəɡˈnɪʃn/ 语音识别 yǔ yīn shí bié machine translation/məˈʃiːn trænˈsleɪʃn/ 机器翻译 jī qì fān yì reinforcement learning/ˌriːɪnˈfɔːsmənt ˈlɜːnɪŋ/ 强化学习 qiáng huà xué xí supervised learning/ˈsuːpəvaɪzd ˈlɜːnɪŋ/ 监督学习 jiān dū xué xí classification/ˌklæsɪfɪˈkeɪʃn/ 分类 fēn lèi 18.1
Aprendizaje automático, aprendizaje profundo, aprendizaje por refuerzo
Aprendizaje automático
El término paraguas — cualquier algoritmo que aprende de datos. Tres paradigmas:
- aprendizaje supervisado — los datos tienen etiquetas (imágenes etiquetadas "gato"/"perro"); el algoritmo aprende entrada → etiqueta. Usado para clasificación (una categoría) y regresión.
- aprendizaje no supervisado — sin etiquetas; el algoritmo encuentra estructura, p. ej. un grupo de clientes similares.
- aprendizaje por refuerzo (abajo).
Usa ML cuando las reglas explícitas serían imprácticas (filtros de spam, recomendaciones, detección de fraudes).
Mismos datos vistos de dos formas: con etiquetas, la tarea es aprender qué separa las clases; sin etiquetas, la tarea es descubrir que existen grupos en absoluto "Describe el aprendizaje supervisado y no supervisado" (las palabras marcadas). Aprendizaje supervisado: el algoritmo se entrena con datos de entrenamiento etiquetados, cada ejemplo emparejado con la salida correcta (el objetivo); aprende la relación entre entradas y salidas y la usa para clasificar o predecir para nuevas entradas; las respuestas son conocidas durante el entrenamiento, por lo que el error se puede medir. Aprendizaje no supervisado: los datos están sin etiquetar, sin respuestas correctas dadas; el algoritmo busca patrones, estructura o agrupaciones en los datos por sí mismo (agrupar elementos similares, encontrar asociaciones); la salida es un conjunto de categorías o relaciones que no se definieron de antemano. Cómo difieren: datos etiquetados contra datos sin etiquetar; salidas conocidas contra estructura descubierta; el supervisado se usa para predecir (clasificación, regresión), el no supervisado para explorar (agrupamiento, detección de anomalías). Ambos son categorías de aprendizaje automático; el tercero es el aprendizaje por refuerzo.

Aprendizaje supervisado: un modelo se entrena con datos etiquetados, luego reconoce nuevos datos Aprendizaje profundo
Un subconjunto de ML que usa redes neuronales profundas. Las capas inferiores aprenden patrones simples (bordes, fonemas), las capas superiores los combinan en conceptos abstractos. Necesita muchos datos y mucho cálculo (GPUs); para conjuntos de datos pequeños, métodos de ML más simples a menudo funcionan mejor.
"Explica qué se entiende por aprendizaje profundo" (tres puntos). Aprendizaje automático que usa redes neuronales artificiales con muchas capas ocultas (redes profundas); la red se entrena con cantidades muy grandes de datos, y cada capa extrae características de la salida de la capa inferior, para que la red aprenda las características que necesita por sí misma en lugar de tenerlas especificadas por el programador. Razones para usarlo: puede resolver problemas demasiado complejos para reglas escritas a mano o modelos poco profundos (reconocer caras, comprender el habla, traducir texto); mejora a medida que hay más datos disponibles; elimina la necesidad de ingeniería de características humana; y puede manejar datos no estructurados como imágenes, sonido y texto. Cómo se hace más efectivo: más (y mejor etiquetados) datos de entrenamiento; más capas o nodos, dentro de los límites del sobreajuste; más potencia de procesamiento (GPUs) y tiempo de entrenamiento; ajustar la tasa de aprendizaje y otros parámetros. Ejemplos: reconocimiento de voz en asistentes de voz, reconocimiento de imágenes en escaneos médicos y coches autónomos, traducción automática, sistemas de recomendación.
Aprendizaje por refuerzo
En aprendizaje por refuerzo, un agente actúa en un entorno; cada acción cambia el estado y devuelve una recompensa. El agente aprende una política (una estrategia) que maximiza la recompensa total con el tiempo, mediante ensayo y error sin etiquetas previas. Usado para problemas de decisión secuencial — juegos, control de robots, conducción autónoma.
"Explica qué se entiende por aprendizaje por refuerzo" (tres puntos). Un agente aprende interactuando con su entorno: toma una acción, el entorno se mueve a un nuevo estado y devuelve una recompensa (o penalización), y el agente ajusta su comportamiento para maximizar la recompensa total con el tiempo. No hay datos etiquetados: el agente aprende por ensayo y error, descubriendo qué acciones son buenas a partir de las recompensas que recoge, y gradualmente forma una política que dice qué hacer en cada estado. Usado donde la respuesta correcta no se conoce de antemano pero el resultado de una acción se puede puntuar: juego (ajedrez, Go), control de robots, temporización de semáforos, asignación de recursos. Una computadora jugando un juego de mesa contra un usuario aprende de esta manera, o busca el árbol del juego con minimax para elegir el movimiento cuyo peor resultado sea el mejor.

Aprendizaje por refuerzo: el agente actúa, el entorno devuelve un nuevo estado y una recompensa, y el agente aprende de ello Un coche autónomo es un ejemplo real. Los sensores Lidar y de cámara (la unidad giratoria en el techo) construyen una imagen en vivo de la carretera, y una política aprendida decide cómo girar, acelerar y frenar con seguridad.

Un coche autónomo usa cámaras y sensores Lidar para ver la carretera a su alrededor 
Brazos robóticos industriales en una línea de producción: el aprendizaje por refuerzo puede enseñar a un robot a controlar sus movimientos Vocabulario EntrenarInglés Chino Pinyin self-driving car/self ˈdraɪvɪŋ kɑː/ 自动驾驶汽车 zì dòng jià shǐ qì chē agent/ˈeɪdʒənt/ 智能体 zhì néng tǐ reward/rɪˈwɔːd/ 奖励 jiǎng lì policy/ˈpɒlɪsi/ 策略 cè lüè lidar/ˈlaɪdɑː/ 激光雷达 jī guāng léi dá backpropagation/ˌbækprəpəˈɡeɪʃn/ 反向传播 fǎn xiàng chuán bō 18.1
Entrenar una ANN: propagación hacia atrás
El entrenamiento ajusta los pesos para que las salidas coincidan con los objetivos. El método estándar es la propagación hacia atrás (propagación de errores) con descenso de gradiente. Para cada ejemplo de entrenamiento:
- paso hacia adelante — alimenta la entrada hasta la salida.
- calcula el error con una función de pérdida (un número único de qué tan incorrecta es la salida).
- paso hacia atrás — propaga el error hacia atrás, encontrando el gradiente de cada peso (cuánto contribuyó al error) usando la regla de la cadena.
- actualiza los pesos con un pequeño paso (determinado por la tasa de aprendizaje) que reduce el error.
Repite sobre muchos ejemplos y muchas pasadas (épocas) hasta que el error deje de disminuir. El nombre "hacia atrás" proviene del paso 3: el error fluye desde la salida hacia atrás hacia la entrada, por lo que el gradiente de cada peso se encuentra en una sola pasada. Después del entrenamiento, una nueva entrada necesita solo una pasada hacia adelante para obtener una predicción.
"Describe el método de propagación hacia atrás de errores" (cuatro puntos). (1) Se introduce una entrada hacia adelante a través de la red y su salida se compara con la salida esperada (objetivo); (2) la diferencia es el error; (3) el error se pasa hacia atrás a través de la red, capa por capa desde la salida hacia la entrada, y se calcula la participación de cada peso en el error; (4) los pesos se ajustan en proporción a su contribución, en la dirección que reduce el error; (5) el proceso se repite con muchos ejemplos hasta que el error es tan pequeño como se requiere. El punto del método es que una red con capas ocultas no tiene una forma directa de saber qué peso interno causó un error de salida; la propagación hacia atrás reparte la culpa.
El entrenamiento ajusta los pesos para alcanzar el error mínimo Vocabulario EntrenarInglés Chino Pinyin gradient descent/ˈɡreɪdɪənt dɪˈsent/ 梯度下降 tī dù xià jiàng loss function/lɒs ˈfʌŋkʃn/ 损失函数 sǔn shī hán shù epochs/ˈiːpɒks/ 训练轮次 xùn liàn lún cì 18.1
Regresión

Algunas tareas predicen un número (precio de una casa, temperatura de mañana) — regresión, en contraste con la clasificación (una categoría).
La regresión lineal ajusta una línea recta (o hiperplano):
$$y = m_{1} x_{1} + m_{2} x_{2} + \ldots + m_{n} x_{n} + c.$$Elige los coeficientes para minimizar la suma de errores cuadrados contra los datos de entrenamiento. Úsalo cuando la relación parece aproximadamente lineal y quieres un modelo interpretable. Para datos curvos, usa métodos de regresión polinomial, de árboles de decisión o de redes neuronales — misma idea: define un modelo, define una pérdida, y ajusta los parámetros para minimizarla. La regresión y la clasificación son ambas supervisadas; la elección depende de si la respuesta es un número o una categoría.
"Describe los métodos de regresión en el aprendizaje automático" (dos puntos). Métodos estadísticos que encuentran la relación entre variables de entrada y una salida continua, ajustando una función (una línea o curva) a los datos de entrenamiento con el error total más pequeño; la función ajustada se usa luego para predecir la salida para nuevas entradas. La regresión lineal ajusta una línea recta; otros métodos ajustan curvas. La regresión predice un valor (un precio, una temperatura, un tiempo); la clasificación predice una categoría, que es la distinción que pide el examen.
La regresión lineal ajusta la línea que hace que el error cuadrático total (las brechas punteadas) sea lo más pequeño posible ExplorarAjuste de una línea de regresión
Arrastra los controles. La regresión lineal traza la línea recta que hace que las distancias al cuadrado a los puntos de datos sean lo más pequeñas posible — luego predice un número para cualquier entrada nueva.
Vocabulario EntrenarInglés Chino Pinyin regression/rɪˈɡreʃn/ 回归 huí guī unsupervised learning/ʌnˈsuːpəvaɪzd ˈlɜːnɪŋ/ 无监督学习 wú jiān dū xué xí cluster/ˈklʌstə/ 聚类 jù lèi training data/ˈtreɪnɪŋ ˈdeɪtə/ 训练数据 xùn liàn shù jù learning rate/ˈlɜːnɪŋ reɪt/ 学习率 xué xí lǜ linear regression/ˈlɪnɪə rɪˈɡreʃn/ 线性回归 xiàn xìng huí guī optical character recognition/ˈɒptɪkl ˈkærɪktə ˌrekəɡˈnɪʃn/ 光学字符识别 guāng xué zì fú shí bié text-to-speech/tekst tə spiːtʃ/ 文本转语音 wén běn zhuǎn yǔ yīn 18.1
Cómo se usa la IA en un escenario real
Muchos escenarios de examen usan el mismo patrón — un modelo de aprendizaje profundo entrenado con datos etiquetados, a menudo varios combinados en una tubería:
- identificación de clientes en una tienda automatizada: el sistema se entrena con imágenes de rostro etiquetadas; una cámara captura un rostro; el reconocimiento de imágenes extrae una representación; se compara con clientes registrados; la coincidencia más cercana identifica a la persona.
- lectura de texto de imágenes: el reconocimiento de imágenes encuentra regiones de texto; el reconocimiento óptico de caracteres extrae los caracteres; la traducción automática los convierte; la síntesis de voz los lee en voz alta.
- detección de artículos en caja registradora: IA de detección de objetos, entrenada con imágenes de productos etiquetadas, ve qué artículos van a la cesta y cobra la cuenta.
Para cuando un usuario interactúa con el sistema, el modelo es rápido — solo realiza inferencia de paso hacia adelante; la inteligencia está en los patrones aprendidos durante el entrenamiento.
Respuestas modelo para las preguntas del escenario. Una cámara de aparcamiento lee matrículas: la cámara captura una imagen; una IA entrenada con muchas imágenes etiquetadas de matracas localiza la placa en la imagen; el reconocimiento de caracteres (un clasificador de aprendizaje profundo, nuevamente entrenado con caracteres etiquetados) convierte la placa en texto; el texto se almacena con la hora y se compara cuando el coche sale. Un sistema CCTV detecta y rastrea a una persona: software de reconocimiento de imágenes entrenado con imágenes etiquetadas de personas identifica a una persona en cada fotograma; el sistema compara fotogramas sucesivos para seguir su movimiento; un movimiento inusual puede desencadenar una alerta. Discurso convertido en comandos: reconocimiento de voz entrenado con muchas voces grabadas convierte el sonido en texto; el sistema compara el texto con un conjunto de comandos conocidos; mejora a medida que se corrige. Una cámara que enfoca rostros: un modelo de detección de rostro entrenado con rostros etiquetados encuentra la región del rostro, y la lente se ajusta para poner esa región en foco. Inicio de sesión con reconocimiento facial de un banco: la app captura el rostro, una red profunda extrae sus características, y se comparan con las características almacenadas para ese cliente. En todos los casos el patrón es: entrenado con ejemplos etiquetados, extrae características, coincide o clasifica nueva entrada.
Ejemplo trabajado. Para cada tarea, di si necesita regresión o clasificación, y cómo se vería la capa de salida de una ANN: (a) predecir la temperatura de mañana; (b) decidir si un correo es spam. Pregunta qué tipo de cosa se está prediciendo. (a) Una temperatura es un número en una escala continua, así que esto es regresión, y la capa de salida es una neurona individual que sostiene ese valor. (b) Spam o no-spam es una categoría, así que esto es clasificación, y la salida da una probabilidad por clase. Ambos son aprendizaje supervisado: cada uno necesita ejemplos etiquetados para entrenar, y el entrenamiento ajusta los pesos mediante propagación hacia atrás para reducir el error. La pregunta decisiva es simplemente número-categoría - no qué difícil parezca la tarea.
18.1
Definiciones que acepta el examinador
Una pregunta de definición se califica contra un texto fijo. Aprende estas exactamente, y da solo una respuesta.
Término Definición grafo (en IA) un conjunto de nodos que representan estados o lugares, unidos por aristas que representan conexiones, a menudo ponderadas, que un algoritmo de búsqueda puede explorar Algoritmo de Dijkstra encuentra la distancia más corta desde un nodo inicial hasta cada otro nodo visitando siempre el nodo no visitado con la distancia más corta hasta ahora Algoritmo A* una búsqueda de camino más corto que expande el nodo con el menor total de distancia recorrida más una estimación heurística de la distancia a la meta red neuronal artificial un modelo de las neuronas del cerebro: capas de nodos unidos por conexiones ponderadas, entrenado ajustando los pesos aprendizaje automático algoritmos que aprenden de datos y mejoran con la experiencia en lugar de seguir reglas fijas aprendizaje supervisado aprendizaje a partir de datos de entrenamiento etiquetados en los que se conoce la salida correcta para cada entrada aprendizaje no supervisado aprendizaje a partir de datos sin etiquetar encontrando patrones, agrupaciones o estructura en ellos aprendizaje por refuerzo un agente aprende por ensayo y error, eligiendo acciones en un entorno para maximizar las recompensas que recibe aprendizaje profundo aprendizaje automático que usa redes neuronales con muchas capas ocultas, entrenadas con grandes cantidades de datos, cada capa extrayendo características de la inferior propagación hacia atrás de errores comparar la salida de la red con el objetivo, pasar el error hacia atrás a través de las capas y ajustar cada peso para reducirlo regresión ajustar una función a los datos de entrenamiento para predecir un valor de salida continuo a partir de entradas 18.1
Consejos para el examen
- Las respuestas de grafos deben nombrar nodos, aristas y pesos, y explicar qué representan; luego describir el algoritmo. Dijkstra: tabla de distancias, visitar la menor, actualizar vecinos. A*: $g$, $h$ y $f = g + h$ en cada fila, expandir la menor $f$.
- Las respuestas de ANN deben nombrar las capas, las conexiones ponderadas y el entrenamiento; el aprendizaje profundo añade muchas capas ocultas, grandes volúmenes de datos y extracción automática de características, con una razón y un ejemplo.
- Las tres categorías en una línea cada una: datos etiquetados y salidas conocidas; datos no etiquetados y estructura descubierta; agente, entorno, acciones y recompensas.
- Retropropagación: comparar con el objetivo, propagar el error hacia atrás a través de las capas, ajustar los pesos para reducirlo, repetir. La regresión predice un valor; la clasificación predice una categoría.
- Las preguntas de escenario requieren describir la tubería: entrenado con ejemplos etiquetados, extrae características, reconoce o clasifica nuevas entradas; nombrar el tipo de IA (reconocimiento de imágenes, reconocimiento de voz, aprendizaje profundo).
Errores comunes
- Describir un grafo como "un gráfico"; en IA son nodos y aristas.
- Ejecutar Dijkstra eligiendo el vecino más cercano del nodo actual en lugar de la distancia más pequeña en general que aún no ha sido visitada; u olvidar actualizar un nodo cuando aparece una ruta más corta.
- Añadir $h$ dentro de $g$ para el siguiente paso en A*; $g$ es solo la distancia real, $h$ se recalcula desde la tabla.
- Decir que el aprendizaje profundo es "aprender mucho"; se refiere a las muchas capas ocultas.
- Confundir el aprendizaje no supervisado con el aprendizaje por refuerzo; el primero encuentra estructuras en los datos, el segundo aprende de las recompensas.
- Describir la retropropagación sin mencionar la comparación con la salida esperada o sin indicar que los pesos se ajustan.
- Llamar "clasificación" a la predicción de un precio; un valor continuo es regresión.
-
19
Pensamiento computacional y resolución de problemas
Ver lección19.1
Algoritmos de búsqueda

Syllabus
Los candidatos deben ser capaces de: Notas y orientación Demostrar comprensión de los métodos de búsqueda lineal y búsqueda binaria Escribir un algoritmo para implementar una búsqueda lineal. Escribir un algoritmo para implementar una búsqueda binaria. Las condiciones necesarias para el uso de una búsqueda binaria. Cómo varía el rendimiento de una búsqueda binaria según el número de elementos de datos. Demostrar comprensión de los métodos de ordenación por inserción y ordenación burbuja Escribir un algoritmo para implementar una ordenación por inserción. Escribir un algoritmo para implementar una ordenación burbuja. El rendimiento de una rutina de ordenación puede depender del orden inicial de los datos y del número de elementos de datos. Demostrar comprensión y uso de Tipos de Datos Abstractos (TDA) Escribir algoritmos para encontrar un elemento en cada uno de los siguientes: lista enlazada, árbol binario. Escribir algoritmos para insertar un elemento en cada uno de los siguientes: pila, cola, lista enlazada, árbol binario. Escribir algoritmos para eliminar un elemento de cada uno de los siguientes: pila, cola, lista enlazada. Demostrar comprensión de que un grafo es un ejemplo de un TDA. Describir las características clave de un grafo y justificar su uso para una situación dada. A los candidatos no se les requerirá escribir código para una estructura de grafo. Demostrar cómo es posible implementar TDAs a partir de otro TDA Describir los siguientes TDAs y demostrar cómo pueden implementarse a partir de tipos integrados adecuados u otros TDAs: pila, cola, lista enlazada, diccionario, árbol binario. Demostrar comprensión de que diferentes algoritmos que realizan la misma tarea se pueden comparar utilizando criterios (p. ej., tiempo necesario para completar la tarea y memoria utilizada) Incluye el uso de la notación Big O para especificar la complejidad temporal y espacial. Fuente: Plan de estudios Cambridge International
Big O: cómo escalan los algoritmos Ordenamiento por inserción: desliza cada tarjeta a su lugar Ordenamiento burbuja, paso a paso Búsqueda binaria: divide y conquista Una búsqueda encuentra un valor objetivo en una colección (a menudo un array 数组) y devuelve su posición o "no encontrado".
Buscar una lista ordenada, como una guía telefónica, es mucho más rápido que revisar cada entrada una por una Búsqueda lineal
Una búsqueda lineal 线性查找 recorre desde el inicio hasta el final, comparando cada elemento con el objetivo:
FOR i ← 1 TO n
    IF A[i] = target THEN
        RETURN i
    ENDIF
NEXT i
RETURN -1   // not found
No se requiere preparación, por lo que funciona con cualquier lista. Caso peor O($n$) (objetivo al final o ausente); mejor caso 1 comparación. Úsala en datos desordenados o listas pequeñas. (El
-1devuelto es un valor centinela —una posición imposible que significa "no encontrado"; el llamado pruebaIF result = -1.)La versión del examen. El Paper 3 te pide completar una búsqueda lineal escrita con una bandera y un bucle
WHILE, y el Paper 4 escribir una función que devuelva el índice o un contador. Ambos se ven así:FUNCTION LinearSearch(Data : ARRAY OF INTEGER, Target : INTEGER) RETURNS INTEGER DECLARE Index, Count : INTEGER Count ← 0 FOR Index ← 1 TO 100 IF Data[Index] = Target THEN Count ← Count + 1 ENDIF NEXT Index RETURN Count // how many times Target occurs; 0 means not found ENDFUNCTIONPara detenerse en la primera coincidencia en su lugar, usa un bucle
WHILE Index <= 100 AND NOT Foundque estableceFound ← TRUEy recuerda el índice. Las marcas son para el bucle sobre cada elemento, la comparación y qué se devuelve cuando el valor está ausente.
La búsqueda lineal revisa cada letra a la vez — 23 comparaciones para encontrar W Búsqueda binaria
Una búsqueda binaria 二分查找 necesita los datos ordenados. Mira el elemento central; si es el objetivo, listo; si el objetivo es menor, busca en la mitad izquierda, si no en la derecha —reduciendo a la mitad el rango cada vez:
low ← 1
high ← n
WHILE low <= high DO
    mid ← (low + high) DIV 2
    IF A[mid] = target THEN
        RETURN mid
    ENDIF
    IF A[mid] < target THEN
        low ← mid + 1
    ELSE
        high ← mid - 1
    ENDIF
ENDWHILE
RETURN -1
Caso peor O($\log_{2} n$) —para un millón de elementos, unas 20 comparaciones. Mucho más rápida que la búsqueda lineal en arrays grandes ordenados, pero debes ordenar primero (un costo único O($n \log n$)), vale la pena si buscas muchas veces.
"Enuncia la condición necesaria para una búsqueda binaria." Los datos deben estar en orden (ordenados, ascendentes o descendentes, según la clave buscada). "Describe cómo realizar una búsqueda binaria" (tres marcas): (1) encuentra el elemento central de la lista (o del rango actual) y compáralo con el objetivo; (2) si coincide, termina la búsqueda; si el objetivo es menor, repite en la mitad inferior, si mayor, en la mitad superior; (3) sigue reduciendo a la mitad el rango hasta que se encuentre el elemento o el rango esté vacío, lo que significa que no está presente.
La versión del examen, con los límites y una bandera, es la que debes reproducir cuando se te pida completar el algoritmo:
DECLARE Lower, Upper, Mid : INTEGER
DECLARE Found : BOOLEAN
Lower ← 0
Upper ← 99
Found ← FALSE
WHILE Lower <= Upper AND NOT Found
    Mid ← (Lower + Upper) DIV 2
    IF Names[Mid] = Target THEN
        Found ← TRUE
    ELSE
        IF Names[Mid] < Target THEN
            Lower ← Mid + 1
        ELSE
            Upper ← Mid - 1
        ENDIF
    ENDIF
ENDWHILE
IF Found THEN
    OUTPUT Mid
ELSE
    OUTPUT "Not found"
ENDIF
"Explica cómo varía el rendimiento con el número de elementos." Cada comparación reduce a la mitad el número de elementos restantes, por lo que el número máximo de comparaciones es aproximadamente $\log_{2} n$: duplicar el tamaño de la lista añade solo una comparación más. Esto es O($\log n$). "Compara búsqueda lineal y búsqueda binaria": una búsqueda lineal necesita hasta $n$ comparaciones (O($n$)) y, en promedio, la mitad de eso, pero funciona con datos desordenados; una búsqueda binaria necesita como máximo $\log_{2} n$ (O($\log n$)) y es mucho más rápida para listas grandes, pero los datos deben estar primero ordenados y debe permitir acceso directo al elemento central (un array, no una lista enlazada). Para ⟨ $1000$⟩ elementos: ⟨ $1000$⟩ frente a ⟨ $10$⟩ comparaciones.

Búsqueda binaria reduce el rango a la mitad en cada paso (low / mid / high) — solo 3 comparaciones para encontrar W 
Un catálogo de tarjetas: los registros ordenados son lo que hacen posible una búsqueda binaria —reduce a la mitad, mira, vuelve a reducir a la mitad ExplorarBúsqueda lineal vs binaria
Busca un valor. La búsqueda binaria reduce la lista a la mitad en cada paso (solo en datos ordenados); la búsqueda lineal revisa uno por uno.
Vocabulario EntrenarInglés Chino Pinyin insertion sort/ɪnˈsɜːʃn sɔːt/ 插入排序 chā rù pái xù bubble sort/ˈbʌbl sɔːt/ 冒泡排序 mào pào pái xù binary search/ˈbaɪnəri sɜːtʃ/ 二分查找 èr fēn chá zhǎo array/əˈreɪ/ 数组 shù zǔ linear search/ˈlɪnɪə sɜːtʃ/ 线性查找 xiàn xìng chá zhǎo 19.1
Algoritmos de ordenamiento

Ordenamiento burbuja
Un ordenamiento burbuja 冒泡排序 recorre repetidamente el array, intercambiando pares adyacentes que están fuera de orden, de modo que las mayores "burbujas" flotan hacia el final en cada pasada:
FOR pass ← 1 TO n - 1
    swapped ← FALSE
    FOR i ← 1 TO n - pass
        IF A[i] > A[i + 1] THEN
            temp ← A[i]
            A[i] ← A[i + 1]
            A[i + 1] ← temp
            swapped ← TRUE
        ENDIF
    NEXT i
    IF swapped = FALSE THEN      // already sorted
        EXIT FOR
    ENDIF
NEXT pass
Mejor caso O($n$) (ya ordenado, con salida anticipada); promedio/peor O($n^{2}$). Simple pero lento para grandes ⟨ $n$⟩.
Ordenamiento por inserción
Un ordenamiento por inserción 插入排序 construye un prefijo ordenado desde la izquierda, insertando cada nuevo elemento en su lugar desplazando los mayores a la derecha:
FOR i ← 2 TO n
    key ← A[i]
    j ← i - 1
    WHILE j >= 1 AND A[j] > key DO
        A[j + 1] ← A[j]
        j ← j - 1
    ENDWHILE
    A[j + 1] ← key
NEXT i
Mejor caso O($n$) (ya ordenado); peor O($n^{2}$). Bueno para arrays pequeños o casi ordenados. Ordena in situ 原地 y es estable 稳定 (mantiene el orden de los elementos iguales).
Rastrear un ordenamiento
Tarea común es mostrar el array después de cada pasada externa. Para ⟨
[D, T, H, R]⟩ con ordenamiento por inserción: pasada 1 (clave T) sin cambio; pasada 2 (clave H) → ⟨[D, H, T, R]⟩; pasada 3 (clave R) → ⟨[D, H, R, T]⟩.Escribir un ordenamiento desde cero. "Escribe pseudocódigo para ordenar ⟨
DataArray[1:1000]⟩ en orden ascendente" se responde con un ordenamiento burbuja completo con la bandera de salida anticipada, o un ordenamiento por inserción, declarado e indentado; ambos obtienen marks completos si funcionan para toda entrada:DECLARE Pass, Index, Temp : INTEGER DECLARE Swapped : BOOLEAN Pass ← 1 REPEAT Swapped ← FALSE FOR Index ← 1 TO 1000 - Pass IF DataArray[Index] > DataArray[Index + 1] THEN Temp ← DataArray[Index] DataArray[Index] ← DataArray[Index + 1] DataArray[Index + 1] ← Temp Swapped ← TRUE ENDIF NEXT Index Pass ← Pass + 1 UNTIL Swapped = FALSE OR Pass = 1000Para el orden descendente, cambie
>a<; para ordenar registros o una matriz 2D por un campo, compare ese campo pero intercambie el registro completo (o todas las columnas). Si se le pide escribir un algoritmo de inserción "que realice la misma tarea" que una burbuja dada, mantenga el mismo nombre de matriz y dirección, y reproduzca la inserción anterior con la comparación invertida si el orden es descendente."Describa dos formas en que el rendimiento de un algoritmo de ordenación se ve afectado por los datos" (dos puntos). (1) El número de elementos: una ordenación $O(n^{2})$ tarda cuatro veces más con el doble de elementos. (2) Qué tan ordenados están los datos: una burbuja con bandera, o una de inserción, termina en un solo paso sobre datos ya ordenados ($O(n)$) y realiza el mayor trabajo con datos en orden inverso; el número de intercambios depende de cuántos pares estén desordenados. (También aceptado: el rango o número de valores duplicados, y si los elementos son registros grandes que son costosos de mover). Tanto la burbuja como la inserción son O($n^{2}$) en los peores y casos promedio, y O($n$) en el mejor caso; quicksort y mergesort son O($n \log n$), por lo que se usan para grandes volúmenes de datos.
Una ordenación por inserción de [D, T, H, R], desplazando cada clave a su lugar paso a pasoExplorarObservar una ejecución de ordenamiento
Recorre un algoritmo de ordenación y observa cómo las barras se acomodan en orden: cómo funciona un algoritmo de ordenación paso a paso.
Vocabulario EntrenarInglés Chino Pinyin stable/ˈsteɪbl/ 稳定 wěn dìng 19.1
ADTs en algoritmos
Los Tipos de Datos Abstractos (ADTs) del Tema 10 aparecen dentro de muchos algoritmos: una pila 栈 impulsa el recorrido en profundidad y el deshacer; una cola 队列 impulsa el recorrido en anchura y el orden de impresión; una lista enlazada 链表 permite que los datos crezcan y disminuyan.
Los ADTs pueden construirse a partir de otros ADTs, no solo de matrices: una cola a partir de dos pilas; una pila a partir de una lista enlazada (push = prependir un nodo 节点); una cola a partir de una lista enlazada con punteros de inicio y final pointers 指针; un árbol binario 二叉树 a partir de nodos con dos punteros de hijo; un diccionario 字典 almacena pares clave→valor (a menudo en una tabla hash). Capar así separa responsabilidades — el algoritmo que usa el ADT no necesita saber cómo está construido.
Los ADTs que el examen pide describir e implementar
Pila (último en entrar, primero en salir): los elementos se añaden (apilados) y se eliminan (desapilados) en el mismo extremo, el tope; un puntero
TopOfStackmantiene el índice del elemento superior. Implementado con una matriz y ese único puntero: push verifica que la pila no esté llena, incrementa el puntero y almacena el elemento; pop verifica que no esté vacía, devuelve el elemento superior y decrementa el puntero.FUNCTION Push(Item : INTEGER) RETURNS BOOLEAN IF TopOfStack = 9 THEN // full (array 0 to 9) RETURN FALSE ENDIF TopOfStack ← TopOfStack + 1 StackData[TopOfStack] ← Item RETURN TRUE ENDFUNCTION FUNCTION Pop() RETURNS INTEGER IF TopOfStack = -1 THEN // empty RETURN -1 ENDIF TopOfStack ← TopOfStack - 1 RETURN StackData[TopOfStack + 1] ENDFUNCTIONCola (primero en entrar, primero en salir): los elementos entran por la parte trasera (enqueue) y salen desde el frente (dequeue); dos punteros y un contador. En una cola lineal el puntero frontal avanza por la matriz hasta que el espacio al principio se desperdicia; una cola circular 循环队列 envuelve ambos punteros alrededor con
MOD, reutilizando cada celda.Una cola circular: los punteros traseros y frontales avanzan con MOD, reutilizando las primeras celdas de la matriz una vez que sus elementos han salido FUNCTION Enqueue(Item : STRING) RETURNS BOOLEAN IF Count = 6 THEN // full RETURN FALSE ENDIF Rear ← (Rear + 1) MOD 6 QueueArray[Rear] ← Item Count ← Count + 1 RETURN TRUE ENDFUNCTION FUNCTION Dequeue() RETURNS STRING IF Count = 0 THEN // empty RETURN "" ENDIF DECLARE Item : STRING Item ← QueueArray[Front] Front ← (Front + 1) MOD 6 Count ← Count - 1 RETURN Item ENDFUNCTIONLista enlazada: una secuencia de nodos, cada uno conteniendo un elemento de datos y un puntero al siguiente nodo; un puntero de inicio da el primer nodo y un puntero nulo (0 o $-1$) finaliza la lista. En una implementación matricial, dos matrices paralelas contienen los datos y los punteros, y las celdas sin usar se encadenan en una lista libre 空闲列表 para que una inserción sepa dónde colocar el nuevo nodo.
Una lista enlazada en dos matrices: el orden de la lista está en los punteros, no en las posiciones; insertar un nombre significa tomar una celda de la lista libre y reenlazar dos punteros FUNCTION FindInList(Target : STRING) RETURNS INTEGER // index, or 0 if absent DECLARE Current : INTEGER Current ← Start WHILE Current <> 0 IF Data[Current] = Target THEN RETURN Current ENDIF Current ← Pointer[Current] ENDWHILE RETURN 0 ENDFUNCTIONPara insertar en una lista ordenada: tome la primera celda libre (
NewNode ← FreeList,FreeList ← Pointer[FreeList]), almacene el elemento, luego recorra la lista con unPreviousy unCurrentpuntero hastaData[Current] > Itemo el final; establezcaPointer[NewNode] ← CurrentyPointer[Previous] ← NewNode(oStart ← NewNodesi va primero). Para eliminar, reenlace el nodo anterior pasando por encima del eliminado y devuelva la celda a la lista libre.Árbol binario: un nodo raíz, cada nodo contiene datos, un puntero izquierdo hacia un subárbol de valores menores y un puntero derecho hacia un subárbol de valores mayores. Implementado como una matriz 2D (o tres matrices 1D)
Tree[Index, 0..2]para puntero izquierdo, datos, puntero derecho, con un puntero raíz y un puntero siguiente-libre.FUNCTION FindInTree(Target : INTEGER) RETURNS INTEGER // index, or -1 DECLARE Current : INTEGER Current ← Root WHILE Current <> -1 IF Tree[Current, 1] = Target THEN RETURN Current ENDIF IF Target < Tree[Current, 1] THEN Current ← Tree[Current, 0] // go left ELSE Current ← Tree[Current, 2] // go right ENDIF ENDWHILE RETURN -1 ENDFUNCTIONPara insertar: almacene el elemento en el siguiente nodo libre con ambos punteros $-1$; si el árbol está vacío, hágalo raíz; de lo contrario, baje desde la raíz, yendo a la izquierda o derecha por comparación, hasta que el puntero que seguiría sea $-1$, y establezca ese puntero al nuevo nodo. Un ADT a partir de otro ADT: una pila es una lista enlazada donde push y pop funcionan ambos al inicio; una cola es una lista enlazada con un puntero de inicio y uno de fin; una cola puede hacerse de dos pilas (apilar en una, desapilar de la otra, moviendo todo a través cuando la segunda está vacía); los nodos de un árbol binario son registros u objetos vinculados por punteros, por lo que se construyen a partir de una estructura enlazada de nodos. Diga qué operaciones del nuevo ADT mapean sobre qué operaciones del antiguo.

Un árbol binario: cada nodo tiene hasta dos nodos hijos 
Tres recorridos en profundidad de un árbol binario: preorden, inorden (ordenado) y postorden Vocabulario EntrenarInglés Chino Pinyin linked list/lɪŋkt lɪst/ 链表 liàn biǎo stack/stæk/ 栈 zhàn queue/kjuː/ 队列 duì liè node/nəʊd/ 节点 jié diǎn pointers/ˈpɔɪntəz/ 指针 zhǐ zhēn binary tree/ˈbaɪnəri triː/ 二叉树 èr chā shù dictionary/ˈdɪkʃənəri/ 字典 zì diǎn circular queue/ˈsɜːkjʊlə kjuː/ 循环队列 xún huán duì liè free list/friː lɪst/ 空闲列表 kòng xián liè biǎo time complexity/taɪm kəmˈpleksɪti/ 时间复杂度 shí jiān fù zá dù Big-O notation/bɪɡ əʊ nəʊˈteɪʃn/ 大O表示法 dà O biǎo shì fǎ space complexity/speɪs kəmˈpleksɪti/ 空间复杂度 kōng jiān fù zá dù 19.1
Comparando algoritmos
Complejidad temporal
Complejidad temporal 时间复杂度 es cómo crece el tiempo de ejecución con el tamaño de entrada $n$, escrito en notación Big-O 大O表示法 (el término dominante): O(1) constante, O($\log n$) búsqueda binaria, O($n$) búsqueda lineal, O($n \log n$) buenos ordenamientos, O($n^{2}$) burbuja/inserción. Un orden menor es mejor a gran escala, incluso si otro algoritmo es más rápido para entradas pequeñas $n$.
Para ilustrarlo: para ordenar un millón de elementos, un ordenamiento $O(n \log n)$ termina en una fracción de segundo, mientras que un ordenamiento $O(n^{2})$ puede tardar minutos.
Ejemplo resuelto. Una lista ordenada contiene $1000$ elementos. ¿Cuántas comparaciones necesita cada búsqueda en el peor caso?
Una búsqueda lineal revisa los elementos uno por uno, por lo que puede necesitar hasta $1000$ comparaciones —esto es $O(n)$. Una búsqueda binaria reduce la lista a la mitad en cada paso, por lo que necesita como máximo $\lceil \log_2 1000 \rceil = 10$ comparaciones —esto es $O(\log n)$. Duplicar la lista a $2000$ elementos añade solo una comparación a la búsqueda binaria, pero hasta otra $1000$ a la búsqueda lineal —por eso el orden de crecimiento, no la velocidad bruta, decide el ganador a gran escala.
Describiendo un orden. O(1): el tiempo es constante, independiente del número de elementos (empujar en una pila, leer un elemento de un array). O($\log n$): el tiempo crece con el logaritmo del número de elementos, por lo que duplicar los datos añade solo un paso extra fijo (búsqueda binaria). O($n$): el tiempo crece en proporción al número de elementos (búsqueda lineal, un recorrido por la lista). O($n \log n$): ligeramente peor que lineal (ordenamientos eficientes). O($n^{2}$): el tiempo crece con el cuadrado del número de elementos, por lo que duplicar los datos cuadruplica el tiempo (burbuja e inserción). "Indica la Big O de una búsqueda binaria en
Names[0:99]" se responde $O(\log n)$, y "describe su significado" como arriba; Big-O mide cómo escalan el tiempo o la memoria, no el tiempo real.Cómo se comparan los órdenes de crecimiento comunes: un orden menor gana a gran escala 
Cómo crece el tiempo de ordenamiento con el número de elementos $n$: los ordenamientos $O(n^2)$ se separan de un ordenamiento $O(n\log n)$ Complejidad espacial
Complejidad espacial 空间复杂度 es la memoria adicional necesaria. Los ordenamientos burbuja e inserción usan O(1) extra (in-place); el ordenamiento fusionado usa O($n$); la recursión usa memoria de pila proporcional a su profundidad. A menudo existe un compromiso entre tiempo y memoria.
Otros criterios
Simplicidad (más fácil de programar y mantener), estabilidad y adaptabilidad (más rápido con datos casi ordenados). El algoritmo adecuado depende de los datos y las restricciones.
ExplorarCómo crece el tiempo de ejecución con n
Desliza n hacia arriba y compara las curvas: O(1) y O(log n) permanecen casi planas, O(n) sube constantemente, O(n²) explota. Por eso Big-O —no un cronómetro— es cómo comparamos algoritmos en entradas grandes.
ExplorarCrecimiento Big-O
Cambia el tamaño de entrada n y compara qué tan rápido crece el trabajo de cada algoritmo: la idea detrás de la complejidad temporal.
Vocabulario EntrenarInglés Chino Pinyin in place/ɪn pleɪs/ 原地 yuán dì 19.2
Recursión

Syllabus
Los candidatos deben ser capaces de: Notas y orientación Demostrar comprensión de la recursión Características esenciales de la recursión Cómo se expresa la recursión en un lenguaje de programación Escribir y rastrear algoritmos recursivos Cuándo es ventajoso el uso de la recursión Demostrar conocimiento de lo que debe hacer un compilador para traducir código de programación recursivo Uso de pilas (stacks) y desenrollado (unwinding) Fuente: Plan de estudios Cambridge International
Recursión: la pila de llamadas se enrolla y desenrolla Algoritmos recursivos usan recursión 递归: la rutina se llama a sí misma con una versión más pequeña del mismo problema, hasta que un caso base 基本情形 detiene la cadena. Tiene dos partes: el caso base (lo suficientemente pequeño para resolverse directamente —sin él la recursión nunca se detiene) y el caso recursivo 递归情形 (reducir la entrada y llamarse a sí misma).
Factorial 阶乘:
FUNCTION Factorial(n : INTEGER) RETURNS INTEGER
    IF n = 0 OR n = 1 THEN
        RETURN 1
    ELSE
        RETURN n * Factorial(n - 1)
    ENDIF
ENDFUNCTION
La recursión es natural para problemas autosimilares: árboles, dividir y vencerás 分治 (búsqueda binaria, ordenamiento fusionado) y datos anidados. Cuando no es adecuada, un bucle suele ser más limpio.
"Describe qué significa la recursión" (dos marcas). Una función o procedimiento definido en términos de sí mismo: se llama a sí misma desde dentro de su propio cuerpo, con una versión más pequeña del problema cada vez, hasta alcanzar un caso base. "Enumera tres características esenciales de la recursión": (1) un caso base (condición de parada) que devuelve un valor sin una llamada adicional; (2) un caso general 一般情形 en el que la rutina se llama a sí misma; (3) cada llamada acerca el problema al caso base (el parámetro se reduce), para que la recursión termine. Algunos esquemas añaden: los valores se devuelven mientras las llamadas se desenrollan.
"Describe cuándo es beneficioso el uso de la recursión y da un ejemplo." Cuando el problema está definido naturalmente en términos de versiones más pequeñas de sí mismo, de modo que la solución recursiva sea más corta, clara y cercana a la definición matemática que un bucle: un factorial o número de Fibonacci, una búsqueda binaria, recorrer un árbol binario, ordenamiento fusionado o quicksort, y procesar estructuras anidadas como carpetas dentro de carpetas. Es una mala elección cuando la profundidad es grande (la pila podría desbordarse) o cuando el mismo subproblema se calcula muchas veces (Fibonacci ingenuo).
Rastrear una llamada recursiva
Para
Factorial(4): las llamadas bajan hastaFactorial(1)=1, luego el desenrollado multiplica hacia arriba:2*1=2,3*2=6,4*6=24. Resultado final24. Rastrea cada llamada pendiente en una pila.Ejemplo resuelto. La función siguiente se presenta sin explicación. Rastrea
Unknown(3, 5)e indica su salida y valor de retorno.FUNCTION Unknown(BYVAL X, BYVAL Y : INTEGER) RETURNS INTEGER IF X < Y THEN OUTPUT X + Y RETURN Unknown(X + 1, Y - 1) + 1 ELSE RETURN 0 ENDIF ENDFUNCTIONLlamada 1: $X = 3, Y = 5$: $3 < 5$, produce 8, llama a
Unknown(4, 4). Llamada 2: $4 < 4$ es falso, devuelve 0. Desenrollado: la llamada 1 retorna $0 + 1 = 1$. Produce 8, valor de retorno 1. Escribe el trazado como una tabla con una fila por llamada (parámetros, condición, salida, qué retorna), y haz los retornos desde la llamada más profunda hacia arriba: eso es lo que busca la rúbrica de corrección en el desenrollado.Ejemplo resuelto (Fibonacci).
Fib(n)retornancuandon < 2, de lo contrarioFib(n - 1) + Fib(n - 2). EncuentraFib(5).Fib(5) = Fib(4) + Fib(3);Fib(4) = Fib(3) + Fib(2);Fib(3) = Fib(2) + Fib(1);Fib(2) = Fib(1) + Fib(0) = 1 + 0 = 1. Por lo tantoFib(3) = 1 + 1 = 2,Fib(4) = 2 + 1 = 3,Fib(5) = 3 + 2 = 5. El caso base se alcanza muchas veces (Fib(2)se calcula tres veces), por lo que esta versión es lenta: realiza 15 llamadas para $n = 5$ y duplica aproximadamente las llamadas por cada aumento en $n$.Conversión de recursión a iteración. Cada rutina recursiva puede reescribirse con un bucle, que usa menos memoria y es más rápida: mantén un resultado acumulativo y itera desde el caso base hacia arriba. Factorial como bucle:
FUNCTION Factorial(N : INTEGER) RETURNS INTEGER
    DECLARE Result, Count : INTEGER
    Result ← 1
    FOR Count ← 2 TO N
        Result ← Result * Count
    NEXT Count
    RETURN Result
ENDFUNCTION
Se te pide cambiar un ordenamiento por inserción recursivo o una búsqueda recursiva en uno iterativo; reemplaza la auto-llamada con un bucle sobre el índice que la recursión estaba avanzando, y convierte el caso base en la condición de salida del bucle.
La recursión usa la pila de llamadas: las llamadas empujan marcos hacia abajo hasta el caso base, luego los retornos se desenrollan hacia arriba Riesgos
- recursión infinita si se omite el caso base: colapsa con un desbordamiento de pila 栈溢出.
- alto uso de memoria para recursión profunda.
- lento si repite trabajo (el Fibonacci ingenuo es exponencial — usa un bucle o memorización 记忆化).
ExplorarLa recursión se desenrolla desde las hojas hacia arriba
Paso a paso fib(4) en el orden en que realmente terminan las llamadas: las hojas (casos base) se resuelven primero, luego cada padre combina sus hijos. Observa que fib(2) se calcula dos veces — ese trabajo repetido es por qué la recursión ingenua es lenta.
Vocabulario EntrenarInglés Chino Pinyin recursion/rɪˈkɜːʃn/ 递归 dì guī call stack/kɔːl stæk/ 调用栈 diào yòng zhàn base case/beɪs keɪs/ 基本情形 jī běn qíng xíng recursive case/rɪˈkɜːsɪv keɪs/ 递归情形 dì guī qíng xíng factorial/fækˈtɔːrɪəl/ 阶乘 jiē chéng divide-and-conquer/dɪˈvaɪd ænd ˈkɒŋkə/ 分治 fēn zhì general case/ˈdʒenərəl keɪs/ 一般情形 yì bān qíng xíng parameters/pəˈræmɪtəz/ 参数 cān shù stack overflow/stæk ˌəʊvəˈfləʊ/ 栈溢出 zhàn yì chū memoisation/ˌmeməʊaɪˈzeɪʃn/ 记忆化 jì yì huà local variables/ˈləʊkl ˈveərɪəblz/ 局部变量 jú bù biàn liàng stack frame/stæk freɪm/ 栈帧 zhàn zhēn return address/rɪˈtɜːn əˈdres/ 返回地址 fǎn huí dì zhǐ 19.2
Qué hace el compilador para el código recursivo
La recursión necesita que cada llamada tenga su propia copia de sus parámetros 参数 y variables locales 局部变量. El compilador mantiene estos datos en la pila de llamadas 调用栈. Para cada llamada, empuja un marco de pila 栈帧 que contiene los parámetros, las variables locales y la dirección de retorno 返回地址 (dónde continuar en el llamador). Cuando la función retorna, el valor de retorno se entrega, el marco se elimina de la pila y el control retoma en la dirección de retorno.
Como cada llamada tiene su propio marco, las llamadas recursivas no sobrescriben las variables de otras. La pila puede crecer mucho para recursión profunda, por lo que la recursión muy profunda puede desbordarla. Este es el mismo mecanismo de llamada y retorno usado para llamadas ordinarias (no recursivas) — no existe un "mecanismo especial" para la recursión.
"Explica por qué una pila es adecuada para implementar la recursión" (tres marcas). Cada llamada recursiva debe guardar su dirección de retorno, sus parámetros y sus variables locales, y las llamadas se completan en orden inverso al de su creación (la última llamada creada es la primera en terminar), lo cual es exactamente el comportamiento de último en entrar, primero en salir de una pila: cada nueva llamada empuja un marco, y cada retorno elimina el marco más reciente, restaurando el estado del llamador y indicándole dónde continuar. Esta es la tarea del compilador al traducir código recursivo: genera el empuje de un marco de pila en cada llamada y el elimine en cada retorno, y los marcos se desenrollan conforme llegan los resultados.
19.2
Definiciones aceptadas por el examinador
Una pregunta de definición se califica según un texto fijo. Aprende estas definiciones exactamente, y da solo una respuesta.
Término Definición búsqueda lineal revisar cada elemento sucesivamente desde el inicio hasta encontrar el objetivo o llegar al final búsqueda binaria comparar repetidamente el objetivo con el elemento medio de una lista ordenada y descartar la mitad que no puede contenerlo ordenamiento burbuja pasar repetidamente por la lista, intercambiando elementos adyacentes en orden incorrecto, hasta que un paso no realice intercambios ordenamiento por inserción tomar cada elemento sucesivamente e insertarlo en su lugar correcto entre los elementos ya ordenados tipo de dato abstracto una colección de datos y las operaciones que se pueden realizar sobre ella, definida independientemente de cómo se almacena pila una estructura último-en-entrar-primer-salir con empuje y elimine en la parte superior cola una estructura primer-en-entrar-primer-salir con elementos añadidos en la parte trasera y eliminados de la parte delantera lista encadenada una secuencia de nodos, cada uno guardando datos y un puntero al siguiente nodo, con un puntero de inicio árbol binario nodos que guardan datos y punteros a un subárbol izquierdo de valores menores y un subárbol derecho de valores mayores notación Big O una forma de clasificar el tiempo (o memoria) que necesita un algoritmo según cómo crece con el tamaño de la entrada recursión una rutina que se llama a sí misma con una versión más pequeña del problema hasta que un caso base detiene las llamadas caso base la condición bajo la cual una rutina recursiva retorna sin llamarse a sí misma desenrollado los retornos de una cadena de llamadas recursivas, desde la llamada más profunda hasta la primera, conforme se eliminan los marcos de pila 19.2
Consejos para el examen
- Búsquedas: la lineal no requiere orden y es O($n$); la binaria requiere un array ordenado, reduce a la mitad cada vez y es O($\log n$). Conoce ambos algoritmos de memoria, incluyendo los límites y la bandera.
- Ordenamientos: burbuja con una bandera de intercambio, inserción con una clave que desplaza elementos mayores a la derecha; ambos son O($n^{2}$) en el peor caso, O($n$) en datos ordenados. El rendimiento depende de la cantidad de elementos y de cuán ordenados estén.
- Implementaciones de TDA son seguimiento de punteros: un puntero superior; frontal, trasero y contador con MOD; inicio, punteros y una lista libre; raíz con punteros izquierdo y derecho. Siempre verifica si está llena y vacía.
- Big O trata sobre escalado: constante, logarítmico, lineal, cuadrático. Di "duplicar los datos añade una comparación" para una búsqueda binaria.
- Recursión: caso base, caso general, progreso hacia el caso base; beneficioso cuando el problema se define en términos de sí mismo; una pila guarda las direcciones de retorno y variables porque las llamadas retornan en orden inverso. Haz trazado con una tabla y desenrolla desde la llamada más profunda.
Errores comunes
- Usar una búsqueda binaria en datos no ordenados, o en una lista encadenada; y establecer
Lower ← Miden lugar deMid + 1, lo cual causa un bucle infinito. - Un bucle interno de ordenamiento burbuja que recorre hasta el final del array en cada paso, o un intercambio sin una variable temporal.
- Un empuje o enqueue que no prueba si está lleno, o un elimine o dequeue que no prueba si está vacío.
- Mover el puntero frontal de la cola sin usar MOD en una cola circular, o tratar front = rear como siempre significar vacío.
- Insertar en una lista encadenada desplazando el contenido del array; solo cambian los punteros.
- Una función recursiva sin caso base, o cuyo llamado recursivo no hace el problema más pequeño.
- Hacer trazado de una llamada recursiva pero olvidar añadir el trabajo pendiente en el camino de regreso hacia arriba.
- Responder "por qué una pila" con "porque es rápida"; la razón es el orden último-en-entrar-primer-salir de los retornos.
-
20
Programación avanzada
Ver lección20.1
Paradigmas de programación

Syllabus
Los candidatos deben ser capaces de: Notas y orientación Comprender lo que se entiende por un paradigma de programación Demostrar comprensión de las características de varios paradigmas de programación: • De bajo nivel Programación de bajo nivel: • comprensión y capacidad para escribir código de bajo nivel que utilice diversos modos de direccionamiento: inmediato, directo, indirecto, indexado y relativo • Imperativa (Procedural) Programación Imperativa (Procedural): • Conocimiento previo y comprensión de la Programación Estructurada (ver detalles en la sección 11.3 del contenido AS) • comprensión y capacidad para escribir código de programación imperativa (procedural) que utilice variables, constructos, procedimientos y funciones. Ver detalles en el contenido AS • Orientada a Objetos Programación Orientada a Objetos (POO): • comprensión de la terminología asociada con la POO (incluyendo objetos, propiedades/atributos, métodos, clases, herencia, polimorfismo, contención (agregación), encapsulamiento, getters, setters, instancias) • comprensión de cómo resolver un problema mediante el diseño de clases adecuadas • comprensión y capacidad para escribir código que demuestre el uso de la POO • Declarativa Programación Declarativa: • comprensión y capacidad para resolver un problema escribiendo hechos y reglas apropiadas basadas en la información proporcionada • comprensión y capacidad para escribir código que pueda satisfacer un objetivo utilizando hechos y reglas Fuente: Plan de estudios Cambridge International
Un paradigma de programación 编程范式 es un estilo de programación — una forma de estructurar programas, con sus propias ideas y características del lenguaje. Cuatro paradigmas de programación están incluidos en este plan de estudios.
"Describa lo que se entiende por un lenguaje imperativo (procedural)" (dos puntos). Un lenguaje en el que el programa es una secuencia de instrucciones que se ejecutan en orden y que cambian el estado del programa; el programador dice cómo se realiza la tarea, utilizando procedimientos, secuencia, selección e iteración. "Describa lo que se entiende por un lenguaje declarativo": el programa establece hechos y reglas (lo que se sabe y lo que se desea) y el motor de inferencia del lenguaje determina cómo encontrar la respuesta; el programador no da la secuencia de pasos.
Identificar el paradigma a partir de una muestra de código (una pregunta regular del Paper 3):
LDD 200,ADD #5,STO 201son de bajo nivel (mnemotécnicos, registros, direcciones de memoria);FOR Count ← 1 TO 10 … NEXT Countcon procedimientos y asignaciones es imperativo;CLASS Dog … PRIVATE Name : STRING … PUBLIC PROCEDURE NEW(…)es orientado a objetos;type(lion, wild).ydangerous(X) IF type(X, wild)son declarativos (lógica). En la pregunta de emparejamiento: bajo nivel se empareja con "mnemotécnicos que corresponden directamente a instrucciones de máquina", imperativo con "una secuencia de sentencias que cambian el estado", POO con "objetos que combinan atributos y métodos", declarativo con "hechos y reglas, sin un orden de ejecución dado".Cuatro paradigmas: bajo nivel, imperativo, orientado a objetos y declarativo Programación de bajo nivel
Programación cercana al hardware en código de máquina 机器码 o lenguaje ensamblador 汇编语言, donde cada instrucción se mapea a lo que ejecuta la CPU. Brinda acceso directo a registros 寄存器 y direcciones de memoria 内存地址, utilizando diferentes modos de direccionamiento 寻址方式 (inmediato, directo, indirecto, indexado y relativo). Es muy rápido y compacto, pero específico de la arquitectura, tedioso y difícil de mantener. Esta es la programación de bajo nivel 低级 programming, utilizada para controladores de dispositivos, firmware y cargadores de arranque.
Los cinco modos de direccionamiento. El plan de estudios solicita código de bajo nivel que utilice cada modo de direccionamiento (el conjunto de instrucciones está en el Tema 4). El operando de una instrucción de carga puede leerse de cinco formas, y el examen le da el contenido de la memoria y pregunta qué contiene el acumulador:
Mismo operando, 105, leído de cinco formas: como valor, como dirección, como la dirección de una dirección, como dirección más el registro índice, y como desplazamiento desde la instrucción actual - inmediato (
LDM #105): el operando es el valor; ACC se convierte en 105. - directo (
LDD 105): el operando es la dirección del valor; ACC se convierte en el contenido de 105, aquí 27. - indirecto (
LDI 105): el operando es la dirección de una dirección; ACC se convierte en el contenido de 27, aquí 91. Usado para punteros y para datos cuya posición se decide en tiempo de ejecución. - indexado (
LDX 105): la dirección es el operando más el registro índice IX; con IX = 2, ACC se convierte en el contenido de 107. Usado para recorrer un array incrementando IX. - relativo (
JMR +65): el destino es un desplazamiento desde la dirección de la instrucción actual, lo que hace que el código sea reubicable.
Ejemplo resuelto. Memoria: 105 contiene 27, 106 contiene 64, 200 contiene 0. Escriba código para sumar los contenidos de 105 y 106, almacenar el resultado en 200 y mostrarlo.
LDD 105(ACC = 27),ADD 106(ACC = 91),STO 200,OUT. Para duplicar el valor en 105 en su lugar:LDD 105,ADD 105,STO 105. Indique el contenido de los registros después de cada línea cuando se pida rastrear.Programación imperativa (procedural)
En la programación imperativa 命令式编程, el programador escribe una secuencia de comandos que cambian el estado del programa — asignaciones, condicionales, bucles, llamadas a funciones. Las variables 变量 almacenan el estado; las sentencias lo cambian; el código se organiza en procedimientos y funciones (también llamado programación estructurada o estructural). Este es el estilo de los Temas 9 y 11 (Python, C). Fuerte cuando el algoritmo tiene pasos secuenciales claros.
Programación orientada a objetos (POO)
En la programación orientada a objetos 面向对象编程, los programas se construyen a partir de objetos 对象 — unidades que combinan datos (atributos 属性) y operaciones (métodos 方法). Los objetos son instancias 实例 de clases 类. Los cuatro pilares:
- encapsulamiento 封装 — los datos de un objeto están ocultos tras sus métodos; el código externo usa solo los métodos públicos, no los datos directamente. Esto protege el objeto y permite que sus internos cambien sin romper a los llamadores. Por ejemplo, un
BankAccountoculta susbalance; usted los cambia solo a través dedeposit()ywithdraw(), que pueden imponer una regla como "nunca bajar de cero". - herencia 继承 — una subclase 子类 especializa una superclase 父类, heredando sus atributos y métodos y añadiendo o reemplazándolos 重写. Modela "es-un" ("un Gerente es un Empleado").
- polimorfismo 多态 — diferentes objetos responden a la misma llamada de método de manera diferente; el llamador no necesita conocer el tipo exacto. Cada
ShapetieneArea(), y unCircley unRectanglelo implementan cada uno a su manera. - abstracción 抽象 — mostrar una interfaz simple y ocultar la implementación.
Otros términos:
- un constructor 构造函数 es un método especial que se ejecuta cuando se crea un objeto, para configurar sus atributos.
- getters y setters leen y escriben los atributos de un objeto (sus propiedades) a través de métodos.
- agregación 聚合 y contención 包含 construyen un objeto a partir de otros objetos (una relación "tiene-un").
La POO se utiliza para sistemas grandes, interfaces gráficas, simulaciones y juegos.

Polimorfismo: la misma llamada de método ejecuta el código propio de cada objeto 
Un diagrama de clases para una Forma: atributos privados y métodos públicos 
Herencia: partTime y fullTime son subclases de employee 
Encapsulamiento: los datos de un objeto son privados, alcanzados solo a través de sus métodos públicos Cómo califica la POO el examinador
Definiciones. Clase: una plantilla (plano) que define los atributos y métodos de los objetos de ese tipo. Objeto: una instancia de una clase, creada a partir de ella, con sus propios valores para los atributos ("una ocurrencia de un objeto" es la frase del examen para una instancia). Atributo (propiedad): un dato perteneciente a una clase. Método: un procedimiento o función perteneciente a una clase que actúa sobre sus atributos. Encapsulación: combinar los atributos y métodos en una sola clase y restringir el acceso externo a los datos: los atributos son privados y solo pueden leerse o modificarse a través de métodos públicos. Herencia: una subclase adquiere los atributos y métodos de su clase padre (super) y puede añadir los suyos propios u anularlos. Polimorfismo: métodos con el mismo nombre que se comportan diferentemente en diferentes clases; típicamente una subclase ** redefine** un método de su padre, y se ejecuta la versión correcta para cada objeto. Contención: una clase tiene un objeto de otra clase como atributo (un coche tiene un motor). "Identificar la característica que restringe el acceso externo a los datos" es encapsulación; "el término para una ocurrencia de un objeto" es instancia.
"Describir la estructura de una clase" (tres puntos): atributos (propiedades) que almacenan los datos del objeto, generalmente declarados como privados; métodos (procedimientos y funciones) que actúan sobre esos atributos, generalmente públicos; y un constructor, un método que se ejecuta cuando se crea un objeto para inicializar los atributos. "Dar tres beneficios de la POO": el código se reutiliza mediante herencia; los datos están protegidos por encapsulación, por lo que solo pueden ser modificados por los métodos de la propia clase; un programa grande se divide en clases que se escriben y prueban de forma independiente, lo que facilita el mantenimiento y la ampliación; las clases modelan entidades del mundo real, por lo que el diseño es más fácil de entender; el polimorfismo permite que la misma llamada funcione para diferentes objetos.
La clase en pseudocódigo, tal como lo establece Paper 3:
CLASS Car
    PRIVATE Registration : STRING
    PRIVATE Year : INTEGER
    PRIVATE Mileage : INTEGER
    PUBLIC PROCEDURE NEW(NewReg : STRING, NewYear : INTEGER)
        Registration ← NewReg
        Year ← NewYear
        Mileage ← 0
    ENDPROCEDURE
    PUBLIC FUNCTION GetMileage() RETURNS INTEGER
        RETURN Mileage
    ENDFUNCTION
    PUBLIC PROCEDURE AddMileage(Extra : INTEGER)
        Mileage ← Mileage + Extra
    ENDPROCEDURE
ENDCLASS
Un objeto se crea con
MyCar ← NEW Car("AB12 CDE", 2020)y se utiliza conMyCar.AddMileage(150)yOUTPUT MyCar.GetMileage(). Una subclase reutiliza el constructor del padre a través deSUPER:CLASS ElectricCar INHERITS Car PRIVATE BatteryCapacity : REAL PUBLIC PROCEDURE NEW(NewReg : STRING, NewYear : INTEGER, NewCapacity : REAL) SUPER.NEW(NewReg, NewYear) BatteryCapacity ← NewCapacity ENDPROCEDURE ENDCLASSLa misma clase en Python, tal como lo espera Paper 4: los atributos se hacen privados con doble guion bajo, el constructor es
__init__, y una subclase nombra a su padre entre corchetes y llama asuper().__init__(…):class Car: def __init__(self, reg, year): self.__registration = reg self.__year = year self.__mileage = 0 def get_mileage(self): return self.__mileage def add_mileage(self, extra): self.__mileage = self.__mileage + extra class ElectricCar(Car): def __init__(self, reg, year, capacity): super().__init__(reg, year) self.__capacity = capacity cars = [] cars.append(Car("AB12 CDE", 2020)) cars.append(ElectricCar("EV21 XYZ", 2023, 75.0)) cars[1].add_mileage(150) print(cars[1].get_mileage())En Java las mismas ideas son
private/publiccampos, un constructor con el nombre de la clase,extendsysuper(…); en VB.NETPrivate/Public,Sub New,InheritsyMyBase.New. Un método polimórfico se escribe en el padre y se anula en el hijo con el mismo nombre; una llamada a través de una variable de tipo padre ejecuta la versión del hijo.Estructuras de datos como objetos. Paper 4 construye una pila, lista enlazada o árbol binario a partir de una
Nodeclase cuyos atributos son los datos y una o dos referencias a otros nodos; unaTree(oLinkedList) clase contiene la raíz (o inicio) y los métodos.
A un árbol binario construido a partir de objetos: cada Nodo contiene Datos además de referencias Izquierda y Derecha, y el Árbol contiene la Raíz; al insertar se recorre hacia abajo por las referencias CLASS Node PUBLIC Data : INTEGER PUBLIC Left : Node // NULL when there is no child PUBLIC Right : Node PUBLIC PROCEDURE NEW(NewData : INTEGER) Data ← NewData Left ← NULL Right ← NULL ENDPROCEDURE ENDCLASS CLASS Tree PRIVATE Root : Node PUBLIC PROCEDURE Insert(NewData : INTEGER) DECLARE NewNode, Current : Node DECLARE Placed : BOOLEAN NewNode ← NEW Node(NewData) IF Root = NULL THEN Root ← NewNode ELSE Current ← Root Placed ← FALSE WHILE NOT Placed IF NewData < Current.Data THEN IF Current.Left = NULL THEN Current.Left ← NewNode Placed ← TRUE ELSE Current ← Current.Left ENDIF ELSE IF Current.Right = NULL THEN Current.Right ← NewNode Placed ← TRUE ELSE Current ← Current.Right ENDIF ENDIF ENDWHILE ENDIF ENDPROCEDURE ENDCLASSUn método buscar recorre el mismo camino y retorna
TRUEcuandoCurrent.Data = Target,FALSEcuando llega aNULL; un método de salida en orden es recursivo: muestra el subárbol izquierdo, el nodo, luego el subárbol derecho. Para una lista enlazada el nodo tiene una referencia,Next, y la clase de la lista contieneStart; para una pila construida a partir de una lista, push y pop funcionan enStart.Ejemplo resuelto. Un juego tiene personajes. Cada uno tiene un nombre, salud (que comienza en 100) y una posición dada por X e Y. Escribe una clase
Charactercon un constructor y un métodoMove(DX, DY); luego una subclaseWizardque añadaMana(que comienza en 50) y un métodoCastSpell()que tome 10 maná y retorneTRUEsi había suficiente.CLASS Character PRIVATE Name : STRING PRIVATE Health : INTEGER PRIVATE X : INTEGER PRIVATE Y : INTEGER PUBLIC PROCEDURE NEW(NewName : STRING, StartX : INTEGER, StartY : INTEGER) Name ← NewName Health ← 100 X ← StartX Y ← StartY ENDPROCEDURE PUBLIC PROCEDURE Move(DX : INTEGER, DY : INTEGER) X ← X + DX Y ← Y + DY ENDPROCEDURE ENDCLASS CLASS Wizard INHERITS Character PRIVATE Mana : INTEGER PUBLIC PROCEDURE NEW(NewName : STRING, StartX : INTEGER, StartY : INTEGER) SUPER.NEW(NewName, StartX, StartY) Mana ← 50 ENDPROCEDURE PUBLIC FUNCTION CastSpell() RETURNS BOOLEAN IF Mana >= 10 THEN Mana ← Mana - 10 RETURN TRUE ELSE RETURN FALSE ENDIF ENDFUNCTION ENDCLASSLos puntos son para atributos privados, un constructor que establece todos los atributos, la línea de herencia, la llamada al constructor del padre y un método que usa y cambia los datos propios del objeto. Cuando la pregunta pide un diagrama de clases, dibuja un cuadro en tres partes (nombre; atributos con
-para privado; métodos con+para público) y une una subclase a su padre con una flecha apuntando al padre.Programación declarativa
En la programación declarativa 声明式编程, usted dice qué calcular, no cómo; el entorno de ejecución determina los pasos. Dos tipos:
- programación funcional 函数式编程 — construida a partir de funciones puras 纯函数 (sin efectos secundarios副作用; la misma entrada siempre produce la misma salida) compuestas entre sí. Ejemplos: Haskell, Lisp.
- programación lógica 逻辑编程 — declara hechos y reglas; el motor responde a un objetivo (consulta) mediante inferencia. Ejemplo: Prolog.
Un ejemplo familiar de programación declarativa es SQL 结构化查询语言:
SELECT * FROM Customer WHERE Country = 'UK'dice qué se desea, no cómo recorrer los registros.Los hechos, las reglas y los objetivos son lo que el examen evalúa en el paradigma declarativo. Dado estos hechos 事实 (enunciados verdaderos) y una regla 规则 (una conclusión válida cuando se cumplen sus condiciones):
01 type(leopard, wild).
02 type(lion, wild).
03 type(tabby, domestic).
04 size(leopard, large).
05 size(lion, large).
06 size(tabby, small).
07 dangerous(X) IF type(X, wild) AND size(X, large).
"Escriba el resultado del objetivo
type(X, wild)":X = leopard, X = lion. El engine empareja el objetivo con cada hecho a su vez; cada emparejamiento es una solución, y una letra mayúscula es una variable que el emparejamiento rellena. "Escriba un hecho para mostrar que un guepardo es salvaje":type(cheetah, wild)."Explique qué hace la línea 07": define una regla con la conclusióndangerous(X), la cual es verdadera para cualquierXque sea tanto salvaje como grande, por lo quedangerous(A)devuelveA = leopard, A = lion. "Escriba una regla: una característicaFpuede estar disponible para un estilo de carroceríaBsiFes una característica yBes un estilo de carrocería yFno está deshabilitado paraB":may_be_available(F, B) IF feature(F) AND body_style(B) AND NOT unavailable(F, B). Copie los nombres de predicados y el orden de argumentos utilizados exactamente en los hechos de la pregunta; un nuevo hecho termina con un punto y las condiciones de una regla están unidas conAND.Comparando paradigmas
Paradigma Fortaleza Lenguajes típicos Bajo nivel máximo control, velocidad Ensamblador Imperativo directo, intuitivo C, Python Orientado a objetos modular, modela entidades Java, C#, Python Funcional claro, sin efectos secundarios Haskell, F# Lógico inferencia, reglas Prolog Base de datos consultas de datos SQL Los lenguajes modernos suelen combinar paradigmas — Python soporta todos los procedimental, POO y funcional. El adecuado depende del problema.
ExplorarLaboratorio de conceptos de programación
Conectar ejemplos con la idea de programación que muestran.
Vocabulario EntrenarInglés Chino Pinyin programming paradigm/ˈprəʊɡræmɪŋ ˈpærədaɪm/ 编程范式 biān chéng fàn shì facts/fækts/ 事实 shì shí rule/ruːl/ 规则 guī zé low-level/ləʊ ˈlevl/ 低级 dī jí registers/ˈredʒɪstəz/ 寄存器 jì cún qì memory addresses/ˈmeməri əˈdresɪz/ 内存地址 nèi cún dì zhǐ objects/ˈɒbdʒekts/ 对象 duì xiàng attributes/ˈætrɪbjuːts/ 属性 shǔ xìng methods/ˈmeθədz/ 方法 fāng fǎ machine code/məˈʃiːn kəʊd/ 机器码 jī qì mǎ assembly language/əˈsemblɪ ˈlæŋɡwɪdʒ/ 汇编语言 huì biān yǔ yán addressing modes/əˈdresɪŋ məʊdz/ 寻址方式 xún zhǐ fāng shì Variables/ˈveərɪəblz/ 变量 biàn liàng object-oriented programming/ˈɒbdʒekt ˈɔːrɪəntɪd ˈprəʊɡræmɪŋ/ 面向对象编程 miàn xiàng duì xiàng biān chéng instances/ˈɪnstənsɪz/ 实例 shí lì classes/ˈklæsɪz/ 类 lèi encapsulation/ɪnˌkæpsjʊˈleɪʃn/ 封装 fēng zhuāng inheritance/ɪnˈherɪtəns/ 继承 jì chéng subclass/ˈsʌbklæs/ 子类 zi lèi superclass/ˈsuːpəklæs/ 父类 fù lèi overriding/ˌəʊvəˈraɪdɪŋ/ 重写 chóng xiě polymorphism/ˈpɒlɪmɔːfɪzəm/ 多态 duō tài abstraction/əbˈstrækʃn/ 抽象 chōu xiàng constructor/kənˈstrʌktə/ 构造函数 gòu zào hán shù aggregation/ˌæɡrɪˈɡeɪʃn/ 聚合 jù hé containment/kənˈteɪnmənt/ 包含 bāo hán declarative programming/dɪˈklærətɪv ˈprəʊɡræmɪŋ/ 声明式编程 shēng míng shì biān chéng functional programming/ˈfʌŋkʃənl ˈprəʊɡræmɪŋ/ 函数式编程 hán shù shì biān chéng pure functions/pjʊə ˈfʌŋkʃnz/ 纯函数 chún hán shù side effects/saɪd ɪˈfekts/ 副作用 fù zuò yòng logic programming/ˈlɒdʒɪk ˈprəʊɡræmɪŋ/ 逻辑编程 luó jí biān chéng SQL/ˌes kjuː ˈel/ 结构化查询语言 jié gòu huà chá xún yǔ yán 20.2
Procesamiento de archivos

Syllabus
Los candidatos deben ser capaces de: Notas y orientación Escribir código para realizar operaciones de procesamiento de archivos Abrir (en modo lectura, escritura, anexar) y cerrar un archivo Leer un registro de un archivo y escribir un registro en un archivo Realizar operaciones de procesamiento de archivos sobre archivos secuenciales, lineales y aleatorios Demostrar comprensión de una excepción y la importancia del manejo de excepciones Saber cuándo es apropiado utilizar el manejo de excepciones Escribir código de programa para utilizar el manejo de excepciones Fuente: Plan de estudios Cambridge International
Esto amplía el manejo de archivos 文件 del Tema 10, procesando archivos secuenciales, lineales y aleatorios (acceso directo). Operaciones pseudocódigo:
OPENFILE name FOR READ | WRITE | APPEND(READ abre un archivo existente, WRITE crea/sobrescribe, APPEND añade al final);READFILE name, line;WRITEFILE name, value;CLOSEFILE name; yEOF(name)que es VERDADERO al final.Leer un archivo completo:
OPENFILE "names.txt" FOR READ
WHILE NOT EOF("names.txt") DO
    READFILE "names.txt", thisName
    OUTPUT thisName
ENDWHILE
CLOSEFILE "names.txt"
Buscar en un archivo (detenerse al encontrarlo):
found ← FALSE
OPENFILE "people.txt" FOR READ
WHILE NOT EOF("people.txt") AND NOT found DO
    READFILE "people.txt", line
    IF line = target THEN
        found ← TRUE
    ENDIF
ENDWHILE
CLOSEFILE "people.txt"
Actualizar un archivo in situ
La mayoría de los lenguajes no pueden editar un archivo de texto in situ. En cambio: abrir el original para READ y un archivo temporal para WRITE; para cada línea, escribir la nueva versión si debe cambiar, de lo contrario la original; cerrar ambos; luego reemplazar el original con el archivo temporal. El mismo patrón maneja la eliminación de líneas (omitarlas) e inserción de líneas.
Actualizar un archivo in situ: leer el original, escribir cambios en un archivo temporal, luego reemplazar el original Registros y archivos de acceso aleatorio
Modos de apertura.
READ: el archivo debe existir y la lectura comienza desde el principio.WRITE: se crea un archivo nuevo, y un archivo existente con ese nombre queda sobrescrito.APPEND: la escritura añade al final de un archivo existente. Todo archivo abierto se cierra conCLOSEFILE, yEOF(name)esTRUEcuando se ha leído el último elemento.Tres organizaciones de archivos. En un archivo serial los registros están en el orden en que fueron añadidos; en un archivo secuencial están en orden de clave; ambos se leen desde el inicio. Un archivo aleatorio 随机文件 (direct-access file) almacena cada registro en una dirección calculada a partir de su clave mediante una función de hashing 哈希, por lo que se encuentra un registro sin leer los demás. Los registros se declaran como un tipo definido por el usuario:
TYPE AccountRecord
    DECLARE AccNo : INTEGER
    DECLARE Name : STRING
    DECLARE Balance : REAL
    DECLARE Active : BOOLEAN
ENDTYPE
Encontrar un registro en un archivo aleatorio: la clave se hashea a una dirección, el puntero del archivo busca directamente en esa ranura y se lee el registro; ningún otro registro es tocado Las operaciones de archivos aleatorios en pseudocódigo son
OPENFILE "Acc.dat" FOR RANDOM,SEEK "Acc.dat", Address(mover el puntero del archivo a ese registro),GETRECORD "Acc.dat", Rec(leer el registro allí) yPUTRECORD "Acc.dat", Rec(escribir el registro allí). Encontrar un cliente por número de cuenta, según Paper 3:DECLARE Rec : AccountRecord DECLARE Target, Address : INTEGER INPUT Target Address ← Target MOD 1000 // the hashing function OPENFILE "Acc.dat" FOR RANDOM SEEK "Acc.dat", Address GETRECORD "Acc.dat", Rec WHILE Rec.AccNo <> Target AND Rec.AccNo <> 0 // 0 marks an empty slot Address ← Address + 1 // a collision: try the next slot SEEK "Acc.dat", Address GETRECORD "Acc.dat", Rec ENDWHILE IF Rec.AccNo = Target THEN OUTPUT Rec.Name, Rec.Balance ELSE OUTPUT "No such account" ENDIF CLOSEFILE "Acc.dat"Para almacenar un registro, hashear su clave,
SEEKa la dirección yPUTRECORD, avanzando sobre cualquier ranura ya ocupada. Las marcas van al hashing, al SEEK antes del GET o PUT, a la comparación con el objetivo, al manejo de colisiones y al cierre del archivo.Ejemplo resuelto.
ActiveFile.datcontieneAccountRecordregistros. Escribe pseudocódigo que copie cada registro cuyo campoActivemarFALSEal final deArchiveFile.dat.DECLARE Rec : AccountRecord OPENFILE "ActiveFile.dat" FOR READ OPENFILE "ArchiveFile.dat" FOR APPEND WHILE NOT EOF("ActiveFile.dat") READFILE "ActiveFile.dat", Rec IF Rec.Active = FALSE THEN WRITEFILE "ArchiveFile.dat", Rec ENDIF ENDWHILE CLOSEFILE "ActiveFile.dat" CLOSEFILE "ArchiveFile.dat"Archivos de texto en Python (Papel 4):
file = open("HighScore.txt", "r"), luegofor line in file:conline.strip()yline.split(",")para separar los campos,int(…)para convertir una puntuación, yfile.close(); para escribir,open(name, "w")(o"a"para añadir) yfile.write(str(score) + "\n"). Una tabla de mejores puntuaciones se lee en una lista de registros, se inserta la nueva puntuación en su lugar, y se escribe toda la lista de nuevo. El examinador califica la apertura con el modo correcto, un bucle que lee cada línea, la conversión de texto a números y el cierre.Trampas
Olvidar cerrar un archivo (puede haber pérdida de datos); abrirlo en modo WRITE cuando se pretendía APPEND (sobrescribe todo); leer más allá de
EOF; rutas codificadas en rígido —una ruta como/Users/Admin/data.txtfalla en otra máquina, así que usa una constante relativa comoDataFile = "./data/scores.txt".ExplorarRuta de acceso al archivo
Seguir un archivo desde el almacenamiento hasta el programa y de vuelta de forma segura.
Vocabulario EntrenarInglés Chino Pinyin file/faɪl/ 文件 wén jiàn random file/ˈrændəm faɪl/ 随机文件 suí jī wén jiàn hashing/ˈhæʃɪŋ/ 哈希 hā xī 20.2
Manejo de excepciones

Una excepción 异常 es un error o condición inesperada durante la ejecución: división por cero, archivo no encontrado, fallo de red, índice de array 数组 fuera de rango. El manejo de excepciones 异常处理 permite a un programa detectarlo y responder con elegancia en lugar de colgarse.
Importa porque los programas reales enfrentan errores que no pueden evitarse de antemano (archivos movidos, redes caídas, entrada incorrecta); sin él, cada operación necesitaría su propia
IFcomprobación; y separa el flujo normal del manejo de errores, haciendo que el camino principal se lea con claridad. Por ejemplo, un archivo puede ser eliminado por otro usuario entre que tu programa verifica que existe y lo abre realmente: no puedes evitar eso, solo manejar el fallo cuando ocurra."Describe, con un ejemplo, qué significa una excepción" (dos marcas). Un evento o error inesperado que ocurre durante la ejecución de un programa (en tiempo de ejecución) e interrumpe su flujo normal; por ejemplo, dividir por cero, abrir un archivo que no existe, convertir una entrada no numérica a entero, un índice de array fuera de rango, o quedarse sin memoria. "Identifica dos causas posibles de excepciones" se responde con esa lista, además de "un dispositivo o red no está disponible" e "entrada de tipo de dato inválido".
"Indica las razones para incluir manejo de excepciones" (tres marcas). Para evitar que el programa se colgue (terminando inesperadamente); para mostrar un mensaje significativo al usuario en lugar de un error del sistema; para permitir que el programa recupere y continúe, por ejemplo pidiendo la entrada de nuevo, o cerrando archivos de forma segura antes de terminar; y porque algunos errores no pueden predecirse cuando se escribe el programa. "Describe cómo se puede evitar la terminación del programa debido a una excepción": pon las sentencias que podrían generar una excepción dentro de un bloque TRY; escribe un bloque EXCEPT (catch) para esa excepción que la maneje, por ejemplo mostrando un mensaje, de modo que la ejecución continúe después del bloque en lugar de detenerse. "Explica qué significa el manejo de excepciones": detectar una excepción cuando ocurre y ejecutar código (el manejador) que la gestione para que el programa continúe.
Patrón
TRY
    OPENFILE "data.txt" FOR READ
    READFILE "data.txt", line
    OUTPUT line
    CLOSEFILE "data.txt"
EXCEPT FileNotFound
    OUTPUT "Sorry, the file does not exist."
EXCEPT ReadError
    OUTPUT "Sorry, error reading the file."
ENDTRY
El bloque
TRYcontiene el código que podría fallar; se ejecuta el primer bloqueEXCEPTcoincidente. Los lenguajes reales también tienen un catch-allEXCEPTy un bloqueFINALLYque se ejecuta haya ocurrido o no una excepción —útil para limpieza (cerrar archivos).Flujo de excepción: una excepción salta al EXCEPT coincidente; FINALLY siempre se ejecuta antes de que el programa continúe Levantar una excepción
Una subrutina que detecta un error puede levantar 抛出 una excepción para que el llamador la maneje:
PROCEDURE Divide(a : INTEGER, b : INTEGER) RETURNS INTEGER
    IF b = 0 THEN
        RAISE DivideByZero
    ENDIF
    RETURN a DIV b
ENDPROCEDURE
Dónde manejar excepciones
Manéjalas cerca del error si la respuesta es sencilla (un mensaje, un reintentar), o más arriba en la pila de llamadas 调用栈 si solo el código externo sabe qué hacer (un bucle GUI de nivel superior registra el error y muestra un diálogo amigable). No tragues las excepciones en silencio —al menos regístralas, o la depuración será imposible.
Excepciones comunes:
FileNotFound,IOError,DivisionByZero,IndexOutOfRange,InvalidArgument,NullReference,OutOfMemory. Envolver cada operación fallida en unTRYcon los manejadoresEXCEPTadecuados da a un programa que degrada con gracia en lugar de colgarse.Ejemplo resuelto (Papel 4). Escribe una función que lea números enteros, uno por línea, de un archivo cuyo nombre se pasa como parámetro y los devuelva en una lista. No debe colgarse si el archivo no existe o una línea no es un número entero.
def read_scores(filename):
    scores = []
    try:
        file = open(filename, "r")
        for line in file:
            scores.append(int(line))
        file.close()
    except FileNotFoundError:
        print("The file", filename, "does not exist")
    except ValueError:
        print("A line in the file was not a whole number")
    return scores
El bloque
trycontiene el código que puede fallar (la apertura y la conversión); cadaexceptnombra una excepción y realiza algo útil; la función todavía devuelve una lista, por lo que el llamador continúa. En Java, la misma estructura estry { … } catch (FileNotFoundException e) { … } catch (NumberFormatException e) { … }; en VB.NET esTry … Catch ex As FileNotFoundException … End Try. Puntuación: las declaraciones de riesgo dentro del try, los nombres correctos de las excepciones, un mensaje para cada una, y el programa continuando después; un catch-allexcept:obtiene la puntuación de colapso pero no la de "excepción apropiada".Ejemplo resuelto. Un archivo de texto de miembros necesita cambiar el número de teléfono de un miembro. ¿Por qué el programa no puede simplemente sobrescribir esa línea y cuál es el patrón? Las líneas de un archivo de texto tienen longitudes diferentes, y el archivo no tiene espacios en blanco para absorber una diferencia: una sustitución más larga chocaría con el siguiente registro, y una más corta dejaría parte de la línea antigua. Por lo tanto, el patrón es abrir el original para LEER y un archivo temporal para ESCRIBIR, leer cada línea a su vez, escribiendo la versión nueva para la línea que cambia y la línea original para todas las demás, cerrar ambos, y luego reemplazar el original con el archivo temporal. La misma estructura maneja la eliminación (saltar la línea) y la inserción (escribir la línea adicional). Tenga en cuenta que todas las líneas se escriben, no solo la cambiada; escribir solo el nuevo registro y perder el resto del archivo es el error clásico.
ExplorarFlujo del manejo de excepciones
Paso a paso de lo que ocurre cuando falla el código. La excepción salta del flujo normal hacia un manejador, FINALLY limpia en cualquier caso, y el programa continúa en lugar de fallar.
Vocabulario EntrenarInglés Chino Pinyin array/əˈreɪ/ 数组 shù zǔ imperative programming/ɪmˈperətɪv ˈprəʊɡræmɪŋ/ 命令式编程 mìng lìng shì biān chéng exception/ekˈsepʃn/ 异常 yì cháng exception handling/ekˈsepʃn ˈhændlɪŋ/ 异常处理 yì cháng chǔ lǐ raise/reɪz/ 抛出 pāo chū call stack/kɔːl stæk/ 调用栈 diào yòng zhàn 20.2
Definiciones aceptadas por el examinador
Una pregunta de definición se califica según un texto fijo. Aprende estas definiciones exactamente, y da solo una respuesta.
Término Definición paradigma de programación un estilo o forma de programar, con su propia manera de estructurar un programa lenguaje imperativo el programa es una secuencia de sentencias que cambian el estado del programa; el programador dice cómo se hace la tarea lenguaje declarativo el programa establece hechos y reglas y el motor de inferencia determina cómo encontrar la respuesta clase una plantilla que define los atributos y métodos de los objetos de ese tipo objeto (instancia) una ocurrencia de una clase, con sus propios valores para los atributos atributo un elemento de datos que pertenece a una clase método un procedimiento o función que pertenece a una clase y actúa sobre sus atributos encapsulación mantener los atributos y métodos juntos en una clase y restringir el acceso externo a los datos, de modo que solo se cambien a través de métodos públicos herencia una subclase adquiere los atributos y métodos de su clase padre y puede agregarlos o reemplazarlos polimorfismo métodos con el mismo nombre que se comportan de manera diferente para diferentes clases constructor un método que se ejecuta cuando se crea un objeto e inicializa sus atributos contención una clase tiene un objeto de otra clase como uno de sus atributos hecho una afirmación en un programa declarativo que es verdadera regla una conclusión que se cumple cuando sus condiciones son verdaderas archivo serial, secuencial, aleatorio registros en el orden en que se agregaron; registros en orden de clave; cada registro en una dirección calculada a partir de su clave excepción un error o evento inesperado durante la ejecución que interrumpe el flujo normal manejo de excepciones detectar una excepción cuando ocurre y ejecutar código que la maneje para que el programa continúe 20.2
Consejos para el examen
- Paradigmas: conozca la descripción de una sola línea de cada uno y esté preparado para nombrar el paradigma a partir de una muestra de código; las preguntas de bajo nivel piden los cinco modos de direccionamiento y lo que recibe el acumulador.
- Las definiciones de POO aparecen en cada sesión: clase, objeto, atributo, método, encapsulación, herencia, polimorfismo, constructor. Escriba una clase en pseudocódigo con atributos PRIVADOS, un PÚBLICO NEW y getters; una subclase con INHERITA y SUPER.NEW.
- Declarativo: una meta con una variable devuelve todos los hechos coincidentes; una regla es una conclusión SI condiciones unidas con Y; copie los nombres de predicados de la pregunta exactamente.
- Archivos: los tres modos y qué hace cada uno con un archivo existente; READFILE en un bucle WHILE NOT EOF; los archivos aleatorios usan un hash, SEEK, GETRECORD y PUTRECORD, con un paso sobre para colisiones.
- Excepciones: definición con un ejemplo, tres razones para manejarlas, y TRY con un EXCEPT nombrado que permite que el programa continúe.
Errores comunes
- Describir un programa declarativo como "una secuencia de pasos que da la respuesta"; establece qué es verdadero y qué se desea, no cómo.
- Confundir un objeto con una clase, o una instancia con un atributo; la pregunta "una ocurrencia de un objeto" busca instancia.
- Declarar los atributos PÚBLICOS, o acceder a ellos desde fuera de la clase en lugar de a través de un getter, lo que pierde la puntuación de encapsulación.
- Un constructor de subclase que establece directamente los atributos del padre en lugar de llamar a SUPER.NEW.
- Explicar el polimorfismo como "muchos objetos"; es el mismo nombre de método que se comporta de manera diferente para diferentes clases.
- Abrir un archivo FOR WRITE para agregar un registro, lo que destruye el contenido existente; use APPEND.
- Leer un archivo aleatorio desde el principio; busque primero en la dirección hasheada.
- Colocar el manejador de excepciones alrededor de código que no puede fallar, o capturar todo sin mensaje, o describir el manejo de excepciones como "comprobar la entrada con IF".
- inmediato (