| Los candidatos deben ser capaces de: | Notas y orientaciones |
|---|---|
| Demostrar comprensión de la abstracción | Necesidad y beneficios del uso de la abstracción. Describir el propósito de la abstracción. Producir un modelo abstracto de un sistema incluyendo únicamente los detalles esenciales. |
| Describir y utilizar la descomposición | Desglosar problemas en subproblemas, lo que conduce al concepto de módulo de programa (procedimiento / función). |
Diseño de algoritmos y resolución de problemas
A-Level Ciencias de la Computación · Tema 9
 14:52
Pensamiento computacional
Aquí hay una tarea: construir un sistema para gestionar el stock de toda una tienda —cada producto, cada venta, cada entrega, cada informe. Como un problema gigante, es demasiado grande para…
Narración en inglés · Subtítulos en inglés + 中文 quemados en pantalla
9.1
Pensamiento computacional

Syllabus
Fuente: Plan de estudios Cambridge International
El pensamiento computacional 计算思维 es el conjunto de herramientas mentales para analizar un problema y diseñar una solución que un ordenador pueda ejecutar. Dos conceptos clave son la abstracción y la descomposición.
Abstracción
La abstracción 抽象 significa mantener las características esenciales de un problema e ignorar los detalles irrelevantes, creando así un modelo más simple.
Ejemplos:
- un mapa de una red ferroviaria mantiene las estaciones y líneas, pero omite la geografía real.
- una clase en programación orientada a objetos conserva solo los atributos y métodos que el sistema necesita.
- una función oculta una parte del trabajo tras un nombre.
Un modelo completo de cualquier problema real sería demasiado complejo para analizar, por lo que la abstracción es esencial.
Al examinador le piden el propósito de la abstracción y sus beneficios. Propósito: producir un modelo más simple de un problema que contenga únicamente los detalles necesarios para resolverlo. Beneficios: el problema es más fácil de entender y programar; el programa es más pequeño, se escribe y prueba más rápido; el mismo modelo puede reutilizarse para problemas similares. Cuando se te pide crear un modelo abstracto de un sistema, enumera solo los datos y acciones que la tarea requiere. Para un horario escolar, esto significa clases, aulas, profesores y periodos; no significa el color de las aulas ni la edad de los profesores.

Descomposición
La descomposición 分解 significa dividir un problema grande en subproblemas más pequeños, cada uno más fácil de resolver y abordado uno a la vez.
- encontrar las partes principales de la tarea.
- dividir cada parte en subtareas más pequeñas.
- continuar hasta que cada una sea lo suficientemente pequeña para diseñarla directamente.
- resolver las tareas pequeñas y combinarlas.
Para el control de stock: "gestionar stock" → "registrar ventas", "registrar entregas", "producir informes" → ("registrar ventas") "consultar producto", "disminuir contador de stock", "guardar transacción". La descomposición hace manejables los problemas grandes, permite que un equipo divida el trabajo y proporciona código modular — cada módulo se convierte en una procedimiento 过程 o función.
"Plicar por qué se usa la descomposición" es una pregunta de tres puntos con una estructura fija. Da tres beneficios separados: cada subproblema 子问题是 lo suficientemente pequeño para diseñar, codificar y probar por sí mismo; diferentes programadores pueden trabajar en diferentes módulos 模块 al mismo tiempo; un módulo que ya existe (o una rutina de biblioteca) puede reutilizarse, y un fallo es más fácil de localizar porque está contenido dentro de un solo módulo. Un diagrama estructural (tema 12) es el diagrama de una descomposición: el programa en la parte superior, sus módulos debajo, y los datos que se pasan entre ellos.

Explorar
Resolver un problema a la manera computacional
Recorra los cuatro pilares en el orden en que los usaría: descomponga el problema, identifique lo que se repite, simplifíquelo a lo esencial y luego escriba los pasos.
Vocabulario
Entrenar
| Inglés | Chino | Pinyin |
|---|---|---|
| computational thinking/ˌkɒmpjuːˈteɪʃənl ˈθɪŋkɪŋ/ | 计算思维 | jì suàn sī wéi |
| abstraction/əbˈstrækʃn/ | 抽象 | chōu xiàng |
| decomposition/ˌdiːkɒmpəˈzɪʃn/ | 分解 | fēn jiě |
| sub-problem/sʌb ˈprɒbləm/ | 子问题 | zi wèn tí |
| procedure/prəˈsiːdʒə/ | 过程 | guò chéng |
| modules/ˈmɒdjuːlz/ | 模块 | mó kuài |
| algorithm/ˈælɡərɪθəm/ | 算法 | suàn fǎ |
| sequence/ˈsiːkwəns/ | 顺序 | shùn xù |
| unambiguous/ʌnæmˈbɪɡjuːəs/ | 无歧义 | wú qí yì |
| deterministic/dɪˌtɜːmɪˈnɪstɪk/ | 确定性 | què dìng xìng |
9.2
Algoritmos
Syllabus
| Los candidatos deben ser capaces de: | Notas y orientación |
|---|---|
| Demostrar comprensión de que un algoritmo es una solución a un problema expresada como una secuencia de pasos definidos | |
| Utilizar nombres de identificadores adecuados para la representación de datos utilizados por un problema y representarlos mediante una tabla de identificadores | |
| Escribir pseudocódigo que contenga entrada, proceso y salida | |
| Escribir pseudocódigo utilizando las tres construcciones básicas de secuencia, selección e iteración (repetición) | |
| Documentar un algoritmo simple mediante una descripción en inglés estructurado, un diagrama de flujo o pseudocódigo | |
| Escribir pseudocódigo a partir de: • una descripción en inglés estructurado • un diagrama de flujo | |
| Dibujar un diagrama de flujo a partir de: • una descripción en inglés estructurado • pseudocódigo | |
| Describir y utilizar el proceso de refinamiento progresivo para expresar un algoritmo hasta un nivel de detalle desde el cual la tarea pueda ser programada | |
| Utilizar sentencias lógicas para definir partes de una solución algorítmica |
Fuente: Plan de estudios Cambridge International
Un algoritmo 算法 es una solución expresada como una secuencia de pasos definidos. Cada paso es sin ambigüedad 无歧义 (un significado), determinista 确定性 (misma entrada → misma salida), finito (los pasos terminan) y efectivo (cada uno puede ejecutarse). Un algoritmo dice qué hacer, independientemente del lenguaje de programación utilizado para implementarlo.
Explorar
Selección: seguir las ramas IF / ELSE
Arrastra la puntuación y observa qué rama se ejecuta. La selección prueba cada condición a su vez y toma la PRIMERA que sea verdadera; así es como funciona IF … ELSE IF … ELSE.
9.2
Tabla de identificadores

Cuando inicias un algoritmo, lista cada pieza de datos en una tabla de identificadores 标识符表 — su identificador 标识符 (el nombre de la variable 变量), tipo de dato 数据类型 y descripción. La tabla del examen tiene exactamente estas tres columnas:
| Identificador | Tipo de dato | Descripción |
|---|---|---|
Category |
STRING |
categoría del producto |
SaleDate |
DATE |
cuándo se vendió el artículo |
ItemCost |
REAL |
costo del artículo |
InStock |
BOOLEAN |
TRUE si está en stock |
Sales |
ARRAY[1:30] OF REAL |
los totales diarios de ventas de los últimos 30 días |
Usa nombres descriptivos (ItemCost, no x): un identificador comienza con una letra, no contiene espacios y se escribe de la misma manera cada vez que aparece. Los tipos comunes son INTEGER, REAL, STRING, CHAR, BOOLEAN, DATE, además de arreglos. La tabla te obliga a nombrar cada pieza de datos antes de escribir código, y una pregunta de "completar la tabla de identificadores" otorga un punto por cada tipo de dato o descripción correcta, así que escribe el tipo exactamente como lo hace la guía de pseudocódigo.
Vocabulario
Entrenar
| Inglés | Chino | Pinyin |
|---|---|---|
| identifier table/aɪˈdentɪfaɪə ˈteɪbl/ | 标识符表 | biāo shí fú biǎo |
| identifier/aɪˈdentɪfaɪə/ | 标识符 | biāo shí fú |
| variable/ˈveərɪəbl/ | 变量 | biàn liàng |
| data type/ˈdeɪtə taɪp/ | 数据类型 | shù jù lèi xíng |
9.2
Pseudocódigo — las tres construcciones básicas

El pseudocódigo 伪代码 es una forma estructurada y neutral al lenguaje para describir algoritmos.
1. Secuencia
Los pasos se ejecutan uno después de otro (secuencia 顺序):
INPUT Name
INPUT Age
OUTPUT "Hello", Name
2. Selección
Una elección de qué pasos ejecutar, basada en una condición (selección 选择):
IF Age >= 18 THEN
    OUTPUT "Adult"
ELSE
    OUTPUT "Minor"
ENDIF
Para más opciones, usa CASE OF ... ENDCASE.
3. Iteración
Repetir un bloque (iteración 迭代, un bucle 循环):
FOR i ← 1 TO 10
    OUTPUT i
NEXT i
Un bucle MIENTRAS verifica la condición antes de cada pasada (puede ejecutarse cero veces); un bucle REPETIR...HASTA verifica después de cada pasada (siempre se ejecuta al menos una vez).
WHILE Total < 100 DO
    INPUT Value
    Total ← Total + Value
ENDWHILE

REPEAT
    INPUT Mark
UNTIL Mark >= 0 AND Mark <= 100
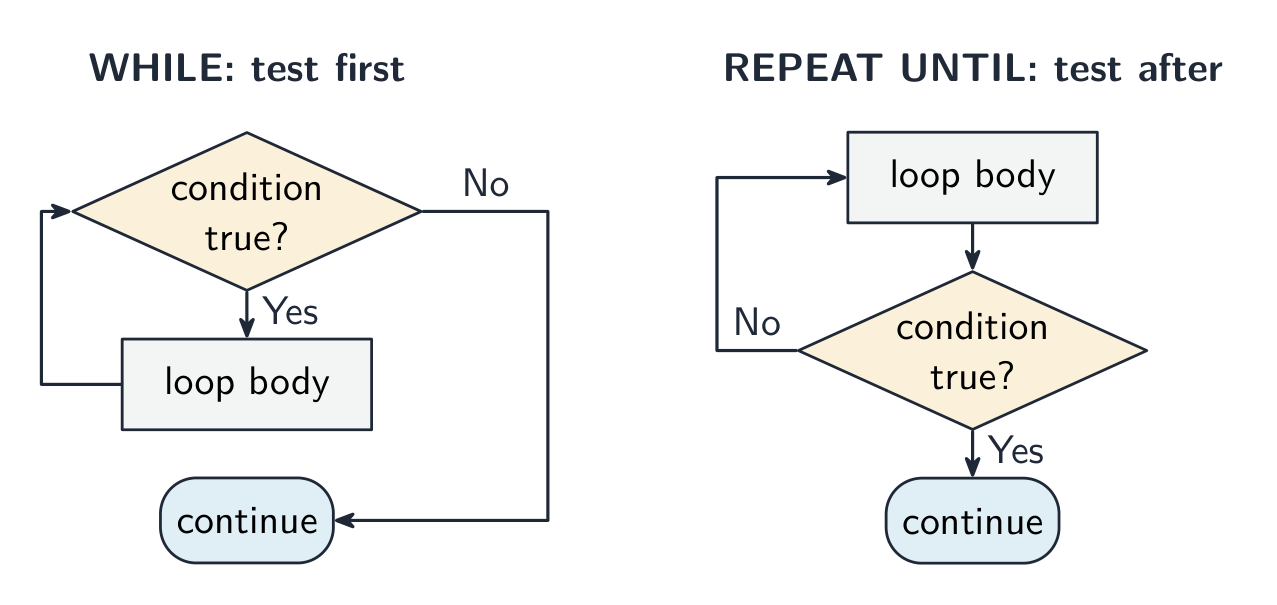
Elegir el bucle es en sí mismo un punto: FOR cuando sabes cuántas veces (un bucle controlado por contador 计数循环); WHILE cuando el bucle podría no ejecutarse en absoluto (un bucle de precondición 前测循环); REPEAT ... UNTIL cuando debe ejecutarse al menos una vez, como en la validación de una entrada (un bucle de poscondición 后测循环). Una respuesta que "describe la construcción de iteración" nombra la construcción, dice dónde se verifica la condición y da la consecuencia (cero veces o al menos una vez).
Operaciones comunes
- asignación 赋值:
x ← 5(una flecha;=es para comparación). - entrada/salida:
INPUT variable,OUTPUT expression. - comparaciones
=,<>,<,>,<=,>=; lógicaAND,OR,NOT. - aritmética
+ - * /, además deDIV(división entera) yMOD(resto). - cadenas:
LENGTH,LEFT,RIGHT,MID, y¶ concatenación 拼接 (unir).
El pseudocódigo que espera el examen
Cada respuesta de pseudocódigo se califica según la guía publicada de Cambridge. Escribe estas formas exactamente:
| Construcción | Pseudocódigo |
|---|---|
| Variable | DECLARE Total : INTEGER |
| Arreglo | DECLARE Marks : ARRAY[1:30] OF REAL |
| Constante | CONSTANT MaxTries = 3 |
| Asignación | Total ← Total + Value |
| Entrada / salida | INPUT NameOUTPUT "Hello ", Name |
| Selección | CASE OF Choice1 : OUTPUT "Add"OTHERWISE OUTPUT "Error"ENDCASE |
| Bucle PARA | FOR i ← 1 TO 10 STEP 2 ... NEXT i |
| Bucle MIENTRAS | WHILE Total < 100 DO ... ENDWHILE |
| Bucle REPETIR | REPEAT ... UNTIL Mark >= 0 |
| Aritmética entera | 17 DIV 5 = 317 MOD 5 = 2 |
| Cadenas | LENGTH(S), LEFT(S, 3), RIGHT(S, 2)MID(S, 2, 4), UCASE(S), LCASE(S) |
| Conversiones | INT(3.7) = 3, NUM_TO_STR(12)STR_TO_NUM("4.5"), ASC('A') = 65, CHR(66) = 'B' |
| Aleatorio | RAND(100)INT(RAND(100)) + 1 |
RAND(100) da un número real desde 0 hasta (pero sin incluir) 100. INT(RAND(100)) + 1 da un entero de 1 a 100.
Dos hábitos ganan puntos en cada pregunta: declarar todas las variables que uses, con el tipo de tu tabla de identificadores, e inicializar 初始化 todo contador 计数器 y total (Count ← 0, Total ← 0) antes del bucle que lo cambia.
Entrada → Proceso → Salida
Todo programa sigue esta forma:
INPUT Length
INPUT Width
Area ← Length * Width
OUTPUT "Area = ", Area
Listar las entradas y salidas primero hace que el algoritmo sea más limpio.
Ejemplo resuelto. Escribe pseudocódigo que introduzca 100 enteros y devuelva cuántos de ellos y la suma de aquellos que están entre 10 y 20 inclusive.
Tabla de identificadores: Count : INTEGER (contador de bucle), Value : INTEGER (el entero acaba de ser introducido), InRange : INTEGER (cuántos estaban en rango), Total : INTEGER (su suma).
DECLARE Count, Value, InRange, Total : INTEGER
InRange ← 0
Total ← 0
FOR Count ← 1 TO 100
    INPUT Value
    IF Value >= 10 AND Value <= 20 THEN
        InRange ← InRange + 1
        Total ← Total + Value
    ENDIF
NEXT Count
OUTPUT InRange, Total
Si la pregunta luego te pide "identificar dos construcciones y stating cómo se usa cada una", responde con la misma estructura: iteración, el bucle FOR, repite la entrada 100 veces; selección, la instrucción IF, añade un valor solo cuando está en rango.
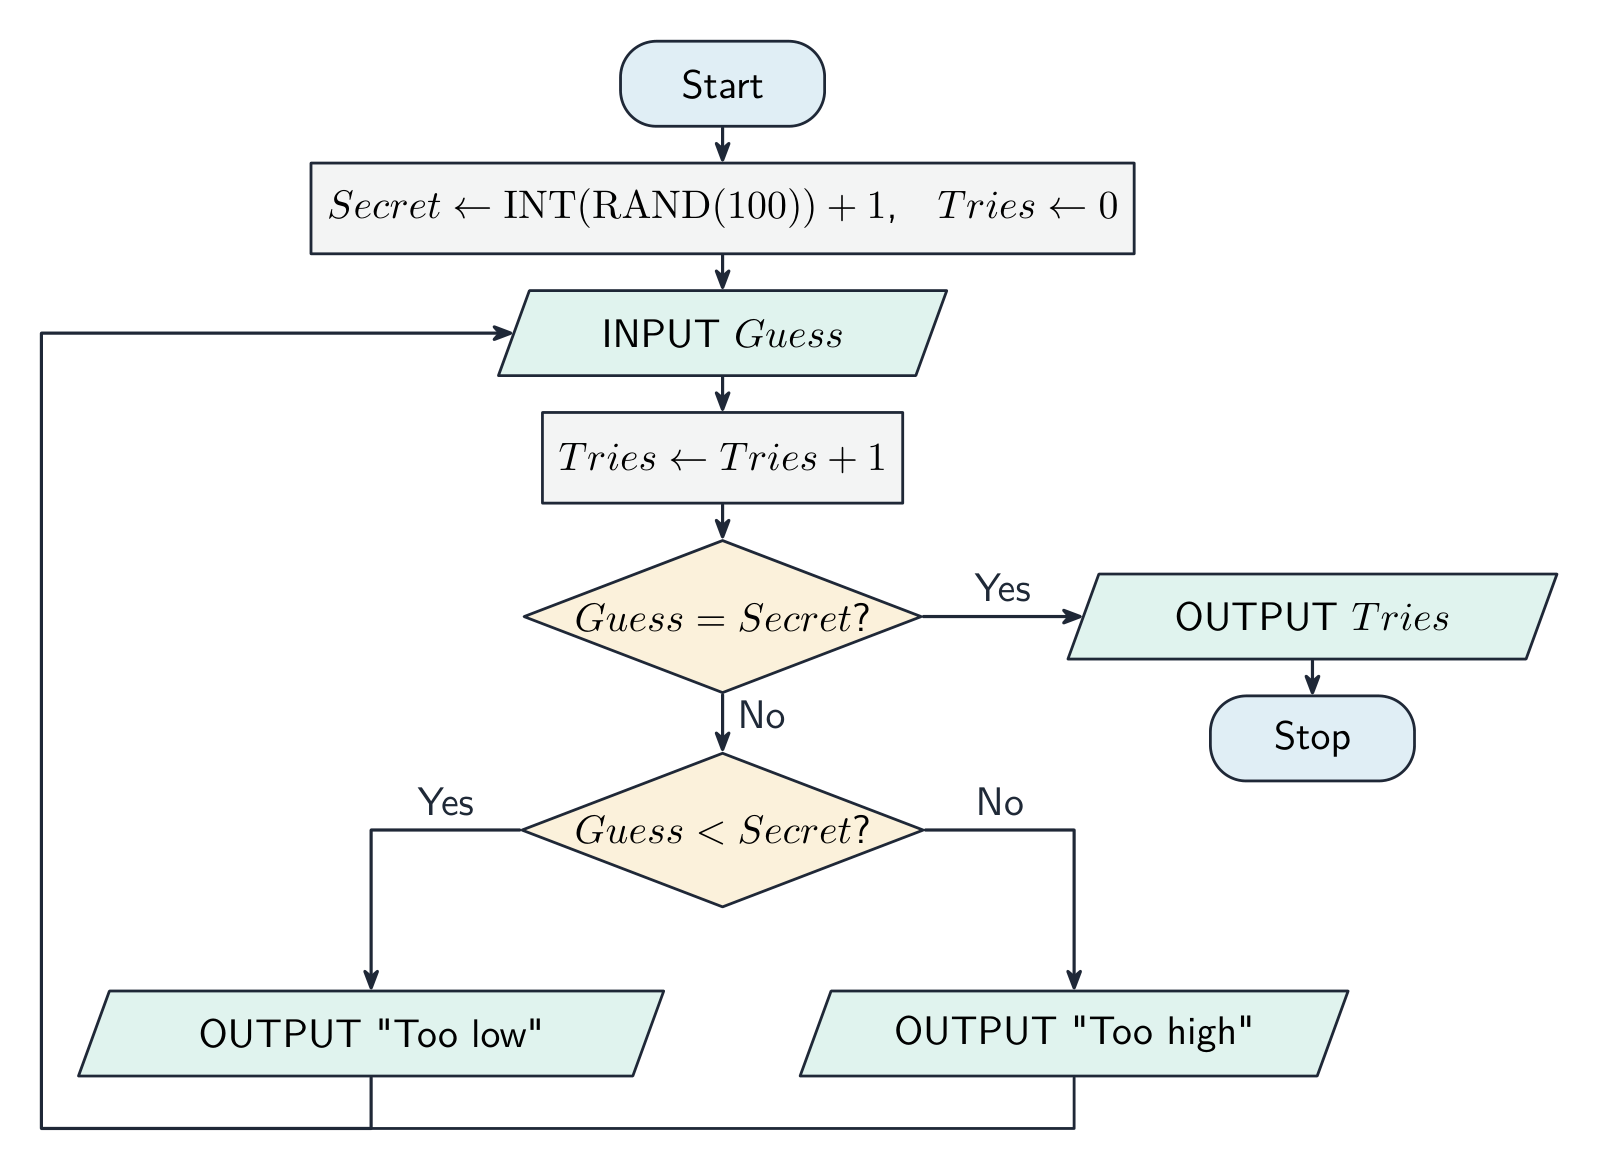
Ejemplo resuelto. Un programa elige un entero secreto de 1 a 100. El usuario adivina hasta acertar; después de cada intento incorrecto el programa dice "Demasiado bajo" o "Demasiado alto", y al final devuelve cuántos intentos se hicieron.
Tabla de identificadores: Secret : INTEGER (el número a adivinar), Guess : INTEGER (la entrada del usuario), Tries : INTEGER (cuántos intentos ha habido hasta ahora).
DECLARE Secret, Guess, Tries : INTEGER
Secret ← INT(RAND(100)) + 1
Tries ← 0
REPEAT
    INPUT Guess
    Tries ← Tries + 1
    IF Guess < Secret THEN
        OUTPUT "Too low"
    ELSE
        IF Guess > Secret THEN
            OUTPUT "Too high"
        ENDIF
    ENDIF
UNTIL Guess = Secret
OUTPUT "You took ", Tries, " guesses"
Un bucle REPEAT ... UNTIL es la opción correcta porque el usuario debe adivinar al menos una vez. Los puntos son para: el número aleatorio en el rango correcto, un bucle que termina con un acierto, el contador que empieza en cero y aumenta dentro del bucle, los dos mensajes bajo las condiciones correctas, y la salida final.
Ejemplo resuelto. Devuelve dos enteros aleatorios diferentes, cada uno entre $-10$ y $10$ inclusive.
Hay 21 valores posibles, por lo que INT(RAND(21)) da de 0 a 20 y restar 10 lo desplaza al rango $-10$ a $10$. El segundo número debe generarse nuevamente hasta que difiera del primero:
DECLARE First, Second : INTEGER
First ← INT(RAND(21)) - 10
REPEAT
    Second ← INT(RAND(21)) - 10
UNTIL Second <> First
OUTPUT First, Second

Explorar
IF … ELSE selección
Cambia el valor y observa qué rama se ejecuta: cómo un programa toma una decisión.
Vocabulario
Entrenar
| Inglés | Chino | Pinyin |
|---|---|---|
| pseudocode/ˈsuːdəʊkəʊd/ | 伪代码 | wěi dài mǎ |
| flowchart/ˈfləʊtʃɑːt/ | 流程图 | liú chéng tú |
| selection/sɪˈlekʃn/ | 选择 | xuǎn zé |
| iteration/ˌɪtəˈreɪʃn/ | 迭代 | dié dài |
| loop/luːp/ | 循环 | xún huán |
| count-controlled loop/kaʊnt kənˈtrəʊld luːp/ | 计数循环 | jì shù xún huán |
| pre-condition loop/priː kənˈdɪʃn luːp/ | 前测循环 | qián cè xún huán |
| post-condition loop/pəʊst kənˈdɪʃn luːp/ | 后测循环 | hòu cè xún huán |
| assignment/əˈsaɪnmənt/ | 赋值 | fù zhí |
| concatenation/kənˌkætəˈneɪʃn/ | 拼接 | pīn jiē |
| initialise/ɪˈnɪʃəlaɪz/ | 初始化 | chū shǐ huà |
| counter/ˈkaʊntə/ | 计数器 | jì shù qì |
| structured English/ˈstrʌktʃəd ˈɪŋɡlɪʃ/ | 结构化英语 | jié gòu huà yīng yǔ |
| stepwise refinement/ˈstepwaɪz rɪˈfaɪnmənt/ | 逐步求精 | zhú bù qiú jīng |
| logic statement/ˈlɒdʒɪk ˈsteɪtmənt/ | 逻辑语句 | luó jí yǔ jù |
| precedence/ˈpresɪdəns/ | 优先级 | yōu xiān jí |
| De Morgan's law/də ˈmɔːɡənz lɔː/ | 德摩根定律 | dé mó gēn dìng lǜ |
9.2
Tres notaciones

El mismo algoritmo puede escribirse de tres formas.
- inglés estructurado 结构化英语 — lenguaje natural con sangría y palabras clave fijas; bueno para una descripción de alto nivel.
- diagrama de flujo 流程图 — un diagrama con formas estándar:
| Forma | Significado |
|---|---|
| Rectángulo redondeado | Inicio / Parada |
| Paralelogramo | Entrada / Salida |
| Rectángulo | Proceso |
| Rombo | Decisión |
| Flecha | Flujo de control |
- pseudocódigo — la notación de palabras clave anterior; más cercano al código.
Deberías poder convertir entre cualquier par: cada IF es un rombo de decisión, cada bucle es una flecha de retorno, y una secuencia son rectángulos apilados.
SI ... ENTONCES ... DE LO CONTRARIO ... FIN SI
9.2
Refinamiento progresivo

El refinamiento progresivo 逐步求精 comienza con un esquema de alto nivel y expande cada paso hasta que sea lo suficientemente pequeño para codificarlo. Para un promedio de $n$ números:
Nivel 1:
Read in the numbers
Compute the average
Output the average
Nivel 2:
INPUT n
total ← 0
FOR i ← 1 TO n
    INPUT value
    total ← total + value
NEXT i
average ← total / n
OUTPUT average
Cada refinamiento mantiene la estructura anterior y añade detalles.
Una pregunta de seis puntos de "aplicar refinamiento progresivo" te da un esquema de alto nivel y quiere que cada paso se expanda en las instrucciones concretas que un programador podría codificar. Mantén los pasos en el mismo orden, nombra los datos que cada paso lee o produce, y detente cuando cada línea sea una sola entrada, asignación, salida, bucle o condición. Por ejemplo, "validar la contraseña" se convierte en: introducir la contraseña; verificar que su longitud sea de al menos 8; verificar que contenga al menos un dígito; output "aceptado" si ambas verificaciones pasan, de lo contrario output "rechazado".
Explorar
Refinamiento paso a paso: de esquema a código
Descender los niveles. Comienza con toda la tarea en una sola línea y sigue expandiendo cada paso en pasos más pequeños — hasta que cada paso sea lo suficientemente simple para codificarse directamente.
9.2
Sentencias lógicas

Una sentencia lógica 逻辑语句 es una condición Booleana 布尔 que controla el salto, construida a partir de comparaciones (x > 10), conectores (AND, OR, NOT) y paréntesis. Úsala como condición de IF, WHILE o REPEAT...UNTIL:
WHILE attempts < 3 AND NOT loggedIn DO
    INPUT password
    IF password = correctPassword THEN
        loggedIn ← TRUE
    ELSE
        attempts ← attempts + 1
    ENDIF
ENDWHILE
Prioridad 优先级 (de mayor a menor): NOT, luego AND, luego OR. Usa paréntesis si estás inseguro. Errores comunes:
a = 1 OR 2es incorrecto — escribea = 1 OR a = 2.NOT a > 5significaNOT (a > 5), es decir,a <= 5.NOT (A AND B)es lo mismo que(NOT A) OR (NOT B)(Ley de De Morgan 德摩根定律) — útil para simplificar condiciones.
Convertir una oración en una sentencia lógica es una habilidad que los exámenes prueban directamente. "Un boleto es gratis para cualquiera menor de 5 o mayor de 65" se convierte en Age < 5 OR Age > 65. "Una nota es válida si es un número entero de 0 a 100" se convierte en Mark >= 0 AND Mark <= 100. "El bucle se detiene cuando el archivo termina o se han leído diez registros" se convierte en UNTIL EOF(File) OR Count = 10. Escribe cada comparación completa: Age > 65 y Age < 5, nunca Age > 65 OR < 5.
Ejemplo resuelto. Escribe una tabla de identificadores y pseudocódigo para leer 10 números y devolver el mayor. La tabla de identificadores nombra cada variable con su tipo de dato y propósito: Count : INTEGER (contador de bucle), Num : REAL (el número acabado de leer), Max : REAL (mayor hasta ahora).
Max ← -999999
FOR Count ← 1 TO 10
    INPUT Num
    IF Num > Max THEN
        Max ← Num
    ENDIF
NEXT Count
OUTPUT Max
La decisión de diseño que lleva los puntos es inicializar Max: debe empezar más bajo que cualquier posible entrada - o, aún más seguro, ser configurado al primer número leído. Inicializarlo a 0 haría que el algoritmo devolviera erróneamente 0 para una lista de números negativos, un error que solo expones si los datos de prueba incluyen un negativo.
Vocabulario
Entrenar
| Inglés | Chino | Pinyin |
|---|---|---|
| Boolean/ˈbuːlɪən/ | 布尔 | bù ěr |
9.2
Definiciones que acepta el examinador
Una pregunta de definición se califica contra un texto fijo. Aprende estas exactamente, y da solo una respuesta.
| Término | Definición |
|---|---|
| abstracción | mantener los detalles esenciales de un problema y omitir los detalles que no se necesitan |
| descomposición | dividir un problema en subproblemas más pequeños, cada uno de los cuales puede resolverse por separado |
| algoritmo | una solución a un problema expresada como una secuencia de pasos definidos |
| tabla de identificadores | una tabla que lista cada identificador usado en un algoritmo con su tipo de dato y una descripción de su propósito |
| pseudocódigo | una forma estructurada e independiente del lenguaje para escribir los pasos de un algoritmo |
| diagrama de flujo | un diagrama que muestra los pasos y decisiones de un algoritmo usando símbolos estándar unidos por flechas |
| secuencia | instrucciones ejecutadas una después de otra en el orden escrito |
| selección | elegir qué instrucciones ejecutar según una condición |
| iteración | repetir un grupo de instrucciones mientras, o hasta, se cumpla una condición |
| refinamiento progresivo | dividir cada paso de un esquema en pasos más pequeños, repetidamente, hasta que cada paso pueda codificarse directamente |
| sentencia lógica | una condición construida a partir de comparaciones y los operadores Y, O y NO que evalúa a VERDADERO o FALSO |
9.2
Consejos de examen
- Define un algoritmo como una secuencia de pasos sin ambigüedad, finita y determinista, independiente del lenguaje.
- Usa correctamente las tres construcciones — secuencia, selección, iteración — y mantén una tabla de identificadores con tipos de dato.
- Divide un problema mediante descomposición y abstracción, luego refinamiento progresivo.
- Escribe pseudocódigo que realmente funcionaría: declara variables y sigue el estilo de pseudocódigo del examen.
Errores comunes
- Usar
=para asignar un valor. La asignación es←;=es una comparación. - Olvidar
ENDIF,ENDWHILE,ENDCASEoNEXT. Cada construcción se cierra, y la palabra de cierre es donde se verifica el punto de la construcción. - No inicializar un total o contador antes del bucle, por lo que el algoritmo suma a un valor que nunca existió.
- Usar un bucle
FORcuando el número de repeticiones es desconocido. Leer hasta un valor centinela o un acierto necesitaWHILEoREPEAT ... UNTIL. - Escribir
Age > 65 OR < 5. Cada lado deORyANDdebe ser una comparación completa. - Responder "explicar por qué se usa la descomposición" con un beneficio escrito de tres formas. Tres puntos necesitan tres beneficios diferentes.
Lecciones interactivas sobre este tema
Trátalo paso a paso, con ejercicios de verificación instantánea.