| Los candidatos deben ser capaces de: | Notas y orientación |
|---|---|
| Demostrar comprensión de los métodos de búsqueda lineal y búsqueda binaria | Escribir un algoritmo para implementar una búsqueda lineal. Escribir un algoritmo para implementar una búsqueda binaria. Las condiciones necesarias para el uso de una búsqueda binaria. Cómo varía el rendimiento de una búsqueda binaria según el número de elementos de datos. |
| Demostrar comprensión de los métodos de ordenación por inserción y ordenación burbuja | Escribir un algoritmo para implementar una ordenación por inserción. Escribir un algoritmo para implementar una ordenación burbuja. El rendimiento de una rutina de ordenación puede depender del orden inicial de los datos y del número de elementos de datos. |
| Demostrar comprensión y uso de Tipos de Datos Abstractos (TDA) | Escribir algoritmos para encontrar un elemento en cada uno de los siguientes: lista enlazada, árbol binario. Escribir algoritmos para insertar un elemento en cada uno de los siguientes: pila, cola, lista enlazada, árbol binario. Escribir algoritmos para eliminar un elemento de cada uno de los siguientes: pila, cola, lista enlazada. Demostrar comprensión de que un grafo es un ejemplo de un TDA. Describir las características clave de un grafo y justificar su uso para una situación dada. A los candidatos no se les requerirá escribir código para una estructura de grafo. |
| Demostrar cómo es posible implementar TDAs a partir de otro TDA | Describir los siguientes TDAs y demostrar cómo pueden implementarse a partir de tipos integrados adecuados u otros TDAs: pila, cola, lista enlazada, diccionario, árbol binario. |
| Demostrar comprensión de que diferentes algoritmos que realizan la misma tarea se pueden comparar utilizando criterios (p. ej., tiempo necesario para completar la tarea y memoria utilizada) | Incluye el uso de la notación Big O para especificar la complejidad temporal y espacial. |
Pensamiento computacional y resolución de problemas
A-Level Ciencias de la Computación · Tema 19
 15:33
Búsqueda y ordenamiento
Una guía telefónica con un millón de nombres. Si los revisas uno por uno, podrías hacer un millón de comparaciones. Pero ya conoces el truco: ábrela en el…
Narración en inglés · subtítulos en inglés y 中文 que puedes cambiar
19.1
Algoritmos de búsqueda
Syllabus
Fuente: Plan de estudios Cambridge International
Una búsqueda encuentra un valor objetivo en una colección (a menudo un arreglo) y devuelve su posición, o «no encontrado».
Búsqueda lineal
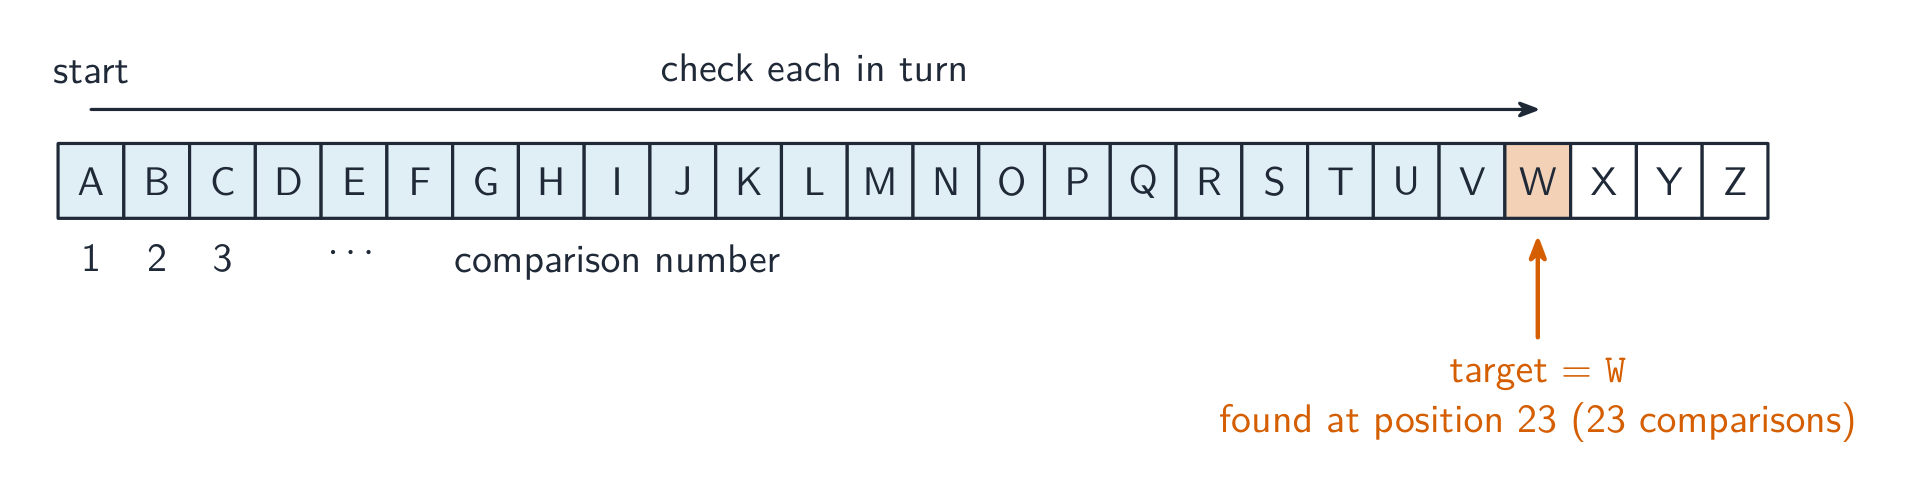
Una búsqueda lineal recorre de principio a fin, comparando cada elemento con el objetivo:
FOR i ← 1 TO n
    IF A[i] = target THEN
        RETURN i
    ENDIF
NEXT i
RETURN -1   // not found
No necesita preparación, por lo que funciona con cualquier lista. Peor caso O($n$) (el objetivo está al final o no está presente); mejor caso 1 comparación. Úsala con datos sin ordenar o listas pequeñas. (El valor -1 devuelto es un valor centinela: una posición imposible que significa «no encontrado»; quien llama comprueba IF result = -1).
La versión del examen. El Paper 3 te pide completar una búsqueda lineal escrita con una bandera y un bucle WHILE, y el Paper 4 escribir una función que devuelva el índice o un contador. Ambos se ven así:
FUNCTION LinearSearch(Data : ARRAY OF INTEGER, Target : INTEGER) RETURNS INTEGER
    DECLARE Index, Count : INTEGER
    Count ← 0
    FOR Index ← 1 TO 100
        IF Data[Index] = Target THEN
            Count ← Count + 1
        ENDIF
    NEXT Index
    RETURN Count          // how many times Target occurs; 0 means not found
ENDFUNCTION
Para detenerse en la primera coincidencia en su lugar, usa un bucle WHILE Index <= 100 AND NOT Found que establece Found ← TRUE y recuerda el índice. Las marcas son para el bucle sobre cada elemento, la comparación y qué se devuelve cuando el valor está ausente.
Búsqueda binaria
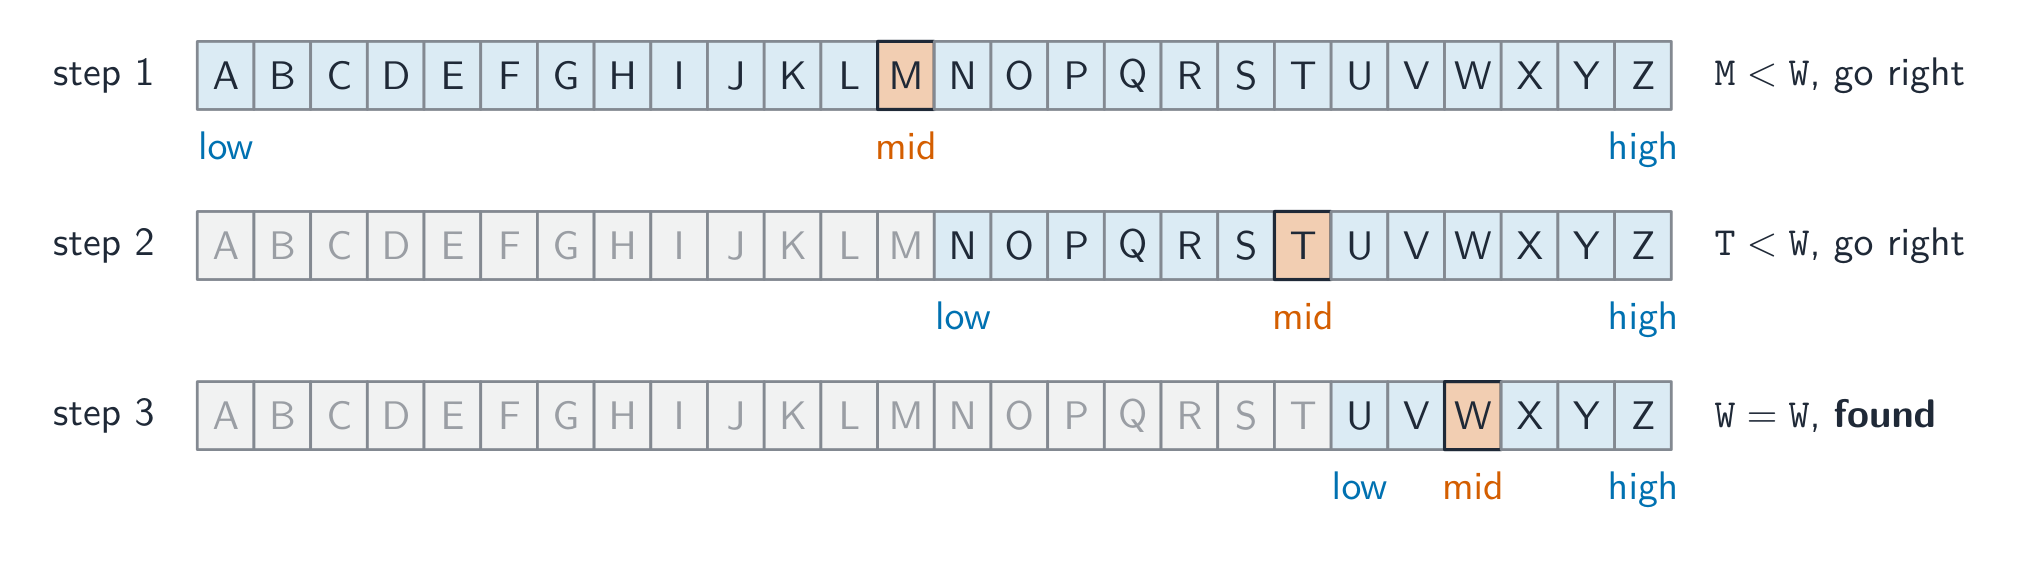
Una búsqueda binaria requiere los datos ordenados. Mire el elemento central; si es el objetivo, ha terminado; si el objetivo es menor, busque en la mitad izquierda, de lo contrario en la mitad derecha, reduciendo el rango a la mitad cada vez:
low ← 1
high ← n
WHILE low <= high DO
    MiddleIndex ← (low + high) DIV 2
    IF A[MiddleIndex] = target THEN
        RETURN MiddleIndex
    ENDIF
    IF A[MiddleIndex] < target THEN
        low ← MiddleIndex + 1
    ELSE
        high ← MiddleIndex - 1
    ENDIF
ENDWHILE
RETURN -1
Caso peor O($\log_{2} n$) —para un millón de elementos, unas 20 comparaciones. Mucho más rápida que la búsqueda lineal en arrays grandes ordenados, pero debes ordenar primero (un costo único O($n \log n$)), vale la pena si buscas muchas veces.
«Indica la condición necesaria para una búsqueda binaria». Los datos deben estar ordenados (en orden ascendente o descendente según la clave buscada). «Describe cómo realizar una búsqueda binaria» (tres puntos): (1) encuentra el elemento central de la lista (o del intervalo actual) y compáralo con el objetivo; (2) si coincide, la búsqueda termina; si el objetivo es menor, repite en la mitad inferior y, si es mayor, en la mitad superior; (3) sigue dividiendo el intervalo por la mitad hasta encontrar el elemento o hasta que el intervalo esté vacío, lo que significa que no está presente.
La versión del examen, con los límites y una bandera, es la que debes reproducir cuando se te pida completar el algoritmo:
DECLARE Lower, Upper, MiddleIndex : INTEGER
DECLARE Found : BOOLEAN
Lower ← 0
Upper ← 99
Found ← FALSE
WHILE Lower <= Upper AND NOT Found
    MiddleIndex ← (Lower + Upper) DIV 2
    IF Names[MiddleIndex] = Target THEN
        Found ← TRUE
    ELSE
        IF Names[MiddleIndex] < Target THEN
            Lower ← MiddleIndex + 1
        ELSE
            Upper ← MiddleIndex - 1
        ENDIF
    ENDIF
ENDWHILE
IF Found THEN
    OUTPUT MiddleIndex
ELSE
    OUTPUT "Not found"
ENDIF
Ejemplo resuelto (traza de una búsqueda binaria). Names[0:9] contiene Ali, Ben, Cai, Dev, Eva, Fay, Gus, Hal, Ivy, Jo. Realiza la traza de la versión del examen para Target = "Ivy" y luego para Target = "Cat", indicando Lower, Upper y MiddleIndex en cada paso.
Para «Ivy»:
| Inferior | Superior | ÍndiceCentral | Nombres[ÍndiceCentral] | Resultado |
|---|---|---|---|---|
| 0 | 9 | 4 | Eva | Eva < Ivy, por lo que Inferior ← 5 |
| 5 | 9 | 7 | Hal | Hal < Ivy, por lo que Inferior ← 8 |
| 8 | 9 | 8 | Ivy | Encontrado ← TRUE |
La salida es 8, después de tres comparaciones. Para «Cat»: centro 4 (Eva > Cat, Superior ← 3); centro 1 (Ben < Cat, Lower ← 2); middle 2 (Cai < Cat, Lower ← 3); middle 3 (Dev > Cat, Superior ← 2). Ahora Lower (3) es mayor que Upper (2), por lo que el bucle termina y se muestra «Not found» después de cuatro comparaciones, el peor caso para diez elementos ($\lceil\log_2 10\rceil = 4$). DIV redondea hacia abajo, por lo que el punto medio de 0 y 9 es 4, no 4.5 ni 5. Las cadenas se comparan en orden alfabético (de código de caracteres).
«Explica cómo varía el rendimiento con el número de elementos». Cada comparación reduce a la mitad el número de elementos restantes, por lo que el número máximo de comparaciones es aproximadamente $\log_{2} n$: duplicar el tamaño de la lista añade solo una comparación más. Esto es O($\log n$). «Compara la búsqueda lineal y la binaria»: una búsqueda lineal necesita hasta $n$ comparaciones (O($n$)) y, en promedio, la mitad, pero funciona con datos sin ordenar; una búsqueda binaria necesita como máximo $\log_{2} n$ (O($\log n$)) y es mucho más rápida para listas grandes, pero primero hay que ordenar los datos y estos deben permitir el acceso directo al elemento central (un arreglo, no una lista enlazada). Para $1000$ elementos: $1000$ frente a $10$ comparaciones.
Explorar
Búsqueda lineal vs binaria
Busca un valor. La búsqueda binaria reduce la lista a la mitad en cada paso (solo en datos ordenados); la búsqueda lineal revisa uno por uno.
Vocabulario
Entrenar
| English | Español |
|---|---|
| insertion sort/ɪnˈsɜːʃn sɔːt/ | ordenamiento por inserción |
| bubble sort/ˈbʌbl sɔːt/ | ordenamiento burbuja |
| binary search/ˈbaɪnəri sɜːtʃ/ | búsqueda binaria |
| array/əˈreɪ/ | matriz |
| linear search/ˈlɪnɪə sɜːtʃ/ | búsqueda lineal |
| stable/ˈsteɪbl/ | estable |
19.1
Algoritmos de ordenamiento
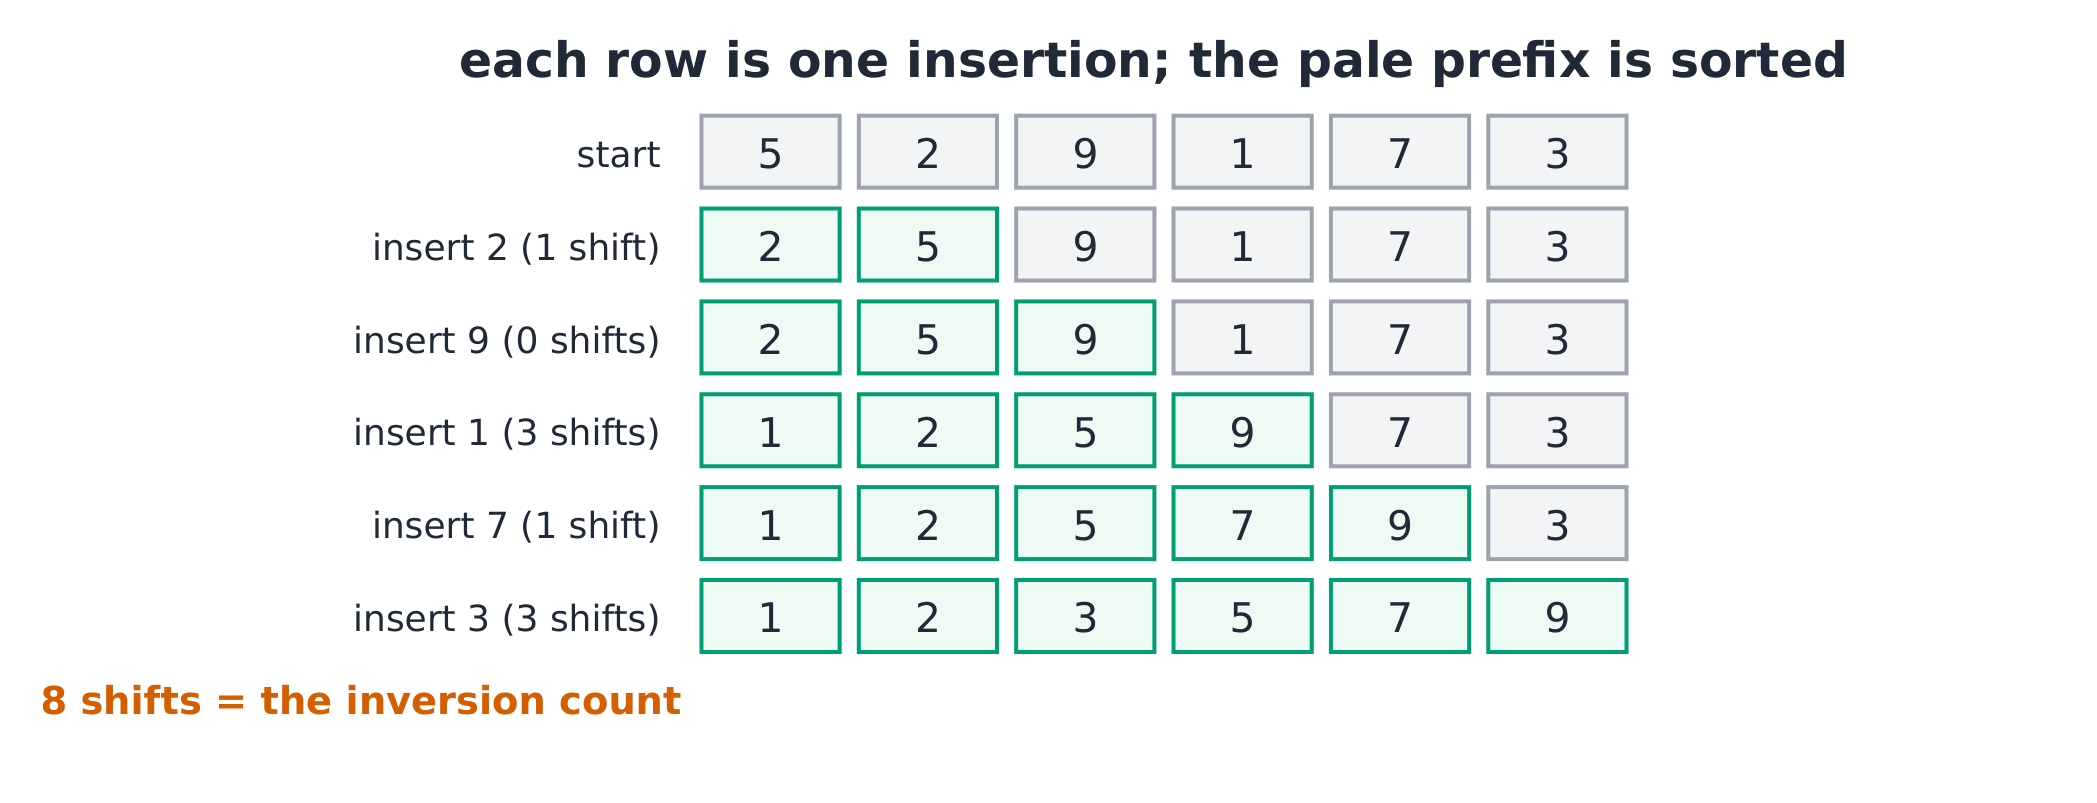
Ordenamiento burbuja
Una ordenación de burbuja recorre repetidamente el arreglo e intercambia pares adyacentes que están fuera de orden, de modo que el mayor «asciende» hasta el final en cada pasada:
FOR pass ← 1 TO n - 1
    swapped ← FALSE
    FOR i ← 1 TO n - pass
        IF A[i] > A[i + 1] THEN
            temp ← A[i]
            A[i] ← A[i + 1]
            A[i + 1] ← temp
            swapped ← TRUE
        ENDIF
    NEXT i
    IF swapped = FALSE THEN      // already sorted
        EXIT FOR
    ENDIF
NEXT pass
Caso mejor O($n$) (ya ordenado, con salida anticipada); promedio/empeorado O($n^{2}$). Simple pero lento para grandes $n$.
Ordenamiento por inserción
Un ordenamiento por inserción construye un prefijo ordenado desde la izquierda, insertando cada nuevo elemento en su lugar desplazando los mayores hacia la derecha:
FOR i ← 2 TO n
    key ← A[i]
    j ← i - 1
    WHILE j >= 1 AND A[j] > key DO
        A[j + 1] ← A[j]
        j ← j - 1
    ENDWHILE
    A[j + 1] ← key
NEXT i
Caso mejor O($n$) (ya ordenado); caso peor O($n^{2}$). Bueno para arrays pequeños o casi ordenados. Ordena in situ y es estable (mantiene el orden de los elementos iguales).
Rastrear un ordenamiento
Una tarea común es mostrar el array después de cada pasada externa. Para [D, T, H, R] con inserción: pasada 1 (clave T) sin cambio; pasada 2 (clave H) → [D, H, T, R]; pasada 3 (clave R) → [D, H, R, T].
La derivación (el conteo de inversiones). Una inversión es un
El mismo arreglo con ordenación de burbuja se mueve de forma diferente: la pasada 1 compara D/T (sin intercambio), T/H (intercambio) y T/R (intercambio), lo que da [D, H, R, T] con el elemento mayor al final; la pasada 2 no realiza intercambios, por lo que la bandera detiene la ordenación. Muestra el arreglo completo después de cada pasada y cuenta las comparaciones si se solicita: $3$ en la pasada 1 y $2$ en la pasada 2 (la versión anterior se detiene una posición antes en cada pasada), $5$ en total.
Escribir una ordenación desde cero. «Escribe pseudocódigo para ordenar DataArray[1:1000] en orden ascendente» se responde con una ordenación de burbuja completa con la bandera de salida anticipada, o una ordenación por inserción, con declaraciones y sangría; cualquiera obtiene la puntuación completa si funciona para todas las entradas:
DECLARE Pass, Index, Temp : INTEGER
DECLARE Swapped : BOOLEAN
Pass ← 1
REPEAT
    Swapped ← FALSE
    FOR Index ← 1 TO 1000 - Pass
        IF DataArray[Index] > DataArray[Index + 1] THEN
            Temp ← DataArray[Index]
            DataArray[Index] ← DataArray[Index + 1]
            DataArray[Index + 1] ← Temp
            Swapped ← TRUE
        ENDIF
    NEXT Index
    Pass ← Pass + 1
UNTIL Swapped = FALSE OR Pass = 1000
Para el orden descendente, cambia > por <; para ordenar registros o un arreglo de 2 dimensiones por un campo, compara ese campo pero intercambia el registro completo (o todas las columnas). Si se pide escribir una ordenación por inserción «que realice la misma tarea» que una ordenación de burbuja dada, conserva el mismo nombre de arreglo y la misma dirección y reproduce la ordenación por inserción anterior con la comparación invertida si el orden es descendente.
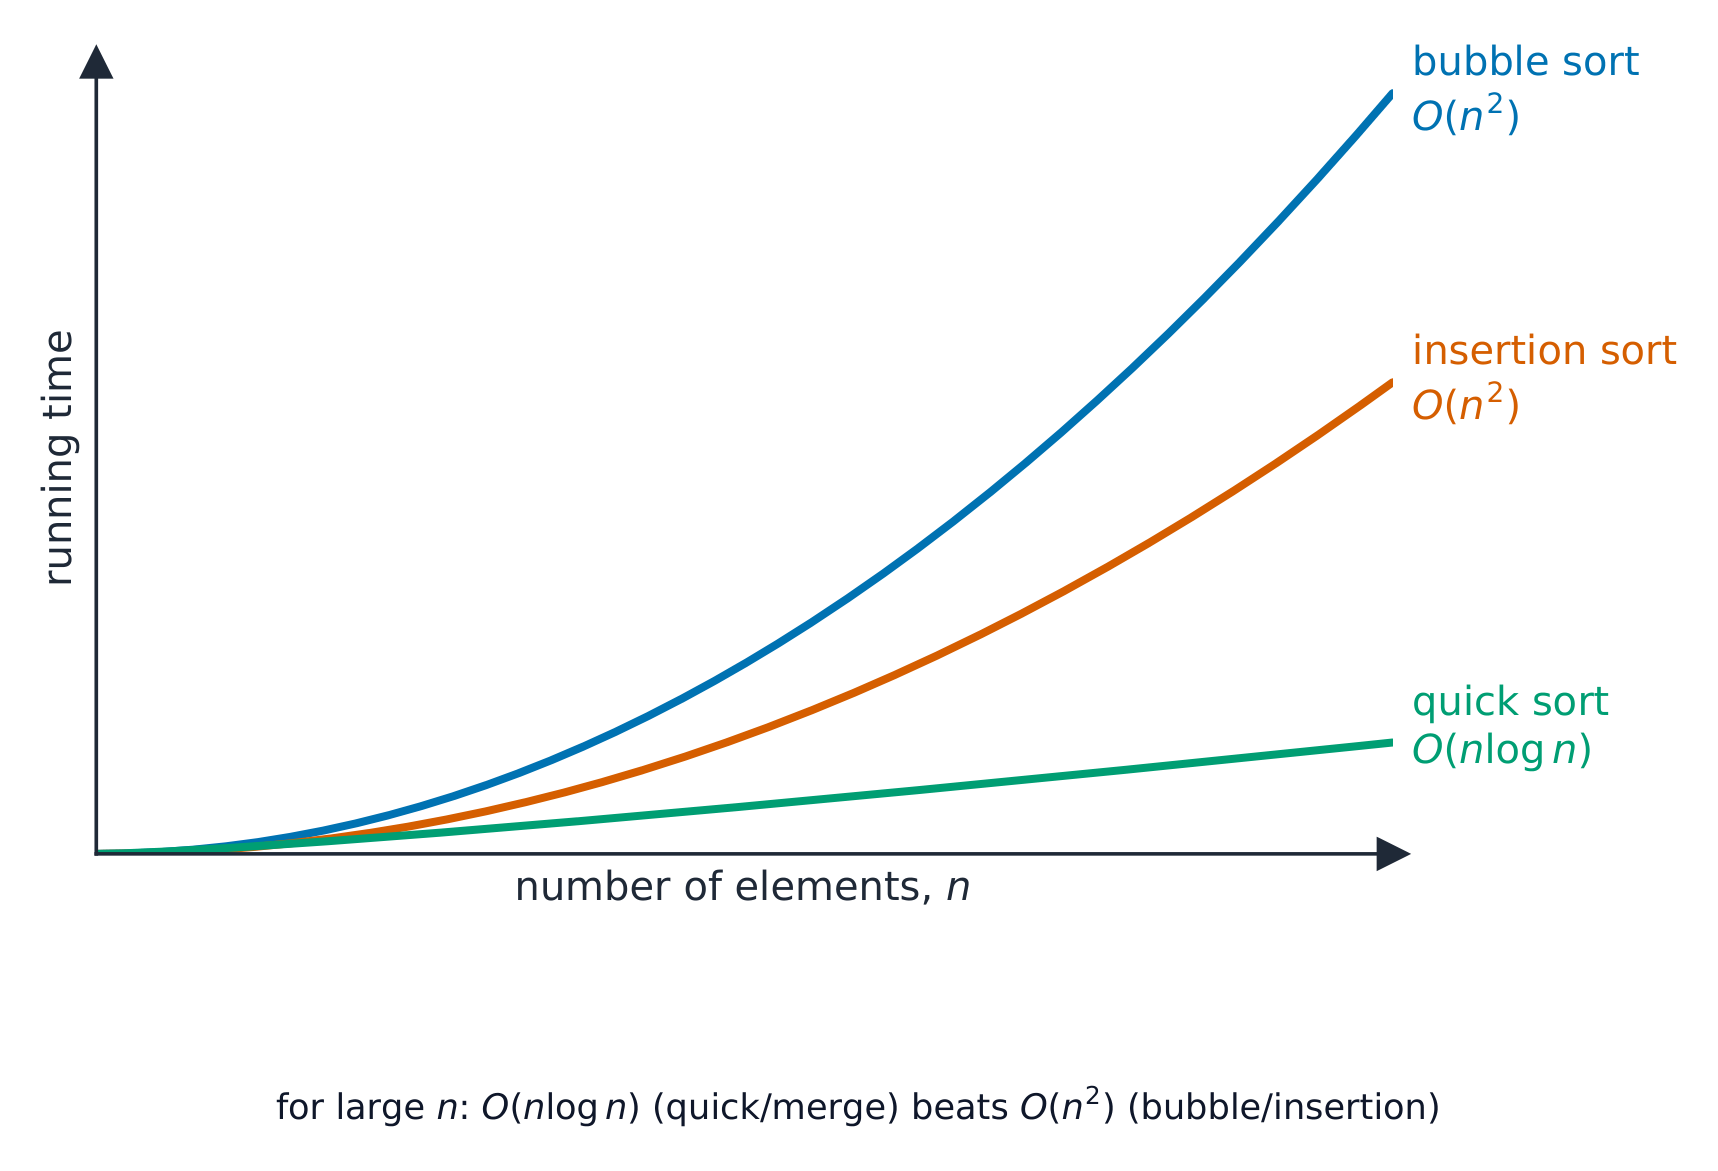
«Describe dos formas en que los datos afectan al rendimiento de una ordenación» (dos puntos). (1) El número de elementos: una ordenación $O(n^{2})$ tarda cuatro veces más con el doble de elementos. (2) En qué medida los datos ya están ordenados: una ordenación de burbuja con bandera, o una ordenación por inserción, termina en una pasada sobre datos ya ordenados ($O(n)$) y realiza la mayor cantidad de trabajo con datos en orden inverso; el número de intercambios depende de cuántos pares estén fuera de orden. (También se acepta: el rango o el número de valores duplicados, y si los elementos son registros grandes cuyo traslado es costoso). La ordenación de burbuja y la de inserción son ambas O($n^{2}$) en el peor caso y en el caso promedio, y O($n$) en el mejor caso; la ordenación rápida y la ordenación por mezcla son O($n \log n$), por lo que se utilizan para grandes cantidades de datos.
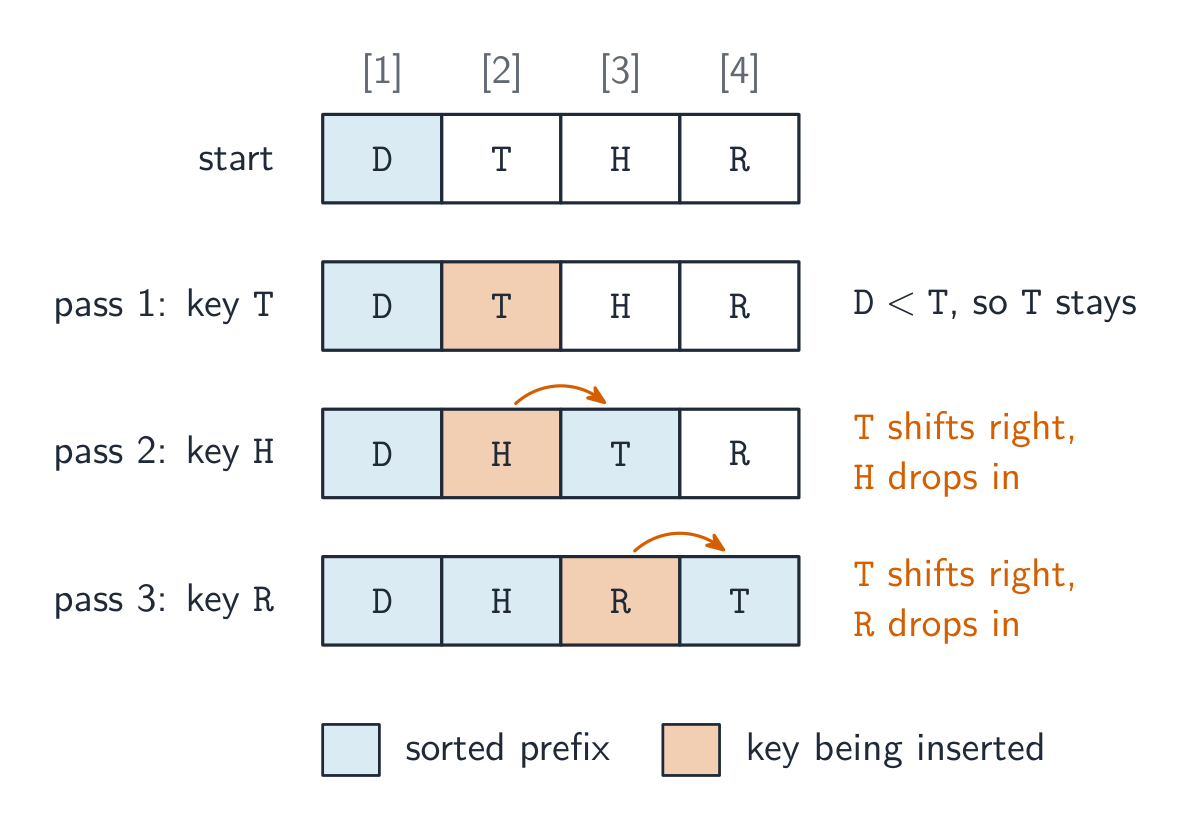
[D, T, H, R], desplazando cada clave a su lugar paso a paso
Explorar
Observar una ejecución de ordenamiento
Recorre un algoritmo de ordenación y observa cómo las barras se acomodan en orden: cómo funciona un algoritmo de ordenación paso a paso.
19.1
ADTs en algoritmos
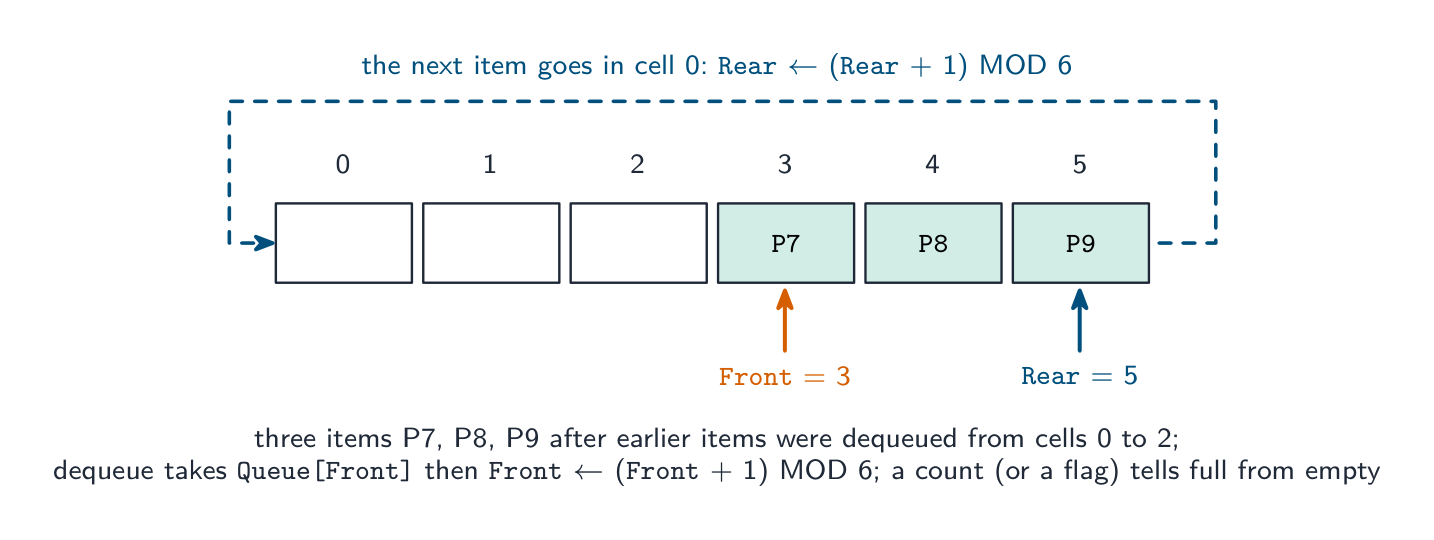
Los Tipos de Datos Abstractos (ADT) del Tema 10 aparecen dentro de muchos algoritmos: una pila impulsa el recorrido en profundidad y el deshacer; una cola impulsa el recorrido en anchura y el orden de impresión; una lista enlazada permite que los datos crezcan y disminuyan.
Los ADT pueden construirse a partir de otros ADT, no solo de arrays: una cola a partir de dos pilas; una pila a partir de una lista enlazada (empujar = agregar un nodo cabeza al inicio); una cola a partir de una lista enlazada con punteros de cabeza y cola; un árbol binario a partir de nodos con dos punteros de hijo; un diccionario almacena pares clave→valor (a menudo en una tabla hash). Apilar esto separa las responsabilidades: el algoritmo que usa el ADT no necesita saber cómo se construye.
Los ADTs que el examen pide describir e implementar
Pila (último en entrar, primero en salir): los elementos se añaden (apilados) y se eliminan (desapilados) en el mismo extremo, el tope; un puntero TopOfStack mantiene el índice del elemento superior. Implementado con una matriz y ese único puntero: push verifica que la pila no esté llena, incrementa el puntero y almacena el elemento; pop verifica que no esté vacía, devuelve el elemento superior y decrementa el puntero.
FUNCTION Push(Item : INTEGER) RETURNS BOOLEAN
    IF TopOfStack = 9 THEN      // full (array 0 to 9)
        RETURN FALSE
    ENDIF
    TopOfStack ← TopOfStack + 1
    StackData[TopOfStack] ← Item
    RETURN TRUE
ENDFUNCTION
FUNCTION Pop() RETURNS INTEGER
    IF TopOfStack = -1 THEN      // empty
        RETURN -1
    ENDIF
    TopOfStack ← TopOfStack - 1
    RETURN StackData[TopOfStack + 1]
ENDFUNCTION
Cola (primero en entrar, primero en salir): los elementos se unen en la parte trasera (encolar) y salen desde la parte frontal (desencolar); dos punteros y un contador. En una cola lineal, el puntero frontal avanza por el array hasta que el espacio al inicio queda desperdiciado; una cola circular envuelve ambos punteros alrededor con MOD, reutilizando cada celda.
FUNCTION Enqueue(Item : STRING) RETURNS BOOLEAN
    IF Count = 6 THEN      // full
        RETURN FALSE
    ENDIF
    Rear ← (Rear + 1) MOD 6
    QueueArray[Rear] ← Item
    Count ← Count + 1
    RETURN TRUE
ENDFUNCTION
FUNCTION Dequeue() RETURNS STRING
    IF Count = 0 THEN      // empty
        RETURN ""
    ENDIF
    DECLARE Item : STRING
    Item ← QueueArray[Front]
    Front ← (Front + 1) MOD 6
    Count ← Count - 1
    RETURN Item
ENDFUNCTION
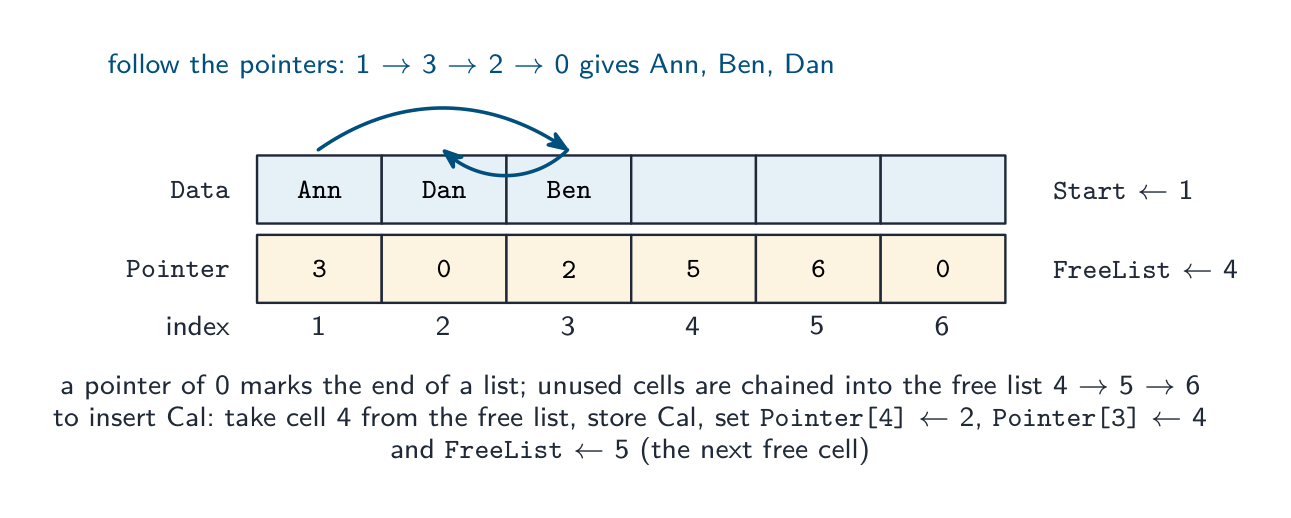
Lista enlazada: una secuencia de nodos, cada uno conteniendo un dato y un puntero al siguiente nodo; un puntero de inicio indica el primer nodo y un puntero nulo (0 o $-1$) termina la lista. En una implementación con array, dos arrays paralelos contienen los datos y los punteros, y las celdas sin usar se encadenan en una lista libre para que una inserción sepa dónde colocar el nuevo nodo.
FUNCTION FindInList(Target : STRING) RETURNS INTEGER   // index, or 0 if absent
    DECLARE Current : INTEGER
    Current ← Start
    WHILE Current <> 0
        IF Data[Current] = Target THEN
            RETURN Current
        ENDIF
        Current ← Pointer[Current]
    ENDWHILE
    RETURN 0
ENDFUNCTION
Para insertar en una lista ordenada: tome la primera celda libre (NewNode ← FreeList, FreeList ← Pointer[FreeList]), almacene el elemento, luego recorra la lista con un Previous y un Current puntero hasta Data[Current] > Item o el final; establezca Pointer[NewNode] ← Current y Pointer[Previous] ← NewNode (o Start ← NewNode si va primero). Para eliminar, reenlace el nodo anterior pasando por encima del eliminado y devuelva la celda a la lista libre.
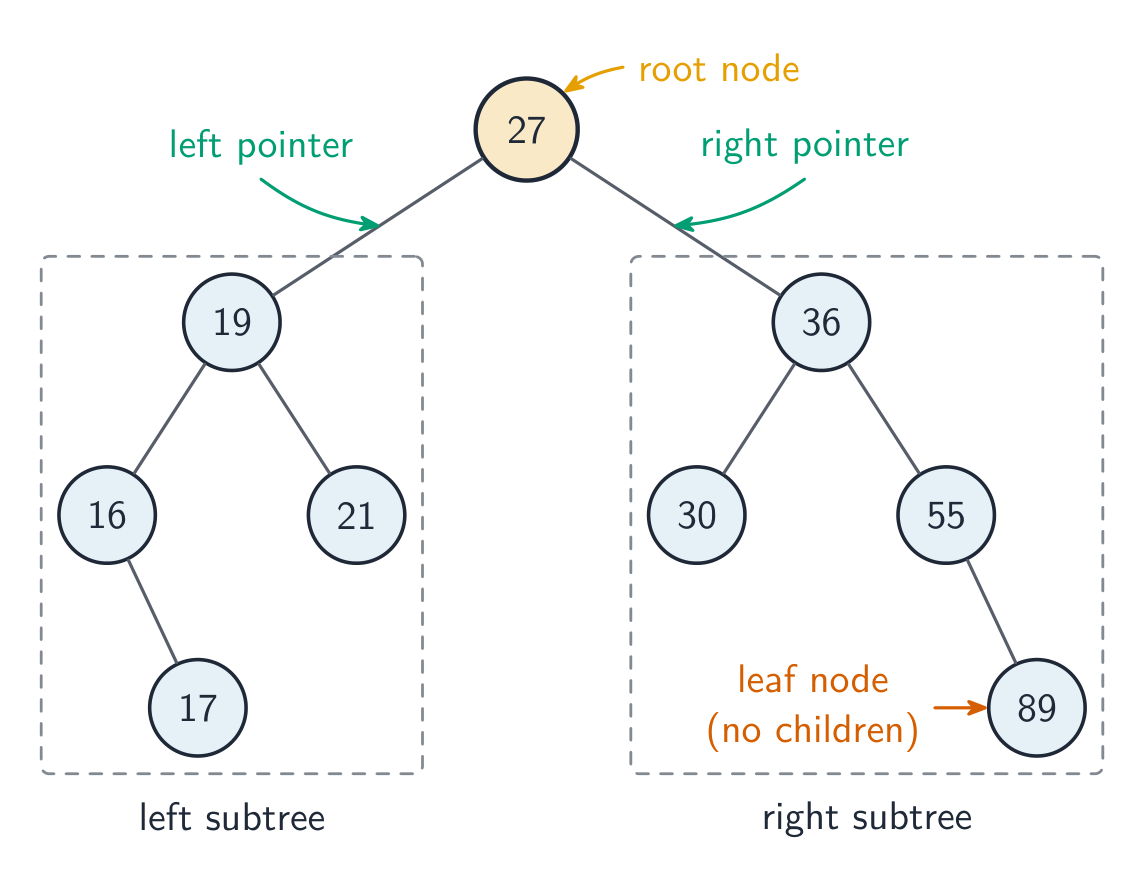
Árbol binario: un nodo raíz, cada nodo contiene datos, un puntero izquierdo hacia un subárbol de valores menores y un puntero derecho hacia un subárbol de valores mayores. Implementado como una matriz 2D (o tres matrices 1D) Tree[Index, 0..2] para puntero izquierdo, datos, puntero derecho, con un puntero raíz y un puntero siguiente-libre.
FUNCTION FindInTree(Target : INTEGER) RETURNS INTEGER   // index, or -1
    DECLARE Current : INTEGER
    Current ← Root
    WHILE Current <> -1
        IF Tree[Current, 1] = Target THEN
            RETURN Current
        ENDIF
        IF Target < Tree[Current, 1] THEN
            Current ← Tree[Current, 0]      // go left
        ELSE
            Current ← Tree[Current, 2]      // go right
        ENDIF
    ENDWHILE
    RETURN -1
ENDFUNCTION
Para insertar: almacene el elemento en el siguiente nodo libre con ambos punteros $-1$; si el árbol está vacío, hágalo raíz; de lo contrario, baje desde la raíz, yendo a la izquierda o derecha por comparación, hasta que el puntero que seguiría sea $-1$, y establezca ese puntero al nuevo nodo. Un ADT a partir de otro ADT: una pila es una lista enlazada donde push y pop funcionan ambos al inicio; una cola es una lista enlazada con un puntero de inicio y uno de fin; una cola puede hacerse de dos pilas (apilar en una, desapilar de la otra, moviendo todo a través cuando la segunda está vacía); los nodos de un árbol binario son registros u objetos vinculados por punteros, por lo que se construyen a partir de una estructura enlazada de nodos. Diga qué operaciones del nuevo ADT mapean sobre qué operaciones del antiguo.
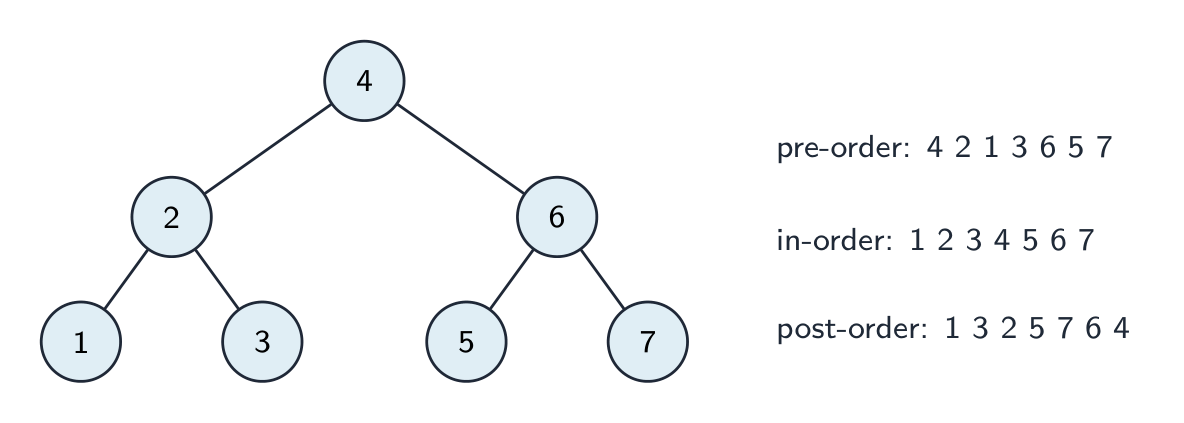
La primera figura muestra un árbol de búsqueda binaria: cada nodo tiene hasta dos nodos hijos, los valores menores que un nodo van a su izquierda y los mayores van a su derecha. La segunda figura muestra las tres formas de recorrer un árbol.
Vocabulario
Entrenar
| English | Español |
|---|---|
| linked list/lɪŋkt lɪst/ | lista enlazada |
| in place/ɪn pleɪs/ | in situ |
| stack/stæk/ | Pila |
| queue/kjuː/ | cola |
| node/nəʊd/ | nodo |
| pointers/ˈpɔɪntəz/ | punteros |
| binary tree/ˈbaɪnəri triː/ | Árbol binario |
| dictionary/ˈdɪkʃənəri/ | diccionario |
| circular queue/ˈsɜːkjʊlə kjuː/ | cola circular |
| free list/friː lɪst/ | lista libre |
| time complexity/taɪm kəmˈpleksɪti/ | Complejidad temporal |
| Big-O notation/bɪɡ əʊ nəʊˈteɪʃn/ | notación O grande |
| space complexity/speɪs kəmˈpleksɪti/ | Complejidad espacial |
19.1
Comparando algoritmos
Complejidad temporal
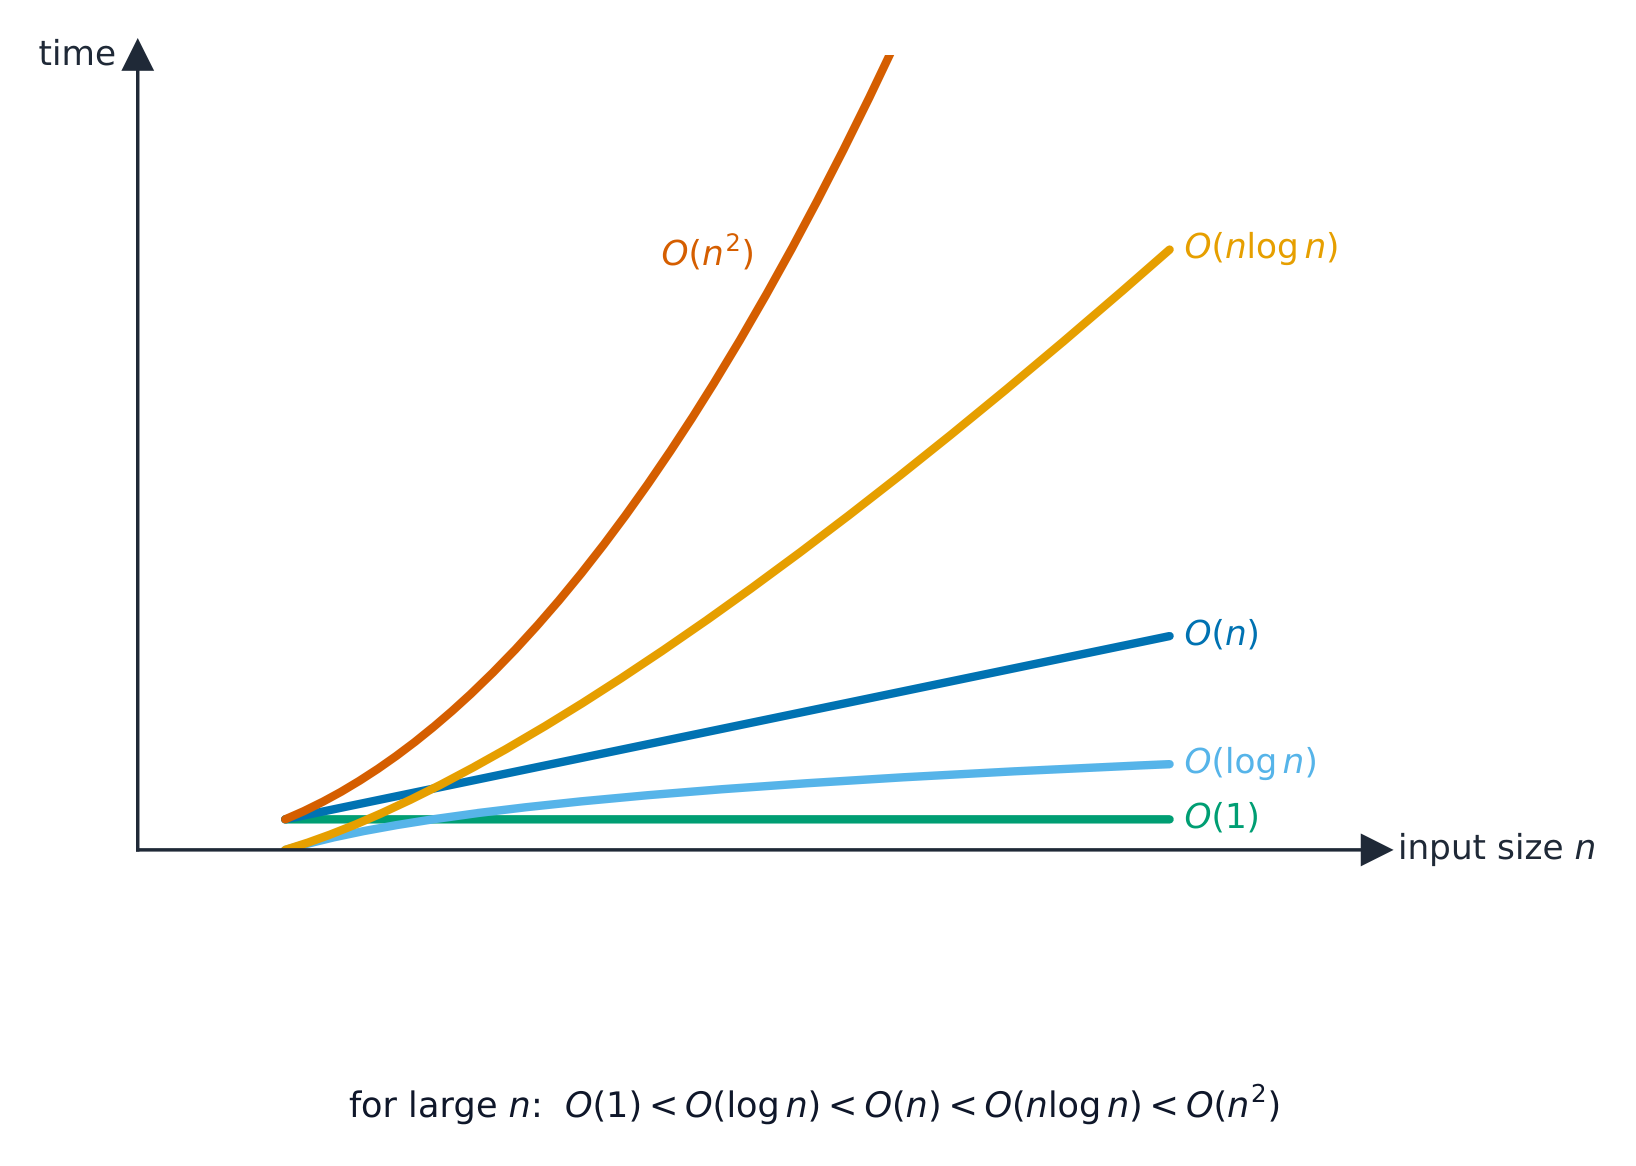
Complejidad temporal es cómo crece el tiempo de ejecución con el tamaño de entrada $n$, escrito en notación Big-OO (el término dominante): O(1) constante, O($\log n$) búsqueda binaria, O($n$) búsqueda lineal, O($n \log n$) buenos algoritmos de ordenamiento, O($n^{2}$) ordenamiento burbuja/inserción. Un orden menor es mejor a gran escala, incluso si otro algoritmo es más rápido para entradas pequeñas $n$.
Para ilustrarlo: para ordenar un millón de elementos, un ordenamiento $O(n \log n)$ termina en una fracción de segundo, mientras que un ordenamiento $O(n^{2})$ puede tardar minutos.
Ejemplo resuelto. Una lista ordenada contiene $1000$ elementos. ¿Cuántas comparaciones necesita cada búsqueda en el peor caso?
Una búsqueda lineal revisa los elementos uno por uno, por lo que puede necesitar hasta $1000$ comparaciones —esto es $O(n)$. Una búsqueda binaria reduce la lista a la mitad en cada paso, por lo que necesita como máximo $\lceil \log_2 1000 \rceil = 10$ comparaciones —esto es $O(\log n)$. Duplicar la lista a $2000$ elementos añade solo una comparación a la búsqueda binaria, pero hasta otra $1000$ a la búsqueda lineal —por eso el orden de crecimiento, no la velocidad bruta, decide el ganador a gran escala.
Describir un orden. O(1): el tiempo es constante, independientemente del número de elementos (insertar en una pila, leer un elemento de un arreglo). O($\log n$): el tiempo crece con el logaritmo del número de elementos, por lo que duplicar los datos añade solo un paso adicional fijo (búsqueda binaria). O($n$): el tiempo crece en proporción al número de elementos (búsqueda lineal, una pasada por una lista). O($n \log n$): algo peor que lineal (ordenaciones eficientes). O($n^{2}$): el tiempo crece con el cuadrado del número de elementos, por lo que duplicar los datos cuadruplica el tiempo (ordenaciones de burbuja y por inserción). «Indica el orden Big O de una búsqueda binaria de Names[0:99]» se responde con $O(\log n)$, y «describe su significado» como se indicó antes; Big O mide cómo escala el tiempo o la memoria, no el tiempo real.
Ejemplo resuelto (el orden de un fragmento de código). Indica la complejidad temporal de cada fragmento, donde n es el número de elementos.
// Fragment A
FOR i ← 1 TO n
    FOR j ← 1 TO n
        Total ← Total + Grid[i, j]
    NEXT j
NEXT i

// Fragment B
Count ← 0
WHILE n > 1
    n ← n DIV 2
    Count ← Count + 1
ENDWHILE

// Fragment C
FOR i ← 1 TO n
    Total ← Total + A[i]
NEXT i
FOR i ← 1 TO n
    OUTPUT A[i] / Total
NEXT i
A es $O(n^{2})$: la instrucción interna se ejecuta $n$ veces por cada una de las $n$ pasadas externas, $n \times n$ en total. B es $O(\log n)$: $n$ se reduce a la mitad en cada pasada, por lo que el bucle se ejecuta aproximadamente $\log_2 n$ veces (para $n = 64$, seis pasadas). C es $O(n)$: dos bucles uno después del otro requieren $n + n = 2n$ pasos, y se omiten las constantes. La regla: los bucles anidados multiplican, los bucles en secuencia suman y solo se conserva el término que crece más rápido, por lo que $3n^{2} + 5n + 2$ es $O(n^{2})$.
Complejidad espacial
Complejidad espacial es la memoria adicional necesaria. El ordenamiento burbuja y por inserción usan O(1) extra (in situ); el ordenamiento por fusión usa O($n$); la recursión usa memoria de pila proporcional a su profundidad. A menudo existe un compromiso entre tiempo y memoria.
Otros criterios
Simplicidad (más fácil de programar y mantener), estabilidad y adaptabilidad (más rápido con datos casi ordenados). El algoritmo adecuado depende de los datos y las restricciones.
Explorar
Cómo crece el tiempo de ejecución con n
Desliza n hacia arriba y compara las curvas: O(1) y O(log n) permanecen casi planas, O(n) sube constantemente, O(n²) explota. Por eso Big-O —no un cronómetro— es cómo comparamos algoritmos en entradas grandes.
Explorar
Crecimiento Big-O
Cambia el tamaño de entrada n y compara qué tan rápido crece el trabajo de cada algoritmo: la idea detrás de la complejidad temporal.
19.2
Recursión
Syllabus
| Los candidatos deben ser capaces de: | Notas y orientación |
|---|---|
| Demostrar comprensión de la recursión | Características esenciales de la recursión Cómo se expresa la recursión en un lenguaje de programación Escribir y rastrear algoritmos recursivos Cuándo es ventajoso el uso de la recursión |
| Demostrar conocimiento de lo que debe hacer un compilador para traducir código de programación recursivo | Uso de pilas (stacks) y desenrollado (unwinding) |
Fuente: Plan de estudios Cambridge International

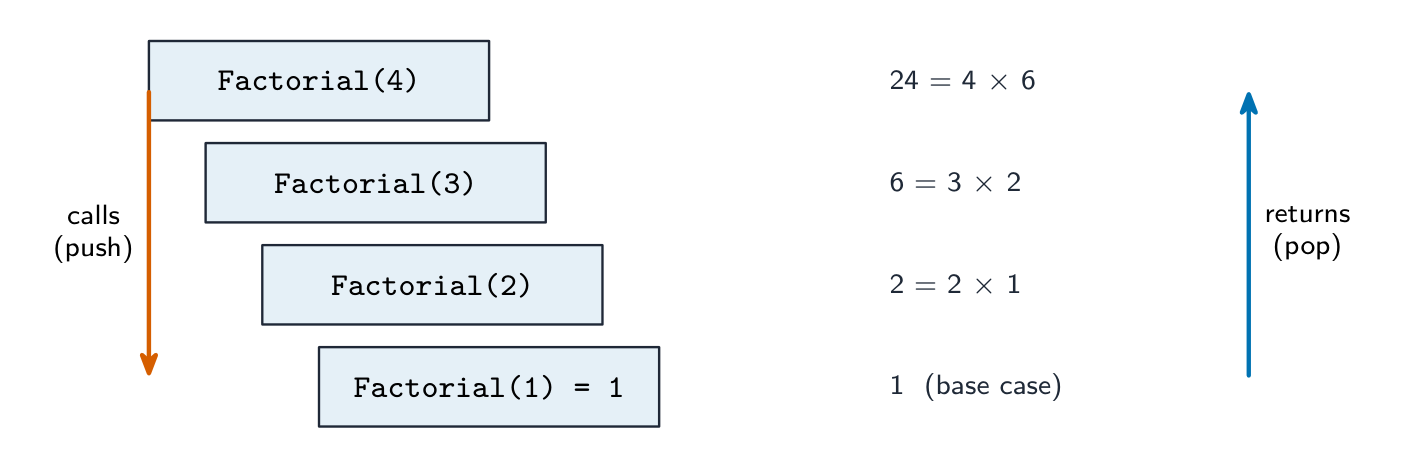
Algoritmos recursivos usan recursión: la rutina se llama a sí misma con una versión más pequeña del mismo problema, hasta que un caso base termina la cadena. Tiene dos partes: el caso base (lo suficientemente pequeño para resolverse directamente — sin él la recursión nunca se detiene) y el caso recursivo (reducir la entrada y llamarse a sí misma).
Factorial:
FUNCTION Factorial(n : INTEGER) RETURNS INTEGER
    IF n = 0 OR n = 1 THEN
        RETURN 1
    ELSE
        RETURN n * Factorial(n - 1)
    ENDIF
ENDFUNCTION
La recursión es natural para problemas autosimilares: árboles, dividir y vencerás (búsqueda binaria, ordenamiento por fusión) y datos anidados. Cuando es una mala opción, un bucle suele ser más limpio.
«Describe qué se entiende por recursión» (dos puntos). Una función o procedimiento definido en términos de sí mismo: se llama a sí mismo desde su propio cuerpo, cada vez con una versión más pequeña del problema, hasta llegar a un caso base. «Indica tres características esenciales de la recursión»: (1) un caso base (condición de parada) que devuelve un valor sin otra llamada; (2) un caso general en el que la rutina se llama a sí misma; (3) cada llamada acerca el problema al caso base (se reduce el parámetro), de modo que la recursión termina. Algunos esquemas añaden: los valores se devuelven al desapilarse las llamadas.
«Describe cuándo es beneficioso utilizar la recursión y da un ejemplo». Cuando el problema se define de forma natural en términos de versiones más pequeñas de sí mismo, de modo que la solución recursiva es más corta, clara y cercana a la definición matemática que un bucle: un factorial o un número de Fibonacci, una búsqueda binaria, el recorrido de un árbol binario, la ordenación por mezcla o la ordenación rápida, y el procesamiento de estructuras anidadas, como carpetas dentro de carpetas. Es una mala elección cuando la profundidad es grande (la pila puede desbordarse) o cuando se calcula el mismo subproblema muchas veces (Fibonacci recursivo simple).
Rastrear una llamada recursiva
Para Factorial(4): las llamadas bajan hasta Factorial(1)=1, luego el desenrollado multiplica hacia arriba: 2*1=2, 3*2=6, 4*6=24. Resultado final 24. Rastrea cada llamada pendiente en una pila.
Ejemplo resuelto. La función siguiente se presenta sin explicación. Rastrea Unknown(3, 5) e indica su salida y valor de retorno.
FUNCTION Unknown(BYVAL X, BYVAL Y : INTEGER) RETURNS INTEGER
    IF X < Y THEN
        OUTPUT X + Y
        RETURN Unknown(X + 1, Y - 1) + 1
    ELSE
        RETURN 0
    ENDIF
ENDFUNCTION
Llamada 1: $X = 3, Y = 5$: $3 < 5$, produce 8, llama a Unknown(4, 4). Llamada 2: $4 < 4$ es falso, devuelve 0. Desenrollado: la llamada 1 retorna $0 + 1 = 1$. Produce 8, valor de retorno 1. Escribe el trazado como una tabla con una fila por llamada (parámetros, condición, salida, qué retorna), y haz los retornos desde la llamada más profunda hacia arriba: eso es lo que busca la rúbrica de corrección en el desenrollado.
Ejemplo resuelto (Fibonacci). Fib(n) retorna n cuando n < 2, de lo contrario Fib(n - 1) + Fib(n - 2). Encuentra Fib(5).
Fib(5) = Fib(4) + Fib(3); Fib(4) = Fib(3) + Fib(2); Fib(3) = Fib(2) + Fib(1); Fib(2) = Fib(1) + Fib(0) = 1 + 0 = 1. Por lo tanto Fib(3) = 1 + 1 = 2, Fib(4) = 2 + 1 = 3, Fib(5) = 3 + 2 = 5. El caso base se alcanza muchas veces (Fib(2) se calcula tres veces), por lo que esta versión es lenta: realiza 15 llamadas para $n = 5$ y duplica aproximadamente las llamadas por cada aumento en $n$.
Conversión de recursión a iteración. Cada rutina recursiva puede reescribirse con un bucle, que usa menos memoria y es más rápida: mantén un resultado acumulativo y itera desde el caso base hacia arriba. Factorial como bucle:
FUNCTION Factorial(N : INTEGER) RETURNS INTEGER
    DECLARE Result, Count : INTEGER
    Result ← 1
    FOR Count ← 2 TO N
        Result ← Result * Count
    NEXT Count
    RETURN Result
ENDFUNCTION
Se te pide cambiar un ordenamiento por inserción recursivo o una búsqueda recursiva en uno iterativo; reemplaza la auto-llamada con un bucle sobre el índice que la recursión estaba avanzando, y convierte el caso base en la condición de salida del bucle.
Riesgos
- recursión infinita si se omite el caso base: falla con un desbordamiento de pila.
- alto uso de memoria para recursión profunda.
- lento si repite trabajo (Fibonacci ingenuo es exponencial: use un bucle o memorización).
Explorar
La recursión se desenrolla desde las hojas hacia arriba
Paso a paso fib(4) en el orden en que realmente terminan las llamadas: las hojas (casos base) se resuelven primero, luego cada padre combina sus hijos. Observa que fib(2) se calcula dos veces — ese trabajo repetido es por qué la recursión ingenua es lenta.
Vocabulario
Entrenar
| English | Español |
|---|---|
| recursion/rɪˈkɜːʃn/ | recursión |
| call stack/kɔːl stæk/ | Pila de llamadas |
| base case/beɪs keɪs/ | Caso base |
| recursive case/rɪˈkɜːsɪv keɪs/ | Caso recursivo |
| factorial/fækˈtɔːrɪəl/ | factorial |
| divide-and-conquer/dɪˈvaɪd ænd ˈkɒŋkə/ | dividir y vencerás |
| general case/ˈdʒenərəl keɪs/ | caso general |
| parameters/pəˈræmɪtəz/ | parámetros |
| stack overflow/stæk ˌəʊvəˈfləʊ/ | Desbordamiento de pila |
| memoisation/ˌmeməʊaɪˈzeɪʃn/ | Memización |
| local variables/ˈləʊkl ˈveərɪəblz/ | variables locales |
| stack frame/stæk freɪm/ | Marco de pila |
| return address/rɪˈtɜːn əˈdres/ | dirección de retorno |
19.2
Qué hace el compilador para el código recursivo
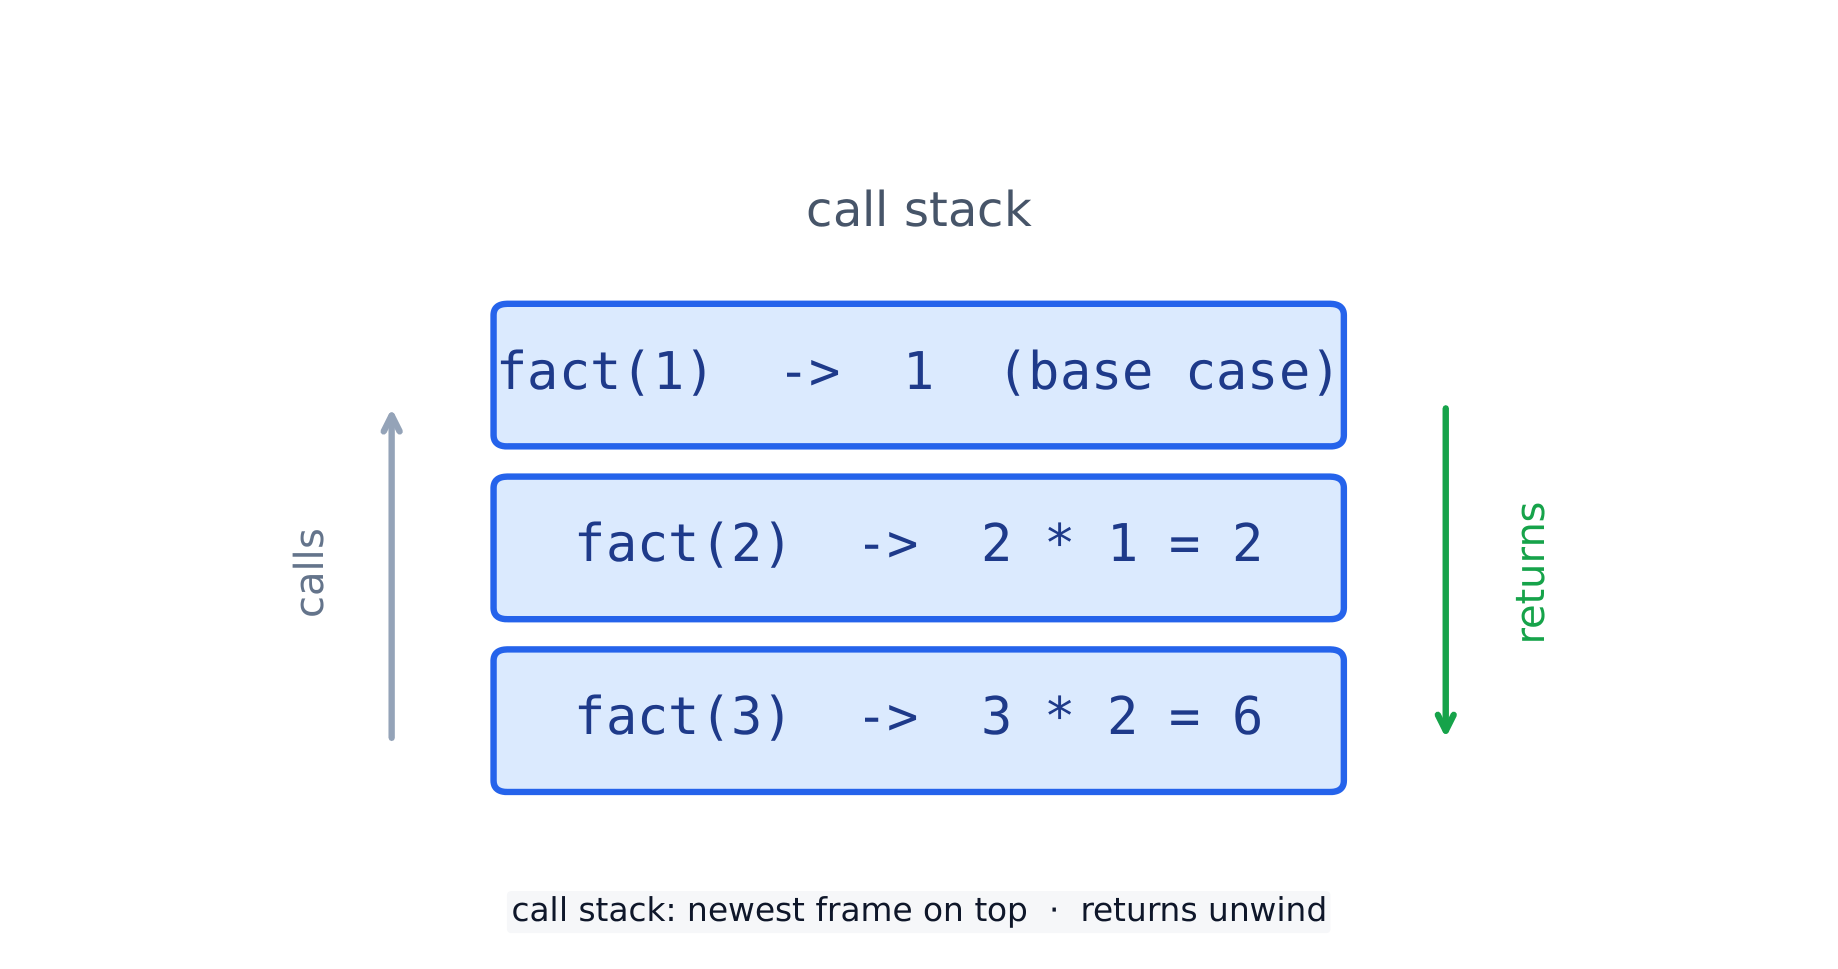
La recursión necesita que cada llamada tenga su propia copia de sus parámetros y variables locales. El compilador mantiene estos en la pila de llamadas. Para cada llamada, empuja un marco de pila que contiene los parámetros, las variables locales y la dirección de retorno (dónde continuar en el llamado). Cuando la función retorna, se devuelve el valor, se elimina el marco y el control continúa en la dirección de retorno.
Como cada llamada tiene su propio marco, las llamadas recursivas no sobrescriben las variables de las demás. La pila puede crecer mucho con una recursión profunda, por lo que una recursión muy profunda puede desbordarla. Este es el mismo mecanismo de llamada y retorno que se utiliza para las llamadas ordinarias (no recursivas): no existe un «mecanismo de recursión» especial.
«Explica por qué una pila es adecuada para implementar la recursión» (tres puntos). Cada llamada recursiva debe guardar su dirección de retorno, sus parámetros y sus variables locales, y las llamadas se completan en el orden inverso al que se hicieron (la última llamada realizada es la primera en terminar), que es precisamente el comportamiento último en entrar, primero en salir de una pila: cada nueva llamada apila un marco y cada retorno desapila el marco más reciente, restaurando el estado de quien llamó e indicando dónde continuar. Esta es la tarea del compilador cuando traduce código recursivo: genera la operación de apilar un marco en cada llamada y la de desapilarlo en cada retorno, y los marcos se desapilan a medida que regresan los resultados.
19.2
Definiciones aceptadas por el examinador
Una pregunta de definición se califica según un texto fijo. Aprende estas definiciones exactamente, y da solo una respuesta.
| Término | Definición |
|---|---|
| búsqueda lineal | revisar cada elemento sucesivamente desde el inicio hasta encontrar el objetivo o llegar al final |
| búsqueda binaria | comparar repetidamente el objetivo con el elemento medio de una lista ordenada y descartar la mitad que no puede contenerlo |
| ordenamiento burbuja | pasar repetidamente por la lista, intercambiando elementos adyacentes en orden incorrecto, hasta que un paso no realice intercambios |
| ordenamiento por inserción | tomar cada elemento sucesivamente e insertarlo en su lugar correcto entre los elementos ya ordenados |
| tipo de dato abstracto | una colección de datos y las operaciones que se pueden realizar sobre ella, definida independientemente de cómo se almacena |
| pila | una estructura último-en-entrar-primer-salir con empuje y elimine en la parte superior |
| cola | una estructura primer-en-entrar-primer-salir con elementos añadidos en la parte trasera y eliminados de la parte delantera |
| lista encadenada | una secuencia de nodos, cada uno guardando datos y un puntero al siguiente nodo, con un puntero de inicio |
| árbol binario | nodos que guardan datos y punteros a un subárbol izquierdo de valores menores y un subárbol derecho de valores mayores |
| notación Big O | una forma de clasificar el tiempo (o memoria) que necesita un algoritmo según cómo crece con el tamaño de la entrada |
| recursión | una rutina que se llama a sí misma con una versión más pequeña del problema hasta que un caso base detiene las llamadas |
| caso base | la condición bajo la cual una rutina recursiva retorna sin llamarse a sí misma |
| desenrollado | los retornos de una cadena de llamadas recursivas, desde la llamada más profunda hasta la primera, conforme se eliminan los marcos de pila |
19.2
Consejos para el examen
- Búsquedas: la lineal no requiere orden y es O($n$); la binaria requiere un array ordenado, reduce a la mitad cada vez y es O($\log n$). Conoce ambos algoritmos de memoria, incluyendo los límites y la bandera.
- Ordenamientos: burbuja con una bandera de intercambio, inserción con una clave que desplaza elementos mayores a la derecha; ambos son O($n^{2}$) en el peor caso, O($n$) en datos ordenados. El rendimiento depende de la cantidad de elementos y de cuán ordenados estén.
- Implementaciones de TDA son seguimiento de punteros: un puntero superior; frontal, trasero y contador con MOD; inicio, punteros y una lista libre; raíz con punteros izquierdo y derecho. Siempre verifica si está llena y vacía.
- Big O trata del escalado: constante, logarítmico, lineal, cuadrático. Para una búsqueda binaria, indica «duplicar los datos añade una comparación».
- Recursión: caso base, caso general, progreso hacia el caso base; beneficioso cuando el problema se define en términos de sí mismo; una pila guarda las direcciones de retorno y variables porque las llamadas retornan en orden inverso. Haz trazado con una tabla y desenrolla desde la llamada más profunda.
Errores comunes
- Escribir $O(2n)$ o $O(n^{2} + n)$: elimina las constantes y los términos menores, para obtener $O(n)$ y $O(n^{2})$.
- Calcular el índice central como $(Lower + Upper) / 2$ en una traza: la versión del examen usa
DIV, así que redondea hacia abajo. - Usar una búsqueda binaria en datos no ordenados, o en una lista encadenada; y establecer
Lower ← MiddleIndexen lugar deMiddleIndex + 1, lo cual causa un bucle infinito. - Un bucle interno de ordenamiento burbuja que recorre hasta el final del array en cada paso, o un intercambio sin una variable temporal.
- Un empuje o enqueue que no prueba si está lleno, o un elimine o dequeue que no prueba si está vacío.
- Mover el puntero frontal de la cola sin usar MOD en una cola circular, o tratar front = rear como siempre significar vacío.
- Insertar en una lista encadenada desplazando el contenido del array; solo cambian los punteros.
- Una función recursiva sin caso base, o cuyo llamado recursivo no hace el problema más pequeño.
- Hacer trazado de una llamada recursiva pero olvidar añadir el trabajo pendiente en el camino de regreso hacia arriba.
- Responder «por qué una pila» con «porque es rápida»; la razón es el orden último en entrar, primero en salir de los retornos.
Lecciones interactivas sobre este tema
Trátalo paso a paso, con ejercicios de verificación instantánea.