| Thí sinh cần có thể: | Ghi chú và hướng dẫn |
|---|---|
| Thể hiện sự hiểu biết về phương pháp linear search và binary search. | Viết thuật toán để thực hiện linear search. Viết thuật toán để thực hiện binary search. Các điều kiện cần thiết để sử dụng binary search. Hiệu suất của binary search thay đổi theo số lượng mục dữ liệu như thế nào. |
| Thể hiện sự hiểu biết về phương pháp insertion sort và bubble sort. | Viết thuật toán để thực hiện insertion sort. Viết thuật toán để thực hiện bubble sort. Hiệu suất của một thủ tục sắp xếp có thể phụ thuộc vào thứ tự ban đầu của dữ liệu và số lượng mục dữ liệu. |
| Thể hiện sự hiểu biết và sử dụng Abstract Data Types (ADT). | Viết thuật toán để tìm kiếm một mục trong mỗi cấu trúc sau: linked list, binary tree. Viết thuật toán để chèn một mục vào mỗi cấu trúc sau: stack, queue, linked list, binary tree. Viết thuật toán để xóa một mục khỏi mỗi cấu trúc sau: stack, queue, linked list. Thể hiện sự hiểu biết rằng một graph là một ví dụ về ADT. Mô tả các đặc điểm chính của một graph và biện giải việc sử dụng nó cho một tình huống cụ thể. thí sinh không yêu cầu viết mã cho cấu trúc graph. |
| Thể hiện cách mà các ADTs có thể được triển khai từ một ADT khác. | Mô tả các ADT sau và chứng minh cách chúng có thể được triển khai từ các kiểu dựng sẵn hoặc các ADT phù hợp: stack, queue, linked list, dictionary, binary tree. |
| Thể hiện sự hiểu biết rằng các thuật toán khác nhau thực hiện cùng một tác vụ có thể được so sánh bằng các tiêu chí (ví dụ: thời gian hoàn thành tác vụ và bộ nhớ sử dụng). | Bao gồm cả việc sử dụng Big O notation để chỉ định độ phức tạp về thời gian và không gian. |
Tư duy tính toán và giải quyết vấn đề
Khoa học máy tính A-Level · Chủ đề 19
 15:32
Tìm kiếm & Sắp xếp
Sổ điện thoại với một triệu tên. Nếu bạn kiểm tra từng cái một, bạn có thể thực hiện một triệu phép so sánh. Nhưng bạn đã biết mẹo rồi: mở nó ở giữa…
Thuyết minh tiếng Anh · Có thể chuyển đổi phụ đề tiếng Anh và tiếng Trung
19.1
Các thuật toán tìm kiếm
Chương trình
Nguồn: Chương trình Cambridge International
Một phép tìm kiếm tìm một giá trị đích trong một tập hợp (thường là một mảng) và trả về vị trí của nó, hoặc “không tìm thấy”.
Tìm kiếm tuyến tính
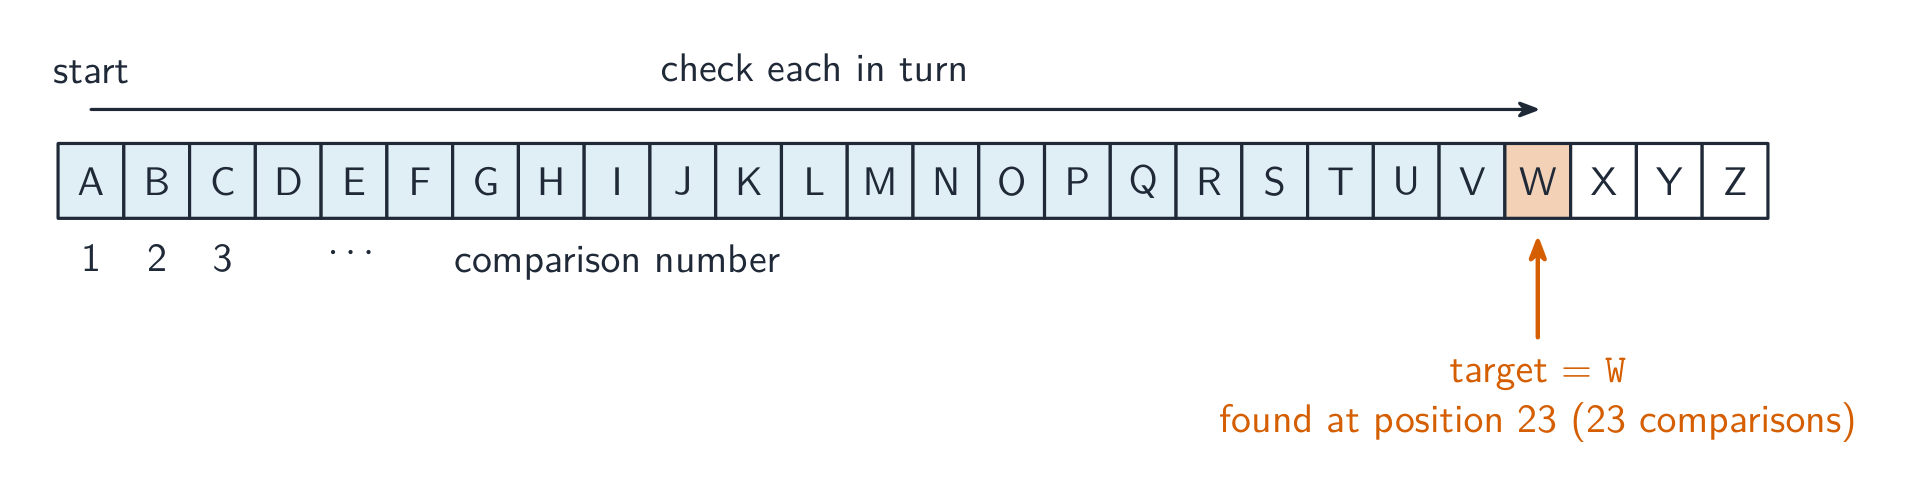
A linear search walks from start to end, comparing each element with the target:
FOR i ← 1 TO n
    IF A[i] = target THEN
        RETURN i
    ENDIF
NEXT i
RETURN -1   // not found
Không cần chuẩn bị nên phương pháp này hoạt động trên mọi danh sách. Trường hợp xấu nhất là O($n$) (giá trị đích ở cuối hoặc không có); trường hợp tốt nhất cần 1 phép so sánh. Dùng cho dữ liệu chưa sắp xếp hoặc danh sách nhỏ. (Giá trị -1 được trả về là một giá trị lính canh — một vị trí không thể có, mang nghĩa “không tìm thấy”; đoạn mã gọi kiểm tra IF result = -1.)
Phiên bản kỳ thi. Bài 3 yêu cầu bạn hoàn thành một thuật toán tìm kiếm tuyến tính được viết với biến cờ và vòng lặp WHILE, và Bài 4 yêu cầu viết một hàm trả về chỉ số hoặc một đếm. Cả hai đều trông giống như thế này:
FUNCTION LinearSearch(Data : ARRAY OF INTEGER, Target : INTEGER) RETURNS INTEGER
    DECLARE Index, Count : INTEGER
    Count ← 0
    FOR Index ← 1 TO 100
        IF Data[Index] = Target THEN
            Count ← Count + 1
        ENDIF
    NEXT Index
    RETURN Count          // how many times Target occurs; 0 means not found
ENDFUNCTION
Để dừng lại ở trùng khớp đầu tiên thay vì vậy, hãy sử dụng vòng lặp WHILE Index <= 100 AND NOT Found thiết lập Found ← TRUE và ghi nhớ chỉ số. Điểm số dành cho vòng lặp qua mọi phần tử, phép so sánh, và những gì được trả về khi giá trị không tồn tại.
Tìm kiếm nhị phân
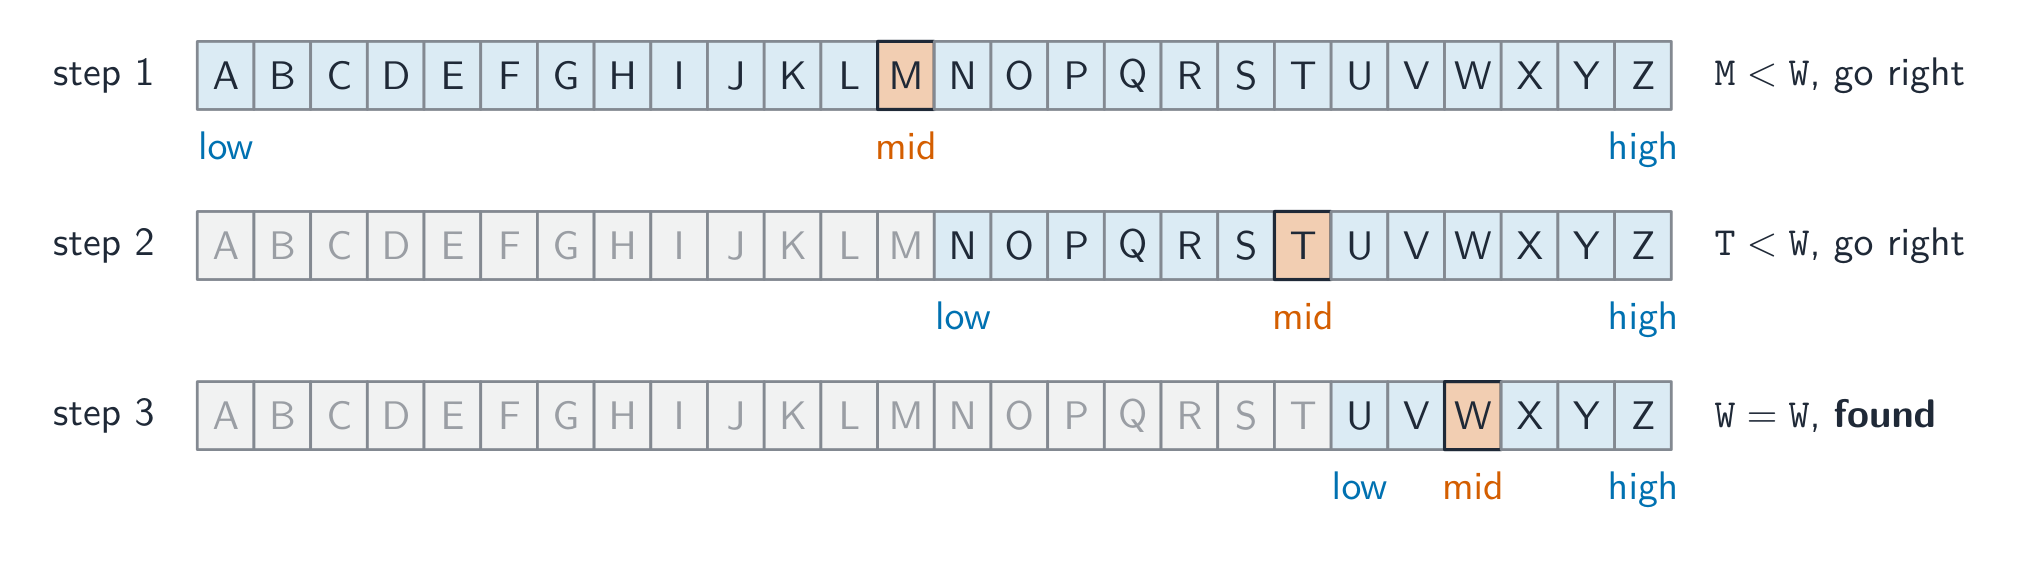
A binary search needs the data sorted. Look at the middle element; if it is the target, done; if the target is smaller, search the left half, else the right half — halving the range each time:
low ← 1
high ← n
WHILE low <= high DO
    MiddleIndex ← (low + high) DIV 2
    IF A[MiddleIndex] = target THEN
        RETURN MiddleIndex
    ENDIF
    IF A[MiddleIndex] < target THEN
        low ← MiddleIndex + 1
    ELSE
        high ← MiddleIndex - 1
    ENDIF
ENDWHILE
RETURN -1
Trường hợp xấu nhất O($\log_{2} n$) — đối với một triệu phần tử, khoảng 20 phép so sánh. Nhanh hơn nhiều so với tìm kiếm tuyến tính trên mảng lớn đã sắp xếp, nhưng bạn phải sắp xếp trước (một chi phí một lần O($n \log n$)), đáng giá nếu bạn tìm kiếm nhiều lần.
“Nêu điều kiện cần thiết để tìm kiếm nhị phân.” Dữ liệu phải có thứ tự (được sắp xếp tăng dần hoặc giảm dần theo khóa đang tìm). “Mô tả cách thực hiện tìm kiếm nhị phân” (ba điểm): (1) tìm phần tử ở giữa danh sách (hoặc phạm vi hiện tại) và so sánh với giá trị đích; (2) nếu khớp thì kết thúc tìm kiếm; nếu giá trị đích nhỏ hơn, lặp lại trên nửa dưới, nếu lớn hơn thì trên nửa trên; (3) tiếp tục chia đôi phạm vi cho đến khi tìm thấy phần tử hoặc phạm vi rỗng, nghĩa là phần tử không tồn tại.
Phiên bản kỳ thi, với các cận và một biến cờ, là thứ bạn phải sao chép lại khi được yêu cầu hoàn thành thuật toán:
DECLARE Lower, Upper, MiddleIndex : INTEGER
DECLARE Found : BOOLEAN
Lower ← 0
Upper ← 99
Found ← FALSE
WHILE Lower <= Upper AND NOT Found
    MiddleIndex ← (Lower + Upper) DIV 2
    IF Names[MiddleIndex] = Target THEN
        Found ← TRUE
    ELSE
        IF Names[MiddleIndex] < Target THEN
            Lower ← MiddleIndex + 1
        ELSE
            Upper ← MiddleIndex - 1
        ENDIF
    ENDIF
ENDWHILE
IF Found THEN
    OUTPUT MiddleIndex
ELSE
    OUTPUT "Not found"
ENDIF
Ví dụ minh họa (lần vết tìm kiếm nhị phân). Names[0:9] chứa Ali, Ben, Cai, Dev, Eva, Fay, Gus, Hal, Ivy, Jo. Lần vết phiên bản trong đề thi cho Target = "Ivy", sau đó cho Target = "Cat", nêu Lower, Upper và MiddleIndex ở mỗi bước.
Với “Ivy”:
| Lower | Upper | MiddleIndex | Names[MiddleIndex] | Kết quả |
|---|---|---|---|---|
| 0 | 9 | 4 | Eva | Eva < Ivy, nên Lower ← 5 |
| 5 | 9 | 7 | Hal | Hal < Ivy, nên Lower ← 8 |
| 8 | 9 | 8 | Ivy | Found ← TRUE |
Đầu ra là 8, sau ba phép so sánh. Với “Cat”: phần tử giữa 4 (Eva > Cat, Upper ← 3); phần tử giữa 1 (Ben < Cat, Lower ← 2); middle 2 (Cai < Cat, Lower ← 3); middle 3 (Dev > Cat, Upper ← 2). Lúc này Lower (3) lớn hơn Upper (2), nên vòng lặp kết thúc và xuất “Not found” sau bốn phép so sánh, trường hợp xấu nhất với mười phần tử ($\lceil\log_2 10\rceil = 4$). DIV làm tròn xuống, nên giá trị giữa 0 và 9 là 4, không phải 4.5 hay 5. Các chuỗi được so sánh theo thứ tự bảng chữ cái (mã ký tự).
“Giải thích hiệu năng thay đổi như thế nào theo số lượng phần tử.” Mỗi phép so sánh giảm một nửa số phần tử còn lại, nên số phép so sánh tối đa xấp xỉ $\log_{2} n$: tăng gấp đôi kích thước danh sách chỉ thêm một phép so sánh. Đây là O($\log n$). “So sánh tìm kiếm tuyến tính và tìm kiếm nhị phân”: tìm kiếm tuyến tính cần tối đa $n$ phép so sánh (O($n$)) và trung bình bằng một nửa số đó, nhưng hoạt động trên dữ liệu chưa sắp xếp; tìm kiếm nhị phân cần tối đa $\log_{2} n$ phép so sánh (O($\log n$)) và nhanh hơn nhiều với danh sách lớn, nhưng dữ liệu trước hết phải được sắp xếp và phải cho phép truy cập trực tiếp đến phần tử giữa (mảng, không phải danh sách liên kết). Với $1000$ phần tử: $1000$ so với $10$ phép so sánh.
Khám phá
Tìm kiếm tuyến tính so với tìm kiếm nhị phân
Tìm kiếm một giá trị. Tìm kiếm nhị phân chia đôi danh sách ở mỗi bước (chỉ áp dụng trên dữ liệu đã sắp xếp); tìm kiếm tuyến tính kiểm tra từng phần tử một.
Từ vựng
Luyện tập
| English | Tiếng Việt |
|---|---|
| insertion sort/ɪnˈsɜːʃn sɔːt/ | sắp xếp chèn |
| bubble sort/ˈbʌbl sɔːt/ | sắp xếp nổi bọt |
| binary search/ˈbaɪnəri sɜːtʃ/ | tìm kiếm nhị phân |
| array/əˈreɪ/ | mảng |
| linear search/ˈlɪnɪə sɜːtʃ/ | tìm kiếm tuyến tính |
19.1
Các thuật toán sắp xếp
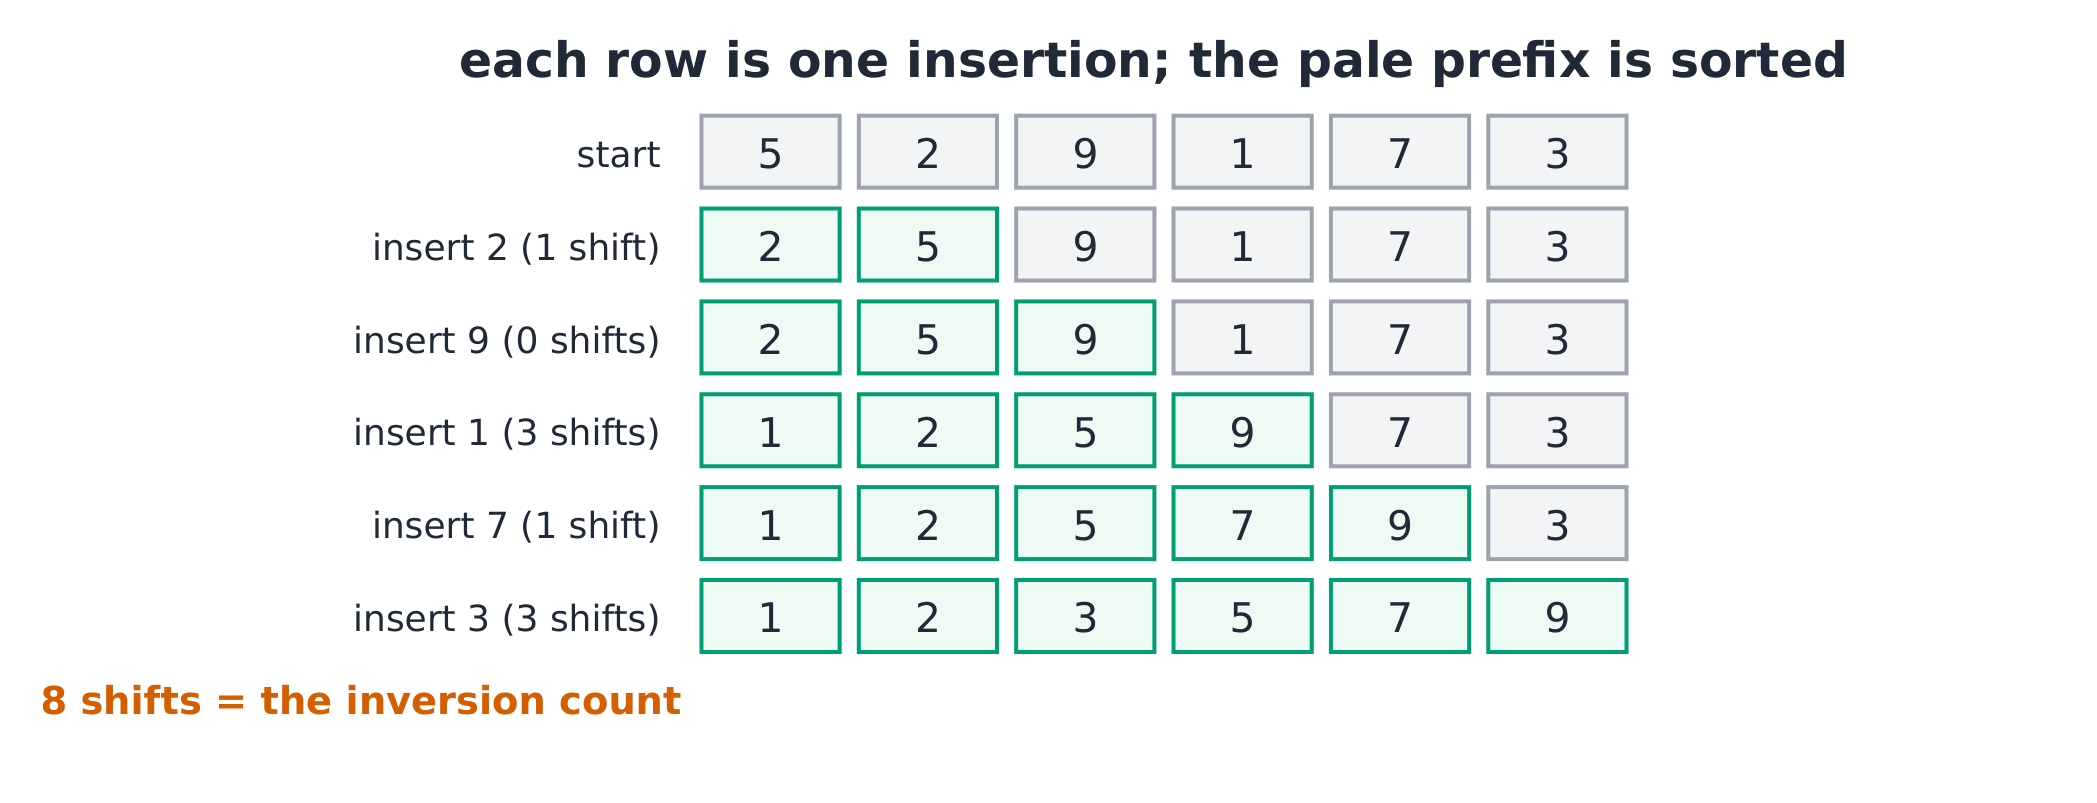
Sắp xếp bọt
Sắp xếp nổi bọt duyệt mảng nhiều lần, hoán đổi các cặp phần tử kề nhau sai thứ tự, để phần tử lớn nhất “nổi” về cuối sau mỗi lượt:
FOR pass ← 1 TO n - 1
    swapped ← FALSE
    FOR i ← 1 TO n - pass
        IF A[i] > A[i + 1] THEN
            temp ← A[i]
            A[i] ← A[i + 1]
            A[i + 1] ← temp
            swapped ← TRUE
        ENDIF
    NEXT i
    IF swapped = FALSE THEN      // already sorted
        EXIT FOR
    ENDIF
NEXT pass
Trường hợp tốt nhất O($n$) (đã sắp xếp, với việc thoát sớm); trung bình/xấu nhất O($n^{2}$). Đơn giản nhưng chậm đối với các $n$ lớn.
Sắp xếp chèn
Sắp xếp chèn xây dựng một đoạn đầu đã sắp xếp từ bên trái, chèn từng phần tử mới vào đúng vị trí bằng cách dịch các phần tử lớn hơn sang phải:
FOR i ← 2 TO n
    key ← A[i]
    j ← i - 1
    WHILE j >= 1 AND A[j] > key DO
        A[j + 1] ← A[j]
        j ← j - 1
    ENDWHILE
    A[j + 1] ← key
NEXT i
Trường hợp tốt nhất O($n$) (đã sắp xếp); xấu nhất O($n^{2}$). Tốt cho các mảng nhỏ hoặc gần như đã sắp xếp. Nó sắp xếp ngay tại chỗ và là ổn định (giữ nguyên thứ tự của các phần tử bằng nhau).
Theo dõi quá trình sắp xếp
Một nhiệm vụ thường gặp là hiển thị mảng sau mỗi lần lặp ngoài. Với [D, T, H, R] sắp xếp chèn: lần lặp 1 (chìa khóa T) không thay đổi; lần lặp 2 (chìa khóa H) → [D, H, T, R]; lần lặp 3 (chìa khóa R) → [D, H, R, T].
Phát triển (đếm số lượng đảo vị trí). Một đảo vị trí là
Cùng mảng đó khi dùng sắp xếp nổi bọt sẽ thay đổi khác: lượt 1 so sánh D/T (không đổi chỗ), T/H (đổi chỗ) và T/R (đổi chỗ), thu được [D, H, R, T] với phần tử lớn nhất ở cuối; lượt 2 không có lần đổi chỗ nào, nên cờ dừng quá trình sắp xếp. Hãy trình bày toàn bộ mảng sau mỗi lượt và đếm số phép so sánh nếu được yêu cầu: $3$ ở lượt 1 và $2$ ở lượt 2 (phiên bản trên dừng sớm hơn một vị trí sau mỗi lượt), tổng cộng $5$.
Tự viết thuật toán sắp xếp. Câu “Viết mã giả để sắp xếp DataArray[1:1000] theo thứ tự tăng dần” được trả lời bằng thuật toán sắp xếp nổi bọt hoàn chỉnh có cờ thoát sớm, hoặc thuật toán sắp xếp chèn, với khai báo và thụt lề đầy đủ; cả hai đều được điểm tối đa nếu hoạt động với mọi đầu vào:
DECLARE Pass, Index, Temp : INTEGER
DECLARE Swapped : BOOLEAN
Pass ← 1
REPEAT
    Swapped ← FALSE
    FOR Index ← 1 TO 1000 - Pass
        IF DataArray[Index] > DataArray[Index + 1] THEN
            Temp ← DataArray[Index]
            DataArray[Index] ← DataArray[Index + 1]
            DataArray[Index + 1] ← Temp
            Swapped ← TRUE
        ENDIF
    NEXT Index
    Pass ← Pass + 1
UNTIL Swapped = FALSE OR Pass = 1000
Để sắp xếp giảm dần, đổi > thành <; để sắp xếp các bản ghi hoặc một mảng 2 chiều theo một trường, hãy so sánh trường đó nhưng hoán đổi toàn bộ bản ghi (hoặc mọi cột). Khi được yêu cầu viết thuật toán sắp xếp chèn “thực hiện cùng nhiệm vụ” với một thuật toán sắp xếp nổi bọt cho trước, hãy giữ nguyên tên mảng và chiều sắp xếp, rồi viết lại thuật toán sắp xếp chèn ở trên, đảo chiều phép so sánh nếu thứ tự là giảm dần.
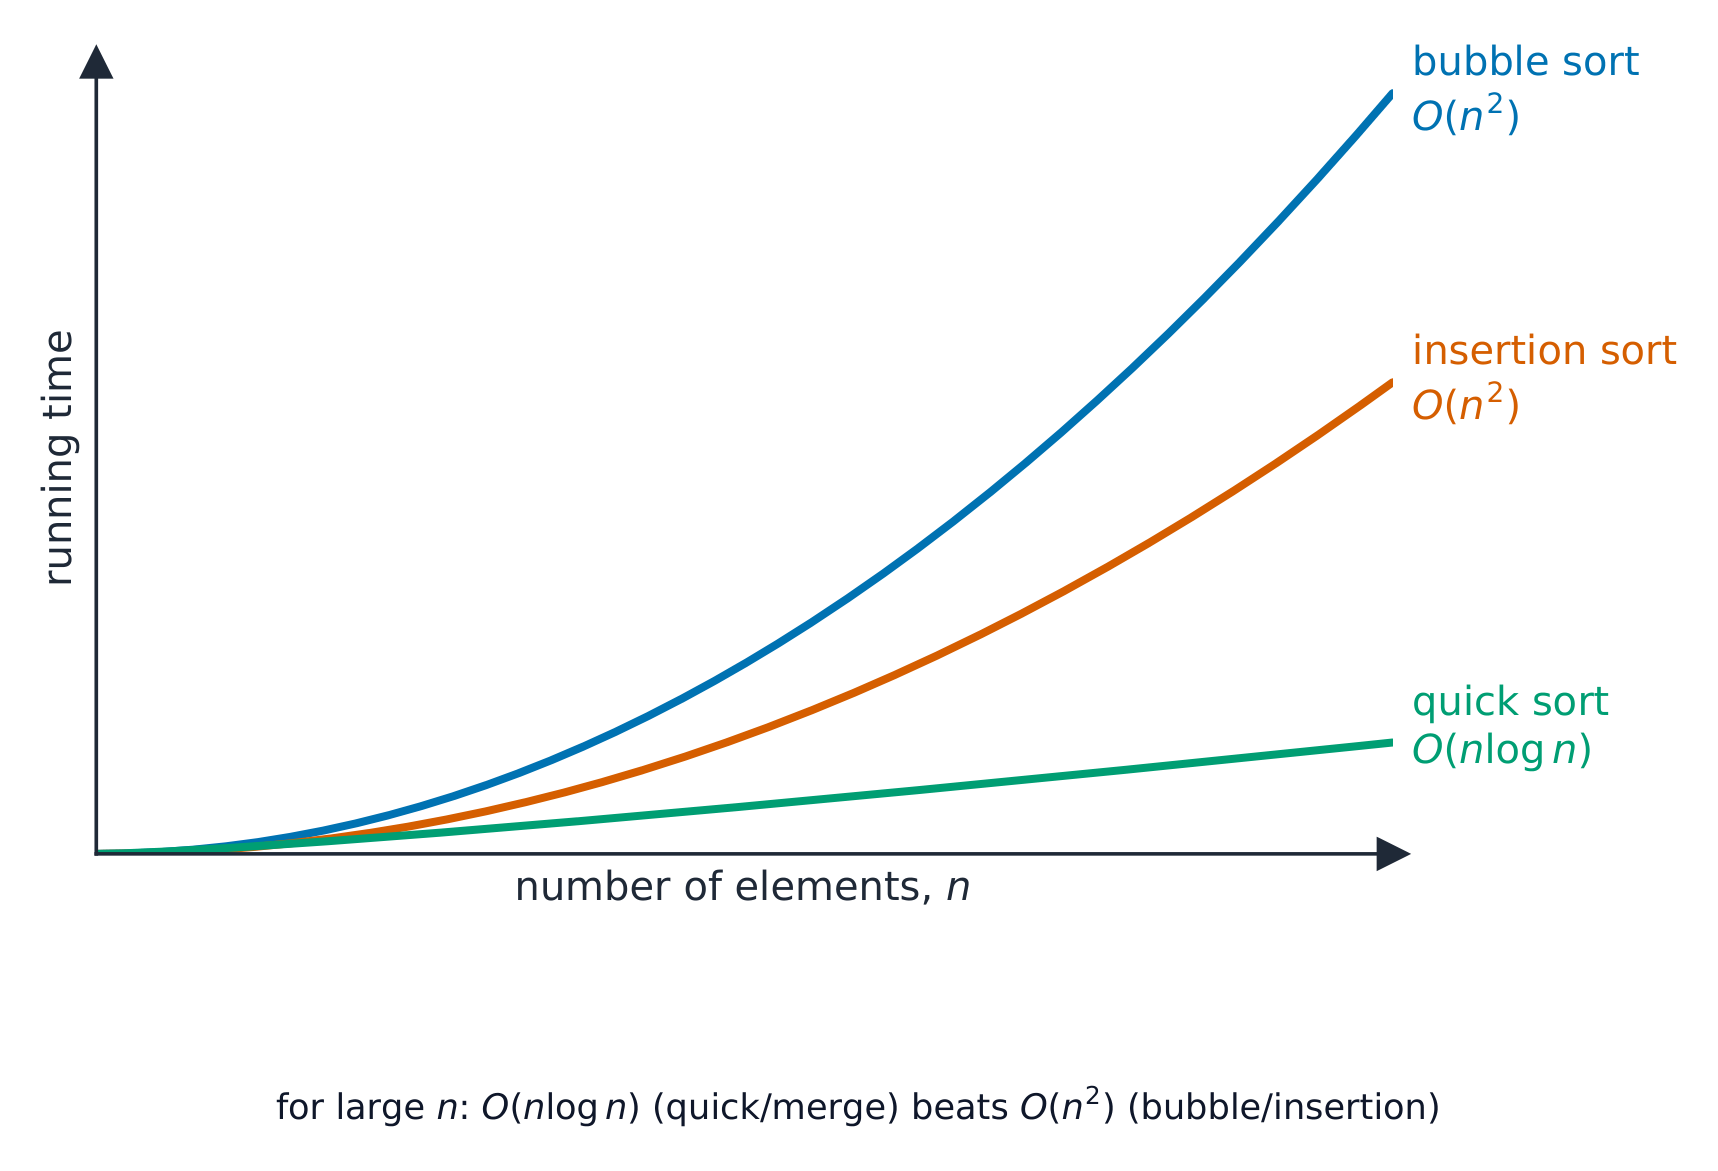
“Mô tả hai cách dữ liệu ảnh hưởng đến hiệu năng của thuật toán sắp xếp” (hai điểm). (1) Số lượng phần tử: thuật toán sắp xếp $O(n^{2})$ mất thời gian gấp bốn lần khi số phần tử tăng gấp đôi. (2) Mức độ dữ liệu đã có thứ tự: sắp xếp nổi bọt có cờ hoặc sắp xếp chèn hoàn thành sau một lượt duyệt dữ liệu đã sắp xếp ($O(n)$) và phải làm nhiều việc nhất với dữ liệu theo thứ tự ngược; số lần hoán đổi phụ thuộc vào số cặp sai thứ tự. (Cũng chấp nhận: phạm vi hoặc số lượng giá trị trùng lặp, và việc các phần tử có phải là bản ghi lớn, tốn công di chuyển hay không.) Sắp xếp nổi bọt và sắp xếp chèn đều có độ phức tạp O($n^{2}$) trong trường hợp xấu nhất và trung bình, và O($n$) trong trường hợp tốt nhất; sắp xếp nhanh và sắp xếp trộn có độ phức tạp O($n \log n$), vì vậy chúng được dùng cho dữ liệu lớn.
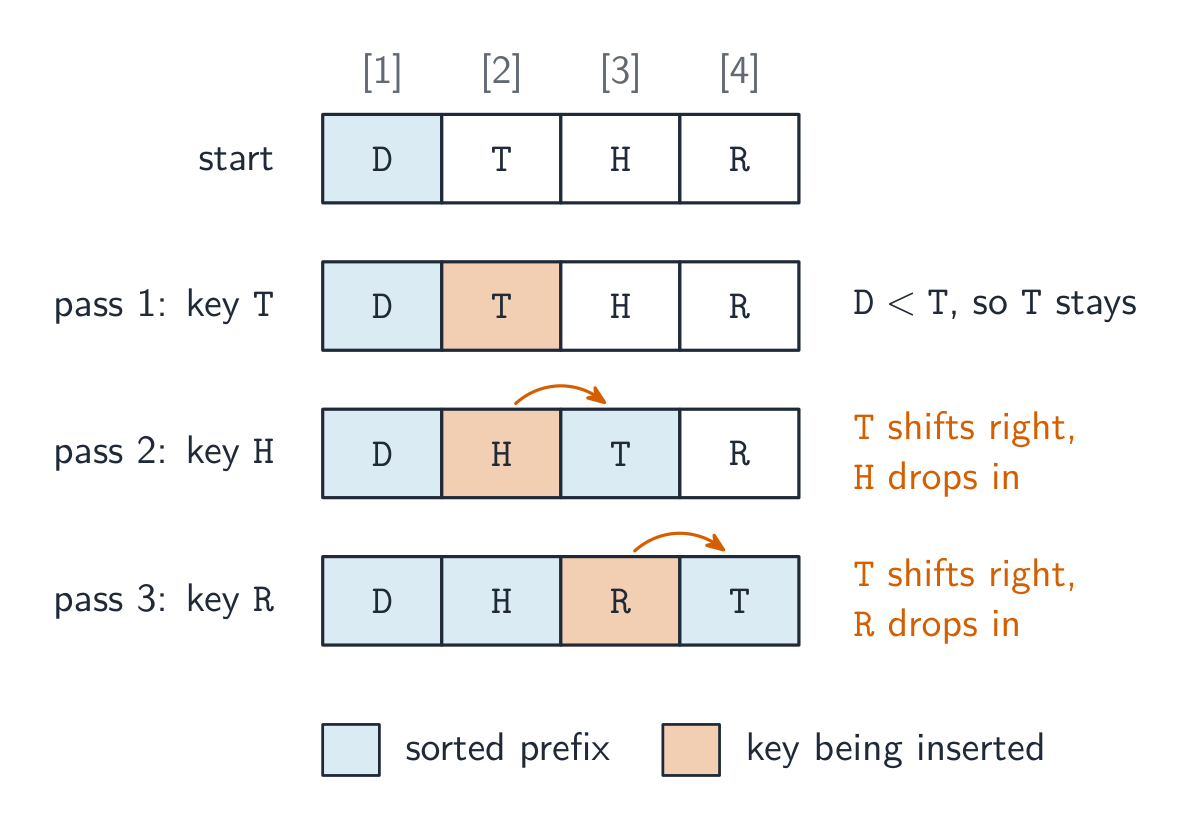
[D, T, H, R], dịch từng khóa vào đúng vị trí qua từng lượt
Khám phá
Xem quá trình sắp xếp chạy
Bước qua quá trình sắp xếp và xem các thanh dữ liệu định vị theo thứ tự — cách hoạt động của thuật toán sắp xếp qua từng lượt.
19.1
Các loại dữ liệu trừu tượng (ADTs) trong thuật toán
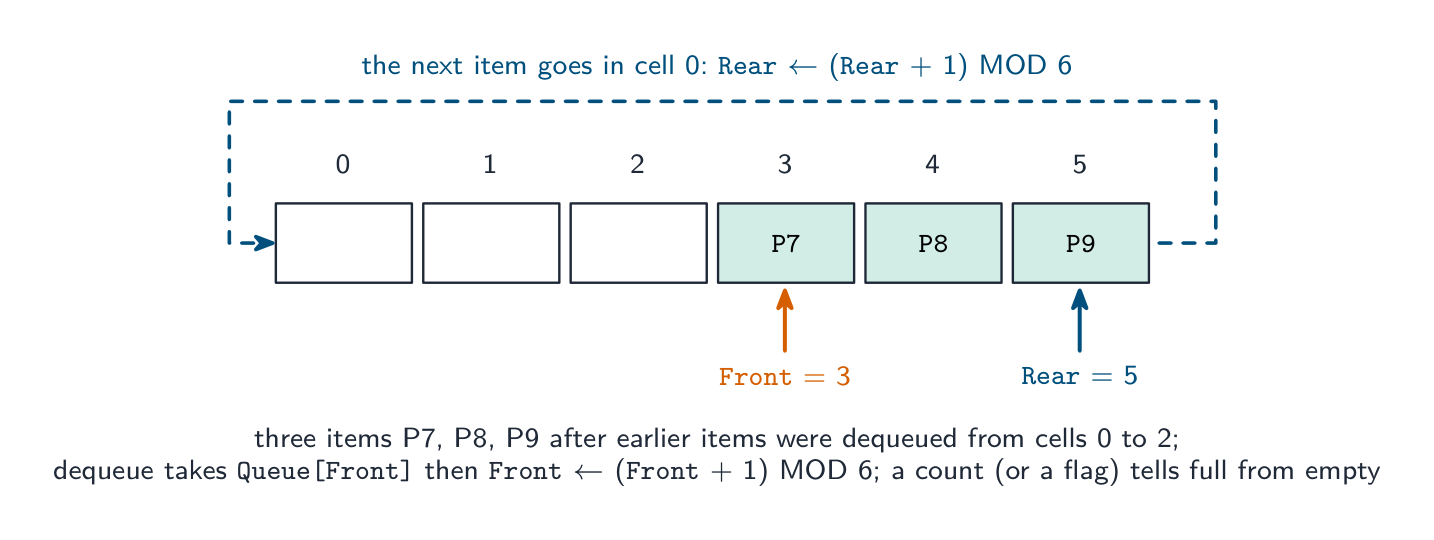
Các Abstract Data Types (ADTs) từ Chủ đề 10 xuất hiện bên trong nhiều thuật toán: một ngăn xếp điều khiển việc duyệt theo chiều sâu và chức năng hoàn tác; một hàng đợi điều khiển việc duyệt theo chiều rộng và thứ tự in ấn; một danh sách liên kết cho phép dữ liệu mở rộng và thu gọn.
ADTs có thể được xây dựng từ các ADTs khác, không chỉ từ mảng: một hàng đợi từ hai ngăn xếp; một ngăn xếp từ danh sách liên kết (push = thêm đầu nút); một hàng đợi từ danh sách liên kết với con trỏ đầu và cuối; một cây nhị phân từ các nút có hai con trỏ con; một từ điển lưu trữ cặp key→value (thường trên bảng hash). Xếp lớp như vậy tách biệt các mối quan tâm — thuật toán sử dụng ADT không cần biết nó được xây dựng như thế nào.
Các ADTs mà đề thi yêu cầu bạn mô tả và triển khai
Ngăn xếp (lối vào cuối, lối ra đầu): các phần tử được thêm (pushed) và lấy ra (popped) ở cùng một đầu, đỉnh; một con trỏ TopOfStack giữ chỉ số của phần tử đỉnh. Được triển khai bằng mảng và con trỏ đơn lẻ này: push kiểm tra ngăn xếp chưa đầy, tăng con trỏ và lưu phần tử; pop kiểm tra chưa rỗng, trả về phần tử đỉnh và giảm con trỏ.
FUNCTION Push(Item : INTEGER) RETURNS BOOLEAN
    IF TopOfStack = 9 THEN      // full (array 0 to 9)
        RETURN FALSE
    ENDIF
    TopOfStack ← TopOfStack + 1
    StackData[TopOfStack] ← Item
    RETURN TRUE
ENDFUNCTION
FUNCTION Pop() RETURNS INTEGER
    IF TopOfStack = -1 THEN      // empty
        RETURN -1
    ENDIF
    TopOfStack ← TopOfStack - 1
    RETURN StackData[TopOfStack + 1]
ENDFUNCTION
Hàng đợi (lối vào đầu, lối ra đầu): các phần tử gia nhập ở cuối (enqueue) và rời đi từ đầu (dequeue); hai con trỏ và một biến đếm. Trong hàng đợi tuyến tính, con trỏ đầu bò dọc theo mảng cho đến khi không gian ở đầu bị lãng phí; một hàng đợi vòng làm tròn cả hai con trỏ với MOD, vì vậy mọi ô nhớ đều được tái sử dụng.
FUNCTION Enqueue(Item : STRING) RETURNS BOOLEAN
    IF Count = 6 THEN      // full
        RETURN FALSE
    ENDIF
    Rear ← (Rear + 1) MOD 6
    QueueArray[Rear] ← Item
    Count ← Count + 1
    RETURN TRUE
ENDFUNCTION
FUNCTION Dequeue() RETURNS STRING
    IF Count = 0 THEN      // empty
        RETURN ""
    ENDIF
    DECLARE Item : STRING
    Item ← QueueArray[Front]
    Front ← (Front + 1) MOD 6
    Count ← Count - 1
    RETURN Item
ENDFUNCTION
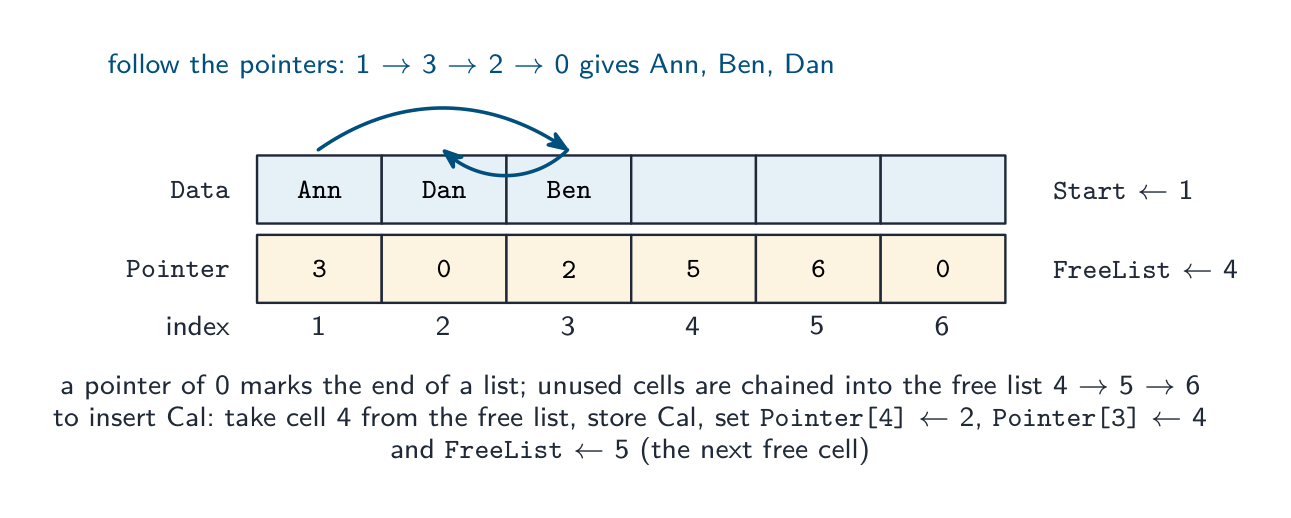
Danh sách liên kết: một chuỗi các nút, mỗi nút chứa một phần tử dữ liệu và một con trỏ trỏ đến nút tiếp theo; một con trỏ bắt đầu chỉ nút đầu tiên và một con trỏ null (0 hoặc $-1$) kết thúc danh sách. Trong triển khai bằng mảng, hai mảng song song chứa dữ liệu và các con trỏ, và các ô trống được nối thành mảng tự do (free list) để việc chèn biết nơi đặt nút mới.
FUNCTION FindInList(Target : STRING) RETURNS INTEGER   // index, or 0 if absent
    DECLARE Current : INTEGER
    Current ← Start
    WHILE Current <> 0
        IF Data[Current] = Target THEN
            RETURN Current
        ENDIF
        Current ← Pointer[Current]
    ENDWHILE
    RETURN 0
ENDFUNCTION
Để chèn vào danh sách đã sắp xếp: lấy ô trống đầu tiên (NewNode ← FreeList, FreeList ← Pointer[FreeList]), lưu phần tử, sau đó duyệt danh sách với con trỏ Previous và Current cho đến khi Data[Current] > Item hoặc hết danh sách; thiết lập Pointer[NewNode] ← Current và Pointer[Previous] ← NewNode (hoặc Start ← NewNode nếu nó vào đầu). Để xóa, liên kết lại nút trước vượt qua nút bị xóa và trả ô về mảng tự do.
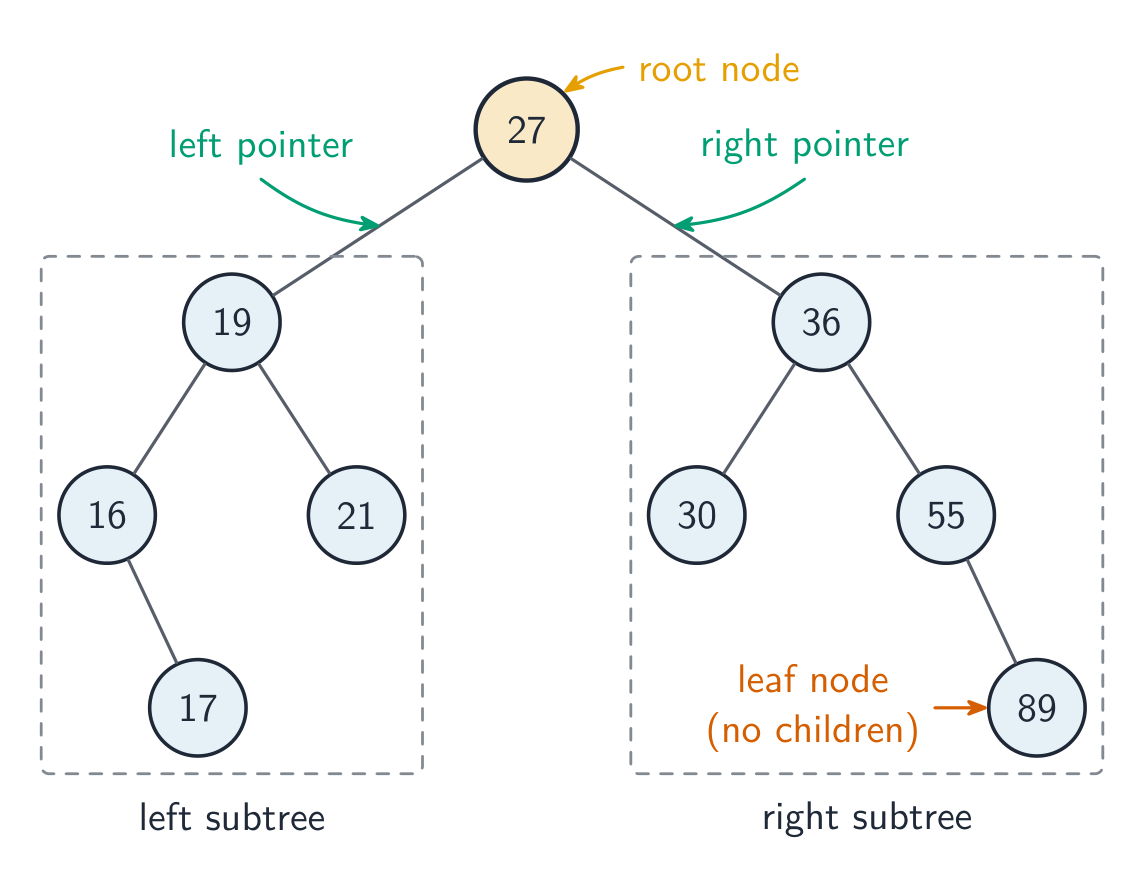
Cây nhị phân: một nút gốc, mỗi nút chứa dữ liệu, một con trỏ trái trỏ đến cây con có giá trị nhỏ hơn và một con trỏ phải trỏ đến cây con có giá trị lớn hơn. Triển khai dưới dạng mảng 2D (hoặc ba mảng 1D) Tree[Index, 0..2] cho con trỏ trái, dữ liệu, con trỏ phải, với con trỏ gốc và con trỏ tự do tiếp theo.
FUNCTION FindInTree(Target : INTEGER) RETURNS INTEGER   // index, or -1
    DECLARE Current : INTEGER
    Current ← Root
    WHILE Current <> -1
        IF Tree[Current, 1] = Target THEN
            RETURN Current
        ENDIF
        IF Target < Tree[Current, 1] THEN
            Current ← Tree[Current, 0]      // go left
        ELSE
            Current ← Tree[Current, 2]      // go right
        ENDIF
    ENDWHILE
    RETURN -1
ENDFUNCTION
Để chèn: lưu phần tử vào nút tự do tiếp theo với cả hai con trỏ $-1$; nếu cây rỗng thì tạo nó làm nút gốc; nếu không thì duyệt xuống từ nút gốc, đi sang trái hoặc phải dựa trên so sánh, cho đến khi con trỏ mà bạn sẽ theo đuổi là $-1$, và thiết lập con trỏ đó trỏ đến nút mới. Một ADT từ một ADT khác: một ngăn xếp là một danh sách liên kết nơi push và pop đều hoạt động ở đầu; một hàng đợi là một danh sách liên kết với con trỏ bắt đầu và con trỏ cuối; một hàng đợi có thể được tạo từ hai ngăn xếp (push vào cái này, pop từ cái kia, di chuyển tất cả sang khi cái kia rỗng); các nút của cây nhị phân là bản ghi hoặc đối tượng được liên kết bởi các con trỏ, vì vậy nó được xây dựng từ cấu trúc danh sách liên kết. Nói xem các thao tác của ADT mới ánh xạ lên các thao tác nào của ADT cũ.
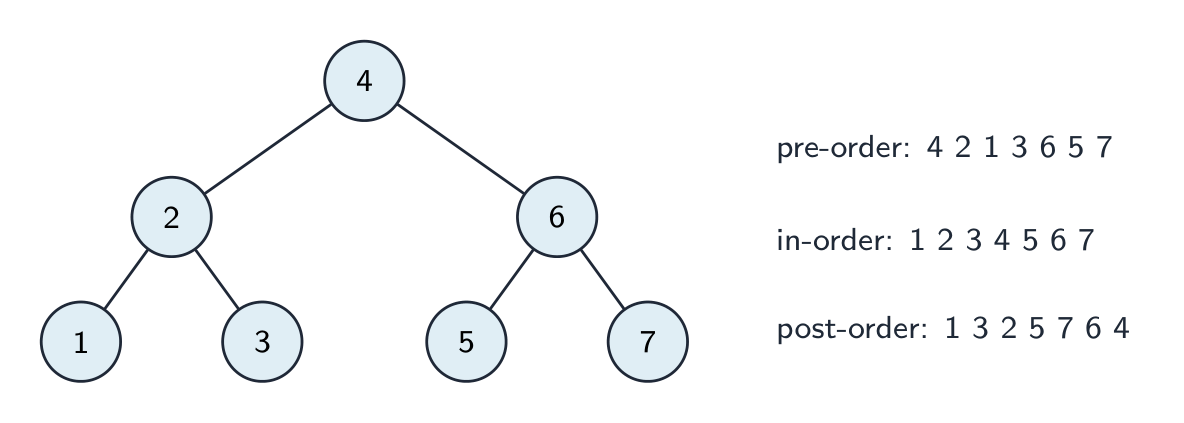
Hình thứ nhất biểu diễn một cây tìm kiếm nhị phân: mỗi nút có tối đa hai nút con, các giá trị nhỏ hơn một nút nằm bên trái và các giá trị lớn hơn nằm bên phải nút đó. Hình thứ hai biểu diễn ba cách duyệt cây.
Từ vựng
Luyện tập
| English | Tiếng Việt |
|---|---|
| linked list/lɪŋkt lɪst/ | danh sách liên kết |
| in place/ɪn pleɪs/ | ngay tại chỗ |
| stable/ˈsteɪbl/ | ổn định |
| stack/stæk/ | Ngăn xếp |
| queue/kjuː/ | hàng đợi |
| node/nəʊd/ | nút |
| pointers/ˈpɔɪntəz/ | con trỏ |
| binary tree/ˈbaɪnəri triː/ | cây nhị phân |
| dictionary/ˈdɪkʃənəri/ | từ điển |
| circular queue/ˈsɜːkjʊlə kjuː/ | hàng đợi vòng tròn |
| free list/friː lɪst/ | danh sách trống |
| time complexity/taɪm kəmˈpleksɪti/ | độ phức tạp thời gian |
| Big-O notation/bɪɡ əʊ nəʊˈteɪʃn/ | ký hiệu Big-O |
| space complexity/speɪs kəmˈpleksɪti/ | độ phức tạp không gian |
19.1
So sánh các thuật toán
Độ phức tạp về thời gian
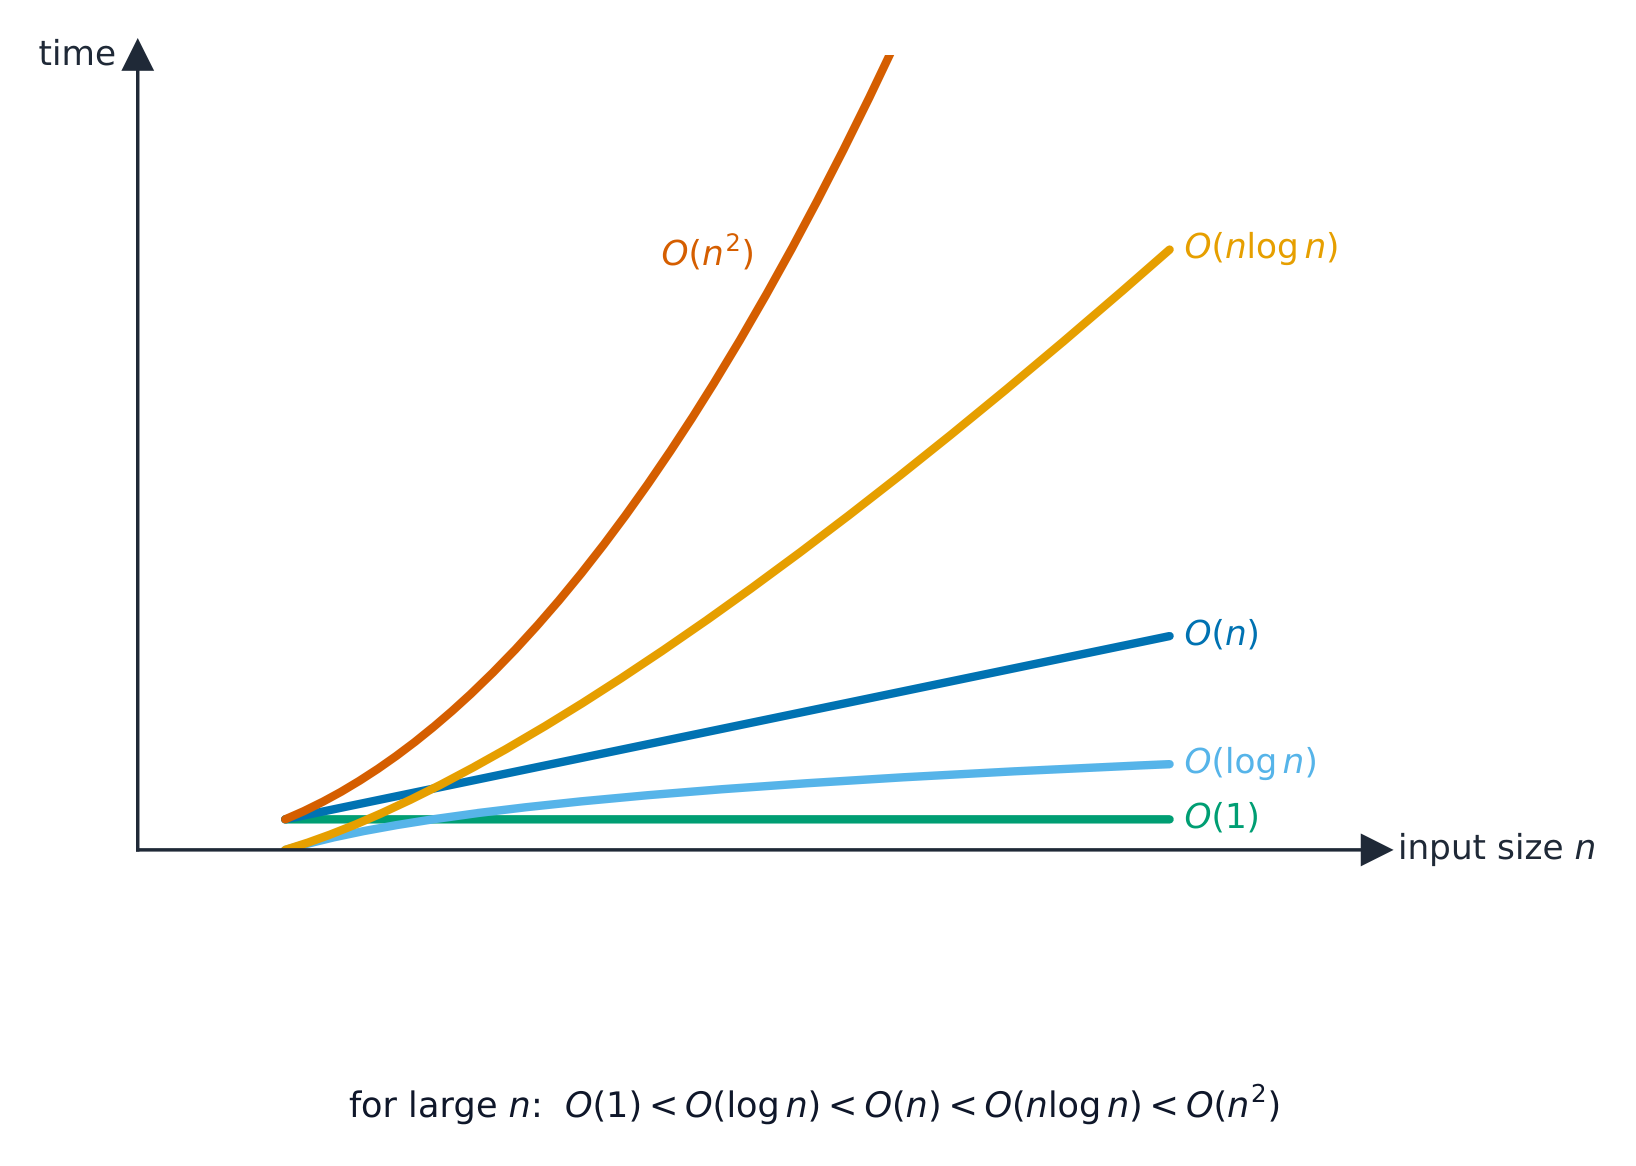
Độ phức tạp thời gian là cách thời gian chạy tăng lên theo kích thước đầu vào $n$, được viết dưới ký hiệu Big-O (hạng mục chi phối): O(1) hằng số, O($\log n$) tìm kiếm nhị phân, O($n$) tìm kiếm tuyến tính, O($n \log n$) các thuật toán sắp xếp tốt, O($n^{2}$) sắp xếp nổi/bubble và sắp xếp chèn/insertion. Hạng mục nhỏ hơn thì tốt hơn ở quy mô lớn, ngay cả khi một thuật toán khác nhanh hơn với dữ liệu nhỏ $n$.
Để minh họa cụ thể: để sắp xếp một triệu mục, một thuật toán $O(n \log n)$ sẽ hoàn thành trong một phần nhỏ của một giây, trong khi một thuật toán $O(n^{2})$ có thể mất vài phút.
Ví dụ đã giải. Một danh sách đã sắp xếp chứa $1000$ mục. Mỗi phép tìm kiếm cần bao nhiêu phép so sánh trong trường hợp xấu nhất?
Tìm kiếm tuyến tính kiểm tra từng mục một, vì vậy nó có thể cần tới $1000$ phép so sánh — đây là $O(n)$. Tìm kiếm nhị phân chia đôi danh sách mỗi bước, nên chỉ cần tối đa $\lceil \log_2 1000 \rceil = 10$ phép so sánh — đây là $O(\log n)$. Gấp đôi danh sách lên $2000$ mục chỉ thêm một phép so sánh cho tìm kiếm nhị phân, nhưng có thể thêm tới $1000$ nữa cho tìm kiếm tuyến tính — đó là lý do hạng mục tăng trưởng, chứ không phải tốc độ tuyệt đối, mới quyết định người chiến thắng ở quy mô lớn.
Mô tả một bậc độ phức tạp. O(1): thời gian là hằng số, không phụ thuộc vào số phần tử (đẩy phần tử vào ngăn xếp, đọc một phần tử mảng). O($\log n$): thời gian tăng theo logarit của số phần tử, nên tăng gấp đôi dữ liệu chỉ thêm một số bước cố định (tìm kiếm nhị phân). O($n$): thời gian tăng tỉ lệ thuận với số phần tử (tìm kiếm tuyến tính, duyệt danh sách một lượt). O($n \log n$): tăng nhanh hơn tuyến tính một chút (các thuật toán sắp xếp hiệu quả). O($n^{2}$): thời gian tăng theo bình phương số phần tử, nên tăng gấp đôi dữ liệu làm thời gian tăng gấp bốn lần (sắp xếp nổi bọt và sắp xếp chèn). Câu “Nêu Big O của tìm kiếm nhị phân trên Names[0:99]” được trả lời bằng $O(\log n)$, còn “mô tả ý nghĩa của nó” được trả lời như trên; Big O đo cách thời gian hoặc bộ nhớ tăng theo quy mô, không đo thời gian thực tế.
Ví dụ minh họa (bậc độ phức tạp của mã). Nêu độ phức tạp thời gian của từng đoạn mã, trong đó n là số phần tử.
// Fragment A
FOR i ← 1 TO n
    FOR j ← 1 TO n
        Total ← Total + Grid[i, j]
    NEXT j
NEXT i

// Fragment B
Count ← 0
WHILE n > 1
    n ← n DIV 2
    Count ← Count + 1
ENDWHILE

// Fragment C
FOR i ← 1 TO n
    Total ← Total + A[i]
NEXT i
FOR i ← 1 TO n
    OUTPUT A[i] / Total
NEXT i
A là $O(n^{2})$: câu lệnh bên trong chạy $n$ lần cho mỗi lượt trong $n$ lượt bên ngoài, tổng cộng $n \times n$ lần. B là $O(\log n)$: $n$ giảm một nửa sau mỗi lượt, nên vòng lặp chạy khoảng $\log_2 n$ lần (với $n = 64$, là sáu lượt). C là $O(n)$: hai vòng lặp nối tiếp nhau cần $n + n = 2n$ bước, và các hằng số được bỏ đi. Quy tắc: vòng lặp lồng nhau thì nhân, vòng lặp nối tiếp thì cộng, và chỉ giữ số hạng tăng nhanh nhất, nên $3n^{2} + 5n + 2$ là $O(n^{2})$.
Độ phức tạp không gian
Độ phức tạp không gian là bộ nhớ bổ sung cần thiết. Sắp xếp nổi và sắp xếp chèn sử dụng O(1) bộ nhớ phụ (ngay tại chỗ); sắp xếp hợp nhất sử dụng O($n$); đệ quy sử dụng bộ nhớ stack tương ứng với độ sâu của nó. Thường tồn tại sự đánh đổi giữa thời gian và bộ nhớ.
Các tiêu chí khác
Tính đơn giản (dễ mã hóa và bảo trì), tính ổn định, và tính thích nghi (nhanh hơn trên dữ liệu gần như đã sắp xếp). Thuật toán phù hợp phụ thuộc vào dữ liệu và các ràng buộc.
Khám phá
Thời gian chạy tăng trưởng theo n như thế nào
Trượt n lên cao hơn và so sánh các đường cong: O(1) và O(log n) giữ gần như phẳng, O(n) tăng đều đặn, O(n²) bùng nổ. Đây là lý do tại sao Big-O — chứ không phải đồng hồ bấm giờ — là cách chúng ta so sánh các thuật toán trên đầu vào lớn.
Khám phá
Tăng trưởng Big-O
Thay đổi kích thước đầu vào n và so sánh tốc độ tăng công việc của từng thuật toán — ý tưởng nền tảng về độ phức tạp thời gian.
19.2
Đệ quy
Chương trình
| Thí sinh cần có thể: | Ghi chú và hướng dẫn |
|---|---|
| Thể hiện sự hiểu biết về recursion. | Các đặc điểm thiết yếu của recursion. Cách recursion được biểu diễn trong ngôn ngữ lập trình. Viết và theo dõi các recursive algorithms. Khi nào việc sử dụng recursion mang lại lợi ích. |
| Thể hiện nhận thức về những gì trình biên dịch phải làm để dịch mã lập trình recursive. | Sử dụng stacks và cơ chế unwinding. |
Nguồn: Chương trình Cambridge International

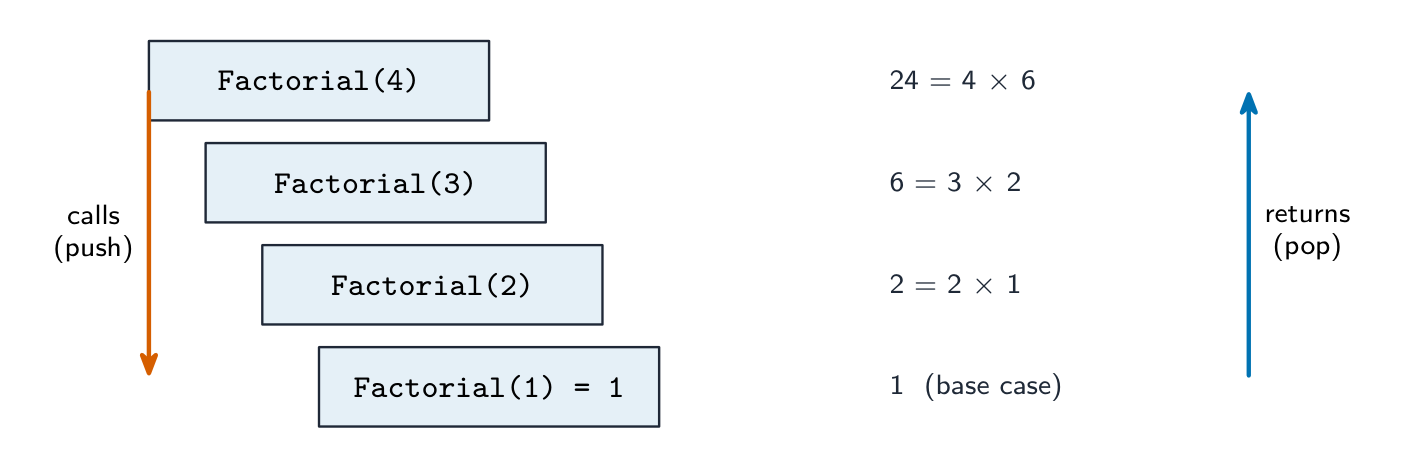
Thuật toán đệ quy sử dụng đệ quy: routine gọi chính nó với phiên bản nhỏ hơn của cùng một vấn đề, cho đến khi một trường hợp cơ sở kết thúc chuỗi. Nó có hai phần: trường hợp cơ sở (nhỏ đủ để giải trực tiếp — nếu không có nó thì đệ quy sẽ không bao giờ dừng) và trường hợp đệ quy (giảm đầu vào và gọi chính nó lại).
Giả thừa:
FUNCTION Factorial(n : INTEGER) RETURNS INTEGER
    IF n = 0 OR n = 1 THEN
        RETURN 1
    ELSE
        RETURN n * Factorial(n - 1)
    ENDIF
ENDFUNCTION
Đệ quy tự nhiên cho các vấn đề tự tương đồng: cây, chia để trị (tìm kiếm nhị phân, sắp xếp hợp nhất), và dữ liệu lồng nhau. Khi nó không phù hợp, vòng lặp thường sạch sẽ hơn.
“Mô tả ý nghĩa của đệ quy” (hai điểm). Một hàm hoặc thủ tục được định nghĩa theo chính nó: nó tự gọi chính mình bên trong thân hàm hoặc thủ tục, mỗi lần với một phiên bản nhỏ hơn của bài toán, cho đến khi đạt trường hợp cơ sở. “Nêu ba đặc điểm thiết yếu của đệ quy”: (1) một trường hợp cơ sở (điều kiện dừng) trả về giá trị mà không gọi thêm; (2) một trường hợp tổng quát trong đó chương trình con tự gọi chính mình; (3) mỗi lần gọi đưa bài toán gần hơn đến trường hợp cơ sở (tham số được giảm), để quá trình đệ quy kết thúc. Một số đáp án bổ sung: các giá trị được trả về khi các lời gọi lần lượt hoàn tất.
“Mô tả khi nào việc sử dụng đệ quy có lợi và nêu một ví dụ.” Khi bài toán được định nghĩa một cách tự nhiên theo các phiên bản nhỏ hơn của chính nó, để lời giải đệ quy ngắn gọn, rõ ràng và gần với định nghĩa toán học hơn so với dùng vòng lặp: tính giai thừa hoặc số Fibonacci, tìm kiếm nhị phân, duyệt cây nhị phân, sắp xếp trộn hoặc sắp xếp nhanh, và xử lý các cấu trúc lồng nhau như thư mục nằm trong thư mục. Đây là lựa chọn kém khi độ sâu lớn (ngăn xếp có thể bị tràn) hoặc khi cùng một bài toán con được tính nhiều lần (cách tính Fibonacci cơ bản).
Theo dõi một cuộc gọi đệ quy
Đối với Factorial(4): các cuộc gọi đi xuống đến Factorial(1)=1, sau đó pop ra nhân ngược lên: 2*1=2, 3*2=6, 4*6=24. Kết quả cuối cùng 24. Theo dõi từng cuộc gọi đang chờ trên stack.
Ví dụ đã giải. Hàm dưới đây được đưa ra mà không có giải thích. Hãy theo dõi Unknown(3, 5) và nêu đầu ra cũng như giá trị trả về.
FUNCTION Unknown(BYVAL X, BYVAL Y : INTEGER) RETURNS INTEGER
    IF X < Y THEN
        OUTPUT X + Y
        RETURN Unknown(X + 1, Y - 1) + 1
    ELSE
        RETURN 0
    ENDIF
ENDFUNCTION
Gọi 1: $X = 3, Y = 5$: $3 < 5$, output 8, gọi Unknown(4, 4). Gọi 2: $4 < 4$ là sai, return 0. Pop ra: gọi 1 trả về $0 + 1 = 1$. Output 8, giá trị trả về 1. Viết quá trình theo dõi dưới dạng bảng với mỗi hàng cho một cuộc gọi (tham số, điều kiện, output, nó trả về gì), và thực hiện các lần trả về từ cuộc gọi sâu nhất lên trên: đó chính là quá trình pop ra mà đáp án chấm điểm mong đợi.
Ví dụ có lời giải (Fibonacci). Fib(n) trả về n khi n < 2, ngược lại trả về Fib(n - 1) + Fib(n - 2). Tìm Fib(5).
Fib(5) = Fib(4) + Fib(3); Fib(4) = Fib(3) + Fib(2); Fib(3) = Fib(2) + Fib(1); Fib(2) = Fib(1) + Fib(0) = 1 + 0 = 1. Vậy Fib(3) = 1 + 1 = 2, Fib(4) = 2 + 1 = 3, Fib(5) = 3 + 2 = 5. Trường hợp cơ sở được đạt được rất nhiều lần (Fib(2) được tính ba lần), đó là lý do phiên bản này chậm: nó thực hiện 15 cuộc gọi cho $n = 5$ và xấp xỉ gấp đôi số cuộc gọi cho mỗi lần tăng $n$.
Biến đổi đệ quy thành lặp. Mọi thủ tục đệ quy đều có thể được viết lại bằng vòng lặp, sử dụng ít bộ nhớ hơn và nhanh hơn: giữ kết quả đang tính và lặp từ trường cơ sở lên trên. Factorial dưới dạng vòng lặp:
FUNCTION Factorial(N : INTEGER) RETURNS INTEGER
    DECLARE Result, Count : INTEGER
    Result ← 1
    FOR Count ← 2 TO N
        Result ← Result * Count
    NEXT Count
    RETURN Result
ENDFUNCTION
Khi được yêu cầu chuyển đổi thuật toán sắp xếp chèn hoặc tìm kiếm đệ quy sang dạng lặp, hãy thay thế lời gọi tự thân bằng vòng lặp trên chỉ số mà đệ quy đã duyệt qua, và biến đổi trường cơ sở thành điều kiện dừng của vòng lặp.
Rủi ro
- đệ quy vô hạn nếu bỏ sót trường cơ sở — gây lỗi vượt quá ngàn (stack overflow) với ngàn tràn.
- tiêu thụ bộ nhớ cao đối với đệ quy sâu.
- chậm nếu thực hiện công việc trùng lặp (Fibonacci thô sơ là hàm mũ — hãy dùng vòng lặp hoặc ghi nhớ/ memoisation).
Khám phá
Đệ quy mở rộng từ các lá lên trên
Bước qua fib(4) theo thứ tự các lời gọi thực sự hoàn thành: các lá (trường hợp cơ bản) được giải quyết trước, sau đó mỗi cha kết hợp con cái của nó. Lưu ý fib(2) được tính hai lần — công việc lặp lại đó là lý do tại sao đệ quy thô sơ lại chậm.
Từ vựng
Luyện tập
| English | Tiếng Việt |
|---|---|
| recursion/rɪˈkɜːʃn/ | đệ quy |
| factorial/fækˈtɔːrɪəl/ | giả thừa |
| divide-and-conquer/dɪˈvaɪd ænd ˈkɒŋkə/ | chia để trị |
| general case/ˈdʒenərəl keɪs/ | trường hợp tổng quát |
| parameters/pəˈræmɪtəz/ | tham số |
| stack overflow/stæk ˌəʊvəˈfləʊ/ | tràn ngăn |
| memoisation/ˌmeməʊaɪˈzeɪʃn/ | ghi nhớ |
| local variables/ˈləʊkl ˈveərɪəblz/ | biến cục bộ |
| stack frame/stæk freɪm/ | khung ngăn |
| return address/rɪˈtɜːn əˈdres/ | địa chỉ trả về |
19.2
Trình biên dịch làm gì với mã đệ quy
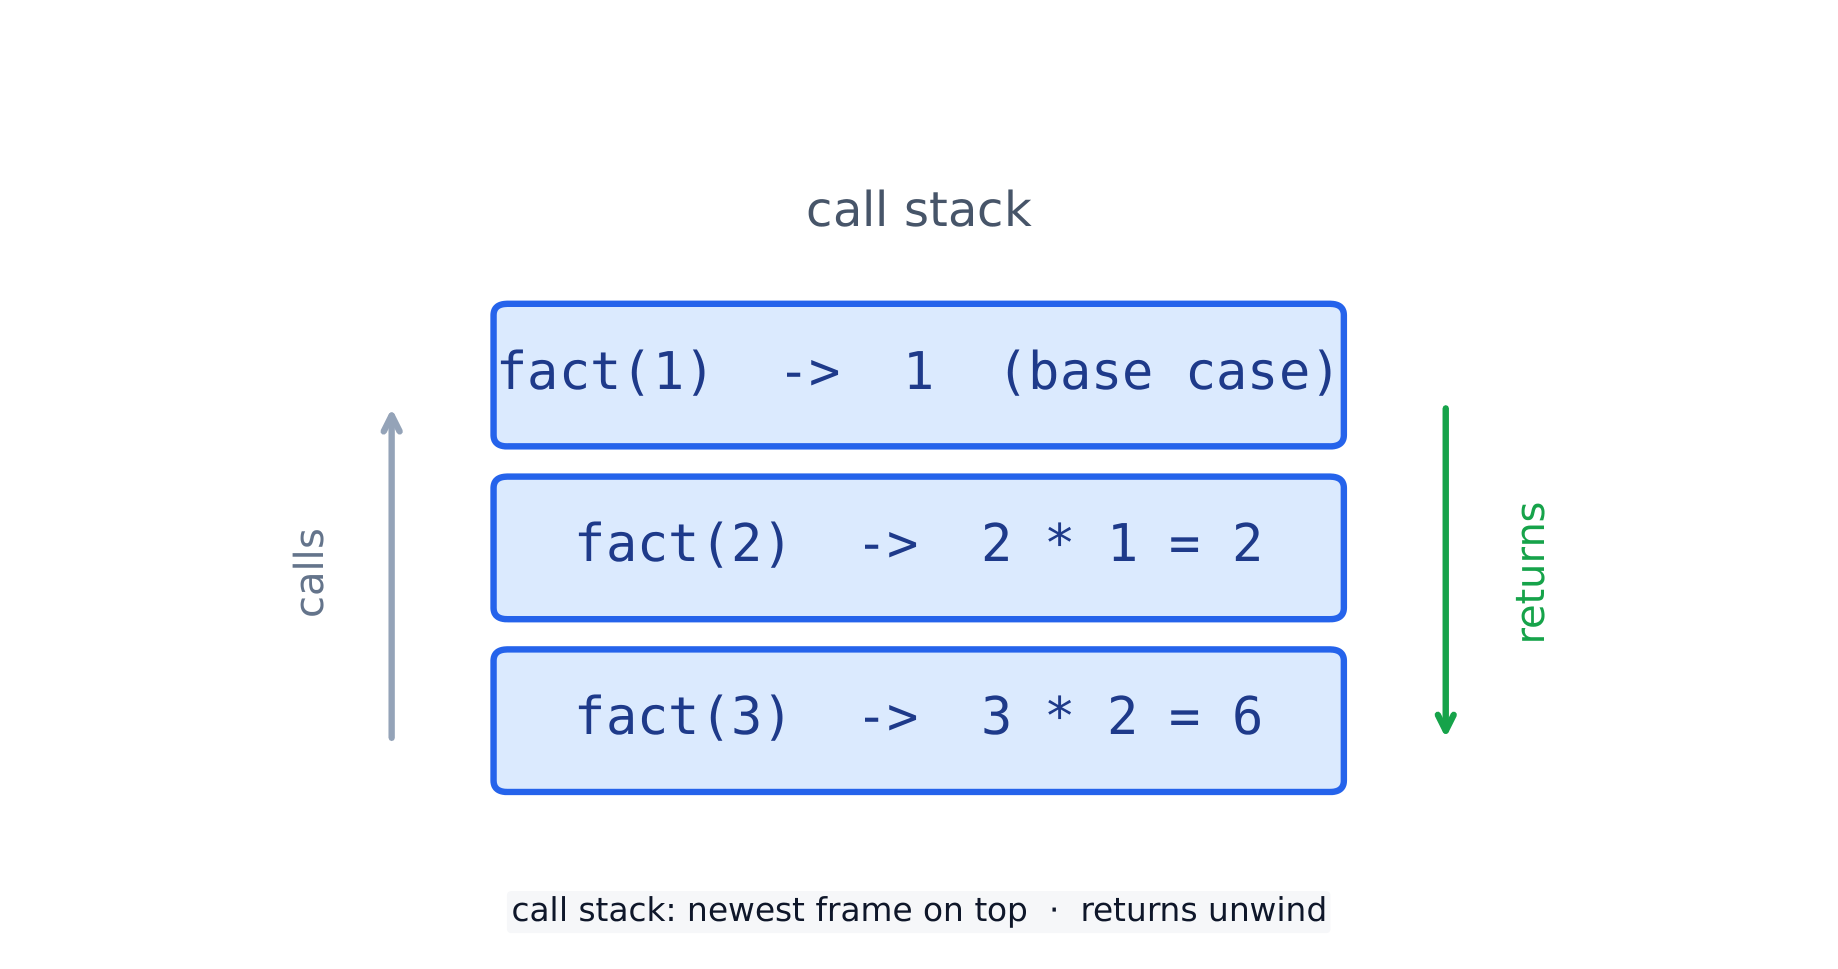
Đệ quy cần mỗi lời gọi phải có bản sao riêng của tham số và biến cục bộ của nó. Trình biên dịch lưu các thứ này trên ngàn gọi. Với mỗi lời gọi, nó đẩy một khung ngàn chứa tham số, biến cục bộ và địa chỉ trả về (nơi tiếp tục trong hàm gọi). Khi hàm trả về, giá trị trả về được giao lại, khung bị loại bỏ, và điều khiển quay lại địa chỉ trả về.
Vì mỗi lời gọi có khung riêng, các lời gọi đệ quy không ghi đè biến của nhau. Ngăn xếp có thể tăng lớn khi đệ quy sâu, vì vậy đệ quy quá sâu có thể làm tràn ngăn xếp. Đây là cùng cơ chế gọi và trả về được dùng cho các lời gọi thông thường (không đệ quy) — không có “cơ chế đệ quy” đặc biệt.
“Giải thích tại sao ngăn xếp phù hợp để thực hiện đệ quy” (ba điểm). Mỗi lời gọi đệ quy phải lưu địa chỉ trả về, các tham số và biến cục bộ của nó, và các lời gọi được hoàn tất theo thứ tự ngược lại với thứ tự được thực hiện (lời gọi cuối cùng hoàn tất đầu tiên), đúng với nguyên tắc vào sau, ra trước của ngăn xếp: mỗi lời gọi mới đẩy một khung vào ngăn xếp, và mỗi lần trả về lấy khung mới nhất ra, khôi phục trạng thái của chương trình gọi và cho biết nơi cần tiếp tục. Đây là nhiệm vụ của trình biên dịch khi dịch mã đệ quy: nó tạo lệnh đẩy một khung ngăn xếp ở mỗi lời gọi và lệnh lấy khung ra ở mỗi lần trả về; các khung lần lượt được lấy ra khi kết quả được trả về.
Từ vựng
Luyện tập
| English | Tiếng Việt |
|---|---|
| call stack/kɔːl stæk/ | ngăn gọi hàm |
| base case/beɪs keɪs/ | trường hợp cơ sở |
| recursive case/rɪˈkɜːsɪv keɪs/ | trường hợp đệ quy |
19.2
Các định nghĩa mà giám khảo chấp nhận
Câu hỏi định nghĩa được chấm dựa trên văn phong cố định. Hãy học thuộc những định nghĩa này và chỉ đưa ra một đáp án duy nhất.
| Thuật ngữ | Định nghĩa |
|---|---|
| tìm kiếm tuyến tính | kiểm tra từng mục theo thứ tự từ đầu cho đến khi tìm thấy mục đích hoặc đạt đến cuối danh sách |
| tìm kiếm nhị phân | liên tục so sánh mục đích với mục ở giữa của danh sách đã sắp xếp và loại bỏ nửa không thể chứa nó |
| sắp xếp bong bóng | liên tục duyệt qua danh sách, hoán đổi các mục liền kề nằm sai thứ tự, cho đến khi một lượt duyệt không còn hoán đổi nào |
| sắp xếp chèn | lấy từng mục theo thứ tự và chèn nó vào vị trí đúng giữa các mục đã được sắp xếp |
| kiểu dữ liệu trừu tượng | một tập hợp dữ liệu và các thao tác có thể thực hiện trên đó, được định nghĩa độc lập với cách lưu trữ của nó |
| ngàn | cấu trúc cuối vào trước ra với các thao tác đẩy và loại bỏ ở đỉnh |
| hàng đợi | cấu trúc đầu vào trước ra với các mục được thêm vào phía sau và loại bỏ từ phía trước |
| danh sách liên kết | một chuỗi các nút, mỗi nút chứa dữ liệu và con trỏ đến nút tiếp theo, kèm theo con trỏ bắt đầu |
| cây nhị phân | các nút mỗi nút chứa dữ liệu và con trỏ đến cây con bên trái có giá trị nhỏ hơn và cây con bên phải có giá trị lớn hơn |
| ký hiệu Big O | phương pháp phân loại thời gian (hoặc bộ nhớ) mà thuật toán cần dựa trên sự tăng trưởng của nó theo kích thước đầu vào |
| đệ quy | một thủ tục gọi chính nó với phiên bản nhỏ hơn của bài toán cho đến khi trường cơ sở dừng các lời gọi |
| trường cơ sở | điều kiện mà tại đó một thủ tục đệ quy trả về mà không gọi chính nó |
| mở rộng ngàn | các lần trả về của một chuỗi các lời gọi đệ quy, từ lời gọi sâu nhất trở lại lời đầu tiên, khi các khung ngàn bị loại bỏ |
19.2
Mẹo làm bài thi
- Tìm kiếm: tìm kiếm tuyến tính không cần thứ tự và có độ phức tạp O($n$); tìm kiếm nhị phân cần mảng đã sắp xếp, giảm một nửa mỗi lần và có độ phức tạp O($\log n$). Hãy thuộc lòng cả hai thuật toán, bao gồm cả cận và cờ báo hiệu.
- Sắp xếp: sắp xếp bong bóng với cờ hoán đổi, sắp xếp chèn với khóa di chuyển các mục lớn hơn sang phải; cả hai đều là O($n^{2}$)finished worst, O($n$)finished best on sorted data. Hiệu suất phụ thuộc vào số lượng mục và mức độ đã sắp xếp của chúng.
- Triển khai ADT là quản lý con trỏ: con trỏ đỉnh; front, rear và count với MOD; start, con trỏ và danh sách trống; root với con trỏ trái và phải. Luôn kiểm tra trạng thái đầy và rỗng.
- Big O nói về mức tăng theo quy mô: hằng số, logarit, tuyến tính, bình phương. Với tìm kiếm nhị phân, hãy nói “tăng gấp đôi dữ liệu thêm một phép so sánh”.
- Đệ quy: trường cơ sở, trường tổng quát, tiến tới trường cơ sở; có lợi khi bài toán được định nghĩa theo chính nó; một ngàn giữ các địa chỉ trả về và biến vì các lời gọi trả về theo thứ tự ngược. Theo dõi bằng bảng và mở rộng ngàn từ lời gọi sâu nhất.
Lỗi thường gặp
- Viết $O(2n)$ hoặc $O(n^{2} + n)$: bỏ các hằng số và số hạng nhỏ hơn, thu được $O(n)$ và $O(n^{2})$.
- Tính chỉ số giữa là $(Lower + Upper) / 2$ khi lần vết: phiên bản trong đề thi dùng
DIV, nên làm tròn xuống. - Sử dụng tìm kiếm nhị phân trên dữ liệu chưa sắp xếp, hoặc trên danh sách liên kết; và đặt
Lower ← MiddleIndexthay vìMiddleIndex + 1, sẽ tạo vòng lặp vô tận. - Vòng lặp bên trong sắp xếp bong bóng chạy đến hết mảng mỗi lượt duyệt, hoặc hoán đổi mà không dùng biến tạm.
- Một lệnh push hoặc enqueue không kiểm tra trạng thái đầy, hoặc pop hoặc dequeue không kiểm tra trạng thái rỗng.
- Di chuyển con trỏ front của hàng đợi mà không dùng MOD trong hàng đợi tròn, hoặc coi front = rear luôn luôn có nghĩa là rỗng.
- Chèn vào danh sách liên kết bằng cách di chuyển nội dung mảng; chỉ có các con trỏ thay đổi.
- Một hàm đệ quy không có trường cơ sở, hoặc một hàm mà lời gọi đệ quy của nó không thu nhỏ bài toán.
- Vẽ lại một lời gọi đệ quy nhưng quên thêm công việc còn dang dở trên đường quay ngược trở lại.
- Trả lời “tại sao dùng ngăn xếp” bằng “vì nó nhanh”; lý do là thứ tự vào sau, ra trước của các lần trả về.
Bài học tương tác về chủ đề này
Làm theo từng bước, kèm theo bài tập kiểm tra ngay lập tức.