| Thí sinh cần có thể: | Ghi chú và hướng dẫn |
|---|---|
| Thể hiện sự hiểu biết về cách đồ thị có thể được sử dụng để hỗ trợ Trí tuệ Nhân tạo (AI) | Mục đích và cấu trúc của đồ thị Sử dụng thuật toán A* và thuật toán Dijkstra để thực hiện tìm kiếm trên đồ thị Học sinh sẽ không yêu cầu viết thuật toán để thiết lập, truy cập hoặc thực hiện tìm kiếm trên đồ thị |
| Thể hiện sự hiểu biết về cách mạng nơ-ron nhân tạo đã giúp đỡ học máy (machine learning) | |
| Thể hiện sự hiểu biết về Deep Learning, Machine Learning và Reinforcement Learning cũng như lý do sử dụng các phương pháp này. | Hiểu được các phân loại của machine learning, bao gồm supervised learning và unsupervised learning. |
| Thể hiện sự hiểu biết về back propagation of errors và các regression methods trong machine learning. |
Trí tuệ nhân tạo (AI)
Khoa học máy tính A-Level · Chủ đề 18
 13:12
AI là gì
Không ai ever viết ra luật lệ để phân biệt mèo với chó. Không lập trình viên nào ngồi xuống và gõ "nếu nó có tai nhọn và râu". Thế nhưng điện thoại của bạn lại làm được…
Giọng đọc tiếng Anh · phụ đề tiếng Anh + 中文 được ghi trực tiếp
18.1
Trí tuệ nhân tạo là gì

Chương trình
Nguồn: Chương trình Cambridge International
Trí tuệ nhân tạo (AI) xây dựng các hệ thống thực hiện các tác vụ thường đòi hỏi trí thông minh của con người — nhận diện giọng nói và hình ảnh, dịch thuật, chơi trò chơi, lái xe, tạo văn bản. Hầu hết AI hiện đại sử dụng học máy — các thuật toán học các mẫu từ dữ liệu thay vì được lập trình từng bước. Trong đó, học sâu, sử dụng mạng nơ-ron với nhiều lớp, đã trở thành xu hướng chủ đạo kể từ thập niên 2010.
Một robot hình người tích hợp nhiều khả năng này vào một cơ thể duy nhất: nó sử dụng AI để nhìn thấy khuôn mặt, hiểu giọng nói và điều khiển biểu cảm khuôn mặt, cánh tay theo cách sinh động giống con người thật.

Khám phá
Phòng thí nghiệm loại học AI
Phân loại các ví dụ về AI dựa trên loại hình học hoặc vấn đề liên quan.
Từ vựng
Luyện tập
| English | Tiếng Việt |
|---|---|
| artificial intelligence/ˌɑːtɪˈfɪʃl ɪnˈtelɪdʒəns/ | trí tuệ nhân tạo |
| machine learning/məˈʃiːn ˈlɜːnɪŋ/ | học máy |
| deep learning/diːp ˈlɜːnɪŋ/ | học sâu |
| neural networks/ˈnjuːrəl ˈnetwɜːks/ | mạng nơ-ron |
| humanoid robot/ˈhjuːmənɔɪd ˈrəʊbɒt/ | robot hình người |
18.1
Đồ thị trong AI

Nhiều bài toán AI được mô hình hóa trên một đồ thị — các nút (trạng thái, địa điểm) được nối với nhau bởi các cạnh (lượt đi, mối quan hệ).
- tìm đường đi: các tuyến đường tạo thành đồ thị; lộ trình ngắn nhất là một phép tìm kiếm trên đồ thị (thuật toán Dijkstra, thuật toán A*).
- chơi trò chơi: mỗi vị trí bàn cờ là một nút, mỗi nước đi là một cạnh; thuật toán minimax với cắt tỉa alpha-beta tìm kiếm cây trò chơi.
- tìm kiếm không gian trạng thái: một bài toán quy hoạch là di chuyển giữa các trạng thái bằng cách áp dụng các toán tử để đạt được mục tiêu.
- biểu diễn tri thức: một mạng ngữ nghĩa có các khái niệm làm nơ-đốt và các mối quan hệ làm cạnh ("chó IS-A động vật"); một sơ đồ tri thức lưu trữ các sự thật về thế giới cho các công cụ tìm kiếm và trợ lý ảo.
Các công cụ chuẩn để điều hướng đồ thị bao gồm tìm kiếm theo độ rộng và tìm kiếm theo độ sâu.
"Mô tả mục đích và cấu trúc của đồ thị trong hệ thống AI." Mục đích: để biểu diễn một bài toán dưới dạng một tập hợp các trạng thái (hoặc vị trí) và các bước di chuyển có thể xảy ra giữa chúng, sao cho một thuật toán có thể tìm kiếm nó để tìm giải pháp, chẳng hạn như tuyến đường ngắn nhất hoặc rẻ nhất, hoặc bước tiếp theo tốt nhất. Cấu trúc: một tập hợp các nơ-đốt (đỉnh), mỗi nơ-đốt đại diện cho một trạng thái, vị trí hoặc đối tượng, được nối với nhau bởi các cạnh biểu diễn các kết nối giữa chúng; mỗi cạnh có thể mang một trọng số (chi phí, khoảng cách hoặc thời gian), và các cạnh có thể là có hướng (một chiều) hoặc vô hướng. "Giải thích việc sử dụng đồ thị để hỗ trợ AI": đồ thị là mô hình mà các thuật toán tìm kiếm của AI chạy trên đó: Thuật toán A* và Dijkstra tìm các đường đi tối ưu thông qua nó (điều hướng, định tuyến), vị trí trò chơi tạo thành một cây được tìm kiếm để tìm nước đi tốt nhất, và tri thức được lưu dưới dạng đồ thị cho phép hệ thống suy luận về cách các sự thật liên quan với nhau.
 Đồ thị được sử dụng bên dưới: các số trên cạnh là khoảng cách thực tế; các số màu đỏ là ước lượng heuristic của từng nơ-đốt về khoảng cách còn lại đến mục tiêu, chỉ A sử dụng*
Thuật toán Dijkstra. Nó tìm khoảng cách ngắn nhất từ điểm bắt đầu đến mọi nơ-đốt. Giữ một bảng khoảng cách tốt nhất đã tìm thấy cho đến nay đến mỗi nơ-đốt (bắt đầu là 0, tất cả các nơ-đốt khác là vô cùng). Lặp lại lấy nơ-đốt chưa thăm có khoảng cách nhỏ nhất, đánh dấu là đã thăm, và với mỗi hàng xóm kiểm tra xem đi qua nơ-đốt này có tạo ra khoảng cách ngắn hơn không; nếu có, cập nhật nó và ghi nhận nguồn gốc. Dừng lại khi mọi nơ-đốt đều đã được thăm (hoặc mục tiêu đã được tìm thấy).
Ví dụ tính toán. Tìm khoảng cách ngắn nhất từ H đến mọi nơ-đốt khác trong đồ thị trên.
| bước | thăm | H | A | B | C | D | G |
|---|---|---|---|---|---|---|---|
| bắt đầu | 0 | ∞ | ∞ | ∞ | ∞ | ∞ | |
| 1 | H (0) | 0 | 4 (H) | 3 (H) | ∞ | ∞ | ∞ |
| 2 | B (3) | 0 | 4 (H) | 3 | ∞ | 9 (B) | ∞ |
| 3 | A (4) | 0 | 4 | 3 | 9 (A) | 8 (A) | ∞ |
| 4 | D (8) | 0 | 4 | 3 | 9 (A) | 8 | 10 (D) |
| 5 | C (9) | 0 | 4 | 3 | 9 | 8 | 10 (D) |
| 6 | G (10) |
Khoảng cách ngắn nhất: A 4, B 3, D 8, C 9, G 10, và đường đi đến G là H–A–D–G (đọc các nhãn "came from" ngược lại). Ở bước 3, A cung cấp cho D khoảng cách $4 + 4 = 8$, tốt hơn so với 9 tìm thấy qua B, nên D được cập nhật; ở bước 5, C có thể đến G ở $9 + 3 = 12$, kém hơn 10, nên không thay đổi gì. Việc hiển thị các so sánh này chính là phần "công việc" mà câu hỏi yêu cầu.
Thuật toán A*. Dijkstra khám phá theo mọi hướng. A* thêm một heuristic $h$, là ước lượng khoảng cách còn lại phải đi, và luôn mở rộng nơ-đốt có ⟨$f = g + h$⟩ nhỏ nhất, trong đó $g$ là khoảng cách đã đi được cho đến nay. Với một heuristic hợp lý (không bao giờ ước lượng quá cao), nó tìm được cùng đường đi ngắn nhất nhưng chỉ cần khám phá ít nơ-đốt hơn nhiều, đó là lý do tại sao thiết bị dẫn đường và trò chơi sử dụng nó. Đề thi đưa ra $h$ cho mỗi nơ-đốt và một bảng để điền.
Ví dụ tính toán. Tìm một đường đi từ H đến G bằng A*, trình bày các bước tính toán.
| nơ-đốt được mở rộng | $g$ đến nay | $h$ | $f = g + h$ | hàng xóm được thêm vào (nơ-đốt: $g$, $h$, $f$) |
|---|---|---|---|---|
| H | 0 | 7 | 7 | A: 4, 5, 9; B: 3, 6, 9 |
| B (hòa với A; chọn cái nào cũng được) | 3 | 6 | 9 | D qua B: 9, 2, 11 |
| A | 4 | 5 | 9 | C: 9, 3, 12; D qua A: 8, 2, 10 (tốt hơn 11, giữ nguyên) |
| D | 8 | 2 | 10 | G: 10, 0, 10; C qua D: 9 (không tốt hơn) |
| G | 10 | 0 | 10 | đạt mục tiêu |
Đường đi H–A–D–G, độ dài 10, giống hệt Dijkstra, nhưng C chưa bao giờ được mở rộng. Mỗi lần một nơ-đốt được tiếp cận bằng một tuyến đường thứ hai, hãy giữ lại ⟨$g$⟩ nhỏ hơn; cuộc tìm kiếm kết thúc khi mục tiêu là nơ-đốt có ⟨$f$⟩ nhỏ nhất. Nêu các giá trị $g$, $h$ và $f$ trong mỗi hàng: đó là các điểm số.
Từ vựng
Luyện tập
| English | Tiếng Việt |
|---|---|
| graph/ɡræf/ | đồ thị |
| nodes/nəʊdz/ | nút |
| edges/ˈedʒɪz/ | cạnh |
| minimax/ˈmɪnɪmæks/ | minimax |
| semantic network/səˈmæntɪk ˈnetwɜːk/ | mạng ngữ nghĩa |
| knowledge graph/ˈnɒlɪdʒ ɡræf/ | biểu đồ tri thức |
| breadth-first search/bredθ fɜːst sɜːtʃ/ | tìm kiếm theo độ sâu |
| depth-first search/depθ fɜːst sɜːtʃ/ | tìm kiếm theo chiều rộng |
| weight/weɪt/ | trọng lực |
| heuristic/hjuːˈrɪstɪk/ | phương tiện heuristic |
| labels/ˈleɪblz/ | nhãn |
18.1
Mạng thần kinh nhân tạo (ANNs)

Một ANN lấy cảm hứng từ các neuron của não bộ. Một neuron nhân tạo:
- nhận nhiều giá trị đầu vào, nhân mỗi giá trị với một trọng số, và cộng tổng chúng với một thông số bias.
- áp dụng một hàm kích hoạt (một hàm phi tuyến tính như ReLU) lên tổng.
- xuất ra kết quả, kết quả này sẽ truyền vào các neuron ở phía sau.
Các neuron sắp xếp thành các lớp: một lớp đầu vào, một hoặc nhiều lớp ẩn (nơi các mẫu nội tại hữu ích được học), và một lớp đầu ra. Với nhiều lớp ẩn, nó là mạng thần kinh sâu, và việc huấn luyện nó là học sâu.

ANNs cho phép các mô hình học các mẫu phức tạp trực tiếp từ dữ liệu thô (pixel, âm thanh, văn bản) mà không cần đặc trưng được thiết kế thủ công — thúc đẩy những đột phá trong nhận diện hình ảnh, nhận diện giọng nói, dịch máy, và chơi game. Chúng hoạt động tốt với lượng dữ liệu lớn, đầu vào nhiễu hoặc rất phức tạp, và các mẫu quá khó để nắm bắt bằng các quy tắc rõ ràng.
"Giải thích ý nghĩa của mạng nơ-ron nhân tạo." Mô phỏng mạng lưới các nơ-ron trong não, bao gồm các lớp các nút kết nối: một lớp đầu vào, một hoặc nhiều lớp ẩn và một lớp đầu ra. Mỗi kết nối có một trọng số; mỗi nút tổng hợp các đầu vào đã được nhân với trọng số và truyền kết quả qua hàm kích hoạt đến lớp tiếp theo. "Giải thích cách ANNs cho phép máy học" (ba điểm): mạng được huấn luyện trên rất nhiều ví dụ; với mỗi ví dụ, đầu ra được so sánh với kết quả mong đợi và lỗi được sử dụng để điều chỉnh trọng số (lan truyền ngược) sao cho lỗi giảm xuống; sau khi đủ ví dụ, trọng số mã hóa các mẫu trong dữ liệu, và mạng sau đó có thể phân loại hoặc dự đoán cho dữ liệu mới mà nó chưa từng thấy. "Nêu lý do tại sao cần nhiều lớp ẩn": mỗi lớp bổ sung kết hợp các đặc điểm tìm thấy bởi lớp trước nó thành các đặc điểm phức tạp hơn, trừu tượng hơn, giúp mạng có thể học các mối quan hệ phức tạp hơn (cạnh, rồi hình dạng, rồi đối tượng); đó chính là điều làm cho mạng trở nên "sâu".
Khám phá
Nhấn vào các thành phần của mạng nơ-ron
Khám phá các lớp. Dữ liệu chảy từ trái sang phải: lớp đầu vào nhận đặc trưng, các lớp ẩn học các mẫu, và lớp đầu ra đưa ra câu trả lời — với mỗi kết nối đều mang theo trọng số mà quá trình huấn luyện điều chỉnh.
Từ vựng
Luyện tập
| English | Tiếng Việt |
|---|---|
| artificial neuron/ˌɑːtɪˈfɪʃl ˈnjuːrɒn/ | nơ-ron nhân tạo |
| bias term/ˈbaɪəs tɜːm/ | hệ số lệch |
| activation function/ˌæktɪˈveɪʃn ˈfʌŋkʃn/ | hàm kích hoạt |
| hidden layers/ˈhɪdn ˈleɪəz/ | lớp ẩn |
| deep neural network/diːp ˈnjuːrəl ˈnetwɜːk/ | mạng nơ-ron sâu |
| image recognition/ˈɪmɪdʒ ˌrekəɡˈnɪʃn/ | nhận dạng hình ảnh |
| speech recognition/spiːtʃ ˌrekəɡˈnɪʃn/ | nhận dạng giọng nói |
| machine translation/məˈʃiːn trænˈsleɪʃn/ | dịch máy |
| reinforcement learning/ˌriːɪnˈfɔːsmənt ˈlɜːnɪŋ/ | học tăng cường |
| supervised learning/ˈsuːpəvaɪzd ˈlɜːnɪŋ/ | học có giám sát |
| classification/ˌklæsɪfɪˈkeɪʃn/ | phân loại |
18.1
Máy học, học sâu, học tăng cường
Máy học
Thuật ngữ bao trùm — bất kỳ thuật toán nào học từ dữ liệu. Ba mô hình:
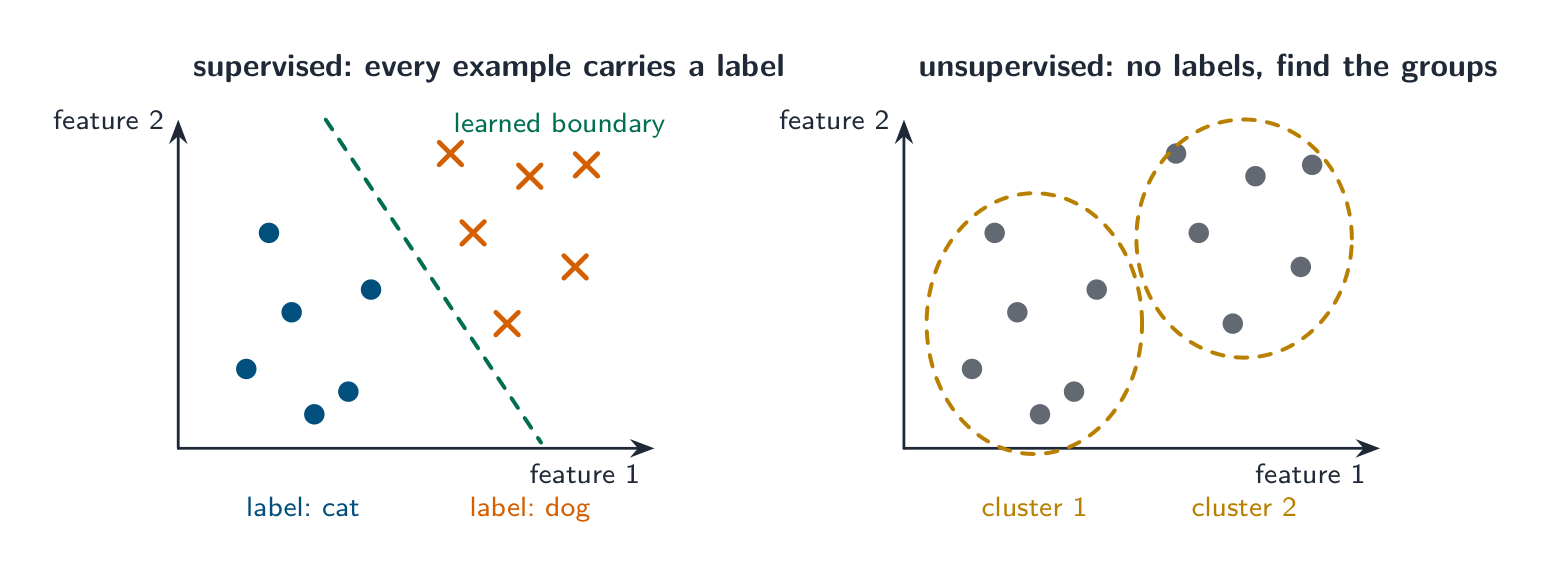
- học có giám sát — dữ liệu có nhãn (hình ảnh gắn nhãn "mèo"/"chó"); thuật toán học input → label. Dùng cho phân loại (một danh mục) và hồi quy.
- học không có giám sát — không có nhãn; thuật toán tìm kiếm cấu trúc, ví dụ như một cụm khách hàng tương tự nhau.
- học tăng cường (bên dưới).
Sử dụng ML khi các quy tắc rõ ràng sẽ không khả thi (bộ lọc spam, đề xuất, phát hiện gian lận).
"Mô tả học có giám sát và học không có giám sát" (các từ được đánh dấu). Học có giám sát: thuật toán được huấn luyện trên dữ liệu huấn luyện có nhãn, mỗi ví dụ đi kèm với kết quả đúng (mục tiêu); nó học mối quan hệ giữa đầu vào và đầu ra và sử dụng nó để phân loại hoặc dự đoán cho đầu vào mới; các câu trả lời đã biết trong quá trình huấn luyện, nên lỗi có thể được đo lường. Học không có giám sát: dữ liệu không có nhãn, không có đáp án đúng được cung cấp; thuật toán tự tìm kiếm mẫu, cấu trúc hoặc sự phân nhóm trong dữ liệu (góm các vật phẩm tương tự, tìm kiếm sự liên kết); đầu ra là một tập hợp các danh mục hoặc mối quan hệ không được xác định từ trước. Sự khác biệt: dữ liệu có nhãn so với không có nhãn; đầu ra đã biết so với cấu trúc được khám phá; học có giám sát dùng để dự đoán (phân loại, hồi quy), học không có giám sát dùng để khám phá (góm, phát hiện bất thường). Cả hai đều là các hạng mục của máy học; thứ ba là học tăng cường.

Học sâu
Một phần của ML sử dụng mạng nơ-ron sâu. Các lớp dưới học các mẫu đơn giản (cạnh, âm vị), các lớp trên kết hợp chúng thành các khái niệm trừu tượng. Nó cần nhiều dữ liệu và nhiều tài nguyên tính toán (GPU); đối với bộ dữ liệu nhỏ, các phương pháp ML đơn giản hơn thường hiệu quả hơn.
"Giải thích ý nghĩa của học sâu" (ba điểm). Máy học sử dụng mạng nơ-ron nhân tạo với nhiều lớp ẩn (mạng sâu); mạng được huấn luyện trên lượng dữ liệu rất lớn, và mỗi lớp trích xuất đặc điểm từ đầu ra của lớp phía dưới, giúp mạng tự học các đặc điểm cần thiết thay vì phải do lập trình viên chỉ định. Lý do sử dụng: nó có thể giải quyết các vấn đề quá phức tạp so với các quy tắc viết tay hoặc mô hình nông (nhận diện khuôn mặt, hiểu giọng nói, dịch văn bản); nó cải thiện khi có thêm dữ liệu; nó loại bỏ nhu cầu về kỹ thuật tạo đặc điểm thủ công của con người; và nó có thể xử lý dữ liệu không có cấu trúc như hình ảnh, âm thanh và văn bản. Cách làm cho nó hiệu quả hơn: nhiều (và có nhãn tốt hơn) dữ liệu huấn luyện; nhiều lớp hoặc nút hơn, trong giới hạn của việc bị quá khớp; nhiều sức mạnh xử lý (GPU) và thời gian huấn luyện hơn; tinh chỉnh tốc độ học và các tham số khác. Ví dụ: nhận diện giọng nói trong trợ lý giọng nói, nhận diện hình ảnh trong quét y tế và xe tự lái, dịch máy, hệ thống đề xuất.
Học tăng cường
Trong học tăng cường, một agent hành động trong môi trường; mỗi hành động thay đổi trạng thái và trả về thưởng. Agent học một chính sách (chiến lược) tối đa hóa tổng thưởng theo thời gian, thông qua deno thử nghiệm mà không có nhãn từ trước. Dùng cho các vấn đề ra quyết định tuần tự — trò chơi, điều khiển robot, lái xe tự động.
"Giải thích ý nghĩa của học tăng cường" (ba điểm). Một tác nhân học bằng cách tương tác với môi trường: nó thực hiện một hành động, môi trường chuyển sang trạng thái mới và trả về một thưởng (hoặc phạt), và tác nhân điều chỉnh hành vi của mình để tối đa hóa tổng phần thưởng theo thời gian. Không có dữ liệu được gán nhãn: tác nhân học qua thử nghiệm và sai lầm, khám phá ra hành động nào tốt dựa trên các phần thưởng thu được, và dần hình thành một chính sách chỉ định những gì cần làm trong mỗi trạng thái. Được áp dụng khi đáp án đúng không biết trước nhưng kết quả của một hành động có thể được chấm điểm: chơi game (cờ vua, Go), điều khiển robot, thời gian đèn giao thông, phân bổ tài nguyên. Một máy tính chơi cờ bàn đối thủ người dùng sẽ học theo cách này, hoặc tìm kiếm trong cây trò chơi bằng thuật toán minimax để chọn nước đi có kết quả xấu nhất là tốt nhất.

Một xe tự lái là ví dụ thực tế. Cảm biến Lidar và camera (bộ phận quay trên nóc xe) tạo ra bản đồ trực quan của con đường, và chính sách đã học quyết định cách lái, tăng tốc và phanh an toàn.


Từ vựng
Luyện tập
| English | Tiếng Việt |
|---|---|
| self-driving car/self ˈdraɪvɪŋ kɑː/ | xe tự lái |
| agent/ˈeɪdʒənt/ | tác nhân |
| reward/rɪˈwɔːd/ | thưởng |
| policy/ˈpɒlɪsi/ | chính sách |
| lidar/ˈlaɪdɑː/ | lidar |
18.1
Huấn luyện mạng thần kinh nhân tạo: lan truyền ngược
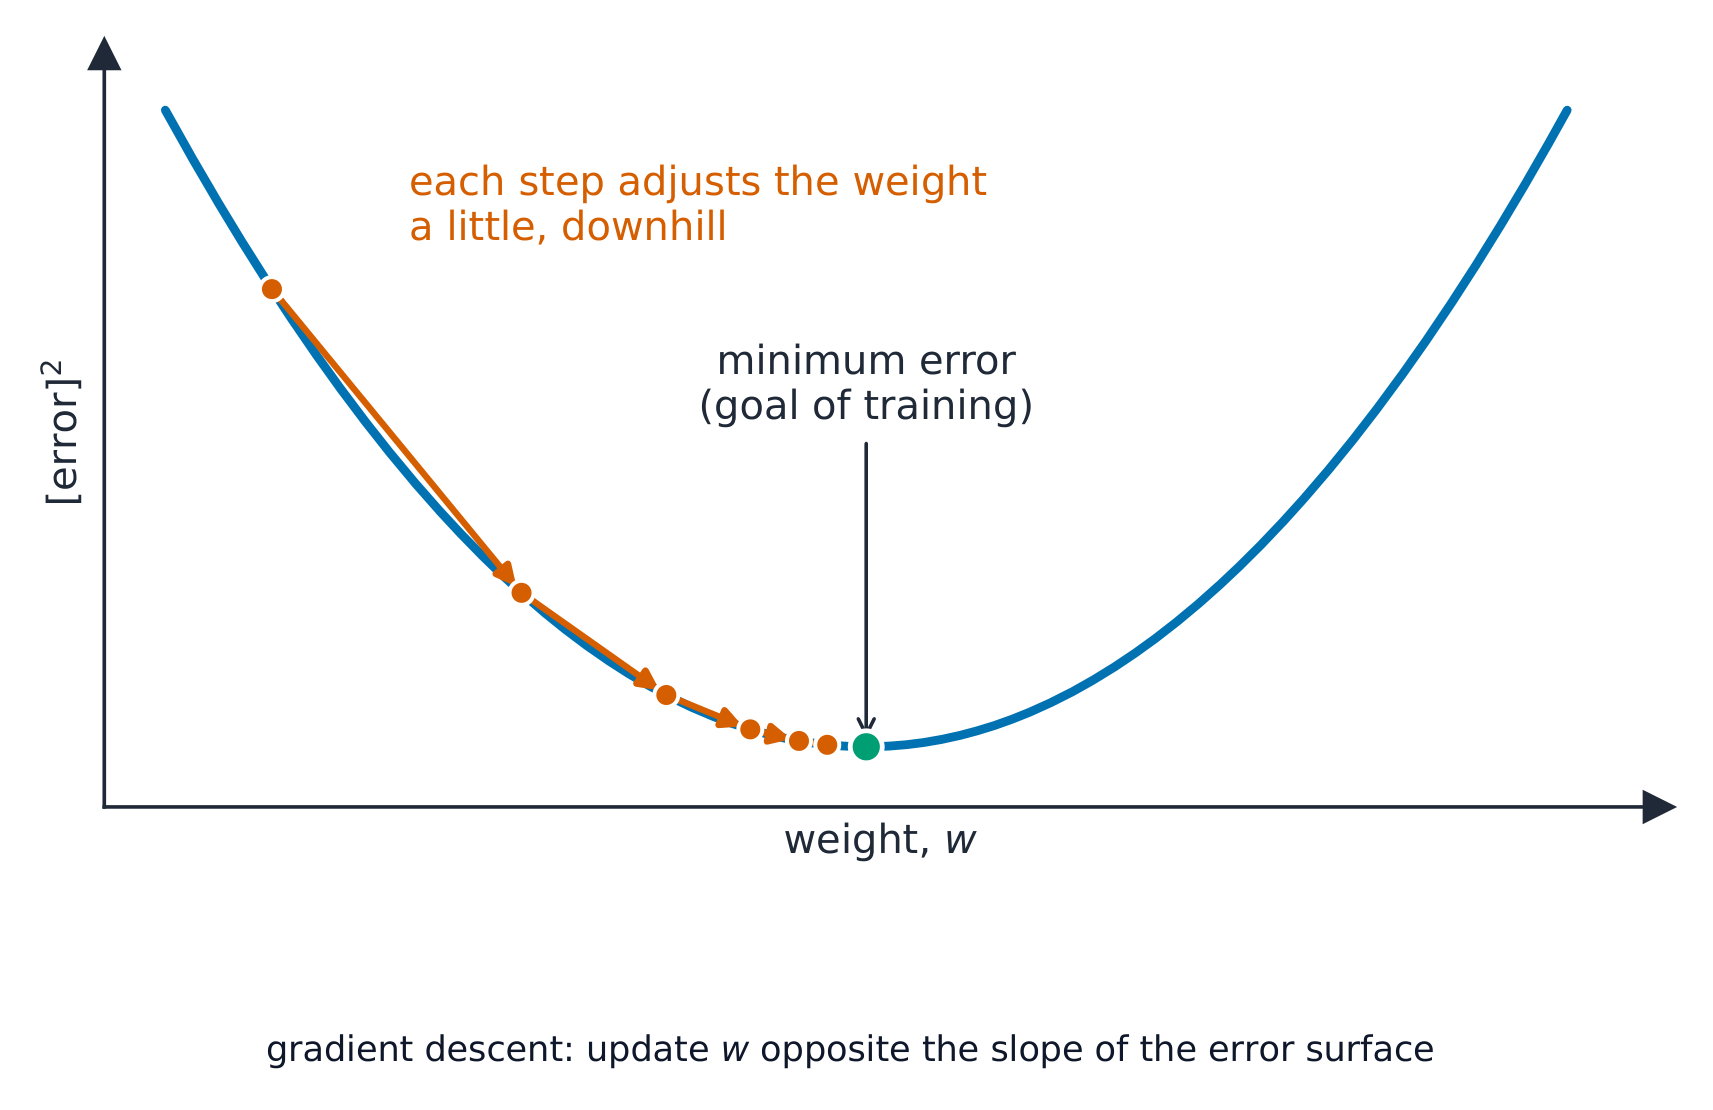
Huấn luyện điều chỉnh các trọng số để đầu ra khớp với mục tiêu. Phương pháp chuẩn là lan truyền ngược (backpropagation - lan truyền lỗi ngược) kết hợp với giảm gradient. Với mỗi ví dụ huấn luyện:
- lượt đi tới — đưa đầu vào xuyên qua mạng đến đầu ra.
- tính toán lỗi bằng hàm mất mát (một giá trị duy nhất biểu thị mức độ sai lệch của đầu ra).
- lượt đi ngược — lan truyền lỗi ngược trở lại, xác định gradient của từng trọng số (mức độ đóng góp vào lỗi) bằng quy tắc chuỗi.
- cập nhật trọng số theo một bước nhỏ (do tốc độ học tập quy định) nhằm giảm lỗi.
Lặp lại qua nhiều ví dụ và nhiều lượt (epoch) cho đến khi lỗi ngừng giảm. Tên gọi "ngược" đến từ bước 3: lỗi chảy từ đầu ra ngược về phía đầu vào, nên gradient của mọi trọng số đều được xác định trong một lần quét. Sau khi huấn luyện, một đầu vào mới chỉ cần một lượt đi tới để có dự đoán.
"Mô tả phương pháp lan truyền lỗi ngược" (bốn điểm). (1) Đầu vào được đưa đi tới qua mạng và so sánh đầu ra của nó với đầu ra mong đợi (mục tiêu); (2) sự chênh lệch chính là lỗi; (3) lỗi được truyền ngược qua mạng, lớp theo lớp từ đầu ra đến đầu vào, và tỷ lệ lỗi của mỗi trọng số được tính toán; (4) các trọng số được điều chỉnh tương ứng với mức độ đóng góp của chúng, theo hướng làm giảm lỗi; (5) quá trình này được lặp lại với nhiều ví dụ cho đến khi lỗi đạt kích thước yêu cầu. Mục đích của phương pháp là mạng có các lớp ẩn không có cách nào trực tiếp biết trọng số nội bộ nào gây ra lỗi đầu ra; lan truyền ngược phân bổ trách nhiệm.
Từ vựng
Luyện tập
| English | Tiếng Việt |
|---|---|
| backpropagation/ˌbækprəpəˈɡeɪʃn/ | truyền ngược |
| gradient descent/ˈɡreɪdɪənt dɪˈsent/ | giảm độ dốc |
| loss function/lɒs ˈfʌŋkʃn/ | hàm mất mát |
| epochs/ˈiːpɒks/ | epochs |
18.1
Hồi quy

Một số bài toán dự đoán một con số (giá nhà, nhiệt độ ngày mai) — hồi quy, trái ngược với phân loại (một danh mục).
Hồi quy tuyến tính vẽ một đường thẳng (hoặc siêu mặt phẳng):
$$y = m_{1} x_{1} + m_{2} x_{2} + \ldots + m_{n} x_{n} + c.$$
Chọn các hệ số để tối thiểu hóa tổng bình phương lỗi so với dữ liệu huấn luyện. Sử dụng khi mối quan hệ trông khá tuyến tính và bạn muốn mô hình dễ giải thích. Đối với dữ liệu cong, hãy sử dụng phương pháp hồi quy đa thức, cây quyết định hoặc mạng thần kinh — cùng ý tưởng: xác định mô hình, xác định hàm mất mát, và điều chỉnh tham số để tối thiểu hóa nó. Hồi quy và phân loại đều thuộc học có giám sát; việc lựa chọn phụ thuộc vào việc đáp án là một con số hay một danh mục.
"Mô tả các phương pháp hồi quy trong học máy" (hai điểm). Các phương pháp thống kê tìm mối quan hệ giữa các biến đầu vào và đầu ra liên tục, bằng cách khớp một hàm (đường thẳng hoặc đường cong) với dữ liệu huấn luyện sao cho tổng lỗi là nhỏ nhất; hàm đã khớp sau đó được dùng để dự đoán đầu ra cho các đầu vào mới. Hồi quy tuyến tính khớp đường thẳng; các phương pháp khác khớp đường cong. Hồi quy dự đoán một giá trị (giá, nhiệt độ, thời gian); phân loại dự đoán một danh mục, đây là sự phân biệt mà đề thi yêu cầu.
Khám phá
Phù hợp đường hồi quy
Kéo các điều khiển. Hồi quy tuyến tính vẽ đường thẳng làm cho tổng bình phương khoảng cách đến các điểm dữ liệu là nhỏ nhất — sau đó nó dự đoán một con số cho bất kỳ đầu vào mới nào.
Từ vựng
Luyện tập
| English | Tiếng Việt |
|---|---|
| regression/rɪˈɡreʃn/ | hồi quy |
| unsupervised learning/ʌnˈsuːpəvaɪzd ˈlɜːnɪŋ/ | học không có giám sát |
| cluster/ˈklʌstə/ | cụm |
| training data/ˈtreɪnɪŋ ˈdeɪtə/ | dữ liệu huấn luyện |
| learning rate/ˈlɜːnɪŋ reɪt/ | tốc độ học tập |
| linear regression/ˈlɪnɪə rɪˈɡreʃn/ | hồi quy tuyến tính |
| optical character recognition/ˈɒptɪkl ˈkærɪktə ˌrekəɡˈnɪʃn/ | nhận dạng ký tự quang học |
| text-to-speech/tekst tə spiːtʃ/ | chuyển đổi văn bản thành giọng nói |
18.1
Cách AI được sử dụng trong tình huống thực tế
Nhiều tình huống đề thi sử dụng cùng một mẫu — một mô hình học sâu được huấn luyện trên dữ liệu có gán nhãn, thường kết hợp nhiều mô hình vào một quy trình:
- xác định khách hàng tại cửa hàng tự động: hệ thống được huấn luyện trên ảnh khuôn mặt có gán nhãn; camera chụp khuôn mặt; nhận diện ảnh trích xuất biểu diễn; nó được đối chiếu với khách hàng đã đăng ký; phép khớp gần nhất xác định người đó.
- đọc văn bản từ hình ảnh: nhận diện hình ảnh tìm các vùng văn bản; nhận dạng ký tự quang học trích xuất các ký tự; dịch máy chuyển đổi chúng; chuyển văn bản thành giọng nói đọc to lên.
- kiểm tra hàng hóa khi thanh toán: AI phát hiện đối tượng, được huấn luyện trên hình ảnh sản phẩm có nhãn, xác định xem những mặt hàng nào được bỏ vào giỏ và trừ tiền từ tài khoản.
Vào thời điểm người dùng tương tác với hệ thống, mô hình hoạt động nhanh — nó chỉ thực hiện suy luận truyền thẳng (forward pass); sự thông minh nằm ở các mẫu đã học được trong quá trình huấn luyện.
Mô hình trả lời cho câu hỏi tình huống. Camera bãi đậu xe đọc biển số: camera chụp lại hình ảnh; một AI được huấn luyện trên nhiều hình ảnh có nhãn của biển số tìm vị trí biển số trong hình; nhận dạng ký tự (một bộ phân loại học sâu, cũng được huấn luyện trên các ký tự có nhãn) chuyển đổi biển số thành văn bản; văn bản được lưu cùng thời gian và khớp khi xe rời đi. Hệ thống CCTV phát hiện và theo dõi người: phần mềm nhận diện hình ảnh được huấn luyện trên hình ảnh có nhãn của con người xác định người đó trong từng khung hình; hệ thống so sánh các khung hình liên tiếp để theo dõi chuyển động của họ; chuyển động bất thường có thể kích hoạt cảnh báo. Biến giọng nói thành lệnh: nhận dạng giọng nói được huấn luyện trên nhiều giọng ghi âm chuyển đổi âm thanh thành văn bản; hệ thống khớp văn bản với một tập hợp các lệnh đã biết; nó cải thiện khi được chỉnh sửa. Camera lấy nét vào khuôn mặt: mô hình phát hiện khuôn mặt được huấn luyện trên khuôn mặt có nhãn tìm vùng khuôn mặt, và ống kính được điều chỉnh để đưa vùng đó vào tiêu cự. Đăng nhập bằng nhận diện khuôn mặt ngân hàng: ứng dụng chụp khuôn mặt, mạng sâu trích xuất đặc trưng của nó, và so sánh với các đặc特征 đã lưu trữ của khách hàng đó. Trong mọi trường hợp, quy trình đều là: được huấn luyện trên các ví dụ có nhãn, trích xuất đặc trưng, khớp hoặc phân loại đầu vào mới.
Ví dụ hướng dẫn. Với mỗi nhiệm vụ, hãy cho biết nó cần hồi quy hay phân loại, và lớp đầu ra của mạng nơ-ron nhân tạo sẽ trông như thế nào: (a) dự đoán nhiệt độ ngày mai; (b) quyết định xem email có phải spam hay không. Hãy hỏi loại cái gì đang được dự đoán. (a) Nhiệt độ là một số trên thang đo liên tục, vì vậy đây là hồi quy, và lớp đầu ra là một nơ-ron đơn chứa giá trị đó. (b) Spam hoặc không spam là một danh mục, vì vậy đây là phân loại, và đầu ra cung cấp xác suất cho từng danh mục. Cả hai đều là học có giám sát: mỗi loại đều cần các ví dụ có nhãn để huấn luyện, và quá trình huấn luyện điều chỉnh các trọng số bằng lỗi lan ngược để giảm thiểu sai số. Câu hỏi quyết định duy nhất chỉ đơn giản là số hay danh mục - không phải cảm giác về mức độ khó của nhiệm vụ.
18.1
Các định nghĩa mà giám khảo chấp nhận
Câu hỏi định nghĩa được chấm dựa trên văn phong cố định. Hãy học thuộc những định nghĩa này và chỉ đưa ra một đáp án duy nhất.
| Thuật ngữ | Định nghĩa |
|---|---|
| đồ thị (trong AI) | một tập hợp các nút đại diện cho trạng thái hoặc địa điểm, được nối với nhau bởi các cạnh đại diện cho kết nối, thường có trọng số, mà thuật toán tìm kiếm có thể khai thác |
| thuật toán Dijkstra | tìm khoảng cách ngắn nhất từ một nút bắt đầu đến mọi nút khác bằng cách luôn ghé thăm nút chưa ghé thăm có khoảng cách nhỏ nhất tính đến lúc đó |
| thuật toán A* | tìm đường đi ngắn nhất mở rộng nút có tổng nhỏ nhất của khoảng cách tính đến lúc đó cộng với ước lượng heuristic về khoảng cách đến đích |
| mạng nơ-ron nhân tạo | mô hình của các nơ-ron trong não: các lớp nút được nối với nhau bởi các kết nối có trọng số, được huấn luyện bằng cách điều chỉnh trọng số |
| học máy | các thuật toán học từ dữ liệu và cải thiện qua kinh nghiệm thay vì tuân theo các quy tắc cố định |
| học có giám sát | học từ dữ liệu huấn luyện có nhãn trong đó đầu ra đúng cho mỗi đầu vào đã biết |
| học không có giám sát | học từ dữ liệu không có nhãn bằng cách tìm kiếm các mẫu, nhóm hoặc cấu trúc trong đó |
| học tăng cường | một tác nhân học bằng thử và sai, chọn hành động trong môi trường để tối đa hóa phần thưởng nhận được |
| học sâu | học máy sử dụng mạng nơ-ron với nhiều lớp ẩn, được huấn luyện trên lượng lớn dữ liệu, mỗi lớp trích xuất đặc trưng từ lớp bên dưới |
| lan truyền lỗi ngược | so sánh đầu ra của mạng với mục tiêu, truyền lỗi ngược qua các lớp và điều chỉnh từng trọng số để giảm nó đi |
| hồi quy | phù hợp một hàm với dữ liệu huấn luyện để dự đoán một giá trị đầu ra liên tục từ các đầu vào |
18.1
Mẹo làm bài thi
- Đáp án đồ thị nêu tên các nút, cạnh và trọng số, và ý nghĩa đại diện của chúng; sau đó là thuật toán. Dijkstra: bảng khoảng cách, ghé thăm nút nhỏ nhất, cập nhật hàng xóm. A*: $g$, $h$ và $f = g + h$ trong mỗi hàng, mở rộng nút nhỏ nhất $f$.
- Đáp án ANN nêu tên các lớp, các kết nối có trọng số và quá trình huấn luyện; học sâu bổ sung nhiều lớp ẩn, dữ liệu lớn và trích xuất đặc trưng tự động, kèm lý do và ví dụ.
- Ba danh mục trong một dòng mỗi loại: dữ liệu có nhãn và đầu ra đã biết; dữ liệu không có nhãn và cấu trúc được khám phá; tác nhân, môi trường, hành động và phần thưởng.
- Lan truyền lỗi ngược: so sánh với mục tiêu, lỗi lan ngược qua các lớp, điều chỉnh trọng số để giảm nó, lặp lại. Hồi quy dự đoán một giá trị; phân loại dự đoán một danh mục.
- Câu hỏi tình huống muốn quy trình: được huấn luyện trên các ví dụ có nhãn, trích xuất đặc trưng, nhận diện hoặc phân loại đầu vào mới; nêu loại AI (nhận diện hình ảnh, nhận diện giọng nói, học sâu).
Lỗi thường gặp
- Miêu tả một đồ thị là "biểu đồ"; trong AI nó là các nút và cạnh.
- Chạy Dijkstra bằng cách chọn hàng xóm gần nhất của nút hiện tại thay vì khoảng cách nhỏ nhất chưa ghé thăm trên toàn bộ; hoặc quên cập nhật một nút khi có tuyến đường ngắn hơn xuất hiện.
- Thêm $h$ vào $g$ cho bước tiếp theo trong A*; $g$ chỉ là khoảng cách thực tế, $h$ được tính toán lại từ bảng dữ liệu.
- Nói rằng học sâu là "học rất nhiều"; thực chất là có nhiều lớp ẩn.
- Nhầm lẫn học không có giám sát với học tăng cường; cái đầu tiên tìm kiếm cấu trúc trong dữ liệu, cái thứ hai học từ phần thưởng.
- Mô tả lan truyền ngược mà không so sánh với đầu ra mong đợi hoặc không đề cập đến việc trọng số được điều chỉnh.
- Gọi một dự đoán giá là "phân loại"; một giá trị liên tục thuộc về hồi quy.
Bài học tương tác về chủ đề này
Làm theo từng bước, kèm theo bài tập kiểm tra ngay lập tức.