Một trường chuỗi đơn giản sẽ vui vẻ lưu trữ những vô nghĩa. Hãy hỏi loại phương tiện, và ai đó gõ "Chuối" — chương trình chấp nhận mà không hề phàn nàn. Nhưng nếu bạn…
English narration · English + 中文 subtitles burned in · Giọng đọc tiếng Anh · phụ đề tiếng Anh + 中文 được ghi trực tiếp
13.1
User-defined data types · Các kiểu dữ liệu do người dùng định nghĩa
Syllabus · Chương trình
English
Candidates should be able to:
Notes and guidance
Show understanding of why user-defined types are necessary
Define and use non-composite types
Including enumerated, pointer
Define and use composite data types
Including set, record and class/object
Choose and design an appropriate user-defined data type for a given problem
Tiếng Việt
Thí sinh cần có thể:
Ghi chú và hướng dẫn
Thể hiện sự hiểu biết về lý do tại sao kiểu dữ liệu do người dùng định nghĩa là cần thiết
Định nghĩa và sử dụng kiểu dữ liệu không tổ hợp
Bao gồm liệt kê, con trỏ
Định nghĩa và sử dụng kiểu dữ liệu tổ hợp
Bao gồm tập hợp, ghi chép và lớp/đối tượng
Chọn và thiết kế một kiểu dữ liệu do người dùng định nghĩa phù hợp cho một bài toán đã cho
Source: Cambridge International syllabus · Nguồn: Chương trình Cambridge International
English
The built-in types (INTEGER, REAL, STRING, CHAR, BOOLEAN) cover the simplest cases. For richer problems you can define user-defined types 用户定义类型, making the code clearer and the compiler stricter.
Why they are needed
A built-in STRING lets you store nonsense in a field that should hold one of a few legal values; a user-defined type can restrict it. Real entities are usually a collection of values of different types. And DECLARE Taxi : Vehicle is clearer (self-documenting) than DECLARE Taxi : STRING.
"Describe the purpose of a user-defined data type" (two marks).A data type defined by the programmer, built from existing (built-in) types, so that data specific to the problem can be represented when no built-in type fits. Both halves score: defined by the programmer and based on existing types. The examiner also accepts "to make the program easier to read and maintain" as a supporting point, never on its own.
"Explain what is meant by non-composite and composite data types" (four marks). A non-composite type is defined without reference to another type: it holds a single value, for example an integer, a real, or an enumerated value. A composite type is a collection of other types (which may themselves be composite): it holds several values under one identifier, for example a record, a set, an array or a class. Give an example with each definition; the exam asks for one.
Non-composite types
Enumerated type
An enumerated type 枚举类型 has values that are a fixed list of named constants:
The names are values of the new type (stored internally as small integers); you cannot assign anything outside the list. Uses: days of the week, colours, status codes.
"State what is meant by an enumerated data type."A non-composite user-defined type defined by listing all its possible values (in order). Because the values are ordered, they can be compared and stepped through: with TYPE Month = (January, February, ..., December), the test IF ThisMonth > June is legal, and the values are stored internally as integers. The pseudocode has three parts and the exam marks each: the keyword TYPE, the identifier with =, and the list in brackets separated by commas.
Worked example. Write pseudocode to define an enumerated type for the days on which a school is open (Monday to Friday), and declare a variable of that type set to Wednesday.
A variable of an enumerated type cannot be given a value outside the list, which is the whole point: Today ← Saturday is a compile-time error, whereas a STRING would have accepted "Saturdy".
Pointer type
A pointer 指针 holds the memory address of another variable (or NULL for "no target"). Pointers build dynamic structures (linked lists, trees) and pass references without copying.
To dereference 解引用 (p^) means to reach the variable it points to.
"State what is meant by a pointer data type."A non-composite type whose value is the memory address of (a reference to) a variable of a given type. The pseudocode declares the type with a caret before the type it points to, and the exam asks for exactly that line:
Pointers are what a dynamic linked list or binary tree (Topic 19) is built from: each node holds a pointer to the next. Two marks are commonly lost here: writing the pointer type as if it held the value itself, and forgetting the caret when reading through the pointer.
Composite types
A composite type 复合类型 (one of the composite data types) groups several values under one name.
record 记录 (Topic 10) — fields of different types in a TYPE ... ENDTYPE block.
set 集合 — an unordered collection of unique values, with operations add, remove, membership test, union, intersection:
class 类 / object 对象 — the OOP composite type, combining data fields (attributes 属性) with operations on them (methods 方法). An object is an instance of a class:
Choosing a type
Use enumerated for a value from a fixed list, pointer for indirection, record for a group of fields, set for an unordered unique collection, and class when you need state and behaviour together.
"Describe the user-defined data type set" (three marks).A composite type that holds a collection of values of the same type, in no particular order and with no duplicates; values can be added and removed, and a value can be tested for membership. Declare the type with SET OF, then define a set constant with its values in brackets:
"Describe the user-defined data type record" (three marks).A composite type made up of a fixed number of fields (items), each with its own identifier and its own type, referred to under a single identifier; the fields are accessed with dot notation.
Worked example. Write pseudocode to declare a record type ClubMember for a club member's first name, last name, membership code (an integer), date of joining and whether fees have been paid; then declare a variable and set two of its fields.
Every field needs its own DECLARE line with an appropriate type, the block ends with ENDTYPE, and a field 字段 is reached as variable.field. Asked to choose a type for each field, match it to the data: a code that is only ever compared is a STRING if it can contain letters, an INTEGER if arithmetic or ordering is needed; a yes/no is BOOLEAN; a date is DATE. A field that can take one of a few named values (a pet's species, a colour) is the one to make an enumerated type.
Records in arrays and files. A table of many members is DECLARE Members : ARRAY[1:100] OF ClubMember; then Members[3].LastName is one field of one element, and a loop over the index processes every record. A record is also the natural unit written to and read from a file (below), one record per PUTRECORD or WRITEFILE.
Worked example. A composite type Pet stores each pet's name (string), species (one of dog, cat, rabbit or hamster) and weight in kilograms (real). Define the types and declare a variable.
The enumerated type is defined first, because the record uses it: order matters in pseudocode as it does in a compiler.
Classes in pseudocode. A class is the composite type that also carries behaviour. The exam asks for the declaration with its attributes marked PRIVATE, a constructor 构造函数 named NEW that sets them, and PUBLIC methods to get or change them:
Attributes are private so that they can only be changed through methods (encapsulation, Topic 20); the constructor is a procedure called NEW with one parameter per attribute; a getter is a function that returns the attribute. Each of these is a separate mark.
Tiếng Việt
Các kiểu có sẵn (INTEGER, REAL, STRING, CHAR, BOOLEAN) bao quát các trường hợp đơn giản nhất. Đối với các bài toán phức tạp hơn, bạn có thể định nghĩa kiểu dữ liệu do người dùng, giúp mã rõ ràng hơn và trình biên dịch nghiêm ngặt hơn.
Tại sao chúng cần thiết
Một kiểu có sẵn STRING cho phép bạn lưu trữ vô nghĩa vào một trường vốn dĩ chỉ chứa một vài giá trị hợp lệ; một kiểu do người dùng định nghĩa có thể hạn chế điều này. Các thực thể thực tế thường là một bộ sưu tập các giá trị thuộc nhiều kiểu khác nhau. Và DECLARE Taxi : Vehicle rõ ràng hơn (tự tài liệu hóa) so với DECLARE Taxi : STRING.
"Mô tả mục đích của một kiểu dữ liệu do người dùng định nghĩa (hai điểm).** Một kiểu dữ liệu do lập trình viên định nghĩa, được xây dựng từ các kiểu có sẵn (predefined), nhằm đại diện cho dữ liệu đặc thù của bài toán khi không có kiểu có sẵn nào phù hợp. Cả hai nửa đều đạt điểm: do lập trình viên định nghĩa và dựa trên các kiểu hiện có. Giám khảo cũng chấp nhận "để làm cho chương trình dễ đọc và bảo trì hơn" như một điểm bổ sung, nhưng không bao giờ tính riêng lẻ.
"Giải thích ý nghĩa của các kiểu dữ liệu không tổ hợp và kiểu dữ liệu tổ hợp" (bốn điểm). Một kiểu không tổ hợp được định nghĩa không tham chiếu đến một kiểu nào khác: nó chứa một giá trị đơn lẻ, ví dụ như số nguyên, số thực hoặc giá trị liệt kê. Một kiểu tổ hợp là tập hợp của các kiểu khác (có thể bản thân chúng cũng là kiểu tổ hợp): nó chứa nhiều giá trị dưới cùng một danh xưng, ví dụ như bản ghi, tập hợp, mảng hoặc lớp. Hãy đưa ra một ví dụ cho mỗi định nghĩa; đề thi yêu cầu chỉ một ví dụ.
Các kiểu không tổ hợp
Kiểu liệt kê
Một kiểu liệt kê có các giá trị là một danh sách cố định các hằng có tên:
Các tên này là các giá trị của kiểu mới (được lưu trữ bên trong dưới dạng số nguyên nhỏ); bạn không thể gán bất kỳ giá trị nào nằm ngoài danh sách đó. Ứng dụng: các ngày trong tuần, màu sắc, mã trạng thái.
"Nêu ý nghĩa của kiểu dữ liệu liệt kê."Một kiểu do người dùng tự định nghĩa không tổ hợp, được xác định bằng cách liệt kê tất cả các giá trị có thể có của nó (theo thứ tự). Vì các giá trị được sắp xếp thứ tự, nên chúng có thể so sánh và duyệt qua từng bước: với TYPE Month = (January, February, ..., December), phép kiểm tra IF ThisMonth > June là hợp lệ, và các giá trị được lưu trữ bên trong dưới dạng số nguyên. Mã giả gồm ba phần và đề thi chấm điểm riêng cho từng phần: từ khóa TYPE, danh xưng đi kèm =, và danh sách trong ngoặc vuông phân tách bởi dấu phẩy.
Ví dụ giải. Viết mã giả để định nghĩa một kiểu liệt kê cho các ngày nhà trường mở cửa (Thứ Hai đến Thứ Sáu), và khai báo một biến của kiểu đó có giá trị là Thứ Tư.
Một biến của kiểu liệt kê không thể được gán một giá trị nằm ngoài danh sách, đây chính là mục đích cốt lõi: Today ← Saturday sẽ gây lỗi biên dịch, trong khi một STRING sẽ chấp nhận được "Saturdy".
Kiểu liệt kê là một danh sách cố định các giá trị có tên
Kiểu conype
Một conype lưu địa chỉ bộ nhớ của một biến khác (hoặc NULL để biểu thị "không có mục tiêu"). Conype tạo nên các cấu trúc động (danh sách liên kết, cây) và truyền tham chiếu mà không cần sao chép dữ liệu.
TYPE PNode = ^TNode    // pointer to a TNode
DECLARE p : PNode
p ← NEW TNode
p^.Value ← 42          // dereference to reach the fields
Để giải tham chiếu (p^) có nghĩa là truy cập trực tiếp vào biến mà nó trỏ tới.
"Nêu ý nghĩa của kiểu dữ liệu conype."Một kiểu không tổ hợp mà giá trị của nó là địa chỉ bộ nhớ (hoặc tham chiếu) đến một biến thuộc một kiểu đã cho. Mã giả khai báo kiểu này bằng cách đặt ký hiệu caret (^) trước tên kiểu mà nó trỏ tới, và đề thi yêu cầu đúng dòng đó:
TYPE SelectParts = ^Parts        // a pointer to a value of type Parts
DECLARE Chosen : SelectParts
Chosen ← ^Keyboard               // Chosen now holds the address of Keyboard
OUTPUT Chosen^                   // dereference: the value stored at that address
Conype là thành phần cơ bản để xây dựng một danh sách liên kết động hay cây nhị phân (Chủ đề 19): mỗi nút chứa một conype trỏ tới nút tiếp theo. Hai điểm thường bị mất ở đây: viết kiểu conype như thể nó chứa chính giá trị đó, và quên bỏ ký hiệu caret khi truy cập thông qua conype.
Con trỏ giữ một địa chỉ; p^ truy cập vào nó để tiếp cận các trường của node
Các kiểu tổ hợp
Một kiểu tổ hợp (một trong các kiểu dữ liệu tổ hợp) nhóm nhiều giá trị dưới cùng một tên gọi.
Set là một tập hợp không thứ tự các giá trị duy nhấtRecord nhóm các trường thuộc các kiểu khác nhau dưới cùng một tên gọi
record (Chủ đề 10) — các trường thuộc các kiểu khác nhau nằm trong khối TYPE ... ENDTYPE.
set — một tập hợp không thứ tự các giá trị duy nhất, với các thao tác add (thêm), remove (xóa), kiểm tra thành viên, union (hợp), intersection (giao):
DECLARE Available : SET OF Colour
Available ← {Red, Blue}
IF Green IN Available THEN
    ...
ENDIF
class / object — kiểu tổ hợp hướng đối tượng, kết hợp các trường dữ liệu (thuộc tính) với các thao tác trên chúng (phương thức). Một object là một thực thể (instance) của một class:
CLASS Taxi
    PRIVATE Capacity : INTEGER
    PUBLIC FUNCTION GetCapacity() RETURNS INTEGER
        RETURN Capacity
    ENDFUNCTION
ENDCLASS
Lựa chọn kiểu dữ liệu
Sử dụng enumerated cho một giá trị từ danh sách cố định, pointer cho sự gián tiếp, record cho một nhóm các trường, set cho một tập hợp không thứ tự và duy nhất, và class khi bạn cần đồng thời cả trạng thái và hành vi.
"Mô tả kiểu dữ liệu set do người dùng tự định nghĩa" (ba điểm). Một kiểu tổ hợp chứa một tập hợp các giá trị cùng loại, không theo thứ tự cụ thể và không có giá trị trùng lặp; có thể thêm và xóa giá trị, cũng như kiểm tra xem một giá trị có thuộc về tập hợp đó hay không. Khai báo kiểu này với SET OF, sau đó định nghĩa một hằng set với các giá trị của nó trong ngoặc vuông:
TYPE EvenNumbers = SET OF INTEGER
DEFINE Evens (2, 4, 6, 8, 10, 12) : EvenNumbers
TYPE SymbolSet = SET OF CHAR
DEFINE Operators ('+', '-', '*', '/') : SymbolSet
"Mô tả kiểu dữ liệu record do người dùng tự định nghĩa" (ba điểm). Một kiểu tổ hợp bao gồm một số lượng cố định các trường (mục), mỗi trường có danh xưng riêng và kiểu dữ liệu riêng, nhưng được tham chiếu chung dưới một danh xưng duy nhất; các trường được truy cập thông qua ký hiệu chấm.
Ví dụ giải. Viết mã giả để khai báo một kiểu record ClubMember cho thành viên câu lạc bộ: tên đầu, họ, mã thành viên (số nguyên), ngày gia nhập và tình trạng đã đóng phí chưa; sau đó khai báo một biến và gán giá trị cho hai trong số các trường của biến đó.
Mỗi trường cần có dòng khai báo riêng với DECLARE phù hợp, khối mã kết thúc bằng ENDTYPE, và một trường được truy cập thông qua variable.field. Khi được yêu cầu chọn kiểu dữ liệu cho mỗi trường, hãy khớp nó với loại dữ liệu: một mã chỉ dùng để so sánh nếu có thể chứa chữ cái thì là STRING, nếu cần toán học hoặc sắp xếp thì là INTEGER; yes/no là BOOLEAN; ngày tháng là DATE. Một trường có thể nhận một trong vài giá trị được đặt tên (loài vật nuôi, màu sắc) thì nên tạo thành kiểu liệt kê.
Mảng chứa các record: mỗi phần tử là một bản ghi hoàn chỉnh, chỉ số chọn phần tử, và ký hiệu chấm chọn trường
Dữ liệu trong mảng và tập tin. Một bảng chứa nhiều thành viên là DECLARE Members : ARRAY[1:100] OF ClubMember; sau đó Members[3].LastName là một trường của một phần tử, và vòng lặp theo chỉ mục sẽ xử lý mọi bản ghi. Một bản ghi cũng là đơn vị tự nhiên được viết vào và đọc từ một tập tin (phần dưới đây), mỗi bản ghi tương ứng với một PUTRECORD hoặc WRITEFILE.
Ví dụ có lời giải. Một kiểu hợp thành Pet lưu tên mỗi vật nuôi (chuỗi ký tự), loài động vật (một trong các lựa chọn: chó, mèo, thỏ hay hamster) và trọng lượng tính bằng kilogram (số thực). Hãy định nghĩa các kiểu dữ liệu và khai báo một biến.
TYPE Species = (Dog, Cat, Rabbit, Hamster)
TYPE Pet
    DECLARE Name : STRING
    DECLARE Kind : Species
    DECLARE Weight : REAL
ENDTYPE
DECLARE MyPet : Pet
MyPet.Kind ← Rabbit
Kiểu liệt kê được định nghĩa trước, vì bản ghi sử dụng nó: thứ tự quan trọng trong giả mã cũng như trong trình biên dịch.
Các lớp trong giả mã. Một lớp là kiểu hợp thành đồng thời mang theo hành vi. Đề thi yêu cầu phần khai báo với các thuộc tính được đánh dấu PRIVATE, một hàm khởi tạo tên là NEW để gán giá trị cho chúng, và PUBLICphương thức để lấy hoặc thay đổi các giá trị này:
CLASS Appointment
    PRIVATE PatientName : STRING
    PRIVATE Treatment : STRING
    PRIVATE Medication : STRING
    PUBLIC PROCEDURE NEW(Name : STRING, Treat : STRING, Med : STRING)
        PatientName ← Name
        Treatment ← Treat
        Medication ← Med
    ENDPROCEDURE
    PUBLIC FUNCTION GetTreatment() RETURNS STRING
        RETURN Treatment
    ENDFUNCTION
ENDCLASS

DECLARE Visit : Appointment
Visit ← NEW Appointment("A. Chen", "filling", "none")
OUTPUT Visit.GetTreatment()
Các thuộc tính được thiết lập riêng tư (private) để chỉ có thể thay đổi thông qua các phương thức (bao đóng, Chủ đề 20); hàm khởi tạo là một thủ tục được gọi NEW với mỗi tham số tương ứng với một thuộc tính; một phương thức truy xuất (getter) là một hàm trả về giá trị thuộc tính. Mỗi yếu tố trên đều được chấm điểm riêng.
File organisation and access · Tổ chức và truy cập tập tin
Syllabus · Chương trình
English
Candidates should be able to:
Notes and guidance
Show understanding of the methods of file organisation and select an appropriate method of file organisation and file access for a given problem
Including serial, sequential (using a key field), random (using a record key)
Show understanding of methods of file access
Including Sequential access for serial and sequential files Direct access for sequential and random files
Show understanding of hashing algorithms
Describe and use different hashing algorithms to read from and write data to a random/sequential file
Tiếng Việt
Thí sinh cần có thể:
Ghi chú và hướng dẫn
Thể hiện sự hiểu biết về các phương pháp sắp xếp tệp và chọn phương pháp sắp xếp tệp và truy cập tệp phù hợp cho một bài toán đã cho
Bao gồm thường trực tiếp, thứ tự (sử dụng trường khóa), ngẫu nhiên (sử dụng khóa ghi)
Thể hiện sự hiểu biết về các phương pháp truy cập tệp
Bao gồm Truy cập thứ tự cho tệp thường trực tiếp và thứ tự Truy cập trực tiếp cho tệp thứ tự và ngẫu nhiên
Thể hiện sự hiểu biết về thuật toán băm
Mô tả và sử dụng các thuật toán băm khác nhau để đọc và ghi dữ liệu vào tệp ngẫu nhiên/thứ tự
Source: Cambridge International syllabus · Nguồn: Chương trình Cambridge International
English
File organisation 文件组织 is how the data is laid out; file access is how the program reaches a record.
serial file 串行文件 — records in the order added, no sorting. Access is sequential only; appending is fast; searching is slow. Used for logs and audit trails.
sequential file 顺序文件 — records sorted by a key. Searching is faster (you can stop early or binary-search); inserting is slow (records must shift). Used for master files updated in batch.
random file 随机文件 (direct-access file) — records at positions computed from the key (often by a hash). Direct access by key is very fast; reading in key order is harder. Used for large lookup tables and customer accounts.
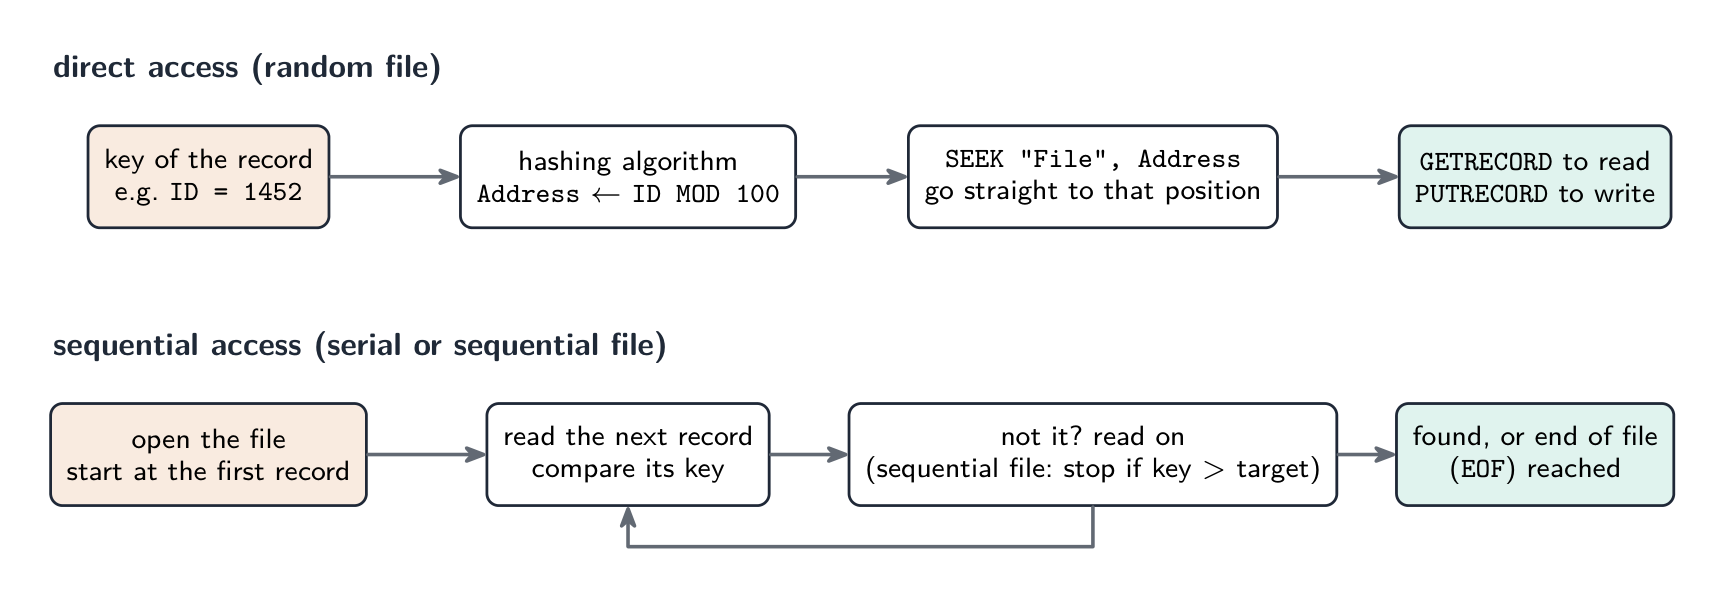
The two access methods are sequential access 顺序存取 (read from start to end) and direct access 直接存取 (jump straight to a known position). Match the structure to the dominant operation: single-key lookups favour random; in-order reports favour sequential.
Describing each organisation (the wording that scores).Serial: records are stored one after another in the order in which they were added, with no ordering by key. Sequential: records are stored in order of a key field (sorted). Random: each record is stored at an address calculated from its key by a hashing algorithm, so the records are not in any order. Comparing serial and sequential: both store records one after another and both are read sequentially, but a sequential file is ordered by key, so a search can stop as soon as a key larger than the target is read, and a new record must be inserted in its correct position (usually by rewriting the file), whereas a serial file is simply appended to.
Describing each access method.Sequential access: start at the beginning of the file and read the records one after another (in the order stored) until the required record is found or the end of the file is reached. Applied to a serial file this means reading every record up to the match, and reading the whole file to establish that a record is absent; applied to a sequential file the search can stop early, as soon as a key greater than the target is read. Direct access: the address of the record is calculated from its key (by a hashing algorithm, or from an index), and the program goes straight to that position without reading the records before it; this is the access method for random files, and for a record referenced by a unique address on a disk.
Choosing. A payroll or utility-billing master file processed in batch, every record in turn, suits a sequential file; a log of transactions in the order they happened suits a serial file; a stock or customer file where single records are looked up and updated by key while the program runs suits a random file with direct access.
File handling in pseudocode. The exam expects the standard statements, and Paper 3 sets algorithms that use them:
Task
Statements
open a text file
OPENFILE "Scores.txt" FOR READ (or FOR WRITE, which creates or overwrites, or FOR APPEND)
read or write a line
READFILE "Scores.txt", Line and WRITEFILE "Scores.txt", Line
test for the end
WHILE NOT EOF("Scores.txt")
close
CLOSEFILE "Scores.txt"
open a random file
OPENFILE "Stock.dat" FOR RANDOM
move to a record position
SEEK "Stock.dat", Address
read or write a whole record
GETRECORD "Stock.dat", Item and PUTRECORD "Stock.dat", Item
Worked example. A random file Stock.dat holds records of type StockItem, stored at the address given by ItemID MOD 100. Write pseudocode that stores a new item at its hashed address if that position is empty, reporting the position if it is already in use.
Two details the mark scheme checks: SEEKbefore each GETRECORD or PUTRECORD (reading moves the position on, so seek again before writing), and the file opened FOR RANDOM and closed at the end. To copy every record of a random file to another, loop over the addresses with SEEK, GETRECORD from one file and PUTRECORD to the other, skipping empty positions.
Tiếng Việt
Tổ chức tập tin là cách dữ liệu được sắp xếp; truy cập tập tin là cách chương trình tiếp cận một bản ghi.
tập tin tuần tự (serial file) — các bản ghi theo thứ tự thêm vào, không sắp xếp. Truy cập chỉ theo dòng chảy liên tiếp; việc thêm vào cuối nhanh; tìm kiếm chậm. Dùng cho nhật ký và hồ sơ kiểm toán.
tập tin lần lượt (sequential file) — các bản ghi được sắp xếp theo khóa. Tìm kiếm nhanh hơn (có thể dừng sớm hoặc dùng tìm kiếm nhị phân); chèn vào chậm (các bản ghi phải di chuyển). Dùng cho tập tin chính được cập nhật theo lô.
tập tin ngẫu nhiên (random file) (tập tin truy cập trực tiếp) — các bản ghi tại các vị trí được tính toán từ khóa (thường qua hàm băm). Truy cập trực tiếp theo khóa rất nhanh; đọc theo thứ tự khóa khó khăn hơn. Dùng cho bảng tra cứu lớn và tài khoản khách hàng.
Tập tin tuần tự: các bản ghi được giữ nguyên thứ tự mà chúng được thêm vàoTập tin lần lượt: các bản ghi được sắp xếp theo một trường khóaTập tin ngẫu nhiên: các bản ghi nằm ở các vị trí được tính toán từ khóa
Hai phương pháp truy cập là truy cập tuần tự (đọc từ đầu đến cuối) và truy cập trực tiếp (nhảy thẳng đến một vị trí đã biết). Ghép nối cấu trúc với thao tác chủ đạo: tra cứu theo khóa đơn ưu tiên ngẫu nhiên; báo cáo theo thứ tự ưu tiên lần lượt.
Mô tả từng tổ chức (cách diễn đạt để đạt điểm).Tuần tự: các bản ghi được lưu trữ liên tiếp nhau theo thứ tự chúng được thêm vào, không có sự sắp xếp theo khóa. Lần lượt: các bản ghi được lưu trữ theo thứ tự của một trường khóa (đã sắp xếp). Ngẫu nhiên: mỗi bản ghi được lưu trữ tại một địa chỉ được tính toán từ khóa của nó bởi thuật toán băm, nên các bản ghi không theo bất kỳ thứ tự nào. So sánh tuần tự và lần lượt: cả hai đều lưu trữ các bản ghi liên tiếp nhau và đều được đọc theo dòng chảy liên tiếp, nhưng tập tin lần lượt được sắp xếp theo khóa, nên việc tìm kiếm có thể dừng ngay khi đọc được một khóa lớn hơn mục tiêu, và một bản ghi mới phải được chèn vào đúng vị trí (thường là bằng cách ghi lại toàn bộ tập tin), trong khi tập tin tuần tự chỉ cần được chèn vào cuối.
Hai phương pháp truy cập dưới dạng thủ tục: truy cập trực tiếp tính nơi cần tìm; truy cập lần lượt tìm kiếm khắp nơi theo thứ tự
Mô tả từng phương pháp truy cập.Truy cập lần lượt: bắt đầu từ đầu tập tin và đọc các bản ghi liên tiếp nhau (theo thứ tự lưu trữ) cho đến khi tìm thấy bản ghi mong muốn hoặc kết thúc tập tin. Áp dụng cho tập tin tuần tự điều này có nghĩa là đọc every record up to the match, and reading the whole file to establish that a record is absent; áp dụng cho tập tin lần lượt việc tìm kiếm có thể dừng sớm, ngay khi đọc được một khóa lớn hơn mục tiêu. Truy cập trực tiếp:địa chỉ của bản ghi được tính toán từ khóa của nó (bởi thuật toán băm, hoặc từ chỉ mục), và chương trình đi thẳng đến vị trí đó mà không đọc các bản ghi phía trước; đây là phương pháp truy cập dành cho tập tin ngẫu nhiên, và đối với một bản ghi được tham chiếu bởi địa chỉ duy nhất trên đĩa.
Lựa chọn. Một tập tin chính lương thưởng hoặc hóa đơn tiện ích được xử lý theo lô, từng bản ghi một, phù hợp với tập tin lần lượt; nhật ký giao dịch theo thứ tự xảy ra phù hợp với tập tin tuần tự; tập tin kho hàng hoặc khách hàng nơi các bản ghi đơn lẻ được tra cứu và cập nhật theo khóa trong khi chương trình chạy phù hợp với tập tin ngẫu nhiên có truy cập trực tiếp.
Xử lý tập tin trong giả mã. Đề thi yêu cầu các câu lệnh tiêu chuẩn, và Paper 3 đưa ra các thuật toán sử dụng chúng:
Nhiệm vụ
Câu lệnh
mở một tập tin văn bản
OPENFILE "Scores.txt" FOR READ (hoặc FOR WRITE, tạo hoặc ghi đè lên, hoặc FOR APPEND)
đọc hoặc ghi một dòng
READFILE "Scores.txt", Line và WRITEFILE "Scores.txt", Line
kiểm tra kết thúc
WHILE NOT EOF("Scores.txt")
đóng
CLOSEFILE "Scores.txt"
mở một tập tin ngẫu nhiên
OPENFILE "Stock.dat" FOR RANDOM
di chuyển đến vị trí bản ghi
SEEK "Stock.dat", Address
đọc hoặc ghi toàn bộ một bản ghi
GETRECORD "Stock.dat", Item và PUTRECORD "Stock.dat", Item
Ví dụ có lời giải. Một tập tin ngẫu nhiên Stock.dat chứa các bản ghi loại StockItem, được lưu tại địa chỉ do ItemID MOD 100 cung cấp. Viết giả mã để lưu một mục mới tại địa chỉ đã băm nếu vị trí đó trống, và báo cáo vị trí nếu nó đã được sử dụng.
DECLARE Item, Existing : StockItem
DECLARE Address : INTEGER
INPUT Item.ItemID, Item.Description, Item.Quantity
Address ← Item.ItemID MOD 100
OPENFILE "Stock.dat" FOR RANDOM
SEEK "Stock.dat", Address
GETRECORD "Stock.dat", Existing
IF Existing.ItemID = 0 THEN
    // 0 marks an empty position
ENDIF
    SEEK "Stock.dat", Address
    PUTRECORD "Stock.dat", Item
    OUTPUT "Stored at ", Address
ELSE
    OUTPUT "Position ", Address, " is in use"
ENDIF
CLOSEFILE "Stock.dat"
Hai chi tiết mà đáp án kiểm tra: SEEKtrước mỗi GETRECORD hoặc PUTRECORD (việc đọc di chuyển vị trí, nên tìm lại trước khi ghi), và tệp được mở FOR RANDOM và đóng ở cuối. Để sao chép mọi bản ghi của tệp ngẫu nhiên sang tệp khác, lặp qua các địa chỉ với SEEK, GETRECORD từ tệp này và PUTRECORD sang tệp kia, bỏ qua các vị trí trống.
Explore · Khám phá
File access route · Đường dẫn truy cập tập tin
Follow a file from storage to program and back safely. · Theo dõi tập tin từ bộ lưu trữ đến chương trình và trở lại an toàn.
A hash function 散列函数 (a hashing algorithm) takes a record key and produces an address where the record is stored. A good one is fast, deterministic 确定性, and spreads keys evenly.
Common hashing algorithms for $N$ slots: modulo hash address ← key MOD N; folding (split the key, add the pieces, MOD N); a string hash (sum the character codes, MOD N).
A collision 冲突 is when two keys hash to the same address. Three ways to resolve it:
Strategy
How it works
Trade-off
linear probing 线性探测
use the next free slot (wrapping around)
simple, but keys cluster
chaining 链接法
each slot points to a linked list 链表 of records
no clustering, but uses more memory
rehashing
apply a second hash function
spreads keys, but more work
To search: hash the key, read that slot; if the keys match you are done, else follow the resolution strategy until a match or an empty slot. To insert: hash the key, write to that slot or the next free one. Keep the load factor 装填因子 (records ÷ slots) below about 70% for near-O(1) lookups.
"Explain what is meant by a hashing algorithm in the context of file access" (three marks).A calculation (function) performed on the key field of a record that produces a value, which is used as the address (location) at which the record is stored in the file and from which it is retrieved. The same calculation on the same key always gives the same address, which is why the record can be found again without searching.
"Outline two methods of overcoming a collision." (1) Linear probing (open addressing): store the record in the next free location after the calculated address, wrapping round to the start if necessary; to retrieve, start at the hashed address and read forward until the key matches. (2) An overflow area 溢出区 or chaining: store the colliding record in a separate overflow area (or a linked list attached to the address), which is searched sequentially after the main address fails to match. Either scores; describe the retrieval as well as the storage.
Worked example. A random file has 11 record positions, numbered 0 to 10, and the hashing algorithm is Address ← Key MOD 11. Records with keys 1250, 1381, 1452, 1613 and 1470 are stored in that order, using linear probing. Show where each record goes, and describe how key 1470 is retrieved.
$1250 \bmod 11 = 7$; $1381 \bmod 11 = 6$; $1452 \bmod 11 = 0$; $1613 \bmod 11 = 7$, a collision with 1250, so 1613 takes the next free position, 8; $1470 \bmod 11 = 7$ again, and positions 7 and 8 are full, so 1470 goes to 9. To retrieve 1470: calculate $7$, read position 7 (key 1250, no match), read 8 (1613, no), read 9 (1470, found). If an empty position is reached before a match, the record is not in the file. Collisions are the price of a small file: a good hashing algorithm spreads the keys evenly, and the file is kept well below full so that probes stay short.
Tiếng Việt
Một hàm hash (một thuật toán hashing) nhận một khóa bản ghi và tạo ra một địa chỉ nơi bản ghi được lưu trữ. Một hàm tốt thì nhanh, xác định, và phân bố đều các khóa.
Các thuật toán hashing phổ biến cho $N$ ô: hash chia dư address ← key MOD N; gập (chia nhỏ khóa, cộng các phần, MOD N); hash chuỗi (tổng mã ký tự, MOD N).
Một xung đột là khi hai khóa có cùng địa chỉ hash. Ba cách khắc phục:
Chiến lược
Cách hoạt động
Đánh đổi
quét tuyến tính
sử dụng ô tiếp theo trống (lăn vòng)
đơn giản, nhưng các khóa bám nhóm
nối链条
mỗi ô trỏ đến một danh sách liên kết các bản ghi
không bị bám nhóm, nhưng tốn bộ nhớ hơn
HASHING LẠI
áp dụng hàm hash thứ hai
phân tán khóa, nhưng tốn công hơn
Khắc phục xung đột hash: quét tuyến tính dùng ô trống tiếp theo; nối链条 giữ danh sách liên kết cho mỗi ô
Để tìm kiếm: hash khóa, đọc ô đó; nếu khóa trùng bạn đã xong, nếu không hãy làm theo chiến lược khắc phục cho đến khi khớp hoặc gặp ô trống. Để chèn: hash khóa, ghi vào ô đó hoặc ô trống tiếp theo. Giữ tỷ lệ tải (số bản ghi ÷ số ô) dưới khoảng 70% để tra cứu gần như O(1).
"Giải thích thuật ngữ thuật toán hashing trong ngữ cảnh truy cập tệp" (ba điểm).Một phép tính (hàm) thực hiện trên trường khóa của bản ghi tạo ra một giá trị, giá trị này được dùng làm địa chỉ (vị trí) lưu trữ bản ghi trong tệp và lấy lại từ đó. Phép tính giống nhau trên cùng một khóa luôn cho cùng một địa chỉ, vì vậy bản ghi có thể được tìm thấy lần nữa mà không cần tìm kiếm.
"Nêu hai phương pháp khắc phục xung đột." (1) Quét tuyến tính (địa chỉ mở): lưu bản ghi vào vị trí tiếp theo trống sau địa chỉ đã tính, lăn vòng về đầu nếu cần thiết; để lấy lại, bắt đầu từ địa chỉ hash và đọc tiến tới cho đến khi khóa khớp. (2) Khu vực tràn hoặc nối链条: lưu bản ghi xung đột vào khu vực tràn riêng biệt (hoặc danh sách liên kết gắn với địa chỉ), khu vực này được tìm tuần tự sau khi địa chỉ chính không khớp. Either scores; mô tả cả việc lấy lại cũng như lưu trữ.
Ví dụ minh họa. Một tệp ngẫu nhiên có 11 vị trí bản ghi, đánh số từ 0 đến 10, và thuật toán hashing là Address ← Key MOD 11. Các bản ghi có khóa 1250, 1381, 1452, 1613 và 1470 được lưu theo thứ tự đó, sử dụng quét tuyến tính. Hãy chỉ ra vị trí của từng bản ghi và mô tả cách lấy lại khóa 1470.
$1250 \bmod 11 = 7$; $1381 \bmod 11 = 6$; $1452 \bmod 11 = 0$; $1613 \bmod 11 = 7$, một xung đột với 1250, vì vậy 1613 chiếm vị trí trống tiếp theo là 8; $1470 \bmod 11 = 7$ một lần nữa, và các vị trí 7 và 8 đã đầy, nên 1470 đi vào 9. Để lấy lại 1470: tính $7$, đọc vị trí 7 (khóa 1250, không khớp), đọc 8 (1613, không), đọc 9 (1470, tìm thấy). Nếu đạt được vị trí trống trước khi khớp, bản ghi không có trong tệp. Xung đột là cái giá của một tệp nhỏ: một thuật toán hashing tốt phân tán đều các khóa, và tệp được giữ远低于满这样探子保持短。
Explore · Khám phá
A hash table · Bảng hash
Watch each key get hashed to a bucket. A good hash spreads keys out so lookups stay fast. · Quan sát mỗi khóa được hash vào một ngăn chứa. Một hàm hash tốt phân tán các khóa ra để việc tra cứu vẫn nhanh.
Read the mantissa as a binary fraction — the first bit after the point is worth $1/2$, the next $1/4$, then $1/8$, and so on. So 0.1010000 is $1/2 + 1/8 = 0.625$; with exponent 00000010 (= 2) the value is $0.625 \times 2^{2} = 2.5$.
Converting
binary → denary: read the mantissa (use two's-complement rules if negative) as a fraction, read the exponent as a signed integer, then multiply mantissa by $2^{\text{exponent}}$.
denary → binary: write the number as a binary fraction × a power of 2, then store the mantissa and exponent in the agreed formats.
Worked example. A number has mantissa 10110000 and exponent 00000011. Find its denary value.
The exponent 00000011 is $+3$. The mantissa begins with a 1, so it is negative. Read as 1.0110000 in two's complement, the sign bit is worth $-1$ and the fraction bits add $\tfrac{1}{4} + \tfrac{1}{8} = 0.375$, so the mantissa is $-1 + 0.375 = -0.625$. Then
$$\text{number} = -0.625 \times 2^{3} = -5.0.$$
Worked example. Store $+2.5$ in this format.
In binary $2.5 = 10.1$. Written as a normalised fraction, $2.5 = 0.101 \times 2^{2}$. So the mantissa is 01010000 (sign bit 0, then .101) and the exponent is 00000010 ($= 2$).
The exam's format: two's complement, a mantissa and an exponent
The exam states a format such as 10 bits for the mantissa and 6 bits for the exponent, both in two's complement. The mantissa's binary point sits after its first (sign) bit, so a positive mantissa is 0.xxxxxxxxx and a negative one 1.xxxxxxxxx; the exponent is an ordinary signed integer. Every conversion uses the same three moves: read the mantissa as a fraction (two's-complement rules if it starts with 1), read the exponent as an integer, multiply by $2^{\text{exponent}}$.
Worked example (binary to denary). Mantissa 0101100000, exponent 000011.
Worked example (negative mantissa). Mantissa 1011000000, exponent 000010.
The mantissa starts with 1, so it is negative. Its value is $-1 + 0.011000000_2 = -1 + (\tfrac{1}{4} + \tfrac{1}{8}) = -0.625$; exponent $= 2$; value $-0.625 \times 4 = -2.5$. (Alternatively, take the two's complement of the mantissa, 0101000000$= 0.625$, and attach the minus sign.) A negative exponent such as 111110$= -2$ divides instead: a mantissa of $0.5$ with that exponent is $0.5 \times 2^{-2} = 0.125$.
Worked example (denary to binary). Store $+6.5$ and $-6.5$ in the 10-bit and 6-bit format, normalised.
$6.5 = 110.1_2 = 0.1101_2 \times 2^{3}$, so the mantissa is 0110100000 and the exponent 000011. For $-6.5$, take the two's complement of the mantissa: 1001100000 (check: $-1 + 0.0011_2 = -1 + 0.1875 = -0.8125$, and $-0.8125 \times 8 = -6.5$), exponent 000011 unchanged. The sign never goes into the exponent; a negative number has a negative mantissa.
Normalisation
A number is normalised 规格化 when the first significant bit is immediately after the binary point (no wasted leading zeros). This maximises precision, because every mantissa bit carries information. To normalise, shift the mantissa left and decrease the exponent (or shift right and increase it) until the first significant bit is in place; the value is unchanged. For negative (two's-complement) mantissas, the sign bit (1) is followed immediately by a 0.
Recognising and producing normalised form. A positive normalised mantissa begins 01; a negative one begins 10. So 0011000000 is not normalised (shift left one place and subtract one from the exponent: 0110000000, exponent one less) and 1100000000 is not either (shift left until the pattern is 10...). Each shift left of the mantissa must be matched by subtracting one from the exponent, or the value changes.
"Explain why numbers are stored in normalised form" (two marks). (1) It gives the maximum precision (accuracy) for the number of bits available, because no bits are wasted on leading zeros (or leading ones for a negative number); (2) each number then has a unique representation, so numbers can be compared; and (3) it makes the best use of the available range. Any two of these score.
Approximation and rounding errors
Many denary reals cannot be stored exactly in binary — e.g. $0.1_{10}$ is the repeating binary fraction $0.000110011\ldots_{2}$, which must be truncated. Consequences:
rounding errors 舍入误差 build up over many operations (0.1 + 0.2 is not exactly 0.3).
comparisons fail — never test a real for equality. Test that the difference is smaller than a small tolerance, IF Difference < 0.000001, where the difference is taken the right way round or through a modulus function that the question would define. ABS is not on the 9618 insert or in the Pseudocode Guide, so do not assume it: the guide says any function a question needs will be given.
subtracting two nearly-equal values loses precision.
overflow 溢出 (a result too large for the exponent's range) and underflow 下溢 (a result too small, rounding to zero) occur when the exponent runs out of range.
For exact needs (currency), use fixed-point 定点 or BCD 二进码十进数 instead of floating-point.
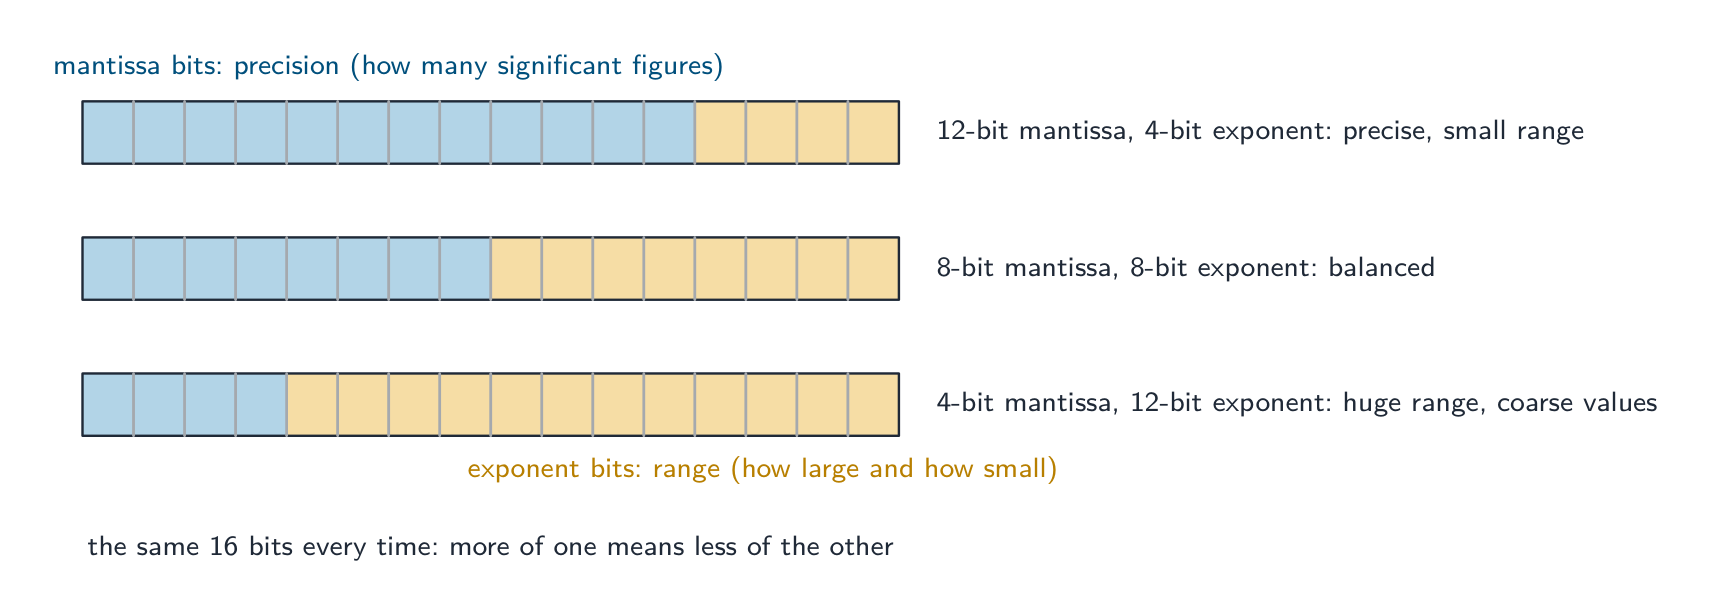
"Describe the effect of changing the allocation of bits" (three marks). With a fixed total number of bits, increasing the mantissa and reducing the exponent gives greater precision 精度 (more significant figures, smaller rounding errors) but a smaller range 范围 (the largest and smallest magnitudes that can be stored shrink); increasing the exponent does the opposite: a larger range at the cost of precision. Name both effects and both directions.
Largest and smallest. In the 10-bit mantissa, 6-bit exponent format the largest positive number has mantissa 0111111111 ($= 1 - 2^{-9}$) and exponent 011111 ($= 31$): about $2^{31}$. The smallest positive normalised number has mantissa 0100000000 ($= 0.5$) and exponent 100000 ($= -32$): $0.5 \times 2^{-32} = 2^{-33}$. The most negative number has mantissa 1000000000 ($= -1$) and exponent $31$: $-2^{31}$.
"Explain what is meant by overflow and underflow."Overflow occurs when the result of a calculation is larger than the largest number that can be represented, so the exponent would need more bits than it has; underflow occurs when a result is smaller than the smallest (non-zero) number that can be represented, too close to zero for the exponent to express, so it is stored as zero. Both come from the exponent's range, not the mantissa's.
Why a binary representation is only an approximation. A binary fraction can only represent sums of $\tfrac{1}{2}, \tfrac{1}{4}, \tfrac{1}{8}, \ldots$ exactly; a value such as $0.1$ or $\tfrac{1}{3}$ has an infinite binary expansion, and the mantissa has a fixed number of bits, so the stored value is the nearest one that fits. The difference is a rounding error; it is small for one number but accumulates over repeated calculations (adding $0.1$ ten times may not give exactly $1$), which is why real numbers should never be tested for exact equality.
Tiếng Việt
Để lưu trữ số thực có kích thước rất khác nhau, máy tính sử dụng định dạng thập phân động — dạng nhị phân của ký hiệu khoa học, với hai trường:
phầnmantissa — các chữ số có ý nghĩa.
số mũ — lũy thừa của 2 để nhân với.
Cả hai đều được lưu dưới dạng số nguyên bù hai. Giá trị là
Đọc mantissa dưới dạng phân số nhị phân — bit đầu tiên sau dấu phẩy có giá trị $1/2$, bit tiếp theo $1/4$, sau đó $1/8$, v.v. Vậy 0.1010000 là $1/2 + 1/8 = 0.625$; với số mũ 00000010 (= 2) giá trị là $0.625 \times 2^{2} = 2.5$.
Giá trị vị trí của mantissa 8-bit và số mũ 8-bit
Chuyển đổi
nhị phân → thập phân: đọc mantissa (sử dụng quy tắc bù hai nếu âm) dưới dạng phân số, đọc số mũ dưới dạng số nguyên có dấu, sau đó nhân mantissa với $2^{\text{exponent}}$.
thập phân → nhị phân: viết số dưới dạng phân số nhị phân × lũy thừa của 2, sau đó lưu mantissa và số mũ theo định dạng thống nhất.
Ví dụ minh họa. Một số có mantissa 10110000 và số mũ 00000011. Tìm giá trị thập phân của nó.
Số mũ 00000011 là $+3$. Mantissa bắt đầu bằng 1, vì vậy nó là số âm. Đọc dưới dạng 1.0110000 trong bù hai, bit dấu có giá trị $-1$ và các bit phân số cộng thêm $\tfrac{1}{4} + \tfrac{1}{8} = 0.375$, nên mantissa là $-1 + 0.375 = -0.625$. Sau đó
$$\text{number} = -0.625 \times 2^{3} = -5.0.$$
Ví dụ minh họa. Lưu $+2.5$ dưới định dạng này.
Trong nhị phân là $2.5 = 10.1$. Viết dưới dạng phân số chuẩn hóa, là $2.5 = 0.101 \times 2^{2}$. Vậy mantissa là 01010000 (bit dấu 0, sau đó là .101) và số mũ là 00000010 ($= 2$).
Định dạng đề thi: bù hai, mantissa và số mũ
Đề thi nêu một định dạng như 10 bit cho phần thập phân và 6 bit cho số mũ, cả hai đều dùng bổ hai. Dấu thập phân nhị phân của phần thập phân nằm ngay sau bit đầu tiên (bit dấu), nên một phần thập phân dương là 0.xxxxxxxxx và một phần thập phân âm là 1.xxxxxxxxx; số mũ là một số nguyên có dấu thông thường. Mọi phép chuyển đổi đều sử dụng ba bước giống nhau: đọc phần thập phân dưới dạng phân số (áp dụng quy tắc bổ hai nếu nó bắt đầu bằng 1), đọc số mũ dưới dạng số nguyên, rồi nhân với $2^{\text{exponent}}$.
Ví dụ đã giải (nhị phân sang thập phân). Phần thập phân 0101100000, số mũ 000011.
Ví dụ đã giải (phần thập phân âm). Phần thập phân 1011000000, số mũ 000010.
Phần thập phân bắt đầu bằng 1, do đó nó là số âm. Giá trị của nó là $-1 + 0.011000000_2 = -1 + (\tfrac{1}{4} + \tfrac{1}{8}) = -0.625$; số mũ $= 2$; giá trị $-0.625 \times 4 = -2.5$. (Hoặc, lấy bổ hai của phần thập phân, 0101000000$= 0.625$, và thêm dấu trừ). Một số mũ âm như 111110$= -2$ sẽ thực hiện phép chia thay vì nhân: một phần thập phân có giá trị $0.5$ kết hợp với số mũ đó sẽ tạo ra $0.5 \times 2^{-2} = 0.125$.
Ví dụ đã giải (thập phân sang nhị phân). Lưu trữ $+6.5$ và $-6.5$ ở định dạng 10 bit và 6 bit, chuẩn hóa.
$6.5 = 110.1_2 = 0.1101_2 \times 2^{3}$, nên phần thập phân là 0110100000 và số mũ là 000011. Đối với $-6.5$, hãy lấy bổ hai của phần thập phân: 1001100000 (kiểm tra: $-1 + 0.0011_2 = -1 + 0.1875 = -0.8125$, và $-0.8125 \times 8 = -6.5$), số mũ 000011 không đổi. Dấu không bao giờ đi vào số mũ; một số âm luôn có một phần thập phân mang dấu âm.
Chuẩn hóa
Một số được chuẩn hóa khi bit có ý nghĩa đầu tiên nằm ngay sau dấu nhị phân (không có số không dẫn đầu vô ích). Điều này tối đa hóa độ chính xác, vì mỗi bit của phần mantissa đều mang thông tin. Để chuẩn hóa, dịch mantissa sang trái và giảm số mũ (hoặc dịch sang phải và tăng nó) cho đến khi bit có ý nghĩa đầu tiên được đặt đúng chỗ; giá trị không thay đổi. Đối với mantissa âm (hai bù), bit dấu (1) được theo ngay sau bởi một 0.
Nhận diện và tạo dạng chuẩn hóa. Một phần thập phân dương chuẩn hóa bắt đầu bằng 01; một phần thập phân âm bắt đầu bằng 10. Vì vậy, 0011000000 không phải là dạng chuẩn hóa (dịch sang trái một vị trí và trừ đi một từ số mũ: 0110000000, số mũ ít hơn một) và 1100000000 cũng không phải (dịch sang trái cho đến khi mẫu hình trở thành 10...). Mỗi lần dịch phần thập phân sang trái phải được cân bằng bằng việc trừ đi một từ số mũ, nếu không giá trị sẽ thay đổi.
"Giải thích tại sao các số được lưu ở dạng chuẩn hoá" (hai điểm). (1) Nó mang lại độ chính xác tối đa (độ chính xác) cho số bit có sẵn, vì không có bit nào bị lãng phí vào các số không đầu (hoặc số một đầu đối với số âm); (2) mỗi số sau đó có một biểu diễn duy nhất, do đó các số có thể được so sánh; và (3) nó sử dụng tốt nhất phạm vi có sẵn. Bất kỳ hai ý nào trong ba ý này đều đạt điểm.
Chuẩn hoá: dịch chuyển phần thập phân sang trái để loại bỏ các số không đầu, đồng thời giảm số mũ đi đúng lượng đó
xấp xỉ và lỗi làm tròn
Nhiều số thực thập phân không thể được lưu trữ chính xác trong hệ nhị phân — ví dụ: $0.1_{10}$ là phân số nhị phân vô hạn $0.000110011\ldots_{2}$, buộc phải cắt cụt. Hệ quả:
lỗi làm tròn tích lũy qua nhiều phép toán (0.1 + 0.2 không chính xác bằng 0.3).
so sánh thất bại — tuyệt đối không kiểm tra sự bằng nhau của số thực. Hãy kiểm tra xem sự chênh lệch có nhỏ hơn một ngưỡng cho phép nhỏ, IF Difference < 0.000001, trong đó sự chênh lệch được tính theo hướng đúng hoặc thông qua một hàm模数 mà đề bài sẽ định nghĩa. ABS không nằm trong tài liệu đính kèm 9618 hay Hướng dẫn Pseudocode, vì vậy đừng giả định rằng nó tồn tại: hướng dẫn nói rằng bất kỳ hàm nào đề bài cần thiết đều sẽ được cung cấp.
trừ hai giá trị gần bằng nhau sẽ mất độ chính xác.
vượt quá giới hạn trên ( Overflow - kết quả quá lớn so với phạm vi của số mũ) và vượt quá giới hạn dưới ( Underflow - kết quả quá nhỏ, làm tròn về zero) xảy ra khi số mũ vượt quá phạm vi cho phép.
Đối với nhu cầu chính xác tuyệt đối (tiền tệ), hãy sử dụng điểm cố định hoặc BCD thay vì số thực động.
Tổng số bit giống nhau được chia sẻ theo hai cách: các bit của phần thập phân mua độ chính xác, các bit của số mũ mua phạm vi, và một bên chỉ có thể phát triển ở mức hy sinh bên kia
"Mô tả tác động của việc thay đổi phân bổ bit" (ba điểm). Với tổng số bit cố định, tăng phần thập phân và giảm số mũ sẽ mang lại độ chính xác cao hơn (nhiều chữ số có ý nghĩa hơn, lỗi làm tròn nhỏ hơn) nhưng phạm vi nhỏ hơn (các giá trị lớn nhất và nhỏ nhất có thể lưu trữ bị thu hẹp); tăng số mũ làm ngược lại: phạm vi lớn hơn nhưng đánh đổi bằng độ chính xác. Phải nêu rõ cả hai tác động và cả hai chiều hướng.
Lớn nhất và nhỏ nhất. Trong định dạng 10 bit cho phần thập phân, 6 bit cho số mũ, số dương lớn nhất có phần thập phân 0111111111 ($= 1 - 2^{-9}$) và số mũ 011111 ($= 31$): khoảng $2^{31}$. Số dương chuẩn hóa nhỏ nhất có phần thập phân 0100000000 ($= 0.5$) và số mũ 100000 ($= -32$): $0.5 \times 2^{-32} = 2^{-33}$. Số âm lớn nhất (giá trị tuyệt đối lớn nhất) có phần thập phân 1000000000 ($= -1$) và số mũ $31$: $-2^{31}$.
"Giải thích ý nghĩa của vượt quá giới hạn trên và dưới."Vượt quá giới hạn trên (Overflow) xảy ra khi kết quả của một phép tính lớn hơn số lớn nhất có thể biểu diễn, khiến số mũ đòi hỏi nhiều bit hơn so với số bit thực tế; vượt quá giới hạn dưới (Underflow) xảy ra khi một kết quả nhỏ hơn số nhỏ nhất (khác không) có thể biểu diễn, quá gần với zero để số mũ có thể biểu diễn, nên nó được lưu trữ là zero. Cả hai đều xuất phát từ phạm vi của số mũ, không phải từ phần thập phân.
Tại sao biểu diễn nhị phân chỉ là một giá trị xấp xỉ. Một phân số nhị phân chỉ có thể biểu diễn chính xác các tổng của $\tfrac{1}{2}, \tfrac{1}{4}, \tfrac{1}{8}, \ldots$; một giá trị như $0.1$ hoặc $\tfrac{1}{3}$ có phần mở rộng nhị phân vô hạn, và mantissa có số bit cố định, nên giá trị được lưu trữ là giá trị gần nhất phù hợp. Sự khác biệt này là lỗi làm tròn; nó nhỏ đối với một số nhưng tích lũy qua các phép tính lặp lại (cộng $0.1$ mười lần có thể không cho ra kết quả chính xác là $1$), do đó các số thực không bao giờ nên được kiểm tra bằng cách so sánh bằng nhau hoàn toàn.
Explore · Khám phá
Build a floating-point number · Xây dựng số thực
Flip the mantissa and exponent bits to make a value, and check whether it is normalised. · Lật ngược các bit phần thập phân và mũ để tạo ra giá trị, và kiểm tra xem nó có được chuẩn hóa hay không.
Explore · Khám phá
Normalising a floating-point number · Chuẩn hóa số thực
Step through normalisation. Shifting the mantissa to remove wasted leading zeros — and adjusting the exponent to match — keeps the value the same but spends every bit on precision.
Definitions the examiner accepts · Các định nghĩa mà giám khảo chấp nhận
English
A definition question is marked against fixed wording. Learn these exactly, and give one answer only.
Term
Definition
user-defined data type
a data type defined by the programmer, based on existing types, to represent data specific to the problem
non-composite type
a type defined without reference to another type; it holds a single value (integer, real, enumerated, pointer)
composite type
a type made up of other types; it holds several values under one identifier (record, set, array, class)
enumerated type
a non-composite type defined by listing all its possible values, in order
pointer type
a non-composite type whose value is the memory address of a variable of a given type
set
a composite type holding a collection of values of one type, unordered and without duplicates
record
a composite type with a fixed number of fields, each with its own identifier and type, accessed by dot notation
class
a composite type combining attributes (data) with the methods (procedures and functions) that act on them; an object is an instance of a class
serial file
records stored one after another in the order in which they were added
sequential file
records stored one after another in order of a key field
random file
records stored at addresses calculated from their keys by a hashing algorithm
sequential access
reading the records in turn from the start of the file until the one required is found
direct access
calculating the address of a record from its key and going straight to that position
hashing algorithm
a calculation on the key of a record that gives the address at which the record is stored and found
collision
two different keys producing the same address
mantissa
the part of a floating-point number that holds its significant bits, as a two's-complement fraction
exponent
the two's-complement integer giving the power of two by which the mantissa is multiplied
normalised
a floating-point number whose mantissa begins 01 (positive) or 10 (negative), so no bits are wasted on leading zeros or ones
overflow
a result too large to be represented in the number of bits available
underflow
a non-zero result too small to be represented, so it is stored as zero
rounding error
the difference between a real number and the nearest value that the binary representation can hold
Tiếng Việt
Câu hỏi định nghĩa được chấm dựa trên văn phong cố định. Hãy học thuộc những định nghĩa này và chỉ đưa ra một đáp án duy nhất.
Thuật ngữ
Định nghĩa
kiểu dữ liệu do người dùng định nghĩa
một kiểu dữ liệu do lập trình viên tạo ra, dựa trên các kiểu đã có, để biểu diễn dữ liệu đặc thù cho vấn đề đang giải quyết
kiểu đơn giản
một kiểu được định nghĩa mà không tham chiếu đến kiểu nào khác; nó chứa một giá trị duy nhất (nguyên, thực, liệt kê, conype)
kiểu phức hợp
một kiểu được cấu thành từ các kiểu khác; nó chứa nhiều giá trị dưới cùng một danh xưng (bản ghi, tập hợp, mảng, lớp)
kiểu liệt kê
một kiểu đơn giản được định nghĩa bằng cách liệt kê tất cả các giá trị có thể có của nó theo thứ tự
kiểu conype
một kiểu đơn giản mà giá trị của nó là địa chỉ bộ nhớ của một biến thuộc một kiểu xác định
tập hợp
một kiểu phức hợp chứa một nhóm các giá trị của một kiểu, không có thứ tự và không có giá trị trùng lặp
bản ghi
một kiểu phức hợp có một số lượng trường cố định, mỗi trường có danh xưng và kiểu riêng, truy cập thông qua ký hiệu chấm
lớp
một kiểu phức hợp kết hợp các thuộc tính (dữ liệu) với các phương thức (thủ tục và hàm) tác động lên chúng; một đối tượng là một实例 của lớp
tập tin tuần tự
các bản ghi được lưu trữ liên tiếp theo đúng thứ tự chúng được thêm vào
tập tin truy cập tuần tự
các bản ghi được lưu trữ liên tiếp theo thứ tự của một trường khóa
tập tin truy cập ngẫu nhiên
các bản ghi được lưu trữ tại các địa chỉ được tính toán từ khóa của chúng bởi một thuật toán băm
truy cập tuần tự
đọc các bản ghi lần lượt từ đầu tập tin cho đến khi tìm thấy bản ghi cần thiết
truy cập trực tiếp
tính toán địa chỉ của một bản ghi từ khóa của nó và truy cập ngay vị trí đó
thuật toán băm
một phép tính trên khóa của một bản ghi mang lại địa chỉ nơi bản ghi được lưu trữ và tìm thấy
va chạm
hai khóa khác nhau sinh ra cùng một địa chỉ
mantissa
phần của số thực chứa các bit có ý nghĩa của nó, dưới dạng phân số bù hai
số mũ
số nguyên bù hai cho biết lũy thừa của hai mà mantissa được nhân với
đã chuẩn hoá
một số thực động mà phần thập phân bắt đầu bằng 01 (số dương) hoặc 10 (số âm), do đó không có bit nào bị lãng phí vào các số không hay số một đầu
tràn
một kết quả quá lớn để được biểu diễn trong số bit khả dụng
thiếu
một kết quả khác 0 quá nhỏ để được biểu diễn, vì vậy nó được lưu trữ như 0
lỗi làm tròn
sự khác biệt giữa một số thực và giá trị gần nhất mà biểu diễn nhị phân có thể chứa
13.3
Exam tips · Mẹo làm bài thi
English
Pseudocode declarations are marked line by line: TYPE ... = (...) for enumerated, TYPE ... = ^... for pointer, TYPE ... = SET OF ... then DEFINE ... (...) : ... for a set, TYPE ... DECLARE ... ENDTYPE for a record, CLASS ... PRIVATE ... PUBLIC PROCEDURE NEW ... ENDCLASS for a class.
Match the type to the data: fixed named values, enumerated; a group of different fields, record; a collection of unique values, set; data plus behaviour, class; an address, pointer.
File organisation is how records are stored; file access is how they are found. Serial and sequential are read sequentially; random files use direct access via a hash of the key. Sequential search of a sequential file can stop early; of a serial file it cannot.
Random-file pseudocode: OPENFILE ... FOR RANDOM, SEEK before every GETRECORD or PUTRECORD, CLOSEFILE at the end. Say how a collision is resolved when you describe hashing.
Floating point: mantissa as a two's-complement fraction (point after the sign bit), exponent as an integer, multiply by $2^{\text{exponent}}$; shift left and subtract one from the exponent to normalise; the mantissa buys precision, the exponent buys range.
The three "explain" stock answers: why normalise (precision, unique form, range), the effect of re-allocating bits (precision against range), and why $0.1$ cannot be stored exactly (an infinite binary fraction in a finite mantissa).
Common mistakes
Writing DECLARE instead of TYPE for a new type, or leaving out ENDTYPE; declaring a set without SET OF, or an enumerated type with quotation marks round its values.
Putting the sign of a floating-point number in the exponent; the sign is the first bit of the mantissa.
Reading a negative mantissa as if it were sign-and-magnitude; it is two's complement, so 1011000000 is $-0.625$, not $-0.375$.
Shifting the mantissa to normalise without changing the exponent, or changing it the wrong way (shift left, exponent down).
Describing a random file as "in random order"; the records are at addresses computed from their keys.
Saying sequential access reads "the whole file" for a sequential file; it stops when a larger key is met.
Explaining hashing without saying what the calculated value is used for (the address to store and retrieve the record), or without a way of handling collisions.
Defining overflow as "too many digits" instead of a result beyond the largest representable value, or blaming the mantissa for it.
Tiếng Việt
Các khai báo giả mã được đánh dấu từng dòng: TYPE ... = (...) cho liệt kê, TYPE ... = ^... cho con trỏ, TYPE ... = SET OF ... sau đó DEFINE ... (...) : ... cho tập hợp, TYPE ... DECLARE ... ENDTYPE cho bản ghi, CLASS ... PRIVATE ... PUBLIC PROCEDURE NEW ... ENDCLASS cho lớp.
Khớp loại với dữ liệu: các giá trị có tên cố định, liệt kê; một nhóm các trường khác nhau, bản ghi; một tập hợp các giá trị độc nhất, tập hợp; dữ liệu plus hành vi, lớp; một địa chỉ, conype.
Tổ chức tập tin là cách các bản ghi được lưu trữ; truy cập tập tin là cách chúng được tìm kiếm. Tuần tự và truy cập tuần tự được đọc lần lượt; tập tin ngẫu nhiên sử dụng truy cập trực tiếp thông qua mã băm của khóa. Tìm kiếm tuần tự của một tập tin truy cập tuần tự có thể dừng sớm; của một tập tin tuần tự thì không thể.
Pseudocode tập tin ngẫu nhiên: OPENFILE ... FOR RANDOM, SEEK trước mỗi GETRECORD hoặc PUTRECORD, CLOSEFILE ở cuối. Nêu cách giải quyết va chạm khi bạn mô tả thuật toán băm.
Số thực: mantissa dưới dạng phân số bù hai (chấm sau bit dấu), số mũ dưới dạng số nguyên, nhân với $2^{\text{exponent}}$; dịch trái và trừ một khỏi số mũ để chuẩn hóa; mantissa mua độ chính xác, số mũ mua phạm vi.
Ba câu trả lời "giải thích" tiêu chuẩn: tại sao phải chuẩn hóa (độ chính xác, dạng duy nhất, phạm vi), ảnh hưởng của việc tái phân bổ bit (độ chính xác chống lại phạm vi), và tại sao $0.1$ không thể được lưu trữ chính xác (một phân số nhị phân vô hạn trong mantissa hữu hạn).
Lỗi thường gặp
Viết DECLARE thay vì TYPE cho một loại mới, hoặc bỏ sót ENDTYPE; khai báo một tập hợp mà không có SET OF, hoặc một kiểu liệt kê với dấu ngoặc kép bao quanh các giá trị của nó.
Đặt dấu của số thực vào số mũ; dấu là bit đầu tiên của mantissa.
Đọc một mantissa âm như thể nó là dấu và độ lớn; nó là bù hai, vì vậy 1011000000 là $-0.625$, không phải $-0.375$.
Dịch chuyển mantissa để chuẩn hóa mà không thay đổi số mũ, hoặc thay đổi nó theo cách sai (dịch trái, số mũ giảm).
Mô tả một tập tin ngẫu nhiên là "theo thứ tự ngẫu nhiên"; các bản ghi nằm tại các địa chỉ được tính toán từ khóa của chúng.
Nói rằng truy cập tuần tự đọc "toàn bộ tập tin" cho một tập tin truy cập tuần tự; nó dừng lại khi gặp một khóa lớn hơn.
Giải thích thuật toán băm mà không nói giá trị được tính toán dùng để làm gì (địa chỉ để lưu và lấy lại bản ghi), hoặc không có cách xử lý va chạm.
Định nghĩa tràn là "quá nhiều chữ số" thay vì một kết quả vượt quá giá trị biểu diễn lớn nhất, hoặc đổ lỗi cho mantissa về điều đó.
Interactive lessons on this topic · Bài học tương tác về chủ đề này
Work through it step by step, with instant-check exercises. · Làm theo từng bước, kèm theo bài tập kiểm tra ngay lập tức.
More topics in A-Level Computer Science · Khoa học máy tính A-Level · Nhiều chủ đề hơn trong A-Level Computer Science · Khoa học máy tính A-Level
Pick one and the site follows you — notes, papers, videos and practice all open on it. · Chọn một môn và trang sẽ điều hướng theo — ghi chú, tài liệu, video và bài tập đều mở ở đó.
Type to search notes, lessons, code, vocabulary and past-paper questions across every subject. · Nhập để tìm ghi chú, bài học, mã, từ vựng và câu hỏi đề thi cũ trên mọi môn học.