| ผู้เข้าสอบควรสามารถ: | หมายเหตุและคำแนะนำ |
|---|---|
| แสดงความเข้าใจเกี่ยวกับวิธีการ linear search และ binary search | เขียนอัลกอริทึมเพื่อทำ linear search เขียนอัลกอริทึมเพื่อทำ binary search เงื่อนไขที่จำเป็นสำหรับการใช้ binary search ประสิทธิภาพของ binary search เปลี่ยนแปลงไปตามจำนวนข้อมูล |
| แสดงความเข้าใจเกี่ยวกับวิธีการ insertion sort และ bubble sort | เขียนอัลกอริทึมเพื่อทำ insertion sort เขียนอัลกอริทึมเพื่อทำ bubble sort ประสิทธิภาพของการเรียงลำดับอาจขึ้นอยู่กับลำดับเริ่มต้นของข้อมูลและจำนวนข้อมูล |
| แสดงความเข้าใจและใช้งาน Abstract Data Types (ADT) | เขียนอัลกอริทึมเพื่อค้นหาไอเท็มใน: linked list, binary tree เขียนอัลกอริทึมเพื่อเพิ่มไอเท็มลงใน: stack, queue, linked list, binary tree เขียนอัลกอริทึมเพื่อลบไอเท็มออกจาก: stack, queue, linked list แสดงความเข้าใจว่า graph เป็นตัวอย่างของ ADT อธิบายคุณสมบัติหลักของ graph และอธิบายเหตุผลในการนำไปใช้ในสถานการณ์ที่กำหนด ผู้เข้าสอบไม่จำเป็นต้องเขียนโค้ดสำหรับโครงสร้าง graph |
| แสดงให้เห็นความเป็นไปได้ที่ ADTs จะถูกสร้างจาก ADT อื่น | อธิบาย ADT ต่างๆ ดังนี้และแสดงวิธีสร้างจากชนิดข้อมูลในตัวหรือ ADT ที่เหมาะสม: stack, queue, linked list, dictionary, binary tree |
| แสดงความเข้าใจว่าอัลกอริทึมที่ทำหน้าที่เดียวกันแต่แตกต่างกันสามารถเปรียบเทียบกันได้โดยใช้เกณฑ์ (เช่น เวลาที่ใช้ในการดำเนินการและความจำที่ใช้) | รวมถึงการใช้ Big O notation เพื่อระบุความซับซ้อนด้านเวลาและพื้นที่ |
การคิดเชิงคำนวณและการแก้ปัญหา
Computer Science A-Level · หัวข้อ 19
 15:32
การค้นหา & การเรียงลำดับ
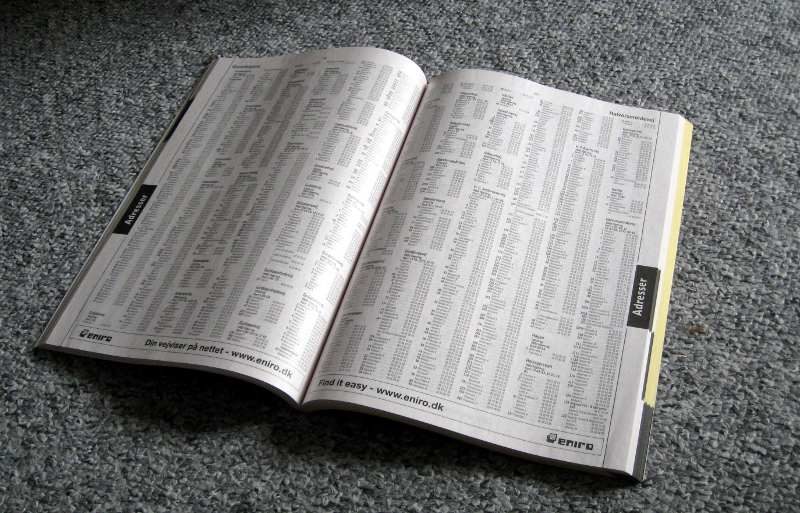
สมุดโทรศัพท์ที่มีชื่อหนึ่งล้านชื่อ หากคุณตรวจสอบทีละชื่อ อาจต้องเปรียบเทียบถึงหนึ่งล้านครั้ง แต่คุณรู้เทคนิคอยู่แล้ว: เปิดมันใน…
บรรยายภาษาอังกฤษ · สลับคำบรรยายภาษาอังกฤษและภาษาจีนได้
19.1
อัลกอริทึมการค้นหา
หลักสูตร
แหล่งที่มา: หลักสูตร Cambridge International
การค้นหาหาค่าเป้าหมายในชุดข้อมูล ซึ่งมักเป็นอาร์เรย์ แล้วคืนค่าตำแหน่ง หรือ “ไม่พบ”
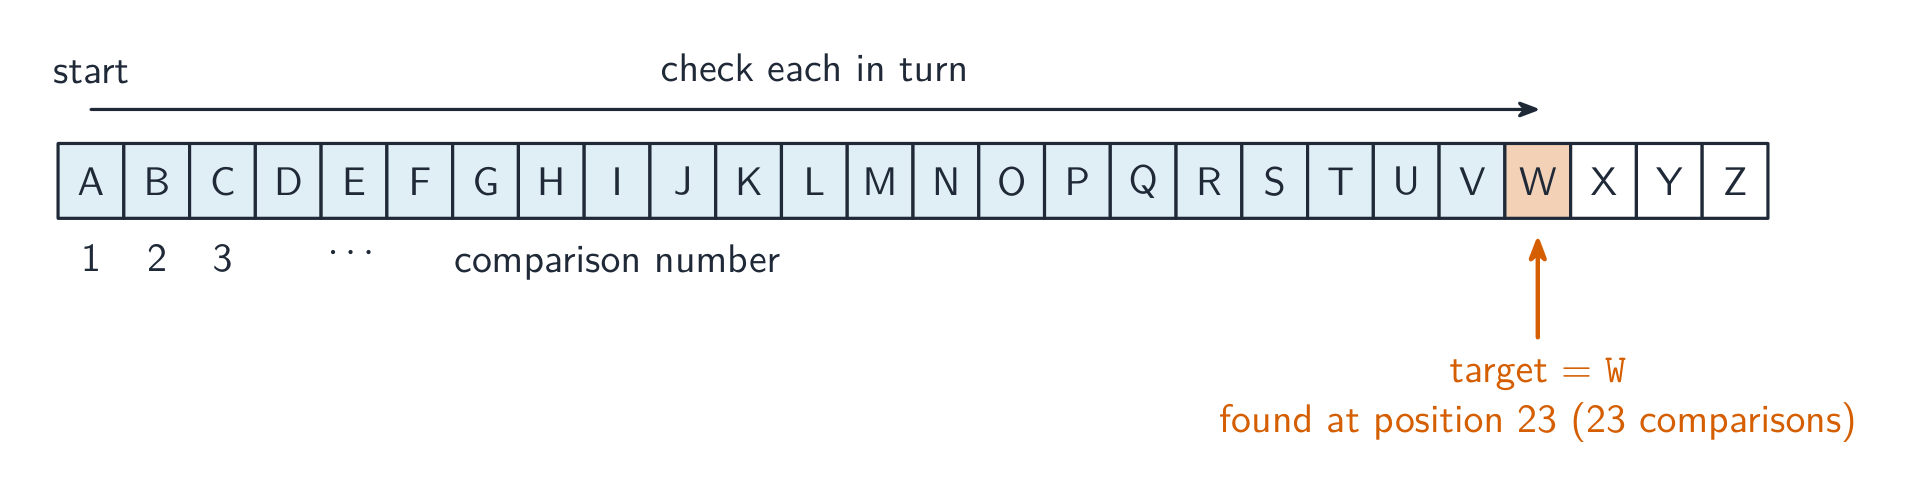
Linear search
A linear search walks from start to end, comparing each element with the target:
FOR i ← 1 TO n
    IF A[i] = target THEN
        RETURN i
    ENDIF
NEXT i
RETURN -1   // not found
ไม่ต้องเตรียมข้อมูล จึงใช้ได้กับรายการใดก็ได้ กรณีแย่ที่สุด O($n$) (เป้าหมายอยู่ท้ายรายการหรือไม่มีอยู่); กรณีดีที่สุดเปรียบเทียบ 1 ครั้ง ใช้กับข้อมูลที่ไม่ได้เรียงลำดับหรือรายการขนาดเล็ก (ค่า -1 ที่ส่งกลับเป็นค่าเฝ้าระวัง คือค่าตำแหน่งที่เป็นไปไม่ได้และหมายถึง “ไม่พบ”; ผู้เรียกตรวจสอบ IF result = -1)
The exam's version. Paper 3 asks you to complete a linear search written with a flag and a WHILE loop, and Paper 4 to write a function that returns the index or a count. Both look like this:
FUNCTION LinearSearch(Data : ARRAY OF INTEGER, Target : INTEGER) RETURNS INTEGER
    DECLARE Index, Count : INTEGER
    Count ← 0
    FOR Index ← 1 TO 100
        IF Data[Index] = Target THEN
            Count ← Count + 1
        ENDIF
    NEXT Index
    RETURN Count          // how many times Target occurs; 0 means not found
ENDFUNCTION
To stop at the first match instead, use a WHILE Index <= 100 AND NOT Found loop that sets Found ← TRUE and remembers the index. The marks are for the loop over every element, the comparison, and what is returned when the value is absent.
Binary search
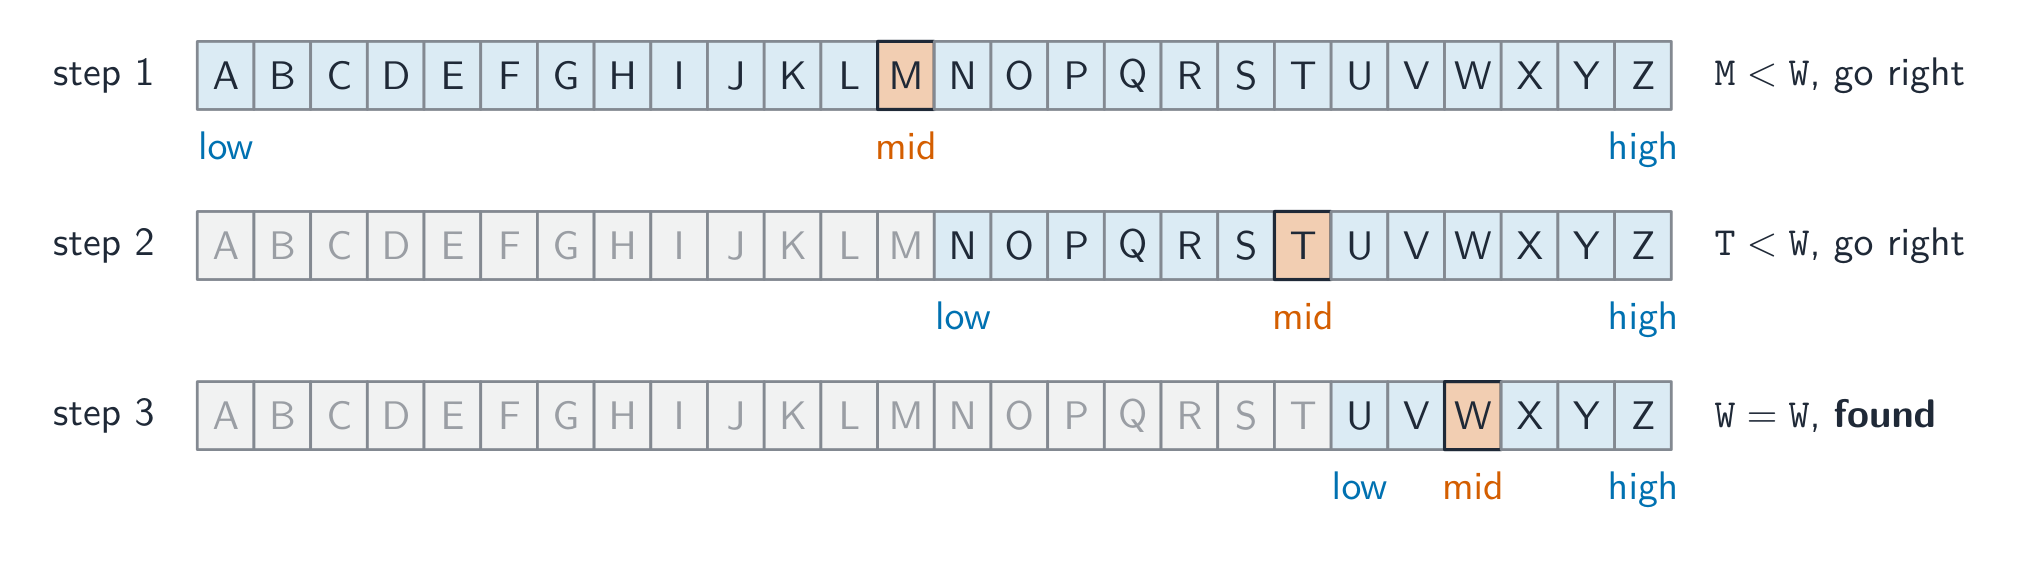
A binary search needs the data sorted. Look at the middle element; if it is the target, done; if the target is smaller, search the left half, else the right half — halving the range each time:
low ← 1
high ← n
WHILE low <= high DO
    MiddleIndex ← (low + high) DIV 2
    IF A[MiddleIndex] = target THEN
        RETURN MiddleIndex
    ENDIF
    IF A[MiddleIndex] < target THEN
        low ← MiddleIndex + 1
    ELSE
        high ← MiddleIndex - 1
    ENDIF
ENDWHILE
RETURN -1
Worst case O($\log_{2} n$) — for a million items, about 20 comparisons. Much faster than linear search on large sorted arrays, but you must sort first (a one-off O($n \log n$) cost), worth it if you search many times.
“ระบุเงื่อนไขที่จำเป็นสำหรับการค้นหาแบบทวิภาค” ข้อมูลต้องเรียงลำดับ จากน้อยไปมากหรือมากไปน้อยตามคีย์ที่ค้นหา “อธิบายวิธีค้นหาแบบทวิภาค” (สามคะแนน): (1) หารายการตรงกลางของรายการหรือช่วงปัจจุบัน แล้วเปรียบเทียบกับเป้าหมาย; (2) หากตรงกันให้สิ้นสุดการค้นหา หากเป้าหมายน้อยกว่าให้ทำซ้ำในครึ่งล่าง หากมากกว่าให้ทำซ้ำในครึ่งบน; (3) แบ่งครึ่งช่วงต่อไปจนพบรายการหรือช่วงว่าง ซึ่งหมายความว่าไม่มีรายการนั้น
The exam's version, with the bounds and a flag, is the one to reproduce when asked to complete the algorithm:
DECLARE Lower, Upper, MiddleIndex : INTEGER
DECLARE Found : BOOLEAN
Lower ← 0
Upper ← 99
Found ← FALSE
WHILE Lower <= Upper AND NOT Found
    MiddleIndex ← (Lower + Upper) DIV 2
    IF Names[MiddleIndex] = Target THEN
        Found ← TRUE
    ELSE
        IF Names[MiddleIndex] < Target THEN
            Lower ← MiddleIndex + 1
        ELSE
            Upper ← MiddleIndex - 1
        ENDIF
    ENDIF
ENDWHILE
IF Found THEN
    OUTPUT MiddleIndex
ELSE
    OUTPUT "Not found"
ENDIF
ตัวอย่างแสดงวิธีทำ (ไล่การค้นหาแบบทวิภาค) Names[0:9] เก็บ Ali, Ben, Cai, Dev, Eva, Fay, Gus, Hal, Ivy, Jo จงไล่การทำงานตามรูปแบบในข้อสอบสำหรับ Target = "Ivy" แล้วสำหรับ Target = "Cat" โดยระบุ Lower, Upper และ MiddleIndex ในแต่ละขั้น
สำหรับ “Ivy”:
| Lower | Upper | MiddleIndex | Names[MiddleIndex] | ผลลัพธ์ |
|---|---|---|---|---|
| 0 | 9 | 4 | Eva | Eva < Ivy ดังนั้น Lower ← 5 |
| 5 | 9 | 7 | Hal | Hal < Ivy ดังนั้น Lower ← 8 |
| 8 | 9 | 8 | Ivy | Found ← TRUE |
ผลลัพธ์คือ 8 หลังจากเปรียบเทียบสามครั้ง สำหรับ “Cat”: ตำแหน่งกลาง 4 (Eva > Cat, Upper ← 3); ตำแหน่งกลาง 1 (Ben < Cat, Lower ← 2); middle 2 (Cai < Cat, Lower ← 3); middle 3 (Dev > Cat, Upper ← 2) ขณะนี้ Lower (3) มากกว่า Upper (2) วงวนจึงสิ้นสุดและส่งออก “Not found” หลังจากเปรียบเทียบสี่ครั้ง ซึ่งเป็นกรณีแย่ที่สุดสำหรับสิบรายการ ($\lceil\log_2 10\rceil = 4$) DIV ปัดลง ดังนั้นค่ากลางของ 0 และ 9 คือ 4 ไม่ใช่ 4.5 หรือ 5 สตริงเปรียบเทียบตามลำดับตัวอักษรหรือลำดับรหัสอักขระ
“อธิบายว่าประสิทธิภาพเปลี่ยนไปอย่างไรตามจำนวนรายการ” การเปรียบเทียบแต่ละครั้งลดจำนวนรายการที่เหลือลงครึ่งหนึ่ง ดังนั้นจำนวนครั้งสูงสุดที่เปรียบเทียบจึงประมาณ $\log_{2} n$: การเพิ่มขนาดรายการเป็นสองเท่าทำให้เปรียบเทียบเพิ่มเพียงหนึ่งครั้ง นี่คือ O($\log n$) “เปรียบเทียบการค้นหาแบบเชิงเส้นและแบบทวิภาค”: การค้นหาแบบเชิงเส้นต้องเปรียบเทียบสูงสุด $n$ ครั้ง (O($n$)) และโดยเฉลี่ยครึ่งหนึ่งของจำนวนนั้น แต่ใช้กับข้อมูลที่ไม่ได้เรียงลำดับได้; การค้นหาแบบทวิภาคต้องเปรียบเทียบสูงสุด $\log_{2} n$ ครั้ง (O($\log n$)) และเร็วกว่ามากสำหรับรายการขนาดใหญ่ แต่ต้องเรียงลำดับข้อมูลก่อนและต้องเข้าถึงรายการตรงกลางได้โดยตรง เช่น อาร์เรย์ ไม่ใช่รายการโยง สำหรับ $1000$ รายการ: เปรียบเทียบ $1000$ ครั้งเทียบกับ $10$ ครั้ง
สำรวจ
การค้นหาเชิงเส้นเทียบกับ binary search
ค้นหาข้อมูล การค้นหาแบบทวิภาค จะแบ่งรายการครึ่งหนึ่งทุกขั้นตอน (ใช้ได้กับข้อมูลที่เรียงลำดับแล้วเท่านั้น) ส่วน การค้นหาแบบเชิงเส้น จะตรวจสอบทีละตัว
คำศัพท์
ฝึกฝน
| English | ไทย |
|---|---|
| insertion sort/ɪnˈsɜːʃn sɔːt/ | การเรียงลำดับด้วยการแทรก |
| bubble sort/ˈbʌbl sɔːt/ | การเรียงลำดับแบบฟองอากาศ |
| binary search/ˈbaɪnəri sɜːtʃ/ | การค้นหาแบบทวิภาค |
| array/əˈreɪ/ | อาร์เรย์ |
| linear search/ˈlɪnɪə sɜːtʃ/ | การค้นหาเชิงเส้น |
19.1
อัลกอริทึมการจัดเรียง
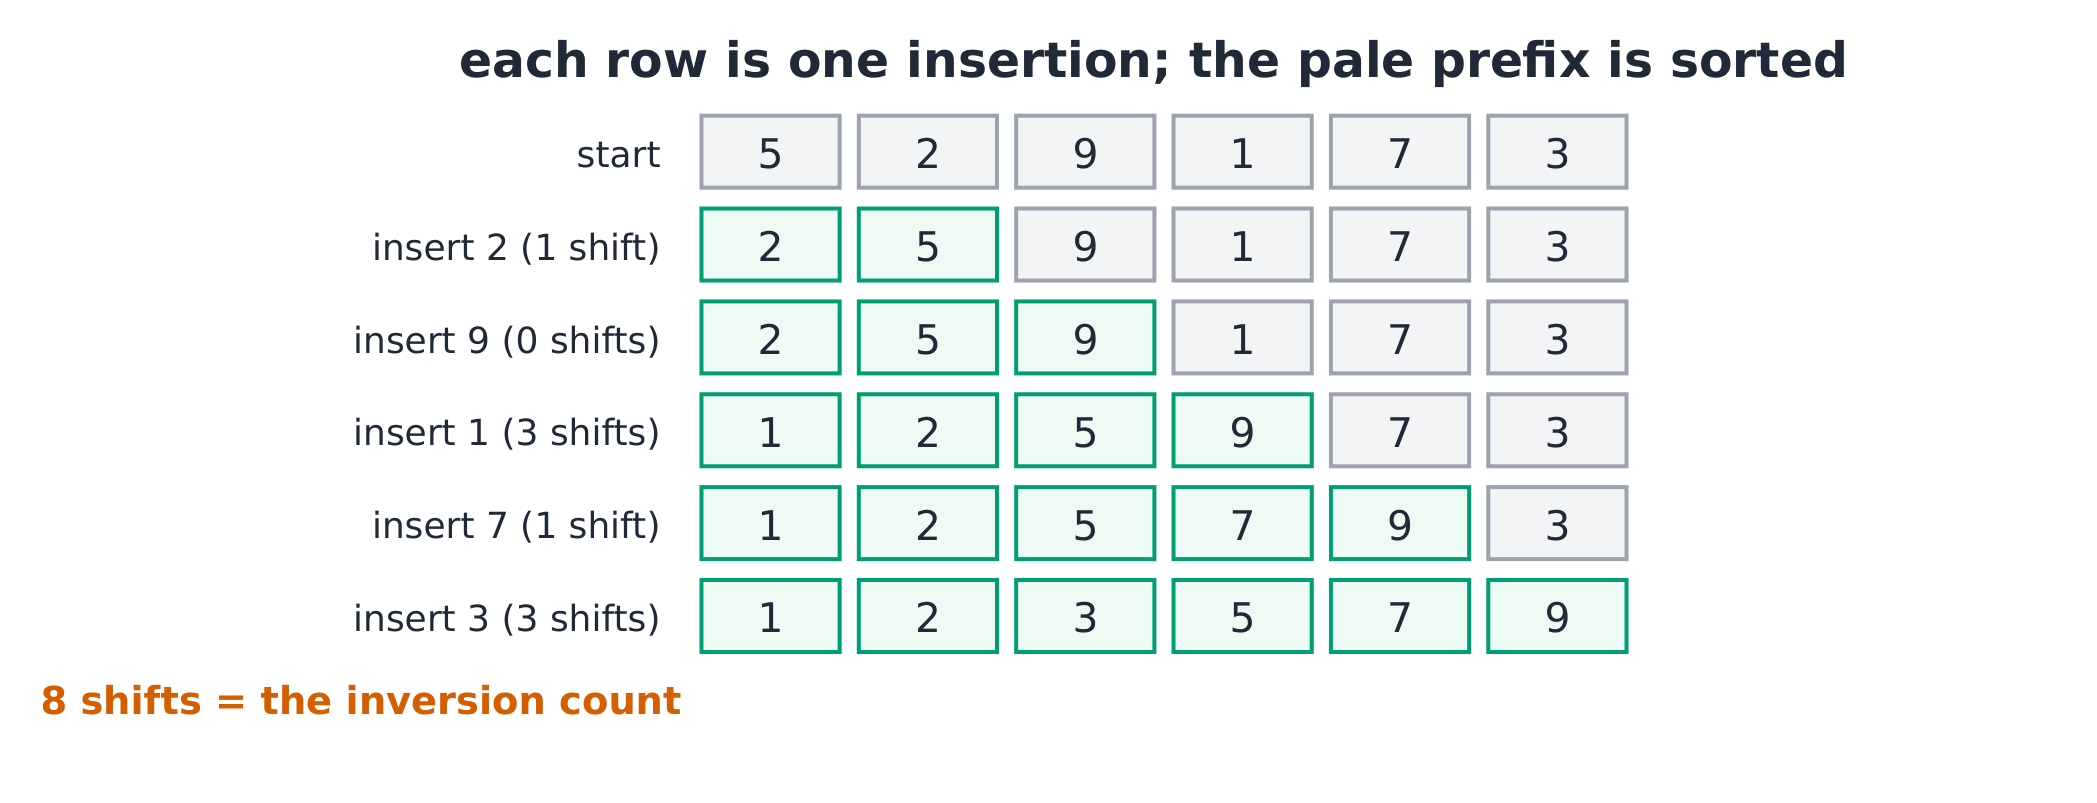
Bubble sort
การเรียงลำดับแบบฟองเดินผ่านอาร์เรย์ซ้ำ ๆ และสลับคู่ข้อมูลที่อยู่ติดกันเมื่อเรียงผิดลำดับ ทำให้ค่ามากที่สุด “ลอย” ไปอยู่ท้ายสุดในการผ่านแต่ละรอบ:
FOR pass ← 1 TO n - 1
    swapped ← FALSE
    FOR i ← 1 TO n - pass
        IF A[i] > A[i + 1] THEN
            temp ← A[i]
            A[i] ← A[i + 1]
            A[i + 1] ← temp
            swapped ← TRUE
        ENDIF
    NEXT i
    IF swapped = FALSE THEN      // already sorted
        EXIT FOR
    ENDIF
NEXT pass
Best case O($n$) (already sorted, with the early exit); average/worst O($n^{2}$). Simple but slow for large $n$.
Insertion sort
An insertion sort builds a sorted prefix from the left, inserting each new element into place by shifting larger ones right:
FOR i ← 2 TO n
    key ← A[i]
    j ← i - 1
    WHILE j >= 1 AND A[j] > key DO
        A[j + 1] ← A[j]
        j ← j - 1
    ENDWHILE
    A[j + 1] ← key
NEXT i
Best case O($n$) (already sorted); worst O($n^{2}$). Good for small or nearly-sorted arrays. It sorts in place and is stable (keeps the order of equal elements).
Tracing a sort
A common task is to show the array after each outer pass. For [D, T, H, R] with insertion sort: pass 1 (key T) no change; pass 2 (key H) → [D, H, T, R]; pass 3 (key R) → [D, H, R, T].
อาร์เรย์เดียวกันเมื่อใช้การเรียงลำดับแบบฟองจะเคลื่อนต่างกัน: รอบที่ 1 เปรียบเทียบ D/T (ไม่สลับ), T/H (สลับ) และ T/R (สลับ) ได้ [D, H, R, T] โดยรายการใหญ่สุดอยู่ท้าย; รอบที่ 2 ไม่มีการสลับ ดังนั้นตัวบ่งชี้จึงหยุดการเรียง แสดงอาร์เรย์ทั้งหมดหลังแต่ละรอบ และนับจำนวนครั้งที่เปรียบเทียบหากโจทย์ถาม: $3$ ครั้งในรอบที่ 1 และ $2$ ครั้งในรอบที่ 2 (รูปแบบข้างต้นหยุดเร็วขึ้นหนึ่งตำแหน่งในแต่ละรอบ) รวมทั้งหมด $5$ ครั้ง
การเขียนขั้นตอนเรียงลำดับตั้งแต่ต้น คำถาม “เขียนรหัสเทียมเพื่อเรียง DataArray[1:1000] จากน้อยไปมาก” ตอบได้ด้วยการเรียงลำดับแบบฟองที่สมบูรณ์พร้อมตัวบ่งชี้หยุดก่อน หรือการเรียงลำดับแบบแทรก โดยประกาศตัวแปรและเยื้องบรรทัดให้ถูกต้อง ทั้งสองวิธีได้คะแนนเต็มหากทำงานได้กับข้อมูลนำเข้าทุกแบบ:
DECLARE Pass, Index, Temp : INTEGER
DECLARE Swapped : BOOLEAN
Pass ← 1
REPEAT
    Swapped ← FALSE
    FOR Index ← 1 TO 1000 - Pass
        IF DataArray[Index] > DataArray[Index + 1] THEN
            Temp ← DataArray[Index]
            DataArray[Index] ← DataArray[Index + 1]
            DataArray[Index + 1] ← Temp
            Swapped ← TRUE
        ENDIF
    NEXT Index
    Pass ← Pass + 1
UNTIL Swapped = FALSE OR Pass = 1000
สำหรับลำดับจากมากไปน้อย ให้เปลี่ยน > เป็น <; หากเรียงระเบียนหรืออาร์เรย์ 2 มิติตามฟิลด์หนึ่ง ให้เปรียบเทียบฟิลด์นั้นแต่สลับระเบียนทั้งระเบียนหรือทุกคอลัมน์ หากโจทย์ให้เขียนการเรียงลำดับแบบแทรกที่ “ทำงานเดียวกัน” กับการเรียงลำดับแบบฟองที่กำหนด ให้ใช้ชื่ออาร์เรย์และทิศทางเดิม และเขียนการเรียงลำดับแบบแทรกข้างต้นโดยกลับเครื่องหมายเปรียบเทียบหากเรียงจากมากไปน้อย
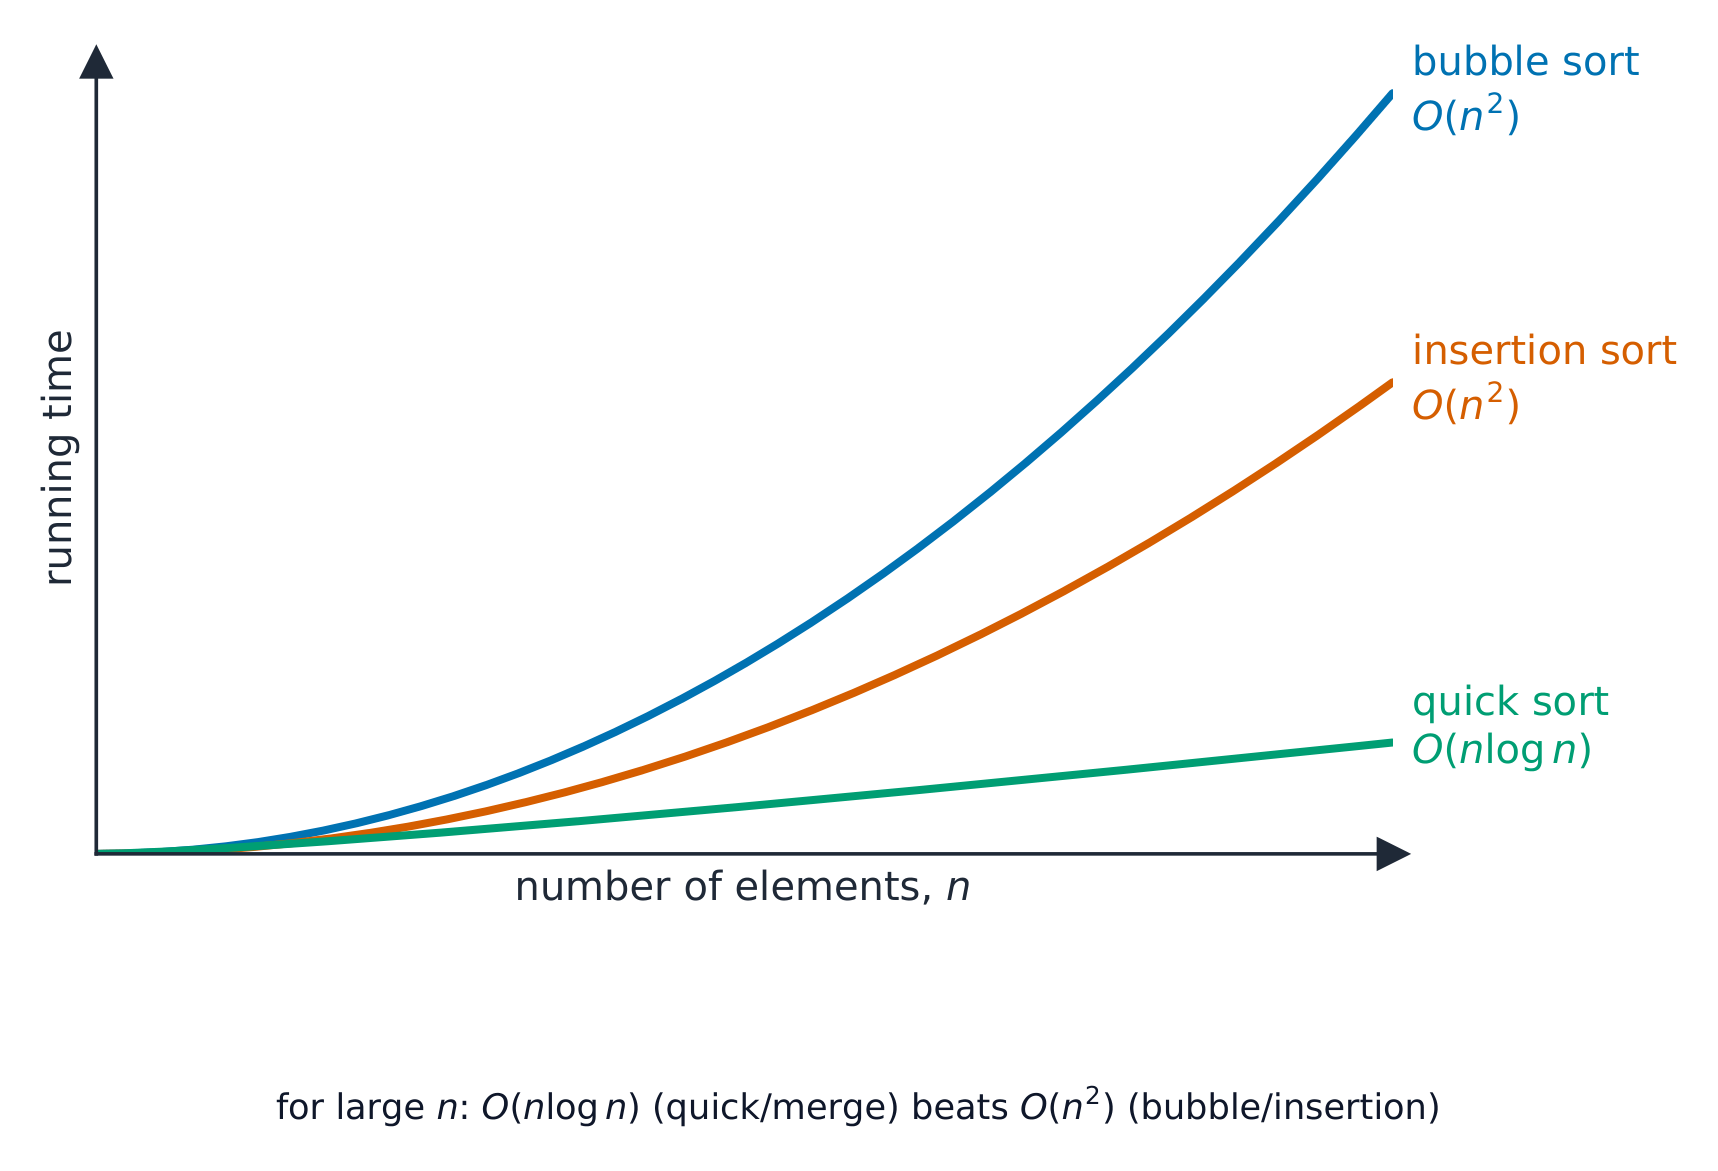
“อธิบายสองวิธีที่ข้อมูลส่งผลต่อประสิทธิภาพของการเรียงลำดับ” (สองคะแนน) (1) จำนวนรายการ: การเรียงลำดับแบบ $O(n^{2})$ ใช้เวลาเพิ่มเป็นสี่เท่าเมื่อจำนวนรายการเพิ่มเป็นสองเท่า (2) ระดับที่ข้อมูลเรียงลำดับอยู่แล้ว: การเรียงลำดับแบบฟองที่มีตัวบ่งชี้หรือการเรียงลำดับแบบแทรกเสร็จภายในรอบเดียวเมื่อข้อมูลเรียงแล้ว ($O(n)$) และทำงานมากที่สุดเมื่อข้อมูลเรียงย้อนลำดับ; จำนวนครั้งที่สลับขึ้นอยู่กับจำนวนคู่ที่เรียงผิดลำดับ (ยอมรับคำตอบเกี่ยวกับช่วงค่าหรือจำนวนค่าซ้ำ และการที่รายการเป็นระเบียนขนาดใหญ่ซึ่งมีต้นทุนการย้ายสูงด้วย) การเรียงลำดับแบบฟองและแบบแทรกมีความซับซ้อน O($n^{2}$) ทั้งในกรณีแย่ที่สุดและกรณีเฉลี่ย และ O($n$) ในกรณีดีที่สุด; การเรียงลำดับแบบเร็วและแบบผสานเป็น O($n \log n$) จึงใช้กับข้อมูลขนาดใหญ่
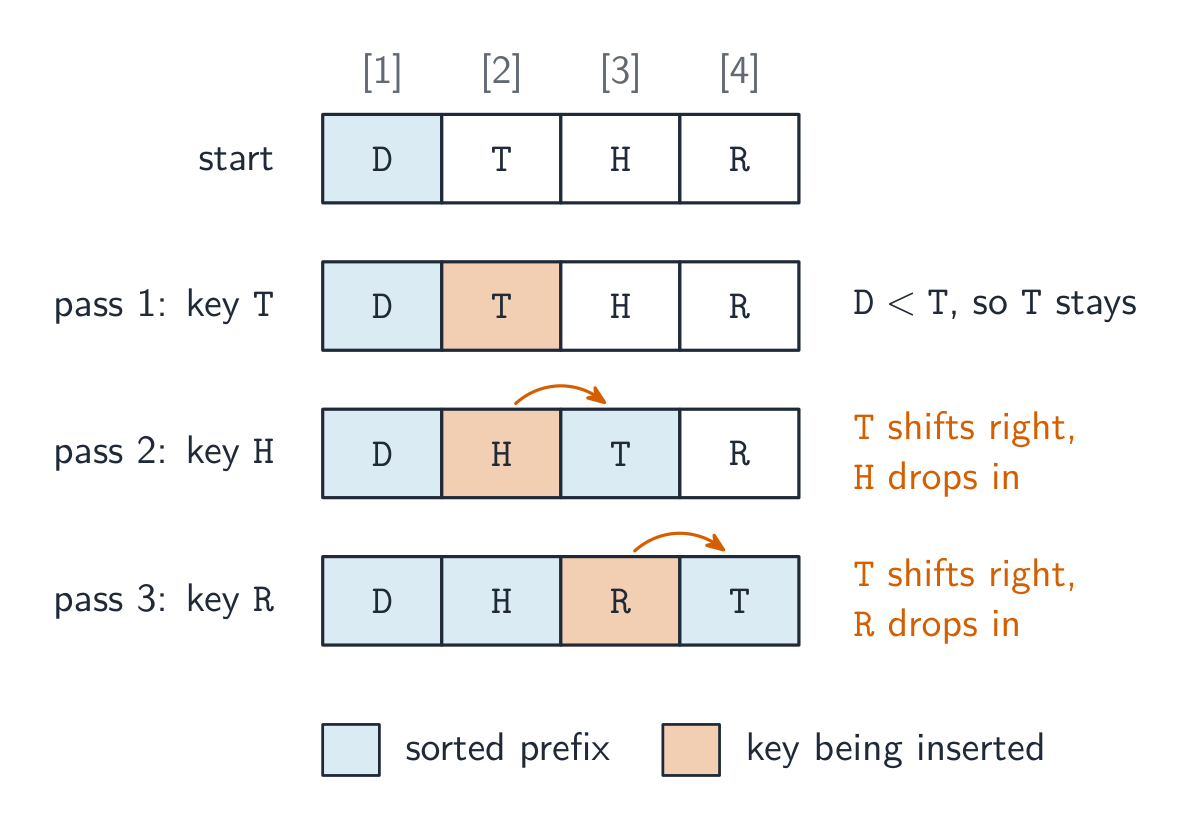
[D, T, H, R], เลื่อนแต่ละคีย์เข้าสู่ตำแหน่งตามลำดับรอบ
สำรวจ
ดูการจัดเรียงทำงาน
เดินผ่านกระบวนการเรียงลำดับเพื่อดูแท่งกราฟจัดเรียงเป็นระเบียบ — แสดงการทำงานของอัลกอริทึมการจัดเรียงแบบทีละขั้นตอน
คำศัพท์
ฝึกฝน
| English | ไทย |
|---|---|
| in place/ɪn pleɪs/ | ในสถานที่ |
| stable/ˈsteɪbl/ | เสถียรภาพ |
19.1
ADT ในอัลกอริทึม
ชนิดข้อมูลนามธรรม (ADT) จากหัวข้อ 10 ปรากฏในหลายอัลกอริทึม: สแตกใช้ในการท่องแบบลึกก่อนและการเลิกทำ; คิวใช้ในการท่องแบบกว้างก่อนและจัดลำดับการพิมพ์; รายการโยงช่วยให้ข้อมูลเพิ่มหรือลดขนาดได้
ADTs สามารถสร้างจาก ADT อื่นได้ ไม่ใช่แค่จาก arrays: queue จาก สอง stacks; stack จาก linked list (push = เพิ่ม head node); queue จาก linked list ที่มี head และ tail pointers; binary tree จาก nodes ที่มี child pointers สองตัว; dictionary เก็บคู่ key→value (มักอยู่บน hash table) การวางซ้อนแบบนี้แยกความสนใจออก — อัลกอริทึมที่ใช้ ADT ไม่จำเป็นต้องรู้ว่าสร้างอย่างไร
ADT ที่ข้อสอบต้องการให้คุณอธิบายและนำไปใช้
Stack (last in, first out): รายการถูกเพิ่ม (pushed) และเอาออก (popped) ที่ปลายเดียวกัน คือ ยอด; พอยน์เตอร์ TopOfStack เก็บดัชนีของรายการยอด Implemented ด้วยอาร์เรย์และพอยน์เตอร์หนึ่งตัว: push ตรวจสอบว่า stack ไม่เต็ม, เพิ่มพอยน์เตอร์และเก็บรายการ; pop ตรวจสอบว่าไม่ว่าง, ย้อนกลับรายการยอดและลดพอยน์เตอร์
FUNCTION Push(Item : INTEGER) RETURNS BOOLEAN
    IF TopOfStack = 9 THEN      // full (array 0 to 9)
        RETURN FALSE
    ENDIF
    TopOfStack ← TopOfStack + 1
    StackData[TopOfStack] ← Item
    RETURN TRUE
ENDFUNCTION
FUNCTION Pop() RETURNS INTEGER
    IF TopOfStack = -1 THEN      // empty
        RETURN -1
    ENDIF
    TopOfStack ← TopOfStack - 1
    RETURN StackData[TopOfStack + 1]
ENDFUNCTION
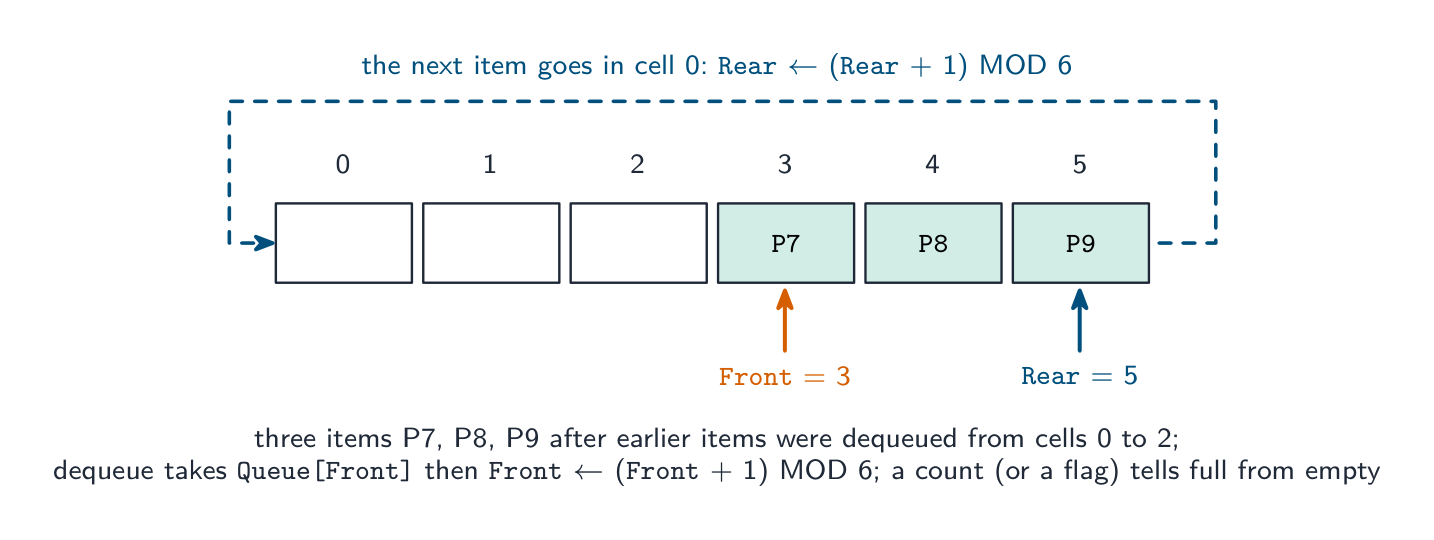
Queue (first in, first out): รายการเข้าร่วมที่ ท้าย (enqueue) และออกจาก หน้า (dequeue); พอยน์เตอร์สองตัวและนับจำนวน ใน linear queue หน้าพอยน์เตอร์เคลื่อนไปตามอาร์เรย์จนพื้นที่ที่เริ่มต้นเสียเปล่า; circular queue หวนทั้งสองพอยน์เตอร์ด้วย MOD, ดังนั้นทุกเซลล์จะถูกนำกลับมาใช้ใหม่
FUNCTION Enqueue(Item : STRING) RETURNS BOOLEAN
    IF Count = 6 THEN      // full
        RETURN FALSE
    ENDIF
    Rear ← (Rear + 1) MOD 6
    QueueArray[Rear] ← Item
    Count ← Count + 1
    RETURN TRUE
ENDFUNCTION
FUNCTION Dequeue() RETURNS STRING
    IF Count = 0 THEN      // empty
        RETURN ""
    ENDIF
    DECLARE Item : STRING
    Item ← QueueArray[Front]
    Front ← (Front + 1) MOD 6
    Count ← Count - 1
    RETURN Item
ENDFUNCTION
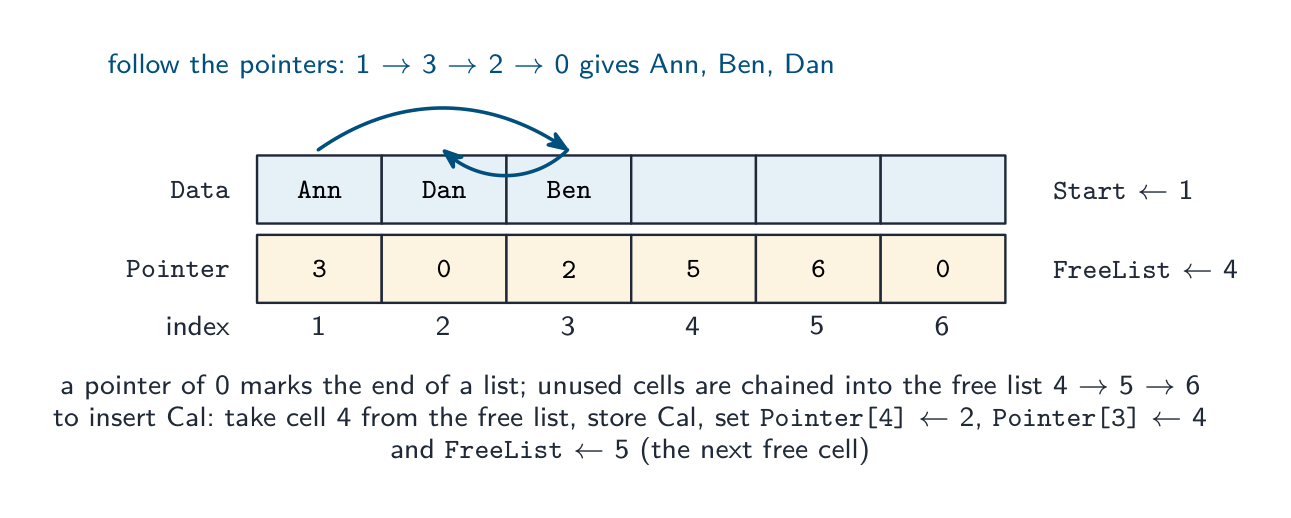
Linked list: ลำดับของ โหนด, แต่ละตัวเก็บรายการข้อมูลและ พอยน์เตอร์ไปยังโหนดถัดไป; start pointer ให้โหนดแรกและ null pointer (0 หรือ $-1$) จบลิสต์ ในการ IMPLEMENTATION แบบ array สอง array ข้างกันเก็บข้อมูลและพอยน์เตอร์, และเซลล์ที่ไม่ได้ใช้งานถูกเชื่อมต่อกันเป็น free list เพื่อให้การ insert รู้ว่าจะวางโหนดใหม่ไว้ที่ไหน
FUNCTION FindInList(Target : STRING) RETURNS INTEGER   // index, or 0 if absent
    DECLARE Current : INTEGER
    Current ← Start
    WHILE Current <> 0
        IF Data[Current] = Target THEN
            RETURN Current
        ENDIF
        Current ← Pointer[Current]
    ENDWHILE
    RETURN 0
ENDFUNCTION
การแทรกในรายการเรียงลำดับ: นำช่องว่างช่องแรก (NewNode ← FreeList, FreeList ← Pointer[FreeList]) มาเก็บรายการ แล้วเดินตามรายการด้วยตัวชี้ Previous และ Current จนถึง Data[Current] > Item หรือท้ายรายการ; กำหนด Pointer[NewNode] ← Current และ Pointer[Previous] ← NewNode (หรือ Start ← NewNode หากแทรกเป็นรายการแรก) การลบ ให้เชื่อมโหนดก่อนหน้าข้ามโหนดที่ลบ แล้วคืนช่องนั้นให้รายการช่องว่าง
Binary tree: โหนด ราก, แต่ละโหนดเก็บข้อมูล, left pointerไปยัง subtree ของค่าที่น้อยกว่าและ right pointerไปยัง subtree ของค่าที่มากกว่า Implemented เป็น 2D array (หรือสาม 1D arrays) Tree[Index, 0..2] สำหรับ left pointer, ข้อมูล, right pointer, กับ root pointer และ next-free pointer
FUNCTION FindInTree(Target : INTEGER) RETURNS INTEGER   // index, or -1
    DECLARE Current : INTEGER
    Current ← Root
    WHILE Current <> -1
        IF Tree[Current, 1] = Target THEN
            RETURN Current
        ENDIF
        IF Target < Tree[Current, 1] THEN
            Current ← Tree[Current, 0]      // go left
        ELSE
            Current ← Tree[Current, 2]      // go right
        ENDIF
    ENDWHILE
    RETURN -1
ENDFUNCTION
เพื่อ insert: เก็บรายการในโหนดถัดไปฟรีด้วยทั้งสองพอยน์เตอร์ $-1$; หาก tree ว่างทำให้มันเป็น root; มิฉะนั้นเดินลงจากราก, ไปซ้ายหรือขวาด้วยการเปรียบเทียบ, จนพอยน์เตอร์ที่คุณจะติดตามคือ $-1$, และตั้งค่าพอยน์เตอร์นั้นไปยังโหนดใหม่ An ADT from another ADT: a stack is a linked list where push and pop both work at the start; a queue is a linked list with a start and an end pointer; a queue can be made from two stacks (push onto one, pop from the other, moving everything across when the second is empty); a binary tree's nodes are records or objects linked by pointers, so it is built from a linked structure of nodes. บอกว่า operations ของ ADT ใหม่จับคู่กับ operations ของ ADT เก่าอย่างไร
ภาพแรกแสดงต้นไม้ค้นหาแบบทวิภาค: แต่ละโหนดมีโหนดลูกได้ไม่เกินสองโหนด ค่าที่น้อยกว่าโหนดอยู่ทางซ้าย และค่าที่มากกว่าอยู่ทางขวา ภาพที่สองแสดงวิธีท่องต้นไม้สามวิธี
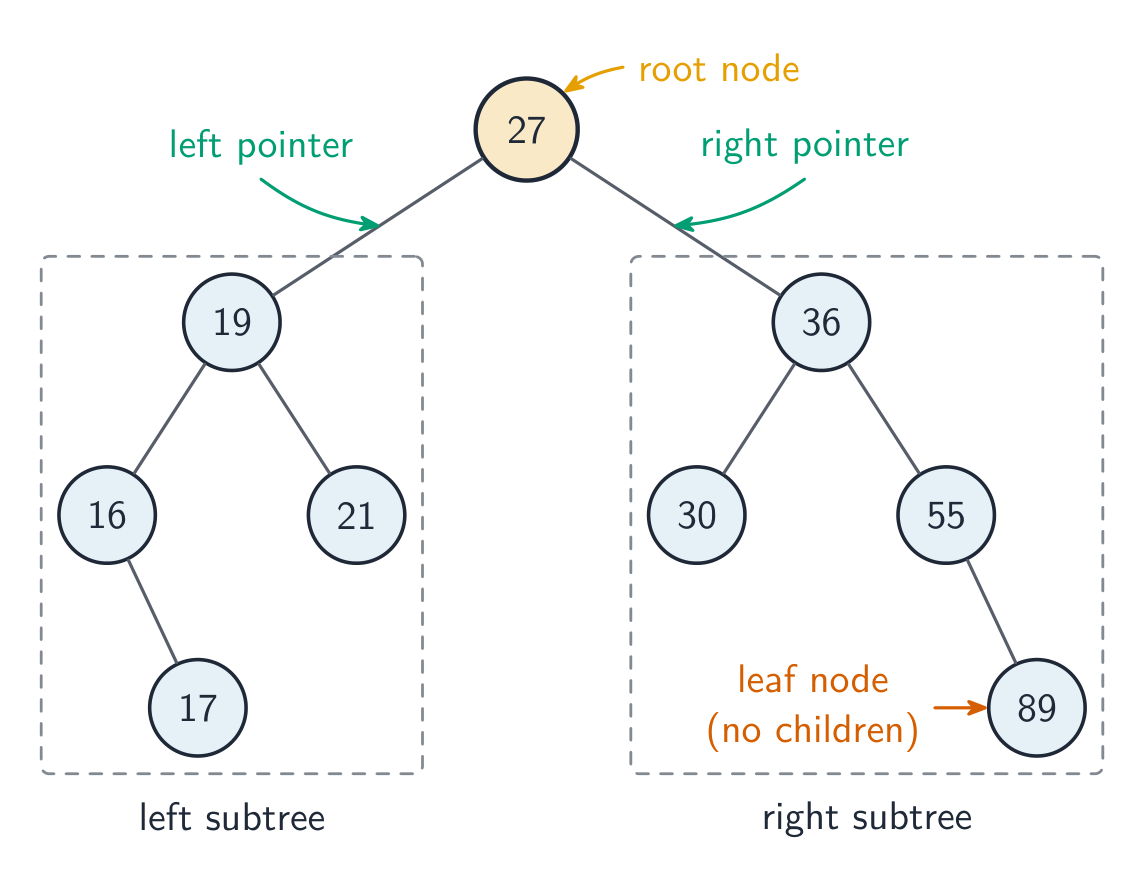
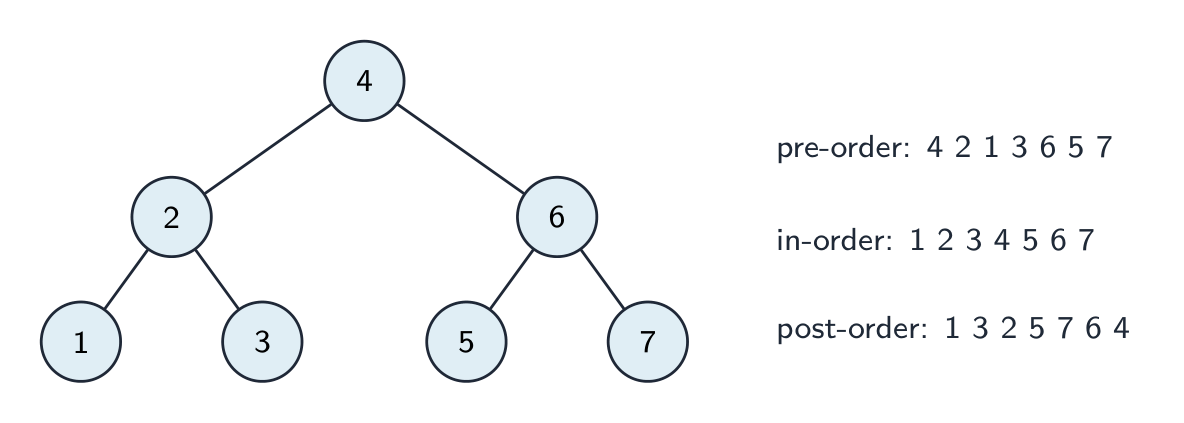 *สามการสำรวจแบบลึกของ binary tree: pre-order, in-order (sorted order) และ post-order
คำศัพท์
ฝึกฝน
| English | ไทย |
|---|---|
| linked list/lɪŋkt lɪst/ | ลิงค์ลิสต์ |
| stack/stæk/ | สตैก |
| queue/kjuː/ | คิว |
| node/nəʊd/ | โหนด |
| pointers/ˈpɔɪntəz/ | ตัวชี้ |
| binary tree/ˈbaɪnəri triː/ | ต้นไม้แบบสองทาง |
| dictionary/ˈdɪkʃənəri/ | คำศัพท์ |
| circular queue/ˈsɜːkjʊlə kjuː/ | คิววงกลม |
| free list/friː lɪst/ | ฟรีลิสต์ |
19.1
เปรียบเทียบอัลกอริทึม
Time complexity
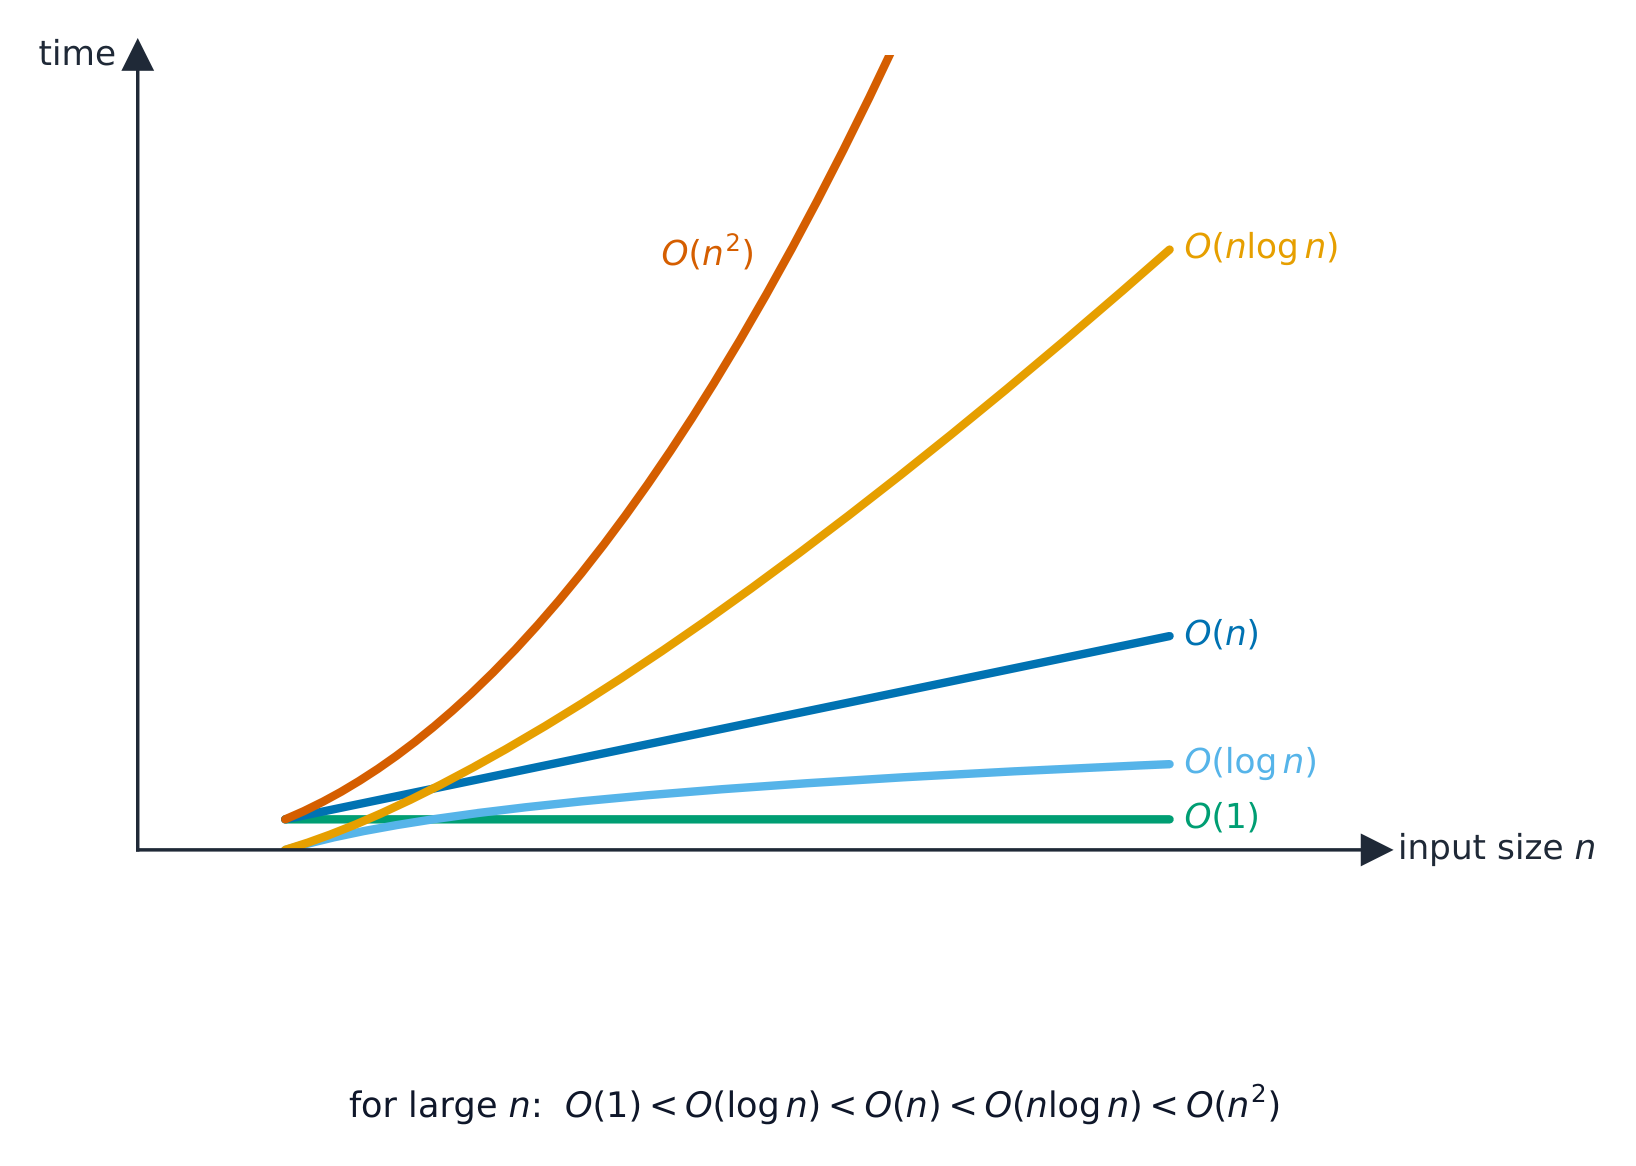
ความซับซ้อนด้านเวลา คือวิธีการที่เวลาในการทำงานเพิ่มขึ้นตามขนาดของข้อมูลเข้า $n$ เขียนในรูปแบบ Big-O notationO (พจน์หลัก): O(1) ค่าคงที่, O($\log n$) การค้นหาแบบทวิภาค, O($n$) การค้นหาแบบเชิงเส้น, O($n \log n$) การจัดเรียงที่ดี, O($n^{2}$) บับเบิล/อินเซอร์ชันโซตซ์ ความซับซ้อนระดับต่ำกว่าจะดีกว่าเมื่อขยายสเกล แม้ว่ามีอัลกอริทึมอื่นจะเร็วกว่าสำหรับขนาดเล็ก ๆ $n$ ก็ตาม
เพื่อให้เห็นภาพชัดเจน: ในการจัดเรียงรายการหนึ่งล้านรายการ อัลกอริทึม $O(n \log n)$ จะเสร็จสิ้นในเสี้ยววินาที ในขณะที่อัลกอริทึม $O(n^{2})$ อาจใช้เวลาเป็นนาที
ตัวอย่างฝึกหัด รายการที่มีลำดับแล้วมี $1000$ รายการ ต้องใช้การเปรียบเทียบกี่ครั้งต่อการค้นหาในแต่ละกรณี worse case?
การค้นหาแบบเชิงเส้นตรวจสอบรายการทีละรายการ ดังนั้นอาจต้องการการเปรียบเทียบสูงสุดถึง $1000$ — นี่คือ $O(n)$ การค้นหาแบบทวิภาคแบ่งรายการครึ่งหนึ่งทุกขั้นตอน ดังนั้นจึงต้องการการเปรียบเทียบไม่เกิน $\lceil \log_2 1000 \rceil = 10$ — นี่คือ $O(\log n)$ การเพิ่มขนาดรายการเป็นสองเท่าเป็น $2000$ รายการ ทำให้การค้นหาแบบทวิภาคเพิ่มเพียง หนึ่ง การเปรียบเทียบ แต่การค้นหาแบบเชิงเส้นอาจเพิ่มอีกสูงสุดถึง $1000$ — นั่นคือเหตุผลที่ว่าความซับซ้อนของการเติบโต ไม่ใช่ความเร็วสัมบูรณ์ ที่ตัดสินผู้ชนะเมื่อขยายสเกล
การอธิบายอันดับความซับซ้อน O(1): เวลาคงที่ไม่ขึ้นกับจำนวนรายการ เช่น การนำข้อมูลใส่สแตกหรืออ่านสมาชิกอาร์เรย์ O($\log n$): เวลาเพิ่มตามลอการิทึมของจำนวนรายการ ดังนั้นการเพิ่มข้อมูลเป็นสองเท่าจึงเพิ่มขั้นตอนเพียงจำนวนคงที่ เช่น การค้นหาแบบทวิภาค O($n$): เวลาเพิ่มเป็นสัดส่วนกับจำนวนรายการ เช่น การค้นหาแบบเชิงเส้นหรือการผ่านรายการหนึ่งรอบ O($n \log n$): เพิ่มเร็วกว่าเชิงเส้นเล็กน้อย เช่น การเรียงลำดับที่มีประสิทธิภาพ O($n^{2}$): เวลาเพิ่มตามกำลังสองของจำนวนรายการ ดังนั้นเมื่อข้อมูลเพิ่มเป็นสองเท่า เวลาจะเพิ่มเป็นสี่เท่า เช่น การเรียงลำดับแบบฟองและแบบแทรก คำถาม “ระบุ Big O ของการค้นหาแบบทวิภาคใน Names[0:99]” ตอบว่า $O(\log n)$ และอธิบายความหมายดังข้างต้น; Big O วัดว่าเวลาหรือหน่วยความจำเพิ่มขึ้นอย่างไรตามขนาดข้อมูล ไม่ใช่เวลาจริง
ตัวอย่างแสดงวิธีทำ (อันดับความซับซ้อนของโค้ด) จงระบุความซับซ้อนด้านเวลาของโค้ดแต่ละส่วน โดย n คือจำนวนรายการ
// Fragment A
FOR i ← 1 TO n
    FOR j ← 1 TO n
        Total ← Total + Grid[i, j]
    NEXT j
NEXT i

// Fragment B
Count ← 0
WHILE n > 1
    n ← n DIV 2
    Count ← Count + 1
ENDWHILE

// Fragment C
FOR i ← 1 TO n
    Total ← Total + A[i]
NEXT i
FOR i ← 1 TO n
    OUTPUT A[i] / Total
NEXT i
A คือ $O(n^{2})$: คำสั่งด้านในทำงาน $n$ ครั้งสำหรับแต่ละรอบจาก $n$ รอบของวงวนด้านนอก รวมทั้งหมด $n \times n$ ครั้ง B คือ $O(\log n)$: $n$ ลดลงครึ่งหนึ่งในแต่ละรอบ วงวนจึงทำงานประมาณ $\log_2 n$ ครั้ง (สำหรับ $n = 64$ ทำงานหกรอบ) C คือ $O(n)$: วงวนสองวงที่ทำงานต่อเนื่องกันใช้ $n + n = 2n$ ขั้นตอน และตัดค่าคงที่ทิ้ง กฎคือ วงวนซ้อนกันให้คูณ วงวนต่อเนื่องกันให้บวก และเก็บเฉพาะพจน์ที่เติบโตเร็วที่สุด ดังนั้น $3n^{2} + 5n + 2$ จึงเป็น $O(n^{2})$
ความซับซ้อนด้านพื้นที่
ความซับซ้อนด้านพื้นที่ คือหน่วยความจำเสริมที่ต้องการ บับเบิลและอินเซอร์ชันโซตซ์ใช้ O(1) เสริม (ทำใน-place); เมอร์จโซตซ์ใช้ O($n$); การเรียกซ้ำใช้หน่วยความจำสเกตที่แปรผันตามความลึก มีแลกเปลี่ยนระหว่างเวลาและหน่วยความจำเสมอ
เกณฑ์อื่นๆ
ความง่าย (เขียนโค้ดและดูแลรักษาง่าย), ความเสถียร, และการปรับตัว (เร็วขึ้นกับข้อมูลที่เรียงเกือบสมบูรณ์) อัลกอริทึมที่เหมาะสมขึ้นอยู่กับข้อมูลและข้อจำกัด
สำรวจ
ความเร็วในการดำเนินการเพิ่มขึ้นตาม n อย่างไร
เลื่อนกราฟ n ขึ้นไปและเปรียบเทียบเส้นโค้ง: O(1) และ O(log n) ค่อนข้างราบเรียบ, O(n) เพิ่มขึ้นอย่างสม่ำเสมอ, O(n²) พุ่งสูงขึ้นอย่างรวดเร็ว นี่คือเหตุผลที่ Big-O — ไม่ใช่นาฬิกาจับเวลา — เป็นวิธีการเปรียบเทียบอัลกอริทึมเมื่อมีอินพุตขนาดใหญ่
สำรวจ
อัตราการเติบโตแบบ Big-O
เปลี่ยนขนาดอินพุต n แล้วเปรียบเทียบว่างานของแต่ละอัลกอริทึมเพิ่มขึ้นเร็วแค่ไหน — นี่คือแนวคิดของ ความซับซ้อนด้านเวลา
คำศัพท์
ฝึกฝน
| English | ไทย |
|---|---|
| time complexity/taɪm kəmˈpleksɪti/ | ความซับซ้อนของเวลา |
| Big-O notation/bɪɡ əʊ nəʊˈteɪʃn/ | สัญลักษณ Big-O |
| space complexity/speɪs kəmˈpleksɪti/ | ความซับซ้อนของพื้นที่ |
19.2
การเรียกซ้ำ
หลักสูตร
| ผู้เข้าสอบควรสามารถ: | หมายเหตุและคำแนะนำ |
|---|---|
| แสดงความเข้าใจใน การเรียกซ้ำ | คุณสมบัติสำคัญของการเรียกซ้ำ การเขียนโปรแกรมที่แสดงถึงการเรียกซ้ำ การเขียนและติดตาม อัลกอริทึมแบบเรียกซ้ำ เมื่อใดการใช้การเรียกซ้ำจะมีความได้เปรียบ |
| แสดงความตระหนักถึงสิ่งที่คอมไพเลอร์ต้องทำเพื่อแปลรหัสโปรแกรมแบบ recursive | การใช้ stacks และการ unwinding |
แหล่งที่มา: หลักสูตร Cambridge International
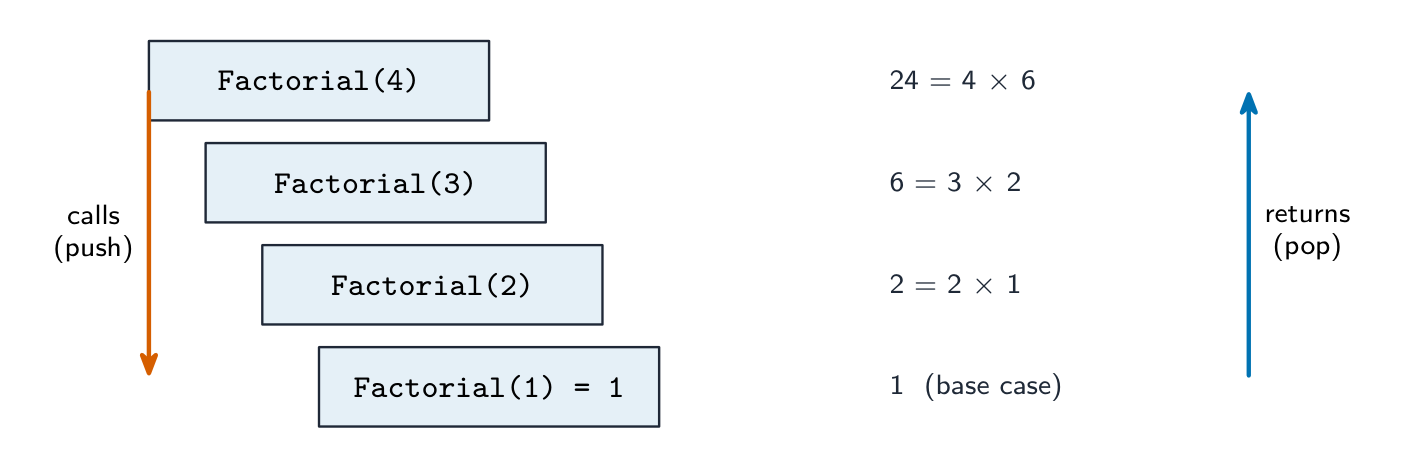
 *การเรียกจะลงสู่กรณีฐาน; ผลลัพธ์จะส่งกลับขึ้นข้างบน
อัลกอริทึมแบบเรียกซ้ำ ใช้ การเรียกซ้ำ: ฟังก์ชันเรียกตัวเองด้วยปัญหาเดิมแต่ขนาดเล็กกว่า จนกระทั่ง เคสฐาน จะหยุดลูป มันมีสองส่วน: เคสฐาน (เล็กพอที่จะแก้ได้โดยตรง — หากไม่มีมันการเรียกซ้ำจะไม่เคยหยุด) และ เคสเรียกซ้ำ (ลดอินพุตลงแล้วเรียกตัวเอง)
แฟกทอเรียล:
FUNCTION Factorial(n : INTEGER) RETURNS INTEGER
    IF n = 0 OR n = 1 THEN
        RETURN 1
    ELSE
        RETURN n * Factorial(n - 1)
    ENDIF
ENDFUNCTION
การเรียกซ้ำเป็นธรรมชาติสำหรับปัญหาที่มีลักษณะคล้ายกันเอง: ต้นไม้, Divide-and-conquer (การค้นหาแบบทวิภาค, เมอร์จโซตซ์), และข้อมูลแบบซ้อนกัน เมื่อไม่เหมาะสม การใช้ลูปมักจะสะอาดกว่า
“อธิบายความหมายของการเรียกซ้ำ” (สองคะแนน) ฟังก์ชันหรือโพรซีเยอร์ที่นิยามโดยอ้างถึงตัวเอง: ภายในตัวมันจะเรียกตัวเอง โดยใช้ปัญหาขนาดเล็กลงในแต่ละครั้ง จนถึงกรณีฐาน “ระบุลักษณะสำคัญสามประการของการเรียกซ้ำ”: (1) กรณีฐานหรือเงื่อนไขหยุดที่คืนค่าโดยไม่เรียกต่อ; (2) กรณีทั่วไปที่รูทีนเรียกตัวเอง; (3) การเรียกแต่ละครั้งทำให้ปัญหาเข้าใกล้กรณีฐานมากขึ้นโดยลดค่าพารามิเตอร์ เพื่อให้การเรียกซ้ำสิ้นสุด บางเกณฑ์เพิ่มว่า มีการคืนค่าเมื่อการเรียกย้อนกลับ
“อธิบายว่าเมื่อใดการใช้การเรียกซ้ำมีประโยชน์ พร้อมยกตัวอย่าง” เมื่อปัญหานิยามได้โดยธรรมชาติจากปัญหาเดียวกันที่มีขนาดเล็กลง ทำให้วิธีเรียกซ้ำสั้นกว่า ชัดเจนกว่า และใกล้เคียงนิยามทางคณิตศาสตร์มากกว่าการใช้วงวน เช่น แฟกทอเรียลหรือลำดับฟีโบนัชชี การค้นหาแบบทวิภาค การท่องต้นไม้ทวิภาค การเรียงลำดับแบบผสานหรือแบบเร็ว และการประมวลผลโครงสร้างซ้อนกัน เช่น โฟลเดอร์ภายในโฟลเดอร์ วิธีนี้ไม่เหมาะเมื่อระดับการเรียกซ้ำลึกมาก เพราะสแตกอาจล้น หรือเมื่อคำนวณปัญหาย่อยเดิมหลายครั้ง เช่น วิธีคำนวณฟีโบนัชชีแบบพื้นฐาน
การติดตามการเรียกซ้ำ
สำหรับ Factorial(4): การเรียกจะลงไปที่ Factorial(1)=1, จากนั้น unwinding คูณกลับขึ้นไป: 2*1=2, 3*2=6, 4*6=24. ผลลัพธ์สุดท้าย 24. ติดตามการเรียก pending แต่ละตัวบน stack
ตัวอย่างฝึกหัด ฟังก์ชันด้านล่างให้มาโดยไม่มีการอธิบาย จงติดตาม Unknown(3, 5) และระบุเอาต์พุตและค่าที่คืนกลับมา
FUNCTION Unknown(BYVAL X, BYVAL Y : INTEGER) RETURNS INTEGER
    IF X < Y THEN
        OUTPUT X + Y
        RETURN Unknown(X + 1, Y - 1) + 1
    ELSE
        RETURN 0
    ENDIF
ENDFUNCTION
Call 1: $X = 3, Y = 5$: $3 < 5$, output 8, call Unknown(4, 4). Call 2: $4 < 4$ is false, return 0. Unwinding: call 1 returns $0 + 1 = 1$. Output 8, return value 1. Write the trace as a table with a row per call (parameters, condition, output, what it returns), and do the returns from the deepest call upwards: that is the unwinding the mark scheme looks for.
ตัวอย่างฝึกหัด (Fibonacci). Fib(n) คืนค่า n เมื่อ n < 2, มิฉะนั้นคืนค่า Fib(n - 1) + Fib(n - 2). หา Fib(5).
Fib(5) = Fib(4) + Fib(3); Fib(4) = Fib(3) + Fib(2); Fib(3) = Fib(2) + Fib(1); Fib(2) = Fib(1) + Fib(0) = 1 + 0 = 1. ดังนั้น Fib(3) = 1 + 1 = 2, Fib(4) = 2 + 1 = 3, Fib(5) = 3 + 2 = 5. เคสฐานถูกเข้าถึง หลาย ครั้ง (Fib(2) ถูกคำนวณสามครั้ง) ซึ่งเป็นสาเหตุที่ทำให้เวอร์ชันนี้ช้า: มันทำการเรียก 15 ครั้งสำหรับ $n = 5$ และประมาณการ doubles จำนวนการเรียกสำหรับทุกการเพิ่มขึ้นใน $n$.
การเปลี่ยนจากเรคอร์ชันเป็นอิตอเรชัน ฟังก์ชันแบบเรคอร์ชันทุกตัวสามารถเขียนใหม่โดยใช้ลูป ซึ่งใช้หน่วยความจำน้อยลงและทำงานได้เร็วขึ้น: เก็บผลลัพธ์ที่สะสมไว้และวนลูปตั้งแต่เคสพื้นฐานขึ้นไปabove Factorial ในรูปของลูป:
FUNCTION Factorial(N : INTEGER) RETURNS INTEGER
    DECLARE Result, Count : INTEGER
    Result ← 1
    FOR Count ← 2 TO N
        Result ← Result * Count
    NEXT Count
    RETURN Result
ENDFUNCTION
เมื่อถูกขอให้เปลี่ยนอัลกอริทึมการจัดเรียงแบบแทรกหรือการค้นหาแบบเรคอร์ชันให้เป็นแบบอิตারেทีทีทิก, ให้แทนการเรียกตัวเองด้วยลูปที่วนตามดัชนีที่เรคอร์ชันกำลังก้าวผ่าน และแปลงเคสพื้นฐานให้เป็นเงื่อนไขการออกของลูป
ความเสี่ยง
- infinite recursion หากพลาดเคสพื้นฐาน — ระบบจะหยุดทำงานพร้อมข้อความ stack overflow
- ใช้หน่วยความจำสูงสำหรับการทำ recursive ลึก
- ช้าหากมีการทำงานซ้ำซ้อน (Fibonacci แบบ naive เป็น exponential — ควรใช้ loop หรือ memoisation)
สำรวจ
Recursion ถอดออกจากใบไม้ขึ้นด้านบน
ผ่าน fib(4) ตามลำดับที่เรียกใช้งานเสร็จจริง: ใบ (base cases) แก้ไขก่อน จากนั้นแต่ละแม่รวมลูกหลานของตน หมายเหตุ fib(2) คำนวณสองครั้ง — งานซ้ำนี้คือเหตุผลว่าทำไม naive recursion จึงช้า
คำศัพท์
ฝึกฝน
| English | ไทย |
|---|---|
| recursion/rɪˈkɜːʃn/ | การเรียกซ้ำ |
| call stack/kɔːl stæk/ | call stack |
| base case/beɪs keɪs/ | กรณีพื้นฐาน |
| recursive case/rɪˈkɜːsɪv keɪs/ | กรณีเรียกซ้ำ |
| factorial/fækˈtɔːrɪəl/ | แฟกทอเรียล |
| divide-and-conquer/dɪˈvaɪd ænd ˈkɒŋkə/ | แบ่งแยกและพิชิต |
| parameters/pəˈræmɪtəz/ | พารามิเตอร์ |
| stack overflow/stæk ˌəʊvəˈfləʊ/ | สแต็กโอเวอร์โฟลว์ |
| memoisation/ˌmeməʊaɪˈzeɪʃn/ | การจำแนกผลลัพธ์ |
19.2
สิ่งที่คอมไพล์เตอร์ทำต่อโค้ดแบบ recursive
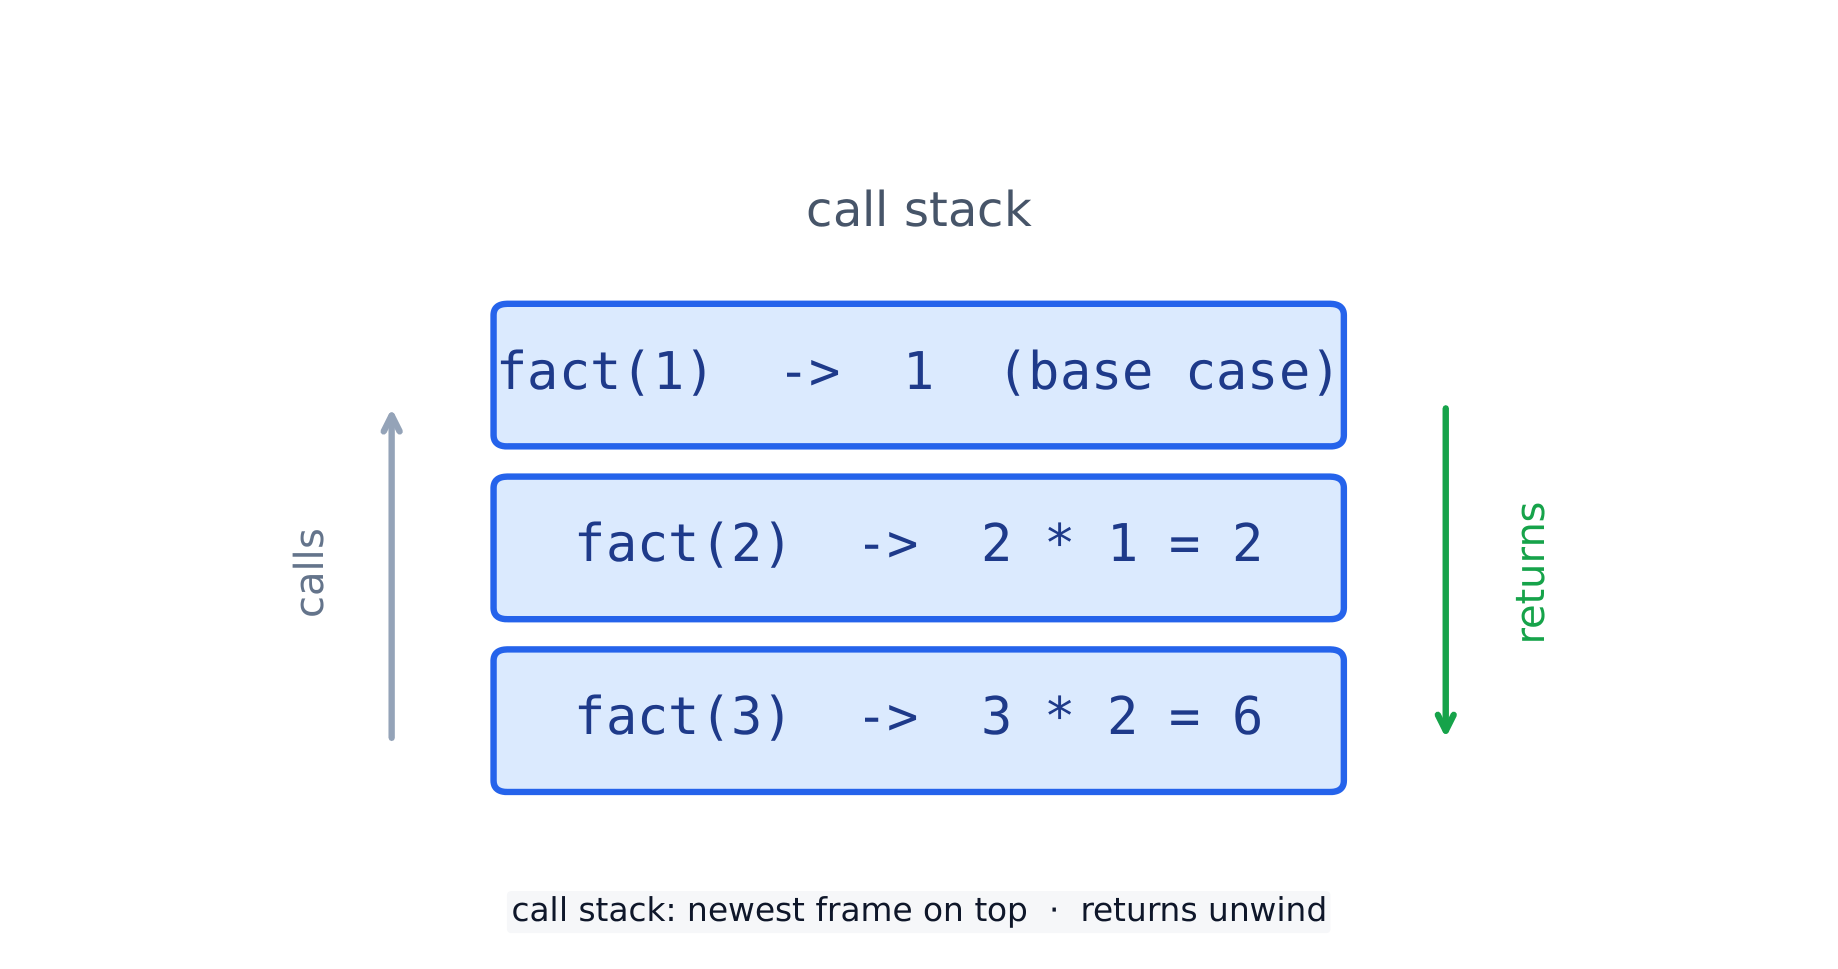
Recursive ต้องการให้ แต่ละการเรียกมีสำเนาของตัวเอง ของ parameters และ local variables คอมไพล์เตอร์จะเก็บสิ่งเหล่านี้ไว้ใน call stack สำหรับแต่ละการเรียก มันจะดัน stack frame ที่เก็บ parameters, local variables และ return address (ตำแหน่งที่จะกลับไปดำเนินการต่อใน caller) เมื่อฟังก์ชันส่งค่ากลับ ค่าที่ได้จะถูกส่งคืน frame ถูกดึงออก และควบคุมงานจะกลับมาดำเนินต่อที่ return address
เนื่องจากการเรียกแต่ละครั้งมีเฟรมของตัวเอง ตัวแปรของการเรียกซ้ำจึงไม่ทับกัน สแตกอาจมีขนาดใหญ่เมื่อเรียกซ้ำหลายระดับ จึงอาจล้นได้หากลึกมาก กลไกการเรียกและคืนค่านี้เหมือนกับที่ใช้ในการเรียกทั่วไปซึ่งไม่เรียกซ้ำ ไม่มีกลไกพิเศษสำหรับ “การเรียกซ้ำ”
“อธิบายว่าเหตุใดสแตกจึงเหมาะสำหรับการทำงานของการเรียกซ้ำ” (สามคะแนน) การเรียกซ้ำแต่ละครั้งต้องบันทึก****ที่อยู่สำหรับกลับ พารามิเตอร์ และตัวแปรเฉพาะที่ และการเรียกจะเสร็จตามลำดับย้อนกลับจากลำดับที่เรียก คือการเรียกครั้งสุดท้ายเสร็จก่อน ซึ่งตรงกับพฤติกรรมเข้าหลังออกก่อนของสแตก: การเรียกใหม่แต่ละครั้งจะเพิ่มเฟรมลงในสแตก และการคืนค่าแต่ละครั้งจะนำเฟรมล่าสุดออก ทำให้คืนสถานะของผู้เรียกและทราบว่าจะดำเนินต่อที่ใด นี่เป็นหน้าที่ของคอมไพเลอร์เมื่อแปลโค้ดเรียกซ้ำ โดยสร้างคำสั่งเพิ่มเฟรมสแตกทุกครั้งที่เรียกและนำเฟรมออกทุกครั้งที่คืนค่า เฟรมจะคลายกลับเมื่อผลลัพธ์ถูกส่งกลับ
คำศัพท์
ฝึกฝน
| English | ไทย |
|---|---|
| local variables/ˈləʊkl ˈveərɪəblz/ | ตัวแปรภายใน |
| stack frame/stæk freɪm/ | เฟรมสแต็ก |
| return address/rɪˈtɜːn əˈdres/ | ที่อยู่กลับคืน |
19.2
คำนิยามที่ผู้สอบยอมรับ
คำถามนิยามจะถูกตรวจด้วยคำศัพท์ตายตัว จงท่องจำเหล่านี้ให้ถูกต้อง และให้คำตอบเพียงข้อเดียว
| พจน์ | นิยาม |
|---|---|
| linear search | ตรวจสอบแต่ละรายการทีละรายการจากต้นจนกว่าจะพบเป้าหมายหรือถึงท้ายรายการ |
| binary search | เปรียบเทียบเป้าหมายกับรายการตรงกลางของชุดข้อมูลที่เรียงลำดับแล้วซ้ำๆ และทิ้งครึ่งที่ไม่อาจมีเป้าหมายอยู่ |
| bubble sort | ผ่านรายการซ้ำๆ สลับรายการที่อยู่ติดกันที่มีลำดับผิด จนกว่าการผ่านครั้งหนึ่งจะไม่มีการสลับเลย |
| insertion sort | นำรายการมาทีละรายการแล้วใส่เข้าไปในตำแหน่งที่ถูกต้องในระหว่างรายการที่เรียงลำดับไว้แล้ว |
| abstract data type | ชุดข้อมูลและการดำเนินการที่สามารถทำได้กับมัน โดยนิยามแยกออกจากวิธีการจัดเก็บ |
| stack | โครงสร้างแบบ last-in-first-out ที่มี push และ pop ที่ด้านบน |
| queue | โครงสร้างแบบ first-in-first-out ที่เพิ่มรายการที่ด้านหลังและลบรายการที่ด้านหน้า |
| linked list | ลำดับของโหนด แต่ละโหนดมีข้อมูลและพอยน์เตอร์ไปยังโหนดถัดไป พร้อมพอยน์เตอร์เริ่มต้น |
| binary tree | โหนดแต่ละตัวมีข้อมูลและพอยน์เตอร์ไปยัง subtree ซ้ายที่มีค่าน้อยกว่า และ subtree ขวาที่มีค่ามากกว่า |
| Big O notation | วิธีการจัดหมวดหมู่เวลา (หรือหน่วยความจำ) ที่อัลกอริทึมต้องการโดยดูจากการเติบโตเมื่อขนาดข้อมูลเข้าเพิ่มขึ้น |
| recursion | Routine ที่เรียกตัวเองด้วยปัญหาที่เล็กลงเรื่อยๆ จนกว่า base case จะหยุดการเรียก |
| base case | เงื่อนไขที่ routine แบบ recursive ส่งค่ากลับโดยไม่เรียกตัวเอง |
| unwinding | การส่งค่ากลับของ chain ของ recursive calls จาก call ที่ลึกที่สุดกลับไปยัง call แรก เมื่อ stack frames ถูกดึงออก |
19.2
ข้อแนะนำสำหรับการสอบ
- Searches: linear needs no order and O($n$); binary needs a sorted array, halves each time and is O($\log n$). Know both algorithms by heart, including the bounds and the flag.
- Sorts: bubble มี swapped flag, insertion มี key ที่เลื่อนรายการที่ใหญ่กว่าไปทางขวา; ทั้งคู่ O($n^{2}$) ในกรณี worst, O($n$) บนข้อมูลที่เรียงลำดับแล้ว ประสิทธิภาพขึ้นอยู่กับจำนวนรายการและความเรียงลำดับของข้อมูล
- ADT implementations คือ pointer bookkeeping: top pointer; front, rear และ count กับ MOD; start, pointers และ free list; root พร้อม left และ right pointers ต้องตรวจสอบเสมอว่าเต็มหรือว่าง
- Big O เกี่ยวกับการเพิ่มขึ้นตามขนาดข้อมูล ได้แก่ คงที่ ลอการิทึม เชิงเส้น และกำลังสอง สำหรับการค้นหาแบบทวิภาคให้กล่าวว่า “การเพิ่มข้อมูลเป็นสองเท่าทำให้เปรียบเทียบเพิ่มหนึ่งครั้ง”
- Recursion: base case, general case, การก้าวหน้า toward base case; เป็นประโยชน์เมื่อปัญหานิยามด้วยตัวเอง; stack เก็บ return addresses และ variables เพราะ calls ส่งค่ากลับใน reverse order Trace ด้วยตารางและ unwind จาก call ที่ลึกที่สุด
ข้อผิดพลาดที่พบบ่อย
- เขียน $O(2n)$ หรือ $O(n^{2} + n)$: ตัดค่าคงที่และพจน์ที่เล็กกว่าทิ้ง ได้ $O(n)$ และ $O(n^{2})$
- คำนวณดัชนีตรงกลางเป็น $(Lower + Upper) / 2$ ขณะไล่การทำงาน: รูปแบบในข้อสอบใช้
DIVจึงต้องปัดลง - การใช้ binary search บนข้อมูลที่ไม่ได้เรียงลำดับ หรือบน linked list; และการตั้ง
Lower ← MiddleIndexแทนMiddleIndex + 1ซึ่งจะทำให้ลูปวนตลอดไป - Inner loop ของ bubble sort ที่วนไปจนสุด array ทุกครั้ง หรือการ swap โดยไม่มี temporary variable
- Push หรือ enqueue ที่ไม่ทดสอบว่าเต็ม, หรือ pop หรือ dequeue ที่ไม่ทดสอบว่าว่าง
- การย้าย front pointer ของ queue โดยไม่มี MOD ใน circular queue, หรือการตีความ front = rear ว่าหมายถึงว่างเสมอ
- การแทรกใน linked list โดยการเลื่อน contents ของ array; มีการเปลี่ยนเฉพาะ pointers เท่านั้น
- Recursive function ที่ไม่มี base case, หรือหนึ่ง whose recursive call does not make the problem smaller.
- การติดตามการเรียกใช้ฟังก์ชันซ้ำ (recursive call) แต่ลืมเพิ่มภาระงานที่ยังค้างอยู่ในการย้อนกลับขึ้น
- ตอบคำถาม “เหตุใดจึงใช้สแตก” ว่า “เพราะเร็ว” เหตุผลคือลำดับการคืนค่าแบบเข้าหลังออกก่อน
คำศัพท์
ฝึกฝน
| English | ไทย |
|---|---|
| general case/ˈdʒenərəl keɪs/ | กรณีทั่วไป |
บทเรียนเชิงโต้ตอบสำหรับหัวข้อนี้
ทำทีละขั้นตอน พร้อมแบบฝึกหัดตรวจสอบผลทันที