| ผู้เข้าสอบควรสามารถ: | หมายเหตุและคำแนะนำ |
|---|---|
| แสดงความเข้าใจว่าทำไม user-defined types จึงจำเป็น | |
| นิยามและใช้ non-composite types | รวมถึง enumerated, pointer |
| นิยามและใช้ composite data types | รวมถึง set, record และ class/object |
| เลือกและออกแบบ user-defined data type ที่เหมาะสมสำหรับโจทย์ที่กำหนด |
การจัดรูปแบบข้อมูล
Computer Science A-Level · หัวข้อ 13
 15:16
ประเภทข้อมูลที่กำหนดโดยผู้ใช้
ฟิลด์ข้อความธรรมดาจะเก็บข้อมูลไร้สาระได้อย่างสบายใจ ขอชนิดยานพาหนะมา คนหนึ่งพิมพ์ "กล้วย" — โปรแกรมรับไว้โดยไม่บ่น แต่หากคุณ…
การบรรยายภาษาอังกฤษ · คำบรรยายภาษาอังกฤษ + 中文 ลอยตัวบนภาพ
13.1
ประเภทข้อมูลที่กำหนดเอง

หลักสูตร
แหล่งที่มา: หลักสูตร Cambridge International
ประเภทที่สร้าง sẵn (INTEGER, REAL, STRING, CHAR, BOOLEAN) ครอบคลุมกรณีพื้นฐาน สำหรับปัญหาที่ซับซ้อนกว่านี้ คุณสามารถกำหนด ประเภทข้อมูลที่ผู้ใช้สร้างเอง เพื่อทำให้โค้ดอ่านง่ายขึ้นและคอมไพเลอร์เข้มงวดขึ้น
ทำไมถึงจำเป็นต้องใช้
ประเภทสร้าง sẵn STRING อนุญาตให้คุณเก็บข้อมูลที่ไม่สมเหตุสมผลไว้ในฟิลด์ที่ควรจะมีค่าถูกต้องเพียงไม่กี่ค่า; ประเภทที่กำหนดเองสามารถจำกัดสิ่งนี้ได้ Entity จริงมักเป็น กลุ่มรวม ของค่าหลายประเภท และ DECLARE Taxi : Vehicle อ่านเข้าใจง่าย (self-documenting) กว่า DECLARE Taxi : STRING
"อธิบายวัตถุประสงค์ของประเภทข้อมูลที่กำหนดเอง (สองคะแนน) ประเภทข้อมูลที่นัก编程者กำหนดเอง สร้างจากประเภทที่มีอยู่ (built-in types) เพื่อให้สามารถแทนค่าข้อมูลเฉพาะของปัญหานั้นได้เมื่อไม่มีประเภทสร้าง sẵnที่เหมาะสม ทั้งสองส่วนได้คะแนน: กำหนดโดยนัก编程者 และ สร้างจากประเภทที่มีอยู่ ผู้ตรวจสอบยังยอมรับคำว่า "เพื่อทำให้โปรแกรมอ่านและบำรุงรักษาง่ายขึ้น" เป็นข้อเสริม แต่ไม่ได้รับคะแนนโดดเดี่ยว
"อธิบายความหมายของชนิดข้อมูลแบบ non-composite และ composite" (สี่คะแนน) non-composite type ถูกกำหนด โดยไม่อ้างอิงถึงชนิดอื่น: เก็บ ค่าเดียว, ตัวอย่างเช่น integer, real, หรือ enumerated value. composite type คือกลุ่มของ ชนิดอื่นๆ (ซึ่งอาจเป็น composite ด้วย): เก็บ หลายค่า ภายใต้ชื่อเดียว, ตัวอย่างเช่น record, set, array หรือ class. ให้ตัวอย่างพร้อมคำจำกัดความแต่ละอย่าง; ข้อสอบ要求在หนึ่ง
ชนิดข้อมูลแบบ non-composite
ชนิด enumerate
ชนิด enumerate มีค่าที่เป็น รายการคงที่ของ named constants:
TYPE Vehicle = (M100, M230, T101, T102, T120, T150)
DECLARE MyTaxi : Vehicle
MyTaxi ← T102
ชื่อเหล่านี้คือค่าของชนิดใหม่ (จัดเก็บภายในเป็นจำนวนเต็มขนาดเล็ก); ไม่สามารถกำหนดค่านอกจากรายการได้ การใช้งาน: วันในสัปดาห์, สี, รหัสสถานะ
"ระบุว่าความหมายของ数据类型 enumerate คืออะไร. non-composite user-defined type ที่กำหนดโดยการระบุค่าที่เป็นไปได้ทั้งหมด (ตามลำดับ) เนื่องจากค่ามี ลำดับ จึงสามารถเปรียบเทียบและวนผ่านได้: กับ TYPE Month = (January, February, ..., December), การทดสอบ IF ThisMonth > June เป็นไปตามกฎ, และค่าถูกจัดเก็บภายในเป็นจำนวนเต็ม. pseudo-code มีสามส่วนและข้อสอบให้คะแนนแต่ละส่วน: คำสำคัญ TYPE, identifier ที่มี =, และรายการในวงเล็บคั่นด้วยลูกน้ำ
ตัวอย่างที่มีคำตอบ เขียน伪-code เพื่อกำหนดชนิด enumerate สำหรับวันที่โรงเรียนเปิดทำการ (วันจันทร์ถึงวันศุกร์), และประกาศตัวแปรชนิดนั้นตั้งค่าเป็นวันพุธ
TYPE SchoolDay = (Monday, Tuesday, Wednesday, Thursday, Friday)
DECLARE Today : SchoolDay
Today ← Wednesday
ตัวแปรของชนิด enumeration ไม่สามารถรับค่าที่อยู่นอกชุดที่กำหนด ซึ่งเป็นจุดประสงค์หลัก: Today ← Saturday เป็นข้อผิดพลาดระดับคอมไพล์ ในขณะที่ STRING จะยอมรับ "Saturdy" ได้
ประเภทพอยเตอร์
พอยเตอร์ (pointer) เก็บ ที่อยู่หน่วยความจำของตัวแปรอื่น (หรือ NULL สำหรับ "ไม่มีเป้าหมาย") พอยเตอร์ใช้สร้างโครงสร้างแบบไดนามิก (ลิสต์เชื่อมโยง, ต้นไม้) และส่งอ้างอิงโดยไม่มีการคัดลอกข้อมูล
TYPE PNode = ^TNode    // pointer to a TNode
DECLARE p : PNode
p ← NEW TNode
p^.Value ← 42          // dereference to reach the fields
การ ดีรีเฟอเรนซ์ (dereference, p^) หมายถึงการเข้าถึงตัวแปรที่พอยเตอร์ชี้ไป
"ระบุความหมายของประเภทข้อมูลพอยเตอร์" ประเภทที่ไม่ใช่คอมโพสิตที่มีค่าเป็นที่อยู่หน่วยความจำ (หรืออ้างอิงถึง) ตัวแปรของประเภทที่กำหนด ใน伪代码จะประกาศประเภทโดยใช้เครื่องหมาย ^ หน้าชื่อประเภทที่ชี้ไป และข้อสอบจะถามเฉพาะบรรทัดนั้น:
TYPE SelectParts = ^Parts        // a pointer to a value of type Parts
DECLARE Chosen : SelectParts
Chosen ← ^Keyboard               // Chosen now holds the address of Keyboard
OUTPUT Chosen^                   // dereference: the value stored at that address
พอยเตอร์คือองค์ประกอบพื้นฐานของ ลิสต์เชื่อมโยง แบบไดนามิก หรือ ต้นไม้แบบทวิภาคี (หัวข้อ 19): โหนดแต่ละตัวมีพอยเตอร์ไปยังโหนดถัดไป ข้อผิดพลาดทั่วไป 2 คะแนนที่มักพบ: การเขียนประเภทพอยเตอร์โดยเข้าใจผิดว่าเป็นการเก็บค่าโดยตรง และการลืมเครื่องหมาย ^ เมื่ออ่านผ่านพอยเตอร์

p^ ดีรีเฟอเรนซ์เพื่อเข้าถึงฟิลด์ของโหนดประเภทคอมโพสิต
ประเภทคอมโพสิต (composite type - หนึ่งใน ประเภทข้อมูลคอมโพสิต) คือการจัดกลุ่มหลายค่าเข้าด้วยกันภายใต้ชื่อเดียว


- record (หัวข้อ 10) — ฟิลด์ที่มีชนิดต่างกันภายในบล็อก
TYPE ... ENDTYPE - เซต — กลุ่มที่ไม่เรียงลำดับของค่าที่เป็นเอกลักษณ์ พร้อม-operation เพิ่ม, ลบ, ตรวจสอบการมีอยู่, ยูเนียน, อินเตอร์เซกชัน:
DECLARE Available : SET OF Colour
Available ← {Red, Blue}
IF Green IN Available THEN
    ...
ENDIF
- คลาส / ออบเจกต์ — ประเภทคอมโพสิตแบบ OOP ที่รวมฟิลด์ข้อมูล (คุณสมบัติ/attributes) เข้ากับการทำงานบนข้อมูล (เมทოდ/methods) ออบเจกต์คืออินสแตนซ์ของคลาส:
CLASS Taxi
    PRIVATE Capacity : INTEGER
    PUBLIC FUNCTION GetCapacity() RETURNS INTEGER
        RETURN Capacity
    ENDFUNCTION
ENDCLASS
การเลือกประเภท
ใช้ enum (enumerated) สำหรับค่าจากรายการคงที่, pointer สำหรับการอ้างอิงอ้อม, record สำหรับกลุ่มฟิลด์, set สำหรับกลุ่มที่ไม่เรียงลำดับและมีค่าไม่ซ้ำ, และ class เมื่อต้องการทั้งสถานะ (state) และ พฤติกรรม together
"อธิบายประเภทข้อมูลที่ผู้ใช้กำหนดว่าด้วยเซต (สามคะแนน)." ประเภทคอมโพสิตที่เก็บกลุ่มของค่าชนิดเดียวกัน โดยไม่มีการเรียงลำดับและไม่มีค่าซ้ำ; สามารถเพิ่มและลบค่าได้ และสามารถตรวจสอบว่าค่าใดอยู่ในเซตหรือไม่. ประกาศประเภทด้วย SET OF แล้วนิยามค่าคงที่เซตโดยใส่ค่าในวงเล็บ:
TYPE EvenNumbers = SET OF INTEGER
DEFINE Evens (2, 4, 6, 8, 10, 12) : EvenNumbers
TYPE SymbolSet = SET OF CHAR
DEFINE Operators ('+', '-', '*', '/') : SymbolSet
"อธิบายประเภทข้อมูลที่ผู้ใช้กำหนดว่าด้วยเรคอร์ด (สามคะแนน)." ประเภทคอมโพสิตที่ประกอบด้วยจำนวนฟิลด์ (รายการ) ที่แน่นอน แต่ละฟิลด์มีตัวระบุและประเภทของตัวเอง ถูกเรียกใช้ภายใต้ตัวระบุเดียว; เข้าถึงฟิลด์ได้ด้วยจุด (dot notation)
ตัวอย่างทำโจทย์. เขียน伪代码 (pseudocode) เพื่อประกาศประเภทข้อมูลบันทึก ClubMember สำหรับชื่อจริง, ชื่อสกุล, รหัสสมาชิก (จำนวนเต็ม), วันที่เข้าเป็นสมาชิก และสถานะการชำระค่าสมาชิก; จากนั้นประกาศตัวแปรและกำหนดค่าสองฟิลด์
TYPE ClubMember
    DECLARE FirstName : STRING
    DECLARE LastName : STRING
    DECLARE Code : INTEGER
    DECLARE DateJoined : DATE
    DECLARE FeesPaid : BOOLEAN
ENDTYPE

DECLARE NewMember : ClubMember
NewMember.LastName ← "Chen"
NewMember.FeesPaid ← TRUE
ทุกฟิลด์จำเป็นต้องมีบรรทัด DECLARE ของตัวเองพร้อมชนิดข้อมูลที่เหมาะสม, บล็อกจะจบลงด้วย ENDTYPE, และการเข้าถึง field จะใช้ variable.field. เมื่อถูกถามให้เลือกชนิดข้อมูลสำหรับแต่ละฟิลด์ ให้จับคู่กับข้อมูล: รหัสที่นำไปเปรียบเทียบเพียงอย่างเดียวคือ STRING หากสามารถมีตัวอักษรได้, เป็น INTEGER หากต้องการคำนวณทางคณิตศาสตร์หรือการจัดลำดับ; คำตอบใช่/ไม่ใช่คือ BOOLEAN; วันที่คือ DATE. ฟิลด์ที่สามารถรับค่าเฉพาะ的几个ค่าหนึ่งได้ (เช่น สัตว์เลี้ยง, สี) ควรกำหนดให้เป็น enumerated type

บันทึกในอาร์เรย์และไฟล์ ตารางที่มีสมาชิกจำนวนมากคือ DECLARE Members : ARRAY[1:100] OF ClubMember; แล้ว Members[3].LastName คือฟิลด์หนึ่งขององค์ประกอบหนึ่ง, และลูปที่วนตามดัชนีจะประมวลผลทุกบันทึก บันทึกยังเป็นหน่วยธรรมชาติที่ถูกเขียนเข้าและอ่านออกจากไฟล์ (ด้านล่าง) โดยหนึ่งบันทึกต่อ PUTRECORD หรือ WRITEFILE
ตัวอย่างวิธีทำ ประเภทคอมโพสิต Pet เก็บชื่อสัตว์เลี้ยง (สตริง), สปีชีส์ (หนึ่งจากสุนัข แมว กระต่าย หรือแฮมสเตอร์) และน้ำหนักเป็นกิโลกรัม (จำนวนจริง) กำหนดประเภทและประกาศตัวแปร
TYPE Species = (Dog, Cat, Rabbit, Hamster)
TYPE Pet
    DECLARE Name : STRING
    DECLARE Kind : Species
    DECLARE Weight : REAL
ENDTYPE
DECLARE MyPet : Pet
MyPet.Kind ← Rabbit
ประเภท枚举ถูกกำหนด ก่อน เพราะว่าบันทึกใช้มัน: ลำดับมีความสำคัญในพseudocode เหมือนกับในคอมไพเลอร์
คลาสในพseudocode คลาส เป็นประเภทคอมโพสิตที่同时还 carries behaviour. การสอบถามถึงการประกาศพร้อมคุณสมบัติที่ระบุ PRIVATE, constructor ชื่อ NEW ที่ตั้งค่ามัน, และ PUBLIC methods เพื่อรับหรือเปลี่ยนมัน:
CLASS Appointment
    PRIVATE PatientName : STRING
    PRIVATE Treatment : STRING
    PRIVATE Medication : STRING
    PUBLIC PROCEDURE NEW(Name : STRING, Treat : STRING, Med : STRING)
        PatientName ← Name
        Treatment ← Treat
        Medication ← Med
    ENDPROCEDURE
    PUBLIC FUNCTION GetTreatment() RETURNS STRING
        RETURN Treatment
    ENDFUNCTION
ENDCLASS

DECLARE Visit : Appointment
Visit ← NEW Appointment("A. Chen", "filling", "none")
OUTPUT Visit.GetTreatment()
คุณสมบัติเป็น private เพื่อให้สามารถเปลี่ยนแปลงได้เฉพาะผ่าน methods (encapsulation, Topic 20); constructor เป็น procedure ที่เรียก NEW พร้อม parameter ต่อหนึ่ง attribute; getter เป็น function ที่คืนค่า attribute แต่ละอย่างนี้เป็นเครื่องหมายแยกต่างหาก
สำรวจ
ห้องปฏิบัติการแนวคิดการเขียนโปรแกรม
เชื่อมโยงตัวอย่างเข้ากับแนวคิดการเขียนโปรแกรมที่แสดงออก
คำศัพท์
ฝึกฝน
| English | ไทย |
|---|---|
| user-defined type/ˈjuːzə dɪˈfaɪnd taɪp/ | ประเภทที่กำหนดโดยผู้ใช้ |
| field/fiːld/ | ฟิลด์ |
| record/ˈrekɔːd/ | record |
| set/set/ | set |
| class/klæs/ | class |
| composite type/ˈkɒmpəzɪt taɪp/ | ประเภทคอมโพสิต |
| enumerated type/ɪˈnjuːməreɪtɪd taɪp/ | ชนิดที่ระบุรายการ |
| pointer/ˈpɔɪntə/ | ปอยเตอร์ |
| dereference/ˌdiːˈrefrəns/ | ดีรีเฟอเรนซ์ |
| attributes/ˈætrɪbjuːts/ | คุณลักษณะ |
| methods/ˈmeθədz/ | methods |
| constructor/kənˈstrʌktə/ | constructor |
| File organisation/faɪl ˌɔːɡənaɪˈzeɪʃn/ | การจัดระเบียบไฟล์ |
13.2
การจัดระเบียบและการเข้าถึงไฟล์

หลักสูตร
| ผู้เข้าสอบควรสามารถ: | หมายเหตุและคำแนะนำ |
|---|---|
| แสดงความเข้าใจถึงวิธีการ การจัดเก็บไฟล์ และเลือกวิธีการจัดเก็บไฟล์และการเข้าถึงไฟล์ที่เหมาะสมสำหรับโจทย์ที่กำหนด | รวมถึง serial, sequential (โดยใช้ key field), random (โดยใช้ record key) |
| แสดงความเข้าใจถึงวิธีการ เข้าถึงไฟล์ | รวมถึง การเข้าถึงแบบ Serial สำหรับไฟล์ serial และ sequential การเข้าถึงโดยตรงสำหรับไฟล์ sequential และ random |
| แสดงความเข้าใจเกี่ยวกับ hashing algorithms | อธิบายและใช้ hashing algorithms ที่แตกต่างกันเพื่ออ่านและเขียนข้อมูลไปยังไฟล์ random/sequential |
แหล่งที่มา: หลักสูตร Cambridge International
การจัดระเบียบไฟล์ คือวิธีการจัดวางข้อมูล; การเข้าถึงไฟล์ คือวิธีการที่โปรแกรมเข้าถึงบันทึก
- ไฟล์แบบ serial — บันทึกตาม ลำดับที่เพิ่ม, ไม่มีการเรียงลำดับ การเข้าถึงเป็นการ access แบบ sequential เท่านั้น; การ append เร็ว; การค้นหาช้า ใช้สำหรับ logs และ audit trails
- ไฟล์แบบ sequential — บันทึก เรียงลำดับด้วย key การค้นหารวดเร็วขึ้น (คุณสามารถหยุดก่อนหน้าหรือ binary-search); การ insert ช้า (บันทึกต้องขยับ) ใช้สำหรับ master files ที่อัปเดตเป็น batch
- ไฟล์แบบ random (direct-access file) — บันทึกอยู่ที่ตำแหน่งที่คำนวณจาก key (มักโดย hash) Direct access by key รวดเร็วมาก; การอ่านตามลำดับ key ยากกว่า ใช้สำหรับตาราง lookup ขนาดใหญ่และบัญชีลูกค้า


วิธีการเข้าถึงสองแบบคือ sequential access (อ่านจากต้นจนจบ) และ direct access (กระโดดตรงไปยังตำแหน่งที่ทราบแล้ว) จับคู่โครงสร้างกับ operation หลัก: การหาข้อมูลด้วย single-key favore random; รายงานแบบ in-order favore sequential
อธิบายการจัดระเบียบแต่ละแบบ (คำพูดที่ได้คะแนน) Serial: บันทึกถูกจัดเก็บ หนึ่งต่อหนึ่งตามลำดับที่เพิ่ม, โดยไม่มีการเรียงลำดับด้วย key Sequential: บันทึกถูกจัดเก็บ ตามลำดับของฟิลด์ key (sorted) Random: บันทึกแต่ละชิ้นถูกจัดเก็บที่ address ที่คำนวณจาก key ของมัน โดยอัลกอริทึม hashing ดังนั้นบันทึกจึงไม่อยู่ในลำดับใด เปรียบเทียบ serial และ sequential: ทั้งสองจัดเก็บบันทึกหนึ่งต่อหนึ่งและอ่านแบบ sequential แต่ไฟล์แบบ sequential เรียงลำดับด้วย key ดังนั้นการค้นหาสามารถหยุดเมื่ออ่าน key ที่มากกว่าเป้าหมายได้ทันที และบันทึกใหม่ต้องใส่ในตำแหน่งที่ถูกต้อง (มักโดยการเขียนทับไฟล์) ในขณะที่ไฟล์แบบ serial เพียงแค่ append เข้าไปเท่านั้น
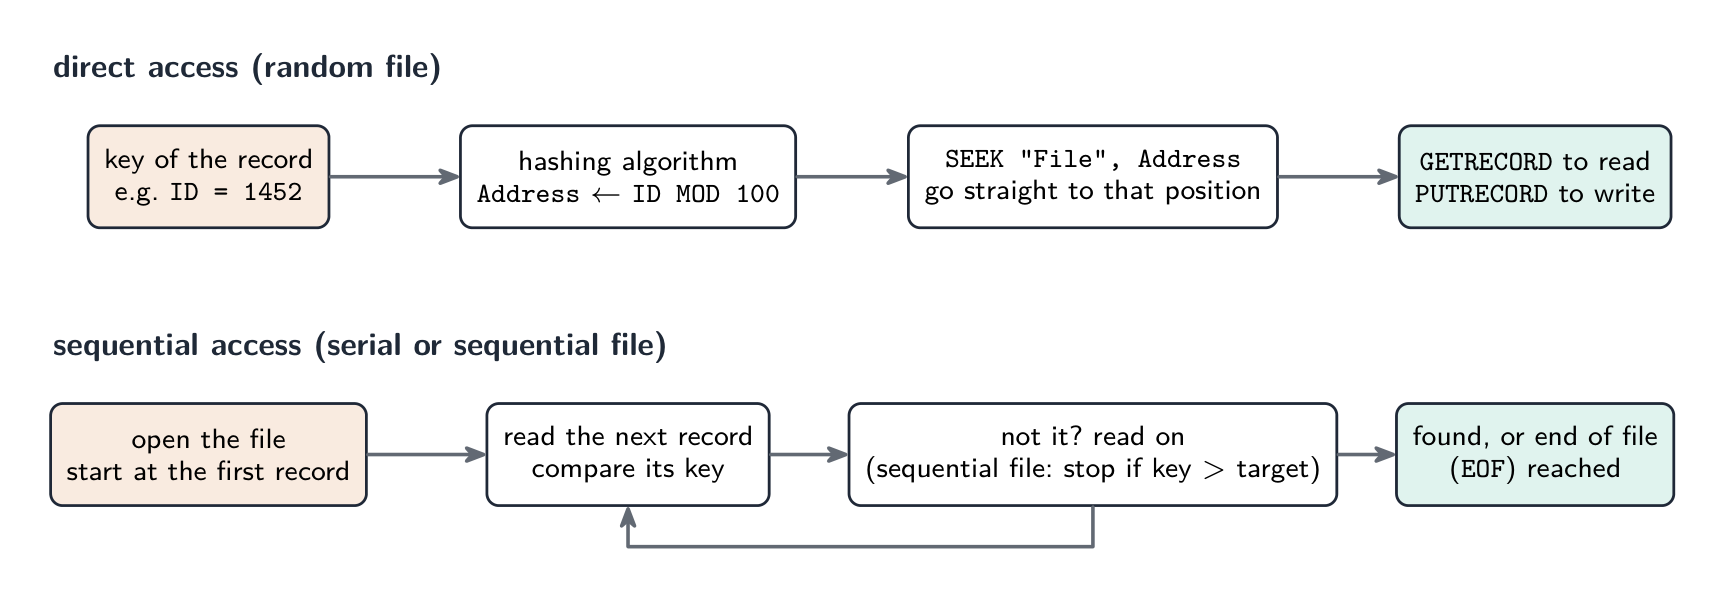
อธิบายวิธีการเข้าถึงแต่ละแบบ Sequential access: เริ่มที่ จุดเริ่มต้น ของไฟล์และอ่านบันทึก หนึ่งต่อหนึ่ง (ตามลำดับที่จัดเก็บ) จนกว่าจะพบบันทึกที่ต้องการหรือถึงปลายไฟล์ เมื่อใช้กับ serial file หมายความว่าอ่านทุกบันทึกจนถึง match, และอ่านทั้งไฟล์เพื่อยืนยันว่าไม่มีบันทึกนั้น; ใช้กับ sequential file การค้นหาสามารถ หยุดก่อนหน้า ทันทีที่อ่าน key ที่มากกว่าเป้าหมาย Direct access: address ของบันทึกถูกคำนวณจาก key ของมัน (โดยอัลกอริทึม hashing, หรือจาก index), และโปรแกรม goTo ตำแหน่งนั้นโดยตรง โดยไม่ต้องอ่านบันทึกก่อนหน้า; นี่คือวิธีการเข้าถึงสำหรับ random files, และสำหรับบันทึกที่อ้างอิงโดย unique address บนดิสก์
การเลือก ไฟล์ master สำหรับเงินเดือนหรือบิล utility ที่ประมวลผลเป็น batch, ทุกบันทึกทีละอัน, เหมาะกับ sequential file; log ของ transaction ตามลำดับที่เกิดขึ้น เหมาะกับ serial file; ไฟล์สินค้าคงคลังหรือลูกค้าที่หาข้อมูลและอัปเดต einzel record โดย key ระหว่าง program ทำงาน เหมาะกับ random file dengan direct access
การจัดการไฟล์ในพseudocode การสอบคาดหวัง statement มาตรฐาน, และ Paper 3 ตั้ง algorithm ที่ใช้พวกมัน:
| งาน | Statements |
|---|---|
| เปิดไฟล์ข้อความ | OPENFILE "Scores.txt" FOR READ (หรือ FOR WRITE, ซึ่งสร้างหรือ overwrite, หรือ FOR APPEND) |
| อ่านหรือเขียนบรรทัด | READFILE "Scores.txt", Line และ WRITEFILE "Scores.txt", Line |
| ตรวจสอบปลายไฟล์ | WHILE NOT EOF("Scores.txt") |
| ปิด | CLOSEFILE "Scores.txt" |
| เปิดไฟล์ random | OPENFILE "Stock.dat" FOR RANDOM |
| ไปยังตำแหน่งบันทึก | SEEK "Stock.dat", Address |
| อ่านหรือเขียนบันทึกทั้งหมด | GETRECORD "Stock.dat", Item และ PUTRECORD "Stock.dat", Item |
ตัวอย่างวิธีทำ ไฟล์ random Stock.dat เก็บบันทึกของประเภท StockItem, จัดเก็บที่ address ที่ให้โดย ItemID MOD 100 เขียน pseudocode ที่เก็บรายการใหม่ที่ hashed address ของมันถ้าตำแหน่งนั้นว่างเปล่า, รายงานตำแหน่งถ้ามันถูกใช้งานอยู่แล้ว
DECLARE Item, Existing : StockItem
DECLARE Address : INTEGER
INPUT Item.ItemID, Item.Description, Item.Quantity
Address ← Item.ItemID MOD 100
OPENFILE "Stock.dat" FOR RANDOM
SEEK "Stock.dat", Address
GETRECORD "Stock.dat", Existing
IF Existing.ItemID = 0 THEN
    // 0 marks an empty position
ENDIF
    SEEK "Stock.dat", Address
    PUTRECORD "Stock.dat", Item
    OUTPUT "Stored at ", Address
ELSE
    OUTPUT "Position ", Address, " is in use"
ENDIF
CLOSEFILE "Stock.dat"
รายละเอียดสองอย่างที่เกณฑ์การให้คะแนนตรวจสอบ: SEEK ก่อน การดำเนินการ GETRECORD หรือ PUTRECORD (การอ่านจะเลื่อนตำแหน่งไป, ต้อง Seek อีกครั้งก่อนเขียน), และไฟล์เปิด FOR RANDOM และปิดท้าย. ในการคัดลอกทุกบันทึกของไฟล์ Random ไปยังไฟล์อื่น, ใช้ลูปวนที่ที่อยู่ด้วย SEEK, GETRECORD จากไฟล์หนึ่งและ PUTRECORD ไปยังอีกไฟล์หนึ่ง, ข้ามตำแหน่งที่ว่างเปล่า.
สำรวจ
ช่องทางเข้าถึงไฟล์ (File access route)
ติดตามไฟล์จากหน่วยจัดเก็บเข้าสู่โปรแกรมและกลับคืนมาอย่างปลอดภัย
คำศัพท์
ฝึกฝน
| English | ไทย |
|---|---|
| serial file/ˈsɪərɪəl faɪl/ | ไฟล์อนุกรม |
| sequential file/siːˈkwenʃl faɪl/ | ไฟล์ลำดับ |
| random file/ˈrændəm faɪl/ | ไฟล์สุ่ม |
| direct access/daɪˈrekt ˈækses/ | การเข้าถึงโดยตรง |
| sequential access/siːˈkwenʃl ˈækses/ | การเข้าถึงแบบลำดับ |
13.2
Hashing

Hash function (hashing algorithm) รับคีย์ของบันทึกและสร้าง address ที่เก็บบันทึกไว้. ตัวที่ดีควรเร็ว, deterministic, และกระจายคีย์อย่างสม่ำเสมอ.
Hashing algorithms ที่พบบ่อยสำหรับ $N$ slots: modulo hash address ← key MOD N; folding (แยกคีย์, บวกส่วนย่อย, MOD N); string hash (รวมรหัสตัวอักษร, MOD N).
Collision คือเมื่อคีย์สองตัว Hash ออกมาอยู่ใน address เดียวกัน. มีสามวิธีแก้ไข:
| กลยุทธ์ | วิธีการทำงาน | ข้อเสียเปรียบ |
|---|---|---|
| linear probing | ใช้สล็อตถัดไปที่ว่าง (วนรอบ) | ง่าย, แต่คีย์จะ cluster |
| chaining | แต่ละสล็อตชี้ไปยัง linked list ของบันทึก | ไม่เกิด cluster, แต่ใช้หน่วยความจำมากขึ้น |
| rehashing | ใช้ฟังก์ชัน Hash อื่นอีกครั้ง | กระจายคีย์, แต่ต้องทำงานมากขึ้น |
*การแก้ Hash collision: Linear probing ใช้สล็อตถัดไปที่ว่าง; Chaining เก็บ linked list ต่อสล็อต
สำหรับการค้นหา: Hash คีย์, อ่านสlots นั้น; หากคีย์ตรงกันก็เสร็จสิ้น, มิฉะนั้นตามกลยุทธ์การแก้ไขจนกว่าจะพบคีย์ตรงหรือเจอสล็อตว่าง. สำหรับการแทรก: Hash คีย์, เขียนลงในสล็อตนั้นหรือสล็อตถัดไปที่ว่าง. รักษา load factor (จำนวนบันทึก ÷ จำนวนสล็อต) ต่ำกว่าประมาณ 70% เพื่อให้การค้นหาค่าใกล้เคียง O(1).
"อธิบายความหมายของอัลกอริทึมแฮชในบริบทของการเข้าถึงไฟล์ (สามคะแนน) การคำนวณ (ฟังก์ชัน) ที่ดำเนินการบนฟิลด์คีย์ของเรคอร์ดเพื่อสร้างค่า ซึ่งใช้ sebagai ที่อยู่ (ตำแหน่ง) ที่เรคอร์ดถูกจัดเก็บในไฟล์ และจากนั้นจึงถูกดึงกลับมา การคำนวณเดียวกันบนคีย์เดียวกันจะให้ที่อยู่เดียวกันเสมอ นี่คือเหตุผลที่เรคอร์ดสามารถหาได้โดยไม่จำเป็นต้องค้นหา
"สรุปวิธีการ overcoming collision สองวิธี" (1) Linear probing (open addressing): จัดเก็บเรคอร์ดใน ตำแหน่งว่างถัดไป หลังที่อยู่ที่คำนวณได้ หากจำเป็นให้วนกลับไปยังจุดเริ่มต้น; ในการดึงข้อมูล ให้เริ่มที่ที่อยู่ hash และอ่านไปข้างหน้าจนกว่าคีย์จะตรงกัน (2) พื้นที่ overflow หรือ chaining: จัดเก็บเรคอร์ดที่ชนกันในพื้นที่ overflow แยกต่างหาก (หรือ linked list ที่เชื่อมต่อกับที่อยู่) ซึ่งทำการค้นหาแบบลำดับหลังจากที่ที่อยู่หลักไม่ตรงกัน ตอบได้ทั้งสองวิธี; อธิบายทั้งการจัดเก็บและการดึงข้อมูล
ตัวอย่างคำอธิบาย ไฟล์สุ่มมี 11 ตำแหน่งเรคอร์ด, เลขที่ 0 ถึง 10, และอัลกอริทึมแฮชคือ Address ← Key MOD 11. เรคอร์ดที่มีคีย์ 1250, 1381, 1452, 1613 และ 1470 ถูกจัดเก็บตามลำดับ โดยใช้ linear probing. แสดงว่าแต่ละเรคอร์ดอยู่ที่ไหน, และอธิบายวิธีการดึงคีย์ 1470.
$1250 \bmod 11 = 7$; $1381 \bmod 11 = 6$; $1452 \bmod 11 = 0$; $1613 \bmod 11 = 7$ เกิด collision กับ 1250 ดังนั้น 1613 จึงไปจัดตำแหน่งว่างถัดไปคือ 8; $1470 \bmod 11 = 7$ อีกครั้ง และตำแหน่ง 7 และ 8 เต็มแล้ว ทำให้ 1470 ไปอยู่ที่ 9 ในการดึงข้อมูล 1470: คำนวณ $7$ อ่านตำแหน่ง 7 (key 1250 ไม่ตรง) อ่าน 8 (1613 ไม่ใช่) อ่าน 9 (1470 พบแล้ว) หากพบตำแหน่ง empty ก่อนที่จะเจอ key ที่ตรงกัน แสดงว่าไม่มีบันทึกในไฟล์ Collision คือสิ่งที่ต้องแลกมาจากการใช้ไฟล์ขนาดเล็ก: อัลกอริทึมการแฮชที่ดีจะกระจาย key อย่างสม่ำเสมอ และควรรักษาไฟล์ให้ว่างไว้มากพอเพื่อให้ระยะการค้นหา (probes) สั้นลง
สำรวจ
哈希表
观察每个键被哈希到 bucket 中。好的哈希将键分散开来,使查找保持快速。
คำศัพท์
ฝึกฝน
| English | ไทย |
|---|---|
| linked list/lɪŋkt lɪst/ | Linked List |
| hash function/hæʃ ˈfʌŋkʃn/ | ฟังก์ชันแฮช |
| deterministic/dɪˌtɜːmɪˈnɪstɪk/ | deterministic |
| collision/kəˈlɪʒn/ | การชนกัน |
| linear probing/ˈlɪnɪə ˈprəʊbɪŋ/ | การสำรวจเชิงเส้น |
| chaining/ˈtʃeɪnɪŋ/ | การเชื่อมโยง |
| load factor/ləʊd ˈfæktə/ | ปัจจัยการโหลด |
| overflow area/ˌəʊvəˈfləʊ ˈeərɪə/ | พื้นที่ล้น |
| overflow/ˌəʊvəˈfləʊ/ | overflow |
13.3
ตัวเลขทศนิยมลอยตัว (Floating-point numbers)

หลักสูตร
| ผู้เข้าสอบควรสามารถ: | หมายเหตุและคำแนะนำ |
|---|---|
| อธิบายรูปแบบของ binary floating-point จำนวนจริง | ใช้รูปแบบ two's complement เข้าใจผลกระทบของการเปลี่ยนจำนวนบิตที่จัดสรรให้กับ mantissa และ exponent ใน表现形式 floating-point |
| แปลง binary floating-point จำนวนจริงให้เป็น denary และในทางกลับกัน | |
| 作 floating-point numbers | เข้าใจเหตุผลของการ normalisation |
| แสดงความเข้าใจถึงผลของการแสดงค่าแบบ binary ที่เป็นเพียงค่าประมาณของจำนวนจริง它所แทน (在某些情况下) | เข้าใจว่า underflow และ overflow สามารถเกิดขึ้นได้อย่างไร |
| แสดงความเข้าใจว่า binary representations สามารถทำให้เกิด rounding errors ได้ |
แหล่งที่มา: หลักสูตร Cambridge International
เพื่อจัดเก็บ จำนวนจริง ที่มีขนาดแตกต่างกันมาก คอมพิวเตอร์ใช้รูปแบบ floating-point — รูปแบบทวินามของการเขียนสัญกรณ์วิทยาศาสตร์, โดยมีสองฟิลด์:
- mantissa — หลัก有意义的 (significant digits).
- exponent — พลังของ 2 ที่จะคูณด้วย.
ทั้งสองถูกจัดเก็บเป็น จำนวนเต็ม two's complement. ค่าคือ
$$\text{number} = \text{mantissa} \times 2^{\text{exponent}}.$$
อ่าน mantissa เป็นเศษส่วนทวินาม — บิตแรกหลังจุดมีค่า $1/2$, บิตถัดไป $1/4$, จากนั้น $1/8$, และ seterusnya. ดังนั้น 0.1010000 คือ $1/2 + 1/8 = 0.625$; ด้วย exponent 00000010 (= 2) ค่าคือ $0.625 \times 2^{2} = 2.5$.
การแปลง
- binary → denary: อ่าน mantissa (ใช้กฎ two's-complement ถ้าเป็นลบ) เป็นเศษส่วน, อ่าน exponent เป็นจำนวนเต็ม signed, แล้วคูณ mantissa ด้วย $2^{\text{exponent}}$.
- denary → binary: เขียนตัวเลขเป็นเศษส่วนทวินาม × พลังของ 2, แล้วจัดเก็บ mantissa และ exponent ในรูปแบบที่ตกลงกันไว้
ตัวอย่างคำอธิบาย ตัวเลขหนึ่งมี mantissa 10110000 และ exponent 00000011. หาค่า tenary ของมัน
Exponent 00000011 คือ $+3$. Mantissa เริ่มด้วย 1, ดังนั้นเป็นลบ. อ่านเป็น 1.0110000 ใน two's complement, sign bit มีค่า $-1$ และบิตเศษส่วนเพิ่ม $\tfrac{1}{4} + \tfrac{1}{8} = 0.375$, ดังนั้น mantissa คือ $-1 + 0.375 = -0.625$. จากนั้น
$$\text{number} = -0.625 \times 2^{3} = -5.0.$$
ตัวอย่างคำอธิบาย จัดเก็บ $+2.5$ ในรูปแบบนี้
ในทวินาม $2.5 = 10.1$. เขียนเป็นเศษส่วน normalised, $2.5 = 0.101 \times 2^{2}$. ดังนั้น mantissa คือ 01010000 (sign bit 0, ตามด้วย .101) และ exponent คือ 00000010 ($= 2$)
รูปแบบการสอบ: การแทนค่าสองส่วนเติม, มานิสซา และเอ็กซ์โพเนนต์
การทดสอบระบุรูปแบบเช่น 10 บิตสำหรับส่วนทศนิยมและ 6 บิตสำหรับเลขชี้กำลัง ทั้งสองแบบเป็นสองส่วนเติมเต็ม จุดทศนิยมของส่วนทศนิยมอยู่หลังบิตแรก (บิตเครื่องหมาย) ดังนั้นส่วนทศนิยมที่เป็นบวกคือ 0.xxxxxxxxx และลบคือ 1.xxxxxxxxx; เลขชี้กำลังเป็นจำนวนเต็มที่มีเครื่องหมายทั่วไป การแปลงทุกแบบใช้การเคลื่อนที่สามขั้นตอนเดียวกัน: อ่านส่วนทศนิยมเป็นเศษส่วน (ตามกฎสองส่วนเติมเต็มหากเริ่มด้วย 1), อ่านเลขชี้กำลังเป็นจำนวนเต็ม, คูณด้วย $2^{\text{exponent}}$
ตัวอย่างวิธีทำ (จากฐานสองเป็นฐานสิบ). ส่วนทศนิยม 0101100000, เลขชี้กำลัง 000011.
ส่วนทศนิยม: $0.101100000_2 = \tfrac{1}{2} + \tfrac{1}{8} + \tfrac{1}{16} = 0.6875$. เลขชี้กำลัง: $000011_2 = 3$. ค่า: $0.6875 \times 2^{3} = 5.5$.
ตัวอย่างวิธีทำ (ส่วนทศนิยมลบ). ส่วนทศนิยม 1011000000, เลขชี้กำลัง 000010.
mantissa เริ่มต้นด้วย 1 ดังนั้นเป็นค่าลบ ค่าของมันคือ $-1 + 0.011000000_2 = -1 + (\tfrac{1}{4} + \tfrac{1}{8}) = -0.625$; exponent $= 2$; ค่าจริง $-0.625 \times 4 = -2.5$. (หรืออีกวิธีหนึ่ง คือใช้ two's complement ของ mantissa, 0101000000 $= 0.625$ แล้วใส่เครื่องหมายลบ) Exponent แบบลบอย่างเช่น 111110 $= -2$ จะทำการหารแทน: mantissa ค่า $0.5$ พร้อม exponent นั้นจะมีค่าเท่ากับ $0.5 \times 2^{-2} = 0.125$
ตัวอย่างวิธีทำ (จากฐานสิบเป็นฐานสอง). เก็บ $+6.5$ และ $-6.5$ ในรูปแบบ 10 บิตและ 6 บิต, ปกติ
$6.5 = 110.1_2 = 0.1101_2 \times 2^{3}$, ดังนั้นส่วนทศนิยมคือ 0110100000 และเลขชี้กำลัง 000011. สำหรับ $-6.5$, นำสองส่วนเติมเต็มของส่วนทศนิยมมาหา: 1001100000 (ตรวจสอบ: $-1 + 0.0011_2 = -1 + 0.1875 = -0.8125$, และ $-0.8125 \times 8 = -6.5$), เลขชี้กำลัง 000011 ไม่เปลี่ยน. สัญญาณไม่เข้าสู่เลขชี้กำลัง; จำนวนลบจะมี ส่วนทศนิยม ที่ลบ
การทำให้เป็นรูปปกติ
จำนวนถูก ทำให้เป็นรูปปกติ เมื่อบิตที่มีนัยสำคัญตัวแรกอยู่ ทันทีหลังจากจุดทศนิยม (ไม่มีศูนย์นำหน้าที่ไม่จำเป็น) สิ่งนี้ เพิ่มความแม่นยำสูงสุด เพราะทุกบิตของส่วนทศนิยมมีข้อมูล เพื่อทำให้เป็นรูปปกติ เลื่อนส่วนทศนิยมไปทางซ้ายและลดเลขชี้กำลัง (หรือเลื่อนไปทางขวาและเพิ่ม) จนกว่าบิตที่มีนัยสำคัญตัวแรกจะอยู่ในตำแหน่ง; ค่าไม่เปลี่ยนแปลง สำหรับส่วนทศนิยมลบ (สองส่วนเติมเต็ม) บิตเครื่องหมาย (1) จะตามด้วย 0 ทันที
การจดจำและสร้างรูปปกติ. ส่วนทศนิยมปกติบวกเริ่มต้น 01; ลบเริ่มต้น 10. ดังนั้น 0011000000 จึงไม่เป็นรูปปกติ (เลื่อนไปทางซ้ายหนึ่งตำแหน่งและลบเลขชี้กำลังหนึ่ง: 0110000000, เลขชี้กำลังลดลงหนึ่ง) และ 1100000000 ก็ไม่เป็นเช่นกัน (เลื่อนไปทางซ้ายจนกระทั่งรูปแบบเป็น 10...). การเลื่อนส่วนทศนิยมไปทางซ้ายทุกครั้งต้องจับคู่กับการลบเลขชี้กำลังหนึ่ง หรือค่าจะเปลี่ยนไป
"อธิบายเหตุผลที่เก็บตัวเลขในรูปแบบปกติ" (2 คะแนน) (1) ให้ ความละเอียดสูงสุด (ความแม่นยำ) สำหรับจำนวนบิตที่มีอยู่ เนื่องจากไม่มีบิตใดถูกใช้ไปกับการนำหน้าเป็นศูนย์ (หรือเลขหนึ่งสำหรับจำนวนลบ); (2) แต่ละตัวเลขจะมีรูปแบบที่เป็น เอกลักษณ์ ทำให้สามารถเปรียบเทียบตัวเลขกันได้; และ (3) ช่วยใช้ช่วงของค่าที่มีอยู่ได้อย่างมีประสิทธิภาพที่สุด ตอบได้ 2 ข้อจากข้อข้างต้น

การประมาณค่าและความคลาดเคลื่อนจากการปัดเศษ
จำนวนจริงหลายจำนวน ไม่สามารถเก็บ Exact ได้ ในฐานสอง — เช่น $0.1_{10}$ คือเศษส่วนฐานสองซ้ำ $0.000110011\ldots_{2}$, ซึ่งต้องตัดทิ้ง. ผลกระทบ:
- ความคลาดเคลื่อนจากการปัดเศษ สะสมในการดำเนินการจำนวนมาก (
0.1 + 0.2ไม่ใช่0.3Exactly). - การเปรียบเทียบล้มเหลว — อย่าทดสอบจำนวนจริงเพื่อหาความเท่ากัน. ทดสอบว่า ผลต่าง น้อยกว่าความทนทานเล็ก ๆ
IF Difference < 0.000001, โดยที่ผลต่างถูกคำนวณในทิศทางที่ถูกต้องหรือผ่านฟังก์ชันโมดูลัสที่โจทย์กำหนด.ABSไม่ได้อยู่ในแผ่นแทรก 9618 หรือคู่มือ伪代码 (Pseudocode Guide), ดังนั้นอย่าสันนิษฐานมัน: คู่มือระบุว่าฟังก์ชันใดๆ ที่โจทย์ต้องการจะถูกให้มา - การลบค่าที่เกือบเท่ากันสองค่าจะสูญเสียความแม่นยำ.
- Overflow (ผลลัพธ์ใหญ่เกินช่วงของเลขชี้กำลัง) และ Underflow (ผลลัพธ์เล็กเกินไป, ปัดเศษเป็นศูนย์) เกิดขึ้นเมื่อเลขชี้กำลังหมดช่วง.
สำหรับความต้องการที่ Exact (เงิน), ใช้ fixed-point หรือ BCD แทน floating-point.
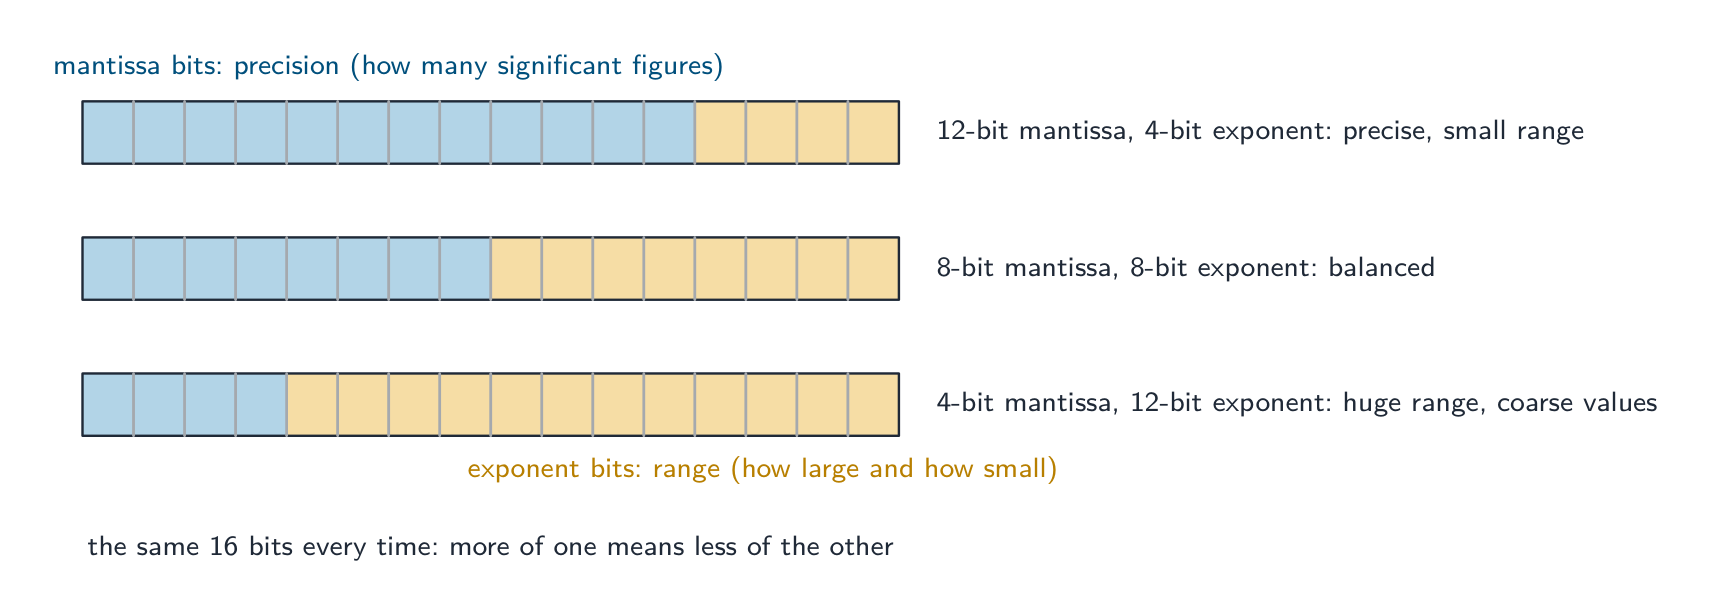
"อธิบายผลกระทบของการเปลี่ยนการจัดสรรบิต (สามคะแนน). ด้วยจำนวนบิตรวมที่ตายตัว, เพิ่มส่วนทศนิยม และลดเลขชี้กำลังให้ ความแม่นยำ สูงขึ้น (หลัก说有 significance มากขึ้น, ความคลาดเคลื่อนจากการปัดเศษเล็กลง) แต่ ช่วง เล็กลง (ขนาดสูงสุดและต่ำสุดที่สามารถเก็บได้หดตัว); เพิ่มเลขชี้กำลัง ทำตรงกันข้าม: ช่วงที่ใหญ่ขึ้นโดยแลกด้วยความแม่นยำ. ชื่อทั้งสองผลกระทบและทั้งสองทิศทาง
ใหญ่ที่สุดและเล็กที่สุด. ในรูปแบบส่วนทศนิยม 10 บิต, เลขชี้กำลัง 6 บิต จำนวนบวกที่มีค่ามากที่สุดมีส่วนทศนิยม 0111111111 ($= 1 - 2^{-9}$) และเลขชี้กำลัง 011111 ($= 31$): ประมาณ $2^{31}$. จำนวนบวก ปกติ ที่มีค่าน้อยที่สุดมีส่วนทศนิยม 0100000000 ($= 0.5$) และเลขชี้กำลัง 100000 ($= -32$): $0.5 \times 2^{-32} = 2^{-33}$. จำนวนลบมากที่สุดมีส่วนทศนิยม 1000000000 ($= -1$) และเลขชี้กำลัง $31$: $-2^{31}$.
"อธิบายความหมายของ overflow และ underflow. Overflow เกิดขึ้นเมื่อผลลัพธ์ของการคำนวณ ใหญ่กว่า จำนวนที่มีค่ามากที่สุดที่สามารถแสดงได้, sehinggaเลขชี้กำลังจำเป็นต้องใช้บิตมากกว่าที่มี; underflow เกิดขึ้นเมื่อผลลัพธ์ เล็กกว่า จำนวนที่มีค่าน้อยที่สุด (non-zero) ที่สามารถแสดงได้, ใกล้เคียงศูนย์มากจนเลขชี้กำลังแสดงไม่ได้, ดังนั้นจึงเก็บเป็นศูนย์. ทั้งสองเกิดจาก ช่วงของเลขชี้กำลัง, ไม่ใช่ส่วนทศนิยม
ทำไมการแทนค่าด้วยระบบทวิภาคจึงเป็นการประมาณเท่านั้น ทศนิยมในระบบทวิภาคสามารถแสดงผลบวกของ $\tfrac{1}{2}, \tfrac{1}{4}, \tfrac{1}{8}, \ldots$ ได้อย่างแม่นยำเท่านั้น ค่าอย่าง $0.1$ หรือ $\tfrac{1}{3}$ มีการขยายแบบทวิภาคที่ไม่สิ้นสุด และmantissa มีจำนวนบิตจำกัด ดังนั้นค่าที่เก็บไว้จึงเป็นค่าที่ใกล้เคียงที่สุดที่เข้ากันได้ ความแตกต่างนี้คือ ความผิดพลาดจากการปัดเศษ; มันมีค่าน้อยสำหรับตัวเลขหนึ่งแต่จะ สะสม ผ่านการคำนวณซ้ำ (การเพิ่ม $0.1$ จำนวนสิบครั้งอาจไม่ได้ผลลัพธ์เป็น $1$ พอดี) นี่คือเหตุผลว่าทำไมจำนวนจริงไม่ควรถูกทดสอบเพื่อหาความเท่ากันที่แม่นยำ
สำรวจ
สร้างจำนวนทศนิยม
กลับด้านบิตของmantissaและexponentเพื่อสร้างค่า และตรวจสอบว่ามันเป็นnormalisedหรือไม่
สำรวจ
การทำnormaliseจำนวนทศนิยม
ผ่านขั้นตอนnormalisation การเลื่อนmantissaเพื่อกำจัดศูนย์นำหน้าที่ไม่จำเป็น — และการปรับexponentให้สอดคล้อง — รักษาค่าเดิมแต่ใช้ทุกบิตเพื่อความละเอียดสูงสุด
คำศัพท์
ฝึกฝน
| English | ไทย |
|---|---|
| floating-point/ˈfləʊtɪŋ pɔɪnt/ | จุดลอย |
| mantissa/mænˈtɪsə/ | mantissa |
| exponent/ekˈspəʊnənt/ | เลขชี้กำลัง |
| two's complement/tuːz ˈkɒmplɪmənt/ | สองคอมพลีเมนต์ |
| normalised/ˈnɔːməlaɪzd/ | ปรับมาตรฐานแล้ว |
| rounding errors/ˈraʊndɪŋ ˈerəz/ | ข้อผิดพลาดจากการปัดเศษ |
| underflow/ˌʌndəˈfləʊ/ | Underflow |
| fixed-point/fɪkst pɔɪnt/ | จุดคงที่ |
| BCD/ˌbiː siː ˈdiː/ | BCD |
| precision/prɪˈsɪʒn/ | ความละเอียด |
| range/reɪndʒ/ | range |
13.3
คำนิยามที่ผู้สอบยอมรับ
คำถามคำนิยามจะให้คะแนนตามข้อความที่กำหนดไว้你必须 exact. เรียนรู้ให้ถูกต้องและตอบเพียงคำตอบเดียวเท่านั้น
| พจน์ | นิยาม |
|---|---|
| user-defined data type | ชนิดข้อมูลที่โปรแกรมเมอร์สร้างขึ้นเอง โดยอ้างอิงจากชนิดเดิมที่มีอยู่ เพื่อใช้แทนข้อมูลเฉพาะสำหรับปัญหาที่กำลังแก้ |
| non-composite type | ชนิดที่กำหนดโดยไม่อ้างอิงถึงชนิดอื่น; เก็บค่าเดียวเท่านั้น (integer, real, enumerated, pointer) |
| composite type | ชนิดที่ประกอบขึ้นจากชนิดอื่นๆ; เก็บหลายค่าภายใต้ชื่อระบุตัวเดียวกัน (record, set, array, class) |
| enumerated type | non-composite type ที่กำหนดโดยการระบุค่าที่เป็นไปได้ทั้งหมดเรียงตามลำดับ |
| pointer type | non-composite type ที่มีค่าเป็นที่อยู่หน่วยความจำของตัวแปรชนิดที่กำหนด |
| set | composite type ที่เก็บกลุ่มของค่าชนิดเดียวกัน โดยไม่เรียงลำดับและไม่ซ้ำกัน |
| record | composite type ที่มีจำนวนฟิเดลัด限定的 แต่ละฟิลด์มีชื่อและชนิดของตัวเอง เข้าถึงผ่าน dot notation |
| class | composite type ที่รวมคุณลักษณะ (data) เข้ากับวิธีการ (methods หรือ procedures และ functions) ที่ทำงานกับข้อมูลนั้น; object คือ instance ของ class |
| serial file | บันทึกที่เก็บเรียงต่อกันตามลำดับเวลาที่เพิ่มเข้าไป |
| sequential file | บันทึกที่เก็บเรียงต่อกันตามลำดับของ key field |
| random file | บันทึกที่เก็บที่ที่อยู่คำนวณจาก key ของมันโดยใช้อัลกอริทึม hashing |
| sequential access | อ่านบันทึกทีละอันตั้งแต่ต้นไฟล์จนกว่าจะเจอที่ต้องการ |
| direct access | คำนวณที่อยู่ของบันทึกจาก key ของมันแล้วเข้าถึงตำแหน่งนั้นโดยตรง |
| อัลกอริทึมการแฮช | การคำนวณบนคีย์ของเรคอร์ดที่ให้ที่อยู่ที่เก็บและค้นหาเรคอร์ดนั้น |
| การชนกัน (collision) | คีย์ที่แตกต่างกันสองตัวสร้างที่อยู่เดียวกัน |
| ส่วนทศนิยม (mantissa) | ส่วนของจำนวนแบบจุดลอยที่เก็บบิตที่มีนัยสำคัญ โดยอยู่ในรูปเศษส่วนแบบสองส่วนเติมเต็ม (two's-complement) |
| เลขชี้กำลัง (exponent) | จำนวนเต็มแบบสองส่วนเติมเต็มที่กำหนดเลขยกกำลังของ 2 ที่นำไปคูณกับส่วนทศนิยม |
| ปกติ | จำนวนทศนิยมที่ส่วนเศษ (mantissa) เริ่มต้นด้วย 01 (ค่าบวก) หรือ 10 (ค่าลบ) เพื่อไม่ให้บิตถูกใช้ไปกับการนำหน้าด้วยศูนย์หรือหนึ่งที่ไม่จำเป็น |
| เกินขอบเขต | ผลลัพธ์ที่มีขนาดใหญ่เกินกว่าจำนวนบิตที่มีอยู่จะแสดงได้ |
| ต่ำเกินขอบเขต | ผลลัพธ์ที่ไม่เป็นศูนย์แต่มีขนาดเล็กเกินไปที่จะแสดงได้ จึงถูกจัดเก็บเป็นศูนย์ |
| ความคลาดเคลื่อนจากการปัดเศษ | ความแตกต่างระหว่างจำนวนจริงกับค่าใกล้เคียงที่สุดที่รูปแบบไบนารีสามารถจัดเก็บได้ |
คำศัพท์
ฝึกฝน
| English | ไทย |
|---|---|
| object/ˈɒbdʒekt/ | 物体本身 |
13.3
ข้อแนะนำสำหรับการสอบ
- การประกาศใน伪代码 (Pseudocode) จะทำเป็นบรรทัด:
TYPE ... = (...)สำหรับค่าที่กำหนดชื่อ,TYPE ... = ^...สำหรับพอยเตอร์,TYPE ... = SET OF ...แล้วDEFINE ... (...) : ...สำหรับเซต,TYPE ... DECLARE ... ENDTYPEสำหรับเรคอร์ด,CLASS ... PRIVATE ... PUBLIC PROCEDURE NEW ... ENDCLASSสำหรับคลาส. - จับคู่ประเภทกับข้อมูล: ค่าที่กำหนดชื่อแบบตายตัว, ค่าที่กำหนดชื่อ; กลุ่มของฟิลด์ที่แตกต่างกัน, เรคอร์ด; ชุดของค่าที่ไม่ซ้ำกัน, เซต; ข้อมูลพร้อมพฤติกรรม, คลาส; ที่อยู่, พอยเตอร์.
- การจัดไฟล์คือวิธีการ จัดเก็บ เรคอร์ด; การเข้าถึงไฟล์คือวิธีการ ค้นหา เรคอร์ดนั้น ไฟล์แบบ serial และ sequential อ่านตามลำดับ; ไฟล์แบบ random ใช้การเข้าถึงโดยตรงผ่าน hash ของคีย์ การค้นหาแบบลำดับของ sequential file สามารถหยุดก่อนกำหนดได้; แต่ของ serial file ไม่สามารถทำได้
- Pseudocode สำหรับไฟล์แบบ random:
OPENFILE ... FOR RANDOM,SEEKก่อนทุกGETRECORDหรือPUTRECORD,CLOSEFILEที่ท้ายสุด อธิบายวิธีจัดการเมื่อเกิด collision ในกรณีอธิบายการทำ hashing - ทศนิยม: ส่วนเศษเป็นเศษส่วนสองส่วนเติมเต็ม (จุดอยู่หลังบิตเครื่องหมาย), เลขชี้กำลังเป็นจำนวนเต็ม, คูณด้วย $2^{\text{exponent}}$; เลื่อนซ้ายและลดเลขชี้กำลังลงหนึ่งหน่วยเพื่อทำให้เป็นปกติ; ส่วนเศษซื้อความแม่นยำ, เลขชี้กำลังซื้อช่วงค่า
- คำตอบมาตรฐานสำหรับคำถาม "อธิบาย": ทำไมต้องทำให้เป็นปกติ (ความแม่นยำ, รูปแบบที่เป็นเอกลักษณ์, ช่วงค่า), ผลของการจัดสรรบิตใหม่ (ความแม่นยำเทียบกับช่วงค่า), และทำไม $0.1$ จึงไม่สามารถจัดเก็บได้อย่างถูกต้อง (เศษส่วนไบนอนิ是有限的ในส่วนเศษจำกัด)
ข้อผิดพลาดที่พบบ่อย
- เขียน
DECLAREแทนTYPEสำหรับชนิดใหม่, หรือละเลยENDTYPE; ประกาศเซตโดยไม่มีการSET OF, หรือประกาศชนิดที่กำหนดชื่อโดยใส่เครื่องหมายอัญQuotes รอบค่าของมัน - วางเครื่องหมายของจำนวนทศนิยมไว้ในเลขชี้กำลัง; เครื่องหมายคือบิตแรกของส่วนเศษ
- อ่านส่วนเศษที่เป็นลบ seolahว่าเป็น sign-and-magnitude; มันเป็นสองส่วนเติมเต็ม ดังนั้น
1011000000คือ $-0.625$, ไม่ใช่ $-0.375$ - เลื่อนส่วนเศษเพื่อทำให้เป็นปกติโดยไม่เปลี่ยนเลขชี้กำลัง, หรือเปลี่ยนมันผิดทาง (เลื่อนซ้าย, ลดเลขชี้กำลัง)
- อธิบายไฟล์แบบ random ว่าอยู่ใน "ลำดับสุ่ม"; เรคอร์ดอยู่ที่ที่อยู่ที่คำนวณจากคีย์ของมัน
- บอกว่าการเข้าถึงแบบลำดับอ่าน "ทั้งไฟล์" สำหรับ sequential file; มันจะหยุดเมื่อพบคีย์ที่ใหญ่กว่า
- อธิบายการทำ hashing โดยไม่บอกว่าคุณค่าที่คำนวณได้ถูกนำไปใช้ทำอะไร (ที่อยู่สำหรับจัดเก็บและดึงเอาเรคอร์ด), หรือไม่มีการจัดการเมื่อเกิด collision
- นิยาม overflow ว่า "มีตัวเลขมากเกินไป" แทนที่จะเป็นผลลัพธ์ที่เกินกว่าค่าสูงสุดที่แสดงได้, หรือโทษส่วนเศษ为之
บทเรียนเชิงโต้ตอบสำหรับหัวข้อนี้
ทำทีละขั้นตอน พร้อมแบบฝึกหัดตรวจสอบผลทันที