| Кандидаты должны уметь: | Примечания и рекомендации |
|---|---|
| Показать понимание методов линейного поиска и бинарного поиска | Написать алгоритм для реализации линейного поиска. Написать алгоритм для реализации бинарного поиска. Условия, необходимые для использования бинарного поиска. Как производительность бинарного поиска зависит от количества элементов данных. |
| Показать понимание методов сортировки вставками (insertion sort) и пузырьковой сортировки (bubble sort) | Написать алгоритм для реализации сортировки вставками. Написать алгоритм для реализации пузырьковой сортировки. Производительность процедуры сортировки может зависеть от исходного порядка данных и количества элементов. |
| Показать понимание и умение использовать абстрактные типы данных (Abstract Data Types — ADT) | Написать алгоритмы для поиска элемента в следующих структурах: связный список, двоичное дерево. Написать алгоритмы для вставки элемента в следующие структуры: стек, очередь, связный список, двоичное дерево. Написать алгоритмы для удаления элемента из следующих структур: стек, очередь, связный список. Показать понимание того, что граф является примером ADT. Описать ключевые особенности графа и обосновать его применение для конкретной ситуации. От кандидатов не требуется писать код для структуры графа. |
| Показать, как возможно реализовать ADT на основе другого ADT | Описать следующие ADT и продемонстрировать, как их можно реализовать с помощью встроенных типов или других ADT: стек, очередь, связный список, словарь (dictionary), двоичное дерево. |
| Показать понимание того, что различные алгоритмы, выполняющие одну и ту же задачу, можно сравнивать по критериям (например, времени выполнения задачи и используемой памяти) | Включая использование нотации Big O для определения временной и пространственной сложности. |
Вычислительное мышление и решение задач
A-Level Computer Science · Тема 19
 15:33
Поиск и сортировка
Телефонная книга на миллион имен. Если проверять их по одному, можно совершить миллион сравнений. Но вы уже знаете секрет: откройте её посередине…
Озвучивание на английском · переключаемые субтитры на английском и китайском языках
19.1
Алгоритмы поиска
Программа
Источник: Программа Cambridge International
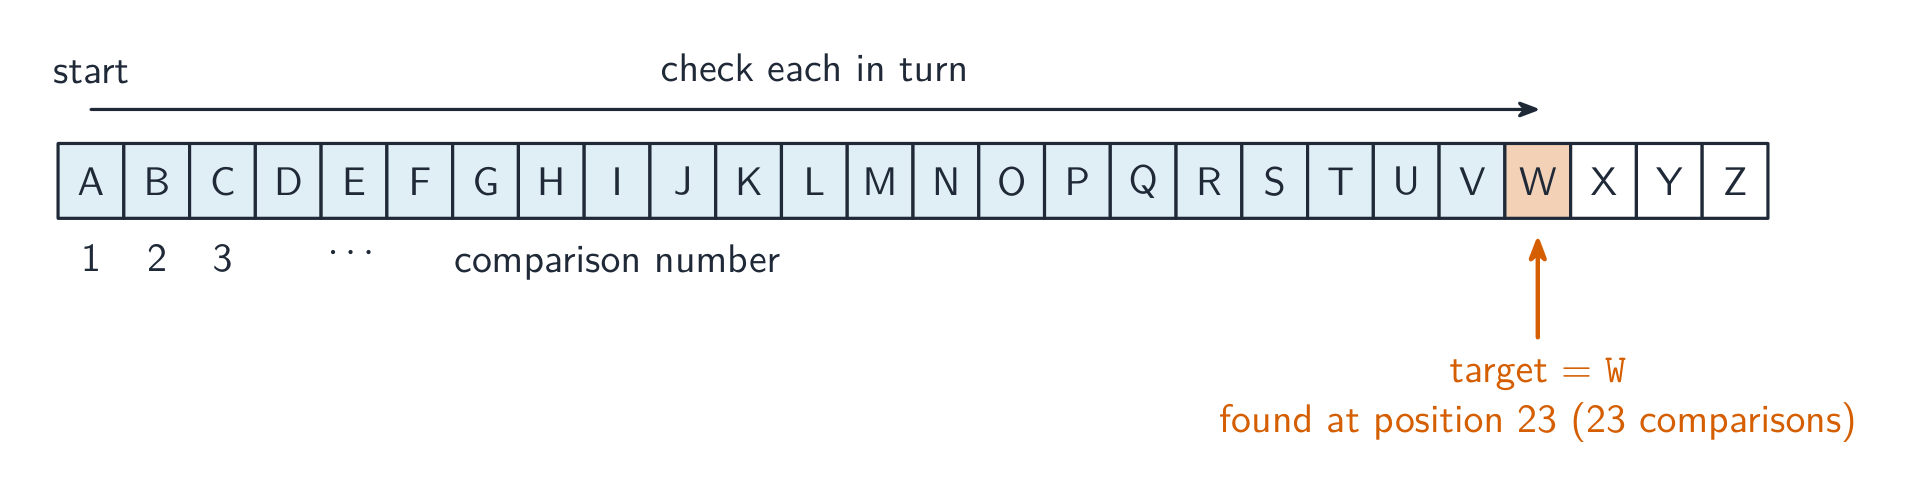
Поиск находит искомое значение в наборе данных (часто в массиве) и возвращает его позицию или сообщение «не найдено».
Линейный поиск
Линейный поиск проходит от начала до конца, сравнивая каждый элемент с целевым:
FOR i ← 1 TO n
    IF A[i] = target THEN
        RETURN i
    ENDIF
NEXT i
RETURN -1   // not found
Подготовка не требуется, поэтому метод работает с любым списком. В худшем случае O($n$) (искомый элемент находится в конце или отсутствует); в лучшем случае — 1 сравнение. Используйте его для неотсортированных данных или небольших списков. (Возвращаемое значение -1 — сигнальное значение, то есть невозможная позиция, означающая «не найдено»; вызывающая программа проверяет IF result = -1.)
Версия для экзамена. В задании Paper 3 требуется дополнить линейный поиск, написанный с использованием флага и цикла WHILE, а в Paper 4 — написать функцию, возвращающую индекс или счетчик. Оба варианта выглядят так:
FUNCTION LinearSearch(Data : ARRAY OF INTEGER, Target : INTEGER) RETURNS INTEGER
    DECLARE Index, Count : INTEGER
    Count ← 0
    FOR Index ← 1 TO 100
        IF Data[Index] = Target THEN
            Count ← Count + 1
        ENDIF
    NEXT Index
    RETURN Count          // how many times Target occurs; 0 means not found
ENDFUNCTION
Чтобы остановиться на первом совпадении, используйте цикл WHILE Index <= 100 AND NOT Found, который устанавливает Found ← TRUE и запоминает индекс. Баллы начисляются за проход по каждому элементу, сравнение и то, что возвращается при отсутствии значения.
Бинарный поиск
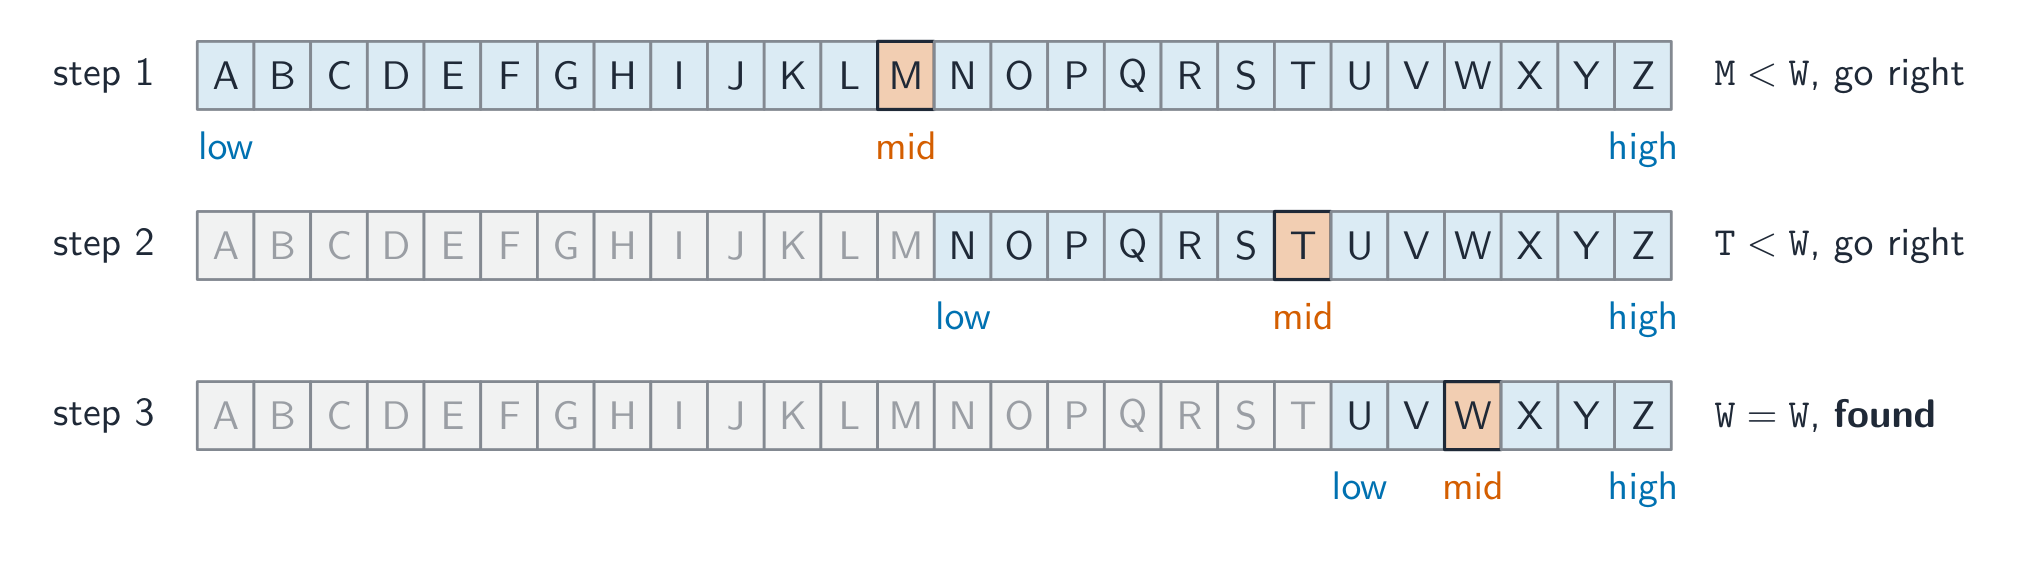
Бинарный поиск требует, чтобы данные были отсортированы. Посмотрите на средний элемент; если он целевой — готово; если цель меньше, ищите в левой половине, иначе в правой — уменьшая диапазон вдвое на каждом шаге:
low ← 1
high ← n
WHILE low <= high DO
    MiddleIndex ← (low + high) DIV 2
    IF A[MiddleIndex] = target THEN
        RETURN MiddleIndex
    ENDIF
    IF A[MiddleIndex] < target THEN
        low ← MiddleIndex + 1
    ELSE
        high ← MiddleIndex - 1
    ENDIF
ENDWHILE
RETURN -1
Худший случай O($\log_{2} n$) — для миллиона элементов около 20 сравнений. Гораздо быстрее линейного поиска на больших отсортированных массивах, но сначала нужно отсортировать (однократная стоимость O($n \log n$)), что оправдано, если поиск выполняется много раз.
«Укажите условие, необходимое для двоичного поиска». Данные должны быть упорядочены (отсортированы по возрастанию или убыванию по искомому ключу). «Опишите, как выполнить двоичный поиск» (три балла): (1) найдите средний элемент списка или текущего диапазона и сравните его с искомым; (2) если они совпадают, поиск завершается; если искомое значение меньше, повторите поиск в нижней половине, если больше — в верхней половине; (3) продолжайте делить диапазон пополам, пока элемент не будет найден или диапазон не станет пустым, что означает отсутствие элемента.
Версия для экзамена, с границами и флагом, — это та, которую следует воспроизвести, когда просят дополнить алгоритм:
DECLARE Lower, Upper, MiddleIndex : INTEGER
DECLARE Found : BOOLEAN
Lower ← 0
Upper ← 99
Found ← FALSE
WHILE Lower <= Upper AND NOT Found
    MiddleIndex ← (Lower + Upper) DIV 2
    IF Names[MiddleIndex] = Target THEN
        Found ← TRUE
    ELSE
        IF Names[MiddleIndex] < Target THEN
            Lower ← MiddleIndex + 1
        ELSE
            Upper ← MiddleIndex - 1
        ENDIF
    ENDIF
ENDWHILE
IF Found THEN
    OUTPUT MiddleIndex
ELSE
    OUTPUT "Not found"
ENDIF
Разобранный пример (трассировка двоичного поиска). Names[0:9] содержит Ali, Ben, Cai, Dev, Eva, Fay, Gus, Hal, Ivy, Jo. Выполните трассировку экзаменационного алгоритма для Target = "Ivy", затем для Target = "Cat", указывая Lower, Upper и MiddleIndex на каждом шаге.
Для «Ivy»:
| Lower | Upper | MiddleIndex | Names[MiddleIndex] | Результат |
|---|---|---|---|---|
| 0 | 9 | 4 | Eva | Eva < Ivy, поэтому Lower ← 5 |
| 5 | 9 | 7 | Hal | Hal < Ivy, поэтому Lower ← 8 |
| 8 | 9 | 8 | Ivy | Found ← TRUE |
Выводится 8 после трёх сравнений. Для «Cat»: середина 4 (Eva > Cat, Upper ← 3); середина 1 (Ben < Cat, Lower ← 2); middle 2 (Cai < Cat, Lower ← 3); middle 3 (Dev > Cat, Upper ← 2). Теперь Lower (3) больше Upper (2), поэтому цикл завершается и после четырёх сравнений выводится «Not found»; это худший случай для десяти элементов ($\lceil\log_2 10\rceil = 4$). DIV округляет вниз, поэтому середина между 0 и 9 — 4, а не 4.5 или 5. Строки сравниваются в алфавитном порядке (по кодам символов).
«Объясните, как производительность зависит от числа элементов». Каждое сравнение уменьшает вдвое число оставшихся элементов, поэтому максимальное число сравнений составляет примерно $\log_{2} n$: удвоение размера списка добавляет всего одно сравнение. Это O($\log n$). «Сравните линейный и двоичный поиск»: линейному поиску требуется до $n$ сравнений (O($n$)), а в среднем вдвое меньше, но он работает с неотсортированными данными; двоичному поиску требуется не более $\log_{2} n$ сравнений (O($\log n$)), и он намного быстрее для больших списков, но данные сначала нужно отсортировать, а также обеспечить прямой доступ к среднему элементу (массив, а не связный список). Для $1000$ элементов: $1000$ сравнений против $10$.
Исследовать
Линейный против бинарного поиска
Поиск значения. Бинарный поиск делит список пополам на каждом шаге (только для отсортированных данных); линейный поиск проверяет элементы по одному.
Словарь
Тренировать
| English | Русский |
|---|---|
| insertion sort/ɪnˈsɜːʃn sɔːt/ | сортировка вставками |
| bubble sort/ˈbʌbl sɔːt/ | сортировка пузырьком |
| binary search/ˈbaɪnəri sɜːtʃ/ | бинарный поиск |
| array/əˈreɪ/ | Массив |
| linear search/ˈlɪnɪə sɜːtʃ/ | линейный поиск |
19.1
Алгоритмы сортировки
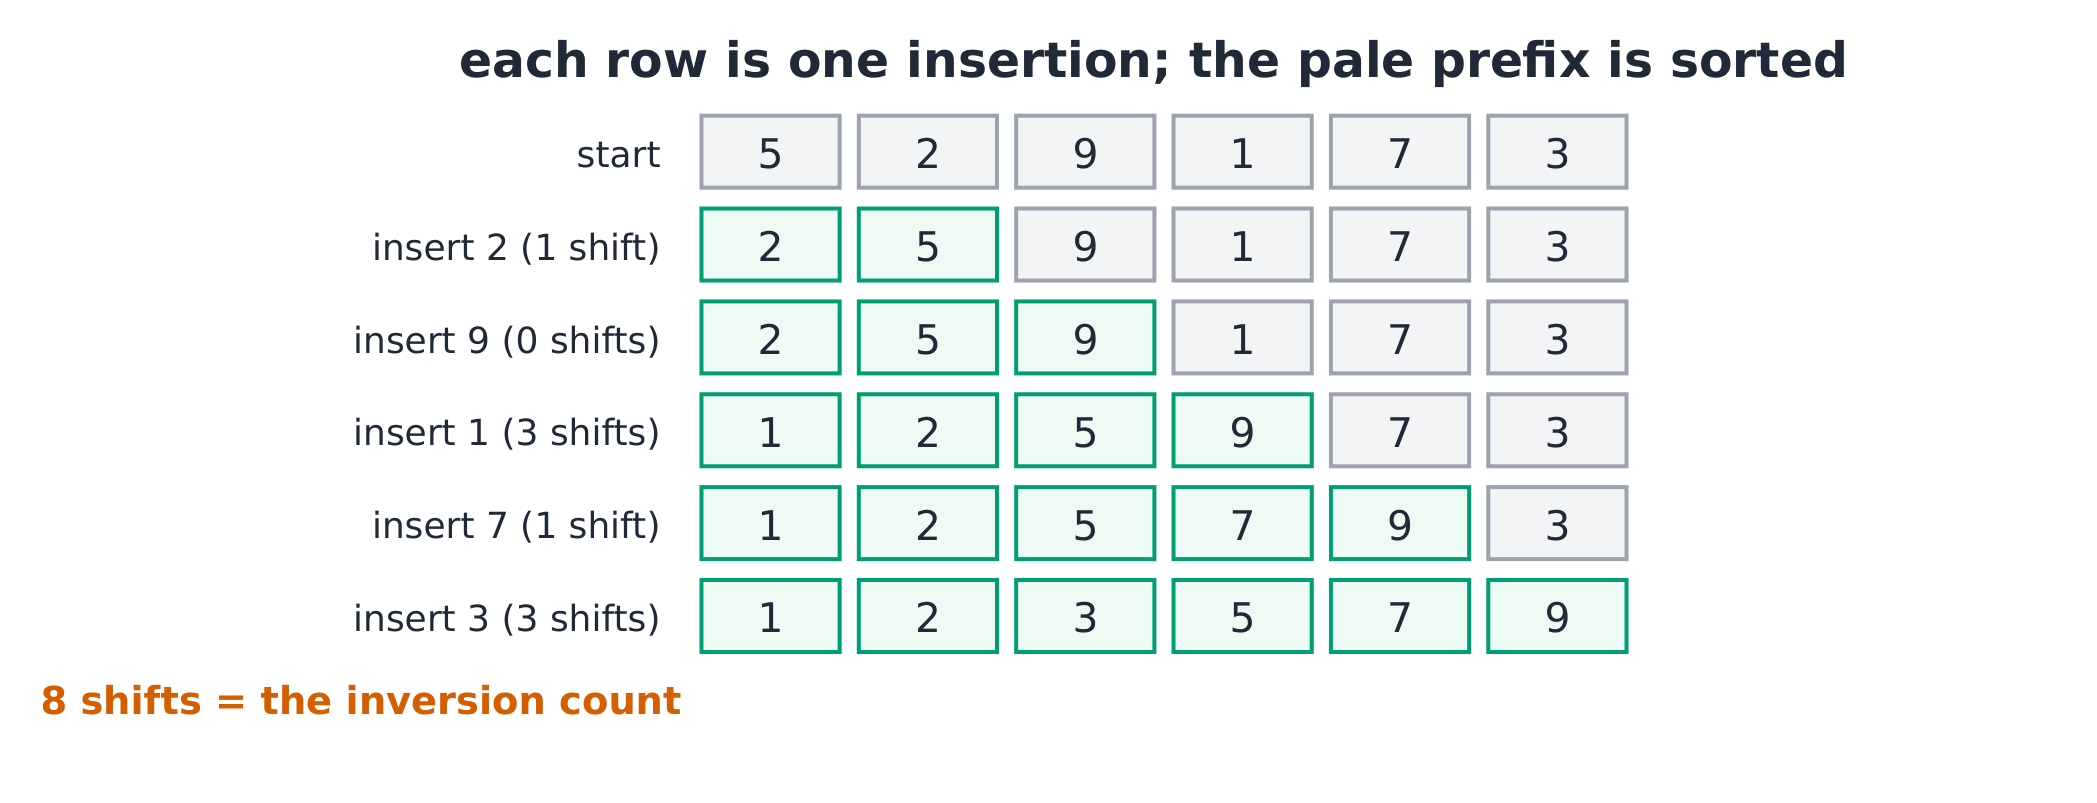
Пузырьковая сортировка
Пузырьковая сортировка многократно проходит по массиву, меняя местами соседние элементы, стоящие не по порядку, так что при каждом проходе наибольший элемент «всплывает» в конец:
FOR pass ← 1 TO n - 1
    swapped ← FALSE
    FOR i ← 1 TO n - pass
        IF A[i] > A[i + 1] THEN
            temp ← A[i]
            A[i] ← A[i + 1]
            A[i + 1] ← temp
            swapped ← TRUE
        ENDIF
    NEXT i
    IF swapped = FALSE THEN      // already sorted
        EXIT FOR
    ENDIF
NEXT pass
Лучший случай O($n$) (уже отсортировано, с ранним выходом); средний/худший O($n^{2}$). Проста, но медленна для больших $n$.
Сортировка вставками
Сортировка вставками формирует отсортированный префикс слева, вставляя каждый новый элемент на место путем сдвига бо́льших элементов вправо:
FOR i ← 2 TO n
    key ← A[i]
    j ← i - 1
    WHILE j >= 1 AND A[j] > key DO
        A[j + 1] ← A[j]
        j ← j - 1
    ENDWHILE
    A[j + 1] ← key
NEXT i
Лучший случай O($n$) (уже отсортировано); худший O($n^{2}$). Хороша для малых или почти отсортированных массивов. Сортирует на месте и является стабильной (сохраняет порядок равных элементов).
Отслеживание сортировки
Типичная задача — показать массив после каждого внешнего прохода. Для [D, T, H, R] со сортировкой вставками: проход 1 (ключ T) без изменений; проход 2 (ключ H) → [D, H, T, R]; проход 3 (ключ R) → [D, H, R, T].
При пузырьковой сортировке тот же массив изменяется иначе: проход 1 сравнивает D/T (без обмена), T/H (обмен) и T/R (обмен), в результате получается [D, H, R, T] с наибольшим элементом в конце; проход 2 не выполняет ни одного обмена, поэтому флаг останавливает сортировку. Покажите весь массив после каждого прохода и при необходимости посчитайте сравнения: $3$ при проходе 1 и $2$ при проходе 2 (в приведённой выше версии каждый следующий проход заканчивается на одну позицию раньше), всего $5$.
Написание сортировки с нуля. В ответ на задание «напишите псевдокод для сортировки DataArray[1:1000] по возрастанию» приведите полную пузырьковую сортировку с флагом досрочного выхода или сортировку вставками, с объявлениями и отступами; любой вариант получит полный балл, если он работает для всех входных данных:
DECLARE Pass, Index, Temp : INTEGER
DECLARE Swapped : BOOLEAN
Pass ← 1
REPEAT
    Swapped ← FALSE
    FOR Index ← 1 TO 1000 - Pass
        IF DataArray[Index] > DataArray[Index + 1] THEN
            Temp ← DataArray[Index]
            DataArray[Index] ← DataArray[Index + 1]
            DataArray[Index + 1] ← Temp
            Swapped ← TRUE
        ENDIF
    NEXT Index
    Pass ← Pass + 1
UNTIL Swapped = FALSE OR Pass = 1000
Для сортировки по убыванию замените > на <; чтобы отсортировать записи или 2-мерный массив по одному полю, сравнивайте это поле, но меняйте местами всю запись или все столбцы. Если требуется написать сортировку вставками, «выполняющую ту же задачу», что и данная пузырьковая сортировка, сохраните то же имя массива и направление сортировки и воспроизведите приведённую выше сортировку вставками, изменив знак сравнения на противоположный для порядка по убыванию.
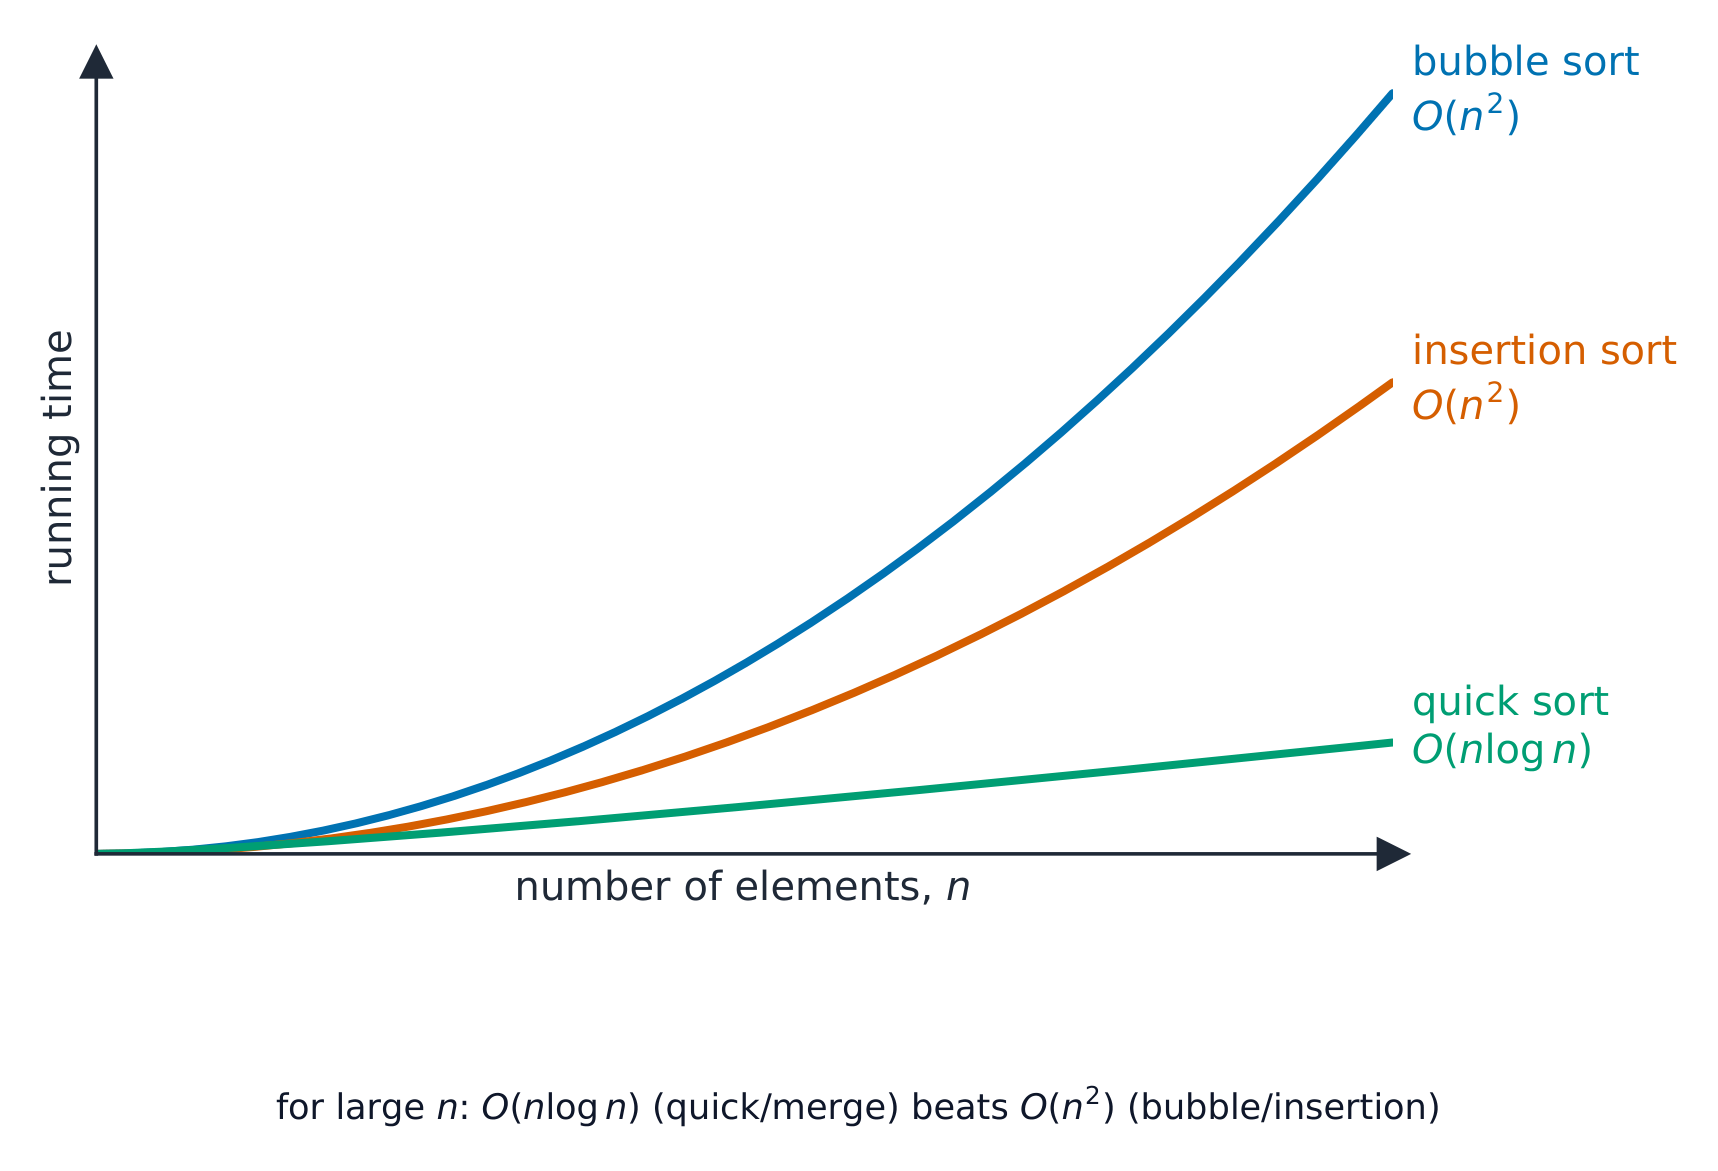
«Опишите два способа, которыми данные влияют на производительность сортировки» (два балла). (1) Число элементов: сортировка $O(n^{2})$ занимает в четыре раза больше времени при удвоении числа элементов. (2) Степень упорядоченности данных: пузырьковая сортировка с флагом или сортировка вставками завершается за один проход по уже отсортированным данным ($O(n)$), а больше всего работы выполняет для данных в обратном порядке; число обменов зависит от количества пар, стоящих не по порядку. Также принимаются: диапазон или число повторяющихся значений и то, являются ли элементы большими записями, перемещение которых требует значительных затрат. Пузырьковая сортировка и сортировка вставками имеют сложность O($n^{2}$) в худшем и среднем случаях и O($n$) в лучшем; быстрая сортировка и сортировка слиянием имеют сложность O($n \log n$), поэтому их применяют для больших объёмов данных.
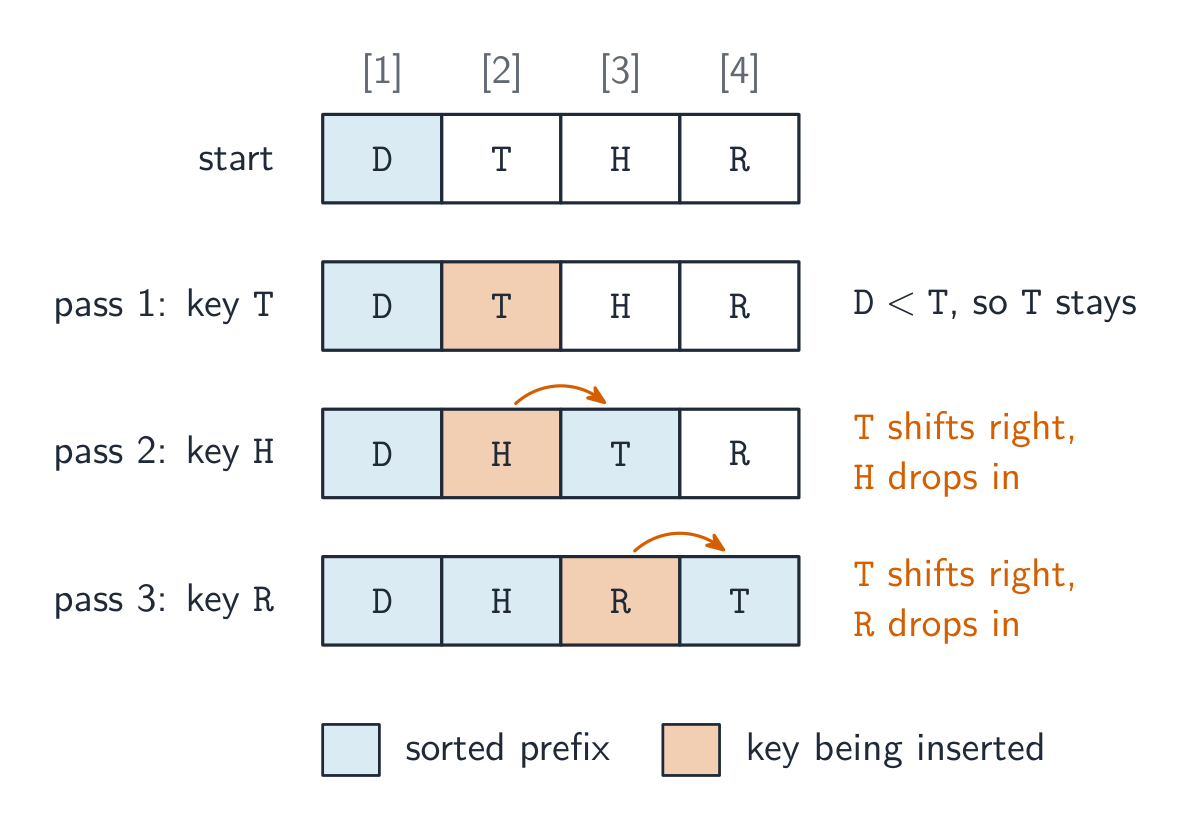
[D, T, H, R], размещающая каждый ключ на своем месте последовательно
Исследовать
Просмотр работы сортировки
Проходите через процесс сортировки и наблюдайте, как столбцы выстраиваются в порядке — как работает алгоритм сортировки шаг за шагом.
19.1
Абстрактные типы данных (ADT) в алгоритмах
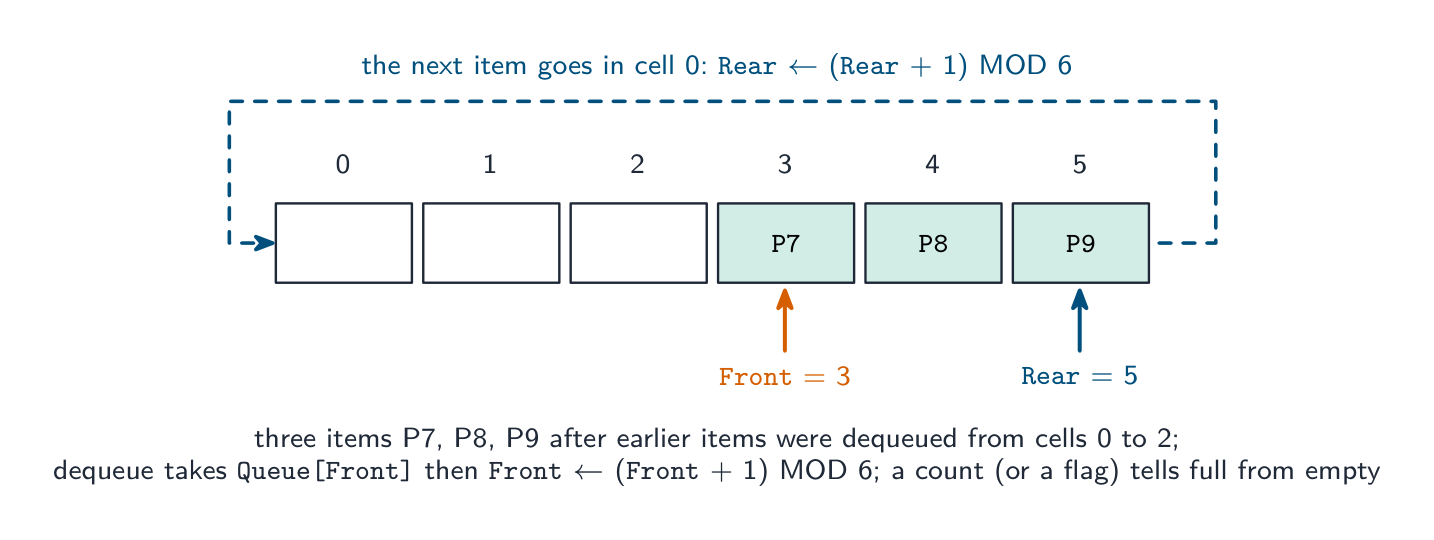
Абстрактные типы данных (ADT) из Темы 10 используются во многих алгоритмах: стек обеспечивает обход в глубину и функцию отмены; очередь обеспечивает обход в ширину и порядок печати; связный список позволяет данным динамически расширяться и уменьшаться.
Абстрактные типы данных (ADT) можно строить на основе других ADT, а не только массивов: очередь из двух стеков; стек на связном списке (push = добавление узла в начало головы); очередь на связном списке с указателями на голову и хвост; двоичное дерево из узлов с двумя указателями на детей; словарь хранит пары ключ→значение (часто на хеш-таблице). Такое построение разделяет ответственность — алгоритм, использующий ADT, не должен знать о его внутренней реализации.
ADT, которые требуется описать и реализовать на экзамене
Стек (last in, first out): элементы добавляются (push) и удаляются (pop) с одного конца — вершины; указатель TopOfStack хранит индекс верхнего элемента. Реализуется с помощью массива и одного указателя: push проверяет, что стек не полон, увеличивает указатель и сохраняет элемент; pop проверяет, что стек не пуст, возвращает верхний элемент и уменьшает указатель.
FUNCTION Push(Item : INTEGER) RETURNS BOOLEAN
    IF TopOfStack = 9 THEN      // full (array 0 to 9)
        RETURN FALSE
    ENDIF
    TopOfStack ← TopOfStack + 1
    StackData[TopOfStack] ← Item
    RETURN TRUE
ENDFUNCTION
FUNCTION Pop() RETURNS INTEGER
    IF TopOfStack = -1 THEN      // empty
        RETURN -1
    ENDIF
    TopOfStack ← TopOfStack - 1
    RETURN StackData[TopOfStack + 1]
ENDFUNCTION
Очередь (first in, first out): элементы добавляются в хвост (enqueue) и покидают из головы (dequeue); два указателя и счетчик. В линейной очереди указатель головы смещается по массиву до тех пор, пока пространство в начале не будет потеряно; циклическая очередь оборачивает оба указателя через MOD, благодаря чему каждая ячейка используется повторно.
FUNCTION Enqueue(Item : STRING) RETURNS BOOLEAN
    IF Count = 6 THEN      // full
        RETURN FALSE
    ENDIF
    Rear ← (Rear + 1) MOD 6
    QueueArray[Rear] ← Item
    Count ← Count + 1
    RETURN TRUE
ENDFUNCTION
FUNCTION Dequeue() RETURNS STRING
    IF Count = 0 THEN      // empty
        RETURN ""
    ENDIF
    DECLARE Item : STRING
    Item ← QueueArray[Front]
    Front ← (Front + 1) MOD 6
    Count ← Count - 1
    RETURN Item
ENDFUNCTION
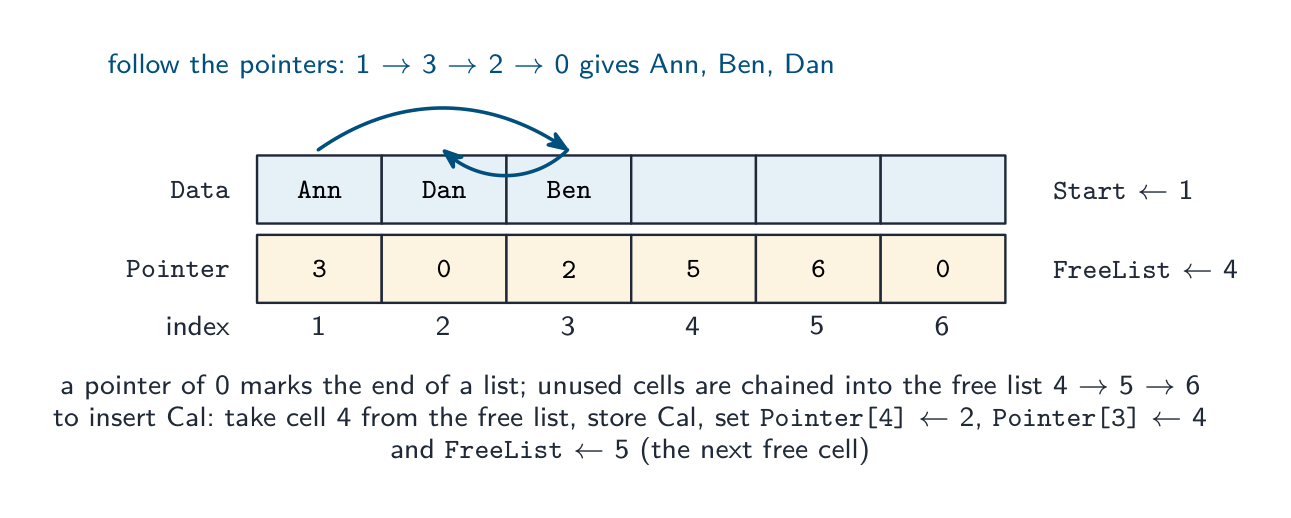
Связный список: последовательность узлов, каждый из которых содержит элемент данных и указатель на следующий узел; указатель начала указывает на первый узел, а нулевой указатель (0 или $-1$) обозначает конец списка. При реализации на массиве два параллельных массива хранят данные и указатели, а неиспользованные ячейки соединяются в свободный список, чтобы при вставке можно было определить место для нового узла.
FUNCTION FindInList(Target : STRING) RETURNS INTEGER   // index, or 0 if absent
    DECLARE Current : INTEGER
    Current ← Start
    WHILE Current <> 0
        IF Data[Current] = Target THEN
            RETURN Current
        ENDIF
        Current ← Pointer[Current]
    ENDWHILE
    RETURN 0
ENDFUNCTION
Для вставки в упорядоченный список: возьмите первую свободную ячейку (NewNode ← FreeList, FreeList ← Pointer[FreeList]), сохраните элемент, затем пройдите по списку со значениями Previous и Current, пока не встретите Data[Current] > Item или конец; установите Pointer[NewNode] ← Current и Pointer[Previous] ← NewNode (или Start ← NewNode, если вставка происходит в начало). Для удаления пересоедините предыдущий узел, минуя удаленный, и верните ячейку в свободный список.
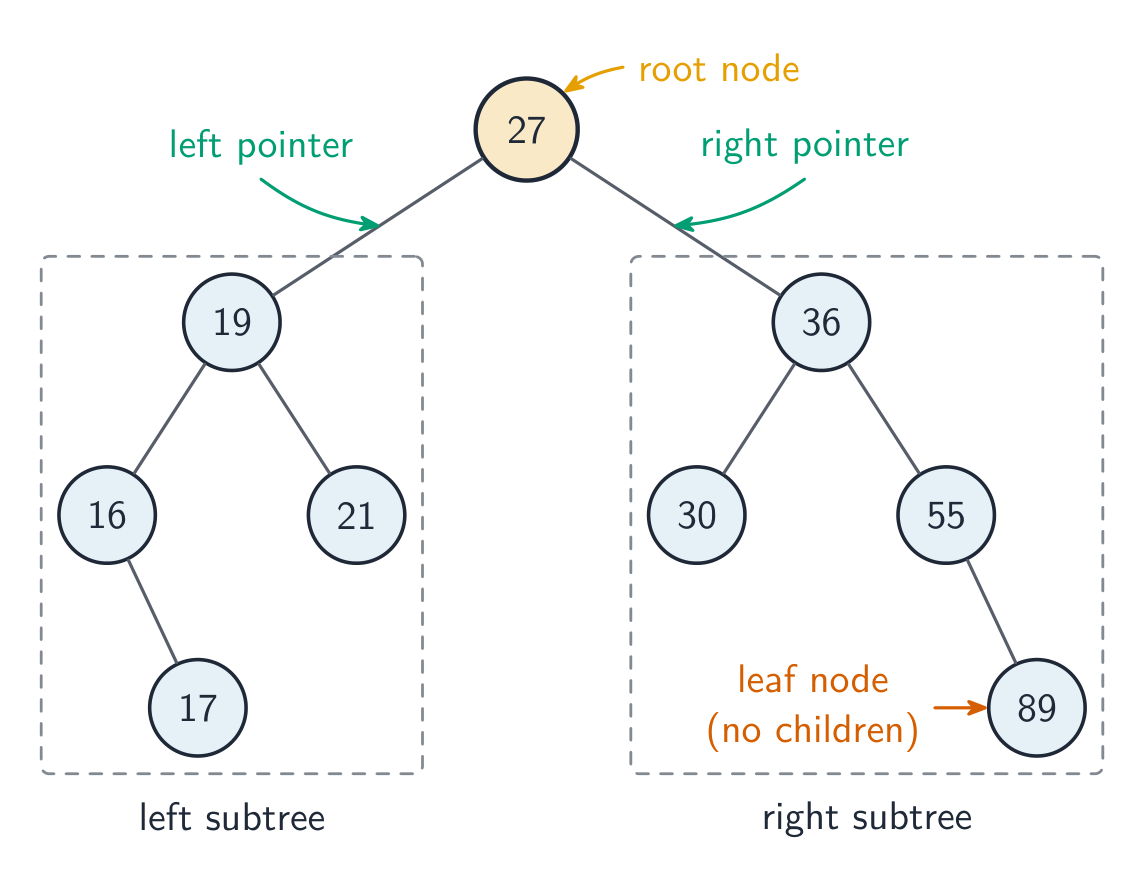
Двоичное дерево: узел корня, каждый узел содержит данные, левый указатель на поддерево меньших значений и правый указатель на поддерево бо́льших значений. Реализуется как 2-мерный массив (или три 1-мерных массива) Tree[Index, 0..2] для левого указателя, данных, правого указателя, с указателем корня и указателем следующего свободного элемента.
FUNCTION FindInTree(Target : INTEGER) RETURNS INTEGER   // index, or -1
    DECLARE Current : INTEGER
    Current ← Root
    WHILE Current <> -1
        IF Tree[Current, 1] = Target THEN
            RETURN Current
        ENDIF
        IF Target < Tree[Current, 1] THEN
            Current ← Tree[Current, 0]      // go left
        ELSE
            Current ← Tree[Current, 2]      // go right
        ENDIF
    ENDWHILE
    RETURN -1
ENDFUNCTION
Для вставки: сохраните элемент в следующую свободную ячейку, установив оба указателя равными $-1$; если дерево пусто, сделайте его корнем; иначе спускайтесь от корня, выбирая левый или правый путь в зависимости от сравнения, пока указатель, по которому следовало бы перейти, не станет $-1$, и установите этот указатель на новый узел. ADT на основе другого ADT: стек — это связный список, где push и pop работают с начала; очередь — это связный список с указателями начала и конца; очередь можно построить из двух стеков (push в один, pop из другого, перемещая все элементы, когда второй становится пустым); узлы бинарного дерева представляют собой записи или объекты, связанные указателями, поэтому оно строится на основе связанной структуры узлов. Укажите, какие операции нового ADT соответствуют операциям старого.
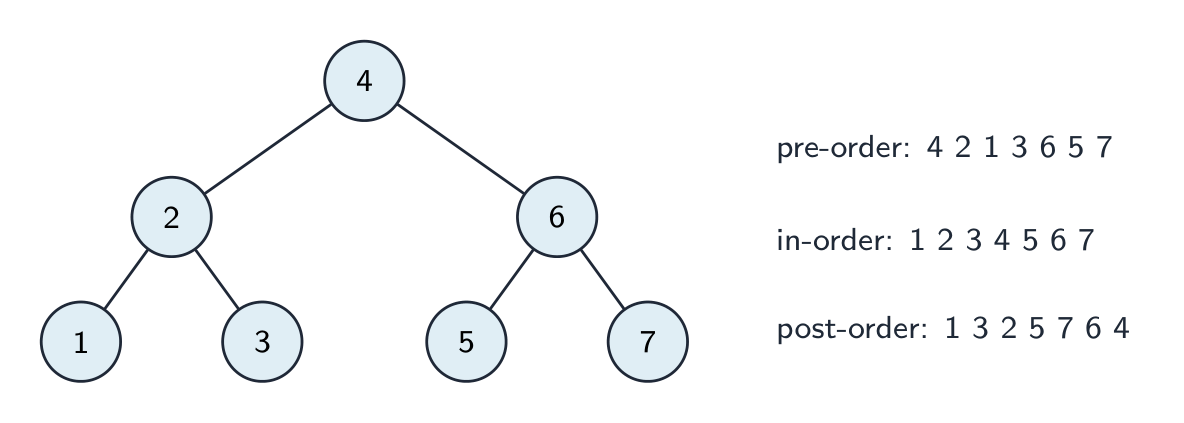
На первом рисунке показано двоичное дерево поиска: каждый узел имеет до двух дочерних узлов, значения меньше значения узла располагаются слева от него, а большие — справа. На втором рисунке показаны три способа обхода дерева.
Словарь
Тренировать
| English | Русский |
|---|---|
| linked list/lɪŋkt lɪst/ | связный список |
| in place/ɪn pleɪs/ | на месте |
| stable/ˈsteɪbl/ | устойчивая |
| stack/stæk/ | Стек |
| queue/kjuː/ | очередь |
| node/nəʊd/ | узел |
| pointers/ˈpɔɪntəz/ | указатели |
| binary tree/ˈbaɪnəri triː/ | двоичное дерево |
| dictionary/ˈdɪkʃənəri/ | словарь |
| circular queue/ˈsɜːkjʊlə kjuː/ | циклическая очередь |
| free list/friː lɪst/ | список свободных ячеек |
| time complexity/taɪm kəmˈpleksɪti/ | временная сложность |
| Big-O notation/bɪɡ əʊ nəʊˈteɪʃn/ | большое O-обозначение |
| space complexity/speɪs kəmˈpleksɪti/ | пространственная сложность |
19.1
Сравнение алгоритмов
Сложность по времени
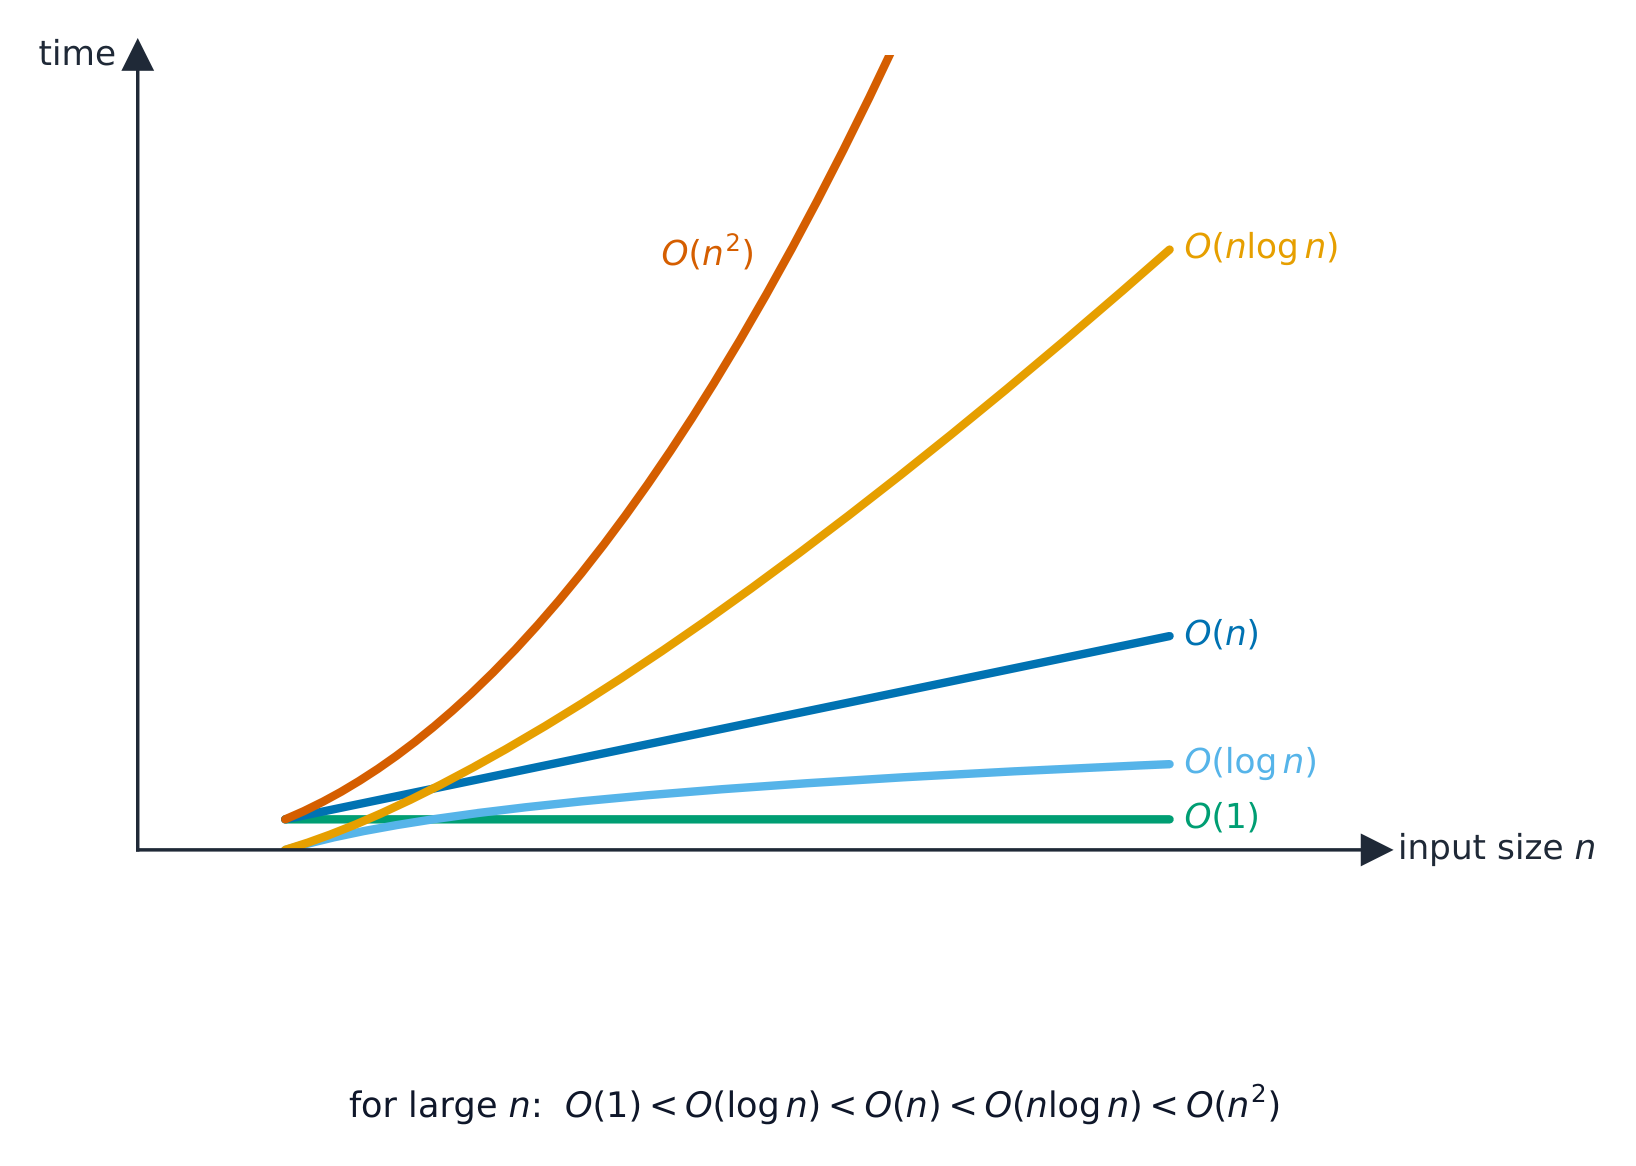
Временная сложность показывает, как время выполнения растет с увеличением размера входных данных $n$. Записывается в нотации Big-O (доминирующий член): O(1) — константная, O($\log n$) — бинарный поиск, O($n$) — линейный поиск, O($n \log n$) — эффективные сортировки, O($n^{2}$) — пузырьковая и сортировка вставками. Меньший порядок роста предпочтительнее на больших объемах данных, даже если другой алгоритм быстрее для малых $n$.
Чтобы это стало понятнее: при сортировке миллиона элементов алгоритм со сложностью $O(n \log n)$ завершится за долю секунды, тогда как алгоритм со сложностью $O(n^{2})$ может занять минуты.
Разобранный пример. Отсортированный список содержит $1000$ элементов. Сколько сравнений потребуется каждому способу поиска в худшем случае?
Линейный поиск проверяет элементы по одному, поэтому ему может потребоваться до $1000$ сравнений — это $O(n)$. Двоичный поиск на каждом шаге делит список пополам, поэтому ему требуется не более $\lceil \log_2 1000 \rceil = 10$ сравнений — это $O(\log n)$. Удвоение списка до $2000$ элементов добавляет всего одно сравнение для двоичного поиска, но до $1000$ сравнений для линейного — поэтому при больших объёмах данных решающим становится порядок роста, а не абсолютная скорость.
Описание порядка сложности. O(1): время постоянно и не зависит от числа элементов (помещение элемента в стек, чтение элемента массива). O($\log n$): время растёт пропорционально логарифму числа элементов, поэтому удвоение объёма данных добавляет лишь фиксированное число шагов (двоичный поиск). O($n$): время растёт пропорционально числу элементов (линейный поиск, один проход по списку). O($n \log n$): рост немного быстрее линейного (эффективные сортировки). O($n^{2}$): время растёт пропорционально квадрату числа элементов, поэтому удвоение объёма данных увеличивает время в четыре раза (пузырьковая сортировка и сортировка вставками). На вопрос «укажите сложность двоичного поиска по нотации O-большое для Names[0:99]» ответьте $O(\log n)$, а её смысл опишите, как указано выше; нотация O-большое показывает, как масштабируется время или память, а не фактическое время выполнения.
Разобранный пример (порядок сложности кода). Укажите временную сложность каждого фрагмента, где n — число элементов.
// Fragment A
FOR i ← 1 TO n
    FOR j ← 1 TO n
        Total ← Total + Grid[i, j]
    NEXT j
NEXT i

// Fragment B
Count ← 0
WHILE n > 1
    n ← n DIV 2
    Count ← Count + 1
ENDWHILE

// Fragment C
FOR i ← 1 TO n
    Total ← Total + A[i]
NEXT i
FOR i ← 1 TO n
    OUTPUT A[i] / Total
NEXT i
A имеет сложность $O(n^{2})$: внутренняя инструкция выполняется $n$ раз для каждого из $n$ проходов внешнего цикла, всего $n \times n$ раз. B имеет сложность $O(\log n)$: $n$ уменьшается вдвое при каждом проходе, поэтому цикл выполняется около $\log_2 n$ раз (для $n = 64$ — шесть проходов). C имеет сложность $O(n)$: два цикла, выполняющиеся один за другим, занимают $n + n = 2n$ шагов, а константы отбрасываются. Правило: для вложенных циклов сложности перемножаются, для последовательных — складываются, и сохраняется только наиболее быстро растущее слагаемое, поэтому $3n^{2} + 5n + 2$ имеет сложность $O(n^{2})$.
Пространственная сложность
Пространственная сложность — это объём необходимой дополнительной памяти. Пузырьковая сортировка и сортировка вставками используют O(1) дополнительной памяти (сортировка на месте); сортировка слиянием использует O($n$); рекурсия использует память стека пропорционально своей глубине. Часто приходится выбирать между затратами времени и памяти.
Другие критерии
Простота (легче кодить и поддерживать), стабильность и адаптивность (быстрее работает на почти отсортированных данных). Правильный выбор алгоритма зависит от данных и ограничений.
Исследовать
Как время выполнения растет вместе с n
Наклоните график n вверх и сравните кривые: O(1) и O(log n) остаются почти горизонтальными, O(n) растет плавно, O(n²) резко возрастает. Вот почему Big-O — а не секундомер — используется для сравнения алгоритмов на больших объемах входных данных.
Исследовать
Рост Big-O
Изменяйте размер входных данных n и сравнивайте, насколько быстро растет объем работы каждого алгоритма — это суть временной сложности.
19.2
Рекурсия
Программа
| Кандидаты должны уметь: | Примечания и рекомендации |
|---|---|
| Показать понимание рекурсии | Сущностные особенности рекурсии. Как рекурсия выражается в языке программирования. Написание и трассировка рекурсивных алгоритмов. Когда применение рекурсии целесообразно. |
| Проявлять осведомленность о том, что должен сделать компилятор для трансляции кода на рекурсивных языках программирования | Использование стеков и разворачивания (unwinding). |
Источник: Программа Cambridge International

Рекурсивные алгоритмы используют рекурсию: процедура вызывает саму себя с уменьшенной версией той же задачи, пока не будет достигнут базовый случай, завершающий цепочку. Она состоит из двух частей: базового случая (достаточно малого для прямого решения — без него рекурсия никогда не остановится) и рекурсивного случая (уменьшение входных данных и вызов самой себя).
Факториал:
FUNCTION Factorial(n : INTEGER) RETURNS INTEGER
    IF n = 0 OR n = 1 THEN
        RETURN 1
    ELSE
        RETURN n * Factorial(n - 1)
    ENDIF
ENDFUNCTION
Рекурсия естественна для самоподобных задач: деревьев, разделяй и властвуй (бинарный поиск, слияние), и вложенных данных. Когда она плохо подходит, цикл обычно чище.
«Опишите, что понимается под рекурсией» (два балла). Функция или процедура, определённая через саму себя: она вызывает саму себя из собственного тела, каждый раз для меньшей версии задачи, пока не будет достигнут базовый случай. «Назовите три необходимых признака рекурсии»: (1) базовый случай (условие остановки), который возвращает значение без дальнейшего вызова; (2) общий случай, в котором подпрограмма вызывает саму себя; (3) каждый вызов приближает задачу к базовому случаю (параметр уменьшается), чтобы рекурсия завершилась. В некоторых схемах оценивания добавляется: значения возвращаются при развёртывании вызовов.
«Опишите, когда использование рекурсии полезно, и приведите пример». Когда задача естественным образом определяется через меньшие версии самой себя, так что рекурсивное решение короче, понятнее и ближе к математическому определению, чем решение с циклом: вычисление факториала или числа Фибоначчи, двоичный поиск, обход двоичного дерева, сортировка слиянием или быстрая сортировка, а также обработка вложенных структур, например папок внутри папок. Рекурсия плохо подходит при большой глубине (стек может переполниться) или при многократном вычислении одной и той же подзадачи (наивный алгоритм Фибоначчи).
Отслеживание рекурсивного вызова
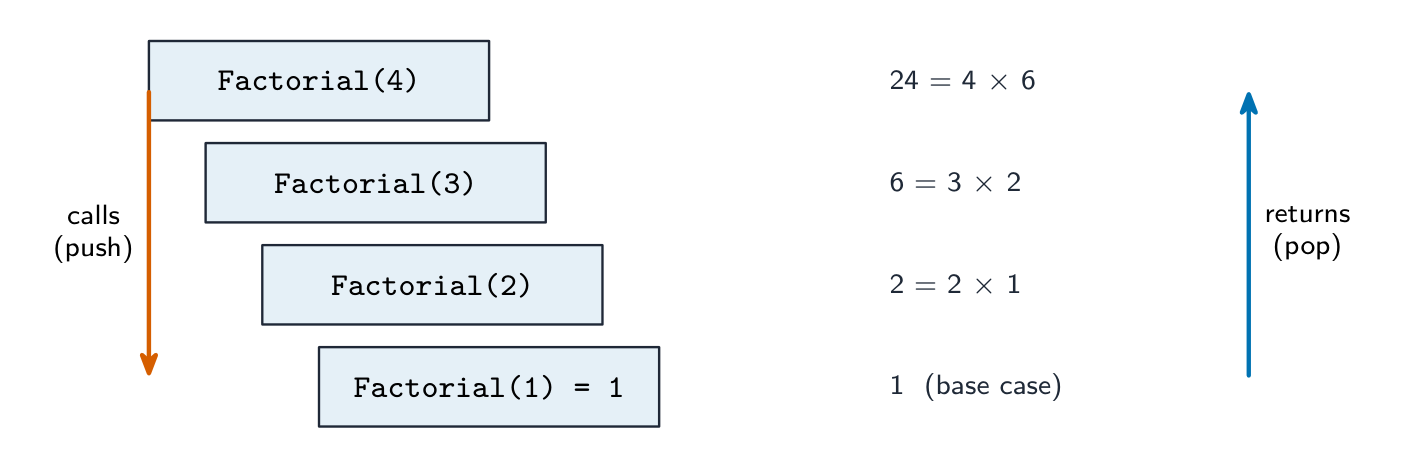
Для Factorial(4): вызовы доходят до Factorial(1)=1, затем при развёртывании происходит последовательное умножение: 2*1=2, 3*2=6, 4*6=24. Итоговый результат 24. Отслеживайте каждый ожидающий вызов в стеке.
Разобранный пример. Приведённая ниже функция дана без объяснения. Выполните трассировку Unknown(3, 5) и укажите вывод и возвращаемое значение.
FUNCTION Unknown(BYVAL X, BYVAL Y : INTEGER) RETURNS INTEGER
    IF X < Y THEN
        OUTPUT X + Y
        RETURN Unknown(X + 1, Y - 1) + 1
    ELSE
        RETURN 0
    ENDIF
ENDFUNCTION
Вызов 1: $X = 3, Y = 5$: $3 < 5$, выводится 8, вызывается Unknown(4, 4). Вызов 2: $4 < 4$ ложно, возвращается 0. Развёртывание: вызов 1 возвращает $0 + 1 = 1$. Вывод 8, возвращаемое значение 1. Запишите трассировку в виде таблицы с одной строкой на вызов (параметры, условие, вывод, возвращаемое значение) и выполняйте возвраты от самого глубокого вызова к верхнему: именно такое развёртывание требуется в схеме оценивания.
Разобранный пример (числа Фибоначчи). Fib(n) возвращает n при n < 2, иначе Fib(n - 1) + Fib(n - 2). Найдите Fib(5).
Fib(5) = Fib(4) + Fib(3); Fib(4) = Fib(3) + Fib(2); Fib(3) = Fib(2) + Fib(1); Fib(2) = Fib(1) + Fib(0) = 1 + 0 = 1. Таким образом, Fib(3) = 1 + 1 = 2, Fib(4) = 2 + 1 = 3, Fib(5) = 3 + 2 = 5. Базовый случай достигается множественно (Fib(2) вычисляется три раза), поэтому эта версия работает медленно: она выполняет 15 вызовов для $n = 5$ и примерно удваивает количество вызовов с каждым увеличением $n$.
Преобразование рекурсии в итерацию. Любую рекурсивную процедуру можно переписать с использованием цикла, который требует меньше памяти и работает быстрее: храните текущий результат и выполняйте цикл от базового случая вверх. Факториал как цикл:
FUNCTION Factorial(N : INTEGER) RETURNS INTEGER
    DECLARE Result, Count : INTEGER
    Result ← 1
    FOR Count ← 2 TO N
        Result ← Result * Count
    NEXT Count
    RETURN Result
ENDFUNCTION
Если требуется преобразовать рекурсивную сортировку вставками или поиск в итеративный, замените самовызов циклом по индексу, через который проходила рекурсия, а базовый случай превратите в условие выхода из цикла.
Риски
- бесконечная рекурсия при отсутствии базового случая — завершается аварийно с ошибкой переполнения стека.
- высокое потребление памяти при глубокой рекурсии.
- медленная работа при повторении вычислений (наивное число Фибоначчи имеет экспоненциальную сложность — используйте цикл или мемоизацию).
Исследовать
Рекурсия раскручивается от листьев вверх
Пройдите вычисление fib(4) в порядке фактического завершения вызовов: сначала разрешаются листья (базовые случаи), затем каждый родитель объединяет своих детей. Заметьте, что fib(2) вычисляется дважды — эта повторяющаяся работа объясняет медленную работу наивной рекурсии.
Словарь
Тренировать
| English | Русский |
|---|---|
| recursion/rɪˈkɜːʃn/ | рекурсия |
| factorial/fækˈtɔːrɪəl/ | факториал |
| divide-and-conquer/dɪˈvaɪd ænd ˈkɒŋkə/ | разделяй и властвуй |
| general case/ˈdʒenərəl keɪs/ | общий случай |
| parameters/pəˈræmɪtəz/ | параметры |
| stack overflow/stæk ˌəʊvəˈfləʊ/ | переполнение стека |
| memoisation/ˌmeməʊaɪˈzeɪʃn/ | мемоизация |
| local variables/ˈləʊkl ˈveərɪəblz/ | локальные переменные |
| stack frame/stæk freɪm/ | кадр стека |
| return address/rɪˈtɜːn əˈdres/ | адрес возврата |
19.2
Что делает компилятор с рекурсивным кодом
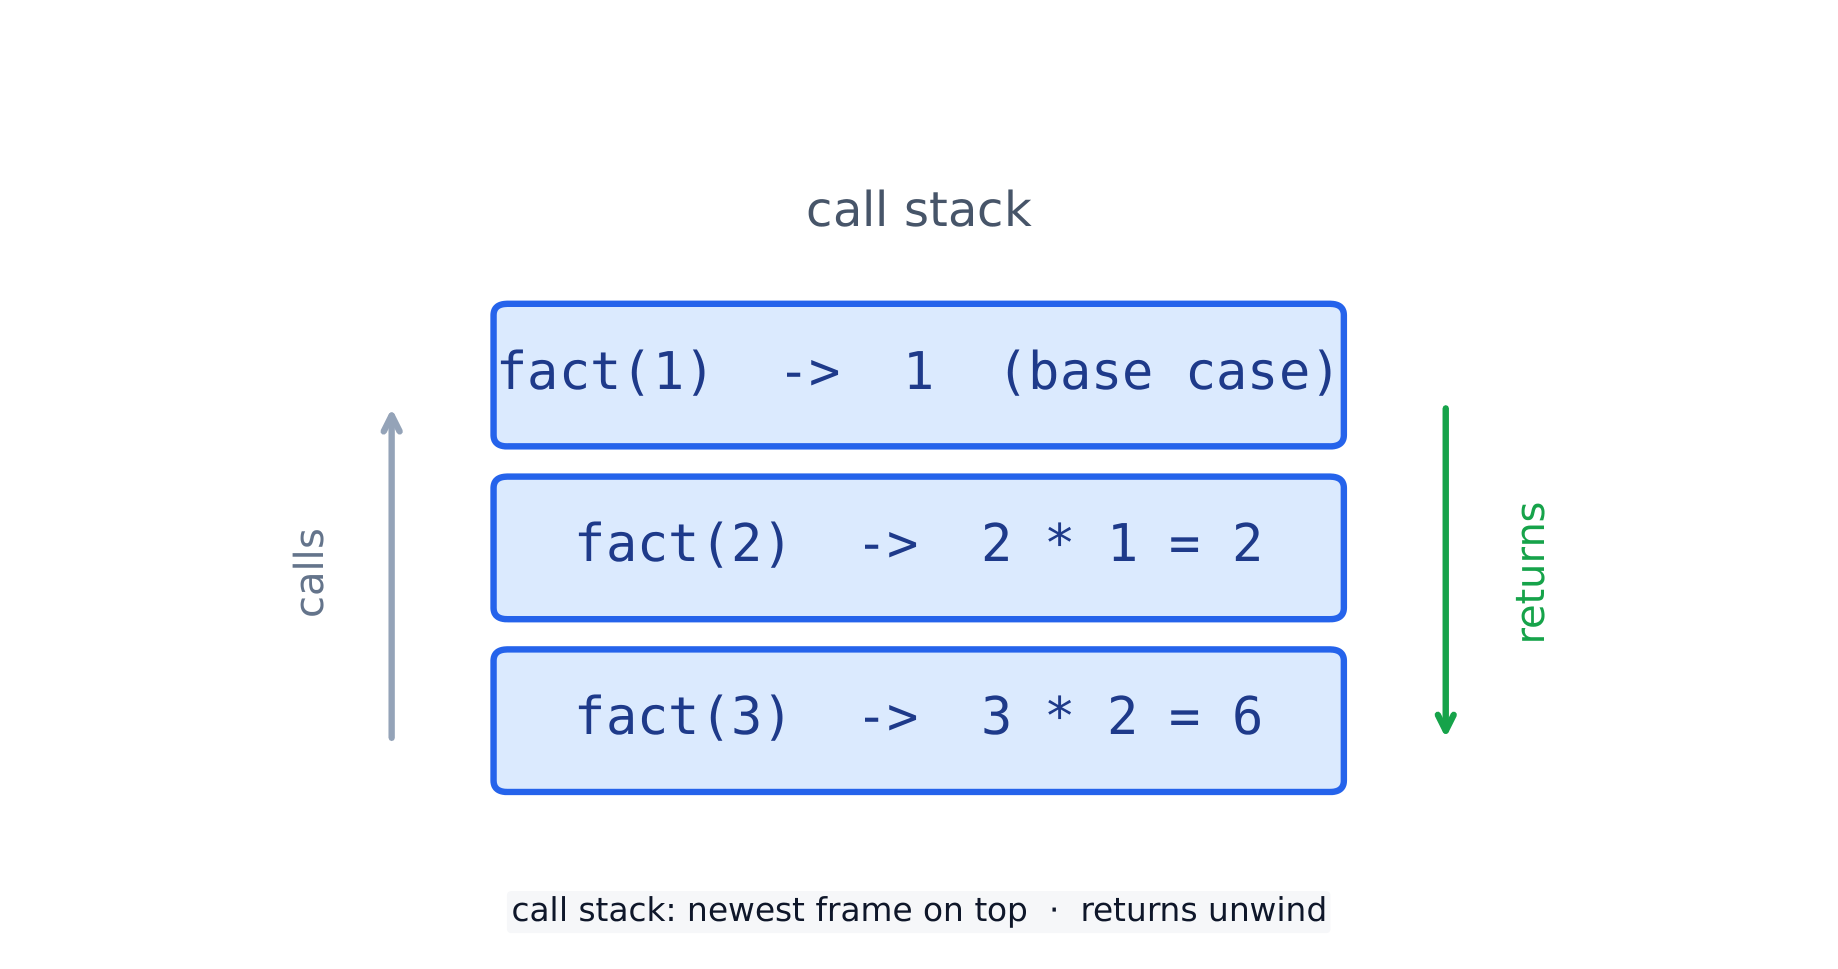
Для рекурсии необходимо, чтобы каждый вызов имел собственную копию своих параметров и локальных переменных. Компилятор хранит эти данные на стеке вызовов. Для каждого вызова он помещает фрейм стека, содержащий параметры, локальные переменные и адрес возврата (место, откуда нужно продолжить выполнение в вызывающей функции). Когда функция завершает работу, значение результата передается обратно, фрейм удаляется из стека, и управление возобновляется по адресу возврата.
Поскольку каждый вызов имеет собственный кадр, рекурсивные вызовы не перезаписывают переменные друг друга. При глубокой рекурсии стек может сильно вырасти и переполниться. Это тот же механизм вызова и возврата, который используется для обычных нерекурсивных вызовов; специального «механизма рекурсии» нет.
«Объясните, почему стек подходит для реализации рекурсии» (три балла). Каждый рекурсивный вызов должен сохранить свой адрес возврата, параметры и локальные переменные, а вызовы завершаются в обратном порядке относительно их выполнения: последний вызванный завершается первым. Это в точности соответствует принципу работы стека «последним пришёл — первым вышел»: каждый новый вызов помещает кадр в стек, а каждый возврат извлекает самый последний кадр, восстанавливая состояние вызывающей программы и указывая, откуда продолжить выполнение. Это задача компилятора при трансляции рекурсивного кода: он создаёт инструкции помещения кадра в стек при каждом вызове и извлечения при каждом возврате; кадры извлекаются по мере возвращения результатов.
Словарь
Тренировать
| English | Русский |
|---|---|
| call stack/kɔːl stæk/ | стек вызовов |
| base case/beɪs keɪs/ | базовый случай |
| recursive case/rɪˈkɜːsɪv keɪs/ | рекурсивный случай |
19.2
Определения, принимаемые экзаменатором
Вопросы на определение оцениваются по фиксированной формулировке. Выучите их точно и дайте только один ответ.
| Термин | Определение |
|---|---|
| линейный поиск | последовательная проверка каждого элемента от начала до тех пор, пока целевой элемент не будет найден или не будет достигнут конец списка |
| бинарный поиск | многократное сравнение целевого значения со средним элементом отсортированного списка и отбрасывание половины, которая не может его содержать |
| пузырьковая сортировка | многократное прохождение по списку с обменом соседних элементов, стоящих в неправильном порядке, пока одно прохождение не пройдет без обменов |
| сортировка вставками | последовательная обработка каждого элемента и его вставка на правильное место среди уже отсортированных элементов |
| абстрактный тип данных | совокупность данных и операций, которые могут быть над ними выполнены, определенная независимо от способа их хранения |
| стек | структура типа «последним вошел — первым вышел» (LIFO) с операциями добавления (push) и удаления (pop) сверху |
| очередь | структура типа «первым вошел — первым вышел» (FIFO) с элементами, добавляемыми сзади и удаляемыми спереди |
| связный список | последовательность узлов, каждый из которых содержит данные и указатель на следующий узел, с указателем начала |
| двоичное дерево | узлы, содержащие данные и указатели на левое поддерево с меньшими значениями и правое поддерево с бо́льшими значениями |
| нотация Big O | способ классификации времени (или памяти), необходимого алгоритму, в зависимости от того, как оно растет вместе с размером входных данных |
| рекурсия | процедура, которая вызывает сама себя с уменьшенной версией задачи до тех пор, пока базовый случай не остановит вызовы |
| базовый случай | условие, при котором рекурсивная процедура завершает работу без собственного вызова |
| разматывание стека | последовательность возвратов цепочки рекурсивных вызовов, от самого глубокого вызова к первому, по мере удаления фреймов из стека |
19.2
Советы для экзамена
- Поиски: линейный поиск не требует упорядоченности и имеет сложность O($n$); бинарный поиск требует отсортированного массива, делит задачу пополам на каждом шаге и имеет сложность O($\log n$). Выучите оба алгоритма наизусть, включая границы и флаги.
- Сортировки: пузырьковая с флагом обмена, вставками с ключом, сдвигающим бо́льшие элементы вправо; обе имеют худшую сложность O($n^{2}$) и лучшую O($n$) на отсортированных данных. Производительность зависит от количества элементов и степени их упорядоченности.
- Реализации АТД требуют управления указателями: указатель верха; front, rear и count с операцией MOD; start, указатели и свободный список; корень с указателями на левое и правое поддеревья. Всегда проверяйте условия полноты и пустоты.
- Нотация O-большое описывает масштабирование: постоянное, логарифмическое, линейное, квадратичное. Для двоичного поиска укажите: «удвоение объёма данных добавляет одно сравнение».
- Рекурсия: базовый случай, общий случай, прогресс к базовому случаю; полезна, когда задача определена через саму себя; стек хранит адреса возврата и переменные, так как вызовы завершаются в обратном порядке. Отслеживайте процесс с помощью таблицы и разматывайте стек от самого глубокого вызова.
Распространенные ошибки
- Записывать $O(2n)$ или $O(n^{2} + n)$: отбросьте константы и менее значимые слагаемые, получив $O(n)$ и $O(n^{2})$.
- Вычислять средний индекс как $(Lower + Upper) / 2$ при трассировке: в экзаменационной версии используется
DIV, поэтому округляйте вниз. - Использование бинарного поиска на неотсортированных данных или на связном списке; а также установка
Lower ← MiddleIndexвместоMiddleIndex + 1, что приводит к бесконечному циклу. - Вложенный цикл пузырьковой сортировки, проходящий до конца массива при каждом проходе, или обмен без использования временной переменной.
- Операция push или enqueue без проверки на переполнение, или pop/dequeue без проверки на пустоту.
- Перемещение указателя front очереди без применения операции MOD в кольцевой очереди или трактовка front = rear как всегда означающего пустую очередь.
- Вставка в связный список путем сдвига содержимого массива; должны меняться только указатели.
- Рекурсивная функция без базового случая или у которой рекурсивный вызов не уменьшает размер задачи.
- Отслеживание рекурсивного вызова, но забывание добавить ожидаемую работу на обратном пути вверх.
- Отвечать на вопрос «почему стек» словами «потому что он быстрый»; причина заключается в порядке возвратов «последним пришёл — первым вышел».
Интерактивные уроки по этой теме
Пройдите его шаг за шагом с упражнениями мгновенной проверки.