Никогда никто не писал правил, чтобы отличить кошку от собаки. Никакой программист не садился и не печатал «если у него заостренные уши и усы». И тем не менее ваш телефон делает это…
English narration · English + 中文 subtitles burned in · Английское озвучивание · Английский + китайские субтитры (встроенные)
18.1
What AI is · Что такое ИИ
Syllabus · Программа
English
Candidates should be able to:
Notes and guidance
Show understanding of how graphs can be used to aid Artificial Intelligence (AI)
Purpose and structure of a graph Use A algorithm* and Dijkstra’s algorithm to perform searches on a graph Candidates will not be required to write algorithms to set up, access, or perform searches on graphs
Show understanding of how artificial neural networks have helped with machine learning
Show understanding of Deep Learning, Machine Learning and Reinforcement Learning and the reasons for using these methods.
Understand machine learning categories, including supervised learning, unsupervised learning
Show understanding of back propagation of errors and regression methods in machine learning
Русский
Кандидаты должны уметь:
Примечания и рекомендации
Показать понимание того, как графы могут использоваться для содействия Искусственному интеллекту (ИИ)
Назначение и структура графа Использовать алгоритм A* и алгоритм Дейкстры для выполнения поиска по графу Кандидатам не потребуется писать алгоритмы для создания, доступа или выполнения поиска по графам
Показать понимание того, как искусственные нейронные сети помогли в машинном обучении
Показать понимание глубокого обучения (Deep Learning), машинного обучения (Machine Learning) и обучения с подкреплением (Reinforcement Learning), а также причин применения этих методов.
Понимать категории машинного обучения, включая обучение с учителем (supervised learning), обучение без учителя (unsupervised learning)
Показать понимание обратного распространения ошибки и методов регрессии в машинном обучении
Source: Cambridge International syllabus · Источник: Программа Cambridge International
English
Artificial intelligence 人工智能 (AI) builds systems that do tasks normally needing human intelligence — recognising speech and images, translating, playing games, driving, generating text. Most modern AI uses machine learning 机器学习 — algorithms that learn patterns from data instead of being programmed step by step. Within it, deep learning 深度学习, using neural networks 神经网络 with many layers, has been dominant since the 2010s.
A humanoid robot 人形机器人 puts many of these abilities into one body: it uses AI to see faces, understand speech and move its face and arms in a lifelike way.
Русский
Искусственный интеллект (AI) создает системы, выполняющие задачи, обычно требующие человеческого интеллекта — распознавание речи и изображений, перевод, игры, вождение, генерация текста. Большинство современного ИИ использует машинное обучение — алгоритмы, которые учатся паттернам из данных, а не программируются шаг за шагом. Внутри него глубокое обучение, использующее нейронные сети со множеством слоев, является доминирующим с 2010-х годов.
Гуманоидный робот помещает многие из этих способностей в одно тело: он использует ИИ, чтобы видеть лица, понимать речь и двигать лицом и руками реалистичным образом.
Гуманоидный робот использует ИИ для восприятия, прослушивания и ответа, как человекГлубокое обучение является частью машинного обучения, которое является частью ИИ
Explore · Исследовать
AI learning type lab · Лаборатория типа обучения ИИ
Classify AI examples by the type of learning or concern involved. · Классифицируйте примеры ИИ по типу обучения или涉及的 concerns involved.
Many AI problems sit on a graph 图 — nodes 节点 (states, places) joined by edges 边 (moves, relationships).
pathfinding: roads form a graph; the shortest route is a graph search (Dijkstra's algorithm, the A* algorithm).
game playing: each board position is a node, each move an edge; minimax 极小化极大 with alpha-beta pruning searches the game tree.
state-space search: a planning problem is moving between states by applying operators to reach a goal.
knowledge representation: a semantic network 语义网络 has concepts as nodes and relationships as edges ("dog IS-A animal"); a knowledge graph 知识图谱 stores facts about the world for search engines and assistants.
Standard tools for navigating graphs include breadth-first search 广度优先搜索 and depth-first search 深度优先搜索.
"Describe the purpose and structure of a graph in an AI system."Purpose: to represent a problem as a set of states (or places) and the possible moves between them, so that an algorithm can search it for a solution, such as the shortest or cheapest route, or the best next move. Structure: a set of nodes (vertices), each representing a state, location or item, joined by edges representing the connections between them; each edge may carry a weight (a cost, distance or time), and edges may be directed (one-way) or undirected. "Explain the use of graphs to aid AI": the graph is the model on which the AI's search algorithms run: A* and Dijkstra's algorithm find optimal paths through it (navigation, routing), game positions form a tree searched for the best move, and knowledge stored as a graph lets a system reason about how facts are related.
The graph used below: the edge numbers are real distances; the red numbers are each node's heuristic 启发式 estimate of how far the goal still is, which only A uses*
Dijkstra's algorithm. It finds the shortest distance from the start to every node. Keep a table of the best distance found so far to each node (start 0, all others infinity). Repeatedly take the unvisited node with the smallest distance, mark it visited, and for each neighbour check whether going through this node gives a shorter distance; if so, update it and record where it came from. Stop when every node is visited (or the target is).
Worked example. Find the shortest distances from H to every other node in the graph above.
step
visit
H
A
B
C
D
G
start
0
∞
∞
∞
∞
∞
1
H (0)
0
4 (H)
3 (H)
∞
∞
∞
2
B (3)
0
4 (H)
3
∞
9 (B)
∞
3
A (4)
0
4
3
9 (A)
8 (A)
∞
4
D (8)
0
4
3
9 (A)
8
10 (D)
5
C (9)
0
4
3
9
8
10 (D)
6
G (10)
Shortest distances: A 4, B 3, D 8, C 9, G 10, and the path to G is H–A–D–G (read the "came from" labels backwards). At step 3, A offers D a distance of $4 + 4 = 8$, better than the 9 found through B, so D is updated; at step 5, C could reach G at $9 + 3 = 12$, worse than 10, so nothing changes. Showing these comparisons is the "working" the question asks for.
The A* algorithm. Dijkstra explores in every direction. A* adds a heuristic$h$, an estimate of the distance still to go, and always expands the node with the smallest $f = g + h$, where $g$ is the distance travelled so far. With a sensible heuristic (never over-estimating), it finds the same shortest path while looking at far fewer nodes, which is why satnavs and games use it. The exam gives $h$ for each node and a table to fill in.
Worked example. Find a path from H to G with A*, showing the working.
node expanded
$g$ so far
$h$
$f = g + h$
neighbours added (node: $g$, $h$, $f$)
H
0
7
7
A: 4, 5, 9; B: 3, 6, 9
B (tie with A; either)
3
6
9
D via B: 9, 2, 11
A
4
5
9
C: 9, 3, 12; D via A: 8, 2, 10 (better than 11, keep)
D
8
2
10
G: 10, 0, 10; C via D: 9 (no better)
G
10
0
10
goal reached
Path H–A–D–G, length 10, the same as Dijkstra's, but C was never expanded. Each time a node is reached by a second route, keep the smaller $g$; the search ends when the goal is the node with the smallest $f$. State the $g$, $h$ and $f$ values in every row: those are the marks.
Русский
Многие задачи ИИ расположены на графе — узлах (состояния, места), соединенных ребрами (ходы, отношения).
поиск пути: дороги образуют граф; кратчайший маршрут — поиск по графу (алгоритм Дейкстры, алгоритм A*).
игры: каждая позиция на доске — узел, каждый ход — ребро; минимакс с альфа-бета отсечением ищет дерево игры.
поиск в пространстве состояний: задача планирования — это перемещение между состояниями с применением операторов для достижения цели.
представление знаний: семантическая сеть имеет концепции в виде узлов и отношения в виде рёбер («собака IS-A животное»); граф знаний хранит факты о мире для поисковых систем и ассистентов.
Задачи ИИ часто моделируются на графах; здесь выделен кратчайший путь
Стандартные инструменты обхода графов включают поиск в ширину и поиск в глубину.
«Опишите назначение и структуру графа в системе ИИ».Назначение:представить задачу в виде множества состояний (или мест) и возможных ходов между ними, чтобы алгоритм мог выполнить поиск решения, например, кратчайшего или наименее дорогостоящего маршрута, или лучшего следующего хода. Структура: множество узлов (вершин), каждый из которых представляет состояние, локацию или объект, соединённых рёбрами, представляющими связи между ними; каждое ребро может иметь вес (стоимость, расстояние или время), а рёбра могут быть направленными (однонаправленными) или ненаправленными. «Объясните использование графов для содействия ИИ»: граф является моделью, на которой работают алгоритмы поиска ИИ: алгоритмы A* и Диjkстры находят оптимальные пути через него (навигация, маршрутизация), позиции игр образуют дерево, которое обходится для нахождения лучшего хода, а знания, представленные в виде графа, позволяют системе рассуждать о том, как связаны факты.
Граф, используемый ниже: числа на рёбрах — реальные расстояния; красные числа — эвристическая оценка каждого узла того, насколько ещё далеко до цели, которую использует только A
Алгоритм Диjkстры. Он находит кратчайшее расстояние от старта до каждого узла. Ведите таблицу наилучшего найденного на данный момент расстояния до каждого узла (старт 0, все остальные бесконечность). Повторяйте взятие непосещённого узла с наименьшим расстоянием, помечайте его посещённым, и для каждого соседа проверяйте, даёт ли прохождение через этот узел меньшее расстояние; если да, обновите его и запишите, откуда оно пришло. Останавливайтесь, когда все узлы посещены (или достигнута цель).
Разобранный пример. Найдите кратчайшие расстояния от H до каждого другого узла на графе выше.
шаг
посещение
H
A
B
C
D
G
старт
0
∞
∞
∞
∞
1
H (0)
0
4 (H)
3 (H)
∞
∞
∞
2
B (3)
0
4 (H)
3
∞
9 (B)
∞
3
A (4)
0
4
3
9 (A)
8 (A)
∞
4
D (8)
0
4
3
9 (A)
8
10 (D)
5
C (9)
0
4
3
9
8
10 (D)
6
G (10)
Кратчайшие расстояния: A 4, B 3, D 8, C 9, G 10, а путь до G — H–A–D–G (читайте метки «пришел из» в обратном порядке). На шаге 3 A предлагает D расстояние $4 + 4 = 8$, что лучше, чем 9, найденное через B, поэтому D обновляется; на шаге 5 C мог бы достичь G за $9 + 3 = 12$, что хуже, чем 10, поэтому ничего не меняется. Демонстрация этих сравнений — это «рабочий процесс», который требует вопрос.
Алгоритм A.* Диjkстра исследует во всех направлениях. A* добавляет эвристику$h$, оценку оставшегося расстояния, и всегда расширяет узел с наименьшим $f = g + h$, где $g$ — пройденное расстояние на данный момент. При разумной эвристике (никогда не переоценивающей), он находит тот же кратчайший путь, рассматривая гораздо меньше узлов, поэтому его используют навигаторы и игры. На экзамене дается $h$ для каждого узла и таблица для заполнения.
Разобранный пример. Найдите путь от H до G с помощью A*, показывая рабочий процесс.
расширенный узел
пока что $g$
$h$
$f = g + h$
добавлены соседи (узел: $g$, $h$, $f$)
H
0
7
7
A: 4, 5, 9; B: 3, 6, 9
B (ничья с A; любой)
3
6
9
D через B: 9, 2, 11
A
4
5
9
C: 9, 3, 12; D через A: 8, 2, 10 (лучше, чем 11, оставляем)
D
8
2
10
G: 10, 0, 10; C через D: 9 (не лучше)
G
10
0
10
цель достигнута
Путь H–A–D–G, длина 10, тот же, что и у Диjkстры, но C так и не был расширен. Каждый раз, когда узел достигается вторым путем, сохраняйте меньшее $g$; поиск заканчивается, когда цель является узлом с наименьшим $f$. Укажите значения $g$, $h$ и $f$ в каждой строке: это баллы.
Artificial neural networks (ANNs) · Искусственные нейронные сети (ИНС)
English
An ANN is inspired by the brain's neurons. An artificial neuron 人工神经元:
takes several input values, multiplies each by a weight 权重, and adds them up with a bias term 偏置项.
applies an activation function 激活函数 (a non-linear function such as ReLU) to the sum.
outputs the result, which feeds neurons further on.
Neurons sit in layers: an input layer, one or more hidden layers 隐藏层 (where useful internal patterns are learned), and an output layer. With many hidden layers it is a deep neural network 深度神经网络, and training it is deep learning.
ANNs let models learn complex patterns straight from raw data (pixels, audio, text) without hand-designed features — driving breakthroughs in image recognition 图像识别, speech recognition 语音识别, machine translation 机器翻译, and game playing. They do well with large amounts of data, noisy or very complex input, and patterns too hard to capture with explicit rules.
"Explain what is meant by an artificial neural network."A model of the brain's network of neurons, made of layers of connected nodes: an input layer, one or more hidden layers and an output layer. Each connection has a weight; each node sums its weighted inputs and passes the result through an activation function to the next layer. "Explain how ANNs enable machine learning" (three marks): the network is trained on many examples; for each example the output is compared with the expected result and the error is used to adjust the weights (back propagation) so that the error falls; after enough examples the weights encode the patterns in the data, and the network can then classify or predict for new data it has never seen. "State the reason for multiple hidden layers": each additional layer combines the features found by the layer before it into more complex, more abstract features, so the network can learn more complex relationships (edges, then shapes, then objects); that is what makes a network deep.
принимает несколько входных значений, умножает каждое на вес и суммирует их с членом смещения.
применяет функцию активации (нелинейную функцию, такую как ReLU) к сумме.
выдает результат, который питает последующие нейроны.
Один нейрон: каждый вход умножается на свой вес, суммируется со смещением, затем функция активации
Нейроны расположены слоями: входной слой, один или несколько скрытых слоев (где изучаются полезные внутренние паттерны) и выходной слой. При наличии многих скрытых слоев это глубокая нейронная сеть, а её обучение называется глубоким обучением.
Нейронная сеть со входным слоем, двумя скрытыми слоями и выходным слоем
ИНС позволяют моделям усваивать сложные паттерны непосредственно из сырых данных (пикселей, аудио, текста) без ручного проектирования признаков — обеспечивая прорывы в распознавании изображений, распознавании речи, машинном переводе и игре в игры. Они хорошо справляются с большими объемами данных, шумным или очень сложным входом и паттернами, которые слишком трудно захватить с помощью явных правил.
«Объясните, что понимается под искусственной нейронной сетью».Модель сети нейронов мозга, состоящая из слоёв соединённых узлов: входного слоя, одного или нескольких скрытых слоёв и выходного слоя. Каждое соединение имеет вес; каждый узел суммирует взвешенные входы и передаёт результат через функцию активации на следующий слой. «Объясните, как ИНС обеспечивают машинное обучение» (три балла): сеть обучается на большом количестве примеров; для каждого примера вывод сравнивается с ожидаемым результатом, и ошибка используется для корректировки весов (обратное распространение ошибки), чтобы уменьшить ошибку; после обработки достаточного количества примеров веса кодируют паттерны в данных, и сеть может классифицировать или предсказывать для новых данных, которые она ранее не видела. «Укажите причину наличия нескольких скрытых слоёв»: каждый дополнительный слой объединяет признаки, найденные предыдущим слоем, в более сложные, более абстрактные признаки, так что сеть может изучать более сложные зависимости (края, затем формы, затем объекты); именно это делает сеть глубокой.
Explore · Исследовать
Tap the parts of a neural network · Нажмите на части нейронной сети
Explore the layers. Data flows left to right: the input layer takes the features, the hidden layers learn patterns, and the output layer gives the answer — with every connection carrying a weight that training adjusts. · Изучите слои. Данные текут слева направо: входной слой принимает признаки, скрытые слои учатся паттернам, а выходной слой дает ответ — при этом каждое соединение имеет вес, который корректируется обучением.
Machine learning, deep learning, reinforcement learning · Машинное обучение, глубокое обучение, обучение с подкреплением
English
Machine learning
The umbrella term — any algorithm that learns from data. Three paradigms:
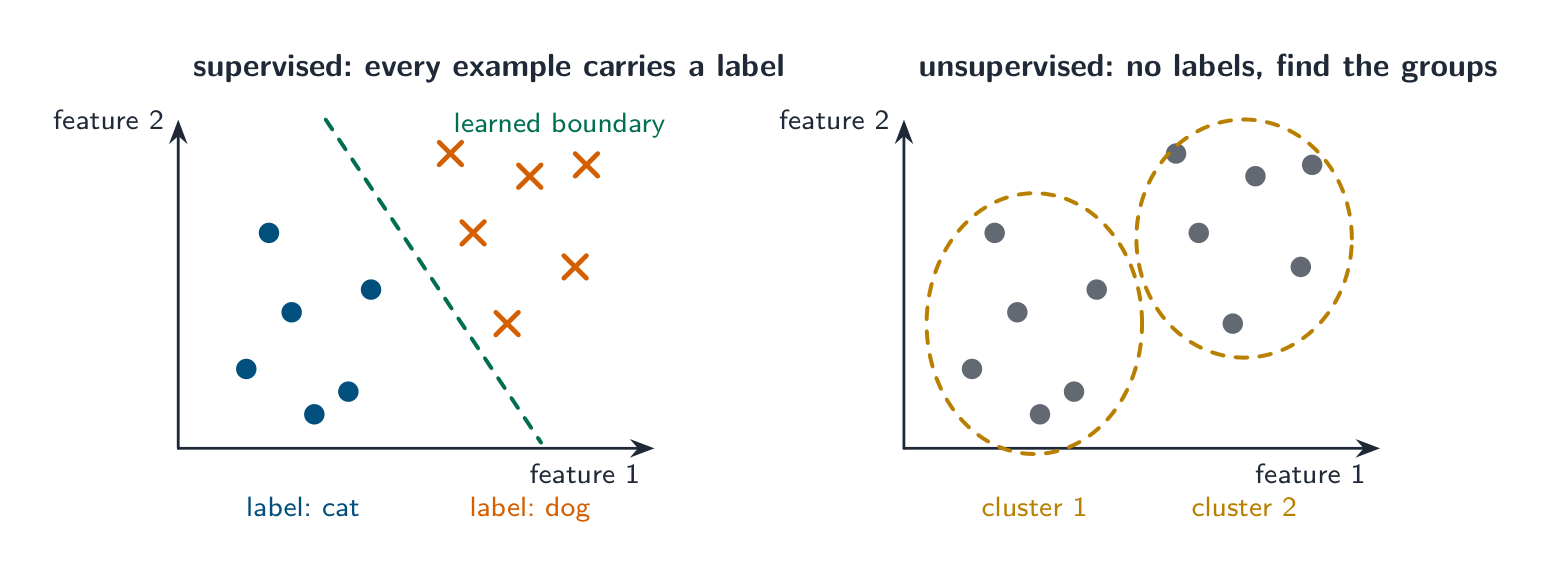
supervised learning 监督学习 — the data has labels 标签 (images tagged "cat"/"dog"); the algorithm learns input → label. Used for classification 分类 (a category) and regression.
unsupervised learning 无监督学习 — no labels; the algorithm finds structure, e.g. a cluster 聚类 of similar customers.
reinforcement learning (below).
Use ML when explicit rules would be impractical (spam filters, recommendations, fraud detection).
"Describe supervised learning and unsupervised learning" (the marked wordings).Supervised learning: the algorithm is trained on labelledtraining data 训练数据, each example paired with the correct output (the target); it learns the relationship between inputs and outputs and uses it to classify or predict for new inputs; the answers are known while training, so the error can be measured. Unsupervised learning: the data is unlabelled, with no correct answers given; the algorithm looks for patterns, structure or groupings in the data by itself (clustering similar items, finding associations); the output is a set of categories or relationships that were not defined in advance. How they differ: labelled against unlabelled data; known outputs against discovered structure; supervised is used to predict (classification, regression), unsupervised to explore (clustering, anomaly detection). Both are categories of machine learning; the third is reinforcement learning.
Deep learning
A subset of ML using deep neural networks. Lower layers learn simple patterns (edges, phonemes), higher layers combine them into abstract concepts. It needs lots of data and lots of compute (GPUs); for small datasets, simpler ML methods often do better.
"Explain what is meant by deep learning" (three marks).Machine learning that uses artificial neural networks with many hidden layers (deep networks); the network is trained on very large amounts of data, and each layer extracts features from the output of the layer below, so that the network learns the features it needs by itself rather than having them specified by the programmer.Reasons for using it: it can solve problems too complex for hand-written rules or shallow models (recognising faces, understanding speech, translating text); it improves as more data becomes available; it removes the need for human feature engineering; and it can handle unstructured data such as images, sound and text. How it is made more effective: more (and better-labelled) training data; more layers or nodes, within the limits of overfitting; more processing power (GPUs) and training time; tuning the learning rate and other parameters. Examples: speech recognition in voice assistants, image recognition in medical scans and self-driving cars, machine translation, recommendation systems.
Reinforcement learning
In reinforcement learning 强化学习, an agent 智能体 acts in an environment; each action changes the state and returns a reward 奖励. The agent learns a policy 策略 (a strategy) that maximises the total reward over time, by trial and error with no labels up front. Used for sequential-decision problems — games, robot control, autonomous driving.
"Explain what is meant by reinforcement learning" (three marks).An agent learns by interacting with its environment: it takes an action, the environment moves to a new state and returns a reward (or penalty), and the agent adjusts its behaviour so as to maximise the total reward over time. There is no labelled data: the agent learns by trial and error, discovering which actions are good from the rewards it collects, and gradually forms a policy that says what to do in each state. Used where the right answer is not known in advance but the result of an action can be scored: game playing (chess, Go), robot control, traffic-light timing, resource allocation. A computer playing a board game against a user learns in this way, or searches the game tree with minimax to choose the move whose worst outcome is best.
A self-driving car 自动驾驶汽车 is a real example. Lidar 激光雷达 and camera sensors (the spinning unit on the roof) build a live picture of the road, and a learned policy decides how to steer, speed up and brake safely.
Русский
Машинное обучение
Обобщающий термин — любой алгоритм, обучающийся на данных. Три парадигмы:
обучение с учителем — данные имеют метки (изображения помечены «кошка»/«собака»); алгоритм учится входу → метке. Используется для классификации (категории) и регрессии.
обучение без учителя — нет меток; алгоритм находит структуру, например, кластер похожих клиентов.
обучение с подкреплением (ниже).
Используйте ML, когда явные правила были бы непрактичными (фильтры спама, рекомендации, обнаружение мошенничества).
Те же данные, рассмотренные двумя способами: с метками задача — выучить, что разделяет классы; без меток задача — обнаружить, что группы вообще существуют
«Опишите обучение с учителем и обучение без учителя» (указанные формулировки). Обучение с учителем: алгоритм обучается на помеченныхобучающих данных, каждый пример сопоставлен с правильным выходом (целевым значением); он учит зависимости между входами и выходами и использует её для классификации или предсказания для новых входов; ответы известны во время обучения, поэтому ошибку можно измерить. Обучение без учителя: данные не помечены, правильные ответы не даны; алгоритм самостоятельно ищет паттерны, структуру или группировки в данных (кластеризация похожих элементов, поиск ассоциаций); результатом является набор категорий или связей, которые не были определены заранее. Как они отличаются: помеченные против непомеченных данных; известные выходы против открытой структуры; обучение с учителем используется для предсказания (классификация, регрессия), обучение без учителя — для исследования (кластеризация, обнаружение аномалий). Оба являются категориями машинного обучения; третья — обучение с подкреплением.
Обучение с учителем: модель обучается на помеченных данных, затем распознает новые данные
Глубокое обучение
Подмножество ML, использующее глубокие нейронные сети. Нижние слои учат простые паттерны (края, фонемы), верхние слои объединяют их в абстрактные концепции. Требует больших объёмов данных и большой вычислительной мощности (GPU); для малых наборов данных более простые методы ML часто работают лучше.
«Объясните, что понимается под глубоким обучением» (три балла). Машинное обучение, использующее искусственные нейронные сети с многими скрытыми слоями (глубокие сети); сеть обучается на очень больших объёмах данных, и каждый слой извлекает признаки из выхода нижнего слоя, так что сеть сама учит необходимые ей признаки, вместо того чтобы они задавались программистом.Причины использования: она может решать задачи, слишком сложные для ручных правил или поверхностных моделей (распознавание лиц, понимание речи, перевод текста); она улучшается по мере появления больше данных; устраняет необходимость человеческой разработки признаков; и может обрабатывать неструктурированные данные, такие как изображения, звук и текст. Как сделать её более эффективной: больше (и лучше помеченных) обучающих данных; больше слоёв или узлов в пределах переобучения; большая вычислительная мощность (GPU) и время обучения; настройка скорости обучения и других параметров. Примеры: распознавание речи в голосовых помощниках, распознавание изображений в медицинских снимках и беспилотных автомобилях, машинный перевод, системы рекомендаций.
Обучение с подкреплением
В обучении с подкреплениемагент действует в среде; каждое действие меняет состояние и возвращает вознаграждение. Агент учит политику (стратегию), максимизирующую общее вознаграждение со временем, методом проб и ошибок без предварительных меток. Используется для задач последовательного принятия решений — игр, управления роботами, автономного вождения.
«Объясните, что означает «обучение с подкреплением» (три балла).»** Агент обучается, взаимодействуя со своей средой: он выполняет действие, среда переходит в новое состояние и возвращает вознаграждение (или штраф), а агент корректирует своё поведение, чтобы максимизировать суммарное вознаграждение во времени. Для обучения не требуется размеченные данные: агент учится методом проб и ошибок, выявляя, какие действия эффективны на основе получаемых им вознаграждений, и постепенно формирует стратегию (политику), определяющую действия в каждом состоянии. Применяется там, где правильный ответ не известен заранее, но результат действия можно оценить: компьютерные игры (шахматы, го), управление роботами, регулировка работы светофоров, распределение ресурсов. Компьютер, играющий в настольную игру против пользователя, обучается таким образом или использует поиск по дереву игры с алгоритмом минимакс для выбора хода, обеспечивающего наилучший возможный исход в худшем случае.
Обучение с подкреплением: агент совершает действие, среда возвращает новое состояние и вознаграждение, а агент учится на этом
Настоящим примером является беспилотный автомобиль. Датчики Lidar и камеры (вращающийся модуль на крыше) создают живое изображение дороги, а обученная стратегия принимает решения о безопасном рулении, ускорении и торможении.
Беспилотный автомобиль использует камеры и датчики Lidar для наблюдения за дорогой вокруг себяПромышленные роботы-руки на конвейере: обучение с подкреплением может научить робота управлять своими движениями
Training an ANN: backpropagation · Обучение искусственной нейронной сети: обратное распространение ошибки
English
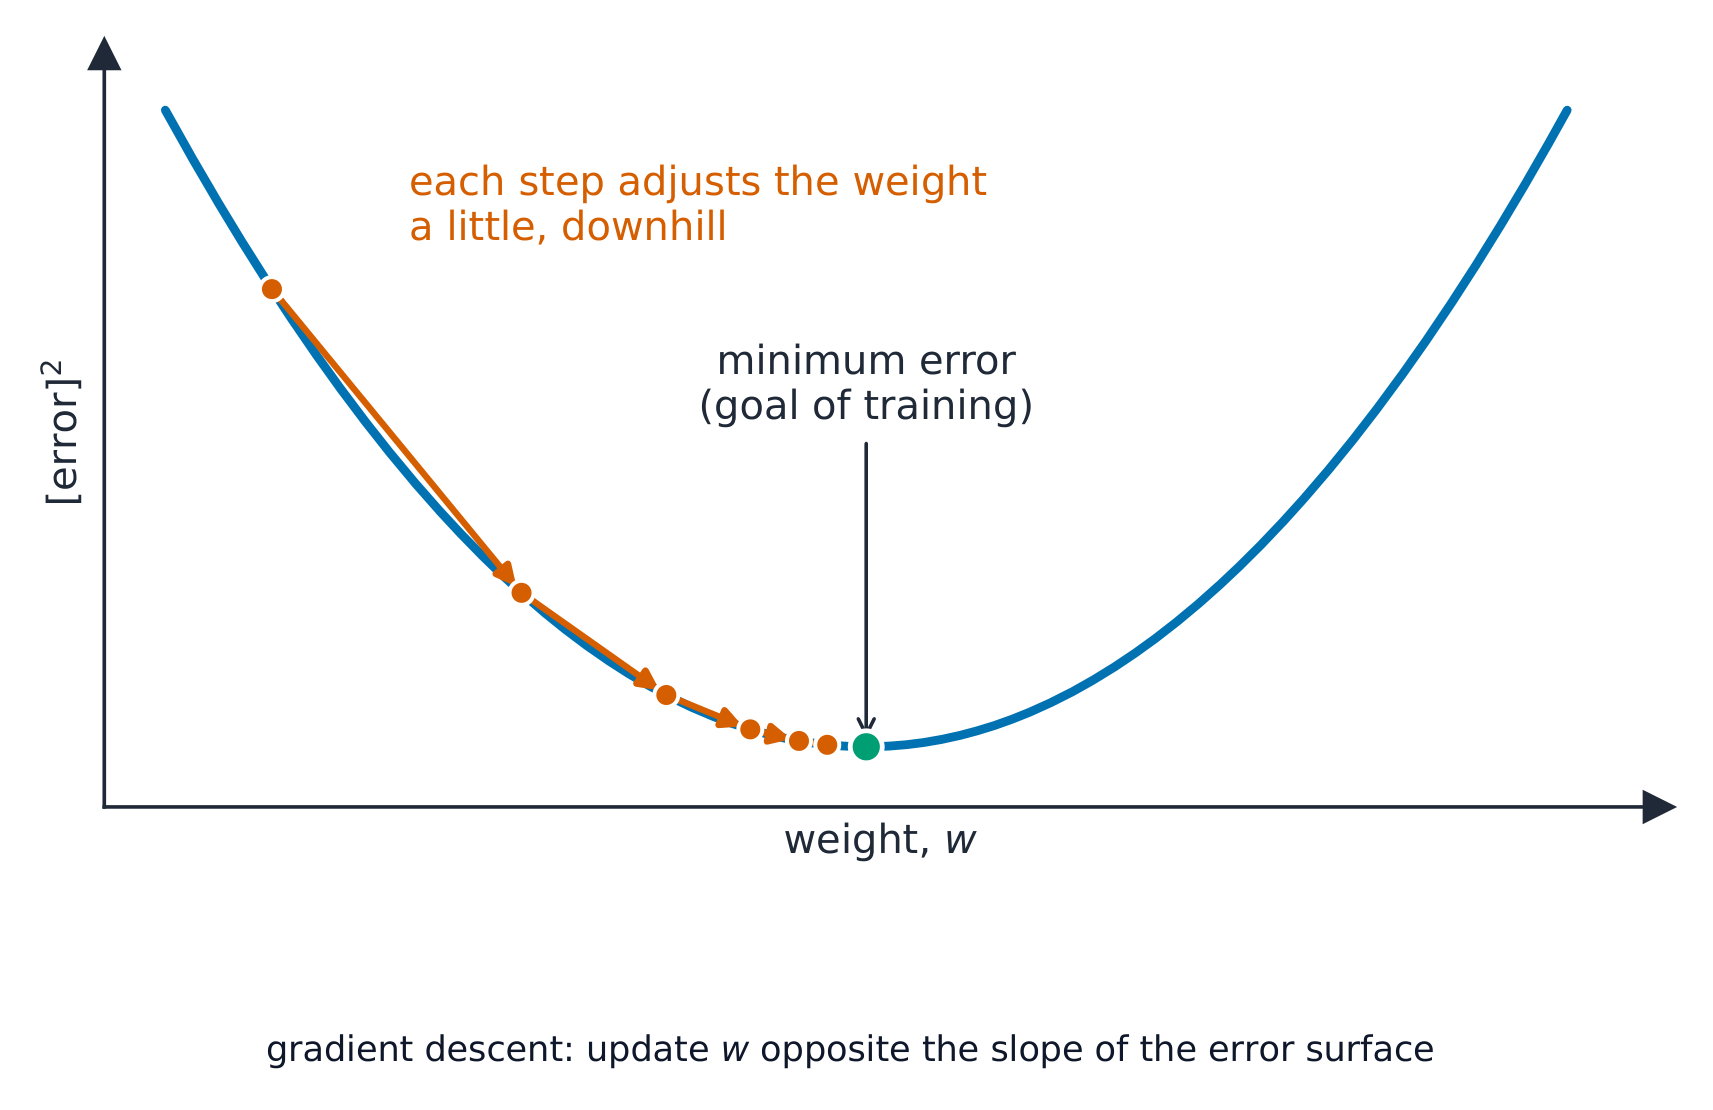
Training adjusts the weights so outputs match the targets. The standard method is backpropagation 反向传播 (back propagation of errors) with gradient descent 梯度下降. For each training example:
forward pass — feed the input through to the output.
compute the error with a loss function 损失函数 (a single number for how wrong the output is).
backward pass — propagate the error backwards, finding each weight's gradient (how much it contributed to the error) using the chain rule.
update the weights by a small step (set by the learning rate 学习率) that reduces the error.
Repeat over many examples and many passes (epochs 训练轮次) until the error stops shrinking. The name "back" comes from step 3: the error flows from the output back towards the input, so every weight's gradient is found in one sweep. After training, a new input needs only one forward pass to get a prediction.
"Describe the back propagation of errors method" (four marks). (1) An input is fed forward through the network and its output is compared with the expected (target) output; (2) the difference is the error; (3) the error is passed backwards through the network, layer by layer from the output to the input, and each weight's share of the error is calculated; (4) the weights are adjusted in proportion to their contribution, in the direction that reduces the error; (5) the process is repeated with many examples until the error is as small as required. The point of the method is that a network with hidden layers has no direct way of knowing which internal weight caused an output error; back propagation apportions the blame.
Русский
Обучение заключается в настройке весов так, чтобы выходы соответствовали целевым значениям. Стандартным методом является обратное распространение ошибки (backpropagation) с использованием спуска по градиенту. Для каждого примера из обучающей выборки:
прямой проход — подача входных данных через сеть к выходу.
вычисление ошибки с помощью функции потерь (одно число, отражающее степень отклонения выхода от цели).
обратный проход — распространение ошибки назад, вычисление градиента каждого веса (вклад которого в ошибку) с использованием правила дифференцирования сложной функции.
обновление весов на небольшой шаг (определяемый скоростью обучения), который уменьшает ошибку.
Процесс повторяется для множества примеров и множество проходов (эпох) до тех пор, пока ошибка перестанет уменьшаться. Название «обратное» происходит от шага 3: ошибка течет от выхода назад к входу, поэтому градиент каждого веса находится за один проход. После обучения для получения прогноза по новому входному данным требуется лишь один прямой проход.
«Опишите метод обратного распространения ошибки» (четыре балла).» (1) Входные данные подаются напрямую через сеть, и их выход сравнивается с ожидаемым (целевым) выходом; (2) разница является ошибкой; (3) ошибка проходит назад через сеть, слой за слоем от выхода к входу, и для каждого веса вычисляется его доля в ошибке; (4) веса корректируются пропорционально их вкладу, в направлении, которое уменьшает ошибку; (5) процесс повторяется с множеством примеров, пока ошибка не станет достаточно малой. Суть метода заключается в том, что сеть со скрытыми слоями не имеет прямого способа узнать, какой именно внутренний вес вызвал ошибку на выходе; обратное распространение распределяет ответственность.
Обучение корректирует веса для достижения минимальной ошибки
Choose the coefficients to minimise the sum of squared errors against the training data. Use it when the relationship looks roughly linear and you want an interpretable model. For curved data, use polynomial, decision-tree, or neural-network regression methods — same idea: define a model, define a loss, and adjust the parameters to minimise it. Regression and classification are both supervised; the choice depends on whether the answer is a number or a category.
"Describe regression methods in machine learning" (two marks).Statistical methods that find the relationship between input variables and a continuous output, by fitting a function (a line or curve) to the training data with the smallest total error; the fitted function is then used to predict the output for new inputs. Linear regression fits a straight line; other methods fit curves. Regression predicts a value (a price, a temperature, a time); classification predicts a category, which is the distinction the exam asks for.
Русский
Некоторые задачи предсказывают число (цену дома, температуру завтра) — это регрессия, в отличие от классификации (категории).
Линейная регрессия аппроксимирует прямую линию (или гиперплоскость):
Необходимо выбрать коэффициенты для минимизации суммы квадратов ошибок относительно обучающих данных. Применяйте этот метод, если зависимость выглядит примерно линейной и вам нужна интерпретируемая модель. Для криволинейных данных используйте полиномиальную, дерево решений или нейросетевые методы регрессии — та же идея: определить модель, задать функцию потерь и настроить параметры для её минимизации. И регрессия, и классификация относятся к обучению с учителем; выбор зависит от того, является ли ответ числом или категорией.
«Опишите методы регрессии в машинном обучении» (два балла).» Статистические методы, находящие связь между входными переменными и непрерывным выходом путем подбора функции (прямой или кривой) к обучающим данным с наименьшей суммой ошибок; затем подобранная функция используется для предсказания выхода для новых входных данных. Линейная регрессия подстраивает прямую линию; другие методы подстраивают кривые. Регрессия предсказывает значение (цену, температуру, время); классификация предсказывает категорию, что и является ключевым различием, ожидаемым на экзамене.
Линейная регрессия подбирает линию, которая делает общую сумму квадратов ошибок (пунктирные разрывы) как можно меньше
Explore · Исследовать
Fitting a regression line · Построение регрессионной линии
Drag the controls. Linear regression draws the straight line that makes the squared distances to the data points as small as possible — then it predicts a number for any new input. · Перетащите ползунки. Линейная регрессия строит прямую линию, которая делает квадраты расстояний до точек данных максимально малыми — затем она предсказывает число для любого нового входа.
optical character recognition/ˈɒptɪkl ˈkærɪktə ˌrekəɡˈnɪʃn/
оптическое распознавание символов
text-to-speech/tekst tə spiːtʃ/
синтез речи
18.1
How AI is used in a real scenario · Как ИИ применяется в реальной ситуации
English
Many exam scenarios use the same pattern — a deep-learning model trained on labelled data, often several combined into a pipeline:
customer identification at an automated shop: the system is trained on labelled face images; a camera captures a face; image recognition extracts a representation; it is matched against registered customers; the closest match identifies the person.
reading text from images: image recognition finds text regions; optical character recognition 光学字符识别 extracts the characters; machine translation converts them; text-to-speech 文本转语音 reads them aloud.
checkout item-detection: object-detection AI, trained on labelled product images, sees which items go into a basket and charges the account.
By the time a user interacts with the system, the model is fast — it only does forward-pass inference; the intelligence is in the patterns learned during training.
Model answers for the scenario questions.A car-park camera reads registration numbers: the camera captures an image; an AI trained on many labelled images of number plates locates the plate in the image; character recognition (a deep-learning classifier, again trained on labelled characters) converts the plate into text; the text is stored with the time and matched when the car leaves. A CCTV system detects and tracks a person: image-recognition software trained on labelled images of people identifies a person in each frame; the system compares successive frames to follow their movement; unusual movement can trigger an alert. Speech turned into commands: speech recognition trained on many recorded voices converts the sound into text; the system matches the text to a set of known commands; it improves as it is corrected. A camera that focuses on faces: a face-detection model trained on labelled faces finds the face region, and the lens is adjusted to bring that region into focus. A bank's face-recognition login: the app captures the face, a deep network extracts its features, and they are compared with the stored features for that customer. In every case the pattern is: trained on labelled examples, extracts features, matches or classifies new input.
Worked example. For each task, say whether it needs regression or classification, and what the output layer of an ANN would look like: (a) predict tomorrow's temperature; (b) decide whether an email is spam. Ask what kind of thing is being predicted. (a) A temperature is a number on a continuous scale, so this is regression, and the output layer is a single neuron holding that value. (b) Spam or not-spam is a category, so this is classification, and the output gives a probability per class. Both are supervised learning: each needs labelled examples to train on, and training adjusts the weights by backpropagation to reduce the error. The deciding question is simply number-or-category - not how difficult the task feels.
Русский
Многие экзаменационные сценарии используют одинаковую схему — глубокую модель, обученную на размеченных данных, часто несколько моделей, объединенных в конвейер обработки:
идентификация клиентов в автоматическом магазине: система обучена на размеченных изображениях лиц; камера фиксирует лицо; распознавание изображений извлекает его представление; оно сопоставляется с зарегистрированными клиентами; наиболее близкое совпадение идентифицирует человека.
чтение текста с изображений: распознавание изображений находит области с текстом; оптическое распознавание символов извлекает символы; машинный перевод преобразует их; синтез речи озвучивает их вслух.
проверка товаров при кассе: искусственный интеллект для обнаружения объектов, обученный на размеченных изображениях продуктов, определяет, какие товары кладутся в корзину, и списывает деньги со счета.
К моменту взаимодействия пользователя с системой модель работает быстро — она выполняет только прямой проход (инференс); вся «интеллектуальность» заложена в паттернах, изученных во время обучения.
Ответы на вопросы по сценариям.Камера парковки считывает номера автомобилей: камера фиксирует изображение; ИИ, обученный на множестве размеченных изображений номерных знаков, находит знак на снимке; распознавание символов (классификатор глубокого обучения, также обученный на размеченных символах) превращает номер в текст; текст сохраняется вместе со временем и сопоставляется при выезде автомобиля. Система видеонаблюдения обнаруживает и отслеживает человека: программное обеспечение для распознавания изображений, обученное на размеченных фото людей, идентифицирует человека на каждом кадре; система сравнивает последовательные кадры, чтобы проследить его движение; необычное поведение может вызвать тревогу. Голосовые команды: распознавание речи, обученное на множестве записанных голосов, преобразует звук в текст; система сопоставляет текст с набором известных команд; она улучшается по мере коррекций. Камера с автофокусом по лицам: модель обнаружения лиц, обученная на размеченных портретах, находит область лица, и объектив фокусируется на этой зоне. Вход в банк через распознавание лица: приложение захватывает лицо, нейросеть выделяет его признаки, которые затем сравниваются с сохраненными данными этого клиента. В каждом случае принцип один: обучение на размеченных примерах, извлечение признаков, сопоставление или классификация нового ввода.
Разобранный пример. Для каждой задачи определите, требуется ли регрессия или классификация, и как выглядит выходной слой нейросети: (a) предсказать температуру завтра; (b) определить, является ли письмо спамом. Задайте вопрос: что именно предсказывается? (a) Температура — это число на непрерывной шкале, значит, это регрессия, а выходной слой содержит один нейрон, хранящий это значение. (b) Спам или неспам — это категория, значит, это классификация, а выход показывает вероятность для каждого класса. Оба случая относятся к обучению с учителем: для каждого нужны размеченные примеры, а обучение корректирует весы методом обратного распространения ошибки для снижения погрешности. Решающий вопрос прост: число или категория — независимо от того, насколько сложной кажется задача.
18.1
Definitions the examiner accepts · Определения, принимаемые экзаменатором
English
A definition question is marked against fixed wording. Learn these exactly, and give one answer only.
Term
Definition
graph (in AI)
a set of nodes representing states or places, joined by edges representing connections, often weighted, that a search algorithm can explore
Dijkstra's algorithm
finds the shortest distance from a start node to every other node by always visiting the unvisited node with the smallest distance so far
A* algorithm
a shortest-path search that expands the node with the smallest total of distance so far plus a heuristic estimate of the distance to the goal
artificial neural network
a model of the brain's neurons: layers of nodes joined by weighted connections, trained by adjusting the weights
machine learning
algorithms that learn from data and improve with experience rather than following fixed rules
supervised learning
learning from labelled training data in which the correct output for each input is known
unsupervised learning
learning from unlabelled data by finding patterns, groupings or structure in it
reinforcement learning
an agent learns by trial and error, choosing actions in an environment to maximise the rewards it receives
deep learning
machine learning using neural networks with many hidden layers, trained on large amounts of data, each layer extracting features from the one below
back propagation of errors
comparing the network's output with the target, passing the error back through the layers and adjusting each weight to reduce it
regression
fitting a function to training data in order to predict a continuous output value from inputs
Русский
Вопросы на определение оцениваются по фиксированной формулировке. Выучите их точно и дайте только один ответ.
Термин
Определение
граф (в ИИ)
множество узлов, представляющих состояния или места, соединенных ребрами, обозначающими связи, часто взвешенными, которые алгоритм поиска может исследовать
алгоритм Дейкстры
находит кратчайшее расстояние от начального узла до всех остальных, всегда посещая непосещенный узел с наименьшим текущим расстоянием
алгоритм A*
поиск кратчайшего пути, расширяющий узел с наименьшей суммой текущего расстояния и эвристической оценки расстояния до цели
искусственная нейронная сеть
модель нейронов мозга: слои узлов, соединенных взвешенными связями, обучаемые путем корректировки весов
машинное обучение
алгоритмы, которые учатся на данных и совершенствуются с опытом, а не следуют жестким правилам
обучение с учителем
обучение на размеченных тренировочных данных, где правильный ответ для каждого входа известен
обучение без учителя
обучение на неразмеченных данных путем выявления в них паттернов, группировок или структуры
подкрепляющее обучение
агент учится методом проб и ошибок, выбирая действия в среде для максимизации получаемого вознаграждения
глубокое обучение
машинное обучение с использованием нейросетей с множеством скрытых слоев, обученных на больших объемах данных, где каждый слой извлекает признаки из нижележащего
обратное распространение ошибки
сравнение выхода сети с целевым значением, пропуск ошибки назад через слои и корректировка каждого веса для ее уменьшения
регрессия
подбор функции к тренировочным данным для предсказания непрерывного выходного значения по входным данным
18.1
Exam tips · Советы для экзамена
English
Graph answers name nodes, edges and weights, and what they represent; then the algorithm. Dijkstra: table of distances, visit the smallest, update neighbours. A*: $g$, $h$ and $f = g + h$ in every row, expand the smallest $f$.
ANN answers name the layers, the weighted connections and training; deep learning adds many hidden layers, large data and automatic feature extraction, with a reason and an example.
The three categories in one line each: labelled data and known outputs; unlabelled data and discovered structure; agent, environment, actions and rewards.
Back propagation: compare with the target, error backwards through the layers, adjust weights to reduce it, repeat. Regression predicts a value; classification predicts a category.
Scenario questions want the pipeline: trained on labelled examples, extracts features, recognises or classifies new input; name the type of AI (image recognition, speech recognition, deep learning).
Common mistakes
Describing a graph as "a chart"; in AI it is nodes and edges.
Running Dijkstra by picking the nearest neighbour of the current node rather than the smallest overall distance not yet visited; or forgetting to update a node when a shorter route appears.
Adding $h$ into $g$ for the next step in A*; $g$ is only the real distance, $h$ is recomputed from the table.
Saying deep learning is "learning a lot"; it is the many hidden layers.
Confusing unsupervised learning with reinforcement learning; the first finds structure in data, the second learns from rewards.
Describing back propagation without the comparison with the expected output or without saying the weights are adjusted.
Calling a prediction of a price "classification"; a continuous value is regression.
Русский
Ответы по графам называют узлы, ребра и веса, объясняют их значение, затем описывают алгоритм. Дейкстра: таблица расстояний, выбор наименьшего, обновление соседей. A*: $g$, $h$ и $f = g + h$ в каждой строке, расширение узла с наименьшим $f$.
Ответы по нейросетям называют слои, взвешенные связи и процесс обучения; глубокое обучение добавляет много скрытых слоев, большие данные и автоматическое извлечение признаков, требует обоснования и примера.
Три категории в одной строке каждая: размеченные данные и известные выходы; неразмеченные данные и выявленная структура; агент, среда, действия и вознаграждения.
Обратное распространение: сравнение с целевым значением, ошибка движется назад через слои, корректировка весов для снижения погрешности, повторение. Регрессия предсказывает значение; классификация предсказывает категорию.
Вопросы по сценариям требуют описания конвейера: обучение на размеченных примерах, извлечение признаков, распознавание или классификация нового ввода; указать тип ИИ (распознавание изображений, распознавание речи, глубокое обучение).
Распространенные ошибки
Описание графа как «диаграммы»; в ИИ это узлы и ребра.
Выполнение алгоритма Дейкстры путем выбора ближайшего соседа текущего узла вместо узла с наименьшим общим нерассмотренным расстоянием; или забвение об обновлении узла при появлении более короткого маршрута.
Добавление $h$ к $g$ для следующего шага в A*; $g$ — это только реальное расстояние, $h$ пересчитывается из таблицы.
Утверждение, что глубокое обучение — это «много учиться»; речь идет о множестве скрытых слоев.
Путаница между обучением без учителя и подкрепляющим обучением: первое выявляет структуру в данных, второе учится на основе вознаграждений.
Описание обратного распространения без сравнения с ожидаемым выходом или без указания того, что веса корректируются.
Называние предсказания цены «классификацией»; непрерывное значение — это регрессия.
Interactive lessons on this topic · Интерактивные уроки по этой теме
Work through it step by step, with instant-check exercises. · Пройдите его шаг за шагом с упражнениями мгновенной проверки.
Pick one and the site follows you — notes, papers, videos and practice all open on it. · Выберите один, и сайт будет вести вас — конспекты, работы, видео и практика откроются там.
Type to search notes, lessons, code, vocabulary and past-paper questions across every subject. · Введите запрос для поиска заметок, уроков, кода, словаря и вопросов с реальных экзаменов по всем предметам.