| Кандидаты должны уметь: | Примечания и рекомендации |
|---|---|
| Демонстрировать понимание необходимости пользовательских типов | |
| Определять и использовать некомpozитные типы данных | Включая перечислимый, указатель |
| Определять и использовать композитные типы данных | Включая множество, запись и класс/объект |
| Выбрать и спроектировать подходящий пользовательский тип данных для данной задачи |
Представление данных
A-Level Информатика · Тема 13
 15:16
Пользовательские типы данных
Обычное строковое поле без проблем хранит бессмыслицу. Запросите тип транспортного средства, и кто-то введет «Бананы» — программа примет это без малейшего возражения. Но если вы…
Английское озвучивание · Английский + китайские субтитры (встроенные)
13.1
Определяемые пользователем типы данных

Программа
Источник: Программа Cambridge International
Встроенные типы (INTEGER, REAL, STRING, CHAR, BOOLEAN) охватывают простейшие случаи. Для более сложных задач можно определить определяемые пользователем типы, делая код понятнее, а компилятор — строже.
Зачем они нужны
Встроенный STRING позволяет хранить бессмыслицу в поле, которое должно содержать одно из нескольких допустимых значений; определяемый тип может это ограничить. Реальные сущности обычно представляют собой набор значений разных типов. И DECLARE Taxi : Vehicle понятнее (самодокументируем) чем DECLARE Taxi : STRING.
"Опишите назначение определяемого пользователем типа данных (два балла).** Тип данных, определенный программистом, составленный из существующих (встроенных) типов, чтобы представлять специфичные для задачи данные, когда подходящий встроенный тип отсутствует. Обе половины оцениваются: определенный программистом и основанный на существующих типах. Экзаменатор также принимает «для упрощения чтения и поддержки программы» в качестве дополнительного пункта, но никогда как единственный ответ.
"Объясните, что понимается под некомпозитными и композитными типами данных" (четыре балла). Некомпозитный тип определяется без ссылки на другой тип: он хранит одно значение, например целое число, вещественное число или перечислимое значение. Композитный тип представляет собой совокупность других типов (которые сами могут быть композитными): он хранит несколько значений под одним идентификатором, например запись, множество, массив или класс. Приведите пример к каждому определению; в экзамене требуется привести один.
Некомпозитные типы
Перечислимый тип
Перечислимый тип имеет значения, которые представляют собой фиксированный список именованных констант:
TYPE Vehicle = (M100, M230, T101, T102, T120, T150)
DECLARE MyTaxi : Vehicle
MyTaxi ← T102
Имена являются значениями нового типа (хранятся внутри как небольшие целые числа); вы не можете присвоить ему значение вне этого списка. Применение: дни недели, цвета, коды статусов.
"Укажите, что понимается под перечисляемым типом данных." Несоставной пользовательский тип, определяемый перечислением всех его возможных значений (в порядке). Поскольку значения упорядочены, их можно сравнивать и перебирать: с TYPE Month = (January, February, ..., December) тест IF ThisMonth > June является корректным, а значения хранятся внутри как целые числа. Псевдокод состоит из трёх частей, за каждую из которых экзаменатор ставит балл: ключевое слово TYPE, идентификатор со = и список в скобках, разделённых запятыми.
Разобранный пример. Напишите псевдокод для определения перечислимого типа дней, когда школа работает (с понедельника по пятницу), и объявите переменную этого типа, установленную в среду.
TYPE SchoolDay = (Monday, Tuesday, Wednesday, Thursday, Friday)
DECLARE Today : SchoolDay
Today ← Wednesday
Переменной перечислимого типа нельзя присвоить значение вне списка, что и является сутью этого типа: Today ← Saturday вызовет ошибку компиляции, тогда как STRING принял бы "Saturdy".
Указательный тип
Указатель хранит адрес памяти другой переменной (или NULL для «отсутствия цели»). Указатели строят динамические структуры (связанные списки, деревья) и передают ссылки без копирования.
TYPE PNode = ^TNode    // pointer to a TNode
DECLARE p : PNode
p ← NEW TNode
p^.Value ← 42          // dereference to reach the fields
Чтобы разыменовать (p^) означает обратиться к переменной, на которую он указывает.
"Укажите, что понимается под указательным типом данных." Некомпозитный тип, значением которого является адрес памяти (ссылка) на переменную заданного типа. Псевдокод объявляет тип с знаком каретки перед типом, на который он указывает, и экзамен требует указать именно эту строку:
TYPE SelectParts = ^Parts        // a pointer to a value of type Parts
DECLARE Chosen : SelectParts
Chosen ← ^Keyboard               // Chosen now holds the address of Keyboard
OUTPUT Chosen^                   // dereference: the value stored at that address
Указатели — это то, из чего построены динамический связанный список или двоичное дерево (Тема 19): каждый узел содержит указатель на следующий. Здесь часто теряют два балла: запись типа указателя так, будто он хранит само значение, и забытая каретка при чтении через указатель.

p^ разыменовывает его для доступа к полям узлаКомпозитные типы
Композитный тип (один из комpozитных типов данных) группирует несколько значений под одним именем.


- запись (Тема 10) — поля разных типов в блоке
TYPE ... ENDTYPE. - множество — неупорядоченная коллекция уникальных значений с операциями добавления, удаления, проверки членства, объединения, пересечения:
DECLARE Available : SET OF Colour
Available ← {Red, Blue}
IF Green IN Available THEN
    ...
ENDIF
- класс / объект — композитный тип ООП, сочетающий поля данных (атрибуты) с операциями над ними (методами). Объект — это экземпляр класса:
CLASS Taxi
    PRIVATE Capacity : INTEGER
    PUBLIC FUNCTION GetCapacity() RETURNS INTEGER
        RETURN Capacity
    ENDFUNCTION
ENDCLASS
Выбор типа
Используйте перечислимый для значения из фиксированного списка, указатель для опосредованного доступа, запись для группы полей, множество для неупорядоченной уникальной коллекции и класс, когда вам нужны состояние и поведение вместе.
"Опишите пользовательский тип данных множество" (три балла). Композитный тип, который хранит коллекцию значений одного типа, в произвольном порядке и без дубликатов; значения можно добавлять и удалять, а также проверять наличие значения в множестве. Объявите тип с помощью SET OF, затем определите константу множества с его значениями в скобках:
TYPE EvenNumbers = SET OF INTEGER
DEFINE Evens (2, 4, 6, 8, 10, 12) : EvenNumbers
TYPE SymbolSet = SET OF CHAR
DEFINE Operators ('+', '-', '*', '/') : SymbolSet
"Опишите пользовательский тип данных запись" (три балла). Композитный тип, состоящий из фиксированного количества полей (элементов), каждое из которых имеет свой идентификатор и свой тип, доступ к которым осуществляется под единым идентификатором; поля обращаются с использованием точечной нотации.
Разобранный пример. Напишите псевдокод для объявления типа записи ClubMember для первого имени, фамилии, кода членства (целое число), даты вступления клуба и факта уплаты взносов члена клуба; затем объявите переменную и установите значения двух её полей.
TYPE ClubMember
    DECLARE FirstName : STRING
    DECLARE LastName : STRING
    DECLARE Code : INTEGER
    DECLARE DateJoined : DATE
    DECLARE FeesPaid : BOOLEAN
ENDTYPE

DECLARE NewMember : ClubMember
NewMember.LastName ← "Chen"
NewMember.FeesPaid ← TRUE
Для каждого поля требуется отдельная строка DECLARE с подходящим типом; блок завершается ENDTYPE, а доступ к полю осуществляется через variable.field. При выборе типа для каждого поля сопоставьте его с данными: код, который используется только для сравнения, является STRING, если он может содержать буквы, или INTEGER, если требуются арифметические операции или упорядочивание; ответ «да/нет» — это BOOLEAN; дата — это DATE. Поле, которое может принимать одно из нескольких названных значений (вид животного, цвет), следует сделать перечисляемым типом.

Записи в массивах и файлах. Таблица из множества записей — это DECLARE Members : ARRAY[1:100] OF ClubMember; тогда Members[3].LastName является одним полем одного элемента, а цикл по индексу обрабатывает каждую запись. Запись также является естественной единицей, записываемой в файл и читаемой из него (ниже), одна запись на PUTRECORD или WRITEFILE.
Разобранный пример. Составной тип Pet хранит имя животного (строка), вид (один из: собака, кошка, кролик или хомяк) и вес в килограммах (вещественное число). Определите типы и объявите переменную.
TYPE Species = (Dog, Cat, Rabbit, Hamster)
TYPE Pet
    DECLARE Name : STRING
    DECLARE Kind : Species
    DECLARE Weight : REAL
ENDTYPE
DECLARE MyPet : Pet
MyPet.Kind ← Rabbit
Перечисляемый тип определяется первым, так как запись использует его: порядок имеет значение в псевдокоде, как и в компиляторе.
Классы в псевдокоде. Класс — это составной тип, который также содержит поведение. На экзамене требуется объявление с отмеченными атрибутами PRIVATE, конструктор с именем NEW, который их устанавливает, и PUBLIC методов для получения или изменения этих значений:
CLASS Appointment
    PRIVATE PatientName : STRING
    PRIVATE Treatment : STRING
    PRIVATE Medication : STRING
    PUBLIC PROCEDURE NEW(Name : STRING, Treat : STRING, Med : STRING)
        PatientName ← Name
        Treatment ← Treat
        Medication ← Med
    ENDPROCEDURE
    PUBLIC FUNCTION GetTreatment() RETURNS STRING
        RETURN Treatment
    ENDFUNCTION
ENDCLASS

DECLARE Visit : Appointment
Visit ← NEW Appointment("A. Chen", "filling", "none")
OUTPUT Visit.GetTreatment()
Атрибуты являются приватными, чтобы их можно было изменять только через методы (инкапсуляция, Тема 20); конструктор — это процедура, вызываемая NEW с одним параметром для каждого атрибута; геттер — это функция, возвращающая значение атрибута. Каждый из этих элементов оценивается отдельно.
Исследовать
Лабораторная работа по программированию
Сопоставьте примеры с показанной ими программной идеей.
Словарь
Тренировать
| English | Русский |
|---|---|
| user-defined type/ˈjuːzə dɪˈfaɪnd taɪp/ | тип, определяемый пользователем |
| field/fiːld/ | поле |
| record/ˈrekɔːd/ | запись |
| set/set/ | множество |
| class/klæs/ | класс |
| composite type/ˈkɒmpəzɪt taɪp/ | составной тип |
| enumerated type/ɪˈnjuːməreɪtɪd taɪp/ | перечислимый тип |
| pointer/ˈpɔɪntə/ | указатель |
| linked list/lɪŋkt lɪst/ | связный список |
| dereference/ˌdiːˈrefrəns/ | разорвать ссылку |
| object/ˈɒbdʒekt/ | самого тела |
| attributes/ˈætrɪbjuːts/ | атрибуты |
| methods/ˈmeθədz/ | методы |
| constructor/kənˈstrʌktə/ | конструктор |
| File organisation/faɪl ˌɔːɡənaɪˈzeɪʃn/ | Организация файлов |
13.2
Организация файлов и доступ к ним

Программа
| Кандидаты должны уметь: | Примечания и рекомендации |
|---|---|
| Проявить понимание методов организации файлов и выбрать подходящий метод организации файлов и доступ к файлам для данной задачи | Включая последовательная (линейная), пошаговая (используя ключевое поле), случайная (используя ключ записи) |
| Проявить понимание методов доступа к файлам | Включая пошаговый доступ для последовательных (линейных) и пошаговых файлов Прямой доступ для пошаговых и случайных файлов |
| Проявить понимание хэш-алгоритмов | Описывать и использовать различные хэш-алгоритмы для чтения и записи данных в случайный/пошаговый файл |
Источник: Программа Cambridge International
Организация файла — это способ расположения данных; доступ к файлу — это то, как программа обращается к записи.
- последовательный файл — записи в порядке добавления, без сортировки. Доступ возможен только последовательно; добавление в конец выполняется быстро; поиск медленный. Используется для журналов и аудиторских трасовок.
- упорядоченный файл — записи отсортированы по ключу. Поиск быстрее (можно прерваться заранее или использовать бинарный поиск); вставка медленная (записи должны сдвигаться). Используется для мастер-файлов, обновляемых пакетно.
- случайный файл (файл прямого доступа) — записи расположены в позициях, вычисленных из ключа (часто с помощью хеш-функции). Прямой доступ по ключу очень быстрый; чтение в порядке ключей сложнее. Используется для больших таблиц поиска и счетов клиентов.


Два метода доступа — это последовательный доступ (чтение от начала до конца) и прямой доступ (переход непосредственно к известной позиции). Сопоставьте структуру с доминирующей операцией: одиночный поиск по ключу благоприятствует случайному доступу; отчеты в порядке следования благоприятствуют последовательному доступу.
Описание каждой организации (формулировки, приносящие баллы). Последовательный: записи хранятся одна за другой в порядке их добавления, без упорядочивания по ключу. Упорядоченный: записи хранятся в порядке поля ключа (отсортированы). Случайный: каждая запись хранится по адресу, вычисленному из её ключа с помощью алгоритма хеширования, поэтому записи не имеют никакого порядка. Сравнение последовательного и упорядоченного: оба типа хранят записи одна за другой и оба читаются последовательно, но в упорядоченном файле поиск может остановиться сразу, как только будет прочитан ключ, больший целевого, а новую запись необходимо вставить на правильное место (обычно путем перезаписи файла), в то время как последовательный файл просто дополняется в конце.
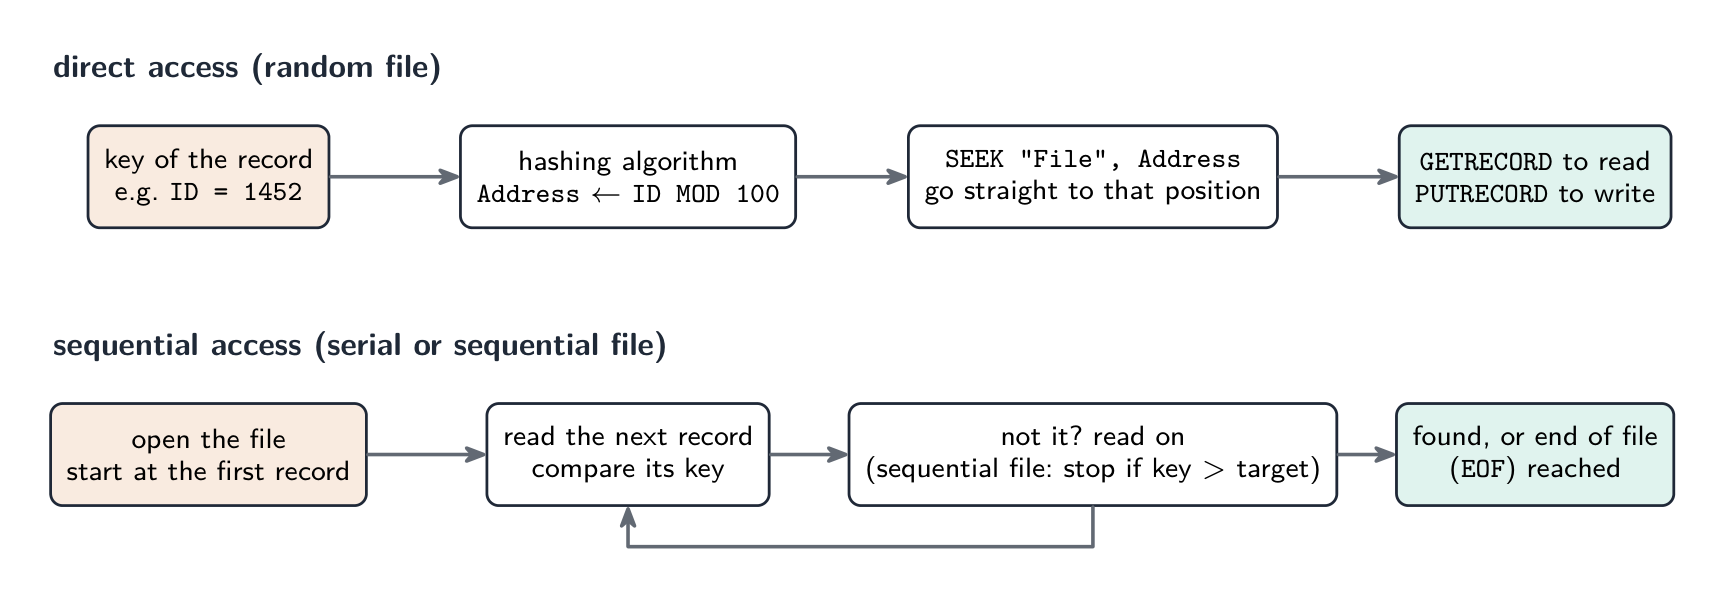
Описание каждого метода доступа. Последовательный доступ: начните с начала файла и читайте записи одна за другой (в порядке хранения), пока нужная запись не будет найдена или не будет достигнут конец файла. Применяя к последовательному файлу, это означает чтение каждой записи до совпадения, а также чтение всего файла для подтверждения отсутствия записи; применяя к упорядоченному файлу, поиск может прерваться досрочно, сразу после чтения ключа, большего целевого. Прямой доступ: адрес записи вычисляется из её ключа (с помощью алгоритма хеширования или по индексу), и программа переходит прямо на эту позицию, минуя чтение предшествующих ей записей; это метод доступа для случайных файлов, а также для записи, на которую ссылается уникальный адрес на диске.
Выбор. Мастер-файл заработной платы или счетов за коммунальные услуги, обрабатываемый пакетно, по одной записи за раз, подходит для упорядоченного файла; журнал транзакций в порядке их возникновения подходит для последовательного файла; файл товаров или клиентов, где отдельные записи ищутся и обновляются по ключу во время работы программы, подходит для случайного файла с прямым доступом.
Обработка файлов в псевдокоде. На экзамене ожидаются стандартные операторы, а в Билете 3 задаются алгоритмы, использующие их:
| Задача | Операторы |
|---|---|
| открыть текстовый файл | OPENFILE "Scores.txt" FOR READ (или FOR WRITE, который создаёт или перезаписывает, или FOR APPEND) |
| прочитать или записать строку | READFILE "Scores.txt", Line и WRITEFILE "Scores.txt", Line |
| проверить конец файла | WHILE NOT EOF("Scores.txt") |
| закрыть | CLOSEFILE "Scores.txt" |
| открыть случайный файл | OPENFILE "Stock.dat" FOR RANDOM |
| перейти к позиции записи | SEEK "Stock.dat", Address |
| прочитать или записать целую запись | GETRECORD "Stock.dat", Item и PUTRECORD "Stock.dat", Item |
Разобранный пример. Случайный файл Stock.dat хранит записи типа StockItem, расположенные по адресу, заданному ItemID MOD 100. Напишите псевдокод, который сохраняет новый элемент по его хешированному адресу, если эта позиция пуста, и сообщает о позиции, если она уже занята.
DECLARE Item, Existing : StockItem
DECLARE Address : INTEGER
INPUT Item.ItemID, Item.Description, Item.Quantity
Address ← Item.ItemID MOD 100
OPENFILE "Stock.dat" FOR RANDOM
SEEK "Stock.dat", Address
GETRECORD "Stock.dat", Existing
IF Existing.ItemID = 0 THEN
    // 0 marks an empty position
ENDIF
    SEEK "Stock.dat", Address
    PUTRECORD "Stock.dat", Item
    OUTPUT "Stored at ", Address
ELSE
    OUTPUT "Position ", Address, " is in use"
ENDIF
CLOSEFILE "Stock.dat"
Два момента, которые проверяет схема ответов: SEEK до каждого GETRECORD или PUTRECORD (чтение перемещает позицию, поэтому нужно искать снова перед записью), а также файл открыт FOR RANDOM и закрыт в конце. Для копирования всех записей случайного файла в другой необходимо пройтись циклом по адресам с помощью SEEK, GETRECORD из одного файла и PUTRECORD в другой, пропуская пустые позиции.
Исследовать
Маршрут доступа к файлу
Безопасно следите за файлом от хранилища до программы и обратно.
Словарь
Тренировать
| English | Русский |
|---|---|
| serial file/ˈsɪərɪəl faɪl/ | серийный файл |
| sequential file/siːˈkwenʃl faɪl/ | последовательный файл |
| random file/ˈrændəm faɪl/ | случайный файл |
| direct access/daɪˈrekt ˈækses/ | произвольный доступ |
| hash function/hæʃ ˈfʌŋkʃn/ | хэш-функция |
| sequential access/siːˈkwenʃl ˈækses/ | последовательный доступ |
| deterministic/dɪˌtɜːmɪˈnɪstɪk/ | детерминистическое |
| collision/kəˈlɪʒn/ | коллизия |
| linear probing/ˈlɪnɪə ˈprəʊbɪŋ/ | линейная пробирка |
| chaining/ˈtʃeɪnɪŋ/ | цепочка |
| load factor/ləʊd ˈfæktə/ | коэффициент загрузки |
| overflow area/ˌəʊvəˈfləʊ ˈeərɪə/ | область переполнения |
| overflow/ˌəʊvəˈfləʊ/ | переполнение |
13.2
Хэширование

Хэш-функция (или алгоритм хэширования) принимает ключ записи и вычисляет адрес, на котором эта запись будет храниться. Хорошая функция работает быстро, является детерминированной и равномерно распределяет ключи.
Распространенные алгоритмы хэширования для $N$ слотов: модульное хэширование address ← key MOD N; сворачивание (разделить ключ, сложить части, взятие остатка от деления на N); хэширование строки (сумма кодов символов, взятие остатка от деления на N).
Коллизия — это ситуация, когда два разных ключа хэшируются в один и тот же адрес. Существует три способа разрешения коллизий:
| Стратегия | Принцип работы | Компромисс |
|---|---|---|
| линейный поиск | используется следующий свободный слот (с возвратом к началу) | просто, но ключи группируются |
| цепочка | каждый слот указывает на связанный список записей | нет группировки, но требуется больше памяти |
| повторное хэширование | применяется вторая хэш-функция | равномерно распределяет ключи, но требует больше вычислений |
Для поиска: вычислите хэш ключа, прочитайте этот слот; если ключи совпадают, задача выполнена, иначе следуйте стратегии разрешения до совпадения ключа или нахождения пустого слота. Для вставки: вычислите хэш ключа, запишите его в этот слот или следующий свободный. Поддерживайте коэффициент заполнения (записи ÷ слоты) ниже примерно 70% для обеспечения скорости поиска почти O(1).
"Объясните, что понимается под алгоритмом хэширования в контексте доступа к файлам" (три балла). Вычисление (функция), выполняемое над полем ключа записи, которое дает значение, используемое в качестве адреса (местоположения), где запись хранится в файле и откуда она извлекается. То же самое вычисление для одного и того же ключа всегда дает одинаковый адрес, благодаря чему запись можно найти повторно без поиска.
"Опишите два метода преодоления коллизии." (1) Линейный поиск (прямое адресование): запись хранится в следующей свободной позиции после вычисленного адреса, с возвратом к началу при необходимости; для извлечения начинается с хэшированного адреса и чтение продолжается вперед до совпадения ключа. (2) Зона переполнения или цепочка: коллирующая запись хранится в отдельной зоне переполнения (или в связанном списке, прикрепленном к адресу), которая просматривается последовательно после неудачи совпадения основного адреса. Любое из этих решений засчитывается; также необходимо описать процесс извлечения, а не только хранения.
Пример решения. Случайный файл имеет 11 позиций для записей, пронумерованных от 0 до 10, а алгоритм хэширования — Address ← Key MOD 11. Записи с ключами 1250, 1381, 1452, 1613 и 1470 хранятся в указанном порядке с использованием линейного поиска. Укажите, куда попадает каждая запись, и опишите процесс извлечения ключа 1470.
$1250 \bmod 11 = 7$; $1381 \bmod 11 = 6$; $1452 \bmod 11 = 0$; $1613 \bmod 11 = 7$, коллизия с 1250, поэтому 1613 занимает следующую свободную позицию, 8; $1470 \bmod 11 = 7$ снова, и позиции 7 и 8 заняты, поэтому 1470 идет в 9. Для извлечения 1470: вычислить $7$, прочитать позицию 7 (ключ 1250, нет совпадения), прочитать 8 (1613, нет), прочитать 9 (1470, найдено). Если перед совпадением достигнута пустая позиция, записи нет в файле. Коллизии — это плата за небольшой размер файла: хороший алгоритм хэширования равномерно распределяет ключи, а файл остается значительно заполненным не полностью, чтобы длина поиска оставалась короткой.
Исследовать
Хэш-таблица
Наблюдайте, как каждый ключ хэшируется в корзину. Хороший хэш распределяет ключи, чтобы поиск оставался быстрым.
13.3
Числа с плавающей точкой

Программа
| Кандидаты должны уметь: | Примечания и рекомендации |
|---|---|
| Описать формат бинарных чисел с плавающей точкой | Использовать форму двоичного дополнения Понимать эффекты изменения распределения битов между мантиссой и экспонентой в представлении числа с плавающей точкой |
| Преобразовывать бинарные числа с плавающей точкой в десятичные и обратно | |
| Нормализовать числа с плавающей точкой | Понимать причины нормализации |
| Проявить понимание последствий того, что бинарное представление является лишь приближением к действительному числу, которое оно представляет (в некоторых случаях) | Понимать, как могут возникать переполнение и перенос вниз (underflow) |
| Демонстрировать понимание того, что бинарные представления могут вызывать ошибки округления |
Источник: Программа Cambridge International
Для хранения действительных чисел очень разного масштаба компьютеры используют формат с плавающей точкой — двоичную форму научной нотации, состоящую из двух полей:
- мантисса — значащие цифры.
- экспонента — степень 2, на которую нужно умножать.
Оба значения хранятся как целые числа в дополнительном коде. Значение равно
$$\text{number} = \text{mantissa} × 2^{\text{exponent}}.$$
Читайте мантиссу как двоичную дробь — первый бит после запятой равен $1/2$, следующий $1/4$, затем $1/8$ и так далее. Таким образом, 0.1010000 равно $1/2 + 1/8 = 0.625$; с экспонентой 00000010 (= 2) значение составляет $0.625 \times 2^{2} = 2.5$.
Преобразование
- двоичная → десятичная: прочитайте мантиссу (используйте правила дополнительного кода, если число отрицательное) как дробь, прочитайте экспоненту как знаковое целое число, затем умножьте мантиссу на $2^{\text{exponent}}$.
- десятичная → двоичная: запишите число как двоичную дробь × степень 2, затем сохраните мантиссу и экспоненту в согласованных форматах.
Пример решения. Число имеет мантиссу 10110000 и экспоненту 00000011. Найдите его десятичное значение.
Экспонента 00000011 равна $+3$. Мантисса начинается с 1, значит она отрицательная. Прочитана как 1.0110000 в дополнительном коде, знаковый бит равен $-1$, а дробные биты дают в сумме $\tfrac{1}{4} + \tfrac{1}{8} = 0.375$, поэтому мантисса равна $-1 + 0.375 = -0.625$. Затем
$$\text{number} = -0.625 \times 2^{3} = -5.0.$$
Пример решения. Запишите $+2.5$ в этом формате.
В двоичной системе это $2.5 = 10.1$. Записанное как нормализованная дробь, это $2.5 = 0.101 \times 2^{2}$. Следовательно, мантисса равна 01010000 (знаковый бит 0, затем .101), а экспонента равна 00000010 ($= 2$).
Формат экзамена: дополнительный код, мантисса и экспонента
Экзамен указывает формат, например: 10 бит для мантиссы и 6 бит для экспоненты, оба в дополнении до двух. Битовая точка мантиссы находится после её первого (знакового) бита, поэтому положительная мантисса — это 0.xxxxxxxxx, а отрицательная — 1.xxxxxxxxx; экспонента представляет собой обычный знаковый целочисленный тип. Каждое преобразование выполняется по трём одинаковым шагам: прочитайте мантиссу как дробь (по правилам дополнения до двух, если она начинается с 1), прочитайте экспоненту как целое число, умножьте на $2^{\text{exponent}}$.
Разобранный пример (двоичная → десятичная). Мантисса 0101100000, экспонента 000011.
Мантисса: $0.101100000_2 = \tfrac{1}{2} + \tfrac{1}{8} + \tfrac{1}{16} = 0.6875$. Экспонента: $000011_2 = 3$. Значение: $0.6875 \times 2^{3} = 5.5$.
Разобранный пример (отрицательная мантисса). Мантисса 1011000000, экспонента 000010.
Мантисса начинается с 1, значит она отрицательная. Её значение равно $-1 + 0.011000000_2 = -1 + (\tfrac{1}{4} + \tfrac{1}{8}) = -0.625$; экспонента $= 2$; результат $-0.625 \times 4 = -2.5$. (Альтернативно: возьмите дополнение до двух от мантиссы, 0101000000 $= 0.625$, и добавьте знак минус.) Отрицательная экспонента, например 111110 $= -2$, означает деление: мантисса $0.5$ с такой экспонентой дает $0.5 \times 2^{-2} = 0.125$.
Разобранный пример (десятичная → двоичная). Запишите $+6.5$ и $-6.5$ в 10-битный и 6-битный форматы, нормализовав их.
$6.5 = 110.1_2 = 0.1101_2 \times 2^{3}$, поэтому мантисса равна 0110100000, а экспонента 000011. Для $-6.5$ возьмите дополнение до двух от мантиссы: 1001100000 (проверка: $-1 + 0.0011_2 = -1 + 0.1875 = -0.8125$, и $-0.8125 \times 8 = -6.5$), экспонента 000011 остается без изменений. Знак никогда не переносится в экспоненту; отрицательное число имеет отрицательную мантиссу.
Нормализация
Число является нормализованным, когда первая значащая единица находится сразу после двоичной точки (нет пустых ведущих нулей). Это максимизирует точность, так как каждый бит мантиссы несет информацию. Чтобы нормализовать число, сдвиньте мантиссу влево и уменьшите экспоненту (или сдвиньте вправо и увеличьте её) до тех пор, пока первая значащая единица не займет правильное положение; при этом значение остается неизменным. Для отрицательных мантисс (дополнение до двух) за знаком (1) сразу следует 0.
Распознавание и получение нормализованной формы. Положительная нормализованная мантисса начинается с 01; отрицательная — с 10. Следовательно, 0011000000 не является нормализованным (сдвиньте влево на одну позицию и вычтите единицу из экспоненты: 0110000000, экспонента уменьшается на один), и 1100000000 также не является таковым (сдвигайте влево, пока паттерн не станет 10...). Каждый сдвиг мантиссы влево должен сопровождаться вычитанием единицы из экспоненты, иначе изменится значение.
«Объясните, почему числа хранятся в нормализованной форме» (два балла). (1) Это обеспечивает максимальную точность (точность) для заданного количества доступных битов, так как ни один бит не тратится впустую на ведущие нули (или ведущие единицы для отрицательного числа); (2) каждое число имеет уникальное представление, что позволяет сравнивать числа; и (3) это обеспечивает оптимальное использование доступного диапазона. Любые два из этих пунктов дают баллы.

Приближение и ошибки округления
Многие десятичные вещественные числа невозможно сохранить точно в двоичном виде — например, $0.1_{10}$ — это повторяющаяся двоичная дробь $0.000110011\ldots_{2}$, которую необходимо обрезать. Последствия:
- ошибки округления накапливаются при выполнении многих операций (
0.1 + 0.2не равно точно0.3). - сравнения не работают — никогда не проверяйте вещественное число на равенство. Проверяйте, что разница меньше небольшого порога,
IF Difference < 0.000001, где разность берется в правильном порядке или через функцию модуля, которая была бы определена в задании.ABSотсутствует во вкладыше 9618 и в Справочнике псевдокода, поэтому не предполагайте его наличие: справочник гласит, что любая необходимая функция будет предоставлена заданием. - вычитание двух почти равных значений приводит к потере точности.
- переполнение (результат слишком велик для диапазона экспоненты) и переполнение вниз (результат слишком мал, округляется до нуля) возникают, когда экспонента выходит за пределы допустимого диапазона.
Для задач, требующих точности (валюта), используйте фиксированную запятую или BCD вместо чисел с плавающей точкой.
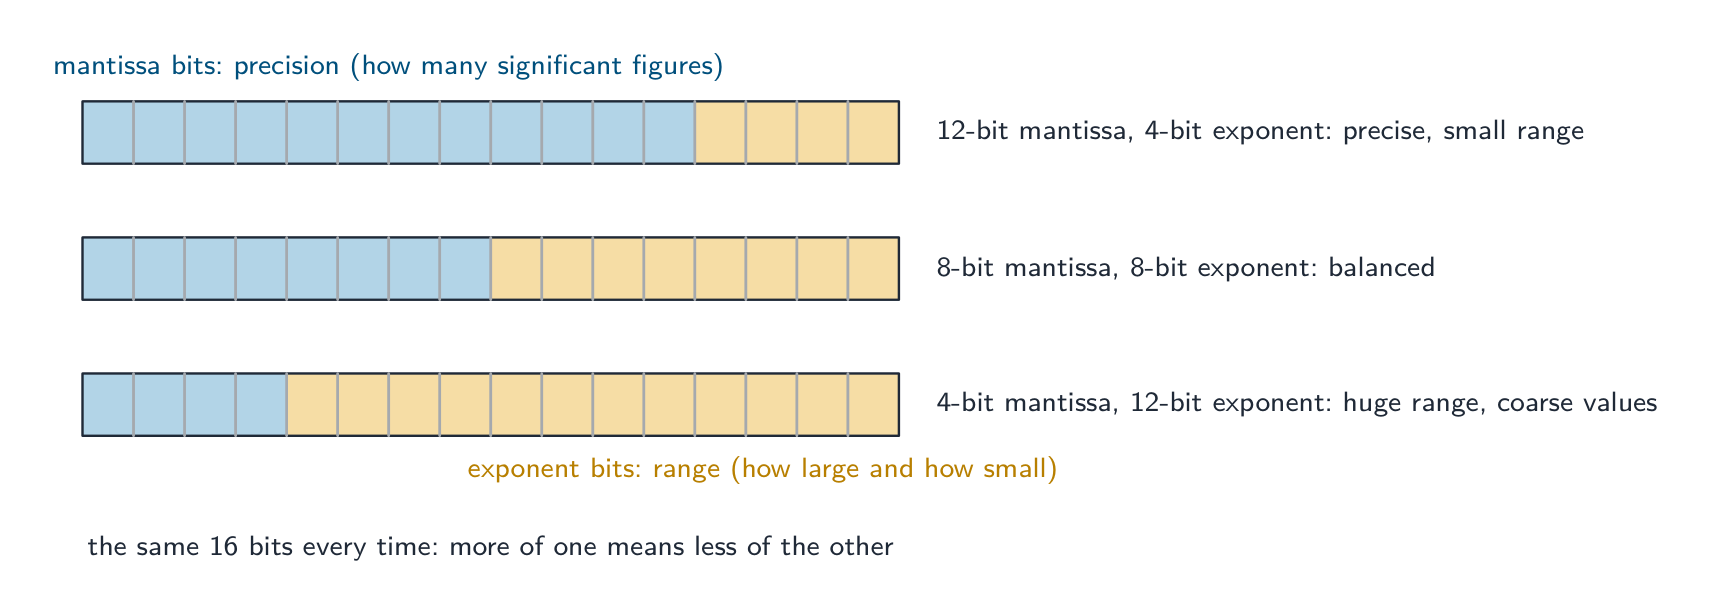
«Опишите эффект изменения распределения битов» (три балла). При фиксированном общем количестве битов увеличение мантиссы и уменьшение экспоненты дают большую точность (больше значащих цифр, меньшие ошибки округления), но меньший диапазон (наибольшее и наименьшее по модулю сохраняемые значения сокращаются); увеличение экспоненты делает наоборот: больший диапазон ценой точности. Назовите оба эффекта и оба направления.
Наибольшее и наименьшее. В формате с 10-битной мантиссой и 6-битной экспонентой наибольшее положительное число имеет мантиссу 0111111111 ($= 1 - 2^{-9}$) и экспоненту 011111 ($= 31$): примерно $2^{31}$. Наименьшее положительное нормализованное число имеет мантиссу 0100000000 ($= 0.5$) и экспоненту 100000 ($= -32$): $0.5 \times 2^{-32} = 2^{-33}$. Наибольшее по модулю отрицательное число имеет мантиссу 1000000000 ($= -1$) и экспоненту $31$: $-2^{31}$.
«Объясните, что подразумевается под переполнением и переполнением вниз». Переполнение возникает, когда результат вычисления превышает максимальное число, которое можно представить, поэтому экспоненте потребовалось бы больше битов, чем у неё есть; переполнение вниз возникает, когда результат меньше минимального (ненулевого) числа, которое можно представить, слишком близко к нулю, чтобы экспонента могла его выразить, поэтому оно сохраняется как ноль. Оба явления обусловлены диапазоном экспоненты, а не мантиссы.
Почему двоичное представление является лишь приближением. Двоичная дробь может точно представлять только суммы степеней числа $\tfrac{1}{2}, \tfrac{1}{4}, \tfrac{1}{8}, \ldots$; такие значения, как $0.1$ или $\tfrac{1}{3}$, имеют бесконечное двоичное разложение, а мантисса имеет фиксированное количество бит, поэтому хранящееся значение является ближайшим подходящим. Разница представляет собой ошибку округления; она мала для одного числа, но накапливается при повторных вычислениях (сложение $0.1$ десять раз может не дать точно значения $1$), поэтому реальные числа никогда нельзя проверять на точное равенство.
Исследовать
Построение числа с плавающей точкой
Перевернуть биты мантиссы и экспоненты, чтобы получить значение, и проверить, нормализовано ли оно.
Исследовать
Нормализация числа с плавающей точкой
Процесс нормализации. Сдвиг мантиссы для удаления бесполезных ведущих нулей — и корректировка экспоненты для сохранения значения — сохраняет само число, но тратит каждый бит на точность.
Словарь
Тренировать
| English | Русский |
|---|---|
| floating-point/ˈfləʊtɪŋ pɔɪnt/ | числа с плавающей точкой |
| mantissa/mænˈtɪsə/ | мантисса |
| exponent/ekˈspəʊnənt/ | показателе степени |
| two's complement/tuːz ˈkɒmplɪmənt/ | дополнительный код |
| normalised/ˈnɔːməlaɪzd/ | нормализованный |
| rounding errors/ˈraʊndɪŋ ˈerəz/ | ошибки округления |
| BCD/ˌbiː siː ˈdiː/ | BCD (двоично-десятичный код) |
| precision/prɪˈsɪʒn/ | точность (прецизионность) |
| range/reɪndʒ/ | область значений |
13.3
Определения, принимаемые экзаменатором
Вопросы на определение оцениваются по фиксированной формулировке. Выучите их точно и дайте только один ответ.
| Термин | Определение |
|---|---|
| пользовательский тип данных | тип данных, определяемый программистом на основе существующих типов, для представления данных, специфичных для задачи |
| несоставной тип | тип, определенный без ссылки на другой тип; он содержит одно значение (целое число, вещественное число, перечисляемый тип, указатель) |
| составной тип | тип, состоящий из других типов; он содержит несколько значений под одним идентификатором (запись, множество, массив, класс) |
| перечисляемый тип | несоставной тип, определенный путем перечисления всех его возможных значений в порядке их следования |
| тип указателя | несоставной тип, значением которого является адрес памяти переменной заданного типа |
| множество | составной тип, содержащий набор значений одного типа, упорядоченный произвольно и без дубликатов |
| запись | составной тип с фиксированным числом полей, каждое из которых имеет свой идентификатор и тип, доступ к которым осуществляется через точку |
| класс | составной тип, объединяющий атрибуты (данные) с методами (процедурами и функциями), действующими над ними; объект является экземпляром класса |
| последовательный файл | записи, хранящиеся одна за другой в том порядке, в котором они были добавлены |
| упорядоченный файл | записи, хранящиеся одна за другой в порядке ключевого поля |
| файл прямого доступа | записи, хранящиеся по адресам, рассчитанным от их ключей с помощью хэш-алгоритма |
| последовательный доступ | чтение записей подряд от начала файла до нахождения нужной |
| прямой доступ | расчет адреса записи по ее ключу и непосредственный переход к этой позиции |
| хэш-алгоритм | вычисление над ключом записи, дающее адрес, по которому эта запись хранится и находится |
| коллизия | два разных ключа, дающих одинаковый адрес |
| мантисса | часть числа с плавающей запятой, содержащая его значащие биты в виде дроби с дополнительным кодом |
| порядок (экспонента) | целое число в дополнительном коде, определяющее степень двойки, на которую умножается мантисса |
| нормализованный | число с плавающей запятой, мантисса которого начинается с 01 (положительное) или 10 (отрицательное), так что нет потерь битов на ведущие нули или единицы |
| переполнение | результат, слишком большой для представления в имеющемся количестве битов |
| переполнение вниз (underflow) | ненулевой результат, слишком малый для представления, поэтому он сохраняется как ноль |
| ошибка округления | разница между действительным числом и ближайшим значением, которое может хранить двоичное представление |
Словарь
Тренировать
| English | Русский |
|---|---|
| underflow/ˌʌndəˈfləʊ/ | переполнение вниз (underflow) |
| fixed-point/fɪkst pɔɪnt/ | числа с фиксированной точкой |
13.3
Советы для экзамена
- Объявления псевдокода помечаются построчно:
TYPE ... = (...)для перечисляемого,TYPE ... = ^...для указателя,TYPE ... = SET OF ...затемDEFINE ... (...) : ...для множества,TYPE ... DECLARE ... ENDTYPEдля записи,CLASS ... PRIVATE ... PUBLIC PROCEDURE NEW ... ENDCLASSдля класса. - Соотнесите тип с данными: фиксированные именованные значения — перечисляемый; группа различных полей — запись; набор уникальных значений — множество; данные плюс поведение — класс; адрес — указатель.
- Организация файлов — это то, как записи хранятся; доступ к файлам — это то, как они находятся. Последовательные и упорядоченные файлы читаются последовательно; файлы прямого доступа используют прямой доступ через хэш ключа. Последовательный поиск в упорядоченном файле может остановиться раньше; в последовательном файле — нет.
- Псевдокод для файла прямого доступа:
OPENFILE ... FOR RANDOM,SEEKперед каждымGETRECORDилиPUTRECORD,CLOSEFILEв конце. Опишите, как разрешается коллизия при описании хэширования. - Число с плавающей запятой: мантисса в виде дроби с дополнительным кодом (точка после бита знака), порядок как целое число, умножение на $2^{\text{exponent}}$; сдвиг влево и вычитание единицы из порядка для нормализации; мантисса обеспечивает точность, порядок — диапазон.
- Три стандартных ответа «объяснить»: почему нужно нормализовать (точность, уникальная форма, диапазон), эффект перераспределения битов (точность против диапазона) и почему $0.1$ нельзя сохранить точно (бесконечная двоичная дробь в конечной мантиссе).
Распространенные ошибки
- Написание
DECLAREвместоTYPEдля нового типа или пропускENDTYPE; объявление множества безSET OFили перечисляемого типа с кавычками вокруг его значений. - Помещение знака числа с плавающей запятой в порядок; знак — это первый бит мантиссы.
- Чтение отрицательной мантиссы так, как будто это код со знаком и дополнением; это дополнительный код, поэтому
1011000000— это $-0.625$, а не $-0.375$. - Сдвиг мантиссы для нормализации без изменения порядка или изменение его неправильно (сдвиг влево, порядок вниз).
- Описание файла прямого доступа как «имеющего случайный порядок»; записи находятся по адресам, вычисленным от их ключей.
- Утверждение, что последовательный доступ читает «весь файл» для упорядоченного файла; он останавливается, когда встречается больший ключ.
- Объяснение хэширования без указания того, для чего используется рассчитанное значение (адрес для хранения и извлечения записи) или без способа обработки коллизий.
- Определение переполнения как «слишком много цифр» вместо результата за пределами наибольшего представимого значения или возложение на него вины за мантиссу.
Интерактивные уроки по этой теме
Пройдите его шаг за шагом с упражнениями мгновенной проверки.