| Os candidatos devem ser capazes de: | Notas e orientações |
|---|---|
| Demonstrar compreensão de como grafos podem ser usados para auxiliar a Inteligência Artificial (IA) | Propósito e estrutura de um grafo. Usar o algoritmo A* e o algoritmo de Dijkstra para realizar buscas em um grafo. Os candidatos não serão exigidos a escrever algoritmos para configurar, acessar ou realizar buscas em grafos |
| Demonstrar compreensão de como as redes neurais artificiais ajudaram no aprendizado de máquina | |
| Demonstrar compreensão de Deep Learning, Machine Learning e Reinforcement Learning e as razões para usar esses métodos. | Compreender categorias de machine learning, incluindo aprendizado supervisionado, aprendizado não supervisionado |
| Demonstrar compreensão de propagação reversa de erros e métodos de regressão no machine learning |
Inteligência Artificial (IA)
Ciência da Computação do A-Level · Tópico 18
 13:12
O que é IA
Ninguém jamais escreveu as regras para distinguir um gato de um cachorro. Nenhum programador sentou-se e digitou "se tiver orelhas pontudas e bigodes". E ainda assim seu celular faz isso…
Narração em inglês · Legendas em inglês + 中文 gravadas
18.1
O que é IA

Programa
Fonte: Programa Cambridge International
Inteligência artificial 人工智能 (AI) constrói sistemas que realizam tarefas normalmente necessárias inteligência humana — reconhecer fala e imagens, traduzir, jogar jogos, dirigir, gerar texto. A maioria das IAs modernas usa aprendizado de máquina 机器学习 — algoritmos que aprendem padrões nos dados em vez de serem programados passo a passo. Dentro dele, aprendizado profundo 深度学习, usando redes neurais 神经网络 com muitas camadas, tem sido dominante desde a década de 2010.
Um robô humanoide 人形机器人 coloca muitas dessas habilidades em um único corpo: usa IA para ver rostos, entender fala e mover seu rosto e braços de forma realista.

Explorar
Laboratório de tipos de aprendizado de IA
Classifique exemplos de IA pelo tipo de aprendizado ou preocupação envolvida.
Vocabulário
Treinar
| Inglês | Chinês | Pinyin |
|---|---|---|
| humanoid robot/ˈhjuːmənɔɪd ˈrəʊbɒt/ | 人形机器人 | rén xíng jī qì rén |
18.1
Grafos na IA

Muitos problemas de IA residem em um grafo 图 — nós 节点 (estados, lugares) unidos por arestas 边 (movimentos, relações).
- busca de caminho: estradas formam um grafo; a rota mais curta é uma busca em grafo (algoritmo de Dijkstra, algoritmo A*).
- jogos: cada posição do tabuleiro é um nó, cada movimento uma aresta; minimax 极小化极大 com poda alfa-beta busca a árvore de jogo.
- busca no espaço de estados: um problema de planejamento é mover entre estados aplicando operadores para atingir um objetivo.
- representação de conhecimento: uma rede semântica 语义网络 tem conceitos como nós e relações como arestas ("cachorro É-UM animal"); um grafo de conhecimento 知识图谱 armazena fatos sobre o mundo para motores de busca e assistentes.
Ferramentas padrão para navegar em grafos incluem busca em largura 广度优先搜索 e busca em profundidade 深度优先搜索.
"Descreva o propósito e a estrutura de um grafo em um sistema de IA. Propósito: representar um problema como um conjunto de estados (ou lugares) e os possíveis movimentos entre eles, para que um algoritmo possa buscá-lo por uma solução, como a rota mais curta ou mais barata, ou o melhor próximo movimento. Estrutura: um conjunto de nós (vértices), cada um representando um estado, localização ou item, unidos por arestas representando as conexões entre eles; cada aresta pode carregar um peso (um custo, distância ou tempo), e as arestas podem ser dirigidas (ida única) ou não dirigidas. "Explique o uso de grafos para auxiliar a IA:" o grafo é o modelo no qual os algoritmos de busca da IA operam: A* e o algoritmo de Dijkstra encontram caminhos ótimos através dele (navegação, roteamento), posições de jogos formam uma árvore buscada pelo melhor movimento, e conhecimento armazenado como grafo permite que um sistema raciocine sobre como os fatos estão relacionados.
 O grafo usado abaixo: os números das arestas são distâncias reais; os números vermelhos são a estimativa de heurística 启发式 de cada nó de quão longe o objetivo ainda está, o que apenas o A usa*
Algoritmo de Dijkstra. Ele encontra a menor distância do início até cada nó. Mantenha uma tabela da melhor distância encontrada até agora para cada nó (início 0, todos os outros infinito). Repita: pegue o nó não visitado com a menor distância, marque-o como visitado e, para cada vizinho, verifique se ir por este nó oferece uma distância menor; se sim, atualize-a e registre de onde veio. Pare quando todos os nós forem visitados (ou o alvo for atingido).
Exemplo resolvido. Encontre as menores distâncias de H até todos os outros nós no grafo acima.
| etapa | visitar | H | A | B | C | D | G |
|---|---|---|---|---|---|---|---|
| início | 0 | ∞ | ∞ | ∞ | ∞ | ∞ | |
| 1 | H (0) | 0 | 4 (H) | 3 (H) | ∞ | ∞ | ∞ |
| 2 | B (3) | 0 | 4 (H) | 3 | ∞ | 9 (B) | ∞ |
| 3 | A (4) | 0 | 4 | 3 | 9 (A) | 8 (A) | ∞ |
| 4 | D (8) | 0 | 4 | 3 | 9 (A) | 8 | 10 (D) |
| 5 | C (9) | 0 | 4 | 3 | 9 | 8 | 10 (D) |
| 6 | G (10) |
Menores distâncias: A 4, B 3, D 8, C 9, G 10, e o caminho para G é H–A–D–G (leia as etiquetas "veio de" de trás para frente). Na etapa 3, A oferece a D uma distância de $4 + 4 = 8$, melhor que as 9 encontradas através de B, então D é atualizada; na etapa 5, C poderia chegar a G em $9 + 3 = 12$, pior que 10, então nada muda. Mostrar essas comparações é o "trabalho" que a questão pede.
O algoritmo A*. Dijkstra explora em todas as direções. A* adiciona uma heurística $h$, uma estimativa da distância restante, e sempre expande o nó com a menor $f = g + h$, onde $g$ é a distância percorrida até agora. Com uma heurística sensata (nunca superestimando), ele encontra o mesmo caminho mais curto enquanto examina muito menos nós, que é por que satnavs e jogos o usam. O exame fornece $h$ para cada nó e uma tabela para preencher.
Exemplo resolvido. Encontre um caminho de H para G com A*, mostrando o trabalho.
| nó expandido | $g$ até agora | $h$ | $f = g + h$ | vizinhos adicionados (nó: $g$, $h$, $f$) |
|---|---|---|---|---|
| H | 0 | 7 | 7 | A: 4, 5, 9; B: 3, 6, 9 |
| B (empate com A; qualquer um) | 3 | 6 | 9 | D via B: 9, 2, 11 |
| A | 4 | 5 | 9 | C: 9, 3, 12; D via A: 8, 2, 10 (melhor que 11, mantenha) |
| D | 8 | 2 | 10 | G: 10, 0, 10; C via D: 9 (sem melhoria) |
| G | 10 | 0 | 10 | objetivo alcançado |
Caminho H–A–D–G, comprimento 10, o mesmo que Dijkstra, mas C nunca foi expandido. Cada vez que um nó é alcançado por uma segunda rota, mantenha a menor $g$; a busca termina quando o objetivo é o nó com a menor $f$. Declare os valores $g$, $h$ e $f$ em todas as linhas: essas são as notas.
Vocabulário
Treinar
| Inglês | Chinês | Pinyin |
|---|---|---|
| graph/ɡræf/ | 图 | tú |
| nodes/nəʊdz/ | 节点 | jié diǎn |
| edges/ˈedʒɪz/ | 边 | biān |
| minimax/ˈmɪnɪmæks/ | 极小化极大 | jí xiǎo huà jí dà |
| semantic network/səˈmæntɪk ˈnetwɜːk/ | 语义网络 | yǔ yì wǎng luò |
| knowledge graph/ˈnɒlɪdʒ ɡræf/ | 知识图谱 | zhī shí tú pǔ |
| breadth-first search/bredθ fɜːst sɜːtʃ/ | 广度优先搜索 | guǎng dù yōu xiān sōu suǒ |
| depth-first search/depθ fɜːst sɜːtʃ/ | 深度优先搜索 | shēn dù yōu xiān sōu suǒ |
| weight/weɪt/ | 权重 | quán zhòng |
| heuristic/hjuːˈrɪstɪk/ | 启发式 | qǐ fā shì |
| labels/ˈleɪblz/ | 标签 | biāo qiān |
18.1
Redes neurais artificiais (ANNs)

Uma ANN é inspirada pelos neurônios do cérebro. Um neurônio artificial 人工神经元:
- recebe vários valores de entrada, multiplica cada um por um peso 权重, e soma-os com um termo de bias 偏置项.
- aplica uma função de ativação 激活函数 (uma função não linear como ReLU) à soma.
- sai o resultado, que alimenta neurônios mais adiante.
Neurônios estão organizados em camadas: uma camada de entrada, uma ou mais camadas ocultas 隐藏层 (onde padrões internos úteis são aprendidos), e uma camada de saída. Com muitas camadas ocultas, trata-se de uma rede neural profunda 深度神经网络, e o treinamento dela é aprendizado profundo.

ANNs permitem que modelos aprendam padrões complexos diretamente de dados brutos (pixels, áudio, texto) sem recursos projetados manualmente — impulsionando avanços em reconhecimento de imagens 图像识别, reconhecimento de fala 语音识别, tradução automática 机器翻译 e jogos. Funcionam bem com grandes quantidades de dados, entrada ruidosa ou muito complexa, e padrões difíceis de capturar com regras explícitas.
"Explique o que se entende por rede neural artificial." Um modelo da rede de neurônios do cérebro, composto por camadas de nós conectados: uma camada de entrada, uma ou mais camadas ocultas e uma camada de saída. Cada conexão tem um peso; cada nó soma suas entradas ponderadas e passa o resultado através de uma função de ativação para a próxima camada. "Explique como ANNs possibilitam o aprendizado de máquina" (três pontos): a rede é treinada em muitos exemplos; para cada exemplo, a saída é comparada com o resultado esperado e o erro é usado para ajustar os pesos (propagação reversa) de modo que o erro diminua; após enough exemplos, os pesos codificam os padrões nos dados, e a rede pode então classificar ou prever para novos dados que nunca viu. "Informe o motivo para múltiplas camadas ocultas": cada camada adicional combina os recursos encontrados pela camada anterior em recursos mais complexos e abstratos, permitindo que a rede aprenda relações mais complexas (bordas, depois formas, depois objetos); isso é o que torna uma rede profunda.
Explorar
Toque nas partes de uma rede neural
Explore as camadas. Os dados fluem da esquerda para a direita: a camada de entrada pega os recursos, as camadas ocultas aprendem padrões e a camada de saída dá a resposta — com cada conexão carregando um peso que o treinamento ajusta.
Vocabulário
Treinar
| Inglês | Chinês | Pinyin |
|---|---|---|
| artificial neuron/ˌɑːtɪˈfɪʃl ˈnjuːrɒn/ | 人工神经元 | rén gōng shén jīng yuán |
| bias term/ˈbaɪəs tɜːm/ | 偏置项 | piān zhì xiàng |
| activation function/ˌæktɪˈveɪʃn ˈfʌŋkʃn/ | 激活函数 | jī huó hán shù |
| hidden layers/ˈhɪdn ˈleɪəz/ | 隐藏层 | yǐn cáng céng |
| deep neural network/diːp ˈnjuːrəl ˈnetwɜːk/ | 深度神经网络 | shēn dù shén jīng wǎng luò |
| image recognition/ˈɪmɪdʒ ˌrekəɡˈnɪʃn/ | 图像识别 | tú xiàng shí bié |
| speech recognition/spiːtʃ ˌrekəɡˈnɪʃn/ | 语音识别 | yǔ yīn shí bié |
| machine translation/məˈʃiːn trænˈsleɪʃn/ | 机器翻译 | jī qì fān yì |
18.1
Aprendizado de máquina, aprendizado profundo, aprendizado por reforço
Aprendizado de máquina
O termo guarda-chuva — qualquer algoritmo que aprende a partir de dados. Três paradigmas:
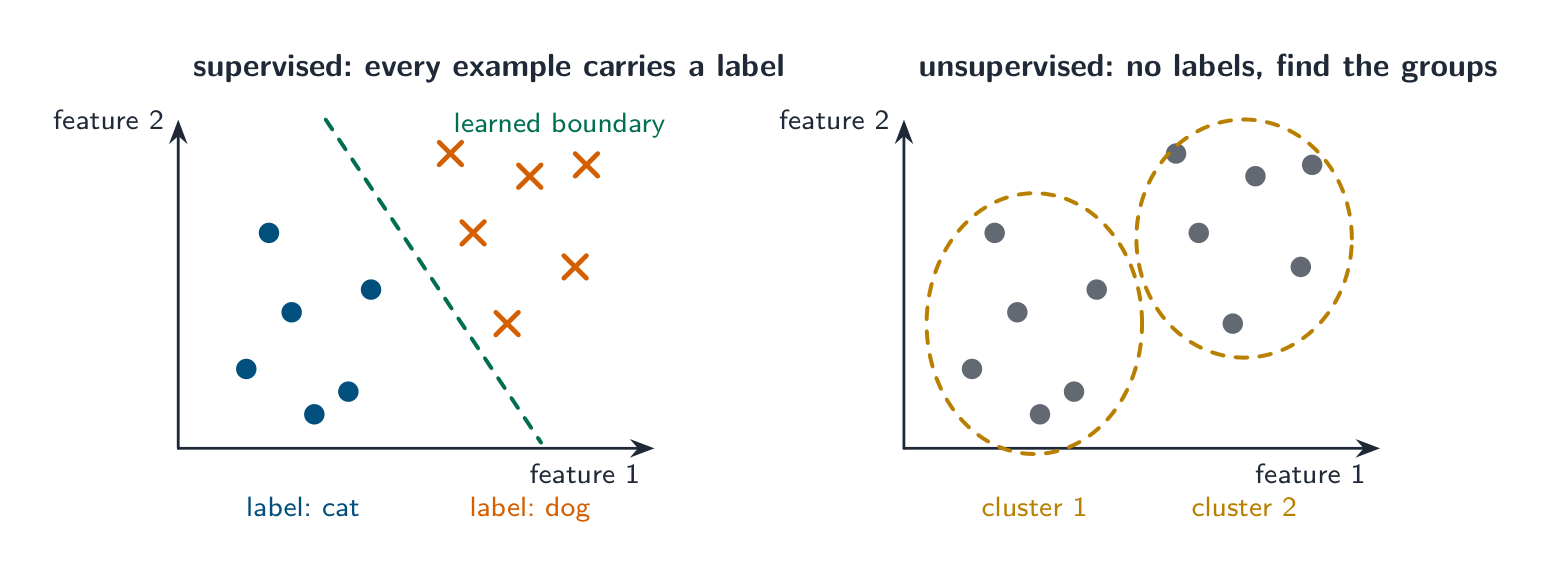
- aprendizado supervisionado 监督学习 — os dados têm rótulos 标签 (imagens marcadas "gato"/"cachorro"); o algoritmo aprende entrada → rótulo. Usado para classificação 分类 (uma categoria) e regressão.
- aprendizado não supervisionado 无监督学习 — sem rótulos; o algoritmo encontra estrutura, ex.: um agrupamento 聚类 de clientes semelhantes.
- aprendizado por reforço (abaixo).
Use ML quando regras explícitas seriam impraticáveis (filtros de spam, recomendações, detecção de fraudes).
"Descreva o aprendizado supervisionado e não supervisionado" (palavras marcadas). Aprendizado supervisionado: o algoritmo é treinado com dados de treinamento rotulados 训练数据, cada exemplo pareado com a saída correta (alvo); ele aprende a relação entre entradas e saídas e usa isso para classificar ou prever novas entradas; as respostas são conhecidas durante o treinamento, então o erro pode ser medido. Aprendizado não supervisionado: os dados estão sem rótulos, sem respostas corretas fornecidas; o algoritmo busca padrões, estrutura ou agrupamentos nos dados por si só (agrupar itens similares, encontrar associações); a saída é um conjunto de categorias ou relações que não foram definidas antecipadamente. Como diferem: dados rotulados contra não rotulados; saídas conhecidas contra estrutura descoberta; supervised é usado para prever (classificação, regressão), unsupervised para explorar (agrupamento, detecção de anomalias). Ambos são categorias de machine learning; o terceiro é reinforcement learning.

Aprendizado profundo
Um subconjunto de ML usando redes neurais profundas. Camadas inferiores aprendem padrões simples (bordas, fonemas), camadas superiores combinam-nos em conceitos abstratos. Precisa de muitos dados e muita computação (GPUs); para pequenos conjuntos de dados, métodos de ML mais simples frequentemente funcionam melhor.
"Explique o que se entende por aprendizado profundo" (três pontos). Machine learning que usa redes neurais artificiais com muitas camadas ocultas (redes profundas); a rede é treinada em quantidades muito grandes de dados, e cada camada extrai características da saída da camada abaixo, de modo que a rede aprende as características necessárias por si só, em vez de serem especificadas pelo programador. Motivos para usá-lo: pode resolver problemas muito complexos para regras escritas à mão ou modelos rasos (reconhecer rostos, entender fala, traduzir texto); melhora conforme há mais dados disponíveis; elimina a necessidade de engenharia de recursos humana; e pode lidar com dados não estruturados como imagens, som e texto. Como é feito mais eficaz: mais (e melhor rotulados) dados de treinamento; mais camadas ou nós, dentro dos limites de overfitting; mais poder de processamento (GPUs) e tempo de treinamento; ajuste da taxa de aprendizagem e outros parâmetros. Exemplos: reconhecimento de fala em assistentes de voz, reconhecimento de imagens em exames médicos e carros autônomos, tradução automática, sistemas de recomendação.
Aprendizado por reforço
Em aprendizado por reforço 强化学习, um agente 智能体 age em um ambiente; cada ação muda o estado e retorna uma recompensa 奖励. O agente aprende uma política 策略 (uma estratégia) que maximiza a recompensa total ao longo do tempo, por tentativa e erro sem rótulos prévios. Usado para problemas de decisão sequencial — jogos, controle robótico, direção autônoma.
"Explique o que se entende por aprendizado por reforço" (três pontos). Um agente aprende interagindo com seu ambiente: ele toma uma ação, o ambiente muda para um novo estado e retorna uma recompensa (ou penalidade), e o agente ajusta seu comportamento para maximizar a recompensa total ao longo do tempo. Não há dados rotulados: o agente aprende por tentativa e erro, descobrindo quais ações são boas pelas recompensas coletadas, e gradualmente forma uma política que diz o que fazer em cada estado. Usado onde a resposta certa não é conhecida antecipadamente, mas o resultado de uma ação pode ser pontuado: jogos (xadrez, Go), controle robótico, sinalização de trânsito, alocação de recursos. Um computador jogando um jogo de tabuleiro contra um usuário aprende dessa forma, ou busca na árvore de jogos com minimax para escolher o movimento cujo pior resultado seja o melhor.

Um carro autônomo 自动驾驶汽车 é um exemplo real. Sensores Lidar 激光雷达 e câmeras (a unidade giratória no teto) constroem uma imagem viva da estrada, e uma política aprendida decide como virar, acelerar e frear com segurança.


Vocabulário
Treinar
| Inglês | Chinês | Pinyin |
|---|---|---|
| artificial intelligence/ˌɑːtɪˈfɪʃl ɪnˈtelɪdʒəns/ | 人工智能 | rén gōng zhì néng |
| machine learning/məˈʃiːn ˈlɜːnɪŋ/ | 机器学习 | jī qì xué xí |
| reinforcement learning/ˌriːɪnˈfɔːsmənt ˈlɜːnɪŋ/ | 强化学习 | qiáng huà xué xí |
| supervised learning/ˈsuːpəvaɪzd ˈlɜːnɪŋ/ | 监督学习 | jiān dū xué xí |
| classification/ˌklæsɪfɪˈkeɪʃn/ | 分类 | fēn lèi |
| self-driving car/self ˈdraɪvɪŋ kɑː/ | 自动驾驶汽车 | zì dòng jià shǐ qì chē |
| agent/ˈeɪdʒənt/ | 智能体 | zhì néng tǐ |
| reward/rɪˈwɔːd/ | 奖励 | jiǎng lì |
| policy/ˈpɒlɪsi/ | 策略 | cè lüè |
| lidar/ˈlaɪdɑː/ | 激光雷达 | jī guāng léi dá |
18.1
Treinando uma ANN: backpropagation
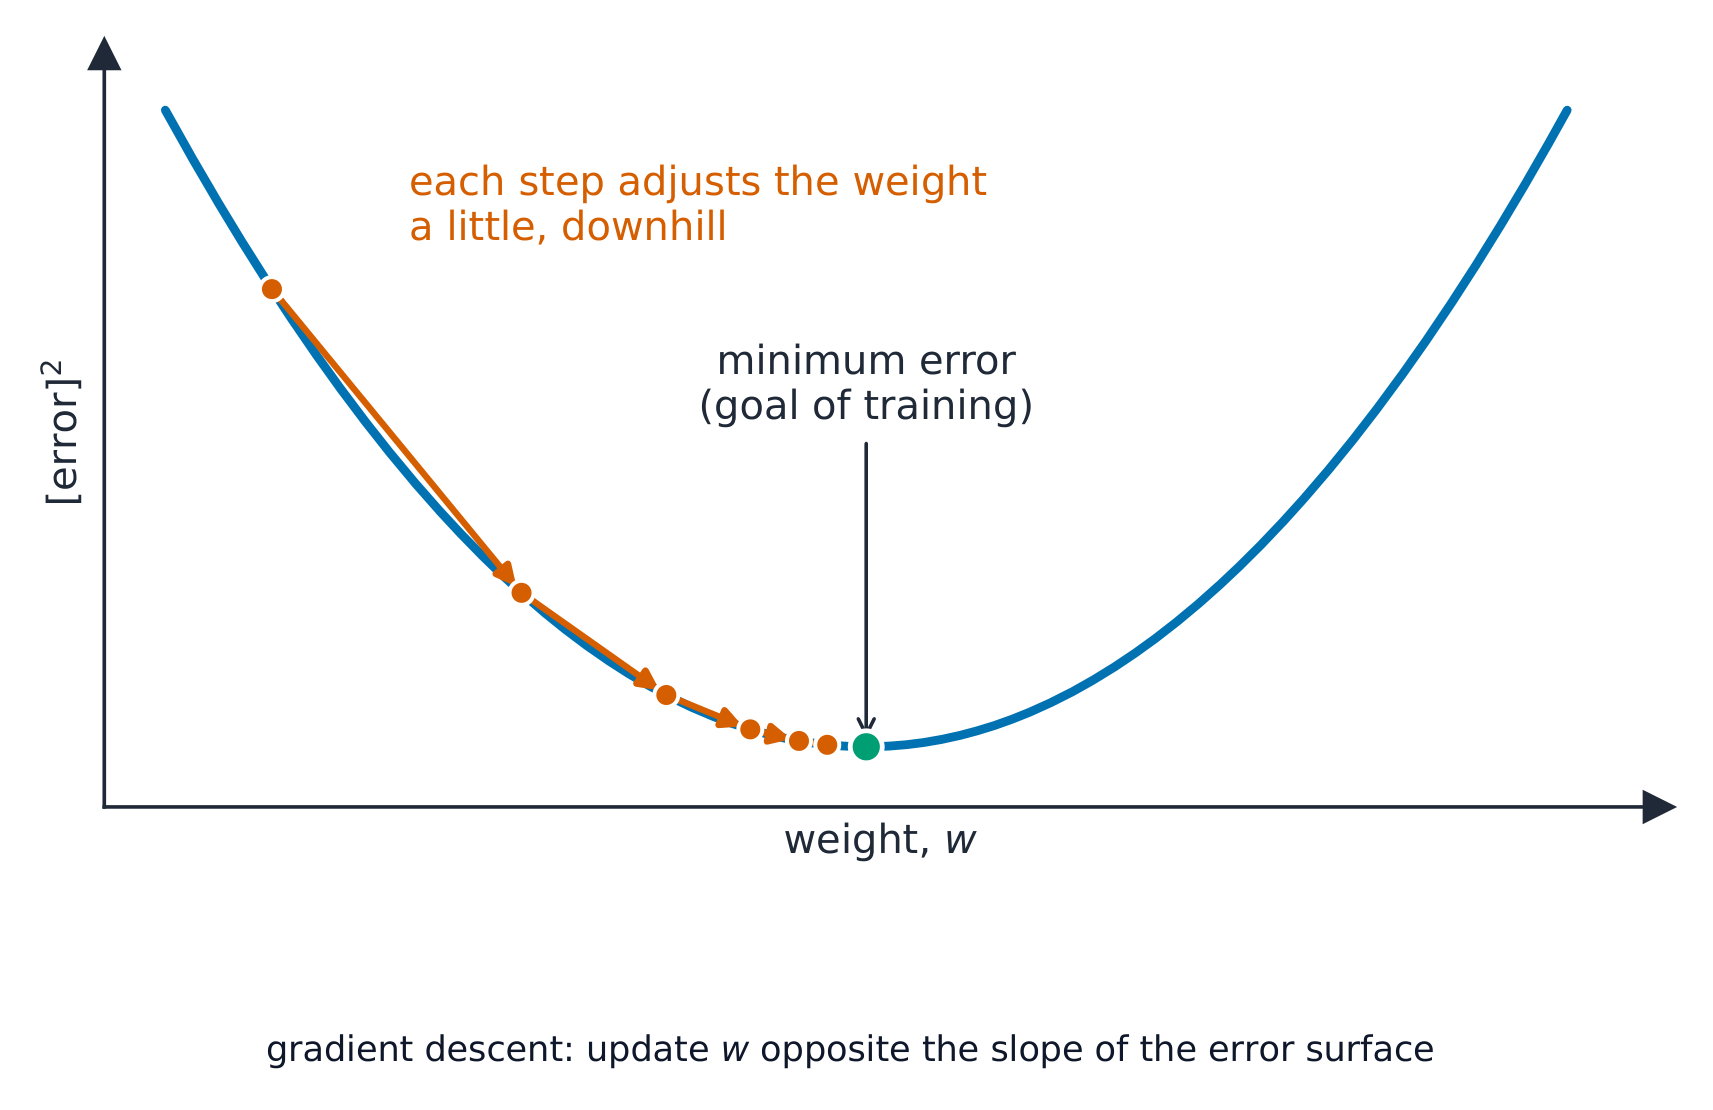
O treinamento ajusta os pesos para que as saídas correspondam aos alvos. O método padrão é backpropagation 反向传播 (propagação reversa de erros) com descida de gradiente 梯度下降. Para cada exemplo de treinamento:
- passagem direta — alimente a entrada até a saída.
- calcule o erro com uma função de perda 损失函数 (um número único sobre o quão errada é a saída).
- passagem reversa — propague o erro para trás, encontrando o gradiente de cada peso (quanto contribuiu para o erro) usando a regra da cadeia.
- atualize os pesos com um pequeno passo (definido pela taxa de aprendizagem 学习率) que reduza o erro.
Repita sobre muitos exemplos e muitas passagens (épocas 训练轮次) até que o erro deixe de diminuir. O nome "back" vem do passo 3: o erro flui da saída de volta em direção à entrada, assim o gradiente de cada peso é encontrado em uma varredura. Após o treinamento, uma nova entrada precisa apenas de uma passagem direta para obter uma previsão.
"Descreva o método de propagação reversa de erros" (quatro pontos). (1) Uma entrada é enviada para frente através da rede e sua saída é comparada com a saída esperada (alvo); (2) a diferença é o erro; (3) o erro é passado para trás através da rede, camada por camada da saída para a entrada, e a parte do erro atribuída a cada peso é calculada; (4) os pesos são ajustados em proporção à sua contribuição, na direção que reduz o erro; (5) o processo é repetido com muitos exemplos até que o erro seja tão pequeno quanto necessário. O ponto do método é que uma rede com camadas ocultas não tem maneira direta de saber qual peso interno causou um erro de saída; a propagação reversa atribui a culpa.
Vocabulário
Treinar
| Inglês | Chinês | Pinyin |
|---|---|---|
| backpropagation/ˌbækprəpəˈɡeɪʃn/ | 反向传播 | fǎn xiàng chuán bō |
| gradient descent/ˈɡreɪdɪənt dɪˈsent/ | 梯度下降 | tī dù xià jiàng |
| loss function/lɒs ˈfʌŋkʃn/ | 损失函数 | sǔn shī hán shù |
| epochs/ˈiːpɒks/ | 训练轮次 | xùn liàn lún cì |
18.1
Regressão

Alguns tasks preveem um número (preço de uma casa, temperatura de amanhã) — regressão 回归, ao contrário de classificação (uma categoria).
Regressão linear 线性 regression ajusta uma linha reta (ou hiperplano):
$$y = m_{1} x_{1} + m_{2} x_{2} + \ldots + m_{n} x_{n} + c.$$
Escolha os coeficientes para minimizar a soma dos erros quadrados em relação aos dados de treinamento. Use-o quando a relação parecer aproximadamente linear e você quiser um modelo interpretável. Para dados curvos, use métodos de regressão polinomial, árvore de decisão ou rede neural — mesma ideia: defina um modelo, defina uma função de perda e ajuste os parâmetros para minimizá-la. Regressão e classificação são ambas supervisionadas; a escolha depende se a resposta é um número ou uma categoria.
"Descreva métodos de regressão em aprendizado de máquina" (duas marcas). Métodos estatísticos que encontram a relação entre variáveis de entrada e uma saída contínua, ajustando uma função (uma linha ou curva) aos dados de treinamento com o menor erro total; a função ajustada é então usada para prever a saída para novos inputs. A regressão linear ajusta uma linha reta; outros métodos ajustam curvas. A regressão prediz um valor (um preço, uma temperatura, um tempo); a classificação prediz uma categoria, que é a distinção que o exame pede.
Explorar
Ajustando uma linha de regressão
Arraste os controles. A regressão linear desenha a linha reta que minimiza as distâncias quadráticas aos pontos de dados — então ela prediz um número para qualquer nova entrada.
Vocabulário
Treinar
| Inglês | Chinês | Pinyin |
|---|---|---|
| regression/rɪˈɡreʃn/ | 回归 | huí guī |
| unsupervised learning/ʌnˈsuːpəvaɪzd ˈlɜːnɪŋ/ | 无监督学习 | wú jiān dū xué xí |
| cluster/ˈklʌstə/ | 聚类 | jù lèi |
| training data/ˈtreɪnɪŋ ˈdeɪtə/ | 训练数据 | xùn liàn shù jù |
| learning rate/ˈlɜːnɪŋ reɪt/ | 学习率 | xué xí lǜ |
| linear regression/ˈlɪnɪə rɪˈɡreʃn/ | 线性回归 | xiàn xìng huí guī |
| optical character recognition/ˈɒptɪkl ˈkærɪktə ˌrekəɡˈnɪʃn/ | 光学字符识别 | guāng xué zì fú shí bié |
| text-to-speech/tekst tə spiːtʃ/ | 文本转语音 | wén běn zhuǎn yǔ yīn |
18.1
Como a IA é usada em um cenário real
Muitos cenários de exames usam o mesmo padrão — um modelo de deep learning treinado em dados rotulados, muitas vezes vários combinados em um pipeline:
- identificação de clientes em uma loja automatizada: o sistema é treinado com imagens de rostos rotuladas; uma câmera captura um rosto; o reconhecimento de imagem extrai uma representação; ela é comparada com clientes registrados; a correspondência mais próxima identifica a pessoa.
- leitura de texto em imagens: o reconhecimento de imagem encontra regiões de texto; reconhecimento óptico de caracteres 光学字符识别 extrai os caracteres; tradução por máquina os converte; texto-para-fala 文本转语音 os lê em voz alta.
- detecção de itens no caixa: IA de detecção de objetos, treinada em imagens de produtos rotuladas, vê quais itens entram na cesta e cobra a conta.
No momento em que um usuário interage com o sistema, o modelo é rápido — ele faz apenas inferência de passagem direta; a inteligência está nos padrões aprendidos durante o treinamento.
Respostas modelo para as perguntas de cenário. Uma câmera de estacionamento lê números de placa: a câmera captura uma imagem; uma IA treinada em muitos imagens rotuladas de placas localiza a placa na imagem; reconhecimento de caracteres (um classificador de deep learning, novamente treinado em caracteres rotulados) converte a placa em texto; o texto é armazenado com a hora e comparado quando o carro sai. Um sistema de CCTV detecta e rastreia uma pessoa: software de reconhecimento de imagem treinado em imagens rotuladas de pessoas identifica uma pessoa em cada quadro; o sistema compara quadros sucessivos para seguir seu movimento; movimento incomum pode acionar um alerta. Fala convertida em comandos: reconhecimento de fala treinado em muitas vozes gravadas converte o som em texto; o sistema compara o texto com um conjunto de comandos conhecidos; melhora à medida que é corrigido. Uma câmera que foca em rostos: um modelo de detecção de rosto treinado em rostos rotulados encontra a região do rosto, e a lente é ajustada para trazer essa região para foco. Login de reconhecimento facial de um banco: o app captura o rosto, uma rede profunda extrai seus recursos, e eles são comparados com os recursos armazenados daquele cliente. Em todos os casos, o padrão é: treinado em exemplos rotulados, extrai recursos, corresponde ou classifica nova entrada.
Exemplo resolvido. Para cada tarefa, diga se precisa de regressão ou classificação, e como seria a camada de saída de uma ANN: (a) prever a temperatura de amanhã; (b) decidir se um e-mail é spam. Pergunte qual tipo de coisa está sendo previsto. (a) Uma temperatura é um número em uma escala contínua, então isso é regressão, e a camada de saída é um único neurônio segurando esse valor. (b) Spam ou não-spam é uma categoria, então isso é classificação, e a saída dá uma probabilidade por classe. Ambas são aprendizagem supervisionada: cada uma precisa de exemplos rotulados para treinar, e o treinamento ajusta os pesos por propagação reversa para reduzir o erro. A pergunta decisiva é simplesmente número-ou-categoria - não quão difícil a tarefa parece.
Vocabulário
Treinar
| Inglês | Chinês | Pinyin |
|---|---|---|
| deep learning/diːp ˈlɜːnɪŋ/ | 深度学习 | shēn dù xué xí |
| neural networks/ˈnjuːrəl ˈnetwɜːks/ | 神经网络 | shén jīng wǎng luò |
18.1
Definições aceitas pelo examinador
Uma questão de definição é avaliada contra wording fixo. Aprenda estas exatamente, e dê apenas uma resposta.
| Termo | Definição |
|---|---|
| grafo (em IA) | um conjunto de nós representando estados ou locais, ligados por arestas representando conexões, frequentemente ponderadas, que um algoritmo de busca pode explorar |
| Algoritmo de Dijkstra | encontra a menor distância de um nó inicial para todos os outros nós visitando sempre o nó não visitado com a menor distância até agora |
| Algoritmo A* | uma busca de caminho mais curto que expande o nó com a menor soma da distância até agora mais uma estimativa heurística da distância ao objetivo |
| rede neural artificial | um modelo dos neurônios do cérebro: camadas de nós ligados por conexões ponderadas, treinadas ajustando os pesos |
| aprendizado de máquina | algoritmos que aprendem com dados e melhoram com a experiência em vez de seguir regras fixas |
| aprendizado supervisionado | aprendizado a partir de dados de treinamento rotulados nos quais a saída correta para cada entrada é conhecida |
| aprendizado não supervisionado | aprendizado a partir de dados sem rótulos encontrando padrões, agrupamentos ou estrutura neles |
| aprendizado por reforço | um agente aprende por tentativa e erro, escolhendo ações em um ambiente para maximizar as recompensas que recebe |
| deep learning | aprendizado de máquina usando redes neurais com muitas camadas ocultas, treinadas em grandes quantidades de dados, cada camada extraindo recursos da camada abaixo |
| propagação reversa de erros | comparar a saída da rede com o alvo, passar o erro de volta através das camadas e ajustar cada peso para reduzi-lo |
| regressão | ajustar uma função aos dados de treinamento para prever um valor de saída contínuo a partir de entradas |
18.1
Dicas de prova
- Respostas de grafos nomeiam nós, arestas e pesos, e o que representam; depois o algoritmo. Dijkstra: tabela de distâncias, visite o menor, atualize vizinhos. A*: $g$, $h$ e $f = g + h$ em cada linha, expanda o menor $f$.
- Respostas de ANN nomeiam as camadas, as conexões ponderadas e o treinamento; deep learning adiciona muitas camadas ocultas, grandes quantidades de dados e extração automática de recursos, com uma razão e um exemplo.
- As três categorias em uma linha cada: dados rotulados e saídas conhecidas; dados sem rótulos e estrutura descoberta; agente, ambiente, ações e recompensas.
- Propagação reversa: compare com o alvo, erro para trás através das camadas, ajuste os pesos para reduzi-lo, repita. Regressão prediz um valor; classificação prediz uma categoria.
- Perguntas de cenário querem o pipeline: treinado em exemplos rotulados, extrai recursos, reconhece ou classifica nova entrada; nomeie o tipo de IA (reconhecimento de imagem, reconhecimento de fala, deep learning).
Erros comuns
- Descrever um grafo como "um gráfico"; em IA são nós e arestas.
- Executar Dijkstra escolhendo o vizinho mais próximo do nó atual em vez da menor distância geral não visitada; ou esquecer de atualizar um nó quando uma rota mais curta aparece.
- Adicionar $h$ em $g$ para o próximo passo em A*; $g$ é apenas a distância real, $h$ é recomputado a partir da tabela.
- Dizer que deep learning é "aprender muito"; são as muitas camadas ocultas.
- Confundir aprendizado não supervisionado com aprendizado por reforço; o primeiro encontra estrutura em dados, o segundo aprende com recompensas.
- Descrever propagação reversa sem a comparação com a saída esperada ou sem dizer que os pesos são ajustados.
- Chamar uma previsão de preço de "classificação"; um valor contínuo é regressão.
Aulas interativas sobre este tópico
Passe por ele passo a passo, com exercícios de verificação instantânea.