| Os candidatos devem ser capazes de: | Notas e orientações |
|---|---|
| Demonstrar compreensão dos métodos de busca linear e busca binária | Escrever um algoritmo para implementar uma busca linear. Escrever um algoritmo para implementar uma busca binária. As condições necessárias para o uso de uma busca binária. Como o desempenho de uma busca binária varia conforme o número de itens de dados |
| Demonstrar compreensão dos métodos de inserção sort e bubble sort | Escrever um algoritmo para implementar um insertion sort. Escrever um algoritmo para implementar um bubble sort. O desempenho de uma rotina de ordenação pode depender da ordem inicial dos dados e do número de itens de dados |
| Demonstrar compreensão e uso de Tipos de Dados Abstratos (ADT) | Escrever algoritmos para encontrar um item em cada um dos seguintes: linked list, binary tree. Escrever algoritmos para inserir um item em cada um dos seguintes: stack, queue, linked list, binary tree. Escrever algoritmos para excluir um item de cada um dos seguintes: stack, queue, linked list. Demonstrar compreensão de que um grafo é um exemplo de ADT. Descrever as características principais de um grafo e justificar seu uso para uma situação dada. Os candidatos não serão exigidos a escrever código para uma estrutura de grafo |
| Demonstrar como é possível implementar ADTs a partir de outro ADT | Descrever os seguintes ADTs e demonstrar como podem ser implementados a partir de tipos embutidos adequados ou outros ADTs: stack, queue, linked list, dictionary, binary tree |
| Demonstrar compreensão de que diferentes algoritmos que realizam a mesma tarefa podem ser comparados usando critérios (por exemplo, tempo necessário para completar a tarefa e memória usada) | Incluindo o uso da notação Big O para especificar complexidade de tempo e espaço |
Pensamento computacional e resolução de problemas
Ciência da Computação A-Level · Tópico 19
 15:33
Busca & Ordenação
Um livro telefônico com um milhão de nomes. Se você verificar um de cada vez, pode fazer um milhão de comparações. Mas você já conhece o truque: abra-o no…
Narração em inglês · legendas em inglês e 中文 que você pode alternar
19.1
Algoritmos de busca
Programa
Fonte: Programa Cambridge International
Uma busca encontra um valor procurado em uma coleção (geralmente um vetor) e retorna sua posição ou “não encontrado”.
Busca linear
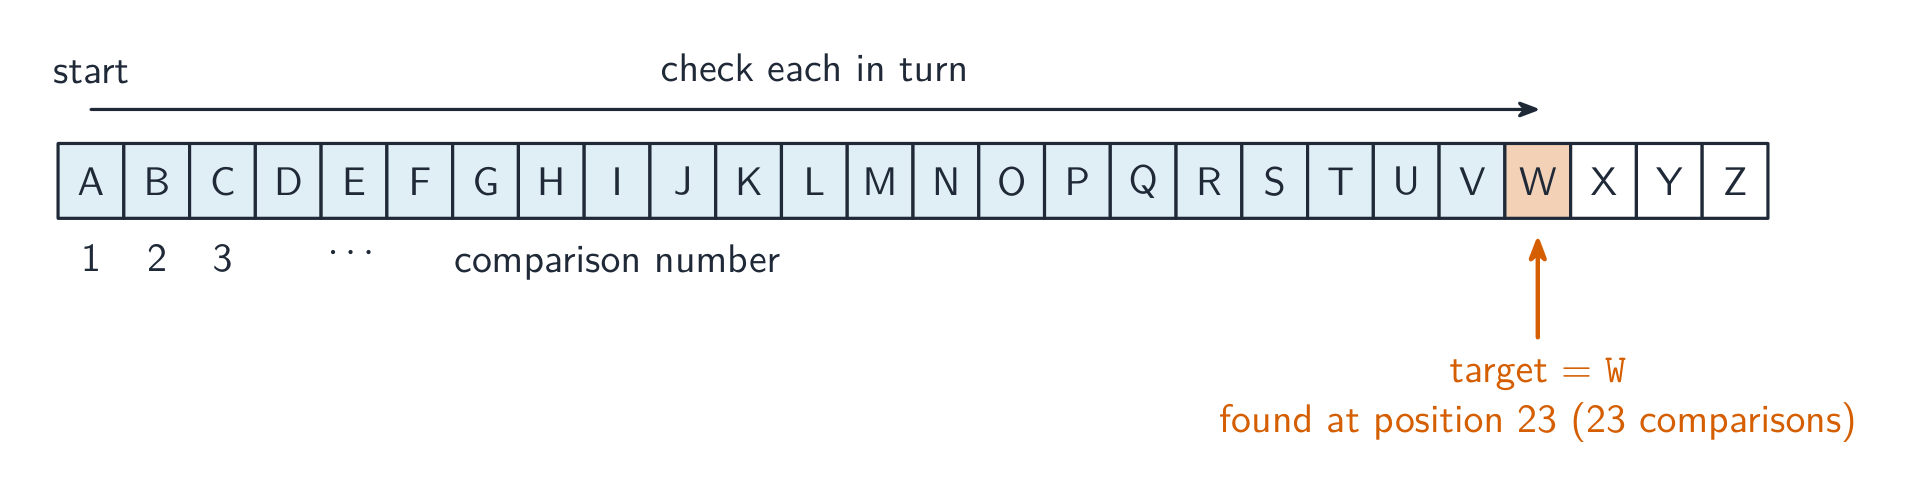
Uma busca linear percorre do início ao fim, comparando cada elemento com o alvo:
FOR i ← 1 TO n
    IF A[i] = target THEN
        RETURN i
    ENDIF
NEXT i
RETURN -1   // not found
Nenhuma preparação é necessária, portanto funciona em qualquer lista. No pior caso, O($n$) (o valor procurado está no fim ou ausente); no melhor caso, 1 comparação. Use-a em dados não ordenados ou listas pequenas. (O -1 retornado é um valor sentinela — uma posição impossível que significa “não encontrado”; quem chamou a busca testa IF result = -1.)
A versão do exame. O Paper 3 pede para completar uma busca linear escrita com uma flag e um loop WHILE, e o Paper 4 pede para escrever uma função que retorne o índice ou uma contagem. Ambos parecem assim:
FUNCTION LinearSearch(Data : ARRAY OF INTEGER, Target : INTEGER) RETURNS INTEGER
    DECLARE Index, Count : INTEGER
    Count ← 0
    FOR Index ← 1 TO 100
        IF Data[Index] = Target THEN
            Count ← Count + 1
        ENDIF
    NEXT Index
    RETURN Count          // how many times Target occurs; 0 means not found
ENDFUNCTION
Para parar na primeira correspondência, use um loop WHILE Index <= 100 AND NOT Found que define Found ← TRUE e lembra o índice. As marcas são pelo loop sobre todo elemento, a comparação e o que é retornado quando o valor está ausente.
Busca binária
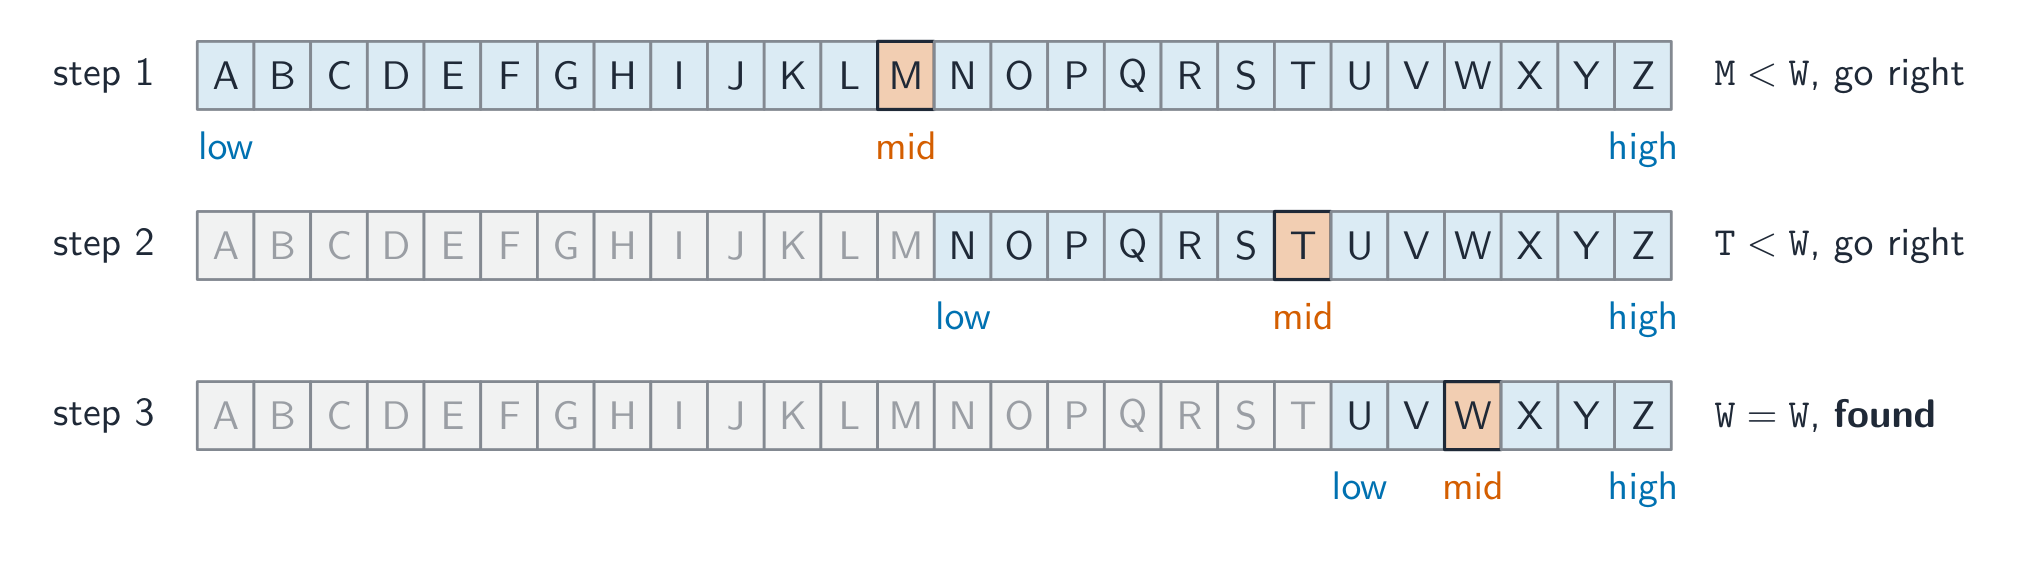
Uma busca binária exige dados ordenados. Observe o elemento central; se for o alvo, conclua; se menor, busque na metade esquerda, senão na direita — reduzindo o intervalo pela metade a cada passo:
low ← 1
high ← n
WHILE low <= high DO
    MiddleIndex ← (low + high) DIV 2
    IF A[MiddleIndex] = target THEN
        RETURN MiddleIndex
    ENDIF
    IF A[MiddleIndex] < target THEN
        low ← MiddleIndex + 1
    ELSE
        high ← MiddleIndex - 1
    ENDIF
ENDWHILE
RETURN -1
Pior caso O($\log_{2} n$) — para um milhão de itens, cerca de 20 comparações. Muito mais rápida que a busca linear em arrays grandes ordenados, mas você deve ordenar primeiro (um custo único O($n \log n$)), vale a pena se buscar muitas vezes.
“Apresente a condição necessária para uma busca binária.” Os dados devem estar em ordem (ordenados de forma crescente ou decrescente pela chave procurada). “Descreva como realizar uma busca binária” (três pontos): (1) encontre o item do meio da lista (ou do intervalo atual) e compare-o com o valor procurado; (2) se forem iguais, a busca termina; se o valor procurado for menor, repita na metade inferior; se for maior, na metade superior; (3) continue dividindo o intervalo ao meio até encontrar o item ou o intervalo ficar vazio, o que significa que ele não está presente.
A versão do exame, com os limites e uma flag, é a que você deve reproduzir quando solicitado a completar o algoritmo:
DECLARE Lower, Upper, MiddleIndex : INTEGER
DECLARE Found : BOOLEAN
Lower ← 0
Upper ← 99
Found ← FALSE
WHILE Lower <= Upper AND NOT Found
    MiddleIndex ← (Lower + Upper) DIV 2
    IF Names[MiddleIndex] = Target THEN
        Found ← TRUE
    ELSE
        IF Names[MiddleIndex] < Target THEN
            Lower ← MiddleIndex + 1
        ELSE
            Upper ← MiddleIndex - 1
        ENDIF
    ENDIF
ENDWHILE
IF Found THEN
    OUTPUT MiddleIndex
ELSE
    OUTPUT "Not found"
ENDIF
Exemplo resolvido (acompanhamento de uma busca binária). Names[0:9] contém Ali, Ben, Cai, Dev, Eva, Fay, Gus, Hal, Ivy, Jo. Acompanhe a versão da prova para Target = "Ivy" e depois para Target = "Cat", informando Lower, Upper e MiddleIndex em cada etapa.
Para “Ivy”:
| Limite inferior | Limite superior | Índice do meio | Nomes[Índice do meio] | Resultado |
|---|---|---|---|---|
| 0 | 9 | 4 | Eva | Eva < Ivy, portanto Limite inferior ← 5 |
| 5 | 9 | 7 | Hal | Hal < Ivy, portanto Limite inferior ← 8 |
| 8 | 9 | 8 | Ivy | Encontrado ← TRUE |
A saída é 8, após três comparações. Para “Cat”: meio 4 (Eva > Cat, Limite superior ← 3); meio 1 (Ben < Cat, Lower ← 2); middle 2 (Cai < Cat, Lower ← 3); middle 3 (Dev > Cat, Limite superior ← 2). Agora Lower (3) é maior que Upper (2), portanto o laço termina e “Not found” é exibido após quatro comparações, o pior caso para dez itens ($\lceil\log_2 10\rceil = 4$). DIV arredonda para baixo, portanto o meio de 0 e 9 é 4, não 4.5 nem 5. As cadeias de caracteres são comparadas em ordem alfabética (dos códigos dos caracteres).
“Explique como o desempenho varia com o número de itens.” Cada comparação reduz pela metade o número de itens restantes, portanto o número máximo de comparações é aproximadamente $\log_{2} n$: dobrar o tamanho da lista acrescenta apenas uma comparação. Isso é O($\log n$). “Compare a busca linear e a binária”: uma busca linear precisa de até $n$ comparações (O($n$)) e, em média, metade disso, mas funciona com dados não ordenados; uma busca binária precisa de no máximo $\log_{2} n$ (O($\log n$)) e é muito mais rápida para listas grandes, mas os dados devem primeiro ser ordenados e devem permitir acesso direto ao item do meio (um vetor, não uma lista encadeada). Para $1000$ itens: $1000$ contra $10$ comparações.
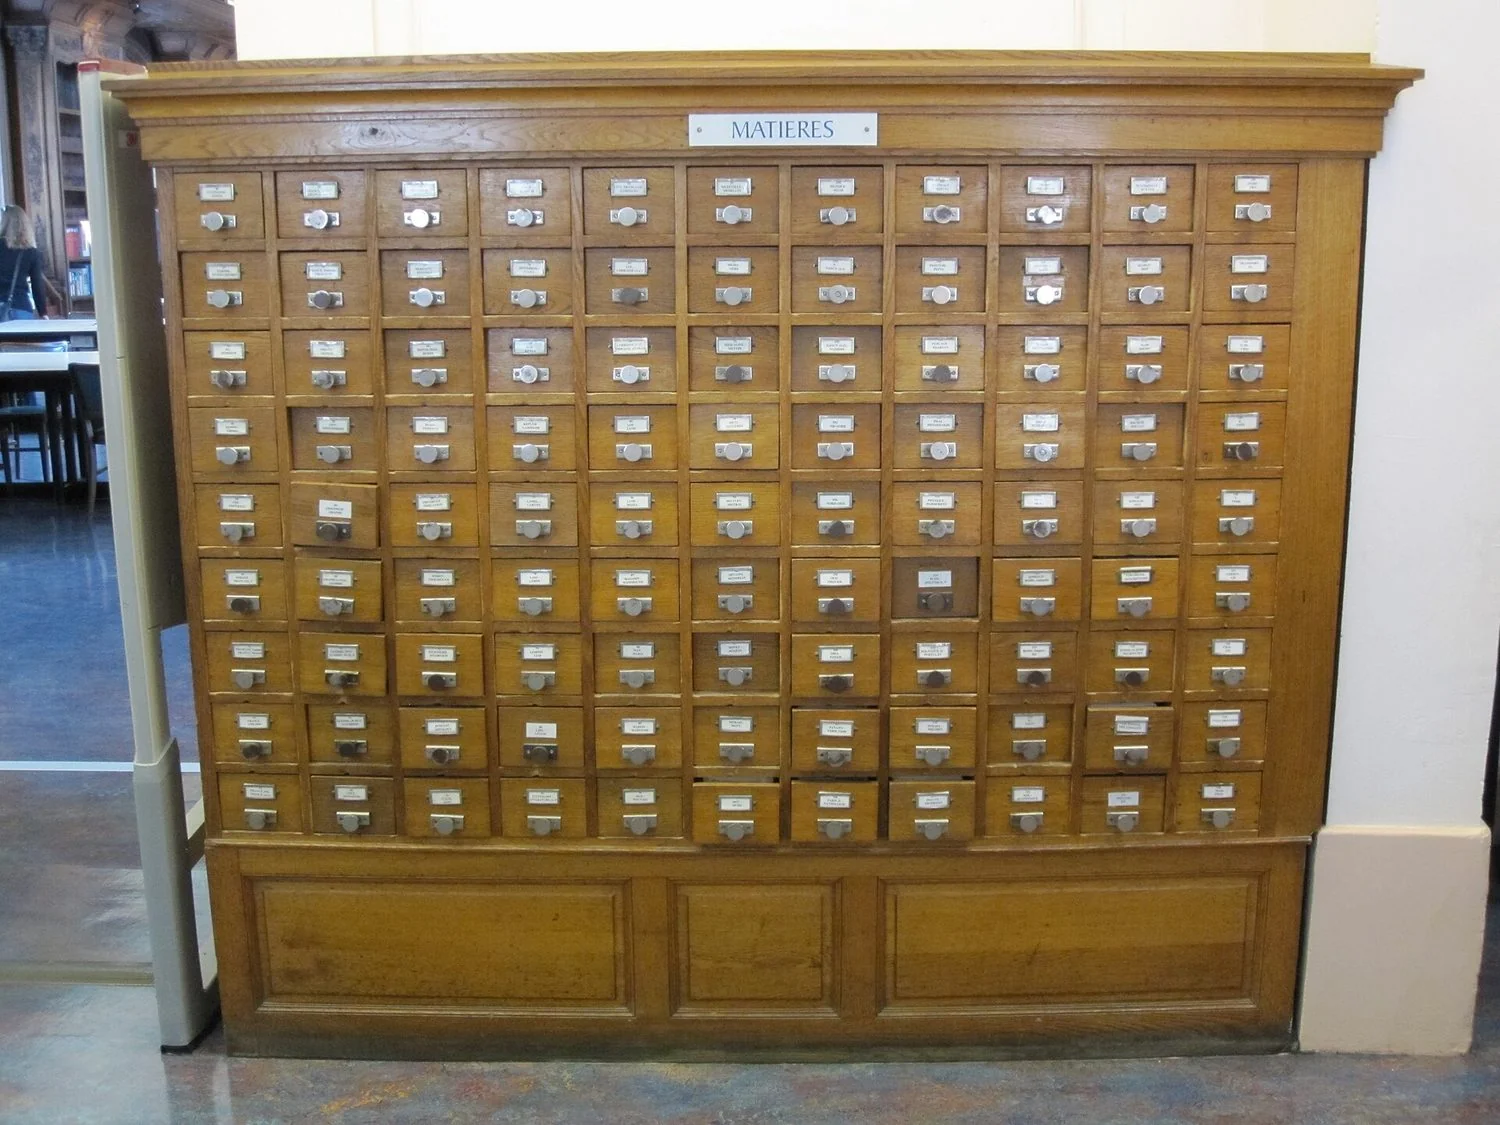 *Um catálogo de cartões: registros ordenados são o que tornam a busca binária possível — reduza pela metade, olhe, reduza novamente
Explorar
Busca linear vs busca binária
Procure por um valor. A busca binária reduz a lista pela metade a cada etapa (apenas em dados ordenados); a busca linear verifica um por um.
Vocabulário
Treinar
| English | Português |
|---|---|
| insertion sort/ɪnˈsɜːʃn sɔːt/ | ordenação por inserção |
| bubble sort/ˈbʌbl sɔːt/ | ordenação por bolha |
| binary search/ˈbaɪnəri sɜːtʃ/ | busca binária |
| array/əˈreɪ/ | array |
| linear search/ˈlɪnɪə sɜːtʃ/ | busca linear |
19.1
Algoritmos de ordenação
Bubble sort (Ordenação por bolha)
Uma ordenação por bolha percorre repetidamente o vetor, trocando pares adjacentes que estão fora de ordem, de modo que o maior item “flutue” até o fim em cada passagem:
FOR pass ← 1 TO n - 1
    swapped ← FALSE
    FOR i ← 1 TO n - pass
        IF A[i] > A[i + 1] THEN
            temp ← A[i]
            A[i] ← A[i + 1]
            A[i + 1] ← temp
            swapped ← TRUE
        ENDIF
    NEXT i
    IF swapped = FALSE THEN      // already sorted
        EXIT FOR
    ENDIF
NEXT pass
Melhor caso O($n$) (já ordenado, com saída antecipada); médio/pior caso O($n^{2}$). Simples, mas lento para grandes $n$.
Insertion sort (Ordenação por inserção)
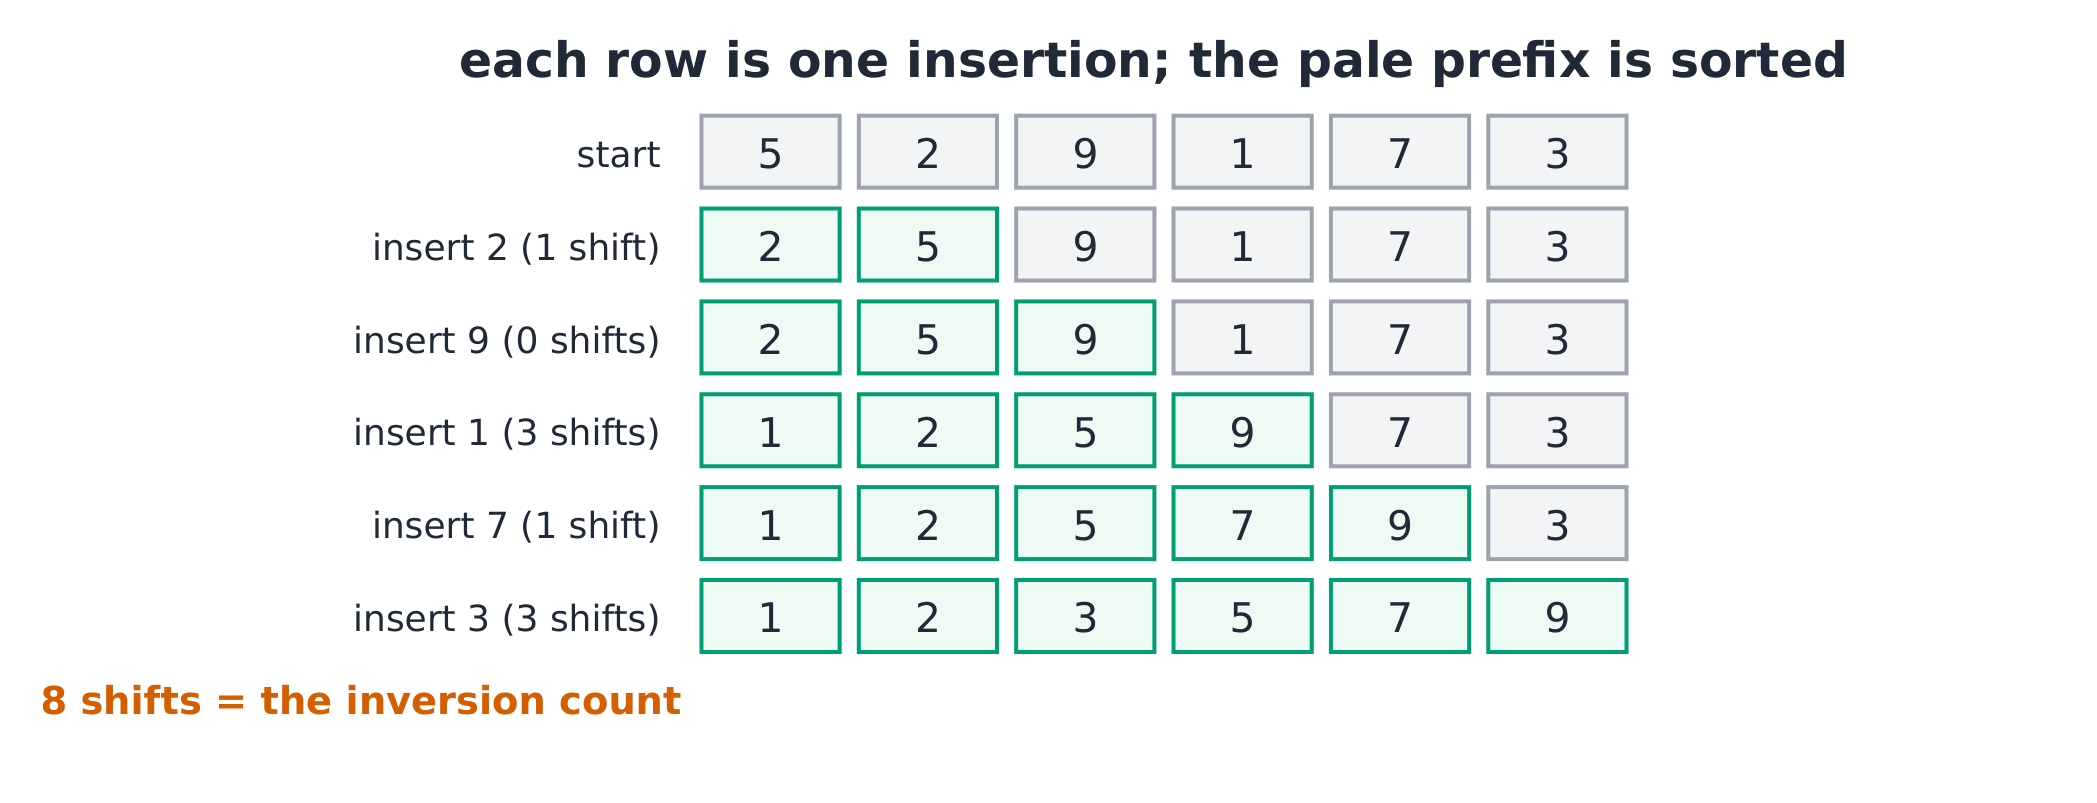
Uma ordenação por inserção constrói um prefixo ordenado da esquerda, inserindo cada novo elemento no lugar correto deslocando maiores para a direita:
FOR i ← 2 TO n
    key ← A[i]
    j ← i - 1
    WHILE j >= 1 AND A[j] > key DO
        A[j + 1] ← A[j]
        j ← j - 1
    ENDWHILE
    A[j + 1] ← key
NEXT i
Melhor caso O($n$) (já ordenado); pior O($n^{2}$). Adequada para arrays pequenos ou quase ordenados. Ordena in-place e é estável (mantém a ordem de elementos iguais).
Rastreamento de uma ordenação
Uma tarefa comum é mostrar o array após cada passagem externa. Para [D, T, H, R] com insertion sort: passada 1 (chave T) sem mudança; passada 2 (chave H) → [D, H, T, R]; passada 3 (chave R) → [D, H, R, T].
O mesmo vetor se move de forma diferente com a ordenação por bolha: a passagem 1 compara D/T (sem troca), T/H (troca) e T/R (troca), resultando em [D, H, R, T] com o maior item no fim; a passagem 2 não faz trocas, portanto o indicador interrompe a ordenação. Mostre o vetor inteiro após cada passagem e conte as comparações se solicitado: $3$ na passagem 1 e $2$ na passagem 2 (a versão acima para uma posição antes a cada passagem), $5$ no total.
Escrevendo uma ordenação do zero. “Escreva um pseudocódigo para ordenar DataArray[1:1000] em ordem crescente” pode ser respondido com uma ordenação por bolha completa com o indicador de parada antecipada ou com uma ordenação por inserção, com declarações e indentação; qualquer uma recebe a pontuação máxima se funcionar para todas as entradas:
DECLARE Pass, Index, Temp : INTEGER
DECLARE Swapped : BOOLEAN
Pass ← 1
REPEAT
    Swapped ← FALSE
    FOR Index ← 1 TO 1000 - Pass
        IF DataArray[Index] > DataArray[Index + 1] THEN
            Temp ← DataArray[Index]
            DataArray[Index] ← DataArray[Index + 1]
            DataArray[Index + 1] ← Temp
            Swapped ← TRUE
        ENDIF
    NEXT Index
    Pass ← Pass + 1
UNTIL Swapped = FALSE OR Pass = 1000
Para ordem decrescente, troque > por <; para ordenar registros ou um vetor de 2 dimensões por um campo, compare esse campo, mas troque o registro inteiro (ou todas as colunas). Se pedirem uma ordenação por inserção “que realize a mesma tarefa” que uma ordenação por bolha apresentada, mantenha o mesmo nome de vetor e a mesma direção e reproduza a ordenação por inserção acima com a comparação invertida se a ordem for decrescente.
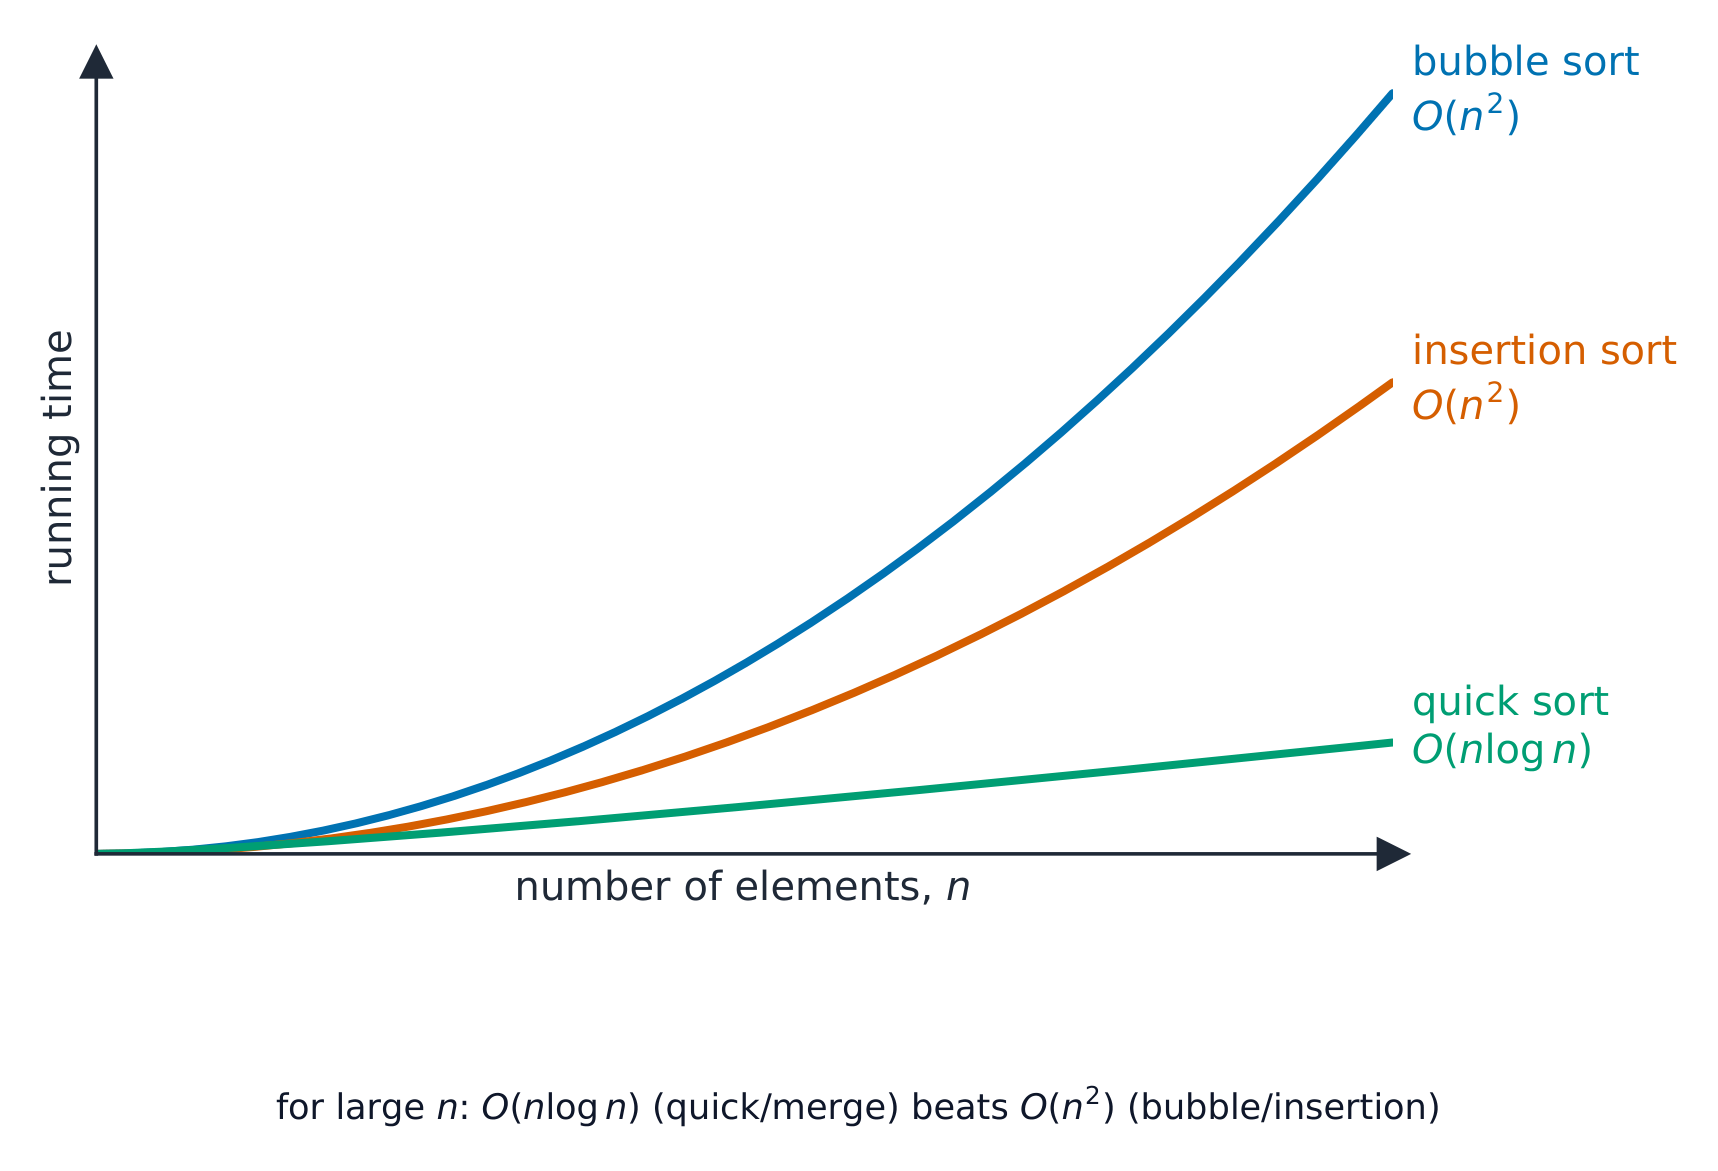
“Descreva duas maneiras pelas quais o desempenho de uma ordenação é afetado pelos dados” (dois pontos). (1) O número de itens: uma ordenação $O(n^{2})$ leva quatro vezes mais tempo para o dobro de itens. (2) O quanto os dados já estão ordenados: uma ordenação por bolha com um indicador, ou uma ordenação por inserção, termina em uma passagem por dados já ordenados ($O(n)$) e realiza o máximo de trabalho com dados em ordem inversa; o número de trocas depende de quantos pares estão fora de ordem. (Também são aceitos: o intervalo ou o número de valores duplicados e se os itens são registros grandes, custosos para mover.) As ordenações por bolha e por inserção são ambas O($n^{2}$) nos casos pior e médio e O($n$) no melhor caso; a ordenação rápida e a ordenação por intercalação são O($n \log n$), por isso são usadas para grandes volumes de dados.
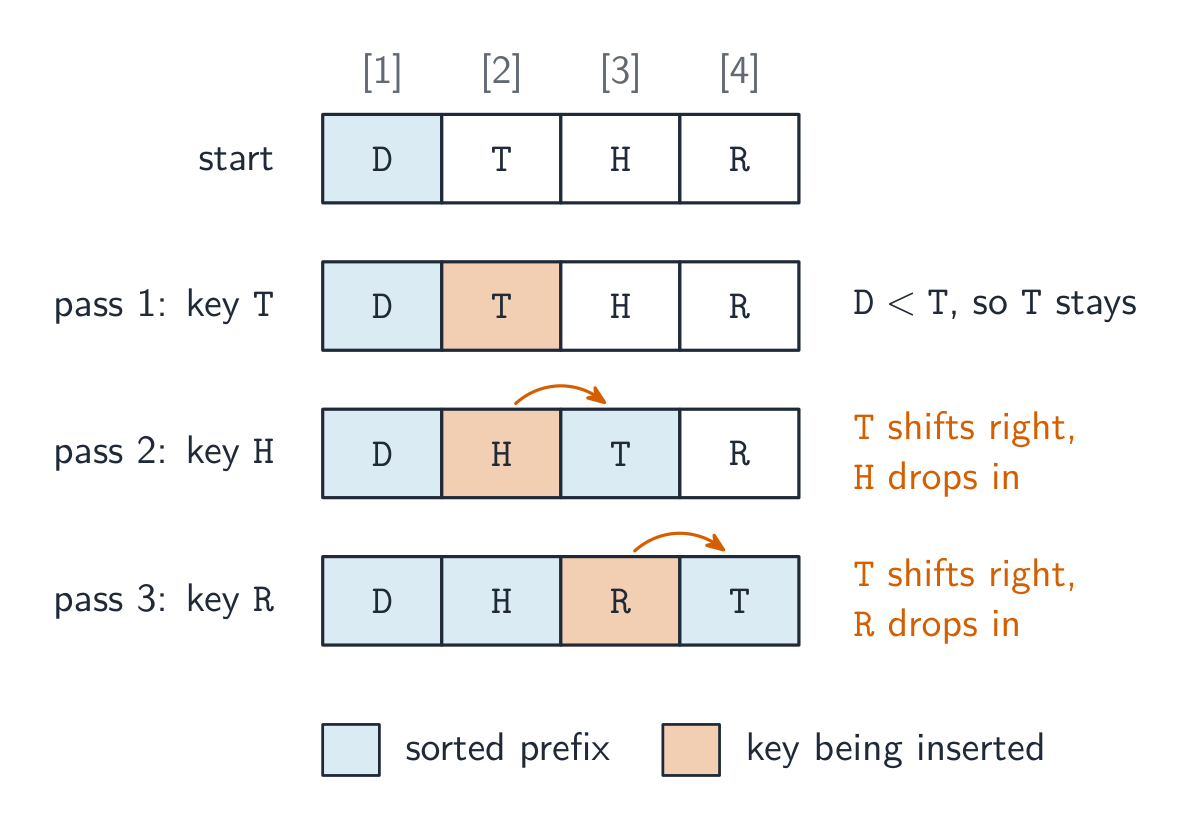
[D, T, H, R], deslocando cada chave para seu lugar, passo a passo
Explorar
Assista uma ordenação rodar
Passe passo a passo por uma ordenação e observe as barras se acomodarem na ordem — como um algoritmo de ordenação funciona iteração por iteração.
Vocabulário
Treinar
| English | Português |
|---|---|
| in place/ɪn pleɪs/ | no local |
| stable/ˈsteɪbl/ | estável |
19.1
ADTs em algoritmos
Os Tipos de Dados Abstratos (TDA) do Tema 10 aparecem em muitos algoritmos: uma pilha guia traversal profunda e desfazer; uma fila guia traversal larga e ordem de impressão; uma lista ligada permite crescimento e contração de dados.
TDAs podem ser construídos a partir de outros TDAs, não apenas arrays: uma fila a partir de duas pilhas; uma pilha a partir de lista ligada (push = adicionar nó cabeça; uma fila a partir de lista ligada com ponteiros de cabeça e cauda; uma árvore binária a partir de nós com dois ponteiros de filho; um dicionário armazena pares chave→valor (geralmente em tabela hash). Camadas assim separam preocupações — o algoritmo usando o TDA não precisa saber como ele é construído.
Os ADTs que o exame pede para você descrever e implementar
Stack (último a entrar, primeiro a sair): os itens são adicionados (empilhados) e removidos (desempilhados) na mesma extremidade, o topo; um ponteiro TopOfStack guarda o índice do item no topo. Implementado com um array e aquele único ponteiro: push verifica se a stack não está cheia, incrementa o ponteiro e armazena o item; pop verifica se não está vazia, retorna o item no topo e decrementa o ponteiro.
FUNCTION Push(Item : INTEGER) RETURNS BOOLEAN
    IF TopOfStack = 9 THEN      // full (array 0 to 9)
        RETURN FALSE
    ENDIF
    TopOfStack ← TopOfStack + 1
    StackData[TopOfStack] ← Item
    RETURN TRUE
ENDFUNCTION
FUNCTION Pop() RETURNS INTEGER
    IF TopOfStack = -1 THEN      // empty
        RETURN -1
    ENDIF
    TopOfStack ← TopOfStack - 1
    RETURN StackData[TopOfStack + 1]
ENDFUNCTION
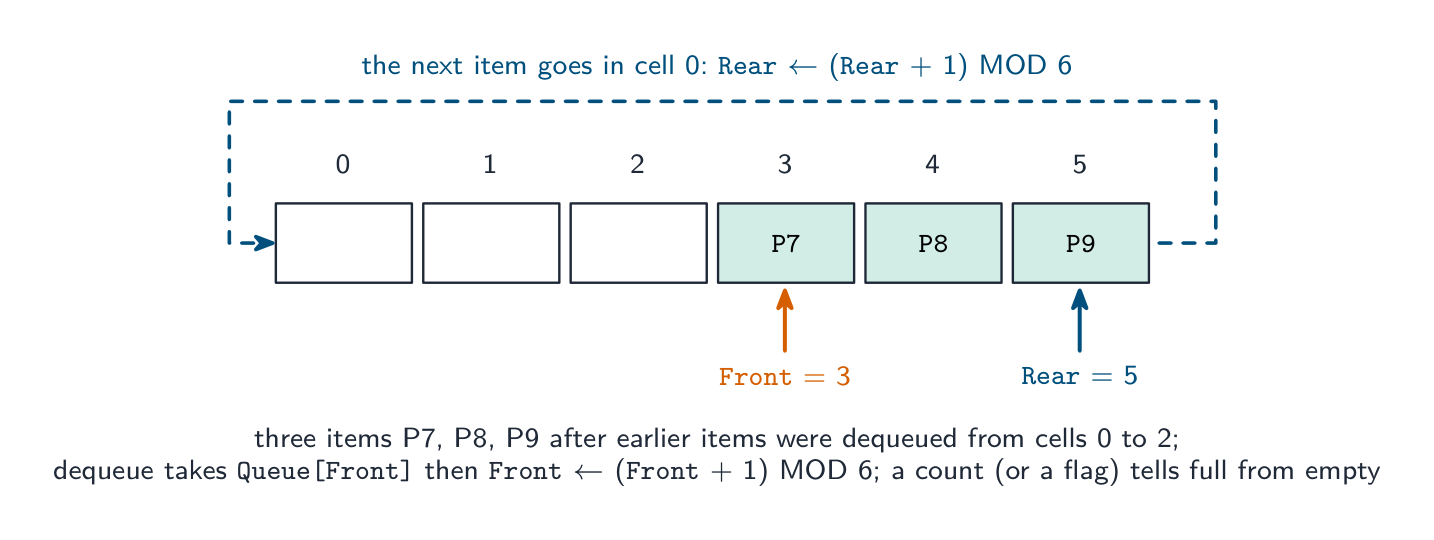
Fila (primeiro a entrar, primeiro a sair): itens entram na parte traseira (enfilhar) e saem pela frente (desenfilhar); dois ponteiros e uma contagem. Em uma fila linear, o ponteiro frontal avança pelo array até que o espaço inicial seja desperdiçado; uma fila circular faz ambos os ponteiros voltarem com MOD, reutilizando todas as células.
*Uma circular queue: os ponteiros traseiro e frontal avançam com MOD, reutilizando as primeiras células do array assim que seus itens saem
FUNCTION Enqueue(Item : STRING) RETURNS BOOLEAN
    IF Count = 6 THEN      // full
        RETURN FALSE
    ENDIF
    Rear ← (Rear + 1) MOD 6
    QueueArray[Rear] ← Item
    Count ← Count + 1
    RETURN TRUE
ENDFUNCTION
FUNCTION Dequeue() RETURNS STRING
    IF Count = 0 THEN      // empty
        RETURN ""
    ENDIF
    DECLARE Item : STRING
    Item ← QueueArray[Front]
    Front ← (Front + 1) MOD 6
    Count ← Count - 1
    RETURN Item
ENDFUNCTION
Lista encadeada: sequência de nós, cada um contendo um item de dados e um ponteiro para o nó seguinte; um ponteiro inicial indica o primeiro nó e um ponteiro nulo (0 ou $-1$) termina a lista. Em uma implementação com array, dois arrays paralelos armazenam os dados e os ponteiros, e células não utilizadas são encadeadas em uma lista livre para que uma inserção saiba onde colocar o novo nó.
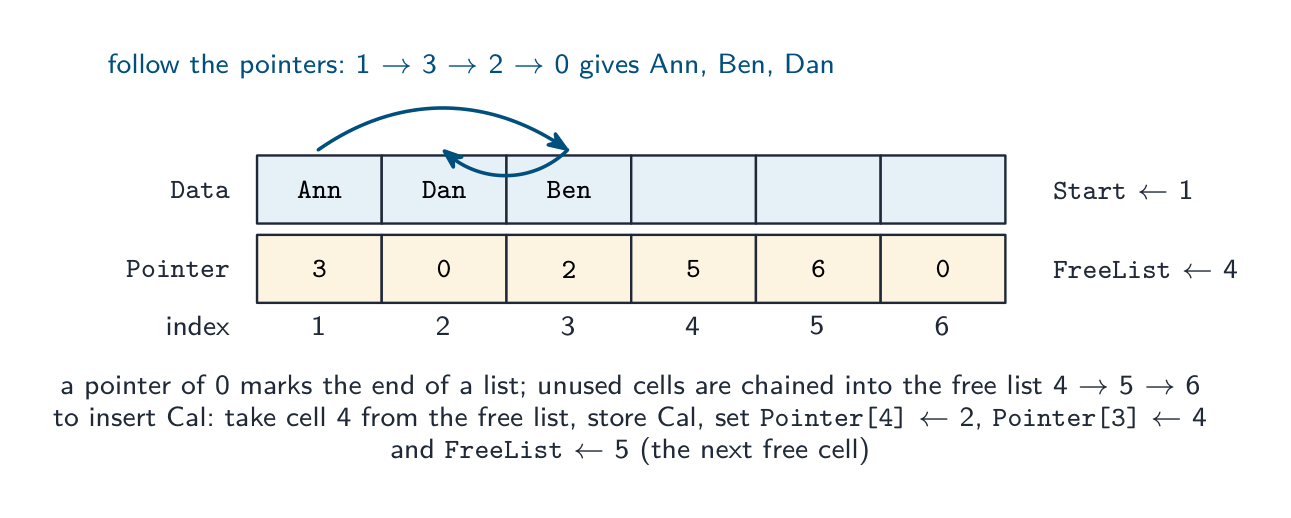 *Uma linked list em dois arrays: a ordem da lista está nos ponteiros, não nas posições; inserir um nome significa pegar uma célula da free list e religar dois ponteiros
FUNCTION FindInList(Target : STRING) RETURNS INTEGER   // index, or 0 if absent
    DECLARE Current : INTEGER
    Current ← Start
    WHILE Current <> 0
        IF Data[Current] = Target THEN
            RETURN Current
        ENDIF
        Current ← Pointer[Current]
    ENDWHILE
    RETURN 0
ENDFUNCTION
Para inserir em uma lista ordenada: pegue a primeira célula livre (NewNode ← FreeList, FreeList ← Pointer[FreeList]), armazene o item, depois percorra a lista com um ponteiro Previous e Current até Data[Current] > Item ou o fim; defina Pointer[NewNode] ← Current e Pointer[Previous] ← NewNode (ou Start ← NewNode se for o primeiro). Para excluir, religue o node anterior além do excluído e devolva a célula à free list.
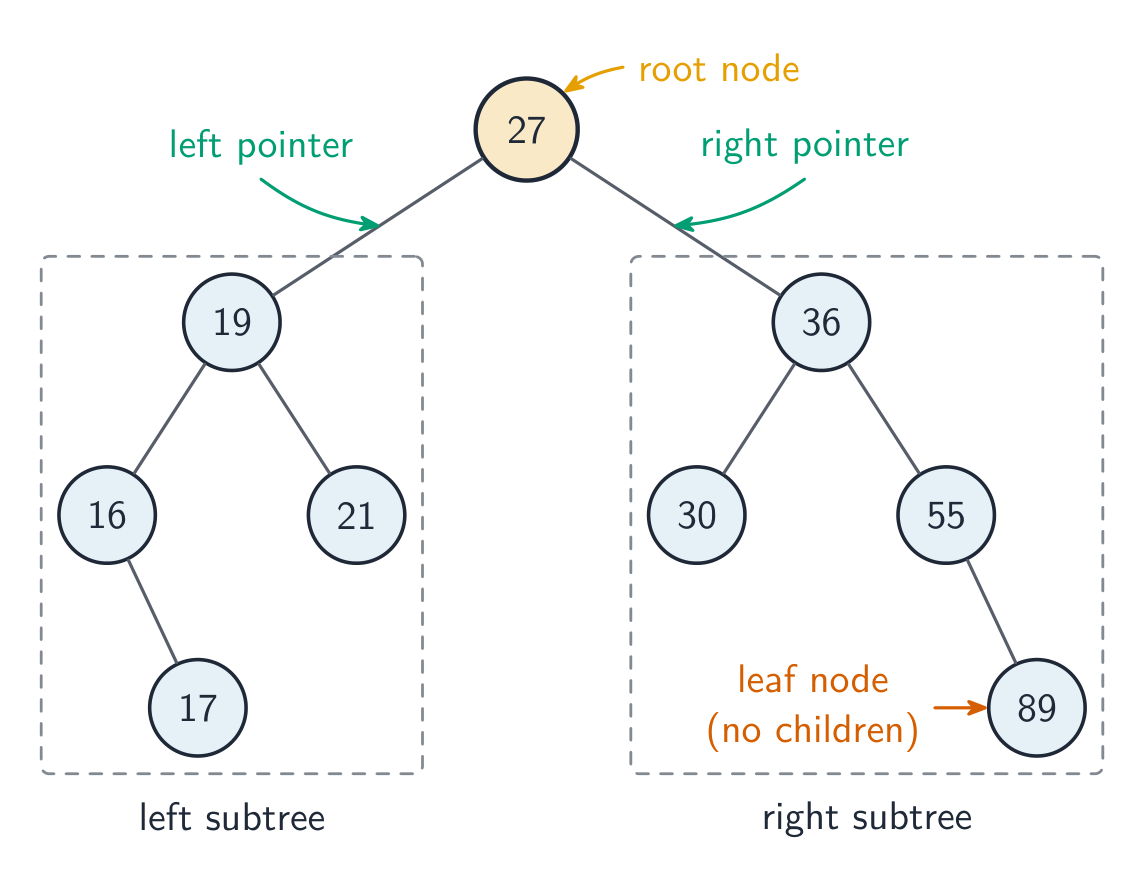
Binary tree: um nó root, cada nó segurando dados, um left pointer para um subtree de valores menores e um right pointer para um subtree de valores maiores. Implementado como um array 2D (ou três arrays 1D) Tree[Index, 0..2] para left pointer, dados, right pointer, com um root pointer e um next-free pointer.
FUNCTION FindInTree(Target : INTEGER) RETURNS INTEGER   // index, or -1
    DECLARE Current : INTEGER
    Current ← Root
    WHILE Current <> -1
        IF Tree[Current, 1] = Target THEN
            RETURN Current
        ENDIF
        IF Target < Tree[Current, 1] THEN
            Current ← Tree[Current, 0]      // go left
        ELSE
            Current ← Tree[Current, 2]      // go right
        ENDIF
    ENDWHILE
    RETURN -1
ENDFUNCTION
Para inserir: armazene o item no próximo nó livre com ambos os ponteiros $-1$; se a árvore estiver vazia, faça-a a root; caso contrário, percorra descendo da root, indo à esquerda ou à direita por comparação, até que o ponteiro que você seguiria fosse $-1$, e defina aquele ponteiro para o novo nó. Um ADT a partir de outro ADT: uma stack é uma linked list onde push e pop funcionam ambos no início; uma queue é uma linked list com um ponteiro de início e um de fim; uma queue pode ser feita a partir de duas stacks (push em uma, pop na outra, movendo tudo quando a segunda estiver vazia); os nós de uma binary tree são records ou objetos ligados por ponteiros, então é construído a partir de uma estrutura ligada de nós. Diga quais operações do novo ADT mapeiam para quais operações do antigo.
A primeira figura mostra uma árvore binária de busca: cada nó tem até dois nós filhos, valores menores que um nó ficam à sua esquerda e valores maiores ficam à sua direita. A segunda figura mostra as três maneiras de percorrer uma árvore.
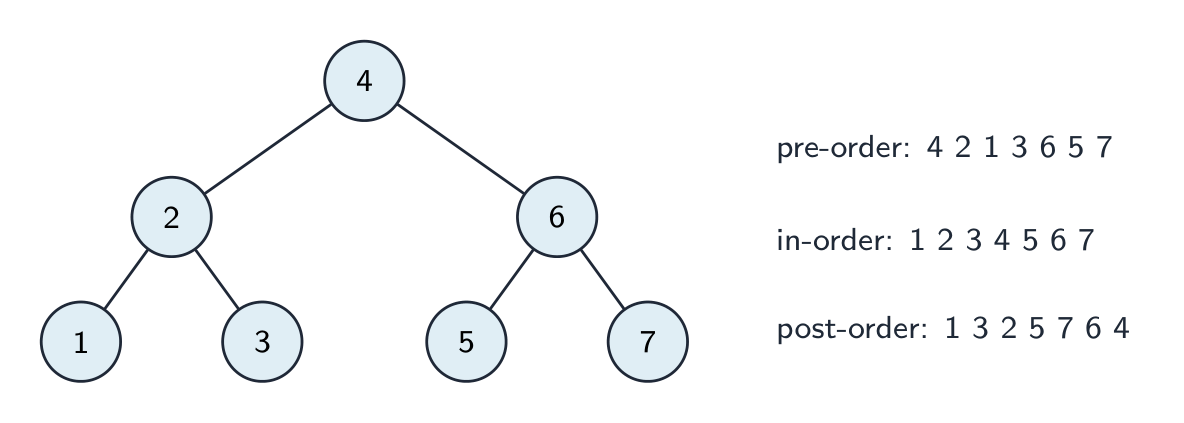 *Três travessias depth-first de uma binary tree: pre-order, in-order (ordem ordenada) e post-order
Vocabulário
Treinar
| English | Português |
|---|---|
| linked list/lɪŋkt lɪst/ | lista encadeada |
| stack/stæk/ | pilha |
| queue/kjuː/ | fila |
| node/nəʊd/ | nó |
| pointers/ˈpɔɪntəz/ | ponteiros |
| binary tree/ˈbaɪnəri triː/ | árvore binária |
| dictionary/ˈdɪkʃənəri/ | dicionário |
| circular queue/ˈsɜːkjʊlə kjuː/ | fila circular |
| free list/friː lɪst/ | lista livre |
| time complexity/taɪm kəmˈpleksɪti/ | complexidade temporal |
| Big-O notation/bɪɡ əʊ nəʊˈteɪʃn/ | notação Big-O |
| space complexity/speɪs kəmˈpleksɪti/ | complexidade espacial |
19.1
Comparando algoritmos
Complexidade temporal
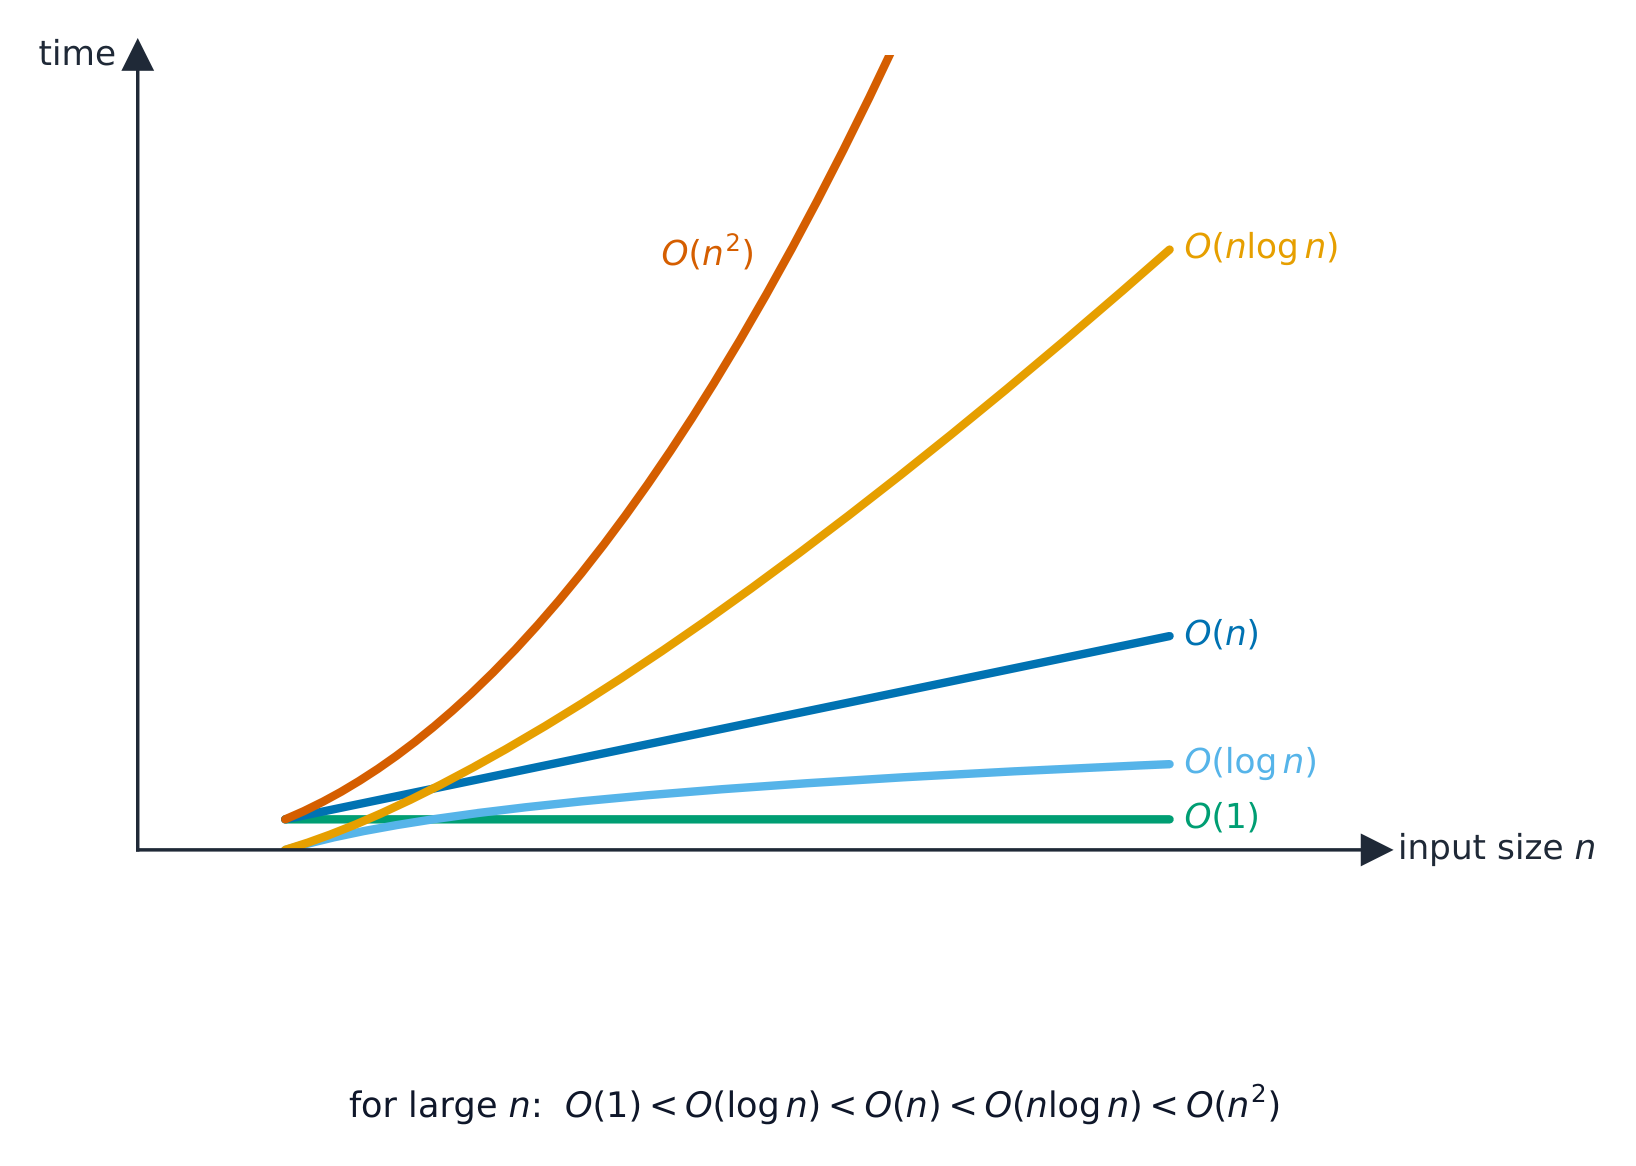
Complexidade temporal é como o tempo de execução cresce com o tamanho da entrada $n$, escrito em notação Big-O O (o termo dominante): O(1) constante, O($\log n$) busca binária, O($n$) busca linear, O($n \log n$) boas ordenações, O($n^{2}$) bubble/insertion sort. Uma ordem menor é melhor em escala, mesmo que outro algoritmo seja mais rápido para entradas pequenas $n$.
Para tornar isso concreto: para ordenar um milhão de itens, uma ordenação $O(n \log n)$ termina em fração de segundo, enquanto uma ordenação $O(n^{2})$ pode levar minutos.
Exemplo resolvido. Uma lista ordenada contém $1000$ itens. Quantas comparações cada busca precisa no pior caso?
Uma busca linear verifica itens um de cada vez, então pode precisar de até $1000$ comparações — isso é $O(n)$. Uma busca binária reduz a lista pela metade a cada passo, então precisa no máximo de $\lceil \log_2 1000 \rceil = 10$ comparações — isso é $O(\log n)$. Dobrar a lista para $2000$ itens adiciona apenas uma comparação à busca binária, mas até mais $1000$ à busca linear — que é por que a ordem de crescimento, não a velocidade bruta, decide o vencedor em escala.
Descrevendo uma ordem de complexidade. O(1): o tempo é constante, independentemente do número de itens (empilhar um item, ler um elemento de um vetor). O($\log n$): o tempo cresce com o logaritmo do número de itens, portanto dobrar os dados acrescenta apenas uma quantidade fixa de etapas (busca binária). O($n$): o tempo cresce proporcionalmente ao número de itens (busca linear, uma passagem por uma lista). O($n \log n$): um pouco pior que linear (ordenações eficientes). O($n^{2}$): o tempo cresce com o quadrado do número de itens, portanto dobrar os dados quadruplica o tempo (ordenações por bolha e por inserção). “Informe o Big O de uma busca binária em Names[0:99]” é respondido com $O(\log n)$, e “descreva seu significado” como acima; Big O mede como o tempo ou a memória cresce, não o tempo real.
Exemplo resolvido (a ordem de complexidade de um trecho de código). Informe a complexidade de tempo de cada trecho, em que n é o número de itens.
// Fragment A
FOR i ← 1 TO n
    FOR j ← 1 TO n
        Total ← Total + Grid[i, j]
    NEXT j
NEXT i

// Fragment B
Count ← 0
WHILE n > 1
    n ← n DIV 2
    Count ← Count + 1
ENDWHILE

// Fragment C
FOR i ← 1 TO n
    Total ← Total + A[i]
NEXT i
FOR i ← 1 TO n
    OUTPUT A[i] / Total
NEXT i
A é $O(n^{2})$: a instrução interna é executada $n$ vezes para cada uma das $n$ passagens externas, $n \times n$ no total. B é $O(\log n)$: $n$ é reduzido à metade em cada passagem, portanto o laço é executado aproximadamente $\log_2 n$ vezes (para $n = 64$, seis passagens). C é $O(n)$: dois laços um após o outro levam $n + n = 2n$ etapas, e as constantes são descartadas. A regra: laços aninhados multiplicam, laços em sequência somam, e apenas o termo que cresce mais rápido é mantido, portanto $3n^{2} + 5n + 2$ é $O(n^{2})$.
*Como as ordens comuns de crescimento se comparam: uma ordem menor vence em escala
Complexidade de espaço
Complexidade espacial é a memória extra necessária. Bubble sort e insertion sort usam O(1) extra (in-place); merge sort usa O($n$); recursão usa memória de pilha proporcional à sua profundidade. Frequentemente há um compromisso entre tempo e memória.
Outros critérios
Simplicidade (mais fácil de codificar e manter), estabilidade e adaptabilidade (mais rápido em dados quase ordenados). O algoritmo correto depende dos dados e das restrições.
Explorar
Como o tempo de execução cresce com n
Deslize n para cima e compare as curvas: O(1) e O(log n) permanecem quase planas, O(n) sobe consistentemente, O(n²) explode. É por isso que o Big-O — não um cronômetro — é como comparamos algoritmos em entradas grandes.
Explorar
Crescimento Big-O
Altere o tamanho da entrada n e compare quão rapidamente o trabalho de cada algoritmo cresce — a ideia por trás da complexidade temporal.
19.2
Recursão
Programa
| Os candidatos devem ser capazes de: | Notas e orientações |
|---|---|
| Demonstrar compreensão de recursão | Características essenciais da recursão. Como a recursão é expressa em uma linguagem de programação. Escrever e rastrear algoritmos recursivos. Quando o uso de recursão é benéfico |
| Demonstrar conhecimento do que um compilador precisa fazer para traduzir código de programação recursivo | Uso de pilhas e desenrolamento |
Fonte: Programa Cambridge International
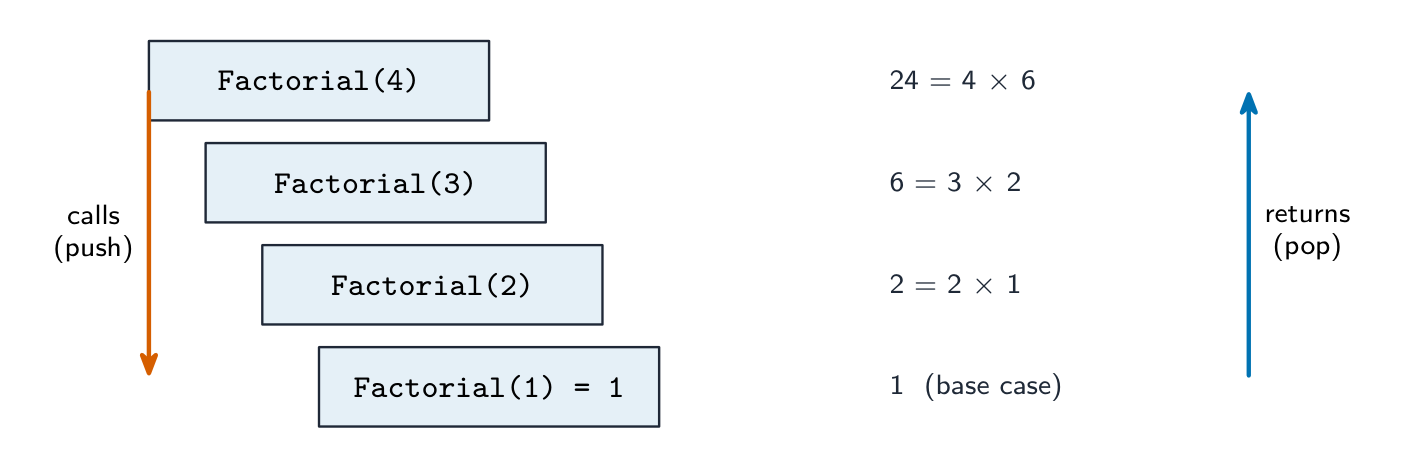
 *Chamadas descem até o caso base; resultados voltam para cima
Algoritmos recursivos usam recursão: a rotina chama a si mesma com uma versão menor do mesmo problema, até um caso base terminar a cadeia. Tem duas partes: o caso base (pequeno suficiente para ser resolvido diretamente — sem ele a recursão nunca para) e o caso recursivo (reduzir a entrada e chamar a si mesma).
Fatorial:
FUNCTION Factorial(n : INTEGER) RETURNS INTEGER
    IF n = 0 OR n = 1 THEN
        RETURN 1
    ELSE
        RETURN n * Factorial(n - 1)
    ENDIF
ENDFUNCTION
A recursão é natural para problemas autorreferentes: árvores, dividir e conquistar (busca binária, merge sort) e dados aninhados. Quando é um ajuste ruim, um loop geralmente é mais limpo.
“Descreva o que significa recursão” (dois pontos). Uma função ou procedimento definido em termos de si mesmo: ele chama a si mesmo dentro de seu próprio corpo, com uma versão menor do problema a cada vez, até atingir um caso base. “Apresente três características essenciais da recursão”: (1) um caso base (condição de parada) que retorna um valor sem outra chamada; (2) um caso geral em que a rotina chama a si mesma; (3) cada chamada aproxima o problema do caso base (o parâmetro é reduzido), para que a recursão termine. Alguns gabaritos acrescentam: os valores são retornados à medida que as chamadas são desempilhadas.
“Descreva quando o uso de recursão é benéfico e dê um exemplo.” Quando o problema é naturalmente definido em termos de versões menores de si mesmo, de modo que a solução recursiva seja mais curta, clara e próxima da definição matemática do que um laço: um fatorial ou número de Fibonacci, uma busca binária, o percurso de uma árvore binária, a ordenação por intercalação ou a ordenação rápida e o processamento de estruturas aninhadas, como pastas dentro de pastas. É uma escolha ruim quando a profundidade é grande (a pilha pode estourar) ou quando o mesmo subproblema é calculado muitas vezes (Fibonacci ingênuo).
Rastreando uma chamada recursiva
Para Factorial(4): as chamadas descem até Factorial(1)=1, depois desenrolar multiplica de volta para cima: 2*1=2, 3*2=6, 4*6=24. Resultado final 24. Rastreie cada chamada pendente numa pilha.
Exemplo resolvido. A função abaixo é dada sem explicação. Rastreie Unknown(3, 5) e indique a sua saída e valor de retorno.
FUNCTION Unknown(BYVAL X, BYVAL Y : INTEGER) RETURNS INTEGER
    IF X < Y THEN
        OUTPUT X + Y
        RETURN Unknown(X + 1, Y - 1) + 1
    ELSE
        RETURN 0
    ENDIF
ENDFUNCTION
Chamada 1: $X = 3, Y = 5$: $3 < 5$, saída 8, chama Unknown(4, 4). Chamada 2: $4 < 4$ é falso, retorna 0. Desenrolamento: chamada 1 retorna $0 + 1 = 1$. Saída 8, valor de retorno 1. Escreva o rastro como uma tabela com uma linha por chamada (parâmetros, condição, saída, o que retorna) e faça os retornos da chamada mais profunda para cima: este é o desenrolamento que o gabarito procura.
Exemplo resolvido (Fibonacci). Fib(n) retorna n quando n < 2, caso contrário Fib(n - 1) + Fib(n - 2). Encontre Fib(5).
Fib(5) = Fib(4) + Fib(3); Fib(4) = Fib(3) + Fib(2); Fib(3) = Fib(2) + Fib(1); Fib(2) = Fib(1) + Fib(0) = 1 + 0 = 1. Assim Fib(3) = 1 + 1 = 2, Fib(4) = 2 + 1 = 3, Fib(5) = 3 + 2 = 5. O caso base é alcançado muitas vezes (Fib(2) é calculado três vezes), razão pela qual esta versão é lenta: faz 15 chamadas para $n = 5$ e dobra aproximadamente as chamadas para cada aumento em $n$.
Converting recursion to iteration. Every recursive routine can be rewritten with a loop, which uses less memory and is faster: keep a running result and loop from the base case upwards. Factorial as a loop:
FUNCTION Factorial(N : INTEGER) RETURNS INTEGER
    DECLARE Result, Count : INTEGER
    Result ← 1
    FOR Count ← 2 TO N
        Result ← Result * Count
    NEXT Count
    RETURN Result
ENDFUNCTION
Ao ser solicitado a alterar uma ordenação por inserção recursiva ou busca em uma iterativa, substitua a auto-chamada por um ciclo sobre o índice pelo qual a recursão estava avançando, e transforme o caso base na condição de saída do ciclo.
Riscos
- recursão infinita se o caso base for omitido — falha com estouro de pilha.
- alto uso de memória para recursão profunda.
- lento se repetir trabalho (fibonacci ingênuo é exponencial — use um loop ou memorização).
Explorar
A recursão desenrola das folhas para cima
Passo a passo de fib(4) na ordem em que as chamadas realmente terminam: as folhas (casos base) resolvem primeiro, depois cada pai combina seus filhos. Note que fib(2) é calculado duas vezes — esse trabalho repetido é por que a recursão ingênua é lenta.
Vocabulário
Treinar
| English | Português |
|---|---|
| recursion/rɪˈkɜːʃn/ | recursão |
| base case/beɪs keɪs/ | caso base |
| recursive case/rɪˈkɜːsɪv keɪs/ | caso recursivo |
| factorial/fækˈtɔːrɪəl/ | fatorial |
| divide-and-conquer/dɪˈvaɪd ænd ˈkɒŋkə/ | divide-and-conquer |
| general case/ˈdʒenərəl keɪs/ | caso geral |
| parameters/pəˈræmɪtəz/ | parâmetros |
| stack overflow/stæk ˌəʊvəˈfləʊ/ | estouro de pilha |
| memoisation/ˌmeməʊaɪˈzeɪʃn/ | memorização |
| local variables/ˈləʊkl ˈveərɪəblz/ | variáveis locais |
| stack frame/stæk freɪm/ | quadro de pilha |
| return address/rɪˈtɜːn əˈdres/ | endereço de retorno |
19.2
O que o compilador faz para código recursivo
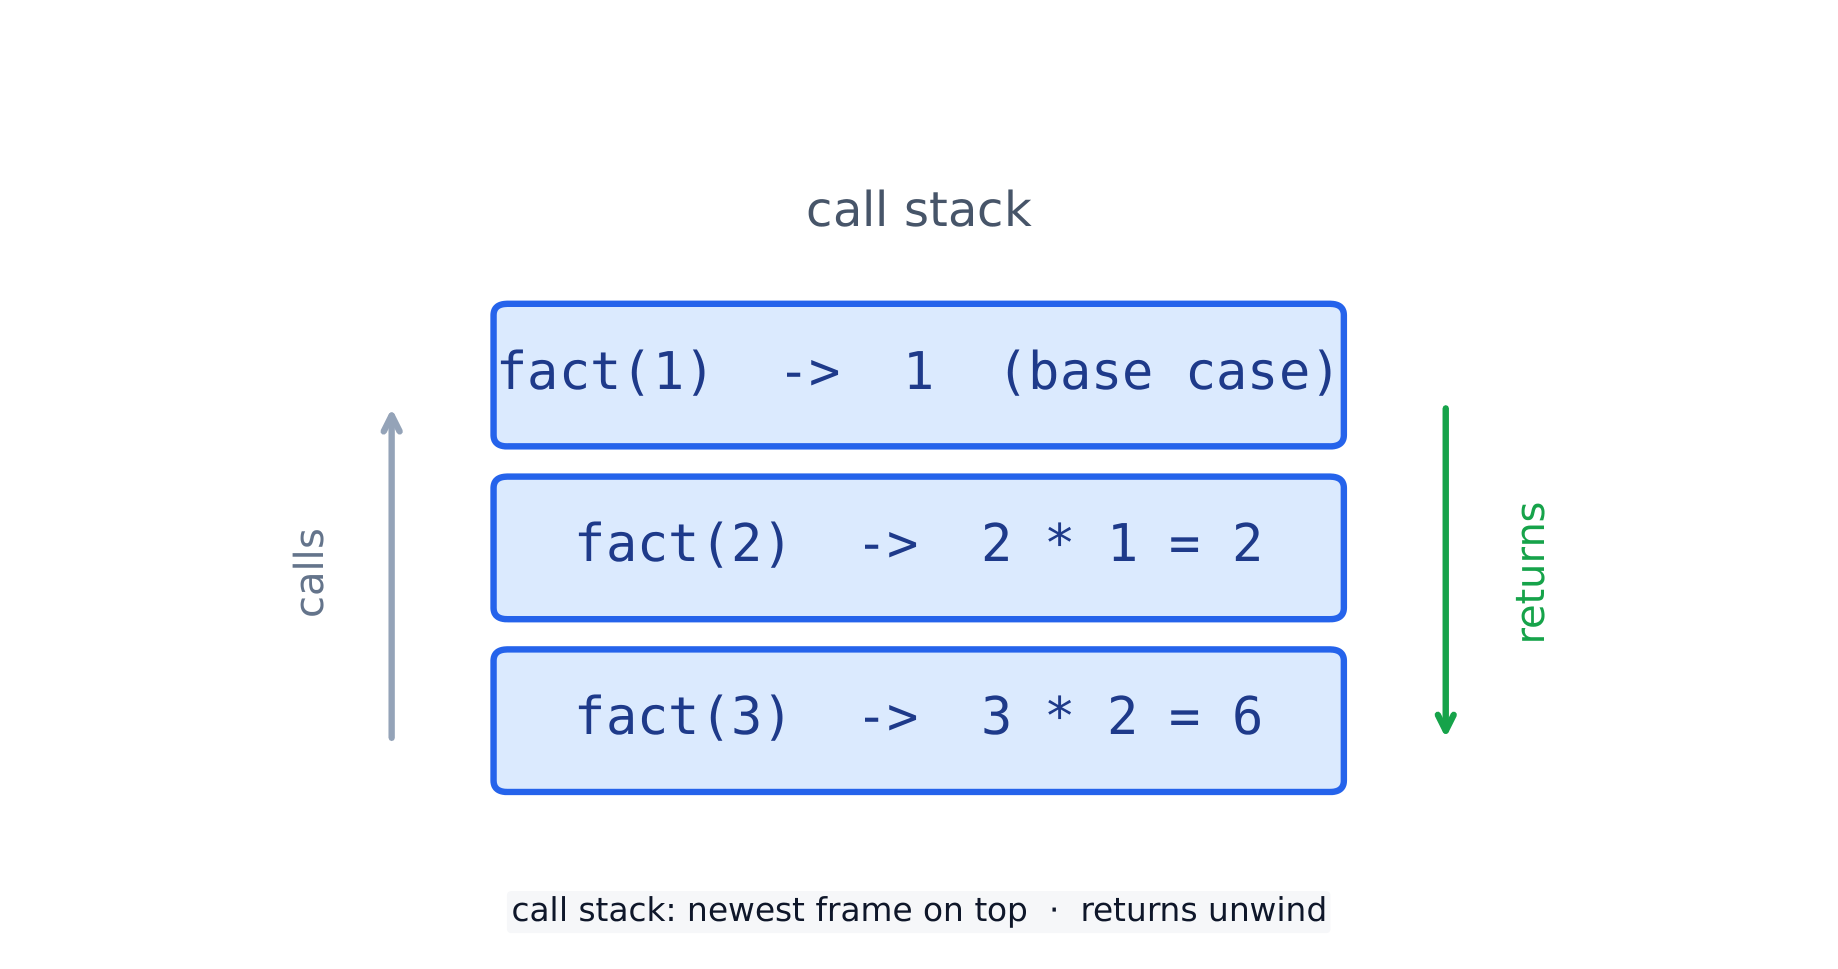
A recursão exige que cada chamada tenha sua própria cópia dos seus parâmetros e variáveis locais. O compilador armazena isso na pilha de chamadas. Para cada chamada, ele empilha um quadro de pilha contendo os parâmetros, as variáveis locais e o endereço de retorno (onde retomar no chamador). Quando a função retorna, o valor de retorno é entregue, o quadro é removido e o controle retoma no endereço de retorno.
Como cada chamada tem seu próprio quadro, as chamadas recursivas não sobrescrevem as variáveis umas das outras. A pilha pode crescer muito em uma recursão profunda, por isso uma recursão muito profunda pode causar seu estouro. Esse é o mesmo mecanismo de chamada e retorno usado para chamadas comuns (não recursivas) — não há um “mecanismo de recursão” especial.
“Explique por que uma pilha é adequada para implementar recursão” (três pontos). Cada chamada recursiva deve salvar seu endereço de retorno, seus parâmetros e suas variáveis locais, e as chamadas são concluídas na ordem inversa àquela em que foram feitas (a última chamada feita é a primeira a terminar), que é exatamente o comportamento último a entrar, primeiro a sair de uma pilha: cada nova chamada empilha um quadro e cada retorno desempilha o quadro mais recente, restaurando o estado de quem fez a chamada e indicando onde continuar. Essa é a função do compilador ao traduzir código recursivo: ele gera o empilhamento de um quadro a cada chamada e seu desempilhamento a cada retorno, e os quadros são desempilhados à medida que os resultados retornam.
Vocabulário
Treinar
| English | Português |
|---|---|
| call stack/kɔːl stæk/ | pilha de chamadas |
19.2
Definições aceitas pelo examinador
Uma questão de definição é avaliada contra wording fixo. Aprenda estas exatamente, e dê apenas uma resposta.
| Termo | Definição |
|---|---|
| busca linear | verificando cada item sucessivamente a partir do início até que o alvo seja encontrado ou o fim seja atingido |
| busca binária | comparando repetidamente o alvo com o item central de uma lista ordenada e descartando a metade que não pode contê-lo |
| bubble sort | passando repetidamente pela lista, trocando itens adjacentes que estão na ordem errada, até que uma passagem não realize trocas |
| insertion sort | pegando cada item sucessivamente e inserindo-o no seu lugar correto entre os itens já ordenados |
| tipo de dado abstrato | uma coleção de dados e as operações que podem ser realizadas sobre eles, definidas independentemente de como são armazenadas |
| pilha | uma estrutura último-entra-primeiro-sai com push e pop no topo |
| fila | uma estrutura primeiro-entra-primeiro-sai com itens adicionados na traseira e removidos da frente |
| lista ligada | uma sequência de nós, cada um segurando dados e um ponteiro para o próximo nó, com um ponteiro inicial |
| árvore binária | nós segurando dados e ponteiros para uma subárvore esquerda de valores menores e uma subárvore direita de valores maiores |
| notação Big O | uma forma de classificar o tempo (ou memória) que um algoritmo precisa dependendo de como cresce com o tamanho da entrada |
| recursão | uma rotina que chama-se a si mesma com uma versão menor do problema até que um caso base pare as chamadas |
| caso base | a condição sob a qual uma rotina recursiva retorna sem chamar-se a si mesma |
| desenrolamento | os retornos de uma cadeia de chamadas recursivas, da chamada mais profunda de volta à primeira, conforme os quadros de pilha são removidos |
19.2
Dicas de prova
- Buscas: linear não precisa de ordem e O($n$); binária precisa de um array ordenado, divide ao meio a cada passo e é O($\log n$). Saiba ambos os algoritmos de cor, incluindo os limites e a flag.
- Ordenações: bubble com flag de troca, insertion com chave que desloca itens maiores para a direita; ambos O($n^{2}$) no pior caso, O($n$) em dados ordenados. O desempenho depende do número de itens e do quão ordenados eles estão.
- Implementações de TDA são gerenciamento de ponteiros: um ponteiro superior; front, rear e count com MOD; start, ponteiros e uma lista livre; raiz com ponteiros esquerdo e direito. Sempre verifique se está cheio e vazio.
- Big O trata do crescimento: constante, logarítmico, linear, quadrático. Diga “dobrar os dados acrescenta uma comparação” para uma busca binária.
- Recursão: caso base, caso geral, progresso em direção ao caso base; benéfico quando o problema é definido em termos de si mesmo; uma pilha guarda os endereços de retorno e variáveis porque as chamadas retornam em ordem inversa. Rastreie com uma tabela e desenrole da chamada mais profunda.
Erros comuns
- Ao escrever $O(2n)$ ou $O(n^{2} + n)$: descarte constantes e termos menores, obtendo $O(n)$ e $O(n^{2})$.
- Ao calcular o índice do meio como $(Lower + Upper) / 2$ em um acompanhamento: a versão da prova usa
DIV, portanto arredonde para baixo. - Usar uma busca binária em dados não ordenados, ou em uma lista ligada; e definir
Lower ← MiddleIndexem vez deMiddleIndex + 1, o que loopa eternamente. - Um loop interno de bubble sort que roda até o fim do array a cada passada, ou uma troca sem variável temporária.
- Um push ou enqueue que não testa para cheio, ou um pop ou dequeue que não testa para vazio.
- Mover o ponteiro frontal da fila sem MOD em uma fila circular, ou tratar front = rear como significando sempre vazio.
- Inserir em uma lista ligada deslocando o conteúdo do array; apenas os ponteiros mudam.
- Uma função recursiva sem caso base, ou cujas chamadas recursivas não tornam o problema menor.
- Rastrear uma chamada recursiva mas esquecer adicionar o trabalho pendente no caminho de volta para cima.
- Responder “por que uma pilha” com “porque é rápida”; o motivo é a ordem dos retornos, em que o último a entrar é o primeiro a sair.
Aulas interativas sobre este tópico
Passe por ele passo a passo, com exercícios de verificação instantânea.