| Os candidatos devem ser capazes de: | Notas e orientações |
|---|---|
| Demonstrar compreensão do modelo básico Von Neumann para um sistema computacional e do conceito de programa armazenado | |
| Demonstrar compreensão do propósito e papel dos registros, incluindo a diferença entre registros de uso geral e registros de uso especial | Registros de uso especial incluem: • Contador de Programa (PC) • Registrador de Dados de Memória (MDR) • Registrador de Endereço de Memória (MAR) • O Acumulador (ACC) • Registrador Indexado (IX) • Registrador de Instrução Atual (CIR) • Registrador de Status |
| Demonstrar compreensão do propósito e papéis da Unidade Aritmética e Lógica (ALU), Unidade de Controle (CU) e relógio do sistema, Armazenamento de Acesso Imediato (IAS) | |
| Demonstrar compreensão de como os dados são transferidos entre vários componentes do sistema computacional usando o ** barramento de endereços**, barramento de dados e barramento de controle | |
| Demonstrar compreensão de como fatores contribuem para o desempenho do sistema computacional | Incluindo: • tipo de processador e número de cores • a largura do barramento • velocidade do clock • memória cache |
| Compreender como diferentes portas fornecem conexão para dispositivos periféricos | Incluindo conexão para: • Universal Serial Bus (USB) • High Definition Multimedia Interface (HDMI) • Video Graphics Array (VGA) |
| Descrever as etapas do ciclo Fetch-Execute (F-E) | Descrever e usar notação de 'register transfer' para descrever o ciclo F-E |
| Demonstrar compreensão do propósito de interrupções | Incluindo: • possíveis causas de interrupções • aplicações de interrupções • uso de uma Rotina de Serviço de Interrupção (ISR) • quando as interrupções são detectadas durante o ciclo fetch-execute • como as interrupções são tratadas |
Fundamentos do Processador
Ciência da Computação A-Level · Tópico 4
 21:23
Arquitetura Von Neumann
Durante a maior parte da história, uma máquina fazia um trabalho. Um tear tecia pano. Uma calculadora somava. Para fazê-la fazer algo novo, você a reconstituía. Depois veio algo decepitivamente simples…
Narração em inglês · legendas em inglês e 中文 que você pode alternar
4.1
Arquitetura Von Neumann
Programa
Fonte: Programa Cambridge International
A arquitetura Von Neumann fundamenta quase todos os computadores de propósito geral:
- uma memória única — a Memória de Acesso Imediato (IAS) — armazena tanto instruções do programa quanto dados (conceito de programa armazenado).
- um processador (CPU) busca instruções na memória e as executa uma de cada vez.
- as instruções rodam em ordem a menos que uma branch altere o fluxo.
A ideia de stored-program é o que torna um computador flexível: mude o programa e você muda o que ele faz, sem reconfigurar cabos.
Explorar
Toque nas partes de um computador Von Neumann
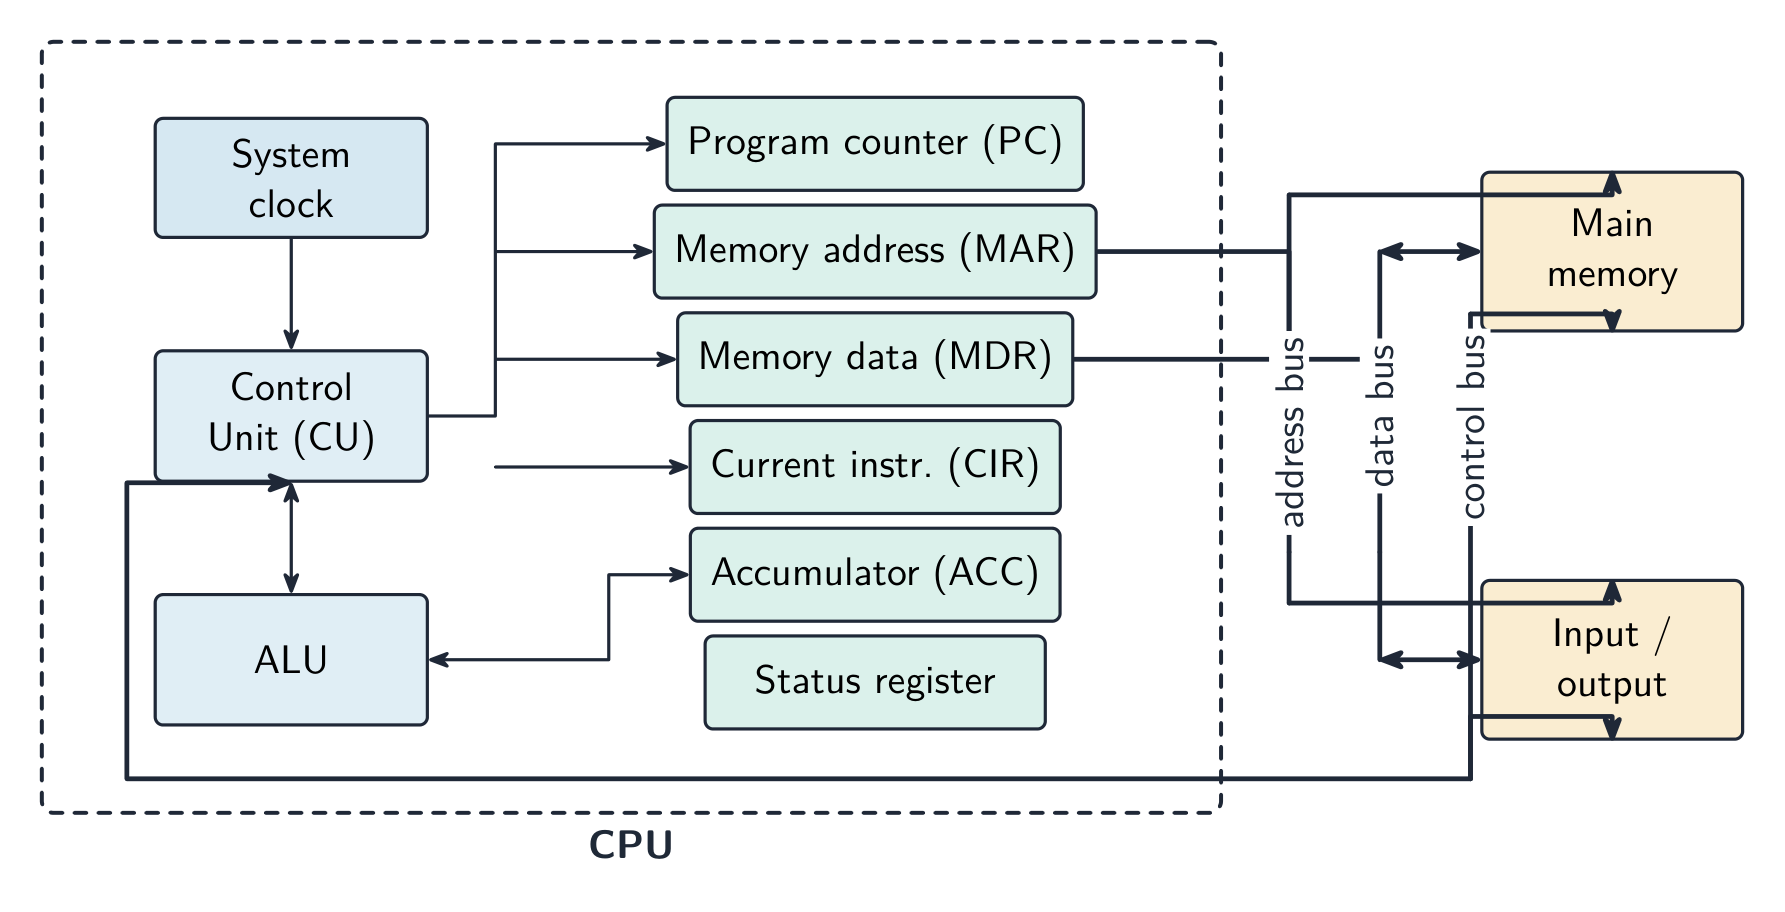
Explore cada bloco. A CPU (unidade de controle, ALU, registradores) fala com uma única memória principal pelos barramentos — e esse único espaço de memória compartilhado para instruções E dados é a ideia de Von Neumann.
Vocabulário
Treinar
| English | Português |
|---|---|
| stored program/stɔːd ˈprəʊɡræm/ | Programa Armazenado |
| processor/ˈprəʊsesə/ | Processador |
| arithmetic and logic unit/ˌærɪθˈmetɪk ənd ˈlɒdʒɪk ˈjuːnɪt/ | unidade aritmética e lógica |
| RAM/ræm/ | RAM |
| page/peɪdʒ/ | página |
4.1
Principais partes da CPU
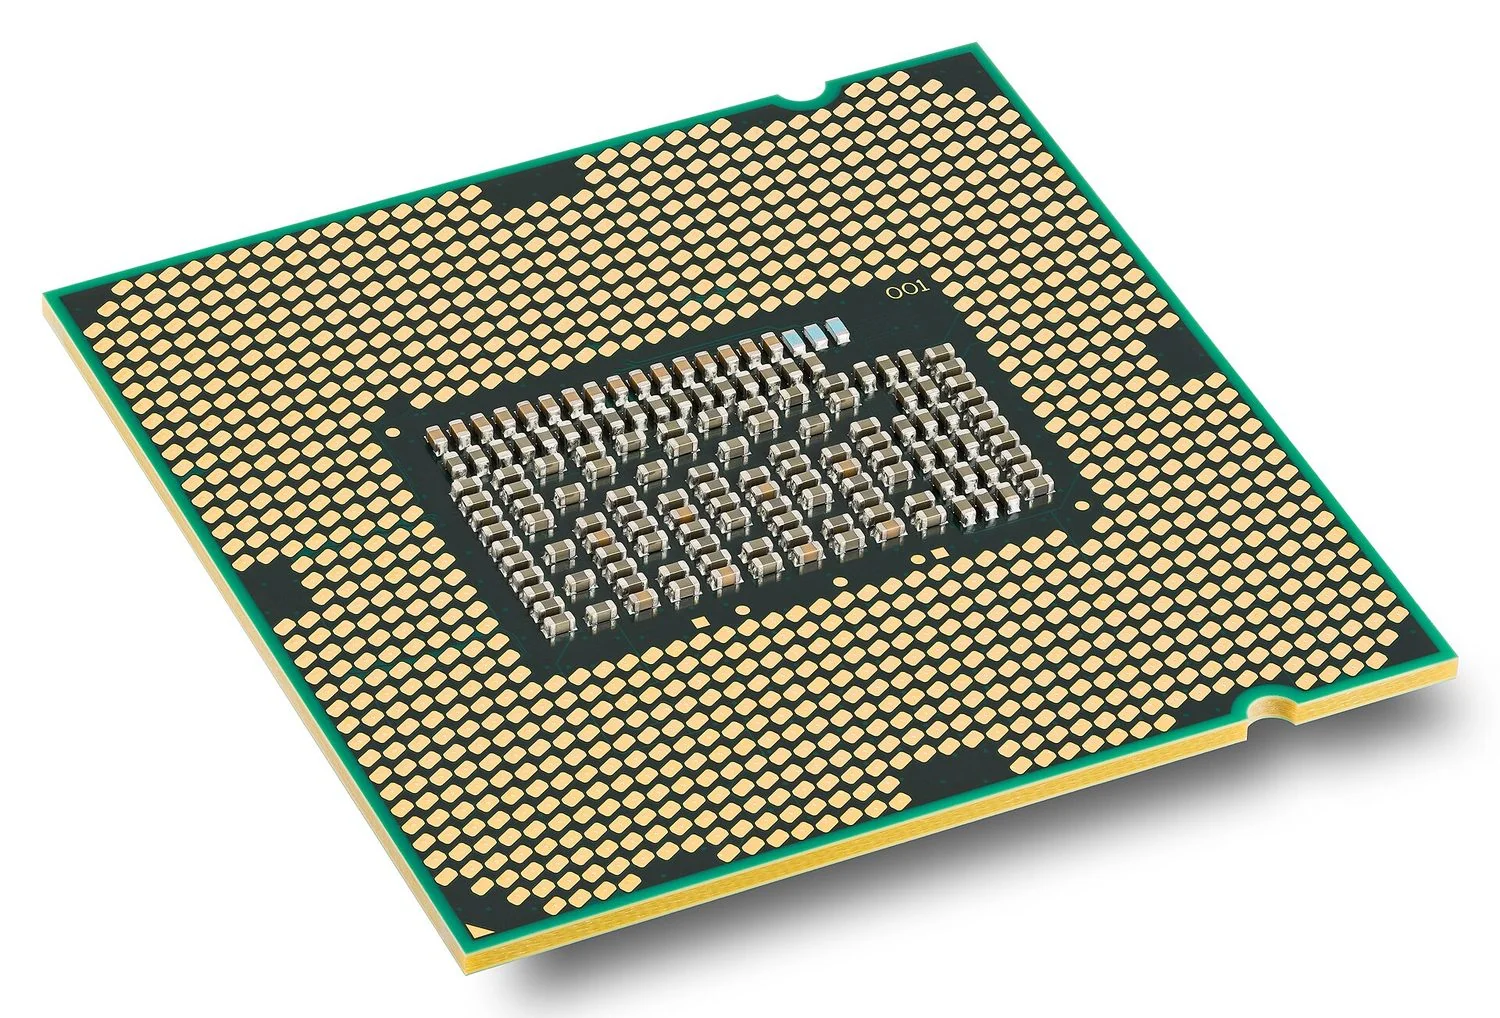
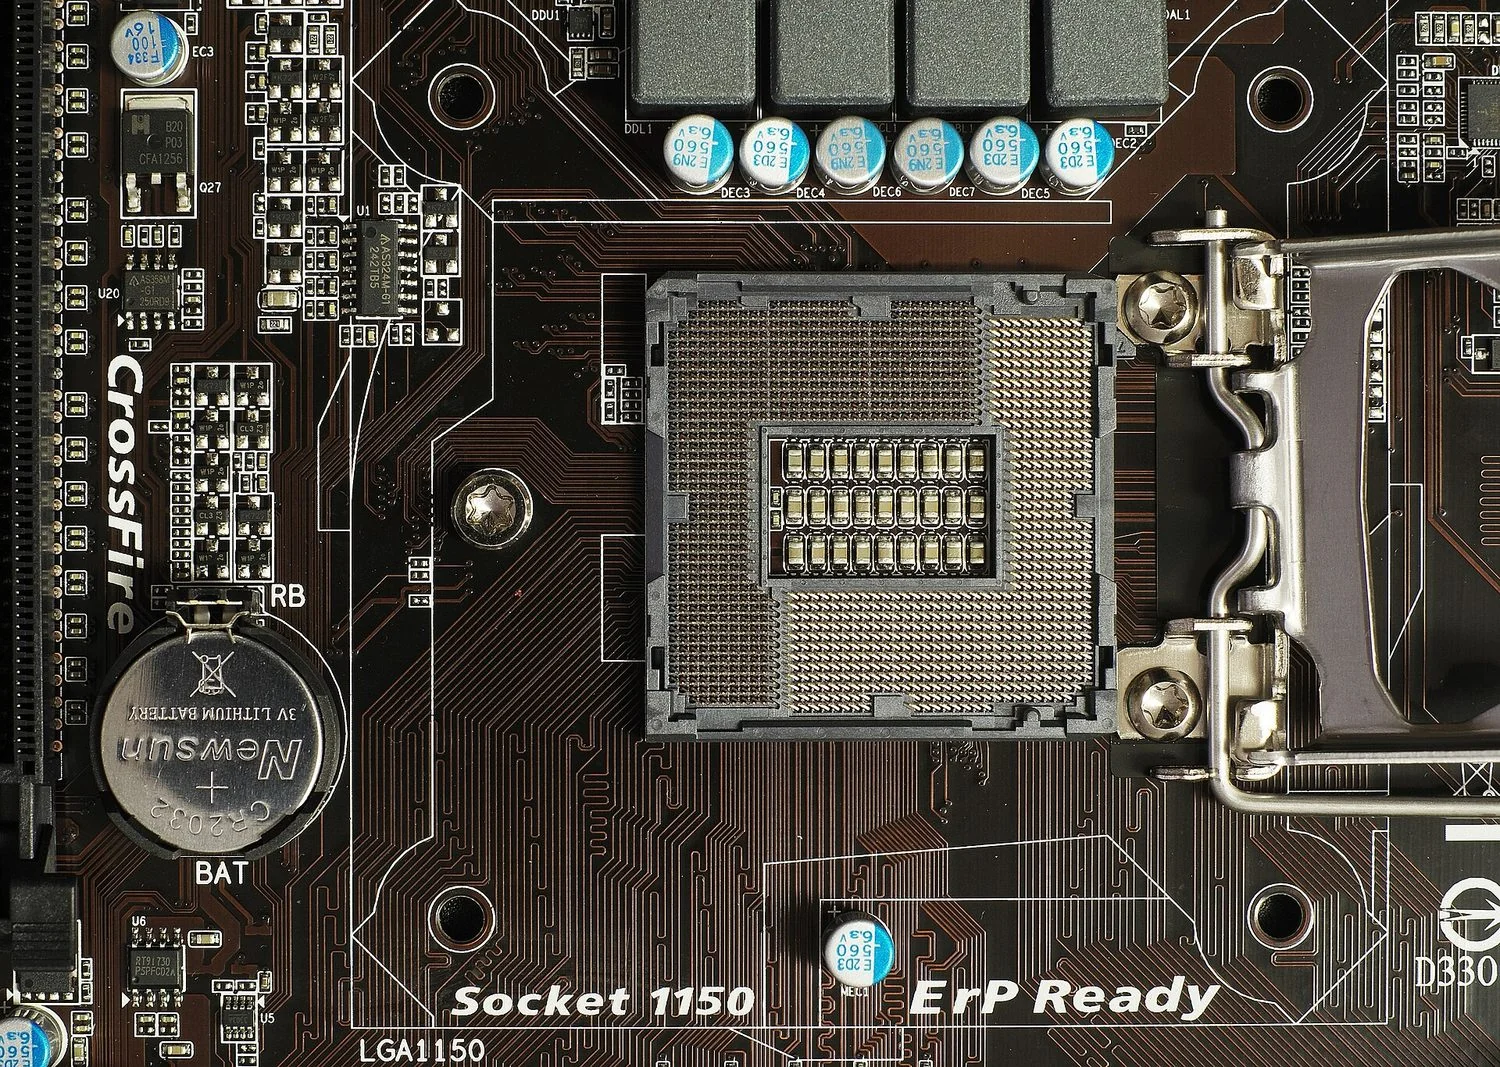
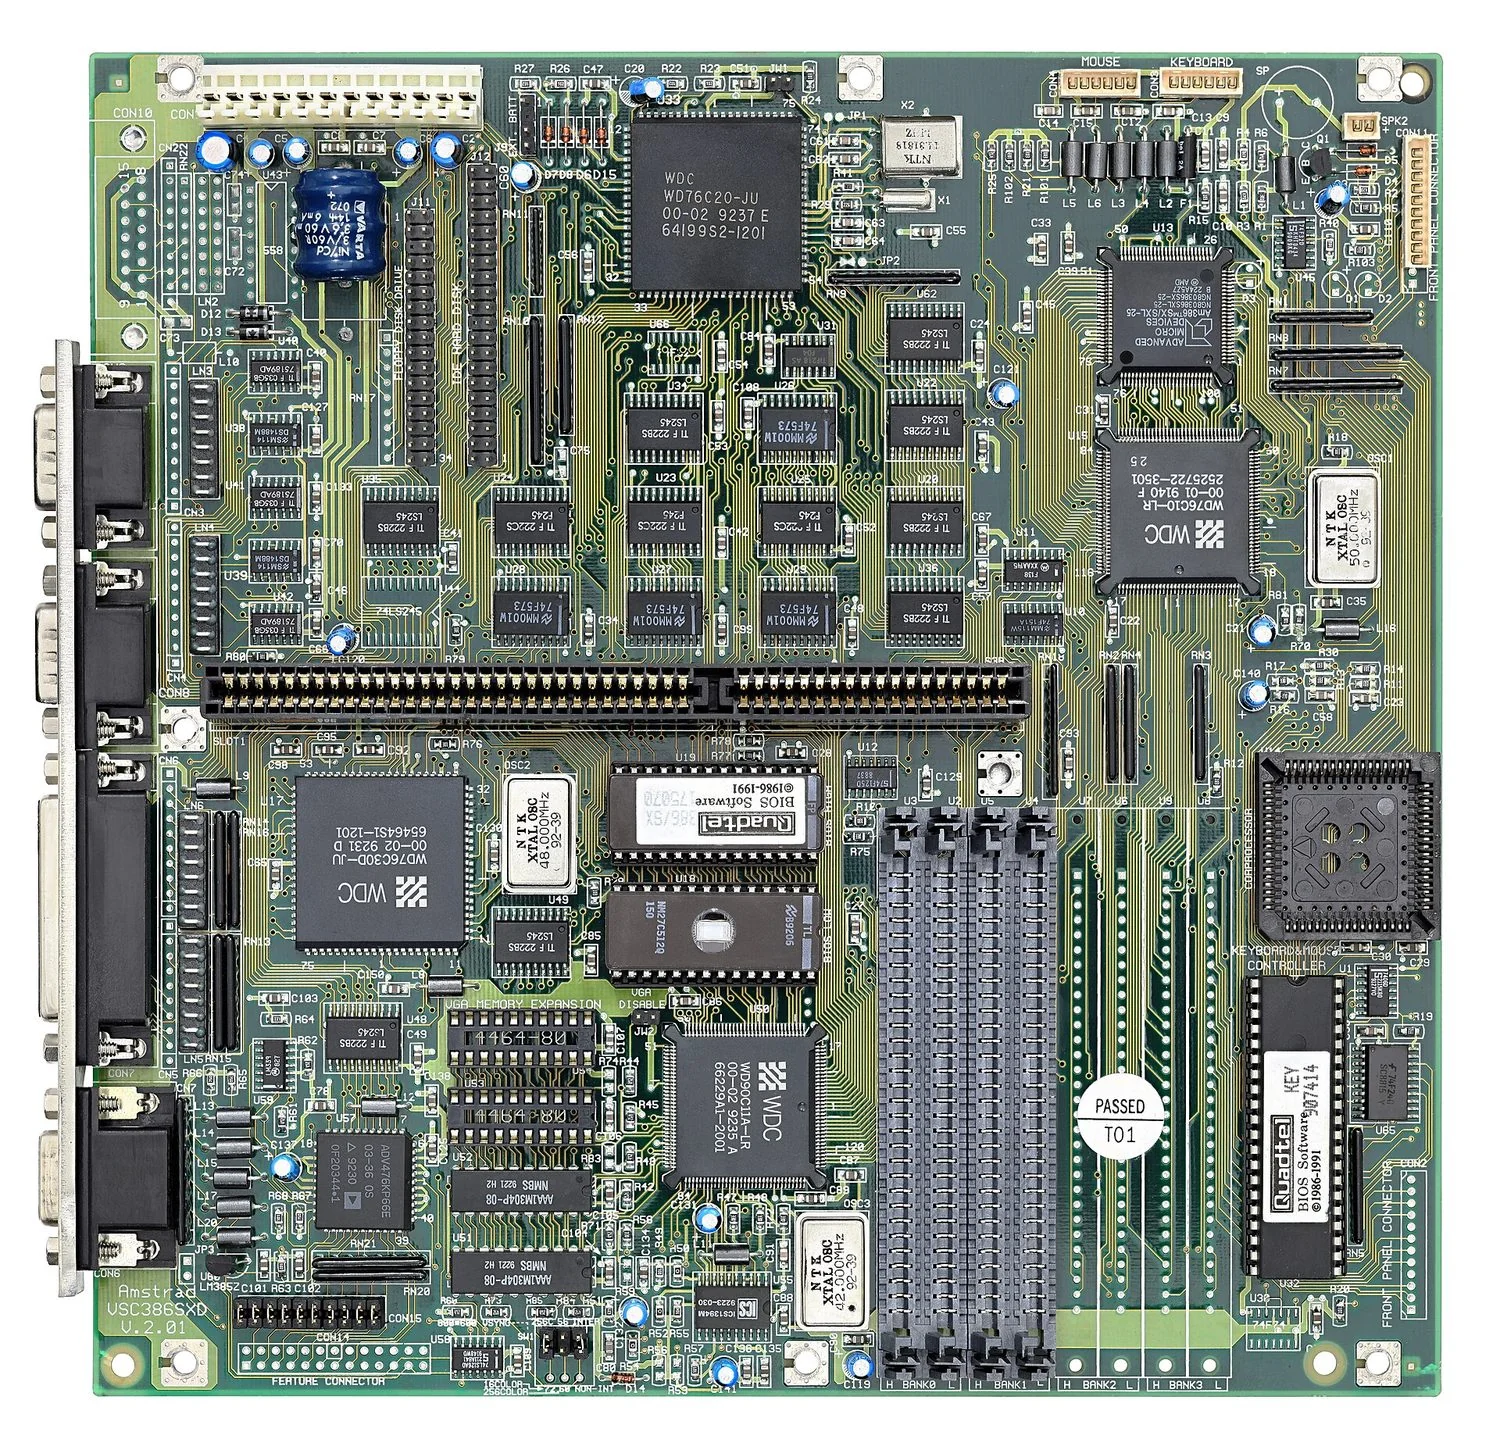
Todas essas partes estão dentro de um único chip pequeno. O diagrama mais adiante nesta seção mostra como elas se conectam; a foto abaixo mostra o real.
Unidade Aritmética Lógica (ALU)
A ALU realiza operações aritméticas (soma, subtração, …) e lógicas (AND, OR, comparações). Ela recebe operandos dos registros e armazena resultados de volta em um registro.
Unidade de Controle (CU)
A unidade de controle decodifica cada instrução e envia os sinais de controle para executá-la — abrindo caminhos de dados, informando à ALU o que fazer e controlando leituras e gravações na memória.
Relógio do sistema
O clock envia uma sequência constante de pulsos que mantêm a CPU sincronizada. Cada instrução leva um número fixo de ciclos, e a velocidade do clock (ex. 3.8 GHz) é um fator no desempenho.
"Explique como a CU e o relógio do sistema trabalham juntos": o relógio emite pulsos em uma frequência fixa; a unidade de controle usa cada pulso para avançar o ciclo fetch-execute em um passo, enviando seus sinais de controle sincronizados com os pulsos, assim toda parte do processador muda de estado junto. Um clock mais rápido significa mais passos por segundo, até o ponto em que os circuitos não conseguem se estabilizar entre os pulsos.
Registros
Os registradores são pequenas e muito rápidas unidades de armazenamento dentro da CPU. Os registradores de uso específico têm uma função fixa no ciclo:
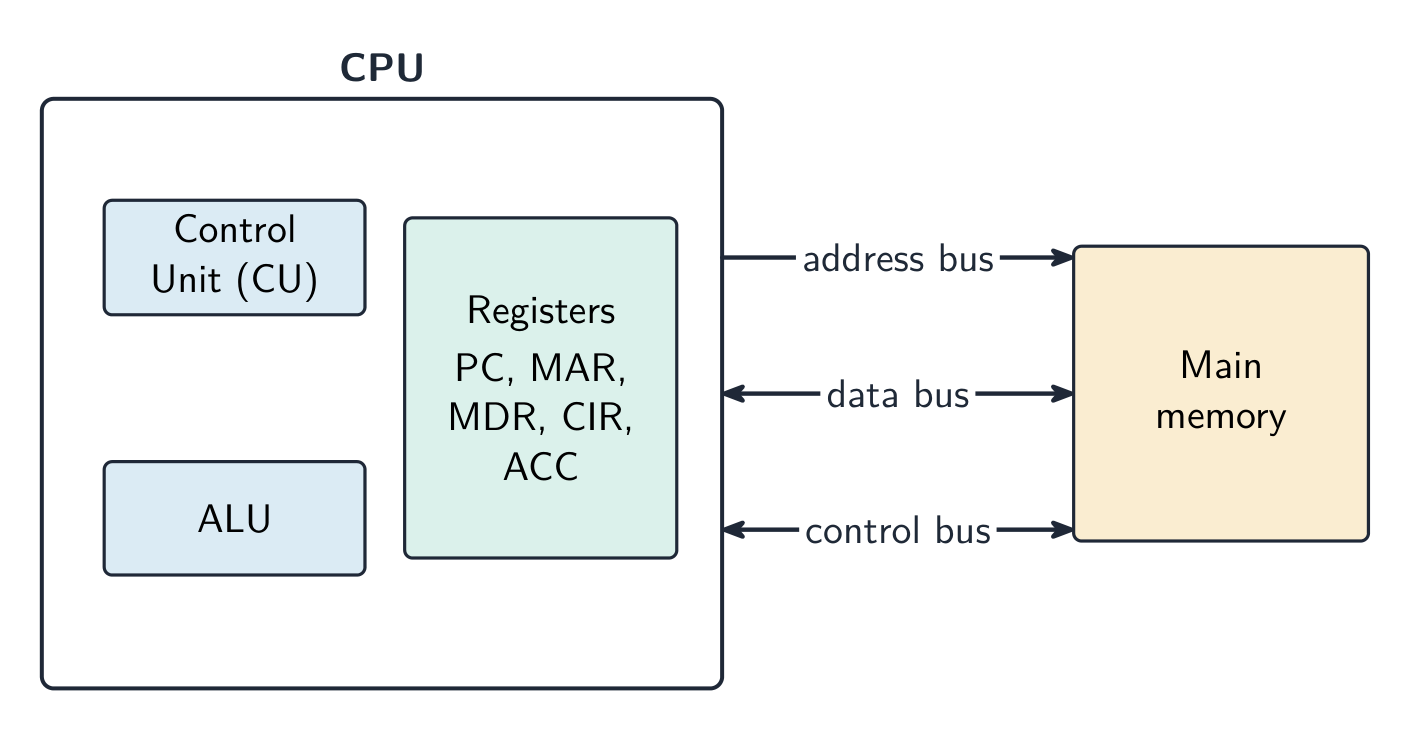
- Contador de Programa (PC) — o endereço da próxima instrução.
- Registrador de Endereço de Memória (MAR) — o endereço sendo lido ou gravado.
- Registrador de Dados de Memória (MDR) — os dados indo ou vindo da memória.
- Registrador de Instrução Atual (CIR) — a instrução sendo decodificada.
- Aumulador (ACC) — o valor com o qual a ALU está trabalhando.
- Registrador de Status — armazena flags (carry, zero, negativo, overflow) usadas por desvios. Cada flag é um bit, definido ou limpo pela ALU após uma operação: a flag zero após uma comparação que correspondeu, a flag carry quando uma adição transbordou o registrador, a flag negativo quando um resultado é negativo. Um salto condicional lê as flags para decidir se deve desviar, e uma flag de overflow pode gerar uma interrupção.
- Registrador de Índice — um offset adicionado a um endereço em endereçamento indexado; incrementá-lo percorre um array um elemento por vez.
A questão "complete a tabela descrevendo o papel de cada registro" quer uma frase precisa por registro nestes termos: o PC armazena o endereço da próxima instrução a ser buscada; o MAR armazena o endereço do local sendo lido ou escrito; o MDR armazena os dados ou instrução acabados de serem lidos desse local, ou prestes a serem gravados; o CIR armazena a instrução atualmente sendo decodificada e executada; o ACC armazena o resultado da última operação aritmética ou lógica.
Registradores de uso geral são usados pelo programador para valores temporários durante um cálculo. Movimentações de dados entre registradores e memória são escritas na notação transferência de registrador — ex.: MAR ← [PC] ("copiar o conteúdo do PC para o MAR").
Vocabulário
Treinar
| English | Português |
|---|---|
| Von Neumann architecture/vɒn ˈnɔɪmən ˈɑːkɪtektʃə/ | Arquitetura de Von Neumann |
| Immediate Access Store/ɪˈmiːdɪət ˈækses stɔː/ | Armazenamento de Acesso Imediato |
| ALU/ˌeɪ el ˈjuː/ | ALU |
| operand/ˈɒpərænd/ | operando |
| flags/flæɡz/ | flags |
| bit/bɪt/ | bit |
| buses/ˈbʌsɪz/ | Barramentos |
| address bus/əˈdres bʌs/ | barragem de endereços |
4.1
Barramentos
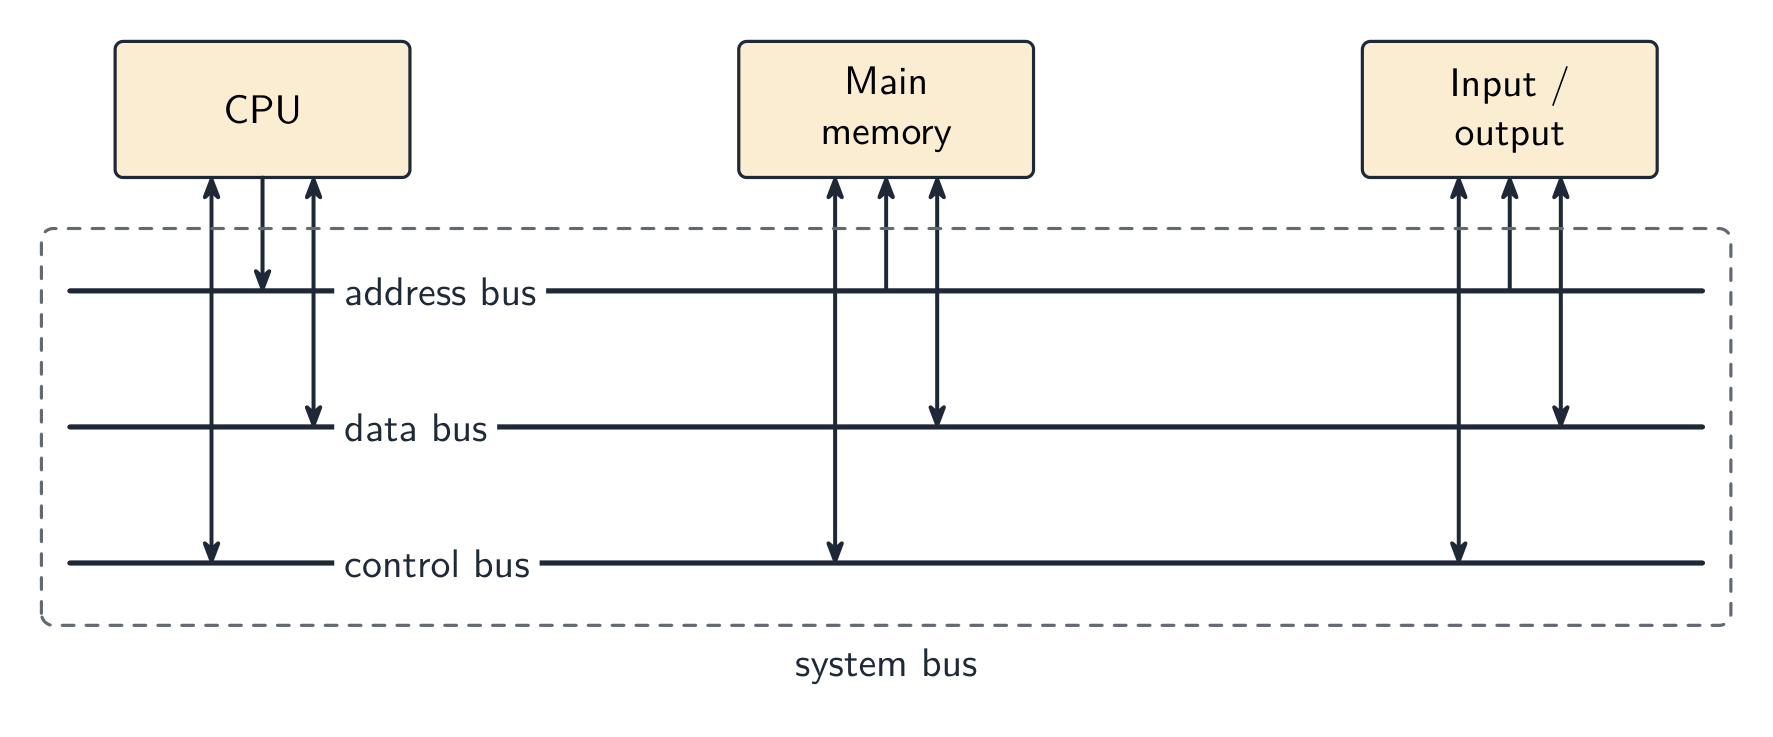
Três barramentos internos (conjuntos de fios paralelos) conectam as partes:
- barramento de endereço — transporta o endereço de memória. Unidirecional (CPU → memória).
- barramento de dados — transporta os dados. Bidirecional.
- barramento de controle — transporta sinais de controle (leitura, escrita, interrupção). Bidirecional.
Um barramento de endereços de $n$ bits pode acessar $2^{n}$ locais de memória. A largura do barramento de dados determina quantos bits são transferidos por acesso (frequentemente o tamanho da palavra).
Vocabulário
Treinar
| English | Português |
|---|---|
| port/pɔːt/ | porta |
| peripheral/pəˈrɪfərəl/ | periférico |
| register transfer notation/ˈredʒɪstə ˈtrænsfɜː nəʊˈteɪʃn/ | notação de transferência de registos |
| interrupt service routine/ˈɪntərʌpt ˈsɜːvɪs ruːˈtiːn/ | rotina de serviço de interrupção |
| interrupt register/ˈɪntərʌpt ˈredʒɪstə/ | registo de interrupção |
4.1
O que afeta o desempenho
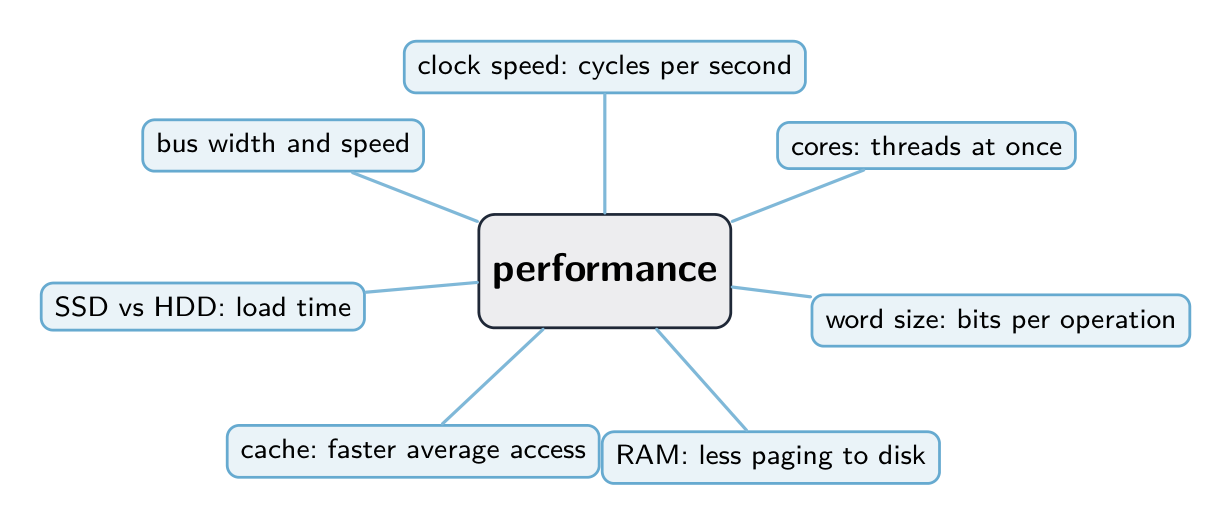
- clock speed — mais ciclos por segundo.
- número de núcleos — uma CPU multi-núcleo executa vários threads simultaneamente.
- tamanho da palavra — uma CPU de 64-bits processa blocos de 64-bits por ciclo e pode endereçar muito mais memória do que uma de 32-bits.
- quantidade de RAM — mais RAM armazena mais do conjunto ativo; pouca força o SO a fazer paginação para disco.
- tamanho da memória cache — mais cache reduz o tempo médio de acesso à memória.
- tipo de armazenamento secundário — um SSD carrega programas muito mais rápido que um HDD.
- bus width and speed — barramentos mais largos/rapidos movem dados mais rapidamente.
Combine as especificações com a carga de trabalho: uma quad-core supera uma dual-core em trabalhos paralelos, mas maior velocidade por core vence em trabalho single-threaded.
Cada fator é uma resposta de duas marcas com uma razão associada:
- More cores: cada core pode buscar e executar sua própria instrução ao mesmo tempo, então vários programas, ou os threads de um programa, executam em paralelo. Mas um programa deve ser escrito para usar mais de um core, então duplicar os cores não duplica a velocidade.
- Higher clock speed: mais ciclos de busca-execução por segundo, então mais instruções por segundo; o limite é o calor gerado.
- Wider bus: um barramento de dados mais largo move mais bits em cada transferência, então menos transferências são necessárias para os mesmos dados; um barramento de endereços mais largo pode acessar mais locais de memória.
- Cache memory: uma memória pequena e rápida dentro ou ao lado do processador que mantém as instruções e os dados usados mais recentemente ou com mais frequência. Lê-los do cache é muito mais rápido que da RAM, então o processador passa menos tempo esperando.
"Explique por que o novo computador tem melhor desempenho" responde-se comparando as duas especificações linha por linha: maior clock speed executa mais instruções por segundo, mais cores executam mais tarefas ao mesmo tempo, mais cache significa menos acessos lentos à RAM, e mais RAM significa menos transferências para o disco.
Vocabulário
Treinar
| English | Português |
|---|---|
| clock speed/klɒk spiːd/ | Velocidade do Relógio |
| cores/kɔːz/ | núcleos |
| amount of RAM/əˈmaʊnt ɒv ræm/ | quantidade de RAM |
| cache memory/kæʃ ˈmeməri/ | memória cache |
| cache/kæʃ/ | cache |
| secondary storage/ˈsekəndəri ˈstɔːrɪdʒ/ | armazenamento secundário |
4.1
Portas
Uma porta é um conector físico para ligar um periférico:
- USB (Universal Serial Bus) — uso geral (teclados, drives, telefones).
- HDMI (High Definition Multimedia Interface) — vídeo digital e áudio para uma tela.
- VGA (Video Graphics Array) — saída de vídeo analógica antiga para um monitor.
- Ethernet (RJ-45) — LAN cablada. Jacks de áudio — fones de ouvido/microfone.
Portas diferentes usam sinais diferentes, então um cabo HDMI não se encaixa em uma porta USB. O USB-C é incomum por transportar vídeo, dados e energia.
"Explique como o computador se conecta ao monitor através do HDMI": a porta HDMI envia o vídeo e o áudio como um único sinal digital por um único cabo, então nenhuma conversão para analógico é necessária e a imagem não é degradada; o cabo suporta resoluções de alta definição e a própria porta do monitor decodifica o sinal. Um dispositivo USB é plug-and-play: quando conectado, o computador o detecta, identifica-o, carrega ou instala o driver necessário, e pode fornecer energia, tudo sem reinicialização.
4.1
Ciclo Fetch-Execute
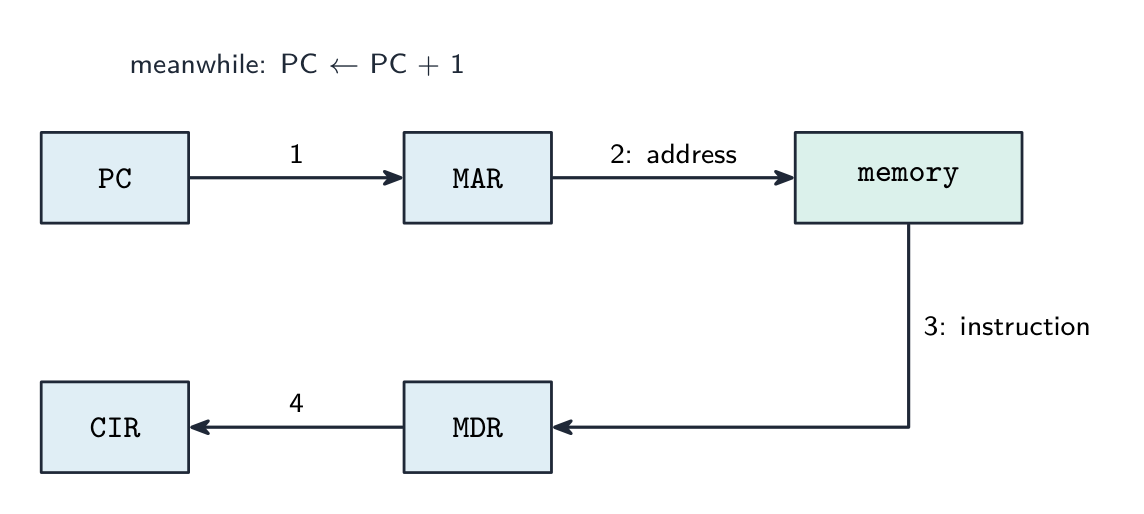
A CPU repete o ciclo busca-execução, uma execução por instrução de máquina.
Fetch
- o endereço do PC é copiado para o MAR.
- o PC é incrementado para apontar para a próxima instrução.
- um sinal de read vai pelo barramento de controle.
- a memória coloca a instrução no barramento de dados.
- ela é copiada para o MDR, depois para o CIR.
A prova pede esses passos em notação de transferência de registro, onde [X] significa o conteúdo do registro X e [[MAR]] significa o conteúdo da localização de memória cujo endereço está no MAR:
MAR ← [PC]          the address of the next instruction goes to the MAR
PC  ← [PC] + 1      the PC now points to the following instruction
MDR ← [[MAR]]       the instruction at that address is read into the MDR
CIR ← [MDR]         the instruction is copied into the CIR for decoding
A ordem importa: o PC é incrementado imediatamente após seu endereço ser copiado, para que um jump executado posteriormente ainda possa sobrescrevê-lo. Durante a execução, a mesma notação descreve cada instrução; para LDD 200, por exemplo, MAR ← 200, MDR ← [[MAR]], ACC ← [MDR].
*As transferências de registro em uma busca: PC → MAR → memory → MDR → CIR, com o PC incrementado
Decode
A CU decodifica a instrução no CIR — qual operação e quais operandos ou endereços.
Execute
A CU a executa: aritmética/lógica vai para a ALU (resultado para o ACC); load/store move dados entre memória e um registro; um branch altera o PC. Então o ciclo se repete.
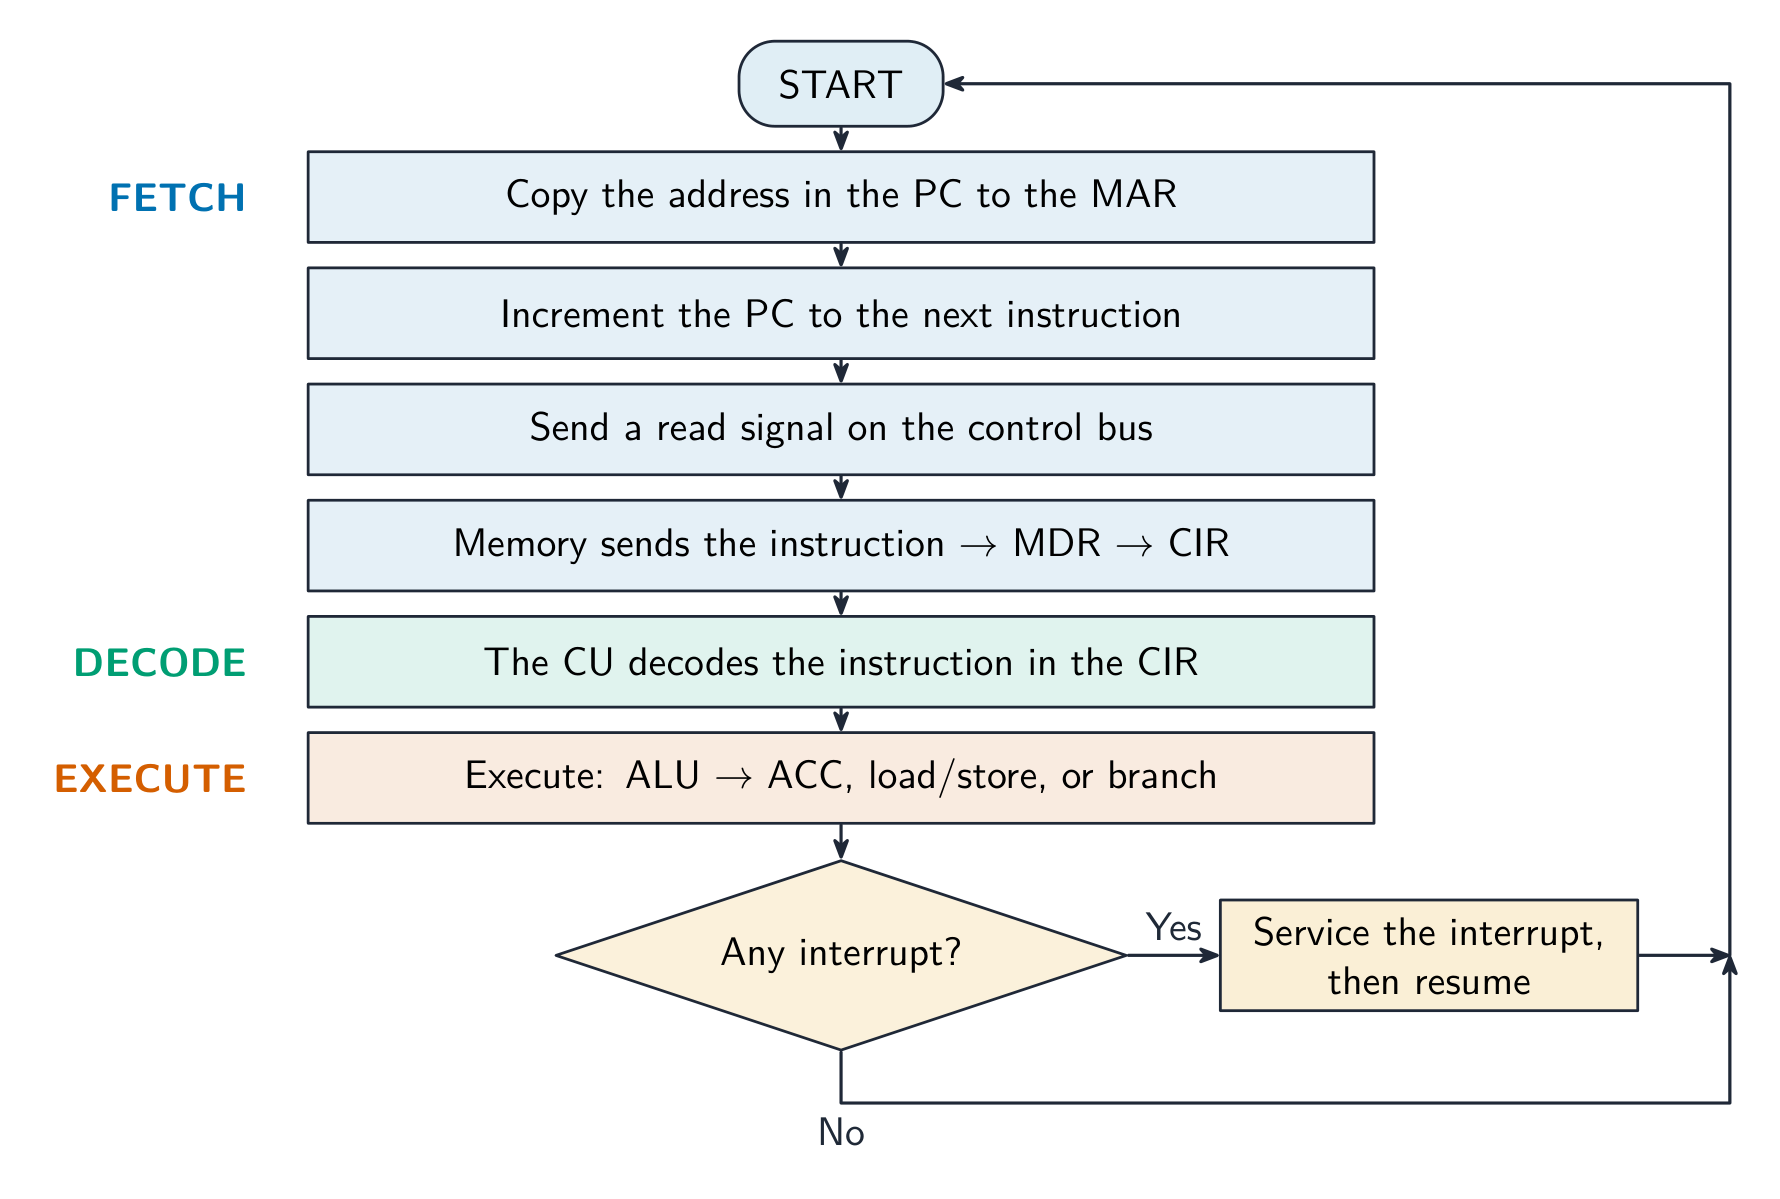 *O ciclo fetch-execute, com verificação de interrupções a cada vez
Explorar
O ciclo fetch-execute
Toque ao redor do loop que a CPU repete bilhões de vezes por segundo. Observe como o fetch usa os registradores PC/MAR/MDR/CIR, depois decode e execute agem sobre o que foi buscado.
Explorar
O ciclo busca-executa
Passe por como a CPU executa uma instrução — busque da memória, decodifique, então execute, repetidamente.
Vocabulário
Treinar
| English | Português |
|---|---|
| fetch-execute cycle/fetʃ ˈeksɪkjuːt ˈsaɪkl/ | ciclo de busca-execução |
| special purpose registers/ˈspeʃl ˈpɜːpəs ˈredʒɪstəz/ | Registradores de Propósito Específico |
| Program Counter/ˈprəʊɡræm ˈkaʊntə/ | Contador de Programa |
| Memory Address Register/ˈmeməri əˈdres ˈredʒɪstə/ | Registrador de Endereço de Memória |
| Memory Data Register/ˈmeməri ˈdeɪtə ˈredʒɪstə/ | Registrador de Dados de Memória |
| Current Instruction Register/ˈkʌrənt ɪnˈstrʌkʃn ˈredʒɪstə/ | Registrador de Instrução Atual |
| accumulator/əˈkjuːmjʊleɪtə/ | A cumulador |
| Status Register/ˈsteɪtəs ˈredʒɪstə/ | Registrador de Status |
| data bus/ˈdeɪtə bʌs/ | barragem de dados |
| word size/wɜːd saɪz/ | tamanho da palavra |
| number of cores/ˈnʌmbə ɒv kɔːz/ | número de núcleos |
4.1
Interrupções
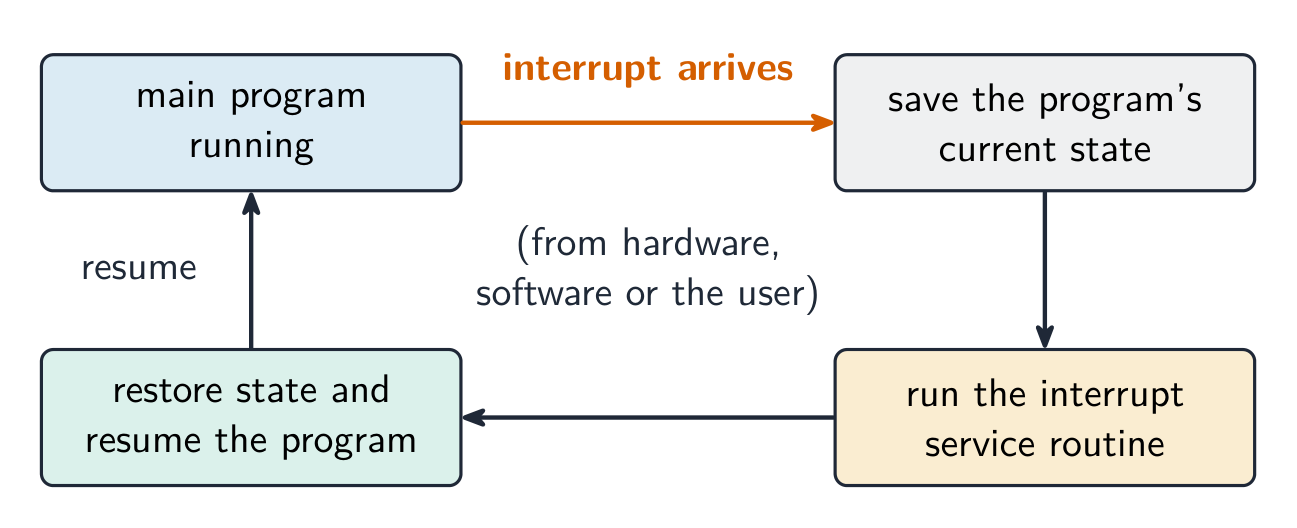
Uma interrupção é um sinal que pausa o ciclo normal para que a CPU possa lidar com um evento urgente (uma tecla pressionada, uma packet arriving, uma falha de hardware, divisão por zero, o temporizador do SO).
Lidando com um:
- termine a instrução atual.
- save the state (PC e registros).
- carrega o endereço da rotina de serviço de interrupção (ISR) no PC e a executa.
- a ISR lida com o evento.
- restore o estado salvo e continue.
Interrupts permitem que o sistema responda prontamente sem a CPU verificar constantemente dispositivos, e são como o SO faz multitarefa.
"Explique como uma interrupção de um dispositivo de entrada é detectada e tratada no ciclo F-E" é uma resposta de quatro pontos com estes itens: o dispositivo envia um sinal de interrupção que define a flag de interrupção no registro de interrupção; o processador verifica esse registro no final de cada ciclo busca-execução, após a instrução atual ter sido executada; se uma flag estiver definida e a interrupção tiver prioridade maior que a tarefa atual, o conteúdo do PC e dos outros registros são salvos na pilha; o endereço da rotina de serviço de interrupção é carregado no PC e a rotina é executada; quando termina, os valores salvados são restaurados da pilha e o programa interrompido continua de onde parou.
Causas dignas de menção: uma interrupção de hardware de um dispositivo (uma tecla pressionada, um buffer de impressora vazio, um pacote de rede chegando), uma interrupção de software de uma falha (divisão por zero, uma instrução ilegal, overflow aritmético), uma interrupção de timer do sistema operacional marcando o fim de uma fatia de tempo, e um aviso de falha de energia.
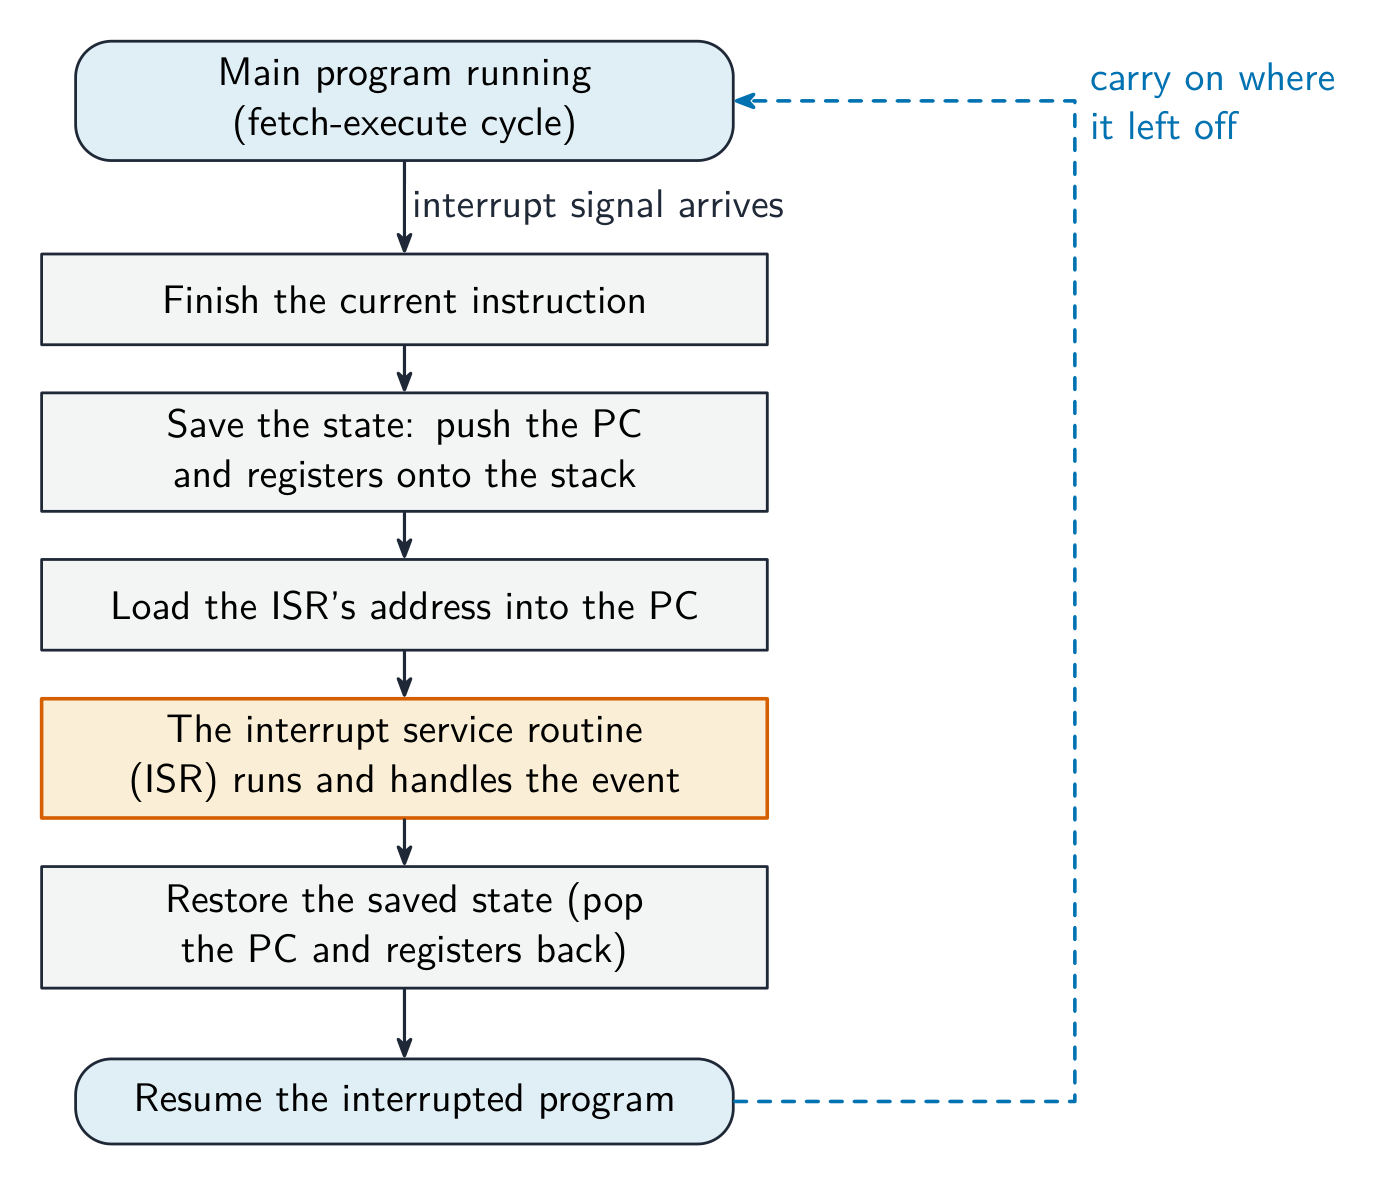 *Como uma interrupção se encaixa no ciclo fetch-execute
Vocabulário
Treinar
| English | Português |
|---|---|
| interrupt/ˈɪntərʌpt/ | interrupção |
| stack/stæk/ | pilha |
| assembly language/əˈsemblɪ ˈlæŋɡwɪdʒ/ | linguagem de montagem |
4.2
Assembly language and machine code
Programa
| Os candidatos devem ser capazes de: | Notas e orientações |
|---|---|
| Demonstrar compreensão da relação entre linguagem assembly e código máquina | |
| Descrever as diferentes etapas do processo de ensamblagem para um ensamblador de duas passagens | Aplicar o processo de ensamblador de duas passagens a um programa simples dado em linguagem assembly |
| Rastrear um programa simples dado em linguagem assembly | |
| Demonstrar compreensão de que um conjunto de instruções são agrupadas | Incluindo os seguintes grupos: • Movimentação de dados • Entrada e saída de dados • Operações aritméticas • Instruções incondicionais e condicionais • Instruções de comparação |
| Demonstrar compreensão e ser capaz de usar diferentes modos de endereçamento | Incluindo imediato, direto, indireto, indexado, relativo |
Fonte: Programa Cambridge International
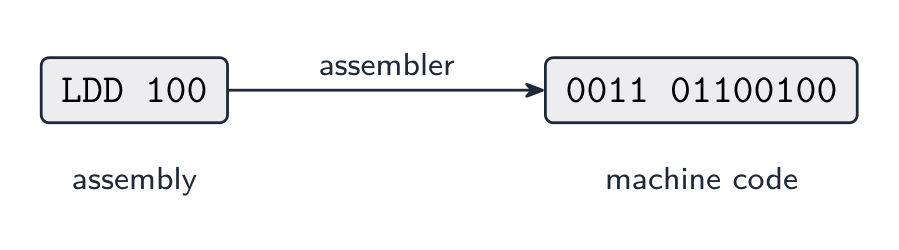
A CPU realmente executa código de máquina — padrões de bits, específicos de uma arquitetura. A linguagem ensambladora é uma forma legível, com uma instrução por instrução de máquina, escrita usando mnemônicos como LDD, ADD, JMP. Um ensamblador traduz isso para código de máquina.
*Um assembler transforma mnemonics em padrões de bits de machine code
Two-pass assembler
Um assembler de duas passadas lê a fonte duas vezes:
- passagem 1 constrói uma tabela de símbolos: sempre que um rótulo (como
LOOP:) aparece, registra seu endereço; ainda sem código. - pass 2 gera código: traduza cada instrução, e quando uma se refere a um label (como
JMP LOOP), procure seu endereço na symbol table.
Duas passagens lidam com referências futuras (um jump para um rótulo definido depois).
Worked example. Aplique o processo de duas passadas a este programa, cuja primeira instrução está no endereço 100.
        LDD  COUNT
LOOP:   DEC  ACC
        CMP  #0
        JPN  LOOP
        END
COUNT:  5
A Passagem 1 lê cada linha, conta o endereço que ocupará e registra todos os rótulos na tabela de símbolos: LOOP = 101 (a linha de DEC) e COUNT = 105 (a linha de dados). Nenhum código é gerado. A Passagem 2 lê o programa novamente e traduz cada linha em código máquina, substituindo cada mnemônico por seu opcode e cada endereço simbólico pelo número da tabela de símbolos: LDD COUNT torna-se o opcode para LDD com operando 105, e JPN LOOP torna-se o opcode para JPN com operando 101. O salto de volta para LOOP poderia ter sido resolvido em uma única passagem, mas um salto para frente para um rótulo ainda não visto não poderia, razão pela qual o ensamblador faz duas passagens.
Example instruction set
Cambridge usa um pequeno conjunto genérico, impresso na tabela de referência do exame, com um registro de propósito geral, o acumulador (ACC), e um registro índice (IX). Um operand escrito #n é um número decimal, Bn um binário e &n um hexadecimal; <address> é um número de localização ou um label.
| Grupo | Instrução | O que faz |
|---|---|---|
| Movimento de dados | LDM #n |
carrega o número n no ACC (imediato) |
LDD <address> |
carrega o conteúdo do endereço no ACC (direto) | |
LDI <address> |
o endereço contém outro endereço; carrega o conteúdo deste último no ACC (indireto) | |
LDX <address> |
adicione IX ao endereço e carregue o conteúdo do resultado em ACC (indexado) | |
LDR #n |
carregue o número n em IX | |
MOV <register> |
copie ACC para o registro nomeado (IX) | |
STO <address> |
armazene o conteúdo de ACC no endereço | |
| Entrada e saída | IN |
leia uma tecla pressionada e coloque seu código ASCII em ACC |
OUT |
exiba o caractere cujo código ASCII está em ACC | |
| Aritmética | ADD <address> / ADD #n |
adicione o conteúdo do endereço, ou o número, a ACC |
SUB <address> / SUB #n |
subtraia de ACC | |
INC <register> / DEC <register> |
adicione 1 ou subtraia 1 de ACC ou IX | |
| Comparação | CMP <address> / CMP #n |
compare ACC com o conteúdo do endereço, ou com n, e defina a flag |
CMI <address> |
compare ACC com o conteúdo do endereço retido no endereço (indireto) | |
| Salto | JMP <address> |
salte para o endereço incondicionalmente |
JPE <address> / JPN <address> |
salte se a última comparação foi igual / não igual | |
| Manipulação de bits | AND, OR, XOR com #n, Bn, &n ou <address> |
operação bit a bit em ACC |
LSL #n / LSR #n |
desloque ACC logicamente n posições para a esquerda ou direita | |
END |
termine o programa |
A questão "as instruções da linguagem assembly são agrupadas" pede os nomes dos grupos e uma instrução de cada: movimento de dados, entrada e saída, aritmética, saltos incondicionais e condicionais, comparação e manipulação de bits.
Explorar
Como funciona um ensamblificador de duas passadas
Passe passo a passo. O ensamblificador lê seu código duas vezes: a passada 1 apenas encontra onde cada label está, para que a passada 2 possa preencher os endereços — é assim que um jump para uma label definida depois ainda funciona.
Vocabulário
Treinar
| English | Português |
|---|---|
| register/ˈredʒɪstə/ | registro |
| control unit/kənˈtrəʊl ˈjuːnɪt/ | Unidade de Controle |
| machine code/məˈʃiːn kəʊd/ | código de máquina |
| mnemonics/nɪˈmɒnɪks/ | mnemônicos |
| assembler/əˈsemblə/ | montador |
| symbol table/ˈsɪmbl ˈteɪbl/ | tabela de símbolos |
| label/ˈleɪbl/ | rótulo |
| forward references/ˈfɔːwəd ˈrefrənsɪz/ | referências futuras |
| opcode/ˈɒpkəʊd/ | código de operação |
4.2
Modos de endereçamento
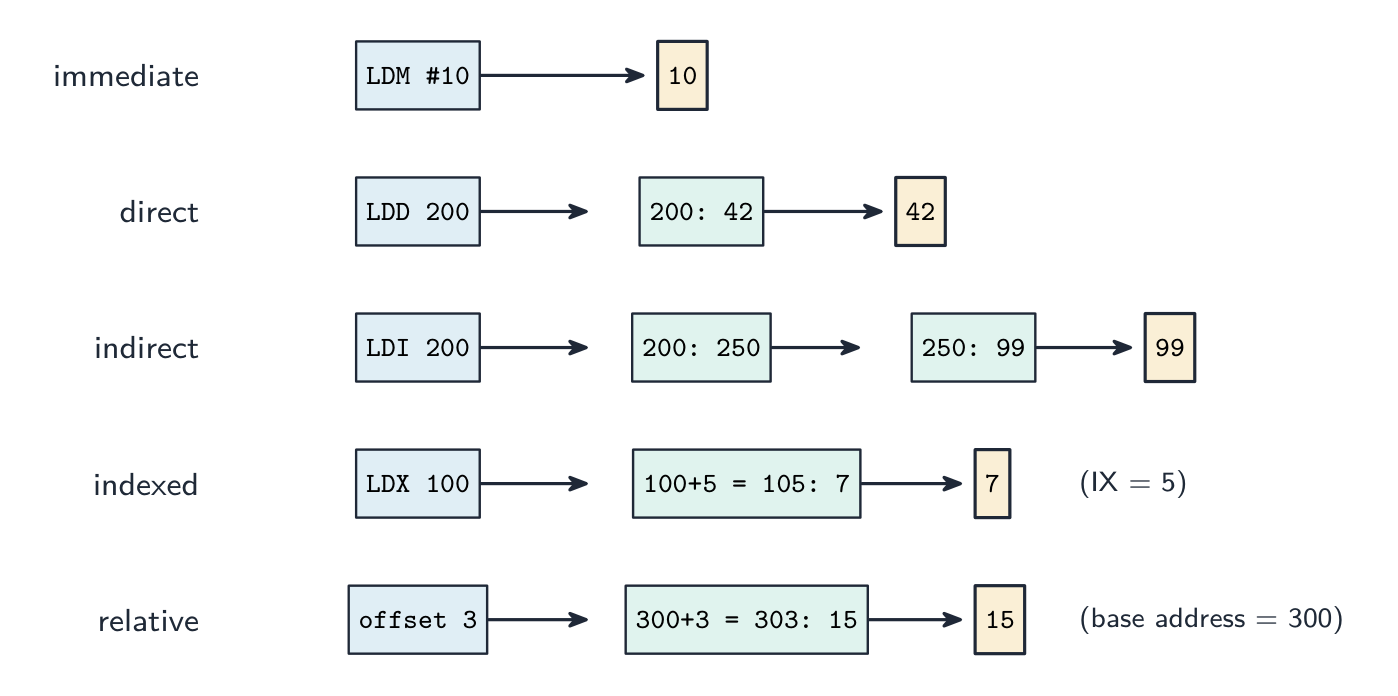
O modo de endereçamento (os modos de endereçamento) diz como a CPU encontra o operando:
- endereçamento imediato — o operando é o valor na instrução.
LDM #10carrega 10. - endereçamento direto — a instrução contém um endereço; o operando é o valor lá.
LDD 200. - endereçamento indireto — a instrução contém um endereço que contém outro endereço, que é o dado.
LDI 200. - endereçamento indexado — endereço efetivo é
address + index register; usado para arrays.LDX 100com IX = 5 lê o endereço 105.
(Endereçamento relativo fornece o endereço como um offset do PC — usado para jumps.)
Exemplo resolvido. Memória contém: local 200 = 250, local 250 = 99, local 105 = 7. O registro índice contém 5. O que está no acumulador após cada um de LDM #200, LDD 200, LDI 200 e LDX 100? Siga até onde cada modo precisa olhar. LDM #200 é imediato - o operando é o número escrito na instrução, então o acumulador contém 200. LDD 200 é direto - vá ao local 200 e pegue o que está lá: 250. LDI 200 é indireto - local 200 contém 250, que é outro endereço, então vá para local 250: 99. LDX 100 é indexado - some o registro índice ao endereço, $100 + 5 = 105$, e leia local 105: 7. Conte as etapas para mantê-los distintos: imediato 0, direto 1, indireto 2, indexado 1 (uma vez que o índice foi adicionado).
Vocabulário
Treinar
| English | Português |
|---|---|
| Index Register/ˈɪndeks ˈredʒɪstə/ | Registrador de Índice |
| indexed addressing/ˈɪndekst əˈdresɪŋ/ | endereçamento indexado |
| general-purpose registers/ˈdʒenərəl ˈpɜːpəs ˈredʒɪstəz/ | Registradores de Propósito Geral |
| register transfer/ˈredʒɪstə ˈtrænsfɜː/ | transferência de registos |
| control bus/kənˈtrəʊl bʌs/ | barragem de controlo |
| addressing mode/əˈdresɪŋ məʊd/ | modo de endereçamento |
| immediate addressing/ɪˈmiːdɪət əˈdresɪŋ/ | endereçamento imediato |
| direct addressing/daɪˈrekt əˈdresɪŋ/ | endereçamento direto |
| indirect addressing/ɪndaɪˈrekt əˈdresɪŋ/ | endereçamento indireto |
| relative addressing/ˈrelətɪv əˈdresɪŋ/ | endereçamento relativo |
| logical shift/ˈlɒdʒɪkl ʃɪft/ | deslocamento lógico |
| cyclic shift/ˈsaɪklɪk ʃɪft/ | deslocamento cíclico |
4.2
Rastreamento de um programa assembly
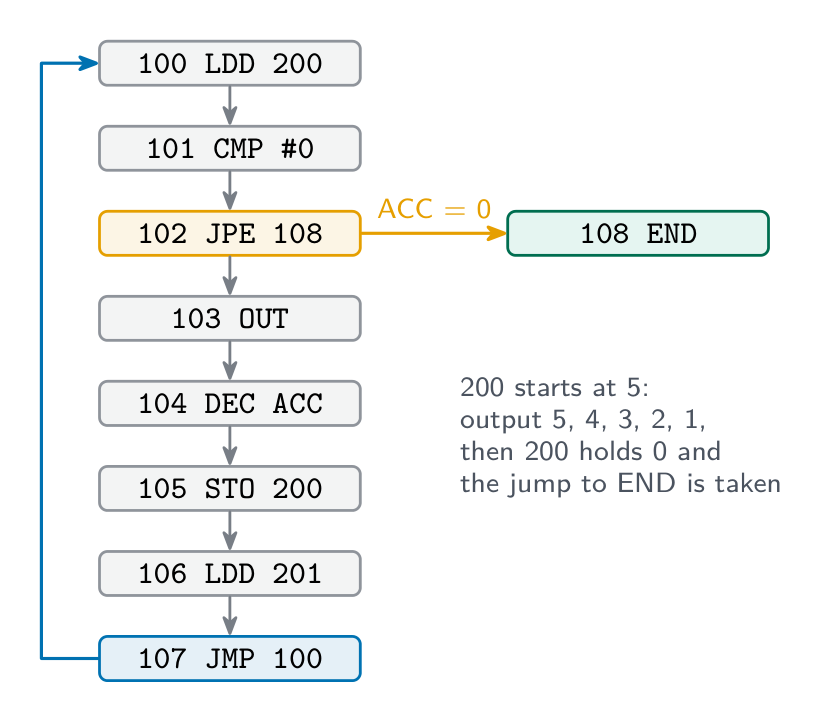
Para rastrear ele: faça uma tabela com colunas para PC, ACC, registro índice, cada variável e quaisquer flags. Passe pelas instruções, atualizando a tabela após cada uma; siga os ramos quando mudarem o PC; pare em END. Um padrão comum é um loop sobre um array usando endereçamento indexado.
Exemplo resolvido. Rastreie este programa. Endereço 200 contém 5 e endereço 201 contém 0.
100   LDD  200
101   CMP  #0
102   JPE  108
103   OUT
104   DEC  ACC
105   STO  200
106   LDD  201
107   JMP  100
108   END
Escreva uma linha para cada instrução executada, preenchendo apenas as colunas que mudam:
| Instrução | ACC | 200 | 201 | Saída |
|---|---|---|---|---|
| início | 5 | 0 | ||
LDD 200 |
5 | |||
CMP #0 |
||||
JPE 108 |
não taken | |||
OUT |
caractere com código 5 | |||
DEC ACC |
4 | |||
STO 200 |
4 | |||
LDD 201 |
0 | |||
JMP 100 |
||||
LDD 200 |
4 |
e assim por diante, até LDD 200 carregar 0, a comparação definir a flag igual, JPE 108 ser taken e o programa terminar. Três coisas que o examinador verifica: um CMP não muda nenhum registro, apenas uma flag; um salto não taken ainda conta como executado; e OUT sai um caractere, então vai na coluna de saída, não na coluna ACC. "Diga o efeito de mudar LDD 10 para LDM #10": o ACC conteria o número 10 em vez do conteúdo do endereço 10.
4.3
Deslocamentos binários
Programa
| Os candidatos devem ser capazes de: | Notas e orientações |
|---|---|
| Demonstrar compreensão e realizar deslocamentos binários | Lógico, aritmético e cíclico Deslocamento para a esquerda, deslocamento para a direita |
| Demonstrar compreensão de como a manipulação de bits pode ser usada para monitorar/controlar um dispositivo | Realizar operações de manipulação de bits Testar e definir um bit (usando máscara de bits) |
| Etiqueta de Instrução | Opcode | Operando | Explicação |
| AND #n / Bn / &n | Operação AND bitwise do conteúdo do ACC com o operando |
| AND | Operação AND bitwise do conteúdo do ACC com o conteúdo de |
| XOR #n / Bn / &n | Operação XOR bitwise do conteúdo do ACC com o operando |
| XOR | Operação XOR bitwise do conteúdo do ACC com o conteúdo de |
| OR #n / Bn / &n | Operação OR bitwise do conteúdo do ACC com o operando |
| OR | Operação OR bitwise do conteúdo do ACC com o conteúdo de |
| LSL #n | Bits no ACC são deslocados logicamente n posições para a esquerda. Zeros são introduzidos na extremidade direita |
| LSR #n | Bits no ACC são deslocados logicamente n posições para a direita. Zeros são introduzidos na extremidade esquerda |
| Rótulo de uma instrução | |
| Fornece um endereço simbólico | |
| Todas as questões assumirão que há apenas um registrador de uso geral disponível (Acumulador) ACC denota Acumulador IX denota Registrador Indexado pode ser um endereço absoluto ou simbólico # denota um número decimal, ex. #123 B denota um número binário, ex. B01001010 & denota um número hexadecimal, ex. &4A |
Fonte: Programa Cambridge International
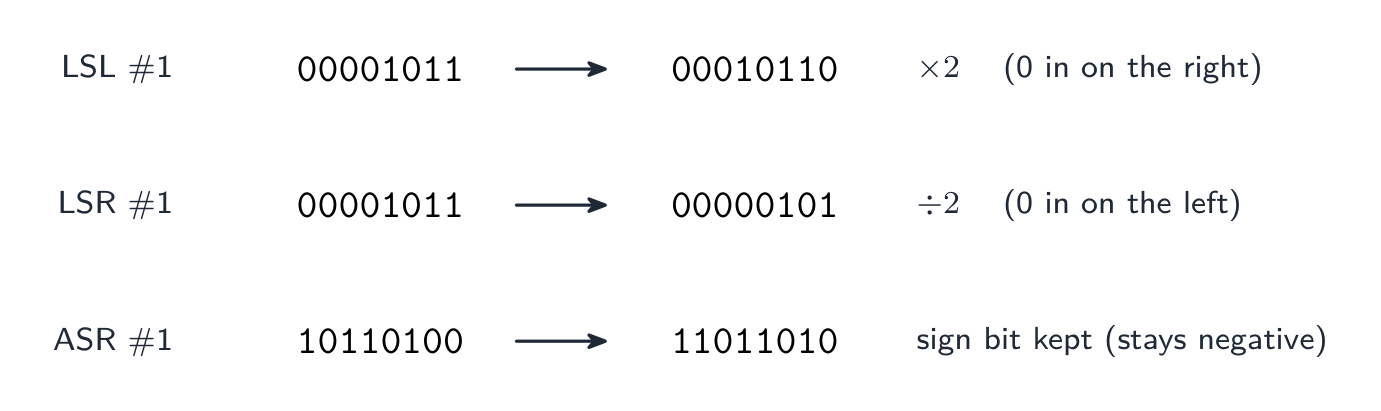
Um shift lógico move todos os bits para a esquerda ou direita em alguns lugares, preenchendo novas posições com 0.
- deslocamento à esquerda por 1 (
LSL #1) — bits movem-se para a esquerda, um 0 entra pela direita; para um número sem sinal isso é × 2. - deslocamento à direita por 1 (
LSR #1) — bits movem-se para a direita, um 0 entra pela esquerda; para um número sem sinal isso é integer ÷ 2.
Deslocar por $n$ posições multiplica ou divide por $2^{n}$. Exemplo: 00001011 (11) LSL #1 → 00010110 (22).
Bits deslocados fora da extremidade são perdidos, então a multiplicação só está correta enquanto eles eram zeros. LSL #2 no inteiro two's complement 11001010 dá 00101000: os dois 1s que caíram da esquerda foram embora, o bit de sinal mudou, e o resultado já não é mais quatro vezes o original.
Um shift aritmético à direita mantém o bit de sinal para que um número negativo com sinal continue negativo. Um shift cíclico (rotate) alimenta o bit que cai de uma extremidade de volta na outra extremidade, então nenhum bit é perdido.
"Mostre o resultado de um deslocamento aritmético à direita de 3 posições em 10011110": copie o bit de sinal em cada lugar vazio, 11110011. O mesmo deslocamento em 01011100 dá 00001011. Um deslocamento cíclico à esquerda de 1 em 10000110 dá 00001101: o 1 inicial reaparece à direita.
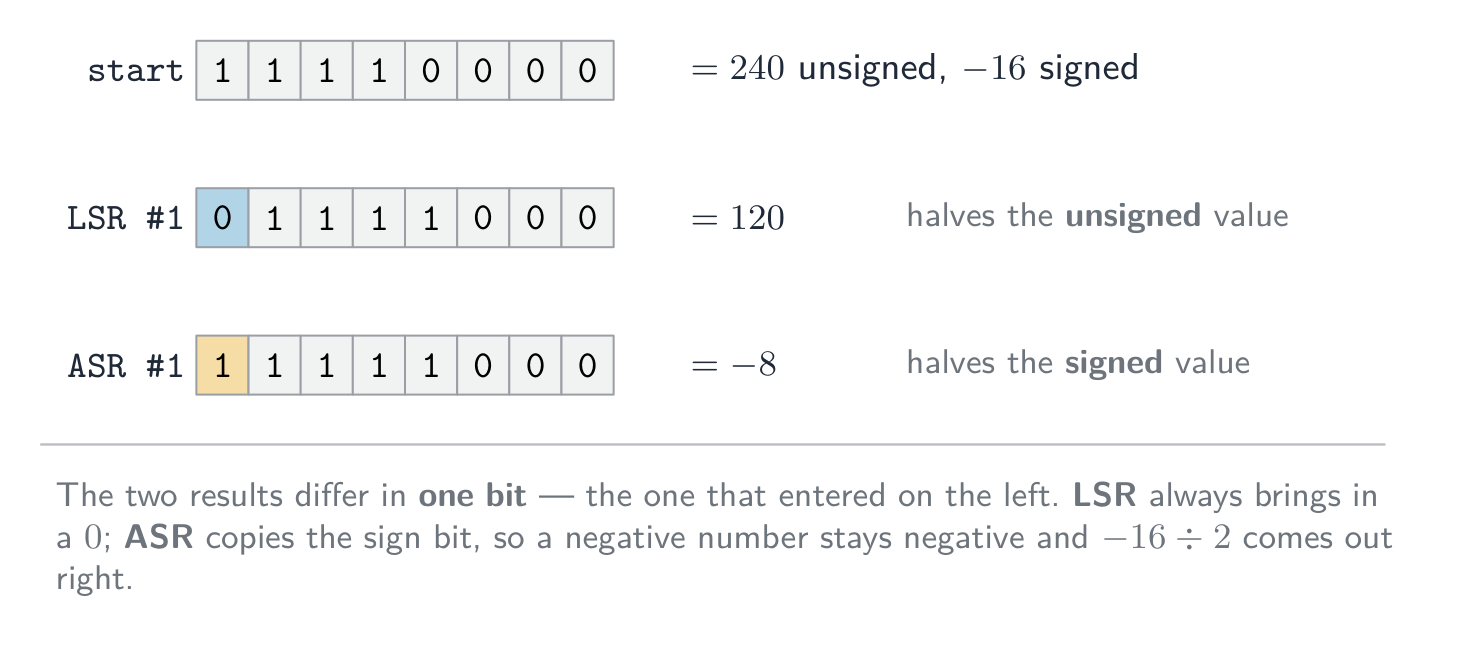
A diferença entre os dois deslocamentos à direita é um único bit. Pegue 11110000, que é 240 lido como sem sinal e $-16$ lido como com sinal. LSR #1 traz um 0 e dá 01111000 $= 120$, que é a metade correta de 240. ASR #1 copia o bit de sinal e dá 11111000 $= -8$, que é a metade correta de $-16$. Nenhum está errado — cada um reduz pelo metade sob uma leitura.
Manipulação de bits para monitoramento/controle
Dispositivos embutidos frequentemente usam um bit de um registro por sinal (ex. bit $n$ = LED $n$). Usando uma máscara — mascaramento de bits — você pode:
- definir bit $n$:
R = R ORuma máscara com bit $n$ definido. - limpar bit $n$:
R = R ANDuma máscara com bit $n$ limpo e o resto definido. - alternar bit $n$:
R = R XORuma máscara com bit $n$ definido. - testar bit $n$:
R ANDa máscara, depois verifique se o resultado é diferente de zero.
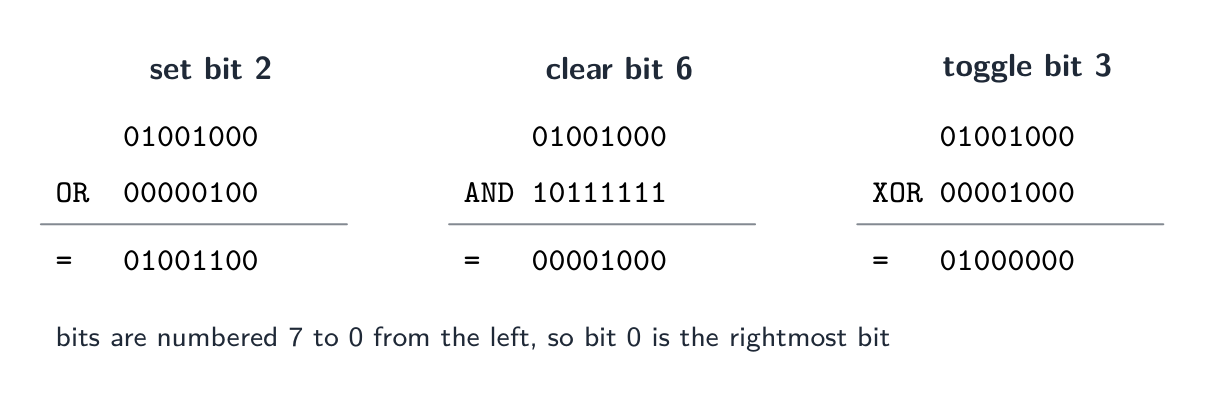
Manipulação de bits é rápida, usa pouca memória e permite que um byte contenha até 8 estados liga/desliga.
No conjunto de instruções do exame estes são AND, OR e XOR com uma máscara escrita como operando decimal, binário ou hexadecimal. Com o ACC contendo 10101100:
| Instrução | Máscara | Resultado em ACC | Efeito |
|---|---|---|---|
AND B00001111 |
00001111 |
00001100 |
mantém apenas os quatro bits inferiores (limpa os outros) |
OR #1 |
00000001 |
10101101 |
define o bit menos significativo, deixando o resto inalterado |
XOR &FF |
11111111 |
01010011 |
inverte todos os bits |
AND B00001000 então CMP #0 |
00001000 |
00001000 |
testa bit 3: a comparação não é igual, então o bit 3 estava definido |
LSL #2 |
10110000 |
desloca à esquerda duas posições, perdendo os dois bits superiores | |
LSR #3 |
00010101 |
desloca à direita três posições, zeros entrando pela esquerda |
"Escreva a instrução que define o bit menos significativo em 1 e deixa os outros inalterados": OR #1, ou OR B00000001. Para limpar um bit use AND com uma máscara que tenha um 0 nesse lugar e 1s nos outros; para testar um bit, AND com uma máscara que tenha um 1 apenas nesse lugar, depois compare o resultado com zero. Em um dispositivo de monitoramento, um bit de um registro por sensor permite que um único AND verifique se um sensor específico está ligado, e um OR ativa o bit de controle de um atuador sem perturbar os outros.
Explorar
Desloque e mascare os bits de um byte
Escolha um operador e veja cada bit resultante. Um deslocamento à esquerda (<<) moves every bit up one place (×2); a right shift (>>) move-os para baixo (÷2); AND com uma máscara limpa os bits que você não quer.
Vocabulário
Treinar
| English | Português |
|---|---|
| mask/mæsk/ | máscara |
4.3
Definições aceitas pelo examinador
Uma questão de definição é avaliada contra wording fixo. Aprenda estas exatamente, e dê apenas uma resposta.
| Termo | Definição |
|---|---|
| conceito de programa armazenado | as instruções do programa e os dados estão ambos armazenados na memória principal, e as instruções são buscadas e executadas uma de cada vez |
| registro | um local de armazenamento pequeno e muito rápido dentro do processador com um propósito específico |
| Contador de Programa | o registro que contém o endereço da próxima instrução a ser buscada |
| Registro de Endereço de Memória | o registro que contém o endereço do local de memória sendo lido ou gravado |
| Registro de Dados de Memória | o registro que contém o dado ou instrução acabou de ser lido de, ou prestes a ser gravado em, memória |
| Registro de Instrução Atual | o registro que contém a instrução atualmente sendo decodificada e executada |
| Acumulador | o registro de uso geral que contém o resultado da última operação aritmética ou lógica |
| memória cache | memória pequena e rápida próxima ao processador que contém instruções e dados frequentemente usados |
| interrupção | um sinal de um dispositivo ou programa que faz o processador pausar a tarefa atual e executar uma rotina de serviço de interrupção |
| linguagem assembly | uma linguagem de baixo nível em que cada instrução mnemônica corresponde a uma instrução de código de máquina |
| endereçamento imediato | o operando é o valor escrito na instrução |
| endereçamento direto | o operando é o conteúdo do endereço escrito na instrução |
| endereçamento indireto | o endereço na instrução contém o endereço do operando |
| endereçamento indexado | o endereço do operando é o endereço na instrução mais o conteúdo do registro índice |
| endereçamento relativo | o endereço do operando é dado como um offset em relação ao endereço da instrução atual |
| deslocamento lógico | cada bit se move para o número de posições especificado e zeros preenchem os lugares vazios |
4.3
Dicas de prova
- Aprenda o ciclo busca-execução em termos de transferência entre registros (PC, MAR, MDR, CIR, ACC) e o que incrementa o PC.
- Nomeie a função de cada registro; o ** barramento de endereços é unidirecional**, o barramento de dados é bidirecional.
- Diferencie os modos de endereçamento (imediato, direto, indireto, indexado) — uma questão frequente.
- Explique como a velocidade do clock, número de núcleos, tamanho do cache e comprimento da palavra afetam o desempenho.
- Para um deslocamento binário, declare se é lógico ou aritmético; um deslocamento à esquerda multiplica por 2, um deslocamento à direita divide por 2.
Erros comuns
- Dizer que o PC armazena a instrução atual, ou que o MDR armazena um endereço. O PC armazena o endereço da próxima instrução; o MDR armazena dados ou uma instrução, nunca um endereço.
- Deixar fora o incremento do PC da busca, ou colocá-lo após a execução. Ele ocorre assim que o endereço é copiado para o MAR.
- Ler
LDD 10como "carregar 10".LDD 10carrega o conteúdo do endereço 10;LDM #10carrega o número 10. - Colocar um valor na coluna ACC para
CMPouOUT. Uma comparação define apenas uma flag; uma saída vai para a coluna de saída. - Dizer que uma interrupção é tratada "imediatamente". O processador termina a instrução atual e verifica interrupções no final do ciclo.
- Usar um deslocamento lógico à direita em um número negativo em complemento de dois. Apenas um deslocamento aritmético mantém o bit de sinal.
Aulas interativas sobre este tópico
Passe por ele passo a passo, com exercícios de verificação instantânea.