| Os candidatos devem ser capazes de: | Notas e orientações |
|---|---|
| Demonstre compreensão das limitações do uso de uma abordagem baseada em ficheiros para o armazenamento e recuperação de dados | |
| Descreva as características de uma base de dados relacional que abordam as limitações de uma abordagem baseada em ficheiros | |
| Demonstre compreensão e utilize a terminologia associada a um modelo de base de dados relacional | Incluindo entidade, tabela, registo, campo, tupla, atributo, chave primária, chave candidata, chave secundária, chave estrangeira, relação (um-para-muitos, um-para-um, muitos-para-muitos), integridade referencial, indexação |
| Utilize um diagrama entidade-relacionamento (E-R) para documentar um projeto de base de dados | |
| Demonstre compreensão do processo de normalização | Primeira Forma Normal (1NF), Segunda Forma Normal (2NF) e Terceira Forma Normal (3NF) |
| Explique porque um conjunto dado de tabelas de base de dados está ou não em 3NF | |
| Produza um projeto de base de dados normalizado para uma descrição de uma base de dados, um conjunto dado de dados ou um conjunto dado de tabelas |
Bancos de Dados
Ciência da Computação A-Level · Tópico 8
 17:16
Bancos de Dados & Modelo Relacional
Antes dos bancos de dados, cada programa mantinha seus próprios arquivos planos — um arquivo por programa. Imagine uma loja. O programa de vendas, o programa de faturamento e o programa de envio…
Narração em inglês · legendas em inglês e 中文 que você pode alternar
8.1
Armazenamento baseado em arquivos e seus limites
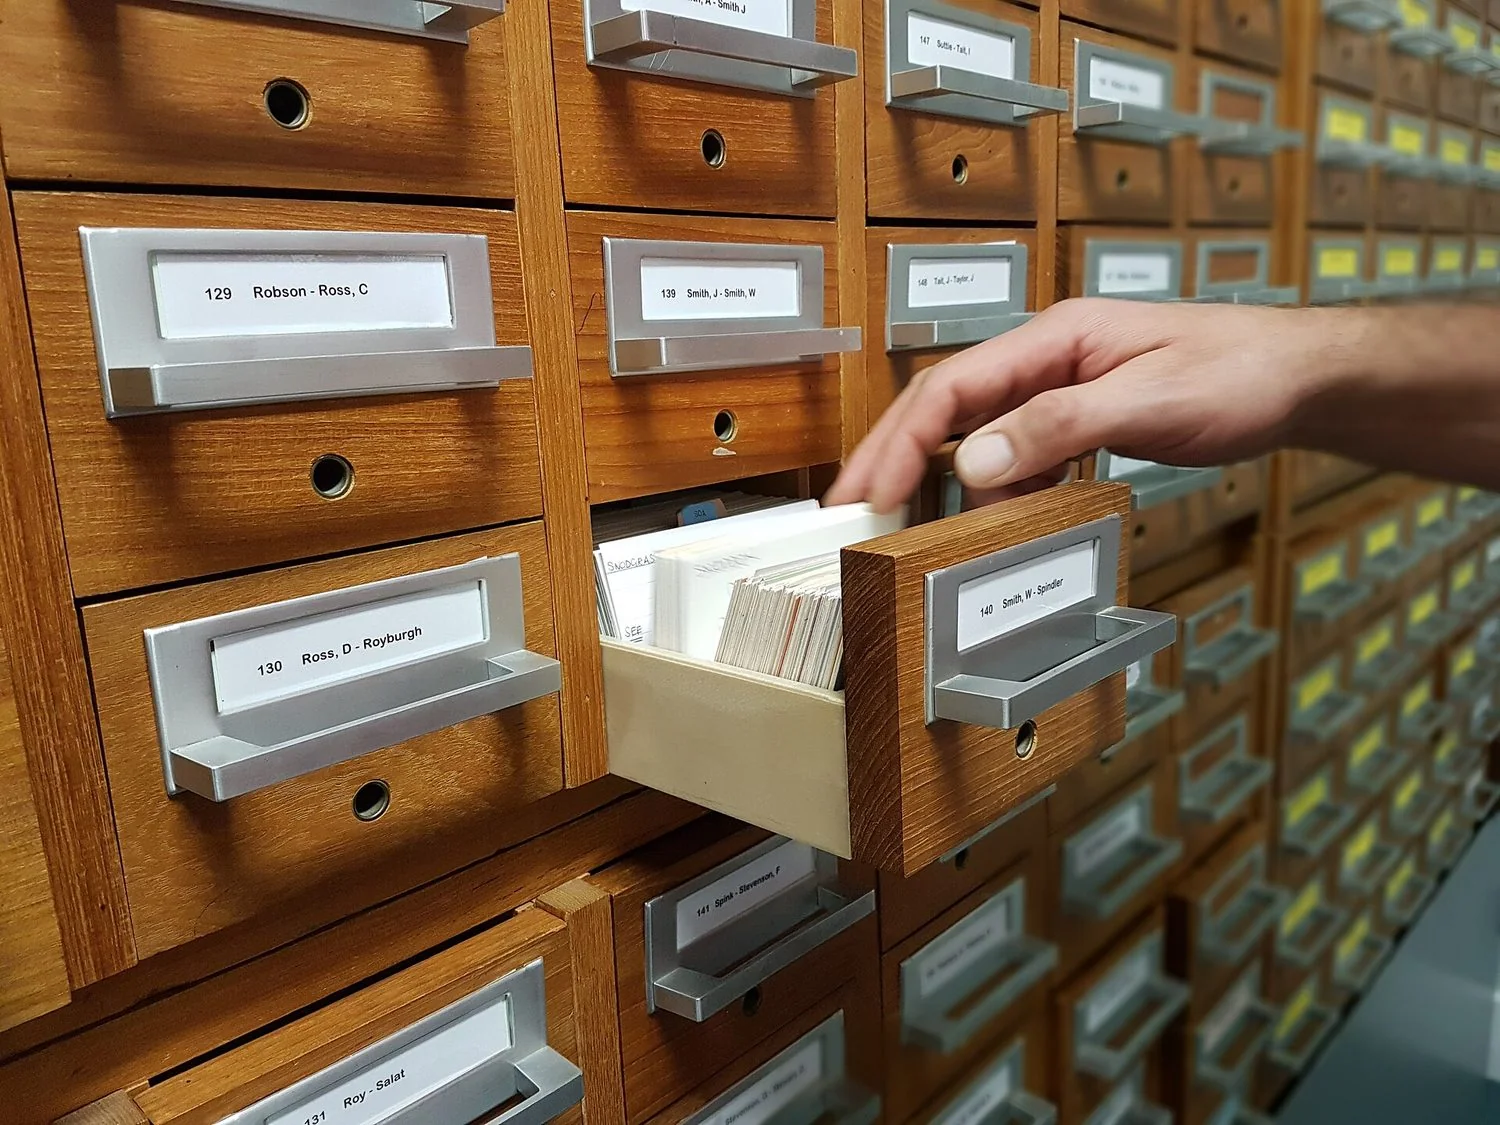
Programa
Fonte: Programa Cambridge International
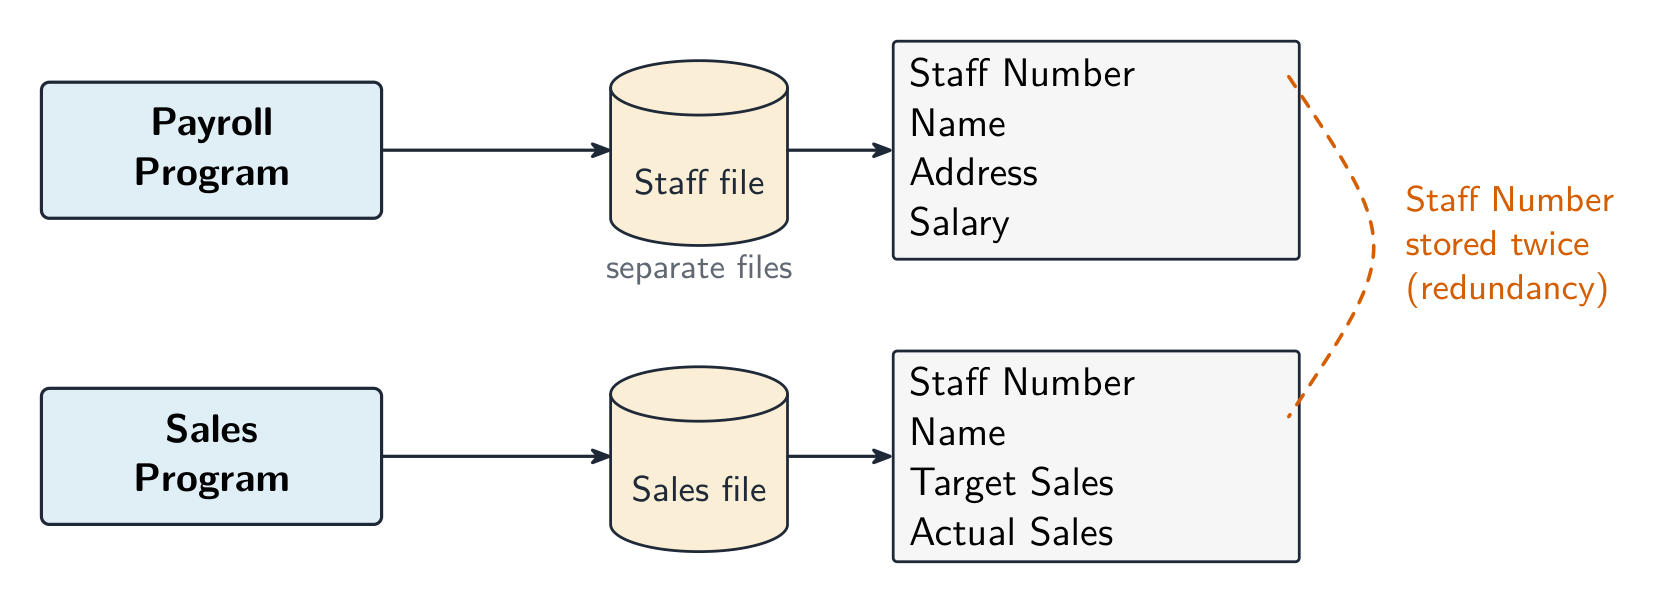
Antes dos bancos de dados, os programas armazenavam dados em arquivos planos — geralmente um arquivo por programa. Isso funciona bem para pequenos volumes de dados, mas falha em escala maior.
Limitações
- redundância de dados — os mesmos dados (o endereço de um cliente) estão mantidos em vários arquivos, um por programa, resultando em armazenamento desperdiçado e exigindo atualização de cada cópia.
- inconsistência de dados — quando uma cópia é atualizada e outra não, os arquivos entram em conflito e ninguém sabe qual está correta.
- dependência de dados — cada programa é escrito para o layout exato de seus arquivos; alterar o comprimento de um campo ou adicionar um campo exige reescrever todo programa que lê o arquivo.
- sem acesso compartilhado — um arquivo é bloqueado enquanto um programa o usa, impedindo que usuários trabalhem nos dados simultaneamente.
- integridade fraca — sem regras centrais que impeçam valores inválidos ou links para clientes inexistentes; segurança fraca — o acesso é por arquivo, não por campo; e consultas entre arquivos exigem um novo programa cada vez.
Um banco de dados relacional corrige esses problemas ao armazenar dados em tabelas gerenciadas por um único software (SGBD) utilizado por todos os programas.
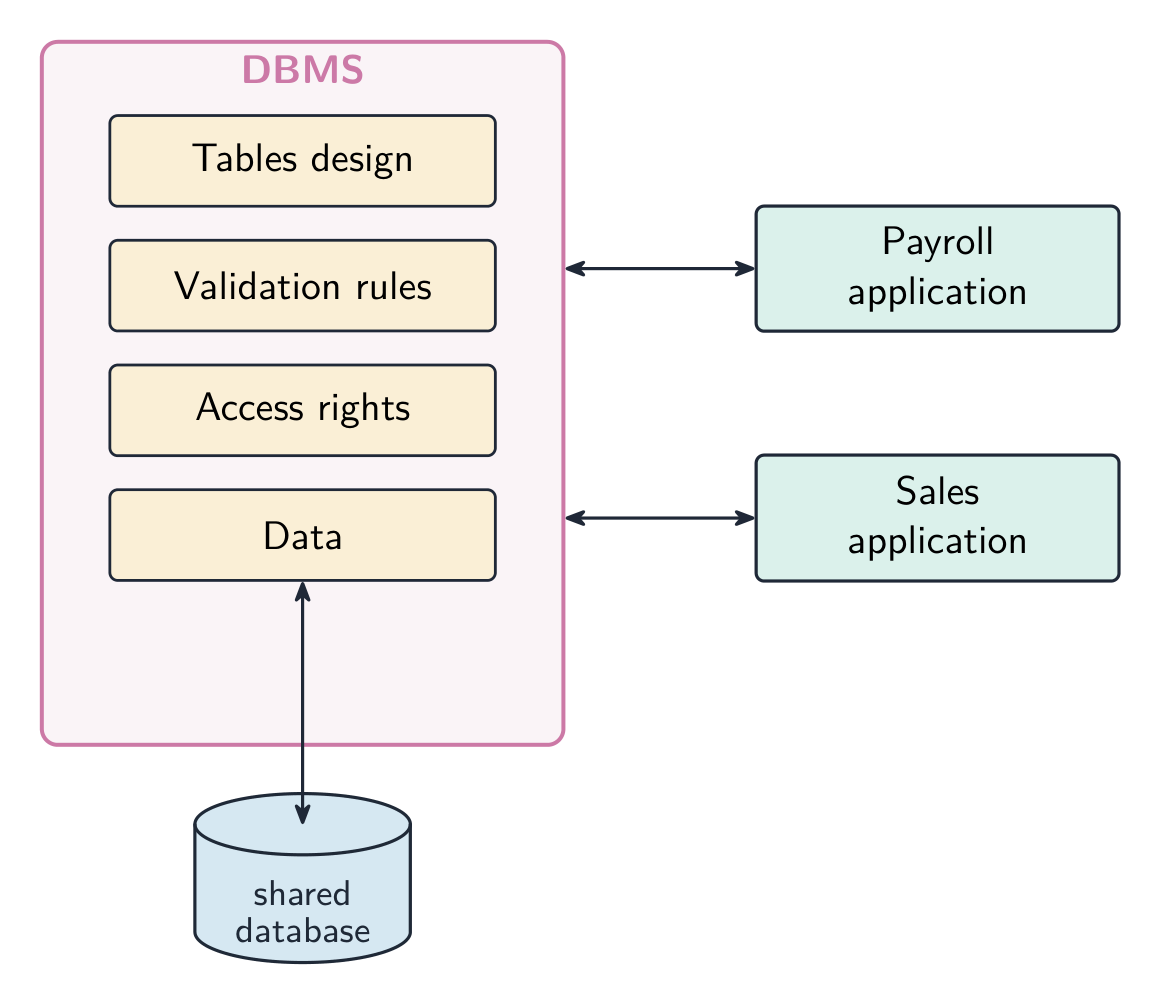
Por que um banco de dados relacional é melhor — a resposta de três pontos. Cada item de dado é armazenado uma única vez, em uma tabela, e as tabelas são ligadas por chaves, não havendo redundância nem inconsistência; os dados são independentes dos programas, que solicitam ao SGBD o que precisam e permanecem inalterados quando a estrutura muda; e o SGBD aplica regras de integridade, controla o acesso por usuário e por campo, permite múltiplos usuários simultaneamente e executa qualquer consulta sem a necessidade de escrever um novo programa.
Exemplo resolvido. Uma oficina armazena seus clientes, dispositivos e serviços de reparo usando uma abordagem baseada em arquivos, com um arquivo por programa. Cite três problemas isso causa e descreva como um banco de dados relacional os eliminaria.
O nome e o número de telefone do cliente estão armazenados no arquivo de reparos e também no arquivo de faturas (redundância); quando um cliente muda de número, um arquivo é atualizado e o outro não (inconsistência); e quando a loja quer um novo relatório — reparos por técnico — um novo programa precisa ser escrito para ler os arquivos (sem consultas ad hoc). Em um banco de dados relacional, o cliente é armazenado uma única vez em uma tabela CUSTOMER e referenciado pelo CustomerID na tabela REPAIR, então a alteração é feita uma única vez e vista em todos os lugares; o relatório é uma única consulta SQL.
Vocabulário
Treinar
| English | Português |
|---|---|
| DBMS/ˌdiː biː em ˈes/ | SGBD |
| SQL/ˌes kjuː ˈel/ | Linguagem SQL |
8.1
Modelo relacional — termos
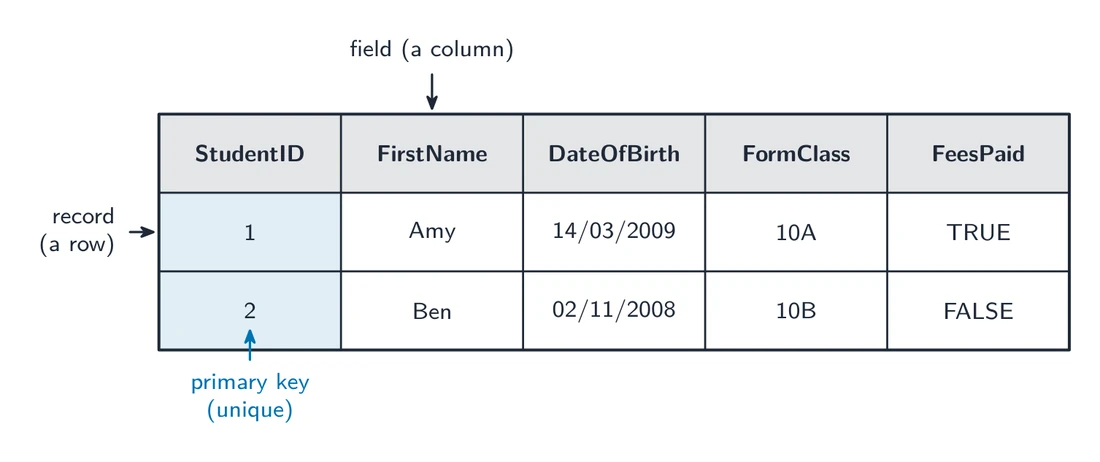
- tabela (relação) — uma grade de linhas e colunas; uma tabela por tipo de entidade (ex.
CUSTOMER). - registro (linha, também chamado de tupla) — uma linha; uma instância da entidade.
- campo (coluna, também chamado de atributo) — uma coluna; uma informação sobre cada registro.
- chave primária — um campo (ou campos) que identifica unicamente cada registro; nunca nulo ou duplicado.
- chave estrangeira — um campo cujo valor corresponde à chave primária de outra tabela, vinculando as duas.
- chave composta — uma chave primária formada por dois ou mais campos juntos.
- chave candidata — qualquer campo(s) que poderia ser a chave primária.
- chave secundária — um campo não primário que possui índice para busca rápida.
- indexação — criação de um índice em um campo para tornar buscas e junções mais rápidas.
- integridade referencial — todo valor de chave estrangeira deve corresponder a uma chave primária existente (sem registros órfãos).
Uma tabela é escrita em notação resumida com a chave primária sublinhada e chaves estrangeiras anotadas:
CUSTOMER(CustomerID, Name, Phone)
ORDER(OrderID, CustomerID, OrderDate)   -- CustomerID is FK → CUSTOMER
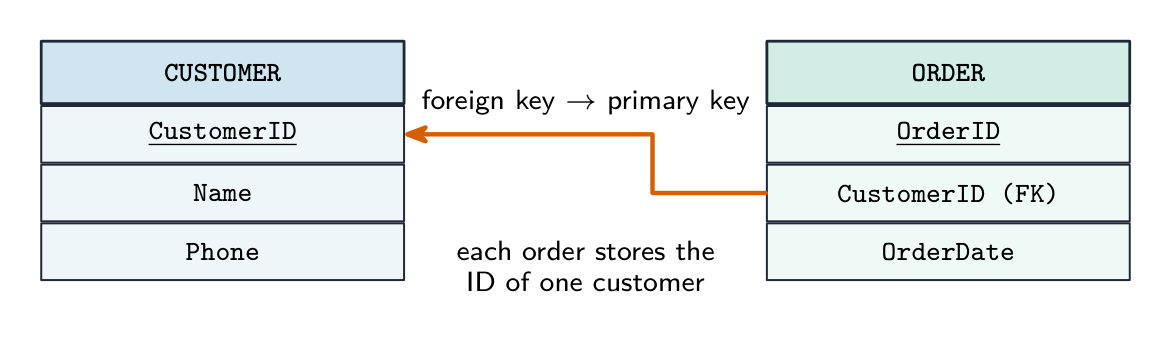
Exemplo resolvido. Explique o significado de entidade, chave primária e integridade referencial em um banco de dados relacional, e complete a tabela de termo ↔ descrição para tupla e atributo.
Uma entidade é algo sobre o qual dados são armazenados — uma pessoa, objeto ou evento — que se torna uma tabela. Uma chave primária é o atributo (ou combinação de atributos) que identifica unicamente cada registro em uma tabela. Integridade referencial significa que todo valor de chave estrangeira deve corresponder ao valor de uma chave primária na tabela a que se refere, para que um registro não possa apontar para um que não existe. Uma tupla é uma linha de uma tabela (um registro); um atributo é uma coluna (um campo). Aprenda os pares: tabela/relação, registro/tupla, campo/atributo.
Explorar
Leia uma tabela relacional com SELECT
Uma tabela relacional é apenas linhas (registros) e colunas (campos). WHERE mantém as linhas que correspondem a uma condição; SELECT então mantém apenas as colunas que você pediu.
Vocabulário
Treinar
| English | Português |
|---|---|
| flat files/flæt faɪlz/ | arquivos planos |
| data redundancy/ˈdeɪtə rɪˈdʌndənsi/ | redundância de dados |
| data inconsistency/ˈdeɪtə ˌɪnkənˈsɪstənsi/ | inconsistência de dados |
| field/fiːld/ | campo |
| table/ˈteɪbl/ | tabela |
| record/ˈrekɔːd/ | registro |
8.1
Diagramas de entidade-relacionamento (E-R)
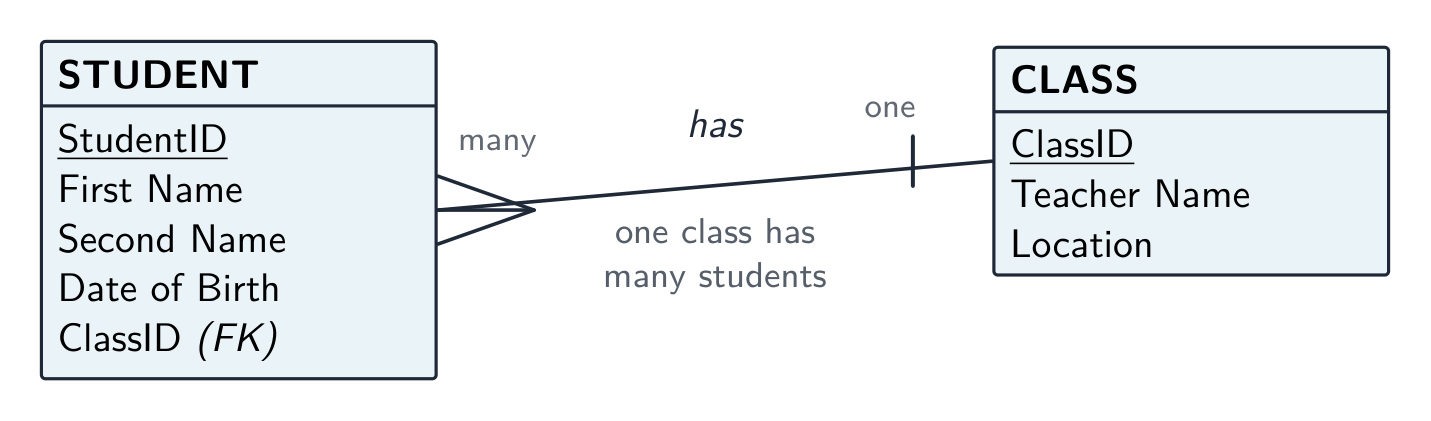
Um diagrama de entidade-relacionamento mostra a estrutura: cada entidade é um retângulo, cada relação uma linha, com a cardinalidade marcada em cada extremidade:
- um-para-um (1:1).
- um-para-muitos (1:M) — cada Cliente tem muitos Pedidos; cada Pedido tem um Cliente.
- muitos-para-muitos (M:N) — Estudantes frequentam muitos Cursos, e Cursos têm muitos Estudantes.
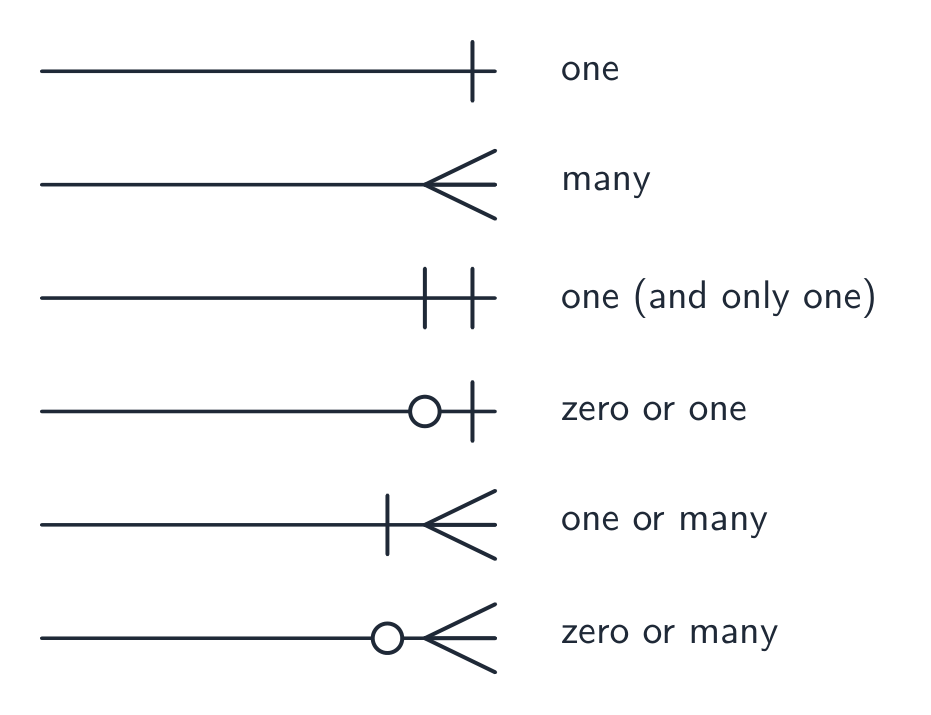
Uma relação muitos-para-muitos não pode ser armazenada diretamente. Divida-a em duas relações um-para-muitos através de uma tabela de ligação contendo as duas chaves estrangeiras:
ENROLMENT(StudentID, CourseID, EnrolmentDate)
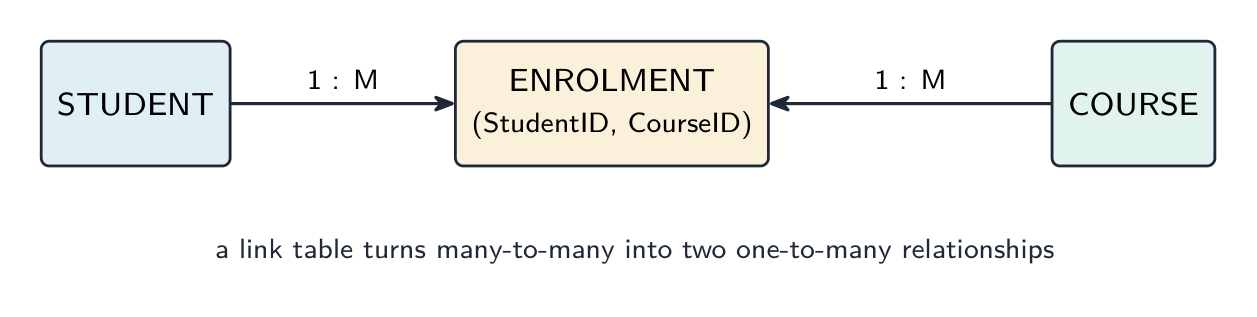
Desenhando o diagrama E-R para um conjunto dado de tabelas. Cada tabela torna-se uma entidade. Um relacionamento existe sempre que uma tabela contenha uma chave estrangeira para outra; ele vai da tabela que contém a chave estrangeira (a extremidade muitos) para a tabela cuja chave primária ela é (a extremidade um). Uma tabela com duas chaves estrangeiras e nenhuma outra identidade geralmente é uma tabela de ligação resolvendo um relacionamento muitos-para-muitos. Roteie cada linha com o tipo de relacionamento.
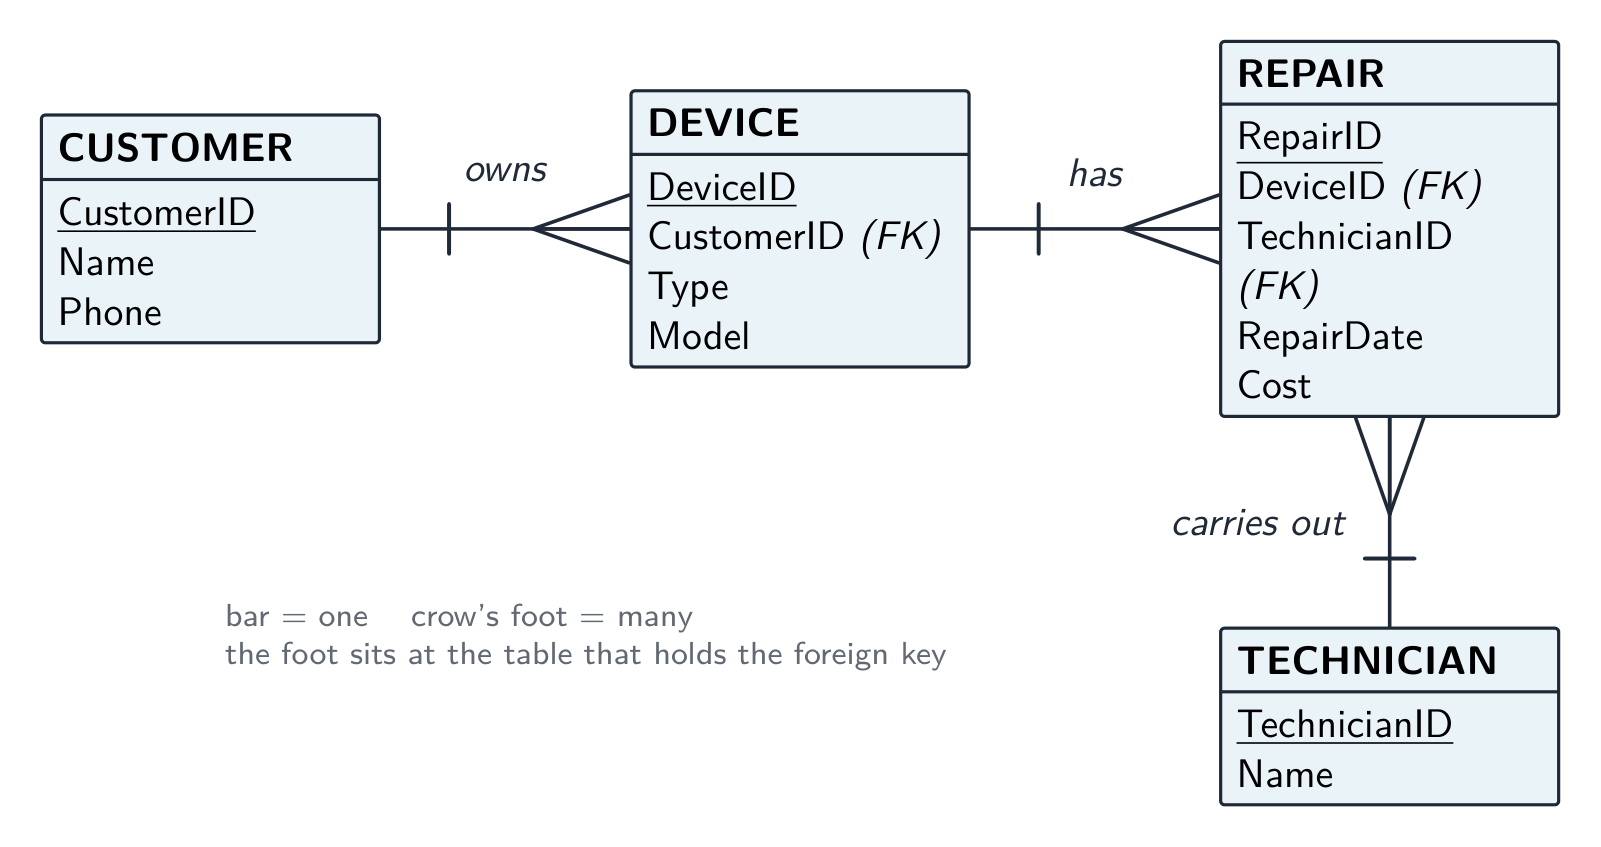
Exemplo resolvido. Uma oficina possui as tabelas CUSTOMER(CustomerID, Name, Phone), DEVICE(DeviceID, CustomerID, Type, Model), TECHNICIAN(TechnicianID, Name) e REPAIR(RepairID, DeviceID, TechnicianID, RepairDate, Cost). Identifique os relacionamentos e seus tipos.
DEVICE contém CustomerID, então CUSTOMER–DEVICE é um-para-muitos (um cliente, muitos dispositivos). REPAIR contém DeviceID, então DEVICE–REPAIR é um-para-muitos; também contém TechnicianID, então TECHNICIAN–REPAIR é um-para-muitos. Não há linha direta CUSTOMER–REPAIR: o link passa por DEVICE. Três linhas, três pés-de-galinha, todos nas extremidades REPAIR ou DEVICE.
Vocabulário
Treinar
| English | Português |
|---|---|
| cardinality/ˌkɑːdɪˈnælɪti/ | cardinalidade |
| one-to-many/wʌn tə ˈmeni/ | um-para-muitos |
| link table/lɪŋk ˈteɪbl/ | tabela de ligação |
8.1
Normalização
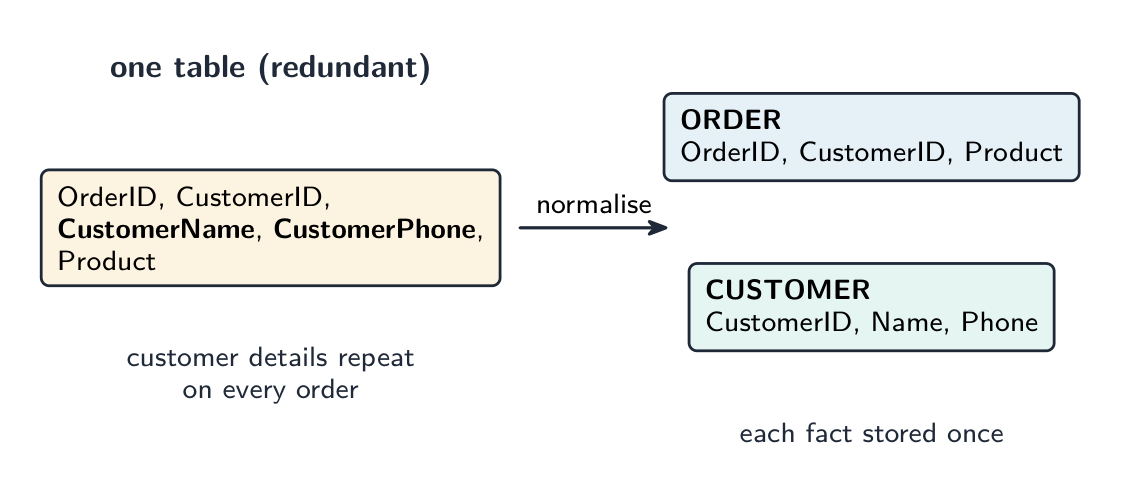
Normalização organiza tabelas para reduzir redundância e inconsistência, seguindo as formas normais em sequência.
- Primeira forma normal (1FN) — cada campo contém um único valor (atômico), sem grupos repetidos, e com uma chave primária.
- Segunda forma normal (2NF) — em 1NF, e cada campo não-chave depende da totalidade da chave primária (importa apenas para uma chave composta).
- Terceira forma normal (3FN) — na 2FN, e todos os campos não-chave dependem apenas da chave primária, não de outro campo não-chave (sem dependência transitiva).
Um design 3NF armazena cada fato uma única vez, assim anomalias de inserção/atualização/exclusão desaparecem. A contrapartida é mais tabelas e mais junções. Almeje 3NF.
Para produzir um design 3NF: encontre as entidades e seus atributos; escolha uma chave primária para cada; divida campos repetidos/não-atômicos (1NF); divida campos que dependem de parte de uma chave composta (2NF); divida campos que dependem transitivamente da chave (3NF); adicione chaves estrangeiras para os relacionamentos.
Exemplo resolvido. A tabela ORDER(OrderID, CustomerID, CustomerName, ProductID, Quantity) tem a chave primária composta (OrderID, ProductID). Normalize-a para 3NF. Teste cada campo não-chave contra a chave. Quantity depende de ambos OrderID e ProductID, o que está correto. Mas CustomerID depende de OrderID sozinho - apenas parte da chave composta. Isso é uma dependência parcial, então a tabela não está em 2NF. Divida-a em ORDER_LINE(OrderID, ProductID, Quantity) e ORDER(OrderID, CustomerID, CustomerName). Agora teste 3NF: naquela nova tabela ORDER, CustomerName depende de CustomerID, que não é a chave - uma dependência transitiva. Divida novamente: ORDER(OrderID, CustomerID) e CUSTOMER(CustomerID, CustomerName). Nomeie a dependência que viola cada forma (parcial viola 2NF, transitiva viola 3NF); "ela tem dados repetidos" descreve o sintoma e não ganha pontos.
As três perguntas a fazer sobre qualquer tabela. Cada célula é um único valor, sem grupo repetido? Se não, não está na 1FN. Se a chave é composta, todo campo não-chave depende da chave inteira? Se algum campo depende apenas de parte dela, há uma dependência parcial e a tabela não está na 2FN. Todo campo não-chave depende apenas da chave? Se um campo depende de outro campo não-chave, há uma dependência transitiva e a tabela não está na 3FN. Uma resposta "explique por que a tabela não está na 3FN" deve nomear a dependência e os campos envolvidos.
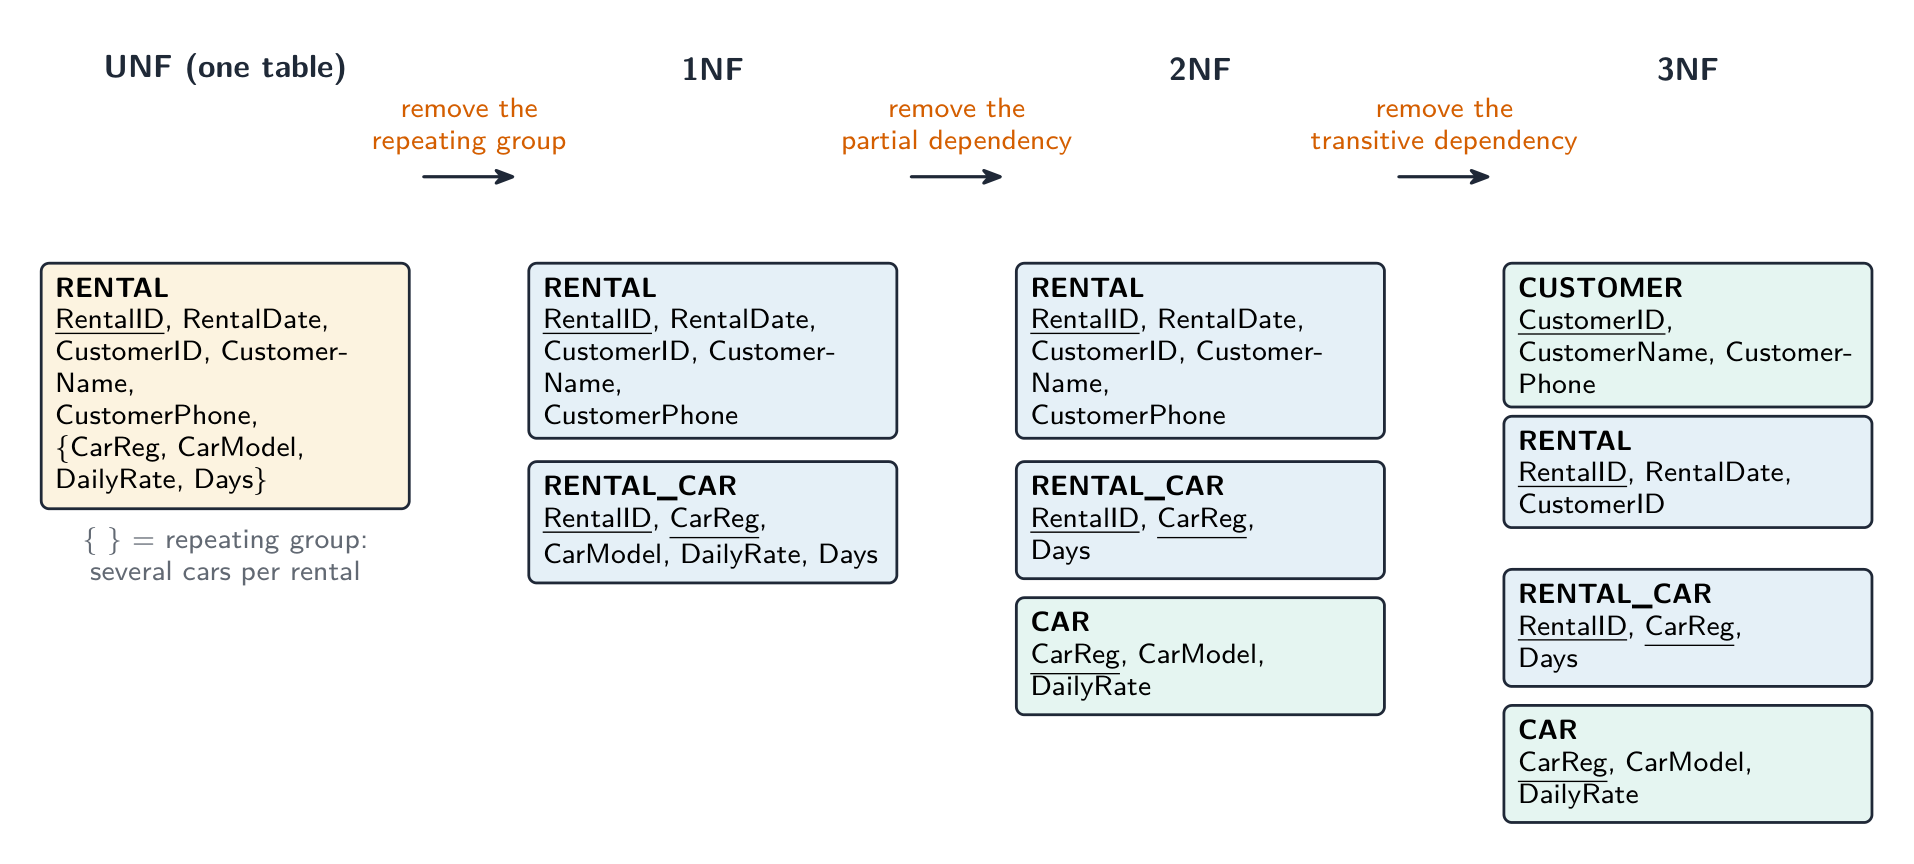
Exemplo resolvido. Uma loja de aluguel de carros registra cada aluguel como RENTAL(RentalID, RentalDate, CustomerID, CustomerName, CustomerPhone, CarReg, CarModel, DailyRate, Days), onde um aluguel pode incluir vários carros. Explique por que a tabela não está normalizada e produza um design 3NF.
Não em 1NF: os campos de carro CarReg, CarModel, DailyRate, Days formam um grupo repetido — um aluguel tem vários carros. Mova-os para RENTAL_CAR(RentalID, CarReg, CarModel, DailyRate, Days) com a chave composta (RentalID, CarReg). Não em 2NF: em RENTAL_CAR, CarModel e DailyRate dependem de CarReg sozinho — uma dependência parcial. Mova-os para CAR(CarReg, CarModel, DailyRate), deixando RENTAL_CAR(RentalID, CarReg, Days). Não em 3NF: em RENTAL, CustomerName e CustomerPhone dependem de CustomerID, um campo não-chave — uma dependência transitiva. Mova-os para CUSTOMER(CustomerID, CustomerName, CustomerPhone), deixando RENTAL(RentalID, RentalDate, CustomerID). O design 3NF é quatro tabelas — CUSTOMER, RENTAL, RENTAL_CAR, CAR — com CustomerID, RentalID e CarReg como chaves estrangeiras; sublinhe todas as chaves primárias.
Vocabulário
Treinar
| English | Português |
|---|---|
| normalisation/ˌnɔːməlaɪˈzeɪʃn/ | normalização |
| normal forms/ˈnɔːml fɔːmz/ | formas normais |
| atomic/əˈtɒmɪk/ | atômico |
| transitive dependency/ˈtrænsɪtɪv dɪˈpendənsi/ | dependência transitiva |
| partial dependency/ˈpɑːʃl dɪˈpendənsi/ | dependência parcial |
8.2
Sistema de Gerenciamento de Banco de Dados (DBMS)
Programa
| Os candidatos devem ser capazes de: | Notas e orientações |
|---|---|
| Demonstre compreensão das funcionalidades fornecidas por um Sistema de Gestão de Bases de Dados (DBMS) que abordam as questões de uma abordagem baseada em ficheiros | Incluindo: • gestão de dados, incluindo manutenção de um dicionário de dados • modelação de dados • esquema lógico • integridade de dados • segurança de dados, incluindo procedimentos de cópia de segurança e uso de direitos de acesso para indivíduos/grupos de utilizadores |
| Demonstre compreensão de como ferramentas de software encontradas num DBMS são utilizadas na prática | Incluindo o uso e propósito de: • interface de desenvolvedor • processador de consultas |
Fonte: Programa Cambridge International
Um SGBD gerencia o banco de dados centralmente. Recursos que superam as limitações dos arquivos:
- dicionário de dados — descrição de todas as tabelas, campos, tipos e chaves; programas consultam-no em vez de codificar a estrutura manualmente.
- controle de redundância/consistência — cada fato armazenado uma única vez.
- controle de acesso simultâneo — bloqueios e transações permitem que vários usuários trabalhem ao mesmo tempo.
- backup e recuperação; segurança e permissões por usuário.
- regras de integridade — chaves, restrições de unicidade e intervalo, aplicadas centralmente.
- transações — um conjunto de operações que todas têm sucesso ou todas falham.
- vistas — tabelas virtuais que mostram a cada usuário "sua" fatia dos dados.
- gestão de dados e modelagem de dados — controlam como os dados são armazenados e definem sua estrutura como um esquema lógico (o projeto lógico, independente do armazenamento físico).
- integridade de dados e segurança de dados — garantem correção e controlam o acesso centralmente.
- um processador de consultas executa queries; uma interface de desenvolvedor fornece ferramentas e APIs para criar aplicativos.
Suas ferramentas incluem um editor de dicionário de dados, um construtor de consultas, um construtor de formulários, um gerador de relatórios, gerenciamento de usuários e um editor SQL.
O que o dicionário de dados armazena (uma questão "listar três itens"): os nomes das tabelas; os nomes dos campos em cada tabela; o tipo de dado e o comprimento de cada campo; as chaves primárias e estrangeiras e os relacionamentos entre tabelas; regras de validação; índices; e quem pode acessar cada tabela. É metadado — dados sobre os dados — e o DBMS o usa para verificar cada consulta e cada alteração.
Como o SGBD mantém os dados seguros (uma questão "descreva dois métodos"): autenticação — nome de usuário e senha, ou biométrica, antes de qualquer acesso; direitos de acesso — cada usuário ou grupo tem permissão para ler, escrever ou excluir apenas tabelas ou campos específicos, frequentemente através de uma vista; criptografia dos dados armazenados e dos dados transmitidos, para que um arquivo copiado seja ilegível; backups realizados regularmente, permitindo restauração após perda; e um registro de transações que registra quem alterou o quê.
As duas ferramentas de software. A developer interface é o que um programador usa para construir o banco de dados e os aplicativos sobre ele: criar tabelas e definir chaves e validações, escrever consultas e SQL, e projetar formulários e relatórios, sem saber como os dados são armazenados fisicamente. O query processor recebe uma consulta (SQL de um programa ou uma consulta construída na interface), verifica-a contra o dicionário de dados, determina a maneira mais eficiente de executá-la, recupera os dados e retorna os resultados.
Logical schema. O DBMS mantém o projeto lógico (quais tabelas e campos existem e como se relacionam) separado do physical storage (arquivos, índices, blocos de disco). Os programas trabalham com o schema lógico, para que o armazenamento físico possa ser reorganizado sem alterar um único programa — esta é a independência de dados que a abordagem baseada em arquivos não possuía.
Explorar
Laboratório de serviço de banco de dados
Assista como um DBMS transforma uma consulta em acesso seguro e compartilhado aos dados.
Explorar
Laboratório de serviço de banco de dados
Assista como um DBMS transforma uma consulta em acesso seguro e compartilhado aos dados.
Vocabulário
Treinar
| English | Português |
|---|---|
| query/ˈkwɪərɪ/ | consulta |
| backup/ˈbækʌp/ | backup |
| views/vjuːz/ | visualizações |
| data management/ˈdeɪtə ˈmænɪdʒmənt/ | gestão de dados |
| data modelling/ˈdeɪtə ˈmɒdəlɪŋ/ | modelagem de dados |
| logical schema/ˈlɒdʒɪkl ˈskiːmə/ | esquema lógico |
| data integrity/ˈdeɪtə ɪnˈteɡrɪti/ | integridade dos dados |
| data security/ˈdeɪtə sɪˈkjʊərɪti/ | segurança dos dados |
| query processor/ˈkwɪərɪ ˈprəʊsesə/ | processador de consultas |
| developer interface/dɪˈveləpə ˈɪntəfeɪs/ | interface do desenvolvedor |
| authentication/ɔːˌθentɪˈkeɪʃn/ | autenticação |
| Data Definition Language/ˈdeɪtə ˌdefɪˈnɪʃn ˈlæŋɡwɪdʒ/ | Linguagem de Definição de Dados |
| Data Manipulation Language/ˈdeɪtə məˌnɪpjʊˈleɪʃn ˈlæŋɡwɪdʒ/ | Linguagem de Manipulação de Dados |
| aggregate functions/ˈæɡrɪɡeɪt ˈfʌŋkʃnz/ | funções agregadas |
8.3
DDL e DML
Programa
| Os candidatos devem ser capazes de: | Notas e orientações |
|---|---|
| Demonstre compreensão de que o DBMS realiza toda a criação/modificação da estrutura da base de dados utilizando sua Linguagem de Definição de Dados (DDL) | |
| Demonstre compreensão de que o DBMS realiza todas as consultas e manutenção de dados utilizando seu DML | |
| Demonstre compreensão de que o padrão da indústria para ambos DDL e DML é a Structured Query Language (SQL) | Compreenda uma declaração SQL dada |
| Compreenda declarações SQL dadas (DDL) e seja capaz de escrever simples declarações SQL (DDL) usando um subconjunto de declarações | Criar uma base de dados (CREATE DATABASE) Criar uma definição de tabela (CREATE TABLE), incluindo a criação de atributos com tipos de dados adequados: • CHARACTER • VARCHAR(n) • BOOLEAN • INTEGER • REAL • DATE • TIME Alterar uma definição de tabela (ALTER TABLE) Adicionar uma chave primária a uma tabela (PRIMARY KEY (field)) Adicionar uma chave estrangeira a uma tabela (FOREIGN KEY (field) REFERENCES Table (Field)) |
| Escreva um script SQL para consultar ou modificar dados (DML) armazenados em (no máximo duas) tabelas de base de dados | Consultas incluindo SELECT... FROM, WHERE, ORDER BY, GROUP BY, INNER JOIN, SUM, COUNT, AVG |
| Manutenção de dados incluindo INSERT INTO, DELETE FROM, UPDATE |
Fonte: Programa Cambridge International
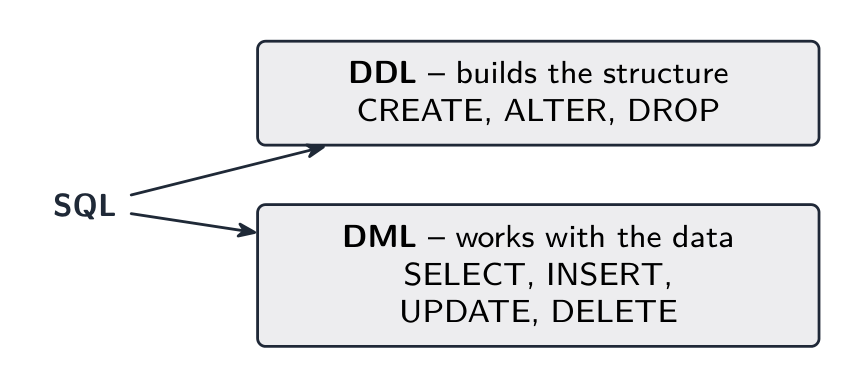
SQL (Linguagem de Consulta Estruturada) tem duas partes:
- Linguagem de Definição de Dados (DDL) — cria ou altera a estrutura (tabelas, chaves, restrições).
- Linguagem de Manipulação de Dados (DML) — opera sobre os dados (inserir, atualizar, excluir, consultar).
Noções básicas de DDL
CREATE TABLE CUSTOMER (
  CustomerID INTEGER PRIMARY KEY,
  Name VARCHAR(50) NOT NULL,
  Phone VARCHAR(20)
);
Adicionar uma chave estrangeira:
CREATE TABLE ORDER (
  OrderID INTEGER PRIMARY KEY,
  CustomerID INTEGER,
  OrderDate DATE,
  FOREIGN KEY (CustomerID) REFERENCES CUSTOMER(CustomerID)
);
Modificar e excluir:
ALTER TABLE CUSTOMER ADD Email VARCHAR(100);
DROP TABLE CUSTOMER;
Tipos comuns: INTEGER, REAL, VARCHAR(n), CHAR(n) (também CHARACTER(n)), DATE, TIME, BOOLEAN, DECIMAL(p, s).
Noções básicas de DML
Consulta com SELECT:
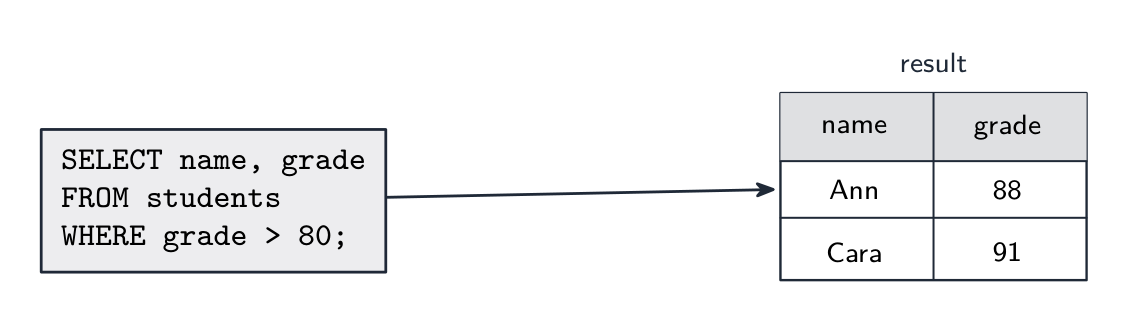
SELECT Name, Phone
FROM CUSTOMER
WHERE City = 'London'
ORDER BY Name ASC;
SELECT lista campos, FROM nomeia a tabela, WHERE filtra linhas, ORDER BY ordena.
Um join combina duas tabelas usando uma relação de chave estrangeira:
SELECT C.Name, O.OrderDate
FROM CUSTOMER C INNER JOIN ORDER O
  ON C.CustomerID = O.CustomerID
WHERE O.OrderDate >= '2024-01-01';
Funções agregadas (COUNT, SUM, AVG, MIN, MAX) são frequentemente usadas com GROUP BY:
SELECT CustomerID, COUNT(*) AS NumOrders
FROM ORDER
GROUP BY CustomerID;
Inserir, atualizar, excluir:
INSERT INTO CUSTOMER (CustomerID, Name, Phone)
VALUES (101, 'Ada Lovelace', '020-1234-5678');

UPDATE CUSTOMER SET Phone = '020-9999-0000' WHERE CustomerID = 101;

DELETE FROM CUSTOMER WHERE CustomerID = 101;
Sempre coloque uma cláusula WHERE em UPDATE e DELETE, ou a alteração atingirá todas as linhas.
Dicas para SQL de exame
- use exatamente os nomes de tabela e campo da questão.
- cite strings com aspas simples (
'Smith'); não cite números. - comparações:
=,<,>,<=,>=,<>. LIKE 'A%'corresponde a tudo que começa com A (%= qualquer string,_= um caractere);IN (1,2,3);BETWEEN 10 AND 20.- combine condições com
AND/OR/NOT, e termine cada statement com ponto e vírgula.
O padrão DDL que o exame quer. Cada CREATE TABLE nomeia cada campo com seu tipo, marca a chave primária e declara cada chave estrangeira com a tabela que ela referencia; uma chave composta é declarada em sua própria linha:
CREATE TABLE RENTAL_CAR (
  RentalID INTEGER,
  CarReg VARCHAR(8),
  Days INTEGER,
  PRIMARY KEY (RentalID, CarReg),
  FOREIGN KEY (RentalID) REFERENCES RENTAL(RentalID),
  FOREIGN KEY (CarReg) REFERENCES CAR(CarReg)
);
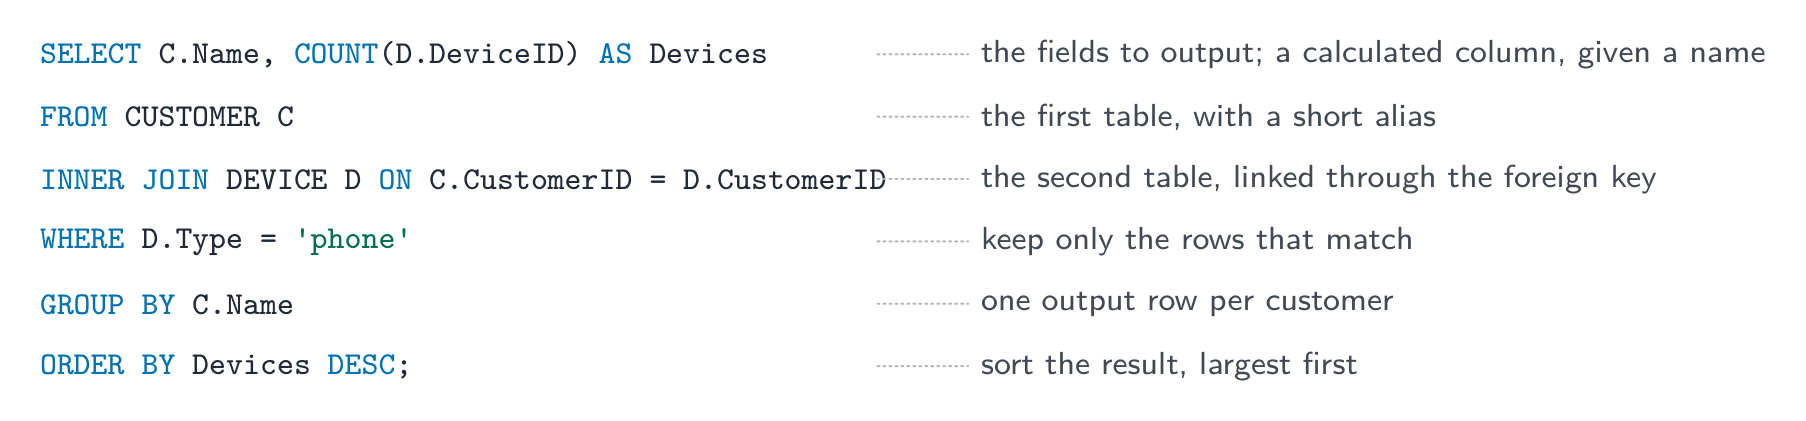
Exemplo resolvido. Usando CUSTOMER(CustomerID, Name, Phone) e DEVICE(DeviceID, CustomerID, Type, Model), escreva scripts SQL para: (a) listar o nome e o número de telefone de todo cliente que possui um dispositivo do tipo 'tablet', em ordem alfabética de nome; (b) contar os dispositivos de cada tipo; (c) registrar que o cliente 17 agora tem o número de telefone '0771 234 5678'; (d) adicionar um novo dispositivo, ID 305, um 'laptop' do modelo 'X1' pertencente ao cliente 17.
(a)
SELECT CUSTOMER.Name, CUSTOMER.Phone
FROM CUSTOMER INNER JOIN DEVICE
  ON CUSTOMER.CustomerID = DEVICE.CustomerID
WHERE DEVICE.Type = 'tablet'
ORDER BY CUSTOMER.Name ASC;
(b)
SELECT Type, COUNT(DeviceID) AS NumberOfDevices
FROM DEVICE
GROUP BY Type;
(c) UPDATE CUSTOMER SET Phone = '0771 234 5678' WHERE CustomerID = 17;
(d) INSERT INTO DEVICE (DeviceID, CustomerID, Type, Model) VALUES (305, 17, 'laptop', 'X1');
Pontuação é dada por cláusula — os campos, as tabelas, a condição de join, o WHERE, o ORDER BY — então um script com uma cláusula errada ainda pontua o resto. Escreva Table.Field sempre que duas tabelas estiverem envolvidas.
Exemplo resolvido. Explique o que este script faz: SELECT T.Name, SUM(R.Cost) AS Total FROM TECHNICIAN T INNER JOIN REPAIR R ON T.TechnicianID = R.TechnicianID GROUP BY T.Name;
Ele exibe o nome de cada técnico com o custo total dos reparos realizados por esse técnico, uma linha por técnico: as duas tabelas são unidas por TechnicianID, as linhas são agrupadas por nome e os custos de cada grupo são somados. Quando pedirem o que um script faz, descreva o resultado, não a sintaxe.
Condições e chaves SQL
LIKE 'Li%' corresponde a texto que começa com Li; % representa qualquer quantidade de caracteres e _ exatamente um. AND exige ambas as condições; OR exige pelo menos uma. Use parênteses ao combiná-las.
CREATE DATABASE Club;
CREATE TABLE Booking (
  MemberID INTEGER,
  EventID INTEGER,
  PRIMARY KEY (MemberID, EventID)
);
ALTER TABLE Booking ADD FOREIGN KEY (MemberID)
  REFERENCES Member(MemberID);
SELECT Name FROM Member
WHERE Name LIKE 'Li%' AND (Year = 12 OR Year = 13)
ORDER BY Name DESC;
A chave primária composta torna o par único, não cada coluna separadamente. Uma chave estrangeira impede referência não nula a um registro pai ausente. ON UPDATE CASCADE propaga alteração da chave pai para linhas referenciadoras; ON DELETE CASCADE exclui essas linhas quando o pai é excluído.
Explorar
Unir duas tabelas com INNER JOIN
Um join combina linhas onde a chave estrangeira é igual à chave primária — aqui Orders.CustomerID = Customer.CustomerID — e une cada par correspondente em uma linha mais larga.
Explorar
SELECT … WHERE
Passe por uma consulta: WHERE mantém as linhas que correspondem, então SELECT escolhe as colunas que você pediu.
Vocabulário
Treinar
| English | Português |
|---|---|
| primary key/ˈpraɪməri kiː/ | chave primária |
| foreign key/ˈfɒrən kiː/ | chave estrangeira |
| join/dʒɔɪn/ | união |
8.3
Definições aceitas pelo examinador
Uma questão de definição é avaliada contra wording fixo. Aprenda estas exatamente, e dê apenas uma resposta.
| Termo | Definição |
|---|---|
| entity | algo sobre o qual dados são armazenados — uma pessoa, objeto ou evento — que se torna uma tabela em um banco de dados relacional |
| attribute | um item de dado sobre uma entidade (uma coluna da tabela) |
| tuple | uma linha de uma tabela: uma instância da entidade |
| primary key | um atributo, ou combinação de atributos, que identifica unicamente cada registro em uma tabela |
| foreign key | um atributo em uma tabela cujo valor corresponde a uma chave primária em outra tabela, usado para ligar as duas |
| candidate key | qualquer atributo (ou combinação) que poderia ser escolhido como chave primária |
| secondary key | um atributo não-primário que é indexado para que a tabela possa ser pesquisada ou ordenada rapidamente nele |
| composite key | uma chave primária feita de dois ou mais atributos juntos |
| referential integrity | todo valor de chave estrangeira deve corresponder a um valor de chave primária existente na tabela a que se refere |
| first normal form | uma tabela em que todo atributo é atômico, não há grupos repetidos e existe uma chave primária |
| second normal form | em 1NF, e todo atributo não-chave depende de toda a chave primária (nenhuma dependência parcial) |
| third normal form | em 2NF, e nenhum atributo não-chave depende de outro atributo não-chave (nenhuma dependência transitiva) |
| data dictionary | os metadados que um DBMS mantém sobre a estrutura do banco de dados: tabelas, campos, tipos, chaves, relacionamentos, validação |
| DDL / DML | a linguagem usada para definir ou alterar a estrutura de um banco de dados / a linguagem usada para consultar e manter os dados nele |
Vocabulário
Treinar
| English | Português |
|---|---|
| integrity/ɪnˈteɡrɪti/ | integridade |
| relational database/rɪˈleɪʃənl ˈdeɪtəbeɪs/ | banco de dados relacional |
| entity/ˈentɪti/ | entidade |
| tuple/ˈtuːpl/ | tupla |
| attribute/ˈætrɪbjuːt/ | atributo |
| composite key/ˈkɒmpəzɪt kiː/ | chave composta |
| candidate key/ˈkændɪdeɪt kiː/ | chave candidata |
| secondary key/ˈsekəndəri kiː/ | chave secundária |
| indexing/ˈɪndeksɪŋ/ | indexação |
| referential integrity/ˌrefəˈrenʃl ɪnˈteɡrɪti/ | integridade referencial |
| entity-relationship diagram/ˈentɪti rɪˈleɪʃənʃɪp ˈdaɪəɡræm/ | diagrama de entidade-relacionamento |
| data dictionary/ˈdeɪtə ˈdɪkʃənəri/ | dicionário de dados |
| concurrent access/kənˈkʌrənt ˈækses/ | acesso concorrente |
| transactions/trænˈsækʃnz/ | transações |
8.3
Dicas de prova
- Defina os termos exatamente: entity, attribute, primary key, foreign key, e os tipos de relacionamento (1:1, 1:muitos, muitos:muitos).
- Dê uma razão em cada forma normal: 1NF (sem grupos repetidos), 2NF (sem dependência parcial), 3NF (sem dependência não-chave) — e nomeie os campos envolvidos.
- Explique o que um DBMS fornece (independência de dados, segurança, integridade, acesso simultâneo, um dicionário de dados, uma interface de desenvolvedor, um processador de consultas).
- Distinga DDL (definir a estrutura) de DML (consultar e alterar os dados), e escreva cláusulas SQL uma por uma:
SELECT,FROM,INNER JOIN … ON,WHERE,GROUP BY,ORDER BY. - Para desenhar um diagrama E-R a partir de tabelas, encontre primeiro cada chave estrangeira: toda chave estrangeira representa um relacionamento de um-para-muitos, com o "muitos" na tabela que a contém.
Erros comuns
- Desenhar um relacionamento de muitos-para-muitos diretamente. Ele deve ser dividido em dois relacionamentos de um-para-muitos através de uma tabela de ligação contendo ambas as chaves estrangeiras.
- Explicando "não em 3NF" como "os dados estão repetidos". Nomeie a dependência (parcial ou transitiva) e os campos envolvidos.
- Aspas duplas em torno de strings no SQL, ou aspas em torno de números. Strings levam
'single quotes'; números não levam nada. - Deixar de fora a condição
ONdepois deINNER JOIN. Sem ela, as duas tabelas não estão ligadas. - Colocar um campo comum ao lado de
COUNTouSUMem umSELECTsem umGROUP BY. UPDATEouDELETEsem umWHERE. Ela altera ou remove todas as linhas da tabela.
Aulas interativas sobre este tópico
Passe por ele passo a passo, com exercícios de verificação instantânea.