디지털 컴퓨터는 1과 0로 쓰는 두 논리 상태를 이용해 데이터를 표현합니다. 두 숫자만 사용하는 체계를 이진법이라고 하며 밑은 2입니다.
컴퓨터가 사용할 수 있도록 모든 종류의 데이터 — 숫자, 텍스트, 소리, 이미지 — 는 먼저 이진법으로 변환되어야 한다. 컴퓨터는 **논리 게이트(logic gates)**를 사용하여 이 이진법을 처리하고, 레지스터(registers) (프로세서 내부의 작고 빠른 저장 장치)에 저장한다.
IGCSE 컴퓨터 과학 · 주제 1
 21:16
컴퓨터가 이_Handle를 사용하는 이유
프로세서 내부에는数十억 개의 미세한 스위치가 있습니다. 각 스위치는 켜짐 또는 꺼짐 상태 중 하나일 뿐입니다. 이것이 컴퓨터가 물리적으로 가지는 모든 것입니다 — 삼, 일곱, … 같은 숫자는 존재하지 않습니다.
영어 내레이션 · 영어와 중국어 자막 전환 가능
디지털 컴퓨터는 1과 0로 쓰는 두 논리 상태를 이용해 데이터를 표현합니다. 두 숫자만 사용하는 체계를 이진법이라고 하며 밑은 2입니다.
컴퓨터가 사용할 수 있도록 모든 종류의 데이터 — 숫자, 텍스트, 소리, 이미지 — 는 먼저 이진법으로 변환되어야 한다. 컴퓨터는 **논리 게이트(logic gates)**를 사용하여 이 이진법을 처리하고, 레지스터(registers) (프로세서 내부의 작고 빠른 저장 장치)에 저장한다.
| English | 한국어 |
|---|---|
| binary/ˈbaɪnəri/ | 이_Handle |
| data/ˈdeɪtə/ | 데이터 |
| logic gate/ˈlɒdʒɪk ɡeɪt/ | 논리 게이트 |
| processor/ˈprəʊsesə/ | 프로세서 |
| register/ˈredʒɪstə/ | 레지스터 |
| 응시자가 다음을 수행할 수 있어야 함: | 참고 사항 및 가이드라인 |
|---|---|
| 1 컴퓨터가 모든 형태의 데이터를 **이진(binary)**으로 표현하는 원리와 이유를 이해함 | • 모든 형태의 데이터는 컴퓨터에 의해 처리되기 위해 이진으로 변환되어야 함 • 데이터는 논리 게이트(logic gates)를 사용하여 처리되고 레지스터(registers)에 저장됨 |
| 2 (a) Understand the denary, binary and hexadecimal number systems (b) Convert between (i) positive denary and positive binary (ii) positive denary and positive hexadecimal (iii) positive hexadecimal and positive binary | • Denary is a base 10 system • Binary is a base 2 system • Hexadecimal is a base 16 system • Values used will be integers only • Conversions in both directions, e.g. denary to binary or binary to denary • Maximum binary number length of 16-bit |
| 3 Understand how and why hexadecimal is used as a beneficial method of data representation | • Areas within computer science that hexadecimal is used should be identified • Hexadecimal is easier for humans to understand than binary, as it is a shorter representation of binary |
| 4 (a) Add two positive 8-bit binary integers (b) Understand the concept of overflow and why it occurs in binary addition | • An overflow error will occur if the value is greater than 255 in an 8-bit register • A computer or a device has a predefined limit that it can represent or store, for example 16-bit • An overflow error occurs when a value outside this limit should be returned |
| 5 양의 8비트 이진 정수에 대해 논리적 이진 이동을 수행하고 이것이 양의 이진 정수에 미치는 영향을 이해합니다. | • 논리적 왼쪽 이동 수행 • 논리적 오른쪽 이동 수행 • 여러 번의 이동 수행 • 레지스터 끝에서 이동된 비트는 손실되고, 반대쪽 끝에 영수가 이동됨 • 수행된 이동에 따라 양의 이진 정수가 곱해지거나 나 • 가장 높은 의미 비트 또는 가장 낮은 의미 비트가 손실됨 |
| 6 Use the two’s complement number system to represent positive and negative 8-bit binary integers | • Convert a positive binary or denary integer to a two’s complement 8-bit integer and vice versa • Convert a negative binary or denary integer to a two’s complement 8-bit integer and vice versa |
출처: Cambridge International syllabus
**숫자 체계(number system)**는 고정된 숫자 집합을 사용하여 숫자를 쓰는 방법이다. 세 가지가 필요하다.
| 체계 | Base | 사용数字 |
|---|---|---|
| 진법 | 10 | 0–9 |
| 이진법 | 2 | 0 및 1 |
| 진수 | 16 | 0–9 이후 A–F |
Base는 해당 체계가 사용하는 서로 다른 숫자의 개수를 알려준다.
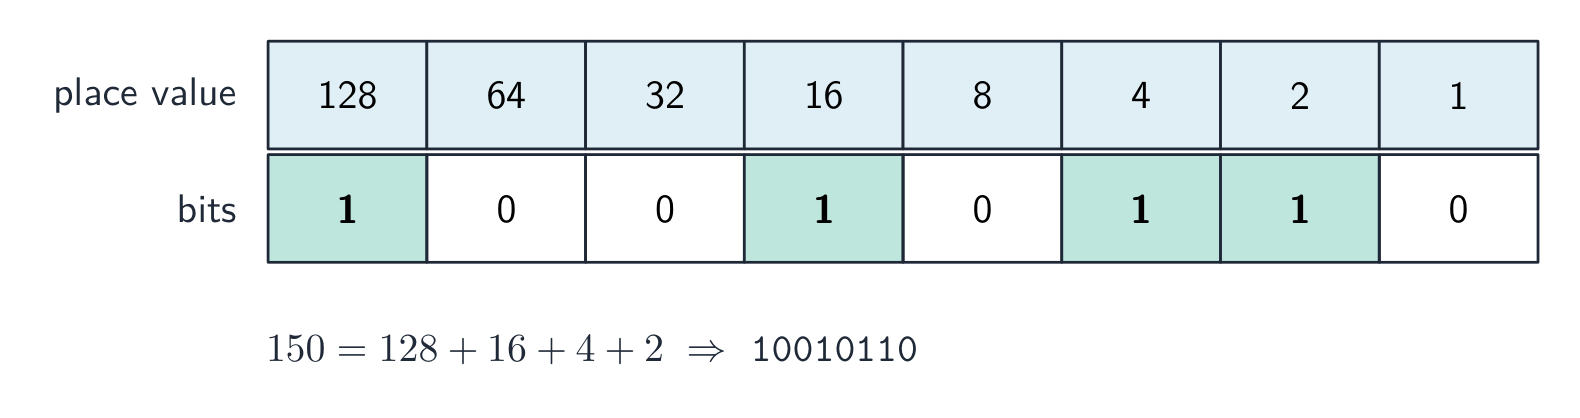
숫자의 각 열에는 자리 값(place value) 이 있다. 이진법에서는 자리 값이 오른쪽에서 왼쪽으로 갈수록 배가된다. 8비트 숫자의 경우 다음과 같다:
128 64 32 16 8 4 2 1
한 비트(bit) 는 단일의 0 또는 1이다. 여 비트는 하나의 바이트(byte) 를 이룬다. 네 비트(반 바이트)는 니블(nibble) 이다.
십진법 → 이진법. 자리 값을 쓰라. 숫자가 되는 값 아래에 1을, 나머지 값 아래에는 0을 넣는다.
예시: 십진법 150을 이진법으로 바꾸기. $150 = 128 + 16 + 4 + 2$.
128 64 32 16 8 4 2 1
  1  0  0  1 0 1 1 0
따라서 $150$ = 10010110이다.
이진법 → 십진법. 1이 있는 자리 값들을 더한다. 10010110 $= 128 + 16 + 4 + 2 = 150$.
Hexadecimal → binary. 각 HEX 자릿수를 자체 4-bit 그룹(nibble)으로 변환합니다.
예: hex F08. $F = 1111$, $0 = 0000$, $8 = 1000$이므로 F08 = 1111 0000 1000입니다.
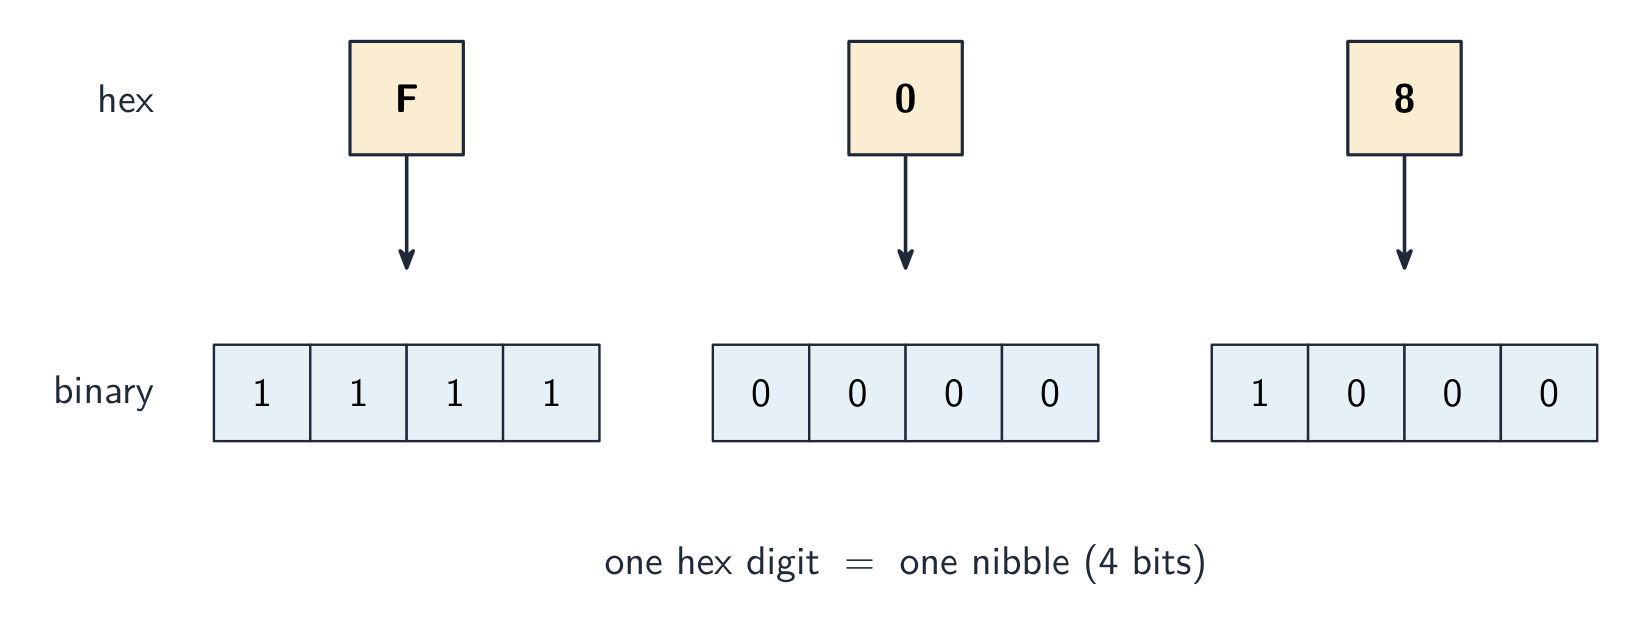
Binary → hexadecimal. Group the bits into nibbles of 4, starting from the right. Change each nibble to one hex digit.
십진법 → 십진법 변환. 가장 쉬운 방법은 먼저 이진법으로 바꾼 뒤, 다시 이진법에서 십진법으로 변환하는 것입니다.
이 표는 십진법 문자 변환에 도움이 됩니다:
| 데네리 | 바이너리 | 헥 |
|---|---|---|
| 10 | 1010 | A |
| 11 | 1011 | B |
| 12 | 1100 | C |
| 13 | 1101 | D |
| 14 | 1110 | E |
| 15 | 1111 | F |
Cambridge 문제는 최대 16비트 길이의 이진법 숫자를 사용한다.
풀이 예제. 십진법 100을 8-비트 이진법으로 변환한 뒤, 십진법으로 변환하십시오.
$100 = 64 + 32 + 4$이므로, 이진법은 01100100입니다. 니블로 나누면, 0110 0100 $= 6$ 및 $4$이 되므로, 십진법은 64입니다.
예제 풀이 (십육진수 → 십진수). 십육진수 2C을 십진수로 바꾸세요. 십육진수의 자릿값은 $16$과 $1$입니다. 2의 값은 $2 \times 16 = 32$이고 C의 값은 $12$이므로 2C $= 32 + 12 = 44$입니다. 이진수를 이용한 확인: 0010 1100 $= 32 + 8 + 4 = 44$.
십진법은 이진법보다 짧아 사람이 읽고 쓰는 데 더 쉽고 편합니다. 십진법 한 자리 숫자는 이진법 4자리 숫자를 대체하므로, 실수를 줄일 수 있습니다. 값은 변하지 않으며, 십진법은 동일한 이진법을 더 짧게 표시하는 방식일 뿐입니다.
컴퓨터 과학자들은 다음 목적을 위해 십진법을 사용합니다:
#FF0000는 빨강)Type a number and see it in binary, denary and hex — and how the place values build it.
| English | 한국어 |
|---|---|
| digit/ˈdɪdʒɪt/ | 숫자 |
| number system/ˈnʌmbə ˈsɪstəm/ | 수계 |
| denary/ˈdiːnəri/ | 진수 |
| hexadecimal/ˌheksəˈdesɪml/ | 십육진수 |
| base/beɪs/ | 근수 |
| place value/pleɪs ˈvæljuː/ | 자리값 |
| bit/bɪt/ | 비트 |
| byte/baɪt/ | 바이트 |
| nibble/ˈnɪbl/ | 니블 |
| memory address/ˈmeməri əˈdres/ | 메모리 주소 |
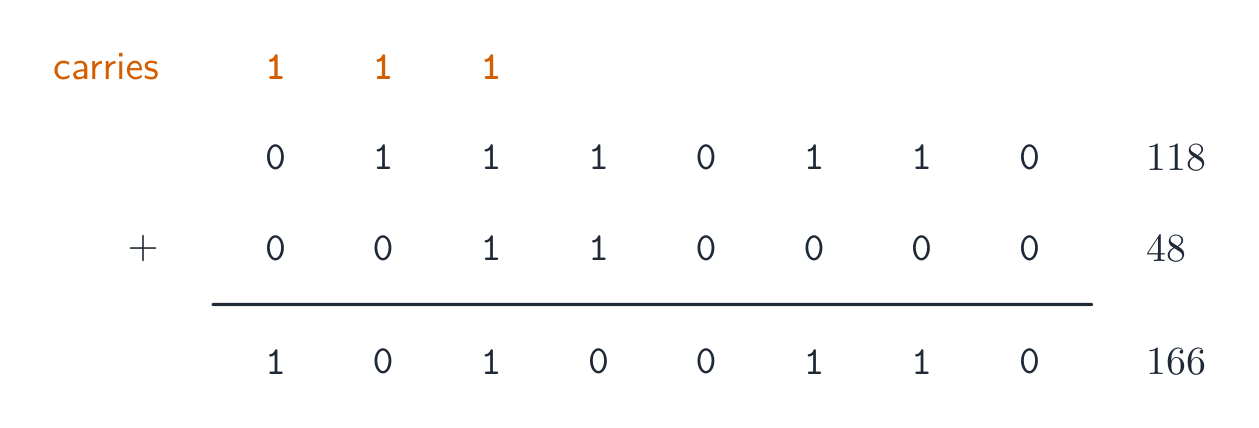
두 8비트 이진법 숫자를 십진법처럼 오른쪽에서 시작하여 열별로 더할 수 있다. 한 열에 대한 규칙은 다음과 같다:
| A | B | 결과 비트 | _Handle |
|---|---|---|---|
| 0 | 0 | 0 | 0 |
| 0 | 1 | 1 | 0 |
| 1 | 0 | 1 | 0 |
| 1 | 1 | 0 | 1 |
_Handle가 들어올 때, $1 + 1 + 1 = 1$가_Handle 1과 함께 처리된다.
예시: 01110110 (118)과 00110000 (48)을 더하기.
  0 1 1 1 0 1 1 0    (118)
+ 0 0 1 1 0 0 0 0    (48)
-------------------
  1 0 1 0 0 1 1 0    (166)
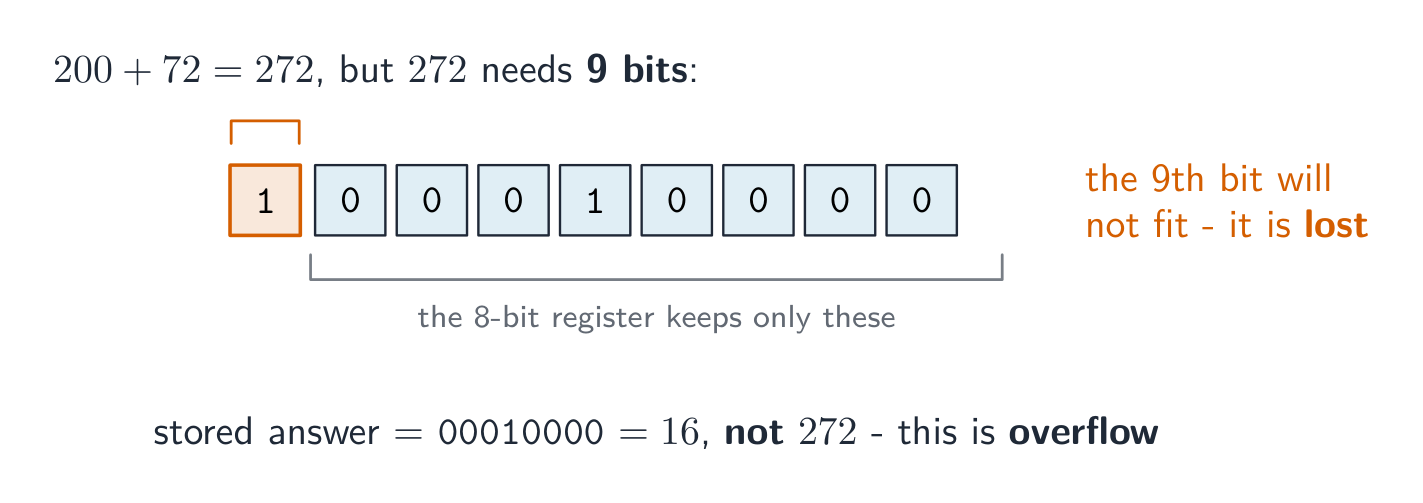
부호 없는 정수로 해석하면 8비트 레지스터는 0부터 255까지의 값을 저장합니다. 덧셈 결과가 255보다 크면 답에 9번째 비트가 필요합니다. 레지스터는 이 추가 비트를 저장할 수 없으므로 해당 비트는 사라집니다. 이를 오버플로 또는 오버플로 오류라고 합니다. 값이 레지스터에 저장할 수 있는 범위를 벗어날 때 발생합니다.
예시: 11001000 (200) $+$ 01001000 (72) $= 272$. 이진법으로는 1 00010000이며, 이는 9비트가 필요하다. 최상위의 1은 8비트에 들어가지 않으므로, 저장된 답은 잘못된다.
| English | 한국어 |
|---|---|
| overflow/ˌəʊvəˈfləʊ/ | 오버플로우 |

**논리적 이진법 시프트(logical binary shift)**는 모든 비트를 몇 자릿수만큼 왼쪽 또는 오른쪽으로 이동시킨다.
부호 없는 정수에서 왼쪽 시프트는 0이 아닌 비트가 사라지지 않는다면 한 자리 이동할 때마다 2을 곱한 효과를 냅니다. 논리 오른쪽 시프트는 한 자리 이동할 때마다 2로 나눈 결과의 정수 부분을 구하며, 가장 오른쪽 비트인 최하위 비트가 사라집니다.
예시: 00110101 (53)을 2자릿수 왼쪽으로 시프트하기.
start:         0 0 1 1 0 1 0 1
left shift 2:  1 1 0 1 0 1 0 0
*2개 왼쪽 시프트: 모든 비트가 2자리씩 왼쪽으로 이동하며, 위쪽 비트들은 잃어지고 오른쪽에는 영제로 채워집니다
결과는 11010100 (212)이며, 이는 $53 \times 4$입니다. 왼쪽 두 개의 비트가 잃어지고 오른쪽에 두 개의 영제가 들어왔습니다. 만약 1이 끝부분에서 밀려나간다면, 그 정보는 영원히 사라지게 됩니다.
예제 풀이 (오른쪽 시프트). 10110100 (180)을 오른쪽으로 3자리 시프트하세요. 결과를 이진수와 십진수로 나타내고 시프트의 효과를 설명하세요.
start:          1 0 1 1 0 1 0 0
right shift 3:  0 0 0 1 0 1 1 0
가장 오른쪽의 세 비트 (100)가 사라지고 왼쪽에 영 세 개가 들어옵니다: 00010110 $= 16 + 4 + 2 = 22$. 오른쪽으로 3자리 이동하면 $2^3 = 8$로 나눈 것과 같습니다: $180 \div 8 = 22.5$. 이 이동은 정수 부분인 $22$만 남깁니다. $0.5$은 사라진 1비트에 담겨 있었습니다.
예제 풀이 (잘못된 결과를 내는 왼쪽 시프트). 01100100 (100)을 왼쪽으로 2자리 시프트하세요. 결과는 10010000 $= 144$이며 $400$가 아닙니다. 1이 왼쪽 끝에서 밀려나 사라졌고, $400$은 어차피 8비트로 나타내기에 너무 큽니다. 왼쪽 시프트는 1 비트가 사라지지 않을 때만 올바른 곱셈 결과를 냅니다.
| English | 한국어 |
|---|---|
| logical binary shift/ˈlɒdʒɪkl ˈbaɪnəri ʃɪft/ | 논리적 이_Handle 시프트 |
| least significant bit/liːst sɪɡˈnɪfɪkənt bɪt/ | 최하위 비트 |
| two's complement/tuːz ˈkɒmplɪmənt/ | 2의 보수 |
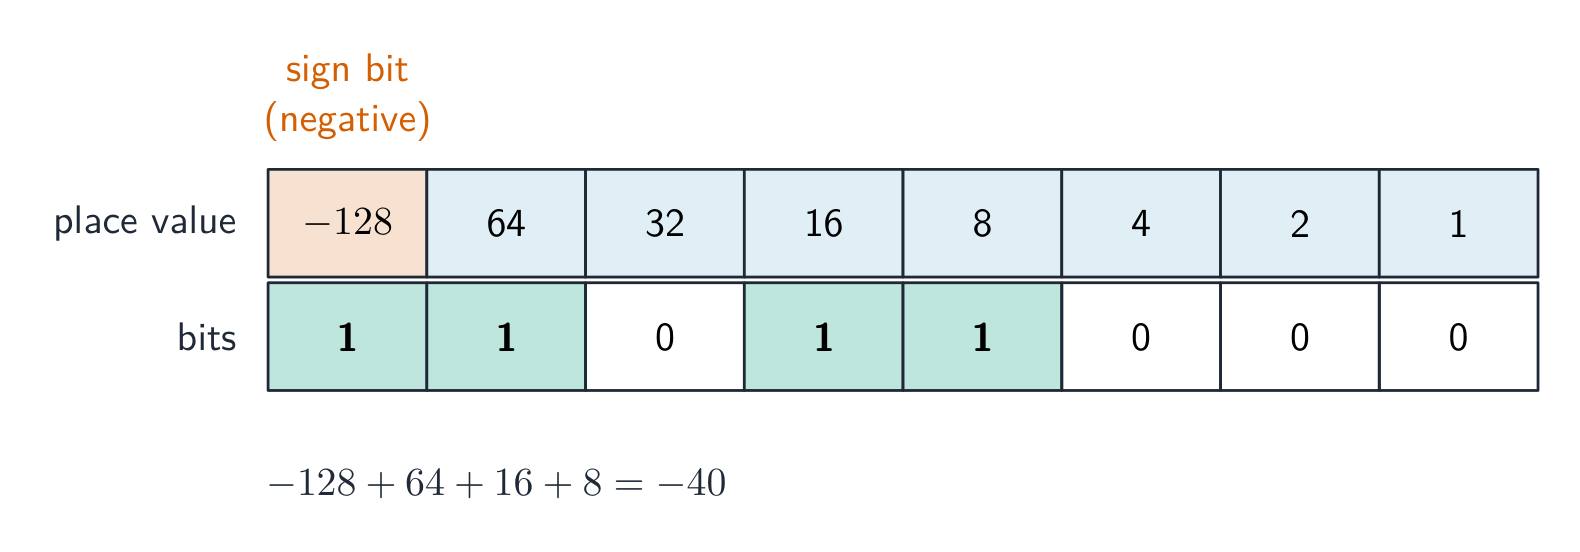
지금까지의 숫자들은 양수였습니다. 2의 보수를 사용하면 8비트 레지스터에 음수까지 저장할 수 있습니다.
2의 보수에서 최상위 비트(가장 높은 순위의 비트, 또는 MSB)는 음수의 자리 값을 가집니다:
-128 64 32 16 8 4 2 1
양수를 음수로 만들기: 양수의 이진수 적시, 모든 비트를 반전(0↔1), 그리고 1을 더합니다.
예: $-40$를 음수로 만들기
001010001101011111011000따라서 $-40$ = 11011000입니다. 자리 값을 더하여 확인해 보면: $-128 + 64 + 16 + 8 = -40$.
음수인 2의 보수 숫자를 읽으려면 자리 값을 단순히 더하면 됩니다(MSB는 $-128$로 계산). 8비트 2의 보수 숫자의 범위는 $-128$부터 $+127$까지입니다.
예제 풀이. 2의 보수로 표현된 수 10011010을 십진수로 바꾸세요. MSB가 1이므로 음수입니다. $-128 + 16 + 8 + 2 = -102$. 다른 방법으로 확인합니다. 비트를 뒤집고 01100101에 1을 더하면 01100110 $= 102$이므로 원래 수는 $-102$입니다.
| English | 한국어 |
|---|---|
| most significant bit/məʊst sɪɡˈnɪfɪkənt bɪt/ | 최고위 비트 |
| 응시자가 다음을 수행할 수 있어야 함: | 참고 사항 및 가이드라인 |
|---|---|
| 1 Understand how and why a computer represents text and the use of character sets, including American standard code for information interchange (ASCII) and Unicode | • Text is converted to binary to be processed by a computer • Unicode allows for a greater range of characters and symbols than ASCII, including different languages and emojis • Unicode requires more bits per character than ASCII |
| 2 Understand how and why a computer represents sound, including the effects of the sample rate and sample resolution | • A sound wave is sampled for sound to be converted to binary, which is processed by a computer • The sample rate is the number of samples taken in a second • The sample resolution is the number of bits per sample • The accuracy of the recording and the file size increases as the sample rate and resolution increase |
| 3 컴퓨터가 이미지를 어떻게 그리고 왜 표현하는지 이해하기, 해상도 및 색상 깊이의 영향 포함 | • 이미지는 일련의 픽셀로 구성되어 있으며, 이는 이진수로 변환되어 컴퓨터에 의해 처리됨 • 해상도는 이미지 내의 픽셀 수임 • 색상 깊이는 각 색상을 표현하는 데 사용된 비트 수임 • 해상도와 색상 깊이가 증가할수록 파일 크기와 이미지 품질이 향상됨 |
출처: Cambridge International syllabus
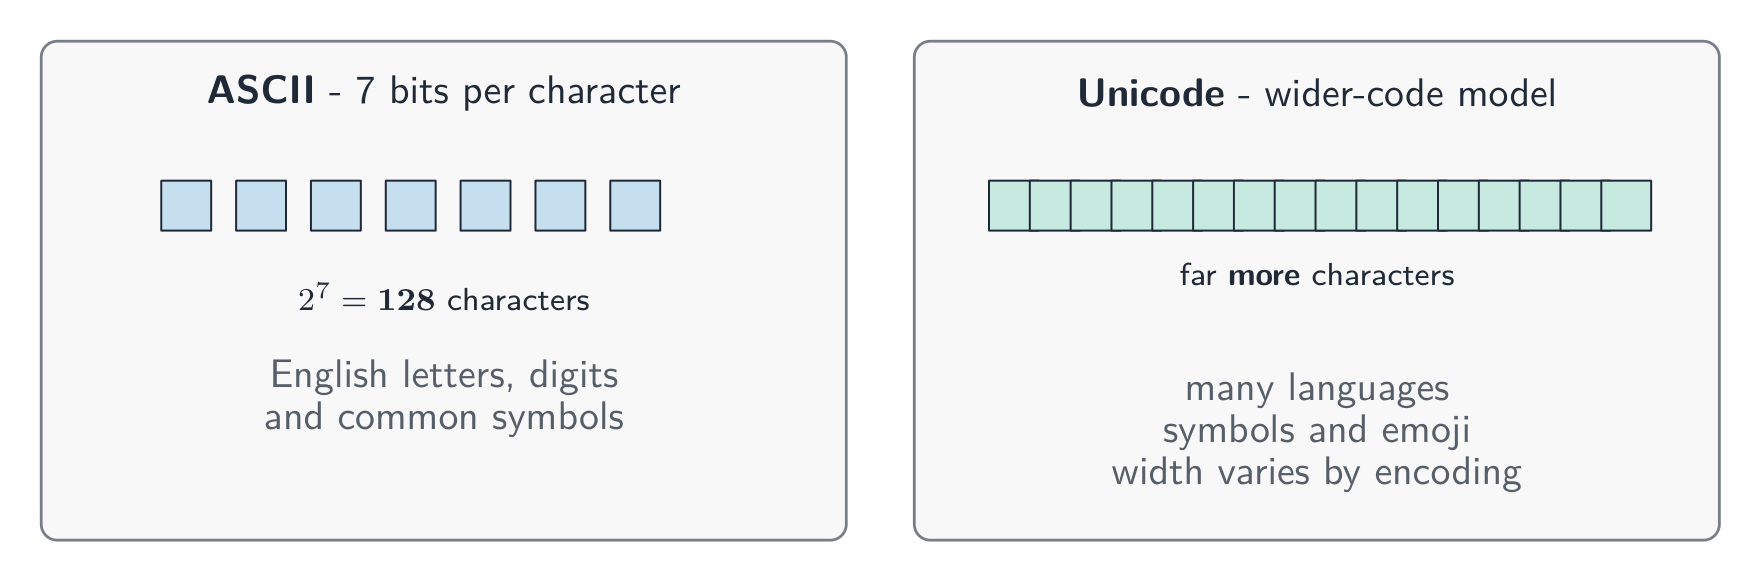
컴퓨터는 텍스트를 저장할 때 각 문자에 번호를 부여하고, 그 번호를 이진수 형태로 저장합니다. 컴퓨터가 사용할 수 있는 문자의 집합과 그에 해당하는 번호를 **문자 집합(character set)**이라고 합니다.
ASCII 는 7-비트 문자 코드를 사용하여 총 $N = 2^b = 2^7 = 128$가지 다른 코드를 제공합니다. 영문 알파벳, 숫자, 일반 기호를 포함하지만 모든 128코드가 알파벳인 것은 아닙니다. 유니코드는 여러 언어와 이모지를 포함한 훨씬 넓은 범위의 문자를 표현합니다.
해 보세요 — 짧은 메시지 인코딩하기. ASCII 추출본에 따르면 A = 65, B = 66, C = 67, 공백 = 32입니다. CAB 의 마지막 공백까지 포함된 네 개의 7-비트 그룹을 쓰세요. 그런 다음 그룹 1000010 1000001 1000011을 디코딩하세요.
풀이 답안. 각 문자를 찾아 코드를 이진수로 변환하세요:
| 문자 | 코드 | 7비트 |
|---|---|---|
| C | 67 | 1000011 |
| A | 65 | 1000001 |
| B | 66 | 1000010 |
| 공백 | 32 | 0100000 |
따라서 CAB 는 1000011 1000001 1000010 0100000입니다. 두 번째 메시지는 BAC로 복호화됩니다. 공백에도 코드가 있으며, 이는 저장된 데이터의 부재를 의미하지 않습니다. Sender와 Receiver는 메시지를 올바르게 해석하기 위해 동일한 문자-코드 매핑을 사용해야 합니다.
Why a larger range matters. ASCII cannot directly represent a Chinese name. Unicode includes Chinese characters as well as English characters and many other languages. For the syllabus comparison, explain that a greater range needs more distinct binary codes, requiring more bits per character than the 7-bit ASCII model.
해 보세요 — 명시된 저장 모델 비교하기. (A) 각 문자당 7비트 및 (B) 각 문자당 16비트로 문자 CAB 네 개를 저장하세요. 패딩이나 추가 파일 정보가 없는 경우 비트가 밀집되어 있다고 가정합니다. 각 모델에서의 텍스트 데이터 크기를 구하세요. 16-비트 값은 이 예제를 위한 가정이지, 모든 유니코드 문자가 16비트를 사용하는 규칙은 아닙니다.
Worked answer. With the same number of characters, multiply by the stated bits per character:
이 예제에서 Model B는 명시된 코드幅이 더 크기 때문에 저장소를 더 많이 사용합니다. 시험 문제에서 제시한 width를 사용하십시오. 실제 파일에서는 인코딩도 중요하며, UTF-8은 ASCII 문자를 ASCII 파일과 동일한 바이트에 저장하므로 유니코드 텍스트가 항상 더 많은 바이트를 차지하지는 않습니다. 이 과목 비교를 위해 UTF-8의 상세 규칙은 필요 없습니다.
y = a sin(bt + c)
사운드는 파동이며, 샘플링은 이를 초당 여러 번 높이 기록합니다.
| English | 한국어 |
|---|---|
| character set/ˈkærɪktə set/ | 문자 집합 |
| emoji/ɪˈməʊdʒi/ | 이모지 |
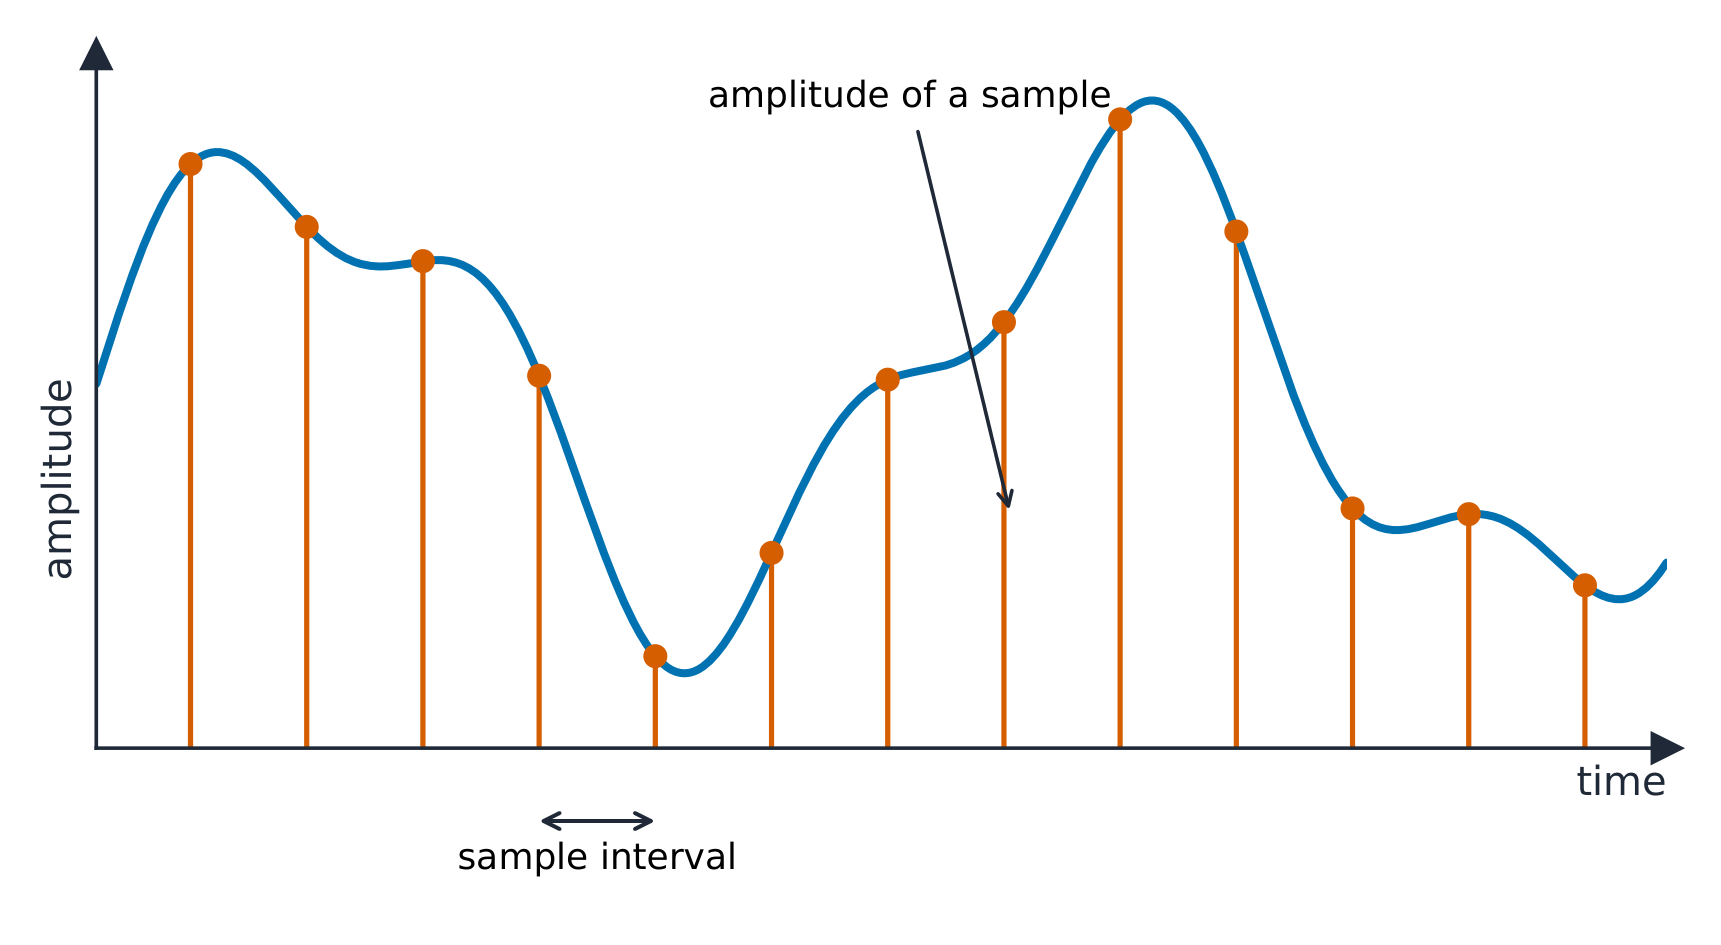
음파는 매끄럽고 항상 변합니다. 이를 저장하려면 컴퓨터가 일정한 시간 간격마다 파동의 높이를 측정합니다. 이를 **샘플링(sampling)**이라 하며, 각 측정은 하나의 샘플(sample)입니다.
A higher sample rate and a higher sample resolution give a more accurate recording, but a larger file.
y = a sin(bt + c)
사운드는 파동이며, 샘플링은 이를 초당 여러 번 높이 기록합니다.
| English | 한국어 |
|---|---|
| sampling/ˈsæmplɪŋ/ | 샘플링 |
| sample rate/ˈsæmpl reɪt/ | 샘플링 속도 |
| sample resolution/ˈsæmpl ˌrezəˈluːʃn/ | 샘플 해상도 |
| amplitude/ˈæmplɪtjuːd/ | 진폭 |
| resolution/ˌrezəˈluːʃn/ | 해상도 |
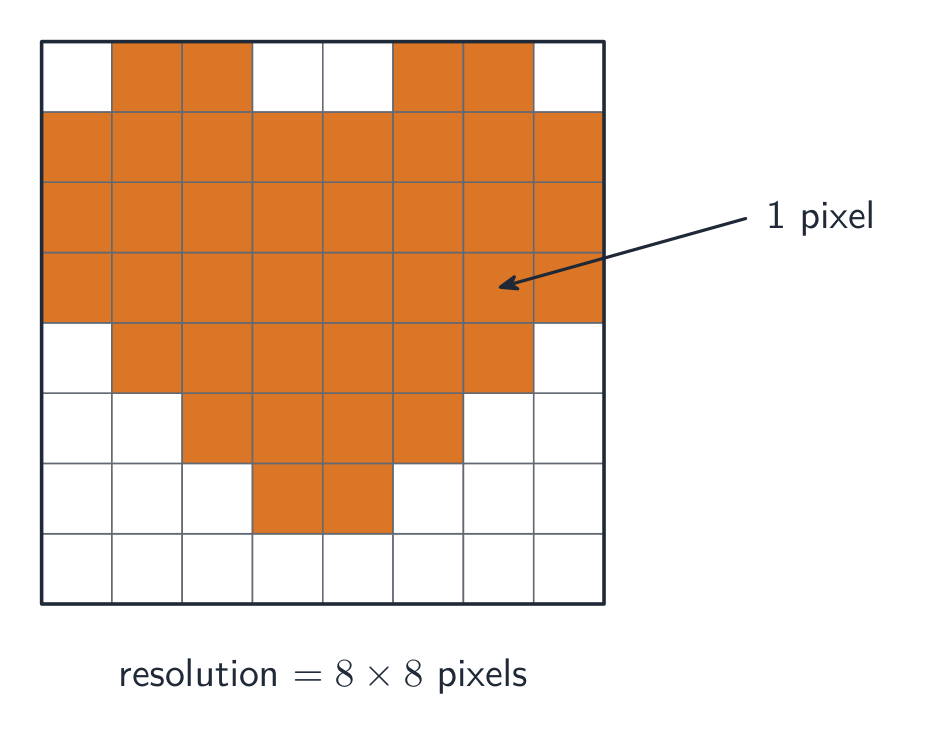
컴퓨터 이미지는 **픽셀(pixel)**이라고 하는 작은 점들의 격자로 구성됩니다.
더 높은 해상도와 더 높은 컬러 딥스는 더 고품질의 이미지를 제공하지만, 파일 크기는 커집니다.
색상 깊이는 각 픽셀이 나타낼 수 있는 서로 다른 색의 수를 결정합니다. $n$비트로는 $2^n$가지 색을 나타낼 수 있습니다. 색상 깊이가 1비트이면 2가지 색인 검은색과 흰색을, 8비트이면 $2^8 = 256$가지 색을, 24비트이면 16백만 가지가 넘는 색을 나타냅니다.
예제 풀이. 이미지에 서로 다른 색이 64가지 사용되었습니다. 가능한 최소 색상 깊이는 얼마인가요? $2^n \geqslant 64$를 만족하는 가장 작은 $n$을 구합니다. $2^6 = 64$이므로 픽셀당 6비트입니다. 색이 65가지 사용되었다면 7비트가 필요합니다. 6비트로는 서로 다른 패턴을 64개만 만들 수 있기 때문입니다.
| English | 한국어 |
|---|---|
| pixel/ˈpɪksl/ | 픽셀 |
| colour depth/ˈkʌlə depθ/ | 색상 깊이 |
| 응시자가 다음을 수행할 수 있어야 함: | 참고 사항 및 가이드라인 |
|---|---|
| 1 데이터 저장을 측정하는 방법을 이해하기 | • 다음 단위 포함: – bit – nibble – byte – kibibyte (KiB) – mebibyte (MiB) – gibibyte (GiB) – tebibyte (TiB) – pebibyte (PiB) – exbibyte (EiB) • 데이터 저장 크기 내의 이전 단위의 양, 예시: – 8 bits in a byte – 1024 mebibytes in a gibibyte |
| 2 제공된 정보를 사용하여 이미지 파일과 사운드 파일의 파일 크기를 계산함 | • 답은 문제에서 지정한 단위여야 함. 계산에는 1024의 단위를 사용하고 1000의 단위는 사용하지 않아야 함 • 제공된 정보에는 다음이 포함될 수 있음: – 이미지 해상도와 컬러 디프스 – 사운드 샘플링레이트, 레지션 및 트랙 길이 |
| 3 데이터 압축의 목적과 필요성을 이해하기 | • 압축은 파일 크기를 줄이기 위해 존재함 • 이로 인한 영향, 예시: – 필요한 대역폭 감소 – 필요한 저장 공간 감소 – 전송 시간 단축 |
| 4 손실 압축(lossy) 및 무손실 압축(lossless) 방식을 사용하여 파일을 압축하는 원리를 이해하기 | • 손실 압축은 데이터를 영구적으로 제거하여 파일 크기를 줄이며, 예시: 해상도 또는 색상 깊이 감소, 샘플레이트 또는 해상도 감소 • 무손실 압축은 데이터의 영구적 손실 없이 파일 크기를 줄이며, 예시:run length encoding (RLE) |
출처: Cambridge International syllabus
데이터 저장량은 아래 단위를 사용합니다. 니블(nibble)은 4비트, 바이트(byte)는 8비트이며, 킬비바이트(kibibyte) 이상에서는 전 단위 대비 1024배씩 증가합니다(이유: $1024 = 2^{10}$는 이진수에 적합하기 때문입니다).
| 단위 | 값 |
|---|---|
| bit | 단일 0 또는 1 |
| nibble | 4비트 |
| byte | 8비트 |
| kibibyte (KiB) | 1024바이트 |
| mebibyte (MiB) | 1024 KiB |
| gibibyte (GiB) | 1024 MiB |
| tebibyte (TiB) | 1024 GiB |
| pebibyte (PiB) | 1024 TiB |
| exbibyte (EiB) | 1024 PiB |
| English | 한국어 |
|---|---|
| storage/ˈstɔːrɪdʒ/ | 저장소 |
| sound wave/saʊnd weɪv/ | 음파 |
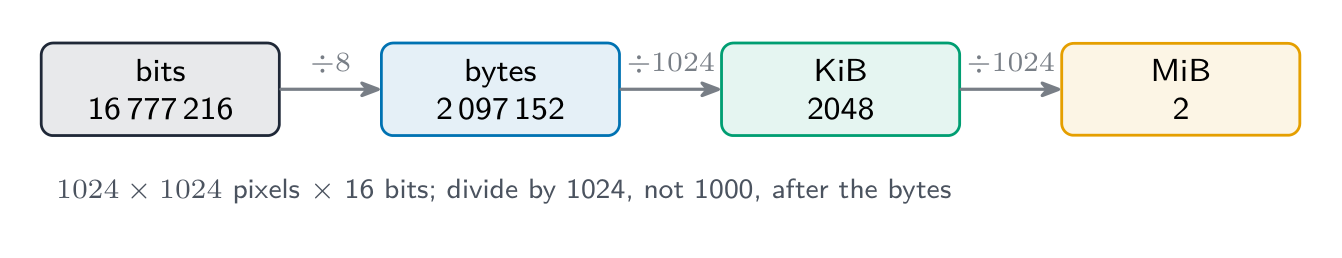
이미지 파일 크기(비트 기준) $=$ 해상도 $\times$ 컬러 딥스 $=$ 폭 $\times$ 높이 $\times$ 컬러 딥스.
예: 한 이미지가 $1024 \times 1024$ 픽셀이며 컬러 딥스가 2바이트($= 16$ 비트)인 경우.
Sound file size (in bits) $=$ sample rate $\times$ sample resolution $\times$ length in seconds.
이 공식들은 파일 헤더를 제외한 비압축 데이터의 크기를 계산합니다. 소리 데이터 공식은 채널 하나에 대한 것이므로 문제에서 채널이 더 많다고 명시하면 채널 수를 곱합니다.
KiB, MiB 등으로 변환할 때는 항상 1000이 아닌 1024로 나누십시오. 문제에서 요구한 단위로 답을 제시하십시오.
풀이 예제. 30초 동안 녹음된 소리의 샘플레이트는 8,000Hz, 샘플 해상도는 16비트입니다. 파일 크기를 킬비바이트(KiB) 단위로 구하십시오.
**압축(compression)**은 파일을 작게 만듭니다. 작은 파일은:
두 가지 유형이 있습니다.
무손실(lossless) 압축은 데이터를 영구적인 손실 없이 파일을 작게 만듭니다. 원본 파일을 정확히 복원할 수 있습니다.
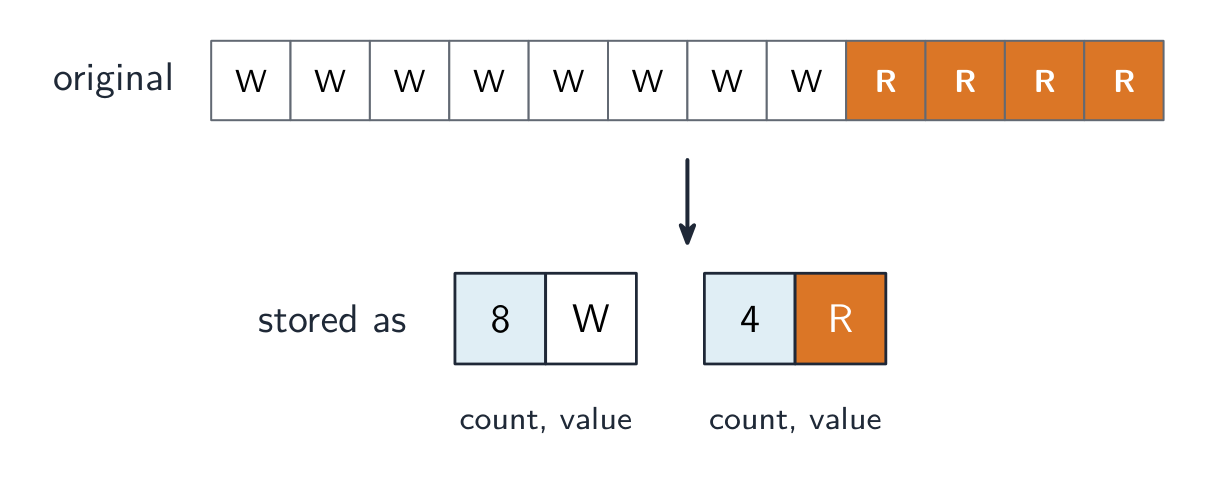
한 가지 방법은 런 렝스 부호화(RLE)입니다. 반복되는 값의 연속 구간을 해당 값 하나와 반복 횟수로 바꿉니다. 예를 들어 WWWWWWWW은 흰색이 8번 반복되는 것으로, '8 W'로 저장됩니다. 이 방법은 데이터에 반복이 많을 때 효과적입니다.
예제 풀이. 흑백 이미지의 한 행이 B B B B B W W B B B B B B B B B이며 픽셀은 16개입니다. RLE로 압축하고, 각 횟수와 각 색을 1바이트로 저장할 때 공간이 절약되는지 설명하세요.
연속 구간은 검은색 5개, 흰색 2개, 검은색 9개이므로 RLE 데이터는 5 B 2 W 9 B입니다. 원본은 픽셀당 1바이트로 6바이트 대신 16바이트입니다. 이 행에는 긴 연속 구간이 있어 공간이 절약됩니다. 픽셀마다 색이 바뀌는 행 B W B W …은 1 B 1 W 1 B 1 W …이 되어 원본보다 두 배 커집니다. RLE는 데이터가 반복될 때만 도움이 됩니다.
손실 압축은 일부 데이터를 영구적으로 제거하여 파일 크기를 크게 줄입니다. 제거된 데이터는 다시 복구할 수 없습니다. 예를 들어:
모든 디테일을 유지해야 할 때(텍스트 및 프로그램 파일)에는 무손실 압축을 사용하고, 사진, 음악, 영상처럼 작은 품질 저하로 훨씬 작은 파일을 얻는 것이 유리할 때는 손실 압축을 사용합니다.
반복되는 기호들이 세기로 압축되어 카운트로 변하는 것을 관찰하라 — 단순한 무손실 압축이다.
| English | 한국어 |
|---|---|
| compression/kəmˈpreʃn/ | 압축 |
| bandwidth/ˈbændwɪdθ/ | 대역폭 |
| transmission/trænˈsmɪʃn/ | 전송 |
| lossless/ˈlɒsləs/ | 무손실 |
| run-length encoding/rʌn leŋθ enˈkəʊdɪŋ/ | 러런 길이 인코딩 |
| lossy/ˈlɒsi/ | 유손실 |
즉시 체크 기능 exercises를 통해 단계별로 진행하세요.