| 응시자가 다음을 수행할 수 있어야 함: | 참고 사항 및 가이드라인 |
|---|---|
| 1 프로그램 개발 생명 주기를 이해하기 (다음으로 제한: 분석, 설계, 코딩 및 테스트) | • 각 단계 식별 및 다음 작업을 각 단계별로 수행: – 분석: 추상화, 문제 분해, 문제 및 요구사항 식별 – 설계: 분해, 구조도, 플로우차트, 가짜 코드 – 코딩: 프로그램 코드 작성 및 반복 테스트 – 테스트: 테스트 데이터 사용하여 프로그램 코드 테스트 |
| 2 (a) 모든 컴퓨터 시스템이 서브 시스템으로 구성되어 있으며, 이 서브 시스템은 다시 더 작은 서브 시스템으로 이루어져 있음을 이해하기 (b) 문제를 구성 요소로 어떻게 분해할 수 있는지 이해하기 | • 다음을 포함: – 입력 – 처리 – 출력 – 저장 |
| (c) 다양한 방법을 사용하여 문제에 대한 해결책을 설계하고 구축하기 | • 다음을 포함: – 구조도 – 플로우차트 – 가짜 코드 |
| 3 주어진 알고리즘의 목적을 설명하기 | • 다음을 포함: – 알고리즘의 목적 명시 – 알고리즘에 포함된 프로세스 설명 |
| 4 표준 해결 방법을 이해하기 | • 다음으로 제한: – 선형 탐색 – 버블 정렬 – 합산 – 세기 – 최대값, 최소값 및 평균값 찾기 |
| 5 (a) 입력 데이터에 대해 검증 체크가 필요하며, 검증 체크의 다양한 유형을 이해하기 | • 다음을 포함: – 범위 체크 – 길이 체크 – 타입 체크 – 존재 체크 – 형식 체크 – 체크 디지트 |
| (b) 입력 데이터에 대해 확인 체크가 필요하며, 확인 체크의 다양한 유형을 이해하기 | • 다음을 포함: – 시각적 체크 – 이중 입력 체크 |
| 6 적절한 테스트 데이터를 제안하고 적용하기 | • 다음으로 제한: – 정상 – 비정상 – 극단 – 경계 • 극단 데이터는 허용 가능한 최대/최소 값이다. • 경계 데이터는 허용 가능한 최대/최소 값 및 그에 대응하는 비허용 최소/최대 값이다. |
| 7 알고리즘의 드라이 런을 문서화하기 위해 트레이스 표를 완성하기 | • 알고리즘의 각 단계마다 다음을 포함: – 변수 – 출력 – 사용자 프롬프트 |
| 8 주어진 알고리즘에서 오류를 식별하고 이를 수정할 방법을 제안하기 | |
| 9 주어진 문제나 시나리오에 대해 알고리즘을 작성하고 수정하기: 가짜 코드, 프로그램 코드 및 플로우차트를 사용 | • 알고리즘 작성 시 정확성이 필요하다. 예를 들어 x > y는 허용되지만 x is greater than y는 허용되지 않는다. • 플로우차트 기호는 4절 참조 • 가짜 코드는 4절 참조 |
알고리즘 설계 및 문제 해결
IGCSE 컴퓨터 과학 · 주제 7
 9:16
프로그래밍 개발 수명 주기
휴대폰의 모든 앱은 이런 사람이 작성했습니다. 하지만 그들은 코드를 타이핑하기 시작하지 않았습니다. 첫 줄보다 먼저, 문제를 연구하고, 해결책을…
영어 내레이션 · 영어와 중국어 자막 전환 가능
Syllabus
출처: Cambridge International syllabus
7.1
프로그램 개발 수명 주기
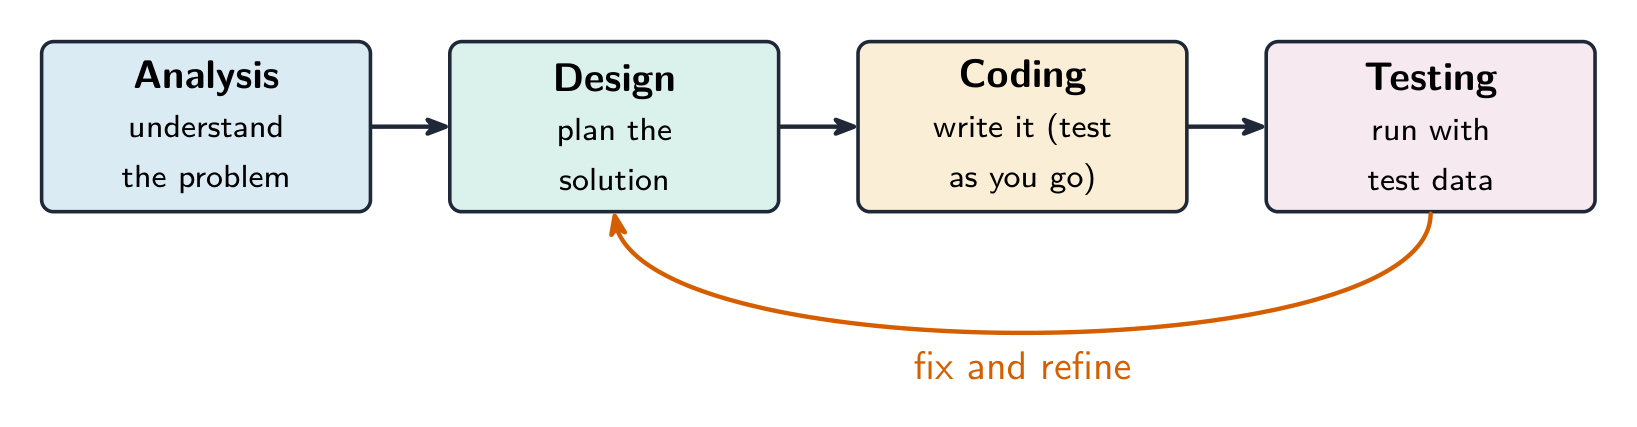
프로그램 개발 수명 주기는 프로그램을 만드는 데 사용되는 단계들의 집합입니다. 네 가지 단계가 있습니다.
| 단계 | 하는 일 |
|---|---|
| 분석 | 문제를 연구하고 필요한 것을 파악함 |
| 설계 | 프로그램이 어떻게 작동할지 계획함 |
| 코딩 | 프로그램 코드를 작성하고 진행하면서 테스트함 |
| 테스트 | 완성된 프로그램을 테스트 데이터로 실행하여 오류를 찾음 |
분석
분석에서는 문제를 이해합니다. 두 가지 핵심 기술이 도움이 됩니다:
- 추상화 — 중요한 세부사항만 남기고 나머지는 무시함;
- 분해 — 큰 문제를 더 작고 쉬운 부분으로 나누기.
설계
설계에서는 해법을 계획하며, 종종 분해를 사용합니다. 구조도(시스템을 더 작은 상자로 나누는 차트)에서 서브시스템으로서 부분들을 보여줄 수 있습니다.
풀이 예제. 주차장에 요금 정산기가 있습니다. 운전자가 자동차 번호판 번호를 입력하면 정산기가 주차 시간과 요금을 계산하고, 운전자가 현금이나 카드로 결제하면 영수증이 출력됩니다. 구조도를 그리세요.
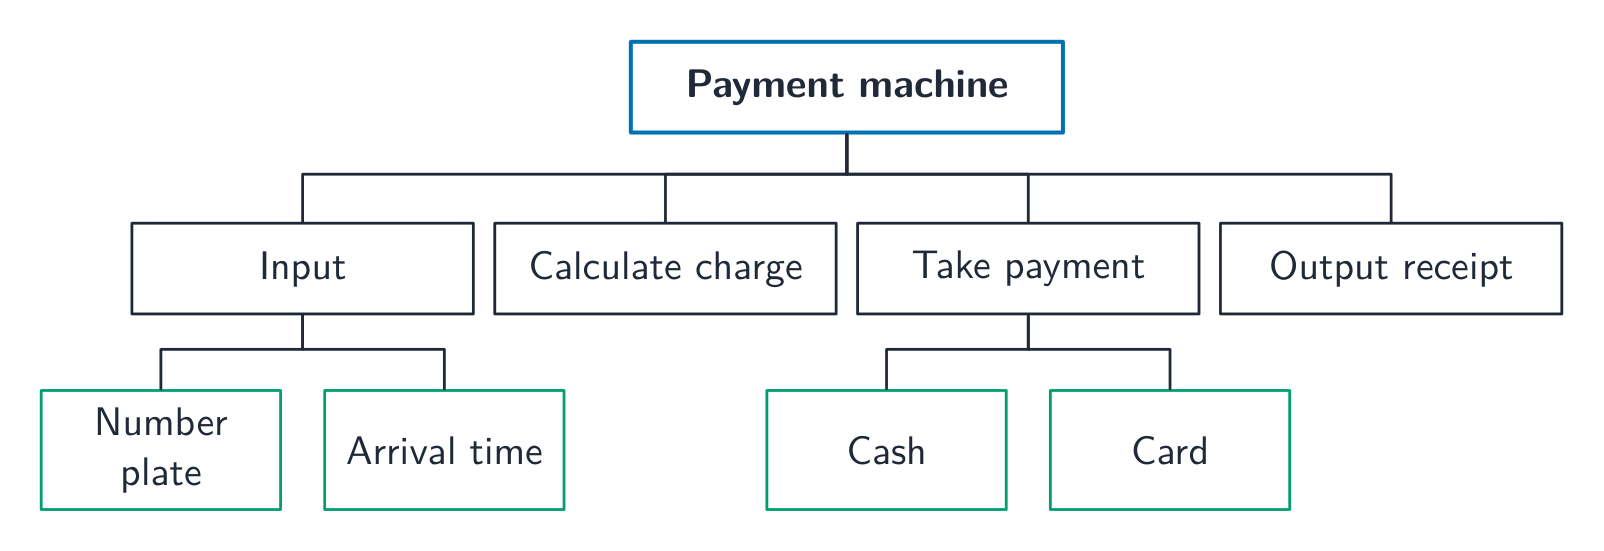
맨 위 상자에는 전체 시스템을 넣습니다. 다음 단계의 각 상자는 시스템이 수행하는 작업 하나를 나타내며, 상자는 다시 나눌 수 있습니다. 결제는 현금과 카드로 나뉩니다. 한 단계에서는 작업이 일어나는 순서대로 왼쪽에서 오른쪽으로 읽습니다. 구조도는 부분을 보여 주며, 결정이나 반복의 순서는 순서도나 의사 코드로 나타냅니다.
코딩 및 테스트
코딩에서는 프로그램 코드를 작성합니다. 반복적 테스트를 사용하여 부품을 만들면서 작은 부분을 반복적으로 테스트합니다. 테스트에서는 전체 프로그램을 테스트 데이터로 실행하여 작동 여부를 확인합니다.
어휘
연습하기
| English | 한국어 |
|---|---|
| structure diagram/ˈstrʌktʃə ˈdaɪəɡræm/ | 구조도 |
| iterative testing/ˈɪtərətɪv ˈtestɪŋ/ | 반복 테스트 |
| test data/test ˈdeɪtə/ | 테스트 데이터 |
| flowchart/ˈfləʊtʃɑːt/ | 플로우차트 |
7.2
설계 도구
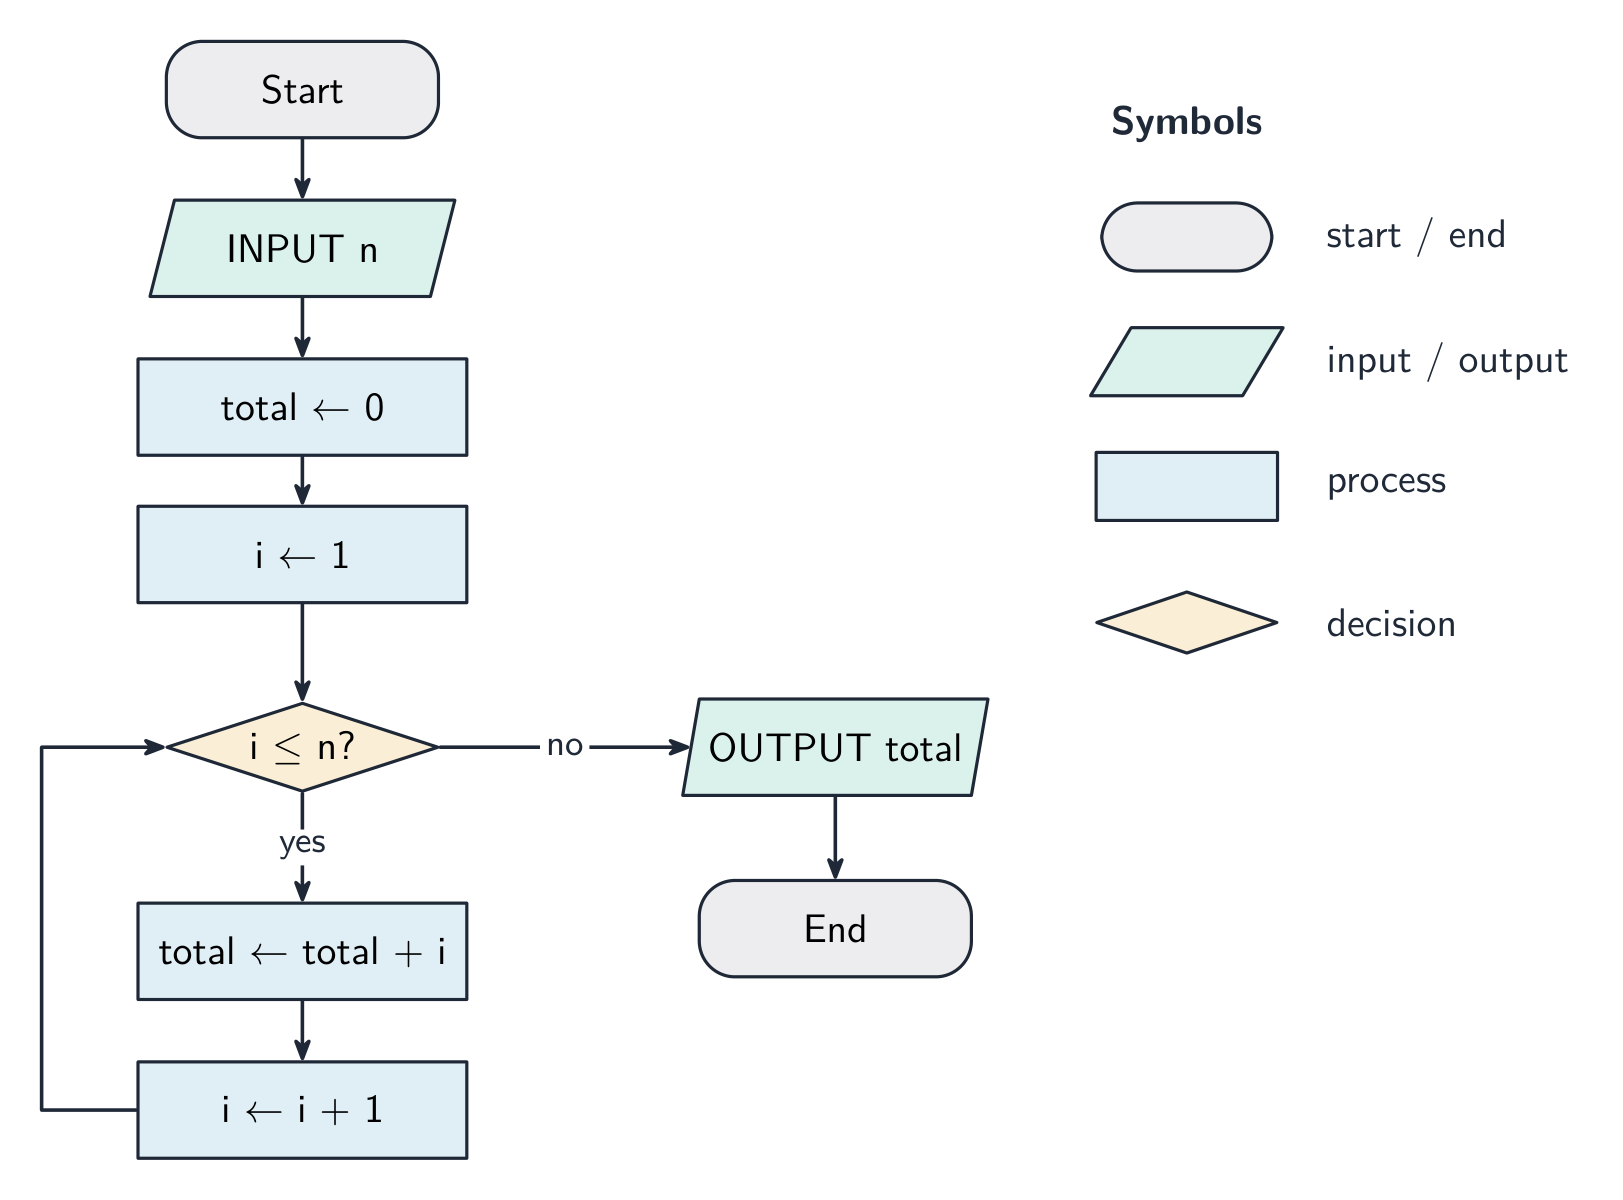
해법을 계획하는 세 가지 주요 방법이 있습니다.
- 구조도 — 시스템의 부분들과 이들이 어떻게 결합되는지를 보여줌;
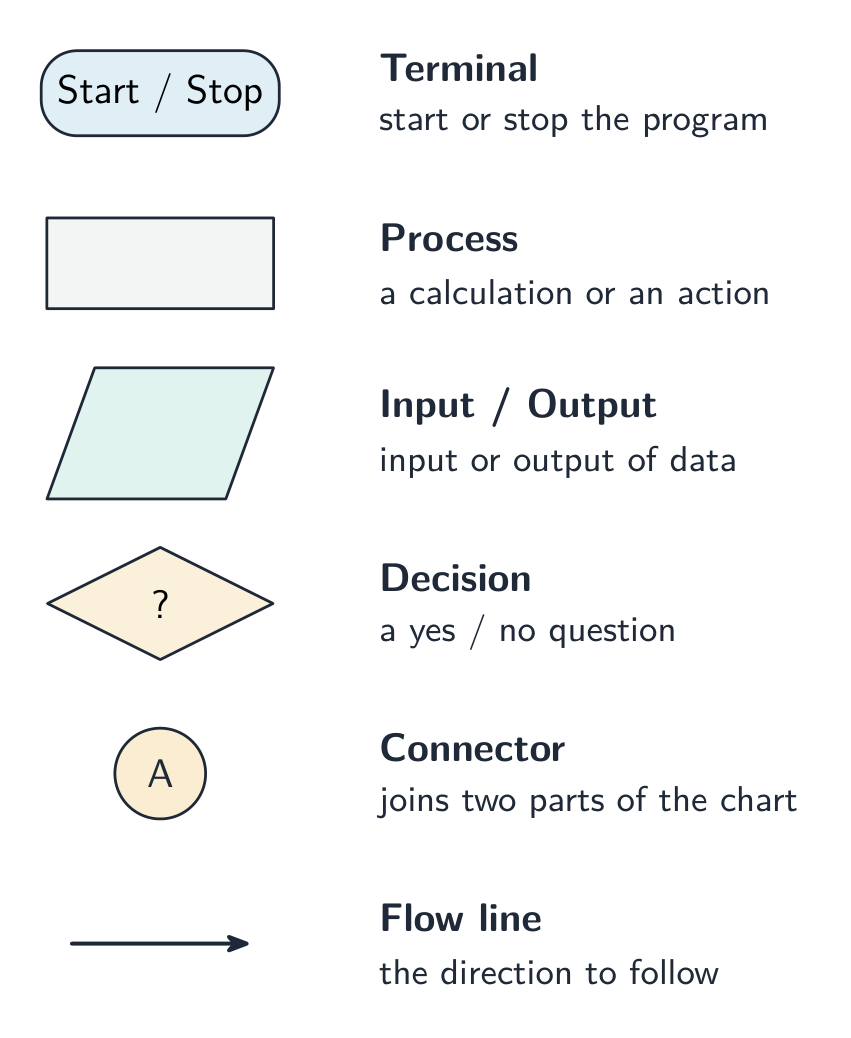
- 플로우차트 — 단계를 순서대로 상자와 화살표를 사용하여 보여주는 다이어그램;
- 가성 코드 — 코드의 형식을 닮은 간단한 영어로 쓰인 단계(실제 언어 아님).
7.3
알고리즘
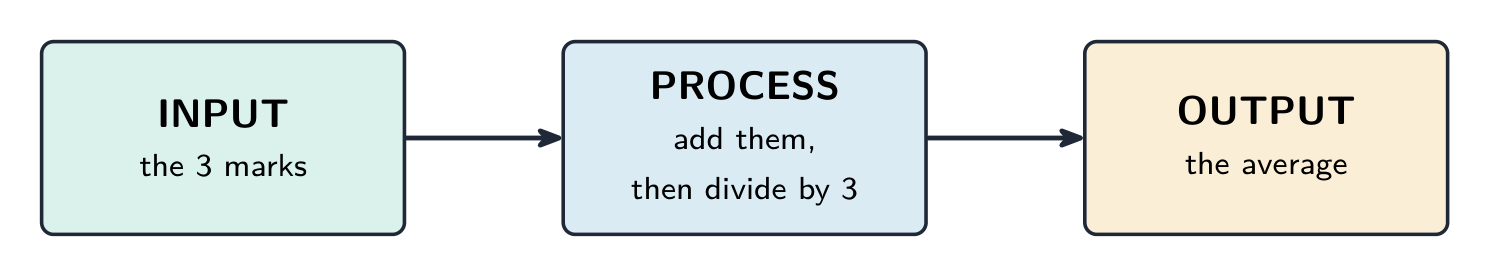
알고리즘은 문제를 해결하기 위해 올바른 순서로 배치된 단계들의 집합입니다. 모든 알고리즘은 세 부분으로 나눌 수 있습니다:
- 입력 — 들어오는 데이터;
- 처리 — 데이터에 수행되는 작업;
- 출력 — 나오는 결과물.
이를 입력, 처리, 출력으로 분해한다고 합니다. 예를 들어 “세 점수의 평균 구하기”에서 입력은 세 점수이고, 처리는 점수를 더해 3으로 나누는 것이며, 출력은 평균입니다.
어휘
연습하기
| English | 한국어 |
|---|---|
| input/ˈɪnpʊt/ | 입력 |
| processing/ˈprəʊsesɪŋ/ | 처리 |
| output/ˈaʊtpʊt/ | 출력 |
| validation/ˌvælɪˈdeɪʃn/ | 검증 |
| range check/reɪndʒ tʃek/ | 범위 검사 |
| bubble sort/ˈbʌbl sɔːt/ | 버블 정렬 |
| totalling/ˈtəʊtəlɪŋ/ | 합계 계산 |
| counting/ˈkaʊntɪŋ/ | 카운팅 |
7.4
검증 및 검증
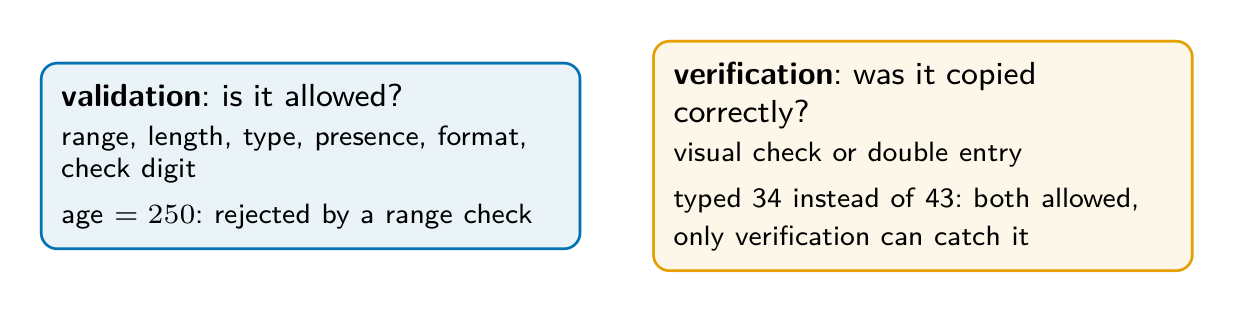
데이터가 입력될 때, 실수를 줄이기 위해 그것을 확인합니다.
검증은 데이터가 타당하고 규칙을 준수하는지 확인합니다. 데이터가 사실임을 확인할 수는 없으며, 허용 가능한 값인지만 확인할 수 있습니다.
| 검증 체크 | 확인 내용 |
|---|---|
| 범위 체크 | 값이 허용된 최소값과 최대값 사이에 있는지 |
| length check | the number of characters is allowed (e.g. a password ≥ 8) |
| 유형 체크 | 데이터가 올바른 유형인지 (예: 숫자, 문자 아님) |
| 존재 체크 | 실제로 입력되었는지 (공란으로 두지 않았는지) |
| 양식 체크 | 데이터가 올바른 패턴인지 (예: dd/mm/yyyy 형식의 날짜) |
| 체크 digit | 숫자를 입력할 때 오류를 감지하기 위한 추가 계산된 digit입니다 |
확인은 데이터가 올바르게 복사되거나 입력되었는지(타입 중 오류가 없는지) 확인합니다. 두 가지 방법이 있습니다:
- 시각적 체크 — 사용자가 입력한 데이터를 원본과 비교함;
- 이중 입력 — 데이터를 두 번 입력하여 두 사본을 비교함.
유효성 검사 루틴 작성하기
시험에서는 검사 코드를 작성하도록 요구하는 경우가 많습니다. 입력이 허용될 때까지 다시 묻는 반복문을 사용하고, 허용되지 않을 때는 사용자에게 메시지를 표시하세요.
풀이 예제. 0부터 100까지의 정수여야 하는 시험 점수를 입력받고 범위 검사, 유효한 점수가 입력될 때까지 계속 다시 묻는 의사 코드를 작성하세요.
DECLARE Mark : INTEGER
REPEAT
    OUTPUT "Enter a mark from 0 to 100"
    INPUT Mark
    IF Mark < 0 OR Mark > 100
      THEN
        OUTPUT "Invalid: the mark must be from 0 to 100"
    ENDIF
UNTIL Mark >= 0 AND Mark <= 100
UNTIL 조건은 허용되는 범위이고 IF 조건은 그 반대입니다. OR이 IF에 있는 것에 주의하세요. 점수는 0보다 작으면서 동시에 100보다 클 수 없으므로 그 위치의 AND은 절대 참이 될 수 없습니다.
다른 검사는 조건만 다를 뿐 같은 패턴을 따릅니다:
| 검사 | 유효한 값의 조건 |
|---|---|
| 길이 검사 (8자 이상인 비밀번호) | LENGTH(Password) >= 8 |
| 존재 여부 검사 (이름을 반드시 입력해야 함) | Name <> "" |
| 범위 검사 (나이 16부터 65까지) | Age >= 16 AND Age <= 65 |
자료형 검사는 보통 언어 자체가 수행합니다. 예를 들어 입력값을 INTEGER 변수에 저장할 때 검사합니다.
어휘
연습하기
| English | 한국어 |
|---|---|
| pseudocode/ˈsuːdəʊkəʊd/ | 가상코드 |
| length check/leŋθ tʃek/ | 길이 검사 |
| type check/taɪp tʃek/ | 타입 체크 |
| presence check/ˈprezəns tʃek/ | 존재성 검사 |
| format check/ˈfɔːmæt tʃek/ | 양식 확인 |
| check digit/tʃek ˈdɪdʒɪt/ | 검증 digit |
| verification/ˌverɪfɪˈkeɪʃn/ | 확인 |
| visual check/ˈvɪʒuːəl tʃek/ | 시각적 확인 |
| double entry/ˈdʌbl ˈentri/ | 이중 입력 |
7.5
추적 표
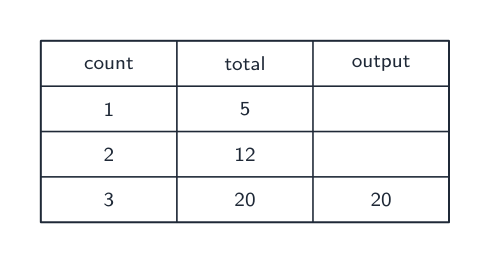
추적 표는 알고리즘이 실행될 때 매 단계마다 각 변수의 값을 기록합니다. 이를 통해 다음을 할 수 있습니다:
- 알고리즘이 올바르게 작동하는지 확인하기 위해;
- 주어진 데이터를 따라가며 알고리즘이 무엇을 하는지 파악하기 위해.
예: 입력 5로 이 알고리즘을 추적해 보십시오.
INPUT N
Total ← 0
FOR I ← 1 TO N
    Total ← Total + I
NEXT I
OUTPUT Total
| i | total | OUTPUT |
|---|---|---|
| 1 | 1 | |
| 2 | 3 | |
| 3 | 6 | |
| 4 | 10 | |
| 5 | 15 | 15 |
이 추적을 보면 알고리즘이 1부터 n까지 더합니다. 입력이 5일 때 출력은 15입니다.
해설 예시. 이 알고리즘을 추적하여 출력을 구하십시오.
X ← 20
Count ← 0
WHILE X > 1
    X ← DIV(X, 2)
    Count ← Count + 1
ENDWHILE
OUTPUT Count
DIV는 나눈 결과의 정수 부분만 반환합니다. 한 번의 반복마다 한 줄씩 작성합니다: x가 10로 변하고(카운트 1), 이후 5로 변하고(카운트 2), 이후 2로 변하고(카운트 3), 이후 1로 변하고(카운트 4)됩니다. 이제 x > 1가 거짓(true)이 아니므로 루프가 종료되고 출력은 4입니다. 이러한 표를 올바르게 작성하기 위한 두 가지 습관이 필요합니다: 각 반복 전에 조건을 테스트해야 반복 후에 테스트하는 것이 아니며, 모든 반복에 대해 새로운 줄을 작성해야 합니다. 값을 머릿속에만 유지하려 하려다 보면 추적이 틀어지는 원인이 됩니다.
오류 찾기와 수정하기
흔히 오류가 있는 알고리즘을 제시하고 오류를 찾아 수정하라는 문제가 나옵니다. 한 줄씩 읽으며 다음을 확인하세요. 모든 변수에 초기값이 주어졌는가? 각 반복문의 길이가 올바른가? 각 비교의 방향이 올바른가? 출력이 올바른 위치에 있는가?
풀이 예제. 이 알고리즘은 숫자 10개를 입력받고 가장 큰 수를 출력해야 합니다. 세 가지 오류를 찾아 수정하세요.
Largest ← 1000
FOR Count ← 1 TO 9
    INPUT Number
    IF Number < Largest
      THEN
        Largest ← Number
    ENDIF
    OUTPUT Largest
NEXT Count
- 1행:
Largest ← 1000의 초기값이 너무 커서 어떤 수도 이를 대체하지 못합니다. 수정:Largest ← -1000또는 첫 번째 수를 입력받아 초기값으로 사용합니다. - 2행: 반복문이 9번만 실행됩니다. 수정:
FOR Count ← 1 TO 10. - 4행:
<은 가장 작은 수를 찾습니다. 수정:IF Number > Largest.
OUTPUT에도 문제가 있습니다. 반복문 안에 있으면 입력할 때마다 그때까지의 최댓값을 출력합니다. 이를 NEXT Count 뒤로 옮기면 최종 답만 출력됩니다. 각 오류에 대해 행을 밝히고 무엇이 잘못되었는지 설명한 뒤 수정된 행을 전체로 쓰세요.
탐색하기
추적 표
루프를 한 단계씩 진행하며 추적 표에 각 반복마다 한 줄씩 값을 채우세요.
어휘
연습하기
| English | 한국어 |
|---|---|
| trace table/treɪs ˈteɪbl/ | 추적표 |
7.6
테스트 데이터
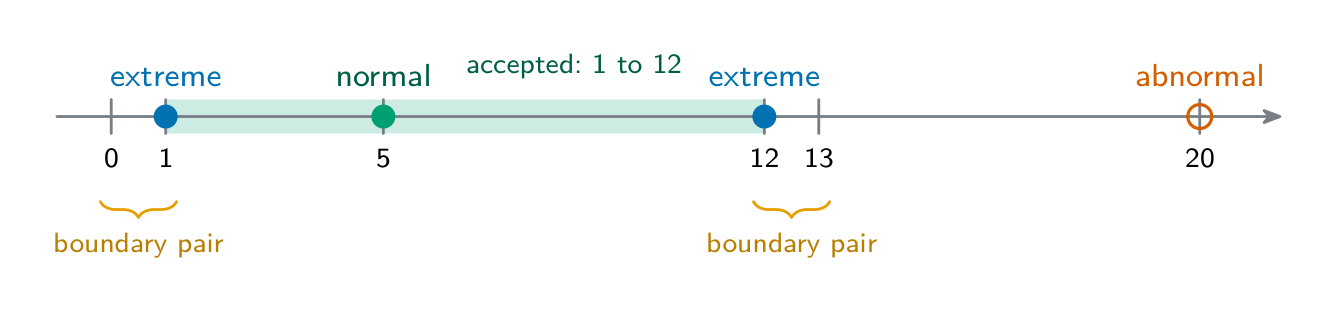
테스트 데이터는 프로그램을 테스트하기 위해 사용하는 데이터입니다. 반드시 알아야 하는 네 가지 유형이 있습니다.
| 유형 | 의미 | 예시 (나이 0–120 허용) |
|---|---|---|
| 일반적(normal) | 수락되어야 할 합리적인 데이터 | 25 |
| 비정상 | 거부되어야 하는 잘못된 데이터 | -4 또는 “고양이” |
| 극단적(extreme) | 여전히 허용되는 최대 및 최소 값 | 0와 120 |
| boundary | the values on each side of a limit (one allowed, one not) | 120 and 121 |
풀이 예제. 한 프로그램은 테이블 예약 인원을 1부터 12까지 받습니다. 각 유형의 테스트 데이터와 예상 결과를 쓰세요.
| 유형 | 테스트 데이터 | 예상 결과 |
|---|---|---|
| 정상 | 5 | 허용 |
| 비정상 | 20 또는 “여섯” | 오류 메시지와 함께 거부 |
| 극단 | 1 및 12 | 허용 |
| 경계 | 12 및 13 또는 0 및 1 | 12 허용, 13 거부 |
항상 데이터와 함께 예상 결과를 쓰세요. 어떤 일이 일어나야 하는지 알아야 테스트가 유용합니다. 극단 데이터는 한계값 자체이고, 경계 데이터는 한계의 양쪽에 있는 값 한 쌍입니다.
어휘
연습하기
| English | 한국어 |
|---|---|
| normal/ˈnɔːml/ | 정상 데이터 |
| abnormal/əbˈnɔːml/ | 비정상 데이터 |
| extreme/ekˈstriːm/ | 극단 데이터 |
| boundary/ˈbaʊndəri/ | 경계 데이터 |
7.7
표준 해결 방법
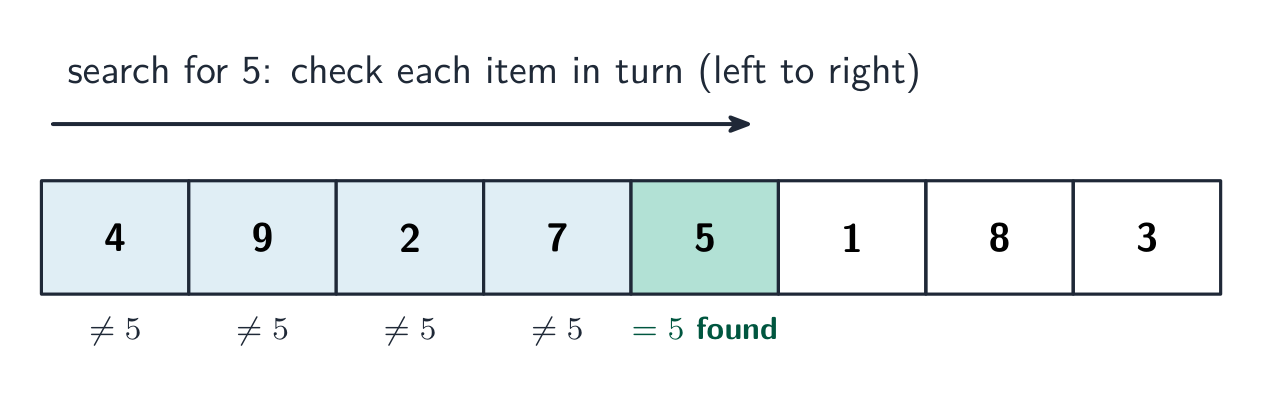
이러한 일반적인 알고리즘들을 알고 있어야 합니다.
선형 검색
선형 검색은 시작점에서부터 각 항목을 목표값과 비교합니다. 값을 찾거나 목록이 끝날 때까지 멈춥니다. 목록은 정렬되어 있을 필요는 없습니다. 다음 예제는 위치 1부터 4까지 사용합니다.
DECLARE List : ARRAY[1:4] OF INTEGER
DECLARE I, SearchValue : INTEGER
DECLARE Found : BOOLEAN
List[1] ← 8
List[2] ← 3
List[3] ← 5
List[4] ← 1
INPUT SearchValue
Found ← FALSE
I ← 1
WHILE I <= 4 AND NOT Found
    IF List[I] = SearchValue
      THEN
        Found ← TRUE
    ENDIF
    I ← I + 1
ENDWHILE
OUTPUT Found
해설 비교. 5를 검색하면 8, 3, 그리고 5을 비교합니다: 총 3번의 비교로, Found가 TRUE로 바뀝니다. 네 번째 항목은 검사되지 않습니다. 9를 검색하면 네 가지 값을 모두 비교하며, Found는 FALSE에 머물러 있습니다. 이 배열 밖인 위치 5를 읽으려 하기 전에 멈춥니다.
버블 정렬
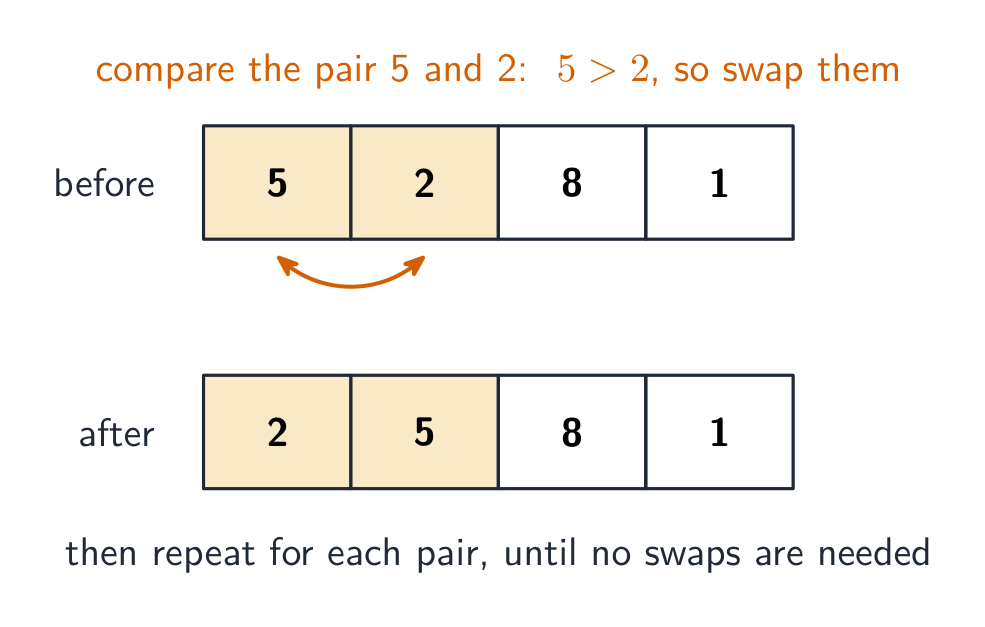
A bubble sort puts a list in order. Compare neighbouring values and swap them if the left value is greater. A single pass is not enough in general. This complete version repeats passes until a whole pass makes no swaps.
DECLARE List : ARRAY[1:4] OF INTEGER
DECLARE I, Temp : INTEGER
DECLARE Swapped : BOOLEAN
List[1] ← 8
List[2] ← 3
List[3] ← 5
List[4] ← 1
REPEAT
    Swapped ← FALSE
    FOR I ← 1 TO 3
        IF List[I] > List[I + 1]
          THEN
            Temp ← List[I]
            List[I] ← List[I + 1]
            List[I + 1] ← Temp
            Swapped ← TRUE
        ENDIF
    NEXT I
UNTIL NOT Swapped
OUTPUT List[1], ", ", List[2], ", ", List[3], ", ", List[4]
Worked passes. Start with 8, 3, 5, 1. In the first pass the list becomes 3, 8, 5, 1, then 3, 5, 8, 1, then 3, 5, 1, 8. This puts the largest value last but leaves the rest unsorted. The second pass ends at 3, 1, 5, 8; the third at 1, 3, 5, 8. The fourth makes no swaps and confirms that this version can stop. Reset Swapped to FALSE at the start of every pass; set it to TRUE on any swap.
총합 계산 및 카운팅
총계 계산은 필요한 각 값을 누적 합계 Total ← Total + Value에 더합니다. 카운팅은 필요한 각 항목당 1를 더합니다: Count ← Count + 1. 값을 처리하기 전에 두 값 모두 0으로 초기화하십시오.
해설 예제. 네 번의 시도된 입력은 −20, 4, 50, 그리고 6입니다. 값은 −20보다 크고 50보다 작을 경우에만 수용합니다. 이 예시는 네 번의 시도된 입력을 처리하는 것이지, 네 번의 수용된 값을 처리하는 것이 아닙니다.
DECLARE I, Count : INTEGER
DECLARE Value, Total : REAL
Total ← 0
Count ← 0
FOR I ← 1 TO 4
    INPUT Value
    IF Value > -20 AND Value < 50
      THEN
        Total ← Total + Value
        Count ← Count + 1
    ENDIF
NEXT I
IF Count > 0
  THEN
    OUTPUT Total, ", ", Count, ", ", Total / Count
  ELSE
    OUTPUT "No accepted values"
ENDIF
| 시도된 값 | 시도 후 총계 | 시도 후 카운트 |
|---|---|---|
| −20 | 0 | 0 |
| 4 | 4 | 1 |
| 50 | 4 | 1 |
| 6 | 10 | 2 |
엄격한 조건은 −20와 50을 거절합니다. 두 업데이트 모두 수락 테스트 내부에 위치하므로, 거절된 시도는 총합이나 개수에 영향을 주지 않습니다. 수락된 값들의 평균은 다음과 같습니다:
$$\text{Average}=\frac{\text{Total}}{\text{Count}}=\frac{10}{2}=5$$
4로 나누지 마십시오: 추가된 값은 오직 두 개뿐입니다. 어떤 값도 수락되지 않으면 개수는 0이 되어 평균을 계산할 수 없으므로, 제제로 나누는 대신 메시지를 출력하십시오.
허용 가능한 값의 고정된 개수로 전송. 작업이 네 번의 시도 대신 50개의 허용 가능한 값을 요구한다면, 고정된 FOR 루프를 WHILE Count < 50로 교체하고 ENDWHILE로 종료하십시오. 내부의 입력 및Acceptance 테스트는 동일하게 유지하십시오. 거절된 입력은 Count를 변경하지 않으므로 추가 입력을 요청합니다. 완료 시 Count는 50이지만, 시도 횟수는 더 많을 수 있습니다. 총계를 출력하고 평균을 Total / Count로 계산하십시오.
최대, 최소 및 평균
최대값은 가장 큰 값이고 최소값은 가장 작은 값입니다. 평균은 총합을 값의 개수로 나눈 결과입니다. 비어 있지 않은 목록의 경우, 초기값을 첫 번째 항목에서 설정하십시오. 나머지 각 항목에 대해 새로운 값이 크면 최대값을, 작으면 최소값을 교체하십시오.
작업 예시. 목록은 −8, −3, −12, −5입니다. 최대값을 0에서 시작하면 실패합니다: 목록의 모든 항목이 0보다 크지 않으므로, 알고리즘은 목록에 없는 숫자를 출력할 것입니다. −8에서 시작하면 데이터가 양수라고 가정하지 않고도 올바르게 작동합니다.
| 최근 고려한 값 | 현재까지의 최대값 | 현재까지의 최소값 |
|---|---|---|
| −8 (초기화) | −8 | −8 |
| −3 | −3 | −8 |
| −12 | −3 | −12 |
| −5 | −3 | −12 |
DECLARE List : ARRAY[1:4] OF INTEGER
DECLARE I, Maximum, Minimum, Total : INTEGER
List[1] ← -8
List[2] ← -3
List[3] ← -12
List[4] ← -5
Maximum ← List[1]
Minimum ← List[1]
Total ← List[1]
FOR I ← 2 TO 4
    IF List[I] > Maximum
      THEN
        Maximum ← List[I]
    ENDIF
    IF List[I] < Minimum
      THEN
        Minimum ← List[I]
    ENDIF
    Total ← Total + List[I]
NEXT I
OUTPUT Maximum, ", ", Minimum, ", ", Total / 4
최대값은 −3이고 최소값은 −12입니다. 평균은 네 개의 모든 값을 사용합니다:
$$\text{Total}=\sum \text{Value}=(-8)+(-3)+(-12)+(-5)=-28$$
$$\text{Average}=\frac{\text{Total}}{\text{Count}}=\frac{-28}{4}=-7$$
평균은 최소값과 최대값 사이에 위치하며, 이는 계산이 정확함을 증명하는 것이 아니라 유용한 검증 방법입니다. 첫 번째 항목에서 초기화하려면 비어 있지 않은 목록이 필요합니다. 해당 항목을 읽으려 하기 전에 빈 목록은 별도로 처리하십시오.
어휘
연습하기
| English | 한국어 |
|---|---|
| linear search/ˈlɪnɪə sɜːtʃ/ | 선형 검색 |
| maximum/ˈmæksɪməm/ | 최대값 |
| minimum/ˈmɪnɪməm/ | 최소값 |
| average/ˈævrɪdʒ/ | 평균 |
7.8
시험 팁
- The four life-cycle stages: analysis → design → coding → testing. Abstraction keeps only what matters; decomposition splits a problem into parts.
- 검증은 데이터가 타당한지(범위, 길이, 유형, 존재 여부, 형식 확인) 확인하고, 확인은 올바르게 복사되었는지(시각적 확인 또는 이중 입력) 검증합니다.
- 네 가지 테스트 데이터 유형을 익히세요: 일반 (수용됨), 비정상 (거부됨), 극단 (허용되는 최대/최소값), 경계 (한계의 양측).
- 트레이스 표는 각 단계에서 모든 변수의 값을 보여주어 알고리즘이 어떤 작업을 수행하는지 나타냅니다.
- 유효성 검사 루틴을 작성하려면
UNTIL조건이 유효한 데이터인REPEAT … UNTIL반복문에 입력을 넣으세요. - 오류를 수정할 때는 해당 행을 인용하고 수정된 행 전체를 쓰세요.
- Know the standard algorithms: linear search (check each item in turn) and bubble sort (swap side-by-side pairs until no swaps are needed).
어휘
연습하기
| English | 한국어 |
|---|---|
| program development life cycle/ˈprəʊɡræm dɪˈveləpmənt laɪf ˈsaɪkl/ | 프로그램 개발 수명 주기 |
| analysis/əˈnæləsɪs/ | 분석 |
| design/dɪˈzaɪn/ | 디자인 |
| coding/ˈkəʊdɪŋ/ | 코딩 |
| testing/ˈtestɪŋ/ | 테스트 |
| abstraction/əbˈstrækʃn/ | 추상화 |
| decomposition/ˌdiːkɒmpəˈzɪʃn/ | 분해 |
| sub-systems/sʌb ˈsɪstəmz/ | 서브시스템 |
| algorithm/ˈælɡərɪθəm/ | 알고리즘 |
이 주제에 대한 인터랙티브 수업
즉시 체크 기능 exercises를 통해 단계별로 진행하세요.