| 응시자가 다음을 수행할 수 있어야 함: | 참고 사항 및 가이드라인 |
|---|---|
| OS가 자원을 최대한으로 활용할 수 있는 방식에 대한 이해를 보임 | |
| 사용자 인터페이스가 하드웨어의 복잡성을 사용자에게 숨기는 방식 설명 | |
| 프로세스 관리에 대한 이해 | 멀티 태스킹과 프로세스의 개념 프로세스 상태: 실행 중, 대기 중, 블록됨 스케줄링의 필요성과 다양한 스케줄링 루틴의 기능 및 장점(예: 라운드 로빈, 최단 작업 우선, 선입선출, 남은 시간 최단) OS 커널이 인터럽트 핸들러로서 작동하는 방식 및 인터럽트 처리가 저수준 스케줄링 관리를 위해 어떻게 사용되는지 |
| 메모리 관리를 위한 가상 메모리, 페이징 및 세그멘테이션에 대한 이해 | 페이징, 가상 메모리 및 세그멘테이션의 개념 페이징과 세그멘테이션의 차이 페이지 교체 방법 디스크 스래싱이 발생할 수 있는 방식 |
시스템 소프트웨어
A-Level 컴퓨터 과학 · 주제 16
 14:07
리소스, 컴파일러 및 RPN
브라우저, 음악 플레이어, 게임을 엽니다. 프로세서는 하나 — 혹은 몇 개의 코어가 있을 뿐 — 이지만 모두 동시에 실행되는 것 같습니다. 그리고 그들은 모두 더 많은 자원을 원합니다…
영어 내레이션 · 영어 + 중국어 자막 burned-in
16.1
OS가 자원을 최대화하는 방법

Syllabus
출처: Cambridge International syllabus
컴퓨터에는 CPU 시간, 메모리, 디스크, I/O 등 다양한 자원이 많고, 이를争夺하는 프로그램도 많습니다. OS는 이들을 공정하고 효율적으로 공유하여 각 자원이 잘 활용되고 시스템이 응답성을 유지하도록 합니다:
- 멀티태스킹 — 프로세스间快速切换CPU,使多个进程看似同时运行。
- 메모리 관리 — 각 프로세스에게 필요한 메모리를 할당;RAM이 부족할 때는 디스크 페이징을 사용。
- 스풀링 및 버퍼링 — 프린트 작업이 디스크에 대기 QUEUE되어 CPU가 프린터를 기다리지 않게 함。
- 캐싱 — 최근에 사용된 디스크 데이터를 캐시 / RAM에 유지。


16.1
사용자 인터페이스
사용자 인터페이스는 친숙한 추상화를 통해 하드웨어를 숨깁니다. 사용자는 주소나 섹터가 아닌 창, 메뉴, 폴더를 보게 됩니다. 아이콘을 한 번 클릭하면 운영체제가 디스크 위에서 프로그램을 찾아 메모리를 할당하고 로드하여 실행합니다. CLI(명령 줄)는 전문가에게 강력하고 스크립트 가능하지만, GUI(그래픽)는 학습하기 더 쉽습니다. 대부분의 시스템은 두 가지를 모두 제공합니다.
"하드웨어의 복잡성이 사용자로부터 어떻게 숨겨지는지 두 가지 방법을 설명하시오." (1) 사용자는 이름으로 파일과 폴더를 작업하며, OS는 이를 디스크의 트랙, 섹터 및 블록으로 변환합니다; (2) 사용자는 클릭 또는 명령으로 프로그램을 실행하며, OS는 주소를 전혀 모른 채에 프로그램 로드, 메모리 할당 및 스케줄링을 수행합니다; (3) 장치 드라이버를 사용하면 프린터나 디스크 제어 방식을 몰라도 인쇄하거나 저장할 수 있습니다; (4) 그래픽 인터페이스는 기계 수준의 명령을 아이콘, 창 및 메뉴로 대체합니다. 학생에게 주는 이점 및 예시: OS는 기술적 지식이 없어도 하드웨어를 사용 가능하게 만듭니다. 예를 들어, 파일 아이콘을 드래그하여 USB 드라이브에 문서를 저장하는 것이 그 예입니다.
"OS가 자원을 극대화하는 방법을 보여주십시오." OS는 프로세스가 준비 상태일 때 CPU가 절대 유휴하지 않도록 프로세서를 스케줄링합니다. 또한 메모리를 관리하여 프로세스에 할당하고 회수하며 가상 메모리로 확장합니다. 입출력을 관리하여 버퍼와 스풀링을 사용하여 빠르고 느린 장치의 작업을 겹치게 합니다. 그리고 저장소(스토리지)를 관리하여 빈 공간과 파일을 추적합니다. 각 항목은 하나의 자원과 그에 대한 OS의 역할을 명시합니다.
16.1
프로세스 관리
프로세스는 실행 중인 프로그램으로, 해당 코드의 현재 상태, 메모리 및 열려 있는 파일들을 의미합니다.
스케줄링
스케줄러는 다음에 실행될 준비된 프로세스를 결정하고, 얼마나 실행할지 정합니다:
- 라운드 로빈 — 각 프로세스는 고정된 타이머 슬라이스를 부여받고, 이후 대기열 뒤로 이동합니다.
- 선입선출(FIFO); shortest job first; shortest remaining time(남은 작업량이 가장 적은 작업 실행); 우선순위; 다단계 피드백 큐.
이러한 방식들의权衡(교차)은 반응성(responsiveness), 처리량(throughput), 공정성(fairness) 사이에서 이루어집니다.
"멀티 태스킹(multi-tasking)의 의미를 설명하고, 이것이 프로세스 관리에 어떤 이점을 주는지 서술하시오." 여러 프로세스가 동시에 메모리에 존재하며, 프로세서가它們之间切换得非常快,使得它们看起来像是同时运行,navbar轮流获得处理器时间份额。其好处在于:当一个进程等待输入或输出时,处理器永远不会空闲,从而提高了处理量(throughput),且用户可同时操作多个程序。"스케줄링이 필요한 이유를 설명하시오." 프로세스의 수가 프로세서를 초과하므로, 어떤 프로세스가 다음에 실행되고 얼마나 실행될지에 대한 결정이 필요합니다. 스케줄링은 모든 프로세스가 진전을 이루게 하고, 프로세서가 완전히 활용되도록 하며, 응답 시간이 적절하게 유지되며, 우선순위가 존중되도록 보장합니다.
고사에서 요구되는 방식으로 스케줄링 루틴을 묘사하십시오.
| 루틴 | 기능 | 장점 | 단점 |
|---|---|---|---|
| 先来先服务(FCFS) | 준비 대기열에 도착한 순서에 따라 프로세스가 실행되어 각 작업이 완료됨 | 단순함; 모든 프로세스가 차례대로 처리되며, 어느 하나도 배제되지 않음 | 긴 프로세스가 뒤에 있는 모든 짧은 프로세스를 지연시킴; 응답성 부족 |
| shortest job first (SJF) | 예상 실행 시간이 가장 짧은 준비된 프로세스가 다음에 실행되어 완료됨 | 평균 대기 시간을 최소화함; 많은 짧은 작업들이 빠르게 완료됨 | 실행 시간이 사전에 알려져야 함; 긴 작업이 절대 실행되지 않을 수 있음(배제/starvation) |
| shortest remaining time (SRT) | SJF의 프리엠티브(pre-emptive) 버전: 실행 중인 프로세스보다 남은 시간이 적은 새로운 프로세스가 도착하면 즉시_execution를接替 | 짧은 프로세스가 더 빠르게 처리됨; 높은 처리량 | 컨텍스트 전환 횟수 증가; 긴 작업이 반복적으로interrupted되어 배제(starve)될 수 있음 |
| round robin (RR) | 각 준비된 프로세스가 고정된 타임 슬라이스를 차례로 부여받음; 시한이 지나면 프로세스가 대기열 뒤로 이동 | 공평함; 모든 프로세스가 제한된 시간 내에 응답하며, 인터랙티브 사용에 적합 | 컨텍스트 전환 오버헤드; 슬라이스가 너무 짧으면 시간 낭비, 너무 길면 다른 프로세스를 지연시킴 |
| priority | 가장 높은 우선순위를 가진 준비된 프로세스가 먼저 실행됨 | 중요하거나 시간敏感的(timely-critical) 작업이 먼저 수행됨 | 우선순위가 낮아진 프로세스들은 우선순위 노화(priority aging) 없이 배제(starve)될 수 있음 |
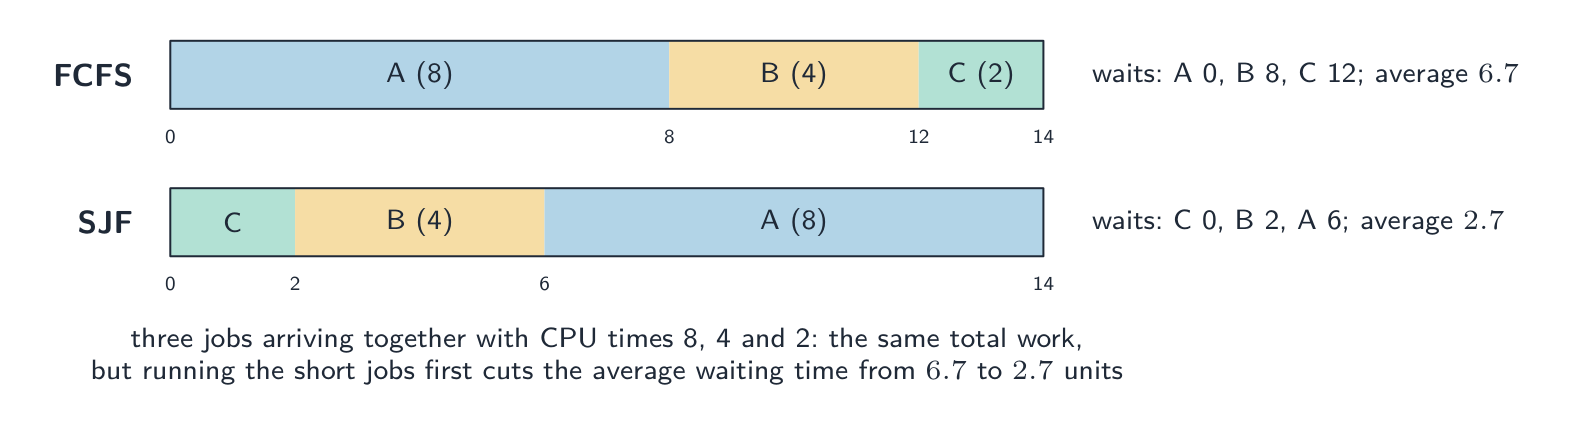
풀이된 예제(Worked example). 세 개의 프로세스가 CPU 소요 시간 8ms, 4ms, 2ms로 동시에 도착했습니다. FCFS(A, B, C의 도착 순서 기준)와 최단작업먼저실행(SJF) 조건에서의 평균 대기 시간을 비교하십시오.
FCFS: A는 0대기, B는 8대기, C는 12대기; 평균 $(0 + 8 + 12)/3 = 6.7\ \text{ms}$. SJF는 C, B, A 순으로 실행: C는 0대기, B는 2대기, A는 6대기; 평균 $2.7\ \text{ms}$. 총 작업량은两种方式都为 14ms이지만, 순서가 대기 시간을 결정합니다. 2ms 슬라이스를 사용하는 라운드 로빈에서는 첫 6ms 동안 A, B, C가 각각 한 번씩 실행되어 C가 6ms에, B가 12ms에, A가 14ms에 완료됩니다: 이는 평균 속도보다는 **반응성(responsive)**이 가장 높은 방식입니다.


프로세스 상태
프로세스는 새로 생성됨, 대기 중(CPU 대기), 실행 중, 블로킹됨(I/O 또는 잠금 대기), 또는 종료됨 상태입니다. 타임 슬라이스가 끝나면 실행 중 → 대기 중으로, I/O 요청 시 실행 중 → 블로킹으로, I/O 완료 시 블로킹 → 대기 중으로 전환됩니다.

세 가지 상태와 프로세스가 이동하는 이유. 실행 중: 프로세스가 프로세서를 사용 중입니다. 대기 중: 실행 가능하지만 프로세서를 대기 중입니다. 블로킹: 다른 일이 일어나지 않으면 실행할 수 없습니다. 각 전이 사유(시험에서는 하나씩 묻음): 실행 중 → 대기 중: 타임 슬라이스가 끝날 때, 또는 우선순위가 높은 프로세스가 대기 중이 되어 이를 선점(interupt)할 때; 실행 중 → 블로킹: 입력 또는 출력을 요청하거나 리소스나 다른 프로세스를 기다릴 때; 블로킹 → 대기 중: 대기 중이던 I/O가 완료될 때(인터럽트로 신호); 대기 중 → 실행 중: 스케줄러가 배정할 때. 블로킹된 프로세스는 즉시 실행 중으로 갈 수 없으며, 반드시 먼저 대기 중이어야 합니다.
프로세스 제어 블록 및 컨텍스트 스위치
OS는 각 프로세스마다 프로세스 제어 블록(PCB)을 유지합니다 — 저장된 프로그램 카운터, 레지스터, 상태, 메모리 정보 등입니다.

- 컨텍스트 스위치는 한 프로세스를 일시 중지하고 다른 프로세스를 시작합니다: 상태를 하나의 PCB에 저장하고 다른 PCB에서 복원합니다. 이 작은 비용은 모든 전환 시 발생합니다.
- 커널(OS의 핵심)은 인터럽트 핸들러 역할을 합니다. 장치나 타이머가 인터럽트를 발생시키면, 인터럽트 처리는 실행 중인 프로세스를 저장하고 적절한 루틴을 실행합니다 — 이것이 저수준 스케줄링을 구동하는 방식입니다.
"커널이 인터럽트 핸들러 역할을 하는 방식을 설명하시오" (2점). 인터럽트가 발생하면 커널은 실행 중인 프로세스의 상태를 저장하며(레지스터와 프로그램 카운터는 프로세스 제어 블록에), 인터럽트의 출처와 우선순위를 식별하고, 적절한 인터럽트 서비스 루틴을 실행한 후, interrupted된 프로세스(또는 우선순위가 높은 프로세스)를 복원하여 실행을 계속합니다. 이것이 타이머가 타임 슬라이스를 종료하고 완료된 I/O 작업이 프로세스를 언블록시키는 방법입니다.
프로세스 간 통신
프로세스는 격리되어 있으므로 OS는 프로세스 간 통신을 제공합니다: 파이프(한 프로그램의 출력이 다른 프로그램의 입력으로 들어옴), 공유 메모리(여러 프로세스가 사용할 수 있는 영역), 메시지 패싱 등입니다.
탐색하기
프로세스의 수명
루프를 돌며 프로세스가 이동합니다. 스케줄러가 선택했을 때만 실행되며, I/O 요청 시 블로킹되고 시간)slice)이 끝나면 다시 준비 상태 queues로 돌아갑니다—완료될 때까지 반복됩니다.
어휘
연습하기
| English | 한국어 |
|---|---|
| multi-tasking/ˈmʌlti ˈtæskɪŋ/ | 멀티-tasking |
| process/ˈprəʊses/ | 프로세스(process) |
| scheduler/ˈʃedjʊlə/ | 스케줄러 |
| round robin/raʊnd ˈrɒbɪn/ | 라운드 로빈 |
| time slice/taɪm slaɪs/ | 타임 슬라이스 |
| pre-emptive/priː ˈemptɪv/ | 선점 방식(pre-emptive) |
| blocked/blɒkt/ | 블로킹(blocked) |
| process control block/ˈprəʊses kənˈtrəʊl blɒk/ | 프로세스 제어 블록(process control block) |
| context switch/ˈkɒntekst swɪtʃ/ | 컨텍스트 스위치 |
| kernel/ˈkɜːnl/ | 커널(kernel) |
| interrupt handler/ˈɪntərʌpt ˈhændlə/ | 인터럽트 핸들러 |
| interrupt handling/ˈɪntərʌpt ˈhændlɪŋ/ | 인터럽트 처리 |
| inter-process communication/ˈɪntə ˈprəʊses kəˌmjuːnɪˈkeɪʃn/ | 프로세스 간 통신(IPC) |
| pipes/paɪps/ | 파이프(pipes) |
| shared memory/ʃeəd ˈmeməri/ | 공유 메모리(shared memory) |
| virtual address space/ˈvɜːtʃuːəl əˈdres speɪs/ | 가상 주소 공간 |
16.1
가상 메모리, 페이징, 세그멘테이션

각 프로세스는 자체적인 가상 주소 공간을 얻습니다 — OS가 물리 메모리에 매핑하는 깔끔하고 연속적인 주소 범위입니다. 이는 각 프로세스에게 간단한 공간을 제공하며, 프로세스를 서로 보호하고, 총 메모리를 물리 RAM보다 크게 할 수 있게 합니다.
페이징에서 가상 공간은 고정 크기의 페이지로, 물리 메모리는 동일한 크기의 프레임으로 나뉩니다. 페이지 테이블은 각 페이지를 프레임에 매핑합니다. 접근한 페이지가 RAM에 없는 경우 — 페이지 폴트 — OS는 스왑 파일에서 프레임을 읽어 오며, RAM이 가득하면 다른 페이지를 방출합니다. 빈번한 폴트는 스워싱(thrashing)(디스크 스워싱)을 유발하여 OS가 유용한 작업을 하기보다 대부분 시간을 페이지 스왑에 소비하게 됩니다.
세그멘테이션에서 메모리는 가변 크기의 논리 세그먼트(코드, 스택, 힙)로 나뉘며, 각에는 자체 권한이 있습니다. 많은 시스템에서 세그먼트 내부에 페이징을 사용합니다.

"가상 메모리의 의미를 설명하시오" (3점). *보조 저장장치(디스크)*를 사용하여 RAM을 확장하므로, 사용 가능한 메모리가 물리 메모리보다 큰 것처럼 보입니다; 프로세스의 주소 공간은 페이지로 나뉘며, 현재 필요한 페이지만 RAM에 유지되고 나머지는 디스크에서 대기합니다; 페이지는 필요에 따라 RAM과 디스크 사이에서 스왑되며, OS는 각 가상 주소를 물리 주소로 변환합니다. OS가 필요한 이유: 실행 중인 프로그램들이 설치된 RAM보다 더 많은 메모리가 필요할 수 있습니다; 여러(또는 더 큰) 프로그램을 동시에 실행할 수 있게 합니다; 프로그램이 물리 메모리보다 클 수 있습니다; 메모리가 효율적으로 사용되므로 프로그램의 활성화된 부분만 RAM을 차지합니다.
페이징 대 세그멘테이션: 시험에서 원하는 차이점. 페이징은 메모리를 하드웨어가 선택한 고정 크기의 블록(페이지와 프레임)으로 나누어 프로그램 구조를 고려하지 않으며, 매핑은 프로그래머에게는 투명합니다; 세그멘테이션은程序的인 단위로 가변 크기의 논리 단위(절, 배열, 스택)로 나누어 크기와 경계가 프로그램에 따르므로, 세그먼트를 단위로서 보호하거나 공유할 수 있습니다. "세그멘테이션 과정을 설명하시오": 프로그램은 다양한 크기의 세그먼트로 나뉘며, 각에 세그먼트 번호가 부여됩니다; 세그먼트 테이블은 각 세그먼트가 메모리에서 어디에서 시작하고 길이가 얼마인지 기록합니다; 논리 주소는 세그먼트 번호와 오프셋이며, OS는 오프셋을 세그먼트의 베이스 주소에 더해 물리적 위치를 찾습니다.
"""디스크 스레싱(disk thrashing)의 의미를 설명하고, 언제 발생하는지 서술하시오.""" 디스크 스레싱은 페이지들이 RAM에 주입되고 추방되는 빈도가 매우 높아 프로세서가 명령어를 실행하기보다 페이지를 이동하는 데 더 많은 시간을 보내게 되어 시스템이 거의 정지 상태에 이르는 현상입니다. 실행 중인 프로세스가 필요로 하는 페이지(작업 집합)에 대한 RAM 용량이 너무 적을 때 발생합니다. 한 번 추방된 페이지가 거의 즉시 다시 필요해져 다시 불러와지면, 이로 인해 다른 페이지가 추방되고 곧 그 페이지도 다시 필요해지는 식으로 반복됩니다. 프로세스 수가 너무 많거나 메모리를 예측 불가능하게 접근하는 프로그램이 이를 유발하며, RAM을 늘리거나 프로세스 수를 줄이면 해결할 수 있습니다.
탐색하기
페이지 faults에 대해 일어나는 일
페이지 faults를 단계별로 살펴보세요. 프로그램이 RAM에 없는 페이지에 접근하면 OS가 디스크에서 조용히 가져와 페이지 테이블을 업데이트합니다—따라서 프로그램은 물리적 존재보다 더 많은 메모리를 볼 수 있습니다.
어휘
연습하기
| English | 한국어 |
|---|---|
| paging/ˈpeɪdʒɪŋ/ | 페이지링(paging)입니다. |
| spooling/ˈspuːlɪŋ/ | 스풀링 |
| cache/kæʃ/ | cache |
| thrashing/ˈθræʃɪŋ/ | 슬러싱 |
| segmentation/ˌseɡmənˈteɪʃn/ | 세그멘테이션 |
| disk thrashing/dɪsk ˈθræʃɪŋ/ | 디스크 스래싱(thrashing) |
| interpreter/ɪnˈtɜːprɪtə/ | 인터프리터 |
| compiler/kəmˈpaɪlə/ | 컴파일러 |
| machine code/məˈʃiːn kəʊd/ | 머신 코드 |
16.2
인터프리터가 프로그램을 실행하는 방식
Syllabus
| 응시자가 다음을 수행할 수 있어야 함: | 참고 사항 및 가이드라인 |
|---|---|
| 인터프리터가 변환된 버전을 생성하지 않고 프로그램을 실행할 수 있는 원리에 대한 이해를 보임 | |
| 프로그램 컴파일의 다양한 단계에 대한 이해 | .lexical 분석, 문법 분석, 코드 생성 및 **최적화 포함 |
| 언어의 문법이 문법 그림 또는 Backus-Naur Form (BNF) 표기를 통해 어떻게 표현되는지에 대한 이해를 보임 | |
| **역폴란드 표기법(RPN)**이 식의 평가에 어떻게 사용될 수 있는지에 대한 이해를 보임 |
출처: Cambridge International syllabus
인터프리터는 소스 코드를 번역하고 동시에 실행합니다. 각 문장을 읽을 때마다 해당 줄을 처리하여 어휘 분석과 구문 분석을 수행하고, 타입을 확인한 후 실행하고 다음 단계로 넘어갑니다. 오류는 즉시 보고되며 보통 실행이 중단되며, 실행 가능한 파일은 생성되지 않습니다. 매 실행 시 번역이 재수행되므로 속도는 느리지만, 빠른 개발 피드백을 제공하고 이식성이 높습니다.
"""번역된 버전 없이 인터프리터가 프로그램을 어떻게 실행하는지 설명하시오(3점).""" 인터프리터는 문장(줄) 하나씩 받아 번역(분석)한 후 즉시 실행하고 다음 문장으로 넘어갑니다. 전체 프로그램에 대한 번역된 버전은 생성되거나 저장되지 않으므로, 루프를 반복할 때마다 포함하여 모든 문장이 매번 번역됩니다. 만약 문장에 오류가 있다면 실행은 그 지점에서 멈추고 오류가 보고됩니다. 이것이 인터프리터가 개발 및 테스트에는 유리하지만 완성된 프로그램을 실행할 때는 느린 이유입니다(오류가 도달하면 바로 발견되며, 변경 사항을 즉시 시도해 볼 수 있음).
16.2
컴파일의 단계

컴파일러는 소스 코드를 기계어로 변환하는 과정을 여러 단계로 나누어 수행합니다:
- 어휘 분석(lexical analysis) — 레ക്서저(lexer)가 문자를 토큰(키워드, 식별자, 연산자, 리터럴)으로 묶고 공백과 주석을 제거합니다.
- 구문 분석(parsing) — 토큰이 문법(규칙)에 부합하는지 확인하고 **추상 구문 트리(AST)**를 구성합니다. 괄호가 누락되면 구문 오류가 발생합니다.
- 의미 분석(semantic analysis) — 프로그램이 논리적으로 타당한지 확인합니다(변수가 선언되었는지, 타입이 일치하는지 등).
- 코드 생성(code generation) — 트리를 순회하여 타겟 코드를 출력하고, 레지스터 및 레이아웃을 결정합니다.
- 코드 최적화(code optimisation) — 파이프라인을 위해 불필요한 작업을 제거하고 상수를 합치며, 순서를 재배열합니다.
최종 출력은 실행 가능한 파일(executable)입니다.
각 단계의 목적 (채점 기준 용어 사용). 어휘 분석: 공백과 주석을 제거하고 소스 코드의 문자를 토큰(키워드, 식별자, 연산자, 상수)으로 변환하며 각 토큰이 언어 내에서 유효한지 확인하고, **기호 표(table)**에 식별자를 등록합니다. 구문 분석: 토큰의 순서가 언어의 **문법(구문 규칙)**을 따르는지 확인하고 parse tree(추상 구문 트리)를 구성하며, 구문 오류를 보고합니다. 타입 검증 및 변수 선언 확인은 때로는 의미 분석으로 분류하기도 합니다. 코드 생성: 검증된 트리를 오브젝트 코드 또는 기계어(중간 코드 경유 가능)로 변환하고, 메모리와 레지스터를 할당합니다. 최적화: 프로그램의 동작은 바꾸지 않으면서 불필요한 명령어를 제거하거나, 계산식을 결합/단순화하며, 루프를 재배열함으로써 코드가 더 빠르게 실행되거나 더 적은 메모리를 사용하도록 만듭니다. matching 문제에서는 각 단계를 위 설명 중 하나와 짝지어야 합니다.
탐색하기
컴파일의 단계들
컴파일이 소스 코드를 처리하는 과정을 단계별로 확인하십시오. 각 단계는 출력을 다음 단계에 전달합니다 — 문자가 토큰으로, 토큰이 트리로, 트리가 최적화된 기계 코드로 변환됩니다.
어휘
연습하기
| English | 한국어 |
|---|---|
| lexical analysis/ˈleksɪkl əˈnæləsɪs/ | 어휘 분석 |
| tokens/ˈtəʊkənz/ | 토큰s(tokens) |
| syntax analysis (parsing)/ˈsɪntæks əˈnæləsɪs/ | 구문 분석(parsing) |
| abstract syntax tree/ˈæbstrækt ˈsɪntæks triː/ | 추상 구문 트리 |
| syntax error/ˈsɪntæks ˈerə/ | 문법 오류(syntax error) |
| semantic analysis/səˈmæntɪk əˈnæləsɪs/ | 의미 분석 |
| code generation/kəʊd ˌdʒenəˈreɪʃn/ | 코드 생성 |
| code optimisation/kəʊd ˌɒptɪmaɪˈzeɪʃn/ | 코드 최적화 |
| symbol table/ˈsɪmbl ˈteɪbl/ | 심볼 테이블 |
16.2
문법: BNF 및 구도 도표

**문법(grammar)**은 어떤 토큰 순서가 유효한 프로그램인지 정의합니다.
Backus-Naur Form(BNF)은 텍스트 기반입니다. **생성 규칙(production rule)**은 다음과 같은 형태를 가집니다:
<symbol> ::= alternative1 | alternative2 | ...
각 대안은 종말 기호(리터럴 텍스트)와 비종말 기호(다른 규칙 이름)의 순열입니다:
<digit>      ::= 0 | 1 | 2 | 3 | 4 | 5 | 6 | 7 | 8 | 9
<identifier> ::= <letter> | <identifier> <letter> | <identifier> <digit>
재귀적인 세 번째 규칙은 "한 글자 뒤에 임의의 개수의 글자나 숫자가 따라옴"을 표현합니다. 아래 IF 문장은:
<if-statement> ::= IF <condition> THEN <statement> ENDIF
                 | IF <condition> THEN <statement> ELSE <statement> ENDIF
**구도 도표(syntax diagram, railroad diagram)**는 동일한 내용을 그래프로 보여줍니다: 비종말 기호는 사각형 상자, 종말 기호는 둥근 상자, 유효한 경로에는 화살표, 반복에는 루프를 사용합니다. 두 표기법은 동등합니다. 파서(parser)는 이 문법을 사용하여 프로그램이 효한지 판단합니다.
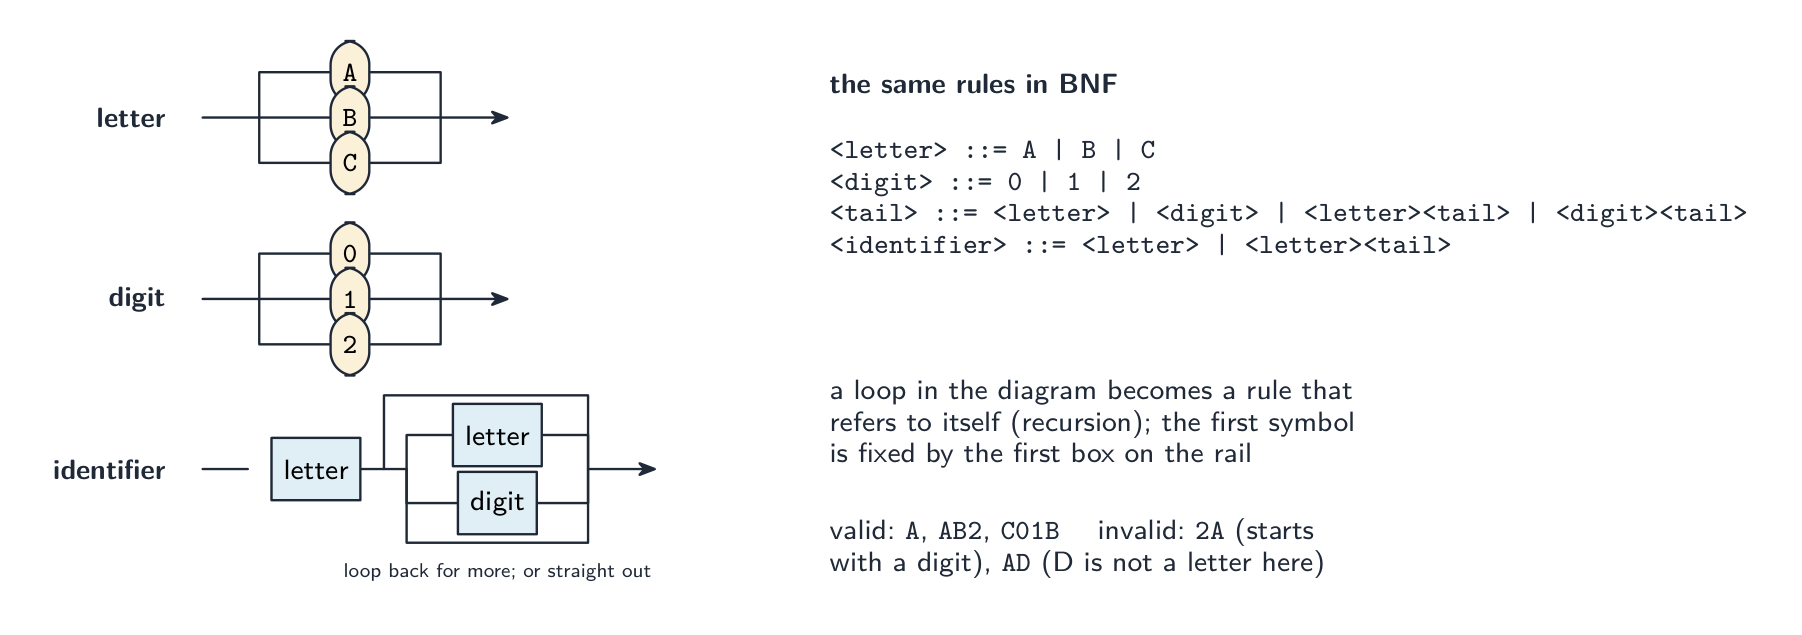
시험 도식 읽기. 각 도식은 하나의 비종말 기호를 정의합니다. 시작점에서 끝점으로 화살표를 따라가면, tracing할 수 있는 모든 경로가 유효한 문자열입니다. 옆에 나란히 배치된 상자의 선택은 대안들의 집합이며, 다시 들어오는 루프는 "마음껏 반복"을 의미하고, 다른 비종말 기호용 상자는 "규칙이 허용하는 것 anything를 삽입"을 뜻합니다. "문자열이 무효인 이유를 설명하라"(state why the string is invalid)는 문장을用於로 해당 규칙을 violations을 설명하는 것을 요구합니다: 9K는 첫 글자가 문자여야 하고 숫자가 아니므로 변수로서 무효입니다; JJ90는 규칙이 숫자 앞에 단 one 문자만 허용하거나, 또는 J가 나열된 문자 집합에 포함되지 않을 경우 무효한 비밀번호입니다. 실제 언어에서許容되는 것을 기준으로 하기보다, 도식이 실제로許容하는 문자 집합에 대해 문자열을 반드시 확인하십시오.
도식에서 BNF 규칙 작성하기. 각 도식은 하나의 규칙 <name> ::= ...이 됩니다; 대안들은 |로 분리하며, 시퀀스는 기호를 하나씩 나열하고, 반복은 재귀적 정의로 표현합니다(BNF에는 루프 기호가 없기 때문): "하나 이상의 문자"는 <word> ::= <letter> | <letter><word>이고, "문자 뒤에 영개 이상의 숫자"는 <variable> ::= <letter> | <letter><digits>에 <digits> ::= <digit> | <digit><digits>를 결합하여 표현합니다.
작중 예시. 차량 번호판의 BNF를 완성하십시오. 두 개의 문자(A B C에서)로 시작한 후, 하나, 둘, 또는 세 개의 숫자(0 1 2에서)가 이어져야 합니다.
<letter>       ::= A | B | C
<digit>        ::= 0 | 1 | 2
<digits>       ::= <digit> | <digit><digit> | <digit><digit><digit>
<registration> ::= <letter><letter><digits>
AB12는 효합니다; A12는 아닙니다(문자가 하나뿐); AB1234는 아닙니다(네 개의 숫자); AD1는 아닙니다(D는 나열된 문자가 아님). "세 번째 문자도 기호일 수 있다"와 같은 제약을 추가하라는 요청이 있을 때, 그 위치에만额外的 대안을 규칙에 추가하고, <symbol>를 자체 규칙으로 정의하십시오.
작중 예시. 변수, 연산자, 그리고 변수 또는 숫자 중 하나를 순서로 가지는 식에 대한 BNF를 작성하십시오. 여기서 변수는 a b c의 단일 소문자이고, 연산자는 + 또는 -입니다.
<variable>   ::= a | b | c
<operator>   ::= + | -
<number>     ::= <digit> | <digit><number>
<expression> ::= <variable><operator><variable> | <variable><operator><number>
재귀적 <number> 규칙은 임의의 개수의 숫자를 허용하며, <expression>의 두 대안은 정의에서 명시된 두 경우를 모두 포괄합니다. 모든 비종말 기호는 괄호 안에 있고, 모든 종말 기호는 괄호 없이 유지하십시오.
어휘
연습하기
| English | 한국어 |
|---|---|
| grammar/ˈɡræmə/ | 문법 |
| Backus-Naur Form/ˈbækəs nɔː fɔːm/ | 바커스-나우르 형식 |
| production rule/prəˈdʌkʃn ruːl/ | 생성 규칙(production rule) |
| terminal/ˈtɜːmɪnl/ | 터미널 |
| non-terminal/nɒn ˈtɜːmɪnl/ | 비터미널 |
| syntax diagram/ˈsɪntæks ˈdaɪəɡræm/ | 구문 다이어그램 |
16.2
역폴란드 표기법 (RPN)
중위(infix) 표기법에서는 연산자가 피연산자 사이에 위치하며(3 + 4 * 2), 괄호와 우선순위 규칙이 필요합니다. **역폴란드 표기법(RPN, **후위(postfix))**에서는 연산자가 피연산자 뒤에 위치하며(3 4 2 * +), 괄호가 필요 없습니다.
중위 표기법에서 RPN으로 변환
연산자 스택을 사용하십시오. 왼쪽에서 오른쪽으로 스캔합니다: 피연산자는 출력하고, 연산자일 때는 먼저 출력에 동일하거나 높은 우선순위를 가진 스택상의 모든 연산자를 pop한 후, 해당 연산자를 push합니다; (를 push합니다; )를 만나면 matching (까지 output에 pop합니다. 마지막에 모든 연산자를 pop합니다. 예: (3 + 4) * 2 → 3 4 + 2 *.
RPN 평가
피연산자의 스택을 사용합니다. 왼쪽에서 오른쪽으로 스캔합니다: 각 피연산자를 push하고, 연산자를 encountering하면 상단의 두 값을 pop하여 적용하고 결과를 push합니다. 3 4 2 * + 평가:
| 큰 | 스택 |
|---|---|
3 |
3 |
4 |
3, 4 |
2 |
3, 4, 2 |
* |
3, 8 |
+ |
11 |
결과: 11. RPN은 평가 시 괄호가 필요없으며 스택 머신에 적합합니다—JVM 및 많은 바이트코드 인터프리터가 작동하는 방식입니다.
"RPN이 식 평가를 위해 사용되는 이유를 설명하시오" (2점). RPN에서는 연산자가 적용되는 순서로 나타나므로, 괄호와 우선순위 규칙 없이 단 one 좌-우 스캔(pass) 으로 식을 평가할 수 있습니다. 따라서 컴파일러나 인터프리터가 처리하기에 더 단순하고 빠릅니다. "유사한 데이터 구조를 식별하고 이유를 제시하시오": 스택입니다. 평가에는 가장 최근에 push된 피연산자가 먼저 필요하기 때문입니다(LIFO: Last In First Out): 각 피연산자는 push되고, 각 연산자는 상단의 두 값을 pop하여 적용하고 결과를 push합니다. 요청될 때마다 각 토큰 후 스택 내용을 표시하십시오.
수작업으로 중위 표기법에서 RPN으로 변환하기. (1) 우선순위 규칙을 사용하여 식에 완전히 괄호를 붙이십시오; (2) 각 연산자를 자신의 짝 closing bracket 바로后面으로 이동시키십시오; (3) 괄호를 제거하십시오. 따라서 $(a - b) * (a + c) / 7$는 $((a - b) * (a + c)) / 7$이 되고, 이후 a b - a c + * 7 /가 됩니다. *과 /는 좌-우로 적용되므로, 나눗셈은 마지막 연산자가 아니라 곱셈입니다. 더 많은 변환: $((7 + 3) - (2 * 8)) / 6$는 7 3 + 2 8 * - 6 /; $(7 - 2 + 8) / (9 - 5)$는 7 2 - 8 + 9 5 - /; $a * b + b - d + 15$는 a b * b + d - 15 +; $(2 - 6) * (13 + 7) / 5$는 2 6 - 13 7 + * 5 /입니다.
将 RPN 还原为中缀表达式。 利用表达式栈逐步处理 RPN:每次遇到操作数即压栈;遇到运算符时弹出两个元素,将其分别置于运算符两侧并加括号,再将结果压栈。例如 a b / 4 * a b + - 对应 $((a / b) * 4) - (a + b)$;5 2 + 9 3 - / 3 * 对应 $((5 + 2) / (9 - 3)) * 3$;b a c - + d b + * c / 对应 $((b + (a - c)) * (d + b)) / c$;a b - c + c a - * d / 对应 $(((a - b) + c) * (c - a)) / d$。务必保留括号,省略括号可能改变表达式的含义。
해설 예제. a b - c d + * e /를 $a = 17$, $b = 5$, $c = 7$, $d = 3$ 및 $e = 10$일 때 평가하고 스택을 보여라.
| 토큰 | 행동 | 스택 (우측이 상단) |
|---|---|---|
a |
17 push | 17 |
b |
5 push | 17, 5 |
- |
5와 17 pop, $17 - 5$ push | 12 |
c |
7 push | 12, 7 |
d |
3 push | 12, 7, 3 |
+ |
3과 7 pop, $7 + 3$ push | 12, 10 |
* |
10과 12 pop, $12 \times 10$ push | 120 |
e |
10 push | 120, 10 |
/ |
10과 120 pop, $120 / 10$ push | 12 |
결과 12. pop의 순서는 -와 /에 중요합니다: 두 번째로 pop된 값이 left operand이므로, a b -는 $a - b$이 아니라 $b - a$입니다. 동일한 방식으로 두 가지 더: d a b + * c a - / with $a = 6, b = 12, c = 15, d = 5$ gives $5 \times (6 + 12) / (15 - 6) = 90 / 9 = 10$; c a - b d + * b c + / with $a = 4, b = 12, c = 24, d = 6$ gives $(24 - 4) \times (12 + 6) / (12 + 24) = 360 / 36 = 10$.
해설 예시. $(A + B) \times (C - D)$를 RPN으로 변환한 후, $(3 + 4) \times (5 - 2)$을 평가하십시오. 연산자 스택을 사용하여 왼쪽에서 오른쪽으로 스캔합니다. (을 스택에 밀어 넣습니다; A을 출력합니다; +을 스택에 밀어 넣습니다; B을 출력합니다. )에 도달하면匹配的 (로 되돌아와서 현재까지 A B +이 됩니다. ×을 밀어 넣고, 두 번째 괄호도 동일한 방식으로 작동하여 C D -이 됩니다. 마지막에 ×을 스택에서 빼냅니다. 결과: A B + C D - ×. 수치를 평가하기 위해 피연산자의 스택을 사용합니다. 3을 밀어 넣고, 4를 밀어 넣습니다. +이 두 값을 모두 빼내어 7을 밀어 넣습니다. 5를 밀어 넣고, 2를 밀어 넣습니다. -이 두 값을 모두 빼내어 3을 밀어 넣습니다. ×이 7과 3을 빼내어 21을 밀어 넣습니다. 이러한 과정이 신뢰할 수 있는 이유는 다음과 같습니다. 피연산자는 변환 과정에서 원래 순서를 유지하며(연산자만 이동함), 모든 연산자가 스택에서 즉시 아래에 있는 두 값에 작용합니다.
탐색하기
연산자 우선순위 — 역폴란드 표기법이 제거하는 부분
일반 중위 수식에서 ×와 ÷는 +와 −보다 결합력이 강하므로, 올바른 순서로 규칙을 적용해야 합니다. 역폴란드 표기법은 피연산자를 먼저 기록합니다(3 4 2 × + 1 −). 이로 인해 우선순위가 명확해져 별도의 우선순위 규칙이 필요 없습니다.
어휘
연습하기
| English | 한국어 |
|---|---|
| infix/ˈɪnfɪks/ | 인픽스 |
| postfix/ˈpəʊstfɪks/ | 포픽스 |
| stack/stæk/ | 스택 |
| precedence/ˈpresɪdəns/ | 우선순위 |
| bytecode/ˈbaɪtkəʊd/ | 바이트코드 |
16.2
출제자가 인정하는 정의
정의 문제는 고정된 문구로 채점합니다. 이 내용들을 정확히 외우고, 답은 하나만 제시하십시오.
| 용어 | 정의 |
|---|---|
| 멀티태스킹 | 여러 프로세스가 동시에 메모리에 존재하며, 프로세서가它們之间切换,使它们看起来同时运行 |
| 프로세스 | 메모리에 로드되어 실행 중이거나 실행 준비가 된 프로그램 |
| 실행 중 / 대기 중 / 블록됨 | 프로세서를 사용 중임 / 프로세서를 대기 중임 / I/O 완료와 같은 이벤트가 끝날 때까지 계속할 수 없음 |
| 스케줄링 | 다음에 프로세서를 사용할 대기 중인 프로세스를 결정하고, 그 기간을 설정하는 것 |
| 전제형 스케줄링 | 실행 중인 프로세스가 중단되어 대기 상태로 옮겨지고, 다른 프로세스가 실행되도록 함 |
| 가상 메모리 | RAM을 확장하기 위해 보조 저장 장치를 사용하여, 현재 필요한 페이지만 물리적 메모리에 보유함 |
| 페이징 | 메모리와 프로그램을 고정 크기 페이지로 나누어 필요할 때 디스크와 RAM 사이에서 이동시킴 |
| 세그멘테이션 | 프로그램을 가변 크기의 논적 세그먼트로 나누고, 각 세그먼트를 세그먼트 테이블을 통해 메모리에 매핑함 |
| 디스크 스와핑 | 페이지가 RAM과 디스크 사이에서 너무 자주 교체되어 유용한 처리가 거의 이루어지지 않음 |
| 인터프리터 | 변환된 버전을 생성하지 않고,程序的语句逐条翻译并执行程序 |
| 컴파일러 | 실행되기 전에 전체 고수준 프로그램을 기계어(오브젝트) 코드로 변환함 |
| 레キシ컬 분석 | 소스 코드를 토큰으로 변환하고, 공백과 주석을 제거하며, 기호표를 구축함 |
| 구문 분석 | 토큰이 언어의 문법 규칙을 따르는지 확인하고, 파싱 트리를 구축함 |
| Backus–Naur Form | 언어의 문법을 나타내는 표기법: 말단 기호와 비말단 기호로 구성된 <name> ::= alternatives 형태의 규칙 |
| Reverse Polish Notation | 각 연산자를 피연산자 뒤에 배치하여 표현을 쓰는 방식입니다. 이를 통해 괄호 없이 스택을 사용하여 평가할 수 있습니다 |
어휘
연습하기
| English | 한국어 |
|---|---|
| Reverse Polish Notation/rɪˈvɜːs ˈpəʊlɪʃ nəʊˈteɪʃn/ | 역 폴란드 기법 |
16.2
시험 팁
- OS 관련 질문은 명명된 메커니즘(스케줄링, 메모리 관리, I/O 버퍼링 및 스풀링, 파일 관리)에 대해 평가됩니다. 인터페이스 관련 질문은 파일명 대신 주소, 클릭 대신 명령어, 드라이버, GUI에 대해 평가됩니다.
- 프로세스 상태와 전환 조건, 그리고 각 전환의 이유; 스케줄링 루틴은 함수 형태 plus_method + 단점 form으로 설명해야 합니다; 커널은 상태를 저장하고, 인터럽트를 식별하고,对它进行处理,然后恢复状态。
- 가상 메모리: 디스크가 RAM을 확장하고, 페이지가交换,地址转换; 페이징은 고정 크기고 투명하며, 세그멘테이션은 가변 크기고 논리적이며, 스와핑은 작업 대신交换发生。
- 인터프리터: 한 줄씩 처리하며, 먼저 변환 후 실행되고, 아무것도 저장되지 않습니다. 컴파일러 단계: 토큰과 기호표, 문법과 파싱 트리, 코드, 최적화.
- BNF: 도식당 하나씩 규칙이 있으며, 선택을 위한
|, 반복을 위한 재귀, 말단 기호는 그대로 쓰고 비말단 기호는 각괄호로 표시합니다. 어떤 규칙이 문자열을 위반했는지 설명하세요. - RPN: 연산자가 피연산자 뒤에 위치하며, 스택을 사용하여 평가하고, 모든 단계를 보여줍니다. 완전히 괄호로 감싸서 변환하며, 다시 변환할 때는 괄호를 유지합니다.
흔한 실수
- 프로세서가它们之间切换说没有提到多任务处理是“同时运行多个程序”。
- 블록된 프로세스를 즉시 실행 상태로 보내거나, 실행 중에서 블록됨으로 가는 이유를 “타임 슬라이스 종료”로 설명하는 것.
- shortest job first (비전제형)를 shortest remaining time (전제형)와 혼동하거나, round robin를 priority와 혼동하는 것.
- pages가交换说没有提到虚拟内存是“将硬盘用作RAM”。
- 인터프리터가 “프로그램을 기계어로 변환한 후 실행한다”라고 말하는 것; 이는 컴파일러의 기능입니다.
- 구문 검사를 레キシ컬 분석에 포함시키거나, 매칭 문제에서 코드 생성 전에 최적화를 배치하는 것.
- BNF의 반복을
<letter>*또는 점선으로 쓰거나, 재귀를 사용하지 않는 것. 비말단 기호의 각괄호를 누락하는 것. - RPN을 평가할 때
-또는/의 피연산자 순서를 반대로 하거나, $a * b + c$의 RPN을a b c + *로 쓰는 것.
어휘
연습하기
| English | 한국어 |
|---|---|
| pages/ˈpeɪdʒɪz/ | 페이지 |
| frames/freɪmz/ | 프레임 |
| page fault/peɪdʒ fɒlt/ | 페이지 페일트 |
| swap file/swɒp faɪl/ | 스왑 파일 |
이 주제에 대한 인터랙티브 수업
즉시 체크 기능 exercises를 통해 단계별로 진행하세요.