| 受験者は以下的能力を備えているべきである: | メモおよびガイドライン |
|---|---|
| 線形探索および二項探索の手法の理解を示す。 | 線形探索を実装するアルゴリズムを記述する。二項探索を実装するアルゴリズムを記述する。二項探索を使用するための条件を説明する。二項探索のパフォーマンスがデータ項目数によってどのように変化するかを説明する。 |
| 挿入ソートおよびバブルソートの手法の理解を示す。 | 挿入ソートを実装するアルゴリズムを記述する。バブルソートを実装するアルゴリズムを記述する。ソートルーチンのパフォーマンスは、データの初期順序やデータ項目数に依存することがある。 |
| 抽象データ型(ADT)の理解と適用を示す。 | 以下の各データ構造内から特定のアイテムを見つけるアルゴリズムを記述する:リンクドリスト、二分木。以下の各データ構造にアイテムを挿入するアルゴリズムを記述する:スタック、キュー、リンクドリスト、二分木。以下の各データ構造からアイテムを削除するアルゴリズムを記述する:スタック、キュー、リンクドリスト。グラフがADTの一例であることを理解する。グラフの主要な特徴を説明し、特定の状況での使用正当性を示す。グラフ構造に対するコード記述は不要である。 |
| ADTが他のADTから実装可能であることを示す。 | 以下のADTを説明し、適切な組み込み型や他のADTからどのように実装できるか演示する:スタック、キュー、リンクドリスト、辞書、二分木。 |
| 同じタスクを行う異なるアルゴリズムを比較するために、基準(例:タスク完了に要する時間や使用メモリなど)を使用できることを理解する。 | Big O記号を用いて時間的・空間的複雑度を指定する用法を含む。 |
計算的思考と問題解決
A-Levelコンピュータ科学 · トピック 19
 15:33
探索 & ソート
百万人の名前が入った電話帳があります。一つずつ確認していくと、百万回の比較が必要になるかもしれません。しかし、すでにそのコツはご存知でしょう:…で開いてみてください。
英語ナレーション・英語+中文字幕 burning-in
19.1
探索アルゴリズム

シラバス
出典: Cambridge International シラバス
探索は、ターゲット値を集合(通常は配列)内に見つけ、その位置を返すか、「見つからない」ことを返す。
線形探索
線形探索は先頭から末尾まで移動し、各要素をターゲットと比較する:
FOR i ← 1 TO n
    IF A[i] = target THEN
        RETURN i
    ENDIF
NEXT i
RETURN -1   // not found
初期準備が不要なため、任意のリストで動作する。最悪ケース O($n$)(ターゲットが最後にある場合や存在しない場合)、最良ケース 1回の比較。未整列データや小さなリストで使用します。(返された -1 はsentinel値です——「見つからない」を意味するあり得ない位置であり、呼び出し側は IF result = -1 をテストします。)
試験における出題形式。 Paper 3では、フラグと WHILE ループで書かれた線形探索を完成させる問題があり、Paper 4ではインデックスまたはカウントを返す関数を書く問題があります。どちらも以下のように見えます:
FUNCTION LinearSearch(Data : ARRAY OF INTEGER, Target : INTEGER) RETURNS INTEGER
    DECLARE Index, Count : INTEGER
    Count ← 0
    FOR Index ← 1 TO 100
        IF Data[Index] = Target THEN
            Count ← Count + 1
        ENDIF
    NEXT Index
    RETURN Count          // how many times Target occurs; 0 means not found
ENDFUNCTION
最初の一致で停止するには、Found ← TRUE を設定してインデックスを記録する WHILE Index <= 100 AND NOT Found ループを使用します。採点ポイントは、全要素に対するループ、比較、そして値が存在しない場合に何-returnするかです。

二項探索
二項探索にはデータを整列しておく必要がある。中央の要素を見る;それがターゲットであれば完了、ターゲットより小さい場合は左半分、大きい場合は右半分を探索する——毎回範囲を半分にする:
low ← 1
high ← n
WHILE low <= high DO
    MiddleIndex ← (low + high) DIV 2
    IF A[MiddleIndex] = target THEN
        RETURN MiddleIndex
    ENDIF
    IF A[MiddleIndex] < target THEN
        low ← MiddleIndex + 1
    ELSE
        high ← MiddleIndex - 1
    ENDIF
ENDWHILE
RETURN -1
最悪ケース O($\log_{2} n$) — 百万個のアイテムに対して、約 20 回の比較が必要。大きな並べ替え済み配列での線形探索より遥かに速いが、最初に並べ替える必要がある(一時的な O($n \log n$) のコスト)。多数回検索する場合、その価値はある。
「二項探索に必要な条件を述べよ。」 データは順序立っている必要があり(探索するキーについて、昇順または降順で整列されている)。「二項探索の実行方法を記述せよ」(3点): (1) リスト(または現在の範囲)の中央のアイテムを見つけ、それをターゲットと比較する;(2) 一致すれば探索終了、ターゲットが小さい場合は下半分で繰り返し、大きい場合は上半分で繰り返す;(3) アイテムが見つかるか範囲が空になる(存在しないことを意味する)まで範囲を半分にしながら続ける。
試験における出題形式では、境界値とフラグが含まれるものが、アルゴリズムの完成を求められた際に再現すべきものである:
DECLARE Lower, Upper, MiddleIndex : INTEGER
DECLARE Found : BOOLEAN
Lower ← 0
Upper ← 99
Found ← FALSE
WHILE Lower <= Upper AND NOT Found
    MiddleIndex ← (Lower + Upper) DIV 2
    IF Names[MiddleIndex] = Target THEN
        Found ← TRUE
    ELSE
        IF Names[MiddleIndex] < Target THEN
            Lower ← MiddleIndex + 1
        ELSE
            Upper ← MiddleIndex - 1
        ENDIF
    ENDIF
ENDWHILE
IF Found THEN
    OUTPUT MiddleIndex
ELSE
    OUTPUT "Not found"
ENDIF
「性能がアイテム数に伴ってどう変化するか説明せよ。」 各比較によって残りのアイテム数が半分になるため、最大比較回数は約$\log_{2} n$:リストのサイズが倍になると、比較回数はただ1回増えるだけである。これは O($\log n$) である。「線形探索と二項探索を比較せよ」: 線形探索は最大で$n$ 回の比較(O($n$))を要し、平均ではその半分だが、ソートされていないデータでも動作する。一方、二項探索は最大で$\log_{2} n$ 回(O($\log n$))で、大きなリストでは遥かに速いが、データは事前にソートされており、中央のアイテムへの直接アクセスが可能な構造(配列、リンクedListではない)である必要があり、$1000$ 個のアイテムに対して$1000$ 対$10$ 回の比較となる。

探索
線形探索と二項探索
値を検索する。二項探索は各ステップでリストを半分にする(並べ替え済みデータのみ);線形探索では順に確認していく。
語彙
練習する
| English | 日本語 |
|---|---|
| insertion sort/ɪnˈsɜːʃn sɔːt/ | 挿入ソート |
| bubble sort/ˈbʌbl sɔːt/ | バブルソート |
| binary search/ˈbaɪnəri sɜːtʃ/ | 二分探索 |
| array/əˈreɪ/ | 配列 |
| linear search/ˈlɪnɪə sɜːtʃ/ | 線形探索 |
19.1
ソートアルゴリズム

バブルソート
バブルソートは配列を反復して通り抜け、順序が逆の隣接するペアを交換するため、最も大きい「泡」が各パスで末尾へ浮き上がる:
FOR pass ← 1 TO n - 1
    swapped ← FALSE
    FOR i ← 1 TO n - pass
        IF A[i] > A[i + 1] THEN
            temp ← A[i]
            A[i] ← A[i + 1]
            A[i + 1] ← temp
            swapped ← TRUE
        ENDIF
    NEXT i
    IF swapped = FALSE THEN      // already sorted
        EXIT FOR
    ENDIF
NEXT pass
最良ケース O($n$)(既に整列されており、早期退出がある場合)、平均/最悪 O($n^{2}$)。単純だが大きな $n$ に対しては遅い。
挿入ソート
挿入ソートは左側から整列された前綴を構築し、新しい要素を適切な位置に挿入するために大きい要素を右へシフトさせる:
FOR i ← 2 TO n
    key ← A[i]
    j ← i - 1
    WHILE j >= 1 AND A[j] > key DO
        A[j + 1] ← A[j]
        j ← j - 1
    ENDWHILE
    A[j + 1] ← key
NEXT i
最良ケース O($n$)(既に整列されている場合)、最悪 O($n^{2}$)。小型またはほぼ整列された配列に適している。インプレイスでソートし、安定(等しい要素の順序を保つ)。
ソートのトレース
一般的なタスクは、各外側パス後の配列を示すことである。[D, T, H, R] に対して挿入ソートを行う場合:パス1(キー T)変更なし;パス2(キー H)→ [D, H, T, R];パス3(キー R)→ [D, H, R, T]。
ゼロからソートを書く。 「DataArray[1:1000] を昇順にソートする擬似コードを書け」に対する答えは、早期退出フラグ付きの完全なバブルソート、または声明されてインデントされた挿入ソートであり、どちらでもすべての入力に対して正しく動作すれば満点となる:
DECLARE Pass, Index, Temp : INTEGER
DECLARE Swapped : BOOLEAN
Pass ← 1
REPEAT
    Swapped ← FALSE
    FOR Index ← 1 TO 1000 - Pass
        IF DataArray[Index] > DataArray[Index + 1] THEN
            Temp ← DataArray[Index]
            DataArray[Index] ← DataArray[Index + 1]
            DataArray[Index + 1] ← Temp
            Swapped ← TRUE
        ENDIF
    NEXT Index
    Pass ← Pass + 1
UNTIL Swapped = FALSE OR Pass = 1000
降順にする場合は > を < に変更する;レコードや2D配列を1つのフィールドでソートする場合、そのフィールドを比較するが全体のレコード(またはすべての列)を交換する。与えられたバブルソートと同じタスクを行う挿入ソートを書くように求められた場合、同じ配列名と方向を維持し、上記の挿入ソートを再現するが、降順の場合は比較を逆にする。
「ソートの性能がデータによってどのように影響されるかを2つ説明しなさい」(2点)。 (1) アイテム数: $O(n^{2})$ソートでは、アイテム数が倍になると実行時間が4倍になります。 (2) データが既に整列されているかどうか: フラグ付きのバブルソートや挿入ソートは、既に整列されたデータに対して1パスで完了します($O(n)$)、逆順のデータに最も多くの作業を要求します。スワップ数は未整列なペアの数によります。(また、範囲や重複値の数、大きなレコードであるかどうかも許容されます。)バブルソートと挿入ソートは最悪・平均ケースでO($n^{2}$)、最良ケースでO($n$)です。クイックソートやマージソートはO($n \log n$)であり、そのため大量のデータに使用されます。
[D, T, H, R]の挿入ソート:各キーをパスごとに正しい位置にシフト
探索
ソートの実行を見る
ソート処理をステップバイステップで見、バーが整列する様子を確認——ソートアルゴリズムの動作を段階的に理解する。
19.1
アルゴリズムにおけるADT
トピック10で扱われた**抽象データ型(ADT)**は多くのアルゴリズムに含まれます。スタックは深さ優先探索やUndo操作を駆動し、キューは幅優先探索や印刷順序を駆動し、リンクドリストはデータの増減を可能にします。
ADTは配列だけでなく他のADTから構築できます:キューは2つのスタックから、スタックはリンクドリスト(push = ヘッドへのノードの追加)から、キューはヘッドとテールのポインタを持つリンクドリストから、二項木は子への2本のポインタを持つノードから、辞書はキー→値のペアを格納します(通常ハッシュテーブル上)。このように階層化することで関心事項を分離でき、ADTを使用するアルゴリズムは内部実装を知る必要はありません。
試験で記述・実装を求められるADT
スタック(後入れ先出し):アイテムは同じ端であるトップに追加(プッシュ)され、取り出されます(ポップ)。ポインタ TopOfStack がトップのインデックスを保持します。配列とこの1本のポインタで実装されます。pushはスタックが満杯でないかチェックし、ポインタを増加させてアイテムを格納します。popは空でないかチェックしてトップのアイテムを返した後、ポインタを減少させます。
FUNCTION Push(Item : INTEGER) RETURNS BOOLEAN
    IF TopOfStack = 9 THEN      // full (array 0 to 9)
        RETURN FALSE
    ENDIF
    TopOfStack ← TopOfStack + 1
    StackData[TopOfStack] ← Item
    RETURN TRUE
ENDFUNCTION
FUNCTION Pop() RETURNS INTEGER
    IF TopOfStack = -1 THEN      // empty
        RETURN -1
    ENDIF
    TopOfStack ← TopOfStack - 1
    RETURN StackData[TopOfStack + 1]
ENDFUNCTION
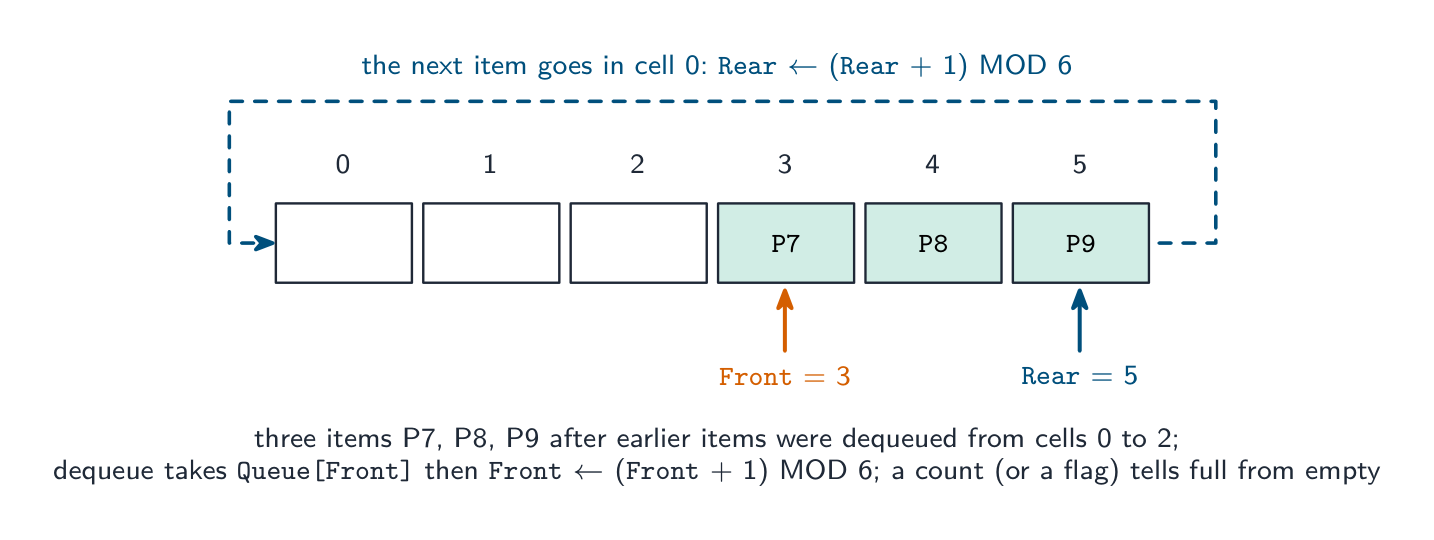
キュー(先入れ先出し):アイテムは裏側(エンキュー)から入り、表側(ディキュー)から出ます。2本のポインタとカウントを使用します。線形キューでは表側のポインタが配列内を進み、開始部分のスペースが破棄されます。環状キューでは両方のポインタがMOD でwrapされるため、すべてのセルが再利用されます。
FUNCTION Enqueue(Item : STRING) RETURNS BOOLEAN
    IF Count = 6 THEN      // full
        RETURN FALSE
    ENDIF
    Rear ← (Rear + 1) MOD 6
    QueueArray[Rear] ← Item
    Count ← Count + 1
    RETURN TRUE
ENDFUNCTION
FUNCTION Dequeue() RETURNS STRING
    IF Count = 0 THEN      // empty
        RETURN ""
    ENDIF
    DECLARE Item : STRING
    Item ← QueueArray[Front]
    Front ← (Front + 1) MOD 6
    Count ← Count - 1
    RETURN Item
ENDFUNCTION
リンクドリスト: ノードの列で、各ノードはデータアイテムと次ノードへのポインタを持ちます。スタートポインタが最初のノードを指し、nullポインタ(0 または $-1$)がリストの終端となります。配列実装では2つの並列配列がデータとポインタを保持し、未使用セルはフリーリストにチェーンされて、挿入時に新しいノードを配置する場所を知ることができます。
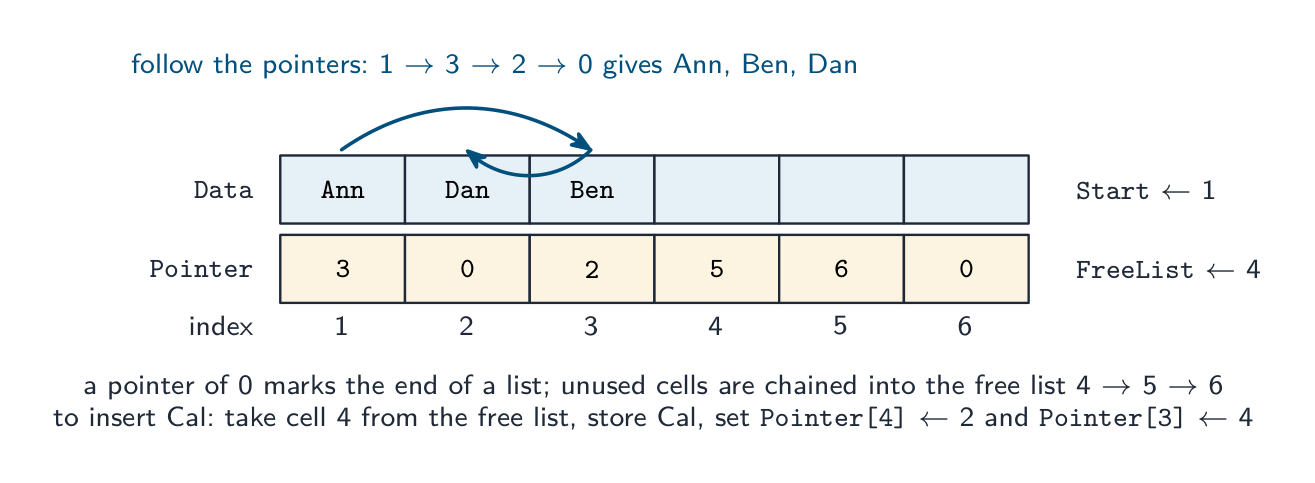
FUNCTION FindInList(Target : STRING) RETURNS INTEGER   // index, or 0 if absent
    DECLARE Current : INTEGER
    Current ← Start
    WHILE Current <> 0
        IF Data[Current] = Target THEN
            RETURN Current
        ENDIF
        Current ← Pointer[Current]
    ENDWHILE
    RETURN 0
ENDFUNCTION
整列リストへの挿入: 最初のフリーセル(NewNode ← FreeList, FreeList ← Pointer[FreeList])を取り出し、アイテムを格納し、Previous とCurrent ポインタでリストを辿ってData[Current] > Item または終端まで到達します。Pointer[NewNode] ← Current とPointer[Previous] ← NewNode を設定します(最初に入る場合はStart ← NewNode)。削除では、直前のノードを削除ノードの次に再リンクし、そのセルをフリーリストに戻します。
二項木: ルートノード、各ノードはデータ、より小さい値の部分木への左ポインタ、より大きい値の部分木への右ポインタを持ちます。2次元配列(または3つの1次元配列)Tree[Index, 0..2] で左ポインタ、データ、右ポインタを格納し、ルートポインタとnext-freeポインタで管理します。
FUNCTION FindInTree(Target : INTEGER) RETURNS INTEGER   // index, or -1
    DECLARE Current : INTEGER
    Current ← Root
    WHILE Current <> -1
        IF Tree[Current, 1] = Target THEN
            RETURN Current
        ENDIF
        IF Target < Tree[Current, 1] THEN
            Current ← Tree[Current, 0]      // go left
        ELSE
            Current ← Tree[Current, 2]      // go right
        ENDIF
    ENDWHILE
    RETURN -1
ENDFUNCTION
挿入: 両方のポインタを$-1$ にしたnext-freeノードにアイテムを格納します。木が空の場合はルートにし、そうでなければ比較によって左または右に進み、追従すべきポインタが$-1$ になるまで下りて、それを新しいノードに設定します。他ADTからのADT: スタックはpushとpopが両方始点で行われるリンクドリスト、キューはstartとendポインタを持つリンクドリスト、2つのスタックでキューを作れます(片方にpush、もう片方からpop、空になったらすべて移動)、二項木のノードはポインタで連結された記録やオブジェクトなので、ノードのリンク構造から作られます。新しいADTの操作が古いADTのどの操作に対応するかを述べなさい。


語彙
練習する
| English | 日本語 |
|---|---|
| linked list/lɪŋkt lɪst/ | 連結リスト |
| in place/ɪn pleɪs/ | インプレイス |
| stable/ˈsteɪbl/ | 安定 |
| stack/stæk/ | スタック |
| queue/kjuː/ | キュー |
| node/nəʊd/ | ノード |
| pointers/ˈpɔɪntəz/ | ポインタ |
| binary tree/ˈbaɪnəri triː/ | 二項木 |
| dictionary/ˈdɪkʃənəri/ | 辞書 |
| circular queue/ˈsɜːkjʊlə kjuː/ | 巡回队列 |
| free list/friː lɪst/ | フリーリスト |
| time complexity/taɪm kəmˈpleksɪti/ | 時間計算量 |
| Big-O notation/bɪɡ əʊ nəʊˈteɪʃn/ | 大O記法 |
| space complexity/speɪs kəmˈpleksɪti/ | 空間計算量 |
19.1
アルゴリズムの比較

時間計算量
時間空間的复杂性 は、入力サイズ $n$ に応じて実行時間がどのように増大するかを示し、Big-O記法(支配項)で表されます:O(1) 定数、O($\log n$) 二分探索、O($n$) 線形探索、O($n \log n$) 高速ソート、O($n^{2}$) バブルソート/挿入ソート。スケールが大きい場合、より低いオーダーの方が有利です。小さな $n$ では他のアルゴリズムが速くても構いません。
これを具体的に示すと、百万個のアイテムをソートする場合、$O(n \log n)$ ソートは数秒以内で完了しますが、$O(n^{2})$ ソートには数分かかることがあります。
** worked example.** 並べ替え済みリストに $1000$ 個のアイテムが含まれています。最悪の場合、各探索には何回の比較が必要でしょうか?
線形探索はアイテムを1つずつ確認するため、最大で $1000$ 回の比較が必要です — これは $O(n)$ です。二分探索はステップごとにリストを半分にするため、最大で $\lceil \log_2 1000 \rceil = 10$ 回の比較で十分 — これは $O(\log n)$ です。リストを $2000$ 個に倍増させると、二分探索には追加で 1回 の比較しか加わりませんが、線形探索には最大で $1000$ 回の追加比较が必要になります — スケールでの勝敗を決めるのは生身の速度ではなく、成長のオーダーだからです。
Describing an order. O(1): the time is constant, independent of the number of items (pushing onto a stack, reading an array element). O($\log n$): the time grows with the logarithm of the number of items, so doubling the data adds only a fixed extra step (binary search). O($n$): the time grows in proportion to the number of items (linear search, one pass through a list). O($n \log n$): a little worse than linear (efficient sorts). O($n^{2}$): the time grows with the square of the number of items, so doubling the data quadruples the time (bubble and insertion sort). "State the Big O of a binary search of Names[0:99]" is answered $O(\log n)$, and "describe its meaning" as above; Big O measures how the time or memory scales, not the actual time.

メモリ空間の複雑性
メモリ空間的复杂性 は必要な追加メモリの量です。バブルソートと挿入ソートは O(1) の追加メモリを使用(インプレイス);マージソートは O($n$) を使用;再帰呼び出しはスタックメモリを使用し、その深さに比例します。時間とメモリのトレードオフがしばしば存在します。
その他の基準
単純さ(コード化・保守が容易)、安定性、適応性(ほぼソート済みのデータで高速)。適切なアルゴリズムはデータと制約条件によって決まります。
探索
実行時間がnにどう依存して増加するか
スライドnを上方に移動して曲線を比較すると:O(1) と O(log n) はほぼ平坦なまま、O(n) は着実に上昇し、O(n²) は爆発的に増加する。これがBig-O記法(ストップウォッチではなく)が、大きな入力に対するアルゴリズムの比較に用いられる理由である。
探索
Big-O成長
入力サイズ n を変化させ、各アルゴリズムの作業量の増加速度を比較する——これが時間計算量の概念である。
19.2
再帰

シラバス
| 受験者は以下的能力を備えているべきである: | メモおよびガイドライン |
|---|---|
| 再帰を理解する | 再帰の必須要素 再帰をプログラミング言語で表現する方法 再帰的アルゴリズムを書き、トレースする 再帰の使用が有益な場合 |
| コンパイラが再帰_programmingコードを翻訳するために必要な処理について認識する。 | スタックとアンワイディングの使用。 |
出典: Cambridge International シラバス
再帰アルゴリズム は 再帰 を用います。同じ問題のより小さいバージョンを引数としてルーチン自体を呼び出し、ベースケース で連鎖を終了します。2つの部分があります:ベースケース(解くのに十分な小ささで、これがないと再帰は停止しない)、および 再帰ケース (入力を縮小して自身を呼び出す)。
階乗 :
FUNCTION Factorial(n : INTEGER) RETURNS INTEGER
    IF n = 0 OR n = 1 THEN
        RETURN 1
    ELSE
        RETURN n * Factorial(n - 1)
    ENDIF
ENDFUNCTION
自己相似な問題(木、** divide-and-conquer** (二分探索、マージソート)、組込みデータ)に対して再帰は自然です。不向きな場合は、ループの方が一般的にすっきりしています。
「再帰の定義を説明せよ」(2点) 自分自身で定義される関数または手続:本体内で 自身を呼び出し 、毎回問題の より小さい バージョンを用いて、ベースケースに到達するまで続ける。 「再帰の必須要素3つを答える」 :(1) 値を返すために further call を行わない ベースケース (終了条件);(2) ルーチンが 自身を呼び出す 一般ケース ;(3) 各呼び出しが問題を ベースケースに近づける (パラメータが減少する)ことで、再帰が終了する。一部の形式では、値が calls が 展開 される際に返されることが加わる。
「再帰の使用が有益な場面を説明し、例を挙げよ。」 問題が 自分自身のより小さいバージョンに基づいて自然に定義 されており、ループよりも再帰解が 短く、明瞭で、数学的定義に近い 場合:階乗やフィボナッチ数列、二分探索、二項木の走査、マージソートやクイックソート、フォルダ内のフォルダのような組込み構造の処理など。深さが大きい場合(スタックオーバーフローの恐れ)や、同じ部分問題が多数計算される場合(素朴なフィボナッチ)には不適切である。
再帰呼び出しのトレース
Factorial(4) に対して:呼び出しは Factorial(1)=1 まで下がり、その後 展開 によって再び上行きになる:2*1=2、3*2=6、4*6=24。最終結果 24。各保留中の呼び出しをスタックで追跡する。
** worked example.** 以下の関数は説明なしで与えられています。Unknown(3, 5) をトレースし、出力と返り値を答える。
FUNCTION Unknown(BYVAL X, BYVAL Y : INTEGER) RETURNS INTEGER
    IF X < Y THEN
        OUTPUT X + Y
        RETURN Unknown(X + 1, Y - 1) + 1
    ELSE
        RETURN 0
    ENDIF
ENDFUNCTION
Call 1: $X = 3, Y = 5$: $3 < 5$, 出力 8, Call Unknown(4, 4). Call 2: $4 < 4$はfalse、返り値 0. Unwinding: Call 1 returns $0 + 1 = 1$. Output 8, return value 1. トレースを表形式で書きなさい(呼び出しごとの行、引数、条件、出力、返り値)、最深の呼び出しから順に返り値を遡って書きます——これが採点基準が見ているunwindingです。
** worked example (フィボナッチ数列)。** Fib(n) は n < 2 のとき n をリターンし、それ以外では Fib(n - 1) + Fib(n - 2) をリターンします。Fib(5) を求めてください。
Fib(5) = Fib(4) + Fib(3); Fib(4) = Fib(3) + Fib(2); Fib(3) = Fib(2) + Fib(1); Fib(2) = Fib(1) + Fib(0) = 1 + 0 = 1。したがって Fib(3) = 1 + 1 = 2、Fib(4) = 2 + 1 = 3、Fib(5) = 3 + 2 = 5。ベースケースは 何度も 達成される(Fib(2) は3回計算される)。このバージョンが遅いのはそのためである:$n = 5$ に対して15回の呼び出しを行い、$n$ の増加ごとに呼び出し数がおおよそ倍増する。
再帰から反復への変換。 全ての再帰関数はループに書き換えられ、メモリ使用量を削減して高速化できます。初期値を維持し、ベースケースから順にループします。階乗のループ例:
FUNCTION Factorial(N : INTEGER) RETURNS INTEGER
    DECLARE Result, Count : INTEGER
    Result ← 1
    FOR Count ← 2 TO N
        Result ← Result * Count
    NEXT Count
    RETURN Result
ENDFUNCTION
再帰挿入ソートや探索を反復型に変更するよう指示された場合、自身への呼び出しをループに置き換え、再帰が進行していたインデックスに対してループを実行し、ベースケースをループの終了条件とします。
リスク
- 無限再帰:ベースケースを忘れると発生し、スタックオーバーフローによるクラッシュを引き起こします。
- 深層再帰ではメモリ使用量が多くなります。
- 作業を重複して行うと遅くなります(素朴なフィボナッチ数列は指数関数的です)。ループやメモ化を使用してください。
探索
再帰は葉から上へ展开される
Step through fib(4) in the order the calls actually finish: the leaves (base cases) resolve first, then each parent combines its children. Notice fib(2) is computed twice — that repeated work is why naive recursion is slow.
語彙
練習する
| English | 日本語 |
|---|---|
| recursion/rɪˈkɜːʃn/ | 再帰 |
| call stack/kɔːl stæk/ | 呼び出しスタック |
| base case/beɪs keɪs/ | 基底ケース |
| recursive case/rɪˈkɜːsɪv keɪs/ | 再帰ケース |
| factorial/fækˈtɔːrɪəl/ | 階乗 |
| divide-and-conquer/dɪˈvaɪd ænd ˈkɒŋkə/ | 分治法 |
| general case/ˈdʒenərəl keɪs/ | 一般ケース |
| parameters/pəˈræmɪtəz/ | パラメータ |
| stack overflow/stæk ˌəʊvəˈfləʊ/ | スタックオーバーフロー |
| memoisation/ˌmeməʊaɪˈzeɪʃn/ | メモ化 |
| local variables/ˈləʊkl ˈveərɪəblz/ | ローカル変数 |
| stack frame/stæk freɪm/ | スタックフレーム |
| return address/rɪˈtɜːn əˈdres/ | 戻り地址 |
19.2
コンパイラが再帰コードに対して行う処理
再帰には、各呼び出しが自身のパラメータとローカル変数のコピーを持つ必要があります。コンパイラはこれらをコールスタック上に保持します。各呼び出しに対し、パラメータ、ローカル変数、およびリターンアドレス(呼び出し元での再開位置)を含むスタックフレームを積みます。関数が完了すると、リターン値が渡され、フレームがポップされ、制御はリターンアドレスで再開されます。
各呼び出しが独自のフレームを持つため、再帰呼び出し同士で変数を上書きすることはありません。深層再帰ではスタックが大きくなるため、非常に深い再帰ではスタックオーバーフローが発生する可能性があります。これは通常の(非再帰的な)呼び出しでも用いられる同じ呼び出し・リターン機構であり、「再帰専用の機構」のようなものは存在しません。
「スタックが再帰の実装に適している理由を説明せよ」(3点)。各再帰呼び出しは、そのリターンアドレス、パラメータ、およびローカル変数を保存する必要があり、呼び出しは発生した順序の逆順で完了します(最後に呼ばれたものが最初に完了する)。これはスタックの**後入れ先出し(LIFO)動作と完全に一致します。新しい呼び出しごとにフレームを積む(push)ことで、各リターン時に最も最近のフレームを取り出す(pop)**ことで、呼び出し元の状態を復元し、次の実行位置を知らせます。これがコンパイラによる再帰コードの翻訳時に行う作業です:すべての呼び出しでスタックフレームの積み上げを生成し、すべてのリターンでポップを行い、結果が戻ってくるにつれてフレームが展開されます。
19.2
出題者が認める定義
定義問題は固定された用語に基づいて採点されます。これらを正確に暗記し、一つの答えのみを答えてください。
| 用語 | 定義 |
|---|---|
| 線形探索 | 最初から順に各項目を確認し、ターゲットが見つかるかリストの終端に達するまで続ける |
| 二項探索 | 並べ替えられたリストの中央の項目とターゲットを繰り返し比較し、ターゲットが含まれ得ない半分を除外していく |
| バブルソート | リストを繰り返し通り抜け、順番の異なる隣接する項目を交換し、一度も交換が行われないパスになるまで続ける |
| 挿入ソート | 各項目を順に取り出し、既にソート済みである項目の中で正しい位置に挿入していく |
| 抽象データ型 | データの集合とそれらに対する操作の定義であり、格納方法とは独立して定義される |
| スタック | 後入れ先出しの構造で、トップでのプッシュとポップを行う |
| キュー | 前入れ先出しの構造で、 rear(裏側)に追加し、front(表側)から取り出す |
| リンクedList | 始点ポインタを持ち、データと次ノードへのポインタを持つノードの列 |
| 二項木 | 各ノードがデータと、より小さい値を持つ左部分木へのポインタ、より大きい値を持つ右部分木へのポインタを持つ |
| Big O記法 | アルゴリズムに必要な時間(またはメモリ)を、入力サイズに対する成長度合いによって分類する方法 |
| 再帰 | ベースケースによって呼び出しが停止するまで、問題のより小さなバージョンで自身を呼び出すdirname |
| ベースケース | 再帰dirnameが自身を呼び出さずにリターンする条件 |
| 展開(unwinding) | 最深の呼び出しから最初の呼び出しへ、スタックフレームがポップされながら連鎖する呼び出しのリターン |
19.2
試験対策
- 探索:線形探索は順序不要でO($n$);二項探索は並べ替えられた配列が必要で、毎回半分にするためO($\log n$)。両方のアルゴリズム、境界値、フラグについて暗記すること。
- ソート:バブルソートはスワップ用フラグ、挿入ソートはキーを用いて大きな要素を右へシフトさせます。最悪ケースはO($n^{2}$)、並べ替え済みデータではO($n$)。性能は項目数と並び具合に依存します。
- ADT実装はポインタ管理です:トップポインタ;MODを用いたfront、rear、count;start、ポインタ、フリーリスト;rootと左右のポインタ。常に満杯と空のチェックを行うこと。
- Big Oはスケールに関するものです:定数、対数、線形、平方。二項探索については「データを倍増させることで比較回数が1回増える」と述べる。
- 再帰:ベースケース、一般ケース、ベースケースへの進展。問題自体を定義に基づいて解く場合に有効です。リターンが逆順であるため、スタックはリターンアドレスと変数を保持します。テーブルを使ってトレースし、最深の呼び出しから展開する。
一般的なミス
- 未整列データやリンクedListにおける二項探索の使用、または
Lower ← MiddleIndexではなくMiddleIndex + 1を設定して永遠にループを続けること。 - 各パスで配列の終端まで内側ループを回すバブルソート、または一時的な変数を使わずスワップすること。
- 満杯チェックを行わないプッシュやエンキュー、あるいは空チェックを行わないポップやディキュー。
- 巡回キューでMODを使わずにfrontポインタを移動させる、または front = rear が常に空を意味すると誤認すること。
- アレイの内容をシフトさせてリンクedListに挿入すること(実際にはポインタのみが変わる)。
- ベースケースを持たない再帰関数、あるいは再帰呼び出しで問題が小さくならないもの。
- 再帰呼び出しのトレースはしたが、戻り道での残りの処理を追加するのを忘れた。
- 「なぜスタックなのか」に「高速だから」と答えるのは不適切。理由は、返り値がLIFO(後入れ先出し)の順序で処理されるからである。
このトピックのインタラクティブ授業
一歩ずつ進め、即時チェック付きの問題で学習します。