| 受験者は以下的能力を備えているべきである: | メモおよびガイドライン |
|---|---|
| グラフが**人工知能(AI)**の支援にどのように使用されるかを理解する | グラフの目的と構造 A*アルゴリズムおよびダイクストラのアルゴリズムを用いてグラフ上の探索を行う 候補者は、グラフの構築、アクセス、または探索に対するアルゴリズムを記述する必要はない |
| 人工ニューラルネットワークが機械学習に寄与した点を理解する | |
| ディープラーニング、機械学習、および強化学習の理解と、これらの手法を用いる理由を示す。 | 機械学習のカテゴリを理解する(教師付き学習、教師なし学習を含む)。 |
| 機械学習における逆伝播法および回帰手法の理解を示す。 |
人工知能(AI)
A-Level Computer Science · トピック 18
 13:12
AIとは何か
猫と犬を区別するためのルールを誰かが書いたことはない。「耳が尖っていてひげがあるなら」という条件式をプログラムが yazilledこともない。それにもかかわらずあなたのスマホはそれを…
英語ナレーション・英語+中文字幕 burning-in
18.1
AIとは何か

シラバス
出典: Cambridge International シラバス
人工知能(AI) は、人間の知的能力を要する通常のタスクを行うシステムを構築する——音声や画像の認識、翻訳、ゲームプレイ、運転、テキスト生成など。現代のほとんどのAIは機械学習を使用しており、これは段階的にプログラムされるのではなく、データからパターンを学ぶアルゴリズムである。その中で、多層のニューラルネットワークを用いるディープラーニングは、2010年代以来支配的となった。
人間型ロボットはこれらの能力の多くを1つの本体に組み込む:顔の認識、音声の理解、そして生々しい動きで顔や腕を動かすためにAIを使用する。

探索
AI学習タイプラボ
AIの例を、関連する学習の種類や関心事に基づいて分類してください。
語彙
練習する
| English | 日本語 |
|---|---|
| artificial intelligence/ˌɑːtɪˈfɪʃl ɪnˈtelɪdʒəns/ | 人工知能 |
| machine learning/məˈʃiːn ˈlɜːnɪŋ/ | 機械学習 |
| deep learning/diːp ˈlɜːnɪŋ/ | ディープラーニング |
| neural networks/ˈnjuːrəl ˈnetwɜːks/ | ニューラルネットワーク |
| humanoid robot/ˈhjuːmənɔɪd ˈrəʊbɒt/ | ヒューマノイドロボット |
18.1
AIにおけるグラフ

多くのAI問題はグラフ上に位置する——ノード(状態、場所)がエッジ(移動、関係)によって結ばれている。
- パスファインディング:道路はグラフを形成し、最短ルートはグラフ探索(ダイクストラ法、A*アルゴリズム)による。
- ゲームプレイ:各盤面の配置はノード、各手はエッジ;アルファ-ベータ剪定付きミニ-max法でゲーム木を探索する。
- 状態空間探索: 計画問題は、=Noneの演算子を適用して状態間を移動し、目標に到達することである。
- 知識表現: 意味網はノードとして概念、エッジとして関係(例:「犬 IS-A 動物」)を持つ;知識グラフは検索エンジンやアシスタントのために世界に関する事実を格納する。
グラフを探索するための標準的なツールには、幅優先探索と深さ優先探索がある。
「AIシステムにおけるグラフの目的と構造を説明せよ。」 目的: 問題を問題とする一連の状態(または場所)およびそれらの間の可能な移動として表現することで、アルゴリズムが解(例:最短かつ最安なルート、あるいは最適な次の手)を検索できるようにする。構造: 各ノードが状態、場所、またはアイテムを表すノード(頂点)の集合で、それらをつなぐエッジによって構成される;各エッジには重み(コスト、距離、時間)が付与されることがあり、エッジは有向(片道)であるか無向であるか可以是的である。「AIを支援するためにグラフを用いる理由を説明せよ」: グラフはAIの探索アルゴリズムが動作するモデルである:A*アルゴリズムとディ(resolve)ストラアルゴリズムは最適経路を特定する(ナビゲーション、ルータリング)、ゲームの局面は最佳の手を探すための木として探索され、グラフとして格納された知識によりシステムは事実間の関連性について推論できる。
 以下に示すグラフ:エッジの数字は実際の距離であり、赤い数字は各ノードから目標までの残りの距離に対するヒューリスティック推定値であり、これはAのみが使用する*
ディ(resolve)ストラアルゴリズム。 始点からすべてのノードへの最短距離を求める。各ノードまでのこれまでに発見された最良の距離を記録するテーブルを維持する(始点は0、他はすべて∞)。未訪問のノードの中で最小の距離を持つものを選び、それを訪問済みとし、各隣接ノードに対して、このノード経由での移動がより短い距離になるかどうかを確認する;もしそうであれば更新し、その元となるノードを記録する。すべてのノードが訪問される(または目標に到達する)まで繰り返す。
演習例。 上のグラフにおいて、Hから他のすべてのノードへの最短距離を求める。
| ステップ | 訪問 | H | A | B | C | D | G |
|---|---|---|---|---|---|---|---|
| 開始 | 0 | ∞ | ∞ | ∞ | ∞ | ∞ | |
| 1 | H (0) | 0 | 4 (H) | 3 (H) | ∞ | ∞ | ∞ |
| 2 | B (3) | 0 | 4 (H) | 3 | ∞ | 9 (B) | ∞ |
| 3 | A (4) | 0 | 4 | 3 | 9 (A) | 8 (A) | ∞ |
| 4 | D (8) | 0 | 4 | 3 | 9 (A) | 8 | 10 (D) |
| 5 | C (9) | 0 | 4 | 3 | 9 | 8 | 10 (D) |
| 6 | G (10) |
最短距離:A 4, B 3, D 8, C 9, G 10、そしてGへの経路はH–A–D–G(「どこから来たか」のラベルを逆順に読む)。ステップ3において、AはDに対して距離 $4 + 4 = 8$ を提供し、B経由で見つかった9よりも短いため、Dは更新される;ステップ5において、CはGに$9 + 3 = 12$ で到達できるが、10より長いため何も変化しない。これらの比較を示すことが、問題が求めている「計算過程」である。
A*アルゴリズム。 ディ(resolve)ストラはあらゆる方向に探索を行う。Aはヒューリスティック $h$ を追加する(まだ進むべき距離の推定値)、そして常に最小の $f = g + h$ を持つノードを展開する。ここで $g$ はこれまでに進んだ距離である。適切なヒューリスティック(過大評価 never over-estimating を行わない)を用いれば、はるかに少ないノードを確認しながら同じ最短経路を見つけることができる。これがナビゲーションシステムやゲームでAが用いられる理由である。試験では各ノードに対して $h$ が与えられ、埋めるべき表がある。
演習例。 A*を用いてHからGへの経路を求め、計算過程を示せ。
| 展開されたノード | $g$ これまで | $h$ | $f = g + h$ | 追加された隣接ノード (ノード: $g$, $h$, $f$) |
|---|---|---|---|---|
| H | 0 | 7 | 7 | A: 4, 5, 9; B: 3, 6, 9 |
| B (Aとの同率;どちらでも可) | 3 | 6 | 9 | D via B: 9, 2, 11 |
| A | 4 | 5 | 9 | C: 9, 3, 12; D via A: 8, 2, 10 (11より良いので保持) |
| D | 8 | 2 | 10 | G: 10, 0, 10; C via D: 9 (改善なし) |
| G | 10 | 0 | 10 | 目標達成 |
パス H–A–D–G、長さ 10、Dijkstra法と同じですが、Cは展開されませんでした。ノードが2経路で到達されたら、より小さい$g$を保持します;探索はゴールノードが最も小さな$f$となるまで終了します。各行の$g$、$h$、$f$の値を記述してください:これが採点ポイントです。
語彙
練習する
| English | 日本語 |
|---|---|
| graph/ɡræf/ | グラフ |
| nodes/nəʊdz/ | ノード |
| edges/ˈedʒɪz/ | エッジ |
| minimax/ˈmɪnɪmæks/ | 極小化最大 |
| semantic network/səˈmæntɪk ˈnetwɜːk/ | 意味ネットワーク |
| knowledge graph/ˈnɒlɪdʒ ɡræf/ | 知識グラフ |
| breadth-first search/bredθ fɜːst sɜːtʃ/ | 幅優先探索 |
| depth-first search/depθ fɜːst sɜːtʃ/ | 深さ優先探索 |
| weight/weɪt/ | 重み付け |
| heuristic/hjuːˈrɪstɪk/ | ヒューリスティック |
| labels/ˈleɪblz/ | ラベル |
18.1
人工ニューラルネットワーク (ANNs)

ANNは脳のニューロンに着想を得ている。人工ニューロン:
- 複数の入力値を受け取り、それぞれに重みを掛けて足し合わせ、バイアス項を加える。
- 和に対して活性化関数(ReLUなどの非線形関数)を適用する。
- 結果を出力し、これをさらに後のニューロンに渡す。
ニューロンは層を形成している:入力層、有用な内部パターンを学習する隠れ層(1つ以上)、そして出力層。隠れ層が多数ある場合、それはディープニューラルネットワークと呼ばれ、それを学習させることはディープラーニングである。

ANNにより、モデルは手作業による特徴設計なしに生データ(ピクセル、音声、テキスト)から複雑なパターンを直接学習できる。画像認識、音声認識、機械翻訳、ゲームプレイ分野での画期的な進歩を可能にした。大量のデータ、ノイズを含む入力、非常に複雑な入力、あるいは明示的なルールでは捉えきれないパターンに対して優秀に機能する。
「人工ニューラルネットワークの概念を説明せよ。」 脳のニューロンネットワークのモデルであり、入力層、1つ以上の隠れ層、出力層からなる接続されたノードのレイヤーで構成される。各接続には重みがあり、各ノードは加重入力を合計し、結果をアクティベーション関数を通じて次の層に渡す。「ANNが機械学習を可能にする仕組みを説明せよ」(3点):ネットワークは多くの例によって学習(トレーニング)され、各例に対して出力と期待値を比較し、誤差を用いて重みを調整(逆伝播法)することで誤差を小さくする。十分な数の例を経た後、重みはデータ内のパターンを表現し、それ以来見たことがない新しいデータに対して分類や予測を行うことができる。「複数の隠れ層を持つ理由を述べよ」:追加される各レイヤーは、前段階のレイヤーで見つけた特徴をより複雑で抽象的な特徴に組み合わせるため、ネットワークはより複雑な関係性(エッジ→形状→物体)を学ぶことができる。このように深さが深くなることでディープネットとなる。
探索
ニューラルネットワークの各部分にタップしてください。
層を探検しましょう。データは左から右へ流れます:入力層が特徴量を受け取り、隠れ層がパターンを学習し、出力層が答えを提示します。すべての接続には重みが付与されており、学習によってその重みが調整されます。
語彙
練習する
| English | 日本語 |
|---|---|
| artificial neuron/ˌɑːtɪˈfɪʃl ˈnjuːrɒn/ | 人工ニューロン |
| bias term/ˈbaɪəs tɜːm/ | バイアス項 |
| activation function/ˌæktɪˈveɪʃn ˈfʌŋkʃn/ | アクティベーション関数 |
| hidden layers/ˈhɪdn ˈleɪəz/ | 隠れ層 |
| deep neural network/diːp ˈnjuːrəl ˈnetwɜːk/ | ディープニューラルネットワーク |
| image recognition/ˈɪmɪdʒ ˌrekəɡˈnɪʃn/ | 画像認識 |
| speech recognition/spiːtʃ ˌrekəɡˈnɪʃn/ | 音声認識 |
| machine translation/məˈʃiːn trænˈsleɪʃn/ | 機械翻訳 |
| reinforcement learning/ˌriːɪnˈfɔːsmənt ˈlɜːnɪŋ/ | 強化学習 |
| supervised learning/ˈsuːpəvaɪzd ˈlɜːnɪŋ/ | 教師あり学習 |
| classification/ˌklæsɪfɪˈkeɪʃn/ | 分類 |
18.1
機械学習、ディープラーニング、強化学習
機械学習
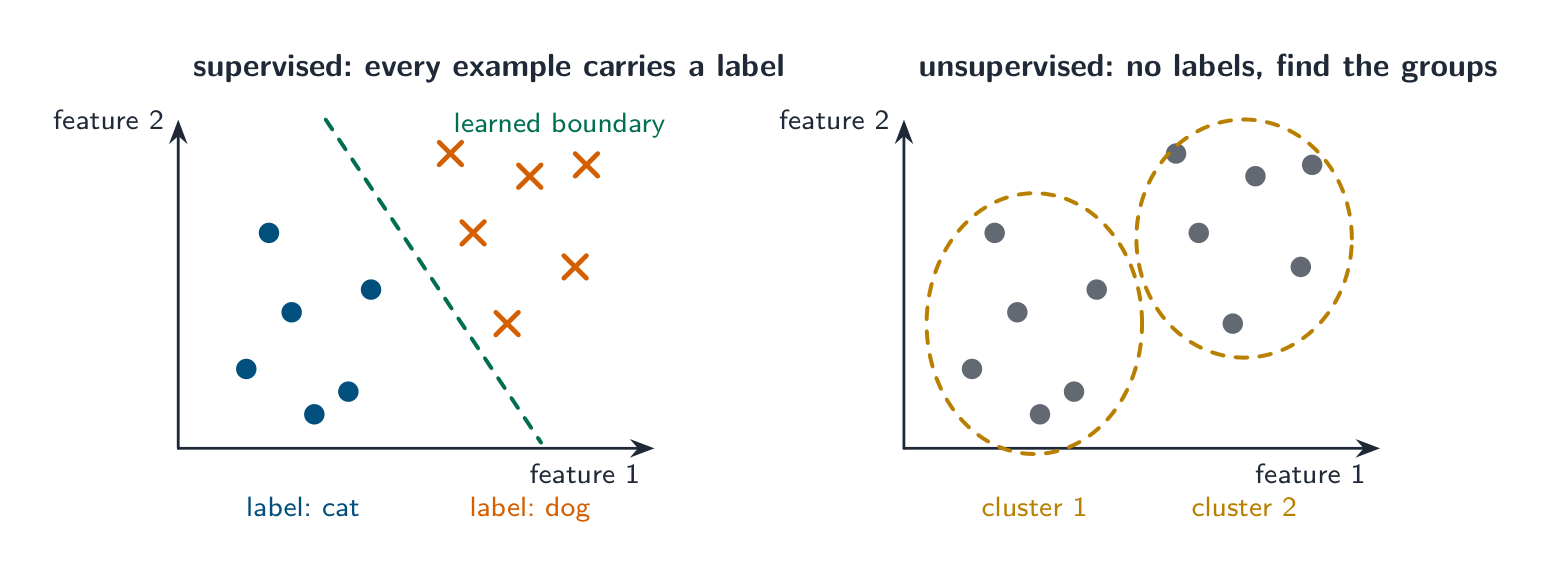
データから学習するあらゆるアルゴリズムを含む総称。3つのパラダイムがある:
- 教師あり学習 — データにラベル(「猫」/「犬」とタグ付けされた画像など)がある;アルゴリズムは入力 → ラベルを学ぶ。分類(カテゴリ化)や回帰に使用される。
- 教師なし学習 — ラベルがなく、アルゴリズムが構造を見つける、例えば類似した顧客のクラスターなど。
- 強化学習(以下参照)。
明示的なルールが実用的でない場合にMLを使用する(スパムフィルター、レコメンドシステム、不正検出など)。
「教師あり学習と教師なし学習を説明せよ」(指定された語句を使用すること)。 教師あり学習:ラベル付きの訓練データを使ってアルゴリズムを学習させ、各例に正解出力(ターゲット)をペアにして与える。これにより入力と出力の関係を学び、新しい入力に対して分類や予測に用いる。学習中に答えが既知であるため、誤差を測定できる。教師なし学習:データはラベル付けされていないため正解が与えられず、アルゴリズムは自発的にデータ内のパターン、構造、あるいはグループ分けを探す(類似項目のクラスタリング、関連性の発見など)。出力は事前に定義されていないカテゴリーや関係性のセットとなる。違い:ラベルあり vs ラベルなしデータ、既知の出力 vs 発見された構造、教師ありは予測(分類、回帰)に使用され、教師なしは探索(クラスタリング、異常検出)に使用される。両者は機械学習のカテゴリであり、第三の手法として強化学習がある。

ディープラーニング
ディープニューラルネットワークを用いる機械学習のサブセット。下位レイヤーは単純なパターン(エッジ、音素)を学び、上位レイヤーはそれらを組み合わせて抽象的な概念を作る。大量のデータと強力な計算リソース(GPU)が必要であり、小規模なデータセットにおいては、より単純なML手法の方が優れることが多い。
「ディープラーニングの概念を説明せよ」(3点)。 多数の隠れ層(ディープネット)を持つ人工ニューラルネットワークを用いる機械学習です。ネットワークは膨大な量のデータで学習され、各レイヤーが下位レイヤーの出力から特徴を抽出するため、ネットワーク自身が必要な特徴を学び取ります(プログラマによる事前指定は不要)。使用される理由:手書きのルールや浅いモデルでは解決困難なほど複雑な問題(顔認識、音声理解、翻訳など)を解決できること、データが増えるにつれて性能が向上すること、人間による特徴量設計の必要がなくなること、画像・音声・テキストなどの構造化されていないデータを扱えること。効率化の方法:より多く(かつ高品質なラベル付き)の訓練データ、過学習の限界内でのより多くのレイヤーやノード、より高い処理能力(GPU)と学習時間、学習率や他のパラメータのチューニングなど。例:ボイスアシスタントの音声認識、医療画像診断および自動運転車の画像認識、機械翻訳、レコメンドシステムなど。
強化学習
強化学習において、エージェントが環境内で行動します。各行動は状態を変化させ、報酬を返します。エージェントは初期にラベルがないまま試行錯誤によって、時間全体で総報酬を最大化する**政策(戦略)**を学びます。ゲーム、ロボット制御、自動運転などの順次意思決定問題に使用されます。
「強化学習の意義を説明せよ」(3点)。 エージェントは環境との相互作用を通じて学習する:行動を取り、環境が新しい状態に遷移し、報酬(または罰)を返す。エージェントはその行動を調整して、時間を通じて総報酬を最大化する。ラベル付きデータは存在しないため、エージェントは試行錯誤によって学習し、得た報酬からどの行動が良いかを発見し、各状態での適切な行動を示すポリシーを段階的に形成する。事前には正解が不明だが、行動の結果を採点できる場面で用いられる:ゲーム(チェス、Go)、ロボット制御、信号機タイミング、リソース配分など。ユーザーに対して盤ゲームを行うコンピュータはこの方法で学習するか、最小最大法を用いてゲーム木を検索し、最悪の場合でも最も良い結果をもたらす手を選ぶ。

自動運転車は現実的な例である。LiDARやカメラセンサー(屋根上の回転ユニット)が道路のリアルタイム画像を構築し、学習済みポリシーが安全な操縦、加速、ブレーキを決定する。


語彙
練習する
| English | 日本語 |
|---|---|
| self-driving car/self ˈdraɪvɪŋ kɑː/ | 自動運転車 |
| agent/ˈeɪdʒənt/ | エージェント |
| reward/rɪˈwɔːd/ | 報酬 |
| policy/ˈpɒlɪsi/ | ポリシー |
| lidar/ˈlaɪdɑː/ | LiDAR |
| backpropagation/ˌbækprəpəˈɡeɪʃn/ | 逆伝播 |
18.1
人工ニューラルネットワークの学習:逆伝播法
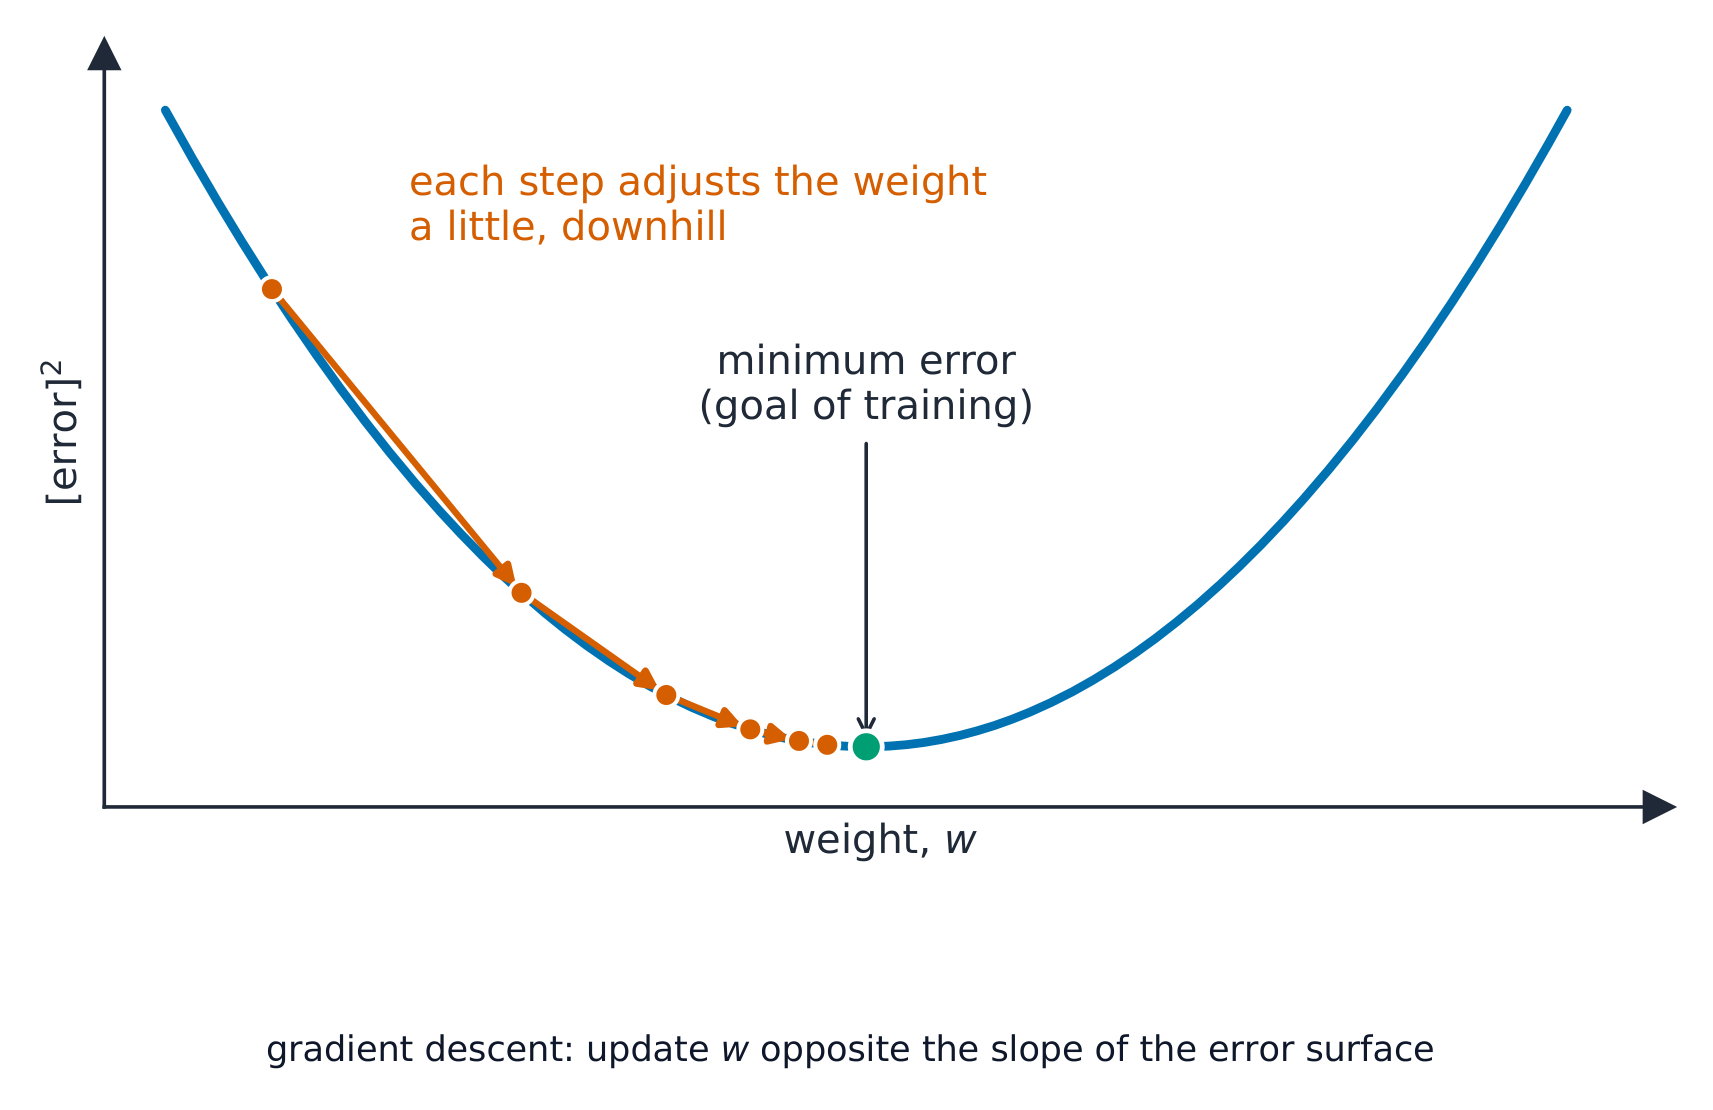
学習は出力がターゲットに一致するように重みを調整する。標準手法は逆伝播法(誤りの逆伝播)および勾配降下法を用いるものとする。各学習例について:
- 順伝播 — 入力から出力までデータを渡す。
- 損失関数を用いて誤差を計算する(出力がいかに間違っているかを示す単一の値)。
- 逆伝播 — 連鎖律を用いて各重みが誤差に寄与した度合い(勾配)を見出すため、誤差を後方へ伝播させる。
- 学習率によって設定される小さなステップで重みを更新し、誤差を減少させる。
誤差が縮小しなくなるまで、多くの例および多くのパス(エポック)に対して繰り返す。「Back」という名前はステップ3に由来する:誤差は出力から入力へと戻って流れるため、一巡で全ての重みの勾配が求められる。学習後、新しい入力を予測するには順伝播のみ1回必要となる。
「誤りの逆伝播法を説明せよ」(4点)。 (1) 入力をネットワークを順方向に渡して出力を出し、期待値(ターゲット)出力と比較する;(2) その差分が誤差である;(3) 誤差は出力から入力へ向かって層ごとにネットワークを逆方向に渡され、各重みが誤差に占める割合が計算される;(4) 重みは誤差を減少させる方向に、その寄与に比例して調整される;(5) 誤差が所望の大きさになるまで多くの例を用いてこのプロセスを繰り返す。この手法の要点は、隠れ層を持つネットワークには出力誤差を引き起こす内部の重みを直接特定する方法がないため、逆伝播によって責任を分配することにある。
語彙
練習する
| English | 日本語 |
|---|---|
| gradient descent/ˈɡreɪdɪənt dɪˈsent/ | 勾配降下法 |
| loss function/lɒs ˈfʌŋkʃn/ | 損失関数 |
| epochs/ˈiːpɒks/ | エポック |
18.1
回帰分析

あるタスクでは数値(家賃価格、明日の気温など)を予測する — これは回帰分析であり、分類(カテゴリー)とは対照的である。
線形回帰は直線(または超平面)をフィットさせる:
$$y = m_{1} x_{1} + m_{2} x_{2} + \ldots + m_{n} x_{n} + c.$$
学習データに対する二乗誤差の和を最小化する係数を選択する。関係性が概ね線形で解釈可能なモデルが欲しい場合に使用される。曲線的なデータについては、多項式、決定木、またはニューラルネットワークの回帰手法を使用する — 同じ考え:モデルを定義し、損失を定義し、それを最小化するためにパラメータを調整する。回帰分析と分類はどちらも教師あり学習であり、答えが数値かカテゴリーかによって選択が変わる。
「機械学習における回帰手法を説明せよ」(2点)。 学習データに対して全誤差が最小となるように関数(直線または曲線)をフィットさせ、入力変数と連続的な出力の間の関係性を見つける統計的手法;拟合された関数はその後、新しい入力の出力を予測するために使用される。線形回帰は直線をフィットさせ、他の手法は曲線をフィットさせる。回帰分析は値(価格、気温、時間など)を予測し、分類はカテゴリーを予測する点が、試験で問われる区別である。
探索
回帰線のフィット
コントロールを動かせ。線形回帰は、データ点への二乗距離を最小にする直線を描き、新しい入力に対して数を予測する。
語彙
練習する
| English | 日本語 |
|---|---|
| regression/rɪˈɡreʃn/ | 回帰 |
| unsupervised learning/ʌnˈsuːpəvaɪzd ˈlɜːnɪŋ/ | 教師なし学習 |
| cluster/ˈklʌstə/ | クラスタリング |
| training data/ˈtreɪnɪŋ ˈdeɪtə/ | 訓練データ |
| learning rate/ˈlɜːnɪŋ reɪt/ | 学習率 |
| linear regression/ˈlɪnɪə rɪˈɡreʃn/ | 線形回帰 |
| optical character recognition/ˈɒptɪkl ˈkærɪktə ˌrekəɡˈnɪʃn/ | 光学文字認識 |
| text-to-speech/tekst tə spiːtʃ/ | テキスト・トゥ・スピーチ |
18.1
実際のシナリオにおけるAIの利用
多くの試験シナリオは同じパターンを用いる — ラベル付きデータで学習されたディープラーニングモデルが用いられ、これらが統合されてパイプラインとなることが多い:
- 自動店舗での顧客識別:システムはラベル付き顔画像で学習されており、カメラが顔をキャッチし、画像認識が表現を抽出し、登録済みの顧客と照合され、最も近い一致が人物を同定する。
- 画像からのテキスト読み取り: 画像認識がテキスト領域を特定し、光学的文字認識(OCR) が文字を抽出し、機械翻訳が変換し、音声合成(TTS) が読み上げます。
- チェックアウト時の商品検出: ラベル付き製品画像で学習した物体検出AIが、カゴに入れるべき商品を識別し、アカウントに請求します。
ユーザーがシステムと相互作用する時点では、モデルは高速です——前向き推論のみを行います。知性は、学習中に獲得されたパターンにあります。
シナリオ問題のモデル回答。 駐車場カメラによるナンバープレート読み取り: カメラが画像を撮影し、多数のラベル付き画像で学習したAIが画像内のプレートを特定し、文字認識(ラベル付き文字で学習した深層学習分類器)がプレートをテキストに変換し、テキストは時刻とともに保存され、車が退出時に照合されます。CCTVシステムによる人物の検出と追跡: 人物のラベル付き画像で学習した画像認識ソフトウェアが各フレームから人物を識別し、システムは連続するフレームを比較して動きを追跡し、不自然な動きはアラームを発動させます。音声によるコマンド変換: 多数の録音声で学習した音声認識が音声をテキストに変換し、システムはテキストを既知のコマンドセットと比較し、修正されることで改善します。顔にフォーカスするカメラ: ラベル付き顔で学習した顔検出モデルが顔領域を見つけ、レンズが調整されてその領域に焦点を合わせます。銀行の顔認証ログイン: アプリが顔をキャッチし、深層ネットワークが特徴量を抽出し、その顧客の保存された特徴量と比較します。あらゆるケースで共通のパターンは以下の通りです:ラベル付き例で学習し、特徴量を抽出し、新しい入力を照合または分類する。
** worked example(解答例)。** 各タスクについて、回帰か分類が必要かを答え、ANNの出力層がどのような形になるかを答える:(a) 明日の気温を予測する;(b) メールがスパムかどうかを判定する。何種類のものが予測されているかを問う。(a) 気温は連続スケール上の数値であるため、これは回帰であり、出力層はその値を持つ単一のニューロンとなります。(b) スパムか非スパムかはカテゴリであるため、これは分類であり、出力は各カテゴリごとの確率を示します。どちらも教師あり学習です——それぞれに学習用のラベル付き例が必要であり、学習は逆伝播によって重みを調整し誤差を減少させます。決定的な質問は simply number-or-category(数値かカテゴリか)であり、タスクの難易感ではありません。
18.1
出題者が認める定義
定義問題は固定された用語に基づいて採点されます。これらを正確に暗記し、一つの答えのみを答えてください。
| 用語 | 定義 |
|---|---|
| グラフ(AIにおける) | 状態や場所を表すノードの集合で、接続を表すエッジによって結合されており、通常は重みが付けられており、探索アルゴリズムが探索できる構造 |
| ディクストラのアルゴリズム | 開始ノードから他のすべてのノードまでの最短距離を、未訪問ノードの中で現在までの距離が最小のものへ常に移動することで見つける |
| A* アルゴリズム | 現在までの距離とゴールへのヒューリスティック推測値の合計が最小となるノードを展開する、最短経路探索法 |
| 人工ニューラルネットワーク | 脳のニューロンのモデル:重み付けされた接続で結合されたノードのレイヤーで構成され、重みの調整によって学習する |
| 機械学習 | 固定ルールに従うのではなく、データから学習し、経験を通じて改善するアルゴリズム |
| 教師あり学習 | 各入力に対する正解出力が既知である、ラベル付き学習データから学習すること |
| 教師なし学習 | ラベルのないデータから、パターン、グループ化、または構造を見つけることによって学習すること |
| 強化学習 | エージェントが試行錯誤により学習し、環境内で行動を選択して受け取る報酬を最大化すること |
| 深層学習 | 多数の隠れ層を持つニューラルネットワークを用いた機械学習で、大量のデータで学習され、各層が下位層から特徴量を抽出する |
| 逆伝播 | ネットワークの出力とターゲットを比較し、誤差をレイヤーを遡って伝達し、各重みを調整して誤差を減少させる |
| 回帰 | 関数を学習データにフィットさせて、入力から連続的な出力値を予測すること |
18.1
試験対策
- グラフの問題はノード名、エッジ、重みが何を表しているかを答え、次にアルゴリズムを説明する。ディクストラ:距離のテーブル、最小のものを訪れ、隣接ノードを更新する。A*:$g$, $h$, $f = g + h$ を各行に、最も小さい $f$ を展開する。
- ANNの問題はレイヤー、重み付けされた接続、学習を答え、深層学習は多くの隠れ層、大量のデータ、自動特徴抽出を加え、理由と例を添える。
- 3つのカテゴリをそれぞれ1行で答える:ラベル付きデータと既知の出力;ラベルなしデータと発見された構造;エージェント、環境、行動、報酬。
- 逆伝播:ターゲットと比較し、誤差をレイヤーを遡って伝え、重みを調整して減少させ、繰り返す。回帰は値を予測し、分類はカテゴリを予測する。
- シナリオ問題はパイプラインを答える:ラベル付き例で学習し、特徴量を抽出し、新しい入力を認識または分類する;AIの種類(画像認識、音声認識、深層学習)を述べる。
一般的なミス
- グラフを「チャート」と説明する;AIにおいてはノードとエッジである。
- 全体的に未訪問の最小距離ではなく、現在のノードの最寄りの隣接ノードを選んでディクストラを実行する;または、より短いルートが見つかった際にノードを更新するのを忘れる。
- A* の次のステップで $h$ を $g$ に加算する;$g$ は実際の距離のみであり、$h$ はテーブルから再計算される。
- 深層学習を「たくさん学ぶ」と言う;それは多くの隠れ層のことである。
- 教師なし学習と強化学習を混同する;前者はデータに構造を見出すものであり、後者は報酬から学習するものである。
- 期待される出力との比較をせず、または重みが調整されることを述べることもなく、逆伝播を説明する。
- 価格の予測を「分類」と呼ぶこと;連続値は回帰である。
このトピックのインタラクティブ授業
一歩ずつ進め、即時チェック付きの問題で学習します。