| 受験者は以下的能力を備えているべきである: | メモおよびガイドライン |
|---|---|
| OSがリソースの使用を最大化する方法を理解する | |
| ユーザーインターフェースがハードウェアの複雑さをユーザーから隠蔽する方法を説明する | |
| プロセス管理の理解 | マルチタスクとプロセスの概念 プロセスの状態:実行中, 就绪, ブロック待機 スケジューリングの必要性および異なるスケジューリングルーチンの機能と利点(ラウンドロビン, 最短ジョブファースト, 先来者サービス, 最短残り時間) OSのカーネルが割り込みハンドラとして機能し、割り込み処理が低レベルスケジューリングを管理するためにどのように使用されるか |
| メモリ管理のための仮想メモリ, ページング, セグメンテーションの理解 | ページング, 仮想メモリ, セグメンテーションの概念 ページングとセグメンテーションの違い ページが置換される方法 ディスクスワッピングが発生する理由 |
システムソフトウェア
A-Levelコンピュータ科学 · トピック 16
 14:07
リソース、コンパイラ & RPN
ブラウザ、音楽プレイヤー、ゲームを開きます。プロセッサは1つ(コアが数個あるかもしれません)ですが、すべてが同時に動いているように見えます。そしてこれらはすべて…もっと必要なことを求めています。
英語ナレーション・英語+中文字幕 burning-in
16.1
OSがリソース使用を最大化する方法

シラバス
出典: Cambridge International シラバス
コンピュータには多数のリソース(CPU時間、メモリ、ディスク、I/O)があり、多数のプログラムがこれらを競合します。OSはこれらを公平かつ効率的に共有し、各リソースが適切に使用され、システムが応答性を維持するようにします:
- マルチタスク — プロセス間で素早くCPUを切り替えて、複数のプロセスが同時に動作しているように見せる。
- メモリ管理 — 各プロセスに必要なメモリを割り当てます。RAMが不足したらディスクページングを使用。
- スプーリングとバッファリング — プリントジョブをディスク上にキューueueして、CPUがプリンタを待つことがないようにする。
- キャッシュ — 最近使用したディスクデータをキャッシュ/RAM内に保持。


16.1
ユーザーインターフェース
ユーザーインターフェースは、親しみやすい抽象化によってハードウェアを背後に隠しています:ユーザーはアドレスやセクターではなく、ウィンドウ、メニュー、フォルダを見ます。アイコンをクリックするだけで、OSがディスク上のプログラムを検索し、メモリを割り当て、読み込んで起動します。CLI(コマンドライン)はエキスパート向けに強力かつスクリプト可能ですが、GUI(グラフィカル)は学習が容易です。ほとんどのシステムは両方を提供しています。
「ハードウェアの複雑さがユーザーからどのように隠されているか、2つの方法を説明せよ。」 (1) ユーザーは名前でファイルとフォルダを操作し、OSはそれらをディスクのトラック、セクター、ブロックに変換します;(2) ユーザーはクリックまたはコマンドでプログラムを実行し、OSはアドレスを何も知らずにプログラムを読み込み、メモリを割り当てスケジューリングします;(3) デバイスドライバーにより、ユーザーはプリンタやディスクの制御方法を知らずに印刷や保存が可能です;(4) グラフィカルインターフェースは、機械レベルのコマンドをアイコン、ウィンドウ、メニューで置き換えます。学生へのメリット(例):OSは技術的知識なしでもハードウェアを使用可能にし、例えばUSBドライブにドキュメントを保存する場合、アイコンをドラッグするだけで済みます。
「OSがリソースの利用を最大化する方法を示せ。」 OSはプロセスが準備できている間プロセッサがアイドルにならないようプロセッサをスケジューリングし、メモリを管理してプロセスに割り当て、回収し、仮想メモリで拡張し、入出力を管理してバッファやスプーリングを使用して高速・低速デバイスの作業を重複させ、ストレージを管理して空きスペースやファイルを追跡します。各ポイントがリソースとそのOSによる処理を指定しています。
16.1
プロセス管理
プロセスとは実行中のプログラムであり、そのコード、現在の状態、メモリ、開いているファイルを含みます。
スケジューリング
スケジューラは次のに実行される準備済みのプロセスと、その実行時間を決定します:
- ラウンドロビン — 各プロセスは固定されたタイムスライスを与えられ、その後キューの末尾に戻ります。
- フォローシーフイーストサービス;ショートジョブファースト;ショートレストアリングタイム(残りの作業量が少ないジョブを実行);優先度;マルチレベルフィードバックキュー。
トレードオフは、応答性 vs Routes throughput vs 公平性です。
「マルチタスクリングの意味と、それがプロセス管理にもたらす利益について説明せよ。」 複数のプロセスが同時にメモリに保持され、プロセッサが極めて速く切り替わるため、同時に動作しているように見える。それぞれ順番にプロセッサ時間のシェアを与えられます。メリット:あるプロセスが入出力を待っている間にプロセッサがアイドルになることはなく、そのため** Routes throughputは高まり、ユーザーは一度に複数のプログラムを操作できます。「スケジューリングの必要性について説明せよ。」** プロセス数がプロセッサ数より多いため、どのプロセスを次に実行するか、そしてどれだけ実行するかという判断が必要です。スケジューリングはすべてのプロセスが進行することを保証し、プロセッサが完全に利用されることを確保し、応答時間が許容範囲内であることを保証し、優先順位を尊重できるようにします。
試験で求められているスケジューリングルーチンの記述。
| ルーチン | 機能 | メリット | デメリット |
|---|---|---|---|
| フォローシーフイーストサービス (FCFS) | プロセスは準備済みキューに入ってきた順に実行され、完了まで続ける | 単純;すべてのプロセスが順に処理され、スターベーションしない | 長いプロセスが其后の短いプロセスをすべて遅延させます;応答性が悪い |
| ショートジョブファースト (SJF) | 推定実行時間が最も短い準備済みプロセスが次に実行され、完了まで続ける | 平均待ち時間を最小化;多くの短いジョブが素早く終了 | 実行時間は事前に必要;長いジョブが全く実行されない可能性がある(スターベーション) |
| ショートレストアリングタイム (SRT) | SJFのプレエンプティブ版:新しいプロセスが到着し、残りの時間が現在実行中のプロセスより少ない場合、それを引き継ぐ | 短いプロセスがさらに高速にサービスされます;良い Routes throughput | コンテキストスイッチが増加;長いプロセスは頻繁に中断され、スターベーションする可能性あり |
| ラウンドロビン (RR) | 各準備済みプロセスは順に固定されたタイムスライスを与えられ、満了するとキューの末尾に戻る | 公平;すべてのプロセスが限られた時間内に応答するため、インタラクティブ用途に適する | コンテキストスイッチのオーバーヘッド;非常に短いスライスは時間を無駄にし、長いスライスは他を遅延させる |
| 優先度 | 最も高い優先度を持つ準備済みプロセスが先に実行される | 重要または時間制約のある業務が先に行われる | 優先度が低いプロセスは、優先度が経時変化する(エイジング)限りスターベーションする可能性がある |
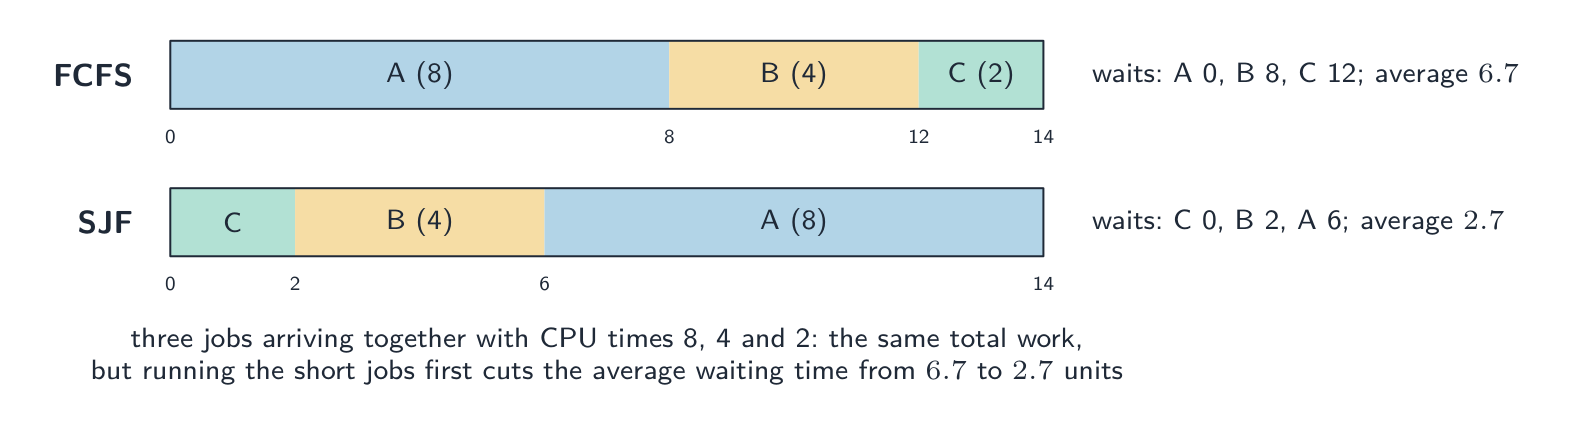
計算例。 CPU時間が8, 4, 2 msである3つのプロセスが同時に到着したとします。FCFS(到着順A, B, C)とショートジョブファーストにおける平均待ち時間を比較してください。
FCFS:Aは0待機、Bは8待機、Cは12待機;平均$(0 + 8 + 12)/3 = 6.7\ \text{ms}$。SJFはC、B、Aの順で実行:Cは0待機、Bは2待機、Aは6待機;平均$2.7\ \text{ms}$。作業量はどちらの場合でも同じ14msですが、順序によって待機時間が異なります。2msのスライスを持つラウンドロビンでは、最初の6msでA、B、Cが順番に実行され、Cは6msで完了、Bは10ms、Aは14ms:平均では最速ではないものの、最も応答性が高い。


プロセスの状態
プロセスは、新規 (new)、就绪 (ready)(CPUを待機中)、実行 (running)、ブロック (blocked)(I/Oまたはロックを待機中)、または終了 (terminated) のいずれかの状態です。タイムスライスが終了すると、実行 → 就绪 に移り、I/Oを要求すると 実行 → ブロック に移り、I/Oが完了すると ブロック → 就绪 に戻ります。

3つの状態とプロセスが移動する理由。 実行: プロセスがプロセッサを使用しています。就绪: 実行可能ですがプロセッサを待機しています。ブロック: 何か else が起きるまで実行できません。各遷移の理由(試験では1つずつ問われる): 実行から就绪: タイムスライスが終了したとき、または優先度の高いプロセスが就绪になり、これをプレエンプト(割り込み)したとき;実行からブロック: 入出力を要求したとき、リソースや他のプロセスを待っているとき;ブロックから就绪: 待機していたI/Oが完了したとき(割り込みにより通知);就绪から実行: スケジューラによって割り当てられたとき。ブロックされたプロセスが直接実行に移動することはなく、必ず就绪-stateになる必要があります。
プロセス制御ブロックおよびコンテキストスイッチ
OSは各プロセスに対してプロセス制御ブロック (PCB) を保持します。これは保存されたプログラムカウンタ、レジスタ、状態、メモリ情報を含みます。

- コンテキストスイッチは1つのプロセスを一時停止して別のプロセスを開始します。それは状態を1つのPCBに保存し、別のPCBから復元します。この小さなコストがすべてのスイッチで発生します。
- カーネル(OSのコア)は割り込みハンドラとして機能します。デバイスやタイマーが割り込みを起こすと、割り込み処理は実行中のプロセスを保存し、適切なルーチンを実行します。これが低レベルスケジューリングを駆動するものです。
「カーネルが割り込みハンドラとしてどのように機能するかを要約せよ」(2点)。割り込みが発生すると、カーネルは実行中のプロセスの状態を保存(そのレジスタとプログラムカウンタ、プロセス制御ブロック内)、割り込みの発生源と優先度を特定し、適切な割り込みサービスルーチンを実行し、その後中断されたプロセス(または優先度の高いプロセス)を復元して実行を継続させます。これがタイマーによるタイムスライスの終了と、完了したI/O操作によるプロセスの Unblock の仕組みです。
プロセス間通信
プロセスは隔離されているため、OSはプロセス間通信を提供します:パイプ(あるプログラムの出力が別のプログラムの入力に接続される)、共有メモリ(複数のプロセスが使用できる領域)、メッセージパッシングなどがあります。
探索
プロセスのライフサイクル
ループ内を巡回するプロセスの軌跡を確認してください。スケジューラによって選択された時にのみ実行され、I/Oが必要になるとブロックされ、タイムスライスが終了するとレディに戻り、完了するまで繰り返されます。
語彙
練習する
| English | 日本語 |
|---|---|
| process/ˈprəʊses/ | プロセス |
| scheduler/ˈʃedjʊlə/ | スケジューラ |
| round robin/raʊnd ˈrɒbɪn/ | ラウンドロビン |
| time slice/taɪm slaɪs/ | タイムスライス |
| pre-emptive/priː ˈemptɪv/ | 搶占方式 |
| blocked/blɒkt/ | ブロック状態 |
| process control block/ˈprəʊses kənˈtrəʊl blɒk/ | プロセス制御ブロック |
| context switch/ˈkɒntekst swɪtʃ/ | コンテキストスイッチ |
| kernel/ˈkɜːnl/ | カーネル |
| interrupt handler/ˈɪntərʌpt ˈhændlə/ | 割り込み処理程序 |
| interrupt handling/ˈɪntərʌpt ˈhændlɪŋ/ | 割り込み処理 |
| inter-process communication/ˈɪntə ˈprəʊses kəˌmjuːnɪˈkeɪʃn/ | プロセス間通信 |
| pipes/paɪps/ | パイプ |
| shared memory/ʃeəd ˈmeməri/ | 共有メモリ |
| virtual address space/ˈvɜːtʃuːəl əˈdres speɪs/ | 仮想アドレス空間 |
| pages/ˈpeɪdʒɪz/ | ページ |
| frames/freɪmz/ | フレーム |
| page fault/peɪdʒ fɒlt/ | ページフォルト |
| swap file/swɒp faɪl/ | スワップファイル |
| thrashing/ˈθræʃɪŋ/ | スラッシング |
16.1
仮想メモリ、ページング、セグメンテーション
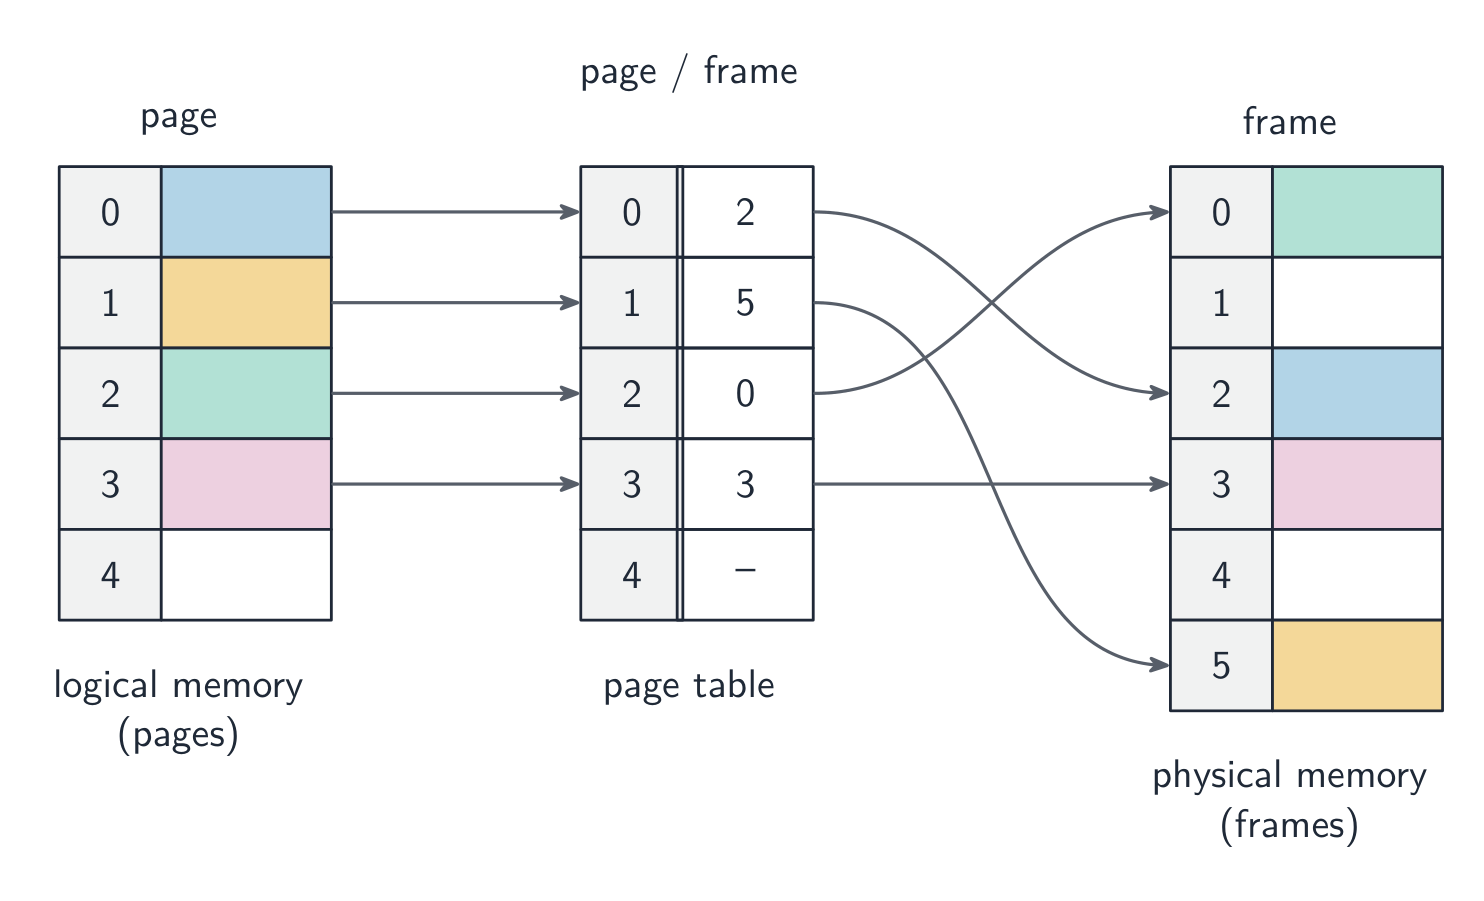
各プロセスには独自の仮想アドレス空間が割り当てられます。これはOSが物理メモリにマッピングする、クリーンで連続的なアドレス範囲です。これにより各プロセスに単純な空間が与えられ、プロセス同士を保護でき、総メモリ量が物理RAMを超えることができます。
ページングでは、仮想空間は固定サイズのページに分割され、物理メモリも同じサイズのフレームに分割されます。ページテーブルは各ページをフレームにマッピングします。アクセスされたページがRAMにない場合(ページフォルト)、OSはそれをスワップファイルから読み込んでフレームに格納し、RAMが満杯の場合は別のページを退去させます。頻繁なフォルトはスラッシング(ディスクスラッシング)を引き起こし、OSが有益な作業を行う代わりに大部分の時間をページの交換に費やすようになります。
セグメンテーションでは、メモリは可変サイズの論理セグメント(コード、スタック、ヒープ)に分割され、それぞれに固有の権限が割り当てられます。多くのシステムではセグメント内でページングを用います。

「仮想記憶とは何かを説明せよ」(3点) *二次ストレージ(ディスク)はRAMを拡張するために使われ、利用可能なメモリが物理メモリより大きく見えるようにします;プロセスのアドレス空間はページに分割され、現在必要なページのみがRAMに保持され、残りはディスク上で待機します;ページは必要に応じてRAMとディスク間でスワップされ、OSは各仮想アドレスを物理アドレスに変換します。OSが必要とする理由: 実行中のプログラムが搭載されたRAMより多くのメモリを必要とする可能性があるためです。これによりより多く(あるいはより大きい)プログラムを同時に実行できます。プログラムが物理メモリより大きくなっても構いません。プログラムの一部しか使用されない部分はRAMを占有しないため、メモリ効率的です。
ページングとセグメンテーションの違い(試験が求めるもの)。 ページング: メモリをハードウェアによって選択された固定サイズのブロック(ページとフレーム)に分割し、プログラムの構造は考慮されず、マッピングはプログラマには見えない;セグメンテーション: プログラムを可変サイズの論理単位(手続、配列、スタックなど)に分割し、そのサイズと境界はプログラムに従うため、セグメント単位で保護したり共有したりできます。「セグメンテーションのプロセスを説明せよ」: プログラムは異なるサイズのセグメントに分割され、それぞれにセグメント番号が与えられます。セグメント表は各セグメントがメモリ内でどこから始まり、どの長さかを記録します。論理アドレスはセグメント番号とオフセットの組み合わせであり、OSはオフセットをセグメントのベースアドレスに加算して物理的な場所を特定します。
"ディスク・スラッシングとは何かを説明し、発生するタイミングを述べよ。" ディスク・スラッシングとは、ページがRAMに読み書きされる頻度が極めて高く、プロセッサが命令の実行よりもページの移動に多くの時間を割いてしまい、システムがほぼ停止状態になる現象である。実行中のプロセスが必要とするページ(ワークセット)に対してRAM容量が小さすぎる場合に発生する。外されたばかりのページが直後に再び必要とされ、再度読み出されると、別のページが追放され、それがすぐに必要となって……という負のスパイラルに陥る。プロセス数が多すぎたり、メモリアクセスが不規則なプログラムであったりすると引き起こされ、RAMを増やすかプロセス数を減らすことで解決できる。
探索
ページフォールトが発生した際发生了什么か
ページフォールトをトレースしてください。プログラムがRAMに存在しないページにアクセスすると、OSは静かにディスクから取得してページテーブルを更新します——これにより、プログラムは物理的に存在する以上のメモリを認識できます。
語彙
練習する
| English | 日本語 |
|---|---|
| multi-tasking/ˈmʌlti ˈtæskɪŋ/ | マルチタスク |
| paging/ˈpeɪdʒɪŋ/ | ページング |
| spooling/ˈspuːlɪŋ/ | スプーリング |
| cache/kæʃ/ | キャッシュ |
| segmentation/ˌseɡmənˈteɪʃn/ | セグメンテーション |
| disk thrashing/dɪsk ˈθræʃɪŋ/ | ディスクスラッシング |
| interpreter/ɪnˈtɜːprɪtə/ | インタープリタ |
| compiler/kəmˈpaɪlə/ | コンパイラ |
| machine code/məˈʃiːn kəʊd/ | 機械語 |
| lexical analysis/ˈleksɪkl əˈnæləsɪs/ | レキシカル解析 |
| tokens/ˈtəʊkənz/ | トークン |
| syntax analysis (parsing)/ˈsɪntæks əˈnæləsɪs/ | 構文解析(パース) |
| abstract syntax tree/ˈæbstrækt ˈsɪntæks triː/ | 抽象構文木 |
| syntax error/ˈsɪntæks ˈerə/ | 構文エラー |
| semantic analysis/səˈmæntɪk əˈnæləsɪs/ | 意味解析 |
| code generation/kəʊd ˌdʒenəˈreɪʃn/ | コード生成 |
| code optimisation/kəʊd ˌɒptɪmaɪˈzeɪʃn/ | コード最適化 |
| symbol table/ˈsɪmbl ˈteɪbl/ | シンボルテーブル |
| grammar/ˈɡræmə/ | 文法 |
16.2
インタープリタによるプログラムの実行方法
シラバス
| 受験者は以下的能力を備えているべきである: | メモおよびガイドライン |
|---|---|
| インタプリタが翻訳版を生成せずにプログラムを実行する仕組みを理解する | |
| プログラムのコンパイルにおける各段階の理解 | レキシカル解析, 構文解析, コード生成, 最適化を含む |
| 構文図または**バックス・ノー形式(BNF)**記法を用いて、ある言語の構文を表現する方法を理解する | |
| **逆ポーランド記法(RPN)**を用いて数式の評価を行う方法を理解する |
出典: Cambridge International シラバス
インタープリタはソースコードを解釈して実行することを同時に行う。各文について、行を読み込み、語彙解析と構文解析を行い、型を確認した後、実行し、次に進む。エラーは即座に報告され、通常はここで停止する。実行可能なファイルは生成されない。毎回翻訳をやり直すため(遅い)、開発のフィードバックが早く、ポータビリティが高いという利点がある。
「インタープリタは翻訳版を生成せず、どのようにプログラムを実行するか」を説明せよ(3点)。インタープリタは文を1つずつ取り出し、翻訳(解析)して、直ちに実行し、次の文に進む。プログラム全体の翻訳版は作成・保存されないため、ループ内の通過を含め、文が実行されるたびに毎回翻訳が行われる。文にエラーが含まれている場合、その時点で実行は停止し、エラーが報告される。これが、インタープリタが開発やテストに適している理由である(エラーに気づきやすく、変更を即座に試せる)。ただし、完成したプログラムの実行では遅い。
16.2
コンパイルの工程

コンパイラはソースコードを機械語に変換する際、以下の工程を経る:
- 語彙解析 — レキサーは文字をトークン(キーワード、識別子、演算子、リテラル)にまとめ、空白文字とコメントを削除する。
- 構文解析(パーシング) — トークンが文法に従っているか確認し、抽象構文木を構築する。括弧が不足している場合は構文エラーとなる。
- 意味解析 — プログラムが意味を持つか確認する(変数の宣言、型の一致など)。
- コード生成 — 木を走査してターゲットコードを出力し、レジスタやレイアウトを選択する。
- コード最適化 — 不要な処理を除去し、定数を折りたたみ、パイプラインに合わせて並べ替える。
最終的な出力物は実行可能ファイルである。
各工程の目的(採点ポイントを含む表現で)。語彙解析: 空白文字とコメントを削除し、ソースコードの文字列を言語内で有効であることが確認されたトークン(キーワード、識別子、演算子、定数)に変換する。識別子を記号表に登録する。構文解析: トークンの並び順が言語の文法(構文規則)に従っているか確認する。解析木(抽象構文木)を構築し、構文エラーを報告する。型チェックや変数宣言の確認は、これに含めて意味解析として数えられることもある。コード生成: 検証済みの木をオブジェクトコードまたは機械語(中間コードを経由する場合もある)に変換し、メモリとレジスタを割り当てる。最適化: プログラムの挙動を変えずに、重複する命令を削除したり、計算を統合・簡略化したり、ループを再編成したりすることで、コードを高速化またはメモリ使用量の削減を図る。この問題では、各工程に対応する記述を選ぶ形式になっている。
探索
コンパイルのフェーズ
コンパイラーがソースに対して行う処理を追跡してください。各フェーズは出力を次のフェーズに渡します——文字列がトークンになり、トークンが木になり、木が最適化された機械語になります。
16.2
文法:BNFと構図

文法は、どのトークンの並びが有効なプログラムかを定義する。
Backus-Naur Form(BNF)はテキストベースである。生成規則は以下の形式をとる:
<symbol> ::= alternative1 | alternative2 | ...
各選択肢は、終端記号( literal text )と非終端記号(他の規則名)の配列である:
<digit>      ::= 0 | 1 | 2 | 3 | 4 | 5 | 6 | 7 | 8 | 9
<identifier> ::= <letter> | <identifier> <letter> | <identifier> <digit>
再帰的な第3則は「文字に続く任意の数の文字または数字」を表します。IF文:
<if-statement> ::= IF <condition> THEN <statement> ENDIF
                 | IF <condition> THEN <statement> ELSE <statement> ENDIF
構図(レールロード図)も同じことを図示で示す:非終端記号は四角い箱、終端記号は丸い箱、有効なパスは矢印、反復はループで表される。2つの表記法は等価である。パーサは文法を使って、プログラムが有効かどうかを判定する。
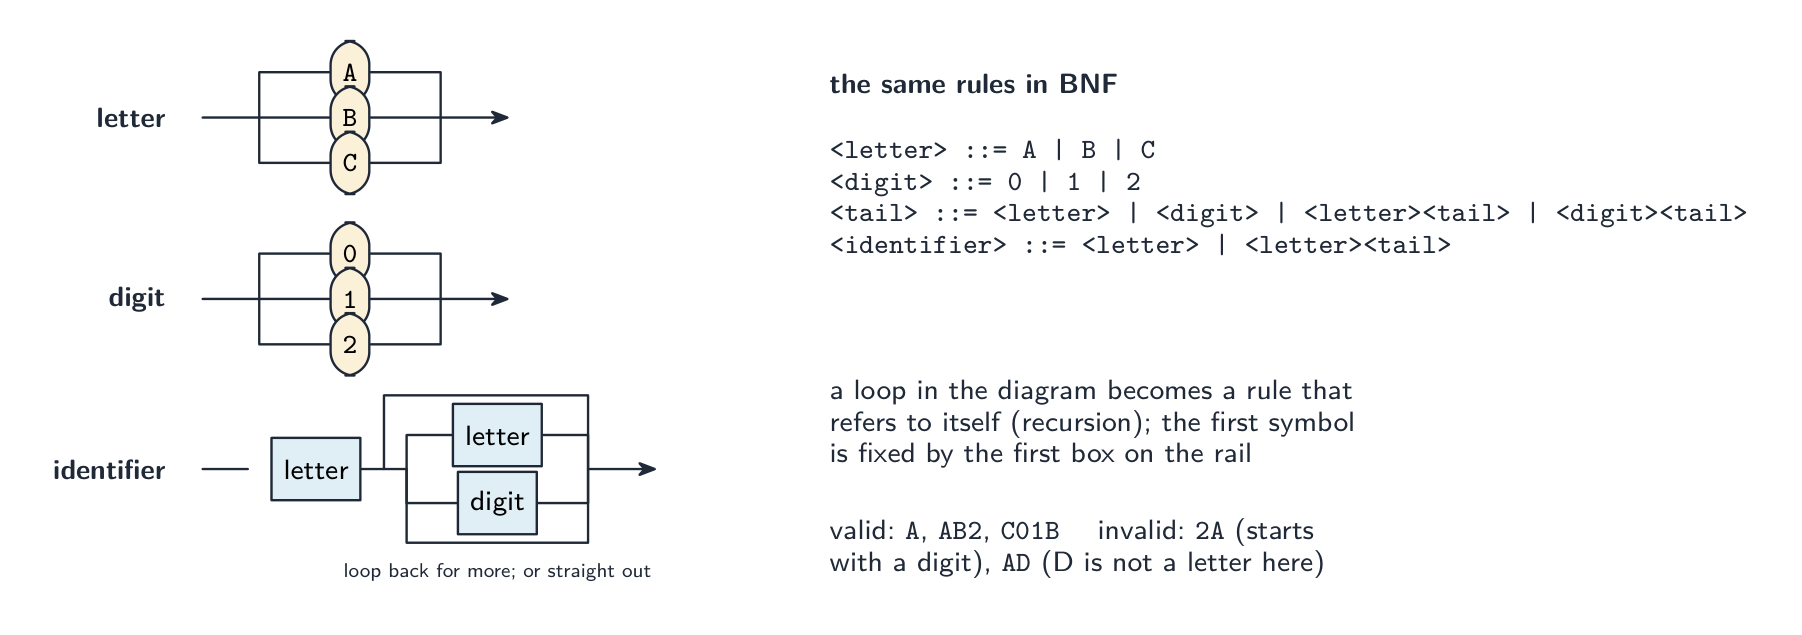
試験の図解を読む。 各図解は1つの非終端記号を定義しています。開始点から終了点へ矢印をたどり、たどり得るすべてのパスが有効な文字列です。横に並んだボックスの選択は代替案のセットです;戻り矢印のループは「好きなだけ繰り返す」を意味します;他の非終端記号のボックスは「ルールで許容されるものをすべて挿入する」ことを意味します。「文字列が無効な理由を説明せよ」とは、言葉で破られているルールを答えることです: 9K は変数として無効です。なぜなら、先頭文字は数字ではなく英字である必要があるからです; JJ90 は、ルールが英字が1文字のみを許容する場合や、 J がリストされた英字のセットに含まれない場合に無効なパスコードとなります。実際の言語が許容することではなく、図解が実際に許容する文字のセットに対して文字列を確認してください。
図解からBNFを書く。 各図解が1つのルール <name> ::= ... になります;代替案は | で区切ります;シーケンスは1つずつ記号を書きます;そして反復は再帰で表します。なぜならBNFにはループ記号がないからです。「1文字以上の英字」は <word> ::= <letter> | <letter><word> であり、「英字の後に0文字以上の数字」は <variable> ::= <letter> | <letter><digits> であり <digits> ::= <digit> | <digit><digits> です。
** worked example(例題)。** 先頭が2文字の英字( A B C より)に続き、1〜3桁の数字( 0 1 2 より)が続く車両登録番号のBNFを完成させよ。
<letter>       ::= A | B | C
<digit>        ::= 0 | 1 | 2
<digits>       ::= <digit> | <digit><digit> | <digit><digit><digit>
<registration> ::= <letter><letter><digits>
AB12 は有効; A12 は無効(英字が1文字のみ); AB1234 は無効(4桁の数字); AD1 は無効( D はリストされた英字ではない)。 「3番目の文字も記号にできる」といった制約を追加するには、その位置のルールのみに追加の代替案を加え、 <symbol> に独自のルールで定義せよ。
** worked example.** 変数、演算子、変数または数の順に並んだ式に対してBNFを記述せよ。ここで、変数は a b c の単一小文字アルファベットであり、演算子は + または - とする。
<variable>   ::= a | b | c
<operator>   ::= + | -
<number>     ::= <digit> | <digit><number>
<expression> ::= <variable><operator><variable> | <variable><operator><number>
再帰的な <number> ルールにより任意の数の数字を許容し、 <expression> の2つの代替案が定義で言及された両方のケースをカバーしている。すべての非終端記号は角括弧で囲み、すべての終端記号は括弧なしで残す。
語彙
練習する
| English | 日本語 |
|---|---|
| Backus-Naur Form/ˈbækəs nɔː fɔːm/ | バックス・ノー形式 |
| production rule/prəˈdʌkʃn ruːl/ | 生成規則 |
| terminal/ˈtɜːmɪnl/ | 終端記号 |
| non-terminal/nɒn ˈtɜːmɪnl/ | 非終端記号 |
| syntax diagram/ˈsɪntæks ˈdaɪəɡræm/ | 構文図 |
| infix/ˈɪnfɪks/ | 中置記法 |
| Reverse Polish Notation/rɪˈvɜːs ˈpəʊlɪʃ nəʊˈteɪʃn/ | 逆ポーランド記法 |
| postfix/ˈpəʊstfɪks/ | 後置記法 |
| stack/stæk/ | スタック |
| precedence/ˈpresɪdəns/ | 優先順位 |
| bytecode/ˈbaɪtkəʊd/ | バイトコード |
16.2
リバース・ポーランド表記法 (RPN)
中置表記法では演算子が被演算者の間にあり( 3 + 4 * 2 )、括弧と優先度ルールが必要である。一方、リバース・ポーランド表記法 (RPN, 後置) では演算子が被演算者の後にあり( 3 4 2 * + )、括弧は不要である。
中置表記からRPNへの変換
演算子のスタックを使用する。左から右へスキャン:被演算者は出力し、演算子の場合はまずスタック上の高いまたは同等の優先度を持つ演算子を出力にポップし、その後それをスタックにプッシュする; ( をプッシュする; ) の場合、対応する ( が見つかるまで出力にポップする。最後にすべての演算子をポップする。例: (3 + 4) * 2 → 3 4 + 2 * 。
RPNの評価
被演算者のスタックを使用する。左から右へスキャン:各被演算者をスタックにプッシュする;演算子の場合は上位2つをポップし、適用して結果をプッシュする。 3 4 2 * + の評価:
| トークン | スタック |
|---|---|
3 |
3 |
4 |
3, 4 |
2 |
3, 4, 2 |
* |
3, 8 |
+ |
11 |
結果: 11。RPNは評価時に括弧を必要とせず、スタックマシンに適している — JVMや多くのバイトコードインタープリタ就是这样動作する。
「RPNが式評価に使われる理由を説明せよ」(2点)。 RPNでは演算者が適用される順序で並び、したがって式は単一の左から右へのパスで括弧も優先度ルールもなく評価可能であるため、コンパイラやインタープリタにとって処理が単純で高速である。 「適切なデータ構造を理由付きで特定せよ」: スタック、なぜなら評価には最も最近プッシュされた被演算者が最初に関与するため(後入れ先出し):各被演算者はプッシュされ、各演算子は上位2つをポップし、自身を適用し、結果をプッシュする。 トークンごとにスタックの内容を示せと求められたら示せ。
手動での中置表記からRPNへの変換。 (1) 優先度ルールを用いて式を完全に括弧で囲む;(2) 各演算子を自身の閉じ括弧の直後へ移動する;(3) 括弧を取り除く。よって $(a - b) * (a + c) / 7$ は $((a - b) * (a + c)) / 7$ となり、さらに a b - a c + * 7 / となる。 * と / は左から右に適用されるため、除算が最後の演算子であり、掛け算ではないことに注意。 他の変換: $((7 + 3) - (2 * 8)) / 6$ は 7 3 + 2 8 * - 6 / ; $(7 - 2 + 8) / (9 - 5)$ は 7 2 - 8 + 9 5 - / ; $a * b + b - d + 15$ は a b * b + d - 15 + ; $(2 - 6) * (13 + 7) / 5$ は 2 6 - 13 7 + * 5 / 。
RPNを中置表記に戻す。 RPNを式のスタックで処理する:各被演算者をスタックにプッシュする;各演算子の場合は2つをポップし、括弧で囲んで両側に書き、結果をスタックにプッシュする。よって a b / 4 * a b + - は $((a / b) * 4) - (a + b)$ ; 5 2 + 9 3 - / 3 * は $((5 + 2) / (9 - 3)) * 3$ ; b a c - + d b + * c / は $((b + (a - c)) * (d + b)) / c$ ; a b - c + c a - * d / は $(((a - b) + c) * (c - a)) / d$ 。 括弧を残す:外すと意味が変わる可能性がある。
** worked example.** a b - c d + * e / を計算し、スタックの状況を示すために、$a = 17$、$b = 5$、$c = 7$、$d = 3$、$e = 10$ の各値について処理する。
| トークン | 行動 | スタック (右側が上位) |
|---|---|---|
a |
17をプッシュ | 17 |
b |
5をプッシュ | 17, 5 |
- |
5と17をポップし、 $17 - 5$ をプッシュ | 12 |
c |
7をプッシュ | 12, 7 |
d |
3をプッシュ | 12, 7, 3 |
+ |
3と7をポップし、 $7 + 3$ をプッシュ | 12, 10 |
* |
10と12をポップし、 $12 \times 10$ をプッシュ | 120 |
e |
10をプッシュ | 120, 10 |
/ |
10と120をポップし、 $120 / 10$ をプッシュ | 12 |
結果 12 。 - と / についてはポップの順序が重要である:2番目にポップされる値が左被演算者であるため、 a b - は $a - b$ であり、 $b - a$ ではない。 さらに2つ同様に: d a b + * c a - / と $a = 6, b = 12, c = 15, d = 5$ は $5 \times (6 + 12) / (15 - 6) = 90 / 9 = 10$ を与え; c a - b d + * b c + / と $a = 4, b = 12, c = 24, d = 6$ は $(24 - 4) \times (12 + 6) / (12 + 24) = 360 / 36 = 10$ を与える。
** worked example.** $(A + B) \times (C - D)$ を RPN に変換し、$(3 + 4) \times (5 - 2)$ を評価します。左から右へスキャンし、演算子 スタック を使用します。( をスタックに押し込み、A を出力し、+ をスタックに押し込み、B を出力し、) で対応する ( までポップして戻すため、結果は A B + となります。× を押し込むと、2番目の括弧も同様に動作し、C D - が得られます。最後に × をポップします。結果: A B + C D - ×。数値の評価には、被演算子 のスタックを使用します。3 を押し込み、4 を押し込み、+ が両方をポップして 7 を押し込み、5 を押し込み、2 を押し込み、- が両方をポップして 3 を押し込み、× が 7 と 3 をポップして 21 を押し込みます。これらが信頼できる理由は2つあります。まず、被演算子は変換を通じて 元の順序 を保ち(演算子のみが移動する)、次に、すべての演算子がスタック上で直下の 2つの値 に作用するためです。
探索
演算子の優先順位 — 逆ポーランド記法が除去するもの
通常の中置数学では、× と ÷ は + と − よりも結合度が高いため、正しい順序で規則を適用する必要があります。逆ポーランド記法では操作子を後に書き(3 4 2 × + 1 −)、順序を固定するため優先順位の規則は不要です。
16.2
出題者が認める定義
定義問題は固定された用語に基づいて採点されます。これらを正確に暗記し、一つの答えのみを答えてください。
| 用語 | 定義 |
|---|---|
| マルチタスク | 複数のプロセスを同時にメモリ上に保持し、プロセッサがそれらを切り替えることで、同時に実行されているように見えること |
| プロセス | メモリにロードされ、実行中(または実行準備ができている)のプログラム |
| ランニング / レディ / ブロック | プロセッサを持っている / プロセッサを待っている / I/O 完了などのイベントが終了するまで進めない |
| スケジューリング | 次のどのレディなプロセスがプロセッサを得て、どれだけの時間使うか決定すること |
| プリーemptive スケジューリング | 実行中のプロセスが中断されてレディ状態に戻され、別のプロセスが実行される |
| 仮想メモリ | 二次記憶装置を使用して RAM を拡張し、現在必要なページのみを物理メモリに保持する |
| ページング | メモリとプログラムを固定サイズのページに分割し、必要に応じてディスクと RAM 間で移動する |
| セグメンテーション | プログラムを可変サイズの論理セグメントに分割し、各セグメントがセグメントテーブルによってメモリにマッピングされる |
| ディスク・スラッシング | ページが RAM とディスク間で頻繁にスワップされ、有用な処理がほとんど行われない状態 |
| インタープリタ | 翻訳版を作成せず、文を1つずつ翻訳して実行する |
| コンパイラ | 実行前に全体の高レベル・プログラムを機械語(オブジェクト・コード)に翻訳する |
| 辞書解析 | ソースコードをトークンに変換し、空白文字とコメントを除去してシンボル表を構築する |
| 構文解析 | トークンが言語の文法に従っているか確認し、パース木を構築する |
| バックス・ノー形式 | 言語の文法の表記法:終端記号と非終端記号から構成される <name> ::= alternatives 型のルール |
| 逆ポーランド表記 | 各演算子を被演算子の後に置く表現の書き方であり、これによりスタックを用いて評価でき、かつ括弧が不要になる |
16.2
試験対策
- OSの問題は、スケジューリング、メモリ管理、I/Oバッファリングとスプーリング、ファイル管理といった名付けられたメカニズムに基づいて採点されます。インターフェースについては、アドレスではなくファイル名、コマンドではなくクリック、ドライバー、GUIが問われます。
- プロセスの状態とその遷移、およびそれぞれの理由;スケジューリングルーチンは、関数+利点+欠点として答える;カーネルは状態を保存し、割り込みを特定し、処理し、復元する。
- 仮想メモリ:ディスクがRAMを拡張し、ページがスワップされ、アドレス変換が行われる;ページングは固定サイズで不可視、セグメンテーションは可変サイズで論理的である;スラッシングは作業ではなくスワップを行うことである。
- インタープリタ:文を1つずつ、翻訳後実行され、何も保存されない。コンパイラの工程:トークンとシンボル表、文法とパース木、コード、最適化。
- BNF: 図ごとにルール、
|は選択、反復には再帰、終端記号はそのまま、非終端記号は角括弧で囲む。どのルールが文字列を破っているかを述べる。 - RPN:演算子は被演算子の後、スタックを用いて評価し、すべてのステップを示す。変換は完全に括弧をつけて行う。逆変換する際は、括弧を残す。
一般的なミス
- 「複数のプログラムを同時に実行する」と説明する際、プロセッサがそれらを切り替えていることを述べない。
- ブロックされたプロセスを直接ランニングにする、あるいは「タイムスライス終了」をランニングからブロックへの理由とする。
- ショートestes・ジョブ・ファースト(非プリーemptive)とショート・リメイニング・タイム(プリーemptive)を混同するか、ラウンド・ロビンとプライオリティを混同する。
- 「ハードディスクをRAMとして使用する」と定義する際、ページがスワップされることに触れない。
- インタープリタが「プログラムを機械コードに変換して実行する」と言う。これはコンパイラである。
- 構文チェックを辞書解析に入れる、またはマッチング問題でコード生成より前に最適化を入れる。
- BNFの反復を
<letter>*や省略号で書く。再帰を使う。非終端記号の角括弧を外す。 - RPN を評価する際に
-や/の被演算子の順序を逆にする、または $a * b + c$ のRPNをa b c + *と書く。
このトピックのインタラクティブ授業
一歩ずつ進め、即時チェック付きの問題で学習します。