| 受験者は以下的能力を備えているべきである: | メモおよびガイドライン |
|---|---|
| ユーザ定義型が必要となる理由に対する理解を示す | |
| 非合成型の定義と使用 | 以下の包括: 列挙型、ポインタ |
| 合成データ型の定義と使用 | 以下の包括: セット、レコード、およびクラス/オブジェクト |
| 与えられた問題に対して適切なユーザ定義データ型を選択・設計する |
データの表現
A-Levelコンピュータ科学 · トピック 13
 15:16
ユーザー定義データ型
単純な文字列フィールドは、意味のない値でも喜んで格納します。「車両タイプ」を求め、誰かが「バナナ」と入力しても、プログラムは異議を唱えずに受け入れます。しかし、あなたが…
英語ナレーション・英語+中文字幕 burning-in
13.1
ユーザー定義データ型

シラバス
出典: Cambridge International シラバス
組み込み型(INTEGER, REAL, STRING, CHAR, BOOLEAN)は最简单的ケースをカバーする。より複雑な問題に対しては、ユーザー定義型を定義することで、コードを明瞭にし、コンパイラのチェックを厳密にできる。
必要とされる理由
組み込みSTRINGを使うと、本来は有限の法的な値のみを保持すべきフィールドに無意味な値を格納してしまう;ユーザー定義型ならこれを制限できる。現実のエンティティは通常、異なる型の値の集合体である。また、DECLARE Taxi : VehicleはDECLARE Taxi : STRINGよりも明瞭(自己文書化)である。
「ユーザー定義データ型の目的を説明せよ」(2点満点) プログラマによって定義されたデータ型であり、既存(組み込み)型を基盤としているため、適合する組み込み型が存在しない場合に、問題固有のデータを表現できる。 両方の要素(プログラマによって定義されている、既存の型に基づいている)が得点対象となる。採点者は「プログラムを読みやすく保守しやすくする」ことも補足要点として認めるが、単独での回答としては点数に入らない。
「非合成型と合成型数据类型の語義を説明せよ」(4点) 非合成型は他の型への言及なしで定義され、単一の値を保持する(例:整数、実数、または列挙値)。合成型は他の型(それ自体が合成型である可能性あり)の集合であり、1つの識別子の下に複数の値を保持する(例:レコード、セット、配列、クラス)。それぞれの定義に例を示せ(試験では1つ要求される)。
非合成型
列挙型
列挙型とは、名前付き定数の固定リストとして定義される値を持つ型である:
TYPE Vehicle = (M100, M230, T101, T102, T120, T150)
DECLARE MyTaxi : Vehicle
MyTaxi ← T102
これらの名前は新しい型の値であり(内部では小さな整数として格納されている)、リスト外の値を割り当てることはできない。用途:曜日の名、色、ステータスコードなど。
「列挙データ型が何を意味するか述べよ。」 すべての可能な値を(順序をつけて)列挙によって定義された非合成ユーザー定義型。 値が順序付けされているため、比較やステップ処理が可能である:TYPE Month = (January, February, ..., December)を用いることでIF ThisMonth > Juneテストは有効であり、値は内部で整数として格納される。擬似コードは3つの部分からなり、試験ではそれぞれに点数が与えられる:キーワードTYPE、=を含む識別子、およびコンマで区切られた括弧内のリスト。
演習例。 学校が開いている日(月曜日から金曜日)に対応する列挙型を定義する擬似コードを書き、その型の変数を水曜日に初期化せよ。
TYPE SchoolDay = (Monday, Tuesday, Wednesday, Thursday, Friday)
DECLARE Today : SchoolDay
Today ← Wednesday
列挙型の変数はリスト外の値を割り当てることができず、これがこの型の本質である:Today ← Saturdayはコンパイル時のエラーとなるのに対し、STRINGであれば"Saturdy"を受け付けていた。
ポインタ型
ポインタは、他の変数のメモリアドレス(または「ターゲットなし」のNULL)を保持する。ポインタは動的構造(連結リスト、ツリー)を構築したり、コピーせずに参照を渡したりするために用いられる。
TYPE PNode = ^TNode    // pointer to a TNode
DECLARE p : PNode
p ← NEW TNode
p^.Value ← 42          // dereference to reach the fields
デレファレンス(p^)とは、指し示している変数にアクセスすることである。
「ポインタデータ型が何を意味するか述べよ。」 特定の型の変数(またはその参照先)のメモリアドレスを値とする非合成型。 擬似コードでは、指し示す型の前に caret(^)をつけて型を宣言し、試験ではまさにその行を求める:
TYPE SelectParts = ^Parts        // a pointer to a value of type Parts
DECLARE Chosen : SelectParts
Chosen ← ^Keyboard               // Chosen now holds the address of Keyboard
OUTPUT Chosen^                   // dereference: the value stored at that address
ポインタは動的連結リストや二項木(トピック19)の構成要素である:各ノードは次のノードへのポインタを保持する。ここでよく失われる2点は、ポインタ型をそのままの値を保持するかのように記述してしまうこと、およびポインタを通る際にcaret(^)を忘れることである。

p^でデレファレンスしてノードのフィールドにアクセスする合成型
合成型(合成データ型の一つ)は、複数の値を1つの名前の下にグループ化する型である。


- レコード(トピック10) — 異なった型のフィールドを
TYPE ... ENDTYPEブロック内に格納する。 - セット — 一意な値の無順序集合であり、add, remove, メンバーシップテスト、union, intersection の操作を持つ:
DECLARE Available : SET OF Colour
Available ← {Red, Blue}
IF Green IN Available THEN
    ...
ENDIF
- クラス / オブジェクト — データフィールド(属性)とそれらに対する操作(メソッド)を組み合わせたOOPの合成型。オブジェクトはクラスのインスタンスである:
CLASS Taxi
    PRIVATE Capacity : INTEGER
    PUBLIC FUNCTION GetCapacity() RETURNS INTEGER
        RETURN Capacity
    ENDFUNCTION
ENDCLASS
型の選択
固定リストからの値には列挙型、間接参照にはポインタ型、フィールドのグループ化にはレコード、無順序かつ一意な集合にはセット、状態(state)と振る舞い(behaviour)を同時に必要な場合にクラスを用いる。
「ユーザー定義データ型セットを説明せよ」(3点)。 同じ型の値の集合を保持する合成型であり、特定の順序を持たず重複も許さない;値の追加・削除ができ、メンバーシップテストも可能である。 型を SET OF で宣言し、次に括弧内で値を指定してセット定数を定義する:
TYPE EvenNumbers = SET OF INTEGER
DEFINE Evens (2, 4, 6, 8, 10, 12) : EvenNumbers
TYPE SymbolSet = SET OF CHAR
DEFINE Operators ('+', '-', '*', '/') : SymbolSet
「ユーザー定義データ型レコードを説明せよ」(3点)。 一定個数のフィールド(項目)からなる合成型であり、各フィールドは独自の識別子と独自の型を持ち、単一の識別子の下で参照される;フィールドへのアクセスはドット表記を用いる。
演習例。 クラブ会員の名前(first name)、姓氏(last name)、会員コード(整数)、入会日、会費支払い有無を表すレコード型 ClubMember を宣言する擬似コードを書き、その後変数を宣言してそのフィールドの2つを初期化せよ。
TYPE ClubMember
    DECLARE FirstName : STRING
    DECLARE LastName : STRING
    DECLARE Code : INTEGER
    DECLARE DateJoined : DATE
    DECLARE FeesPaid : BOOLEAN
ENDTYPE

DECLARE NewMember : ClubMember
NewMember.LastName ← "Chen"
NewMember.FeesPaid ← TRUE
各フィールドには適切な型を持つ独立した DECLARE 行が必要であり、ブロックは ENDTYPE で終了し、フィールドは variable.field でアクセスされる。各フィールドに適した型を選ぶように求められた場合、データに照らして対応させる:比較のみに行われるコードは文字を含む場合は STRING、計算や順序付けが必要な場合は INTEGER である;はい/いいえは BOOLEAN、日付は DATE である。いくつかの名前付き値のいずれかをとりうるフィールド(ペットの種、色など)には列挙型を使用する。

配列とファイルのレコード。 多数のメンバーを持つ表は DECLARE Members : ARRAY[1:100] OF ClubMember です。次に Members[3].LastName は要素の一つのフィールドであり、インデックスによるループ処理ですべてのレコードを処理します。レコードはまた、ファイルへの書き込みおよび読み出しの自然な単位でもあります(以下参照)。1レコードあたり PUTRECORD または WRITEFILE 。
** worked example(例題)。** 複合型 Pet は、各ペットの名前(文字列)、種別(犬、猫、ウサギ、ハムスターのいずれか)、体重(キログラム単位の実数)を格納します。型を定義し、変数を宣言してください。
TYPE Species = (Dog, Cat, Rabbit, Hamster)
TYPE Pet
    DECLARE Name : STRING
    DECLARE Kind : Species
    DECLARE Weight : REAL
ENDTYPE
DECLARE MyPet : Pet
MyPet.Kind ← Rabbit
列挙型は 最初に定義 されます。なぜならレコードがそれを使用するためです;擬似コードでは順序が重要であり、コンパイラと同様です。
擬似コードのクラス。 クラス は、振る舞いも伴う複合型です。試験では、属性が PRIVATE で示された声明、それらを初期化する NEW と名付けられた コンストラクタ、そしてそれらを取得または変更するための PUBLIC メソッドが求められます:
CLASS Appointment
    PRIVATE PatientName : STRING
    PRIVATE Treatment : STRING
    PRIVATE Medication : STRING
    PUBLIC PROCEDURE NEW(Name : STRING, Treat : STRING, Med : STRING)
        PatientName ← Name
        Treatment ← Treat
        Medication ← Med
    ENDPROCEDURE
    PUBLIC FUNCTION GetTreatment() RETURNS STRING
        RETURN Treatment
    ENDFUNCTION
ENDCLASS

DECLARE Visit : Appointment
Visit ← NEW Appointment("A. Chen", "filling", "none")
OUTPUT Visit.GetTreatment()
属性はプライベートであるため、メソッドを通じてのみ変更できます(カプセル化、トピック20);コンストラクタは、属性ごとに1つのパラメータを持つ NEW として呼び出される手続です。ゲッターは属性を返す関数です。これらはそれぞれ独立した採点ポイントとなります。
探索
プログラミング概念ラボ
各例とそれが示すプログラミングの概念を結びつけてください。
語彙
練習する
| English | 日本語 |
|---|---|
| user-defined type/ˈjuːzə dɪˈfaɪnd taɪp/ | ユーザー定義型 |
| field/fiːld/ | フィールド |
| record/ˈrekɔːd/ | レコード |
| set/set/ | セット |
| class/klæs/ | クラス |
| composite type/ˈkɒmpəzɪt taɪp/ | 複合型 |
| enumerated type/ɪˈnjuːməreɪtɪd taɪp/ | 列挙型 |
| pointer/ˈpɔɪntə/ | ポインタ |
| linked list/lɪŋkt lɪst/ | 連結リスト |
| dereference/ˌdiːˈrefrəns/ | デレファレンス |
| object/ˈɒbdʒekt/ | オブジェクト |
| attributes/ˈætrɪbjuːts/ | 属性 |
| methods/ˈmeθədz/ | メソッド |
| constructor/kənˈstrʌktə/ | コンストラクタ |
| File organisation/faɪl ˌɔːɡənaɪˈzeɪʃn/ | ファイル組織化 |
13.2
ファイルの構成とアクセス

シラバス
| 受験者は以下的能力を備えているべきである: | メモおよびガイドライン |
|---|---|
| ファイル組織の方法に対する理解を示し、与えられた問題に対して適切なファイル組織およびファイルアクセス方法を選択する | 以下の包括: シリアル、順次(キーフィールドを使用)、ランダム(レコードキーを使用) |
| ファイルアクセスの方法に対する理解を示す | 以下の包括: シリアルおよび順次ファイルの順次アクセス、順次およびランダムファイルの直接アクセス |
| ハッシュアルゴリズムに対する理解を示す | 読み出しおよびランダム/順次ファイルへの書き出しに異なるハッシュアルゴリズムを記述して使用する |
出典: Cambridge International シラバス
ファイルの構成 はデータの配置方法であり、ファイルアクセス はプログラムがレコードにどう到達するかです。
- シリアルファイル — 追加された 順に並んだレコード、ソートなし。アクセスは順次のみ;追加は高速;検索は低速。ログや監査トレースに使用。
- シーケンシャルファイル — キーによってソートされたレコード。検索が速い(早期終了や二項探索が可能);挿入が遅い(レコードのシフトが必要)。バッチ更新用マスターファイルに使用。
- ランダムファイル(直接アクセスファイル)— キーから計算された位置にあるレコード(ハッシュによるものが多い)。キーによる直接アクセスは非常に速い;キー順での読取りは難しい。大規模な照会テーブルや顧客口座に使用。


2つのアクセス方法は 順次アクセス (先頭から末尾まで読む)と 直接アクセス (既知の位置にジャンプする)です。構造を主要な操作にマッチさせます:単一キー照会はランダムを好む;順次出力レポートはシーケンシャルを好む。
各構成の説明(採点ポイントとなる表現)。 シリアル: レコードは追加された 順に一つずつ格納され、キーによる順序付けはありません。 シーケンシャル: レコードは キーフィールドの順に格納されます(ソート済み)。 ランダム: 各レコードはハッシングアルゴリズムによりキーから 計算されたアドレスに格納される ので、レコードはいかなる順序にもありません。 シリアルとシーケンシャルの比較: 両方ともレコードを一つずつ格納し、順次読み取りますが、シーケンシャルファイルはキーで順序付けられているため、ターゲットより大きいキーを読んだ時点で検索を停止でき、新しいレコードは正しい位置に挿入する必要があります(通常はファイルの再書き込みによる)。一方、シリアルファイルは単に追加されます。
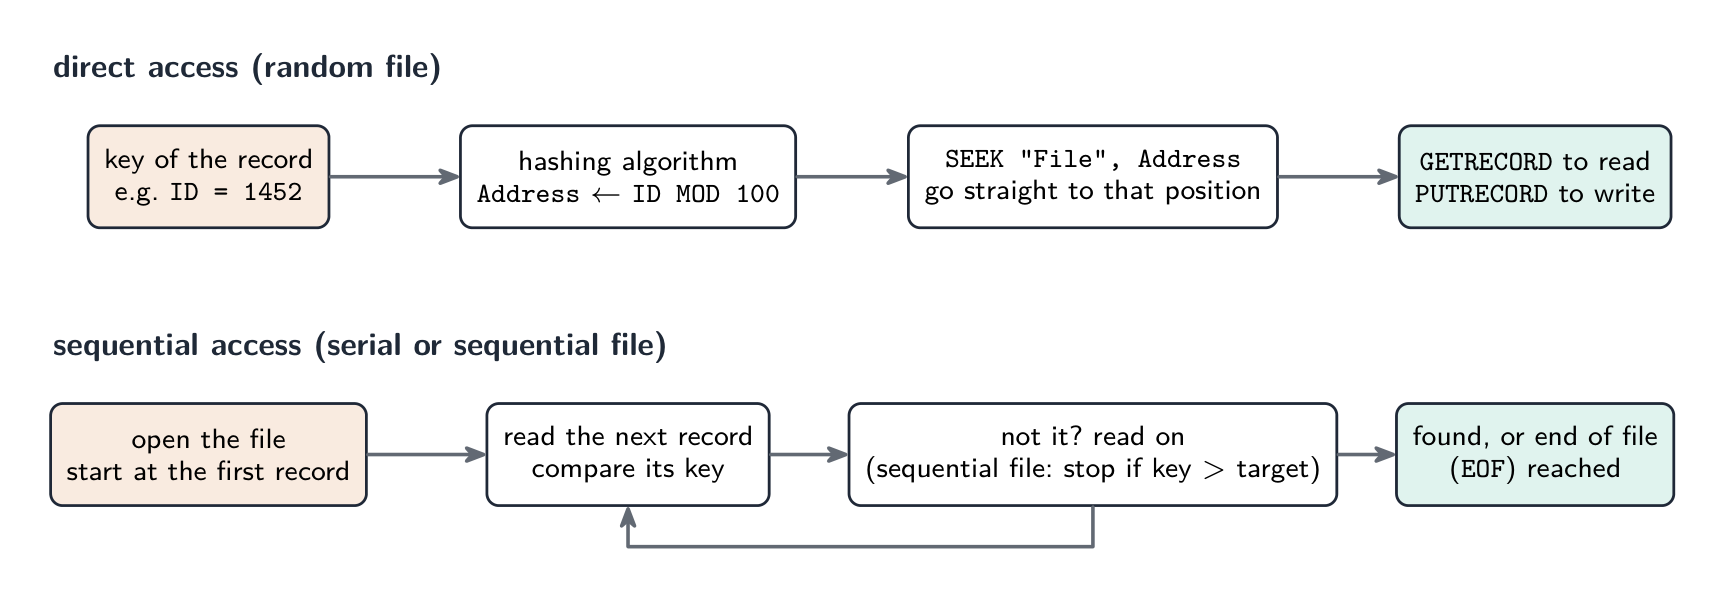
各アクセス方法の説明。 順次アクセス: ファイルの 先頭 に始まり、必要なレコードが見つかるかファイルの終わりに達するまで、 一つずつ順に (格納順に)レコードを読む。シリアル ファイルに適用すると、一致するまですべてのレコードを読み、レコードが存在しないことを確認するためにファイル全体を読むことになる。シーケンシャル ファイルに適用すると、ターゲットより大きいキーを読んだ時点で検索を 早期に停止 できる。 直接アクセス: レコードの アドレス はハッシングアルゴリズム(またはインデックス)によってキーから計算され、プログラムは そのままその位置へ移動 して前のレコードを読まずに済みます。これはランダムファイルのためのアクセス方法であり、ディスク上で一意のアドレスで参照されるレコードにも適用されます。
選択。 バッチ処理で逐次すべてのレコードを処理する給与や公用料請求のマスターファイルには シーケンシャルファイル が適しています;発生順の取引ログには シリアルファイル が適しています;実行中にキーで単一レコードを照会・更新する在庫や顧客ファイルには、直接アクセス付きの ランダムファイル が適しています。
擬似コードのファイル操作。 試験では標準文が期待され、Paper 3ではそれらを用いるアルゴリズムが出題されます:
| タスク | 文 |
|---|---|
| テキストファイルを開く | OPENFILE "Scores.txt" FOR READ (または FOR WRITE 、作成または上書き、または FOR APPEND ) |
| 行を読むまたは書く | READFILE "Scores.txt", Line と WRITEFILE "Scores.txt", Line |
| 終了テスト | WHILE NOT EOF("Scores.txt") |
| 閉じる | CLOSEFILE "Scores.txt" |
| ランダムファイルを開く | OPENFILE "Stock.dat" FOR RANDOM |
| レコード位置へ移動 | SEEK "Stock.dat", Address |
| 完全なレコードを読むまたは書く | GETRECORD "Stock.dat", Item と PUTRECORD "Stock.dat", Item |
** worked example(例題)。** ランダムファイル Stock.dat は、类型为 StockItem のレコードを、 ItemID MOD 100 によって与えられたアドレスに格納します。その位置が空であればハッシュされたアドレスに新しいアイテムを格納する擬似コードを書き、すでに使用中の場合は位置を報告してください。
DECLARE Item, Existing : StockItem
DECLARE Address : INTEGER
INPUT Item.ItemID, Item.Description, Item.Quantity
Address ← Item.ItemID MOD 100
OPENFILE "Stock.dat" FOR RANDOM
SEEK "Stock.dat", Address
GETRECORD "Stock.dat", Existing
IF Existing.ItemID = 0 THEN    // 0 marks an empty position
    SEEK "Stock.dat", Address
    PUTRECORD "Stock.dat", Item
    OUTPUT "Stored at ", Address
ELSE
    OUTPUT "Position ", Address, " is in use"
ENDIF
CLOSEFILE "Stock.dat"
マークSchemeが確認する2つの詳細: SEEK 各 GETRECORD または PUTRECORD の前(読み取りで位置が進むため、書き込み前に再シークする)、そしてファイルが FOR RANDOM で開かれ、最後に閉じられること。ランダムファイルの全レコードを別のファイルへコピーするには、SEEK を用いてGETRECORD から始まるファイルのアドレスをループし、PUTRECORD を用いてもう一方のファイルへ書き込み、空いている位置をスキップする。
探索
ファイルアクセスルート
ストレージからプログラムへ、そして戻ってくるまでファイルを安全に追跡する。
語彙
練習する
| English | 日本語 |
|---|---|
| serial file/ˈsɪərɪəl faɪl/ | 直列ファイル |
| sequential file/siːˈkwenʃl faɪl/ | 順次ファイル |
| random file/ˈrændəm faɪl/ | ランダムファイル |
| direct access/daɪˈrekt ˈækses/ | 直接アクセス |
| hash function/hæʃ ˈfʌŋkʃn/ | ハッシュ関数 |
| sequential access/siːˈkwenʃl ˈækses/ | 順次アクセス |
| deterministic/dɪˌtɜːmɪˈnɪstɪk/ | 決定論的 |
| collision/kəˈlɪʒn/ | 衝突 |
| linear probing/ˈlɪnɪə ˈprəʊbɪŋ/ | 線形プローブ |
| chaining/ˈtʃeɪnɪŋ/ | チェーン法 |
| load factor/ləʊd ˈfæktə/ | ロードファクター |
| overflow area/ˌəʊvəˈfləʊ ˈeərɪə/ | オーバーフロー領域 |
| overflow/ˌəʊvəˈfləʊ/ | オーバーフロー |
13.2
ハッシュ

ハッシュ関数(ハッシュアルゴリズム)はレコードのキーを受け取り、そのレコードが格納されるアドレスを生成する。良いハッシュ関数は高速で、決定論的であり、かつキーを均等に分散させる。
$N$ スロットに対する一般的なハッシュアルゴリズム:モジュロハッシュ address ← key MOD N;フォールディング(キーを分割して部分値を足し合わせ、MOD N);文字列ハッシュ(文字コードの総和をとり、MOD N)。
衝突とは、2つのキーが同じアドレスにハッシュされることを指す。解決方法は3つある:
| 戦略 | 仕組み | トレードオフ |
|---|---|---|
| リニアプロービング | 次の空いているスロットを使用する(wrap-around) | 単純だが、キーがクラスター化する |
| チェーニング | 各スロットがレコードのリンクリストを指す | クラスター化しないが、メモリ使用量が増える |
| リハッシュ | 第2のハッシュ関数を適用する | キーを分散できるが、処理負荷が増える |
検索の場合:キーをハッシュして該当スロットを読み取る。キーが一致すれば完了。否则、一致するか空のスロットに到達するまで解決戦略に従って進める。挿入の場合:キーをハッシュして該当スロットまたは次の空いたスロットに書き込む。ほぼO(1)での検索を保つため、ロードファクター(レコード数 ÷ スロット数)を約70%以下に保つ。
"ファイルアクセスの文脈におけるハッシュアルゴリズムの意味を説明せよ"(3点)。レコードのキーフィールドに対して計算(関数)を行い、その値をファイル内に格納され、そこから取得されるためのアドレス(場所)として利用する。 同じキーに対して同じ計算を行うと常に同じアドレスが得られるため、検索せずにレコードを再度見つけることができる。
"衝突を回避するための2つの方法を概要で述べよ。" (1) リニアプロービング(オープンアドレッシング):計算したアドレスの次の空いた位置にレコードを格納し、必要に応じて先頭へwrap-aroundする。取得の際はハッシュアドレスから始め、キーが一致するか前向きに読み進める。(2) オーバーフローエリアまたはチェーニング:衝突したレコードを別個のオーバーフローエリア(またはアドレスに付随するリンクリスト)に格納し、メインアドレスで一致しなかった場合に順次検索する。どちらでも正解となるが、格納方法だけでなく取得方法も説明すること。
** worked example.** ランダムファイルには11のレコード位置があり、0から10までの番号が振られている。ハッシュアルゴリズムはAddress ← Key MOD 11である。キーが1250, 1381, 1452, 1613, 1470のレコードをこの順に格納し、リニアプロービングを用いる。各レコードの格納位置を示し、キー1470の取得方法を説明せよ。
$1250 \bmod 11 = 7$;$1381 \bmod 11 = 6$;$1452 \bmod 11 = 0$;$1613 \bmod 11 = 7$、1250との衝突のため、1613は次の空いた位置8を取る;$1470 \bmod 11 = 7$ で再度計算し、7と8が埋まっているため、1470は9に格納される。1470を取得する場合:$7$ を計算し、位置7(キー1250、一致せず)を読み取り、8(1613、不一致)、9(1470、発見)と順に読む。一致する前に空の位置に到達した場合、そのレコードはファイル内には存在しない。衝突はファイルが小さいための代償である。良いハッシュアルゴリズムはキーを均等に分散させ、ファイルは満杯に近づけないことでプローブの長さを短く保つ。
探索
ハッシュテーブル
各キーがバケットにハッシュされる様子を見てください。適切なハッシュ関数はキーを広範囲に分散させ、検索を高速に保ちます。
13.3
フローティングポイント数

シラバス
| 受験者は以下的能力を備えているべきである: | メモおよびガイドライン |
|---|---|
| バイナリ浮動小数点実数の形式を説明する | 2の補数形式を理解する。浮動小数点表現におけるmantissa(尾数)と指数へのビット割り当ての変更がもたらす影響を理解する |
| 二進 浮動小数点実数を十進に変換し、その逆も行う | |
| 浮動小数点数を正規化する | 正規化の理由を理解する |
| (特定のケースにおいて)二進表現が表す実数の近似に過ぎないことの結果に対する理解を示す | アンダーフローおよびオーバーフローが発生する仕組みを理解する |
| 二進表現が丸め誤差を生じ得ることを理解する |
出典: Cambridge International シラバス
非常に異なる大きさの実数を格納するため、コンピュータはフローティングポイント形式を用いる。これは科学表記の二進形であり、2つのフィールドを持つ:
- mantissa — 有効数字
- exponent — 掛けるべき2の累乗
両方とも2の補数整数として格納される。値は
$$\text{number} = \text{mantissa} \times 2^{\text{exponent}}.$$
mantissa(尾数)を二進分数として読み取る — 小数点直後の最初のビットは $1/2$ の価値を持ち、次は $1/4$ 、そして $1/8$ と続く。したがって 0.1010000 は $1/2 + 1/8 = 0.625$ に相当する;指数が 00000010 (= 2 )の場合、その値は $0.625 \times 2^{2} = 2.5$ となる。
変換
- 二進 → 十進:mantissaを分数として読む(負の場合は2の補数のルールを用い)、exponentを符号付き整数として読み、mantissaに$2^{\text{exponent}}$ を掛ける。
- 十進 → 二進:数を「二進小数 × 2の累乗」の形で書き、その後 mantissa と exponent を合意された形式で格納する。
** worked example.** mantissa が10110000 、exponent が00000011 の数がある。その十進値を求めよ。
指数00000011 は$+3$ である。mantissa は1で始まるので負である。2の補数で1.0110000 として読み取ると、符号ビットの価値は$-1$ で、分数ビットの合計は$\tfrac{1}{4} + \tfrac{1}{8} = 0.375$ なので、mantissa は$-1 + 0.375 = -0.625$ となる。したがって
$$\text{number} = -0.625 \times 2^{3} = -5.0.$$
** worked example.** $+2.5$ をこの形式で格納せよ。
二進法で$2.5 = 10.1$ 。正規化された分数として書くと$2.5 = 0.101 \times 2^{2}$ 。よってmantissa は01010000 (符号ビット0、後に.101 )であり、exponent は00000010 ($= 2$ )である。
試験の形式:2の補数、mantissa、exponent
The exam states a format such as 10 bits for the mantissa and 6 bits for the exponent, both in two's complement. The mantissa's binary point sits after its first (sign) bit, so a positive mantissa is 0.xxxxxxxxx and a negative one 1.xxxxxxxxx; the exponent is an ordinary signed integer. Every conversion uses the same three moves: read the mantissa as a fraction (two's-complement rules if it starts with 1), read the exponent as an integer, multiply by $2^{\text{exponent}}$.
** worked example(二進法から十進法へ)。** mantissa 0101100000 、指数 000011 。
Mantissa: $0.101100000_2 = \tfrac{1}{2} + \tfrac{1}{8} + \tfrac{1}{16} = 0.6875$。Exponent: $000011_2 = 3$。Value: $0.6875 \times 2^{3} = 5.5$。
** worked example (負のmantissa)。** Mantissa 1011000000, exponent 000010。
Mantissaは1で始まるため負です。その値は$-1 + 0.011000000_2 = -1 + (\tfrac{1}{4} + \tfrac{1}{8}) = -0.625$、exponentは$= 2$、値は$-0.625 \times 4 = -2.5$です。(あるいは、mantissaの2の補数である0101000000$= 0.625$を取り、マイナス記号を付けます。)111110$= -2$のようなnegative exponentの場合、割り算になります:このexponentを持つmantissa $0.5$の値は$0.5 \times 2^{-2} = 0.125$です。
** worked example (デシラルからバイナリ)。** $+6.5$と$-6.5$を10ビットおよび6ビットの形式に正規化して格納する。
$6.5 = 110.1_2 = 0.1101_2 \times 2^{3}$なので、mantissaは0110100000、exponentは000011となる。$-6.5$については、mantissaの2の補数を取る:1001100000(確認:$-1 + 0.0011_2 = -1 + 0.1875 = -0.8125$、かつ$-0.8125 \times 8 = -6.5$)、exponent000011は変更しない。符号はexponentには含まれず、負の数は負のmantissaを持つ。
正規化
数字が正規化されているとは、最初の有効ビットがバイナリポイントの直後にあることを指す(先頭の不要なゼロがない)。これは精度を最大化するためであり、各mantissaのビットが情報を保持するからである。正規化するには、mantissaを左にシフトしてexponentを減らす(または右にシフトして増やす)ことで、最初の有効ビットが正しい位置に来るまで調整し、値は変化しない。負の(2の補数)mantissaの場合、符号ビット(1)の直後に0が続く。
正規化形式の識別と生成。 正の正規化mantissaは01で始まり、負のものは10で始まる。したがって、0011000000は正規化されていない(1つ左にシフトしてexponentから1を引く:0110000000、exponentは1小さく)、1100000000も正規化されていない(パターンが10...になるまで左にシフトする)。mantissaを1つ左にシフトするたびに、exponentから1を引く必要があり、そうでなければ値が変わってしまう。
"Explain why numbers are stored in normalised form" (two marks). (1) It gives the maximum precision (accuracy) for the number of bits available, because no bits are wasted on leading zeros (or leading ones for a negative number); (2) each number then has a unique representation, so numbers can be compared; and (3) it makes the best use of the available range. Any two of these score.

近似と丸め誤差
多くのデシマル実数は正確に格納できない — 例として、$0.1_{10}$は反復バイナリ分数$0.000110011\ldots_{2}$であり、切り捨てる必要がある。影響:
- 丸め誤差が多数の演算を通じて蓄積する(
0.1 + 0.2は0.3と正確に一致しない)。 - 比較が失敗する — 実数の等価性をテストしてはいけない。微小な許容誤差
IF Difference < 0.000001より差分が小さいかをテストせよ(差分は正しい順序で取るか、問題で定義されたモジュロ関数を通じて)。ABSは9618の挿入図やPseudocode Guideにはないため、仮定してはいけない:ガイドによれば、問題が必要な関数はすべて与えられる。 - ほぼ等しい2つの値を引くと精度が失われる。
- オーバーフロー(結果がexponentの範囲を超えて大きすぎる場合)およびアンダーフロー(結果が小さすぎて丸めによりゼロになる場合)は、exponentの範囲が限界に達したときに発生する。
正確な計算が必要な場合(通貨など)には、浮動小数点数ではなく固定小数点数またはBCDを使用する。
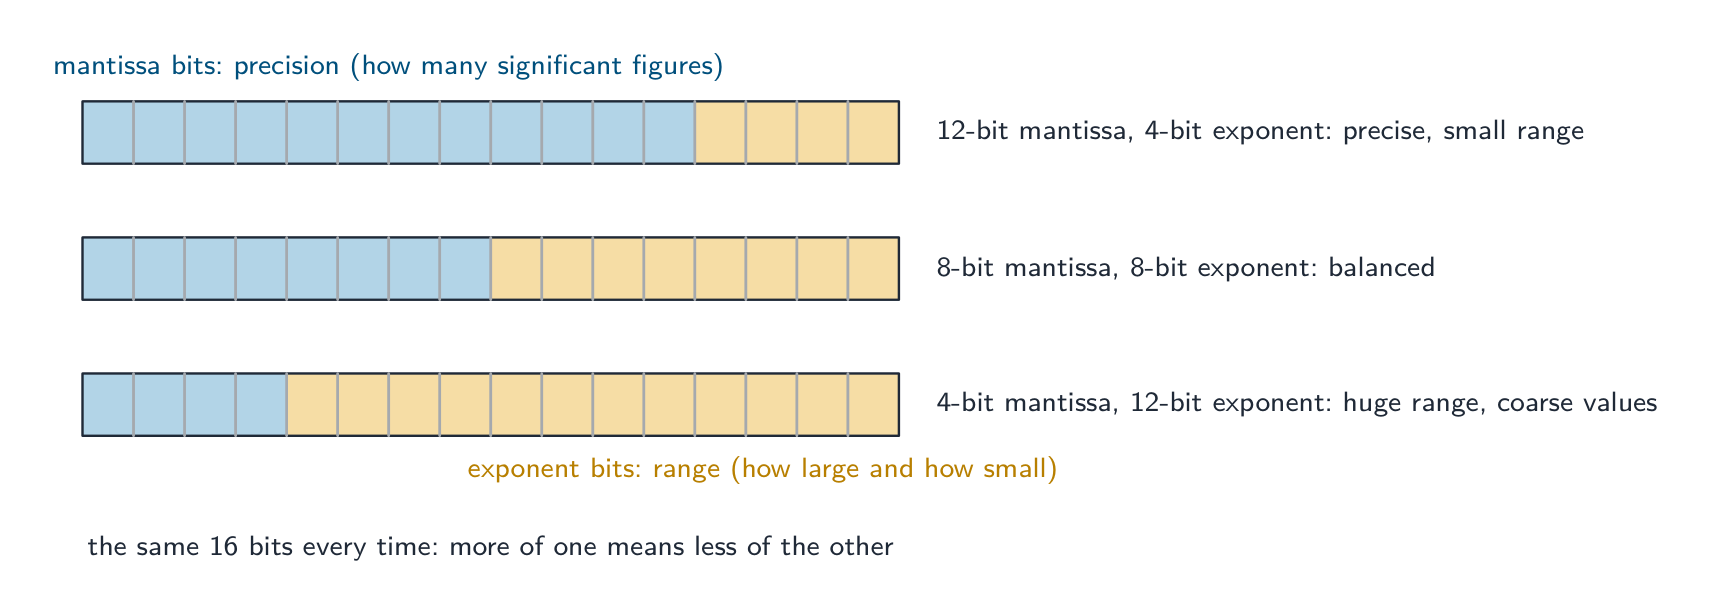
「ビットの割り当ての変更の影響を説明せよ」(3点) 固定された総ビット数において、mantissaを増やしてexponentを減らすと精度が高まり(有効桁数が増え、丸め誤差が小さくなる)、範囲は小さくなる(格納可能な最大・最小の絶対値が縮小する)。逆にexponentを増やすと逆の効果が生じ、精度を犠牲にして大きな範囲を得る。両方の変化と方向を名指しで答えること。
最大値と最小値。 10ビットmantissa、6ビットexponentの形式において、最大の正の数はmantissa 0111111111 ($= 1 - 2^{-9}$)、exponent 011111 ($= 31$) で、約$2^{31}$。最小的な正の正規化数はmantissa 0100000000 ($= 0.5$)、exponent 100000 ($= -32$) で、$0.5 \times 2^{-32} = 2^{-33}$。最も負の数はmantissa 1000000000 ($= -1$)、exponent $31$ で、$-2^{31}$。
「オーバーフローとアンダーフローの意味を説明せよ」 オーバーフローとは、計算の結果が表現できる最大の数よりも大きい場合に起こり、exponentに必要なビット数が不足する。一方、アンダーフローとは、結果が表現できる最小の(ゼロでない)数よりも小さい場合に起こり、ゼロに近すぎてexponentで表現できないため、ゼロとして格納される。どちらもmantissaではなくexponentの範囲によるものである。
なぜ二進表現は近似に過ぎないか。 二進分数は $\tfrac{1}{2}, \tfrac{1}{4}, \tfrac{1}{8}, \ldots$ の和のみ正確に表せる。$0.1$ や $\tfrac{1}{3}$ といった値は無限の二進展開を持つため、mantissaの有効桁数が固定されていると、格納される値は収まる最も近い値となる。この差は丸め誤差と呼ばれる。1つの数においては小さいが、反復計算を通じて蓄積する($0.1$ を10回足しても厳密に $1$ にならないことがある)。そのため、実数に対して厳密な等価性をテストしてはならない。
探索
浮動小数点数を構築する
mantissa(尾数)と指数ビットを反転させて値を作成し、正規化されているか確認する。
探索
浮動小数点数の正規化
正規化の手順を踏む。mantissa の先頭の不要なゼロを削除するためにシフトし、それに合わせて指数を調整することで、値は同じまま但しすべてのビットが有効性(精度)に使われるようになる。
語彙
練習する
| English | 日本語 |
|---|---|
| floating-point/ˈfləʊtɪŋ pɔɪnt/ | 浮動小数点 |
| exponent/ekˈspəʊnənt/ | 指数 |
| two's complement/tuːz ˈkɒmplɪmənt/ | 補数 |
| normalised/ˈnɔːməlaɪzd/ | 正規化 |
| rounding errors/ˈraʊndɪŋ ˈerəz/ | 丸め誤差 |
| underflow/ˌʌndəˈfləʊ/ | アンダーフロー |
| fixed-point/fɪkst pɔɪnt/ | 固定小数点 |
| BCD/ˌbiː siː ˈdiː/ | BCD |
| precision/prɪˈsɪʒn/ | 精度 |
| range/reɪndʒ/ | 範囲 |
13.3
出題者が認める定義
定義問題は固定された用語に基づいて採点されます。これらを正確に暗記し、一つの答えのみを答えてください。
| 用語 | 定義 |
|---|---|
| ユーザー定義データ型 | プログラマによって既存のタイプに基づき定義され、特定の問題に対応するデータを表すデータ型 |
| 非合成型 | 他タイプへの参照なしに定義されたタイプ;単一の値(整数、実数、列挙型、ポインタ)を保持します |
| 合成型 | 他のタイプから構成されるタイプ;1つの識別子の下に複数の値を保持します(レコード、セット、配列、クラス) |
| 列挙型 | 非合成型の一種で、可能なすべての値を順序に従ってリストアップすることで定義されます |
| ポインタ型 | 非合成型の一種で、その値は指定されたタイプの变量のメモリアドレスです |
| セット | 合成型で、あるタイプの値の集合を保持します。順序は任意であり、重複は許容されません |
| レコード | 合成型で、固定個のフィールドを持ちます。各フィールドは独自の識別子とタイプを持ち、ドット表記でアクセスします |
| クラス | 合成型で、属性(データ)とそれらに作用するメソッド(プロシージャおよび関数)を組み合わせたものです。オブジェクトはクラスのインスタンスです |
| シリアルファイル | 記録が追加された順に、1つずつ連ねて格納されたファイル |
| 順次ファイル | 記録がキーフィールドの順序に従って、1つずつ連ねて格納されたファイル |
| ランダムファイル | 記録がハッシュアルゴリズムによりキーから計算されたアドレスに格納されたファイル |
| 順次アクセス | ファイルの先頭から順に記録を読み取っていき、必要な記録が見つかるまで続けること |
| 直接アクセス | キーから記録のアドレスを計算し、その位置へ直接移動すること |
| ハッシュアルゴリズム | 記録のキーに対して計算を行い、記録が格納・検索されるアドレスを求める手法 |
| コリジョン | 異なる2つのキーが同じアドレスを生み出すこと |
| mantissa(尾数) | 浮動小数点数字において有効桁を保持する部分。2の補数形式の分数として表されます |
| 指数 | 2の補数整数で、mantissaを乗算する2の累乗の値を示します |
| normalised | a floating-point number whose mantissa begins 01 (positive) or 10 (negative), so no bits are wasted on leading zeros or ones |
| オーバーフロー | 利用可能なビット数では表現できないほど大きな結果 |
| アンダーフロー | 非ゼロの結果が小さすぎて表現できず、ゼロとして格納される状態 |
| 丸め誤差 | 実数と、二進表現が保持できる最も近い値との間の差 |
13.3
試験対策
- 疑似コードの宣言は行ごとに以下のように标记される:列挙型には
TYPE ... = (...)、ポインタにはTYPE ... = ^...、セットにはTYPE ... = SET OF ...followed byDEFINE ... (...) : ...、レコードにはTYPE ... DECLARE ... ENDTYPE、クラスにはCLASS ... PRIVATE ... PUBLIC PROCEDURE NEW ... ENDCLASS。 - タイプとデータの対応付け:固定した名付けた値は列挙型、複数の異なるフィールドのグループはレコード、一意の値の集まりはセット、データ+振る舞いはクラス、アドレスはポインタ型です。
- ファイル組織は記録を格納する方法、ファイルアクセスは記録を見つける方法です。シリアルと順次は順次読み取りが行われ、ランダムファイルはキーのハッシュによる直接アクセスを用います。順次ファイルの順次探索では早期終了が可能ですが、シリアルファイルでは不可能です。
- ランダムファイルの擬似コード:
OPENFILE ... FOR RANDOMとSEEKはGETRECORDまたはPUTRECORDの前に必ず置き、CLOSEFILEは最後に置きます。ハッシュの説明では、コリジョンが解決される方法を述べてください。 - 浮動小数点:mantissaは符号ビットの後に小数点を持つ2の補数分数、指数は整数、$2^{\text{exponent}}$ で乗算します。正規化するには左シフトして指数から1を引きます。mantissaは精度を、指数は範囲を提供します。
- 「説明せよ」の定型回答の3つ:正規化の理由(精度、一意性、範囲)、ビットの再割り当ての効果(精度と範囲のトレードオフ)、なぜ$0.1$を正確に格納できないか(有限のmantissa内の無限の二進分数)。
一般的なミス
- 新しいタイプに
DECLAREをTYPEの代わりに書くか、ENDTYPEを省略する。SET OFなくしてセットを宣言するか、列挙型の値を引用符で囲む。 - 浮動小数点の符号を指数に入れる。符号はmantissaの最初のビットである。
- 負のmantissaを符号付き絶対値形式のように読み取ってしまう; 実際は2の補数なので、
1011000000は $-0.625$ であり、$-0.375$ ではない。 - 指数を変えずにmantissaを正規化のためにシフトするか、逆にシフトして指数を下げる。
- ランダムファイルを「ランダムな順序で」と説明する。記録はキーから計算されたアドレスにある。
- 順次ファイルについて順次アクセスが「ファイル全体」を読むと言う。大きいキーに出会ったら停止する。
- ハッシュを説明する際、計算値が何に使われるか(記録を格納・検索するためのアドレス)を述べない、またはコリジョンの対処法を述べる。
- オーバーフローを「桁数が多すぎる」と定義するのではなく、表現可能な最大値を超える結果であるとする。またはそれをmantissaのせいにする。
語彙
練習する
| English | 日本語 |
|---|---|
| mantissa/mænˈtɪsə/ | 尾数 |
このトピックのインタラクティブ授業
一歩ずつ進め、即時チェック付きの問題で学習します。