| Kandidat harus mampu: | Catatan dan panduan |
|---|---|
| Tunjukkan pemahaman tentang bagaimana graf dapat digunakan untuk membantu Kecerdasan Buatan (AI) | Tujuan dan struktur graf Gunakan algoritma A* dan algoritma Dijkstra untuk melakukan pencarian pada graf Kandidat tidak akan diminta menulis algoritma untuk mengatur, mengakses, atau melakukan pencarian pada graf |
| Tunjukkan pemahaman tentang bagaimana jaringan saraf tiruan buatan telah membantu pembelajaran mesin | |
| Tunjukkan pemahaman tentang Deep Learning, Machine Learning dan Reinforcement Learning serta alasan penggunaan metode-metode ini. | Pahami kategori machine learning, termasuk supervised learning, unsupervised learning |
| Tunjukkan pemahaman tentang back propagation of errors dan regression methods dalam machine learning |
Kecerdasan Buatan (AI)
Ilmu Komputer A-Level · Topik 18
 13:12
Apa itu AI
Tidak pernah ada yang menulis aturan untuk membedakan kucing dari anjing. Tidak ada programmer yang duduk dan mengetik "jika memiliki telinga runcing dan kumis". Namun ponsel Anda melakukannya…
Narasi bahasa Inggris · Subtitle bahasa Inggris + 中文 disematkan langsung
18.1
Apa itu AI

Silabus
Sumber: Silabus Cambridge International
Kecerdasan buatan (AI) membangun sistem yang melakukan tugas-tugas yang biasanya membutuhkan kecerdasan manusia — mengenali suara dan gambar, menerjemahkan, bermain permainan, berkendara, menghasilkan teks. Sebagian besar AI modern menggunakan belajar mesin — algoritma yang mempelajari pola dari data alih-alih diprogram langkah demi langkah. Di dalamnya, belajar mendalam, menggunakan jaringan saraf dengan banyak lapisan, telah dominan sejak dekade 2010-an.
Sebuah robot humanoid memasukkan banyak kemampuan ini ke dalam satu tubuh: ia menggunakan AI untuk melihat wajah, memahami suara, dan menggerakkan wajah serta lengannya dengan cara yang menyerupai kehidupan nyata.

Jelajahi
Lab jenis pembelajaran AI
Klasifikasikan contoh AI berdasarkan jenis pembelajaran atau perhatian yang terlibat.
Kosa kata
Latih
| English | Bahasa Indonesia |
|---|---|
| artificial intelligence/ˌɑːtɪˈfɪʃl ɪnˈtelɪdʒəns/ | kecerdasan buatan |
| machine learning/məˈʃiːn ˈlɜːnɪŋ/ | pembelajaran mesin |
| deep learning/diːp ˈlɜːnɪŋ/ | pembelajaran mendalam |
| neural networks/ˈnjuːrəl ˈnetwɜːks/ | jaringan saraf tiruan |
| humanoid robot/ˈhjuːmənɔɪd ˈrəʊbɒt/ | robot humanoid |
18.1
Graf dalam AI

Banyak masalah AI berada pada sebuah graf — simpul (keadaan, tempat) yang terhubung oleh sisi (pergerakan, hubungan).
- penemuan jalur: jalan membentuk graf; rute terpendek adalah pencarian graf (algoritma Dijkstra, algoritma A*).
- bermain permainan: setiap posisi papan adalah simpul, setiap gerakan adalah sisi; minimax dengan pemangkahan alpha-beta mencari pohon permainan.
- pencarian ruang-keadaan: masalah perencanaan adalah bergerak antar keadaan dengan menerapkan operator untuk mencapai tujuan.
- representasi pengetahuan: sebuah jaring semantik memiliki konsep sebagai simpul dan hubungan sebagai sisi ("anjing IS-A hewan"); sebuah graf pengetahuan menyimpan fakta tentang dunia untuk mesin pencari dan asisten.
Alat standar untuk menavigasi graf termasuk pencarian lebar-dahulu dan pencarian kedalaman-dahulu.
"Jelaskan tujuan dan struktur graf dalam sistem AI." Tujuan: untuk merepresentasikan masalah sebagai himpunan keadaan (atau tempat) dan gerakan yang mungkin di antaranya, sehingga algoritma dapat mencarinya untuk menemukan solusi, seperti rute terpendek atau termurah, atau langkah terbaik berikutnya. Struktur: himpunan simpul (verteks), masing-masing merepresentasikan keadaan, lokasi, atau item, yang dihubungkan oleh sisi yang mewakili koneksi di antaranya; setiap sisi mungkin membawa bobot (biaya, jarak, atau waktu), dan sisi-sisi tersebut bisa terarah (searah) atau tidak terarah. "Jelaskan penggunaan graf untuk membantu AI": graf adalah model tempat algoritma pencarian AI berjalan: Algoritma A* dan Dijkstra menemukan jalur optimal di dalamnya (navigasi, penyetoran rute), posisi permainan membentuk pohon yang dicari untuk langkah terbaik, dan pengetahuan yang disimpan sebagai graf memungkinkan sistem bernalar tentang bagaimana fakta-fakta saling berkaitan.
 Graf yang digunakan di bawah ini: angka pada sisi adalah jarak nyata; angka merah adalah estimasi heuristik setiap simpul mengenai seberapa jauh lagi menuju tujuan, yang hanya digunakan oleh A"
Algoritma Dijkstra. Ini menemukan jarak terpendek dari titik awal ke setiap simpul. Simpan tabel jarak terbaik yang ditemukan sejauh ini ke setiap simpul (awal 0, semua lainnya tak terhingga). Berulang-ulang ambil simpul yang belum dikunjungi dengan jarak terkecil, tandai sebagai dikunjungi, dan untuk setiap tetangga periksa apakah lewat simpul ini memberikan jarak yang lebih pendek; jika ya, perbarui dan catat darimana itu berasal. Berhenti ketika setiap simpul telah dikunjungi (atau target tercapai).
Contoh terpecahkan. Temukan jarak terpendek dari H ke setiap simpul lain pada graf di atas.
| langkah | kunjungi | H | A | B | C | D | G |
|---|---|---|---|---|---|---|---|
| mulai | 0 | ∞ | ∞ | ∞ | ∞ | ∞ | |
| 1 | H (0) | 0 | 4 (H) | 3 (H) | ∞ | ∞ | ∞ |
| 2 | B (3) | 0 | 4 (H) | 3 | ∞ | 9 (B) | ∞ |
| 3 | A (4) | 0 | 4 | 3 | 9 (A) | 8 (A) | ∞ |
| 4 | D (8) | 0 | 4 | 3 | 9 (A) | 8 | 10 (D) |
| 5 | C (9) | 0 | 4 | 3 | 9 | 8 | 10 (D) |
| 6 | G (10) |
Jarak terpendek: A 4, B 3, D 8, C 9, G 10, dan jalur menuju G adalah H–A–D–G (baca label "dari mana" secara terbalik). Pada langkah 3, A menawarkan D jarak $4 + 4 = 8$, lebih baik daripada 9 yang ditemukan melalui B, jadi D diperbarui; pada langkah 5, C bisa mencapai G pada $9 + 3 = 12$, lebih buruk daripada 10, jadi tidak ada perubahan. Menunjukkan perbandingan-perbandingan ini adalah "kerja" yang diminta oleh pertanyaan tersebut.
Algoritma A.* Dijkstra menjelajah ke segala arah. A* menambahkan heuristik $h$, estimasi jarak yang masih harus ditempuh, dan selalu memperluas simpul dengan $f = g + h$ terkecil, di mana $g$ adalah jarak yang telah ditempuh sejauh ini. Dengan heuristik yang masuk akal (tidak pernah melebih-lebihkan), ia menemukan jalur terpendek yang sama sambil memeriksa jauh lebih sedikit simpul, itulah sebabnya satnav dan game menggunakannya. Soal ujian memberikan $h$ untuk setiap simpul dan tabel untuk diisi.
Contoh terpecahkan. Temukan jalur dari H ke G menggunakan A*, tunjukkan kerjanya.
| simpul yang diekspansi | $g$ sejauh ini | $h$ | $f = g + h$ | tetangga ditambahkan (simpul: $g$, $h$, $f$) |
|---|---|---|---|---|
| H | 0 | 7 | 7 | A: 4, 5, 9; B: 3, 6, 9 |
| B (seri dengan A; salah satu) | 3 | 6 | 9 | D via B: 9, 2, 11 |
| A | 4 | 5 | 9 | C: 9, 3, 12; D via A: 8, 2, 10 (lebih baik dari 11, simpan) |
| D | 8 | 2 | 10 | G: 10, 0, 10; C via D: 9 (tidak lebih baik) |
| G | 10 | 0 | 10 | tujuan tercapai |
Jalur H–A–D–G, panjang 10, sama dengan Dijkstra, tetapi C tidak pernah diekspansi. Setiap kali simpul dicapai oleh rute kedua, simpan $g$ yang lebih kecil; pencarian berakhir ketika tujuan adalah simpul dengan $f$ terkecil. Nyatakan nilai $g$, $h$, dan $f$ di setiap baris: itu adalah poinnya.
Kosa kata
Latih
| English | Bahasa Indonesia |
|---|---|
| graph/ɡræf/ | grafik |
| nodes/nəʊdz/ | nod |
| edges/ˈedʒɪz/ | tepian |
| minimax/ˈmɪnɪmæks/ | minimax |
| semantic network/səˈmæntɪk ˈnetwɜːk/ | jaringan semantik |
| knowledge graph/ˈnɒlɪdʒ ɡræf/ | graf pengetahuan |
| breadth-first search/bredθ fɜːst sɜːtʃ/ | pencarian breadth-first |
| depth-first search/depθ fɜːst sɜːtʃ/ | pencarian depth-first |
| weight/weɪt/ | berat |
| heuristic/hjuːˈrɪstɪk/ | heuristik |
| labels/ˈleɪblz/ | label |
18.1
Jaringan syaraf tiruan (ANNs)

Sebuah ANN terinspirasi oleh neuron otak. Sebuah neuron buatan:
- menerima beberapa nilai input, mengalikan masing-masing dengan bobot, dan menjumlahkannya dengan istilah bias.
- menerapkan fungsi aktivasi (fungsi non-linear seperti ReLU) pada jumlah tersebut.
- menghasilkan hasil, yang kemudian memberi umpan ke neuron-neuron selanjutnya.
Neuron terletak dalam lapisan: lapisan input, satu atau lebih lapisan tersembunyi (di mana pola internal yang berguna dipelajari), dan lapisan output. Dengan banyak lapisan tersembunyi, ini disebut jaringan syaraf dalam, dan melatihnya disebut pembelajaran mendalam.

ANNs memungkinkan model mempelajari pola kompleks langsung dari data mentah (pixel, audio, teks) tanpa fitur yang dirancang manual — mendorong terobosan dalam pengenalan gambar, pengenalan ucapan, terjemahan mesin, dan bermain game. Mereka bekerja baik dengan jumlah data besar, input yang bising atau sangat kompleks, dan pola yang terlalu sulit ditangkap dengan aturan eksplisit.
"Jelaskan apa yang dimaksud dengan jaringan saraf tiruan." Model dari jaringan neuron dalam otak, yang terdiri dari lapisan-lapisan simpul yang terhubung: lapisan input, satu atau lebih lapisan tersembunyi, dan lapisan output. Setiap koneksi memiliki bobot; setiap simpul menjumlahkan input terbobotnya dan meneruskan hasilnya melalui fungsi aktivasi ke lapisan berikutnya. "Jelaskan bagaimana ANNs memungkinkan pembelajaran mesin" (tiga nilai): jaringan tersebut dilatih pada banyak contoh; untuk setiap contoh, output dibandingkan dengan hasil yang diharapkan dan kesalahan digunakan untuk menyesuaikan bobot (backpropagation) sehingga kesalahan menurun; setelah cukup banyak contoh, bobot mengkodekan pola dalam data, dan jaringan kemudian dapat mengklasifikasikan atau memprediksi untuk data baru yang belum pernah dilihatnya sebelumnya. "Nyatakan alasan adanya lapisan tersembunyi ganda": setiap lapisan tambahan menggabungkan fitur yang ditemukan oleh lapisan sebelumnya menjadi fitur yang lebih kompleks dan lebih abstrak, sehingga jaringan dapat mempelajari hubungan yang lebih kompleks (garis tepi, kemudian bentuk, kemudian objek); itulah yang membuat sebuah jaringan menjadi "dalam".
Jelajahi
Ketuk bagian-bagian dari jaringan saraf
Jelajahi lapisan-lapisannya. Data mengalir dari kiri ke kanan: lapisan input menerima fitur, lapisan tersembunyi mempelajari pola, dan lapisan output memberikan jawaban — dengan setiap koneksi membawa bobot yang disesuaikan oleh pelatihan.
Kosa kata
Latih
| English | Bahasa Indonesia |
|---|---|
| artificial neuron/ˌɑːtɪˈfɪʃl ˈnjuːrɒn/ | neuron buatan |
| bias term/ˈbaɪəs tɜːm/ | istilah bias |
| activation function/ˌæktɪˈveɪʃn ˈfʌŋkʃn/ | fungsi aktivasi |
| hidden layers/ˈhɪdn ˈleɪəz/ | lapisan tersembunyi |
| deep neural network/diːp ˈnjuːrəl ˈnetwɜːk/ | jaringan saraf dalam |
| image recognition/ˈɪmɪdʒ ˌrekəɡˈnɪʃn/ | pengenalan gambar |
| speech recognition/spiːtʃ ˌrekəɡˈnɪʃn/ | pengenalan suara |
| machine translation/məˈʃiːn trænˈsleɪʃn/ | terjemahan mesin |
| reinforcement learning/ˌriːɪnˈfɔːsmənt ˈlɜːnɪŋ/ | pembelajaran penguatan |
| supervised learning/ˈsuːpəvaɪzd ˈlɜːnɪŋ/ | pembelajaran terawasi |
| classification/ˌklæsɪfɪˈkeɪʃn/ | klasifikasi |
| backpropagation/ˌbækprəpəˈɡeɪʃn/ | backpropagation |
18.1
Pembelajaran mesin, pembelajaran mendalam, pembelajaran penguatan
Pembelajaran mesin
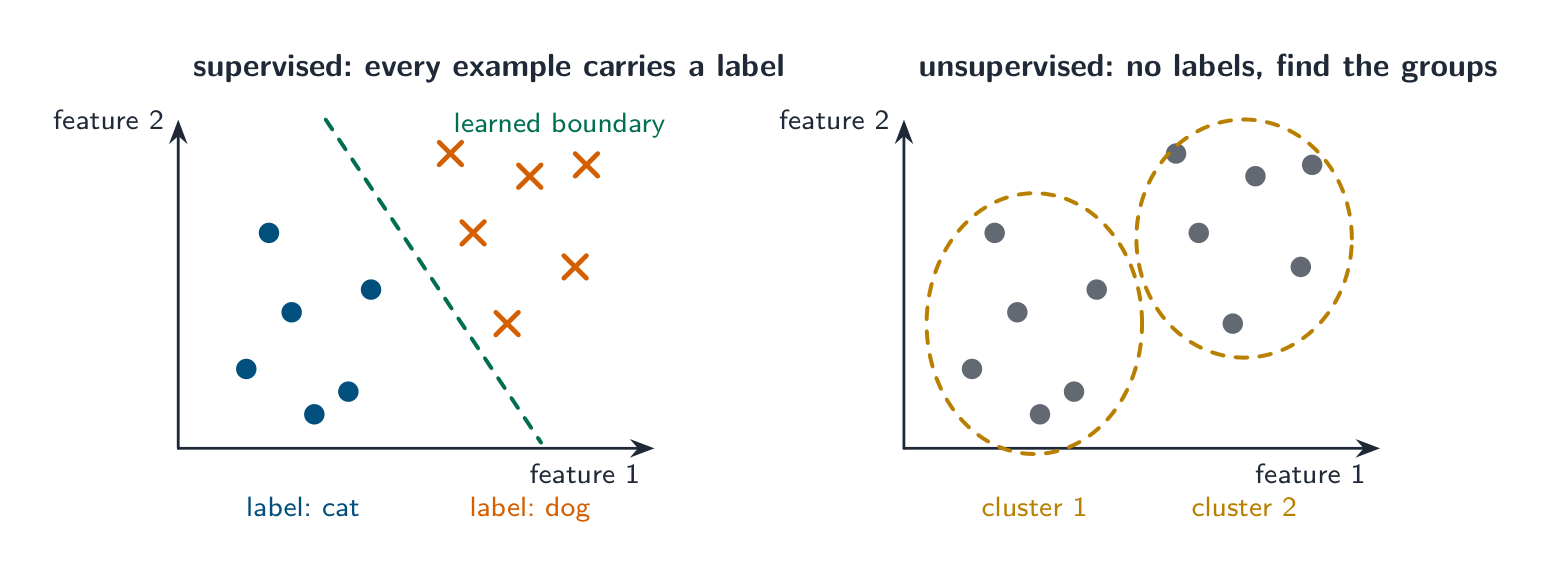
Istilah payung — algoritma apa pun yang belajar dari data. Tiga paradigma:
- pembelajaran terawasi — data memiliki label (gambar ditandai "kucing"/"anjing"); algoritma belajar input → label. Digunakan untuk klasifikasi (kategori) dan regresi.
- pembelajaran tak terawasi — tanpa label; algoritma menemukan struktur, mis. kelompok pelanggan yang serupa.
- pembelajaran penguatan (di bawah ini).
Gunakan ML ketika aturan eksplisit tidak praktis (filter spam, rekomendasi, deteksi penipuan).
"Jelaskan pembelajaran terawasi dan pembelajaran tak terawasi" (pengertian kata yang diberi tanda). Pembelajaran terawasi: algoritma dilatih pada data pelatihan yang berlabel, setiap contoh dipasangkan dengan output yang benar (target); ia mempelajari hubungan antara input dan output dan menggunakannya untuk mengklasifikasikan atau memprediksi input baru; jawabannya diketahui selama pelatihan, sehingga kesalahan dapat diukur. Pembelajaran tak terawasi: data tidak berlabel, tanpa jawaban benar yang diberikan; algoritma mencari pola, struktur, atau pengelompokan dalam data secara mandiri (mengelompokkan item serupa, menemukan asosiasi); outputnya adalah sekumpulan kategori atau hubungan yang tidak didefinisikan sebelumnya. Perbedaan mereka: data berlabel berbanding data tidak berlabel; output yang diketahui berbanding struktur yang ditemukan; pembelajaran terawasi digunakan untuk memprediksi (klasifikasi, regresi), pembelajaran tak terawasi untuk menjelajahi (pengelompokan, deteksi anomali). Keduanya adalah kategori pembelajaran mesin; yang ketiga adalah pembelajaran penguatan.

Pembelajaran mendalam
Subset dari ML menggunakan jaringan saraf tiruan yang dalam. Lapisan bawah mempelajari pola sederhana (garis tepi, fonem), lapisan atas menggabungkannya menjadi konsep abstrak. Memerlukan banyak data dan komputasi besar (GPU); untuk dataset kecil, metode ML yang lebih sederhana sering kali memberikan hasil lebih baik.
"Jelaskan apa yang dimaksud dengan pembelajaran mendalam" (tiga nilai). Pembelajaran mesin yang menggunakan jaringan saraf tiruan dengan banyak lapisan tersembunyi (jaringan dalam); jaringan tersebut dilatih pada jumlah data yang sangat besar, dan setiap lapisan mengekstrak fitur dari output lapisan di bawahnya, sehingga jaringan mempelajari fitur yang dibutuhkan secara mandiri alih-alih ditentukan oleh programmer. Alasan penggunaannya: dapat menyelesaikan masalah yang terlalu kompleks untuk aturan tulisan tangan atau model dangkal (mengenal wajah, memahami ucapan, menerjemahkan teks); membaik seiring bertambahnya data yang tersedia; menghilangkan kebutuhan rekayasa fitur manual manusia; dan dapat menangani data tak terstruktur seperti gambar, suara, dan teks. Cara membuatnya lebih efektif: lebih banyak (dan berlabel lebih baik) data pelatihan; lebih banyak lapisan atau simpul, dalam batas overfitting; lebih banyak daya pemrosesan (GPU) dan waktu pelatihan; penyetelan laju pembelajaran dan parameter lainnya. Contoh: pengenalan ucapan dalam asisten suara, pengenalan gambar dalam pemindaian medis dan mobil otonom, penerjemahan mesin, sistem rekomendasi.
Pembelajaran penguatan
Dalam pembelajaran penguatan, sebuah agen bertindak dalam lingkungan; setiap tindakan mengubah keadaan dan mengembalikan hadiah. Agen mempelajari kebijakan (strategi) yang memaksimalkan total hadiah sepanjang waktu, melalui percobaan dan kesalahan tanpa label di awal. Digunakan untuk masalah keputusan berurutan — permainan, kontrol robot, berkendara otonom.
"Jelaskan apa yang dimaksud dengan pembelajaran penguatan" (tiga nilai). Sebuah agen belajar melalui berinteraksi dengan lingkungannya: ia melakukan tindakan, lingkungan berpindah ke keadaan baru dan mengembalikan hadiah (atau hukuman), serta agen menyesuaikan perilakunya untuk memaksimalkan total hadiah seiring waktu. Tidak ada data berlabel: agen belajar melalui percobaan dan kesalahan, menemukan tindakan mana yang baik dari hadiah yang dikumpulkan, dan secara bertahap membentuk kebijakan yang menyatakan apa yang harus dilakukan di setiap keadaan. Digunakan ketika jawaban yang benar tidak diketahui sebelumnya tetapi hasil dari suatu tindakan dapat dinilai: permainan komputer (catur, Go), kontrol robot, pengaturan lampu lalu lintas, alokasi sumber daya. Sebuah komputer yang memainkan permainan papan melawan pengguna belajar dengan cara ini, atau menelusuri pohon permainan dengan minimax untuk memilih langkah yang hasil terburuknya adalah yang terbaik.

Sebuah mobil tanpa pengemudi adalah contoh nyata. Sensor Lidar dan kamera (unit berputar di atap) membangun gambar jalan secara langsung, dan kebijakan yang telah dipelajari memutuskan bagaimana kemudi, mempercepat, dan mengerem dengan aman.


Kosa kata
Latih
| English | Bahasa Indonesia |
|---|---|
| self-driving car/self ˈdraɪvɪŋ kɑː/ | mobil tanpa pengemudi |
| agent/ˈeɪdʒənt/ | agen |
| reward/rɪˈwɔːd/ | reward |
| policy/ˈpɒlɪsi/ | kebijakan |
| lidar/ˈlaɪdɑː/ | lidar |
18.1
Melatih ANN: propagasi balik
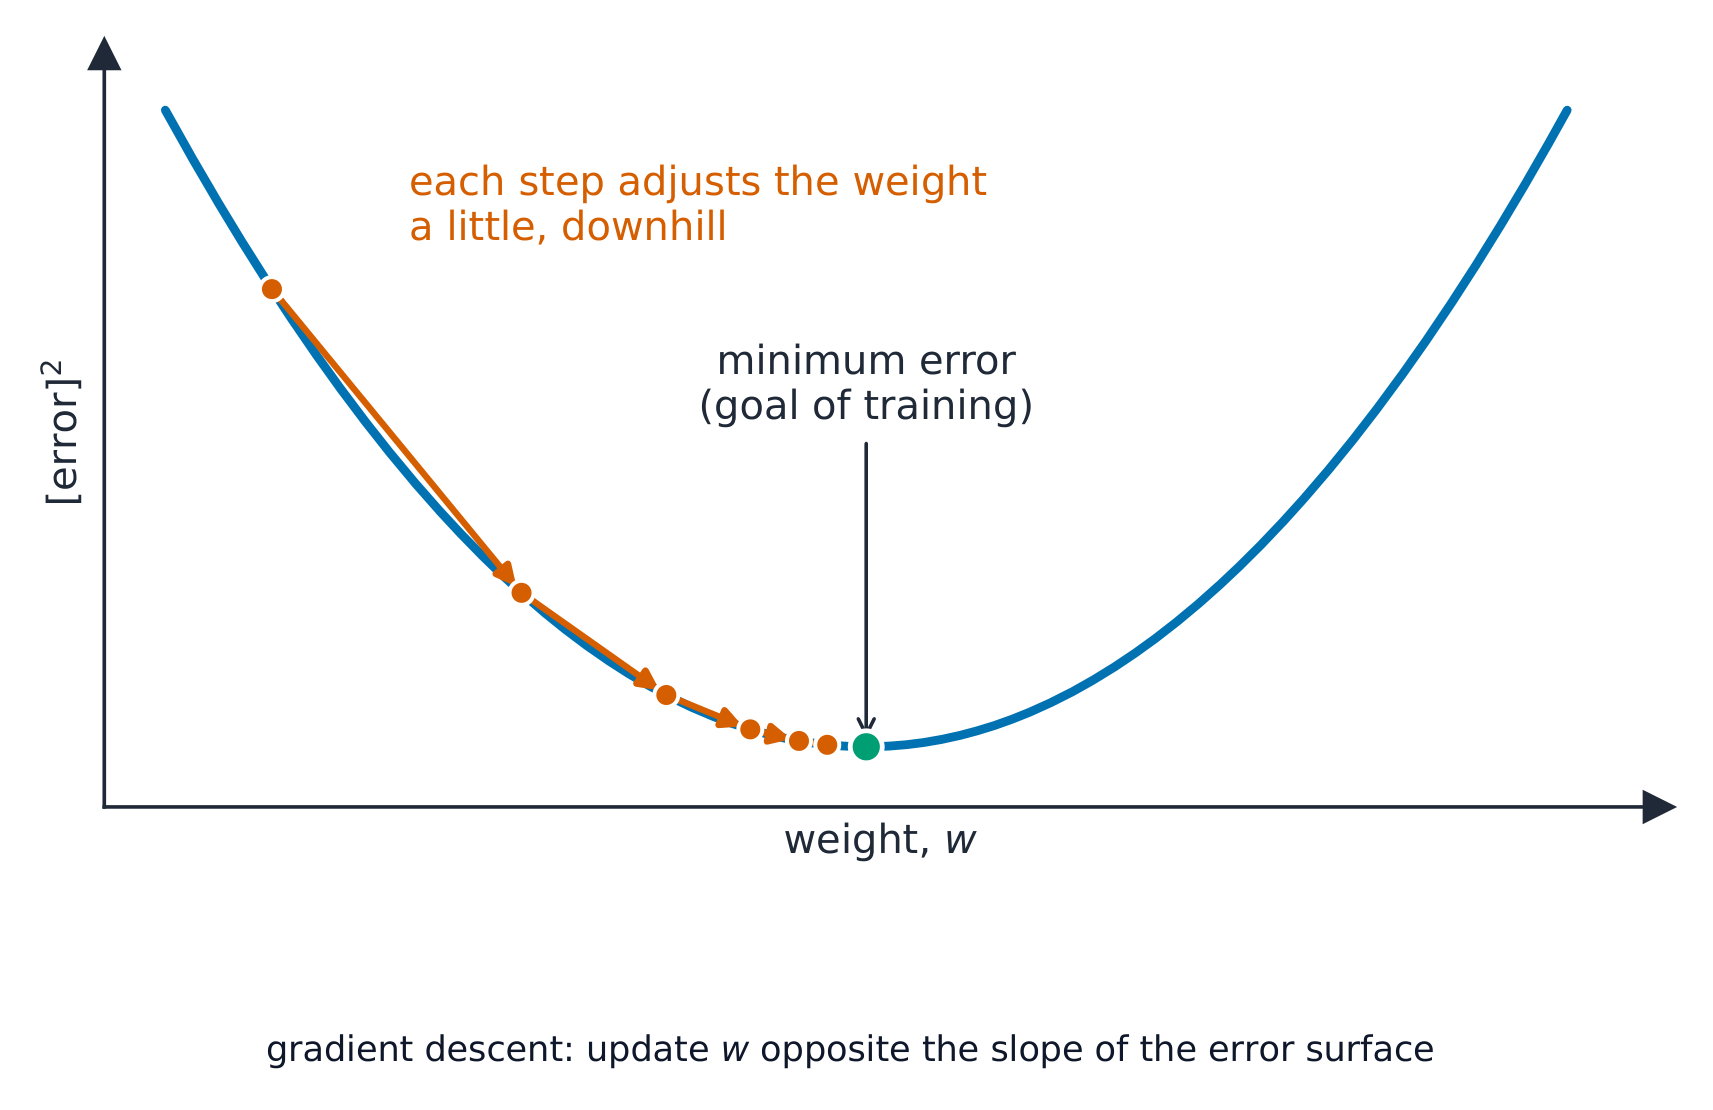
Pelatihan menyesuaikan bobot agar keluaran sesuai dengan target. Metode standarnya adalah propagasi balik (back propagation of errors) dengan penurunan gradien. Untuk setiap contoh pelatihan:
- laju maju — umpankan input hingga ke output.
- hitunglah kesalahan dengan fungsi kehilangan (sebuah angka tunggal untuk seberapa salah output tersebut).
- laju mundur — propagasikan kesalahan mundur, menemukan gradien setiap bobot (seberapa besar kontribusinya terhadap kesalahan) menggunakan aturan rantai.
- perbarui bobot dengan langkah kecil (ditentukan oleh tingkat pembelajaran) yang mengurangi kesalahan.
Ulangi melintasi banyak contoh dan banyak laju (epoch) hingga kesalahan berhenti mengecil. Nama "mundur" berasal dari langkah 3: kesalahan mengalir dari output mundur menuju input, sehingga gradien setiap bobot ditemukan dalam satu kali sapuan. Setelah pelatihan, input baru hanya memerlukan satu laju maju untuk mendapatkan prediksi.
"Deskripsikan metode propagasi balik kesalahan" (empat nilai). (1) Input diumpankan maju melalui jaringan dan keluarannya dibandingkan dengan keluaran yang diharapkan (target); (2) perbedaannya adalah kesalahan; (3) kesalahan tersebut diteruskan mundur melalui jaringan, lapis demi lapis dari output ke input, dan bagian kesalahan dari setiap bobot dihitung; (4) bobot disesuaikan sebanding dengan kontribusi mereka, ke arah yang mengurangi kesalahan; (5) proses ini diulang dengan banyak contoh hingga kesalahan sekecil yang diperlukan. Inti dari metode ini adalah bahwa jaringan dengan lapisan tersembunyi tidak memiliki cara langsung untuk mengetahui bobot internal mana yang menyebabkan kesalahan output; propagasi balik memberikan beban kesalahan.
Kosa kata
Latih
| English | Bahasa Indonesia |
|---|---|
| gradient descent/ˈɡreɪdɪənt dɪˈsent/ | penurunan gradien |
| loss function/lɒs ˈfʌŋkʃn/ | fungsi kerugian |
| epochs/ˈiːpɒks/ | epoch |
18.1
Regresi

Beberapa tugas memprediksi sebuah angka (harga rumah, suhu besok) — regresi, sebagai lawan klasifikasi (kategori).
Regresi linear menyesuaikan garis lurus (atau hiperbidang):
$$y = m_{1} x_{1} + m_{2} x_{2} + \ldots + m_{n} x_{n} + c.$$
Pilih koefisien untuk meminimalkan jumlah kesalahan kuadrat terhadap data pelatihan. Gunakan ketika hubungan terlihat kira-kira linear dan Anda menginginkan model yang dapat ditafsirkan. Untuk data lengkung, gunakan metode regresi polinomial, pohon keputusan, atau jaringan saraf — ide yang sama: tentukan model, tentukan fungsi kehilangan, dan sesuaikan parameternya untuk meminimalkannya. Regresi dan klasifikasi keduanya bersifat terarah; pilihannya bergantung pada apakah jawabannya berupa angka atau kategori.
"Deskripsikan metode regresi dalam pembelajaran mesin" (dua nilai). Metode statistik yang menemukan hubungan antara variabel input dan output kontinu, dengan menyesuaikan fungsi (garis atau kurva) ke data pelatihan dengan total kesalahan terkecil; fungsi yang disesuaikan kemudian digunakan untuk memprediksi output untuk input baru. Regresi linear menyesuaikan garis lurus; metode lain menyesuaikan kurva. Regresi memprediksi sebuah nilai (harga, suhu, waktu); klasifikasi memprediksi sebuah kategori, yang merupakan perbedaan yang diminta oleh ujian.
Jelajahi
Menyesuaikan garis regresi
Seret kontrol. Regresi linear menggambar garis lurus yang membuat jarak kuadrat ke titik data seminimal mungkin — lalu memprediksi angka untuk setiap input baru.
Kosa kata
Latih
| English | Bahasa Indonesia |
|---|---|
| regression/rɪˈɡreʃn/ | regresi |
| unsupervised learning/ʌnˈsuːpəvaɪzd ˈlɜːnɪŋ/ | pembelajaran tak terawasi |
| cluster/ˈklʌstə/ | klaster |
| training data/ˈtreɪnɪŋ ˈdeɪtə/ | data pelatihan |
| learning rate/ˈlɜːnɪŋ reɪt/ | laju pembelajaran |
| linear regression/ˈlɪnɪə rɪˈɡreʃn/ | regresi linear |
| optical character recognition/ˈɒptɪkl ˈkærɪktə ˌrekəɡˈnɪʃn/ | pengenalan karakter optik |
| text-to-speech/tekst tə spiːtʃ/ | teks-ke-suara |
18.1
Bagaimana AI digunakan dalam skenario nyata
Banyak skenario ujian menggunakan pola yang sama — model pembelajaran mendalam yang dilatih pada data berlabel, sering kali beberapa digabungkan menjadi sebuah pipeline:
- identifikasi pelanggan di toko otomatis: sistem dilatih pada gambar wajah berlabel; kamera menangkap wajah; pengenalan gambar mengekstrak representasi; hal itu dicocokkan dengan pelanggan terdaftar; kecocokan terdekat mengidentifikasi orang tersebut.
- membaca teks dari gambar: pengenalan citra menemukan area teks; pengenalan karakter optik mengekstrak karakternya; terjemahan mesin mengubahnya; teks-ke-pengucapan membacakannya keras.
- pencocokan item saat checkout: AI pendeteksi objek, yang dilatih dengan gambar produk berlabel, melihat item mana yang masuk ke keranjang dan menagih akun.
Sebelum pengguna berinteraksi dengan sistem, model sudah cepat — ia hanya melakukan inferensi maju; kecerdasan ada pada pola yang dipelajari selama pelatihan.
Jawaban model untuk pertanyaan skenario. Kamera parkir membaca nomor plat: kamera menangkap gambar; AI yang dilatih pada banyak gambar berlabel dari plat nomor melokalisasi plat dalam gambar; pengenalan karakter (klasifier pembelajaran mendalam, kembali dilatih pada karakter berlabel) mengubah plat menjadi teks; teks disimpan bersama waktu dan dicocokkan saat mobil keluar. Sistem CCTV mendeteksi dan melacak seseorang: perangkat lunak pengenalan citra yang dilatih pada gambar berlabel orang mengidentifikasi seseorang di setiap bingkai; sistem membandingkan bingkai berturutan untuk mengikuti pergerakannya; gerakan tidak寻常 dapat memicu peringatan. Ucapan diubah menjadi perintah: pengenalan ucapan yang dilatih pada banyak suara terekam mengubah suara menjadi teks; sistem mencocokkan teks dengan kumpulan perintah yang diketahui; sistem ini membaik seiring koreksinya. Kamera yang fokus pada wajah: model deteksi wajah yang dilatih pada wajah berlabel menemukan area wajah, dan lensa disesuaikan agar area tersebut fokus. Login pengenalan wajah bank: aplikasi menangkap wajah, jaringan mendalam mengekstrak fiturnya, dan dibandingkan dengan fitur tersimpan untuk pelanggan tersebut. Dalam setiap kasus polanya adalah: dilatih pada contoh berlabel, mengekstrak fitur, mencocokkan atau mengklasifikasikan input baru.
Contoh kerja. Untuk setiap tugas, katakan apakah itu memerlukan regresi atau klasifikasi, dan bagaimana lapisan output ANN akan terlihat: (a) ramalkan suhu besok; (b) tentukan apakah email adalah spam. Tanyakan apa jenis hal yang diprediksi. (a) Suhu adalah angka pada skala kontinu, jadi ini adalah regresi, dan lapisan outputnya adalah satu neuron yang menyimpan nilai tersebut. (b) Spam atau bukan spam adalah kategori, jadi ini adalah klasifikasi, dan output memberikan probabilitas per kelas. Keduanya adalah pembelajaran terawasi: masing-masing membutuhkan contoh berlabel untuk dilatih, dan pelatihan menyesuaikan bobot melalui backpropagation untuk mengurangi kesalahan. Pertanyaan penentunya hanyalah angka atau kategori - bukan seberapa sulit terasa tugasnya.
18.1
Definisi yang diterima oleh penguji
Soal definisi dinilai berdasarkan frasa tetap. Hafalkan ini persis, dan berikan hanya satu jawaban.
| Istilah | Definisi |
|---|---|
| grafik (dalam AI) | sekumpulan simpul yang merepresentasikan keadaan atau tempat, dihubungkan oleh sisi-sisi yang merepresentasikan koneksi, sering kali berbobot, yang dapat dijelajahi oleh algoritma pencarian |
| algoritma Dijkstra | menemukan jarak terpendek dari simpul awal ke setiap simpul lain dengan selalu mengunjungi simpul yang belum dikunjungi dengan jarak sejauh ini terkecil |
| algoritma A* | pencarian jalur terpendek yang memperluas simpul dengan total terkecil dari jarak sejauh ini ditambah estimasi heuristik jarak menuju tujuan |
| jaringan saraf tiruan buatan | model neuron otak: lapisan simpul yang terhubung oleh koneksi berbobot, dilatih dengan menyesuaikan bobot |
| pembelajaran mesin | algoritma yang belajar dari data dan membaik dengan pengalaman alih-alih mengikuti aturan tetap |
| pembelajaran terawasi | belajar dari data pelatihan berlabel di mana output yang benar untuk setiap input diketahui |
| pembelajaran tak terawasi | belajar dari data tanpa label dengan menemukan pola, pengelompokan, atau struktur di dalamnya |
| pembelajaran penguatan | agen belajar melalui coba-coba, memilih tindakan dalam lingkungan untuk memaksimalkan imbalan yang diterima |
| pembelajaran mendalam | pembelajaran mesin menggunakan jaringan saraf dengan banyak lapisan tersembunyi, dilatih pada jumlah data besar, setiap lapisan mengekstrak fitur dari lapisan di bawahnya |
| propagasi balik kesalahan | membandingkan output jaringan dengan target, meneruskan kesalahan kembali melalui lapisan dan menyesuaikan setiap bobot untuk menguranginya |
| regresi | menyesuaikan fungsi pada data pelatihan untuk memprediksi nilai output kontinu dari input |
18.1
Tips ujian
- Jawaban grafik menyebut nama simpul, sisi, dan bobot, serta apa yang mereka wakili; lalu algoritmanya. Dijkstra: tabel jarak, kunjungi yang terkecil, perbarui tetangga. A*: $g$, $h$ dan $f = g + h$ di setiap baris, perluas yang terkecil $f$.
- Jawaban ANN menyebut lapisan, koneksi berbobot, dan pelatihan; pembelajaran mendalam menambahkan banyak lapisan tersembunyi, data besar, dan ekstraksi fitur otomatis, beserta alasan dan contoh.
- Tiga kategori dalam satu baris masing-masing: data berlabel dan output diketahui; data tanpa label dan struktur yang ditemukan; agen, lingkungan, tindakan, dan imbalan.
- Propagasi balik: bandingkan dengan target, kesalahan mundur melalui lapisan, sesuaikan bobot untuk menguranginya, ulangi. Regresi memprediksi nilai; klasifikasi memprediksi kategori.
- Pertanyaan skenario menginginkan alur kerja: dilatih pada contoh berlabel, mengekstrak fitur, mengenali atau mengklasifikasikan input baru; sebutkan jenis AI (pengenalan citra, pengenalan ucapan, pembelajaran mendalam).
Kesalahan umum
- Mendeskripsikan grafik sebagai "grafik"; dalam AI itu adalah simpul dan sisi.
- Menjalankan Dijkstra dengan memilih tetangga terdekat dari simpul saat ini alih-alih jarak keseluruhan terkecil yang belum dikunjungi; atau lupa memperbarui simpul ketika rute lebih pendek muncul.
- Menambahkan $h$ ke dalam $g$ untuk langkah berikutnya dalam A*; $g$ hanya jarak sebenarnya, $h$ dihitung ulang dari tabel.
- Mengatakan pembelajaran mendalam adalah "belajar banyak"; itu adalah banyak lapisan tersembunyi.
- Membingungkan pembelajaran tak terawasi dengan pembelajaran penguatan; yang pertama menemukan struktur dalam data, yang kedua belajar dari imbalan.
- Mendeskripsikan propagasi balik tanpa perbandingan dengan output yang diharapkan atau tanpa menyatakan bahwa bobot disesuaikan.
- Menamakan ramalan harga sebagai "klasifikasi"; nilai kontinu adalah regresi.
Pelajaran interaktif untuk topik ini
Kerjakan langkah demi langkah, dengan latihan pengecekan instan.