| המועמדים צריכים להיות מסוגלים: | הערות והנחיות |
|---|---|
| הצג הבנה מדוע סוגי נתונים מוגדרים על ידי משתמש נדרשים | |
| הגדר ושתמש בסוגי נתונים לא-מורכבים | כולל מונה, איشارה (פוינטר) |
| הגדר ושתמש בסוגי נתונים מורכבים | כולל סט, רקורד וקלאס/אובייקט |
| בחר ועצב סוג נתונים מותאם אישית מתאים לבעיה נתונה |
ייצוג נתונים
מדעי המחשב A-Level · נושא 13
 15:16
סוגי נתונים מוגדרים על ידי משתמש
שדה טקסט פשוט יאחסן בקלות נתונים חסרי משמעות. תבקשו סוג רכב, ואדם יכתוב "בננות" — התוכנה תקבל זאת ללא התנגדות. אך אם ת…
קריאת קול באנגלית · תרגום אנגלי + סינית שרוף בתוך הסרטון
13.1
סוגי מידע מוגדרים על ידי המשתמש

סיילבוס
מקור: הסיילבוס הבינלאומי של קמבריד'ג'
הסוגים המובנים (INTEGER, REAL, STRING, CHAR, BOOLEAN) מכסים את המקרים הפשוטים ביותר. עבור בעיות עשירות יותר ניתן להגדיר סוגים מוגדרים על ידי משתמש, מה שהופך את הקוד ברור יותר ואת המתרגם מחמיר יותר.
מדוע הם נדרשים
סוג מובנה STRING מאפשר לאחסן חוסר משמעות בשדה שמיועד לערך חוקי אחד מספר ערכים אפשריים; סוג מוגדר על ידי המשתמש יכול להגביל זאת. ישויות אמיתיות הן בדרך כלל קבוצה של ערכים מסוגים שונים. וDECLARE Taxi : Vehicle ברור יותר (מתיעד עצמו) מאשר DECLARE Taxi : STRING.
"תאר את מטרתו של סוג מידע מוגדר על ידי המשתמש (שתי נקודות)." סוג מידע שהוגדר על ידי המתכנן, בנוי מסוגים קיימים (מובנים), כדי שנתונים ספציפיים לבעיה יוכלו להיות מיוצגים כאשר אין סוג מובנה שמתאים. שתי החלקים זוכים בנקודות: הוגדר על ידי המתכנן ו-בנוי מסוגים קיימים. המבקר מקבל גם "להפוך את התוכנית לקלה יותר לקריאה ולתחזוקה" כנקודה תומכת, אך לעולם לא לבד.
"הסבר מה נ meant by non-composite and composite data types (ארבע נקודות)." סוג לא-קומפוזיטי מוגדר ללא ייחוס לסוג אחר: הוא מחזיק ערך אחד, לדוגמה מספר שלם, מספר אמיתי או ערך מונה. סוג קומפוזיטי הוא קבוצה של סוגים אחרים (שהם עשויים להיות קומפוזיטיים גם כם): הוא מחזיק מספר ערכים תחת מזהה אחד, לדוגמה רקורד, קבוצה, מערך או מחלקה. תן דוגמה לכל הגדרה; הבחינה דורשת דוגמה אחת.
סוגים לא-קומפוזיטיים
סוג מונה
לסוג מונה יש ערכים שהם רשימה קבועה של קבועים ממונים:
TYPE Vehicle = (M100, M230, T101, T102, T120, T150)
DECLARE MyTaxi : Vehicle
MyTaxi ← T102
השמות הם ערכים של הסוג החדש (מואחסנים פנימית כמספרים שלמים קטנים); אין למנות כל דבר מחוץ לרשימה. שימושים: ימי השבוע, צבעים, קודי סטטוס.
"צין מה נ meant by an enumerated data type." סוג מידע לא-קומפוזיטי מוגדר על ידי המשתמש בהגדרת כל הערכים האפשריים שלו (בסדר). מכיוון שהערכים מונוים, ניתן להשוות ביניהם ולעבור עליהם: עם TYPE Month = (January, February, ..., December), הבדיקה IF ThisMonth > June היא חוקית, והערכים מאוחסנים פנימית כמספרים שלמים. לפסאו-קוד יש שלושה חלקים והבחינה מונה כל אחד מהם: המילת המפתח TYPE, המזהה עם =, והרשימה בסוגריים המופרדת בפסיקים.
דוגמה פותרת. כתוב פסאו-קוד להגדרת סוג מונה לימים שבהם בית ספר פתוח (שני-שישי), והכרז משתנה מסוג זה עם ערך ארבע-יום.
TYPE SchoolDay = (Monday, Tuesday, Wednesday, Thursday, Friday)
DECLARE Today : SchoolDay
Today ← Wednesday
משתנה מסוג מונה לא יכול לקבל ערך מחוץ לרשימה, וזהו整全 הנקודה: Today ← Saturday היא שגיאת קומפילציה, בעוד שSTRING הייתה מקבלת את "Saturdy".
סוג מחוון
מחוון מחזיק את כתובת הזיכרון של משתנה אחר (או NULL עבור "ללא יעד"). מחוונים בונים מבנים דינמיים (רשימות מקושרות, עצים) ומעבירים רפרנסים ללא העתקה.
TYPE PNode = ^TNode    // pointer to a TNode
DECLARE p : PNode
p ← NEW TNode
p^.Value ← 42          // dereference to reach the fields
לדיראפרינס (p^) פירושו להגיע למשתנה אליו הוא מצביע.
"הגדר מהו סוג נתונים מחוון." סוג שאינו קומפוזיטי שערך שלו הוא כתובת הזיכרון (או רפרנס) למשתנה מסוג נתונים נתון. הפסודוקוד מכריז על הסוג עם סימן כובע לפני הסוג אליו הוא מצביע, והמבחן דורש בדיוק שורה זו:
TYPE SelectParts = ^Parts        // a pointer to a value of type Parts
DECLARE Chosen : SelectParts
Chosen ← ^Keyboard               // Chosen now holds the address of Keyboard
OUTPUT Chosen^                   // dereference: the value stored at that address
מחוונים הם המרכיבים מהם בנויה רשימה מקושרת דינמית או עץ בינארי (נושא 19): כל נקודה מחזיקה מחוון לנקודה הבאה. לעיתים קרובות מאבדים כאן שני נקודות: כתיבת סוג המחוון כאילו הוא מכיל את הערך עצמו, ושכחת סימן הכובע בקריאה דרך המחוון.

p^ מבצע דיראפרינס כדי להגיע לשדות הנקודהסוגים קומפוזיטיים
סוג קומפוזיטי (אחד ה-סוגי הנתונים הקומפוזיטיים) מקבץ ערכים מספרים תחת שם אחד.


- רקורד (נושא 10) — שדות מסוגים שונים בבלוק
TYPE ... ENDTYPE. - סט — איסוף לא-סדורי של ערכים ייחודיים, עם פעולות add, remove, בדיקת חברות, איחוד, חיתוך:
DECLARE Available : SET OF Colour
Available ← {Red, Blue}
IF Green IN Available THEN
    ...
ENDIF
- class / object — סוג הנתונים הקומפוזיטי של OOP, המשלב שדות נתונים (attributes) עם פעולות עליהם (methods). אובייקט הוא הדגמה של class:
CLASS Taxi
    PRIVATE Capacity : INTEGER
    PUBLIC FUNCTION GetCapacity() RETURNS INTEGER
        RETURN Capacity
    ENDFUNCTION
ENDCLASS
בחירת סוג
השתמש ב-enumerated לערך מרשימה קבועה, pointer לנעילה/אינדירקציה, record לקבוצת שדות, set לאיסוף לא-סדורי ייחודי, ו-class כאשר אתה צריך גם מצב וגם התנהגות יחד.
"תיאר את סוג הנתונים המוגדר על ידי המשתמש set" (שלוש נקודות). סוג קומפוזיטי שמחזיק איסוף של ערכים מאותו סוג, ללא סדר מסוים וללא כפילות; ניתן להוסיף ולהסיר ערכים, ובדוק אם ערך נמצא באיסוף. הכרז את הסוג עם SET OF, ולאחר מכן הגדר קבוע סט עם הערכים בסוגריים:
TYPE EvenNumbers = SET OF INTEGER
DEFINE Evens (2, 4, 6, 8, 10, 12) : EvenNumbers
TYPE SymbolSet = SET OF CHAR
DEFINE Operators ('+', '-', '*', '/') : SymbolSet
"תיאר את סוג הנתונים המוגדר על ידי המשתמש record" (שלוש נקודות). סוג קומפוזיטי המורכב ממספר קבוע של שדות (פריטים), לכל אחד מהם זיהוי וסוג משלו, המופיעים תחת זיהוי אחד; השדות מופעלים באמצעות נקודתיות.
דוגמה מופת. כתוב פסודוקוד להצהרת סוג רשומה ClubMember לשם פרטי, שם משפחתי, קוד חברות (מספר שלם), תאריך הצטרפות והאם התשלום שולם; ולאחר מכן הצהר משתנה וקבע ערכים בשני מהשדות שלו.
TYPE ClubMember
    DECLARE FirstName : STRING
    DECLARE LastName : STRING
    DECLARE Code : INTEGER
    DECLARE DateJoined : DATE
    DECLARE FeesPaid : BOOLEAN
ENDTYPE

DECLARE NewMember : ClubMember
NewMember.LastName ← "Chen"
NewMember.FeesPaid ← TRUE
לכל שדה נדרשת שורת DECLARE בודדת עם סוג מתאים. הסיום של הסוג הוא ENDTYPE, ושדה מגיע כ-variable.field. כאשר מבקשים לבחור סוג לכל שדה, התאם אותו לנתונים: קוד המשווה רק הוא STRING אם יכול להכיל אותיות, או INTEGER אם נדרש חישוב אריתמטי או סידור; כן/לא הוא BOOLEAN; תאריך הוא DATE. שדה שיכול לקבל אחת מכמה ערכים מוגדרים (סוג חיית מחמד, צבע) יש להגדיר כסוג מונה.

רשומות במערכים ובקבצים. טבלה של הרבה חברים היא DECLARE Members : ARRAY[1:100] OF ClubMember; לאחר מכן Members[3].LastName הוא שדה אחד של אלמנט אחד, ולולאה על האינדקס מעבדת כל רשומה. רשומה היא גם יחידה טבעית שנכתבת ונקראת מקובץ (להלן), רשומה אחת לכל PUTRECORD או WRITEFILE.
דוגמה מופת. סוג מורכב Pet מאחסן את שם כל חיית המחמד (מחרוזת), המין (אחת מ: כלב, חתול, ארנבון או חמקן) והמשקל בק"ג (מספר ממשי). הגדר את הסוגים והצהר משתנה.
TYPE Species = (Dog, Cat, Rabbit, Hamster)
TYPE Pet
    DECLARE Name : STRING
    DECLARE Kind : Species
    DECLARE Weight : REAL
ENDTYPE
DECLARE MyPet : Pet
MyPet.Kind ← Rabbit
הסוג המונה מוגדר ראשית, כי הרשומה משתמשת בו: הסדר חשוב בפסודוקוד כמו במייצר.
מחלקות בפסודוקוד. מחלקה היא הסוג המורכב שמכיל גם התנהגות. הבחינה דורשת את ההצהרה עם המאפיינים מסומנים PRIVATE, בונה (constructor) בשם NEW שמוגדר אותם, ו-PUBLIC שיטות לקבל או לשנות אותם:
CLASS Appointment
    PRIVATE PatientName : STRING
    PRIVATE Treatment : STRING
    PRIVATE Medication : STRING
    PUBLIC PROCEDURE NEW(Name : STRING, Treat : STRING, Med : STRING)
        PatientName ← Name
        Treatment ← Treat
        Medication ← Med
    ENDPROCEDURE
    PUBLIC FUNCTION GetTreatment() RETURNS STRING
        RETURN Treatment
    ENDFUNCTION
ENDCLASS

DECLARE Visit : Appointment
Visit ← NEW Appointment("A. Chen", "filling", "none")
OUTPUT Visit.GetTreatment()
מאפיינים הם פרטיים כדי שאפשר יהיה לשנותם רק דרך שיטות (עיטוף, נושא 20); הבונה הוא פרוצדורה הנקראת NEW עם פרמטר אחד לכל מאפיין; getter היא פונקציה החזירה את המאפיין. כל אחד מהאלמנטים הללו זוכה לניקוד נפרד.
חקור
מעבדת מושגי תכנות
קשר בין הדוגמאות לבין הרעיון התכנותי שהן מדגימות.
מילון מונחים
אימון
| English | עברית |
|---|---|
| user-defined type/ˈjuːzə dɪˈfaɪnd taɪp/ | סוג מוגדר על ידי המשתמש |
| field/fiːld/ | שדה |
| record/ˈrekɔːd/ | רשום |
| set/set/ | סט |
| class/klæs/ | כיתה |
| composite type/ˈkɒmpəzɪt taɪp/ | סוג מורכב |
| enumerated type/ɪˈnjuːməreɪtɪd taɪp/ | טיפוס מונה |
| pointer/ˈpɔɪntə/ | איشارת זיכרון |
| linked list/lɪŋkt lɪst/ | רשימה מקושרת |
| dereference/ˌdiːˈrefrəns/ | פרשור |
| object/ˈɒbdʒekt/ | אובייקט |
| attributes/ˈætrɪbjuːts/ | מאפיינים |
| methods/ˈmeθədz/ | שיטות |
| constructor/kənˈstrʌktə/ | בונה |
| File organisation/faɪl ˌɔːɡənaɪˈzeɪʃn/ | ארגון קבצים |
13.2
ארגון קבצים וגישה

סיילבוס
| המועמדים צריכים להיות מסוגלים: | הערות והנחיות |
|---|---|
| הצג הבנה של שיטות ארגון קבצים ובחר בשיטה מתאימה לארגון קבצים ולגישה לקבצים עבור בעיה נתונה | כולל סיבירי, עוקבי (בשימוש בשדה מפתח), אקראי (בשימוש במפתח רקורד) |
| הצג הבנה של שיטות גישה לקבצים | כולל גישה עוקבת לגודל קבצים סיביריים ועוקבים, גישה ישירה לקבצים עוקבים ואקראיים |
| הצג הבנה של אלגוריתמי השחזה | תאר ושתמש באלגוריתמי השחזה שונים לקריאת נתונים וכתיבה לקובץ אקראי/עוקב |
מקור: הסיילבוס הבינלאומי של קמבריד'ג'
ארגון קבצים הוא האופן שבו הנתונים מסודרים; גישה לקובץ היא האופן שבו התוכנית מגיעה לרשומה.
- קובץ סדרתי — רשומות ב-סדר ההוספה, ללא סינון. הגישה היא סדרתית בלבד; הוספת (append) היא מהירה; חיפוש הוא איטי. משמש ליומן ולמסלולי ביקורת.
- קובץ רציף — רשומות ממוסדרות לפי מפתח. חיפוש מהיר יותר (ניתן לעצור מוקדם או לחפש באמצעות בינרי); הכנסה היא איטית (יש להזיז רשומות). משמש לקבצי מאסטר המתעדכנים במ batches.
- קובץ מקרי (קובץ גישה ישירה) — רשומות במיקומים המוחשבים מהמפתח (לרוב באמצעות hash). גישה ישירה לפי מפתח היא מאוד מהירה; קריאה בסדר המפתחות קשה יותר. משמש לטבלאות חיפוש גדולות וחשבונות לקוחות.
*קובץ סדרתי: רשומות נשמרות בסדר ההוספה שלהן
 *קובץ רציף: רשומות ממוסדרות לפי שדה מפתח

שתי שיטות הגישה הן גישה סדרתית (קריאה מהתחלה ועד הסוף) וגישה ישירה (קפיצה ישרה למיקום ידוע). התאם את המבנה לתפעול הדומיננטי: חיפושים על ידי מפתח יחיד תומכים בגישה אקראית; דוחות בסדר נמו-גבוה תומכים בגישה סדרתית.
תיאור כל ארגון (ניסוח שמביא נקודות). סריל: רשומות מאוחסנות אחת אחרי השנייה בסדר הוספתן, ללא סיווג לפי מפתח. סדרתי: רשומות מאוחסנות בסדר שדה מפתח (ממוין). אקראי: כל רשומה מאוחסנת בכתובת המופקת ממפתחה באמצעות אלגוריתם גישוש, כך שהרשומות אינן מסודרות בכל צורה. השוואה בין סריל לסדרתי: שניהם מאחסנים רשומות אחת אחרי השנייה ושניהם קוראים אותן ברצף, אך קובץ סדרתי ממוין לפי מפתח, ולכן החיפוש יכול להפסיק ברגע שקוראים מפתח גדול מהמיועד, ורשומה חדשה חייבת להיות מוכנסת במיקום הנכון שלה (בדרך כלל באמצעות כתיבה מחדש של הקובץ), בעוד שקובץ סריל פשוט מוסיף את הרשומה בסוף.
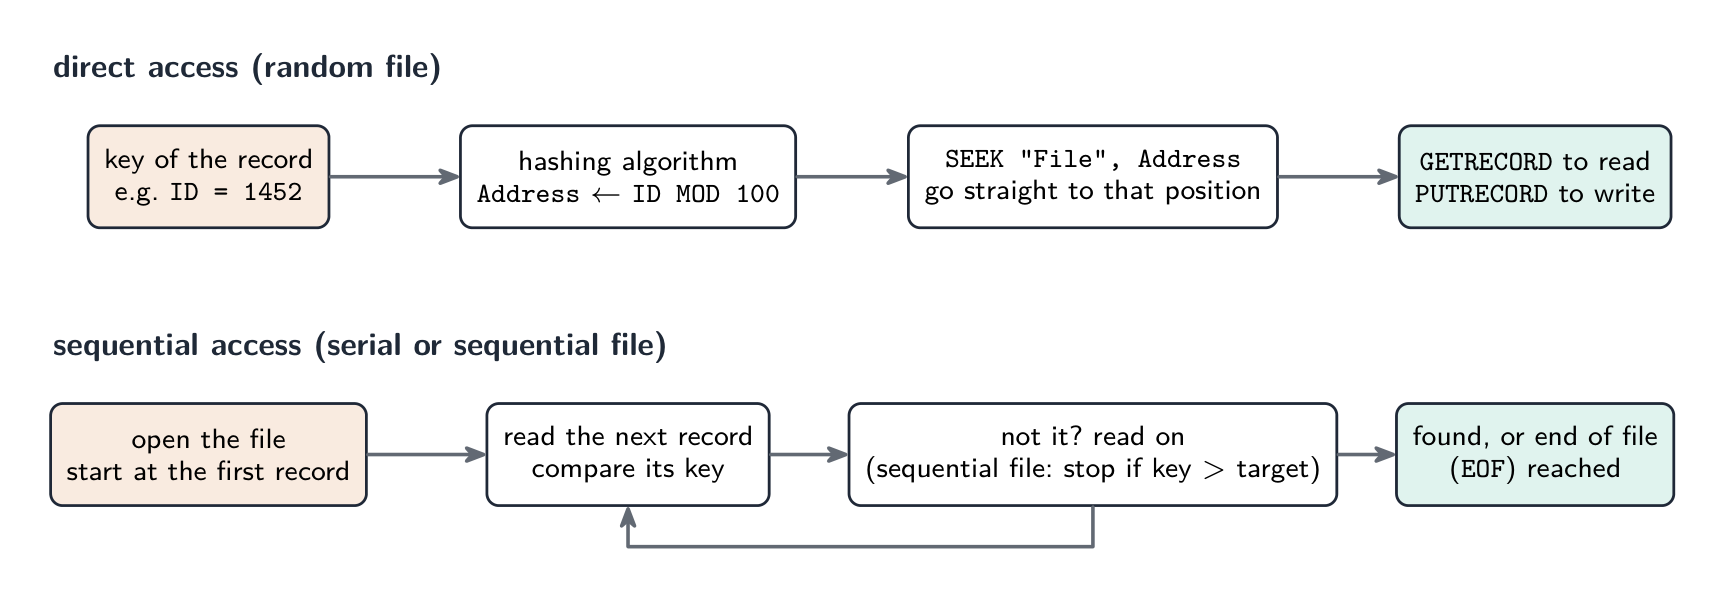
תיאור כל שיטת גישה. גישה סדרתית: מתחילים בתחלת הקובץ וקוראים את הרשומות אחת אחרי השנייה (בסדר האחסון) עד שמצאים את הרשומה הנדרשת או מגיעים לסוף הקובץ. בהחלת קובץ סריל משמעות הדבר היא לקרוא כל רשומה עד להתאמה, ולקרוא את כל הקובץ כדי לוודא שאין רשומה; בהחלת קובץ סדרתי ניתן לעצור מוקדם, ברגע שקוראים מפתח גדול מהמיועד. גישה ישירה: הכתובת של הרשומה מופקת ממפתחה (באמצעות אלגוריתם גישוש, או מאינדקס), והתוכנה הולכת ישרה למיקום זה ללא קריאת הרשומות שעוברות לפניו; זוהי שיטת הגישה לקבצים אקראיים, ולרשומה המופנית בכתובת ייחודית על דיסק.
בחירה. קובץ ראשי של משכורות או חשבונות שירותים המעובד בתור-תור, כל רשומה בתור, מתאים לקובץ סדרתי; רשום עסקאות בסדר התרחשותן מתאים לקובץ סריל; קובץ מלאי או לקוחות בו נערכים חיפושים ועדכוני רשומות יחידים לפי מפתח בזמן ביצוע התוכנה מתאים לקובץ אקראי עם גישה ישירה.
טיפול בקובץ בפסאודוקוד. המבחן מצפה לנחיות סטנדרטיות, ובמבחן 3 מוגדרים אלגוריתמים המשתמשים בהם:
| משימה | נחיות |
|---|---|
| פתיחת קובץ טקסט | OPENFILE "Scores.txt" FOR READ (או FOR WRITE, היוצר או מכסה, או FOR APPEND) |
| קריאה או כתיבה של שורה | READFILE "Scores.txt", Line וWRITEFILE "Scores.txt", Line |
| בדיקה אם הגיענו לסוף | WHILE NOT EOF("Scores.txt") |
| סגירה | CLOSEFILE "Scores.txt" |
| פתיחת קובץ אקראי | OPENFILE "Stock.dat" FOR RANDOM |
| מעבר למיקום רשומה | SEEK "Stock.dat", Address |
| קריאה או כתיבה של רשומה שלמה | GETRECORD "Stock.dat", Item וPUTRECORD "Stock.dat", Item |
דוגמה מפורטת. קובץ אקראי Stock.dat מחזיק רשומות מסוג StockItem, מאוחסנות בכתובת הנתונה על ידי ItemID MOD 100. כתוב פסאודוקוד שמאחסן פריט חדש בכתובת המוגשת שלו אם המיקום ריק, ומדווח על המיקום אם הוא תפוס כבר.
DECLARE Item, Existing : StockItem
DECLARE Address : INTEGER
INPUT Item.ItemID, Item.Description, Item.Quantity
Address ← Item.ItemID MOD 100
OPENFILE "Stock.dat" FOR RANDOM
SEEK "Stock.dat", Address
GETRECORD "Stock.dat", Existing
IF Existing.ItemID = 0 THEN
    // 0 marks an empty position
ENDIF
    SEEK "Stock.dat", Address
    PUTRECORD "Stock.dat", Item
    OUTPUT "Stored at ", Address
ELSE
    OUTPUT "Position ", Address, " is in use"
ENDIF
CLOSEFILE "Stock.dat"
שני פרטים שמבדק הפתרונות בודק: SEEK לפני כל GETRECORD או PUTRECORD (קריאה מזיזה את המיקום, לכן יש לחפש שוב לפני הכתיבה), והקובץ שנפתח FOR RANDOM ונסגר בסוף. להעתיק כל רשומה מקובץ אקראי לקובץ אחר, לעבור על הכתובות עם SEEK, GETRECORD מקובץ אחד וPUTRECORD לקובץ השני, תוך דילוג על מיקומים ריקים.
חקור
מסלול גישה לקובץ
עקבו אחר קובץ מהאחסון לתוכנית וחזרה בבטחה.
מילון מונחים
אימון
| English | עברית |
|---|---|
| serial file/ˈsɪərɪəl faɪl/ | קובץ סדרתי |
| sequential file/siːˈkwenʃl faɪl/ | קובץ רצף-עוקבי |
| random file/ˈrændəm faɪl/ | קובץ אקראי |
| direct access/daɪˈrekt ˈækses/ | גישה ישירה |
| hash function/hæʃ ˈfʌŋkʃn/ | פונקציית גישה (hash) |
| sequential access/siːˈkwenʃl ˈækses/ | גישה רצף-עוקבת |
| deterministic/dɪˌtɜːmɪˈnɪstɪk/ | דיטרמיניסטיבי |
| collision/kəˈlɪʒn/ | התנגשות |
13.2
גישוש

פונקציית גישוש (אלגוריתם גישוש) לוקחת מפתח רשומה ומפיקה כתובת בה הרשומה מאוחסנת. אחת טובה היא מהירה, דיטרמיניסטית, ומפזרת מפתחים באופן שווה.
אלגוריתמי גישוש נפוצים עבור $N$ תאים: גישוש מודולו address ← key MOD N; קיפול (לפרק את המפתח, לחבר את החלקים, MOD N); גישוש למחרוזת (לסכם קודי תווים, MOD N).
התנגשות היא מצב שבו שני מקראות מתאחזים (hash) לאותו כתובת. שלושה דרכים לפתור אותה:
| אסטרטגיה | כיצד זה עובד | פיצול תועלות |
|---|---|---|
| חיפוש ליניארי (linear probing) | שימוש בתיק הרווק הבא (עם חזרה התחלה) | פשוט, אך מקראות מתכנסים |
| שרשרת (chaining) | כל תיק מצביע על רשימה מקושרת של רשומות | ללא התכנסות, אך דורש זיכרון נוסף |
| מחזוריות מחדש (rehashing) | יישום פונקציית התאחזה שנייה | מפזר מקראות, אך דורש יותר עבודה |
לחיפוש: התאחז את המקרא, קרוא את התיק; אם המקראות תואמים סיימת, אחרת המשיך באסטרטגיית הפתרון עד למציאת התאמה או תיק ריק. להוספה: התאחז את המקרא, כתוב בתיק זה או בתיק הרווק הבא. שמור על גורם העומס (רשומות ÷ תיקים) מתחת ל-70% בקירוב לחיפושים קרובים ל-O(1).
"הסבר מה נדרש מאלגוריתם התאחזה בהקשר של גישה לקבצים" (שלוש נקודות). חישוב (פונקציה) המבוצע על שדה המקרא ברשומה ומייצר ערך המשמש ככתובת (מיקום) שבה הרשומה מאוחסנת בקובץ וממנה היא מושבת. אותו חישוב על אותו מקרא תמיד נותן את אותה כתובת, ולכן ניתן למצוא את הרשומה שוב ללא צורך בחיפוש.
"סקור שתי שיטות להתגבר על התנגשות." (1) חיפוש ליניארי (כתובת פתוחה): אחסן את הרשומה במיקום הרווק הבא לאחר הכתובת המחושבת, עם חזרה ההתחלה אם נדרש; לקבלה, התחל בכתובת המתאחזת וקרוא קדימה עד שהמקרא יתאים. (2) אזור עדיפות (overflow) או שרשרת: אחסן את הרשומה המתנגשת באזור עדיפות נפרד (או ברשימה מקושרת המצומדת לכתובת), אשר נחקר רצף לאחר שהכתובת הראשית לא התאימה. כל אחת מהן תקבל נקודות; יש לתאר גם את הקבלה וגם האחסון.
דוגמה מפורטת. קובץ אקראי מכיל 11 מיקומי רשומות, מסומנים מ-0 עד 10, ואלגוריתם ההתאחזה הוא Address ← Key MOD 11. רשומות עם מקראות 1250, 1381, 1452, 1613 ו-1470 מאוחסנות בסדר זה, בעזרת חיפוש ליניארי. הצג לאן כל רשומה הולכת, וסבר כיצד המקרא 1470 מושב.
$1250 \bmod 11 = 7$; $1381 \bmod 11 = 6$; $1452 \bmod 11 = 0$; $1613 \bmod 11 = 7$, התנגשות עם 1250, לכן 1613 לוקח את המיקום הרווק הבא, 8; $1470 \bmod 11 = 7$ שוב, ומכיוון שמיקומים 7 ו-8 מלאים, 1470 הולך ל-9. לקבלת 1470: חשב $7$, קרא מיקום 7 (מקרא 1250, אין התאמה), קרא 8 (1613, אין), קרא 9 (1470, נמצא). אם מגיעים למיקום ריק לפני המציאה, הרשומה אינה בקובץ. התנגשות היא המחיר של קובץ קטן: אלגוריתם התאחזה טוב מפזר מקראות באופן שווה, והקובץ נשמר רחוק ממילוי כדי שהחיפושים יישארו קצרים.
חקור
טבלת גישה
הצפה כל מפתח מגיע ל-מיכל באמצעות פונקציית גישה. פונקציית גישה טובה מפזרת את המפתחות כך שהחיפשים נשארים מהירים.
מילון מונחים
אימון
| English | עברית |
|---|---|
| linear probing/ˈlɪnɪə ˈprəʊbɪŋ/ | חיפוש ליניארי |
| chaining/ˈtʃeɪnɪŋ/ | שרשראות |
| load factor/ləʊd ˈfæktə/ | גורם עומס |
| overflow area/ˌəʊvəˈfləʊ ˈeərɪə/ | אזור גרידה |
| overflow/ˌəʊvəˈfləʊ/ | גלישה |
13.3
מספרים במצוף

סיילבוס
| המועמדים צריכים להיות מסוגלים: | הערות והנחיות |
|---|---|
| תאר את פורמט המספרים המציאותיים עם הנקודה הצפה במערכת בינארית | השתמש בפורמט משלימים שניים הבן את ההשפעות של שינוי הקצאת הביטים לmantissa ולexponent בייצוג עם נקודה צפה |
| המר מספרים מציאותיים עם נקודה צפה במערכת בינארית למערכת עשרונית ולהפך | |
| נרמל מספרים עם נקודה צפה | הבן את הסיבות לנרמול |
| הצג הבנה של ההשלכות מכך שייצוג בינארי הוא לעיתים רק קירוב למספר המציאותי שהוא מייצג (במקרים מסוימים) | הבן כיצד יכול להתרחש תחתזרימה ועליוזרימה |
| הצג הבנה כי ייצוגים בינאריים עלולים לגרום לשגיאות עיגול |
מקור: הסיילבוס הבינלאומי של קמבריד'ג'
לאחסון מספרים אמיתיים בגדלים שונים מאוד, מחשבים משתמשים בפורמט מצוף — צורה בינארית של סימון מדעי, עם שני שדות:
- מנטסה — הספרות המשמעותיות.
- מעריך — החזקה של 2 להכפלה.
שניהם מאוחסנים כמספרים שלמים ב-משלימה של שניים. הערך הוא
$$\text{number} = \text{mantissa} \times 2^{\text{exponent}}.$$
קראו את המנטיסה כשבר בינארי – הביט הראשון אחרי הנקודה שווה $1/2$, הבא שווה $1/4$, ואז $1/8$, וכך הלאה. אז 0.1010000 הוא $1/2 + 1/8 = 0.625$; עם אקספוננט 00000010 (= 2) הערך הוא $0.625 \times 2^{2} = 2.5$.
המרה
- בינארי → עשרוני: קראו את המנטסה (השתמשו בכללי השלם-שניים אם היא שלילית) כשבר, קראו את המעריך כמספר שלם סימני, ואז כפולו את המנטסה ב$2^{\text{exponent}}$.
- עשרוני → בינארי: כתבו את המספר כשבר בינארי כפול חזקה של 2, ואז אחסנו את המנטסה והמעריך בפורמטים המוסכמים.
דוגמה פתורה. מספר יש לו מנטסה 10110000 ומעריך 00000011. מצאו את ערכו העשרוני.
המעריך 00000011 הוא $+3$. המנטסה מתחילה ב-1, ולכן היא שלילית. קריאה כ1.0110000 בשלם-שניים, הביט הסימן שווה ל$-1$ והביטים השבריים מוסיפים $\tfrac{1}{4} + \tfrac{1}{8} = 0.375$, ולכן המנטסה היא $-1 + 0.375 = -0.625$. אז
$$\text{number} = -0.625 \times 2^{3} = -5.0.$$
דוגמה פתורה. אחסנו את $+2.5$ בפורמט זה.
בבינארי это $2.5 = 10.1$. כתוב כשבר נורמלי, זה $2.5 = 0.101 \times 2^{2}$. אז המנטסה היא 01010000 (ביט סימן 0, ולאחריו .101) והמעריך הוא 00000010 ($= 2$).
הפורמט במבחן: שלם-שניים, מנטסה ומעריך
המבחן מציין פורמט כמו 10 ביטים למנטסה ו-6 ביטים למעריך, שניהם בשלם-שניים. נקודת הבינארי של המנטסה נמצאת לאחר הביט הראשון שלה (ביט הסימן), ולכן מנטסה חיובית היא 0.xxxxxxxxx ושלילית היא 1.xxxxxxxxx; המעריך הוא מספר שלם סימני רגיל. כל המרה משתמשת באותם שלושה צעדים: קריאת המנטסה כשבר (כלי שלם-שניים אם היא מתחילה ב-1), קריאת המעריך כמספר שלם, הכפלה ב$2^{\text{exponent}}$.
דוגמה פתורה (בינארי לעשרוני). מנטסה 0101100000, מעריך 000011.
מנטסה: $0.101100000_2 = \tfrac{1}{2} + \tfrac{1}{8} + \tfrac{1}{16} = 0.6875$. מעריך: $000011_2 = 3$. ערך: $0.6875 \times 2^{3} = 5.5$.
דוגמה פתורה (מנטסה שלילית). מנטסה 1011000000, מעריך 000010.
המנטסה מתחילה ב-1, ולכן היא שלילית. ערכה הוא $-1 + 0.011000000_2 = -1 + (\tfrac{1}{4} + \tfrac{1}{8}) = -0.625$; מעריך $= 2$; ערך $-0.625 \times 4 = -2.5$. (או לחלופין, לקחת את השלם-שניים של המנטסה, 0101000000 $= 0.625$, ולהוסיף את סימן החיסור.) מעריך שלילי כמו 111110 $= -2$ מבצע חלוקה במקום כפל: מנטסה של $0.5$ עם מעריך זה היא $0.5 \times 2^{-2} = 0.125$.
דוגמה פתורה (עשרוני לבינארי). אחסנו את $+6.5$ ו$-6.5$ בפורמט של 10 ביטים ו-6 ביטים, נורמלי.
$6.5 = 110.1_2 = 0.1101_2 \times 2^{3}$, ולכן המנטסה היא 0110100000 והמעריך 000011. עבור $-6.5$, לקחת את השלם-שניים של המנטסה: 1001100000 (בדיקה: $-1 + 0.0011_2 = -1 + 0.1875 = -0.8125$, ו$-0.8125 \times 8 = -6.5$), מעריך 000011 ללא שינוי. הסימן מעולם אינו עובר למעריך; למספר שלילי יש מנטסה שלילית.
נורמליזציה
מספר הוא נורמלי כאשר הביט המשמעותי הראשון נמצא מיד לאחר נקודת הבינארי (ללא אפסים מובילים מיותרים). זאת מקסמת את הדיוק, כי כל ביט במנטסה נושא מידע. כדי לנרמל, הזזו את המנטסה שמאלה והקטינו את המעריך (או הזזו ימינה והגדילו אותו) עד שהביט המשמעותי הראשון יהיה במקומו; הערך נשאר ללא שינוי. עבור מנטסות שליליות (שלם-שניים), הביט הסימן (1) מופעל מיד על ידי 0.
זיהוי ויצירת צורת נורמלית. מנטסה נורמלית חיובית מתחילה ב01; שלילית מתחילה ב10. אז 0011000000 אינה נורמלית (הזז שמאלה מקום אחד והפחתו אחד מהמעריך: 0110000000, מעריך פחות באחד) ו1100000000 גם כן אינה (הזז שמאלה עד שהתבנית תהיה 10...). כל הזזה שמאלה של המנטסה חייבת להיות מלווה בהפחתת אחד מהמעריך, אלא אם כן הערך משתנה.
"הסבירו מדוע מספרים מאוחסנים בצורה נורמלית" (2 נקודות). (1) זה נותן את הדיוק המקסימלי (הדיוק) לכמות הביטים הקיימת, כי אין ביטים מיותרים על אפסים מובילים (או על אחדים מובילים עבור מספר שלילי); (2) לכל מספר יש אז ייצוג ייחודי, כך שמספרים יכולים להשוות; ו(3) זה מאפשר את השימוש הטוב ביותר בטווח הקיים. שתי נקודות מכל אחת מהאפשרויות אלו תזכו בנקודות.

טעויות קירוב ועיגול
מספרים אמיתיים רבים לא ניתן לאחסן בדיוק במערכת בינארית — למשל $0.1_{10}$ הוא השבר הבינארי החוזר $0.000110011\ldots_{2}$, שיש לקצרו. ההשלכות:
- טעויות עיגול מצטברות לאורך פעולות רבות (
0.1 + 0.2אינו שווה בדיוק ל0.3). - השוואות נכשלות — לעולם אל תבצע בדיקת שוויון על מספר אמיתי. בדוק שה-הפרש קטן מתמימות קטנה,
IF Difference < 0.000001, כאשר ההפרש מחושב בצורה הנכונה או דרך פונקציית מודולוס שתוגדר בשאלה.ABSאינו מופיע בתוסף 9618 או במדריך הקוד הפסדו-אודי, ולכן אל תניח אותו: המדריך קובע שכל פונקציה שהשאלה זקוקה לה תינתן. - חיסור של שני ערכים הדומים זה לזה גורם לאובדן דיוק.
- גלישה מעל הגבול (תוצאה גדולה מדי לגודל התחום של המעריך) ו-גלישה מתחת לגבול (תוצאה קטנה מדי, העיגול לאפס) מתרחשים כאשר המעריך יוצא מהתחום האפשרי.
לצרכים הדורשים דיוק מוחלט (כמו מטבע), השתמש בנקודה קבועה או ב-BCD במקום בנקודה צפה.
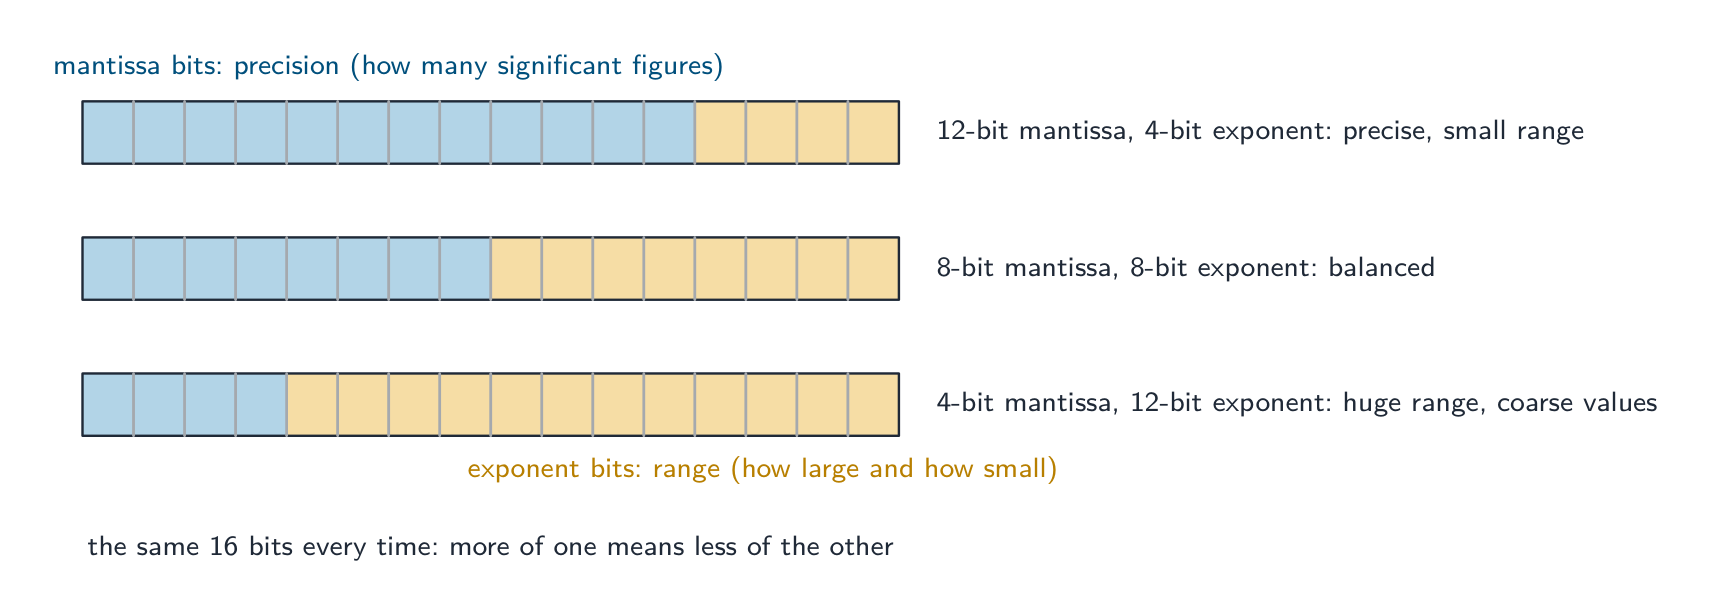
"תאר את השפעת שינוי הקצאת הביטים" (שלוש נקודות). עם כמות ביטים כוללת קבועה, הגדלת המנטסה והפחתת המעריך נותנת דיוק גדול יותר (ספרות משמעותיות יותר, טעויות עיגול קטנות) אך תחום קטן יותר (הגדולים והקטנים ביותר של הגדלים שאפשר לאחסן מתכווצים); הגדלת המעריך עושה את ההפך: תחום גדול יותר על חשבון הדיוק. ציין את שתי ההשפעות ואת שני הכיוונים.
הגדול והקטן. בפורמט מנטסה 10-ביט ומעריך 6-ביט, המספר חיובי הגדול ביותר יש לו מנטסה 0111111111 ($= 1 - 2^{-9}$) ומעריך 011111 ($= 31$): בערך $2^{31}$. המספר החיובי הקטן ביותר נרמל יש לו מנטסה 0100000000 ($= 0.5$) ומעריך 100000 ($= -32$): $0.5 \times 2^{-32} = 2^{-33}$. המספר השלילי ביותר יש לו מנטסה 1000000000 ($= -1$) ומעריך $31$: $-2^{31}$.
"הסבר מה מתכוונים בגלישה מעל הגבול ובגלישה מתחת לגבול." גלישה מעל הגבול מתרחשת כאשר תוצאת חישוב היא גדולה מהמספר הגדול ביותר שניתן לייצג, כך שהמעריך היה צריך יותר ביטים מאשר יש לו; גלישה מתחת לגבול מתרחשת כאשר תוצאה היא קטנה מהמספר הקטן ביותר (לא-אפסי) שניתן לייצג, קרובה מדי לאפס כך שהמעריך לא יכול לבטא אותה, ולכן היא מאוחסת כאפס. שניהם נובעים מתחום המעריך, ולא מתחום המנטסה.
מדוע ייצוג בינארי הוא רק קירוב. שבר בינארי יכול לייצג רק סכומים של $\tfrac{1}{2}, \tfrac{1}{4}, \tfrac{1}{8}, \ldots$ בדיוק; ערך כמו $0.1$ או $\tfrac{1}{3}$ יש לו הרחבה בינארית אינסופית, ולמנטסה יש כמות ביטים קבועה, ולכן הערך המאוחסן הוא הקרוב ביותר שמתאים. ההפרש הוא טעות עיגול; היא קטנה עבור מספר אחד אך מצטברת בחישובים חוזרים (חיבור $0.1$ עשר פעמים עשוי לא לתת בדיוק $1$), ולכן לעולם אין לבצע בדיקת שוויון מדויקת על מספרים אמיתיים.
חקור
בניית מספר מעוגל
הפיכת ביטי המנטיסה והאקספוננט ליצירת ערך, ובדיקה האם הוא תקין.
חקור
נורמליזציה של מספר בעל נקודה צפה
תהליך הנורמליזציה: הזזת המנטיסה כדי להסיר אפסים מובילים מיותרים — ולכוון את המעריך בהתאם — שומר על הערך האמיתי אך משקיע כל ביט בדייקנות.
מילון מונחים
אימון
| English | עברית |
|---|---|
| floating-point/ˈfləʊtɪŋ pɔɪnt/ | מספר עם נקודה צפה |
| mantissa/mænˈtɪsə/ | mantissa (חלק המנונה) |
| exponent/ekˈspəʊnənt/ | מעריך (exponent) |
| two's complement/tuːz ˈkɒmplɪmənt/ | משלים של שניים |
| normalised/ˈnɔːməlaɪzd/ | נורמליזציה |
| rounding errors/ˈraʊndɪŋ ˈerəz/ | שגיאות עיגול |
| underflow/ˌʌndəˈfləʊ/ | היפחתות מתחת לגבול |
| fixed-point/fɪkst pɔɪnt/ | נקודה קבועה |
| BCD/ˌbiː siː ˈdiː/ | BCD |
| precision/prɪˈsɪʒn/ | דיוק |
| range/reɪndʒ/ | טווח |
13.3
הגדרות מקובלות בקורס
שאלת הגדרה מוקדמת לפי טקסט קבוע. לימודן במדויק, ותן תשובה אחת בלבד.
| מונח | הגדרה |
|---|---|
| סוג נתונים מוגדר על ידי משתמש | סוג נתונים המוגדר על ידי המתכנת, על בסיס סוגים קיימים, כדי לייצג נתונים ספציפיים לבעיה |
| סוג לא-קומפוזיטי | סוג המוגדר ללא התייחסות לסוג אחר; הוא מחזיק ערך יחיד (שלם, אמיתי, ממונה, מצביע) |
| סוג קומפוזיטי | סוג המורכב מסוגים אחרים; הוא מחזיק כמה ערכים תחת מזהה אחד (רקורד, סט, מערך, מחלקה) |
| סוג ממונה | סוג לא-קומפוזיטי המוגדר על ידי רשימת כל הערכים האפשריים שלו, בסדר |
| סוג מצביע | סוג לא-קומפוזיטי שערכו הוא כתובת הזיכרון של משתנה מסוג נתונים נתון |
| סט | סוג מורכב המאחסן קבוצת ערכים מסוג אחד, ללא סדר וללא כפילויות |
| רקורד | סוג מורכב בעל מספר קבוע של שדות, כאשר לכל שדה יש מזהה וסוג משלו, והגישה מתבצעת באמצעות סימון נקודה (dot notation) |
| מחלקה | סוג מורכב המשלב מאפיינים (נתונים) עם שיטות (פרוצדורות ופונקציות) הפועלות עליהם; אובייקט הוא דוגמה למחלקה |
| קובץ סריאלי | רקורדים המאוחסנים אחד אחרי השני בסדר הוספתם |
| קובץ סידורי | רקורדים המאוחסנים אחד אחרי השני לפי סדר של שדה מפתח |
| קובץ מקרי | רקורדים המאוחסנים בכתובות המחושבות מהמפתחות שלהם באמצעות אלגוריתם האשינג |
| גישה סידורית | קריאת הרקורדים בתור מהתחלת הקובץ עד שמציאים את הנדרש |
| גישה ישירה | חישוב כתובת הרקורד על בסיס המפתח שלו וגישה ישירה למיקום זה |
| אלגוריתם האשינג | חישוב על המפתח של רקורד המניב את הכתובת בה הוא מאוחסן ונמצא |
| התנגשות | שני מפתחות שונים המייצרים אותה כתובת |
| חוליה | החלק של מספר צף המאחסן את הביטים המשמעותיים שלו, כשבר בשלימת שניים |
| מעריך | שלם בשלימת שניים המייצג את חזקת השתייה שבה מוכפלת החוליה |
| נורמלי | מספר צף whose חוליתו מתחילה ב-01 (חיובי) או ב-10 (שלילי), כך שאין בזבוז ביטים על אפסים או יחידות מובילות |
| הגדלת יתר | תוצאה גדולה מדי כדי להצג במספר הביטים הזמינים |
| ירידת ערך | תוצאה אי-ספואה קטנה מדי כדי להצג, ולכן היא מאוחסנת כאפס |
| טעות עיגול | ההפרש בין מספר אמיתי לבין הערך הקרוב ביותר שהייצוג הבינארי יכול לאחסן |
13.3
טיפים לבחינות
- הצהרות פסאודוקוד מסומנות שורה שורה:
TYPE ... = (...)עבור מונה,TYPE ... = ^...עבור שליונית,TYPE ... = SET OF ...ולאחר מכןDEFINE ... (...) : ...עבור קבוצה,TYPE ... DECLARE ... ENDTYPEעבור רקורד,CLASS ... PRIVATE ... PUBLIC PROCEDURE NEW ... ENDCLASSעבור מחלקה. - התאם את הסוג לנתונים: ערכים קבועים וממונון, ערכים ממונון; קבוצה של שדות שונים, רקורד; קבוצה של ערכים ייחודיים, סט; נתונים ועמידה, מחלקה; כתובת, מצביע.
- ארגון קובץ הוא כיצד הרקורדים מאוחסנים; גישה לקובץ היא כיצד הם נמצאים. קבצים סריאליים וסידוריים קוראים אותם ברצף; קבצים מקריים משתמשים בגישה ישירה באמצעות האשינג של המפתח. חיפוש סידורי של קובץ סידורי יכול להפסיק מוקדם; בקובץ סריאלי אין זאת אפשרי.
- פסודוקוד לקובץ מקרי:
OPENFILE ... FOR RANDOM,SEEKלפני כלGETRECORDאוPUTRECORD,CLOSEFILEבסוף. הסבר כיצד פותרים התנגשות בעת תיאור האשינג. - מספרים בעשרוניים: מנטיסה כשבר בשלבים של שני (נקודה אחרי ביט הסימן), אקספוננט כמספר שלם, הכפלה ב$2^{\text{exponent}}$; הזזה שמאלה והורדת אחד מהאקספוננט לנרמול; המנטיסה מעניקה דיוק, האקספוננט מעניק טווח.
- שלושת התשובות הסטנדרטיות "הסבר": מדוע לנרמל (דיוק, צורה יחידה, טווח), השפעת שינוי חלוקת הביטים (דיוק מול טווח), ומדוע $0.1$ לא ניתן לאחסון במדויק (שבר בינארי אינסופי במנטיסה סופית).
טעויות נפוצות
- כתיבת
DECLAREבמקוםTYPEלערכי סוג חדש, או השמטתENDTYPE; הגדרת קבוצה ללאSET OF, או סוג מונה עם ערכיו בתוך סימני הציטוט. - הנחת סימן המספר העשרוני באקספוננט; הסימן הוא למעשה ביט הראשון של המנטיסה.
- קריאת מנטיסה שלילית כאילו הייתה בייצוג סימן-גודל; היא למעשה בשלבים של שני, ולכן
1011000000היא $-0.625$, ולא $-0.375$. - הזזת המנטיסה לנרמול ללא שינוי באקספוננט, או שינוי באקספוננט בצורה שגויה (הזזה שמאלה, אקספוננט יורד).
- תיאור קובץ אקראי כ"בסדר אקראי"; הרקורדים נמצאים בכתובות המחושבות מהקוד שלהן.
- טענה שהגישה הסדרית קוראת "את כל הקובץ" בקובץ סדרתי; הגישה נעצרת כאשר מתקבל קוד גדול יותר.
- הסבר על גיבוי (Hashing) ללא ציון למה משמש הערך המחושב (הכתובת לאחסון וקריאת הרקורד), או ללא דרך לטיפול בהתנגשויות.
- הגדרת גלישה (Overflow) כ"יותר מדי ספרות" במקום תוצאה החורגת מערך הגדול ביותר שתואכן, או האשמת המנטיסה בכך.
שיעורים אינטראקטיביים בנושא זה
לעבור על הדברים צעד אחר צעד, עם תרגילים לבדיקה מיידית.