| English | 释义 | 拼音 |
|---|---|---|
| regression/rɪˈɡreʃn/ | 回归 | huí guī |
| classification/ˌklæsɪfɪˈkeɪʃn/ | 分类 | fēn lèi |
| linear regression/ˈlɪnɪə rɪˈɡreʃn/ | 线性回归 | xiàn xìng huí guī |
| OCR/ˌəʊ siː ˈɑː/ | 光学字符识别 | guāng xué zì fú shí bié |
预测一个数,而不是一个名字
- 问模型"这封邮件是垃圾邮件吗?",它必须从一组固定的答案里选。问它"这套房子会卖多少钱?",却没有可选的集合:答案是一个数,而差一千英镑几乎就算对了。
- 这是两种不同的任务,把它们混为一谈是本单元最常见的错误。两者都是监督学习;不同的只是答案的形状。
- 这一课讲回归(regression)与分类(classification)的对比、线性回归(linear regression)怎样选出它那条直线,以及真实产品怎样把训练好的模型串成流水线。
回归与分类
- 分类从一个固定集合中预测一个类别:猫还是狗、垃圾邮件还是不是、十个数字中的哪一个。
- 回归在连续的尺度上预测一个数:房价、明天的气温、一次行程要多久。
- 两者都是监督的:都从有标签的样例中学习。在它们之间的选择由一个问题决定:答案是一个标签还是一个数?
- 这个区分改变了衡量成败的方式。分类器要么对要么错;回归器则是差了多少,这就是它们的损失函数不同的原因。
The difference between regression and classification is that regression predicts:
难度 1/5 · 今日首次完成可获 100 金币及少量额外奖励
Regression outputs a continuous number (price, temperature); classification outputs a category.
Regression predicts a continuous number (a price, a temperature), while classification predicts a category (cat vs dog).
难度 1/5 · 今日首次完成可获 100 金币及少量额外奖励
Number out = regression; category out = classification — the two main kinds of supervised prediction.
例题:哪个任务是哪一种
- 预测一位购物者属于五种顾客类型中的哪一种。 分类:答案是固定类别集合中的一个。
- 预测那位购物者下个月会花多少钱。 回归:答案是一个数,接近就算基本正确。
- 预测一台机器下周是否会故障。 分类:是或否。预测还有几天会故障。 回归。
- 同样的底层数据可以喂给任何一种。要读被问的问题,而不是看题材。
Match each prediction task to its kind.
难度 2/5 · 今日首次完成可获 140 金币及少量额外奖励
The same data can feed either. Read the question: a label from a fixed set, or a number on a scale.
线性回归
- 线性回归拟合一条直线,当输入有多个时则是一个平面:
- 这些系数被选来最小化平方误差之和——即直线的预测值与训练数据实际值之差的平方和。
- 用平方,考试接受两个理由:这样线上方和下方的误差不会互相抵消,而且一个大误差受到的惩罚远大于几个小误差。
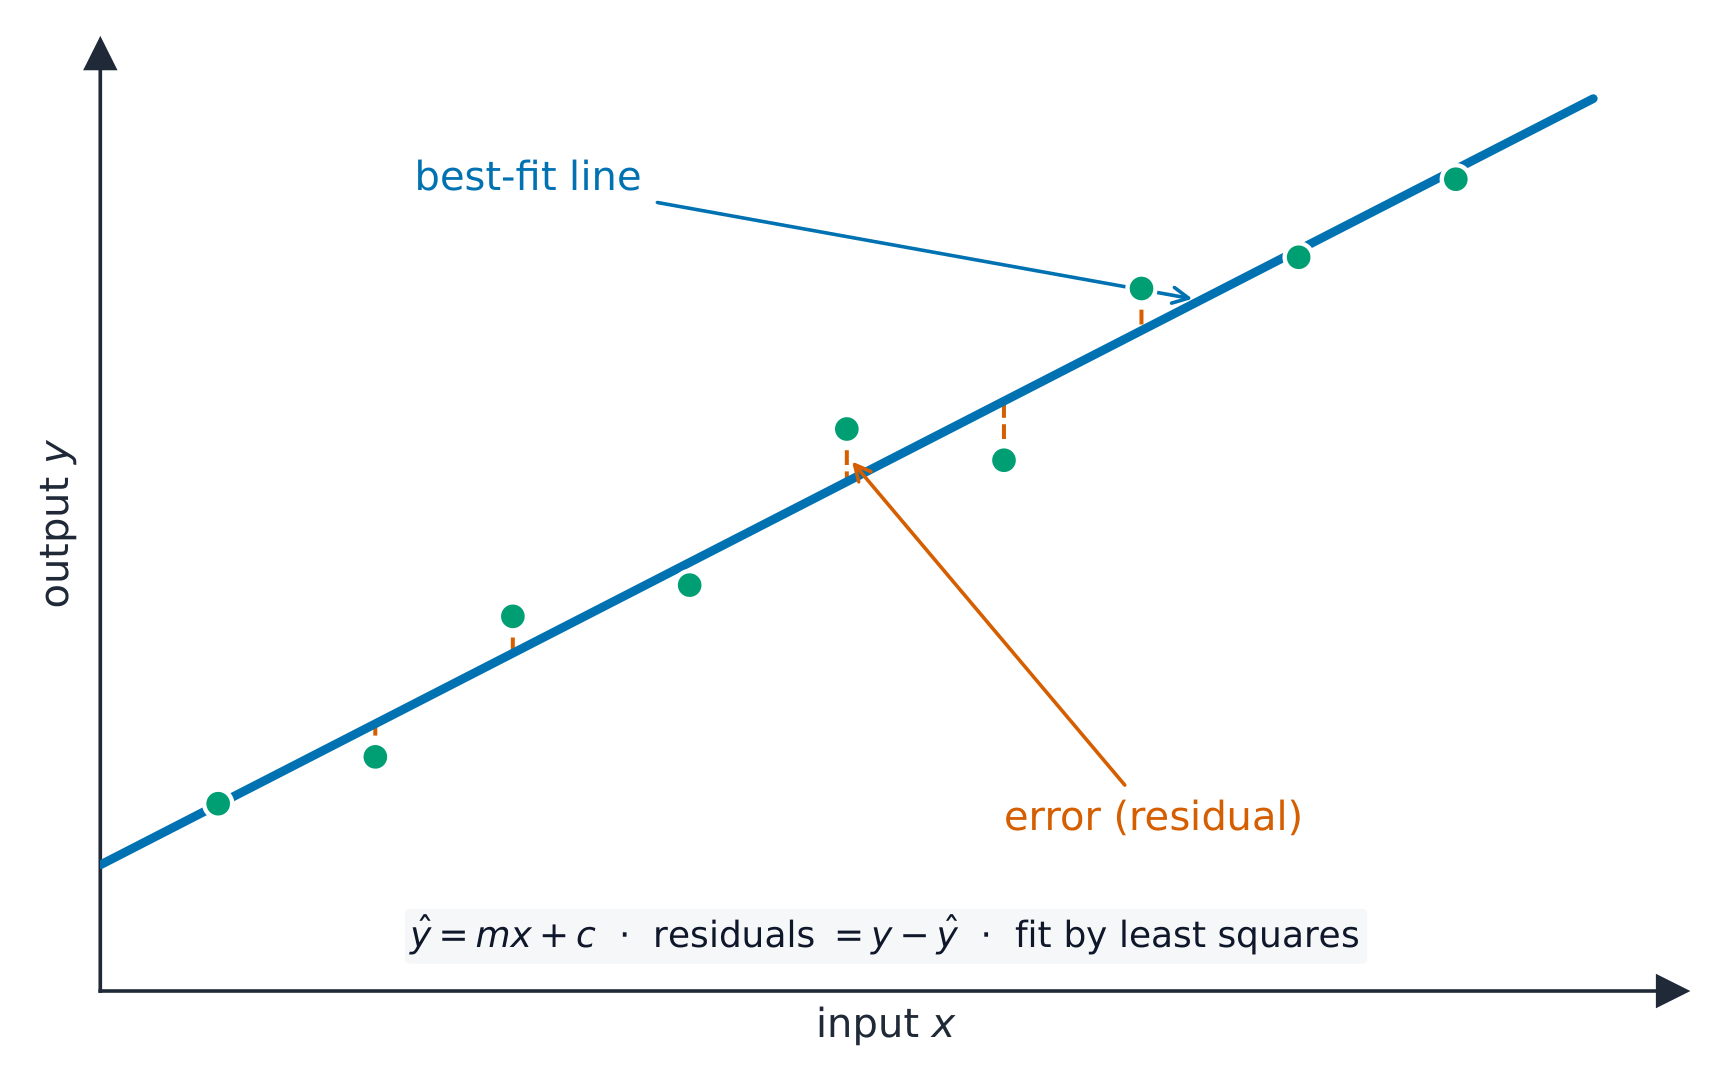
留下最小总平方距离的那条线
Fitting a regression line
Drag the controls. Linear regression draws the straight line that makes the squared distances to the data points as small as possible — then it predicts a number for any new input.
Linear regression chooses its coefficients to:
难度 1/5 · 今日首次完成可获 100 金币及少量额外奖励
It fits the line/hyperplane that makes the squared differences from the data points as small as possible.
Why does linear regression minimise the sum of the SQUARED errors rather than the errors themselves?
难度 1/5 · 今日首次完成可获 100 金币及少量额外奖励
Both reasons are accepted. Without squaring, a line could have a huge error above and below and still score zero.
什么时候直线是对的模型
- 当关系看起来大致线性、而且你想要一个人能读懂的模型时,就用线性回归:每个系数说出那个输入有多重要、朝哪个方向。
- 当数据是弯的,同样的想法换个模型仍然适用:多项式回归、决策树,或神经网络。每一种情况下配方都一样:选一个模型、定义一个损失、把它最小化。
- 这个配方正是本课与上一课的连接:当答案没有公式时,梯度下降不过是完成"最小化"的方式。
真实产品里的 AI
- 真实系统很少只用一个模型。它们把几个训练好的模型串成一条流水线,每个做一步。
- 门口的人脸识别:摄像头捕捉人脸,图像识别把它转换成数值表示,再拿它与已登记者的表示做匹配。
- 为旅行者朗读路牌:图像识别定位文字,光学字符识别(OCR)把像素变成字符,机器翻译转换词语,文本转语音产生音频。
- 考试给一个情境,问用到哪些模型、按什么顺序。要说出每个阶段,以及它交给下一个阶段什么。
Match each AI idea to what it means.
难度 2/5 · 今日首次完成可获 140 金币及少量额外奖励
Training fits the model once; inference is the quick prediction each time a user interacts.
A "read a sign aloud" feature typically chains which models?
难度 1/5 · 今日首次完成可获 100 金币及少量额外奖励
Several trained models form a pipeline: find the text, extract characters, translate, then speak.
Put the stages of an app that reads a foreign sign aloud in order.
难度 3/5 · 今日首次完成可获 200 金币及少量额外奖励
Several trained models chained together, each handing its output to the next. Name the stage and what it produces.
例题:训练与推理的对比
- 一个手机应用能瞬间从照片认出一种植物,而训练它的模型却在许多台机器上花了几周。解释为什么。
- 训练在一个非常大的有标签数据集上反复进行前向和反向传播,历经很多轮次调整数百万个权重。那才是花掉几周的事。
- 推理,即使用训练好的模型,是在权重已固定的网络上做一次前向传播:逐层相乘、相加、激活,一次而已。
- 智能存在于学到的权重里,这就是完成后的模型足够小、足够快、能装进手机的原因。
Using a trained model to make a prediction requires only a single ____ pass.
难度 1/5 · 今日首次完成可获 100 金币及少量额外奖励
Training repeats forward and backward passes over a huge dataset; inference runs the fixed weights once, which is why it is instant.
容易丢掉的分
- **分类给出类别,回归给出数字。**两者都是监督的;那不是区别所在。
- 线性回归最小化的是平方误差之和,不是"总距离"。要说平方,并说出为什么。
- 流水线的答案必须按顺序给出各阶段,并说出每个交给下一个什么。
- 训练是反复的前向和反向传播;推理是一次前向传播。题目问使用时不要去描述训练。
你掌握了
- 分类预测类别,回归预测数字;两者都是监督的,由问题答案的形状决定用哪个
- 线性回归通过最小化平方误差之和来拟合 $y = m_1x_1 + \ldots + c$,这样误差不会抵消,大误差受重罚
- 弯曲的数据需要别的模型,但配方不变:选模型、定损失、最小化
- 真实产品把模型串起来:图像识别、OCR、翻译和文本转语音;训练是许多次前向和反向传播,推理是一次前向传播