| English | 释义 | 拼音 |
|---|---|---|
| linear search/ˈlɪnɪə sɜːtʃ/ | 线性查找 | xiàn xìng chá zhǎo |
| binary search/ˈbaɪnəri sɜːtʃ/ | 二分查找 | èr fēn chá zhǎo |
用二十个问题找出一百万个名字中的一个
- 一本电话簿有一百万个名字。一个一个查,你大概要比较五十万次才能找到想要的那个。
- 换个办法:从中间翻开,判断名字在哪一半,把另一半扔掉。重复。任何一个名字都能在 二十 次比较内找到。
- 五十万对二十不是一点小节省;那是一个能用的程序和一个不能用的程序之间的差别。而它只要一个代价:列表必须已经有序。
- 这一课讲线性查找(linear search)和二分查找(binary search)、各自的性能,以及怎样选择。
线性查找
FOR i ← 1 TO n
    IF A[i] = target THEN
        RETURN i
    ENDIF
NEXT i
RETURN -1                     // not found
- 它从头走起,把每个元素与目标比较,找到匹配或走到末尾就停下。
- 它对任何列表都有效,有序无序都行,对任何能逐个走过的结构也都有效。
- 最坏情况:目标在最后或根本不在,于是全部 $n$ 个元素都被比较,即 $O(n)$。平均大约一半。
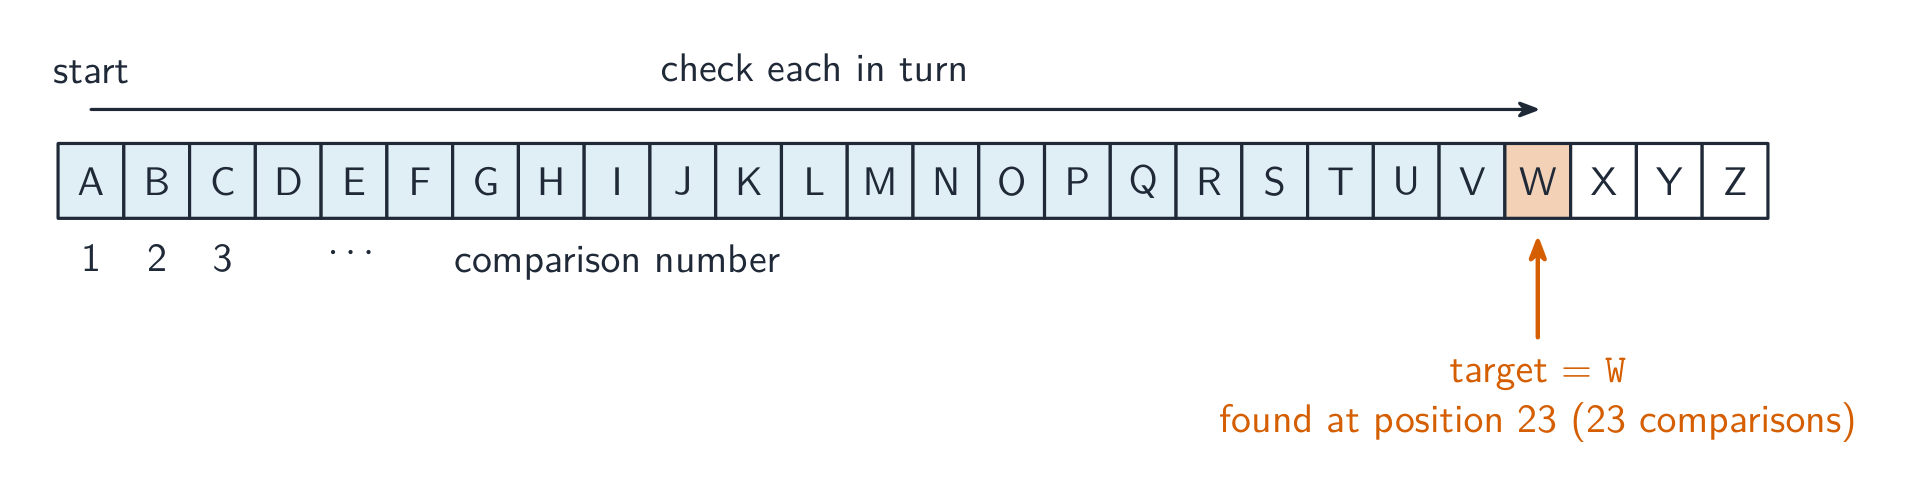
一次一个,从头开始
一个线性搜索:
难度 1/5 · 今日首次完成可获 100 金币及少量额外奖励
线性搜索不需要准备并在任何列表上工作,最坏 O(n)。
当数据是以下时,线性搜索是更好的选择:
难度 1/5 · 今日首次完成可获 100 金币及少量额外奖励
没有顺序可利用(或一个很小的列表),线性搜索避免先排序的代价。
二分查找
low ← 1 ;  high ← n
WHILE low <= high DO
    MiddleIndex ← (low + high) DIV 2
    IF A[MiddleIndex] = target THEN
        RETURN MiddleIndex
    ENDIF
    IF A[MiddleIndex] < target THEN
        low ← MiddleIndex + 1
    ELSE high ← MiddleIndex - 1
ENDWHILE
RETURN -1
- 它要求数据有序。把中间元素与目标比较:相等就停;目标更大就丢掉下半部分;否则丢掉上半部分。
- 每次比较把还要搜索的范围减半,所以比较次数是 $O(\log_2 n)$。
- 这就是一百万项只需约二十次比较的原因:$2^{20}$ 刚过一百万。
搜索算法
二分每步把范围减半
线性搜索检查每个项;二分把一个已排序的列表减半——少得多的比较。
二分搜索的最坏情况时间复杂度是:
难度 1/5 · 今日首次完成可获 100 金币及少量额外奖励
每步把范围减半给出对数数量的比较。
一个二分搜索对一百万个已排序的项需要大约多少次比较?
难度 2/5 · 今日首次完成可获 140 金币及少量额外奖励
$\log_2(1\,000\,000) \approx 20$——大约 20 次比较。
二分查找可以用在任何列表上,有序无序都行。
难度 1/5 · 今日首次完成可获 100 金币及少量额外奖励
它通过与中间元素比较来决定丢掉哪一半,而这只有在数据有序时才有意义。
二分搜索属于$O(\log n)$算法,因为每次比较都可____待搜索范围。
难度 1/5 · 今日首次完成可获 100 金币及少量额外奖励
二十次减半可将百万降至一,正因如此,只需记住略超百万的$2^{20}$即可。
例题:追踪一次二分查找
- 有序列表是 2, 5, 8, 12, 16, 23, 38, 56, 72, 91。追踪对 23 的查找。
low是 1,high是 10,所以mid是 5,那里是 16。16 小于 23,所以丢掉下半部分:low变成 6。low6、high10,所以mid是 8,那里是 56。56 大于 23,所以high变成 7。low6、high7,所以mid是 6,那里是 23。找到,用了三次比较,而线性查找要六次。- 每一步都要写出
low、high、mid和那里的值。大部分分数在追踪过程里,不在答案里。
在有序列表 2, 5, 8, 12, 16, 23, 38, 56, 72, 91 中,二分查找找到 23 需要几次比较?
难度 2/5 · 今日首次完成可获 140 金币及少量额外奖励
mid 5 是 16(太小),mid 8 是 56(太大),mid 6 是 23。线性查找要六次。
在它们之间选择
| 线性 | 二分 | |
|---|---|---|
| 数据必须有序 | 否 | 是 |
| 最坏情况比较次数 | $n$ | $\log_2 n$ |
| 一百万项 | 最多 1,000,000 | 约 20 |
| 适合 | 无序或小列表、链表 | 反复查找的大型有序数组 |
- 先排序的代价大于一次线性查找,所以只有当列表已经有序、或者会被查找很多次时,二分查找才划算。
- 二分查找还需要对中间元素的直接存取,数组有,链表没有。
例题:论证选择
- 一个程序在 50 条无序记录中查找一次。 线性查找:先给列表排序的代价远大于这次查找所需的 50 次比较。
- 一个程序每秒在一百万条有序记录中查找上千次。 二分查找:数据已经有序,每次查找约 20 次比较而不是最多一百万次。
- 一个程序在链表中查找。 线性查找:二分查找需要直接跳到中间元素,而链表只能从头往下走。
- 说出算法,再说出决定它的那条数据性质。
把每个搜索与它的关键事实配对。
难度 2/5 · 今日首次完成可获 140 金币及少量额外奖励
二分搜索快得多(O(log n))但只在已排序的数据上;线性在任何地方以 O(n) 工作。
什么时候线性查找是更好的选择?选出所有适用的。
难度 2/5 · 今日首次完成可获 140 金币及少量额外奖励
最后一种情形正是二分查找取胜的地方。先排序比一次线性查找代价更大,所以只有在多次查找时才划算。
保持文件有序的代价
- 二分查找只能用在已排序的列表上,而排序不是免费的。要求你论证选择的题,问的就是这笔账。
- 如果数据经常被查、很少被改,就排序一次,以后每次查找都是 $\log_2 n$。字典或查找表就是这种情形。
- 如果数据不断变化,每次插入都要维持顺序,代价是把后面的元素移位。那么在无序数据上做线性查找,总代价反而可能更低。
- 数字能把论证说实:一百万条记录线性查找最多要比较一百万次,而二分查找只要 20 次,因为 $2^{20} > 10^6$。
- 所以评分认可的答案要说出两半:被查得多频繁,以及被改得多频繁。
把选择查找算法的论证按顺序排列。
难度 3/5 · 今日首次完成可获 200 金币及少量额外奖励
论证题要的是权衡,不是赢家。在不断变化的列表上用二分查找,总代价可能高于线性查找。
容易丢掉的分
- 二分查找要求数据有序。不带这个条件只说"它更快"会丢分。
- 每一步把范围减半,这就是 $\log_2 n$ 的来源。要给出理由,不只是记号。
- 两种查找都必须能报告未找到,那个
-1和循环条件就是干这个的。 - 二分查找需要直接存取,所以即使链表有序,它也用不上。
你掌握了
- 线性查找从头逐个比较,对任何列表都有效,是 $O(n)$
- 二分查找需要有序且能直接存取的数据,比较中间元素并每次把范围减半,得到 $O(\log_2 n)$:一百万项约 20 次比较
- 追踪二分查找时要在每一步写出
low、high、mid和那里的值 - 从数据出发选择:无序、很小或是链表就用线性;大、有序且常被查找就用二分