| Кандидаты должны уметь: | Примечания и рекомендации |
|---|---|
| Проявить понимание ограничений использования файлового подхода для хранения и извлечения данных | |
| Описать особенности реляционной базы данных, устраняющие недостатки файлового подхода | |
| Проявить понимание и использовать терминологию, связанную с реляционной моделью данных | Включая: сущность, таблица, запись, поле, кортеж, атрибут, первичный ключ, кандидатский ключ, вторичный ключ, внешний ключ, связь (один-ко-многим, один-к-одному, многие-ко-многим), ссылочная целостность, индексирование |
| Использовать диаграмму «сущность–связь» (E-R) для документирования проектирования базы данных | |
| Проявить понимание процесса нормализации | Первая нормальная форма (1NF), Вторая нормальная форма (2NF) и Третья нормальная форма (3NF) |
| Объяснить, почему заданный набор таблиц баз данных находится или не находится в 3NF | |
| Создать нормализованную структуру базы данных по описанию БД, заданному набору данных или заданному набору таблиц |
Базы данных
A-Level Computer Science · Тема 8
 17:16
Базы данных и реляционная модель
До появления баз данных каждая программа хранила свои собственные плоские файлы — по одному файлу на программу. Представьте магазин. Программа продаж, программа выставления счетов и программа доставки…
Озвучивание на английском · переключаемые субтитры на английском и китайском языках
8.1
Хранение на основе файлов и его ограничения
Программа
Источник: Программа Cambridge International
До появления баз данных программы хранили данные в плоских файлах — обычно по одному файлу на программу. Это приемлемо для небольших объемов данных, но не работает при масштабировании.
Ограничения
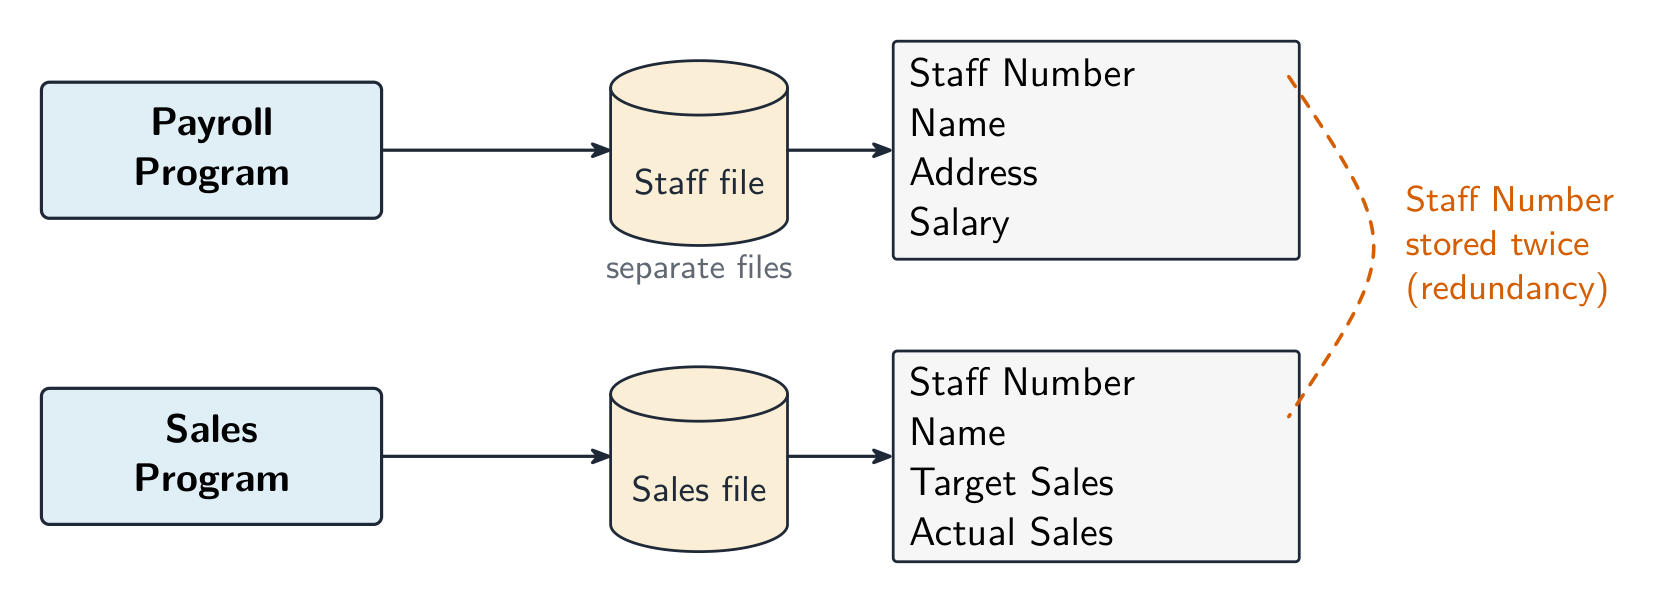
- избыточность данных — одни и те же данные (адрес клиента) хранятся в нескольких файлах, по одному на программу; это приводит к потере места на диске, и каждую копию необходимо обновлять.
- несогласованность данных — когда одна копия обновлена, а другая нет, файлы содержат противоречащие друг другу сведения, и невозможно определить, какая информация верна.
- зависимость от данных — каждая программа написана под конкретную структуру своих файлов; изменение длины поля или добавление нового поля требует переписывания всех программ, читающих этот файл.
- отсутствие общего доступа — файл блокируется во время использования одной программой, поэтому пользователи не могут одновременно работать с данными.
- слабая целостность — отсутствуют централизованные правила, предотвращающие ввод невалидных значений или ссылок на несуществующих клиентов; слабая безопасность — доступ осуществляется на уровне файла, а не отдельного поля; запросы к данным из разных файлов требуют создания новой программы каждый раз.
Реляционная база данных устраняет эти проблемы, храня данные в таблицах, управляемых одним программным обеспечением (СБД), которое используют все программы.
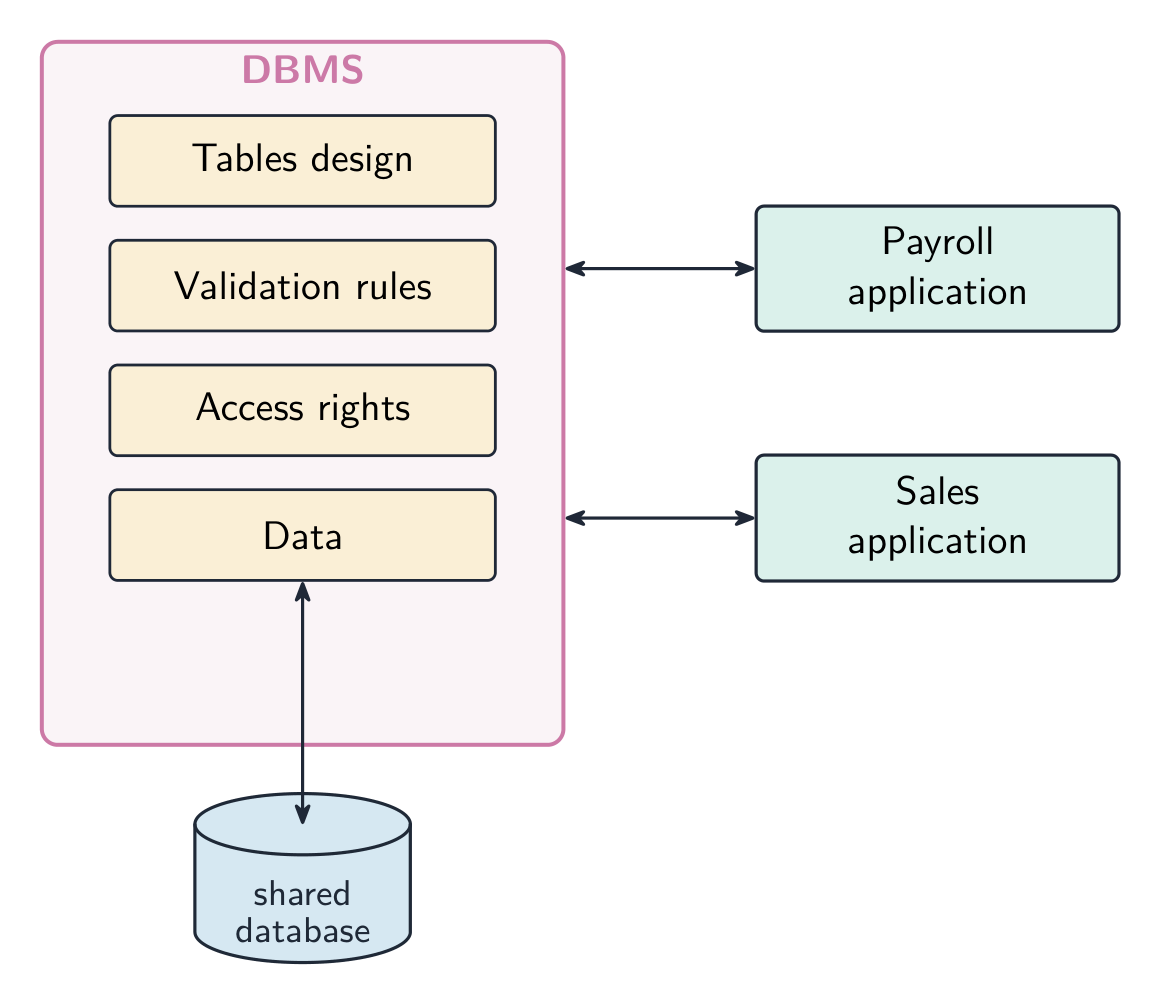
Почему реляционная база данных лучше — ответ на три балла. Каждый элемент данных хранится один раз в одной таблице, а таблицы связаны ключами, поэтому отсутствует избыточность и несогласованность; данные независимы от программ, которые запрашивают у СБД необходимое и не страдают при изменении структуры; СБД обеспечивает соблюдение правил целостности, управляет доступом для каждого пользователя и каждого поля, позволяет множеству пользователей работать одновременно и отвечает на любые запросы без написания новой программы.
Разобранное решение примера. Магазин по ремонту техники хранит информацию о клиентах, устройствах и ремонтах с использованием подхода на основе файлов, по одному файлу на программу. Назовите три проблемы, которые это вызывает, и опишите, как реляционная база данных устранила бы их.
Имя и телефон клиента хранятся в файле ремонтов и в файле счетов (избыточность); при изменении номера телефона обновляется один файл, а другой остается старым (несогласованность); когда магазину нужен новый отчет — например, количество ремонтов на одного техника, — приходится писать новую программу для чтения файлов (нет возможности создавать запросы на лету). В реляционной базе данных клиент хранится один раз в таблице CUSTOMER и ссылается через CustomerID из таблицы REPAIR, поэтому изменения вносятся один раз и видны везде; отчет формируется одним SQL-запросом.
Словарь
Тренировать
| English | Русский |
|---|---|
| SQL/ˌes kjuː ˈel/ | SQL |
| entity/ˈentɪti/ | сущность |
| record/ˈrekɔːd/ | запись |
| tuple/ˈtuːpl/ | кортеж |
| attribute/ˈætrɪbjuːt/ | атрибут |
8.1
Реляционная модель — терминология
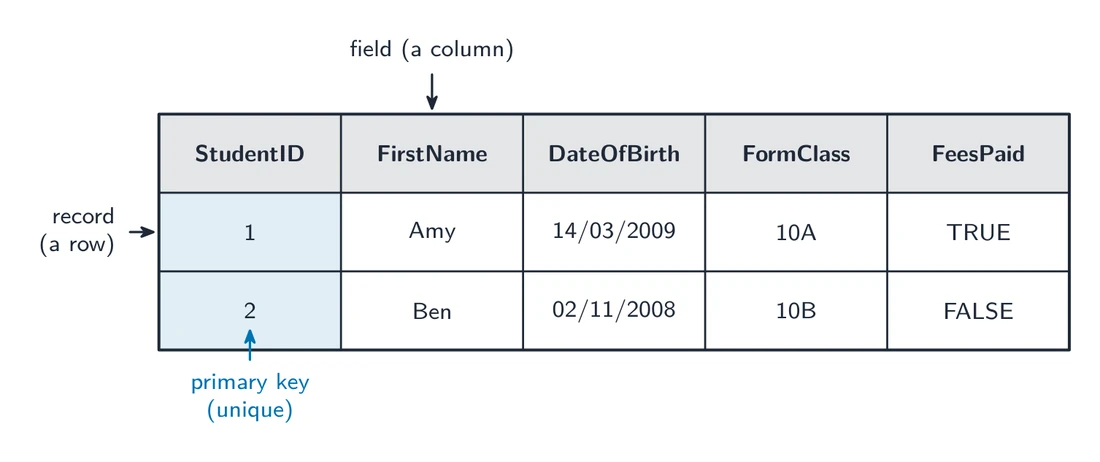
- таблица (отношение) — сетка строк и столбцов; одна таблица для каждого типа сущности (например,
CUSTOMER). - запись (строка, также называемая кортежем) — одна строка; один экземпляр сущности.
- поле (столбец, также называемый атрибутом) — один столбец; одно свойство информации о каждой записи.
- первичный ключ — поле (или набор полей), которое уникально идентифицирует каждую запись; не может быть пустым (null) или дублироваться.
- внешний ключ — поле, значение которого совпадает с первичным ключом другой таблицы, связывая две таблицы между собой.
- составной ключ — первичный ключ, состоящий из двух или более полей вместе взятых.
- кандидатский ключ — любое поле (или набор полей), которое могло бы стать первичным ключом.
- вторичный ключ — поле, не являющееся первичным, но проиндексированное для быстрого поиска.
- индексирование — создание индекса на поле для ускорения операций поиска и соединения таблиц.
- ссылочная целостность — каждое значение внешнего ключа должно соответствовать существующему первичному ключу (отсутствуют «осиротевшие» записи).
Таблица записывается в сокращенном виде с подчеркиванием первичного ключа и отметкой внешних ключей:
CUSTOMER(CustomerID, Name, Phone)
ORDER(OrderID, CustomerID, OrderDate)   -- CustomerID is FK → CUSTOMER
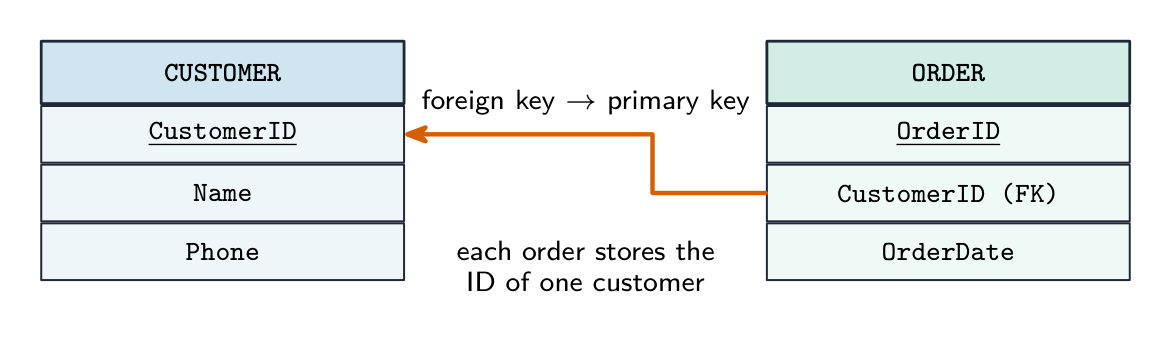
Разобранное решение примера. Объясните, что означают сущность, первичный ключ и ссылочная целостность в реляционной базе данных, а также заполните таблицу соответствия «термин ↔ описание» для понятий кортеж и атрибут.
Сущность — это объект, для которого хранятся данные (человек, предмет или событие), который становится отдельной таблицей. Первичный ключ — это атрибут (или комбинация атрибутов), уникально идентифицирующий каждую запись в таблице. Ссылочная целостность означает, что каждое значение внешнего ключа должно соответствовать значению первичного ключа в той таблице, на которую оно ссылается, поэтому запись не может ссылаться на несуществующую. Кортеж — это одна строка таблицы (одна запись); атрибут — это один столбец (одно поле). Выучите пары: таблица/отношение, запись/кортеж, поле/атрибут.
Исследовать
Чтение реляционной таблицы с помощью SELECT
Реляционная таблица состоит из строк (записей) и столбцов (полей). WHERE оставляет строки, соответствующие условию; SELECT оставляет только запрошенные столбцы.
Словарь
Тренировать
| English | Русский |
|---|---|
| table/ˈteɪbl/ | таблица |
8.1
Диаграммы «сущность-связь» (E-R)
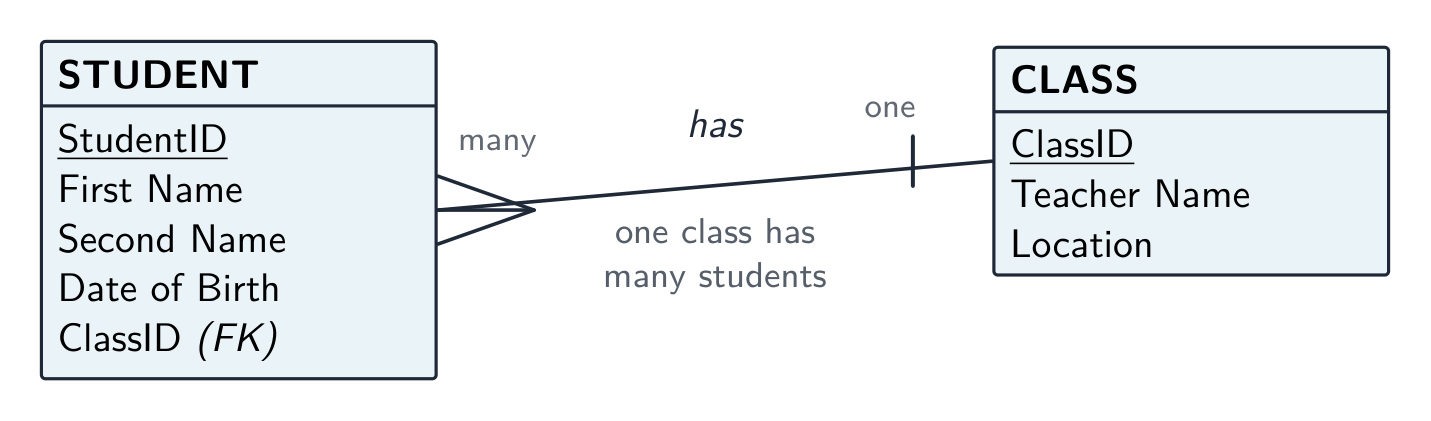
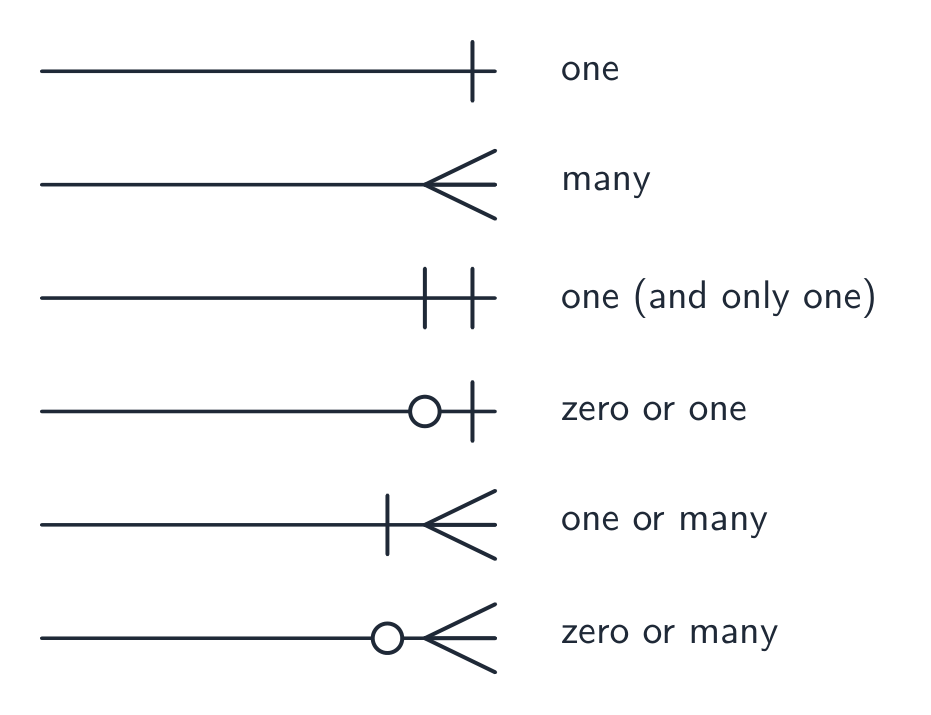
Диаграмма «сущность-связь» показывает структуру: каждая сущность обозначается прямоугольником, каждая связь — линией, с указанием кардинальности на каждом конце:
- «один-к-одному» (1:1).
- один-ко-многим (1:M) — у каждого Клиента много Заказов; каждый Заказ принадлежит одному Клиенту.
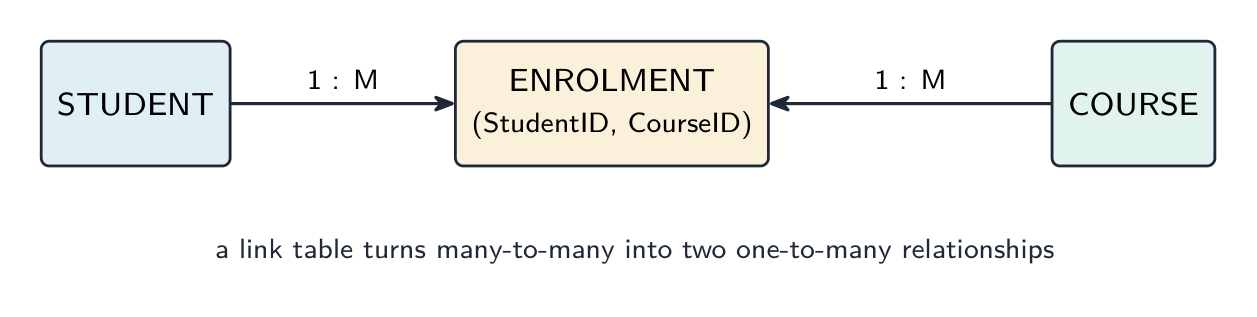
- многие-ко-многим (M:N) — Студенты посещают множество Курсов, а Курсы имеют множество Студентов.
Связь многие-ко-многим нельзя сохранить напрямую. Разбейте её на две связи один-ко-многим через связующую таблицу, содержащую два внешних ключа:
ENROLMENT(StudentID, CourseID, EnrolmentDate)
Построение схемы «сущность-связь» по набору таблиц. Каждая таблица становится сущностью. Существование связи определяется там, где одна таблица содержит внешний ключ на другую; линия идёт от таблицы, содержащей внешний ключ (конец многих), к таблице, являющейся носителем первичного ключа (конец одного). Таблица с двумя внешними ключами и без другой идентичности обычно является связующей таблицей, разрешающей связь многие-ко-многим. Подпишите каждую линию типом связи.
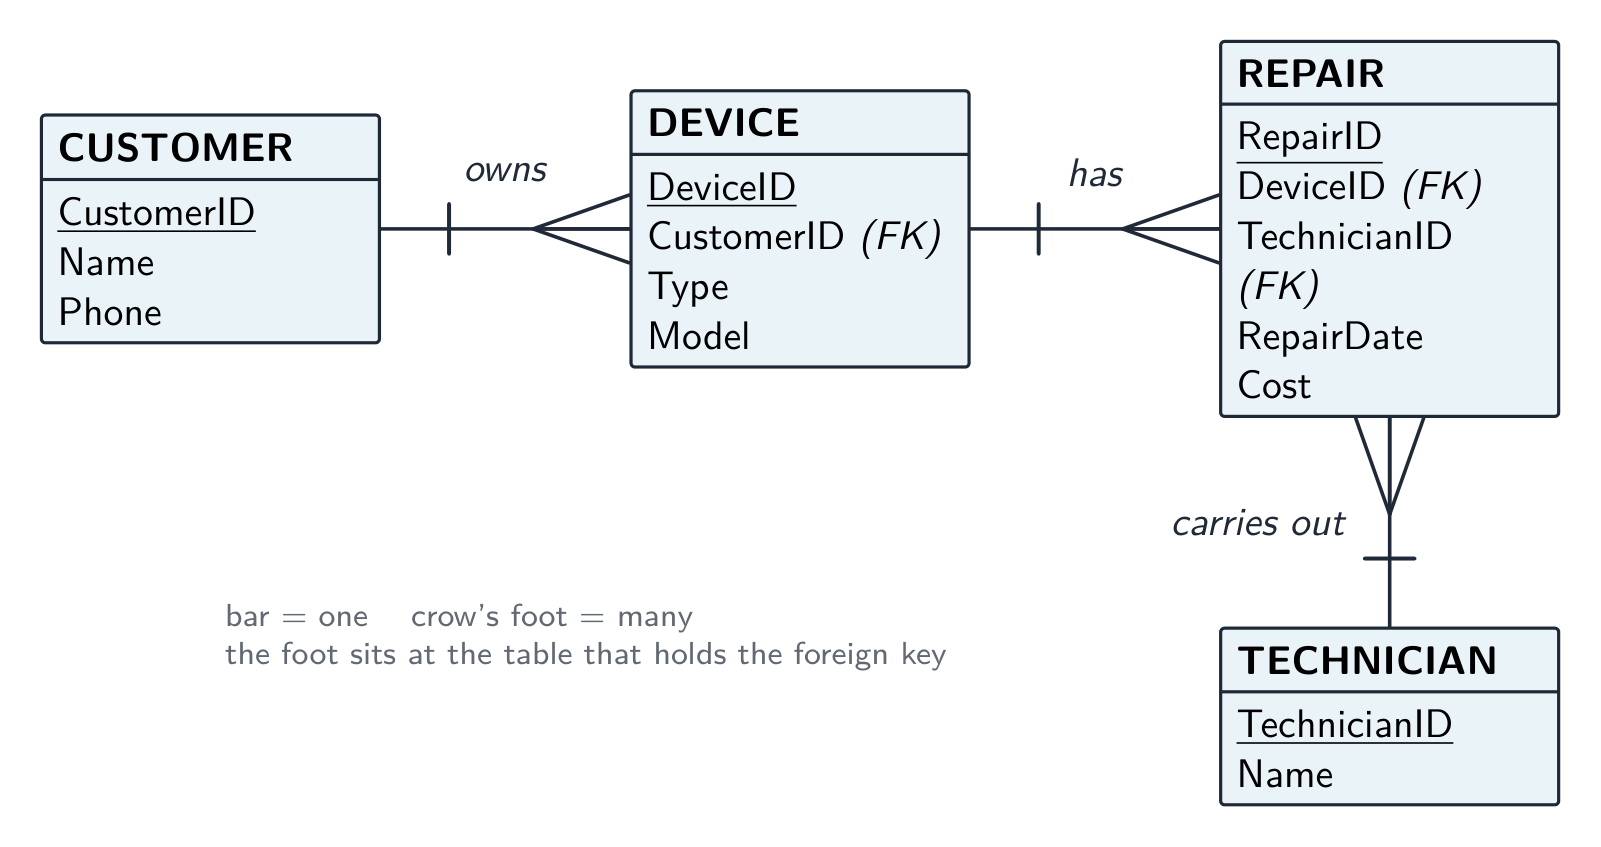
Разобранный пример. Мастерская по ремонту имеет таблицы CUSTOMER(CustomerID, Name, Phone), DEVICE(DeviceID, CustomerID, Type, Model), TECHNICIAN(TechnicianID, Name) и REPAIR(RepairID, DeviceID, TechnicianID, RepairDate, Cost). Определите связи и их типы.
DEVICE содержит CustomerID, поэтому CUSTOMER–DEVICE — это связь один-ко-многим (один клиент, много устройств). REPAIR содержит DeviceID, поэтому DEVICE–REPAIR — это связь один-ко-многим; она также содержит TechnicianID, поэтому TECHNICIAN–REPAIR — это связь один-ко-многим. Прямой линии CUSTOMER–REPAIR нет: связь проходит через DEVICE. Три линии, три «вороньи лапки», все находятся на концах REPAIR или DEVICE.
Словарь
Тренировать
| English | Русский |
|---|---|
| cardinality/ˌkɑːdɪˈnælɪti/ | кардинальность |
| one-to-many/wʌn tə ˈmeni/ | один-ко-многим |
| link table/lɪŋk ˈteɪbl/ | связующая таблица |
8.1
Нормализация
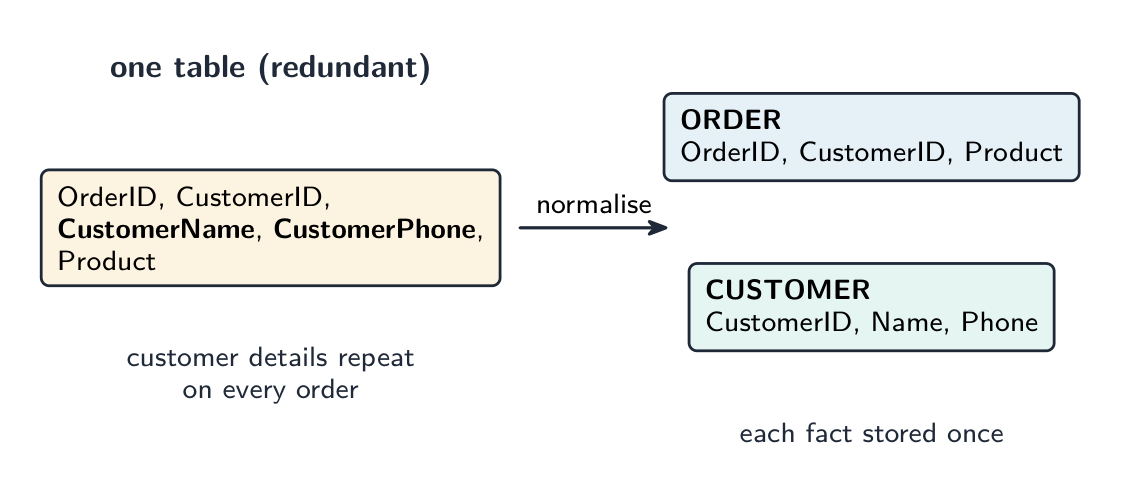
Нормализация упорядочивает таблицы для сокращения избыточности и несогласованности, последовательно проходя нормальные формы.
- Первая нормальная форма (1NF) — каждое поле содержит одно (атомарное) значение, без повторяющихся групп, и имеется первичный ключ.
- Вторая нормальная форма (2NF) — выполнение условий 1NF, и каждое неключевое поле зависит от целого первичного ключа (важно только для составного ключа).
- Третья нормальная форма (3NF) — выполнение условий 2NF, и каждое неключевое поле зависит только от первичного ключа, а не от другого неключевого поля (отсутствие транзитивной зависимости).
Проект в 3NF хранит каждый факт один раз, поэтому исчезают аномалии вставки/обновления/удаления. Компромисс заключается в большем количестве таблиц и соединений. Стремитесь к 3NF.
Для получения проекта в 3NF: определите сущности и их атрибуты; выберите первичный ключ для каждой; разделите повторяющиеся/неатомарные поля (1NF); разделите поля, зависящие от части составного ключа (2NF); разделите поля, транзитивно зависящие от ключа (3NF); добавьте внешние ключи для связей.
Разобранный пример. Таблица ORDER(OrderID, CustomerID, CustomerName, ProductID, Quantity) имеет составной первичный ключ (OrderID, ProductID). Нормализуйте её до 3NF. Проверьте каждое неключевое поле относительно ключа. Quantity зависит от обоих OrderID и ProductID, что допустимо. Но CustomerID зависит от OrderID только - лишь от части составного ключа. Это частичная зависимость, поэтому таблица не находится в 2NF. Разделите её на ORDER_LINE(OrderID, ProductID, Quantity) и ORDER(OrderID, CustomerID, CustomerName). Теперь проверьте 3NF: в новой таблице ORDER поле CustomerName зависит от CustomerID, которое не является ключом - это транзитивная зависимость. Разделите снова: на ORDER(OrderID, CustomerID) и CUSTOMER(CustomerID, CustomerName). Назовите зависимость, нарушающую каждую форму (частичная нарушает 2NF, транзитивная нарушает 3NF); фраза «в ней есть повторяющиеся данные» описывает симптом и не оценивается баллами.
Три вопроса для любой таблицы. Содержит ли каждая ячейка одно значение и отсутствуют ли повторяющиеся группы? Если нет, таблица не находится в 1NF. Если ключ составной, зависит ли каждое неключевое поле от всего ключа? Если какое-либо поле зависит от его части, имеет место частичная зависимость, и таблица не находится в 2NF. Зависит ли каждое неключевое поле только от ключа? Если поле зависит от другого неключевого поля, имеет место транзитивная зависимость, и таблица не находится в 3NF. В ответе на вопрос «объясните, почему таблица не находится в 3NF» назовите зависимость и соответствующие поля.
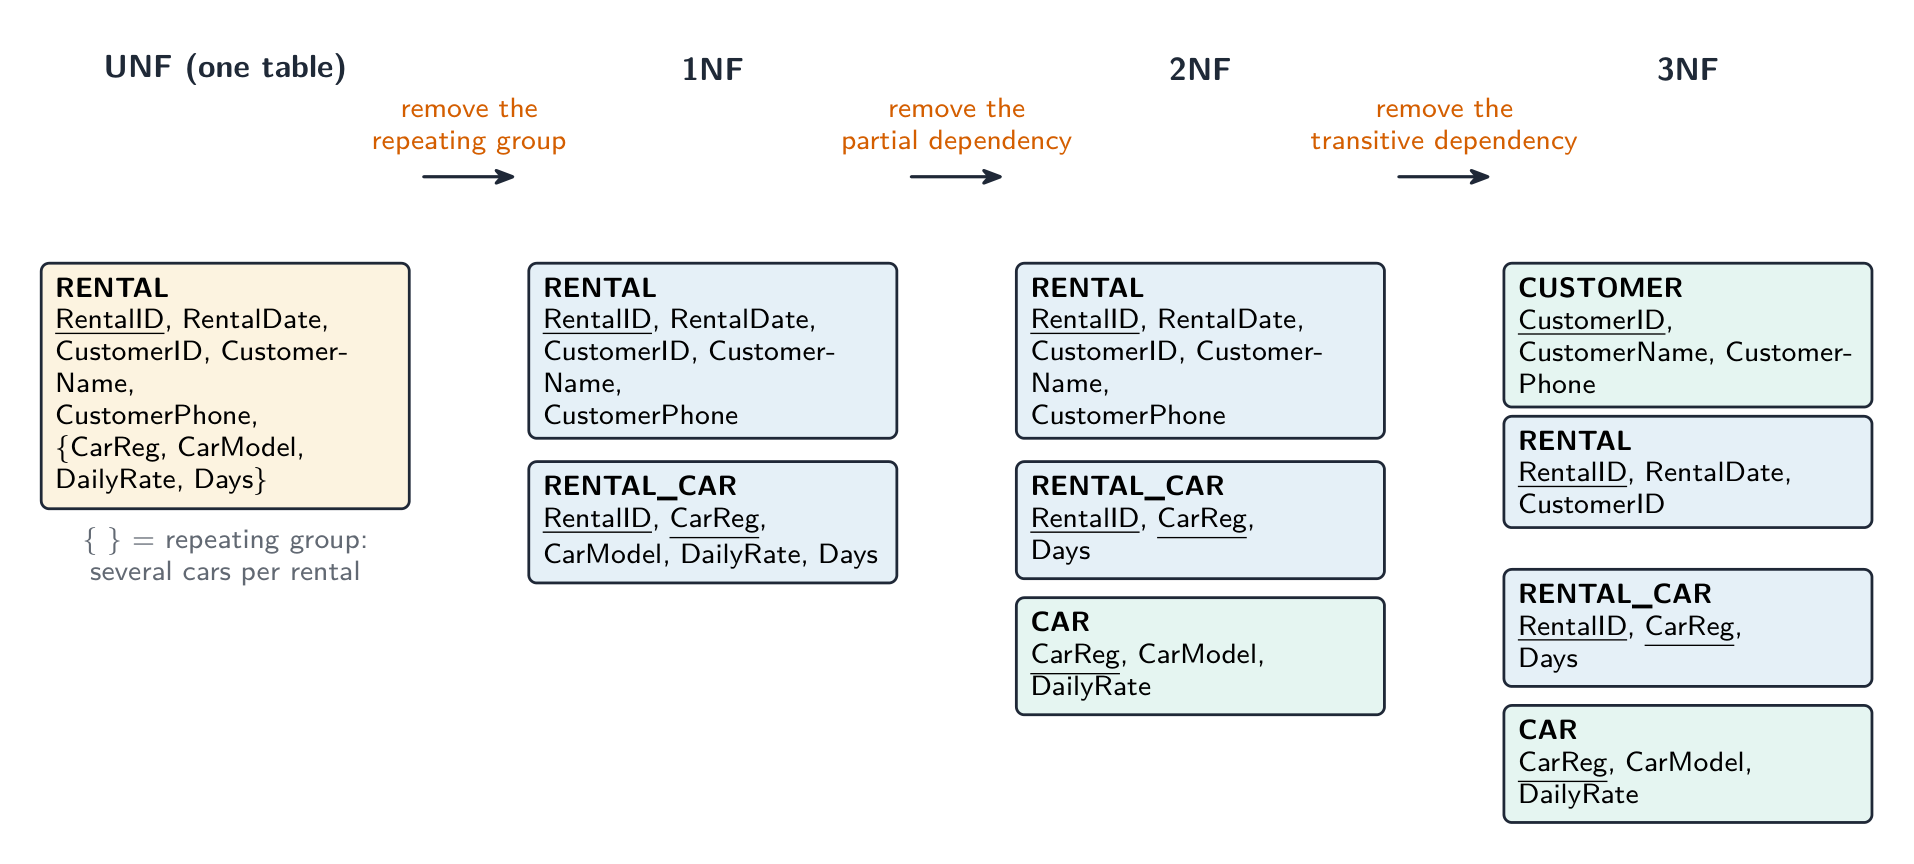
Разобранный пример. Магазин проката автомобилей регистрирует каждую аренду как RENTAL(RentalID, RentalDate, CustomerID, CustomerName, CustomerPhone, CarReg, CarModel, DailyRate, Days), где одна аренда может включать несколько машин. Объясните, почему таблица не нормализована, и создайте проект в 3NF.
Не в 1NF: поля автомобиля CarReg, CarModel, DailyRate, Days образуют повторяющуюся группу — одна аренда включает несколько автомобилей. Перенесите их в RENTAL_CAR(RentalID, CarReg, CarModel, DailyRate, Days) с составным ключом (RentalID, CarReg). Не в 2NF: в RENTAL_CAR поля CarModel и DailyRate зависят только от CarReg — это частичная зависимость. Перенесите их в CAR(CarReg, CarModel, DailyRate), оставив RENTAL_CAR(RentalID, CarReg, Days). Не в 3NF: в RENTAL поля CustomerName и CustomerPhone зависят от CustomerID, неключевого поля, — это транзитивная зависимость. Перенесите их в CUSTOMER(CustomerID, CustomerName, CustomerPhone), оставив RENTAL(RentalID, RentalDate, CustomerID). Структура в 3NF состоит из четырёх таблиц — CUSTOMER, RENTAL, RENTAL_CAR, CAR — с внешними ключами CustomerID, RentalID и CarReg; подчеркните каждый первичный ключ.
Словарь
Тренировать
| English | Русский |
|---|---|
| normalisation/ˌnɔːməlaɪˈzeɪʃn/ | нормализация |
| normal forms/ˈnɔːml fɔːmz/ | нормальные формы |
| atomic/əˈtɒmɪk/ | атомарный |
| transitive dependency/ˈtrænsɪtɪv dɪˈpendənsi/ | транзитивная зависимость |
| partial dependency/ˈpɑːʃl dɪˈpendənsi/ | Частичная зависимость |
| data dictionary/ˈdeɪtə ˈdɪkʃənəri/ | словарь данных |
| concurrent access/kənˈkʌrənt ˈækses/ | совместный доступ |
| transactions/trænˈsækʃnz/ | Транзакции |
| backup/ˈbækʌp/ | резервная копия |
| views/vjuːz/ | Представления |
| data management/ˈdeɪtə ˈmænɪdʒmənt/ | управление данными |
| data modelling/ˈdeɪtə ˈmɒdəlɪŋ/ | моделирование данных |
| logical schema/ˈlɒdʒɪkl ˈskiːmə/ | логическая схема |
| data integrity/ˈdeɪtə ɪnˈteɡrɪti/ | целостность данных |
| data security/ˈdeɪtə sɪˈkjʊərɪti/ | безопасность данных |
| query processor/ˈkwɪərɪ ˈprəʊsesə/ | обработчик запросов |
| developer interface/dɪˈveləpə ˈɪntəfeɪs/ | интерфейс разработчика |
| authentication/ɔːˌθentɪˈkeɪʃn/ | аутентификация |
| Data Definition Language/ˈdeɪtə ˌdefɪˈnɪʃn ˈlæŋɡwɪdʒ/ | Язык определения данных |
| Data Manipulation Language/ˈdeɪtə məˌnɪpjʊˈleɪʃn ˈlæŋɡwɪdʒ/ | Язык манипулирования данными |
| aggregate functions/ˈæɡrɪɡeɪt ˈfʌŋkʃnz/ | aggregate functions |
8.2
Система управления базами данных (СУБД)
Программа
| Кандидаты должны уметь: | Примечания и рекомендации |
|---|---|
| Проявить понимание функций, предоставляемых Системой управления базами данных (СУБД), которые решают проблемы файлового подхода | Включая: • управление данными, включая ведение словаря данных • моделирование данных • логическая схема • целостность данных • безопасность данных, включая процедуры резервного копирования и использование прав доступа для отдельных лиц / групп пользователей |
| Проявить понимание того, как на практике используются инструменты программного обеспечения внутри СУБД | Включая использование и назначение: • интерфейса разработчика • процессора запросов |
Источник: Программа Cambridge International
СУБД централизованно управляет базой данных. Функции, устраняющие ограничения файлового подхода:
- словарь данных — описание каждой таблицы, поля, типа и ключа; программы обращаются к нему вместо жесткого кодирования структуры.
- контроль избыточности/согласованности — каждый факт хранится один раз.
- контроль совместного доступа — блокировки и транзакции позволяют множеству пользователей работать одновременно.
- резервное копирование и восстановление; безопасность и разрешения на уровне пользователя.
- правила целостности — ключи, уникальность и диапазоны ограничений, enforce centrally.
- транзакции — группа операций, которые либо все выполняются, либо ни одна не выполняется.
- представления (виды) — виртуальные таблицы, показывающие каждому пользователю «его» часть данных.
- управление данными и моделирование данных — управление способом хранения данных и определение его структуры как логической схемы (логический дизайн, независимый от физического хранения).
- целостность данных и безопасность данных — обеспечение корректности и централизованный контроль доступа.
- процессор запросов выполняет запросы; интерфейс разработчика предоставляет инструменты и API для создания приложений.
Его инструменты включают редактор словаря данных, конструктор запросов, конструктор форм, генератор отчетов, управление пользователями и редактор SQL.
Что содержит словарь данных (вопрос типа «назовите три элемента»): имена таблиц; имена полей в каждой таблице; тип данных и длину каждого поля; первичные и внешние ключи, а также связи между таблицами; правила валидации; индексы; и кто может получить доступ к каждой таблице. Это метаданные — данные о данных — и СУБД использует их для проверки каждого запроса и каждого изменения.
Как СУБД обеспечивает безопасность данных (вопрос типа «опишите два метода»): аутентификация — имя пользователя и пароль или биометрия перед любым доступом; права доступа — каждому пользователю или группе разрешено читать, записывать или удалять только определенные таблицы или поля, часто через представление; шифрование хранимых данных и данных, передаваемых им, чтобы скопированный файл был недоступен; резервные копии, создаваемые регулярно, чтобы данные можно было восстановить после потери; и журнал транзакций, фиксирующий, кто и что изменил.
Два программных инструмента. Интерфейс разработчика — это то, что использует программист для создания базы данных и приложений на ней: создания таблиц и установки ключей и правил валидации, написания запросов и SQL, а также дизайна форм и отчетов, не зная, как физически хранятся данные. Процессор запросов принимает запрос (SQL из программы или запрос, созданный в интерфейсе), проверяет его на соответствие словарю данных, определяет наиболее эффективный способ его выполнения, извлекает данные и возвращает результаты.
Логическая схема. СУБД сохраняет логический дизайн (какие таблицы и поля существуют и как они связаны) отдельно от физического хранения (файлы, индексы, блоки диска). Программы работают с логической схемой, поэтому физическое хранение может быть реорганизовано без изменения единой программы — это независимость данных, которой lacked файловый подход.
Исследовать
Лабораторная работа по сервисам баз данных
Посмотрите, как СУБМ преобразует запрос в безопасный доступ к общим данным.
Исследовать
Лабораторная работа по сервисам баз данных
Посмотрите, как СУБМ преобразует запрос в безопасный доступ к общим данным.
8.3
DDL и DML
Программа
| Кандидаты должны уметь: | Примечания и рекомендации |
|---|---|
| Проявить понимание того, что СУБД выполняет все операции создания/изменения структуры базы данных с помощью своего Языка определения данных (DDL) | |
| Проявить понимание того, что СУБД выполняет все запросы и обслуживание данных с помощью своего Языка манипулирования данными (DML) | |
| Проявить понимание того, что отраслевым стандартом как для DDL, так и для DML является Structured Query Language (SQL) | Понимать заданное SQL-выражение |
| Понимать заданные SQL-выражения (DDL) и уметь писать простые SQL-выражения (DDL) с использованием подмножества команд | Создание базы данных (CREATE DATABASE) Создание определения таблицы (CREATE TABLE), включая создание атрибутов с подходящими типами данных: • CHARACTER • VARCHAR(n) • BOOLEAN • INTEGER • REAL • DATE • TIME Изменение определения таблицы (ALTER TABLE) Добавление первичного ключа к таблице (PRIMARY KEY (field)) Добавление внешнего ключа к таблице (FOREIGN KEY (field) REFERENCES Table (Field)) |
| Написать SQL-скрипт для запроса или изменения данных (DML), хранящихся в (не более чем двух) таблицах базы данных | Запросы включают: SELECT... FROM, WHERE, ORDER BY, GROUP BY, INNER JOIN, SUM, COUNT, AVG |
| Обслуживание данных, включая INSERT INTO, DELETE FROM, UPDATE |
Источник: Программа Cambridge International
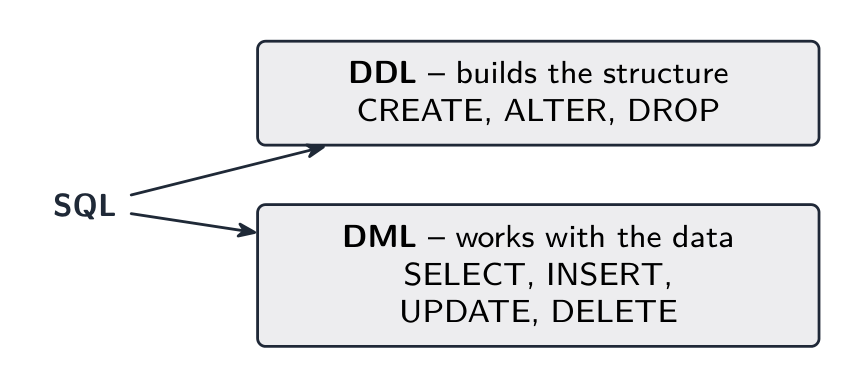
SQL (Structured Query Language) имеет две половины:
- Язык определения данных (DDL) — создает или изменяет структуру (таблицы, ключи, ограничения).
- Язык манипулирования данными (DML) — работает с данными (вставка, обновление, удаление, запрос).
Основы DDL
CREATE TABLE CUSTOMER (
  CustomerID INTEGER PRIMARY KEY,
  Name VARCHAR(50) NOT NULL,
  Phone VARCHAR(20)
);
Добавить внешний ключ:
CREATE TABLE ORDER (
  OrderID INTEGER PRIMARY KEY,
  CustomerID INTEGER,
  OrderDate DATE,
  FOREIGN KEY (CustomerID) REFERENCES CUSTOMER(CustomerID)
);
Изменить и удалить:
ALTER TABLE CUSTOMER ADD Email VARCHAR(100);
DROP TABLE CUSTOMER;
Распространенные типы: INTEGER, REAL, VARCHAR(n), CHAR(n) (также CHARACTER(n)), DATE, TIME, BOOLEAN, DECIMAL(p, s).
Основы DML
Запрос с помощью SELECT:
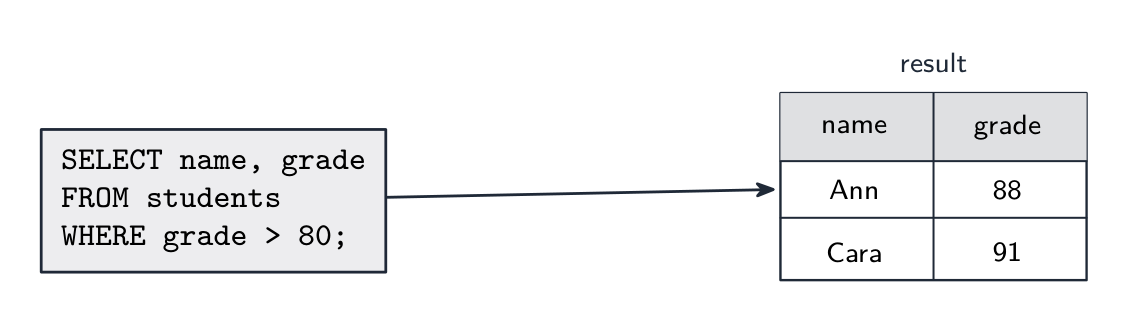
SELECT Name, Phone
FROM CUSTOMER
WHERE City = 'London'
ORDER BY Name ASC;
SELECT перечисляет поля, FROM называет таблицу, WHERE фильтрует строки, ORDER BY сортирует.
JOIN объединяет две таблицы с использованием связи внешнего ключа:
SELECT C.Name, O.OrderDate
FROM CUSTOMER C INNER JOIN ORDER O
  ON C.CustomerID = O.CustomerID
WHERE O.OrderDate >= '2024-01-01';
Агрегатные функции (COUNT, SUM, AVG, MIN, MAX) часто используются вместе с GROUP BY:
SELECT CustomerID, COUNT(*) AS NumOrders
FROM ORDER
GROUP BY CustomerID;
Вставить, обновить, удалить:
INSERT INTO CUSTOMER (CustomerID, Name, Phone)
VALUES (101, 'Ada Lovelace', '020-1234-5678');

UPDATE CUSTOMER SET Phone = '020-9999-0000' WHERE CustomerID = 101;

DELETE FROM CUSTOMER WHERE CustomerID = 101;
Всегда добавляйте clause WHERE к UPDATE и DELETE, иначе изменение затронет каждую строку.
Советы по SQL на экзамене
- используйте точные имена таблиц и полей из вопроса.
- обводите строки одинарными кавычками (
'Smith'); не обводите числа. - сравнения:
=,<,>,<=,>=,<>. LIKE 'A%'совпадает с любым значением, начинающимся с A (%= любая строка,_= один символ);IN (1,2,3);BETWEEN 10 AND 20.- объединяйте условия с помощью
AND/OR/NOTи завершайте каждое выражение точкой с запятой.
Шаблон DDL, который требуется на экзамене. Каждый CREATE TABLE определяет имя каждого поля с его типом, указывает первичный ключ и объявляет каждый внешний ключ вместе с таблицей, на которую он ссылается; составной ключ объявляется в отдельной строке:
CREATE TABLE RENTAL_CAR (
  RentalID INTEGER,
  CarReg VARCHAR(8),
  Days INTEGER,
  PRIMARY KEY (RentalID, CarReg),
  FOREIGN KEY (RentalID) REFERENCES RENTAL(RentalID),
  FOREIGN KEY (CarReg) REFERENCES CAR(CarReg)
);
Разобранное решение. Используя CUSTOMER(CustomerID, Name, Phone) и DEVICE(DeviceID, CustomerID, Type, Model), напишите SQL-скрипты для: (a) вывода имени и номера телефона каждого клиента, владеющего устройством типа 'tablet', в алфавитном порядке по имени; (b) подсчета количества устройств каждого типа; (c) записи того, что у клиента 17 теперь номер телефона '0771 234 5678'; (d) добавления нового устройства ID 305, устройства 'laptop' модели 'X1', принадлежащего клиенту 17.
(a)
SELECT CUSTOMER.Name, CUSTOMER.Phone
FROM CUSTOMER INNER JOIN DEVICE
  ON CUSTOMER.CustomerID = DEVICE.CustomerID
WHERE DEVICE.Type = 'tablet'
ORDER BY CUSTOMER.Name ASC;
(b)
SELECT Type, COUNT(DeviceID) AS NumberOfDevices
FROM DEVICE
GROUP BY Type;
(c) UPDATE CUSTOMER SET Phone = '0771 234 5678' WHERE CustomerID = 17;
(d) INSERT INTO DEVICE (DeviceID, CustomerID, Type, Model) VALUES (305, 17, 'laptop', 'X1');
Баллы начисляются за каждую часть запроса — поля, таблицы, условие соединения, WHERE, ORDER BY — поэтому скрипт с одной ошибочной частью все равно получит баллы за остальные. Пишите Table.Field, когда участвуют две таблицы.
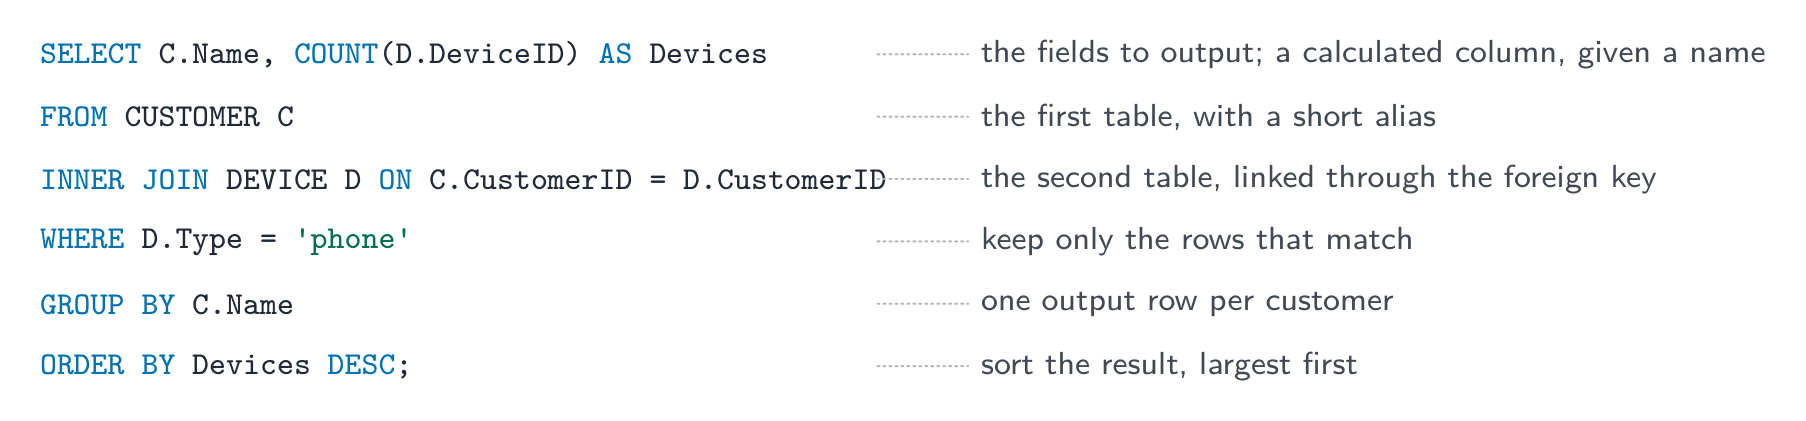
Разобранное решение. Объясните, что делает этот скрипт: SELECT T.Name, SUM(R.Cost) AS Total FROM TECHNICIAN T INNER JOIN REPAIR R ON T.TechnicianID = R.TechnicianID GROUP BY T.Name;
Он выводит имя каждого техника с общей стоимостью ремонтов, которые он выполнил, по одной строке на техника: две таблицы соединены по TechnicianID, строки сгруппированы по имени, а затраты в каждой группе суммируются. Когда спрашивают, что делает скрипт, опишите результат, а не синтаксис.
Условия SQL и ключи
LIKE 'Li%' соответствует тексту, начинающемуся с Li; % представляет любое количество символов, а _ — ровно один. AND требует выполнения обоих условий; OR требует выполнения хотя бы одного. Используйте скобки при их объединении.
CREATE DATABASE Club;
CREATE TABLE Booking (
  MemberID INTEGER,
  EventID INTEGER,
  PRIMARY KEY (MemberID, EventID)
);
ALTER TABLE Booking ADD FOREIGN KEY (MemberID)
  REFERENCES Member(MemberID);
SELECT Name FROM Member
WHERE Name LIKE 'Li%' AND (Year = 12 OR Year = 13)
ORDER BY Name DESC;
Составной первичный ключ делает пару уникальной, а не каждый столбец отдельно. Внешний ключ предотвращает ссылку на несуществующую запись родителя, если значение не пустое. ON UPDATE CASCADE переносит изменение родительского ключа на связанные строки; ON DELETE CASCADE удаляет эти строки при удалении родителя.
Исследовать
Объединение двух таблиц с помощью INNER JOIN
JOIN сопоставляет строки, где внешний ключ равен первичному ключу — здесь Orders.CustomerID = Customer.CustomerID — и объединяет каждую пару совпадений в одну более широкую строку.
Исследовать
SELECT … WHERE
Пройдите пошагово запрос: WHERE оставляет только строки, соответствующие условию, затем SELECT выбирает запрошенные столбцы.
Словарь
Тренировать
| English | Русский |
|---|---|
| flat files/flæt faɪlz/ | плоские файлы |
| data redundancy/ˈdeɪtə rɪˈdʌndənsi/ | избыточность данных |
| data inconsistency/ˈdeɪtə ˌɪnkənˈsɪstənsi/ | непоследовательность данных |
| field/fiːld/ | поле |
| integrity/ɪnˈteɡrɪti/ | целостность |
| relational database/rɪˈleɪʃənl ˈdeɪtəbeɪs/ | реляционная база данных |
| query/ˈkwɪərɪ/ | Запрос |
| primary key/ˈpraɪməri kiː/ | первичный ключ |
| foreign key/ˈfɒrən kiː/ | внешний ключ |
| composite key/ˈkɒmpəzɪt kiː/ | составной ключ |
| candidate key/ˈkændɪdeɪt kiː/ | кандидатский ключ |
| secondary key/ˈsekəndəri kiː/ | вторичный ключ |
| indexing/ˈɪndeksɪŋ/ | индексирование |
| join/dʒɔɪn/ | Соединение |
| referential integrity/ˌrefəˈrenʃl ɪnˈteɡrɪti/ | справочная целостность |
| entity-relationship diagram/ˈentɪti rɪˈleɪʃənʃɪp ˈdaɪəɡræm/ | диаграмма «сущность–связь» |
8.3
Определения, принимаемые экзаменатором
Вопросы на определение оцениваются по фиксированной формулировке. Выучите их точно и дайте только один ответ.
| Термин | Определение |
|---|---|
| сущность | объект, о котором хранятся данные — человек, объект или событие, — который становится таблицей в реляционной базе данных |
| атрибут | единица данных о сущности (столбец таблицы) |
| кортеж | одна строка таблицы: одна экземплярация сущности |
| первичный ключ | атрибут или комбинация атрибутов, уникально идентифицирующих каждую запись в таблице |
| внешний ключ | атрибут в одной таблице, значение которого совпадает с первичным ключом в другой таблице, используемый для связи этих двух таблиц |
| кандидационный ключ | любой атрибут (или их комбинация), который может быть выбран в качестве первичного ключа |
| вторичный ключ | непервичный атрибут, для которого создан индекс, чтобы таблицу можно было быстро искать или сортировать по нему |
| составной ключ | первичный ключ, состоящий из двух или более атрибутов вместе |
| ссылочная целостность | каждое значение внешнего ключа должно совпадать со существующим значением первичного ключа в таблице, на которую оно ссылается |
| первая нормальная форма | таблица, в которой каждый атрибут атомарен, нет повторяющихся групп и есть первичный ключ |
| вторая нормальная форма | в 1NF, и каждый непервичный атрибут зависит от всего первичного ключа (нет частичной зависимости) |
| третья нормальная форма | в 2NF, и ни один непервичный атрибут не зависит от другого непервичного атрибута (нет транзитивной зависимости) |
| словарь данных | метаданные, которые DBMS хранит о структуре базы данных: таблицах, полях, типах, ключах, связях, проверках корректности |
| DDL / DML | язык, используемый для определения или изменения структуры базы данных / язык, используемый для запросов и поддержки данных в ней |
Словарь
Тренировать
| English | Русский |
|---|---|
| DBMS/ˌdiː biː em ˈes/ | СМБД |
8.3
Советы для экзамена
- Определите термины точно: сущность, атрибут, первичный ключ, внешний ключ и типы отношений (1:1, 1:многие, многие:многие).
- Для каждой нормальной формы укажите причину: 1NF (нет повторяющихся групп), 2NF (нет частичных зависимостей), 3NF (нет зависимостей от неключевых полей) — и назовите соответствующие поля.
- Объясните, что предоставляет DBMS (независимость данных, безопасность, целостность, совместный доступ, словарь данных, интерфейс разработчика, процессор запросов).
- Различайте DDL (определение структуры) и DML (запросы и изменение данных), и пишите SQL-запрос по частям:
SELECT,FROM,INNER JOIN … ON,WHERE,GROUP BY,ORDER BY. - Чтобы нарисовать E-R диаграмму по таблицам, сначала найдите каждый внешний ключ: каждый внешний ключ — это одно отношение «один ко многим», где «многие» находятся в таблице, содержащей этот ключ.
Распространенные ошибки
- Отрисовка отношения «многие ко многим» напрямую. Его необходимо разбить на два отношения «один ко многим» через промежуточную таблицу, содержащую оба внешних ключа.
- Объяснять, что таблица «не находится в 3NF», тем, что «данные повторяются». Назовите зависимость (частичную или транзитивную) и соответствующие поля.
- Кавычки окружают строки в SQL, или кавычки окружают числа. Строки требуют
'single quotes'; числа требуют ничего. - Пропуск условия
ONпослеINNER JOIN. Без него две таблицы не будут связаны. - Размещение обычного поля рядом с
COUNTилиSUMв структуреSELECTбез наличияGROUP BY. UPDATEилиDELETEбез наличияWHERE. Она изменяет или удаляет все строки в таблице.
Интерактивные уроки по этой теме
Пройдите его шаг за шагом с упражнениями мгновенной проверки.