| Os candidatos devem ser capazes de: | Notas e orientações |
|---|---|
| Demonstrar compreensão de como um SO pode maximizar o uso de recursos | |
| Descrever as maneiras pelas quais a interface do usuário esconde a complexidade do hardware do usuário | |
| Demonstrar compreensão do gerenciamento de processos | O conceito de multitarefa e de um processo. Os estados do processo: executando, pronto e bloqueado. A necessidade de agendamento e a função e benefícios de diferentes rotinas de agendamento (incluindo round robin, shortest job first, first come first served, shortest remaining time). Como o kernel do SO atua como manipulador de interrupções e como o manuseio de interrupções é usado para gerenciar o agendamento de baixo nível |
| Demonstrar compreensão de memória virtual, segmentação e paginação para gerenciamento de memória | Os conceitos de paginação, memória virtual e segmentação. A diferença entre paginação e segmentação. Como as páginas podem ser substituídas. Como o thrashing de disco pode ocorrer |
Software de Sistema
Ciência da Computação do A-Level · Tópico 16
 14:07
Recursos, Compiladores e RPN
Abra um navegador, um player de música e um jogo. Você tem um processador — talvez alguns núcleos —, mas todos parecem rodar ao mesmo tempo. E juntos eles querem mais…
Narração em inglês · Legendas em inglês + 中文 gravadas
16.1
Como um SO maximiza o uso de recursos

Programa
Fonte: Programa Cambridge International
Um computador possui muitos recursos (tempo de CPU, memória, disco, E/S) e muitos programas competindo por eles. O SO os compartilha de forma justa e eficiente para que cada um seja bem utilizado e o sistema permaneça responsivo:
*O SO compartilha a CPU, memória, disco e E/S entre programas
- multi-tarefa 多任务 — alternar rapidamente a CPU entre processos para que pareçam executar simultaneamente.
- gerenciamento de memória — atribuir a cada processo a memória necessária; usar paging 分页 no disco quando a RAM acabar.
- spooling 假脱机 e buffering — filas de trabalhos de impressão no disco para que a CPU nunca espere pela impressora.
- cache — manter dados de disco recentemente usados em cache 高速缓存 / RAM.
 *O processador é um recurso chave que o SO compartilha entre tarefas concorrentes
 *O SO também gerencia a memória (RAM), decidindo o que manter nela e o que paging para o disco
Vocabulário
Treinar
| Inglês | Chinês | Pinyin |
|---|---|---|
| multi-tasking/ˈmʌlti ˈtæskɪŋ/ | 多任务 | duō rèn wù |
| paging/ˈpeɪdʒɪŋ/ | 分页 | fēn yè |
| spooling/ˈspuːlɪŋ/ | 假脱机 | jiǎ tuō jī |
| cache/kæʃ/ | 高速缓存 | gāo sù huǎn cún |
16.1
Interface do usuário
A interface do usuário esconde o hardware atrás de abstrações amigáveis: o usuário vê janelas, menus e pastas, não endereços ou setores. Um clique em um ícone faz o SO encontrar o programa no disco, alocar memória, carregá-lo e iniciá-lo. Uma CLI (linha de comando) é poderosa e scriptável para especialistas; uma GUI (gráfica) é mais fácil de aprender. A maioria dos sistemas oferece ambas.
"Descreva duas formas pelas quais as complexidades do hardware são ocultadas do usuário." (1) O usuário trabalha com arquivos e pastas por nome, e o SO os traduz em faixas, setores e blocos do disco; (2) o usuário executa um programa com um clique ou comando, e o SO o carrega, aloca memória e o escala sem que o usuário saiba qualquer endereço; (3) drivers de dispositivo permitem que o usuário imprima ou salve sem saber como a impressora ou disco é controlada; (4) uma interface gráfica substitui comandos de nível de máquina por ícones, janelas e menus. O benefício para um estudante, com exemplo: o SO torna o hardware utilizável sem conhecimento técnico, por exemplo salvando um documento em um pendrive arrastando seu ícone.
"Mostre como um SO maximiza o uso de recursos." Ele escala o processador para que este nunca fique ocioso enquanto um processo está pronto; gerencia a memória, alocando-a para processos, recuperando-a e estendendo-a com memória virtual; gerencia entrada e saída, usando buffers e spooling para que dispositivos rápidos e lentos sobreponham seus trabalhos; e gerencia armazenamento, mantendo controle do espaço livre e arquivos. Cada ponto cita um recurso e o que o SO faz com ele.
16.1
Gerenciamento de processos
Um processo 进程 é um programa em execução — seu código, estado atual, memória e arquivos abertos.
Escalonamento
O escaloner 调度器 escolhe qual processo pronto executa a seguir e por quanto tempo:
- round robin 轮转 — cada processo recebe um time slice 时间片 fixo, depois vai para o final da fila.
- primeiro a chegar, primeiro a servir; menor trabalho primeiro; menor tempo restante (execute o trabalho com menos trabalho restante); prioridade; filas de feedback multinível.
O compromisso é responsividade vs taxa de transferência vs justiça.
"Descreva o que se entende por multi-tarefa e como ela beneficia o gerenciamento de processos." Vários processos são mantidos na memória ao mesmo tempo e o processador alterna entre eles tão rapidamente que parecem executar simultaneamente, cada um recebendo uma parcela de tempo do processador por vez. O benefício: o processador nunca fica ocioso enquanto um processo espera por entrada ou saída, então taxa de transferência é maior e o usuário pode trabalhar em vários programas ao mesmo tempo. "Explique a necessidade de escalonamento." Existem mais processos do que processadores, então uma decisão deve ser tomada sobre qual processo executa a seguir e por quanto tempo; o escalonamento garante que todo processo faça progresso, que o processador esteja plenamente utilizado, que tempos de resposta sejam aceitáveis e que prioridades possam ser respeitadas.
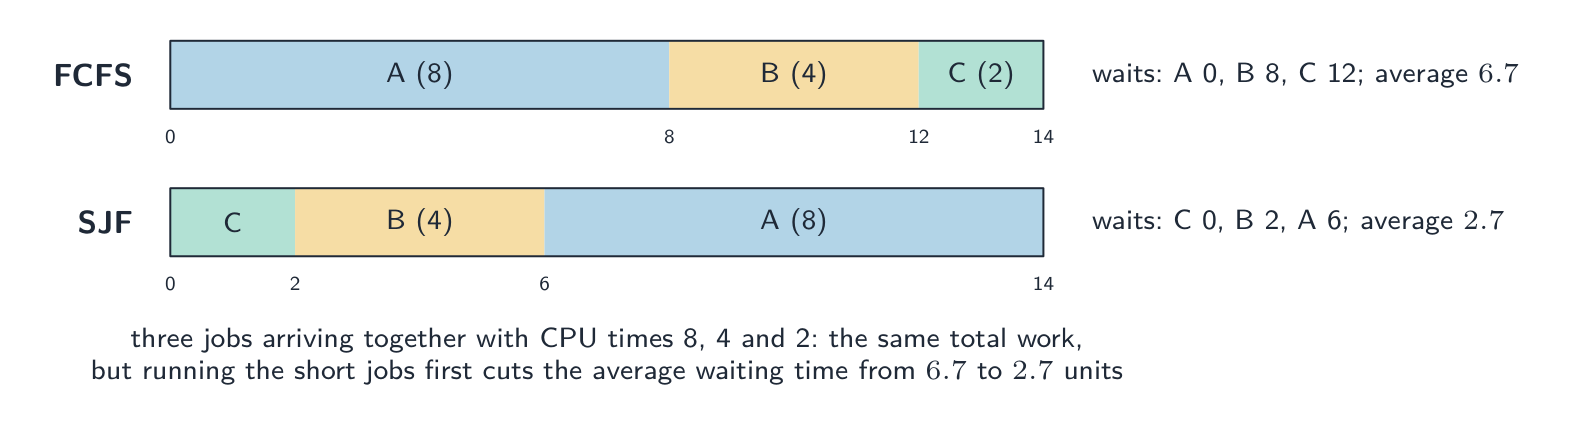
*O mesmo trabalho em uma ordem diferente: menor trabalho primeiro coloca as tarefas curtas para fora, de modo que a maioria espera menos, com o risco de uma tarefa longa esperar eternamente
As rotinas de escalonamento, tal como o exame deseja que sejam descritas.
| Rotina | Função | Benefício | Desvantagem |
|---|---|---|---|
| primeiro a chegar, primeiro a ser atendido (FCFS) | os processos são executados na ordem em que chegam à fila de prontos, cada um até sua conclusão | simples; todos os processos são atendidos por vez, nenhum é excluído | um processo longo atrasa todos os curtos atrás dele; resposta pobre |
| menor tempo de execução primeiro (SJF) | o processo pronto com menor tempo estimado de execução roda próximo, até sua conclusão | minimiza o tempo médio de espera; muitos trabalhos curtos terminam rapidamente | tempos de execução devem ser conhecidos antecipadamente; um trabalho longo pode nunca rodar (exclusão) |
| menor tempo restante (SRT) | versão preemptiva 抢占式 do SJF: se um novo processo chega com menos tempo restante que o atual, ele assume o controle | processos curtos são atendidos ainda mais rápido; bom throughput | mais trocas de contexto; um processo longo pode ser interrompido repetidamente e excluir-se |
| round robin (RR) | cada processo pronto recebe uma fatia de tempo fixa time slice por vez; quando expira, o processo vai para o final da fila | justo; todos respondem dentro de um tempo limitado, bom para uso interativo | sobrecarga de troca de contexto; uma fatia muito curta desperdiça tempo, uma longa atrasa outros |
| prioridade | o processo pronto com maior prioridade roda primeiro | trabalho importante ou crítico no tempo é feito primeiro | processos de baixa prioridade podem excluir-se a menos que as prioridades envelham |
Exemplo resolvido. Três processos chegam juntos com tempos de CPU de 8, 4 e 2 ms. Compare o tempo médio de espera sob FCFS (na ordem de chegada A, B, C) e shortest job first.
FCFS: A espera 0, B espera 8, C espera 12; média $(0 + 8 + 12)/3 = 6.7\ \text{ms}$. SJF executa C, B, A: C espera 0, B espera 2, A espera 6; média $2.7\ \text{ms}$. O trabalho total é o mesmo, 14 ms de ambos os lados; a ordem decide quem espera. Round robin com fatia de 2 ms daria a A, B e C uma vez cada nos primeiros 6 ms, então C termina em 6 ms, B em 12 ms e A em 14 ms: o mais responsivo, não o mais rápido em média.


Estados do processo
Um processo é novo, pronto (aguardando a CPU), executando, bloqueado 阻塞 (aguardando E/S ou uma trava), ou terminado. Quando sua fatia de tempo termina, ele vai de executando → pronto; quando solicita E/S, vai de executando → bloqueado; quando a E/S termina, vai de bloqueado → pronto.

Os três estados e por que um processo se move. Executando: o processo tem o processador. Pronto: poderia rodar mas está esperando pelo processador. Bloqueado: não pode rodar até que algo aconteça. Razões para cada transição, das quais o exame pede uma de cada vez: executando para pronto quando seu fatia de tempo acaba, ou quando um processo de maior prioridade fica pronto e o preempte (um interrupt); executando para bloqueado quando solicita entrada ou saída ou espera por um recurso ou outro processo; bloqueado para pronto quando a E/S pela qual esperava completa (sinalizada por um interrupt); pronto para executando quando o escalona dor o despacha. Um processo bloqueado nunca pode ir diretamente para executando: deve tornar-se pronto primeiro.
Bloco de controle de processo e troca de contexto
Para cada processo, o SO mantém um bloco de controle de processo 进程控制块 (PCB) — o contador de programa salvo, registradores, estado e informações de memória.

- uma troca de contexto 上下文切换 suspende um processo e inicia outro: salva o estado em um PCB e o restaura de outro. Esse pequeno custo é pago em toda troca.
- o kernel 内核 (núcleo do SO) atua como manipulador de interrupções 中断处理程序. Quando um dispositivo ou o temporizador gera uma interrupção, tratamento de interrupções 中断处理 salva o processo em execução e executa a rotina certa — isso é o que impulsiona o escalonamento de baixo nível.
"Descreva como o kernel age como manipulador de interrupções" (duas marcas). Quando uma interrupção é levantada, o kernel salva o estado do processo em execução (seus registradores e contador de programa, em seu bloco de controle de processo), identifica a origem e a prioridade da interrupção, executa a rotina de serviço de interrupção apropriada e, em seguida, restaura o processo interrompido (ou um de maior prioridade) para que a execução continue. É assim que o temporizador encerra uma fatia de tempo e como uma operação de E/S concluída desbloqueia um processo.
Comunicação entre processos
Processos são isolados, então o SO fornece comunicação entre processos 进程间通信: tubulações 管道 (a saída de um programa alimenta a entrada de outro), memória compartilhada 共享内存 (uma região que vários processos podem usar) e passagem de mensagens.
Explorar
A vida de um processo
Observe o ciclo pelo qual um processo passa. Ele só executa quando o escalonador o seleciona; necessitar de E/S o envia para bloqueado, e terminar seu slice de tempo o devolve à fila de prontos — rodando e rodando até que termine.
Vocabulário
Treinar
| Inglês | Chinês | Pinyin |
|---|---|---|
| process/ˈprəʊses/ | 进程 | jìn chéng |
| scheduler/ˈʃedjʊlə/ | 调度器 | diào dù qì |
| round robin/raʊnd ˈrɒbɪn/ | 轮转 | lún zhuàn |
| time slice/taɪm slaɪs/ | 时间片 | shí jiān piàn |
| pre-emptive/priː ˈemptɪv/ | 抢占式 | qiǎng zhàn shì |
| context switch/ˈkɒntekst swɪtʃ/ | 上下文切换 | shàng xià wén qiè huàn |
| kernel/ˈkɜːnl/ | 内核 | nèi hé |
| interrupt handler/ˈɪntərʌpt ˈhændlə/ | 中断处理程序 | zhōng duàn chǔ lǐ chéng xù |
| interrupt handling/ˈɪntərʌpt ˈhændlɪŋ/ | 中断处理 | zhōng duàn chǔ lǐ |
| inter-process communication/ˈɪntə ˈprəʊses kəˌmjuːnɪˈkeɪʃn/ | 进程间通信 | jìn chéng jiān tōng xìn |
| pipes/paɪps/ | 管道 | guǎn dào |
| shared memory/ʃeəd ˈmeməri/ | 共享内存 | gòng xiǎng nèi cún |
| virtual address space/ˈvɜːtʃuːəl əˈdres speɪs/ | 虚拟地址空间 | xū nǐ dì zhǐ kōng jiān |
| pages/ˈpeɪdʒɪz/ | 页 | yè |
| frames/freɪmz/ | 页框 | yè kuāng |
| page fault/peɪdʒ fɒlt/ | 缺页 | quē yè |
| swap file/swɒp faɪl/ | 交换文件 | jiāo huàn wén jiàn |
16.1
Memória virtual, segmentação em páginas, segmentação

Cada processo recebe seu próprio espaço de endereços virtuais 虚拟地址空间 — uma faixa limpa e contígua de endereços que o SO mapeia para memória física. Isso dá a cada processo um espaço simples, protege processos uns dos outros e permite que a memória total exceda a RAM física.
Na segmentação em páginas, o espaço virtual é dividido em páginas 页 de tamanho fixo e a memória física em quadros 页框 do mesmo tamanho. Uma tabela de páginas mapeia cada página para um quadro. Se uma página acessada não estiver na RAM — uma falta de página 缺页 — o SO a lê do arquivo de swap 交换文件 para um quadro, expulsando outra página se a RAM estiver cheia. Falhas frequentes causam thrashing 抖动 (thrashing de disco), onde o SO passa a maior parte do tempo trocando páginas em vez de fazer trabalho útil.
Na segmentação 分段, a memória é dividida em segmentos lógicos de tamanho variável (código, pilha, heap), cada um com suas próprias permissões. Muitos sistemas usam segmentação em páginas dentro de segmentos.

"Explique o que significa memória virtual" (três marcas).** Armazenamento secundário (disco) é usado para estender a RAM*, de modo que a memória disponível pareça maior que a memória física; o espaço de endereços de um processo é dividido em páginas, e apenas as páginas atualmente necessárias são mantidas na RAM enquanto o resto aguarda no disco; páginas são trocadas entre RAM e disco conforme necessário, e o SO traduz cada endereço virtual em um físico. Por que um SO precisa dela: os programas em execução podem precisar de mais memória do que a RAM instalada; permite que mais (ou maiores) programas rodam ao mesmo tempo; um programa pode ser maior que a memória física; a memória é usada eficientemente porque apenas as partes ativas dos programas ocupam a RAM.
Segmentação em páginas contra segmentação: a diferença que o exame quer. Segmentação em páginas divide a memória em blocos de tamanho fixo (páginas e quadros) escolhidos pelo hardware, sem considerar a estrutura do programa, e o mapeamento é invisível ao programador; segmentação divide um programa em unidades lógicas de tamanho variável (um procedimento, uma matriz, a pilha) cujos tamanhos e limites seguem o programa, de modo que um segmento pode ser protegido ou compartilhado como unidade. "Descreva o processo de segmentação": o programa é dividido em segmentos de diferentes tamanhos, cada um receiving a número de segmento; uma tabela de segmentos registra onde cada segmento começa na memória e quanto tempo ele tem; um endereço lógico é um número de segmento mais um offset, e o SO adiciona o offset ao endereço base do segmento para encontrar a localização física.
"Explique o que significa thrashing de disco" e quando ocorre.** Thrashing de disco** 磁盘抖动 é o estado em que páginas são trocadas para dentro e para fora da RAM tão frequentemente que o processador passa mais tempo movendo páginas do que executando instruções, e o sistema desacelera quase a um ponto morto. Ocorre quando a RAM é muito pequena para as páginas que os processos em execução precisam (seus conjuntos de trabalho): uma página acabada de sair é necessária novamente quase imediatamente, então é buscada de volta, o que empurra outra página que logo será necessária, e assim por diante. Muitos processos ou um programa que acessa a memória imprevisivelmente o provocam; mais RAM ou menos processos o curam.
Explorar
O que acontece em um page fault
Passo a passo de um page fault. Quando o programa acessa uma página que não está na RAM, o SO busca silenciosamente do disco e atualiza a tabela de páginas — para que o programa veja mais memória do que fisicamente existe.
Vocabulário
Treinar
| Inglês | Chinês | Pinyin |
|---|---|---|
| thrashing/ˈθræʃɪŋ/ | 抖动 | dǒu dòng |
| segmentation/ˌseɡmənˈteɪʃn/ | 分段 | fēn duàn |
| disk thrashing/dɪsk ˈθræʃɪŋ/ | 磁盘抖动 | cí pán dǒu dòng |
| interpreter/ɪnˈtɜːprɪtə/ | 解释器 | jiě shì qì |
| compiler/kəmˈpaɪlə/ | 编译器 | biān yì qì |
| machine code/məˈʃiːn kəʊd/ | 机器码 | jī qì mǎ |
| lexical analysis/ˈleksɪkl əˈnæləsɪs/ | 词法分析 | cí fǎ fēn xī |
16.2
Como um interpretador executa um programa
Programa
| Os candidatos devem ser capazes de: | Notas e orientações |
|---|---|
| Demonstrar compreensão de como um interpretador pode executar programas sem produzir uma versão traduzida | |
| Demonstrar compreensão das várias etapas no compilador de um programa | Incluindo análise léxica, análise sintática, geração de código e otimização |
| Demonstrar compreensão de como a gramática de uma linguagem pode ser expressa usando diagramas de sintaxe ou notação Backus-Naur Form (BNF) | |
| Demonstrar compreensão de como a Notação Polonesa Reversa (RPN) pode ser usada para realizar a avaliação de expressões |
Fonte: Programa Cambridge International
Um interpretador 解释器 traduz e executa o código-fonte ao mesmo tempo. Para cada instrução, ele lê a linha, faz análise léxica e sintática, verifica tipos, então executa a ação e avança. Erros são reportados imediatamente e geralmente para; nenhuma versão executável é produzida. A tradução é refeita a cada execução (mais lento), mas oferece feedback rápido de desenvolvimento e é portátil.
"Explique como um interpretador executa um programa sem produzir uma versão traduzida" (três marcas).** O interpretador pega uma instrução (linha) de cada vez, traduz (analisa) e executa imediatamente, antes de passar para a próxima; nenhuma versão traduzida do programa inteiro é criada ou armazenada, então cada instrução é traduzida todas as vezes que é executada, incluindo cada passagem por um loop; se uma instrução contém um erro, a execução para ali e o erro é reportado. Isso é o que torna um interpretador bom para desenvolver e testar (erros são encontrados à medida que são alcançados, e uma mudança pode ser testada imediatamente) mas mais lento para executar programas terminados.
16.2
Etapas de compilação

Um compilador 编译器 transforma o código-fonte em código máquina 机器码 em fases:
- análise léxica 词法分析 — o lexer agrupa caracteres em tokens 词法单元 (palavras-chave, identificadores, operadores, literais), descartando espaços em branco e comentários.
- análise sintática (parsing) 语法分析 — verifica se os tokens se encaixam na gramática e constrói uma árvore de sintaxe abstrata 抽象语法树. Um colchete faltante causa um erro de sintaxe 语法错误.
- análise semântica 语义分析 — verifica se o programa faz sentido (variáveis declaradas, tipos correspondentes).
- geração de código 代码生成 — percorre a árvore e emite código-alvo, escolhe registradores e layouts.
- otimização de código — remova trabalho redundante, combine constantes, reordene para o pipeline.
The output is an executable.
O propósito de cada etapa, nas palavras que pontuam. Análise léxica: remove espaços em branco e comentários; converte os caracteres do código-fonte em tokens (palavras-chave, identificadores, operadores, constantes), verificando se cada um é válido na linguagem; insere identificadores na tabela de símbolos 符号表. Análise sintática: verifica se a sequência de tokens obedece à gramática (regras de sintaxe) da linguagem; constrói uma árvore de análise (árvore de sintaxe abstrata); reporta erros de sintaxe; verificação de tipos e verificação de declarações de variáveis às vezes são contadas aqui como análise semântica. Geração de código: converte a árvore verificada em código objeto ou código de máquina (possivelmente via código intermediário), alocando memória e registradores. Otimização: faz o código rodar mais rápido ou usar menos memória, removendo instruções redundantes, combinando ou simplificando cálculos e reorganizando loops, sem alterar o que o programa faz. A questão de correspondência associa cada etapa a uma dessas descrições.
Explorar
As fases da compilação
Passo a passo do que um compilador faz com seu código-fonte. Cada fase entrega sua saída para a próxima — caracteres tornam-se tokens, tokens tornam-se uma árvore, a árvore torna-se código máquina otimizado.
Vocabulário
Treinar
| Inglês | Chinês | Pinyin |
|---|---|---|
| tokens/ˈtəʊkənz/ | 词法单元 | cí fǎ dān yuán |
| syntax analysis (parsing)/ˈsɪntæks əˈnæləsɪs/ | 语法分析 | yǔ fǎ fēn xī |
| abstract syntax tree/ˈæbstrækt ˈsɪntæks triː/ | 抽象语法树 | chōu xiàng yǔ fǎ shù |
| syntax error/ˈsɪntæks ˈerə/ | 语法错误 | yǔ fǎ cuò wù |
| semantic analysis/səˈmæntɪk əˈnæləsɪs/ | 语义分析 | yǔ yì fēn xī |
| code generation/kəʊd ˌdʒenəˈreɪʃn/ | 代码生成 | dài mǎ shēng chéng |
| code optimisation/kəʊd ˌɒptɪmaɪˈzeɪʃn/ | 代码优化 | dài mǎ yōu huà |
| symbol table/ˈsɪmbl ˈteɪbl/ | 符号表 | fú hào biǎo |
| grammar/ˈɡræmə/ | 文法 | wén fǎ |
16.2
Grammar: BNF and syntax diagrams

Uma gramática diz quais sequências de tokens são programas válidos.
Backus-Naur Form 巴科斯-诺尔范式 (BNF) is textual. A production rule 产生式 has the form:
<symbol> ::= alternative1 | alternative2 | ...
Cada alternativa é uma sequência de símbolos terminais (texto literal) e símbolos não terminais (outros nomes de regras):
<digit>      ::= 0 | 1 | 2 | 3 | 4 | 5 | 6 | 7 | 8 | 9
<identifier> ::= <letter> | <identifier> <letter> | <identifier> <digit>
A terceira regra recursiva expressa "uma letra seguida por qualquer número de letras ou dígitos". Uma instrução IF:
<if-statement> ::= IF <condition> THEN <statement> ENDIF
                 | IF <condition> THEN <statement> ELSE <statement> ENDIF
Um diagrama de sintaxe 语法图 (diagrama de ferrovia) mostra a mesma coisa graficamente: caixas para não-terminais, caixas arredondadas para terminais, setas para caminhos válidos, loops para repetição. As duas notações são equivalentes. O analisador sintático usa a gramática para decidir se um programa é válido.
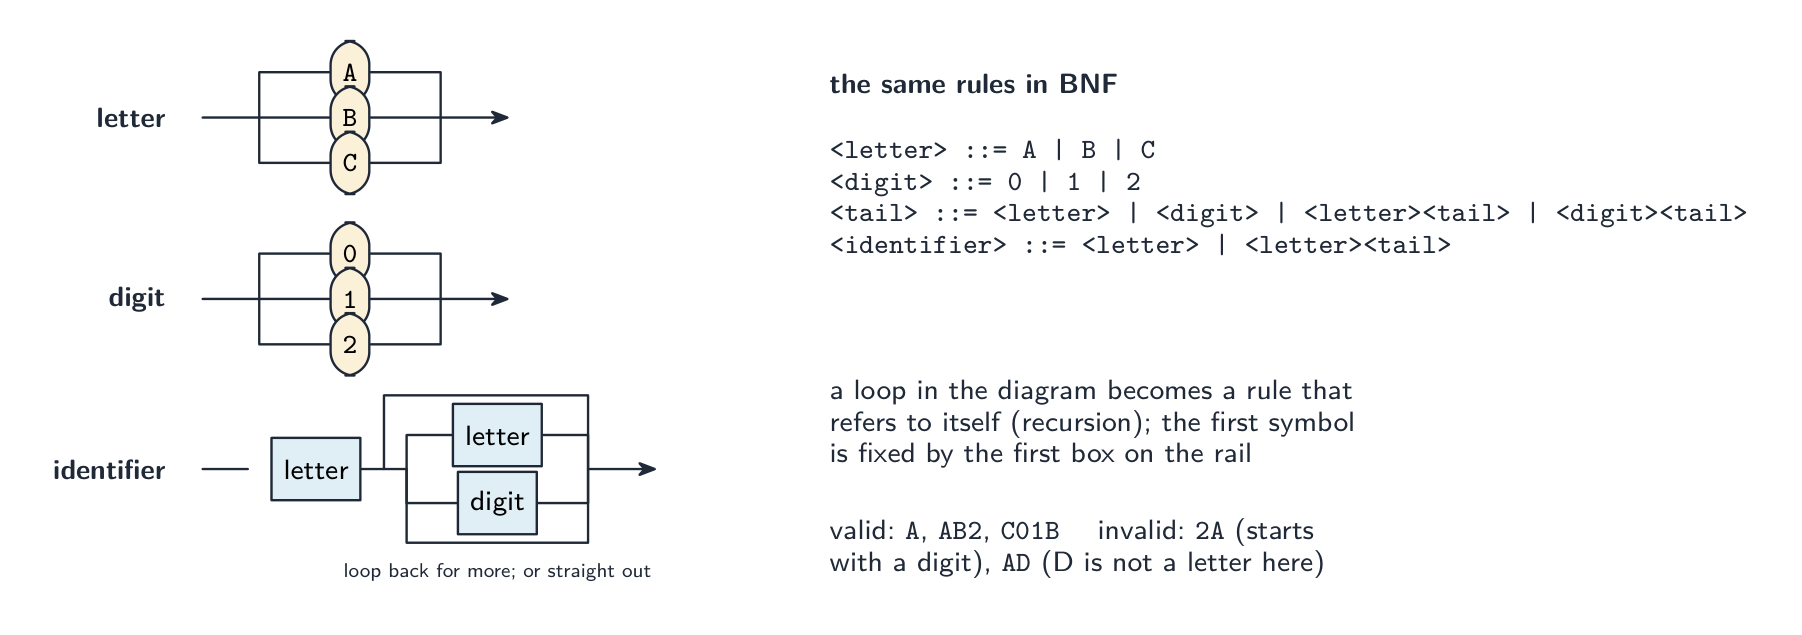
Lendo os diagramas do exame. Cada diagrama define um não-terminal; siga as setas da entrada até a saída, e todo caminho que você puder traçar é uma string válida. Uma escolha de caixas lado a lado é um conjunto de alternativas; um laço de volta significa "repita quantas vezes quiser"; uma caixa para outro não-terminal significa "insira qualquer coisa que a regra permita". "Explique por que a string é inválida" quer a regra que ela viola, em palavras: 9K é inválido como variável porque o primeiro caractere deve ser uma letra, não um dígito; JJ90 é um código de acesso inválido se a regra permitir apenas uma letra antes dos dígitos, ou se J não estiver no conjunto de letras listadas. Sempre verifique a string contra o conjunto de caracteres que o diagrama realmente permite, não contra o que uma linguagem real aceitaria.
Escrevendo BNF a partir de um diagrama. Cada diagrama torna-se uma regra <name> ::= ...; as alternativas são separadas por |; uma sequência é escrita um símbolo após o outro; e a repetição é escrita com recursão, porque o BNF não tem símbolo de loop: "uma ou mais letras" é <word> ::= <letter> | <letter><word>, e "zero ou mais dígitos após uma letra" é <variable> ::= <letter> | <letter><digits> com <digits> ::= <digit> | <digit><digits>.
Exemplo resolvido. Complete o BNF para uma matrícula de veículo que deve começar com duas letras (de A B C) seguidas por um, dois ou três dígitos (de 0 1 2).
<letter>       ::= A | B | C
<digit>        ::= 0 | 1 | 2
<digits>       ::= <digit> | <digit><digit> | <digit><digit><digit>
<registration> ::= <letter><letter><digits>
AB12 é válido; A12 não é (apenas uma letra); AB1234 não é (quatro dígitos); AD1 não é (D não é uma letra listada). Pedem para adicionar uma restrição como "o terceiro caractere também pode ser um símbolo", adicione a alternativa extra à regra para essa posição apenas e defina <symbol> com sua própria regra.
Exemplo resolvido. Escreva BNF para uma expressão que seja uma variável, seguida por um operador, seguida por outra variável ou um número, onde uma variável é uma única letra minúscula de a b c e um operador é + ou -.
<variable>   ::= a | b | c
<operator>   ::= + | -
<number>     ::= <digit> | <digit><number>
<expression> ::= <variable><operator><variable> | <variable><operator><number>
A regra recursiva <number> permite qualquer número de dígitos; as duas alternativas de <expression> cobrem ambos os casos nomeados na definição. Mantenha todos os não-terminais entre colchetes angulares e todos os terminais sem eles.
Vocabulário
Treinar
| Inglês | Chinês | Pinyin |
|---|---|---|
| Backus-Naur Form/ˈbækəs nɔː fɔːm/ | 巴科斯-诺尔范式 | bā kē sī - nuò ěr fàn shì |
| production rule/prəˈdʌkʃn ruːl/ | 产生式 | chǎn shēng shì |
| terminal/ˈtɜːmɪnl/ | 终结符 | zhōng jié fú |
| non-terminal/nɒn ˈtɜːmɪnl/ | 非终结符 | fēi zhōng jié fú |
| syntax diagram/ˈsɪntæks ˈdaɪəɡræm/ | 语法图 | yǔ fǎ tú |
16.2
Reverse Polish Notation (RPN)
Na notação infixa 中缀, o operador fica entre seus operandos (3 + 4 * 2), necessitando de parênteses e regras de precedência. Na Notação Polonesa Reversa 逆波兰表示法 (RPN, pós-fixa 后缀), o operador segue seus operandos (3 4 2 * +), não necessitando de parênteses.
Converting infix to RPN
Use uma pilha 栈 de operadores. Varre da esquerda para a direita: output de um operando; para um operador, primeiro pop quaisquer operadores empilhados de precedência 优先级 maior ou igual ao output, depois push-o; push (; em ) pop para output até o ( correspondente. No final, pop todos os operadores. Exemplo: (3 + 4) * 2 → 3 4 + 2 *.
Evaluating RPN
Use uma pilha de operandos. Varra da esquerda para a direita: empurre cada operando; ao encontrar um operador, pop os dois superiores, aplique-o e empurre o resultado. Avaliando 3 4 2 * +:
| Token | Stack |
|---|---|
3 |
3 |
4 |
3, 4 |
2 |
3, 4, 2 |
* |
3, 8 |
+ |
11 |
Resultado: 11. RPN não precisa de parênteses na avaliação e se adapta a uma máquina de pilha — que é como a JVM e muitos interpretadores de bytecode funcionam.
"Explique por que a RPN é usada para avaliar expressões" (duas marcas). Na RPN, os operadores aparecem na ordem em que são aplicados, então uma expressão pode ser avaliada em uma única passagem da esquerda para a direita com sem parênteses e sem regras de precedência; portanto, é mais simples e rápida para o compilador ou interpretador processar. "Identifique, com razões, uma estrutura de dados adequada": uma pilha, porque a avaliação precisa dos operandos empurrados mais recentemente primeiro (último a entrar, primeiro a sair): cada operando é empurrado, e cada operador pop dos dois superiores, aplica-se a si mesmo e push do resultado. Mostre o conteúdo da pilha após cada token quando solicitado.
Convertendo infix para RPN à mão. (1) Complete a expressão com parênteses usando as regras de precedência; (2) mova cada operador para logo após o parêntese fechado de seu próprio par; (3) remova os parênteses. Então $(a - b) * (a + c) / 7$ torna-se $((a - b) * (a + c)) / 7$, então a b - a c + * 7 /. Note que * e / são aplicados da esquerda para a direita, então a divisão é o último operador, não a multiplicação. Mais conversões: $((7 + 3) - (2 * 8)) / 6$ é 7 3 + 2 8 * - 6 /; $(7 - 2 + 8) / (9 - 5)$ é 7 2 - 8 + 9 5 - /; $a * b + b - d + 15$ é a b * b + d - 15 +; $(2 - 6) * (13 + 7) / 5$ é 2 6 - 13 7 + * 5 /.
Convertendo RPN de volta para infix. Trabalhe através da RPN com uma pilha de expressões: push de cada operando; para cada operador pop de dois, escreva-os de cada lado dele entre parênteses e push do resultado. Então a b / 4 * a b + - é $((a / b) * 4) - (a + b)$; 5 2 + 9 3 - / 3 * é $((5 + 2) / (9 - 3)) * 3$; b a c - + d b + * c / é $((b + (a - c)) * (d + b)) / c$; a b - c + c a - * d / é $(((a - b) + c) * (c - a)) / d$. Mantenha os parênteses: descartá-los pode mudar o significado.
Worked example. Avaliar a b - c d + * e / when $a = 17$, $b = 5$, $c = 7$, $d = 3$ e $e = 10$, showing the stack.
| token | action | stack (top on the right) |
|---|---|---|
a |
push 17 | 17 |
b |
push 5 | 17, 5 |
- |
pop 5 and 17, push $17 - 5$ | 12 |
c |
push 7 | 12, 7 |
d |
push 3 | 12, 7, 3 |
+ |
pop 3 and 7, push $7 + 3$ | 12, 10 |
* |
pop 10 and 12, push $12 \times 10$ | 120 |
e |
push 10 | 120, 10 |
/ |
pop 10 e 120, push $120 / 10$ | 12 |
Resultado 12. A ordem dos pops importa para - e /: o valor popped segundo é o operando esquerdo, então a b - é $a - b$, não $b - a$. Mais dois, da mesma forma: d a b + * c a - / com $a = 6, b = 12, c = 15, d = 5$ dá $5 \times (6 + 12) / (15 - 6) = 90 / 9 = 10$; c a - b d + * b c + / com $a = 4, b = 12, c = 24, d = 6$ dá $(24 - 4) \times (12 + 6) / (12 + 24) = 360 / 36 = 10$.
Exemplo resolvido. Converta $(A + B) \times (C - D)$ para RPN, depois avalie $(3 + 4) \times (5 - 2)$. Varra da esquerda para a direita usando uma pilha 栈 de operadores. Push (; output A; push +; output B; em ) pop de volta até o ( correspondente, dando A B + até agora. Push ×, e o segundo parêntese comporta-se da mesma maneira, dando C D -. No final pop o ×. Resultado: A B + C D - ×. Para avaliar os números, use uma pilha de operandos: push 3, push 4; + pop de ambos e push 7; push 5, push 2; - pop de ambos e push 3; × pop 7 e 3 e push 21. Duas coisas tornam isso confiável: os operandos mantêm sua ordem original através da conversão (apenas os operadores se movem) e cada operador atua nos dois valores imediatamente abaixo dele na pilha.
Explorar
Precedência de operadores — o que a RPN elimina
Na matemática infixa comum, × e ÷ têm precedência maior que + e −, então você deve aplicar as regras na ordem certa. A Notação Polonesa Reversa escreve os operandos primeiro (3 4 2 × + 1 −), fixando a ordem para que nenhuma regra de precedência seja necessária.
Vocabulário
Treinar
| Inglês | Chinês | Pinyin |
|---|---|---|
| infix/ˈɪnfɪks/ | 中缀 | zhōng zhuì |
| Reverse Polish Notation/rɪˈvɜːs ˈpəʊlɪʃ nəʊˈteɪʃn/ | 逆波兰表示法 | nì bō lán biǎo shì fǎ |
| postfix/ˈpəʊstfɪks/ | 后缀 | hòu zhuì |
| stack/stæk/ | 栈 | zhàn |
| precedence/ˈpresɪdəns/ | 优先级 | yōu xiān jí |
| bytecode/ˈbaɪtkəʊd/ | 字节码 | zì jié mǎ |
16.2
Definições aceitas pelo examinador
Uma questão de definição é avaliada contra wording fixo. Aprenda estas exatamente, e dê apenas uma resposta.
| Termo | Definição |
|---|---|
| multi-tarefa | vários processos mantidos na memória ao mesmo tempo, com o processador alternando entre eles para que pareçam estar sendo executados simultaneamente |
| processo | um programa que foi carregado na memória e está sendo executado (ou está pronto para ser) |
| executando / pronto / bloqueado | possui o processador / aguardando o processador / não pode continuar até que um evento, como a conclusão de E/S, ocorra |
| escalonamento | decidir qual processo pronto receberá o processador em seguida e por quanto tempo |
| escalonamento preemptivo | o processo em execução pode ser interrompido e movido para pronto para que outro processo seja executado |
| memória virtual | usar armazenamento secundário para estender a RAM, mantendo apenas as páginas necessárias atualmente na memória física |
| paginação | dividir a memória e os programas em páginas de tamanho fixo que são movidas entre o disco e a RAM conforme necessário |
| segmentação | dividir um programa em segmentos lógicos de tamanho variável, cada um mapeado para a memória por uma tabela de segmentos |
| thrashing de disco | páginas sendo trocadas entre RAM e disco tão frequentemente que pouco processamento útil é realizado |
| interpretador | traduz e executa um programa uma instrução por vez, sem produzir uma versão traduzida |
| compilador | traduz todo um programa de alto nível para código de máquina (objeto) antes de ser executado |
| análise lexical | converte o código-fonte em tokens, removendo espaços em branco e comentários, e constrói a tabela de símbolos |
| análise sintática | verifica se os tokens obedecem à gramática da linguagem e constrói uma árvore de análise |
| Forma de Backus–Naur | uma notação para a gramática de uma linguagem: regras da forma <name> ::= alternatives construídas a partir de terminais e não-terminais |
| Notação Polonesa Reversa | uma maneira de escrever expressões em que cada operador vem depois dos seus operandos, permitindo avaliação com uma pilha e sem parênteses |
16.2
Dicas de prova
- As questões do SO são avaliadas em mecanismos nomeados: escalonamento, gerenciamento de memória, buffering e spooling de E/S, gerenciamento de arquivos; quanto à interface, nomes de arquivo em vez de endereços, cliques em vez de comandos, drivers, GUI.
- Estados do processo com suas transições e o motivo de cada uma; rotinas de escalonamento como função mais benefício mais desvantagem; o kernel salva o estado, identifica a interrupção, atende-a, restaura.
- Memória virtual: disco estende RAM, páginas trocadas, tradução de endereço; paging é tamanho fixo e invisível, segmentação é tamanho variável e lógico; thrashing (thrashing) é troca de páginas em vez de trabalho útil.
- Interpretador: uma instrução por vez, traduzida depois executada, nada armazenado. Estágios do compilador: tokens e tabela de símbolos, gramática e árvore de análise, código, otimização.
- BNF: uma regra por diagrama,
|para escolha, recursão para repetição, terminais nus e não-terminais entre colchetes angulares. Diga qual regra uma string viola. - RPN: operadores após os operandos, avalie com uma pilha, mostre cada passo; converta adicionando parênteses completos; ao converter de volta, mantenha os parênteses.
Erros comuns
- Descrever multitarefa como "executar vários programas ao mesmo tempo" sem dizer que o processador alterna entre eles.
- Enviar um processo bloqueado diretamente para executing, ou dar "time slice ended" como razão para executing ir para blocked.
- Confundir shortest job first (não preempitivo) com shortest remaining time (preempitivo), ou round robin com prioridade.
- Definir memória virtual como "usar o disco rígido como RAM" sem mencionar que as páginas são trocadas.
- Dizer que um interpretador "converte o programa para código de máquina e então o executa"; isso é um compilador.
- Colocar verificação de sintaxe na análise léxica, ou otimização antes da geração de código na questão de correspondência.
- Escrever repetição BNF como
<letter>*ou com reticências; use recursão. Deixar colchetes angulares fora dos não-terminais. - Revertendo os operandos de
-ou/ao avaliar RPN, ou escrevendo a RPN de $a * b + c$ comoa b c + *.
Vocabulário
Treinar
| Inglês | Chinês | Pinyin |
|---|---|---|
| blocked/blɒkt/ | 阻塞 | zǔ sè |
| process control block/ˈprəʊses kənˈtrəʊl blɒk/ | 进程控制块 | jìn chéng kòng zhì kuài |
Aulas interativas sobre este tópico
Passe por ele passo a passo, com exercícios de verificação instantânea.