| Os candidatos devem ser capazes de: | Notas e orientações |
|---|---|
| Demonstrar compreensão do porquê tipos definidos pelo usuário são necessários | |
| Definir e usar tipos não compostos | Incluindo enumerado, ponteiro |
| Definir e usar tipos de dados compostos | Incluindo conjunto, registro e classe/objeto |
| Escolher e projetar um tipo de dado definido pelo usuário adequado para um problema dado |
Representação de Dados
Ciência da Computação do A-Level · Tópico 13
 15:16
Tipos de Dados Definidos pelo Usuário
Um campo string simples armazenará bobagens alegremente. Peça por um tipo de veículo, e alguém digita Bananas — o programa aceita sem murmurar. Mas se você…
Narração em inglês · Legendas em inglês + 中文 gravadas
13.1
Tipos de dados definidos pelo usuário

Programa
Fonte: Programa Cambridge International
Os tipos embutidos (INTEGER, REAL, STRING, CHAR, BOOLEAN) cobrem os casos mais simples. Para problemas mais complexos, você pode definir tipos de dados definidos pelo usuário 用户定义类型, tornando o código mais claro e o compilador mais rigoroso.
Por que são necessários
Um tipo embutido STRING permite armazenar nonsense em um campo que deveria conter um de poucos valores legais; um tipo definido pelo usuário pode restringi-lo. Entidades reais geralmente são uma coleção de valores de diferentes tipos. E DECLARE Taxi : Vehicle é mais claro (autodocumentável) do que DECLARE Taxi : STRING.
"Descreva o propósito de um tipo de dado definido pelo usuário" (duas marks). Um tipo de dado definido pelo programador, construído a partir de tipos existentes (inatos), para que dados específicos do problema possam ser representados quando nenhum tipo inato se encaixa. Ambas as metades pontuam: definido pelo programador e baseado em tipos existentes. O examinador também aceita "para tornar o programa mais legível e manutenível" como ponto de apoio, nunca isoladamente.
"Explique o que se entende por tipos de dados não-compostos e compostos" (quatro marks). Um tipo não-composto é definido sem referência a outro tipo: ele armazena um único valor, por exemplo um inteiro, um real ou um valor enumerado. Um tipo composto é uma coleção de outros tipos (que podem ser compostos por sua vez): ele armazena vários valores sob um único identificador, por exemplo um registro, um conjunto, um array ou uma classe. Dê um exemplo com cada definição; o exame pede apenas um.
Tipos não-compostos
Tipo enumerado
Um tipo enumerado 枚举类型 tem valores que são uma lista fixa de constantes nomeadas:
TYPE Vehicle = (M100, M230, T101, T102, T120, T150)
DECLARE MyTaxi : Vehicle
MyTaxi ← T102
Os nomes são valores do novo tipo (armazenados internamente como inteiros pequenos); você não pode atribuir nada fora da lista. Usos: dias da semana, cores, códigos de status.
"Afirme o que se entende por um tipo de dado enumerado." Um tipo definido pelo usuário não-composto definido listando todos os seus valores possíveis (em ordem). Como os valores são ordenados, eles podem ser comparados e percorridos: com TYPE Month = (January, February, ..., December), o teste IF ThisMonth > June é legal, e os valores são armazenados internamente como inteiros. A pseudocódigo tem três partes e o exame marca cada uma: a palavra-chave TYPE, o identificador com =, e a lista entre colchetes separada por vírgulas.
Exemplo resolvido. Escreva pseudocódigo para definir um tipo enumerado para os dias em que uma escola está aberta (segunda a sexta-feira) e declare uma variável desse tipo definida como quarta-feira.
TYPE SchoolDay = (Monday, Tuesday, Wednesday, Thursday, Friday)
DECLARE Today : SchoolDay
Today ← Wednesday
Uma variável de um tipo enumerado não pode receber um valor fora da lista, que é exatamente o ponto: Today ← Saturday é um erro de tempo de compilação, enquanto um STRING teria aceito "Saturdy".
Tipo ponteiro
Um ponteiro 指针 armazena o endereço de memória de outra variável (ou NULL para "sem alvo"). Ponteiros constroem estruturas dinâmicas (listas encadeadas, árvores) e passam referências sem copiar.
TYPE PNode = ^TNode    // pointer to a TNode
DECLARE p : PNode
p ← NEW TNode
p^.Value ← 42          // dereference to reach the fields
Para desreferenciar 解引用 (p^) significa alcançar a variável a qual aponta.
"Afirme o que se entende por um tipo de dado ponteiro." Um tipo não-composto cujo valor é o endereço de memória de (uma referência a) uma variável de um tipo dado. A pseudocódigo declara o tipo com um acento circunflexo antes do tipo ao qual aponta, e o exame pede exatamente essa linha:
TYPE SelectParts = ^Parts        // a pointer to a value of type Parts
DECLARE Chosen : SelectParts
Chosen ← ^Keyboard               // Chosen now holds the address of Keyboard
OUTPUT Chosen^                   // dereference: the value stored at that address
Ponteiros são o que uma lista encadeada dinâmica linked list ou uma árvore binária (Tópico 19) é construída: cada nó contém um ponteiro para o próximo. Duas marks são frequentemente perdidas aqui: escrever o tipo de ponteiro como se ele contivesse o valor em si, e esquecer o acento circunflexo ao ler através do ponteiro.

p^ o desrefencia para acessar os campos do nóTipos compostos
Um tipo composto 复合类型 (um dos tipos de dados compostos) agrupa vários valores sob um único nome.


- registro 记录 (Tópico 10) — campos de tipos diferentes em um bloco
TYPE ... ENDTYPE. - conjunto 集合 — uma coleção não ordenada de valores únicos, com operações add, remove, teste de pertencimento, união, interseção:
DECLARE Available : SET OF Colour
Available ← {Red, Blue}
IF Green IN Available THEN
    ...
ENDIF
- classe 类 / objeto 对象 — o tipo composto OOP, combinando campos de dados (atributos 属性) com operações sobre eles (métodos 方法). Um objeto é uma instância de uma classe:
CLASS Taxi
    PRIVATE Capacity : INTEGER
    PUBLIC FUNCTION GetCapacity() RETURNS INTEGER
        RETURN Capacity
    ENDFUNCTION
ENDCLASS
Escolhendo um tipo
Use enumerado para um valor de uma lista fixa, ponteiro para indireção, registro para um grupo de campos, conjunto para uma coleção única não ordenada, e classe quando precisar de estado e comportamento juntos.
"Descreva o tipo de dado definido pelo usuário conjunto" (três marks). Um tipo composto que armazena uma coleção de valores do mesmo tipo, em nenhuma ordem específica e sem duplicatas; valores podem ser adicionados e removidos, e um valor pode ser testado quanto ao pertencimento. Declare o tipo com SET OF, depois defina uma constante de conjunto com seus valores entre colchetes:
TYPE EvenNumbers = SET OF INTEGER
DEFINE Evens (2, 4, 6, 8, 10, 12) : EvenNumbers
TYPE SymbolSet = SET OF CHAR
DEFINE Operators ('+', '-', '*', '/') : SymbolSet
"Descreva o tipo de dado definido pelo usuário registro" (três marks). Um tipo composto composto por um número fixo de campos (itens), cada um com seu próprio identificador e seu próprio tipo, referenciado sob um único identificador; os campos são acessados com notação de ponto.
Exemplo resolvido. Escreva pseudocódigo para declarar um tipo de registro ClubMember para o primeiro nome, último nome, código de membro (um inteiro), data de entrada e se as taxas foram pagas de um membro de clube; depois declare uma variável e defina dois de seus campos.
TYPE ClubMember
    DECLARE FirstName : STRING
    DECLARE LastName : STRING
    DECLARE Code : INTEGER
    DECLARE DateJoined : DATE
    DECLARE FeesPaid : BOOLEAN
ENDTYPE

DECLARE NewMember : ClubMember
NewMember.LastName ← "Chen"
NewMember.FeesPaid ← TRUE
Campo precisa de sua própria linha DECLARE com um tipo apropriado, o bloco termina com ENDTYPE, e um campo 字段 é alcançado como variable.field. Pedido para escolher um tipo para cada campo, corresponda-o aos dados: um código que é sempre comparado é um STRING se puder conter letras, um INTEGER se aritmética ou ordenação for necessária; um sim/não é BOOLEAN; uma data é DATE. Um campo que pode assumir um de alguns valores nomeados (espécie de animal de estimação, cor) é aquele para fazer um tipo enumerado.

Registros em arrays e arquivos. Uma tabela de muitos membros é DECLARE Members : ARRAY[1:100] OF ClubMember; então Members[3].LastName é um campo de um elemento, e um loop sobre o índice processa todo o registro. Um registro também é a unidade natural escrita e lida de um arquivo (abaixo), um registro por PUTRECORD ou WRITEFILE.
Exemplo resolvido. Um tipo composto Pet armazena o nome de cada pet (string), espécie (um de dog, cat, rabbit ou hamster) e peso em quilogramas (real). Defina os tipos e declare uma variável.
TYPE Species = (Dog, Cat, Rabbit, Hamster)
TYPE Pet
    DECLARE Name : STRING
    DECLARE Kind : Species
    DECLARE Weight : REAL
ENDTYPE
DECLARE MyPet : Pet
MyPet.Kind ← Rabbit
O tipo enumerado é definido primeiro, porque o registro o usa: ordem importa na pseudocódigo assim como em um compilador.
Classes na pseudocódigo. Uma classe é o tipo composto que também carrega comportamento. O exame pede a declaração com seus atributos marcados PRIVATE, um construtor 构造函数 nomeado NEW que os define, e PUBLIC métodos para obter ou alterar eles:
CLASS Appointment
    PRIVATE PatientName : STRING
    PRIVATE Treatment : STRING
    PRIVATE Medication : STRING
    PUBLIC PROCEDURE NEW(Name : STRING, Treat : STRING, Med : STRING)
        PatientName ← Name
        Treatment ← Treat
        Medication ← Med
    ENDPROCEDURE
    PUBLIC FUNCTION GetTreatment() RETURNS STRING
        RETURN Treatment
    ENDFUNCTION
ENDCLASS

DECLARE Visit : Appointment
Visit ← NEW Appointment("A. Chen", "filling", "none")
OUTPUT Visit.GetTreatment()
Atributos são privados para que só possam ser alterados através de métodos (encapsulamento, Tópico 20); o construtor é um procedimento chamado NEW com um parâmetro por atributo; um getter é uma função que retorna o atributo. Cada um desses é uma marca separada.
Explorar
Laboratório de conceito de programação
Conecte exemplos à ideia de programação que eles mostram.
Vocabulário
Treinar
| Inglês | Chinês | Pinyin |
|---|---|---|
| user-defined type/ˈjuːzə dɪˈfaɪnd taɪp/ | 用户定义类型 | yòng hù dìng yì lèi xíng |
| field/fiːld/ | 字段 | zì duàn |
| record/ˈrekɔːd/ | 记录 | jì lù |
| set/set/ | 集合 | jí hé |
| class/klæs/ | 类 | lèi |
| composite type/ˈkɒmpəzɪt taɪp/ | 复合类型 | fù hé lèi xíng |
| enumerated type/ɪˈnjuːməreɪtɪd taɪp/ | 枚举类型 | méi jǔ lèi xíng |
| pointer/ˈpɔɪntə/ | 指针 | zhǐ zhēn |
| linked list/lɪŋkt lɪst/ | 链表 | liàn biǎo |
| dereference/ˌdiːˈrefrəns/ | 解引用 | jiě yǐn yòng |
| object/ˈɒbdʒekt/ | 对象 | duì xiàng |
| attributes/ˈætrɪbjuːts/ | 属性 | shǔ xìng |
| methods/ˈmeθədz/ | 方法 | fāng fǎ |
| constructor/kənˈstrʌktə/ | 构造函数 | gòu zào hán shù |
| File organisation/faɪl ˌɔːɡənaɪˈzeɪʃn/ | 文件组织 | wén jiàn zǔ zhī |
13.2
Organização e acesso a arquivos

Programa
| Os candidatos devem ser capazes de: | Notas e orientações |
|---|---|
| Demonstrar compreensão dos métodos de organização de arquivos e selecionar um método adequado de organização e acesso a arquivos para um problema dado | Incluindo serial, sequencial (usando um campo chave), aleatório (usando uma chave de registro) |
| Demonstrar compreensão dos métodos de acesso a arquivos | Incluindo acesso sequencial para arquivos seriais e sequenciais. Acesso direto para arquivos sequenciais e aleatórios |
| Demonstrar compreensão de algoritmos de hash | Descrever e usar diferentes algoritmos de hash para ler e escrever dados em um arquivo aleatório/sequencial |
Fonte: Programa Cambridge International
Organização de arquivo 文件组织 é como os dados estão dispostos; acesso a arquivo é como o programa alcança um registro.
- arquivo serial 串行文件 — registros na ordem adicionada, sem ordenação. Acesso é sequencial apenas; anexar é rápido; buscar é lento. Usado para logs e rastreamentos de auditoria.
- arquivo sequencial 顺序文件 — registros ordenados por uma chave. Buscar é mais rápido (você pode parar cedo ou fazer busca binária); inserir é lento (registros devem ser movidos). Usado para arquivos mestres atualizados em lote.
- arquivo aleatório 随机文件 (arquivo de acesso direto) — registros em posições calculadas a partir da chave (muitas vezes por um hash). Acesso direto por chave é muito rápido; ler em ordem de chave é mais difícil. Usado para grandes tabelas de consulta e contas de clientes.


Os dois métodos de acesso são acesso sequencial 顺序存取 (ler do início ao fim) e acesso direto 直接存取 (pular diretamente para uma posição conhecida). Corresponda a estrutura à operação dominante: consultas de chave única favorecem aleatório; relatórios em ordem favorecem sequencial.
Descrevendo cada organização (a formulação que pontua). Serial: registros são armazenados um após o outro na ordem em que foram adicionados, sem ordenação por chave. Sequencial: registros são armazenados em ordem de um campo de chave (ordenados). Aleatório: cada registro é armazenado em um endereço calculado a partir de sua chave por um algoritmo de hashing, então os registros não estão em nenhuma ordem. Comparando serial e sequencial: ambos armazenam registros um após o outro e ambos são lidos sequencialmente, mas um arquivo sequencial está ordenado por chave, então uma busca pode parar assim que uma chave maior que a alvo é lida, e um novo registro deve ser inserido em sua posição correta (geralmente reescrevendo o arquivo), enquanto um arquivo serial é simplesmente anexado.
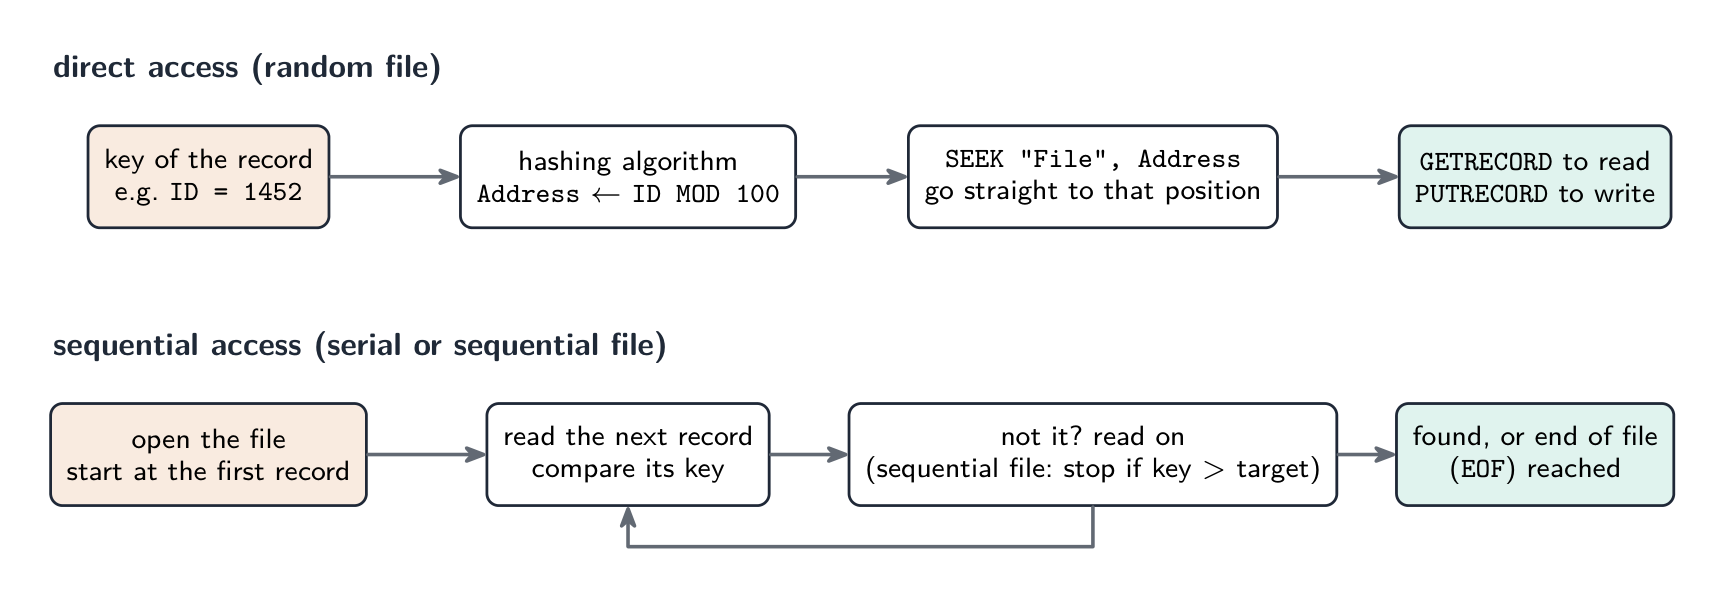
Descrevendo cada método de acesso. Acesso sequencial: inicia no início do ficheiro e lê os registos um após o outro (na ordem em que estão armazenados) até encontrar o registo pretendido ou atingir o fim do ficheiro. Aplicado a um ficheiro serial, isto significa ler todos os registos até à correspondência, e ler todo o ficheiro para estabelecer que um registo está ausente; aplicado a um ficheiro sequencial, a pesquisa pode parar cedo, assim que uma chave maior que a alvo é lida. Acesso direto: o endereço do registo é calculado a partir da sua chave (por um algoritmo de hash, ou a partir de um índice), e o programa vai diretamente para aquela posição sem ler os registos anteriores; este é o método de acesso para ficheiros aleatórios, e para um registo referenciado por um endereço único num disco.
Escolha. Um ficheiro mestre de folha de pagamento ou faturação de serviços públicos processado em lote, registos um após o outro, adequa-se a um ficheiro sequencial; um registo de transações na ordem em que ocorreram adequa-se a um ficheiro serial; um ficheiro de stock ou clientes onde registos individuais são consultados e atualizados por chave durante a execução do programa adequa-se a um ficheiro aleatório com acesso direto.
Gestão de ficheiros em pseudocódigo. O exame espera as instruções padrão, e o Paper 3 define algoritmos que os utilizam:
| Tarefa | Instruções |
|---|---|
| abrir um arquivo de texto | OPENFILE "Scores.txt" FOR READ (ou FOR WRITE, que cria ou sobrescreve, ou FOR APPEND) |
| ler ou escrever uma linha | READFILE "Scores.txt", Line e WRITEFILE "Scores.txt", Line |
| testar o final | WHILE NOT EOF("Scores.txt") |
| fechar | CLOSEFILE "Scores.txt" |
| abrir um ficheiro aleatório | OPENFILE "Stock.dat" FOR RANDOM |
| mover para uma posição de registo | SEEK "Stock.dat", Address |
| ler ou escrever um registo completo | GETRECORD "Stock.dat", Item e PUTRECORD "Stock.dat", Item |
Exemplo resolvido. Um ficheiro aleatório Stock.dat contém registos do tipo StockItem, armazenados no endereço dado por ItemID MOD 100. Escreva pseudocódigo que armazene um novo item no seu endereço hashed se essa posição estiver vazia, reportando a posição se já estiver em uso.
DECLARE Item, Existing : StockItem
DECLARE Address : INTEGER
INPUT Item.ItemID, Item.Description, Item.Quantity
Address ← Item.ItemID MOD 100
OPENFILE "Stock.dat" FOR RANDOM
SEEK "Stock.dat", Address
GETRECORD "Stock.dat", Existing
IF Existing.ItemID = 0 THEN
    // 0 marks an empty position
ENDIF
    SEEK "Stock.dat", Address
    PUTRECORD "Stock.dat", Item
    OUTPUT "Stored at ", Address
ELSE
    OUTPUT "Position ", Address, " is in use"
ENDIF
CLOSEFILE "Stock.dat"
Dois detalhes que o gabarito verifica: SEEK antes de cada GETRECORD ou PUTRECORD (a leitura move a posição, logo busque novamente antes de escrever), e o ficheiro aberto FOR RANDOM e fechado no final. Para copiar cada registo de um ficheiro aleatório para outro, faça um loop sobre os endereços com SEEK, GETRECORD de um ficheiro e PUTRECORD para o outro, saltando posições vazias.
Explorar
Rota de acesso a arquivo
Siga um arquivo do armazenamento ao programa e de volta com segurança.
Vocabulário
Treinar
| Inglês | Chinês | Pinyin |
|---|---|---|
| serial file/ˈsɪərɪəl faɪl/ | 串行文件 | chuàn xíng wén jiàn |
| sequential file/siːˈkwenʃl faɪl/ | 顺序文件 | shùn xù wén jiàn |
| random file/ˈrændəm faɪl/ | 随机文件 | suí jī wén jiàn |
| direct access/daɪˈrekt ˈækses/ | 直接存取 | zhí jiē cún qǔ |
| hash function/hæʃ ˈfʌŋkʃn/ | 散列函数 | sàn liè hán shù |
| sequential access/siːˈkwenʃl ˈækses/ | 顺序存取 | shùn xù cún qǔ |
| deterministic/dɪˌtɜːmɪˈnɪstɪk/ | 确定性 | què dìng xìng |
| collision/kəˈlɪʒn/ | 冲突 | chōng tū |
13.2
Hashing

Uma função de hash 散列函数 (um algoritmo de hashing) toma a chave de um registo e produz um endereço onde o registo é armazenado. Uma boa é rápida, determinística 确定性, e espalha as chaves uniformemente.
Algoritmos comuns de hashing para $N$ slots: hash módulo address ← key MOD N; folding (dividir a chave, somar as partes, MOD N); um hash de string (somar os códigos dos caracteres, MOD N).
Uma colisão 冲突 é quando duas chaves hash para o mesmo endereço. Três formas de resolvê-la:
| Estratégia | Como funciona | Compromisso |
|---|---|---|
| linear probing 线性探测 | usar o próximo slot livre (envolvendo-se) | simples, mas as chaves agrupam-se |
| chaining 链接法 | cada slot aponta para uma lista ligada 链表 de registos | sem agrupamento, mas usa mais memória |
| rehashing | aplicar uma segunda função hash | espalha as chaves, mas requer mais trabalho |
Para pesquisar: hash a chave, leia esse slot; se as chaves corresponderem você terminou, senão siga a estratégia de resolução até uma correspondência ou um slot vazio. Para inserir: hash a chave, escreva nesse slot ou no próximo livre. Mantenha o load factor 装填因子 (registos ÷ slots) abaixo de cerca de 70% para buscas quase-O(1).
"""Explique o que se entende por um algoritmo de hash no contexto de acesso a ficheiros""" (três marcas). Um cálculo (função) realizado no campo de chave de um registo que produz um valor, que é usado como o endereço (localização) em que o registo é armazenado no ficheiro e do qual é recuperado. O mesmo cálculo na mesma chave sempre dá o mesmo endereço, pelo que o registo pode ser encontrado novamente sem pesquisa.
"""Desenhe dois métodos para superar uma colisão.""" (1) Linear probing (open addressing): armazene o registo na próxima posição livre após o endereço calculado, voltando ao início se necessário; para recuperar, comece no endereço hashed e leia para frente até a chave corresponder. (2) Uma área de overflow 溢出区 ou chaining: armazene o registo em colisão numa área de overflow separada (ou numa lista ligada anexada ao endereço), que é pesquisada sequencialmente após o endereço principal falhar em corresponder. Qualquer um pontua; descreva tanto a recuperação quanto o armazenamento.
Exemplo resolvido. Um ficheiro aleatório tem 11 posições de registo, numeradas de 0 a 10, e o algoritmo de hash é Address ← Key MOD 11. Registos com chaves 1250, 1381, 1452, 1613 e 1470 são armazenados nessa ordem, usando linear probing. Mostre onde cada registo vai, e descreva como a chave 1470 é recuperada.
$1250 \bmod 11 = 7$; $1381 \bmod 11 = 6$; $1452 \bmod 11 = 0$; $1613 \bmod 11 = 7$, uma colisão com 1250, logo 1613 ocupa a próxima posição livre, 8; $1470 \bmod 11 = 7$ novamente, e as posições 7 e 8 estão cheias, logo 1470 vai para 9. Para recuperar 1470: calcule $7$, leia a posição 7 (chave 1250, sem correspondência), leia 8 (1613, não), leia 9 (1470, encontrada). Se uma posição vazia for atingida antes de uma correspondência, o registo não está no ficheiro. Colisões são o preço de um ficheiro pequeno: um bom algoritmo de hash espalha as chaves uniformemente, e o ficheiro é mantido bem abaixo do cheio para que as sondagens permaneçam curtas.
Explorar
Uma tabela hash
Observe cada chave ser hasheada para um balde. Um bom hash espalha as chaves para que as buscas permaneçam rápidas.
Vocabulário
Treinar
| Inglês | Chinês | Pinyin |
|---|---|---|
| linear probing/ˈlɪnɪə ˈprəʊbɪŋ/ | 线性探测 | xiàn xìng tàn cè |
| chaining/ˈtʃeɪnɪŋ/ | 链接法 | liàn jiē fǎ |
| load factor/ləʊd ˈfæktə/ | 装填因子 | zhuāng tián yīn zi |
| overflow area/ˌəʊvəˈfləʊ ˈeərɪə/ | 溢出区 | yì chū qū |
| overflow/ˌəʊvəˈfləʊ/ | 溢出 | yì chū |
13.3
Números de ponto flutuante

Programa
| Os candidatos devem ser capazes de: | Notas e orientações |
|---|---|
| Descrever o formato de números reais de ponto flutuante binário | Usar a forma de complemento de dois. Compreender os efeitos da alteração da alocação de bits para a mantissa e o exponente em uma representação de ponto flutuante |
| Converter números reais de ponto flutuante binário para decimal e vice-versa | |
| Normalizar números de ponto flutuante | Compreender as razões para a normalização |
| Demonstrar compreensão das consequências de uma representação binária ser apenas uma aproximação do número real que ela representa (em certos casos) | Compreender como underflow e overflow podem ocorrer |
| Demonstrar compreensão de que representações binárias podem gerar erros de arredondamento |
Fonte: Programa Cambridge International
Para armazenar números reais de tamanhos muito diferentes, computadores usam um formato ponto flutuante 浮点 — uma forma binária de notação científica, com dois campos:
- uma mantissa 尾数 — os dígitos significativos.
- um exponente 指数 — a potência de 2 para multiplicar.
Ambos são armazenados como inteiros em complemento de dois 补码. O valor é
$$\text{number} = \text{mantissa} \times 2^{\text{exponent}}.$$
Leia a mantissa como uma fração binária — o primeiro bit após o ponto vale $1/2$, o seguinte $1/4$, depois $1/8$, e assim por diante. Assim, 0.1010000 é $1/2 + 1/8 = 0.625$; com exponente 00000010 (= 2) o valor é $0.625 \times 2^{2} = 2.5$.
Conversão
- binário → decimal: leia a mantissa (use regras de complemento de dois se negativo) como uma fração, leia o exponente como um inteiro com sinal, então multiplique a mantissa por $2^{\text{exponent}}$.
- decimal → binário: escreva o número como uma fração binária × uma potência de 2, depois armazene a mantissa e o exponente nos formatos combinados.
Exemplo resolvido. Um número tem mantissa 10110000 e exponente 00000011. Encontre o seu valor decimal.
O exponente 00000011 é $+3$. A mantissa começa com um 1, logo é negativa. Lida como 1.0110000 em complemento de dois, o bit de sinal vale $-1$ e os bits de fração somam $\tfrac{1}{4} + \tfrac{1}{8} = 0.375$, logo a mantissa é $-1 + 0.375 = -0.625$. Então
$$\text{number} = -0.625 \times 2^{3} = -5.0.$$
Exemplo resolvido. Armazene $+2.5$ neste formato.
Em binário $2.5 = 10.1$. Escrito como uma fração normalizada, $2.5 = 0.101 \times 2^{2}$. Logo a mantissa é 01010000 (bit de sinal 0, depois .101) e o exponente é 00000010 ($= 2$).
O formato do exame: complemento de dois, uma mantissa e um exponente
A prova estabelece um formato como 10 bits para a mantissa e 6 bits para o expoente, ambos em complemento para dois. O ponto binário da mantissa fica após seu primeiro bit (de sinal), então uma mantissa positiva é 0.xxxxxxxxx e uma negativa 1.xxxxxxxxx; o expoente é um inteiro assinado comum. Toda conversão usa os mesmos três movimentos: leia a mantissa como uma fração (regras de complemento para dois se começar com 1), leia o expoente como um inteiro, multiplique por $2^{\text{exponent}}$.
Exemplo resolvido (binário para decimal). Mantissa 0101100000, exponente 000011.
Mantissa: $0.101100000_2 = \tfrac{1}{2} + \tfrac{1}{8} + \tfrac{1}{16} = 0.6875$. Exponente: $000011_2 = 3$. Valor: $0.6875 \times 2^{3} = 5.5$.
Exemplo resolvido (mantissa negativa). Mantissa 1011000000, exponente 000010.
A mantissa começa com 1, então ela é negativa. Seu valor é $-1 + 0.011000000_2 = -1 + (\tfrac{1}{4} + \tfrac{1}{8}) = -0.625$; expoente $= 2$; valor $-0.625 \times 4 = -2.5$. (Alternativamente, tome o complemento para dois da mantissa, 0101000000 $= 0.625$, e anexe o sinal de menos.) Um expoente negativo como 111110 $= -2$ divide em vez de multiplicar: uma mantissa de $0.5$ com esse expoente é $0.5 \times 2^{-2} = 0.125$.
Exemplo resolvido (decimal para binário). Armazene $+6.5$ e $-6.5$ no formato de 10 bits e 6 bits, normalizado.
$6.5 = 110.1_2 = 0.1101_2 \times 2^{3}$, logo a mantissa é 0110100000 e o exponente 000011. Para $-6.5$, tome o complemento de dois da mantissa: 1001100000 (verifique: $-1 + 0.0011_2 = -1 + 0.1875 = -0.8125$, e $-0.8125 \times 8 = -6.5$), exponente 000011 inalterado. O sinal nunca vai para o exponente; um número negativo tem uma mantissa negativa.
Normalização
Um número está normalizado 规格化 quando o primeiro bit significativo está imediatamente após o ponto binário (sem zeros à esquerda desperdiçados). Isto maximiza a precisão, porque cada bit da mantissa carrega informação. Para normalizar, desloque a mantissa para a esquerda e diminua o exponente (ou desloque para a direita e aumente-o) até o primeiro bit significativo estar no lugar; o valor permanece inalterado. Para mantissas negativas (complemento de dois), o bit de sinal (1) é seguido imediatamente por um 0.
Reconhecimento e produção de forma normalizada. Uma mantissa positiva normalizada começa 01; uma negativa começa 10. Assim, 0011000000 não está normalizada (desloque para a esquerda um lugar e subtraia um do exponente: 0110000000, exponente um menor) e 1100000000 também não está (desloque para a esquerda até o padrão ser 10...). Cada deslocação para a esquerda da mantissa deve ser acompanhada por subtrair um do exponente, senão o valor muda.
"""Explique por que números são armazenados em forma normalizada""" (duas marcas). (1) Dá a máxima precisão (precisão) para o número de bits disponíveis, porque nenhum bit é desperdiçado em zeros à esquerda (ou uns à esquerda para um número negativo); (2) cada número tem então uma representação única, permitindo comparar números; e (3) faz o melhor uso do intervalo disponível. Quaisquer dois destes pontuam.

Aproximação e erros de arredondamento
Muitos reais decimais não podem ser armazenados exatamente em binário — ex: $0.1_{10}$ é a fração binária repetitiva $0.000110011\ldots_{2}$, que deve ser truncada. Consequências:
- erros de arredondamento 舍入误差 acumulam-se ao longo de muitas operações (
0.1 + 0.2não é exatamente0.3). - comparações falham — nunca teste um real para igualdade. Teste se a diferença é menor que uma tolerância pequena,
IF Difference < 0.000001, onde a diferença é tomada da forma correta ou através de uma função módulo que a questão definiria.ABSnão está no inserto 9618 nem no Guia de Pseudocódigo, portanto não assuma isso: o guia diz que qualquer função que a questão precise será fornecida. - subtrair dois valores quase iguais perde precisão.
- transbordamento 溢出 (um resultado muito grande para a faixa do expoente) e subdesbordamento 下溢 (um resultado muito pequeno, arredondando para zero) ocorrem quando o expoente esgota sua faixa.
Para necessidades exatas (moeda), use ponto fixo 定点 ou BCD 二进码十进数 em vez de ponto flutuante.
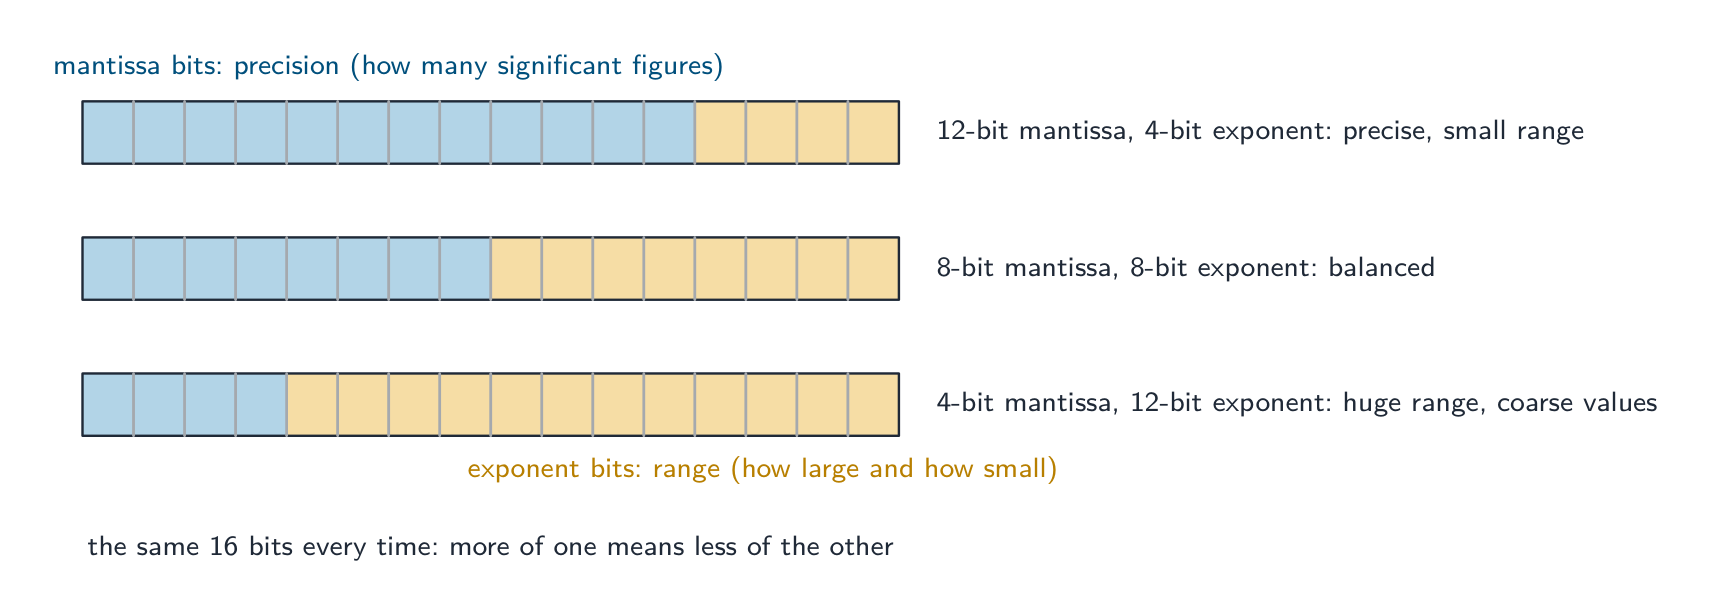
"Descreva o efeito de alterar a alocação de bits" (três marcas). Com um número fixo total de bits, aumentar a mantissa e reduzir o expoente dá maior precisão 精度 (mais algarismos significativos, menores erros de arredondamento) mas uma faixa menor 范围 (as maiores e menores magnitudes que podem ser armazenadas diminuem); aumentar o expoente faz o oposto: uma faixa maior às custas da precisão. Nomeie ambos os efeitos e ambas as direções.
Maior e menor. No formato de 10 bits de mantissa e 6 bits de expoente, o maior número positivo tem mantissa 0111111111 ($= 1 - 2^{-9}$) e expoente 011111 ($= 31$): cerca de $2^{31}$. O menor número normalizado positivo tem mantissa 0100000000 ($= 0.5$) e expoente 100000 ($= -32$): $0.5 \times 2^{-32} = 2^{-33}$. O número mais negativo tem mantissa 1000000000 ($= -1$) e expoente $31$: $-2^{31}$.
"Explique o que significa transbordamento e subdesbordamento." Transbordamento ocorre quando o resultado de um cálculo é maior que o maior número que pode ser representado, então o expoente precisaria de mais bits do que possui; subdesbordamento ocorre quando um resultado é menor que o menor (não-zero) número que pode ser representado, muito próximo de zero para o expoente expressar, então é armazenado como zero. Ambos vêm da faixa do expoente, não da mantissa.
Por que uma representação binária é apenas uma aproximação. Uma fração binária só pode representar somas de $\tfrac{1}{2}, \tfrac{1}{4}, \tfrac{1}{8}, \ldots$ exatamente; um valor como $0.1$ ou $\tfrac{1}{3}$ tem uma expansão binária infinita, e a mantissa tem um número fixo de bits, então o valor armazenado é o mais próximo que se encaixa. A diferença é um erro de arredondamento; é pequeno para um número mas acumula-se em cálculos repetidos (adicionar $0.1$ dez vezes pode não dar exatamente $1$), por isso números reais nunca devem ser testados para igualdade exata.
Explorar
Construir um número de ponto flutuante
Inverter os bits da mantissa e do expoente para formar um valor e verificar se está normalizado.
Explorar
Normalizando um número de ponto flutuante
Passos da normalização. Deslocar a mantissa para remover zeros à esquerda desperdiçados — e ajustar o expoente correspondentemente — mantém o valor inalterado, mas utiliza cada bit para precisão.
Vocabulário
Treinar
| Inglês | Chinês | Pinyin |
|---|---|---|
| floating-point/ˈfləʊtɪŋ pɔɪnt/ | 浮点 | fú diǎn |
| mantissa/mænˈtɪsə/ | 尾数 | wěi shù |
| exponent/ekˈspəʊnənt/ | 指数 | zhǐ shù |
| two's complement/tuːz ˈkɒmplɪmənt/ | 补码 | bǔ mǎ |
| normalised/ˈnɔːməlaɪzd/ | 规格化 | guī gé huà |
| rounding errors/ˈraʊndɪŋ ˈerəz/ | 舍入误差 | shě rù wù chā |
| underflow/ˌʌndəˈfləʊ/ | 下溢 | xià yì |
| fixed-point/fɪkst pɔɪnt/ | 定点 | dìng diǎn |
| BCD/ˌbiː siː ˈdiː/ | 二进码十进数 | èr jìn mǎ shí jìn shù |
| precision/prɪˈsɪʒn/ | 精度 | jīng dù |
| range/reɪndʒ/ | 范围 | fàn wéi |
13.3
Definições aceitas pelo examinador
Uma questão de definição é avaliada contra wording fixo. Aprenda estas exatamente, e dê apenas uma resposta.
| Termo | Definição |
|---|---|
| tipo de dados definido pelo usuário | um tipo de dados definido pelo programador, baseado em tipos existentes, para representar dados específicos do problema |
| tipo não-composto | um tipo definido sem referência a outro tipo; ele armazena um único valor (inteiro, real, enumerado, ponteiro) |
| tipo composto | um tipo feito de outros tipos; ele armazena vários valores sob um único identificador (registro, conjunto, array, classe) |
| tipo enumerado | um tipo não-composto definido listando todos os seus valores possíveis, em ordem |
| tipo ponteiro | um tipo não-composto cujo valor é o endereço de memória de uma variável de um tipo dado |
| conjunto | um tipo composto contendo uma coleção de valores de um tipo, sem ordem e sem duplicatas |
| registro | um tipo composto com um número fixo de campos, cada um com seu próprio identificador e tipo, acessado por notação de ponto |
| classe | um tipo composto combinando atributos (dados) com métodos (procedimentos e funções) que atuam sobre eles; um objeto é uma instância de uma classe |
| arquivo serial | registros armazenados um após o outro na ordem em que foram adicionados |
| arquivo sequencial | registros armazenados um após o outro em ordem de um campo chave |
| arquivo aleatório | registros armazenados em endereços calculados a partir de suas chaves por um algoritmo de hash |
| acesso sequencial | ler os registros sucessivamente do início do arquivo até encontrar o desejado |
| acesso direto | calcular o endereço de um registro a partir de sua chave e ir diretamente para aquela posição |
| algoritmo de hash | um cálculo na chave de um registro que dá o endereço em que o registro é armazenado e encontrado |
| colisão | duas chaves diferentes produzindo o mesmo endereço |
| mantissa | a parte de um número de ponto flutuante que contém seus bits significativos, como uma fração em complemento de dois |
| expoente | o inteiro em complemento de dois que dá a potência de dois pela qual a mantissa é multiplicada |
| normalizado | um número de ponto flutuante cuja mantissa começa com 01 (positivo) ou 10 (negativo), assim nenhum bit é desperdiçado com zeros ou uns iniciais |
| transbordamento | um resultado muito grande para ser representado nos bits disponíveis |
| subdesbordamento | um resultado não-zero muito pequeno para ser representado, então é armazenado como zero |
| erro de arredondamento | a diferença entre um número real e o valor mais próximo que a representação binária pode manter |
13.3
Dicas de prova
- Declarações de pseudocódigo são marcadas linha por linha:
TYPE ... = (...)para enumerado,TYPE ... = ^...para ponteiro,TYPE ... = SET OF ...entãoDEFINE ... (...) : ...para um conjunto,TYPE ... DECLARE ... ENDTYPEpara um registro,CLASS ... PRIVATE ... PUBLIC PROCEDURE NEW ... ENDCLASSpara uma classe. - Associe o tipo aos dados: valores fixos nomeados, enumerado; um grupo de campos diferentes, registro; uma coleção de valores únicos, conjunto; dados mais comportamento, classe; um endereço, ponteiro.
- Organização de arquivos é como os registros são armazenados; acesso a arquivos é como eles são encontrados. Seriais e sequenciais são lidos sequencialmente; arquivos aleatórios usam acesso direto via hash da chave. Busca sequencial de um arquivo sequencial pode parar cedo; de um arquivo serial não pode.
- Pseudocódigo de arquivo aleatório:
OPENFILE ... FOR RANDOM,SEEKantes de cadaGETRECORDouPUTRECORD,CLOSEFILEno final. Diga como uma colisão é resolvida ao descrever o hashing. - Ponto flutuante: mantissa como fração em complemento de dois (ponto após o bit de sinal), expoente como inteiro, multiplique por $2^{\text{exponent}}$; desloque para a esquerda e subtraia um do expoente para normalizar; a mantissa compra precisão, o expoente compra faixa.
- As três respostas "explique" padrão: por que normalizar (precisão, forma única, faixa), o efeito de realocar bits (precisão contra faixa) e por que $0.1$ não pode ser armazenado exatamente (uma fração binária infinita em uma mantissa finita).
Erros comuns
- Escrever
DECLAREem vez deTYPEpara um novo tipo, ou omitirENDTYPE; declarar um conjunto semSET OF, ou um tipo enumerado com aspas em torno de seus valores. - Colocar o sinal de um número de ponto flutuante no expoente; o sinal é o primeiro bit da mantissa.
- Ler uma mantissa negativa como se fosse sinal e magnitude; é complemento de dois, então
1011000000é $-0.625$, não $-0.375$. - Deslocar a mantissa para normalizar sem alterar o expoente, ou alterá-lo da forma errada (deslocar para a esquerda, expoente para baixo).
- Descrever um arquivo aleatório como "em ordem aleatória"; os registros estão em endereços computados a partir de suas chaves.
- Dizer que acesso sequencial lê "todo o arquivo" para um arquivo sequencial; ele para quando uma chave maior é encontrada.
- Explicar hashing sem dizer para que o valor calculado é usado (o endereço para armazenar e recuperar o registro), ou sem uma maneira de lidar com colisões.
- Definir transbordamento como "muitos dígitos" em vez de um resultado além do maior valor representável, ou culpar a mantissa por isso.
Aulas interativas sobre este tópico
Passe por ele passo a passo, com exercícios de verificação instantânea.